Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
最先端NLP勉強会2026_Self-Distillation_Enables_Continu...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Koki Itai
August 29, 2026
330
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
最先端NLP勉強会2026_Self-Distillation_Enables_Continual_Learning
Koki Itai
August 29, 2026
More Decks by Koki Itai
See All by Koki Itai
J-RAGBench: 日本語RAGにおける Generator評価ベンチマークの構築
koki_itai
0
2k
Featured
See All Featured
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
260
Game over? The fight for quality and originality in the time of robots
wayneb77
1
290
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
42k
How GitHub (no longer) Works
holman
316
150k
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
830
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.6k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
500
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
530
[SF Ruby Conf 2025] Rails X
palkan
3
1.4k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
250
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3k
Transcript
最先端NLP勉強会2026 (2026/08/31) Self-Distillation Enables Continual Learning Idan Shenfeld, Mehul Damani,
Jonas Hübotter, Pulkit Agrawal ICML 2026 spotlight 紹介者:板井 孝樹 (SB Intuitions)
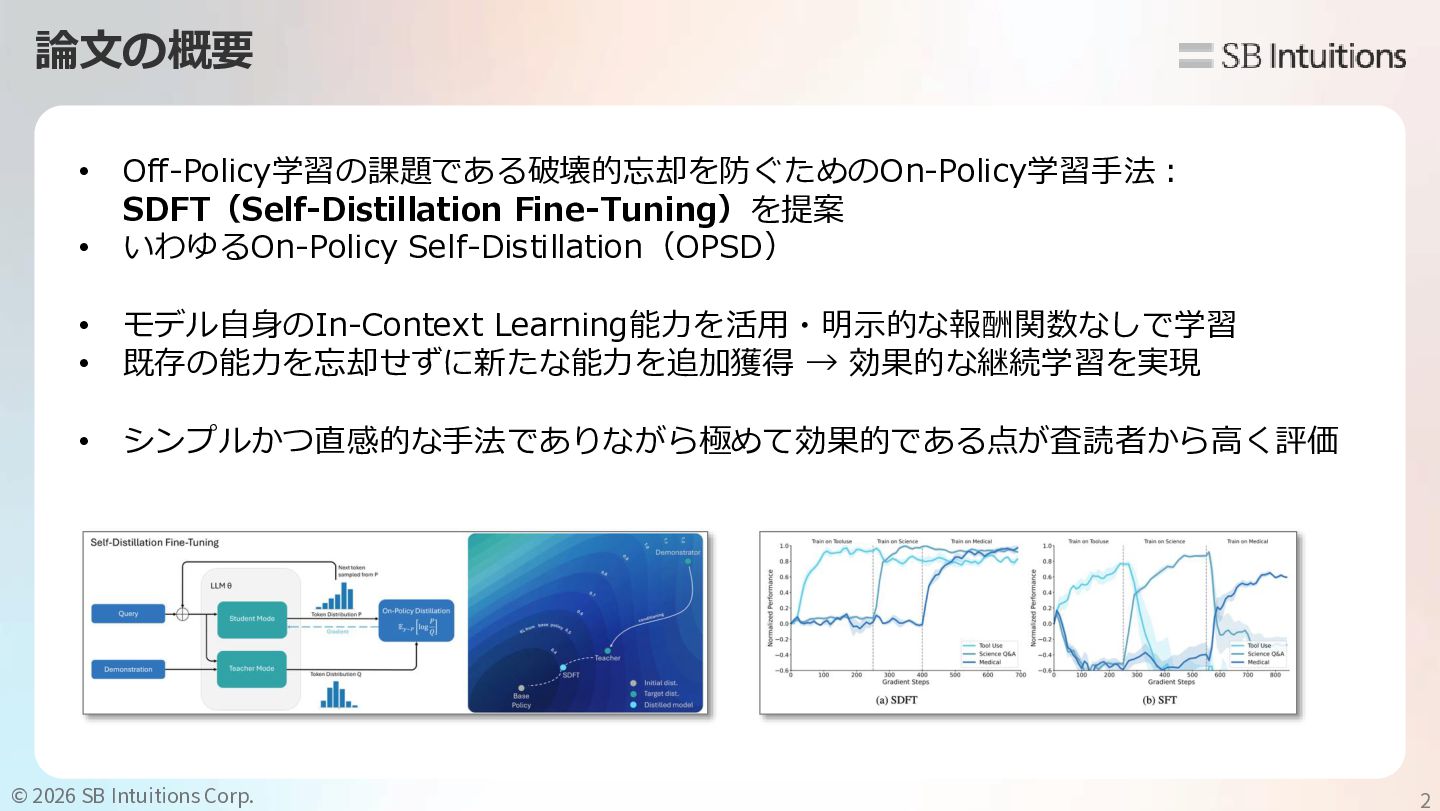
論文の概要 • Off-Policy学習の課題である破壊的忘却を防ぐためのOn-Policy学習手法: SDFT(Self-Distillation Fine-Tuning)を提案 いわゆるOn-Policy Self-Distillation(OPSD) • • モデル自身のIn-Context
Learning能力を活用・明示的な報酬関数なしで学習 既存の能力を忘却せずに新たな能力を追加獲得 → 効果的な継続学習を実現 • シンプルかつ直感的な手法でありながら極めて効果的である点が査読者から高く評価 • ©︎ 2026 SB Intuitions Corp. 2
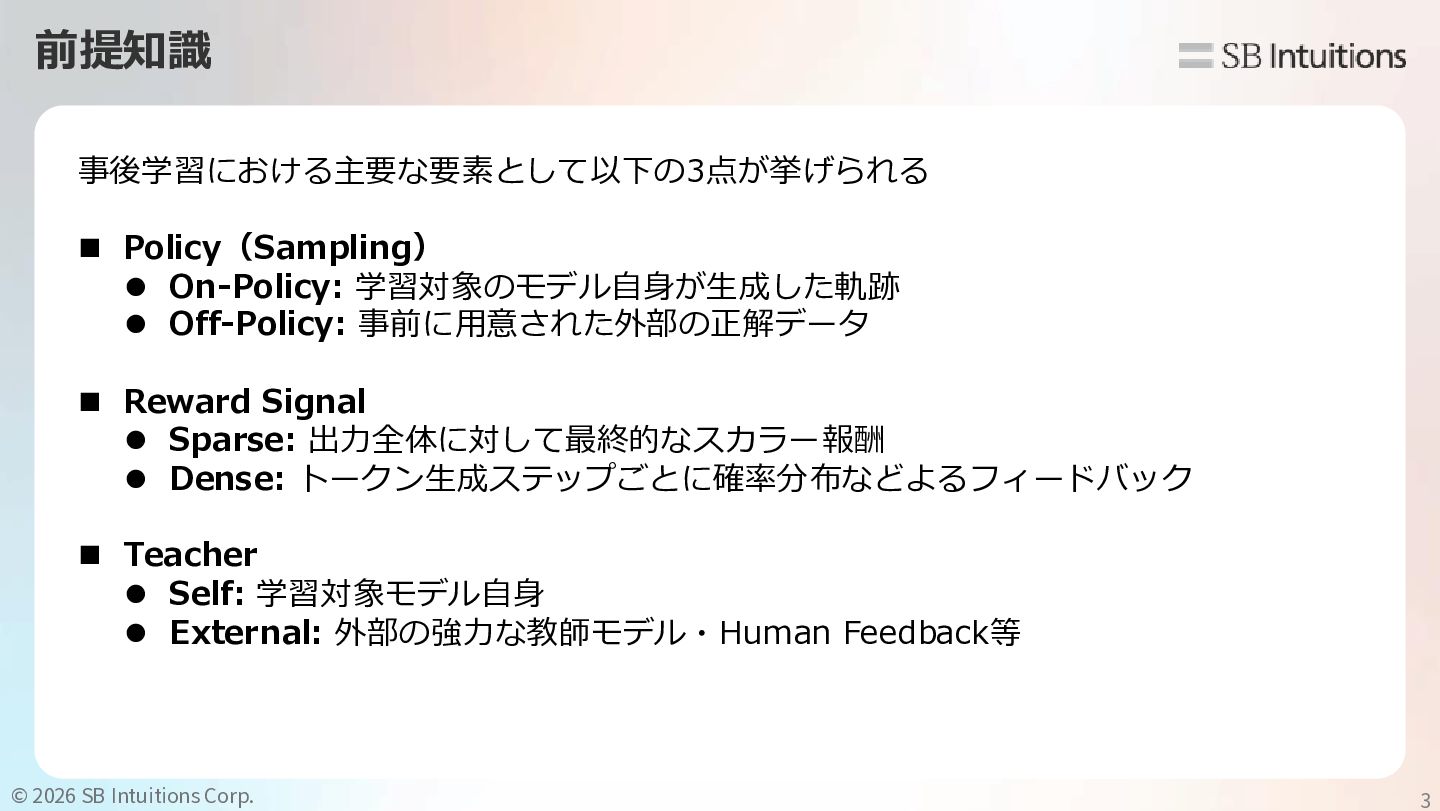
前提知識 事後学習における主要な要素として以下の3点が挙げられる ◼ Policy(Sampling) ⚫ On-Policy: 学習対象のモデル自身が生成した軌跡 ⚫ Off-Policy: 事前に用意された外部の正解データ
◼ Reward Signal ⚫ Sparse: 出力全体に対して最終的なスカラー報酬 ⚫ Dense: トークン生成ステップごとに確率分布などよるフィードバック ◼ Teacher ⚫ Self: 学習対象モデル自身 ⚫ External: 外部の強力な教師モデル・Human Feedback等 ©︎ 2026 SB Intuitions Corp. 3
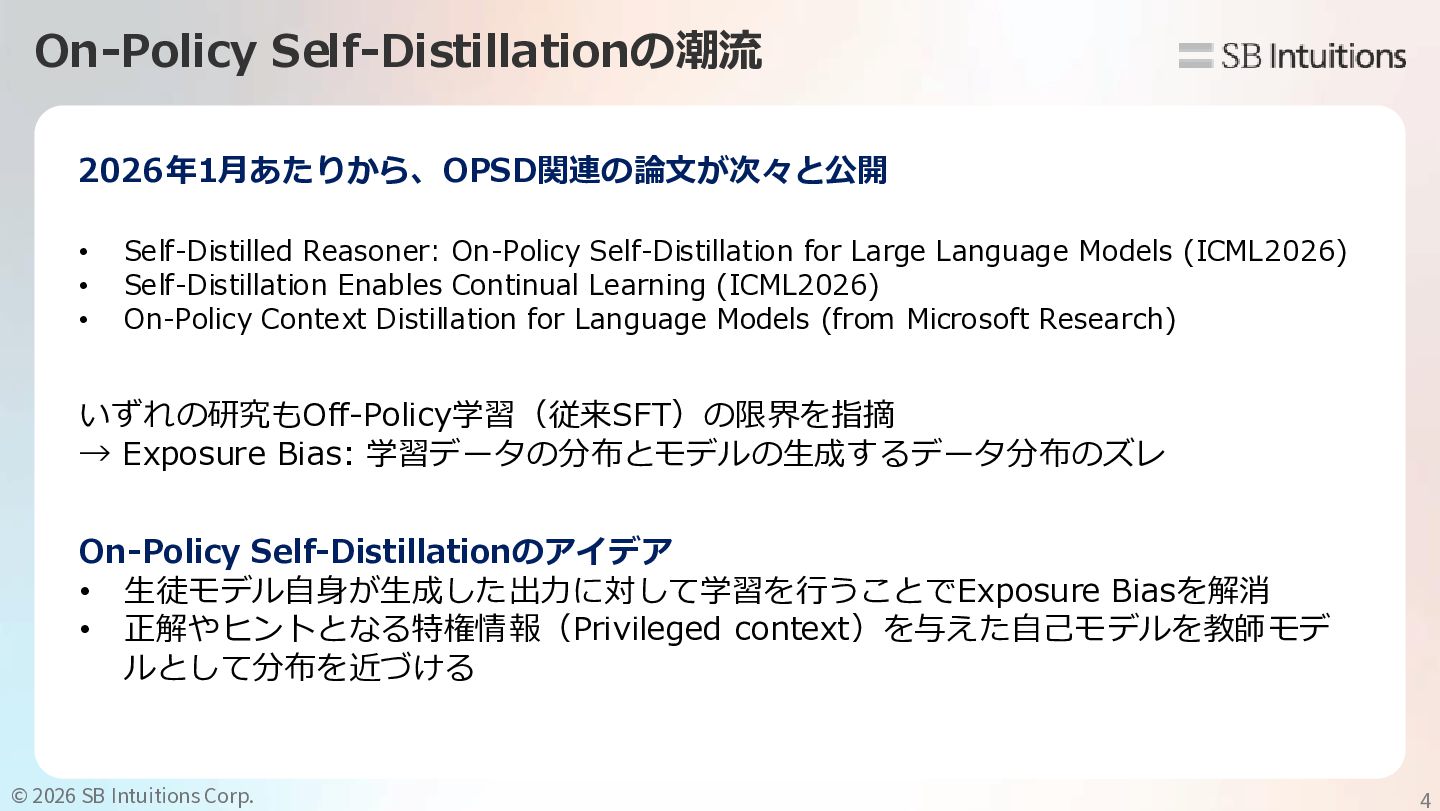
On-Policy Self-Distillationの潮流 2026年1月あたりから、OPSD関連の論文が次々と公開 • • • Self-Distilled Reasoner: On-Policy Self-Distillation
for Large Language Models (ICML2026) Self-Distillation Enables Continual Learning (ICML2026) On-Policy Context Distillation for Language Models (from Microsoft Research) いずれの研究もOff-Policy学習(従来SFT)の限界を指摘 → Exposure Bias: 学習データの分布とモデルの生成するデータ分布のズレ On-Policy Self-Distillationのアイデア • 生徒モデル自身が生成した出力に対して学習を行うことでExposure Biasを解消 • 正解やヒントとなる特権情報(Privileged context)を与えた自己モデルを教師モデ ルとして分布を近づける ©︎ 2026 SB Intuitions Corp. 4
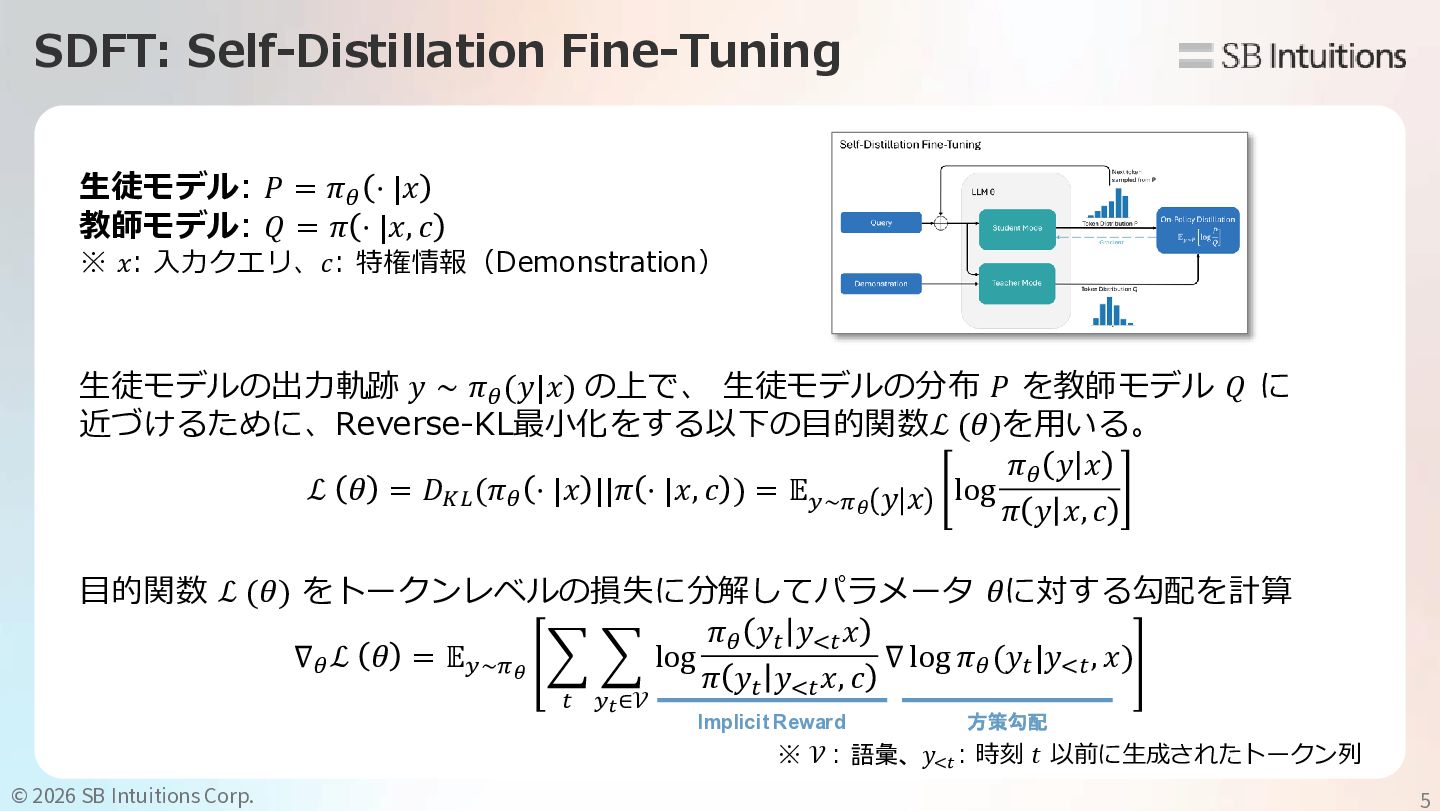
SDFT: Self-Distillation Fine-Tuning 生徒モデル: 𝑃 = 𝜋𝜃 ⋅ |𝑥 教師モデル:
𝑄 = 𝜋 ⋅ |𝑥, 𝑐 ※ 𝑥: 入力クエリ、𝑐: 特権情報(Demonstration) 生徒モデルの出力軌跡 𝑦 ∼ 𝜋𝜃 (𝑦|𝑥) の上で、 生徒モデルの分布 𝑃 を教師モデル 𝑄 に 近づけるために、Reverse-KL最小化をする以下の目的関数ℒ (𝜃)を用いる。 𝜋𝜃 𝑦 𝑥 ℒ 𝜃 = 𝐷𝐾𝐿 (𝜋𝜃 ⋅ |𝑥 ||𝜋 ⋅ |𝑥, 𝑐 ) = 𝔼𝑦∼𝜋𝜃 𝑦 𝑥 log 𝜋 𝑦 𝑥, 𝑐 目的関数 ℒ (𝜃) をトークンレベルの損失に分解してパラメータ 𝜃に対する勾配を計算 𝜋𝜃 𝑦𝑡 𝑦<𝑡 𝑥 ∇𝜃 ℒ 𝜃 = 𝔼𝑦∼𝜋𝜃 log ∇ log 𝜋𝜃 (𝑦𝑡 |𝑦<𝑡 , 𝑥) 𝜋 𝑦𝑡 𝑦<𝑡 𝑥, 𝑐 𝑡 𝑦𝑡 ∈𝒱 Implicit Reward 方策勾配 ※ 𝒱 : 語彙、𝑦<𝑡 : 時刻 𝑡 以前に生成されたトークン列 ©︎ 2026 SB Intuitions Corp. 5
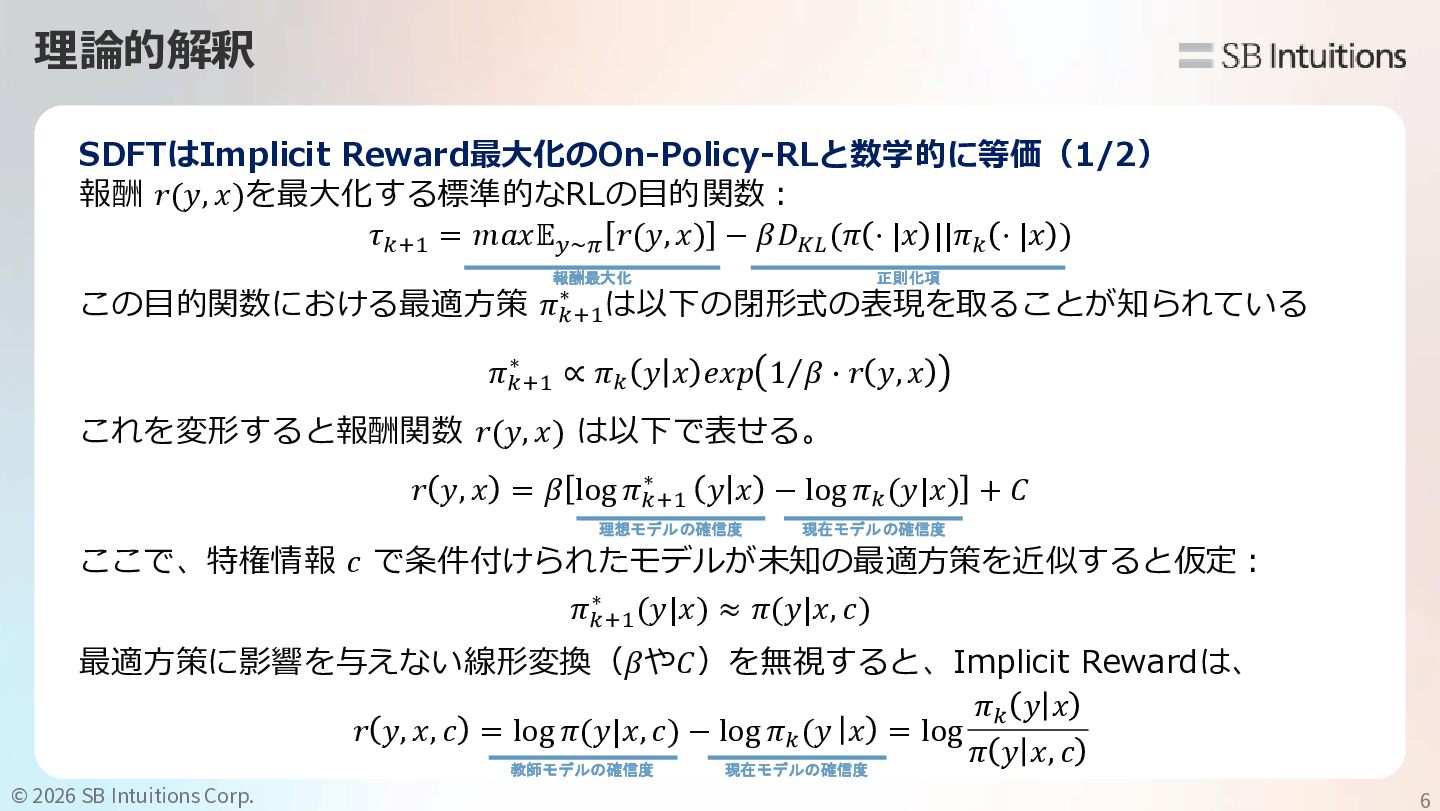
理論的解釈 SDFTはImplicit Reward最大化のOn-Policy-RLと数学的に等価(1/2) 報酬 𝑟(𝑦, 𝑥)を最大化する標準的なRLの目的関数: 𝜏𝑘+1 = 𝑚𝑎𝑥𝔼𝑦~𝜋 𝑟(𝑦,
𝑥) − 𝛽𝐷𝐾𝐿 (𝜋 ⋅ |𝑥 ||𝜋𝑘 ⋅ |𝑥 ) 報酬最大化 正則化項 ∗ この目的関数における最適方策 𝜋𝑘+1 は以下の閉形式の表現を取ることが知られている ∗ 𝜋𝑘+1 ∝ 𝜋𝑘 𝑦 𝑥 𝑒𝑥𝑝 1Τ𝛽 ∙ 𝑟 𝑦, 𝑥 これを変形すると報酬関数 𝑟(𝑦, 𝑥) は以下で表せる。 ∗ 𝑟 𝑦, 𝑥 = 𝛽 log 𝜋𝑘+1 𝑦 𝑥 − log 𝜋𝑘 (𝑦|𝑥) + 𝐶 理想モデルの確信度 現在モデルの確信度 ここで、特権情報 𝑐 で条件付けられたモデルが未知の最適方策を近似すると仮定: ∗ 𝜋𝑘+1 (𝑦|𝑥) ≈ 𝜋(𝑦|𝑥, 𝑐) 最適方策に影響を与えない線形変換(𝛽や𝐶)を無視すると、Implicit Rewardは、 𝜋𝑘 𝑦 𝑥 𝑟 𝑦, 𝑥, 𝑐 = log 𝜋(𝑦|𝑥, 𝑐) − log 𝜋𝑘 (𝑦 𝑥 = log 𝜋 𝑦 𝑥, 𝑐 教師モデルの確信度 現在モデルの確信度 ©︎ 2026 SB Intuitions Corp. 6
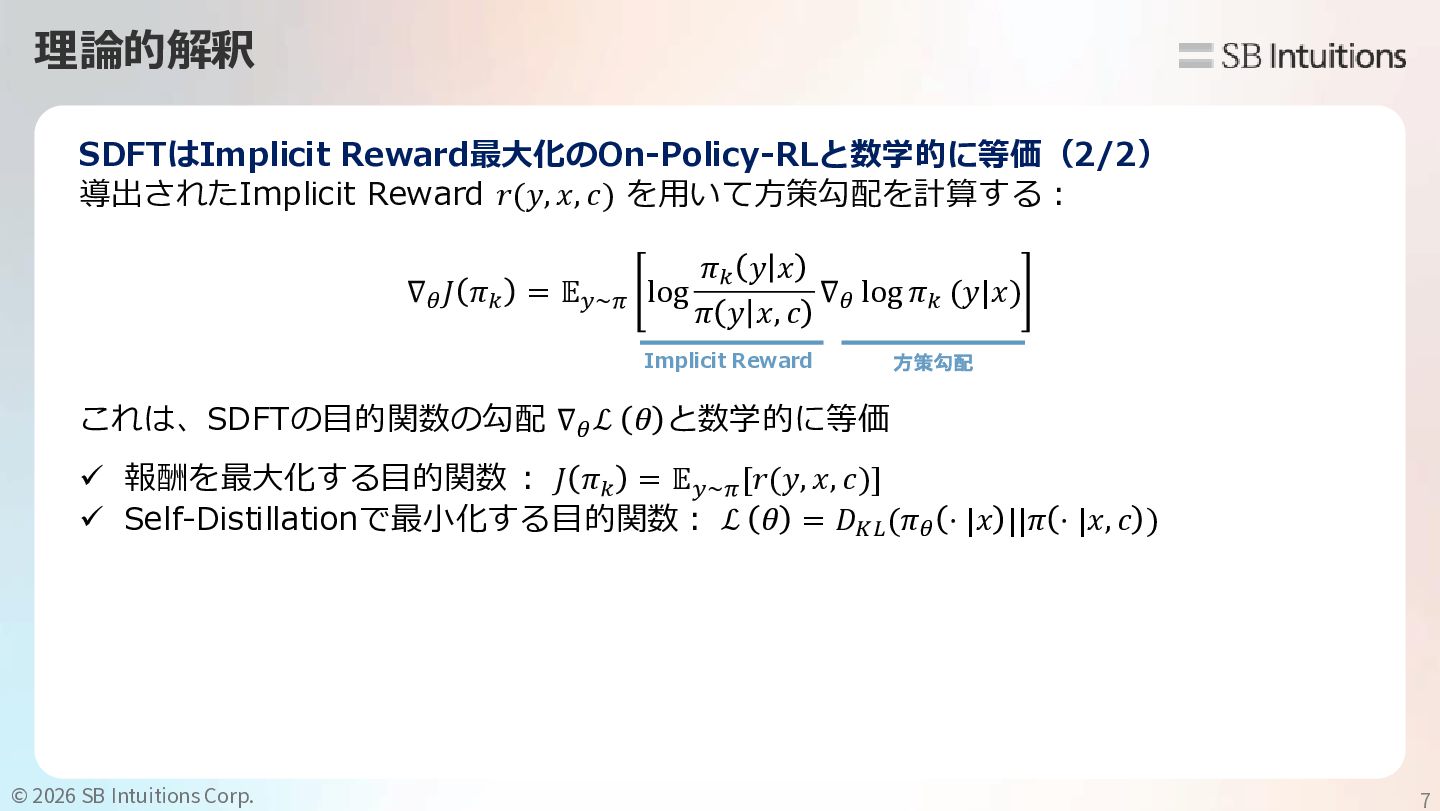
理論的解釈 SDFTはImplicit Reward最大化のOn-Policy-RLと数学的に等価(2/2) 導出されたImplicit Reward 𝑟(𝑦, 𝑥, 𝑐) を用いて方策勾配を計算する: ∇𝜃
𝐽 𝜋𝑘 = 𝔼𝑦~𝜋 log 𝜋𝑘 𝑦 𝑥 ∇ log 𝜋𝑘 (𝑦|𝑥) 𝜋 𝑦 𝑥, 𝑐 𝜃 Implicit Reward 方策勾配 これは、SDFTの目的関数の勾配 ∇𝜃 ℒ 𝜃 と数学的に等価 ✓ 報酬を最大化する目的関数 : 𝐽 𝜋𝑘 = 𝔼𝑦~𝜋 [𝑟(𝑦, 𝑥, 𝑐)] ✓ Self-Distillationで最小化する目的関数: ℒ 𝜃 = 𝐷𝐾𝐿 (𝜋𝜃 ⋅ |𝑥 ||𝜋 ⋅ |𝑥, 𝑐 ) ©︎ 2026 SB Intuitions Corp. 7
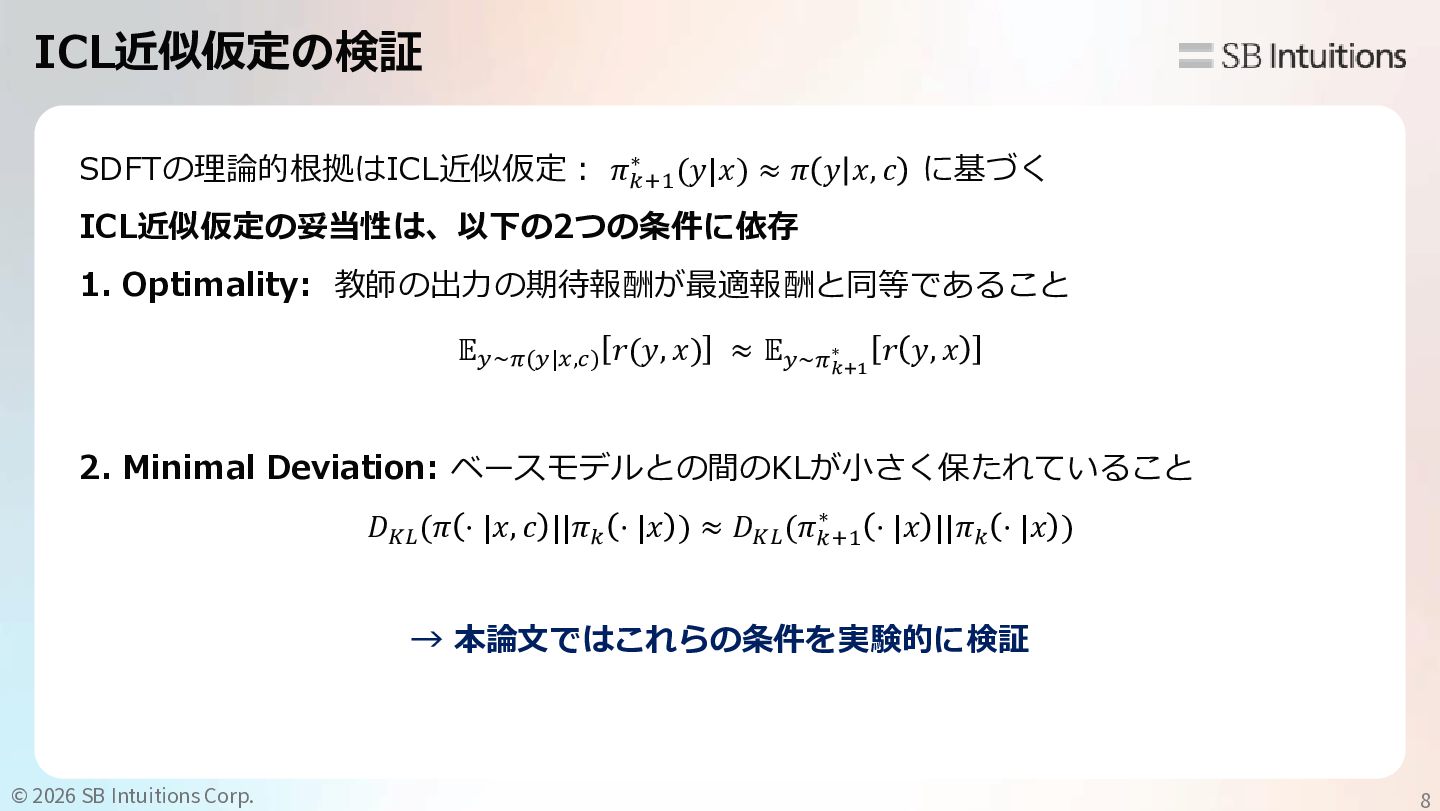
ICL近似仮定の検証 ∗ SDFTの理論的根拠はICL近似仮定: 𝜋𝑘+1 (𝑦|𝑥) ≈ 𝜋 𝑦 𝑥, 𝑐
に基づく ICL近似仮定の妥当性は、以下の2つの条件に依存 1. Optimality: 教師の出力の期待報酬が最適報酬と同等であること ∗ 𝔼𝑦~𝜋(𝑦|𝑥,𝑐) 𝑟(𝑦, 𝑥) ≈ 𝔼𝑦~𝜋𝑘+1 𝑟 𝑦, 𝑥 2. Minimal Deviation: ベースモデルとの間のKLが小さく保たれていること ∗ 𝐷𝐾𝐿 (𝜋 ⋅ |𝑥, 𝑐 ||𝜋𝑘 ⋅ |𝑥 ) ≈ 𝐷𝐾𝐿 (𝜋𝑘+1 ⋅ |𝑥 ||𝜋𝑘 ⋅ |𝑥 ) → 本論文ではこれらの条件を実験的に検証 ©︎ 2026 SB Intuitions Corp. 8
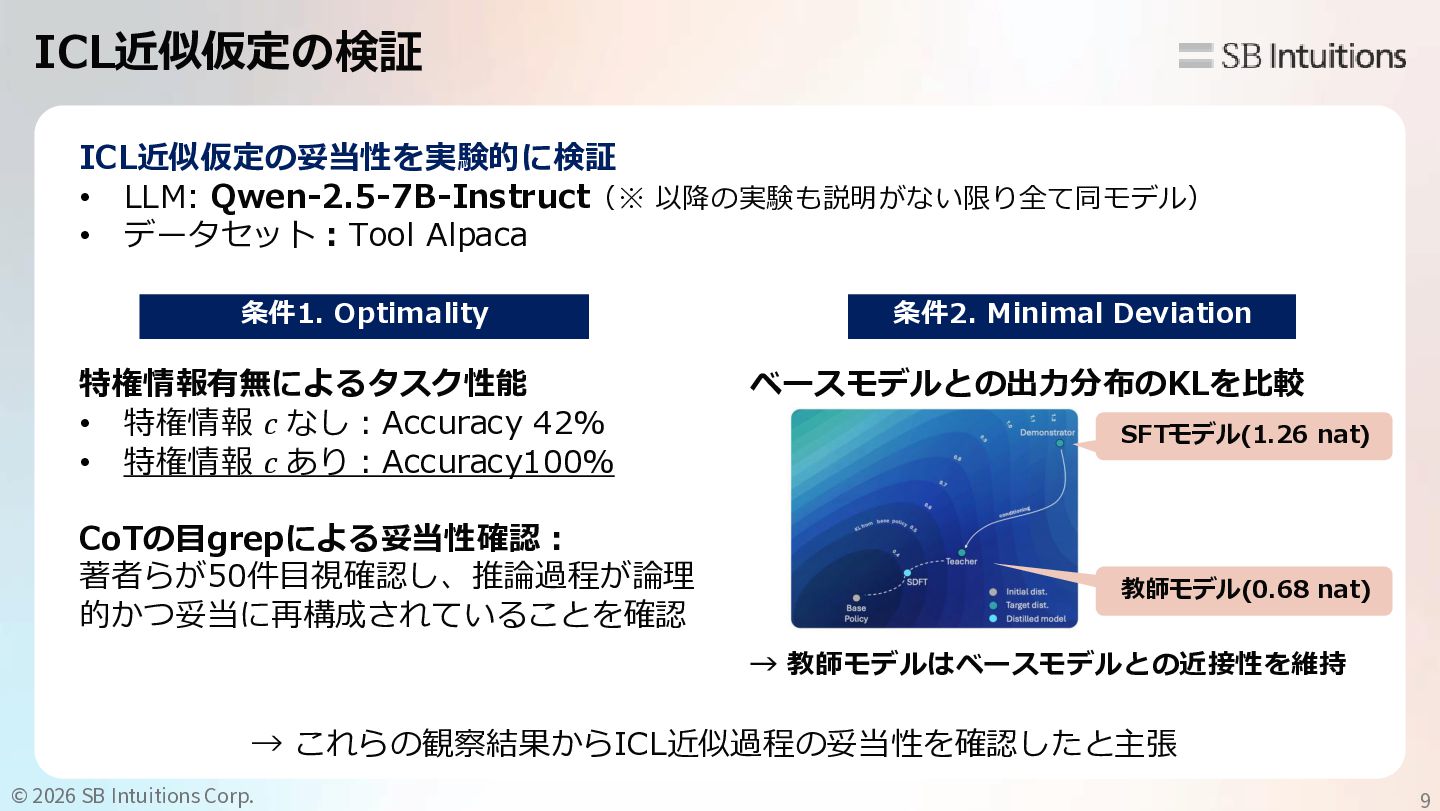
ICL近似仮定の検証 ICL近似仮定の妥当性を実験的に検証 • LLM: Qwen-2.5-7B-Instruct(※ 以降の実験も説明がない限り全て同モデル) • データセット:Tool Alpaca 条件1.
Optimality 特権情報有無によるタスク性能 • 特権情報 𝑐 なし:Accuracy 42% • 特権情報 𝑐 あり:Accuracy100% CoTの目grepによる妥当性確認: 著者らが50件目視確認し、推論過程が論理 的かつ妥当に再構成されていることを確認 条件2. Minimal Deviation ベースモデルとの出力分布のKLを比較 SFTモデル(1.26 nat) 教師モデル(0.68 nat) → 教師モデルはベースモデルとの近接性を維持 → これらの観察結果からICL近似過程の妥当性を確認したと主張 ©︎ 2026 SB Intuitions Corp. 9
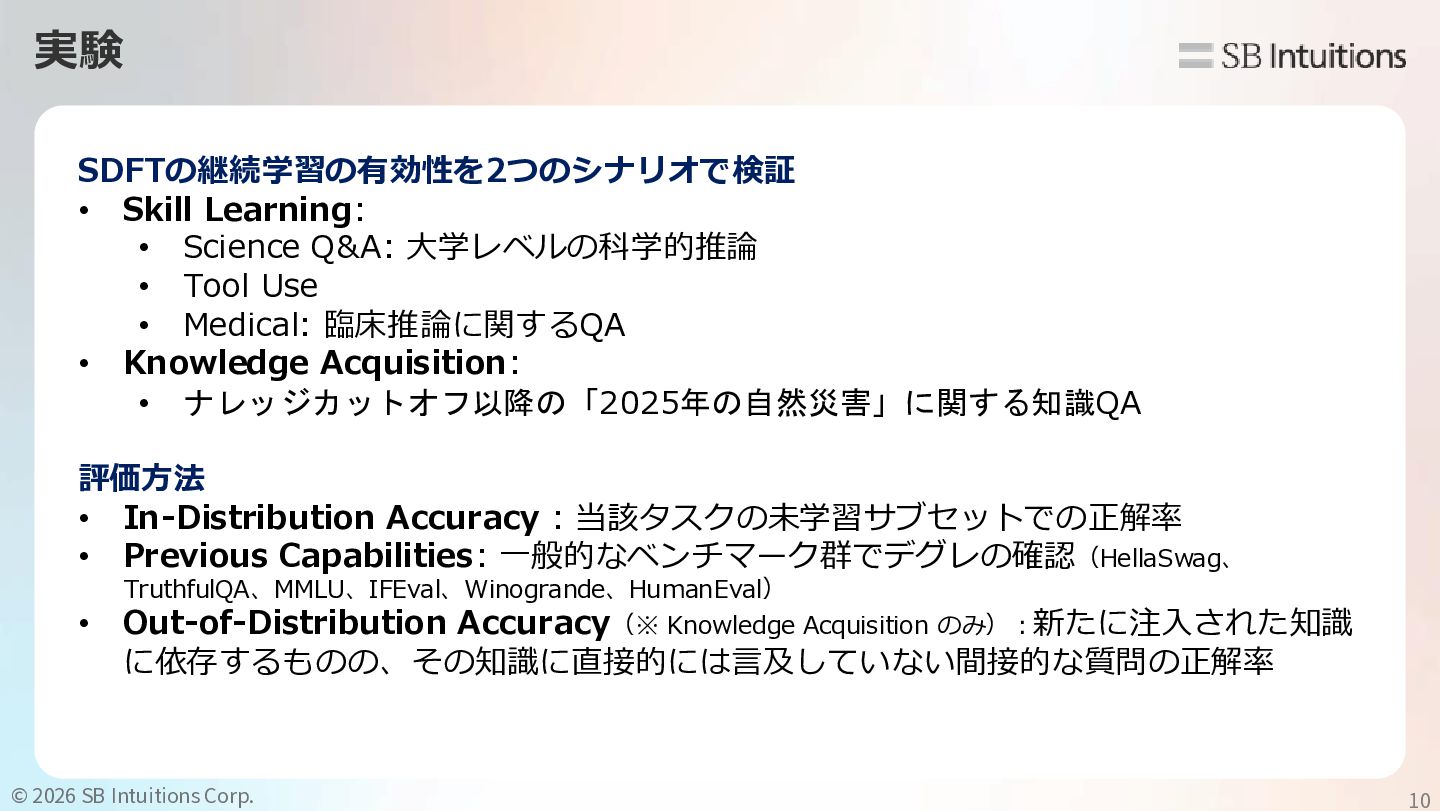
実験 SDFTの継続学習の有効性を2つのシナリオで検証 • Skill Learning: • Science Q&A: 大学レベルの科学的推論 •
Tool Use • Medical: 臨床推論に関するQA • Knowledge Acquisition: • ナレッジカットオフ以降の「2025年の自然災害」に関する知識QA 評価方法 • In-Distribution Accuracy : 当該タスクの未学習サブセットでの正解率 • Previous Capabilities: 一般的なベンチマーク群でデグレの確認(HellaSwag、 • TruthfulQA、MMLU、IFEval、Winogrande、HumanEval) Out-of-Distribution Accuracy(※ Knowledge Acquisition のみ):新たに注入された知識 に依存するものの、その知識に直接的には言及していない間接的な質問の正解率 ©︎ 2026 SB Intuitions Corp. 10
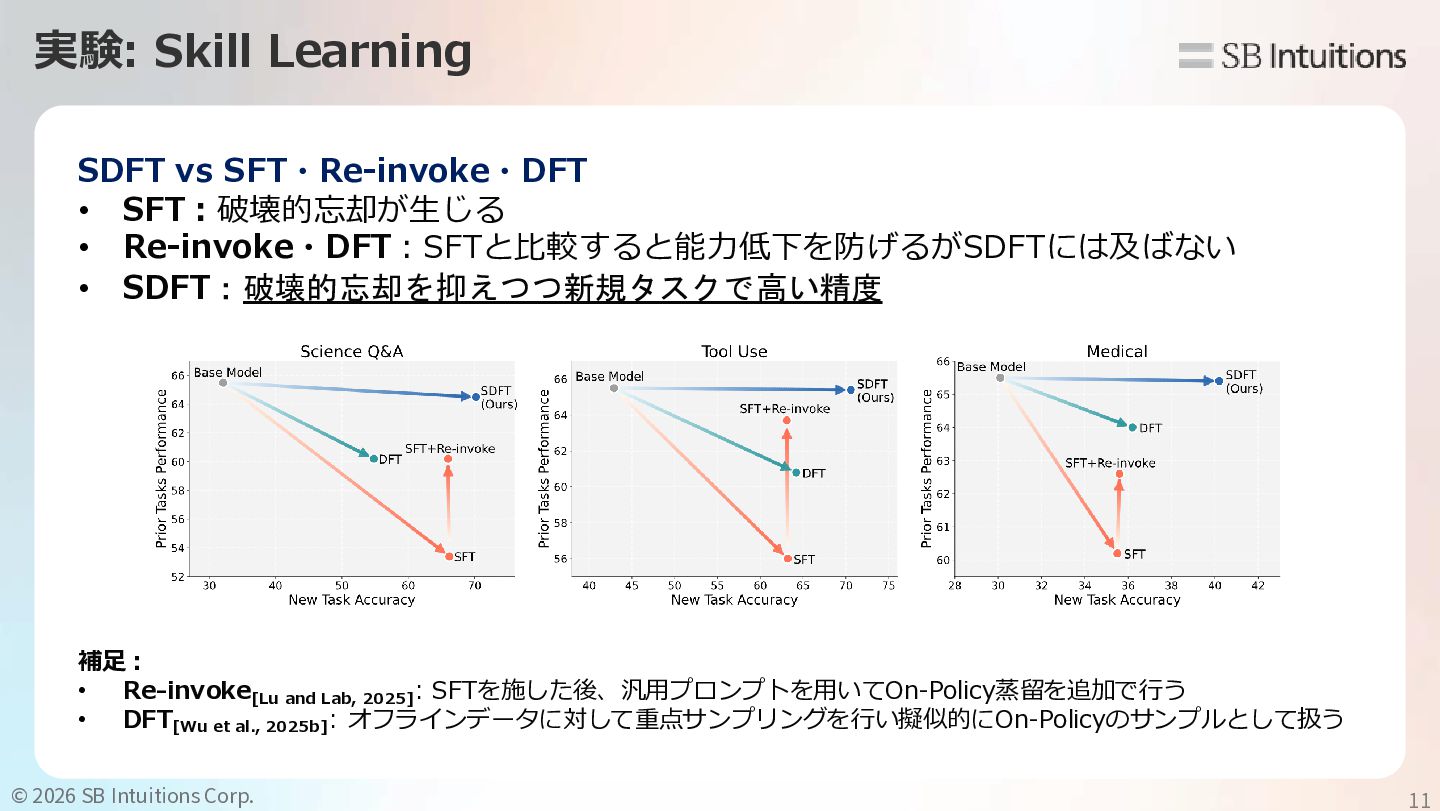
実験: Skill Learning SDFT vs SFT・Re-invoke・DFT • SFT:破壊的忘却が生じる • Re-invoke・DFT:SFTと比較すると能力低下を防げるがSDFTには及ばない
• SDFT:破壊的忘却を抑えつつ新規タスクで高い精度 補足: • Re-invoke[Lu and Lab, 2025]: SFTを施した後、汎用プロンプトを用いてOn-Policy蒸留を追加で行う • DFT[Wu et al., 2025b]: オフラインデータに対して重点サンプリングを行い擬似的にOn-Policyのサンプルとして扱う ©︎ 2026 SB Intuitions Corp. 11
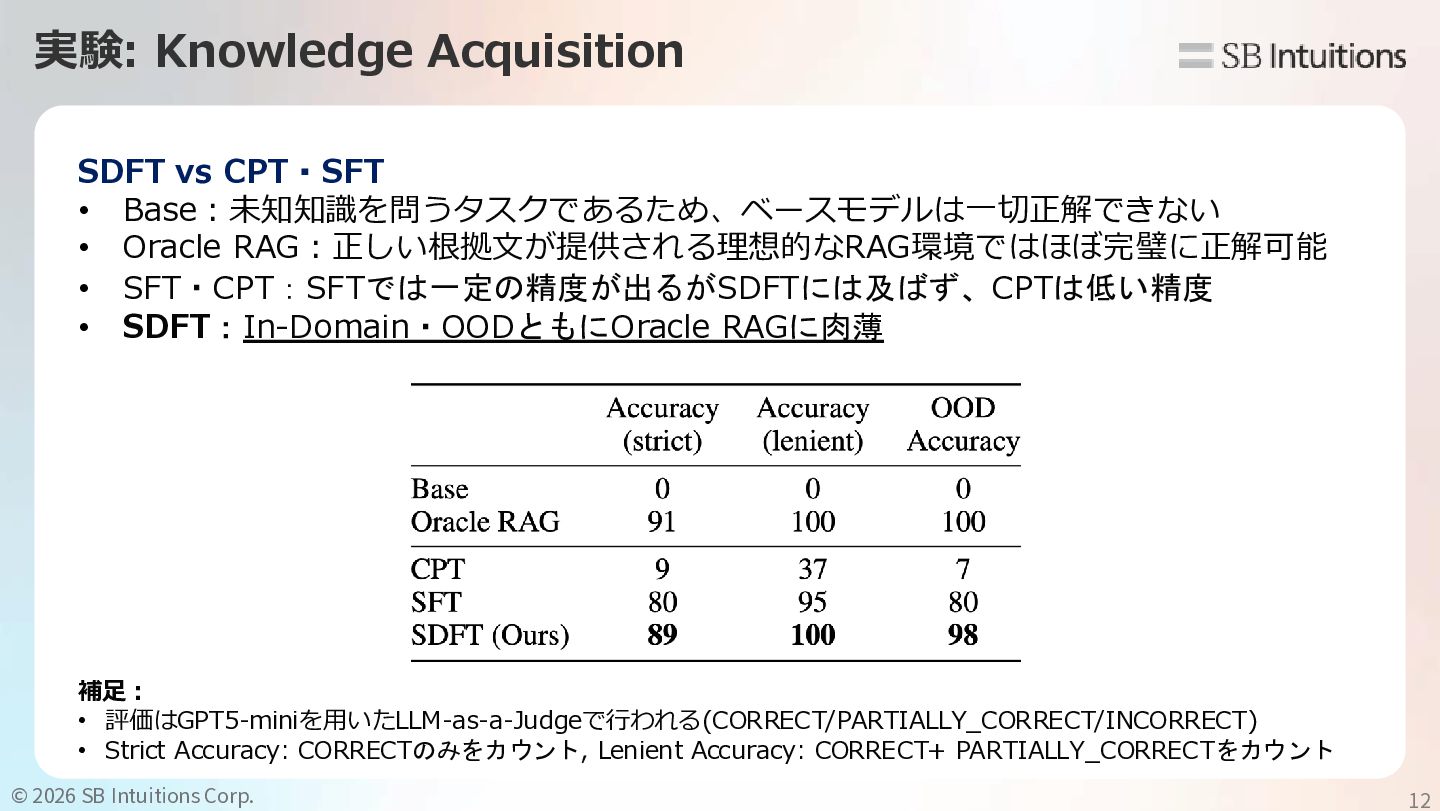
実験: Knowledge Acquisition SDFT vs CPT・SFT • Base:未知知識を問うタスクであるため、ベースモデルは一切正解できない • Oracle
RAG:正しい根拠文が提供される理想的なRAG環境ではほぼ完璧に正解可能 • SFT・CPT:SFTでは一定の精度が出るがSDFTには及ばず、CPTは低い精度 • SDFT:In-Domain・OODともにOracle RAGに肉薄 補足: • 評価はGPT5-miniを用いたLLM-as-a-Judgeで行われる(CORRECT/PARTIALLY_CORRECT/INCORRECT) • Strict Accuracy: CORRECTのみをカウント, Lenient Accuracy: CORRECT+ PARTIALLY_CORRECTをカウント ©︎ 2026 SB Intuitions Corp. 12
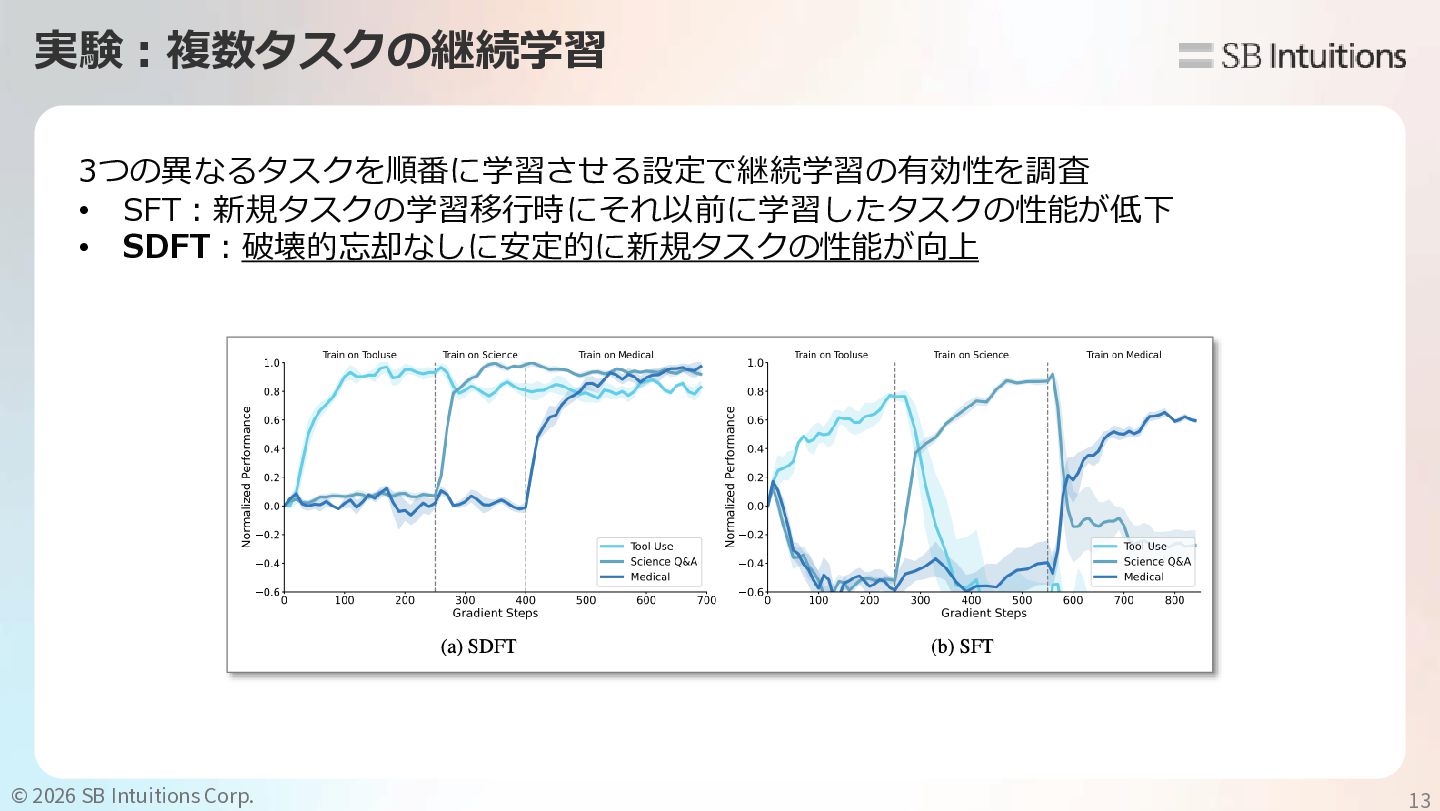
実験:複数タスクの継続学習 3つの異なるタスクを順番に学習させる設定で継続学習の有効性を調査 • SFT:新規タスクの学習移行時にそれ以前に学習したタスクの性能が低下 • SDFT:破壊的忘却なしに安定的に新規タスクの性能が向上 ©︎ 2026 SB Intuitions
Corp. 13
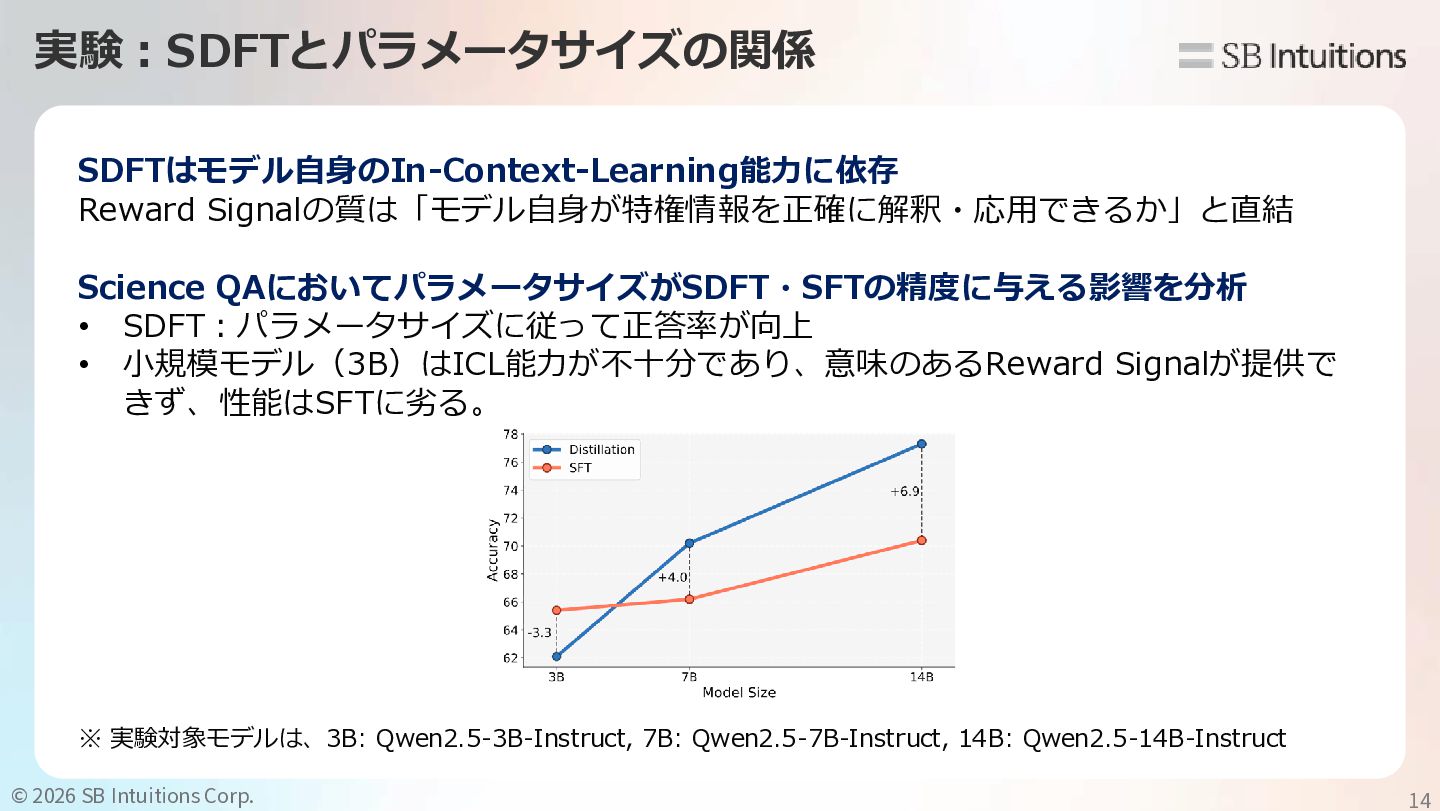
実験:SDFTとパラメータサイズの関係 SDFTはモデル自身のIn-Context-Learning能力に依存 Reward Signalの質は「モデル自身が特権情報を正確に解釈・応用できるか」と直結 Science QAにおいてパラメータサイズがSDFT・SFTの精度に与える影響を分析 • SDFT:パラメータサイズに従って正答率が向上 • 小規模モデル(3B)はICL能力が不十分であり、意味のあるReward
Signalが提供で きず、性能はSFTに劣る。 ※ 実験対象モデルは、3B: Qwen2.5-3B-Instruct, 7B: Qwen2.5-7B-Instruct, 14B: Qwen2.5-14B-Instruct ©︎ 2026 SB Intuitions Corp. 14
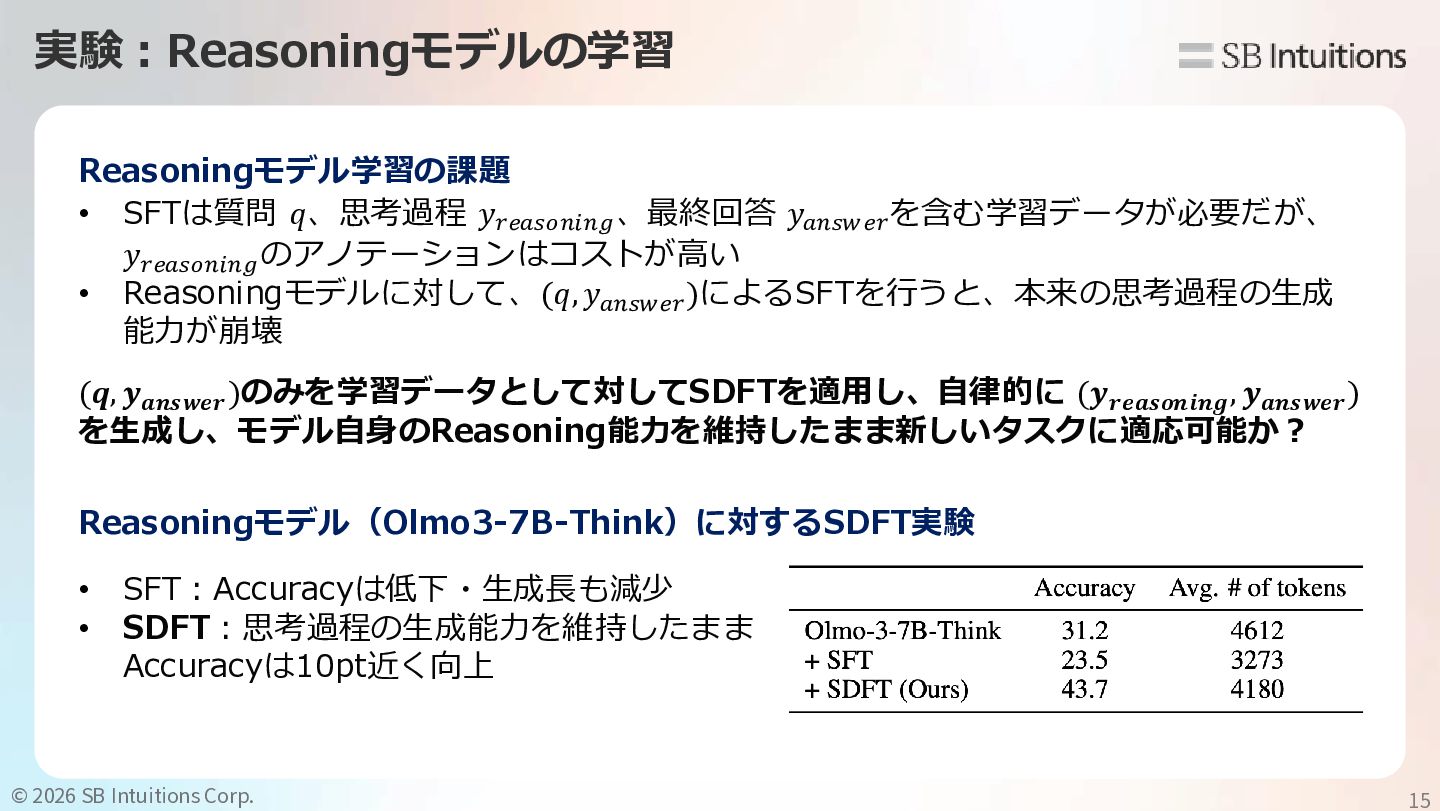
実験:Reasoningモデルの学習 Reasoningモデル学習の課題 • SFTは質問 𝑞、思考過程 𝑦𝑟𝑒𝑎𝑠𝑜𝑛𝑖𝑛𝑔 、最終回答 𝑦𝑎𝑛𝑠𝑤𝑒𝑟 を含む学習データが必要だが、 𝑦𝑟𝑒𝑎𝑠𝑜𝑛𝑖𝑛𝑔
のアノテーションはコストが高い • Reasoningモデルに対して、(𝑞, 𝑦𝑎𝑛𝑠𝑤𝑒𝑟 )によるSFTを行うと、本来の思考過程の生成 能力が崩壊 (𝒒, 𝒚𝒂𝒏𝒔𝒘𝒆𝒓 )のみを学習データとして対してSDFTを適用し、自律的に (𝒚𝒓𝒆𝒂𝒔𝒐𝒏𝒊𝒏𝒈 , 𝒚𝒂𝒏𝒔𝒘𝒆𝒓 ) を生成し、モデル自身のReasoning能力を維持したまま新しいタスクに適応可能か? Reasoningモデル(Olmo3-7B-Think)に対するSDFT実験 • • SFT:Accuracyは低下・生成長も減少 SDFT:思考過程の生成能力を維持したまま Accuracyは10pt近く向上 ©︎ 2026 SB Intuitions Corp. 15
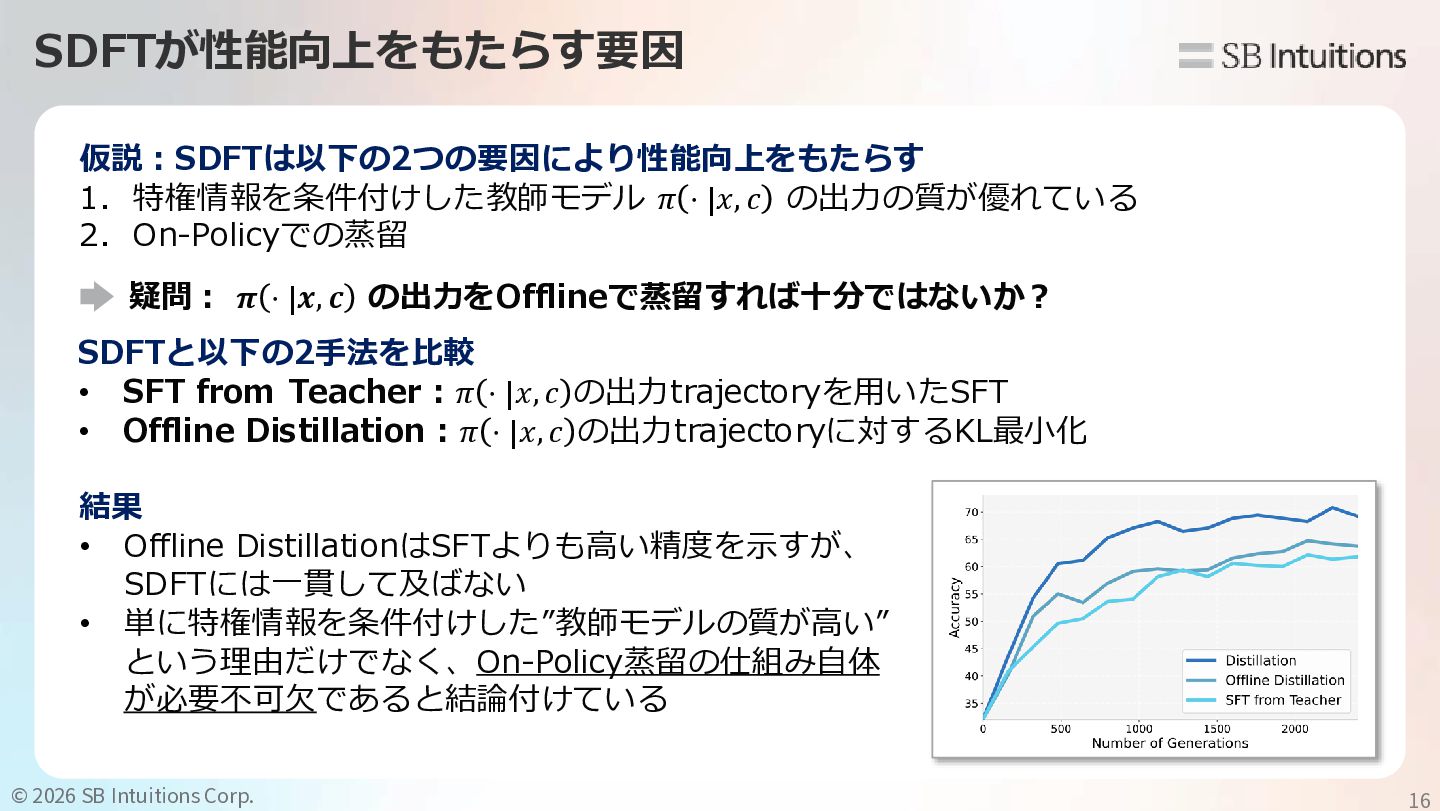
SDFTが性能向上をもたらす要因 仮説:SDFTは以下の2つの要因により性能向上をもたらす 1. 特権情報を条件付けした教師モデル 𝜋 ⋅ |𝑥, 𝑐 の出力の質が優れている 2.
On-Policyでの蒸留 疑問: 𝝅 ⋅ |𝒙, 𝒄 の出力をOfflineで蒸留すれば十分ではないか? SDFTと以下の2手法を比較 • SFT from Teacher:𝜋 ⋅ |𝑥, 𝑐 の出力trajectoryを用いたSFT • Offline Distillation:𝜋 ⋅ |𝑥, 𝑐 の出力trajectoryに対するKL最小化 結果 • Offline DistillationはSFTよりも高い精度を示すが、 SDFTには一貫して及ばない • 単に特権情報を条件付けした”教師モデルの質が高い” という理由だけでなく、On-Policy蒸留の仕組み自体 が必要不可欠であると結論付けている ©︎ 2026 SB Intuitions Corp. 16
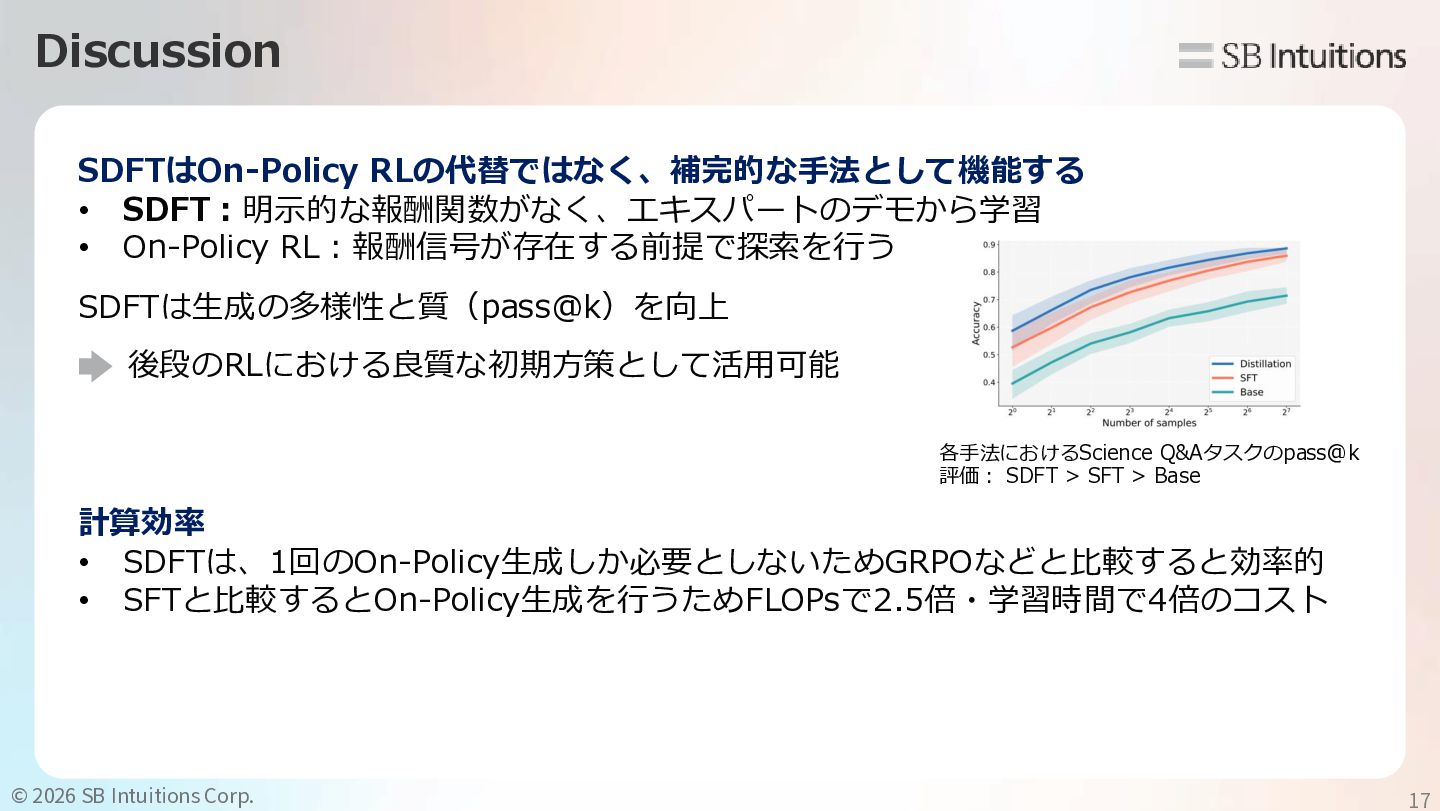
Discussion SDFTはOn-Policy RLの代替ではなく、補完的な手法として機能する • SDFT:明示的な報酬関数がなく、エキスパートのデモから学習 • On-Policy RL:報酬信号が存在する前提で探索を行う SDFTは生成の多様性と質(pass@k)を向上 後段のRLにおける良質な初期方策として活用可能
各手法におけるScience Q&Aタスクのpass@k 評価: SDFT > SFT > Base 計算効率 • SDFTは、1回のOn-Policy生成しか必要としないためGRPOなどと比較すると効率的 • SFTと比較するとOn-Policy生成を行うためFLOPsで2.5倍・学習時間で4倍のコスト ©︎ 2026 SB Intuitions Corp. 17
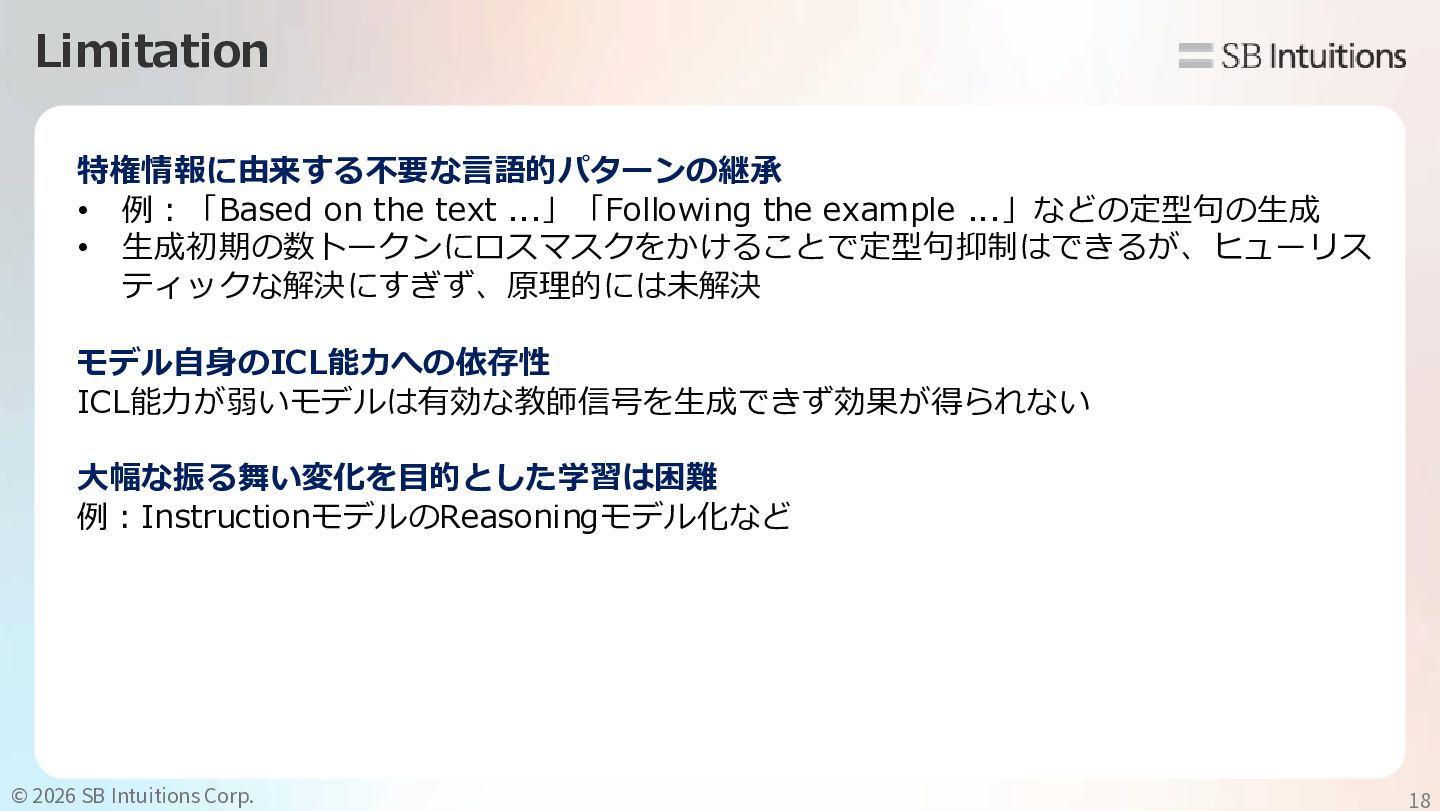
Limitation 特権情報に由来する不要な言語的パターンの継承 • 例:「Based on the text ...」「Following the example
...」などの定型句の生成 • 生成初期の数トークンにロスマスクをかけることで定型句抑制はできるが、ヒューリス ティックな解決にすぎず、原理的には未解決 モデル自身のICL能力への依存性 ICL能力が弱いモデルは有効な教師信号を生成できず効果が得られない 大幅な振る舞い変化を目的とした学習は困難 例:InstructionモデルのReasoningモデル化など ©︎ 2026 SB Intuitions Corp. 18
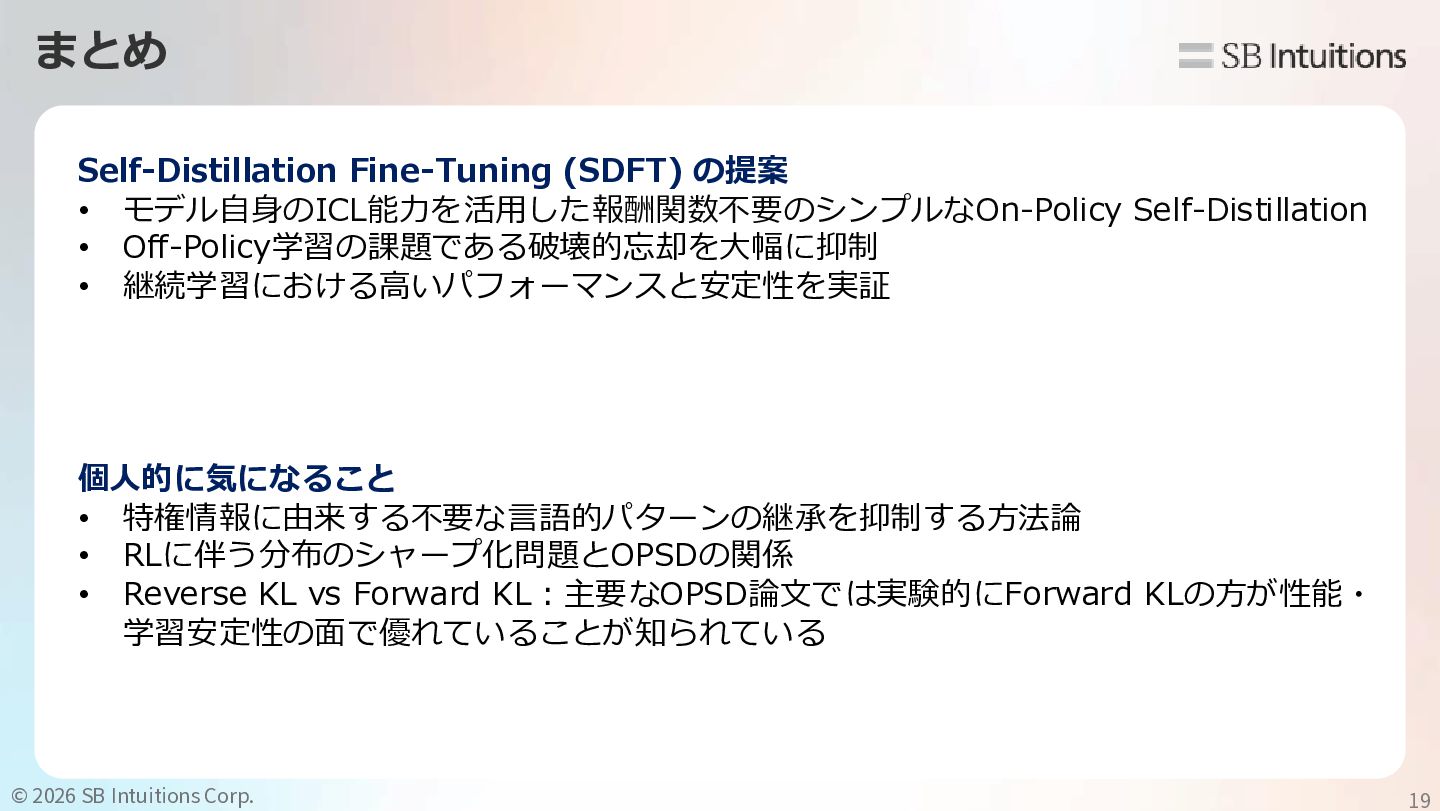
まとめ Self-Distillation Fine-Tuning (SDFT) の提案 • モデル自身のICL能力を活用した報酬関数不要のシンプルなOn-Policy Self-Distillation • Off-Policy学習の課題である破壊的忘却を大幅に抑制
• 継続学習における高いパフォーマンスと安定性を実証 個人的に気になること • 特権情報に由来する不要な言語的パターンの継承を抑制する方法論 • RLに伴う分布のシャープ化問題とOPSDの関係 • Reverse KL vs Forward KL:主要なOPSD論文では実験的にForward KLの方が性能・ 学習安定性の面で優れていることが知られている ©︎ 2026 SB Intuitions Corp. 19
None

 Your Podcast. Everywhere. Effortlessly.


 koki_itai
 davidcarrasco
 wayneb77
 akihiro_kokubo
 holman
 kimpetersen
 sergeychernyshev
 keavy
 nikkihalliwell
 pwiseman
 palkan
 tmiket
 eileencodes