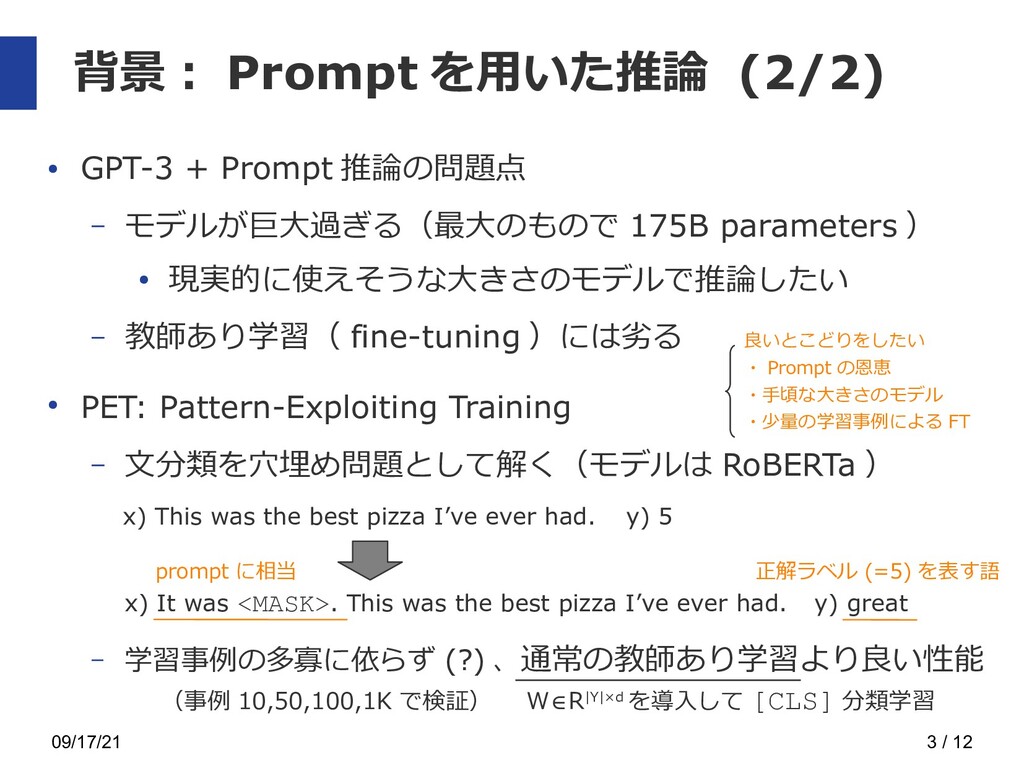
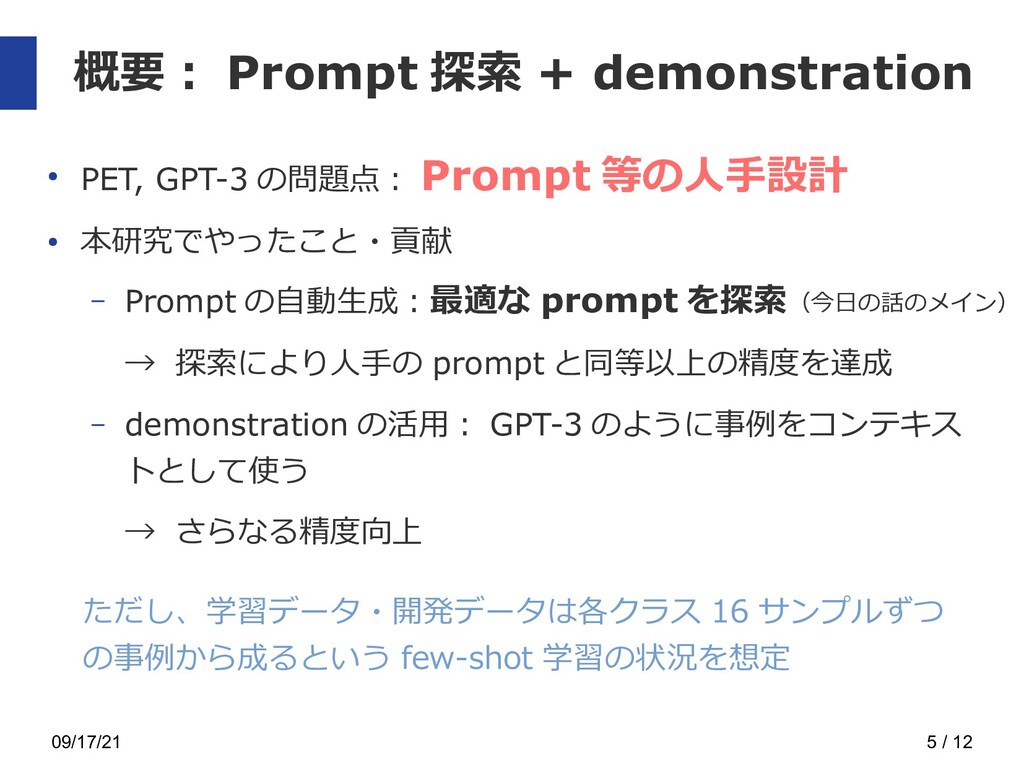
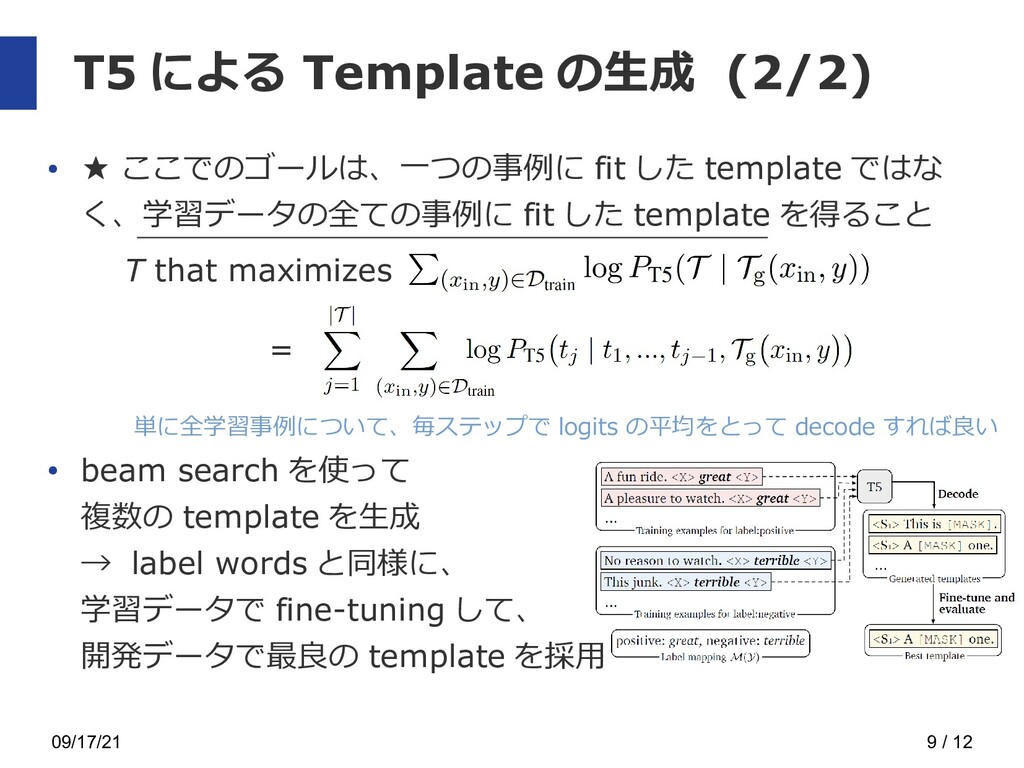
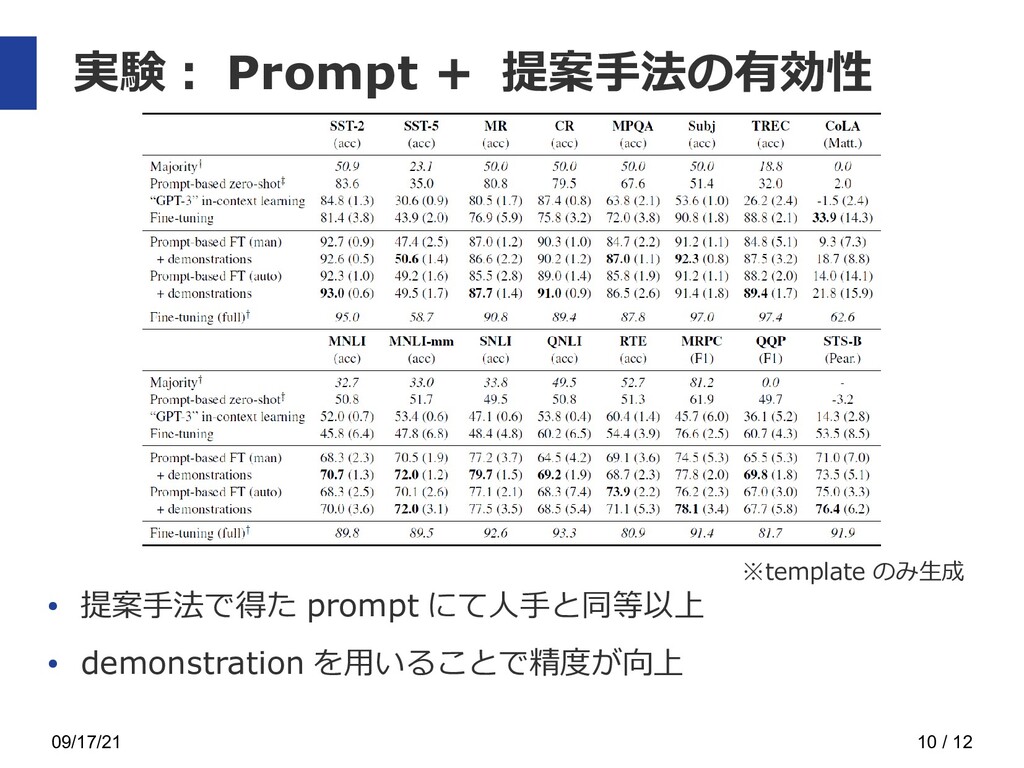
+ Prompt 推論の問題点 – モデルが巨大過ぎる(最大のもので 175B parameters ) • 現実的に使えそうな大きさのモデルで推論したい – 教師あり学習( fine-tuning )には劣る • PET: Pattern-Exploiting Training – 文分類を穴埋め問題として解く(モデルは RoBERTa ) – 学習事例の多寡に依らず (?) 、通常の教師あり学習より良い性能 x) This was the best pizza I’ve ever had. y) 5 x) It was <MASK>. This was the best pizza I’ve ever had. y) great prompt に相当 正解ラベル (=5) を表す語 良いとこどりをしたい ・ Prompt の恩恵 ・手頃な大きさのモデル ・少量の学習事例による FT W∈R|Y|×d を導入して [CLS] 分類学習 (事例 10,50,100,1K で検証)
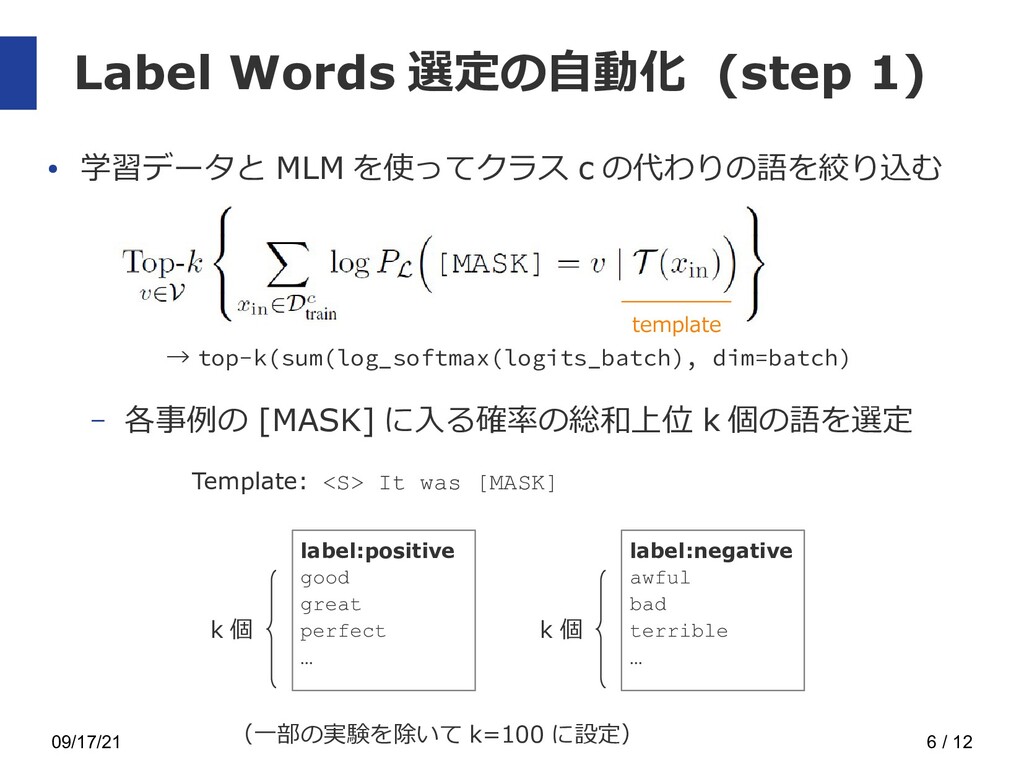
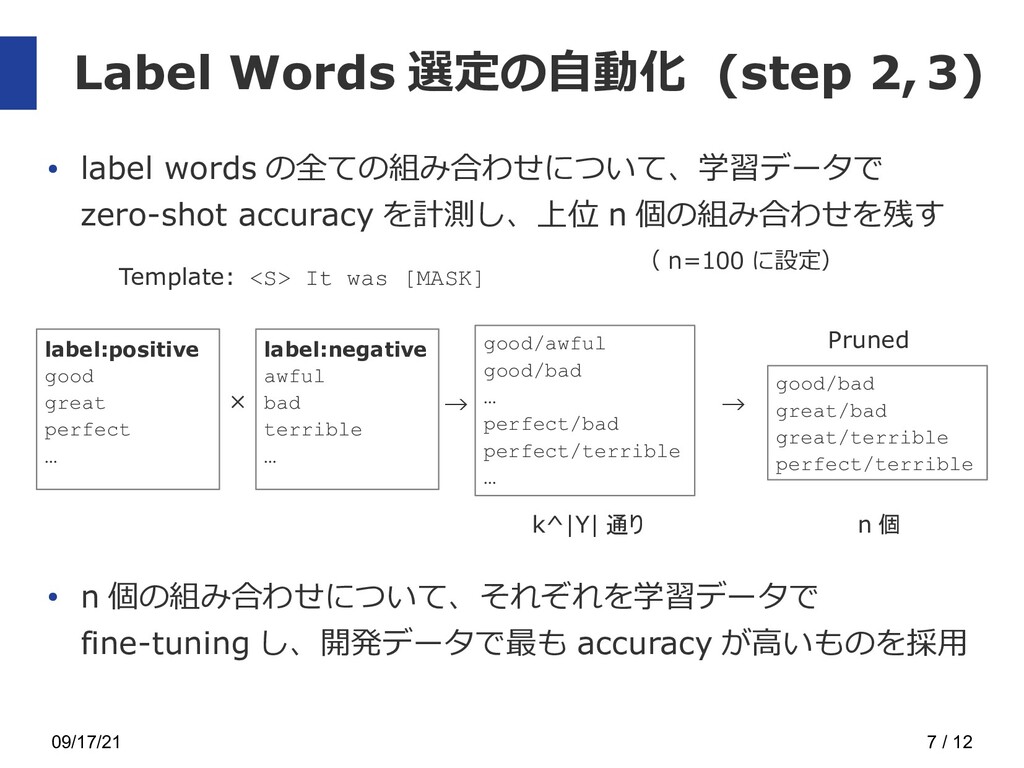
学習データと MLM を使ってクラス c の代わりの語を絞り込む – 各事例の [MASK] に入る確率の総和上位 k 個の語を選定 → top-k(sum(log_softmax(logits_batch), dim=batch) template Template: <S> It was [MASK] label:negative awful bad terrible … label:positive good great perfect … k 個 k 個 (一部の実験を除いて k=100 に設定)
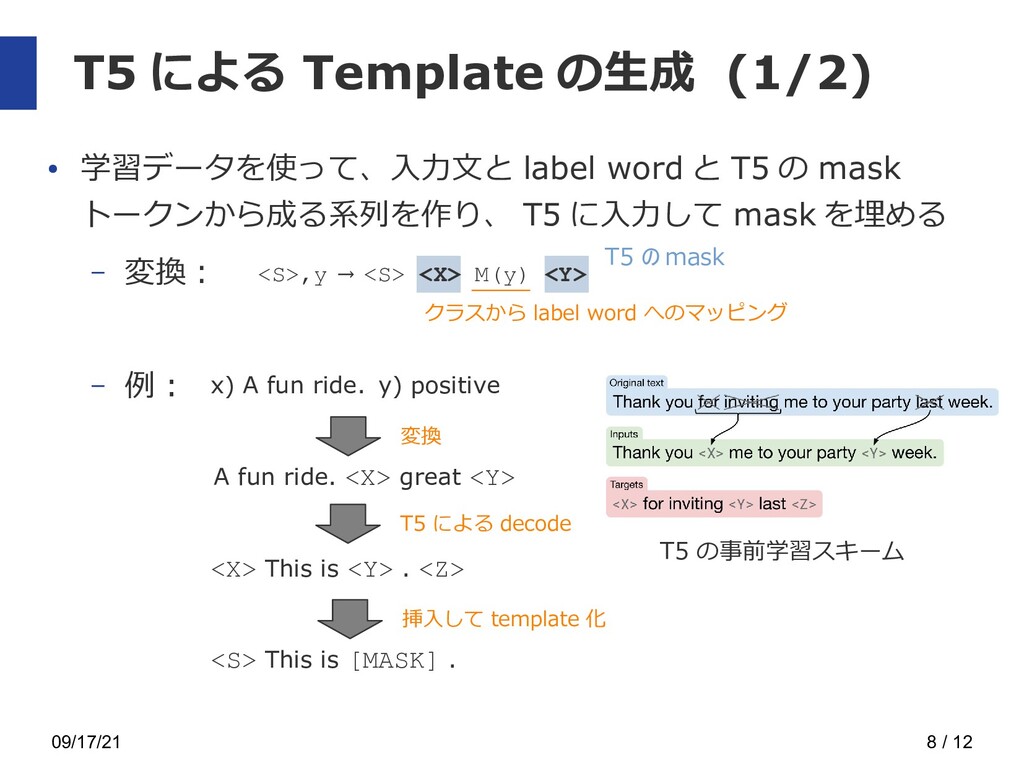
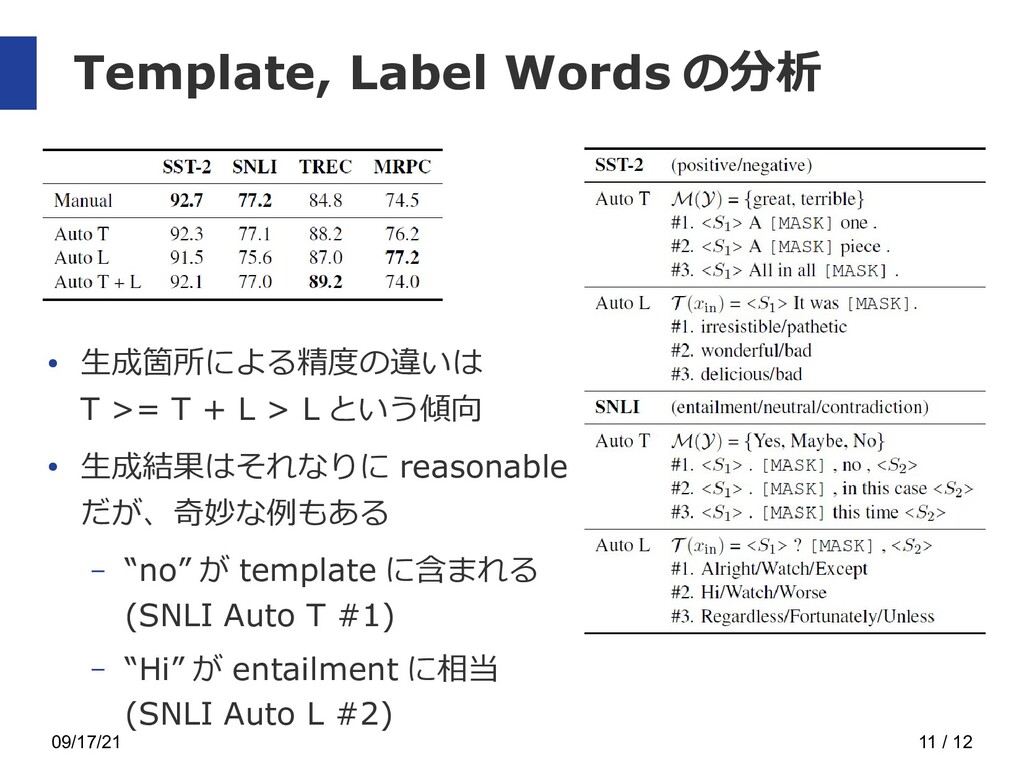
T >= T + L > L という傾向 • 生成結果はそれなりに reasonable だが、奇妙な例もある – “no” が template に含まれる (SNLI Auto T #1) – “Hi” が entailment に相当 (SNLI Auto L #2) ※template のみ生成


 varn
 letsgokoyo
 baasie
 shlominoach
 codingconduct
 techseoconnect
 tammyeverts
 marcduiker
 nikkihalliwell
 sferik
 eileencodes
 jeffersonlam