Upgrade to Pro — share decks privately, control downloads, hide ads and more …

バイブコーディングで 文書作成を完全自動化!

Avatar for kaori sakae kaori sakae
January 31, 2026
61

バイブコーディングで 文書作成を完全自動化!

関連するワード:
ChatGPT  バイブコーディング DX バックオフィス オペレーション改善 属人化解消 UX  BPR プロセス設計 業務設計 
スプレッドシート  エクセル 効率化  業務自動化 業務改善 書類作成 Googleドキュメント Doc  時短 人手不足解消 AI活用 生成AI

Avatar for kaori sakae

kaori sakae

January 31, 2026

Transcript

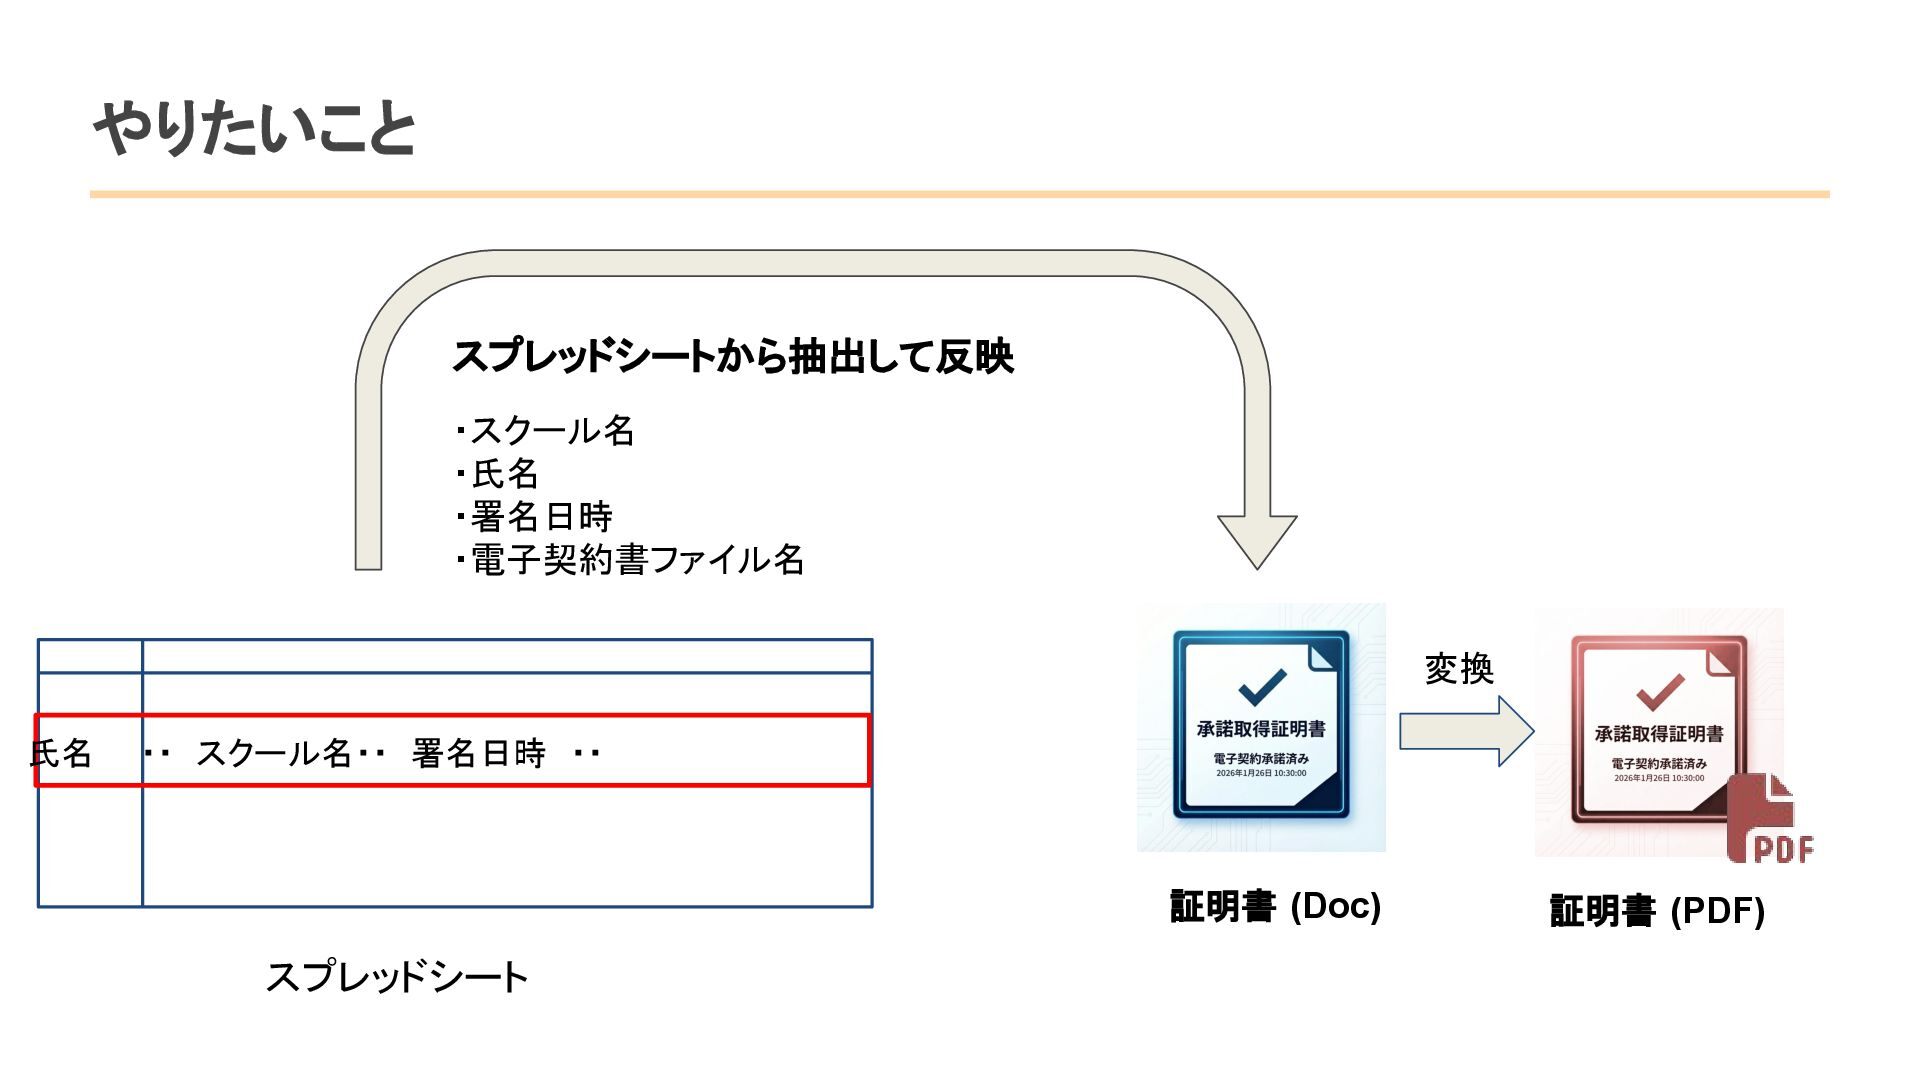
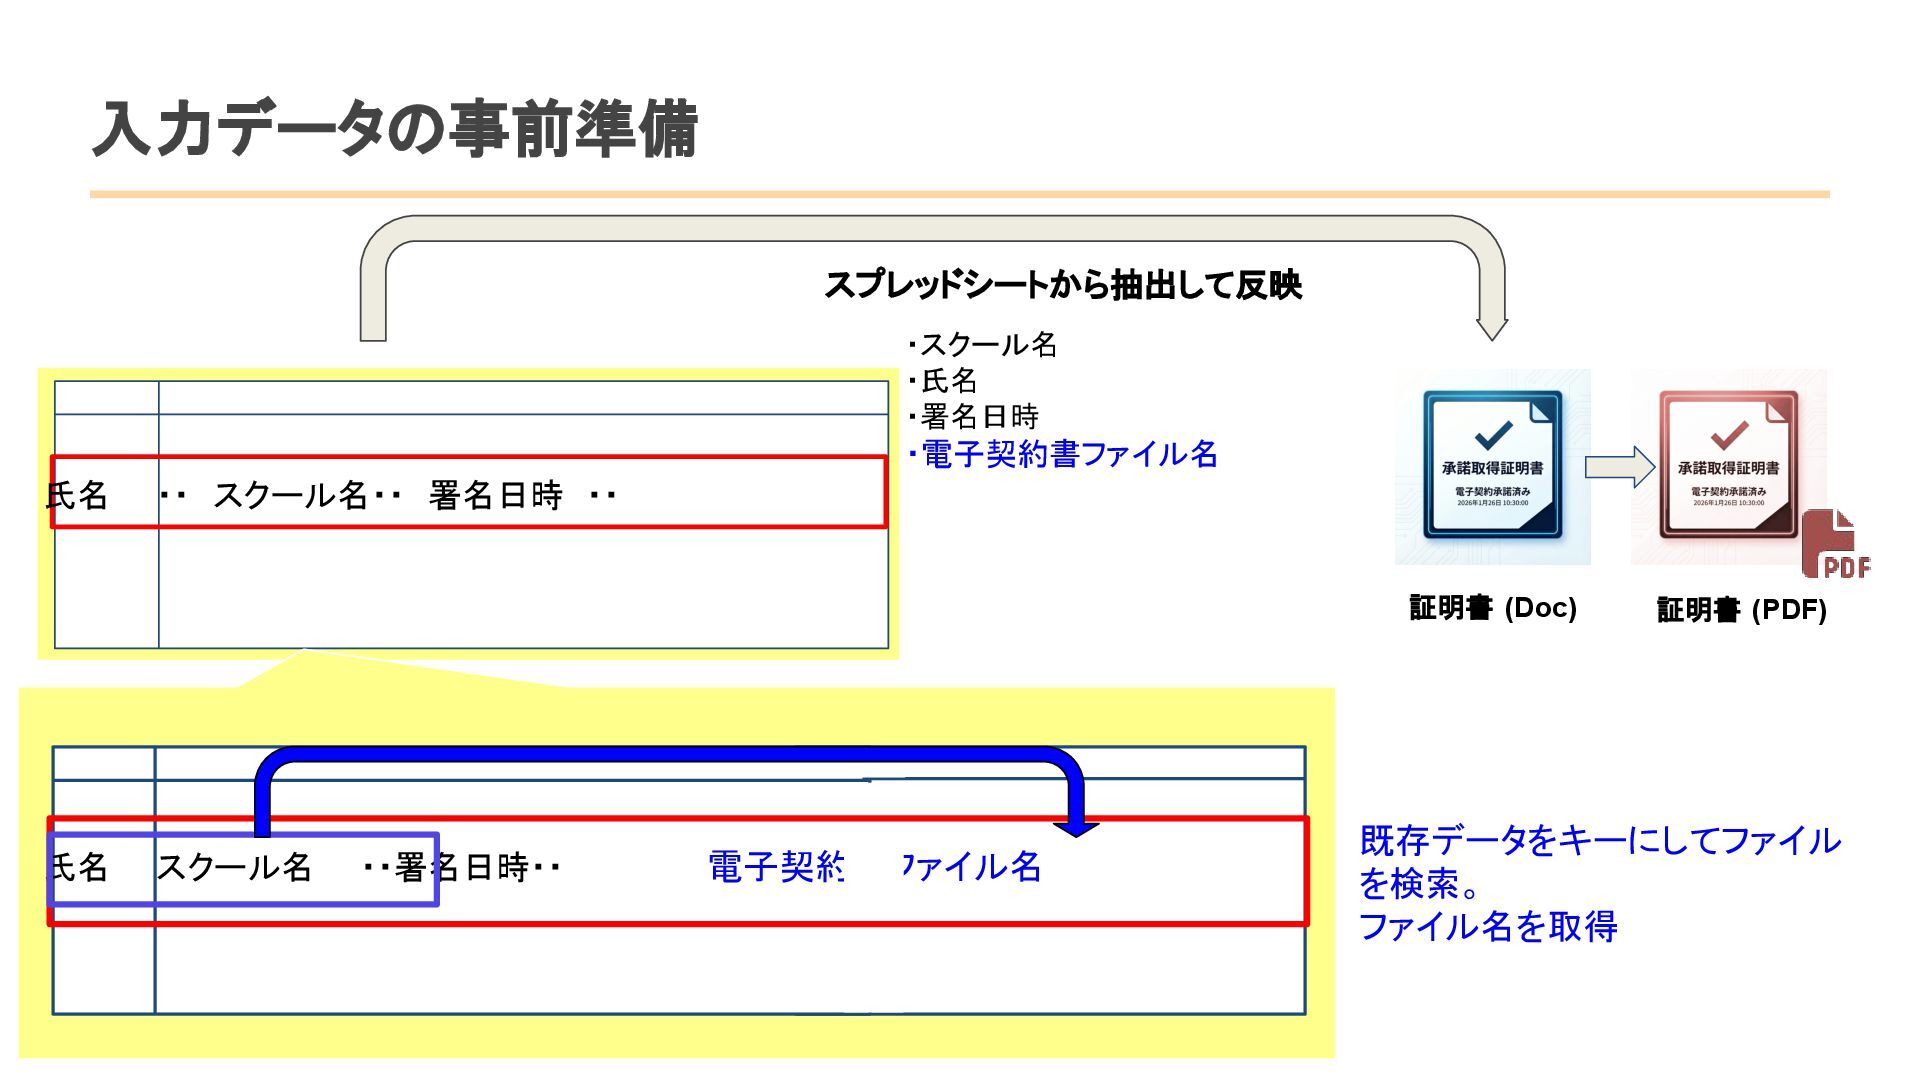
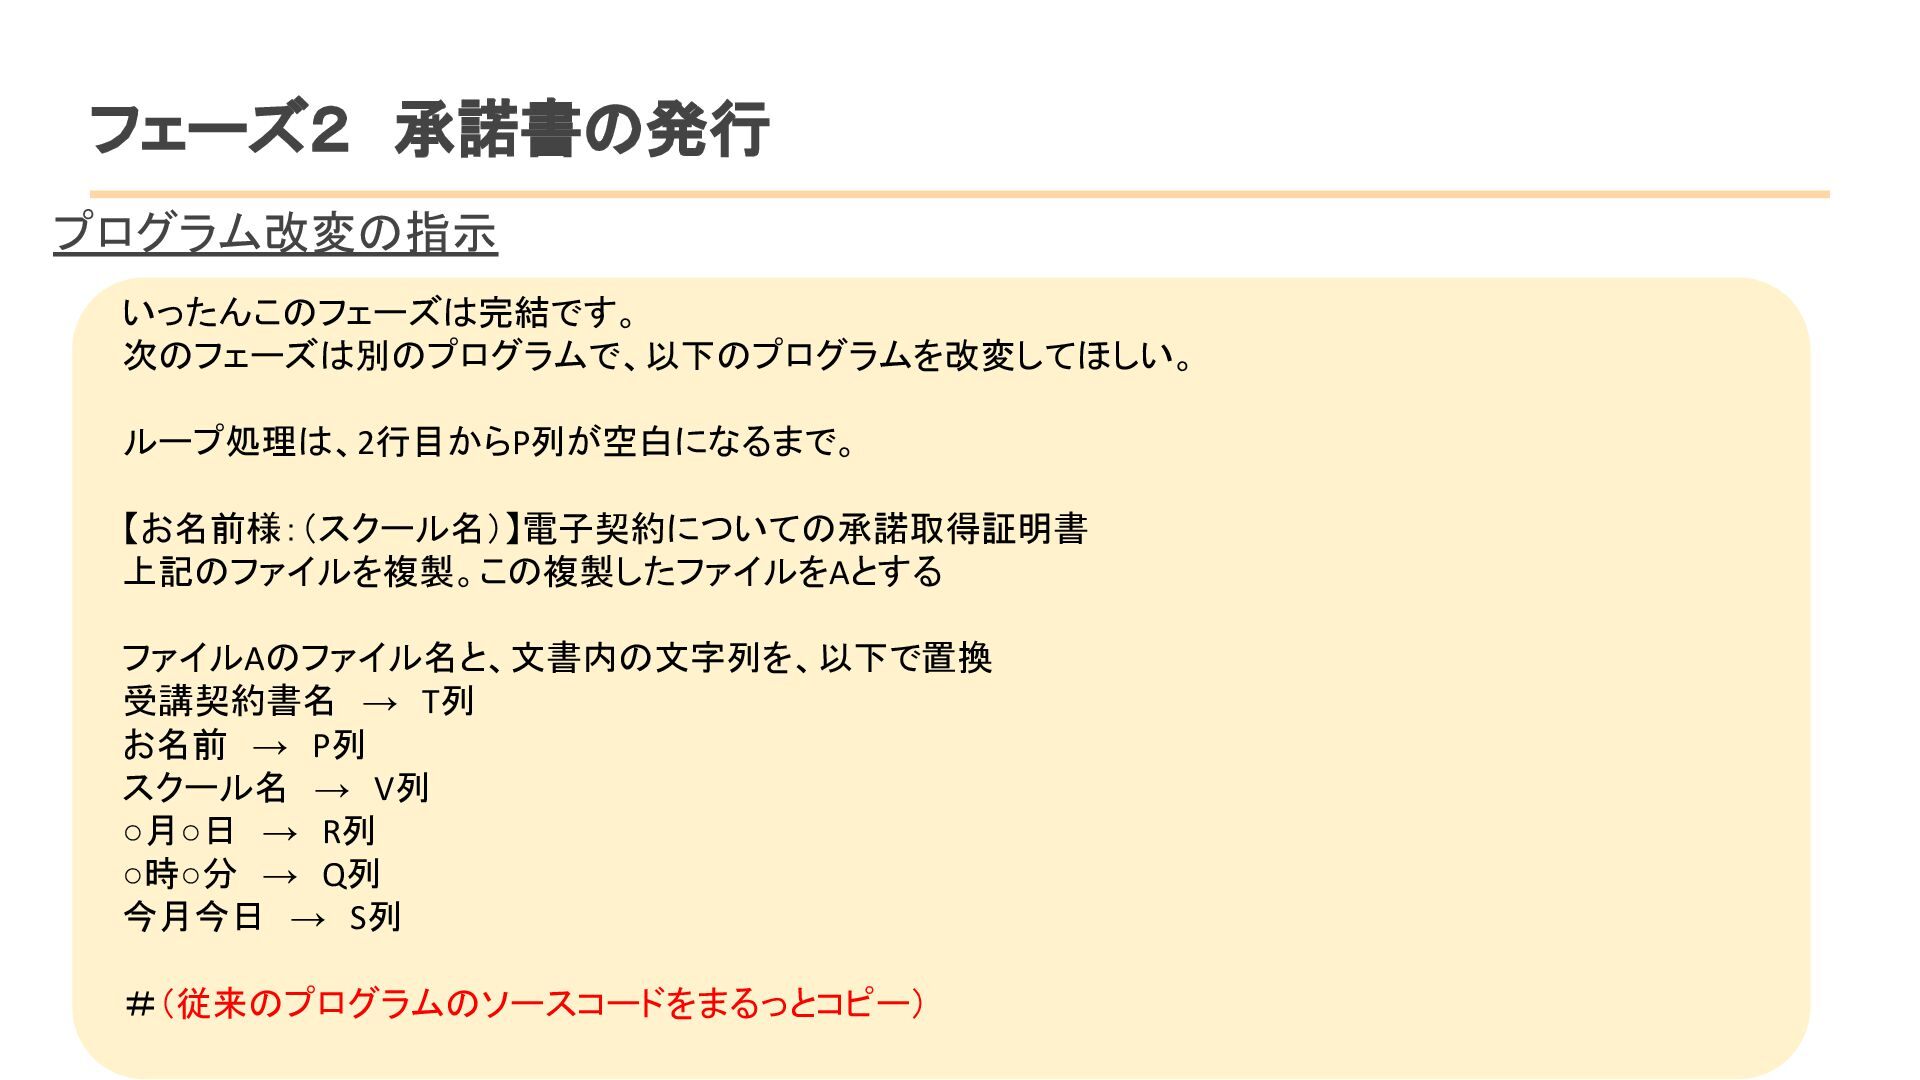
  1. 00 入力データの事前準備 証明書 (Doc) スプレッドシートから抽出して反映     ・スクール名     ・氏名     ・署名日時     ・電子契約書ファイル名    氏名  ・・ スクール名・・ 署名日時 ・・

    証明書 (PDF) 既存データをキーにしてファイル を検索。 ファイル名を取得    氏名  スクール名  ・・署名日時・・      電子契約書ファイル名
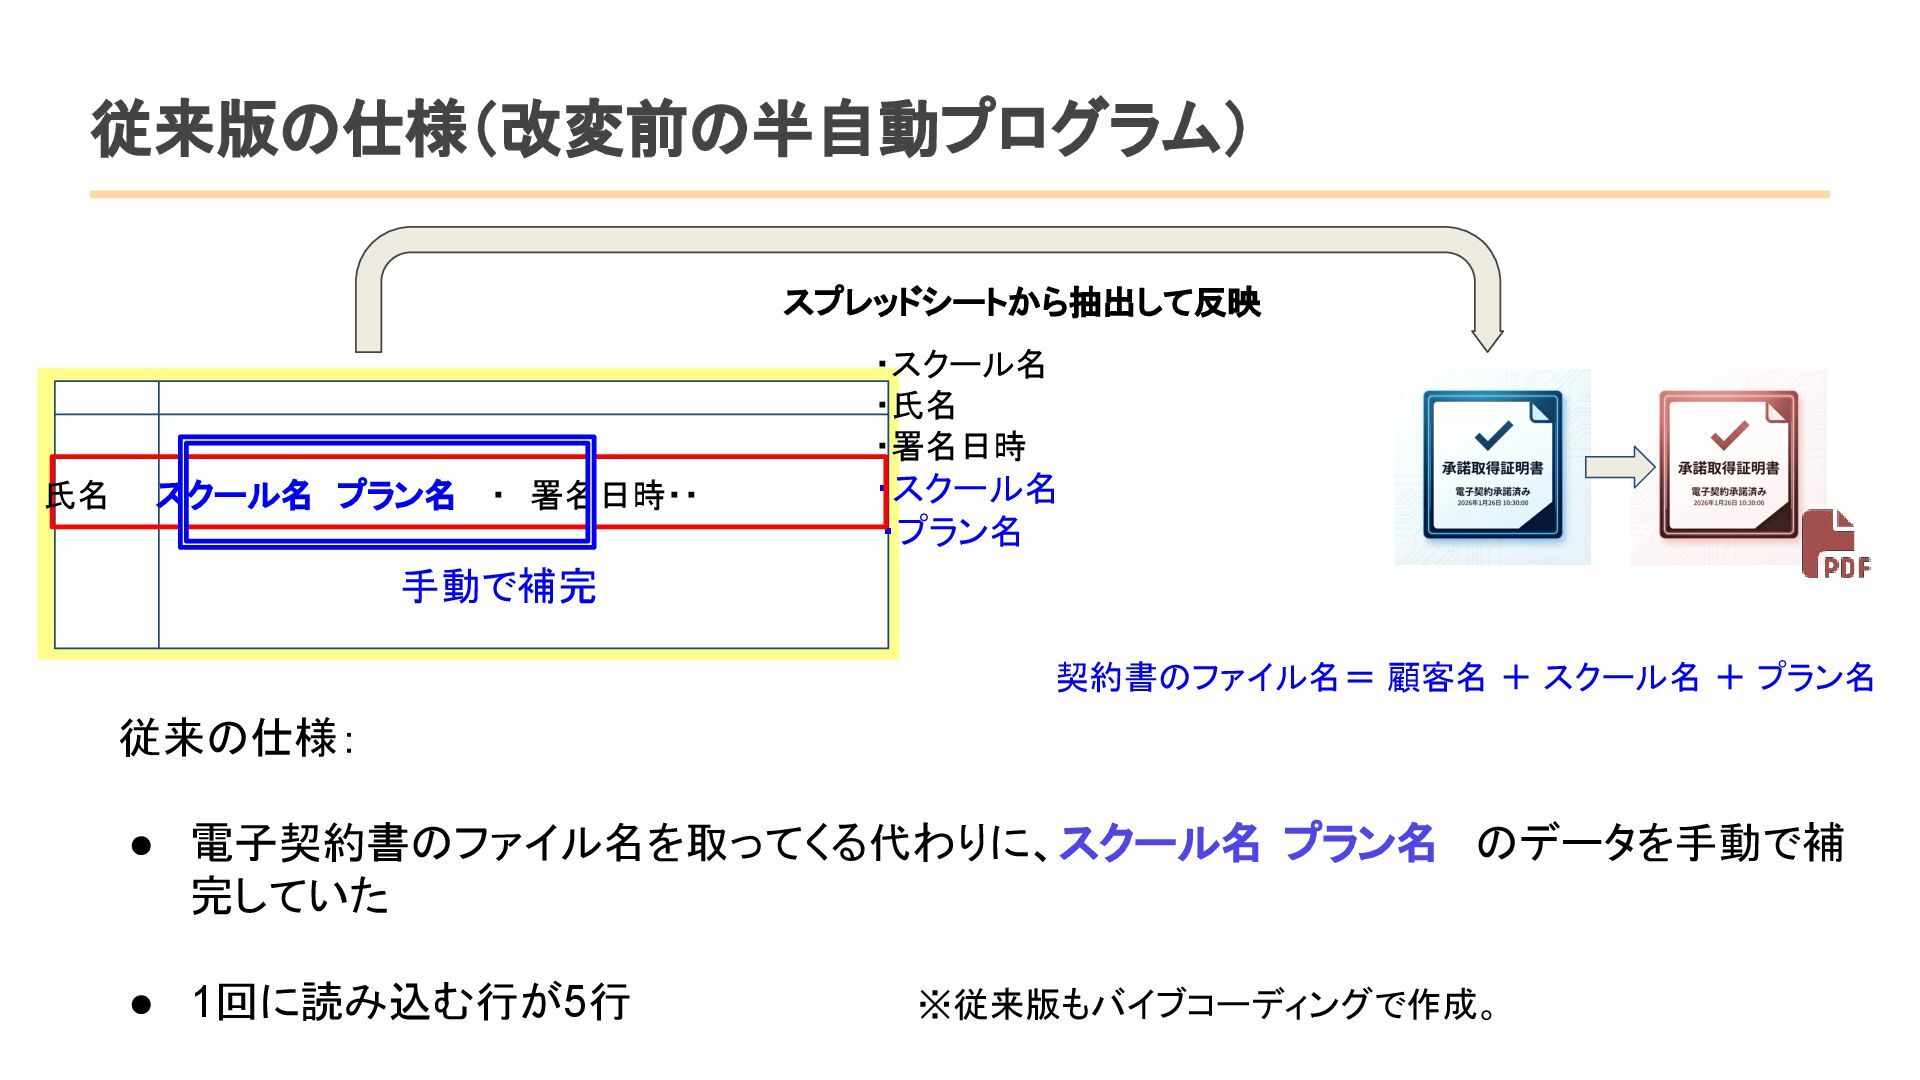
  2. 00 従来版の仕様(改変前の半自動プログラム) スプレッドシートから抽出して反映     ・スクール名     ・氏名     ・署名日時     ・スクール名      ・プラン名    氏名  スクール名 プラン名  ・ 署名日時・・

    従来の仕様: • 電子契約書のファイル名を取ってくる代わりに、スクール名 プラン名 のデータを手動で補 完していた • 1回に読み込む行が5行        ※従来版もバイブコーディングで作成。 手動で補完 契約書のファイル名= 顧客名 + スクール名 + プラン名
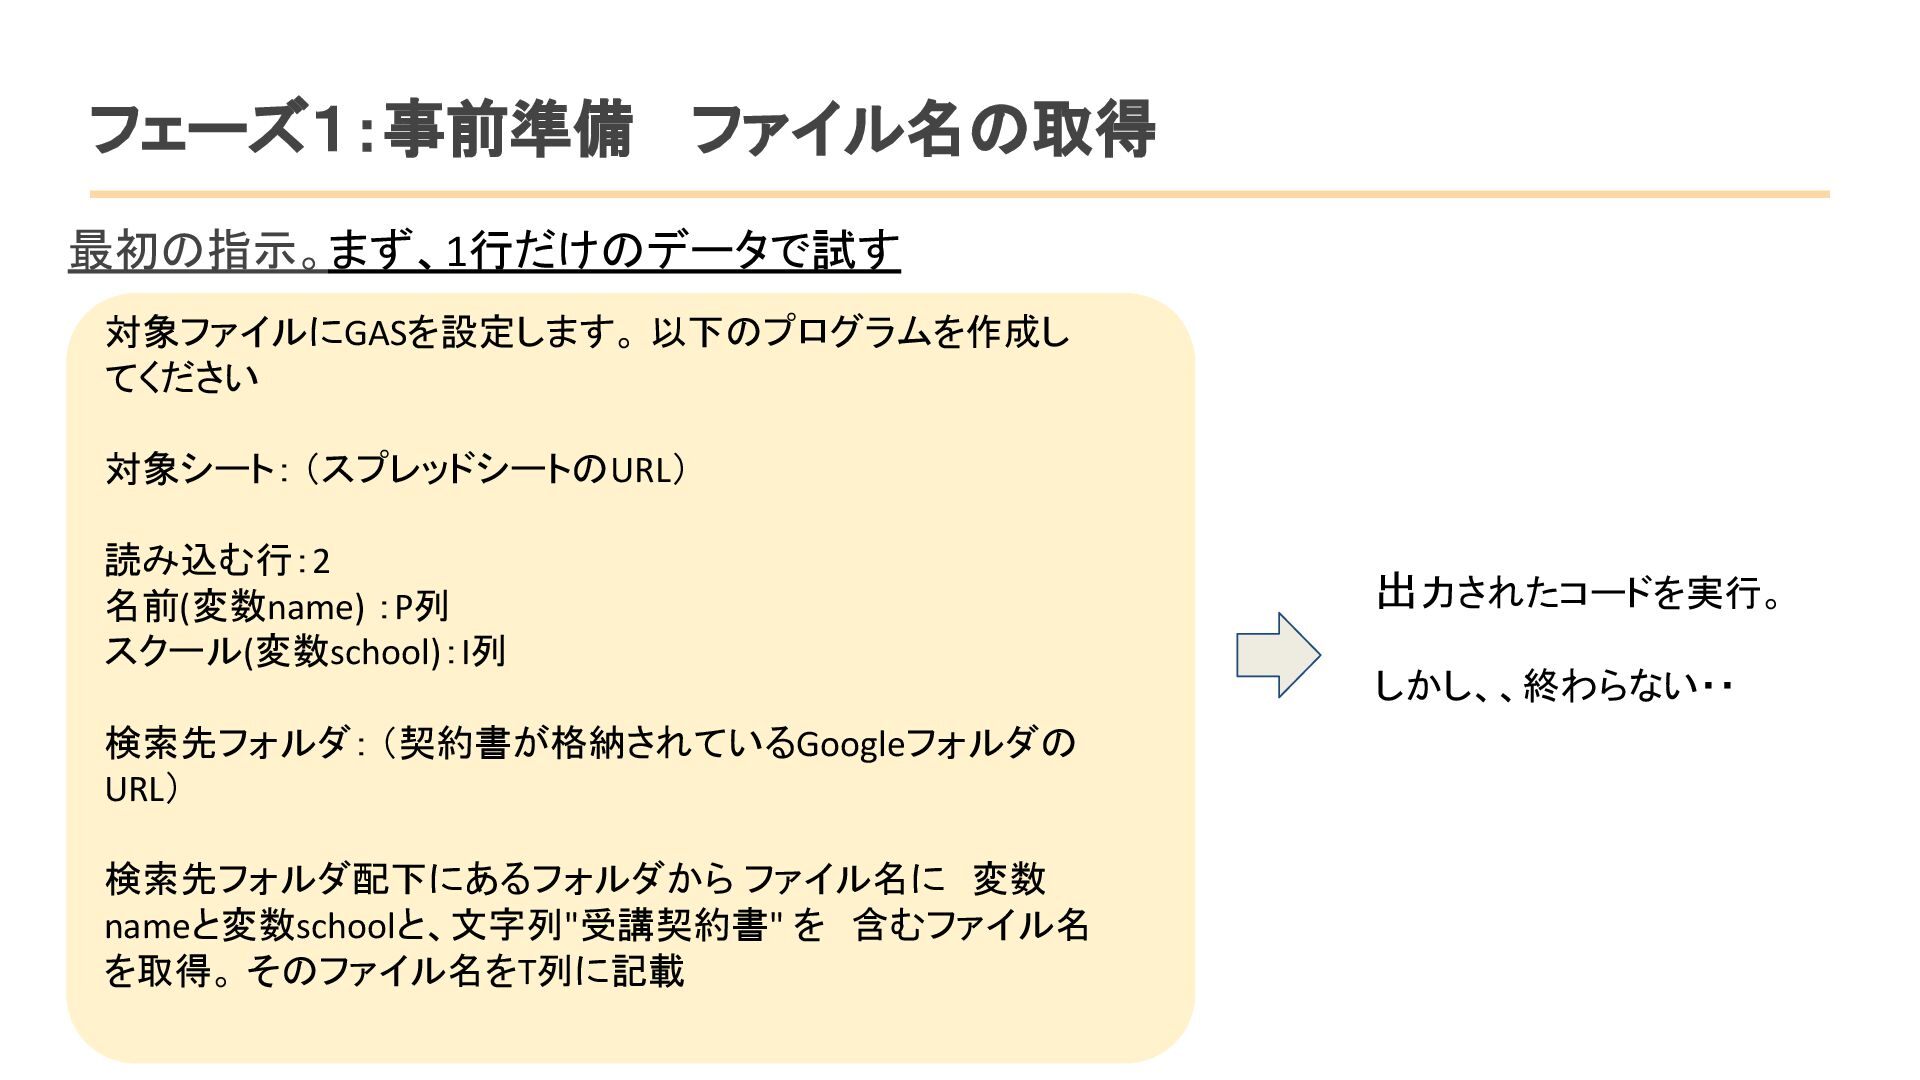
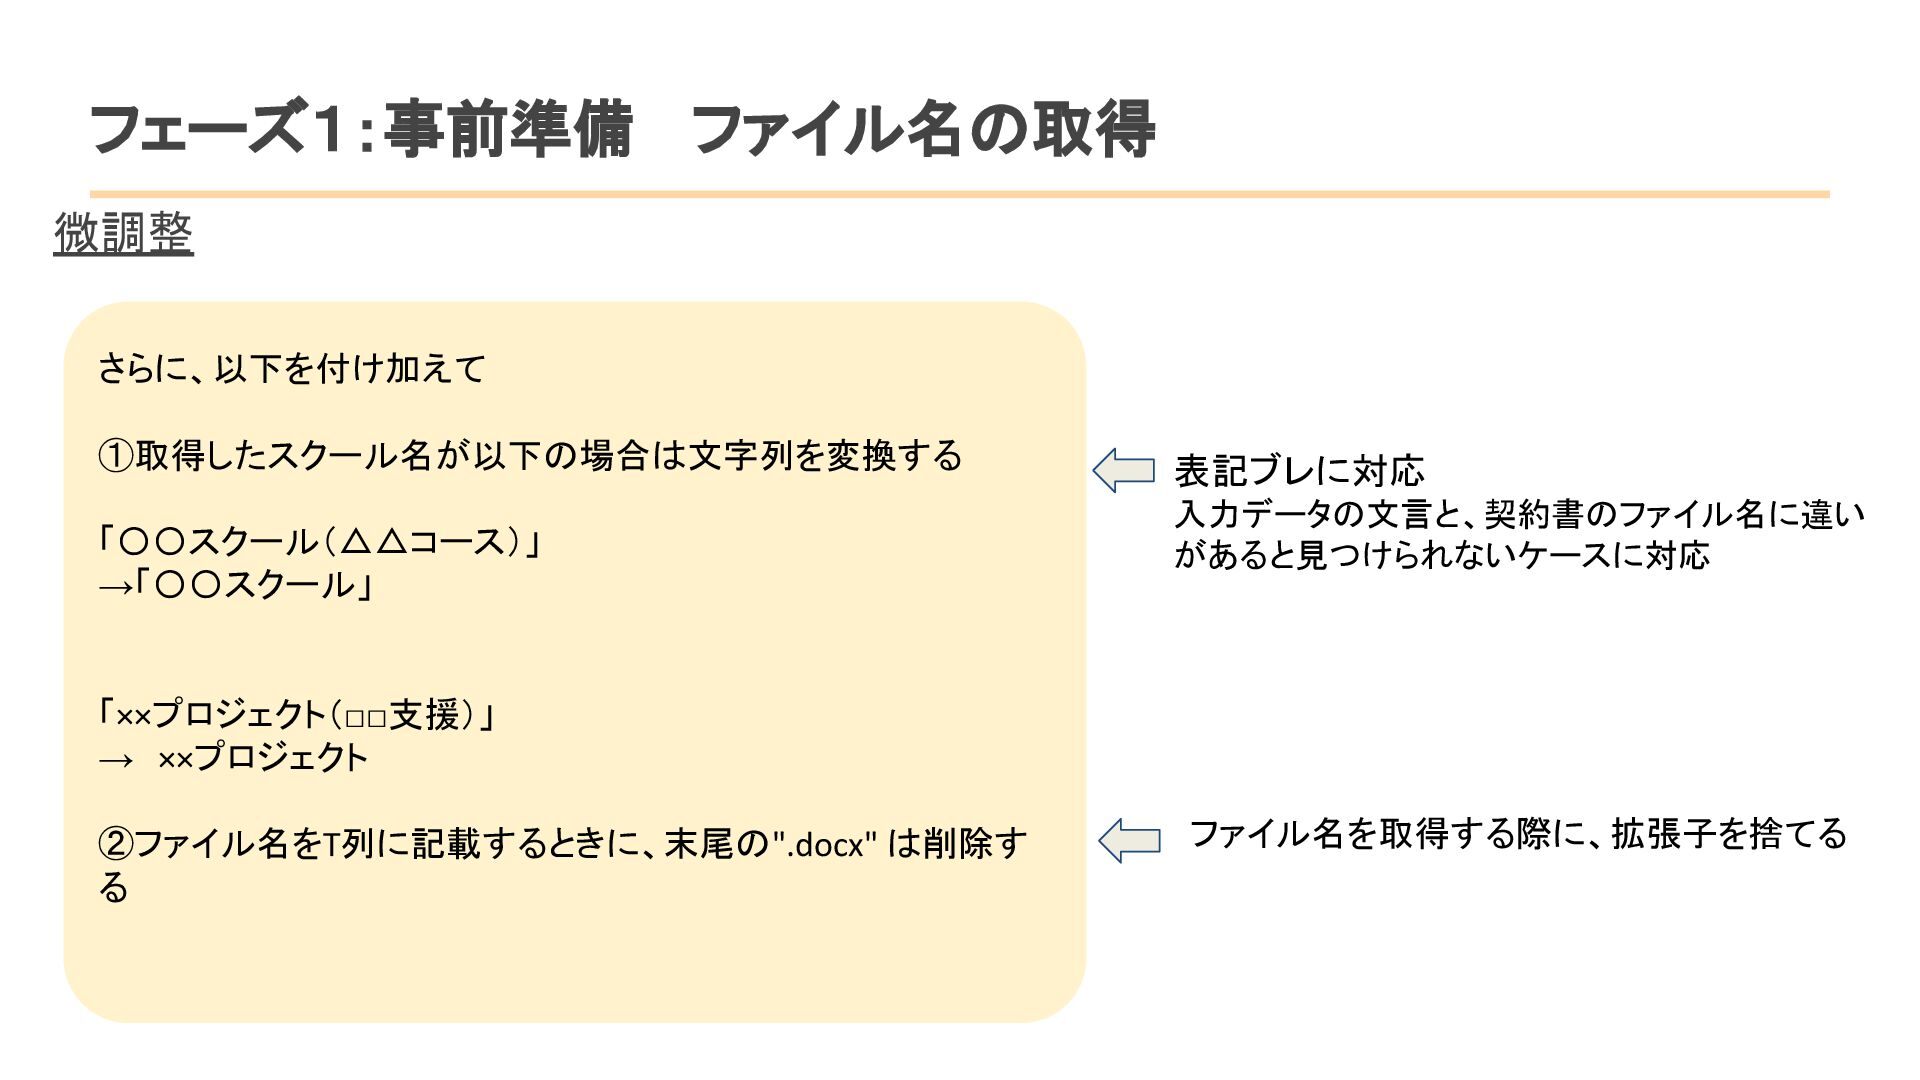
  3. フェーズ1:事前準備 ファイル名の取得 対象ファイルにGASを設定します。 以下のプログラムを作成し てください 対象シート: (スプレッドシートのURL) 読み込む行:2 名前(変数name) :P列

    スクール(変数school):I列 検索先フォルダ: (契約書が格納されているGoogleフォルダの URL) 検索先フォルダ配下にあるフォルダから ファイル名に 変数 nameと変数schoolと、文字列"受講契約書" を 含むファイル名 を取得。 そのファイル名をT列に記載 出力されたコードを実行。 しかし、、終わらない・・ 最初の指示。まず、1行だけのデータで試す
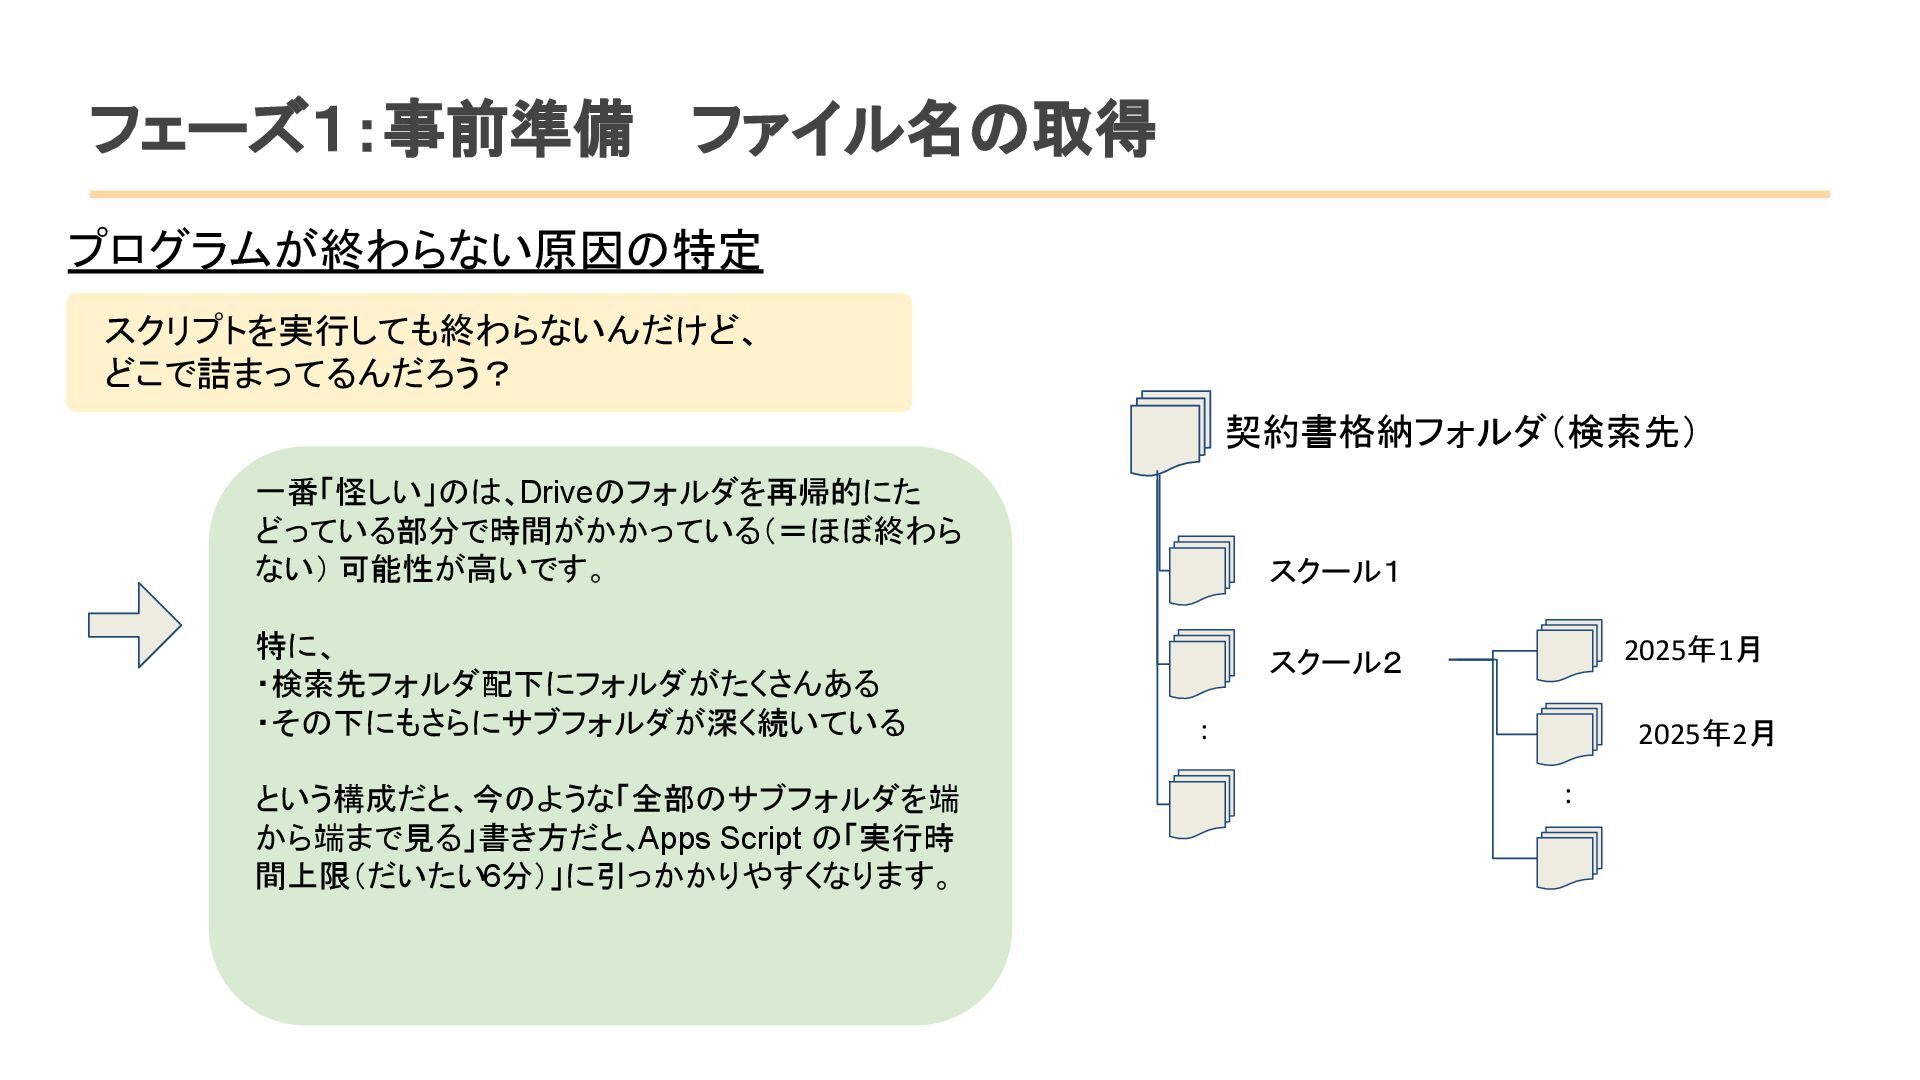
  4. フェーズ1:事前準備 ファイル名の取得 スクリプトを実行しても終わらないんだけど、 どこで詰まってるんだろう? プログラムが終わらない原因の特定 一番「怪しい」のは、Driveのフォルダを再帰的にた どっている部分で時間がかかっている(=ほぼ終わら ない) 可能性が高いです。 特に、

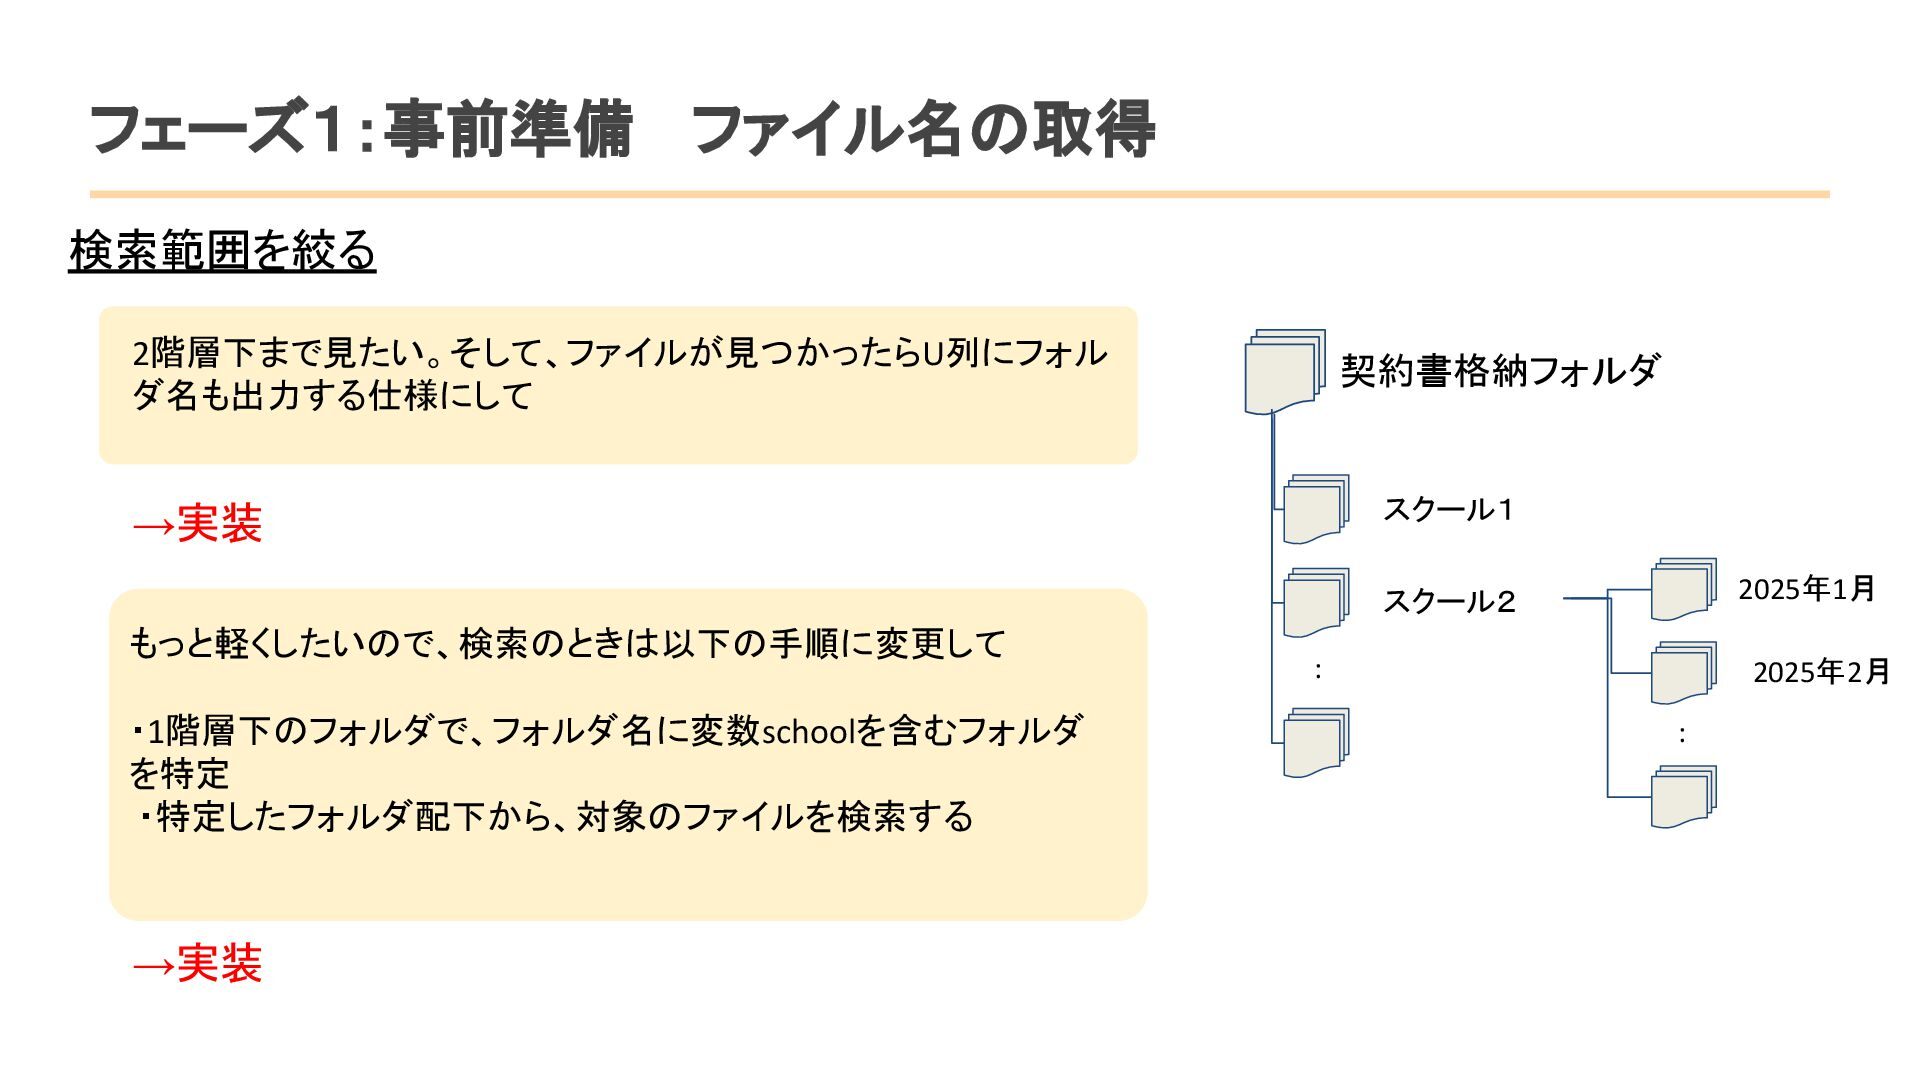
    ・検索先フォルダ配下にフォルダがたくさんある ・その下にもさらにサブフォルダが深く続いている という構成だと、今のような「全部のサブフォルダを端 から端まで見る」書き方だと、Apps Script の「実行時 間上限(だいたい6分)」に引っかかりやすくなります。 スクール1 スクール2 契約書格納フォルダ(検索先) 2025年1月 2025年2月 : :
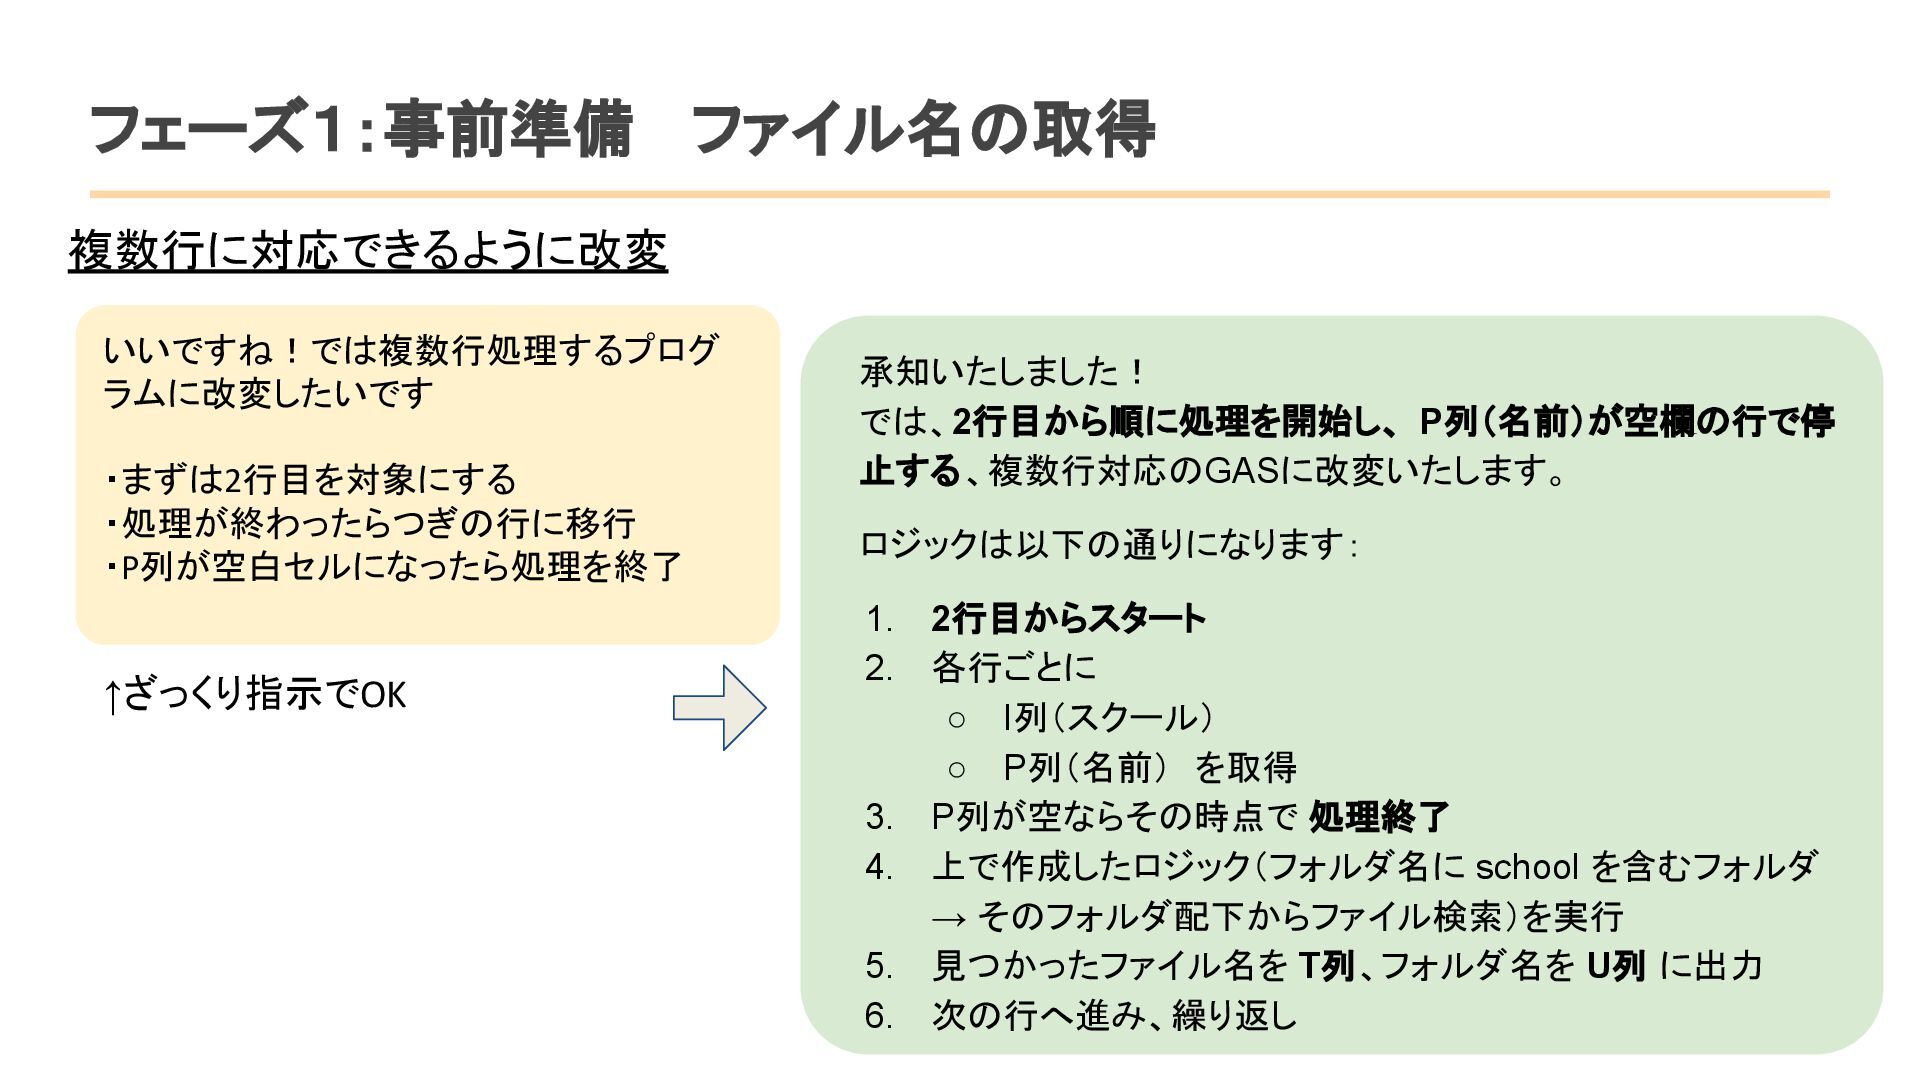
  5. フェーズ1:事前準備 ファイル名の取得 いいですね!では複数行処理するプログ ラムに改変したいです ・まずは2行目を対象にする ・処理が終わったらつぎの行に移行 ・P列が空白セルになったら処理を終了 複数行に対応できるように改変 承知いたしました! では、2行目から順に処理を開始し、

    P列(名前)が空欄の行で停 止する、複数行対応のGASに改変いたします。 ロジックは以下の通りになります: 1. 2行目からスタート 2. 各行ごとに ◦ I列(スクール) ◦ P列(名前) を取得 3. P列が空ならその時点で 処理終了 4. 上で作成したロジック(フォルダ名に school を含むフォルダ → そのフォルダ配下からファイル検索)を実行 5. 見つかったファイル名を T列、フォルダ名を U列 に出力 6. 次の行へ進み、繰り返し ↑ざっくり指示でOK
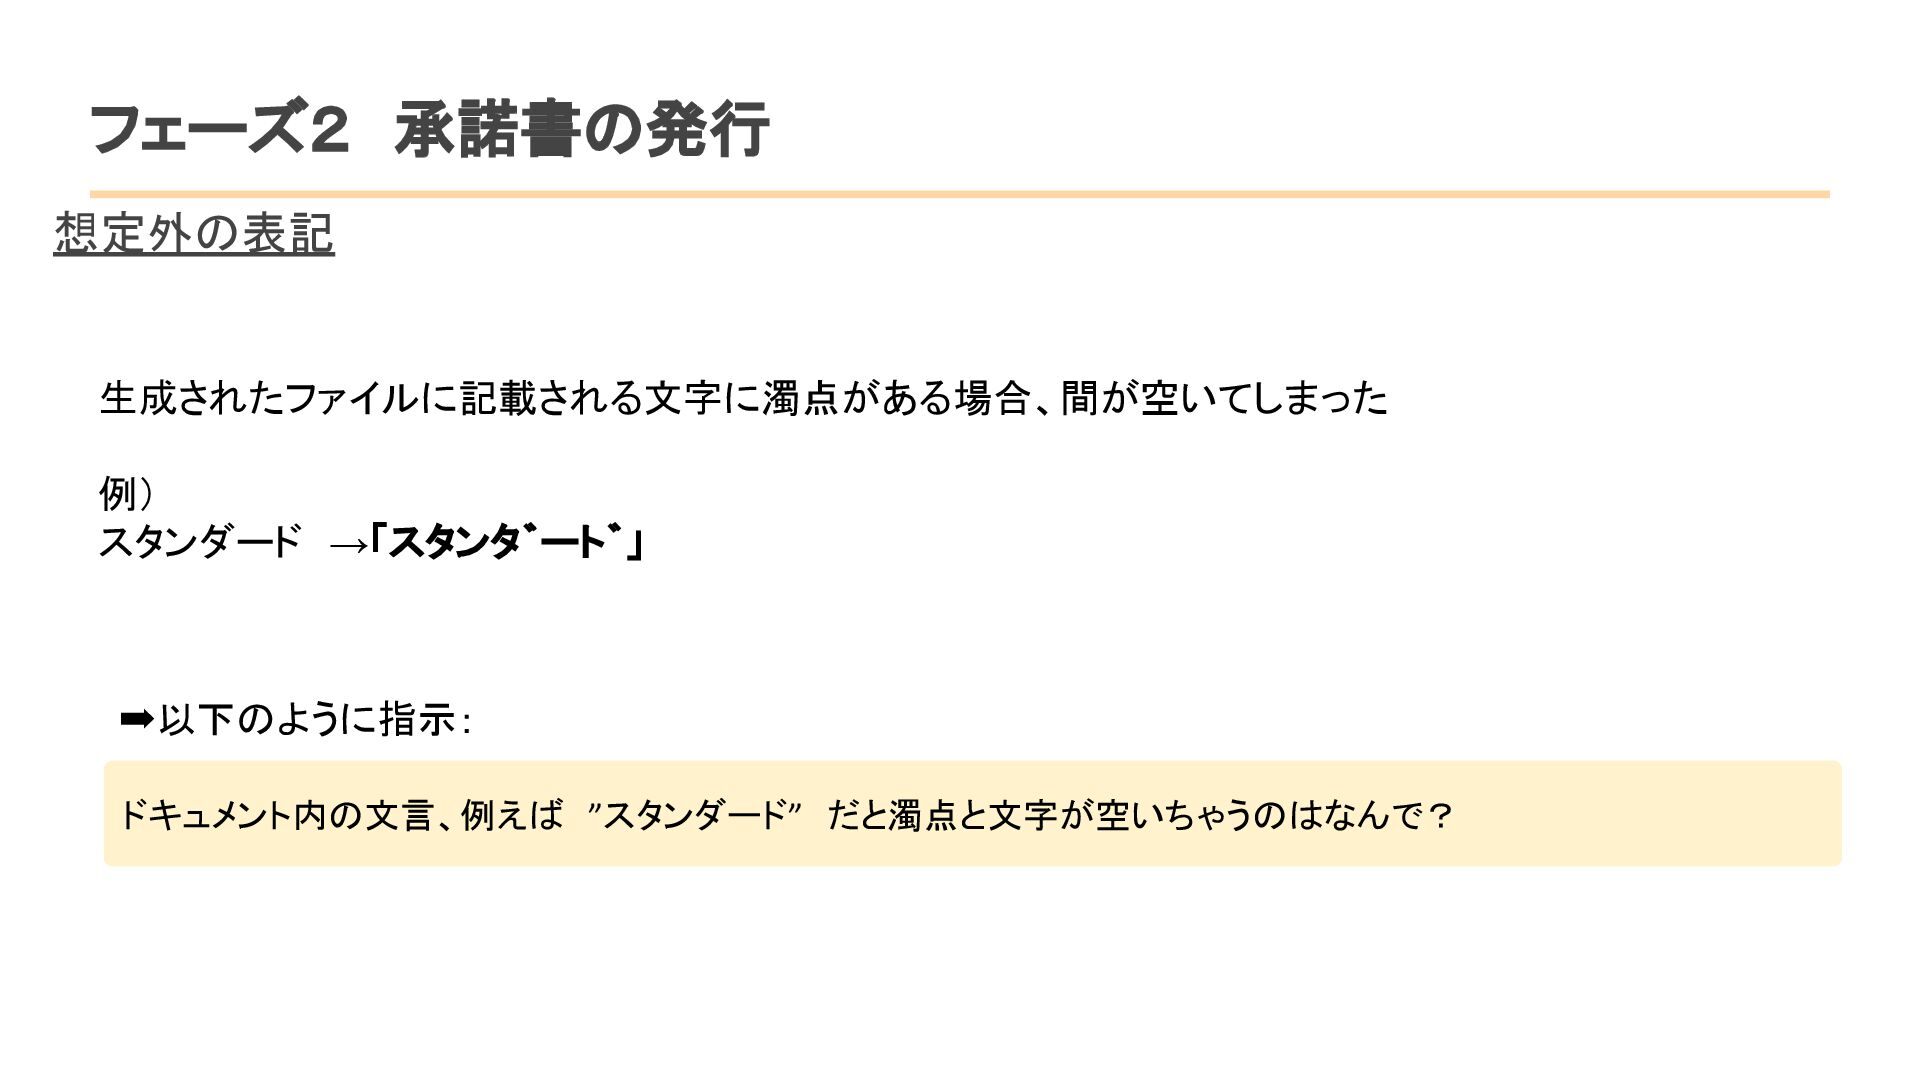
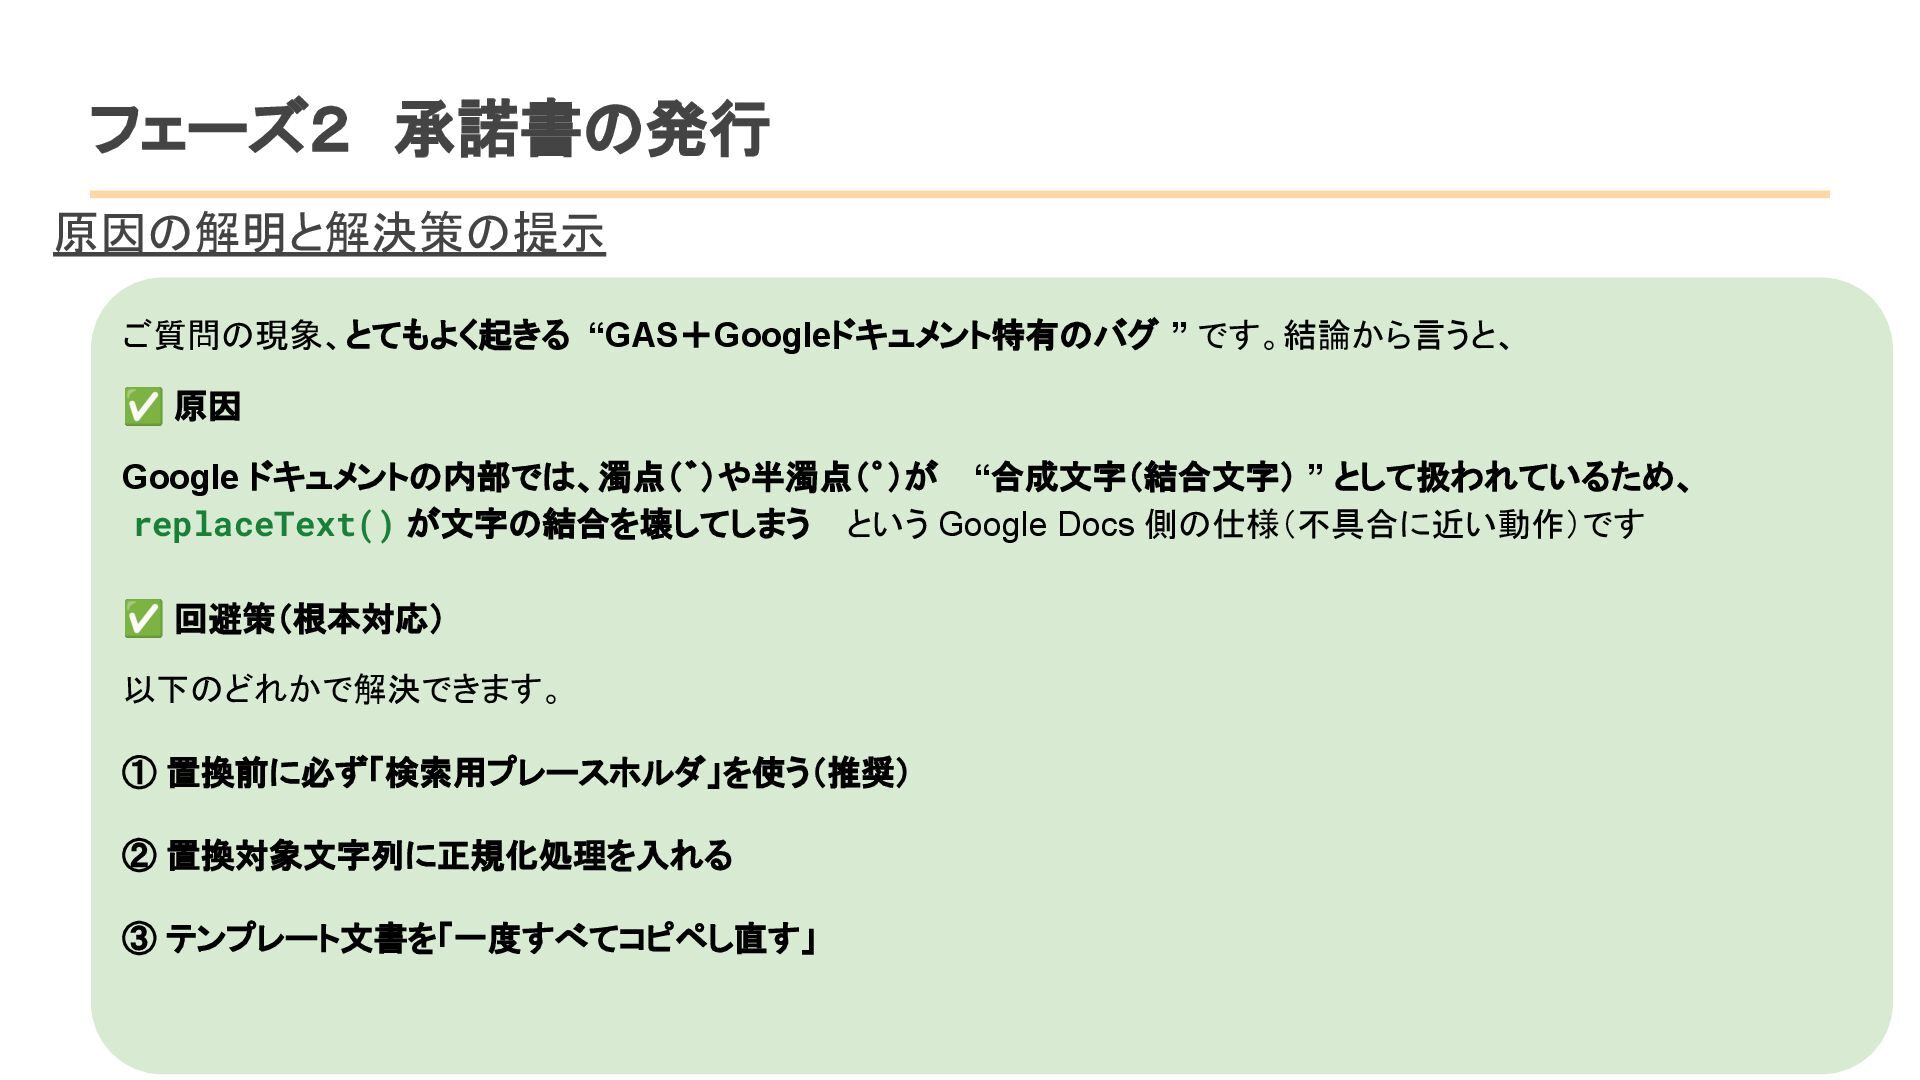
  6. フェーズ2 承諾書の発行 原因の解明と解決策の提示 ご質問の現象、とてもよく起きる “GAS+Googleドキュメント特有のバグ ” です。結論から言うと、 ✅ 原因 Google ドキュメントの内部では、濁点(゛)や半濁点(゜)が

    “合成文字(結合文字) ” として扱われているため、 replaceText() が文字の結合を壊してしまう  という Google Docs 側の仕様(不具合に近い動作)です ✅ 回避策(根本対応) 以下のどれかで解決できます。 ① 置換前に必ず「検索用プレースホルダ」を使う(推奨) ② 置換対象文字列に正規化処理を入れる ③ テンプレート文書を「一度すべてコピペし直す」
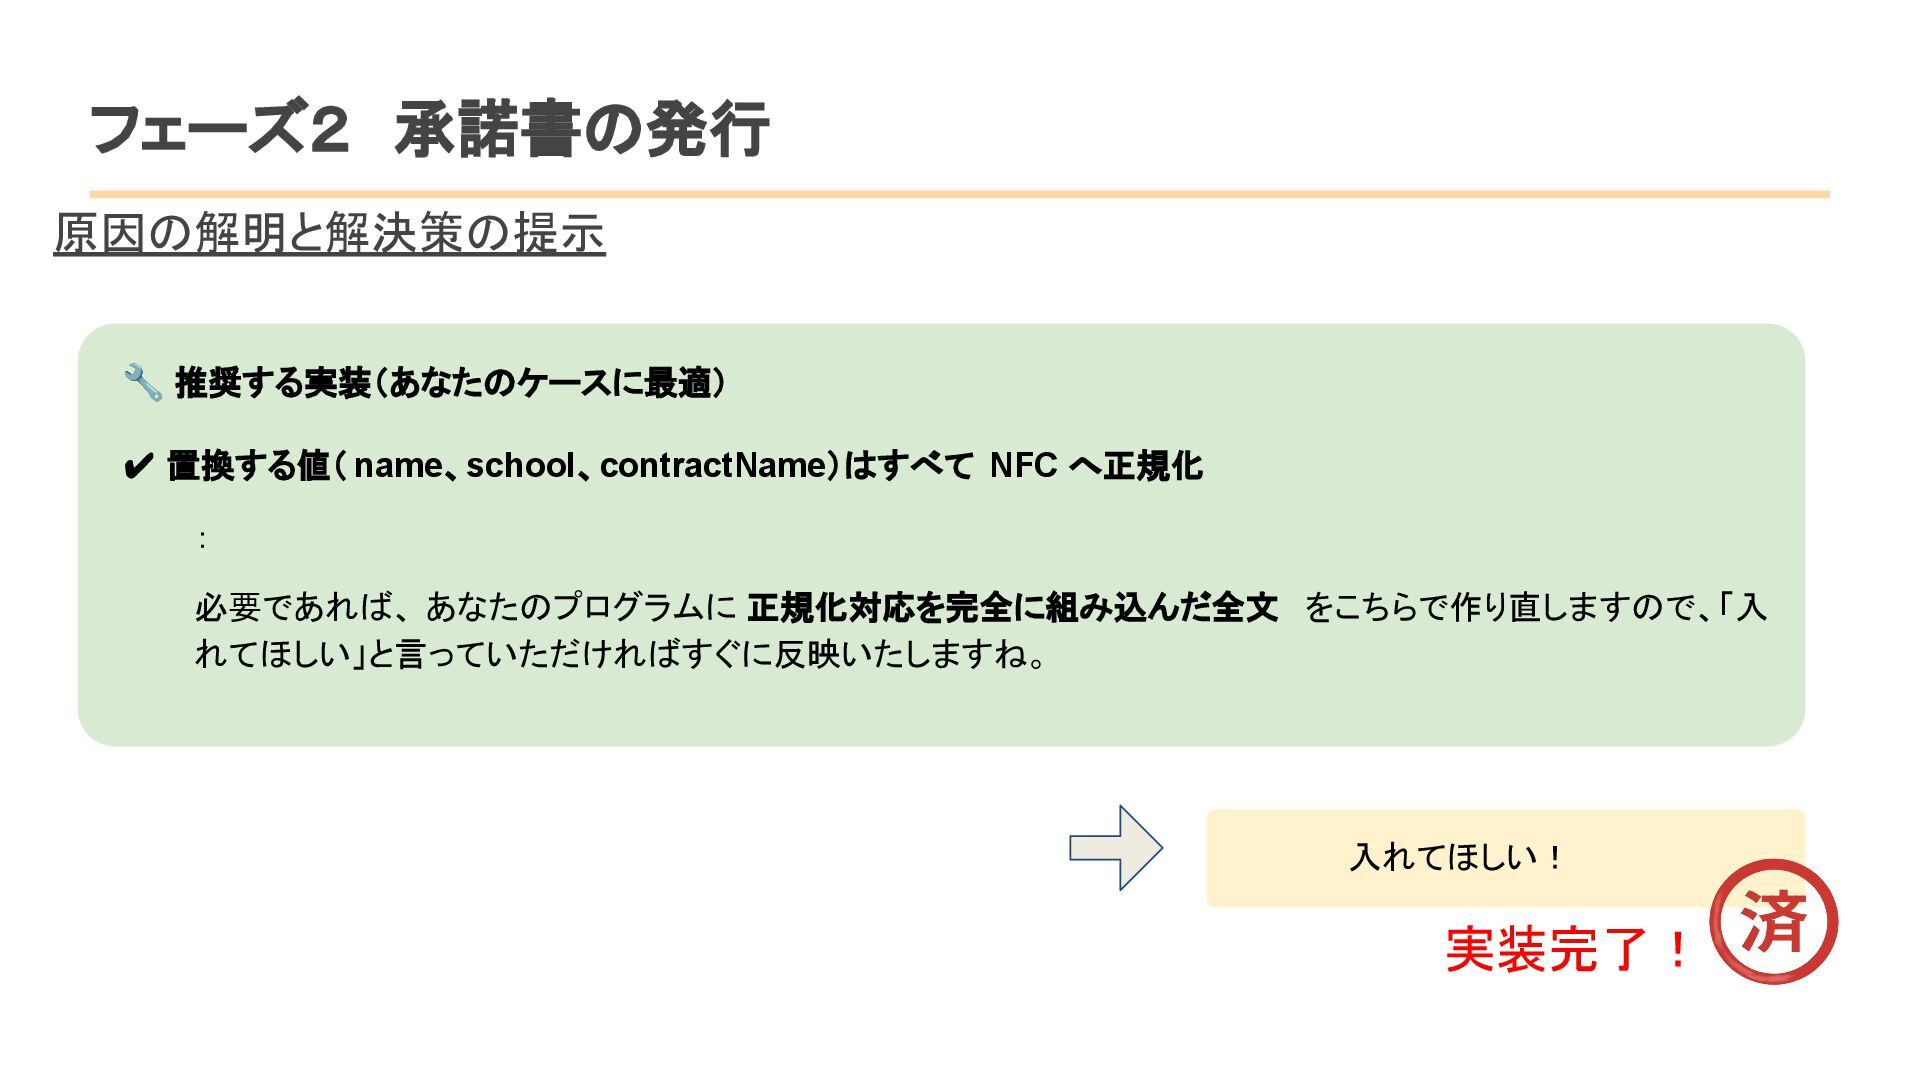
  7. フェーズ2 承諾書の発行 原因の解明と解決策の提示 🔧 推奨する実装(あなたのケースに最適) ✔ 置換する値( name、school、contractName)はすべて NFC へ正規化 :

    必要であれば、 あなたのプログラムに 正規化対応を完全に組み込んだ全文 をこちらで作り直しますので、「入 れてほしい」と言っていただければすぐに反映いたしますね。 入れてほしい! 実装完了!