Upgrade to Pro — share decks privately, control downloads, hide ads and more …

強化学習本(Sutton本)~第2章 評価フィードバック~

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for ksg ksg
November 09, 2019
130

 強化学習本(Sutton本)~第2章 評価フィードバック~

まとめてみました!

Avatar for ksg

ksg

November 09, 2019

Transcript

  1. 学習の種類 • Reinforcement Learning ‐ 行動の評価を訓練情報としてフィードバック ‐ 良い行動を直接探索するため試行錯誤による能動的な探索が必要 • 評価フィードバック

    ‐ 進化的手法を含めた関数最適化手法の基礎 ‐ 行動がどれくらい良いのか知らされる ‐ 可能な行動の中で最良か最悪かは知らされない 実行した行動に依存
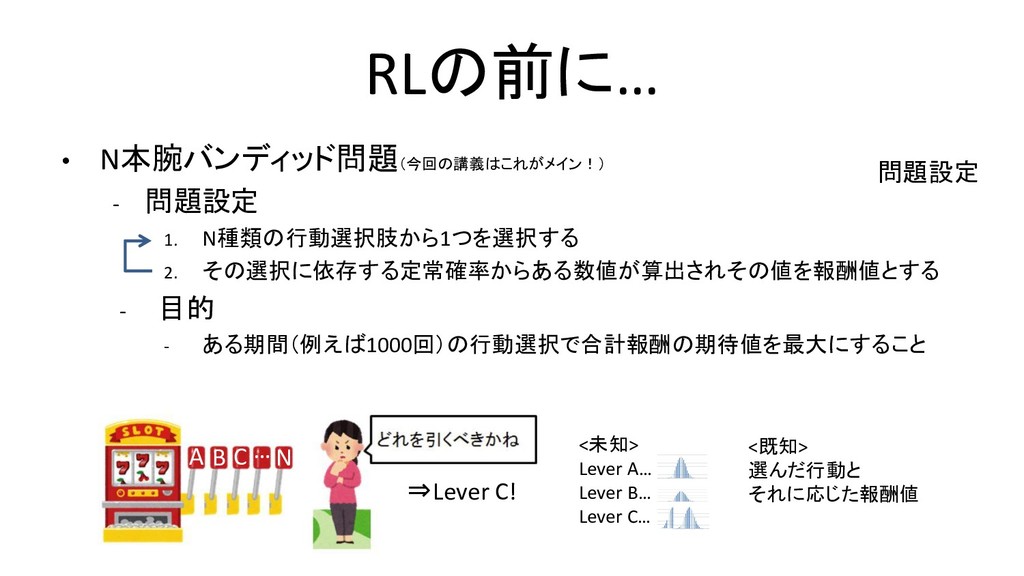
  2. RLの前に… • N本腕バンディッド問題(今回の講義はこれがメイン!) ‐ 問題設定 1. N種類の行動選択肢から1つを選択する 2. その選択に依存する定常確率からある数値が算出されその値を報酬値とする ‐

    目的 ‐ ある期間(例えば1000回)の行動選択で合計報酬の期待値を最大にすること A B C … N <未知> Lever A… Lever B… Lever C… <既知> 選んだ行動と それに応じた報酬値 ⇒Lever C! 問題設定
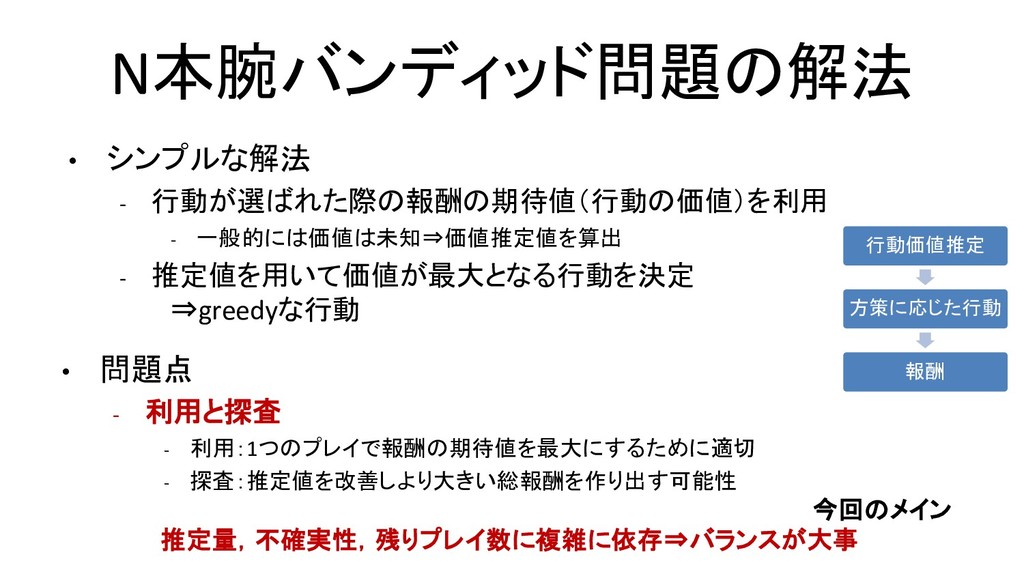
  3. N本腕バンディッド問題の解法 • シンプルな解法 ‐ 行動が選ばれた際の報酬の期待値(行動の価値)を利用 ‐ 一般的には価値は未知⇒価値推定値を算出 ‐ 推定値を用いて価値が最大となる行動を決定 ⇒greedyな行動

    • 問題点 ‐ 利用と探査 ‐ 利用:1つのプレイで報酬の期待値を最大にするために適切 ‐ 探査:推定値を改善しより大きい総報酬を作り出す可能性 推定量,不確実性,残りプレイ数に複雑に依存⇒バランスが大事 今回のメイン 行動価値推定 方策に応じた行動 報酬
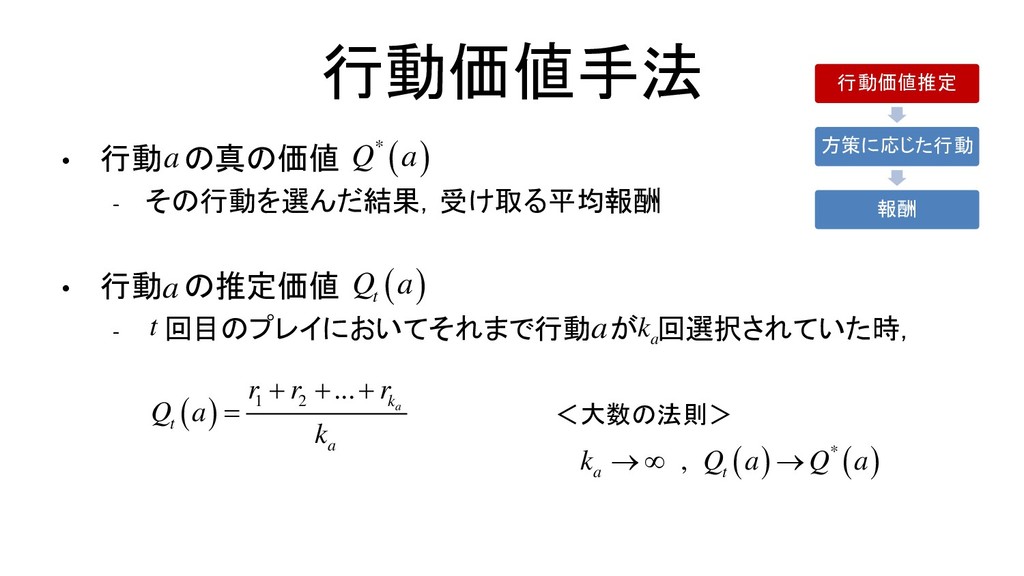
  4. 行動価値手法 • 行動 の真の価値 ‐ その行動を選んだ結果,受け取る平均報酬 • 行動 の推定価値 ‐

    回目のプレイにおいてそれまで行動 が 回選択されていた時, ( ) * Q a ( ) t Q a a ( ) 1 2 ... a k t a r r r Q a k + + + = a a t a k <大数の法則> ( ) ( ) * , a t k Q a Q a →  → 行動価値推定 方策に応じた行動 報酬
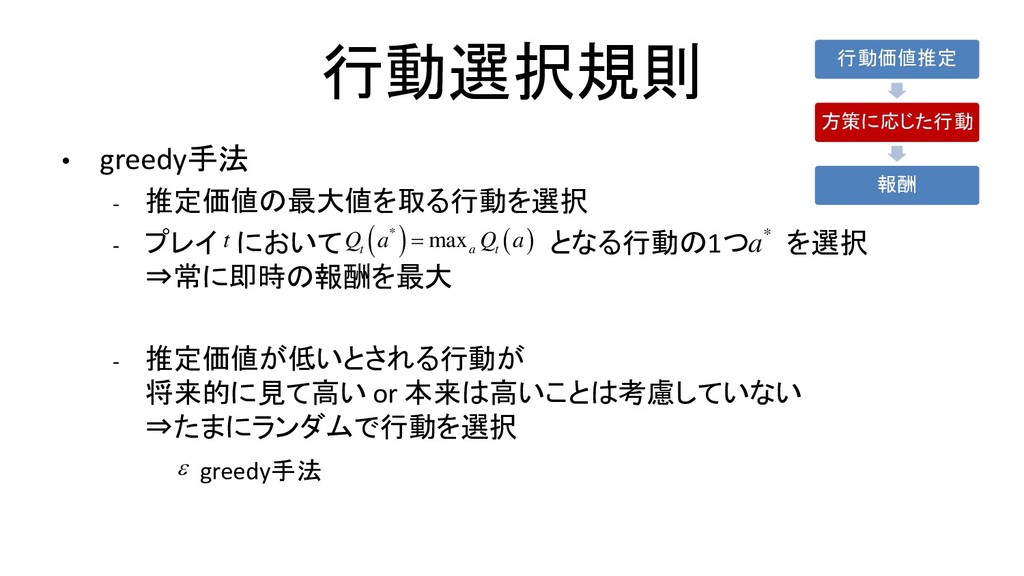
  5. 行動選択規則 • greedy手法 ‐ 推定価値の最大値を取る行動を選択 ‐ プレイ において となる行動の1つ を選択

    ⇒常に即時の報酬を最大 ‐ 推定価値が低いとされる行動が 将来的に見て高い or 本来は高いことは考慮していない ⇒たまにランダムで行動を選択 ( ) ( ) * max t a t Q a Q a = * a t greedy手法  行動価値推定 方策に応じた行動 報酬
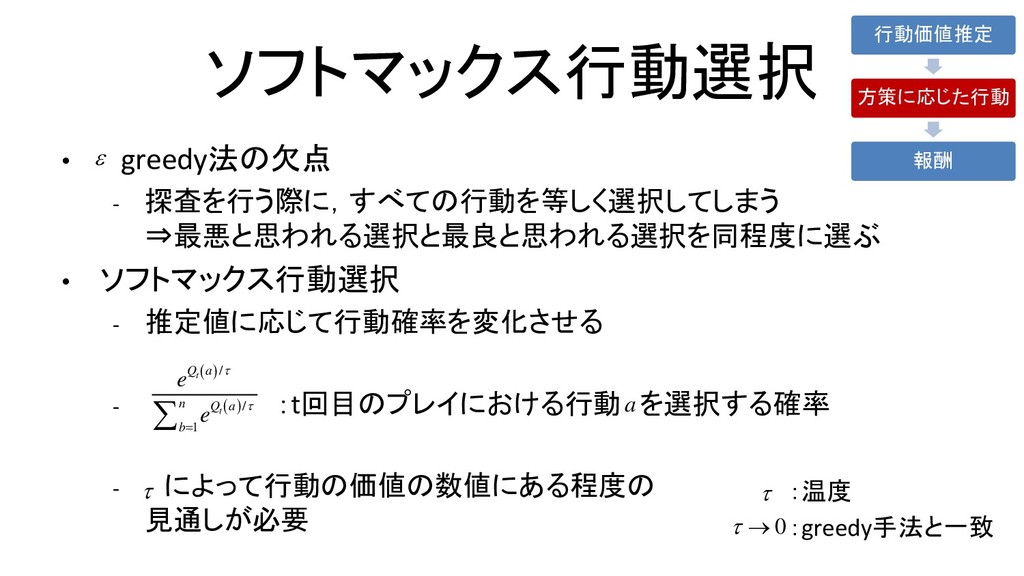
  6. ソフトマックス行動選択 • greedy法の欠点 ‐ 探査を行う際に,すべての行動を等しく選択してしまう ⇒最悪と思われる選択と最良と思われる選択を同程度に選ぶ • ソフトマックス行動選択 ‐ 推定値に応じて行動確率を変化させる

    ‐ :t回目のプレイにおける行動 を選択する確率 ‐ によって行動の価値の数値にある程度の 見通しが必要  ( ) ( ) / / 1 t t Q a n Q a b e e   =  a  :温度 0  → :greedy手法と一致  行動価値推定 方策に応じた行動 報酬
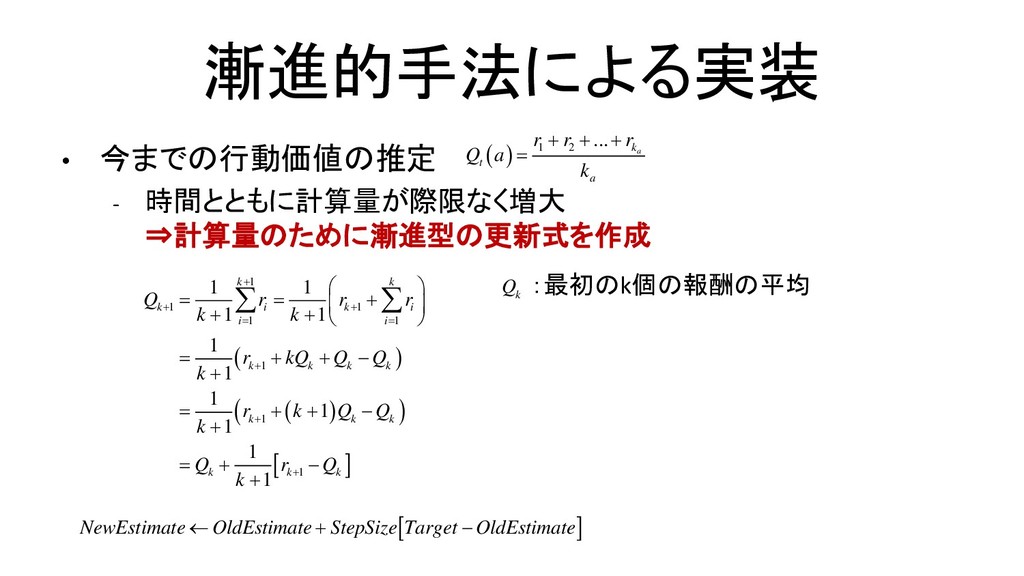
  7. 漸進的手法による実装 • 今までの行動価値の推定 ‐ 時間とともに計算量が際限なく増大 ⇒計算量のために漸進型の更新式を作成 ( ) 1 2

    ... a k t a r r r Q a k + + + = ( ) ( ) ( )   1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 k k k i k i i i k k k k k k k k k k Q r r r k k r kQ Q Q k r k Q Q k Q r Q k + + + = = + + +   = = +   + +   = + + − + = + + − + = + − +   k Q :最初のk個の報酬の平均   NewEstimate OldEstimate StepSize Target OldEstimate  + −
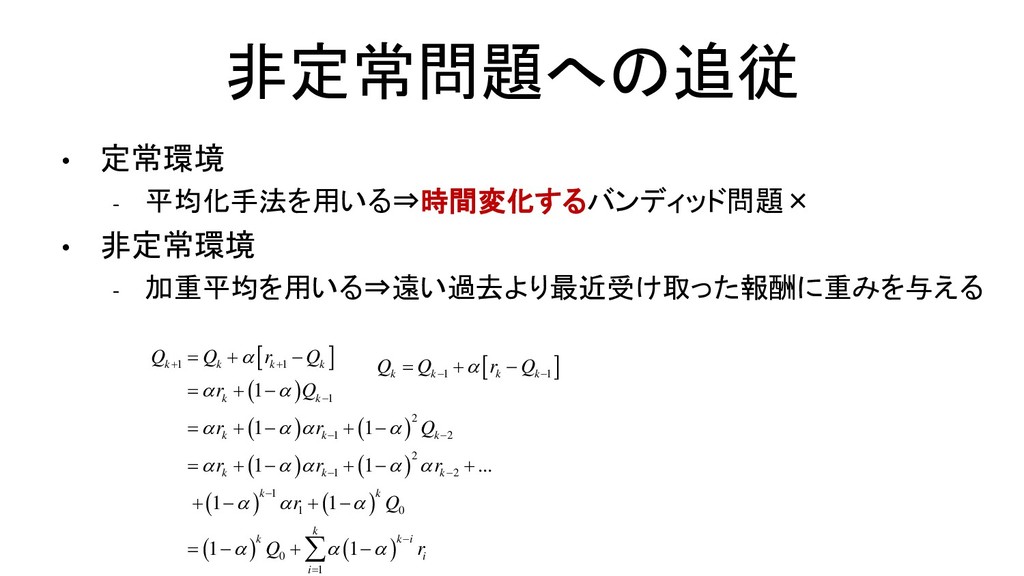
  8. 非定常問題への追従 • 定常環境 ‐ 平均化手法を用いる⇒時間変化するバンディッド問題× • 非定常環境 ‐ 加重平均を用いる⇒遠い過去より最近受け取った報酬に重みを与える 

     ( ) ( ) ( ) ( ) ( ) ( ) ( ) ( ) ( ) 1 1 1 2 1 2 2 1 2 1 1 0 0 1 1 1 1 1 1 ... 1 1 1 1 k k k k k k k k k k k k k k k k k i i i Q Q r Q r Q r r Q r r r r Q Q r                   + + − − − − − − − = = + − = + − = + − + − = + − + − + + − + − = − + −    1 1 k k k k Q Q r Q  − − = + −
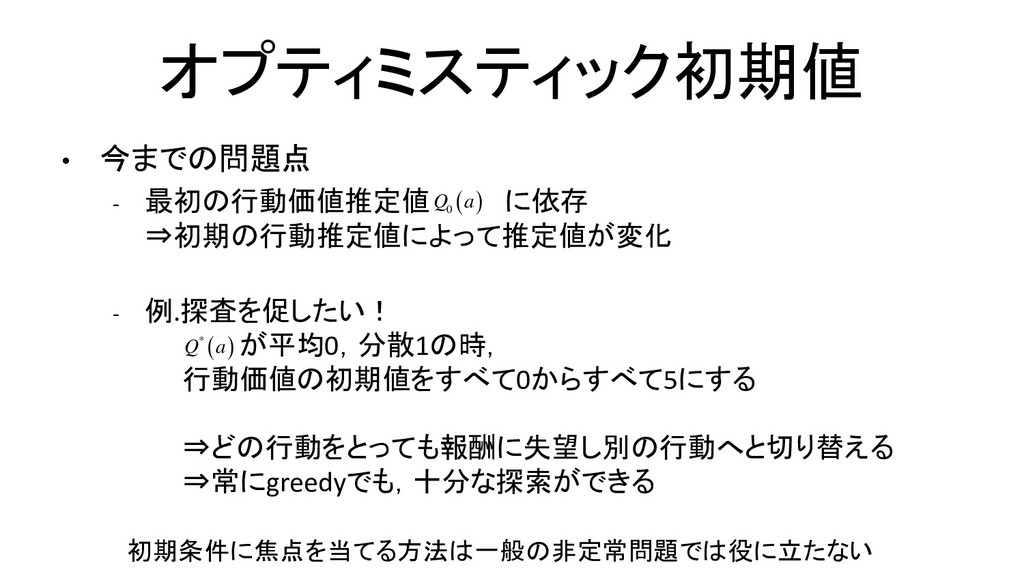
  9. オプティミスティック初期値 • 今までの問題点 ‐ 最初の行動価値推定値 に依存 ⇒初期の行動推定値によって推定値が変化 ‐ 例.探査を促したい! が平均0,分散1の時,

    行動価値の初期値をすべて0からすべて5にする ⇒どの行動をとっても報酬に失望し別の行動へと切り替える ⇒常にgreedyでも,十分な探索ができる ( ) 0 Q a ( ) * Q a 初期条件に焦点を当てる方法は一般の非定常問題では役に立たない
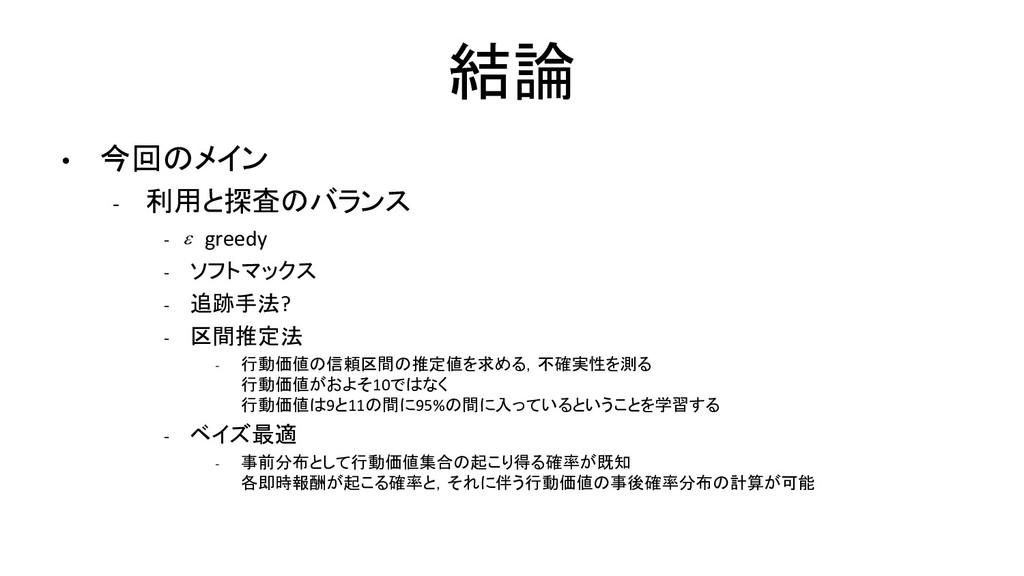
  10. 結論 • 今回のメイン ‐ 利用と探査のバランス ‐ greedy ‐ ソフトマックス ‐

    追跡手法? ‐ 区間推定法 ‐ 行動価値の信頼区間の推定値を求める,不確実性を測る 行動価値がおよそ10ではなく 行動価値は9と11の間に95%の間に入っているということを学習する ‐ ベイズ最適 ‐ 事前分布として行動価値集合の起こり得る確率が既知 各即時報酬が起こる確率と,それに伴う行動価値の事後確率分布の計算が可能 