Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ゼロつく2_輪読.pdf
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Pirotyyy
February 21, 2024
86
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ゼロつく2_輪読.pdf
Pirotyyy
February 21, 2024
More Decks by Pirotyyy
See All by Pirotyyy
ゼロつく2輪読会 資料 2.1 - 2.4
pirotyyy
0
83
IDEA 2月度 LT資料
pirotyyy
0
60
Featured
See All Featured
Exploring anti-patterns in Rails
aemeredith
4
540
Everyday Curiosity
cassininazir
0
350
The Cult of Friendly URLs
andyhume
79
7k
Building Flexible Design Systems
yeseniaperezcruz
330
41k
We Are The Robots
honzajavorek
0
400
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Git: the NoSQL Database
bkeepers
PRO
433
67k
Optimizing for Happiness
mojombo
378
71k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
990
Balancing Empowerment & Direction
lara
6
1.3k
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Transcript
ゼロつく2 輪読 第2章4節 〜 千葉大学工学部情報工学コース3年 @pirotyyy 輪読くらぶ
概要 前回の復習 (自己)相互情報量の導入 SVDによる次元削減 まとめ
前回の復習
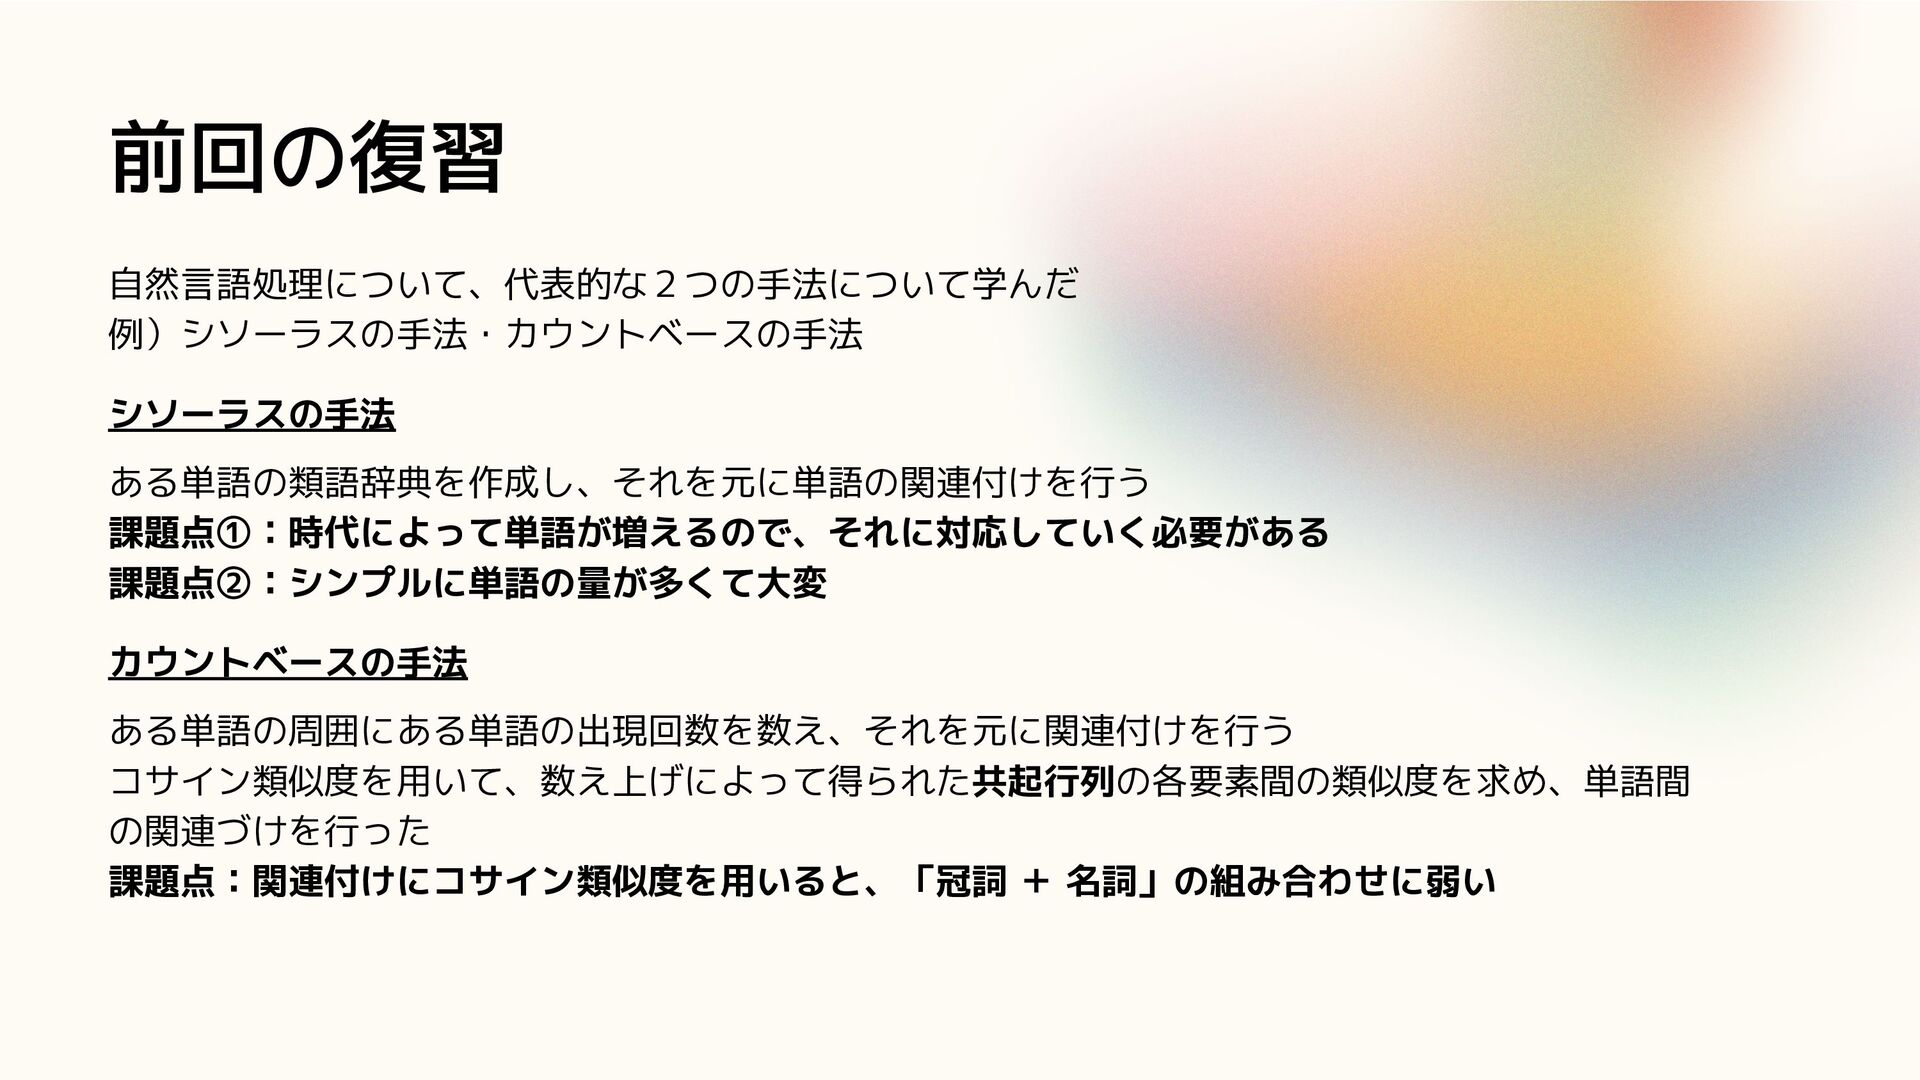
前回の復習 自然言語処理について、代表的な2つの手法について学んだ 例)シソーラスの手法・カウントベースの手法 シソーラスの手法 ある単語の類語辞典を作成し、それを元に単語の関連付けを行う 課題点①:時代によって単語が増えるので、それに対応していく必要がある 課題点②:シンプルに単語の量が多くて大変 カウントベースの手法 ある単語の周囲にある単語の出現回数を数え、それを元に関連付けを行う コサイン類似度を用いて、数え上げによって得られた共起行列の各要素間の類似度を求め、単語間
の関連づけを行った 課題点:関連付けにコサイン類似度を用いると、「冠詞 + 名詞」の組み合わせに弱い
(自己)相互情報量の導入
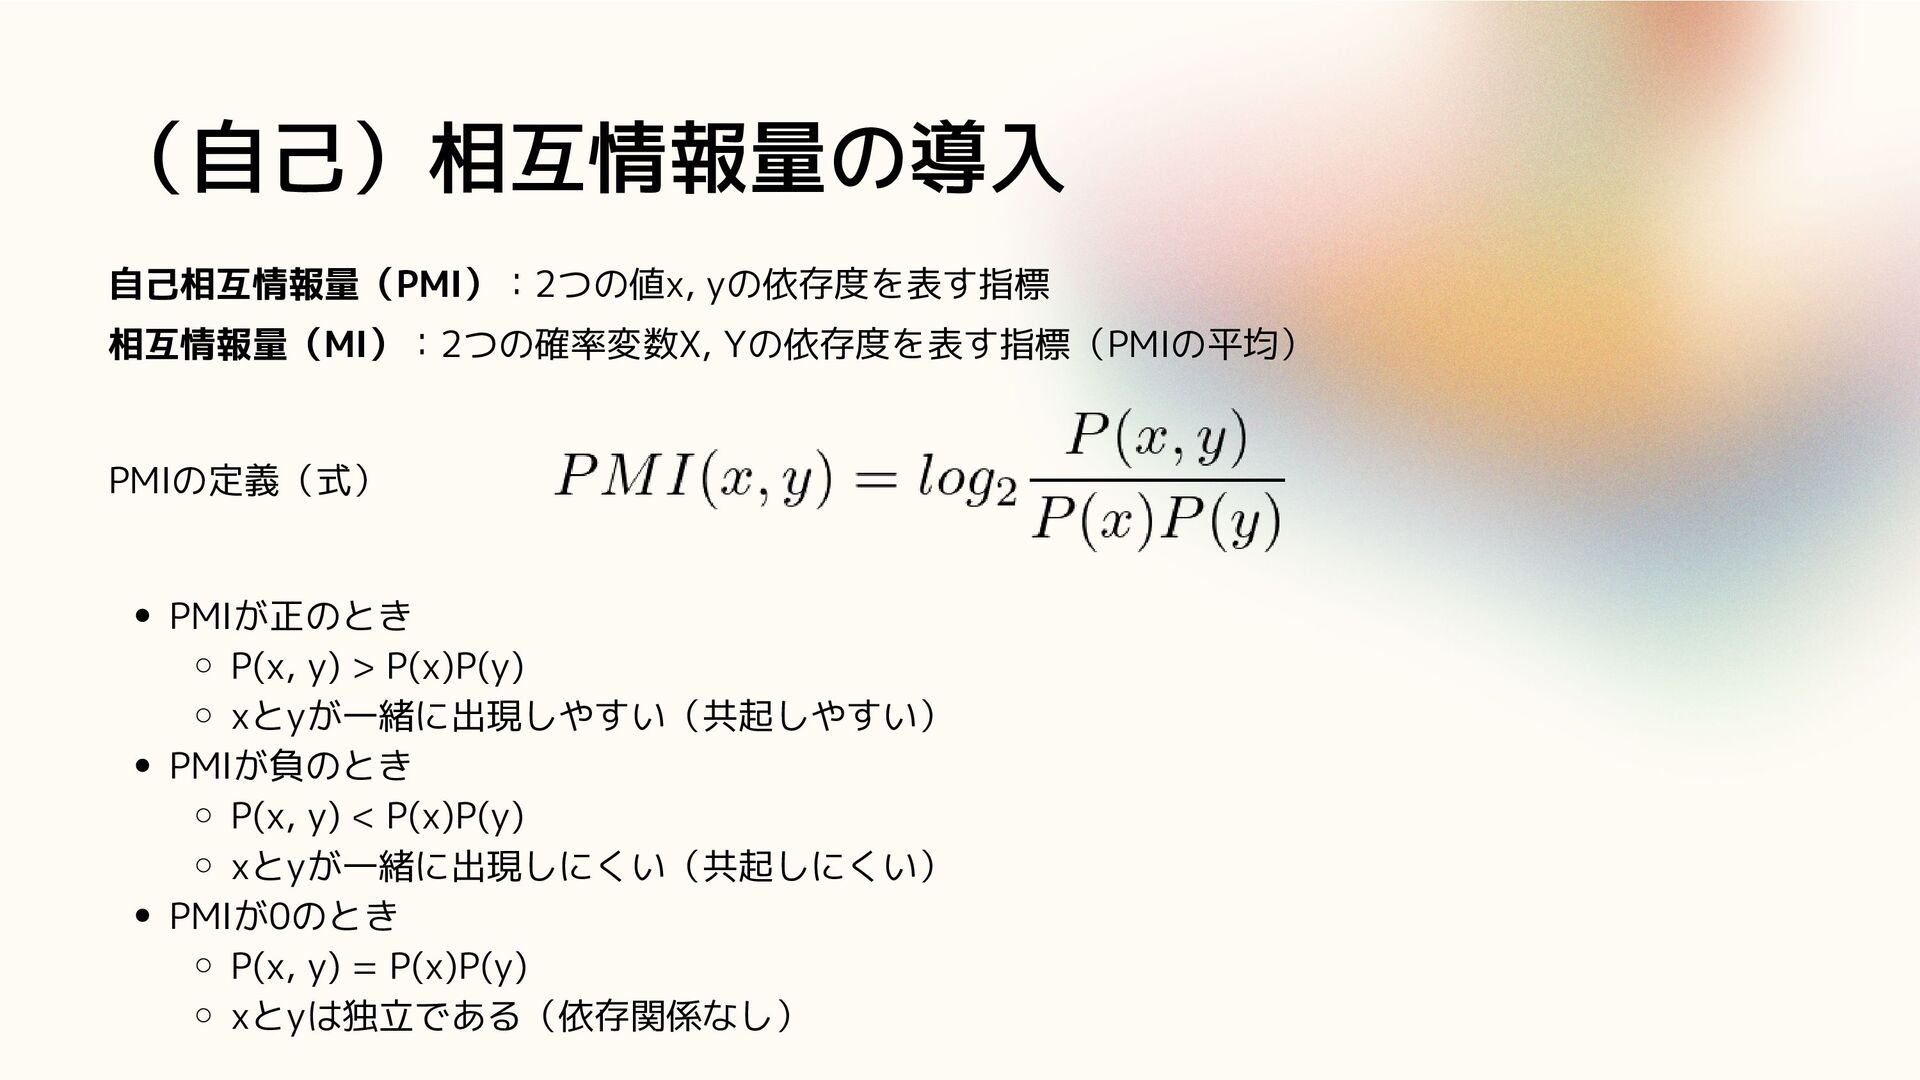
(自己)相互情報量の導入 自己相互情報量(PMI):2つの値x, yの依存度を表す指標 相互情報量(MI):2つの確率変数X, Yの依存度を表す指標(PMIの平均) PMIの定義(式) PMIが正のとき P(x, y) >
P(x)P(y) xとyが一緒に出現しやすい(共起しやすい) PMIが負のとき P(x, y) < P(x)P(y) xとyが一緒に出現しにくい(共起しにくい) PMIが0のとき P(x, y) = P(x)P(y) xとyは独立である(依存関係なし)
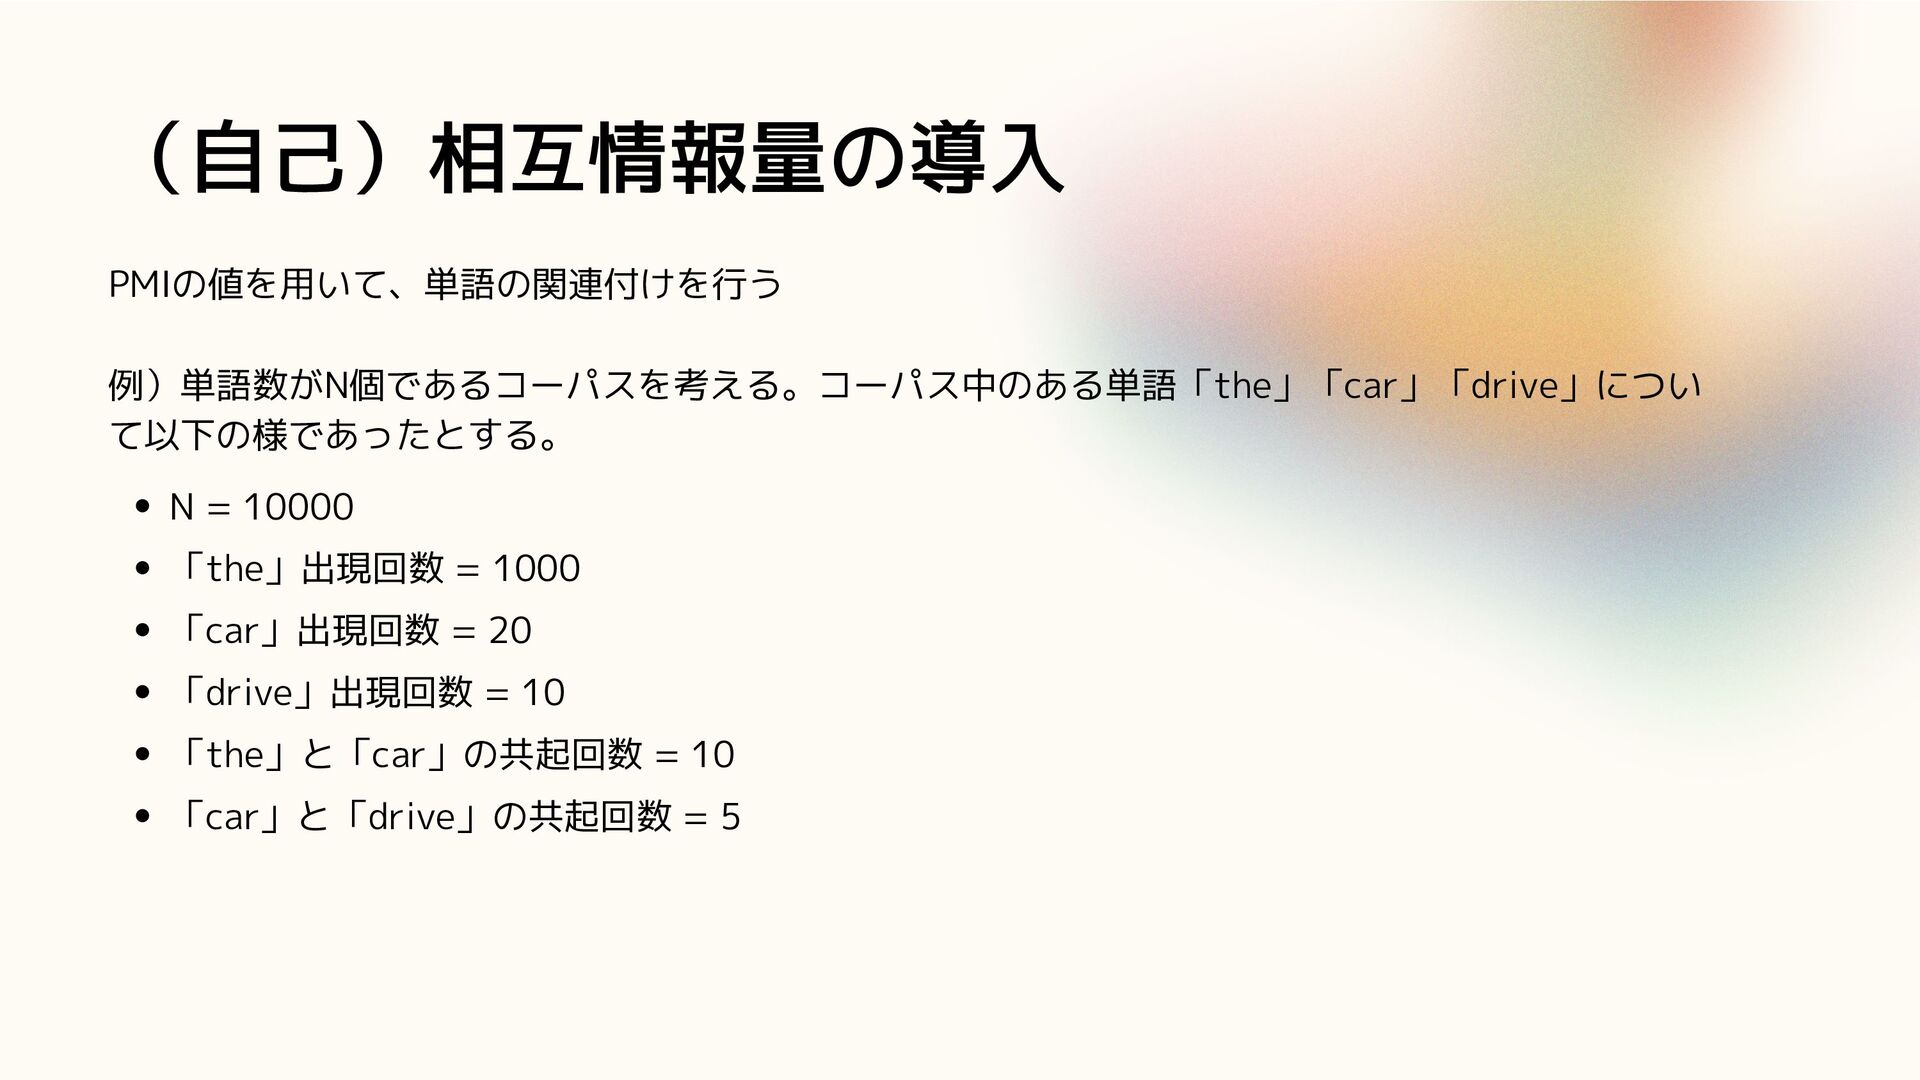
(自己)相互情報量の導入 PMIの値を用いて、単語の関連付けを行う 例)単語数がN個であるコーパスを考える。コーパス中のある単語「the」「car」「drive」につい て以下の様であったとする。 N = 10000 「the」出現回数 = 1000
「car」出現回数 = 20 「drive」出現回数 = 10 「the」と「car」の共起回数 = 10 「car」と「drive」の共起回数 = 5
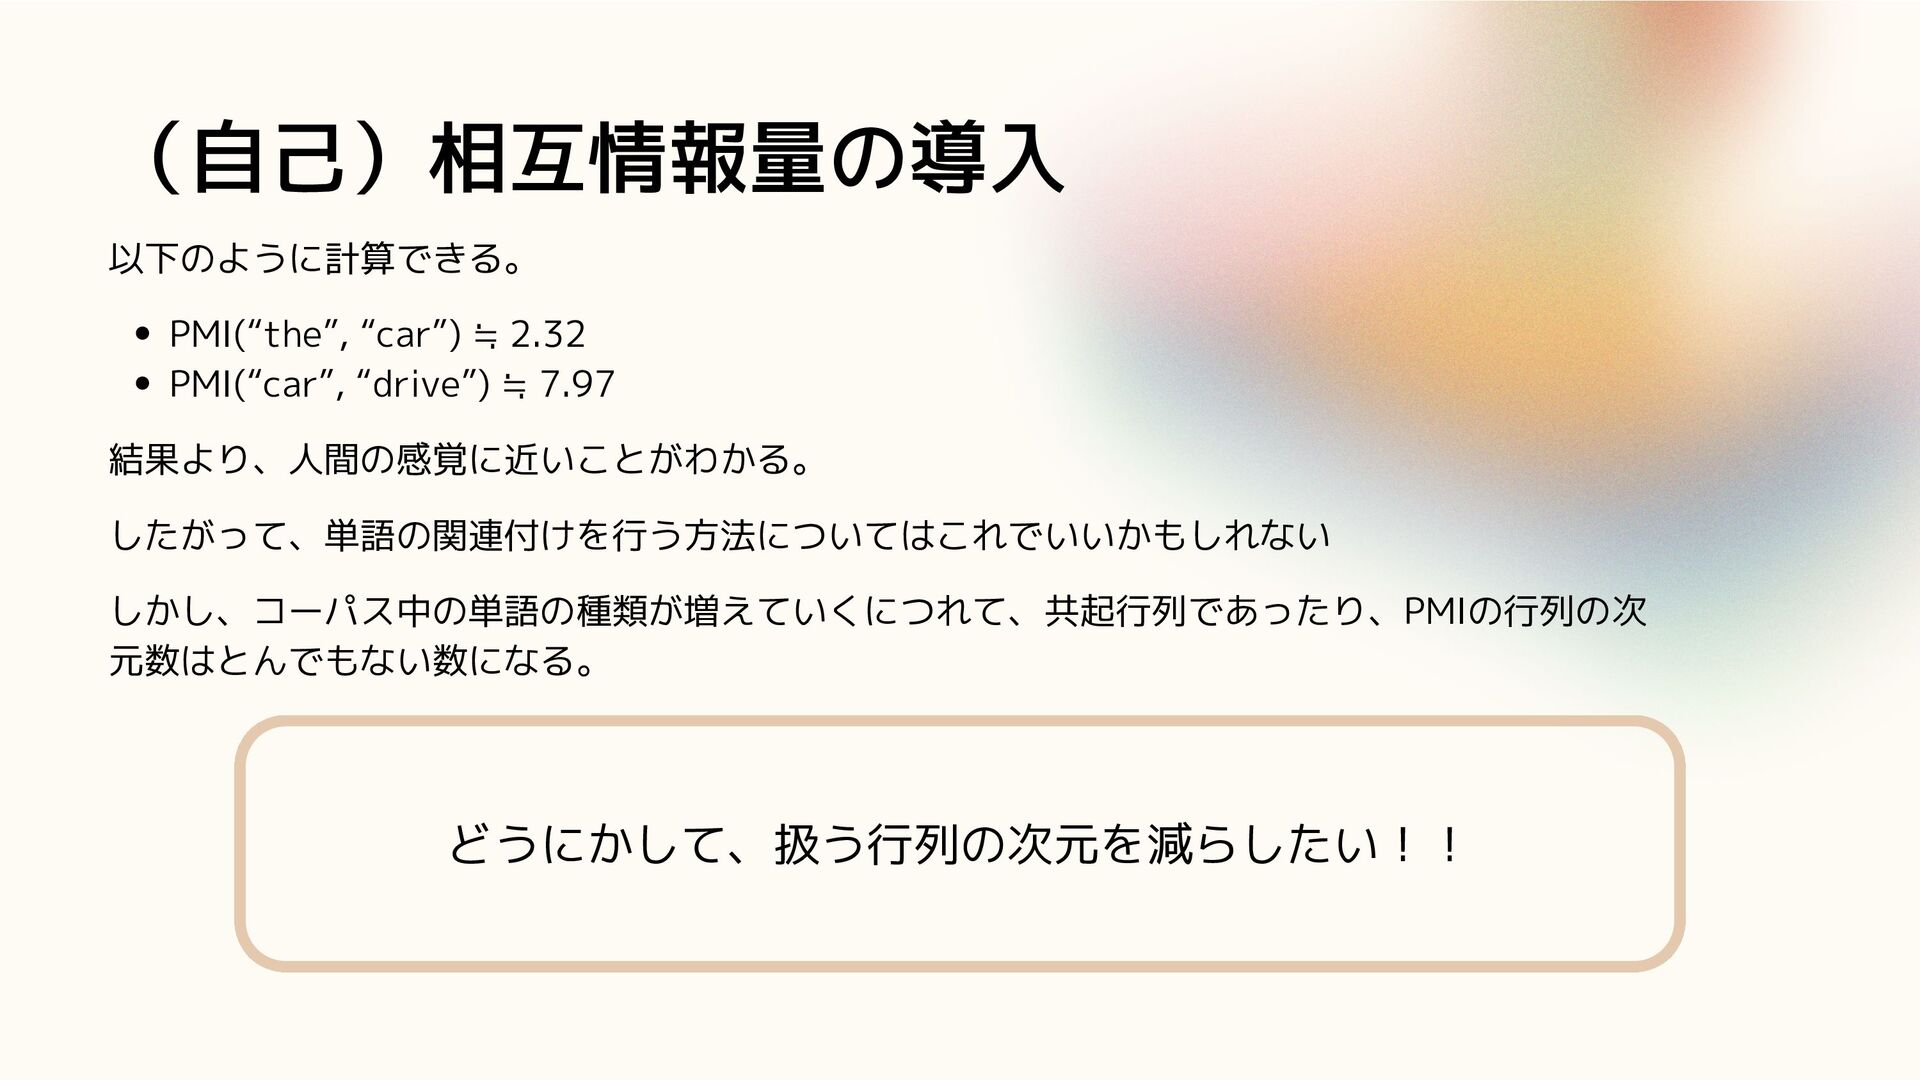
(自己)相互情報量の導入 PMI(“the”, “car”) ≒ 2.32 PMI(“car”, “drive”) ≒ 7.97 以下のように計算できる。
結果より、人間の感覚に近いことがわかる。 したがって、単語の関連付けを行う方法についてはこれでいいかもしれない しかし、コーパス中の単語の種類が増えていくにつれて、共起行列であったり、PMIの行列の次 元数はとんでもない数になる。 どうにかして、扱う行列の次元を減らしたい!!
SVDによる次元削減
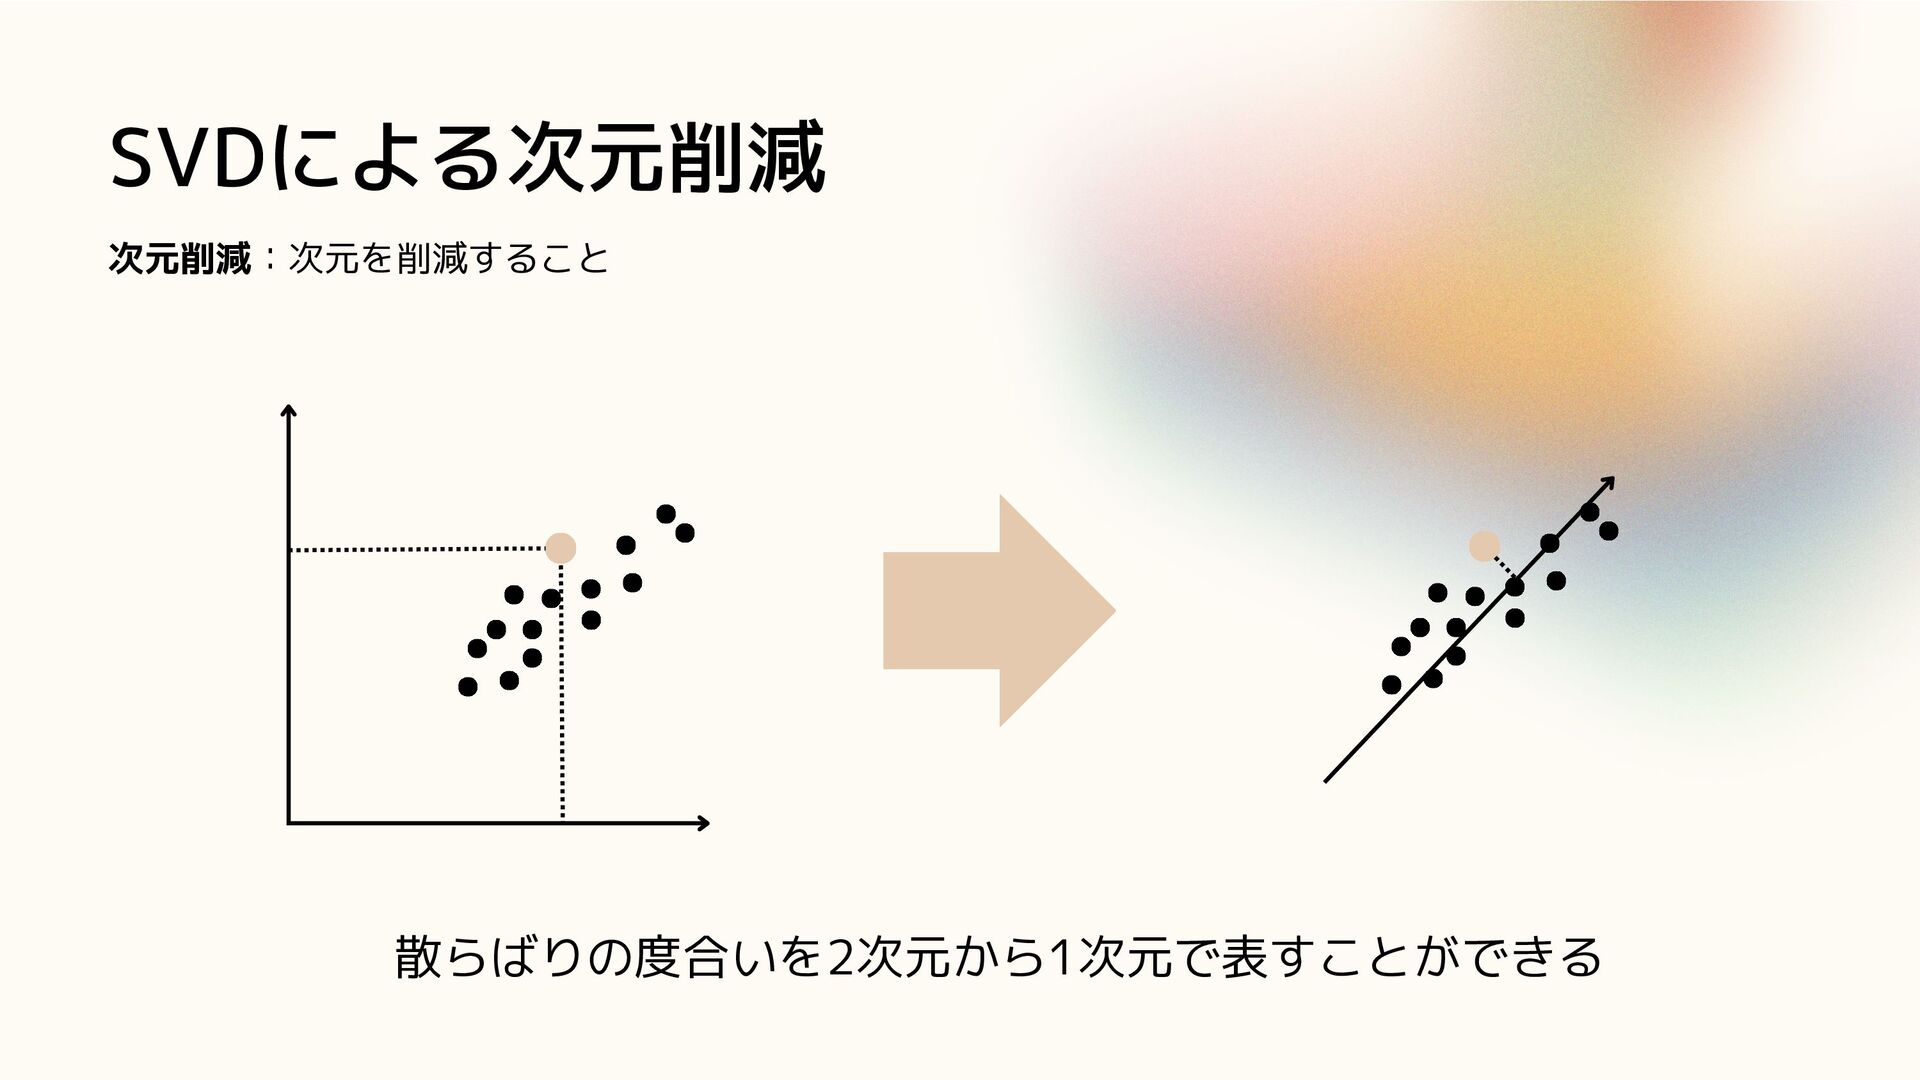
SVDによる次元削減 次元削減:次元を削減すること 散らばりの度合いを2次元から1次元で表すことができる
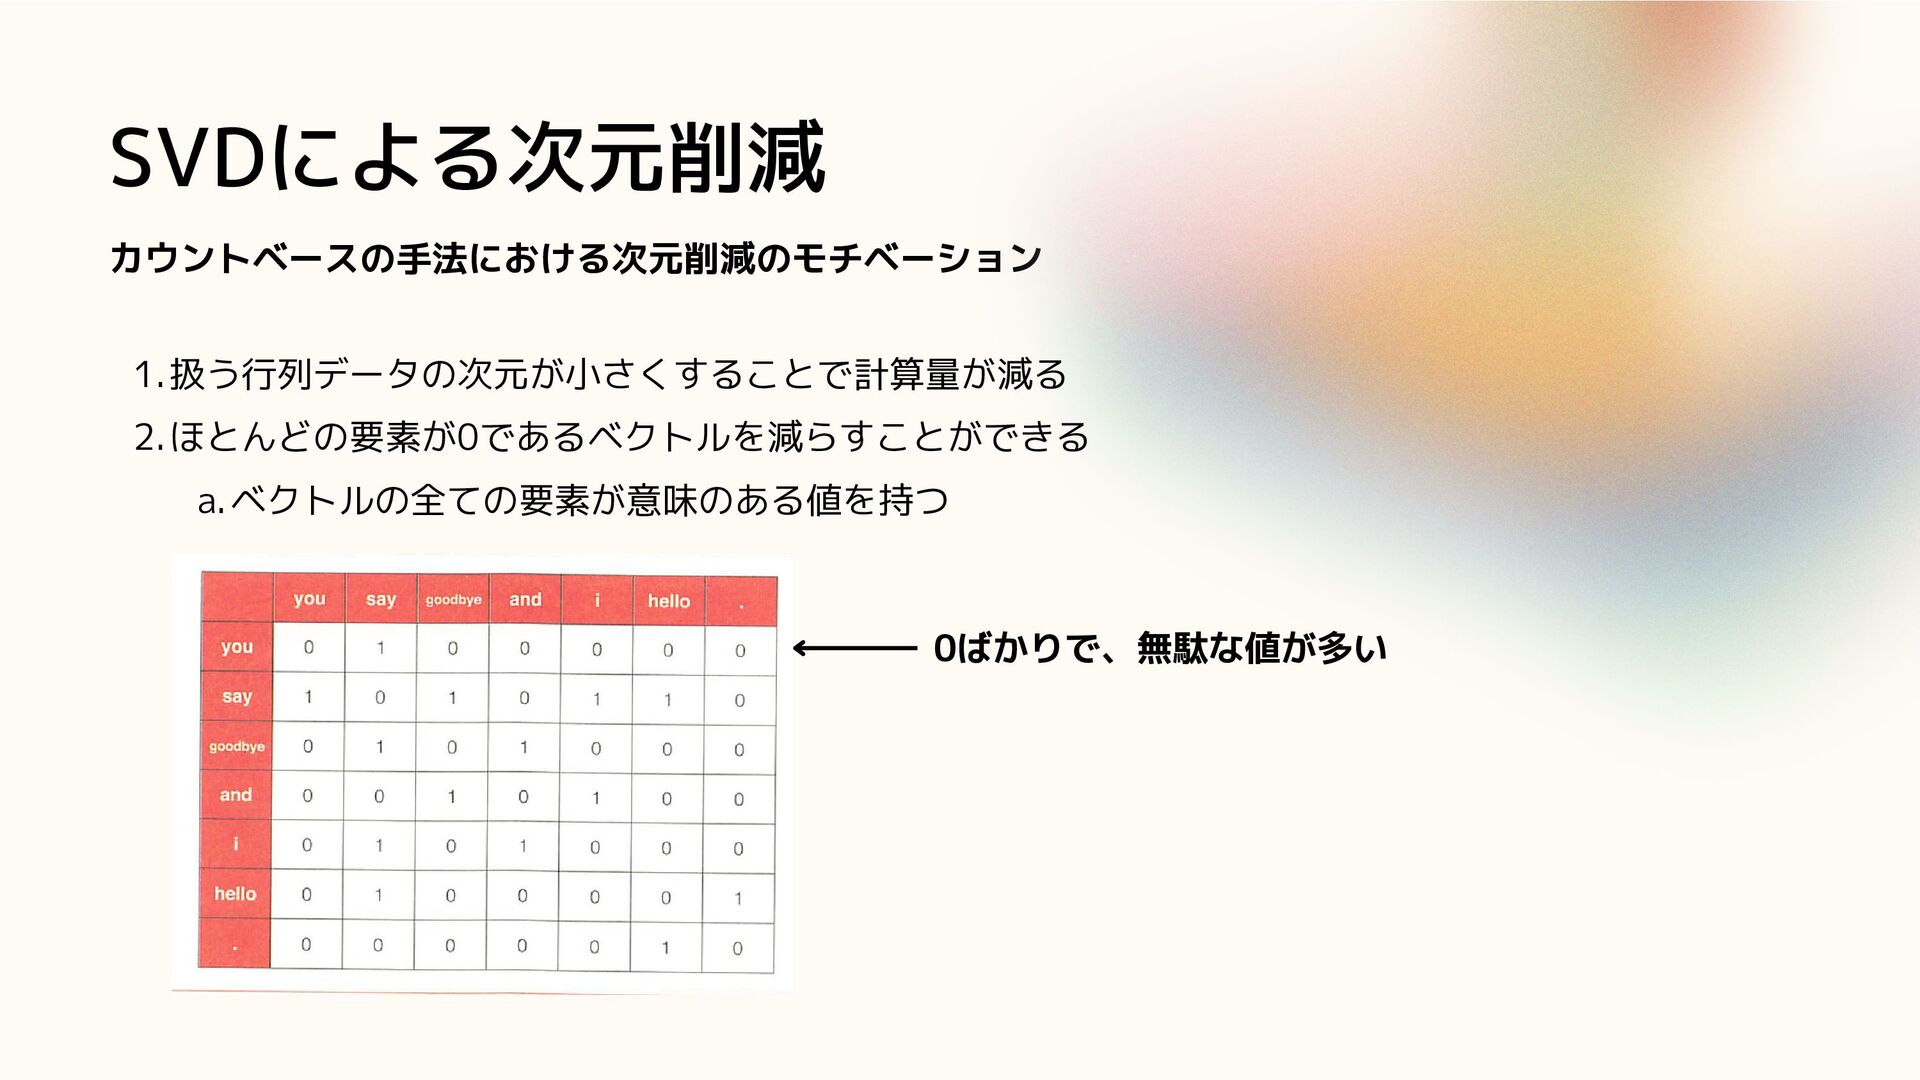
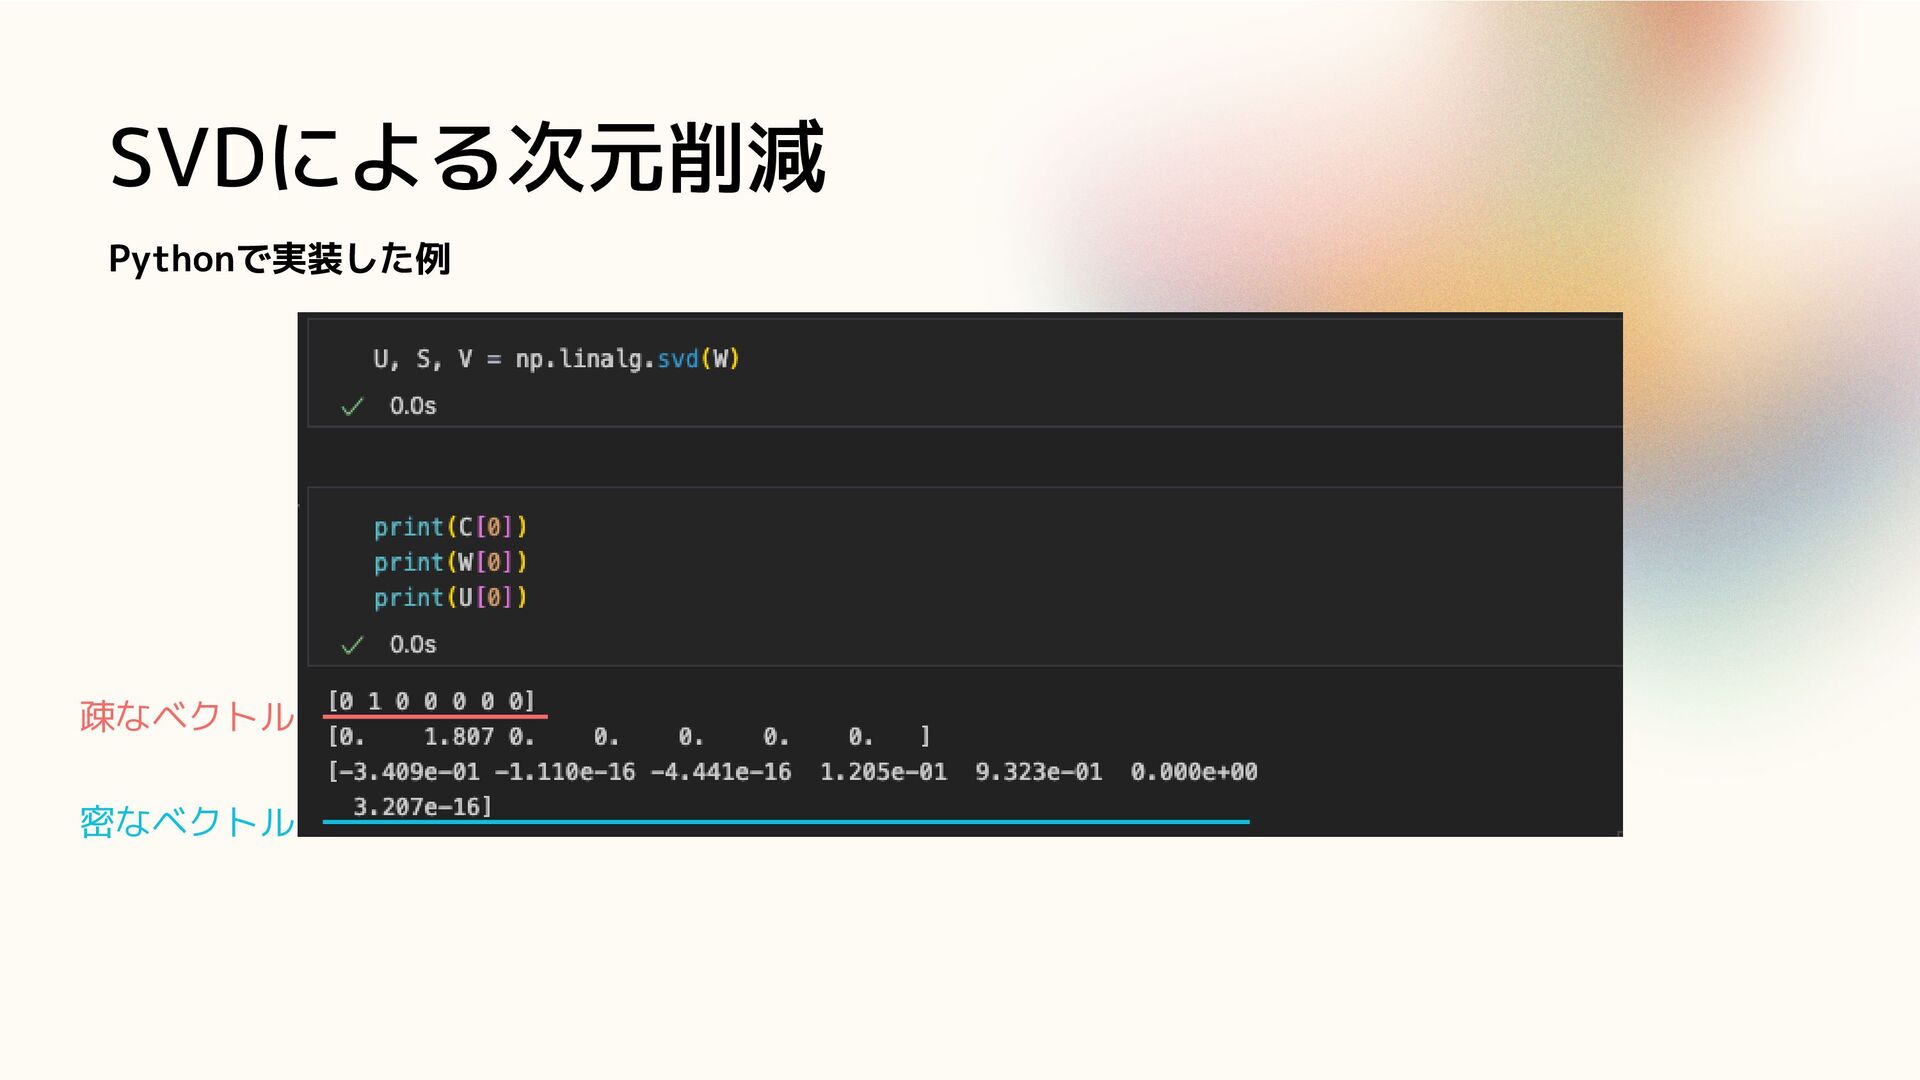
SVDによる次元削減 カウントベースの手法における次元削減のモチベーション 扱う行列データの次元が小さくすることで計算量が減る 1. ほとんどの要素が0であるベクトルを減らすことができる 2. ベクトルの全ての要素が意味のある値を持つ a. 0ばかりで、無駄な値が多い
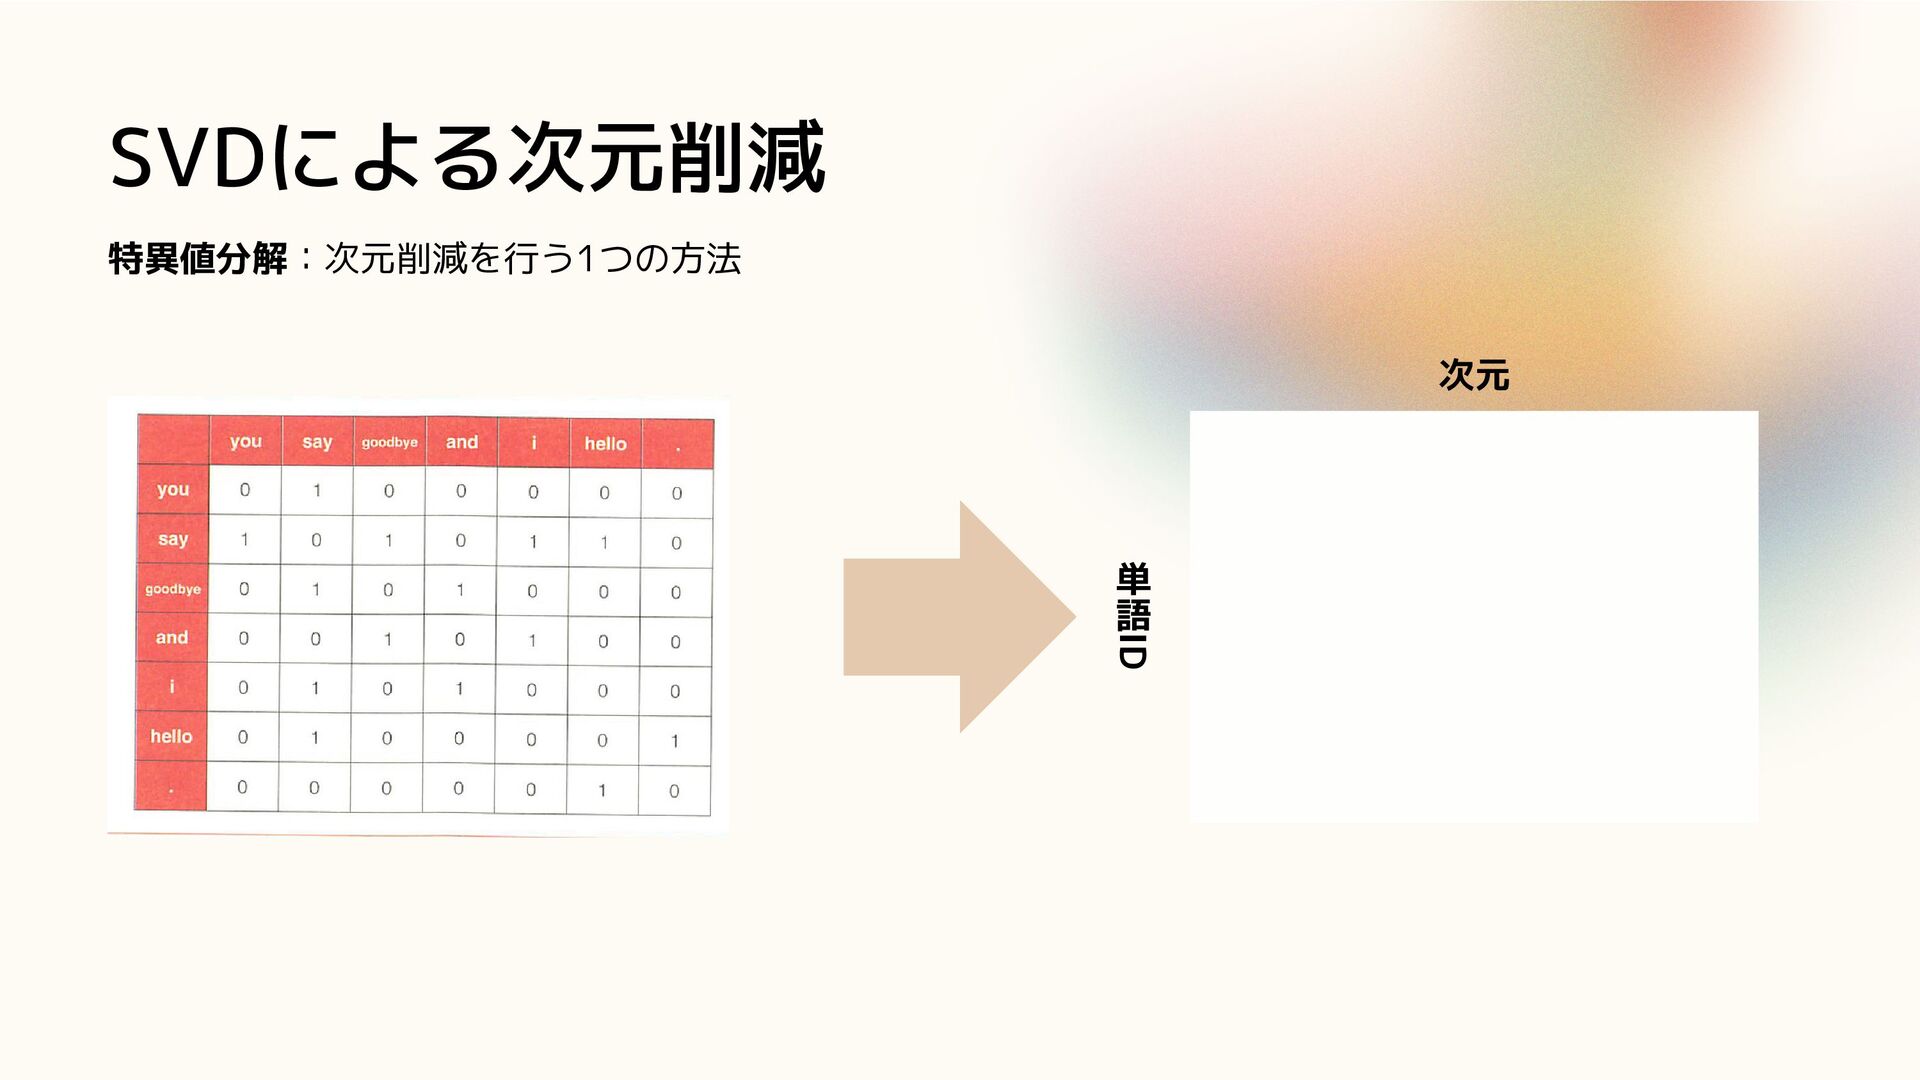
SVDによる次元削減 特異値分解:次元削減を行う1つの方法 単 語 ID 次元
SVDによる次元削減 Pythonで実装した例 疎なベクトル 密なベクトル
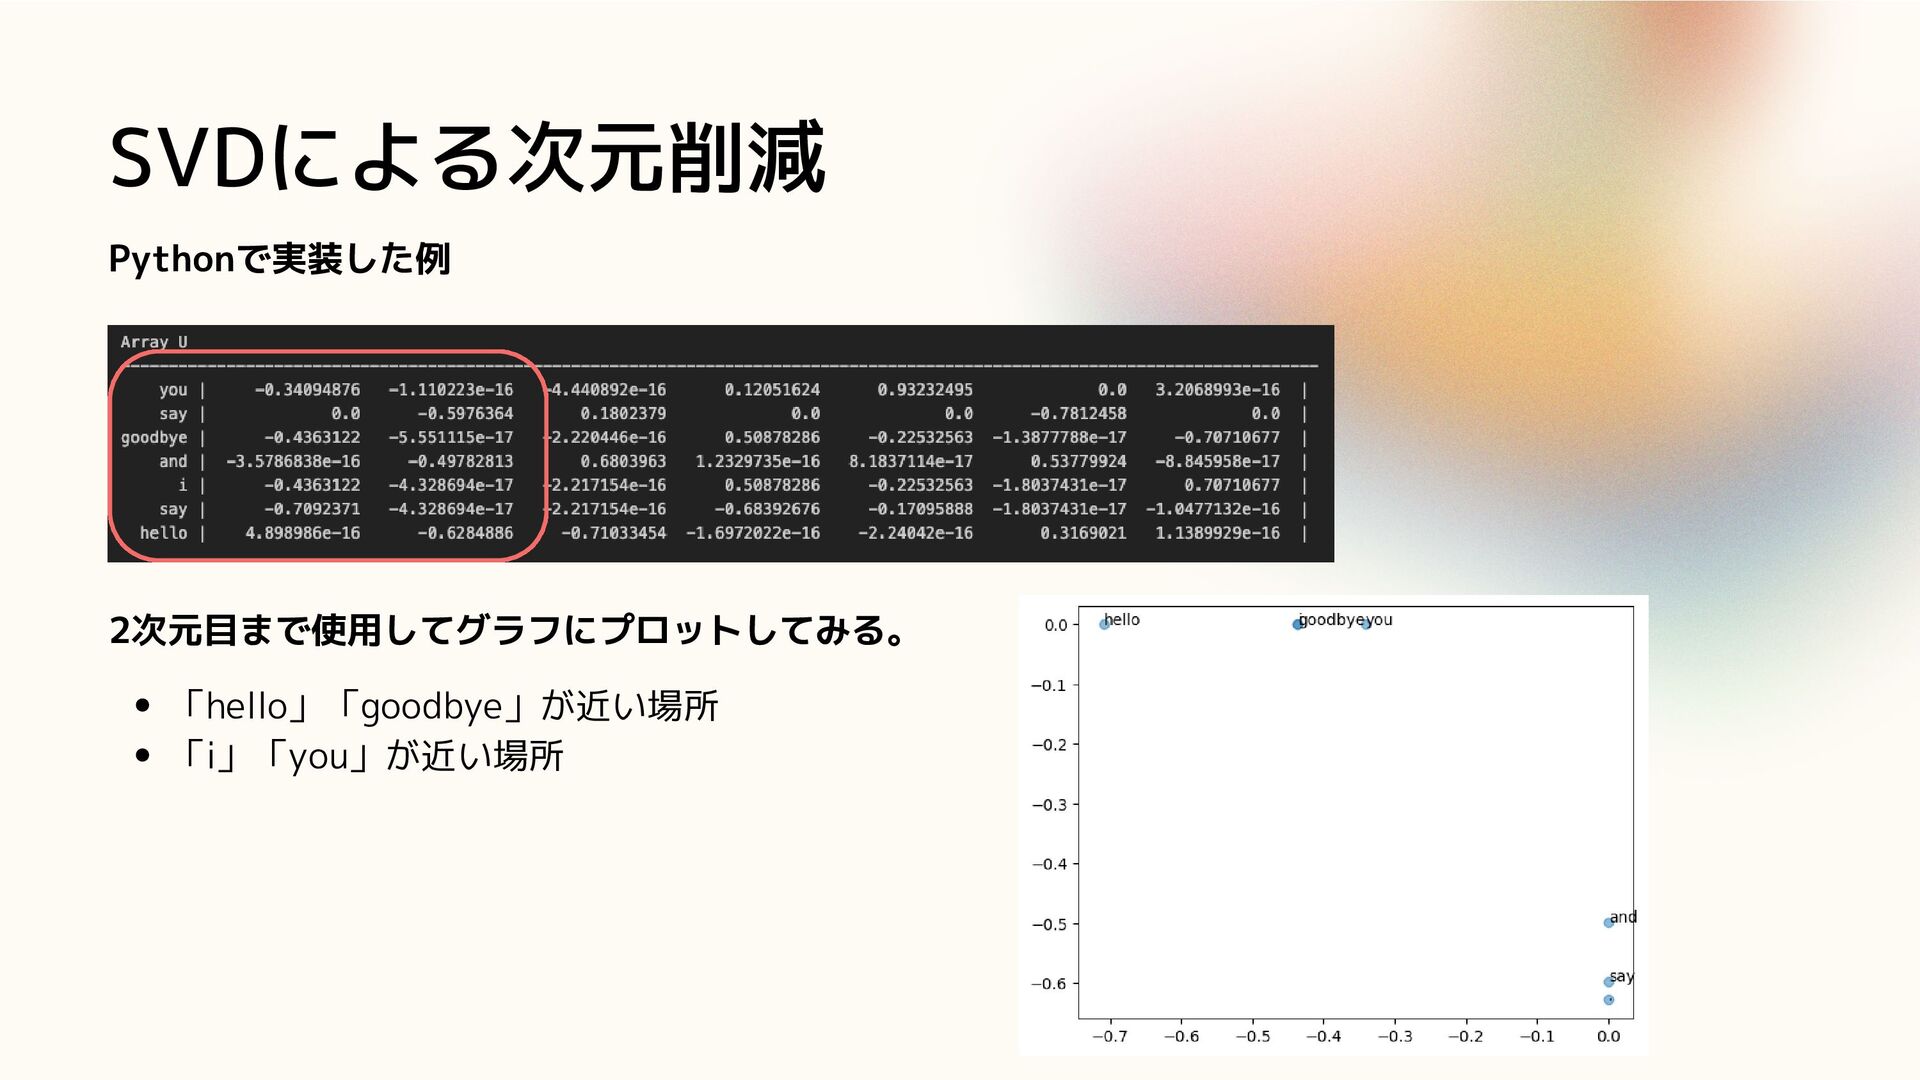
SVDによる次元削減 Pythonで実装した例 2次元目まで使用してグラフにプロットしてみる。 「hello」「goodbye」が近い場所 「i」「you」が近い場所
まとめ SVDによって、正確にコーパス中の単語の関連付けを行うことができた


 pirotyyy
 aemeredith
 cassininazir
 andyhume
 yeseniaperezcruz
 honzajavorek
 maggiecrowley
 chrisshort
 bkeepers
 mojombo
 frankvandijk
 lara
 lynnandtonic