Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
スキーマオンライトな Apache Iceberg に、スキーマオンリード風に書く
Search
ryuki sawada
June 11, 2026
14
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
スキーマオンライトな Apache Iceberg に、スキーマオンリード風に書く
ryuki sawada
June 11, 2026
Featured
See All Featured
Balancing Empowerment & Direction
lara
6
1.3k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
380
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
Unsuck your backbone
ammeep
672
58k
The Art of Programming - Codeland 2020
erikaheidi
57
14k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Mind Mapping
helmedeiros
1
400
KATA
mclloyd
PRO
35
16k
Noah Learner - AI + Me: how we built a GSC Bulk Export data pipeline
techseoconnect
PRO
0
460
Rebuilding a faster, lazier Slack
samanthasiow
85
9.7k
How to build a perfect <img>
jonoalderson
1
6.1k
Transcript
スキーマオンライトな Apache Icebergに スキーマオンリード⾵で書く Data CBU 澤⽥ ⻯希 LINEヤフー 2026/6/11 Apache
Iceberg実践 ! ベストプラクティス meetup
名前・所属 澤⽥ ⻯希(LINEヤフー株式会社 Data CBU, 2023~) 担当業務 旧ヤフー、旧LINE それぞれの全社ログ分析パイプラ イン基盤の構築・運⽤(Apache Spark,Apache
Flink, Apache Hadoop周り) ⾃⼰紹介 趣味 ゲーム、ゴルフ、アニメ、読書、美味しいご飯 1
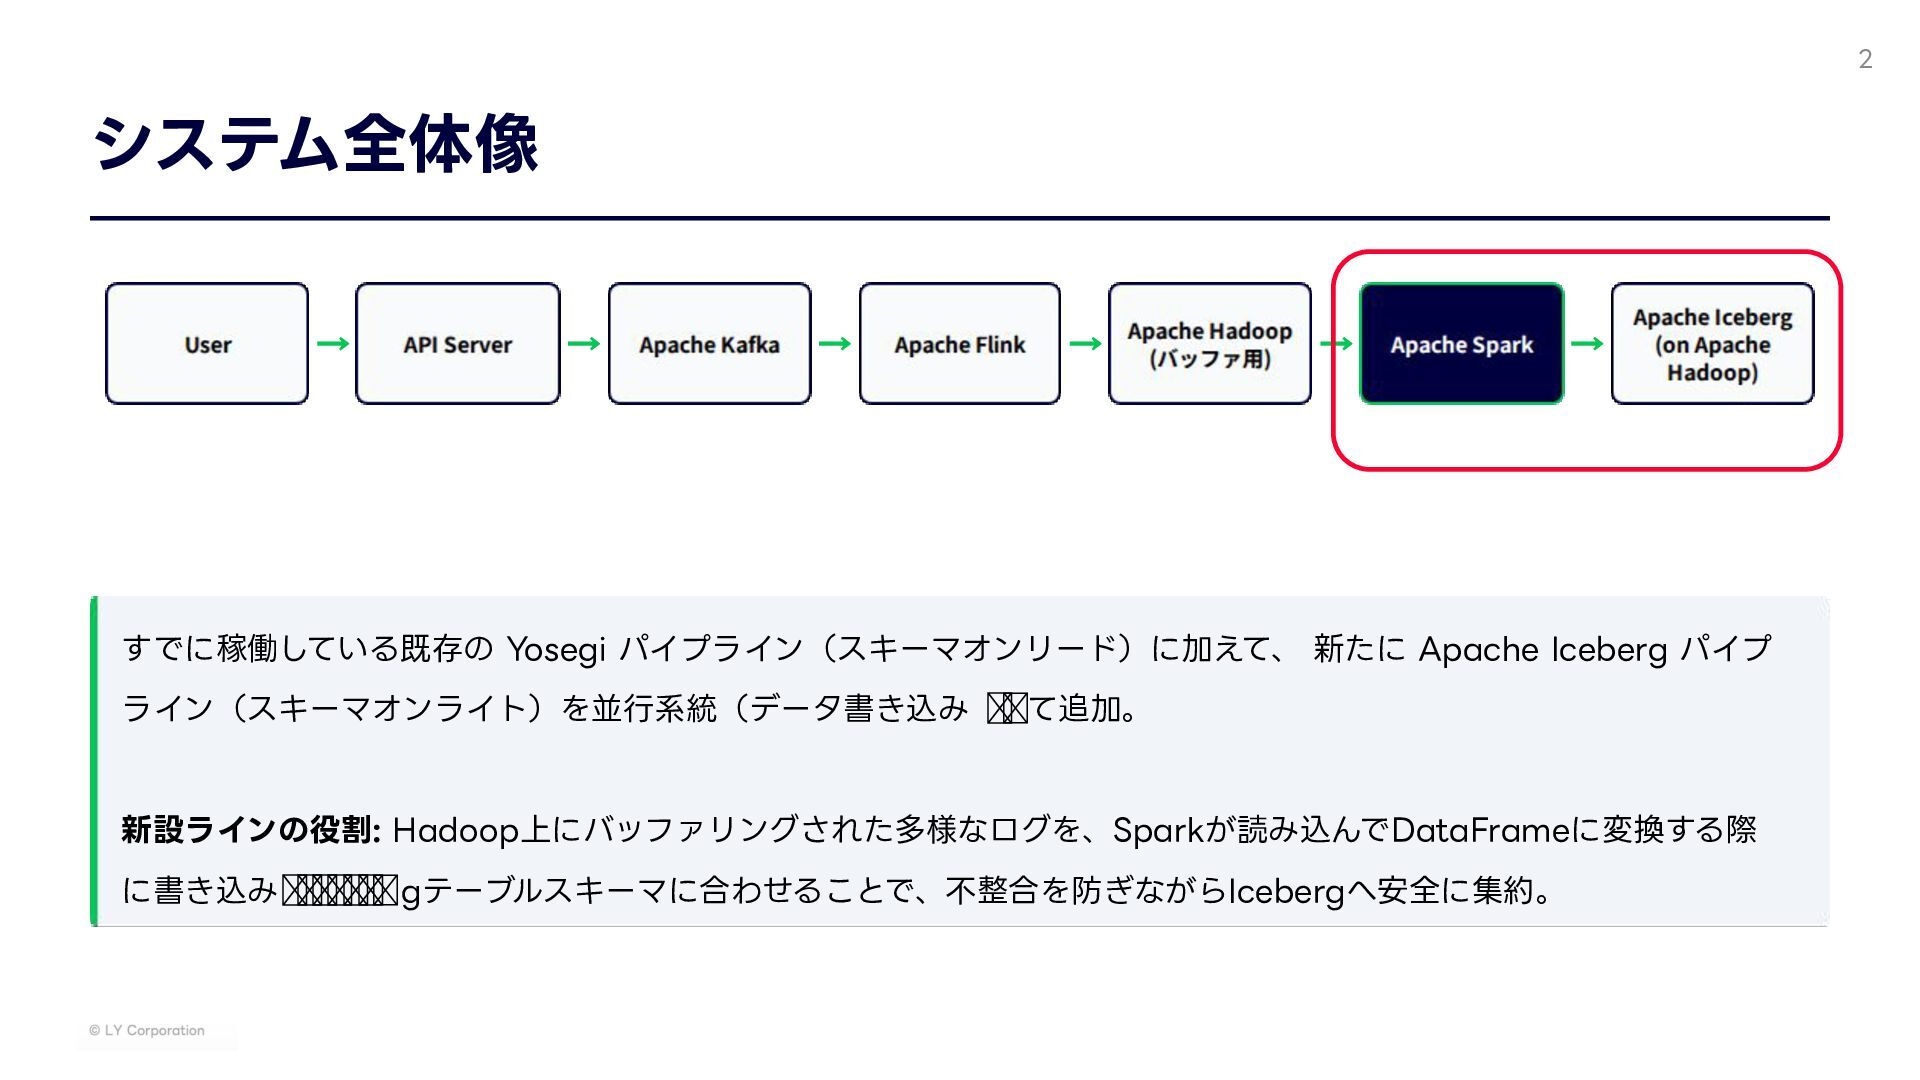
すでに稼働している既存の Yosegi パイプライン(スキーマオンリード)に加えて、 新たに Apache Iceberg パイプ ライン(スキーマオンライト)を並⾏系統(データ書き込み先)として追加。 新設ラインの役割: Hadoop上にバッファリングされた多様なログを、Sparkが読み込んでDataFrameに変換する際
に書き込み先のIcebergテーブルスキーマに合わせることで、不整合を防ぎながらIcebergへ安全に集約。 システム全体像 2 → → → → → →
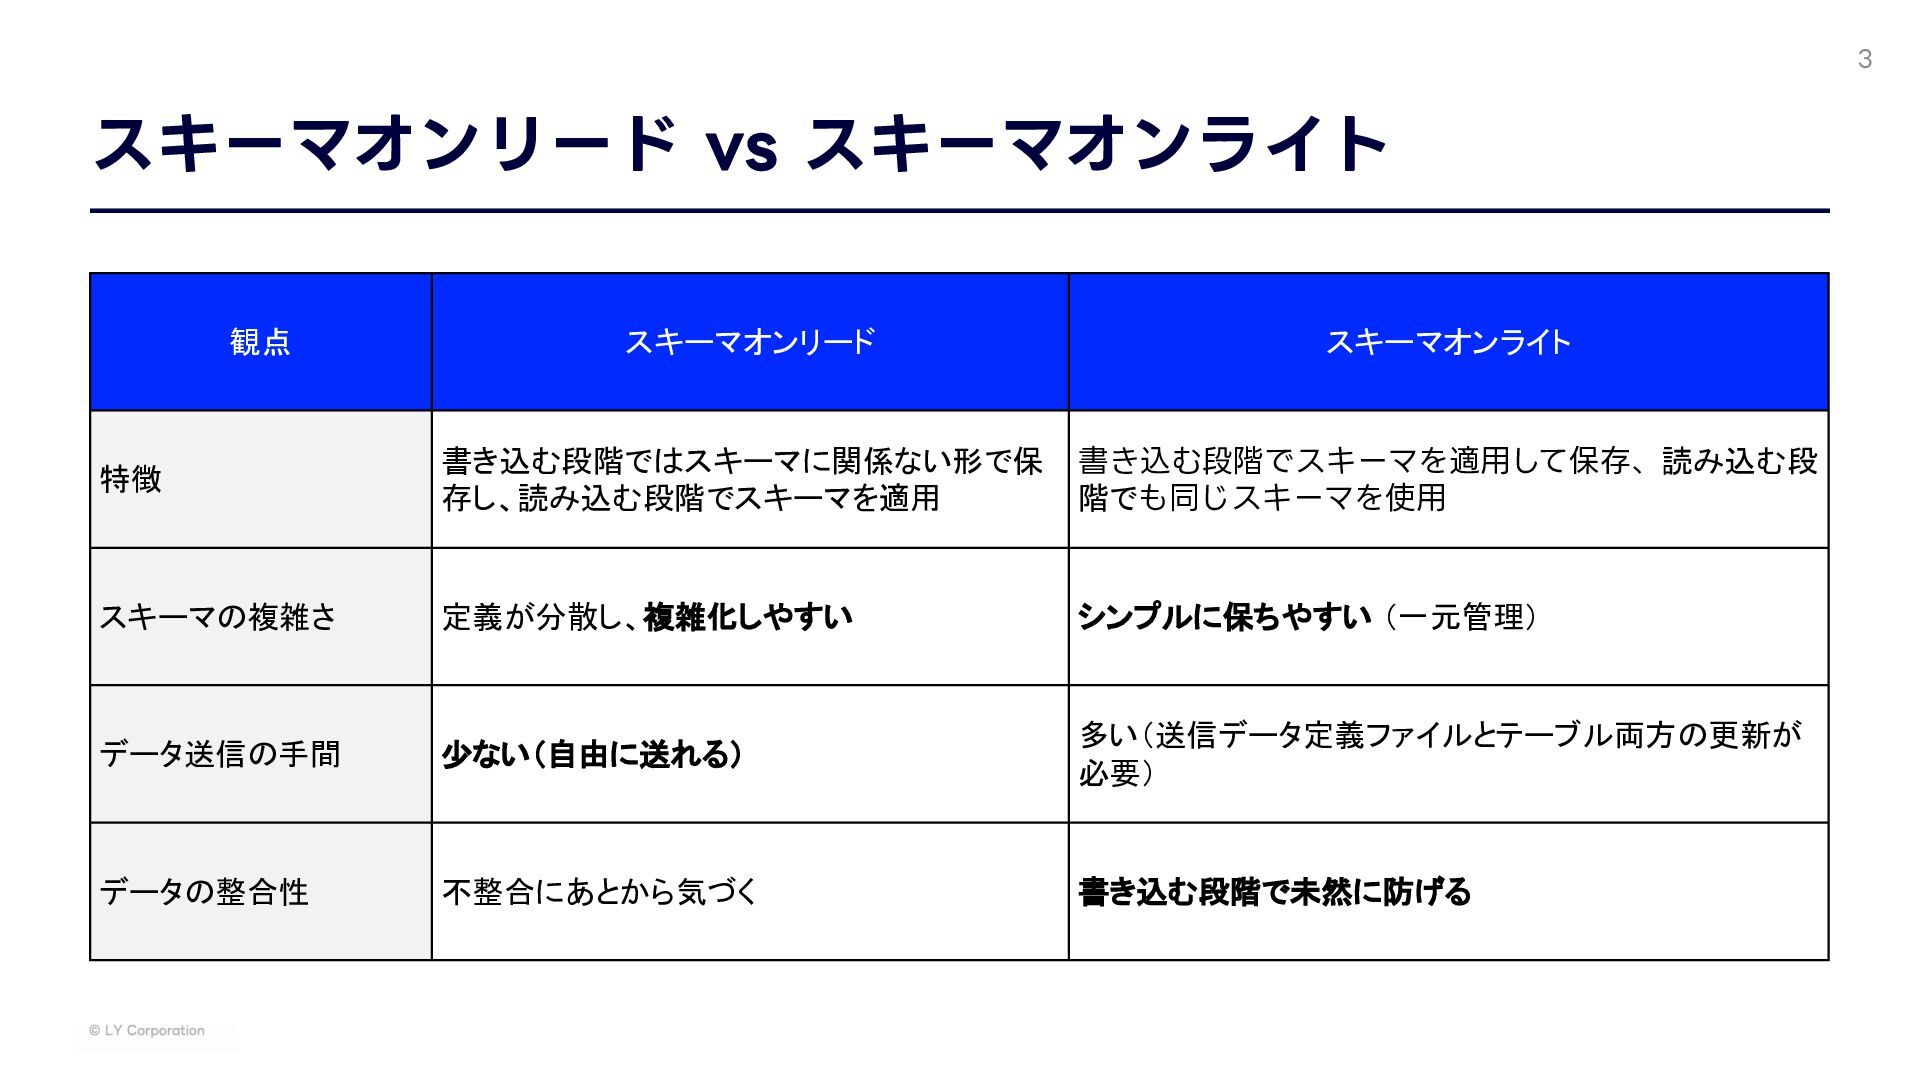
観点 スキーマオンリード スキーマオンライト 特徴 書き込む段階ではスキーマに関係ない形で保 存し、読み込む段階でスキーマを適用 書き込む段階でスキーマを適⽤して保存、読み込む段 階でも同じスキーマを使⽤ スキーマの複雑さ 定義が分散し、複雑化しやすい
シンプルに保ちやすい (一元管理) データ送信の手間 少ない(自由に送れる) 多い(送信データ定義ファイルとテーブル両方の更新が 必要) データの整合性 不整合にあとから気づく 書き込む段階で未然に防げる スキーマオンリード vs スキーマオンライト 3
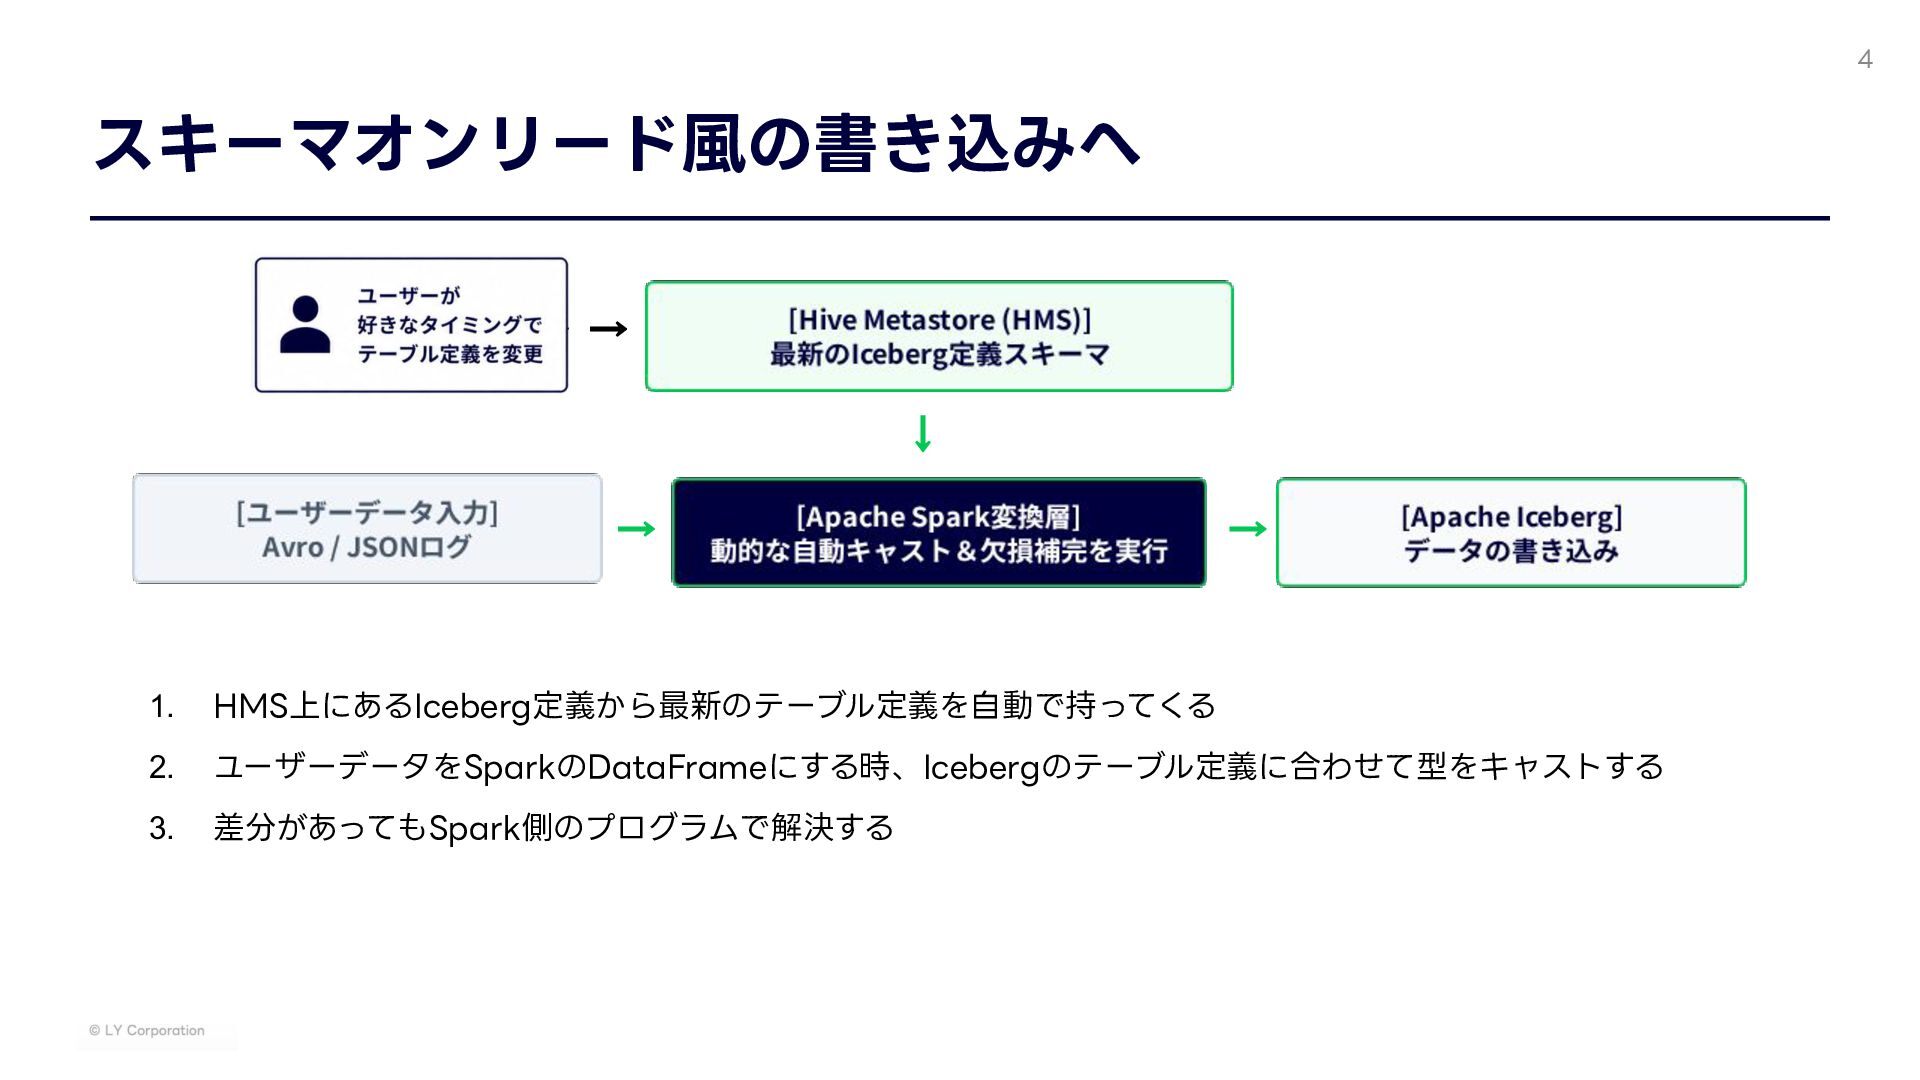
1. HMS上にあるIceberg定義から最新のテーブル定義を⾃動で持ってくる 2. ユーザーデータをSparkのDataFrameにする時、Icebergのテーブル定義に合わせて型をキャストする 3. 差分があってもSpark側のプログラムで解決する スキーマオンリード⾵の書き込みへ 4 → →
→ →
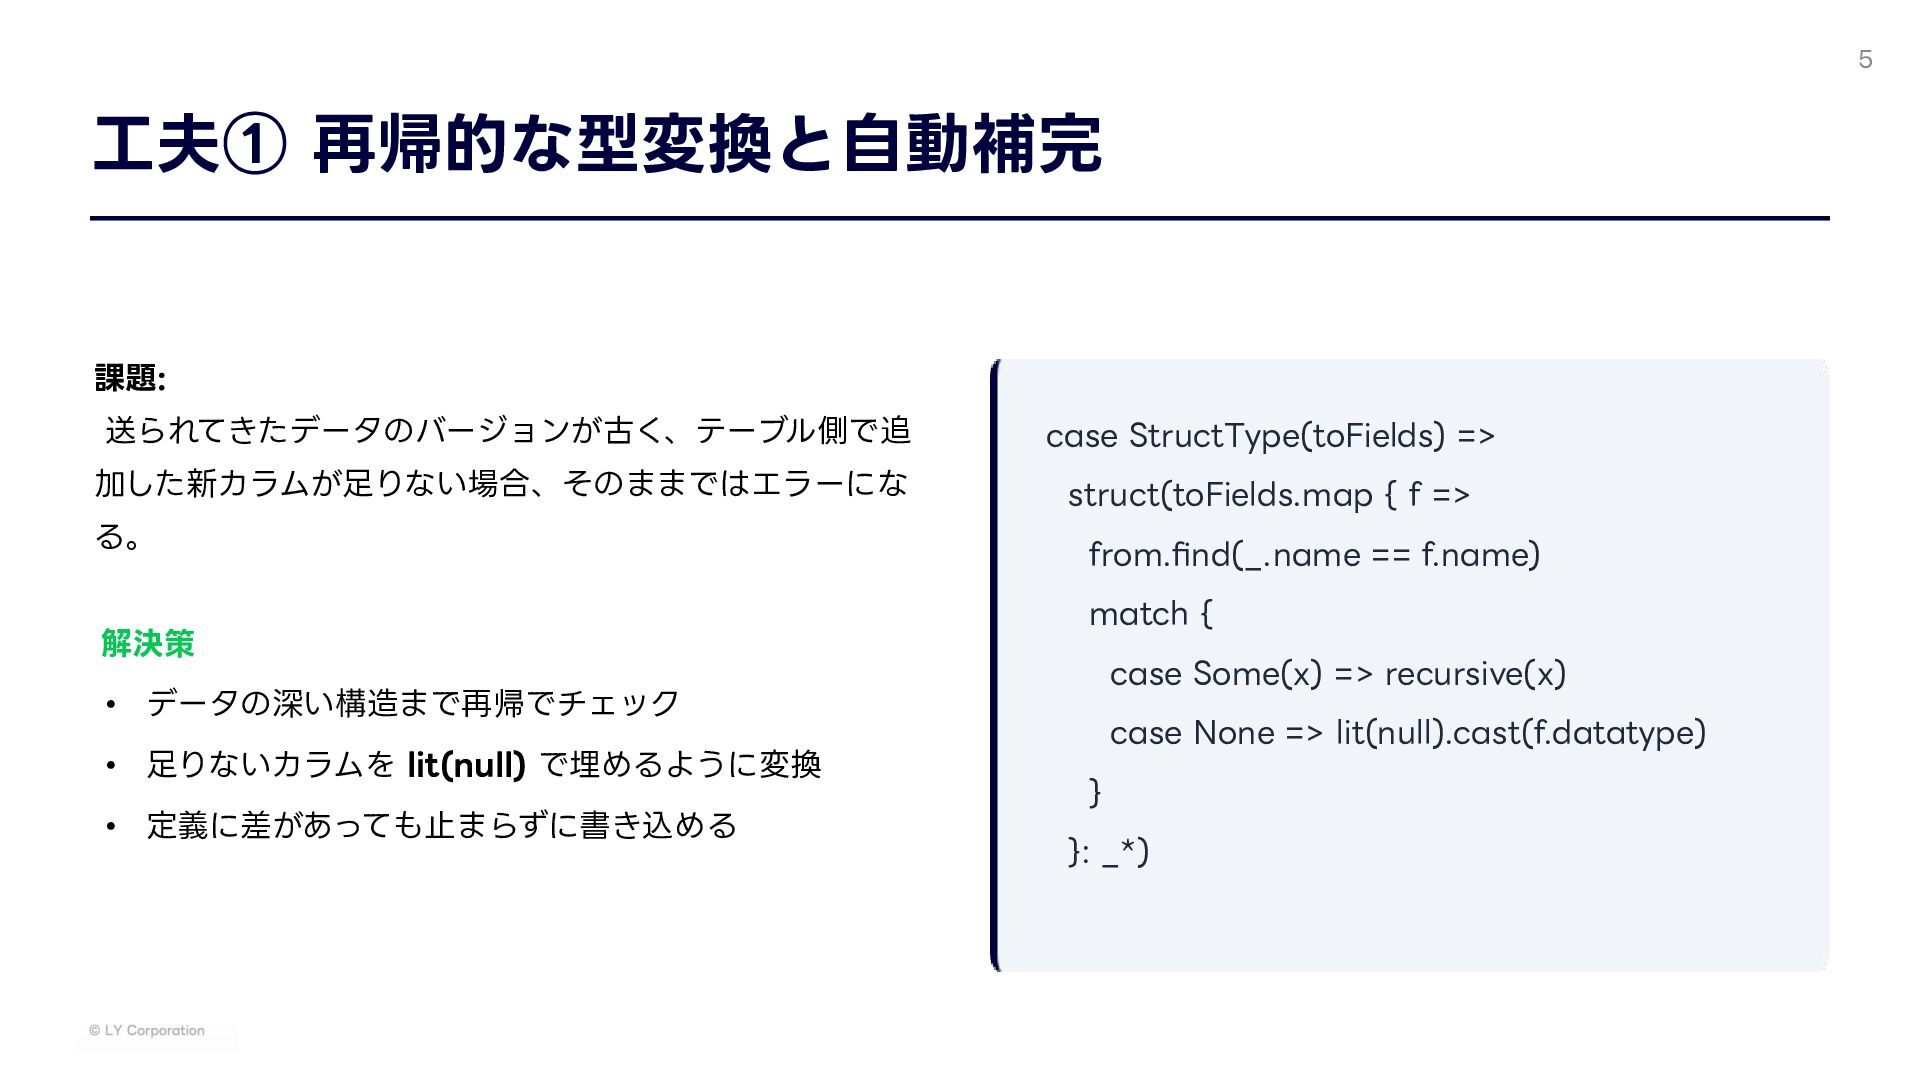
課題: 送られてきたデータのバージョンが古く、テーブル側で追 加した新カラムが⾜りない場合、そのままではエラーにな る。 解決策 • データの深い構造まで再帰でチェック • ⾜りないカラムを lit(null)
で埋めるように変換 • 定義に差があっても⽌まらずに書き込める ⼯夫① 再帰的な型変換と⾃動補完 case StructType(toFields) => struct(toFields.map { f => from.find(_.name == f.name) match { case Some(x) => recursive(x) case None => lit(null).cast(f.datatype) } }: _*) 5
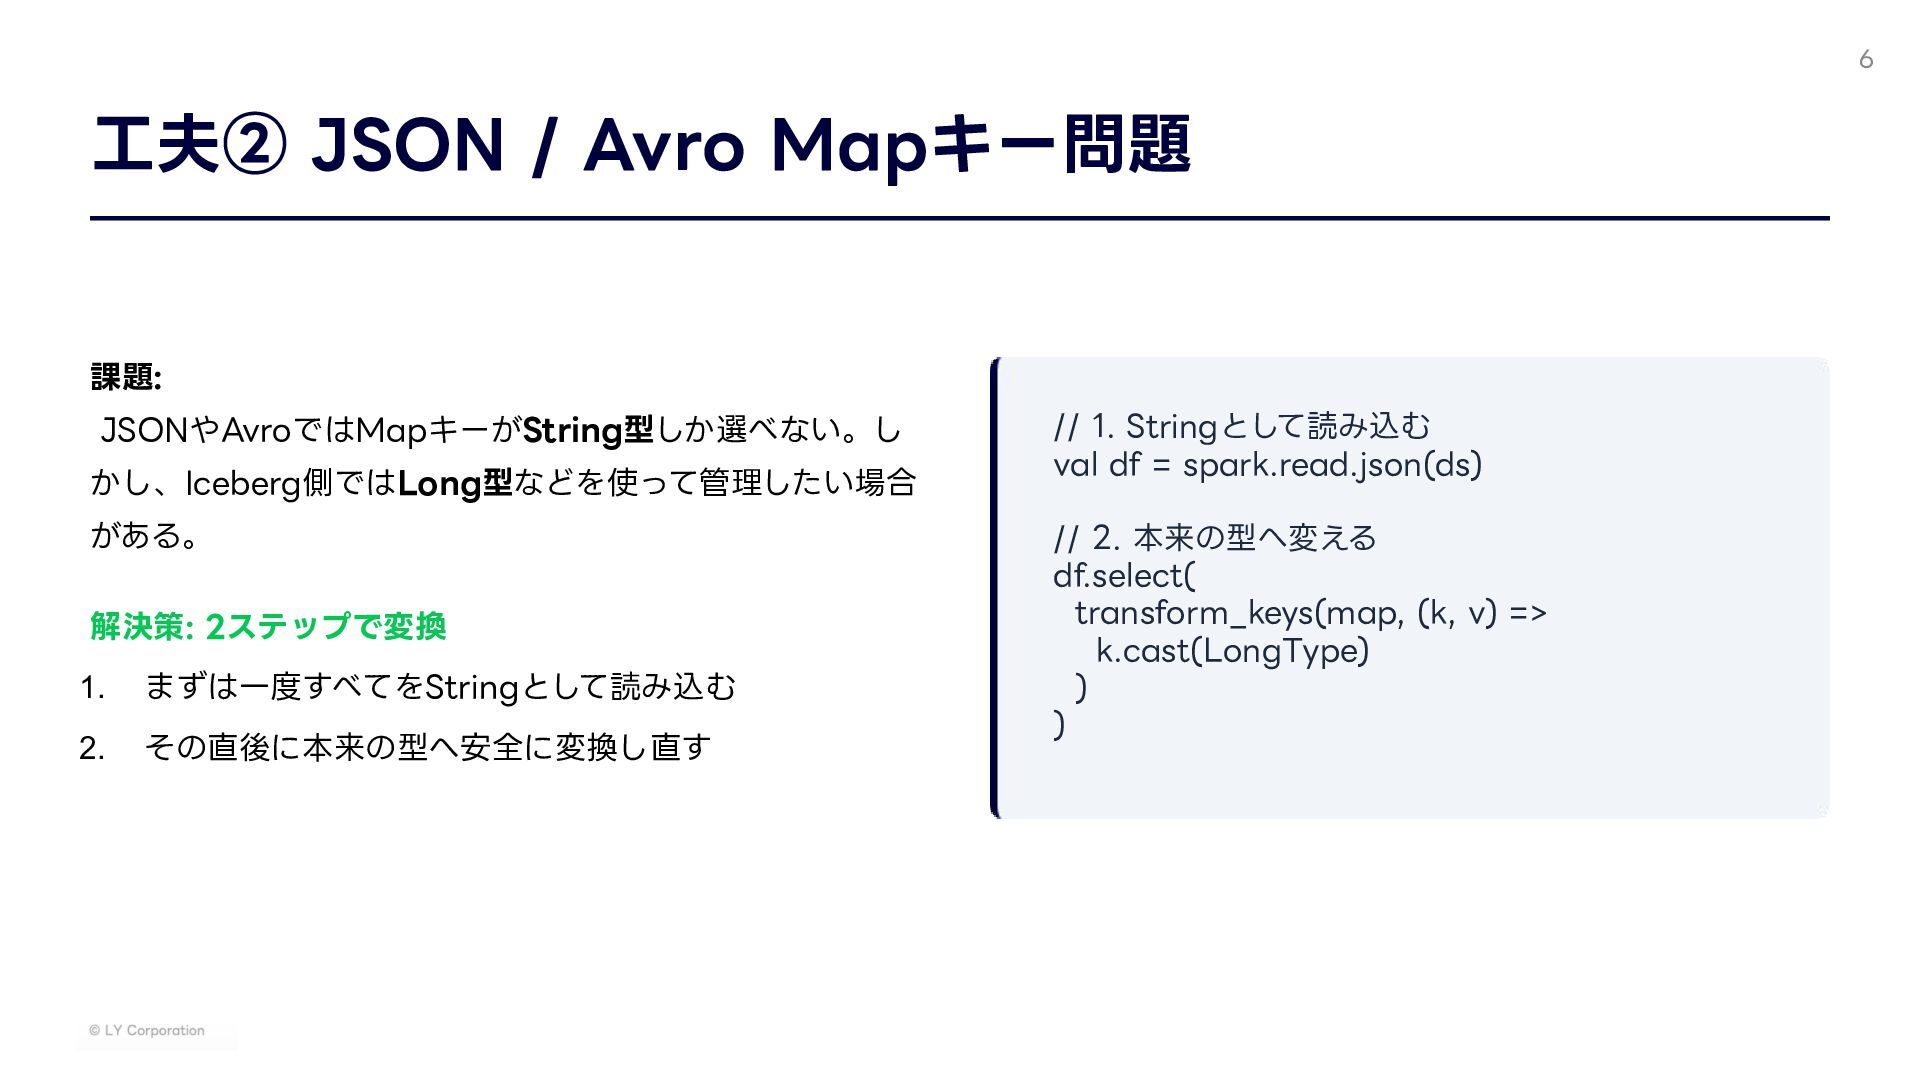
課題: JSONやAvroではMapキーがString型しか選べない。し かし、Iceberg側ではLong型などを使って管理したい場合 がある。 解決策: 2ステップで変換 1. まずは⼀度すべてをStringとして読み込む 2. その直後に本来の型へ安全に変換し直す
⼯夫② JSON / Avro Mapキー問題 // 1. Stringとして読み込む val df = spark.read.json(ds) // 2. 本来の型へ変える df.select( transform_keys(map, (k, v) => k.cast(LongType) ) ) 6
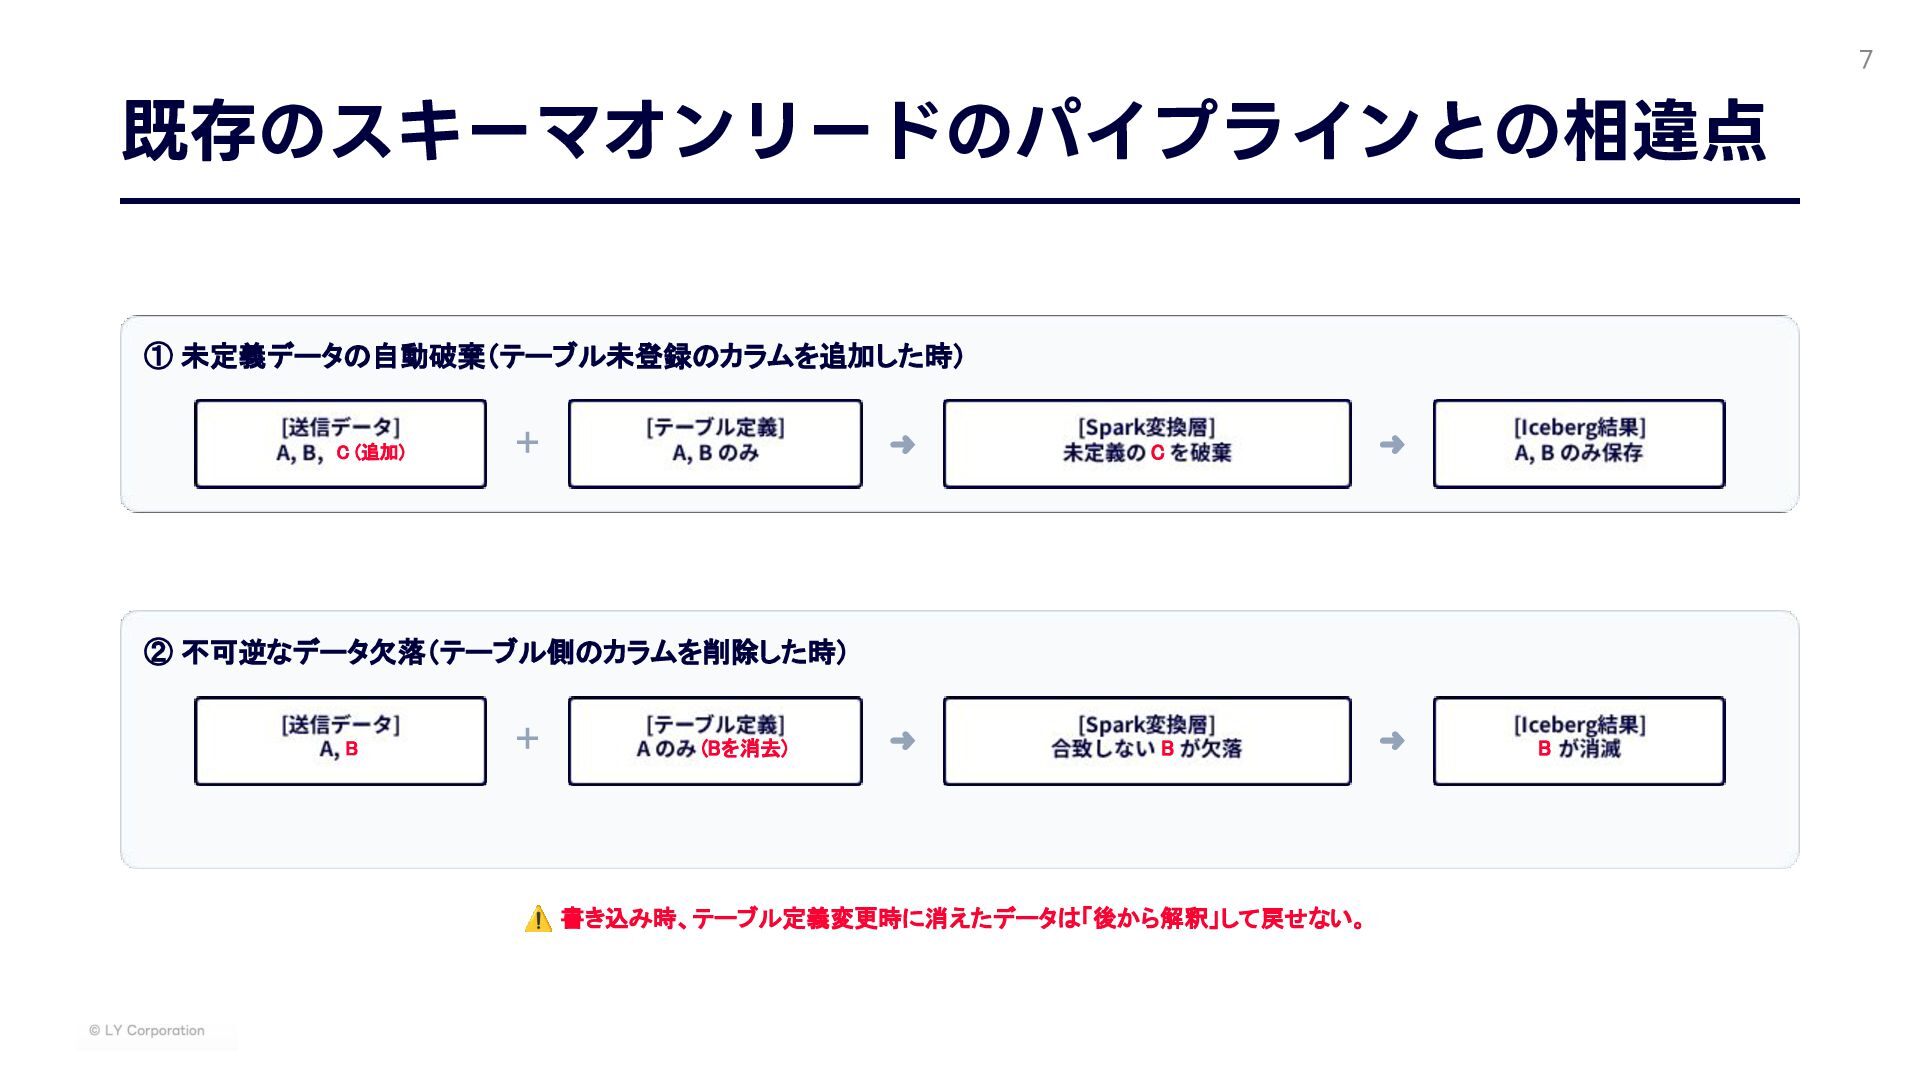
既存のスキーマオンリードのパイプラインとの相違点 7 ① 未定義データの自動破棄(テーブル未登録のカラムを追加した時) ② 不可逆なデータ欠落(テーブル側のカラムを削除した時) ⚠ 書き込み時、テーブル定義変更時に消えたデータは「後から解釈」して戻せない。 + ➜
➜ + ➜ ➜ C (追加) C B (Bを消去) B B
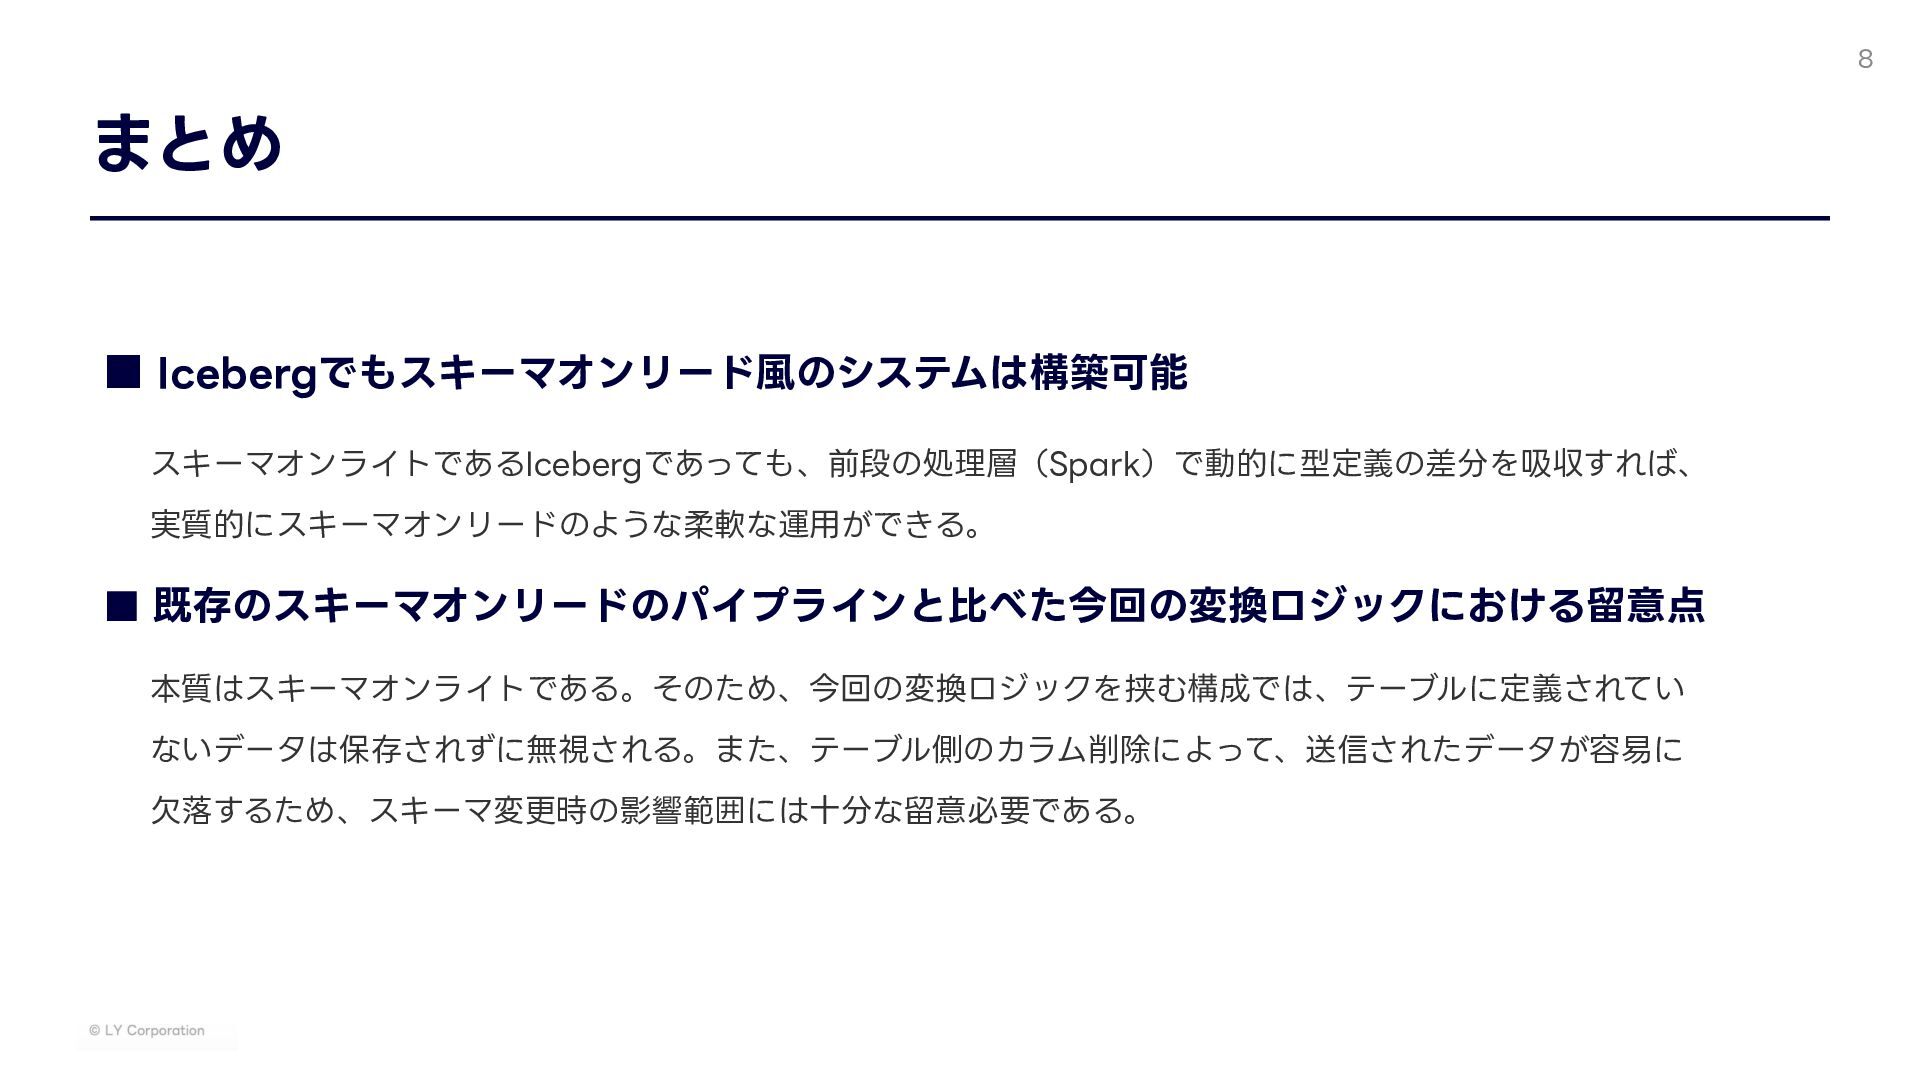
まとめ ▪ Icebergでもスキーマオンリード⾵のシステムは構築可能 スキーマオンライトであるIcebergであっても、前段の処理層(Spark)で動的に型定義の差分を吸収すれば、 実質的にスキーマオンリードのような柔軟な運⽤ができる。 ▪ 既存のスキーマオンリードのパイプラインと⽐べた今回の変換ロジックにおける留意点 本質はスキーマオンライトである。そのため、今回の変換ロジックを挟む構成では、テーブルに定義されてい ないデータは保存されずに無視される。また、テーブル側のカラム削除によって、送信されたデータが容易に ⽋落するため、スキーマ変更時の影響範囲には⼗分な留意必要である。
8
Thank You ご清聴ありがとうございました


 lara
 bcantrill
 jdejongh
 productmarketing
 ammeep
 erikaheidi
 tammyeverts
 helmedeiros
 mclloyd
 techseoconnect
 samanthasiow
 jonoalderson