Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文調査
Search
tomoki
July 27, 2025
11
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文調査
tomoki
July 27, 2025
Featured
See All Featured
Side Projects
sachag
456
43k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
43k
Tips & Tricks on How to Get Your First Job In Tech
honzajavorek
1
800
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
SERP Conf. Vienna - Web Accessibility: Optimizing for Inclusivity and SEO
sarafernandez
2
1.6k
KATA
mclloyd
PRO
35
16k
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
2.9k
Test your architecture with Archunit
thirion
2
2.4k
We Are The Robots
honzajavorek
0
400
Why You Should Never Use an ORM
jnunemaker
PRO
61
10k
Agile that works and the tools we love
rasmusluckow
331
22k
Transcript
Beyond Words: Exploring Cultural Value Sensitivity in Multimodal Models Srishti
Yadav, Zhi Zhang, Daniel Hershcovich, Ekaterina Shutova Findings of the Association for Computational Linguistics: NAACL 2025
概要 本研究は、大規模視覚言語モデル(VLM)が文化的な価値観をどの程度理解し、整合 性のある応答を生成できるかを評価するものです [cite: 5, 8]。具体的には、世界価値観 調査(WVS)の質問に対し、国名のみをプロンプトとして与えた場合と、文化を象徴 する画像をプロンプトとして与えた場合の応答を比較しました [cite: 47,
48]。その結 果、画像はモデルの文化理解を助ける可能性がある一方で、その効果は文脈に大きく 依存し、モデルが高収入国の価値観に偏るバイアスも存在することが明らかになりま した [cite: 9, 10, 352]。
背景 大規模言語モデル(LLM)における文化的なバイアスや価値観の研究は進んでいま すが、画像とテキストを扱う視覚言語モデル(VLM)ではまだ十分に探求されて いません [cite: 5, 6]。 VLMが世界的に普及するにつれて、モデルが多様な文化の価値観をどのように表 現し、扱うかが極めて重要になっています [cite:
7]。 文化は言葉だけでなく、服装、儀式、食べ物といった視覚的な要素にも深く根付 いており、画像は言語だけでは伝えきれない文化的なニュアンスを捉える可能性 があります [cite: 67]。
目的 本研究は以下の3つの目的を掲げています。 1. 評価フレームワークの提案: テキストと画像を組み合わせ、マルチモーダルモデル が持つ文化的な価値観への感受性を評価するための包括的なフレームワークを提 案する [cite: 26, 52]。
2. モデルサイズの影響分析: 13B、34B、72Bといった異なるパラメータサイズのモデ ルが、価値観の整合性にどのように影響するかを分析する [cite: 55]。 3. トピック別の詳細評価: 宗教、人種、移民、ジェンダーなど、多様なトピックにわ たるモデルの応答を詳細に評価し、文脈に応じた性能を明らかにする [cite: 56]。
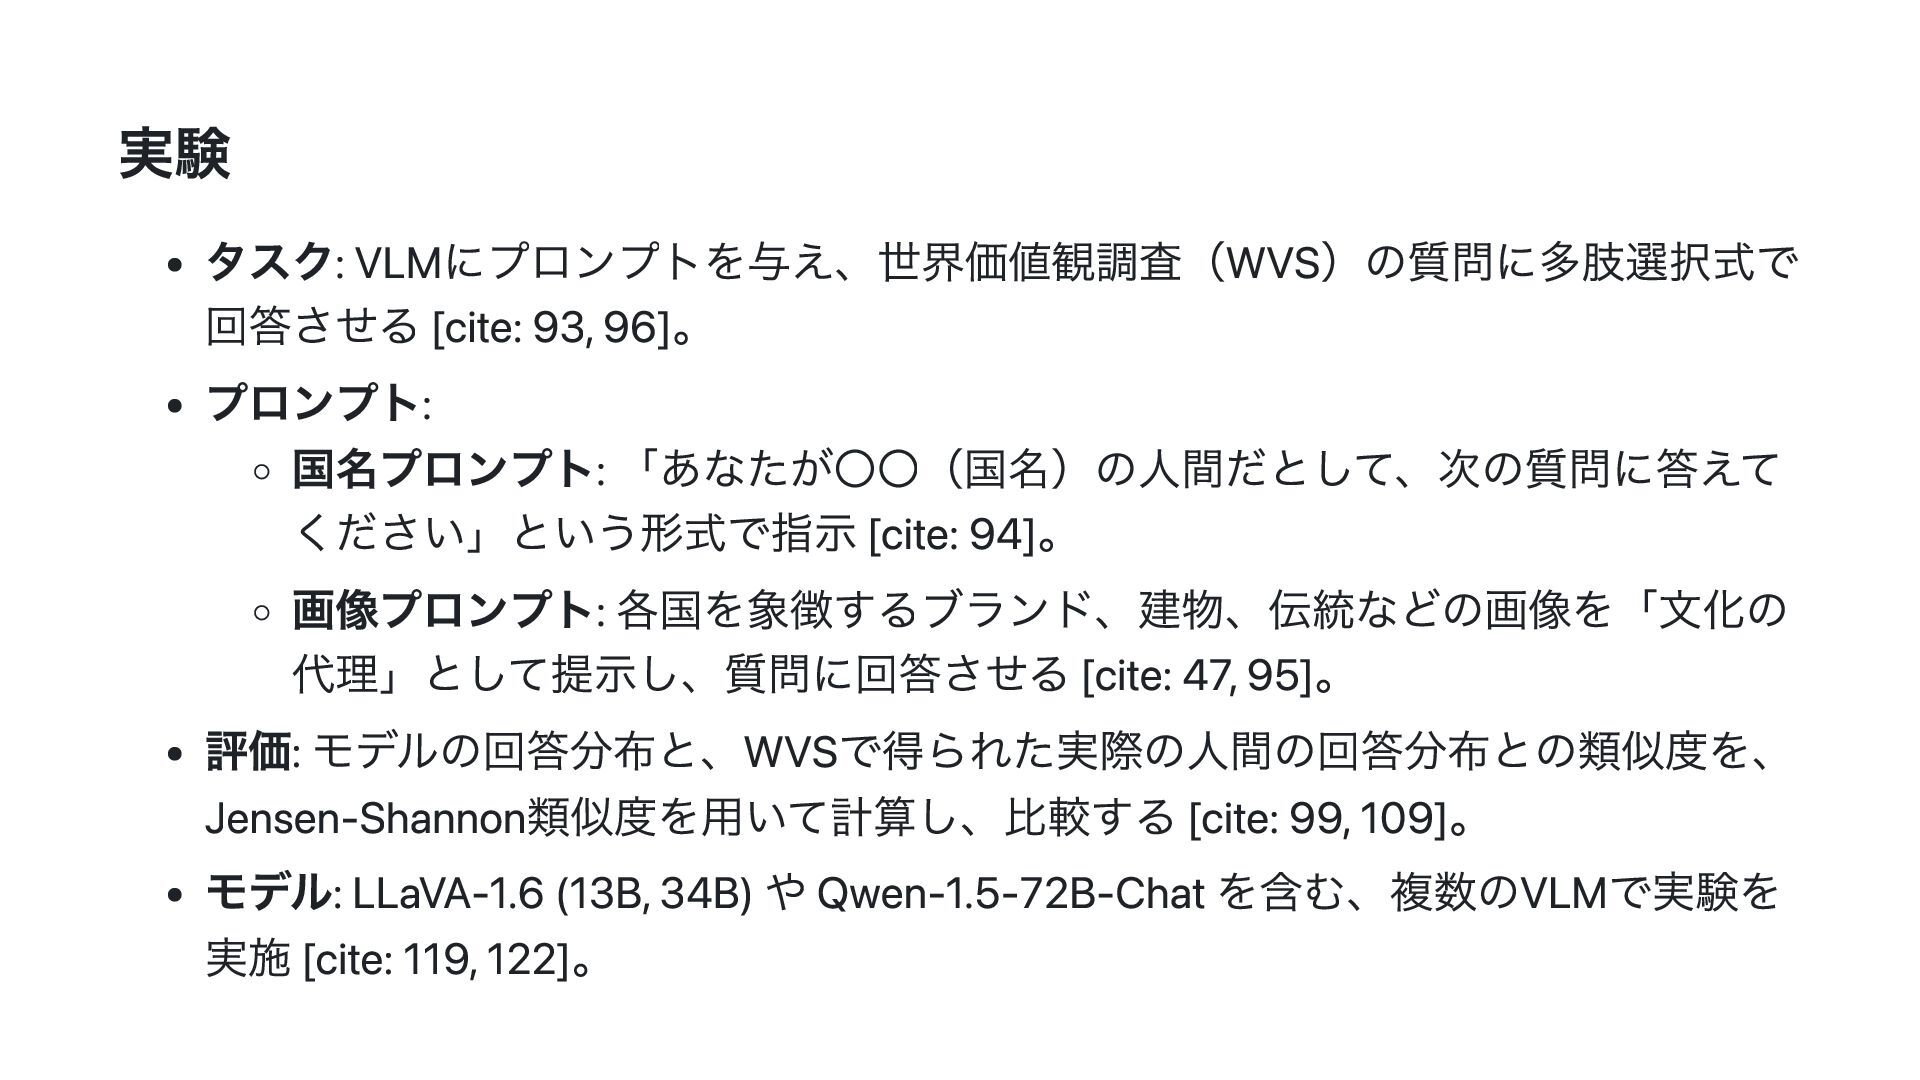
実験 タスク: VLMにプロンプトを与え、世界価値観調査(WVS)の質問に多肢選択式で 回答させる [cite: 93, 96]。 プロンプト: 国名プロンプト: 「あなたが〇〇(国名)の人間だとして、次の質問に答えて
ください」という形式で指示 [cite: 94]。 画像プロンプト: 各国を象徴するブランド、建物、伝統などの画像を「文化の 代理」として提示し、質問に回答させる [cite: 47, 95]。 評価: モデルの回答分布と、WVSで得られた実際の人間の回答分布との類似度を、 Jensen-Shannon類似度を用いて計算し、比較する [cite: 99, 109]。 モデル: LLaVA-1.6 (13B, 34B) や Qwen-1.5-72B-Chat を含む、複数のVLMで実験を 実施 [cite: 119, 122]。
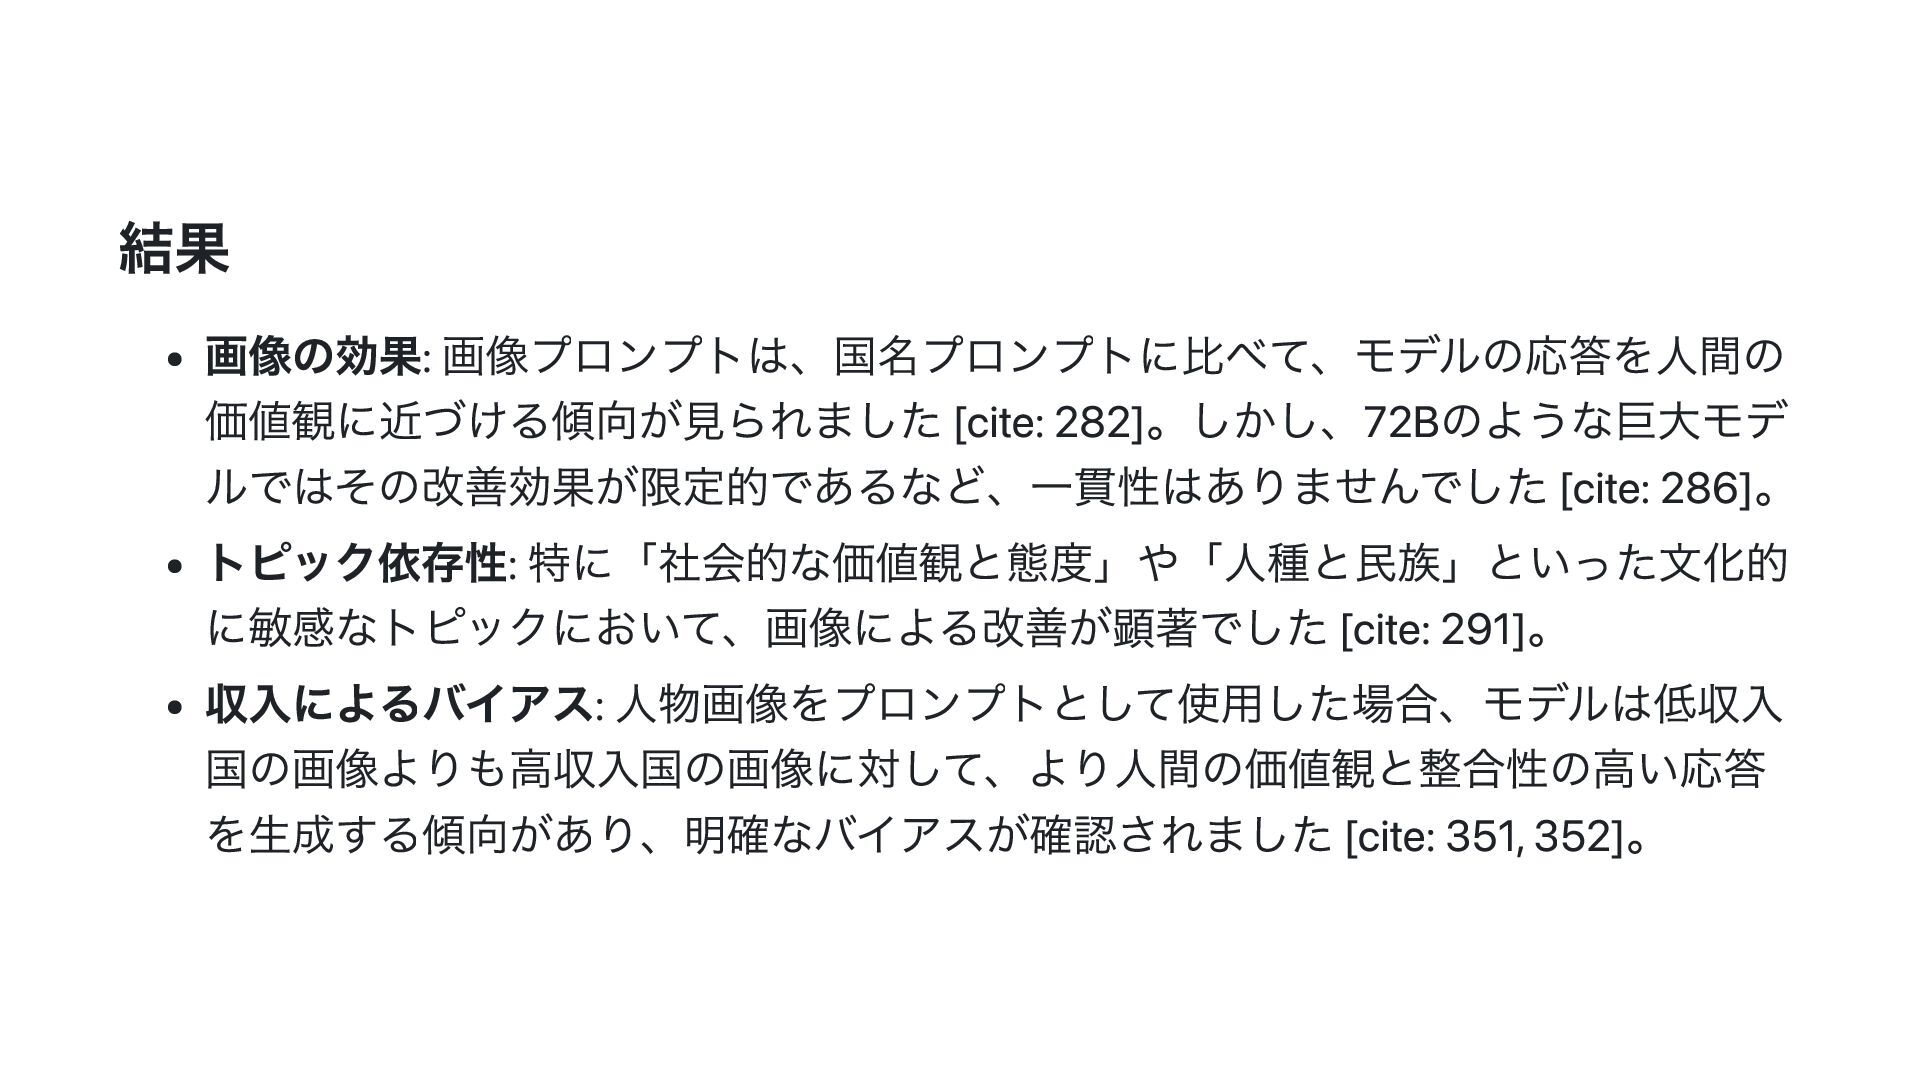
結果 画像の効果: 画像プロンプトは、国名プロンプトに比べて、モデルの応答を人間の 価値観に近づける傾向が見られました [cite: 282]。しかし、72Bのような巨大モデ ルではその改善効果が限定的であるなど、一貫性はありませんでした [cite: 286]。 トピック依存性:
特に「社会的な価値観と態度」や「人種と民族」といった文化的 に敏感なトピックにおいて、画像による改善が顕著でした [cite: 291]。 収入によるバイアス: 人物画像をプロンプトとして使用した場合、モデルは低収入 国の画像よりも高収入国の画像に対して、より人間の価値観と整合性の高い応答 を生成する傾向があり、明確なバイアスが確認されました [cite: 351, 352]。
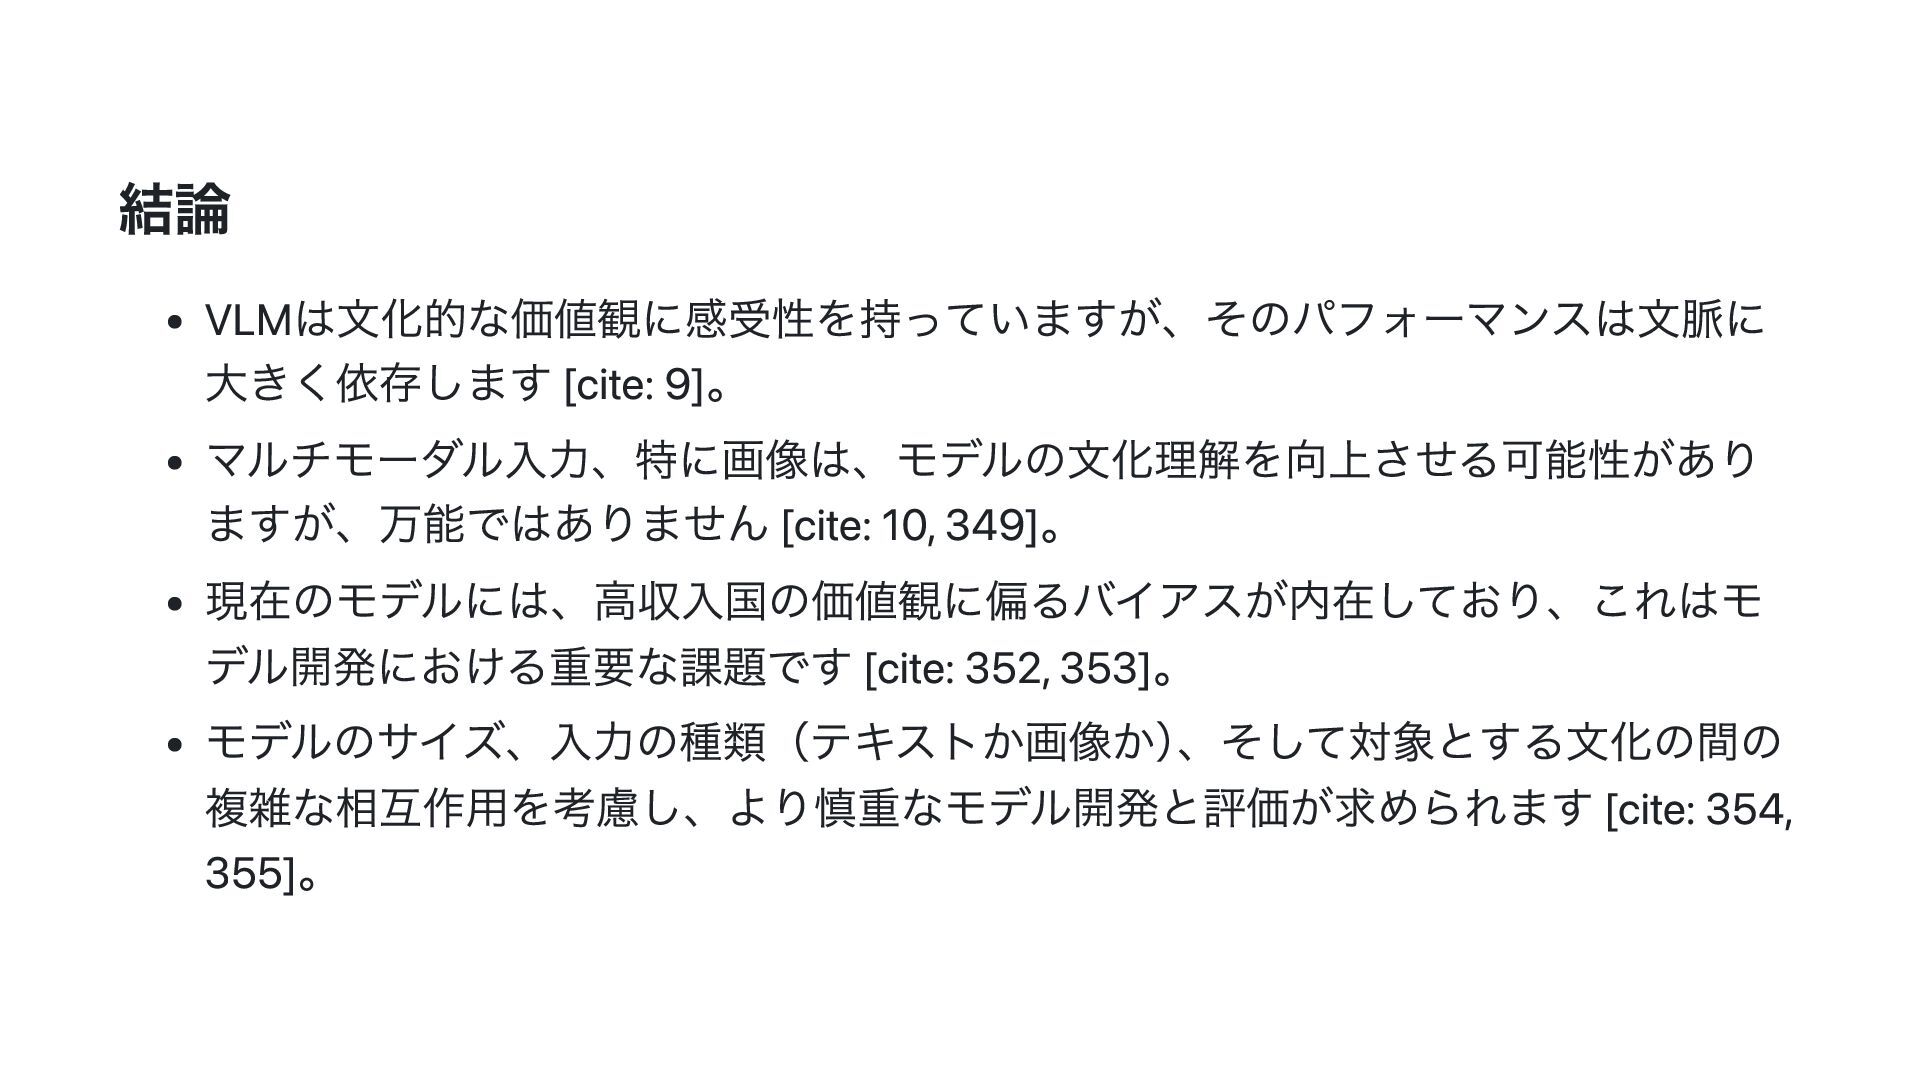
結論 VLMは文化的な価値観に感受性を持っていますが、そのパフォーマンスは文脈に 大きく依存します [cite: 9]。 マルチモーダル入力、特に画像は、モデルの文化理解を向上させる可能性があり ますが、万能ではありません [cite: 10, 349]。
現在のモデルには、高収入国の価値観に偏るバイアスが内在しており、これはモ デル開発における重要な課題です [cite: 352, 353]。 モデルのサイズ、入力の種類(テキストか画像か) 、そして対象とする文化の間の 複雑な相互作用を考慮し、より慎重なモデル開発と評価が求められます [cite: 354, 355]。


 sachag
 eileencodes
 akihiro_kokubo
 honzajavorek
 reverentgeek
 sarafernandez
 mclloyd
 marktimemedia
 thirion
 jnunemaker
 rasmusluckow