Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
BQにおけるSQLアンチパターンとslot消費削減策
Search
株式会社Curious Vehicle
September 15, 2025
35
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
BQにおけるSQLアンチパターンとslot消費削減策
株式会社Curious Vehicle
September 15, 2025
More Decks by 株式会社Curious Vehicle
See All by 株式会社Curious Vehicle
AI Agent Harness 入門
curicle
0
6
クネビンフレームワークで考える最初の一歩
curicle
0
6
AIガバナンス
curicle
0
7
PQCが変える暗号の世界
curicle
0
49
最近流行ってるClaudeについて
curicle
0
17
ElasticsearchのHA構成について
curicle
0
27
機械学習で絶対音感になりたかった
curicle
0
20
VibeKanbanについて
curicle
0
16
"バーチャル宮本さん"を作ってみた
curicle
0
15
Featured
See All Featured
4 Signs Your Business is Dying
shpigford
187
23k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
Paper Plane (Part 1)
katiecoart
PRO
2
12k
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.7k
AI Search: Where Are We & What Can We Do About It?
aleyda
0
8.1k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
930
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
640
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
630
Six Lessons from altMBA
skipperchong
29
4.5k
The Art of Delivering Value - GDevCon NA Keynote
reverentgeek
16
2.2k
Transcript
BQにおけるSQLアンチパターンとslot消費削減策 明田川 主
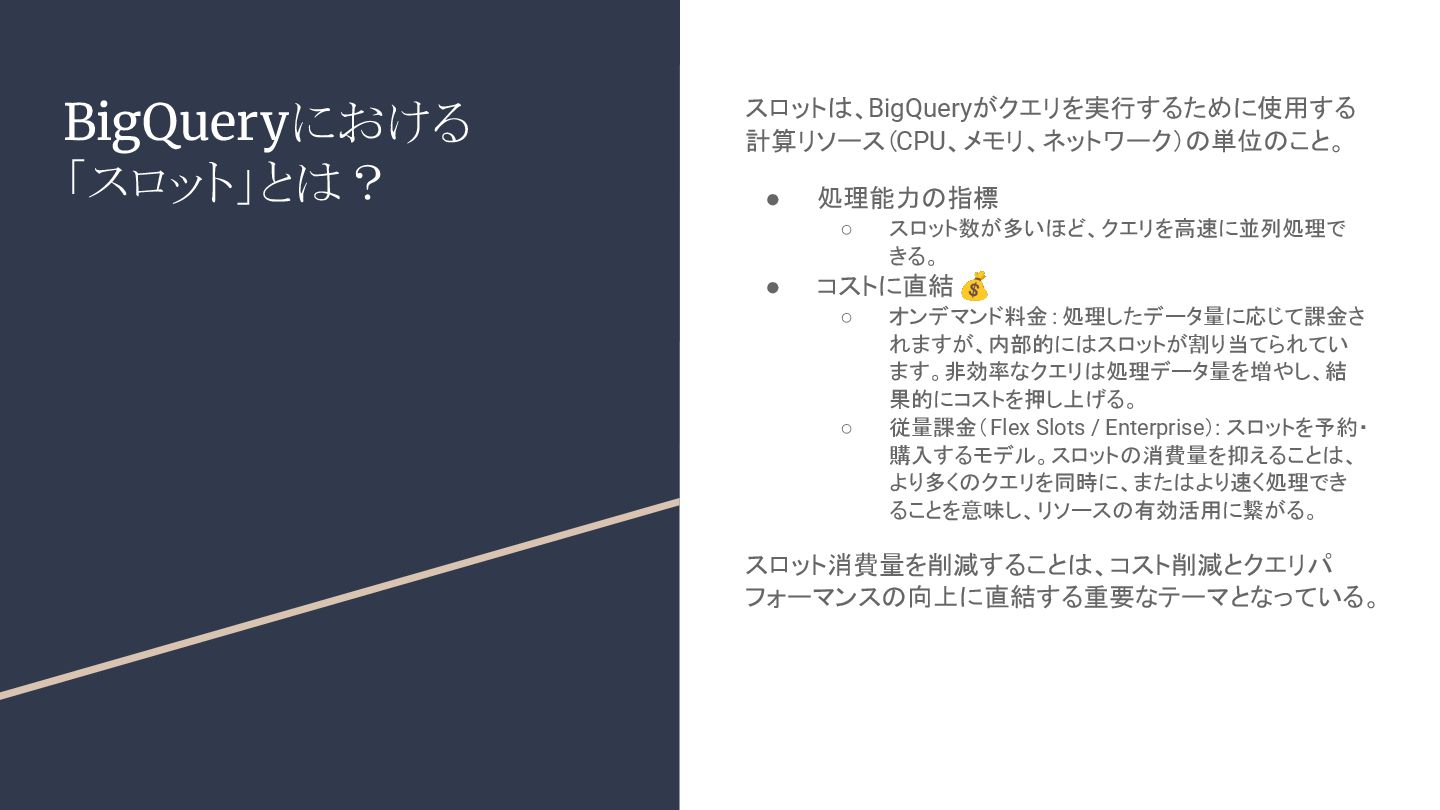
BigQueryにおける 「スロット」とは? スロットは、BigQueryがクエリを実行するために使用する 計算リソース(CPU、メモリ、ネットワーク)の単位のこと。 • 処理能力の指標 ◦ スロット数が多いほど、クエリを高速に並列処理で きる。 •
コストに直結 💰 ◦ オンデマンド料金 : 処理したデータ量に応じて課金さ れますが、内部的にはスロットが割り当てられてい ます。非効率なクエリは処理データ量を増やし、結 果的にコストを押し上げる。 ◦ 従量課金(Flex Slots / Enterprise): スロットを予約・ 購入するモデル。スロットの消費量を抑えることは、 より多くのクエリを同時に、またはより速く処理でき ることを意味し、リソースの有効活用に繋がる。 スロット消費量を削減することは、コスト削減とクエリパ フォーマンスの向上に直結する重要なテーマとなっている。
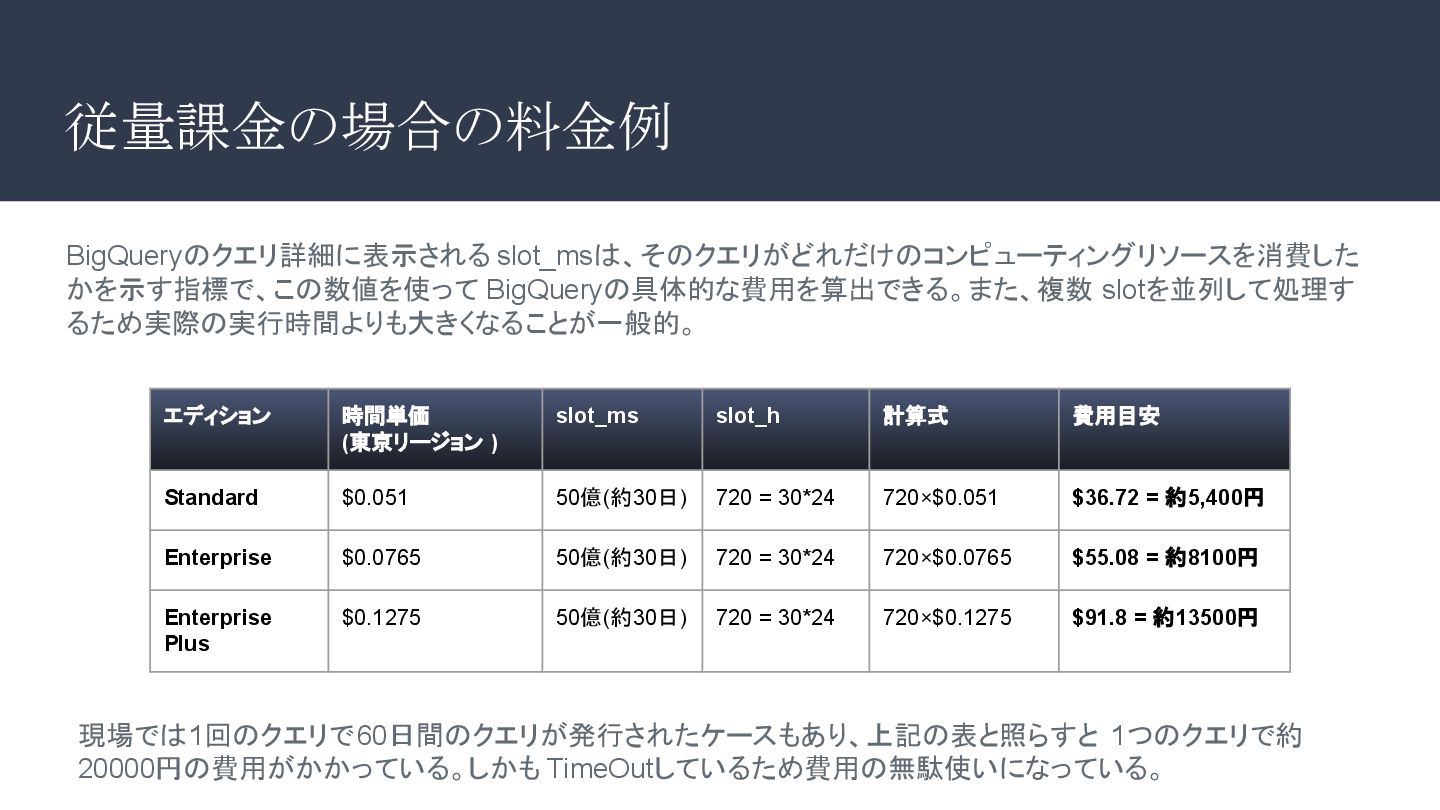
従量課金の場合の料金例 エディション 時間単価 (東京リージョン ) slot_ms slot_h 計算式 費用目安 Standard
$0.051 50億(約30日) 720 = 30*24 720×$0.051 $36.72 = 約5,400円 Enterprise $0.0765 50億(約30日) 720 = 30*24 720×$0.0765 $55.08 = 約8100円 Enterprise Plus $0.1275 50億(約30日) 720 = 30*24 720×$0.1275 $91.8 = 約13500円 BigQueryのクエリ詳細に表示される slot_msは、そのクエリがどれだけのコンピューティングリソースを消費した かを示す指標で、この数値を使って BigQueryの具体的な費用を算出できる。また、複数 slotを並列して処理す るため実際の実行時間よりも大きくなることが一般的。 現場では1回のクエリで60日間のクエリが発行されたケースもあり、上記の表と照らすと 1つのクエリで約 20000円の費用がかかっている。しかも TimeOutしているため費用の無駄使いになっている。
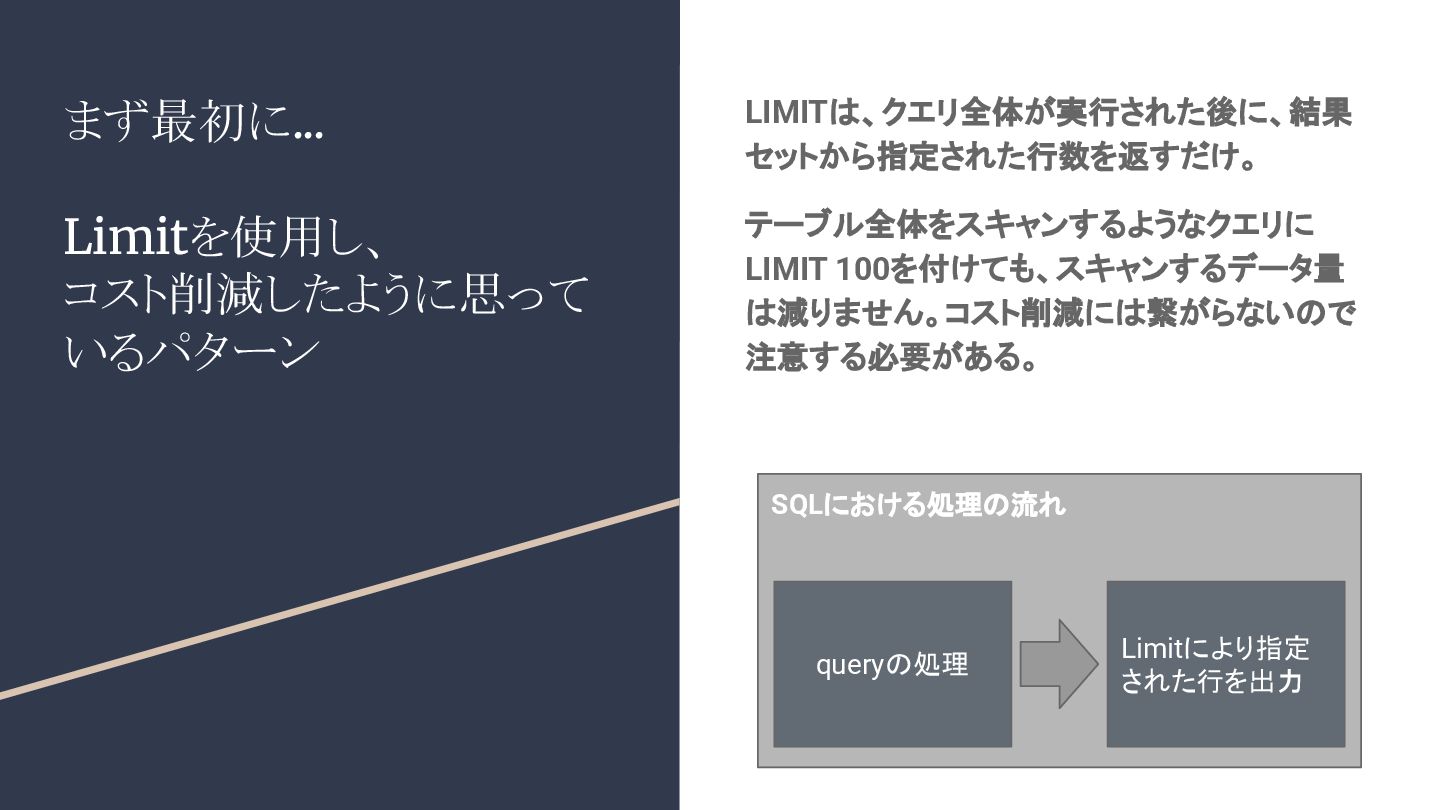
まず最初に... Limitを使用し、 コスト削減したように思って いるパターン LIMITは、クエリ全体が実行された後に、結果 セットから指定された行数を返すだけ。 テーブル全体をスキャンするようなクエリに LIMIT 100を付けても、スキャンするデータ量 は減りません。コスト削減には繋がらないので
注意する必要がある。 SQLにおける処理の流れ queryの処理 Limitにより指定 された行を出力
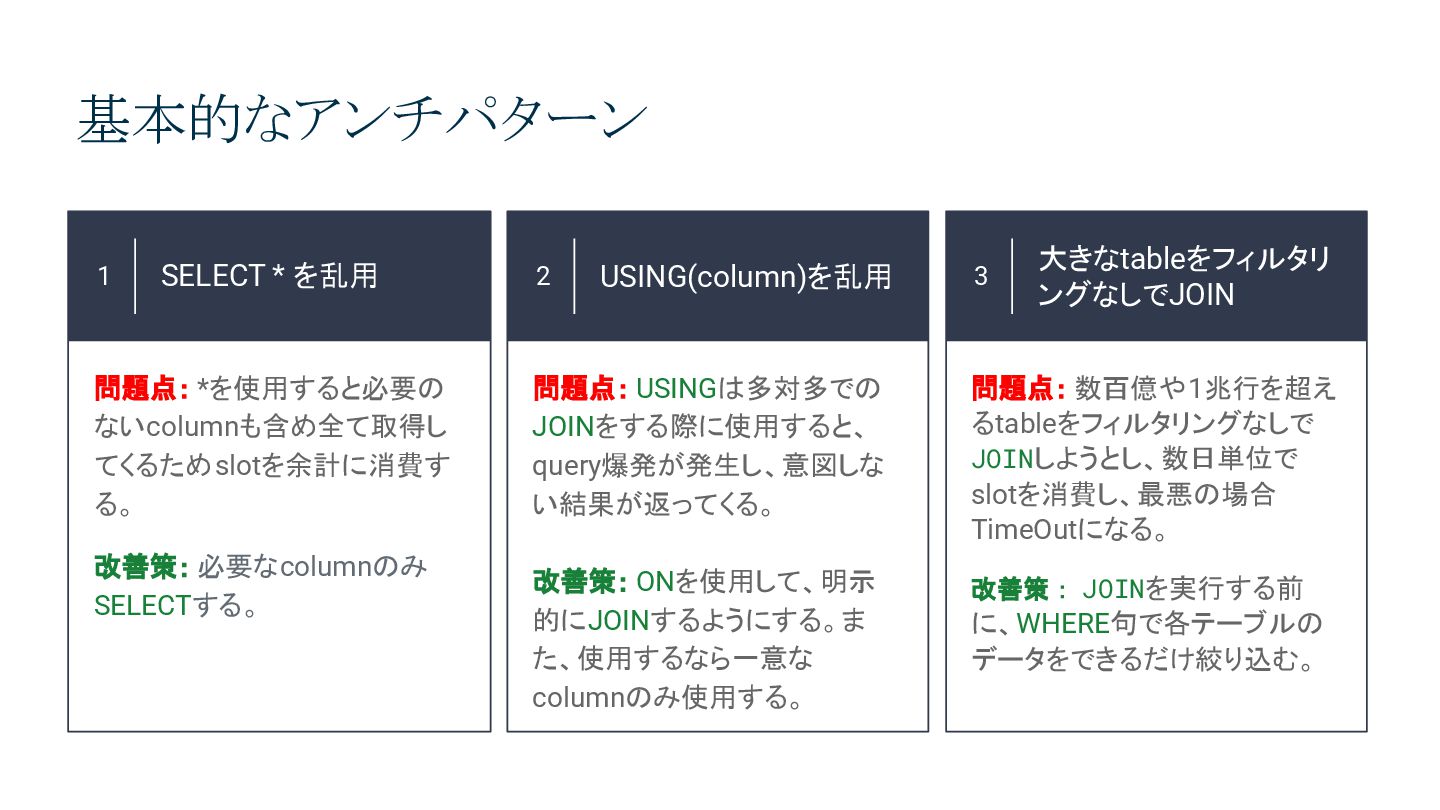
基本的なアンチパターン 1 SELECT * を乱用 問題点: *を使用すると必要の ないcolumnも含め全て取得し てくるためslotを余計に消費す る。
改善策: 必要なcolumnのみ SELECTする。 2 USING(column)を乱用 問題点: USINGは多対多での JOINをする際に使用すると、 query爆発が発生し、意図しな い結果が返ってくる。 改善策: ONを使用して、明示 的にJOINするようにする。ま た、使用するなら一意な columnのみ使用する。 3 大きなtableをフィルタリ ングなしでJOIN 問題点: 数百億や1兆行を超え るtableをフィルタリングなしで JOINしようとし、数日単位で slotを消費し、最悪の場合 TimeOutになる。 改善策: JOINを実行する前 に、WHERE句で各テーブルの データをできるだけ絞り込む。
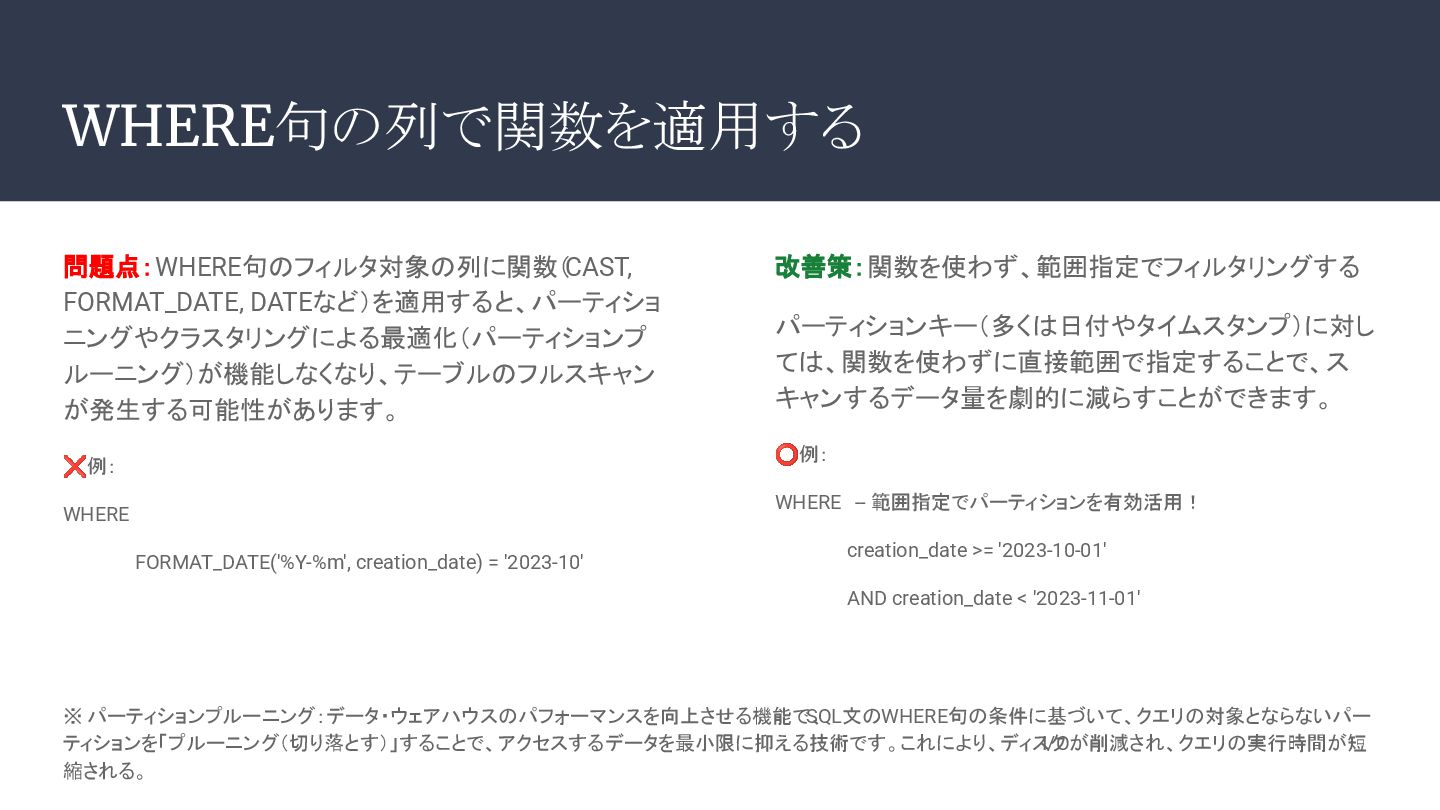
WHERE句の列で関数を適用する 問題点:WHERE句のフィルタ対象の列に関数( CAST, FORMAT_DATE, DATEなど)を適用すると、パーティショ ニングやクラスタリングによる最適化(パーティションプ ルーニング)が機能しなくなり、テーブルのフルスキャン が発生する可能性があります。 ❌例: WHERE
FORMAT_DATE('%Y-%m', creation_date) = '2023-10' 改善策:関数を使わず、範囲指定でフィルタリングする パーティションキー(多くは日付やタイムスタンプ)に対し ては、関数を使わずに直接範囲で指定することで、ス キャンするデータ量を劇的に減らすことができます。 ⭕例: WHERE -- 範囲指定でパーティションを有効活用! creation_date >= '2023-10-01' AND creation_date < '2023-11-01' ※ パーティションプルーニング:データ・ウェアハウスのパフォーマンスを向上させる機能で、 SQL文のWHERE句の条件に基づいて、クエリの対象とならないパー ティションを「プルーニング(切り落とす)」することで、アクセスするデータを最小限に抑える技術です。これにより、ディスク I/Oが削減され、クエリの実行時間が短 縮される。
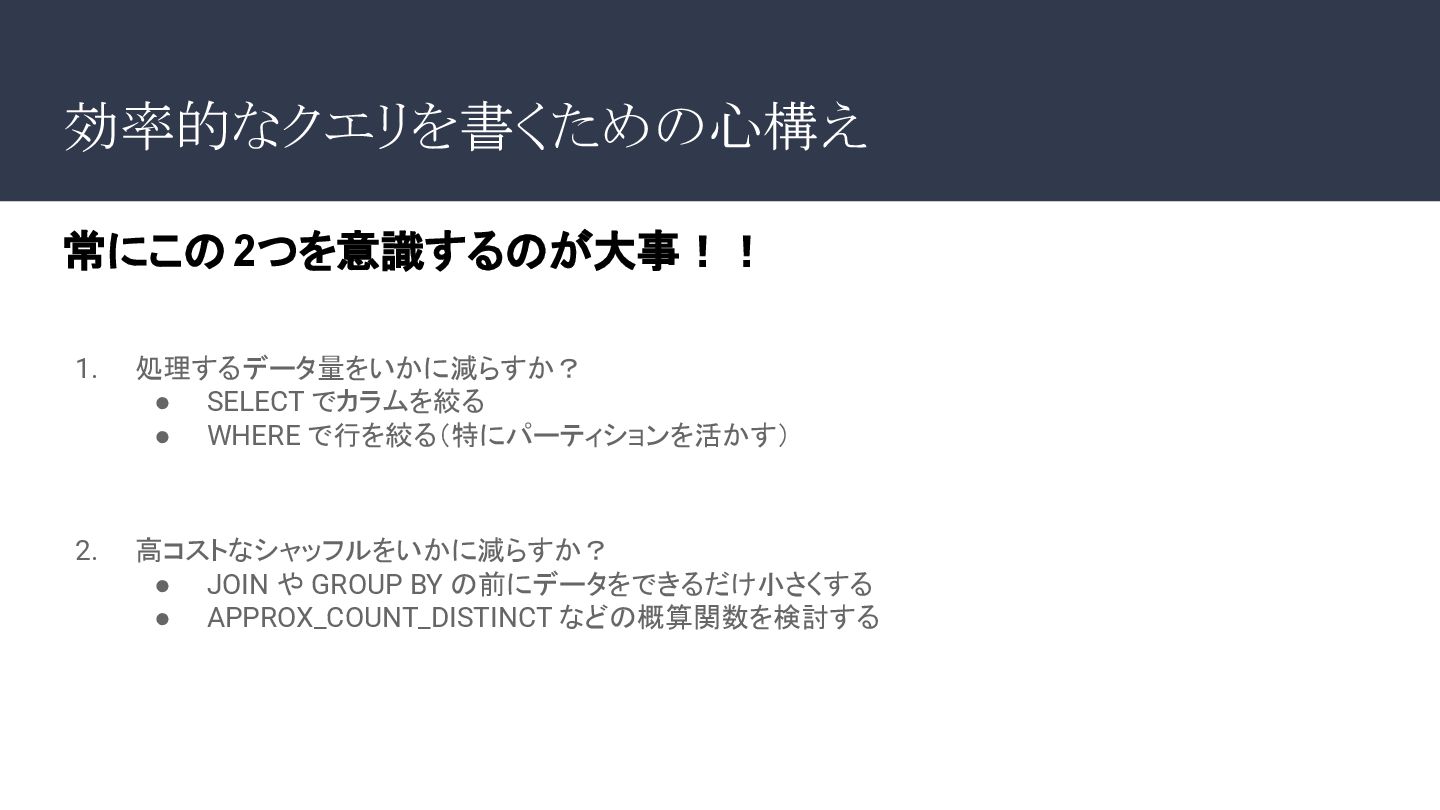
効率的なクエリを書くための心構え 1. 処理するデータ量をいかに減らすか? • SELECT でカラムを絞る • WHERE で行を絞る(特にパーティションを活かす) 2.
高コストなシャッフルをいかに減らすか? • JOIN や GROUP BY の前にデータをできるだけ小さくする • APPROX_COUNT_DISTINCT などの概算関数を検討する 常にこの2つを意識するのが大事!!
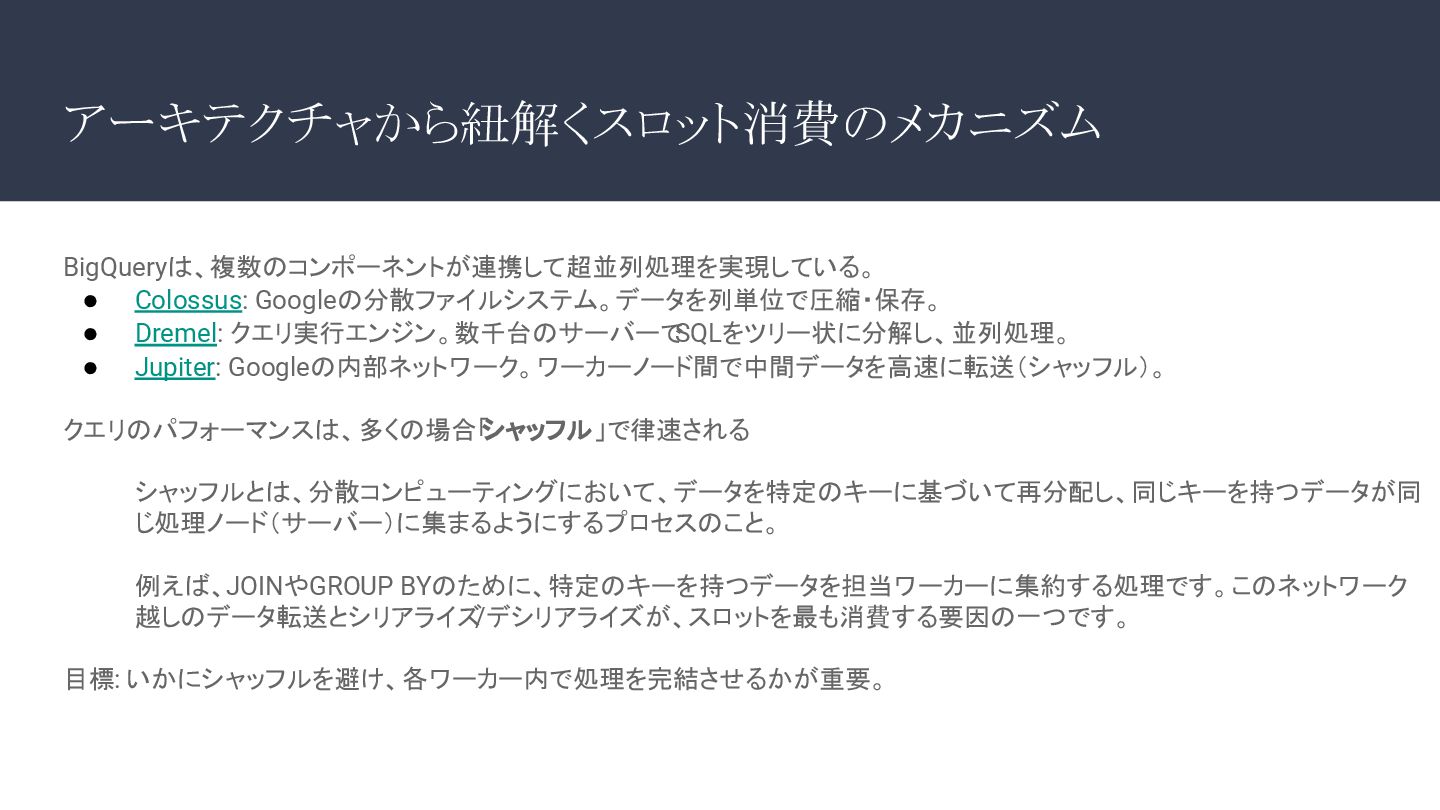
アーキテクチャから紐解くスロット消費のメカニズム BigQueryは、複数のコンポーネントが連携して超並列処理を実現している。 • Colossus: Googleの分散ファイルシステム。データを列単位で圧縮・保存。 • Dremel: クエリ実行エンジン。数千台のサーバーで SQLをツリー状に分解し、並列処理。 •
Jupiter: Googleの内部ネットワーク。ワーカーノード間で中間データを高速に転送(シャッフル)。 クエリのパフォーマンスは、多くの場合「 シャッフル」で律速される シャッフルとは、分散コンピューティングにおいて、データを特定のキーに基づいて再分配し、同じキーを持つデータが同 じ処理ノード(サーバー)に集まるようにするプロセスのこと。 例えば、JOINやGROUP BYのために、特定のキーを持つデータを担当ワーカーに集約する処理です。このネットワーク 越しのデータ転送とシリアライズ /デシリアライズが、スロットを最も消費する要因の一つです。 目標: いかにシャッフルを避け、各ワーカー内で処理を完結させるかが重要。
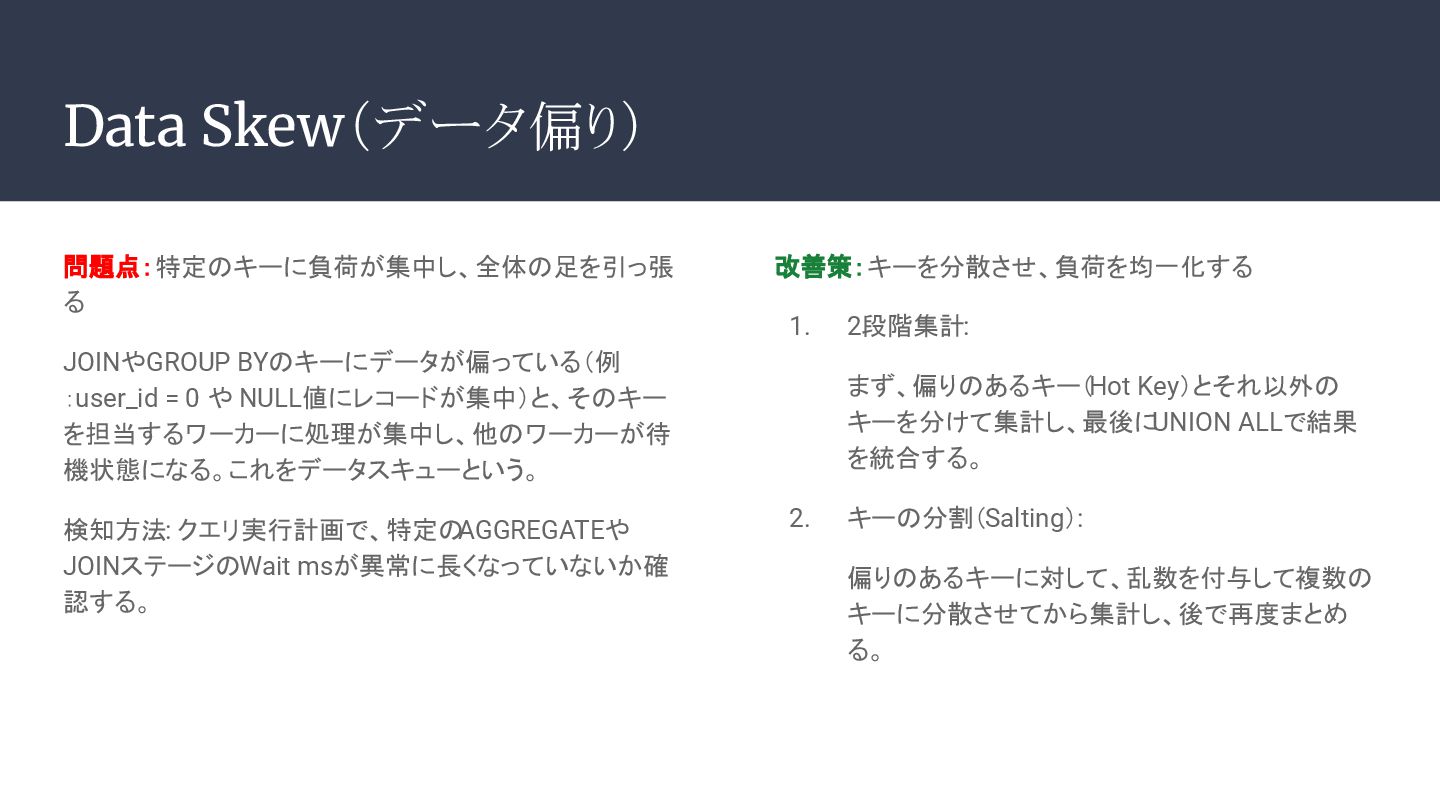
Data Skew(データ偏り) 問題点:特定のキーに負荷が集中し、全体の足を引っ張 る JOINやGROUP BYのキーにデータが偏っている(例 :user_id = 0 や
NULL値にレコードが集中)と、そのキー を担当するワーカーに処理が集中し、他のワーカーが待 機状態になる。これをデータスキューという。 検知方法: クエリ実行計画で、特定の AGGREGATEや JOINステージのWait msが異常に長くなっていないか確 認する。 改善策:キーを分散させ、負荷を均一化する 1. 2段階集計: まず、偏りのあるキー(Hot Key)とそれ以外の キーを分けて集計し、最後に UNION ALLで結果 を統合する。 2. キーの分割(Salting): 偏りのあるキーに対して、乱数を付与して複数の キーに分散させてから集計し、後で再度まとめ る。
BigQueryの思想:JOINは高価。可能な限り避けよ 背景:従来のRDBでは正規化が推奨されていたが、分散システムである BigQueryでは非正規化がパフォーマンスの鍵を 握る。 理論と構築方法:STRUCT(構造体)とARRAY(配列)を使い、関連するデータを 1レコード内にネストして保持すること で、 コストの高いJOINを完全に排除できる。 つまり、出したい出力を想定し、そのためにテーブル構造を考え、1テーブルのみで処理が完結するようにテーブル設計を する必要がある。
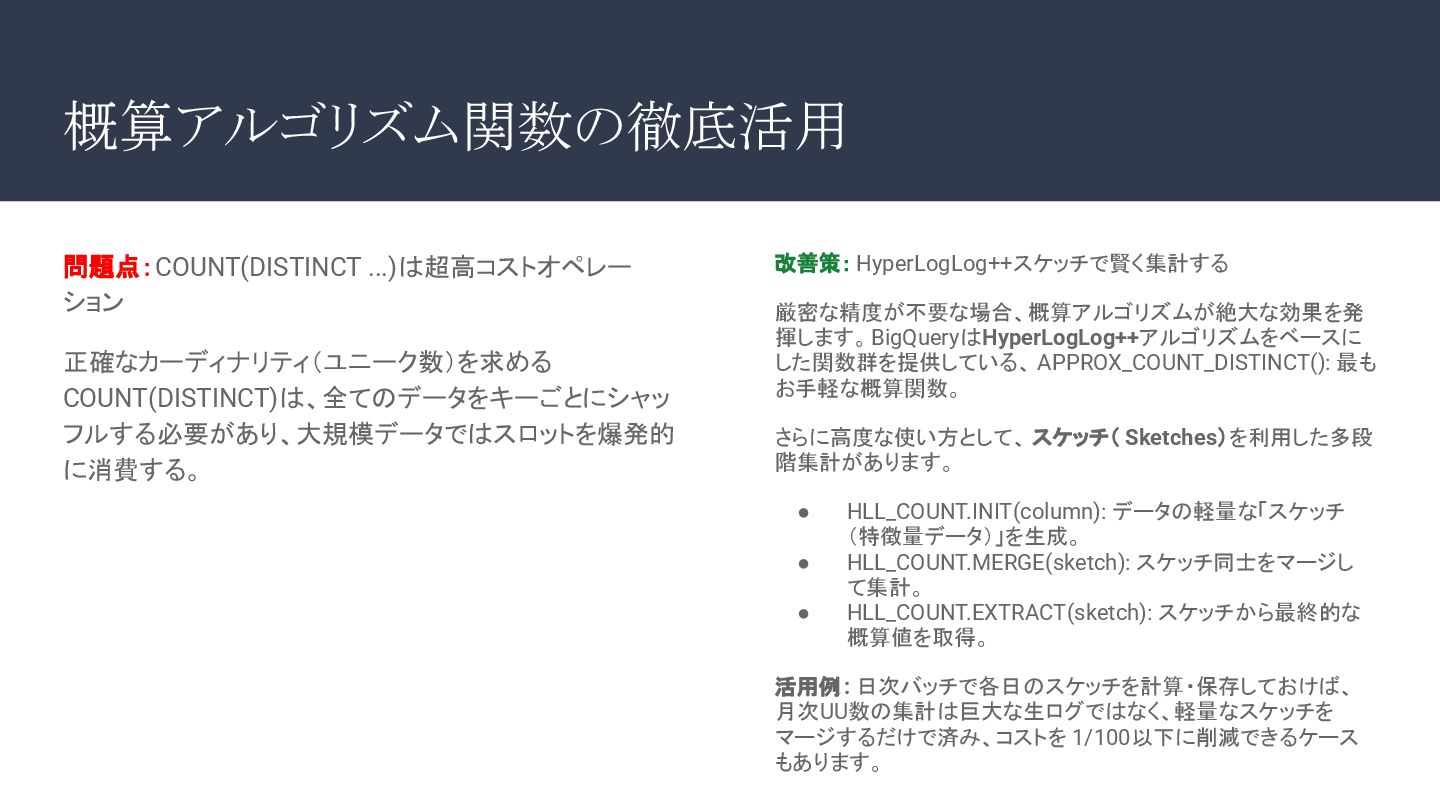
概算アルゴリズム関数の徹底活用 問題点:COUNT(DISTINCT ...)は超高コストオペレー ション 正確なカーディナリティ(ユニーク数)を求める COUNT(DISTINCT)は、全てのデータをキーごとにシャッ フルする必要があり、大規模データではスロットを爆発的 に消費する。 改善策: HyperLogLog++スケッチで賢く集計する
厳密な精度が不要な場合、概算アルゴリズムが絶大な効果を発 揮します。BigQueryはHyperLogLog++アルゴリズムをベースに した関数群を提供している、 APPROX_COUNT_DISTINCT(): 最も お手軽な概算関数。 さらに高度な使い方として、 スケッチ( Sketches)を利用した多段 階集計があります。 • HLL_COUNT.INIT(column): データの軽量な「スケッチ (特徴量データ)」を生成。 • HLL_COUNT.MERGE(sketch): スケッチ同士をマージし て集計。 • HLL_COUNT.EXTRACT(sketch): スケッチから最終的な 概算値を取得。 活用例: 日次バッチで各日のスケッチを計算・保存しておけば、 月次UU数の集計は巨大な生ログではなく、軽量なスケッチを マージするだけで済み、コストを 1/100以下に削減できるケース もあります。
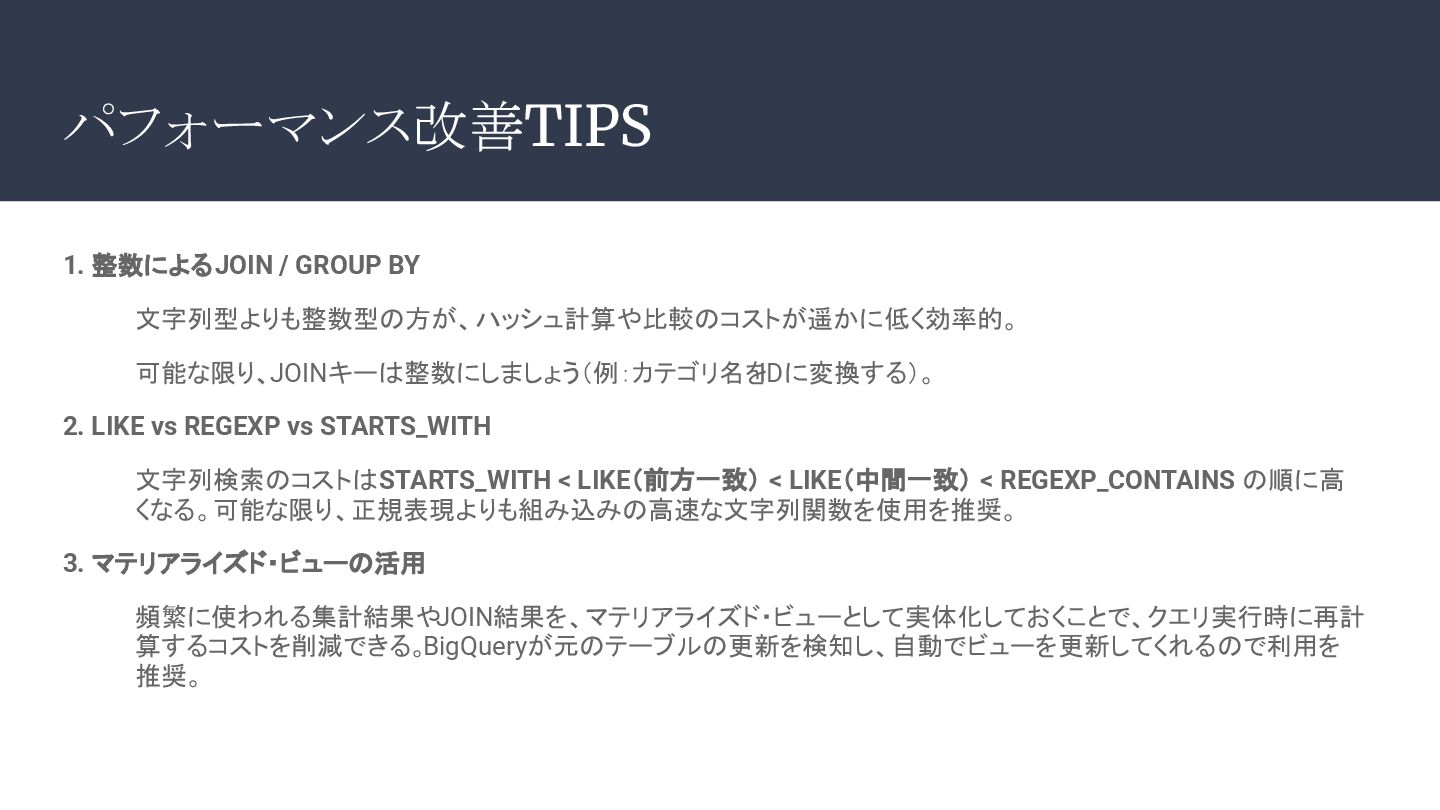
パフォーマンス改善TIPS 1. 整数によるJOIN / GROUP BY 文字列型よりも整数型の方が、ハッシュ計算や比較のコストが遥かに低く効率的。 可能な限り、JOINキーは整数にしましょう(例:カテゴリ名を IDに変換する)。 2.
LIKE vs REGEXP vs STARTS_WITH 文字列検索のコストは STARTS_WITH < LIKE(前方一致) < LIKE(中間一致) < REGEXP_CONTAINS の順に高 くなる。可能な限り、正規表現よりも組み込みの高速な文字列関数を使用を推奨。 3. マテリアライズド・ビューの活用 頻繁に使われる集計結果や JOIN結果を、マテリアライズド・ビューとして実体化しておくことで、クエリ実行時に再計 算するコストを削減できる。 BigQueryが元のテーブルの更新を検知し、自動でビューを更新してくれるので利用を 推奨。


 curicle
 shpigford
 lindahogenes
 aleyda
 katiecoart
 addyosmani
 tammyeverts
 katarinadahlin
 reverentgeek
 konakalab
 skipperchong