Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
GPT_LangChain_LlamaIndexを活用しDB作業の生産性10倍を考える
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
神谷築
June 12, 2023
Programming
230
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
GPT_LangChain_LlamaIndexを活用しDB作業の生産性10倍を考える
LangChainとLhamaIndexの簡易解説
ツールを利用しているpythonプログラムの解説
デモ(いい感じに完成していたら紹介します。。。w)
神谷築
June 12, 2023
More Decks by 神谷築
See All by 神谷築
Backlogで開発プロセスを可視化した話
eg_kamiya
0
210
GPTを使って行ったプレスリリースまでのプロセス
eg_kamiya
0
180
Other Decks in Programming
See All in Programming
コードで差別化できない時代の ソフトウェアエンジニアリング / Software Engineering in an Era Where Code Doesn’t Differentiate
kishida
2
180
npm との違いを手がかりにGo の依存管理を理解したい
optim
0
810
[ハンズオン]AIへの指示だけで「五目並べ」を作ってみよう
satoshi256kbyte
1
380
當我們開始不讀 Code - AI Agent 時代,Code Review 與 Clean Code 還剩下什麼?
jame2408
1
260
見えないものを探る要求要件定義に必要な基本的思考 / invisible-requirement-thinking
minodriven
15
8.5k
Apple Intelligence を用いた個人情報誤送信防止、及びユーザーリクエスト体験の改善について
yukiny
0
350
気持ちぃ〜角丸 Squircle
ryu1013
0
320
AIに “答え“を書かせるのを やめてみた
___akari11
0
120
SalesForceを内製化!? ~ HR事業を支える顧客管理基盤のインフラを大公開 ~
oku053
0
180
AI時代のコードレビューは人に向けるな、仕組みに向けろ
texmeijin
5
3.7k
Simple Storage Service(S3) is not simple
iwatsukayura
0
290
現場と育てるRailsモデリング 〜Spreadsheetから始めたモデル設計〜
siroemk
2
630
Featured
See All Featured
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
Future Trends and Review - Lecture 12 - Web Technologies (1019888BNR)
signer
PRO
0
3.8k
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.7k
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Optimising Largest Contentful Paint
csswizardry
37
4k
Paper Plane (Part 1)
katiecoart
PRO
2
12k
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Understanding Cognitive Biases in Performance Measurement
bluesmoon
32
3.1k
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
320
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
Producing Creativity
orderedlist
PRO
348
41k
Transcript
GPT/LangChain/LlamaIndexを活用しDB 作業の生産性10倍を考える GPT Okinawa
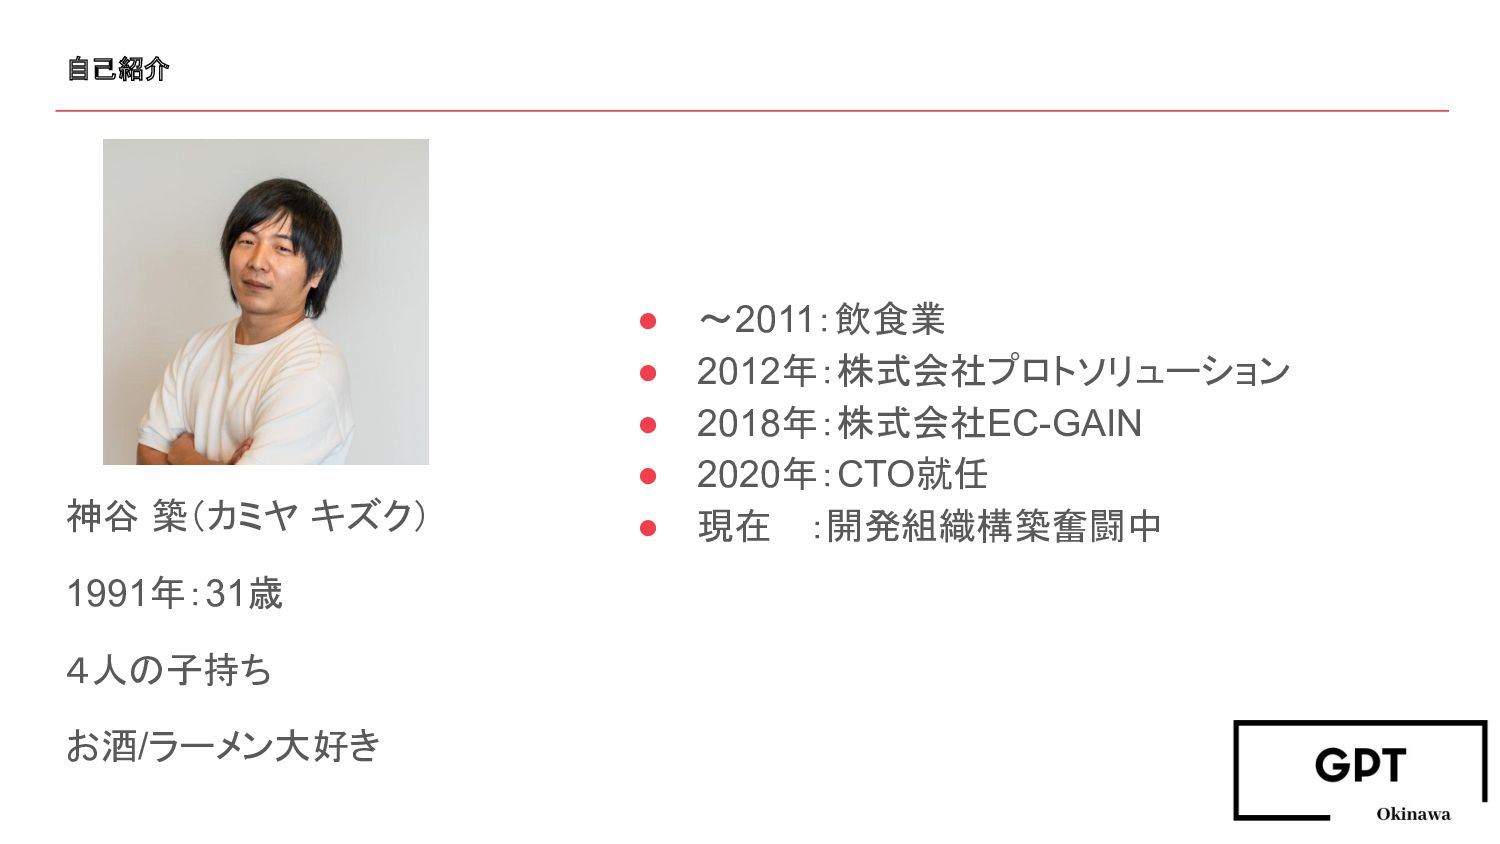
自己紹介 • 〜2011:飲食業 • 2012年:株式会社プロトソリューション • 2018年:株式会社EC-GAIN • 2020年:CTO就任 •
現在 :開発組織構築奮闘中 神谷 築(カミヤ キズク) 1991年:31歳 4人の子持ち お酒/ラーメン大好き
GPT Okinawa Mission GPTを使って開発生産性を10倍にしたい
Slack
今日の流れ - LangChain/LhamaIndex解説 - LT - ディスカッション
GPT の課題 最新情報や独自の情報を持っていない
GPT の課題に対するアプローチ - Fine -tuning - In-Context Learning
Fine-tuning モデル自体にデータを与えて再学習させる方法
In-Context Learning 情報を先に与えておいて、GPTにアプローチする方法
今回の話 In-Context Learning
使うツール LangChain LhamaIndex
LangChainとは LangChainは、GPT-3のような大規模言語モデル( Large Language Model: LLM)を利用してサービスの開発 をしたいときに便利に使えるライブラリです。 例えば、ChatGPT のような AI
とチャットできるサービスを開発する場合を考えます。 OpenAI が提供する GPT-3 の API だけでも非常にシンプルで使いやすいので、 GPT-3 のみを使用した AI チャットサービスを開発 するには LangChain は不要かもしれません。 しかし、例えば、開発したいチャットアプリの要件に、「最新の検 索結果の内容も踏まえて AIに返答をさせたい」といった条件が追加された場合には LangChain が有効です。 LangChain には、「検索エンジンでの検索結果を API で返してくれるサービス」である SerpApi と LLM を組み 合わせる機能があります。 この機能を使うことで、よくある「最新の検索結果の内容も踏まえて AI に返答をさせ たい」という要望を数行のコードで実装できます。 このように、LangChain は LLM を使ってサービスを開発したいときのよくある機能をまとめて提供してくれてい るライブラリです。 引用:https://book.st-hakky.com/docs/langcain-intro/
LangChain要約 GPTを簡単に扱えるようにする 便利なやつ
LhamaIndexとは GPTのようなLLMにプライベートなデータを補強するために、in-context learningという 枠組みがあり、これを行うには データの取り込み インデックス化が必要 ということです。そこで、このデータの取り込み、インデックス化、またそのインデックスを 利用して質問(クエリ)に回答するところまでの機能を一気通貫で提供してくれるのが LlamaIndex、となります。 引用:https://dev.classmethod.jp/articles/llamaindex-overview/
LhamaIndex要約 in-context learning を簡単にできるやつ
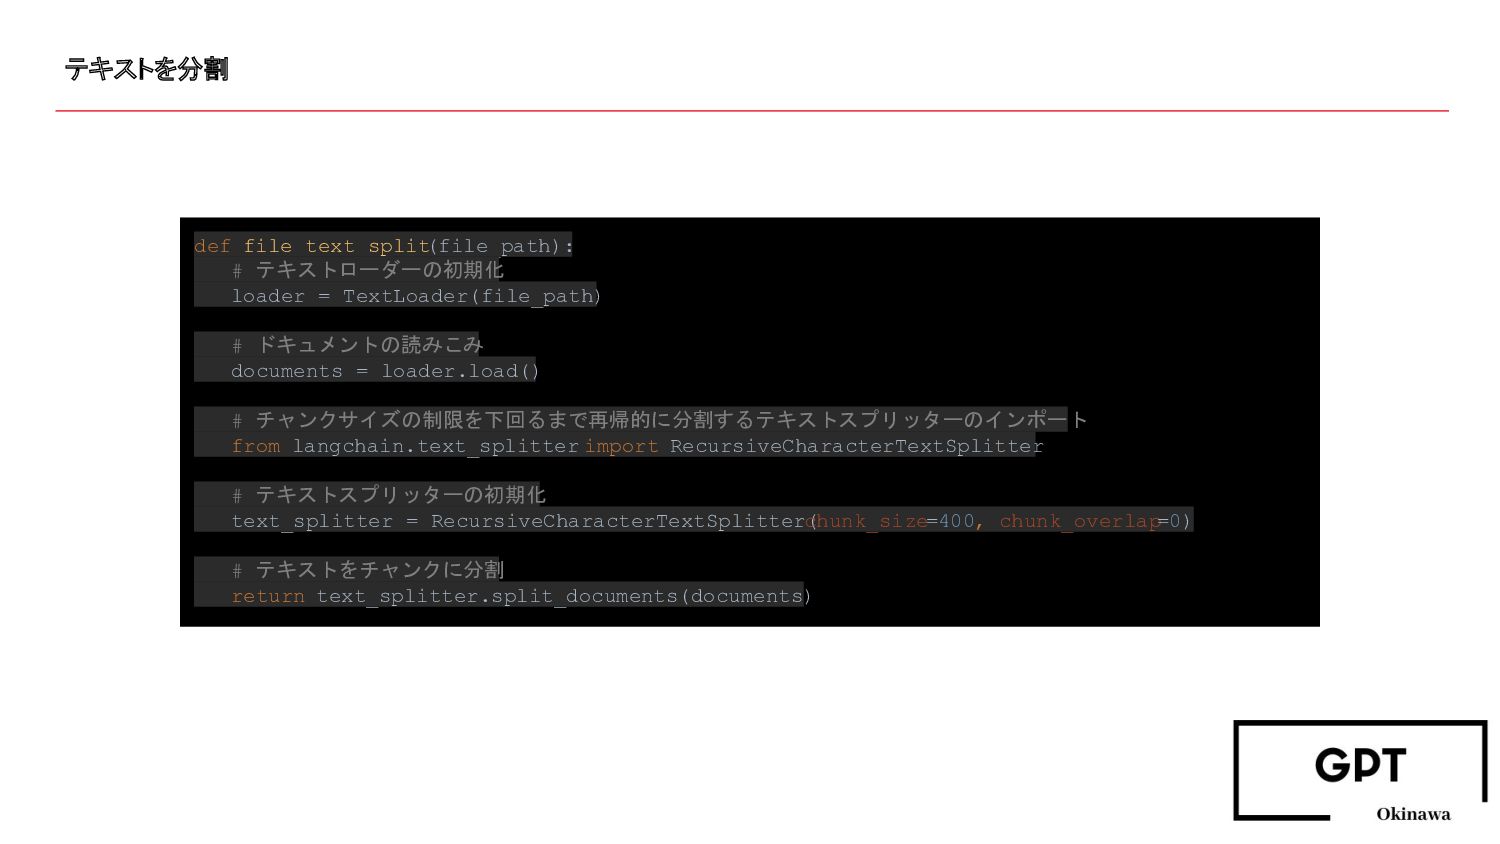
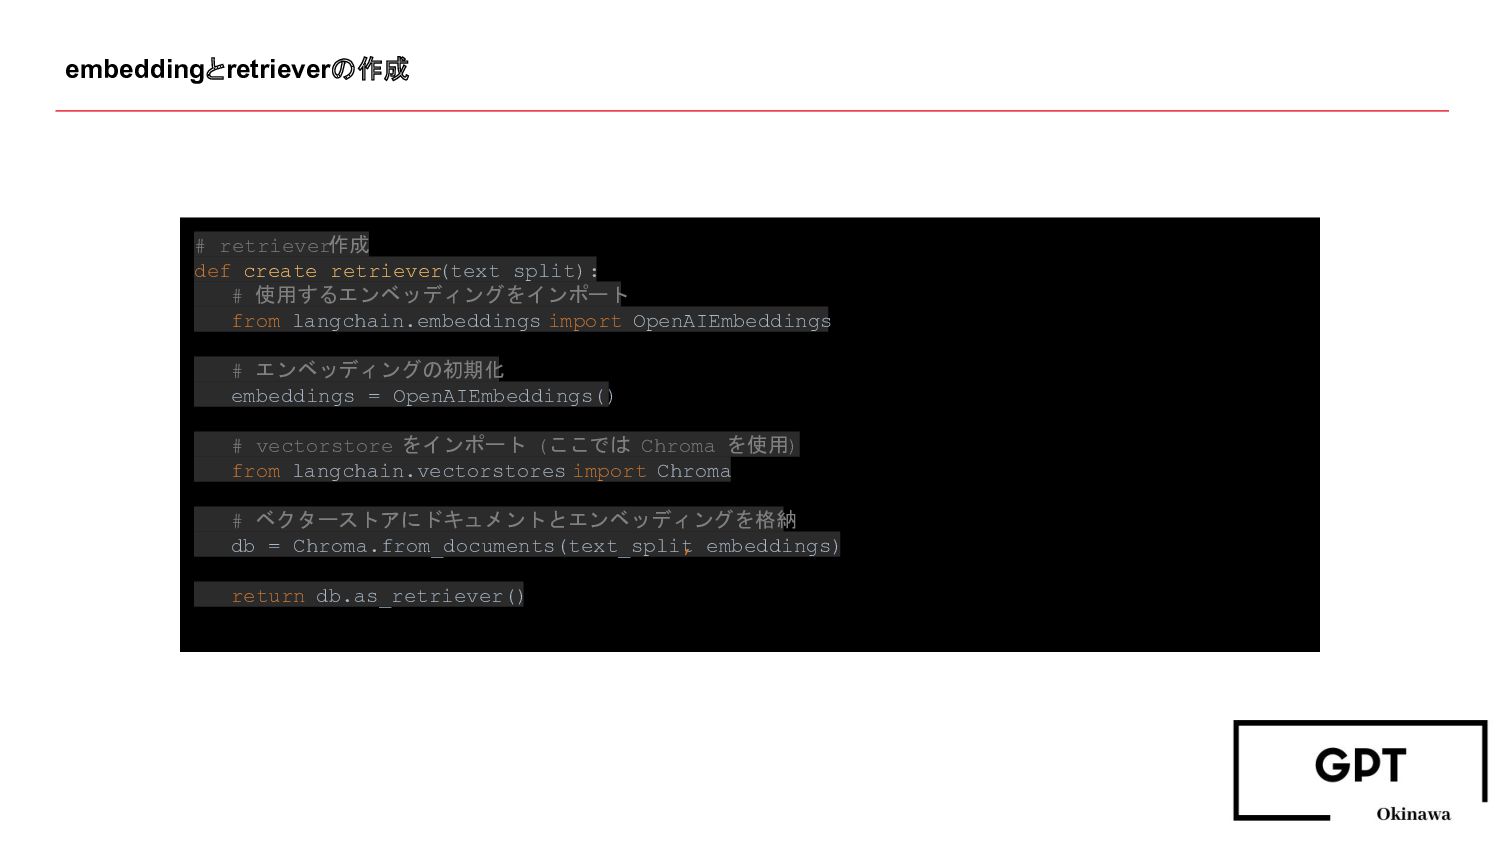
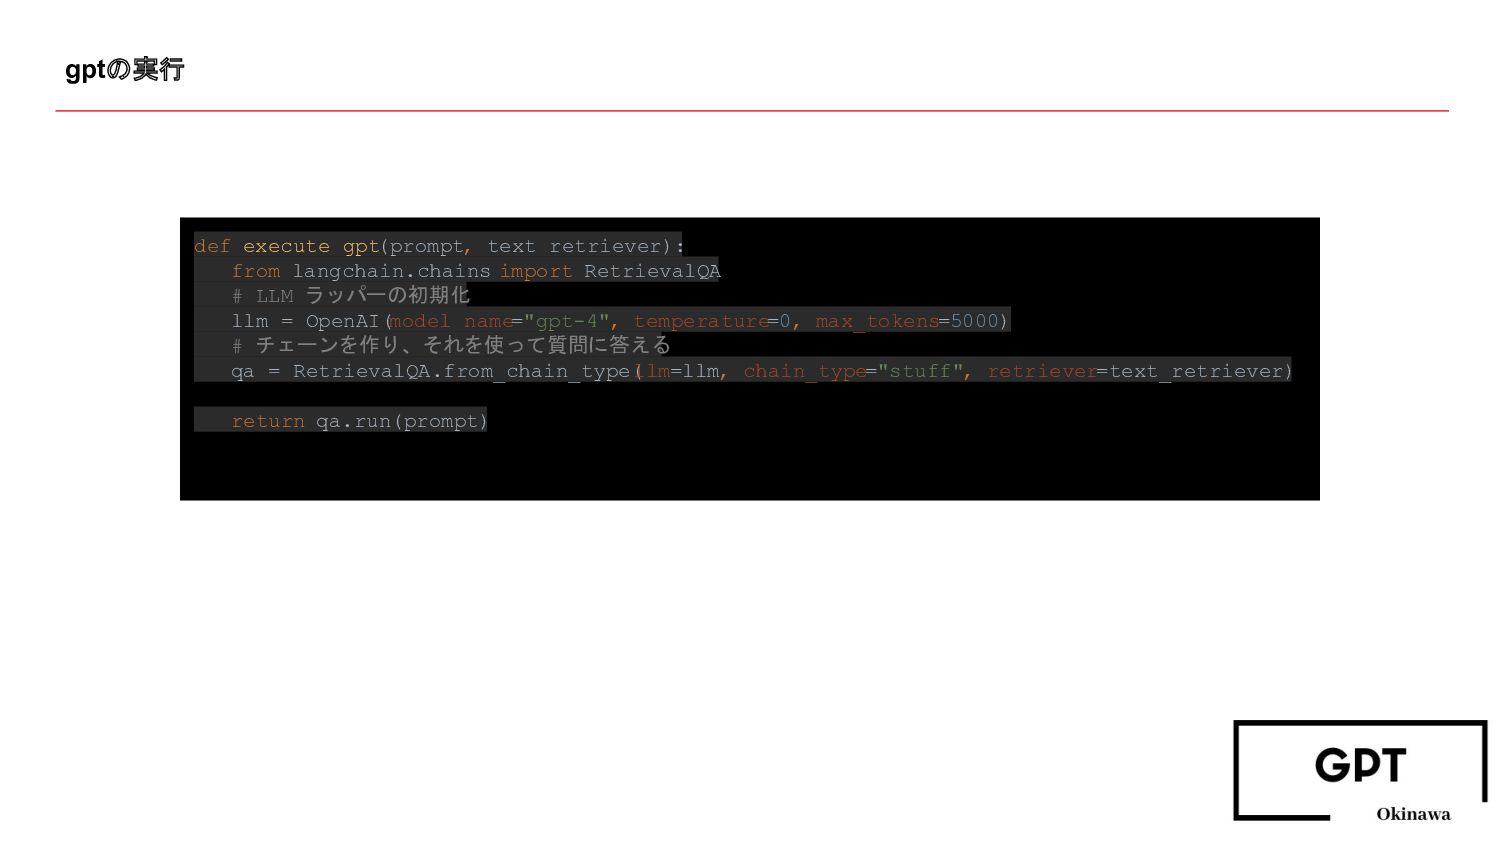
プログラムのステップ - テキストを分割 - embeddingとretrieverの作成 - gptの実行
テキストを分割 def file_text_split (file_path): # テキストローダーの初期化 loader = TextLoader(file_path) #
ドキュメントの読みこみ documents = loader.load() # チャンクサイズの制限を下回るまで再帰的に分割するテキストスプリッターのインポート from langchain.text_splitter import RecursiveCharacterTextSplitter # テキストスプリッターの初期化 text_splitter = RecursiveCharacterTextSplitter( chunk_size=400, chunk_overlap=0) # テキストをチャンクに分割 return text_splitter.split_documents(documents)
embeddingとretrieverの作成 # retriever作成 def create_retriever (text_split): # 使用するエンベッディングをインポート from langchain.embeddings
import OpenAIEmbeddings # エンベッディングの初期化 embeddings = OpenAIEmbeddings() # vectorstore をインポート (ここでは Chroma を使用) from langchain.vectorstores import Chroma # ベクターストアにドキュメントとエンベッディングを格納 db = Chroma.from_documents(text_split , embeddings) return db.as_retriever()
gptの実行 def execute_gpt(prompt, text_retriever): from langchain.chains import RetrievalQA # LLM
ラッパーの初期化 llm = OpenAI(model_name="gpt-4", temperature=0, max_tokens=5000) # チェーンを作り、それを使って質問に答える qa = RetrievalQA.from_chain_type( llm=llm, chain_type="stuff", retriever=text_retriever) return qa.run(prompt)
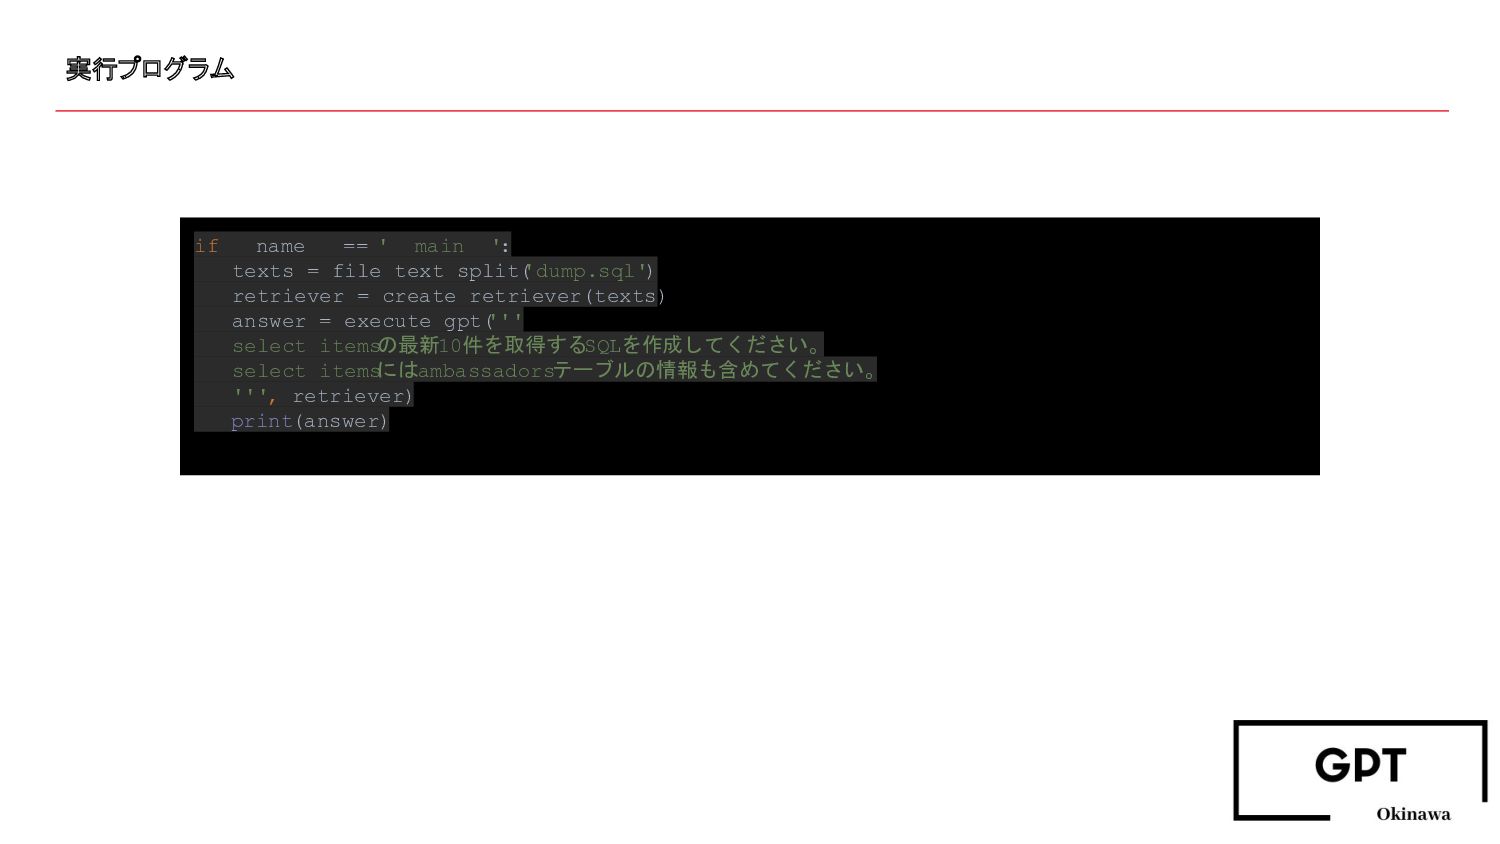
実行プログラム if __name__ == '__main__': texts = file_text_split( 'dump.sql') retriever
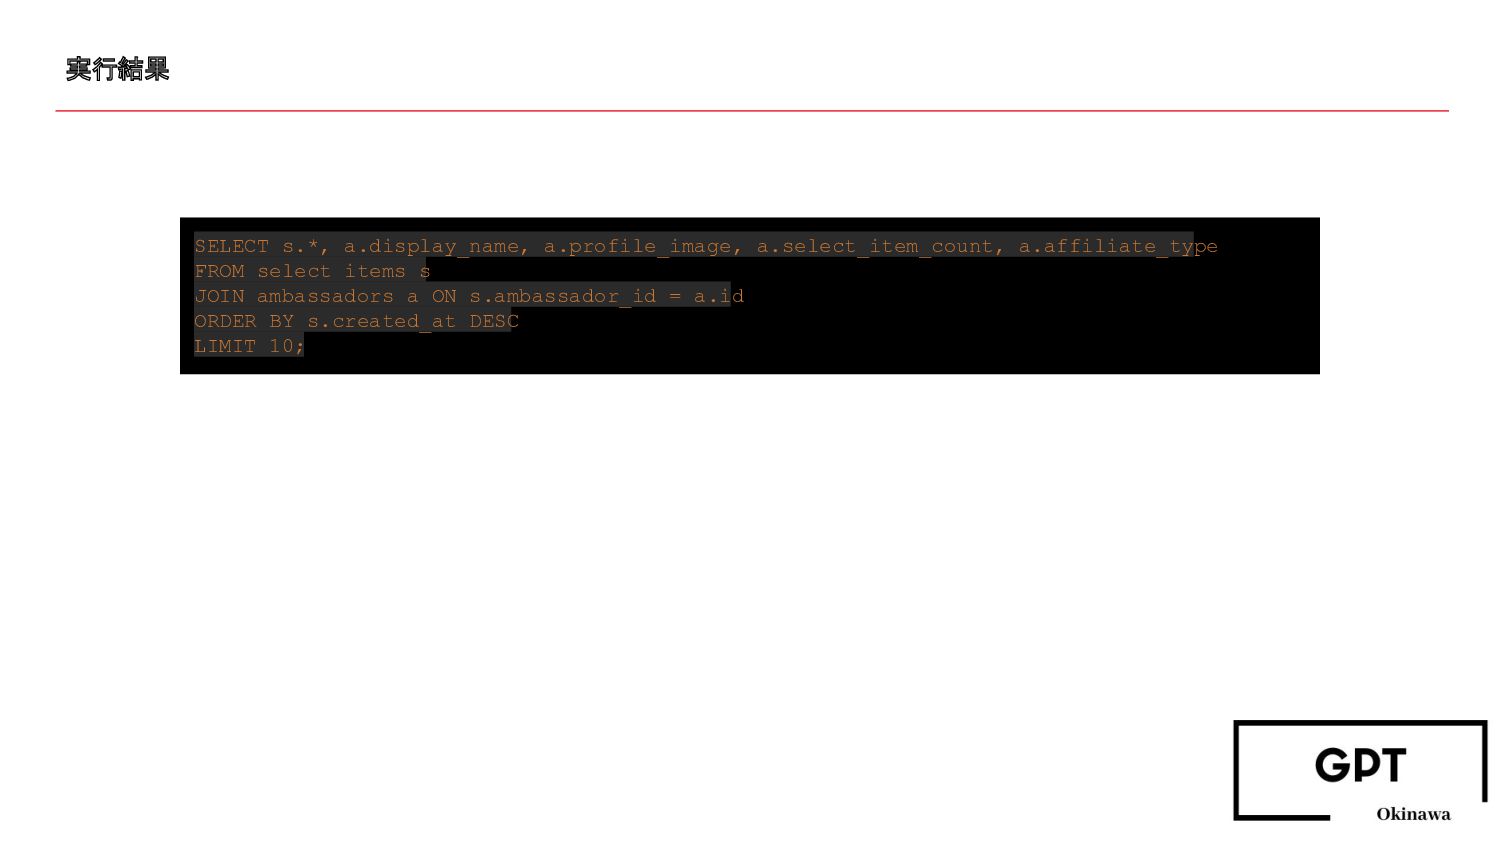
= create_retriever(texts) answer = execute_gpt( ''' select_items の最新10件を取得するSQLを作成してください。 select_items にはambassadorsテーブルの情報も含めてください。 ''', retriever) print(answer)
実行結果 SELECT s.*, a.display_name, a.profile_image, a.select_item_count, a.affiliate_type FROM select_items s
JOIN ambassadors a ON s.ambassador_id = a.id ORDER BY s.created_at DESC LIMIT 10;
感想 おおお!
読み込ませたdump.sql データベースのdumpデータを食わせた。 185,426文字のデータ
テキスト分割について 全てのテキストを一回で処理する事が制限されておりできない。 意味のある単位で、テキストをある程度分割する必要がある。 今回は適当に分割してみた。
embeddingとretrieverについて embeddingとは文字をベクトル表現に変換すること 雑に言うと文字が下記のようにマシンが処理しやすい形で管理されるようになる [0.002369190799072385, -0.004423773847520351] retrieverとは、情報を検索して言語モデルに情報を渡せるやつ。 今回だと、GPTの言語モデルにsql dumpのデータを検索して渡している。 正直、内部の詳細はわかっていない。
まとめ - In-Context Learningの実装は難しくない(テキストデータが必要) - ChatGPTには投げられない量のデータを扱える
最後に でかい独自のテキストデータと GPTを簡単に組み合わせる事ができる 色々な活用方法がありますよね!
以上!


 eg_kamiya
 kishida
 optim
 satoshi256kbyte
 jame2408
 minodriven
 yukiny
 ryu1013
 ___akari11
 oku053
 texmeijin
 iwatsukayura
 siroemk
 hatefulcrawdad
 signer
 addyosmani
 inesmontani
 csswizardry
 katiecoart
 keithpitt
 bluesmoon
 malarkey
 ryanjones
 axbom
 orderedlist