Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ICCV2025論文まとめ: VLMにおけるトークン削減 (KVTP, STTM, METEOR)

Avatar for takami takami
December 15, 2025
220

ICCV2025論文まとめ: VLMにおけるトークン削減 (KVTP, STTM, METEOR)

VLMのトークン削減論文まとめ
・Keyframe-oriented Vision Token Pruning: Enhancing Efficiency of Large Vision Language Models on Long-Form Video Processing
・Multi-Granular Spatio-Temporal Token Merging for Training-Free Acceleration of Video LLMs
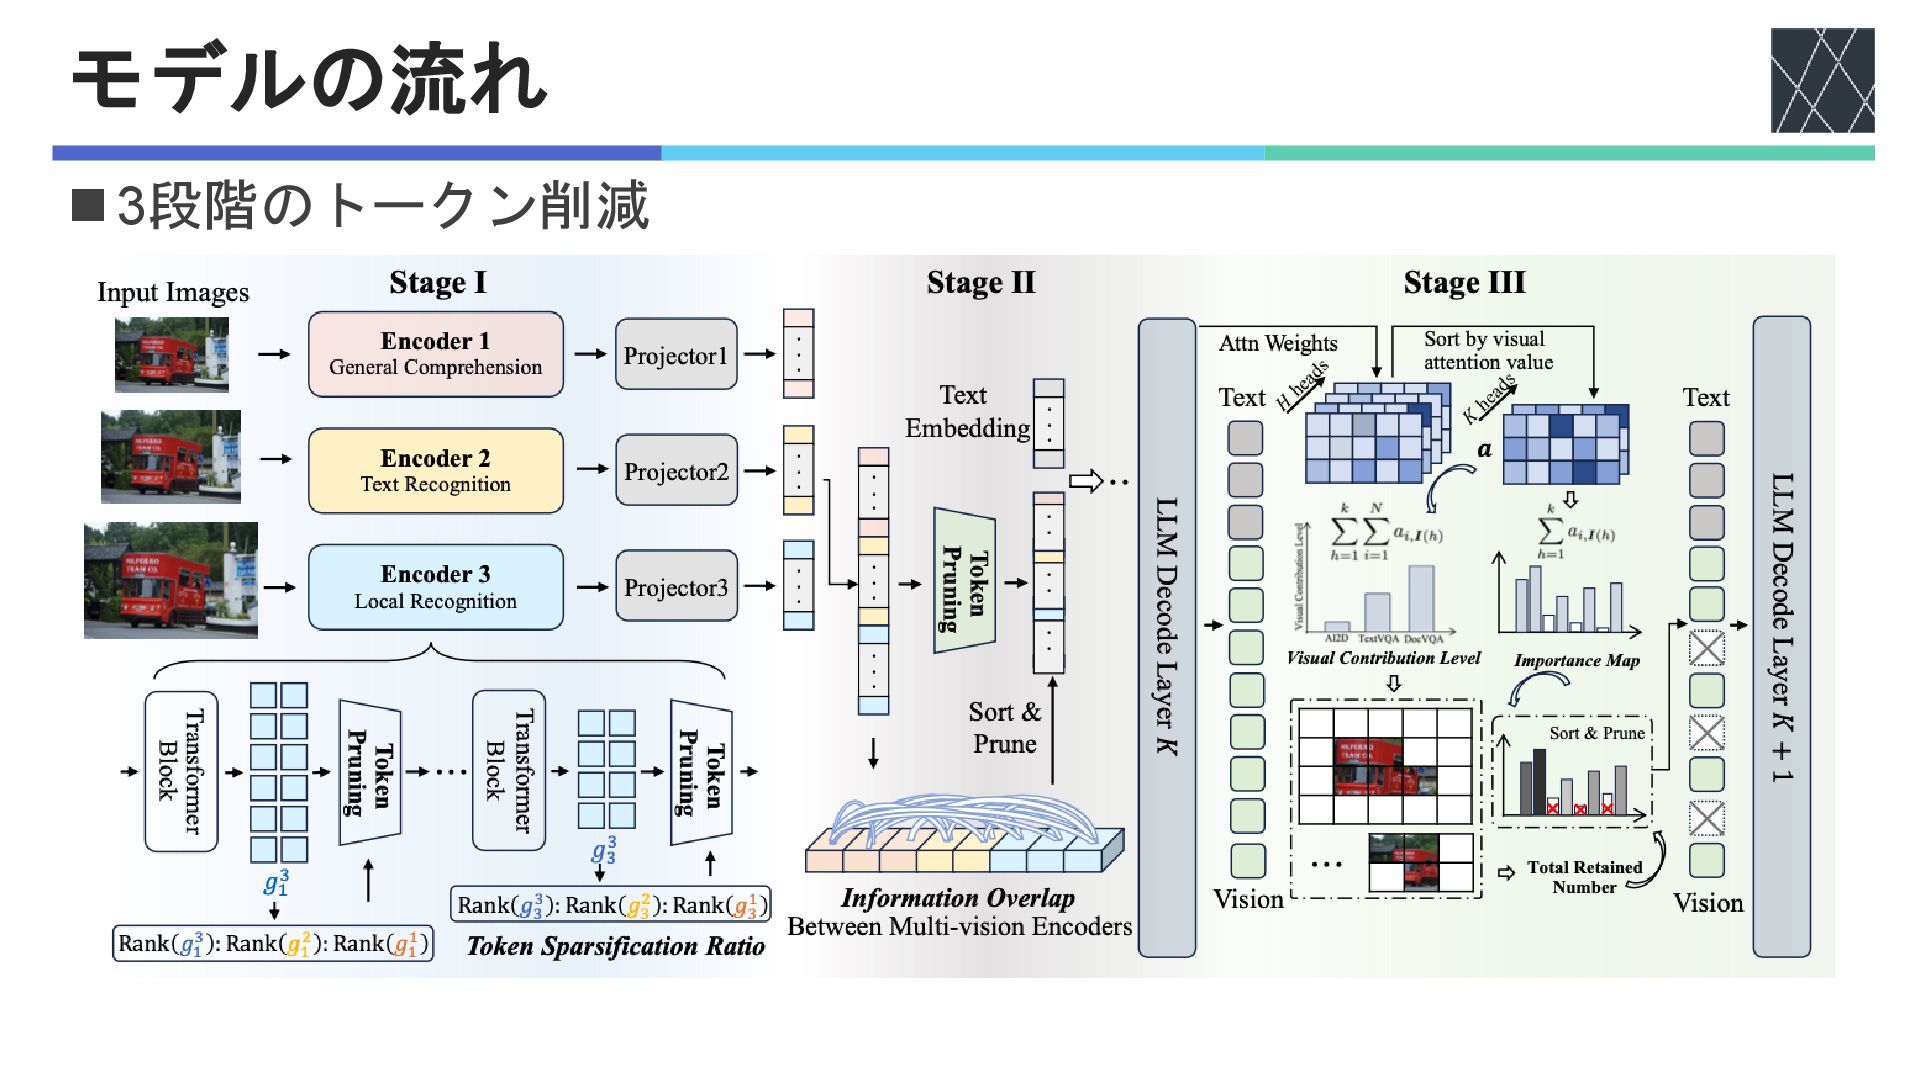
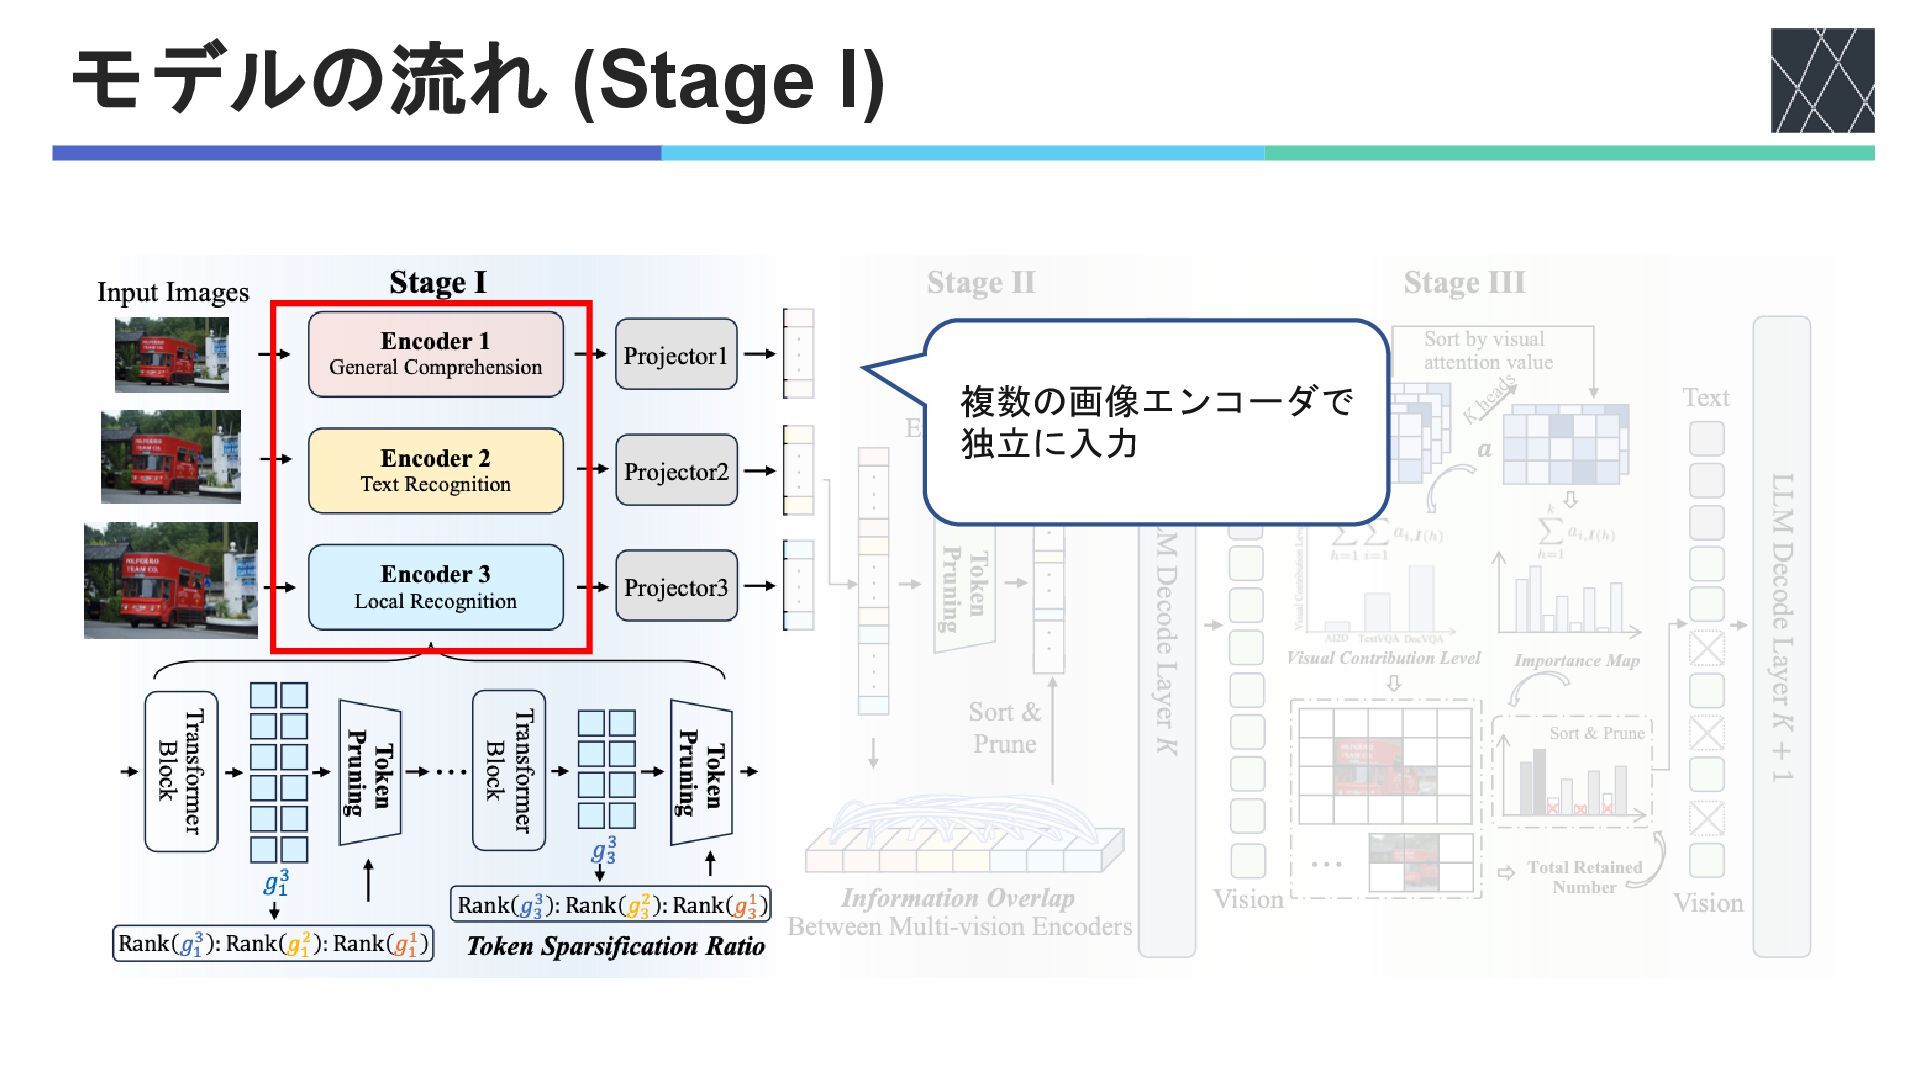
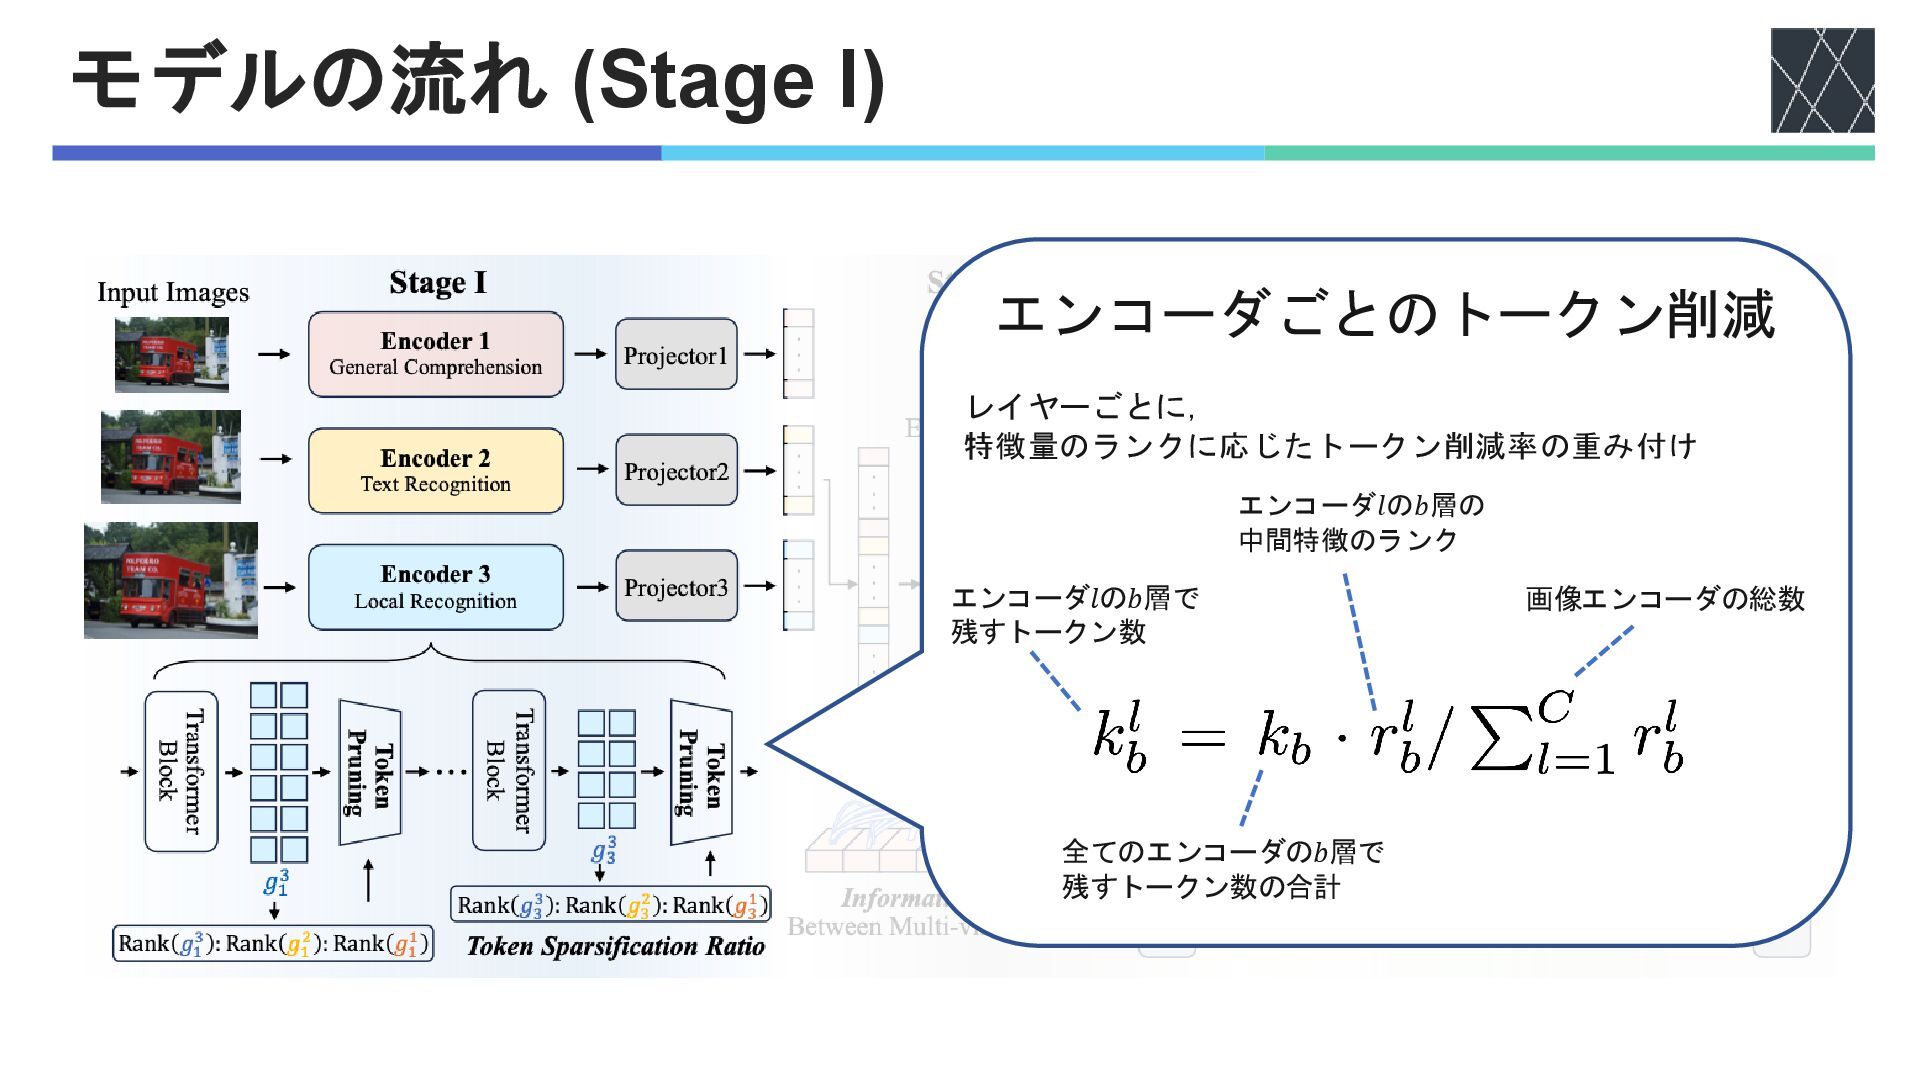
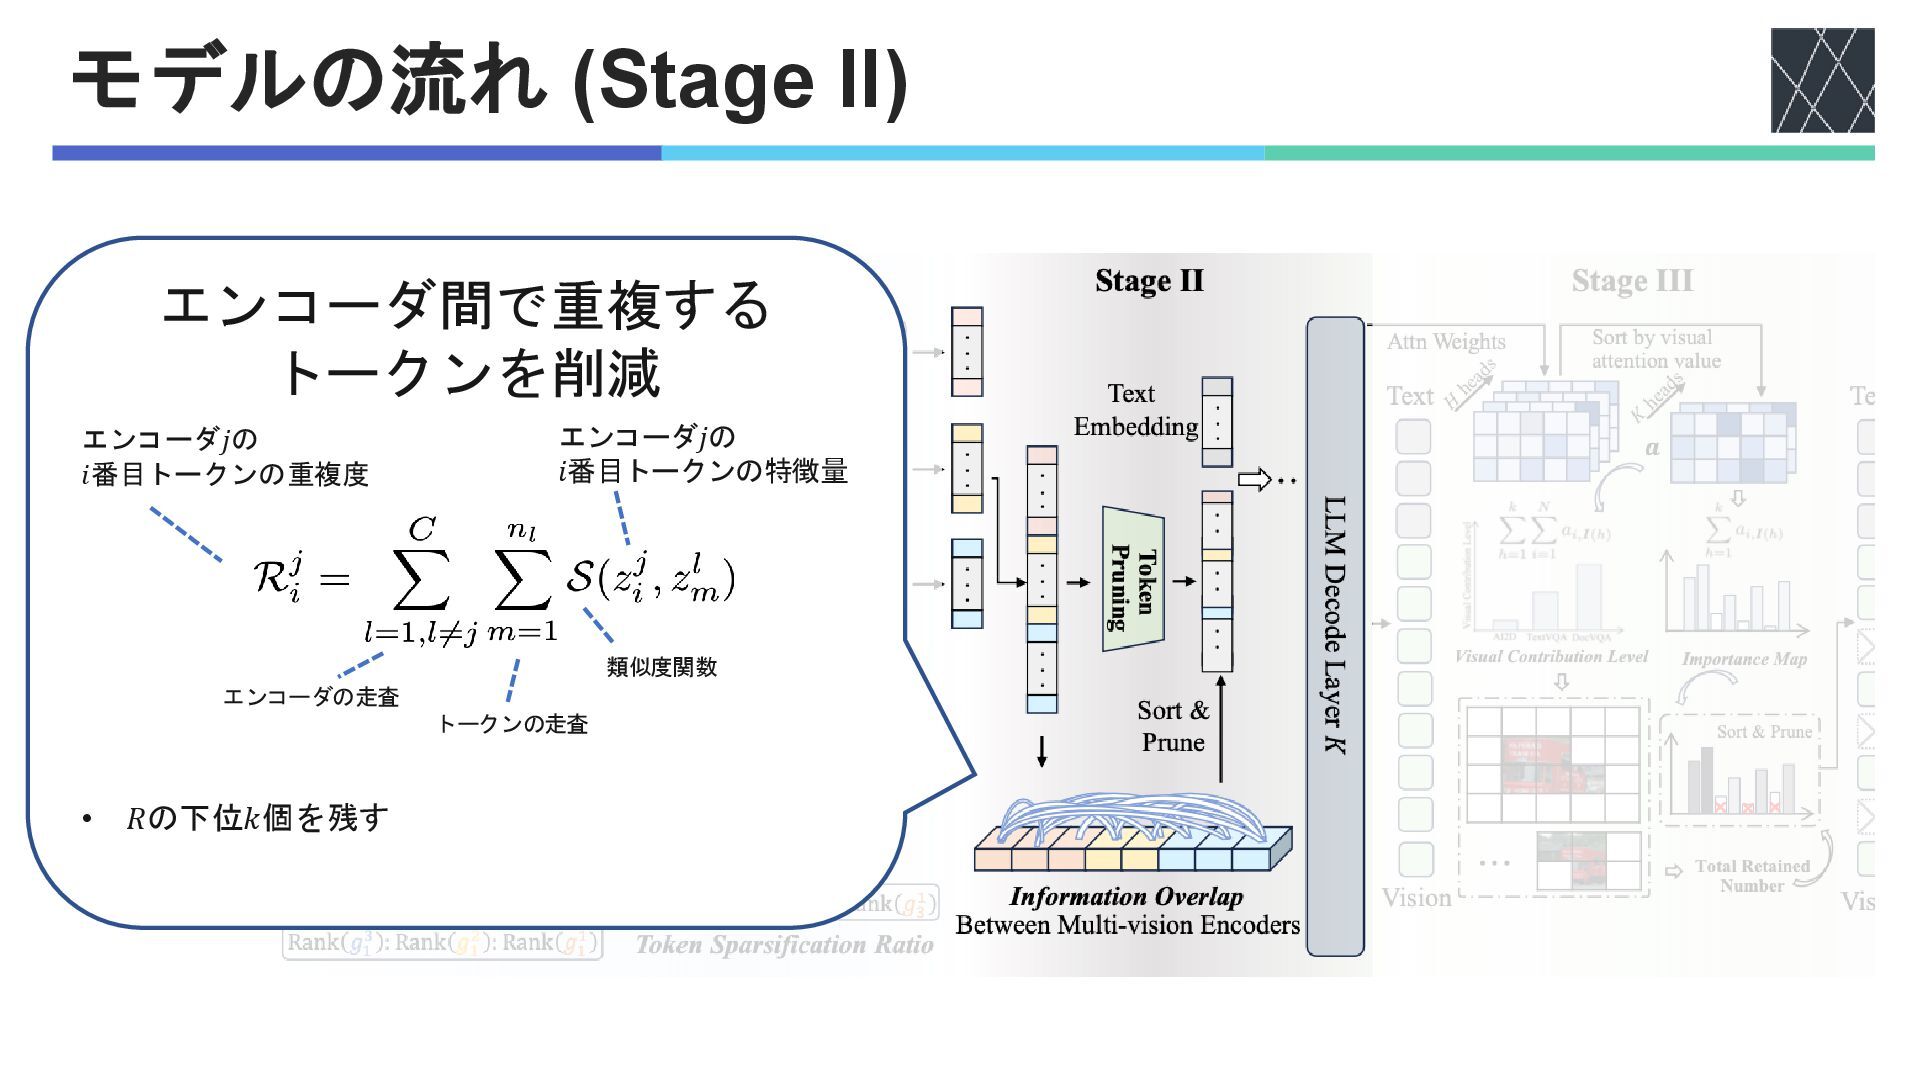
・METEOR: Multi-Encoder Collaborative Token Pruning for Efficient Vision Language Models

Avatar for takami

takami

December 15, 2025

Transcript

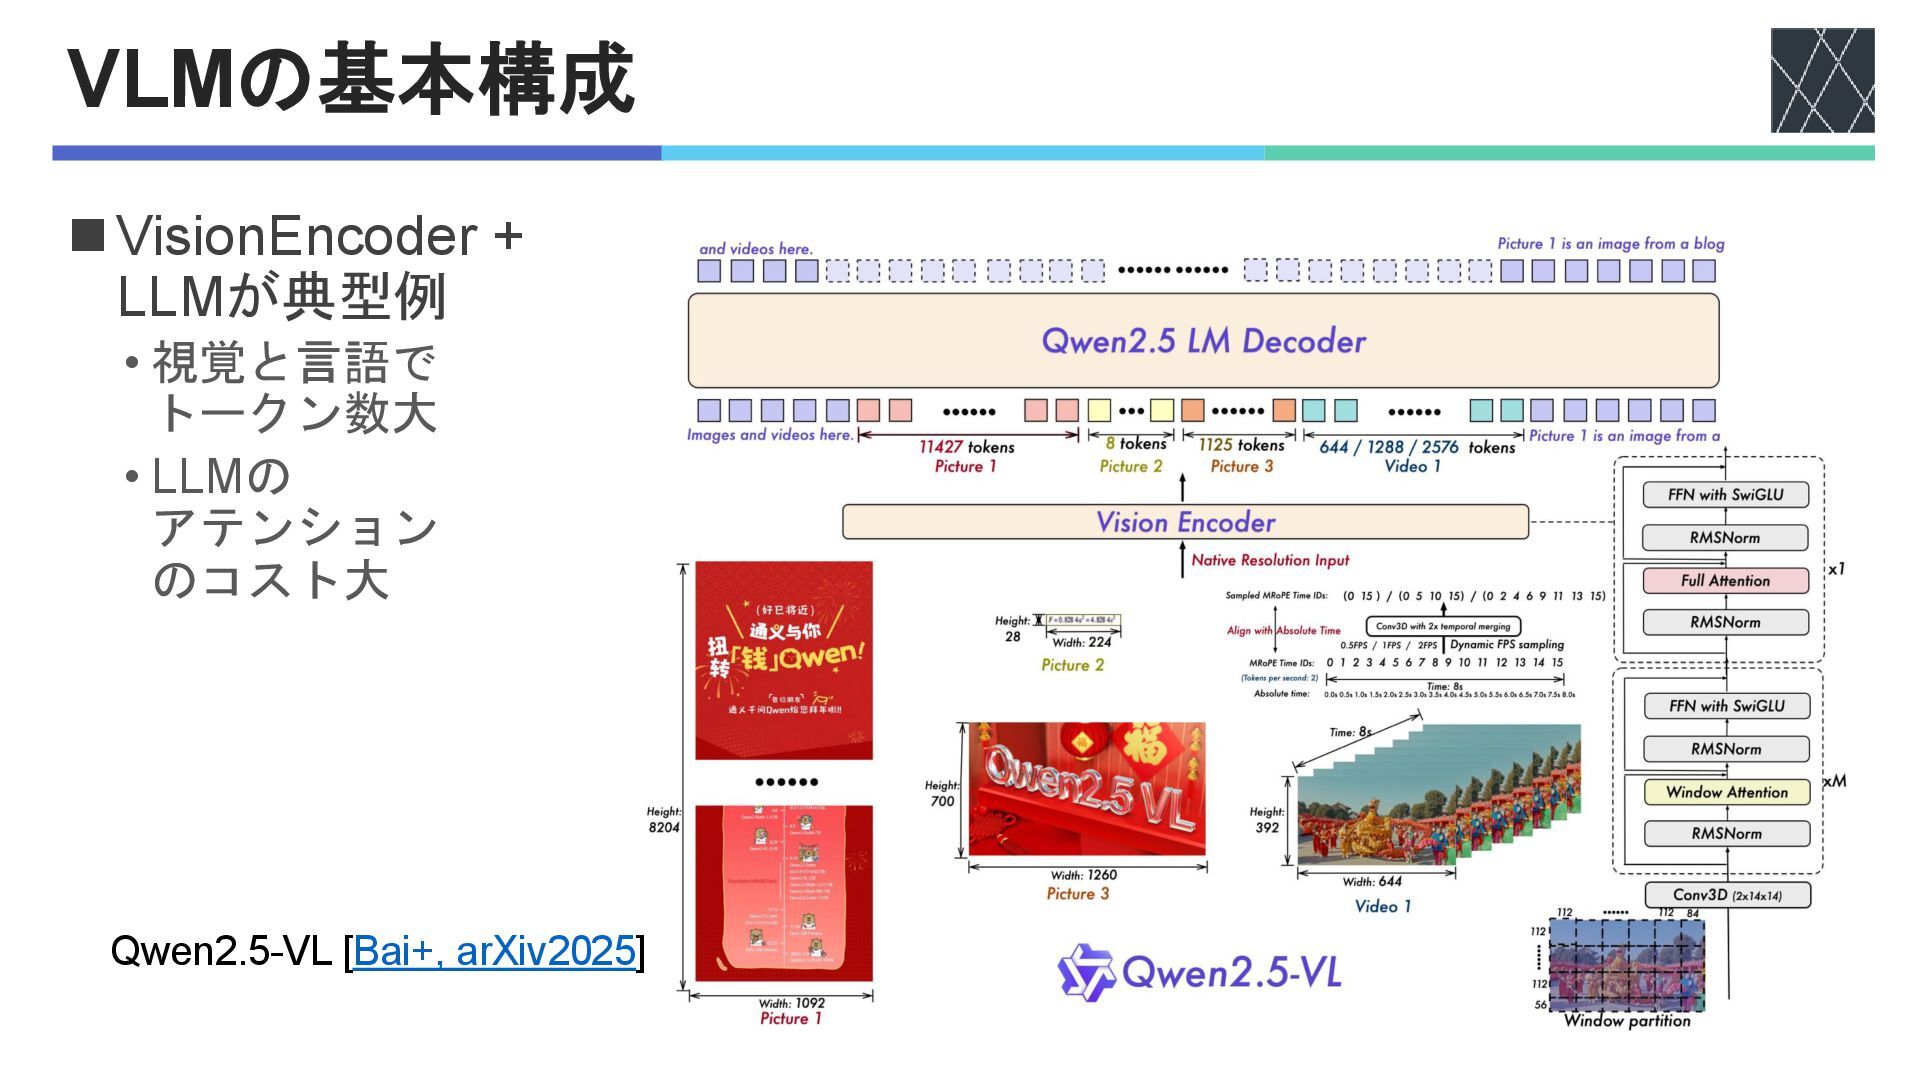
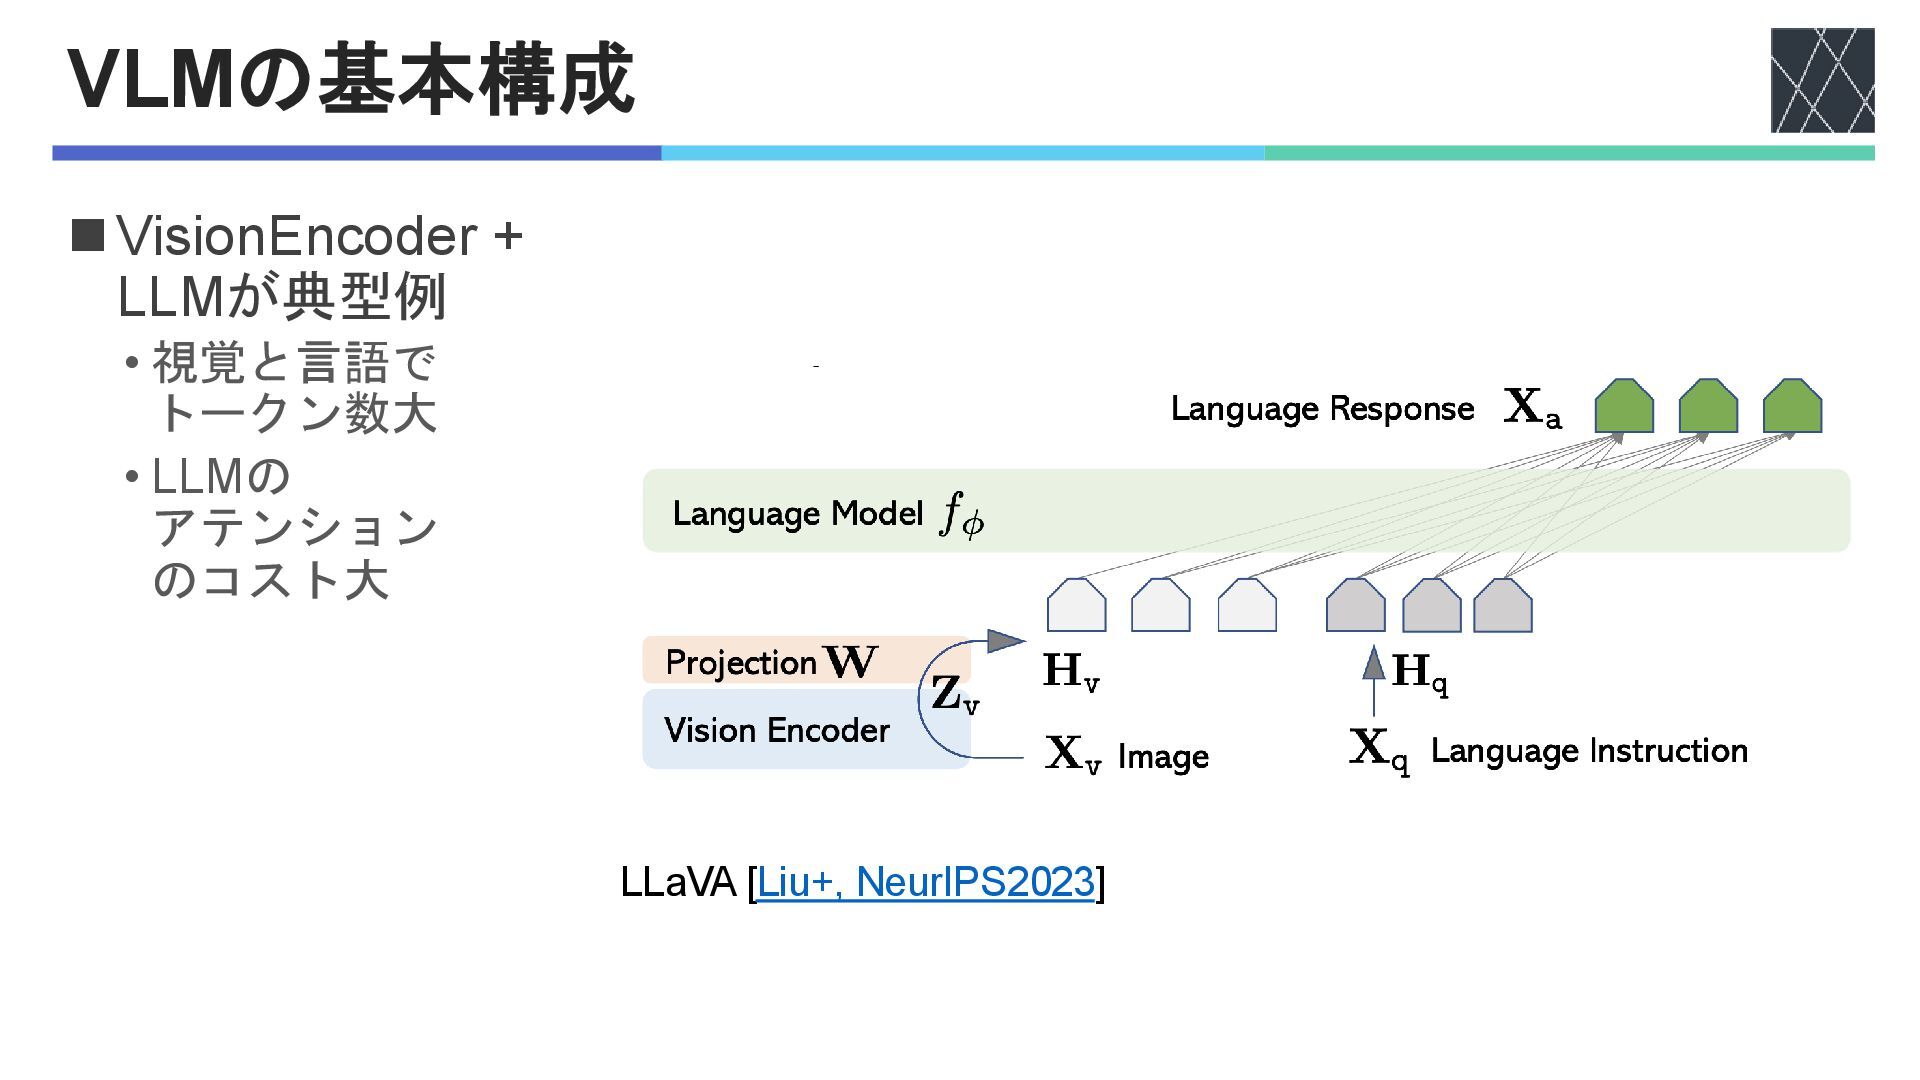
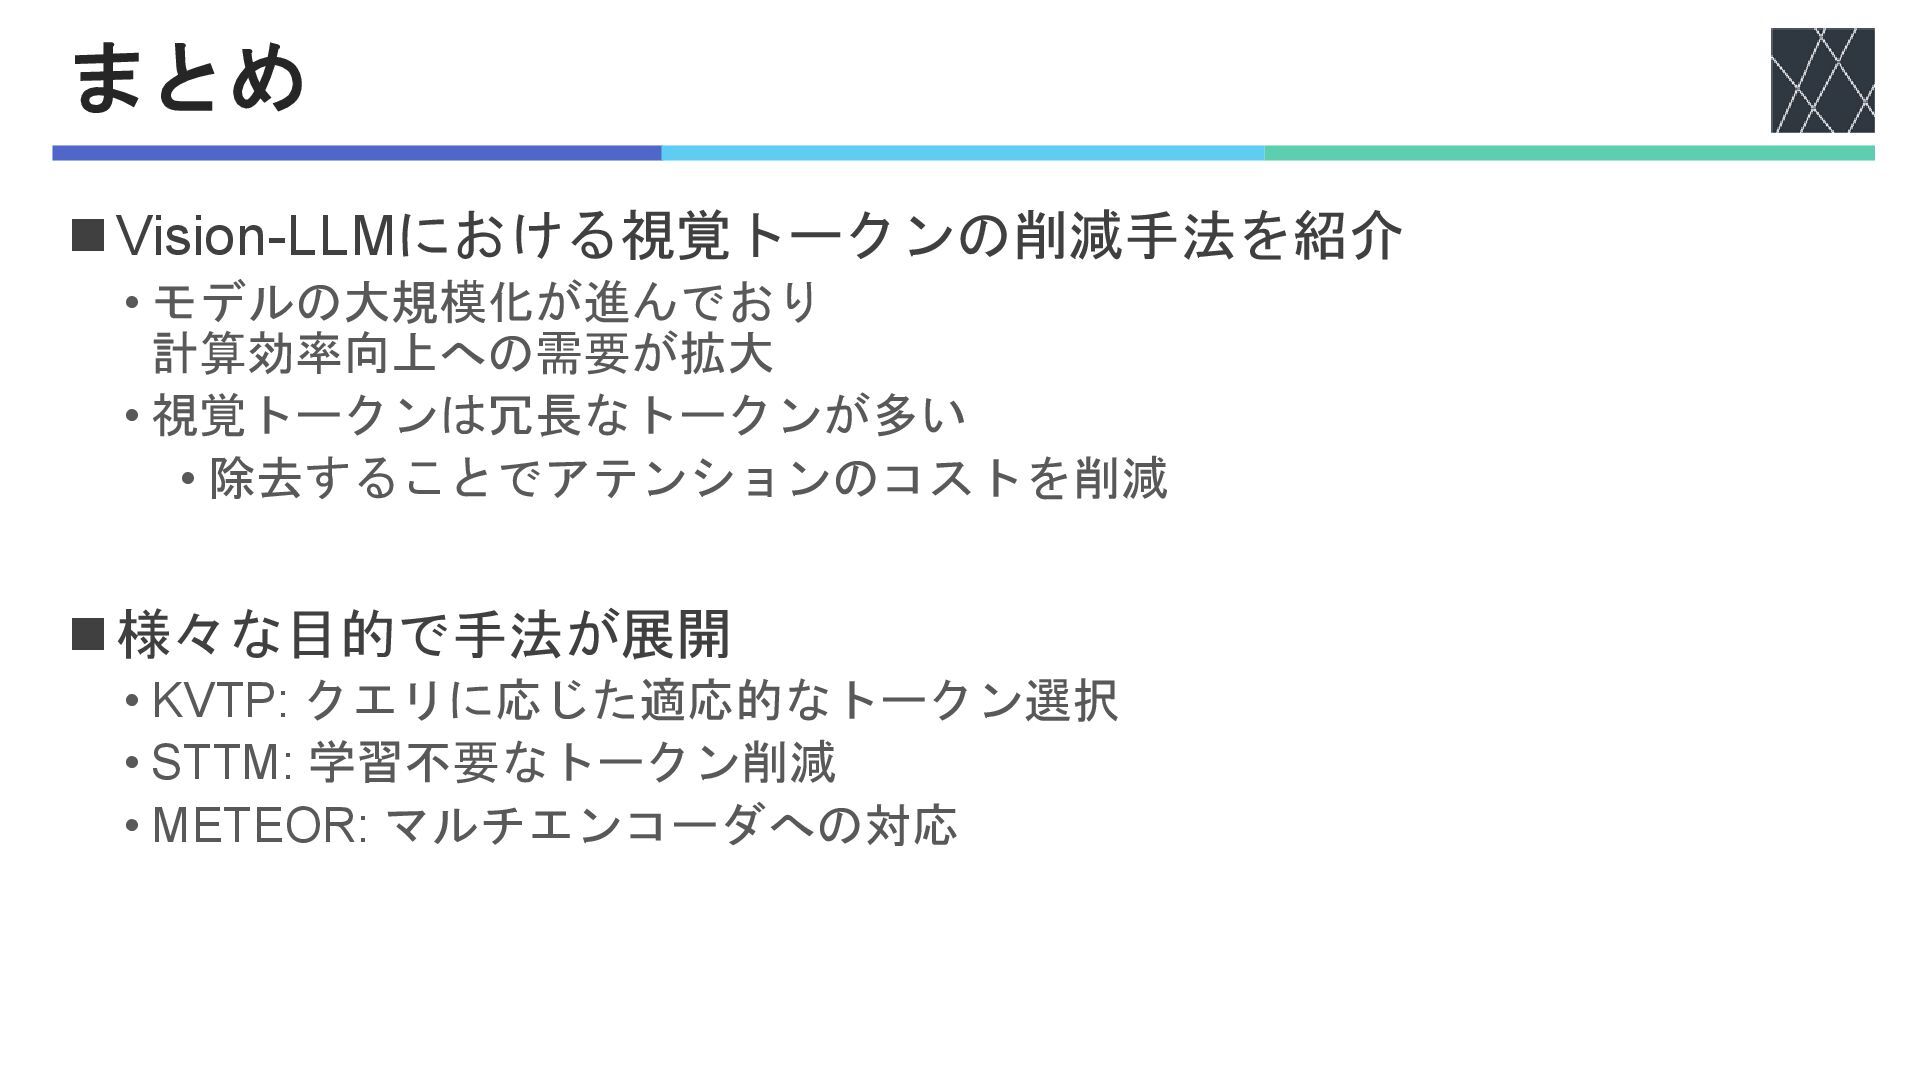
  1. 全体概要 ◼テーマ:Vision-LLMのトークン削減 • モデルサイズの増加に伴って効率化の需要が拡大 • 冗長な視覚トークンを削減する手法が増加 • 共通課題:計算効率向上と性能維持の両立 ◼ICCV2025から3つ論文を紹介 •

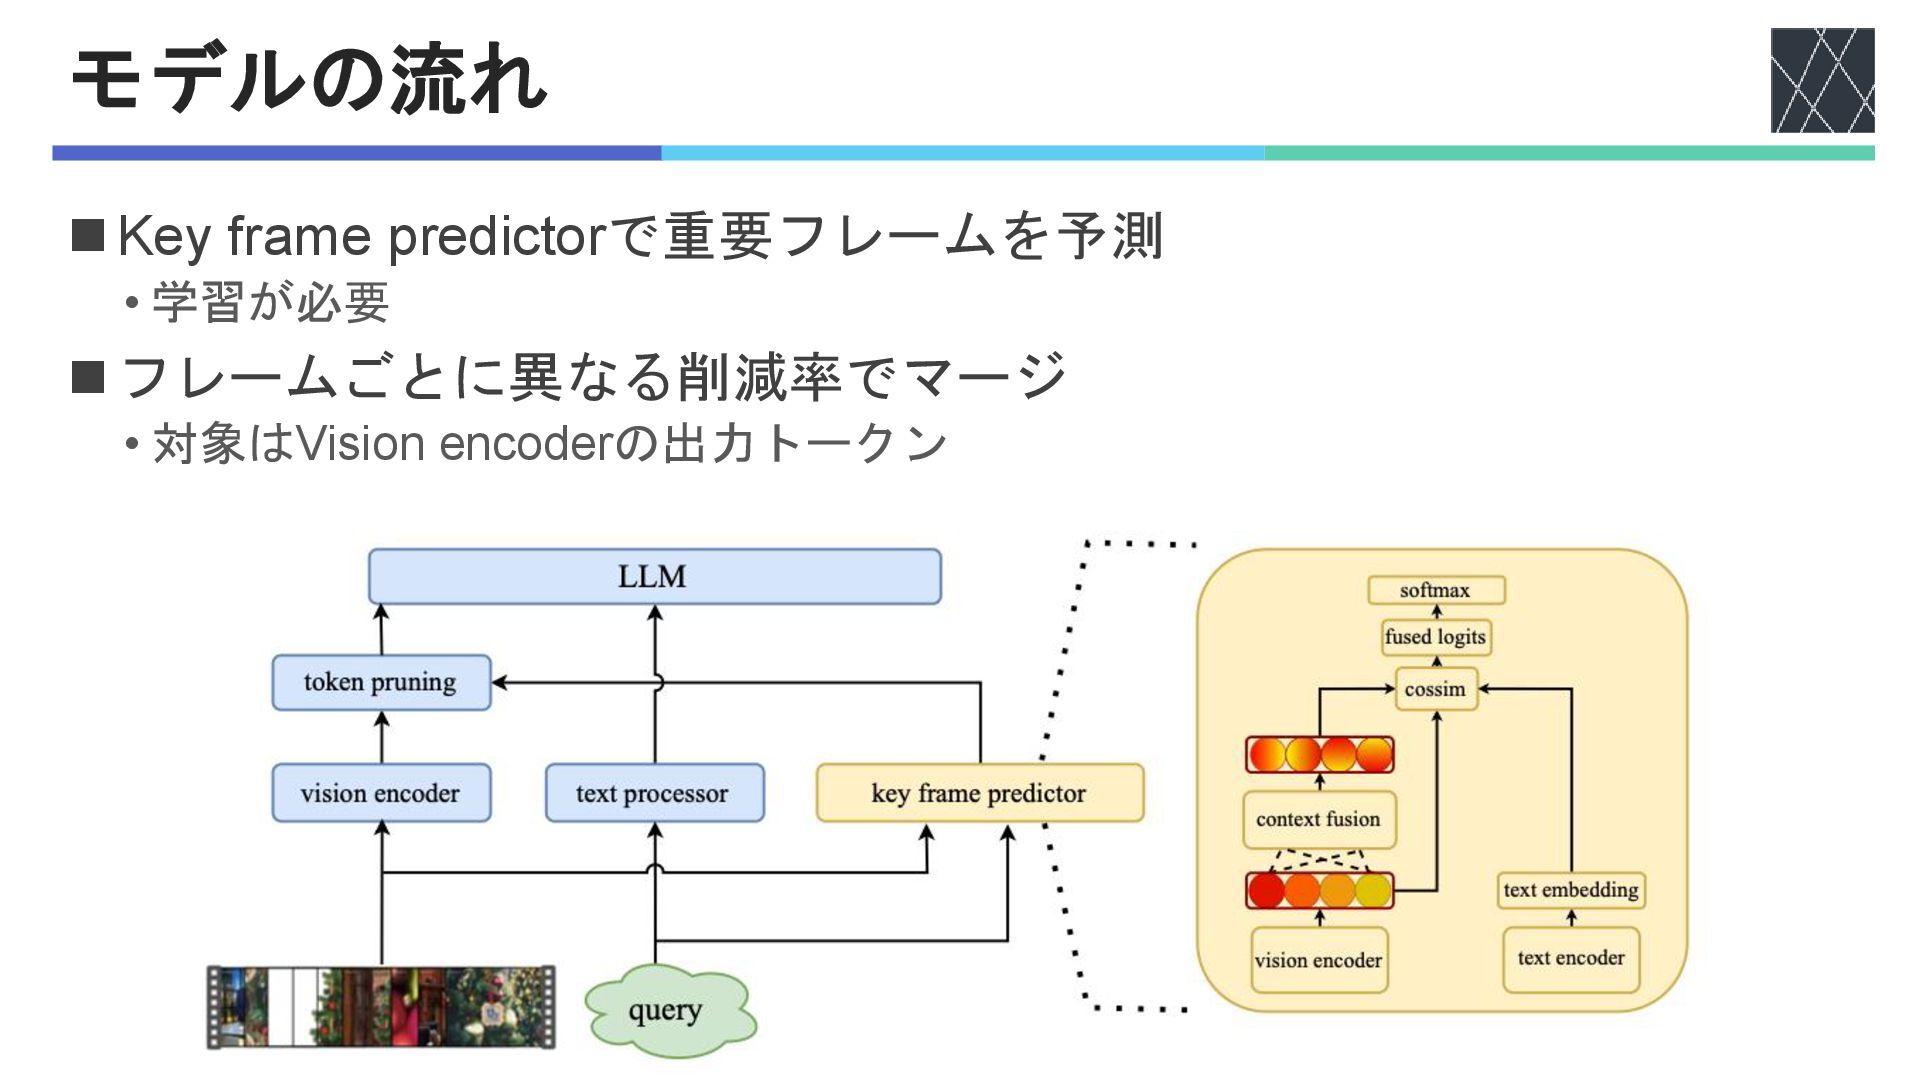
    KVTP: クエリに応じて重要フレームを判断し, フレーム単位でプルーニング率を調整 • STTM: 空間・時間の冗長性を利用したトークンマージ • METEOR: マルチエンコーダ環境で協調的にトークンを段階的プルーニング
  2. Keyframe-oriented Vision Token Pruning: Enhancing Efficiency of Large Vision Language

    Models on Long-Form Video Processing Yudong Liu, Jingwei Sun, Yueqian Lin, Jingyang Zhang, Ming Yin, Qinsi Wang, Jianyi Zhang, Hai Li, Yiran Chen, ICCV2025 KVTP
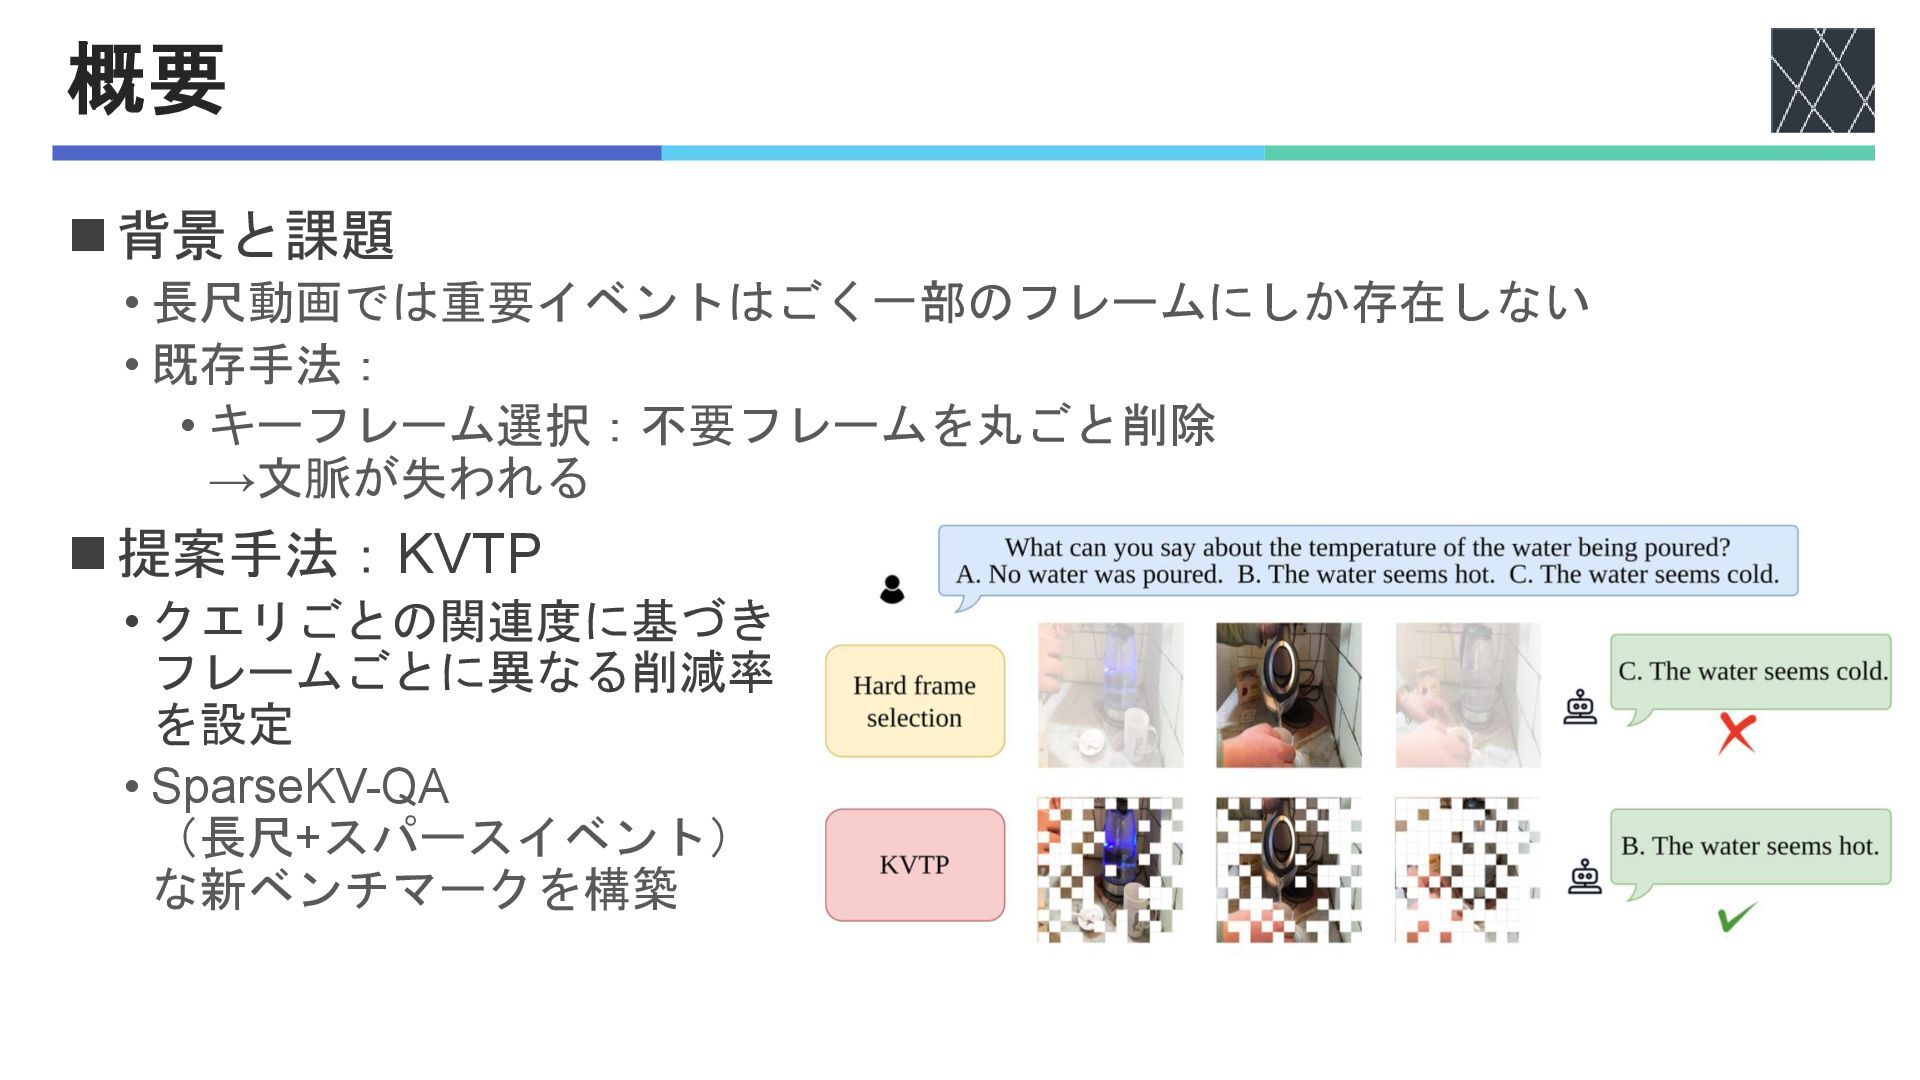
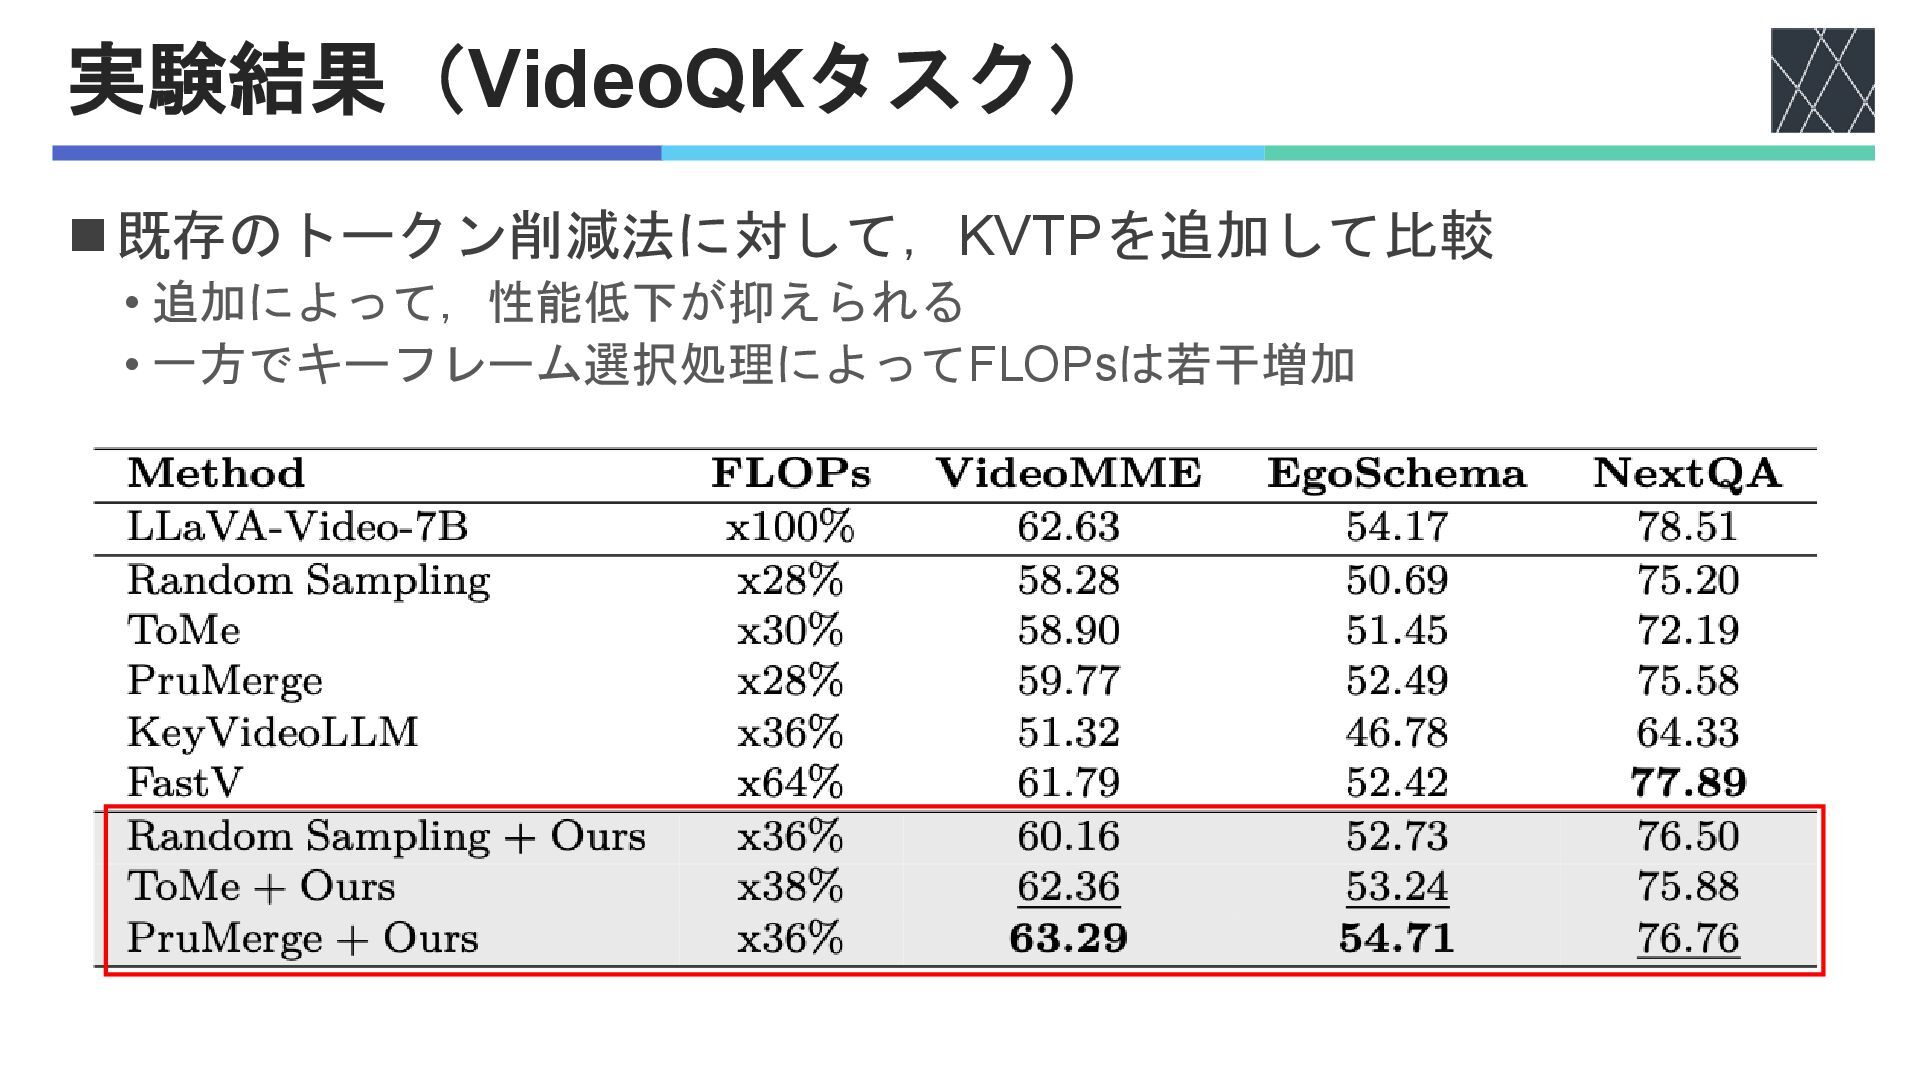
  3. 概要 ◼背景と課題 • 長尺動画では重要イベントはごく一部のフレームにしか存在しない • 既存手法: • キーフレーム選択:不要フレームを丸ごと削除 →文脈が失われる ◼提案手法:KVTP

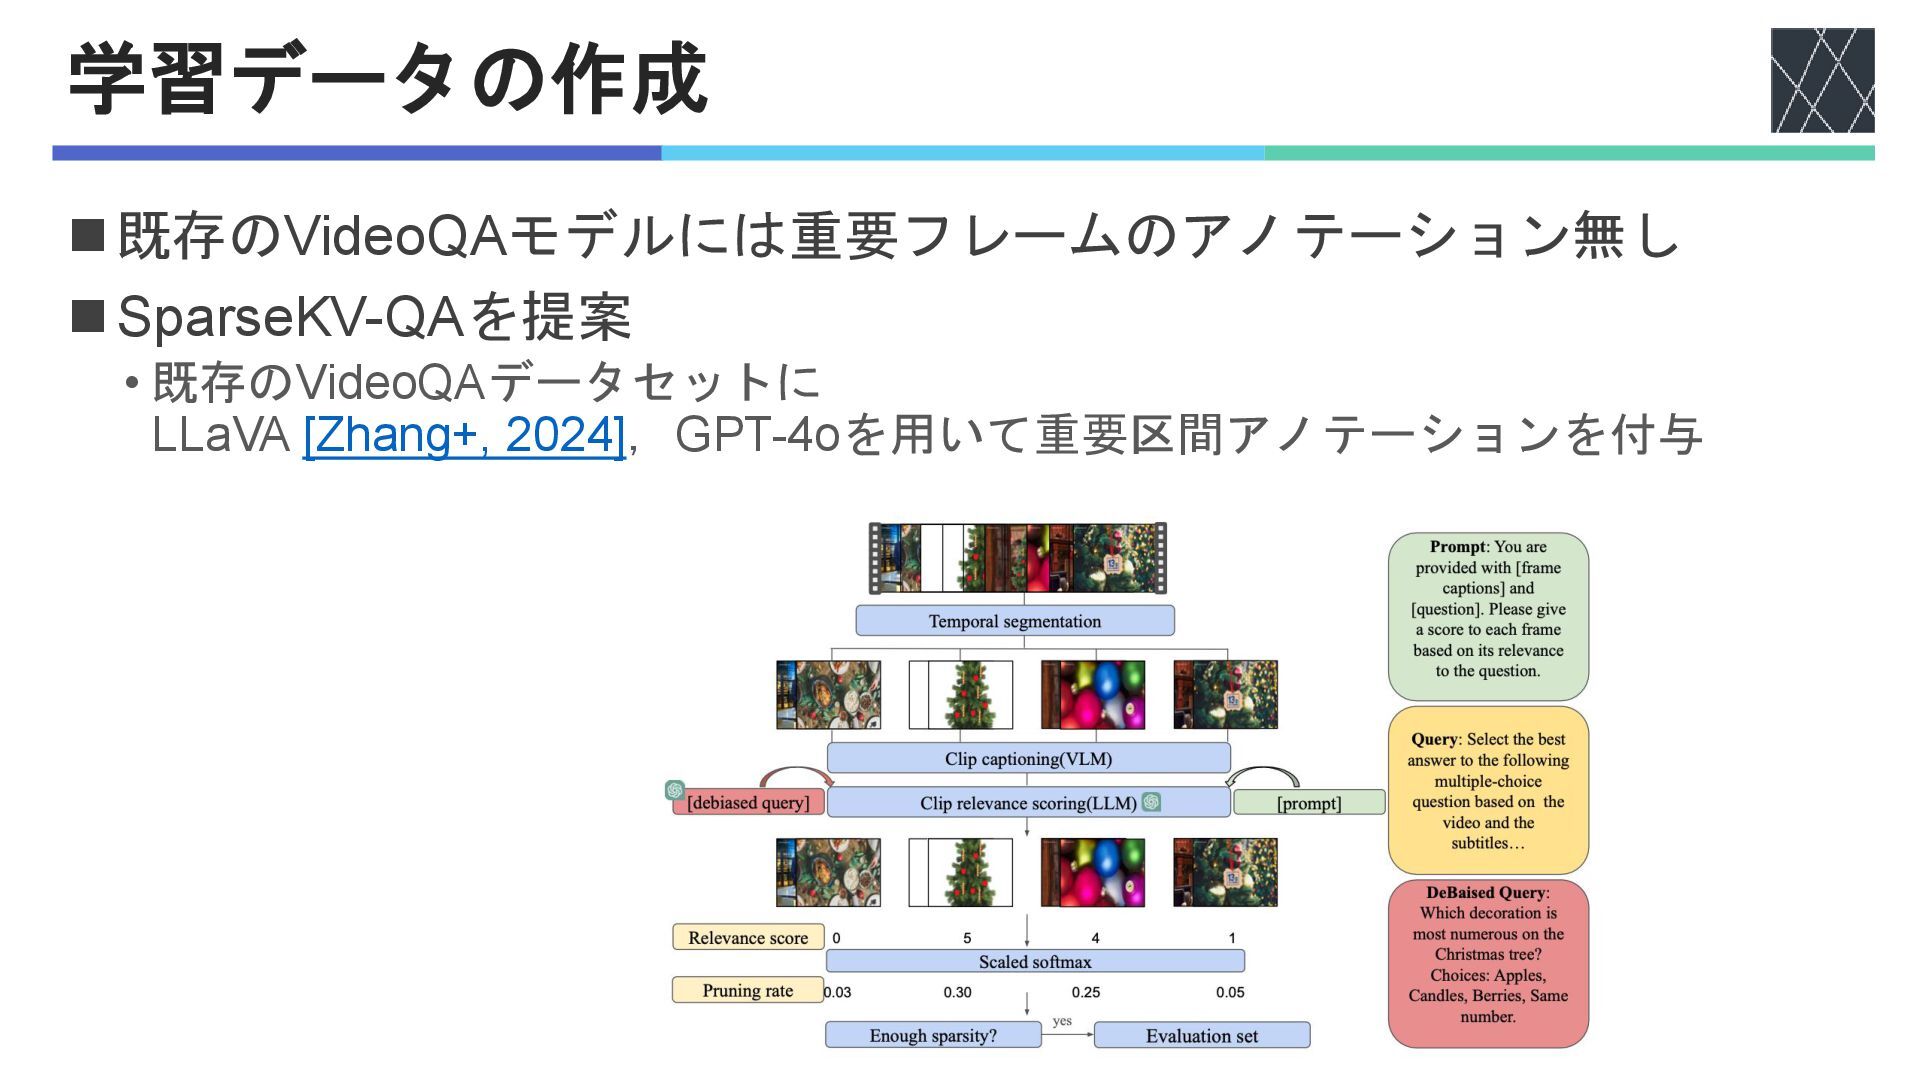
    • クエリごとの関連度に基づき フレームごとに異なる削減率 を設定 • SparseKV-QA (長尺+スパースイベント) な新ベンチマークを構築
  4. Multi-Granular Spatio-Temporal Token Merging for Training-Free Acceleration of Video LLMs

    Jeongseok Hyun, Sukjun Hwang, Su Ho Han, Taeoh Kim, Inwoong Lee, Dongyoon Wee, Joon-Young Lee, Seon Joo Kim, Minho Shim, ICCV2025 STTM
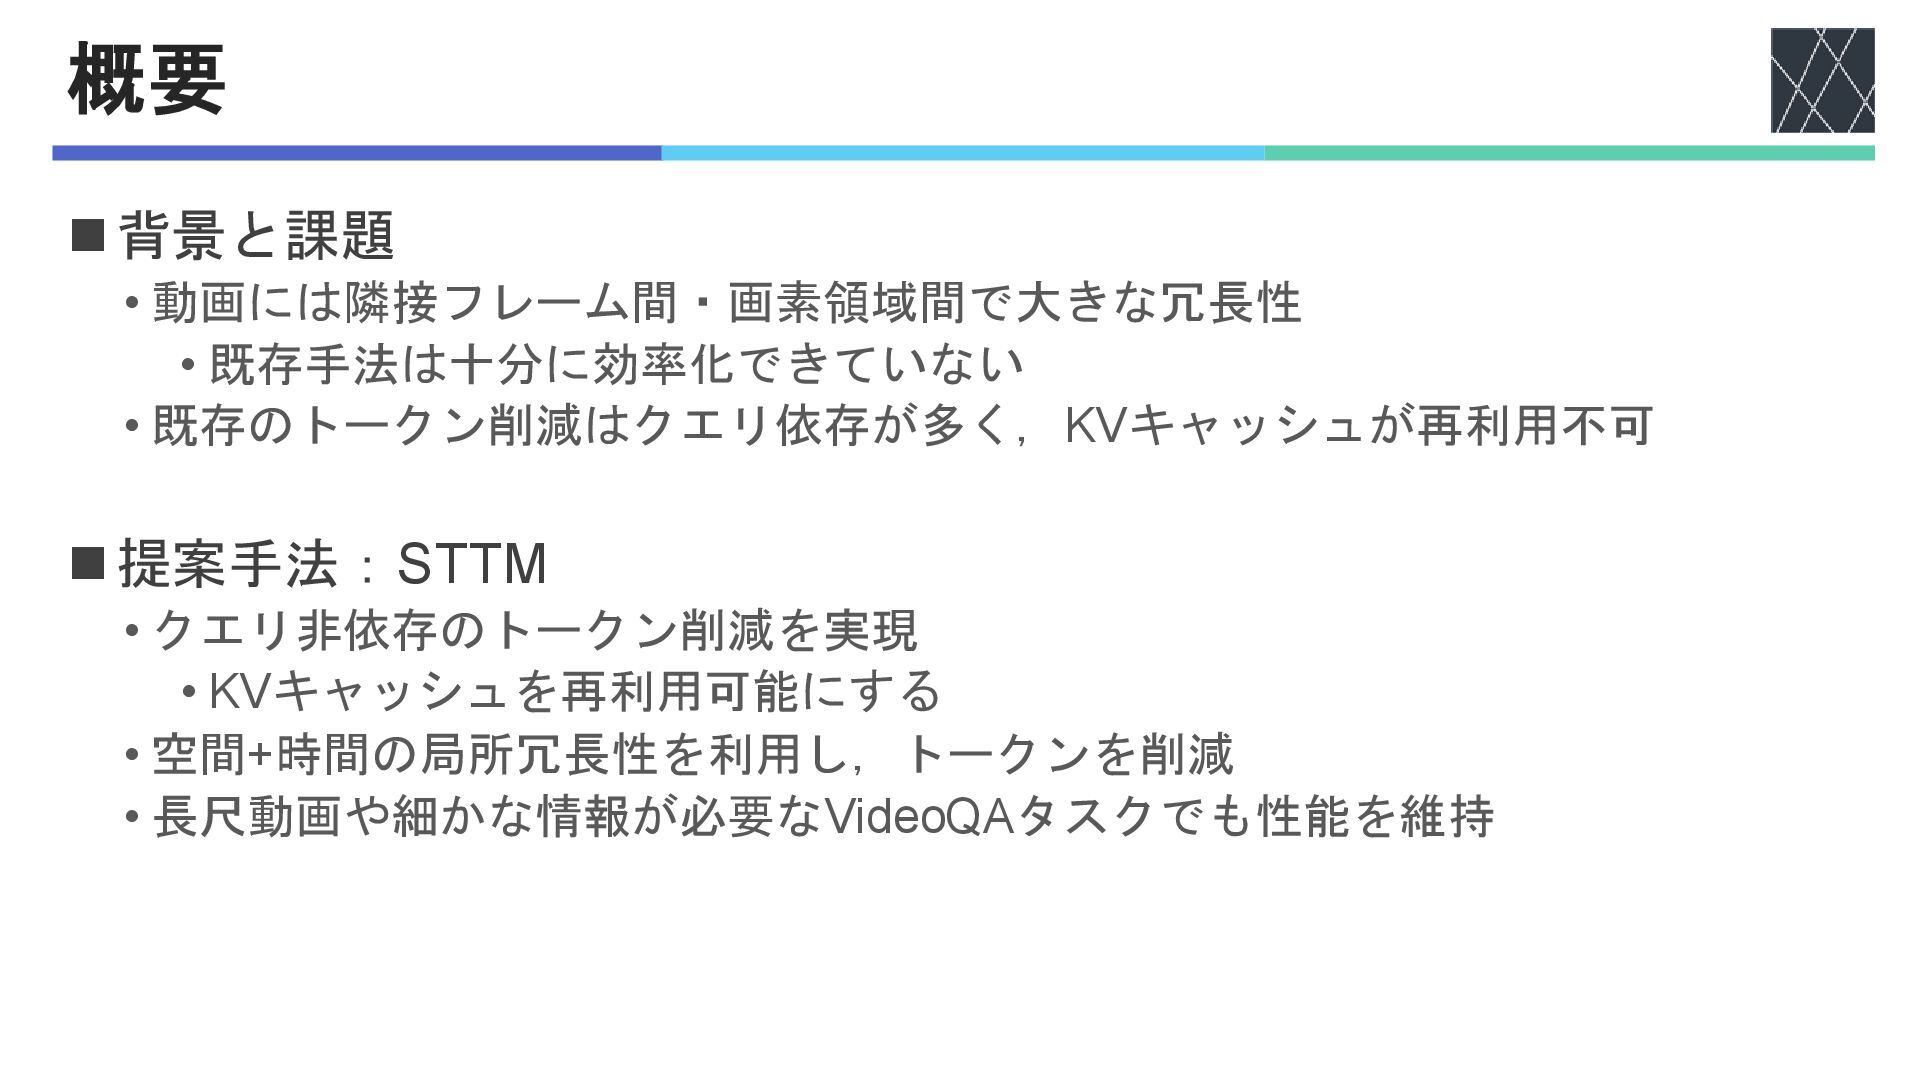
  5. 概要 ◼背景と課題 • 動画には隣接フレーム間・画素領域間で大きな冗長性 • 既存手法は十分に効率化できていない • 既存のトークン削減はクエリ依存が多く,KVキャッシュが再利用不可 ◼提案手法:STTM •

    クエリ非依存のトークン削減を実現 • KVキャッシュを再利用可能にする • 空間+時間の局所冗長性を利用し,トークンを削減 • 長尺動画や細かな情報が必要なVideoQAタスクでも性能を維持
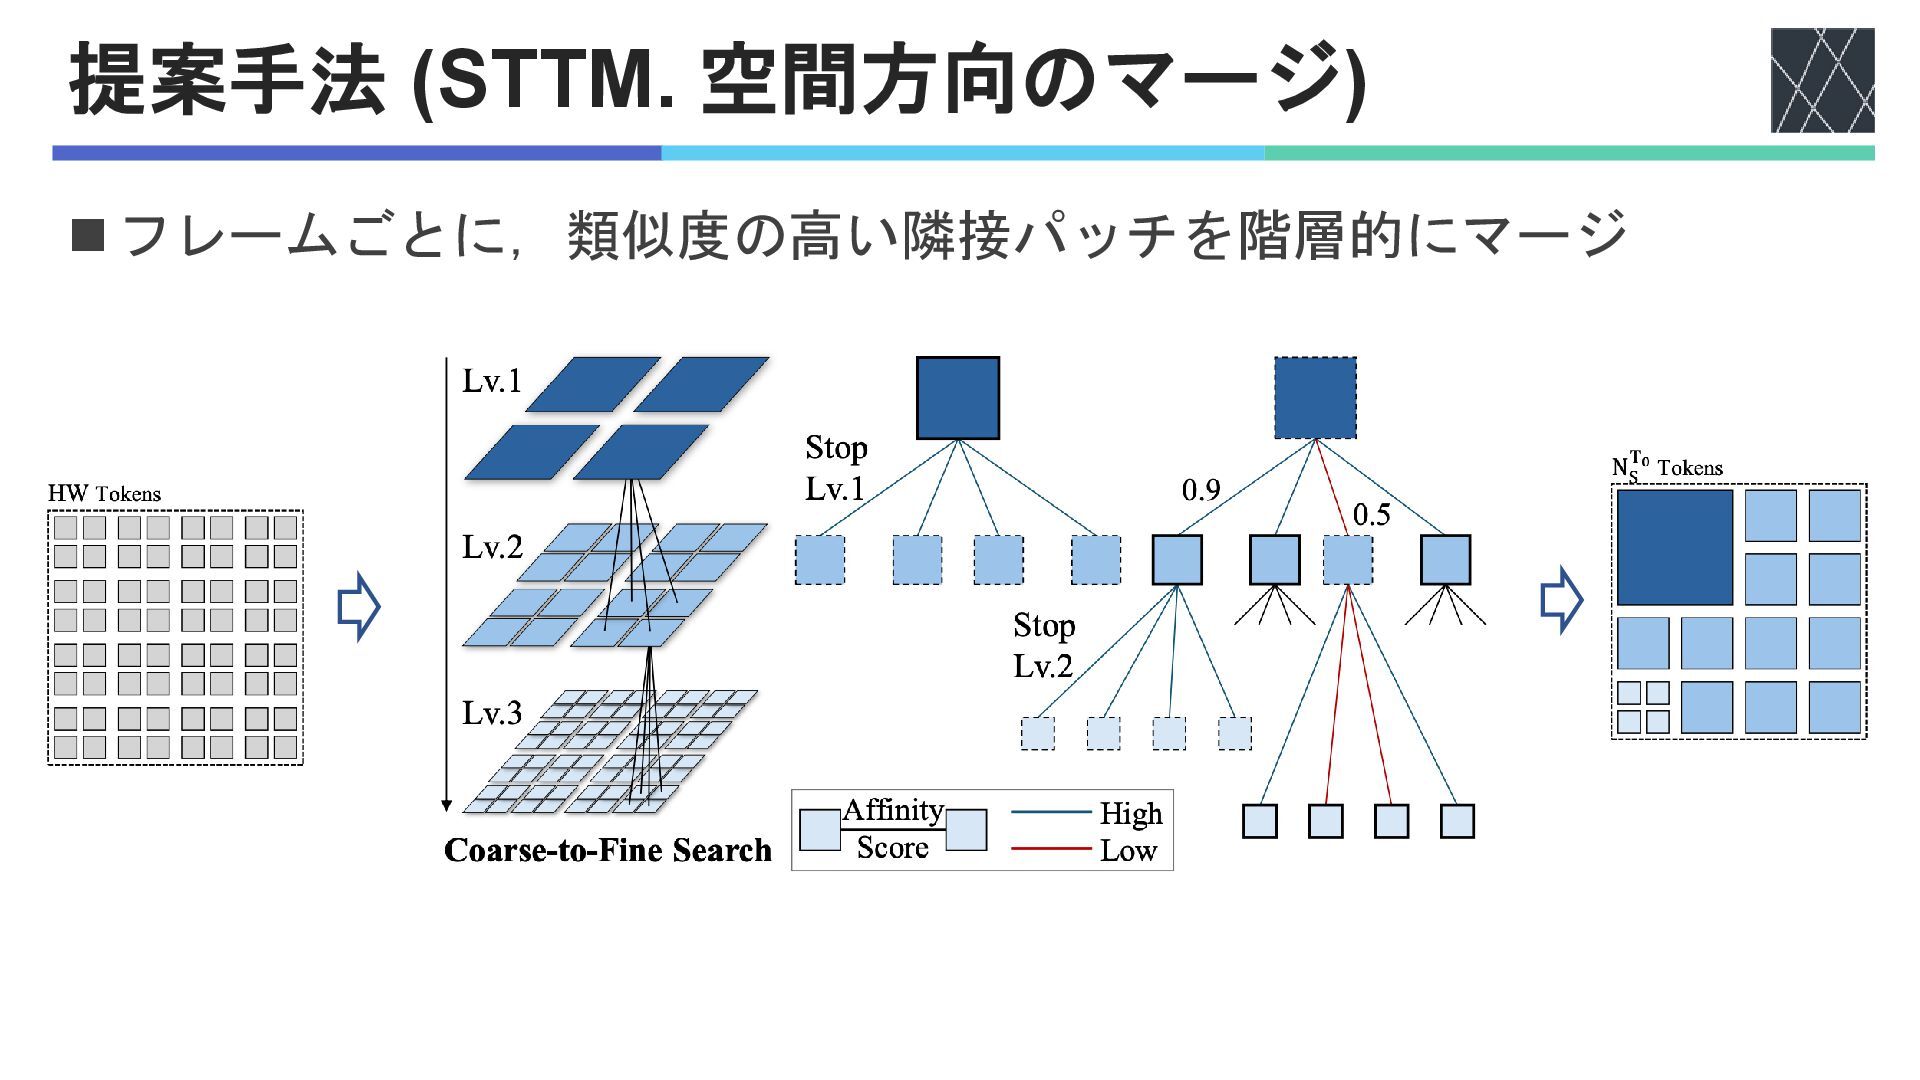
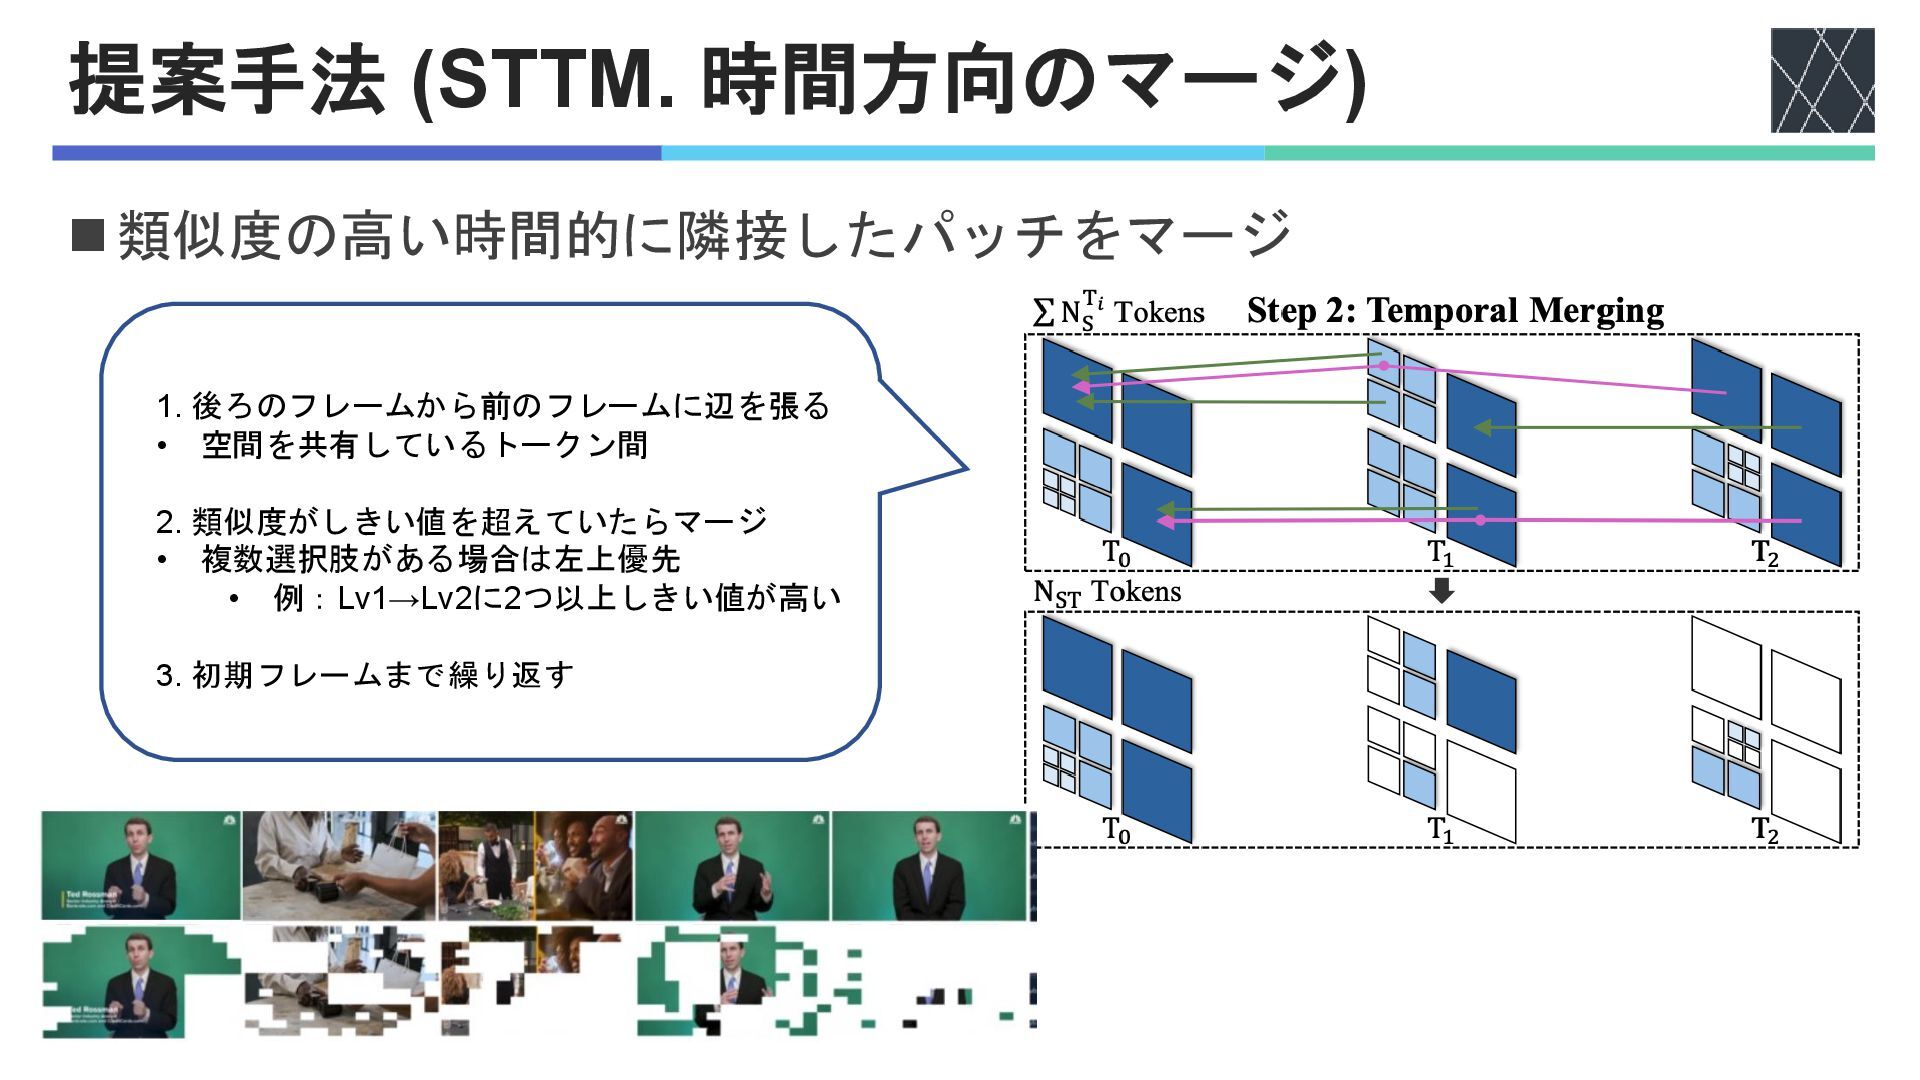
  6. 提案手法 (STTM. 時間方向のマージ) 1. 後ろのフレームから前のフレームに辺を張る • 空間を共有しているトークン間 2. 類似度がしきい値を超えていたらマージ •

    複数選択肢がある場合は左上優先 • 例:Lv1→Lv2に2つ以上しきい値が高い 3. 初期フレームまで繰り返す ◼類似度の高い時間的に隣接したパッチをマージ
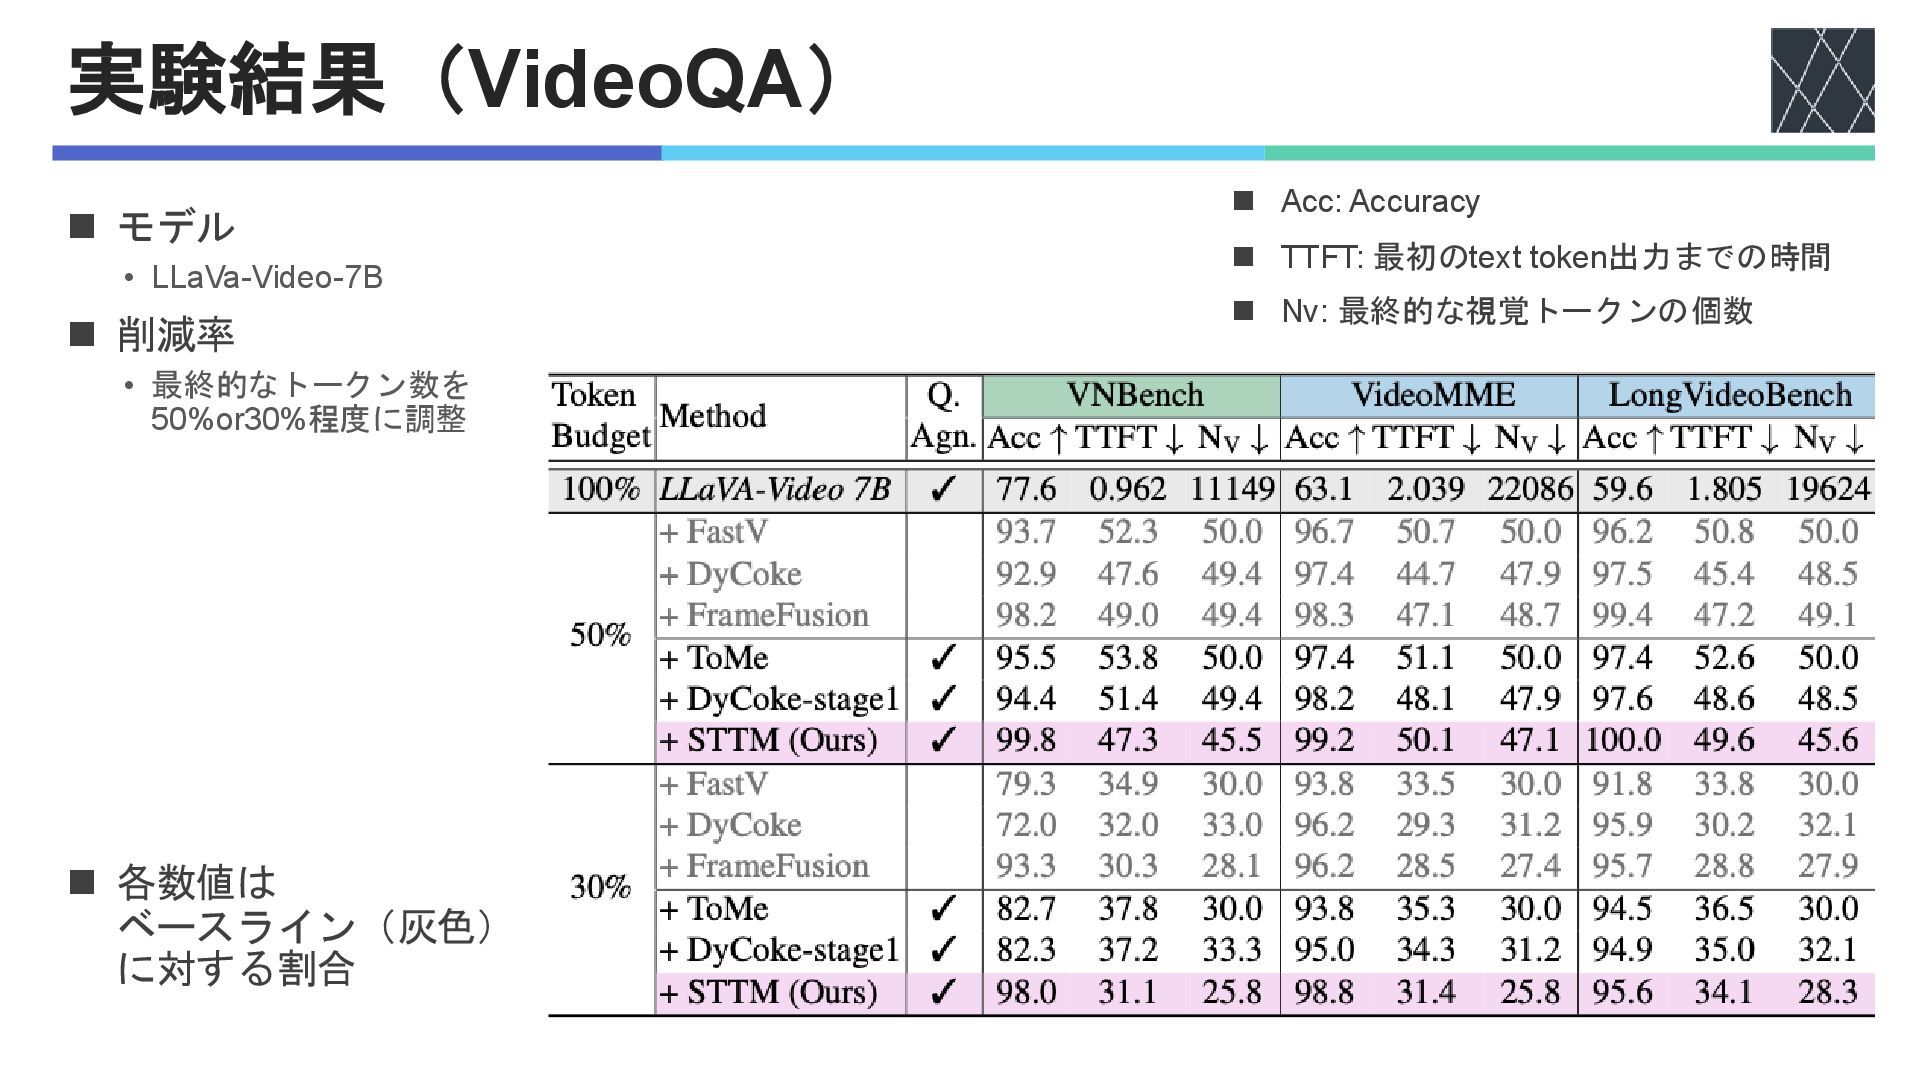
  7. 実験結果(VideoQA) ◼ モデル • LLaVa-Video-7B ◼ 削減率 • 最終的なトークン数を 50%or30%程度に調整

    ◼ 各数値は ベースライン(灰色) に対する割合 ◼ Acc: Accuracy ◼ TTFT: 最初のtext token出力までの時間 ◼ Nv: 最終的な視覚トークンの個数
  8. METEOR: Multi-Encoder Collaborative Token Pruning for Efficient Vision Language Models

    Yuchen Liu, Yaoming Wang, Bowen Shi, Xiaopeng Zhang, Wenrui Dai, Chenglin Li, Hongkai Xiong, Qi Tian, ICCV2025 METEOR
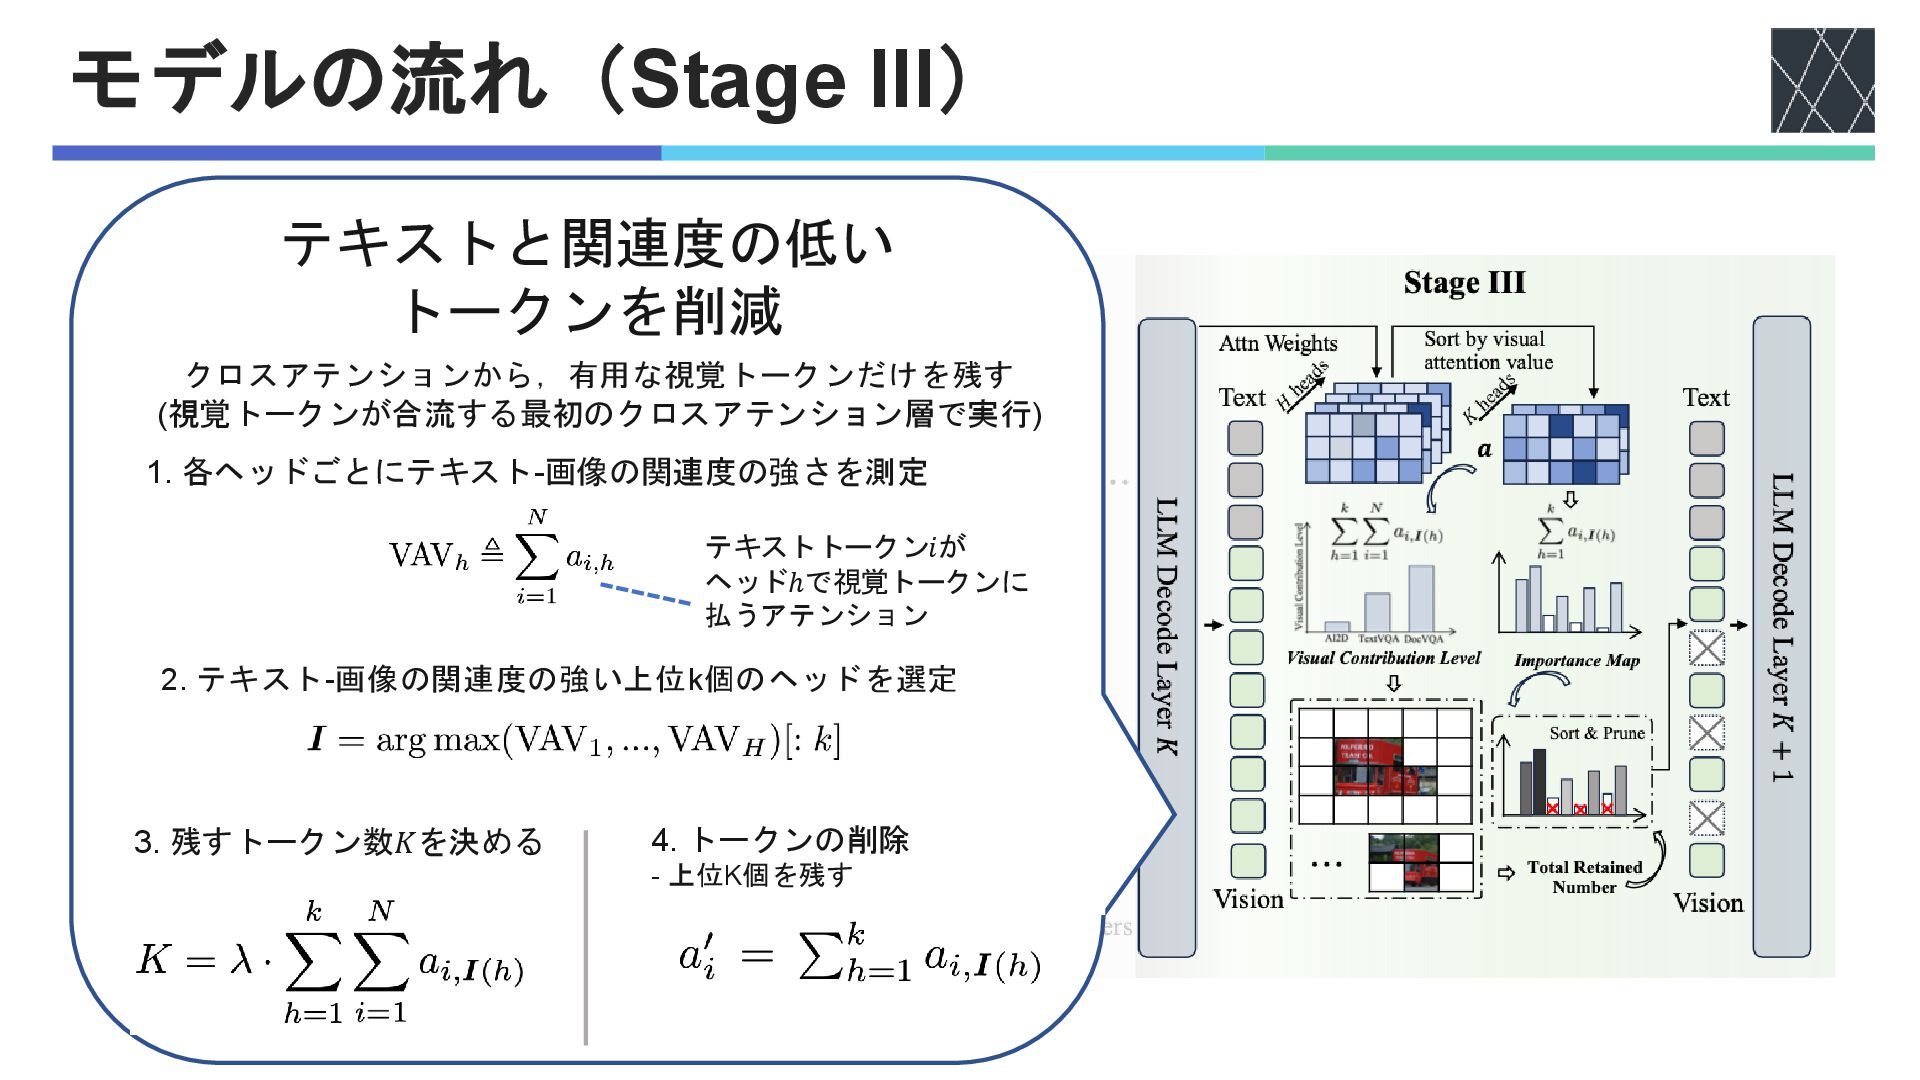
  9. 概要 ◼背景と課題 • マルチエンコーダ型MLLM(OCR, CLIP系など複数)を組み合わせると 様々なタスクに強くなる • ただし,計算コストが現実的でない ◼提案手法:METEOR •

    各エンコーダに最適な削減率を割り当て • エンコーダ間の冗長性を協調的に削減 • 同じ情報を持つトークンを削除 • 実運用可能なマルチエンコーダMLLMを実現 • ※ 動画でなく画像入力
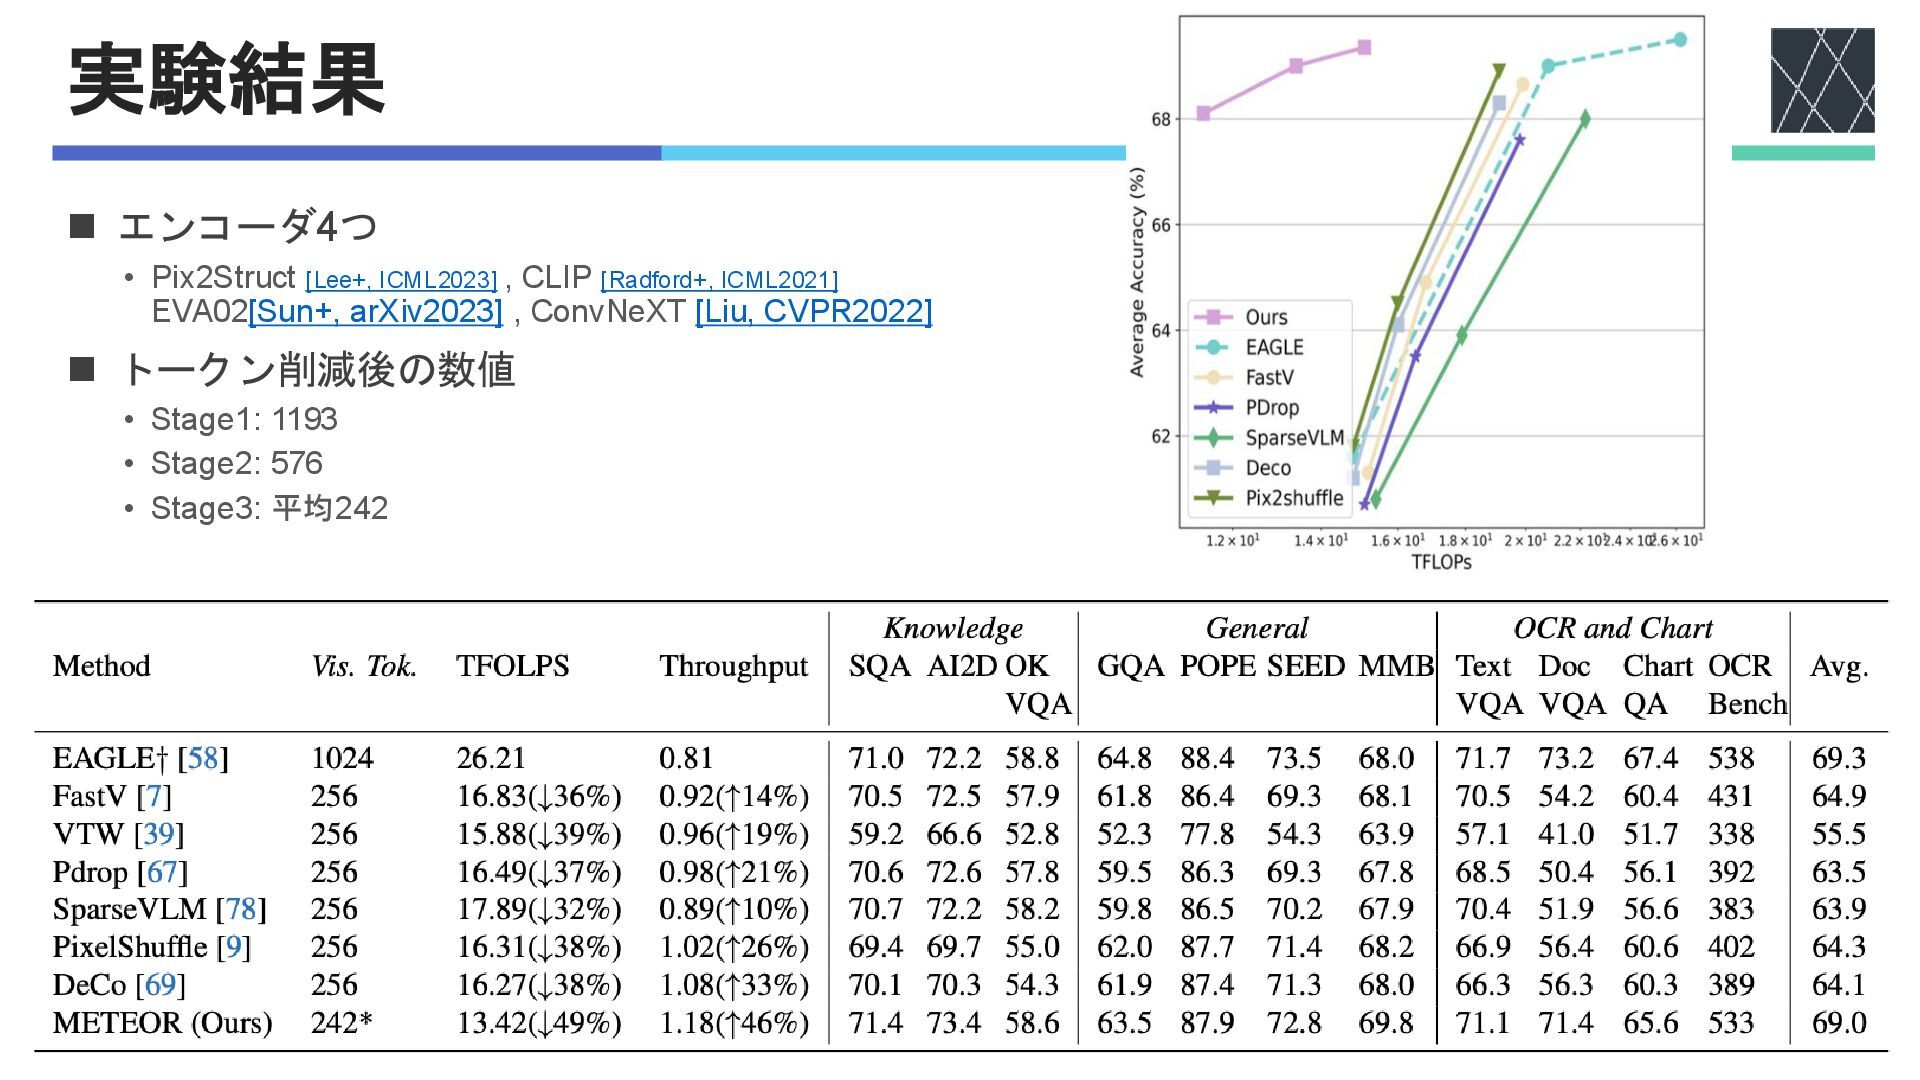
  10. 実験結果 ◼ エンコーダ4つ • Pix2Struct [Lee+, ICML2023] , CLIP [Radford+,

    ICML2021] EVA02[Sun+, arXiv2023] , ConvNeXT [Liu, CVPR2022] ◼ トークン削減後の数値 • Stage1: 1193 • Stage2: 576 • Stage3: 平均242