Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
キヨさん続編14_VLM編
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
コロッケそば
November 10, 2026
Technology
42
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
キヨさん続編14_VLM編
コロッケそば
November 10, 2026
More Decks by コロッケそば
See All by コロッケそば
キヨさん続編15_暗黙知編
happysamurai294
0
16
キヨさん続編13_コンテキスト汚染編
happysamurai294
0
32
キヨさん続編12_パスコード多要素認証編_
happysamurai294
0
38
キヨさん続編11_スキル編
happysamurai294
0
30
キヨさん続編8_トランスフォーマー編
happysamurai294
0
48
キヨさん続編9_ハイパーパラメータ編
happysamurai294
0
41
キヨさん続編10_ニューラルネット編
happysamurai294
0
42
キヨさん続編6_判断AI編
happysamurai294
0
55
キヨさん続編7_忖度編
happysamurai294
0
44
Other Decks in Technology
See All in Technology
Kiro Crew の Bot (続く役目を任せる窓口) | 目指せ Kiro マスター 12
inariku
PRO
2
360
Context Ontology Accelerator 入門 (業務データの意味を、AI エージェントに渡す)
inariku
PRO
3
620
llm-d に入門してみた / Try out llm-d
kota2and3kan
0
110
GCASアップデート(202607-202610)
techniczna
1
250
Microsoft Entra Kerberos で実現するクラウド デバイス管理
tamaiyutaro
2
660
狙われているAPIの脆弱性!今こそ手をつけるべき根本的な対策とは?
nagix
0
110
Kiro アップデート 2026 年 11 月号 (11 月 8 日時点) | 目指せ Kiro マスター アップデート編
inariku
PRO
2
100
ライフワーク「猫でもわかるDirectConnect」
kentapapa
0
310
[dbts2026]数十PBの超巨大データ×AI活用を支えるSnowflakeの実力〜大規模環境におけるアーキテクチャと運用のリアル〜
y_matsubara
0
130
The future of architectural work
ufried
0
200
Kiro を使うコツ (頼み方、覚えさせ方、任せ方) | 目指せ Kiro マスター 09
inariku
PRO
3
140
AWSを利用する上で知っておきたい名前解決の話 2026
nagisa53
5
3.4k
Featured
See All Featured
Building Applications with DynamoDB
mza
96
7.3k
Odyssey Design
rkendrick25
PRO
3
940
Leo the Paperboy
mayatellez
11
2.5k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
77k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.9k
Exploring anti-patterns in Rails
aemeredith
4
560
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
400
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
Typedesign – Prime Four
hannesfritz
42
3.2k
Practical Orchestrator
shlominoach
192
12k
Transcript
キヨさん続編14_VLM編 | VLM(視覚言語モデル)と物体ハルシネーション キヨさん、 AIの目を 検眼する 目 AIが写真を見て、それらしく説明してくれる。でも、写っていないものまで見える らしい。 昭和のSEキヨさんが、AIの「目」の仕組みと、その見間違いを調べる話
VLM マルチモーダルLLM ViT プロジェクタ アライメント学習 物体ハルシネーション ※この物語はフィクションです。登場人物は架空です。技術や研究の説明は、公開された資料に基づきます。 「昭和の端末室に、 マウスはない!」
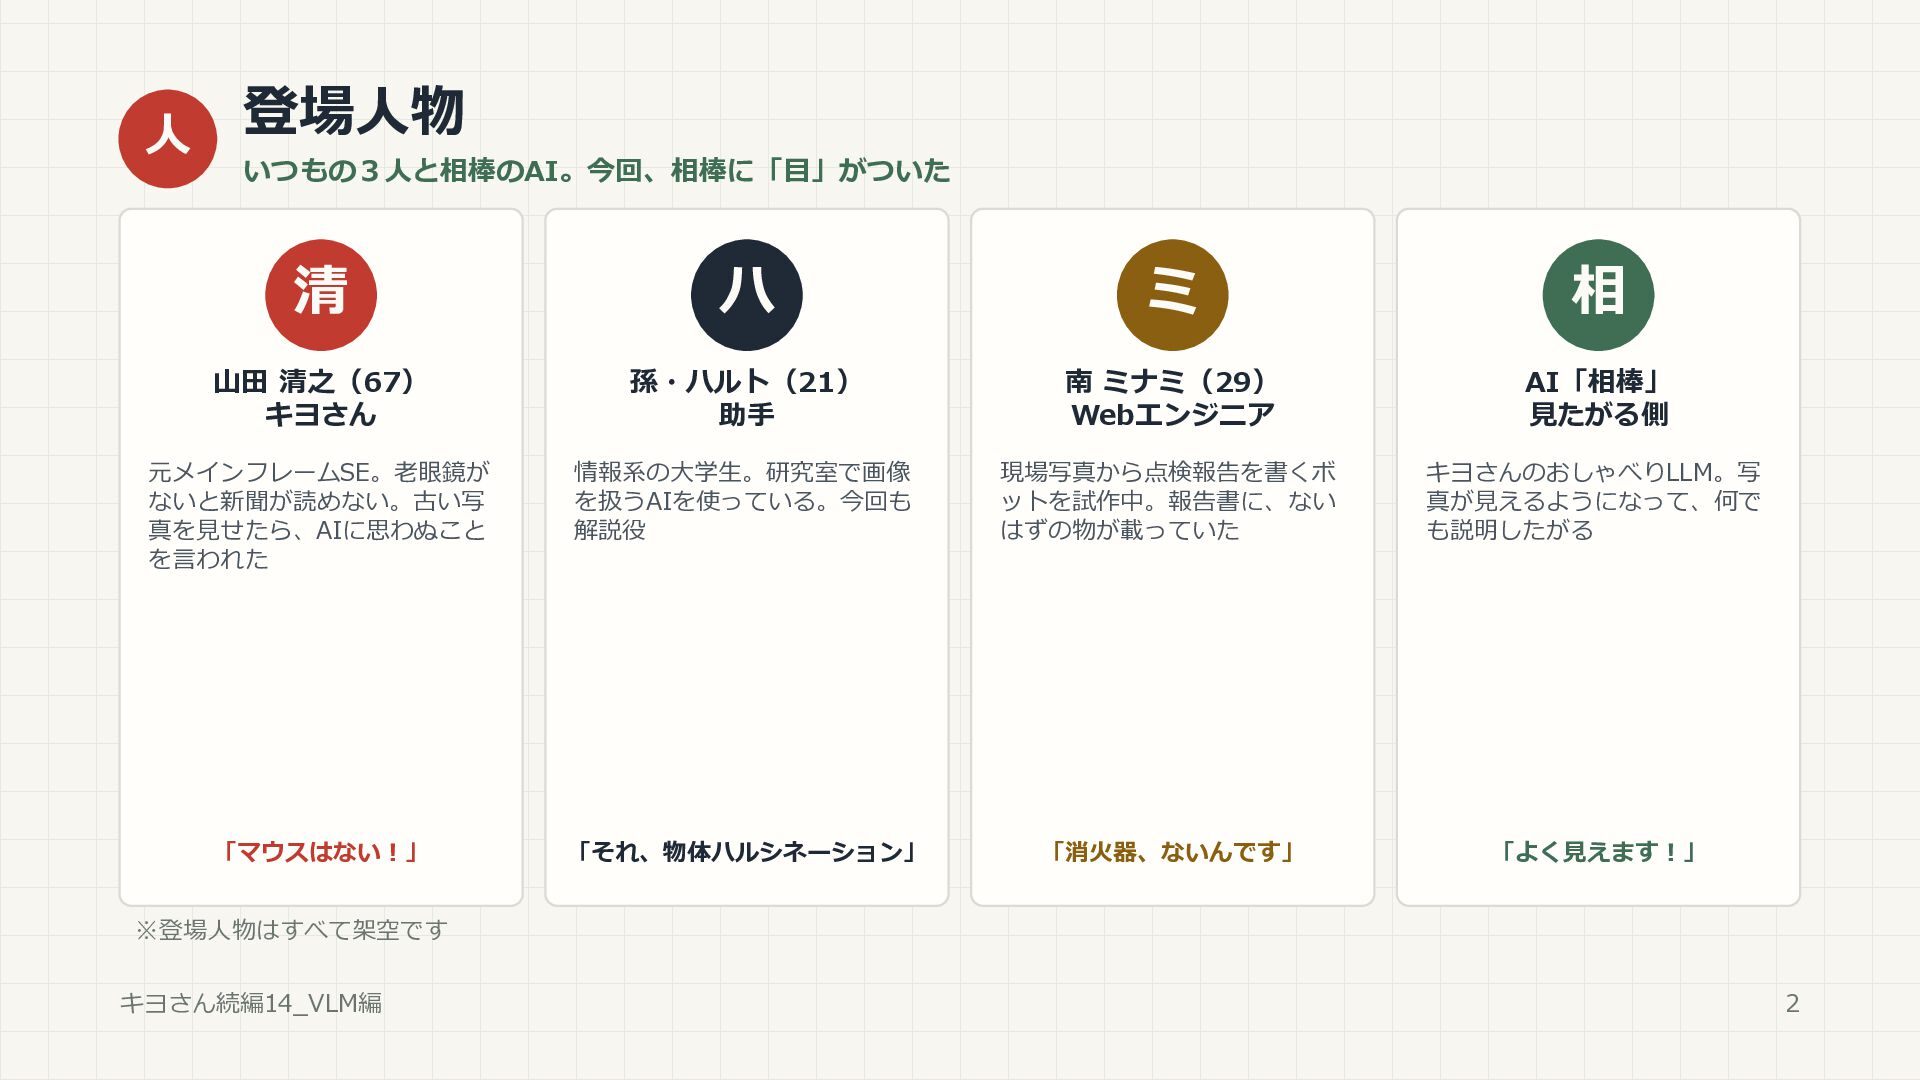
人 登場人物 いつもの3人と相棒のAI。今回、相棒に「目」がついた 清 ハ ミ 相 山田 清之(67) キヨさん
孫・ハルト(21) 助手 南 ミナミ(29) Webエンジニア AI「相棒」 見たがる側 元メインフレームSE。老眼鏡が ないと新聞が読めない。古い写 真を見せたら、AIに思わぬこと を言われた 情報系の大学生。研究室で画像 を扱うAIを使っている。今回も 解説役 現場写真から点検報告を書くボ ットを試作中。報告書に、ない はずの物が載っていた キヨさんのおしゃべりLLM。写 真が見えるようになって、何で も説明したがる 「マウスはない!」 「それ、物体ハルシネーション」 「消火器、ないんです」 「よく見えます!」 ※登場人物はすべて架空です キヨさん続編14_VLM編 2
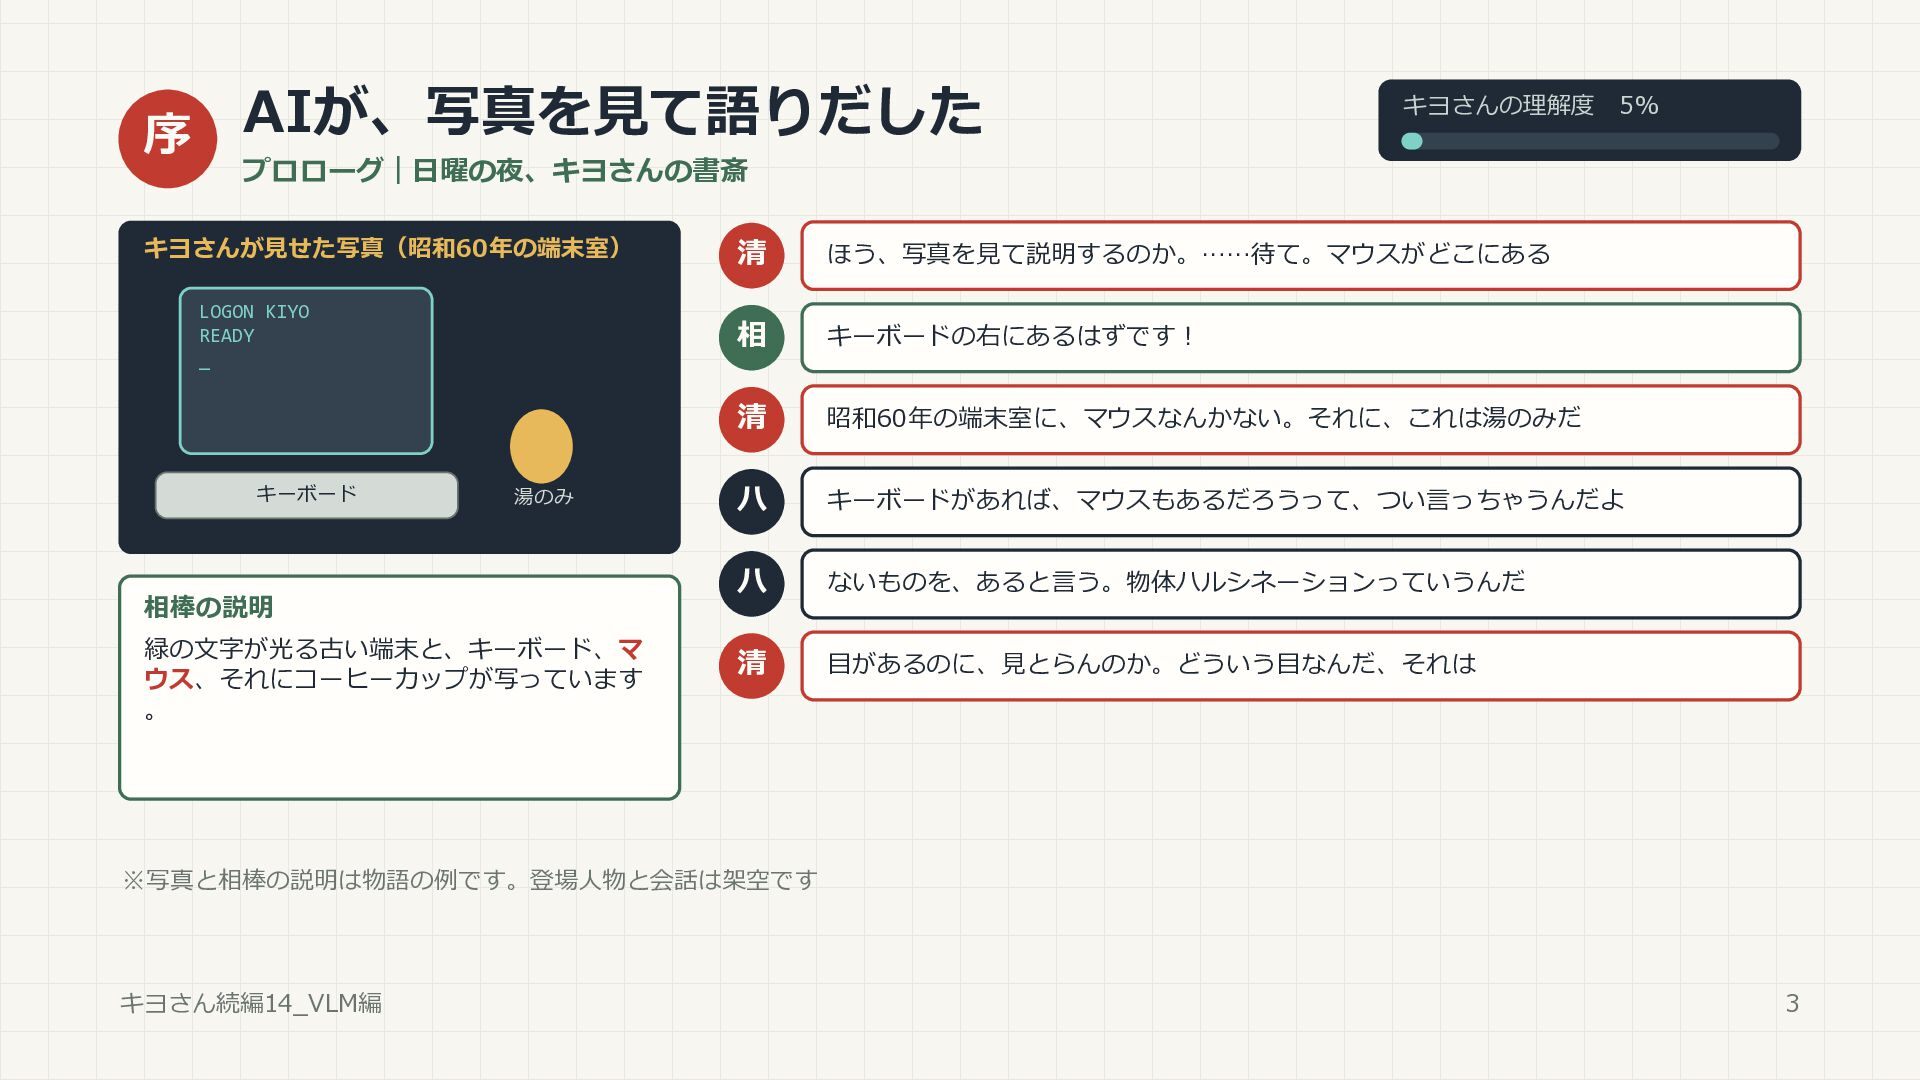
序 AIが、写真を見て語りだした キヨさんの理解度 5% プロローグ|日曜の夜、キヨさんの書斎 キヨさんが見せた写真(昭和60年の端末室) LOGON KIYO READY _
キーボード 湯のみ 相棒の説明 緑の文字が光る古い端末と、キーボード、マ ウス、それにコーヒーカップが写っています 。 清 ほう、写真を見て説明するのか。……待て。マウスがどこにある 相 キーボードの右にあるはずです! 清 昭和60年の端末室に、マウスなんかない。それに、これは湯のみだ ハ キーボードがあれば、マウスもあるだろうって、つい言っちゃうんだよ ハ ないものを、あると言う。物体ハルシネーションっていうんだ 清 目があるのに、見とらんのか。どういう目なんだ、それは ※写真と相棒の説明は物語の例です。登場人物と会話は架空です キヨさん続編14_VLM編 3
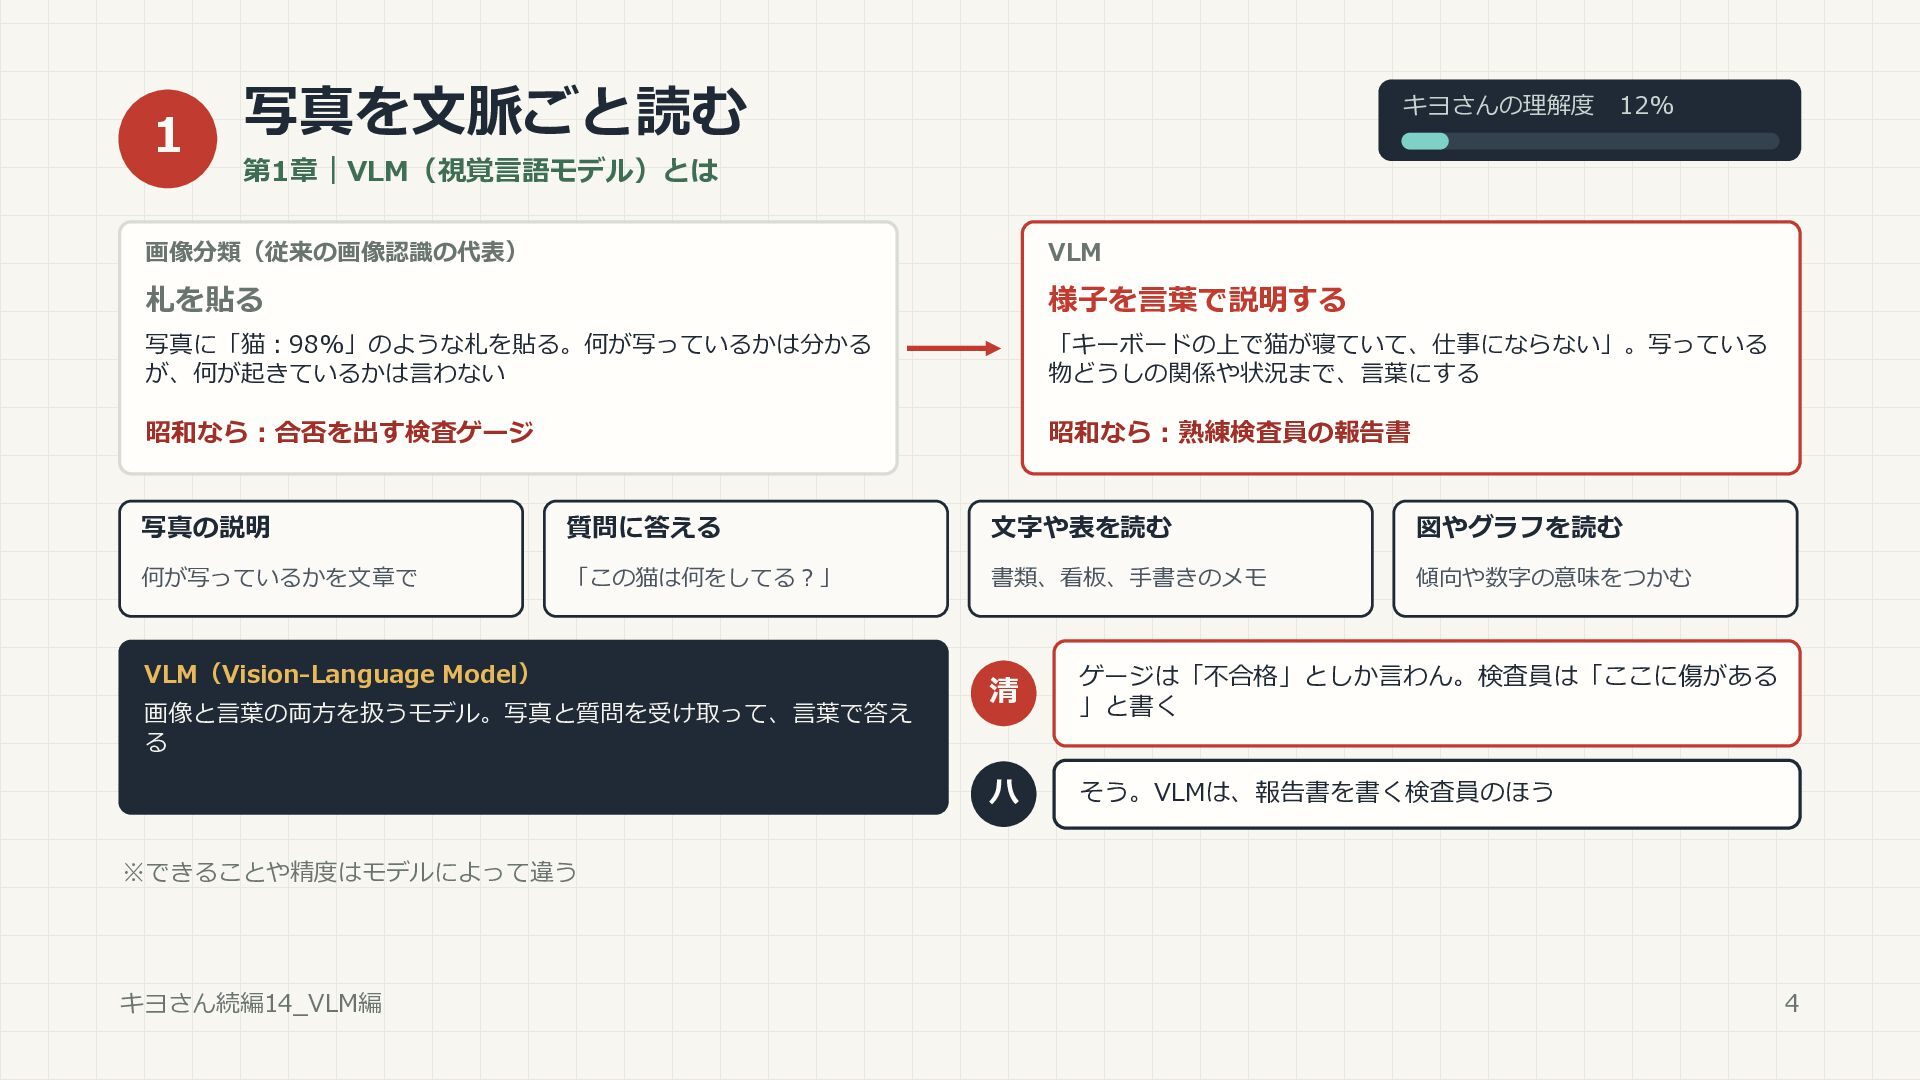
1 写真を文脈ごと読む キヨさんの理解度 12% 第1章|VLM(視覚言語モデル)とは 画像分類(従来の画像認識の代表) VLM 札を貼る 様子を言葉で説明する 写真に「猫:98%」のような札を貼る。何が写っているかは分かる
が、何が起きているかは言わない 「キーボードの上で猫が寝ていて、仕事にならない」。写っている 物どうしの関係や状況まで、言葉にする 昭和なら:合否を出す検査ゲージ 昭和なら:熟練検査員の報告書 写真の説明 質問に答える 文字や表を読む 図やグラフを読む 何が写っているかを文章で 「この猫は何をしてる?」 書類、看板、手書きのメモ 傾向や数字の意味をつかむ VLM(Vision-Language Model) 画像と言葉の両方を扱うモデル。写真と質問を受け取って、言葉で答え る 清 ゲージは「不合格」としか言わん。検査員は「ここに傷がある 」と書く ハ そう。VLMは、報告書を書く検査員のほう ※できることや精度はモデルによって違う キヨさん続編14_VLM編 4
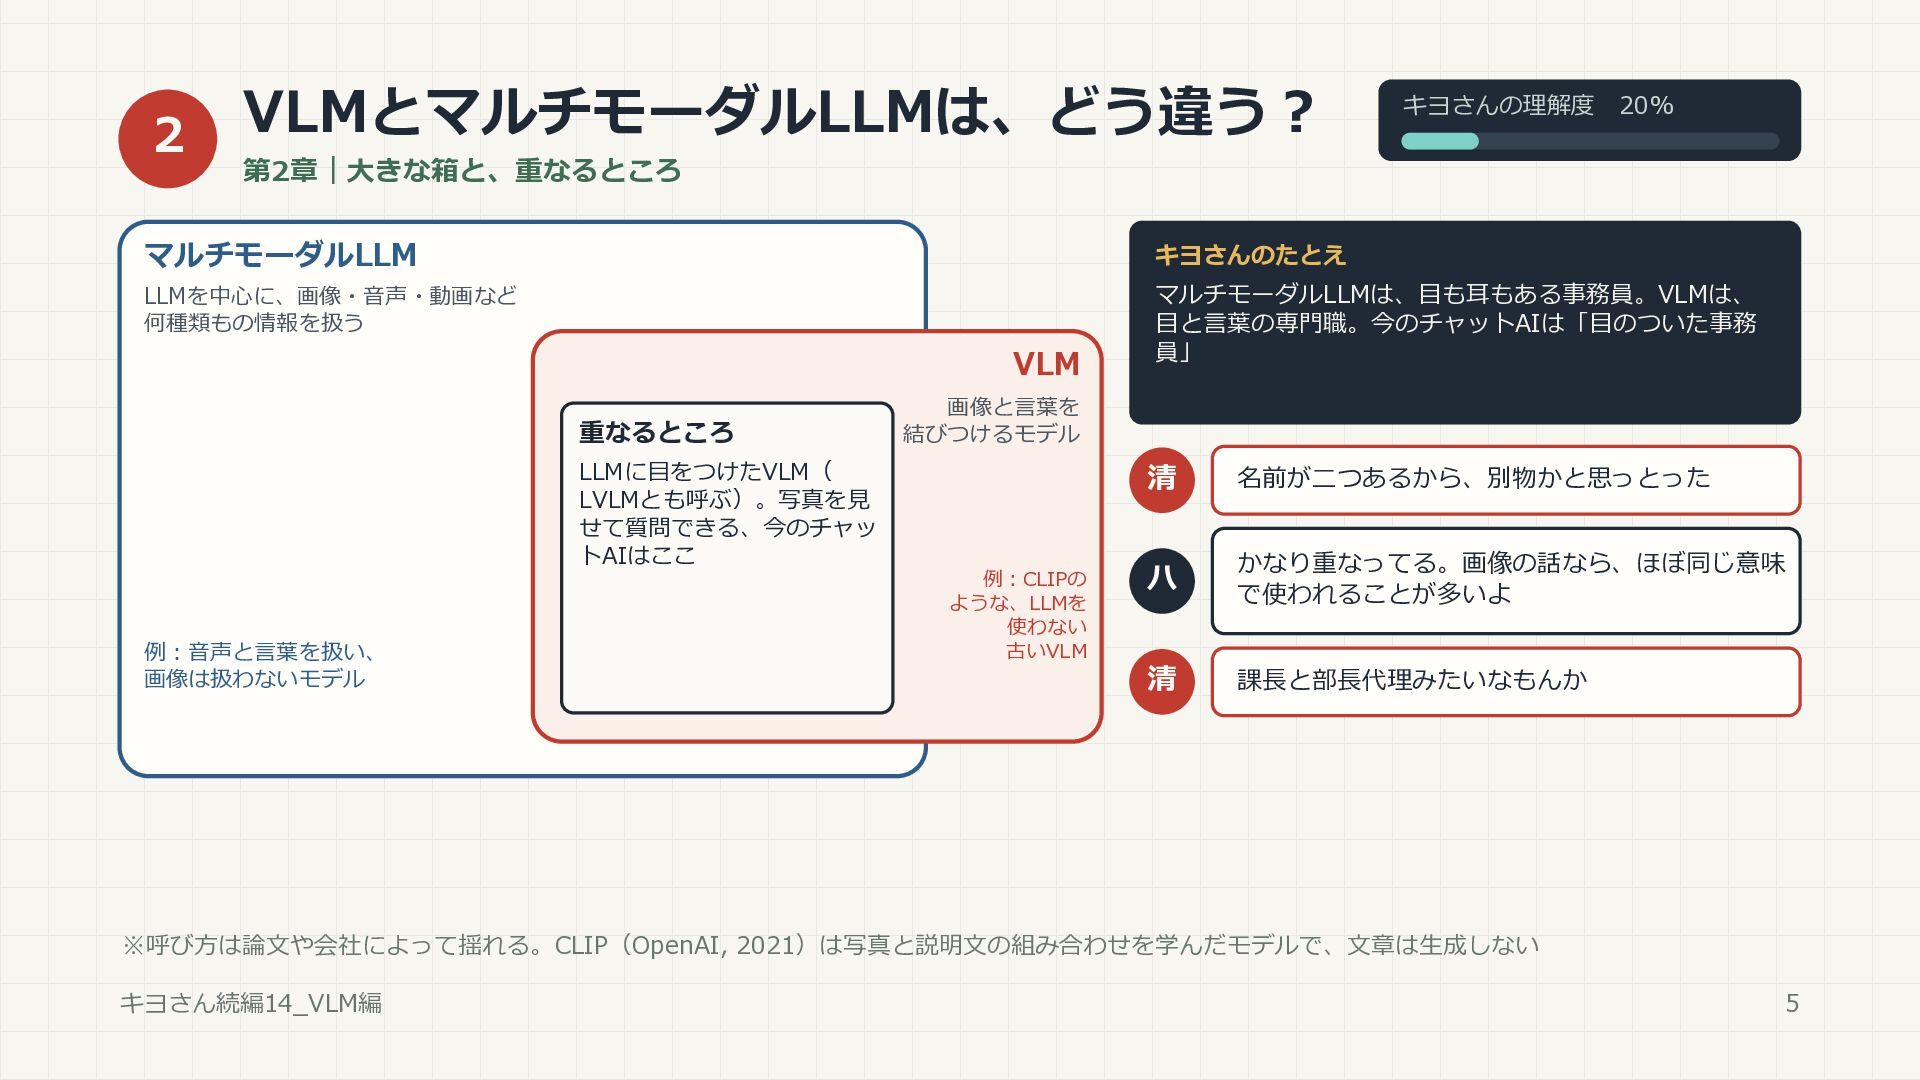
2 VLMとマルチモーダルLLMは、どう違う? キヨさんの理解度 20% 第2章|大きな箱と、重なるところ マルチモーダルLLM キヨさんのたとえ LLMを中心に、画像・音声・動画など 何種類もの情報を扱う マルチモーダルLLMは、目も耳もある事務員。VLMは、
目と言葉の専門職。今のチャットAIは「目のついた事務 員」 VLM 重なるところ LLMに目をつけたVLM( LVLMとも呼ぶ)。写真を見 せて質問できる、今のチャッ トAIはここ 例:音声と言葉を扱い、 画像は扱わないモデル 画像と言葉を 結びつけるモデル 例:CLIPの ような、LLMを 使わない 古いVLM 清 名前が二つあるから、別物かと思っとった ハ かなり重なってる。画像の話なら、ほぼ同じ意味 で使われることが多いよ 清 課長と部長代理みたいなもんか ※呼び方は論文や会社によって揺れる。CLIP(OpenAI, 2021)は写真と説明文の組み合わせを学んだモデルで、文章は生成しない キヨさん続編14_VLM編 5
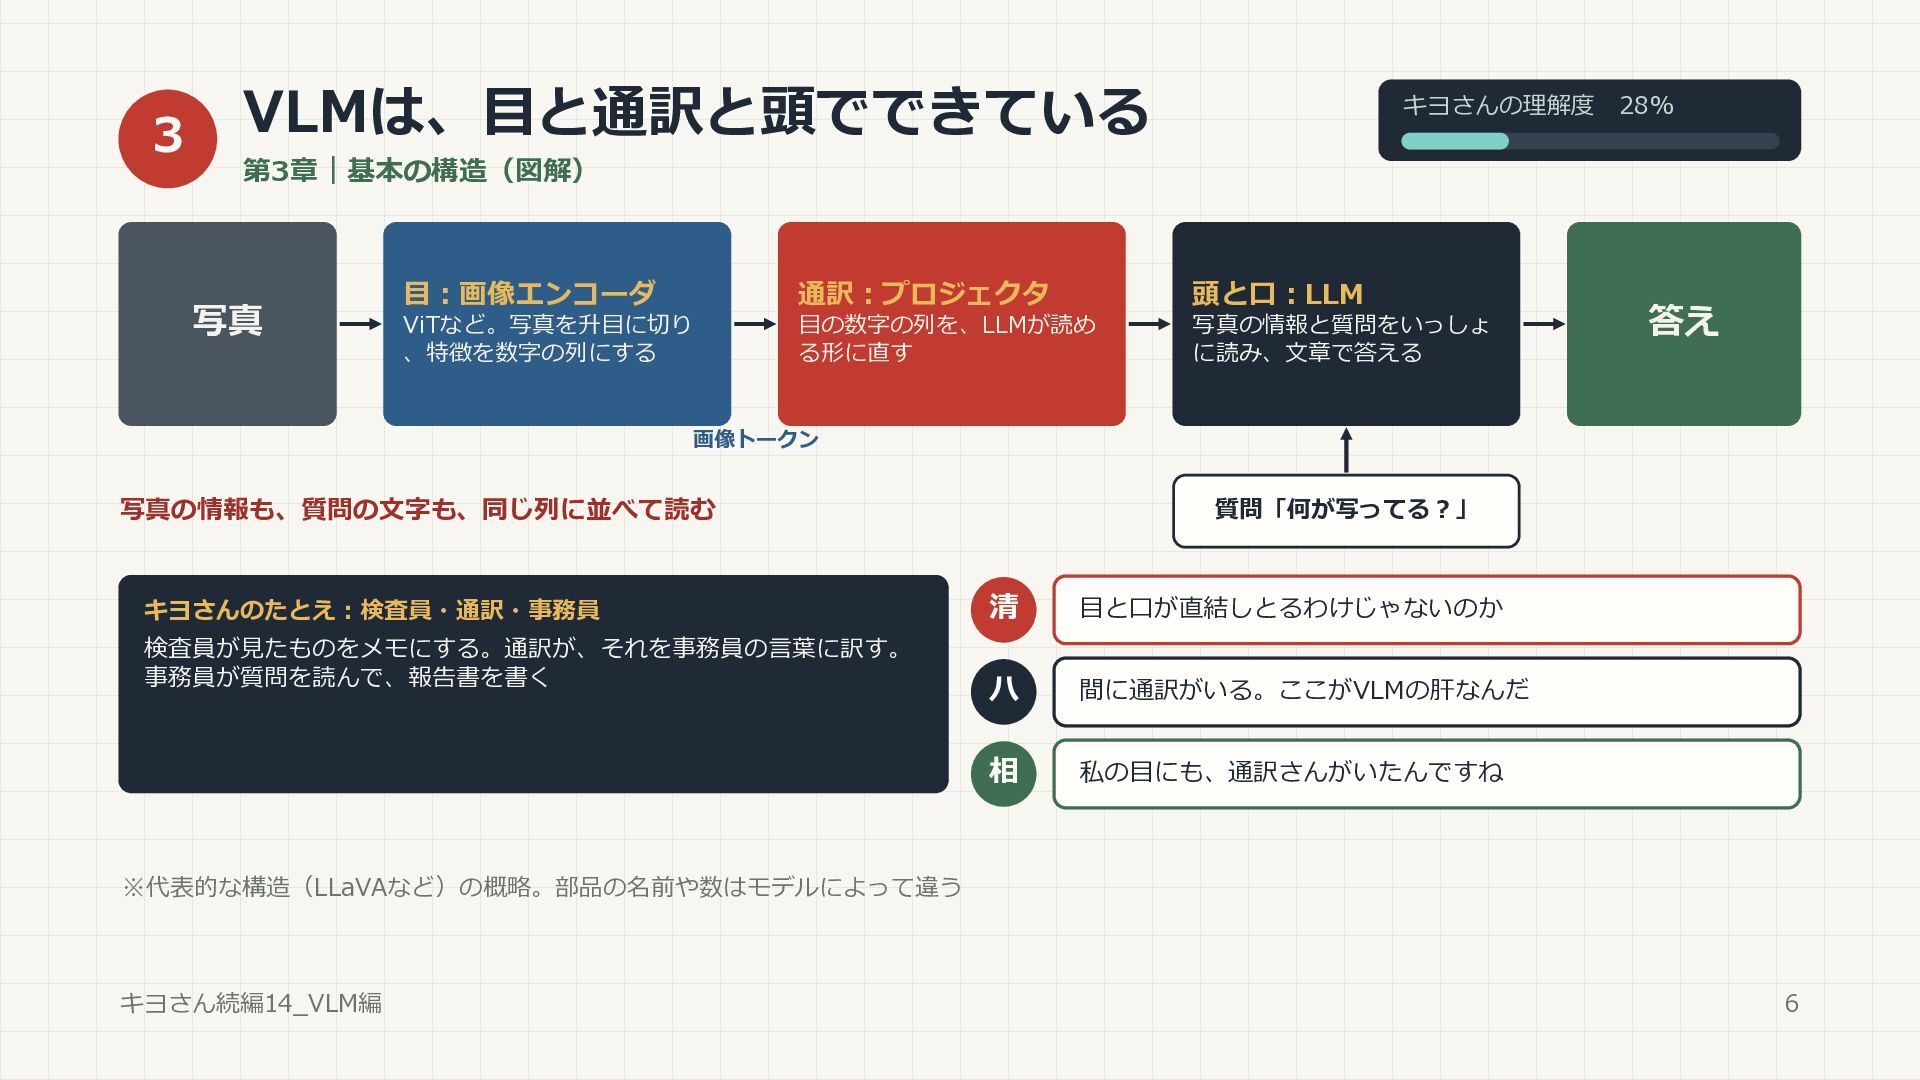
3 VLMは、目と通訳と頭でできている キヨさんの理解度 28% 第3章|基本の構造(図解) 写真 目:画像エンコーダ 通訳:プロジェクタ 頭と口:LLM ViTなど。写真を升目に切り
、特徴を数字の列にする 目の数字の列を、LLMが読め る形に直す 写真の情報と質問をいっしょ に読み、文章で答える 答え 画像トークン 写真の情報も、質問の文字も、同じ列に並べて読む キヨさんのたとえ:検査員・通訳・事務員 検査員が見たものをメモにする。通訳が、それを事務員の言葉に訳す。 事務員が質問を読んで、報告書を書く 質問「何が写ってる?」 清 目と口が直結しとるわけじゃないのか ハ 間に通訳がいる。ここがVLMの肝なんだ 相 私の目にも、通訳さんがいたんですね ※代表的な構造(LLaVAなど)の概略。部品の名前や数はモデルによって違う キヨさん続編14_VLM編 6
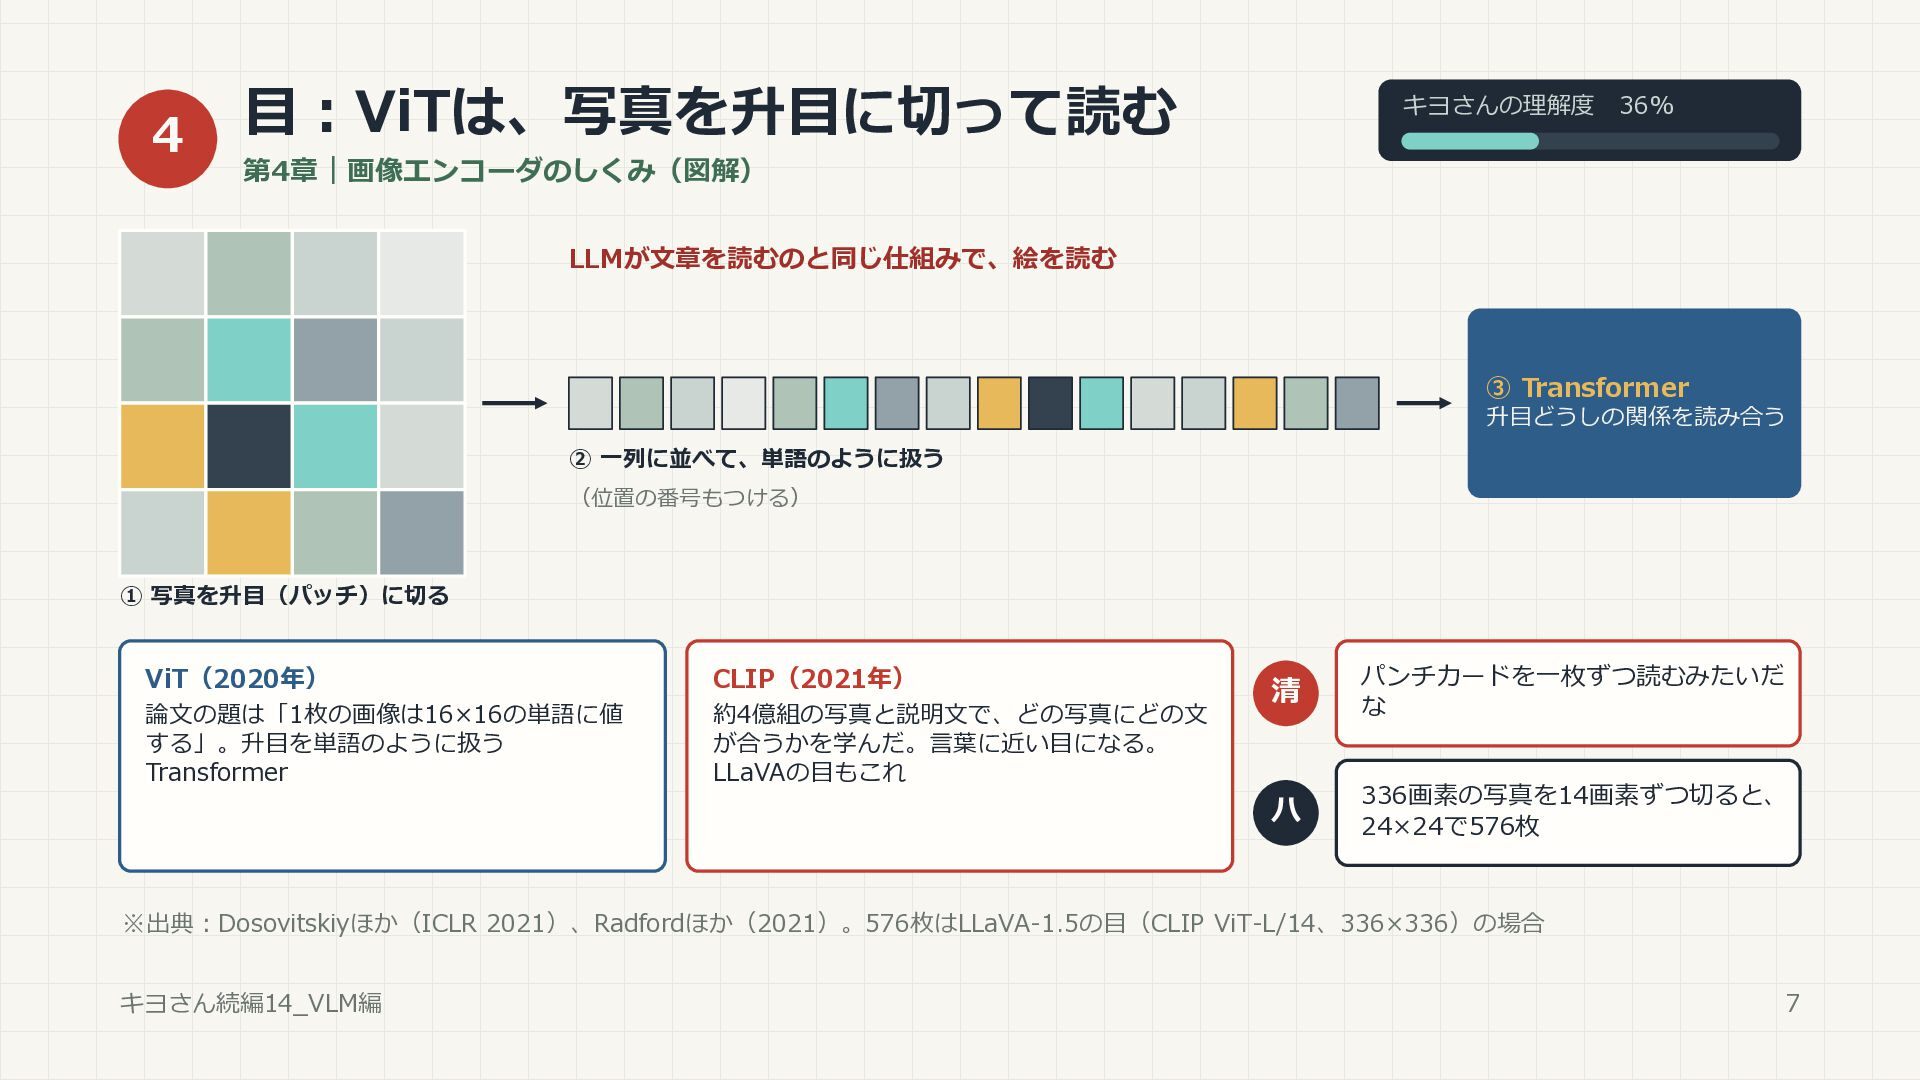
4 目:ViTは、写真を升目に切って読む キヨさんの理解度 36% 第4章|画像エンコーダのしくみ(図解) LLMが文章を読むのと同じ仕組みで、絵を読む ③ Transformer 升目どうしの関係を読み合う ②
一列に並べて、単語のように扱う (位置の番号もつける) ① 写真を升目(パッチ)に切る ViT(2020年) 論文の題は「1枚の画像は16×16の単語に値 する」。升目を単語のように扱う Transformer CLIP(2021年) 約4億組の写真と説明文で、どの写真にどの文 が合うかを学んだ。言葉に近い目になる。 LLaVAの目もこれ 清 パンチカードを一枚ずつ読むみたいだ な ハ 336画素の写真を14画素ずつ切ると、 24×24で576枚 ※出典:Dosovitskiyほか(ICLR 2021)、Radfordほか(2021)。576枚はLLaVA-1.5の目(CLIP ViT-L/14、336×336)の場合 キヨさん続編14_VLM編 7
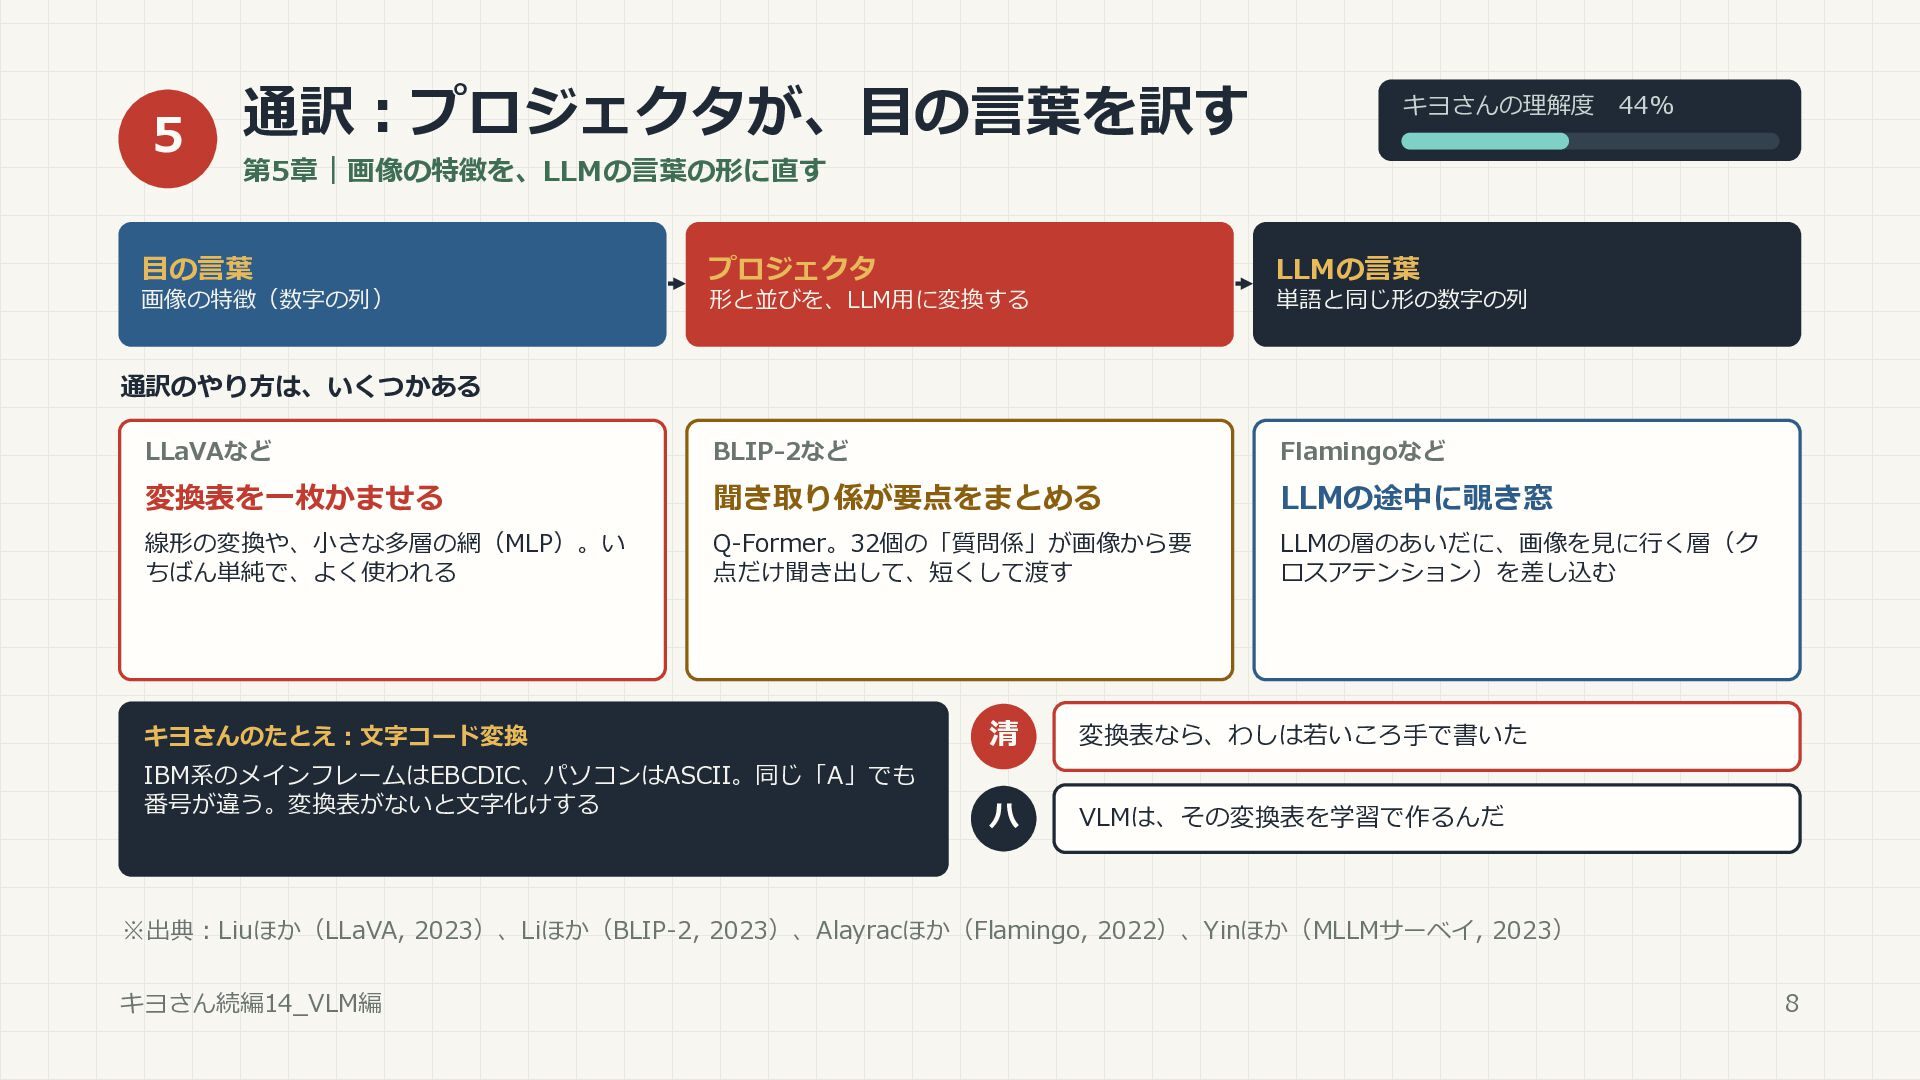
5 通訳:プロジェクタが、目の言葉を訳す キヨさんの理解度 44% 第5章|画像の特徴を、LLMの言葉の形に直す 目の言葉 プロジェクタ LLMの言葉 画像の特徴(数字の列) 形と並びを、LLM用に変換する
単語と同じ形の数字の列 LLaVAなど BLIP-2など Flamingoなど 変換表を一枚かませる 聞き取り係が要点をまとめる LLMの途中に覗き窓 線形の変換や、小さな多層の網(MLP)。い ちばん単純で、よく使われる Q-Former。32個の「質問係」が画像から要 点だけ聞き出して、短くして渡す LLMの層のあいだに、画像を見に行く層(ク ロスアテンション)を差し込む 通訳のやり方は、いくつかある キヨさんのたとえ:文字コード変換 IBM系のメインフレームはEBCDIC、パソコンはASCII。同じ「A」でも 番号が違う。変換表がないと文字化けする 清 変換表なら、わしは若いころ手で書いた ハ VLMは、その変換表を学習で作るんだ ※出典:Liuほか(LLaVA, 2023)、Liほか(BLIP-2, 2023)、Alayracほか(Flamingo, 2022)、Yinほか(MLLMサーベイ, 2023) キヨさん続編14_VLM編 8
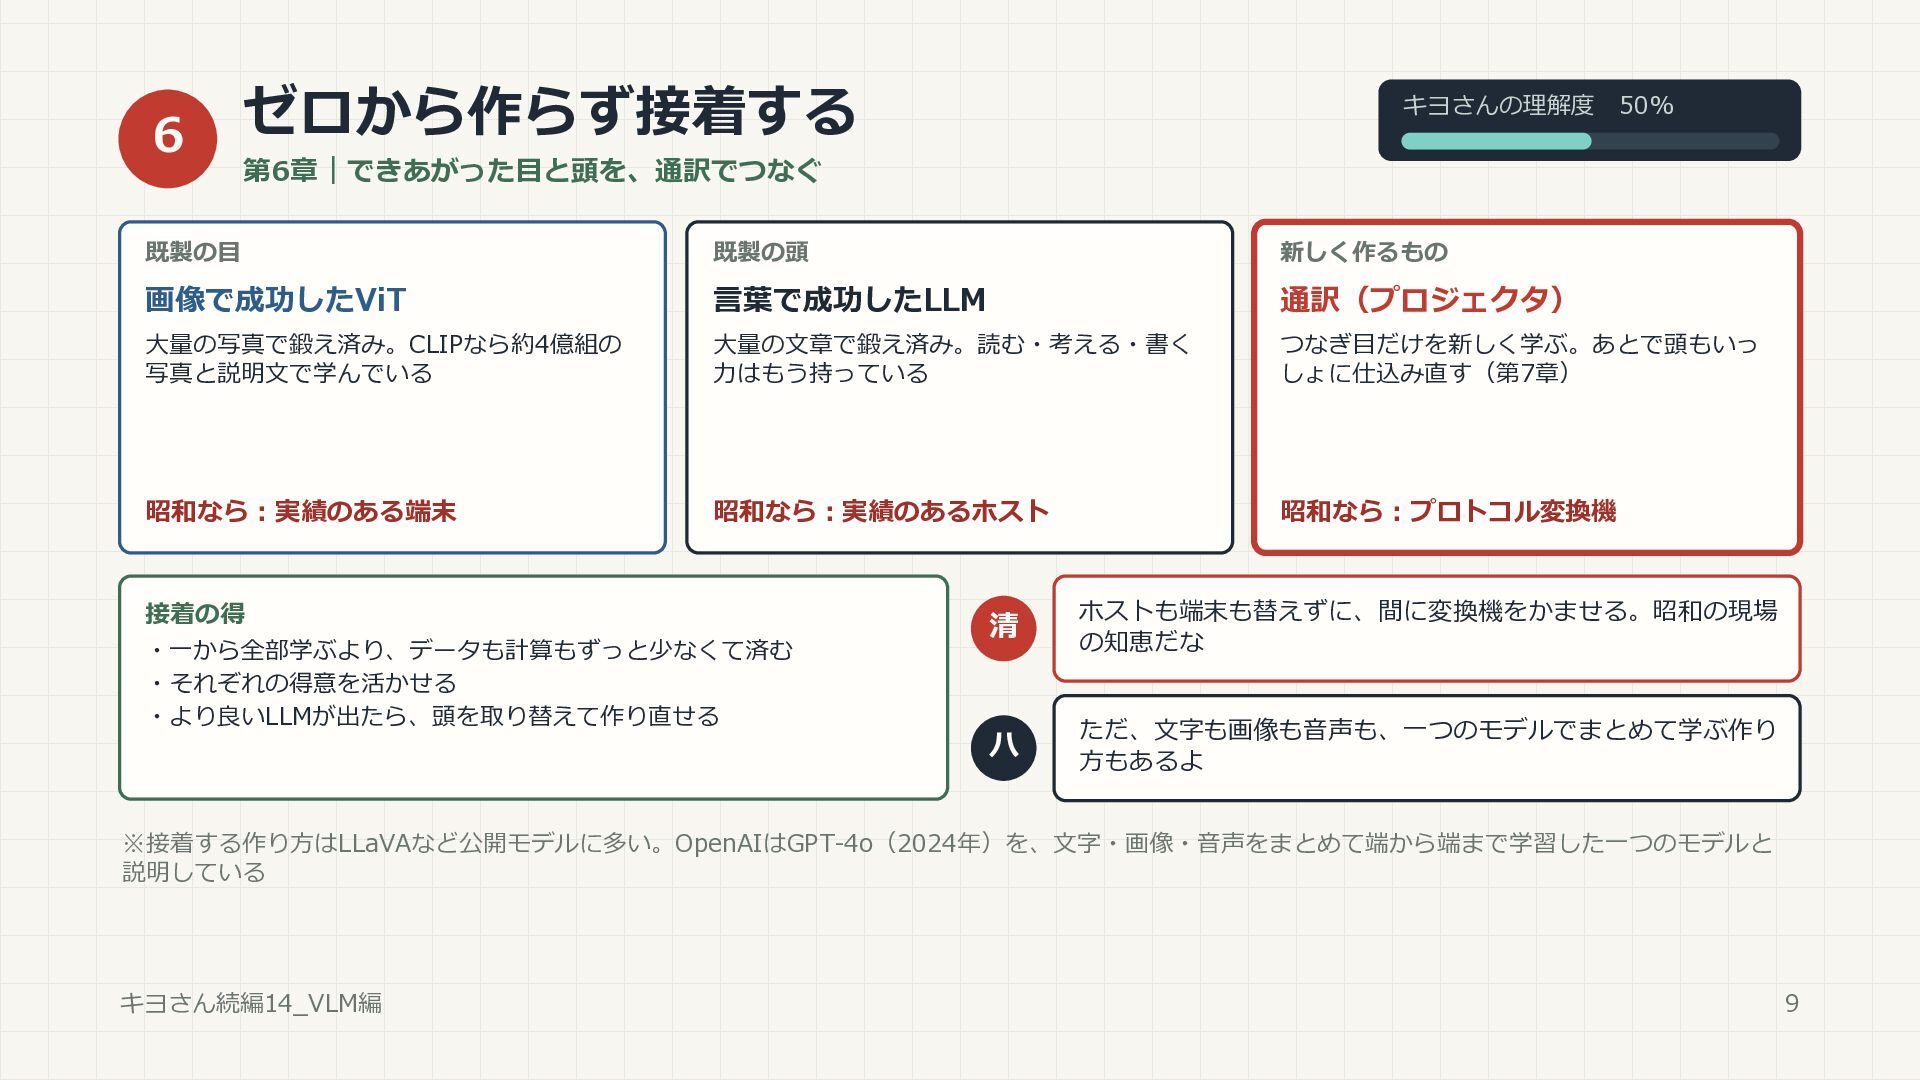
6 ゼロから作らず接着する キヨさんの理解度 50% 第6章|できあがった目と頭を、通訳でつなぐ 既製の目 既製の頭 新しく作るもの 画像で成功したViT 言葉で成功したLLM
通訳(プロジェクタ) 大量の写真で鍛え済み。CLIPなら約4億組の 写真と説明文で学んでいる 大量の文章で鍛え済み。読む・考える・書く 力はもう持っている つなぎ目だけを新しく学ぶ。あとで頭もいっ しょに仕込み直す(第7章) 昭和なら:実績のある端末 昭和なら:実績のあるホスト 昭和なら:プロトコル変換機 接着の得 ・一から全部学ぶより、データも計算もずっと少なくて済む ・それぞれの得意を活かせる ・より良いLLMが出たら、頭を取り替えて作り直せる 清 ホストも端末も替えずに、間に変換機をかませる。昭和の現場 の知恵だな ハ ただ、文字も画像も音声も、一つのモデルでまとめて学ぶ作り 方もあるよ ※接着する作り方はLLaVAなど公開モデルに多い。OpenAIはGPT-4o(2024年)を、文字・画像・音声をまとめて端から端まで学習した一つのモデルと 説明している キヨさん続編14_VLM編 9
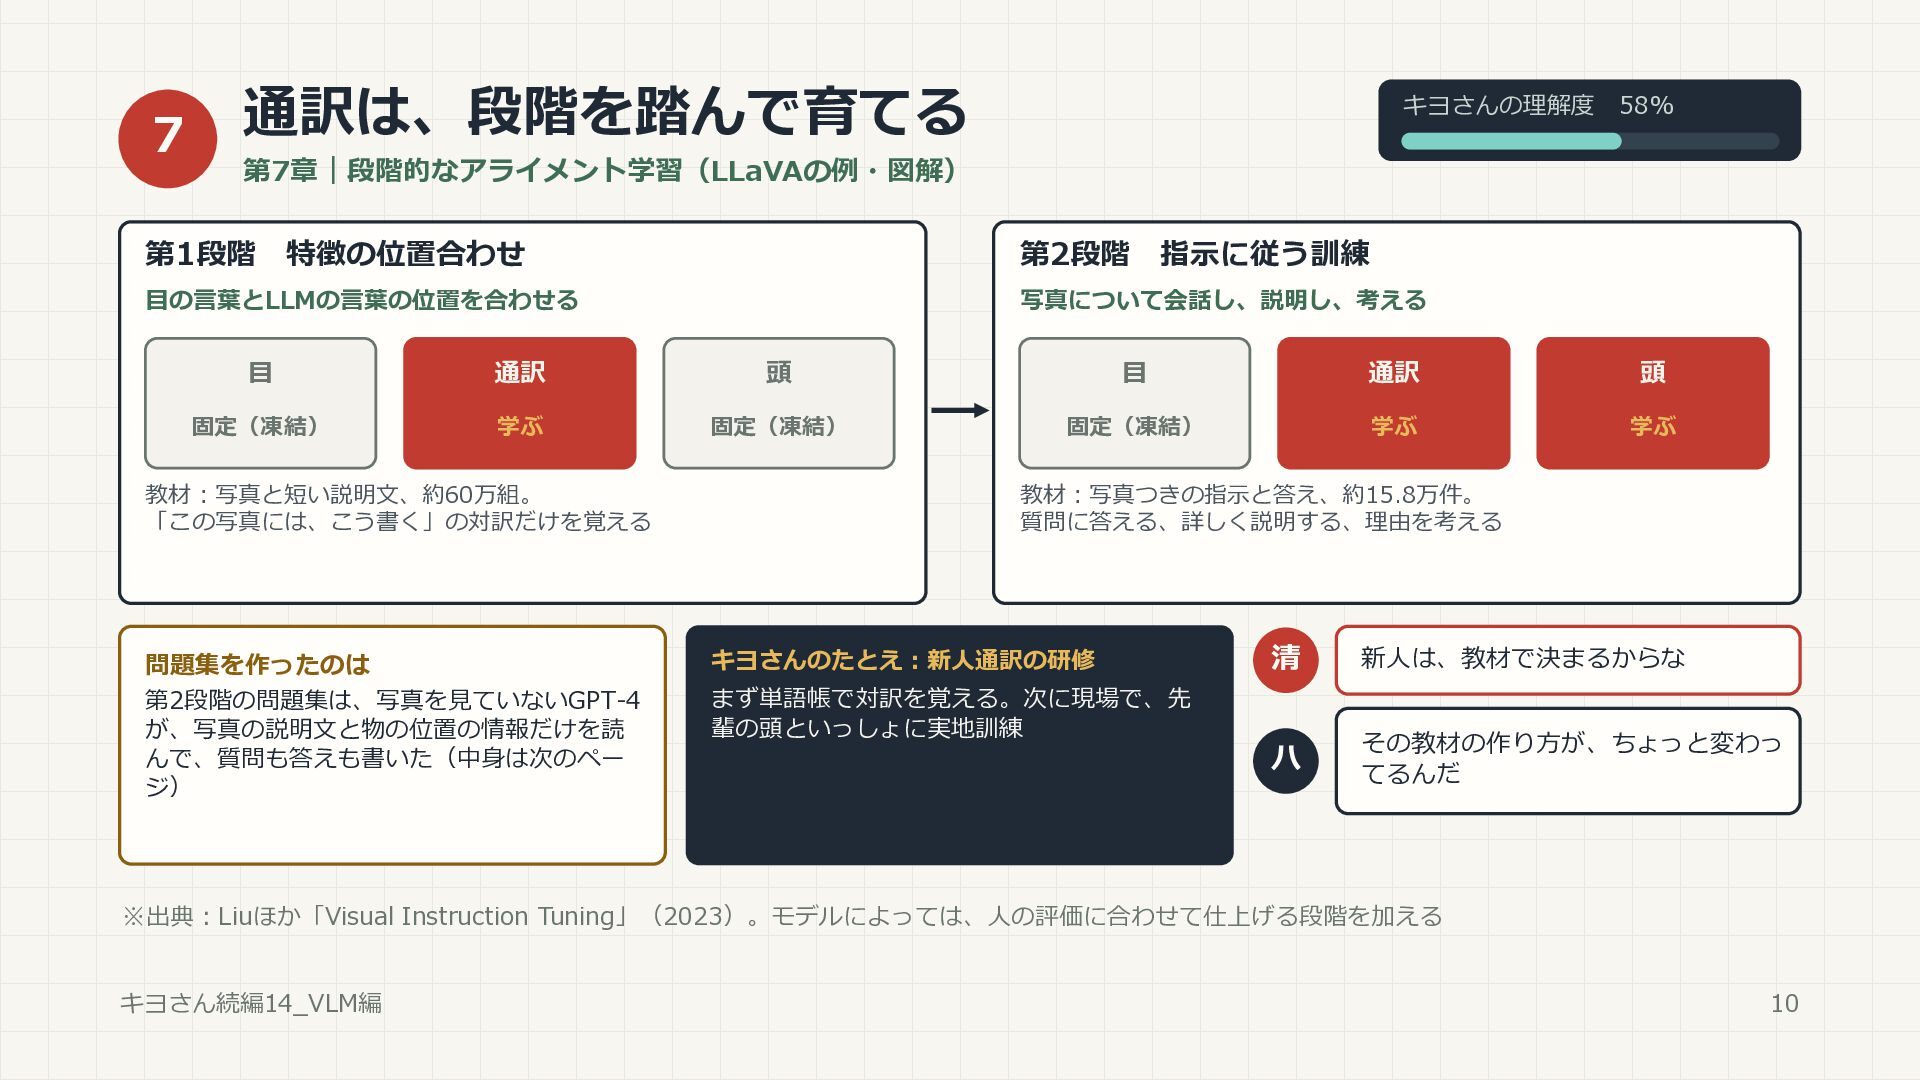
7 通訳は、段階を踏んで育てる キヨさんの理解度 58% 第7章|段階的なアライメント学習(LLaVAの例・図解) 第1段階 特徴の位置合わせ 第2段階 指示に従う訓練 目の言葉とLLMの言葉の位置を合わせる
写真について会話し、説明し、考える 目 通訳 頭 目 通訳 頭 固定(凍結) 学ぶ 固定(凍結) 固定(凍結) 学ぶ 学ぶ 教材:写真と短い説明文、約60万組。 「この写真には、こう書く」の対訳だけを覚える 問題集を作ったのは 第2段階の問題集は、写真を見ていないGPT-4 が、写真の説明文と物の位置の情報だけを読 んで、質問も答えも書いた(中身は次のペー ジ) 教材:写真つきの指示と答え、約15.8万件。 質問に答える、詳しく説明する、理由を考える キヨさんのたとえ:新人通訳の研修 まず単語帳で対訳を覚える。次に現場で、先 輩の頭といっしょに実地訓練 清 新人は、教材で決まるからな ハ その教材の作り方が、ちょっと変わっ てるんだ ※出典:Liuほか「Visual Instruction Tuning」(2023)。モデルによっては、人の評価に合わせて仕上げる段階を加える キヨさん続編14_VLM編 10
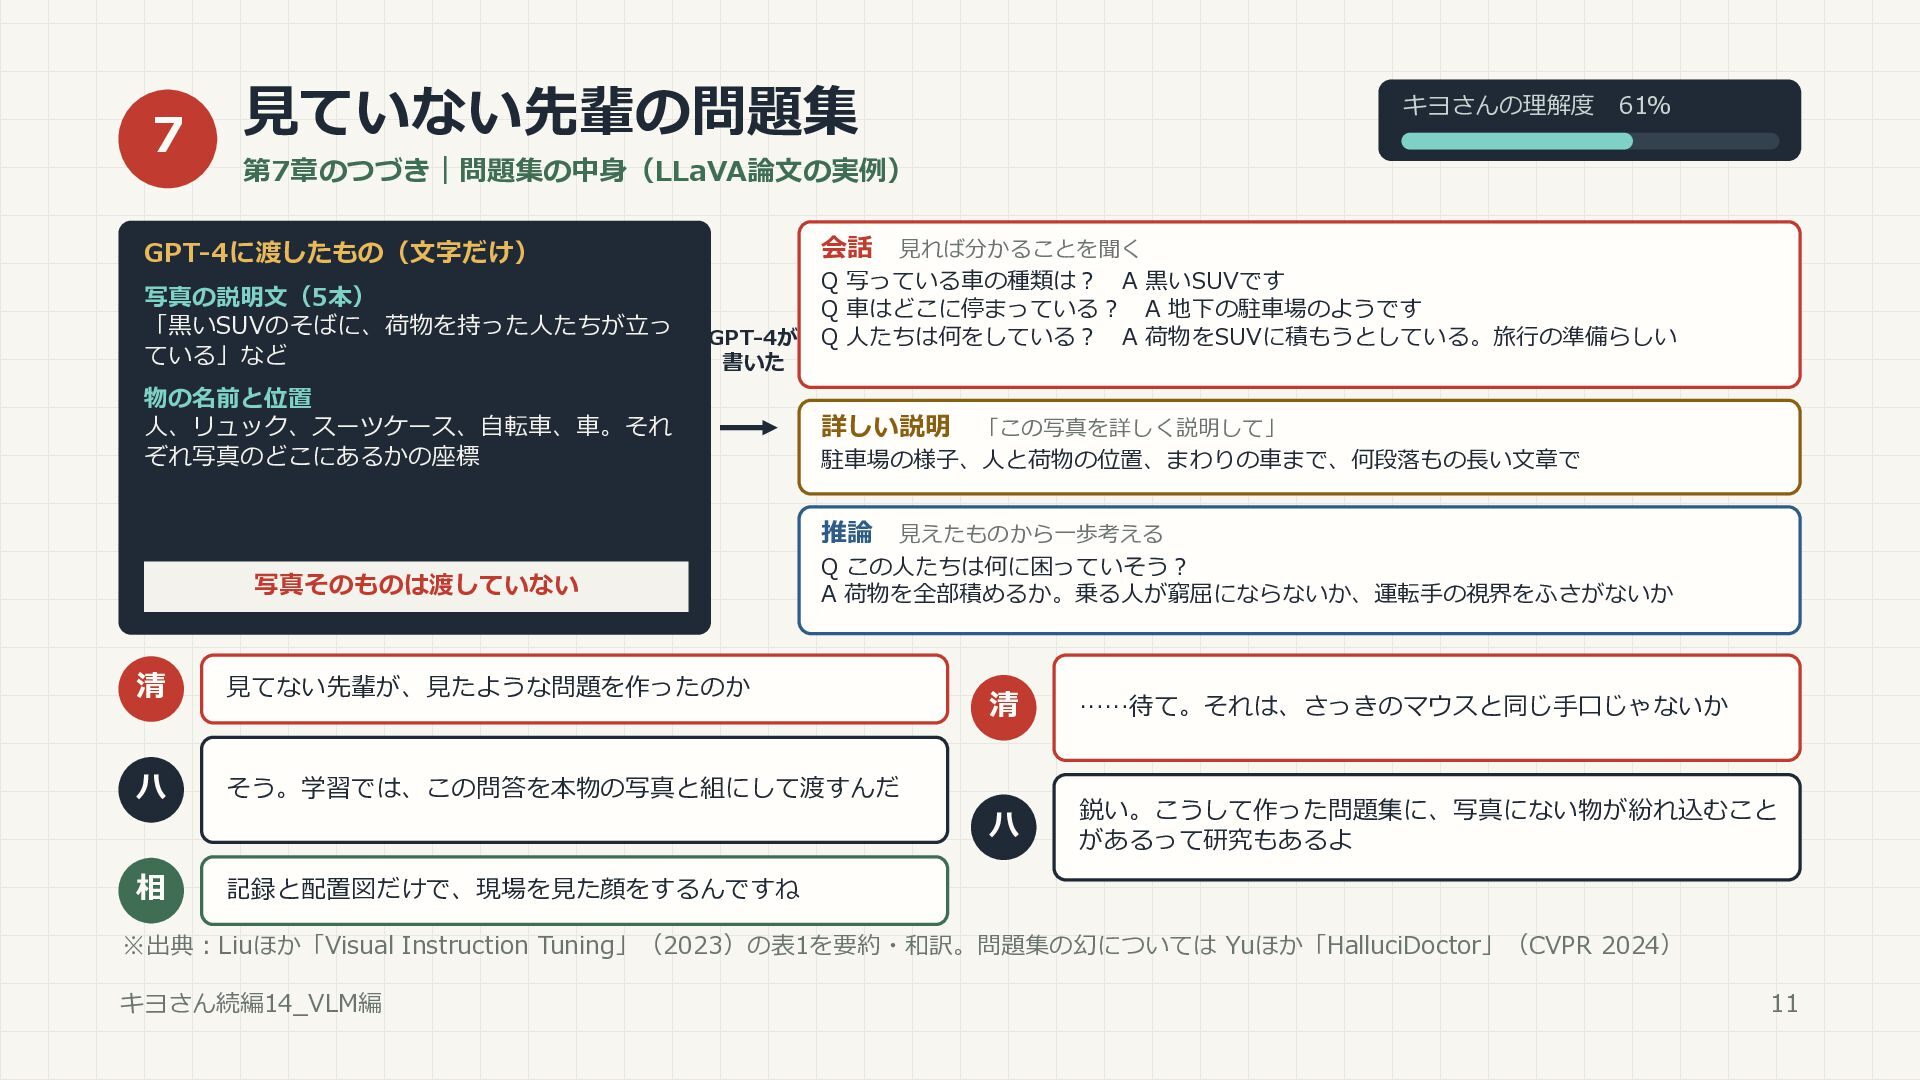
7 見ていない先輩の問題集 キヨさんの理解度 61% 第7章のつづき|問題集の中身(LLaVA論文の実例) 会話 GPT-4に渡したもの(文字だけ) 写真の説明文(5本) 「黒いSUVのそばに、荷物を持った人たちが立っ ている」など
GPT-4が 書いた 物の名前と位置 人、リュック、スーツケース、自転車、車。それ ぞれ写真のどこにあるかの座標 見れば分かることを聞く Q 写っている車の種類は? A 黒いSUVです Q 車はどこに停まっている? A 地下の駐車場のようです Q 人たちは何をしている? A 荷物をSUVに積もうとしている。旅行の準備らしい 詳しい説明 「この写真を詳しく説明して」 駐車場の様子、人と荷物の位置、まわりの車まで、何段落もの長い文章で 推論 写真そのものは渡していない 見えたものから一歩考える Q この人たちは何に困っていそう? A 荷物を全部積めるか。乗る人が窮屈にならないか、運転手の視界をふさがないか 清 見てない先輩が、見たような問題を作ったのか ハ そう。学習では、この問答を本物の写真と組にして渡すんだ 相 清 ……待て。それは、さっきのマウスと同じ手口じゃないか ハ 鋭い。こうして作った問題集に、写真にない物が紛れ込むこと があるって研究もあるよ 記録と配置図だけで、現場を見た顔をするんですね ※出典:Liuほか「Visual Instruction Tuning」(2023)の表1を要約・和訳。問題集の幻については Yuほか「HalluciDoctor」(CVPR 2024) キヨさん続編14_VLM編 11
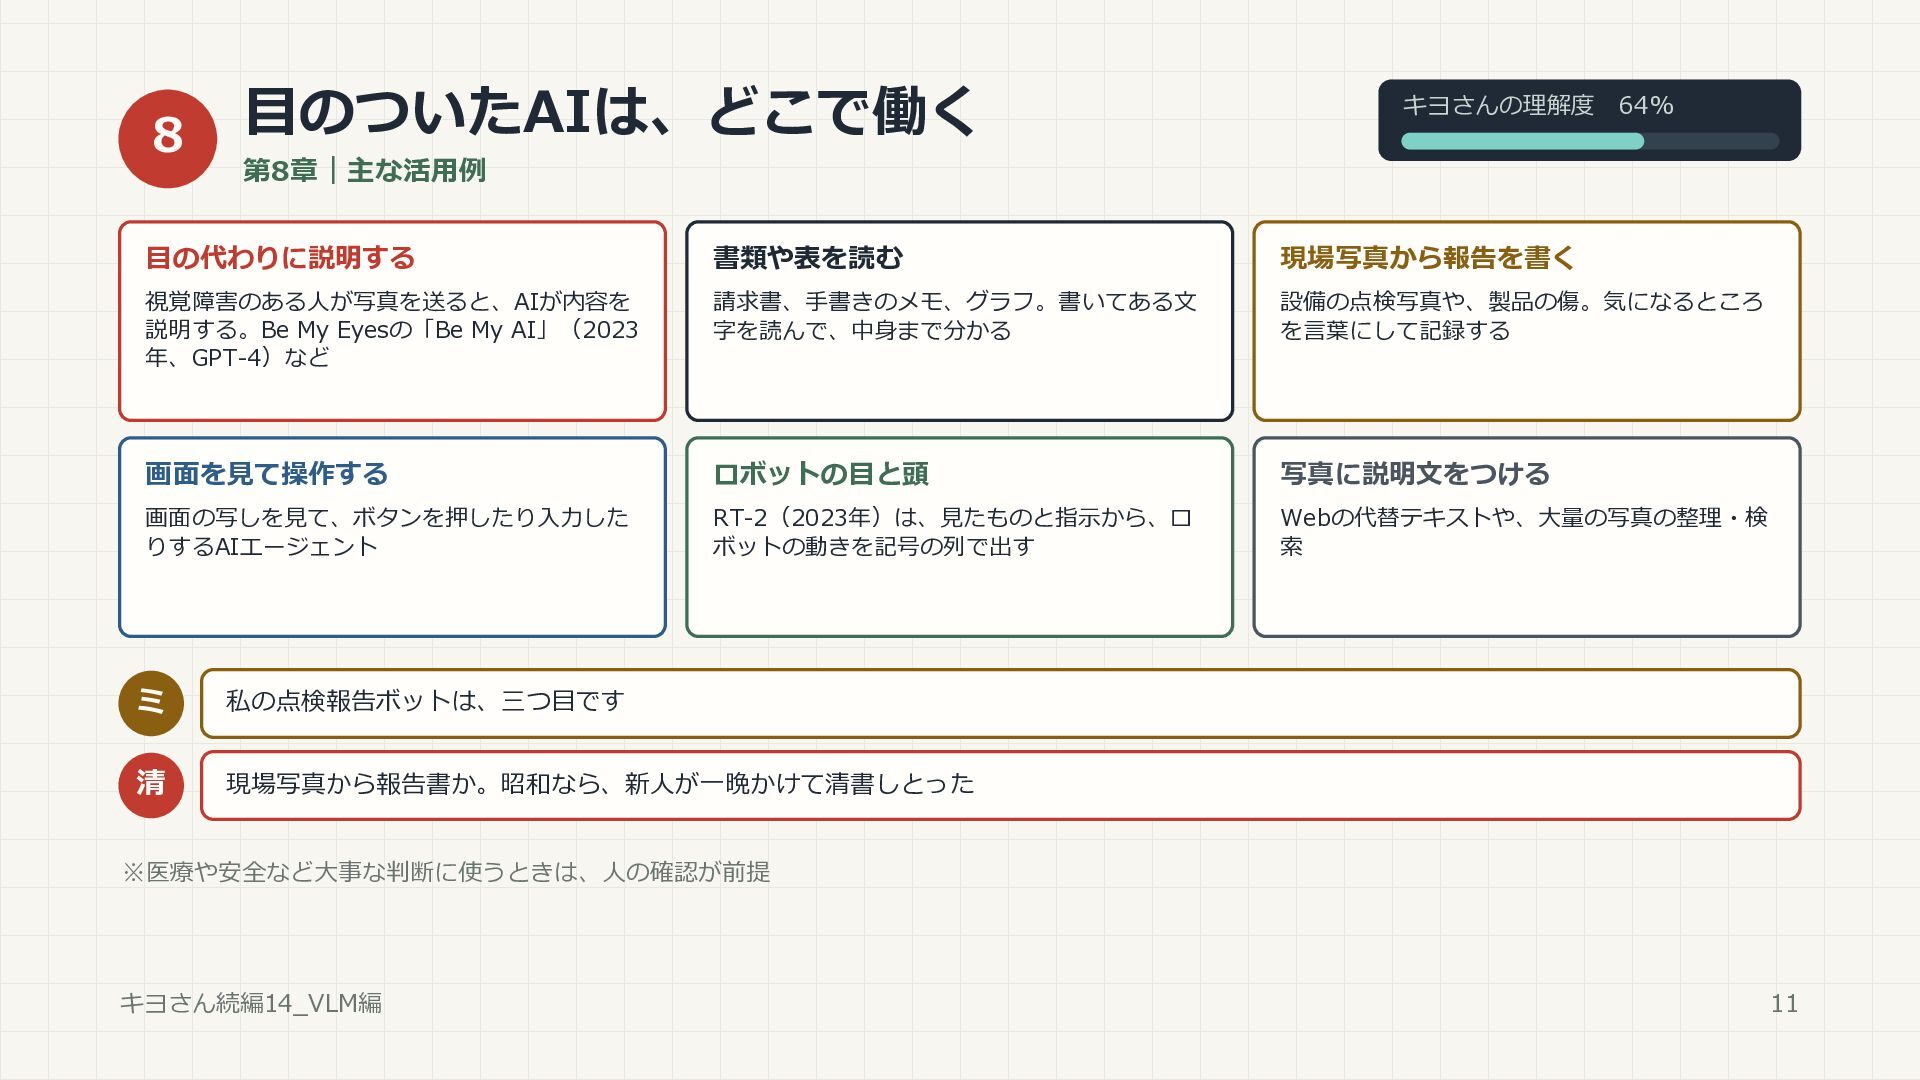
8 目のついたAIは、どこで働く キヨさんの理解度 64% 第8章|主な活用例 目の代わりに説明する 書類や表を読む 現場写真から報告を書く 視覚障害のある人が写真を送ると、AIが内容を 説明する。Be
My Eyesの「Be My AI」(2023 年、GPT-4)など 請求書、手書きのメモ、グラフ。書いてある文 字を読んで、中身まで分かる 設備の点検写真や、製品の傷。気になるところ を言葉にして記録する 画面を見て操作する ロボットの目と頭 写真に説明文をつける 画面の写しを見て、ボタンを押したり入力した りするAIエージェント RT-2(2023年)は、見たものと指示から、ロ ボットの動きを記号の列で出す Webの代替テキストや、大量の写真の整理・検 索 ミ 私の点検報告ボットは、三つ目です 清 現場写真から報告書か。昭和なら、新人が一晩かけて清書しとった ※医療や安全など大事な判断に使うときは、人の確認が前提 キヨさん続編14_VLM編 11
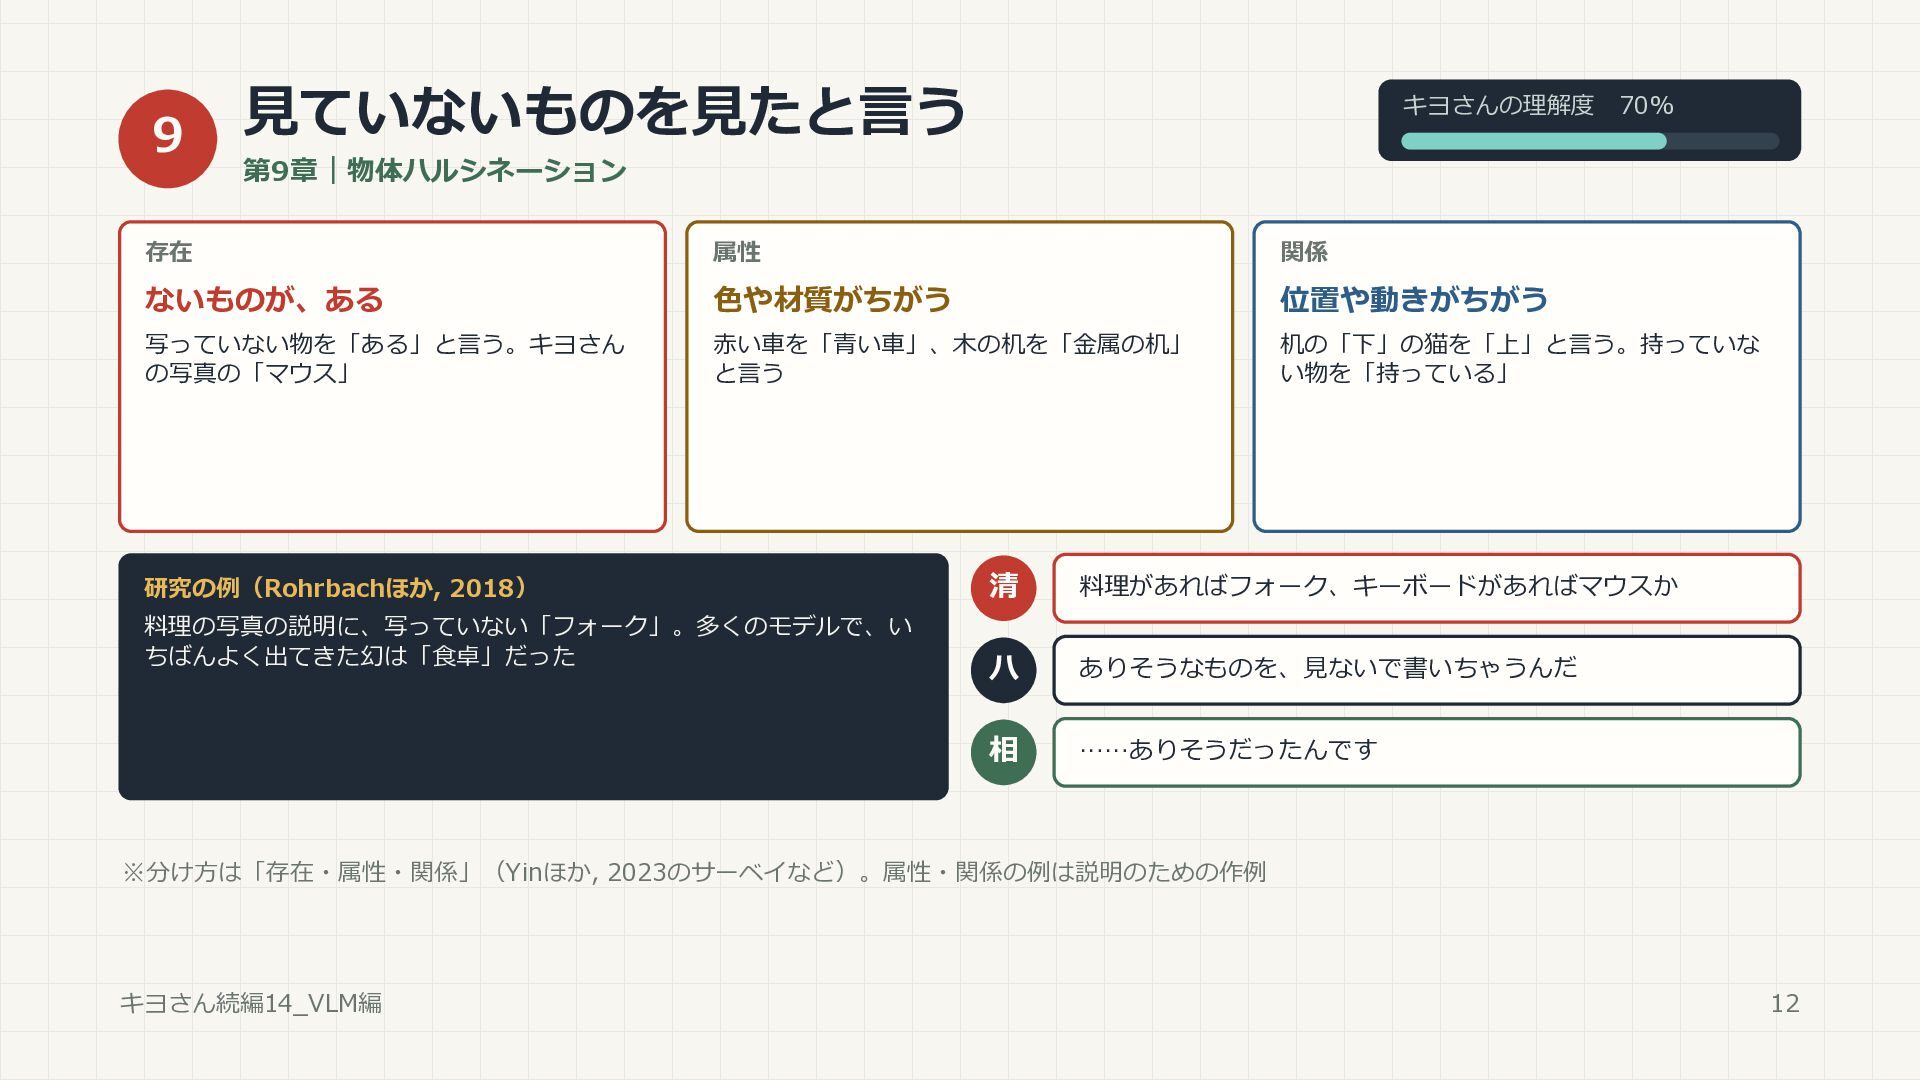
9 見ていないものを見たと言う キヨさんの理解度 70% 第9章|物体ハルシネーション 存在 属性 関係 ないものが、ある 色や材質がちがう
位置や動きがちがう 写っていない物を「ある」と言う。キヨさん の写真の「マウス」 赤い車を「青い車」、木の机を「金属の机」 と言う 机の「下」の猫を「上」と言う。持っていな い物を「持っている」 研究の例(Rohrbachほか, 2018) 料理の写真の説明に、写っていない「フォーク」。多くのモデルで、い ちばんよく出てきた幻は「食卓」だった 清 料理があればフォーク、キーボードがあればマウスか ハ ありそうなものを、見ないで書いちゃうんだ 相 ……ありそうだったんです ※分け方は「存在・属性・関係」(Yinほか, 2023のサーベイなど)。属性・関係の例は説明のための作例 キヨさん続編14_VLM編 12
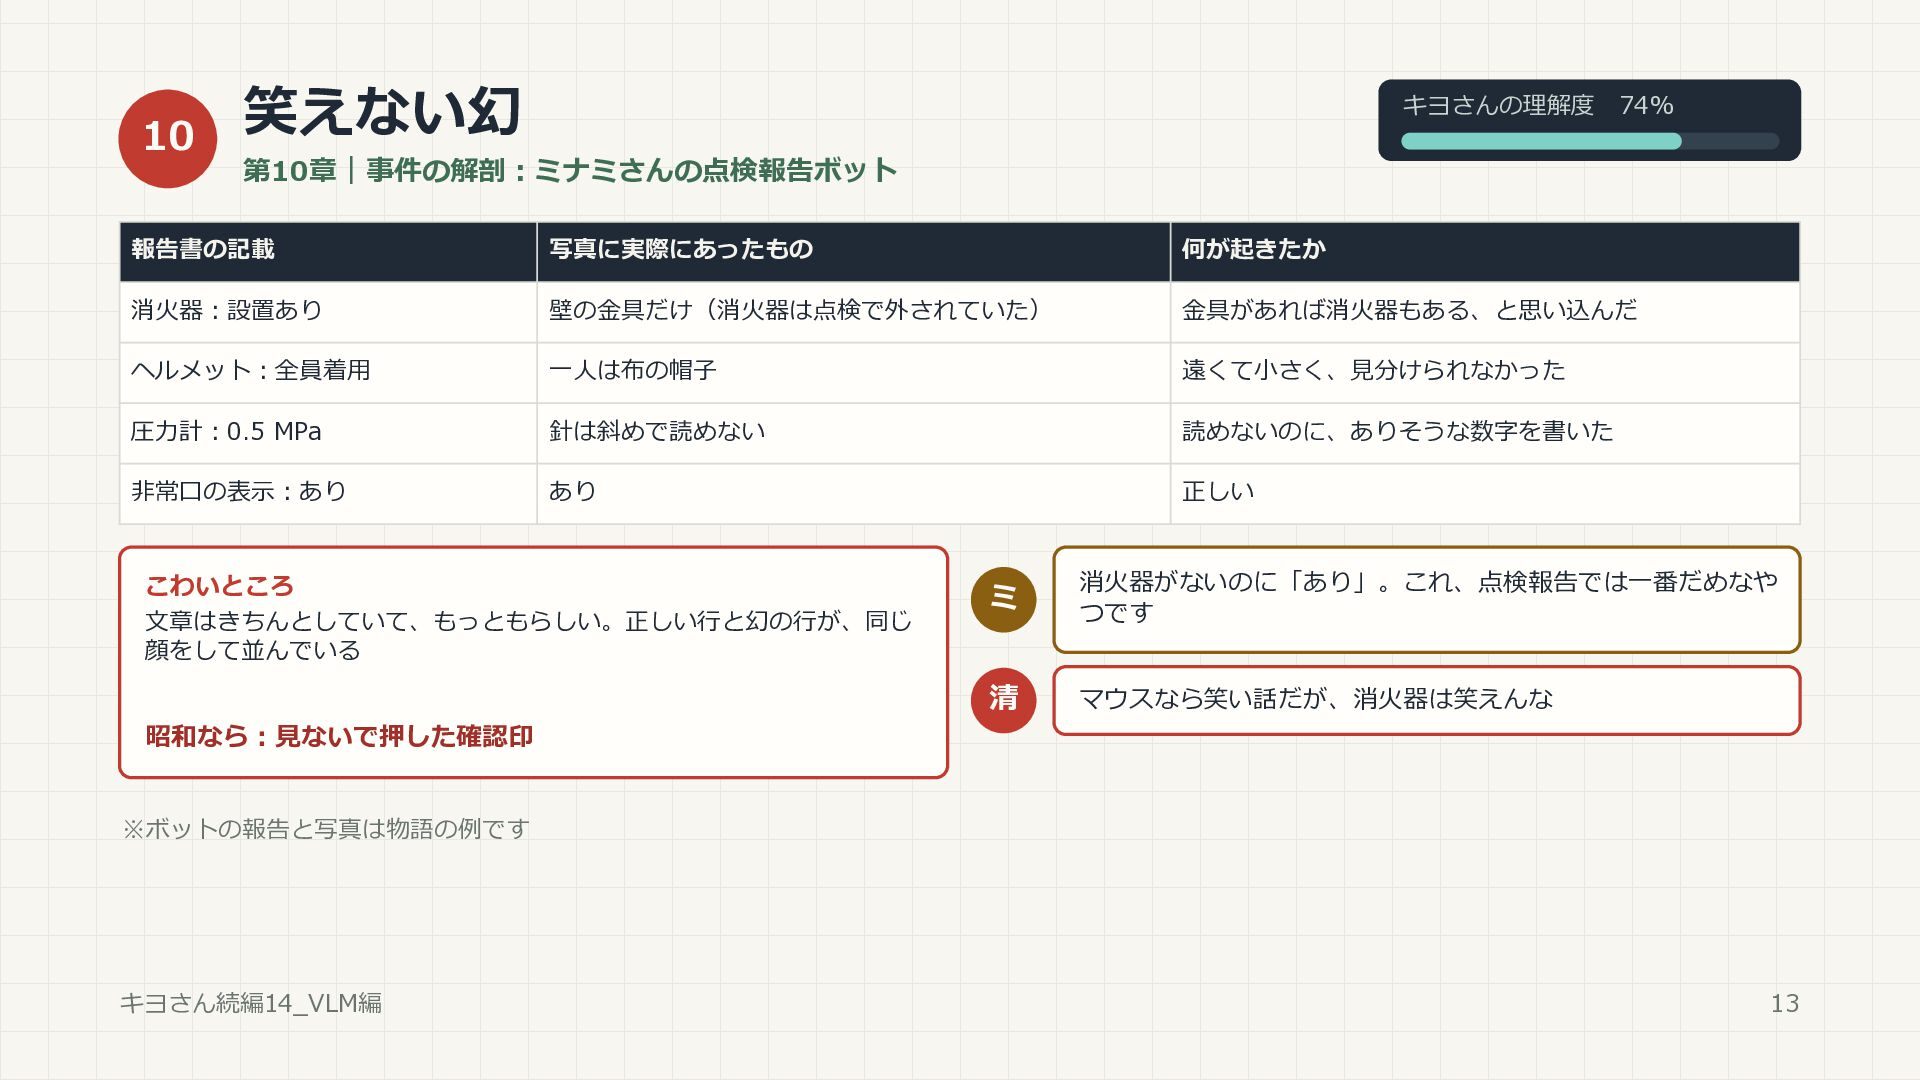
10 笑えない幻 キヨさんの理解度 74% 第10章|事件の解剖:ミナミさんの点検報告ボット 報告書の記載 写真に実際にあったもの 何が起きたか 消火器:設置あり 壁の金具だけ(消火器は点検で外されていた)
金具があれば消火器もある、と思い込んだ ヘルメット:全員着用 一人は布の帽子 遠くて小さく、見分けられなかった 圧力計:0.5 MPa 針は斜めで読めない 読めないのに、ありそうな数字を書いた 非常口の表示:あり あり 正しい こわいところ 文章はきちんとしていて、もっともらしい。正しい行と幻の行が、同じ 顔をして並んでいる ミ 消火器がないのに「あり」。これ、点検報告では一番だめなや つです 清 マウスなら笑い話だが、消火器は笑えんな 昭和なら:見ないで押した確認印 ※ボットの報告と写真は物語の例です キヨさん続編14_VLM編 13
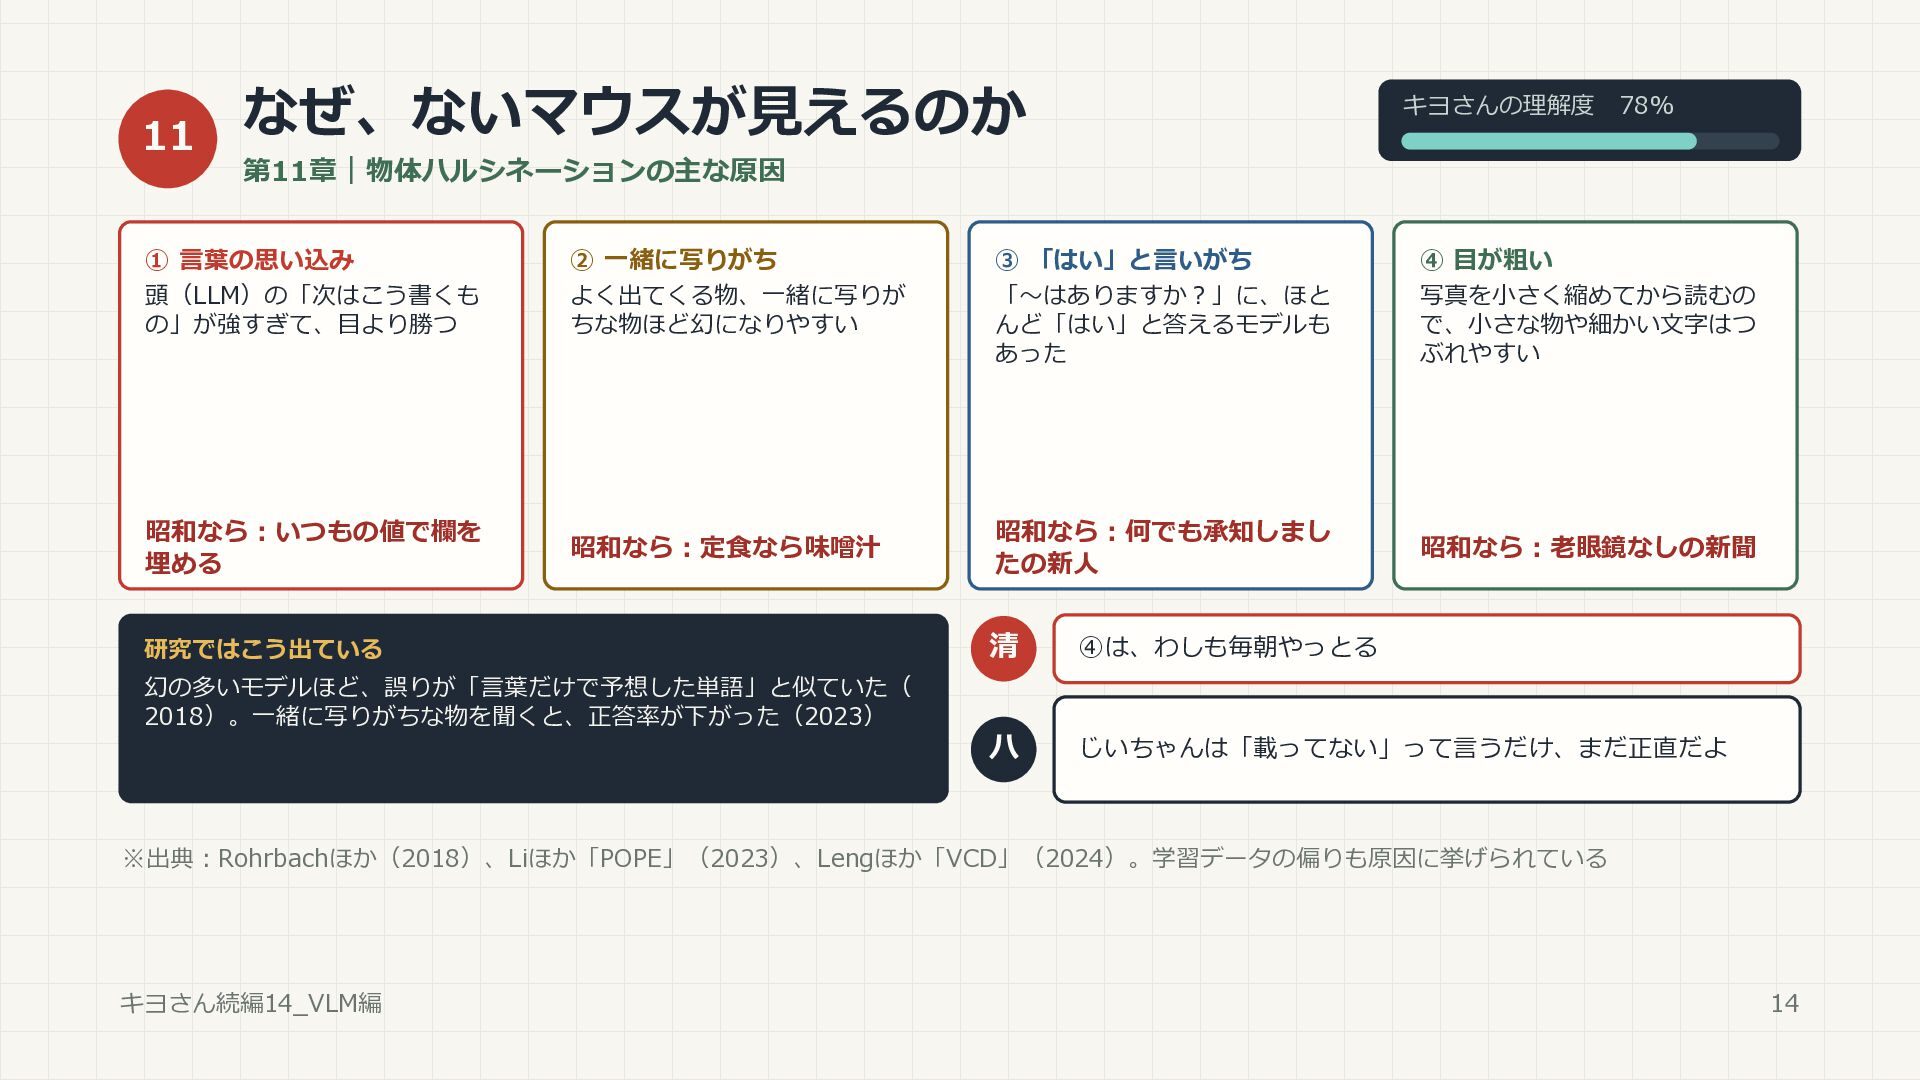
11 なぜ、ないマウスが見えるのか キヨさんの理解度 78% 第11章|物体ハルシネーションの主な原因 ① 言葉の思い込み 頭(LLM)の「次はこう書くも の」が強すぎて、目より勝つ ②
一緒に写りがち よく出てくる物、一緒に写りが ちな物ほど幻になりやすい 昭和なら:いつもの値で欄を 埋める 昭和なら:定食なら味噌汁 研究ではこう出ている 幻の多いモデルほど、誤りが「言葉だけで予想した単語」と似ていた( 2018)。一緒に写りがちな物を聞くと、正答率が下がった(2023) ③ 「はい」と言いがち 「〜はありますか?」に、ほと んど「はい」と答えるモデルも あった ④ 目が粗い 写真を小さく縮めてから読むの で、小さな物や細かい文字はつ ぶれやすい 昭和なら:何でも承知しまし たの新人 昭和なら:老眼鏡なしの新聞 清 ④は、わしも毎朝やっとる ハ じいちゃんは「載ってない」って言うだけ、まだ正直だよ ※出典:Rohrbachほか(2018)、Liほか「POPE」(2023)、Lengほか「VCD」(2024)。学習データの偏りも原因に挙げられている キヨさん続編14_VLM編 14
目をつぶっても言えるなら見ていない 12 キヨさんの理解度 82% 第12章|作る側の対策 学ぶとき 答えるとき 答えたあと 「ない」も教える 見えにくい写真と比べる
裏取りして書き直す ない物を聞く問題をわざと混ぜる。「ある」 と「ない」は半々がよかった(LRVInstruction)。人が誤りを直した答えで学ば せる方法もある(RLHF-V) ノイズを混ぜて見えにくくした写真でも同じ ように出てくる言葉は、目ではなく思い込み から来ているので割り引く。学び直しは要ら ない(VCD) 答えから物の名前を拾い、物体検出の道具で 本当にあるか確かめ、書き直す。場所の枠も つける(Woodpecker) 昭和なら:不良品も見せる新人研修 昭和なら:目をつぶっても言えるか 昭和なら:検算とダブルチェック 清 目をつぶっても同じことを言うなら、それは見て言っとらん。人間の検査員も同じだ ハ あと、目を細かくする手もある。写真を高い解像度で読めるようにするんだ ※出典:Liuほか(LRV-Instruction, 2023)、Yuほか(RLHF-V, CVPR 2024)、Lengほか(VCD, CVPR 2024)、Yinほか(Woodpecker, 2023) キヨさん続編14_VLM編 15
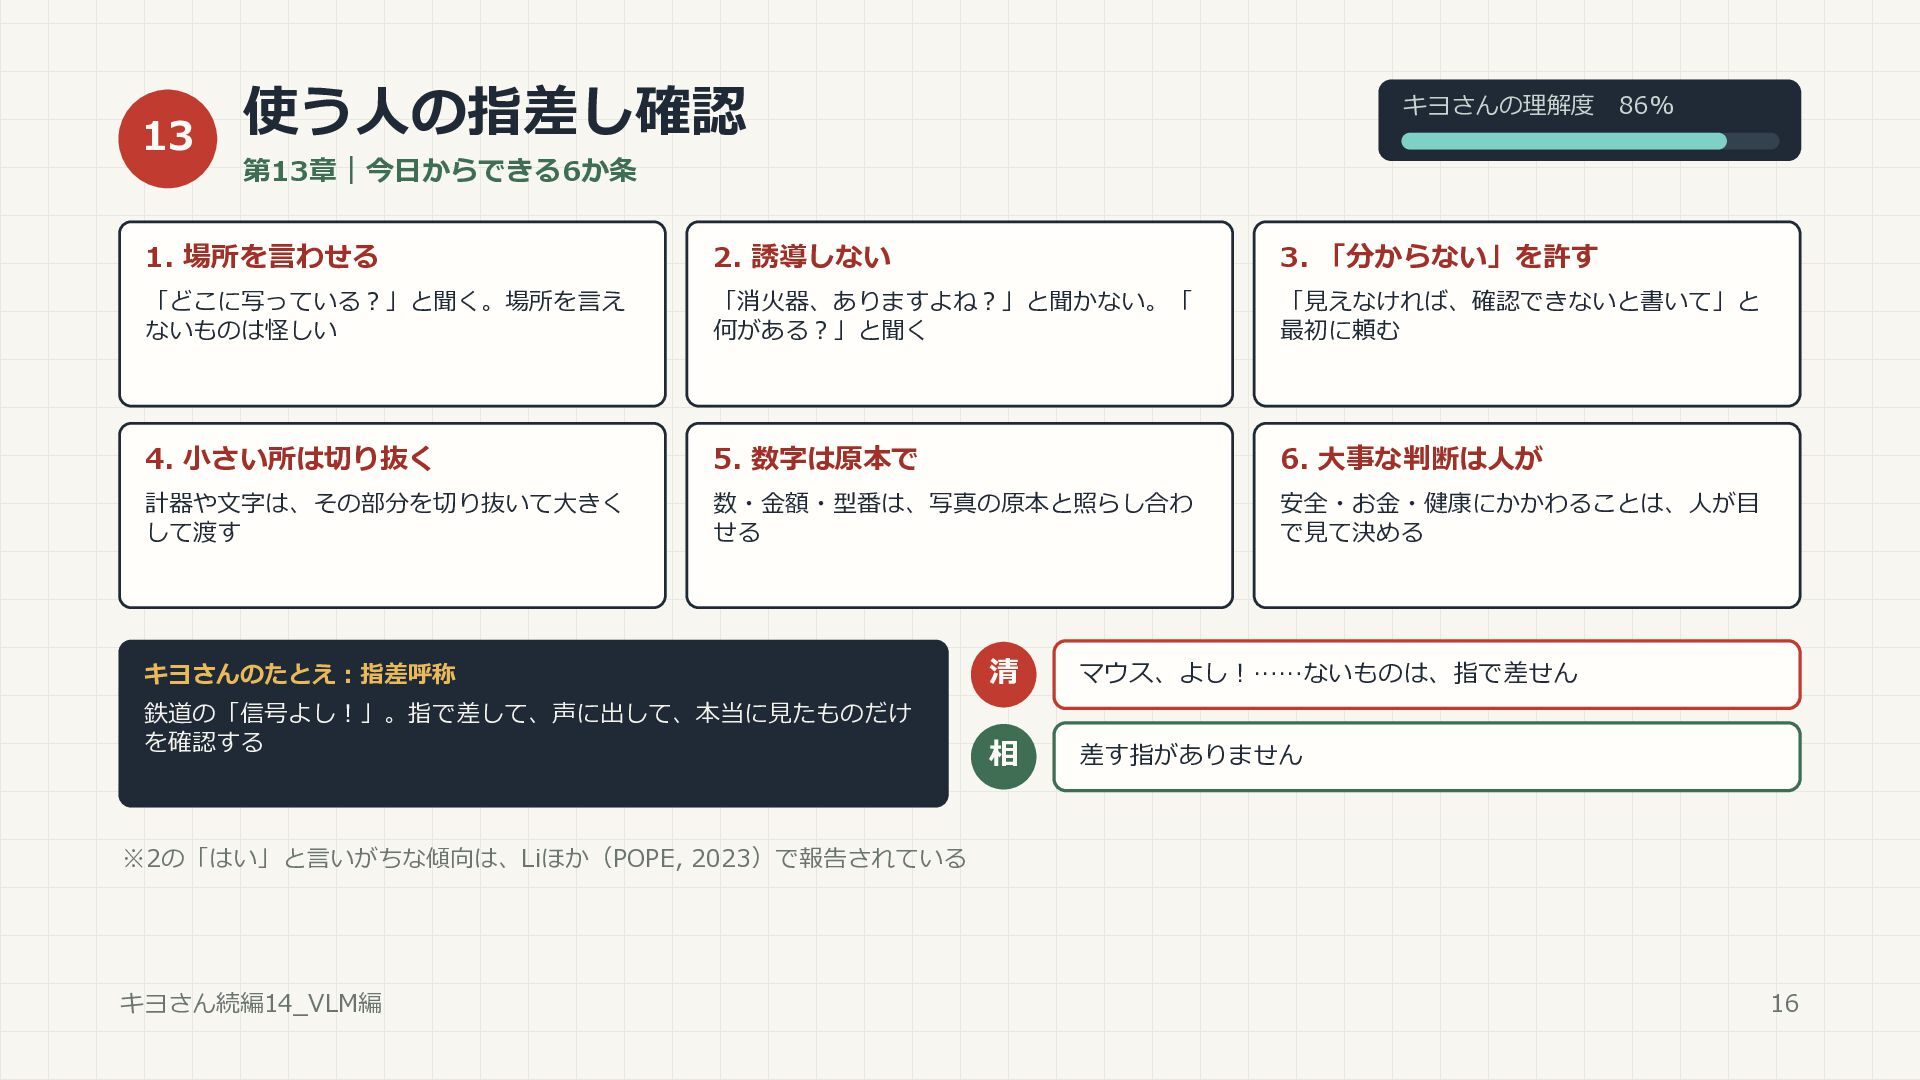
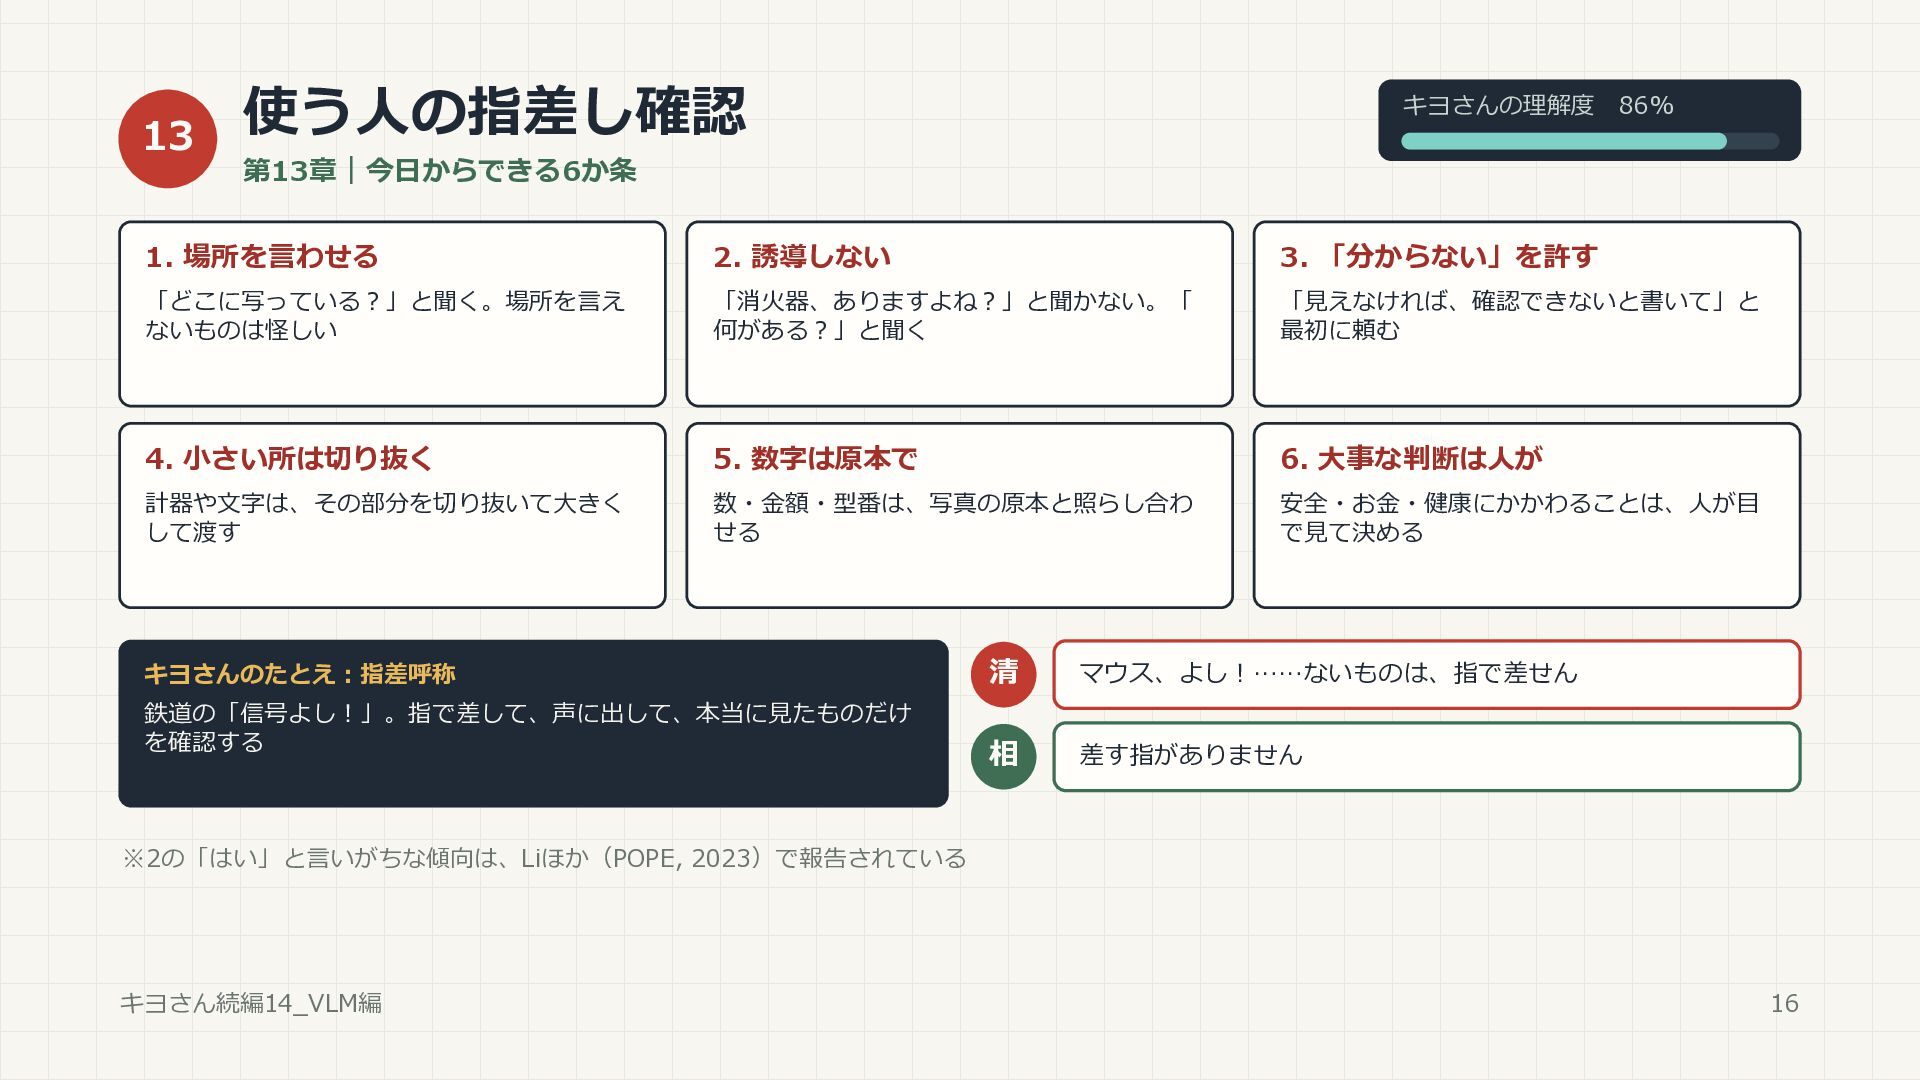
13 使う人の指差し確認 キヨさんの理解度 86% 第13章|今日からできる6か条 1. 場所を言わせる 2. 誘導しない 3.
「分からない」を許す 「どこに写っている?」と聞く。場所を言え ないものは怪しい 「消火器、ありますよね?」と聞かない。「 何がある?」と聞く 「見えなければ、確認できないと書いて」と 最初に頼む 4. 小さい所は切り抜く 5. 数字は原本で 6. 大事な判断は人が 計器や文字は、その部分を切り抜いて大きく して渡す 数・金額・型番は、写真の原本と照らし合わ せる 安全・お金・健康にかかわることは、人が目 で見て決める キヨさんのたとえ:指差呼称 鉄道の「信号よし!」。指で差して、声に出して、本当に見たものだけ を確認する 清 マウス、よし!……ないものは、指で差せん 相 差す指がありません ※2の「はい」と言いがちな傾向は、Liほか(POPE, 2023)で報告されている キヨさん続編14_VLM編 16
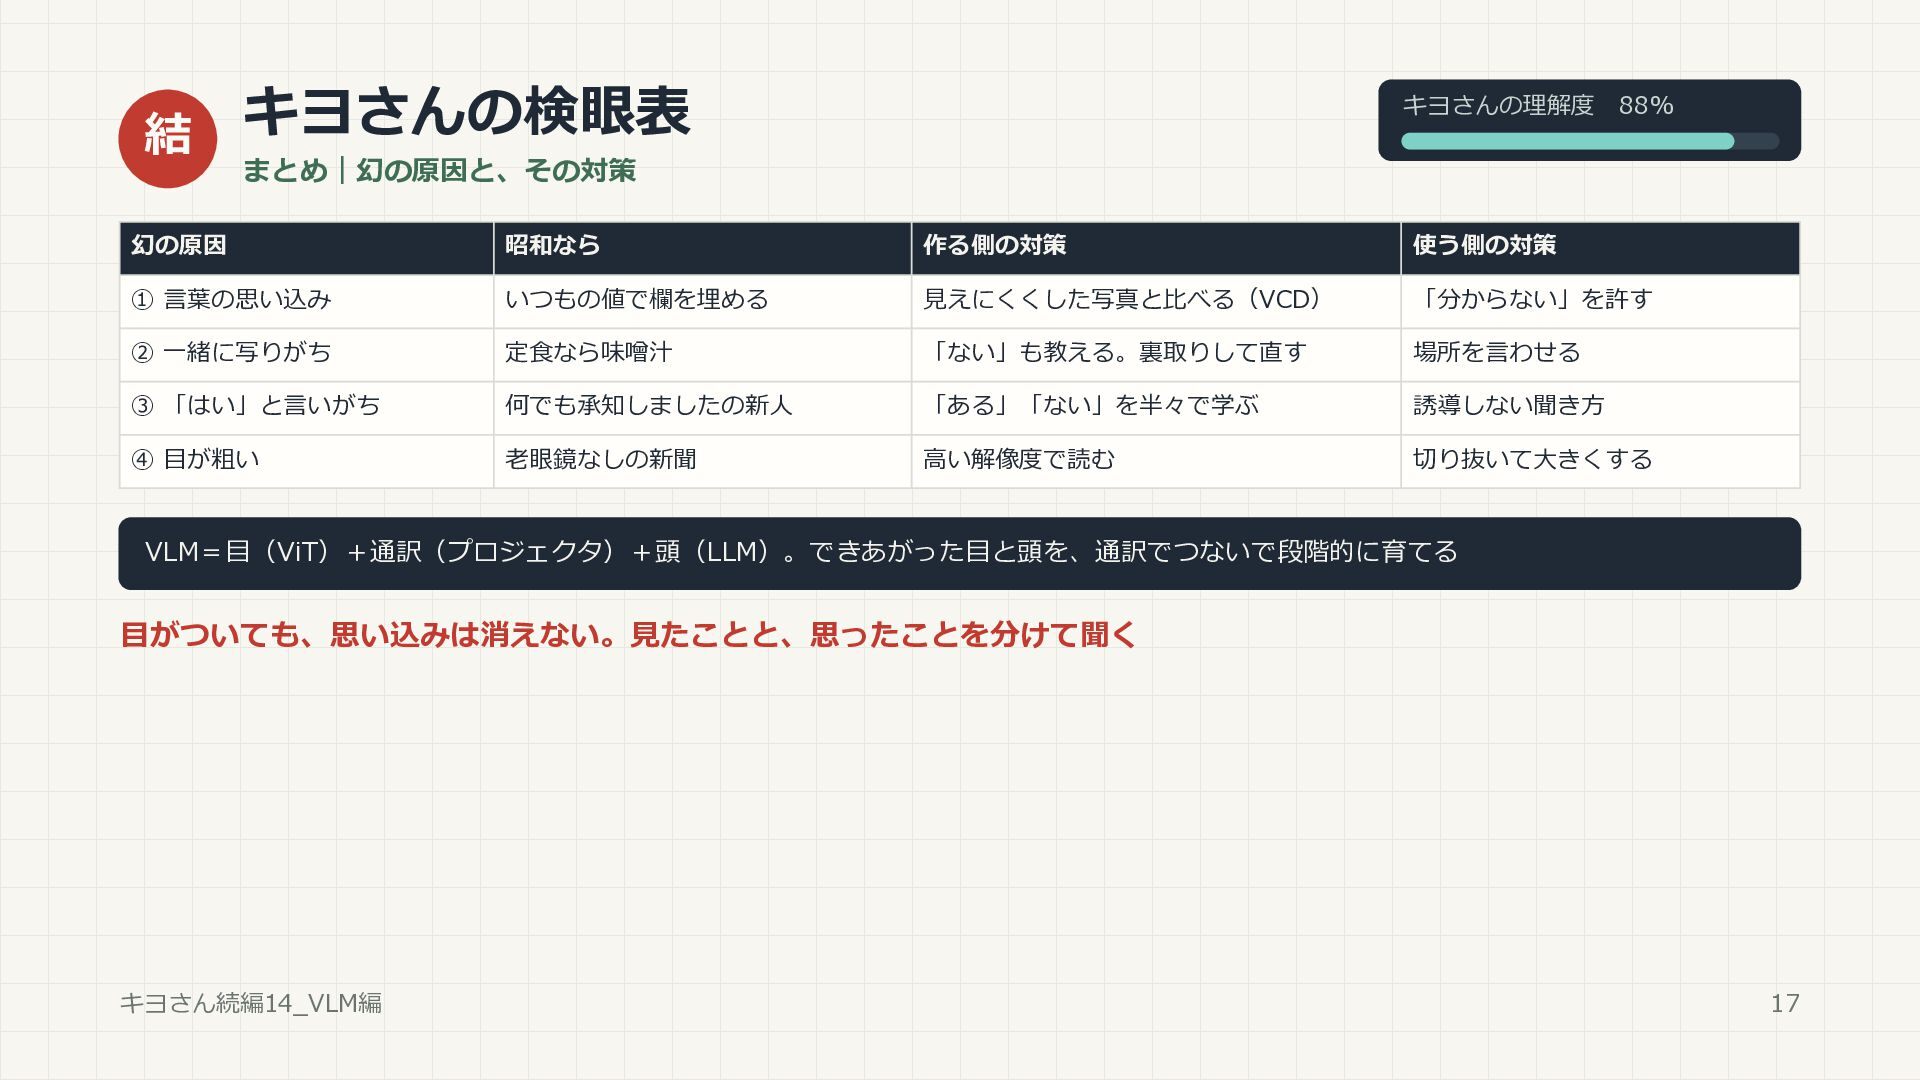
結 キヨさんの検眼表 キヨさんの理解度 88% まとめ|幻の原因と、その対策 幻の原因 昭和なら 作る側の対策 使う側の対策 ①
言葉の思い込み いつもの値で欄を埋める 見えにくくした写真と比べる(VCD) 「分からない」を許す ② 一緒に写りがち 定食なら味噌汁 「ない」も教える。裏取りして直す 場所を言わせる ③ 「はい」と言いがち 何でも承知しましたの新人 「ある」「ない」を半々で学ぶ 誘導しない聞き方 ④ 目が粗い 老眼鏡なしの新聞 高い解像度で読む 切り抜いて大きくする VLM=目(ViT)+通訳(プロジェクタ)+頭(LLM)。できあがった目と頭を、通訳でつないで段階的に育てる 目がついても、思い込みは消えない。見たことと、思ったことを分けて聞く キヨさん続編14_VLM編 17
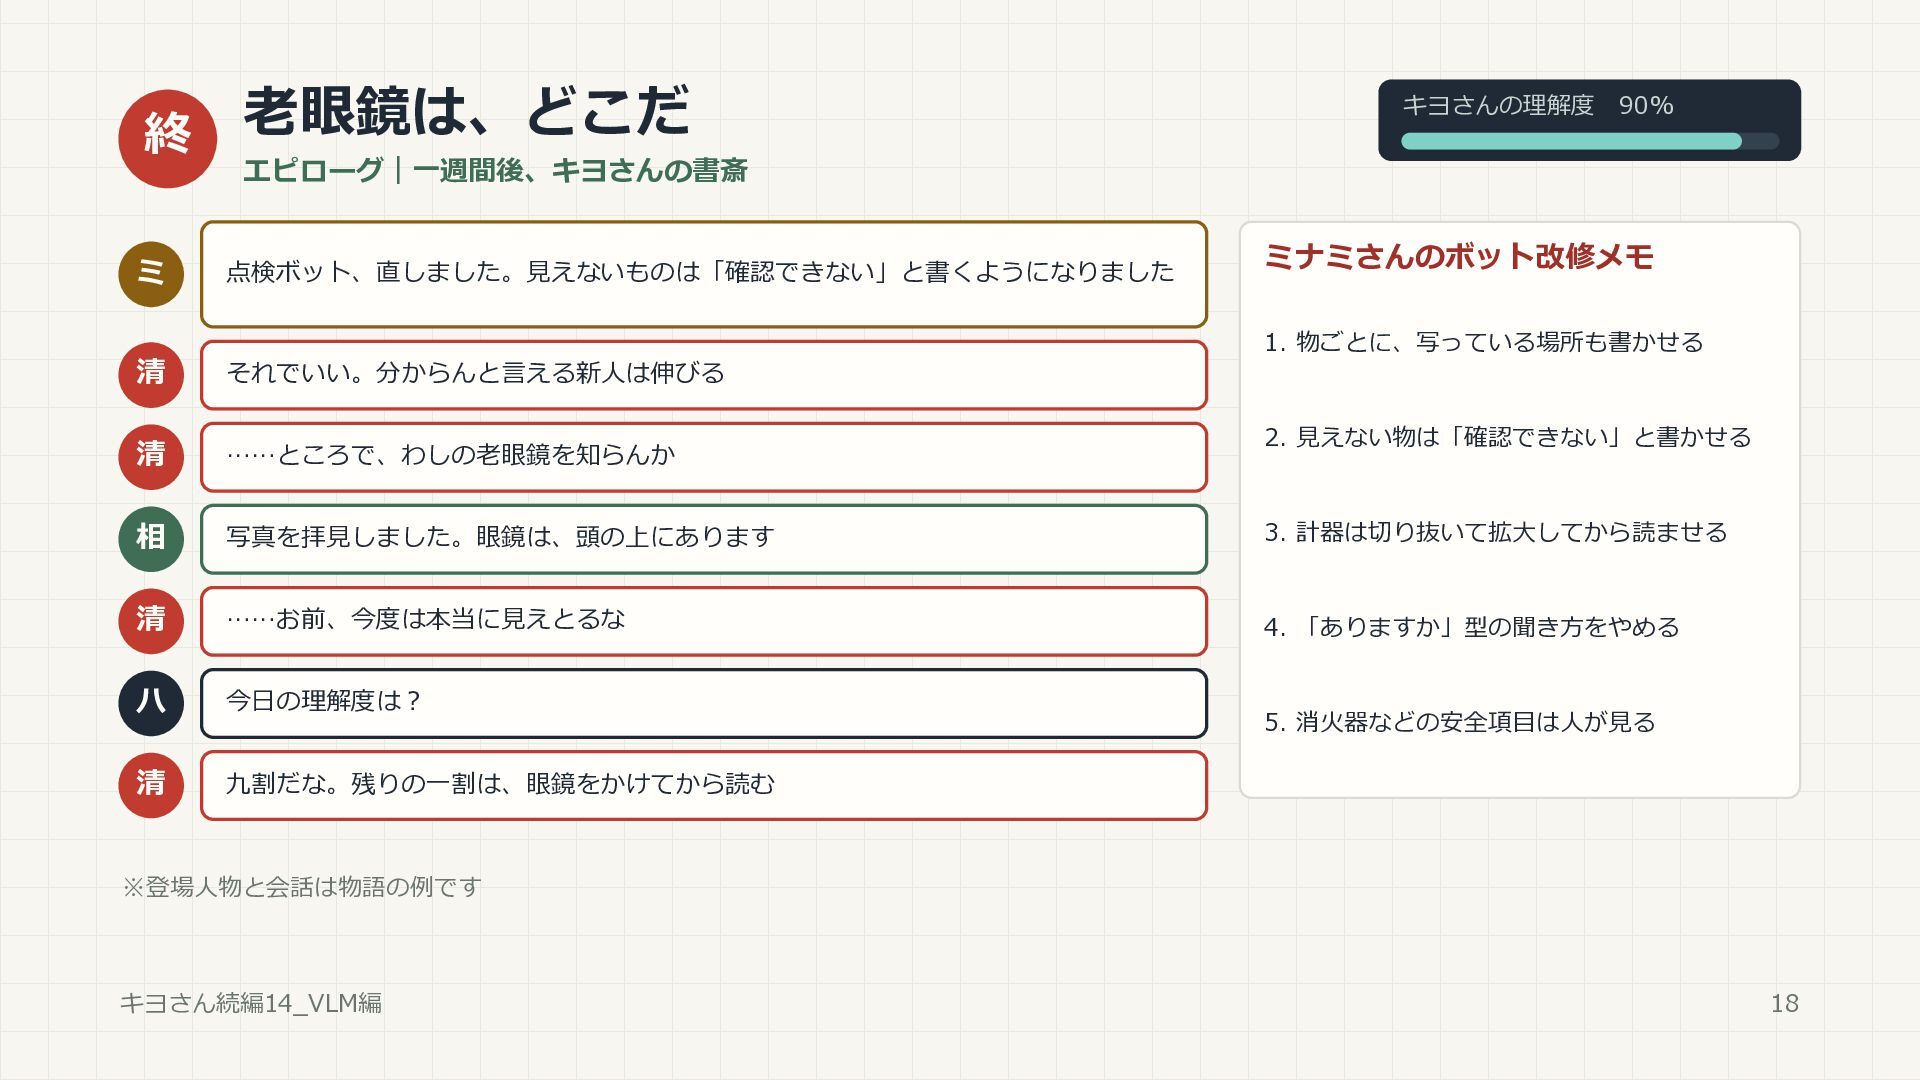
終 老眼鏡は、どこだ キヨさんの理解度 90% エピローグ|一週間後、キヨさんの書斎 ミ 点検ボット、直しました。見えないものは「確認できない」と書くようになりました ミナミさんのボット改修メモ 1. 物ごとに、写っている場所も書かせる
清 それでいい。分からんと言える新人は伸びる 清 ……ところで、わしの老眼鏡を知らんか 相 写真を拝見しました。眼鏡は、頭の上にあります 3. 計器は切り抜いて拡大してから読ませる 清 ……お前、今度は本当に見えとるな 4. 「ありますか」型の聞き方をやめる ハ 今日の理解度は? 清 九割だな。残りの一割は、眼鏡をかけてから読む 2. 見えない物は「確認できない」と書かせる 5. 消火器などの安全項目は人が見る ※登場人物と会話は物語の例です キヨさん続編14_VLM編 18
完 見たことと、思ったことを分けて言え。 見えんものは、見えんと言え。 ―― キヨさん ラストカット:キヨさんの新作「マウスなき 昭和の卓に マウス見ゆ」。 相棒「今の句、季語が見当たりません」。キヨさん「見えんものを見えんと言えたな。合格だ」。 おしまい
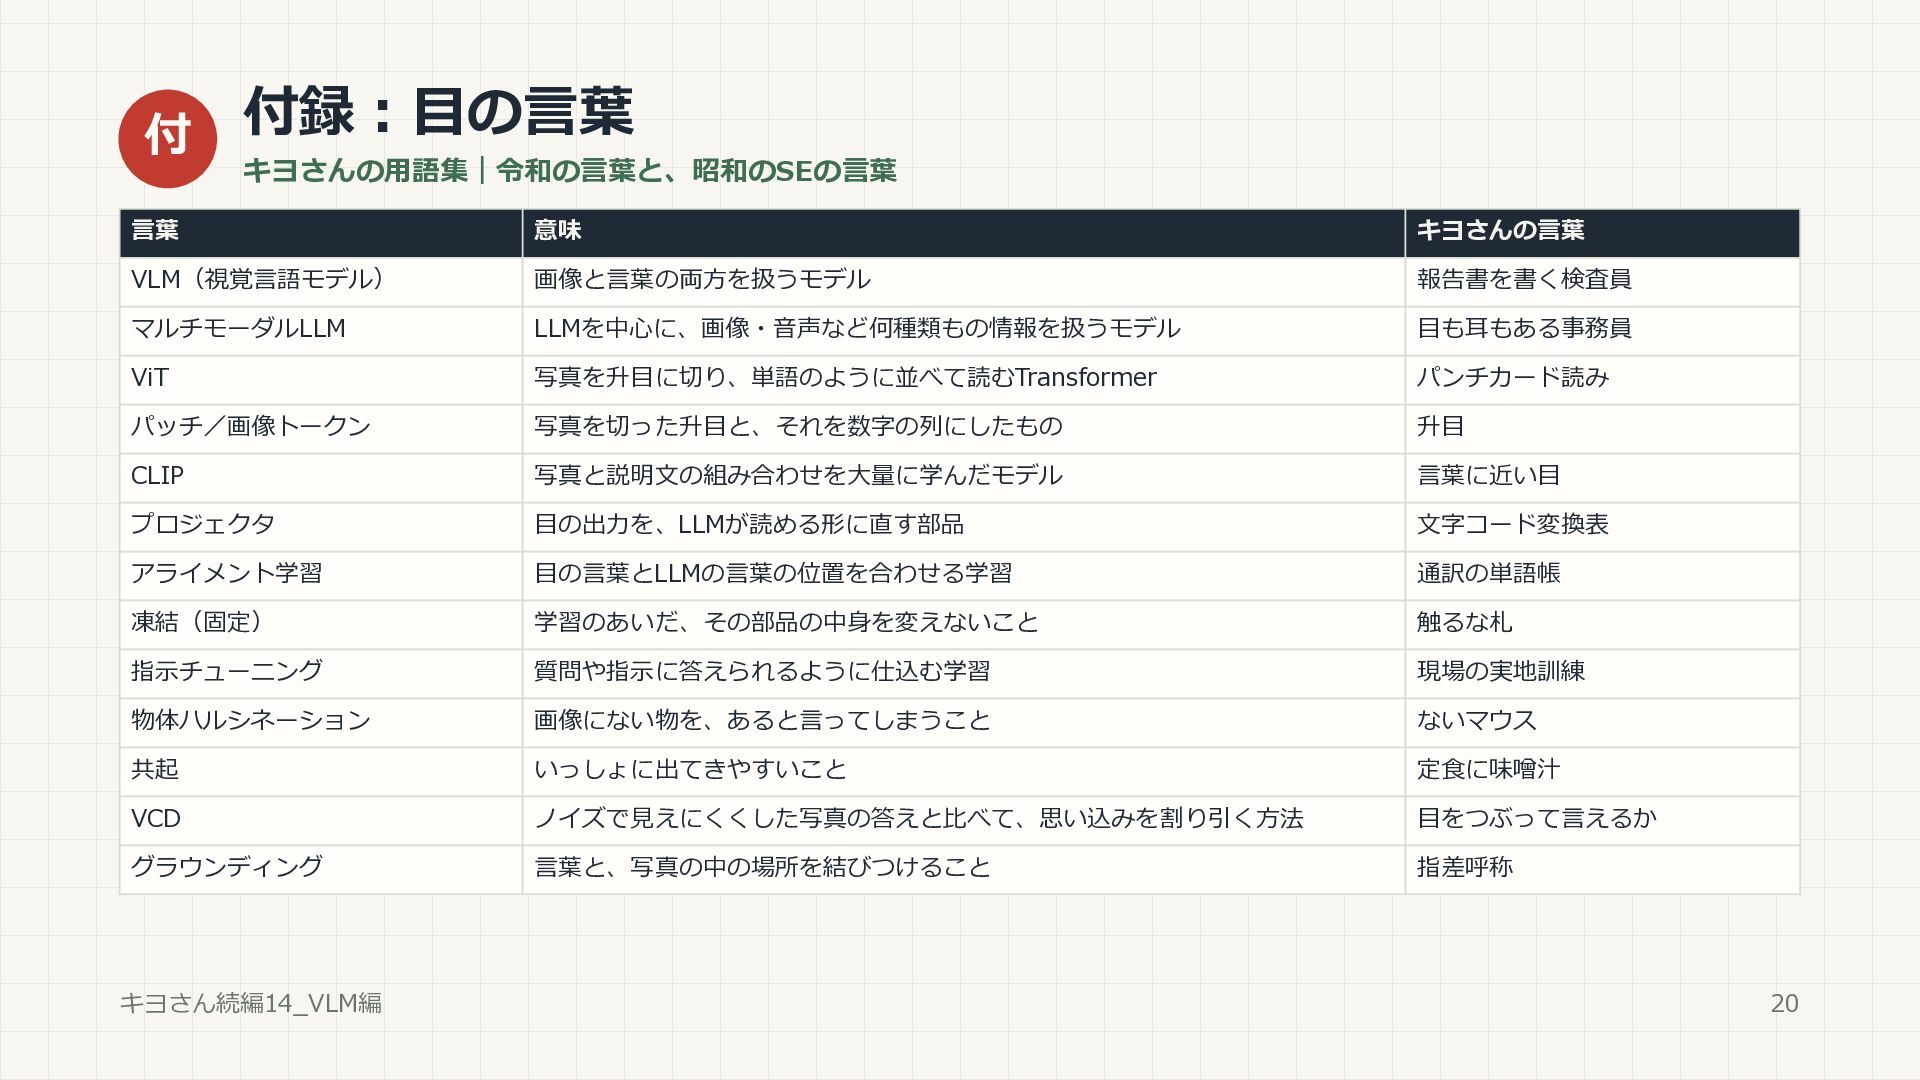
付 付録:目の言葉 キヨさんの用語集|令和の言葉と、昭和のSEの言葉 言葉 意味 キヨさんの言葉 VLM(視覚言語モデル) 画像と言葉の両方を扱うモデル 報告書を書く検査員 マルチモーダルLLM
LLMを中心に、画像・音声など何種類もの情報を扱うモデル 目も耳もある事務員 ViT 写真を升目に切り、単語のように並べて読むTransformer パンチカード読み パッチ/画像トークン 写真を切った升目と、それを数字の列にしたもの 升目 CLIP 写真と説明文の組み合わせを大量に学んだモデル 言葉に近い目 プロジェクタ 目の出力を、LLMが読める形に直す部品 文字コード変換表 アライメント学習 目の言葉とLLMの言葉の位置を合わせる学習 通訳の単語帳 凍結(固定) 学習のあいだ、その部品の中身を変えないこと 触るな札 指示チューニング 質問や指示に答えられるように仕込む学習 現場の実地訓練 物体ハルシネーション 画像にない物を、あると言ってしまうこと ないマウス 共起 いっしょに出てきやすいこと 定食に味噌汁 VCD ノイズで見えにくくした写真の答えと比べて、思い込みを割り引く方法 目をつぶって言えるか グラウンディング 言葉と、写真の中の場所を結びつけること 指差呼称 キヨさん続編14_VLM編 20


 happysamurai294
 inariku
 kota2and3kan
 techniczna
 tamaiyutaro
 nagix
 kentapapa
 y_matsubara
 ufried
 nagisa53
 mza
 rkendrick25
 mayatellez
 chrisshort
 soudai
 rmw
 aemeredith
 jdejongh
 aleyda
 hannesfritz
 shlominoach