Share
Embed
Langfuseで支える AIエージェントの監視・評価
https://sansan.connpass.com/event/380668/
こちらのイベントにて登壇させていただいた時の発表資料になります
Haruki Nagasawa
February 17, 2026
Transcript
20 slides
-
自己紹介 長澤春希 (Nagasawa Haruki) • 東北大学 Tohoku NLP 出身 ◦
学部早期卒業後、修士課程に進学・修了 ◦ ACL・EMNLP・ICASSP採択歴あり • 2023/10 よりサイバーエージェントに Join ◦ AI Shiftで機械学習エンジニアとして勤務 ◦ 音声認識精度の向上、チャットボットの改修、論文執筆、 自律型エージェントの開発、監視基盤のデプロイ・組み込み etc. • 好きなもの ◦ 梅干しとHipHopとLa La Land @sp_1999N -
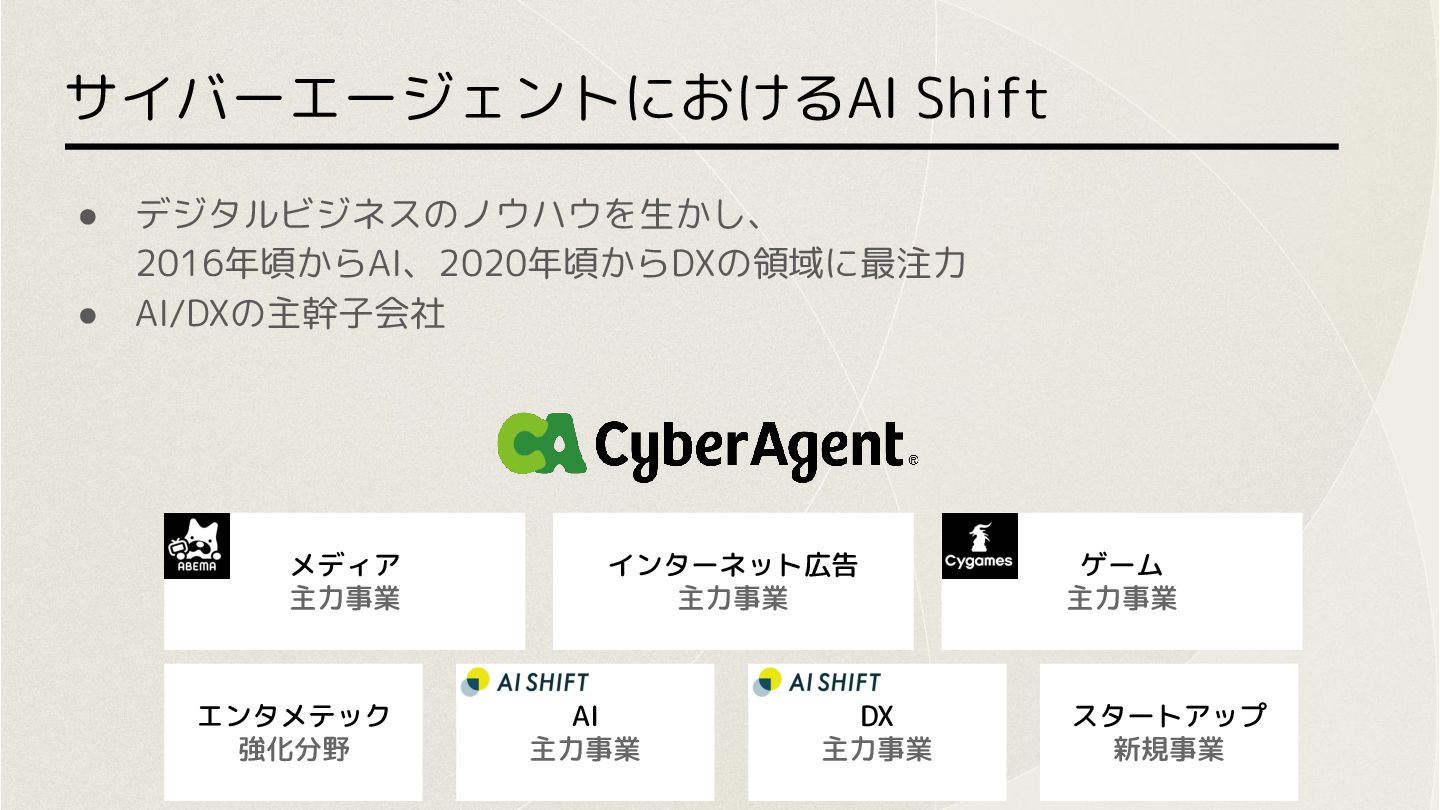
メディア 主力事業 サイバーエージェントにおけるAI Shift • デジタルビジネスのノウハウを生かし、 2016年頃からAI、2020年頃からDXの領域に最注力 • AI/DXの主幹子会社 インターネット広告
主力事業 ゲーム 主力事業 エンタメテック 強化分野 AI 主力事業 DX 主力事業 スタートアップ 新規事業 -
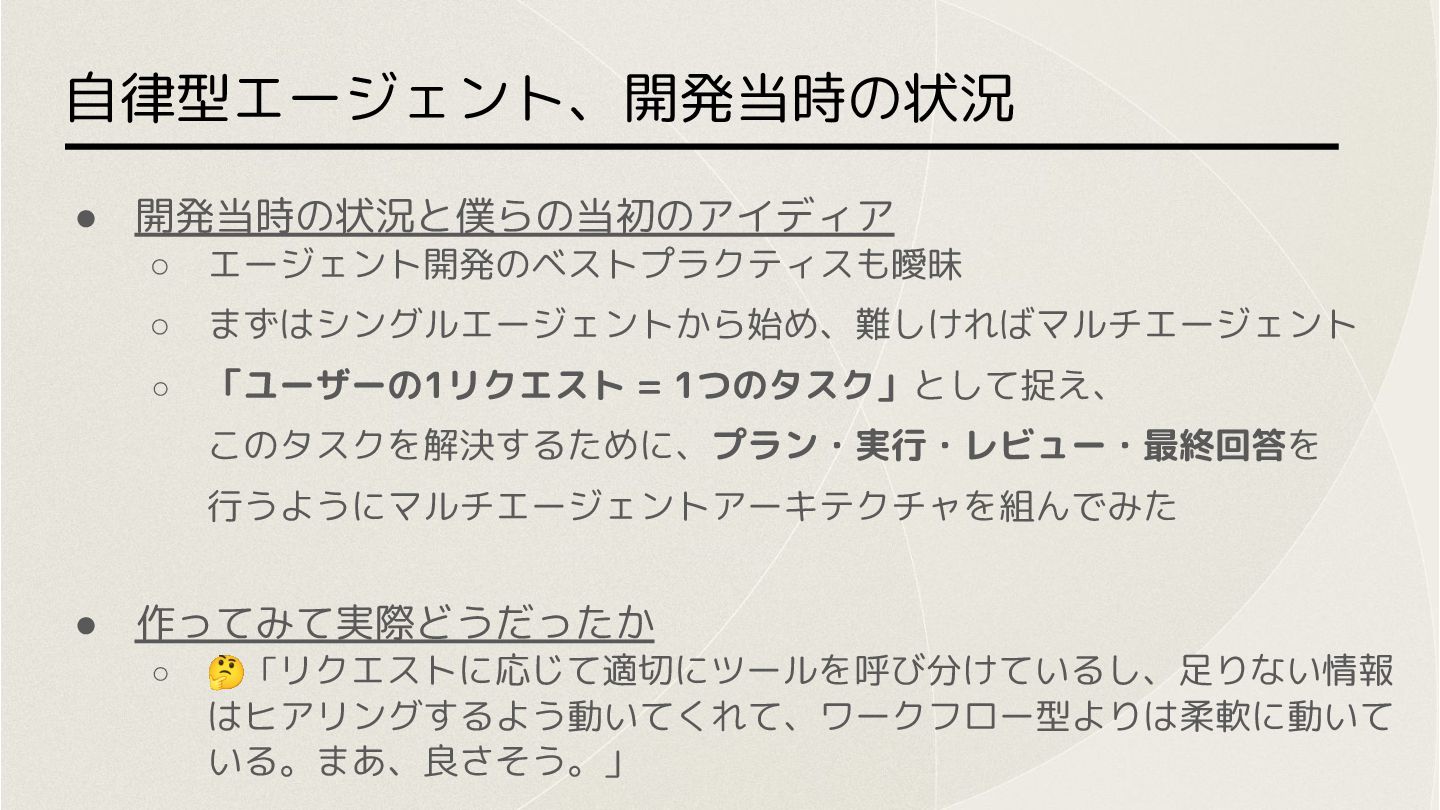
自律型エージェント、開発当時の状況 • 開発当時の状況と僕らの当初のアイディア ◦ エージェント開発のベストプラクティスも曖昧 ◦ まずはシングルエージェントから始め、難しければマルチエージェント ◦ 「ユーザーの1リクエスト =
1つのタスク」として捉え、 このタスクを解決するために、プラン・実行・レビュー・最終回答を 行うようにマルチエージェントアーキテクチャを組んでみた • 作ってみて実際どうだったか ◦ 🤔「リクエストに応じて適切にツールを呼び分けているし、足りない情報 はヒアリングするよう動いてくれて、ワークフロー型よりは柔軟に動いて いる。まあ、良さそう。」 -
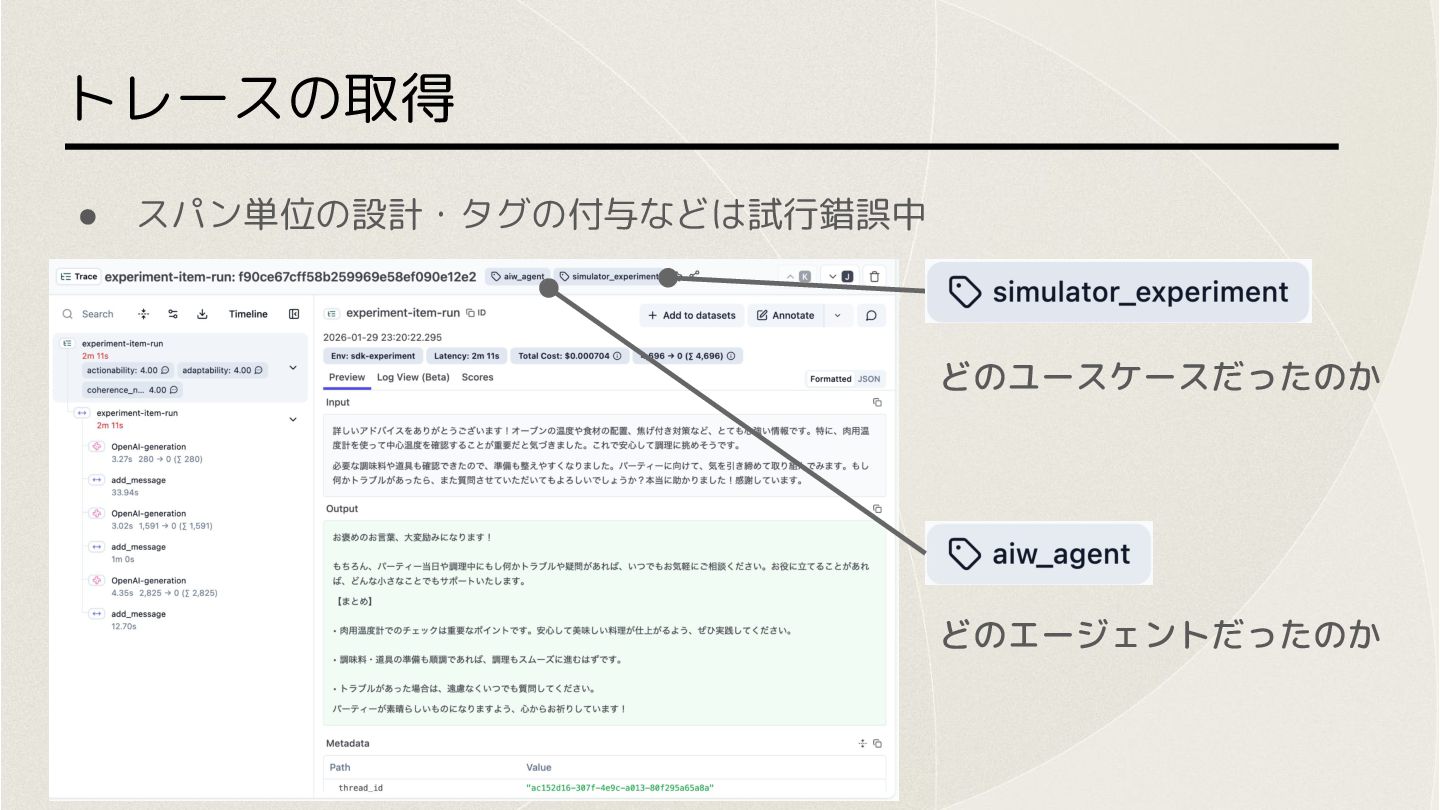
どうしてLangfuseを選んだのか • AI Worker は TypeScript で実装→エージェント開発フレームワークは TypeScriptネイティブなMastraを利用していた • ビジネス要件などの観点から、データの保存場所は自分たちで管理したい
• 監視して終わりではなく、評価基盤としても機能できるものが良い 調査して色々見比べた結果、条件を満たす Langfuse or Arize Phoenix の二択に Langfuse: ダッシュボードの機能が充実している Mastra には公式にサポートしている監視基盤がいくつかあり、Langfuse は当時その1つ Phoenix: 評価基盤が充実している -
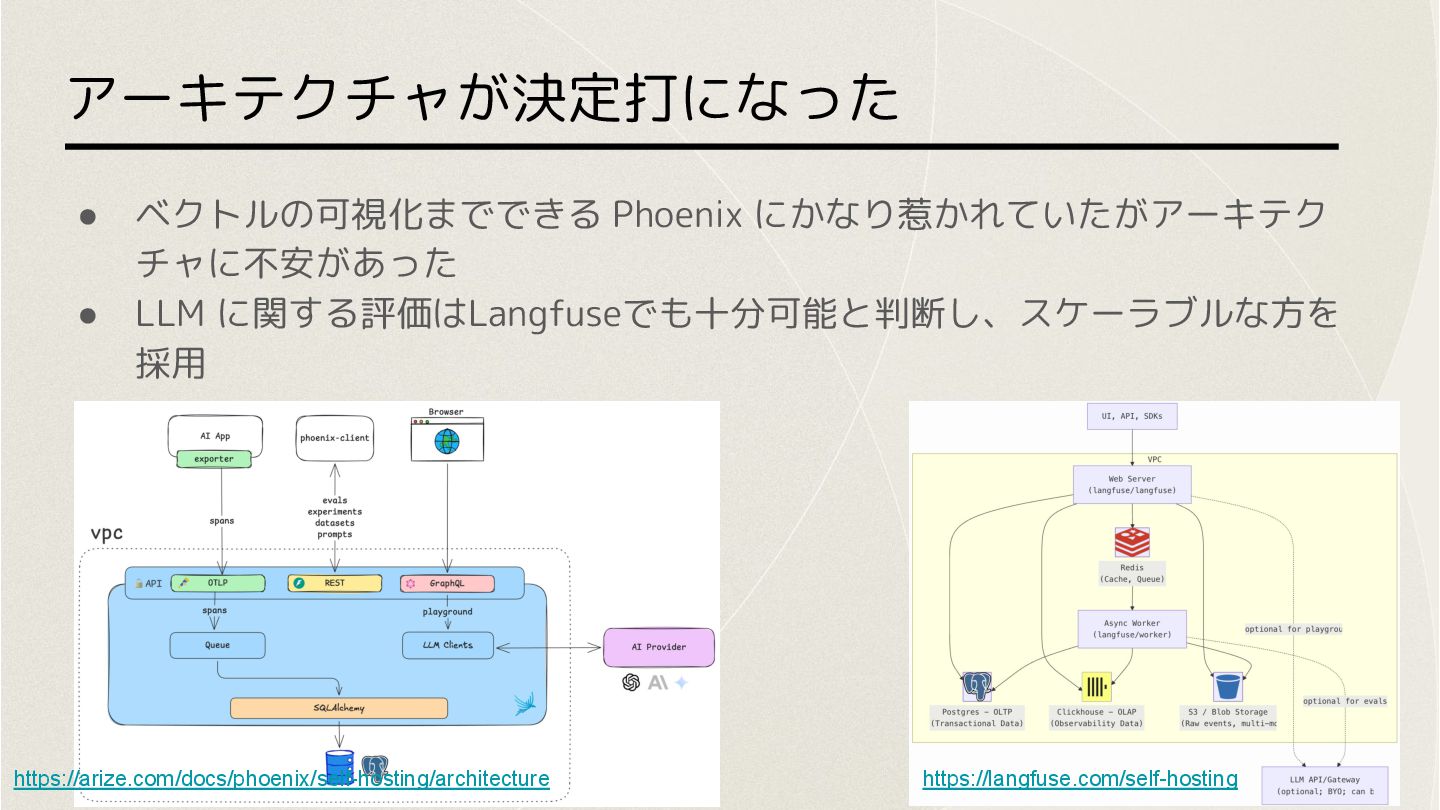
アーキテクチャが決定打になった • ベクトルの可視化までできる Phoenix にかなり惹かれていたがアーキテク チャに不安があった • LLM に関する評価はLangfuseでも十分可能と判断し、スケーラブルな方を 採用
https://langfuse.com/self-hosting https://arize.com/docs/phoenix/self-hosting/architecture -
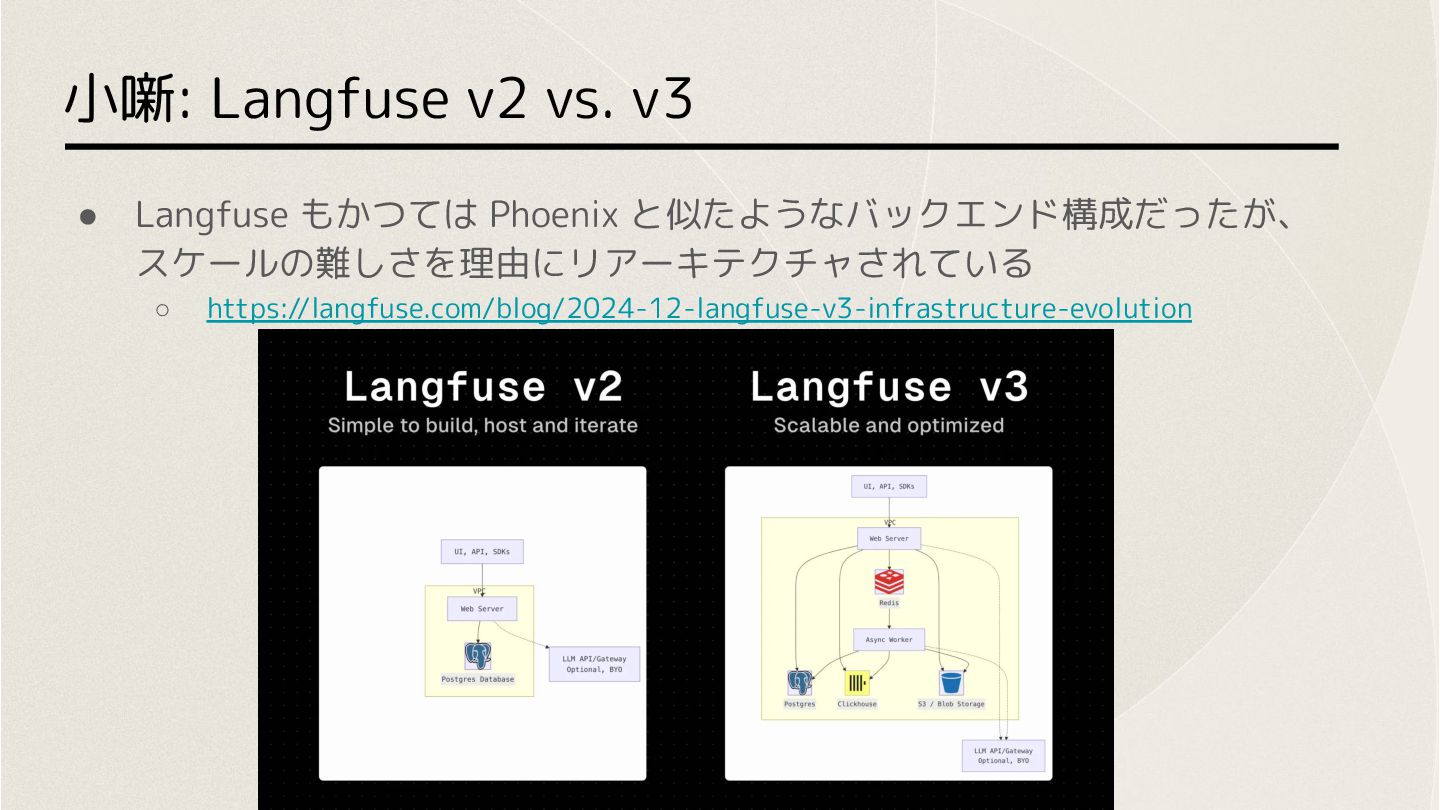
小噺: Langfuse v2 vs. v3 • Langfuse もかつては Phoenix と似たようなバックエンド構成だったが、
スケールの難しさを理由にリアーキテクチャされている ◦ https://langfuse.com/blog/2024-12-langfuse-v3-infrastructure-evolution -
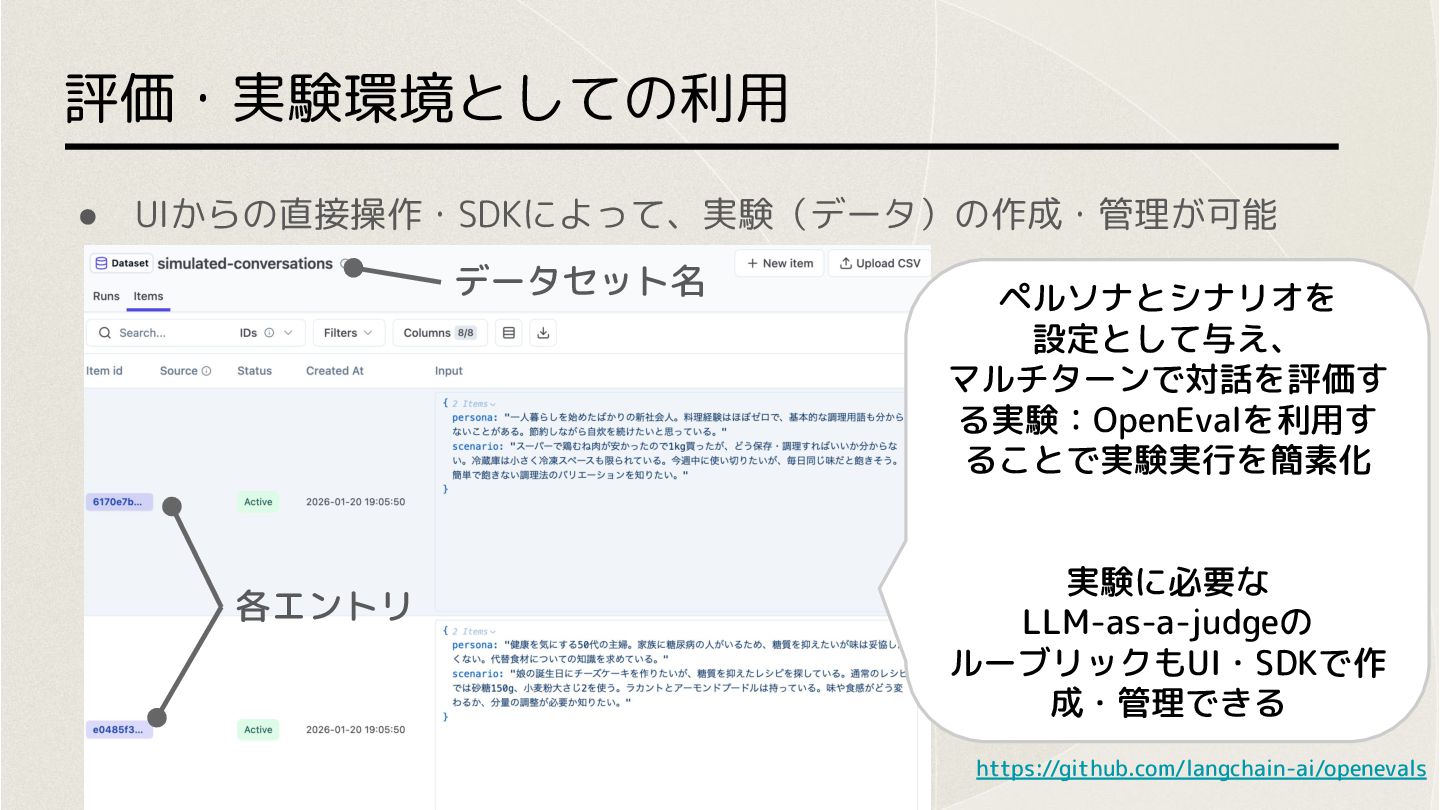
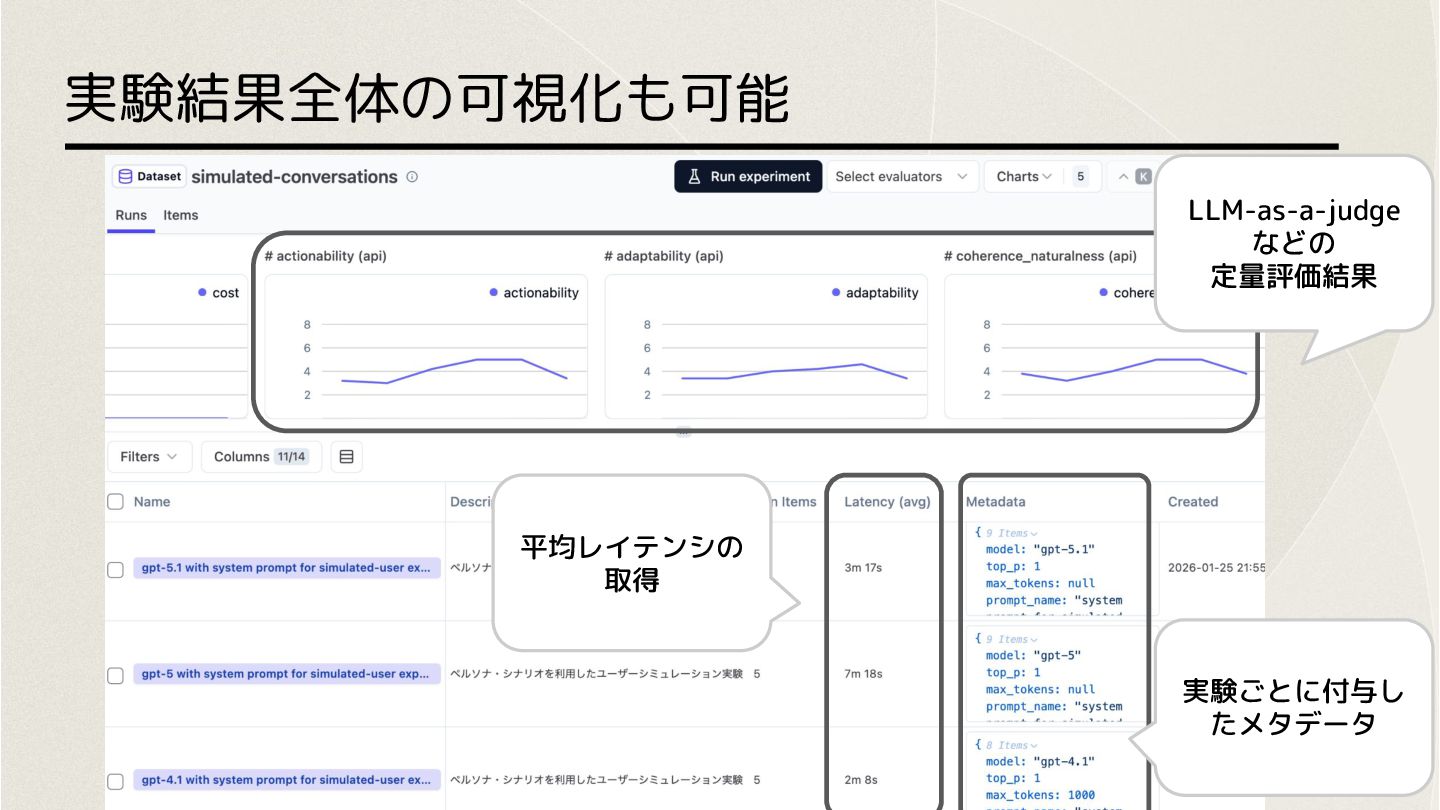
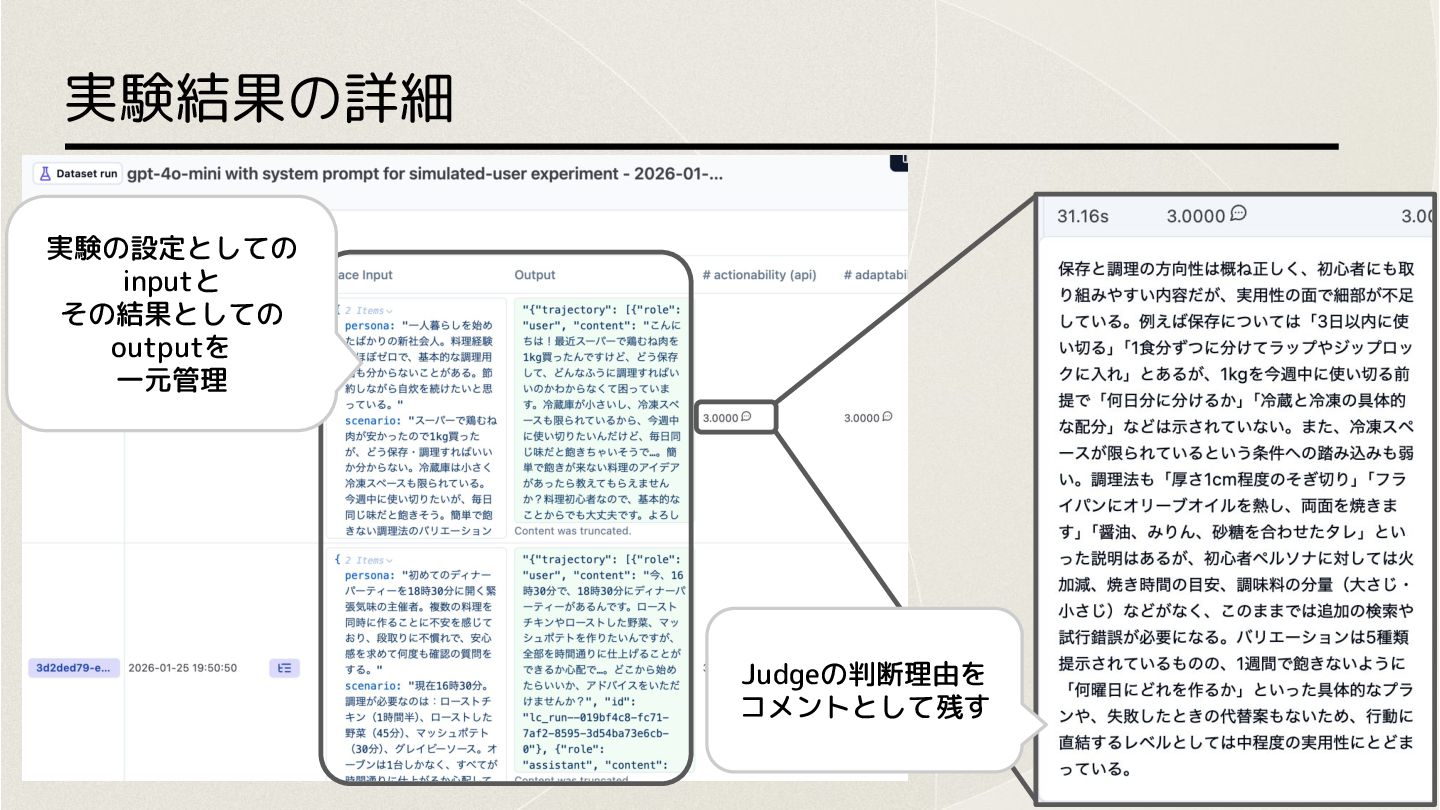
評価・実験環境としての利用 • UIからの直接操作・SDKによって、実験(データ)の作成・管理が可能 ペルソナとシナリオを 設定として与え、 マルチターンで対話を評価す る実験:OpenEvalを利用す ることで実験実行を簡素化 実験に必要な LLM-as-a-judgeの
ルーブリックもUI・SDKで作 成・管理できる https://github.com/langchain-ai/openevals データセット名 各エントリ -
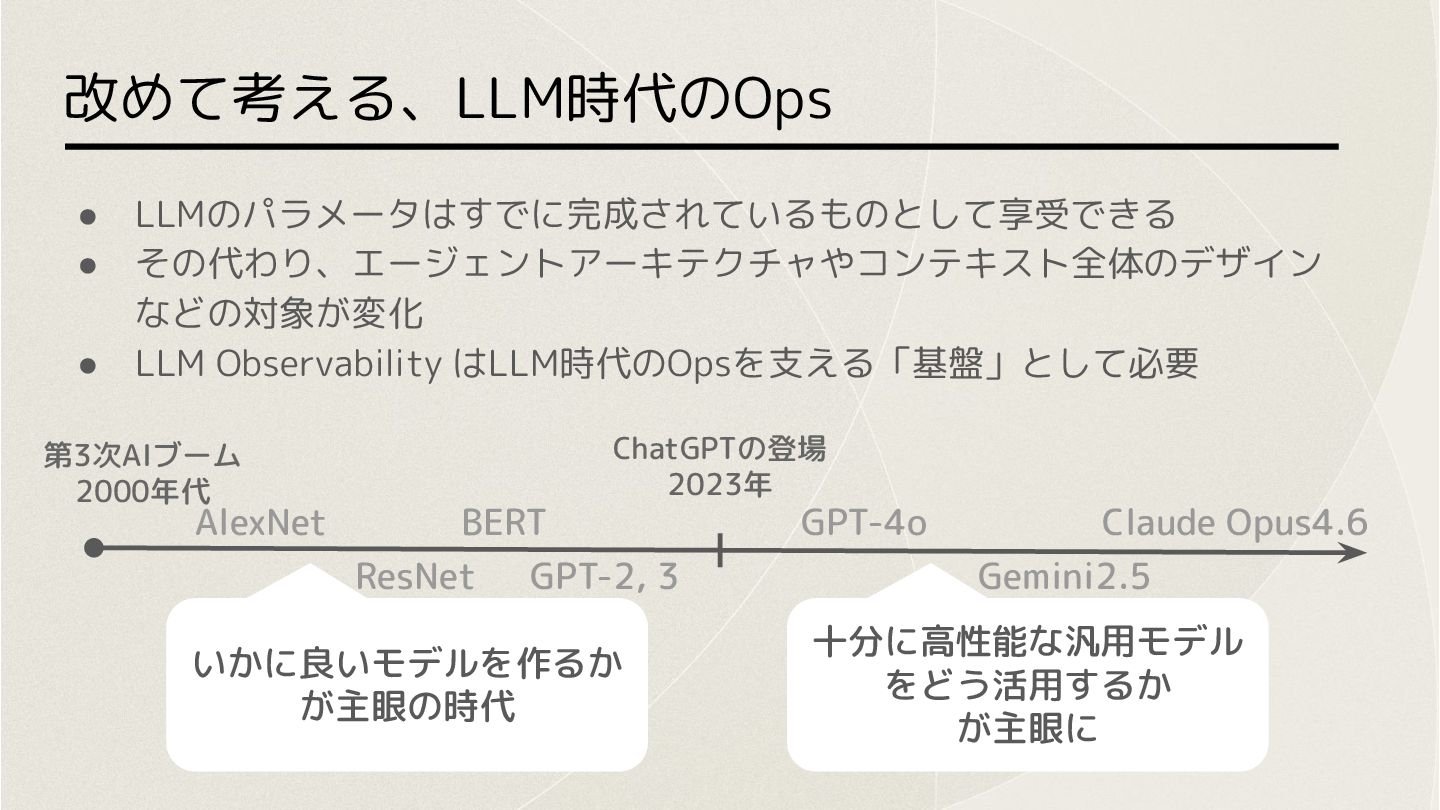
改めて考える、LLM時代のOps • LLMのパラメータはすでに完成されているものとして享受できる • その代わり、エージェントアーキテクチャやコンテキスト全体のデザイン などの対象が変化 • LLM Observability はLLM時代のOpsを支える「基盤」として必要
ChatGPTの登場 2023年 第3次AIブーム 2000年代 いかに良いモデルを作るか が主眼の時代 十分に高性能な汎用モデル をどう活用するか が主眼に AlexNet BERT GPT-2, 3 ResNet GPT-4o Gemini2.5 Claude Opus4.6 -
Evalも(**の方が**)大事 “Using evals strategically can make a customer-facing product or
internal tool more reliable at scale, decrease high-severity errors, protect against downside risk, and give an organization a measurable path to higher ROI. “ – OpenAI “Good evaluations help teams ship AI agents more confidently. Without them, it’s easy to get stuck in reactive loops — catching issues only in production, where fixing one failure creates others.” – Anthropic https://openai.com/index/evals-drive-next-chapter-of-ai/ https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents -
関連ブログ 本日お話しした内容に関連するものをブログとしても公開しています よければご覧ください • LLMエージェントオブサーバビリティ基盤についてまとめてみた ◦ https://www.ai-shift.co.jp/techblog/6009 • Langfuse セルフホストでハマったポイントをまとめてみる
◦ https://www.ai-shift.co.jp/techblog/6554 • OpenEvals × Langfuseで始めるAIエージェントのマルチターン評価 ◦ https://www.ai-shift.co.jp/techblog/6705