Share
Embed
[JSAI23] Learning-To-Rank Approach for Identifying Everyday Objects Using a Physical-World Search Engine
Semantic Machine Intelligence Lab., Keio Univ. PRO
May 31, 2023
Transcript
20 slides
-
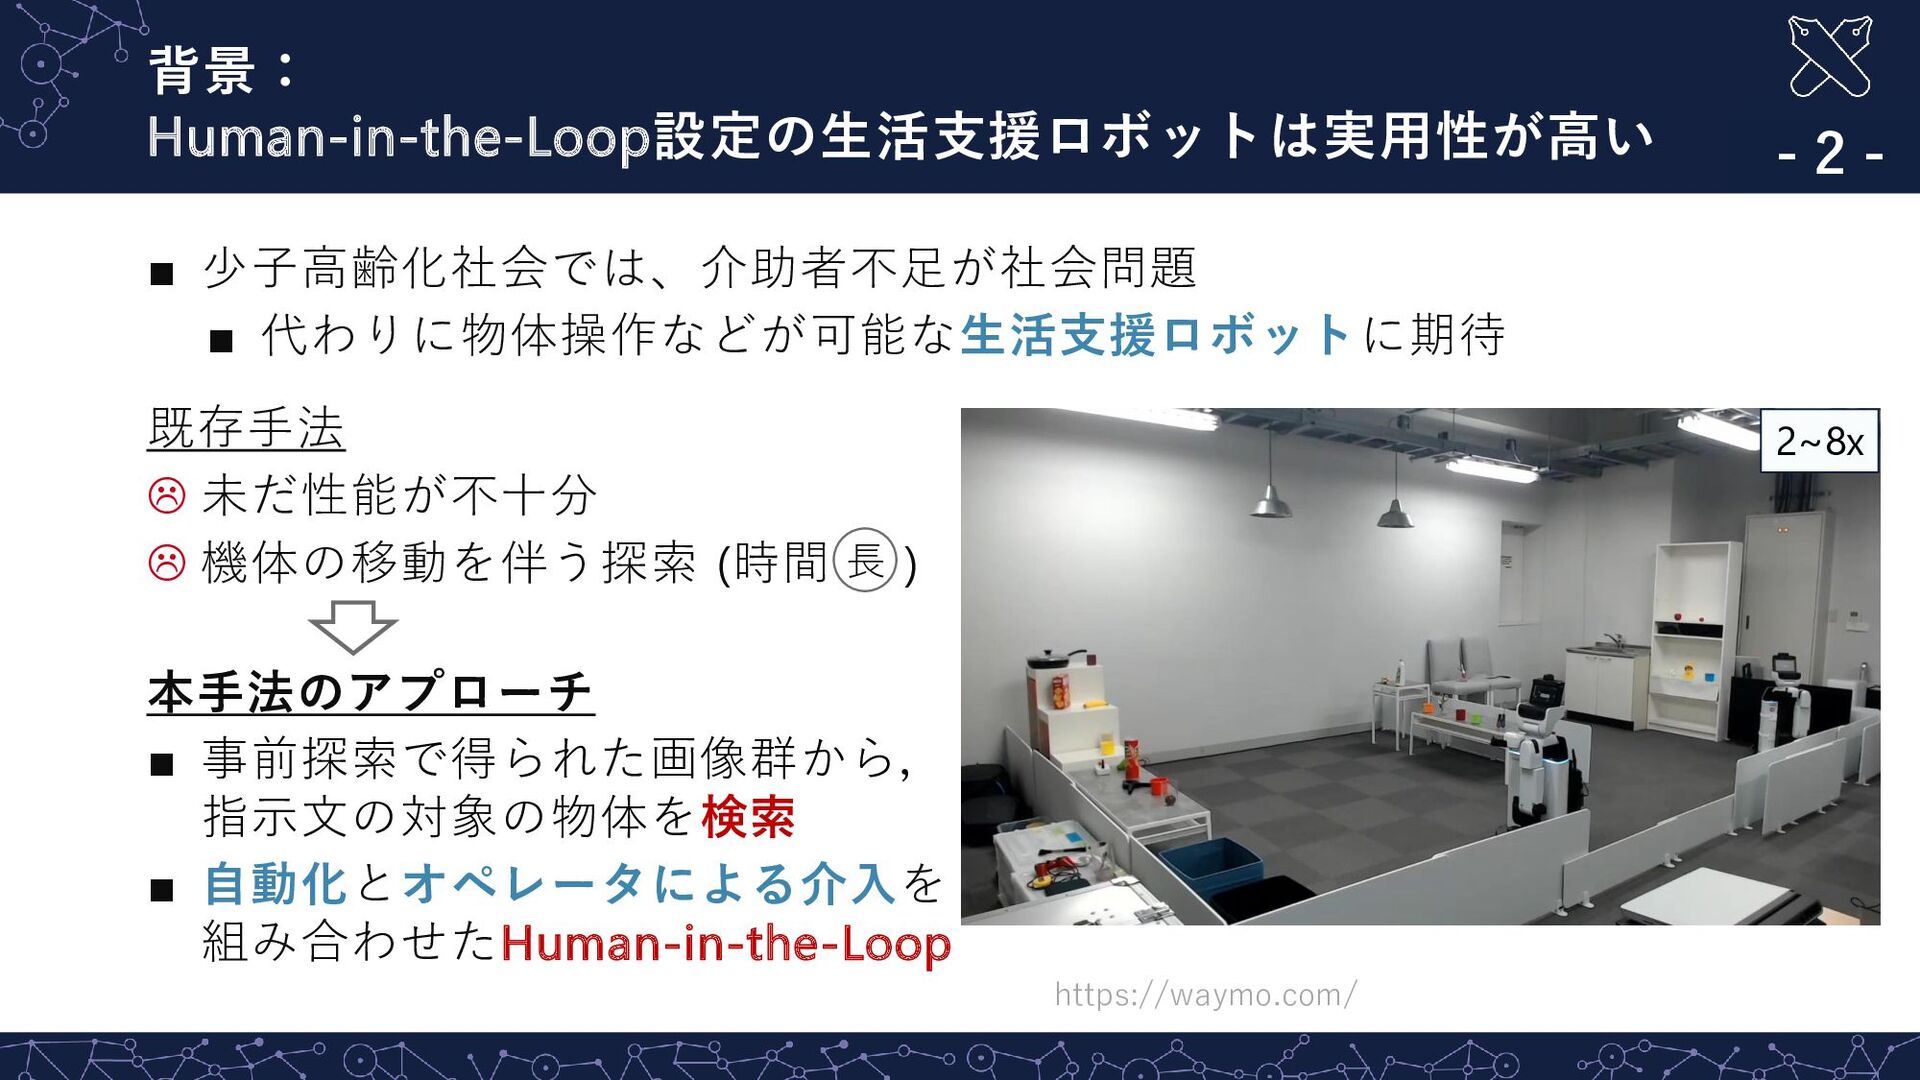
背景: Human-in-the-Loop設定の生活支援ロボットは実用性が高い - 2 - ▪ 少子高齢化社会では、介助者不足が社会問題 ▪ 代わりに物体操作などが可能な生活支援ロボットに期待 既存手法
未だ性能が不十分 機体の移動を伴う探索 (時間 ) 本手法のアプローチ ▪ 事前探索で得られた画像群から, 指示文の対象の物体を検索 ▪ 自動化とオペレータによる介入を 組み合わせたHuman-in-the-Loop 2~8x https://waymo.com/ 長 -
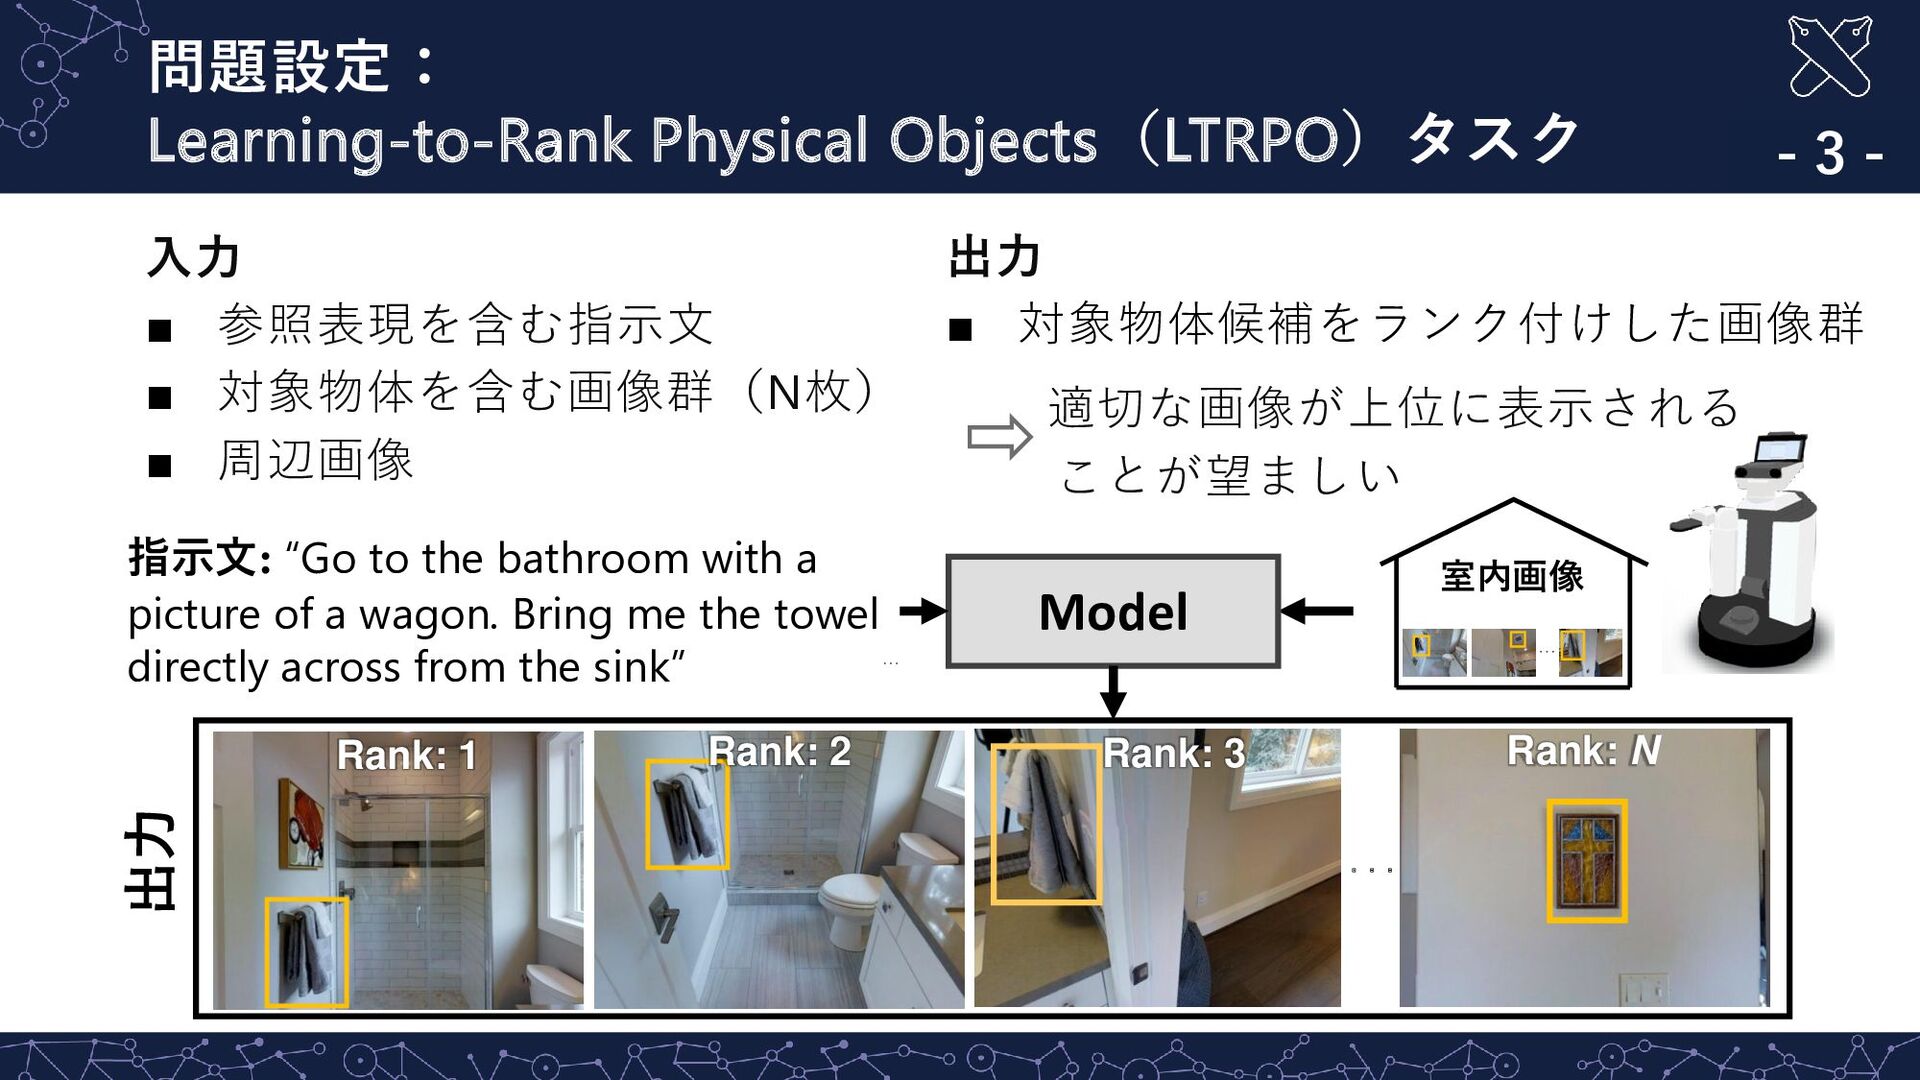
問題設定: Learning-to-Rank Physical Objects(LTRPO)タスク - 3 - 入力 ▪ 参照表現を含む指示文
▪ 対象物体を含む画像群(N枚) ▪ 周辺画像 指示文: “Go to the bathroom with a picture of a wagon. Bring me the towel directly across from the sink” ・・・ Model Rank: N Rank: 3 Rank: 2 ・・・ 室内画像 Rank: 1 出力 出力 ▪ 対象物体候補をランク付けした画像群 適切な画像が上位に表示される ことが望ましい ・・・ -
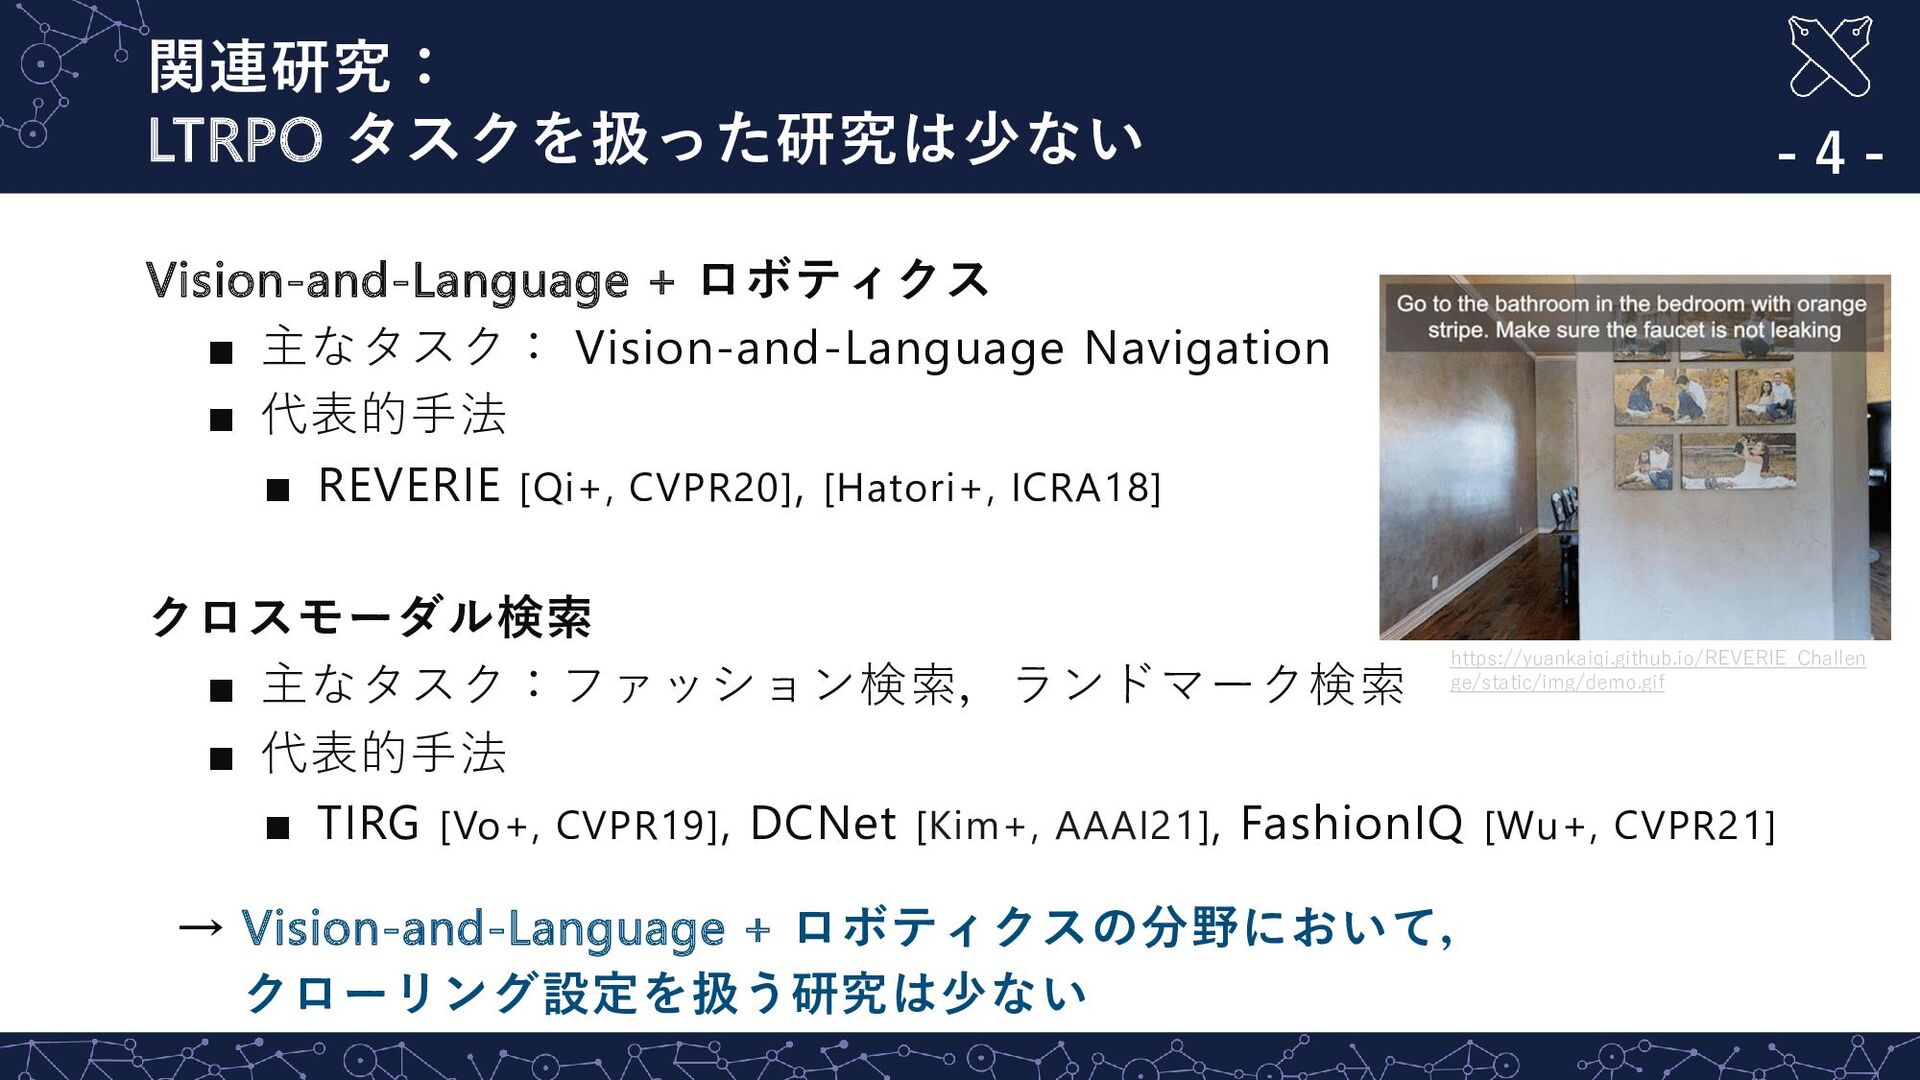
関連研究: LTRPO タスクを扱った研究は少ない - 4 - Vision-and-Language + ロボティクス ▪
主なタスク: Vision-and-Language Navigation ▪ 代表的手法 ▪ REVERIE [Qi+, CVPR20], [Hatori+, ICRA18] クロスモーダル検索 ▪ 主なタスク:ファッション検索,ランドマーク検索 ▪ 代表的手法 ▪ TIRG [Vo+, CVPR19], DCNet [Kim+, AAAI21], FashionIQ [Wu+, CVPR21] → Vision-and-Language + ロボティクスの分野において, クローリング設定を扱う研究は少ない https://yuankaiqi.github.io/REVERIE_Challen ge/static/img/demo.gif -
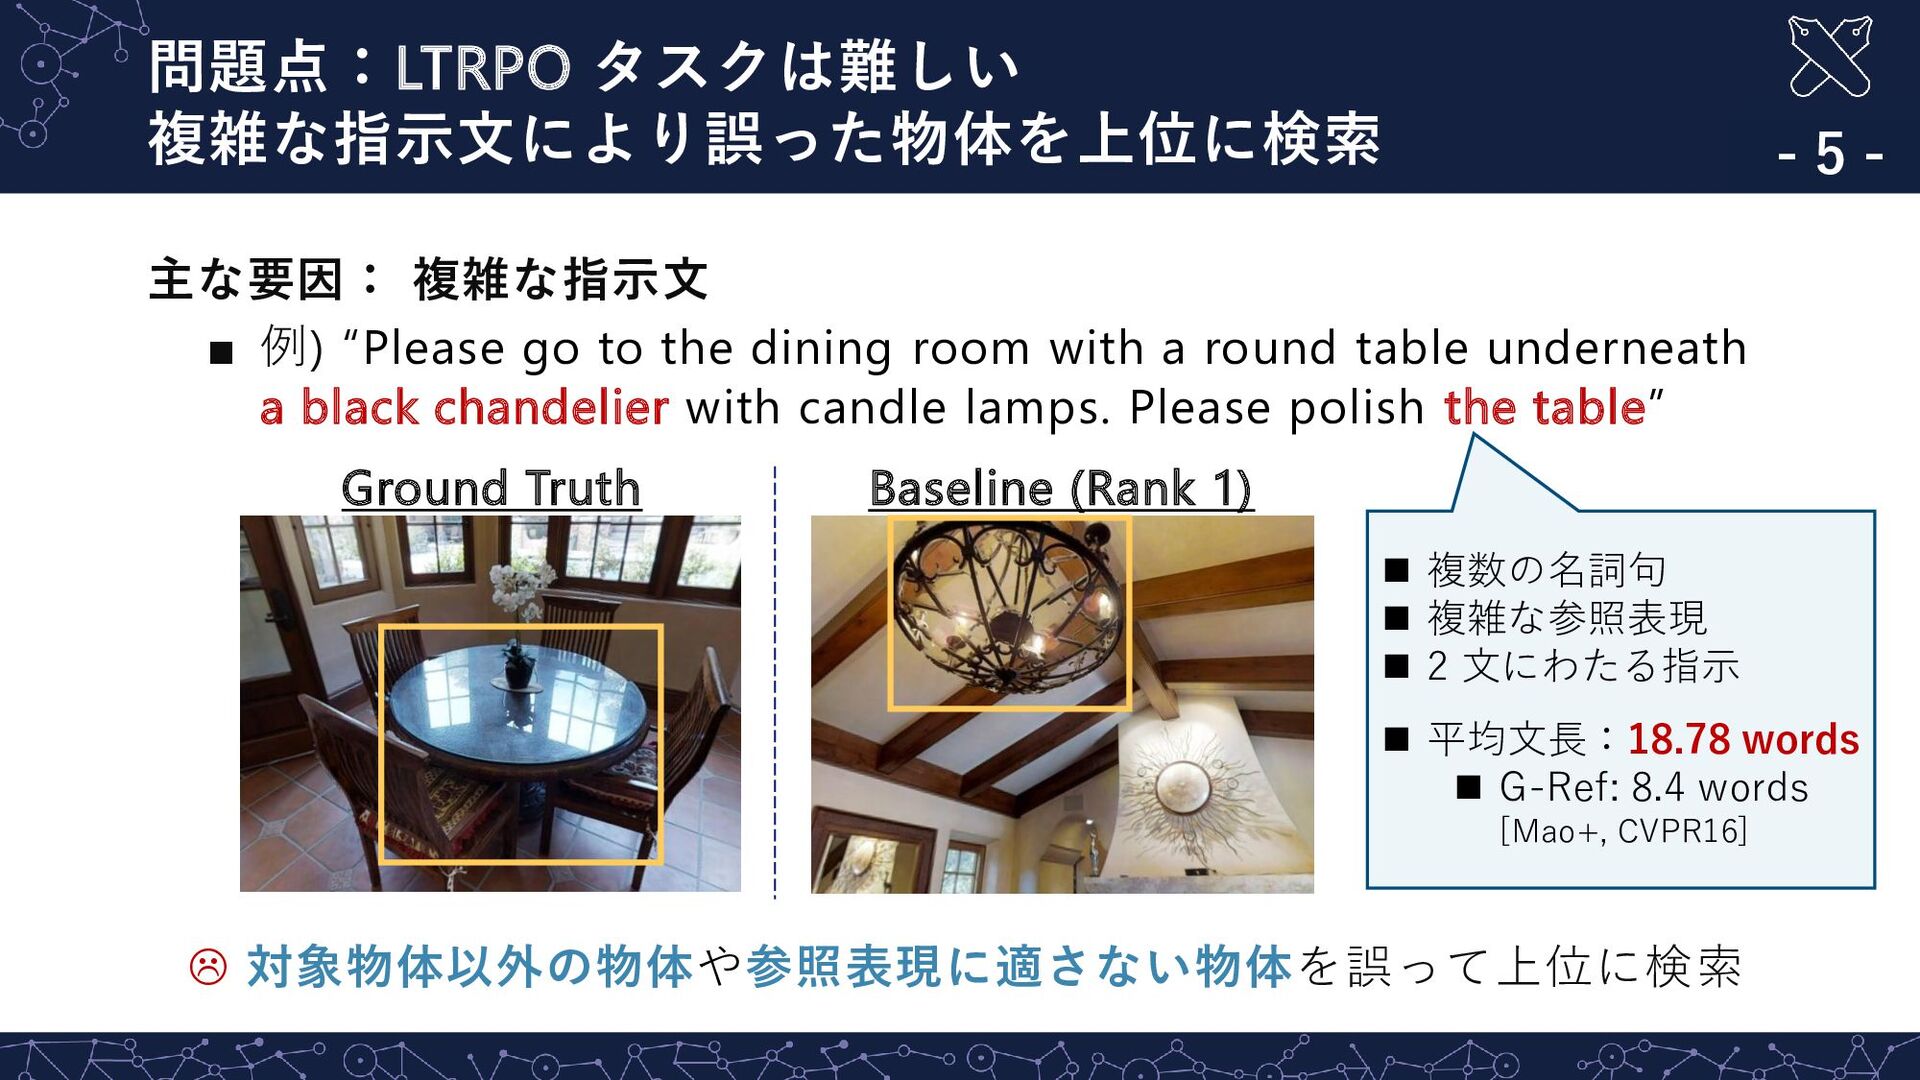
主な要因: 複雑な指示文 ▪ 例) “Please go to the dining room
with a round table underneath a black chandelier with candle lamps. Please polish the table” 対象物体以外の物体や参照表現に適さない物体を誤って上位に検索 問題点:LTRPO タスクは難しい 複雑な指示文により誤った物体を上位に検索 - 5 - Ground Truth Baseline (Rank 1) ◼ 複数の名詞句 ◼ 複雑な参照表現 ◼ 2 文にわたる指示 ◼ 平均文長:18.78 words ◼ G-Ref: 8.4 words [Mao+, CVPR16] -
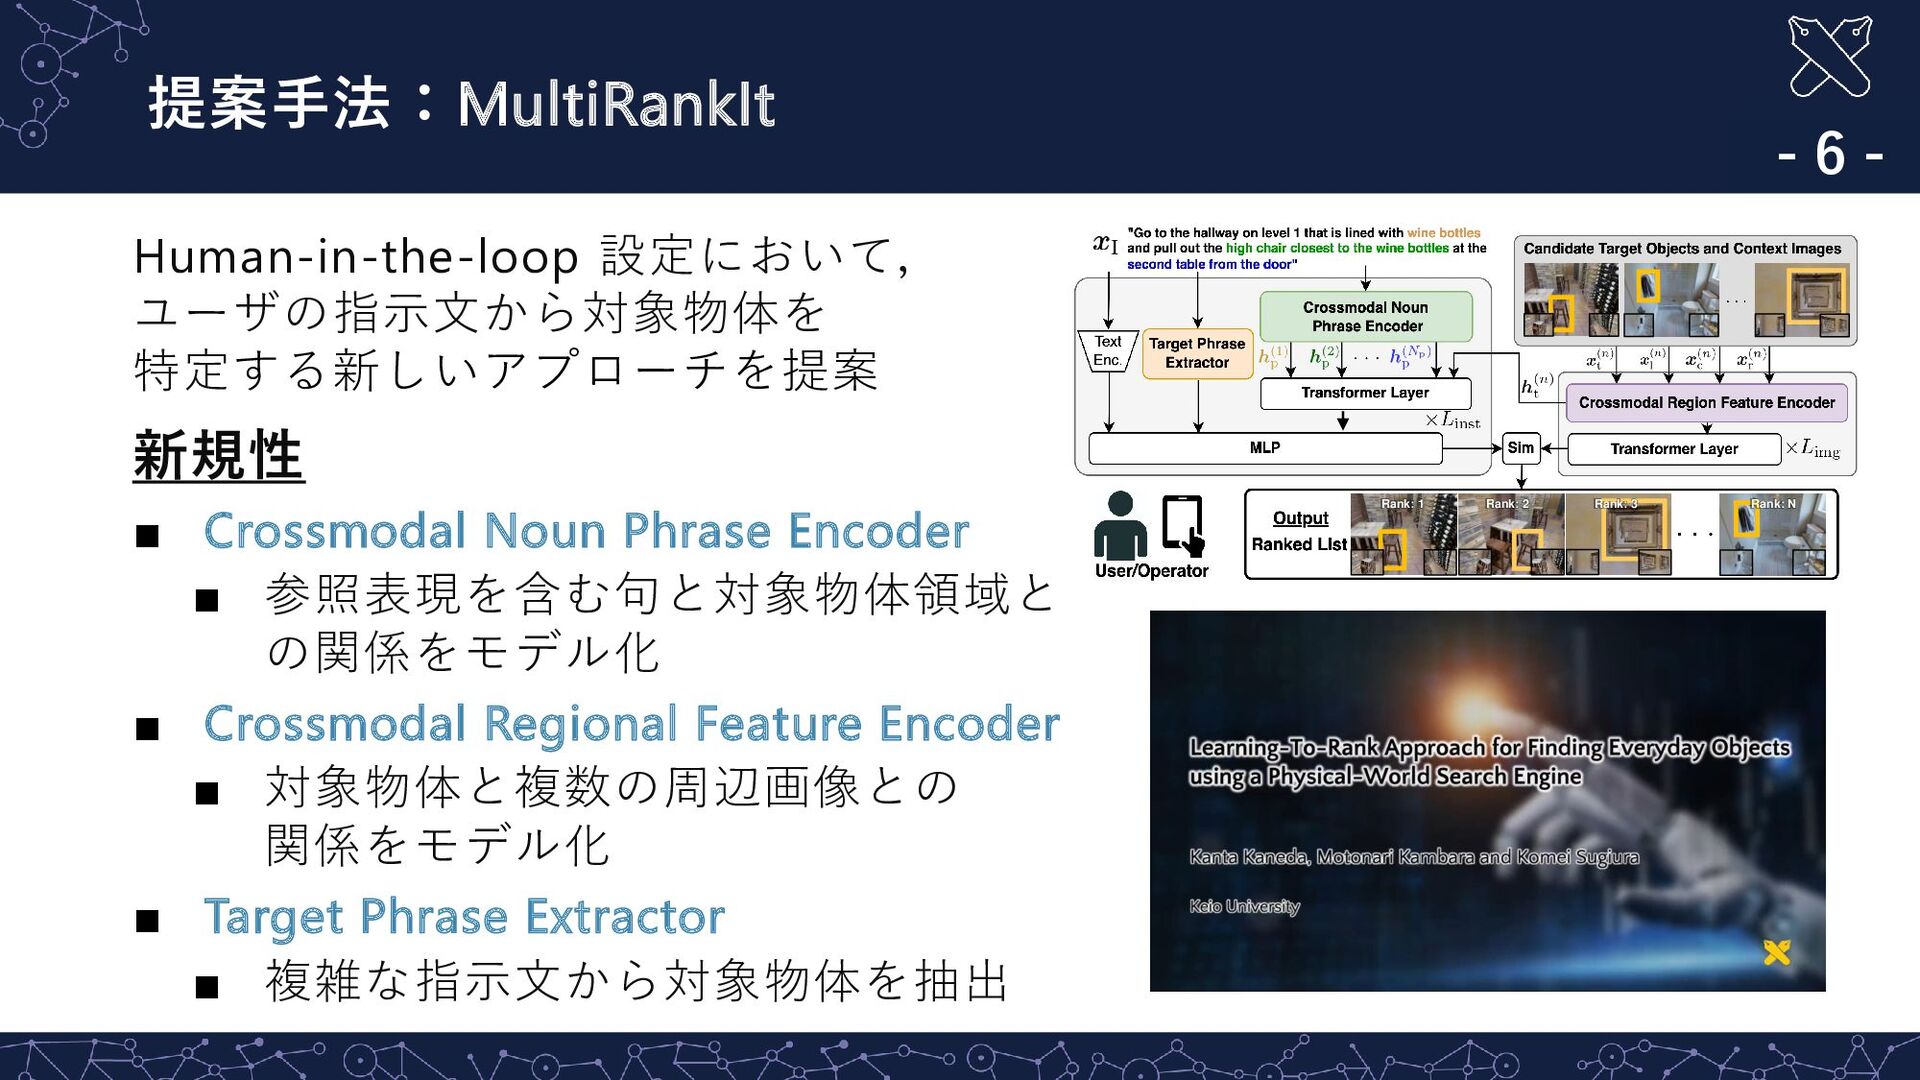
提案手法:MultiRankIt - 6 - Human-in-the-loop 設定において, ユーザの指示文から対象物体を 特定する新しいアプローチを提案 新規性 ▪
Crossmodal Noun Phrase Encoder ▪ 参照表現を含む句と対象物体領域と の関係をモデル化 ▪ Crossmodal Regional Feature Encoder ▪ 対象物体と複数の周辺画像との 関係をモデル化 ▪ Target Phrase Extractor ▪ 複雑な指示文から対象物体を抽出 Rank: 3 Rank: 2 Rank: 1 Rank: N -
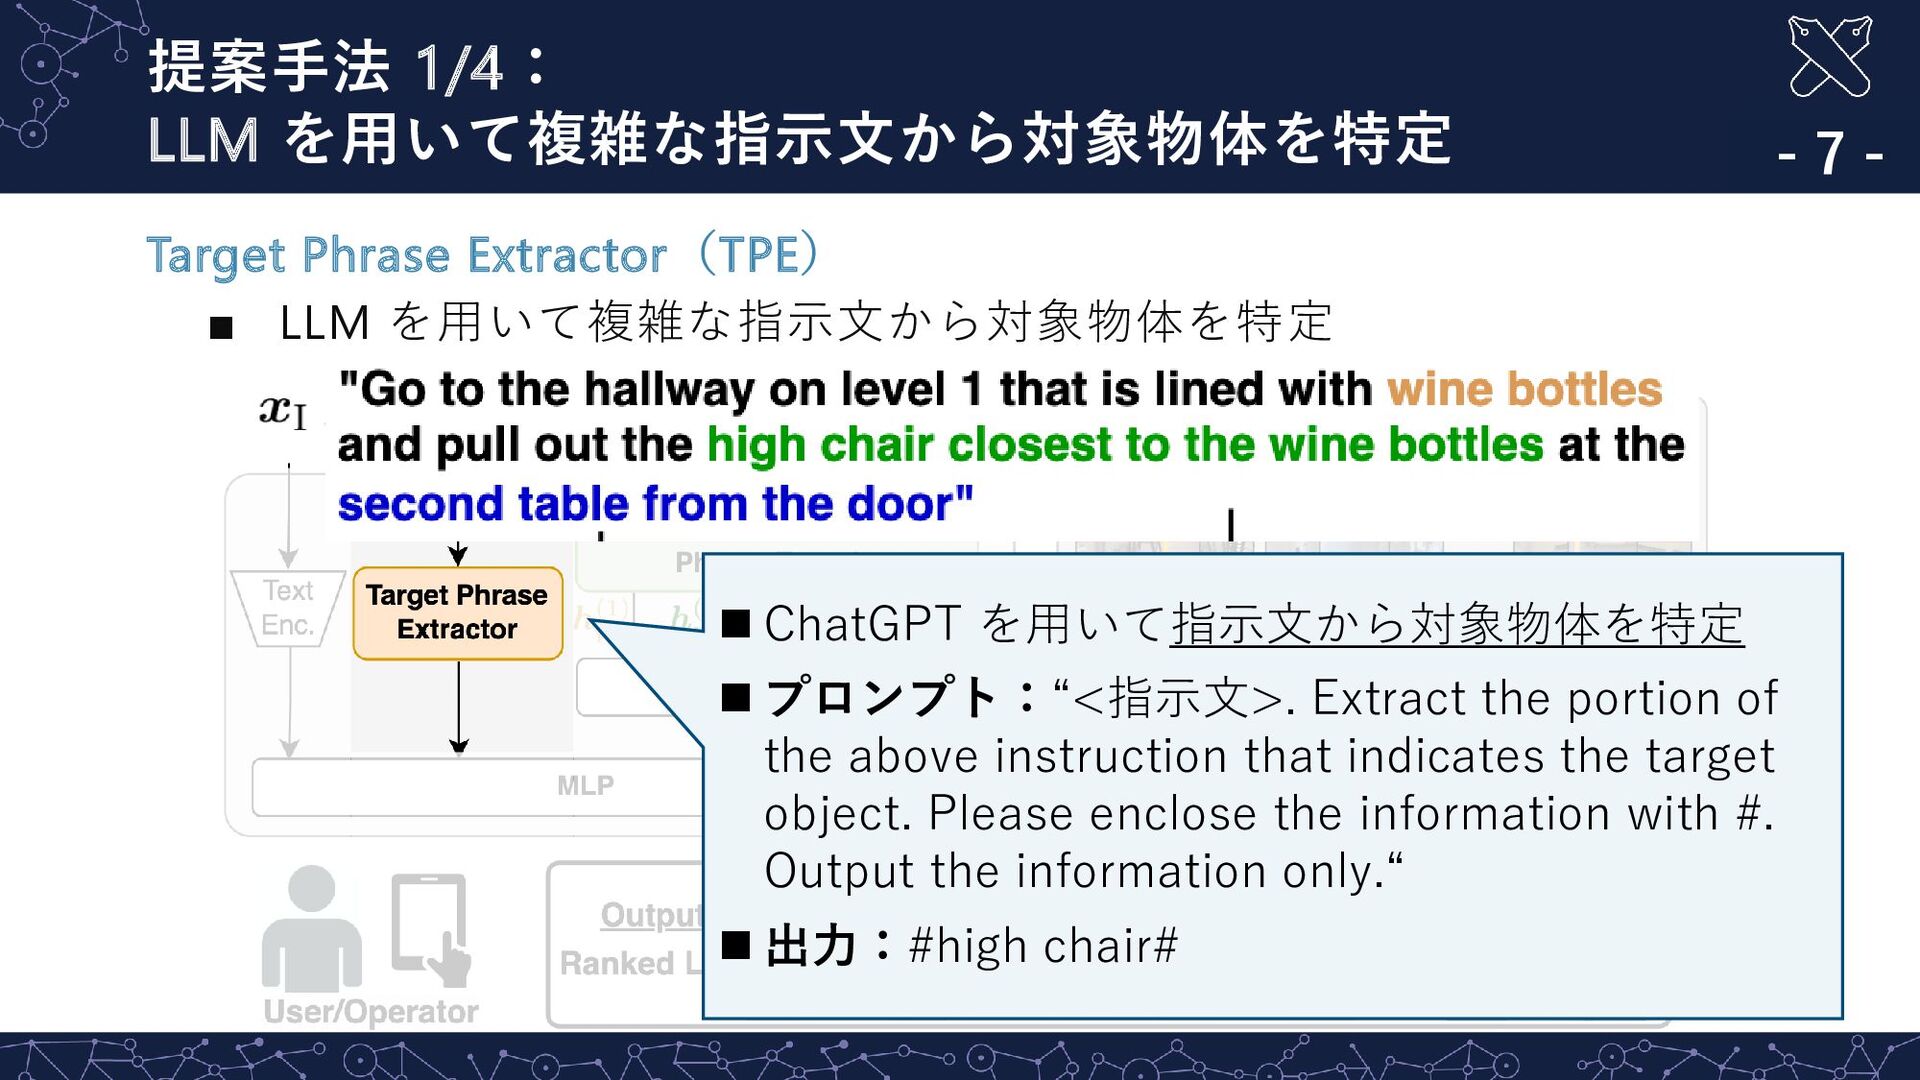
Rank: 3 Rank: 2 Rank: 1 Rank: N 提案手法 1/4:
LLM を用いて複雑な指示文から対象物体を特定 - 7 - Target Phrase Extractor(TPE) ▪ LLM を用いて複雑な指示文から対象物体を特定 ◼ ChatGPT を用いて指示文から対象物体を特定 ◼ プロンプト:“<指示文>. Extract the portion of the above instruction that indicates the target object. Please enclose the information with #. Output the information only.“ ◼ 出力:#high chair# -
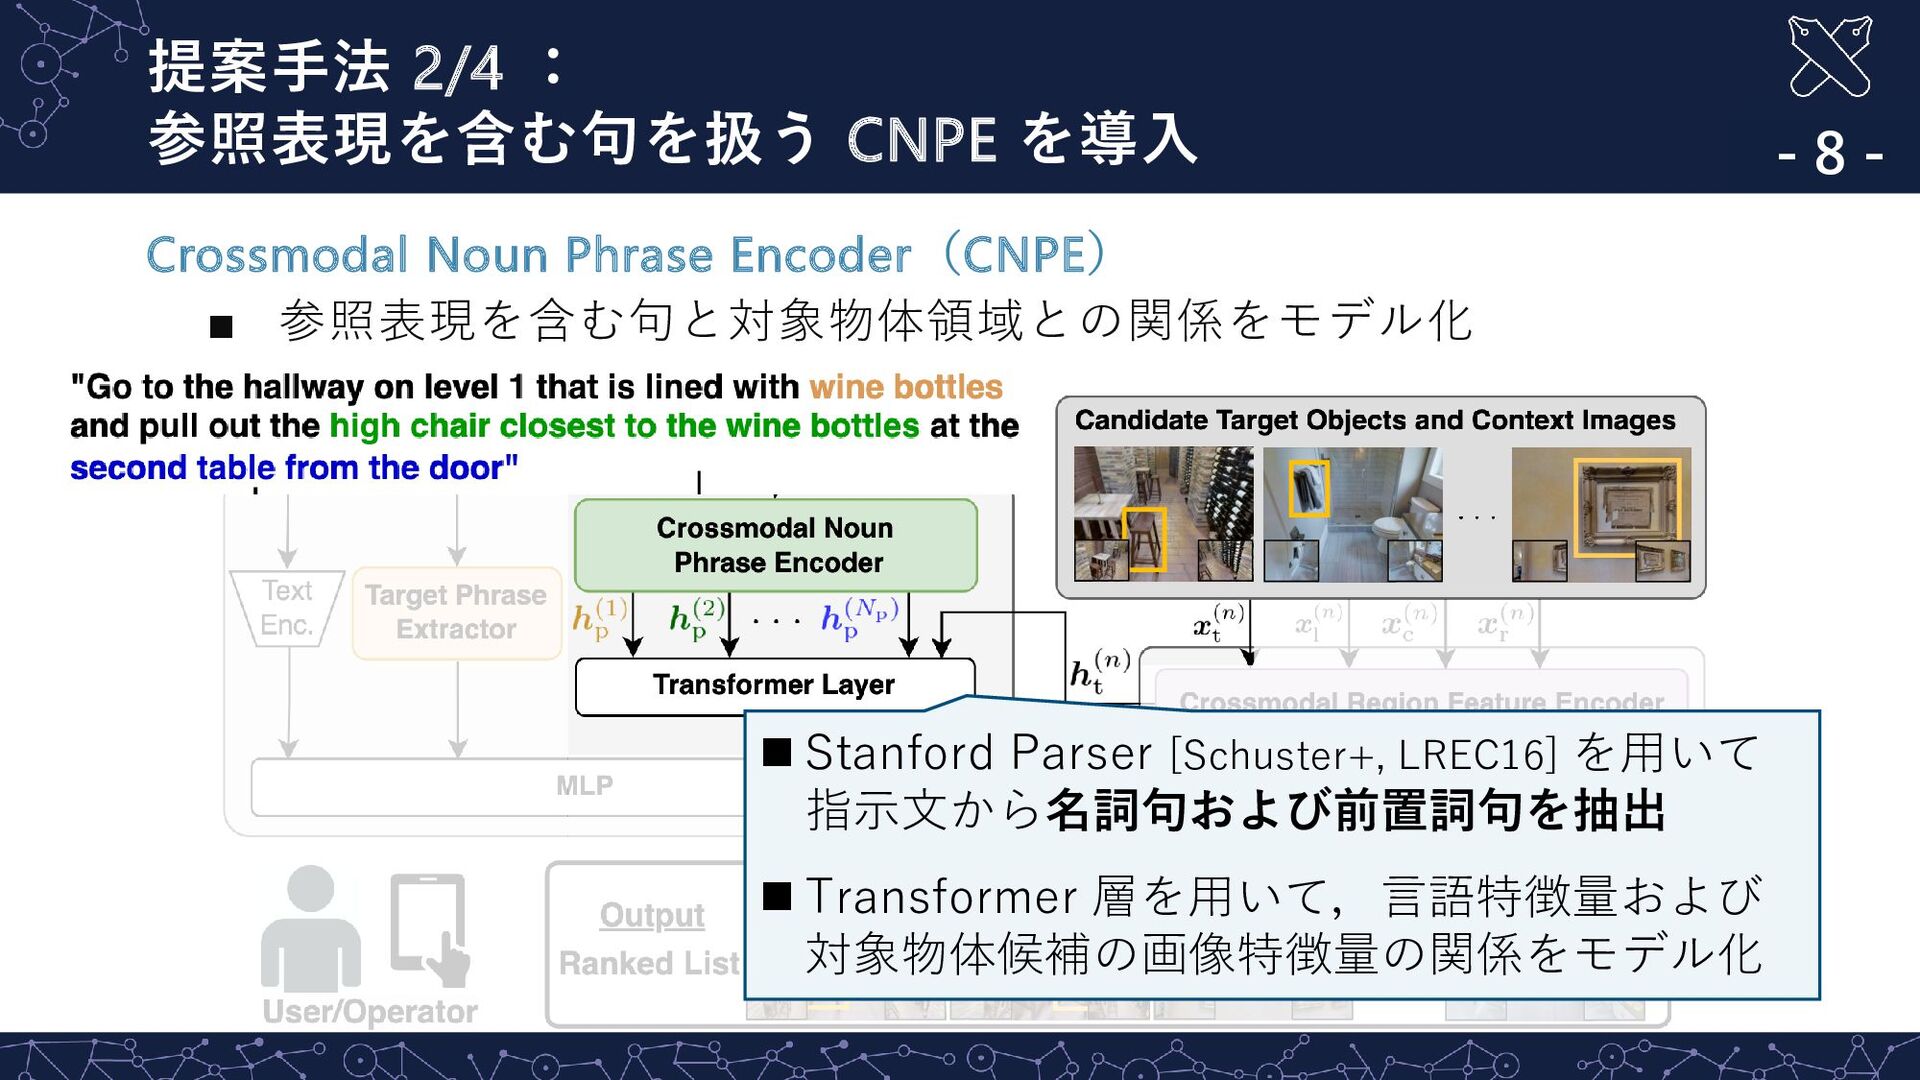
Rank: 3 Rank: 2 Rank: 1 Rank: N 提案手法 2/4
: 参照表現を含む句を扱う CNPE を導入 - 8 - Crossmodal Noun Phrase Encoder(CNPE) ▪ 参照表現を含む句と対象物体領域との関係をモデル化 ◼ Stanford Parser [Schuster+, LREC16] を用いて 指示文から名詞句および前置詞句を抽出 ◼ Transformer 層を用いて,言語特徴量および 対象物体候補の画像特徴量の関係をモデル化 -
Rank: 3 Rank: 2 Rank: 1 Rank: N 提案手法 3/4
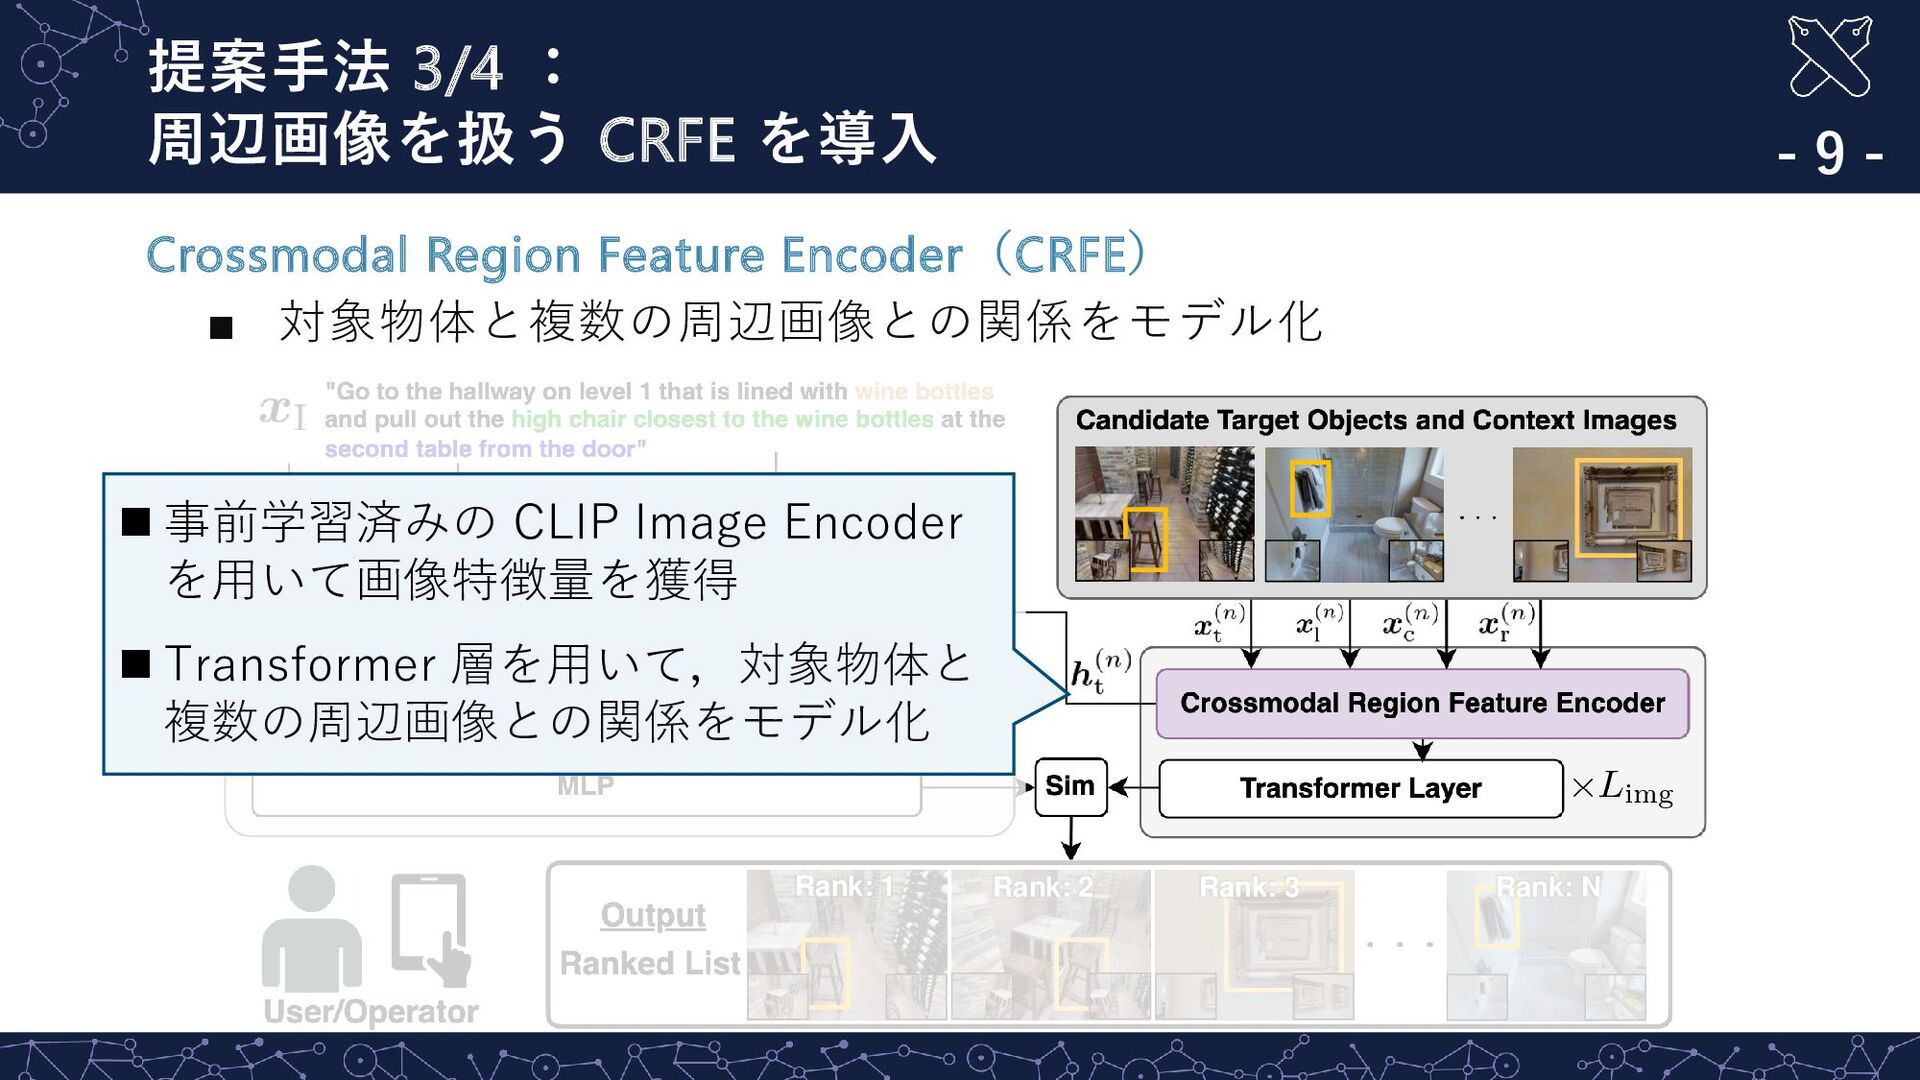
: 周辺画像を扱う CRFE を導入 - 9 - Crossmodal Region Feature Encoder(CRFE) ▪ 対象物体と複数の周辺画像との関係をモデル化 ◼ 事前学習済みの CLIP Image Encoder を用いて画像特徴量を獲得 ◼ Transformer 層を用いて,対象物体と 複数の周辺画像との関係をモデル化 -
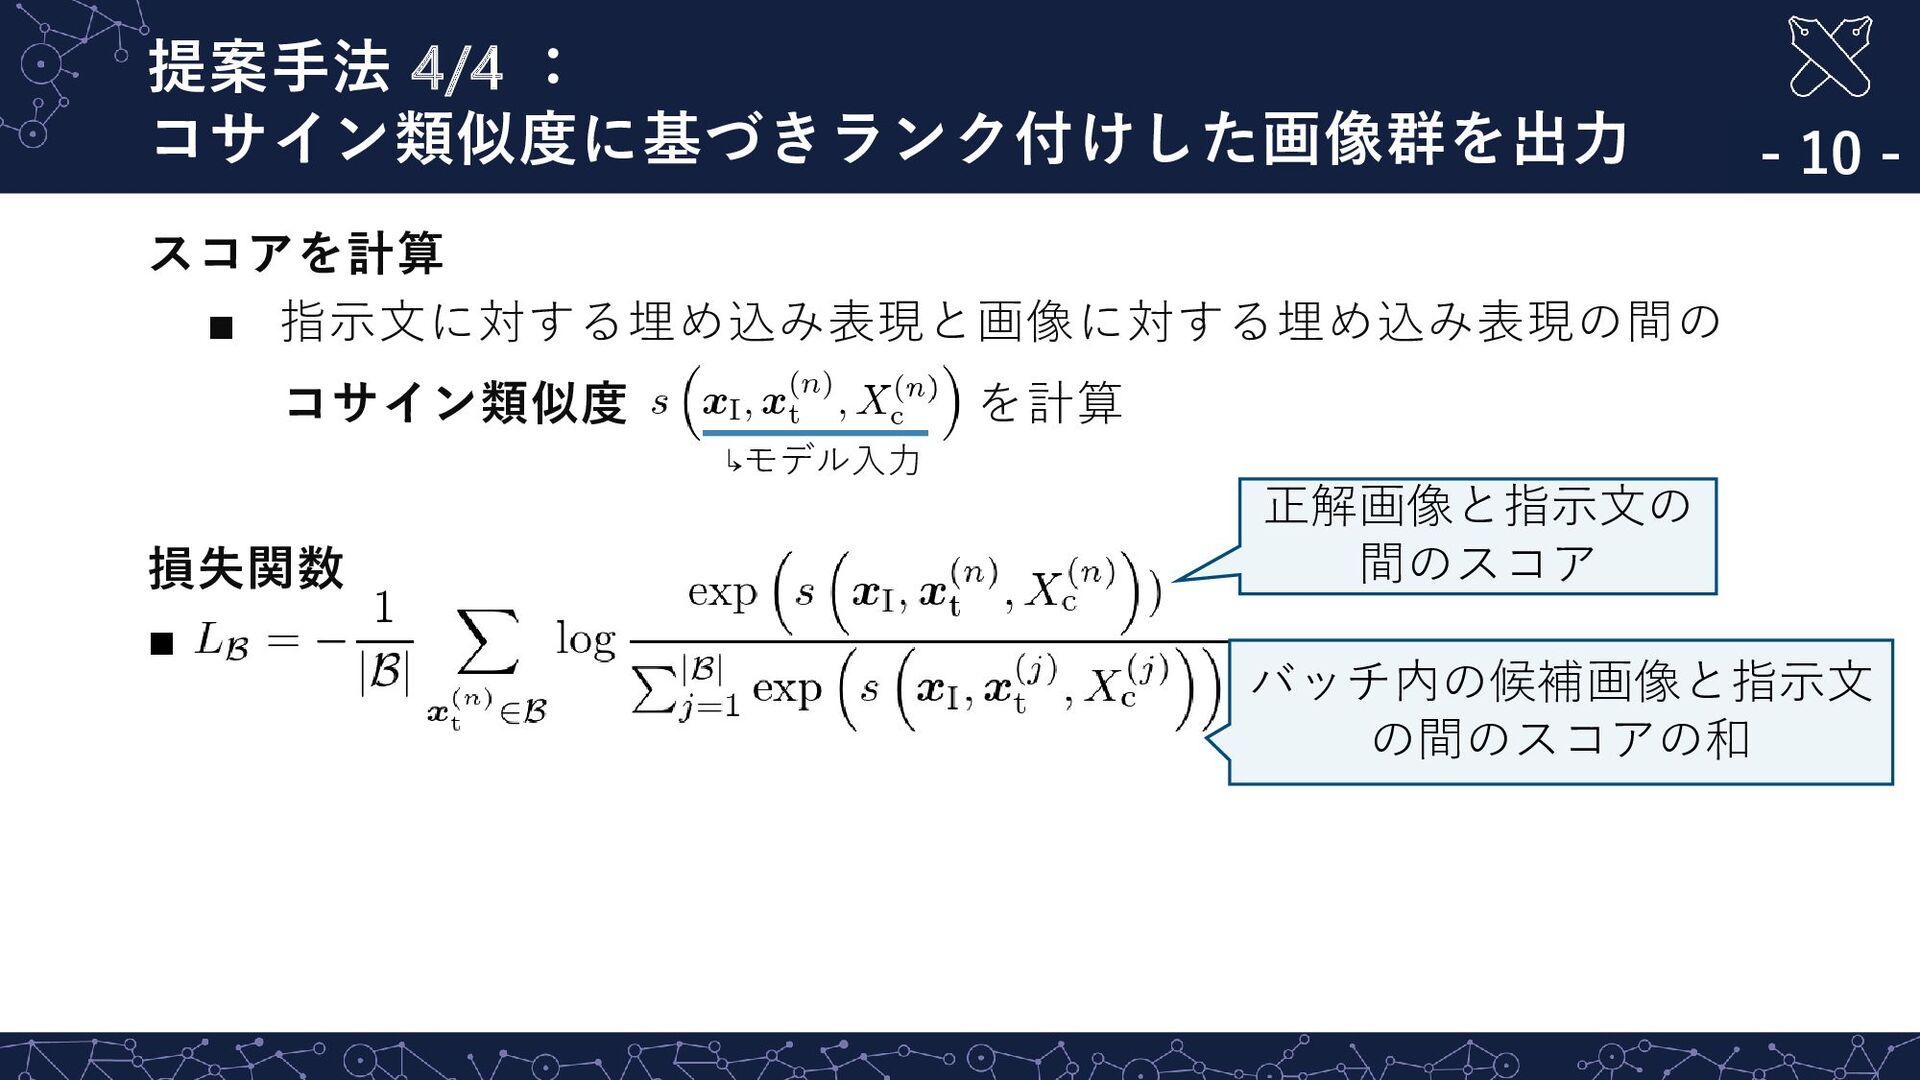
スコアを計算 ▪ 指示文に対する埋め込み表現と画像に対する埋め込み表現の間の コサイン類似度 を計算 損失関数 ▪ . 提案手法 4/4
: コサイン類似度に基づきランク付けした画像群を出力 - 10 - バッチ内の候補画像と指示文 の間のスコアの和 正解画像と指示文の 間のスコア ↳モデル入力 -
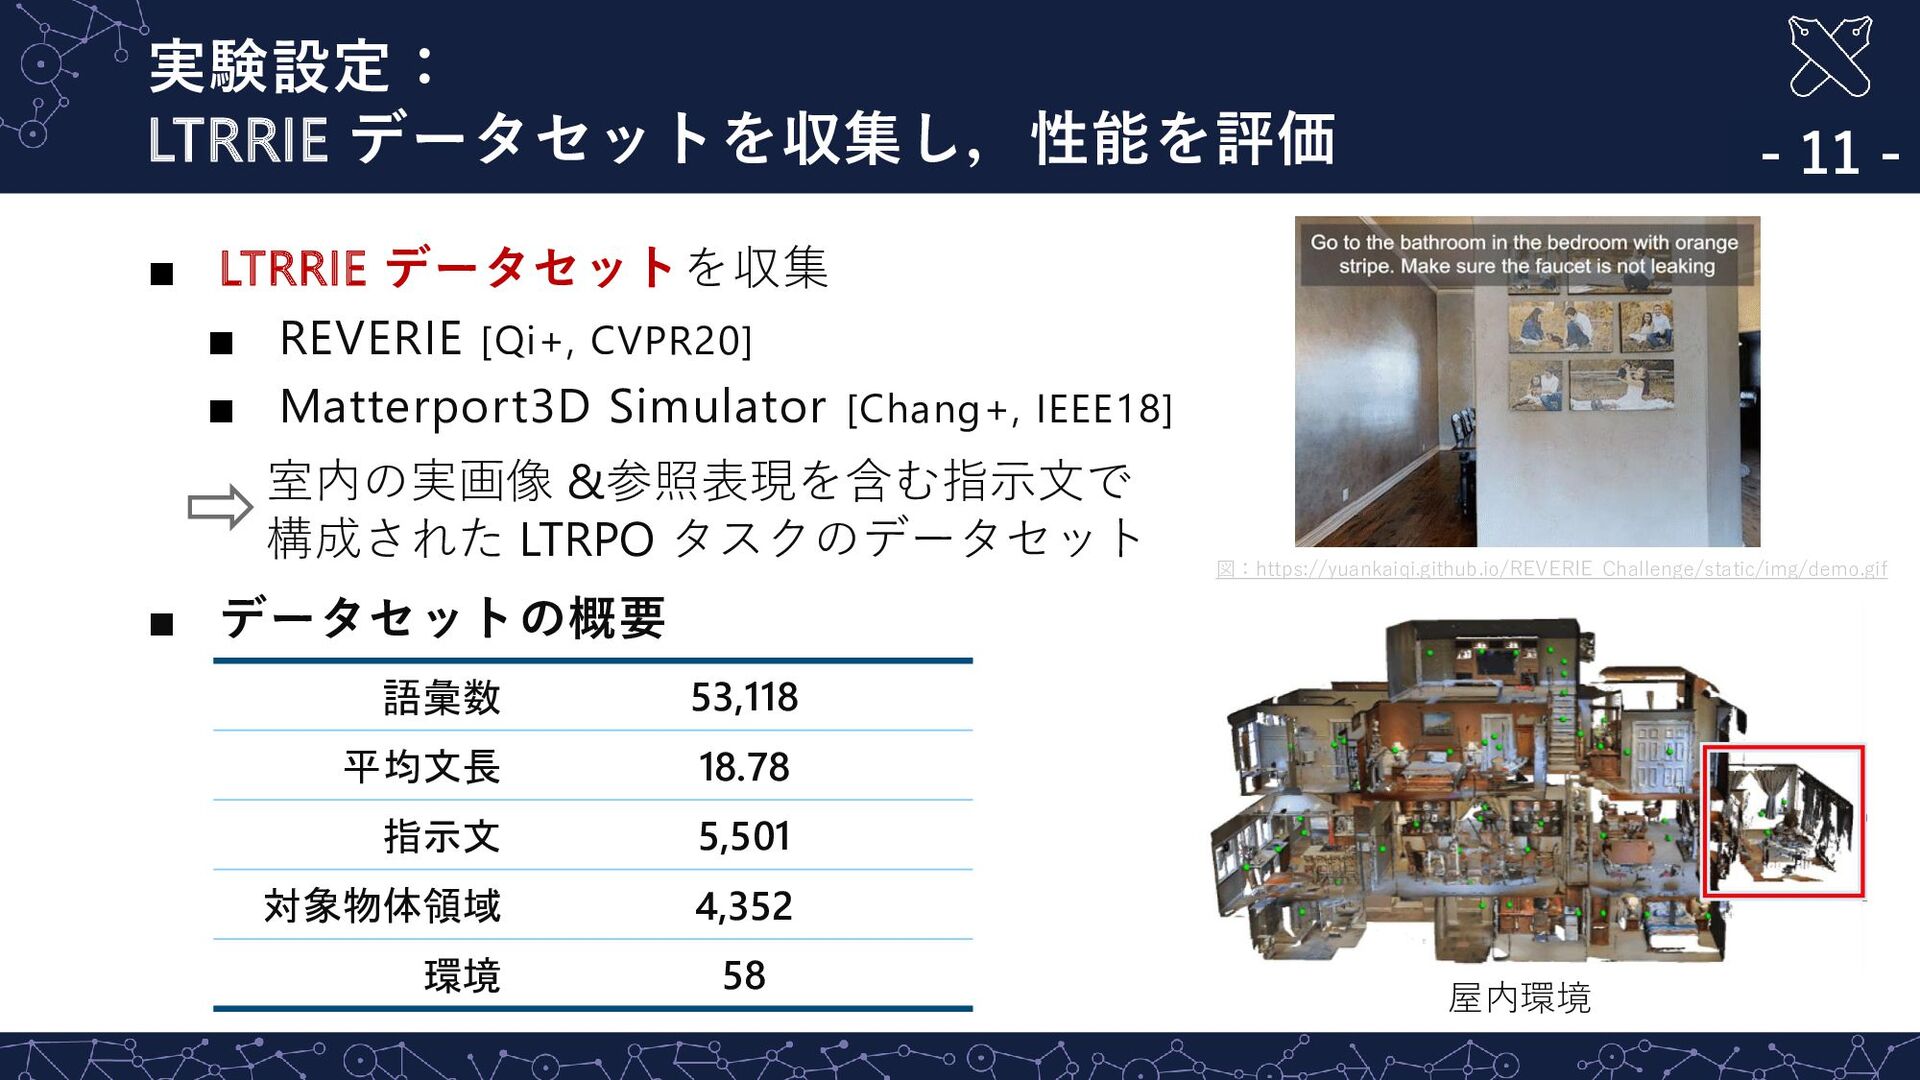
実験設定: LTRRIE データセットを収集し,性能を評価 - 11 - ▪ LTRRIE データセットを収集 ▪
REVERIE [Qi+, CVPR20] ▪ Matterport3D Simulator [Chang+, IEEE18] ▪ データセットの概要 語彙数 53,118 平均文長 18.78 指示文 5,501 対象物体領域 4,352 環境 58 室内の実画像 &参照表現を含む指示文で 構成された LTRPO タスクのデータセット 図:https://yuankaiqi.github.io/REVERIE_Challenge/static/img/demo.gif 屋内環境 -
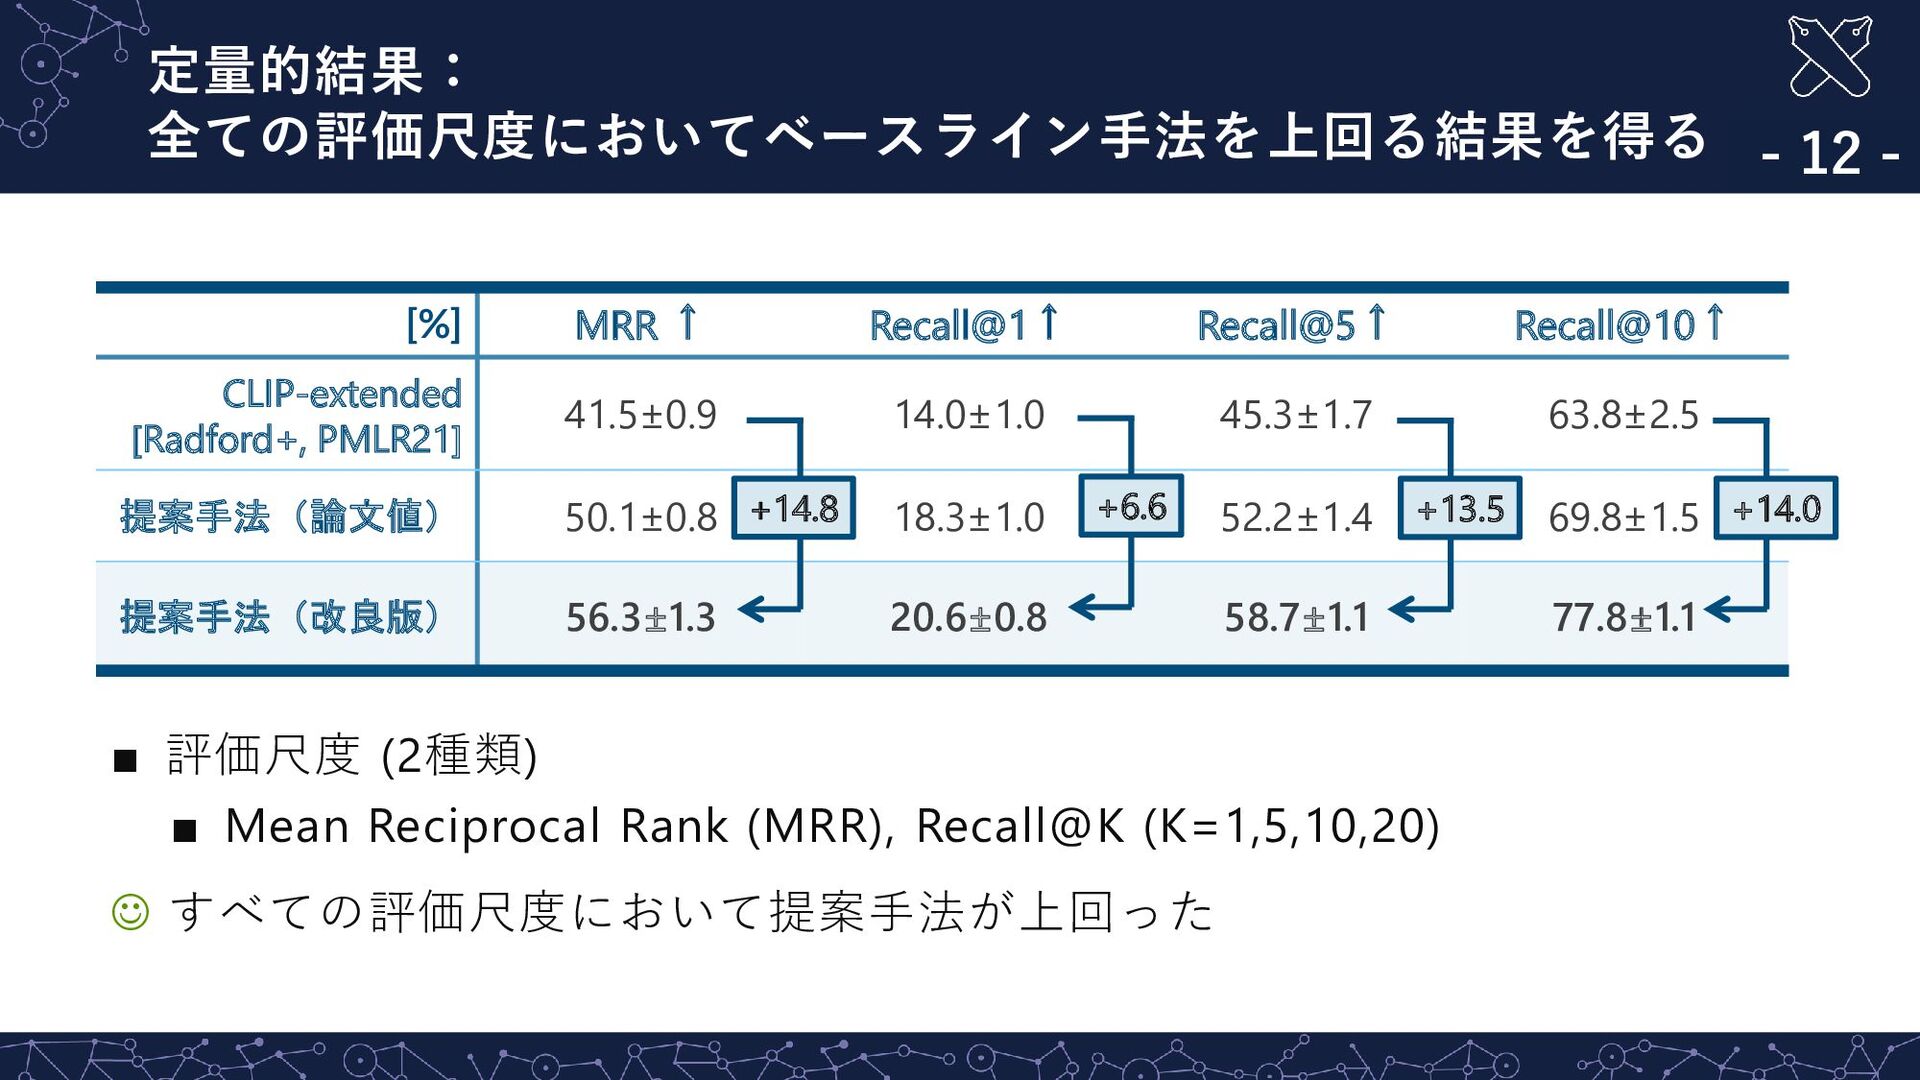
定量的結果: 全ての評価尺度においてベースライン手法を上回る結果を得る - 12 - ▪ 評価尺度 (2種類) ▪ Mean
Reciprocal Rank (MRR), Recall@K (K=1,5,10,20) ☺ すべての評価尺度において提案手法が上回った [%] MRR ↑ Recall@1↑ Recall@5↑ Recall@10↑ CLIP-extended [Radford+, PMLR21] 41.5±0.9 14.0±1.0 45.3±1.7 63.8±2.5 提案手法(論文値) 50.1±0.8 18.3±1.0 52.2±1.4 69.8±1.5 提案手法(改良版) 56.3±1.3 20.6±0.8 58.7±1.1 77.8±1.1 +14.8 +6.6 +13.5 +14.0 -
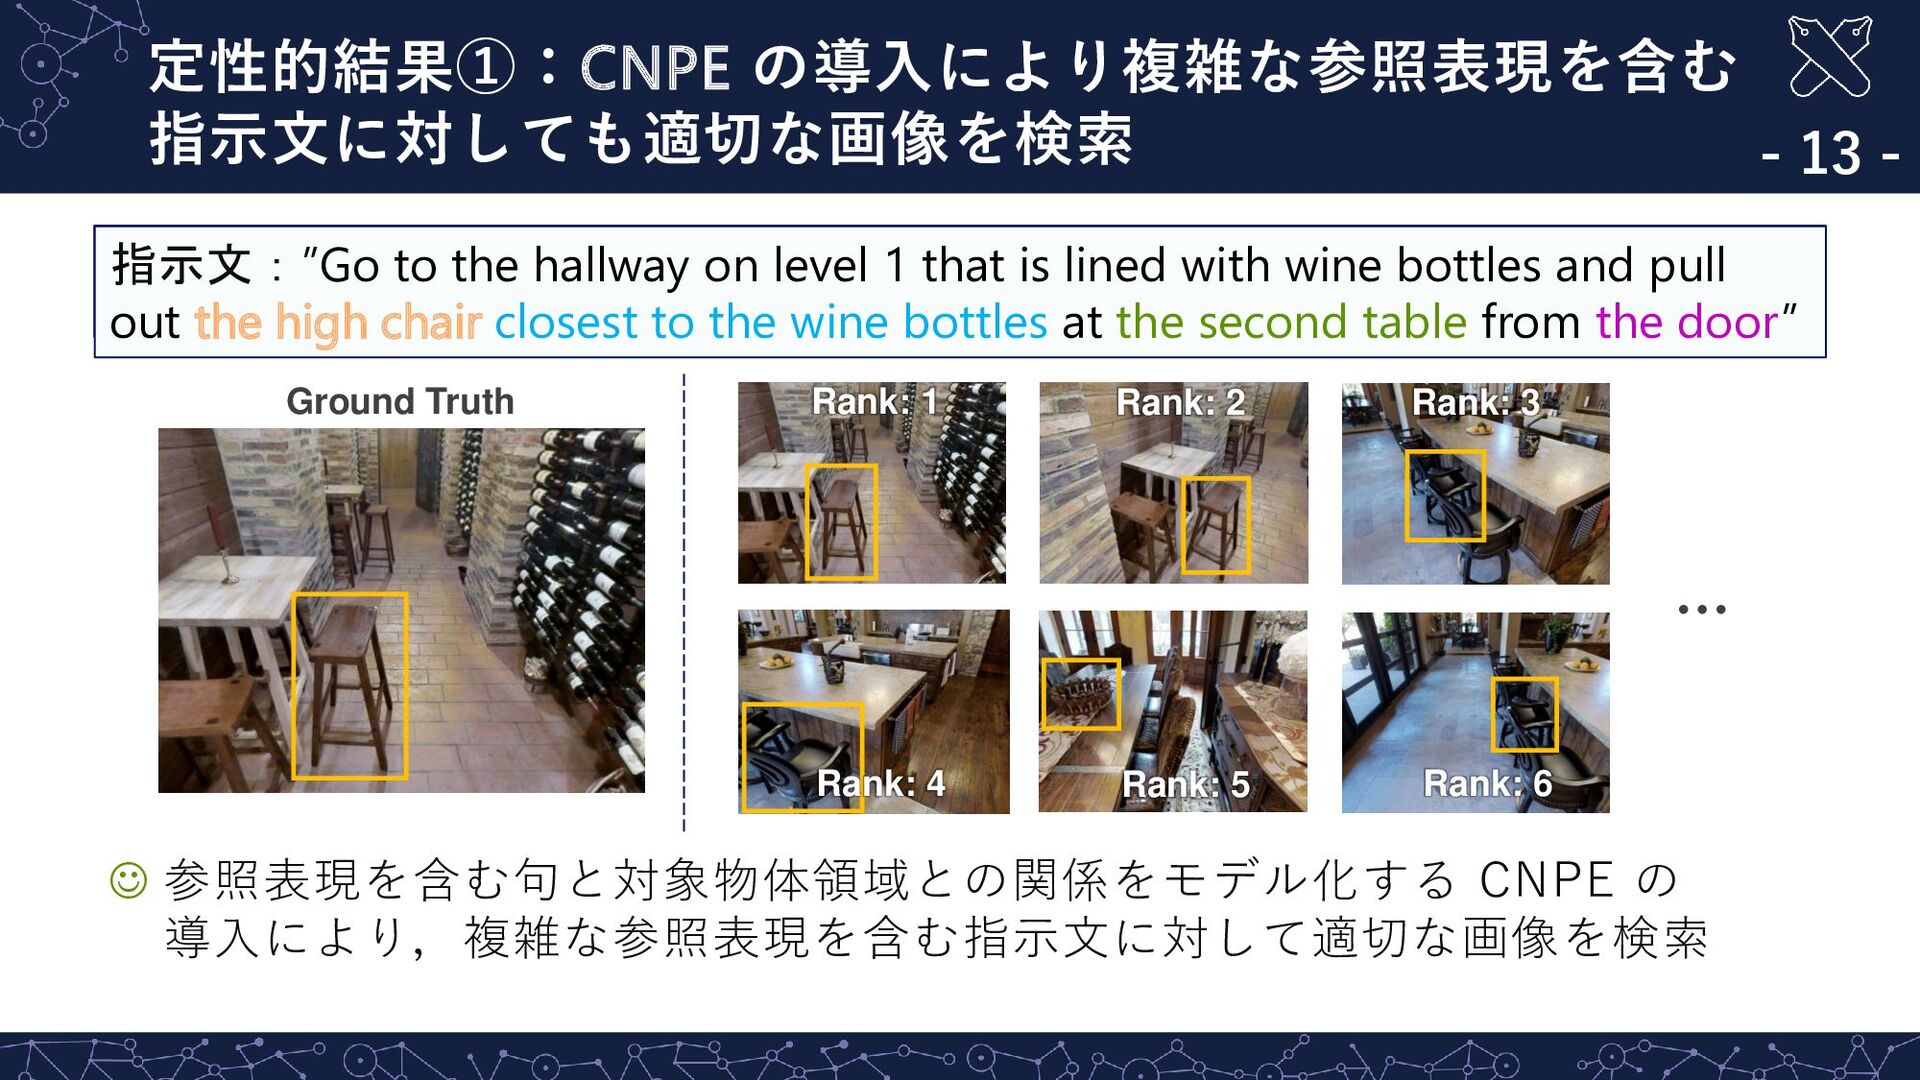
定性的結果①:CNPE の導入により複雑な参照表現を含む 指示文に対しても適切な画像を検索 - 13 - Rank: 1 … Ground
Truth Rank: 2 Rank: 3 Rank: 4 Rank: 5 Rank: 6 指示文:”Go to the hallway on level 1 that is lined with wine bottles and pull out the high chair closest to the wine bottles at the second table from the door” 指示文:”Go to the hallway on level 1 that is lined with wine bottles and pull out the high chair closest to the wine bottles at the second table from the door” ☺ 参照表現を含む句と対象物体領域との関係をモデル化する CNPE の 導入により,複雑な参照表現を含む指示文に対して適切な画像を検索 -
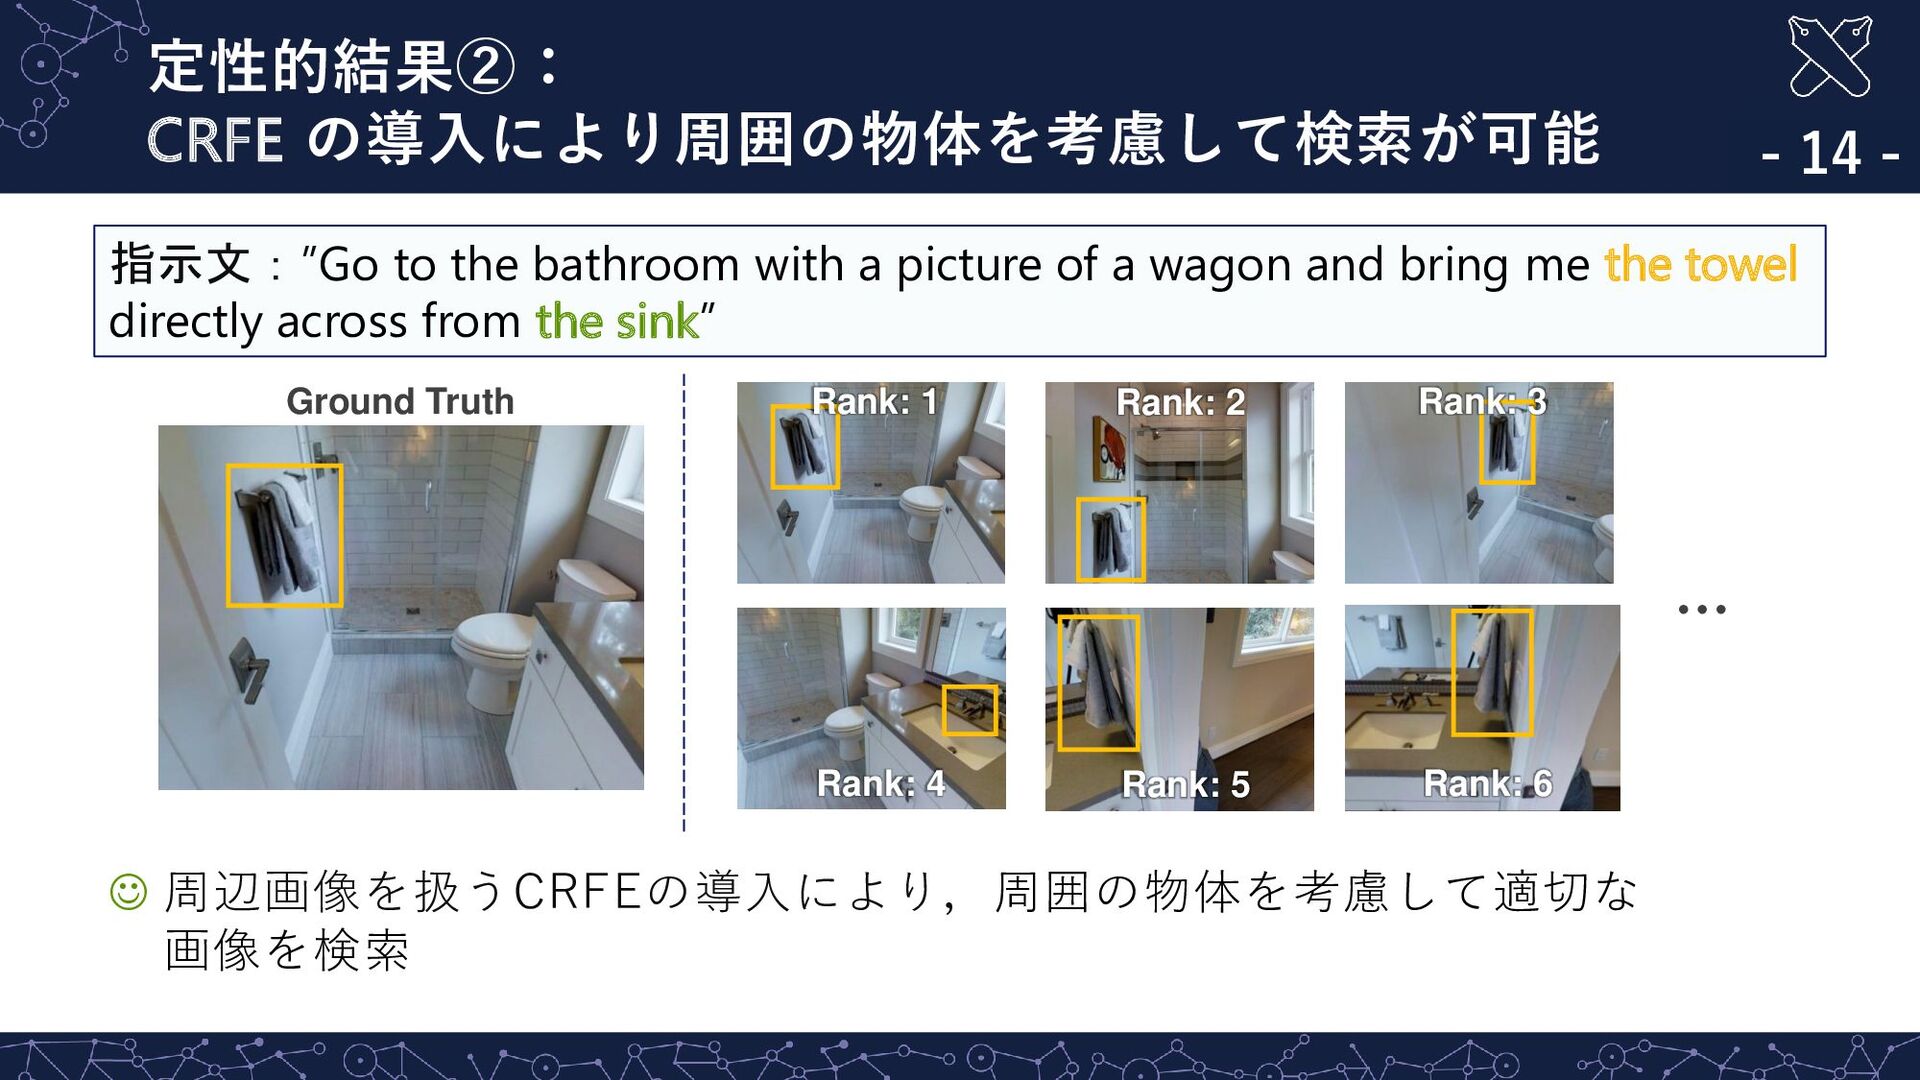
定性的結果②: CRFE の導入により周囲の物体を考慮して検索が可能 - 14 - ☺ 周辺画像を扱うCRFEの導入により,周囲の物体を考慮して適切な 画像を検索 Rank:
1 … 指示文:”Go to the bathroom with a picture of a wagon and bring me the towel directly across from the sink” Ground Truth Rank: 2 Rank: 3 Rank: 4 Rank: 5 Rank: 6 -
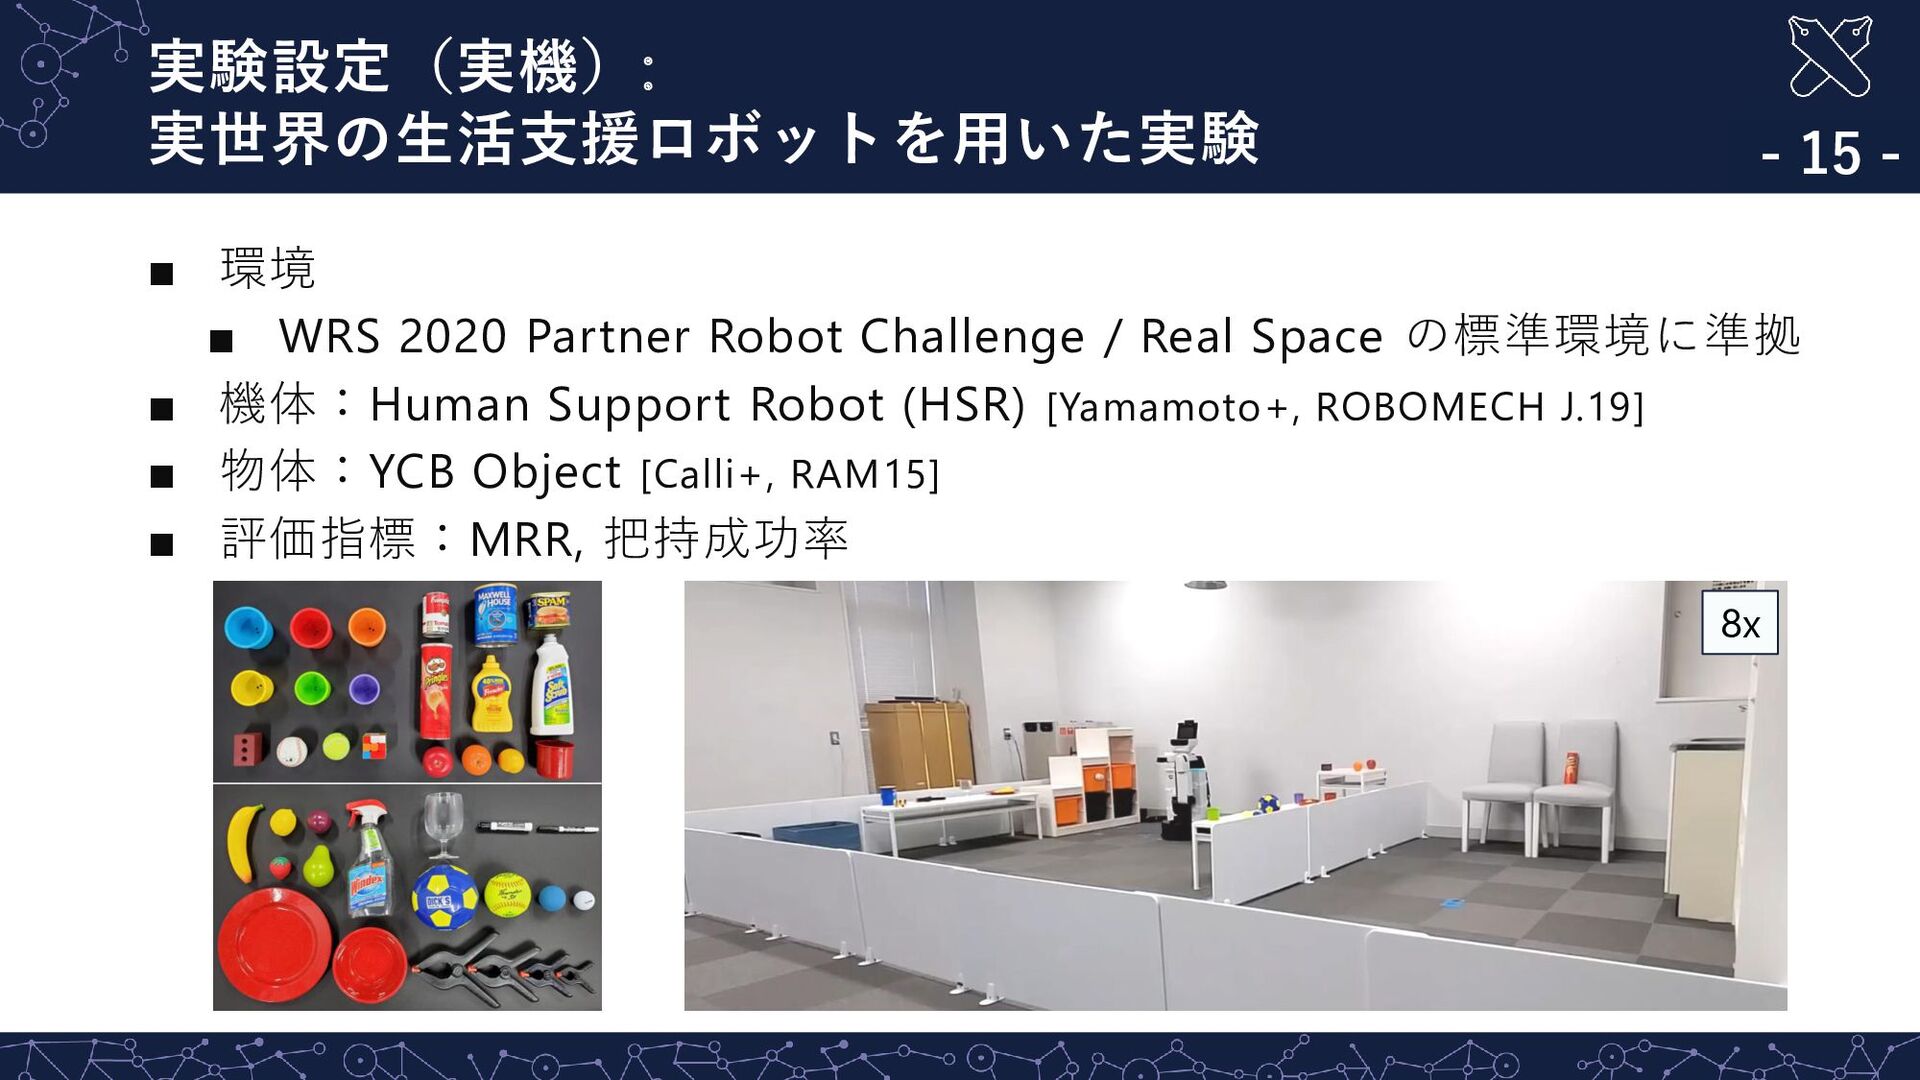
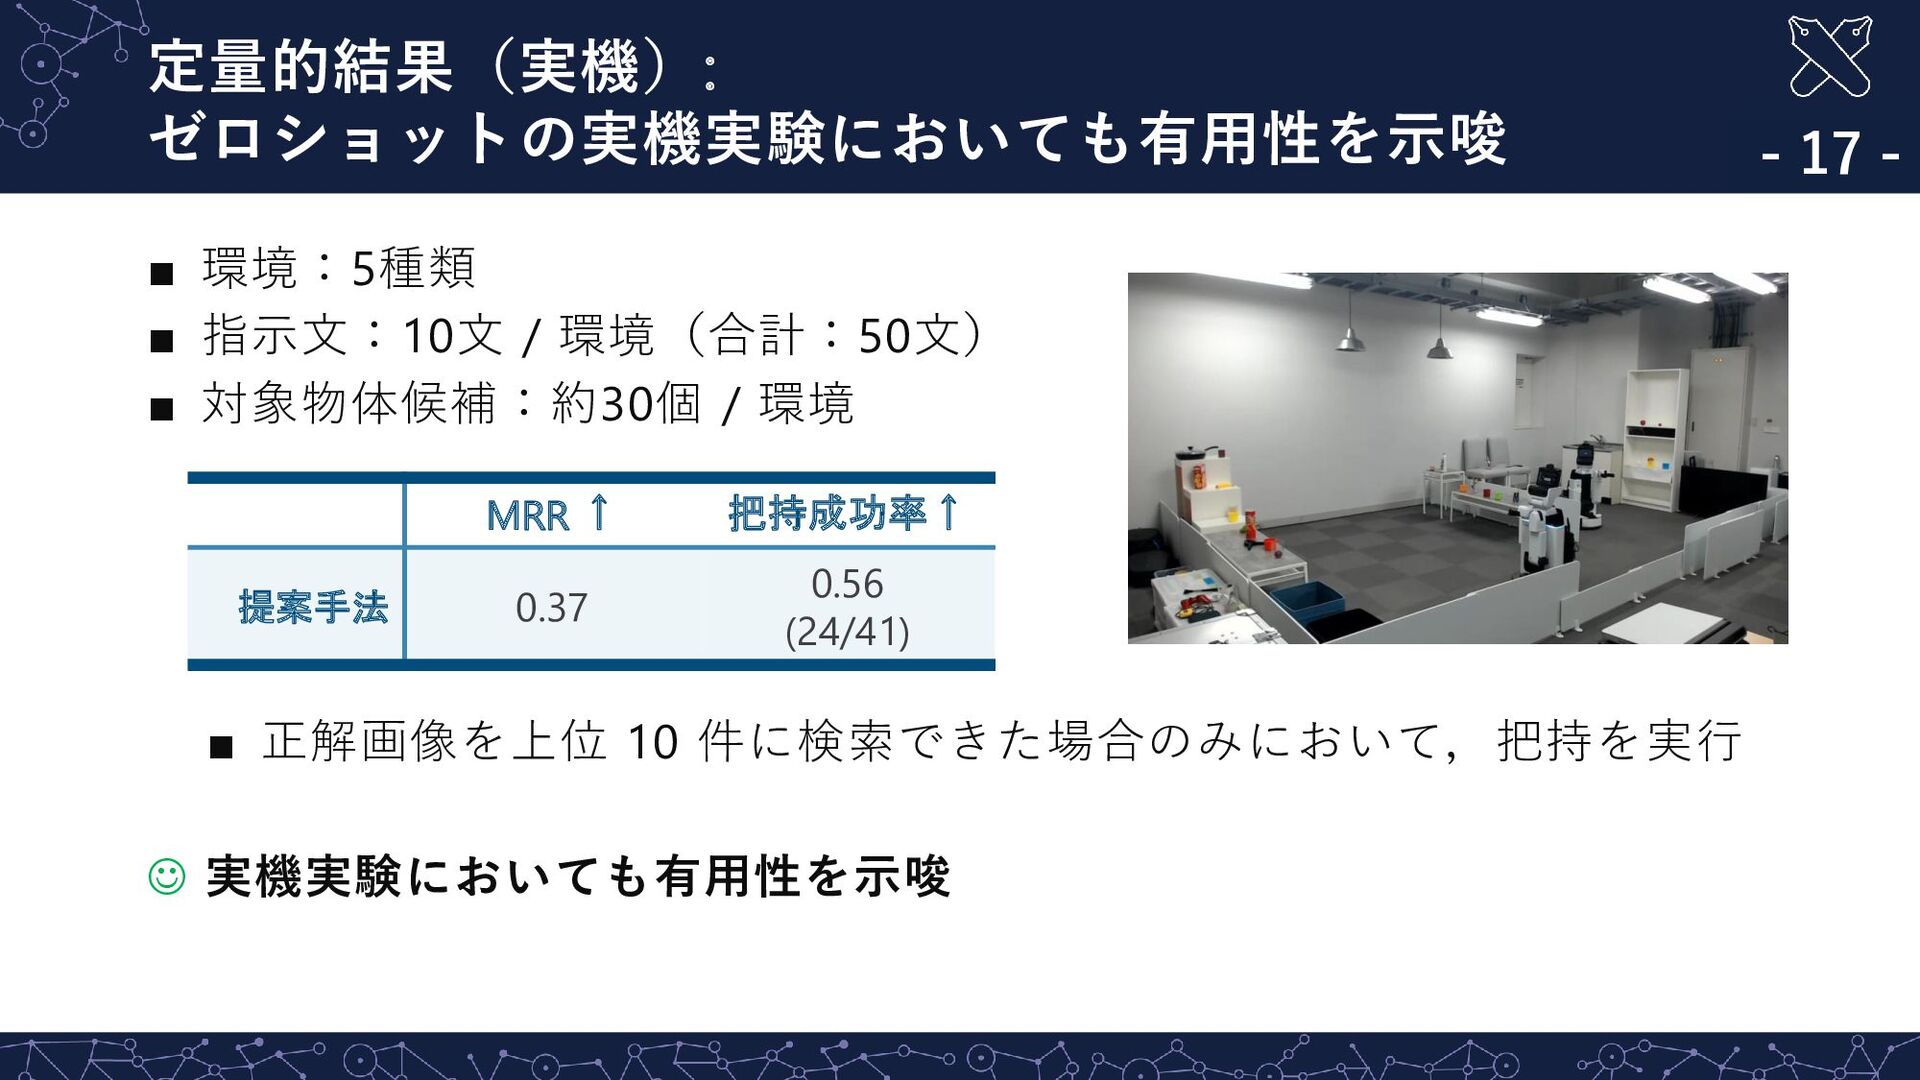
実験設定(実機): 実世界の生活支援ロボットを用いた実験 - 15 - ▪ 環境 ▪ WRS 2020
Partner Robot Challenge / Real Space の標準環境に準拠 ▪ 機体:Human Support Robot (HSR) [Yamamoto+, ROBOMECH J.19] ▪ 物体:YCB Object [Calli+, RAM15] ▪ 評価指標:MRR, 把持成功率 8x -
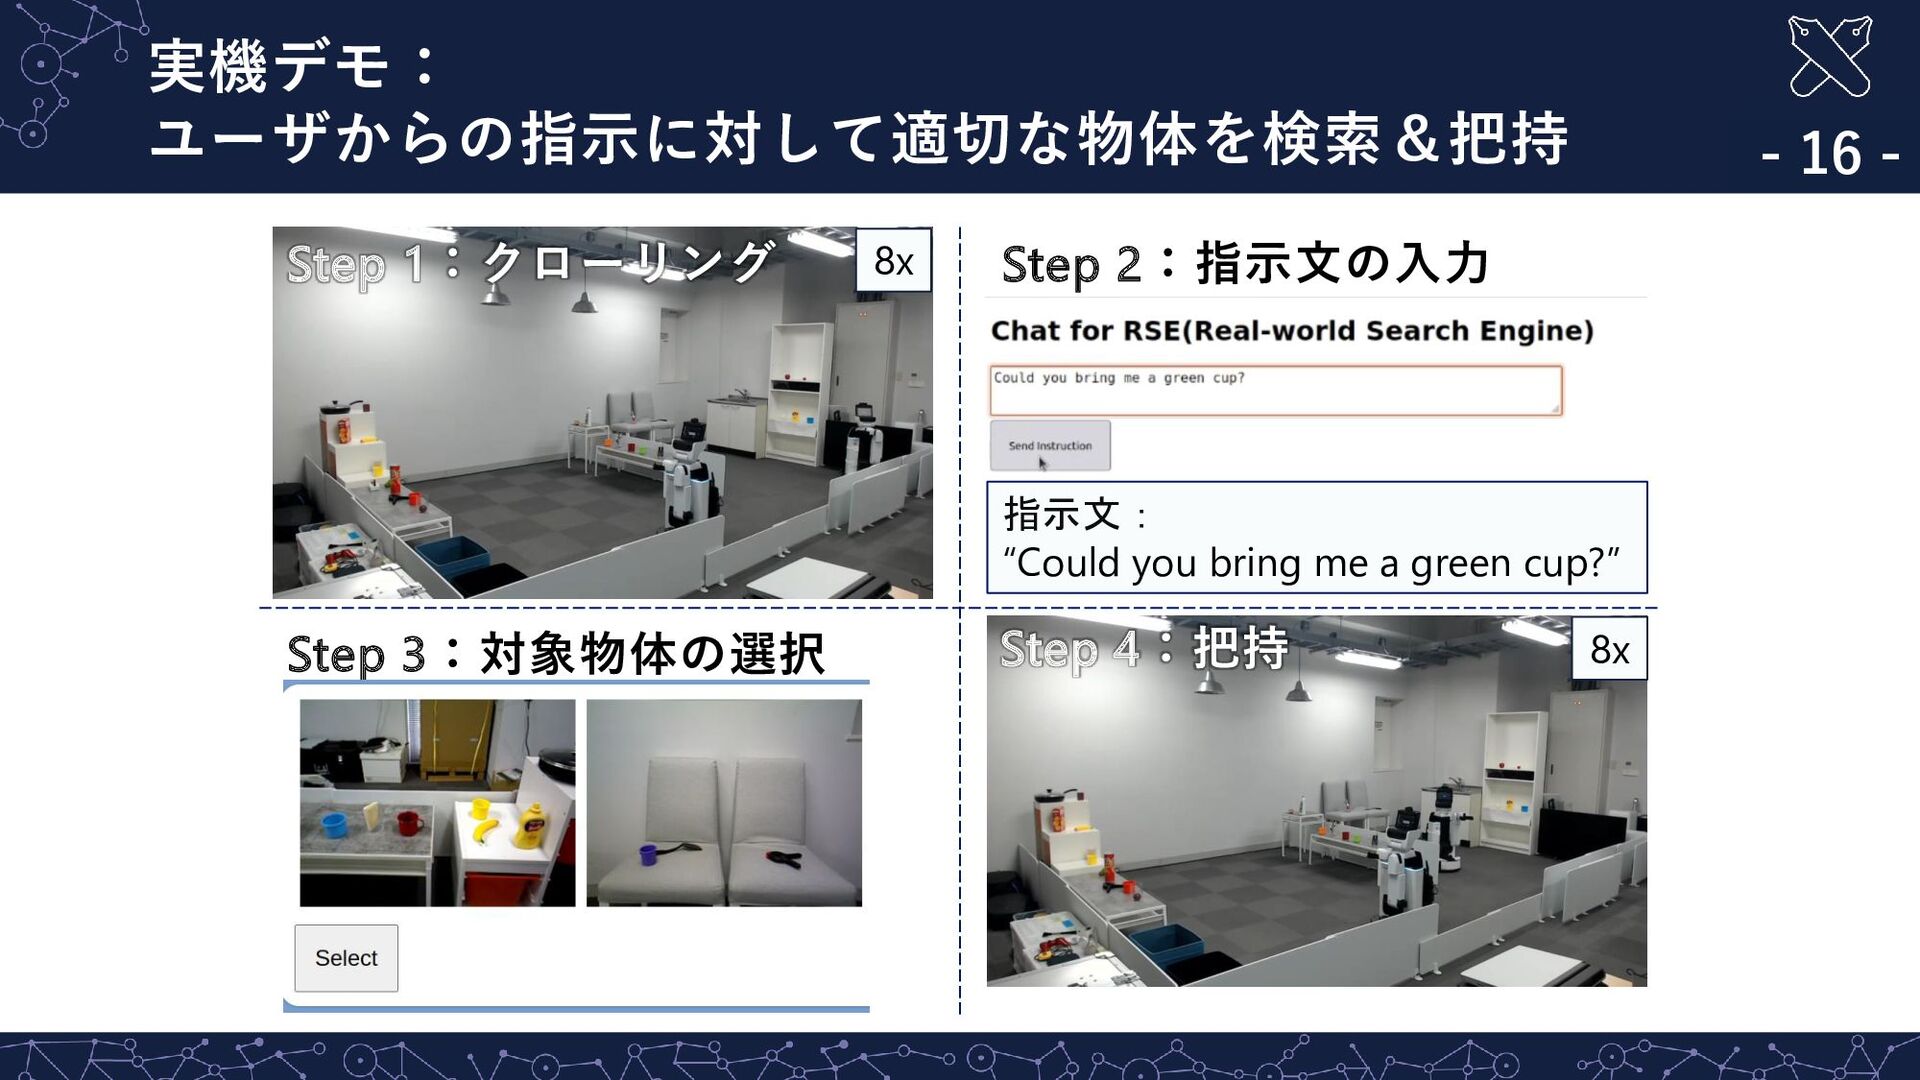
実機デモ: ユーザからの指示に対して適切な物体を検索&把持 - 16 - Step 1:クローリング Step 2:指示文の入力 Step
4:把持 8x 8x Step 3:対象物体の選択 指示文: “Could you bring me a green cup?” -
定量的結果(実機): ゼロショットの実機実験においても有用性を示唆 - 17 - ▪ 環境:5種類 ▪ 指示文:10文 /
環境(合計:50文) ▪ 対象物体候補:約30個 / 環境 ▪ 正解画像を上位 10 件に検索できた場合のみにおいて,把持を実行 ☺ 実機実験においても有用性を示唆 MRR ↑ 把持成功率↑ 提案手法 0.37 0.56 (24/41) -
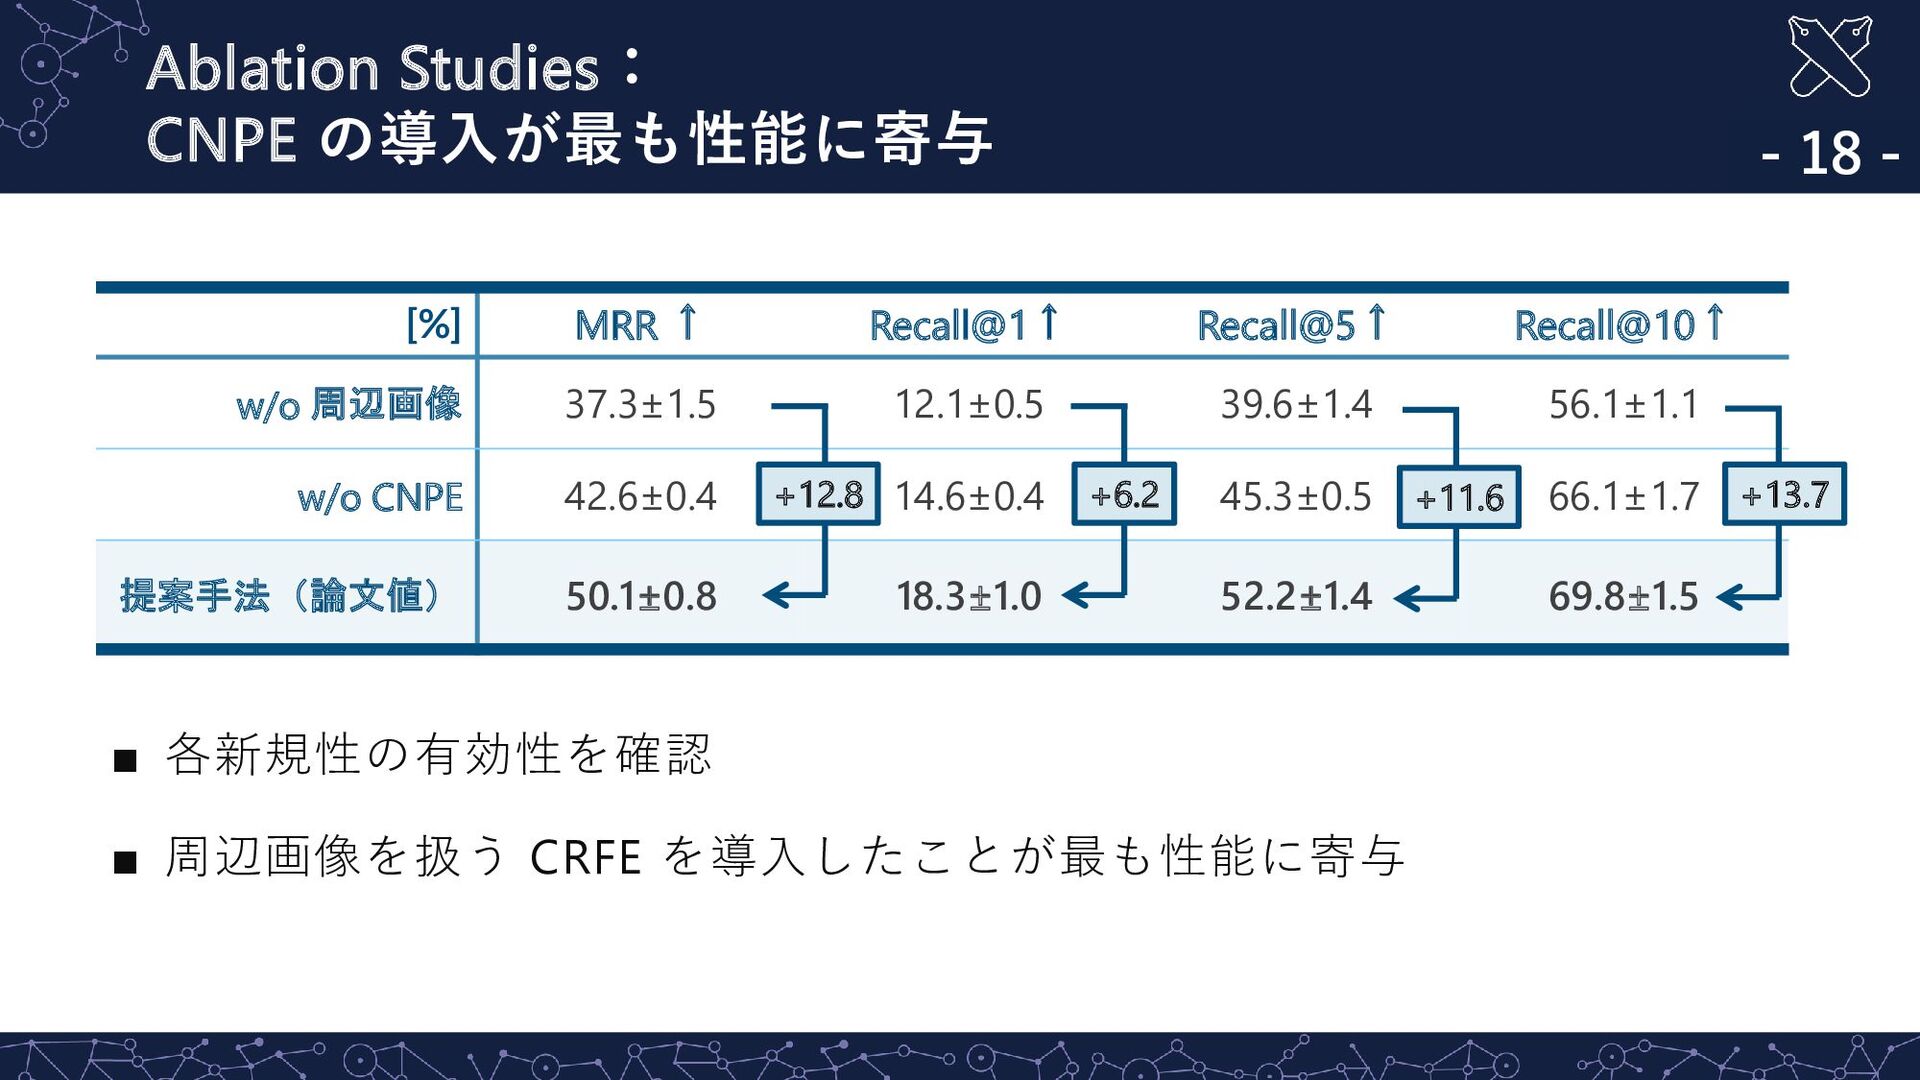
Ablation Studies: CNPE の導入が最も性能に寄与 - 18 - ▪ 各新規性の有効性を確認 ▪
周辺画像を扱う CRFE を導入したことが最も性能に寄与 [%] MRR ↑ Recall@1↑ Recall@5↑ Recall@10↑ w/o 周辺画像 37.3±1.5 12.1±0.5 39.6±1.4 56.1±1.1 w/o CNPE 42.6±0.4 14.6±0.4 45.3±0.5 66.1±1.7 提案手法(論文値) 50.1±0.8 18.3±1.0 52.2±1.4 69.8±1.5 +12.8 +6.2 +11.6 +13.7 -
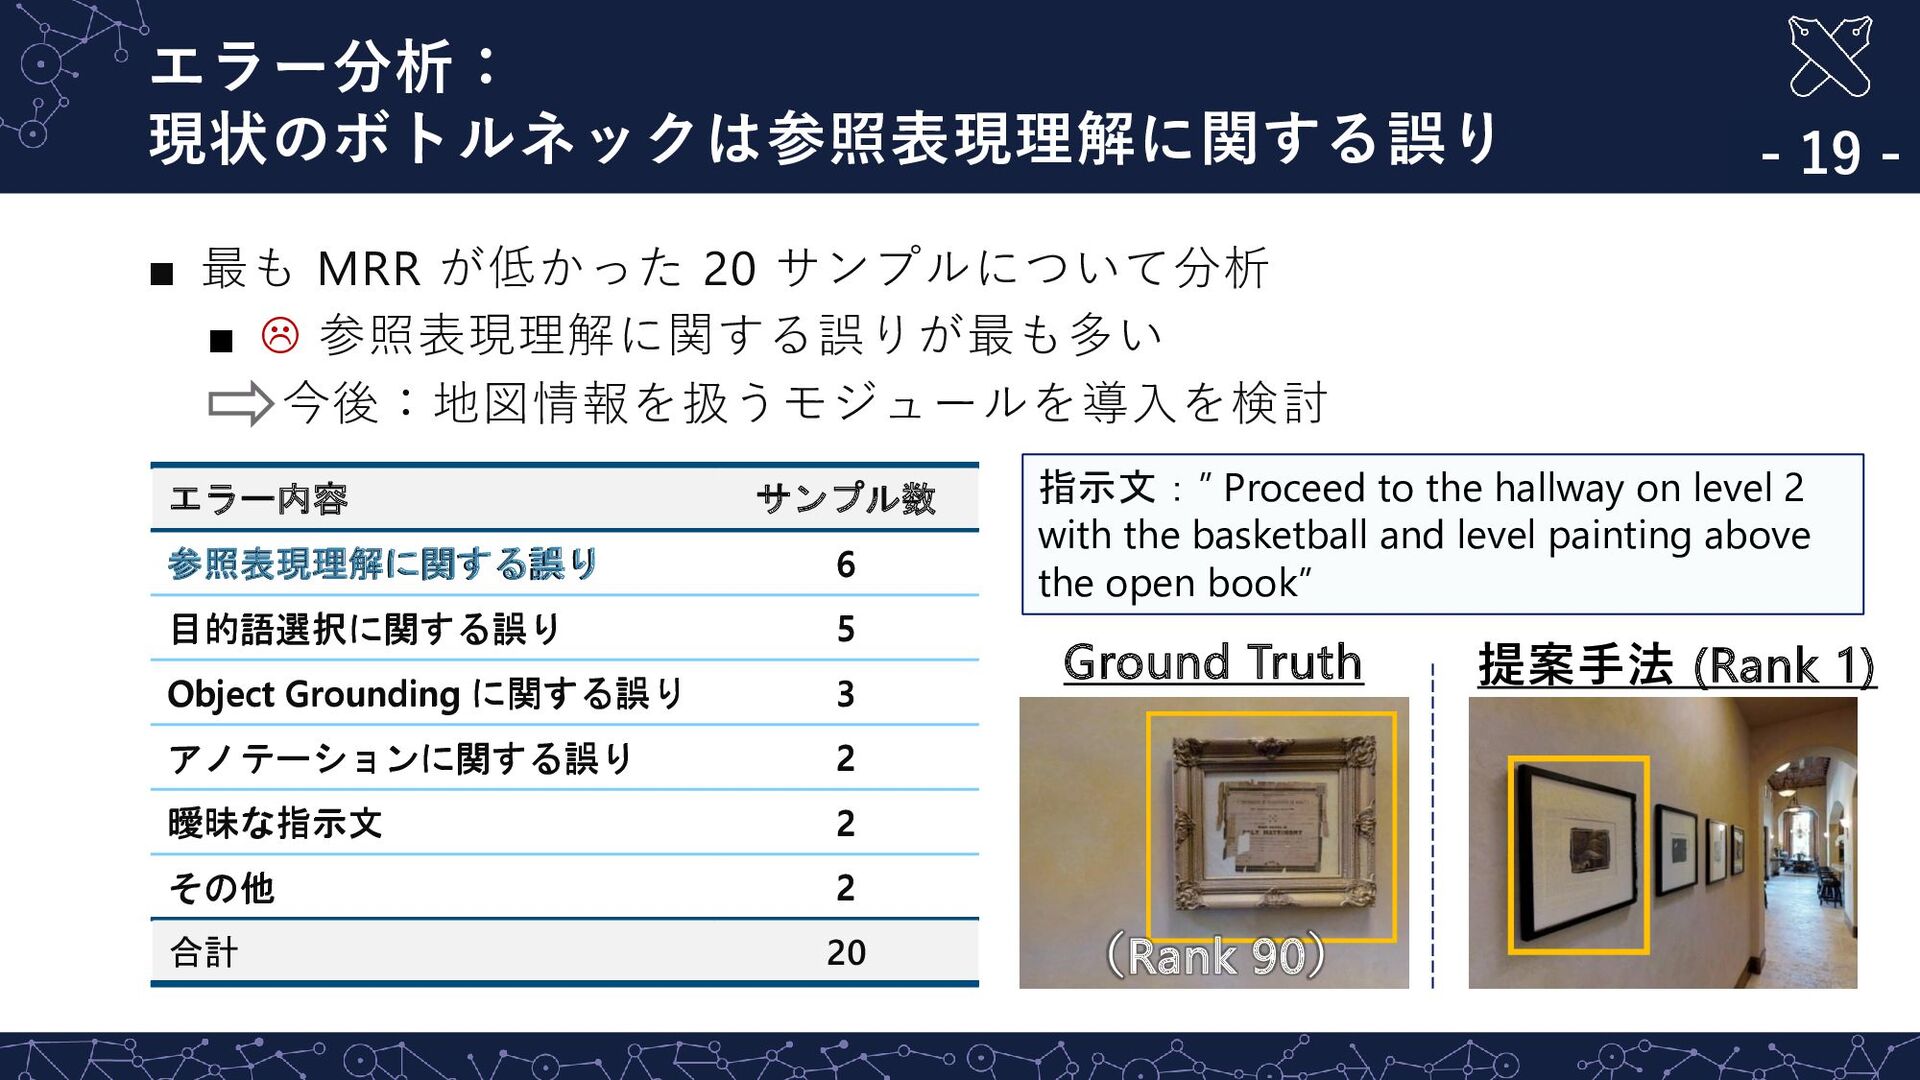
エラー分析: 現状のボトルネックは参照表現理解に関する誤り - 19 - ▪ 最も MRR が低かった 20
サンプルについて分析 ▪ 参照表現理解に関する誤りが最も多い 今後:地図情報を扱うモジュールを導入を検討 エラー内容 サンプル数 参照表現理解に関する誤り 6 目的語選択に関する誤り 5 Object Grounding に関する誤り 3 アノテーションに関する誤り 2 曖昧な指示文 2 その他 2 合計 20 Ground Truth 提案手法 (Rank 1) (Rank 90) 指示文:” Proceed to the hallway on level 2 with the basketball and level painting above the open book” エラー内容 サンプル数 参照表現理解に関する誤り 6 目的語選択に関する誤り 5 Object Grounding に関する誤り 3 アノテーションに関する誤り 2 曖昧な指示文 2 その他 2 合計 20 -
まとめ - 20 - ▪ 背景 ▪ 在宅介護者の不足に対して, 生活支援ロボットに期待 ▪
提案 ▪ Human-in-the-loop 設定に おいて,ユーザの指示文から 対象物体を特定するMultiRankIt ▪ 結果 ▪ MRR, Recall@K において ベースライン手法を上回った