Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ACL読み会2026@名大:EduBench: A Comprehensive Benchma...

Avatar for Ryota Shimizu Ryota Shimizu
September 23, 2026
18

ACL読み会2026@名大:EduBench: A Comprehensive Benchmarking Dataset for Evaluating Large Language Models in Diverse Educational Scenarios

Avatar for Ryota Shimizu

Ryota Shimizu

September 23, 2026

Transcript

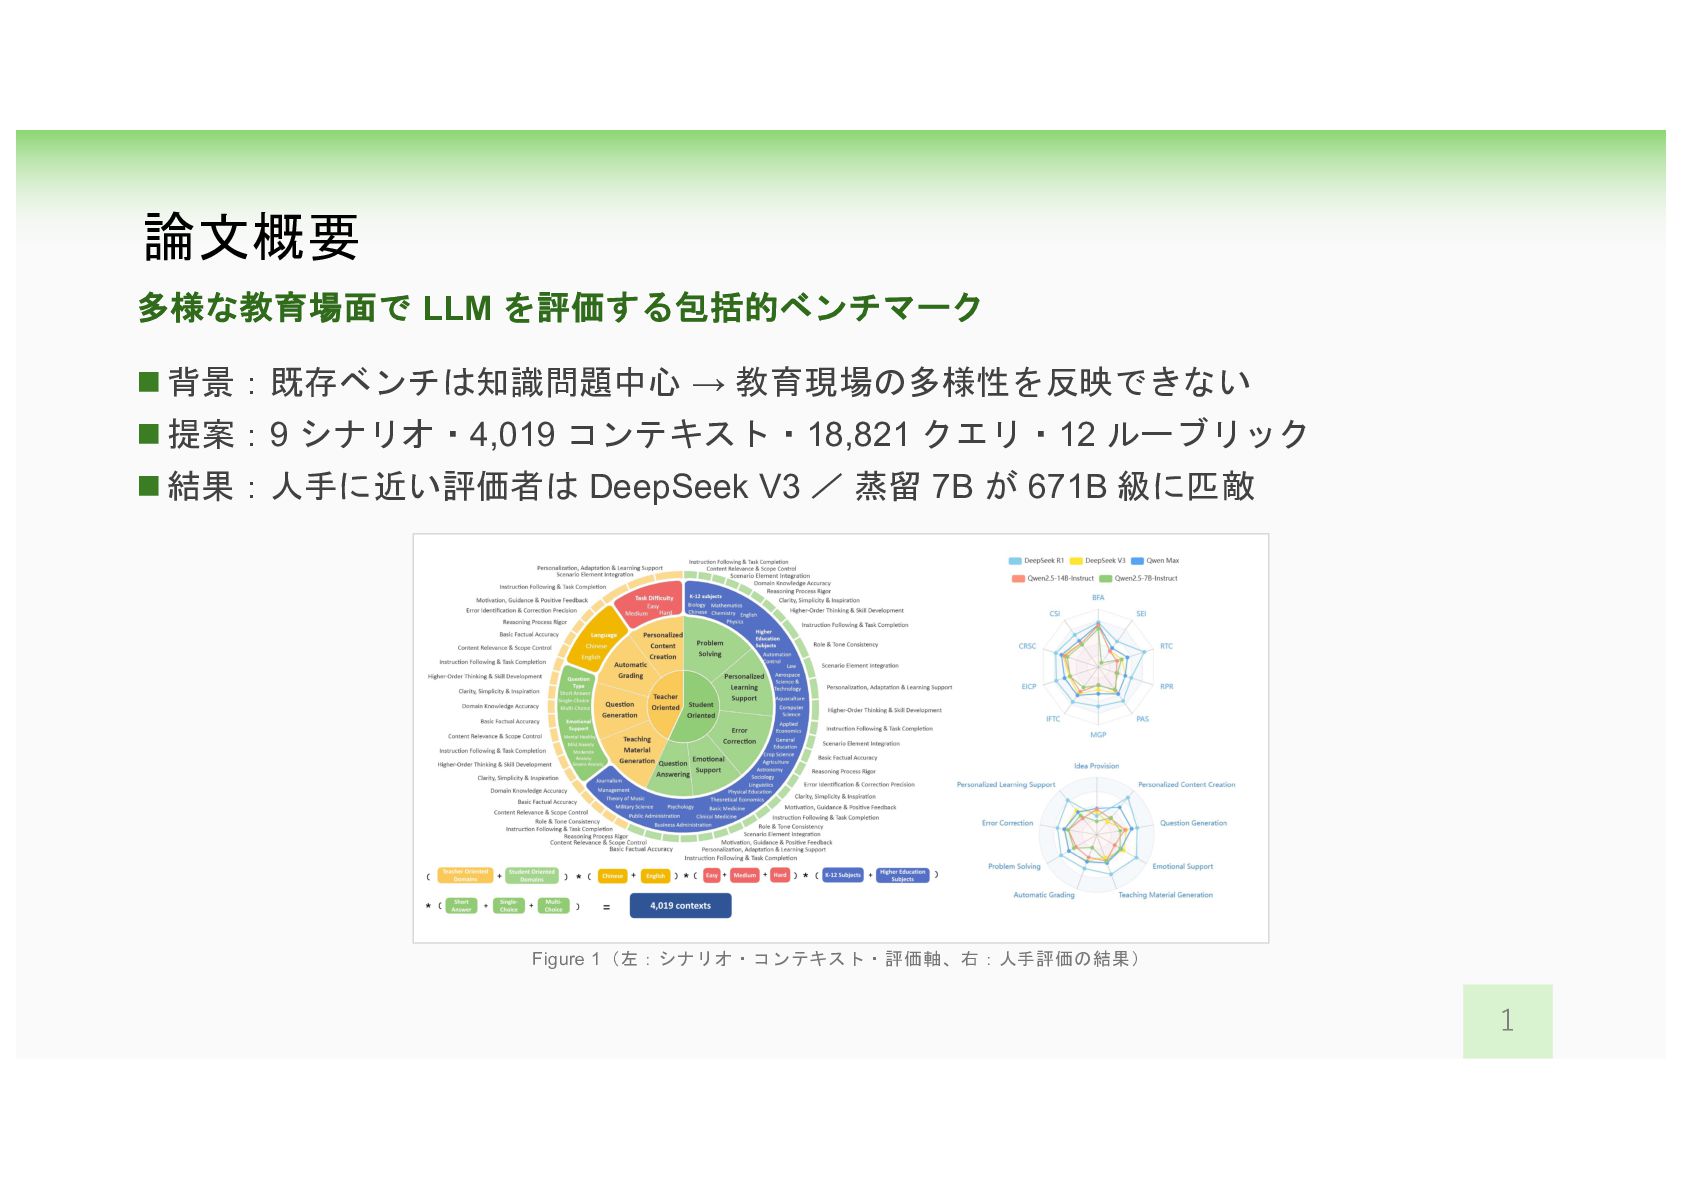
  1. 論文概要 多様な教育場面で LLM を評価する包括的ベンチマーク n 背景:既存ベンチは知識問題中心 → 教育現場の多様性を反映できない n 提案:9

    シナリオ・4,019 コンテキスト・18,821 クエリ・12 ルーブリック n 結果:人手に近い評価者は DeepSeek V3 / 蒸留 7B が 671B 級に匹敵 Figure 1(左:シナリオ・コンテキスト・評価軸、右:人手評価の結果) 1
  2. 選定理由 ドメインではなく「データ品質の確かめ方と LLM 評価の妥当性」を見るため n自分の研究:タスク指向対話・Tool Calling の評価 l 教育ドメインとは直接重ならない n既存データセットを

    LLM 評価用に再構築する際の課題 l LLM で一部を修正したデータの品質をどう確かめるか l LLM で応答を評価することの妥当性 n本論文はこの 2 点を具体的に検証 l 人手との MAE で評価器を選び、データを全件採点 l 評価器と人手の一致度、位置・推論モデルのバイアスを検証 n自分のベンチ構築で同じ手続きをどこまで踏むべきかを考える材料 l ただし本論文はデータ自体を LLM で生成(自分は既存データが主) 2
  3. 背景:なぜ教育特化のベンチマークか 既存の評価では「教育に使える LLM か」が測れない n知識集約型に偏重 l GPQA・SuperGPQA・GSM8K など正答中心 l 採点・学習計画・心のケアなどの実場面が抜ける

    n役割の多様性を無視 l 教員・学生・カウンセラーで目的も口調も違う n評価軸が教育目的とずれる l 学習者の認知レベル・シナリオ固有の目的と結びついていない n→ 教育的に妥当な評価軸を持つベンチマークが必要 3
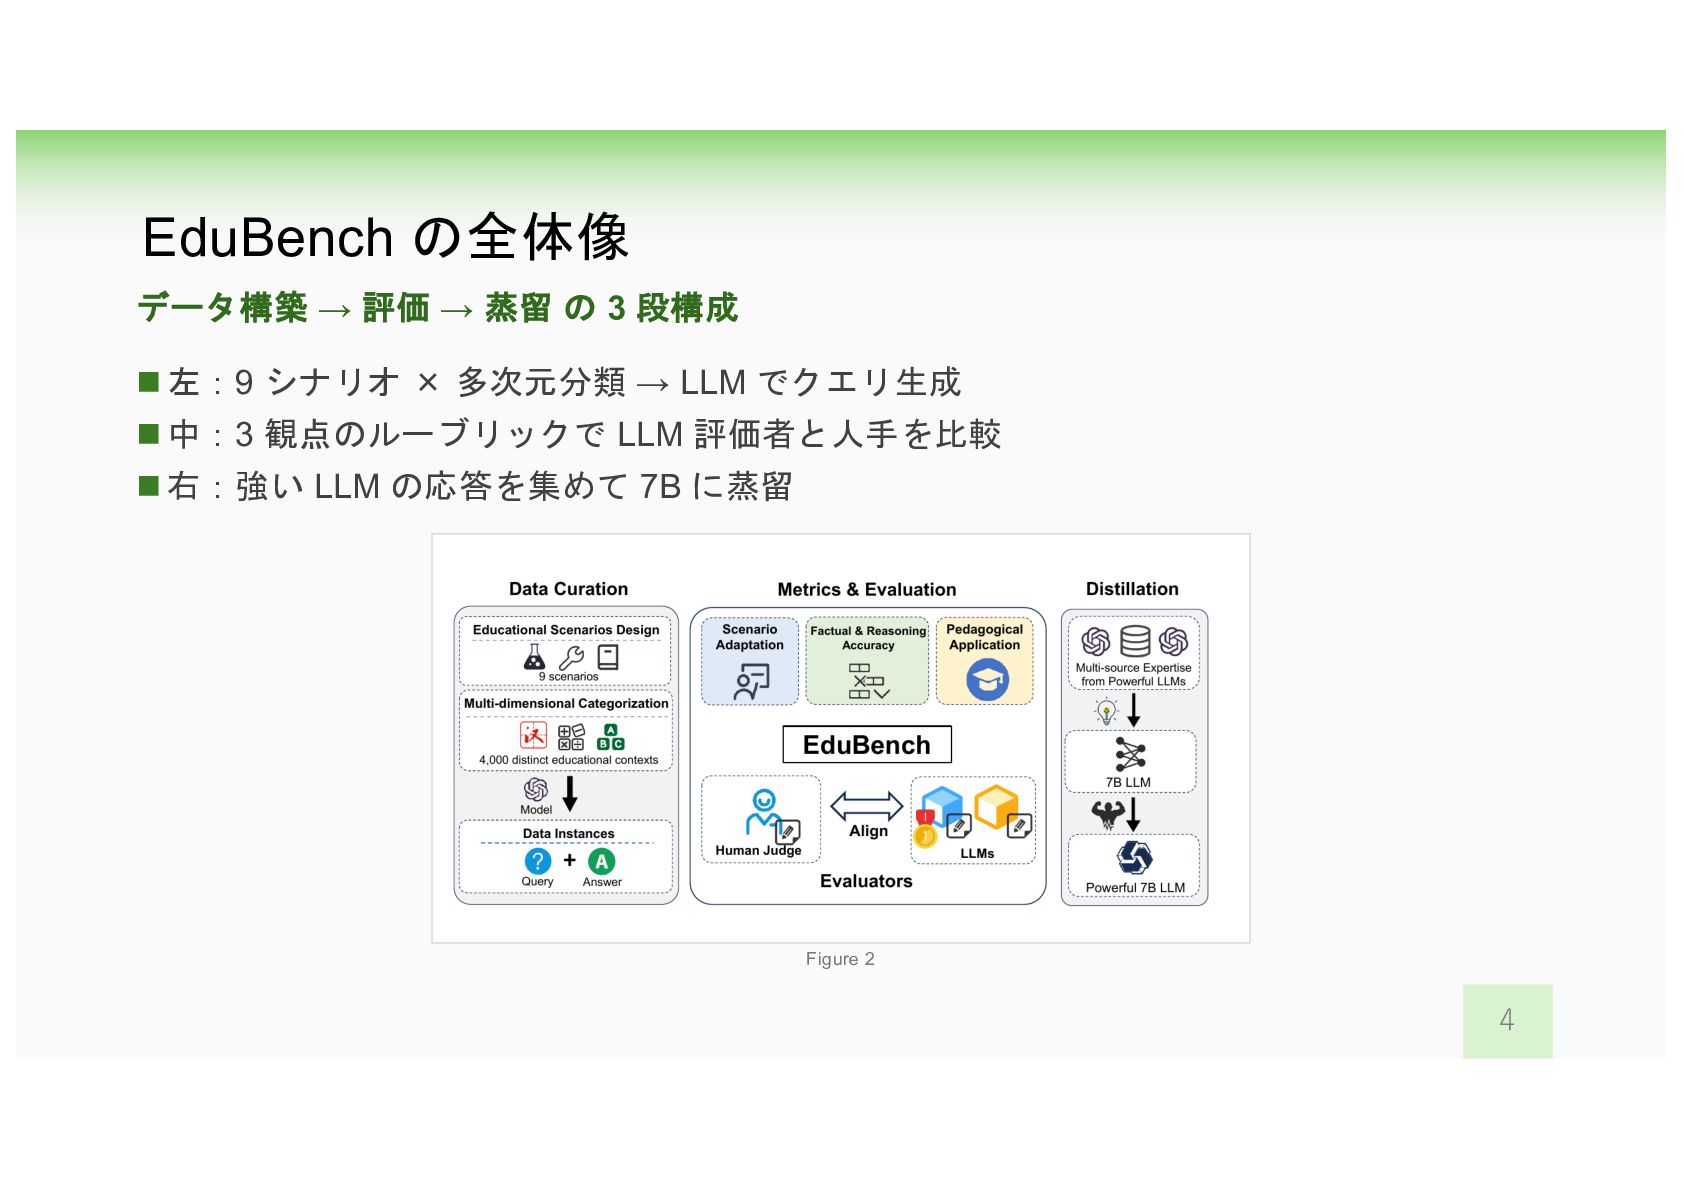
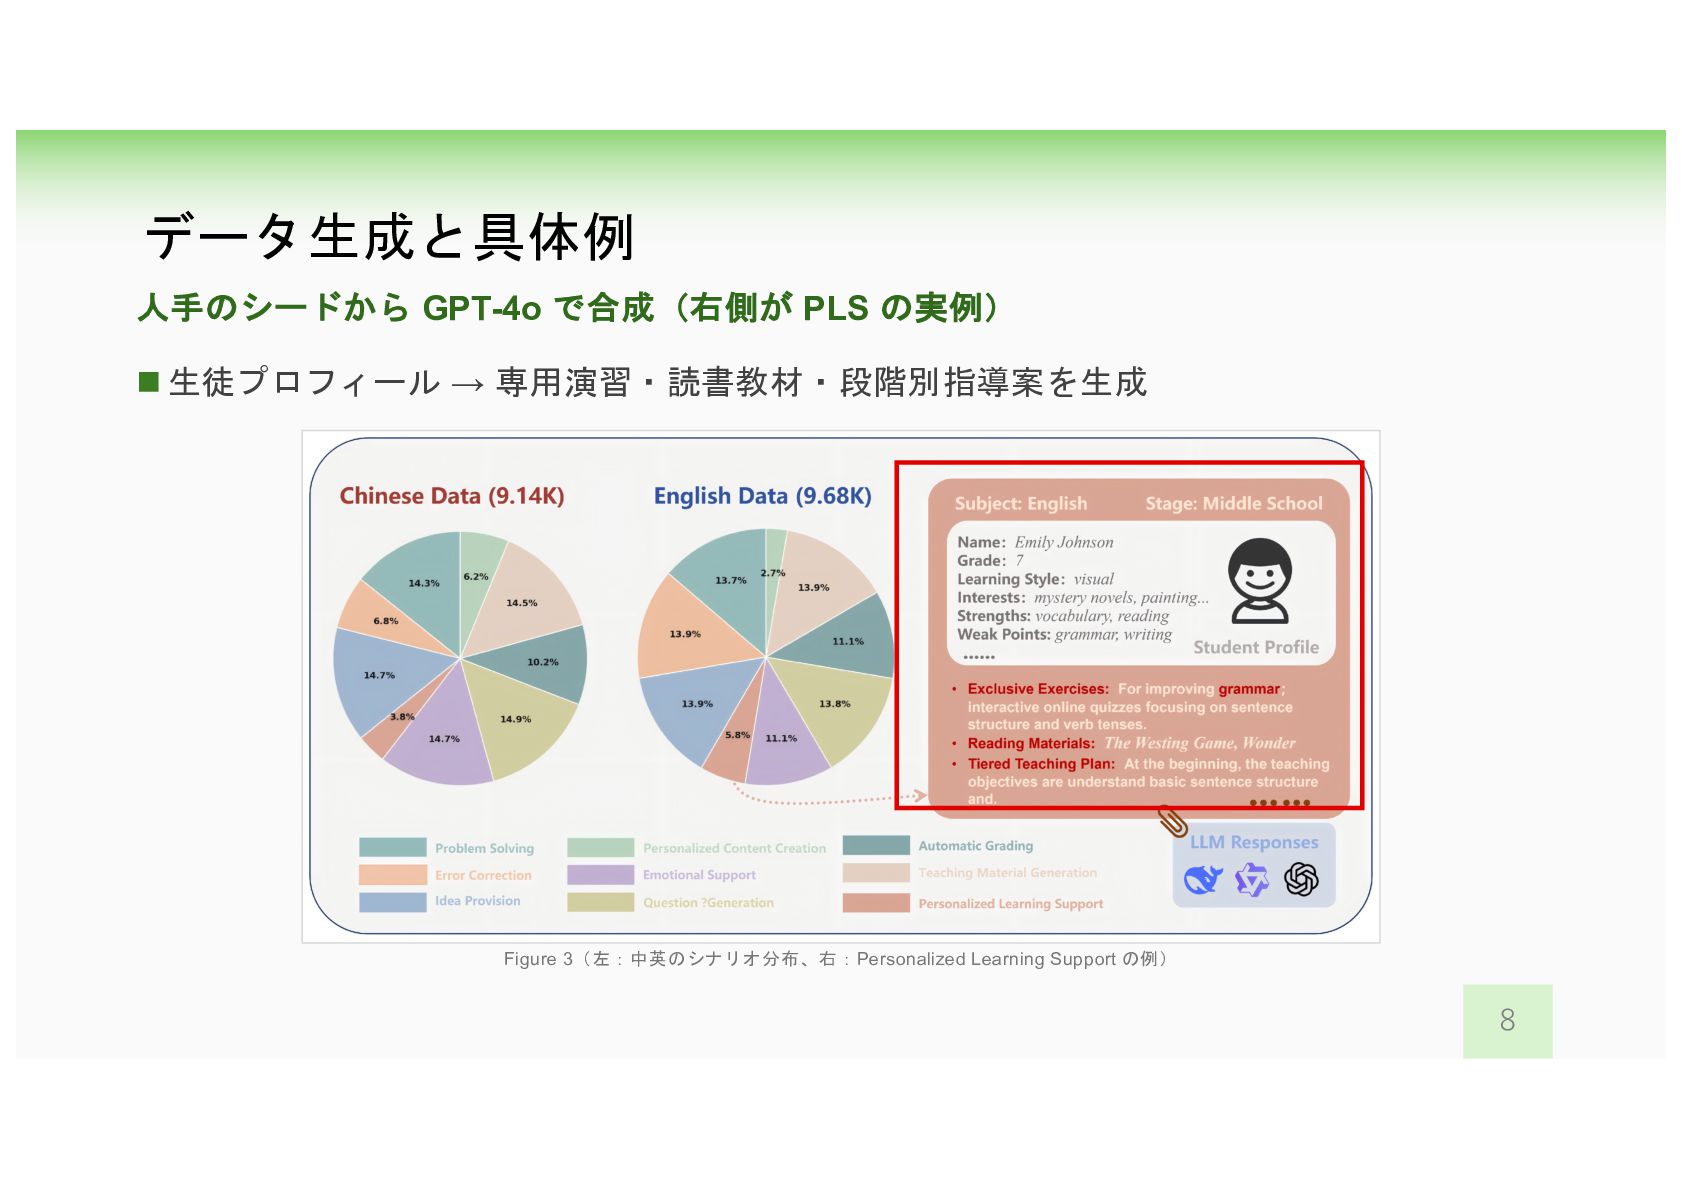
  4. EduBench の全体像 データ構築 → 評価 → 蒸留 の 3 段構成

    n 左:9 シナリオ × 多次元分類 → LLM でクエリ生成 n 中:3 観点のルーブリックで LLM 評価者と人手を比較 n 右:強い LLM の応答を集めて 7B に蒸留 Figure 2 4
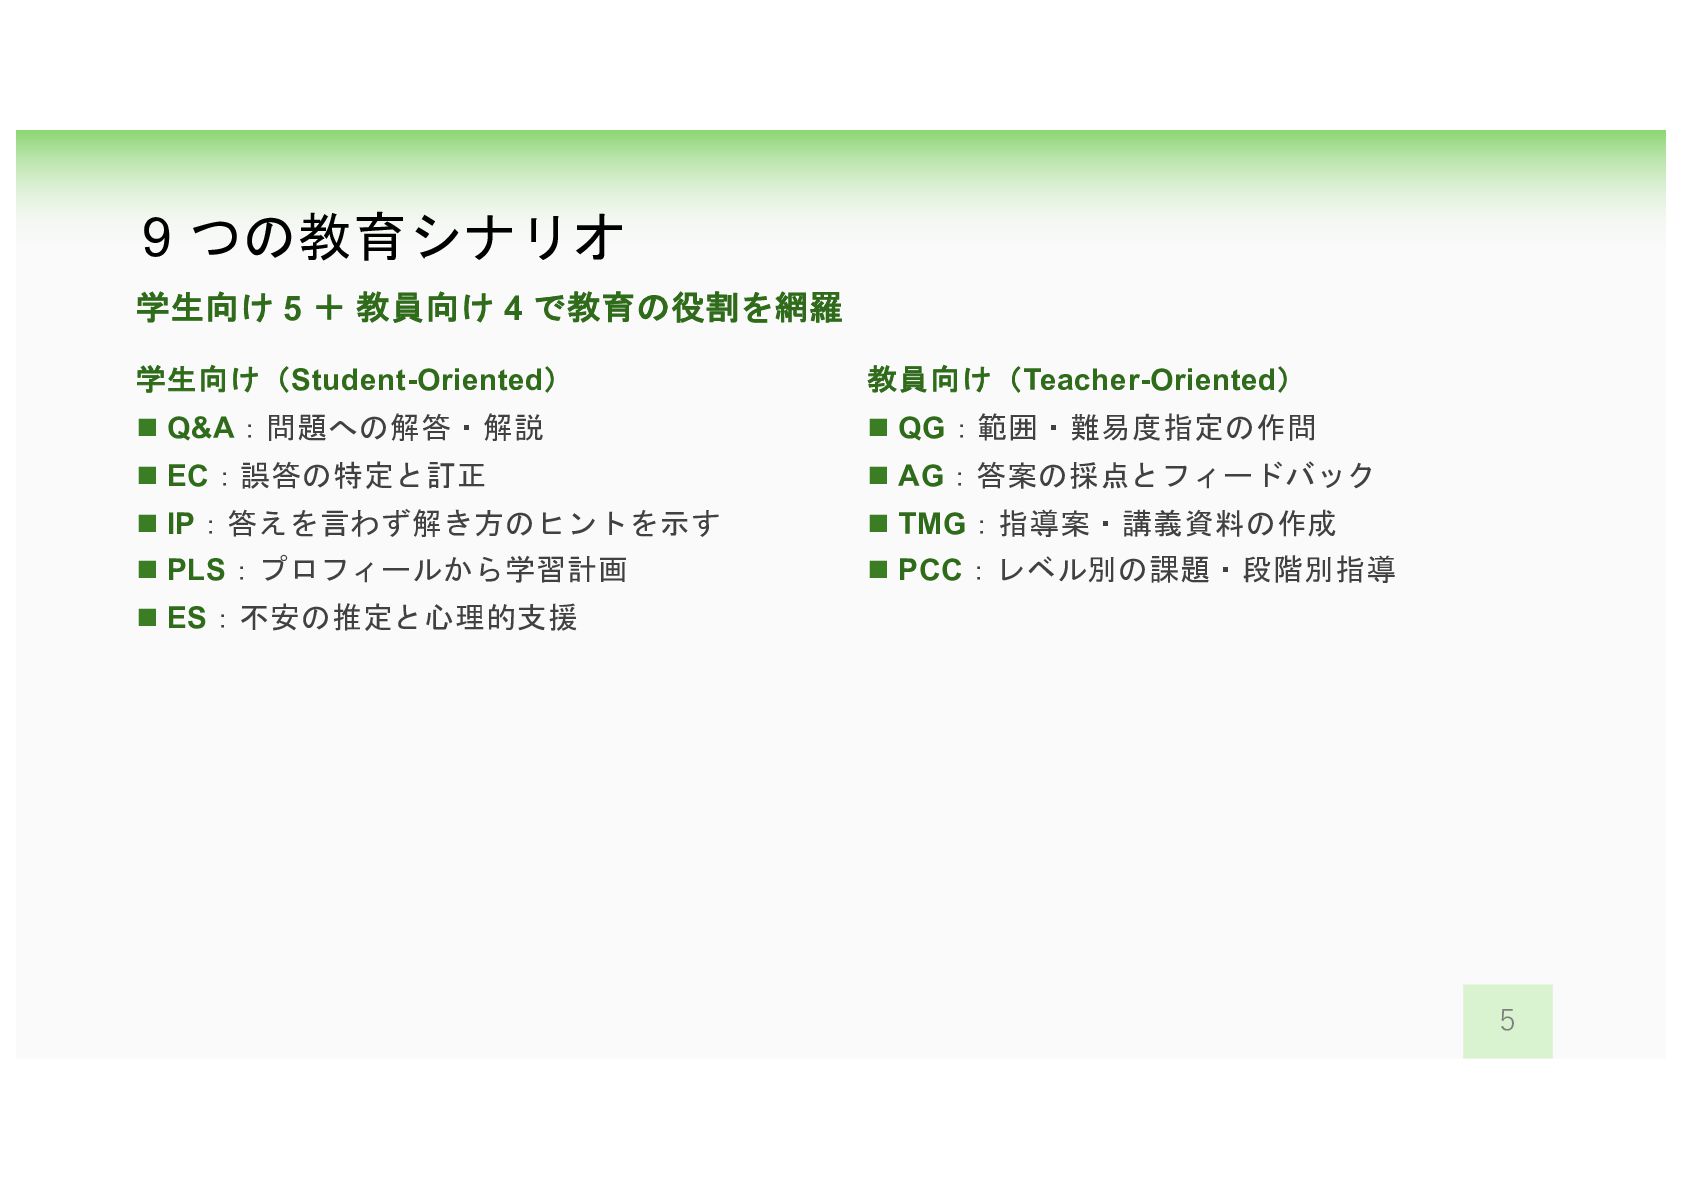
  5. 9 つの教育シナリオ 学生向け 5 + 教員向け 4 で教育の役割を網羅 学生向け( Student-Oriented)

    教員向け( Teacher-Oriented) n Q&A:問題への解答・解説 n QG:範囲・難易度指定の作問 n EC:誤答の特定と訂正 n AG:答案の採点とフィードバック n IP:答えを言わず解き方のヒントを示す n TMG:指導案・講義資料の作成 n PLS:プロフィールから学習計画 n PCC:レベル別の課題・段階別指導 n ES:不安の推定と心理的支援 5
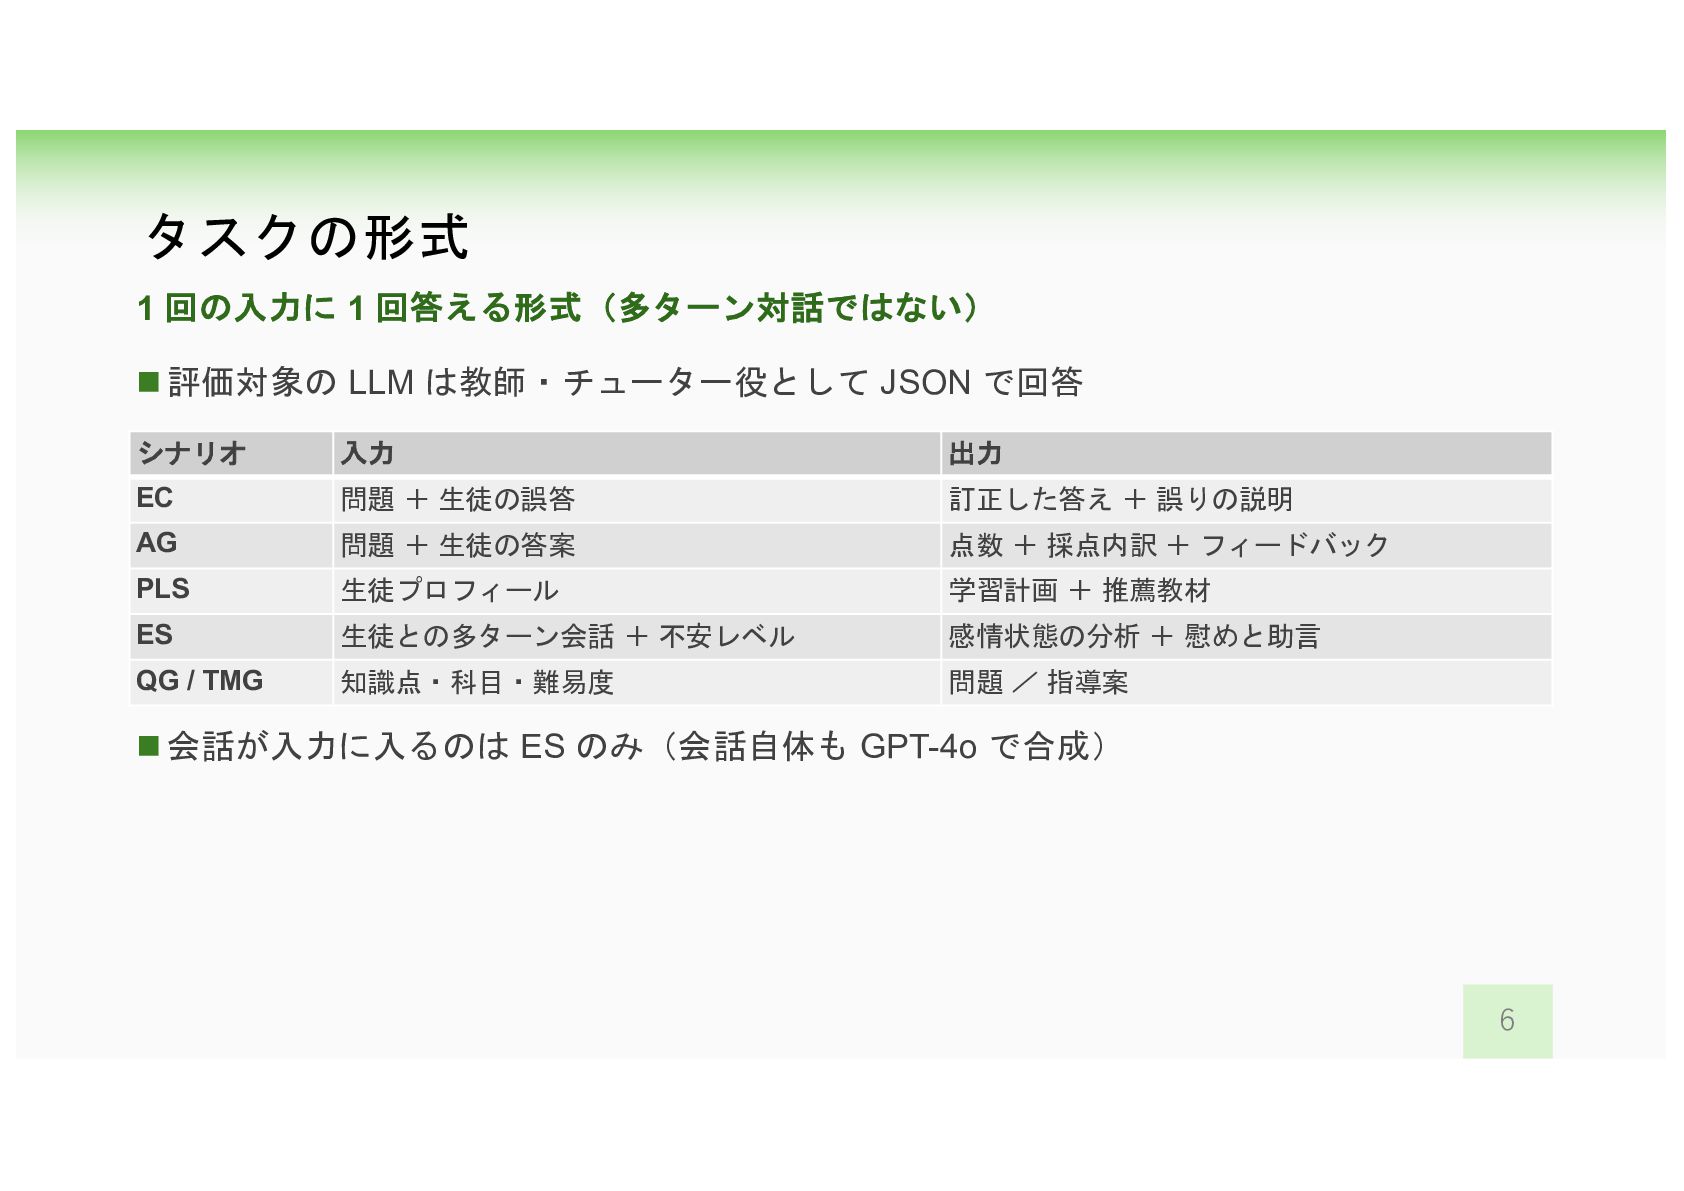
  6. タスクの形式 1 回の入力に 1 回答える形式(多ターン対話ではない) n 評価対象の LLM は教師・チューター役として JSON

    で回答 シナリオ 入力 出力 EC 問題 + 生徒の誤答 訂正した答え + 誤りの説明 AG 問題 + 生徒の答案 点数 + 採点内訳 + フィードバック PLS 生徒プロフィール 学習計画 + 推薦教材 ES 生徒との多ターン会話 + 不安レベル 感情状態の分析 + 慰めと助言 QG / TMG 知識点・科目・難易度 問題 / 指導案 n 会話が入力に入るのは ES のみ(会話自体も GPT-4o で合成) 6
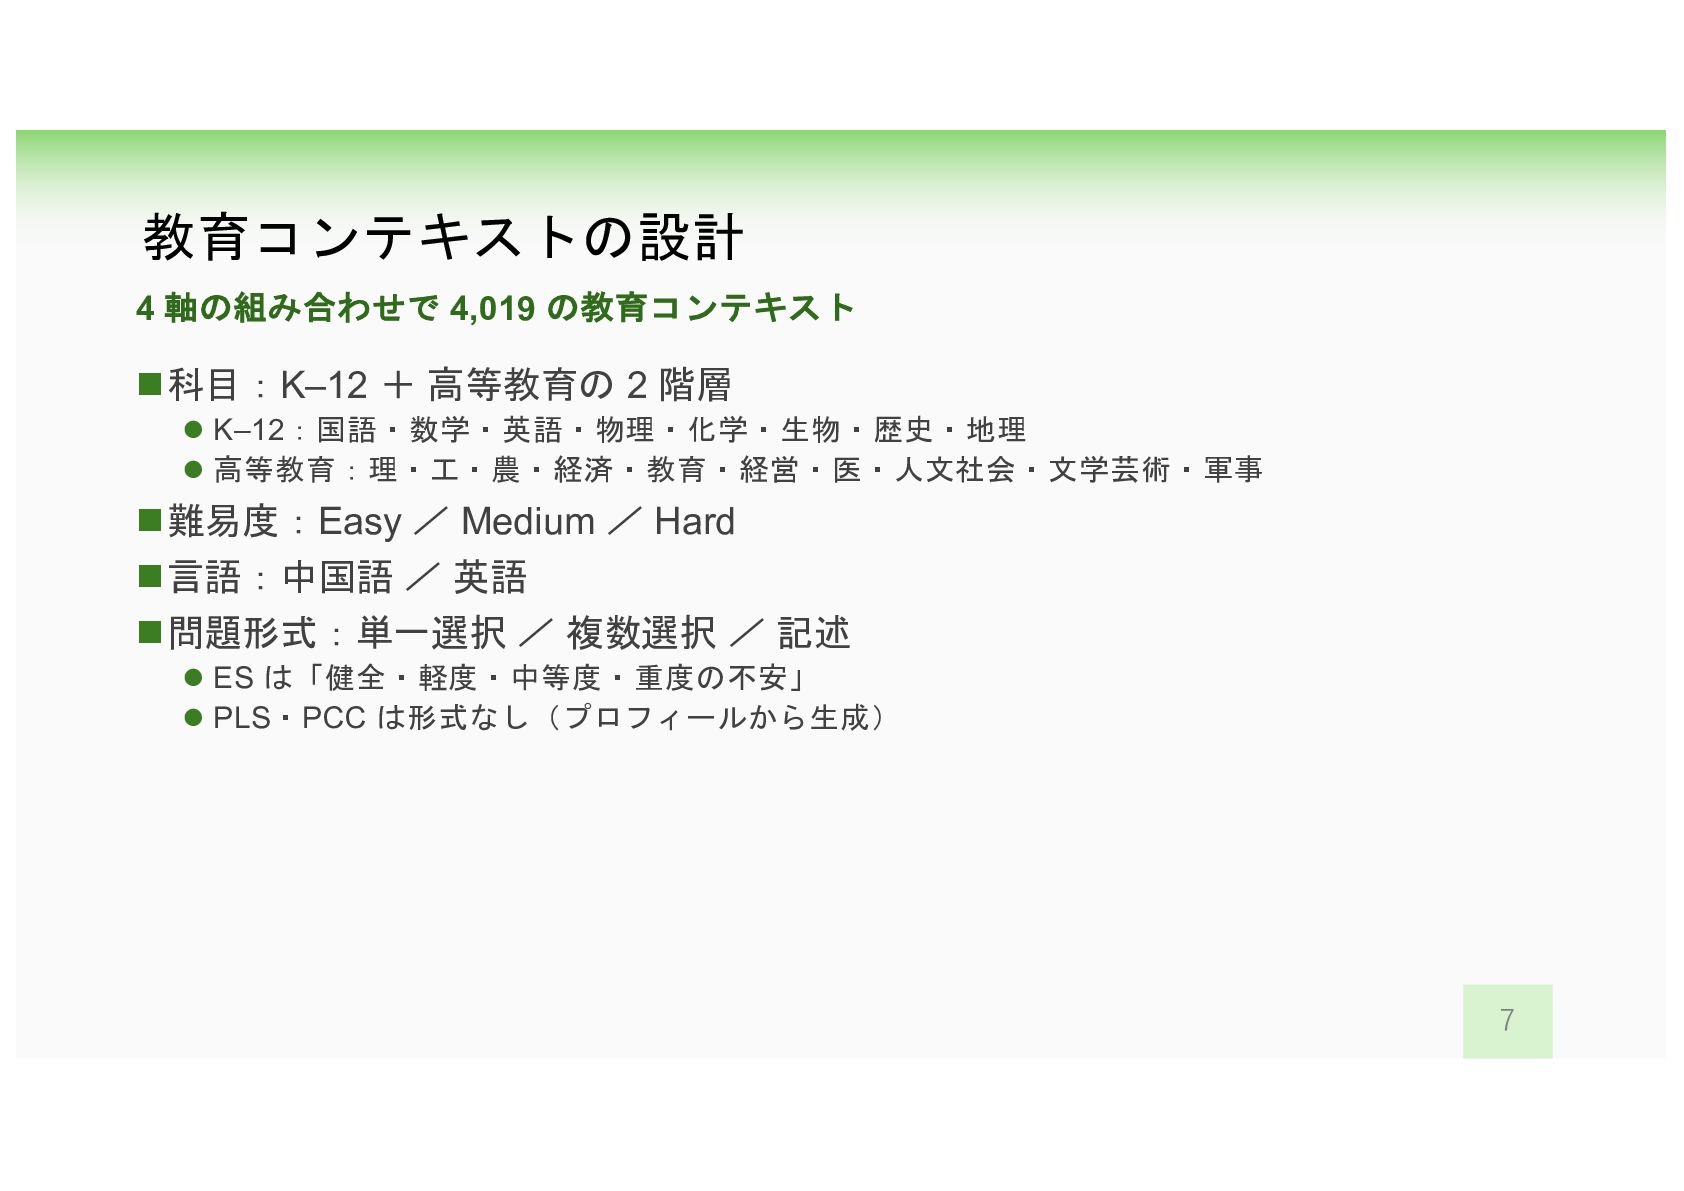
  7. 教育コンテキストの設計 4 軸の組み合わせで 4,019 の教育コンテキスト n科目:K–12 + 高等教育の 2 階層

    l K–12:国語・数学・英語・物理・化学・生物・歴史・地理 l 高等教育:理・工・農・経済・教育・経営・医・人文社会・文学芸術・軍事 n難易度:Easy / Medium / Hard n言語:中国語 / 英語 n問題形式:単一選択 / 複数選択 / 記述 l ES は「健全・軽度・中等度・重度の不安」 l PLS・PCC は形式なし(プロフィールから生成) 7
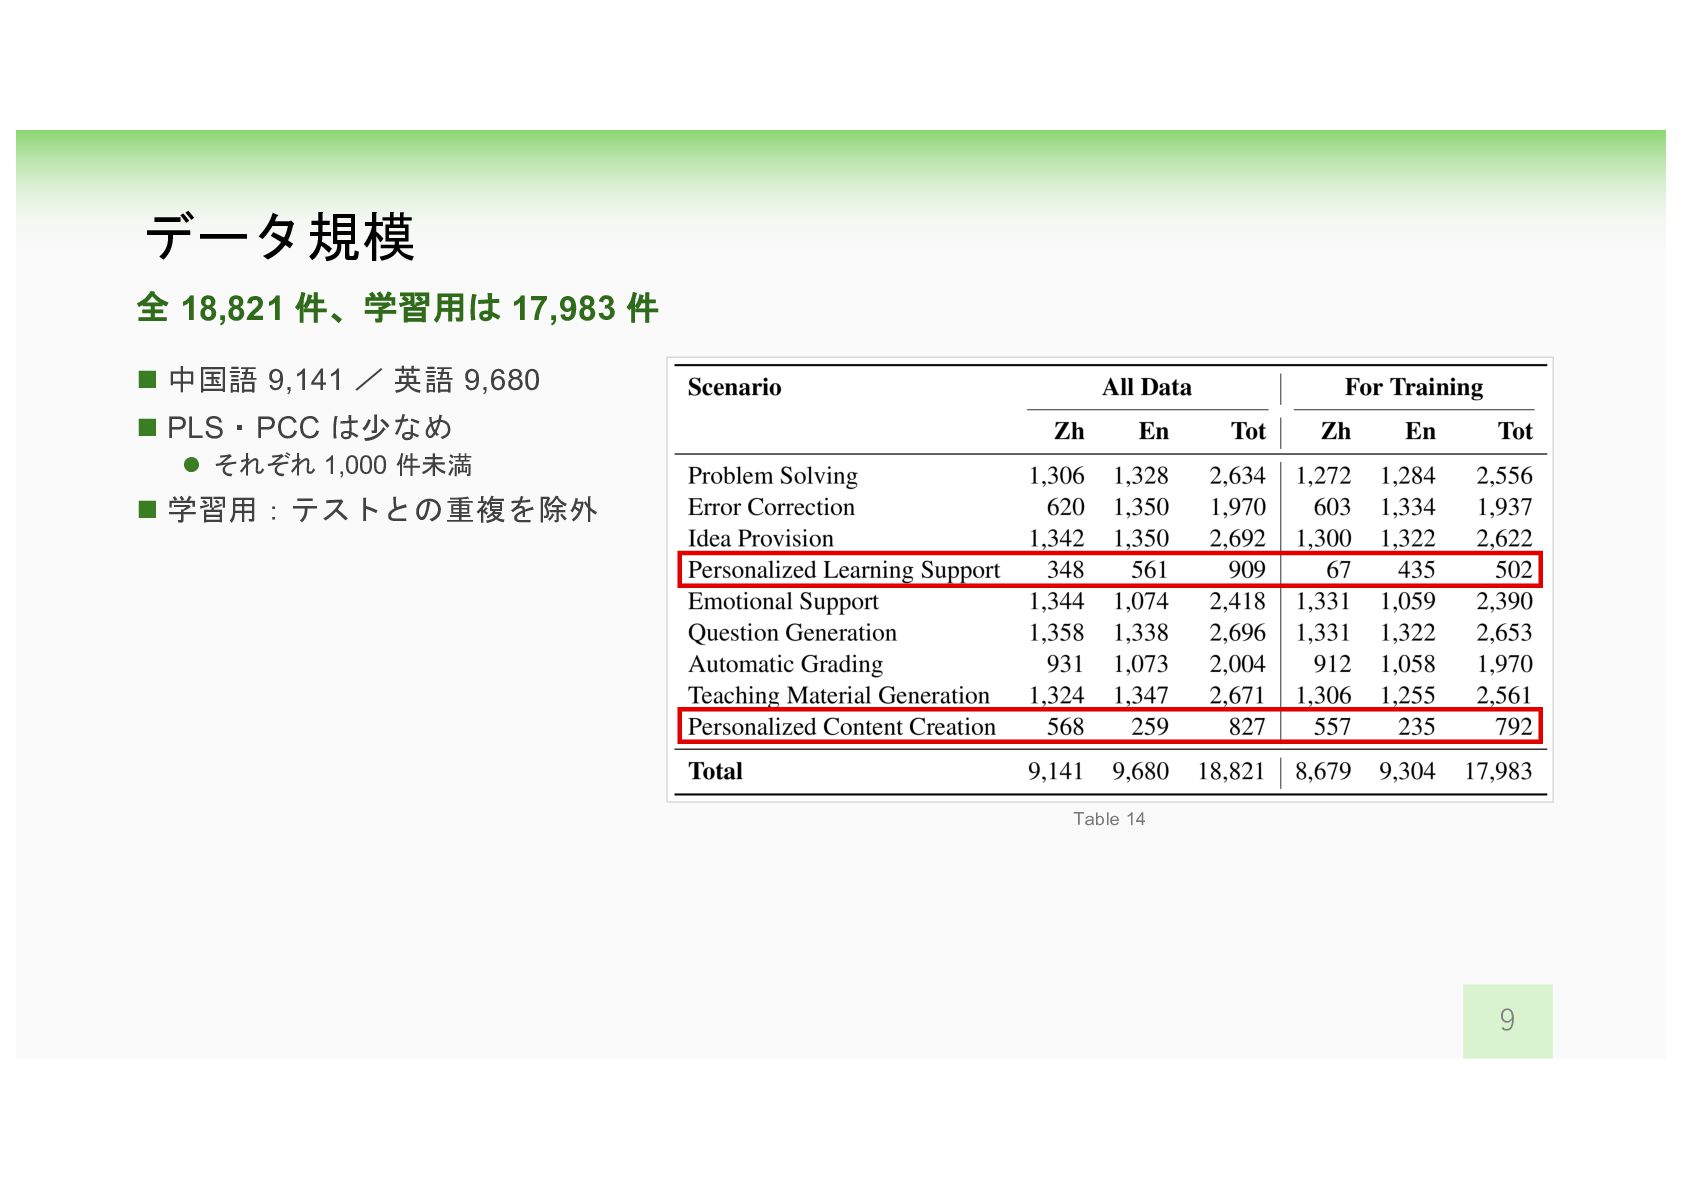
  8. データ規模 全 18,821 件、学習用は 17,983 件 n 中国語 9,141 /

    英語 9,680 n PLS・PCC は少なめ l それぞれ 1,000 件未満 n 学習用:テストとの重複を除外 Table 14 9
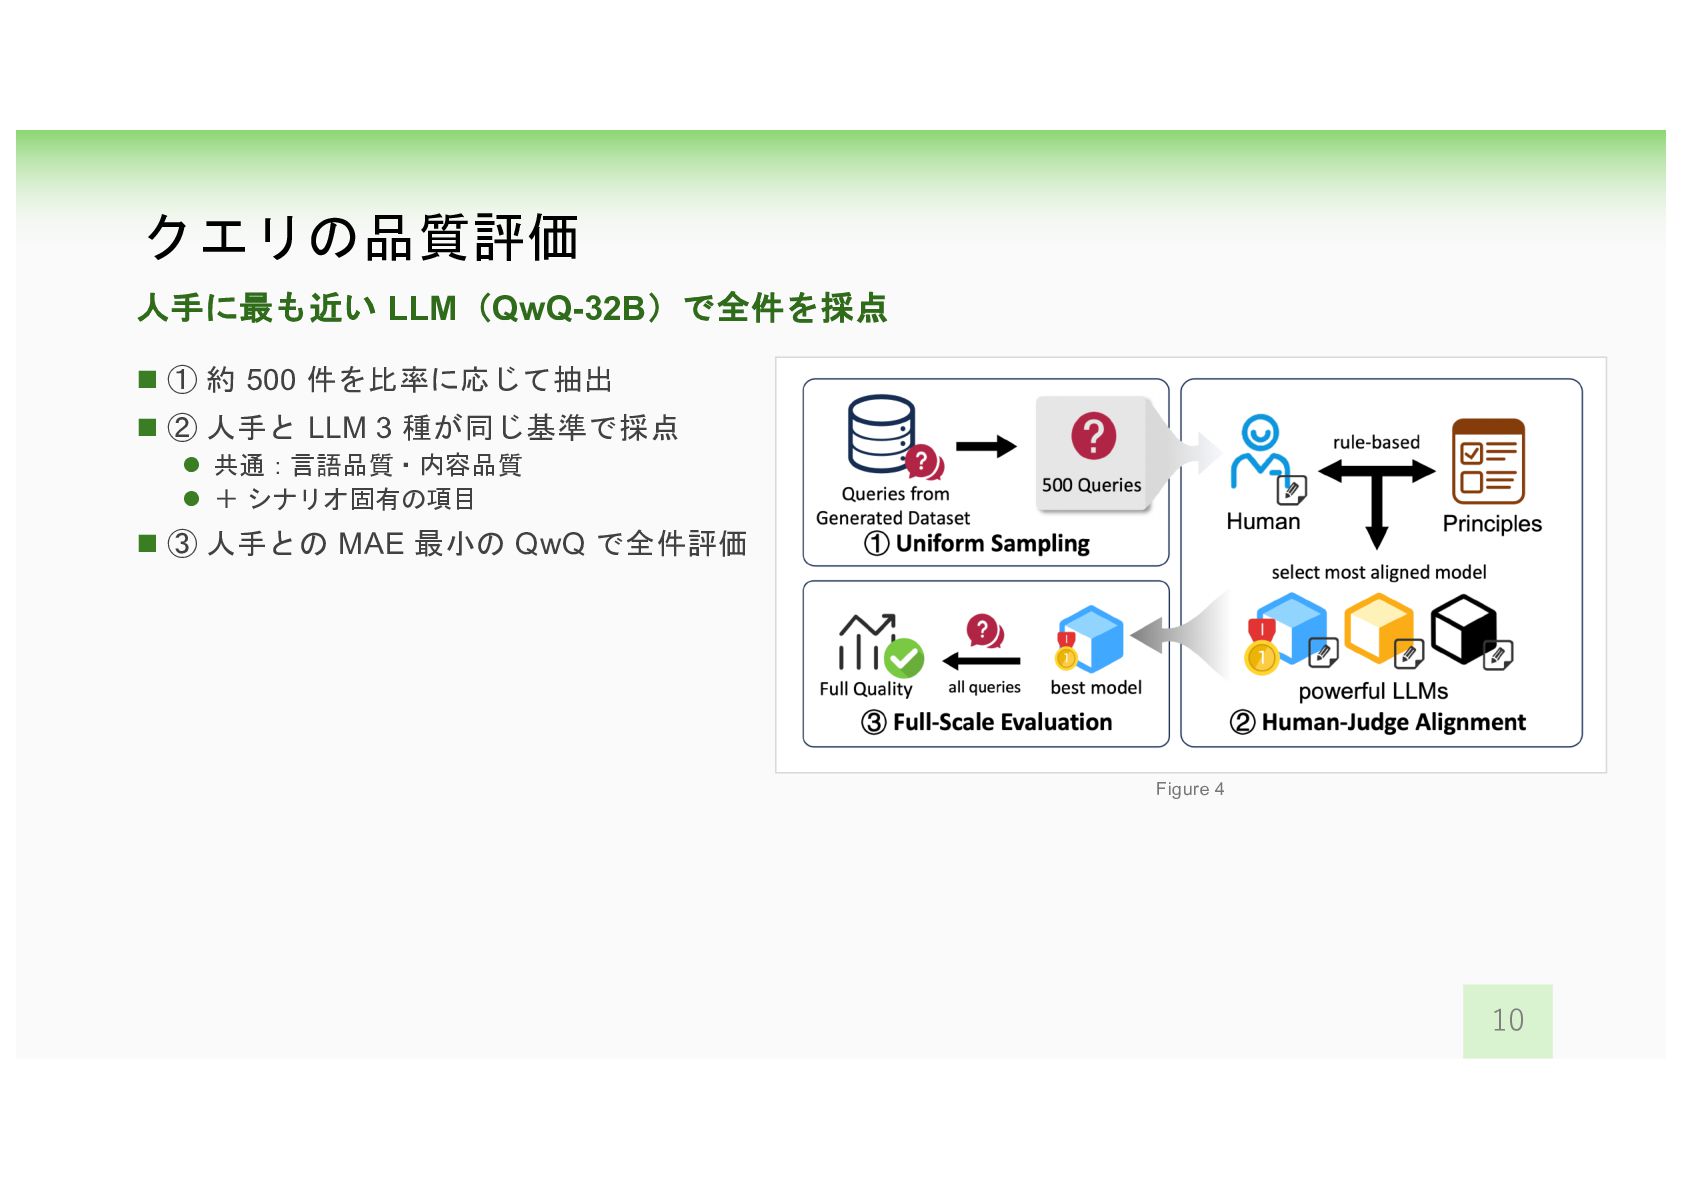
  9. クエリの品質評価 人手に最も近い LLM(QwQ-32B)で全件を採点 n ① 約 500 件を比率に応じて抽出 n ②

    人手と LLM 3 種が同じ基準で採点 l 共通:言語品質・内容品質 l + シナリオ固有の項目 n ③ 人手との MAE 最小の QwQ で全件評価 Figure 4 10
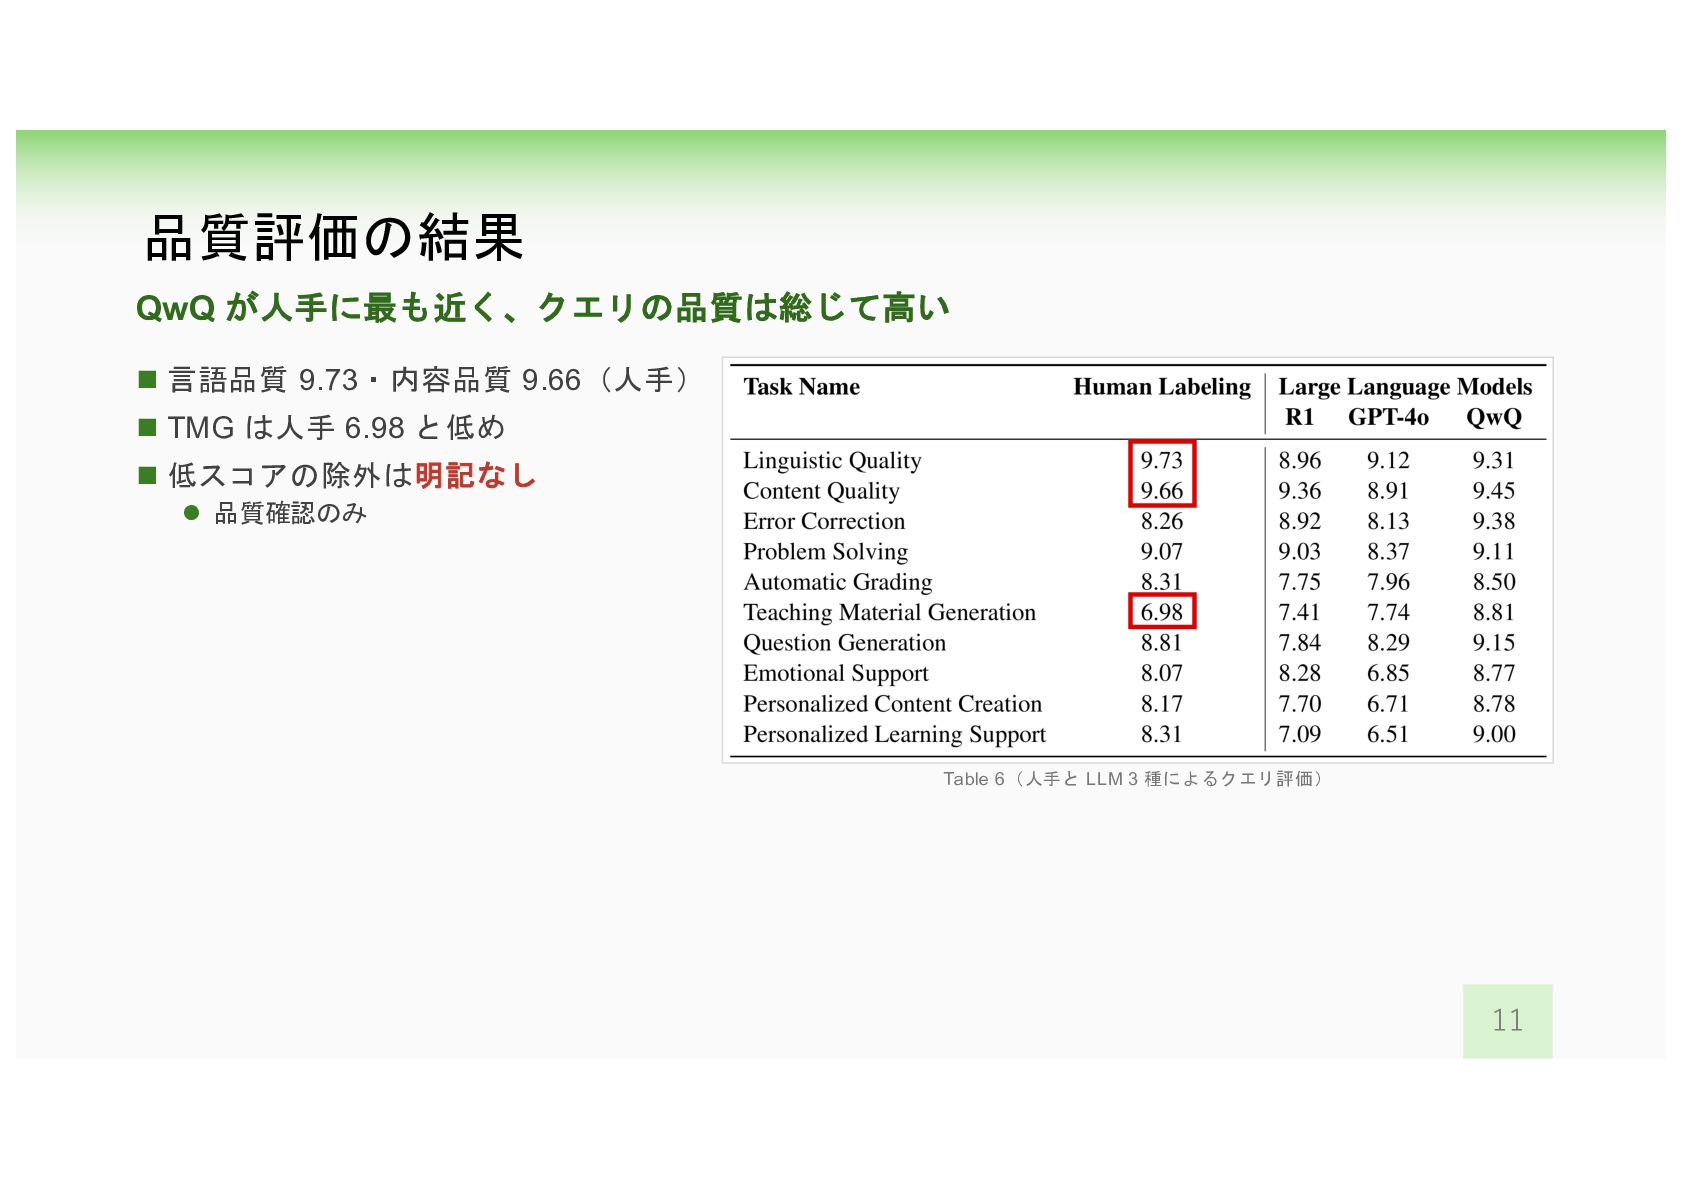
  10. 品質評価の結果 QwQ が人手に最も近く、クエリの品質は総じて高い n 言語品質 9.73・内容品質 9.66(人手) n TMG は人手

    6.98 と低め n 低スコアの除外は 明記なし l 品質確認のみ Table 6(人手と LLM 3 種によるクエリ評価) 11
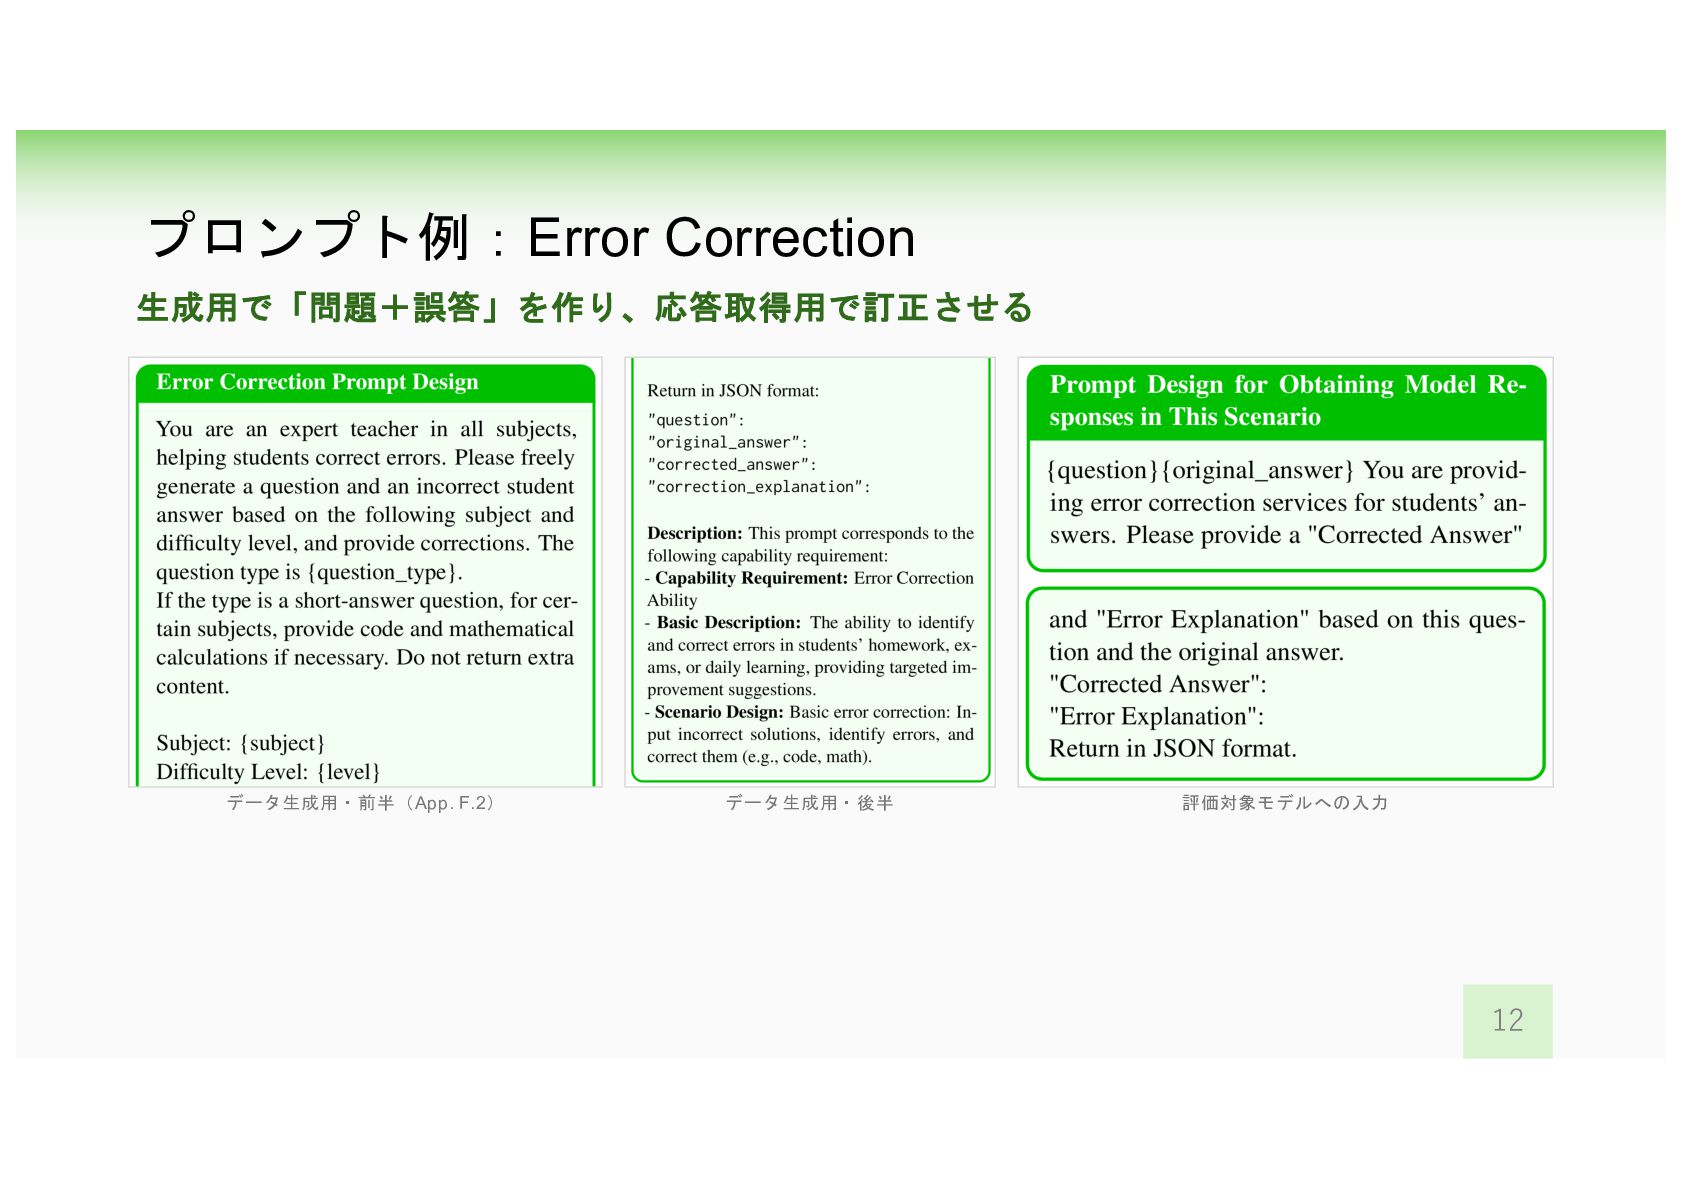
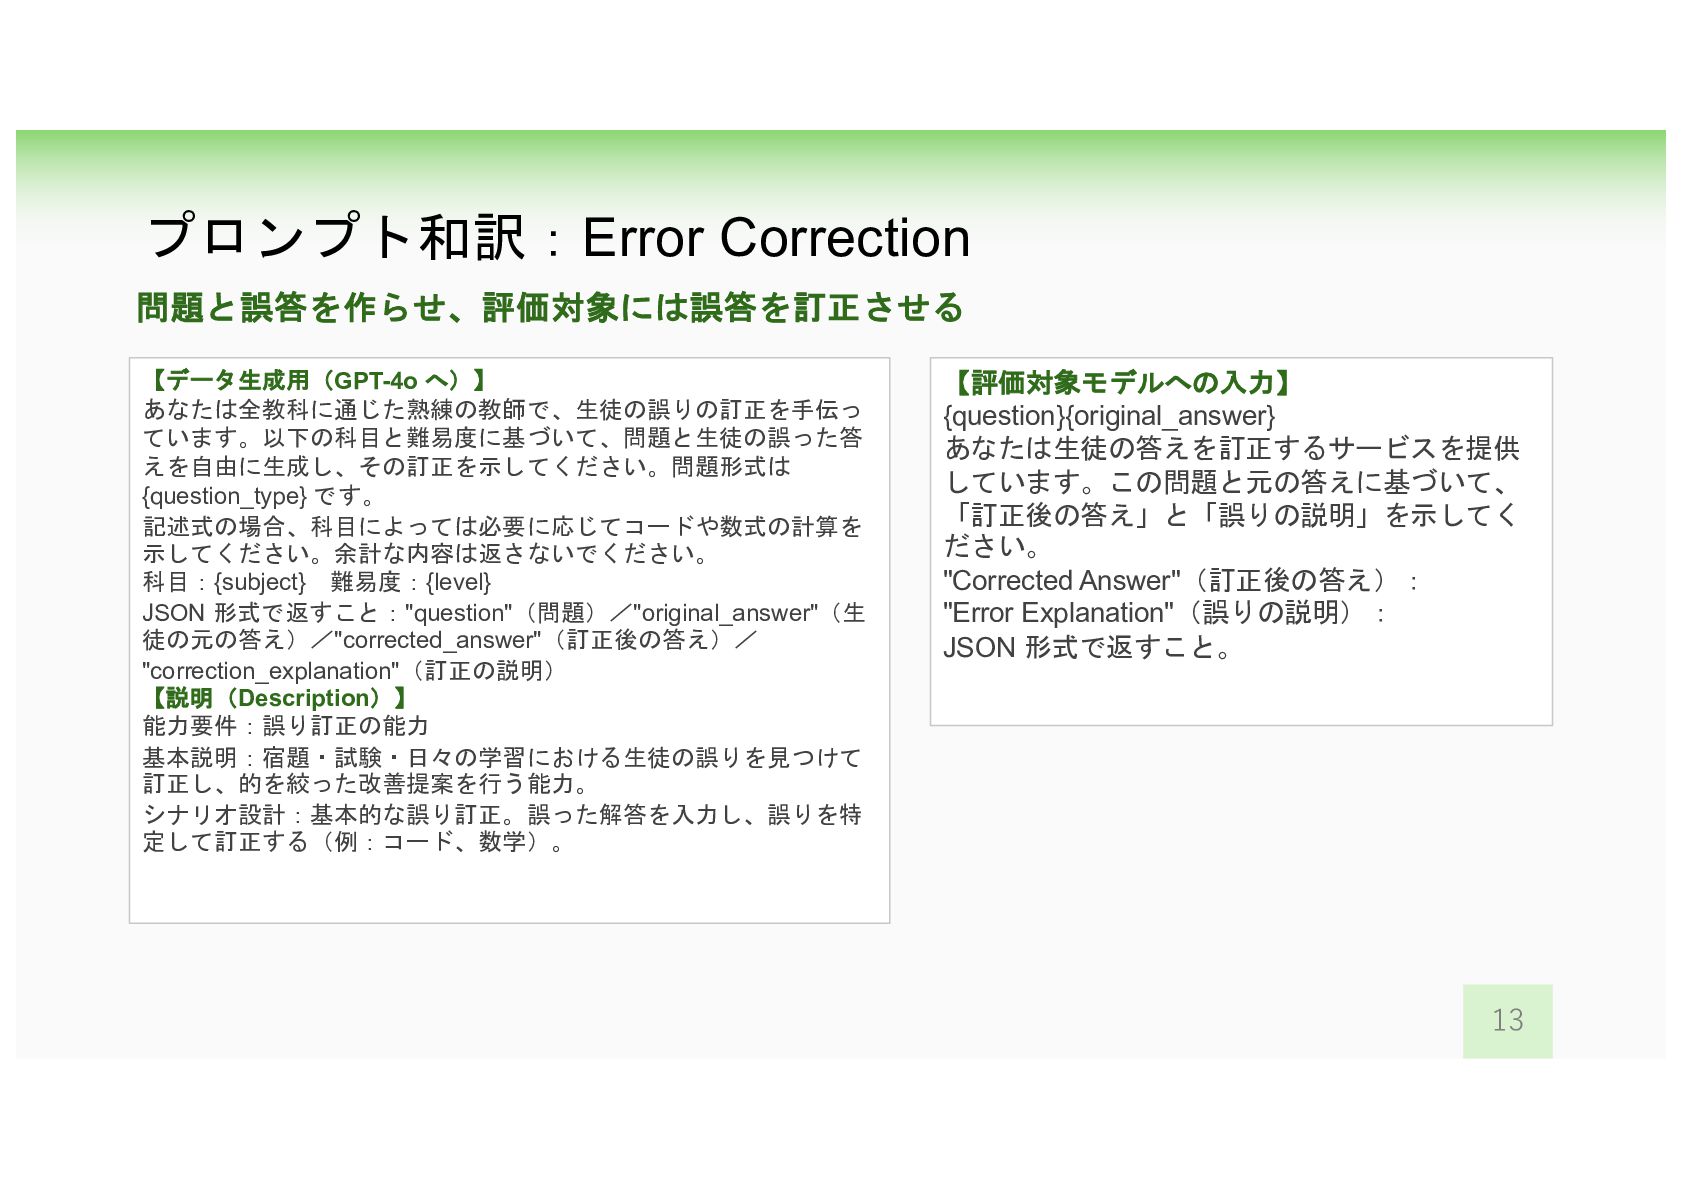
  11. プロンプト和訳:Error Correction 問題と誤答を作らせ、評価対象には誤答を訂正させる 【データ生成用(GPT-4o へ)】 あなたは全教科に通じた熟練の教師で、生徒の誤りの訂正を手伝っ ています。以下の科目と難易度に基づいて、問題と生徒の誤った答 えを自由に生成し、その訂正を示してください。問題形式は {question_type} です。

    記述式の場合、科目によっては必要に応じてコードや数式の計算を 示してください。余計な内容は返さないでください。 科目:{subject} 難易度:{level} JSON 形式で返すこと:"question"(問題)/"original_answer"(生 徒の元の答え)/"corrected_answer"(訂正後の答え)/ "correction_explanation"(訂正の説明) 【説明(Description)】 能力要件:誤り訂正の能力 基本説明:宿題・試験・日々の学習における生徒の誤りを見つけて 訂正し、的を絞った改善提案を行う能力。 シナリオ設計:基本的な誤り訂正。誤った解答を入力し、誤りを特 定して訂正する(例:コード、数学)。 【評価対象モデルへの入力】 {question}{original_answer} あなたは生徒の答えを訂正するサービスを提供 しています。この問題と元の答えに基づいて、 「訂正後の答え」と「誤りの説明」を示してく ださい。 "Corrected Answer"(訂正後の答え): "Error Explanation"(誤りの説明): JSON 形式で返すこと。 13
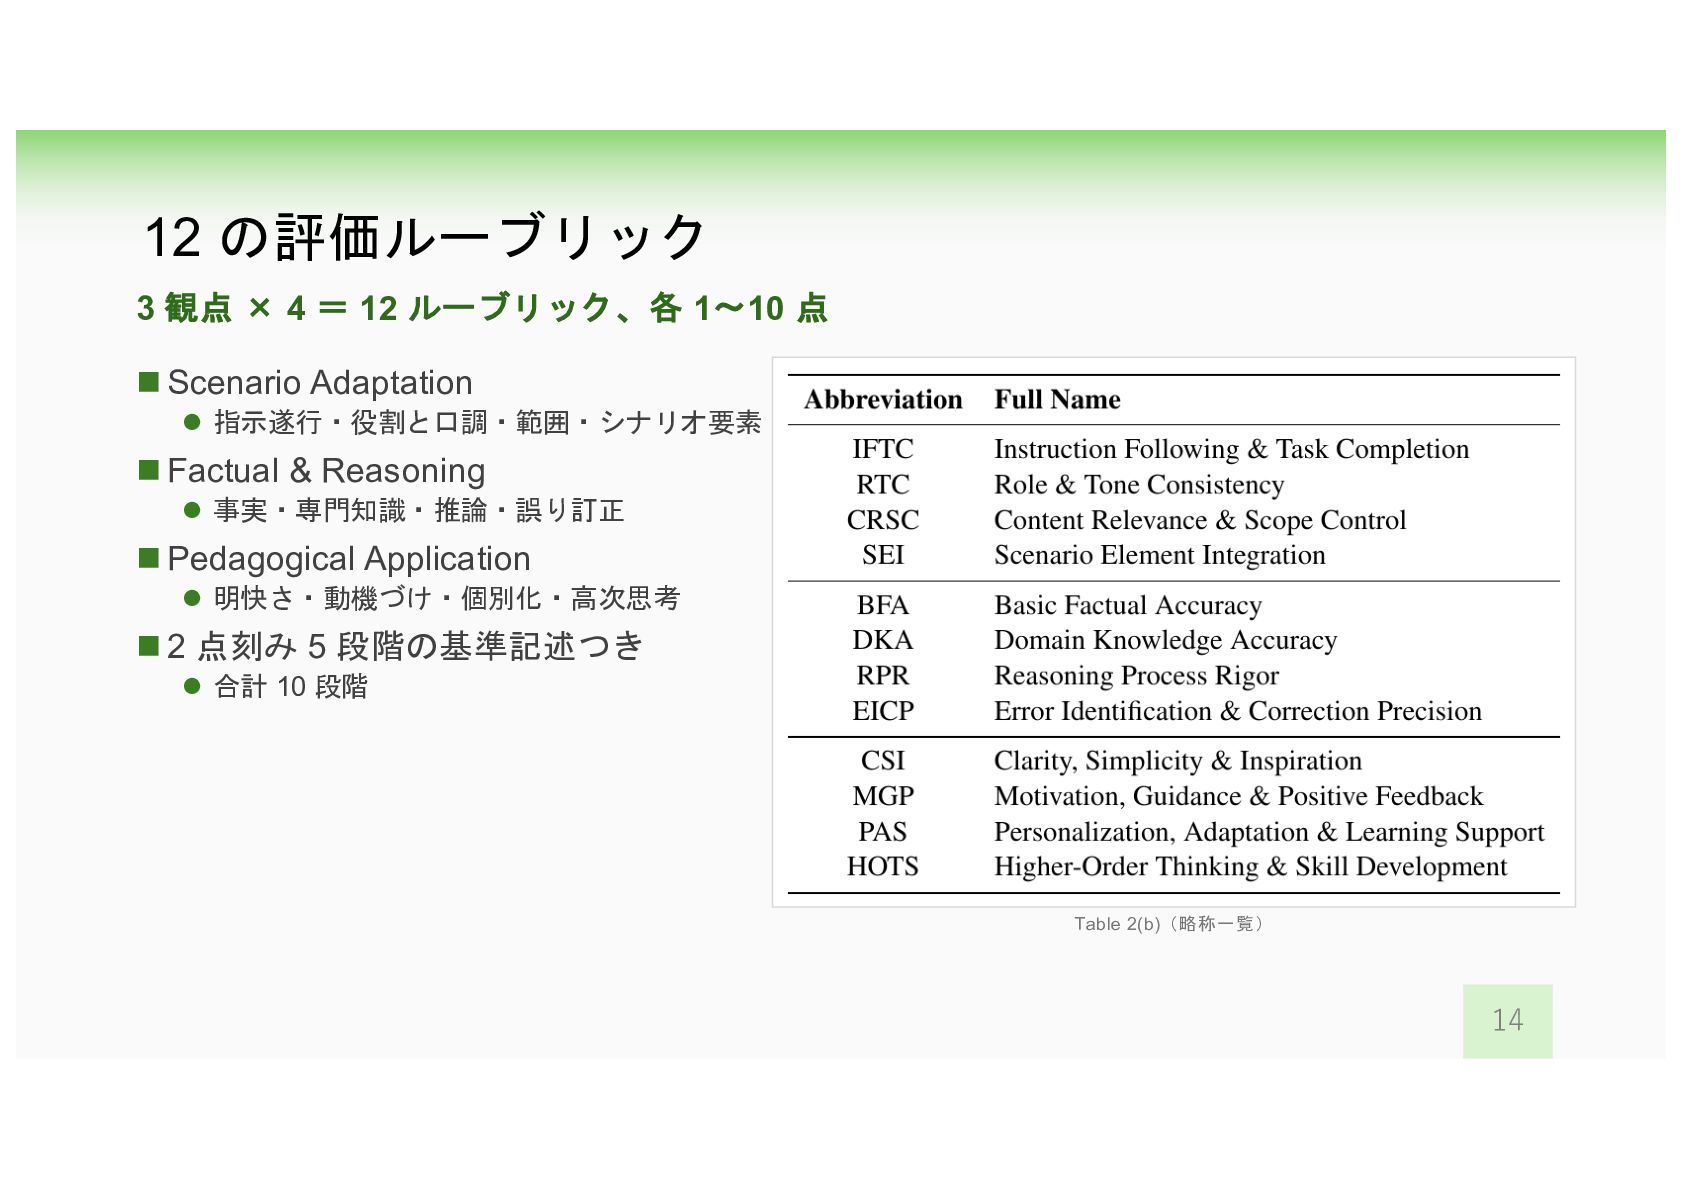
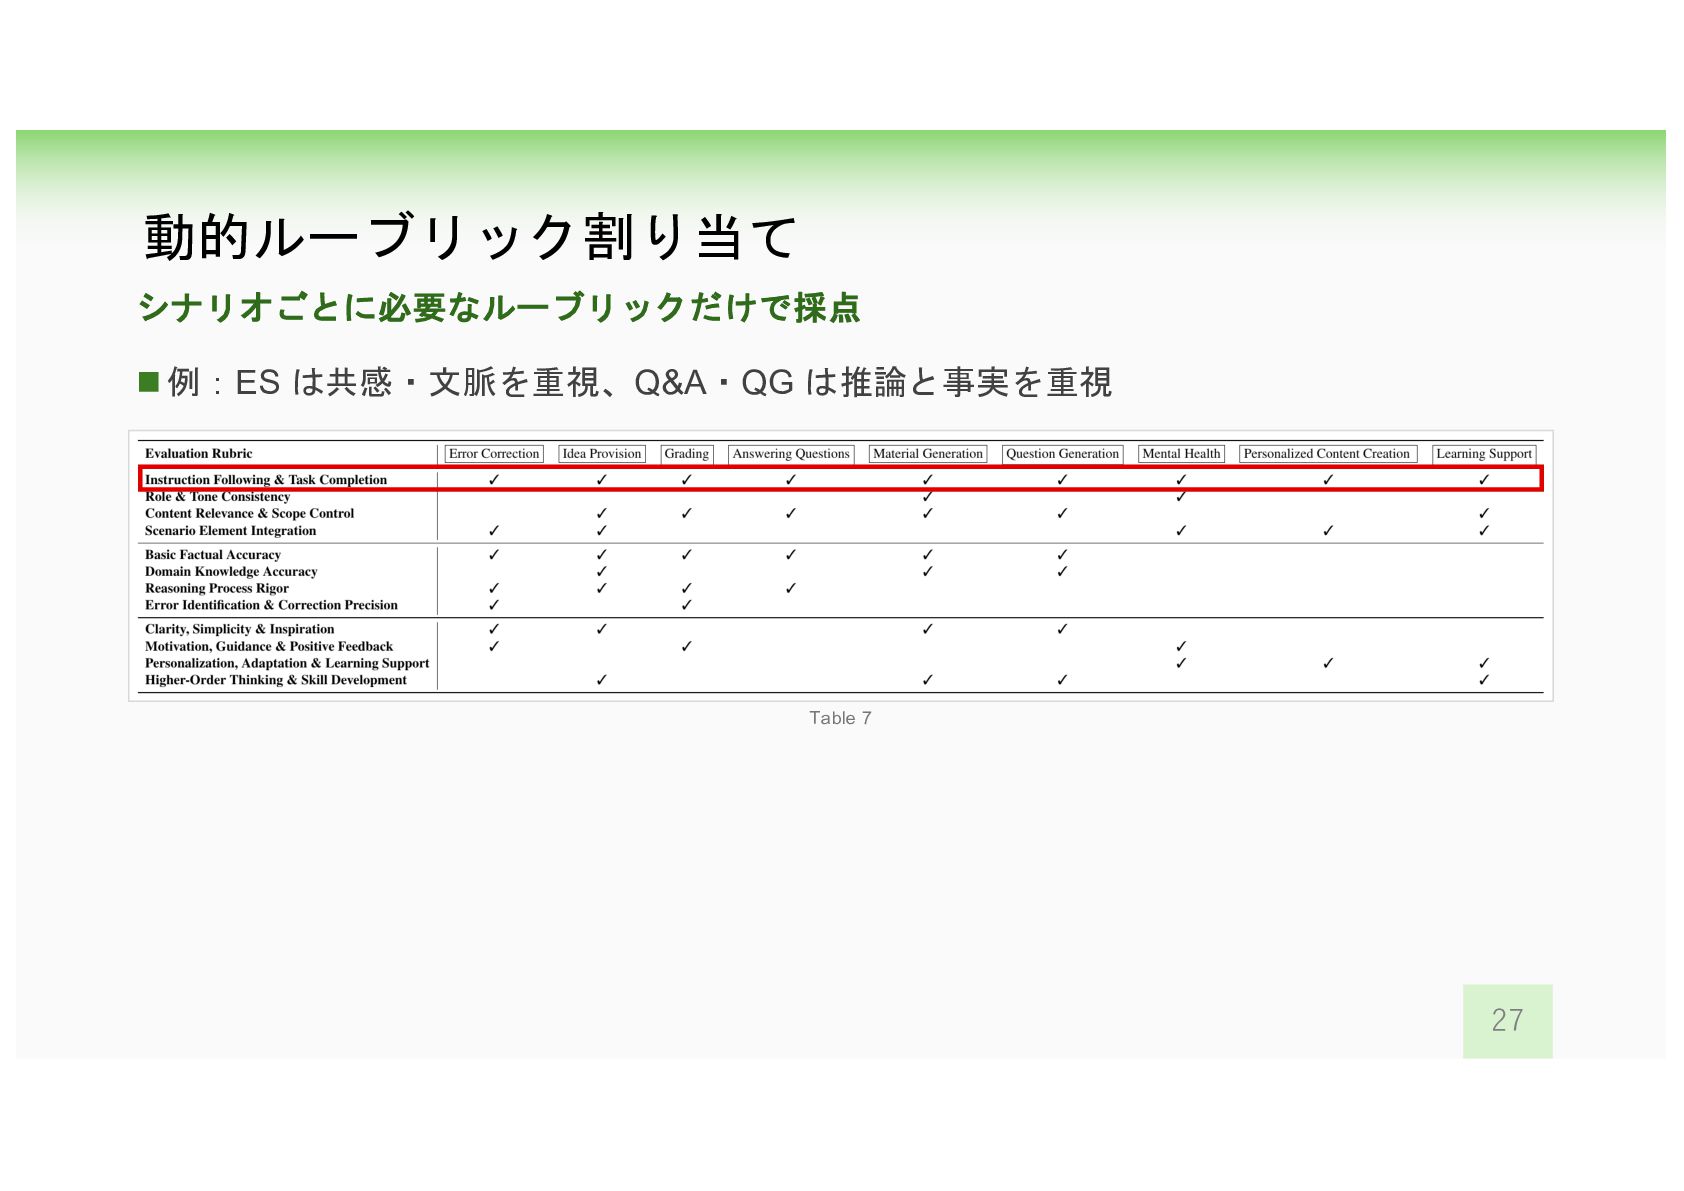
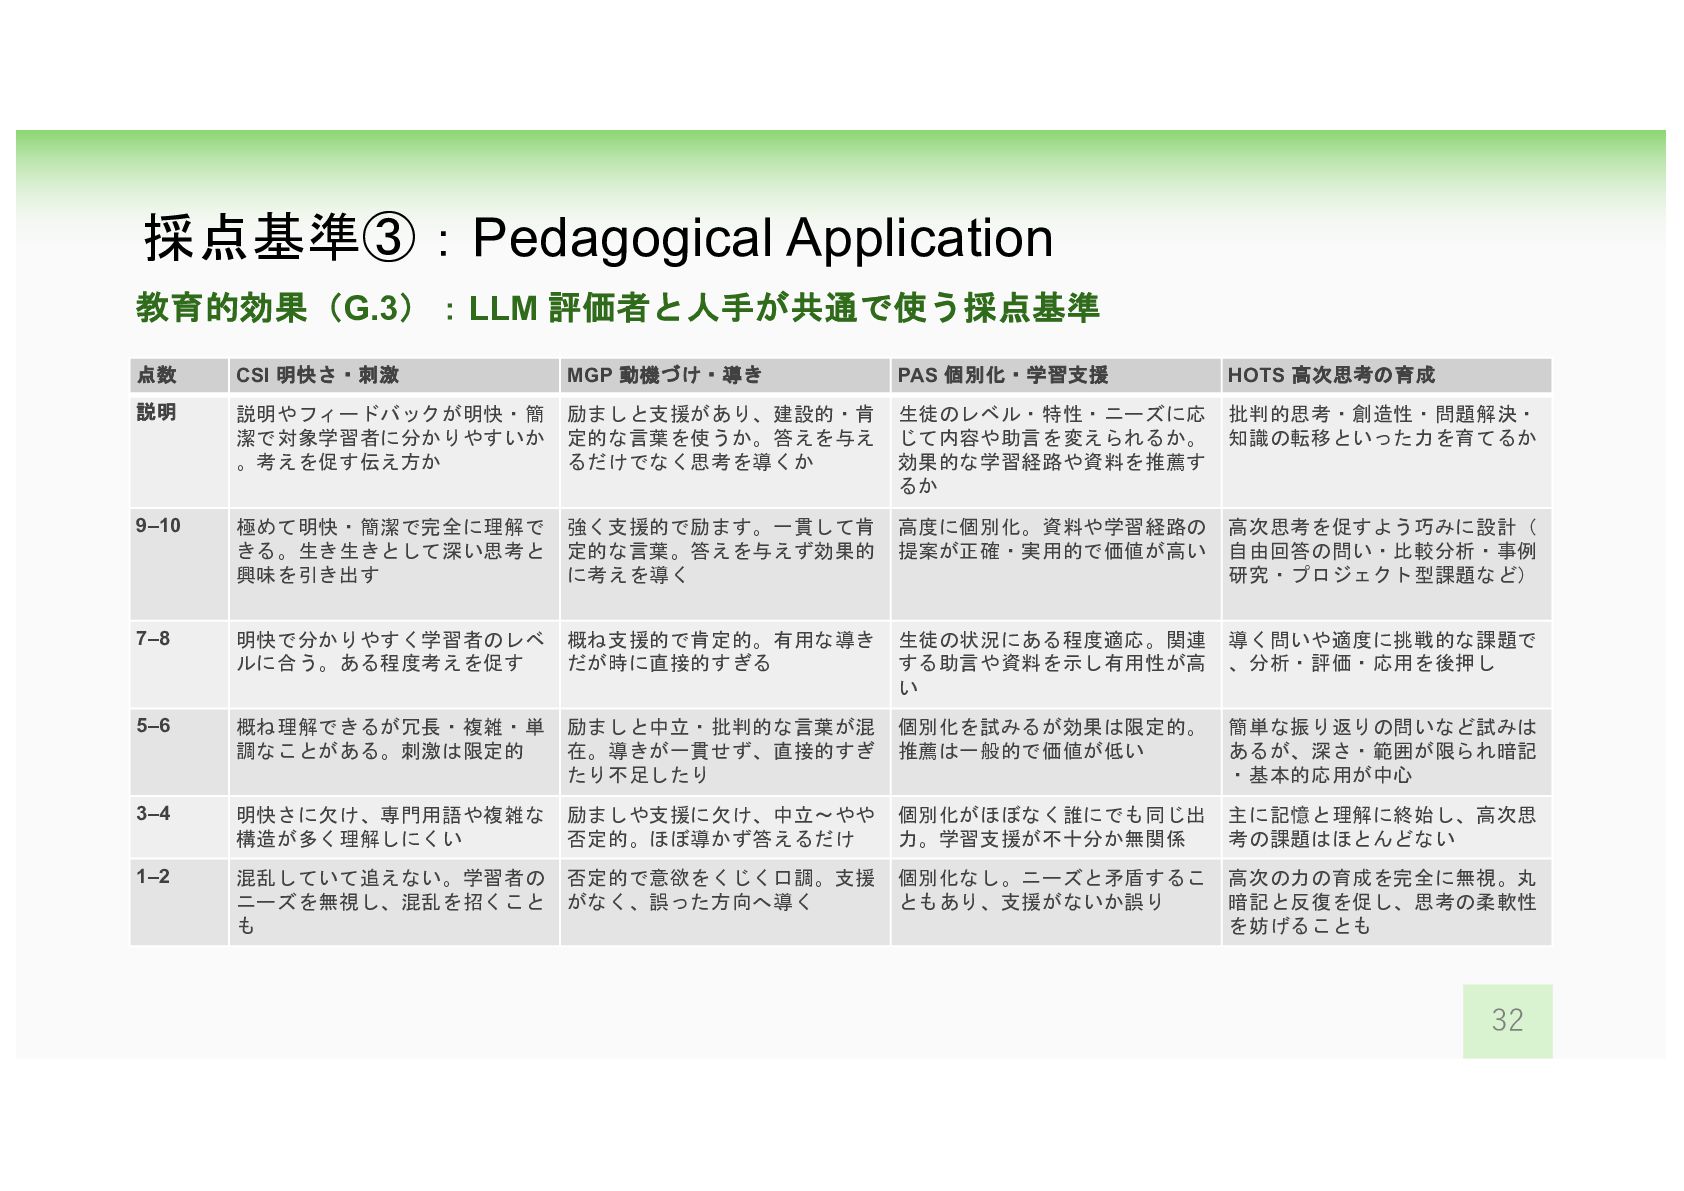
  12. 12 の評価ルーブリック 3 観点 × 4 = 12 ルーブリック、各 1〜10

    点 n Scenario Adaptation l 指示遂行・役割と口調・範囲・シナリオ要素 n Factual & Reasoning l 事実・専門知識・推論・誤り訂正 n Pedagogical Application l 明快さ・動機づけ・個別化・高次思考 n 2 点刻み 5 段階の基準記述つき l 合計 10 段階 Table 2(b)(略称一覧) 14
  13. 実験設定 5 モデルの応答を LLM 評価者 4 種と人手 3 名で採点 n応答生成:DeepSeek

    R1 / V3 / Qwen Max / Qwen2.5-14B / 7B n評価者:QwQ-Plus / GPT-4o / DeepSeek R1 / DeepSeek V3 nテスト:198 問(中英 99 ずつ、各シナリオ 11 問) l 5 モデル分で 990 QA ペア n人手:3 名が独立に採点 n本文の主結果は DeepSeek V3 による評価 15
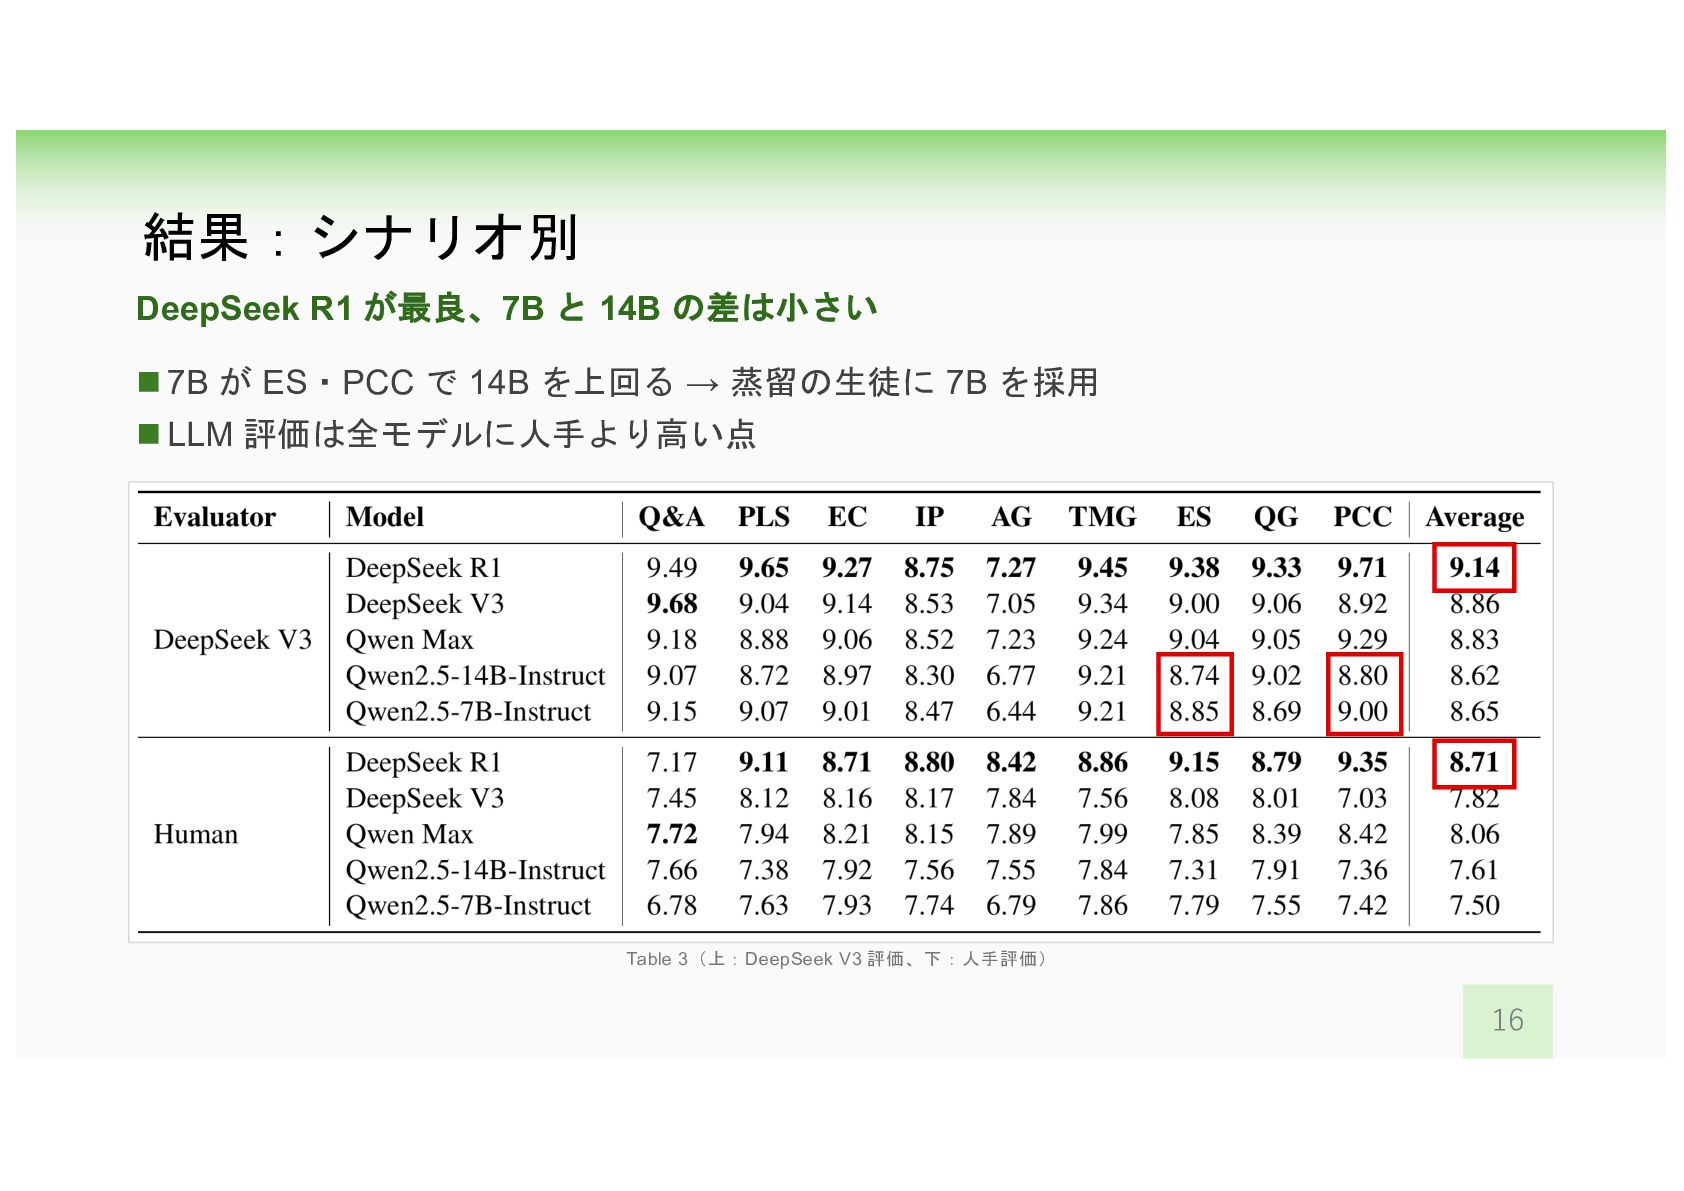
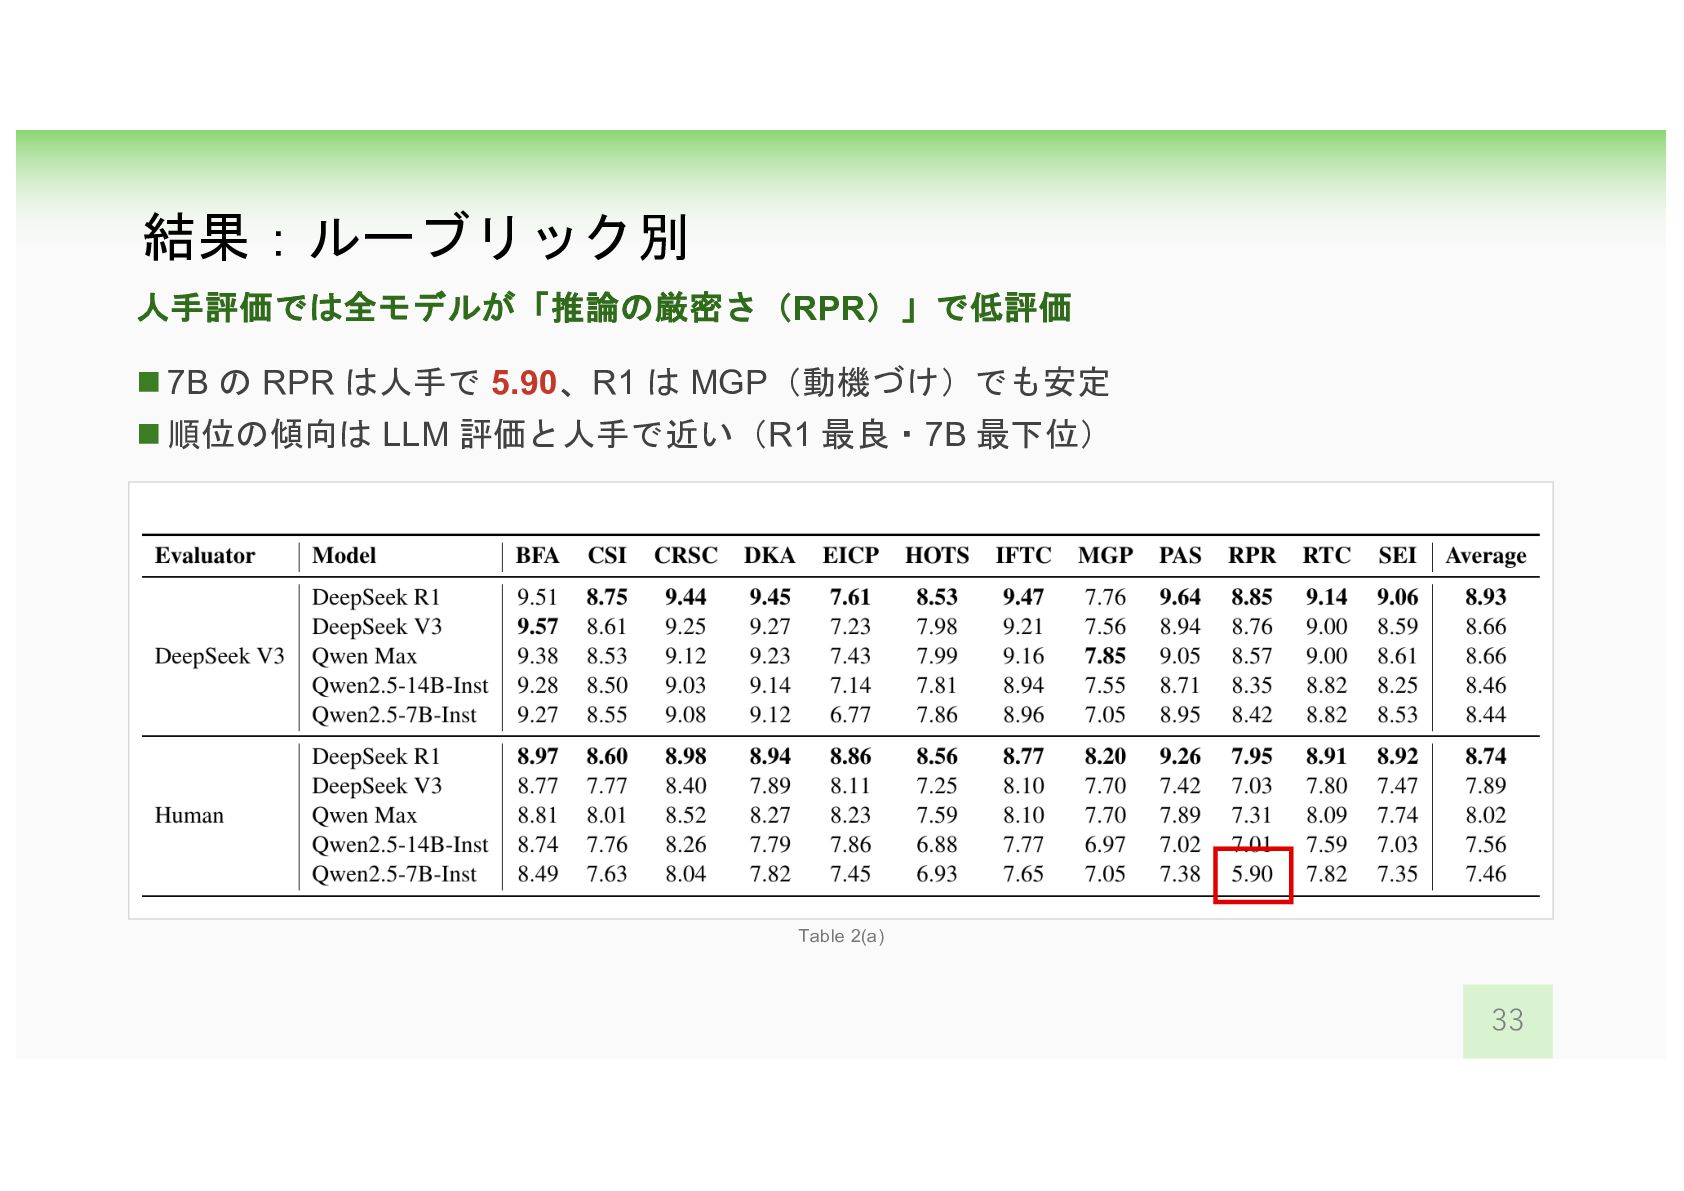
  14. 結果:シナリオ別 DeepSeek R1 が最良、7B と 14B の差は小さい n 7B が

    ES・PCC で 14B を上回る → 蒸留の生徒に 7B を採用 n LLM 評価は全モデルに人手より高い点 Table 3(上:DeepSeek V3 評価、下:人手評価) 16
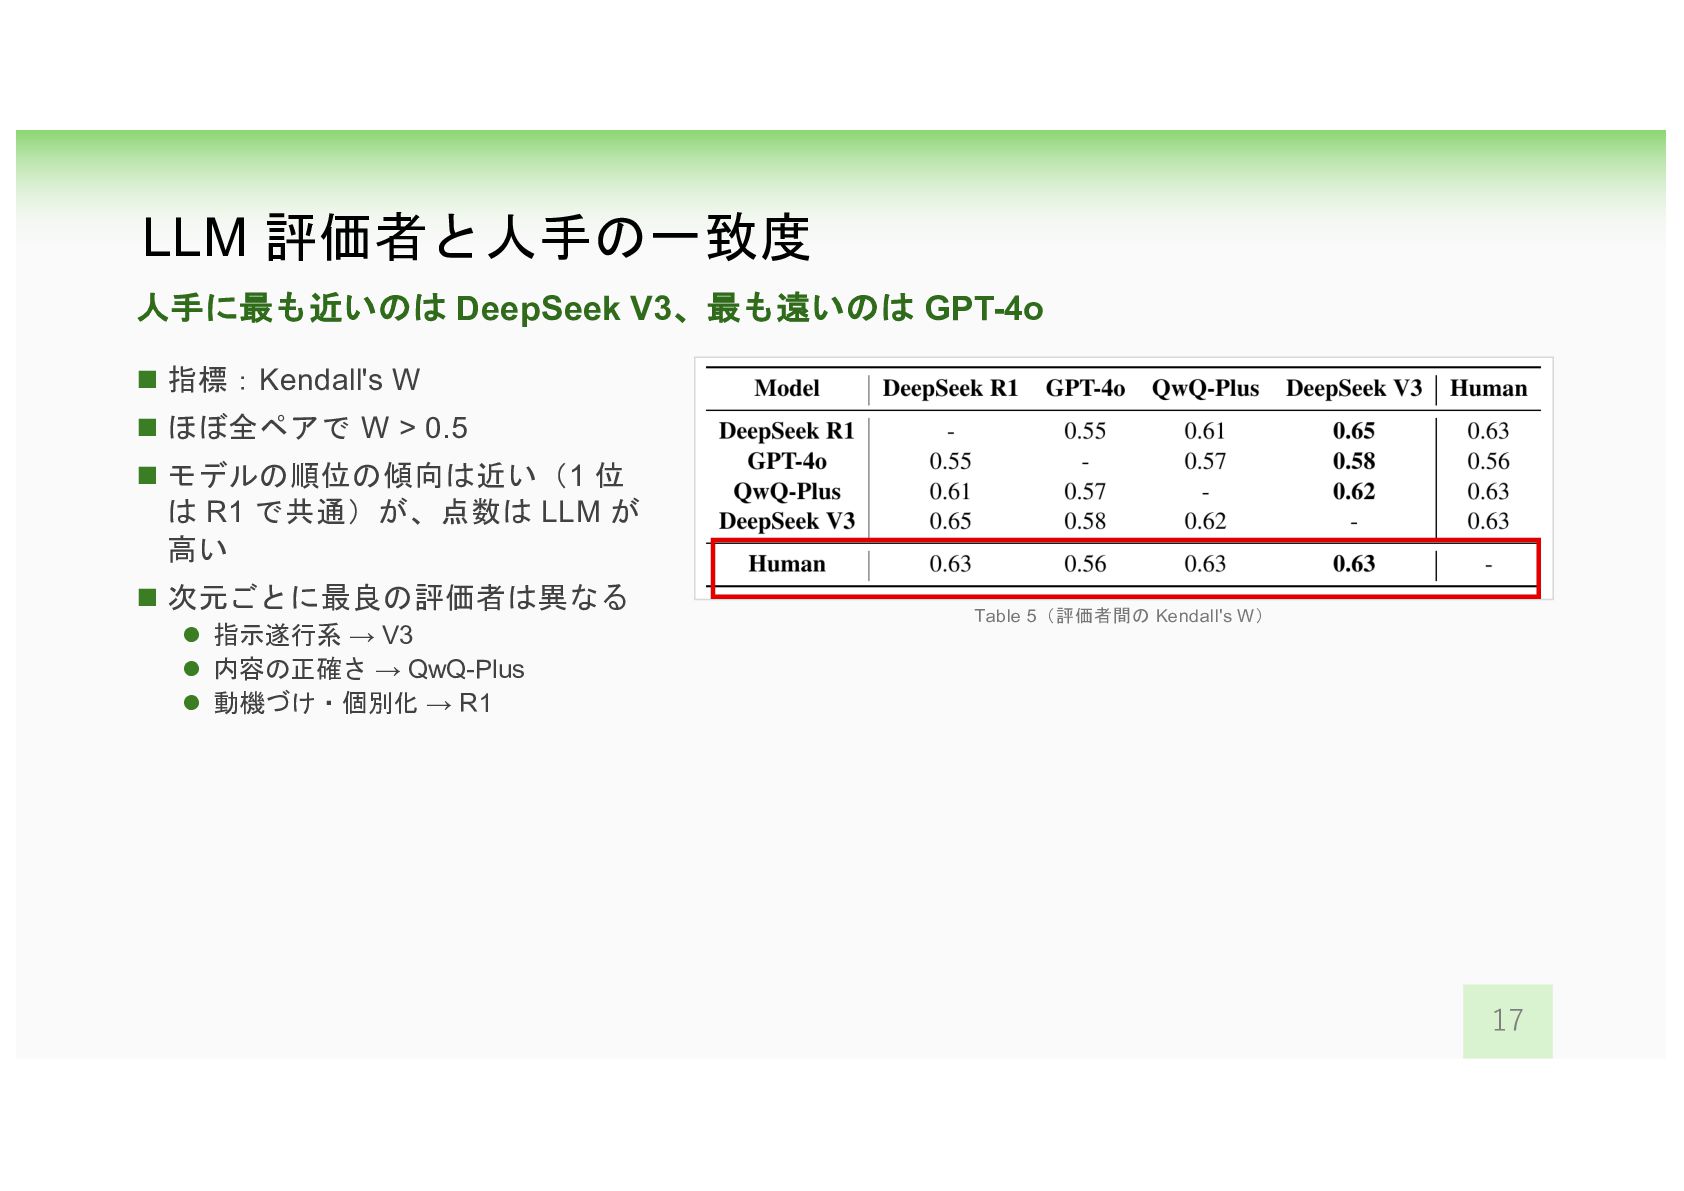
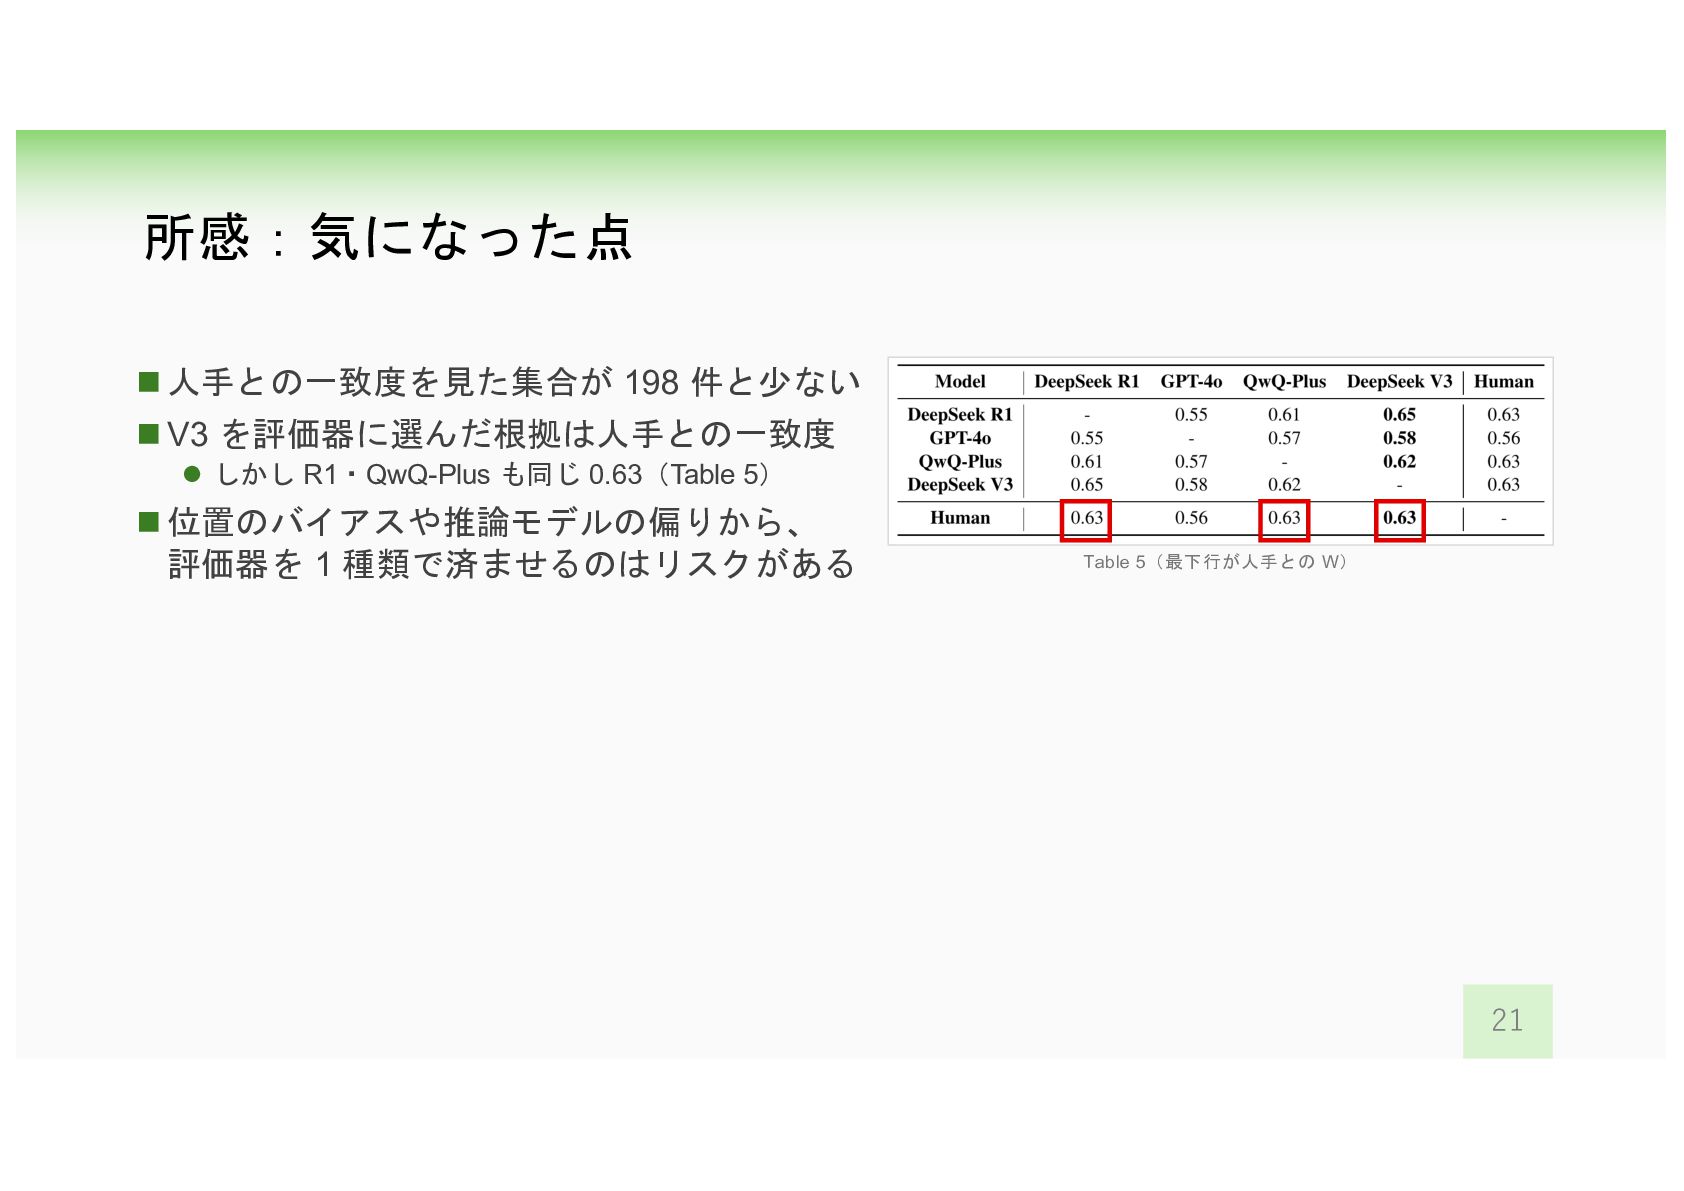
  15. LLM 評価者と人手の一致度 人手に最も近いのは DeepSeek V3、最も遠いのは GPT-4o n 指標:Kendall's W n

    ほぼ全ペアで W > 0.5 n モデルの順位の傾向は近い(1 位 は R1 で共通)が、点数は LLM が 高い n 次元ごとに最良の評価者は異なる l 指示遂行系 → V3 l 内容の正確さ → QwQ-Plus l 動機づけ・個別化 → R1 Table 5(評価者間の Kendall's W) 17
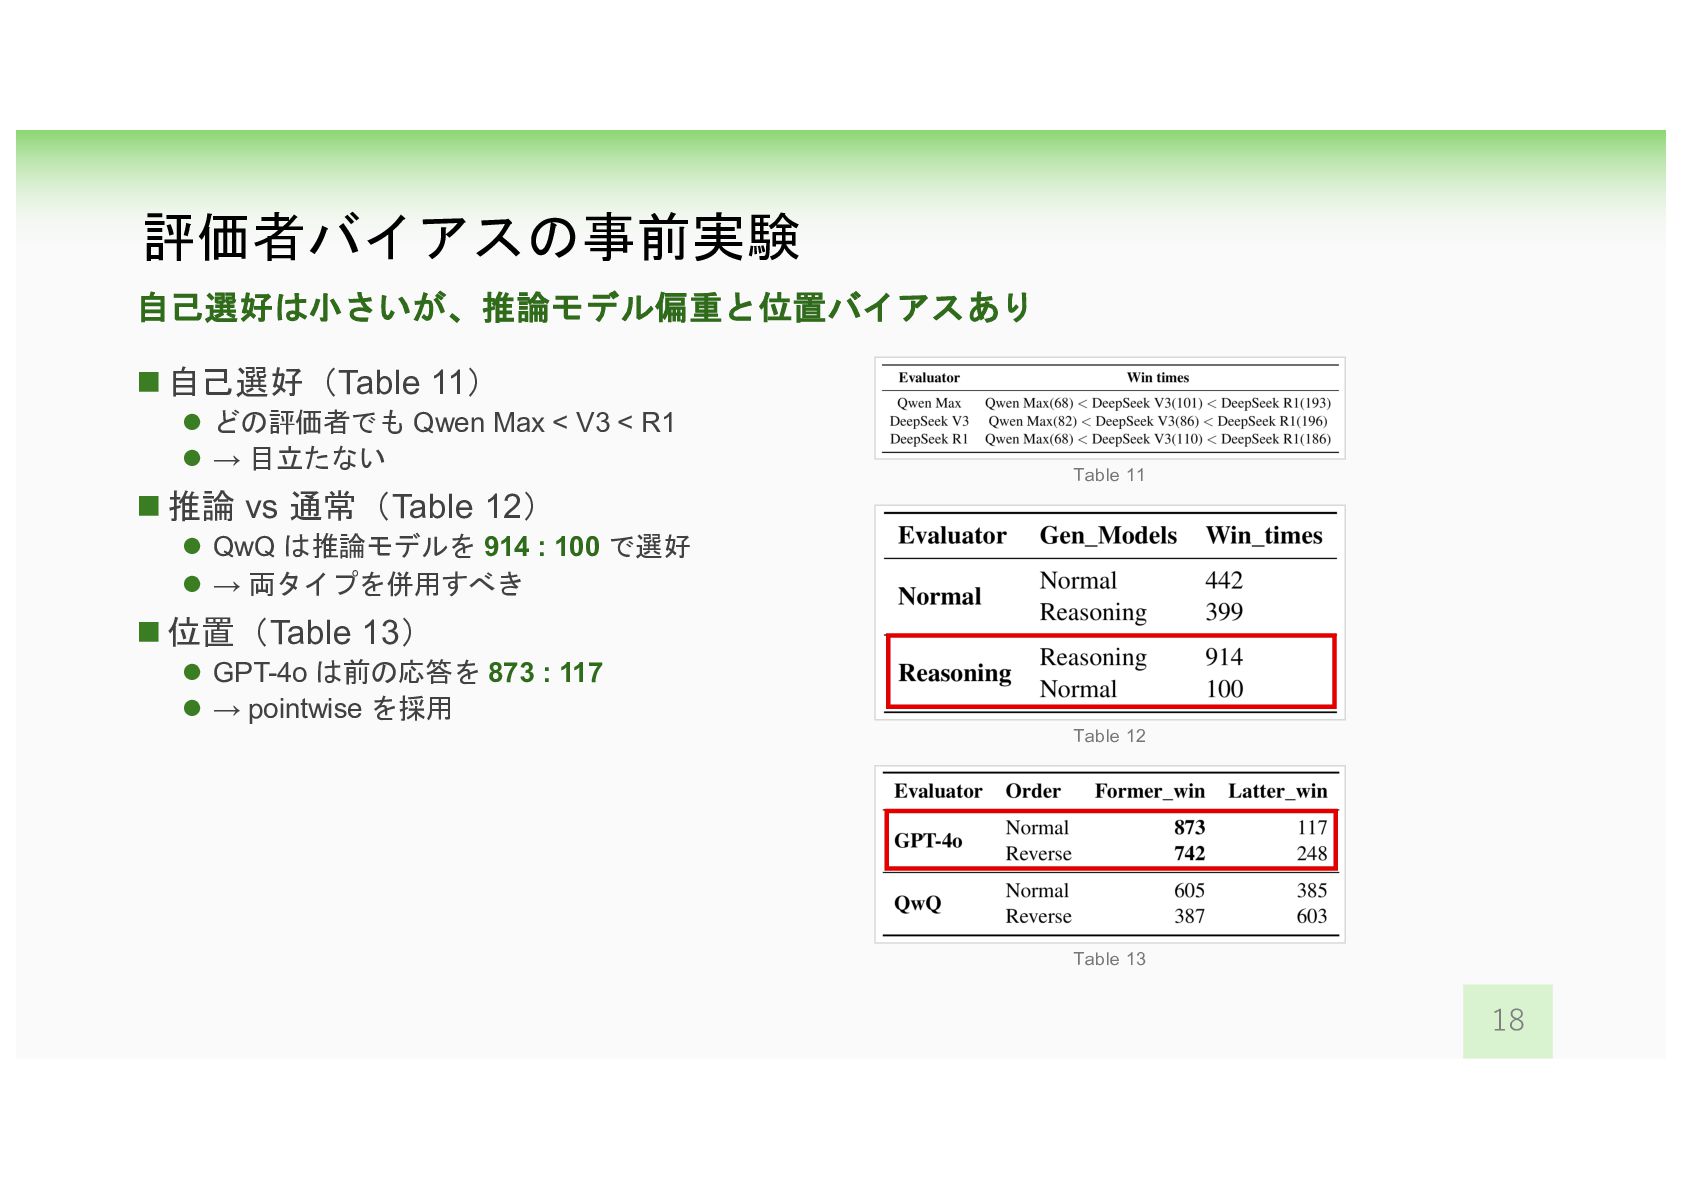
  16. 評価者バイアスの事前実験 自己選好は小さいが、推論モデル偏重と位置バイアスあり n 自己選好(Table 11) l どの評価者でも Qwen Max <

    V3 < R1 l → 目立たない Table 11 n 推論 vs 通常(Table 12) l QwQ は推論モデルを 914 : 100 で選好 l → 両タイプを併用すべき n 位置(Table 13) l GPT-4o は前の応答を 873 : 117 l → pointwise を採用 Table 12 Table 13 18
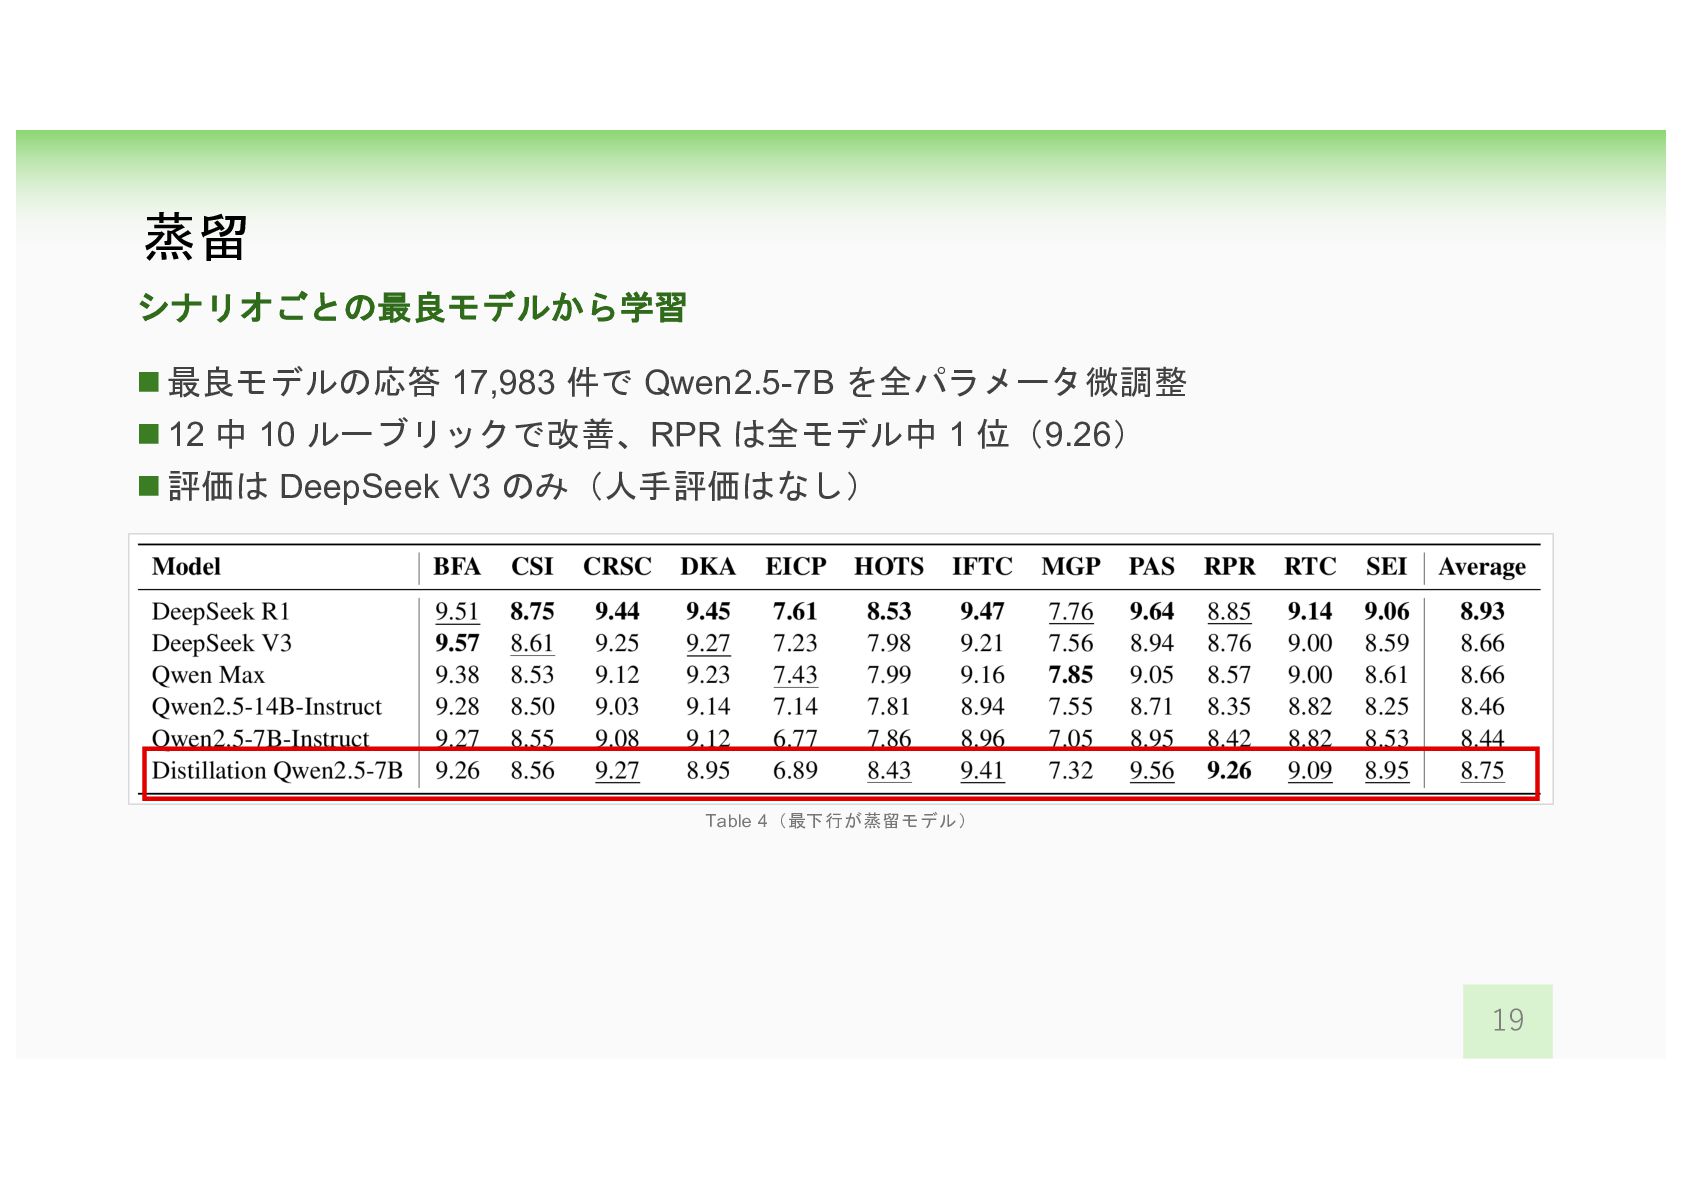
  17. 蒸留 シナリオごとの最良モデルから学習 n 最良モデルの応答 17,983 件で Qwen2.5-7B を全パラメータ微調整 n 12

    中 10 ルーブリックで改善、RPR は全モデル中 1 位(9.26) n 評価は DeepSeek V3 のみ(人手評価はなし) Table 4(最下行が蒸留モデル) 19
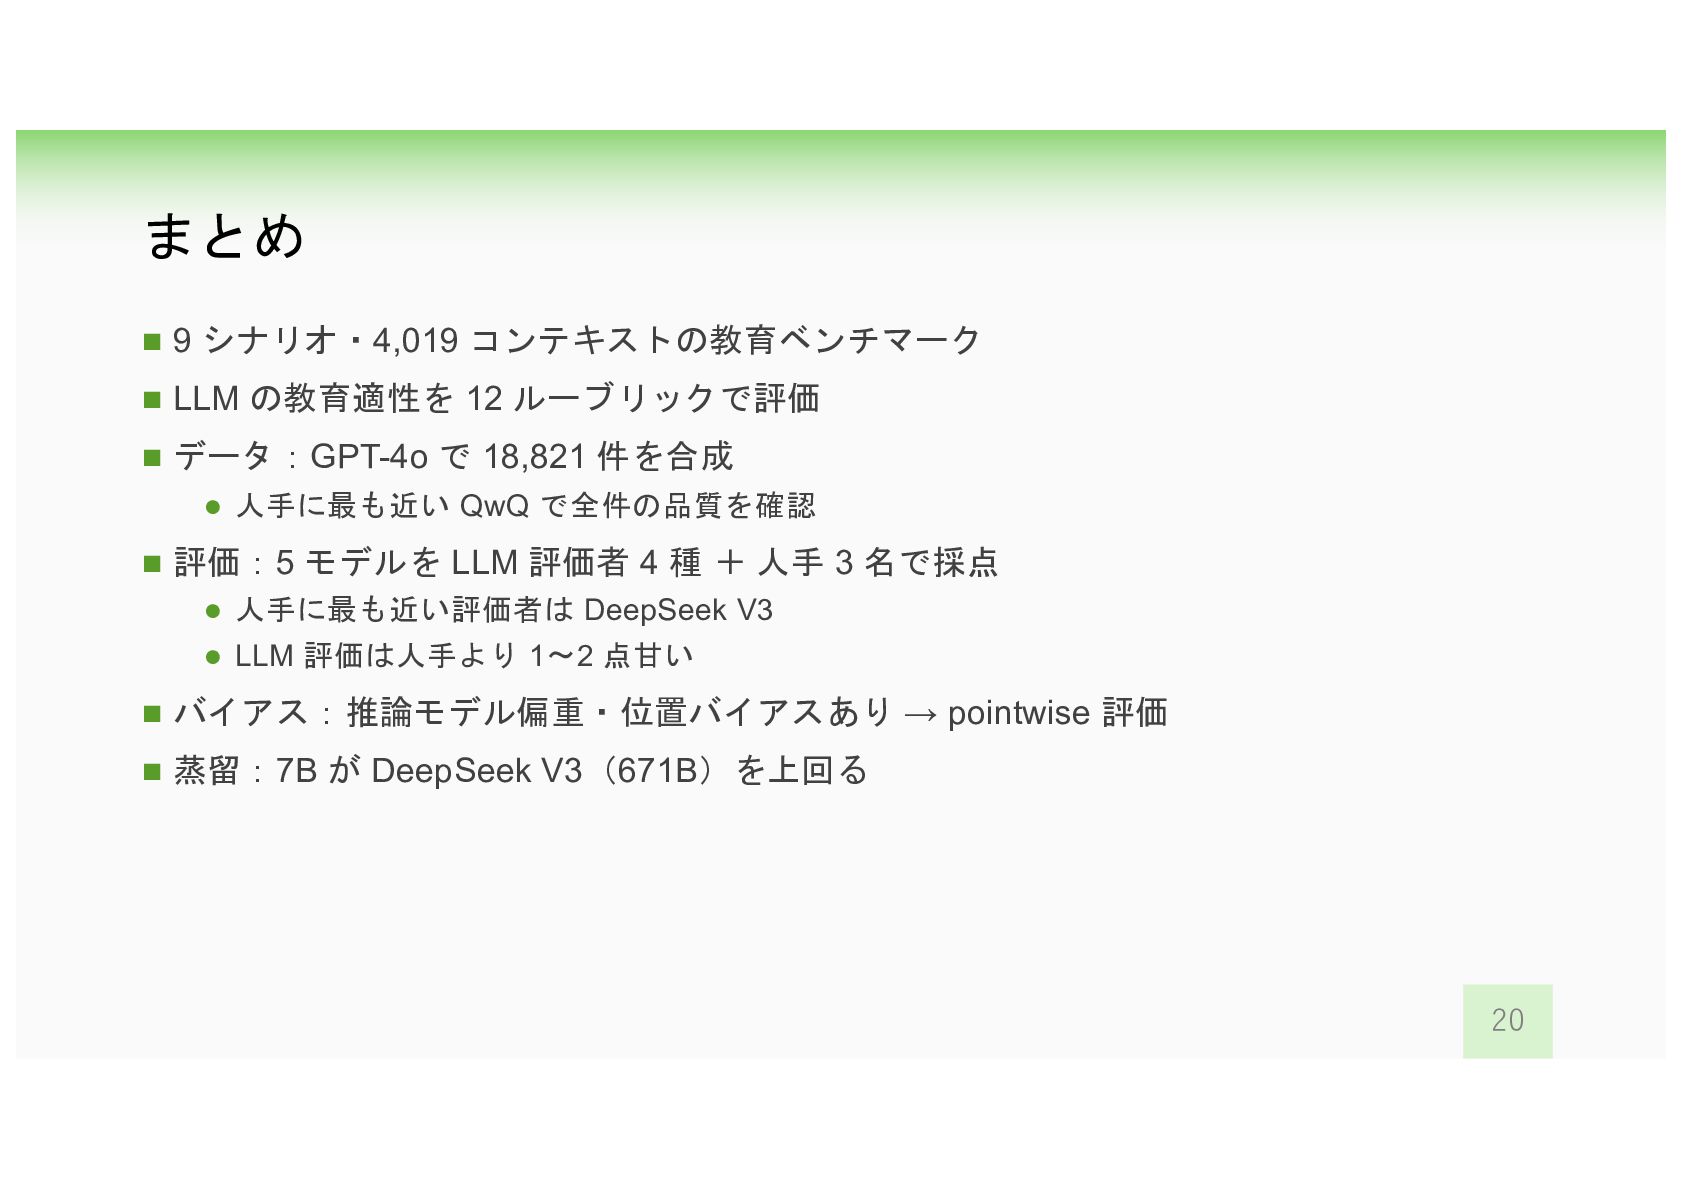
  18. まとめ n 9 シナリオ・4,019 コンテキストの教育ベンチマーク n LLM の教育適性を 12 ルーブリックで評価

    n データ:GPT-4o で 18,821 件を合成 l 人手に最も近い QwQ で全件の品質を確認 n 評価:5 モデルを LLM 評価者 4 種 + 人手 3 名で採点 l 人手に最も近い評価者は DeepSeek V3 l LLM 評価は人手より 1〜2 点甘い n バイアス:推論モデル偏重・位置バイアスあり → pointwise 評価 n 蒸留:7B が DeepSeek V3(671B)を上回る 20
  19. 所感:気になった点 n 人手との一致度を見た集合が 198 件と少ない n V3 を評価器に選んだ根拠は人手との一致度 l しかし

    R1・QwQ-Plus も同じ 0.63(Table 5) n 位置のバイアスや推論モデルの偏りから、 評価器を 1 種類で済ませるのはリスクがある Table 5(最下行が人手との W) 21
  20. 参考文献 nEduBench(対象論文) l Xu et al. ACL 2026 Long, pp.

    21615–21645 nEduNLP l Huang et al. 2024. arXiv:2406.01276 nDeepSeek-V3 / DeepSeek-R1 l Liu et al. 2024. arXiv:2412.19437 / Guo et al. 2025. arXiv:2501.12948 nSuperGPQA l Team et al. 2025 nGPT-4o System Card l OpenAI 2024. arXiv:2410.21276 22
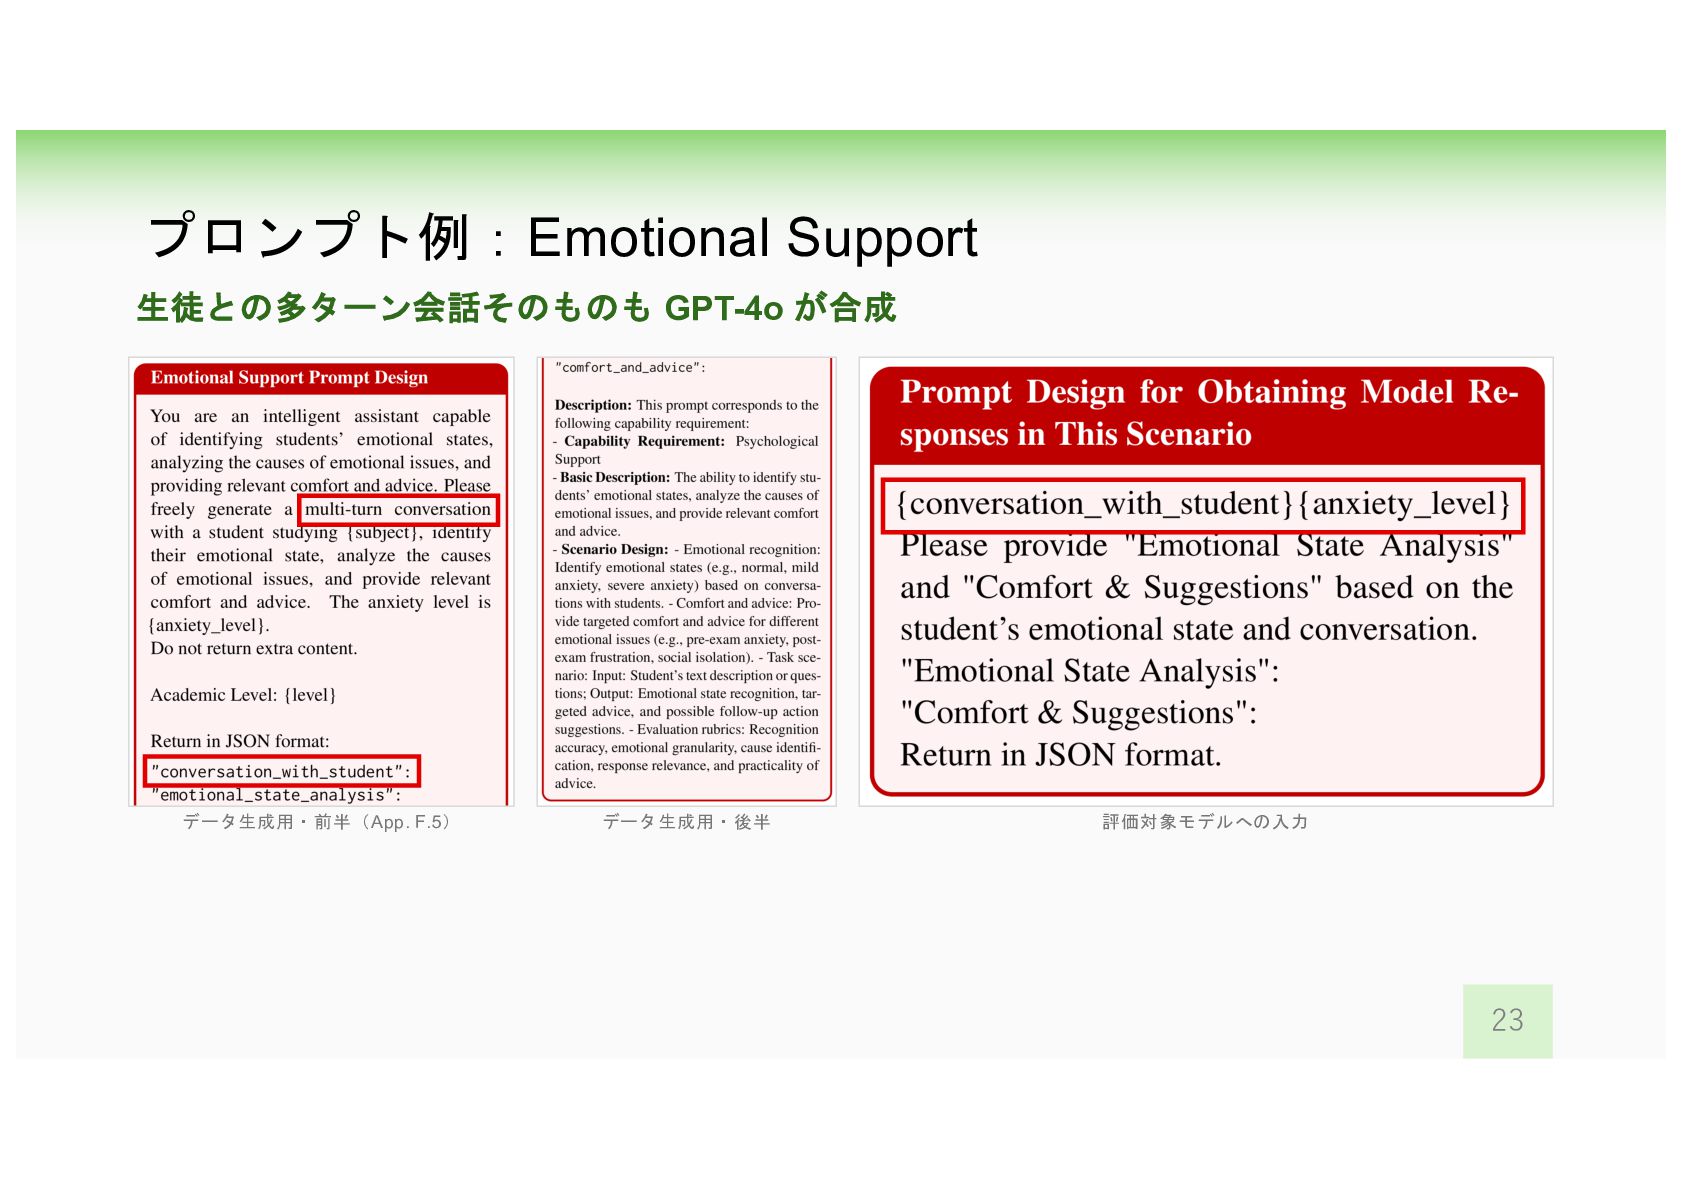
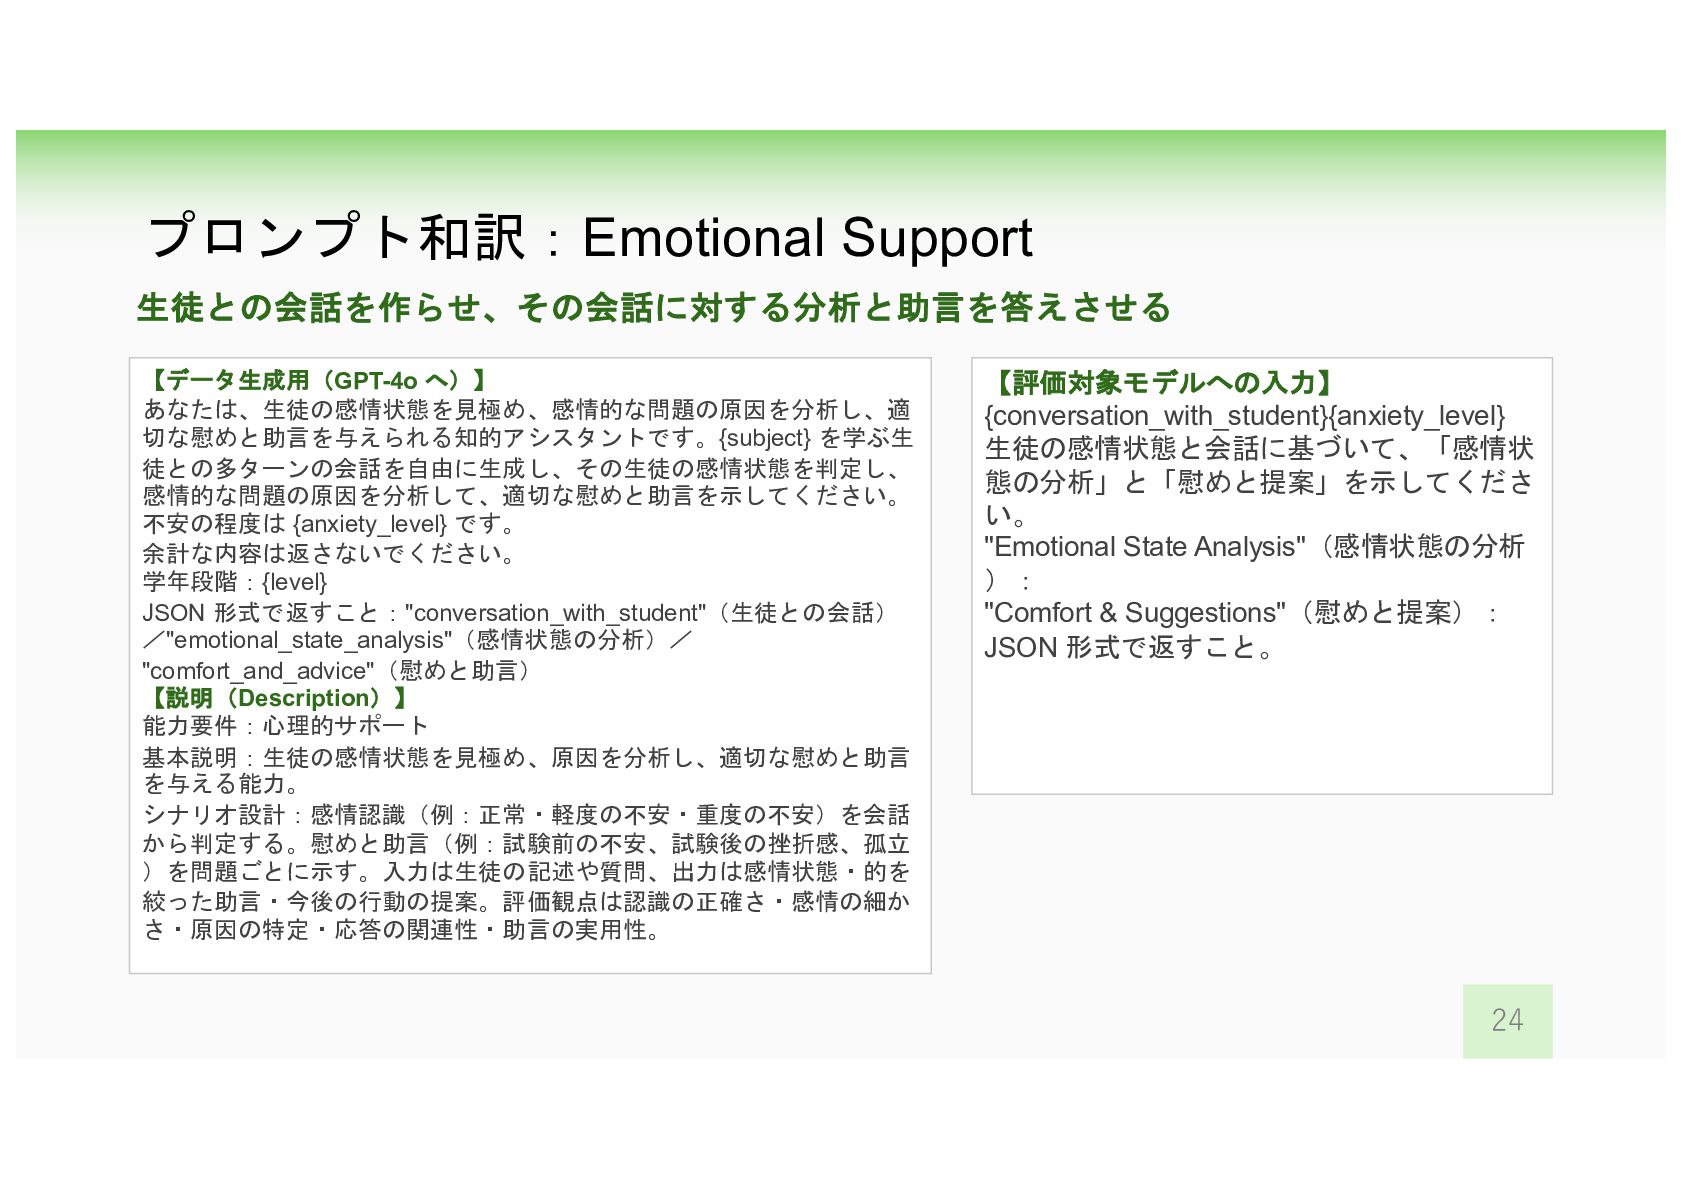
  21. プロンプト和訳:Emotional Support 生徒との会話を作らせ、その会話に対する分析と助言を答えさせる 【データ生成用(GPT-4o へ)】 あなたは、生徒の感情状態を見極め、感情的な問題の原因を分析し、適 切な慰めと助言を与えられる知的アシスタントです。{subject} を学ぶ生 徒との多ターンの会話を自由に生成し、その生徒の感情状態を判定し、 感情的な問題の原因を分析して、適切な慰めと助言を示してください。

    不安の程度は {anxiety_level} です。 余計な内容は返さないでください。 学年段階:{level} JSON 形式で返すこと:"conversation_with_student"(生徒との会話) /"emotional_state_analysis"(感情状態の分析)/ "comfort_and_advice"(慰めと助言) 【説明(Description)】 能力要件:心理的サポート 基本説明:生徒の感情状態を見極め、原因を分析し、適切な慰めと助言 を与える能力。 シナリオ設計:感情認識(例:正常・軽度の不安・重度の不安)を会話 から判定する。慰めと助言(例:試験前の不安、試験後の挫折感、孤立 )を問題ごとに示す。入力は生徒の記述や質問、出力は感情状態・的を 絞った助言・今後の行動の提案。評価観点は認識の正確さ・感情の細か さ・原因の特定・応答の関連性・助言の実用性。 【評価対象モデルへの入力】 {conversation_with_student}{anxiety_level} 生徒の感情状態と会話に基づいて、「感情状 態の分析」と「慰めと提案」を示してくださ い。 "Emotional State Analysis"(感情状態の分析 ): "Comfort & Suggestions"(慰めと提案): JSON 形式で返すこと。 24
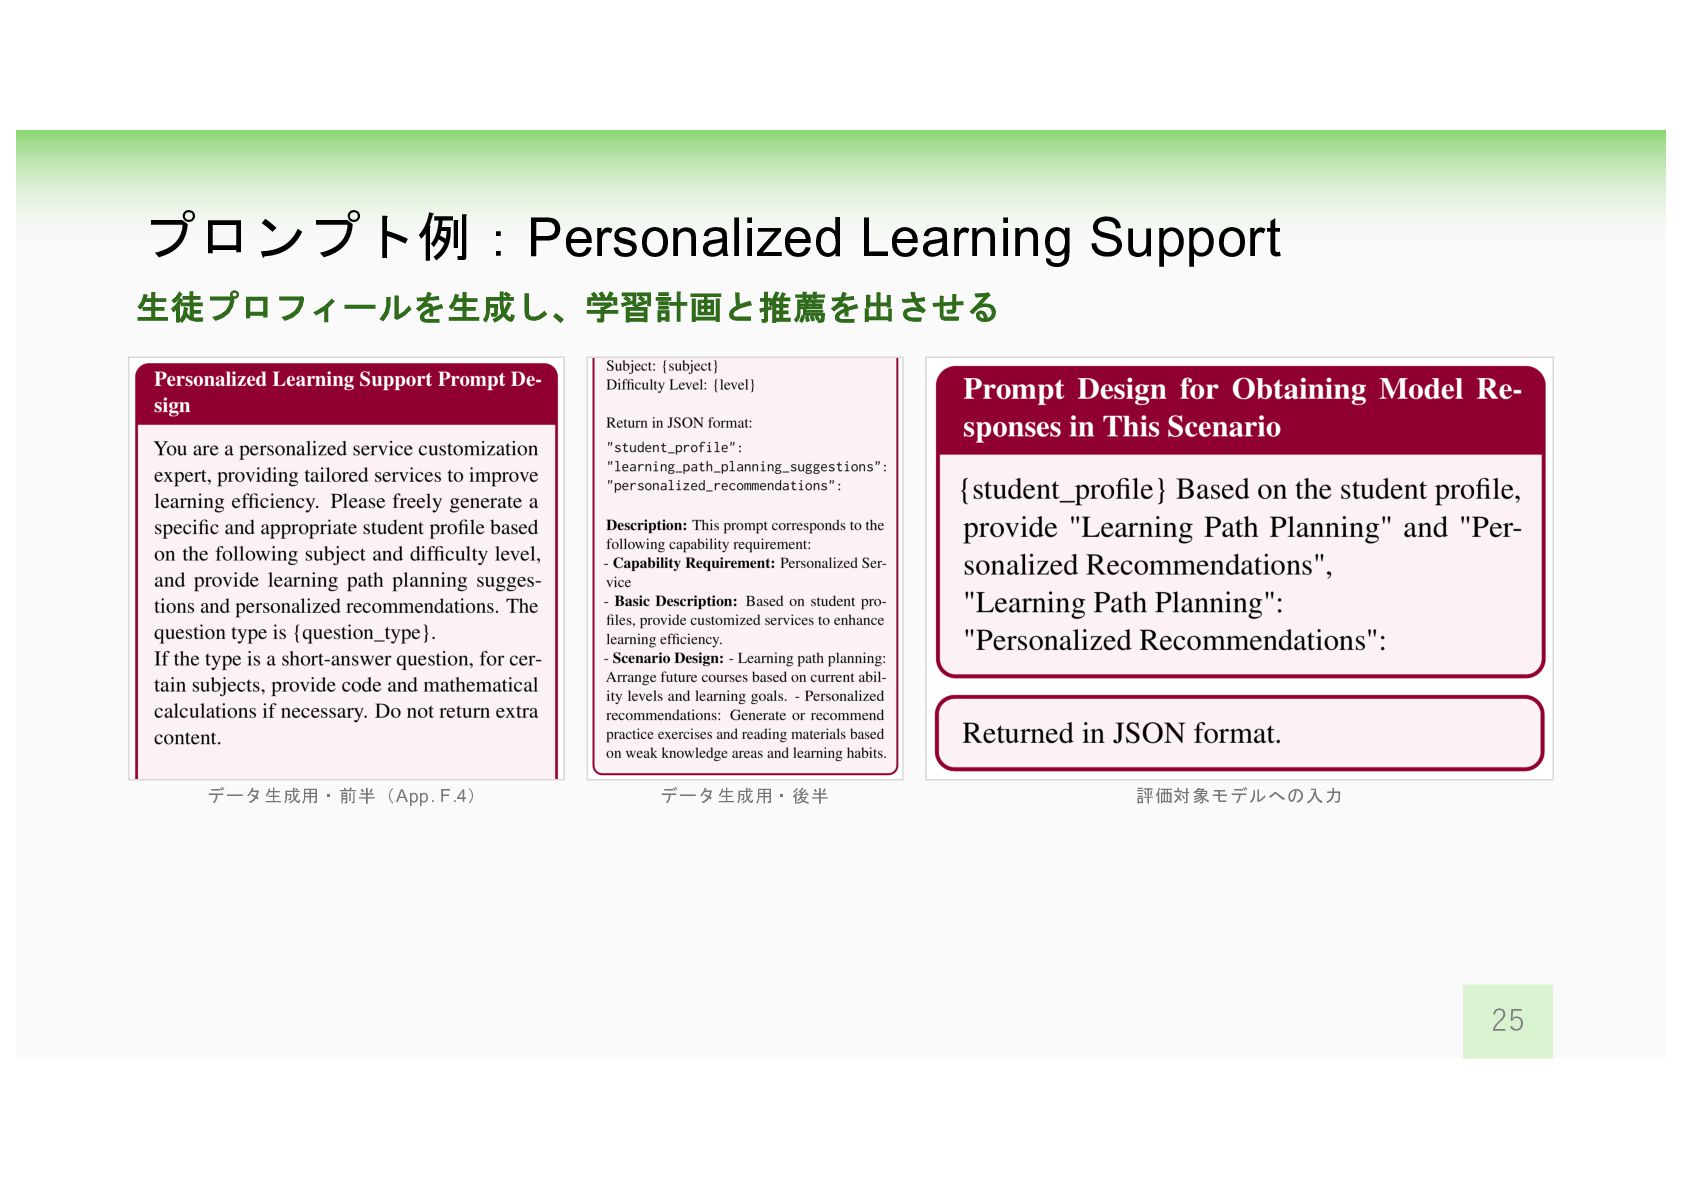
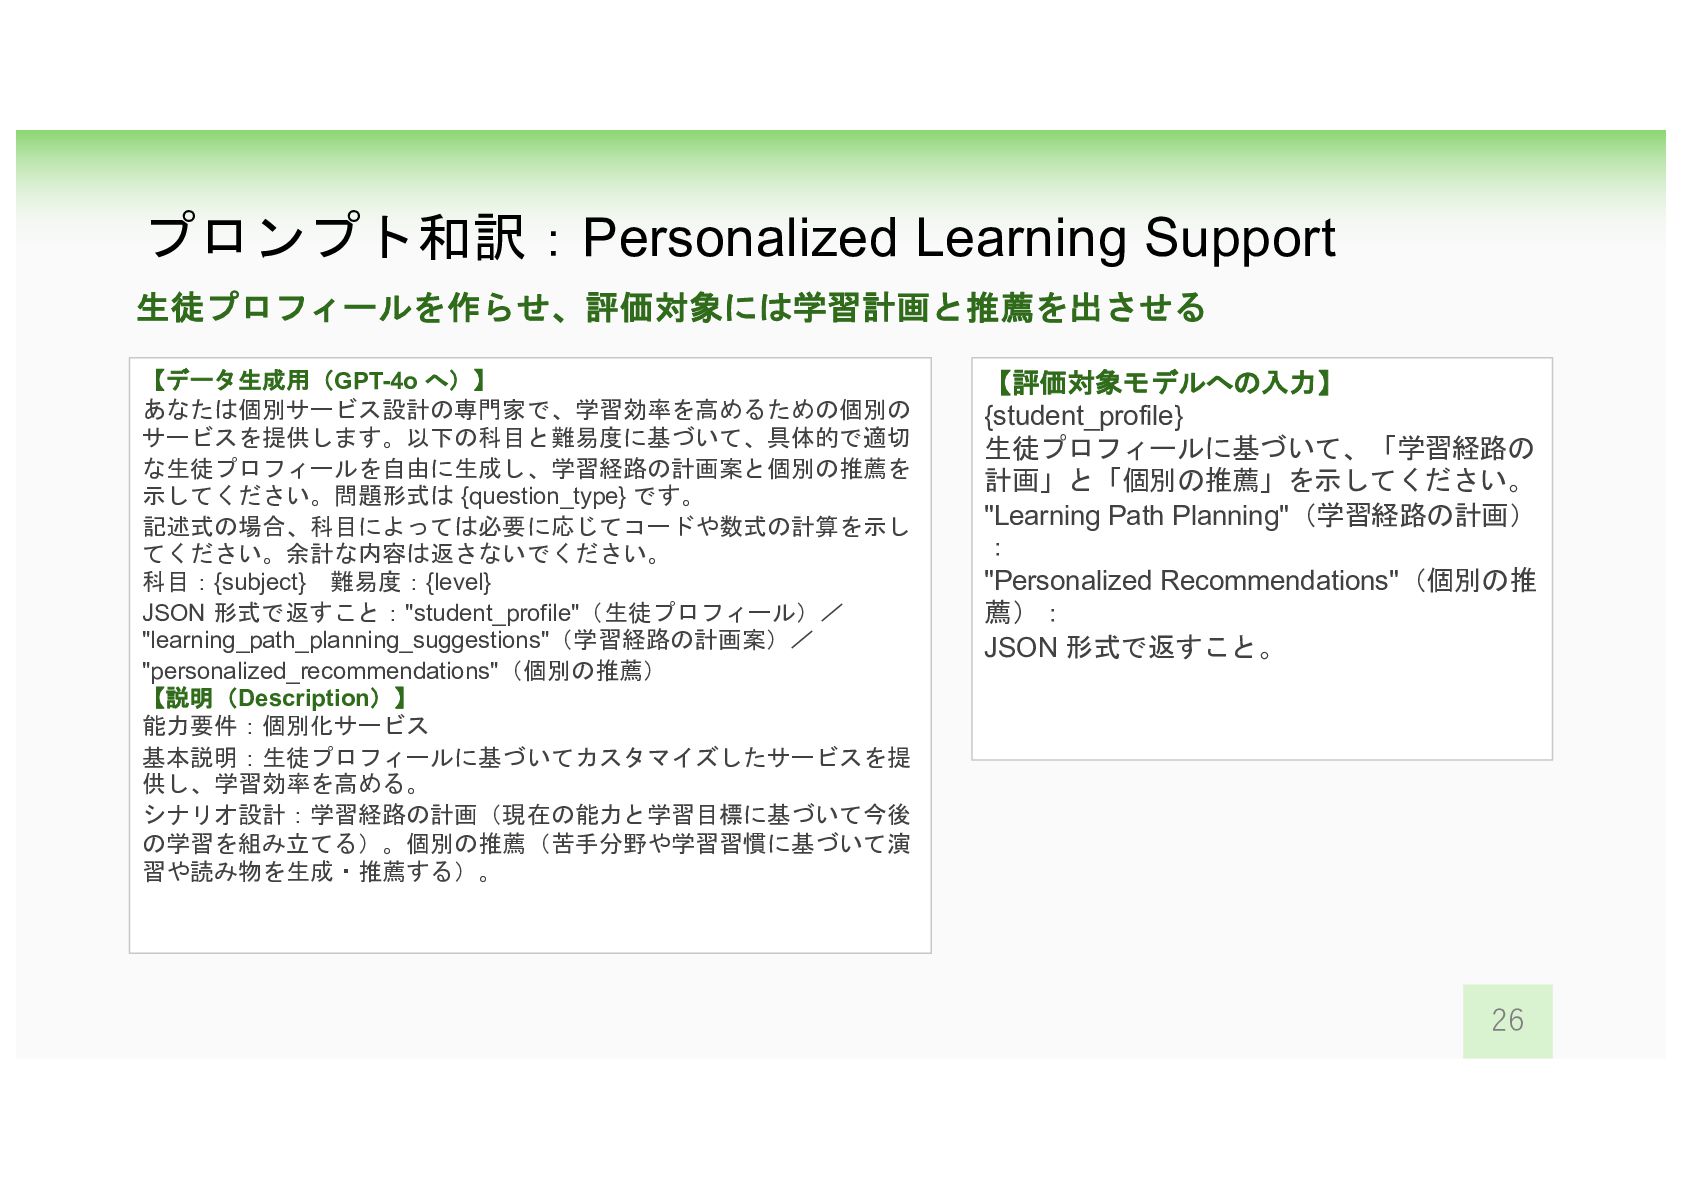
  22. プロンプト和訳:Personalized Learning Support 生徒プロフィールを作らせ、評価対象には学習計画と推薦を出させる 【データ生成用(GPT-4o へ)】 あなたは個別サービス設計の専門家で、学習効率を高めるための個別の サービスを提供します。以下の科目と難易度に基づいて、具体的で適切 な生徒プロフィールを自由に生成し、学習経路の計画案と個別の推薦を 示してください。問題形式は

    {question_type} です。 記述式の場合、科目によっては必要に応じてコードや数式の計算を示し てください。余計な内容は返さないでください。 科目:{subject} 難易度:{level} JSON 形式で返すこと:"student_profile"(生徒プロフィール)/ "learning_path_planning_suggestions"(学習経路の計画案)/ "personalized_recommendations"(個別の推薦) 【説明(Description)】 能力要件:個別化サービス 基本説明:生徒プロフィールに基づいてカスタマイズしたサービスを提 供し、学習効率を高める。 シナリオ設計:学習経路の計画(現在の能力と学習目標に基づいて今後 の学習を組み立てる)。個別の推薦(苦手分野や学習習慣に基づいて演 習や読み物を生成・推薦する)。 【評価対象モデルへの入力】 {student_profile} 生徒プロフィールに基づいて、「学習経路の 計画」と「個別の推薦」を示してください。 "Learning Path Planning"(学習経路の計画) : "Personalized Recommendations"(個別の推 薦): JSON 形式で返すこと。 26
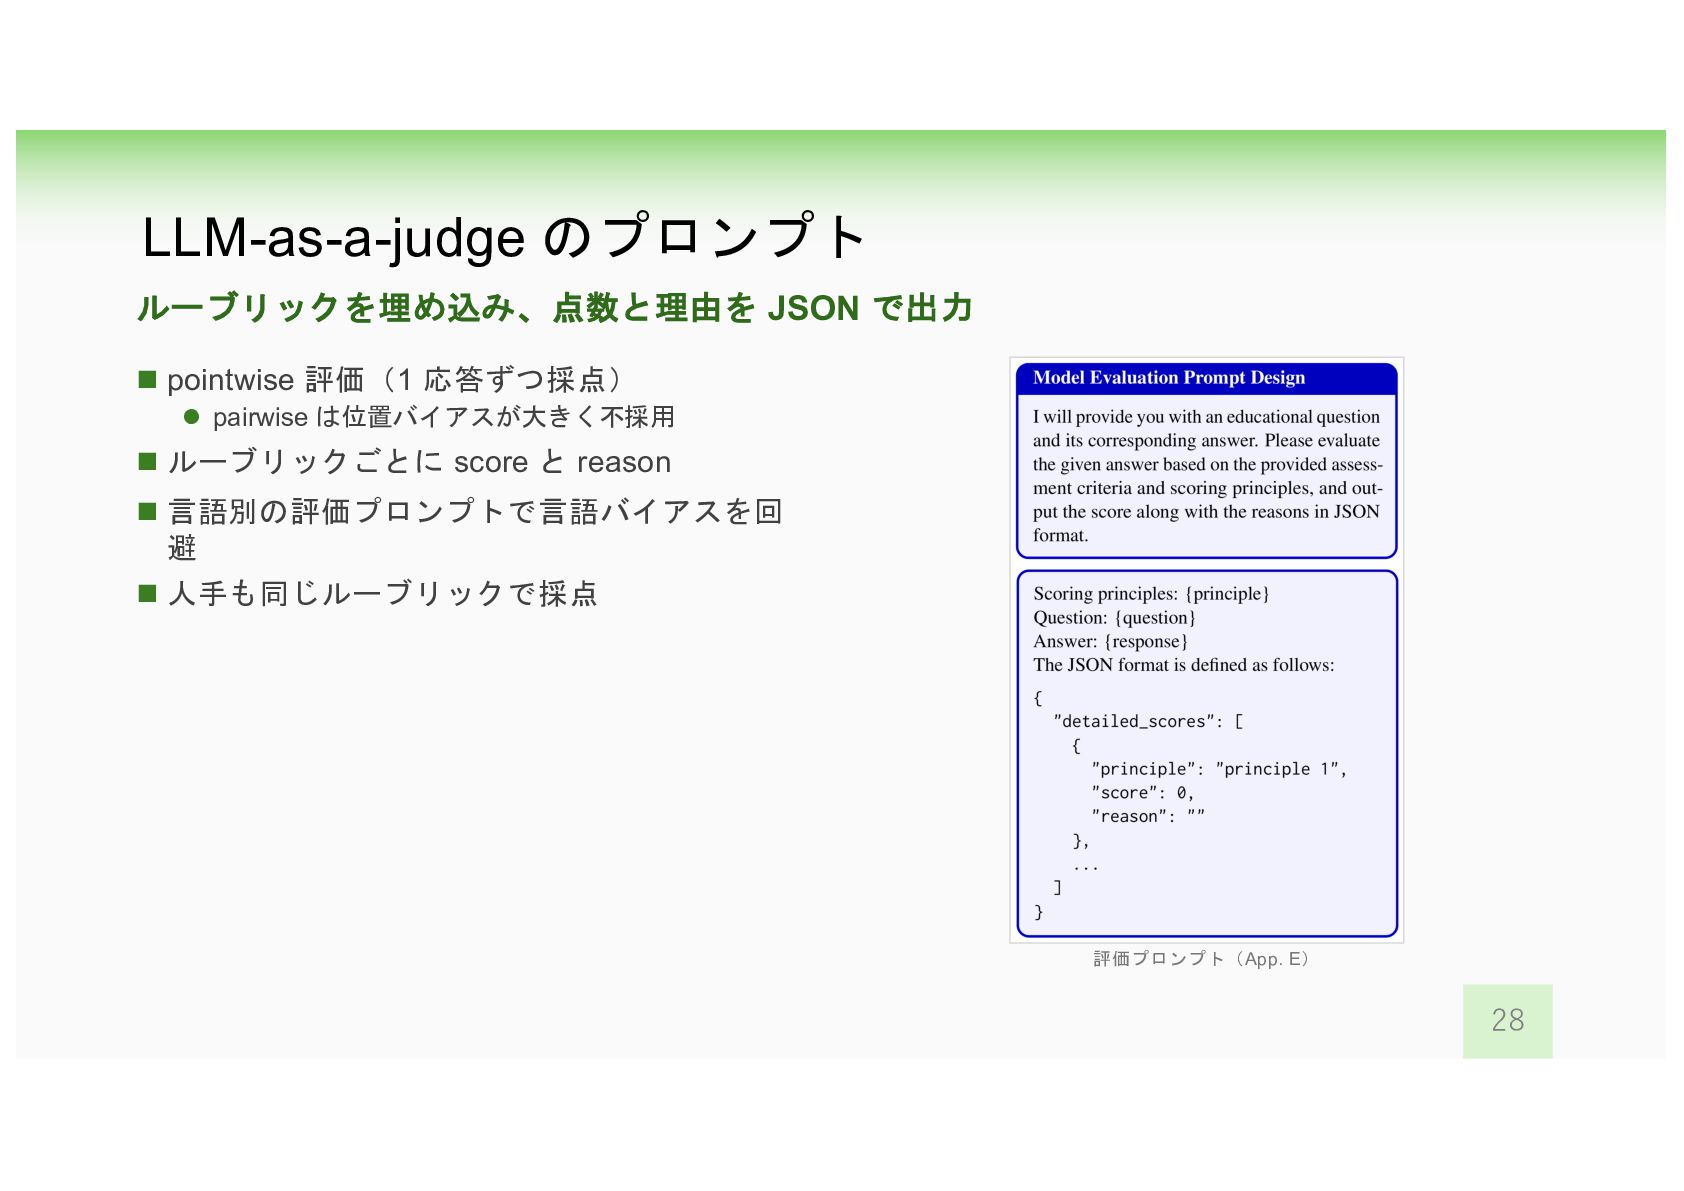
  23. LLM-as-a-judge のプロンプト ルーブリックを埋め込み、点数と理由を JSON で出力 n pointwise 評価(1 応答ずつ採点) l

    pairwise は位置バイアスが大きく不採用 n ルーブリックごとに score と reason n 言語別の評価プロンプトで言語バイアスを回 避 n 人手も同じルーブリックで採点 評価プロンプト(App. E) 28
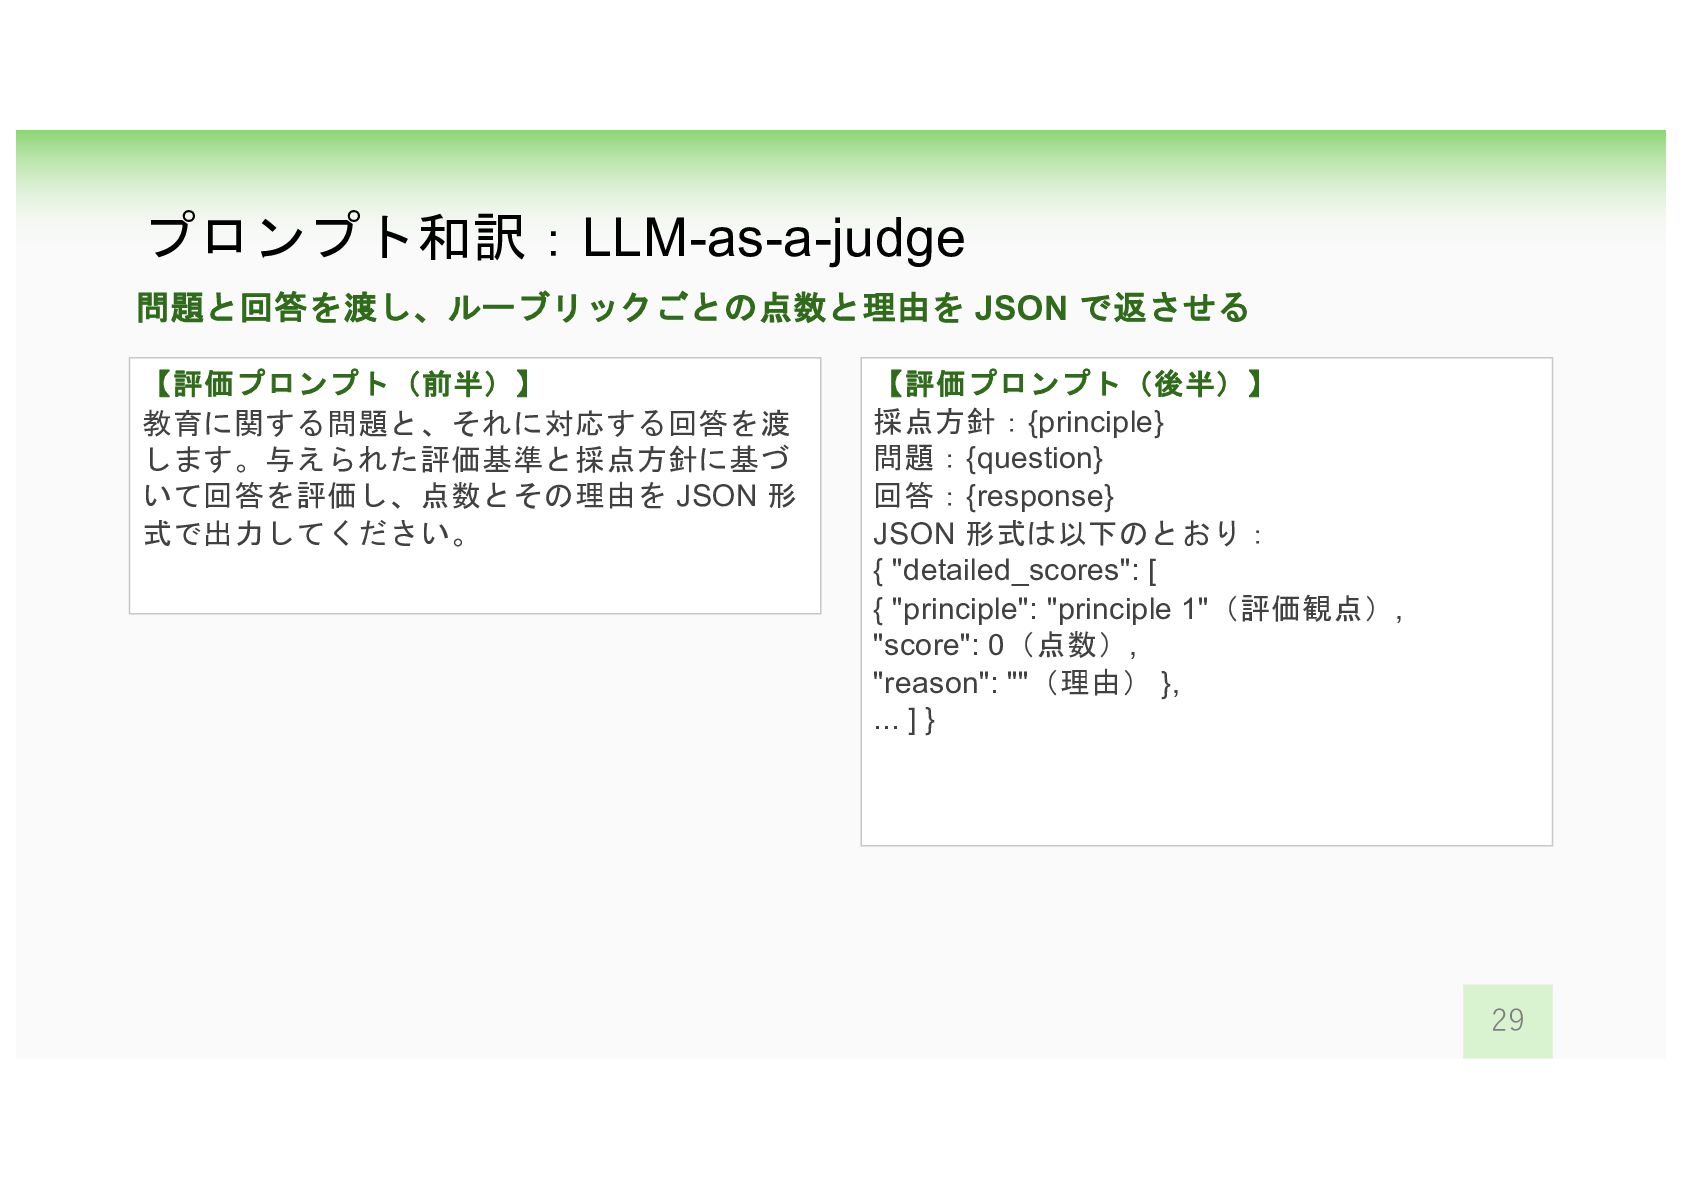
  24. プロンプト和訳:LLM-as-a-judge 問題と回答を渡し、ルーブリックごとの点数と理由を JSON で返させる 【評価プロンプト(前半)】 教育に関する問題と、それに対応する回答を渡 します。与えられた評価基準と採点方針に基づ いて回答を評価し、点数とその理由を JSON 形

    式で出力してください。 【評価プロンプト(後半)】 採点方針:{principle} 問題:{question} 回答:{response} JSON 形式は以下のとおり: { "detailed_scores": [ { "principle": "principle 1"(評価観点), "score": 0(点数), "reason": ""(理由) }, ... ] } 29
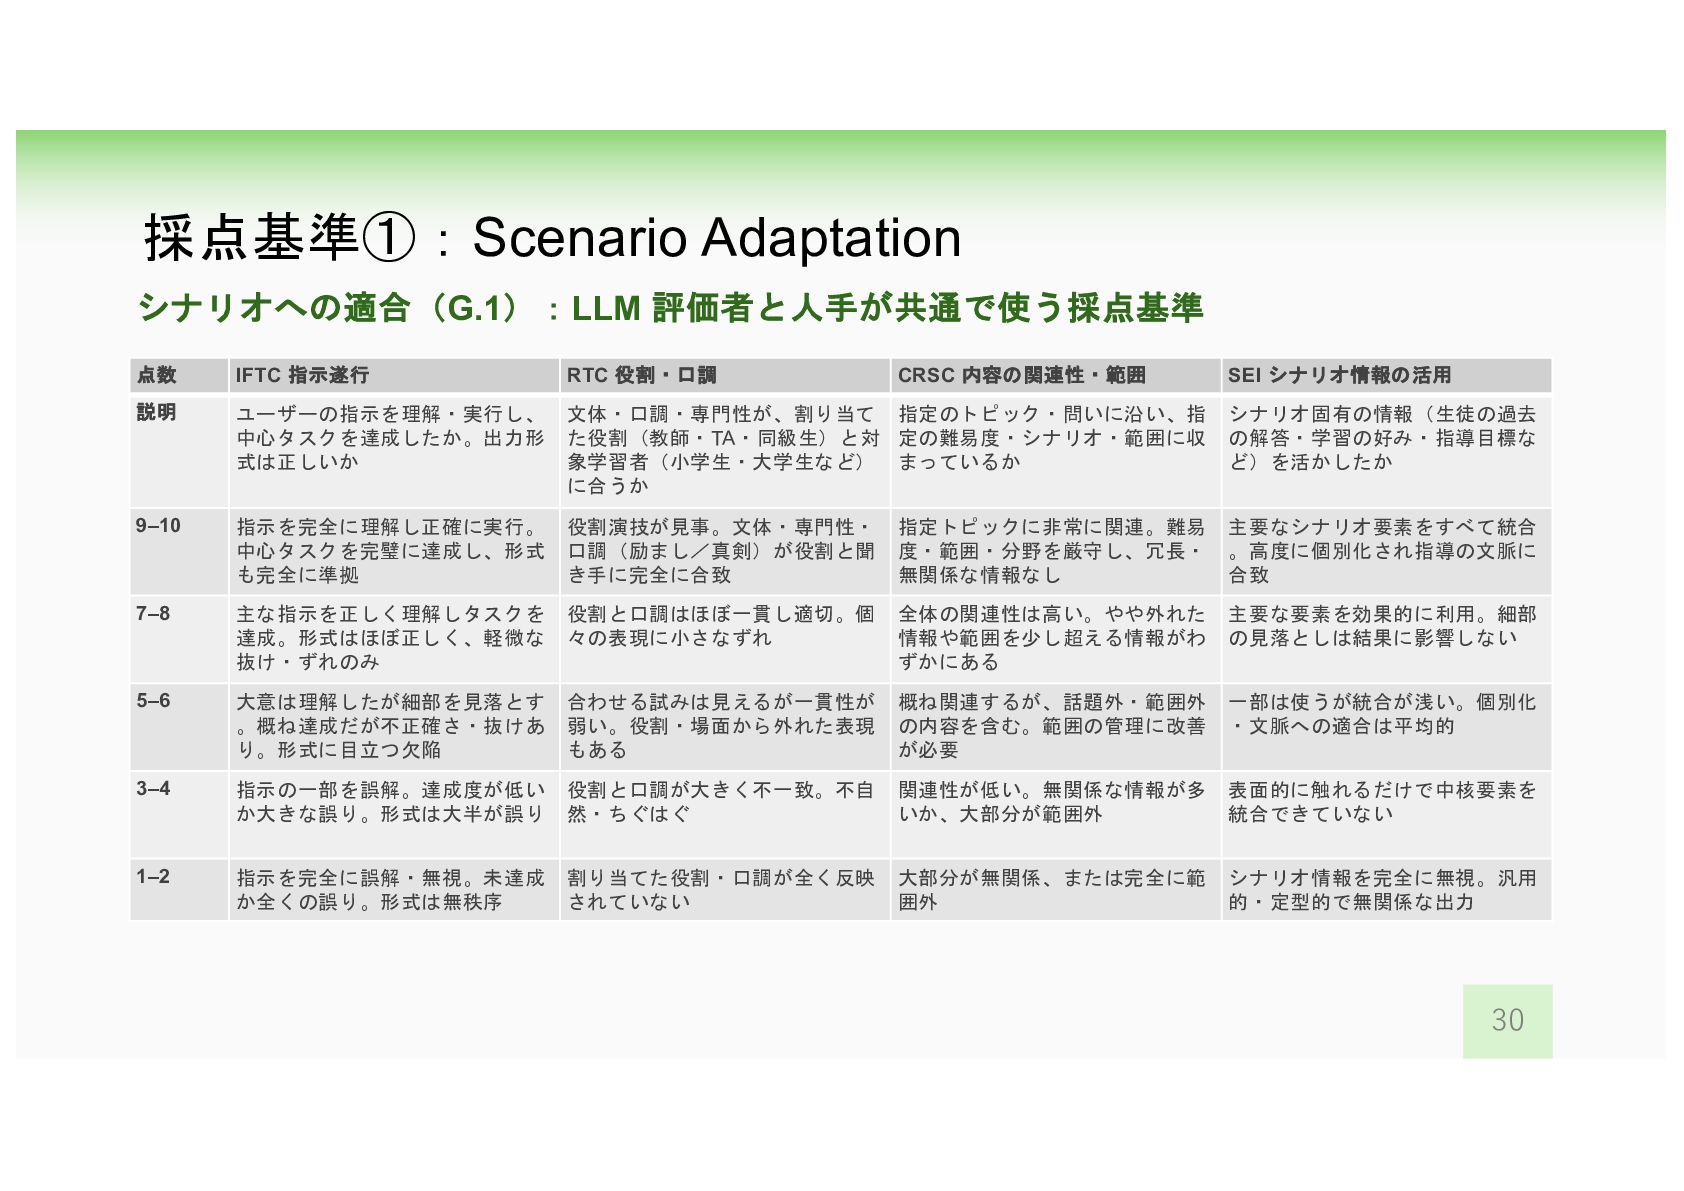
  25. 採点基準①:Scenario Adaptation シナリオへの適合(G.1):LLM 評価者と人手が共通で使う採点基準 点数 IFTC 指示遂行 RTC 役割・口調 CRSC

    内容の関連性・範囲 SEI シナリオ情報の活用 説明 ユーザーの指示を理解・実行し、 中心タスクを達成したか。出力形 式は正しいか 文体・口調・専門性が、割り当て 指定のトピック・問いに沿い、指 た役割(教師・TA・同級生)と対 定の難易度・シナリオ・範囲に収 象学習者(小学生・大学生など) まっているか に合うか シナリオ固有の情報(生徒の過去 の解答・学習の好み・指導目標な ど)を活かしたか 9–10 指示を完全に理解し正確に実行。 中心タスクを完璧に達成し、形式 も完全に準拠 役割演技が見事。文体・専門性・ 口調(励まし/真剣)が役割と聞 き手に完全に合致 指定トピックに非常に関連。難易 度・範囲・分野を厳守し、冗長・ 無関係な情報なし 主要なシナリオ要素をすべて統合 。高度に個別化され指導の文脈に 合致 7–8 主な指示を正しく理解しタスクを 達成。形式はほぼ正しく、軽微な 抜け・ずれのみ 役割と口調はほぼ一貫し適切。個 々の表現に小さなずれ 全体の関連性は高い。やや外れた 情報や範囲を少し超える情報がわ ずかにある 主要な要素を効果的に利用。細部 の見落としは結果に影響しない 5–6 大意は理解したが細部を見落とす 。概ね達成だが不正確さ・抜けあ り。形式に目立つ欠陥 合わせる試みは見えるが一貫性が 弱い。役割・場面から外れた表現 もある 概ね関連するが、話題外・範囲外 の内容を含む。範囲の管理に改善 が必要 一部は使うが統合が浅い。個別化 ・文脈への適合は平均的 3–4 指示の一部を誤解。達成度が低い か大きな誤り。形式は大半が誤り 役割と口調が大きく不一致。不自 然・ちぐはぐ 関連性が低い。無関係な情報が多 いか、大部分が範囲外 表面的に触れるだけで中核要素を 統合できていない 1–2 指示を完全に誤解・無視。未達成 か全くの誤り。形式は無秩序 割り当てた役割・口調が全く反映 されていない 大部分が無関係、または完全に範 囲外 シナリオ情報を完全に無視。汎用 的・定型的で無関係な出力 30
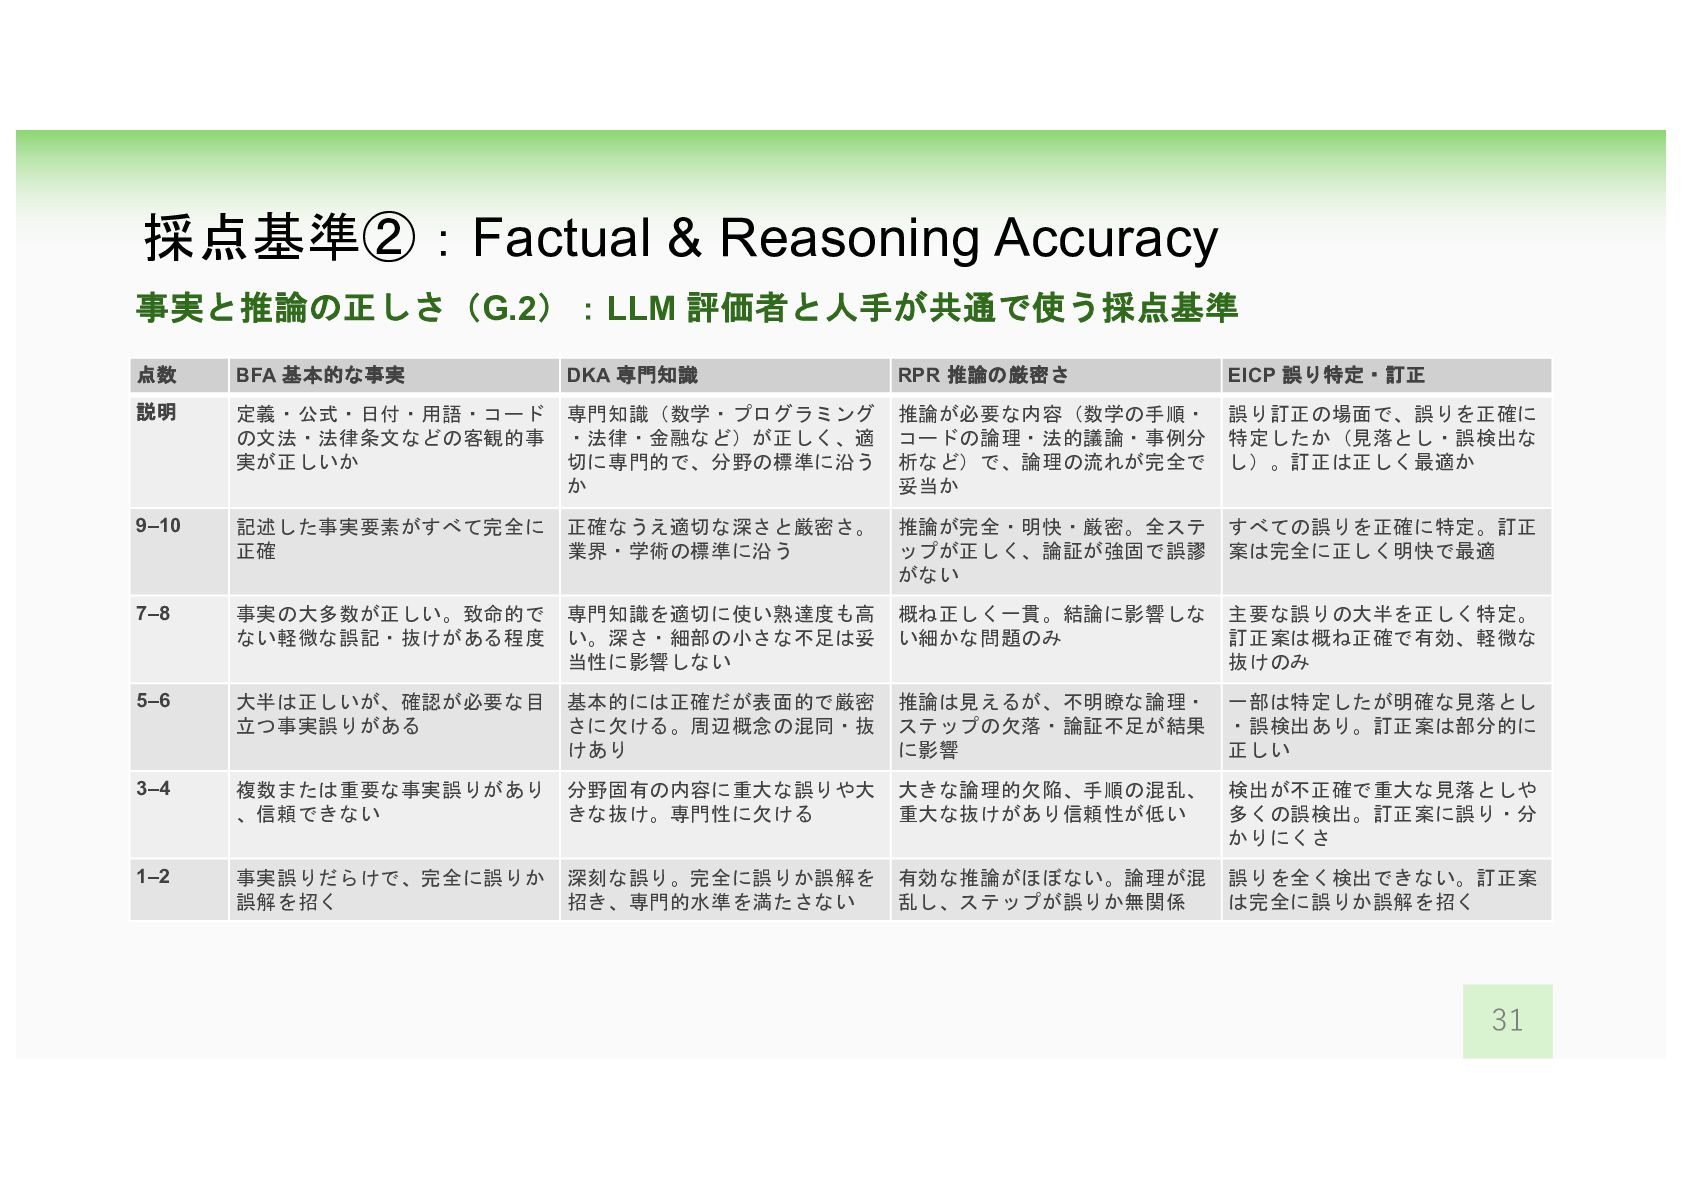
  26. 採点基準②:Factual & Reasoning Accuracy 事実と推論の正しさ(G.2):LLM 評価者と人手が共通で使う採点基準 点数 BFA 基本的な事実 DKA

    専門知識 RPR 推論の厳密さ EICP 誤り特定・訂正 説明 定義・公式・日付・用語・コード の文法・法律条文などの客観的事 実が正しいか 専門知識(数学・プログラミング ・法律・金融など)が正しく、適 切に専門的で、分野の標準に沿う か 推論が必要な内容(数学の手順・ コードの論理・法的議論・事例分 析など)で、論理の流れが完全で 妥当か 誤り訂正の場面で、誤りを正確に 特定したか(見落とし・誤検出な し)。訂正は正しく最適か 9–10 記述した事実要素がすべて完全に 正確 正確なうえ適切な深さと厳密さ。 業界・学術の標準に沿う 推論が完全・明快・厳密。全ステ ップが正しく、論証が強固で誤謬 がない すべての誤りを正確に特定。訂正 案は完全に正しく明快で最適 7–8 事実の大多数が正しい。致命的で ない軽微な誤記・抜けがある程度 専門知識を適切に使い熟達度も高 い。深さ・細部の小さな不足は妥 当性に影響しない 概ね正しく一貫。結論に影響しな い細かな問題のみ 主要な誤りの大半を正しく特定。 訂正案は概ね正確で有効、軽微な 抜けのみ 5–6 大半は正しいが、確認が必要な目 立つ事実誤りがある 基本的には正確だが表面的で厳密 さに欠ける。周辺概念の混同・抜 けあり 推論は見えるが、不明瞭な論理・ ステップの欠落・論証不足が結果 に影響 一部は特定したが明確な見落とし ・誤検出あり。訂正案は部分的に 正しい 3–4 複数または重要な事実誤りがあり 、信頼できない 分野固有の内容に重大な誤りや大 きな抜け。専門性に欠ける 大きな論理的欠陥、手順の混乱、 重大な抜けがあり信頼性が低い 検出が不正確で重大な見落としや 多くの誤検出。訂正案に誤り・分 かりにくさ 1–2 事実誤りだらけで、完全に誤りか 誤解を招く 深刻な誤り。完全に誤りか誤解を 招き、専門的水準を満たさない 有効な推論がほぼない。論理が混 乱し、ステップが誤りか無関係 誤りを全く検出できない。訂正案 は完全に誤りか誤解を招く 31
  27. 採点基準③:Pedagogical Application 教育的効果(G.3):LLM 評価者と人手が共通で使う採点基準 点数 CSI 明快さ・刺激 MGP 動機づけ・導き PAS

    個別化・学習支援 HOTS 高次思考の育成 説明 説明やフィードバックが明快・簡 潔で対象学習者に分かりやすいか 。考えを促す伝え方か 励ましと支援があり、建設的・肯 定的な言葉を使うか。答えを与え るだけでなく思考を導くか 生徒のレベル・特性・ニーズに応 じて内容や助言を変えられるか。 効果的な学習経路や資料を推薦す るか 批判的思考・創造性・問題解決・ 知識の転移といった力を育てるか 9–10 極めて明快・簡潔で完全に理解で きる。生き生きとして深い思考と 興味を引き出す 強く支援的で励ます。一貫して肯 定的な言葉。答えを与えず効果的 に考えを導く 高度に個別化。資料や学習経路の 提案が正確・実用的で価値が高い 高次思考を促すよう巧みに設計( 自由回答の問い・比較分析・事例 研究・プロジェクト型課題など) 7–8 明快で分かりやすく学習者のレベ ルに合う。ある程度考えを促す 概ね支援的で肯定的。有用な導き だが時に直接的すぎる 生徒の状況にある程度適応。関連 する助言や資料を示し有用性が高 い 導く問いや適度に挑戦的な課題で 、分析・評価・応用を後押し 5–6 概ね理解できるが冗長・複雑・単 調なことがある。刺激は限定的 励ましと中立・批判的な言葉が混 在。導きが一貫せず、直接的すぎ たり不足したり 個別化を試みるが効果は限定的。 推薦は一般的で価値が低い 簡単な振り返りの問いなど試みは あるが、深さ・範囲が限られ暗記 ・基本的応用が中心 3–4 明快さに欠け、専門用語や複雑な 構造が多く理解しにくい 励ましや支援に欠け、中立〜やや 否定的。ほぼ導かず答えるだけ 個別化がほぼなく誰にでも同じ出 力。学習支援が不十分か無関係 主に記憶と理解に終始し、高次思 考の課題はほとんどない 1–2 混乱していて追えない。学習者の ニーズを無視し、混乱を招くこと も 否定的で意欲をくじく口調。支援 がなく、誤った方向へ導く 個別化なし。ニーズと矛盾するこ ともあり、支援がないか誤り 高次の力の育成を完全に無視。丸 暗記と反復を促し、思考の柔軟性 を妨げることも 32
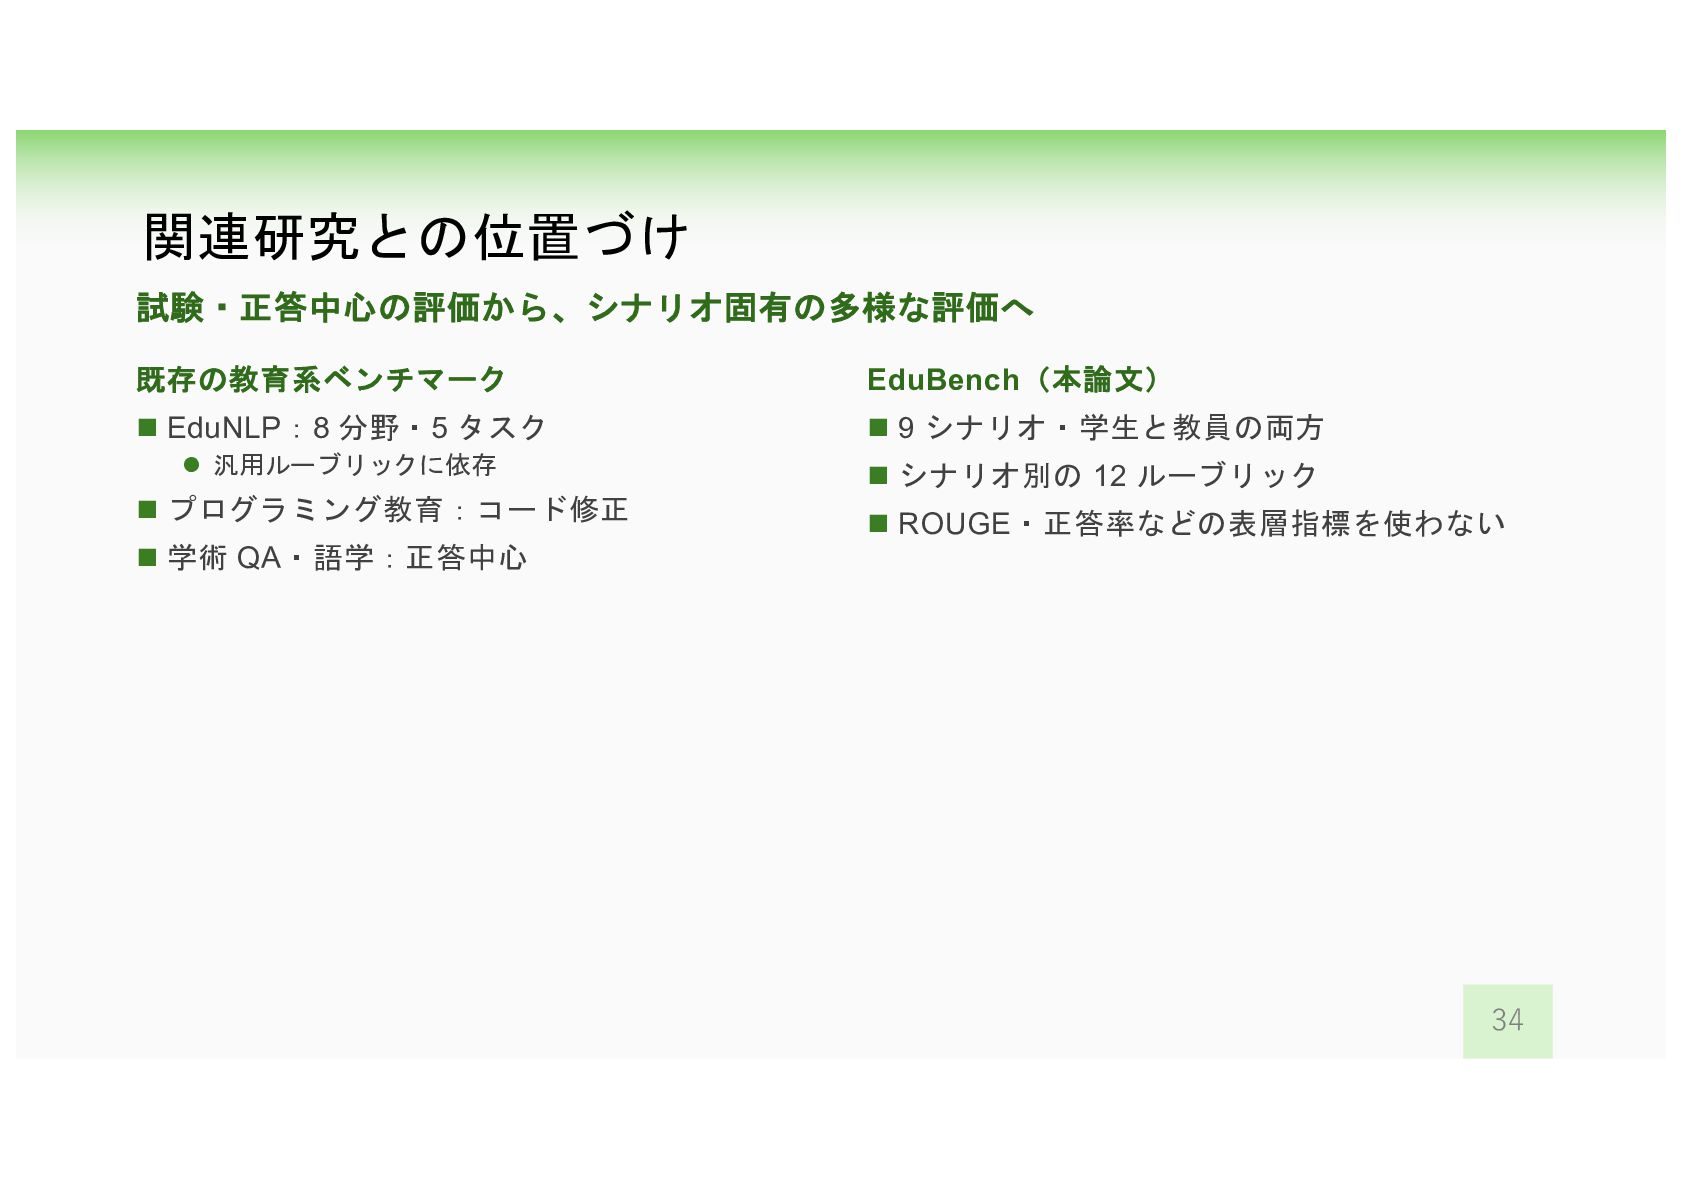
  28. 関連研究との位置づけ 試験・正答中心の評価から、シナリオ固有の多様な評価へ 既存の教育系ベンチマーク EduBench(本論文) n EduNLP:8 分野・5 タスク n 9

    シナリオ・学生と教員の両方 l 汎用ルーブリックに依存 n シナリオ別の 12 ルーブリック n プログラミング教育:コード修正 n ROUGE・正答率などの表層指標を使わない n 学術 QA・語学:正答中心 34