Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AI技術共有会資料_LLM強化学習手法のまとめ

Avatar for K K
December 16, 2025
25

 AI技術共有会資料_LLM強化学習手法のまとめ

LLMの強化学習について、ChatGPTの元となったInstructGPTから最近のReasoningモデルがどのようにして学習されているかをまとめました

Avatar for K

K

December 16, 2025

Transcript

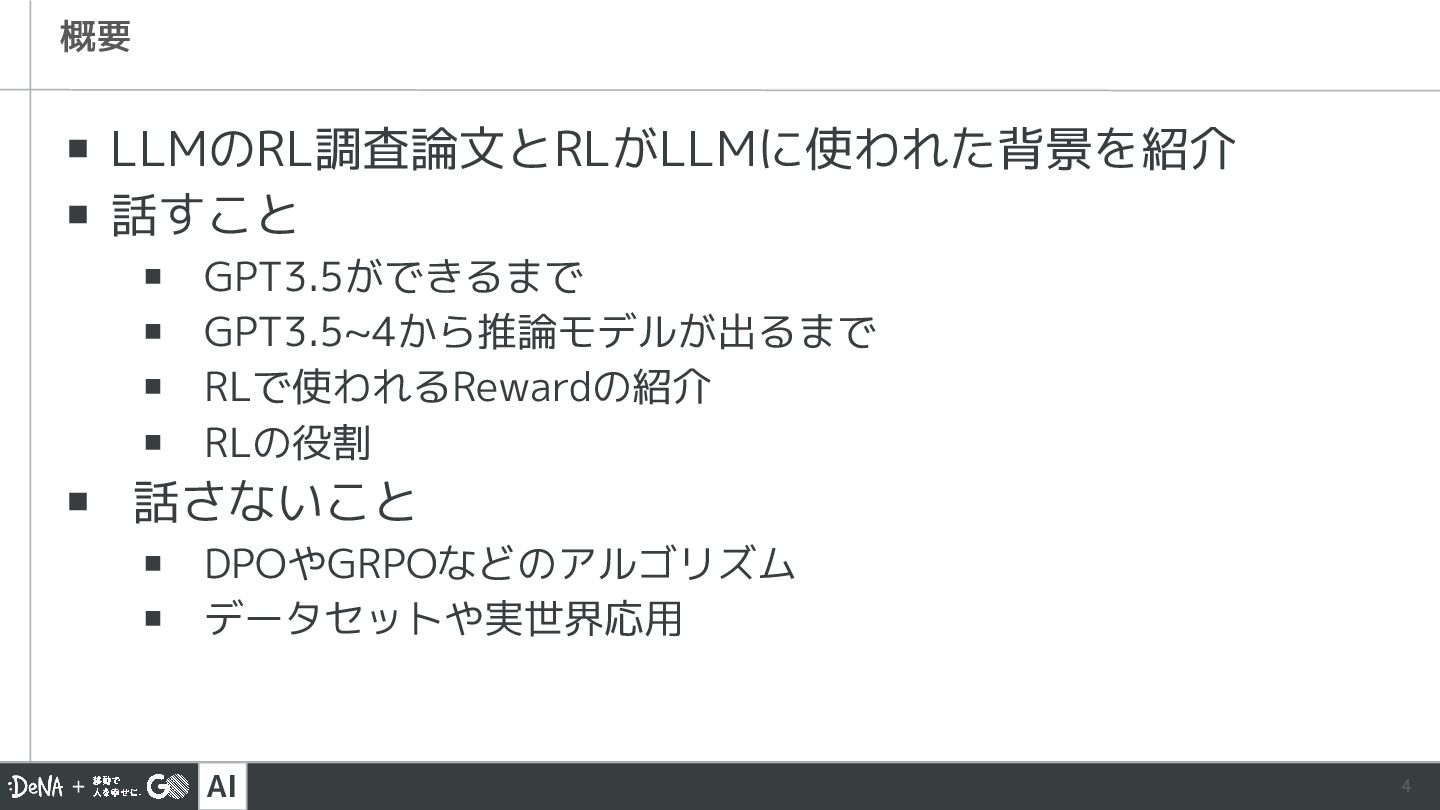
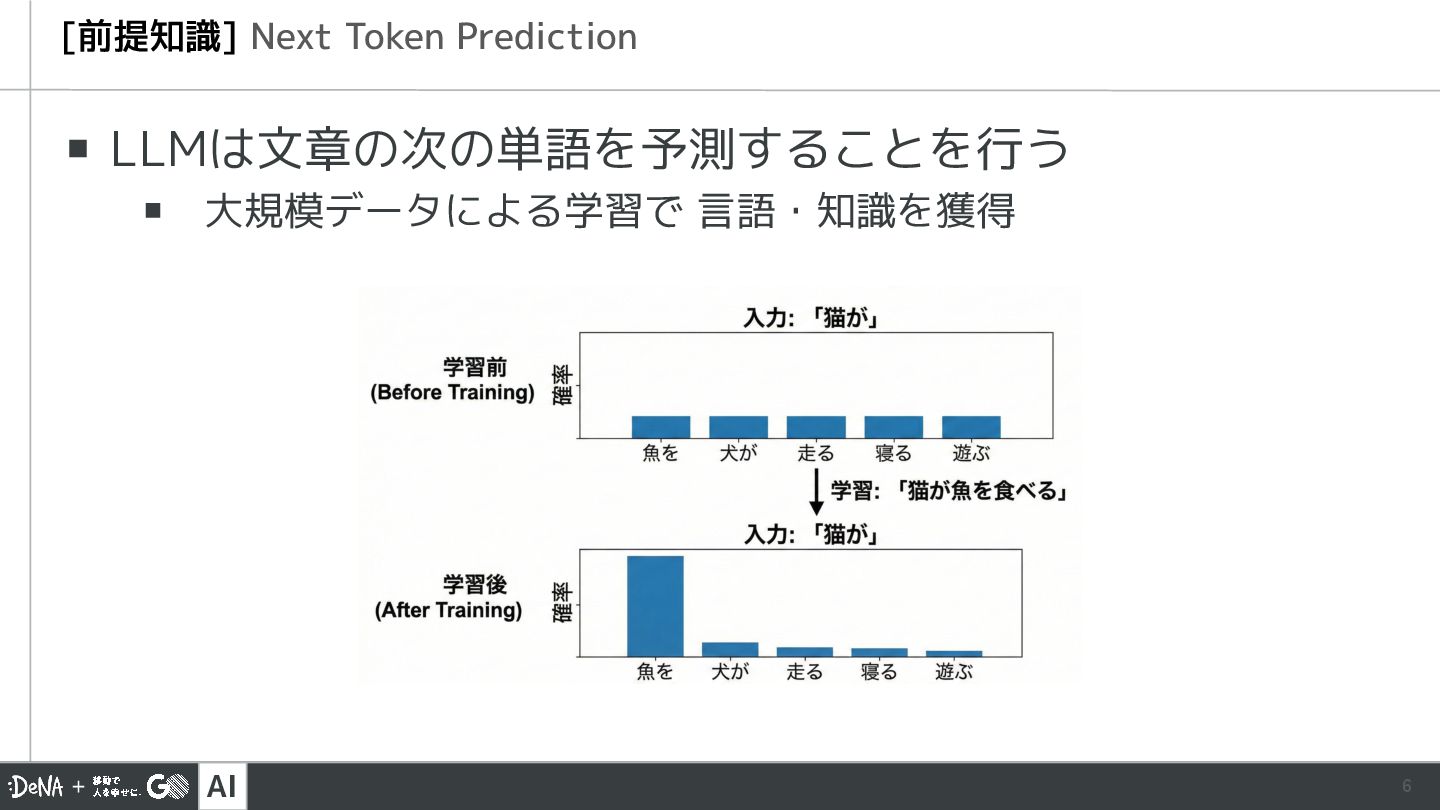
  1. AI 4 ▪ LLMのRL調査論文とRLがLLMに使われた背景を紹介 ▪ 話すこと ▪ GPT3.5ができるまで ▪ GPT3.5~4から推論モデルが出るまで

    ▪ RLで使われるRewardの紹介 ▪ RLの役割 ▪ 話さないこと ▪ DPOやGRPOなどのアルゴリズム ▪ データセットや実世界応用 概要
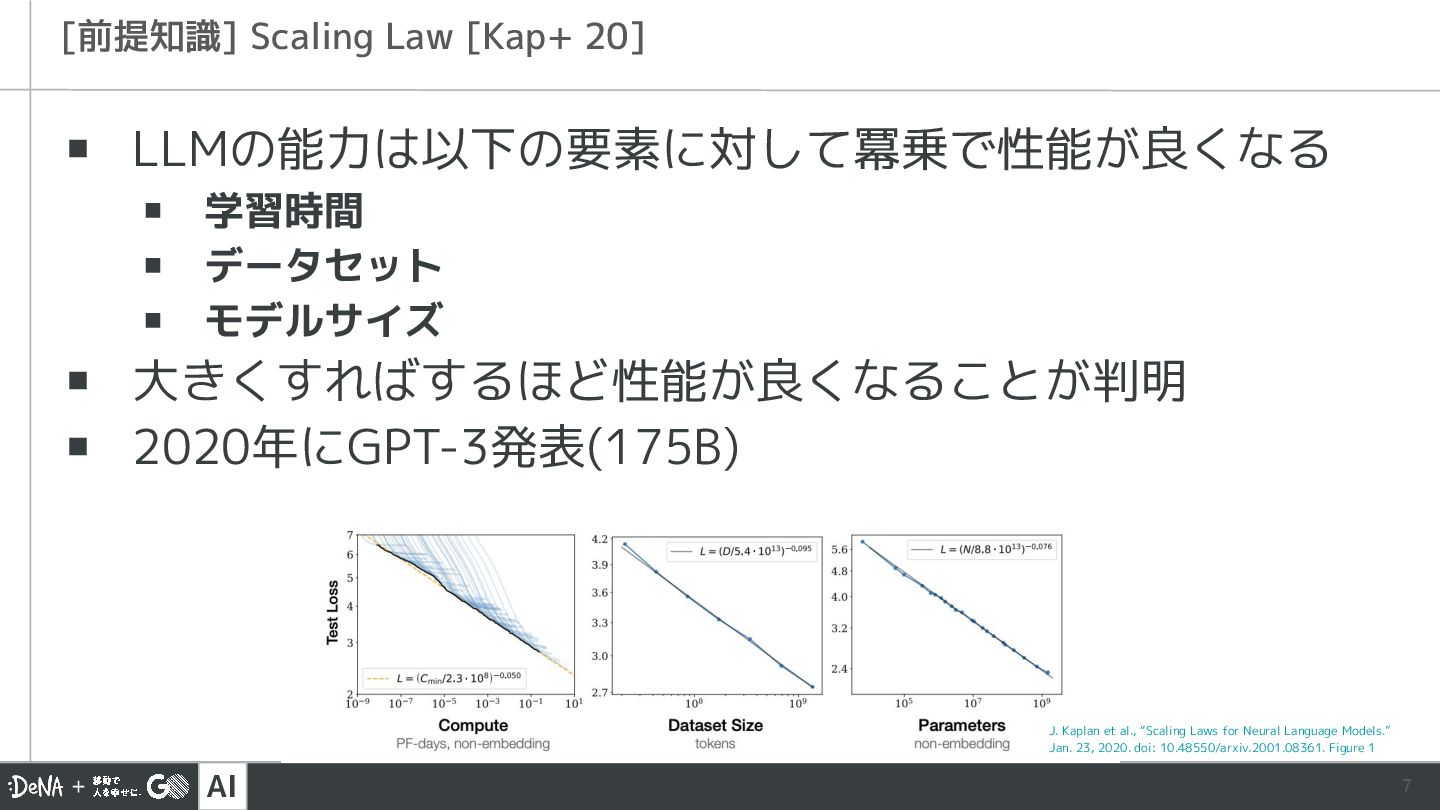
  2. AI 7 ▪ LLMの能力は以下の要素に対して冪乗で性能が良くなる ▪ 学習時間 ▪ データセット ▪ モデルサイズ

    ▪ 大きくすればするほど性能が良くなることが判明 ▪ 2020年にGPT-3発表(175B) [前提知識] Scaling Law [Kap+ 20] J. Kaplan et al., “Scaling Laws for Neural Language Models.” Jan. 23, 2020. doi: 10.48550/arxiv.2001.08361. Figure 1
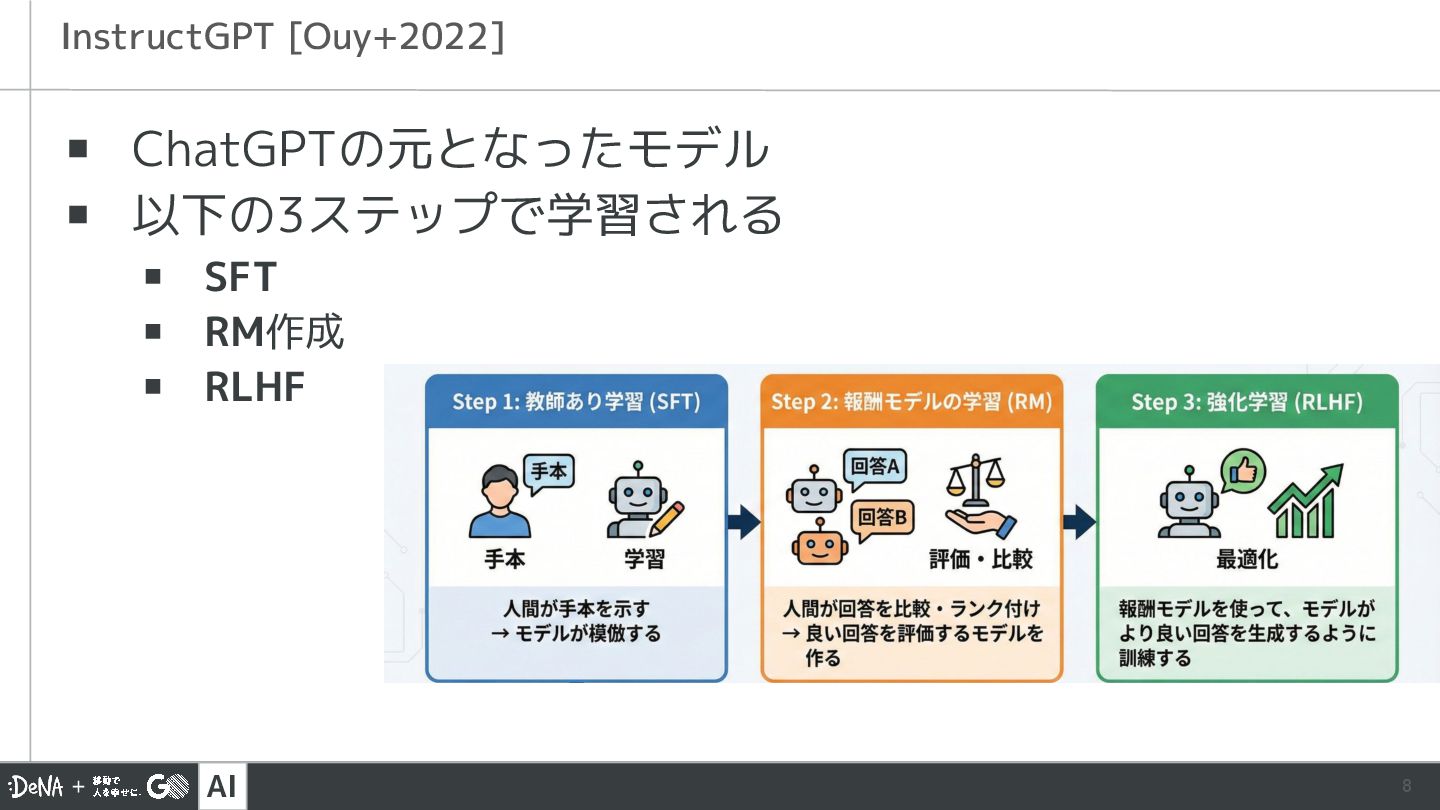
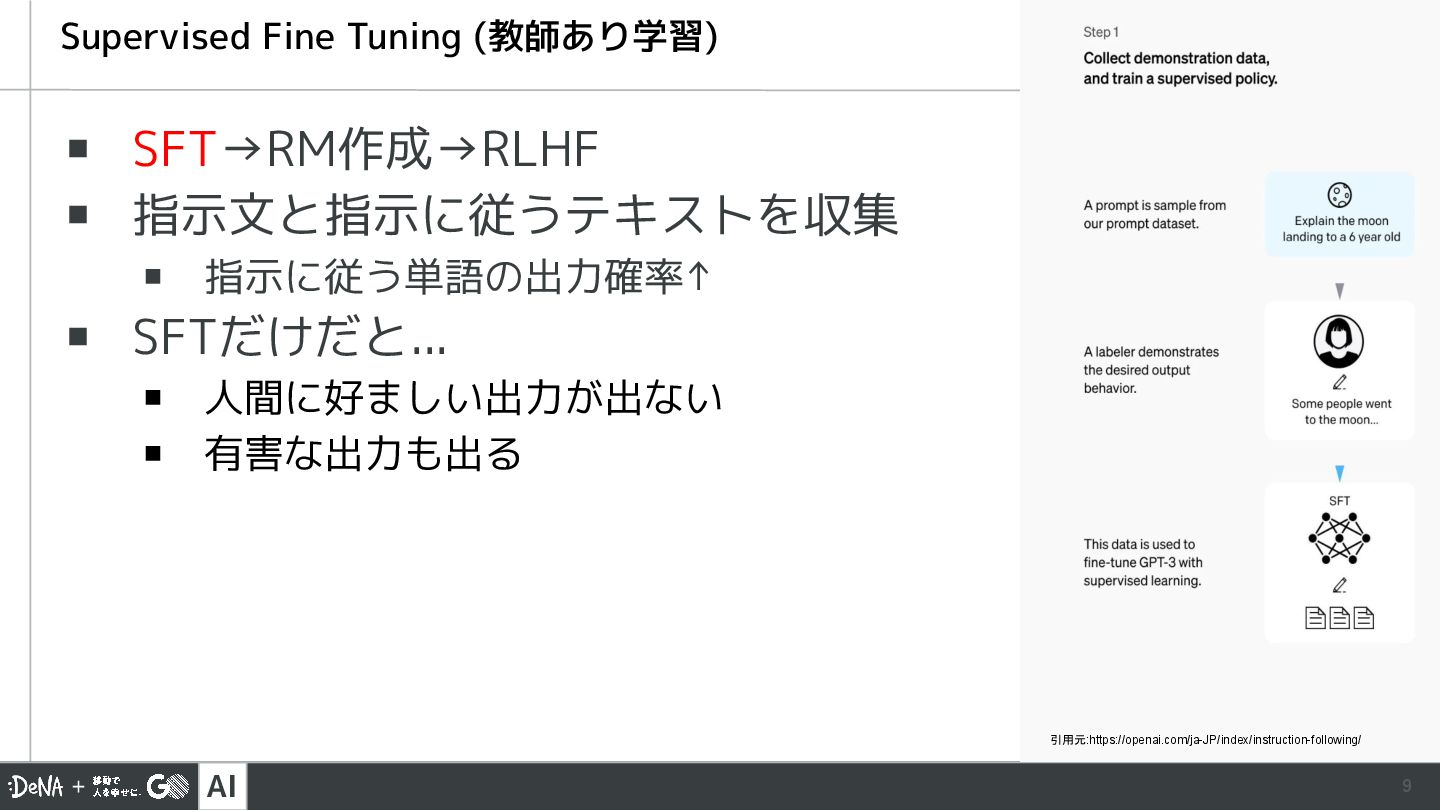
  3. AI 9 ▪ SFT→RM作成→RLHF ▪ 指示文と指示に従うテキストを収集 ▪ 指示に従う単語の出力確率↑ ▪ SFTだけだと...

    ▪ 人間に好ましい出力が出ない ▪ 有害な出力も出る Supervised Fine Tuning (教師あり学習) 引用元:https://openai.com/ja-JP/index/instruction-following/
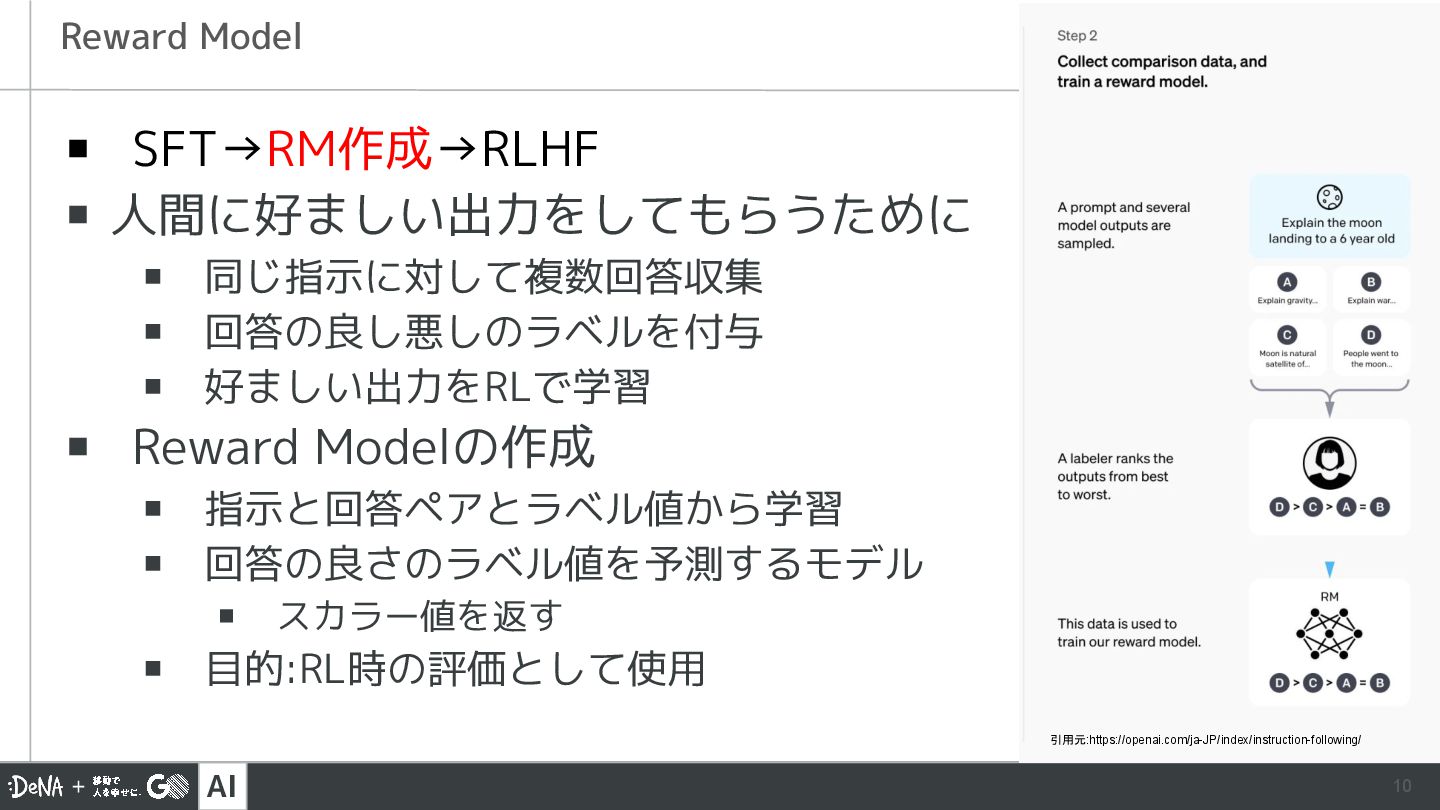
  4. AI 10 ▪ SFT→RM作成→RLHF ▪ 人間に好ましい出力をしてもらうために ▪ 同じ指示に対して複数回答収集 ▪ 回答の良し悪しのラベルを付与

    ▪ 好ましい出力をRLで学習 ▪ Reward Modelの作成 ▪ 指示と回答ペアとラベル値から学習 ▪ 回答の良さのラベル値を予測するモデル ▪ スカラー値を返す ▪ 目的:RL時の評価として使用 Reward Model 引用元:https://openai.com/ja-JP/index/instruction-following/
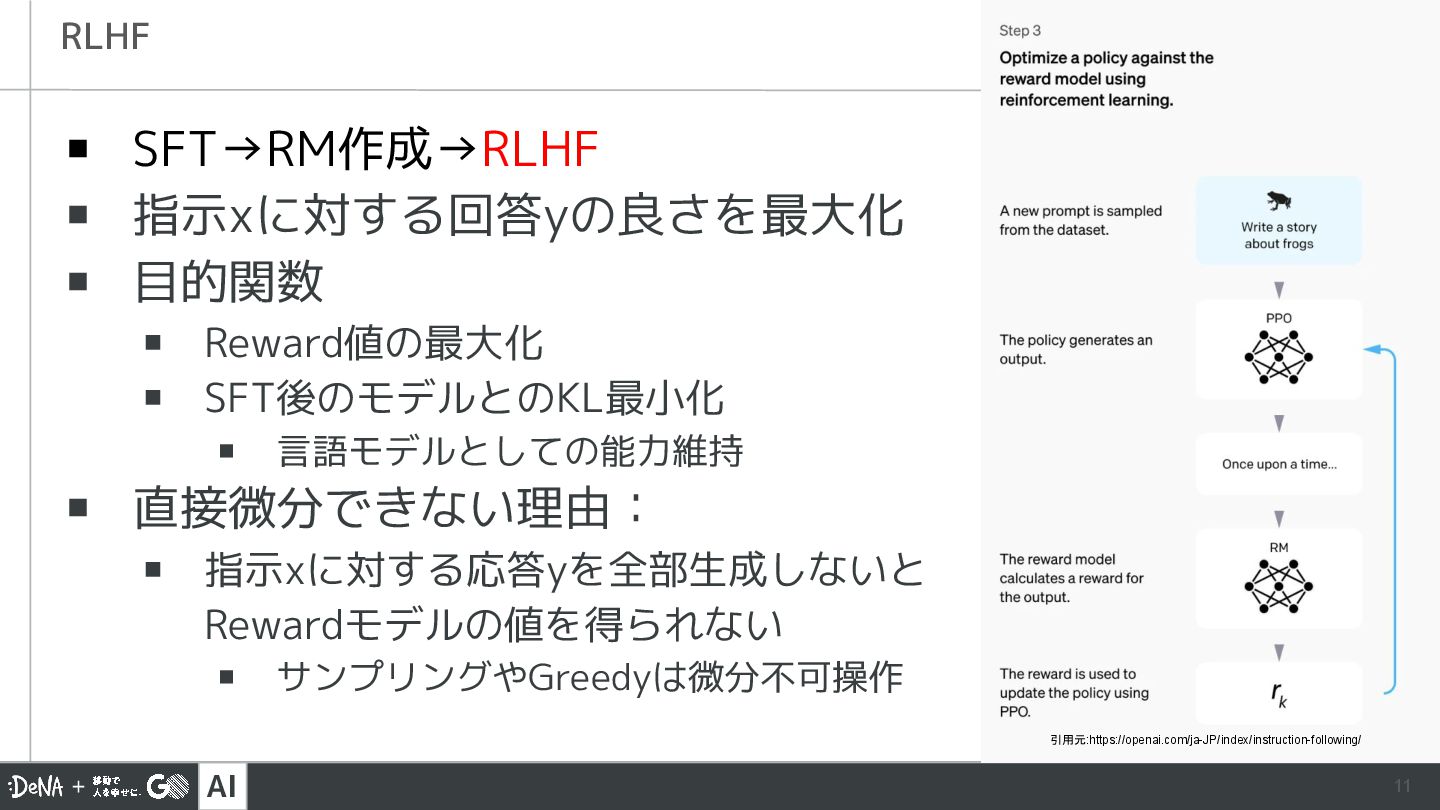
  5. AI 11 ▪ SFT→RM作成→RLHF ▪ 指示xに対する回答yの良さを最大化 ▪ 目的関数 ▪ Reward値の最大化

    ▪ SFT後のモデルとのKL最小化 ▪ 言語モデルとしての能力維持 ▪ 直接微分できない理由: ▪ 指示xに対する応答yを全部生成しないと Rewardモデルの値を得られない ▪ サンプリングやGreedyは微分不可操作 RLHF 引用元:https://openai.com/ja-JP/index/instruction-following/
  6. AI 12 ▪ InstructGPTをベースとしてChatGPTをリリース ▪ これまでの流れ ▪ 言語モデルの大規模化 ▪ InstructGPT

    ▪ データ ▪ 指示とそれに従うテキストデータ ▪ 人間に好ましい回答と好ましくない回答 ▪ SFT→RM作成→RLHF ▪ 人が好む出力ができるようになった ChatGPTリリース (2022.11)
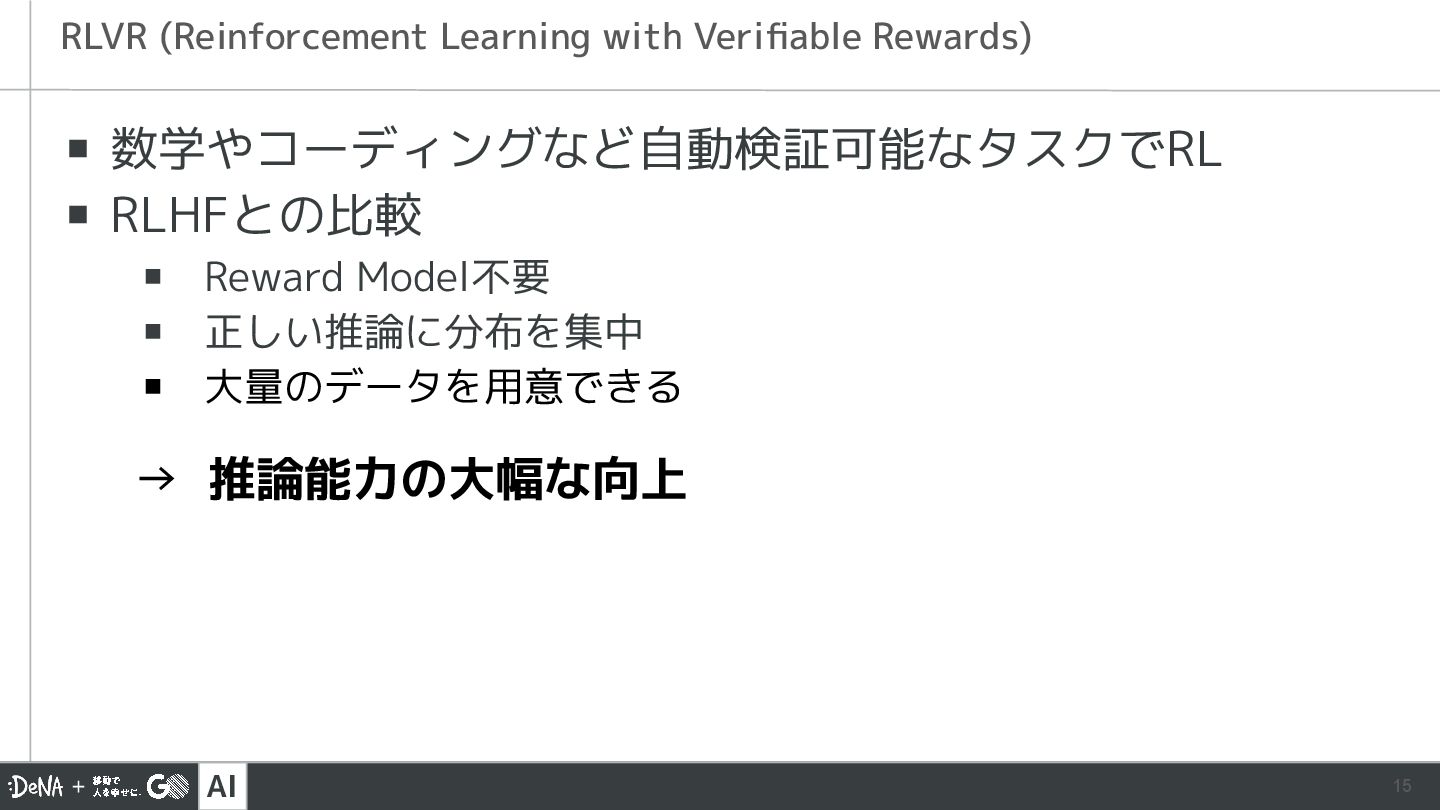
  7. AI 15 ▪ 数学やコーディングなど自動検証可能なタスクでRL ▪ RLHFとの比較 ▪ Reward Model不要 ▪

    正しい推論に分布を集中 ▪ 大量のデータを用意できる → 推論能力の大幅な向上 RLVR (Reinforcement Learning with Verifiable Rewards)
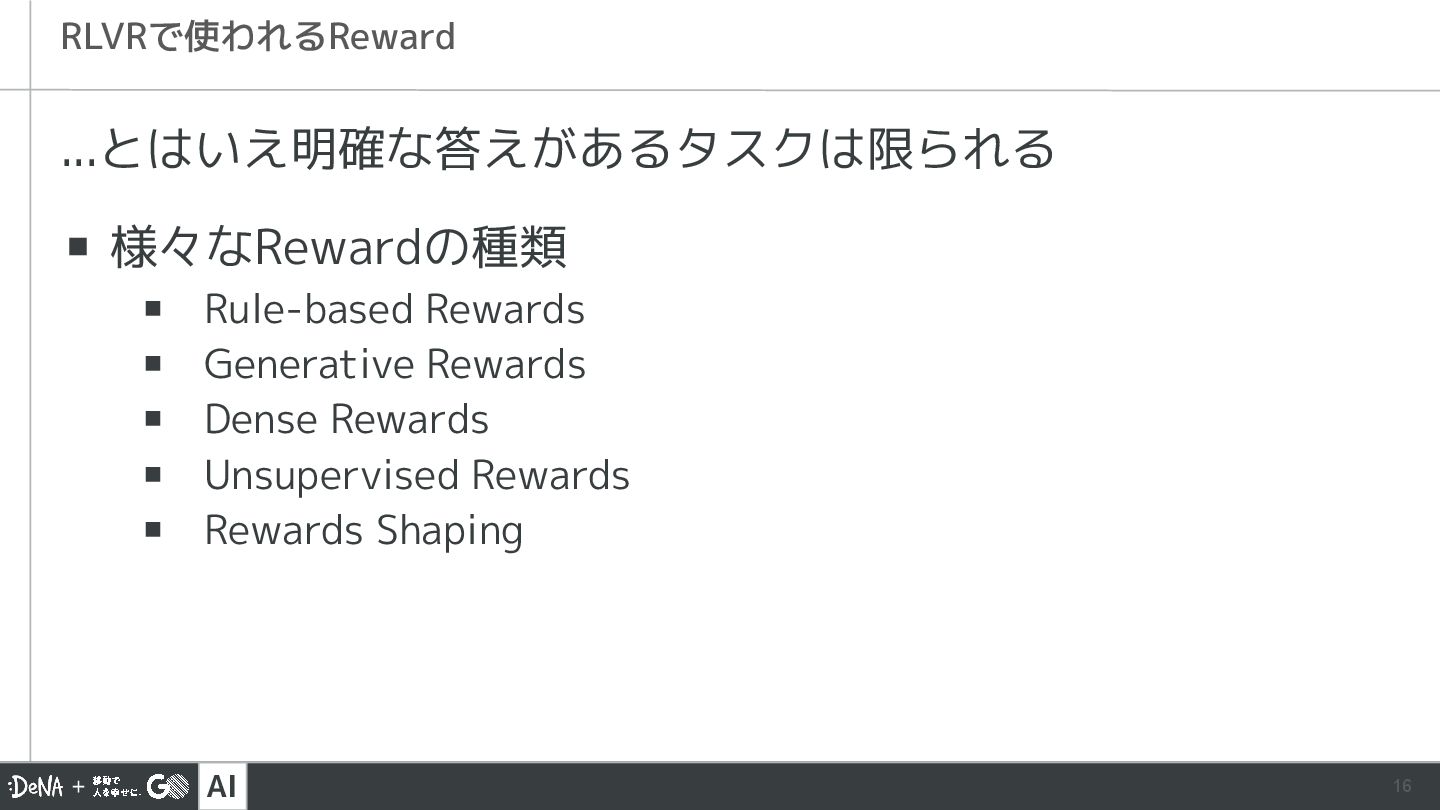
  8. AI 16 ...とはいえ明確な答えがあるタスクは限られる ▪ 様々なRewardの種類 ▪ Rule-based Rewards ▪ Generative

    Rewards ▪ Dense Rewards ▪ Unsupervised Rewards ▪ Rewards Shaping RLVRで使われるReward
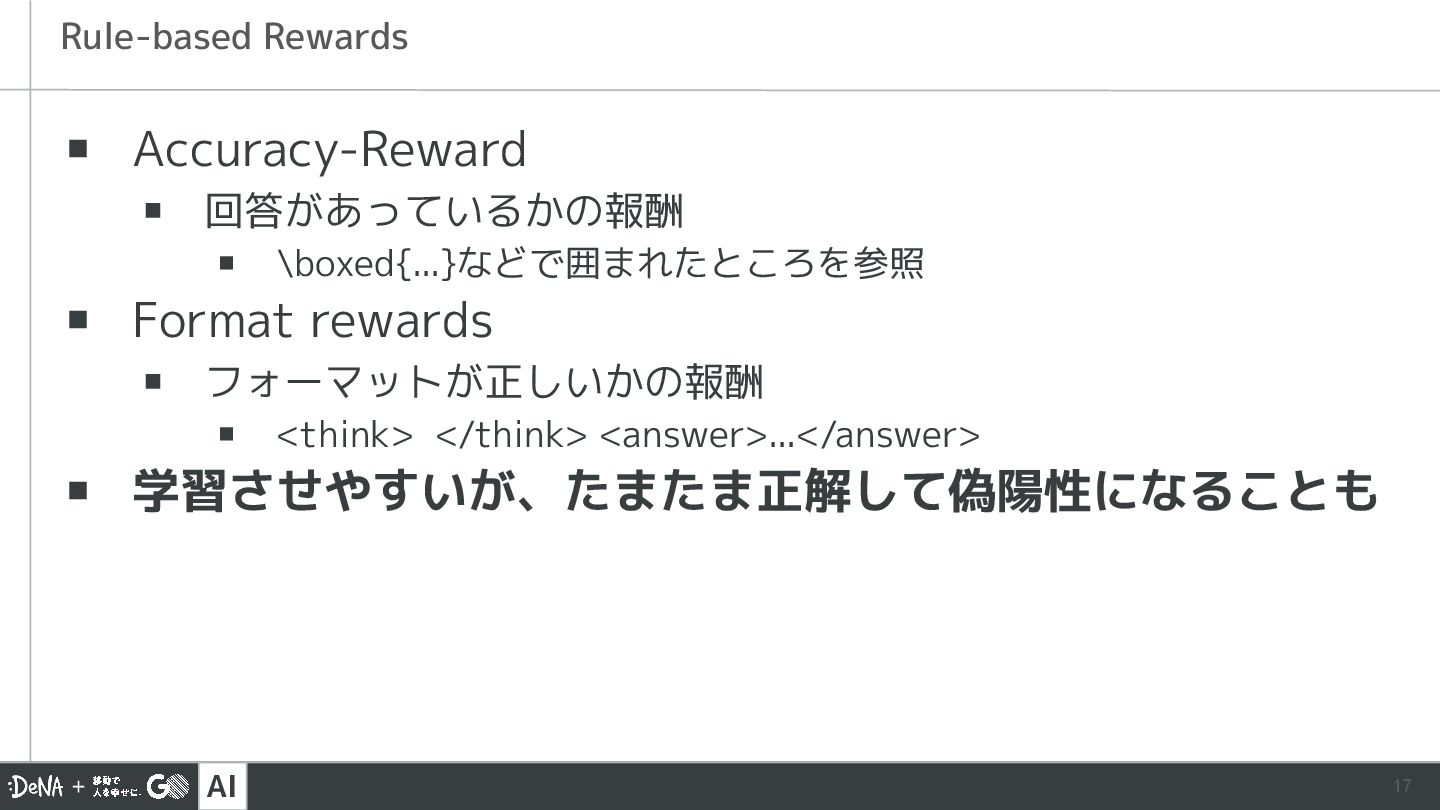
  9. AI 17 ▪ Accuracy-Reward ▪ 回答があっているかの報酬 ▪ \boxed{...}などで囲まれたところを参照 ▪ Format

    rewards ▪ フォーマットが正しいかの報酬 ▪ <think> </think> <answer>...</answer> ▪ 学習させやすいが、たまたま正解して偽陽性になることも Rule-based Rewards
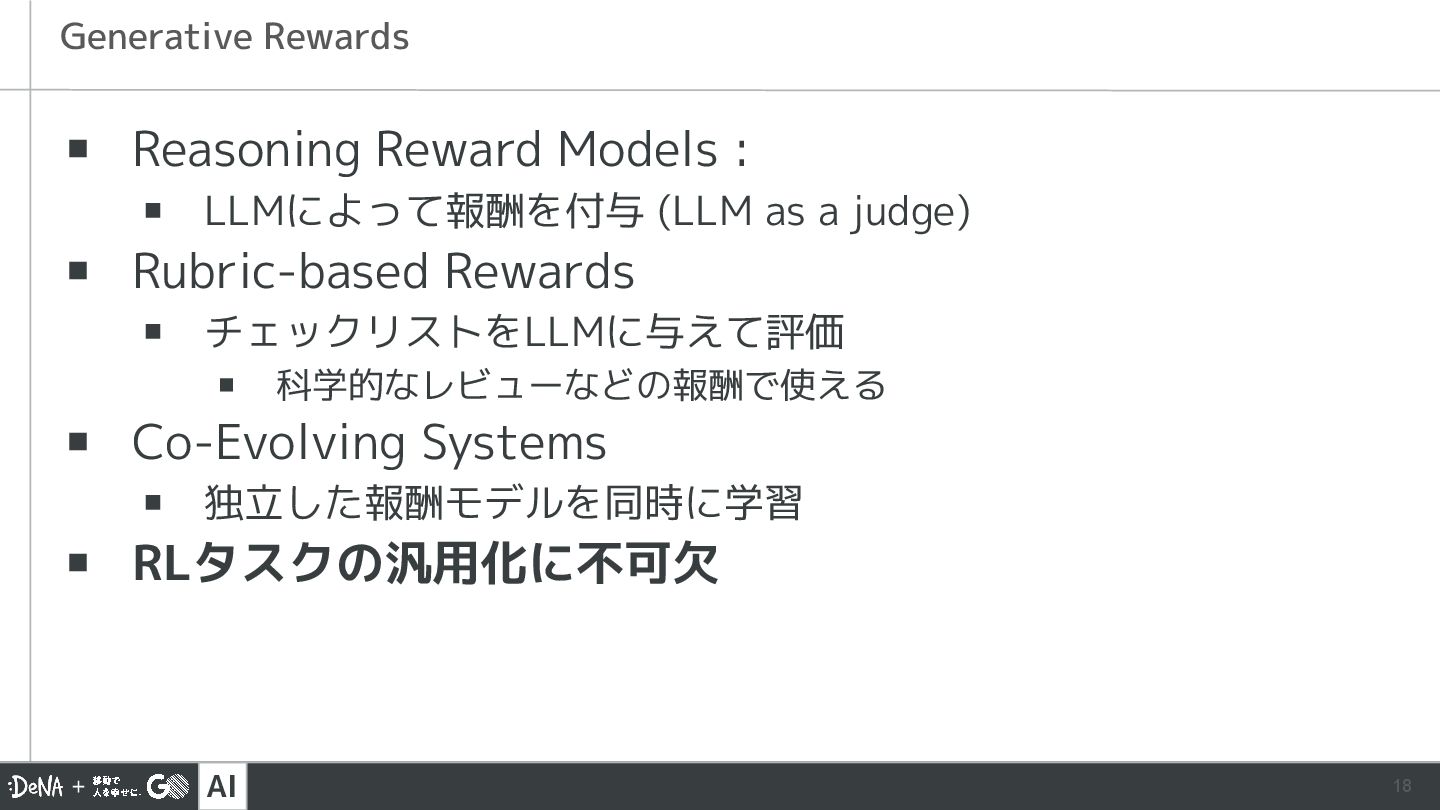
  10. AI 18 ▪ Reasoning Reward Models : ▪ LLMによって報酬を付与 (LLM

    as a judge) ▪ Rubric-based Rewards ▪ チェックリストをLLMに与えて評価 ▪ 科学的なレビューなどの報酬で使える ▪ Co-Evolving Systems ▪ 独立した報酬モデルを同時に学習 ▪ RLタスクの汎用化に不可欠 Generative Rewards
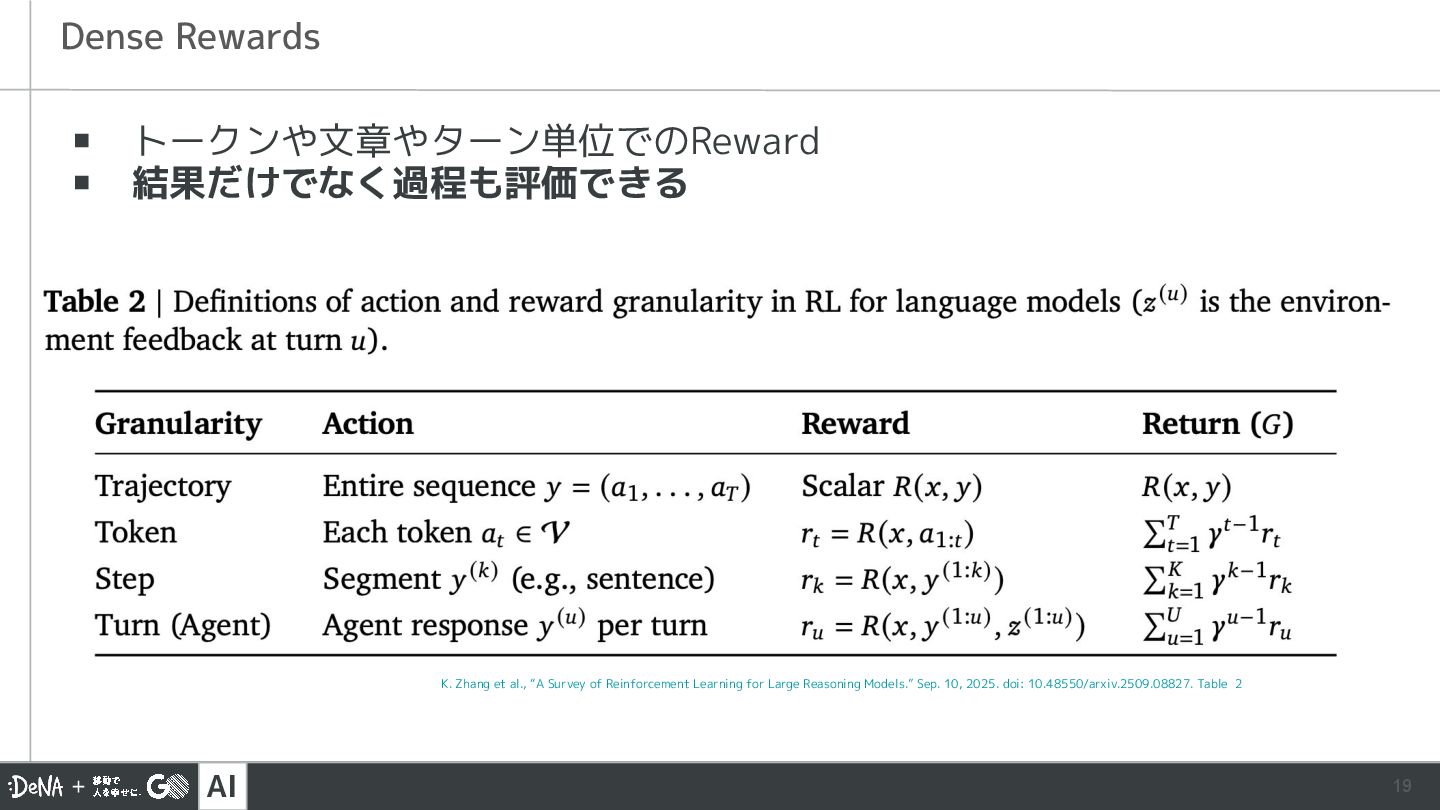
  11. AI 19 ▪ トークンや文章やターン単位でのReward ▪ 結果だけでなく過程も評価できる Dense Rewards K. Zhang

    et al., “A Survey of Reinforcement Learning for Large Reasoning Models.” Sep. 10, 2025. doi: 10.48550/arxiv.2509.08827. Table 2
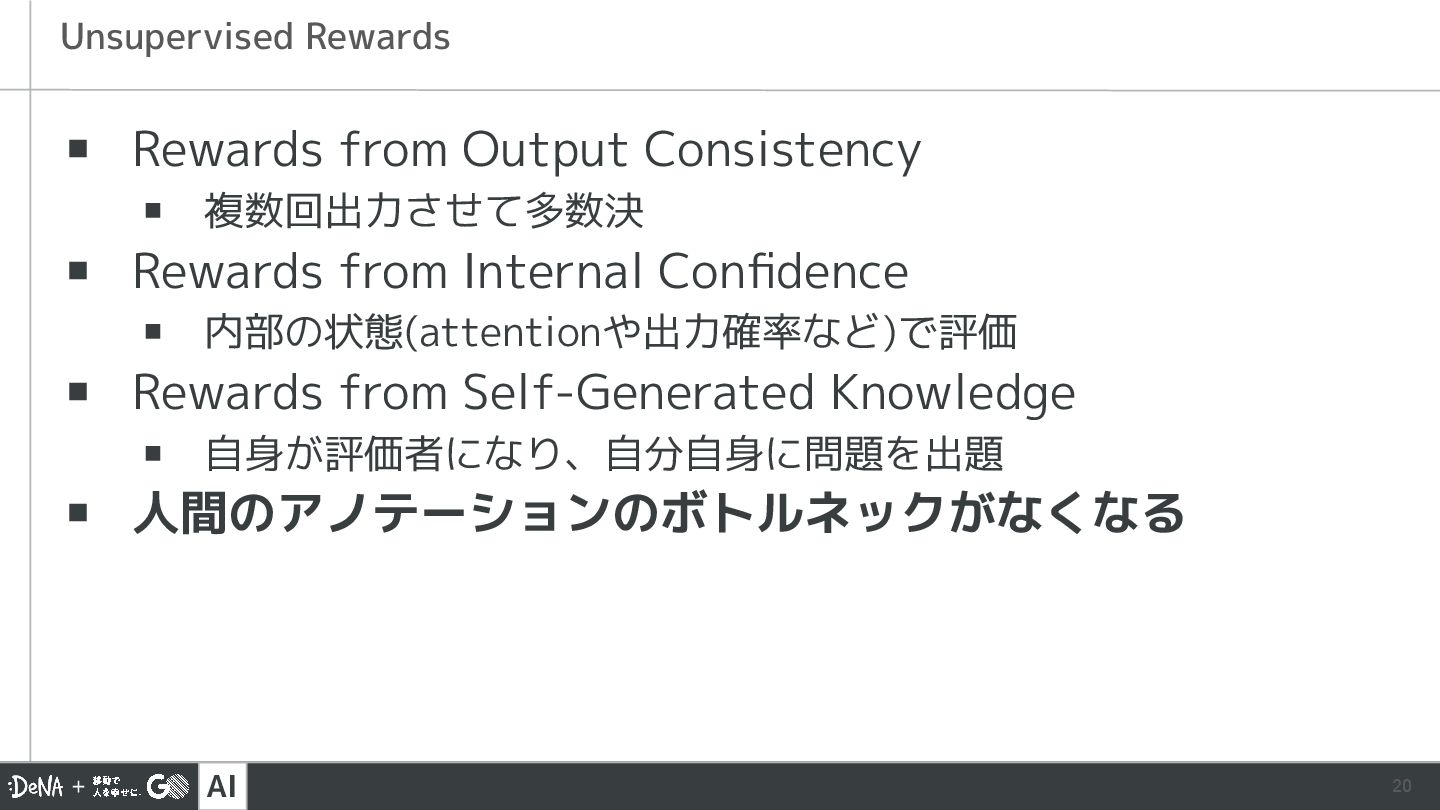
  12. AI 20 ▪ Rewards from Output Consistency ▪ 複数回出力させて多数決 ▪

    Rewards from Internal Confidence ▪ 内部の状態(attentionや出力確率など)で評価 ▪ Rewards from Self-Generated Knowledge ▪ 自身が評価者になり、自分自身に問題を出題 ▪ 人間のアノテーションのボトルネックがなくなる Unsupervised Rewards
  13. AI 21 ▪ 報酬の組み合せ ▪ Rule-based Reward Shaping ▪ ルールベース報酬とリワードモデルのどちらも使う

    ▪ Structure-based Reward Shaping ▪ 複数の回答候補を一つのグループとしてまとめて評価 Rewards Shaping
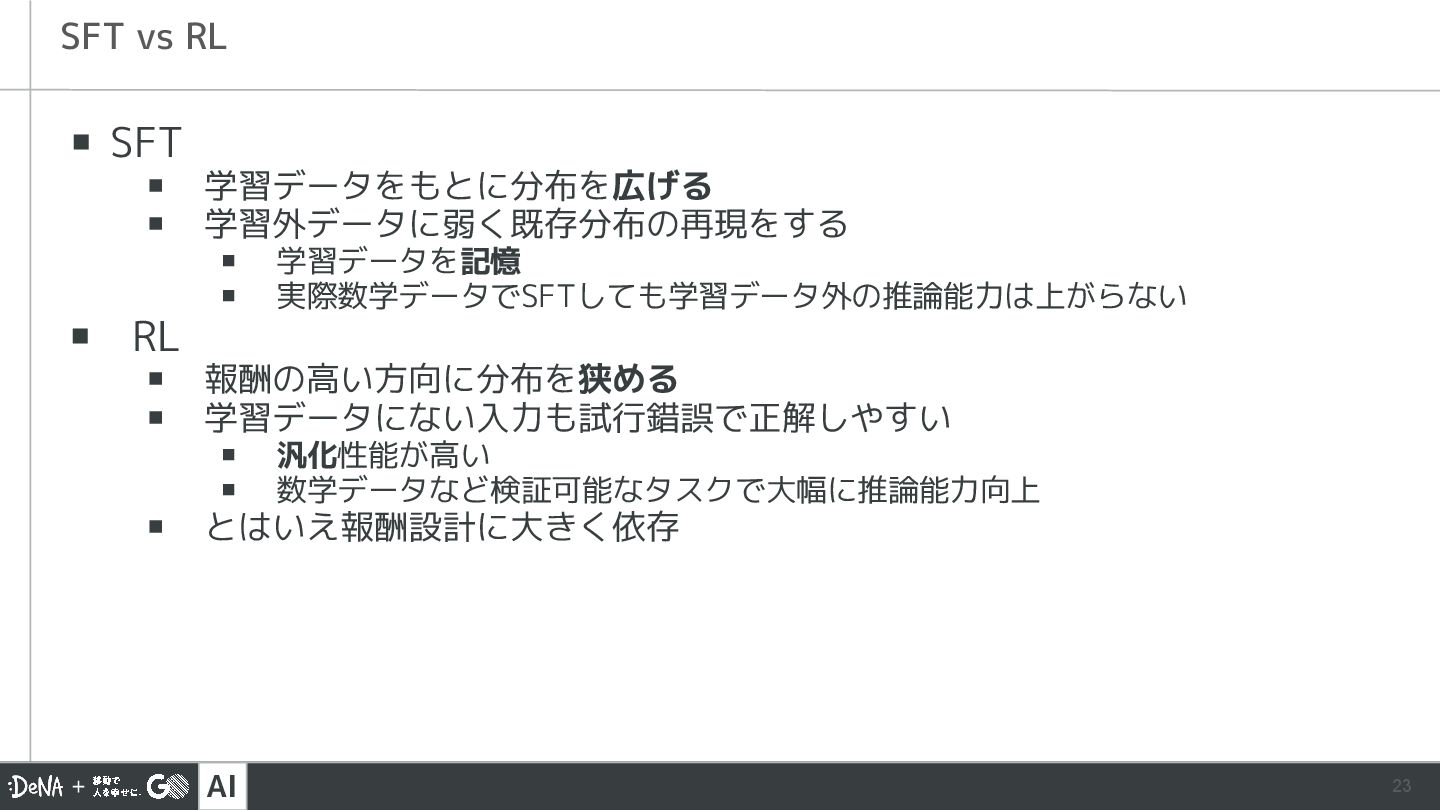
  14. AI 23 ▪ SFT ▪ 学習データをもとに分布を広げる ▪ 学習外データに弱く既存分布の再現をする ▪ 学習データを記憶

    ▪ 実際数学データでSFTしても学習データ外の推論能力は上がらない ▪ RL ▪ 報酬の高い方向に分布を狭める ▪ 学習データにない入力も試行錯誤で正解しやすい ▪ 汎化性能が高い ▪ 数学データなど検証可能なタスクで大幅に推論能力向上 ▪ とはいえ報酬設計に大きく依存 SFT vs RL
  15. AI 24 ▪ RLは鋭化なのか発見しているのかの議論 ▪ 鋭化: ▪ ベースモデルの分布を尖らせ推論 ▪ ex.

    1サンプルのRLでも劇的に性能が上がる ▪ 発見: ▪ RLで新しい推論パターンの発見 ▪ ex. DeepSeekのアハ体験 RLの役割:Sharpening vs Discovery
  16. AI 25 ▪ RLは鋭化なのか発見しているのかの議論 ▪ 鋭化: ▪ ベースモデルの分布を尖らせ推論 ▪ ex.

    1サンプルのRLでも劇的に性能が上がる ▪ 発見: ▪ RLで新しい推論パターンの発見 ▪ ex. DeepSeekのアハ体験 RLの役割:Sharpening vs Discovery
  17. AI 26 ▪ どちらの側面も持っていると言われている ▪ Rewardの種類 ▪ Rule-based→Sharpening ▪ Generative

    Reward → Discovery ▪ モデルの強さ ▪ モデルが弱い→ Discovery ▪ モデルが強い → Sharpening ▪ Sampling手法 (データの多さや温度) ▪ 広い探索 → Discovery ▪ 狭い探索→ Sharpening RLの役割:Sharpening vs Discovery
  18. AI 28 ▪ Scaling LawによりLLMは大規模化 ▪ SFT、RLHFで人間に好ましい応答が可能に (GPT3.5) ▪ 検証可能なタスクでRL

    ▪ 大幅な推論能力上昇 (o1,DeepSeek) ▪ SFTは記憶、RLは汎化させる ▪ RLは鋭化と発見の両側面を持つ まとめ
  19. AI 29 ▪ L. Ouyang et al., “Training language models

    to follow instructions with human feedback.” cornell university, Mar. 04, 2022. doi: 10.48550/arxiv.2203.02155. ▪ K. Zhang et al., “A Survey of Reinforcement Learning for Large Reasoning Models.” Sep. 10, 2025. doi: 10.48550/arxiv.2509.08827. ▪ J. Kaplan et al., “Scaling Laws for Neural Language Models.” Jan. 23, 2020. doi: 10.48550/arxiv.2001.08361. ▪ T. Brown et al., “Language Models are Few-Shot Learners.” cornell university, May 28, 2020. doi: 10.48550/arxiv.2005.14165. 参考文献