Share
Embed
TFUG_PPL_compare_HELLOCYBER.pdf
This article was a slide used at TFUG bayes branch in Japan which was created by HELLOCYBERNETICS.
hellocyber
September 08, 2020
Transcript
34 slides
-
TFUG: ベイズ分科会 2020/9/6 ブログ : HELLO CYBERNETICS Twitter : ML_deep
やってます 近年の PPL の動向 -
自己紹介 • 学生時代: Brain Computer Interface の分野 – 制御や最適化に興味があった(応用対象は問わず) –
流れの中で機械学習を学ぶことを決意(ブログ) • 今:ロボティクスの分野 – 制御や認識を扱っている興味の分野に戻ってきた – 逆に機械学習・確率モデリング楽しい -
目次 • PPL の役割と意義 • PPL 速度比較 • モデリング、推論 API
を簡単に比較 • Pyro で Gaussian Mixture Model の MCMC, ADVI -
なぜ PPL を利用するのか ▪ データ分析の大まかな流れ – 仮説を構築 – データ収集 –
データと現象のモデリング – 推論実行 – 説明、予測実施 -
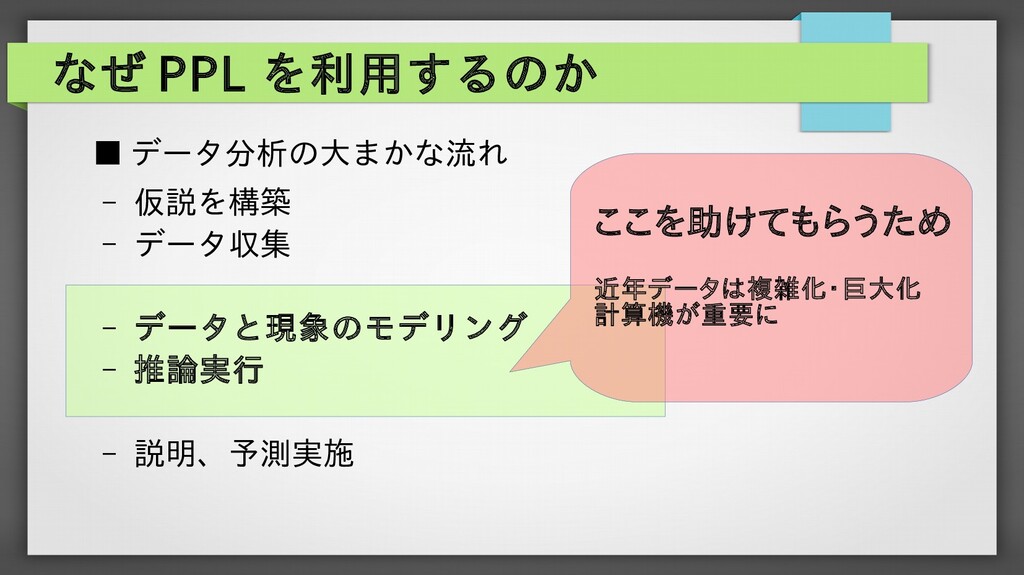
なぜ PPL を利用するのか ▪ データ分析の大まかな流れ – 仮説を構築 – データ収集 –
データと現象のモデリング – 推論実行 – 説明、予測実施 ここを助けてもらうため 近年データは複雑化・巨大化 計算機が重要に -
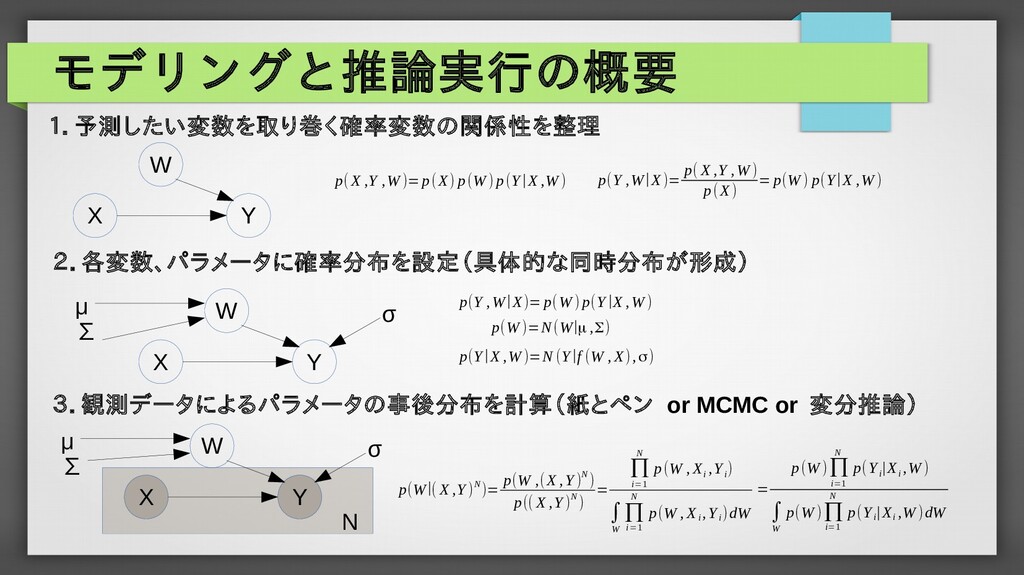
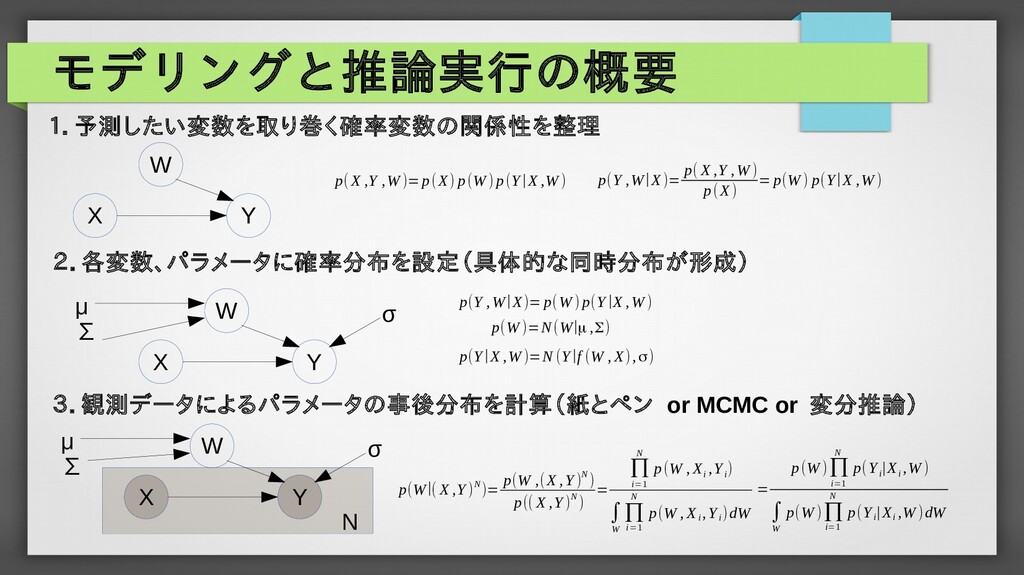
モデリングと推論実行の概要 X Y W X Y W μ ∑ σ
p( X ,Y ,W )=p(X) p(W ) p(Y|X ,W ) p(Y ,W|X)=p(W ) p(Y|X ,W ) p(W )=N (W|μ ,Σ) p(Y ,W|X)= p( X ,Y ,W ) p(X) =p(W ) p(Y|X ,W ) p(Y|X ,W )=N (Y|f (W , X),σ) X Y W μ ∑ σ N p(W|( X ,Y )N )= p(W ,(X ,Y )N ) p(( X ,Y)N ) 1.予測したい変数を取り巻く確率変数の関係性を整理 2.各変数、パラメータに確率分布を設定(具体的な同時分布が形成) 3.観測データによるパラメータの事後分布を計算(紙とペン or MCMC or 変分推論) = ∏ i=1 N p(W , X i ,Y i ) ∫ W ∏ i=1 N p(W , X i ,Y i )dW = p(W )∏ i=1 N p(Y i |X i ,W ) ∫ W p(W )∏ i=1 N p(Y i |X i ,W )dW -
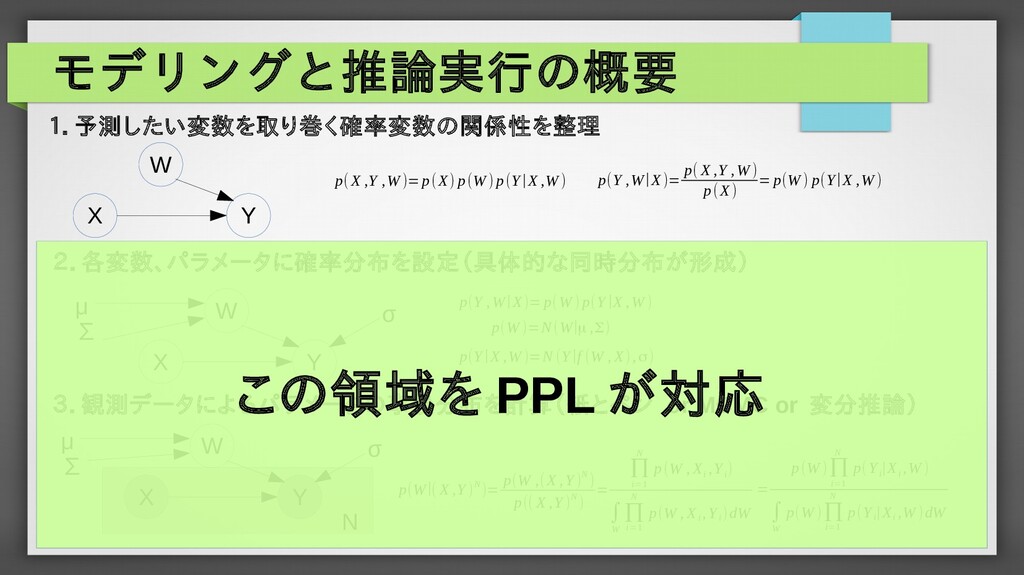
モデリングと推論実行の概要 X Y W X Y W μ ∑ σ
p( X ,Y ,W )=p(X) p(W ) p(Y|X ,W ) p(Y ,W|X)=p(W ) p(Y|X ,W ) p(W )=N (W|μ ,Σ) p(Y ,W|X)= p( X ,Y ,W ) p(X) =p(W ) p(Y|X ,W ) p(Y|X ,W )=N (Y|f (W , X),σ) X Y W μ ∑ σ N p(W|( X ,Y )N )= p(W ,(X ,Y )N ) p(( X ,Y)N ) 1.予測したい変数を取り巻く確率変数の関係性を整理 2.各変数、パラメータに確率分布を設定(具体的な同時分布が形成) 3.観測データによるパラメータの事後分布を計算(紙とペン or MCMC or 変分推論) = ∏ i=1 N p(W , X i ,Y i ) ∫ W ∏ i=1 N p(W , X i ,Y i )dW = p(W )∏ i=1 N p(Y i |X i ,W ) ∫ W p(W )∏ i=1 N p(Y i |X i ,W )dW この領域を PPL が対応 -
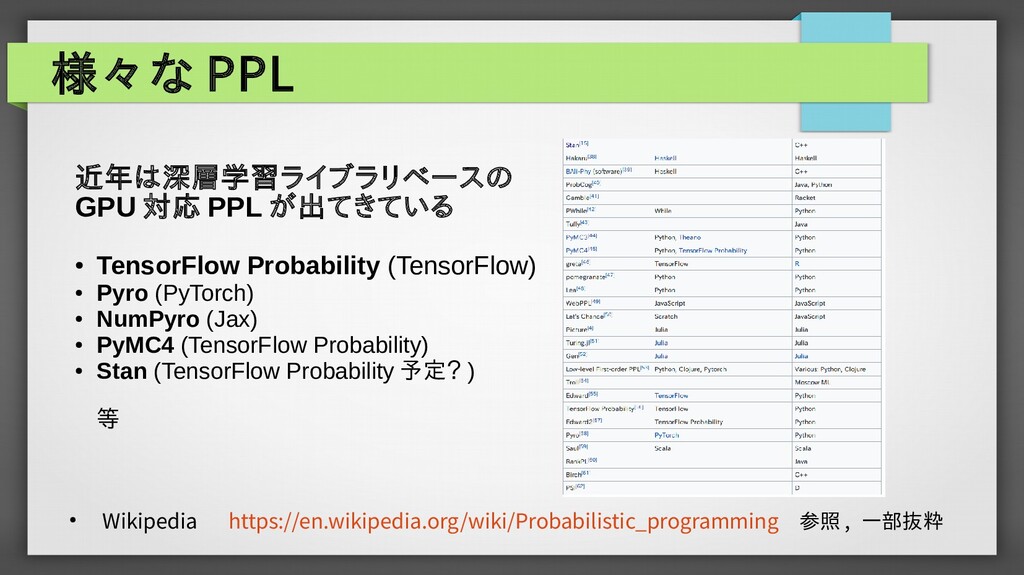
様々な PPL • Wikipedia https://en.wikipedia.org/wiki/Probabilistic_programming 参照 , 一部抜粋 近年は深層学習ライブラリベースの GPU
対応 PPL が出てきている • TensorFlow Probability (TensorFlow) • Pyro (PyTorch) • NumPyro (Jax) • PyMC4 (TensorFlow Probability) • Stan (TensorFlow Probability 予定? ) 等 -
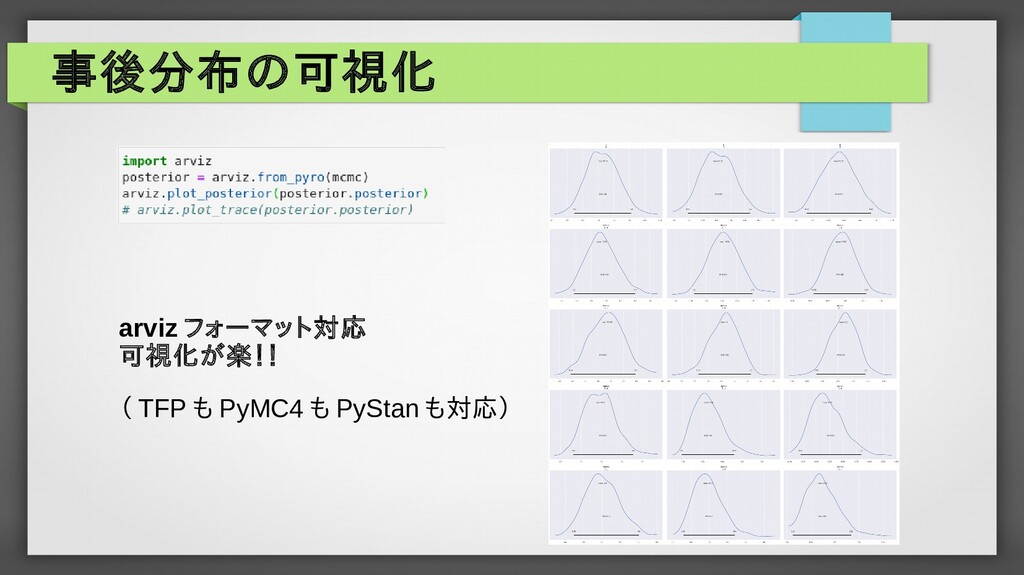
可視化ライブラリ ArviZ • 共通のデータ構造である InferenceData を提供 • Python, Julia から利用可能
• TFP, PyMC, Pyro, PyStan 対応 pip install arviz https://arviz-devs.github.io/arviz/ -
ざっくりとした雰囲気 ArviZ 粒度小 粒度大 • TF Probability • Pyro /
NumPyro • Stan • PyMC -
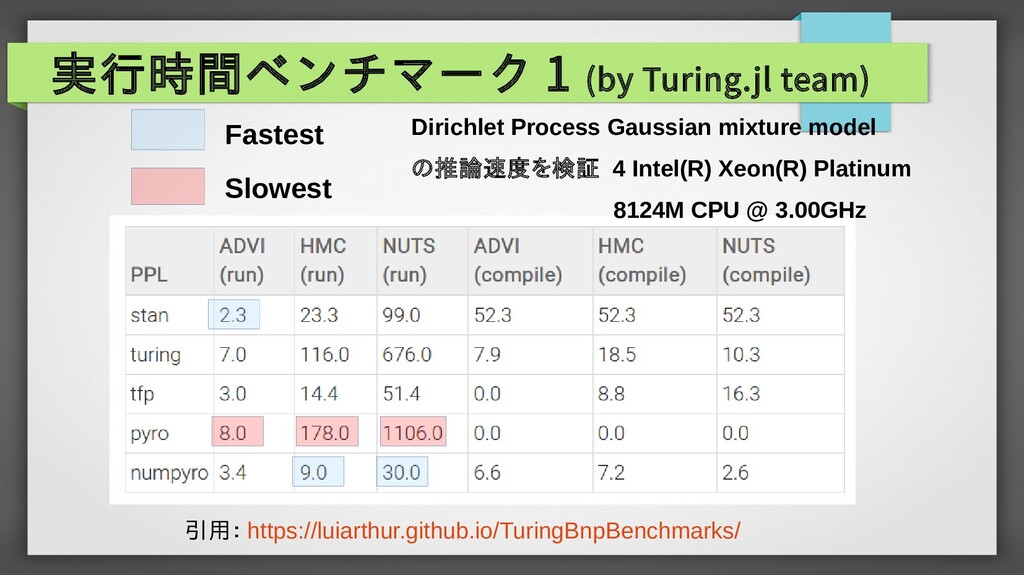
実行時間ベンチマーク 1 (by Turing.jl team) Slowest Fastest Dirichlet Process Gaussian
mixture model の推論速度を検証 4 Intel(R) Xeon(R) Platinum 8124M CPU @ 3.00GHz 引用: https://luiarthur.github.io/TuringBnpBenchmarks/ -
実行時間ベンチマーク 2 (by Turing.jl team) Slowest Fastest Gaussian Process regression
model の推論速度を検証( c5.xlarge AWS instance. ) 引用: https://luiarthur.github.io/TuringBnpBenchmarks/ -
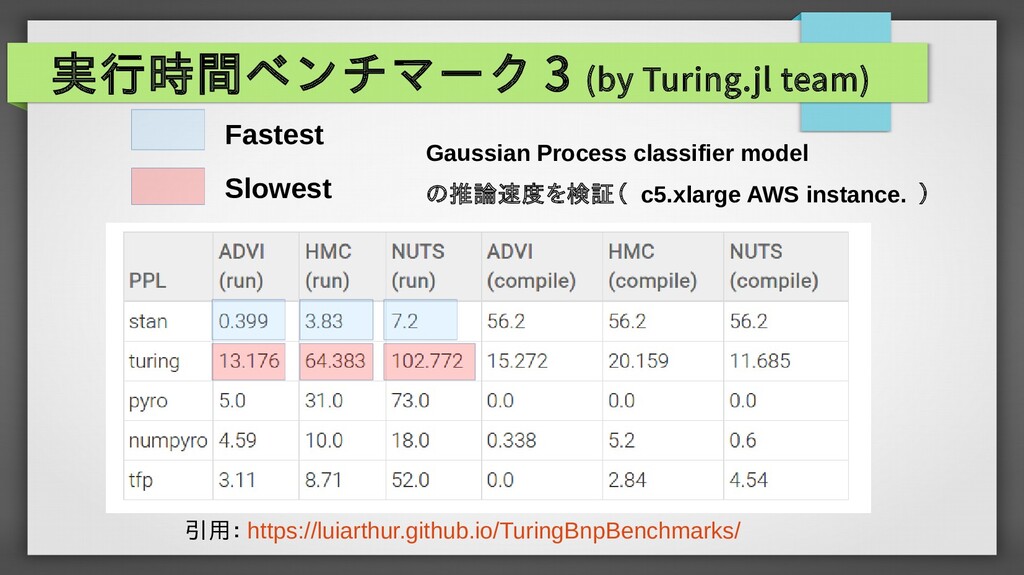
実行時間ベンチマーク 3 (by Turing.jl team) Slowest Fastest Gaussian Process classifier
model の推論速度を検証( c5.xlarge AWS instance. ) 引用: https://luiarthur.github.io/TuringBnpBenchmarks/ -
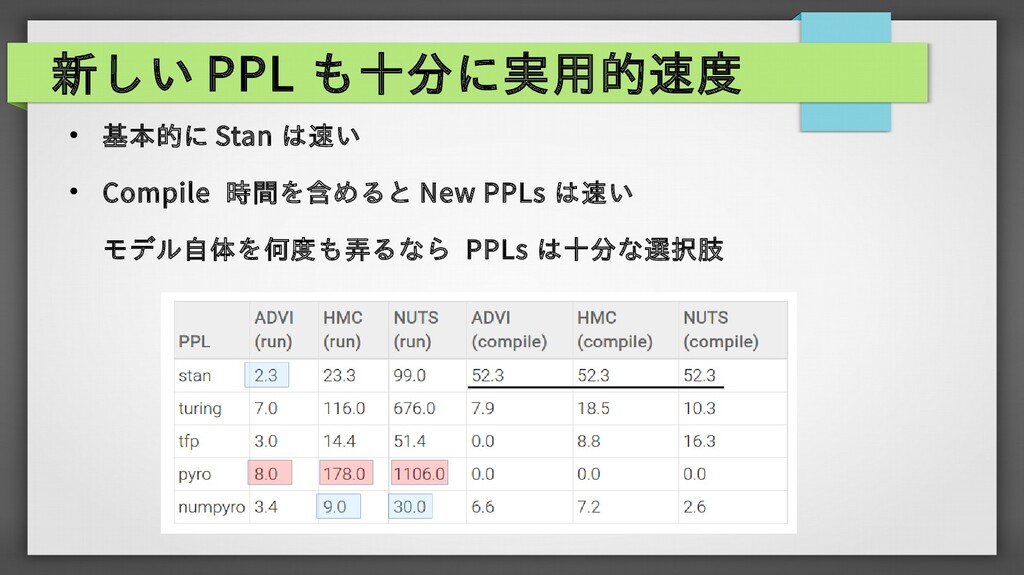
新しい PPL も十分に実用的速度 • 基本的に Stan は速い • Compile 時間を含めると
New PPLs は速い モデル自体を何度も弄るなら PPLs は十分な選択肢 -
各 PPL のコードを比較 性能は分かった。使いやすさはどうか。 単回帰を MCMC で推論するコードを比較 (本来 MCMC を持ち出すモデルではないが…)
それぞれの書き方、 API の雰囲気を見る -
モデリングと推論実行の概要 X Y W X Y W μ ∑ σ
p( X ,Y ,W )=p(X) p(W ) p(Y|X ,W ) p(Y ,W|X)=p(W ) p(Y|X ,W ) p(W )=N (W|μ ,Σ) p(Y ,W|X)= p( X ,Y ,W ) p(X) =p(W ) p(Y|X ,W ) p(Y|X ,W )=N (Y|f (W , X),σ) X Y W μ ∑ σ N p(W|( X ,Y )N )= p(W ,(X ,Y )N ) p(( X ,Y)N ) 1.予測したい変数を取り巻く確率変数の関係性を整理 2.各変数、パラメータに確率分布を設定(具体的な同時分布が形成) 3.観測データによるパラメータの事後分布を計算(紙とペン or MCMC or 変分推論) = ∏ i=1 N p(W , X i ,Y i ) ∫ W ∏ i=1 N p(W , X i ,Y i )dW = p(W )∏ i=1 N p(Y i |X i ,W ) ∫ W p(W )∏ i=1 N p(Y i |X i ,W )dW -
Stan で単回帰 1. モデル作成 ( Stan ファイルフォーマットに従う) 2. MCMC サンプル取得
Stan (C++) を Python や R から叩く Stan にやらせたいことは Stan ファイルに書ききる -
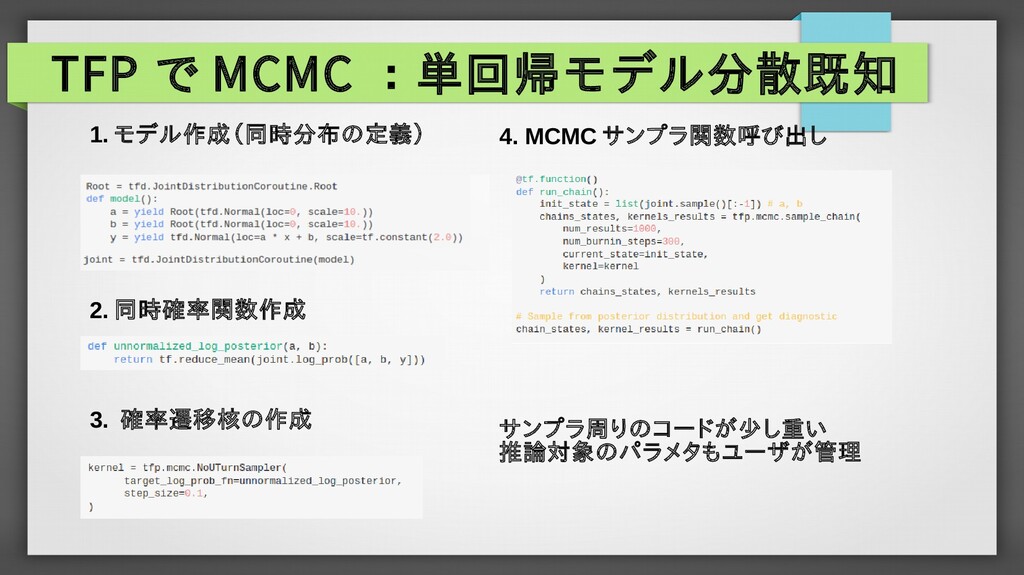
TFP で MCMC :単回帰モデル分散既知 1. モデル作成(同時分布の定義) 2. 同時確率関数作成 3. 確率遷移核の作成
4. MCMC サンプラ関数呼び出し サンプラ周りのコードが少し重い 推論対象のパラメタもユーザが管理 -
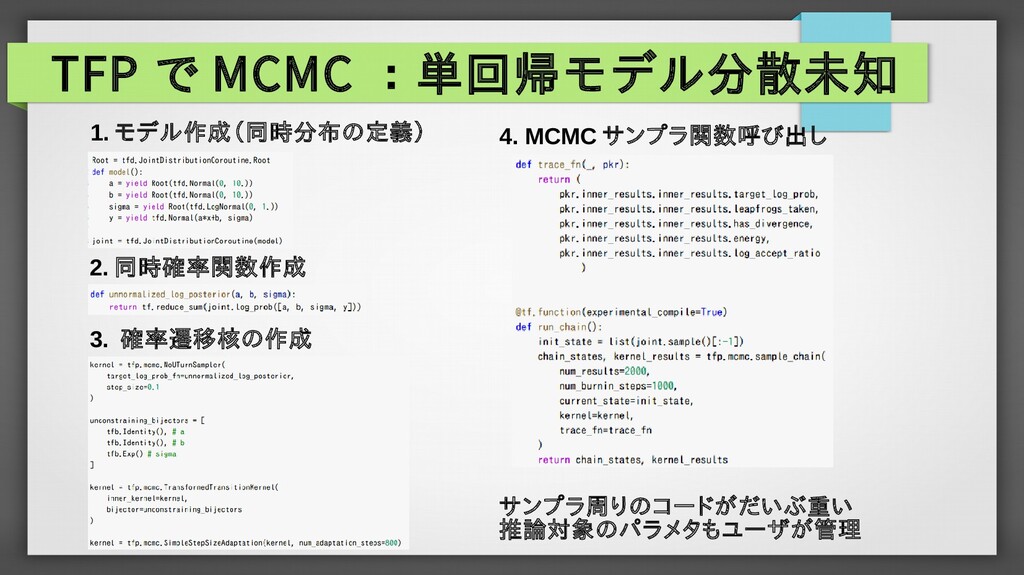
TFP で MCMC :単回帰モデル分散未知 1. モデル作成(同時分布の定義) 2. 同時確率関数作成 3. 確率遷移核の作成
4. MCMC サンプラ関数呼び出し サンプラ周りのコードがだいぶ重い 推論対象のパラメタもユーザが管理 -
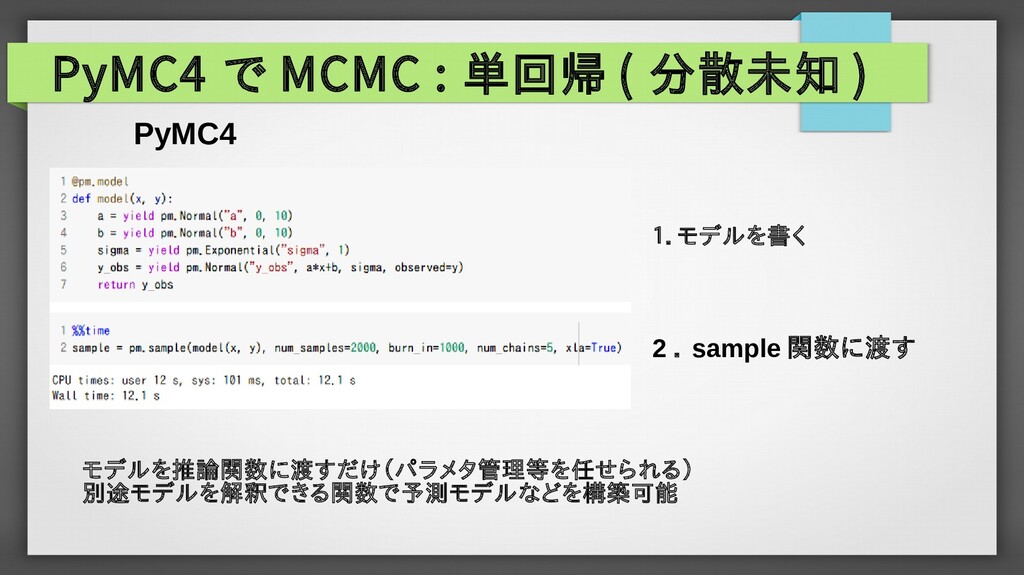
PyMC4 で MCMC : 単回帰 ( 分散未知 ) PyMC4 モデルを推論関数に渡すだけ(パラメタ管理等を任せられる)
別途モデルを解釈できる関数で予測モデルなどを構築可能 1.モデルを書く 2 . sample 関数に渡す -
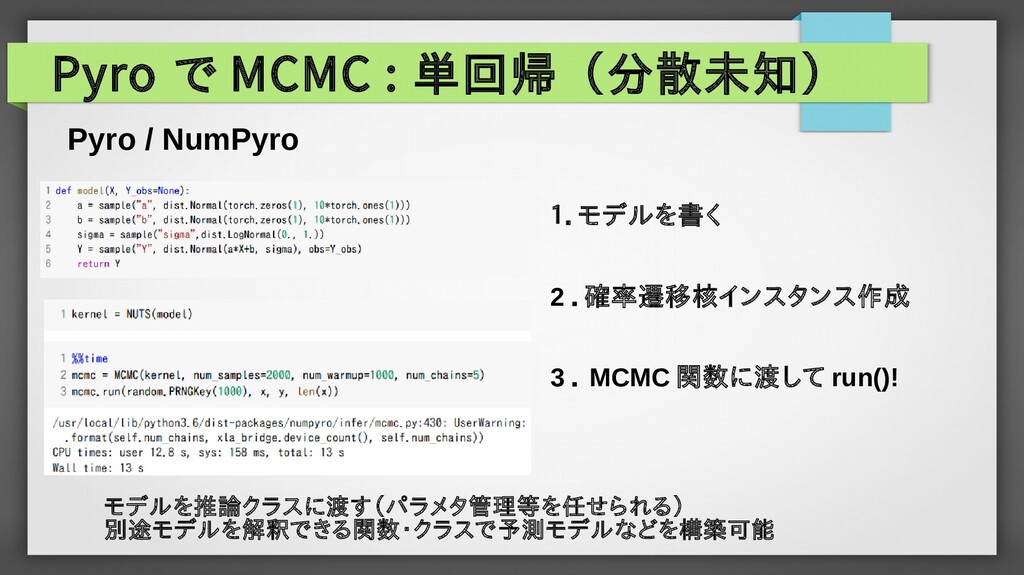
Pyro で MCMC : 単回帰(分散未知) Pyro / NumPyro モデルを推論クラスに渡す(パラメタ管理等を任せられる) 別途モデルを解釈できる関数・クラスで予測モデルなどを構築可能
1.モデルを書く 3 . MCMC 関数に渡して run()! 2 .確率遷移核インスタンス作成 -
書きやすさに関する所感 • TensorFlow Probability は一段低いとこから書く 細かいことを書ける / 書かなければいけない • 個人的には
Pyro のインターフェースが気に入っている • PyMC4 は完成すれば第一候補 ( PyMC4 で弄れない時に仕方なく TFP を使う感じ) -
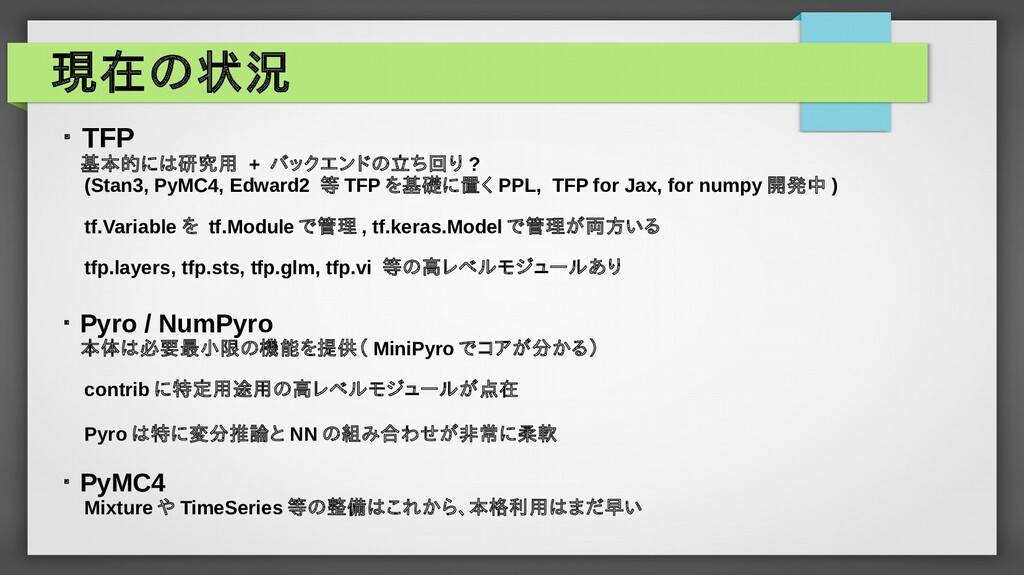
現在の状況 ・ TFP 基本的には研究用 + バックエンドの立ち回り ? (Stan3, PyMC4,
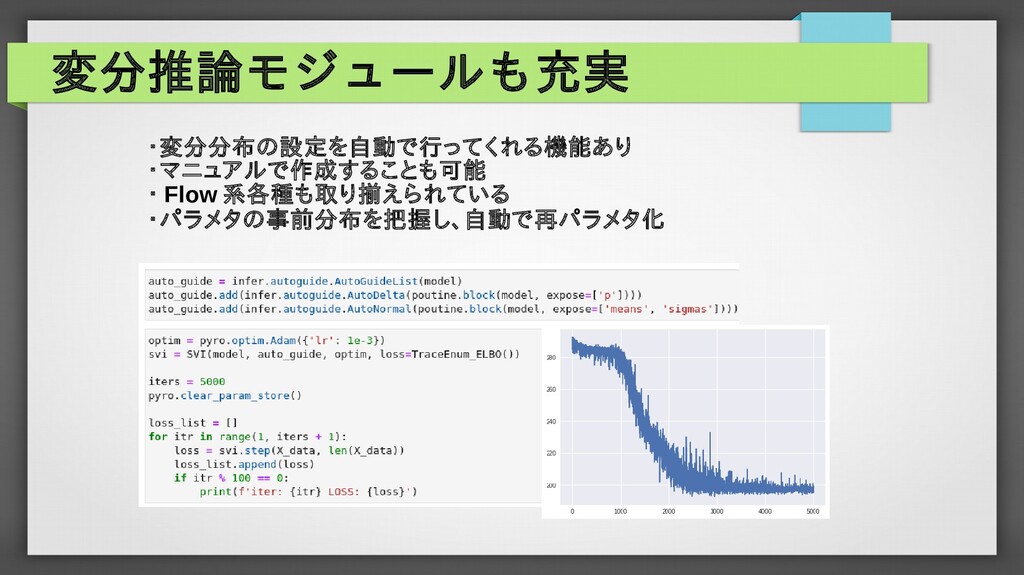
Edward2 等 TFP を基礎に置く PPL, TFP for Jax, for numpy 開発中 ) tf.Variable を tf.Module で管理 , tf.keras.Model で管理が両方いる tfp.layers, tfp.sts, tfp.glm, tfp.vi 等の高レベルモジュールあり ・ Pyro / NumPyro 本体は必要最小限の機能を提供( MiniPyro でコアが分かる) contrib に特定用途用の高レベルモジュールが点在 Pyro は特に変分推論と NN の組み合わせが非常に柔軟 ・ PyMC4 Mixture や TimeSeries 等の整備はこれから、本格利用はまだ早い -
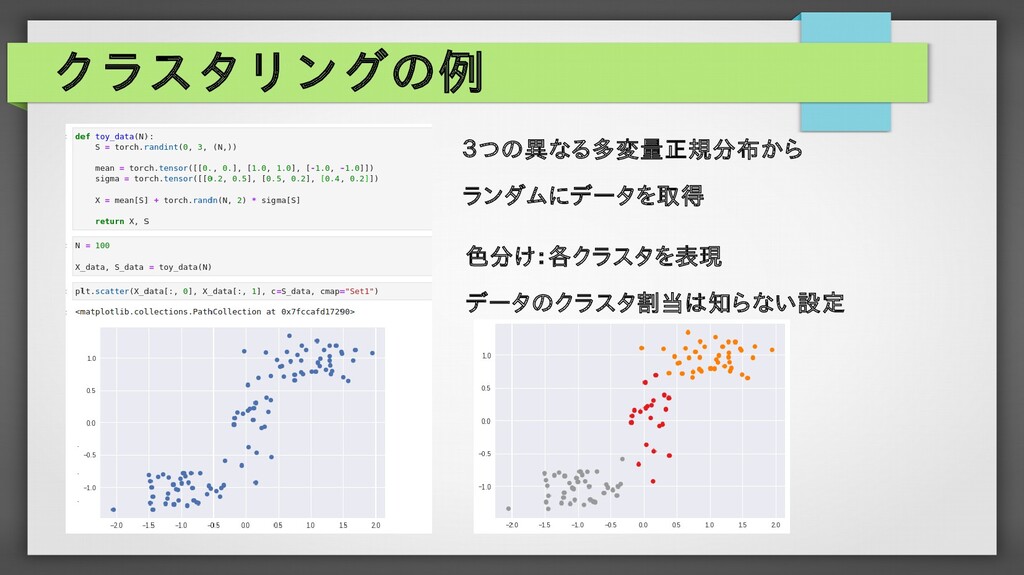
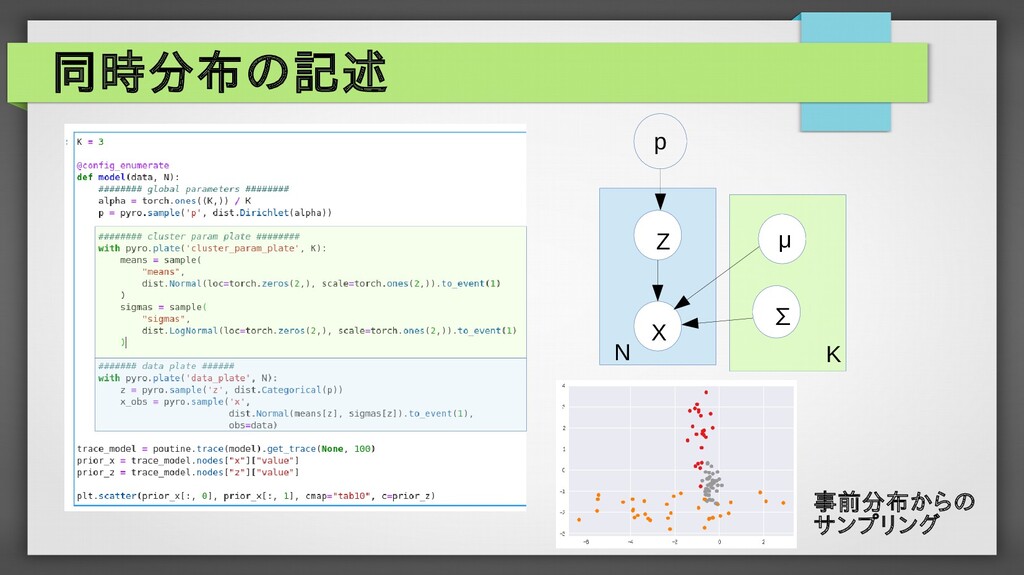
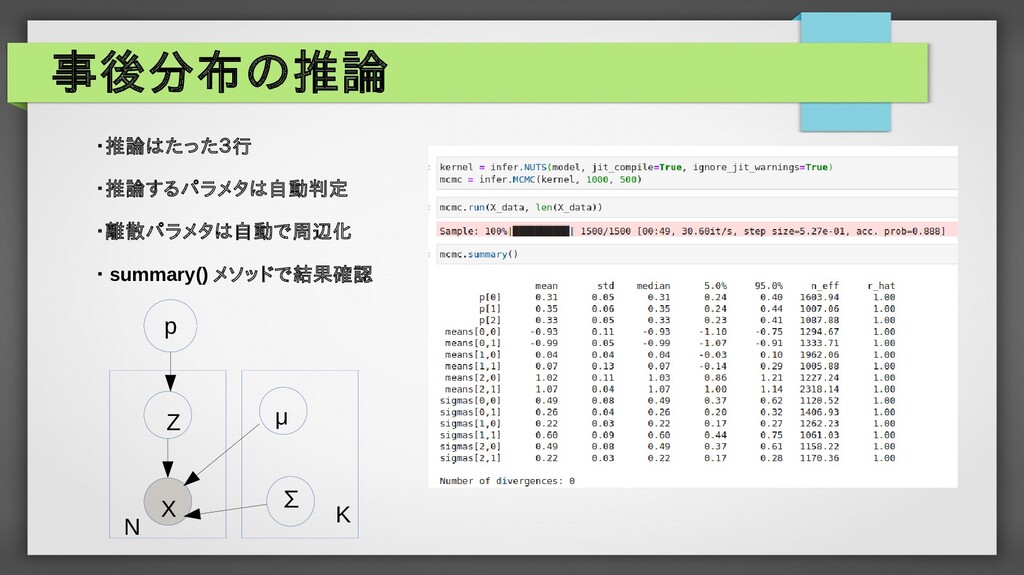
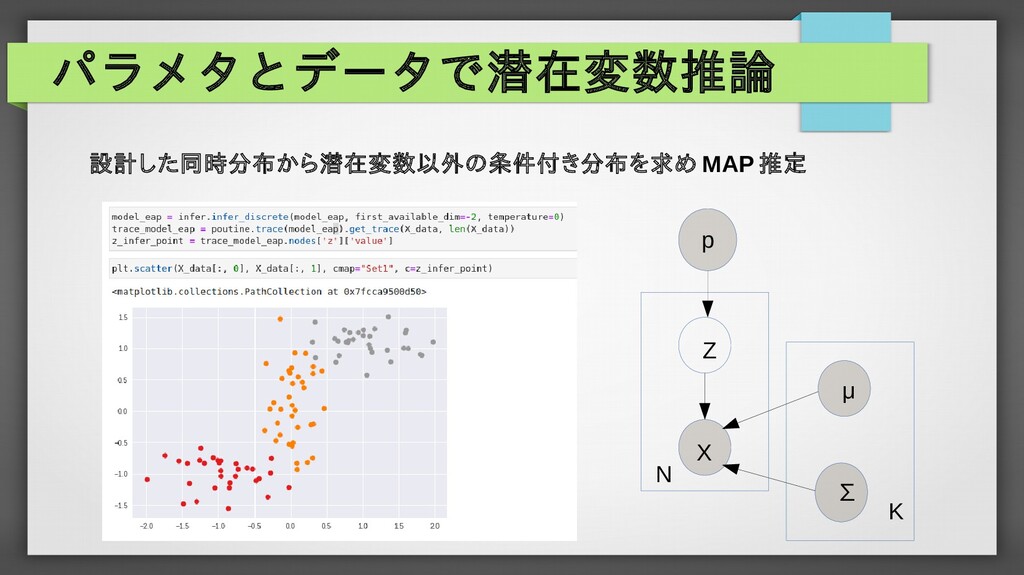
Pyro で GMM を一通り • TFP の使い方、例は他の発表で見られる • PPL 比較のために
Pyro の例を出していく -
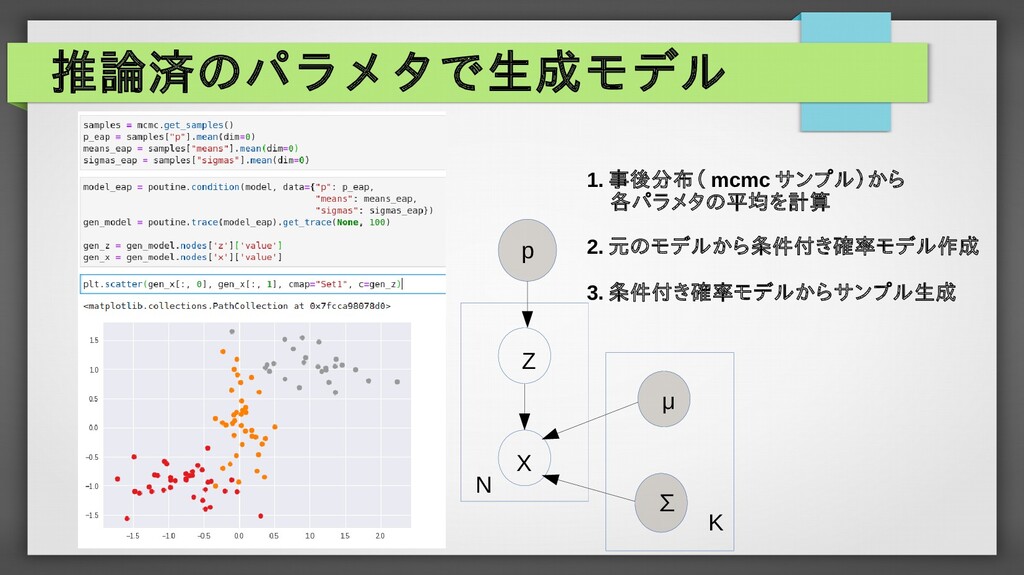
推論済のパラメタで生成モデル p μ ∑ X Z K N 1. 事後分布(
mcmc サンプル)から 各パラメタの平均を計算 2. 元のモデルから条件付き確率モデル作成 3. 条件付き確率モデルからサンプル生成 -
最後に • Deep Learning がライブラリの整備で隆盛した • Julia Lang でも Turing.jl
や Gen.jl 等が開発中 • 今後 PPL の整備で確率モデリングの人口増加、有用性認知 • TFP と PyMC4 は確率モデリングをブーストするはず • 今は個人的に Pyro が使いやすいが、今後の整備に注目 -
参考 DynamicPPL: Stan-like Speed for Dynamic Probabilistic Model https://arxiv.org/abs/2002.02702 Turing.jl
チームメンバによる PPL の比較 https://luiarthur.github.io/TuringBnpBenchmarks/dpsbgmm ArviZ https://arviz-devs.github.io/arviz/ TensorFlow Probability https://www.tensorflow.org/probability?hl=ja