Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Feature Storeを中心とした基盤システムで、 ユーザ課題に向き合うメンバー自身が、フ...

Avatar for MasatoMasaMasa MasatoMasaMasa
October 23, 2026
18

Feature Storeを中心とした基盤システムで、 ユーザ課題に向き合うメンバー自身が、フルサイクルに自走して改善を回せる世界へ!

Feature Storeを中心とした基盤システムで、ユーザ課題に向き合うメンバー自身が、フルサイクルに自走して改善を回せる世界へ!
~ユーザ理解・コンテンツ理解データが生み出す成果をもっとスケールさせるための試み~

Avatar for MasatoMasaMasa

MasatoMasaMasa

October 23, 2026

Transcript

  1. 2026-10-16 Nagoya Tech Talk #4 〜データ活用のリアル〜 Feature Storeを中心とした基盤システムで、 ユーザ課題に向き合うメンバー自身が、フルサ イクルに自走して改善を回せる世界へ!

    ~ユーザ理解・コンテンツ理解データが生み出す成果をもっとス ケールさせるための試み ~ 株式会社ユーザベース 森田大登
  2. 最初に自己紹介です!初めまして! 森田 大登 / Morita Masato • 株式会社ユーザベースにて、 ソーシャル経済メディア NewsPicks

    のプロダクトエンジニア として働いています! • Xアカウント: @moritama7431 • RecSysやMLOps周りに興味があります!! (あとKpopダンス) 📝 過去のブログ ! ・NewsPicks に推薦システムを本番導入する上で一番優先すべきだったこと(2024.08) ・新モデルの本番投入を加速せよ!ML パイプライン追加の学習コスト& 開発工数の大幅削減 (2025.08) ・NewsPicks の MLOps における特徴量ストアの4 つの重要観点 (2025.12) 「情報は発信する人のところに集まる」という考えのもと、 なんとか果敢に発表してぜひ情報交換を加速させたい気持ちです ...!! よろしくお願いしますー !!🎤
  3. ユーザ/コンテンツ理解の特徴量を、もっと多様なプロダクト 体験の改善につなげたい! 特徴量(Feature) って?? ユーザやコンテンツなどの性質を、機械学習やプロダクト上で扱える数値にしたも の。 >「優れた機械学習の専門家がもつリソースをすべて使えたとしても、成果の大半は優れた 特徴量から生まれる 。」 出典:

    M. Zinkevich, "Rules of Machine Learning: Best Practices for ML Engineering", Google for Developers. って言われるくらい、特徴量は、 MLを使ったプロダクトの中心資産 ...!! また、LLM・Coding Agentの普及でデータ活用の実装ハードルが下がる今、高品質 な特徴量をプロダクト全体で活用しやすくすることが、ますます重要になる のでは...!! 5
  4. 学びが必要なデータ活用PJでは、分業制よりもフルサイクル!! Eric Colsonさん(元NetflixのVP of Data Science and Engieering)の主張 を意訳して抜粋 (資料「Beware

    the data science pin factory: The power of the full-stack data science generalist and the perils of division of labor through function」より) • • • 労働分業は、生産するものが明らか で、漸近的な効率を求めるときに行うもの。 一方で、データサイエンスPJの目標は、学び、深い新しいビジネス能力を開発 すること。 固有の不確実性を持ち、実験・試行錯誤・反復を通じて学ばれなければならない。 専門化 (労働分業) はデータサイエンスPJの目標を妨げる: ◦ 1. 調整コストの増加 : 各工程や変更のたびに専門家間の調整が必要になり、反復 にかかる”税金”として試行錯誤を遅らせる ◦ 2. 待機時間の悪化 : 専門家の予定がそろわず、短い作業でも日/週/月単位で待た される ◦ 3. 文脈が狭まる : 自分の持ち場の中だけを最適化し、より大きな改善の機会に気づ けない 8
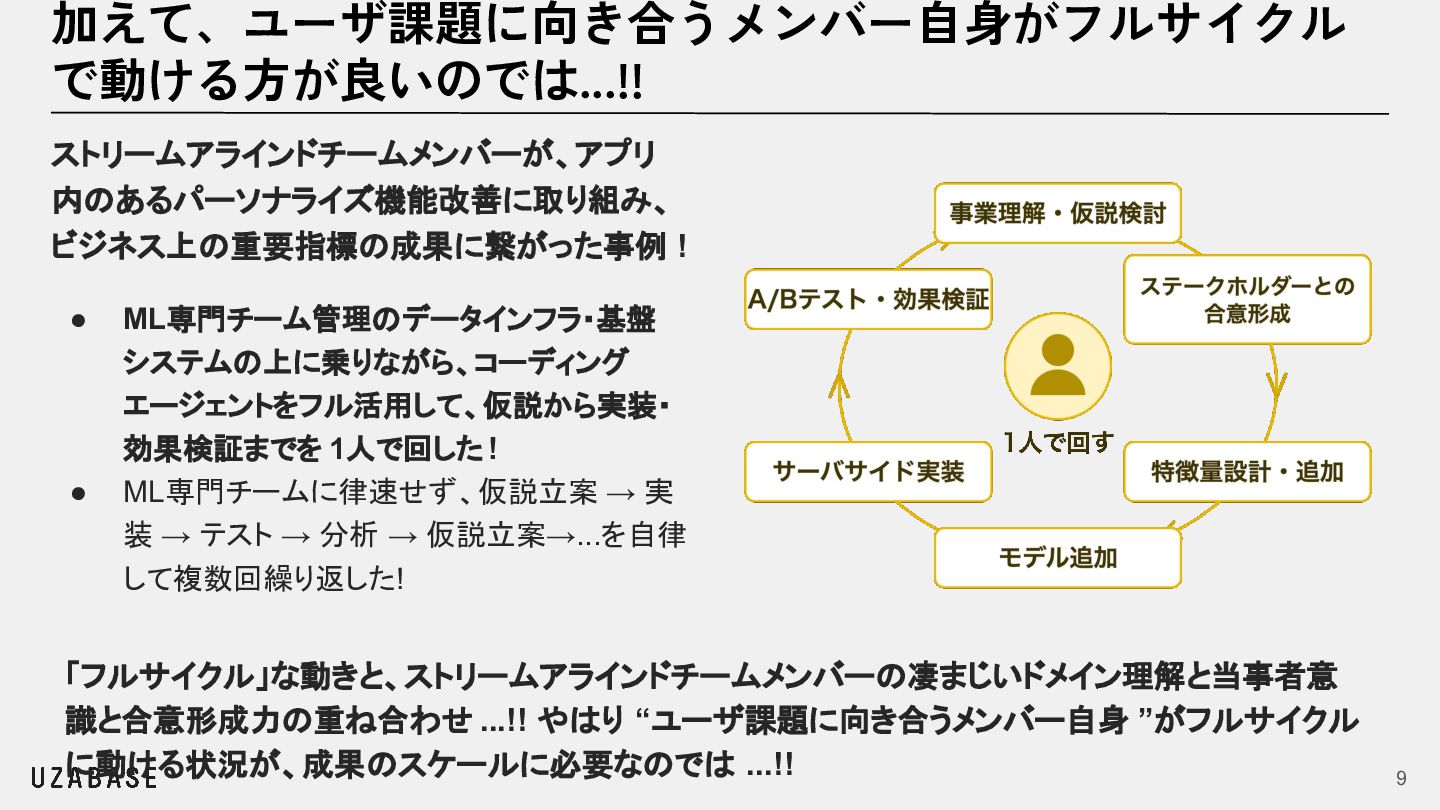
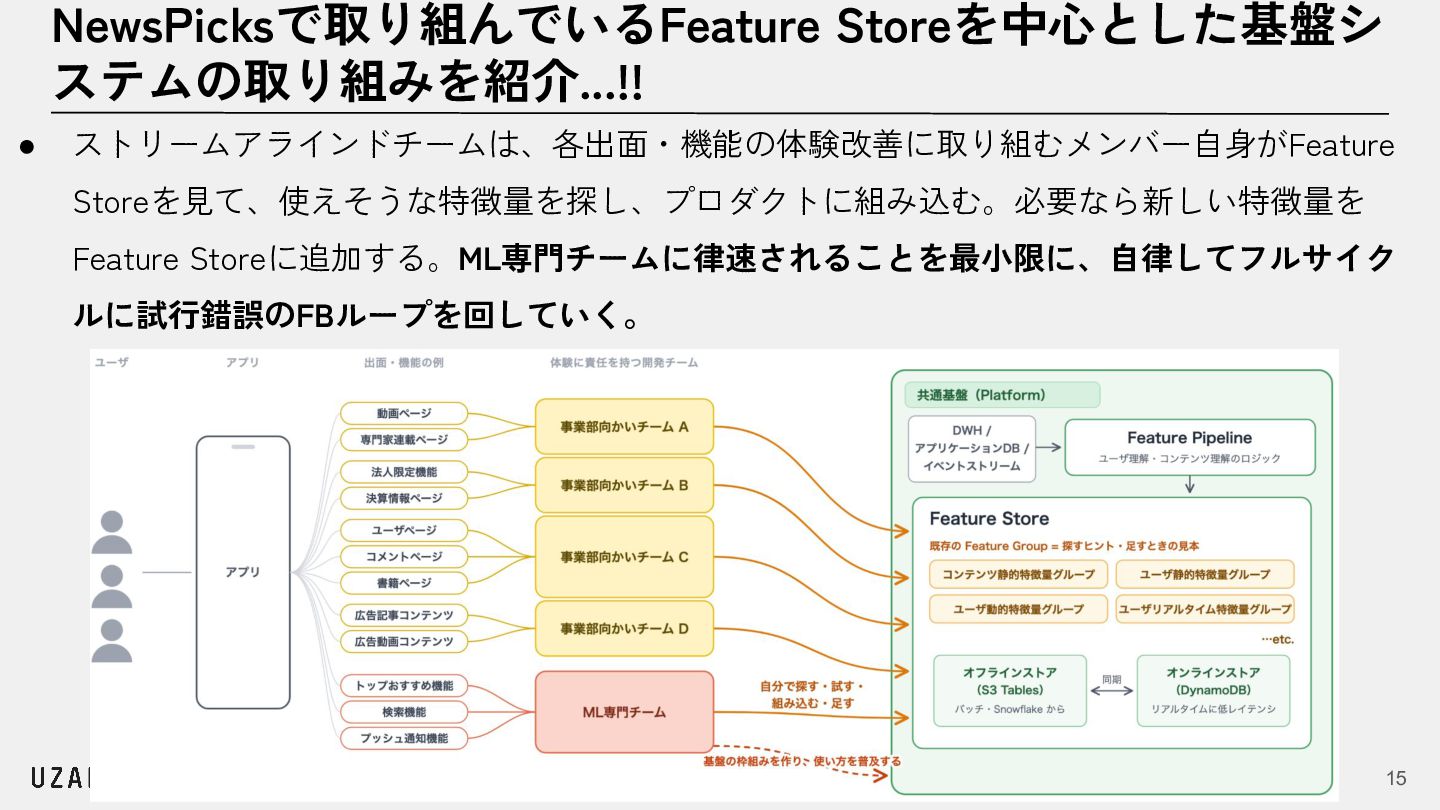
  5. 加えて、ユーザ課題に向き合うメンバー自身がフルサイクル で動ける方が良いのでは...!! ストリームアラインドチームメンバーが、アプリ 内のあるパーソナライズ機能改善に取り組み、 ビジネス上の重要指標の成果に繋がった事例 ! • • ML専門チーム管理のデータインフラ・基盤 システムの上に乗りながら、コーディング

    エージェントをフル活用して、仮説から実装・ 効果検証までを 1人で回した ! ML専門チームに律速せず、仮説立案 → 実 装 → テスト → 分析 → 仮説立案→...を自律 して複数回繰り返した! 「フルサイクル」な動きと、ストリームアラインドチームメンバーの凄まじいドメイン理解と当事者意 識と合意形成力の重ね合わせ ...!! やはり “ユーザ課題に向き合うメンバー自身 ”がフルサイクル に動ける状況が、成果のスケールに必要なのでは ...!! 9
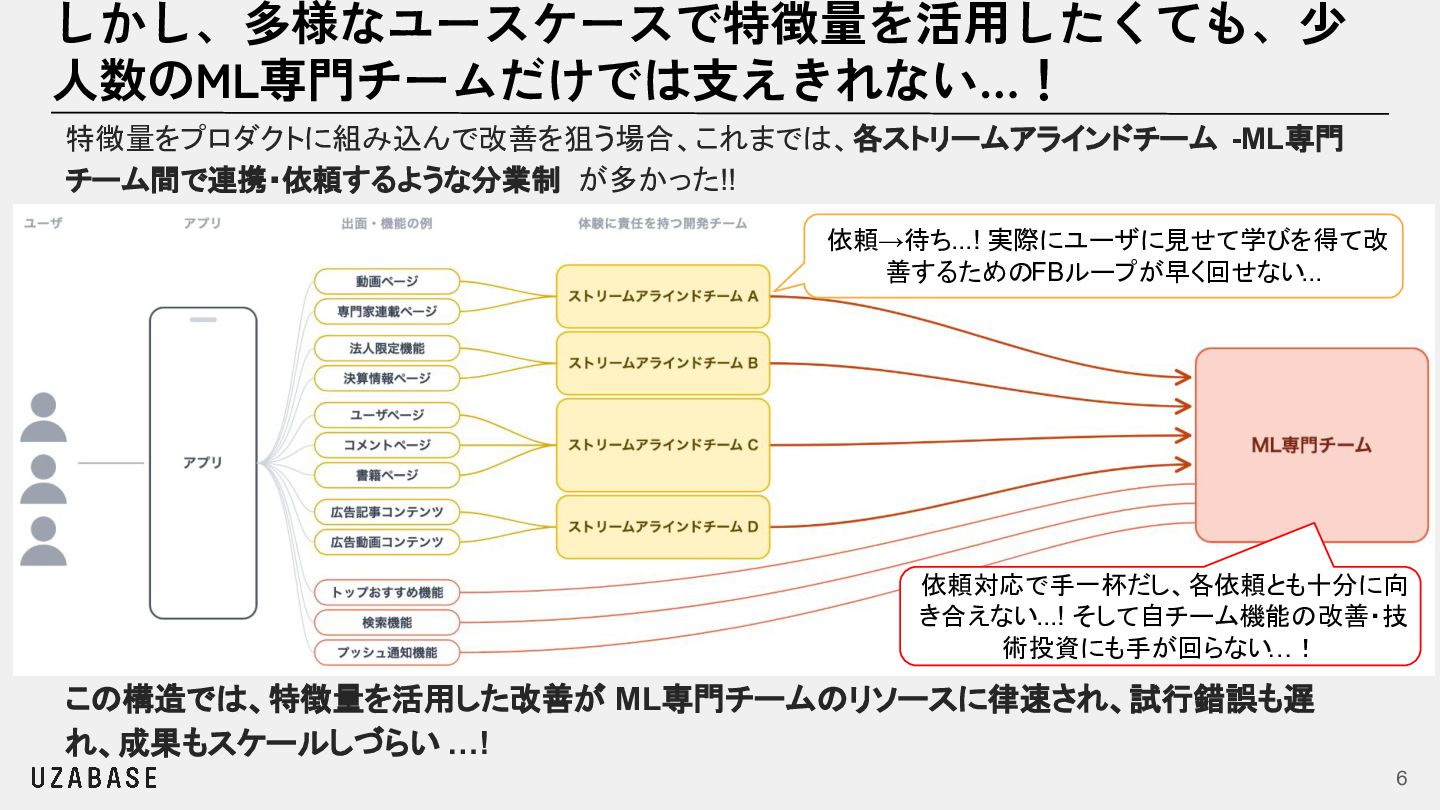
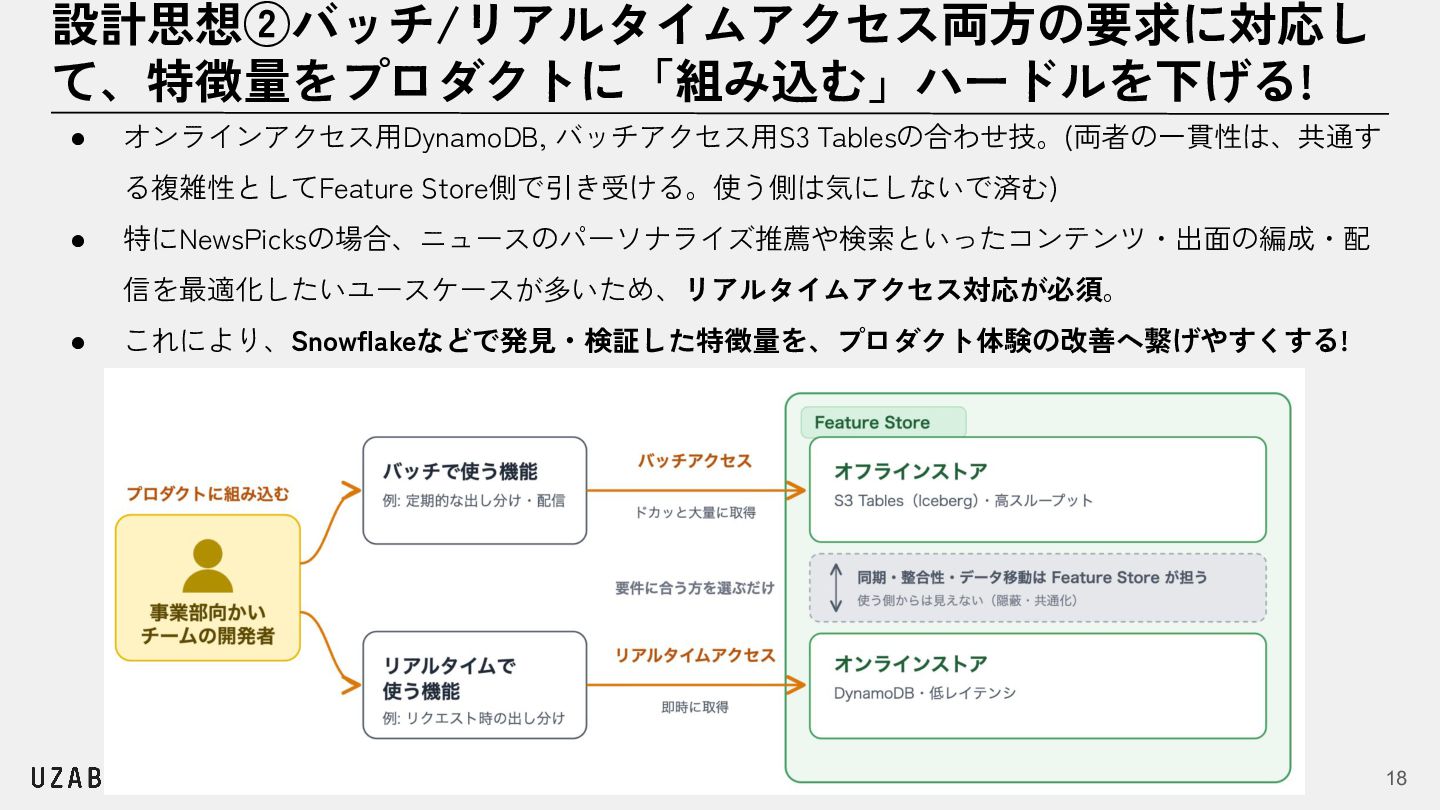
  6. フルサイクルといえども、各チームがインフラまで個別構築 するような形ではスケールしない! • 実際、各チームが独自に作ろうとするとインフラ由来の課題・制約に結構時間を取られる: ◦ この特徴量って、レイテンシー要件を満たせる範囲でリアルタイムに作れるっけ?? ◦ 事前計算しておくとしたら保存場所は?? データレイクやDWHだと低レイテンシでアクセ スできないよね。でも学習とかの際はむしろ高スループットで取りたい...

    ◦ • 特徴量の鮮度要件によって、求められる更新頻度も様々...! バッチ?ストリーム? また、データ・仕組み・学びが個々のチームに閉じ、再利用されづらくなって辛い: ◦ 特徴量を事前計算してキャッシュする仕組みが、ユースケースごとに別々で持っちゃっ てコストが膨らんできてる...!! ◦ LLMでコンテンツにタグ付けする似たような仕組みが全然別のインフラ構成で複数動い てる? • 我々がフルサイクル化したいのは、ユーザ・コンテンツ理解の特徴量を用いたプロダクト改 善! データパイプラインやインフラまで毎回ゼロから構築することではない!! 11
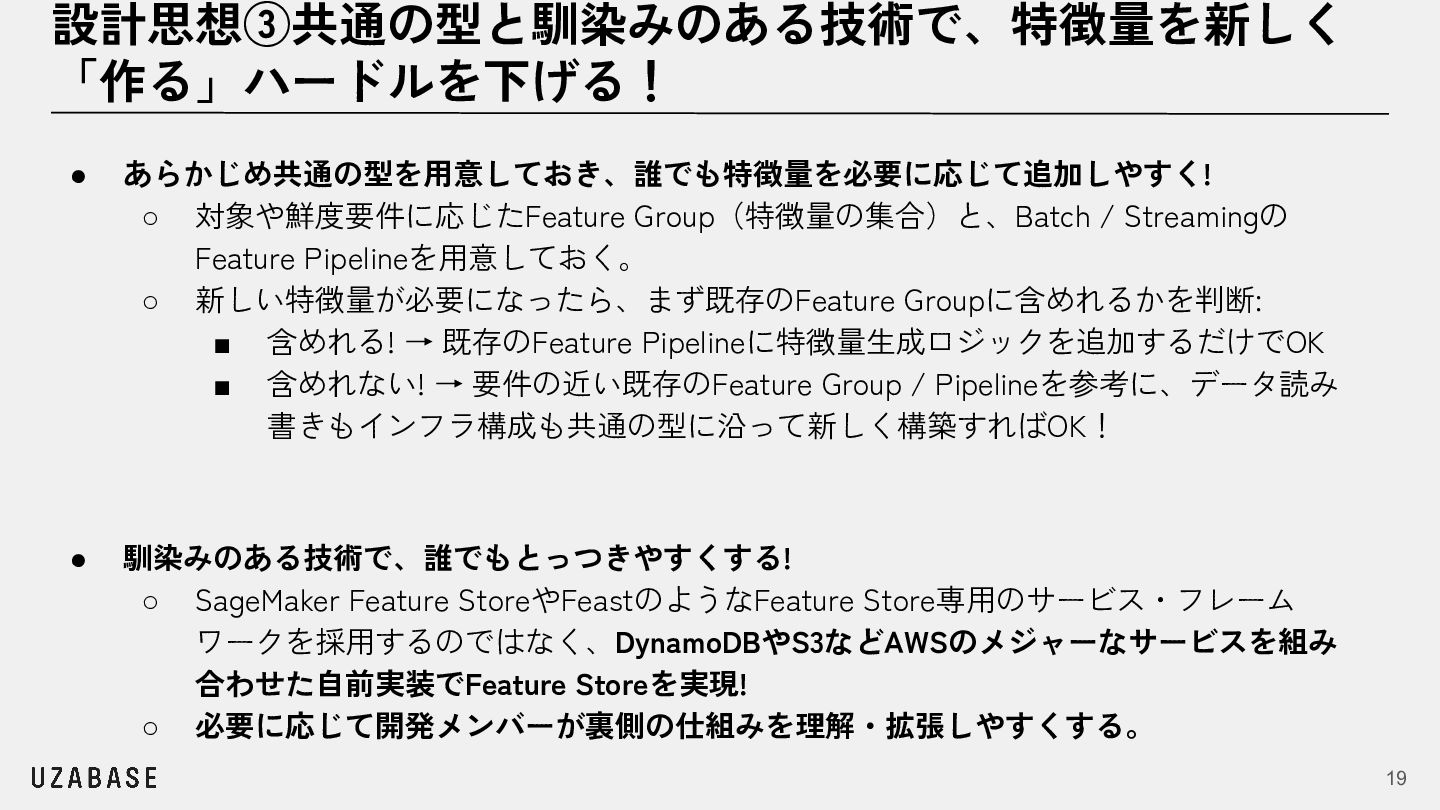
  7. 設計思想③共通の型と馴染みのある技術で、特徴量を新しく 「作る」ハードルを下げる! • あらかじめ共通の型を用意しておき、誰でも特徴量を必要に応じて追加しやすく! ◦ 対象や鮮度要件に応じたFeature Group(特徴量の集合)と、Batch / Streamingの Feature

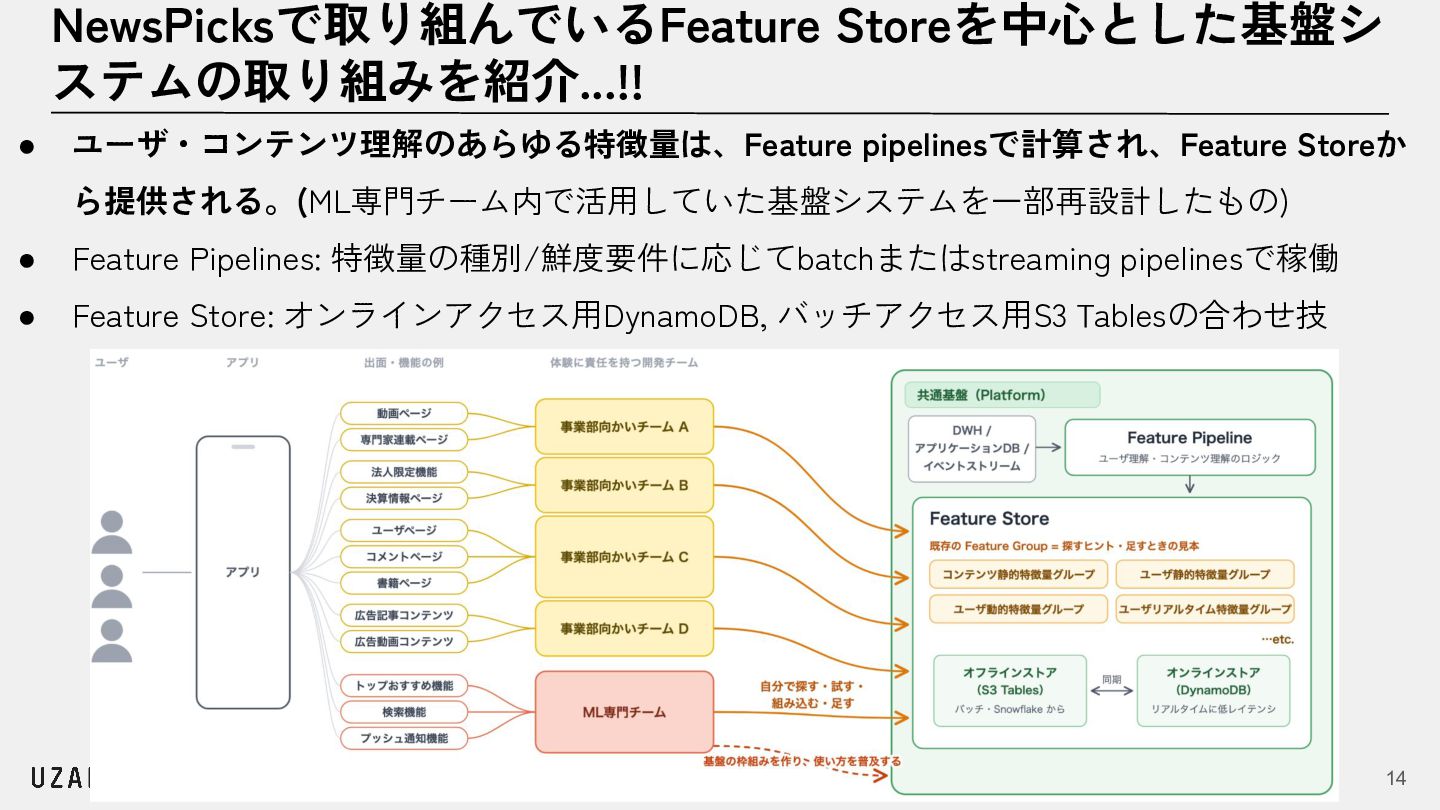
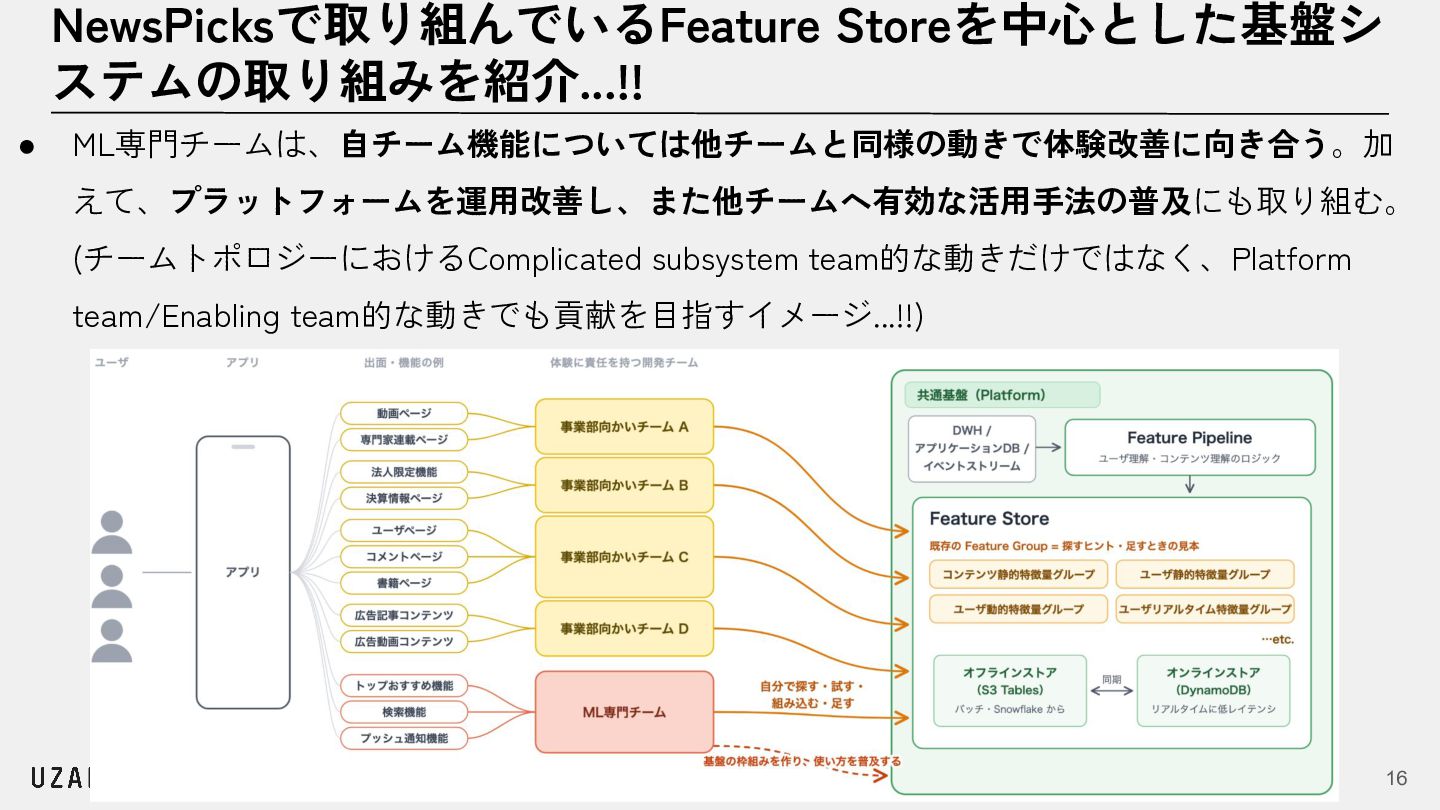
    Pipelineを用意しておく。 ◦ 新しい特徴量が必要になったら、まず既存のFeature Groupに含めれるかを判断: ▪ 含めれる! → 既存のFeature Pipelineに特徴量生成ロジックを追加するだけでOK ▪ 含めれない! → 要件の近い既存のFeature Group / Pipelineを参考に、データ読み 書きもインフラ構成も共通の型に沿って新しく構築すればOK! • 馴染みのある技術で、誰でもとっつきやすくする! ◦ SageMaker Feature StoreやFeastのようなFeature Store専用のサービス・フレーム ワークを採用するのではなく、DynamoDBやS3などAWSのメジャーなサービスを組み 合わせた自前実装でFeature Storeを実現! ◦ 必要に応じて開発メンバーが裏側の仕組みを理解・拡張しやすくする。 19
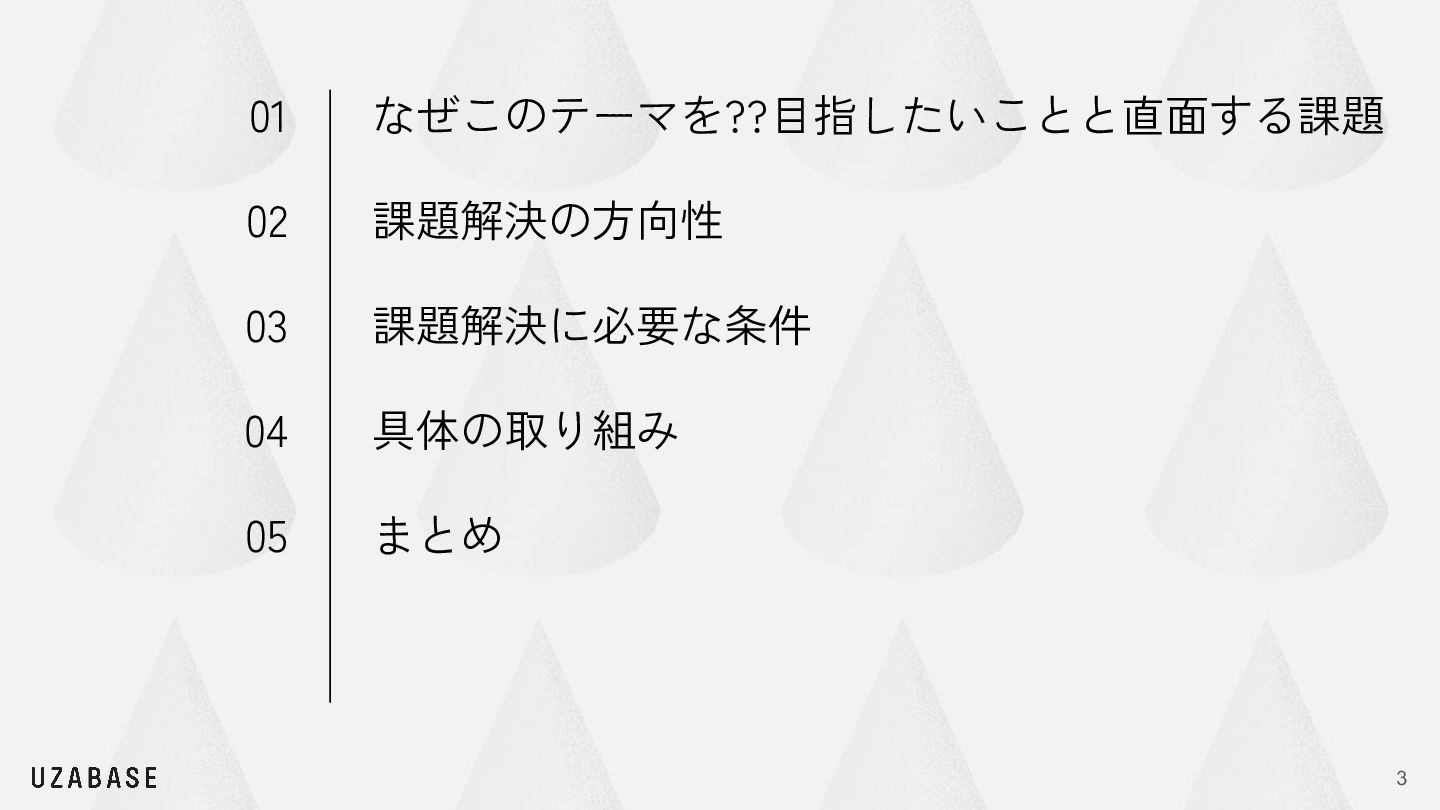
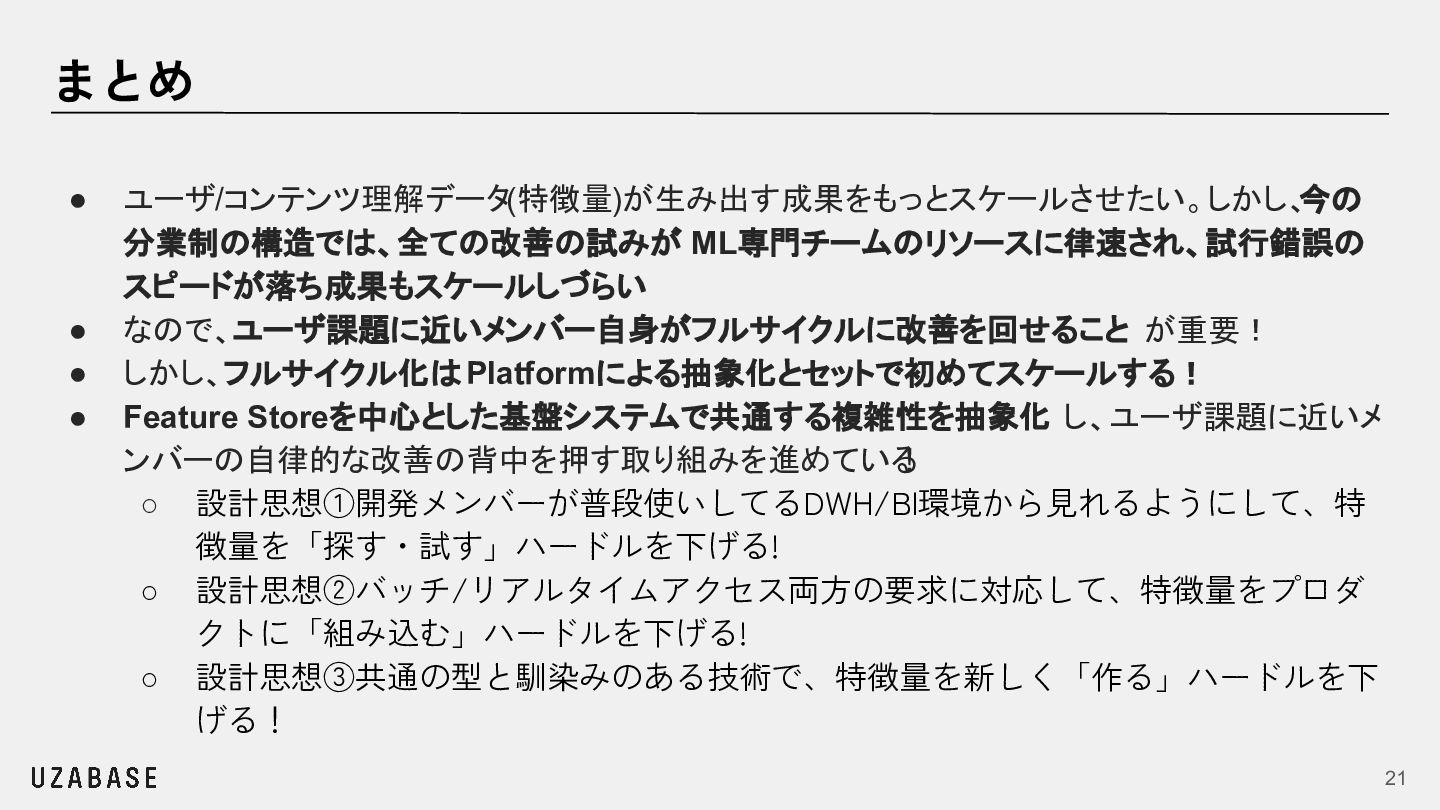
  8. まとめ • • • • ユーザ/コンテンツ理解データ(特徴量)が生み出す成果をもっとスケールさせたい。しかし、今の 分業制の構造では、全ての改善の試みが ML専門チームのリソースに律速され、試行錯誤の スピードが落ち成果もスケールしづらい なので、ユーザ課題に近いメンバー自身がフルサイクルに改善を回せること

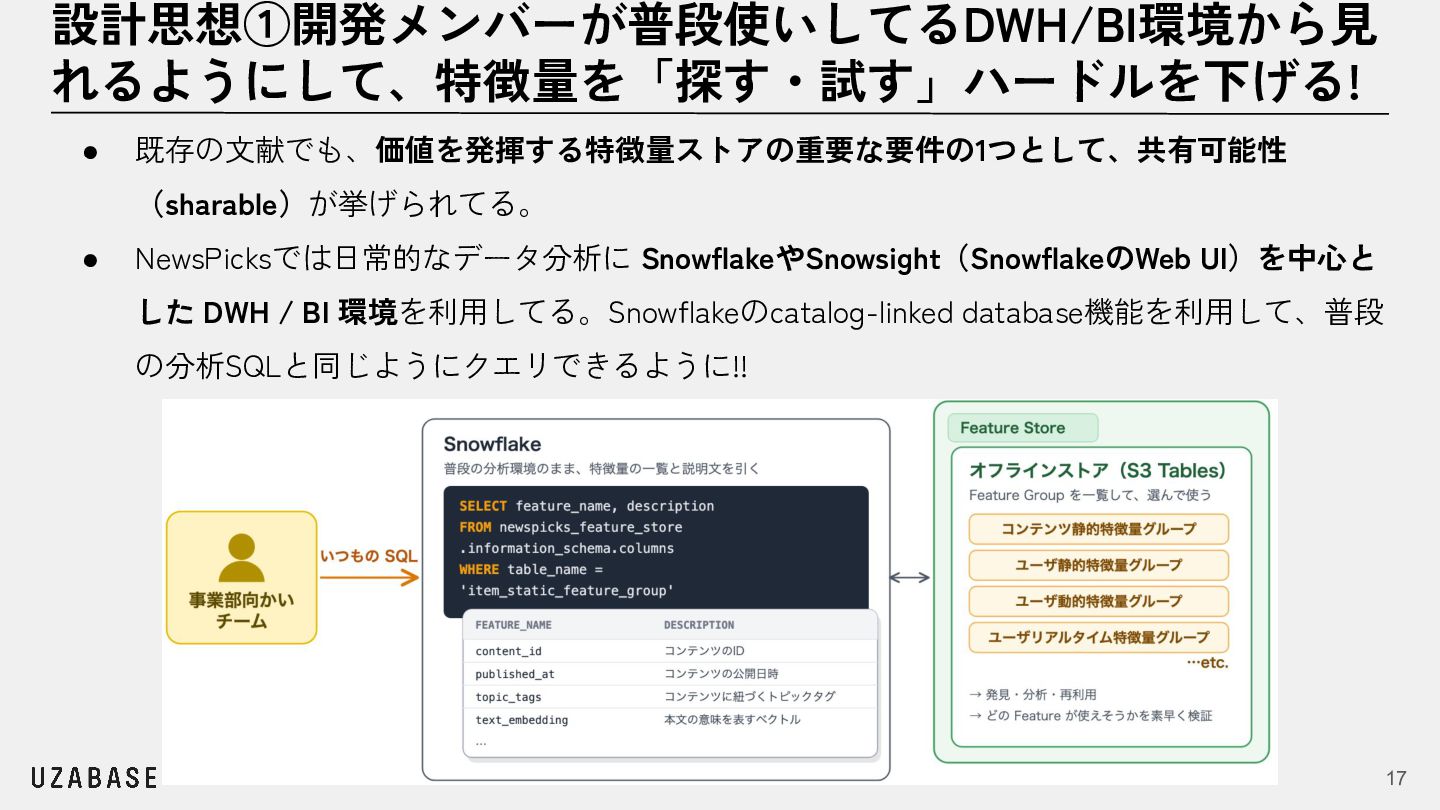
    が重要! しかし、フルサイクル化は Platformによる抽象化とセットで初めてスケールする! Feature Storeを中心とした基盤システムで共通する複雑性を抽象化 し、ユーザ課題に近いメ ンバーの自律的な改善の背中を押す取り組みを進めている! ◦ 設計思想①開発メンバーが普段使いしてるDWH/BI環境から見れるようにして、特 徴量を「探す・試す」ハードルを下げる! ◦ 設計思想②バッチ/リアルタイムアクセス両方の要求に対応して、特徴量をプロダ クトに「組み込む」ハードルを下げる! ◦ 設計思想③共通の型と馴染みのある技術で、特徴量を新しく「作る」ハードルを下 げる! 21