Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
EgoX: Egocentric Video Generation from a Single...
Search
peisuke
August 28, 2026
180
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
EgoX: Egocentric Video Generation from a Single Exocentric Video
第67回 コンピュータビジョン勉強会@関東「CVPR2026読み会(前編)」
peisuke
August 28, 2026
More Decks by peisuke
See All by peisuke
Moto: Latent Motion Token as the Bridging Language for Learning Robot Manipulation from Videos
peisuke
0
270
VGGT: Visual Geometry Grounded Transformer
peisuke
1
2k
AI for Kids:小学生に画像認識を教えてみた話
peisuke
1
110
LangGraphで始めるマルチエージェントシステム
peisuke
14
5.1k
Self-RAG: Learning to Retrieve, Generate and Critique through Self-Reflections
peisuke
9
1.7k
Mip-NeRF 360: Unbounded Anti-Aliased Neural Radiance Fields
peisuke
0
14k
LangChain Toolsの運用と改善
peisuke
5
3k
GNeRF: GAN-based Neural Radiance Field without Posed Camera
peisuke
1
860
TTS Skins: Speaker Conversion via ASR
peisuke
0
460
Featured
See All Featured
The untapped power of vector embeddings
frankvandijk
2
1.9k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
So, you think you're a good person
axbom
PRO
2
2.1k
Building Applications with DynamoDB
mza
96
7.2k
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.3k
The SEO identity crisis: Don't let AI make you average
varn
0
550
How to build a perfect <img>
jonoalderson
1
6k
How to Ace a Technical Interview
jacobian
281
24k
Faster Mobile Websites
deanohume
310
32k
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.8k
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
Building the Perfect Custom Keyboard
takai
2
870
Transcript
第67回 コンピュータビジョン勉強会@関東 CVPR2026 読み会 EgoX: Egocentric Video Generation from a
Single Exocentric Video Author: T. Kang, K. Kim, D. Kim, M. Park, J. Hyung, J. Choo Presenter: @peisuke
自己紹介 藤本 敬介 ABEJA CEO室/Labs ラボ⻑ ▷ 経歴 2010-2016:⽇⽴製作所 2016-:ABEJA
▷ SNS X:@peisuke github:@peisuke Qiita:peisuke ▷ 著書 ディープラーニングG検定公式テキスト AI⽩書2023, 2025
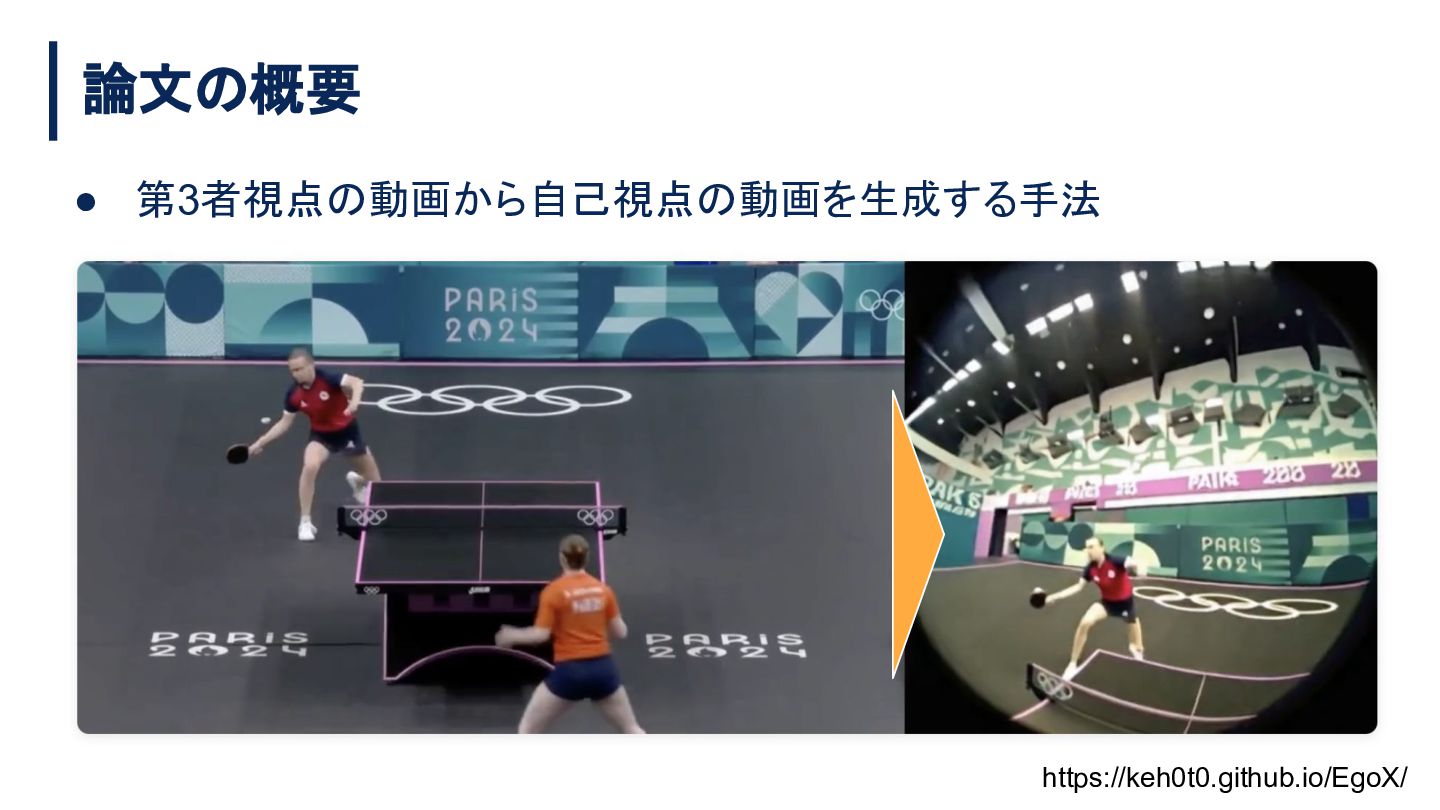
論文 概要 • 第3者視点 動画から自己視点 動画を生成する手法 https://keh0t0.github.io/EgoX/
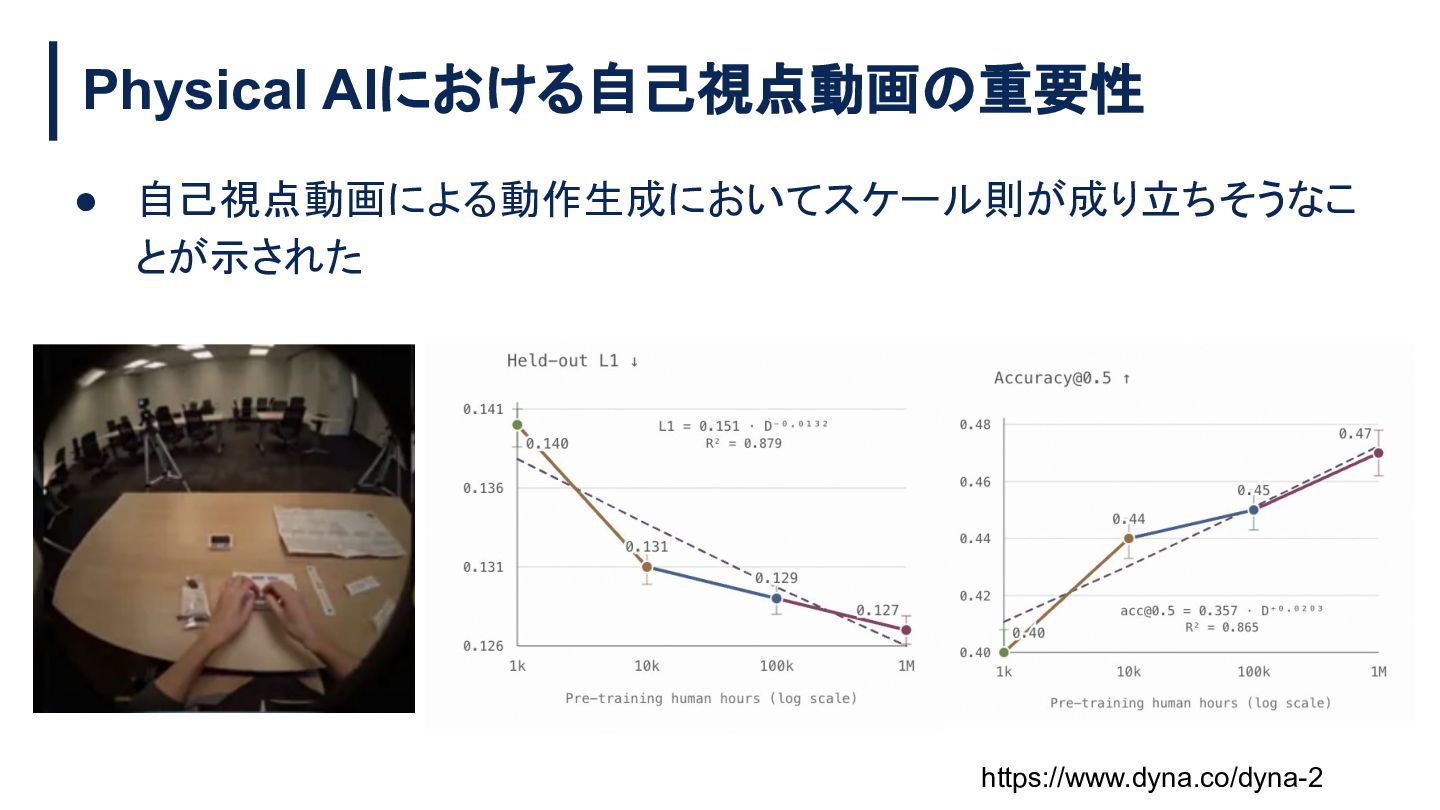
Physical AIにおける自己視点動画 重要性 • 自己視点動画による動作生成においてスケール則が成り立ちそうなこ とが示された https://www.dyna.co/dyna-2
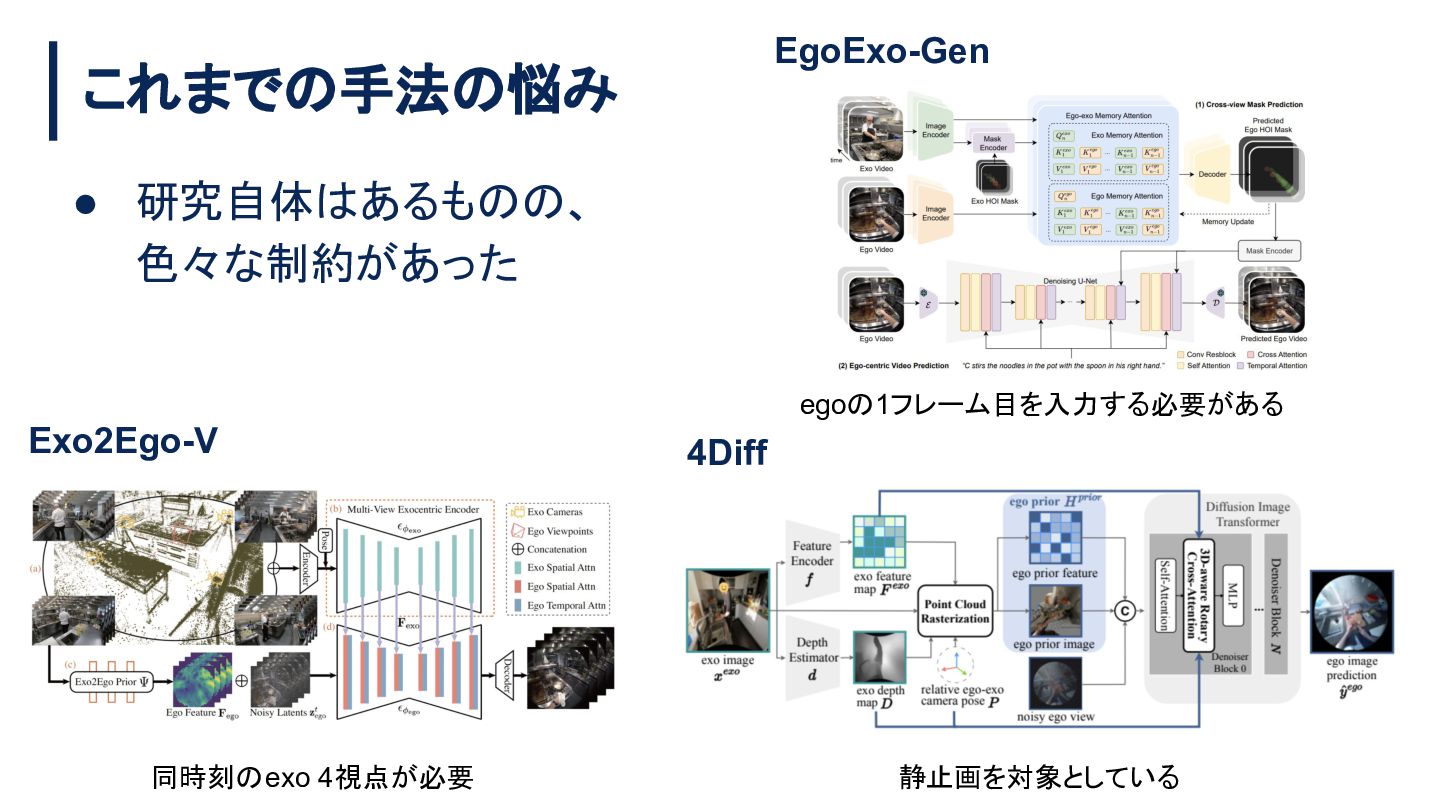
これまで 手法 EgoExo-Gen 悩み • 研究自体 あるも 色々な制約があった 、 ego
Exo2Ego-V 同時刻 1フレーム目を入力する必要がある 4Diff exo 4視点が必要 静止画を対象としている
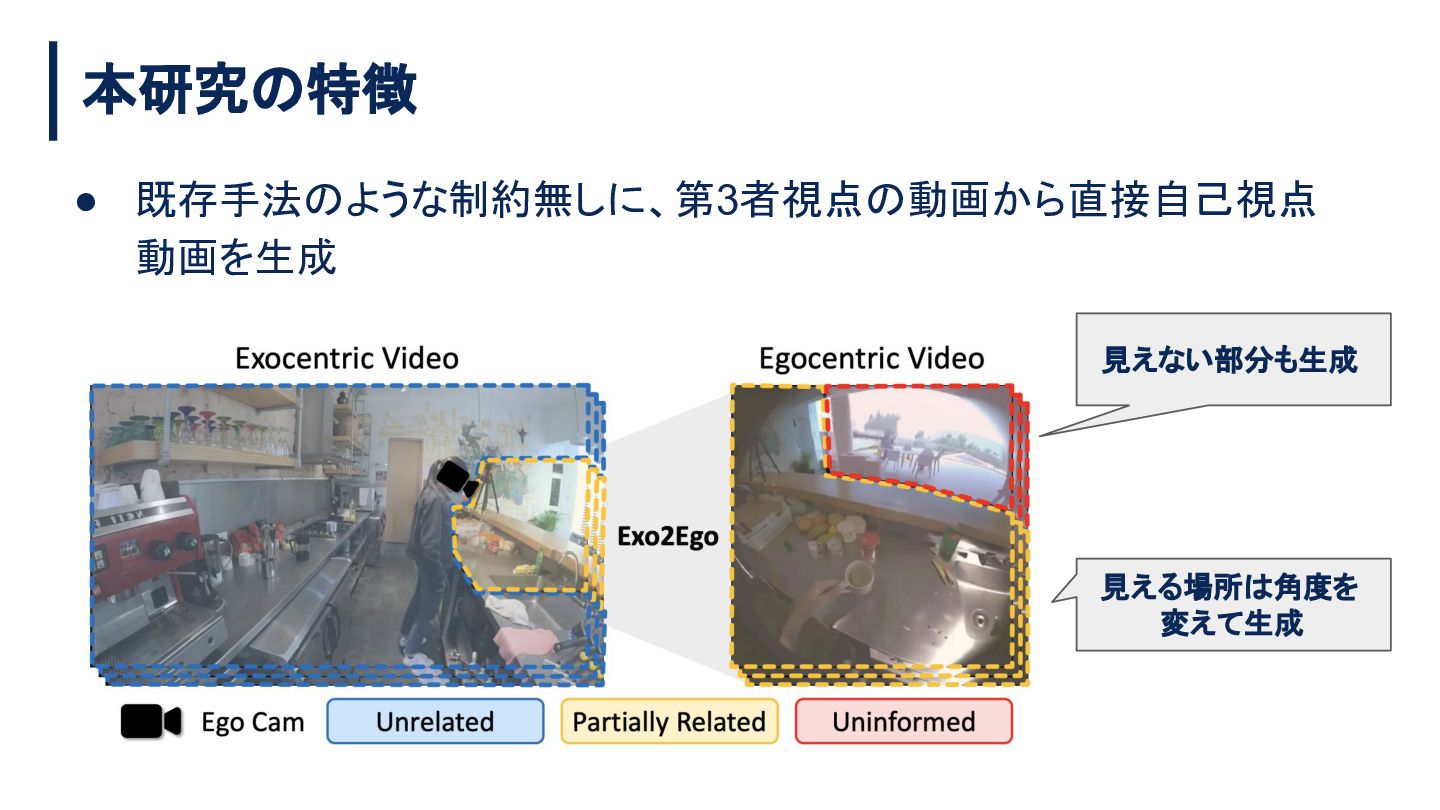
本研究 特徴 • 既存手法 ような制約無しに、第3者視点 動画を生成 動画から直接自己視点 見えない部分も生成 見える場所 角度を
変えて生成
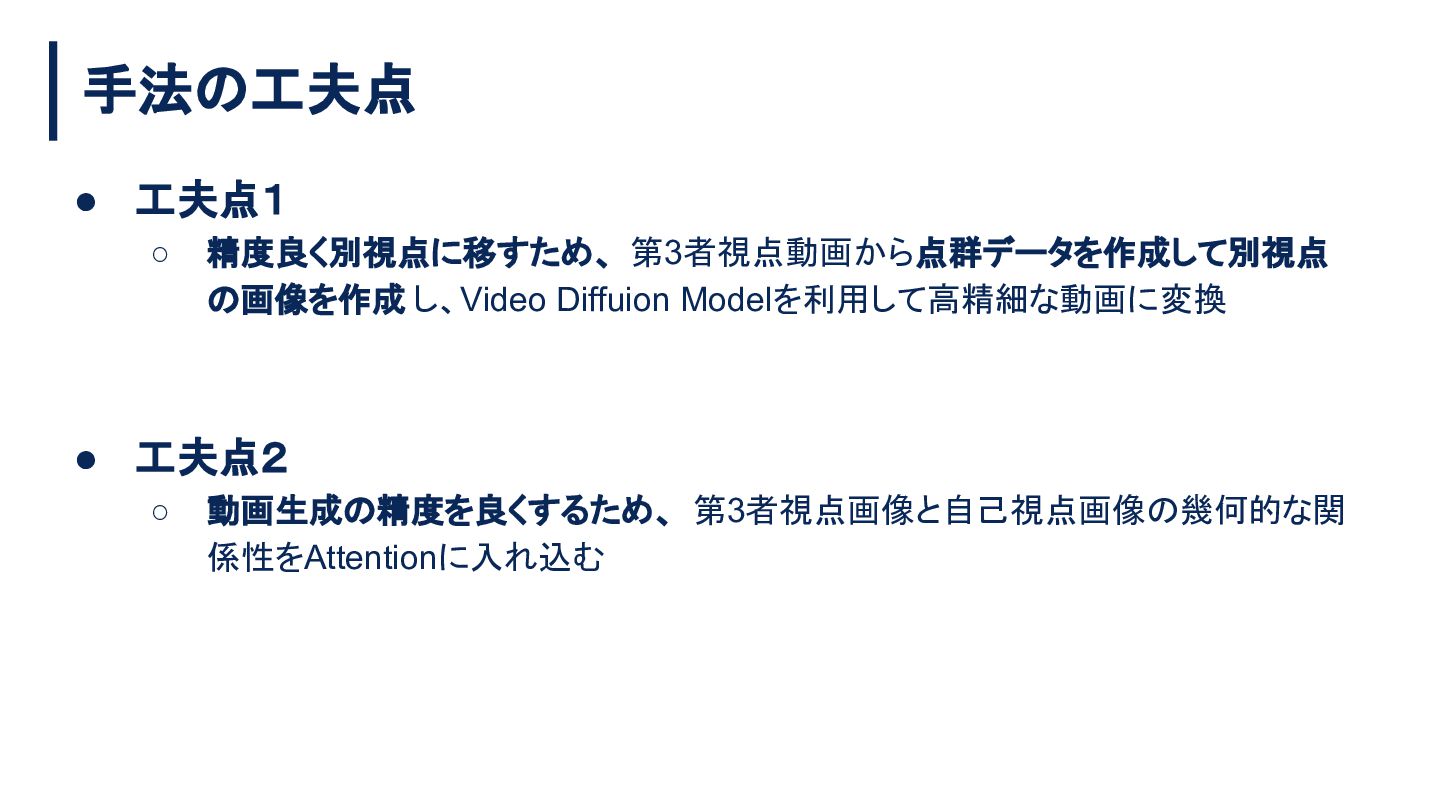
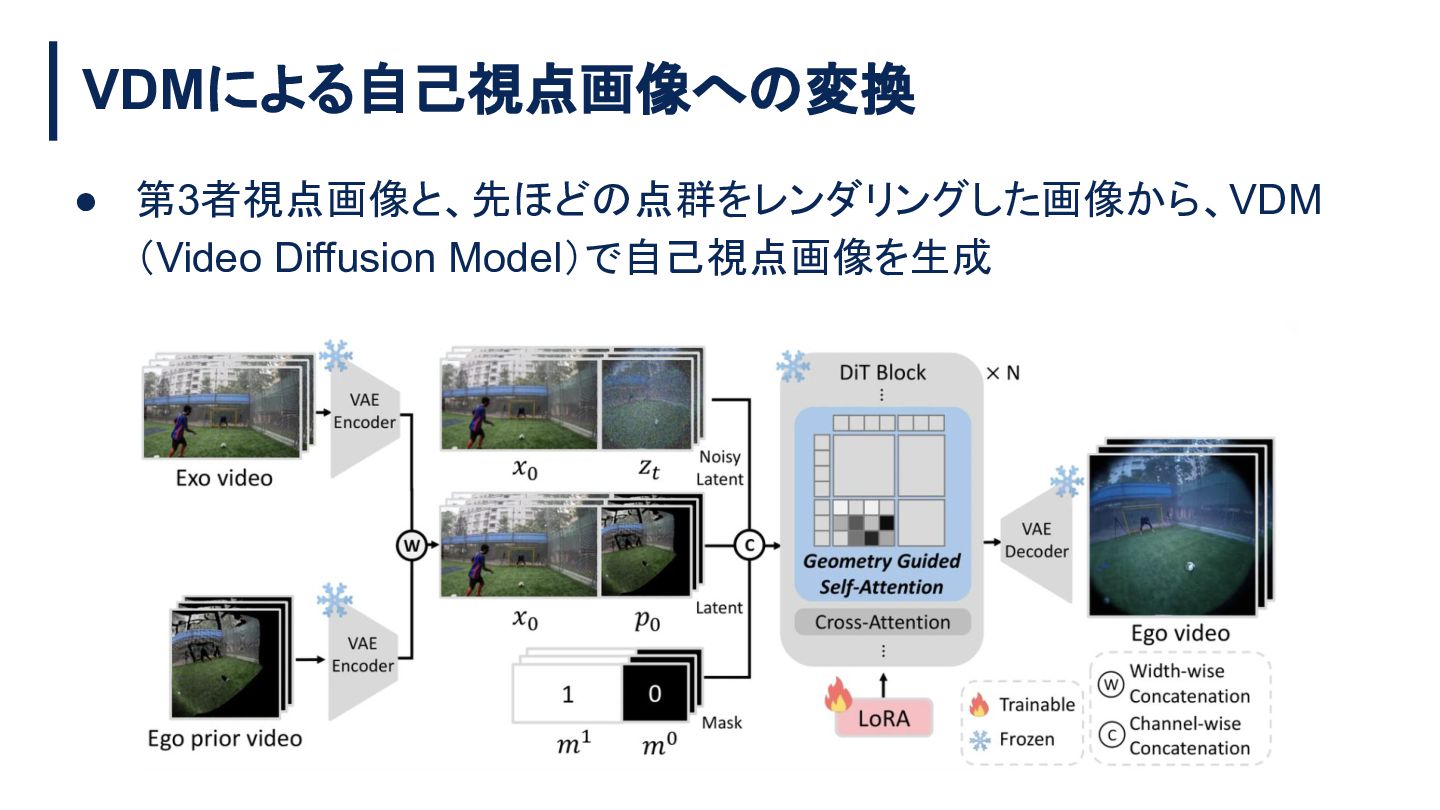
手法 工夫点 • 工夫点1 ◦ 精度良く別視点に移すため、 第3者視点動画から点群データを作成して別視点 画像を作成 し、Video Diffuion
Modelを利用して高精細な動画に変換 • 工夫点2 ◦ 動画生成 精度を良くするため、 第3者視点画像と自己視点画像 幾何的な関 係性をAttentionに入れ込む
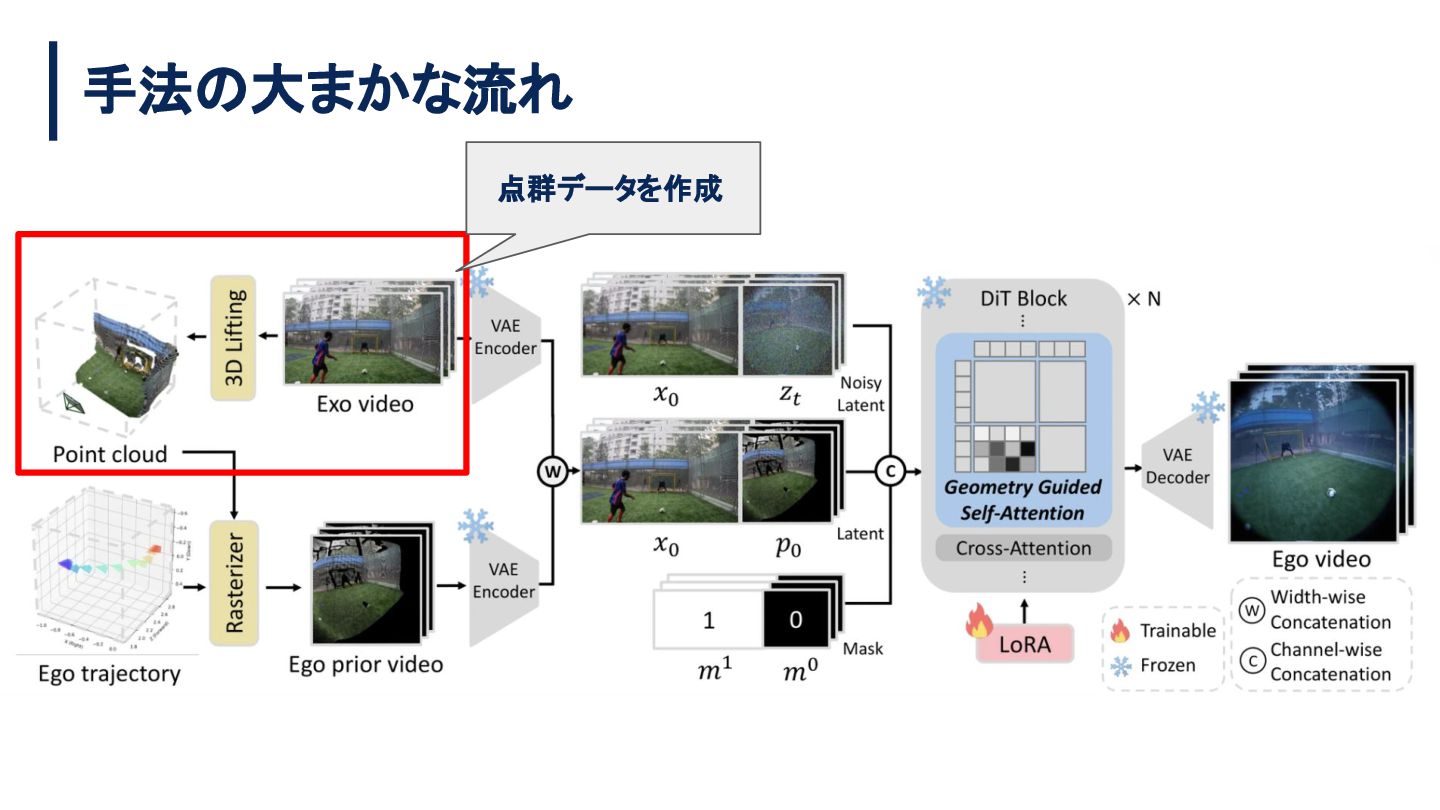
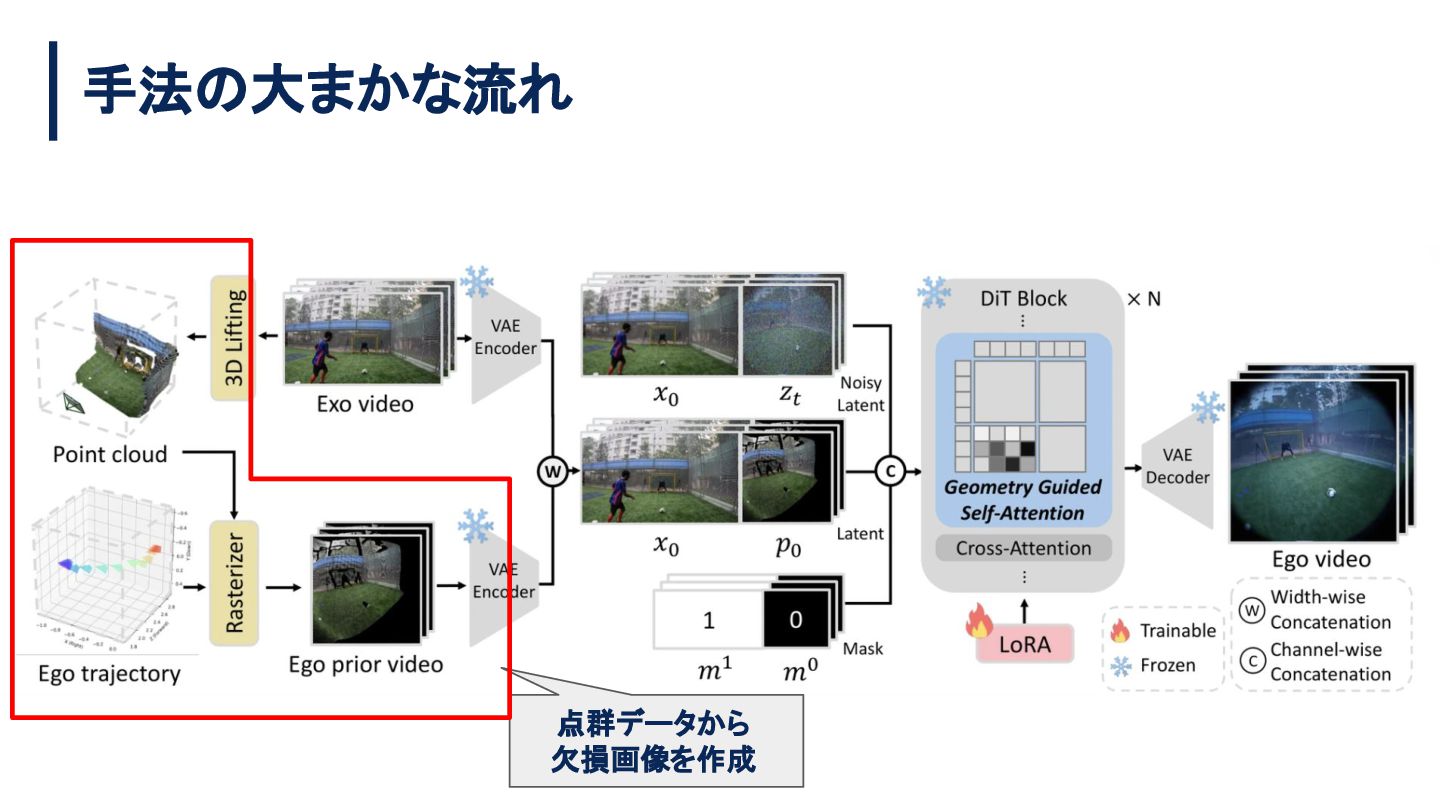
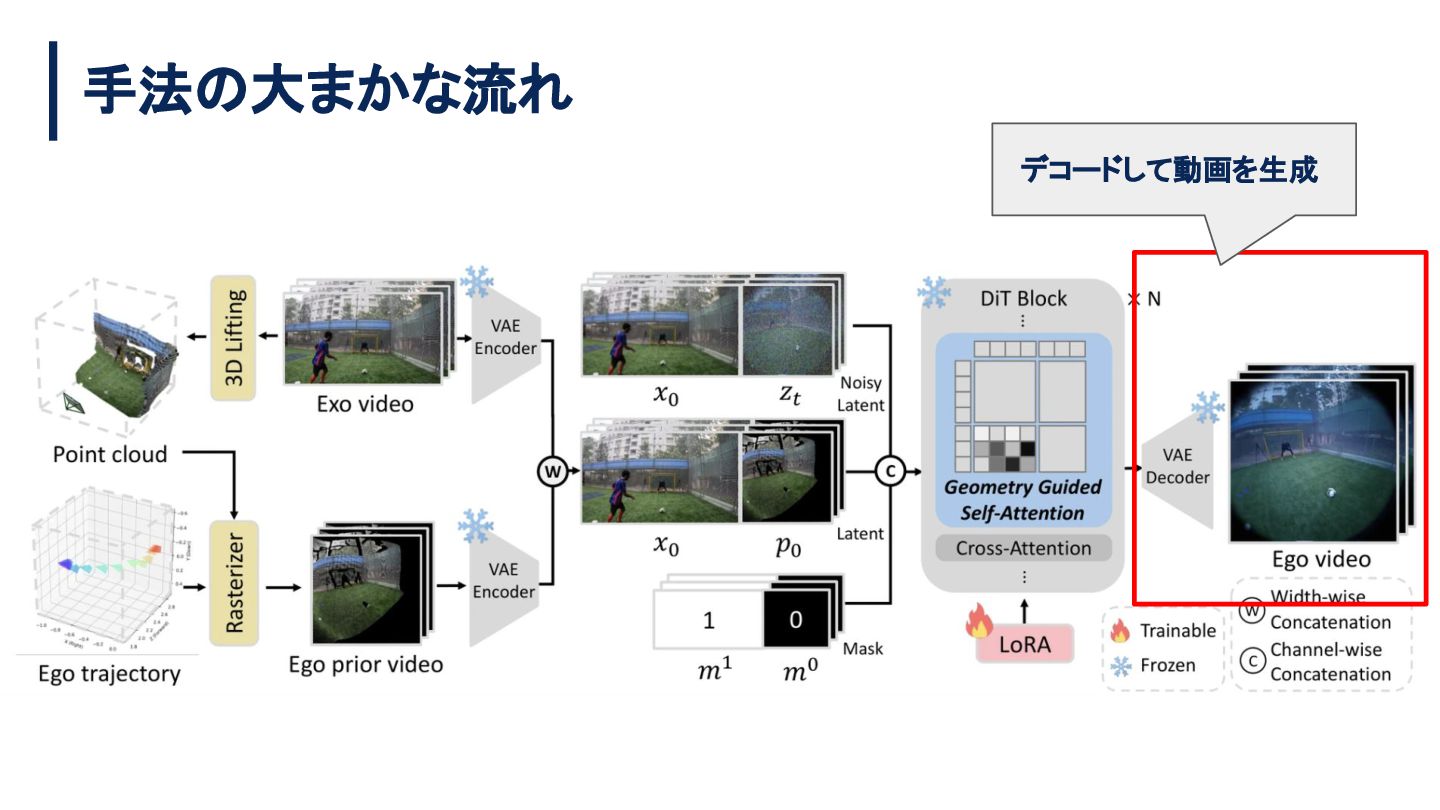
手法 大まかな流れ 点群データを作成
手法 大まかな流れ 点群データから 欠損画像を作成
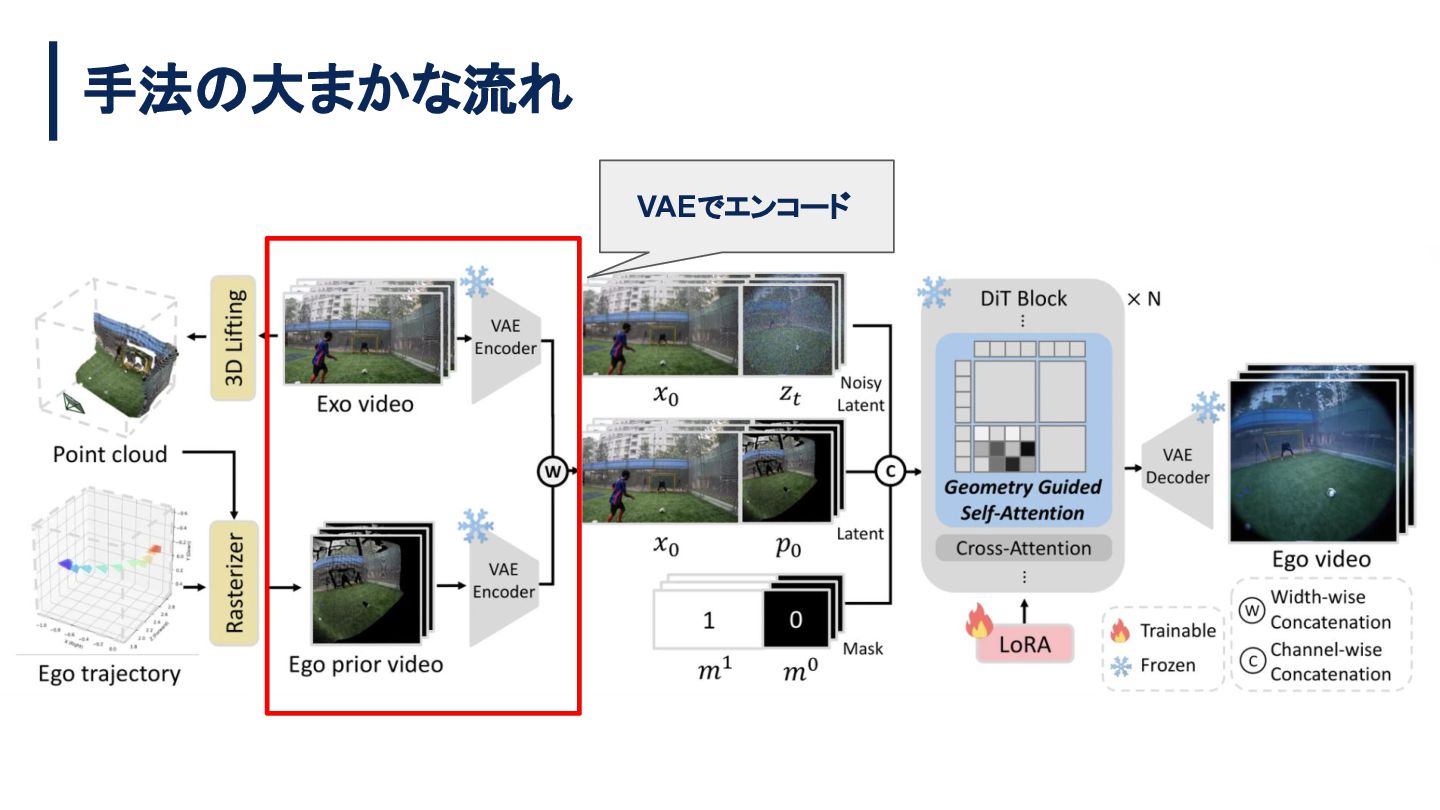
手法 大まかな流れ VAEでエンコード
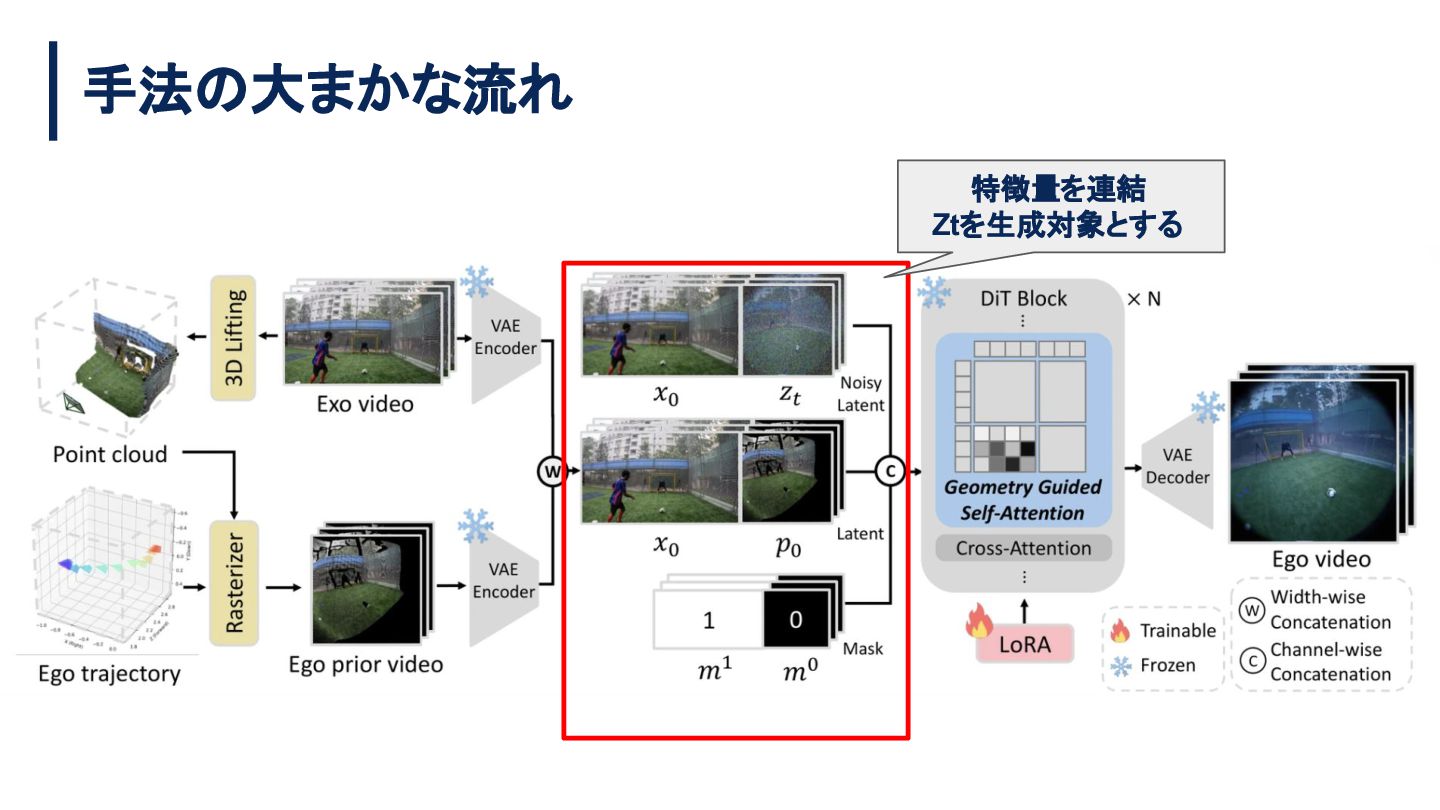
手法 大まかな流れ 特徴量を連結 Ztを生成対象とする
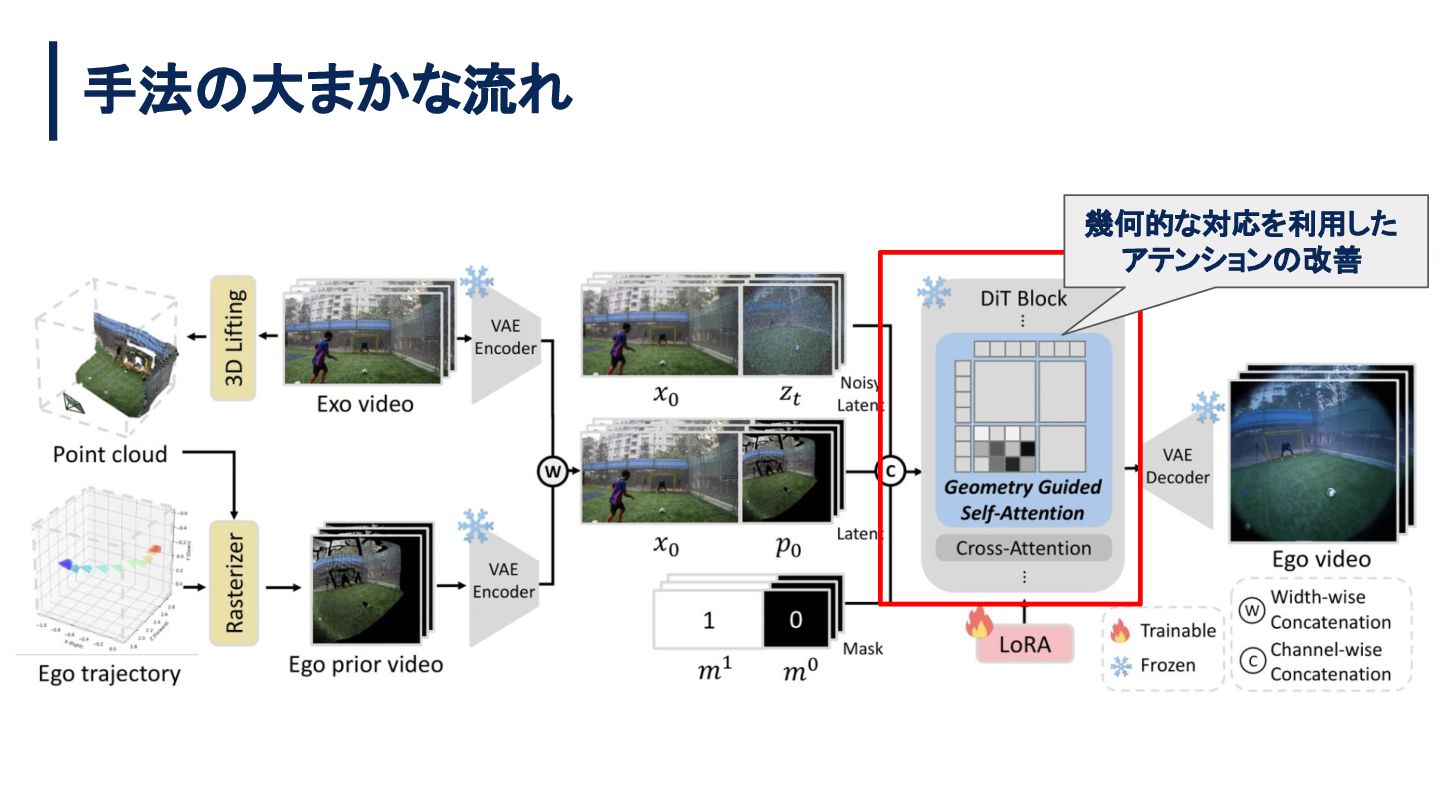
手法 大まかな流れ 幾何的な対応を利用した アテンション 改善
手法 大まかな流れ デコードして動画を生成
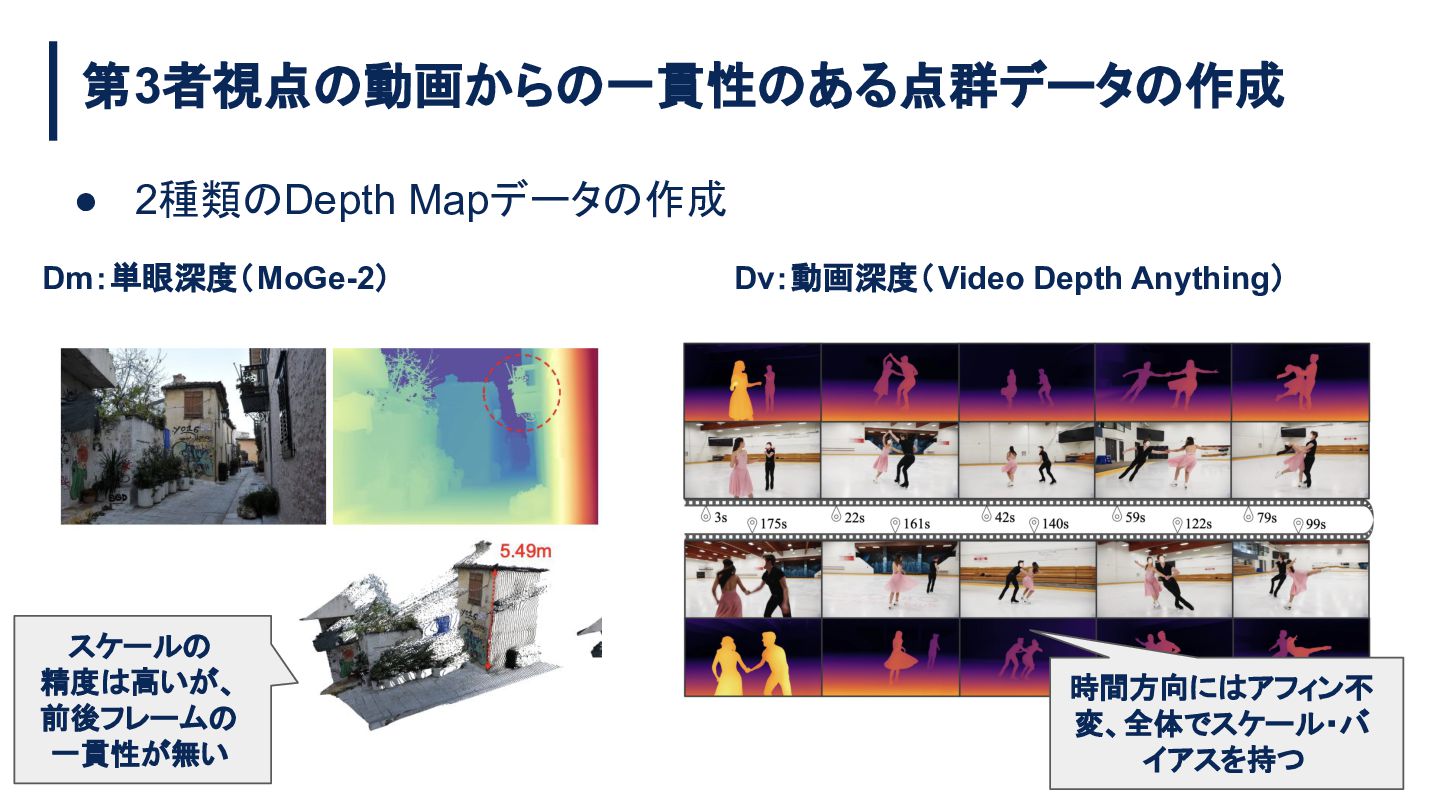
第3者視点 動画から 一貫性 • 2種類 Depth Mapデータ 作成 Dm:単眼深度( MoGe-2)
スケール 精度 高いが、 前後フレーム 一貫性が無い ある点群データ 作成 Dv:動画深度( Video Depth Anything) 時間方向に アフィン不 変、全体でスケール・バ イアスを持つ
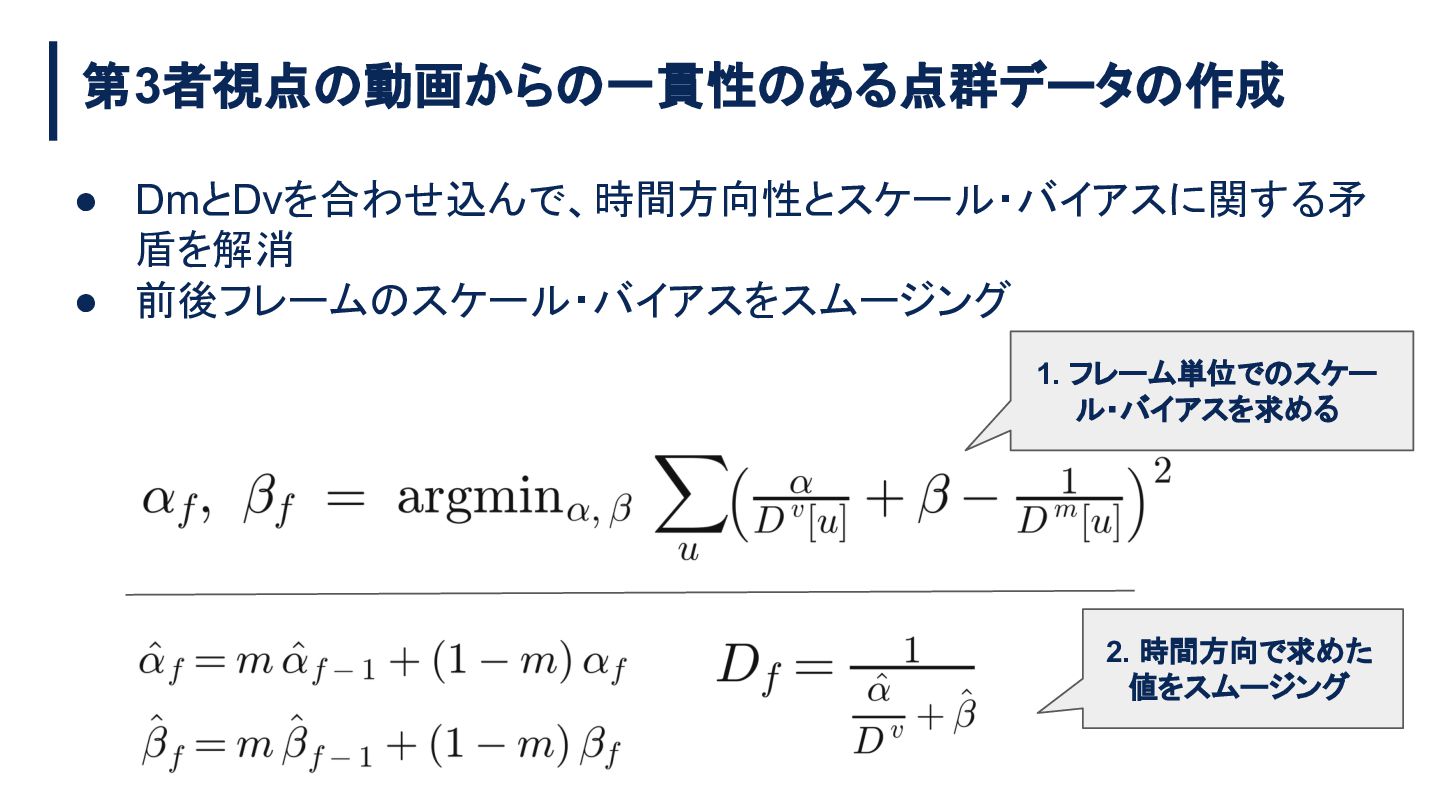
第3者視点 動画から 一貫性 ある点群データ 作成 • DmとDvを合わせ込んで、時間方向性とスケール・バイアスに関する矛 盾を解消 • 前後フレーム
スケール・バイアスをスムージング 1. フレーム単位で スケー ル・バイアスを求める 2. 時間方向で求めた 値をスムージング
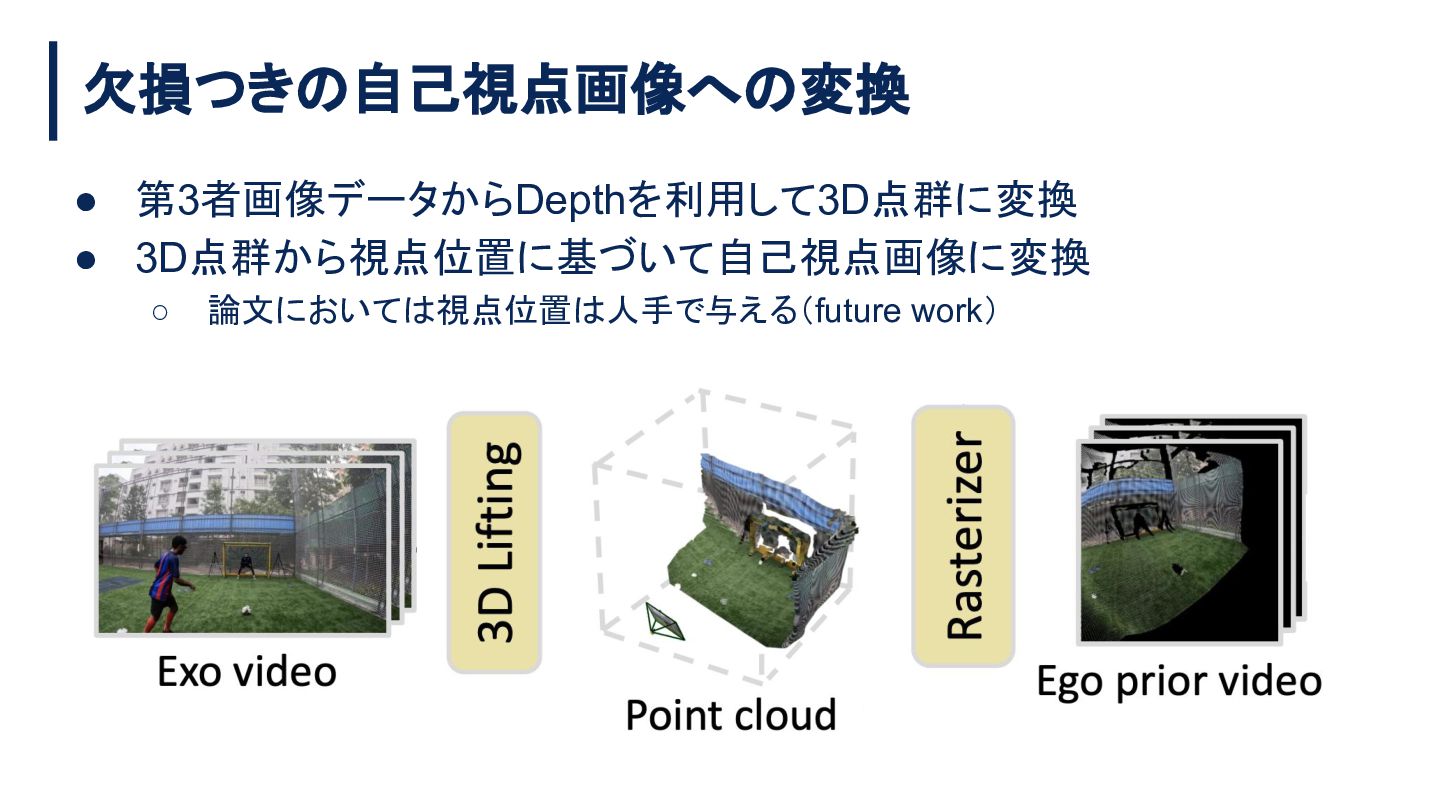
欠損つき 自己視点画像へ 変換 • 第3者画像データからDepthを利用して3D点群に変換 • 3D点群から視点位置に基づいて自己視点画像に変換 ◦ 論文において 視点位置
人手で与える(future work)
VDMによる自己視点画像へ 変換 • 第3者視点画像と、先ほど 点群をレンダリングした画像から、VDM (Video Diffusion Model)で自己視点画像を生成
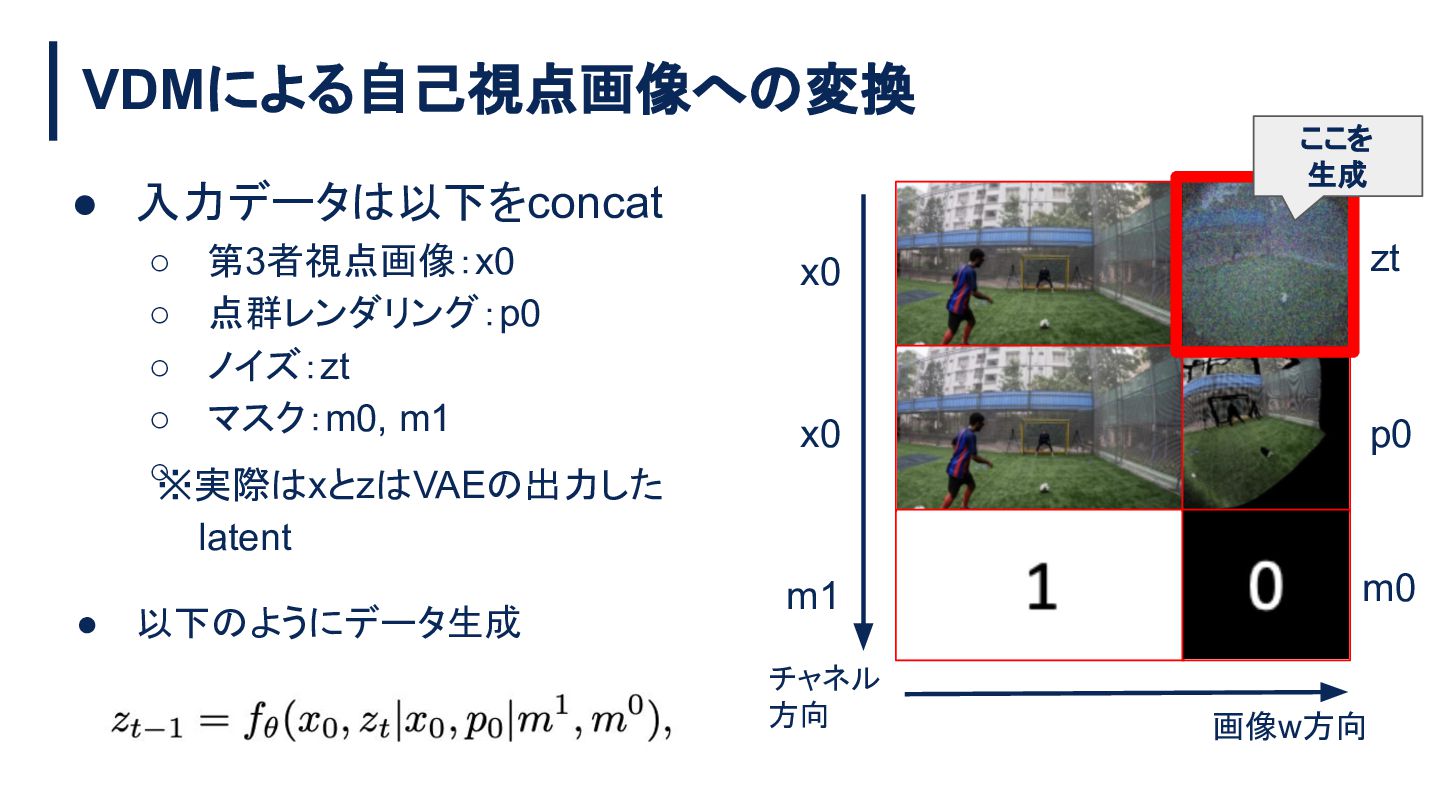
VDMによる自己視点画像へ 変換 ここを 生成 • 入力データ 以下をconcat ◦ 第3者視点画像:x0 ◦
点群レンダリング:p0 ◦ ノイズ:zt ◦ マスク:m0, m1 ◦※実際 xとz VAE 出力した x0 zt x0 p0 m1 m0 latent • 以下 ようにデータ生成 チャネル 方向 画像w方向
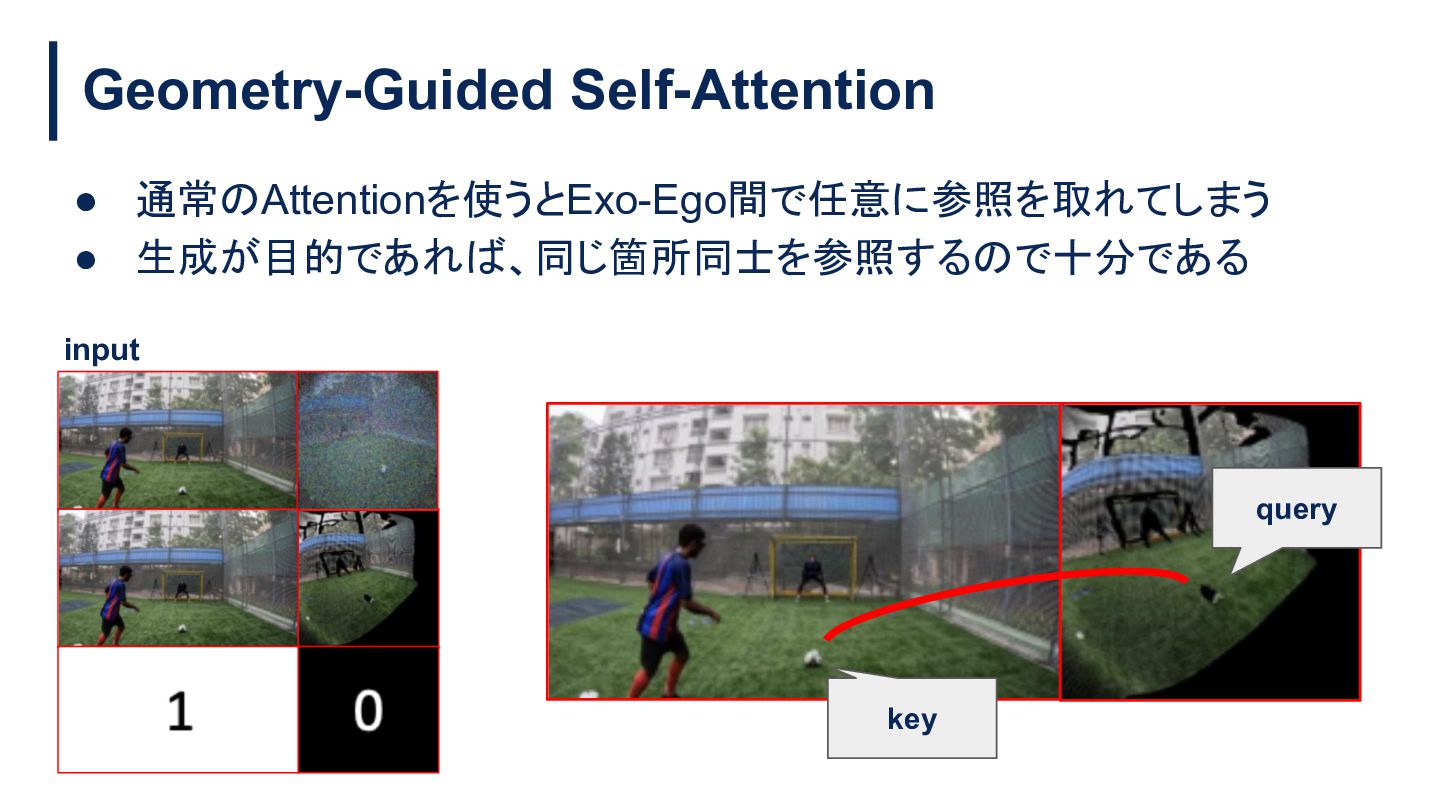
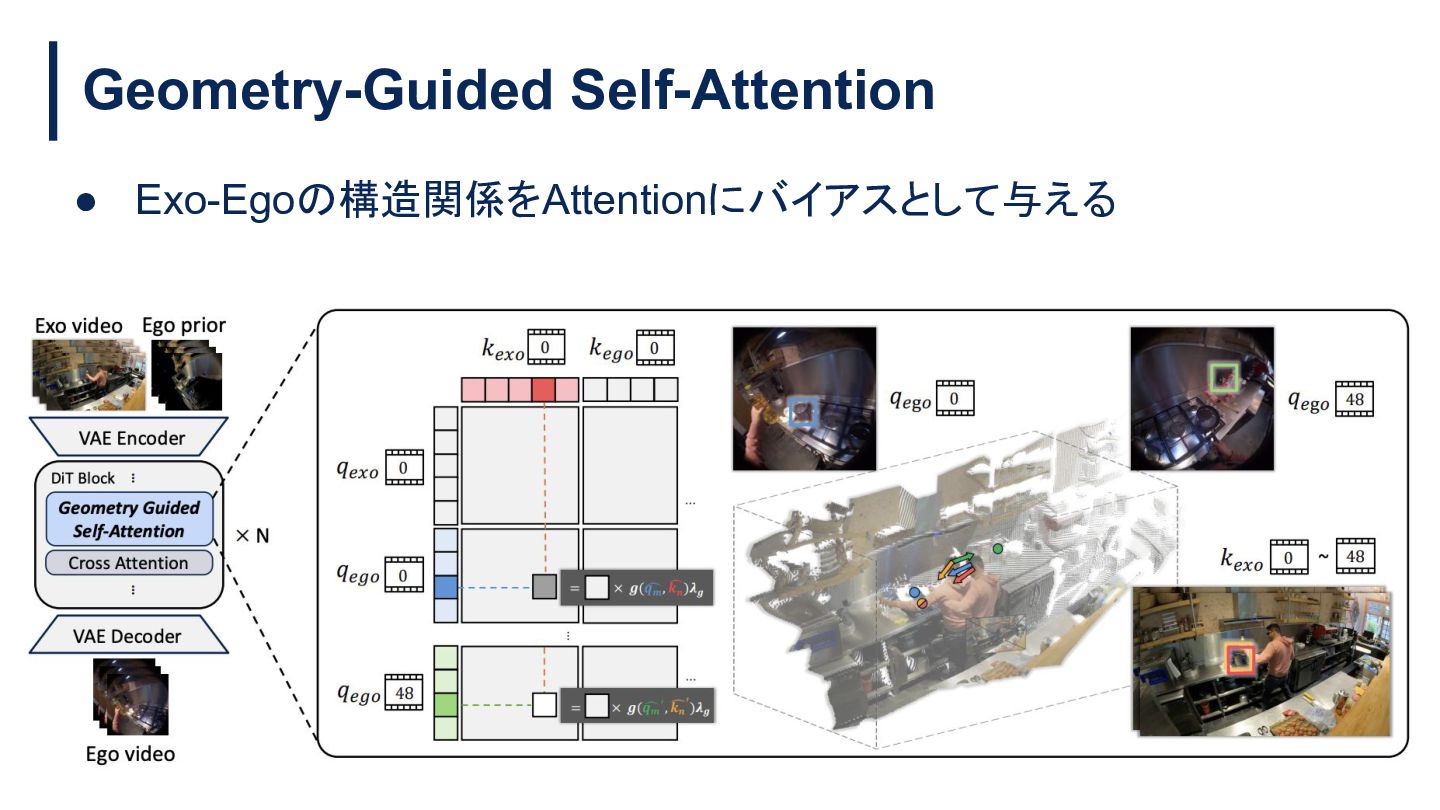
Geometry-Guided Self-Attention • 通常 Attentionを使うとExo-Ego間で任意に参照を取れてしまう • 生成が目的であれ 、同じ箇所同士を参照する で十分である input
query key
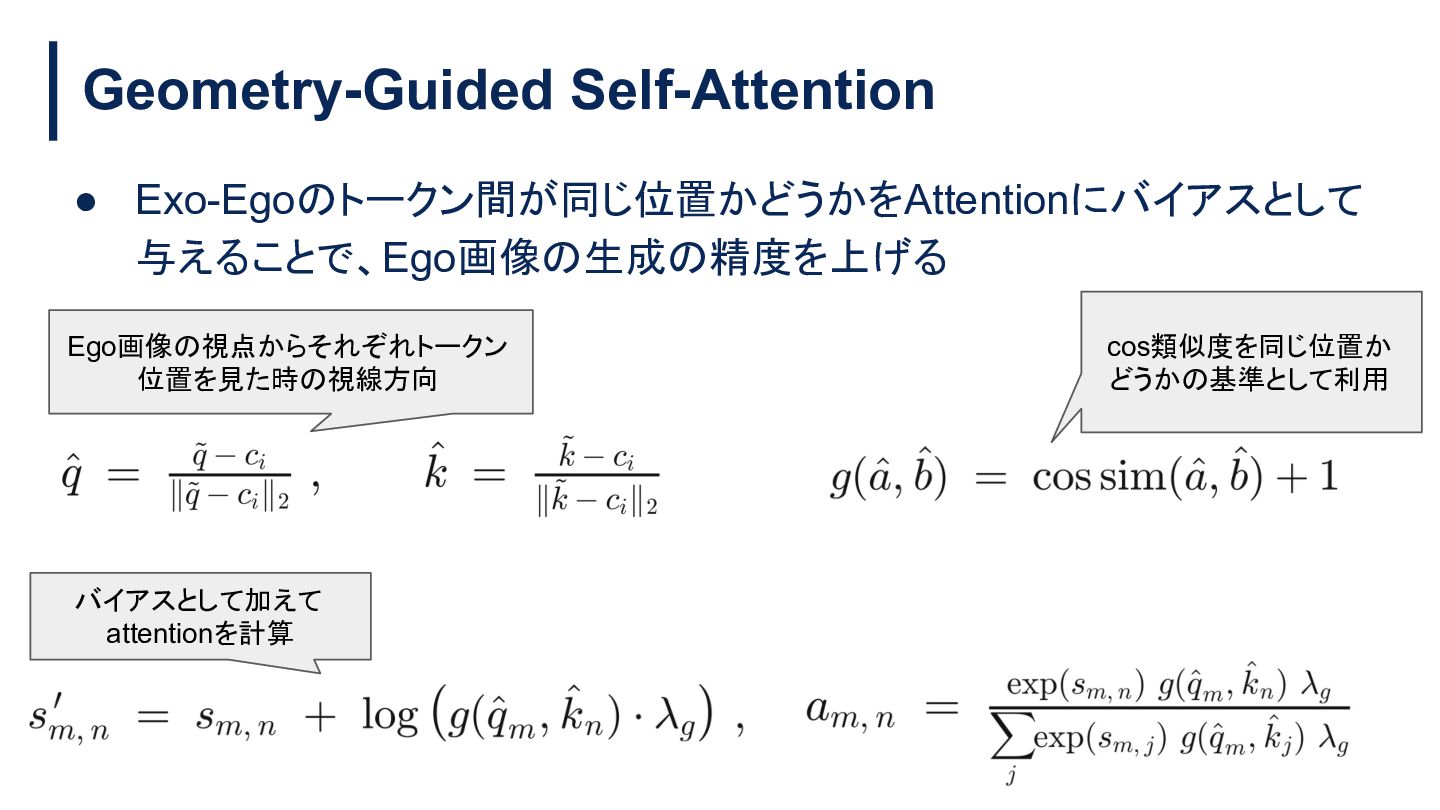
Geometry-Guided Self-Attention • Exo-Ego トークン間が同じ位置かどうかをAttentionにバイアスとして 与えることで、Ego画像 生成 精度を上げる Ego画像 視点からそれぞれトークン
位置を見た時 視線方向 バイアスとして加えて attentionを計算 cos類似度を同じ位置か どうか 基準として利用
Geometry-Guided Self-Attention • Exo-Ego 構 関係をAttentionにバイアスとして与える
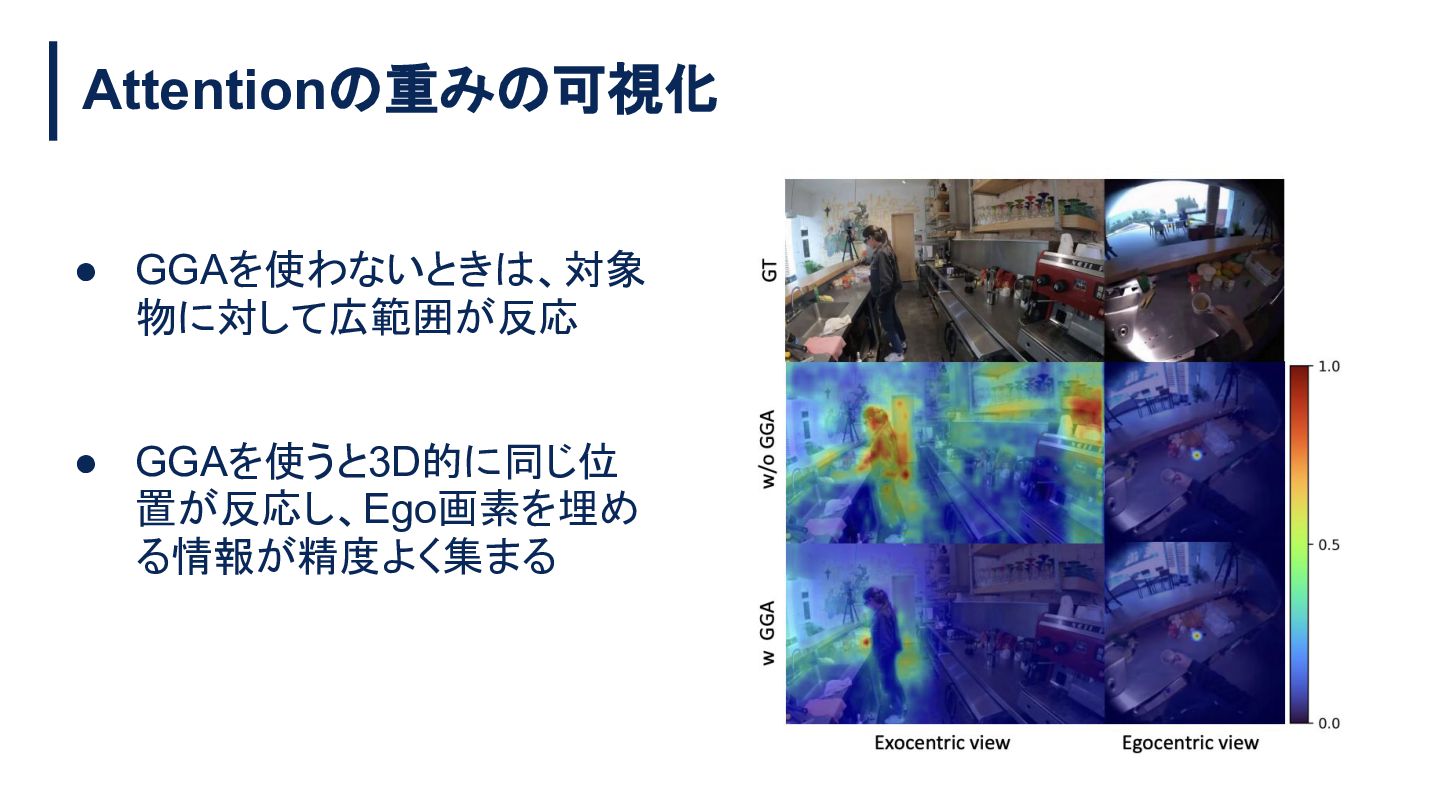
Attention 重み 可視化 • GGAを使わないとき 、対象 物に対して広範囲が反応 • GGAを使うと3D的に同じ位 置が反応し、Ego画素を埋め
る情報が精度よく集まる
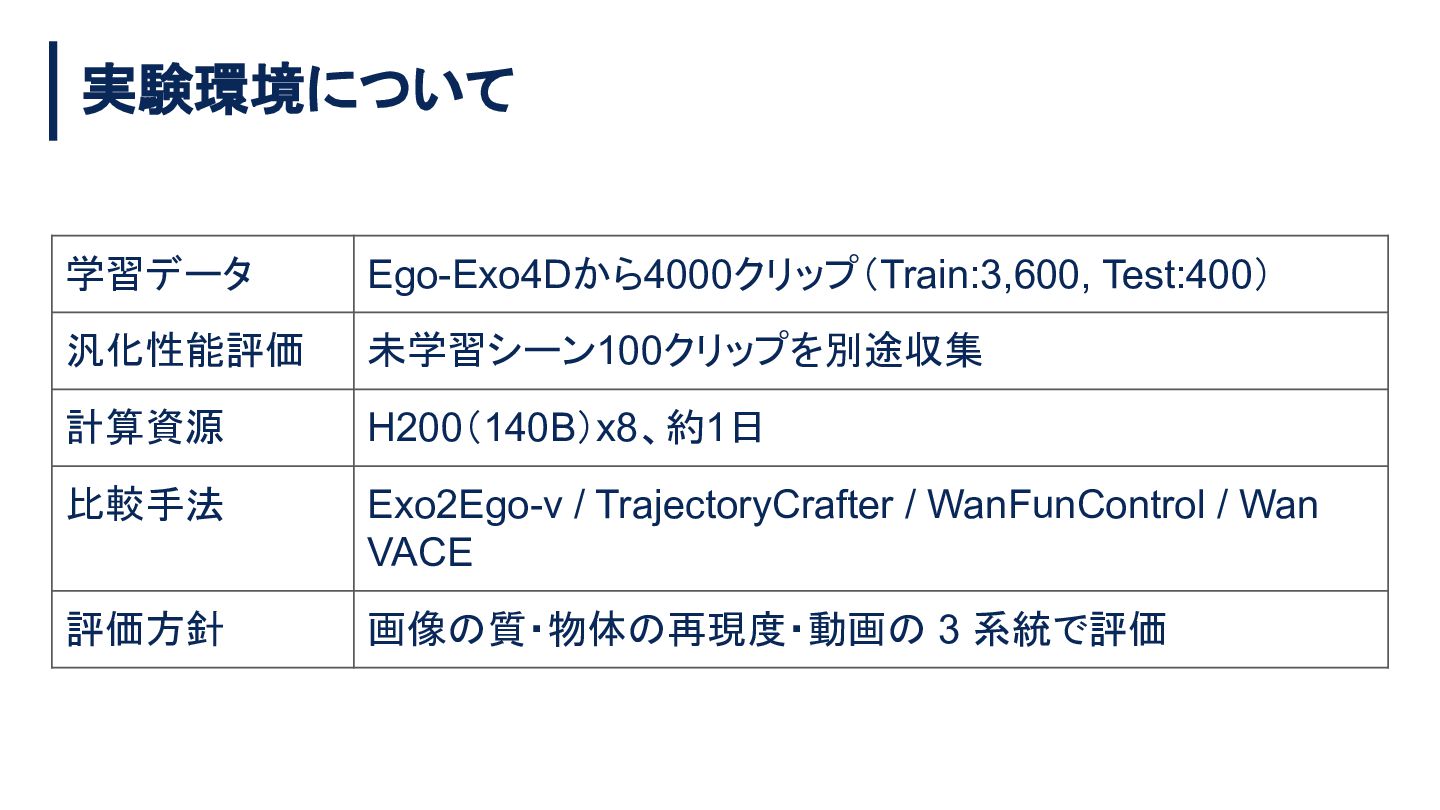
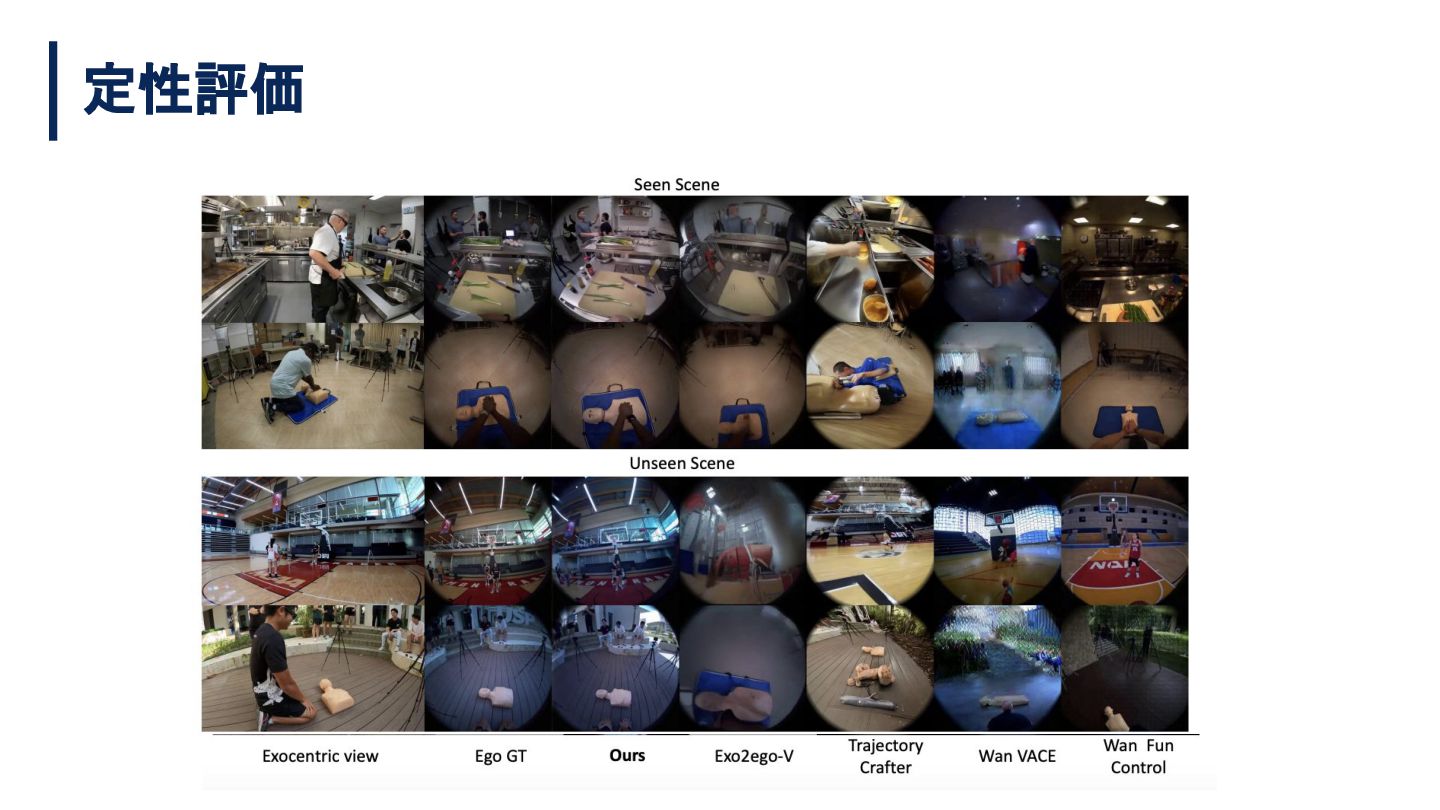
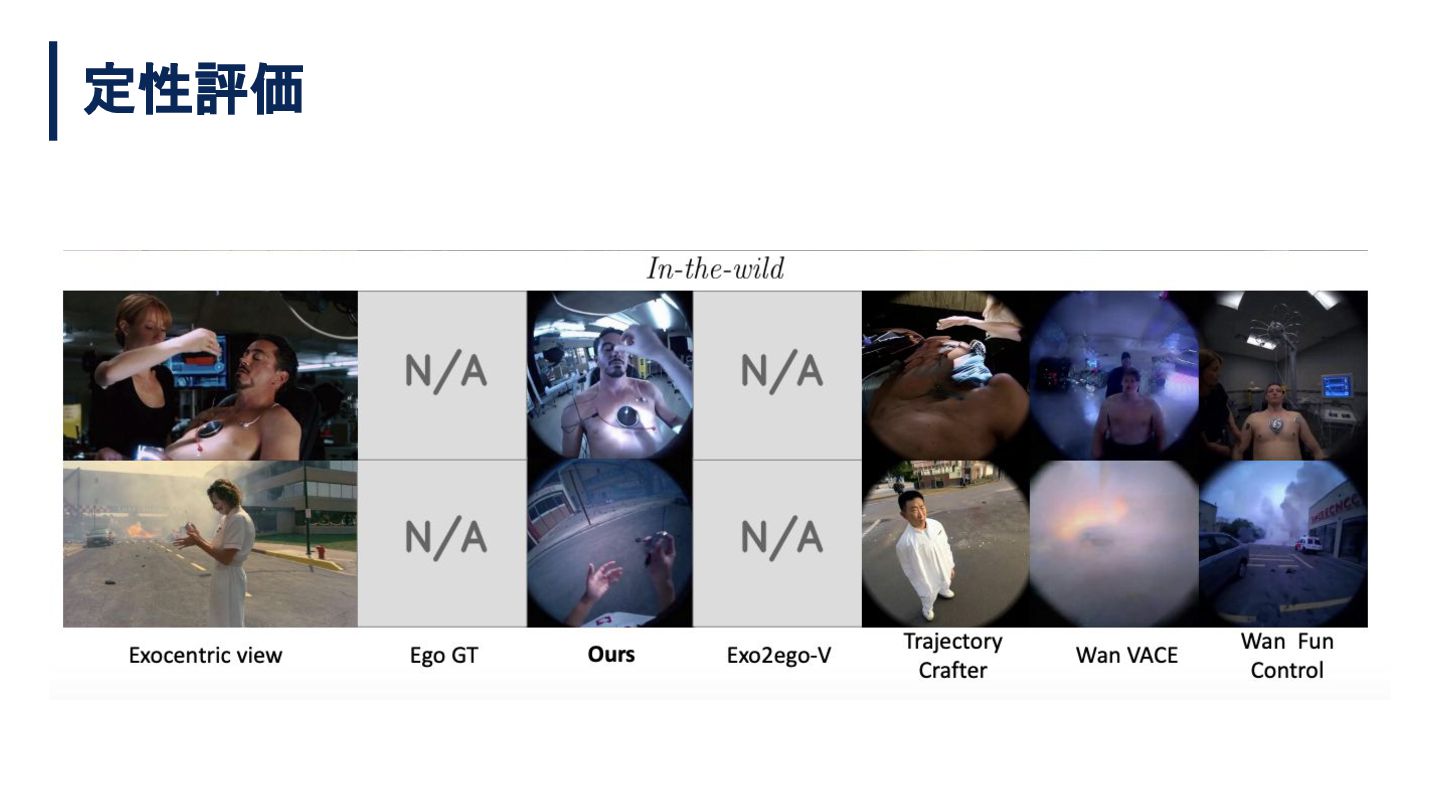
実験環境について 学習データ Ego-Exo4Dから4000クリップ(Train:3,600, Test:400) 汎化性能評価 未学習シーン100クリップを別途収集 計算資源 H200(140B)x8、約1日 比較手法 Exo2Ego-v
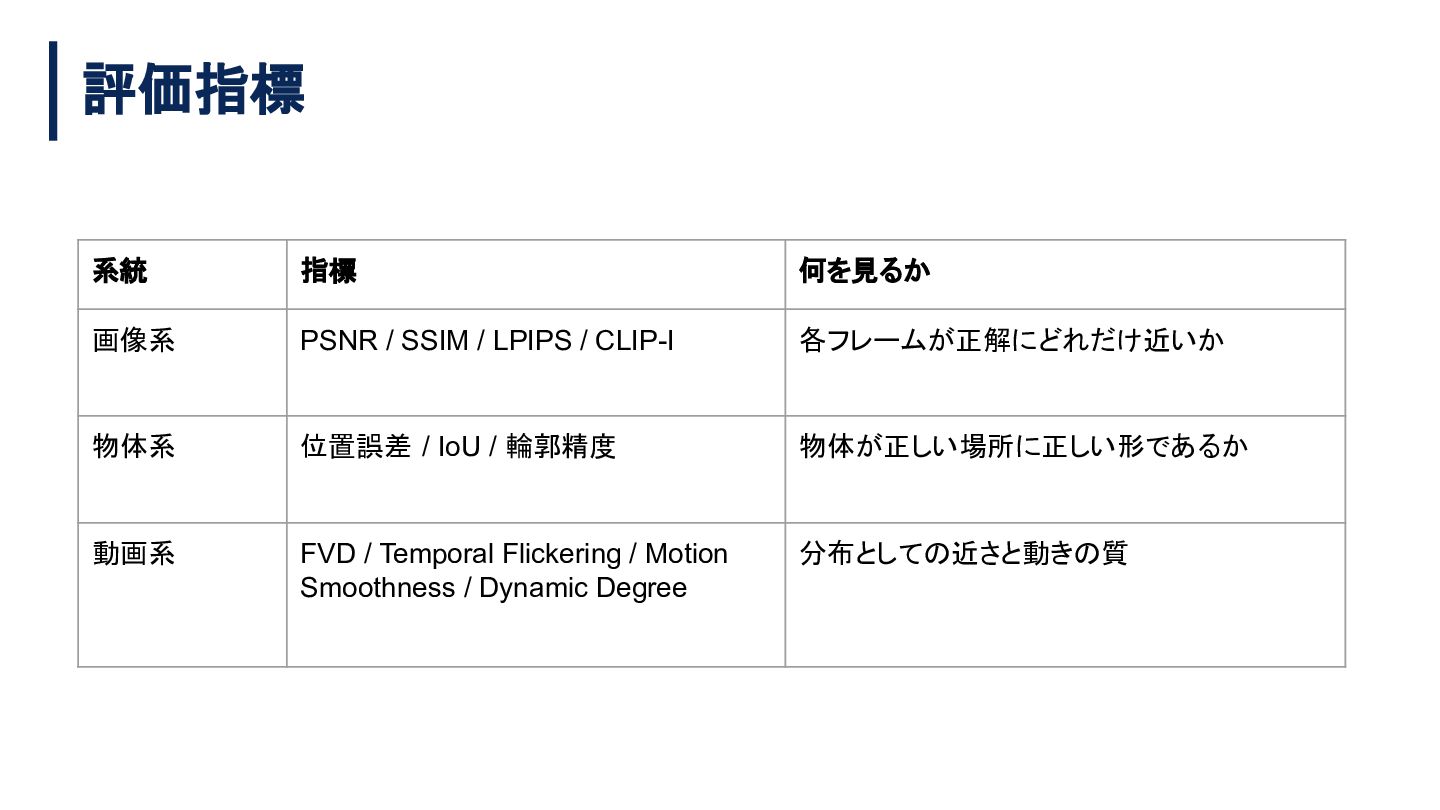
/ TrajectoryCrafter / WanFunControl / Wan VACE 評価方針 画像 質・物体 再現度・動画 3 系統で評価
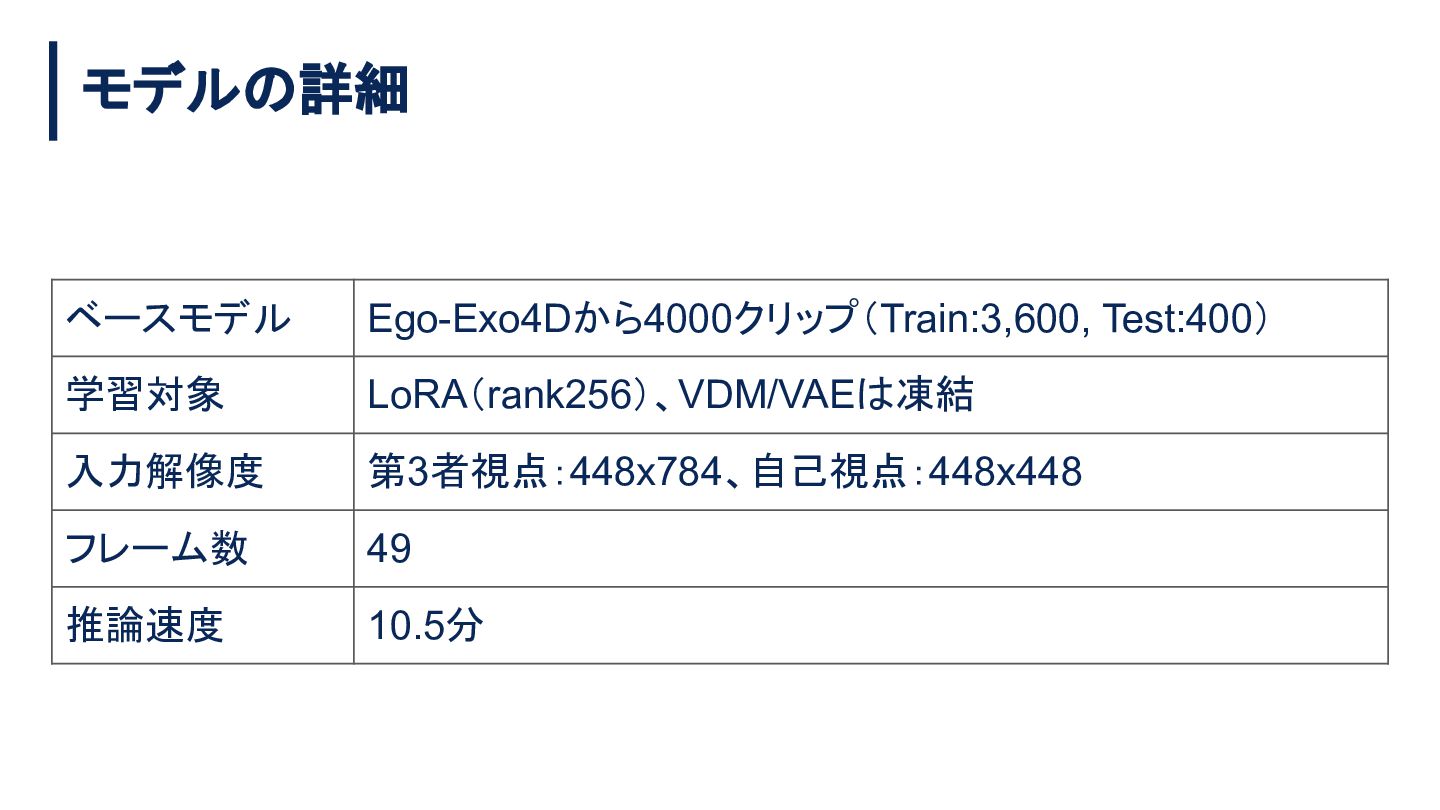
モデル 詳細 ベースモデル Ego-Exo4Dから4000クリップ(Train:3,600, Test:400) 学習対象 LoRA(rank256)、VDM/VAE 入力解像度 第3者視点:448x784、自己視点:448x448 フレーム数
49 推論 度 10.5分 凍結
定性評価
定性評価
評価指標 系統 指標 何を見るか 画像系 PSNR / SSIM / LPIPS
/ CLIP-I 各フレームが正解にどれだけ近いか 物体系 位置誤差 / IoU / 輪郭精度 物体が正しい場所に正しい形であるか 動画系 FVD / Temporal Flickering / Motion Smoothness / Dynamic Degree 分布として 近さと動き 質
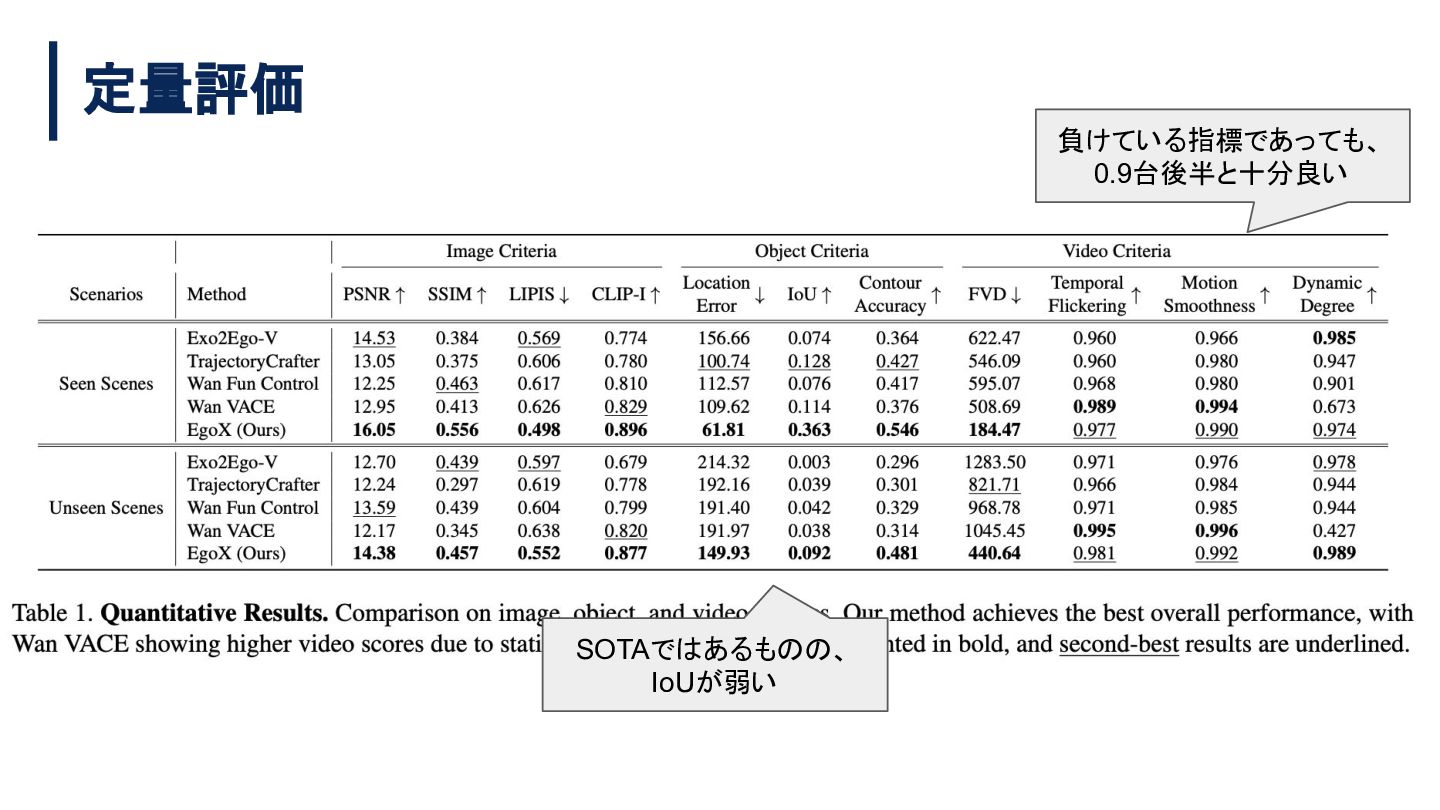
定量評価 負けている指標であっても、 0.9台後半と十分良い SOTAで あるも IoUが弱い 、
考察 • 未観測領域が画面 ◦ 視点が違う 大半を占める で、原理的に どうしても発生してしまう • 動体がマスクされ、ego
prior に入っていない ◦ “Dynamic objects are masked out so that only static background regions are used during both alignment and rendering”→点群作る時に動いているも マ スクしちゃっているが、作業動画 動いているも が重要 • 深度 ◦ 限界 Dv(深度動画推定)、Dm(深度画像推定)を合わせ込んでいるが、スケールとバイ アスを修正することしかできない
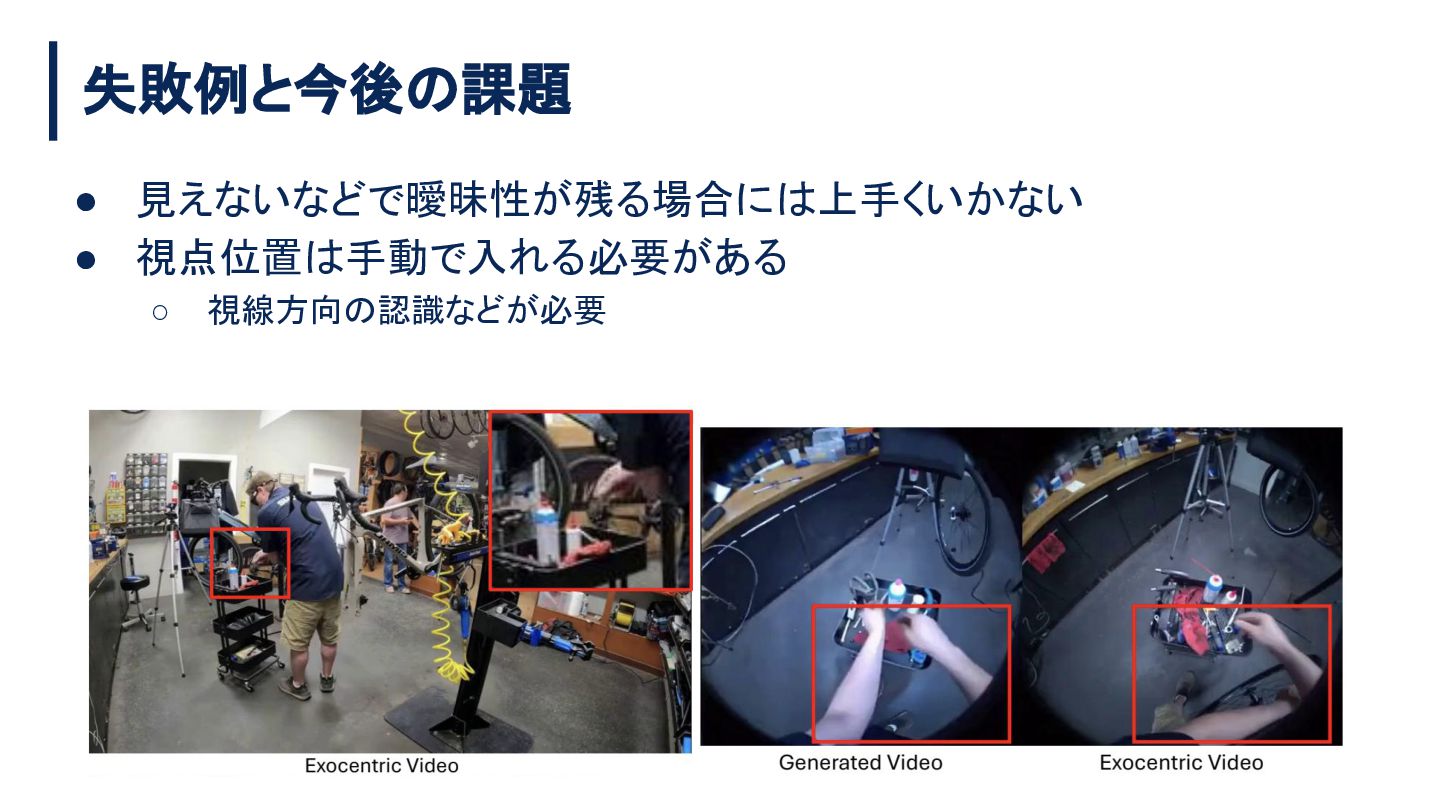
失敗例と今後 課題 • 見えないなどで曖昧性が残る場合に 上手くいかない • 視点位置 手動で入れる必要がある ◦ 視線方向
認識などが必要
まとめ • 第3者視点 動画から自己視点画像を生成する手法を提案 • 制約が少ないにも関わらず高精度な動画 ◦ 時系列 Depth Map
高精度化やアテンション 生成が可能 工夫 • 自己視点位置を人手で入力したり曖昧な環境で る 成功しないこともあ


 peisuke
 frankvandijk
 eileencodes
 axbom
 mza
 addyosmani
 varn
 jonoalderson
 jacobian
 deanohume
 jcasabona
 sonatard
 takai