Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ACL読み会2026_宇野駿希
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
宇野駿希
September 24, 2026
Technology
96
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ACL読み会2026_宇野駿希
宇野駿希
September 24, 2026
Other Decks in Technology
See All in Technology
DWH の限界突破! AI エージェント向け爆速リアルタイムデータ基盤 ClickHouse
jozono
1
470
宣言型部分更新は何を解決しどこへ向かうのか
shuta13
1
450
オントロジーって 結局なにもの? AI エージェントに「意味」を渡す知識設計の話
greenmidori
0
190
実践! SRE × AI - ABEMA における AIOps -
tetsuya28
8
3.1k
Classmethod Company Deck
satoshi7
1
680
その Valkey 使いこなしていますか?
onk
PRO
5
1.5k
Rustuna: Rustによる高速なOptuna実装
pfn
PRO
0
190
「Docker Desktop不要の時代」は 来たのか?
ueponx
0
770
子育てエンジニアの可処分時間が減っても成長を諦めない戦い方
sudoakiy
6
4.6k
SAENM ~Jupyterで残すPoCの試行錯誤、未来の自分と仲間を助ける記録!~
terapyon
0
110
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
140
Claude Code本は、どのように執筆チームで書かれたか
oikon48
1
380
Featured
See All Featured
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
360
Build your cross-platform service in a week with App Engine
jlugia
234
19k
Faster Mobile Websites
deanohume
310
32k
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Bash Introduction
62gerente
615
220k
Highjacked: Video Game Concept Design
rkendrick25
PRO
1
480
Optimising Largest Contentful Paint
csswizardry
37
4k
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
69
67k
The Pragmatic Product Professional
lauravandoore
37
7.5k
Skip the Path - Find Your Career Trail
mkilby
1
260
Transcript
※図表は論文より引用 ACL 2026読み会@名大 読み手:宇野 駿希(豊田工業大学 知識データ工学研究室 B4)
論文概要 • 背景 • 手話検索は,視覚的に似た手話を区別する際,大きく性能低下 • 原因は視覚的に似た負例を用いた学習の不足 • 手法 •
Sign-Aware Hard Negative Mining (SAN) を提案 • 意味的に似た語ではなく手話の見た目が似た語で区別が難しい事例を作成 • 結果 • 視覚的に似た手話の識別性能向上 2
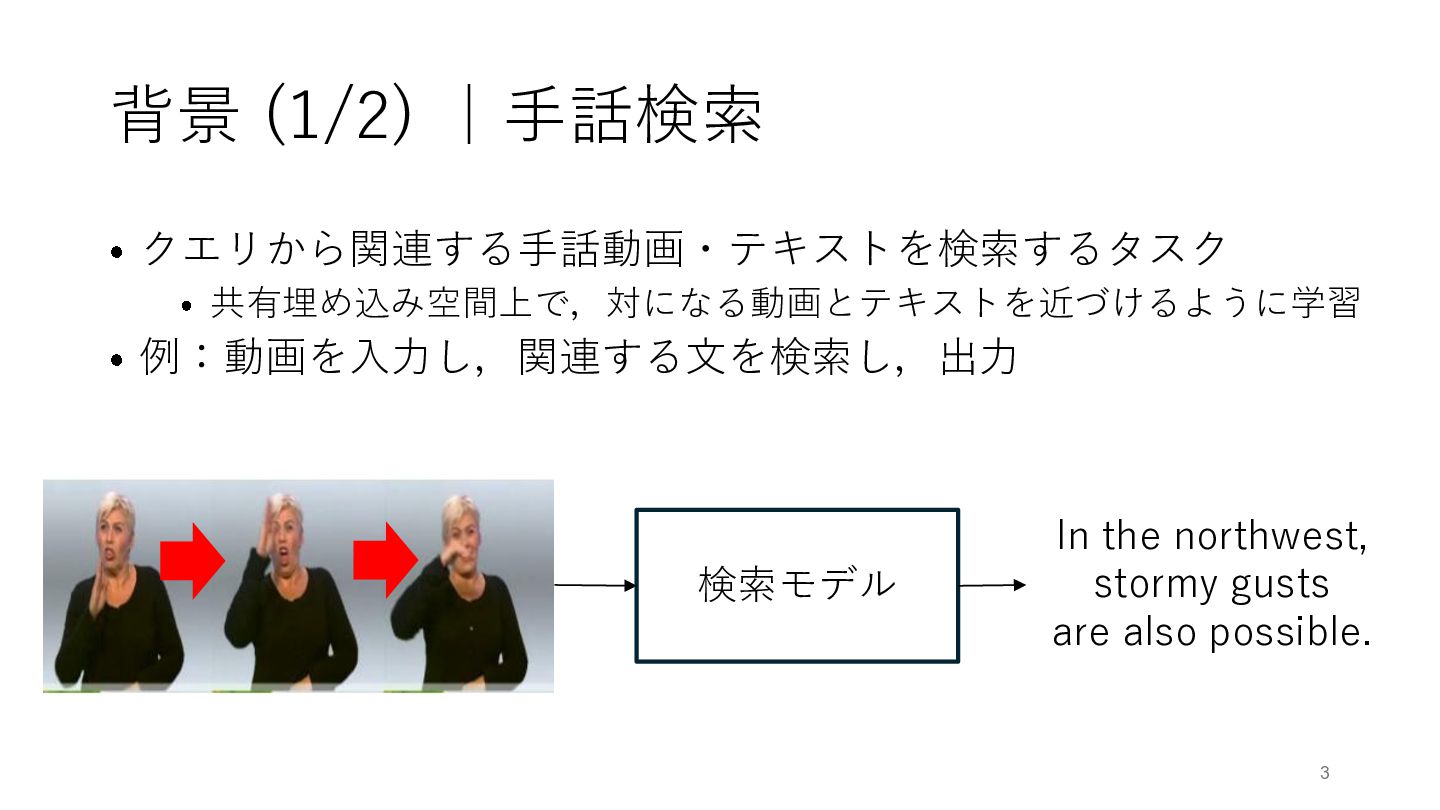
背景 (1/2) |手話検索 • クエリから関連する手話動画・テキストを検索するタスク • 共有埋め込み空間上で,対になる動画とテキストを近づけるように学習 • 例:動画を入力し,関連する文を検索し,出力 検索モデル
In the northwest, stormy gusts are also possible. 3
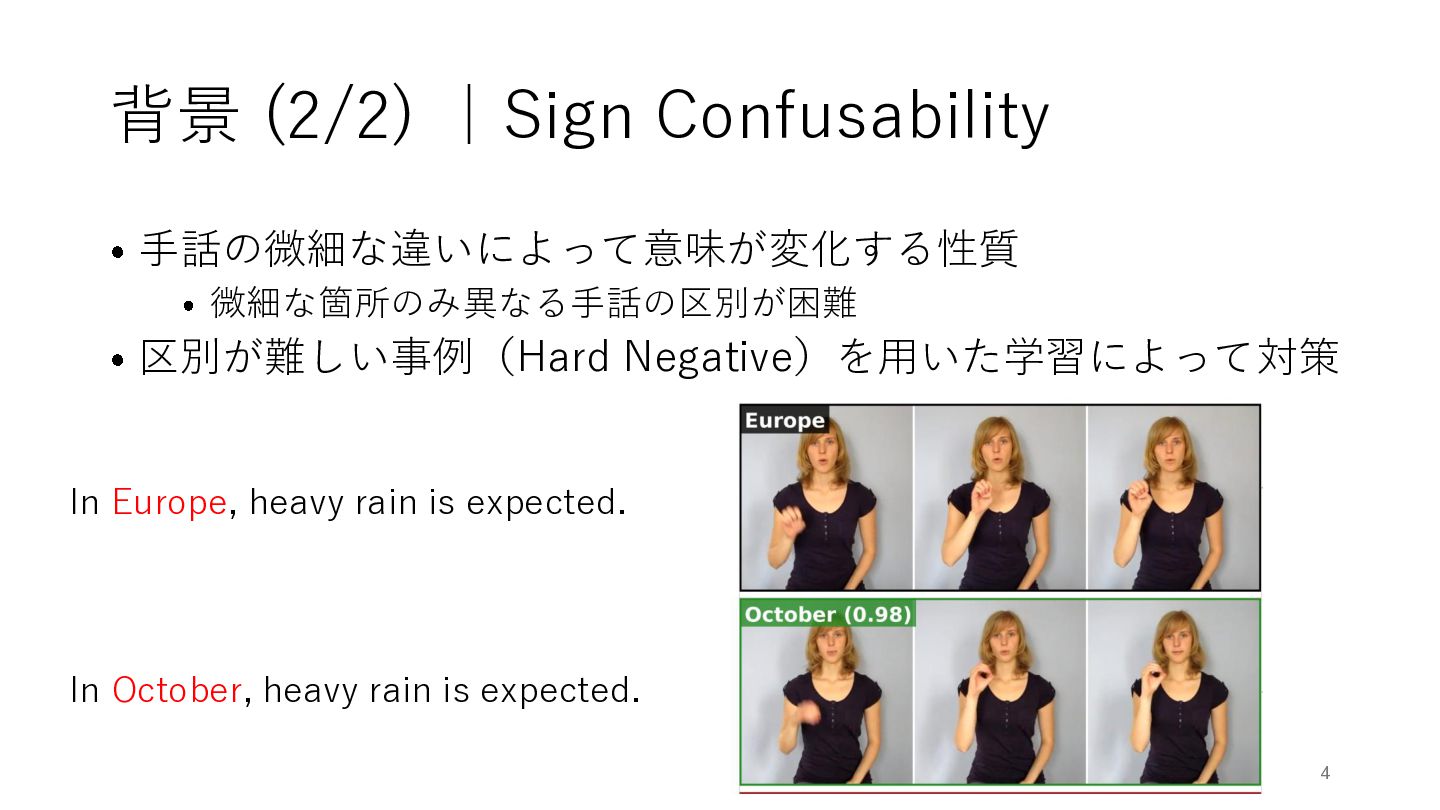
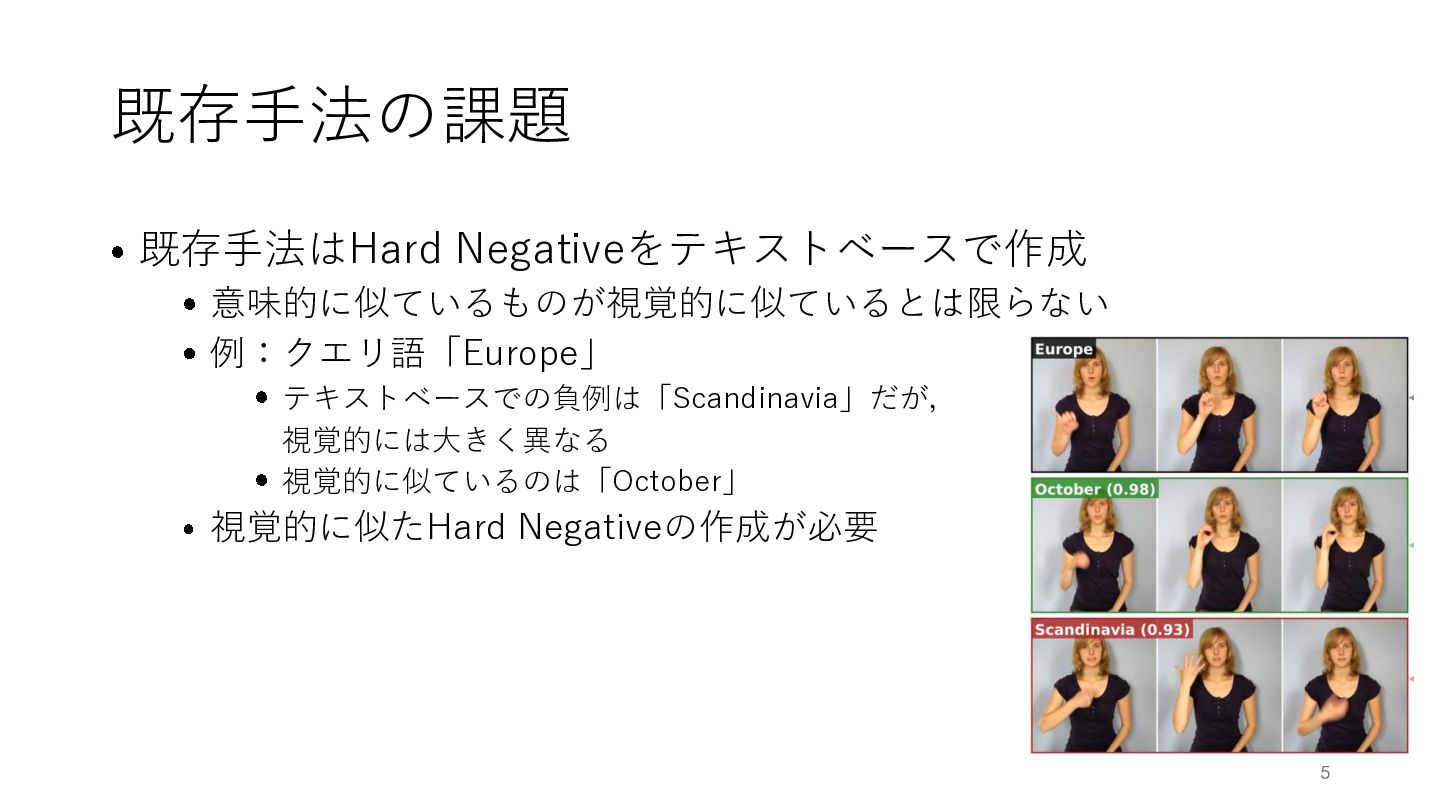
背景 (2/2) |Sign Confusability • 手話の微細な違いによって意味が変化する性質 • 微細な箇所のみ異なる手話の区別が困難 • 区別が難しい事例(Hard
Negative)を用いた学習によって対策 In Europe, heavy rain is expected. In October, heavy rain is expected. 4
既存手法の課題 • 既存手法はHard Negativeをテキストベースで作成 • 意味的に似ているものが視覚的に似ているとは限らない • 例:クエリ語「Europe」 • テキストベースでの負例は「Scandinavia」だが,
視覚的には大きく異なる • 視覚的に似ているのは「October」 • 視覚的に似たHard Negativeの作成が必要 5
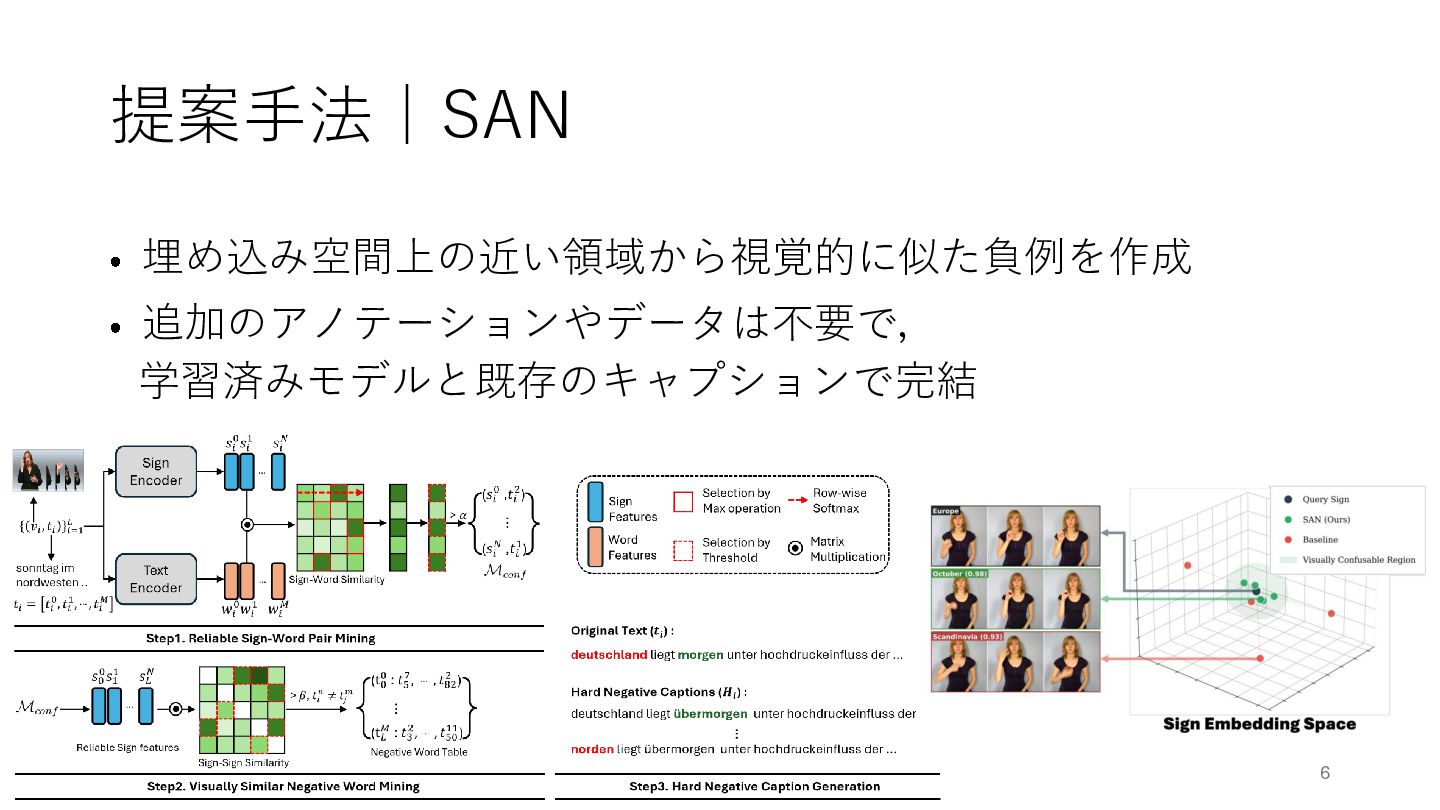
提案手法|SAN • 埋め込み空間上の近い領域から視覚的に似た負例を作成 • 追加のアノテーションやデータは不要で, 学習済みモデルと既存のキャプションで完結 6
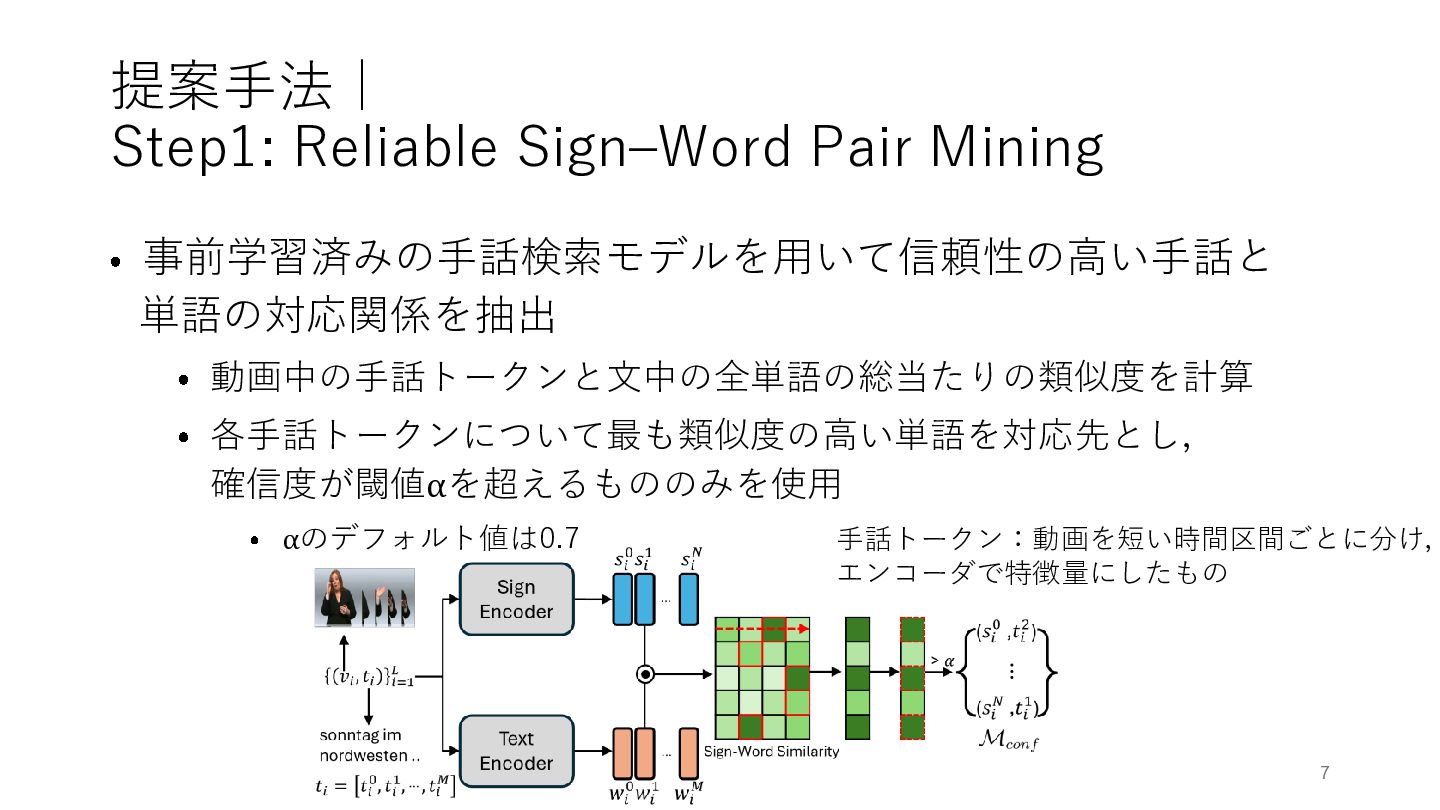
提案手法| Step1: Reliable Sign–Word Pair Mining • 事前学習済みの手話検索モデルを用いて信頼性の高い手話と 単語の対応関係を抽出 •
動画中の手話トークンと文中の全単語の総当たりの類似度を計算 • 各手話トークンについて最も類似度の高い単語を対応先とし, 確信度が閾値αを超えるもののみを使用 • αのデフォルト値は0.7 手話トークン:動画を短い時間区間ごとに分け, エンコーダで特徴量にしたもの 7
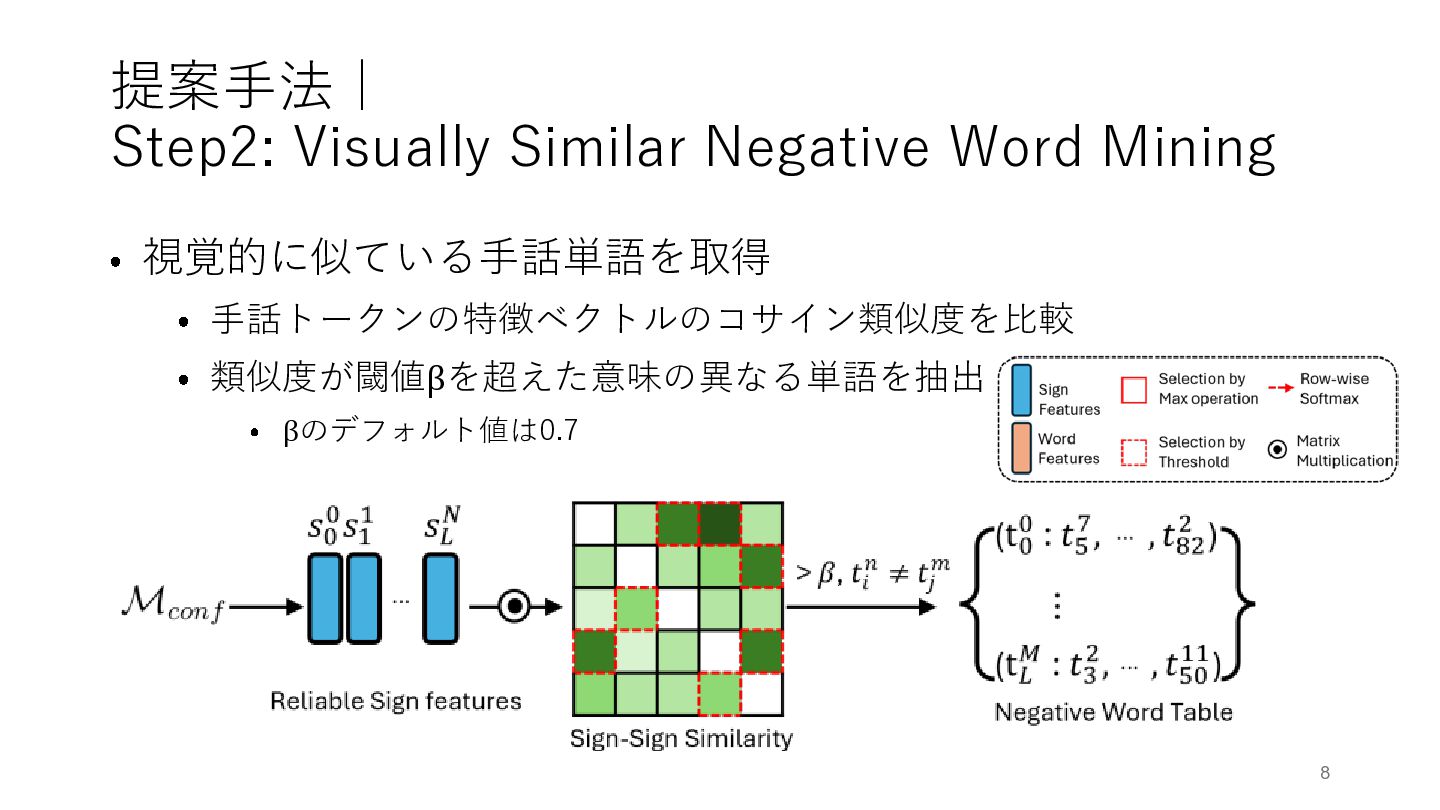
提案手法| Step2: Visually Similar Negative Word Mining • 視覚的に似ている手話単語を取得 •
手話トークンの特徴ベクトルのコサイン類似度を比較 • 類似度が閾値βを超えた意味の異なる単語を抽出 • βのデフォルト値は0.7 8
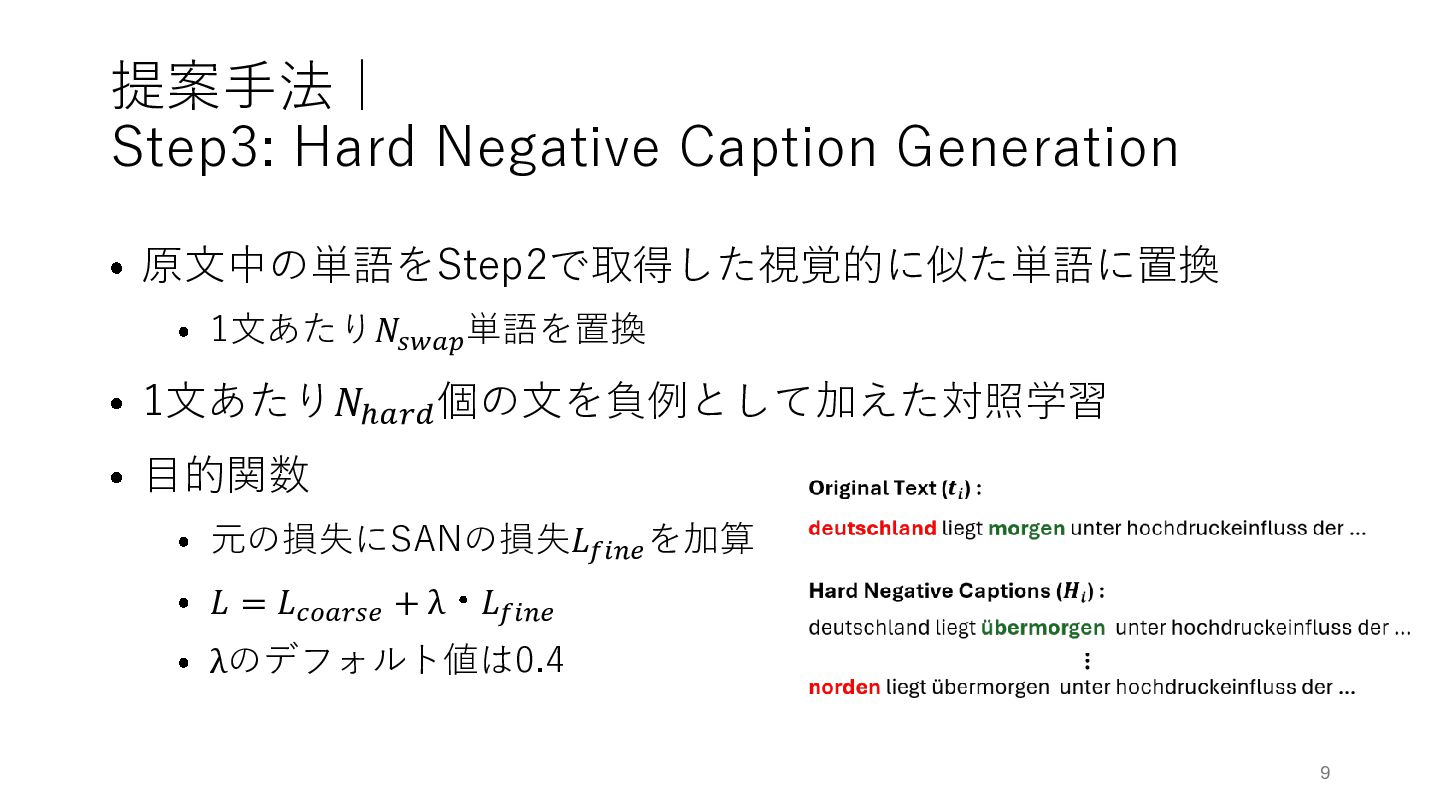
提案手法| Step3: Hard Negative Caption Generation • 原文中の単語をStep2で取得した視覚的に似た単語に置換 • 1文あたり𝑁𝑠𝑤𝑎𝑝
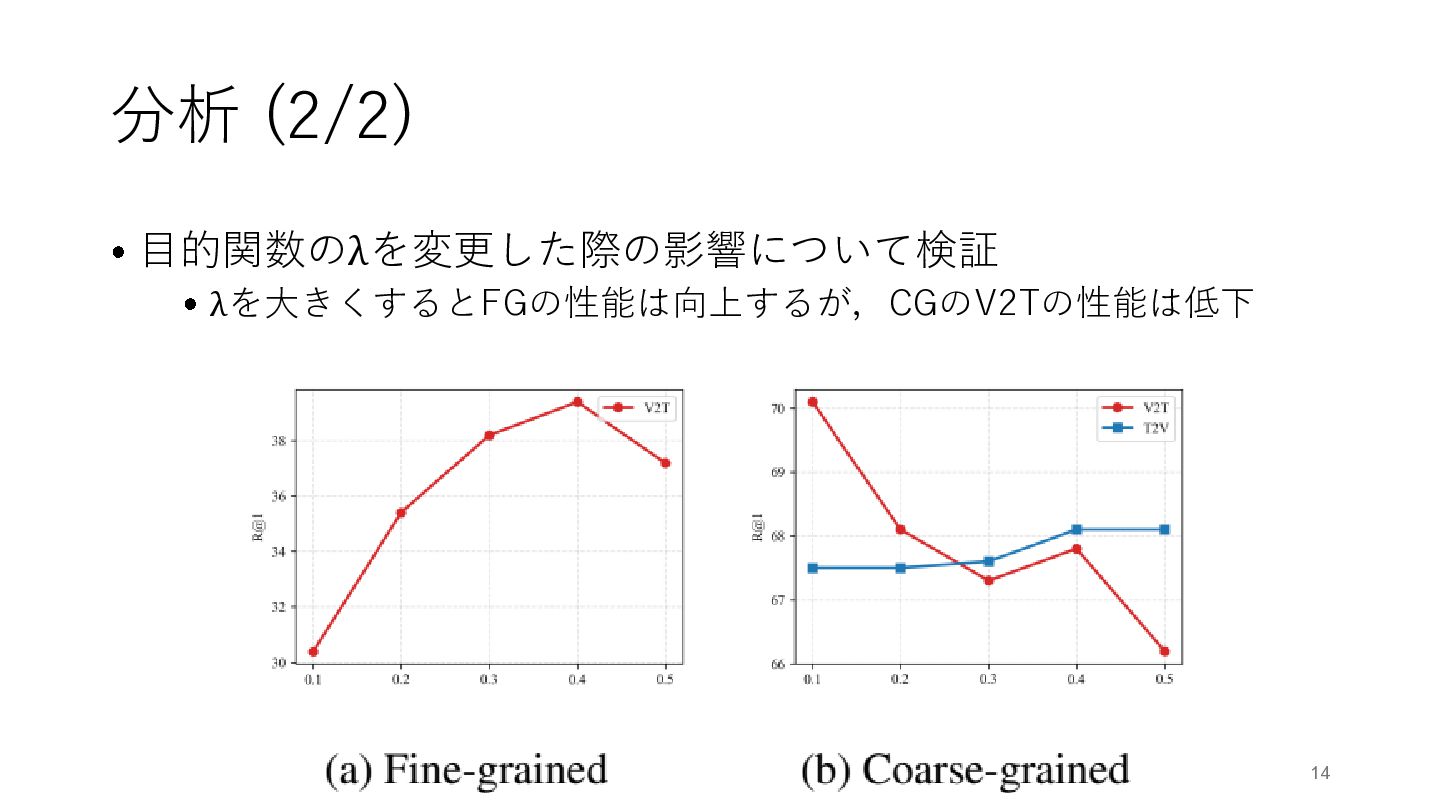
単語を置換 • 1文あたり𝑁ℎ𝑎𝑟𝑑 個の文を負例として加えた対照学習 • 目的関数 • 元の損失にSANの損失𝐿𝑓𝑖𝑛𝑒 を加算 • 𝐿 = 𝐿𝑐𝑜𝑎𝑟𝑠𝑒 + λ・ 𝐿𝑓𝑖𝑛𝑒 • λのデフォルト値は0.4 9
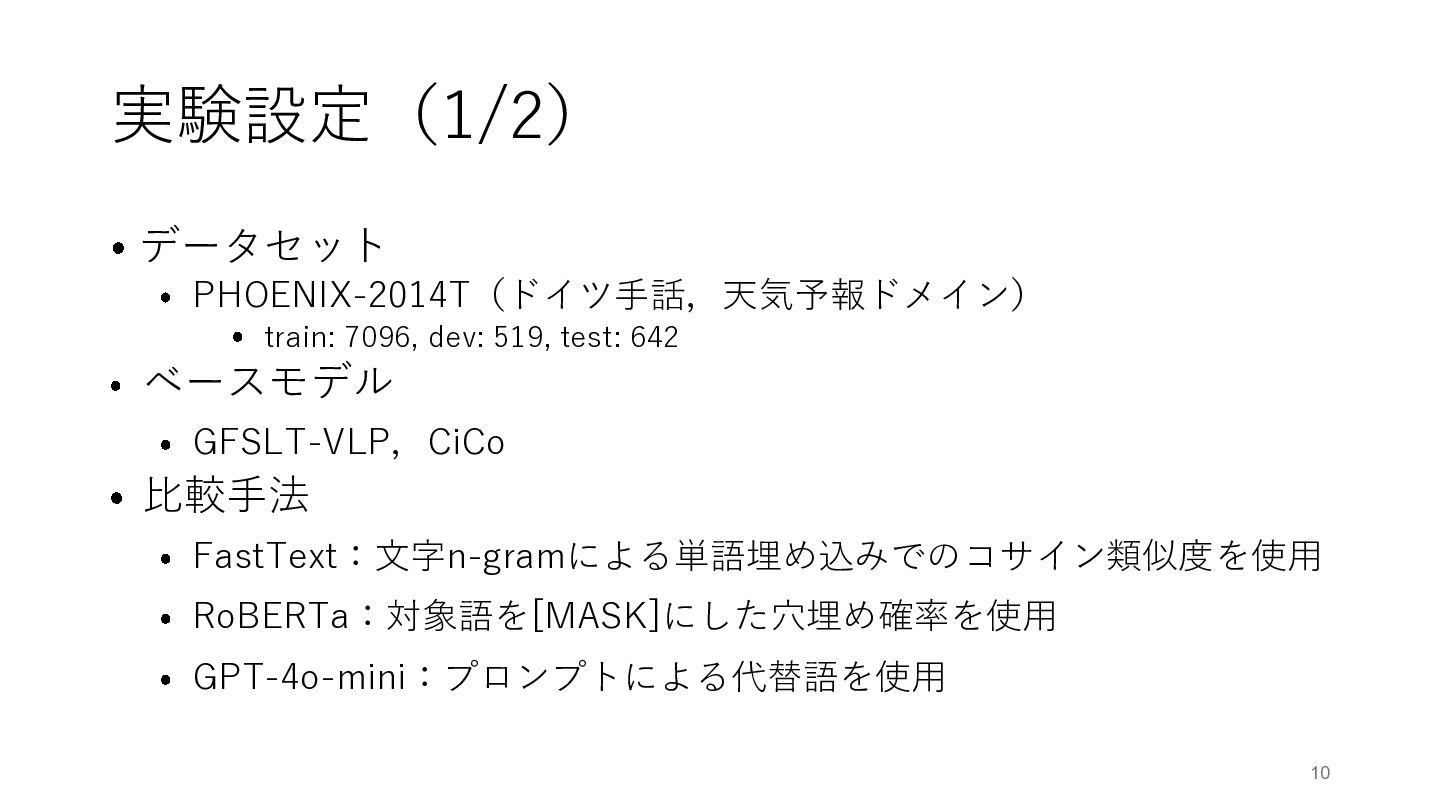
実験設定(1/2) • データセット • PHOENIX-2014T(ドイツ手話,天気予報ドメイン) • train: 7096, dev: 519,
test: 642 • ベースモデル • GFSLT-VLP,CiCo • 比較手法 • FastText:文字n-gramによる単語埋め込みでのコサイン類似度を使用 • RoBERTa:対象語を[MASK]にした穴埋め確率を使用 • GPT-4o-mini:プロンプトによる代替語を使用 10
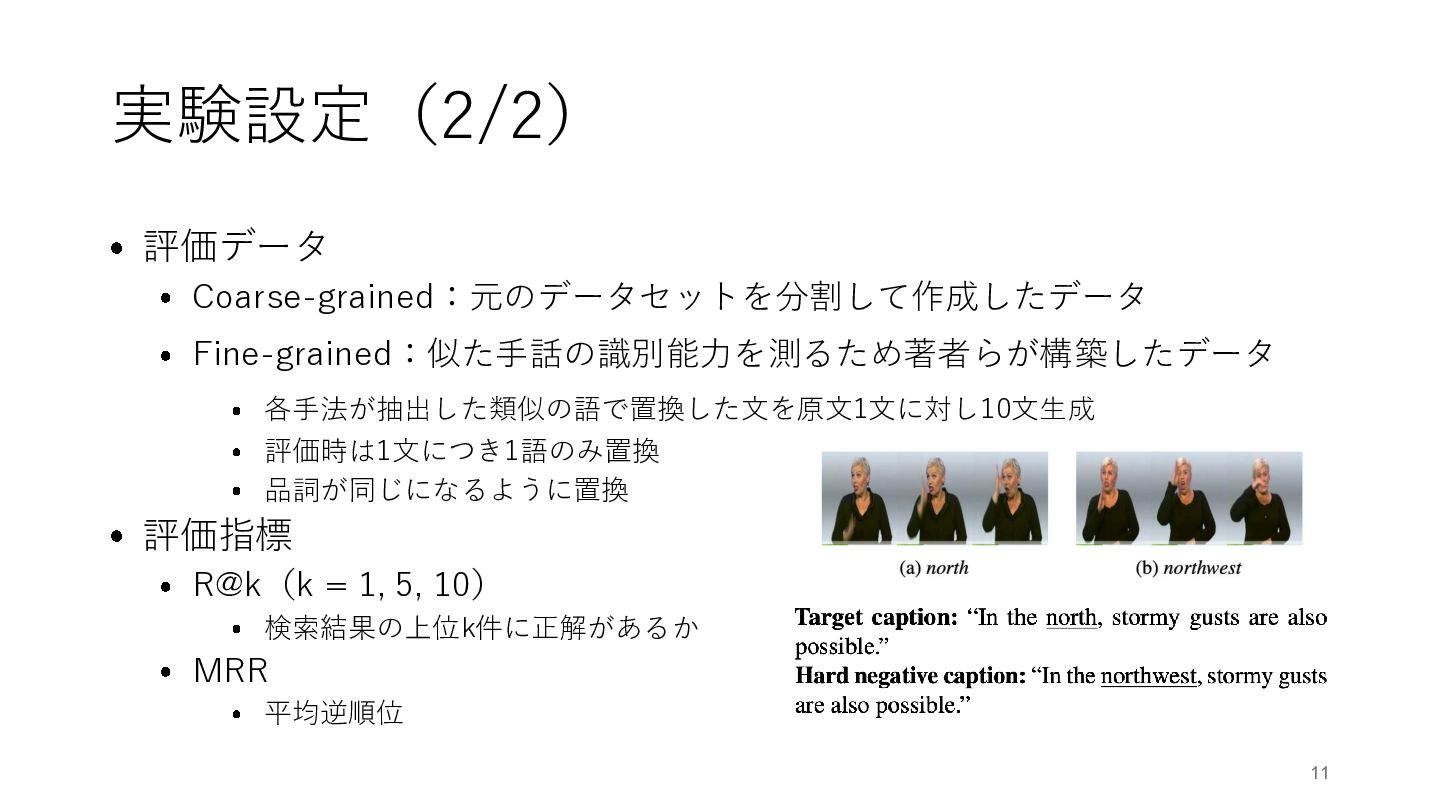
実験設定(2/2) • 評価データ • Coarse-grained:元のデータセットを分割して作成したデータ • Fine-grained:似た手話の識別能力を測るため著者らが構築したデータ • 各手法が抽出した類似の語で置換した文を原文1文に対し10文生成 •
評価時は1文につき1語のみ置換 • 品詞が同じになるように置換 • 評価指標 • R@k(k = 1, 5, 10) • 検索結果の上位k件に正解があるか • MRR • 平均逆順位 11
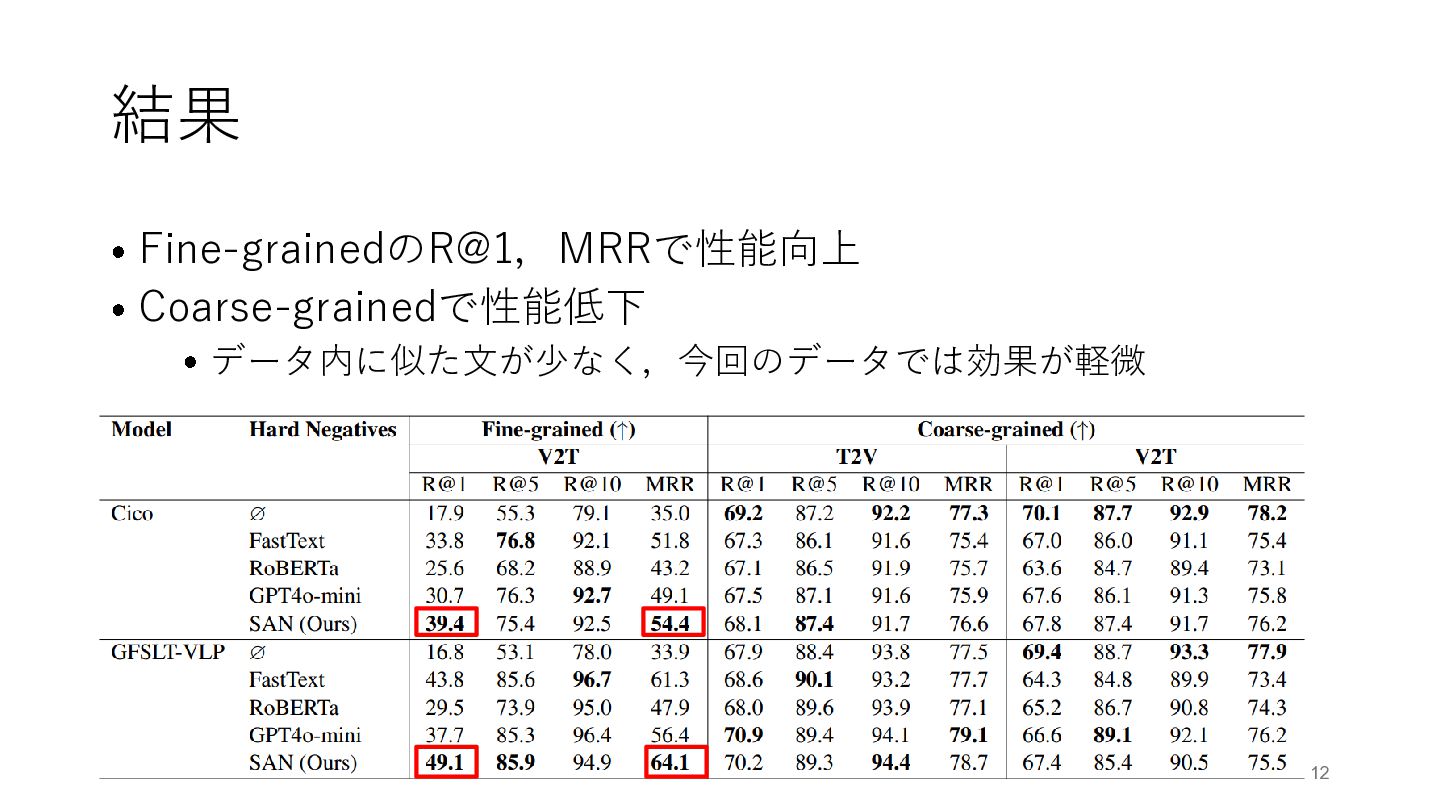
結果 • Fine-grainedのR@1,MRRで性能向上 • Coarse-grainedで性能低下 • データ内に似た文が少なく,今回のデータでは効果が軽微 12
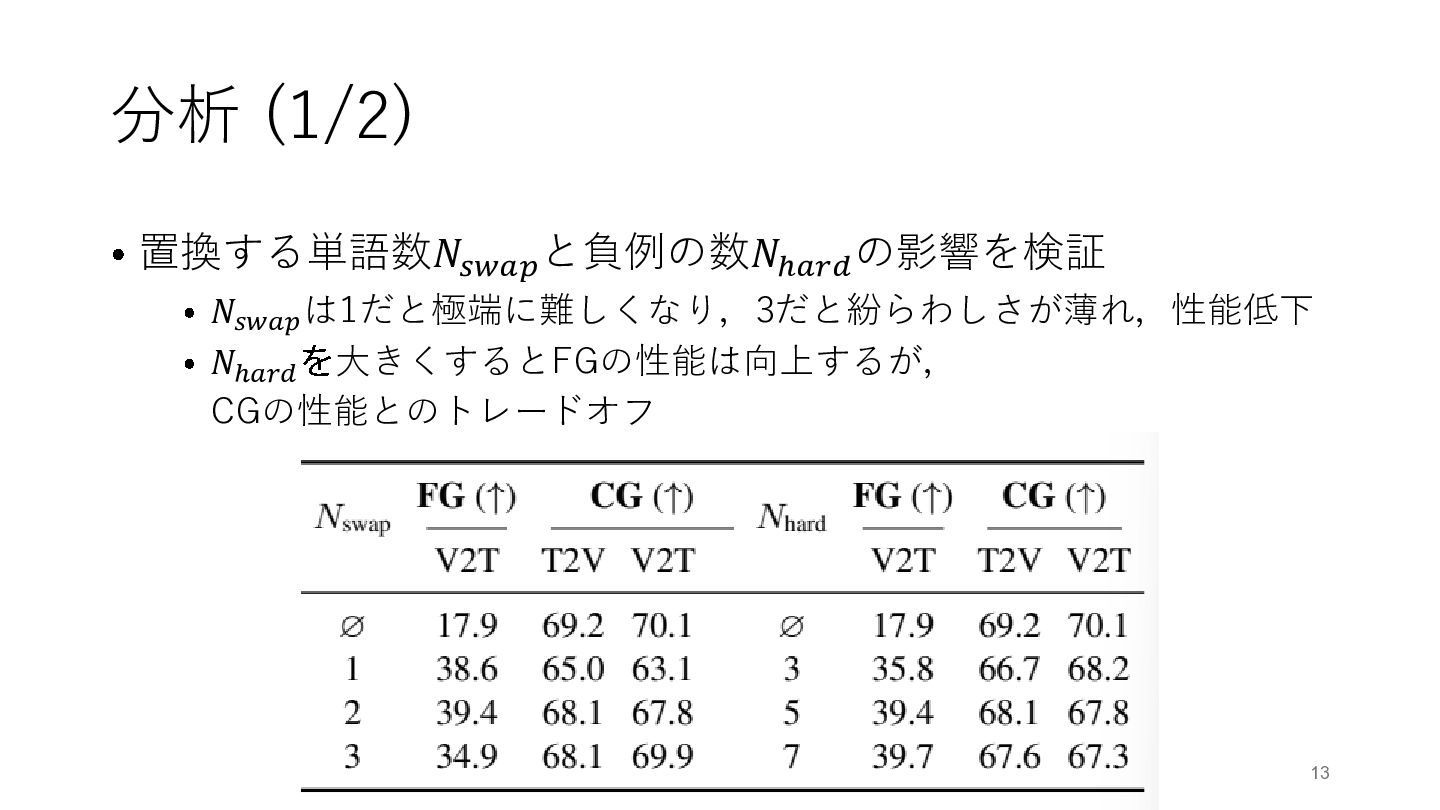
分析 (1/2) • 置換する単語数𝑁𝑠𝑤𝑎𝑝 と負例の数𝑁ℎ𝑎𝑟𝑑 の影響を検証 • 𝑁𝑠𝑤𝑎𝑝 は1だと極端に難しくなり,3だと紛らわしさが薄れ,性能低下 •
𝑁ℎ𝑎𝑟𝑑 を 大きくするとFGの性能は向上するが, CGの性能とのトレードオフ 13
分析 (2/2) • 目的関数のλを変更した際の影響について検証 • λを大きくするとFGの性能は向上するが,CGのV2Tの性能は低下 14
まとめ • 課題:手話検索において視覚的に似た手話の区別が困難 • 原因:言語的意味に基づいた負例抽出による,視覚的に 似た負例の不足 • 提案:手話埋め込み空間の視覚的類似度による負例の抽出 • 結論:Fine-grainedにおける性能向上
15
所感 • • • モデル非依存で,損失の追加のみのため, 既存の手話検索モデルに組み込みやすく,興味深い 一部のR@k(k≥5)でテキストベースの手法が提案手法を 上回っているのが気になった Coarse-grained の議論が
V2T のみで,T2V への言及が なかったので,議論してほしかった 16


 jozono
 shuta13
 greenmidori
 tetsuya28
 satoshi7
 onk
 pfn
 ueponx
 sudoakiy
 terapyon
 jtakeda
 oikon48
 nikkihalliwell
 jlugia
 deanohume
 inesmontani
 bermonpainter
 62gerente
 rkendrick25
 csswizardry
 smashingmag
 madoxten
 lauravandoore
 mkilby