Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
learning prompt
Search
Rick
January 23, 2024
16
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
learning prompt
fast learning prompt
Rick
January 23, 2024
Featured
See All Featured
For a Future-Friendly Web
brad_frost
184
10k
Claude Code のすすめ
schroneko
67
230k
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
Let's Do A Bunch of Simple Stuff to Make Websites Faster
chriscoyier
508
140k
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
370
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
Un-Boring Meetings
codingconduct
0
460
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
570
Transcript
作为优化器的大型语言模型 Chengrun YangXuezhi Wang Yifeng Lu Hanxiao Liu Quoc诉Le Denny
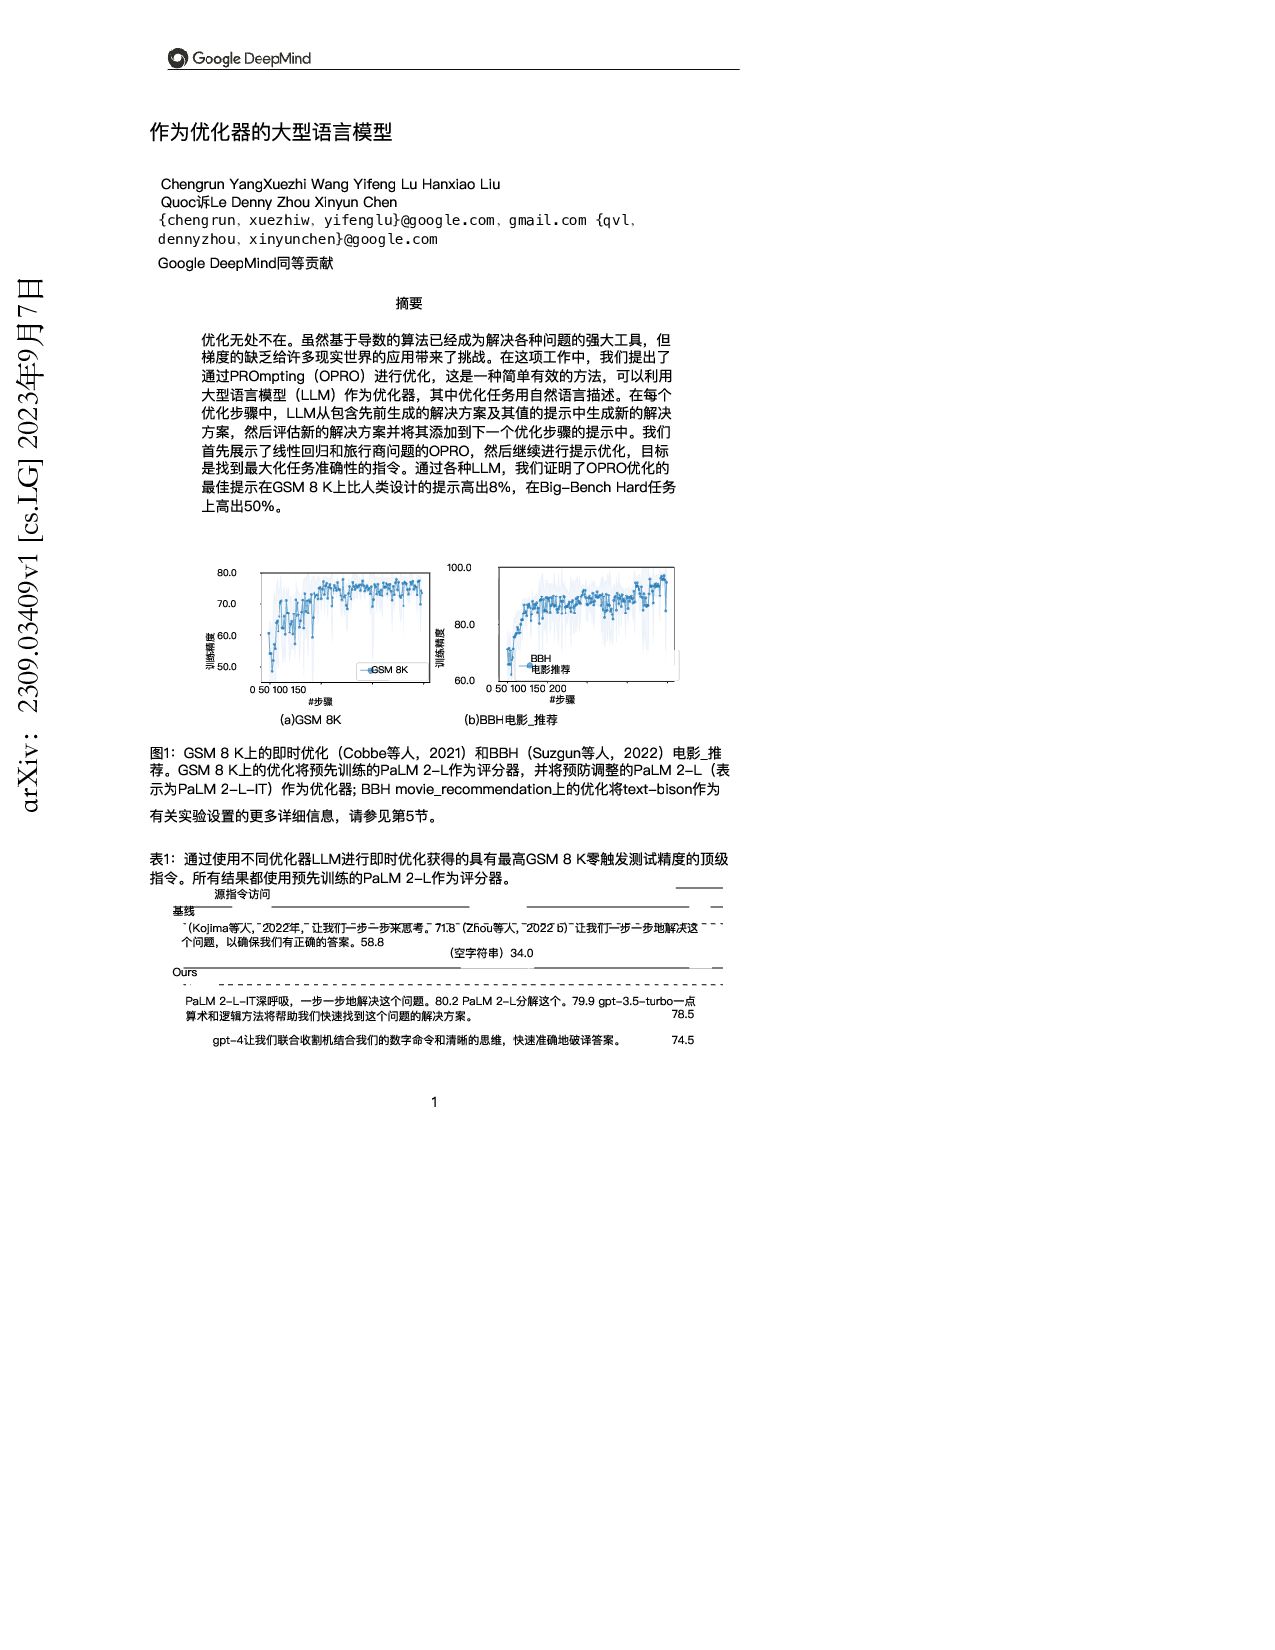
Zhou Xinyun Chen {chengrun,xuezhiw,yifenglu}@google.com,gmail.com {qvl, dennyzhou,xinyunchen}@google.com Google DeepMind同等贡献 摘要 优化无处不在。虽然基于导数的算法已经成为解决各种问题的强大工具,但 梯度的缺乏给许多现实世界的应用带来了挑战。在这项工作中,我们提出了 通过PROmpting(OPRO)进行优化,这是一种简单有效的方法,可以利用 大型语言模型(LLM)作为优化器,其中优化任务用自然语言描述。在每个 优化步骤中,LLM从包含先前生成的解决方案及其值的提示中生成新的解决 方案,然后评估新的解决方案并将其添加到下一个优化步骤的提示中。我们 首先展示了线性回归和旅行商问题的OPRO,然后继续进行提示优化,目标 是找到最大化任务准确性的指令。通过各种LLM,我们证明了OPRO优化的 最佳提示在GSM 8 K上比人类设计的提示高出8%,在Big-Bench Hard任务 上高出50%。 0 50 100 150 #步骤 50.0 60.0 70.0 80.0 训练精度 GSM 8K (a)GSM 8K 0 50 100 150 200 #步骤 60.0 80.0 100.0 训练精度 BBH 电影推荐 (b)BBH电影_推荐 图1:GSM 8 K上的即时优化(Cobbe等人,2021)和BBH(Suzgun等人,2022)电影_推 荐。GSM 8 K上的优化将预先训练的PaLM 2-L作为评分器,并将预防调整的PaLM 2-L(表 示为PaLM 2-L-IT)作为优化器; BBH movie_recommendation上的优化将text-bison作为 有关实验设置的更多详细信息,请参见第5节。 表1:通过使用不同优化器LLM进行即时优化获得的具有最高GSM 8 K零触发测试精度的顶级 指令。所有结果都使用预先训练的PaLM 2-L作为评分器。 源指令访问 基线 (Kojima等人,2022年,让我们一步一步来思考。71.8(Zhou等人,2022 b)让我们一步一步地解决这 个问题,以确保我们有正确的答案。58.8 (空字符串)34.0 Ours PaLM 2-L-IT深呼吸,一步一步地解决这个问题。80.2 PaLM 2-L分解这个。79.9 gpt-3.5-turbo一点 算术和逻辑方法将帮助我们快速找到这个问题的解决方案。 78.5 gpt-4让我们联合收割机结合我们的数字命令和清晰的思维,快速准确地破译答案。 74.5 1 arXiv:2309.03409v1 [cs.LG] 2023年9月7日
大型语言模型作为优化器 1引言 优化对所有领域都至关重要。许多优化技术都是迭代的:优化从初始解开始,然后迭代地更 新解以优化目标函数(Amari,1993; Qian,1999; Kingma & Ba,2015; Bäck &
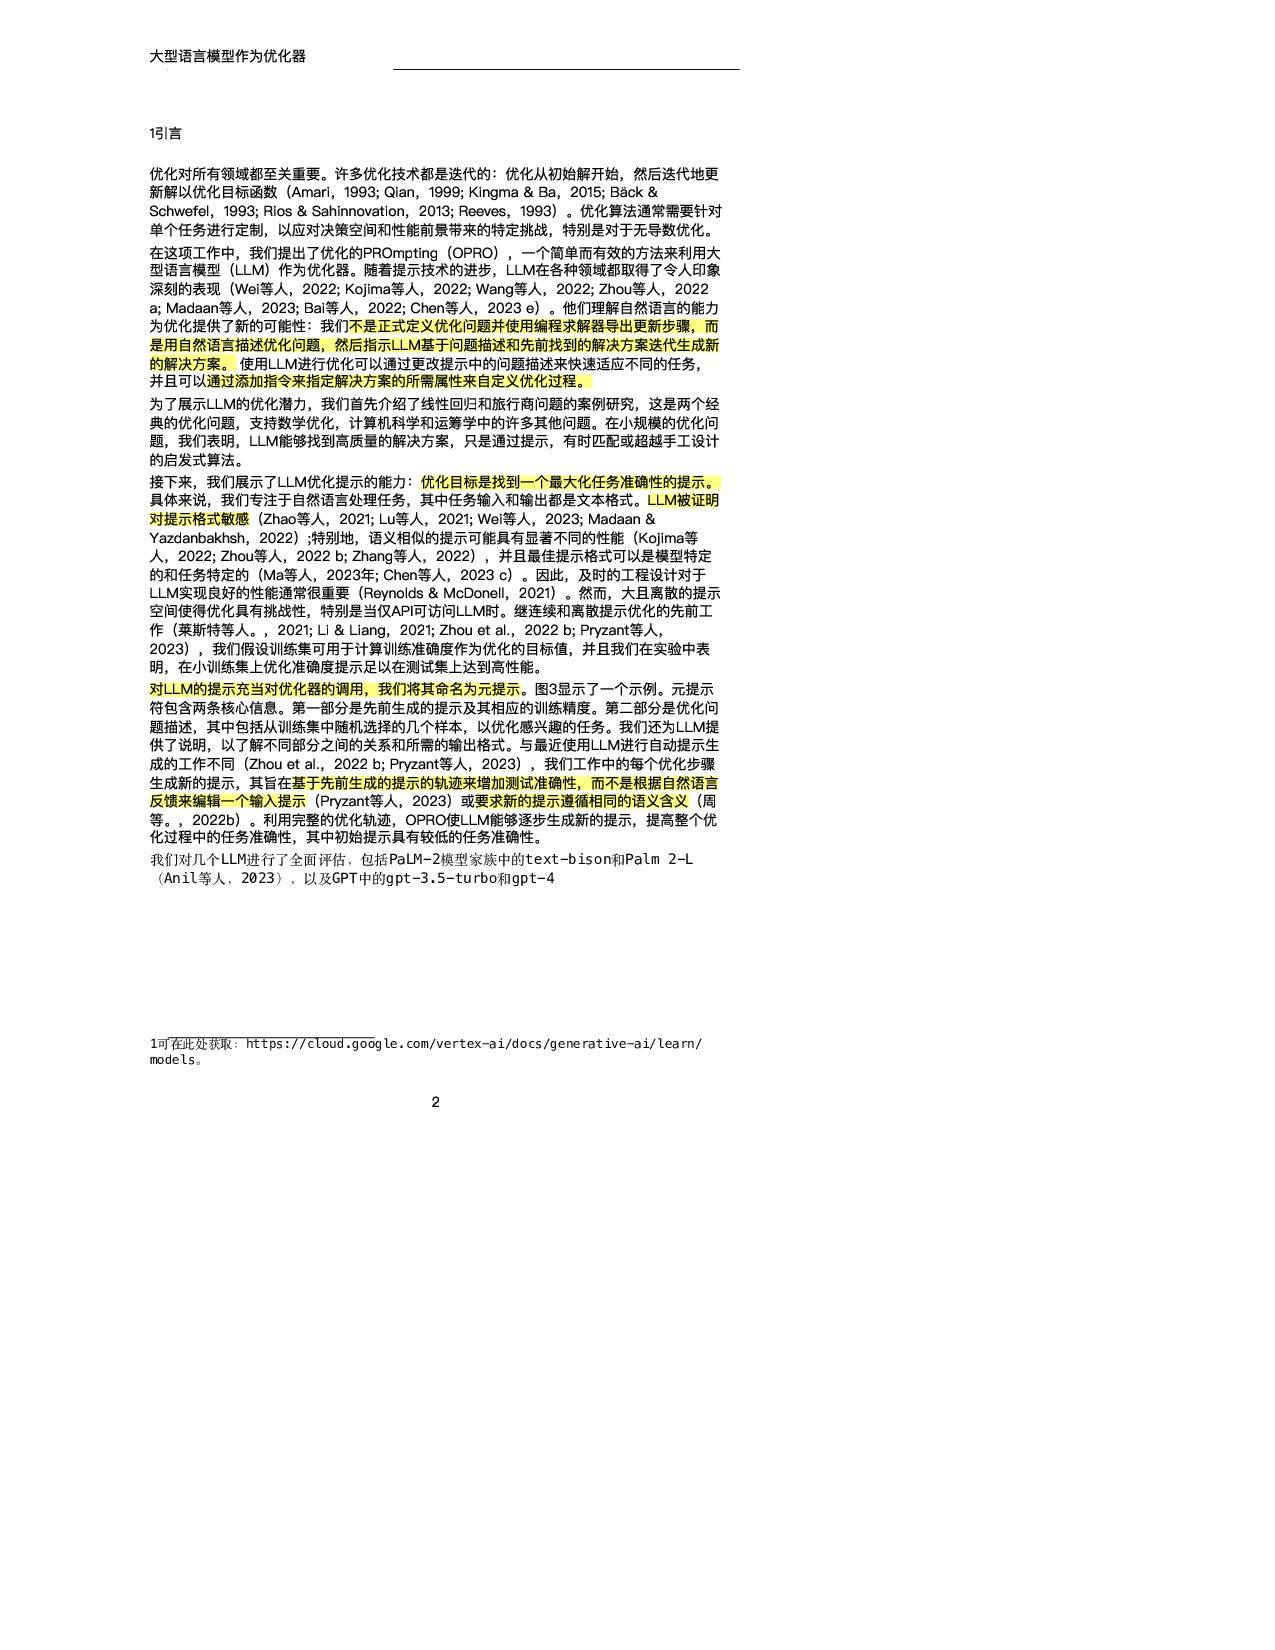
Schwefel,1993; Rios & Sahinnovation,2013; Reeves,1993)。优化算法通常需要针对 单个任务进行定制,以应对决策空间和性能前景带来的特定挑战,特别是对于无导数优化。 在这项工作中,我们提出了优化的PROmpting(OPRO),一个简单而有效的方法来利用大 型语言模型(LLM)作为优化器。随着提示技术的进步,LLM在各种领域都取得了令人印象 深刻的表现(Wei等人,2022; Kojima等人,2022; Wang等人,2022; Zhou等人,2022 a; Madaan等人,2023; Bai等人,2022; Chen等人,2023 e)。他们理解自然语言的能力 为优化提供了新的可能性:我们不是正式定义优化问题并使用编程求解器导出更新步骤,而 是用自然语言描述优化问题,然后指示LLM基于问题描述和先前找到的解决方案迭代生成新 的解决方案。 使用LLM进行优化可以通过更改提示中的问题描述来快速适应不同的任务, 并且可以通过添加指令来指定解决方案的所需属性来自定义优化过程。 为了展示LLM的优化潜力,我们首先介绍了线性回归和旅行商问题的案例研究,这是两个经 典的优化问题,支持数学优化,计算机科学和运筹学中的许多其他问题。在小规模的优化问 题,我们表明,LLM能够找到高质量的解决方案,只是通过提示,有时匹配或超越手工设计 的启发式算法。 接下来,我们展示了LLM优化提示的能力:优化目标是找到一个最大化任务准确性的提示。 具体来说,我们专注于自然语言处理任务,其中任务输入和输出都是文本格式。LLM被证明 对提示格式敏感(Zhao等人,2021; Lu等人,2021; Wei等人,2023; Madaan & Yazdanbakhsh,2022);特别地,语义相似的提示可能具有显著不同的性能(Kojima等 人,2022; Zhou等人,2022 b; Zhang等人,2022),并且最佳提示格式可以是模型特定 的和任务特定的(Ma等人,2023年; Chen等人,2023 c)。因此,及时的工程设计对于 LLM实现良好的性能通常很重要(Reynolds & McDonell,2021)。然而,大且离散的提示 空间使得优化具有挑战性,特别是当仅API可访问LLM时。继连续和离散提示优化的先前工 作(莱斯特等人。,2021; Li & Liang,2021; Zhou et al.,2022 b; Pryzant等人, 2023),我们假设训练集可用于计算训练准确度作为优化的目标值,并且我们在实验中表 明,在小训练集上优化准确度提示足以在测试集上达到高性能。 对LLM的提示充当对优化器的调用,我们将其命名为元提示。图3显示了一个示例。元提示 符包含两条核心信息。第一部分是先前生成的提示及其相应的训练精度。第二部分是优化问 题描述,其中包括从训练集中随机选择的几个样本,以优化感兴趣的任务。我们还为LLM提 供了说明,以了解不同部分之间的关系和所需的输出格式。与最近使用LLM进行自动提示生 成的工作不同(Zhou et al.,2022 b; Pryzant等人,2023),我们工作中的每个优化步骤 生成新的提示,其旨在基于先前生成的提示的轨迹来增加测试准确性,而不是根据自然语言 反馈来编辑一个输入提示(Pryzant等人,2023)或要求新的提示遵循相同的语义含义(周 等。,2022b)。利用完整的优化轨迹,OPRO使LLM能够逐步生成新的提示,提高整个优 化过程中的任务准确性,其中初始提示具有较低的任务准确性。 我们对几个LLM进行了全面评估,包括PaLM-2模型家族中的text-bison和Palm 2-L (Anil等人,2023),以及GPT中的gpt-3.5-turbo和gpt-4 1可在此处获取:https://cloud.google.com/vertex-ai/docs/generative-ai/learn/ models。 2
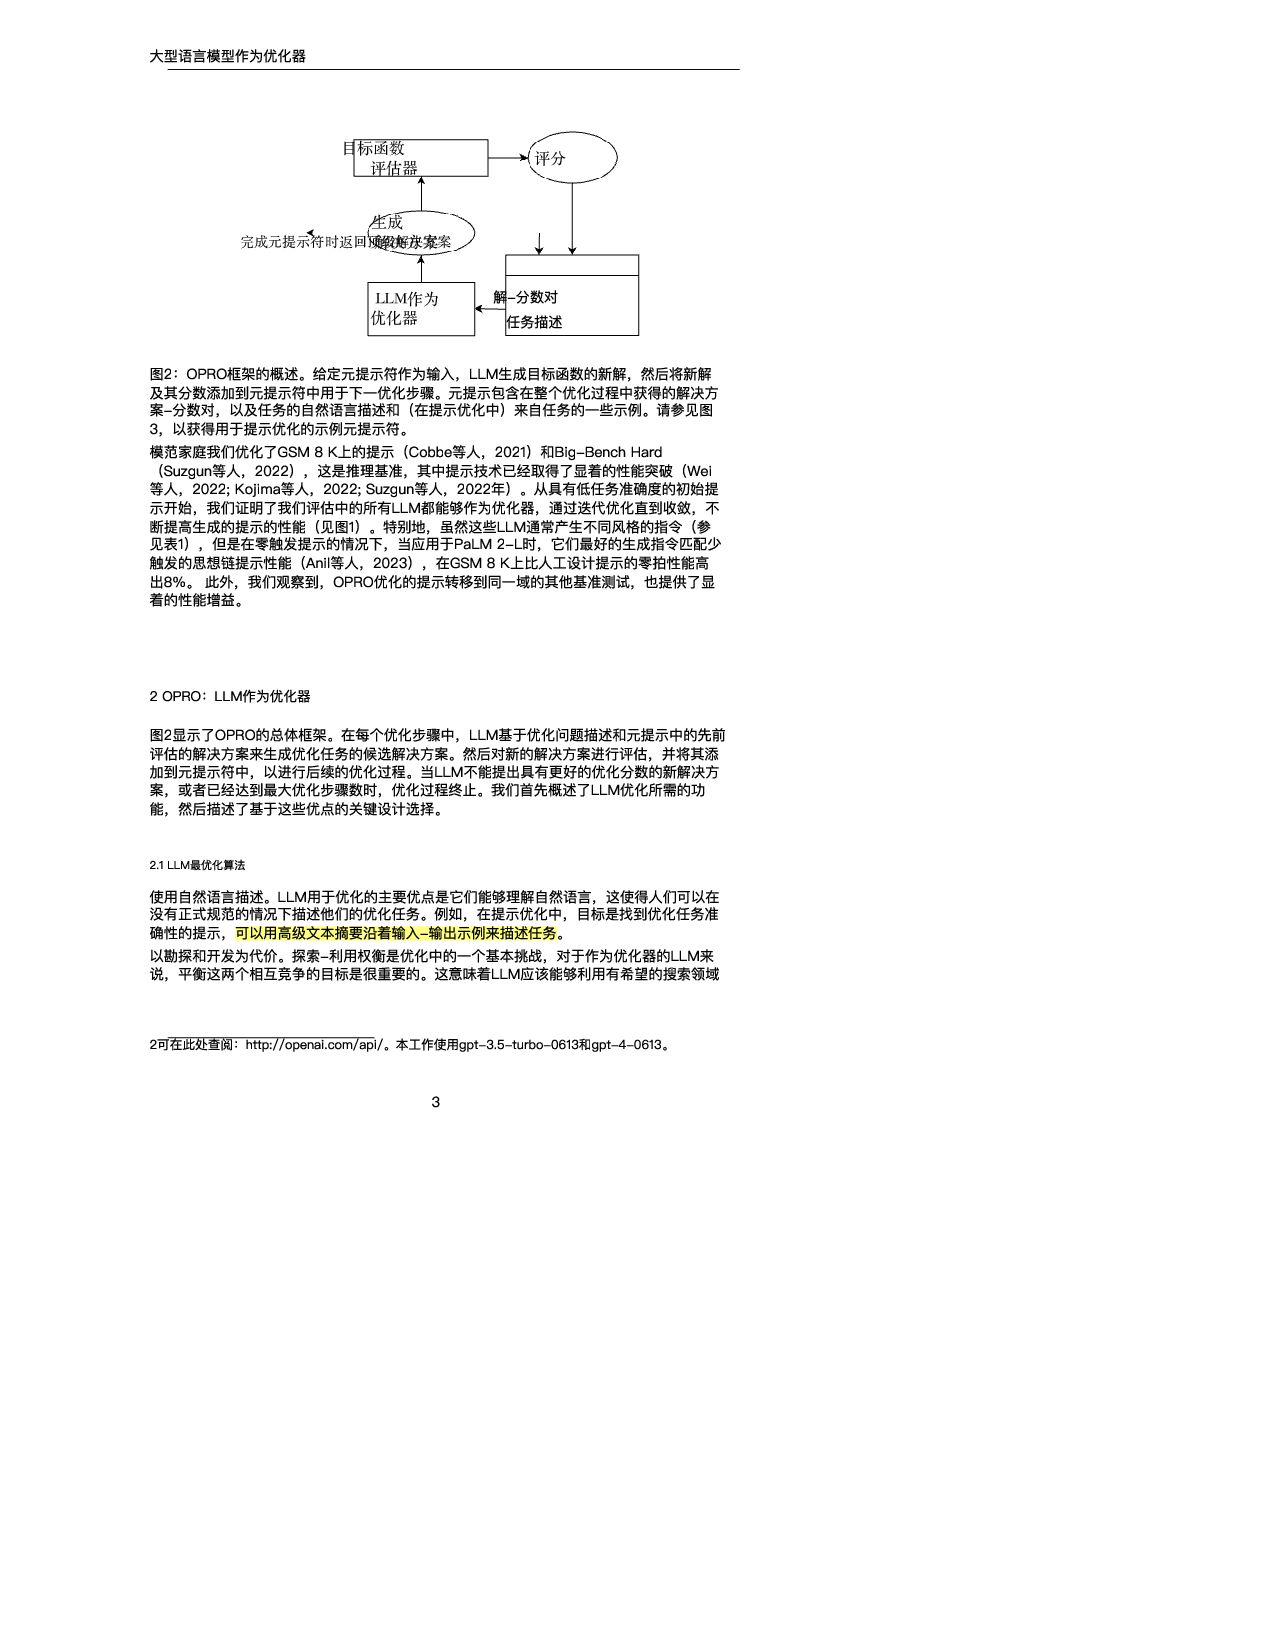
大型语言模型作为优化器 评分 生成 解决方案 LLM作为 优化器 目标函数 评估器 完成元提示符时返回顶级解决方案 解-分数对
任务描述 图2:OPRO框架的概述。给定元提示符作为输入,LLM生成目标函数的新解,然后将新解 及其分数添加到元提示符中用于下一优化步骤。元提示包含在整个优化过程中获得的解决方 案-分数对,以及任务的自然语言描述和(在提示优化中)来自任务的一些示例。请参见图 3,以获得用于提示优化的示例元提示符。 模范家庭我们优化了GSM 8 K上的提示(Cobbe等人,2021)和Big-Bench Hard (Suzgun等人,2022),这是推理基准,其中提示技术已经取得了显着的性能突破(Wei 等人,2022; Kojima等人,2022; Suzgun等人,2022年)。从具有低任务准确度的初始提 示开始,我们证明了我们评估中的所有LLM都能够作为优化器,通过迭代优化直到收敛,不 断提高生成的提示的性能(见图1)。特别地,虽然这些LLM通常产生不同风格的指令(参 见表1),但是在零触发提示的情况下,当应用于PaLM 2-L时,它们最好的生成指令匹配少 触发的思想链提示性能(Anil等人,2023),在GSM 8 K上比人工设计提示的零拍性能高 出8%。 此外,我们观察到,OPRO优化的提示转移到同一域的其他基准测试,也提供了显 着的性能增益。 2 OPRO:LLM作为优化器 图2显示了OPRO的总体框架。在每个优化步骤中,LLM基于优化问题描述和元提示中的先前 评估的解决方案来生成优化任务的候选解决方案。然后对新的解决方案进行评估,并将其添 加到元提示符中,以进行后续的优化过程。当LLM不能提出具有更好的优化分数的新解决方 案,或者已经达到最大优化步骤数时,优化过程终止。我们首先概述了LLM优化所需的功 能,然后描述了基于这些优点的关键设计选择。 2.1 LLM最优化算法 使用自然语言描述。LLM用于优化的主要优点是它们能够理解自然语言,这使得人们可以在 没有正式规范的情况下描述他们的优化任务。例如,在提示优化中,目标是找到优化任务准 确性的提示,可以用高级文本摘要沿着输入-输出示例来描述任务。 以勘探和开发为代价。探索-利用权衡是优化中的一个基本挑战,对于作为优化器的LLM来 说,平衡这两个相互竞争的目标是很重要的。这意味着LLM应该能够利用有希望的搜索领域 2可在此处查阅:http://openai.com/api/。本工作使用gpt-3.5-turbo-0613和gpt-4-0613。 3
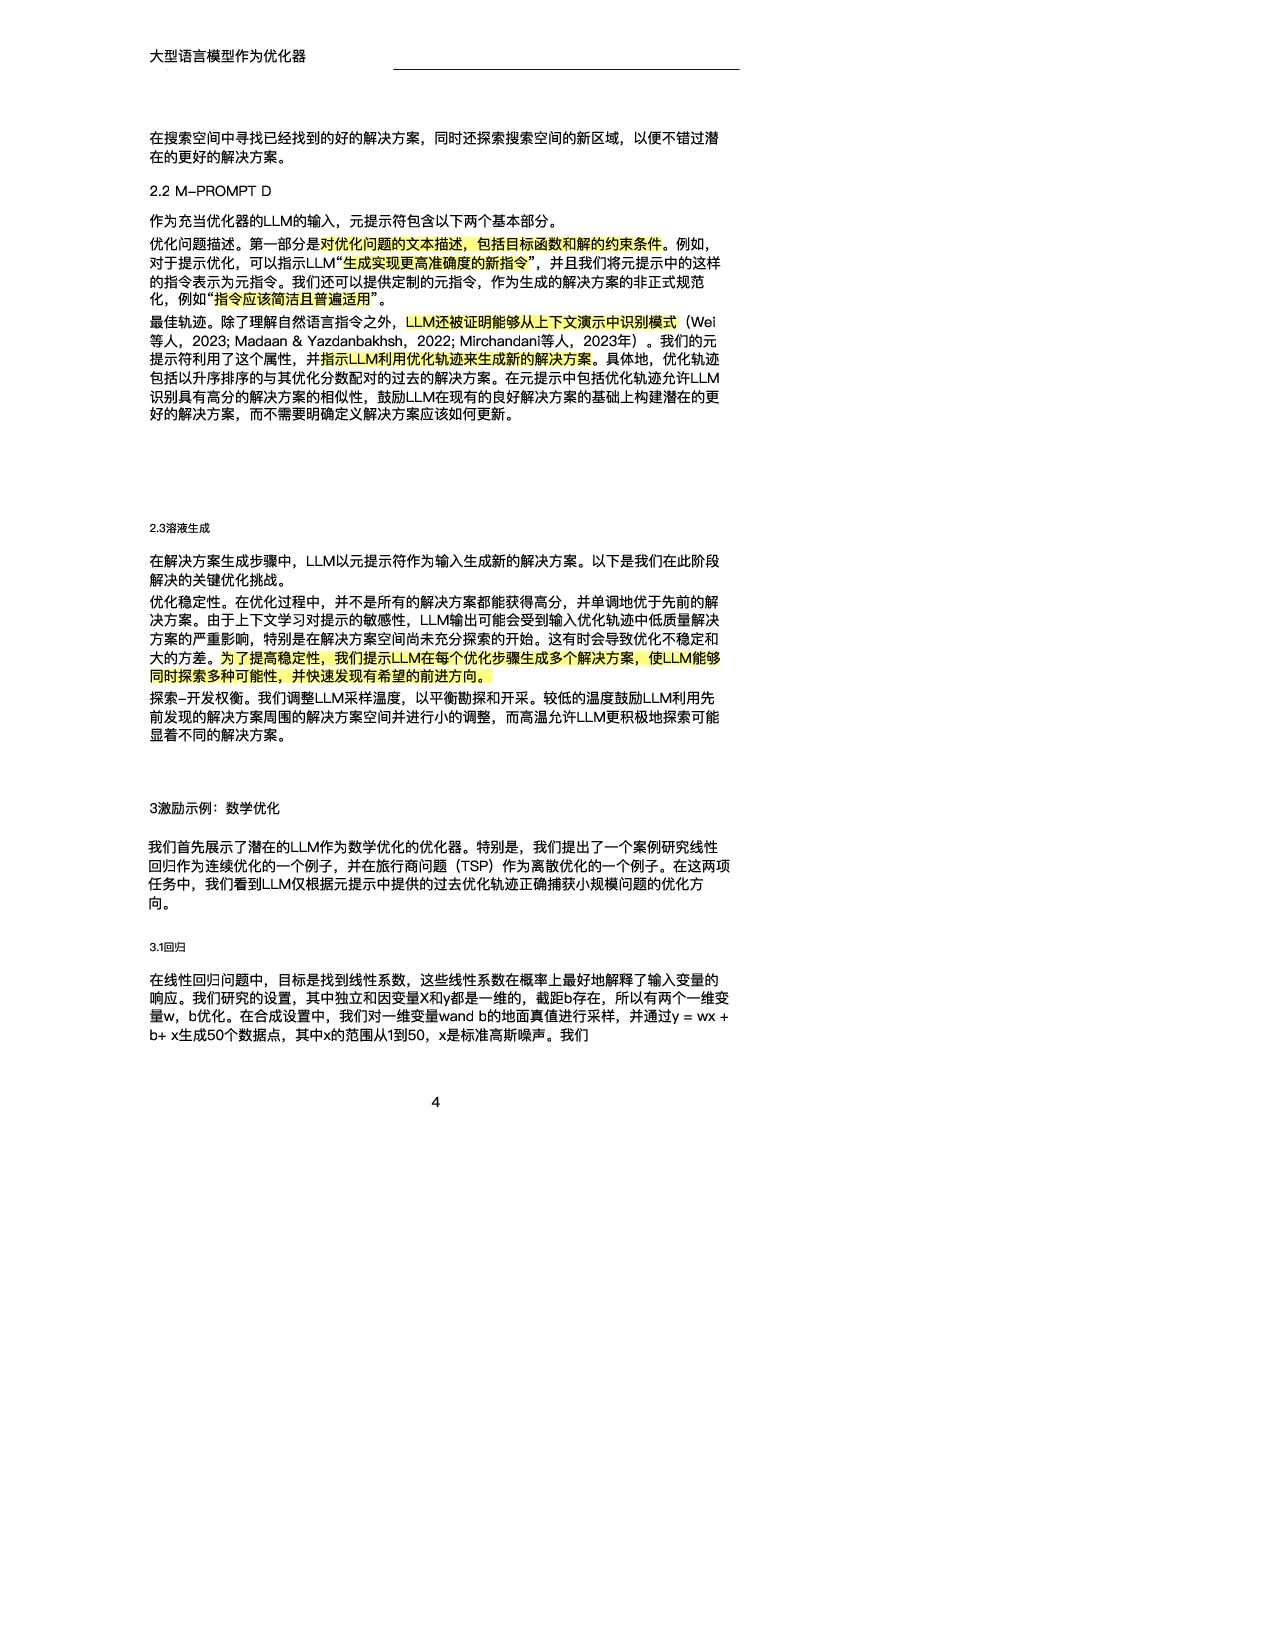
大型语言模型作为优化器 在搜索空间中寻找已经找到的好的解决方案,同时还探索搜索空间的新区域,以便不错过潜 在的更好的解决方案。 2.2 M-PROMPT D 作为充当优化器的LLM的输入,元提示符包含以下两个基本部分。 优化问题描述。第一部分是对优化问题的文本描述,包括目标函数和解的约束条件。例如, 对于提示优化,可以指示LLM“生成实现更高准确度的新指令”,并且我们将元提示中的这样 的指令表示为元指令。我们还可以提供定制的元指令,作为生成的解决方案的非正式规范
化,例如“指令应该简洁且普遍适用”。 最佳轨迹。除了理解自然语言指令之外,LLM还被证明能够从上下文演示中识别模式(Wei 等人,2023; Madaan & Yazdanbakhsh,2022; Mirchandani等人,2023年)。我们的元 提示符利用了这个属性,并指示LLM利用优化轨迹来生成新的解决方案。具体地,优化轨迹 包括以升序排序的与其优化分数配对的过去的解决方案。在元提示中包括优化轨迹允许LLM 识别具有高分的解决方案的相似性,鼓励LLM在现有的良好解决方案的基础上构建潜在的更 好的解决方案,而不需要明确定义解决方案应该如何更新。 2.3溶液生成 在解决方案生成步骤中,LLM以元提示符作为输入生成新的解决方案。以下是我们在此阶段 解决的关键优化挑战。 优化稳定性。在优化过程中,并不是所有的解决方案都能获得高分,并单调地优于先前的解 决方案。由于上下文学习对提示的敏感性,LLM输出可能会受到输入优化轨迹中低质量解决 方案的严重影响,特别是在解决方案空间尚未充分探索的开始。这有时会导致优化不稳定和 大的方差。为了提高稳定性,我们提示LLM在每个优化步骤生成多个解决方案,使LLM能够 同时探索多种可能性,并快速发现有希望的前进方向。 探索-开发权衡。我们调整LLM采样温度,以平衡勘探和开采。较低的温度鼓励LLM利用先 前发现的解决方案周围的解决方案空间并进行小的调整,而高温允许LLM更积极地探索可能 显着不同的解决方案。 3激励示例:数学优化 我们首先展示了潜在的LLM作为数学优化的优化器。特别是,我们提出了一个案例研究线性 回归作为连续优化的一个例子,并在旅行商问题(TSP)作为离散优化的一个例子。在这两项 任务中,我们看到LLM仅根据元提示中提供的过去优化轨迹正确捕获小规模问题的优化方 向。 3.1回归 在线性回归问题中,目标是找到线性系数,这些线性系数在概率上最好地解释了输入变量的 响应。我们研究的设置,其中独立和因变量X和y都是一维的,截距b存在,所以有两个一维变 量w,b优化。在合成设置中,我们对一维变量wand b的地面真值进行采样,并通过y = wx + b+ x生成50个数据点,其中x的范围从1到50,x是标准高斯噪声。我们 4
大型语言模型作为优化器 表2:优化器LLM的线性回归:在达到全局最优值之前探索的步骤数和唯一(w,b)对的数 量的平均值±标准差。w和b都从[10,20]中的5个随机起点开始。我们为所有型号使用温度 1.0。每个设置运行5次。起始点在优化器LLM之间是相同的,但在5次运行之间是不同的,并 且按以下方式分组:在起始区域内,在起始区域外部且靠近起始区域,以及在起始区域外部 且远离起始区域 粗体数字表示每种设置中三种LLM中最好的 wb步骤数探索的唯一(w,b)对的数量 text-bison gpt-3.5-turbo
gpt-4 text-bison gpt-3.5-turbo gpt-4 15 14 5.8 7.6 4.0 40.0 36.0 17.2 17 17 4.0 12.6 6.0 33.4 53.8 26.0 16 10 3.8 10.4 6.2 30.2 42.8 24.2 3 5 9.8 10.8 12.2 55.8 39.6 33.0 25 23 19.6 26.4 12.2 104.0 78.6 44.2 2 30 31.4 42.8 38.0 126.4 125.6 99.0 36 -1 35.8 45.4 50.4 174.0 142.2 116.4 优化从5个随机采样的(w,B)对开始。在每一步中,我们用一个元提示符提示一个已调优 的LLM,其中包括历史上最好的20个(w,b)对及其排序的目标值。然后,元提示符要求 进一步减小目标值的新的(w,B)对。附录C.1的图17显示了一个元提示符示例。为了提高 优化的稳定性,我们对元提示符进行了8次提示,以在每一步中生成最多8个新的(w,B) 对。然后,我们评估所提出的对的客观价值,并将其添加到历史中。我们进行黑盒优化:分 析形式不会出现在元提示符文本中。这是因为LLM通常可以直接从解析形式计算解。 表2总结了使用以下优化器LLM之一的结果:text-bison、gpt-3.5-turbo和gpt-4。我们研 究了wand B的三种设置:在起始区域[10,20] × [10,20]内,“近外”(每个wand bis在起 始区域外但距离小于10),和“远外”(每个wand bis在起始区域外且距离大于10)。我们看 到: • 每个模型探索的唯一(w,b)对的数量少于穷举搜索,表明这些模型能够进行黑盒优 化:比较数字并提出下降方向。 • text-bison和gpt-4模型在收敛速度上优于gpt-3.5-turbo:它们以更少的步骤达到最 优。gpt-4模型在寻找具有较少探索的独特点的最优值方面也表现出色。仔细看看优化轨 迹,我们发现gpt-4最擅长从历史中提出合理的下一步:例如,当历史显示目标值(w, b)=(8,7)、(w,b)=(8,6)和(w,b)=(8,5)正在减小时,它具有最高的 机会提出(w,b)=(8,(4)评价。 • 当地面实况远离起始区域时,所有模型的问题都变得更加困难:所有模型都需要更多的 探索和更多的步骤。 3.2旅行推销员问题(TSP) 接下来,我们考虑旅行商问题(TSP)(Jünger et al.,一九九五年; Gutin & Punnen, 2006),一种经典的组合优化问题,在文献中提出了许多算法,包括启发式算法和求解器 (Rosenkrantz等人,1977; Golden等人,1980; Optimization等,2020; Applegate等人, 2006; Helsgaun,2017),以及基于训练深度神经网络的方法(Kool等人,2019; Deudon 等人,2018; Chen & Tian,2019; Nazari等人,2018年)。具体来说,给定一组n个节点及 其坐标,TSP任务是找到从起始节点遍历所有节点并最终返回起始节点的最短路径。 我们的LLM优化过程从5个随机生成的解决方案开始,每个优化步骤最多产生8个新的解决方 案。我们在附录C.1的图18中展示了元提示符。我们通过在[−100,100]中对x和y坐标的n个 节点进行采样来生成问题实例。我们使用Guidelines求解器(Optimization et al.,2020) 来构造 解决方案并计算所有方法的 优性差 其中 优性差 被定义为 5
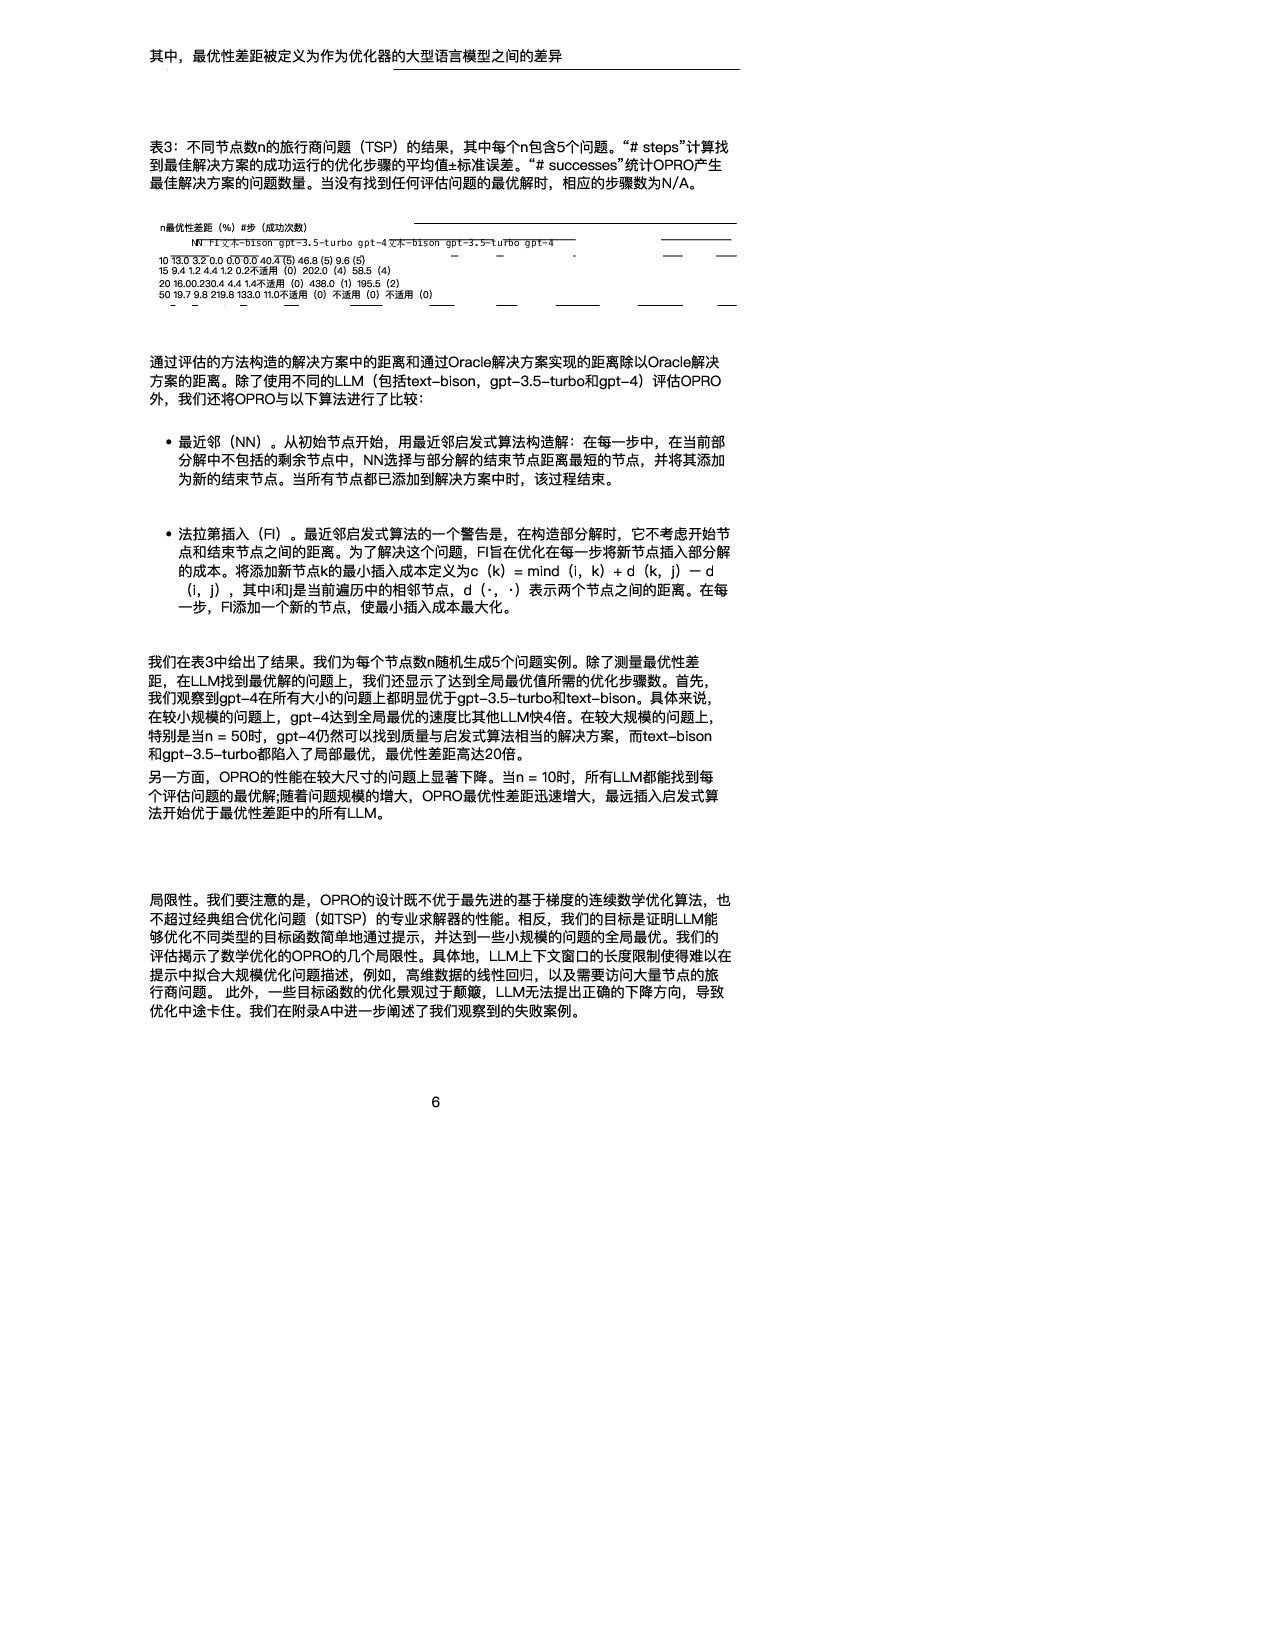
其中,最优性差距被定义为作为优化器的大型语言模型之间的差异 表3:不同节点数n的旅行商问题(TSP)的结果,其中每个n包含5个问题。“# steps”计算找 到最佳解决方案的成功运行的优化步骤的平均值±标准误差。“# successes”统计OPRO产生 最佳解决方案的问题数量。当没有找到任何评估问题的最优解时,相应的步骤数为N/A。 n最优性差距(%)#步(成功次数) NN FI文本-bison gpt-3.5-turbo
gpt-4文本-bison gpt-3.5-turbo gpt-4 10 13.0 3.2 0.0 0.0 0.0 40.4 (5) 46.8 (5) 9.6 (5) 15 9.4 1.2 4.4 1.2 0.2不适用(0)202.0(4)58.5(4) 20 16.00.230.4 4.4 1.4不适用(0)438.0(1)195.5(2) 50 19.7 9.8 219.8 133.0 11.0不适用(0)不适用(0)不适用(0) 通过评估的方法构造的解决方案中的距离和通过Oracle解决方案实现的距离除以Oracle解决 方案的距离。除了使用不同的LLM(包括text-bison,gpt-3.5-turbo和gpt-4)评估OPRO 外,我们还将OPRO与以下算法进行了比较: • 最近邻(NN)。从初始节点开始,用最近邻启发式算法构造解:在每一步中,在当前部 分解中不包括的剩余节点中,NN选择与部分解的结束节点距离最短的节点,并将其添加 为新的结束节点。当所有节点都已添加到解决方案中时,该过程结束。 • 法拉第插入(FI)。最近邻启发式算法的一个警告是,在构造部分解时,它不考虑开始节 点和结束节点之间的距离。为了解决这个问题,FI旨在优化在每一步将新节点插入部分解 的成本。将添加新节点k的最小插入成本定义为c(k)= mind(i,k)+ d(k,j)− d (i,j),其中i和j是当前遍历中的相邻节点,d(·,·)表示两个节点之间的距离。在每 一步,FI添加一个新的节点,使最小插入成本最大化。 我们在表3中给出了结果。我们为每个节点数n随机生成5个问题实例。除了测量最优性差 距,在LLM找到最优解的问题上,我们还显示了达到全局最优值所需的优化步骤数。首先, 我们观察到gpt-4在所有大小的问题上都明显优于gpt-3.5-turbo和text-bison。具体来说, 在较小规模的问题上,gpt-4达到全局最优的速度比其他LLM快4倍。在较大规模的问题上, 特别是当n = 50时,gpt-4仍然可以找到质量与启发式算法相当的解决方案,而text-bison 和gpt-3.5-turbo都陷入了局部最优,最优性差距高达20倍。 另一方面,OPRO的性能在较大尺寸的问题上显著下降。当n = 10时,所有LLM都能找到每 个评估问题的最优解;随着问题规模的增大,OPRO最优性差距迅速增大,最远插入启发式算 法开始优于最优性差距中的所有LLM。 局限性。我们要注意的是,OPRO的设计既不优于最先进的基于梯度的连续数学优化算法,也 不超过经典组合优化问题(如TSP)的专业求解器的性能。相反,我们的目标是证明LLM能 够优化不同类型的目标函数简单地通过提示,并达到一些小规模的问题的全局最优。我们的 评估揭示了数学优化的OPRO的几个局限性。具体地,LLM上下文窗口的长度限制使得难以在 提示中拟合大规模优化问题描述,例如,高维数据的线性回归,以及需要访问大量节点的旅 行商问题。 此外,一些目标函数的优化景观过于颠簸,LLM无法提出正确的下降方向,导致 优化中途卡住。我们在附录A中进一步阐述了我们观察到的失败案例。 6
大型语言模型作为优化器 我有一些文本沿着与他们相应的分数。文本根据其分数按升序排列,分数越高表示质量越 好。 正文: 我们一起想办法! 评分: 61 正文: 让我们来解决这个问题。 评分:
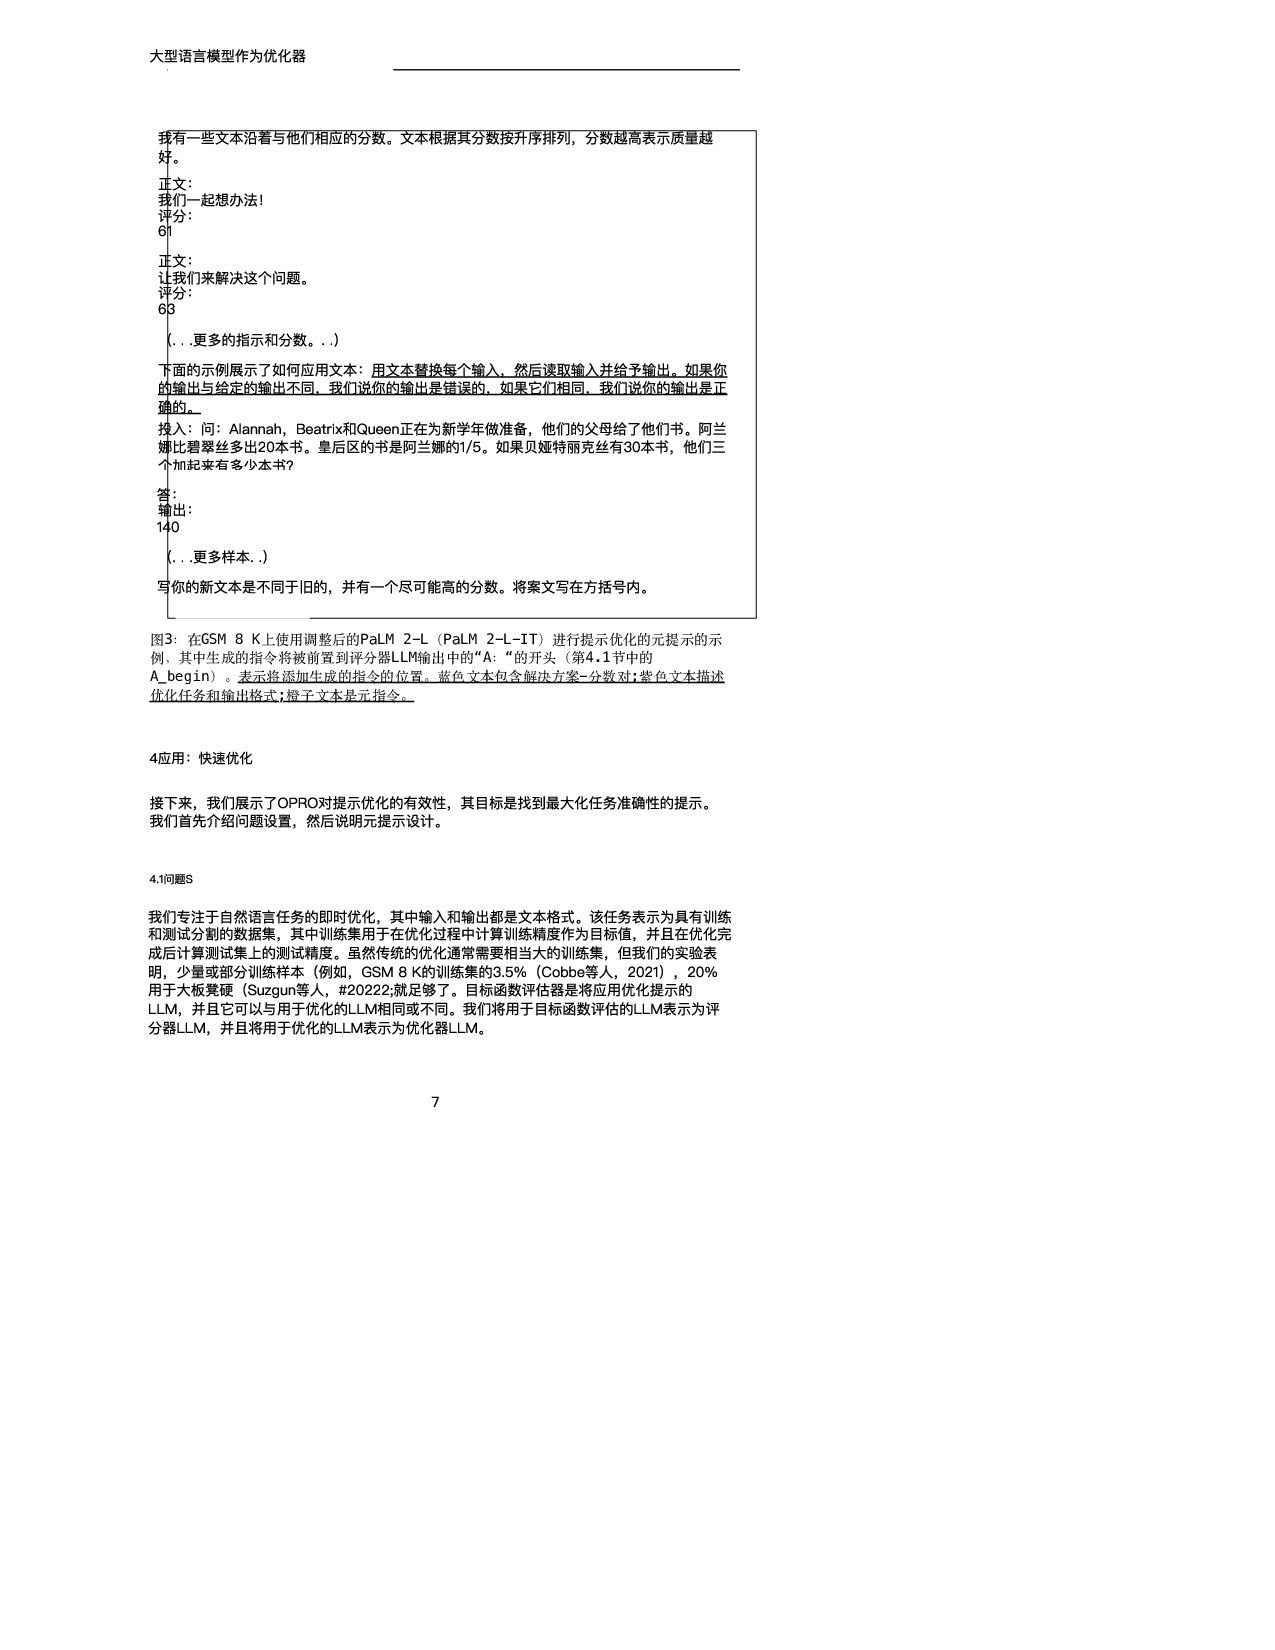
63 (. . .更多的指示和分数。. .) 下面的示例展示了如何应用文本:用文本替换每个输入,然后读取输入并给予输出。如果你 的输出与给定的输出不同,我们说你的输出是错误的,如果它们相同,我们说你的输出是正 确的。 投入:问:Alannah,Beatrix和Queen正在为新学年做准备,他们的父母给了他们书。阿兰 娜比碧翠丝多出20本书。皇后区的书是阿兰娜的1/5。如果贝娅特丽克丝有30本书,他们三 个加起来有多少本书? 答: 输出: 140 (. . .更多样本. .) 写你的新文本是不同于旧的,并有一个尽可能高的分数。将案文写在方括号内。 图3:在GSM 8 K上使用调整后的PaLM 2-L(PaLM 2-L-IT)进行提示优化的元提示的示 例,其中生成的指令将被前置到评分器LLM输出中的“A:“的开头(第4.1节中的 A_begin)。表示将添加生成的指令的位置。蓝色文本包含解决方案-分数对;紫色文本描述 优化任务和输出格式;橙子文本是元指令。 4应用:快速优化 接下来,我们展示了OPRO对提示优化的有效性,其目标是找到最大化任务准确性的提示。 我们首先介绍问题设置,然后说明元提示设计。 4.1问题S 我们专注于自然语言任务的即时优化,其中输入和输出都是文本格式。该任务表示为具有训练 和测试分割的数据集,其中训练集用于在优化过程中计算训练精度作为目标值,并且在优化完 成后计算测试集上的测试精度。虽然传统的优化通常需要相当大的训练集,但我们的实验表 明,少量或部分训练样本(例如,GSM 8 K的训练集的3.5%(Cobbe等人,2021),20% 用于大板凳硬(Suzgun等人,#20222;就足够了。目标函数评估器是将应用优化提示的 LLM,并且它可以与用于优化的LLM相同或不同。我们将用于目标函数评估的LLM表示为评 分器LLM,并且将用于优化的LLM表示为优化器LLM。 7
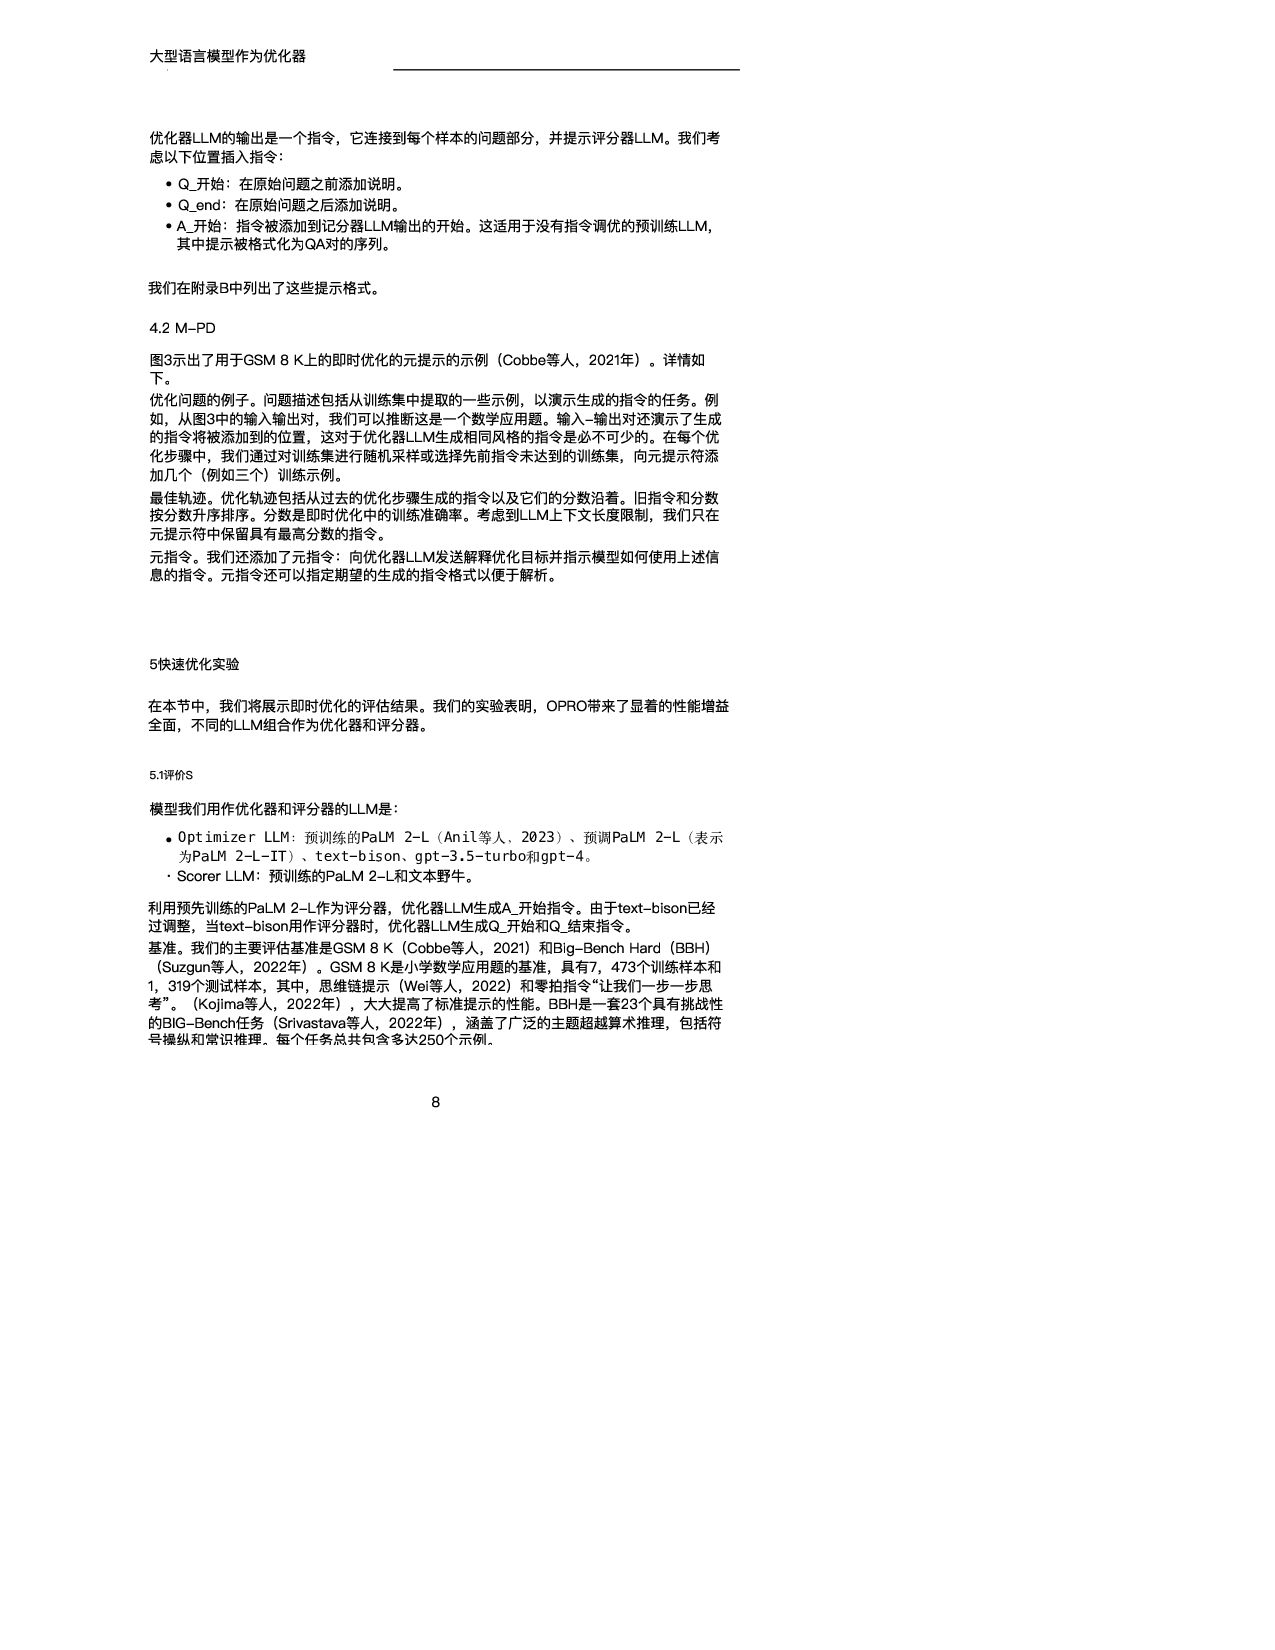
大型语言模型作为优化器 优化器LLM的输出是一个指令,它连接到每个样本的问题部分,并提示评分器LLM。我们考 虑以下位置插入指令: • Q_开始:在原始问题之前添加说明。 • Q_end:在原始问题之后添加说明。 • A_开始:指令被添加到记分器LLM输出的开始。这适用于没有指令调优的预训练LLM, 其中提示被格式化为QA对的序列。
我们在附录B中列出了这些提示格式。 4.2 M-PD 图3示出了用于GSM 8 K上的即时优化的元提示的示例(Cobbe等人,2021年)。详情如 下。 优化问题的例子。问题描述包括从训练集中提取的一些示例,以演示生成的指令的任务。例 如,从图3中的输入输出对,我们可以推断这是一个数学应用题。输入-输出对还演示了生成 的指令将被添加到的位置,这对于优化器LLM生成相同风格的指令是必不可少的。在每个优 化步骤中,我们通过对训练集进行随机采样或选择先前指令未达到的训练集,向元提示符添 加几个(例如三个)训练示例。 最佳轨迹。优化轨迹包括从过去的优化步骤生成的指令以及它们的分数沿着。旧指令和分数 按分数升序排序。分数是即时优化中的训练准确率。考虑到LLM上下文长度限制,我们只在 元提示符中保留具有最高分数的指令。 元指令。我们还添加了元指令:向优化器LLM发送解释优化目标并指示模型如何使用上述信 息的指令。元指令还可以指定期望的生成的指令格式以便于解析。 5快速优化实验 在本节中,我们将展示即时优化的评估结果。我们的实验表明,OPRO带来了显着的性能增益 全面,不同的LLM组合作为优化器和评分器。 5.1评价S 模型我们用作优化器和评分器的LLM是: • Optimizer LLM:预训练的PaLM 2-L(Anil等人,2023)、预调PaLM 2-L(表示 为PaLM 2-L-IT)、text-bison、gpt-3.5-turbo和gpt-4。 · Scorer LLM:预训练的PaLM 2-L和文本野牛。 利用预先训练的PaLM 2-L作为评分器,优化器LLM生成A_开始指令。由于text-bison已经 过调整,当text-bison用作评分器时,优化器LLM生成Q_开始和Q_结束指令。 基准。我们的主要评估基准是GSM 8 K(Cobbe等人,2021)和Big-Bench Hard(BBH) (Suzgun等人,2022年)。GSM 8 K是小学数学应用题的基准,具有7,473个训练样本和 1,319个测试样本,其中,思维链提示(Wei等人,2022)和零拍指令“让我们一步一步思 考”。(Kojima等人,2022年),大大提高了标准提示的性能。BBH是一套23个具有挑战性 的BIG-Bench任务(Srivastava等人,2022年),涵盖了广泛的主题超越算术推理,包括符 号操纵和常识推理。每个任务总共包含多达250个示例。 8
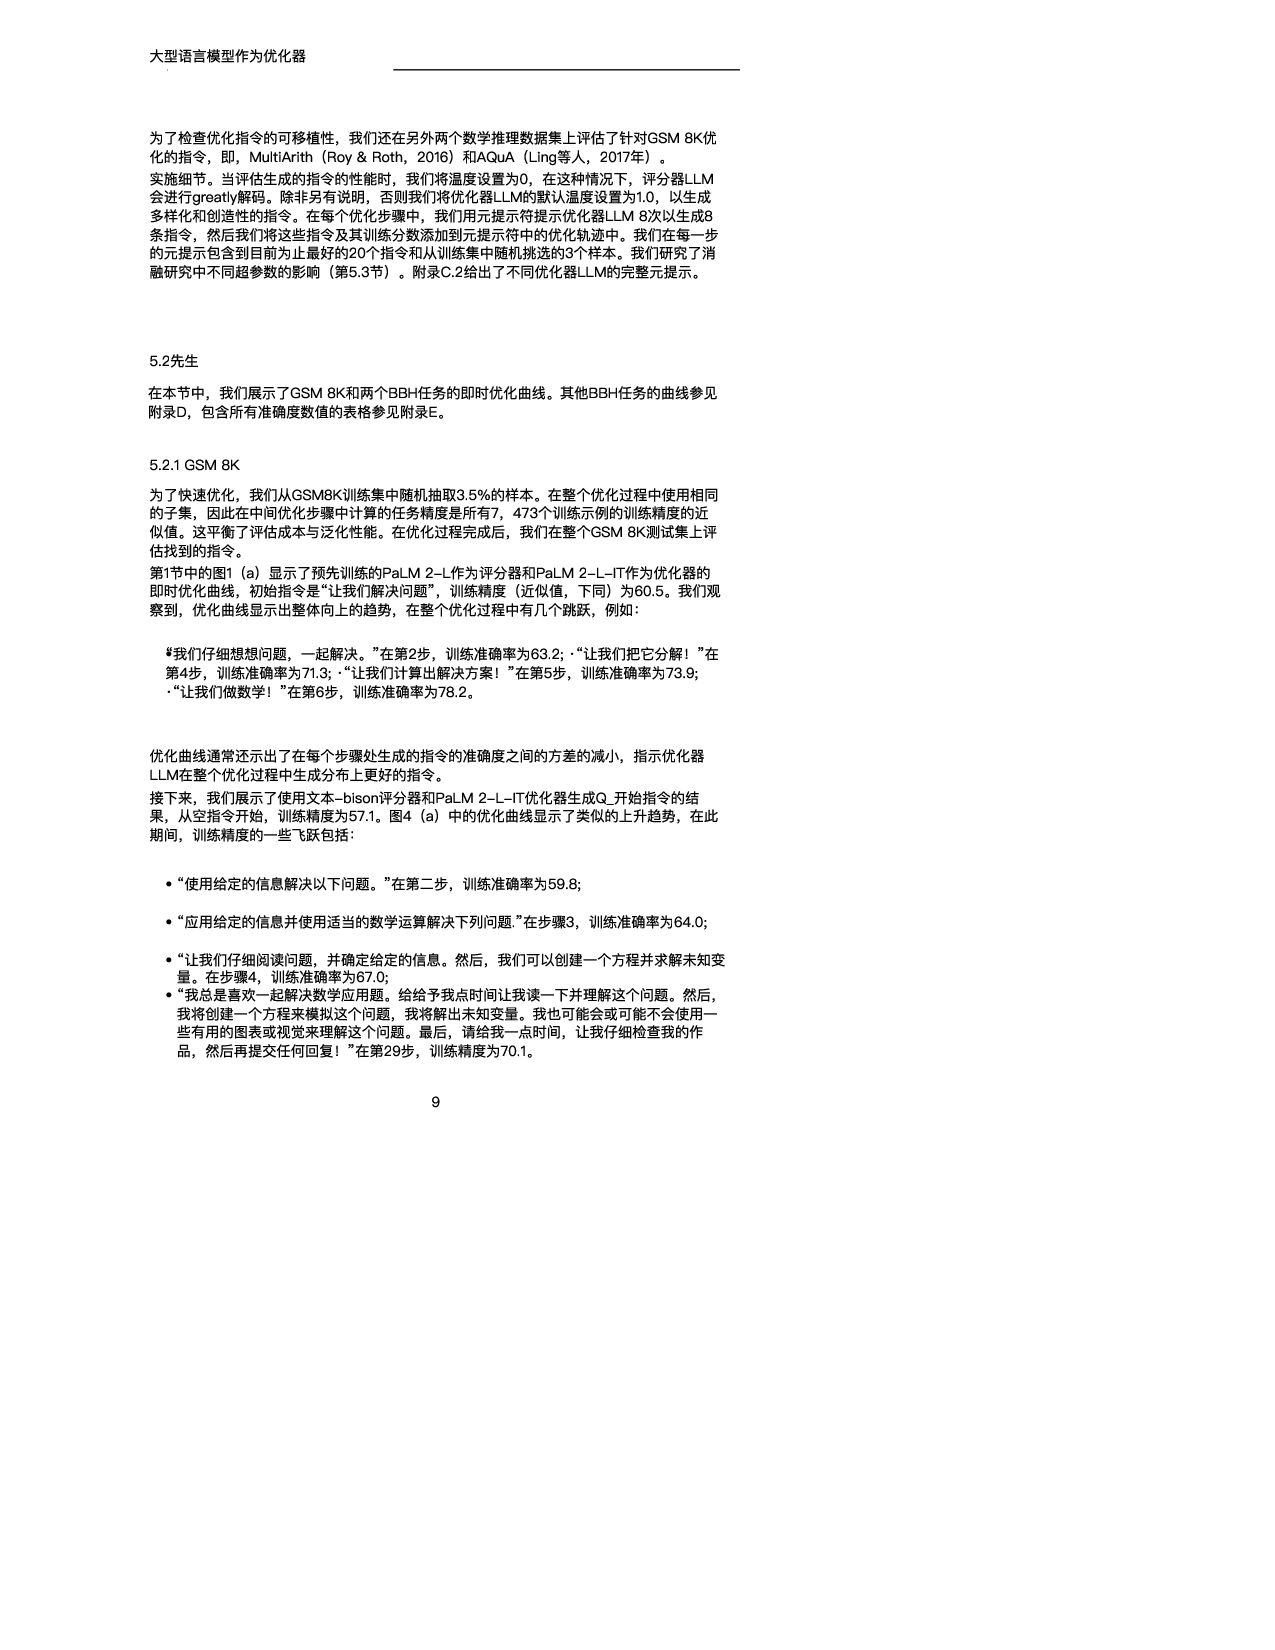
大型语言模型作为优化器 为了检查优化指令的可移植性,我们还在另外两个数学推理数据集上评估了针对GSM 8K优 化的指令,即,MultiArith(Roy & Roth,2016)和AQuA(Ling等人,2017年)。 实施细节。当评估生成的指令的性能时,我们将温度设置为0,在这种情况下,评分器LLM 会进行greatly解码。除非另有说明,否则我们将优化器LLM的默认温度设置为1.0,以生成 多样化和创造性的指令。在每个优化步骤中,我们用元提示符提示优化器LLM 8次以生成8
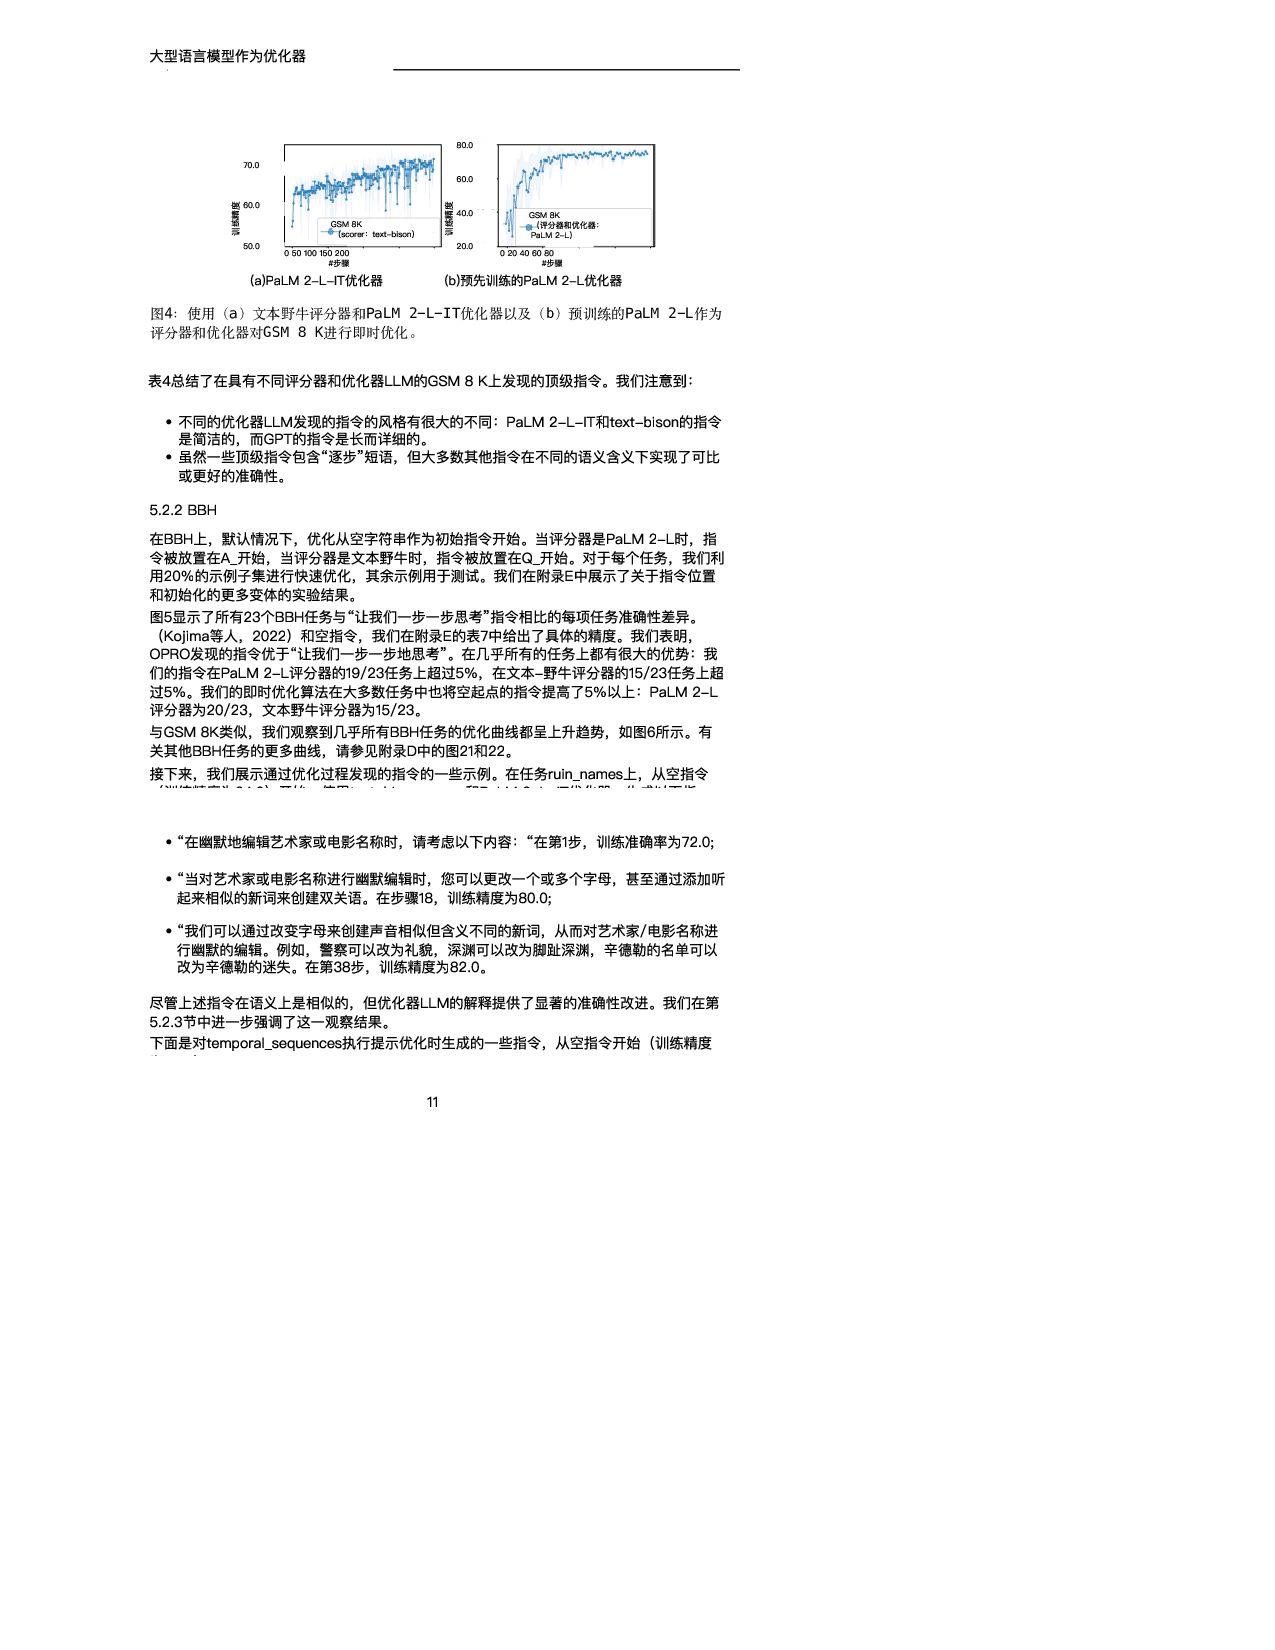
条指令,然后我们将这些指令及其训练分数添加到元提示符中的优化轨迹中。我们在每一步 的元提示包含到目前为止最好的20个指令和从训练集中随机挑选的3个样本。我们研究了消 融研究中不同超参数的影响(第5.3节)。附录C.2给出了不同优化器LLM的完整元提示。 5.2先生 在本节中,我们展示了GSM 8K和两个BBH任务的即时优化曲线。其他BBH任务的曲线参见 附录D,包含所有准确度数值的表格参见附录E。 5.2.1 GSM 8K 为了快速优化,我们从GSM8K训练集中随机抽取3.5%的样本。在整个优化过程中使用相同 的子集,因此在中间优化步骤中计算的任务精度是所有7,473个训练示例的训练精度的近 似值。这平衡了评估成本与泛化性能。在优化过程完成后,我们在整个GSM 8K测试集上评 估找到的指令。 第1节中的图1(a)显示了预先训练的PaLM 2-L作为评分器和PaLM 2-L-IT作为优化器的 即时优化曲线,初始指令是“让我们解决问题”,训练精度(近似值,下同)为60.5。我们观 察到,优化曲线显示出整体向上的趋势,在整个优化过程中有几个跳跃,例如: • “我们仔细想想问题,一起解决。”在第2步,训练准确率为63.2; ·“让我们把它分解!”在 第4步,训练准确率为71.3; ·“让我们计算出解决方案!”在第5步,训练准确率为73.9; ·“让我们做数学!”在第6步,训练准确率为78.2。 优化曲线通常还示出了在每个步骤处生成的指令的准确度之间的方差的减小,指示优化器 LLM在整个优化过程中生成分布上更好的指令。 接下来,我们展示了使用文本-bison评分器和PaLM 2-L-IT优化器生成Q_开始指令的结 果,从空指令开始,训练精度为57.1。图4(a)中的优化曲线显示了类似的上升趋势,在此 期间,训练精度的一些飞跃包括: • “使用给定的信息解决以下问题。”在第二步,训练准确率为59.8; • “应用给定的信息并使用适当的数学运算解决下列问题.”在步骤3,训练准确率为64.0; • “让我们仔细阅读问题,并确定给定的信息。然后,我们可以创建一个方程并求解未知变 量。在步骤4,训练准确率为67.0; • “我总是喜欢一起解决数学应用题。给给予我点时间让我读一下并理解这个问题。然后, 我将创建一个方程来模拟这个问题,我将解出未知变量。我也可能会或可能不会使用一 些有用的图表或视觉来理解这个问题。最后,请给我一点时间,让我仔细检查我的作 品,然后再提交任何回复!”在第29步,训练精度为70.1。 9
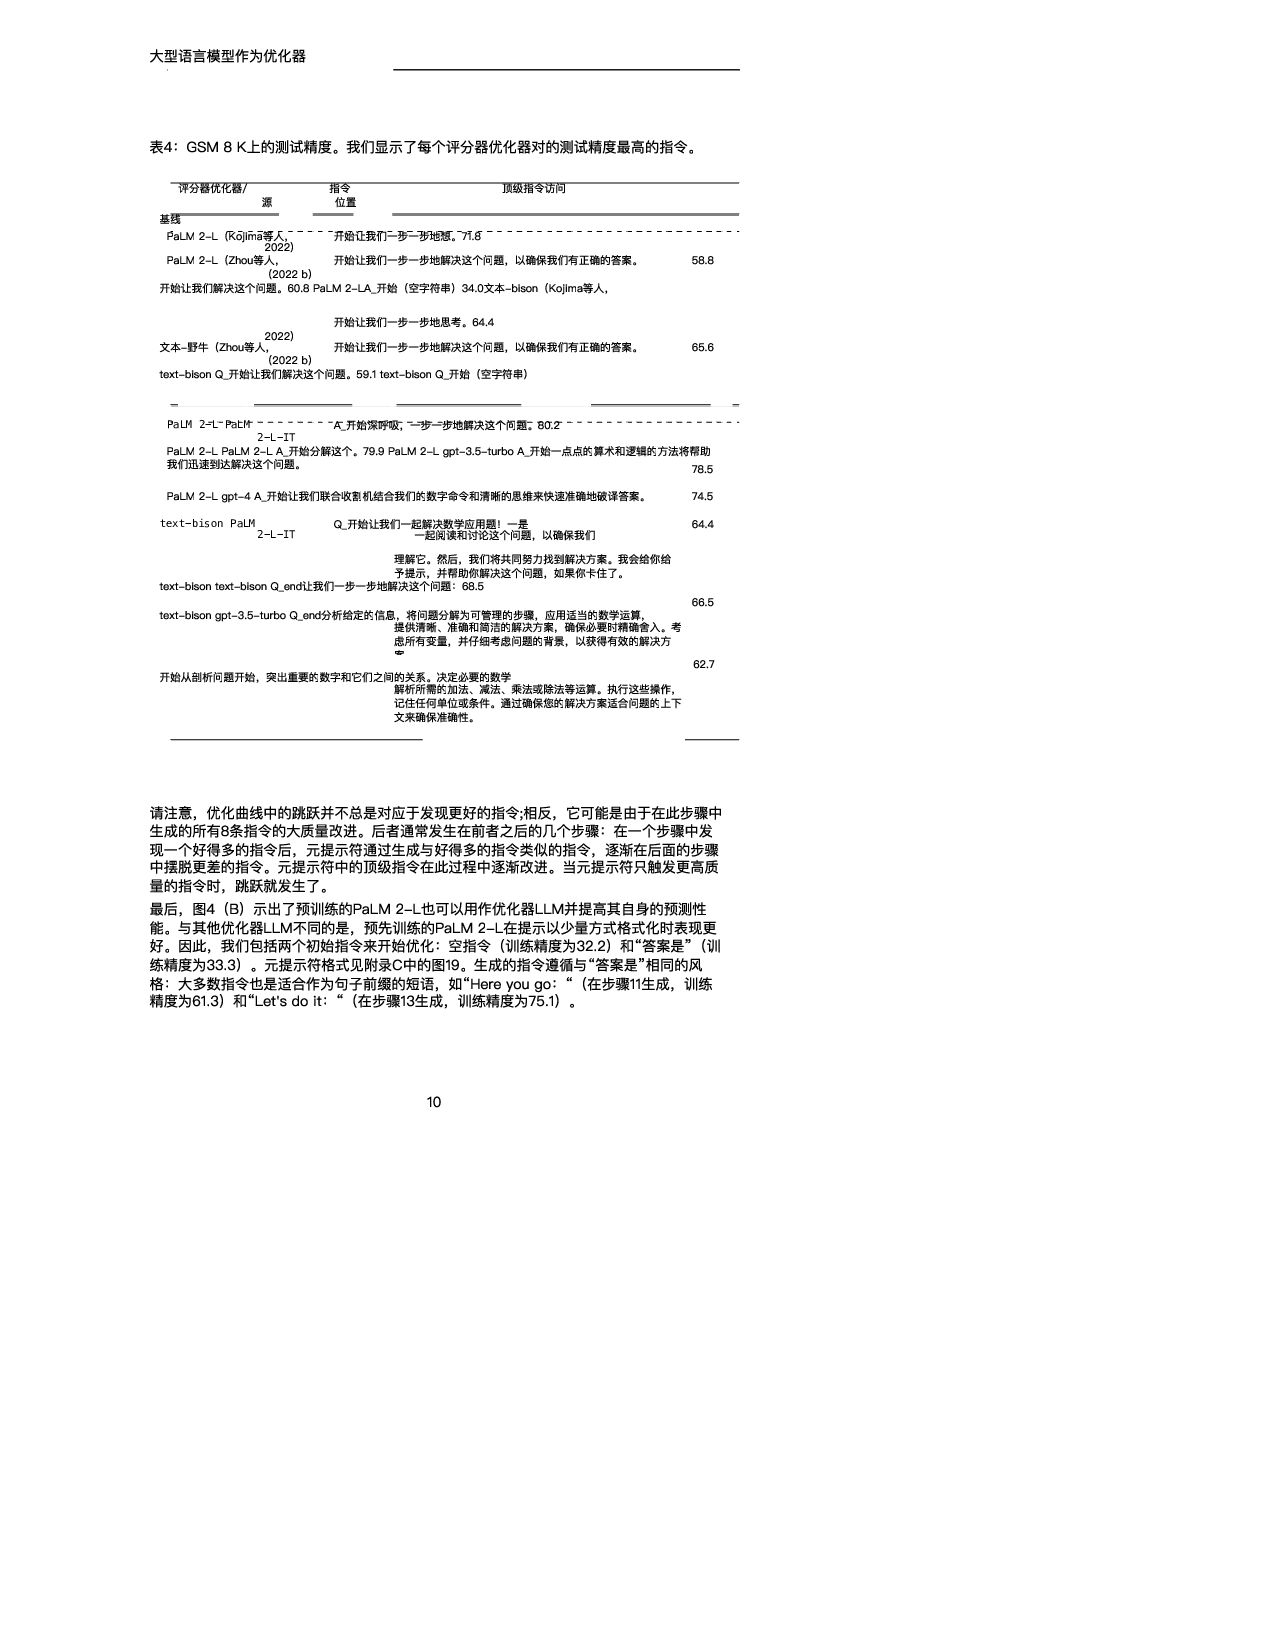
大型语言模型作为优化器 表4:GSM 8 K上的测试精度。我们显示了每个评分器优化器对的测试精度最高的指令。 评分器优化器/ 源 指令 位置 顶级指令访问 基线
PaLM 2-L(Kojima等人, 2022) 开始让我们一步一步地想。71.8 PaLM 2-L(Zhou等人, (2022 b) 开始让我们一步一步地解决这个问题,以确保我们有正确的答案。 58.8 开始让我们解决这个问题。60.8 PaLM 2-LA_开始(空字符串)34.0文本-bison(Kojima等人, 2022) 开始让我们一步一步地思考。64.4 文本-野牛(Zhou等人, (2022 b) 开始让我们一步一步地解决这个问题,以确保我们有正确的答案。 65.6 text-bison Q_开始让我们解决这个问题。59.1 text-bison Q_开始(空字符串) PaLM 2-L PaLM 2-L-IT A_开始深呼吸,一步一步地解决这个问题。80.2 PaLM 2-L PaLM 2-L A_开始分解这个。79.9 PaLM 2-L gpt-3.5-turbo A_开始一点点的算术和逻辑的方法将帮助 我们迅速到达解决这个问题。 78.5 PaLM 2-L gpt-4 A_开始让我们联合收割机结合我们的数字命令和清晰的思维来快速准确地破译答案。 74.5 text-bison PaLM 2-L-IT Q_开始让我们一起解决数学应用题!一是 一起阅读和讨论这个问题,以确保我们 理解它。然后,我们将共同努力找到解决方案。我会给你给 予提示,并帮助你解决这个问题,如果你卡住了。 64.4 text-bison text-bison Q_end让我们一步一步地解决这个问题:68.5 text-bison gpt-3.5-turbo Q_end分析给定的信息,将问题分解为可管理的步骤,应用适当的数学运算, 提供清晰、准确和简洁的解决方案,确保必要时精确舍入。考 虑所有变量,并仔细考虑问题的背景,以获得有效的解决方 案 66.5 开始从剖析问题开始,突出重要的数字和它们之间的关系。决定必要的数学 解析所需的加法、减法、乘法或除法等运算。执行这些操作, 记住任何单位或条件。通过确保您的解决方案适合问题的上下 文来确保准确性。 62.7 请注意,优化曲线中的跳跃并不总是对应于发现更好的指令;相反,它可能是由于在此步骤中 生成的所有8条指令的大质量改进。后者通常发生在前者之后的几个步骤:在一个步骤中发 现一个好得多的指令后,元提示符通过生成与好得多的指令类似的指令,逐渐在后面的步骤 中摆脱更差的指令。元提示符中的顶级指令在此过程中逐渐改进。当元提示符只触发更高质 量的指令时,跳跃就发生了。 最后,图4(B)示出了预训练的PaLM 2-L也可以用作优化器LLM并提高其自身的预测性 能。与其他优化器LLM不同的是,预先训练的PaLM 2-L在提示以少量方式格式化时表现更 好。因此,我们包括两个初始指令来开始优化:空指令(训练精度为32.2)和“答案是”(训 练精度为33.3)。元提示符格式见附录C中的图19。生成的指令遵循与“答案是”相同的风 格:大多数指令也是适合作为句子前缀的短语,如“Here you go:“(在步骤11生成,训练 精度为61.3)和“Let's do it:“(在步骤13生成,训练精度为75.1)。 10
大型语言模型作为优化器 0 50 100 150 200 #步骤 50.0 60.0 70.0
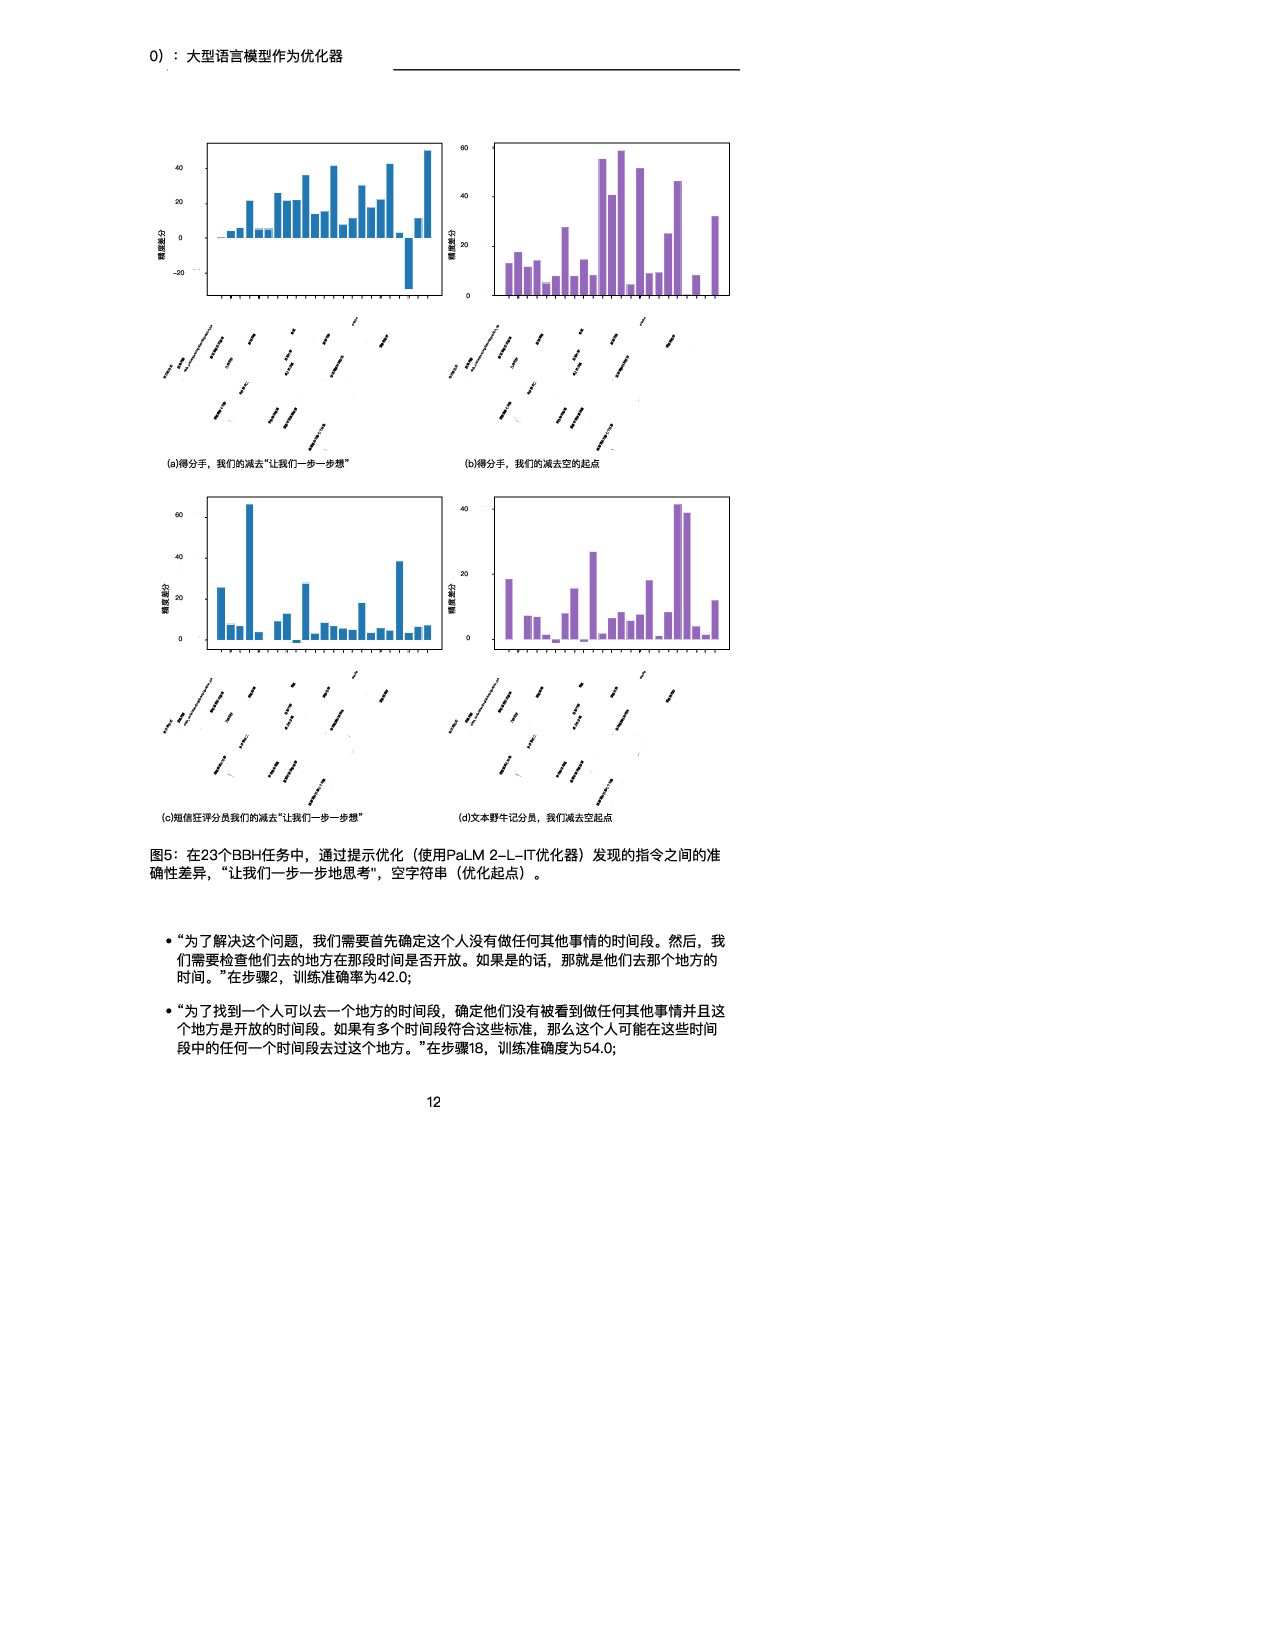
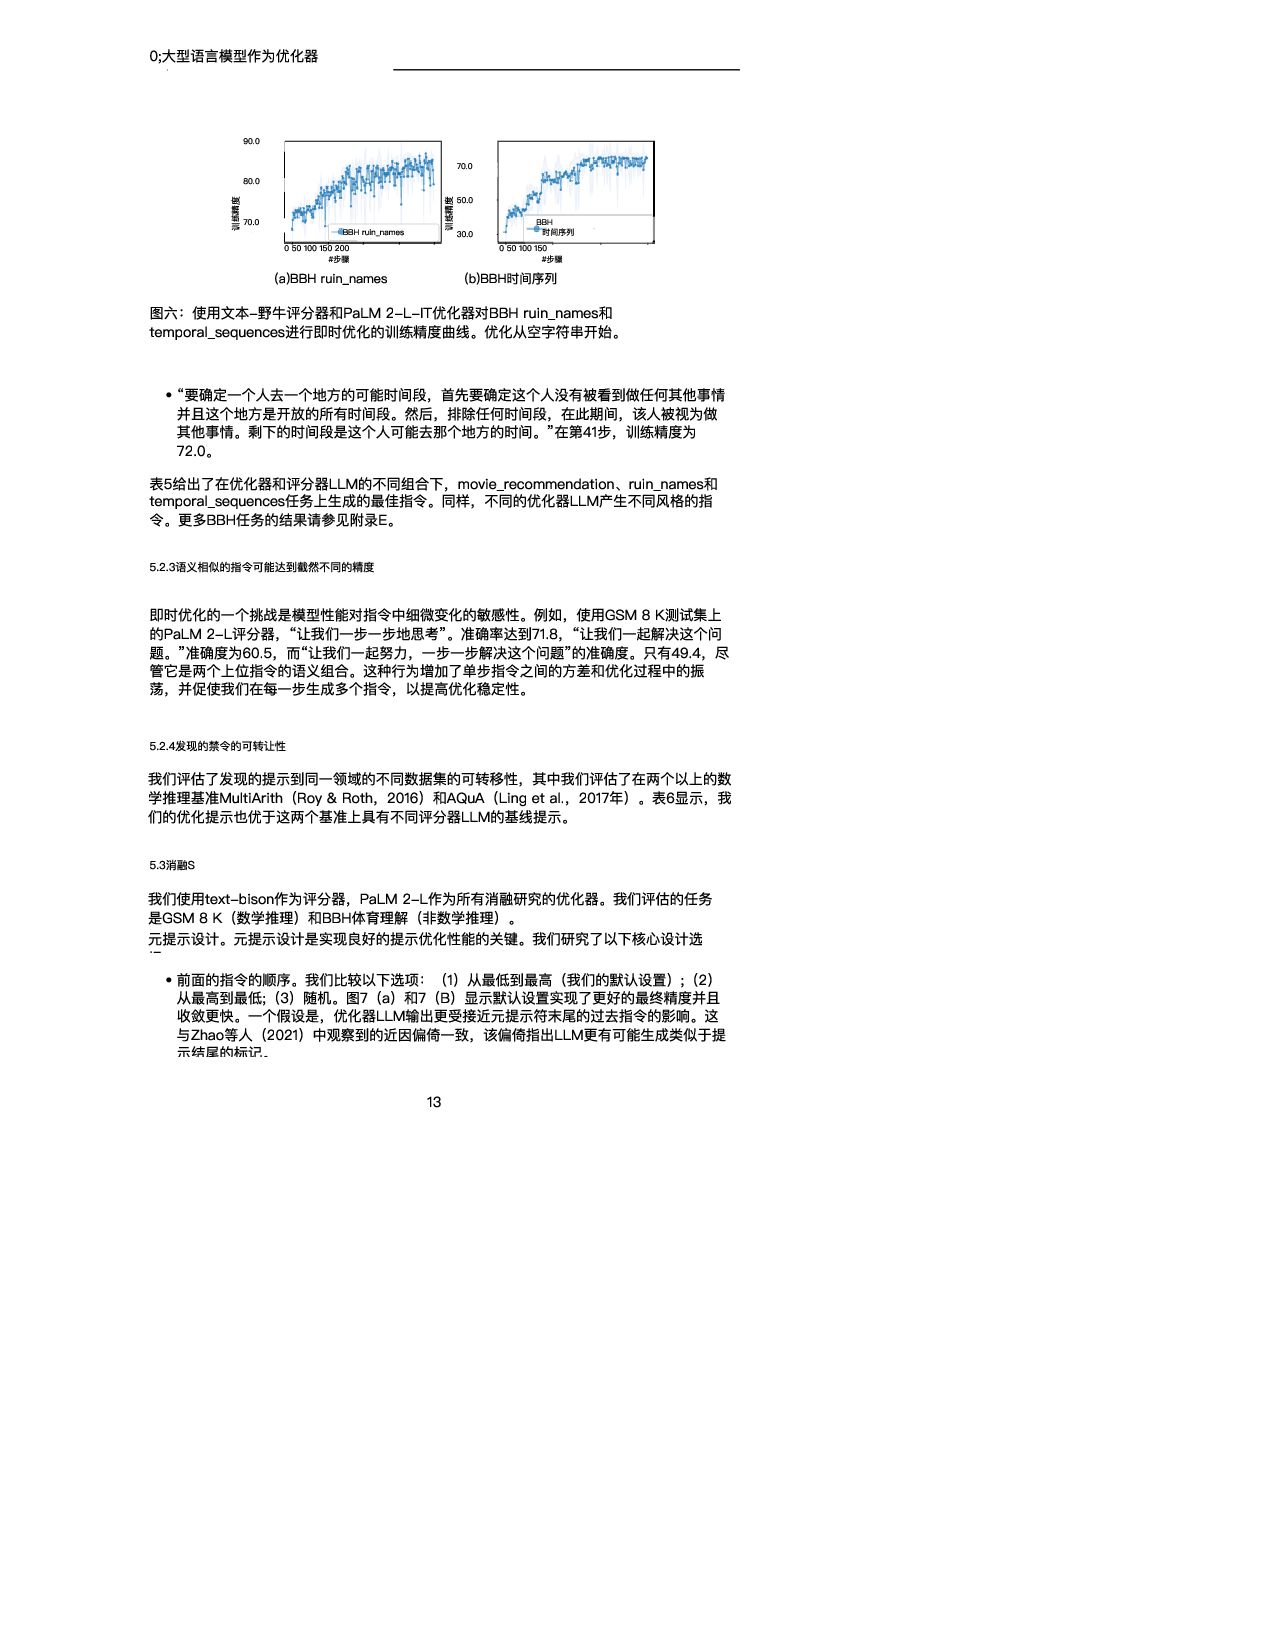
训练精度 GSM 8K (scorer:text-bison) (a)PaLM 2-L-IT优化器 0 20 40 60 80 #步骤 20.0 40.0 60.0 80.0 训练精度 GSM 8K (评分器和优化器: PaLM 2-L) (b)预先训练的PaLM 2-L优化器 图4:使用(a)文本野牛评分器和PaLM 2-L-IT优化器以及(b)预训练的PaLM 2-L作为 评分器和优化器对GSM 8 K进行即时优化。 表4总结了在具有不同评分器和优化器LLM的GSM 8 K上发现的顶级指令。我们注意到: • 不同的优化器LLM发现的指令的风格有很大的不同:PaLM 2-L-IT和text-bison的指令 是简洁的,而GPT的指令是长而详细的。 • 虽然一些顶级指令包含“逐步”短语,但大多数其他指令在不同的语义含义下实现了可比 或更好的准确性。 5.2.2 BBH 在BBH上,默认情况下,优化从空字符串作为初始指令开始。当评分器是PaLM 2-L时,指 令被放置在A_开始,当评分器是文本野牛时,指令被放置在Q_开始。对于每个任务,我们利 用20%的示例子集进行快速优化,其余示例用于测试。我们在附录E中展示了关于指令位置 和初始化的更多变体的实验结果。 图5显示了所有23个BBH任务与“让我们一步一步思考”指令相比的每项任务准确性差异。 (Kojima等人,2022)和空指令,我们在附录E的表7中给出了具体的精度。我们表明, OPRO发现的指令优于“让我们一步一步地思考”。在几乎所有的任务上都有很大的优势:我 们的指令在PaLM 2-L评分器的19/23任务上超过5%,在文本-野牛评分器的15/23任务上超 过5%。我们的即时优化算法在大多数任务中也将空起点的指令提高了5%以上:PaLM 2-L 评分器为20/23,文本野牛评分器为15/23。 与GSM 8K类似,我们观察到几乎所有BBH任务的优化曲线都呈上升趋势,如图6所示。有 关其他BBH任务的更多曲线,请参见附录D中的图21和22。 接下来,我们展示通过优化过程发现的指令的一些示例。在任务ruin_names上,从空指令 (训练精度为640)开始 使用t t bi 和P LM 2 L IT优化器 生成以下指 • “在幽默地编辑艺术家或电影名称时,请考虑以下内容:“在第1步,训练准确率为72.0; • “当对艺术家或电影名称进行幽默编辑时,您可以更改一个或多个字母,甚至通过添加听 起来相似的新词来创建双关语。在步骤18,训练精度为80.0; • “我们可以通过改变字母来创建声音相似但含义不同的新词,从而对艺术家/电影名称进 行幽默的编辑。例如,警察可以改为礼貌,深渊可以改为脚趾深渊,辛德勒的名单可以 改为辛德勒的迷失。在第38步,训练精度为82.0。 尽管上述指令在语义上是相似的,但优化器LLM的解释提供了显著的准确性改进。我们在第 5.2.3节中进一步强调了这一观察结果。 下面是对temporal_sequences执行提示优化时生成的一些指令,从空指令开始(训练精度 为 ) 11
0):大型语言模型作为优化器 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航
目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 -20 0 20 40 精度差分 (a)得分手,我们的减去“让我们一步一步想” 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 60 精度差分 (b)得分手,我们的减去空的起点 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 60 精度差分 (c)短信狂评分员我们的减去“让我们一步一步想” 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 精度差分 (d)文本野牛记分员,我们减去空起点 图5:在23个BBH任务中,通过提示优化(使用PaLM 2-L-IT优化器)发现的指令之间的准 确性差异,“让我们一步一步地思考",空字符串(优化起点)。 • “为了解决这个问题,我们需要首先确定这个人没有做任何其他事情的时间段。然后,我 们需要检查他们去的地方在那段时间是否开放。如果是的话,那就是他们去那个地方的 时间。”在步骤2,训练准确率为42.0; • “为了找到一个人可以去一个地方的时间段,确定他们没有被看到做任何其他事情并且这 个地方是开放的时间段。如果有多个时间段符合这些标准,那么这个人可能在这些时间 段中的任何一个时间段去过这个地方。”在步骤18,训练准确度为54.0; 12
0;大型语言模型作为优化器 0 50 100 150 200 #步骤 70.0 80.0 90.0
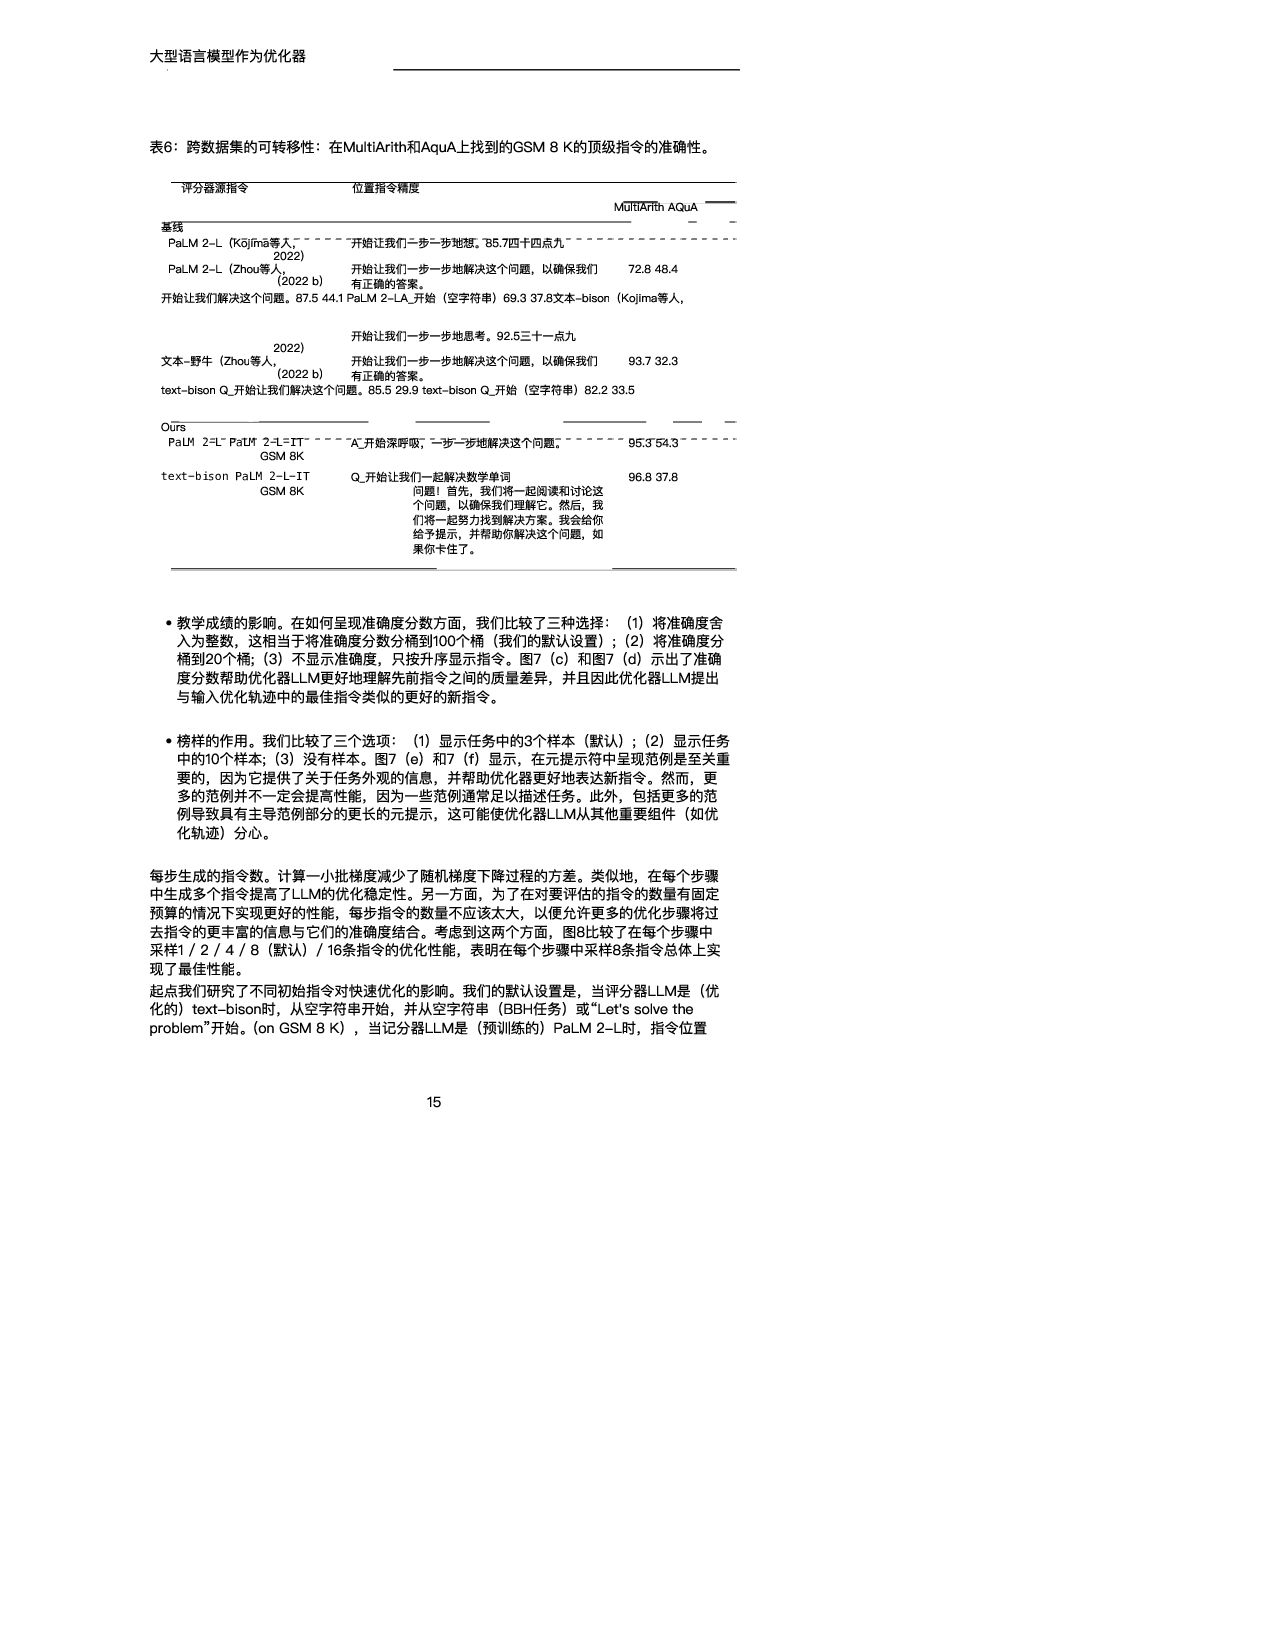
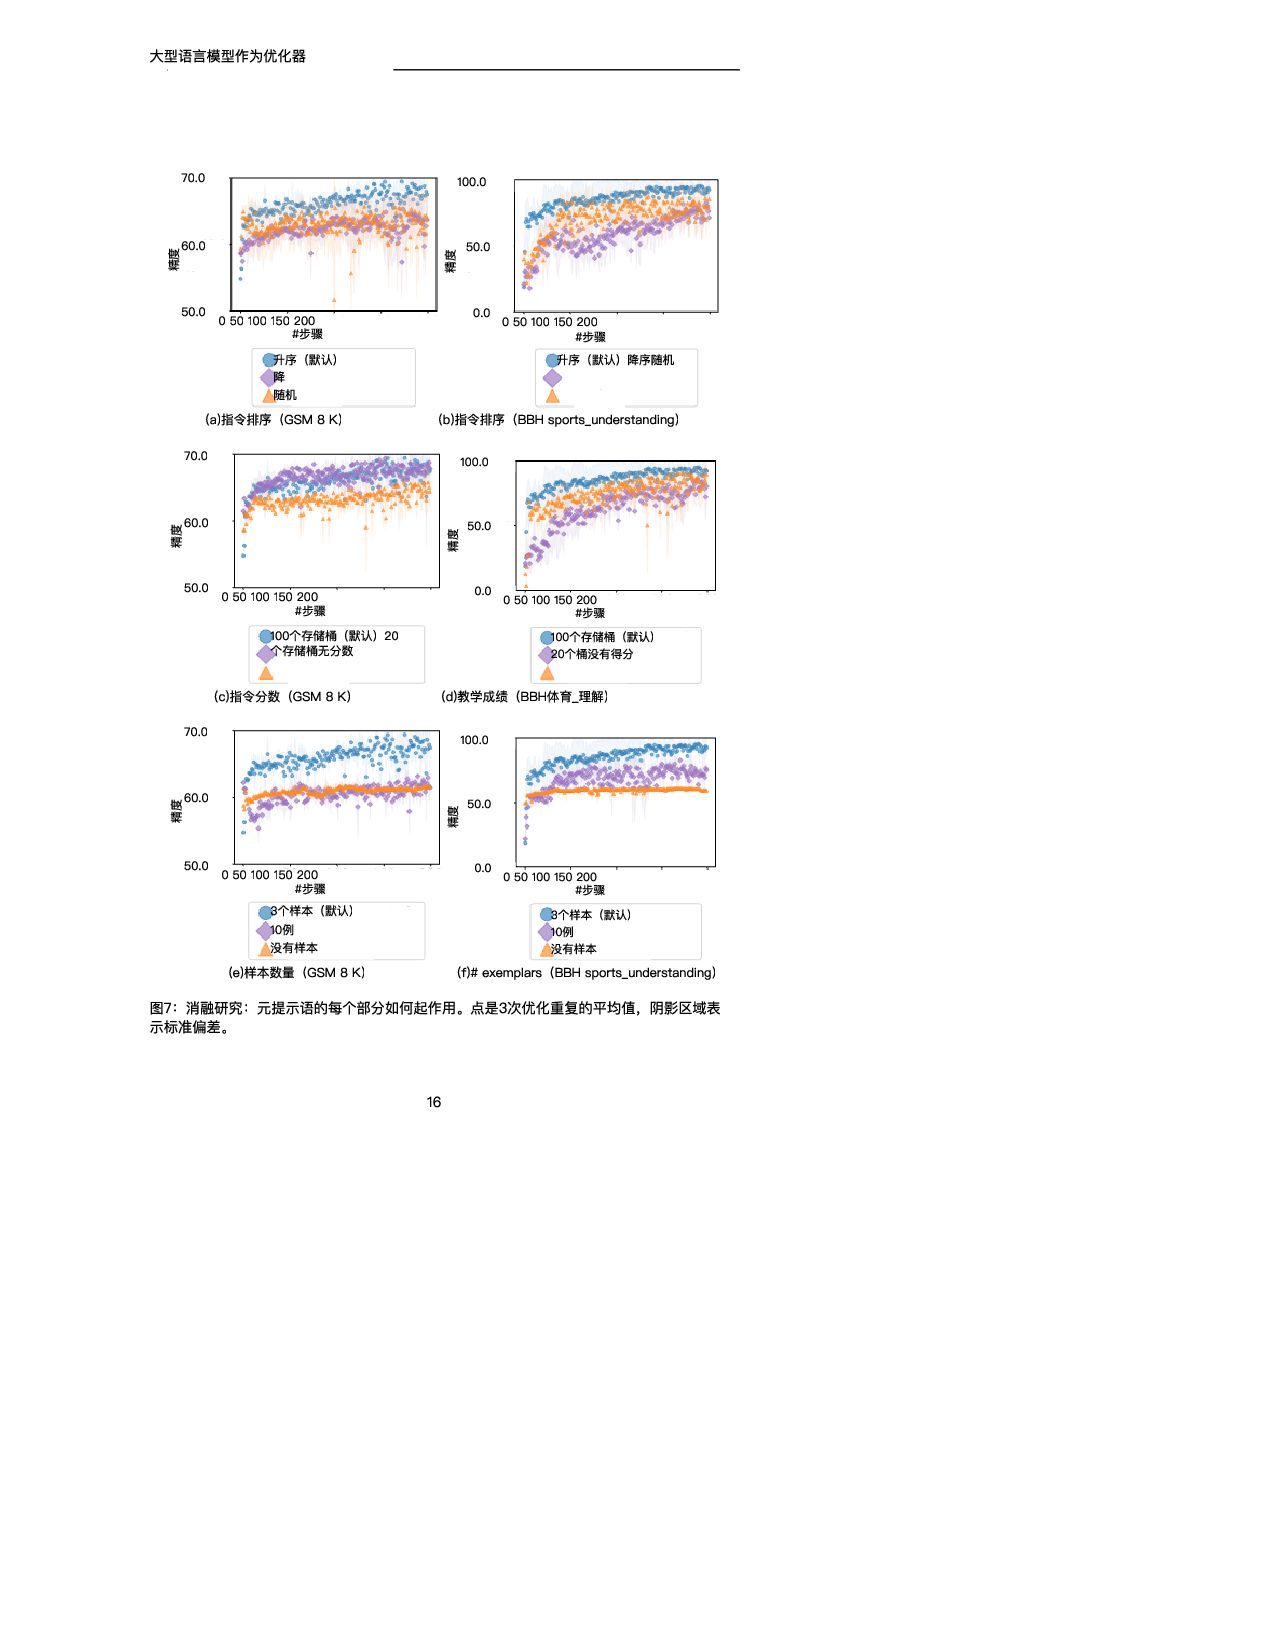
训练精度 BBH ruin_names (a)BBH ruin_names 0 50 100 150 #步骤 30.0 50.0 70.0 训练精度 BBH 时间序列 (b)BBH时间序列 图六:使用文本-野牛评分器和PaLM 2-L-IT优化器对BBH ruin_names和 temporal_sequences进行即时优化的训练精度曲线。优化从空字符串开始。 • “要确定一个人去一个地方的可能时间段,首先要确定这个人没有被看到做任何其他事情 并且这个地方是开放的所有时间段。然后,排除任何时间段,在此期间,该人被视为做 其他事情。剩下的时间段是这个人可能去那个地方的时间。”在第41步,训练精度为 72.0。 表5给出了在优化器和评分器LLM的不同组合下,movie_recommendation、ruin_names和 temporal_sequences任务上生成的最佳指令。同样,不同的优化器LLM产生不同风格的指 令。更多BBH任务的结果请参见附录E。 5.2.3语义相似的指令可能达到截然不同的精度 即时优化的一个挑战是模型性能对指令中细微变化的敏感性。例如,使用GSM 8 K测试集上 的PaLM 2-L评分器,“让我们一步一步地思考”。准确率达到71.8,“让我们一起解决这个问 题。”准确度为60.5,而“让我们一起努力,一步一步解决这个问题”的准确度。只有49.4,尽 管它是两个上位指令的语义组合。这种行为增加了单步指令之间的方差和优化过程中的振 荡,并促使我们在每一步生成多个指令,以提高优化稳定性。 5.2.4发现的禁令的可转让性 我们评估了发现的提示到同一领域的不同数据集的可转移性,其中我们评估了在两个以上的数 学推理基准MultiArith(Roy & Roth,2016)和AQuA(Ling et al.,2017年)。表6显示,我 们的优化提示也优于这两个基准上具有不同评分器LLM的基线提示。 5.3消融S 我们使用text-bison作为评分器,PaLM 2-L作为所有消融研究的优化器。我们评估的任务 是GSM 8 K(数学推理)和BBH体育理解(非数学推理)。 元提示设计。元提示设计是实现良好的提示优化性能的关键。我们研究了以下核心设计选 择 • 前面的指令的顺序。我们比较以下选项:(1)从最低到最高(我们的默认设置);(2) 从最高到最低;(3)随机。图7(a)和7(B)显示默认设置实现了更好的最终精度并且 收敛更快。一个假设是,优化器LLM输出更受接近元提示符末尾的过去指令的影响。这 与Zhao等人(2021)中观察到的近因偏倚一致,该偏倚指出LLM更有可能生成类似于提 示结尾的标记。 13
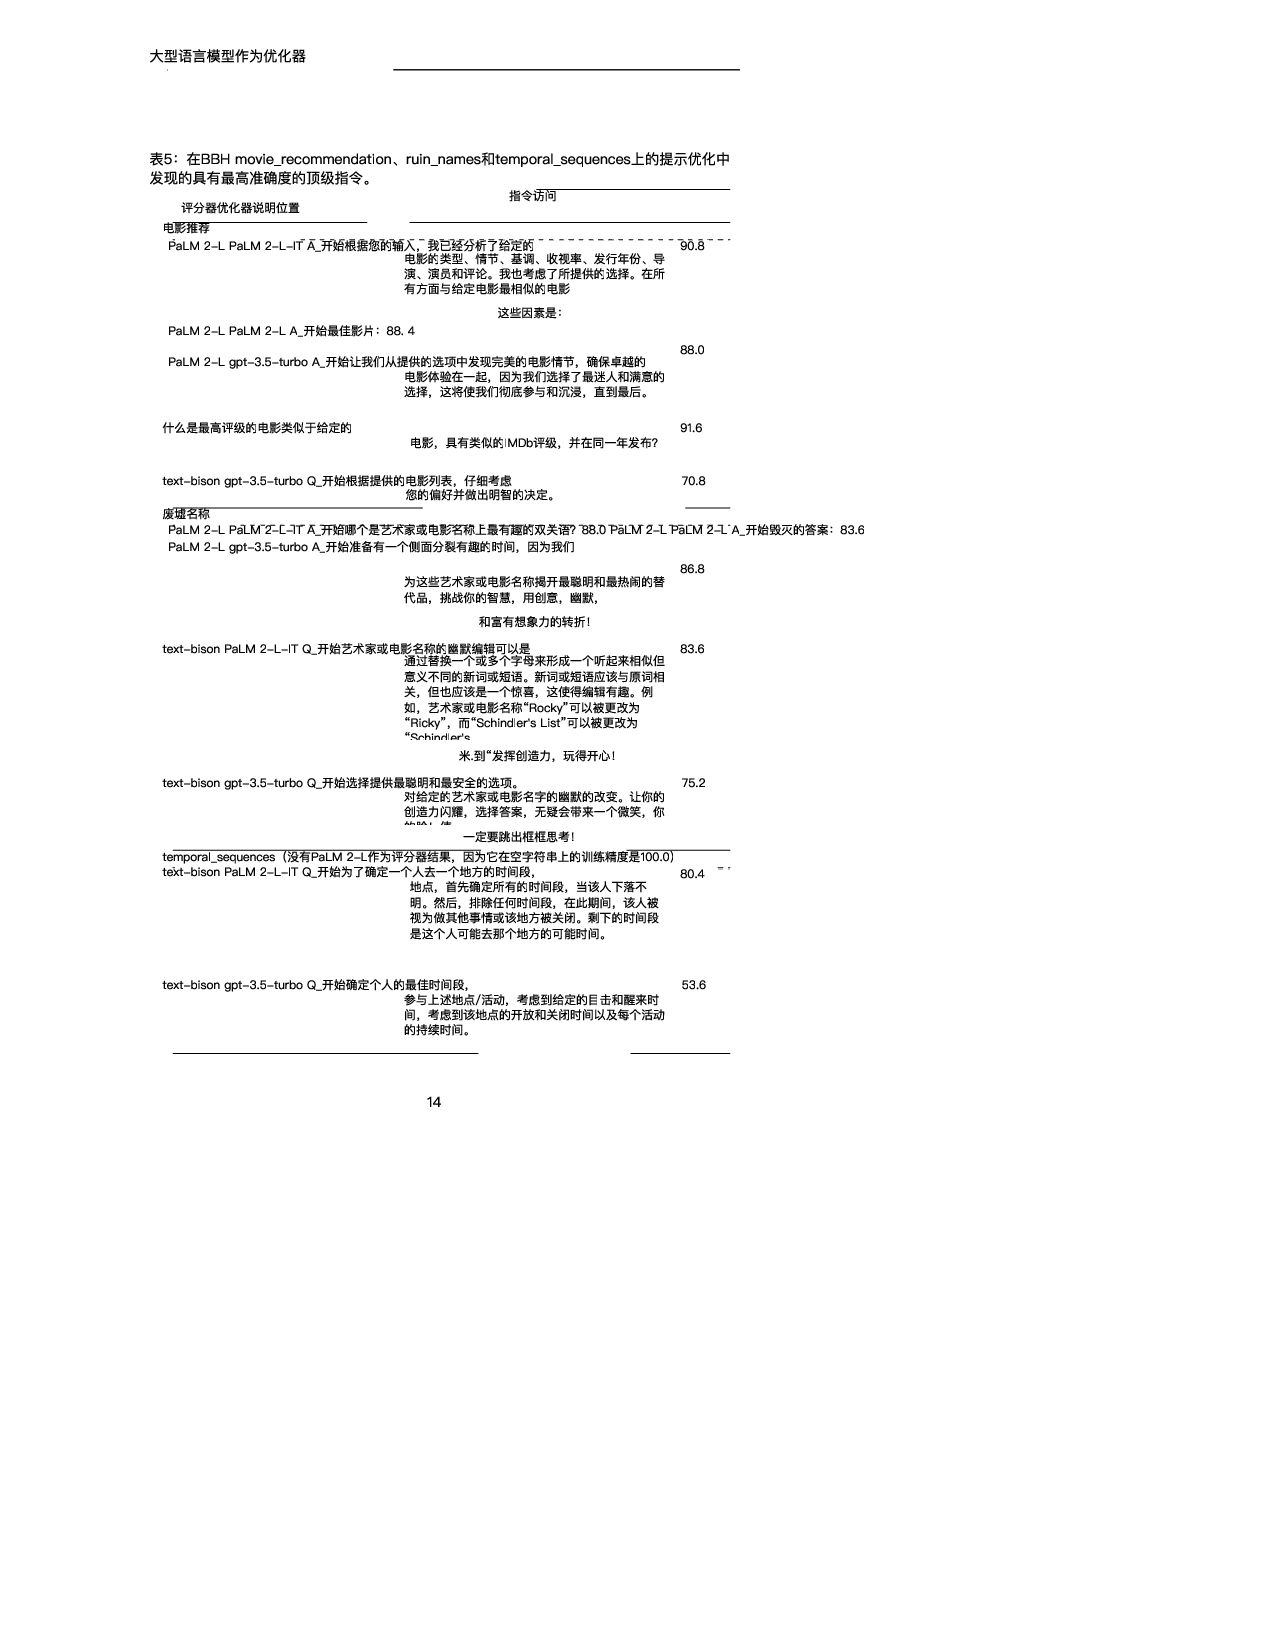
大型语言模型作为优化器 表5:在BBH movie_recommendation、ruin_names和temporal_sequences上的提示优化中 发现的具有最高准确度的顶级指令。 评分器优化器说明位置 指令访问 电影推荐 PaLM 2-L PaLM
2-L-IT A_开始根据您的输入,我已经分析了给定的 电影的类型、情节、基调、收视率、发行年份、导 演、演员和评论。我也考虑了所提供的选择。在所 有方面与给定电影最相似的电影 这些因素是: 90.8 PaLM 2-L PaLM 2-L A_开始最佳影片:88. 4 PaLM 2-L gpt-3.5-turbo A_开始让我们从提供的选项中发现完美的电影情节,确保卓越的 电影体验在一起,因为我们选择了最迷人和满意的 选择,这将使我们彻底参与和沉浸,直到最后。 88.0 什么是最高评级的电影类似于给定的 电影,具有类似的IMDb评级,并在同一年发布? 91.6 text-bison gpt-3.5-turbo Q_开始根据提供的电影列表,仔细考虑 您的偏好并做出明智的决定。 70.8 废墟名称 PaLM 2-L PaLM 2-L-IT A_开始哪个是艺术家或电影名称上最有趣的双关语?88.0 PaLM 2-L PaLM 2-L A_开始毁灭的答案:83.6 PaLM 2-L gpt-3.5-turbo A_开始准备有一个侧面分裂有趣的时间,因为我们 为这些艺术家或电影名称揭开最聪明和最热闹的替 代品,挑战你的智慧,用创意,幽默, 和富有想象力的转折! 86.8 text-bison PaLM 2-L-IT Q_开始艺术家或电影名称的幽默编辑可以是 通过替换一个或多个字母来形成一个听起来相似但 意义不同的新词或短语。新词或短语应该与原词相 关,但也应该是一个惊喜,这使得编辑有趣。例 如,艺术家或电影名称“Rocky”可以被更改为 “Ricky”,而“Schindler's List”可以被更改为 “Schindler's 米.到“发挥创造力,玩得开心! 83.6 text-bison gpt-3.5-turbo Q_开始选择提供最聪明和最安全的选项。 对给定的艺术家或电影名字的幽默的改变。让你的 创造力闪耀,选择答案,无疑会带来一个微笑,你 的脸!使 一定要跳出框框思考! 75.2 temporal_sequences(没有PaLM 2-L作为评分器结果,因为它在空字符串上的训练精度是100.0) text-bison PaLM 2-L-IT Q_开始为了确定一个人去一个地方的时间段, 地点,首先确定所有的时间段,当该人下落不 明。然后,排除任何时间段,在此期间,该人被 视为做其他事情或该地方被关闭。剩下的时间段 是这个人可能去那个地方的可能时间。 80.4 text-bison gpt-3.5-turbo Q_开始确定个人的最佳时间段, 参与上述地点/活动,考虑到给定的目击和醒来时 间,考虑到该地点的开放和关闭时间以及每个活动 的持续时间。 53.6 14
大型语言模型作为优化器 表6:跨数据集的可转移性:在MultiArith和AquA上找到的GSM 8 K的顶级指令的准确性。 评分器源指令 位置指令精度 MultiArith AQuA 基线 PaLM
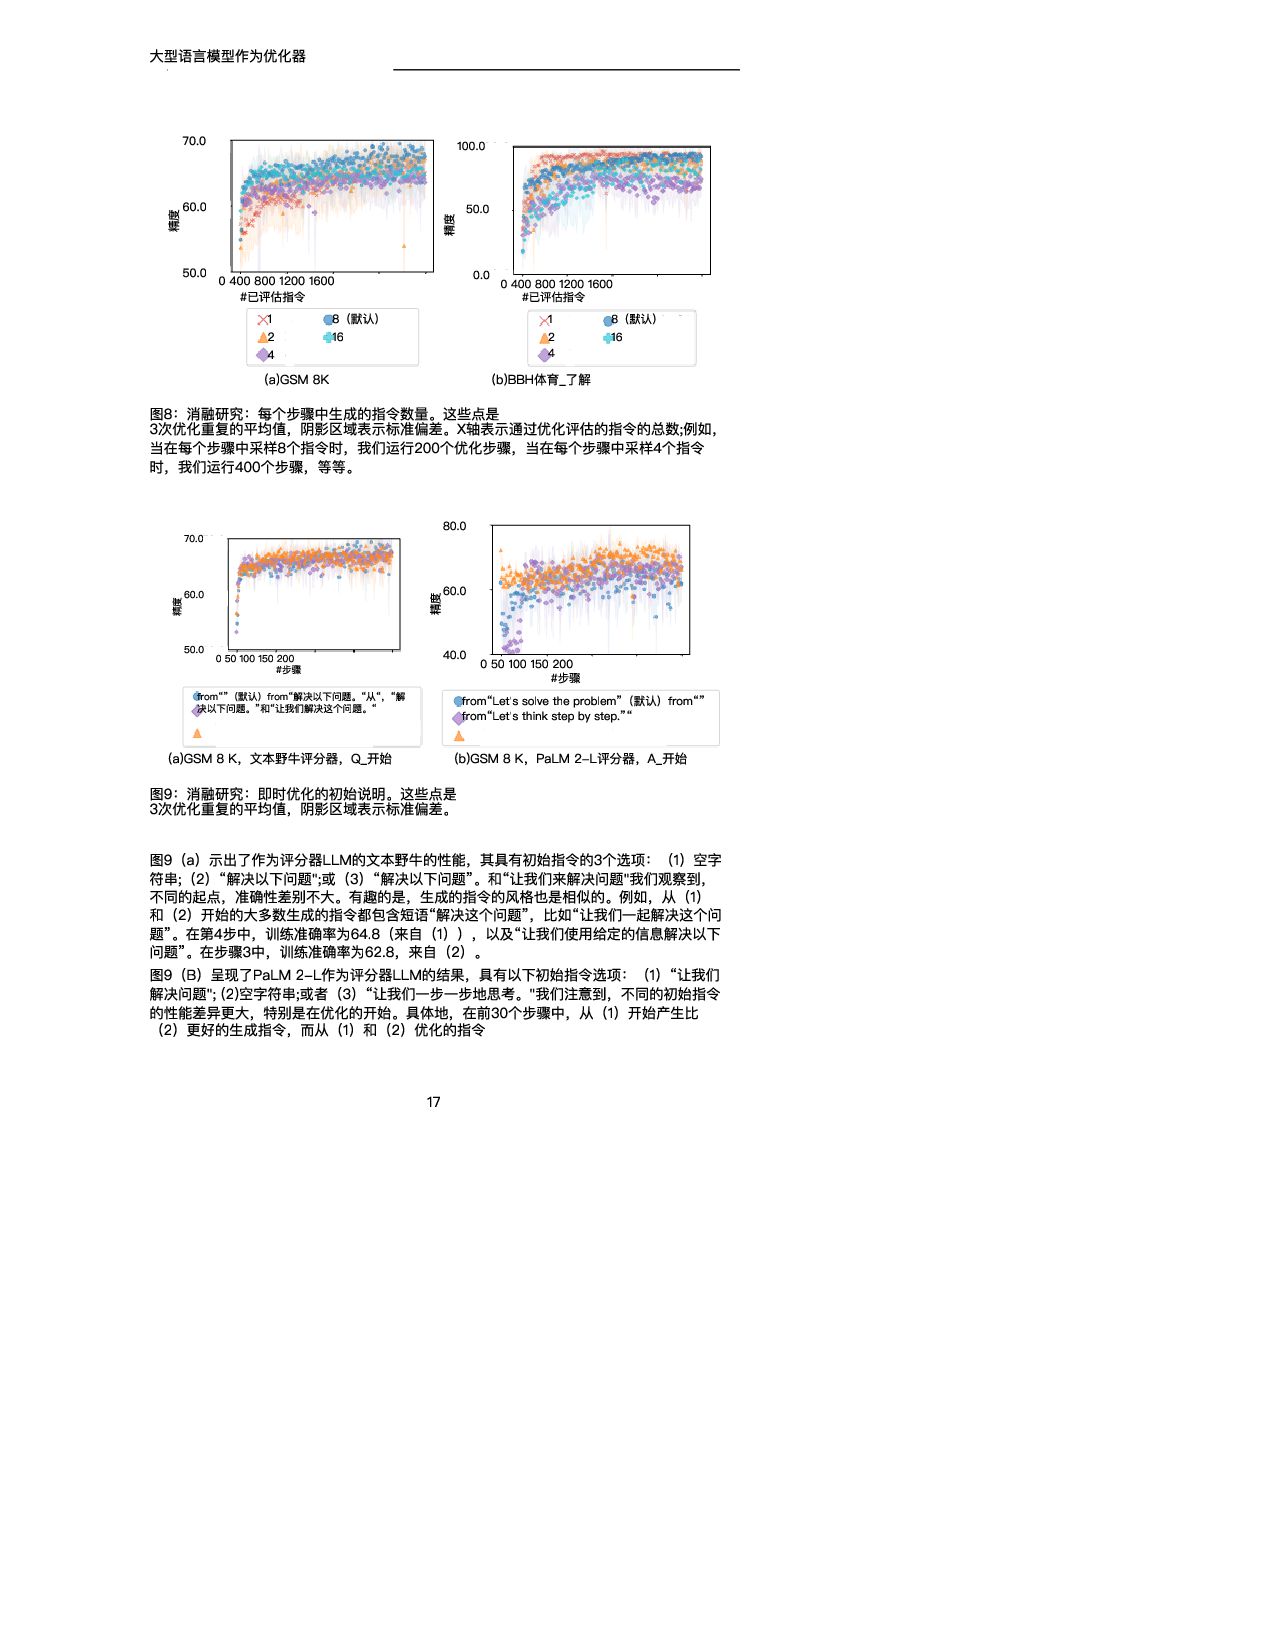
2-L(Kojima等人, 2022) 开始让我们一步一步地想。85.7四十四点九 PaLM 2-L(Zhou等人, (2022 b) 开始让我们一步一步地解决这个问题,以确保我们 有正确的答案。 72.8 48.4 开始让我们解决这个问题。87.5 44.1 PaLM 2-LA_开始(空字符串)69.3 37.8文本-bison(Kojima等人, 2022) 开始让我们一步一步地思考。92.5三十一点九 文本-野牛(Zhou等人, (2022 b) 开始让我们一步一步地解决这个问题,以确保我们 有正确的答案。 93.7 32.3 text-bison Q_开始让我们解决这个问题。85.5 29.9 text-bison Q_开始(空字符串)82.2 33.5 Ours PaLM 2-L PaLM 2-L-IT GSM 8K A_开始深呼吸,一步一步地解决这个问题。 95.3 54.3 text-bison PaLM 2-L-IT GSM 8K Q_开始让我们一起解决数学单词 问题!首先,我们将一起阅读和讨论这 个问题,以确保我们理解它。然后,我 们将一起努力找到解决方案。我会给你 给予提示,并帮助你解决这个问题,如 果你卡住了。 96.8 37.8 • 教学成绩的影响。在如何呈现准确度分数方面,我们比较了三种选择:(1)将准确度舍 入为整数,这相当于将准确度分数分桶到100个桶(我们的默认设置);(2)将准确度分 桶到20个桶;(3)不显示准确度,只按升序显示指令。图7(c)和图7(d)示出了准确 度分数帮助优化器LLM更好地理解先前指令之间的质量差异,并且因此优化器LLM提出 与输入优化轨迹中的最佳指令类似的更好的新指令。 • 榜样的作用。我们比较了三个选项:(1)显示任务中的3个样本(默认);(2)显示任务 中的10个样本;(3)没有样本。图7(e)和7(f)显示,在元提示符中呈现范例是至关重 要的,因为它提供了关于任务外观的信息,并帮助优化器更好地表达新指令。然而,更 多的范例并不一定会提高性能,因为一些范例通常足以描述任务。此外,包括更多的范 例导致具有主导范例部分的更长的元提示,这可能使优化器LLM从其他重要组件(如优 化轨迹)分心。 每步生成的指令数。计算一小批梯度减少了随机梯度下降过程的方差。类似地,在每个步骤 中生成多个指令提高了LLM的优化稳定性。另一方面,为了在对要评估的指令的数量有固定 预算的情况下实现更好的性能,每步指令的数量不应该太大,以便允许更多的优化步骤将过 去指令的更丰富的信息与它们的准确度结合。考虑到这两个方面,图8比较了在每个步骤中 采样1 / 2 / 4 / 8(默认)/ 16条指令的优化性能,表明在每个步骤中采样8条指令总体上实 现了最佳性能。 起点我们研究了不同初始指令对快速优化的影响。我们的默认设置是,当评分器LLM是(优 化的)text-bison时,从空字符串开始,并从空字符串(BBH任务)或“Let's solve the problem”开始。(on GSM 8 K),当记分器LLM是(预训练的)PaLM 2-L时,指令位置 15
大型语言模型作为优化器 0 50 100 150 200 #步骤 50.0 60.0 70.0
精度 升序(默认) 降 随机 (a)指令排序(GSM 8 K) 0 50 100 150 200 #步骤 0.0 50.0 100.0 精度 升序(默认)降序随机 (b)指令排序(BBH sports_understanding) 0 50 100 150 200 #步骤 50.0 60.0 70.0 精度 100个存储桶(默认)20 个存储桶无分数 (c)指令分数(GSM 8 K) 0 50 100 150 200 #步骤 0.0 50.0 100.0 精度 100个存储桶(默认) 20个桶没有得分 (d)教学成绩(BBH体育_理解) 0 50 100 150 200 #步骤 50.0 60.0 70.0 精度 3个样本(默认) 10例 没有样本 (e)样本数量(GSM 8 K) 0 50 100 150 200 #步骤 0.0 50.0 100.0 精度 3个样本(默认) 10例 没有样本 (f)# exemplars(BBH sports_understanding) 图7:消融研究:元提示语的每个部分如何起作用。点是3次优化重复的平均值,阴影区域表 示标准偏差。 16
大型语言模型作为优化器 0 400 800 1200 1600 #已评估指令 50.0 60.0 70.0
精度 1 2 4 8(默认) 16 (a)GSM 8K 0 400 800 1200 1600 #已评估指令 0.0 50.0 100.0 精度 1 2 4 8(默认) 16 (b)BBH体育_了解 图8:消融研究:每个步骤中生成的指令数量。这些点是 3次优化重复的平均值,阴影区域表示标准偏差。X轴表示通过优化评估的指令的总数;例如, 当在每个步骤中采样8个指令时,我们运行200个优化步骤,当在每个步骤中采样4个指令 时,我们运行400个步骤,等等。 0 50 100 150 200 #步骤 50.0 60.0 70.0 精度 from“”(默认)from“解决以下问题。“从“,“解 决以下问题。”和“让我们解决这个问题。“ (a)GSM 8 K,文本野牛评分器,Q_开始 0 50 100 150 200 #步骤 40.0 60.0 80.0 精度 from“Let's solve the problem”(默认)from“” from“Let's think step by step.”“ (b)GSM 8 K,PaLM 2-L评分器,A_开始 图9:消融研究:即时优化的初始说明。这些点是 3次优化重复的平均值,阴影区域表示标准偏差。 图9(a)示出了作为评分器LLM的文本野牛的性能,其具有初始指令的3个选项:(1)空字 符串;(2)“解决以下问题";或(3)“解决以下问题”。和“让我们来解决问题"我们观察到, 不同的起点,准确性差别不大。有趣的是,生成的指令的风格也是相似的。例如,从(1) 和(2)开始的大多数生成的指令都包含短语“解决这个问题”,比如“让我们一起解决这个问 题”。在第4步中,训练准确率为64.8(来自(1)),以及“让我们使用给定的信息解决以下 问题”。在步骤3中,训练准确率为62.8,来自(2)。 图9(B)呈现了PaLM 2-L作为评分器LLM的结果,具有以下初始指令选项:(1)“让我们 解决问题"; (2)空字符串;或者(3)“让我们一步一步地思考。"我们注意到,不同的初始指令 的性能差异更大,特别是在优化的开始。具体地,在前30个步骤中,从(1)开始产生比 (2)更好的生成指令,而从(1)和(2)优化的指令 17
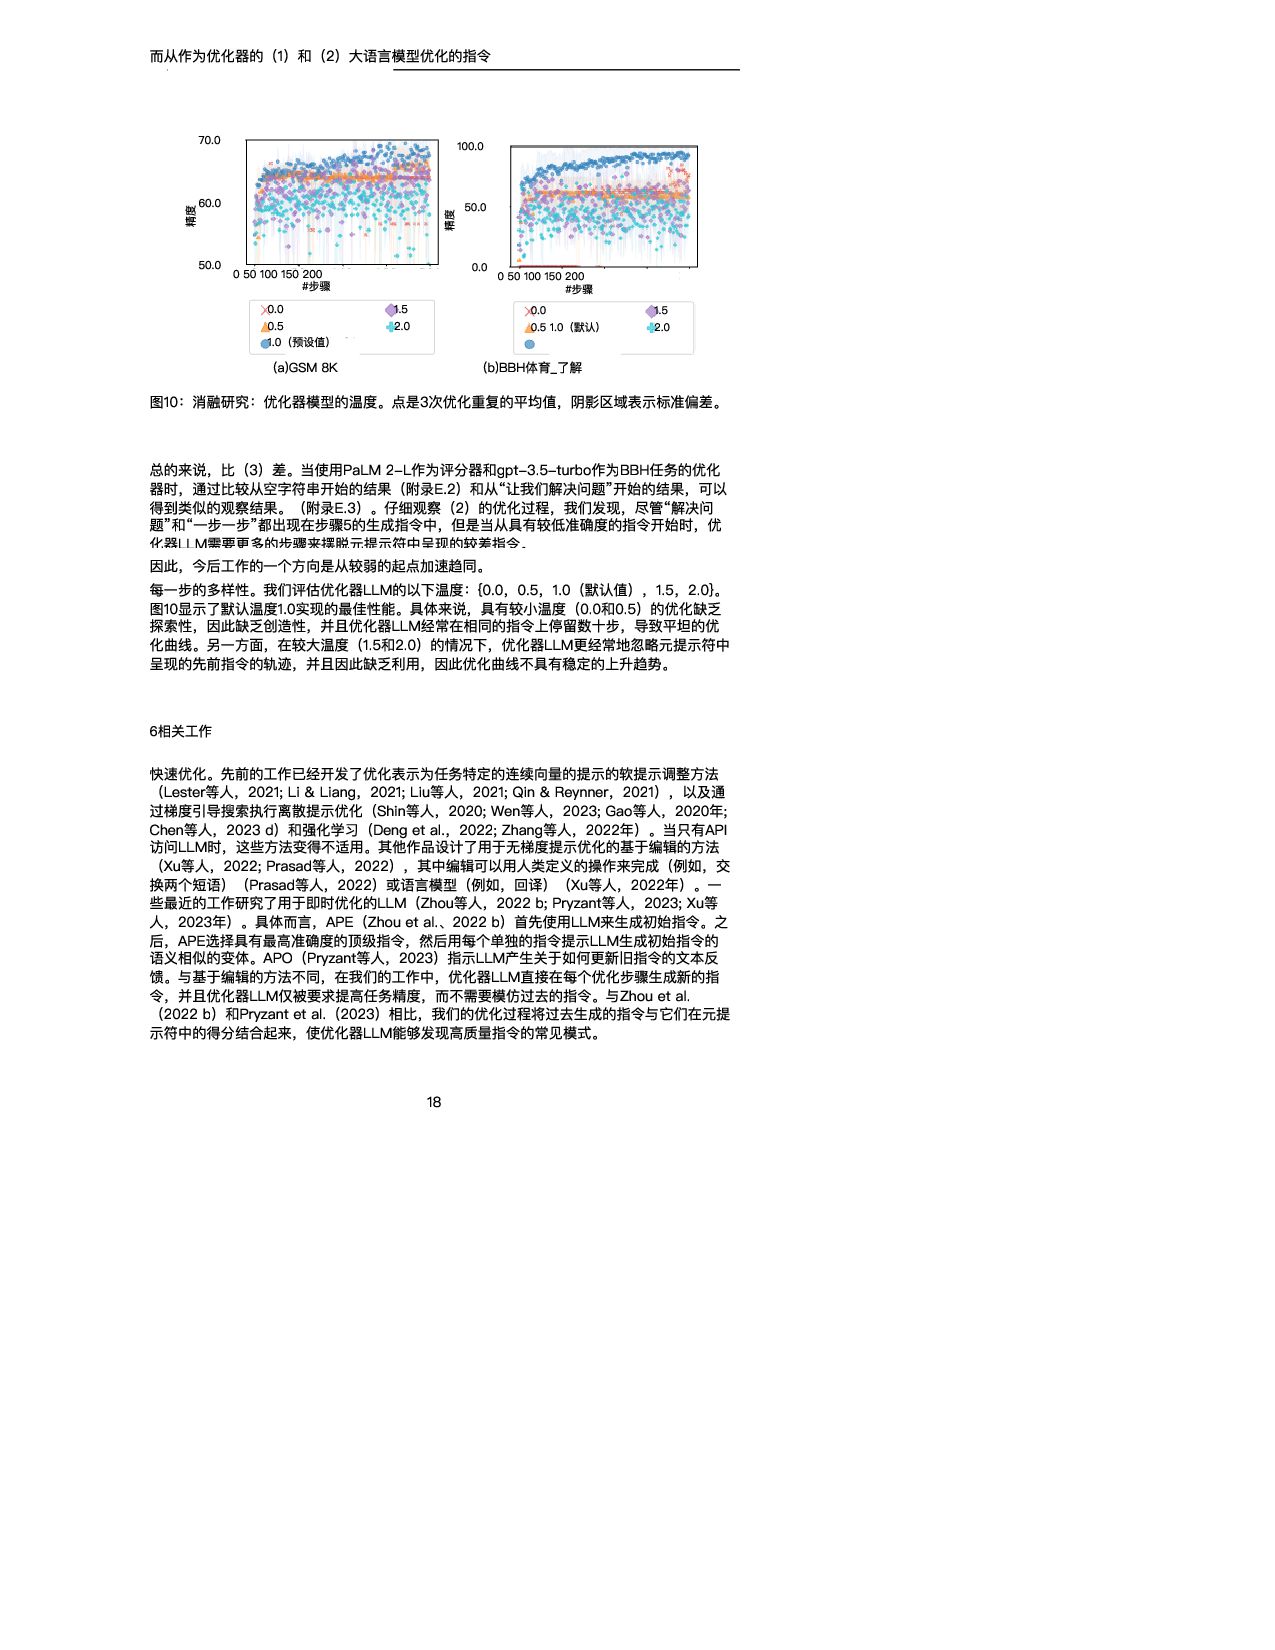
而从作为优化器的(1)和(2)大语言模型优化的指令 0 50 100 150 200 #步骤 50.0 60.0 70.0
精度 0.0 0.5 1.0(预设值) 1.5 2.0 (a)GSM 8K 0 50 100 150 200 #步骤 0.0 50.0 100.0 精度 0.0 0.5 1.0(默认) 1.5 2.0 (b)BBH体育_了解 图10:消融研究:优化器模型的温度。点是3次优化重复的平均值,阴影区域表示标准偏差。 总的来说,比(3)差。当使用PaLM 2-L作为评分器和gpt-3.5-turbo作为BBH任务的优化 器时,通过比较从空字符串开始的结果(附录E.2)和从“让我们解决问题”开始的结果,可以 得到类似的观察结果。(附录E.3)。仔细观察(2)的优化过程,我们发现,尽管“解决问 题”和“一步一步”都出现在步骤5的生成指令中,但是当从具有较低准确度的指令开始时,优 化器LLM需要更多的步骤来摆脱元提示符中呈现的较差指令。 因此,今后工作的一个方向是从较弱的起点加速趋同。 每一步的多样性。我们评估优化器LLM的以下温度:{0.0,0.5,1.0(默认值),1.5,2.0}。 图10显示了默认温度1.0实现的最佳性能。具体来说,具有较小温度(0.0和0.5)的优化缺乏 探索性,因此缺乏创造性,并且优化器LLM经常在相同的指令上停留数十步,导致平坦的优 化曲线。另一方面,在较大温度(1.5和2.0)的情况下,优化器LLM更经常地忽略元提示符中 呈现的先前指令的轨迹,并且因此缺乏利用,因此优化曲线不具有稳定的上升趋势。 6相关工作 快速优化。先前的工作已经开发了优化表示为任务特定的连续向量的提示的软提示调整方法 (Lester等人,2021; Li & Liang,2021; Liu等人,2021; Qin & Reynner,2021),以及通 过梯度引导搜索执行离散提示优化(Shin等人,2020; Wen等人,2023; Gao等人,2020年; Chen等人,2023 d)和强化学习(Deng et al.,2022; Zhang等人,2022年)。当只有API 访问LLM时,这些方法变得不适用。其他作品设计了用于无梯度提示优化的基于编辑的方法 (Xu等人,2022; Prasad等人,2022),其中编辑可以用人类定义的操作来完成(例如,交 换两个短语)(Prasad等人,2022)或语言模型(例如,回译)(Xu等人,2022年)。一 些最近的工作研究了用于即时优化的LLM(Zhou等人,2022 b; Pryzant等人,2023; Xu等 人,2023年)。具体而言,APE(Zhou et al.、2022 b)首先使用LLM来生成初始指令。之 后,APE选择具有最高准确度的顶级指令,然后用每个单独的指令提示LLM生成初始指令的 语义相似的变体。APO(Pryzant等人,2023)指示LLM产生关于如何更新旧指令的文本反 馈。与基于编辑的方法不同,在我们的工作中,优化器LLM直接在每个优化步骤生成新的指 令,并且优化器LLM仅被要求提高任务精度,而不需要模仿过去的指令。与Zhou et al. (2022 b)和Pryzant et al.(2023)相比,我们的优化过程将过去生成的指令与它们在元提 示符中的得分结合起来,使优化器LLM能够发现高质量指令的常见模式。 18
大型语言模型作为优化器 使用自然语言反馈。最近的一系列工作研究了通过用自然语言反馈来提示以修改模型输出来 改善LLM性能的方法,这在减少有害的LLM输出方面已经显示出有效性(Bai等人,2022; Ganguli等人,2023),改善推理(Shinn等人,2023; Madaan等人,2023)和代码生成 性能(Chen等人,2023 e; Olausson等人,2023; Shinn等人,2023年; Chen等人,2023
b)、对话应用(Nair等人,2023; Madaan等人,2023; Yuan等人,2023),等等(Kim 等人,2023; Wang等人,2023年)。具体来说,Yuan等人(2023)开发了一个人在回路 框架,用于从实例级反馈的集合中获得系统级反馈,然后用于细化数据。在我们的工作中, 优化器LLM利用提示中的优化轨迹,这隐含地要求LLM总结具有相似分数的解决方案之间的 共同特征。 我们考虑将显式的自然语言反馈生成的解决方案,为以后的优化步骤作为未来 的工作。 优化语言模型。以前的一些工作调整或提示语言模型的行为作为进化算法中的变异和交叉算 子。Meyerson等人(2023)利用具有少量样本的语言模型来提出图像和代码生成等任务的 进化交叉。在Lehman et al.(2022)中,在代码差异生成上训练的大型语言模型被用作变 异算子,他们进一步设计了一种微调方法,以提高机器人仿真的Sodarace域的性能。诱发 (Chen等人,2023 a)使用大型语言模型来进化神经网络架构,其中它们将联合收割机进 化搜索与软提示调优相结合。关于将轨迹作为优化的输入,OptFormer(Chen等人, 2022)在大量超参数优化数据集合上训练Transformer模型。另一方面,我们的工作仅通过 提示进行优化 而无需额外的培训 第七章结论 我们开始采用LLM作为优化器,LLM逐步生成新的解决方案来优化目标函数。我们首先用线 性回归和旅行商问题激励OPRO,然后作为具体应用进行提示优化。我们的评估表明,LLM 有能力逐步提高生成的解决方案的基础上,过去的优化轨迹。有趣的是,在小规模的旅行商 问题上,OPRO的表现与一些手工制作的启发式算法不相上下。对于提示优化,优化的提示 在GSM 8 K和Big-Bench Hard上的表现明显优于人工设计的提示,有时超过50%。 一些未解决的问题是开放的,为未来的研究LLM优化。总体而言,如何降低对初始化的敏感 性并更好地平衡开采与勘探仍然是一项挑战。具体地,对于即时优化,我们当前实现的一个 限制是优化器LLM不能有效地利用训练集中的错误情况来推断有希望的方向以改进所生成的 指令。在我们的实验中,我们尝试在元提示符中包含错误案例,而不是在每个优化步骤中从 训练集中随机采样,但结果是相似的,这表明错误案例本身并不足以让优化器LLM掌握错误 预测的原因。另一个限制是,即时优化需要一个训练集来计算指导优化过程的准确性。 目 前,训练集至少包含数十个样本,因此优化后的提示不会严重过拟合训练样本。一个有前途 的方向是除了聚合准确度之外,还包括关于错误案例的更丰富的反馈,并总结在优化轨迹中 区分高质量和低质量生成提示的关键特征。这样的信息可以通知优化器LLM如何更有效地改 进过去生成的指令,并且潜在地进一步减小即时优化所需的示例集大小。 致谢 我们感谢Daiyi Peng、Shuo Chen、Tim Rocktäschel、Chrisantha Fernando、Dylan Banarse、Henryk Michalewski和Simon Osindero提供的宝贵反馈。 19
大型语言模型作为优化器 引用 甘利俊一反向传播与随机梯度下降法。神经计算,5(4-5):185-196,1993。 罗汉阿尼尔,安德鲁M戴,奥尔汉Firat,梅尔文约翰逊,德米特里Lepikhin,亚历山大帕索 斯,Siamak Shakeri,伊曼纽尔Taropa,佩奇贝利,陈志峰,等。棕榈2技术报告。arXiv 预印本arXiv:2305.10403,2023。 大卫·阿普尔盖特,里伯·比克斯比,瓦塞克·查瓦塔尔和威廉·库克。协和tsp求解器,2006年。 托马斯贝克和汉斯-保罗施韦费尔。参数优化的进化算法综述。演化计算,1(1):1-23, 1993。
Yuntao Bai,Saurav Kadavath,Sandipan Kundu,阿曼达Askell,杰克逊Kernion,Andy Jones,安娜陈,安娜戈尔迪,Azalia Mirhoseini,卡梅隆麦金农,et al. Constitutional ai:Harmlessness from ai feedback. arXiv预印本arXiv:2212.08073,2022。 蔡天乐,王学智,马腾宇,陈新云,周丹尼。作为工具制造者的大型语言模型。arXiv预印本 arXiv:2305.17126,2023。 Angelica Chen,大卫M Dohan,和大卫R So. Evoprompting:用于代码级神经架构搜索的 语言模型。arXiv预印本arXiv:2302.14838,2023 a。 Angelica Chen,Jérémy Scheurer,Tomasz Korbak,Jon Ander Campos,Jun Shern Chan,Samuel R Bowman,Kyunghyun Cho,and Ethan Perez.通过自然语言反馈训练来 改进代码生成。arXiv预印本arXiv:2303.16749,2023 b。 陈九海,陈立昌,黄恒,周天翼。什么时候需要chatgpt的思想链提示?arXiv预印本arXiv: 2304.03262,2023c。 Lichang Chen Jiuhai Chen Tom Goldstein Heng Huang and Tianyi Zhou 陈新云,田远东。学习执行组合优化的局部重写。神经信息处理系统的进展,32,2019。 Xinyun Chen,麦克斯韦林,Nathanael Schärli,和Denny Zhou.教大型语言模型进行自调 试。arXiv预印本arXiv:2304.05128,2023 e。 Yutian Chen,Xingyou Song,Chansoo Lee,Zi Wang,Richard Zhang,大大卫 Dohan,Kazuya Kawakami,Greg Kochanski,Arnaud Doucet,Marc'aurelio Ranzato,et al. Towards learning universal hyperparameter optimizers with transformers.神经信息处理系统的进展,35:32053-32068,2022。 Karl Cobbe,Vineet Kanghaju,Mohammad Bavarian,Mark Chen,Heewoo Jun, Lukasz Kaiser,Matthias Plappert,Jerry Tworek,Jacob希尔顿,Reiichiro中野,et al. 训练验证者解决数学单词问题。arXiv预印本arXiv:2110.14168,2021。 Mingkai Deng,Jianyu Wang,Cheng-Ping Hsieh,Yihan Wang,Han Guo,Tianmin Shu,Meng Song,Eric P Xing,and Zhiting Hu. Rlprompt:使用强化学习优化离散文本 提示。arXiv预印本arXiv:2205.12548,2022。 约束 编程 , 人工 智能 和 运营 研究 , PP 。170-181. Springer , 2018 。 Deep Ganguli , Amanda Askell , Nicholas Schiefer , Thomas Liao , Kamil e Lukoš i UT e , Anna Chen , Anna Goldie , Azalia Mirhoseini , Catherine Olsson , Danny Hernandez 等 。arXiv preprint arXiv : 2302.07459 , 2023 . 我们 可以 使用 arXiv . 20
大型语言模型作为优化器 布鲁斯戈尔登、劳伦斯博丁、T道尔和小W斯图尔特。近似旅行商算法。运筹学,28(3- part-ii):694-711,1980。 Gregory Gutin和Abraham P Punnen。旅行推销员问题及其变化,第12卷。 Springer Science &
Business Media,2006. 凯尔德·赫尔斯冈lin-kernighan-helsgaun tsp求解器在有约束旅行商和车辆路径问题中的扩 展。罗斯基勒:罗斯基勒大学,2017年12月。 Michael Jünger,Gerhard Reinelt,and Giovanni Rinaldi.旅行推销员问题。运筹学与管理 科学手册,7:225-330,1995。 金健宇皮埃尔巴尔迪斯蒂芬麦卡雷语言模型可以解决计算机任务 arXiv预印本arXiv:2303.17491,2023。 Diederik P Kingma和Jimmy Ba。Adam:一种随机优化方法。在2015年国际学习代表会议 上。 Takeshi Kojima,Shixiang Shane Gu,Machel Reid,Yutaka Matsuo,and Yusuke I 大型语言模型是零机会推理机 Xi 预印本 Xi :220511916 2022 沃特·库尔,赫克·货车·霍夫,马克斯·威林.注意,学会解决布线问题!2019年国际学习代表会议。URL https:/ net/forum?id=ByxBFsRqYm。 Joel Lehman,Jonathan Gordon,Shawn Jain,Kamal Ndousse,Cathy Yeh和Kenneth O Stanley。 通过大型模型进行进化。arXiv预印本arXiv:2206.08896,2022。 布莱恩·莱斯特,拉米·艾尔-瑞福,诺亚·康斯坦。规模的力量,参数高效的即时调整。 arXiv预印本arXiv:2104.08691,2021。 丽莎李翔和珀西梁。前缀调优:优化生成的连续提示。arXiv预印本arXiv:2101.00190, 2021。 王玲,Dani Yogatama,Chris Dyer和Phil Blunsom。通过基本原理生成的程序归纳:学习 解决和解释代数单词问题。arXiv预印本arXiv:1705.04146,2017。 Xiao Liu,Yanan Zheng,Zhengxiao Du,Ming Ding,Yujie Qian,Zhilin Yang,and Jie Tang. Gpt也理解。arXiv预印本arXiv:2103.10385,2021。 姚璐、马克斯·巴托罗、阿拉斯泰尔摩尔、塞巴斯蒂安·里德尔和本图斯·斯特内托普。奇妙 有序的提示和在哪里找到它们:克服少数提示顺序敏感性。arXiv预印本arXiv: 2104.08786,2021。 Xiao Ma,Swaroop Mishra,Ahmad Beirami,Alex Beutel,and Jilin Chen.让我们做一 个思想实验:使用反事实来提高道德推理。arXiv预印本arXiv:2306.14308,2023。 阿曼·马达安和阿米尔·亚兹丹巴赫什文本和模式:为了有效的思想链,探戈舞需要两个人。 arXiv预印本arXiv:2209.07686,2022。 Aman Madaan,Niket Tandon,Prakhar Gupta,Skyler Hallinan,Luyu Gao,Sarah Wiegreffe,Uri Alon,Nouha Dongi,Shrimai Prabhumoye,Yiming Yang,et al. Self- refine:Iterative refinement with self-feedback. arXiv预印本arXiv:2303.17651, 2023。 埃利奥特·迈耶森、马克·J·纳尔逊、赫比·布拉德利、阿拉什·莫拉迪、艾米·K·胡佛和乔尔· 雷曼。语言模型交叉:通过少量提示的变化。arXiv预印本arXiv:2302.12170,2023。 Suvir Mirchandani,Fei Xia,Pete佛罗伦萨,Brian Ichter,Danny Driess,Montserrat arXiv预印本arXiv:2307.04721,2023。 21
大型语言模型作为优化器 Varun Nair,Elliot Schumacher,Geoffrey Tso,and Anitha Kannan. Dera:使用启用对 话框的解析代理增强大型语言模型的完成。arXiv预印本arXiv:2303.17071,2023。 MohammadReza
Nazari,Afshin Oroojlooy,Lawrence Snyder,and Martin Takac.强化 学习在车辆路径问题求解中的应用。在神经信息处理系统的进展,pp。9861-9871,2018 年。 揭秘gpt代码生成的自我修复。arXiv预印本arXiv:2306.09896,2023。 Guesthouse Optimization et al. Guesthouse optimizer reference manual,2020. Archiki Prasad,Peter Hase,Xiang Zhou,and Mohit Bansal. Grips:无约束,基于编辑 的指令搜索,用于提示大型语言模型。arXiv预印本arXiv:2203.07281,2022。 Reid Pryzant、Dan Iter、Jerry Li、Yin达特李、Chenguang Zhu和Michael Zeng。自动提 示优化与”梯度下降”和波束搜索。arXiv预印本arXiv:2305.03495,2023。 宁倩。梯度下降学习算法中的动量项。神经网络,12(1):145-151,1999年。 Guanghui Qin和Jason Reynner。学习如何提问:使用软提示的混合查询lms。arXiv预印本arXiv:2104.06599,202 科林·R·里维斯。组合问题的现代启发式技术。John Wiley & Sons,Inc. 1993. 拉莉亚·雷诺兹和凯尔·麦克唐纳。大型语言模型的快速编程:超越 少数范例在2021年CHI计算机系统人为因素会议的扩展摘要中,pp. 2021年1-7日。 Luis Miguel Rios和Nikolaos V Sahinjiang。无导数优化:算法综述和软件实现比较。 Journal of Global Optimization,56:1247-1293,2013. 丹尼尔J罗森克兰茨,理查德E斯特恩斯和菲利普M刘易斯,II。旅行商问题的几种算法分 析。SIAM journal on computing,6(3):563-581,1977. 苏布洛·罗伊和丹·罗斯解决一般算术题。arXiv预印本arXiv:1608.01413,2016。 Timo Schick、Jane Dwivedi-Yu、Roberto Desseste、Roberta Raileanu、Maria Lomeli、Luke Zettlemoyer、Nicola Cancedda和托马斯Scialom。Toolformer:语言模型 可以教自己使用工具。arXiv预印本arXiv:2302.04761,2023。 Taylor Shin,Yasaman Razeghi,Robert L Logan IV,Eric Wallace和Sameer Singh。自 动提示:通过自动生成的提示从语言模型中获取知识。arXiv预印本arXiv:2010.15980, 2020。 Noah Shinn,Beck Labash,和Ashwin Gopinath.反射:具有动态记忆和自我反思的自主 智能体。arXiv预印本arXiv:2303.11366,2023。 Aarohi Srivastava,Abhinav Rastogi,Abhishek Rao,Abu Awal Md Shoeb,Abubakar Abid,Adam菲施,Adam R Brown,Adam Santoro,Aditya Gupta,Adrià Garriga- Alonso,et al. Beyond the imitation game:Quantifying and extrapolating the capabilities of language models. arXiv预印本arXiv:2206.04615,2022。 Mirac Suzgun,Nathan Scales,Nathanael Schärli,塞巴斯蒂安Gehrmann,Yi Tay, Hyung Won Chung,Aakanksha Chowdhery,Quoc V Le,艾德H Chi,Denny Zhou,et al. arXiv预印本arXiv:2210.09261,2022。 Guanzhi Wang,Yuqi Xie,Yunfan Jiang,Ajay Mandlekar,Chaowei Xiao,Yuke 22
大型语言模型作为优化器 Xuezhi Wang,Jason Wei,Dale Schuurmans,Quoc Le,Ed Chi,Sharan Narang, Aakanksha Chowdhery和Denny
Zhou。语言模型中的思想推理之链自我一致性改进。 arXiv preprint arXiv:2203.11171,2022.地图 Jason Wei,Xuezhi Wang,Dale Schuurmans,Maarten Bosma,Ed Chi,Quoc Le和 Denny Zhou。在大型语言模型中促进精英的推理。arXiv preprint arXiv:2201.11903, 2022.(arXiv) Jerry Wei,Jason Wei,Yi Tay,Dustin Tran,Albert Webson,Yifeng Lu,Xinyun Chen,Hanxiao Liu,Da Huang,Denny Zhou等。arXiv preprint arXiv:2303.03846, 2023.地图 Hard prompt made easy:gradient—based discrete optimization for prompt tuning and discovery(基于梯 度的离散优化,快速调整和发现) arXiv preprint arXiv:2302.03668,2023.地图 Can Xu,Qingfeng Sun,Kai Zheng,Xiubo Geng,Pu Zhao,Jiazhan Feng, Chongyang Tao,and Daxin Jiang.(Can Xu,Qingfeng Sun,Kai Zheng,Xiubo Geng,Pu Zhao,Jiazhan Feng,Chongyang,and Daxin Jiang.)Wizardlm: Empowering large language models to follow complex instructions.使大语言模型能够遵 循复杂的指令。arXiv preprint arXiv:2304.12244,2023.我们可以使用arXiv preprint. Hanwei Xu,Yujun Chen,Yulun Du,Nan Shao,Yanggang Wang,Haiyu Li,and Zhilin Yang. GPS:遗传快速搜索,用于高效的少数学习。arXiv预印本arXiv: 2210.17041,2022。 袁伟哲赵京铉杰森韦斯顿系统级自然语言反馈。arXiv预印本arXiv:2306.13588,2023。 Tianjun Zhang,Xuezhi Wang,Denny Zhou,Dale Schuurmans,and Joseph E Gonzalez Tempera:通过强化学习进行测试时提示编辑 在第十一届国际学习代表大会 12697-12706. PMLR,2021年。 Denny Zhou,Nathanael Schärli,Le Hou,Jason Wei,Nathan Scales,Xuechi Wang,Dale Schuurmans,Claire Cui,Olivier Bousquet,Quoc Le,et al. Least-to- most prompting enables complex reasoning in large language models. arXiv预印本 arXiv:2205.10625,2022 a。 Yongchao Zhou,Andrei Ioan Muresanu,Ziwen Han,Keiran Paster,Silviu Pitis, 23
大型语言模型作为优化器 一些失败案例 尽管LLM展示了优化基本数学问题(第3节)和提示(第4节)的能力,但我们看到所有优化 器LLM都存在一些限制,这些限制可能会阻碍它们解决更具挑战性的问题。这些限制包括: • 幻想需要来自数学计算的值:优化器LLM 经常输出类似“函数值在(5,3)是15”的内容,尽管真实值不是15。如果触发了能够可 靠地计算值的外部工具,模型就会正确。何时以及如何触发这样的工具用例仍然是一个有 趣的话题(参见例如,(Schick等人,2023; Cai等人,2023))。
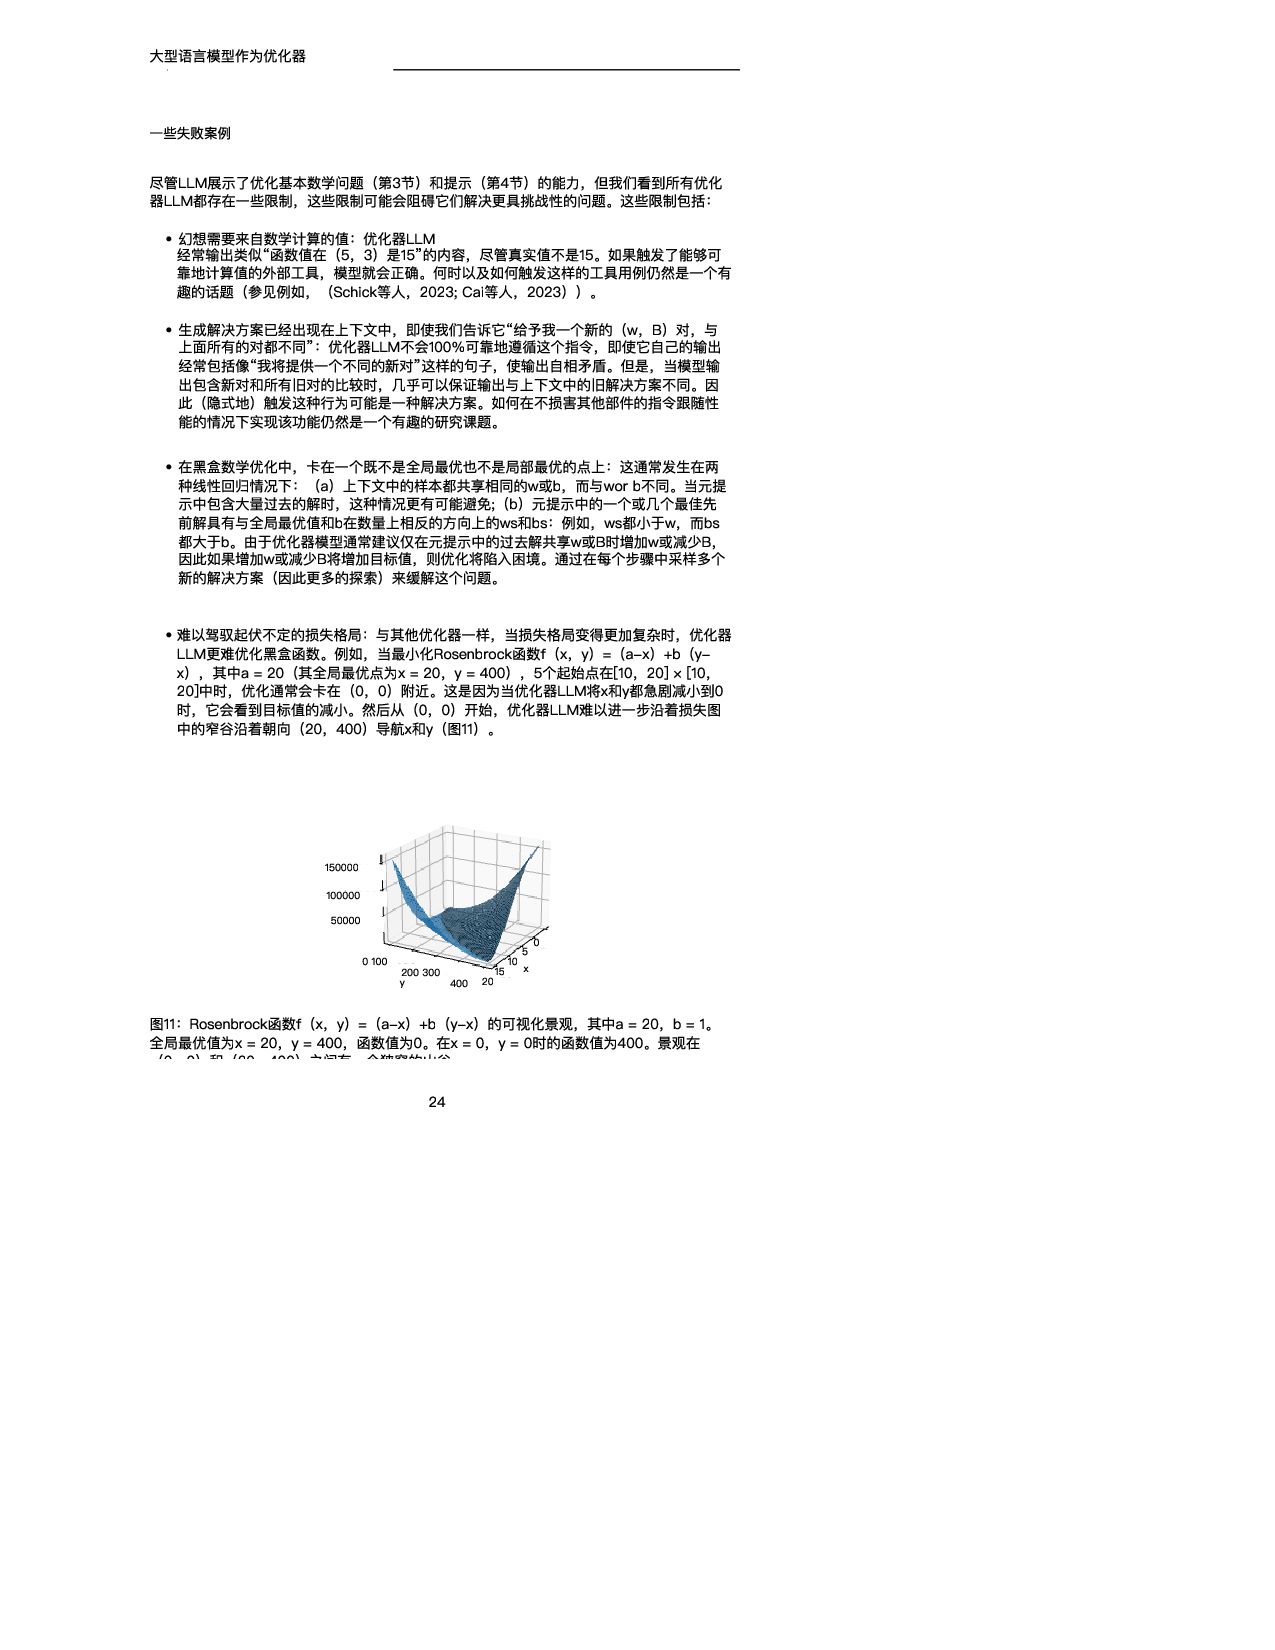
• 生成解决方案已经出现在上下文中,即使我们告诉它“给予我一个新的(w,B)对,与 上面所有的对都不同”:优化器LLM不会100%可靠地遵循这个指令,即使它自己的输出 经常包括像“我将提供一个不同的新对”这样的句子,使输出自相矛盾。但是,当模型输 出包含新对和所有旧对的比较时,几乎可以保证输出与上下文中的旧解决方案不同。因 此(隐式地)触发这种行为可能是一种解决方案。如何在不损害其他部件的指令跟随性 能的情况下实现该功能仍然是一个有趣的研究课题。 • 在黑盒数学优化中,卡在一个既不是全局最优也不是局部最优的点上:这通常发生在两 种线性回归情况下:(a)上下文中的样本都共享相同的w或b,而与wor b不同。当元提 示中包含大量过去的解时,这种情况更有可能避免;(b)元提示中的一个或几个最佳先 前解具有与全局最优值和b在数量上相反的方向上的ws和bs:例如,ws都小于w,而bs 都大于b。由于优化器模型通常建议仅在元提示中的过去解共享w或B时增加w或减少B, 因此如果增加w或减少B将增加目标值,则优化将陷入困境。通过在每个步骤中采样多个 新的解决方案(因此更多的探索)来缓解这个问题。 • 难以驾驭起伏不定的损失格局:与其他优化器一样,当损失格局变得更加复杂时,优化器 LLM更难优化黑盒函数。例如,当最小化Rosenbrock函数f(x,y)=(a-x)+b(y- x),其中a = 20(其全局最优点为x = 20,y = 400),5个起始点在[10,20] × [10, 20]中时,优化通常会卡在(0,0)附近。这是因为当优化器LLM将x和y都急剧减小到0 时,它会看到目标值的减小。然后从(0,0)开始,优化器LLM难以进一步沿着损失图 中的窄谷沿着朝向(20,400)导航x和y(图11)。 x 0 5 10 15 20 y 0 100 200 300 400 50000 100000 150000 图11:Rosenbrock函数f(x,y)=(a-x)+b(y-x)的可视化景观,其中a = 20,b = 1。 全局最优值为x = 20,y = 400,函数值为0。在x = 0,y = 0时的函数值为400。景观在 (0 0)和(20 400)之间有 个狭窄的山谷 24
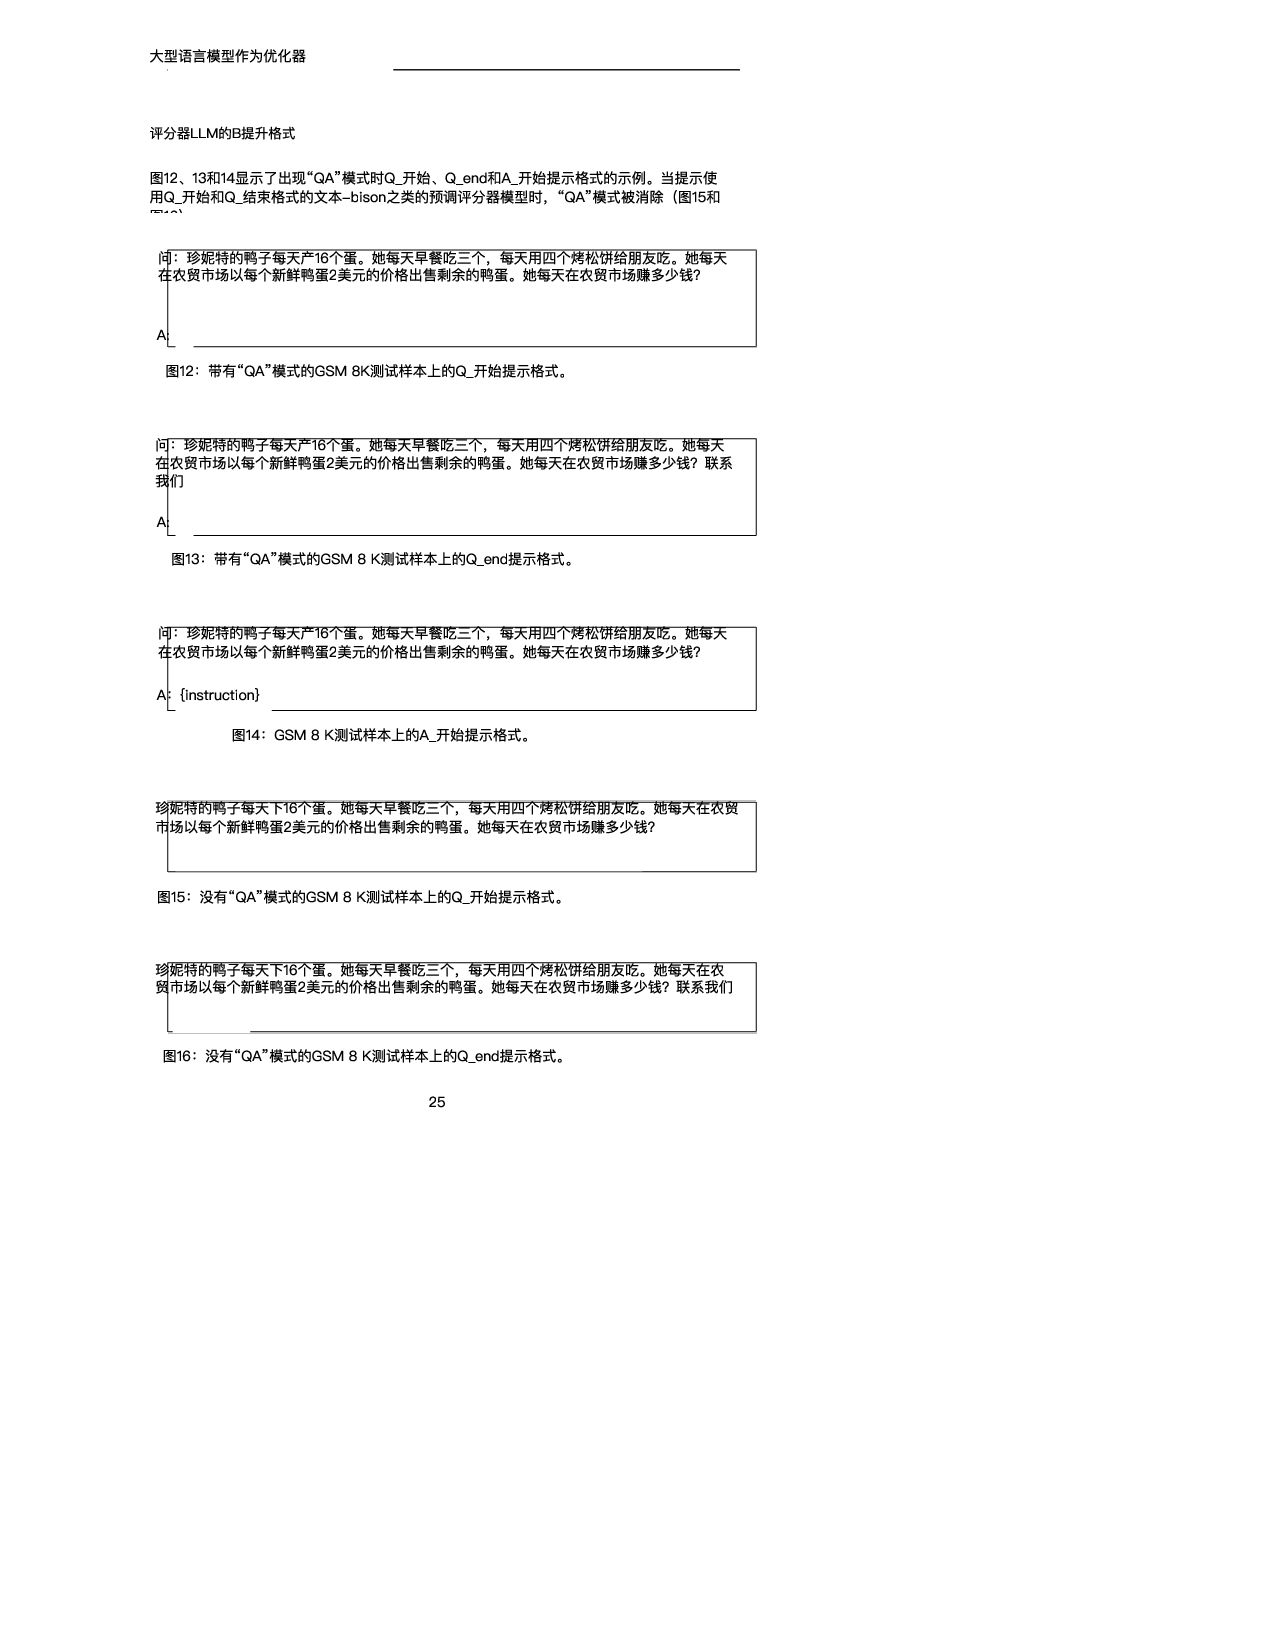
大型语言模型作为优化器 评分器LLM的B提升格式 图12、13和14显示了出现“QA”模式时Q_开始、Q_end和A_开始提示格式的示例。当提示使 用Q_开始和Q_结束格式的文本-bison之类的预调评分器模型时,“QA”模式被消除(图15和 图16) 问:珍妮特的鸭子每天产16个蛋。她每天早餐吃三个,每天用四个烤松饼给朋友吃。她每天 在农贸市场以每个新鲜鸭蛋2美元的价格出售剩余的鸭蛋。她每天在农贸市场赚多少钱? A: 图12:带有“QA”模式的GSM 8K测试样本上的Q_开始提示格式。
问:珍妮特的鸭子每天产16个蛋。她每天早餐吃三个,每天用四个烤松饼给朋友吃。她每天 在农贸市场以每个新鲜鸭蛋2美元的价格出售剩余的鸭蛋。她每天在农贸市场赚多少钱?联系 我们 A: 图13:带有“QA”模式的GSM 8 K测试样本上的Q_end提示格式。 问:珍妮特的鸭子每天产16个蛋。她每天早餐吃三个,每天用四个烤松饼给朋友吃。她每天 在农贸市场以每个新鲜鸭蛋2美元的价格出售剩余的鸭蛋。她每天在农贸市场赚多少钱? A:{instruction} 图14:GSM 8 K测试样本上的A_开始提示格式。 珍妮特的鸭子每天下16个蛋。她每天早餐吃三个,每天用四个烤松饼给朋友吃。她每天在农贸 市场以每个新鲜鸭蛋2美元的价格出售剩余的鸭蛋。她每天在农贸市场赚多少钱? 图15:没有“QA”模式的GSM 8 K测试样本上的Q_开始提示格式。 珍妮特的鸭子每天下16个蛋。她每天早餐吃三个,每天用四个烤松饼给朋友吃。她每天在农 贸市场以每个新鲜鸭蛋2美元的价格出售剩余的鸭蛋。她每天在农贸市场赚多少钱?联系我们 图16:没有“QA”模式的GSM 8 K测试样本上的Q_end提示格式。 25
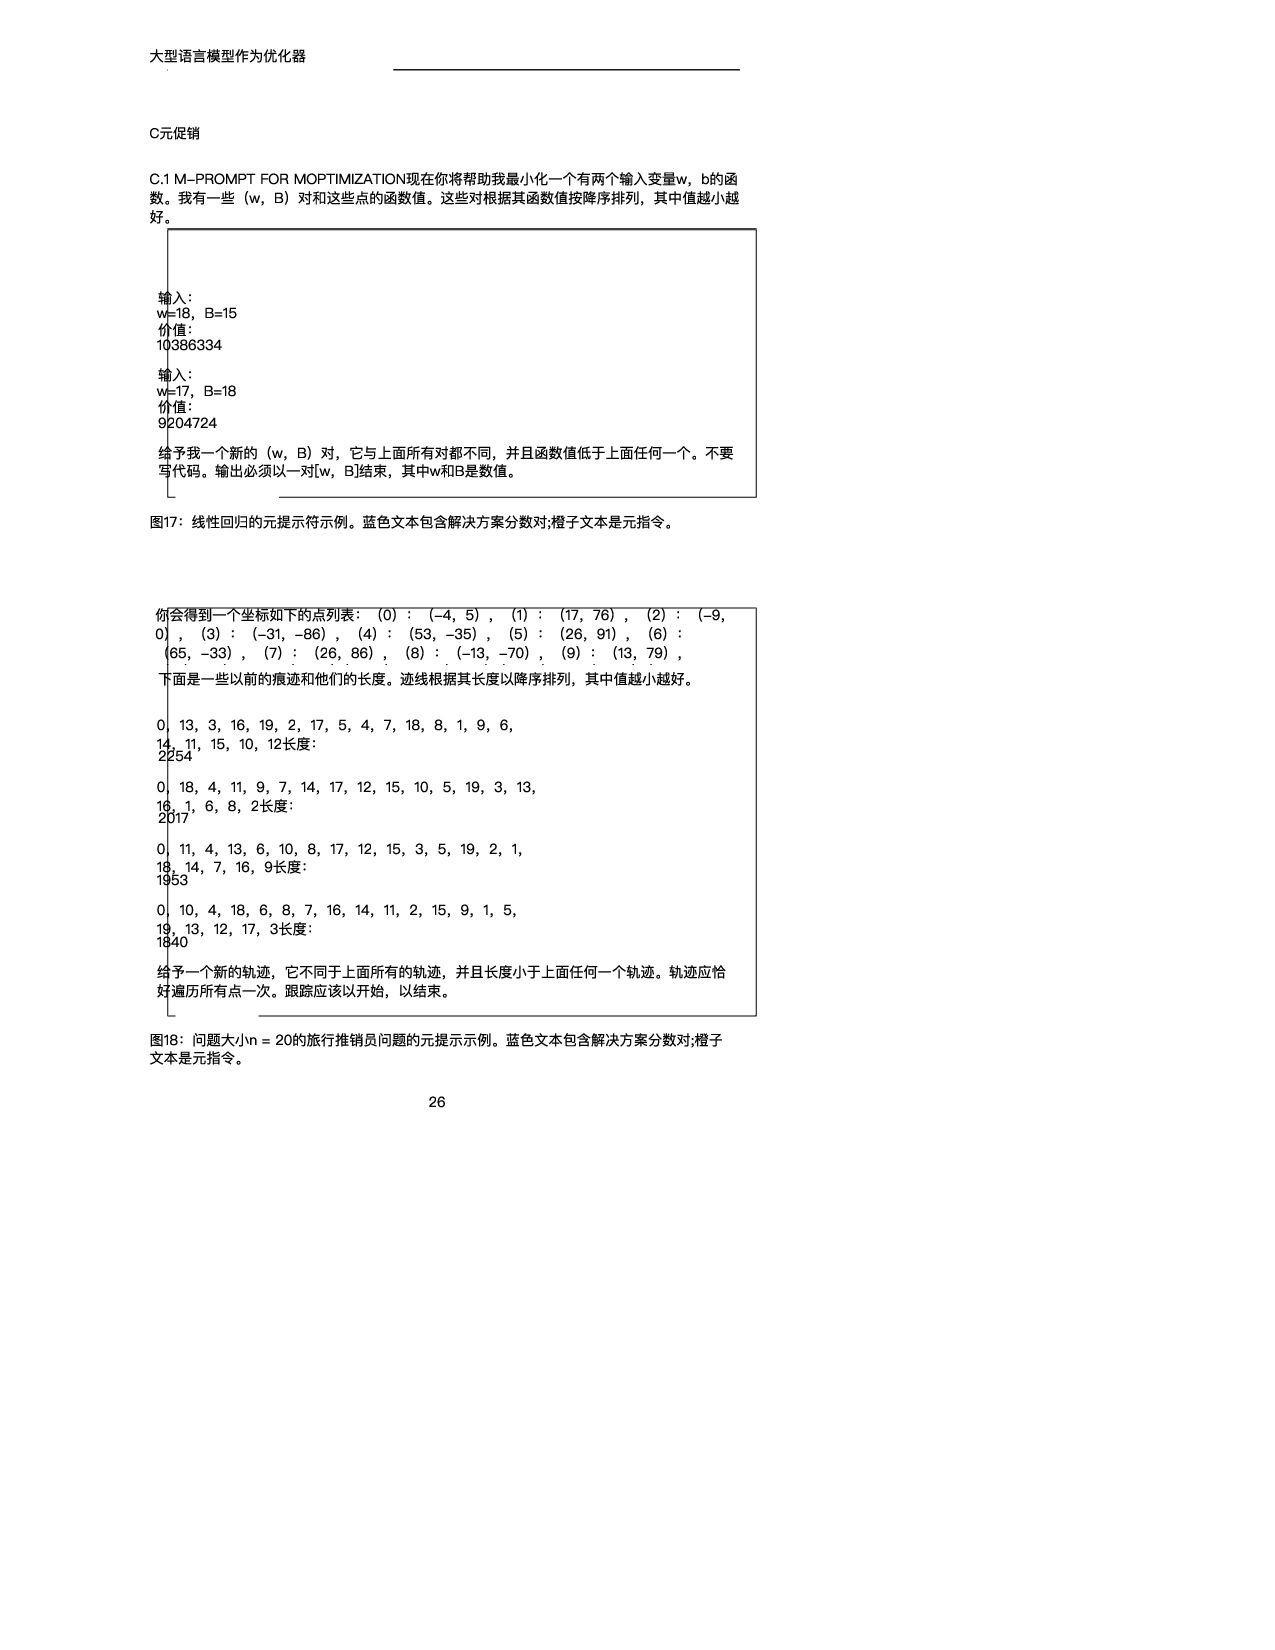
大型语言模型作为优化器 C元促销 C.1 M-PROMPT FOR MOPTIMIZATION现在你将帮助我最小化一个有两个输入变量w,b的函 数。我有一些(w,B)对和这些点的函数值。这些对根据其函数值按降序排列,其中值越小越 好。 输入: w=18,B=15
价值: 10386334 输入: w=17,B=18 价值: 9204724 给予我一个新的(w,B)对,它与上面所有对都不同,并且函数值低于上面任何一个。不要 写代码。输出必须以一对[w,B]结束,其中w和B是数值。 图17:线性回归的元提示符示例。蓝色文本包含解决方案分数对;橙子文本是元指令。 你会得到一个坐标如下的点列表:(0):(-4,5),(1):(17,76),(2):(-9, 0),(3):(-31,-86),(4):(53,-35),(5):(26,91),(6): (65,-33),(7):(26,86),(8):(-13,-70),(9):(13,79), ( ) ( ) ( ) ( ) ( ) ( ) ( ) 下面是一些以前的痕迹和他们的长度。迹线根据其长度以降序排列,其中值越小越好。 0,13,3,16,19,2,17,5,4,7,18,8,1,9,6, 14,11,15,10,12长度: 2254 0,18,4,11,9,7,14,17,12,15,10,5,19,3,13, 16,1,6,8,2长度: 2017 0,11,4,13,6,10,8,17,12,15,3,5,19,2,1, 18,14,7,16,9长度: 1953 0,10,4,18,6,8,7,16,14,11,2,15,9,1,5, 19,13,12,17,3长度: 1840 给予一个新的轨迹,它不同于上面所有的轨迹,并且长度小于上面任何一个轨迹。轨迹应恰 好遍历所有点一次。跟踪应该以开始,以结束。 图18:问题大小n = 20的旅行推销员问题的元提示示例。蓝色文本包含解决方案分数对;橙子 文本是元指令。 26
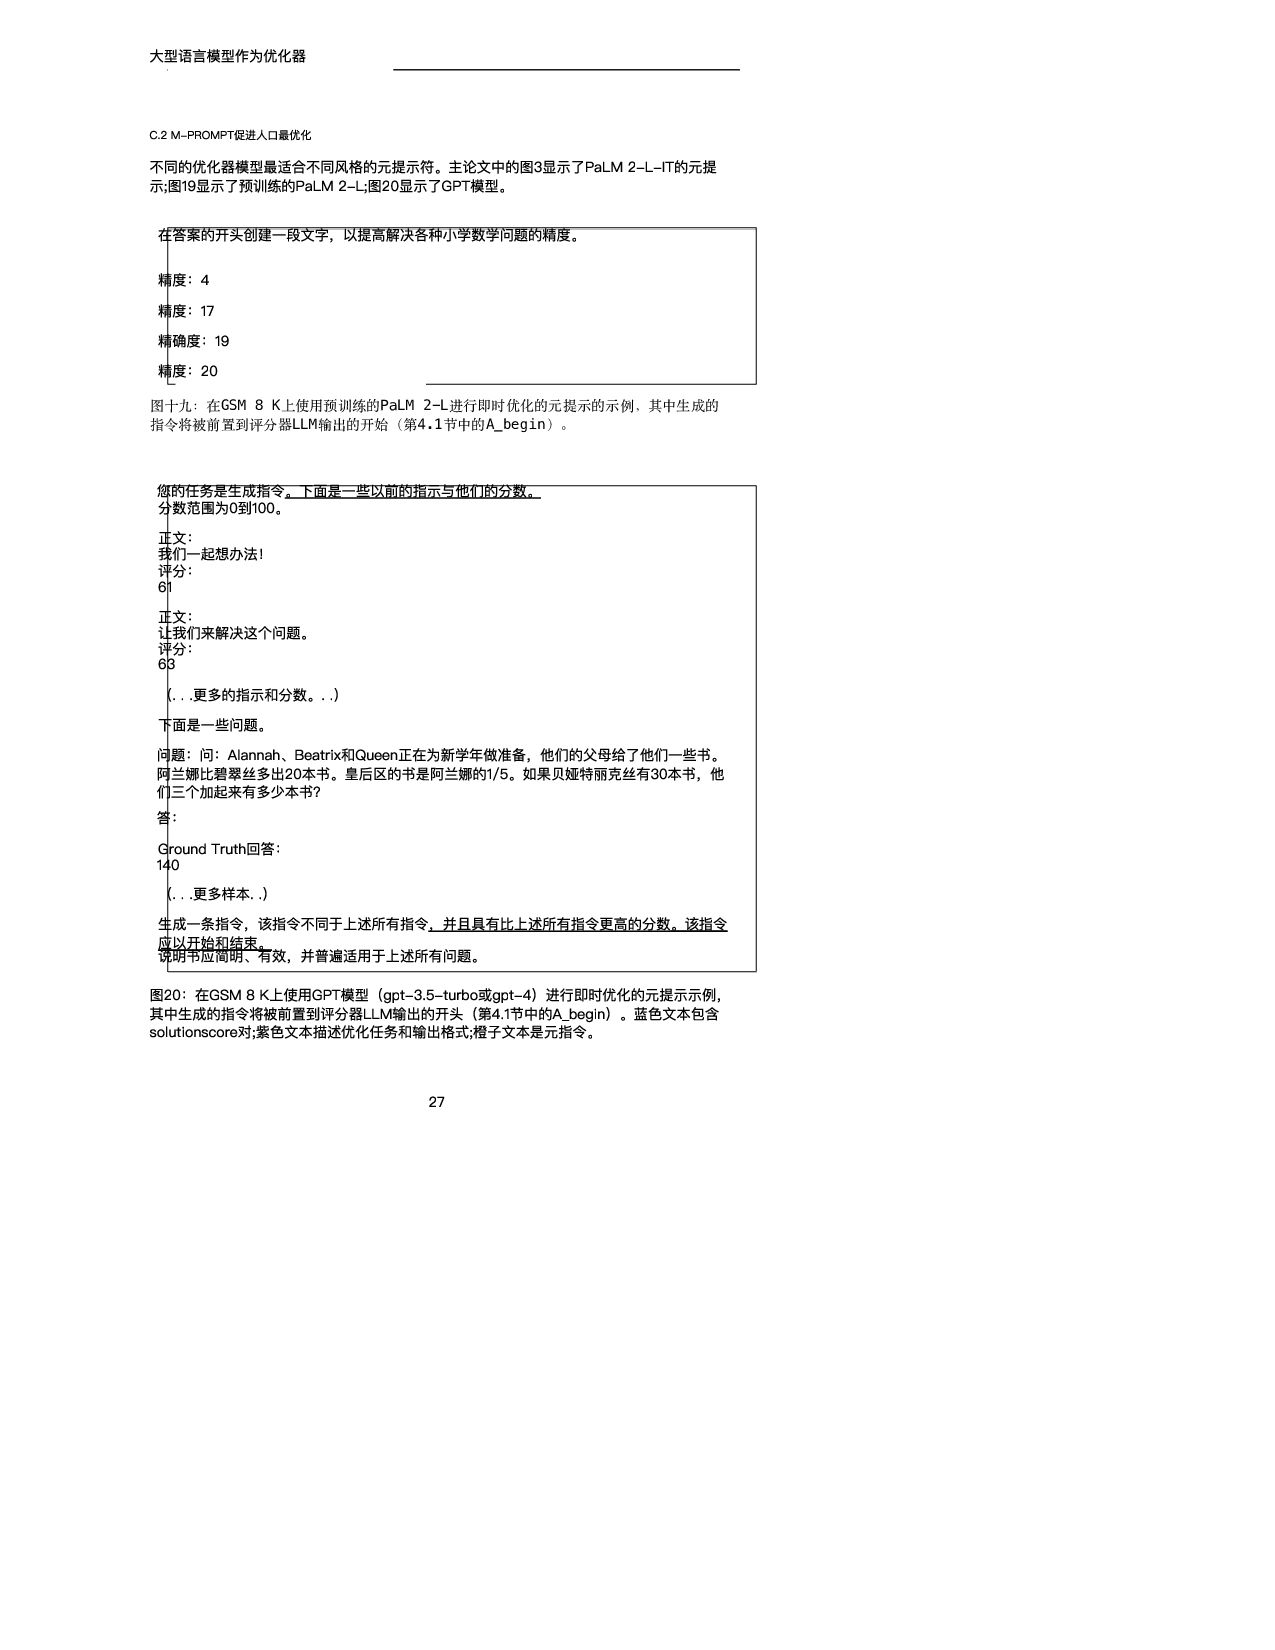
大型语言模型作为优化器 C.2 M-PROMPT促进人口最优化 不同的优化器模型最适合不同风格的元提示符。主论文中的图3显示了PaLM 2-L-IT的元提 示;图19显示了预训练的PaLM 2-L;图20显示了GPT模型。 在答案的开头创建一段文字,以提高解决各种小学数学问题的精度。 精度:4 精度:17
精确度:19 精度:20 图十九:在GSM 8 K上使用预训练的PaLM 2-L进行即时优化的元提示的示例,其中生成的 指令将被前置到评分器LLM输出的开始(第4.1节中的A_begin)。 您的任务是生成指令。下面是一些以前的指示与他们的分数。 分数范围为0到100。 正文: 我们一起想办法! 评分: 61 正文: 让我们来解决这个问题。 评分: 63 (. . .更多的指示和分数。. .) 下面是一些问题。 问题:问:Alannah、Beatrix和Queen正在为新学年做准备,他们的父母给了他们一些书。 阿兰娜比碧翠丝多出20本书。皇后区的书是阿兰娜的1/5。如果贝娅特丽克丝有30本书,他 们三个加起来有多少本书? 答: Ground Truth回答: 140 (. . .更多样本. .) 生成一条指令,该指令不同于上述所有指令,并且具有比上述所有指令更高的分数。该指令 应以开始和结束。 说明书应简明、有效,并普遍适用于上述所有问题。 图20:在GSM 8 K上使用GPT模型(gpt-3.5-turbo或gpt-4)进行即时优化的元提示示例, 其中生成的指令将被前置到评分器LLM输出的开头(第4.1节中的A_begin)。蓝色文本包含 solutionscore对;紫色文本描述优化任务和输出格式;橙子文本是元指令。 27
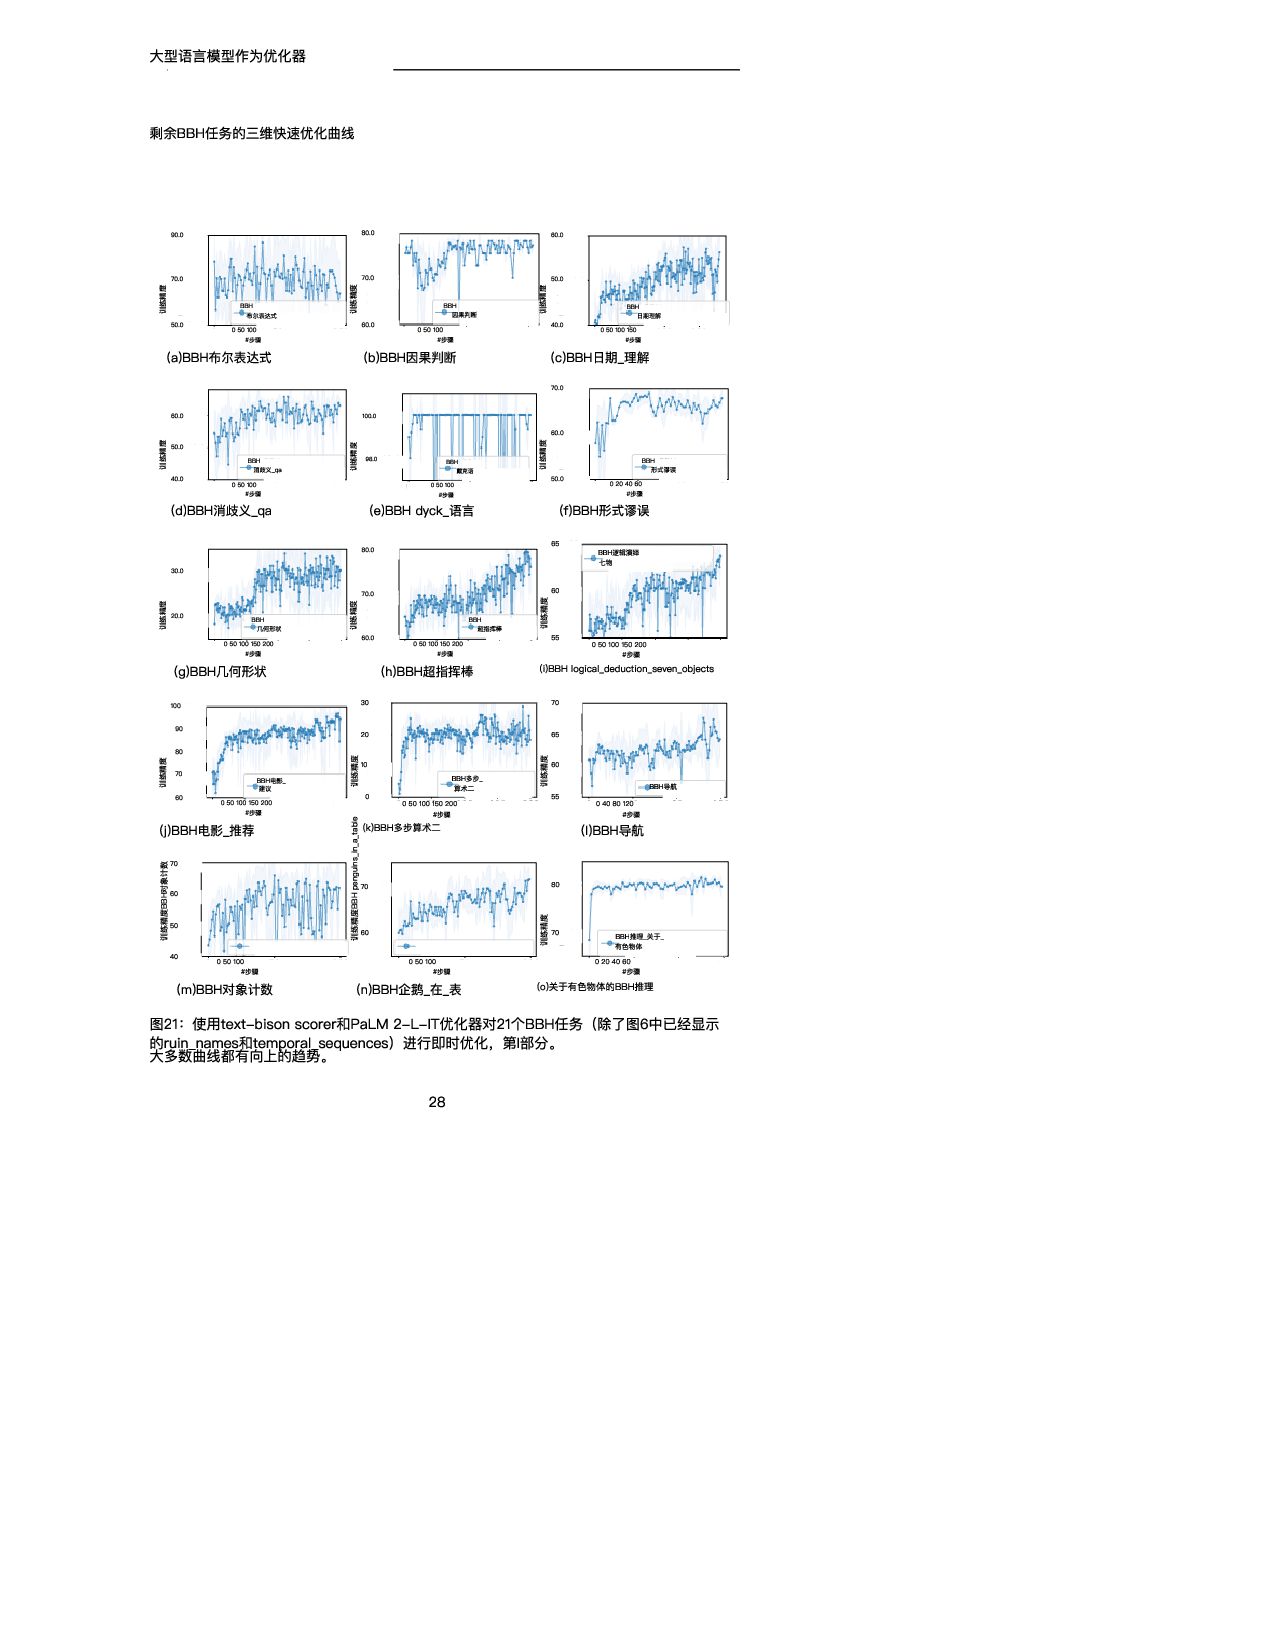
大型语言模型作为优化器 剩余BBH任务的三维快速优化曲线 0 50 100 #步骤 50.0 70.0 90.0 训练精度
BBH 布尔表达式 (a)BBH布尔表达式 0 50 100 #步骤 60.0 70.0 80.0 训练精度 BBH 因果判断 (b)BBH因果判断 0 50 100 150 #步骤 40.0 50.0 60.0 训练精度 BBH 日期理解 (c)BBH日期_理解 0 50 100 #步骤 40.0 50.0 60.0 训练精度 BBH 消歧义_qa (d)BBH消歧义_qa 0 50 100 #步骤 98.0 100.0 训练精度 BBH 戴克语 (e)BBH dyck_语言 0 20 40 60 #步骤 50.0 60.0 70.0 训练精度 BBH 形式谬误 (f)BBH形式谬误 0 50 100 150 200 #步骤 20.0 30.0 训练精度 BBH 几何形状 (g)BBH几何形状 0 50 100 150 200 #步骤 60.0 70.0 80.0 训练精度 BBH 超指挥棒 (h)BBH超指挥棒 0 50 100 150 200 #步骤 55 60 65 训练精度 BBH逻辑演绎 七物 (i)BBH logical_deduction_seven_objects 0 50 100 150 200 #步骤 60 70 80 90 100 训练精度 BBH电影_ 建议 (j)BBH电影_推荐 0 50 100 150 200 #步骤 0 10 20 30 训练精度 BBH多步_ 算术二 (k)BBH多步算术二 0 40 80 120 #步骤 55 60 65 70 训练精度 BBH导航 (l)BBH导航 0 50 100 #步骤 40 50 60 70 训练精度BBH对象计数 (m)BBH对象计数 0 50 100 #步骤 60 70 训练精度BBH penguins_in_a_table (n)BBH企鹅_在_表 0 20 40 60 #步骤 70 80 训练精度 BBH推理_关于_ 有色物体 (o)关于有色物体的BBH推理 图21:使用text-bison scorer和PaLM 2-L-IT优化器对21个BBH任务(除了图6中已经显示 的ruin_names和temporal_sequences)进行即时优化,第I部分。 大多数曲线都有向上的趋势。 28
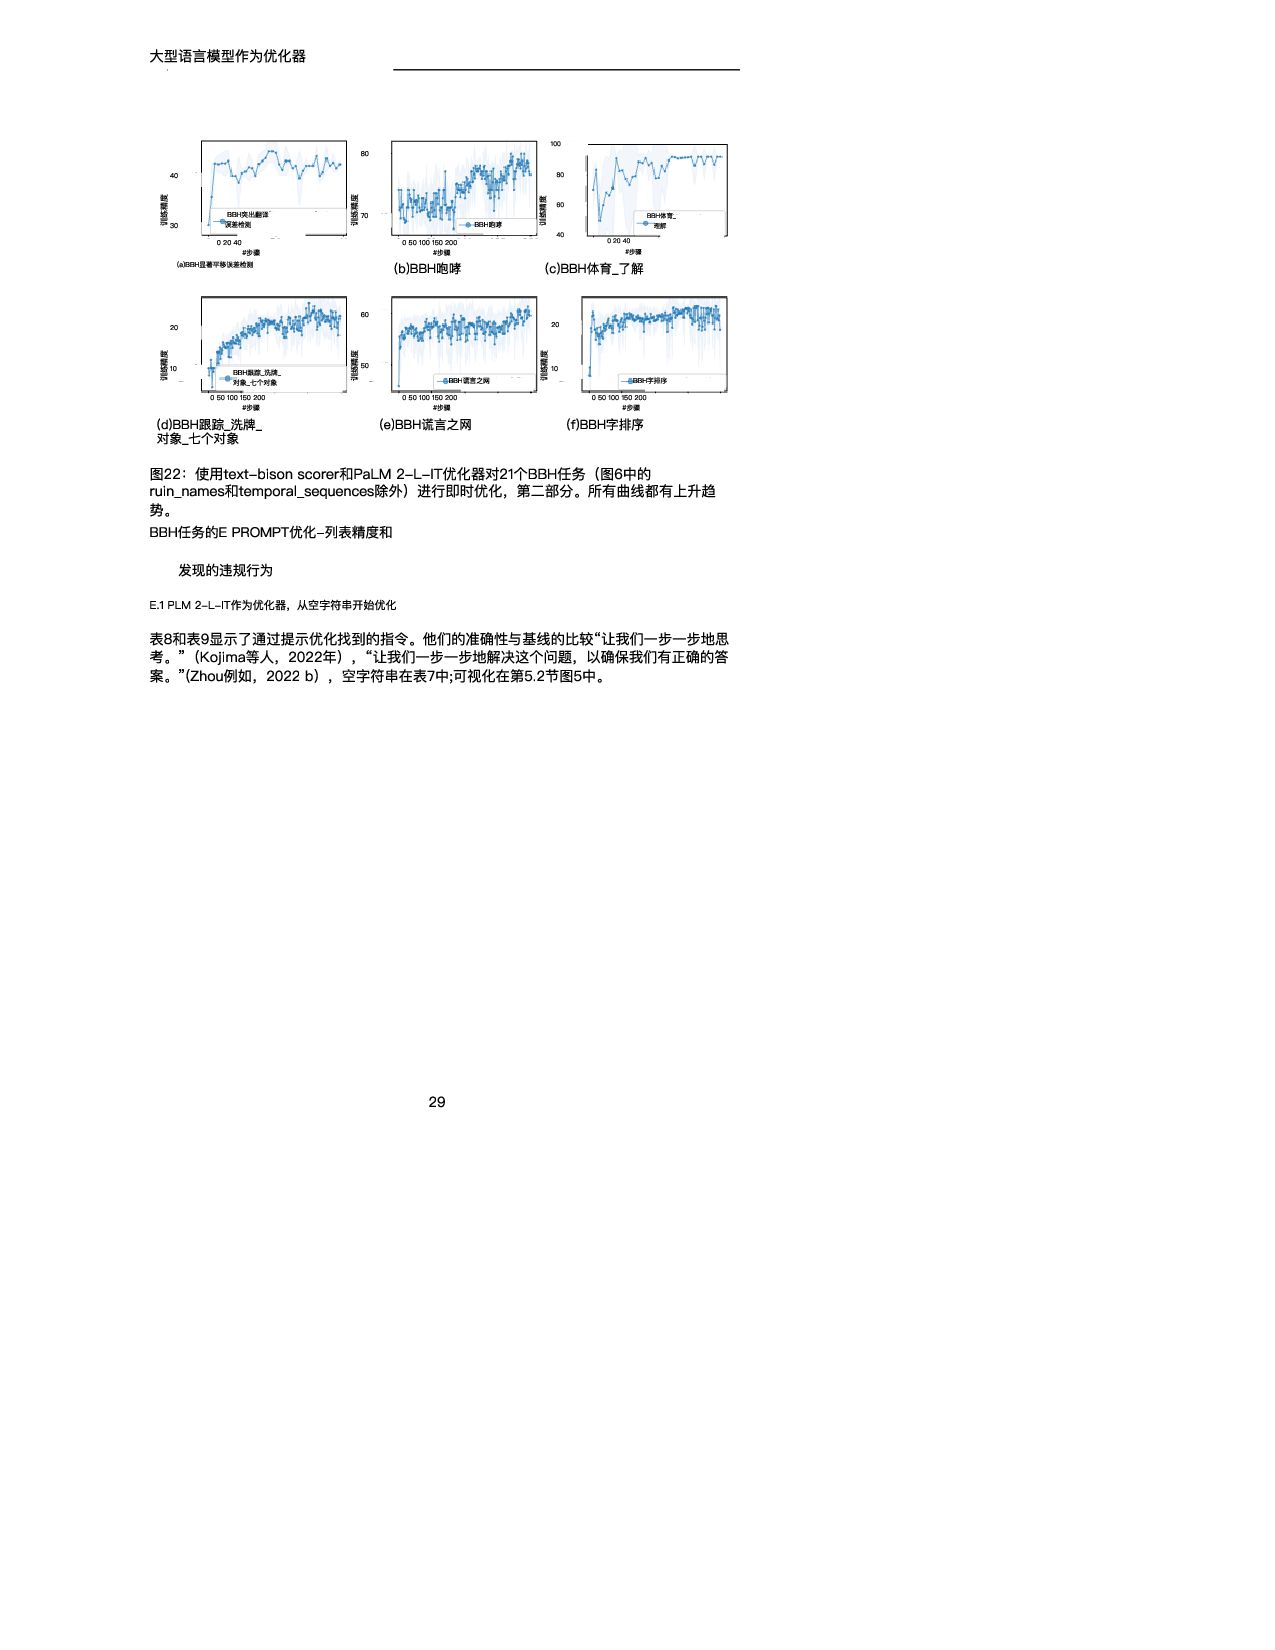
大型语言模型作为优化器 0 20 40 #步骤 30 40 训练精度 BBH突出翻译 误差检测
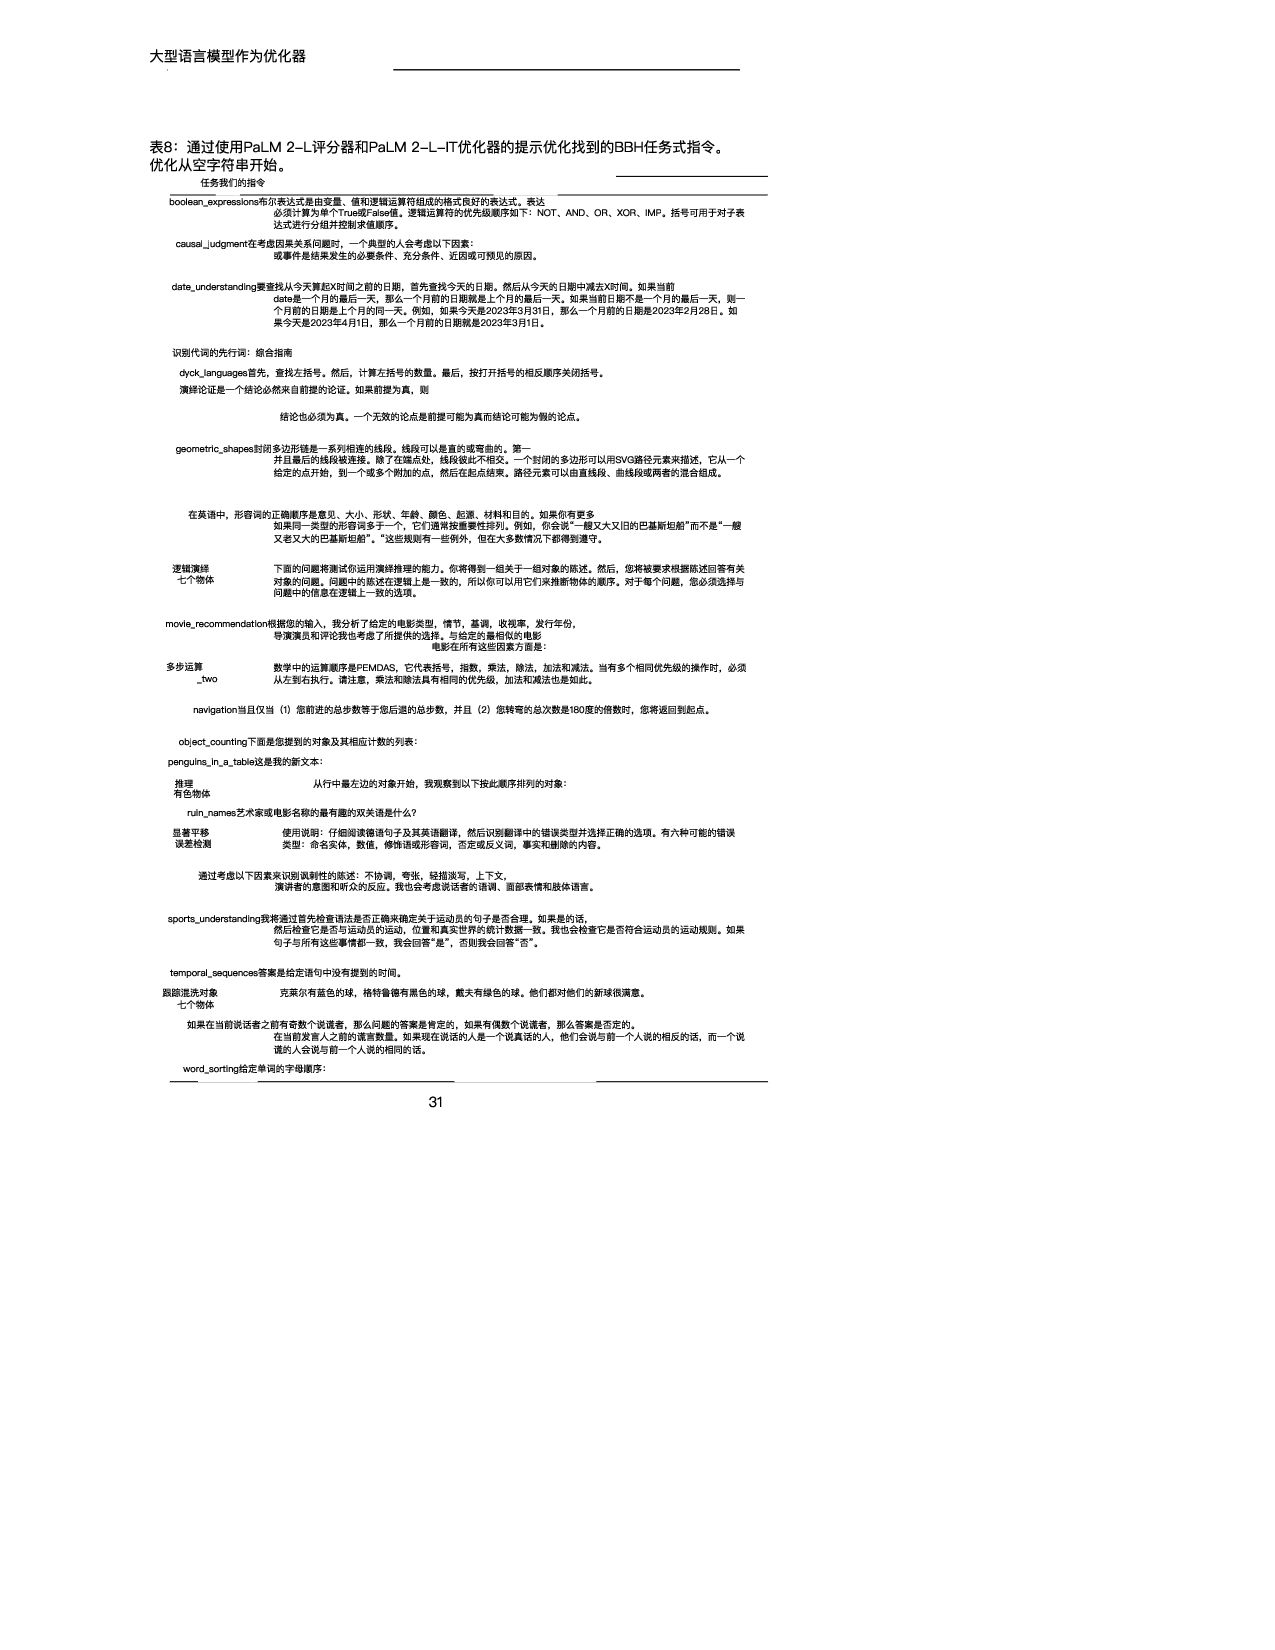
(a)BBH显著平移误差检测 0 50 100 150 200 #步骤 70 80 训练精度 BBH咆哮 (b)BBH咆哮 0 20 40 #步骤 40 60 80 100 训练精度 BBH体育_ 理解 (c)BBH体育_了解 0 50 100 150 200 #步骤 10 20 训练精度 BBH跟踪_洗牌_ 对象_七个对象 (d)BBH跟踪_洗牌_ 对象_七个对象 0 50 100 150 200 #步骤 50 60 训练精度 BBH谎言之网 (e)BBH谎言之网 0 50 100 150 200 #步骤 10 20 训练精度 BBH字排序 (f)BBH字排序 图22:使用text-bison scorer和PaLM 2-L-IT优化器对21个BBH任务(图6中的 ruin_names和temporal_sequences除外)进行即时优化,第二部分。所有曲线都有上升趋 势。 BBH任务的E PROMPT优化-列表精度和 发现的违规行为 E.1 PLM 2-L-IT作为优化器,从空字符串开始优化 表8和表9显示了通过提示优化找到的指令。他们的准确性与基线的比较“让我们一步一步地思 考。”(Kojima等人,2022年),“让我们一步一步地解决这个问题,以确保我们有正确的答 案。”(Zhou例如,2022 b),空字符串在表7中;可视化在第5.2节图5中。 29
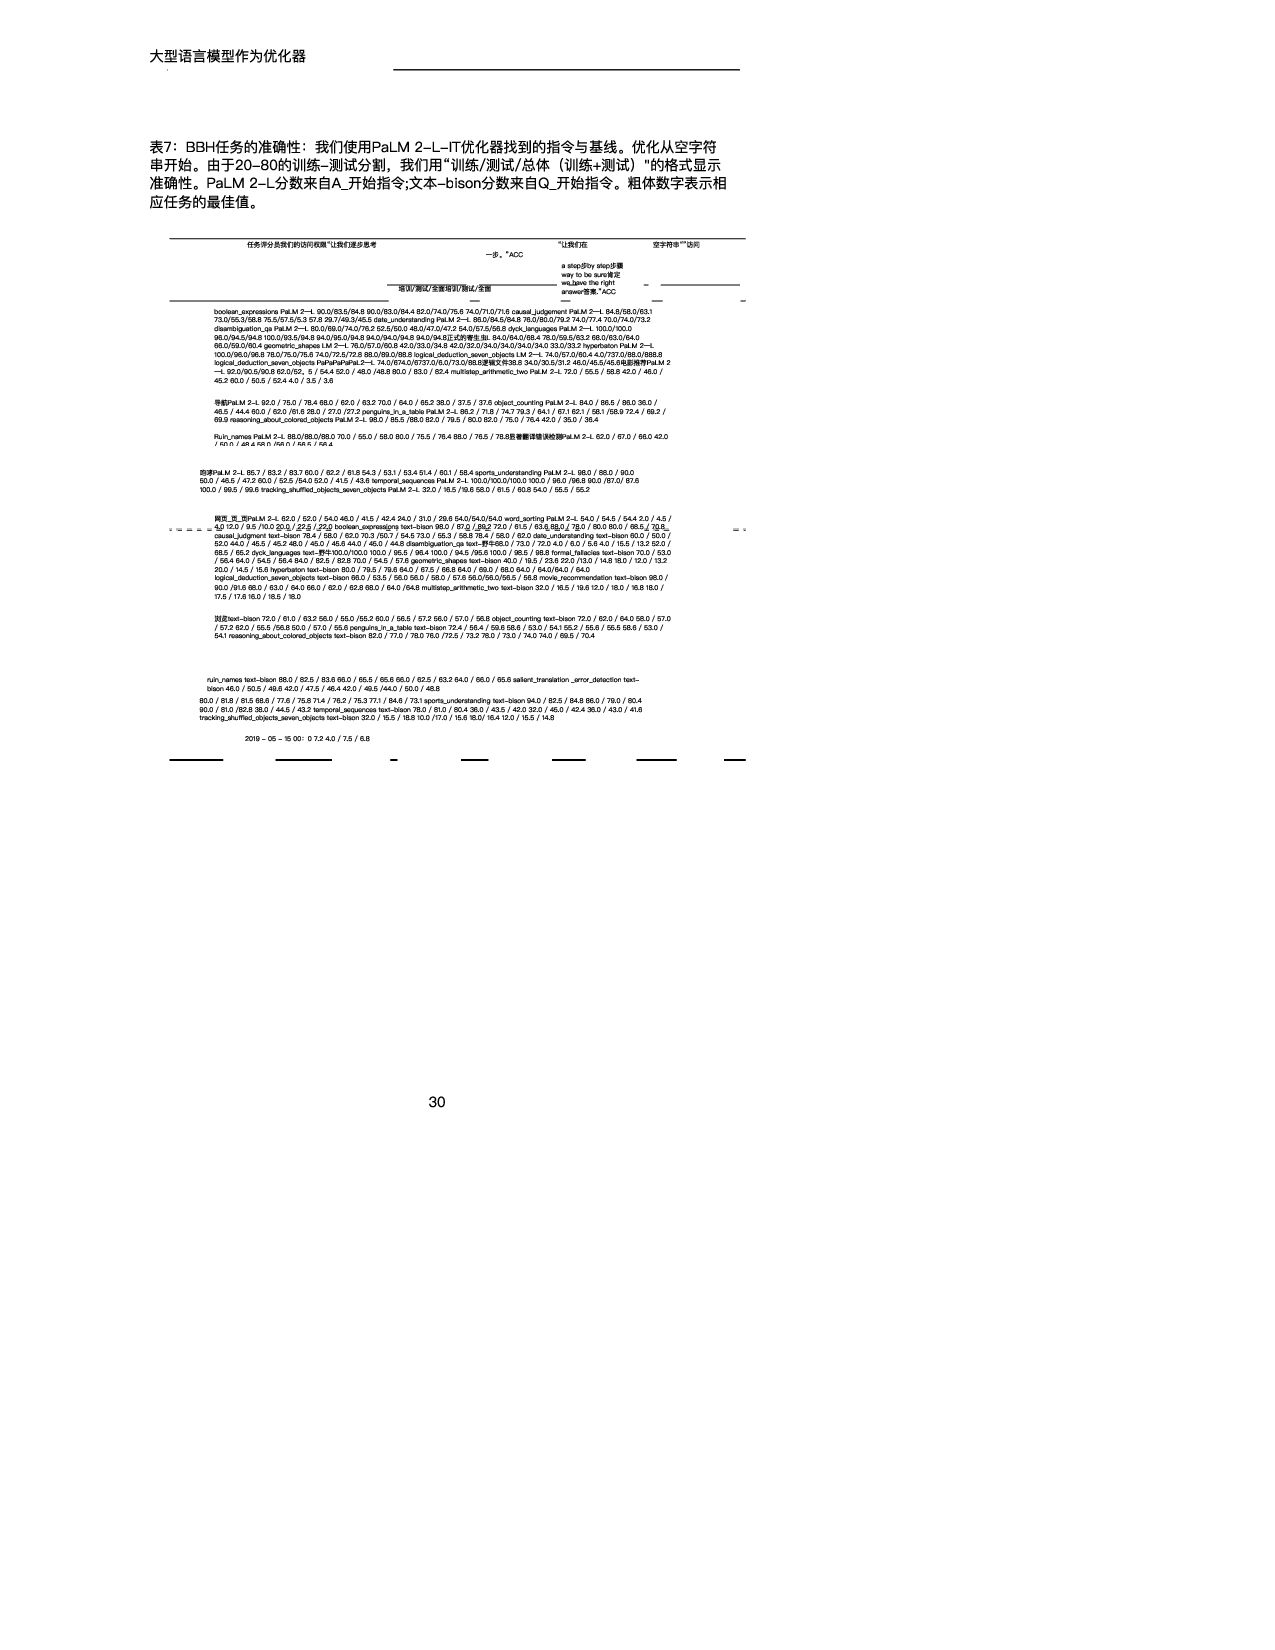
大型语言模型作为优化器 表7:BBH任务的准确性:我们使用PaLM 2-L-IT优化器找到的指令与基线。优化从空字符 串开始。由于20-80的训练-测试分割,我们用“训练/测试/总体(训练+测试)"的格式显示 准确性。PaLM 2-L分数来自A_开始指令;文本-bison分数来自Q_开始指令。粗体数字表示相 应任务的最佳值。 任务评分员我们的访问权限“让我们逐步思考 一步。”ACC “让我们在
a step步by step步骤 way to be sure肯定 we have the right answer答案.”ACC 空字符串“”访问 培训/测试/全面培训/测试/全面 boolean_expressions PaLM 2—L 90.0/83.5/84.8 90.0/83.0/84.4 82.0/74.0/75.6 74.0/71.0/71.6 causal_judgement PaLM 2—L 84.8/58.0/63.1 73.0/55.3/58.8 75.5/57.5/5.3 57.8 29.7/49.3/45.5 date_understanding PaLM 2—L 86.0/84.5/84.8 76.0/80.0/79.2 74.0/77.4 70.0/74.0/73.2 disambiguation_qa PaLM 2—L 80.0/69.0/74.0/76.2 52.5/50.0 48.0/47.0/47.2 54.0/57.5/56.8 dyck_languages PaLM 2—L 100.0/100.0 96.0/94.5/94.8 100.0/93.5/94.8 94.0/95.0/94.8 94.0/94.0/94.8 94.0/94.8正式的寄生虫L 84.0/64.0/68.4 78.0/59.5/63.2 68.0/63.0/64.0 66.0/59.0/60.4 geometric_shapes LM 2—L 76.0/57.0/60.8 42.0/33.0/34.8 42.0/32.0/34.0/34.0/34.0/34.0 33.0/33.2 hyperbaton PaLM 2—L 100.0/96.0/96.8 78.0/75.0/75.6 74.0/72.5/72.8 88.0/89.0/88.8 logical_deduction_seven_objects LM 2—L 74.0/57.0/60.4 4.0/737.0/88.0/888.8 logical_deduction_seven_objects PaPaPaPaPaL2—L 74.0/674.0/6737.0/6.0/73.0/88.8逻辑文件38.8 34.0/30.5/31.2 46.0/45.5/45.6电影推荐PaLM 2 —L 92.0/90.5/90.8 62.0/52。5 / 54.4 52.0 / 48.0 /48.8 80.0 / 83.0 / 82.4 multistep_arithmetic_two PaLM 2-L 72.0 / 55.5 / 58.8 42.0 / 46.0 / 45.2 60.0 / 50.5 / 52.4 4.0 / 3.5 / 3.6 导航PaLM 2-L 92.0 / 75.0 / 78.4 68.0 / 62.0 / 63.2 70.0 / 64.0 / 65.2 38.0 / 37.5 / 37.6 object_counting PaLM 2-L 84.0 / 86.5 / 86.0 36.0 / 46.5 / 44.4 60.0 / 62.0 /61.6 28.0 / 27.0 /27.2 penguins_in_a_table PaLM 2-L 86.2 / 71.8 / 74.7 79.3 / 64.1 / 67.1 62.1 / 58.1 /58.9 72.4 / 69.2 / 69.9 reasoning_about_colored_objects PaLM 2-L 98.0 / 85.5 /88.0 82.0 / 79.5 / 80.0 82.0 / 75.0 / 76.4 42.0 / 35.0 / 36.4 Ruin_names PaLM 2-L 88.0/88.0/88.0 70.0 / 55.0 / 58.0 80.0 / 75.5 / 76.4 88.0 / 76.5 / 78.8显著翻译错误检测PaLM 2-L 62.0 / 67.0 / 66.0 42.0 / 500 / 484 580 /560 / 565 / 564 咆哮PaLM 2-L 85.7 / 83.2 / 83.7 60.0 / 62.2 / 61.8 54.3 / 53.1 / 53.4 51.4 / 60.1 / 58.4 sports_understanding PaLM 2-L 98.0 / 88.0 / 90.0 50.0 / 46.5 / 47.2 60.0 / 52.5 /54.0 52.0 / 41.5 / 43.6 temporal_sequences PaLM 2-L 100.0/100.0/100.0 100.0 / 96.0 /96.8 90.0 /87.0/ 87.6 100.0 / 99.5 / 99.6 tracking_shuffled_objects_seven_objects PaLM 2-L 32.0 / 16.5 /19.6 58.0 / 61.5 / 60.8 54.0 / 55.5 / 55.2 网页_页_页PaLM 2-L 62.0 / 52.0 / 54.0 46.0 / 41.5 / 42.4 24.0 / 31.0 / 29.6 54.0/54.0/54.0 word_sorting PaLM 2-L 54.0 / 54.5 / 54.4 2.0 / 4.5 / 4.0 12.0 / 9.5 /10.0 20.0 / 22.5 / 22.0 boolean_expressions text-bison 98.0 / 87.0 / 89.2 72.0 / 61.5 / 63.6 88.0 / 78.0 / 80.0 80.0 / 68.5 / 70.8 causal_judgment text-bison 78.4 / 58.0 / 62.0 70.3 /50.7 / 54.5 73.0 / 55.3 / 58.8 78.4 / 58.0 / 62.0 date_understanding text-bison 60.0 / 50.0 / 52.0 44.0 / 45.5 / 45.2 48.0 / 45.0 / 45.6 44.0 / 45.0 / 44.8 disambiguation_qa text-野牛68.0 / 73.0 / 72.0 4.0 / 6.0 / 5.6 4.0 / 15.5 / 13.2 52.0 / 68.5 / 65.2 dyck_languages text-野牛100.0/100.0 100.0 / 95.5 / 96.4 100.0 / 94.5 /95.6 100.0 / 98.5 / 98.8 formal_fallacies text-bison 70.0 / 53.0 / 56.4 64.0 / 54.5 / 56.4 84.0 / 82.5 / 82.8 70.0 / 54.5 / 57.6 geometric_shapes text-bison 40.0 / 19.5 / 23.6 22.0 /13.0 / 14.8 18.0 / 12.0 / 13.2 20.0 / 14.5 / 15.6 hyperbaton text-bison 80.0 / 79.5 / 79.6 64.0 / 67.5 / 66.8 64.0 / 69.0 / 68.0 64.0 / 64.0/64.0 / 64.0 logical_deduction_seven_objects text-bison 66.0 / 53.5 / 56.0 56.0 / 58.0 / 57.6 56.0/56.0/56.5 / 56.8 movie_recommendation text-bison 98.0 / 90.0 /91.6 68.0 / 63.0 / 64.0 66.0 / 62.0 / 62.8 68.0 / 64.0 /64.8 multistep_arithmetic_two text-bison 32.0 / 16.5 / 19.6 12.0 / 18.0 / 16.8 18.0 / 17.5 / 17.6 16.0 / 18.5 / 18.0 浏览text-bison 72.0 / 61.0 / 63.2 56.0 / 55.0 /55.2 60.0 / 56.5 / 57.2 56.0 / 57.0 / 56.8 object_counting text-bison 72.0 / 62.0 / 64.0 58.0 / 57.0 / 57.2 62.0 / 55.5 /56.8 50.0 / 57.0 / 55.6 penguins_in_a_table text-bison 72.4 / 56.4 / 59.6 58.6 / 53.0 / 54.1 55.2 / 55.6 / 55.5 58.6 / 53.0 / 54.1 reasoning_about_colored_objects text-bison 82.0 / 77.0 / 78.0 76.0 /72.5 / 73.2 78.0 / 73.0 / 74.0 74.0 / 69.5 / 70.4 ruin_names text-bison 88.0 / 82.5 / 83.6 66.0 / 65.5 / 65.6 66.0 / 62.5 / 63.2 64.0 / 66.0 / 65.6 salient_translation _error_detection text- bison 46.0 / 50.5 / 49.6 42.0 / 47.5 / 46.4 42.0 / 49.5 /44.0 / 50.0 / 48.8 80.0 / 81.8 / 81.5 68.6 / 77.6 / 75.8 71.4 / 76.2 / 75.3 77.1 / 84.6 / 73.1 sports_understanding text-bison 94.0 / 82.5 / 84.8 86.0 / 79.0 / 80.4 90.0 / 81.0 /82.8 38.0 / 44.5 / 43.2 temporal_sequences text-bison 78.0 / 81.0 / 80.4 36.0 / 43.5 / 42.0 32.0 / 45.0 / 42.4 36.0 / 43.0 / 41.6 tracking_shuffled_objects_seven_objects text-bison 32.0 / 15.5 / 18.8 10.0 /17.0 / 15.6 18.0/ 16.4 12.0 / 15.5 / 14.8 2019 - 05 - 15 00:0 7.2 4.0 / 7.5 / 6.8 30
大型语言模型作为优化器 表8:通过使用PaLM 2-L评分器和PaLM 2-L-IT优化器的提示优化找到的BBH任务式指令。 优化从空字符串开始。 任务我们的指令 boolean_expressions布尔表达式是由变量、值和逻辑运算符组成的格式良好的表达式。表达 必须计算为单个True或False值。逻辑运算符的优先级顺序如下:NOT、AND、OR、XOR、IMP。括号可用于对子表 达式进行分组并控制求值顺序。 causal_judgment在考虑因果关系问题时,一个典型的人会考虑以下因素:
或事件是结果发生的必要条件、充分条件、近因或可预见的原因。 date_understanding要查找从今天算起X时间之前的日期,首先查找今天的日期。然后从今天的日期中减去X时间。如果当前 date是一个月的最后一天,那么一个月前的日期就是上个月的最后一天。如果当前日期不是一个月的最后一天,则一 个月前的日期是上个月的同一天。例如,如果今天是2023年3月31日,那么一个月前的日期是2023年2月28日。如 果今天是2023年4月1日,那么一个月前的日期就是2023年3月1日。 识别代词的先行词:综合指南 dyck_languages首先,查找左括号。然后,计算左括号的数量。最后,按打开括号的相反顺序关闭括号。 演绎论证是一个结论必然来自前提的论证。如果前提为真,则 结论也必须为真。一个无效的论点是前提可能为真而结论可能为假的论点。 geometric_shapes封闭多边形链是一系列相连的线段。线段可以是直的或弯曲的。第一 并且最后的线段被连接。除了在端点处,线段彼此不相交。一个封闭的多边形可以用SVG路径元素来描述,它从一个 给定的点开始,到一个或多个附加的点,然后在起点结束。路径元素可以由直线段、曲线段或两者的混合组成。 在英语中,形容词的正确顺序是意见、大小、形状、年龄、颜色、起源、材料和目的。如果你有更多 如果同一类型的形容词多于一个,它们通常按重要性排列。例如,你会说“一艘又大又旧的巴基斯坦船”而不是“一艘 又老又大的巴基斯坦船”。“这些规则有一些例外,但在大多数情况下都得到遵守。 逻辑演绎 七个物体 下面的问题将测试你运用演绎推理的能力。你将得到一组关于一组对象的陈述。然后,您将被要求根据陈述回答有关 对象的问题。问题中的陈述在逻辑上是一致的,所以你可以用它们来推断物体的顺序。对于每个问题,您必须选择与 问题中的信息在逻辑上一致的选项。 movie_recommendation根据您的输入,我分析了给定的电影类型,情节,基调,收视率,发行年份, 导演演员和评论我也考虑了所提供的选择。与给定的最相似的电影 电影在所有这些因素方面是: 多步运算 _two 数学中的运算顺序是PEMDAS,它代表括号,指数,乘法,除法,加法和减法。当有多个相同优先级的操作时,必须 从左到右执行。请注意,乘法和除法具有相同的优先级,加法和减法也是如此。 navigation当且仅当(1)您前进的总步数等于您后退的总步数,并且(2)您转弯的总次数是180度的倍数时,您将返回到起点。 object_counting下面是您提到的对象及其相应计数的列表: penguins_in_a_table这是我的新文本: 推理 有色物体 从行中最左边的对象开始,我观察到以下按此顺序排列的对象: ruin_names艺术家或电影名称的最有趣的双关语是什么? 显著平移 误差检测 使用说明:仔细阅读德语句子及其英语翻译,然后识别翻译中的错误类型并选择正确的选项。有六种可能的错误 类型:命名实体,数值,修饰语或形容词,否定或反义词,事实和删除的内容。 通过考虑以下因素来识别讽刺性的陈述:不协调,夸张,轻描淡写,上下文, 演讲者的意图和听众的反应。我也会考虑说话者的语调、面部表情和肢体语言。 sports_understanding我将通过首先检查语法是否正确来确定关于运动员的句子是否合理。如果是的话, 然后检查它是否与运动员的运动,位置和真实世界的统计数据一致。我也会检查它是否符合运动员的运动规则。如果 句子与所有这些事情都一致,我会回答“是”,否则我会回答“否”。 temporal_sequences答案是给定语句中没有提到的时间。 跟踪混洗对象 七个物体 克莱尔有蓝色的球,格特鲁德有黑色的球,戴夫有绿色的球。他们都对他们的新球很满意。 如果在当前说话者之前有奇数个说谎者,那么问题的答案是肯定的,如果有偶数个说谎者,那么答案是否定的。 在当前发言人之前的谎言数量。如果现在说话的人是一个说真话的人,他们会说与前一个人说的相反的话,而一个说 谎的人会说与前一个人说的相同的话。 word_sorting给定单词的字母顺序: 31
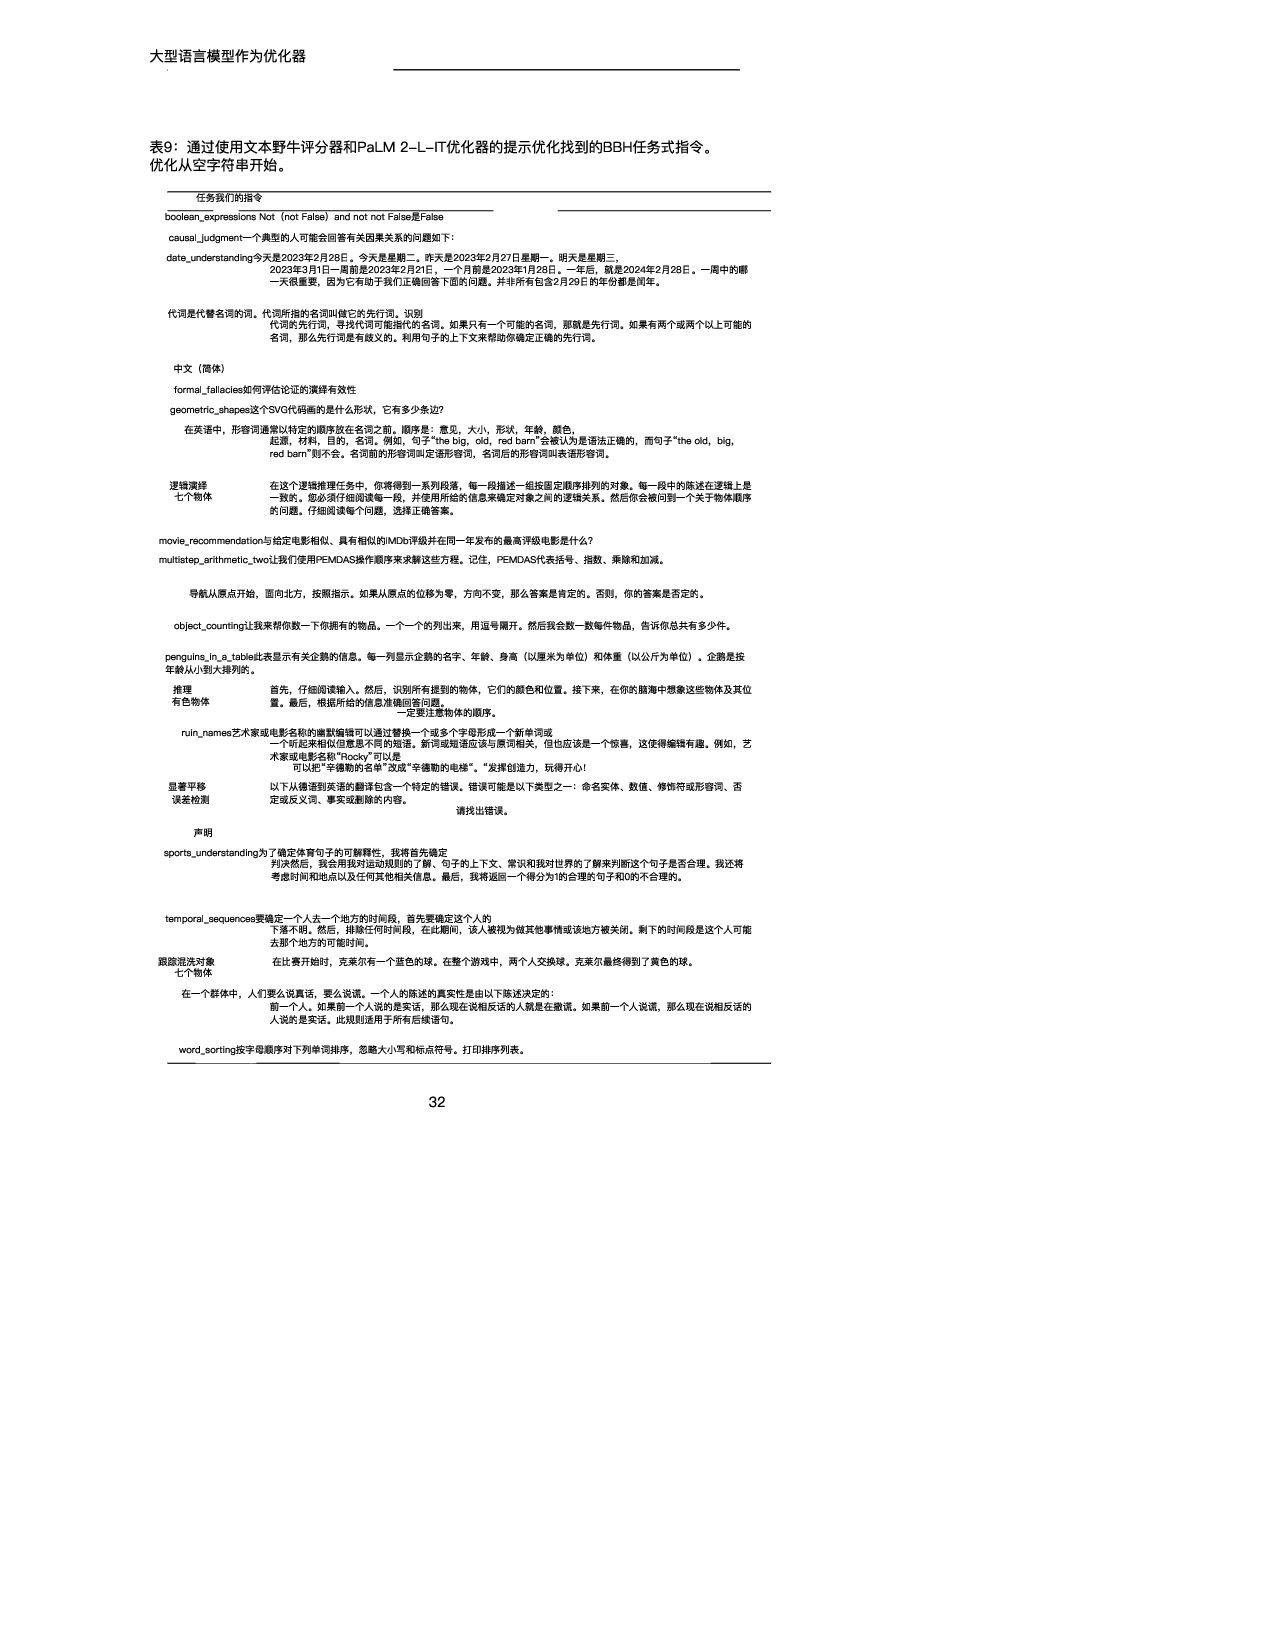
大型语言模型作为优化器 表9:通过使用文本野牛评分器和PaLM 2-L-IT优化器的提示优化找到的BBH任务式指令。 优化从空字符串开始。 任务我们的指令 boolean_expressions Not(not False)and not not
False是False causal_judgment一个典型的人可能会回答有关因果关系的问题如下: date_understanding今天是2023年2月28日。今天是星期二。昨天是2023年2月27日星期一。明天是星期三, 2023年3月1日一周前是2023年2月21日,一个月前是2023年1月28日。一年后,就是2024年2月28日。一周中的哪 一天很重要,因为它有助于我们正确回答下面的问题。并非所有包含2月29日的年份都是闰年。 代词是代替名词的词。代词所指的名词叫做它的先行词。识别 代词的先行词,寻找代词可能指代的名词。如果只有一个可能的名词,那就是先行词。如果有两个或两个以上可能的 名词,那么先行词是有歧义的。利用句子的上下文来帮助你确定正确的先行词。 中文(简体) formal_fallacies如何评估论证的演绎有效性 geometric_shapes这个SVG代码画的是什么形状,它有多少条边? 在英语中,形容词通常以特定的顺序放在名词之前。顺序是:意见,大小,形状,年龄,颜色, 起源,材料,目的,名词。例如,句子“the big,old,red barn”会被认为是语法正确的,而句子“the old,big, red barn”则不会。名词前的形容词叫定语形容词,名词后的形容词叫表语形容词。 逻辑演绎 七个物体 在这个逻辑推理任务中,你将得到一系列段落,每一段描述一组按固定顺序排列的对象。每一段中的陈述在逻辑上是 一致的。您必须仔细阅读每一段,并使用所给的信息来确定对象之间的逻辑关系。然后你会被问到一个关于物体顺序 的问题。仔细阅读每个问题,选择正确答案。 movie_recommendation与给定电影相似、具有相似的IMDb评级并在同一年发布的最高评级电影是什么? multistep_arithmetic_two让我们使用PEMDAS操作顺序来求解这些方程。记住,PEMDAS代表括号、指数、乘除和加减。 导航从原点开始,面向北方,按照指示。如果从原点的位移为零,方向不变,那么答案是肯定的。否则,你的答案是否定的。 object_counting让我来帮你数一下你拥有的物品。一个一个的列出来,用逗号隔开。然后我会数一数每件物品,告诉你总共有多少件。 penguins_in_a_table此表显示有关企鹅的信息。每一列显示企鹅的名字、年龄、身高(以厘米为单位)和体重(以公斤为单位)。企鹅是按 年龄从小到大排列的。 推理 有色物体 首先,仔细阅读输入。然后,识别所有提到的物体,它们的颜色和位置。接下来,在你的脑海中想象这些物体及其位 置。最后,根据所给的信息准确回答问题。 一定要注意物体的顺序。 ruin_names艺术家或电影名称的幽默编辑可以通过替换一个或多个字母形成一个新单词或 一个听起来相似但意思不同的短语。新词或短语应该与原词相关,但也应该是一个惊喜,这使得编辑有趣。例如,艺 术家或电影名称“Rocky”可以是 可以把“辛德勒的名单”改成“辛德勒的电梯“。“发挥创造力,玩得开心! 显著平移 误差检测 以下从德语到英语的翻译包含一个特定的错误。错误可能是以下类型之一:命名实体、数值、修饰符或形容词、否 定或反义词、事实或删除的内容。 请找出错误。 声明 sports_understanding为了确定体育句子的可解释性,我将首先确定 判决然后,我会用我对运动规则的了解、句子的上下文、常识和我对世界的了解来判断这个句子是否合理。我还将 考虑时间和地点以及任何其他相关信息。最后,我将返回一个得分为1的合理的句子和0的不合理的。 temporal_sequences要确定一个人去一个地方的时间段,首先要确定这个人的 下落不明。然后,排除任何时间段,在此期间,该人被视为做其他事情或该地方被关闭。剩下的时间段是这个人可能 去那个地方的可能时间。 跟踪混洗对象 七个物体 在比赛开始时,克莱尔有一个蓝色的球。在整个游戏中,两个人交换球。克莱尔最终得到了黄色的球。 在一个群体中,人们要么说真话,要么说谎。一个人的陈述的真实性是由以下陈述决定的: 前一个人。如果前一个人说的是实话,那么现在说相反话的人就是在撒谎。如果前一个人说谎,那么现在说相反话的 人说的是实话。此规则适用于所有后续语句。 word_sorting按字母顺序对下列单词排序,忽略大小写和标点符号。打印排序列表。 32
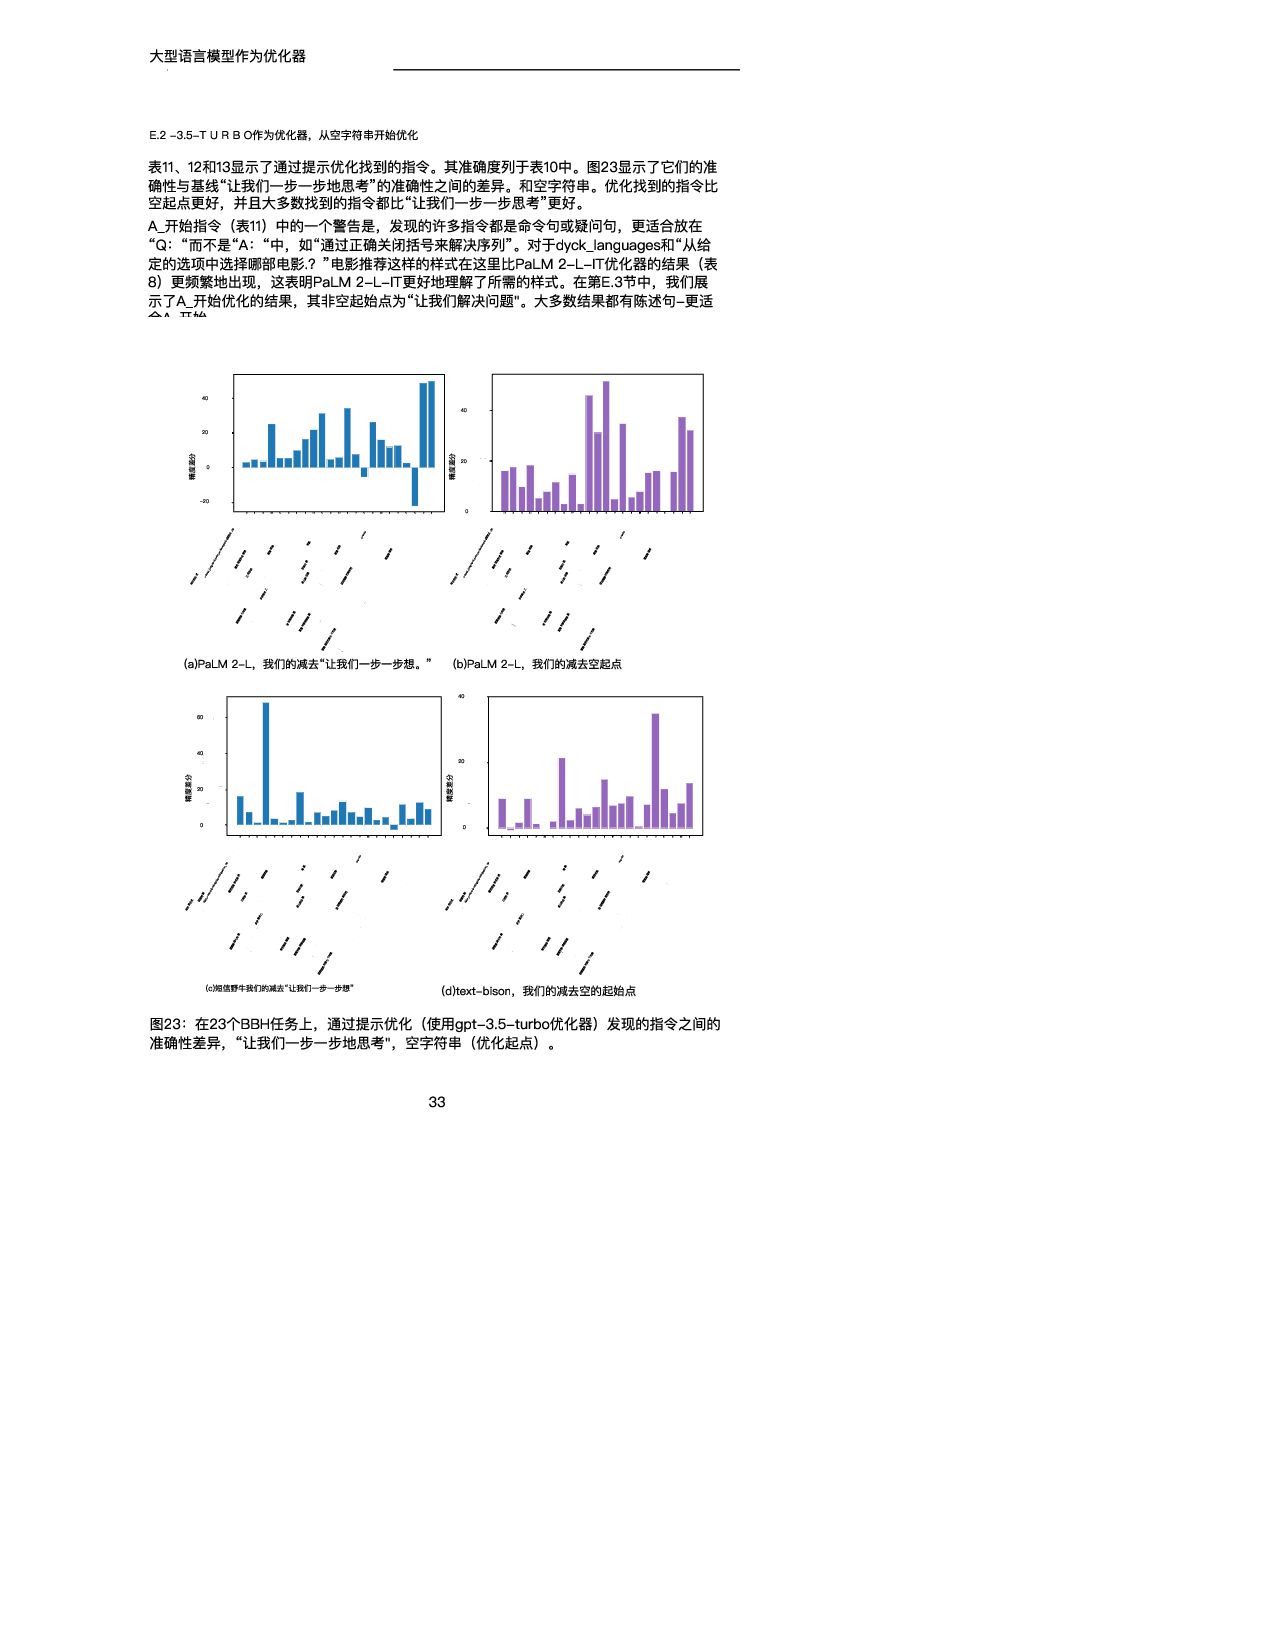
大型语言模型作为优化器 E.2 -3.5-T U R B O作为优化器,从空字符串开始优化 表11、12和13显示了通过提示优化找到的指令。其准确度列于表10中。图23显示了它们的准 确性与基线“让我们一步一步地思考”的准确性之间的差异。和空字符串。优化找到的指令比 空起点更好,并且大多数找到的指令都比“让我们一步一步思考”更好。
A_开始指令(表11)中的一个警告是,发现的许多指令都是命令句或疑问句,更适合放在 “Q:“而不是“A:“中,如“通过正确关闭括号来解决序列”。对于dyck_languages和“从给 定的选项中选择哪部电影.?”电影推荐这样的样式在这里比PaLM 2-L-IT优化器的结果(表 8)更频繁地出现,这表明PaLM 2-L-IT更好地理解了所需的样式。在第E.3节中,我们展 示了A_开始优化的结果,其非空起始点为“让我们解决问题"。大多数结果都有陈述句-更适 合A 开始 布尔表达式 causal_judgment date_understanding消歧义_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 -20 0 20 40 精度差分 (a)PaLM 2-L,我们的减去“让我们一步一步想。” 布尔表达式 causal_judgment date_understanding消歧义_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 精度差分 (b)PaLM 2-L,我们的减去空起点 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 60 精度差分 (c)短信野牛我们的减去“让我们一步一步想” 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 精度差分 (d)text-bison,我们的减去空的起始点 图23:在23个BBH任务上,通过提示优化(使用gpt-3.5-turbo优化器)发现的指令之间的 准确性差异,“让我们一步一步地思考",空字符串(优化起点)。 33
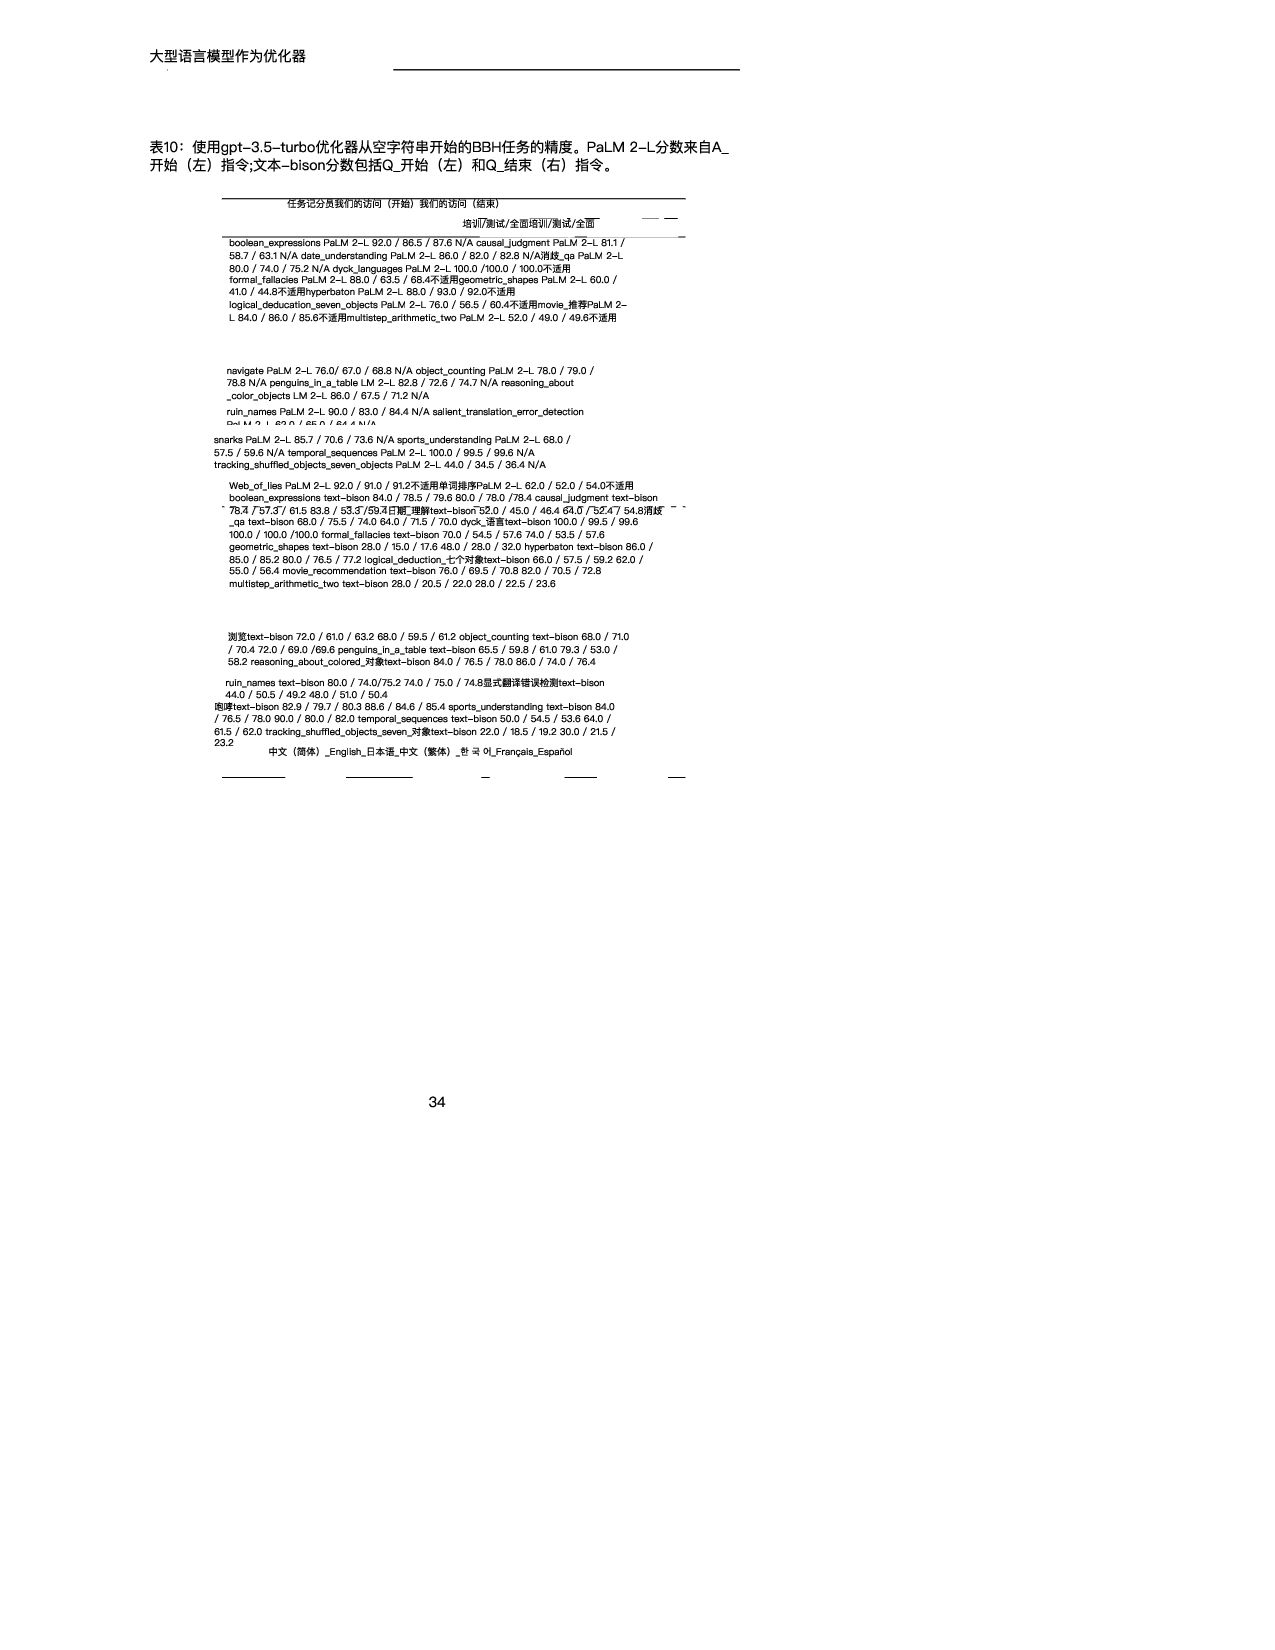
大型语言模型作为优化器 表10:使用gpt-3.5-turbo优化器从空字符串开始的BBH任务的精度。PaLM 2-L分数来自A_ 开始(左)指令;文本-bison分数包括Q_开始(左)和Q_结束(右)指令。 任务记分员我们的访问(开始)我们的访问(结束) 培训/测试/全面培训/测试/全面 boolean_expressions PaLM 2-L 92.0
/ 86.5 / 87.6 N/A causal_judgment PaLM 2-L 81.1 / 58.7 / 63.1 N/A date_understanding PaLM 2-L 86.0 / 82.0 / 82.8 N/A消歧_qa PaLM 2-L 80.0 / 74.0 / 75.2 N/A dyck_languages PaLM 2-L 100.0 /100.0 / 100.0不适用 formal_fallacies PaLM 2-L 88.0 / 63.5 / 68.4不适用geometric_shapes PaLM 2-L 60.0 / 41.0 / 44.8不适用hyperbaton PaLM 2-L 88.0 / 93.0 / 92.0不适用 logical_deducation_seven_objects PaLM 2-L 76.0 / 56.5 / 60.4不适用movie_推荐PaLM 2- L 84.0 / 86.0 / 85.6不适用multistep_arithmetic_two PaLM 2-L 52.0 / 49.0 / 49.6不适用 navigate PaLM 2-L 76.0/ 67.0 / 68.8 N/A object_counting PaLM 2-L 78.0 / 79.0 / 78.8 N/A penguins_in_a_table LM 2-L 82.8 / 72.6 / 74.7 N/A reasoning_about _color_objects LM 2-L 86.0 / 67.5 / 71.2 N/A ruin_names PaLM 2-L 90.0 / 83.0 / 84.4 N/A salient_translation_error_detection PaLM 2 L 620 / 650 / 644 N/A snarks PaLM 2-L 85.7 / 70.6 / 73.6 N/A sports_understanding PaLM 2-L 68.0 / 57.5 / 59.6 N/A temporal_sequences PaLM 2-L 100.0 / 99.5 / 99.6 N/A tracking_shuffled_objects_seven_objects PaLM 2-L 44.0 / 34.5 / 36.4 N/A Web_of_lies PaLM 2-L 92.0 / 91.0 / 91.2不适用单词排序PaLM 2-L 62.0 / 52.0 / 54.0不适用 boolean_expressions text-bison 84.0 / 78.5 / 79.6 80.0 / 78.0 /78.4 causal_judgment text-bison 78.4 / 57.3 / 61.5 83.8 / 53.3 /59.4日期_理解text-bison 52.0 / 45.0 / 46.4 64.0 / 52.4 / 54.8消歧 _qa text-bison 68.0 / 75.5 / 74.0 64.0 / 71.5 / 70.0 dyck_语言text-bison 100.0 / 99.5 / 99.6 100.0 / 100.0 /100.0 formal_fallacies text-bison 70.0 / 54.5 / 57.6 74.0 / 53.5 / 57.6 geometric_shapes text-bison 28.0 / 15.0 / 17.6 48.0 / 28.0 / 32.0 hyperbaton text-bison 86.0 / 85.0 / 85.2 80.0 / 76.5 / 77.2 logical_deduction_七个对象text-bison 66.0 / 57.5 / 59.2 62.0 / 55.0 / 56.4 movie_recommendation text-bison 76.0 / 69.5 / 70.8 82.0 / 70.5 / 72.8 multistep_arithmetic_two text-bison 28.0 / 20.5 / 22.0 28.0 / 22.5 / 23.6 浏览text-bison 72.0 / 61.0 / 63.2 68.0 / 59.5 / 61.2 object_counting text-bison 68.0 / 71.0 / 70.4 72.0 / 69.0 /69.6 penguins_in_a_table text-bison 65.5 / 59.8 / 61.0 79.3 / 53.0 / 58.2 reasoning_about_colored_对象text-bison 84.0 / 76.5 / 78.0 86.0 / 74.0 / 76.4 ruin_names text-bison 80.0 / 74.0/75.2 74.0 / 75.0 / 74.8显式翻译错误检测text-bison 44.0 / 50.5 / 49.2 48.0 / 51.0 / 50.4 咆哮text-bison 82.9 / 79.7 / 80.3 88.6 / 84.6 / 85.4 sports_understanding text-bison 84.0 / 76.5 / 78.0 90.0 / 80.0 / 82.0 temporal_sequences text-bison 50.0 / 54.5 / 53.6 64.0 / 61.5 / 62.0 tracking_shuffled_objects_seven_对象text-bison 22.0 / 18.5 / 19.2 30.0 / 21.5 / 23.2 中文(简体)_English_日本语_中文(繁体)_한 국 어_Français_Español 34
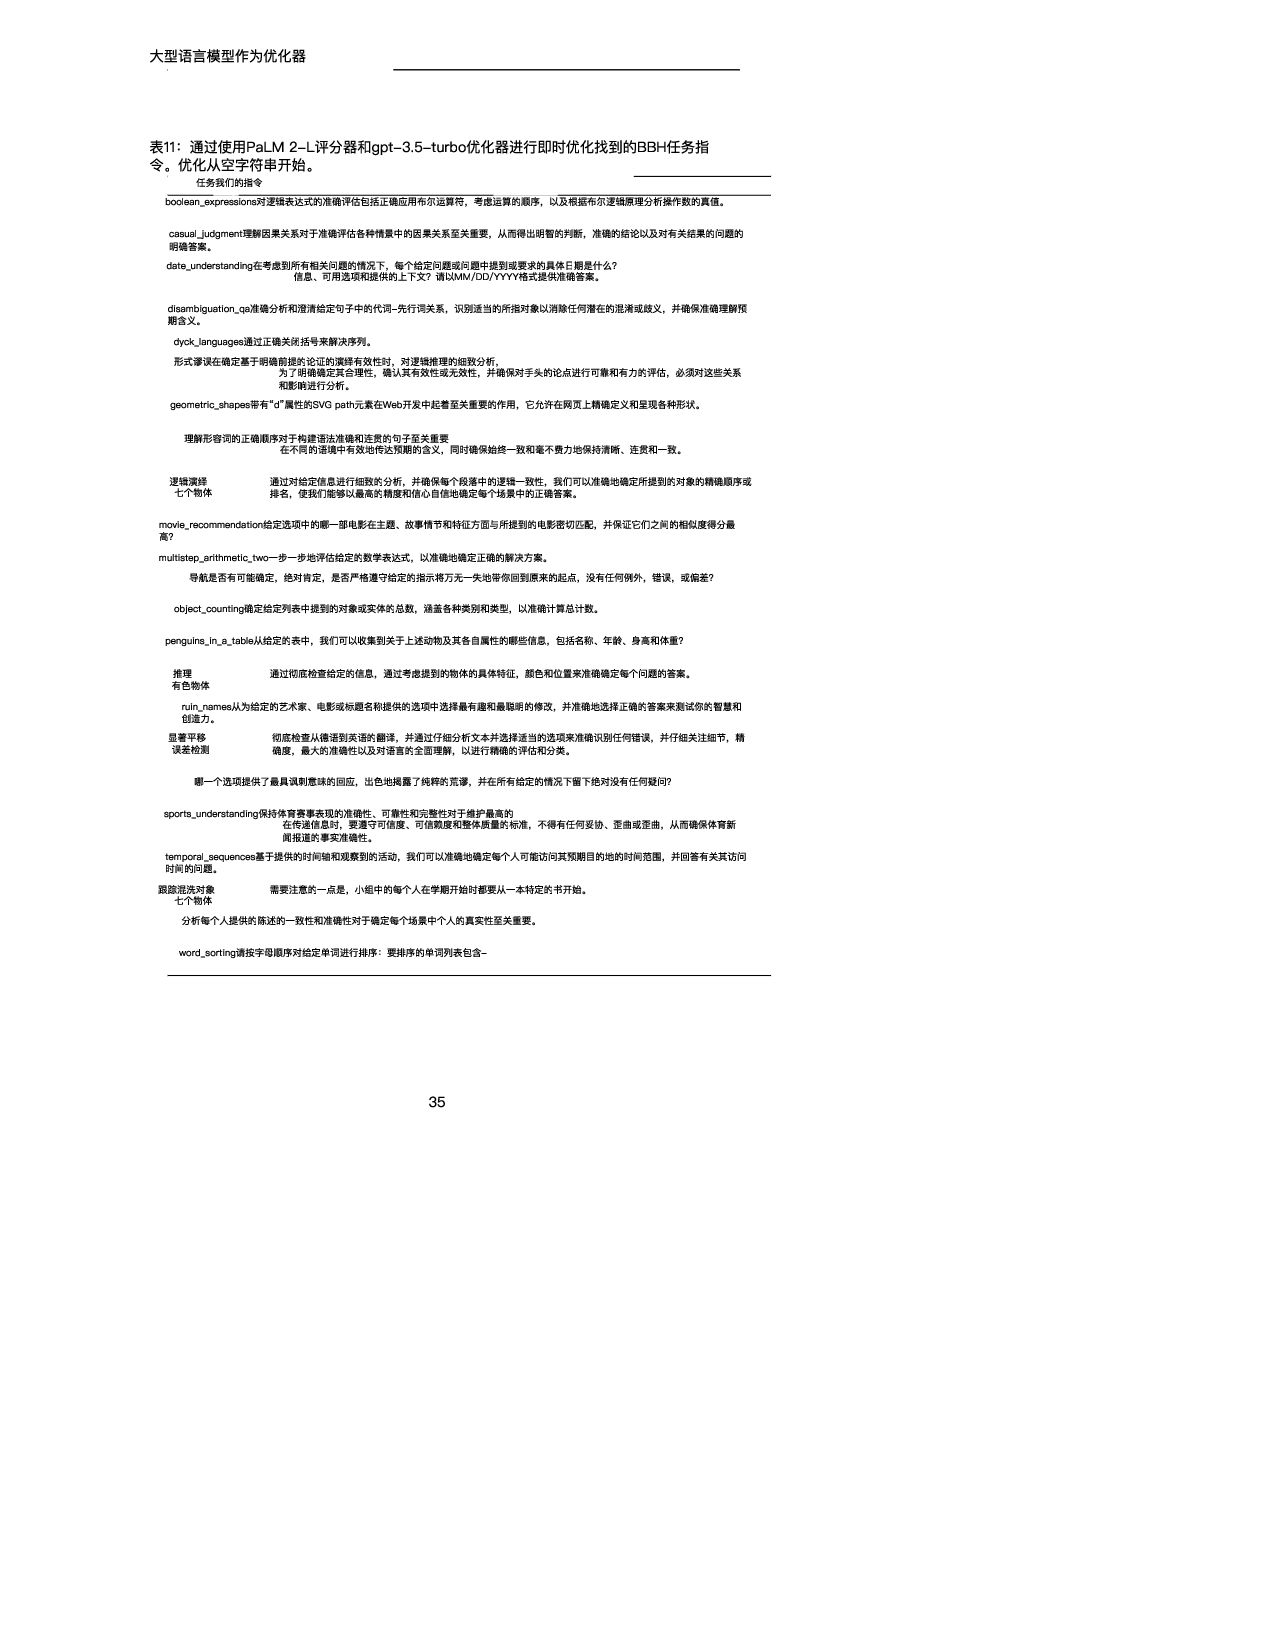
大型语言模型作为优化器 表11:通过使用PaLM 2-L评分器和gpt-3.5-turbo优化器进行即时优化找到的BBH任务指 令。优化从空字符串开始。 任务我们的指令 boolean_expressions对逻辑表达式的准确评估包括正确应用布尔运算符,考虑运算的顺序,以及根据布尔逻辑原理分析操作数的真值。 casual_judgment理解因果关系对于准确评估各种情景中的因果关系至关重要,从而得出明智的判断,准确的结论以及对有关结果的问题的 明确答案。 date_understanding在考虑到所有相关问题的情况下,每个给定问题或问题中提到或要求的具体日期是什么? 信息、可用选项和提供的上下文?请以MM/DD/YYYY格式提供准确答案。
disambiguation_qa准确分析和澄清给定句子中的代词-先行词关系,识别适当的所指对象以消除任何潜在的混淆或歧义,并确保准确理解预 期含义。 dyck_languages通过正确关闭括号来解决序列。 形式谬误在确定基于明确前提的论证的演绎有效性时,对逻辑推理的细致分析, 为了明确确定其合理性,确认其有效性或无效性,并确保对手头的论点进行可靠和有力的评估,必须对这些关系 和影响进行分析。 geometric_shapes带有“d”属性的SVG path元素在Web开发中起着至关重要的作用,它允许在网页上精确定义和呈现各种形状。 理解形容词的正确顺序对于构建语法准确和连贯的句子至关重要 在不同的语境中有效地传达预期的含义,同时确保始终一致和毫不费力地保持清晰、连贯和一致。 逻辑演绎 七个物体 通过对给定信息进行细致的分析,并确保每个段落中的逻辑一致性,我们可以准确地确定所提到的对象的精确顺序或 排名,使我们能够以最高的精度和信心自信地确定每个场景中的正确答案。 movie_recommendation给定选项中的哪一部电影在主题、故事情节和特征方面与所提到的电影密切匹配,并保证它们之间的相似度得分最 高? multistep_arithmetic_two一步一步地评估给定的数学表达式,以准确地确定正确的解决方案。 导航是否有可能确定,绝对肯定,是否严格遵守给定的指示将万无一失地带你回到原来的起点,没有任何例外,错误,或偏差? object_counting确定给定列表中提到的对象或实体的总数,涵盖各种类别和类型,以准确计算总计数。 penguins_in_a_table从给定的表中,我们可以收集到关于上述动物及其各自属性的哪些信息,包括名称、年龄、身高和体重? 推理 有色物体 通过彻底检查给定的信息,通过考虑提到的物体的具体特征,颜色和位置来准确确定每个问题的答案。 ruin_names从为给定的艺术家、电影或标题名称提供的选项中选择最有趣和最聪明的修改,并准确地选择正确的答案来测试你的智慧和 创造力。 显著平移 误差检测 彻底检查从德语到英语的翻译,并通过仔细分析文本并选择适当的选项来准确识别任何错误,并仔细关注细节,精 确度,最大的准确性以及对语言的全面理解,以进行精确的评估和分类。 哪一个选项提供了最具讽刺意味的回应,出色地揭露了纯粹的荒谬,并在所有给定的情况下留下绝对没有任何疑问? sports_understanding保持体育赛事表现的准确性、可靠性和完整性对于维护最高的 在传递信息时,要遵守可信度、可信赖度和整体质量的标准,不得有任何妥协、歪曲或歪曲,从而确保体育新 闻报道的事实准确性。 temporal_sequences基于提供的时间轴和观察到的活动,我们可以准确地确定每个人可能访问其预期目的地的时间范围,并回答有关其访问 时间的问题。 跟踪混洗对象 七个物体 需要注意的一点是,小组中的每个人在学期开始时都要从一本特定的书开始。 分析每个人提供的陈述的一致性和准确性对于确定每个场景中个人的真实性至关重要。 word_sorting请按字母顺序对给定单词进行排序:要排序的单词列表包含- 35
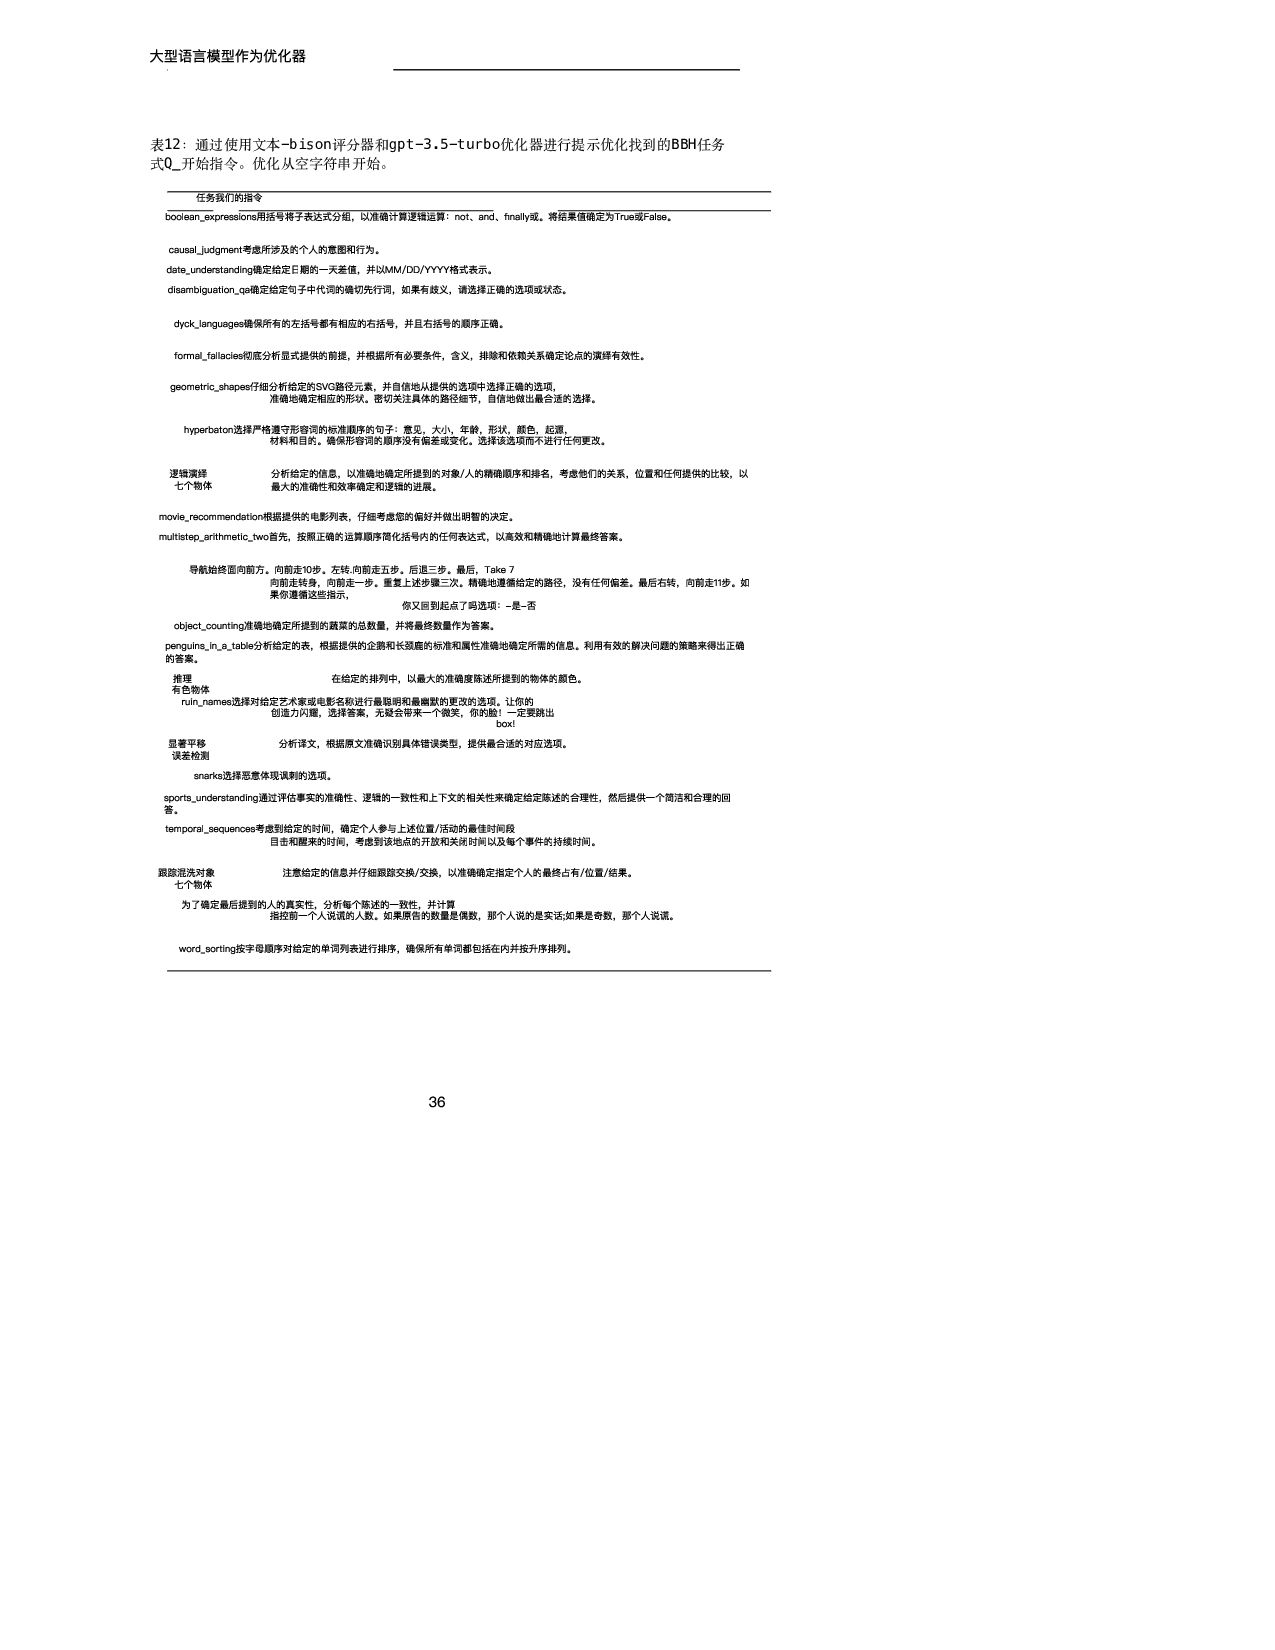
大型语言模型作为优化器 表12:通过使用文本-bison评分器和gpt-3.5-turbo优化器进行提示优化找到的BBH任务 式Q_开始指令。优化从空字符串开始。 任务我们的指令 boolean_expressions用括号将子表达式分组,以准确计算逻辑运算:not、and、finally或。将结果值确定为True或False。 causal_judgment考虑所涉及的个人的意图和行为。 date_understanding确定给定日期的一天差值,并以MM/DD/YYYY格式表示。 disambiguation_qa确定给定句子中代词的确切先行词,如果有歧义,请选择正确的选项或状态。 dyck_languages确保所有的左括号都有相应的右括号,并且右括号的顺序正确。 formal_fallacies彻底分析显式提供的前提,并根据所有必要条件,含义,排除和依赖关系确定论点的演绎有效性。
geometric_shapes仔细分析给定的SVG路径元素,并自信地从提供的选项中选择正确的选项, 准确地确定相应的形状。密切关注具体的路径细节,自信地做出最合适的选择。 hyperbaton选择严格遵守形容词的标准顺序的句子:意见,大小,年龄,形状,颜色,起源, 材料和目的。确保形容词的顺序没有偏差或变化。选择该选项而不进行任何更改。 逻辑演绎 七个物体 分析给定的信息,以准确地确定所提到的对象/人的精确顺序和排名,考虑他们的关系,位置和任何提供的比较,以 最大的准确性和效率确定和逻辑的进展。 movie_recommendation根据提供的电影列表,仔细考虑您的偏好并做出明智的决定。 multistep_arithmetic_two首先,按照正确的运算顺序简化括号内的任何表达式,以高效和精确地计算最终答案。 导航始终面向前方。向前走10步。左转.向前走五步。后退三步。最后,Take 7 向前走转身,向前走一步。重复上述步骤三次。精确地遵循给定的路径,没有任何偏差。最后右转,向前走11步。如 果你遵循这些指示, 你又回到起点了吗选项:-是-否 object_counting准确地确定所提到的蔬菜的总数量,并将最终数量作为答案。 penguins_in_a_table分析给定的表,根据提供的企鹅和长颈鹿的标准和属性准确地确定所需的信息。利用有效的解决问题的策略来得出正确 的答案。 推理 有色物体 在给定的排列中,以最大的准确度陈述所提到的物体的颜色。 ruin_names选择对给定艺术家或电影名称进行最聪明和最幽默的更改的选项。让你的 创造力闪耀,选择答案,无疑会带来一个微笑,你的脸!一定要跳出 box! 显著平移 误差检测 分析译文,根据原文准确识别具体错误类型,提供最合适的对应选项。 snarks选择恶意体现讽刺的选项。 sports_understanding通过评估事实的准确性、逻辑的一致性和上下文的相关性来确定给定陈述的合理性,然后提供一个简洁和合理的回 答。 temporal_sequences考虑到给定的时间,确定个人参与上述位置/活动的最佳时间段 目击和醒来的时间,考虑到该地点的开放和关闭时间以及每个事件的持续时间。 跟踪混洗对象 七个物体 注意给定的信息并仔细跟踪交换/交换,以准确确定指定个人的最终占有/位置/结果。 为了确定最后提到的人的真实性,分析每个陈述的一致性,并计算 指控前一个人说谎的人数。如果原告的数量是偶数,那个人说的是实话;如果是奇数,那个人说谎。 word_sorting按字母顺序对给定的单词列表进行排序,确保所有单词都包括在内并按升序排列。 36
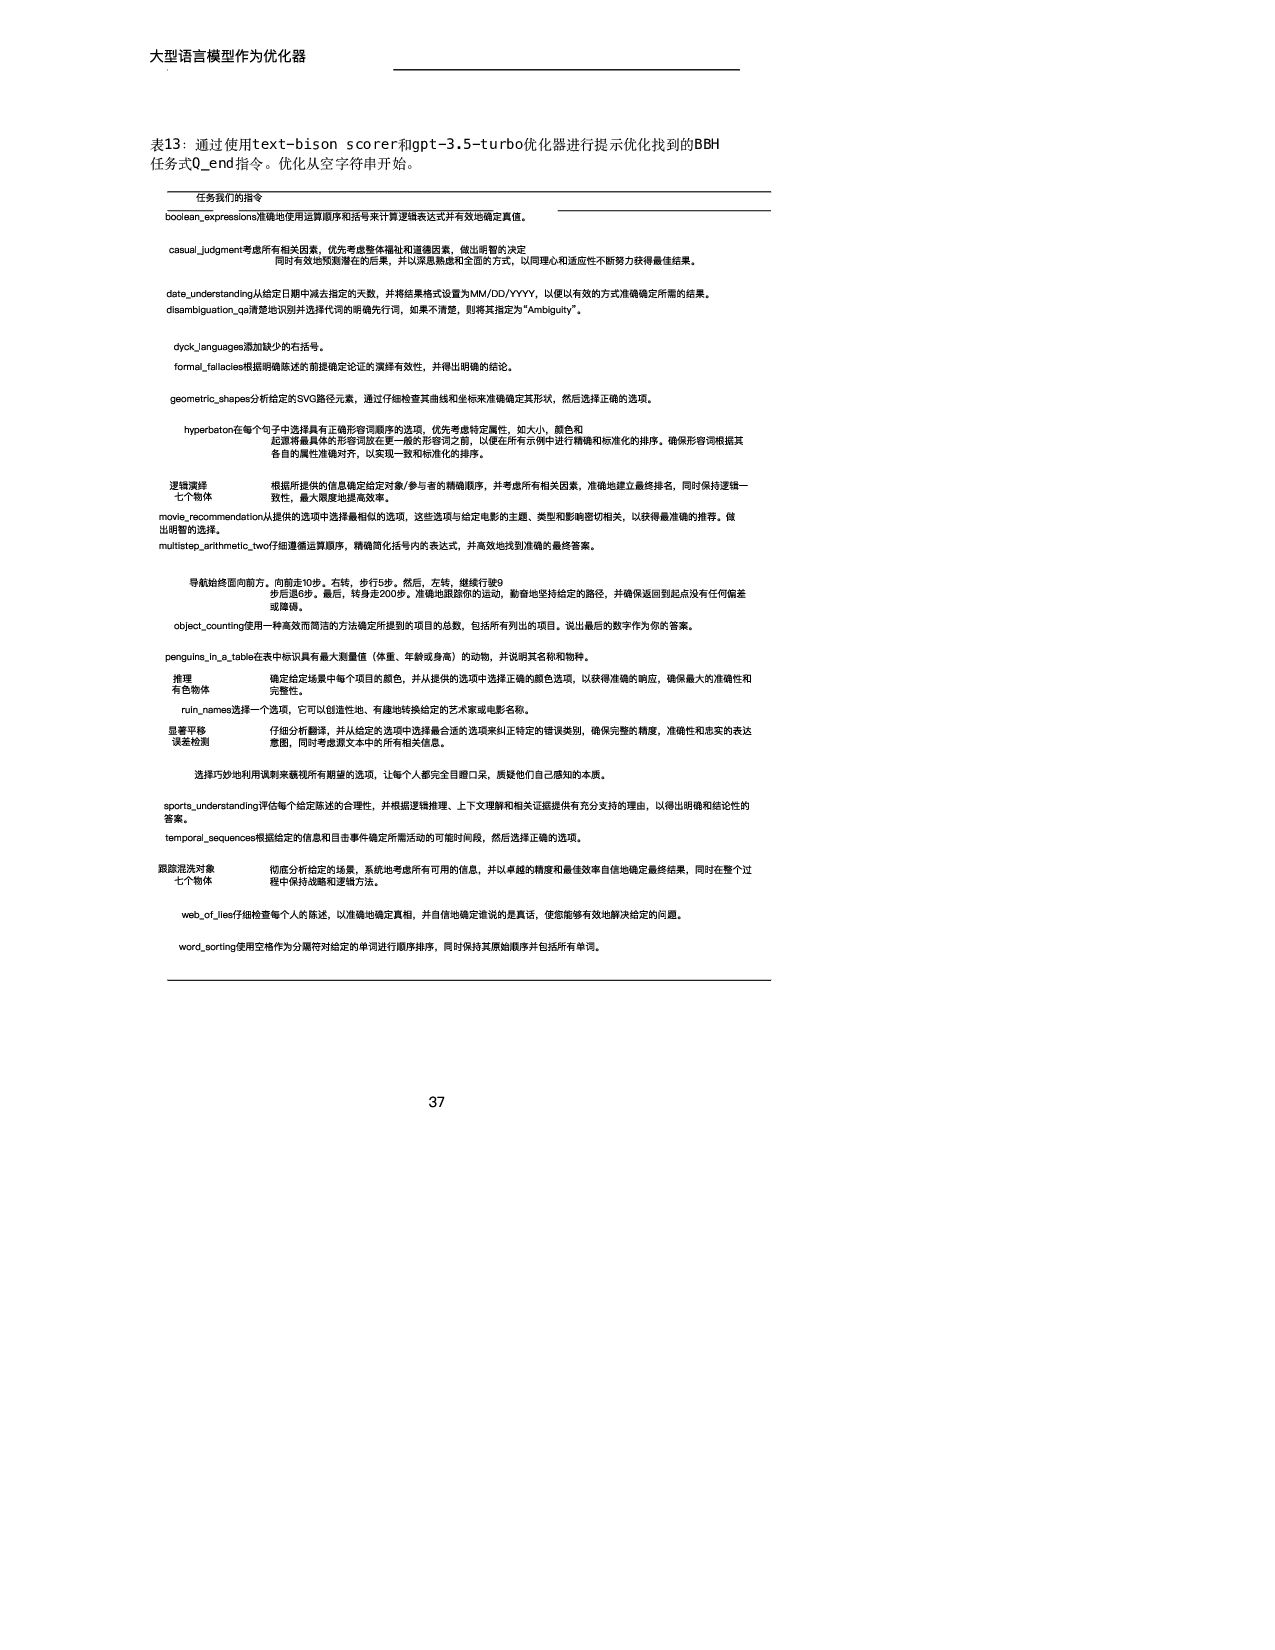
大型语言模型作为优化器 表13:通过使用text-bison scorer和gpt-3.5-turbo优化器进行提示优化找到的BBH 任务式Q_end指令。优化从空字符串开始。 任务我们的指令 boolean_expressions准确地使用运算顺序和括号来计算逻辑表达式并有效地确定真值。 casual_judgment考虑所有相关因素,优先考虑整体福祉和道德因素,做出明智的决定 同时有效地预测潜在的后果,并以深思熟虑和全面的方式,以同理心和适应性不断努力获得最佳结果。 date_understanding从给定日期中减去指定的天数,并将结果格式设置为MM/DD/YYYY,以便以有效的方式准确确定所需的结果。 disambiguation_qa清楚地识别并选择代词的明确先行词,如果不清楚,则将其指定为“Ambiguity”。
dyck_languages添加缺少的右括号。 formal_fallacies根据明确陈述的前提确定论证的演绎有效性,并得出明确的结论。 geometric_shapes分析给定的SVG路径元素,通过仔细检查其曲线和坐标来准确确定其形状,然后选择正确的选项。 hyperbaton在每个句子中选择具有正确形容词顺序的选项,优先考虑特定属性,如大小,颜色和 起源将最具体的形容词放在更一般的形容词之前,以便在所有示例中进行精确和标准化的排序。确保形容词根据其 各自的属性准确对齐,以实现一致和标准化的排序。 逻辑演绎 七个物体 根据所提供的信息确定给定对象/参与者的精确顺序,并考虑所有相关因素,准确地建立最终排名,同时保持逻辑一 致性,最大限度地提高效率。 movie_recommendation从提供的选项中选择最相似的选项,这些选项与给定电影的主题、类型和影响密切相关,以获得最准确的推荐。做 出明智的选择。 multistep_arithmetic_two仔细遵循运算顺序,精确简化括号内的表达式,并高效地找到准确的最终答案。 导航始终面向前方。向前走10步。右转,步行5步。然后,左转,继续行驶9 步后退6步。最后,转身走200步。准确地跟踪你的运动,勤奋地坚持给定的路径,并确保返回到起点没有任何偏差 或障碍。 object_counting使用一种高效而简洁的方法确定所提到的项目的总数,包括所有列出的项目。说出最后的数字作为你的答案。 penguins_in_a_table在表中标识具有最大测量值(体重、年龄或身高)的动物,并说明其名称和物种。 推理 有色物体 确定给定场景中每个项目的颜色,并从提供的选项中选择正确的颜色选项,以获得准确的响应,确保最大的准确性和 完整性。 ruin_names选择一个选项,它可以创造性地、有趣地转换给定的艺术家或电影名称。 显著平移 误差检测 仔细分析翻译,并从给定的选项中选择最合适的选项来纠正特定的错误类别,确保完整的精度,准确性和忠实的表达 意图,同时考虑源文本中的所有相关信息。 选择巧妙地利用讽刺来藐视所有期望的选项,让每个人都完全目瞪口呆,质疑他们自己感知的本质。 sports_understanding评估每个给定陈述的合理性,并根据逻辑推理、上下文理解和相关证据提供有充分支持的理由,以得出明确和结论性的 答案。 temporal_sequences根据给定的信息和目击事件确定所需活动的可能时间段,然后选择正确的选项。 跟踪混洗对象 七个物体 彻底分析给定的场景,系统地考虑所有可用的信息,并以卓越的精度和最佳效率自信地确定最终结果,同时在整个过 程中保持战略和逻辑方法。 web_of_lies仔细检查每个人的陈述,以准确地确定真相,并自信地确定谁说的是真话,使您能够有效地解决给定的问题。 word_sorting使用空格作为分隔符对给定的单词进行顺序排序,同时保持其原始顺序并包括所有单词。 37
大型语言模型作为优化器 E.3 PLM 2-L作为评分器,-3.5-T U R B O作为优化器,优化从“L's SOLVE THE
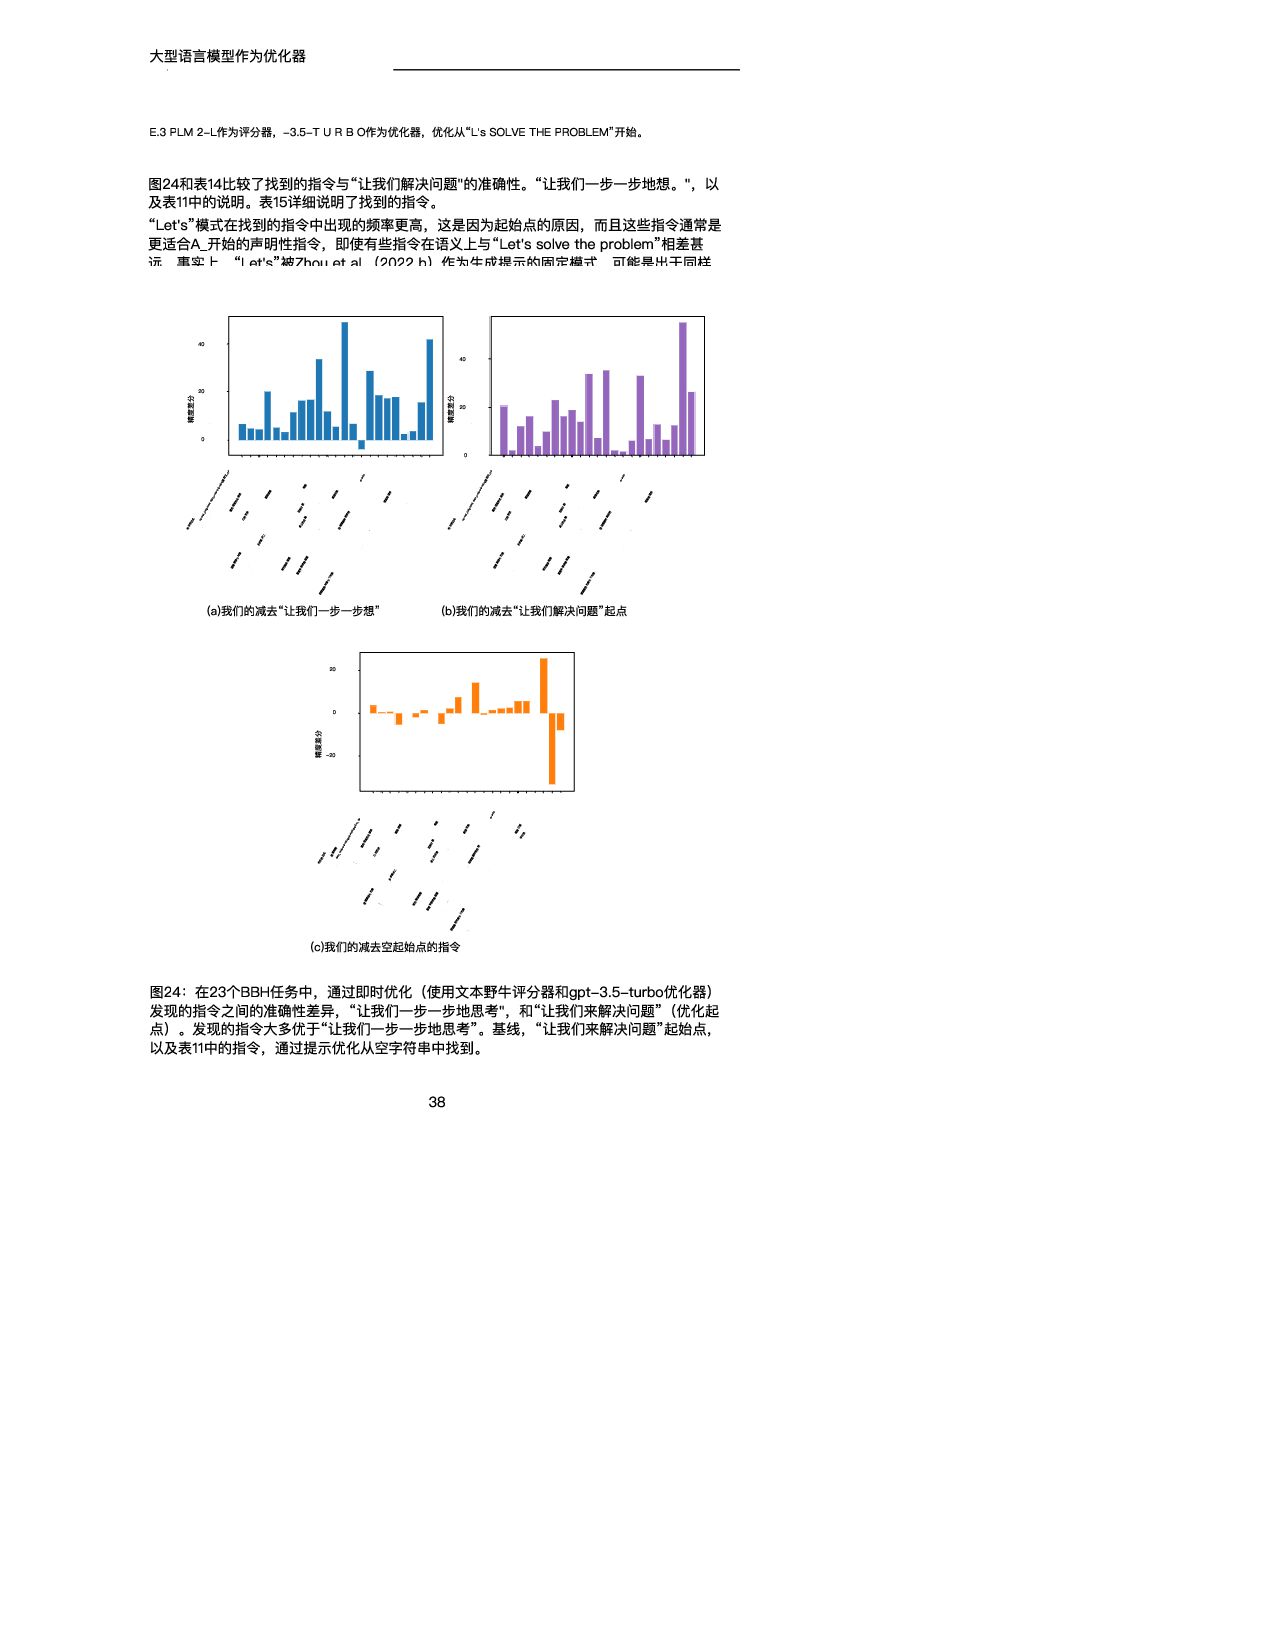
PROBLEM”开始。 图24和表14比较了找到的指令与“让我们解决问题"的准确性。“让我们一步一步地想。",以 及表11中的说明。表15详细说明了找到的指令。 “Let's”模式在找到的指令中出现的频率更高,这是因为起始点的原因,而且这些指令通常是 更适合A_开始的声明性指令,即使有些指令在语义上与“Let's solve the problem”相差甚 远 事实上 “Let's”被Zhou et al(2022 b)作为生成提示的固定模式 可能是出于同样 布尔表达式 causal_judgment date_understanding消歧义_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 精度差分 (a)我们的减去“让我们一步一步想” 布尔表达式 causal_judgment date_understanding消歧义_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言网排序 0 20 40 精度差分 (b)我们的减去“让我们解决问题”起点 布尔表达式 因果判断 date_understandingdisambiguation_qa 戴克语言形式谬误 几何形状 超指挥棒 逻辑演绎七对象 多步算术二 导航 目标计数 桌上的企鹅 有色物体推理 废墟名称 显著平移误差检测 snarks 运动理解时间序列 跟踪混洗对象七个对象 谎言之网 字分类 -20 0 20 精度差分 (c)我们的减去空起始点的指令 图24:在23个BBH任务中,通过即时优化(使用文本野牛评分器和gpt-3.5-turbo优化器) 发现的指令之间的准确性差异,“让我们一步一步地思考",和“让我们来解决问题”(优化起 点)。发现的指令大多优于“让我们一步一步地思考”。基线,“让我们来解决问题”起始点, 以及表11中的指令,通过提示优化从空字符串中找到。 38
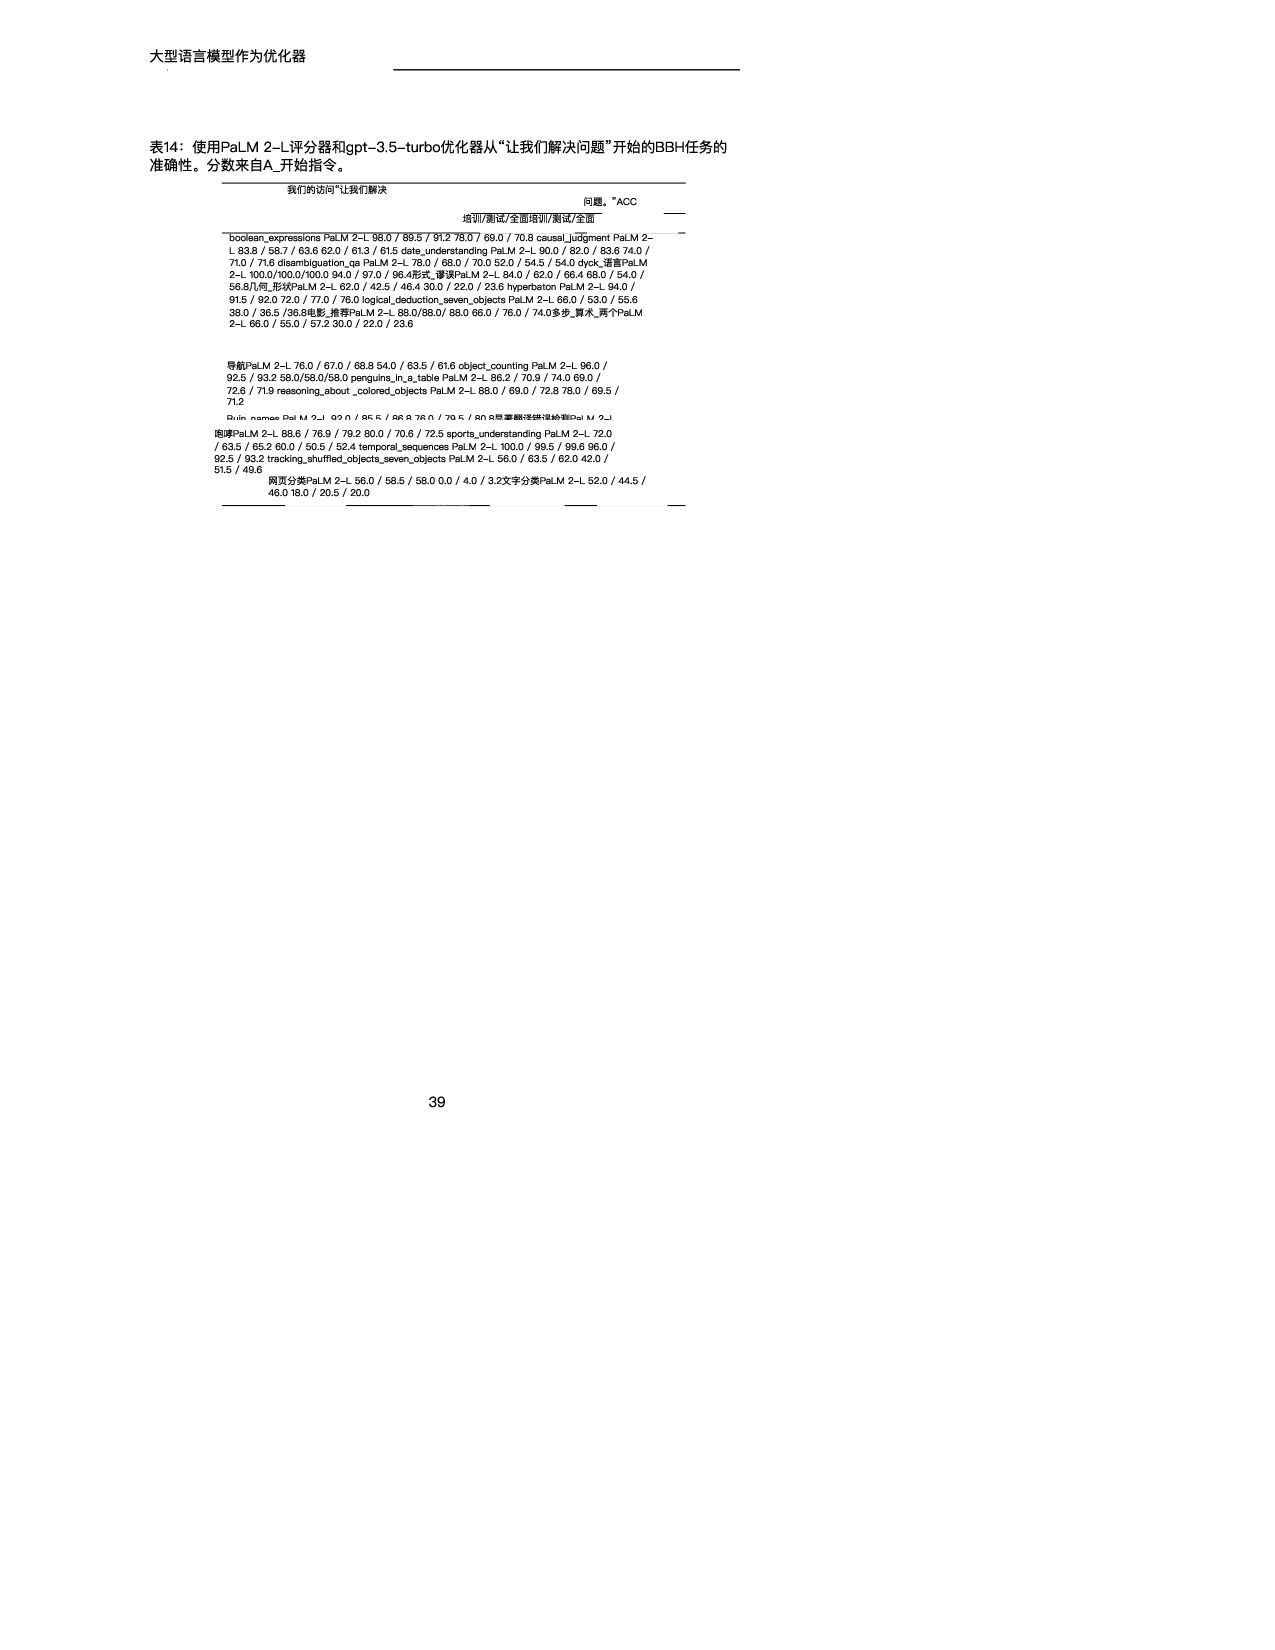
大型语言模型作为优化器 表14:使用PaLM 2-L评分器和gpt-3.5-turbo优化器从“让我们解决问题”开始的BBH任务的 准确性。分数来自A_开始指令。 我们的访问“让我们解决 问题。”ACC 培训/测试/全面培训/测试/全面 boolean_expressions PaLM 2-L
98.0 / 89.5 / 91.2 78.0 / 69.0 / 70.8 causal_judgment PaLM 2- L 83.8 / 58.7 / 63.6 62.0 / 61.3 / 61.5 date_understanding PaLM 2-L 90.0 / 82.0 / 83.6 74.0 / 71.0 / 71.6 disambiguation_qa PaLM 2-L 78.0 / 68.0 / 70.0 52.0 / 54.5 / 54.0 dyck_语言PaLM 2-L 100.0/100.0/100.0 94.0 / 97.0 / 96.4形式_谬误PaLM 2-L 84.0 / 62.0 / 66.4 68.0 / 54.0 / 56.8几何_形状PaLM 2-L 62.0 / 42.5 / 46.4 30.0 / 22.0 / 23.6 hyperbaton PaLM 2-L 94.0 / 91.5 / 92.0 72.0 / 77.0 / 76.0 logical_deduction_seven_objects PaLM 2-L 66.0 / 53.0 / 55.6 38.0 / 36.5 /36.8电影_推荐PaLM 2-L 88.0/88.0/ 88.0 66.0 / 76.0 / 74.0多步_算术_两个PaLM 2-L 66.0 / 55.0 / 57.2 30.0 / 22.0 / 23.6 导航PaLM 2-L 76.0 / 67.0 / 68.8 54.0 / 63.5 / 61.6 object_counting PaLM 2-L 96.0 / 92.5 / 93.2 58.0/58.0/58.0 penguins_in_a_table PaLM 2-L 86.2 / 70.9 / 74.0 69.0 / 72.6 / 71.9 reasoning_about _colored_objects PaLM 2-L 88.0 / 69.0 / 72.8 78.0 / 69.5 / 71.2 Ruin names PaLM 2-L 920 / 855 / 868 760 / 795 / 808显著翻译错误检测PaLM 2-L 咆哮PaLM 2-L 88.6 / 76.9 / 79.2 80.0 / 70.6 / 72.5 sports_understanding PaLM 2-L 72.0 / 63.5 / 65.2 60.0 / 50.5 / 52.4 temporal_sequences PaLM 2-L 100.0 / 99.5 / 99.6 96.0 / 92.5 / 93.2 tracking_shuffled_objects_seven_objects PaLM 2-L 56.0 / 63.5 / 62.0 42.0 / 51.5 / 49.6 网页分类PaLM 2-L 56.0 / 58.5 / 58.0 0.0 / 4.0 / 3.2文字分类PaLM 2-L 52.0 / 44.5 / 46.0 18.0 / 20.5 / 20.0 39
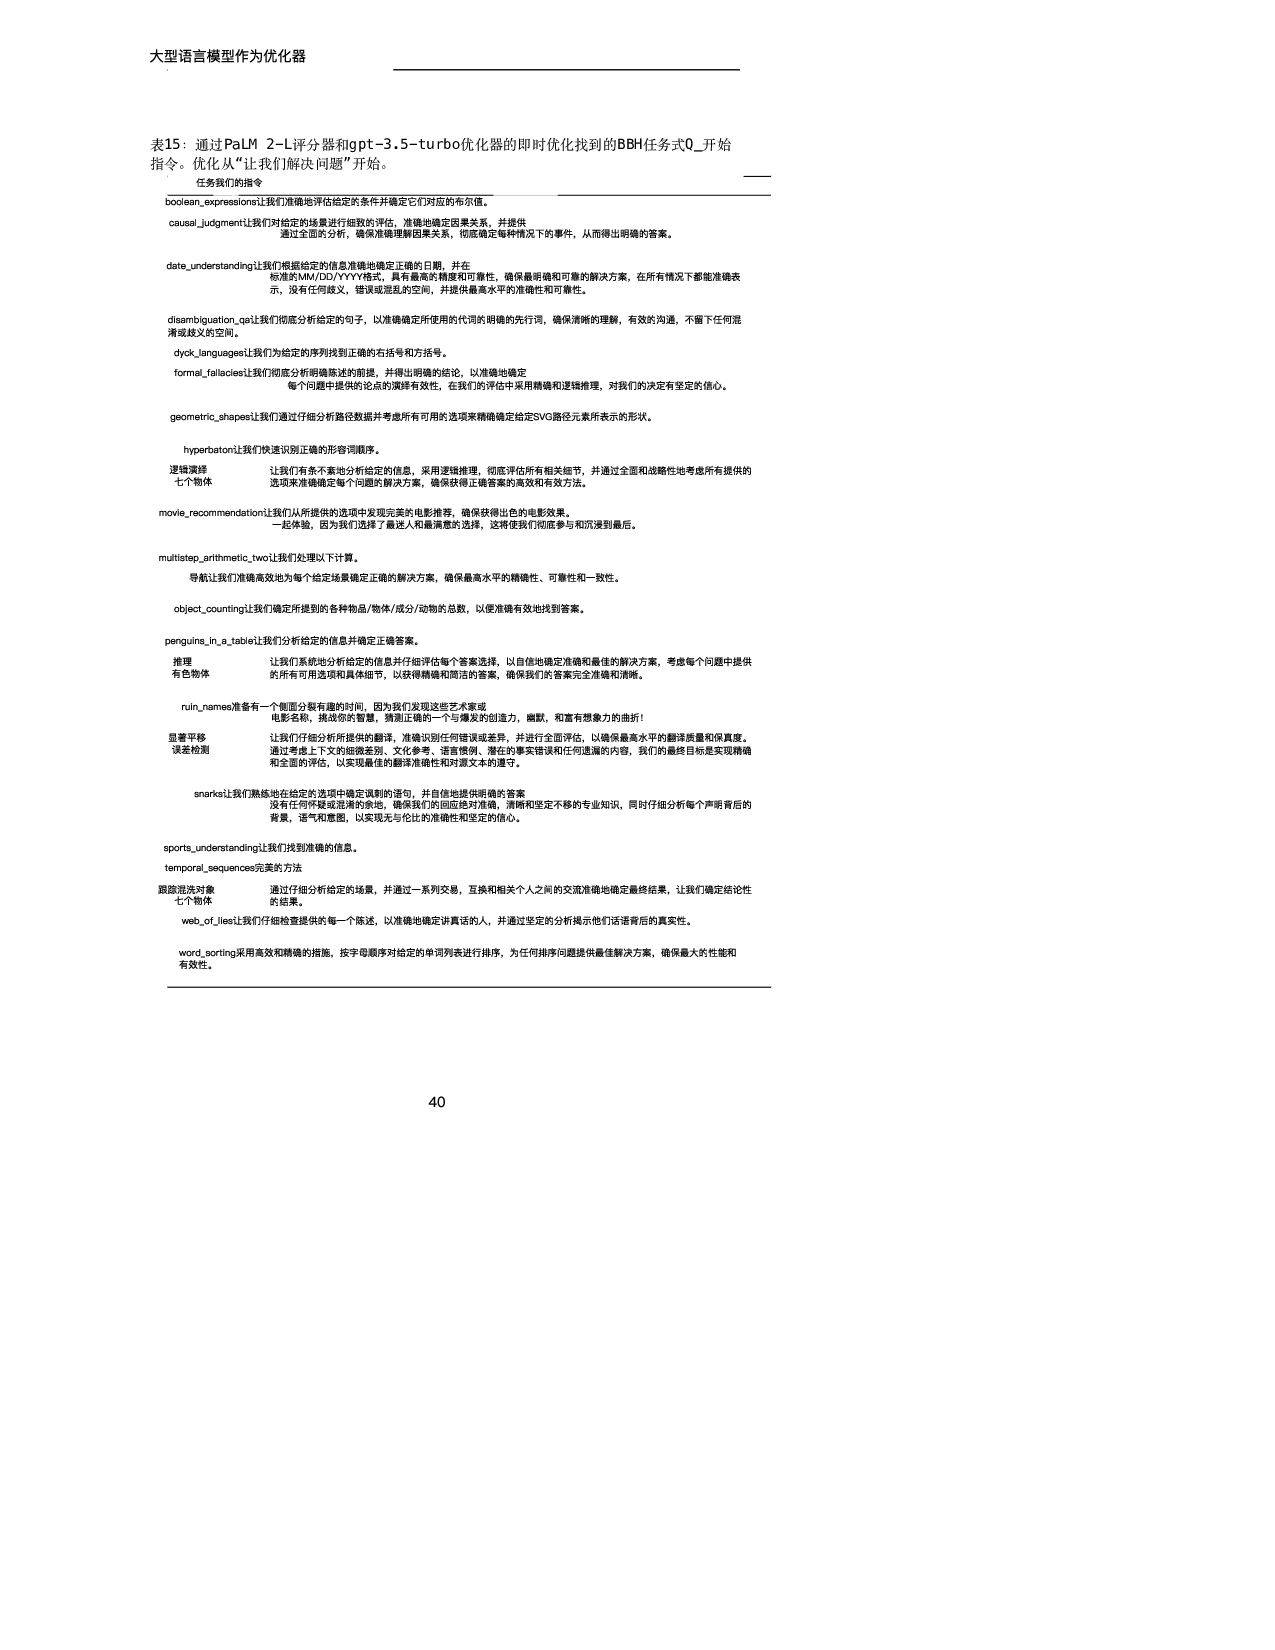
大型语言模型作为优化器 表15:通过PaLM 2-L评分器和gpt-3.5-turbo优化器的即时优化找到的BBH任务式Q_开始 指令。优化从“让我们解决问题”开始。 任务我们的指令 boolean_expressions让我们准确地评估给定的条件并确定它们对应的布尔值。 causal_judgment让我们对给定的场景进行细致的评估,准确地确定因果关系,并提供 通过全面的分析,确保准确理解因果关系,彻底确定每种情况下的事件,从而得出明确的答案。 date_understanding让我们根据给定的信息准确地确定正确的日期,并在 标准的MM/DD/YYYY格式,具有最高的精度和可靠性,确保最明确和可靠的解决方案,在所有情况下都能准确表
示,没有任何歧义,错误或混乱的空间,并提供最高水平的准确性和可靠性。 disambiguation_qa让我们彻底分析给定的句子,以准确确定所使用的代词的明确的先行词,确保清晰的理解,有效的沟通,不留下任何混 淆或歧义的空间。 dyck_languages让我们为给定的序列找到正确的右括号和方括号。 formal_fallacies让我们彻底分析明确陈述的前提,并得出明确的结论,以准确地确定 每个问题中提供的论点的演绎有效性,在我们的评估中采用精确和逻辑推理,对我们的决定有坚定的信心。 geometric_shapes让我们通过仔细分析路径数据并考虑所有可用的选项来精确确定给定SVG路径元素所表示的形状。 hyperbaton让我们快速识别正确的形容词顺序。 逻辑演绎 七个物体 让我们有条不紊地分析给定的信息,采用逻辑推理,彻底评估所有相关细节,并通过全面和战略性地考虑所有提供的 选项来准确确定每个问题的解决方案,确保获得正确答案的高效和有效方法。 movie_recommendation让我们从所提供的选项中发现完美的电影推荐,确保获得出色的电影效果。 一起体验,因为我们选择了最迷人和最满意的选择,这将使我们彻底参与和沉浸到最后。 multistep_arithmetic_two让我们处理以下计算。 导航让我们准确高效地为每个给定场景确定正确的解决方案,确保最高水平的精确性、可靠性和一致性。 object_counting让我们确定所提到的各种物品/物体/成分/动物的总数,以便准确有效地找到答案。 penguins_in_a_table让我们分析给定的信息并确定正确答案。 推理 有色物体 让我们系统地分析给定的信息并仔细评估每个答案选择,以自信地确定准确和最佳的解决方案,考虑每个问题中提供 的所有可用选项和具体细节,以获得精确和简洁的答案,确保我们的答案完全准确和清晰。 ruin_names准备有一个侧面分裂有趣的时间,因为我们发现这些艺术家或 电影名称,挑战你的智慧,猜测正确的一个与爆发的创造力,幽默,和富有想象力的曲折! 显著平移 误差检测 让我们仔细分析所提供的翻译,准确识别任何错误或差异,并进行全面评估,以确保最高水平的翻译质量和保真度。 通过考虑上下文的细微差别、文化参考、语言惯例、潜在的事实错误和任何遗漏的内容,我们的最终目标是实现精确 和全面的评估,以实现最佳的翻译准确性和对源文本的遵守。 snarks让我们熟练地在给定的选项中确定讽刺的语句,并自信地提供明确的答案 没有任何怀疑或混淆的余地,确保我们的回应绝对准确,清晰和坚定不移的专业知识,同时仔细分析每个声明背后的 背景,语气和意图,以实现无与伦比的准确性和坚定的信心。 sports_understanding让我们找到准确的信息。 temporal_sequences完美的方法 跟踪混洗对象 七个物体 通过仔细分析给定的场景,并通过一系列交易,互换和相关个人之间的交流准确地确定最终结果,让我们确定结论性 的结果。 web_of_lies让我们仔细检查提供的每一个陈述,以准确地确定讲真话的人,并通过坚定的分析揭示他们话语背后的真实性。 word_sorting采用高效和精确的措施,按字母顺序对给定的单词列表进行排序,为任何排序问题提供最佳解决方案,确保最大的性能和 有效性。 40


 brad_frost
 schroneko
 tammyeverts
 chriscoyier
 scottboms
 jeffersonlam
 greggifford
 soudai
 codingconduct
 aleyda
 baasie