Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LLMはステートレスである
Search
28
May 08, 2026
0
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LLMはステートレスである
28
May 08, 2026
Featured
See All Featured
The Success of Rails: Ensuring Growth for the Next 100 Years
eileencodes
47
8.4k
Navigating Weather and Climate Data
rabernat
0
560
Into the Great Unknown - MozCon
thekraken
41
2.8k
Let's Do A Bunch of Simple Stuff to Make Websites Faster
chriscoyier
508
140k
Believing is Seeing
oripsolob
1
240
Color Theory Basics | Prateek | Gurzu
gurzu
1
490
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
How STYLIGHT went responsive
nonsquared
100
6.3k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
How to train your dragon (web standard)
notwaldorf
96
6.9k
Paper Plane
katiecoart
PRO
5
54k
Writing Fast Ruby
sferik
630
63k
Transcript
LLMはステートレスである 2026-05-08
結論として LLMの推論は 本質的にステートレス。 会話が続いて見えるのは、 アプリ層が毎回「会話履歴を全部」送り直しているから。 「ステートフルな体験」は錯覚。仕組みは外側にある。 2026-05-08 / 28 2
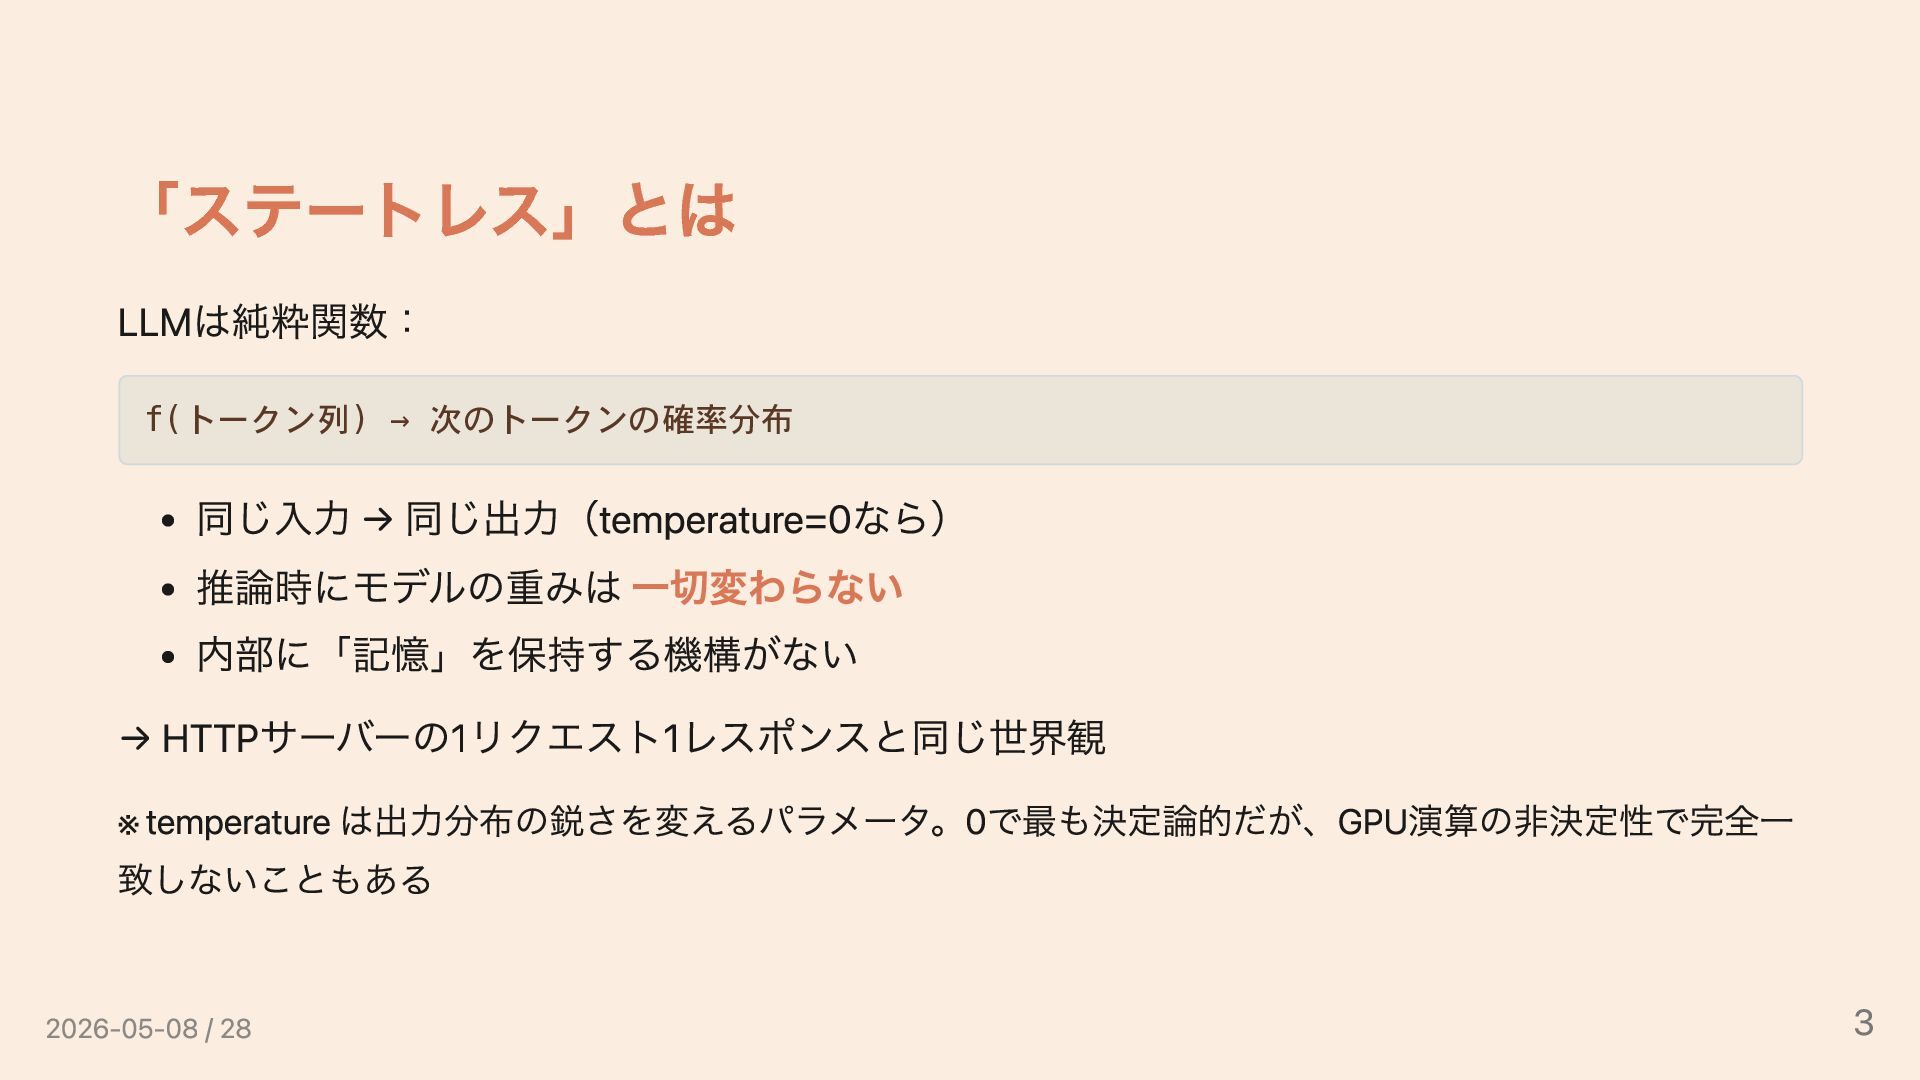
「ステートレス」とは LLMは純粋関数: f(トークン列) → 次のトークンの確率分布 同じ入力 → 同じ出力(temperature=0なら) 推論時にモデルの重みは 一切変わらない
内部に「記憶」を保持する機構がない → HTTPサーバーの1リクエスト1レスポンスと同じ世界観 ※ temperature は出力分布の鋭さを変えるパラメータ。0で最も決定論的だが、GPU演算の非決定性で完全一 致しないこともある 2026-05-08 / 28 3
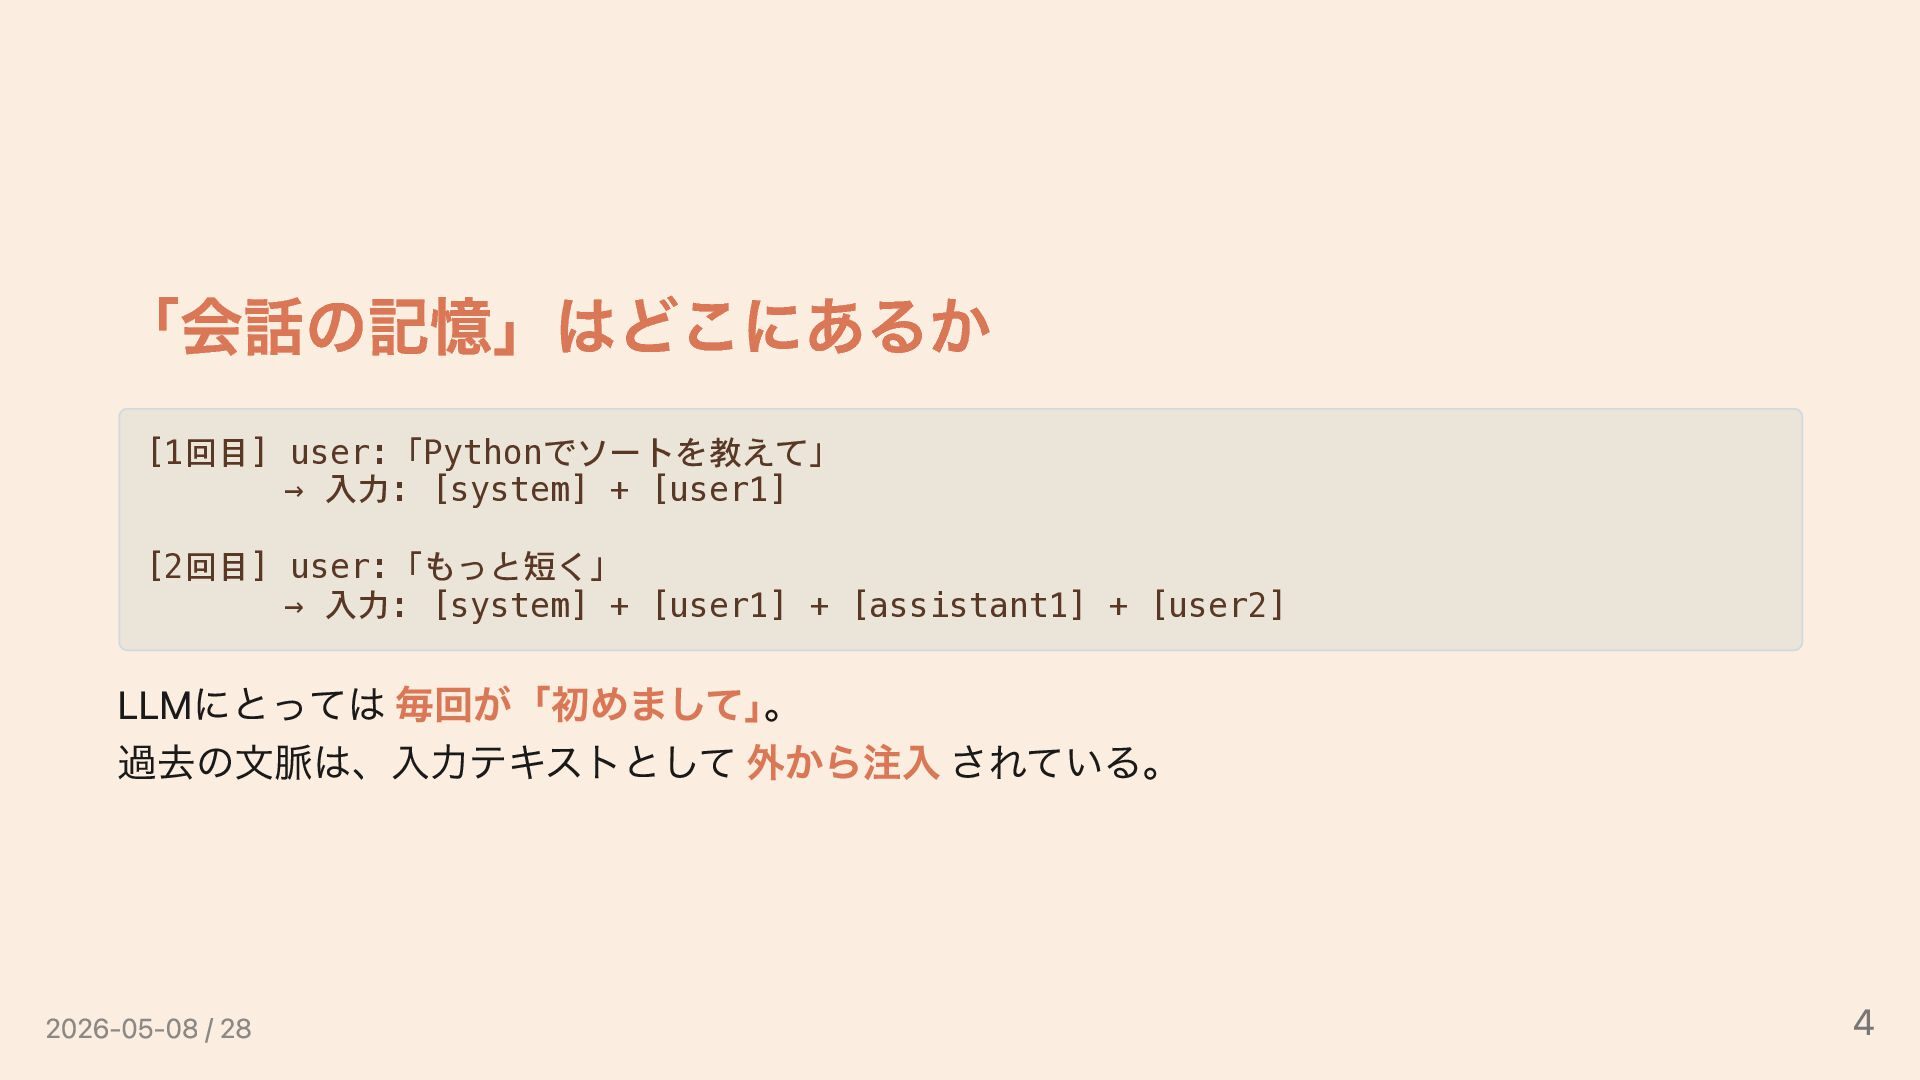
「会話の記憶」はどこにあるか [1回目] user:「Pythonでソートを教えて」 → 入力: [system] + [user1] [2回目] user:「もっと短く」
→ 入力: [system] + [user1] + [assistant1] + [user2] LLMにとっては 毎回が「初めまして」 。 過去の文脈は、入力テキストとして 外から注入 されている。 2026-05-08 / 28 4
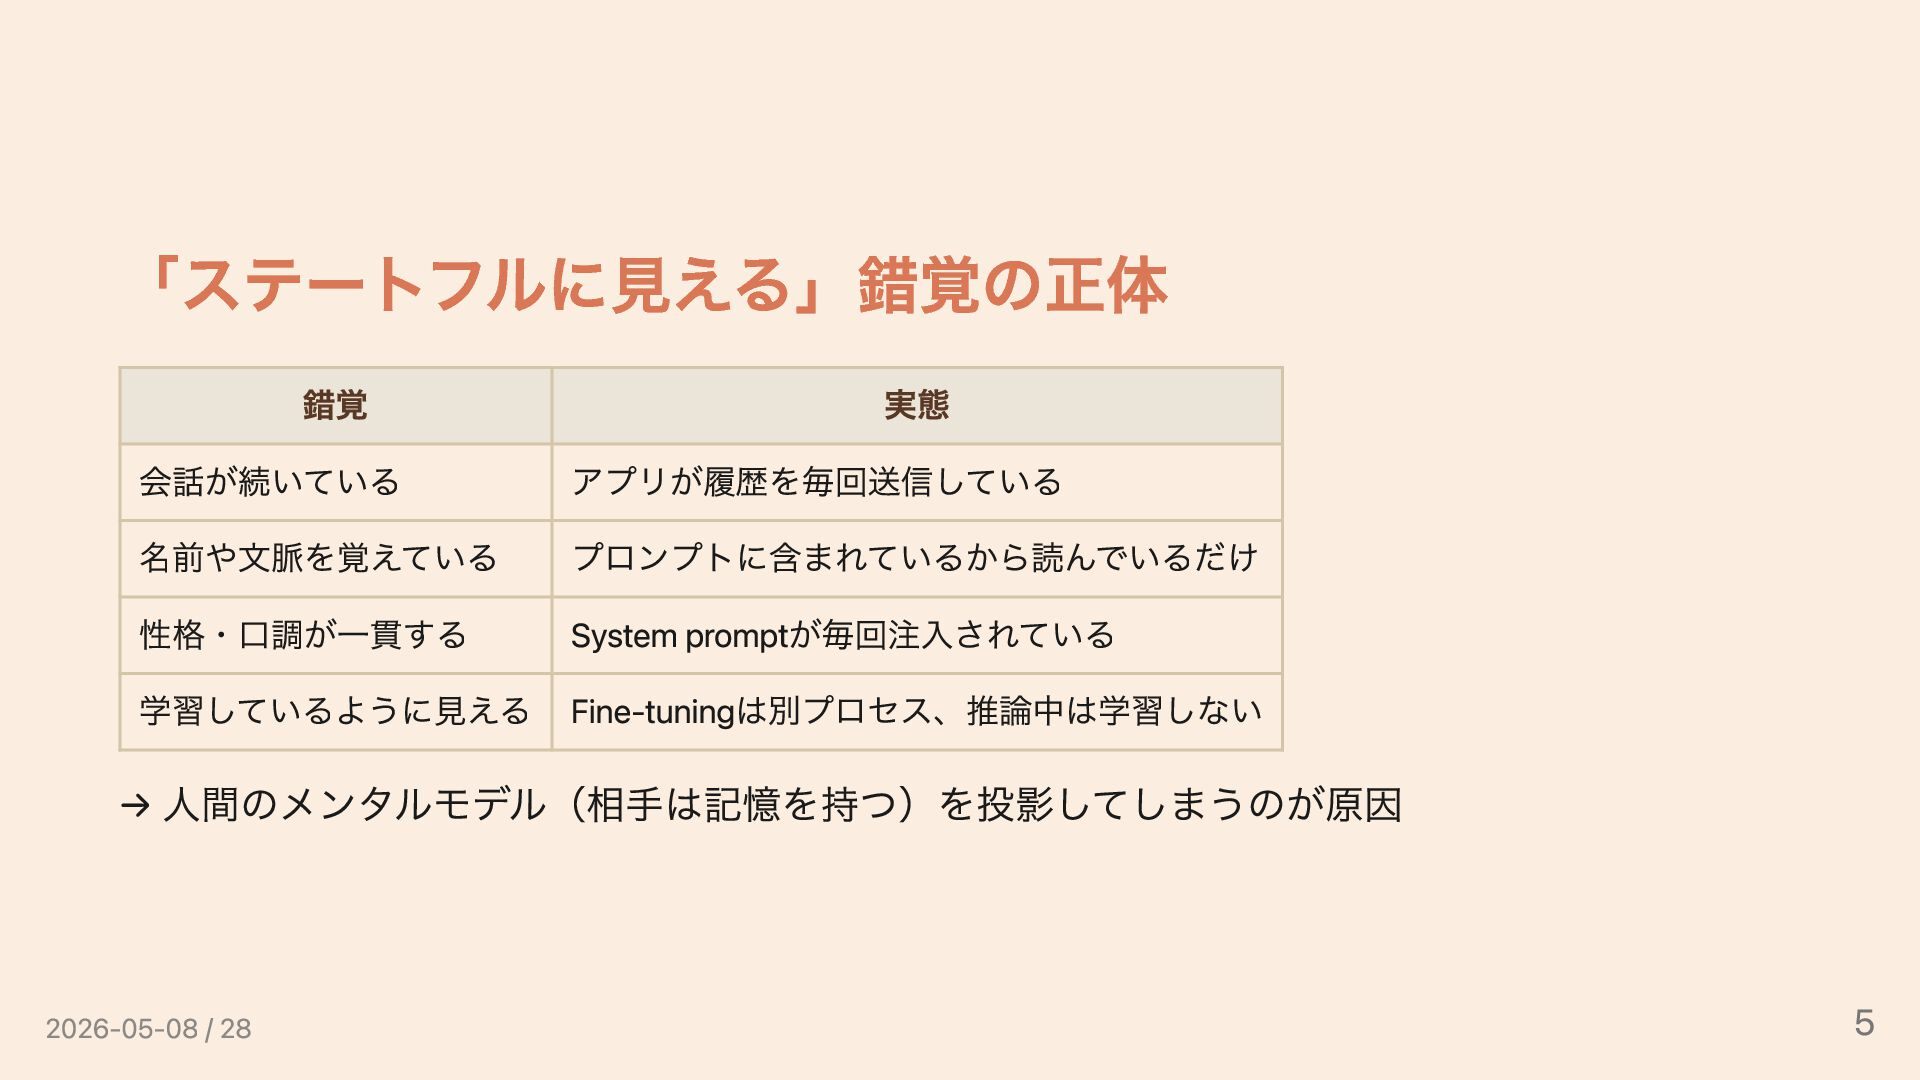
「ステートフルに見える」錯覚の正体 錯覚 実態 会話が続いている アプリが履歴を毎回送信している 名前や文脈を覚えている プロンプトに含まれているから読んでいるだけ 性格・口調が一貫する System promptが毎回注入されている
学習しているように見える Fine-tuningは別プロセス、推論中は学習しない → 人間のメンタルモデル(相手は記憶を持つ)を投影してしまうのが原因 2026-05-08 / 28 5
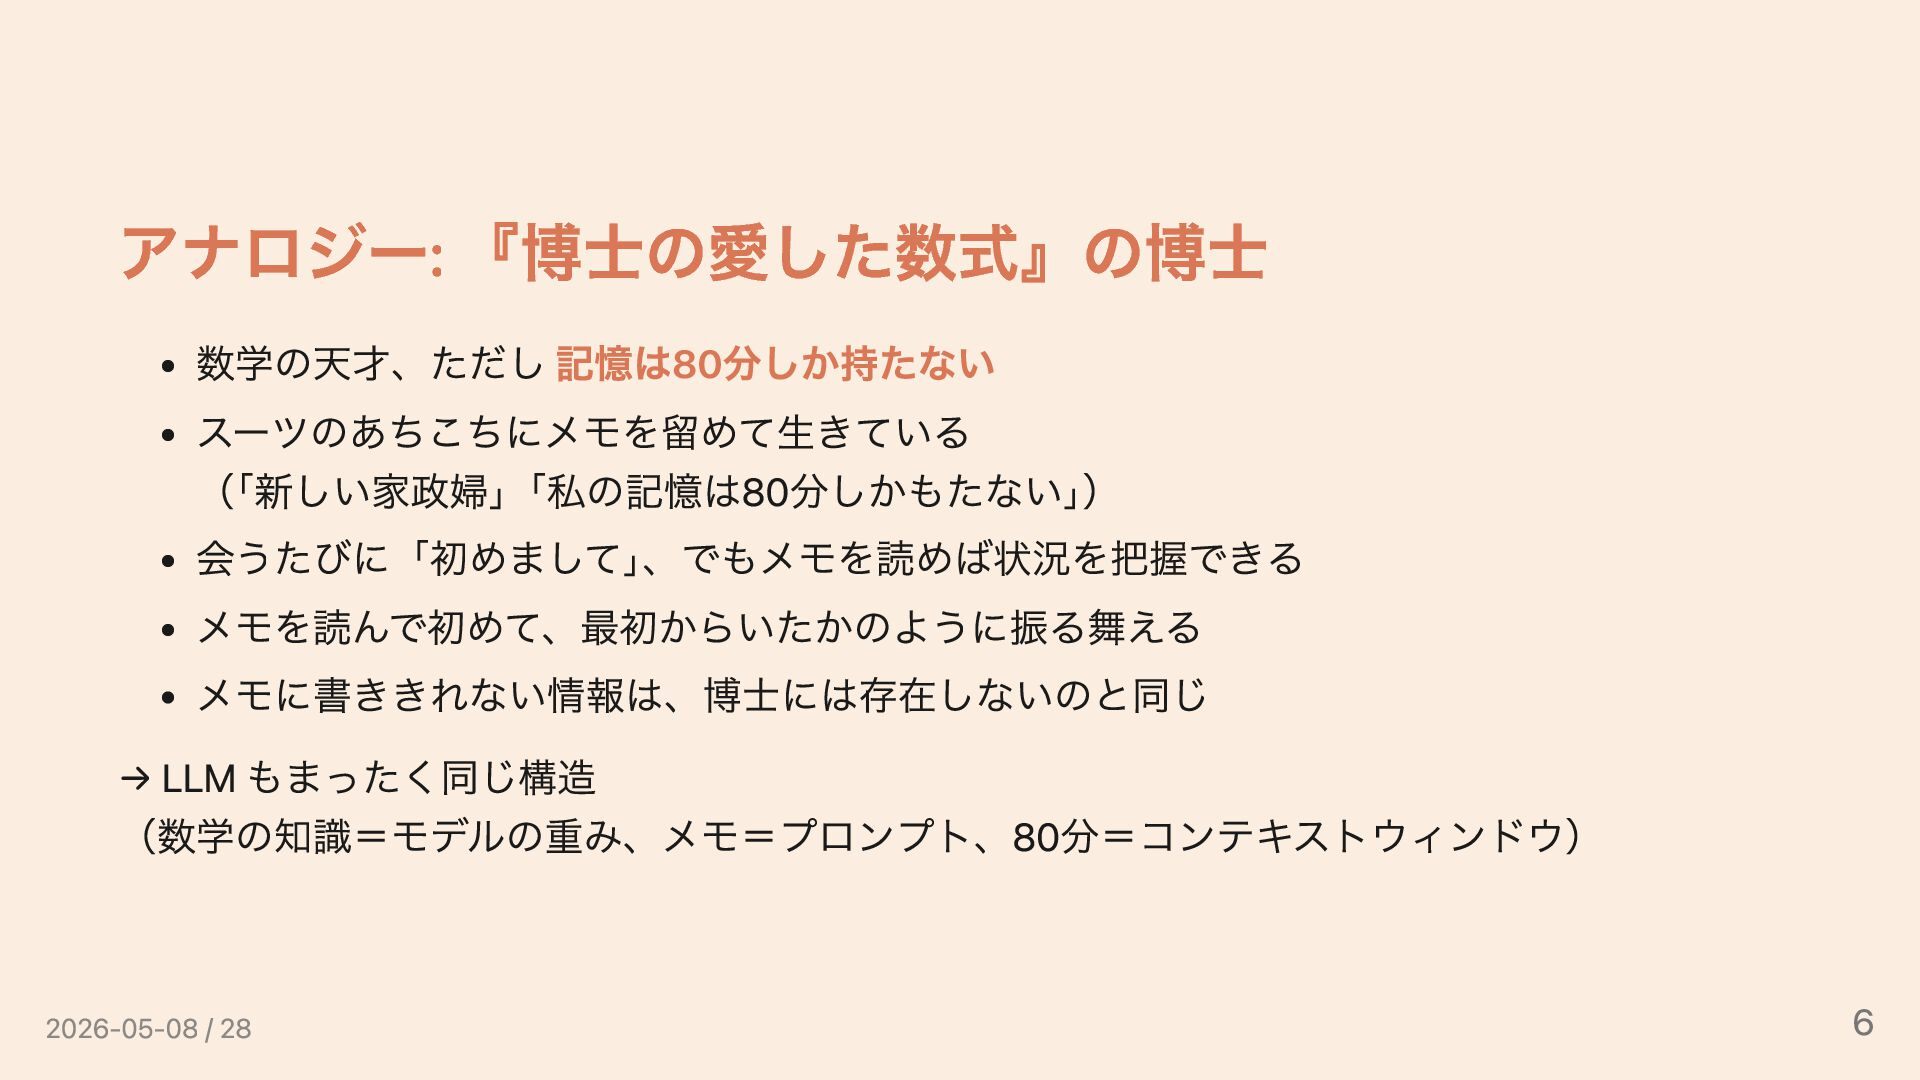
アナロジー: 『博士の愛した数式』の博士 数学の天才、ただし 記憶は80分しか持たない スーツのあちこちにメモを留めて生きている ( 「新しい家政婦」 「私の記憶は80分しかもたない」 ) 会うたびに「初めまして」
、でもメモを読めば状況を把握できる メモを読んで初めて、最初からいたかのように振る舞える メモに書ききれない情報は、博士には存在しないのと同じ → LLM もまったく同じ構造 (数学の知識=モデルの重み、メモ=プロンプト、80分=コンテキストウィンドウ) 2026-05-08 / 28 6
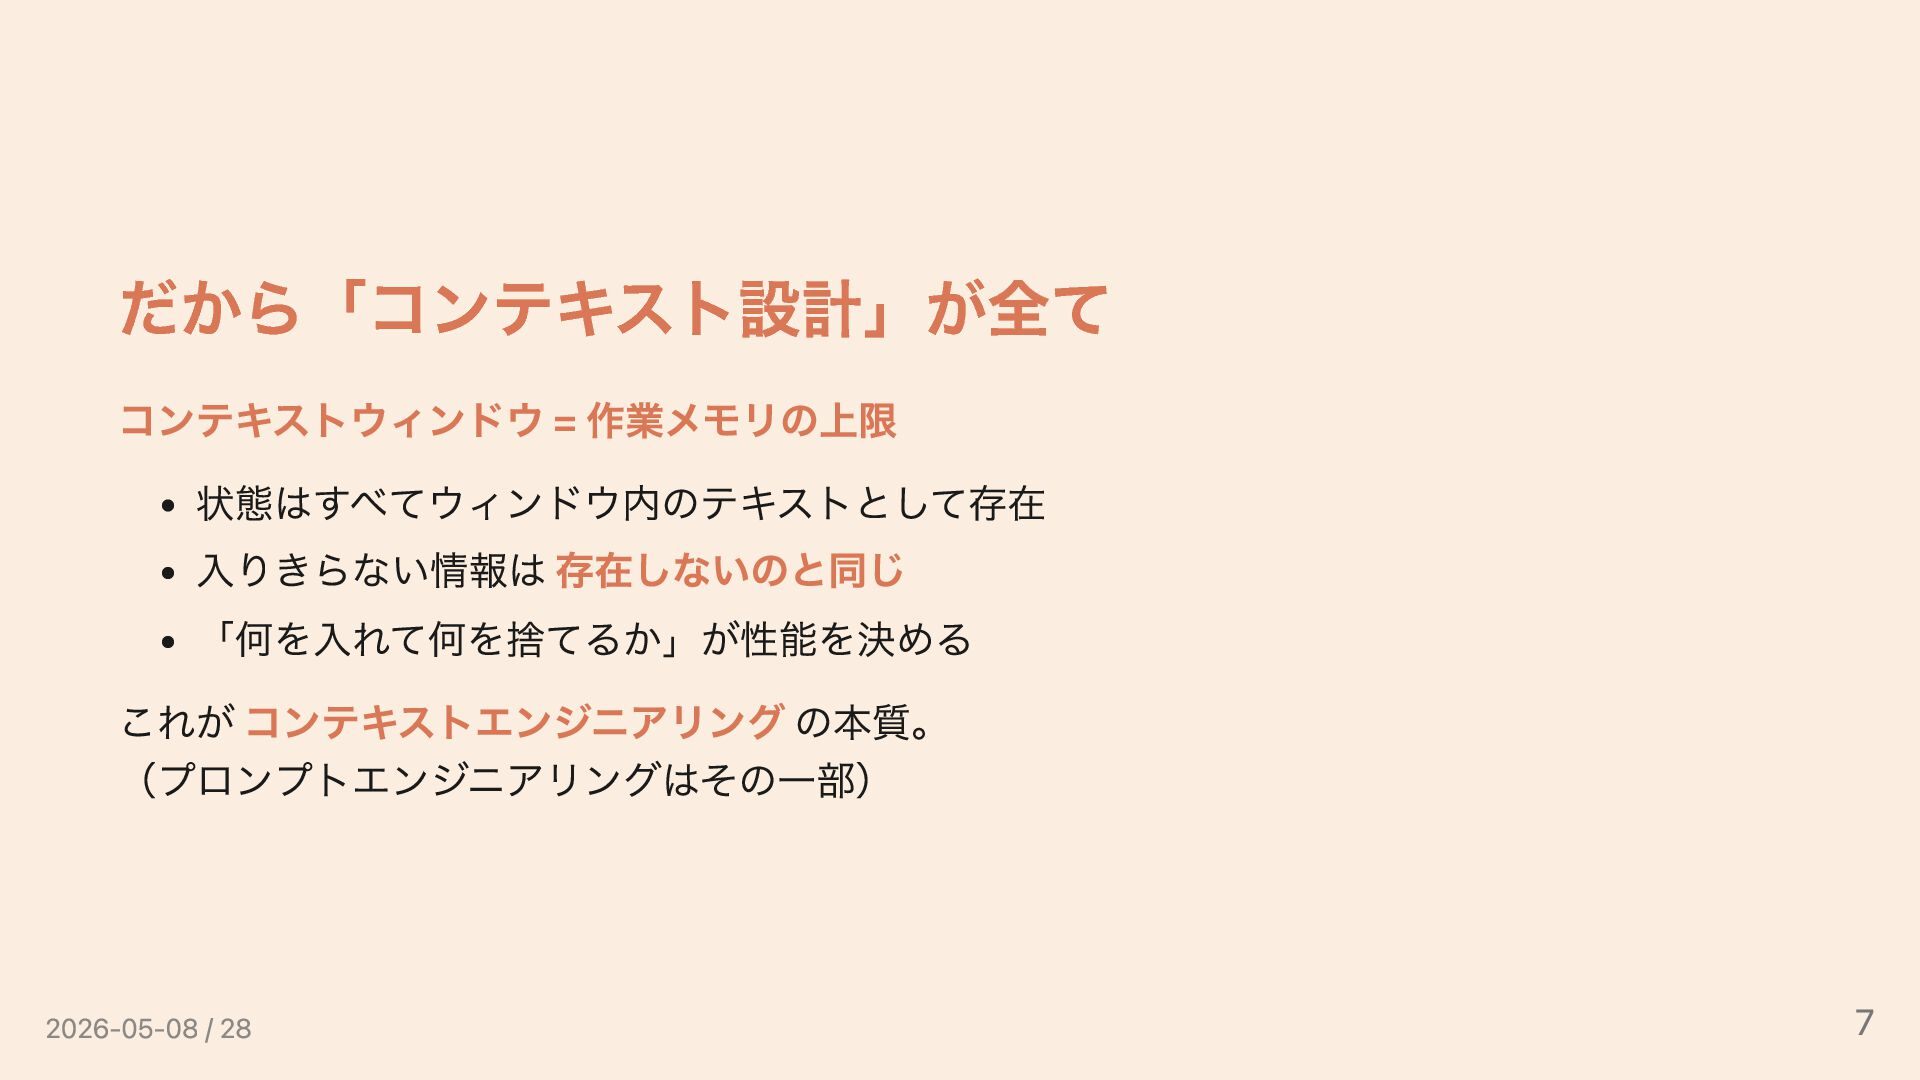
だから「コンテキスト設計」が全て コンテキストウィンドウ = 作業メモリの上限 状態はすべてウィンドウ内のテキストとして存在 入りきらない情報は 存在しないのと同じ 「何を入れて何を捨てるか」が性能を決める これが コンテキストエンジニアリング
の本質。 (プロンプトエンジニアリングはその一部) 2026-05-08 / 28 7
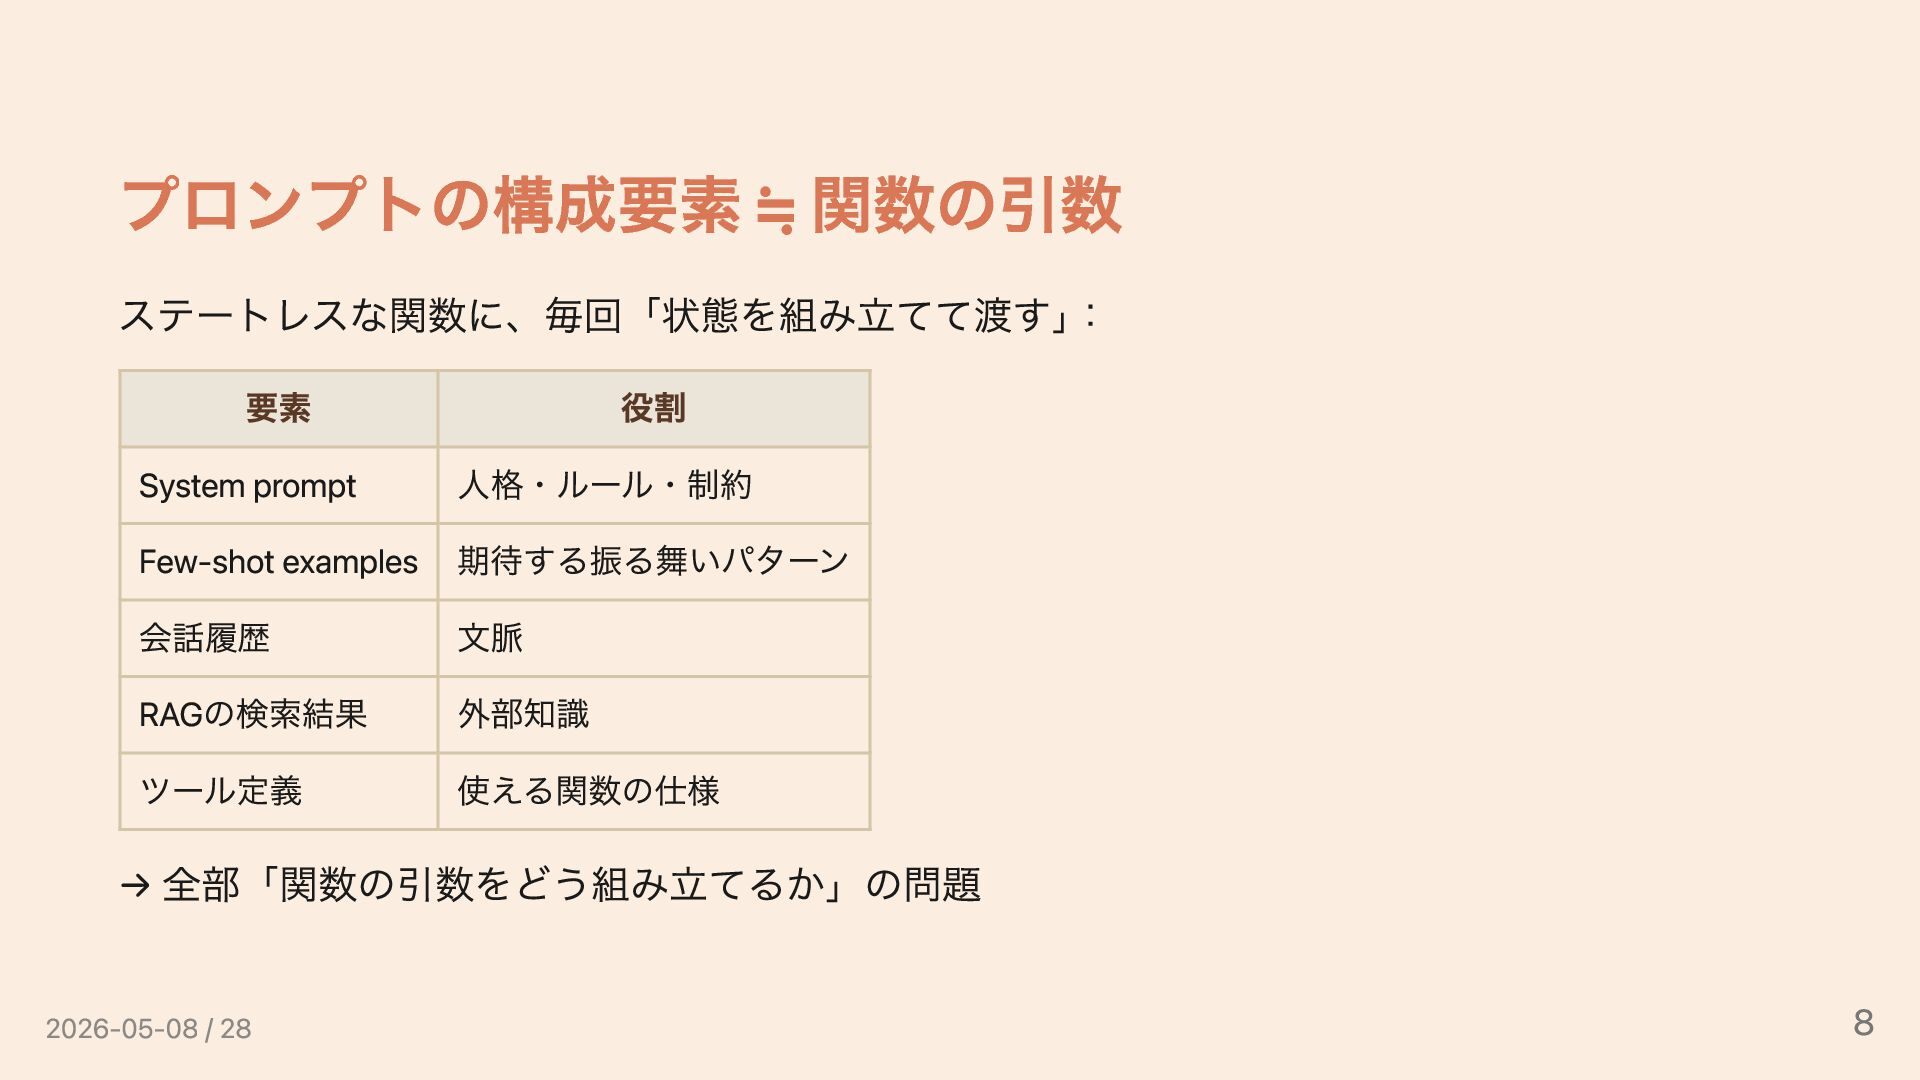
プロンプトの構成要素 ≒ 関数の引数 ステートレスな関数に、毎回「状態を組み立てて渡す」 : 要素 役割 System prompt 人格・ルール・制約
Few-shot examples 期待する振る舞いパターン 会話履歴 文脈 RAGの検索結果 外部知識 ツール定義 使える関数の仕様 → 全部「関数の引数をどう組み立てるか」の問題 2026-05-08 / 28 8
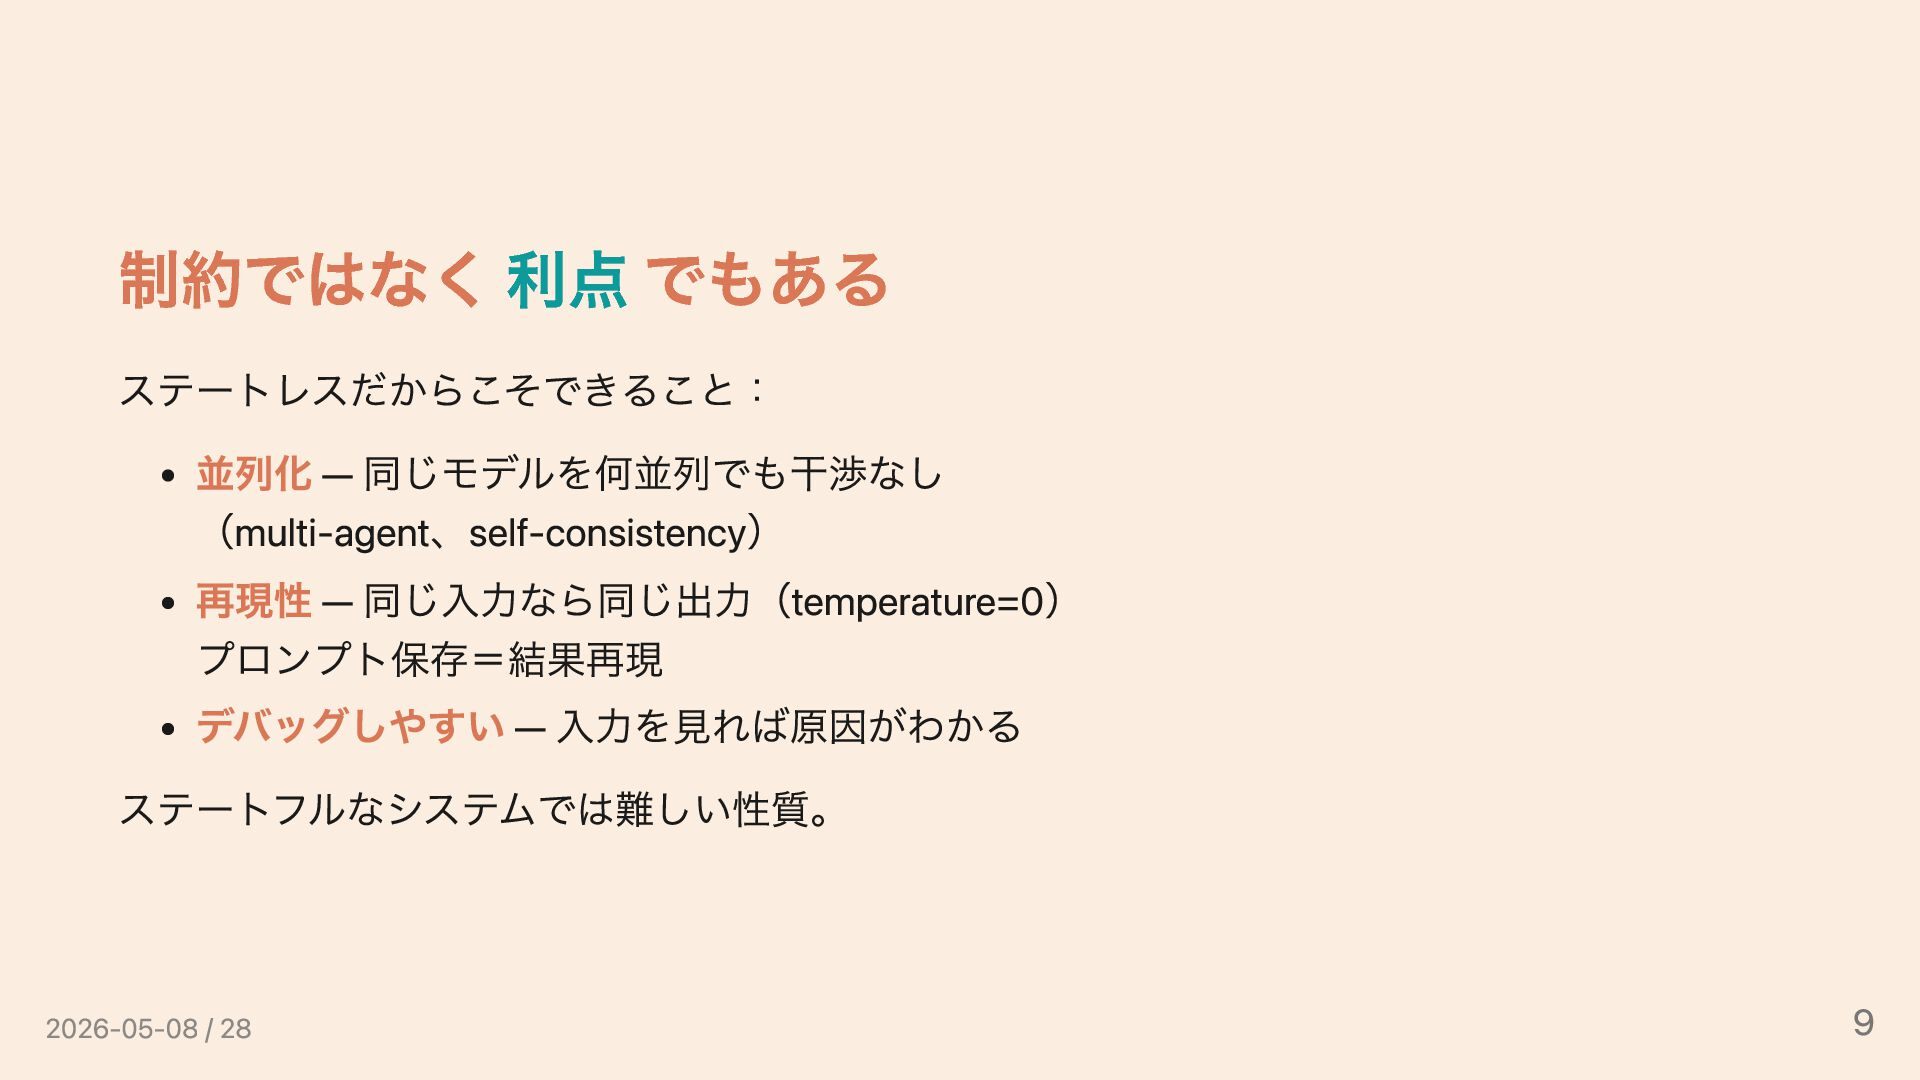
制約ではなく 利点 でもある ステートレスだからこそできること: 並列化 — 同じモデルを何並列でも干渉なし (multi-agent、self-consistency) 再現性 —
同じ入力なら同じ出力(temperature=0) プロンプト保存=結果再現 デバッグしやすい — 入力を見れば原因がわかる ステートフルなシステムでは難しい性質。 2026-05-08 / 28 9
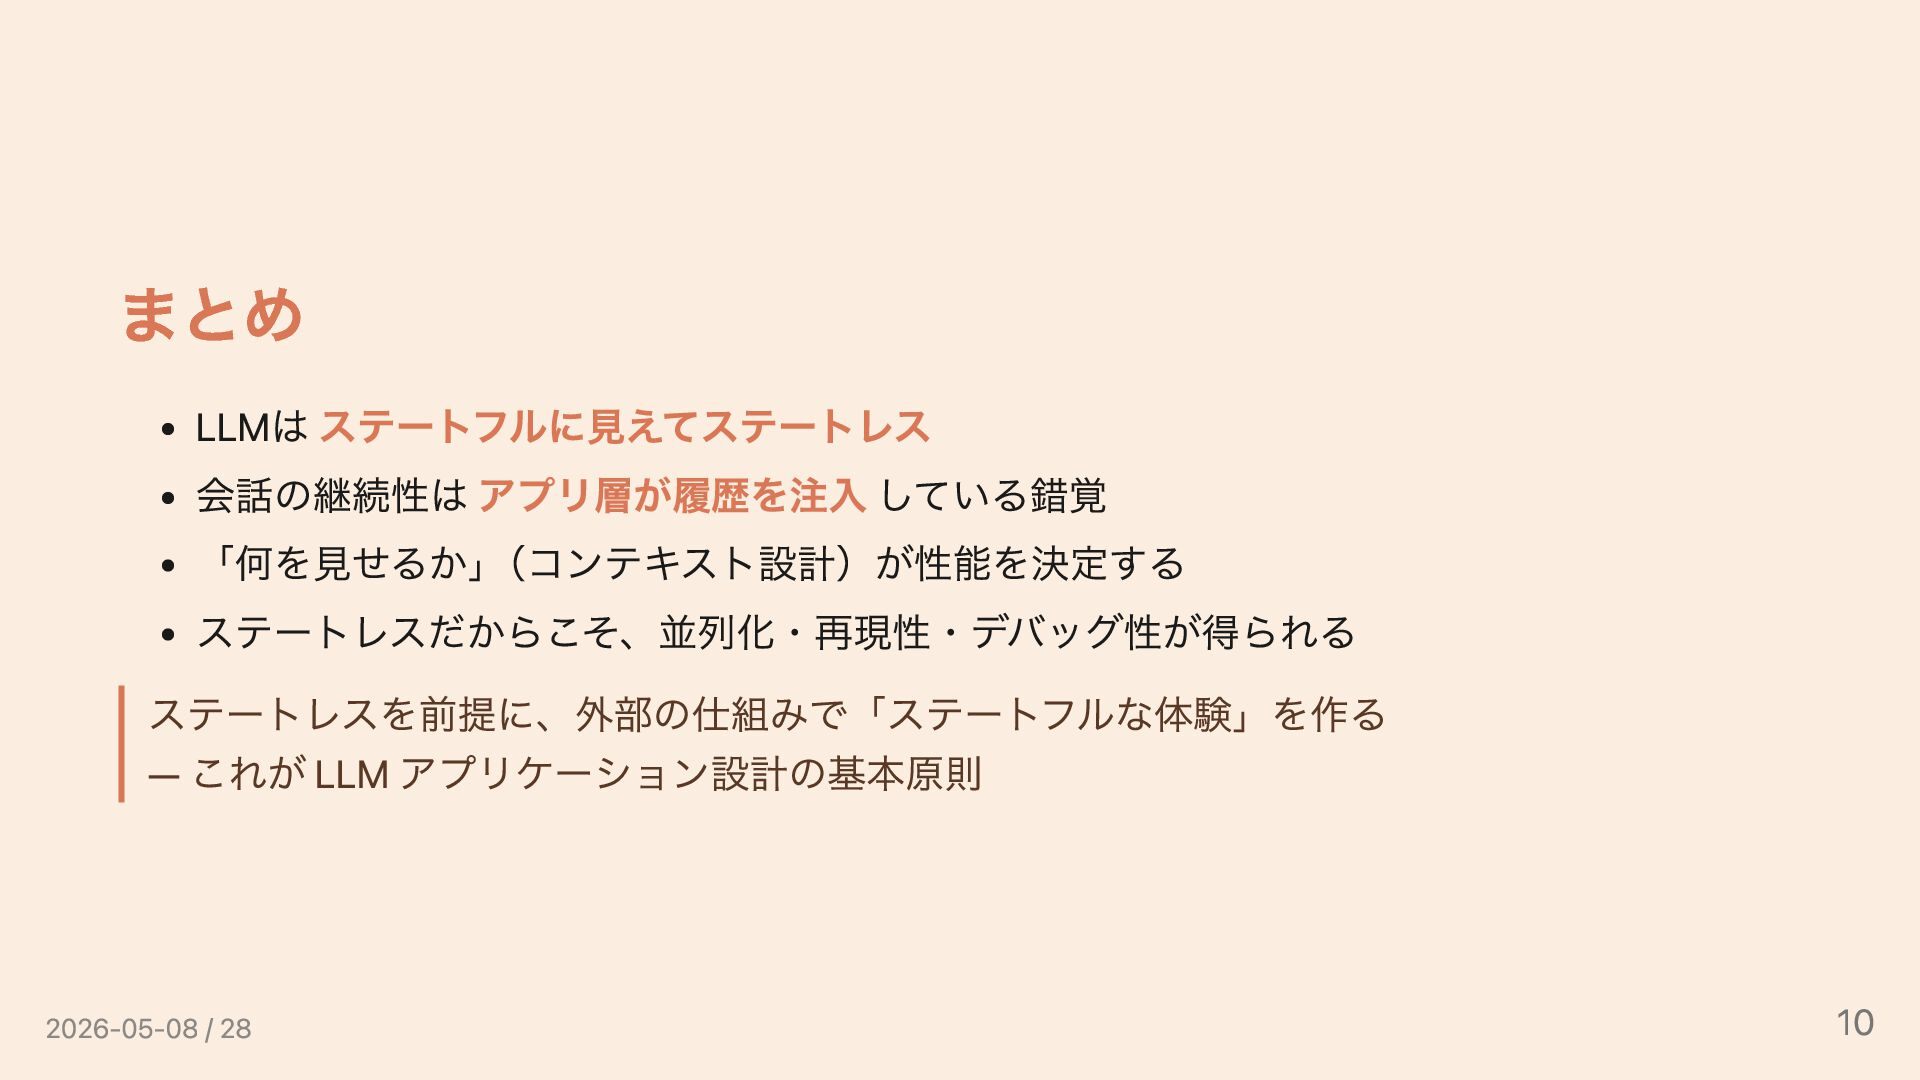
まとめ LLMは ステートフルに見えてステートレス 会話の継続性は アプリ層が履歴を注入 している錯覚 「何を見せるか」 (コンテキスト設計)が性能を決定する ステートレスだからこそ、並列化・再現性・デバッグ性が得られる ステートレスを前提に、外部の仕組みで「ステートフルな体験」を作る
— これが LLM アプリケーション設計の基本原則 2026-05-08 / 28 10
参考 小川洋子『博士の愛した数式』新潮社 Anthropic: Effective context engineering for AI agents LangChain:
Context Engineering for Agents 2026-05-08 / 28


 eileencodes
 rabernat
 thekraken
 chriscoyier
 oripsolob
 gurzu
 sonatard
 nonsquared
 jeffersonlam
 notwaldorf
 katiecoart
 sferik