Your Podcast. Everywhere. Effortlessly.
「この障害って半年前の、あのプロジェクトと同じ原因ですよね?なぜ防げないんですか?」
複数のAndroidプロジェクトを抱えるエンジニアであれば、この一言にギクリとした経験があるはずです。
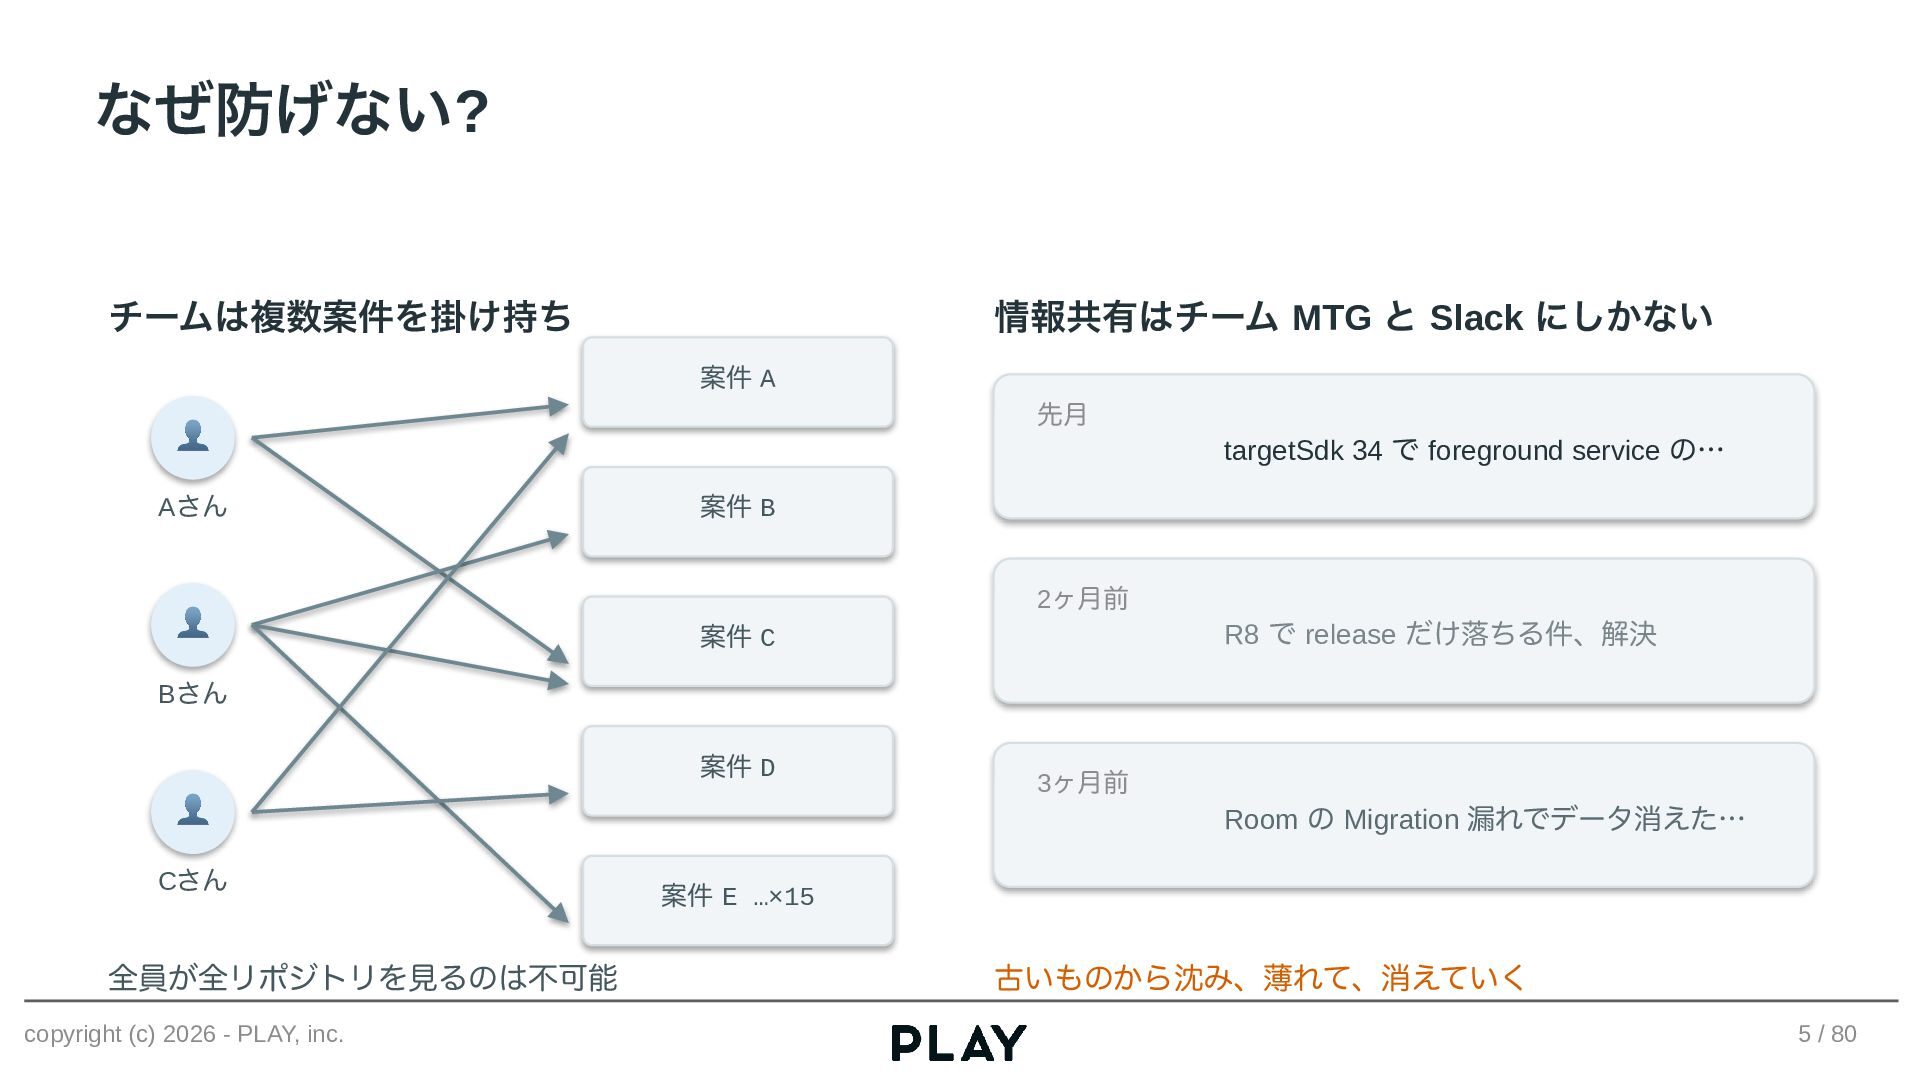
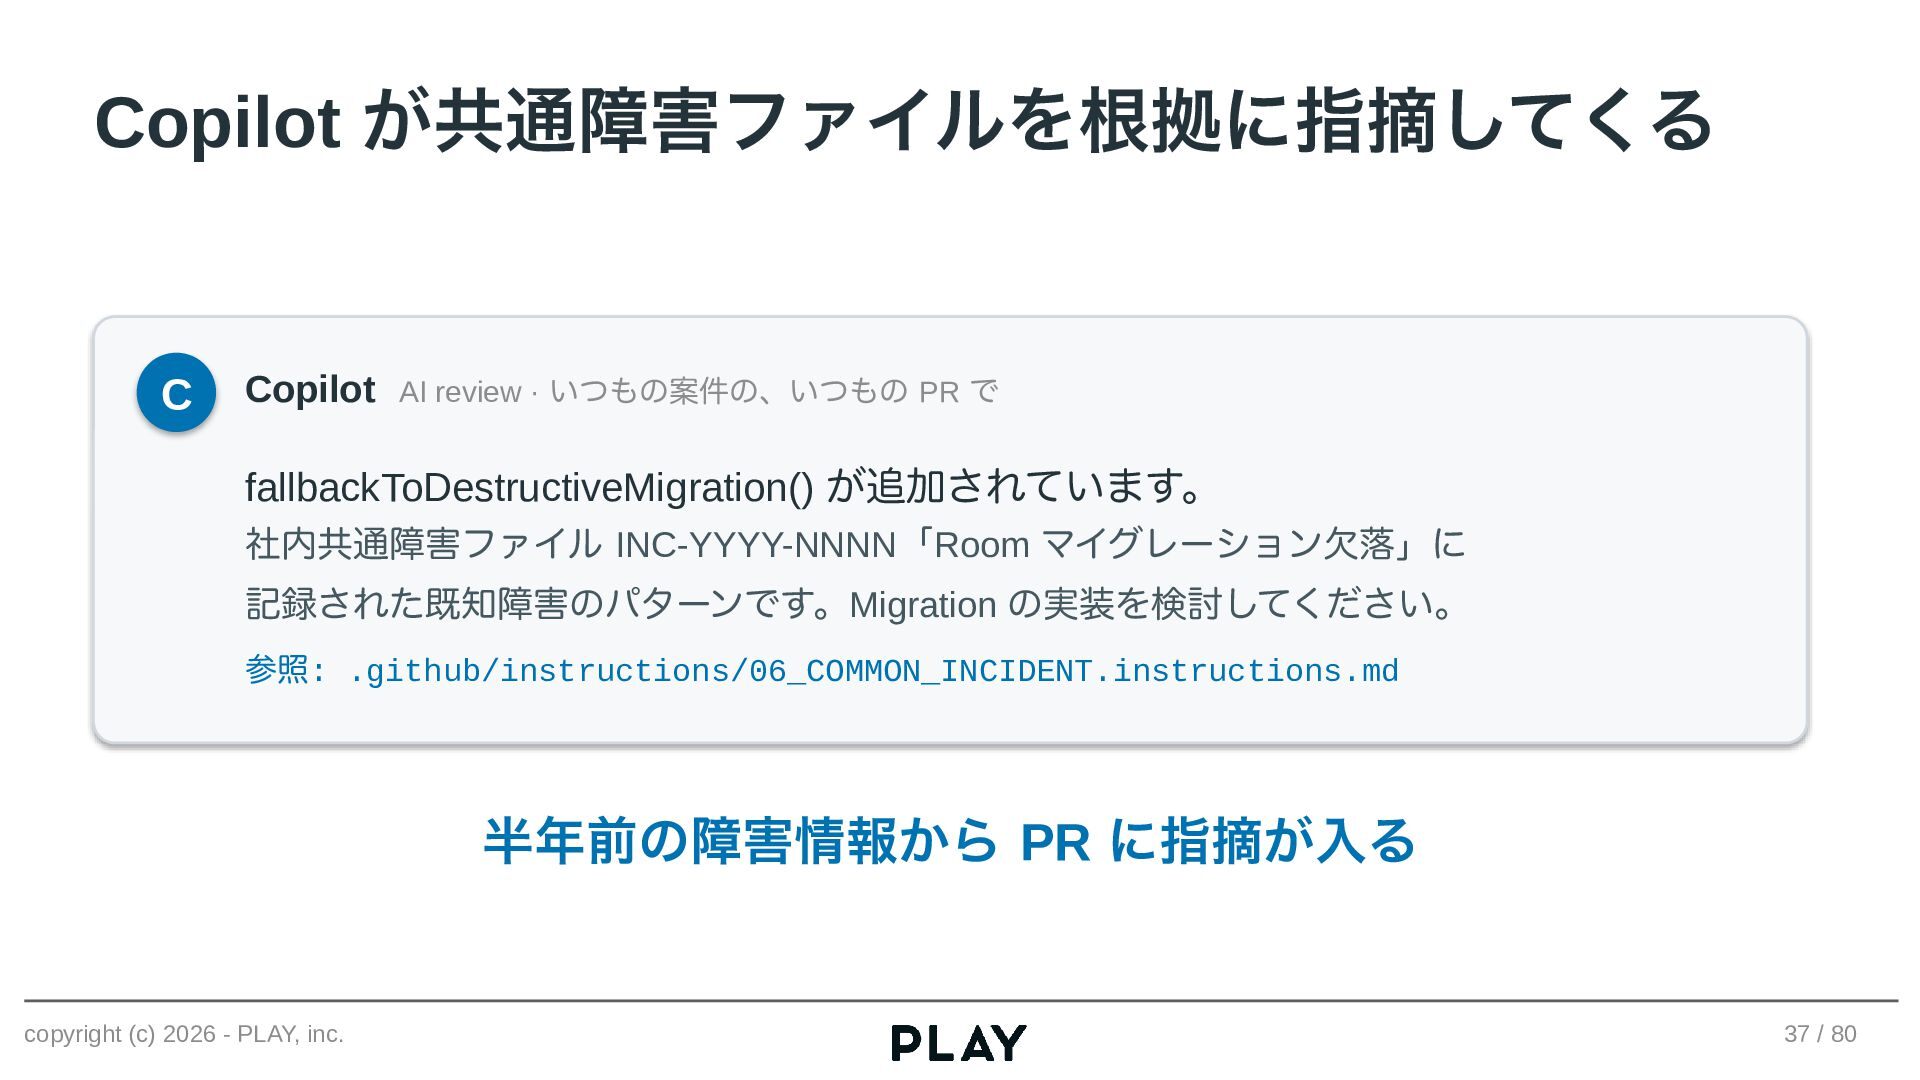
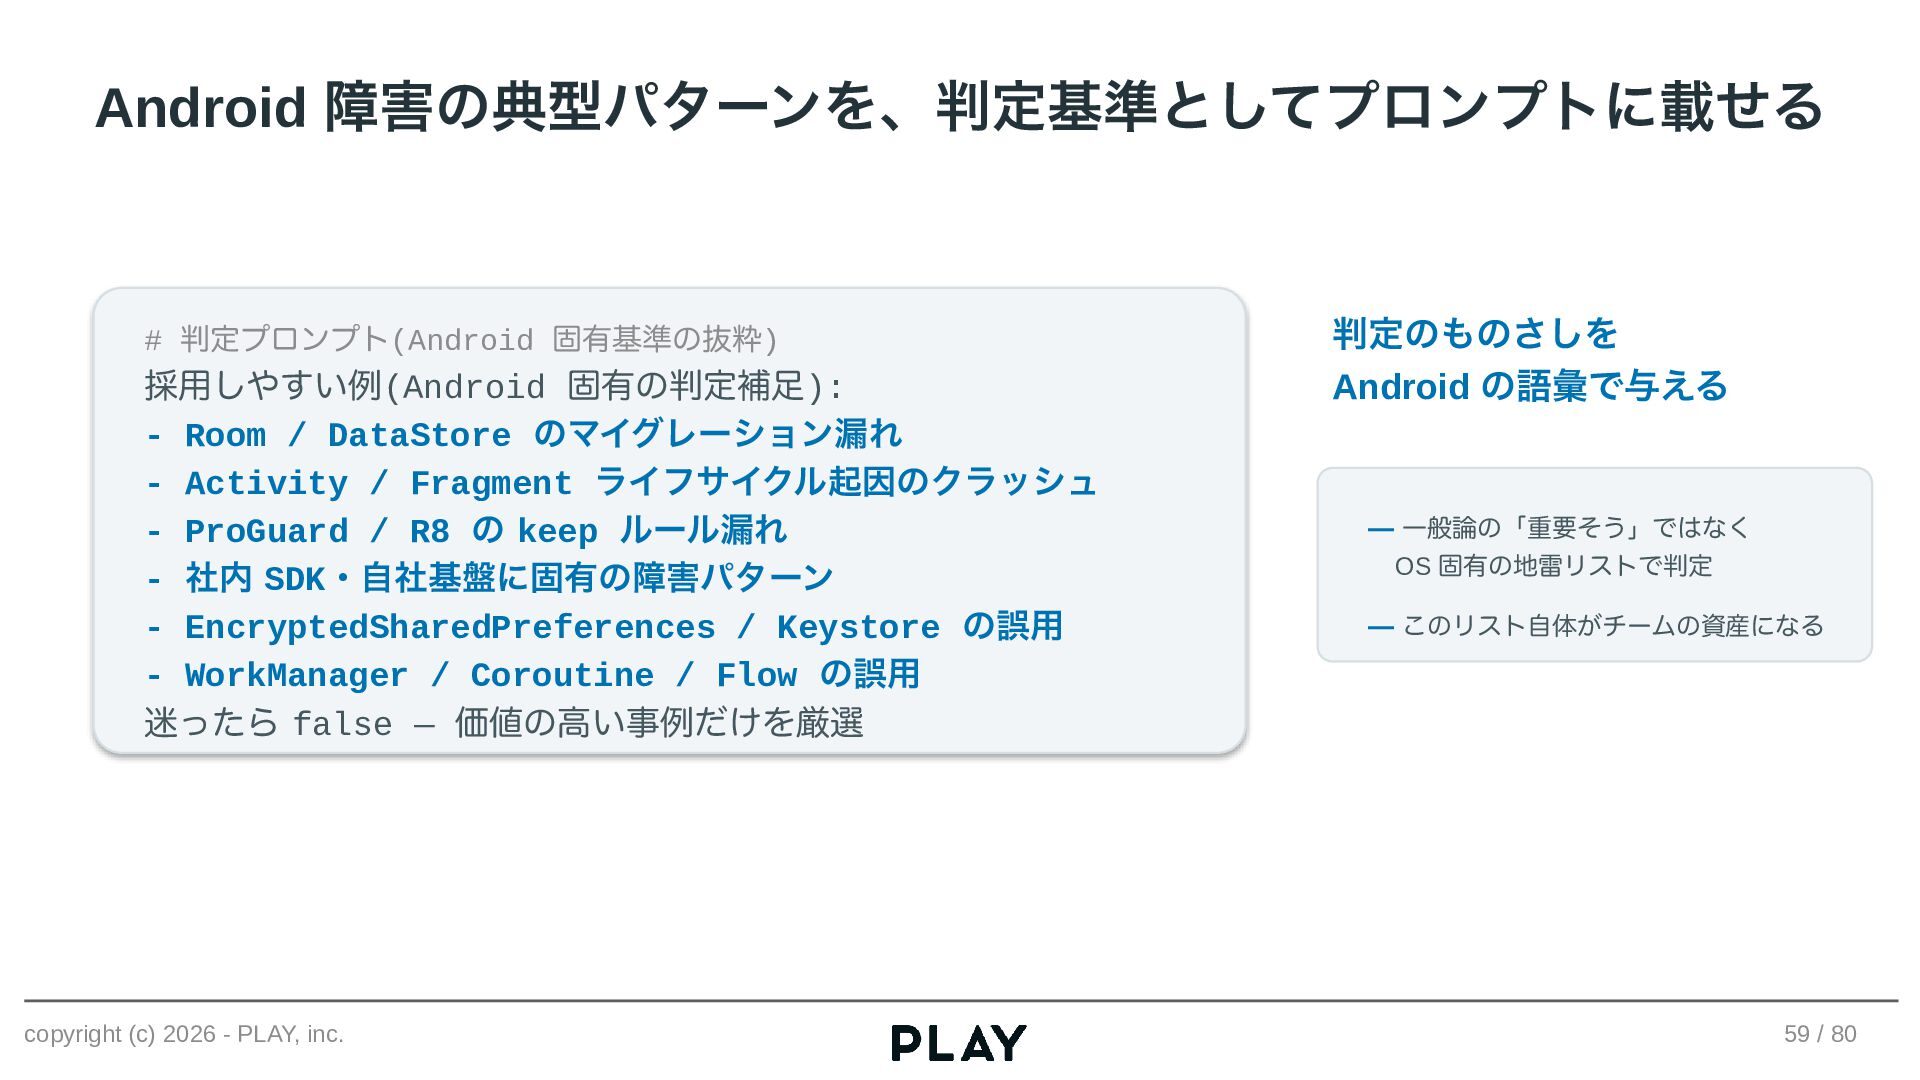
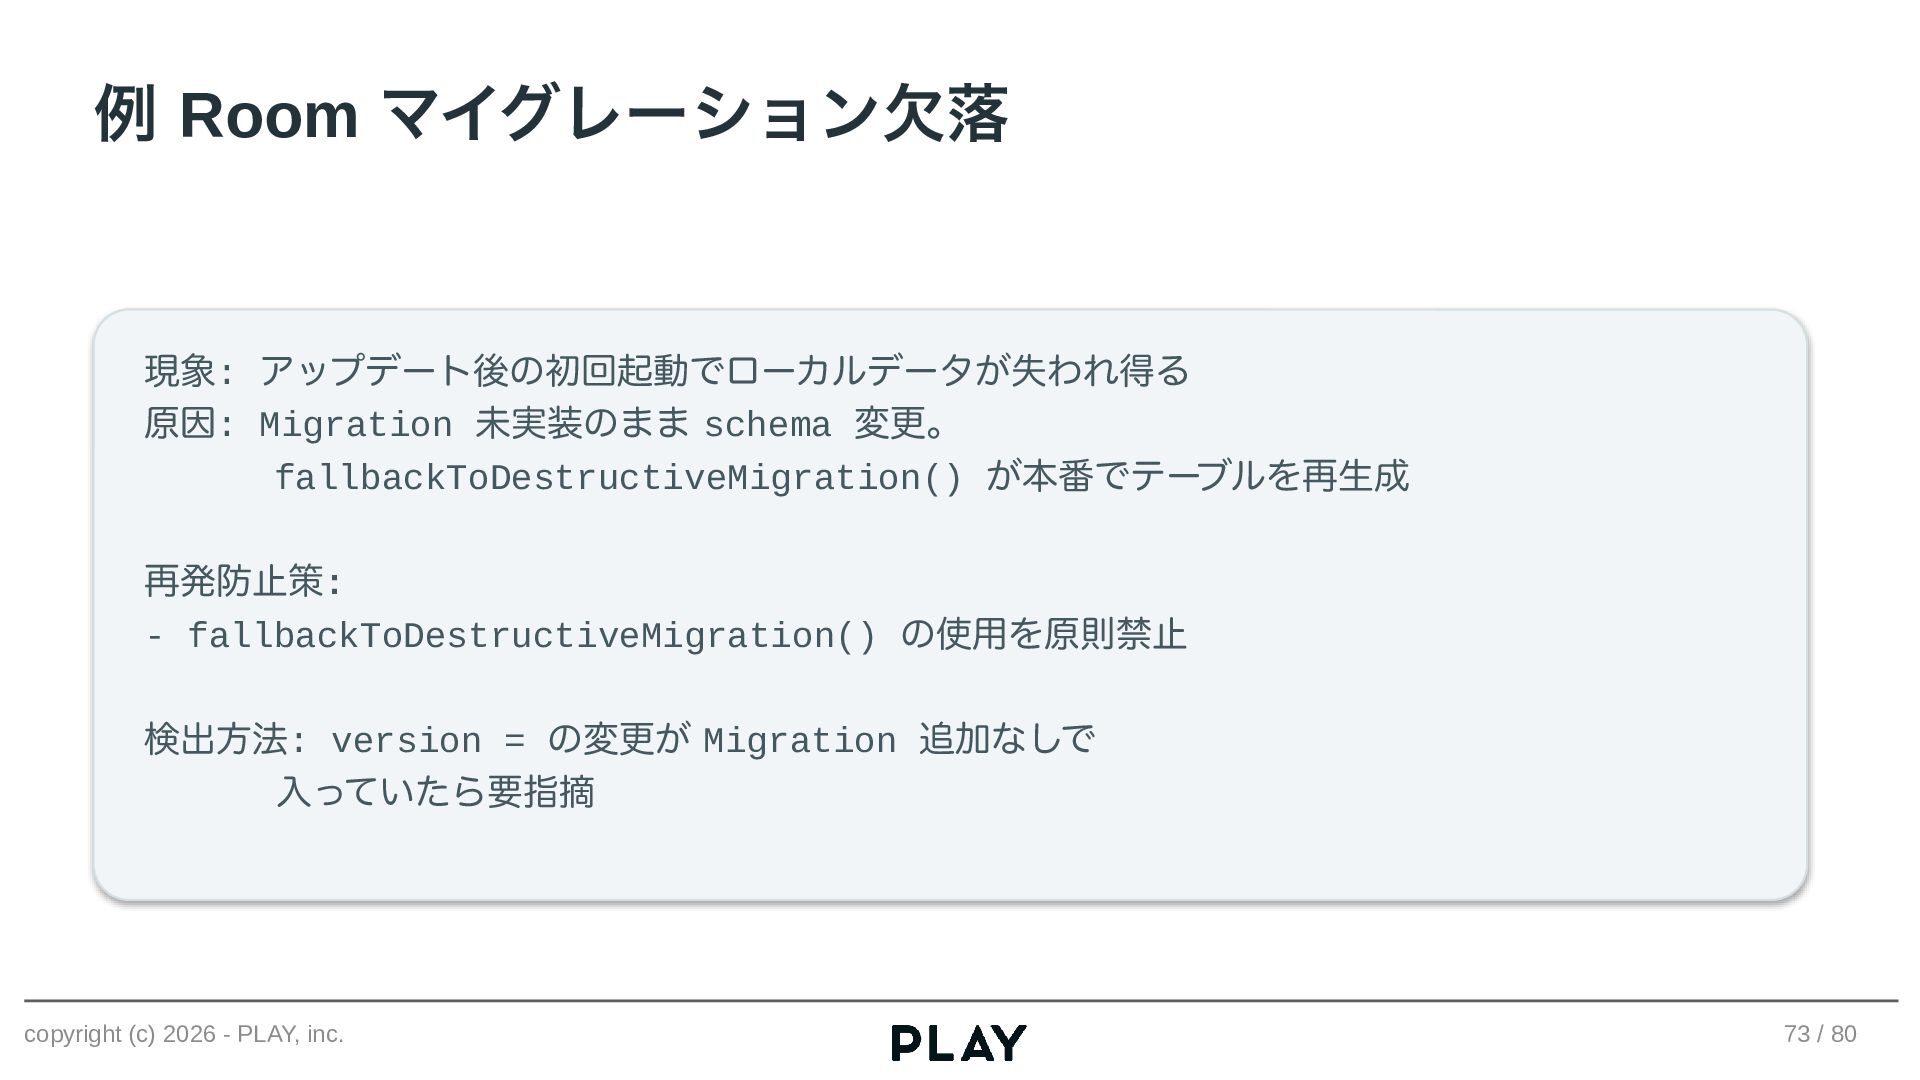
- Roomのマイグレーション漏れで端末アップデート後にユーザーデータが消えた。
- ProGuard / R8 の keep ルール漏れでリリースビルドだけがクラッシュした。
どちらも「半年前にも別のプロジェクトで踏みましたよね?」と言いたくなる典型例です。
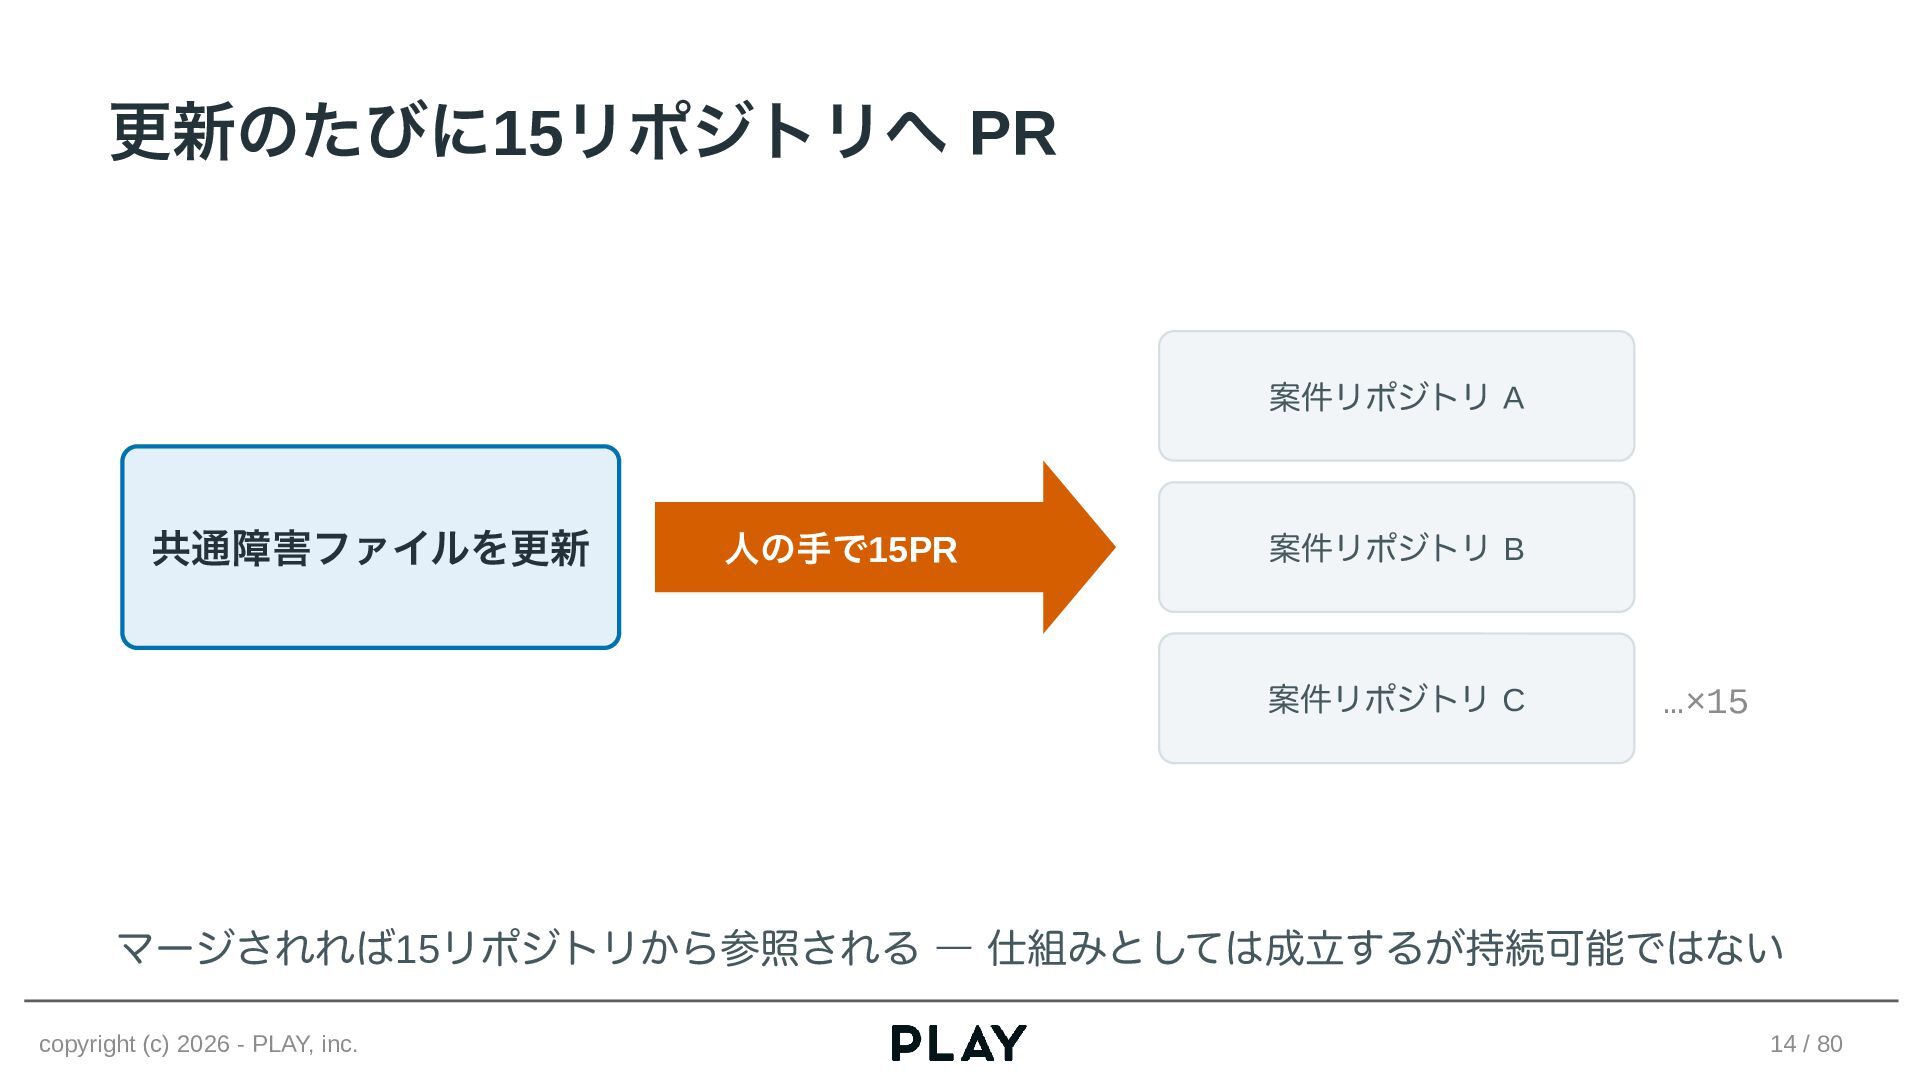
私たちのチームは約20名で15プロジェクトを横断的に開発しており、OSやSDK起因のAndroid共通障害発生時のアラートはチームMTGやSlackしかありませんでした。
さらに、エンジニアは数ヶ月単位でプロジェクトをローテーションすることもあるため、過去の障害が別プロジェクトで再発する構造的リスクがありました。
この課題を改善するため、
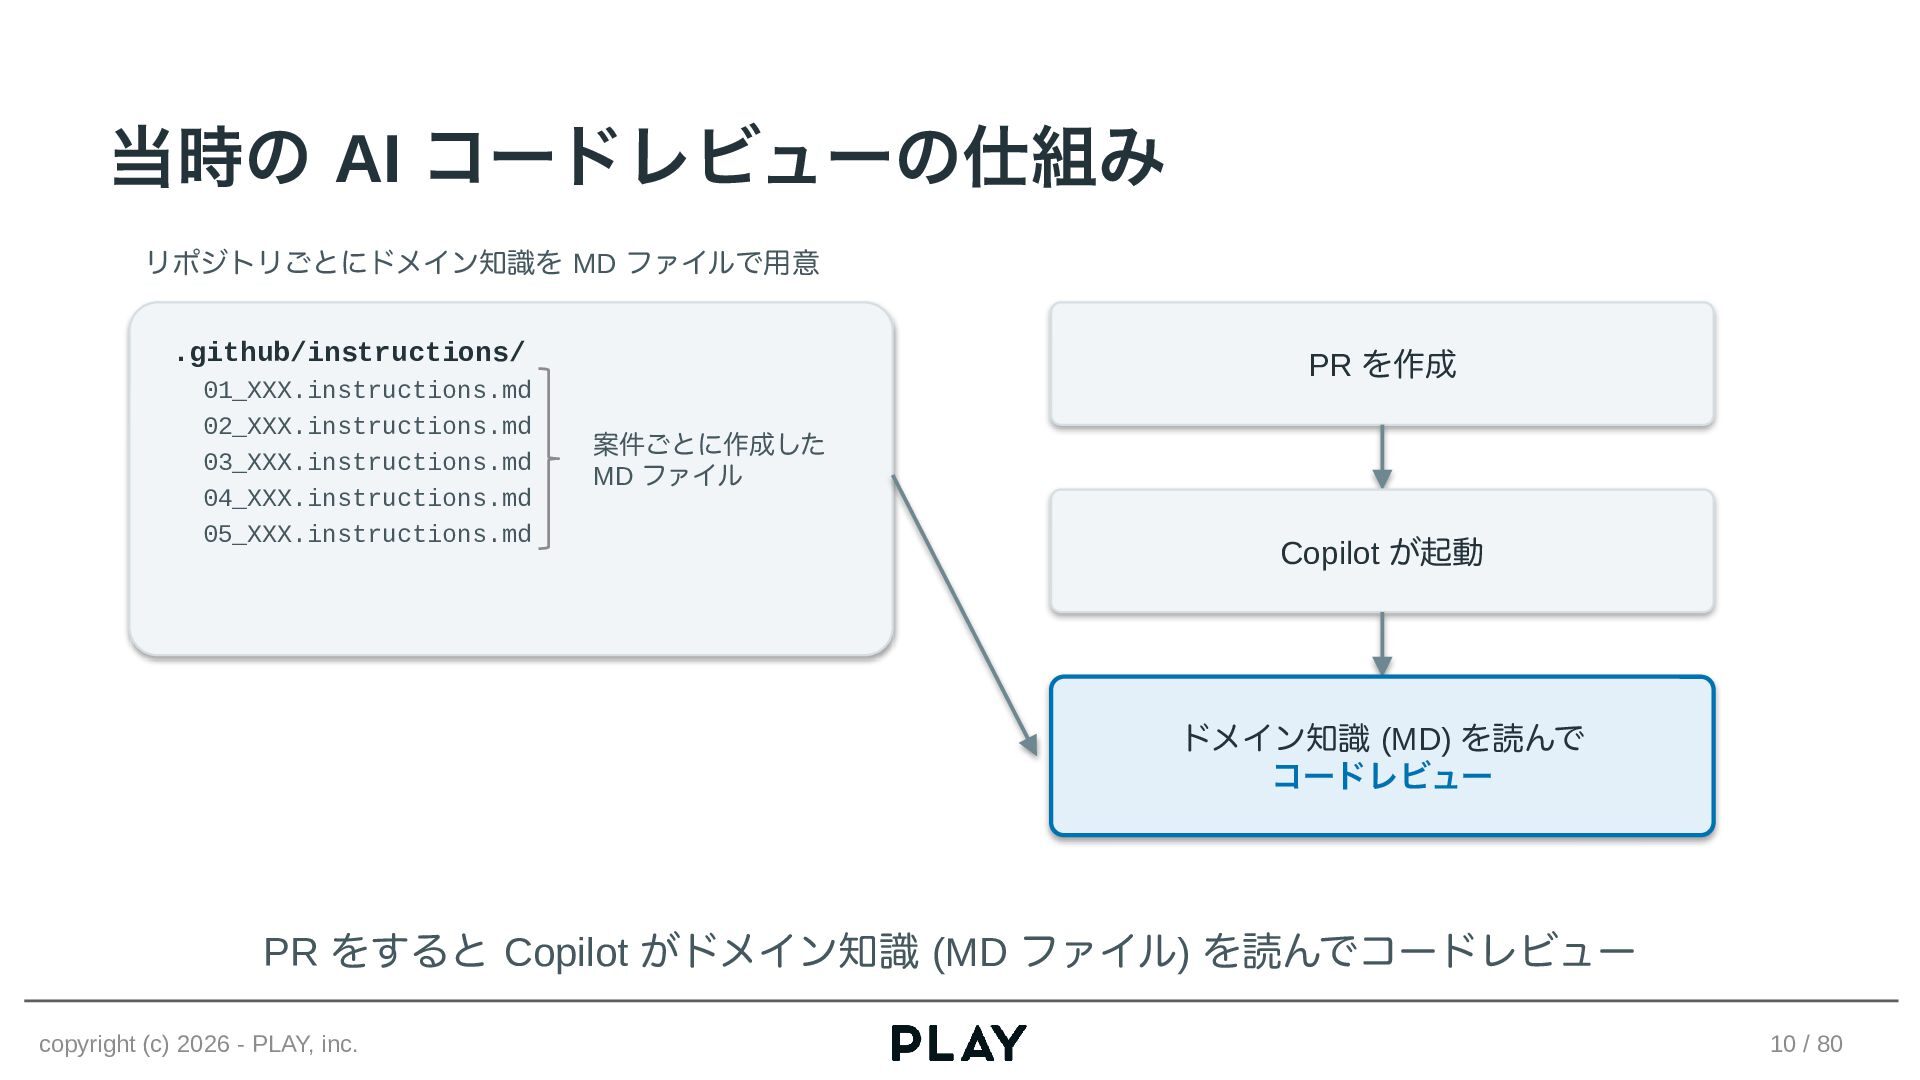
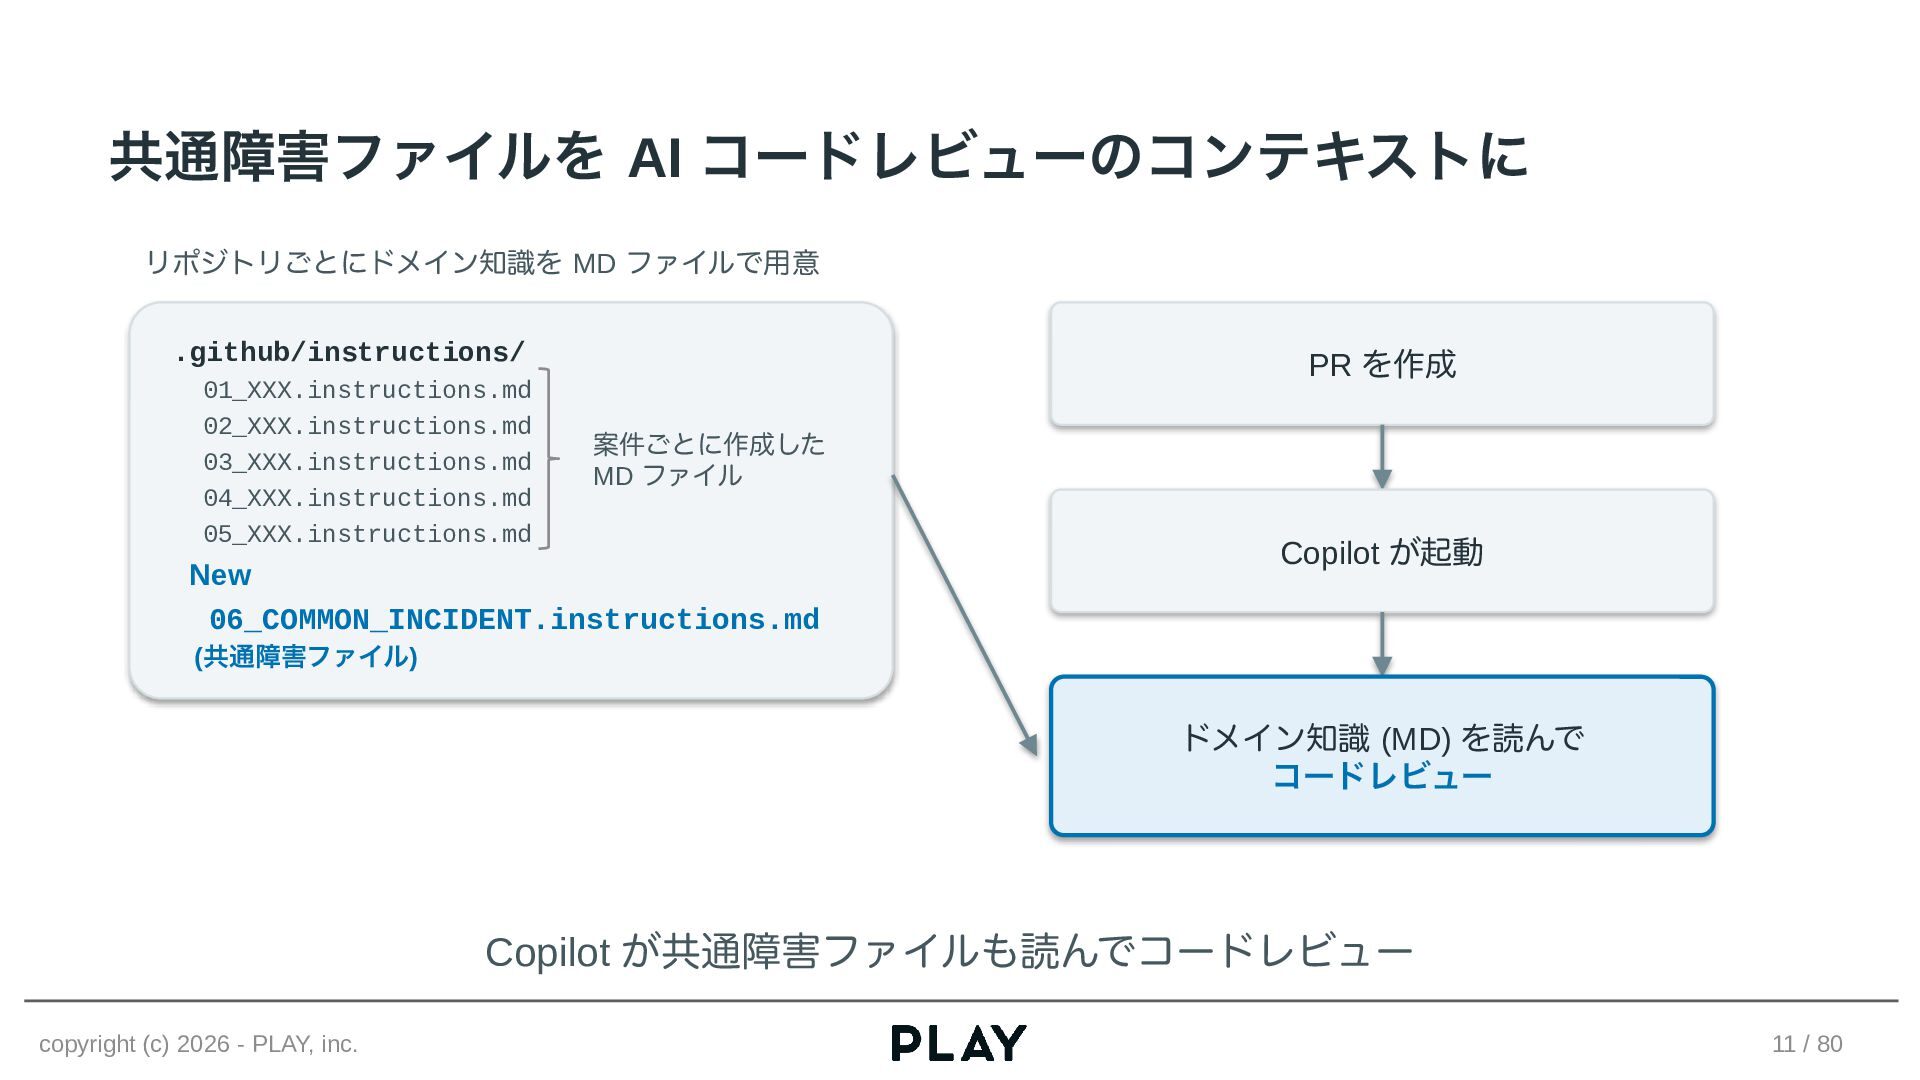
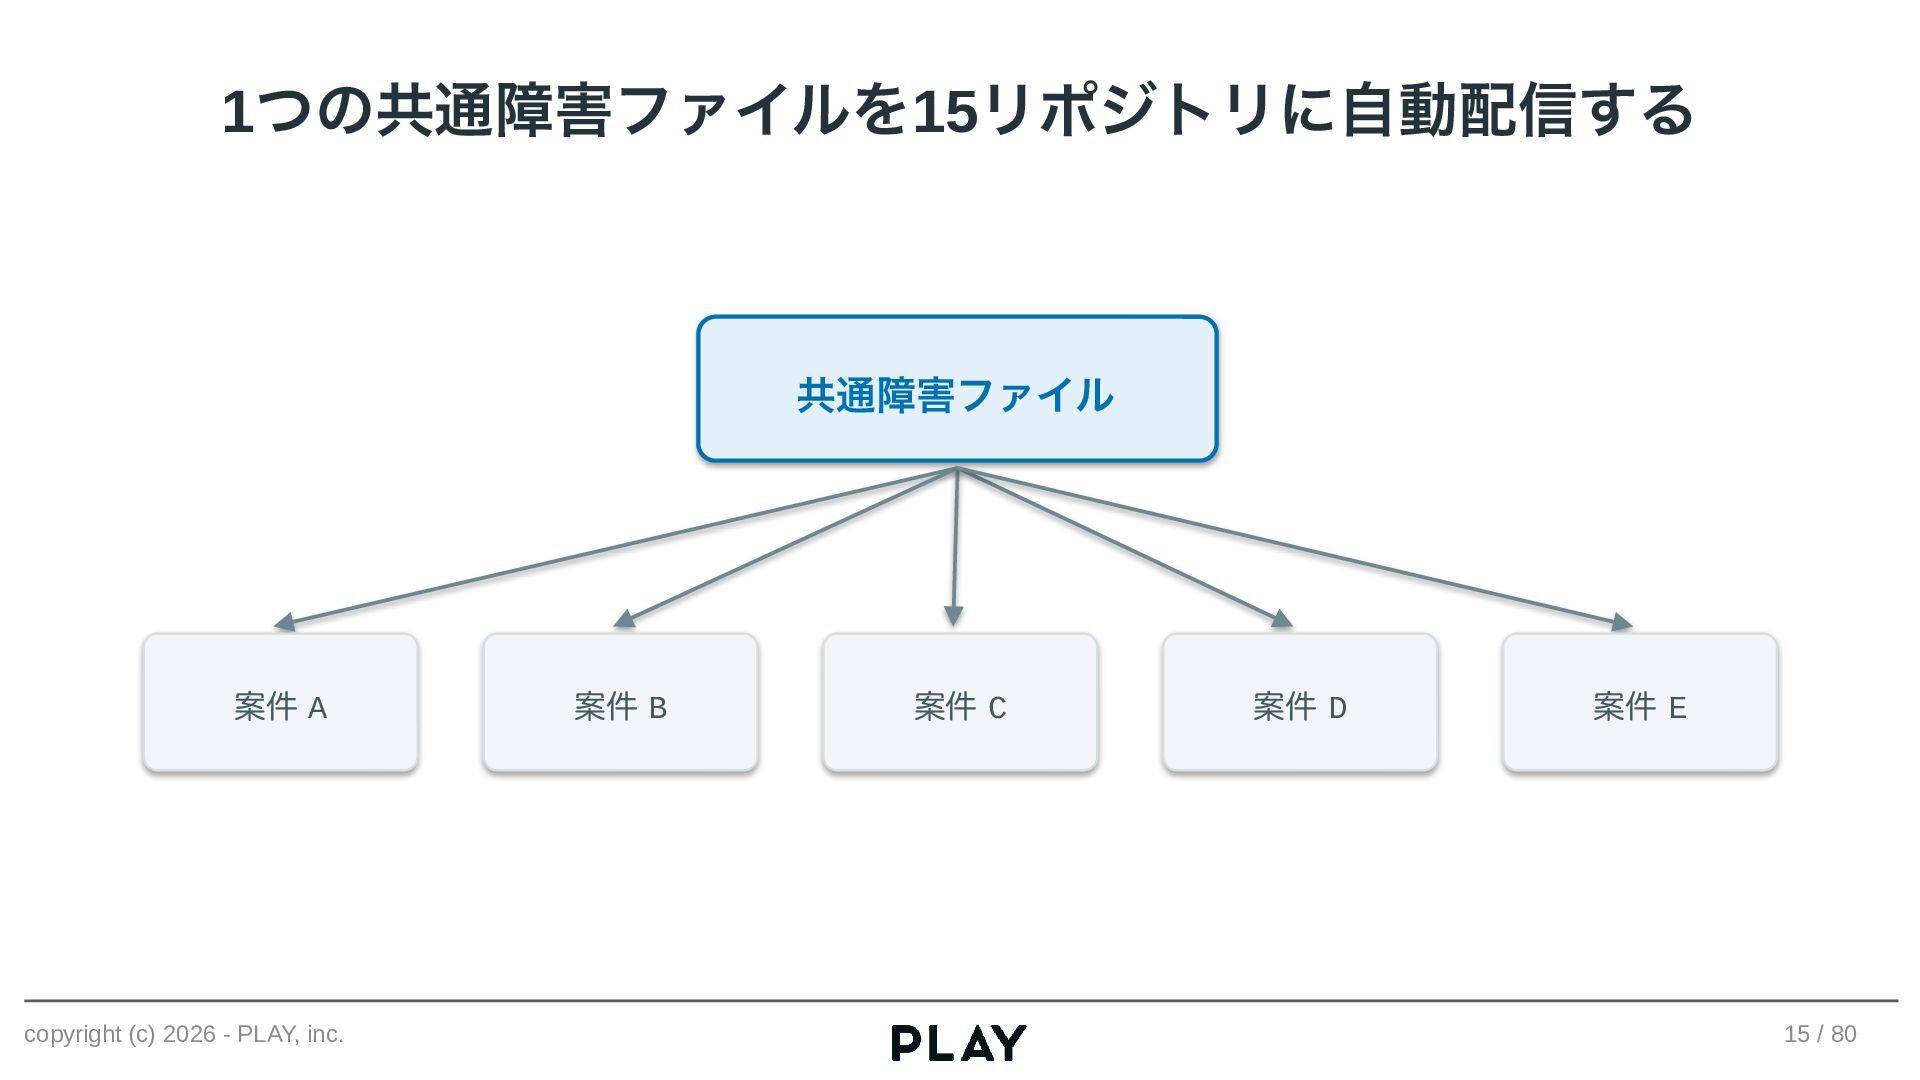
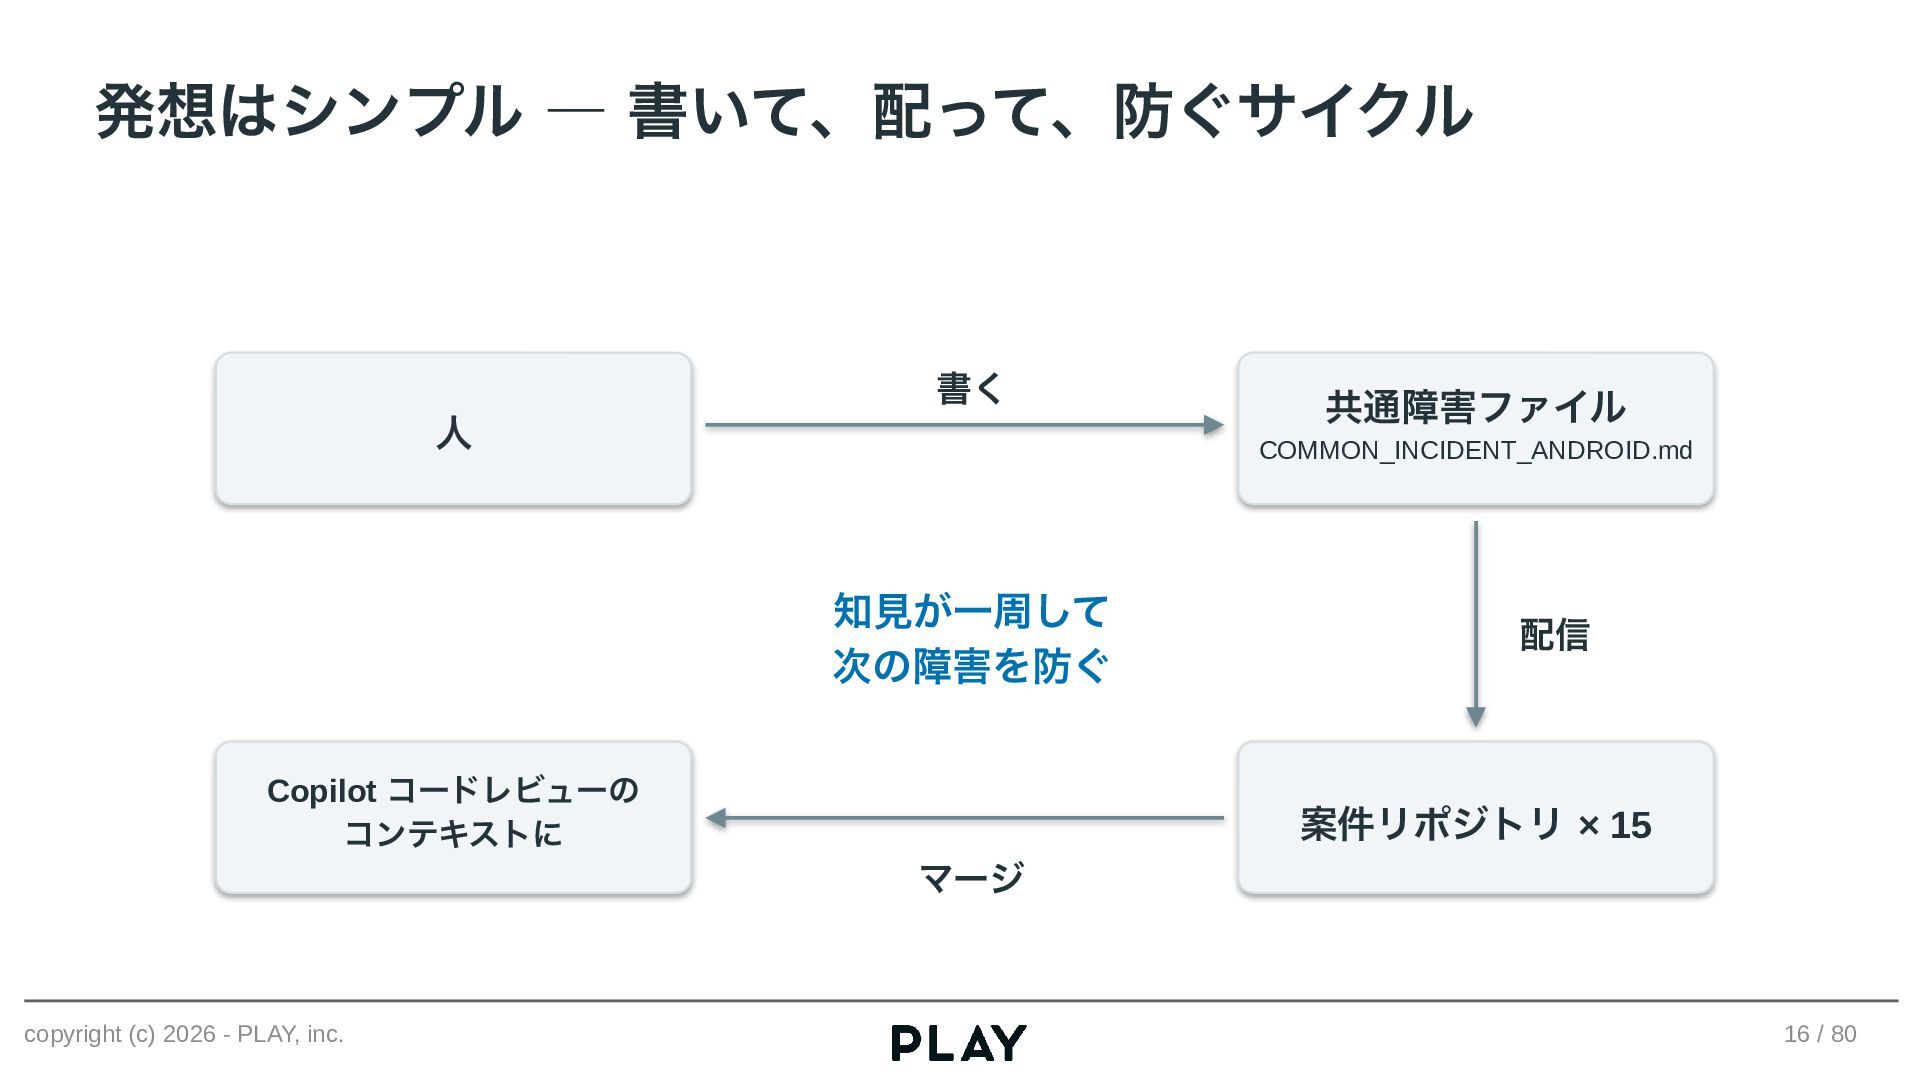
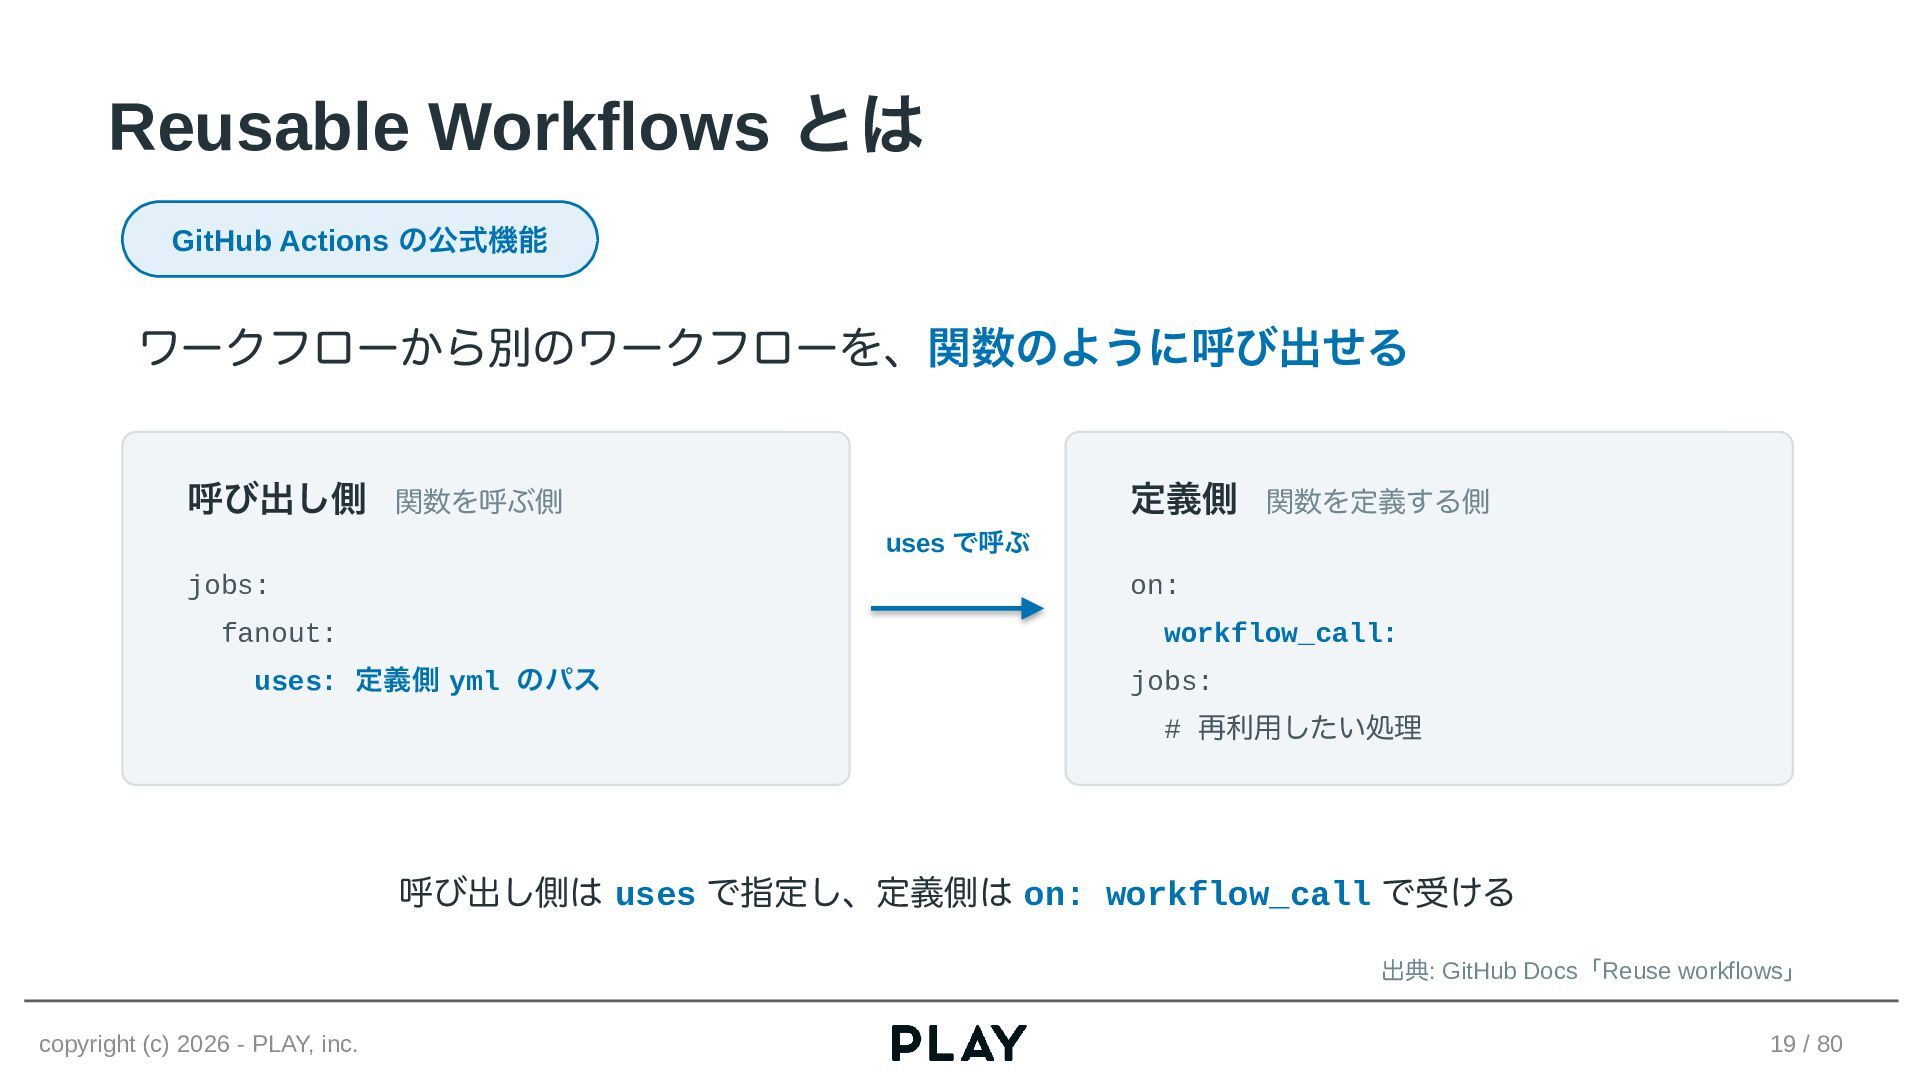
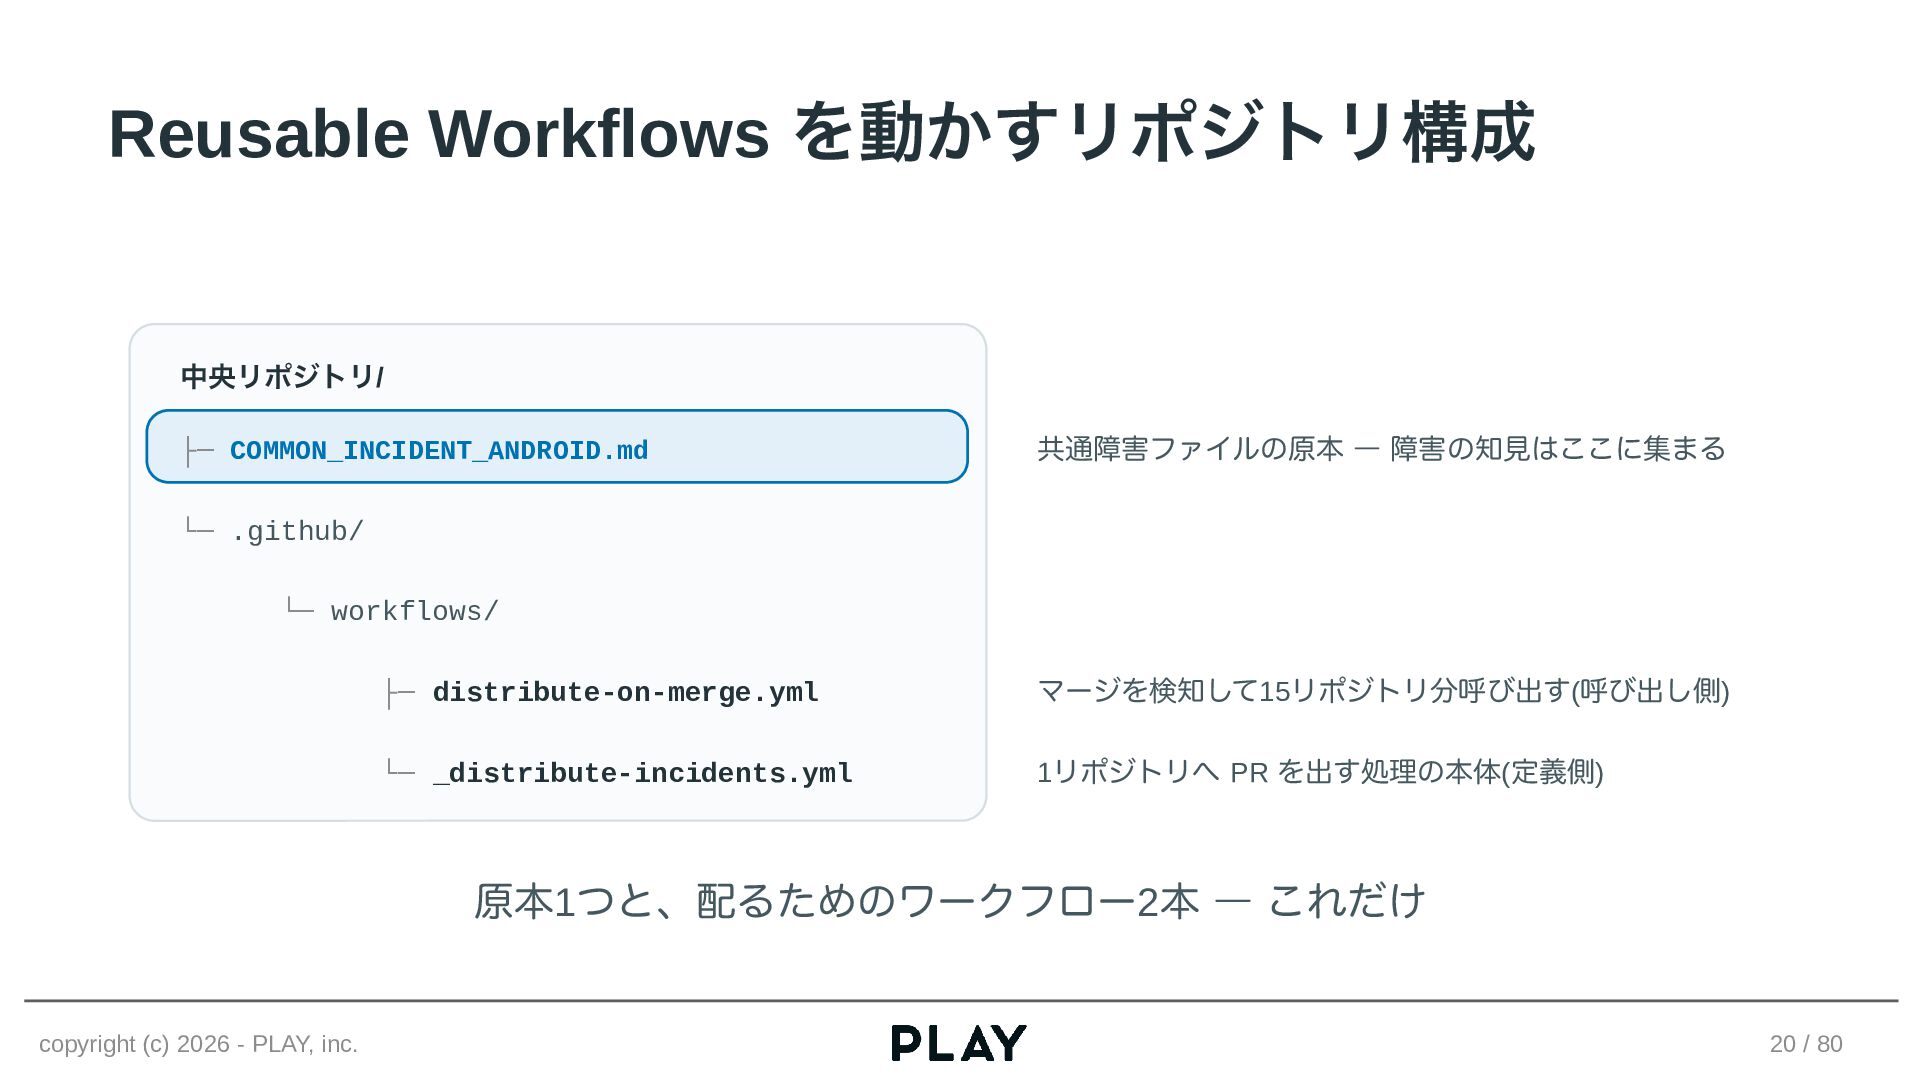
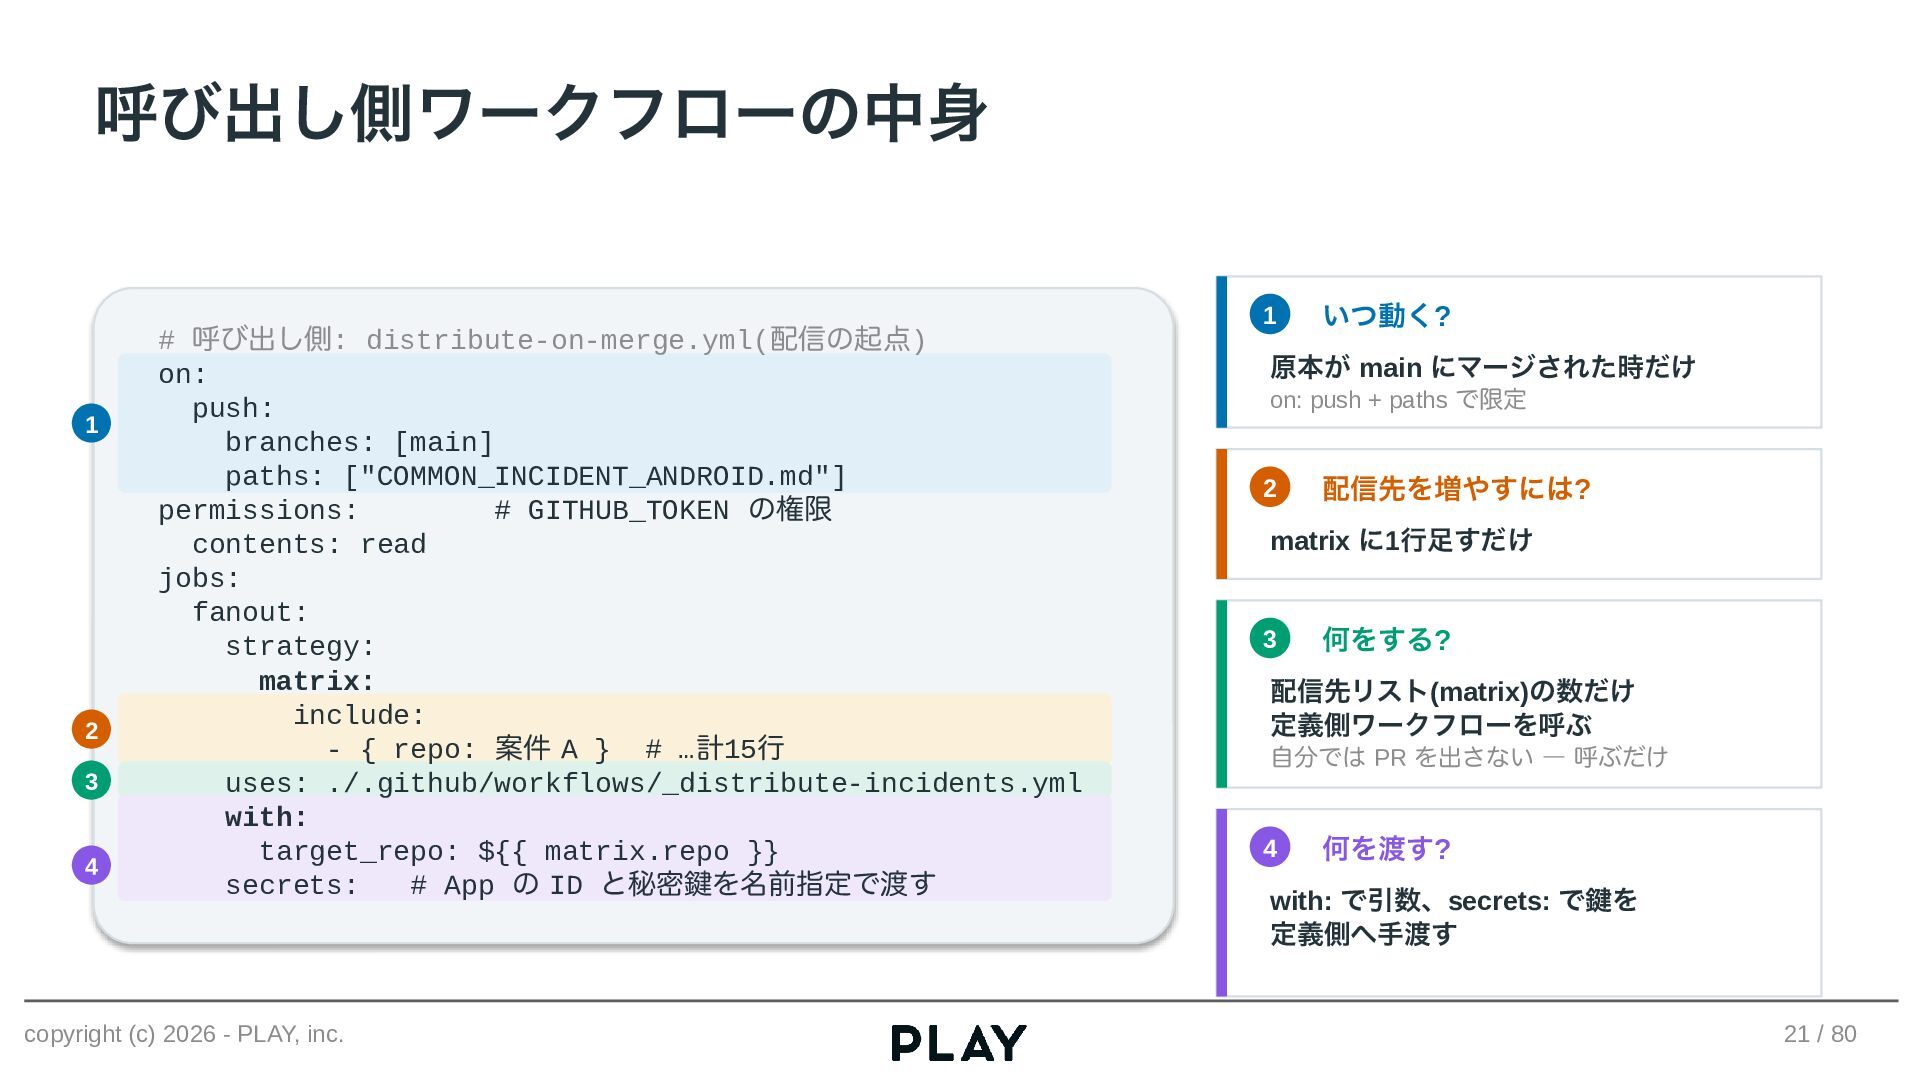
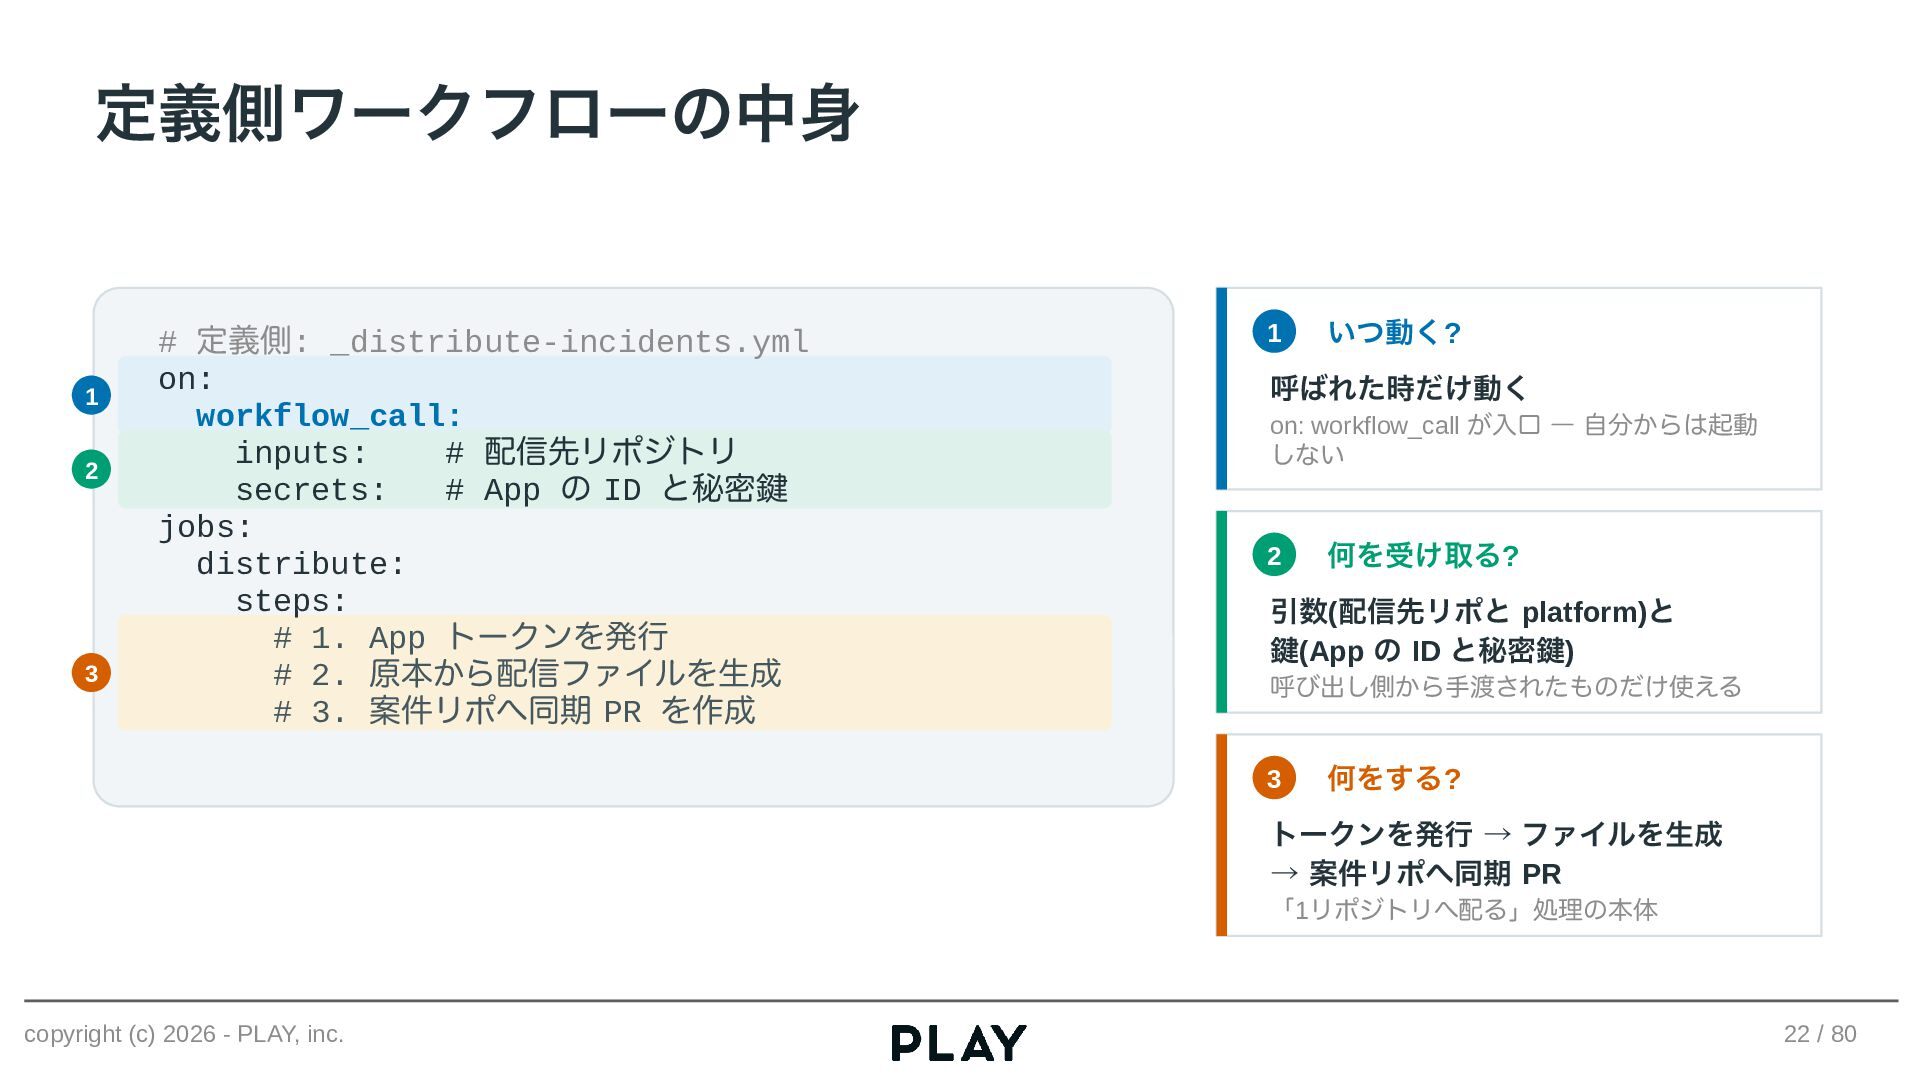
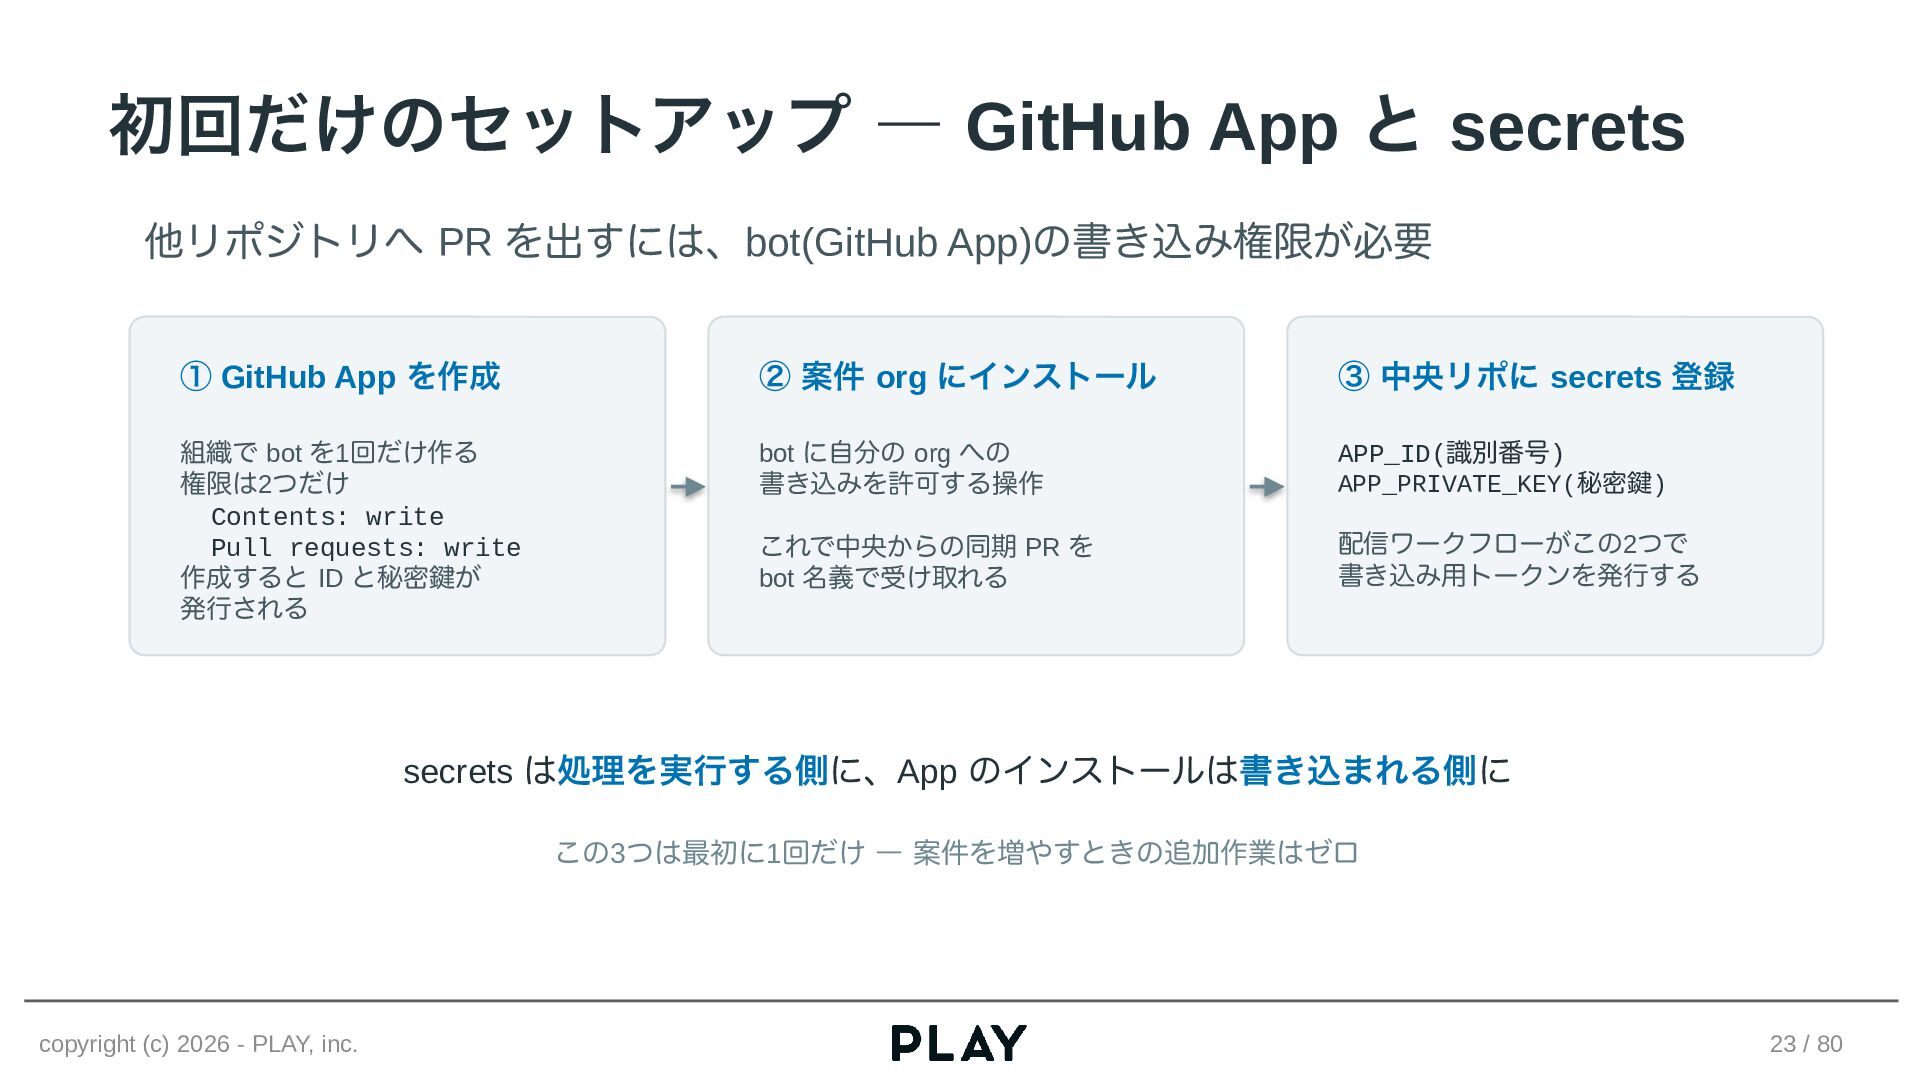
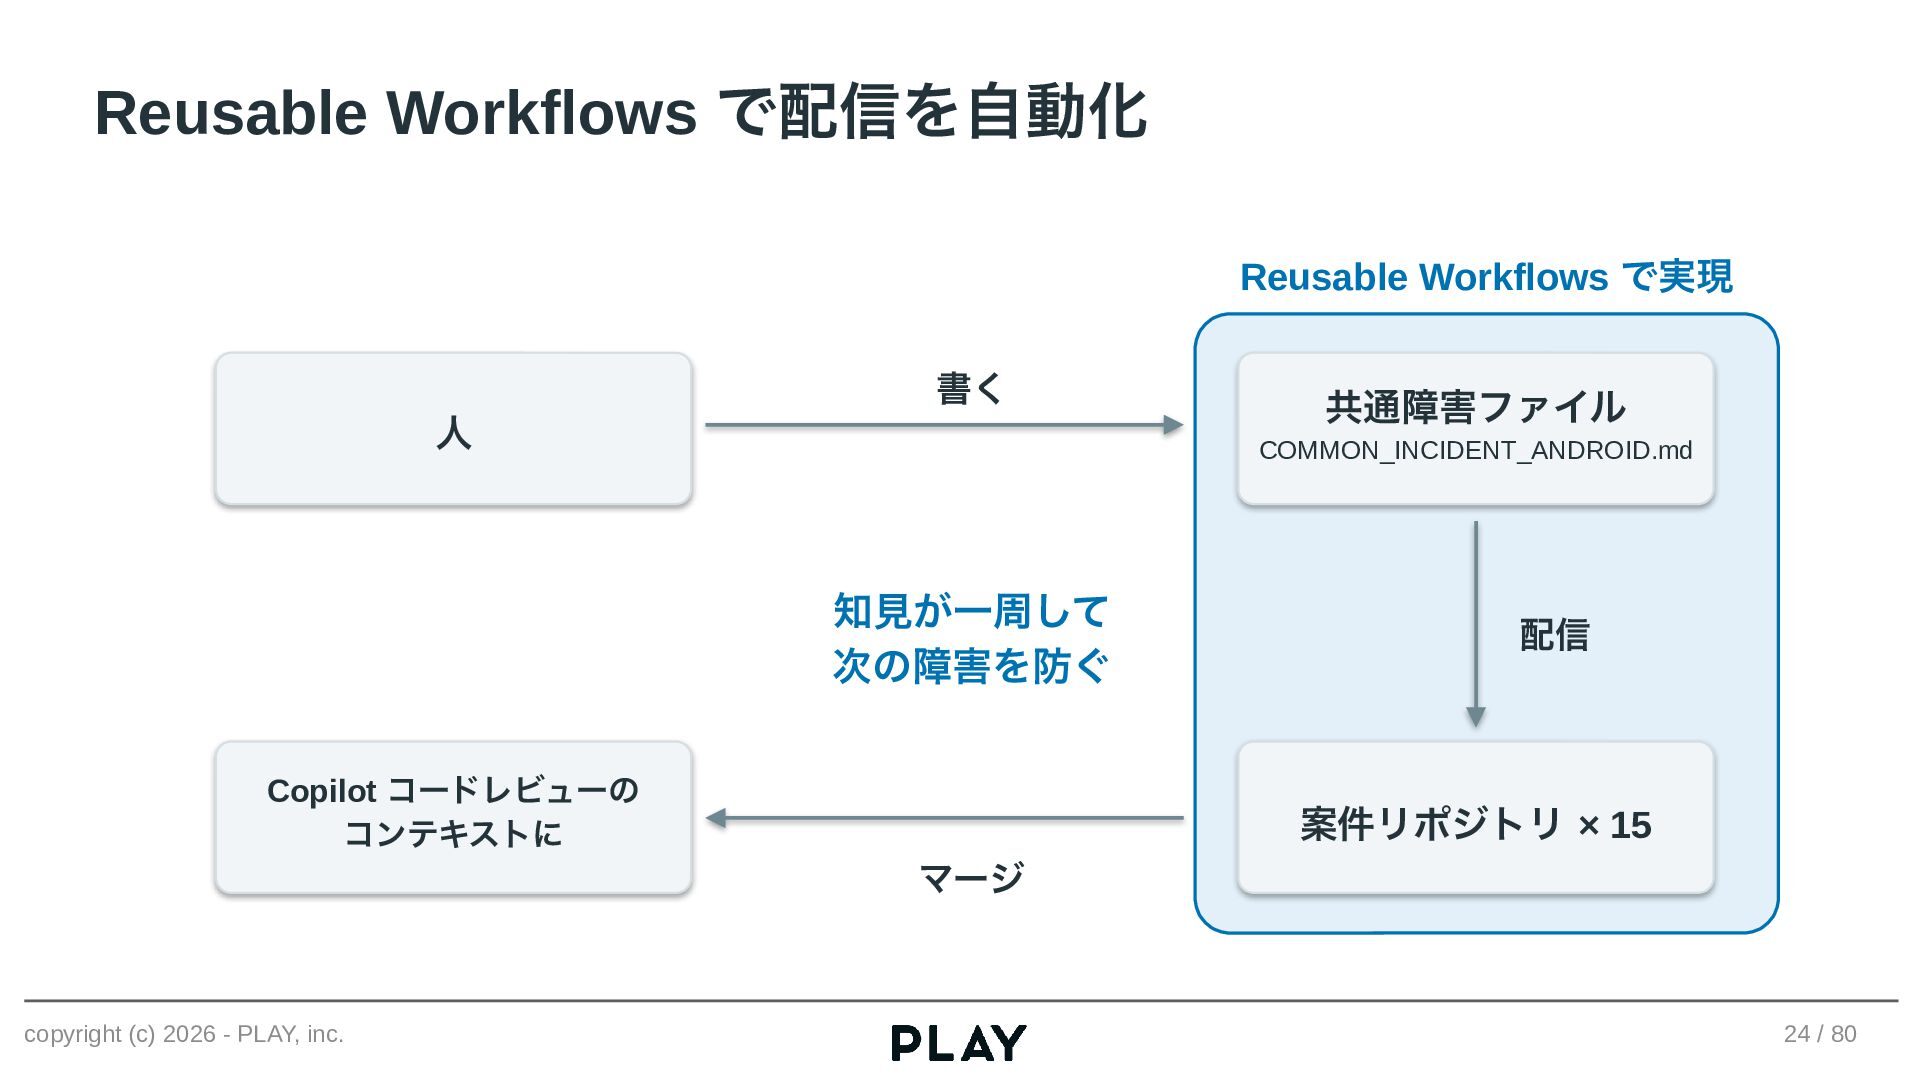
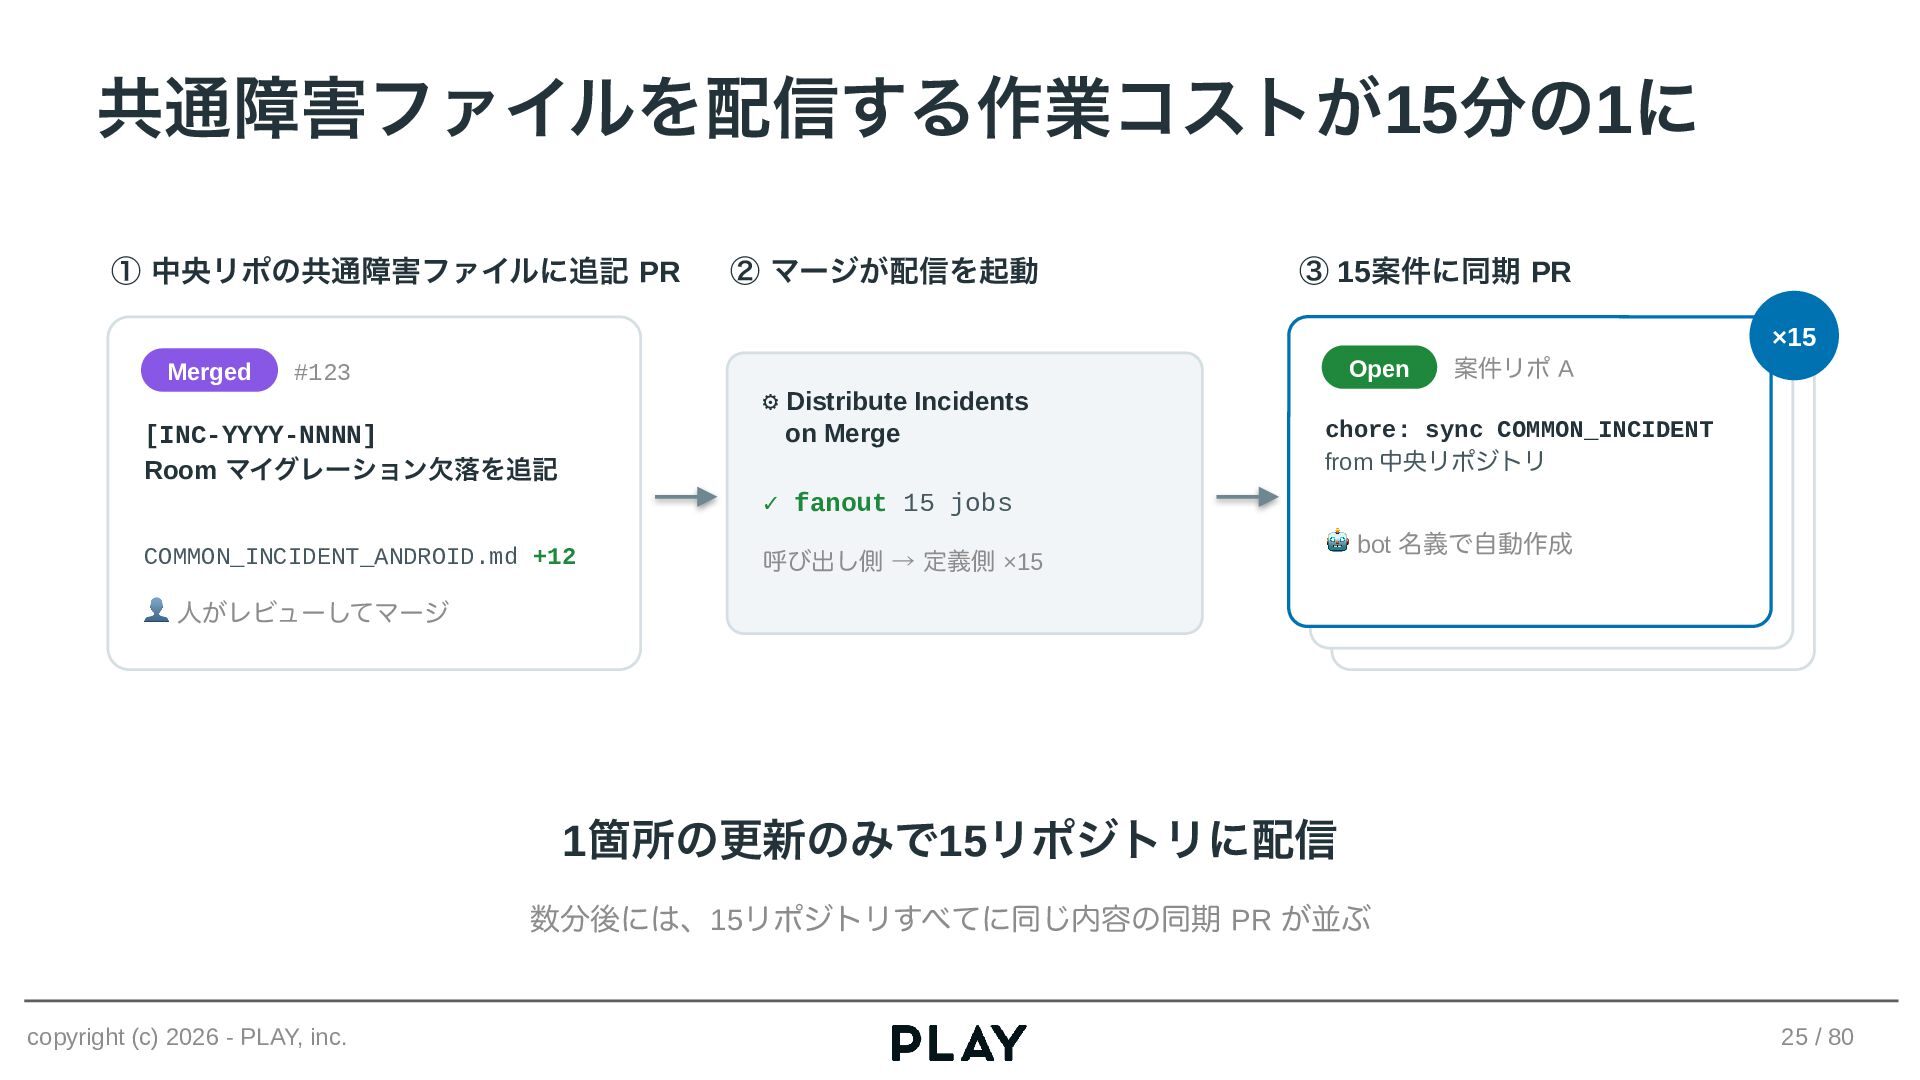
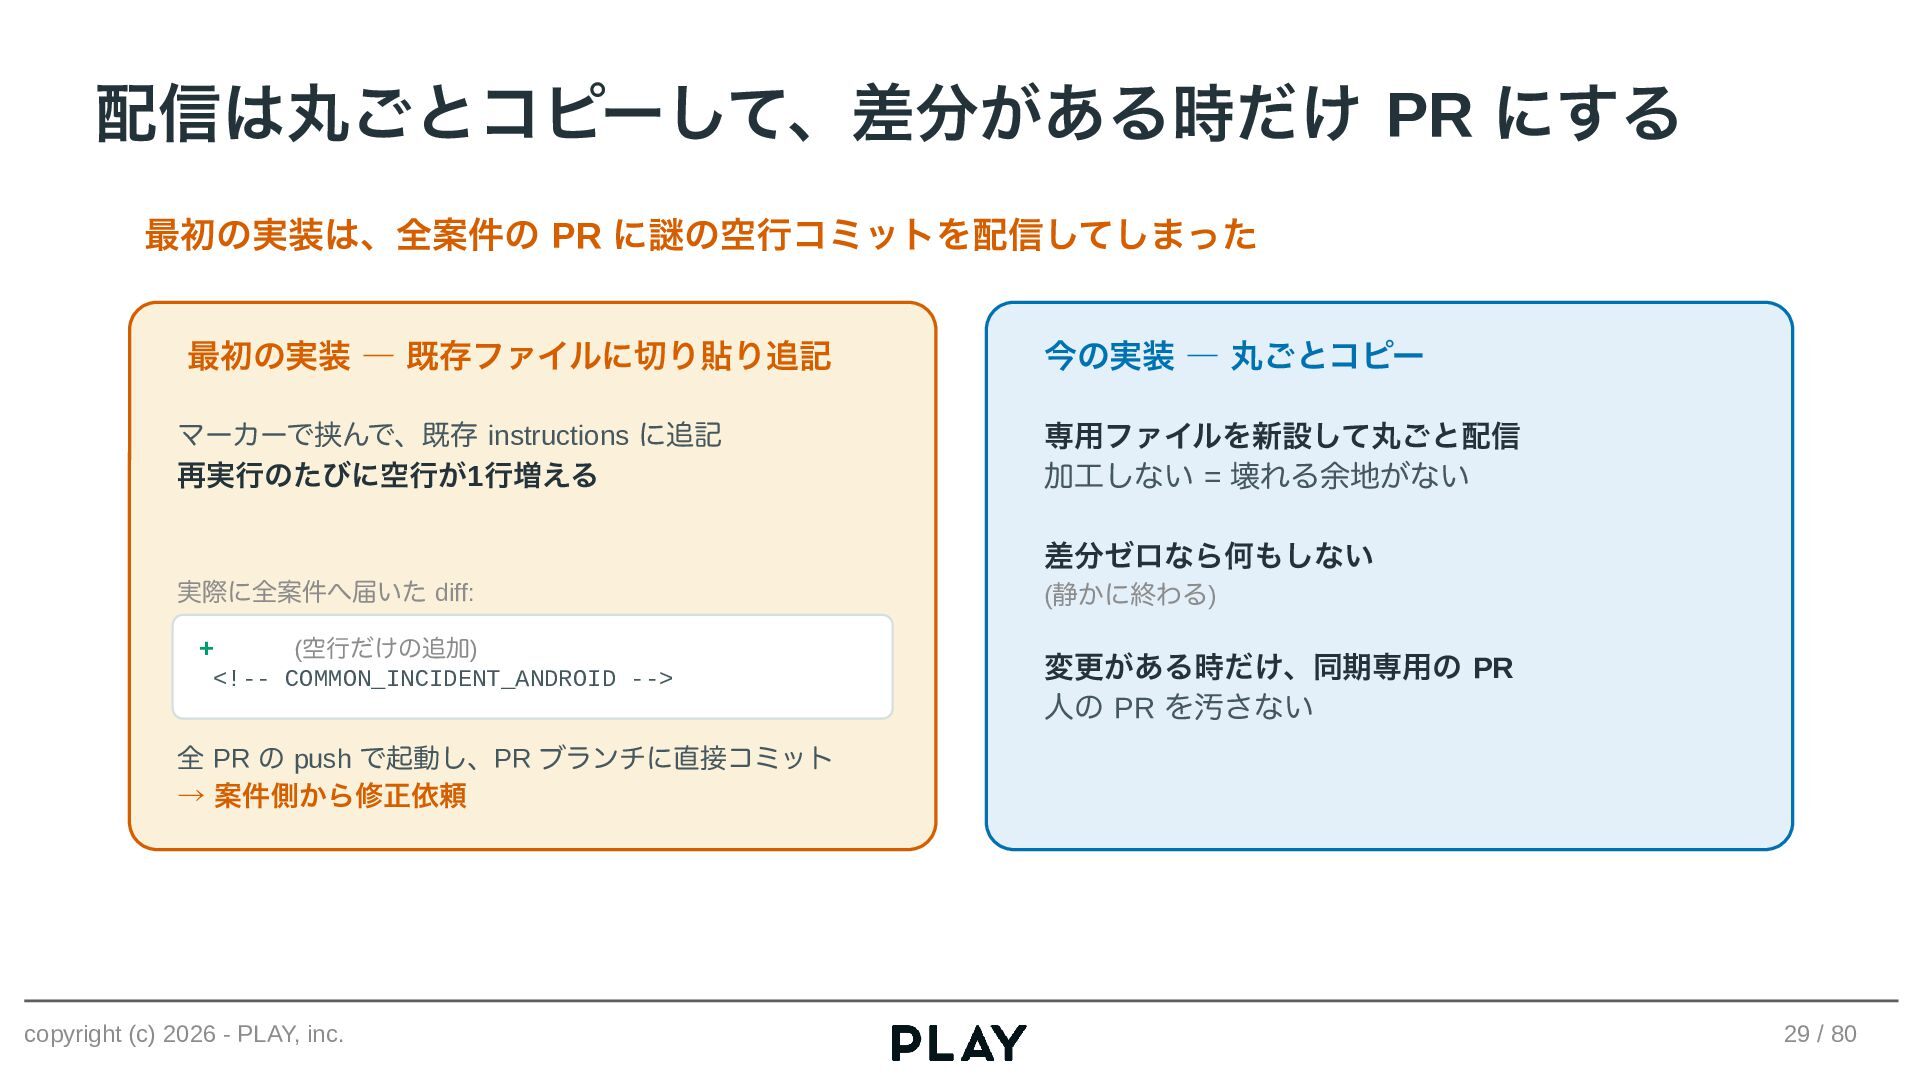
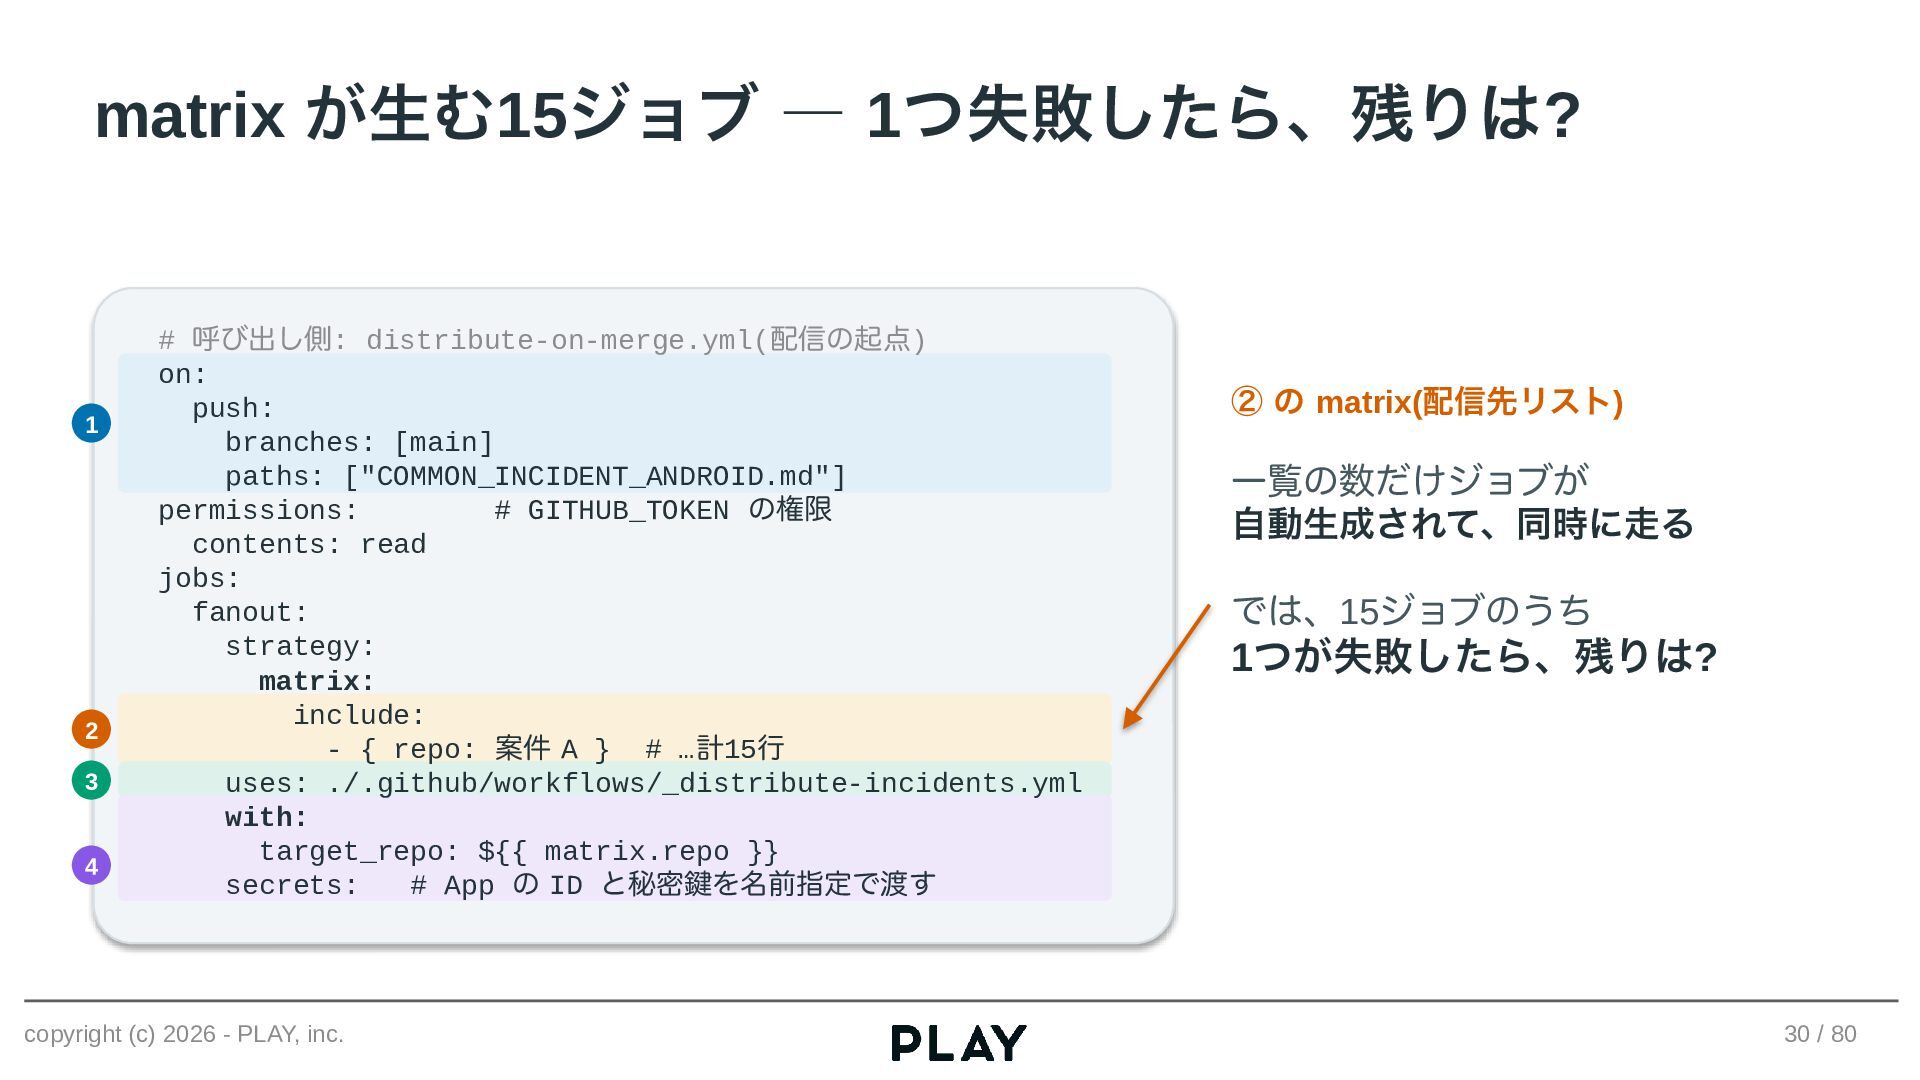
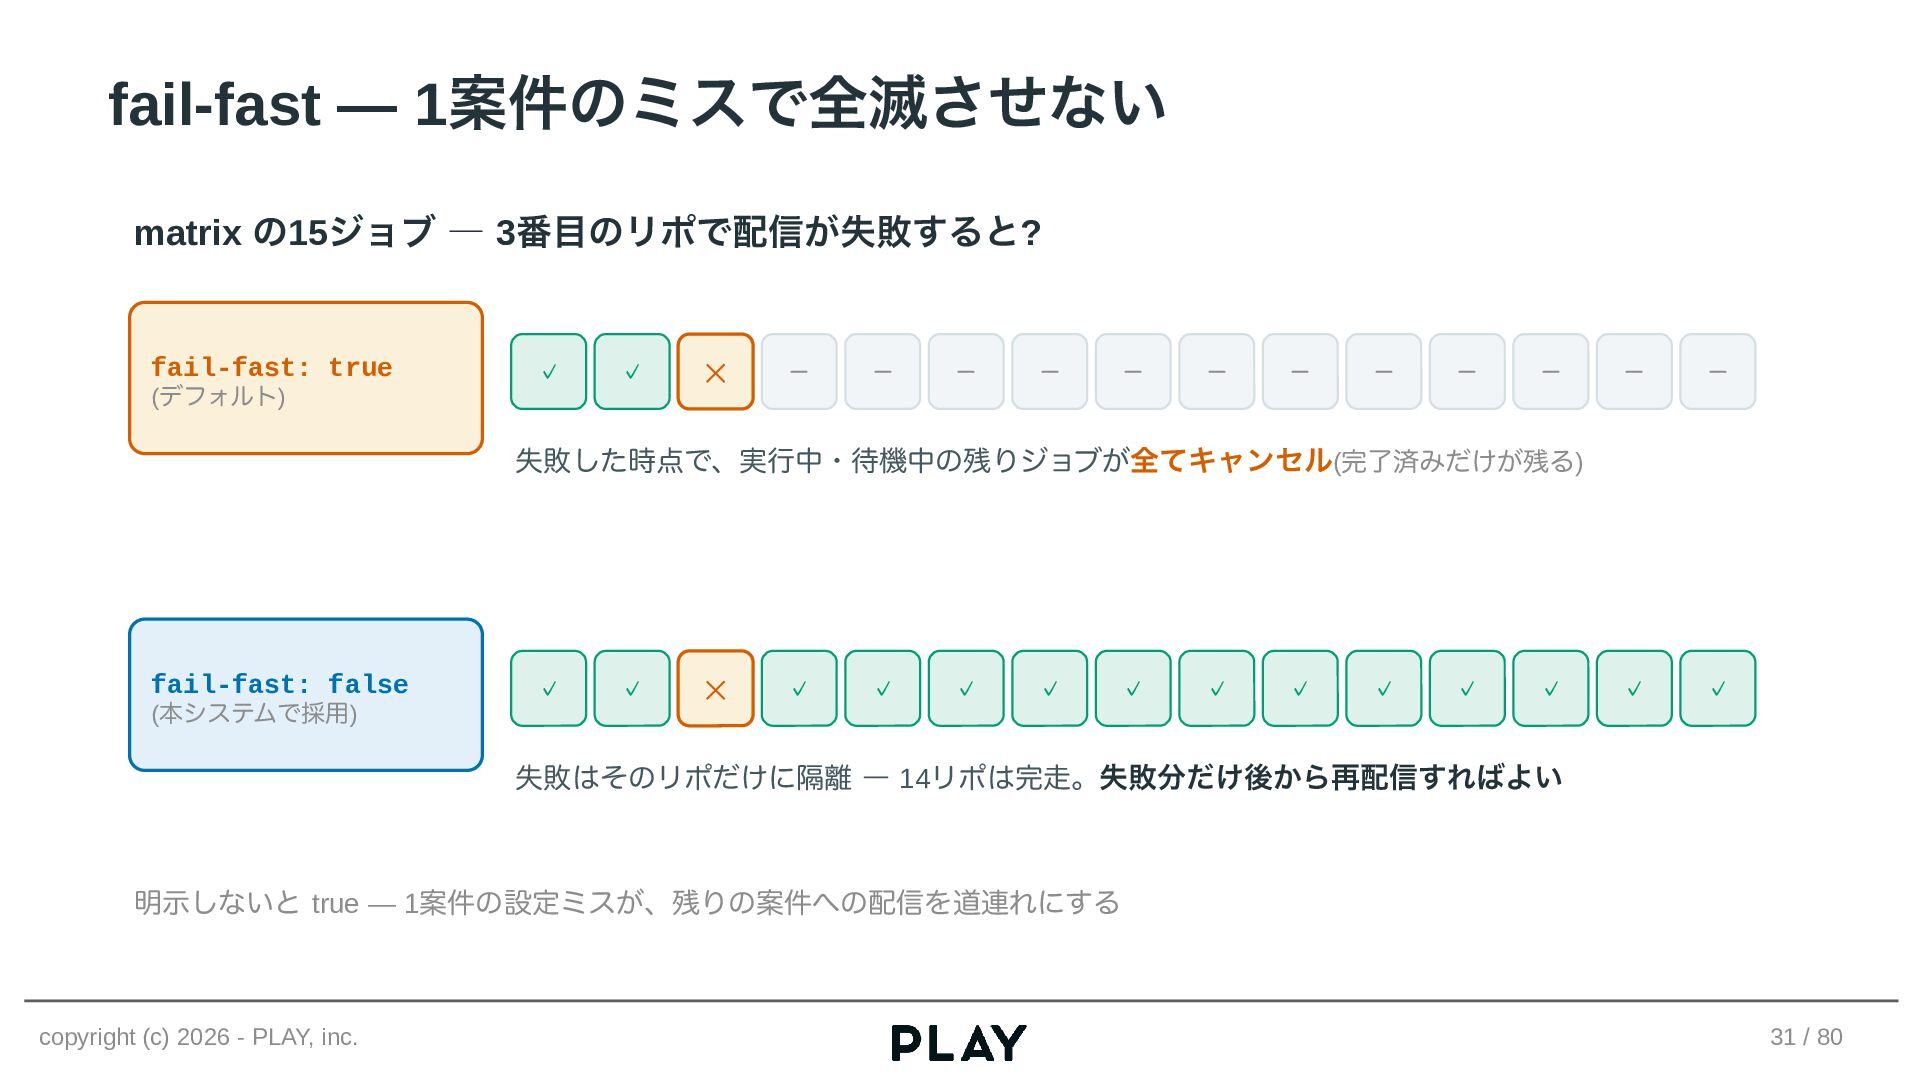
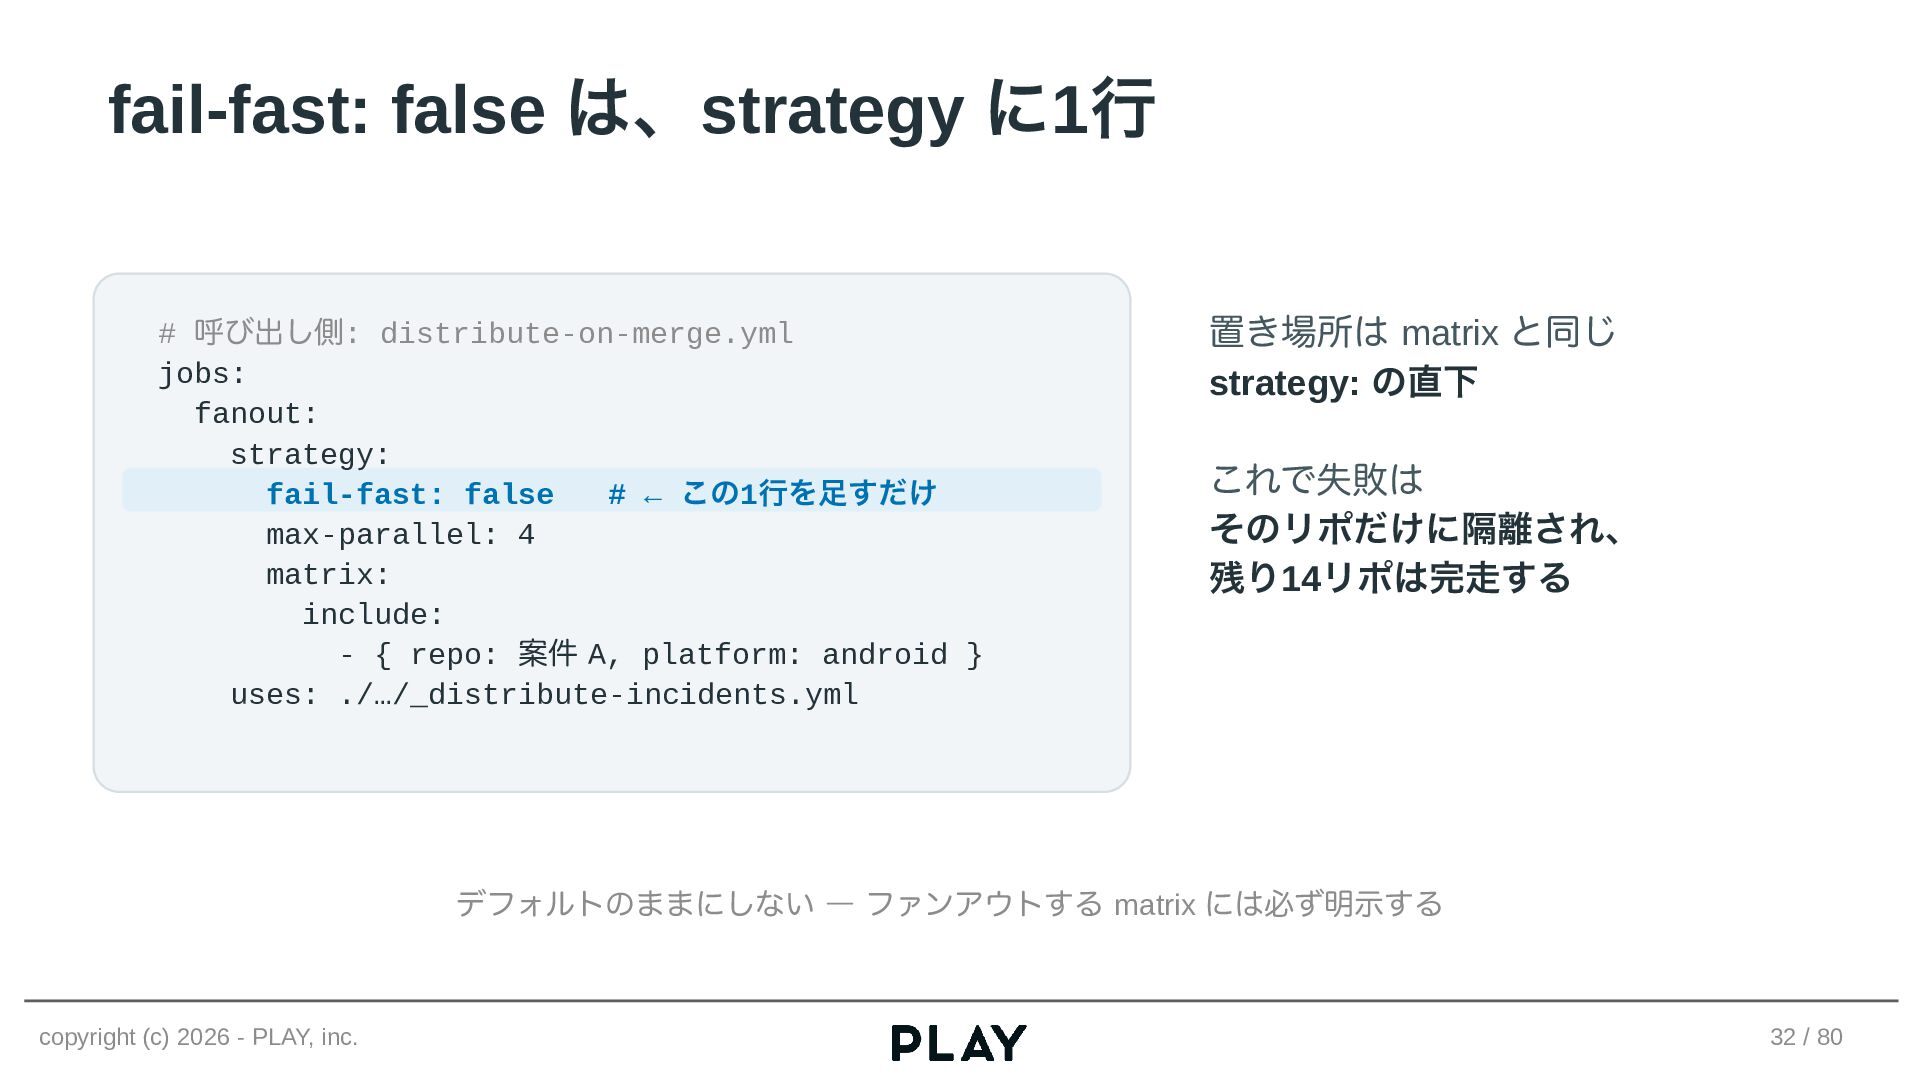
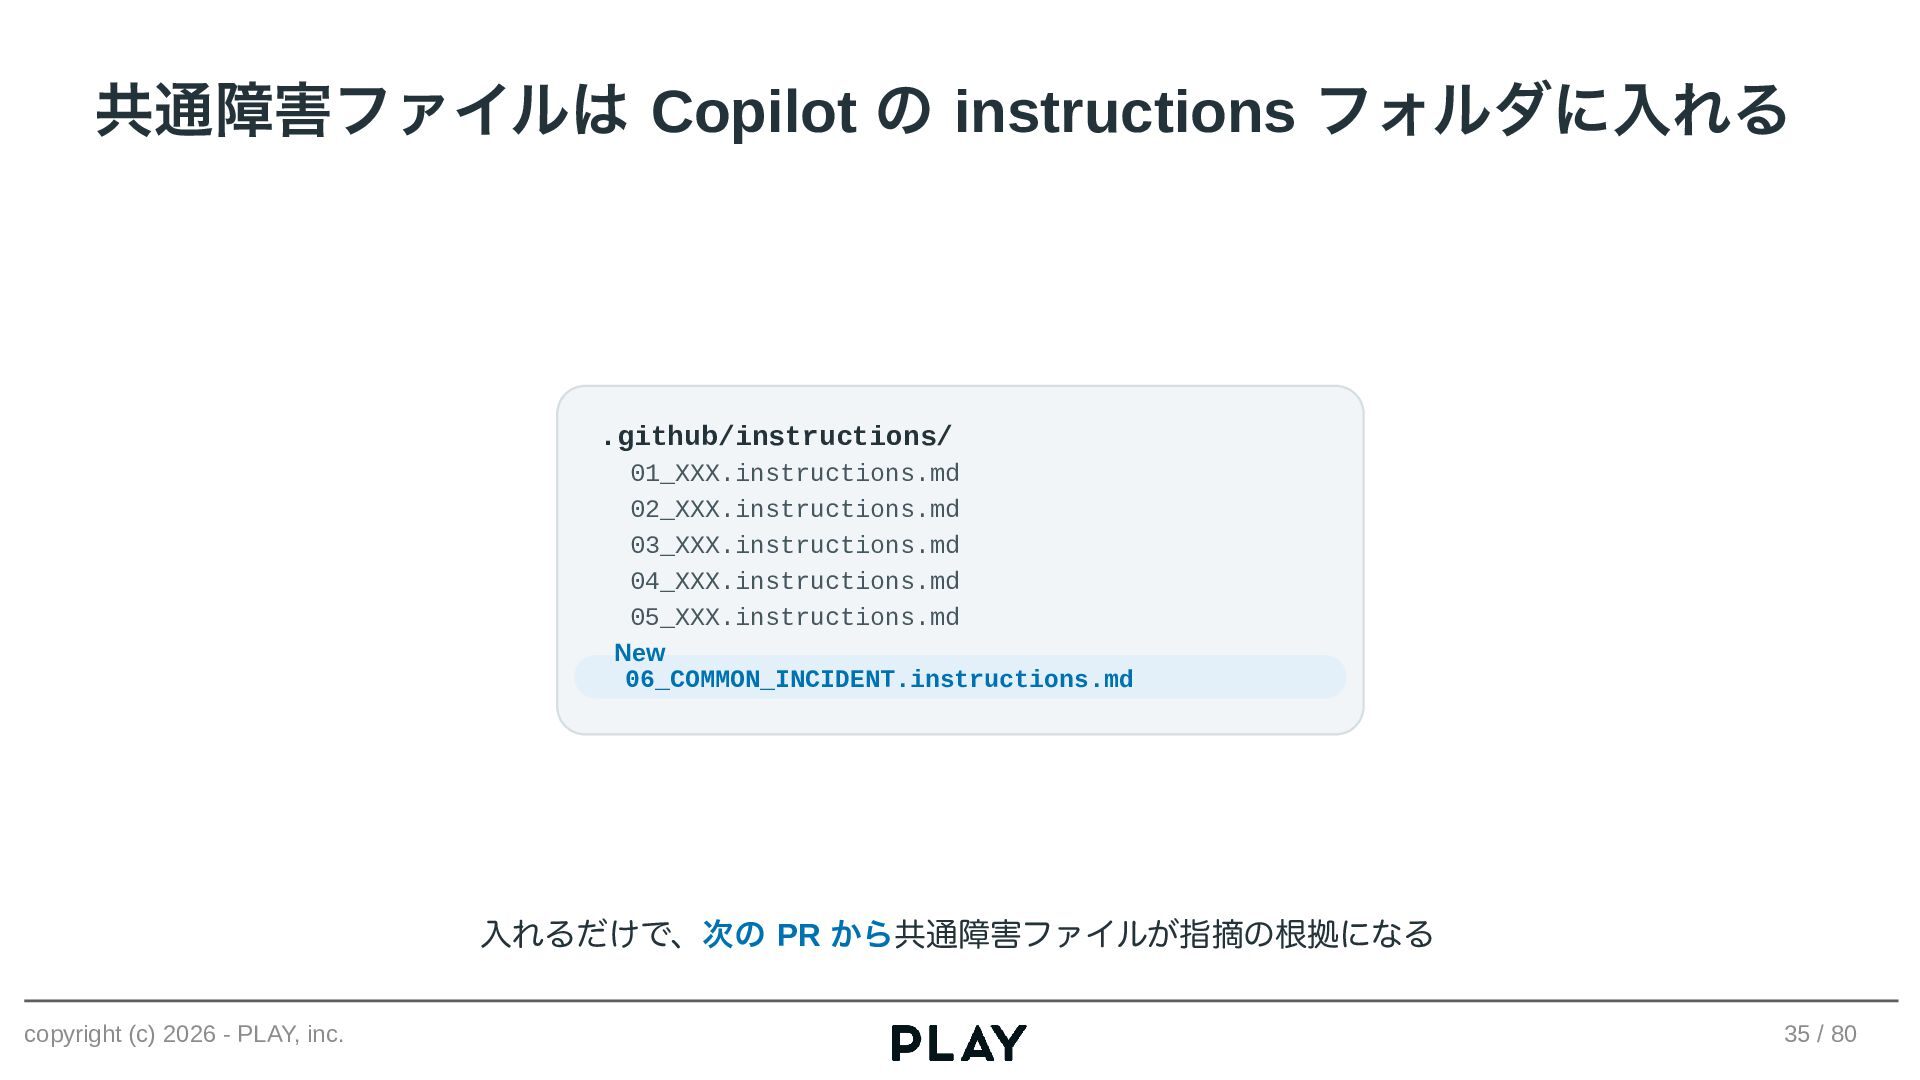
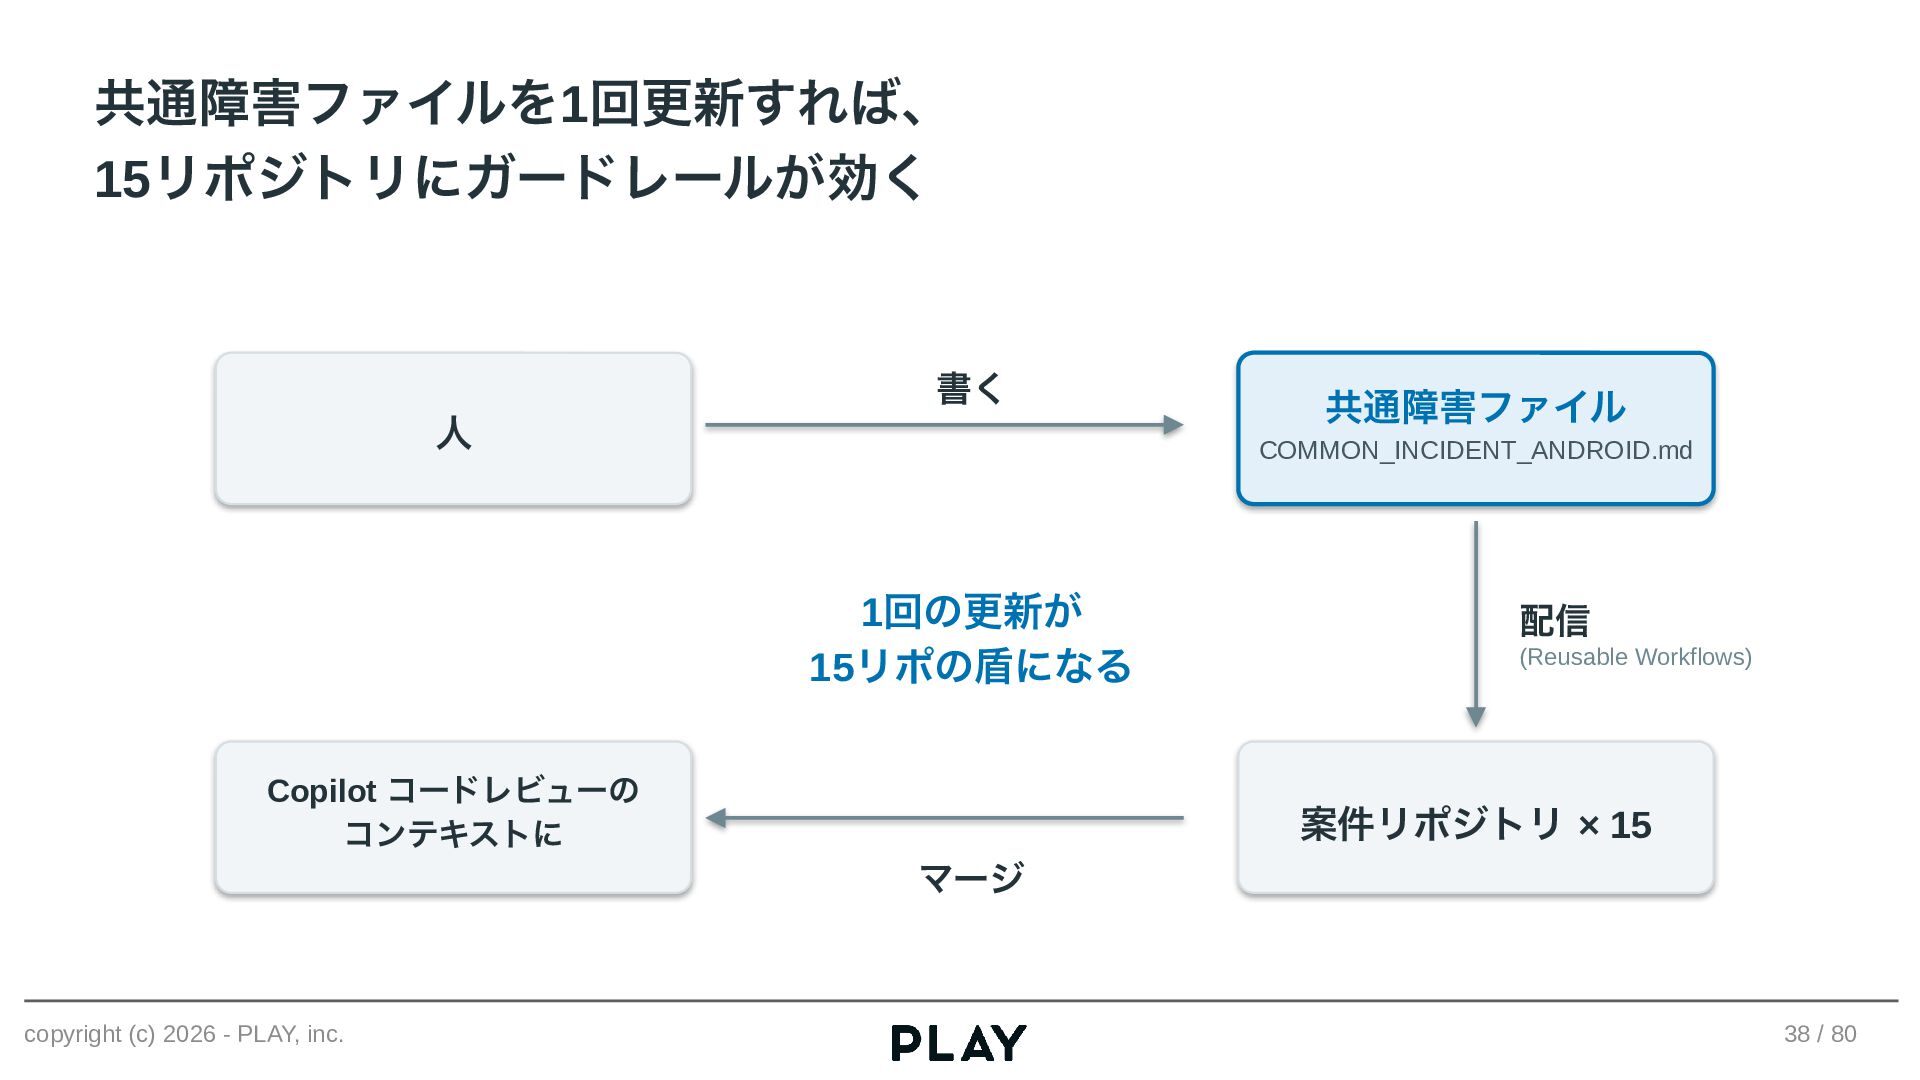
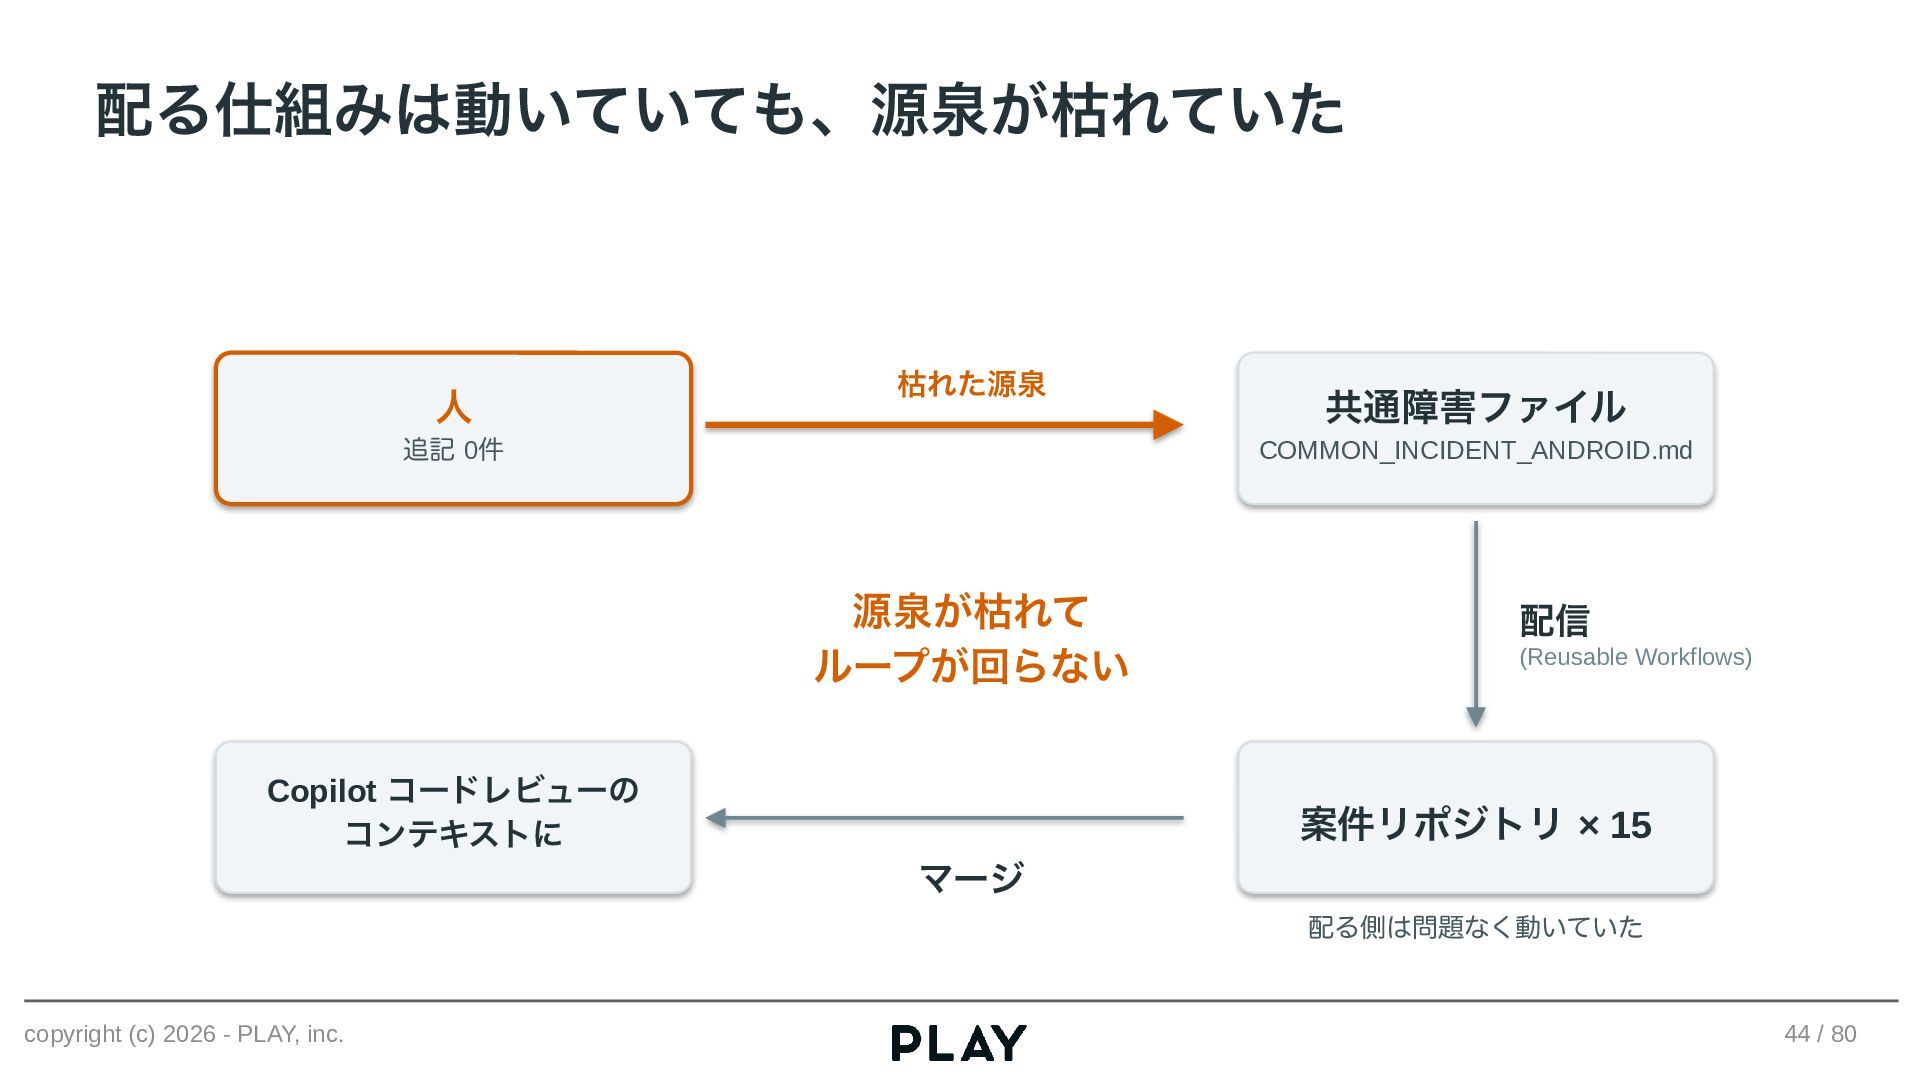
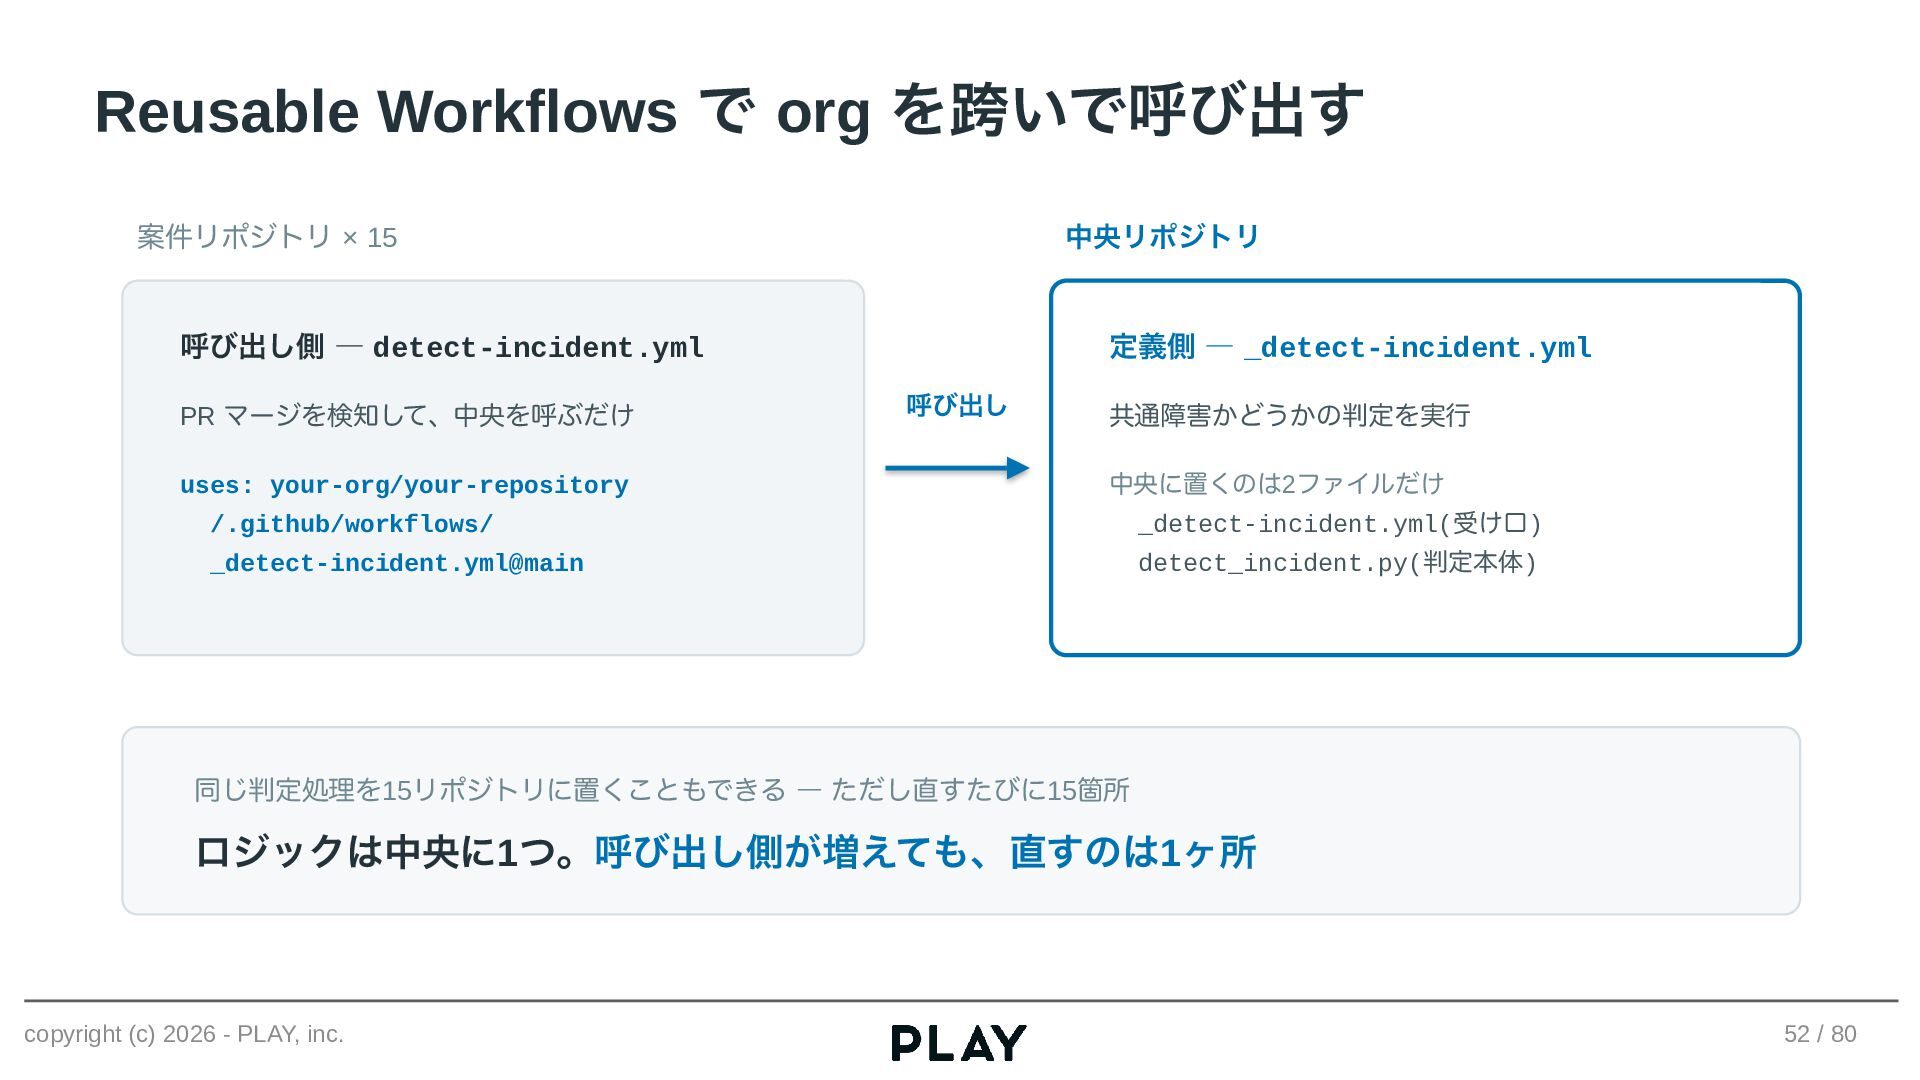
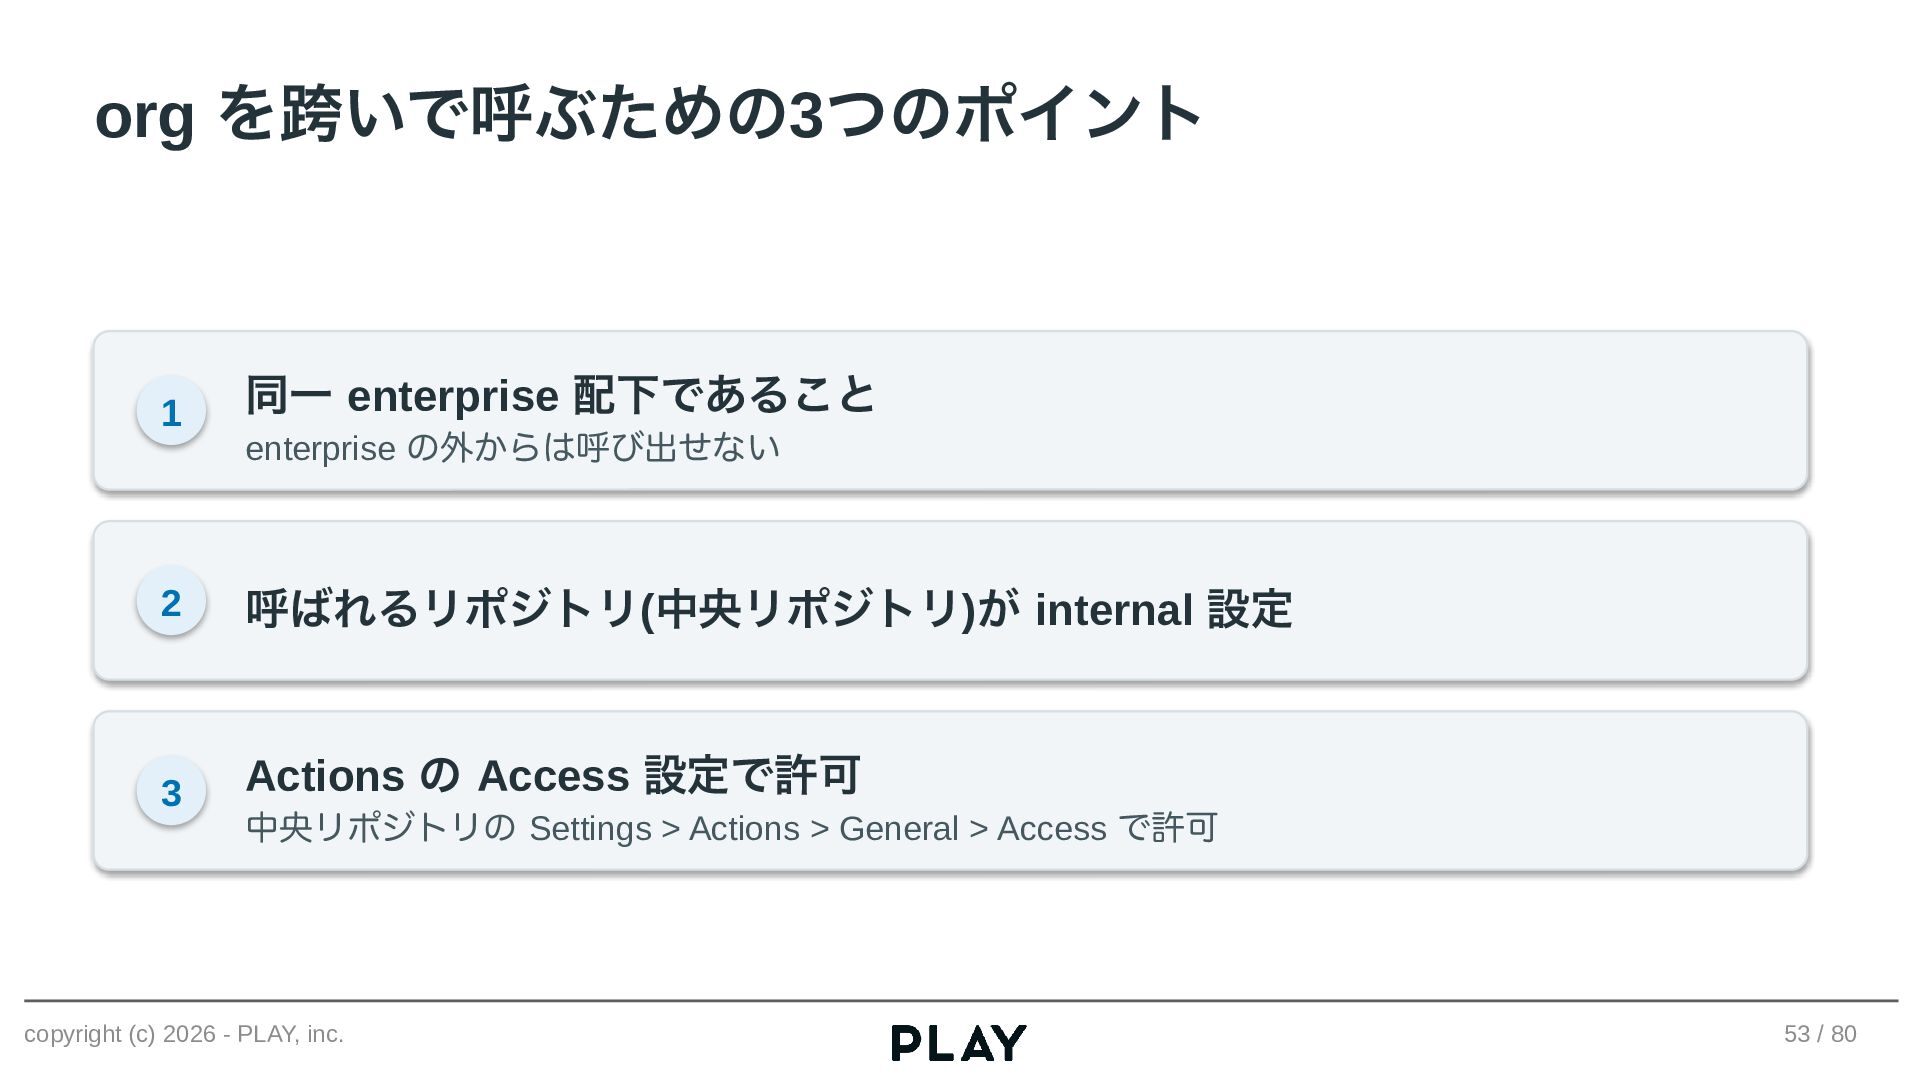
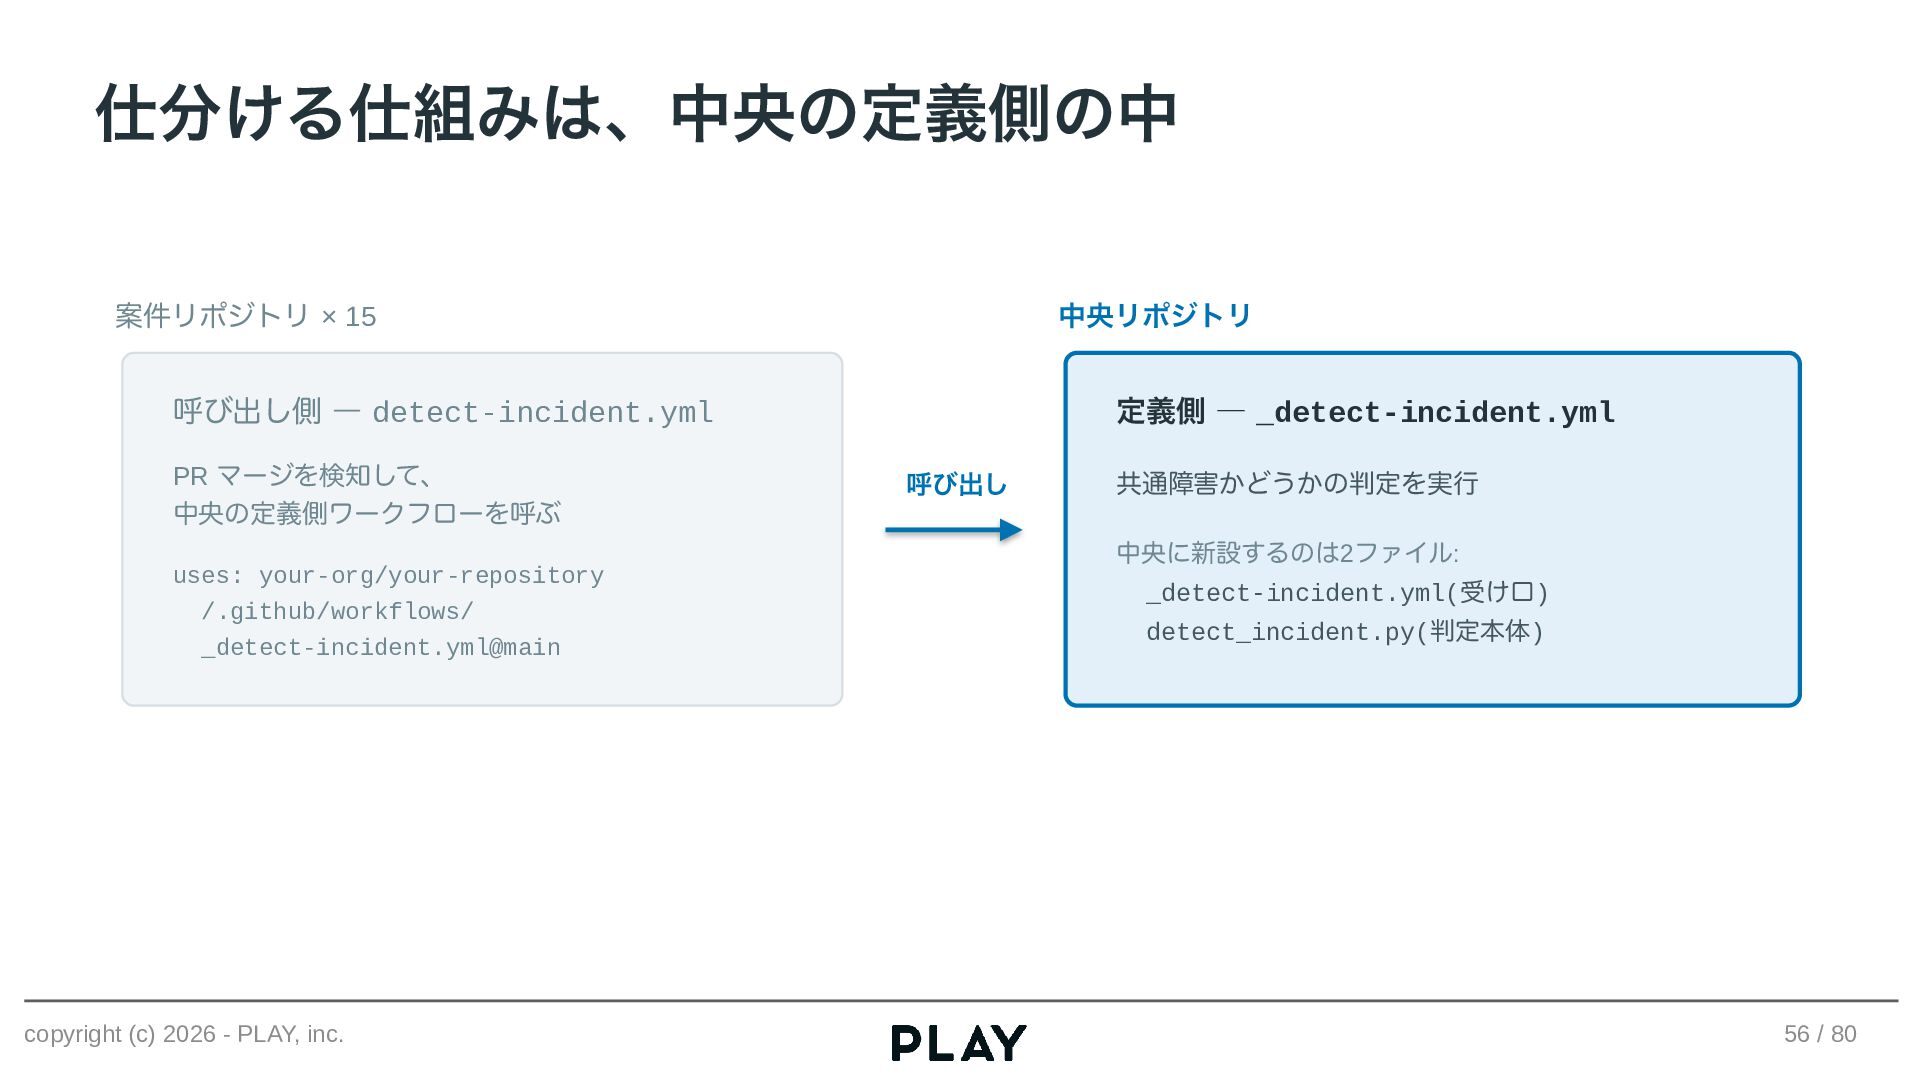
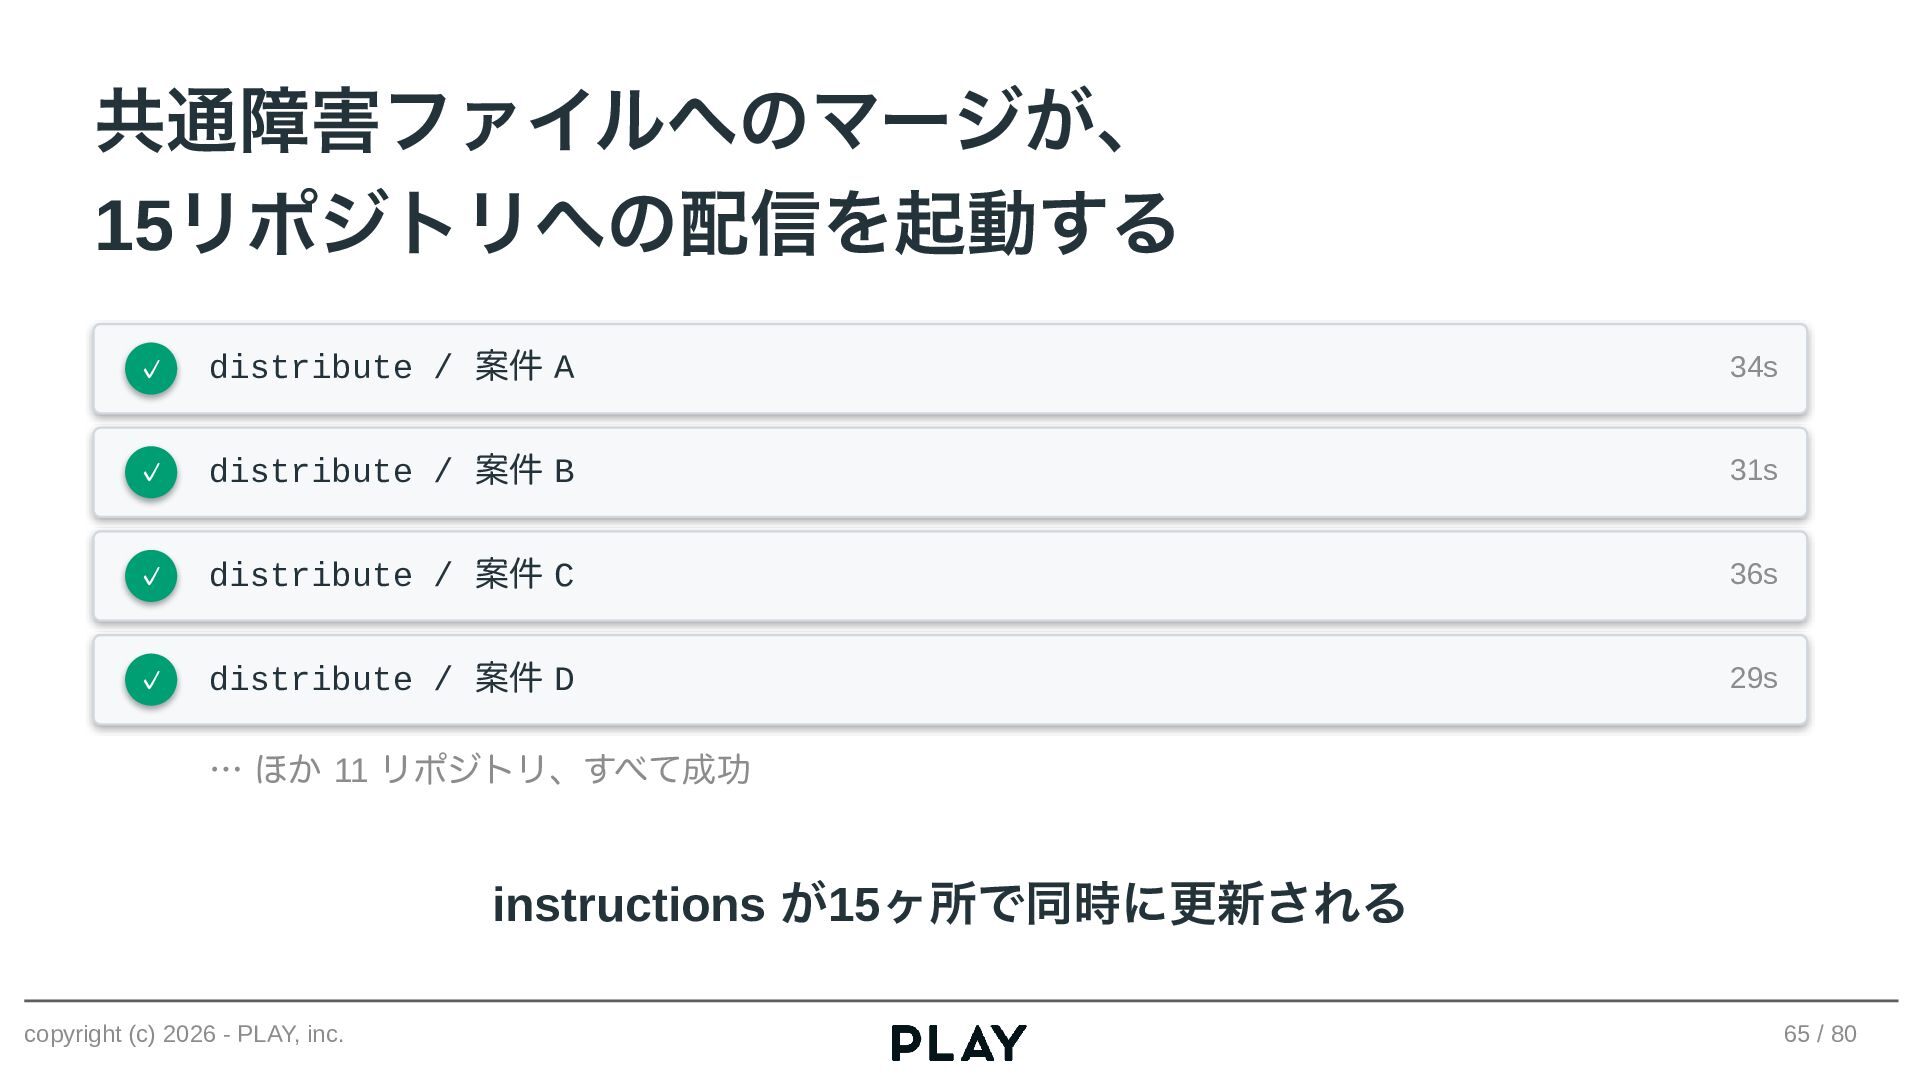
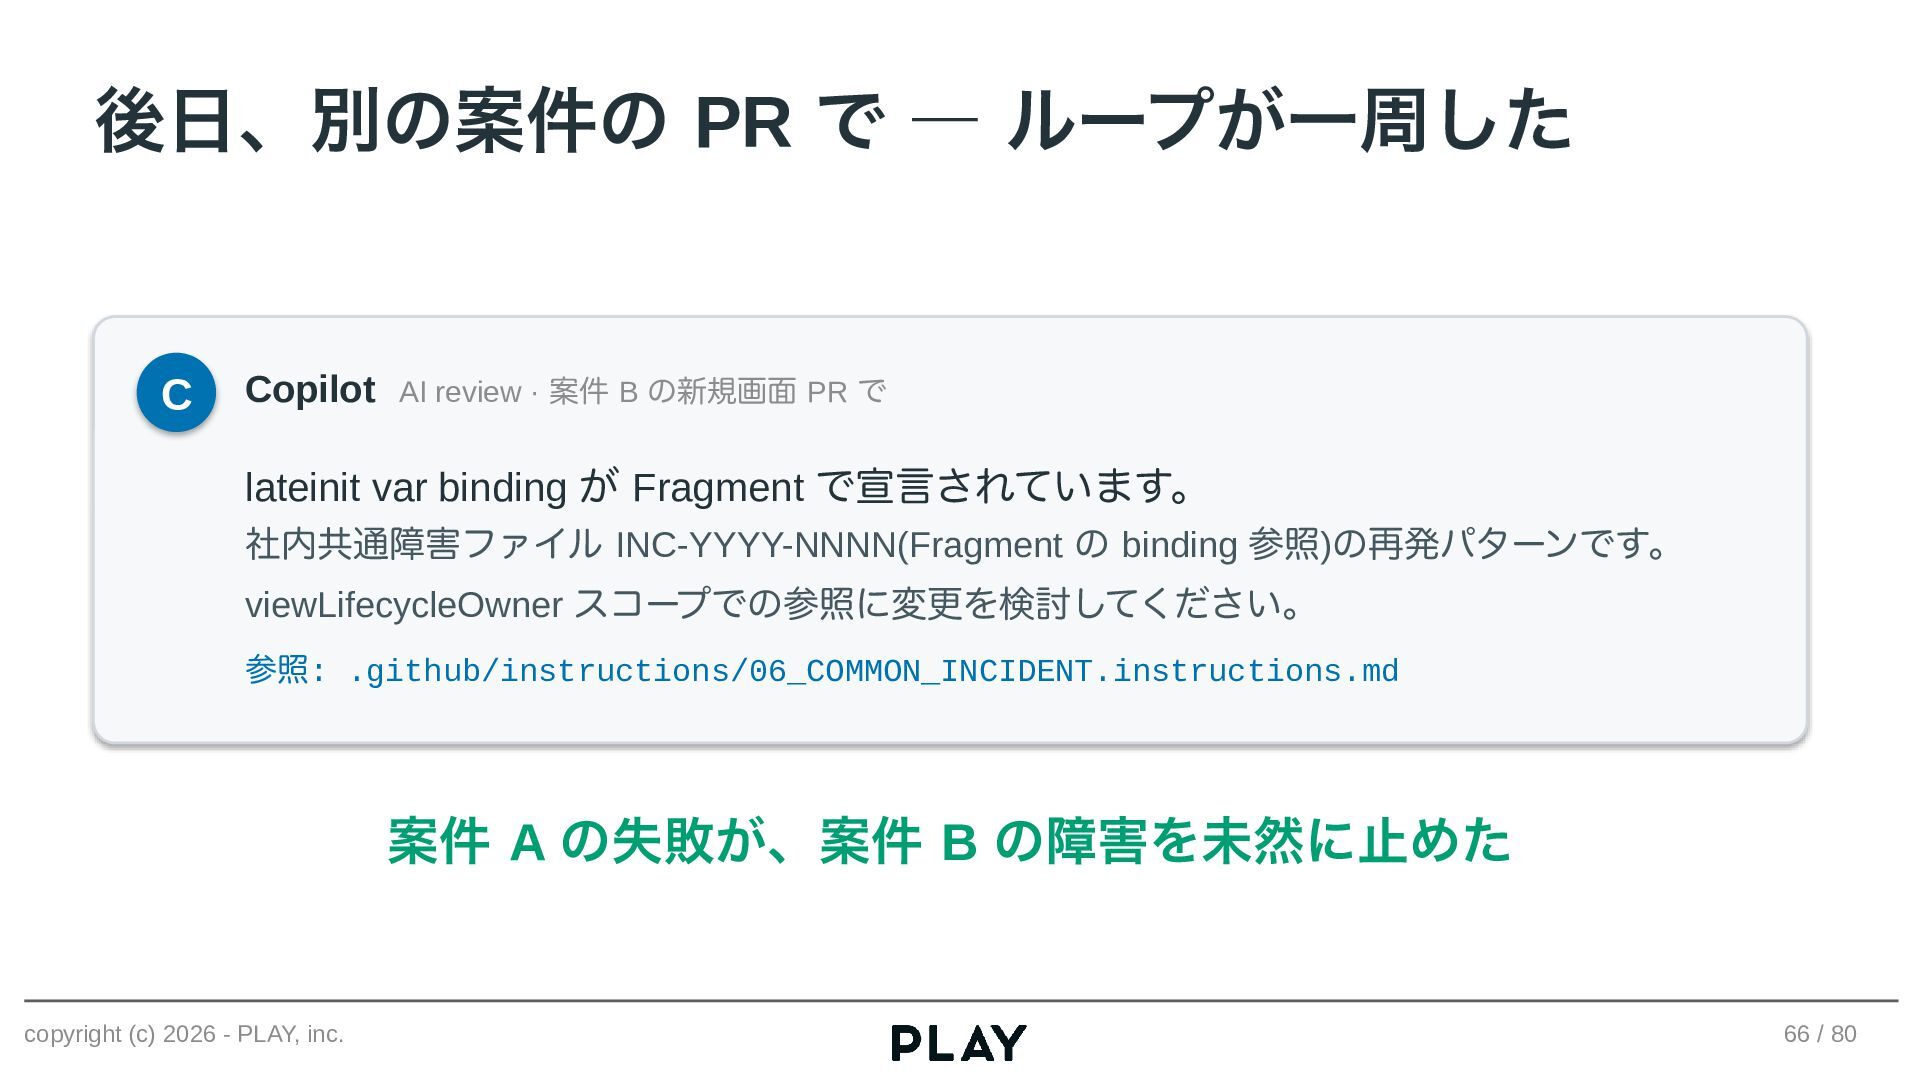
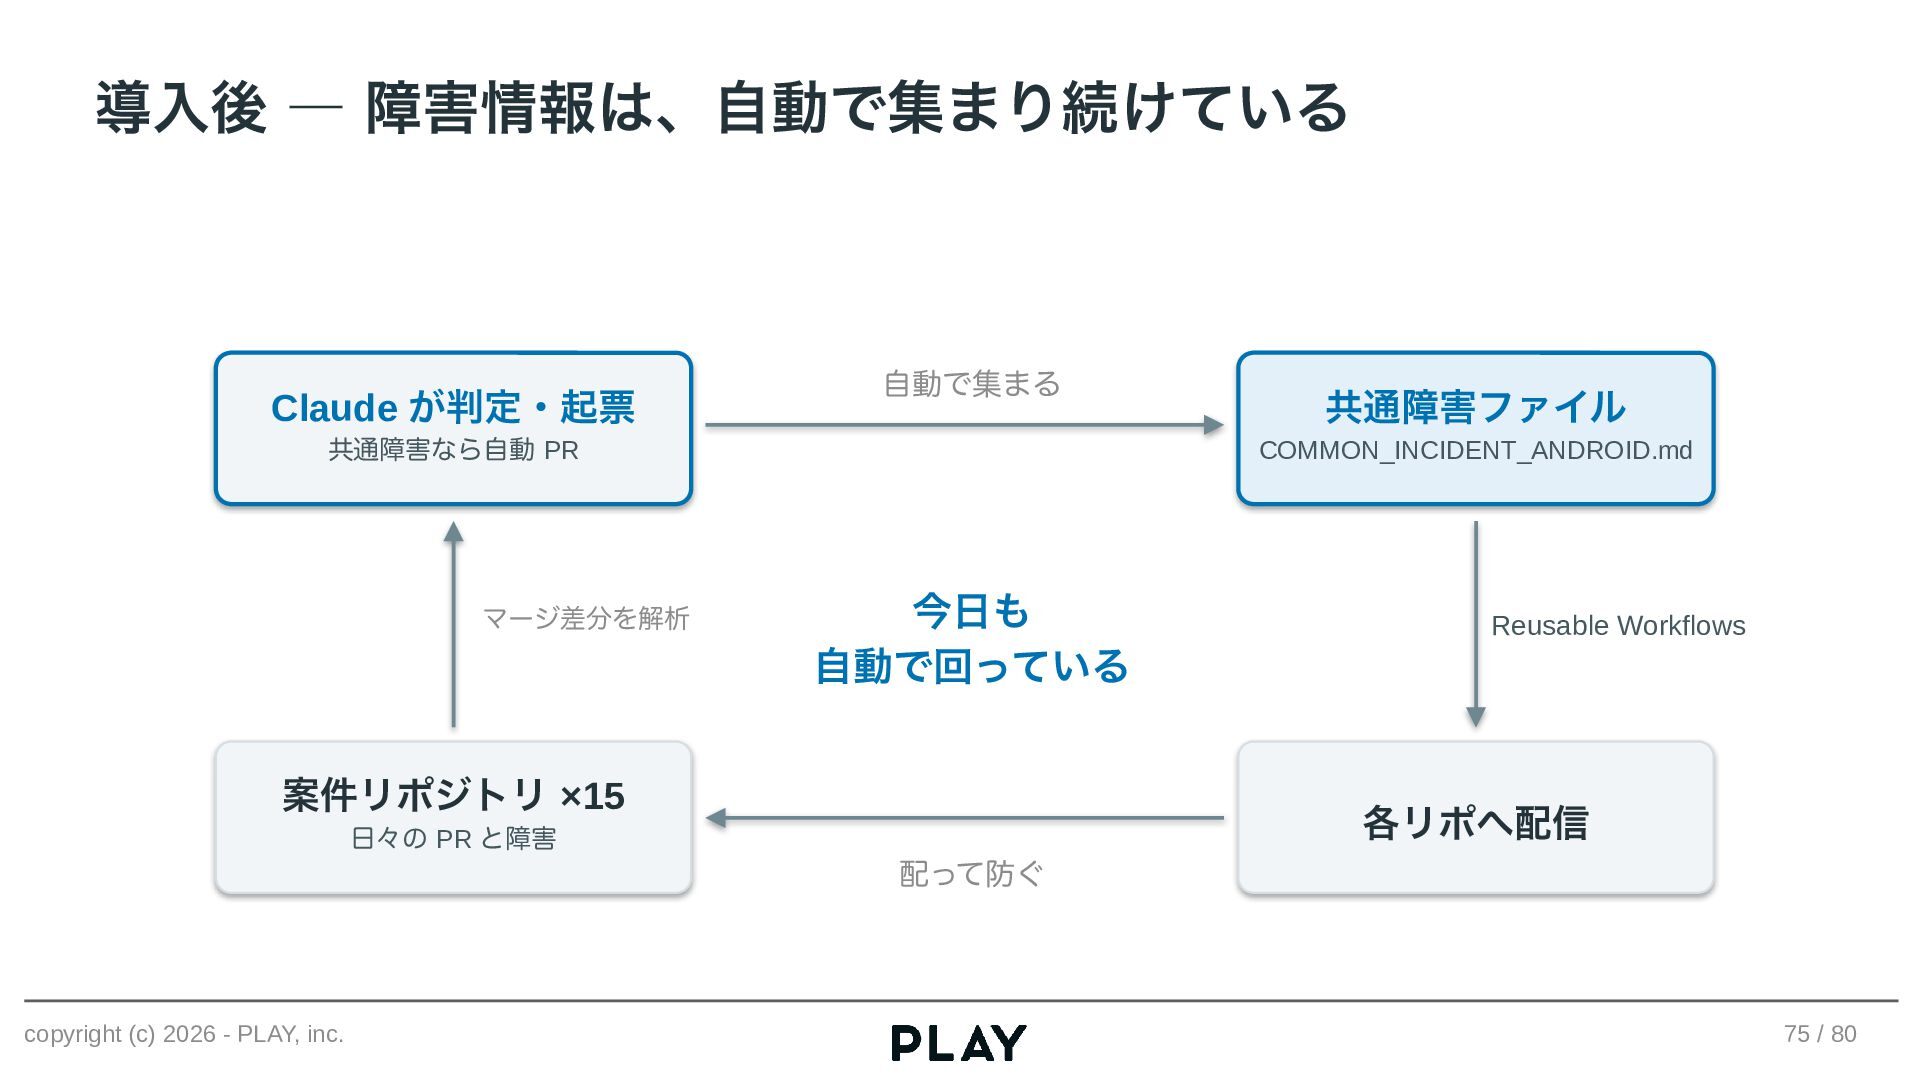
Android共通障害カタログを1つのMarkdownで一元管理し、その更新をトリガーにGitHub ActionsのReusable Workflowsの仕組みを利用し、15プロジェクトリポジトリへ自動配布、さらにCopilotコードレビューのinstructionsとして障害情報を参照させる仕組みを構築しました。
これにより、「カタログを1つ更新するだけで全リポジトリへ自動展開され、AIコードレビューによる横断的なガードレールが効く」状態を実現したつもりでした。
しかし事はそう上手く運びません。
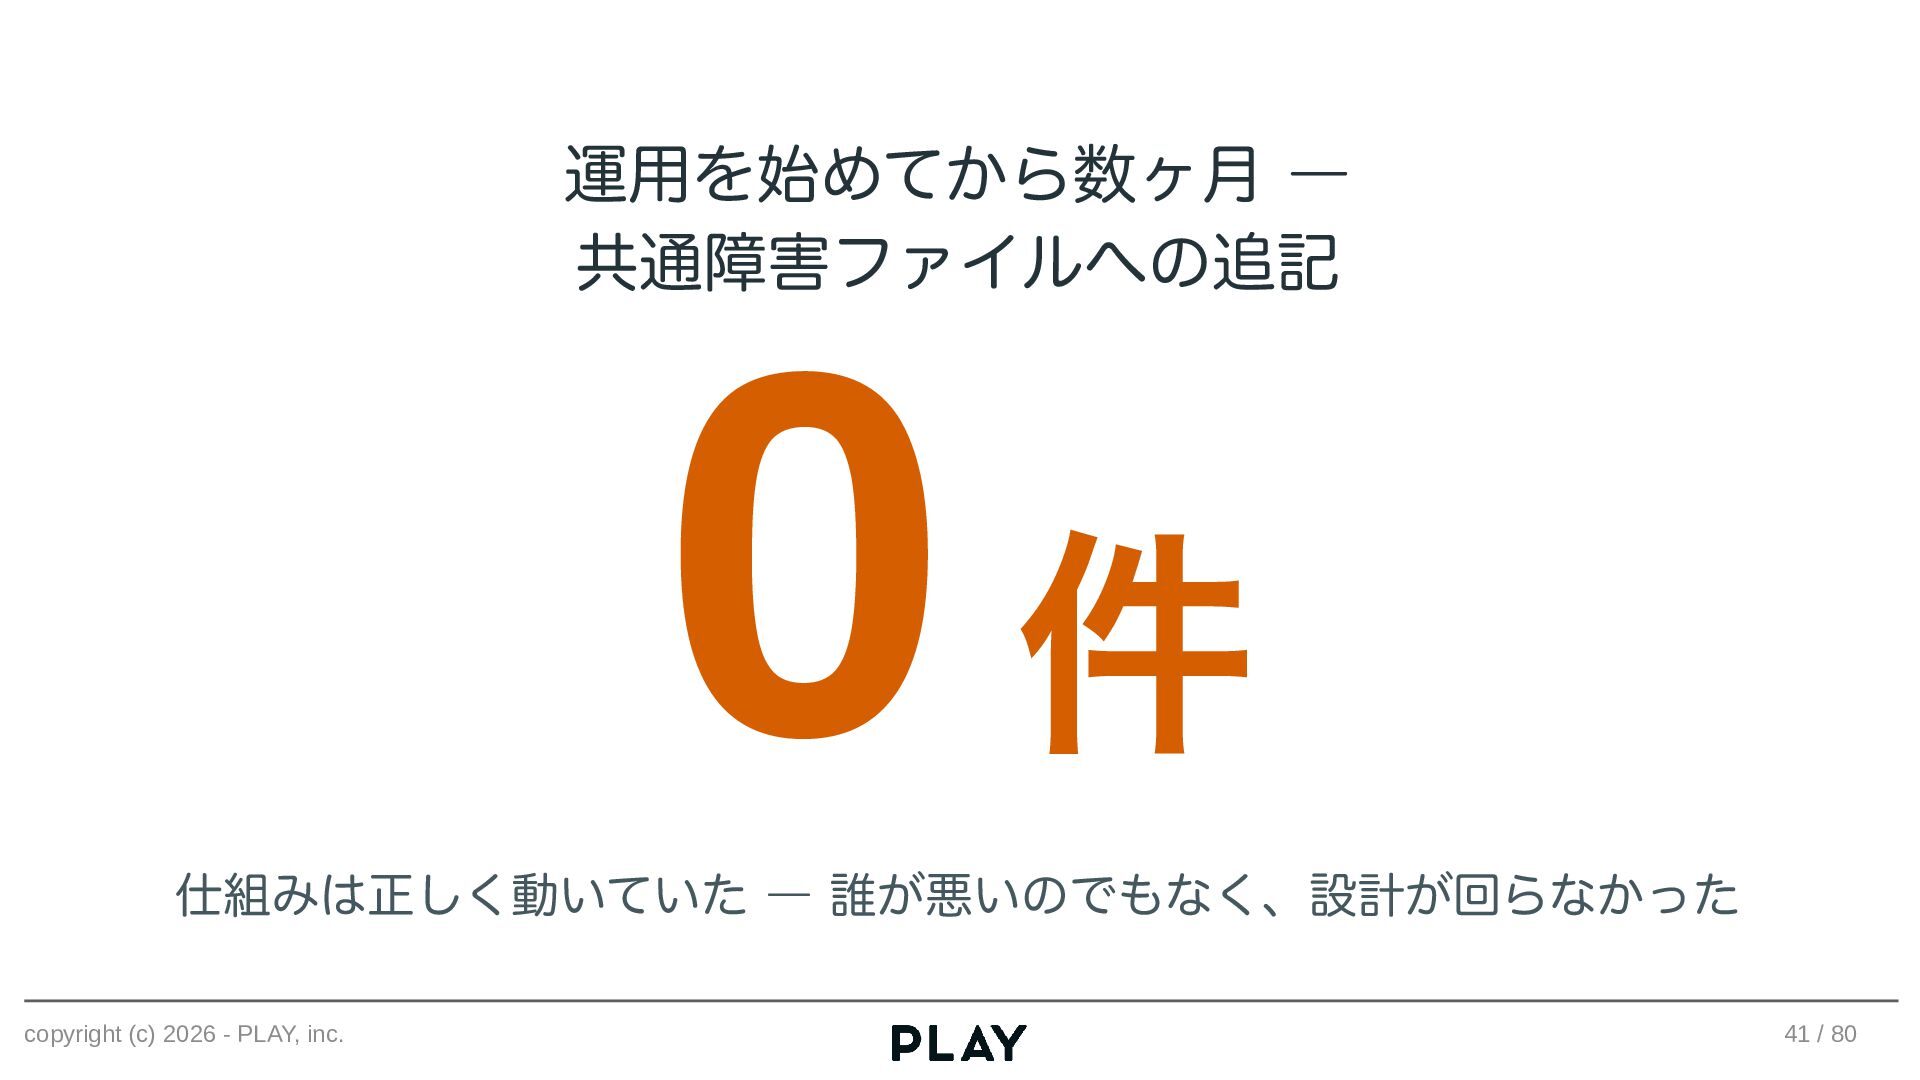
数ヶ月が経過しても、私以外のメンバーからのAndroid障害カタログへの追記数は0件だったのです。
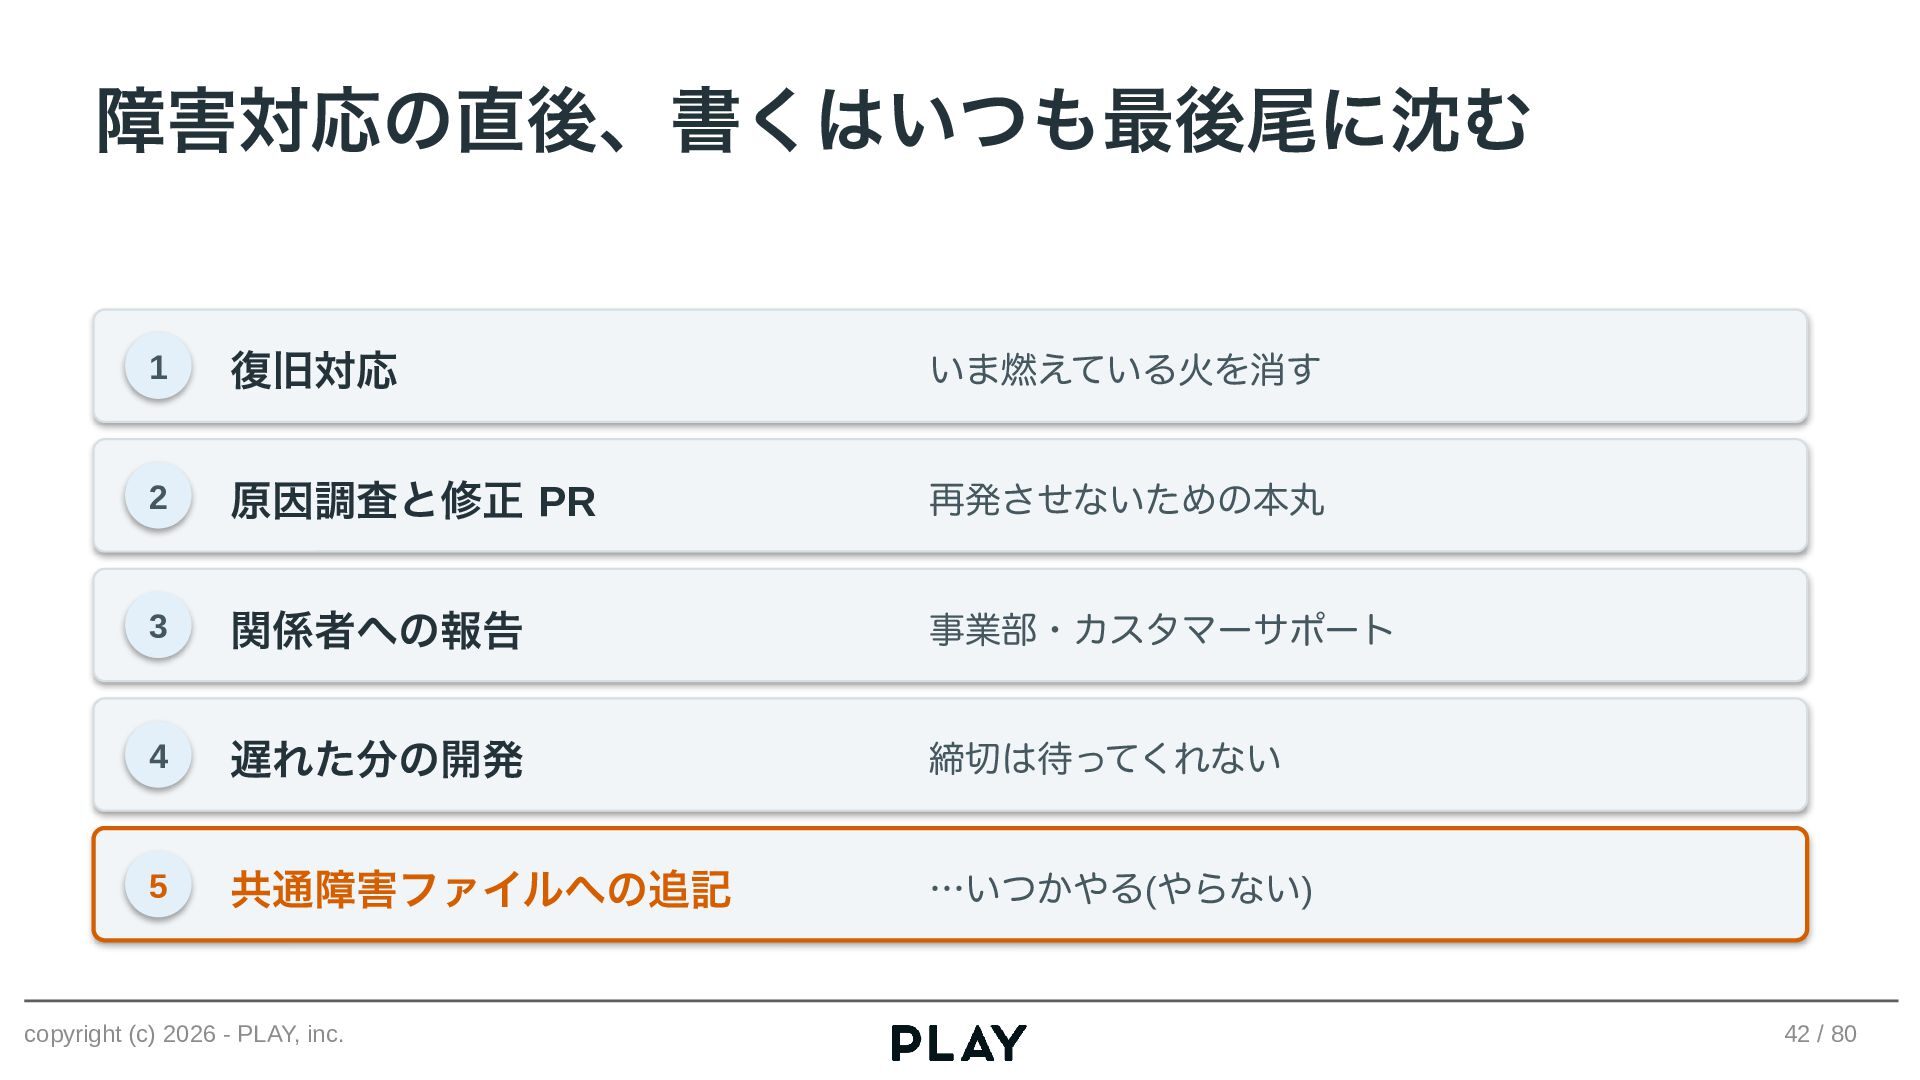
通常業務で忙しい中で、仕組みだけ作っても障害情報のナレッジは追加されないというシビアな現実を突きつけられました。
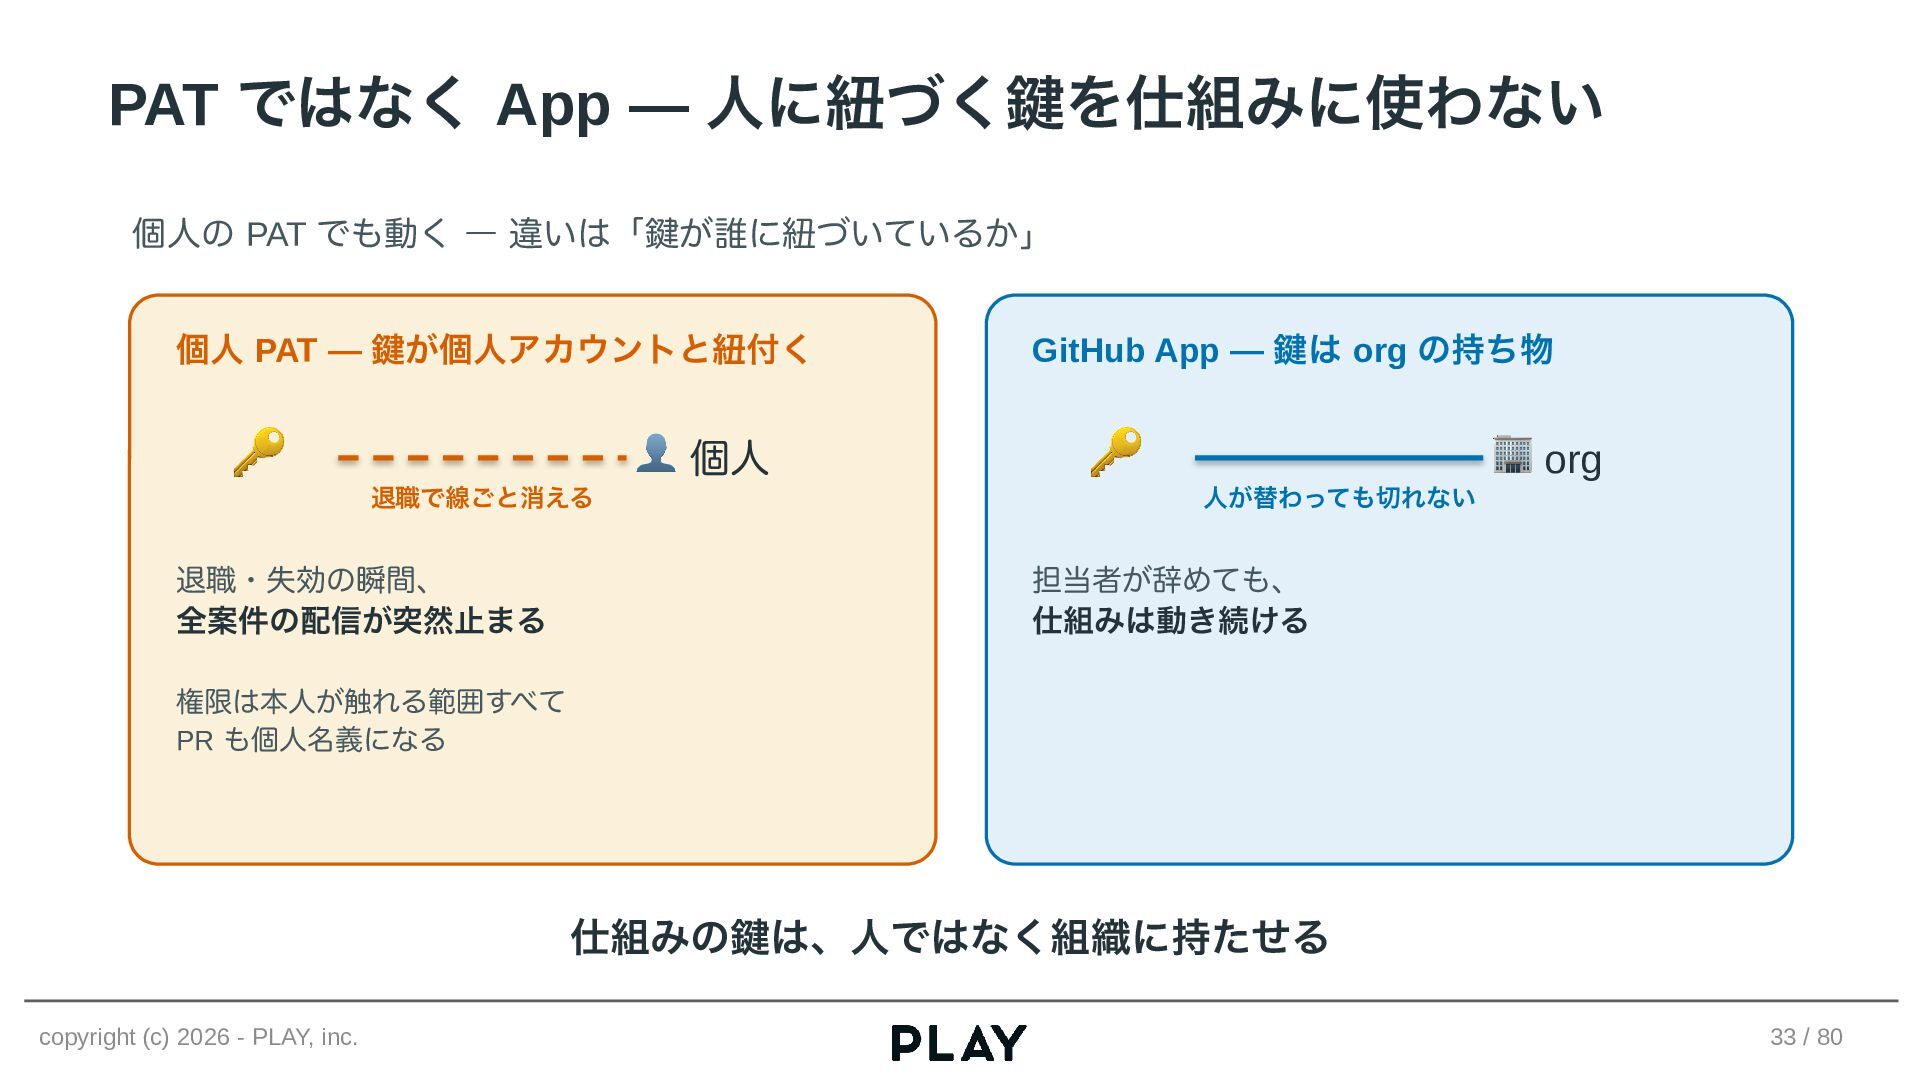
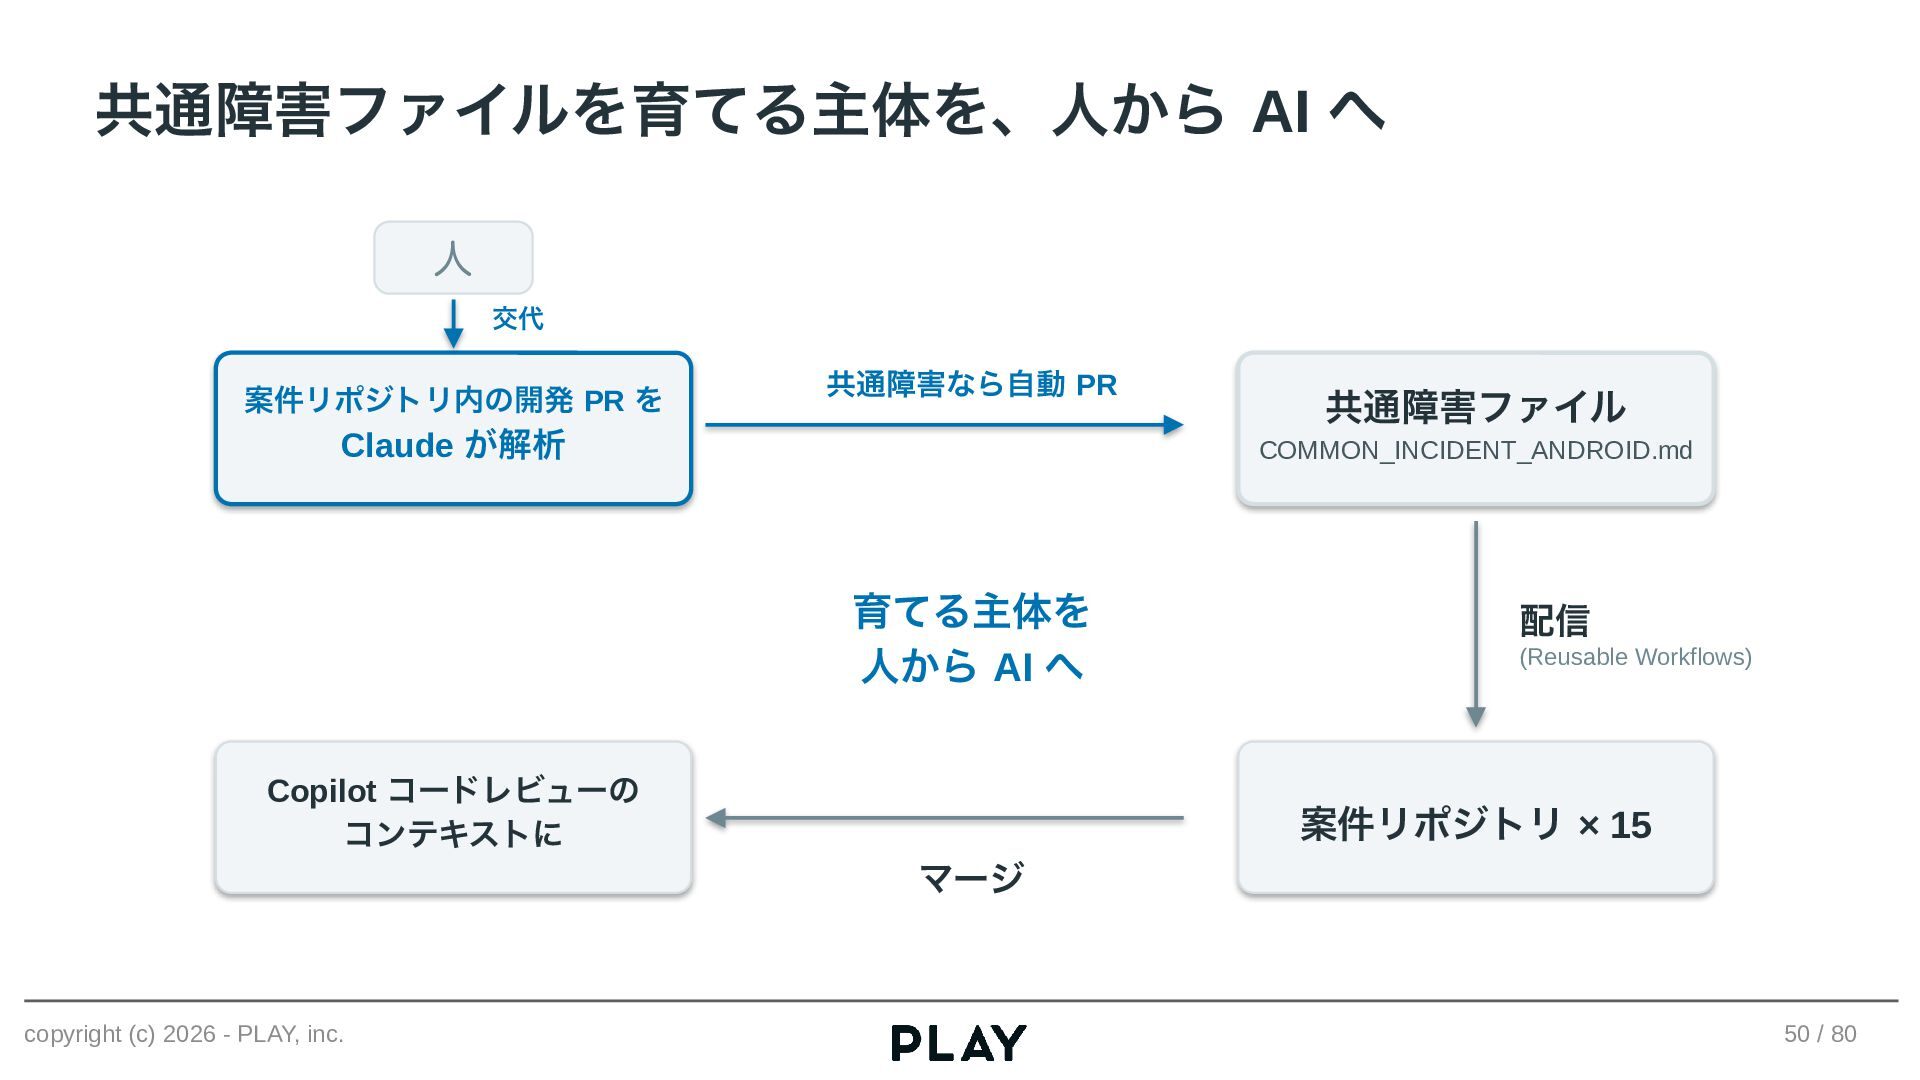
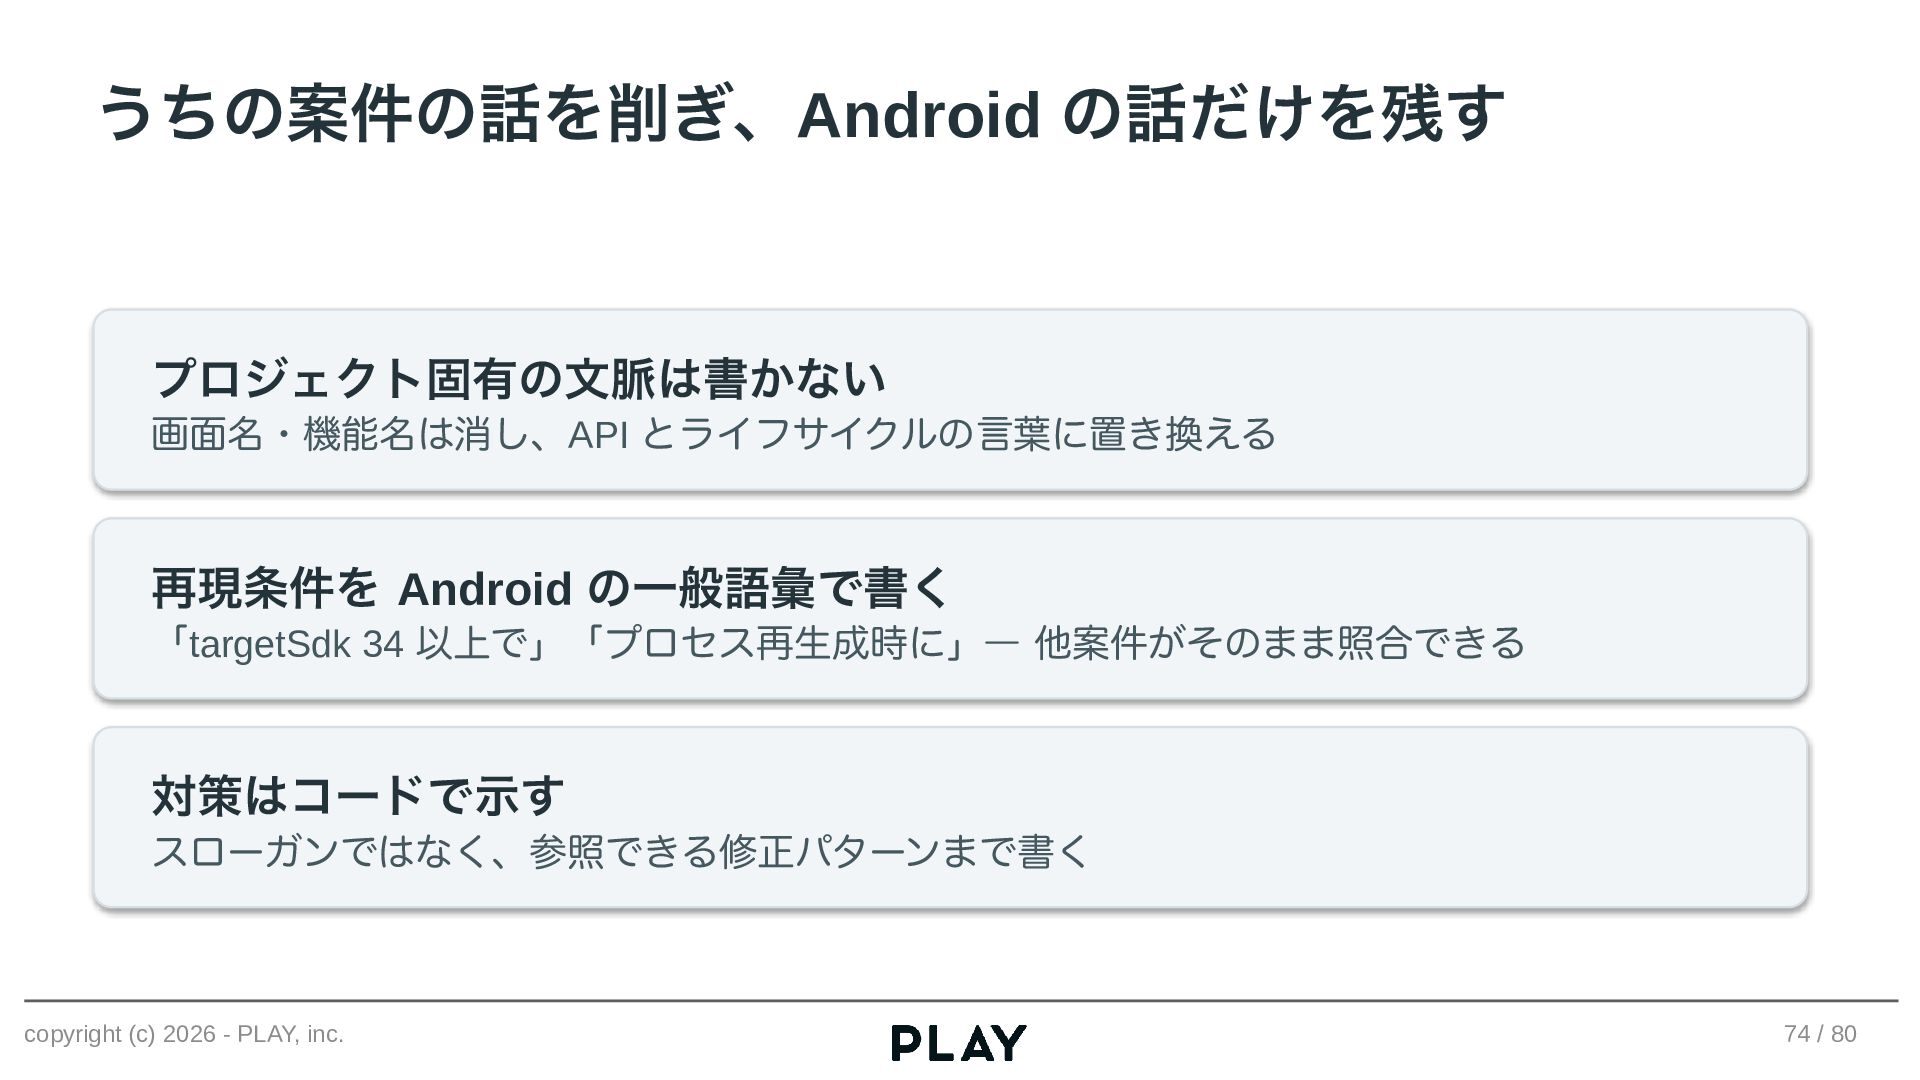
そこでカタログを育てる主体を、人ではなくAIに移行することにしました。
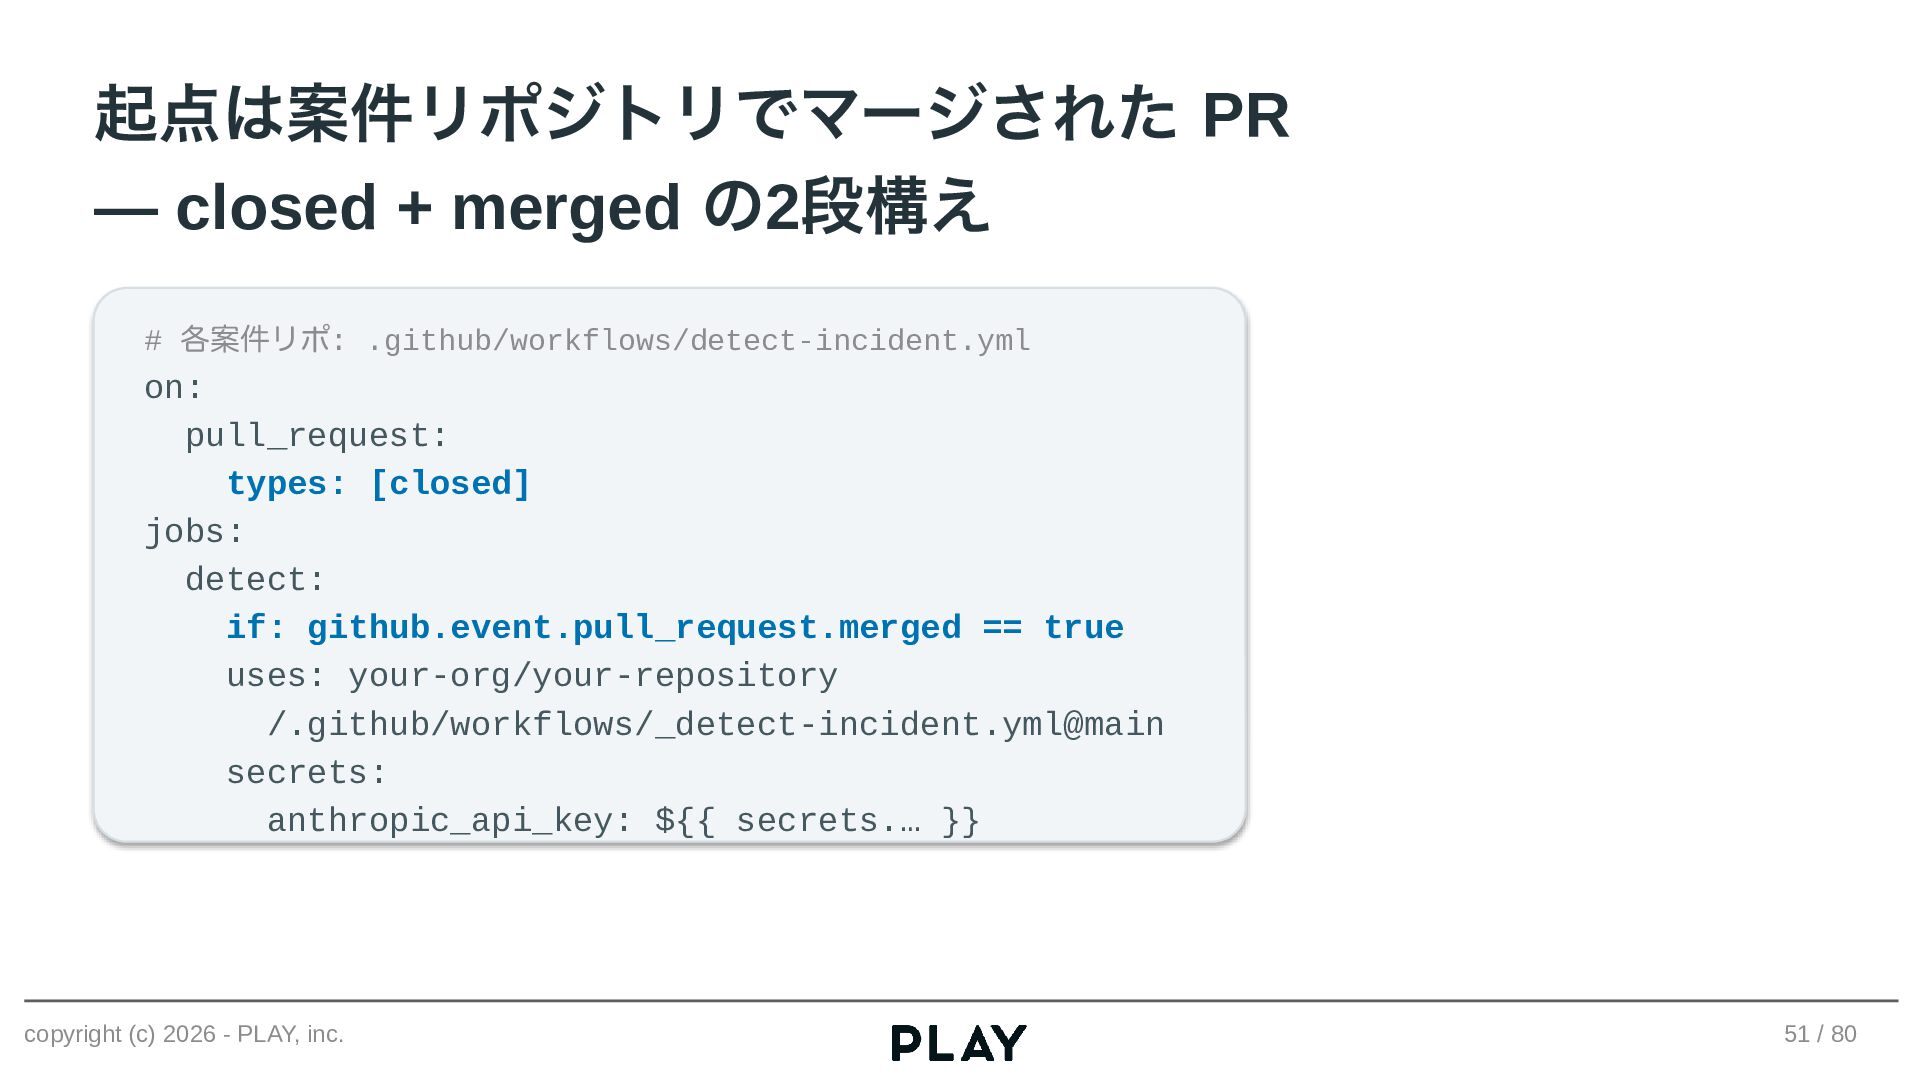
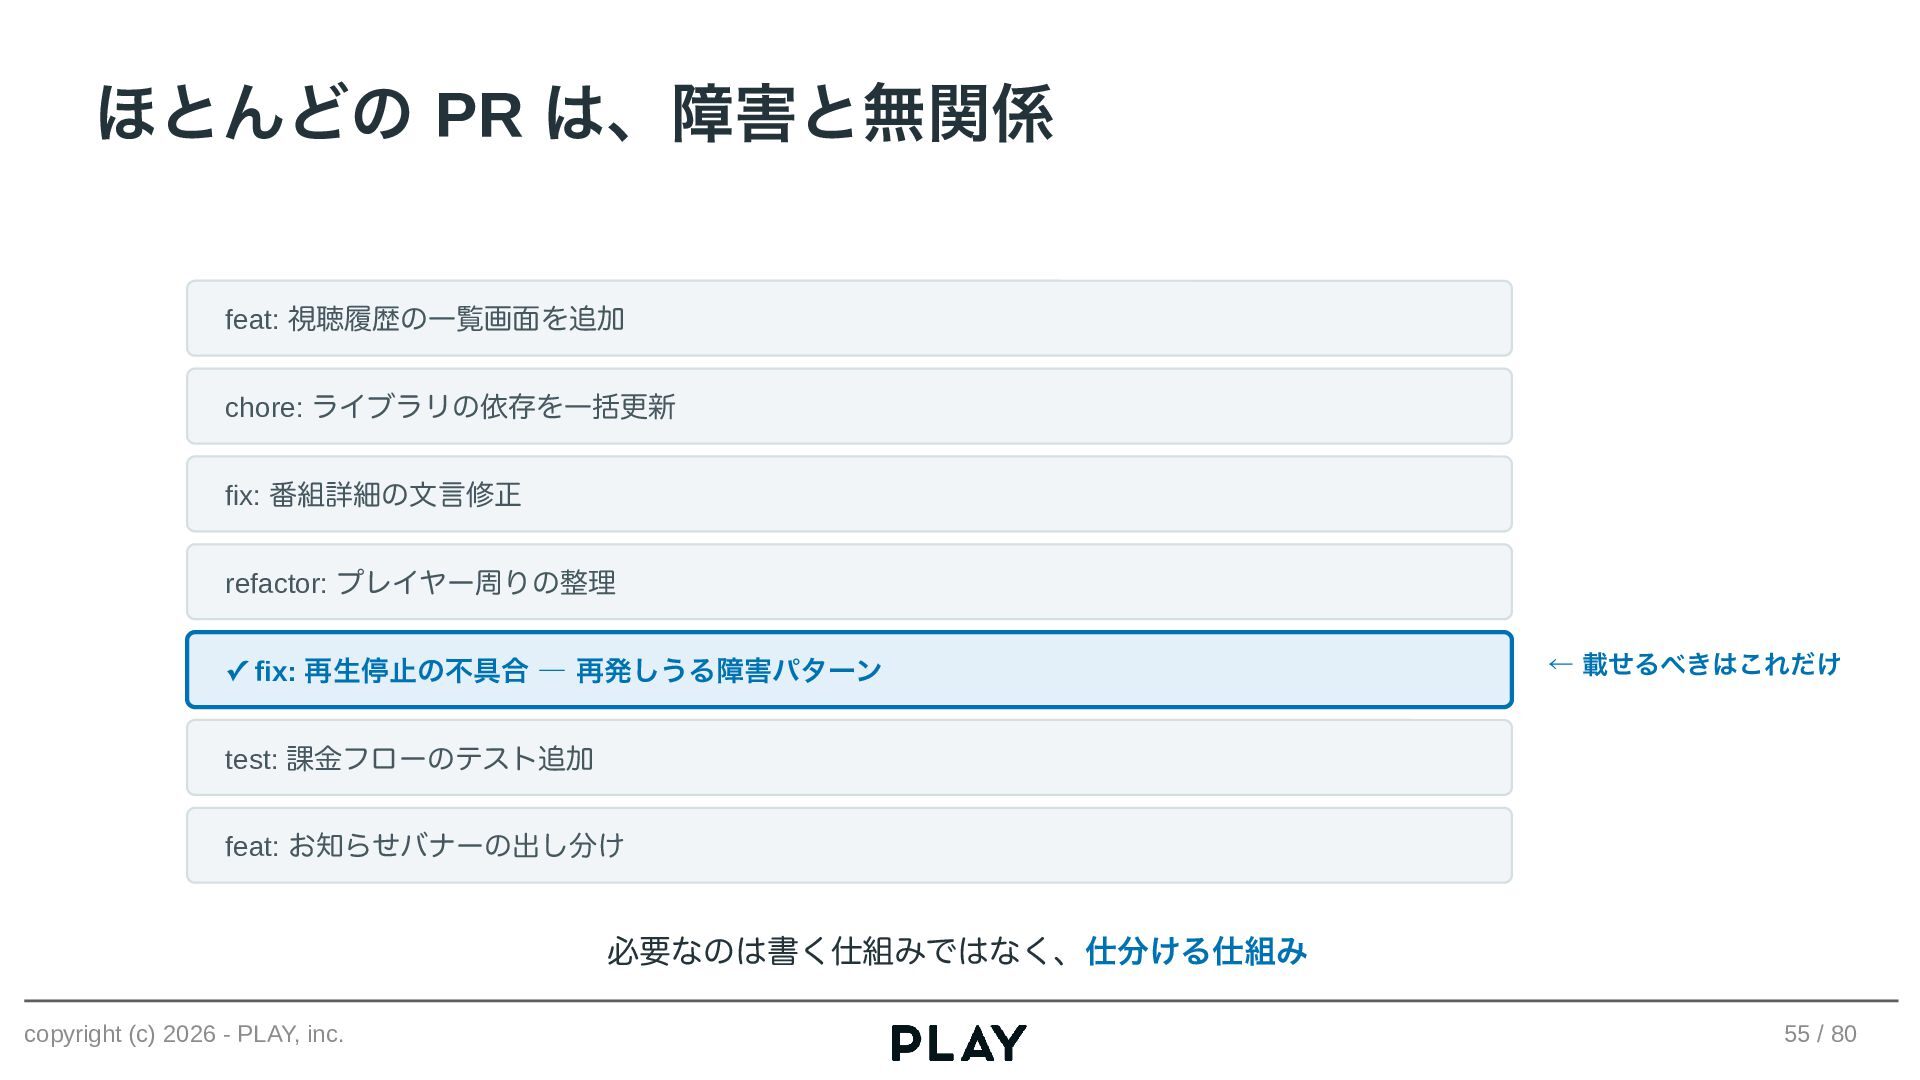
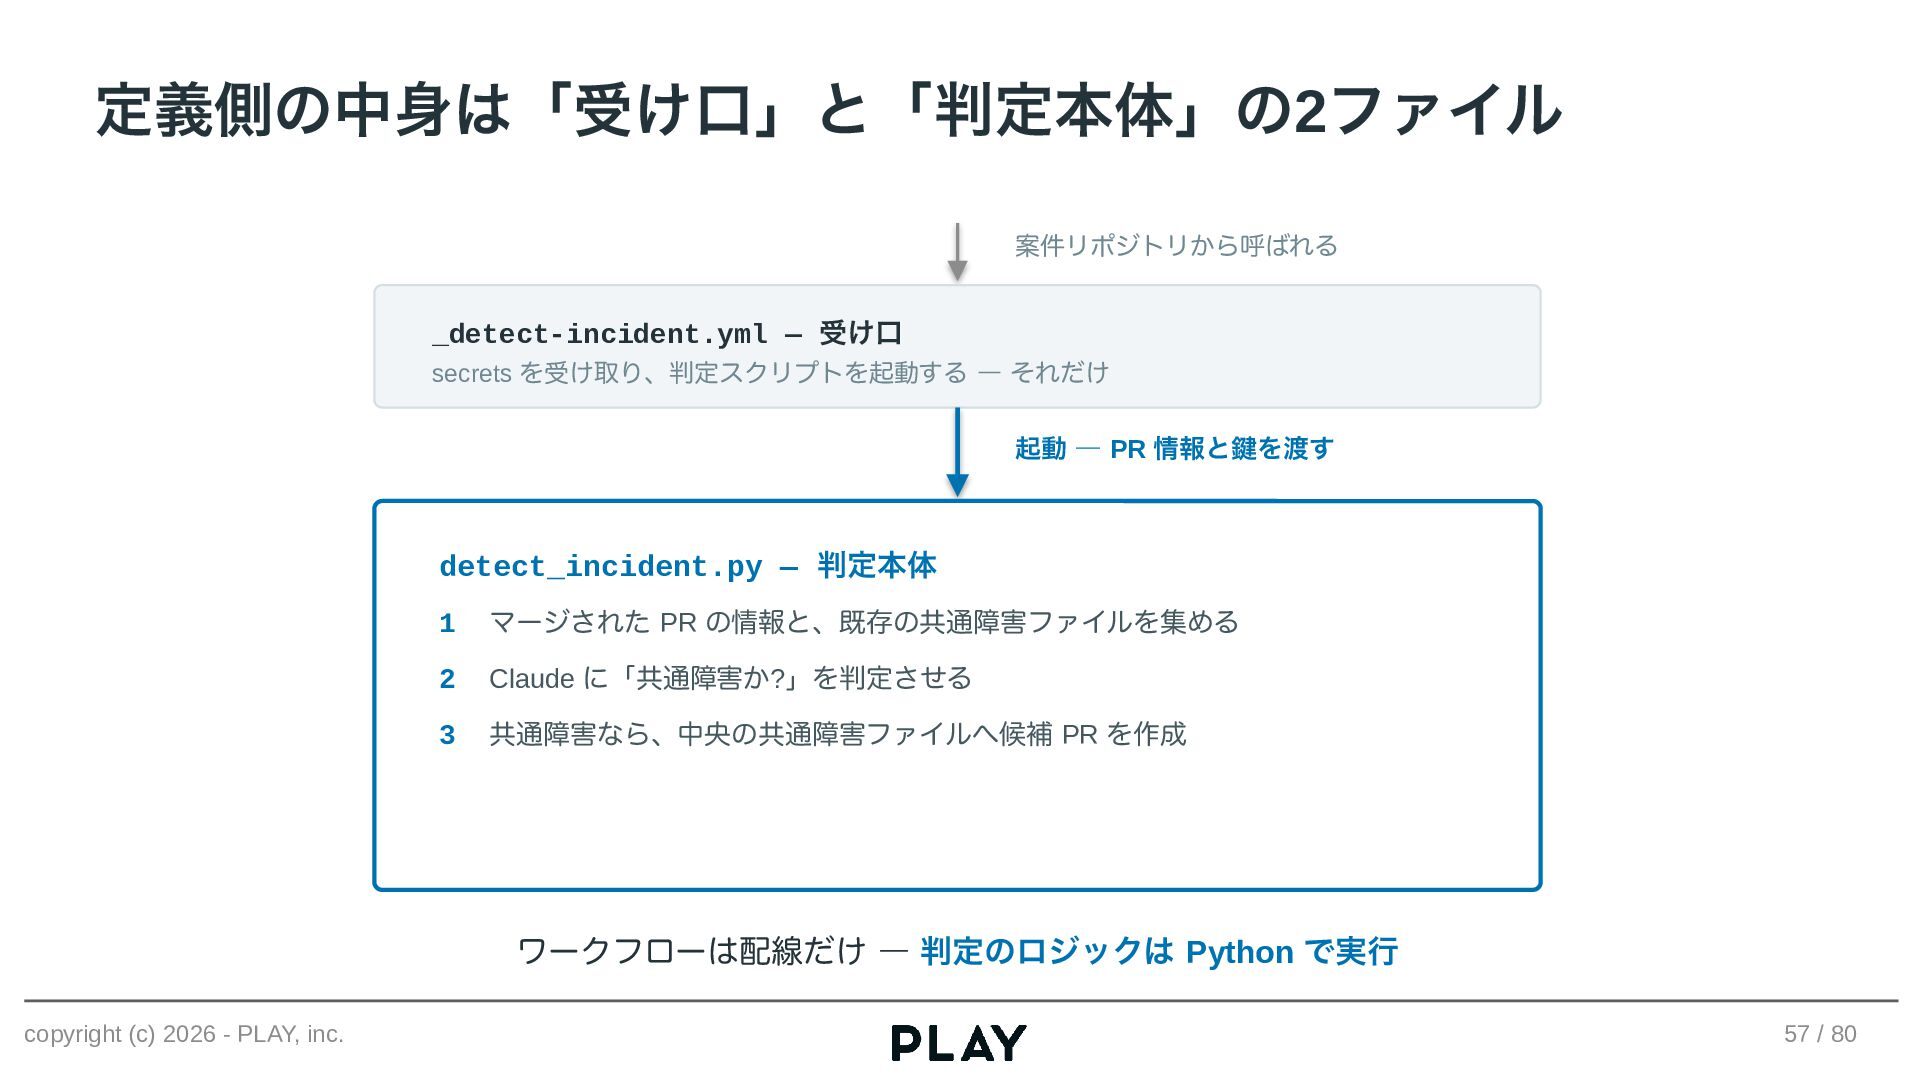
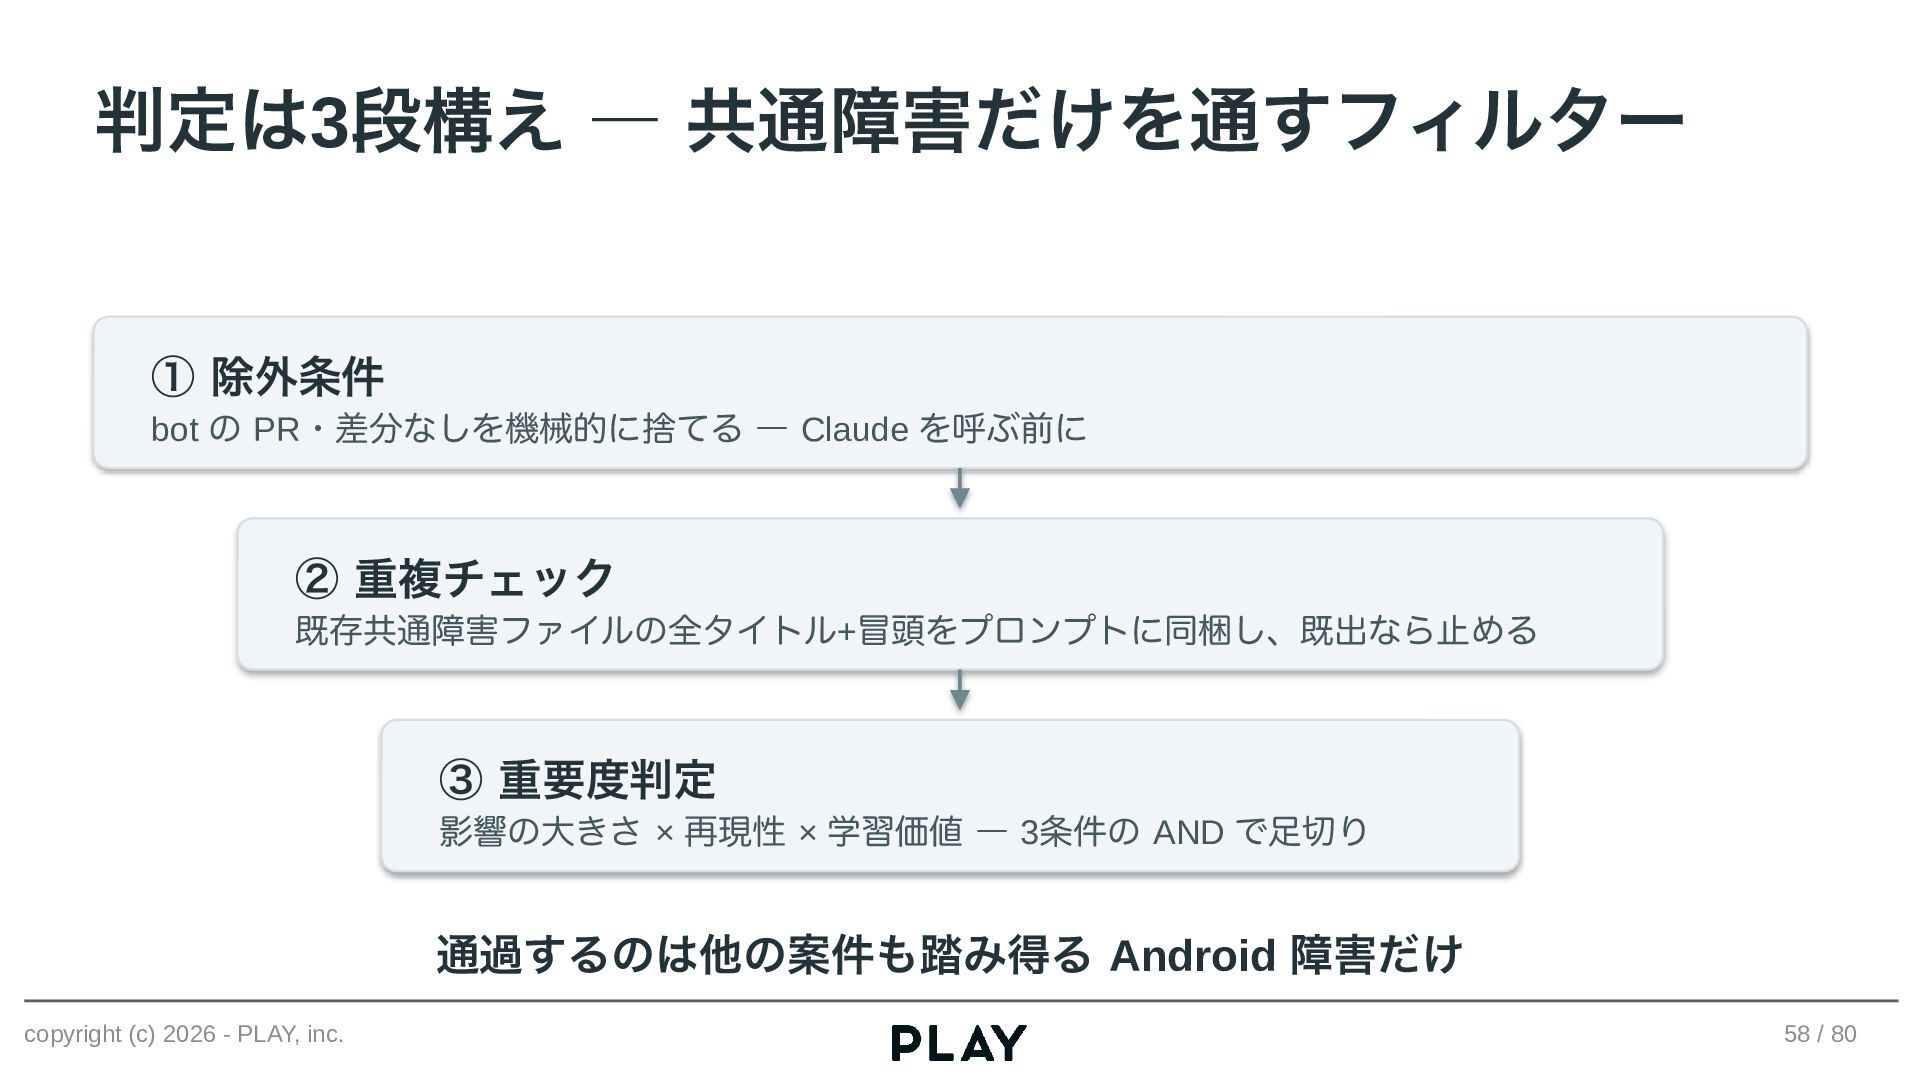
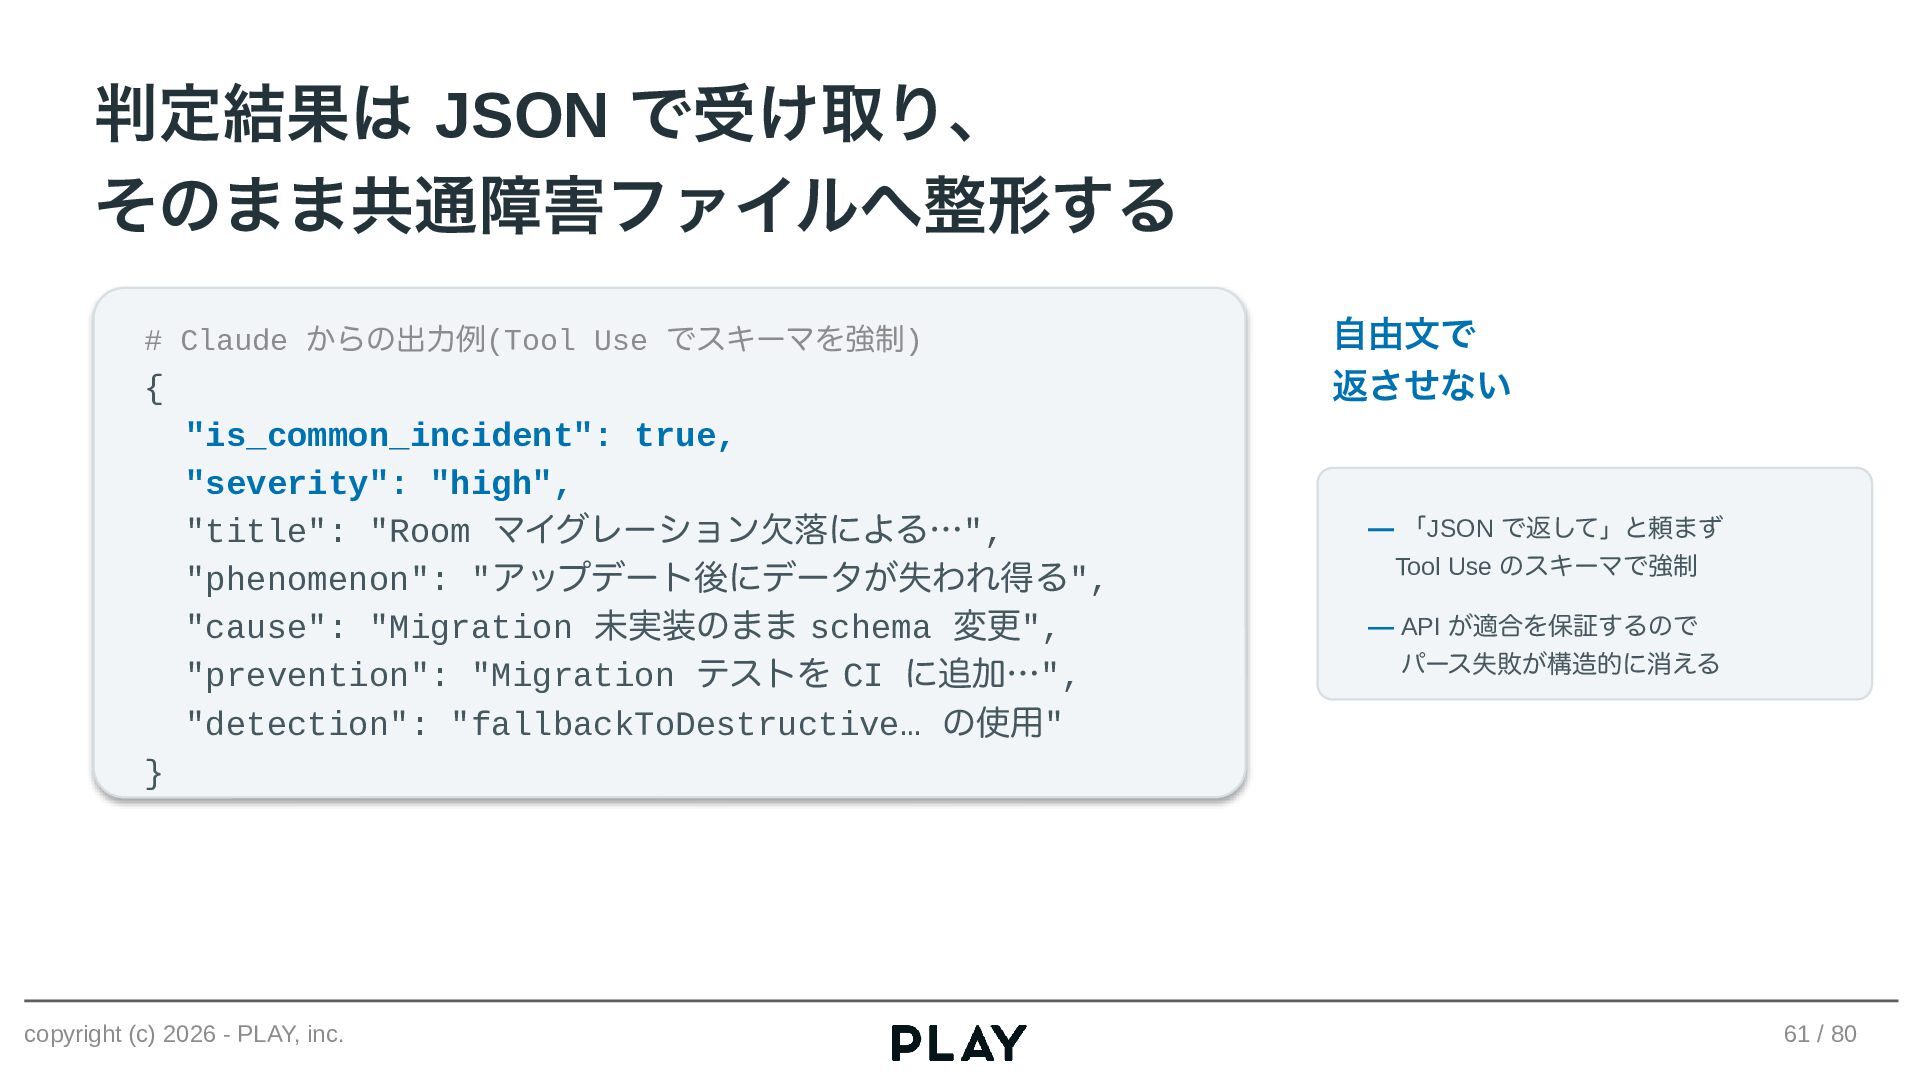
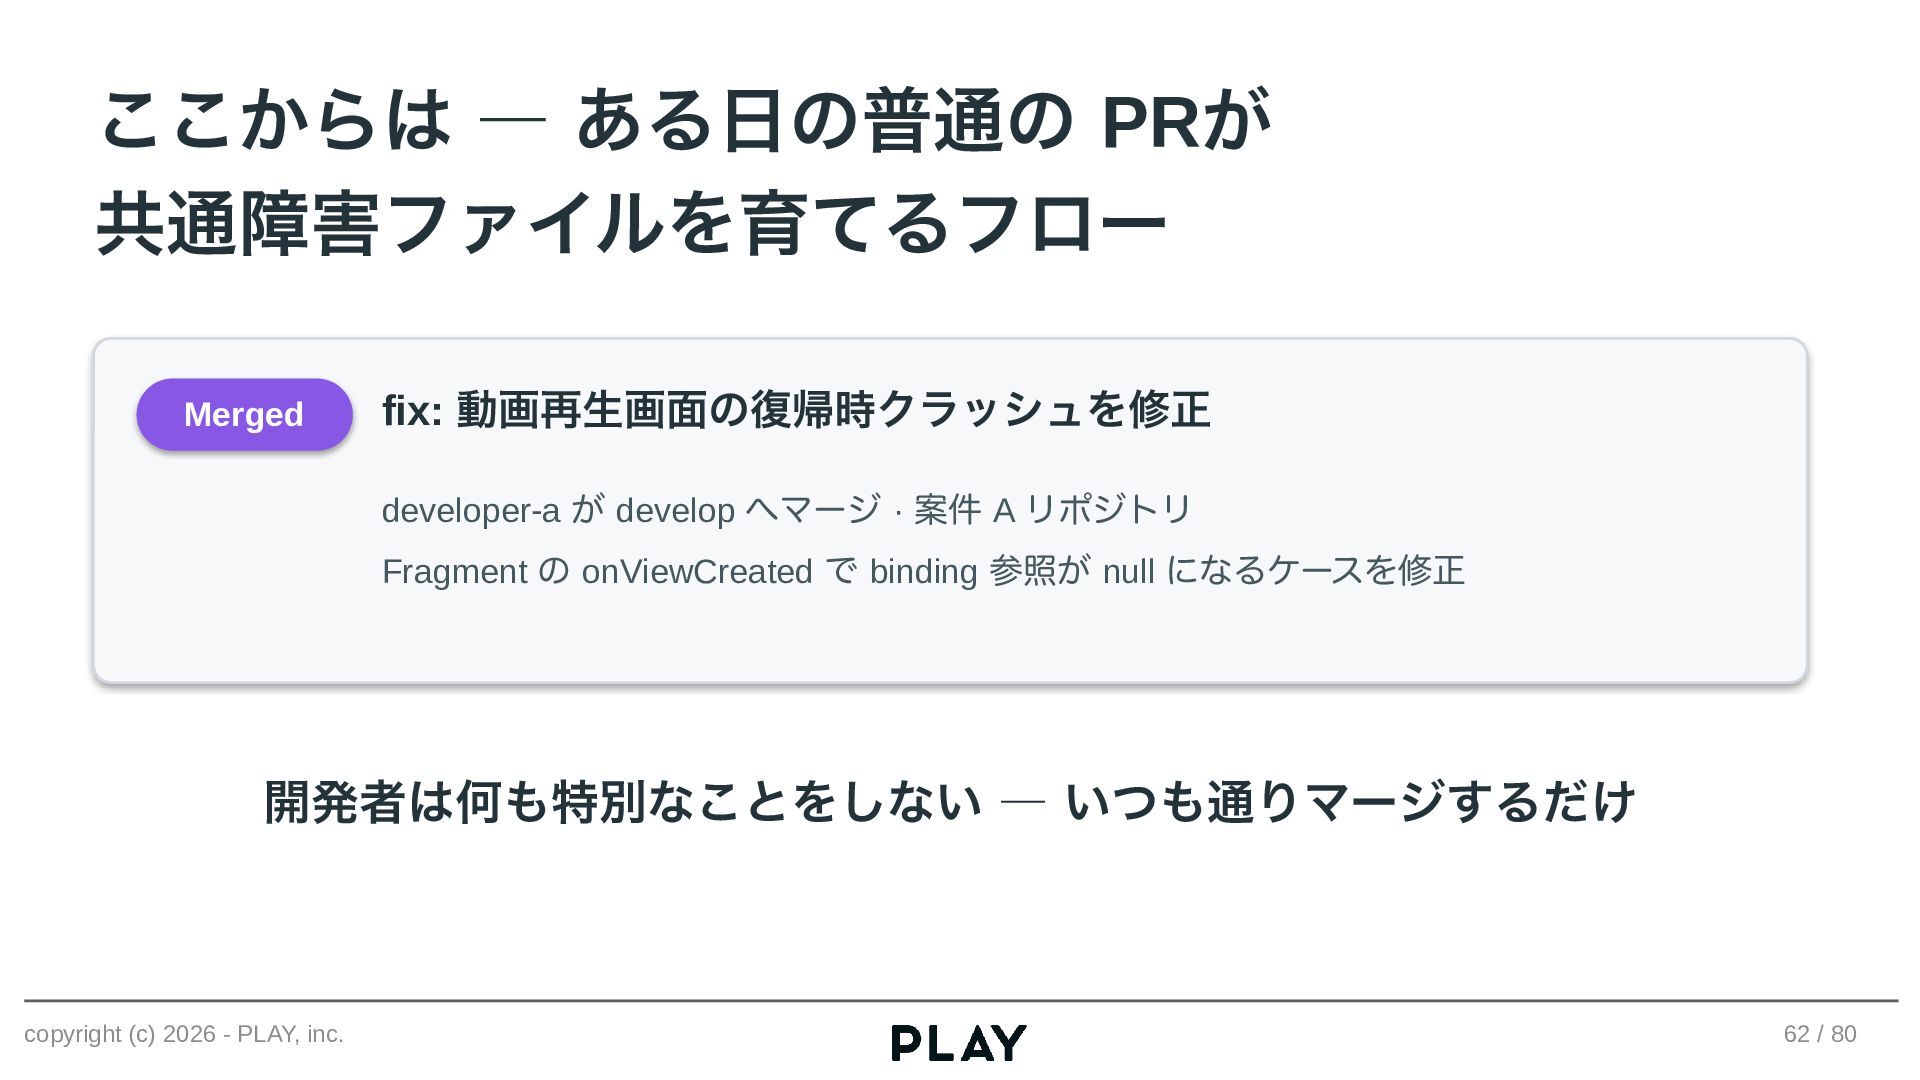
ClaudeをGitHub Actionsに組み込み、各プロジェクトのPRマージ時に差分を解析し、「他のAndroidプロジェクトが参考にすべき共通障害が含まれているか」の判定をします。
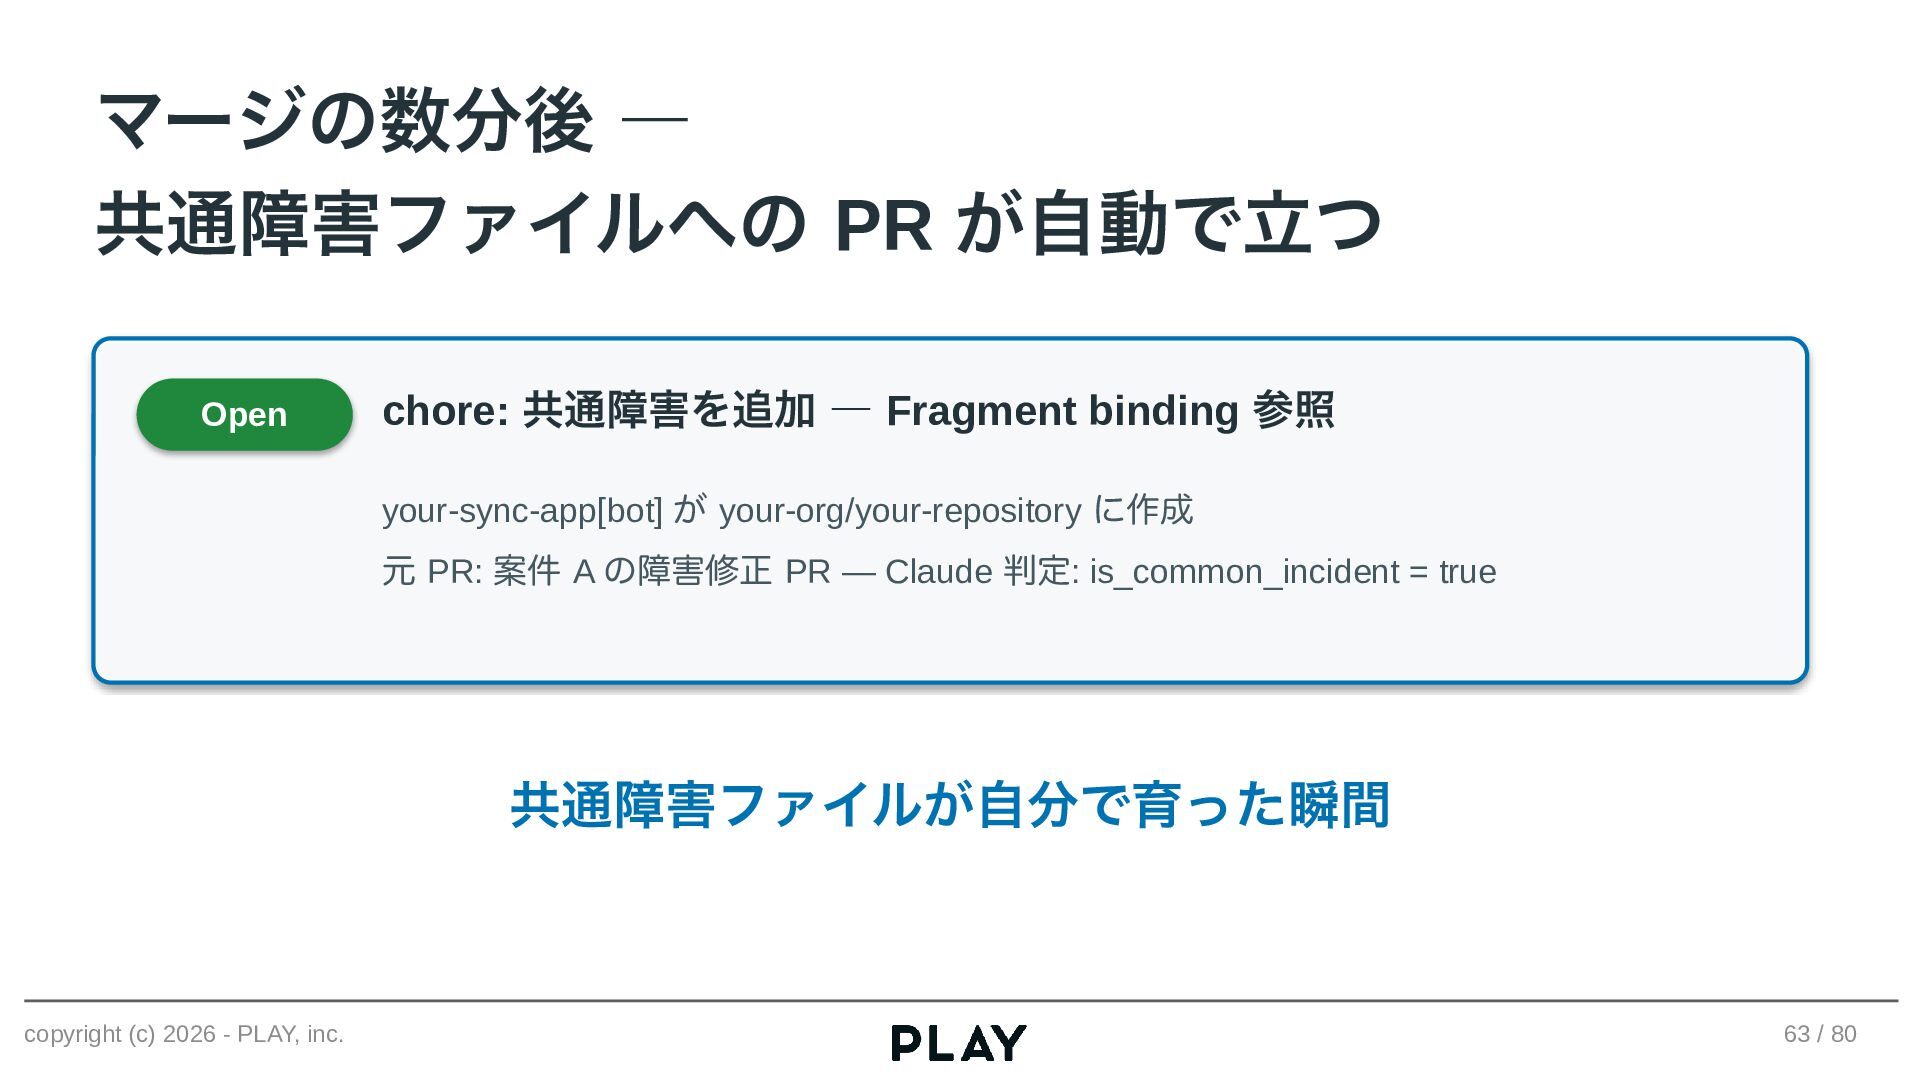
Yesなら、他リポジトリでも再利用しやすい形に構造化し、カタログへ自動PRを作成します。
レビューしマージ後、Reusable Workflowsが15個のリポジトリに配信し、Copilotがレビュー時に参照する。
人が能動的に動かなくても、Android共通障害カタログが日々成長し続ける仕組みが完成しました。
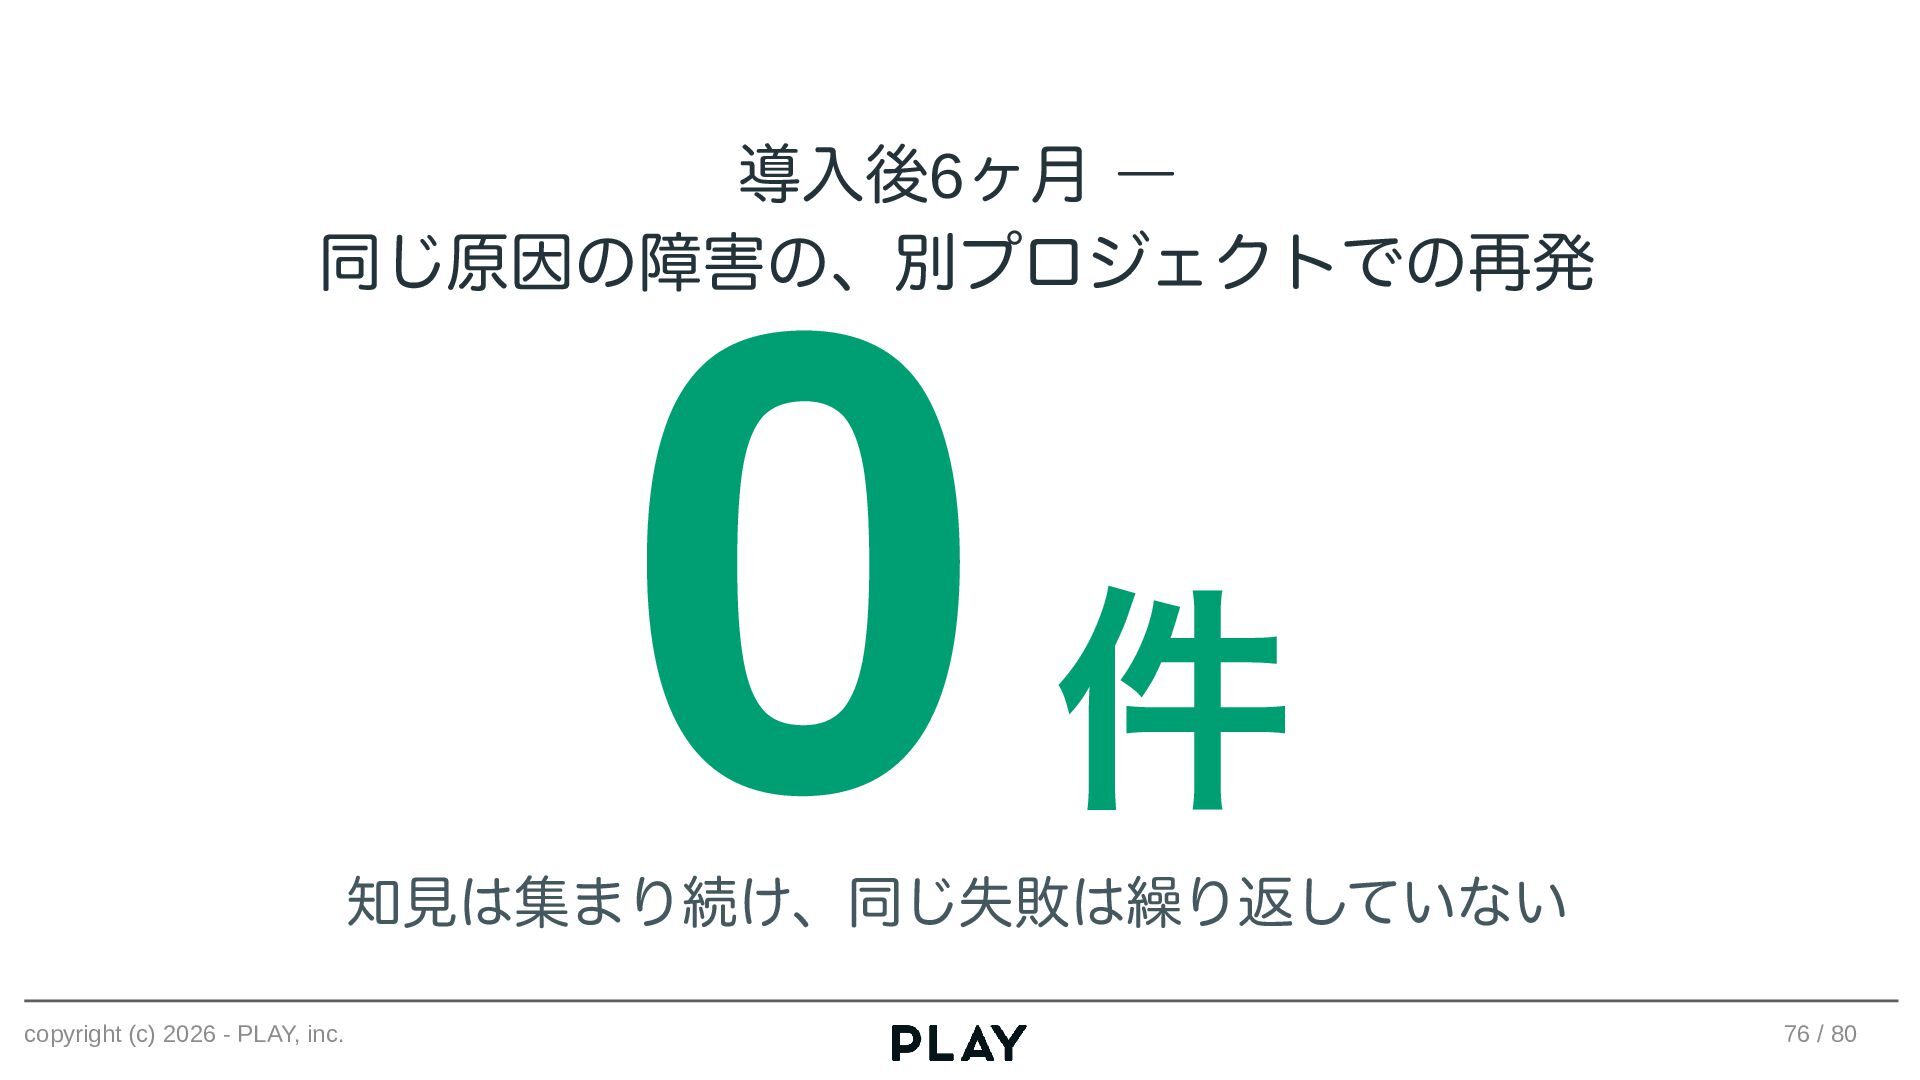
導入後は15プロジェクトから障害情報を自動収集・展開し続け、モバイルチームの重大な共通障害は0件を維持しています。
本セッションでは皆さまのプロジェクトでも明日から導入し運用できるよう以下をご紹介いたします。
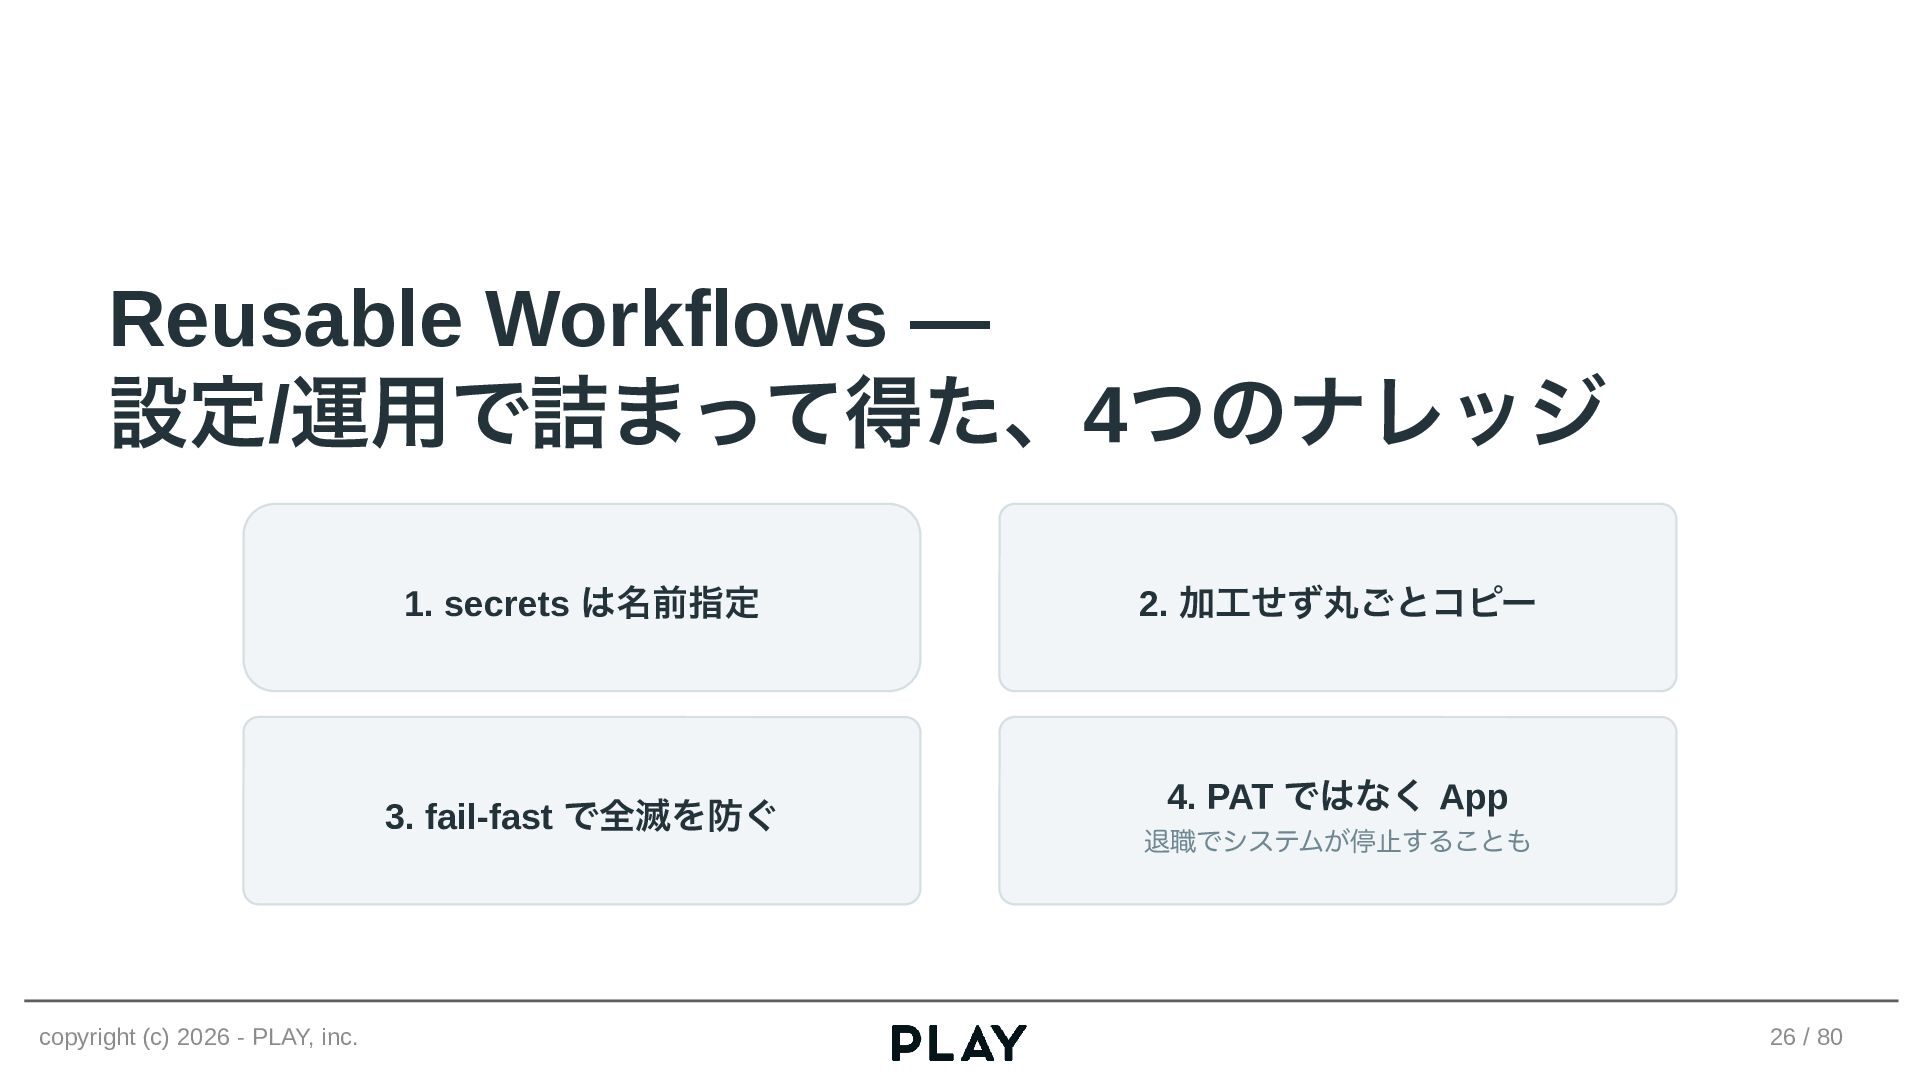
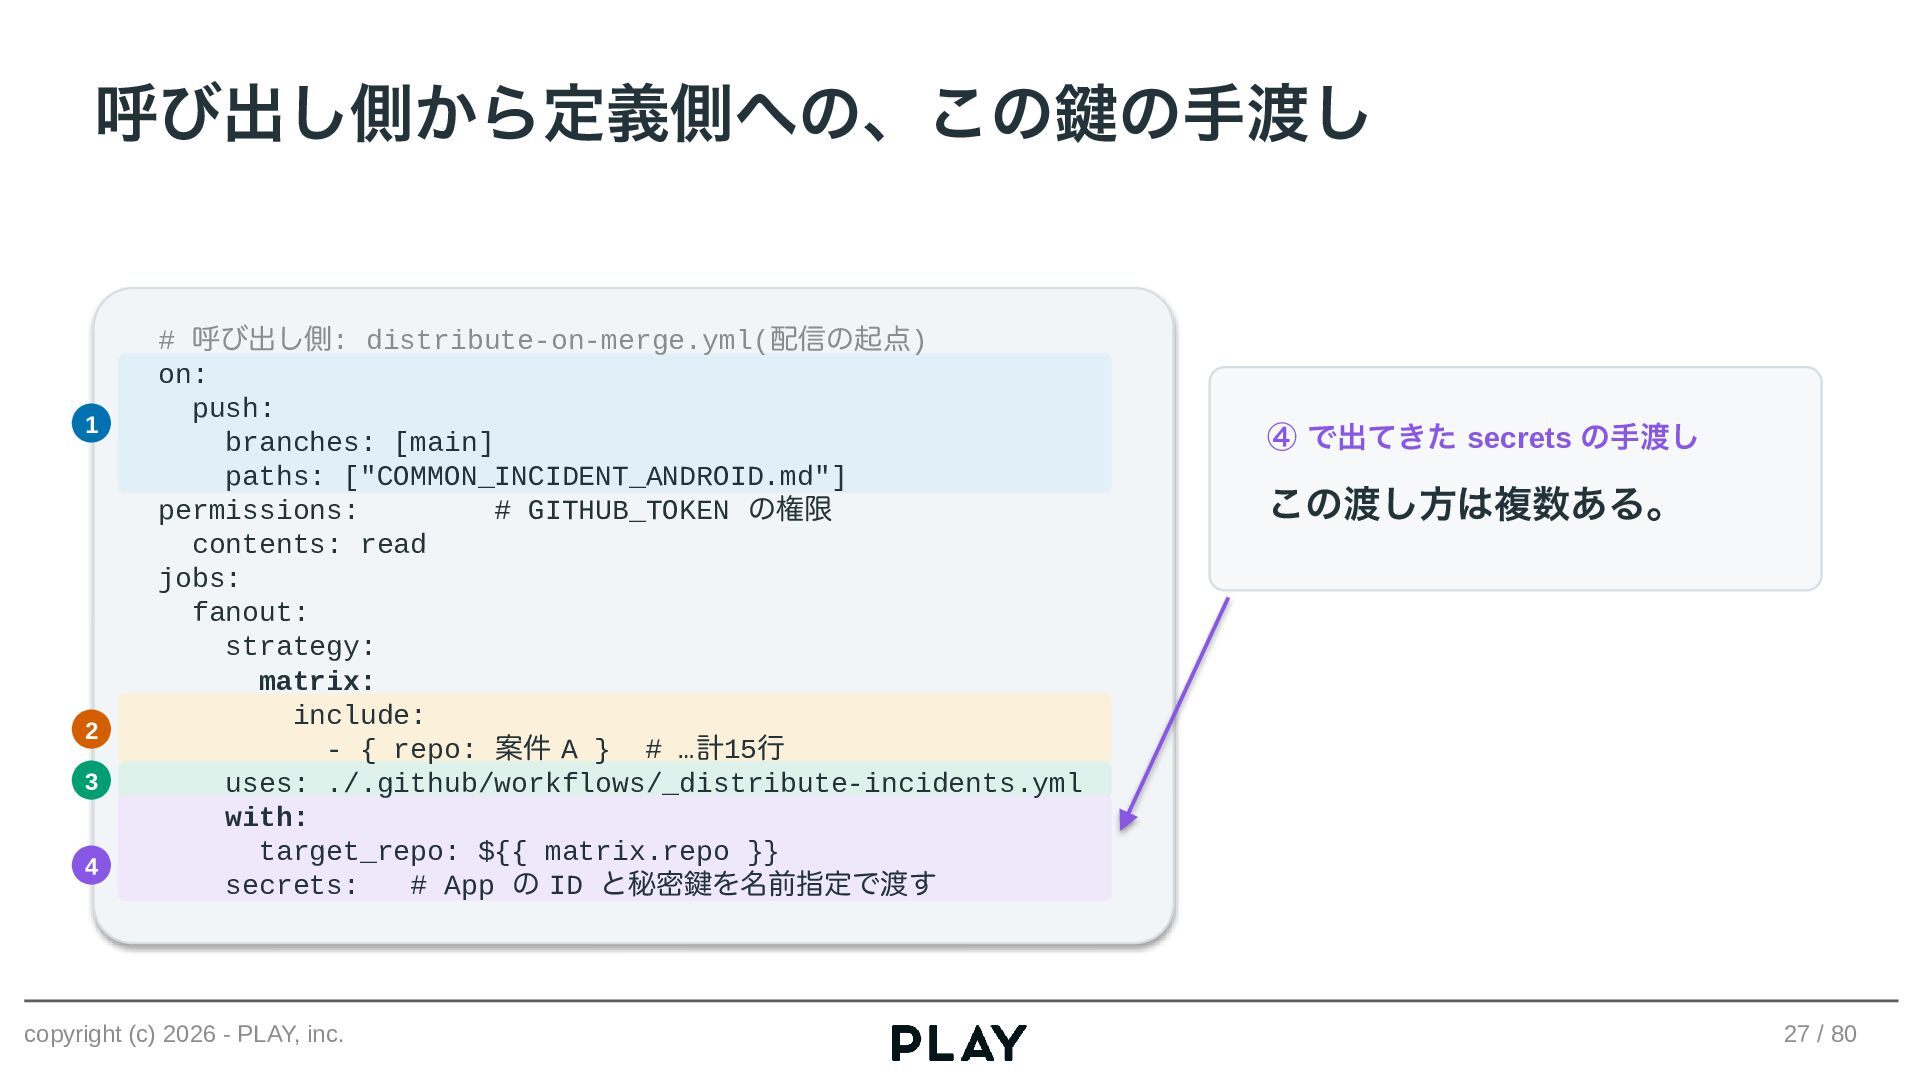
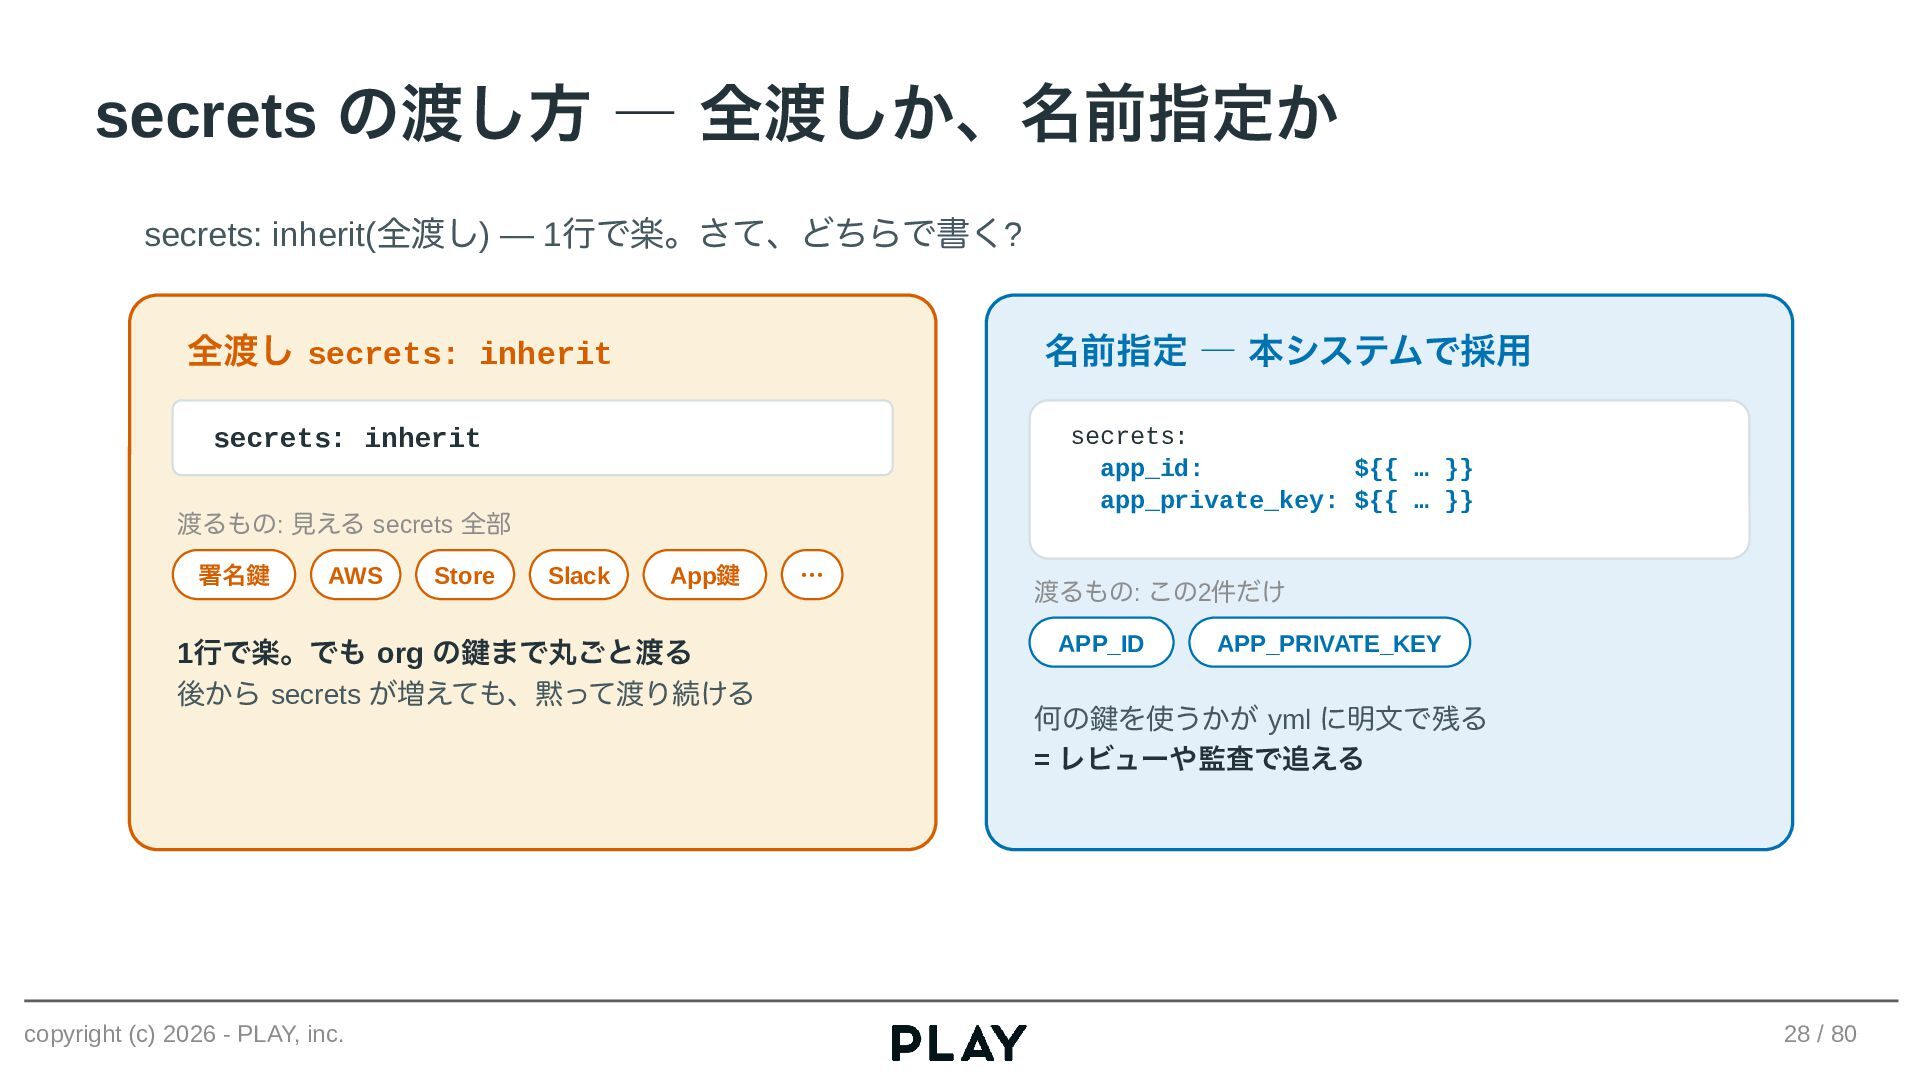
- GitHub Actionsの「Reusable Workflows」を利用したリポジトリ間を跨ぐMarkdown配布の仕組みと設定方法
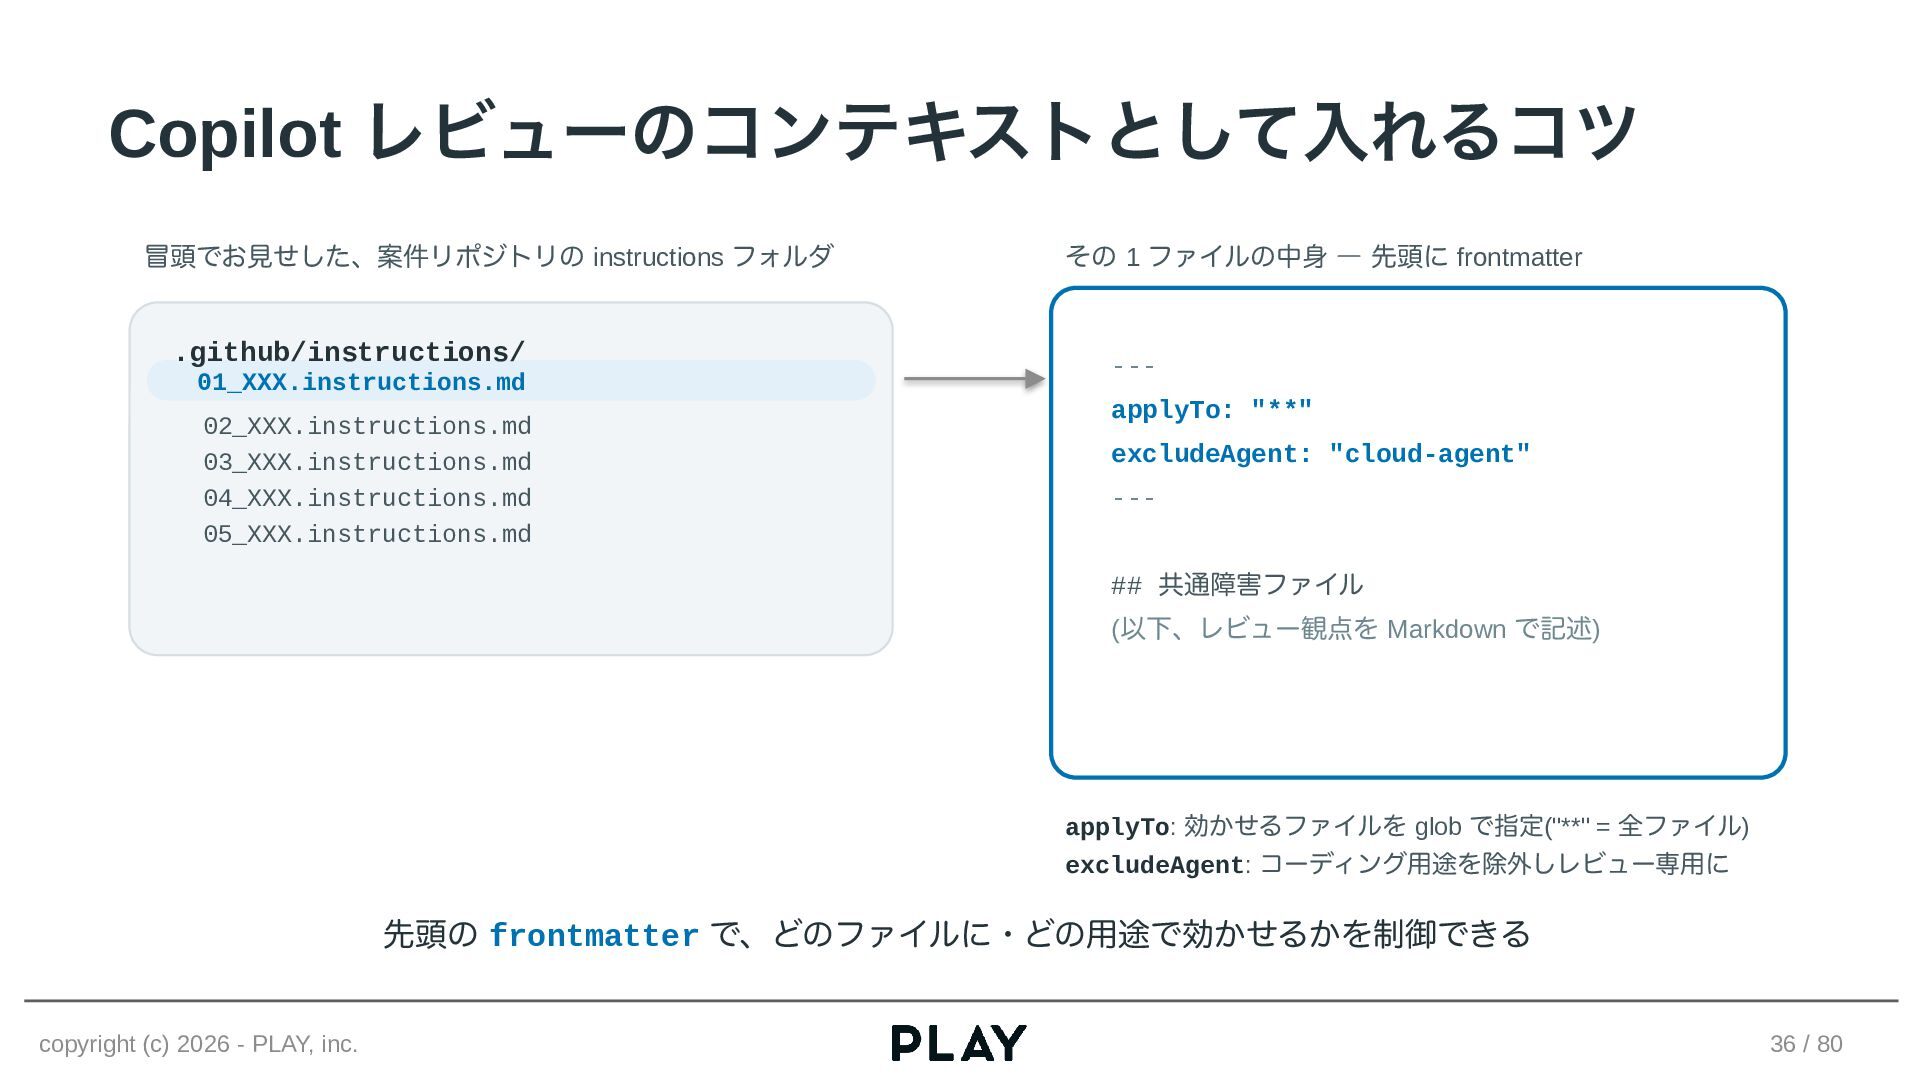
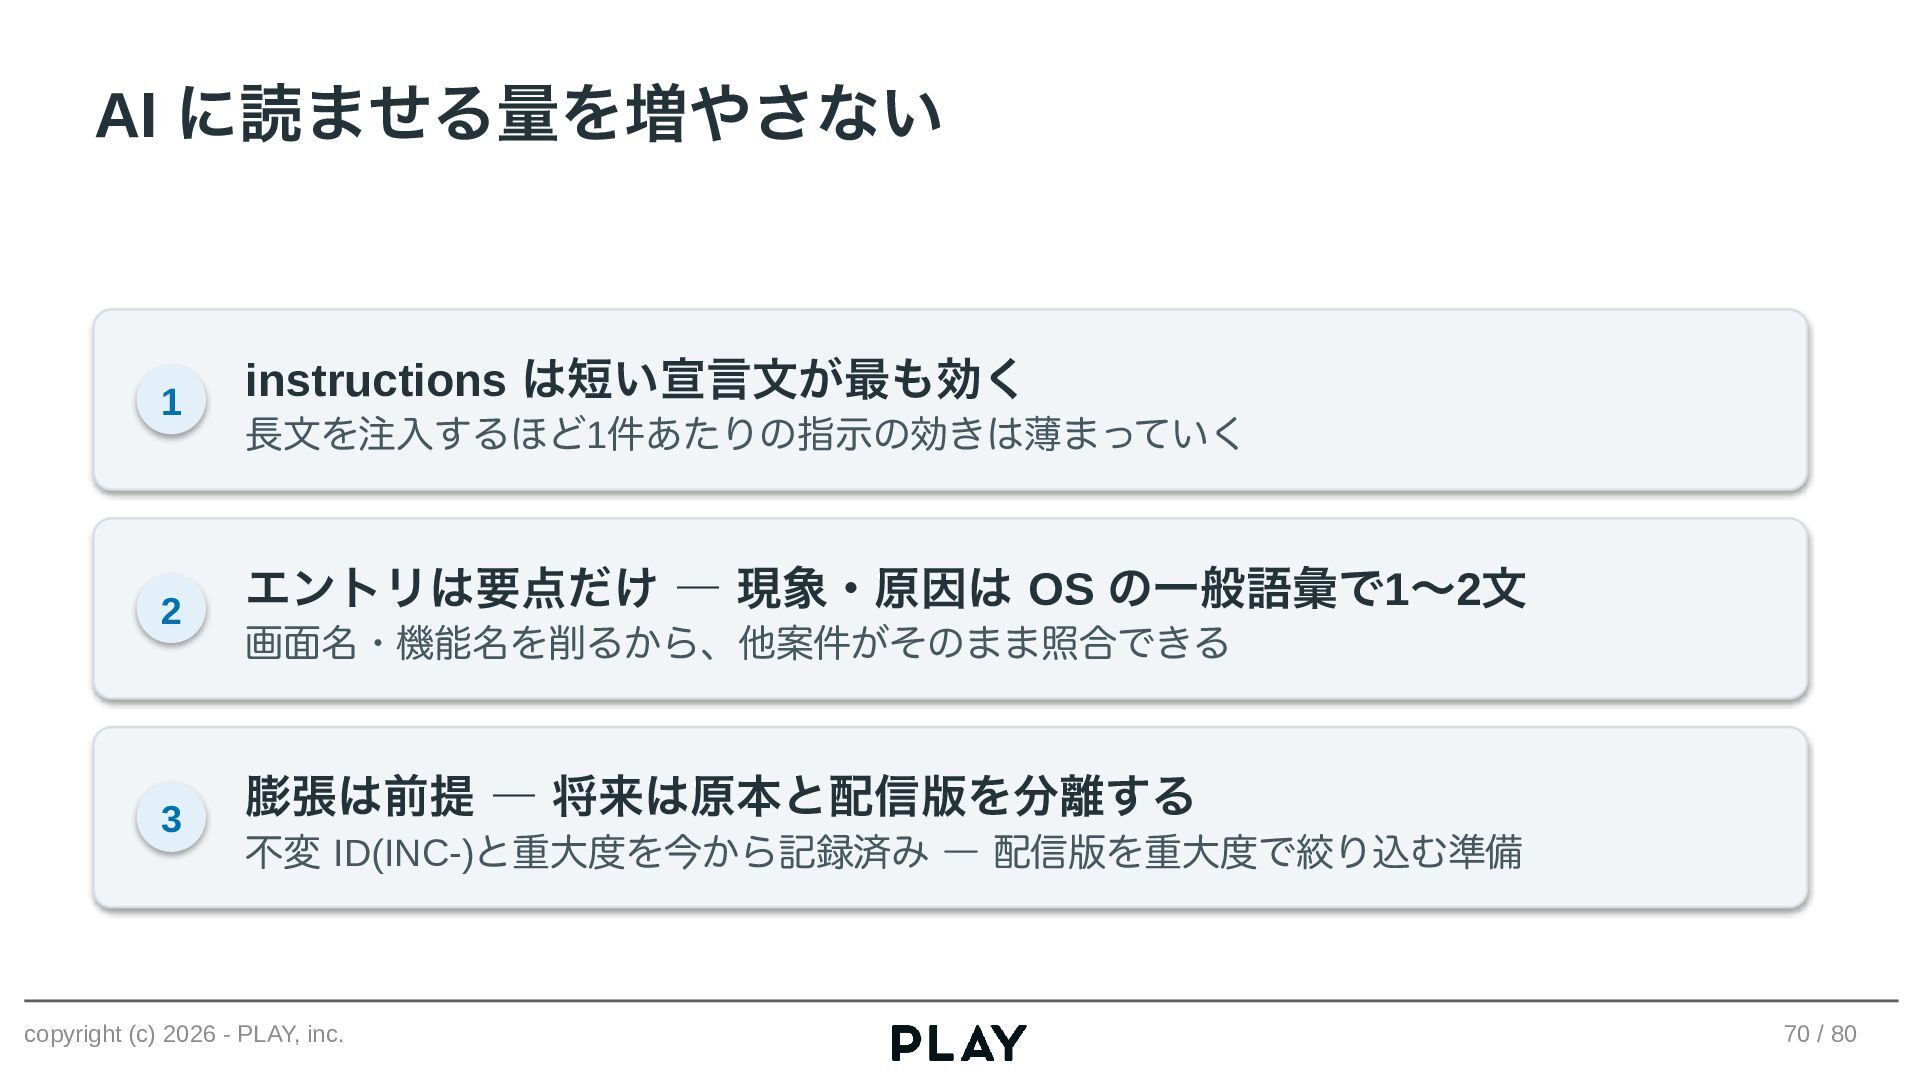
- プロジェクト間の接続をなめらかにするCopilot instructions共通化戦略
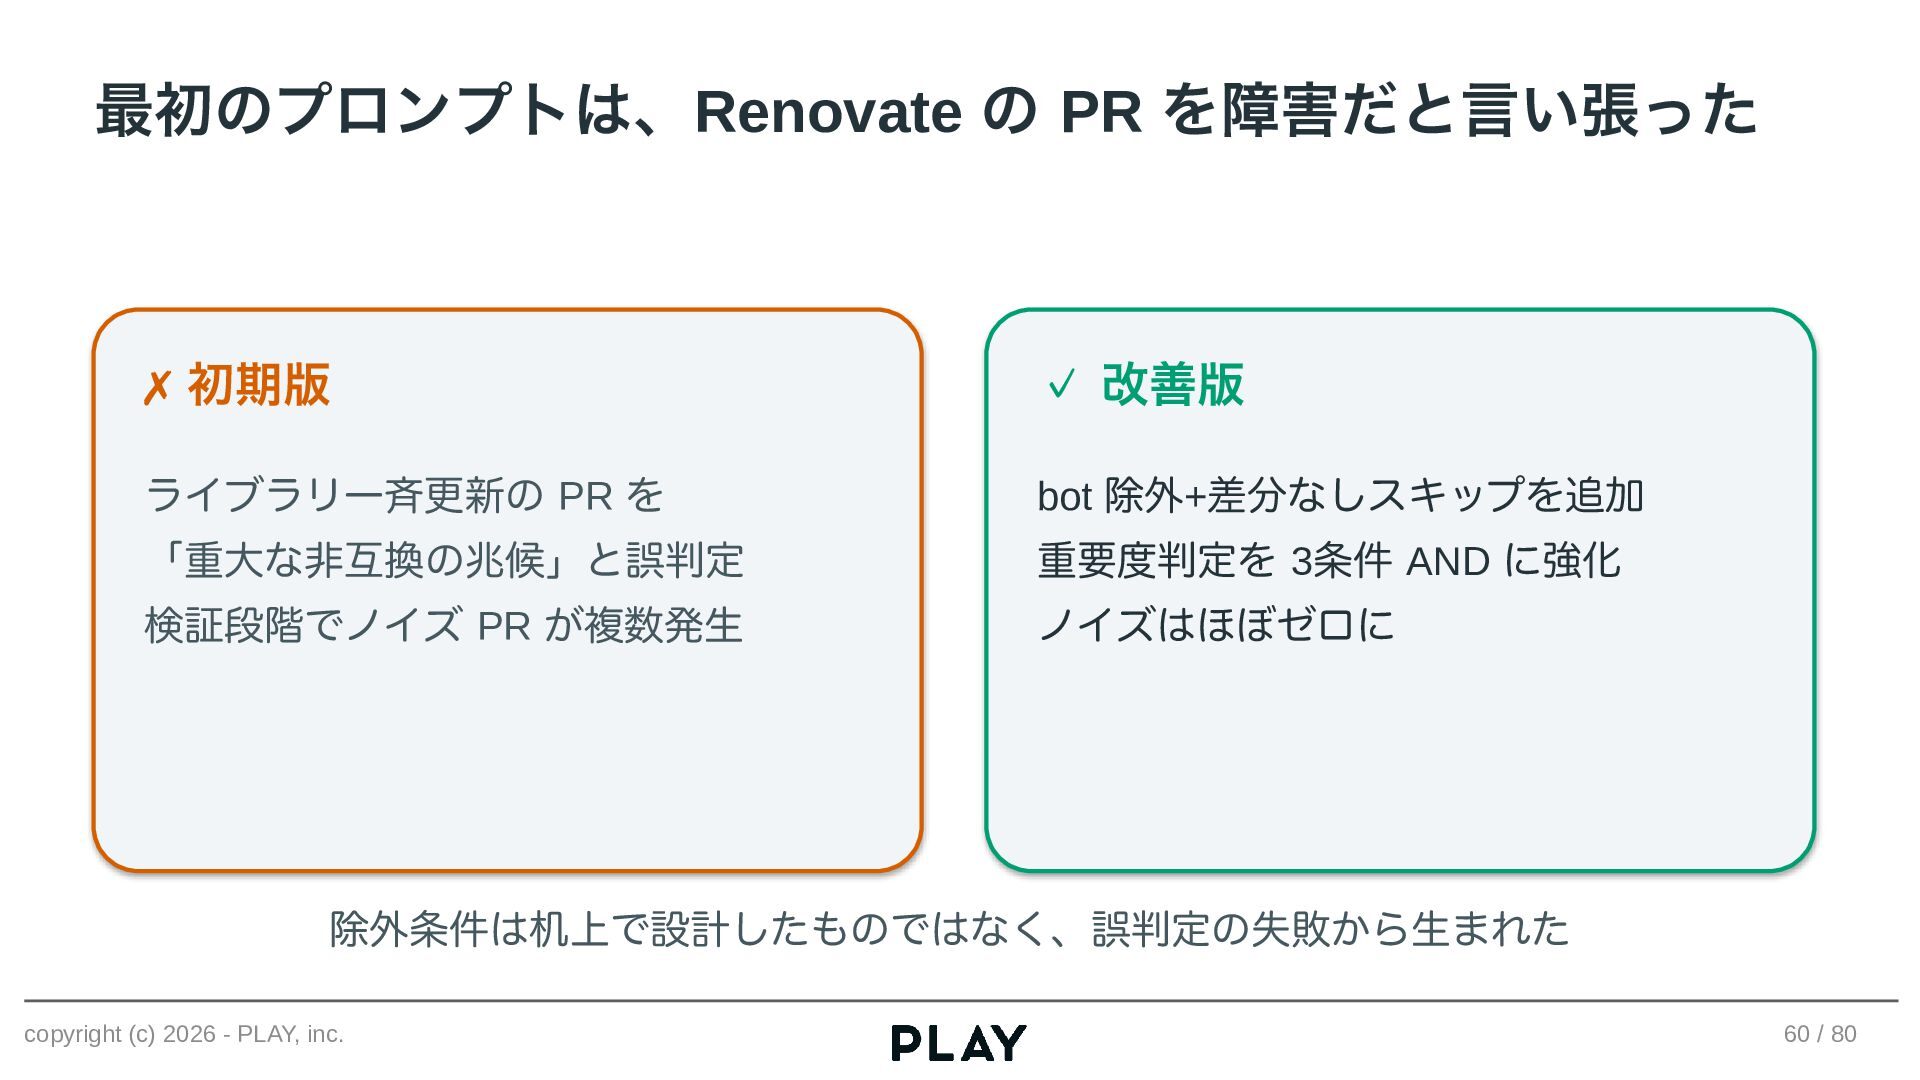
- GitHub ActionsにClaudeを組み込み、PR差分から「Android共通障害か」を判定するためのプロンプト設計・除外条件のTips
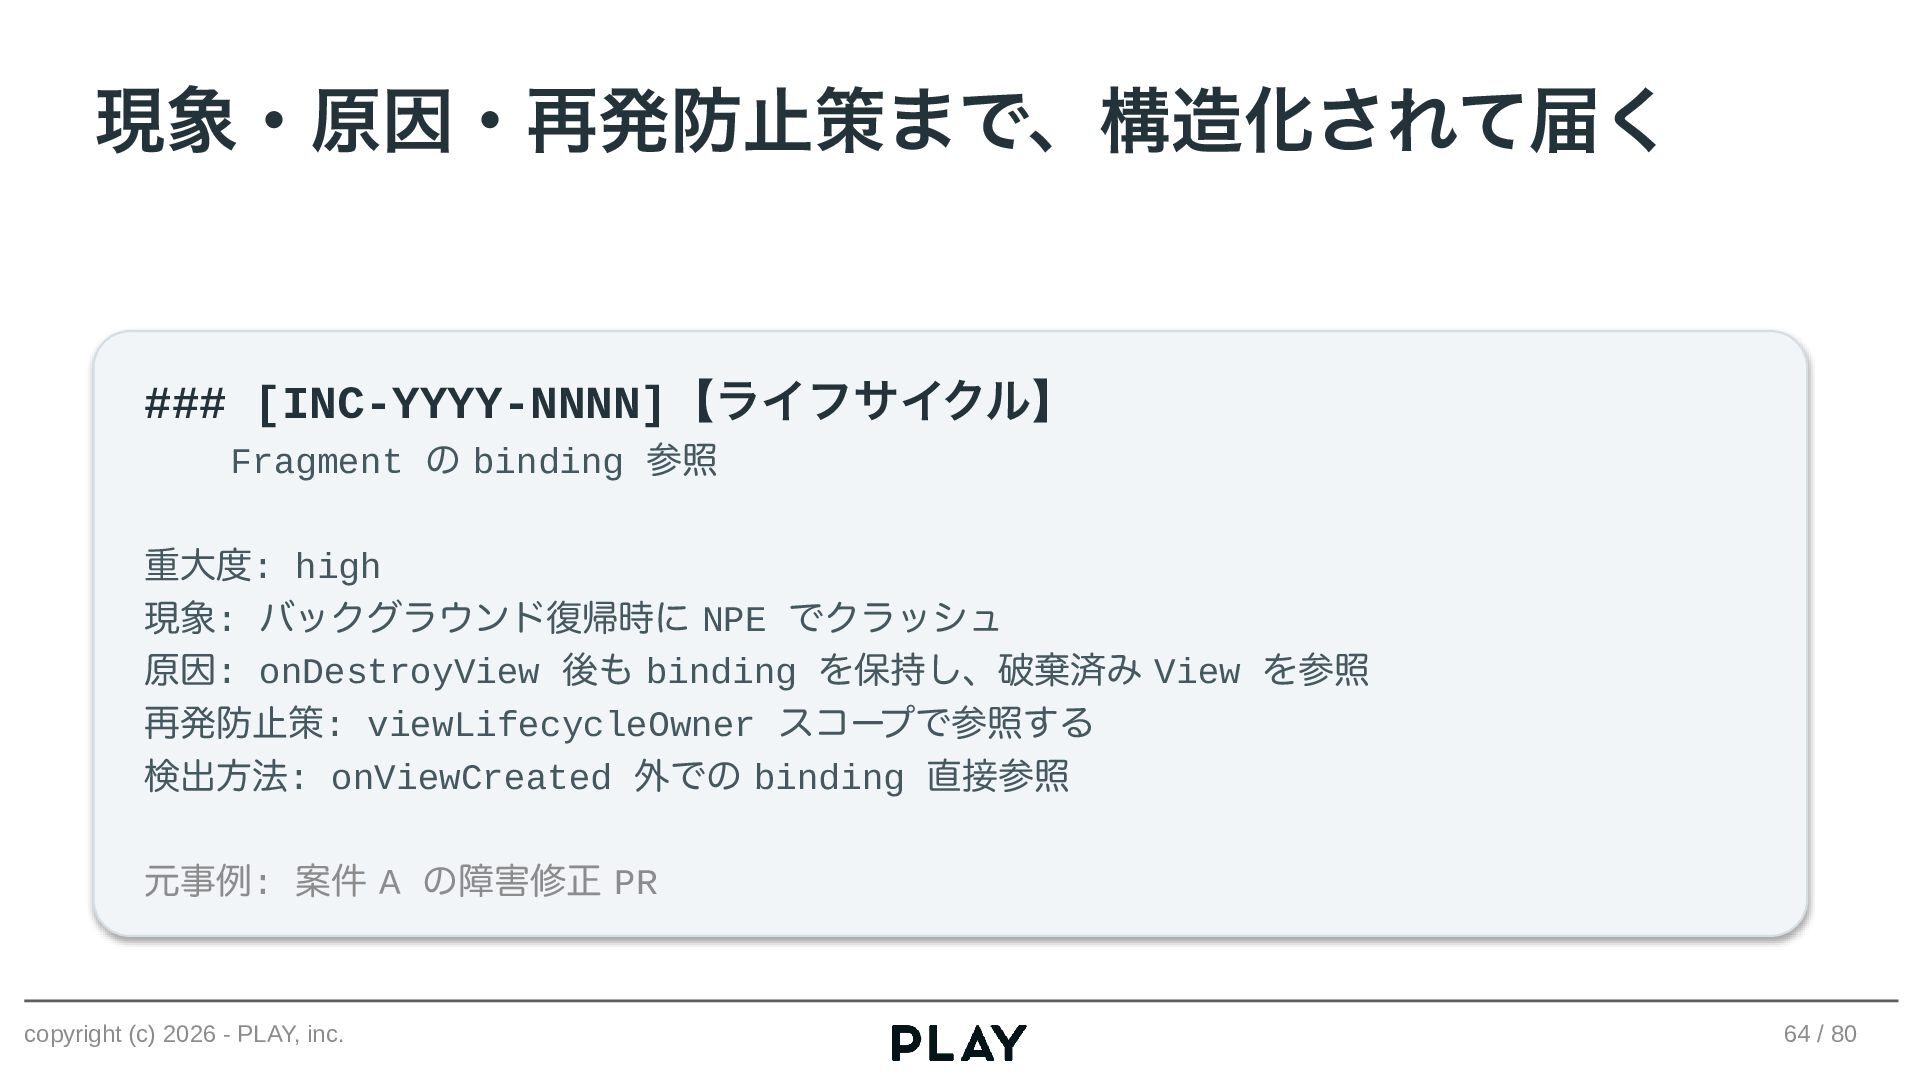
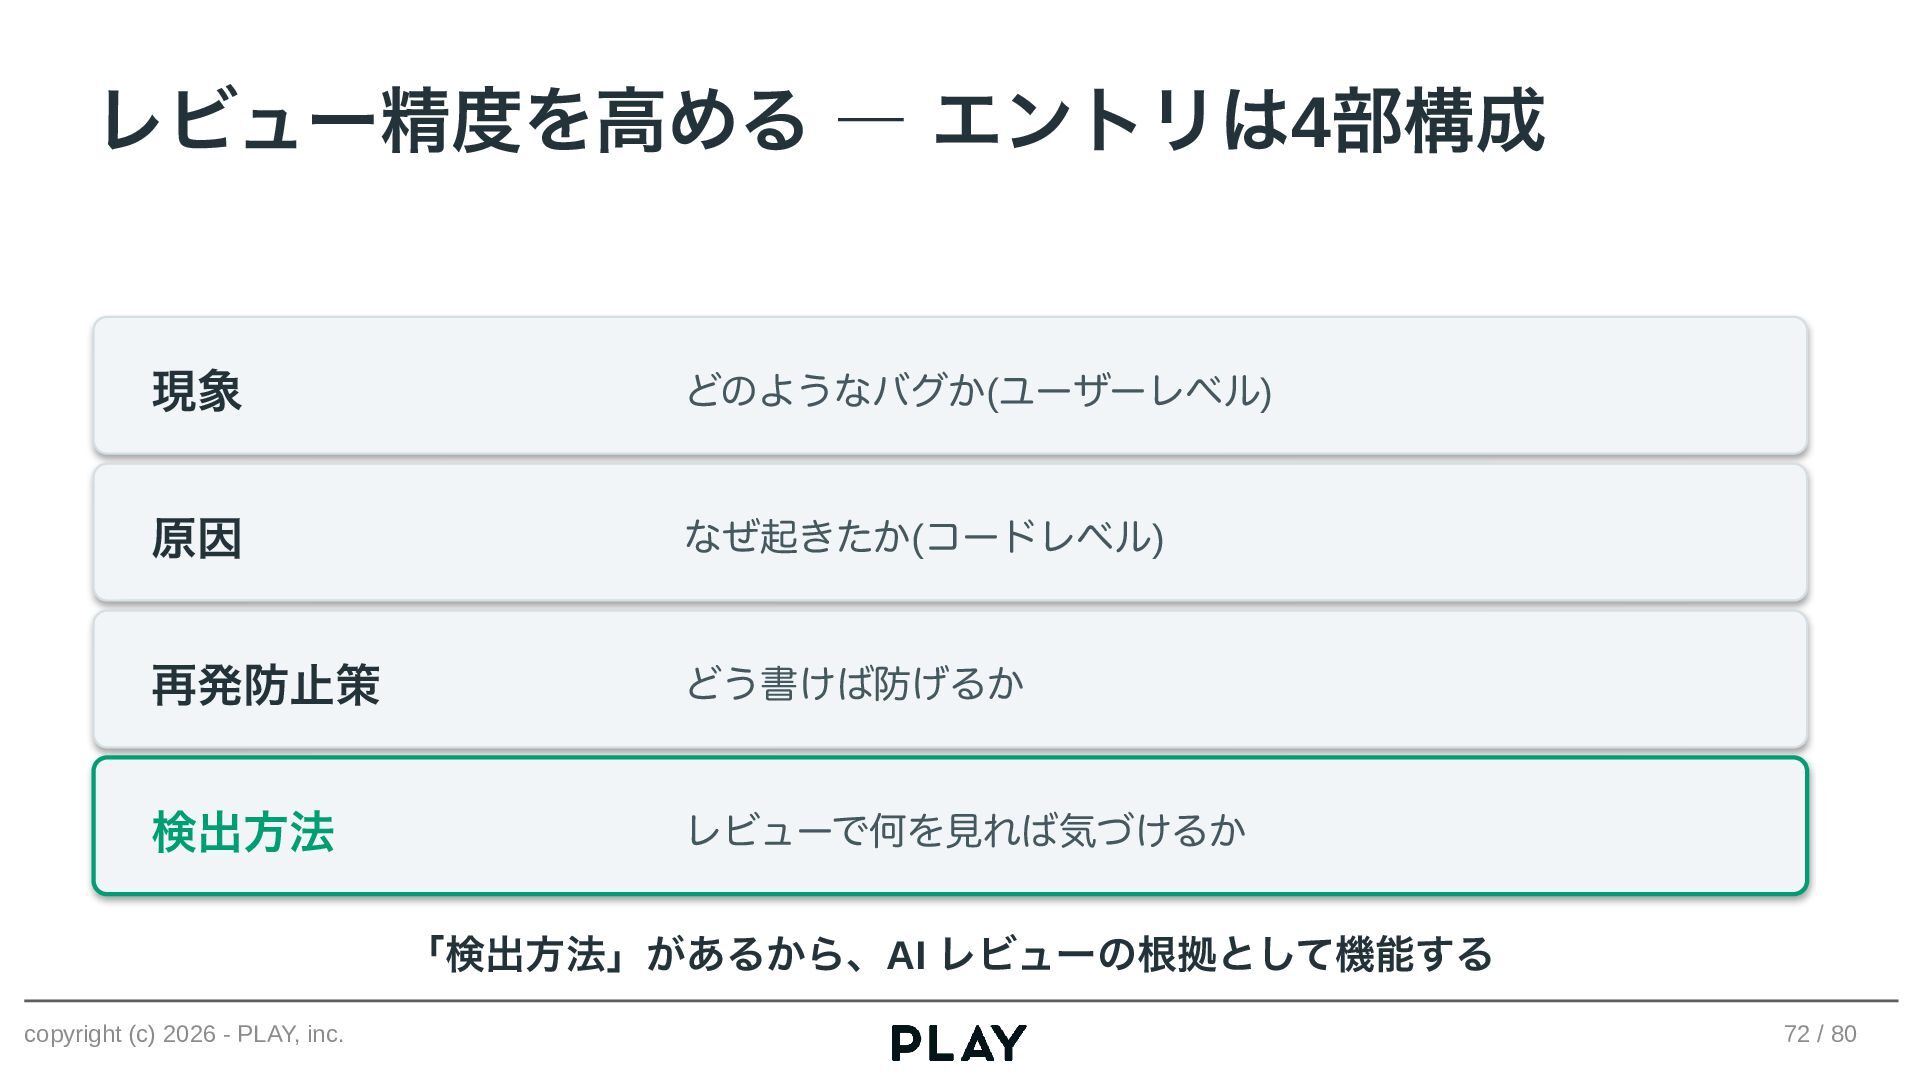
- 私たちが運用しているAndroid共通障害カタログから、現象・原因・再発防止策のフォーマットと、すぐ持ち帰って使えるエントリ例
AIで開発スピードは飛躍的に向上する一方、チームが踏む障害の母数も増え続けています。
一度作れば自走する障害のガードレール、その設計と実装をお持ち帰りいただけます。
対象者
- 複数のAndroidプロジェクトを管理しており、Roomマイグレーションやライフサイクル起因のクラッシュなど、過去のAndroid障害が別プロジェクトで再発することに頭を抱えているリードエンジニア / プロジェクトマネージャー
- GitHub ActionsのReusable Workflowsを知りたい、本格的に運用したい、または導入を検討している方
- Claudeなどの生成AIをCI/CDのフローに組み込み、Androidプロジェクトで活用したい方
- GitHub Copilotコードレビューのinstructionsを活用し、自社のAndroid障害ナレッジをAIレビューのコンテキストに乗せたいと考えている方
- 「仕組みを作ったのに形骸化した」失敗を経験したことがある、あるいはこれから経験しそうな組織の方


 suzukitomu
 jnunemaker
 lauravandoore
 nikkihalliwell
 bcantrill
 khoart
 jacobian
 reverentgeek
 codingconduct
 inesmontani
 thoeni
 andyhume
 oripsolob