Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Uma introdução à computação em GPU e à arquitet...

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on. →

Uma introdução à computação em GPU e à arquitetura CUDA

Um curso básico e introdutório da utilização da plataforma CUDA.
Apresentação utilizada na 'III Semana da Computação do IF Sudeste MG - Campus Rio Pomba'.

Avatar for Tamillys Pantuza

Tamillys Pantuza

October 19, 2013

More Decks by Tamillys Pantuza

Other Decks in Technology

Transcript

  1.  Definição;  Finalidade;  Funcionamento;  Evolução:  Dispositivos

    de Rasterização;  Fixed Function GPU;  Programmable GPU;  Arquitetura Unificada.  Vantagem.
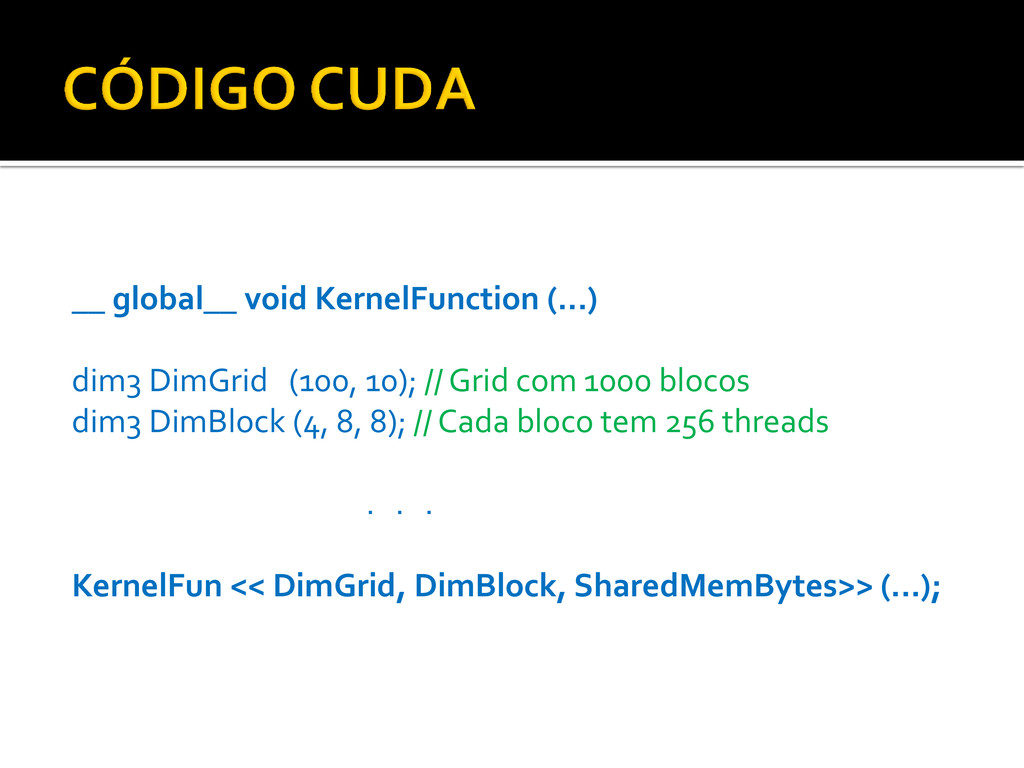
  2. __ global__ void KernelFunction (...) dim3 DimGrid (100, 10); //

    Grid com 1000 blocos dim3 DimBlock (4, 8, 8); // Cada bloco tem 256 threads . . . KernelFun << DimGrid, DimBlock, SharedMemBytes>> (...);
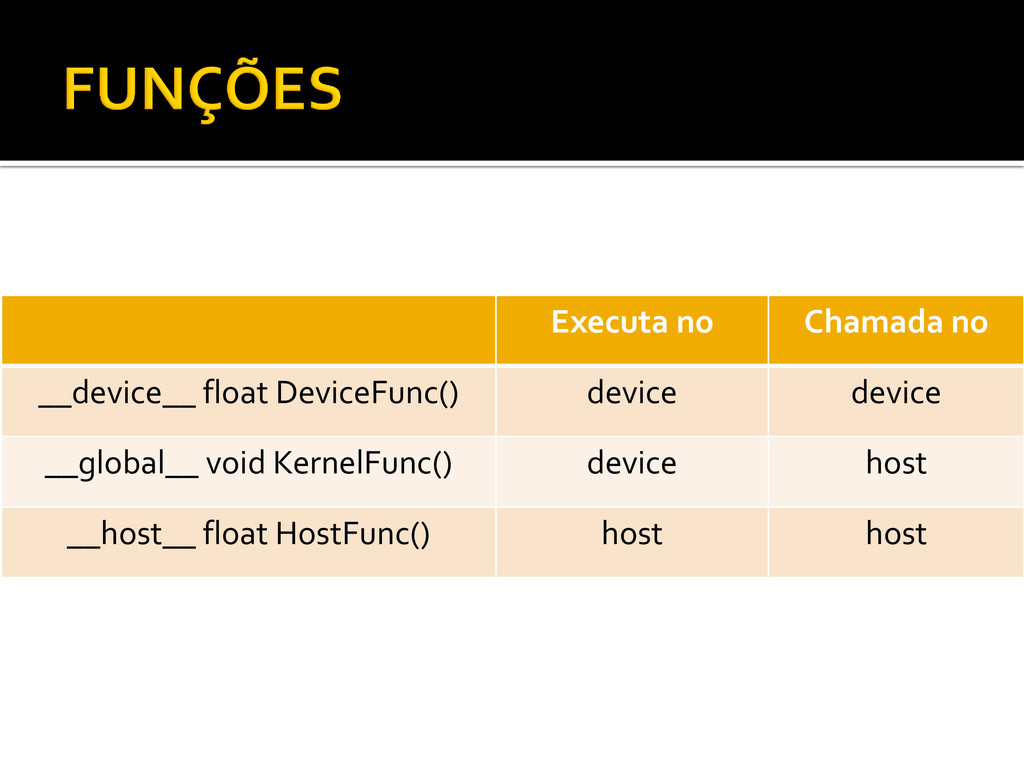
  3. Executa no Chamada no __device__ float DeviceFunc() device device __global__

    void KernelFunc() device host __host__ float HostFunc() host host
  4.  Pré-requisitos:  Placa com GPU Nvidia acima da série

    8000  Link para Download:  https://developer.nvidia.com/cuda-downloads  Baixar:  Toolkit  Driver  SDK  (Nsight) //Recomendado para quem utiliza a ferramenta Visual Studio
  5.  Emulador //Para quem não possui GPU da Nvidia 

    Visual Studio Express C++ 2005 ▪ http://www.superdownloads.com.br/download/176/visu al-c-2005-express-edition/  CUDA Toolkit 2.3 Downloads ▪ https://developer.nvidia.com/cuda-toolkit-23- downloads  Seguir tutorial à partir do passo 4 ▪ http://hpcden.blogspot.com.br/2012/06/how-to-run- cuda-in-emulation-mode.html
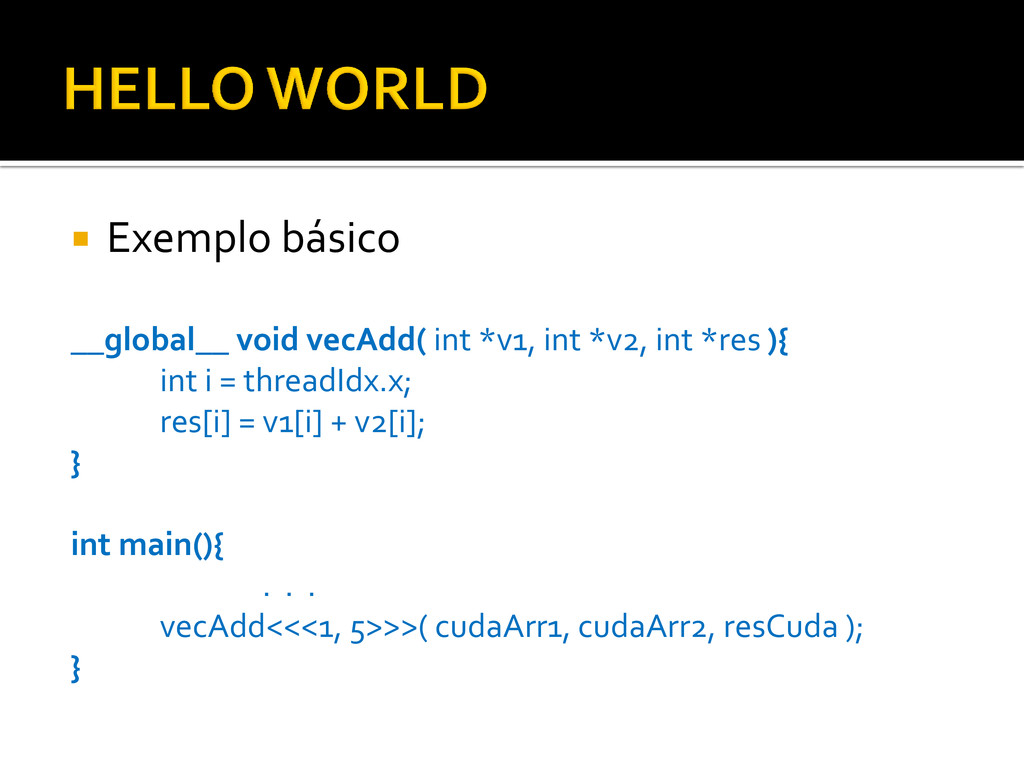
  6.  Exemplo básico __global__ void vecAdd( int *v1, int *v2,

    int *res ){ int i = threadIdx.x; res[i] = v1[i] + v2[i]; } int main(){ . . . vecAdd<<<1, 5>>>( cudaArr1, cudaArr2, resCuda ); }
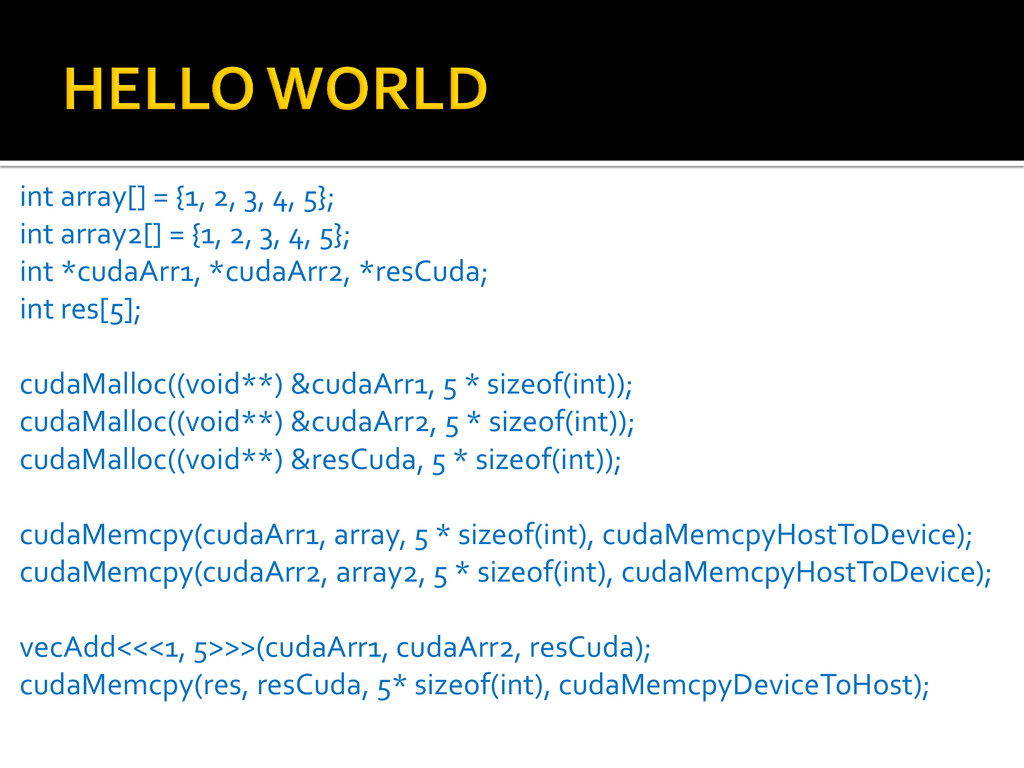
  7. int array[] = {1, 2, 3, 4, 5}; int array2[]

    = {1, 2, 3, 4, 5}; int *cudaArr1, *cudaArr2, *resCuda; int res[5]; cudaMalloc((void**) &cudaArr1, 5 * sizeof(int)); cudaMalloc((void**) &cudaArr2, 5 * sizeof(int)); cudaMalloc((void**) &resCuda, 5 * sizeof(int)); cudaMemcpy(cudaArr1, array, 5 * sizeof(int), cudaMemcpyHostToDevice); cudaMemcpy(cudaArr2, array2, 5 * sizeof(int), cudaMemcpyHostToDevice); vecAdd<<<1, 5>>>(cudaArr1, cudaArr2, resCuda); cudaMemcpy(res, resCuda, 5* sizeof(int), cudaMemcpyDeviceToHost);
  8.  Verdadeiro Hello World (em paralelo)  Pega a string

    “Hello", imprime, e em seguida passa para a função CUDA com um array de compensações.  Logo após, os deslocamentos são adicionados em paralelo para produzir a string “World!“ - Fonte: http://computer-graphics.se/hello-world-for-cuda.html
  9.  GPUs permitem um excelente desempenho a um baixo custo.

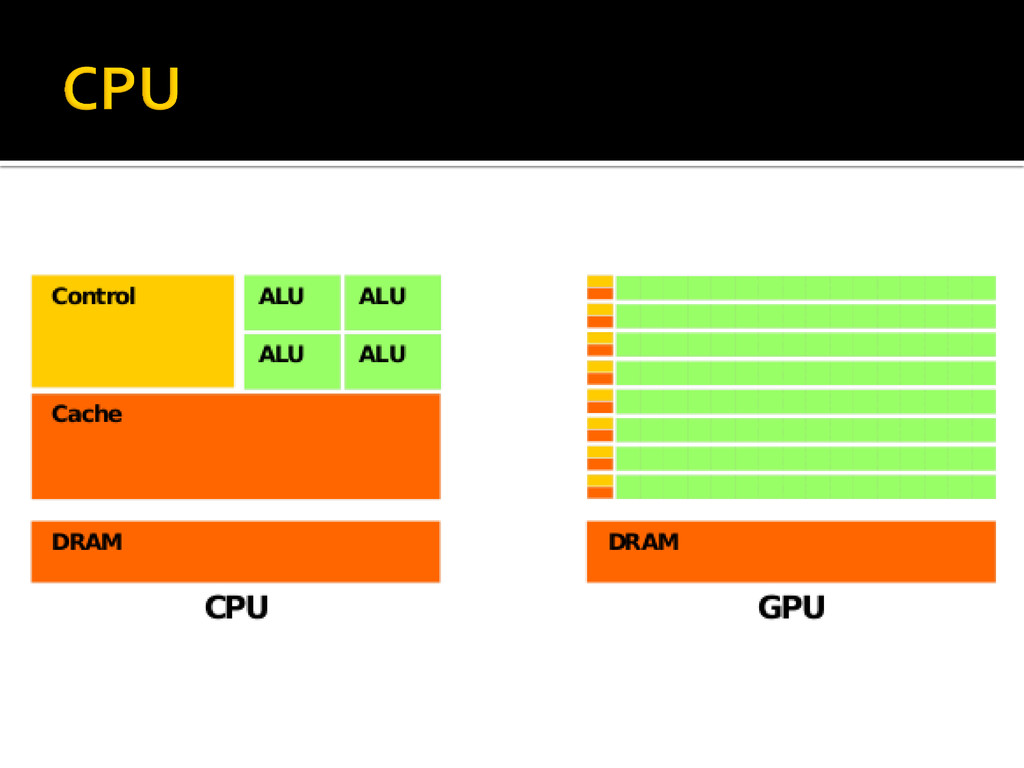
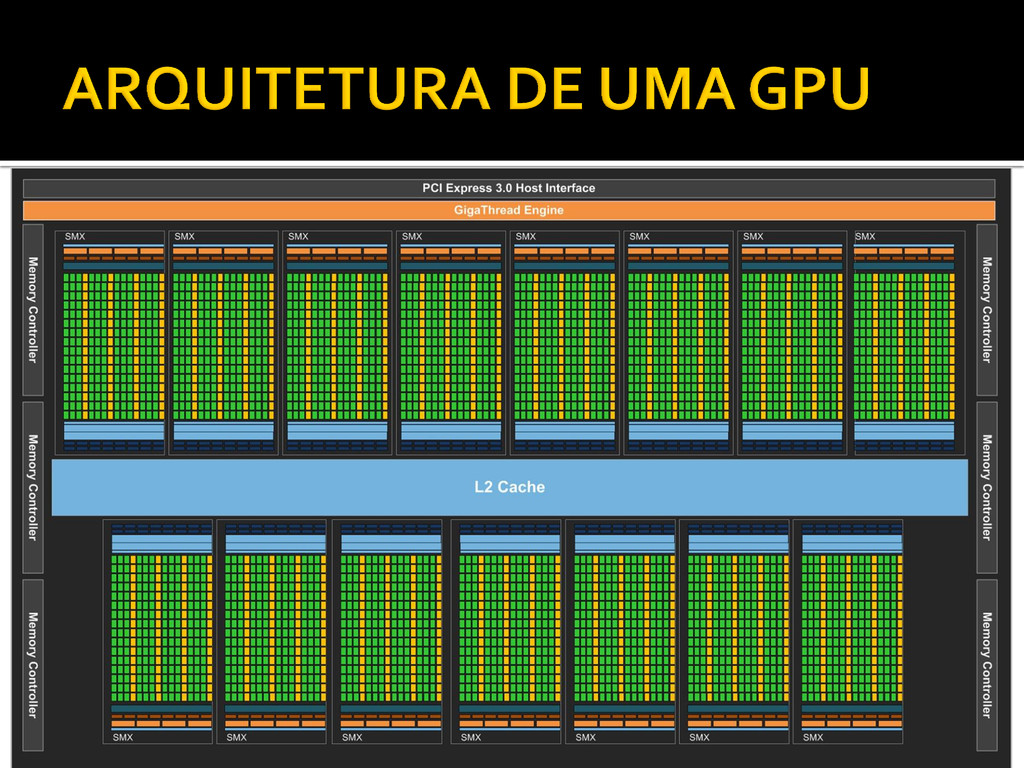
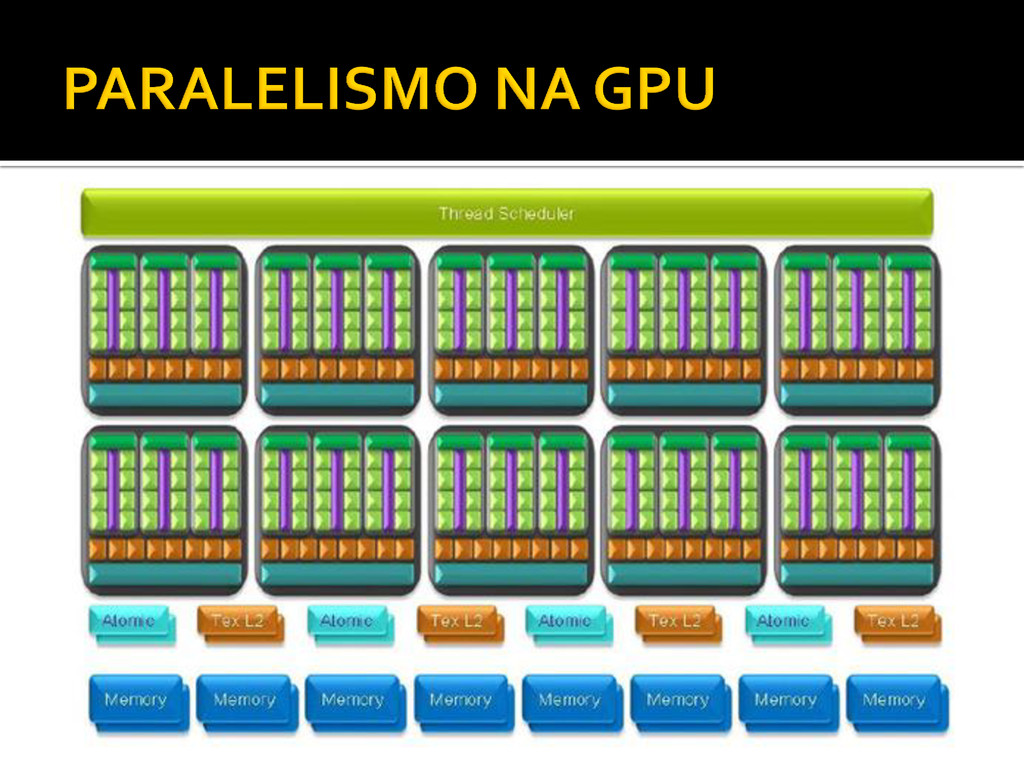
     São compostas por centenas de processadores simples e um barramento compartilhado para acesso a memória.  Não fornecem bom desempenho para qualquer tipo de aplicação.
  10.  A plataforma CUDA permite o uso de GPUs para

    executar aplicações paralelas.  Extensão da linguagem C, sendo de fácil aprendizado.  Para rodar de modo eficiente, é essencial que o código seja otimizado.
  11.  Cuda Education & Training  https://developer.nvidia.com/cuda-education- training  CUDA

    Programming Guide e CUDA Best Practices  Cuda Developer Zone  https://developer.nvidia.com/category/zone/cuda- zone
  12.  Demais documentações:  Quickstart guide  Programming guide 

    Reference manual  Toolkit release notes  SDK release notes
  13.  Esteban Clua  Mark Joselli  José Ricardo da

    Silva Junior  http://www2.ic.uff.br/~medialab/wordpress/  Raphael Y. de Camargo