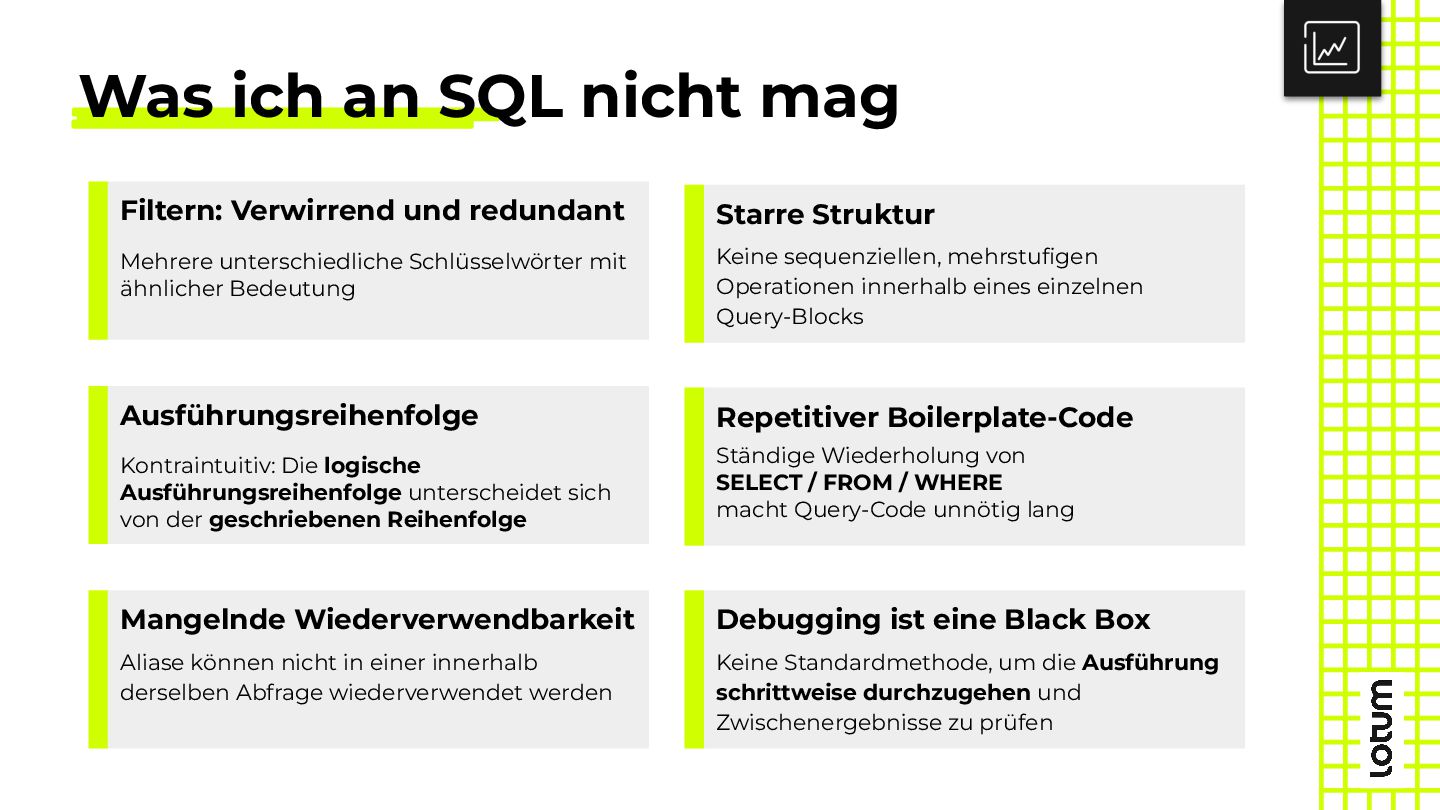
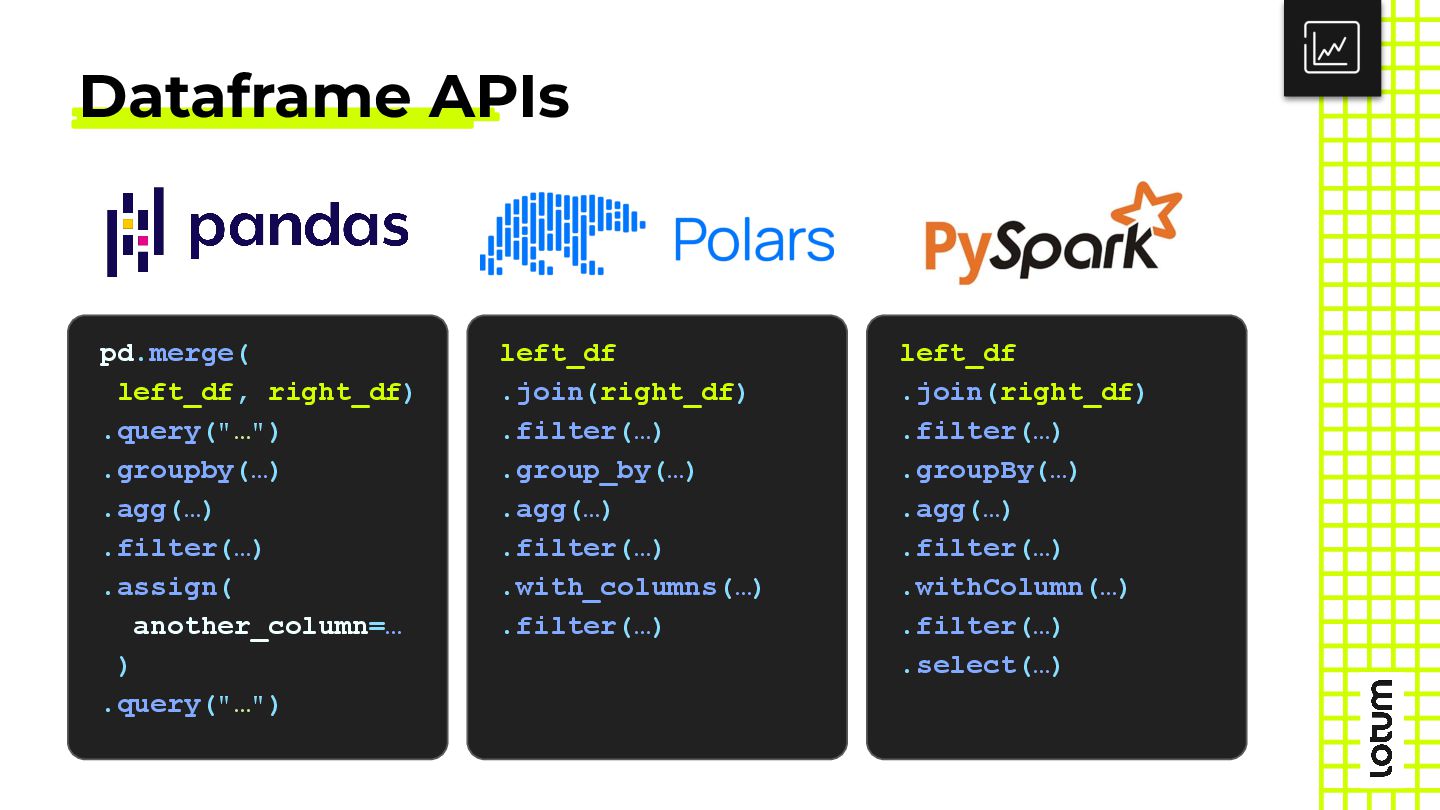
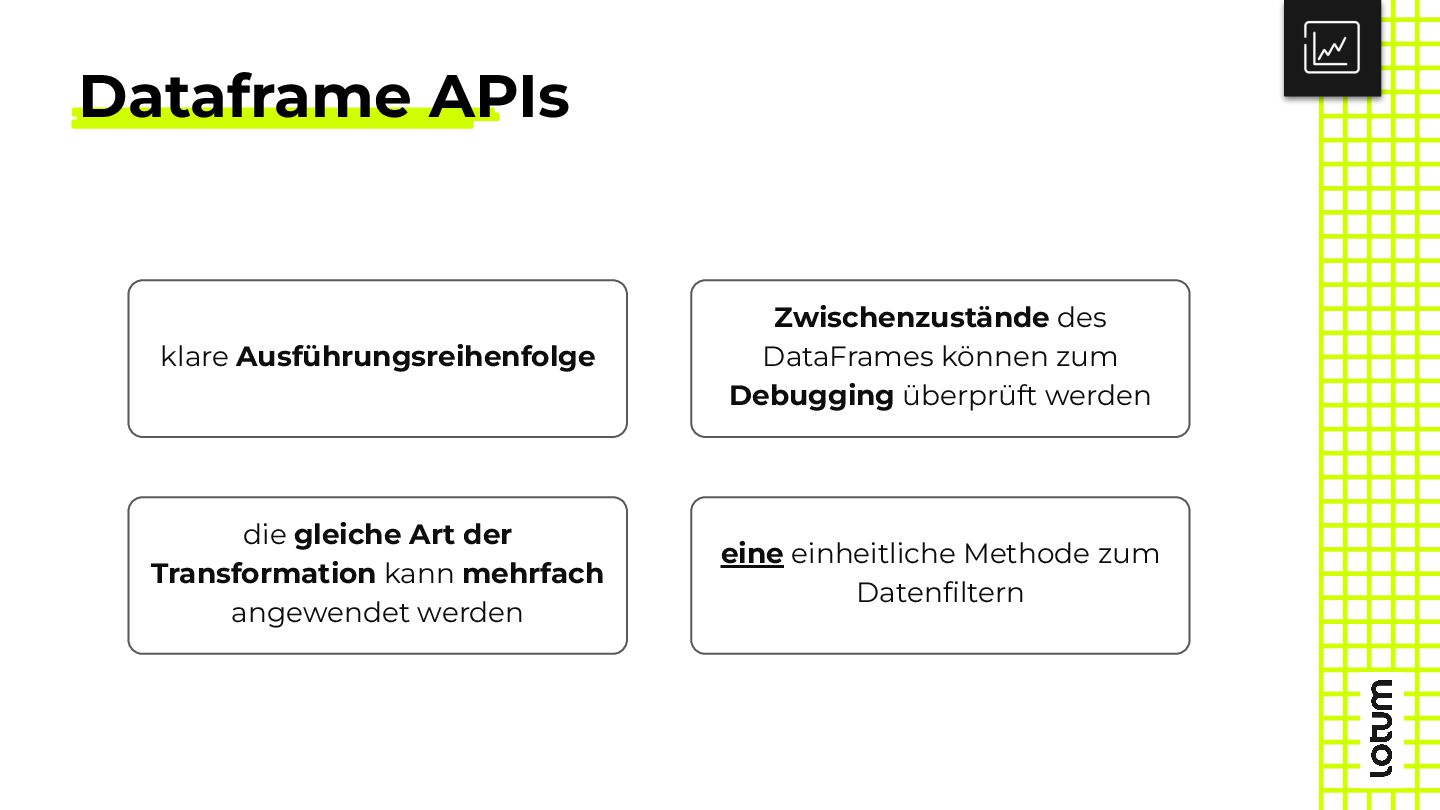
logische Ausführungsreihenfolge unterscheidet sich von der geschriebenen Reihenfolge Filtern: Verwirrend und redundant Mehrere unterschiedliche Schlüsselwörter mit ähnlicher Bedeutung Mangelnde Wiederverwendbarkeit Aliase können nicht in einer innerhalb derselben Abfrage wiederverwendet werden Starre Struktur Keine sequenziellen, mehrstufigen Operationen innerhalb eines einzelnen Query-Blocks Repetitiver Boilerplate-Code Ständige Wiederholung von SELECT / FROM / WHERE macht Query-Code unnötig lang Debugging ist eine Black Box Keine Standardmethode, um die Ausführung schrittweise durchzugehen und Zwischenergebnisse zu prüfen
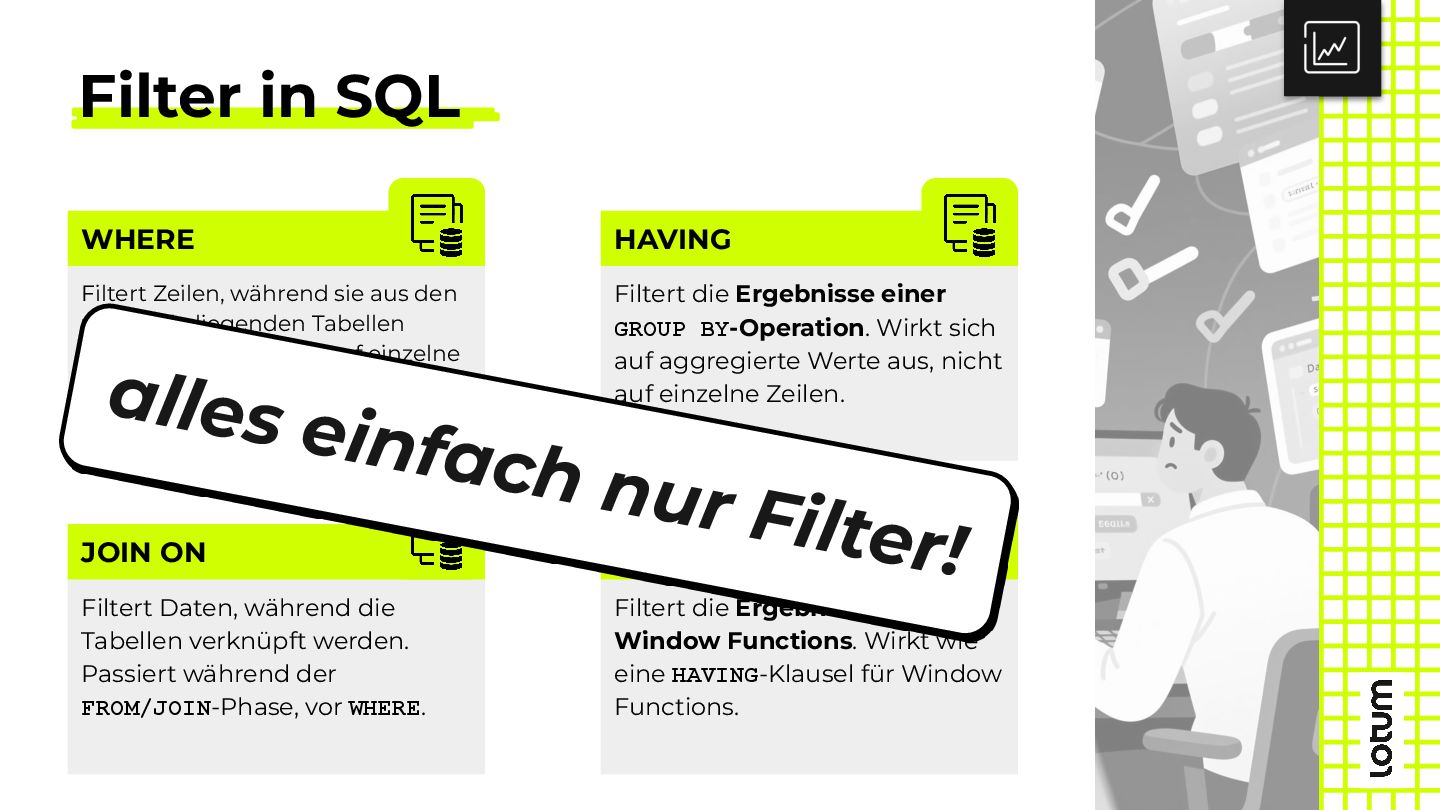
Daten zu filtern: Um korrekten und effizienten SQL-Code zu schreiben, ist es entschiedend die Reihenfolge der Ausführung der einzelnen Operationen zu verstehen WHERE JOIN ON HAVING QUALIFY
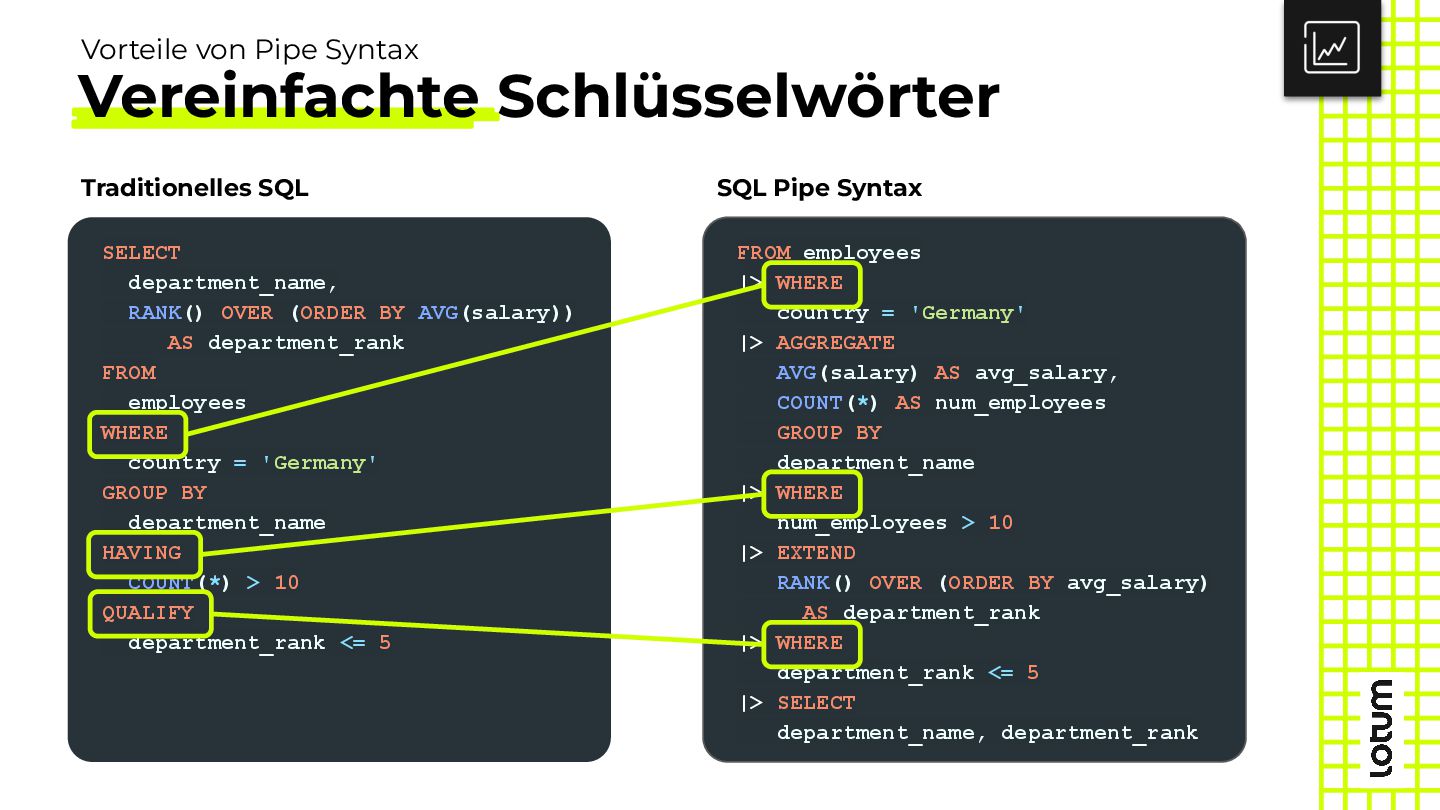
zugrunde liegenden Tabellen gelesen werden. Wird auf einzelne Zeilen angewendet, bevor eine Gruppierung oder Aggregation stattfindet. WHERE Filtert Daten, während die Tabellen verknüpft werden. Passiert während der FROM/JOIN-Phase, vor WHERE. JOIN ON Filtert die Ergebnisse einer GROUP BY-Operation. Wirkt sich auf aggregierte Werte aus, nicht auf einzelne Zeilen. HAVING Filtert die Ergebnisse von Window Functions. Wirkt wie eine HAVING-Klausel für Window Functions. QUALIFY alles einfach nur Filter!
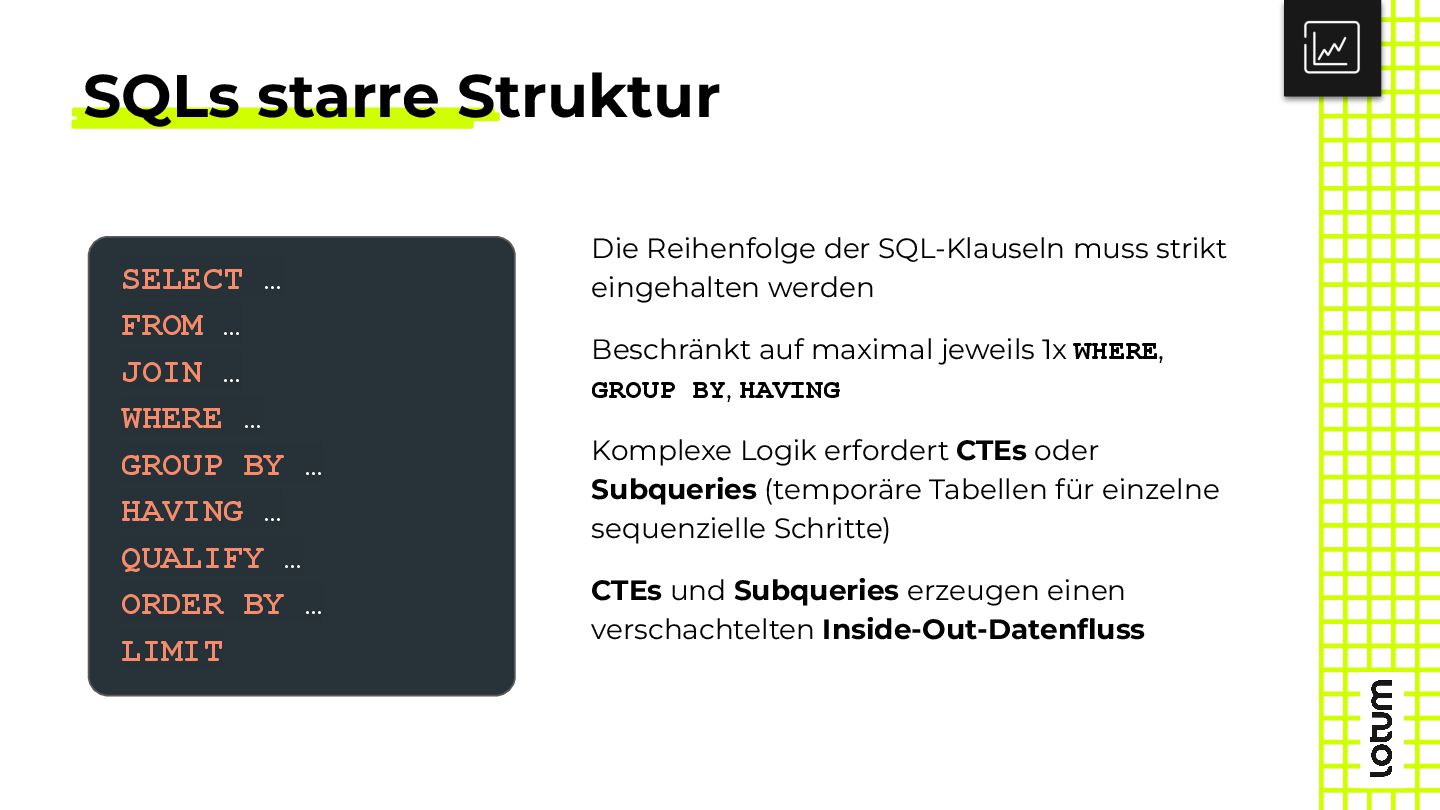
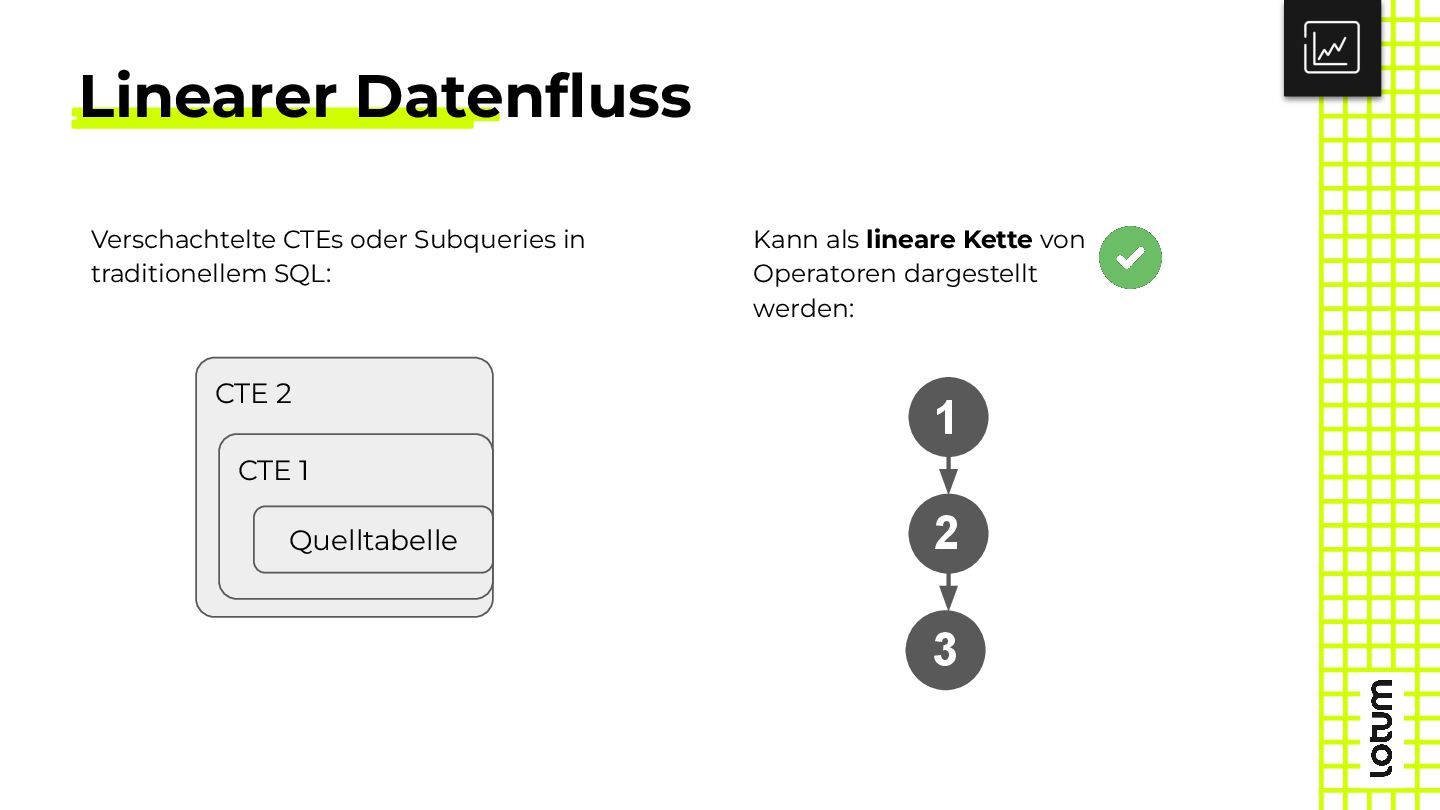
WHERE … GROUP BY … HAVING … QUALIFY … ORDER BY … LIMIT Die Reihenfolge der SQL-Klauseln muss strikt eingehalten werden Beschränkt auf maximal jeweils 1x WHERE, GROUP BY, HAVING Komplexe Logik erfordert CTEs oder Subqueries (temporäre Tabellen für einzelne sequenzielle Schritte) CTEs und Subqueries erzeugen einen verschachtelten Inside-Out-Datenfluss
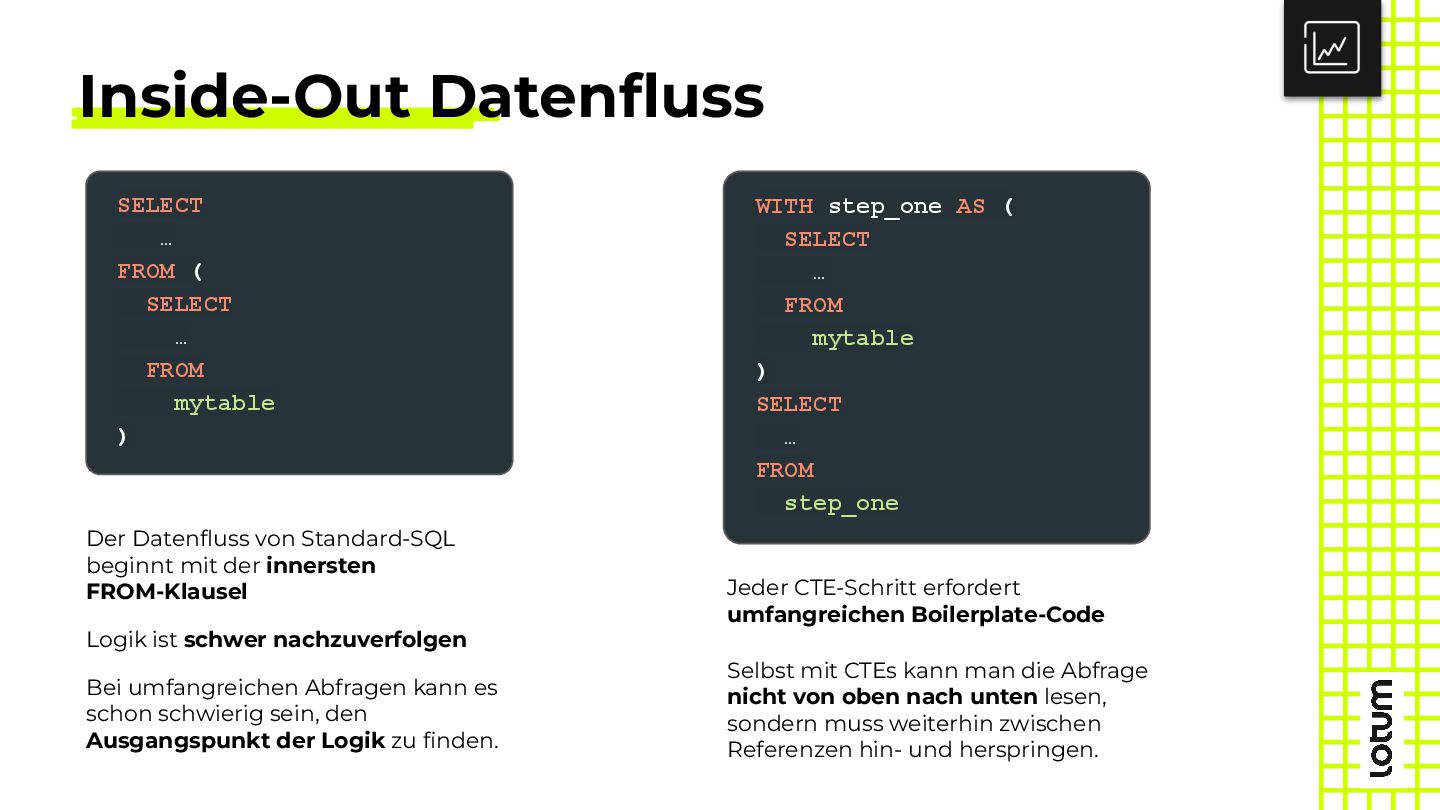
innersten FROM-Klausel Logik ist schwer nachzuverfolgen Bei umfangreichen Abfragen kann es schon schwierig sein, den Ausgangspunkt der Logik zu finden. Jeder CTE-Schritt erfordert umfangreichen Boilerplate-Code Selbst mit CTEs kann man die Abfrage nicht von oben nach unten lesen, sondern muss weiterhin zwischen Referenzen hin- und herspringen. SELECT … FROM ( SELECT … FROM mytable ) WITH step_one AS ( SELECT … FROM mytable ) SELECT … FROM step_one
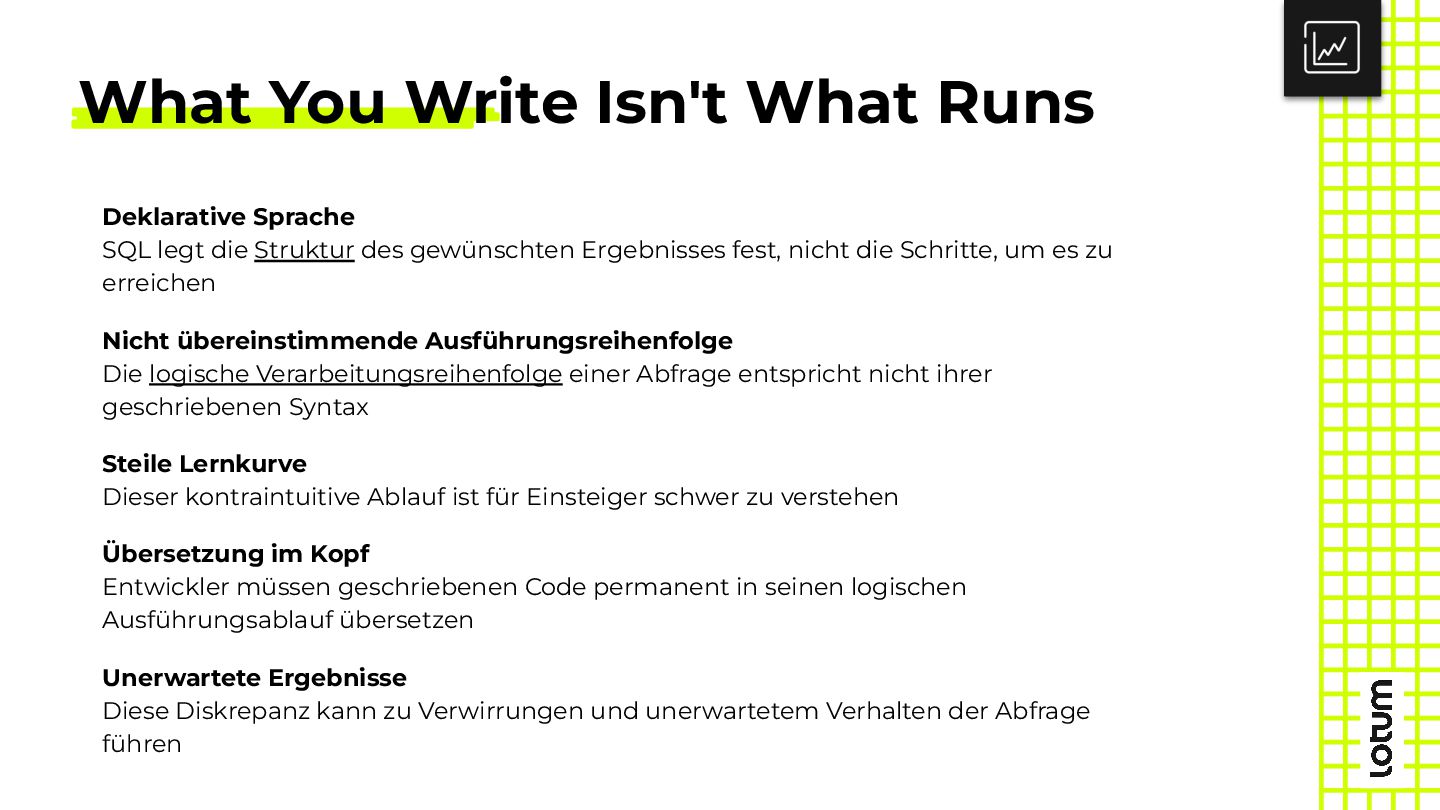
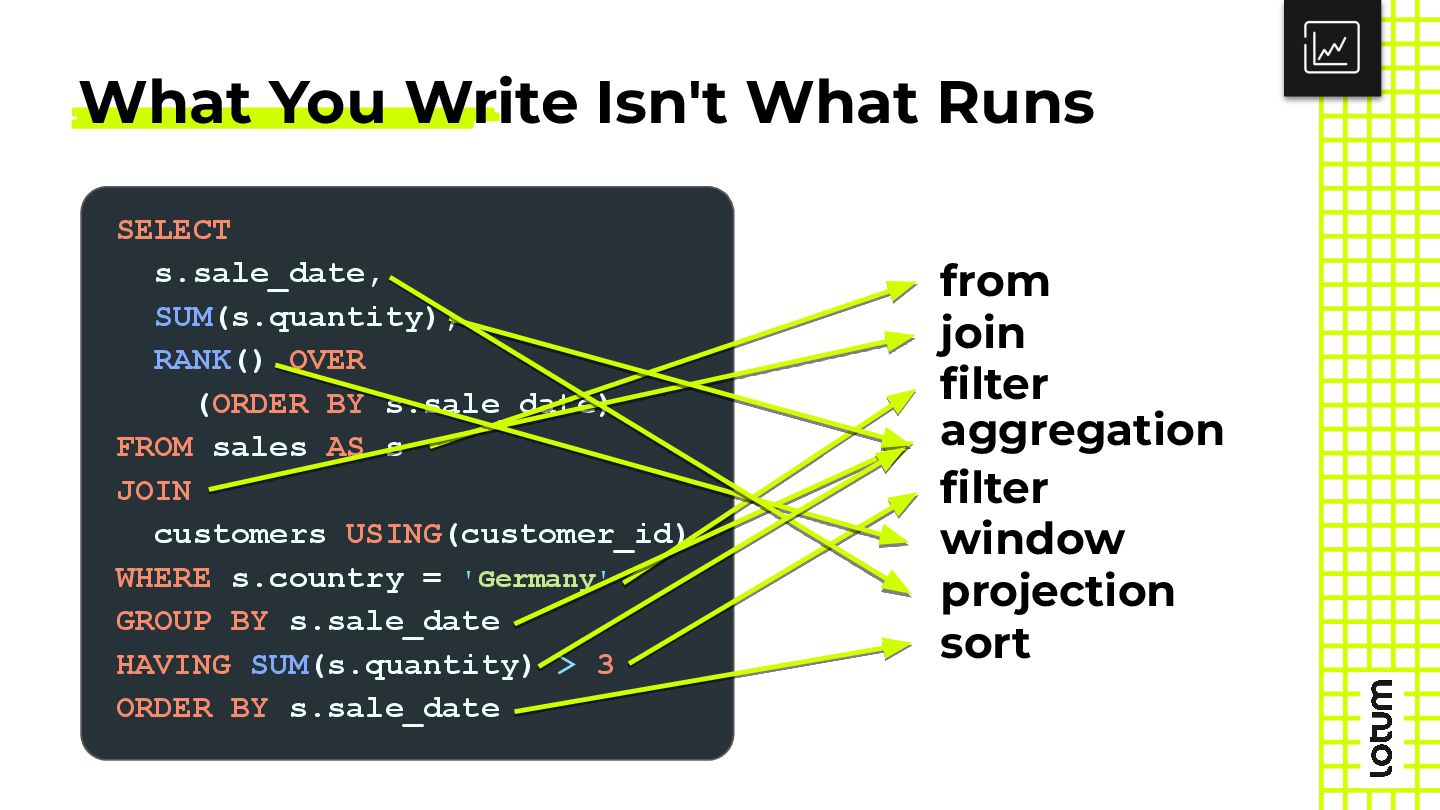
legt die Struktur des gewünschten Ergebnisses fest, nicht die Schritte, um es zu erreichen Nicht übereinstimmende Ausführungsreihenfolge Die logische Verarbeitungsreihenfolge einer Abfrage entspricht nicht ihrer geschriebenen Syntax Steile Lernkurve Dieser kontraintuitive Ablauf ist für Einsteiger schwer zu verstehen Übersetzung im Kopf Entwickler müssen geschriebenen Code permanent in seinen logischen Ausführungsablauf übersetzen Unerwartete Ergebnisse Diese Diskrepanz kann zu Verwirrungen und unerwartetem Verhalten der Abfrage führen
RANK() OVER (ORDER BY s.sale_date) FROM sales AS s JOIN customers USING(customer_id) WHERE s.country = 'Germany' GROUP BY s.sale_date HAVING SUM(s.quantity) > 3 ORDER BY s.sale_date from join filter aggregation filter sort window projection
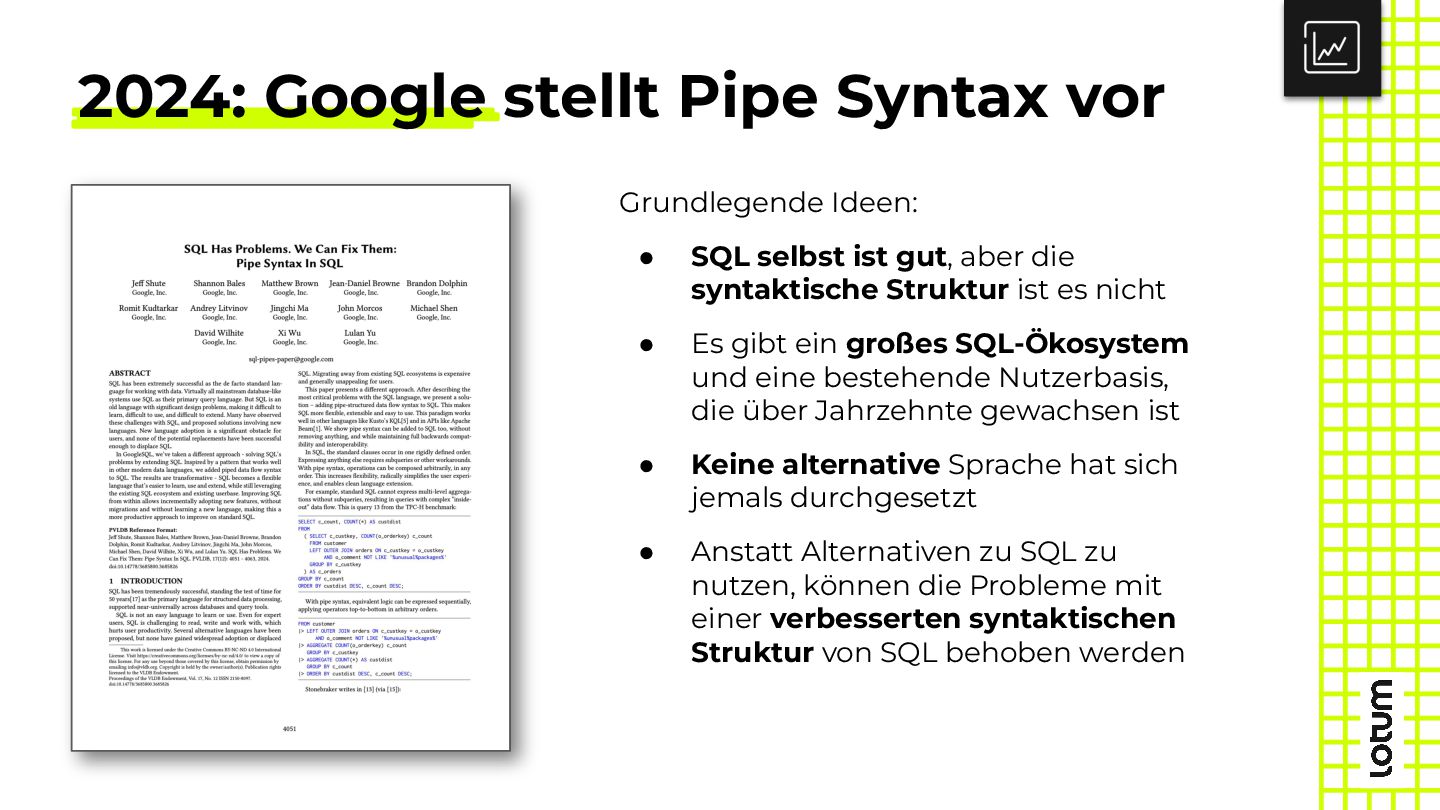
SQL selbst ist gut, aber die syntaktische Struktur ist es nicht • Es gibt ein großes SQL-Ökosystem und eine bestehende Nutzerbasis, die über Jahrzehnte gewachsen ist • Keine alternative Sprache hat sich jemals durchgesetzt • Anstatt Alternativen zu SQL zu nutzen, können die Probleme mit einer verbesserten syntaktischen Struktur von SQL behoben werden
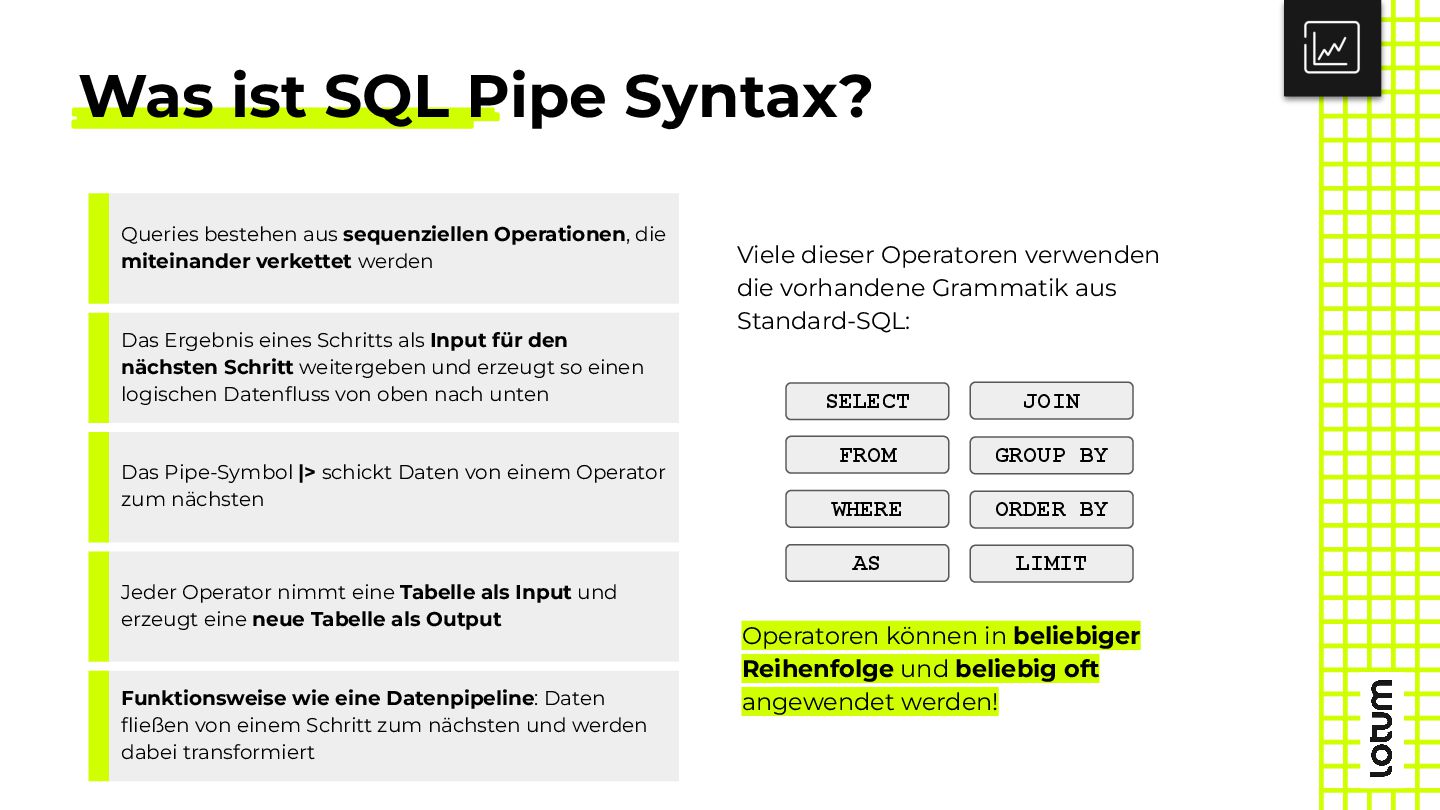
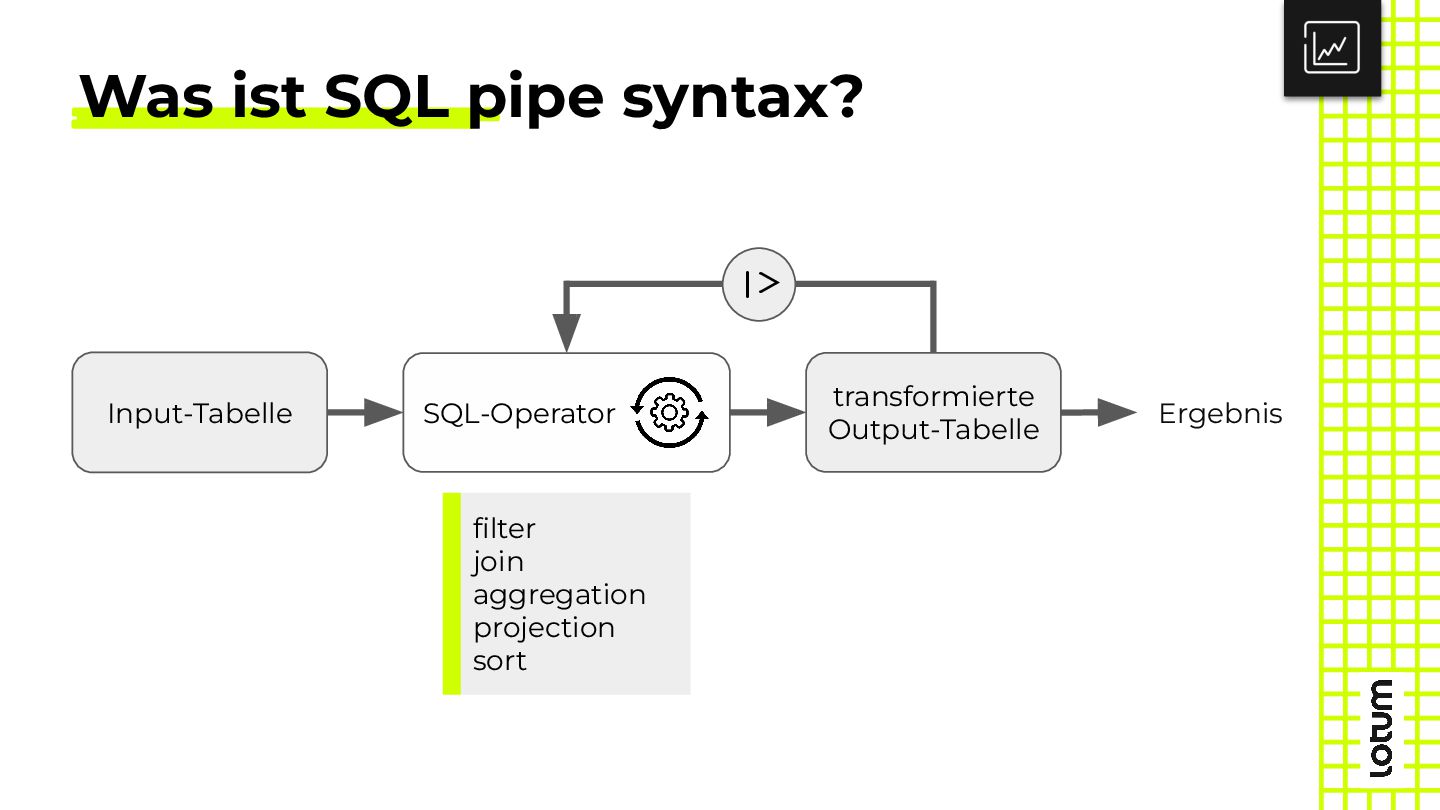
Operationen, die miteinander verkettet werden Das Ergebnis eines Schritts als Input für den nächsten Schritt weitergeben und erzeugt so einen logischen Datenfluss von oben nach unten Das Pipe-Symbol |> schickt Daten von einem Operator zum nächsten Jeder Operator nimmt eine Tabelle als Input und erzeugt eine neue Tabelle als Output Operatoren können in beliebiger Reihenfolge und beliebig oft angewendet werden! FROM WHERE JOIN SELECT GROUP BY ORDER BY LIMIT AS Viele dieser Operatoren verwenden die vorhandene Grammatik aus Standard-SQL: Funktionsweise wie eine Datenpipeline: Daten fließen von einem Schritt zum nächsten und werden dabei transformiert
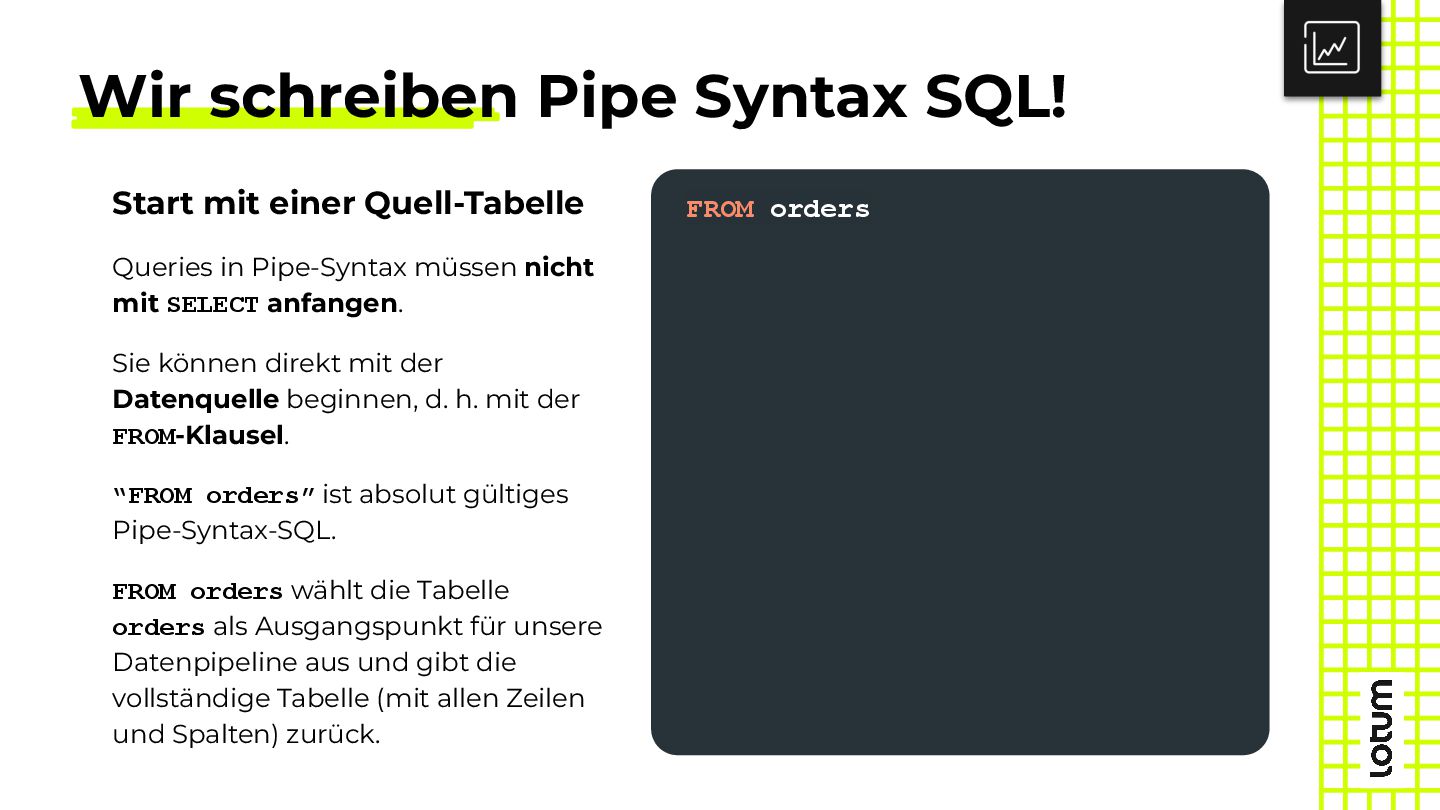
Queries in Pipe-Syntax müssen nicht mit SELECT anfangen. Sie können direkt mit der Datenquelle beginnen, d. h. mit der FROM-Klausel. “FROM orders” ist absolut gültiges Pipe-Syntax-SQL. FROM orders wählt die Tabelle orders als Ausgangspunkt für unsere Datenpipeline aus und gibt die vollständige Tabelle (mit allen Zeilen und Spalten) zurück. FROM orders
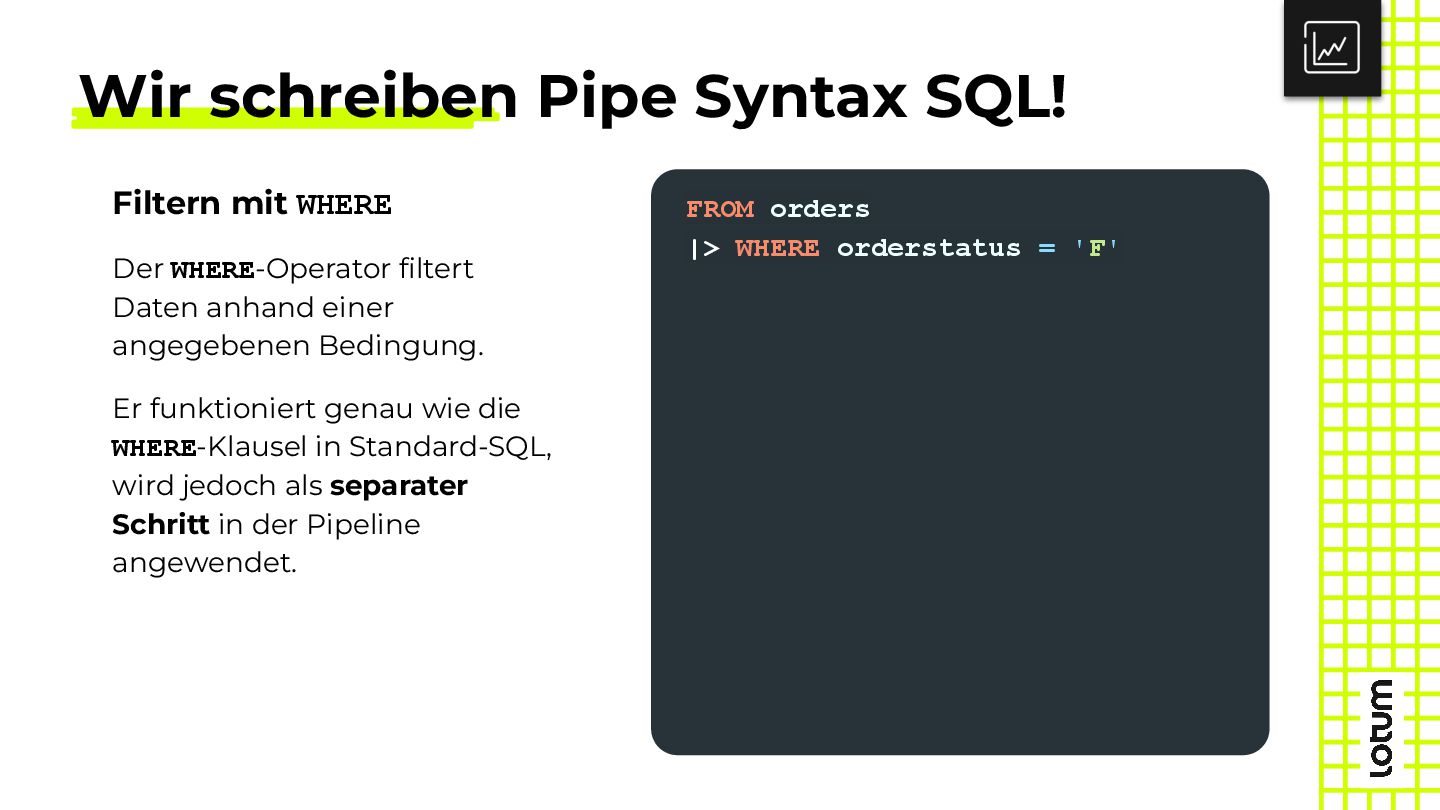
WHERE-Operator filtert Daten anhand einer angegebenen Bedingung. Er funktioniert genau wie die WHERE-Klausel in Standard-SQL, wird jedoch als separater Schritt in der Pipeline angewendet. FROM orders |> WHERE orderstatus = 'F'
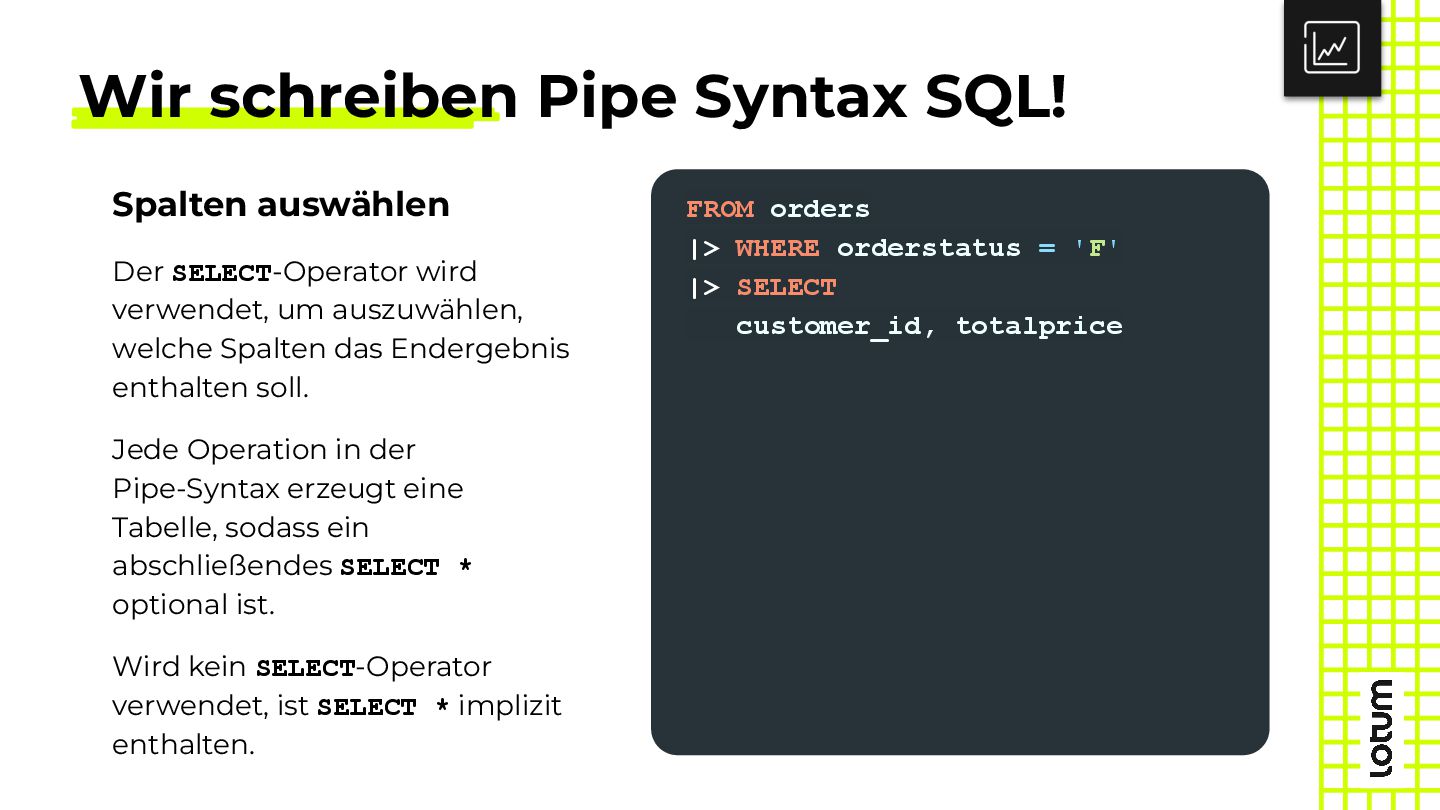
wird verwendet, um auszuwählen, welche Spalten das Endergebnis enthalten soll. Jede Operation in der Pipe-Syntax erzeugt eine Tabelle, sodass ein abschließendes SELECT * optional ist. Wird kein SELECT-Operator verwendet, ist SELECT * implizit enthalten. FROM orders |> WHERE orderstatus = 'F' |> SELECT customer_id, totalprice
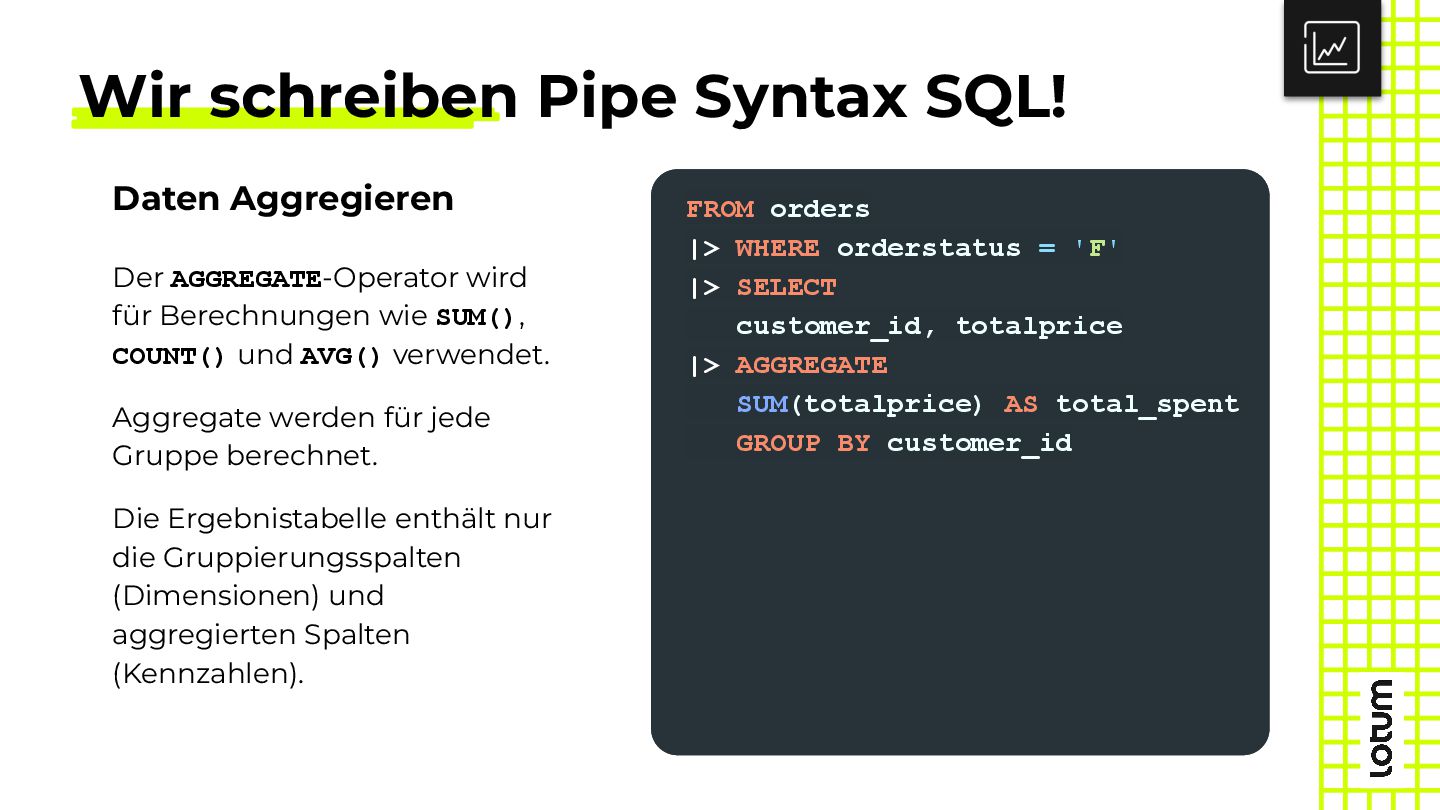
Berechnungen wie SUM(), COUNT() und AVG() verwendet. Aggregate werden für jede Gruppe berechnet. Die Ergebnistabelle enthält nur die Gruppierungsspalten (Dimensionen) und aggregierten Spalten (Kennzahlen). Daten Aggregieren FROM orders |> WHERE orderstatus = 'F' |> SELECT customer_id, totalprice FROM orders |> WHERE orderstatus = 'F' |> SELECT customer_id, totalprice |> AGGREGATE SUM(totalprice) AS total_spent GROUP BY customer_id
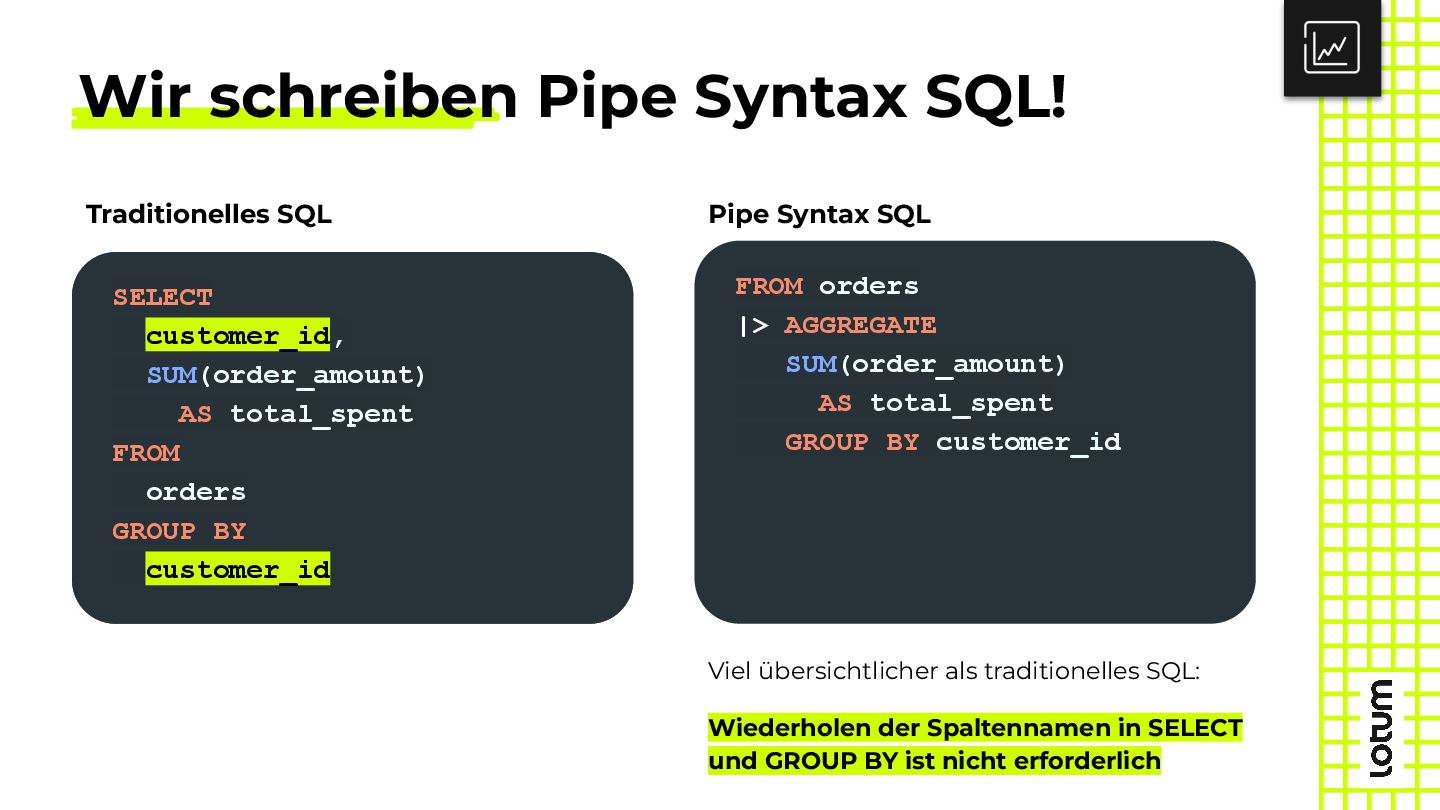
total_spent FROM orders GROUP BY customer_id Traditionelles SQL FROM orders |> AGGREGATE SUM(order_amount) AS total_spent GROUP BY customer_id Pipe Syntax SQL SELECT customer_id, SUM(order_amount) AS total_spent FROM orders GROUP BY customer_id Viel übersichtlicher als traditionelles SQL: Wiederholen der Spaltennamen in SELECT und GROUP BY ist nicht erforderlich
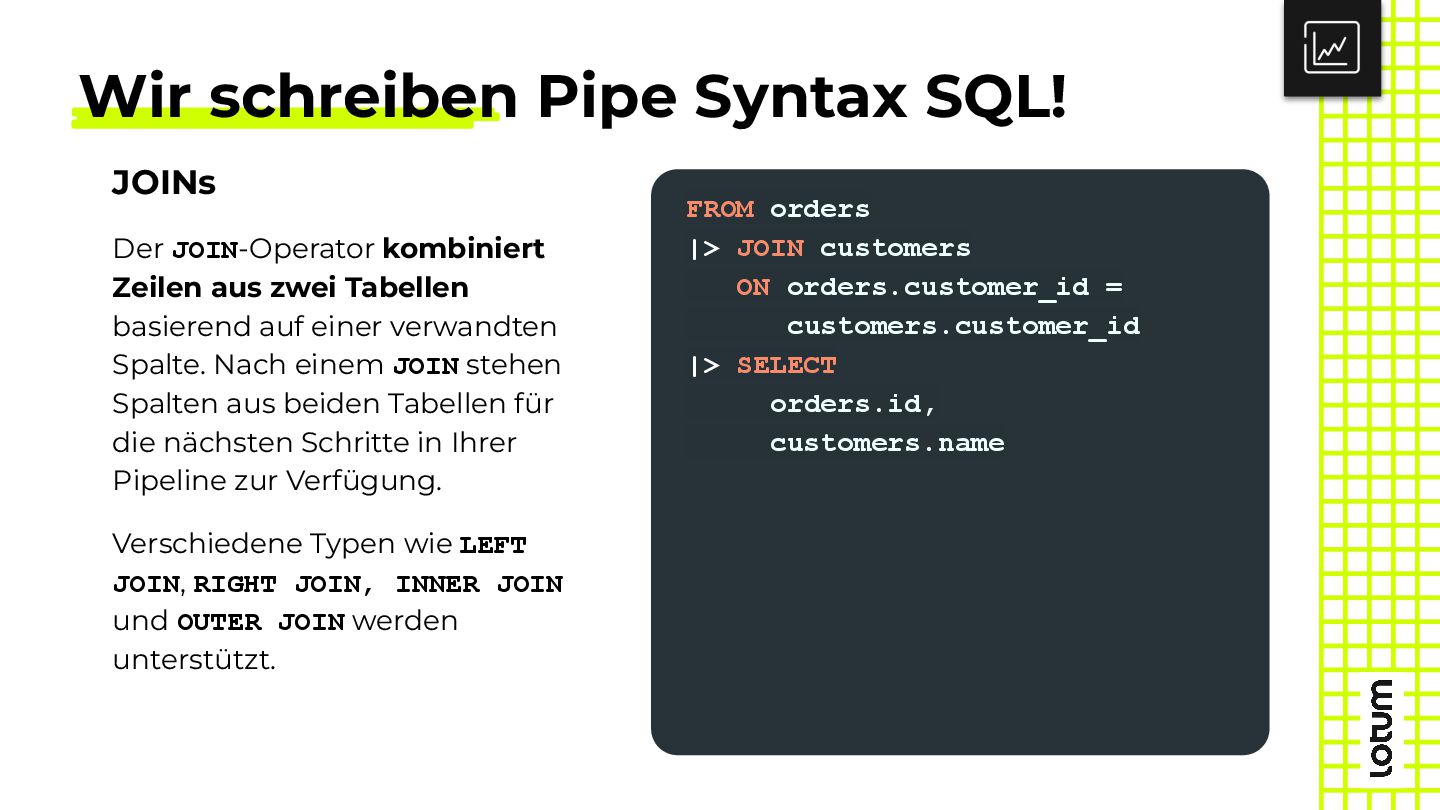
aus zwei Tabellen basierend auf einer verwandten Spalte. Nach einem JOIN stehen Spalten aus beiden Tabellen für die nächsten Schritte in Ihrer Pipeline zur Verfügung. Verschiedene Typen wie LEFT JOIN, RIGHT JOIN, INNER JOIN und OUTER JOIN werden unterstützt. FROM orders |> JOIN customers ON orders.customer_id = customers.customer_id |> SELECT orders.id, customers.name JOINs
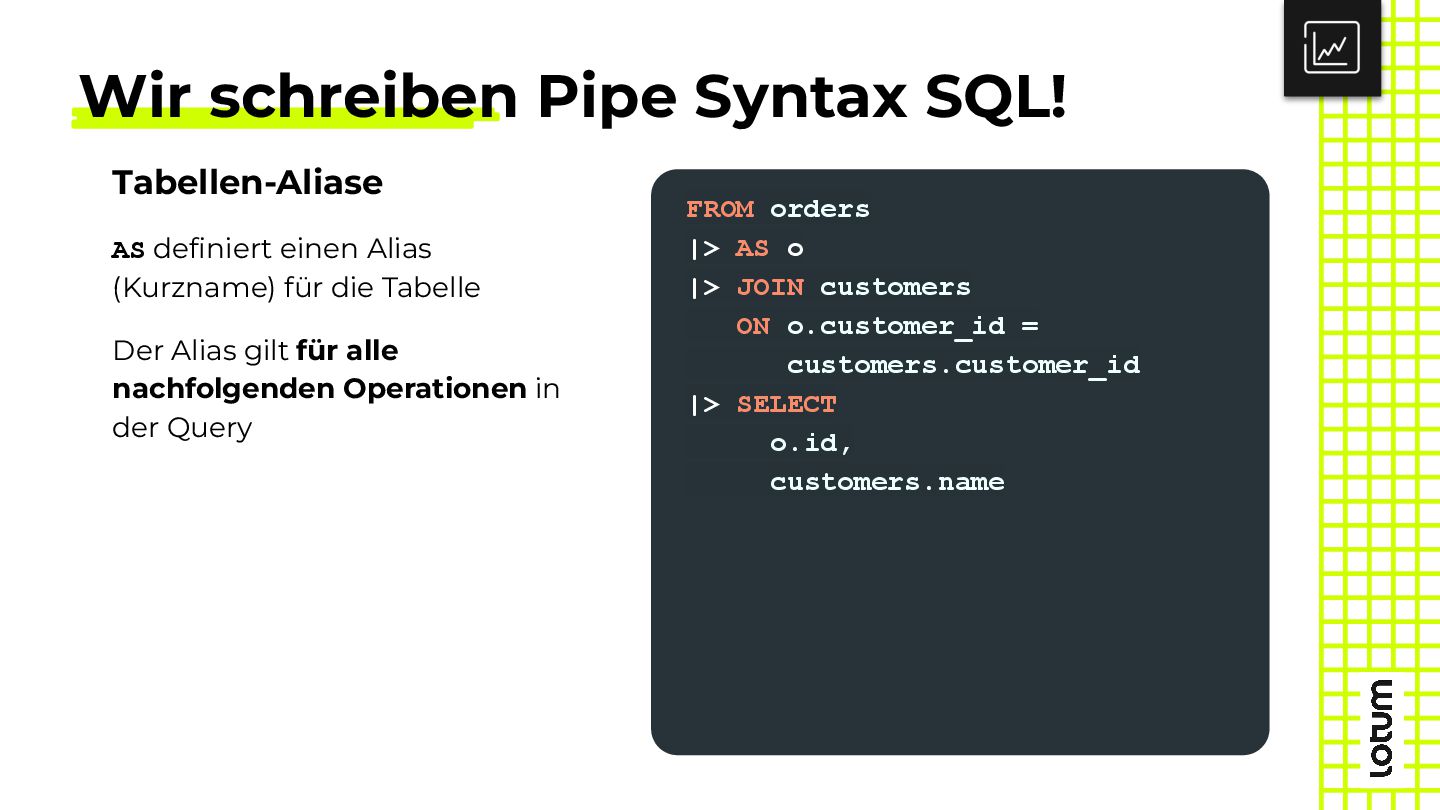
(Kurzname) für die Tabelle Der Alias gilt für alle nachfolgenden Operationen in der Query FROM orders |> AS o |> JOIN customers ON o.customer_id = customers.customer_id |> SELECT o.id, customers.name Tabellen-Aliase
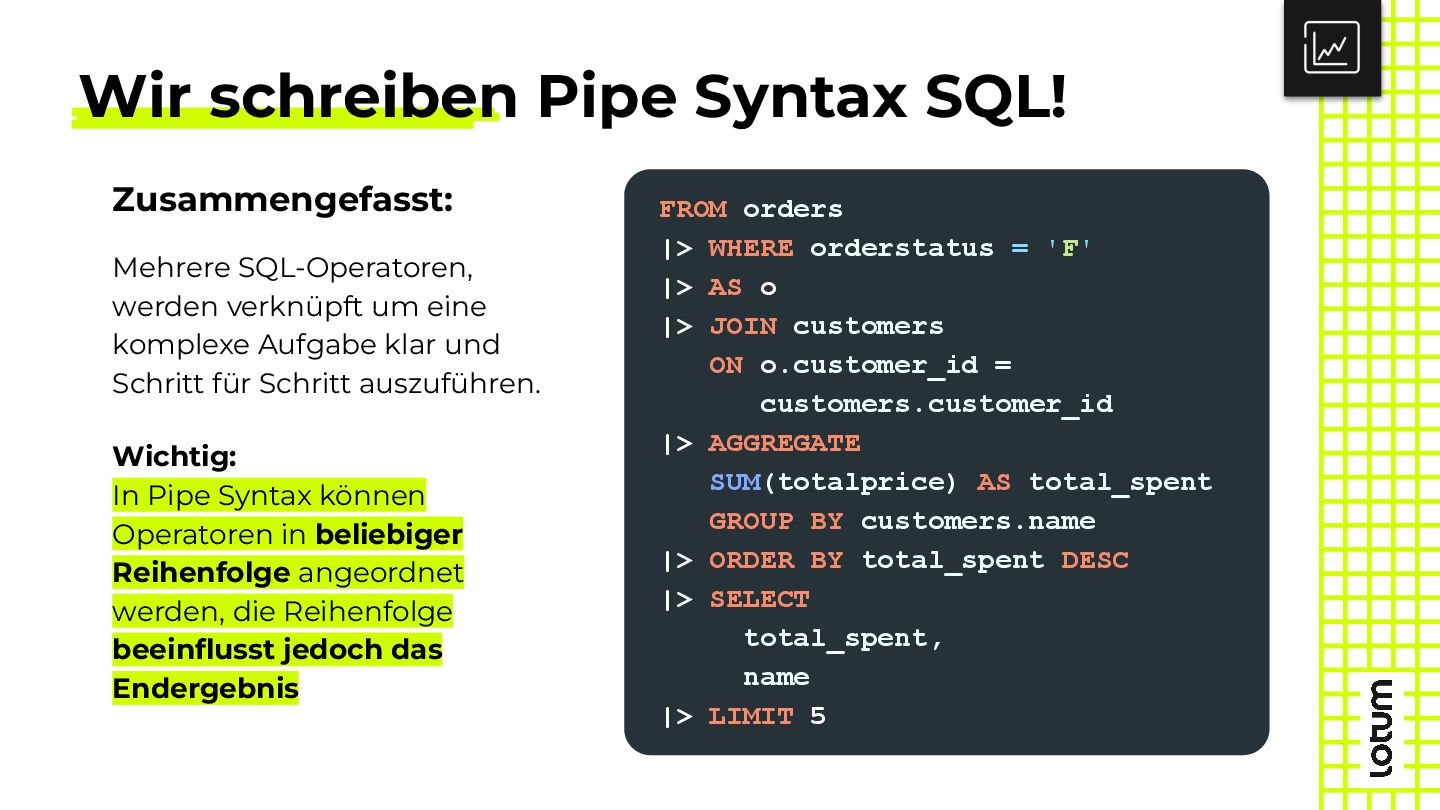
um eine komplexe Aufgabe klar und Schritt für Schritt auszuführen. FROM orders |> WHERE orderstatus = 'F' |> AS o |> JOIN customers ON o.customer_id = customers.customer_id |> AGGREGATE SUM(totalprice) AS total_spent GROUP BY customers.name |> ORDER BY total_spent DESC |> SELECT total_spent, name |> LIMIT 5 Zusammengefasst: Wichtig: In Pipe Syntax können Operatoren in beliebiger Reihenfolge angeordnet werden, die Reihenfolge beeinflusst jedoch das Endergebnis
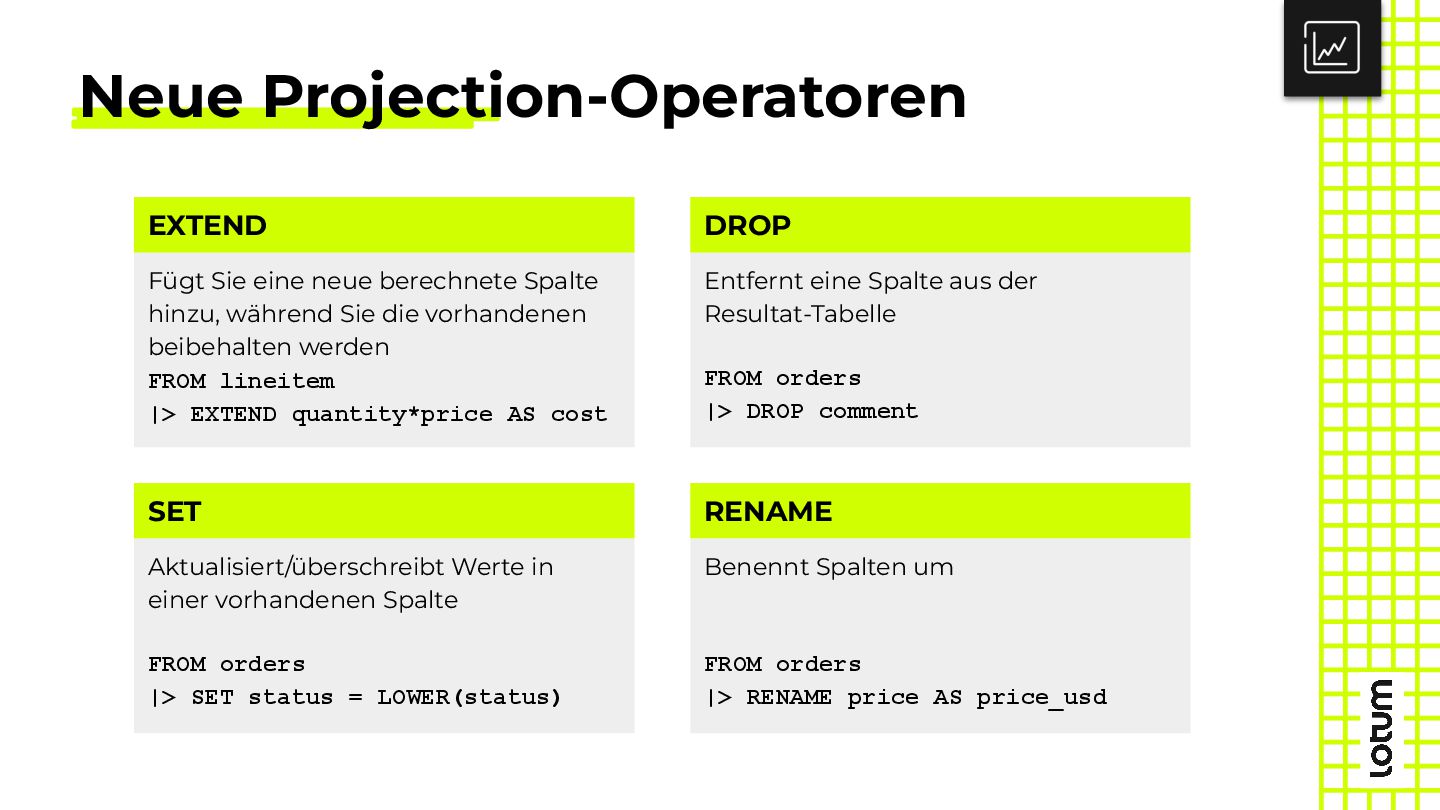
während Sie die vorhandenen beibehalten werden FROM lineitem |> EXTEND quantity*price AS cost EXTEND Aktualisiert/überschreibt Werte in einer vorhandenen Spalte FROM orders |> SET status = LOWER(status) SET Entfernt eine Spalte aus der Resultat-Tabelle FROM orders |> DROP comment DROP Benennt Spalten um FROM orders |> RENAME price AS price_usd RENAME
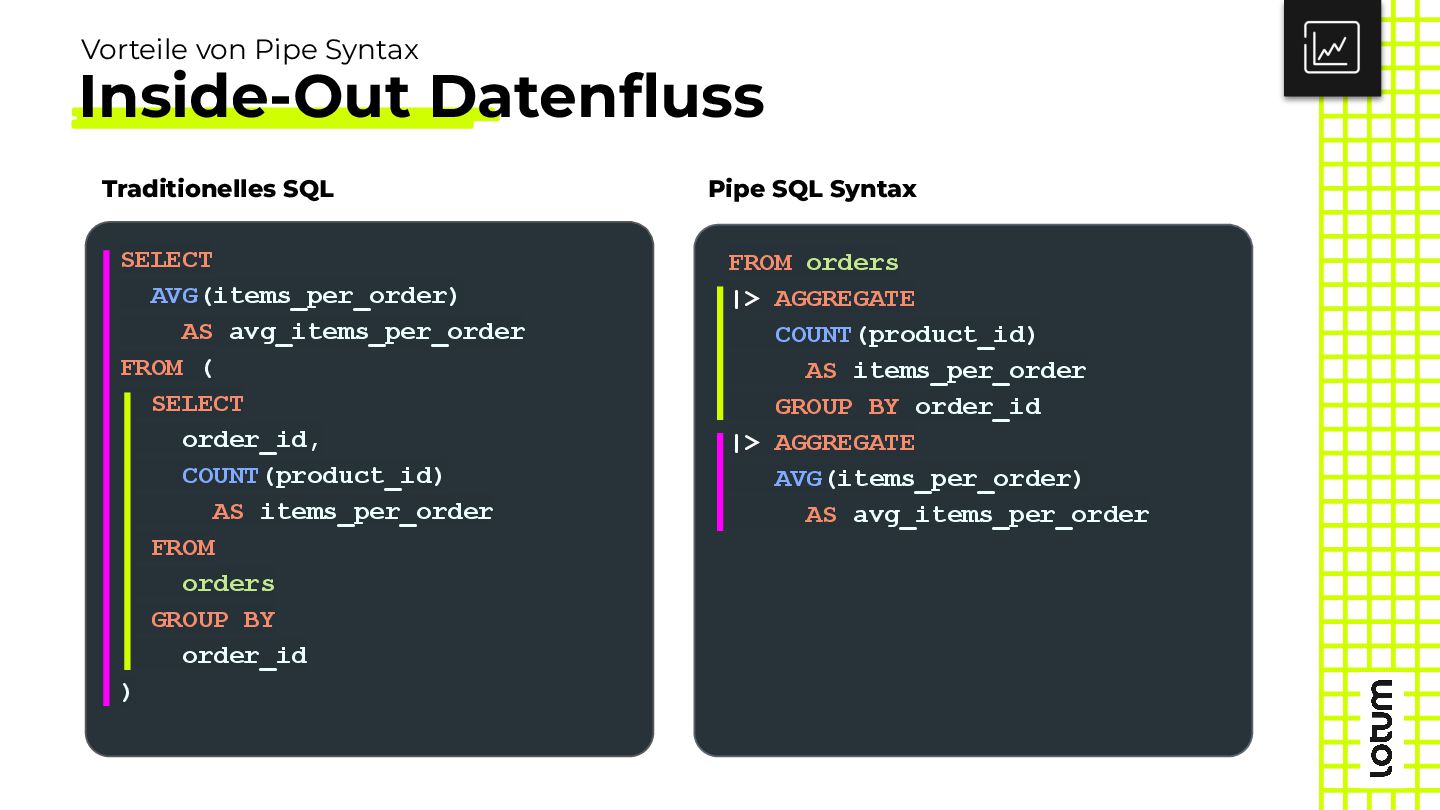
AVG(items_per_order) AS avg_items_per_order FROM ( SELECT order_id, COUNT(product_id) AS items_per_order FROM orders GROUP BY order_id ) Pipe SQL Syntax FROM orders |> AGGREGATE COUNT(product_id) AS items_per_order GROUP BY order_id |> AGGREGATE AVG(items_per_order) AS avg_items_per_order
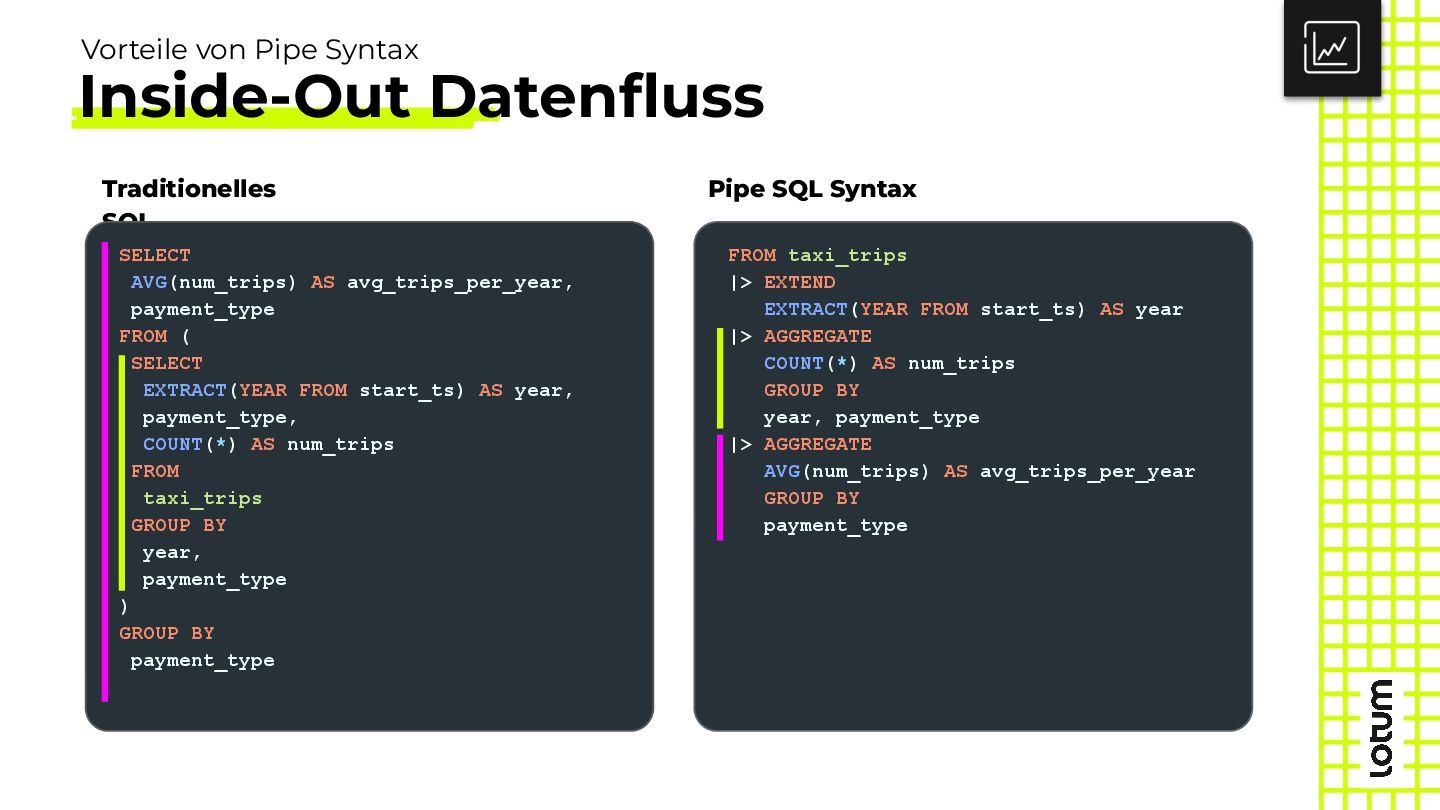
AVG(num_trips) AS avg_trips_per_year, payment_type FROM ( SELECT EXTRACT(YEAR FROM start_ts) AS year, payment_type, COUNT(*) AS num_trips FROM taxi_trips GROUP BY year, payment_type ) GROUP BY payment_type Pipe SQL Syntax FROM taxi_trips |> EXTEND EXTRACT(YEAR FROM start_ts) AS year |> AGGREGATE COUNT(*) AS num_trips GROUP BY year, payment_type |> AGGREGATE AVG(num_trips) AS avg_trips_per_year GROUP BY payment_type
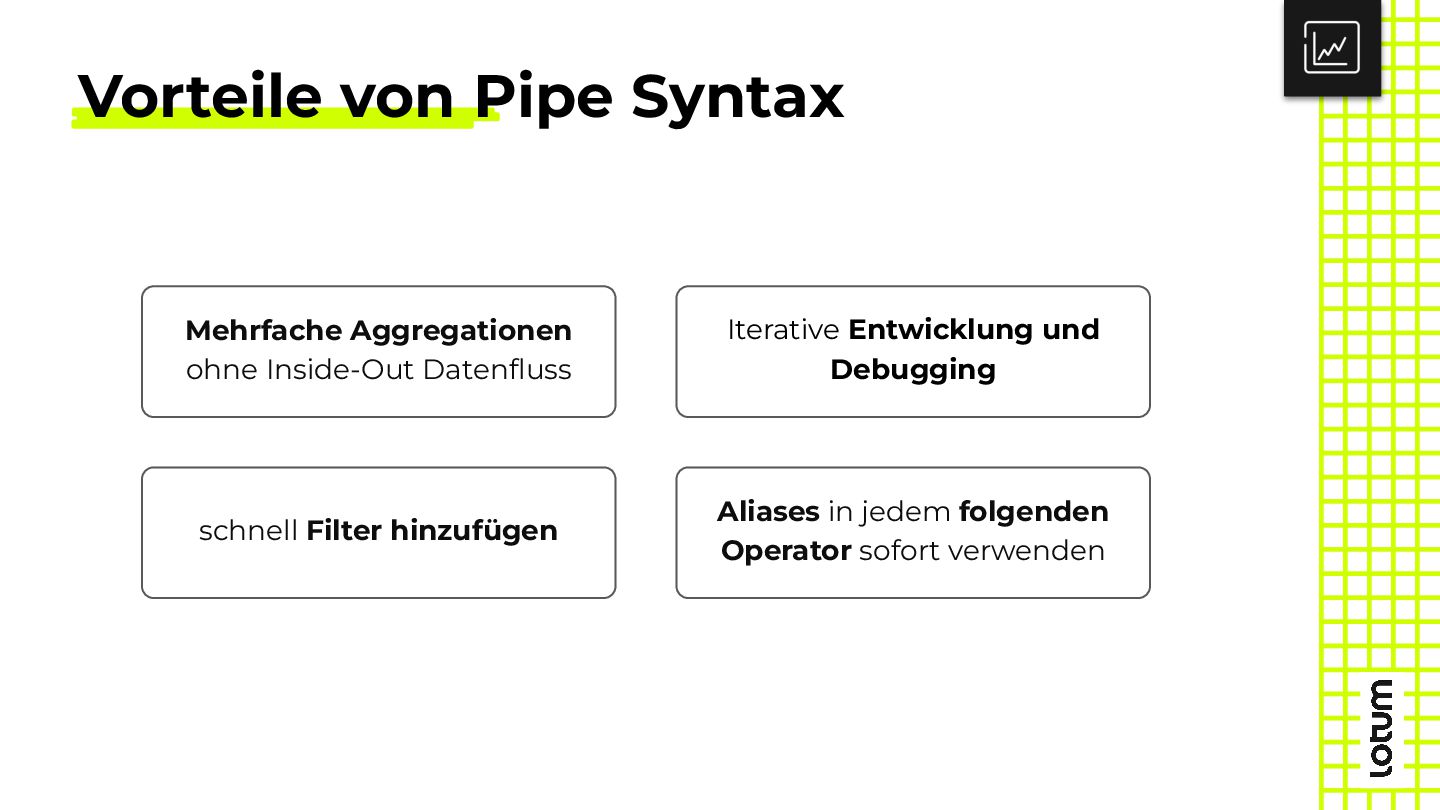
SQL-Pipe-Operatoren stellt jede Teilmenge der ersten m <= n Operatoren ebenfalls eine gültige Abfrage dar. Die Abfrage bis zu einem beliebigen Punkt in der Pipeline ausgeführt werden, indem die darunter liegenden Zeilen gelöscht oder auskommentiert werden. Die Zwischenergebnisse nach jeder Operation können einfach geprüft und Fehler schnell lokalisiert werden. Iterative Entwicklung & Debugging Vorteile von Pipe Syntax Traditionelles SQL Debugging komplexer Queries erfordert üblicherweise: • Auskommentieren großer Codeblöcke • Subqueries isoliert ausführen und das Resultat prüfen Sicherzustellen, dass die geänderte Abfrage weiterhin korrekt ist, ist schwierig!
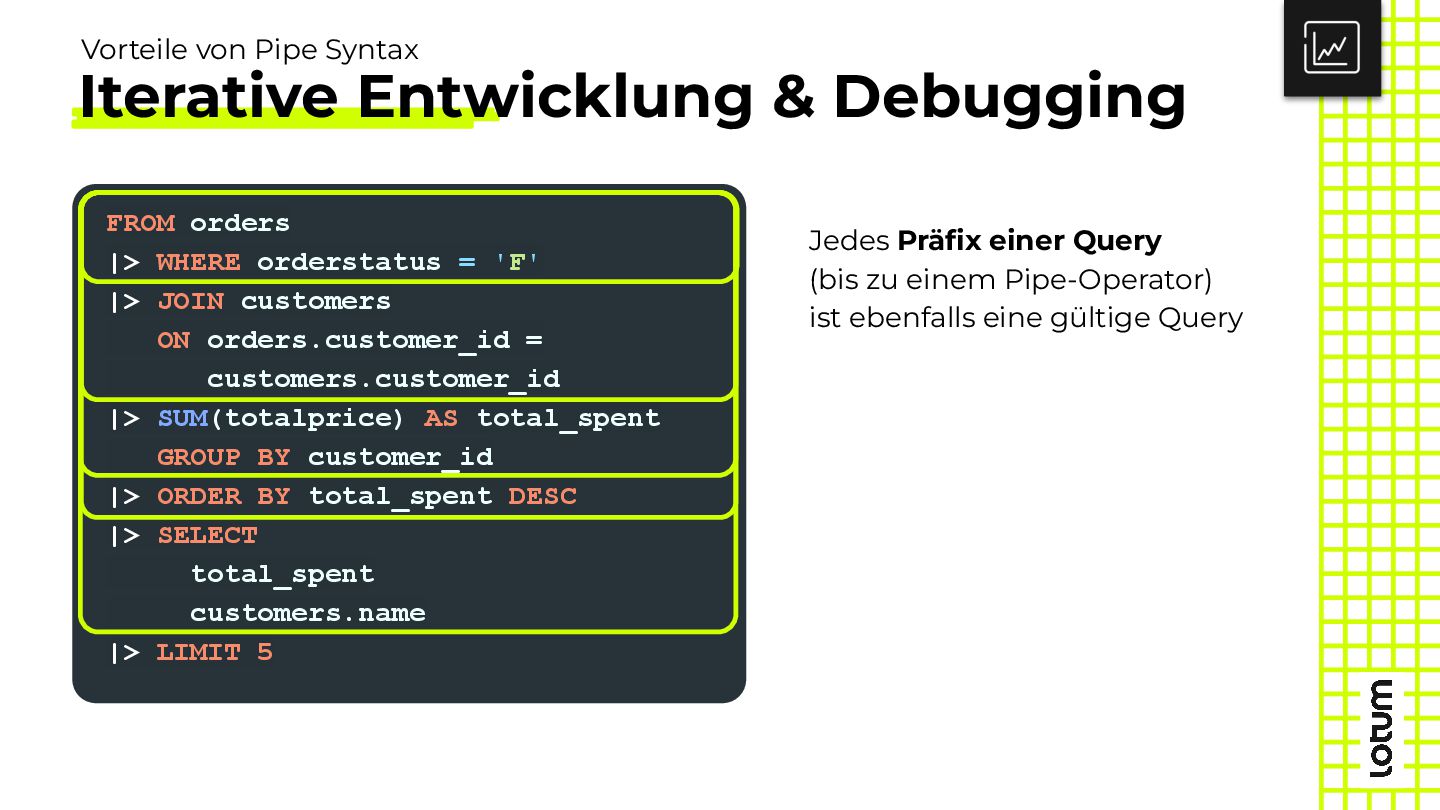
orders |> WHERE orderstatus = 'F' |> JOIN customers ON orders.customer_id = customers.customer_id |> SUM(totalprice) AS total_spent GROUP BY customer_id |> ORDER BY total_spent DESC |> SELECT total_spent customers.name |> LIMIT 5 Jedes Präfix einer Query (bis zu einem Pipe-Operator) ist ebenfalls eine gültige Query
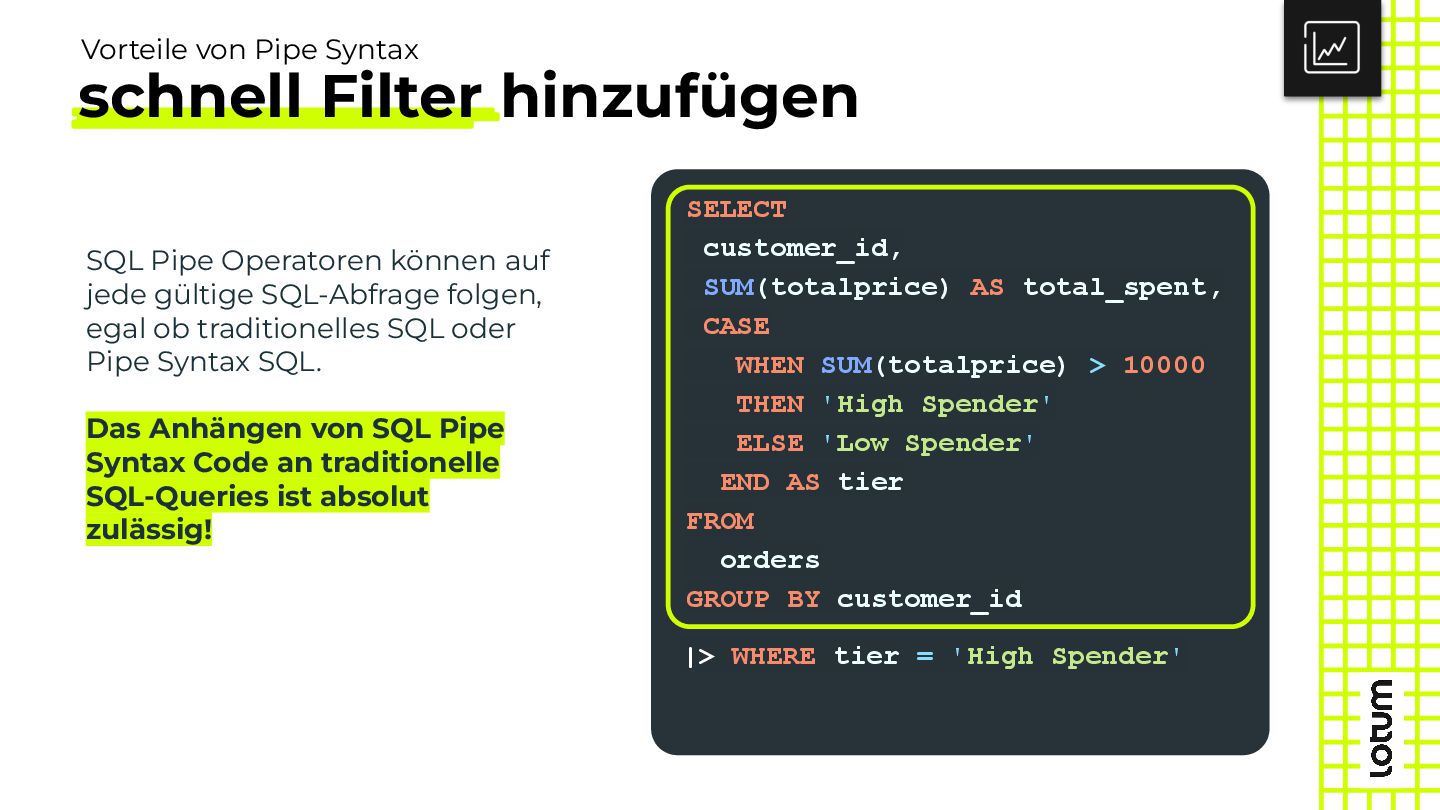
Operatoren können auf jede gültige SQL-Abfrage folgen, egal ob traditionelles SQL oder Pipe Syntax SQL. Das Anhängen von SQL Pipe Syntax Code an traditionelle SQL-Queries ist absolut zulässig! SELECT customer_id, SUM(totalprice) AS total_spent, CASE WHEN SUM(totalprice) > 10000 THEN 'High Spender' ELSE 'Low Spender' END AS tier FROM orders GROUP BY customer_id |> WHERE tier = 'High Spender'
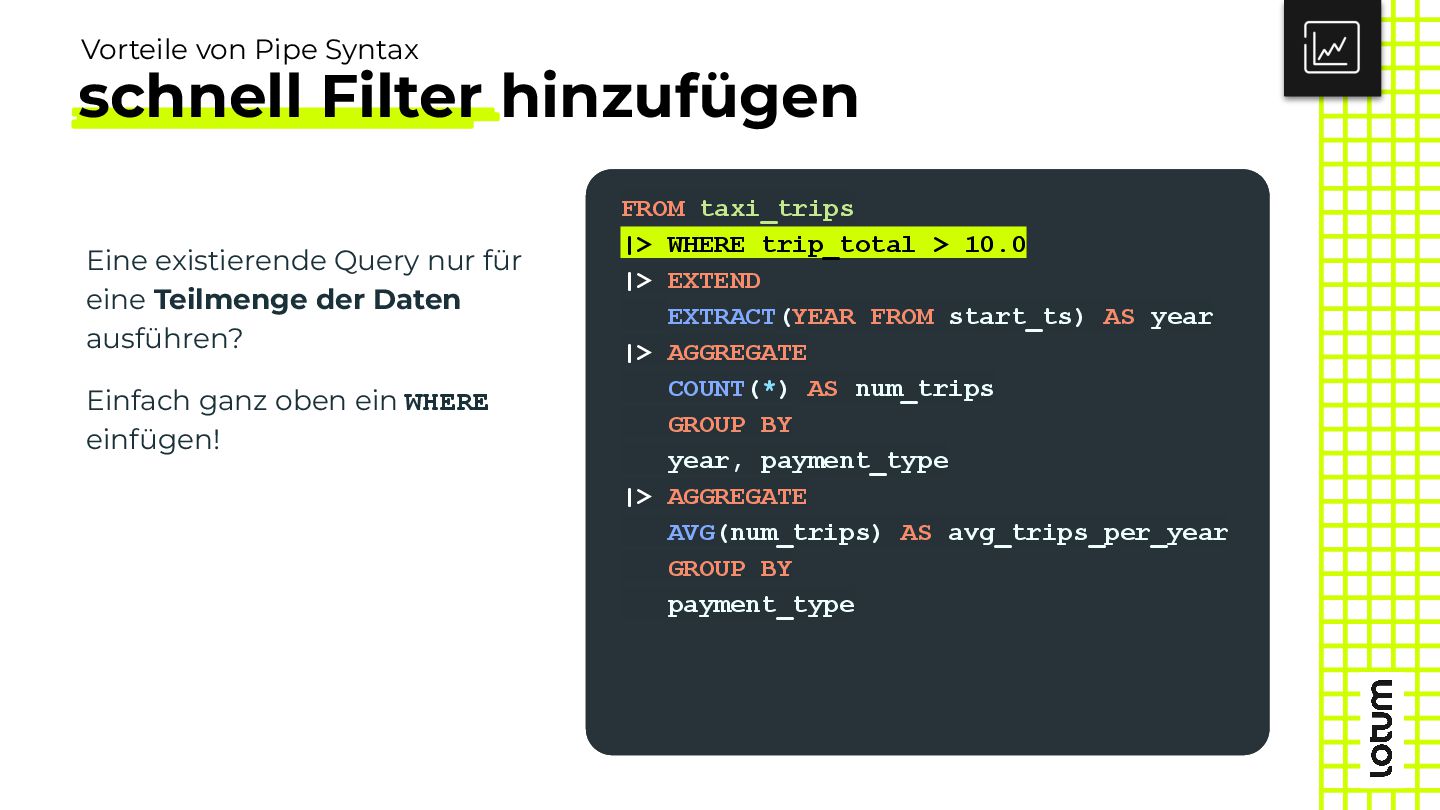
Query nur für eine Teilmenge der Daten ausführen? Einfach ganz oben ein WHERE einfügen! FROM taxi_trips |> EXTEND EXTRACT(YEAR FROM start_ts) AS year |> AGGREGATE COUNT(*) AS num_trips GROUP BY year, payment_type |> AGGREGATE AVG(num_trips) AS avg_trips_per_year GROUP BY payment_type FROM taxi_trips |> WHERE trip_total > 10.0 |> EXTEND EXTRACT(YEAR FROM start_ts) AS year |> AGGREGATE COUNT(*) AS num_trips GROUP BY year, payment_type |> AGGREGATE AVG(num_trips) AS avg_trips_per_year GROUP BY payment_type
AS department_rank FROM employees WHERE country = 'Germany' GROUP BY department_name HAVING COUNT(*) > 10 QUALIFY department_rank <= 5 FROM employees |> WHERE country = 'Germany' |> AGGREGATE AVG(salary) AS avg_salary, COUNT(*) AS num_employees GROUP BY department_name |> WHERE num_employees > 10 |> EXTEND RANK() OVER (ORDER BY avg_salary) AS department_rank |> WHERE department_rank <= 5 |> SELECT department_name, department_rank SQL Pipe Syntax Traditionelles SQL Vorteile von Pipe Syntax
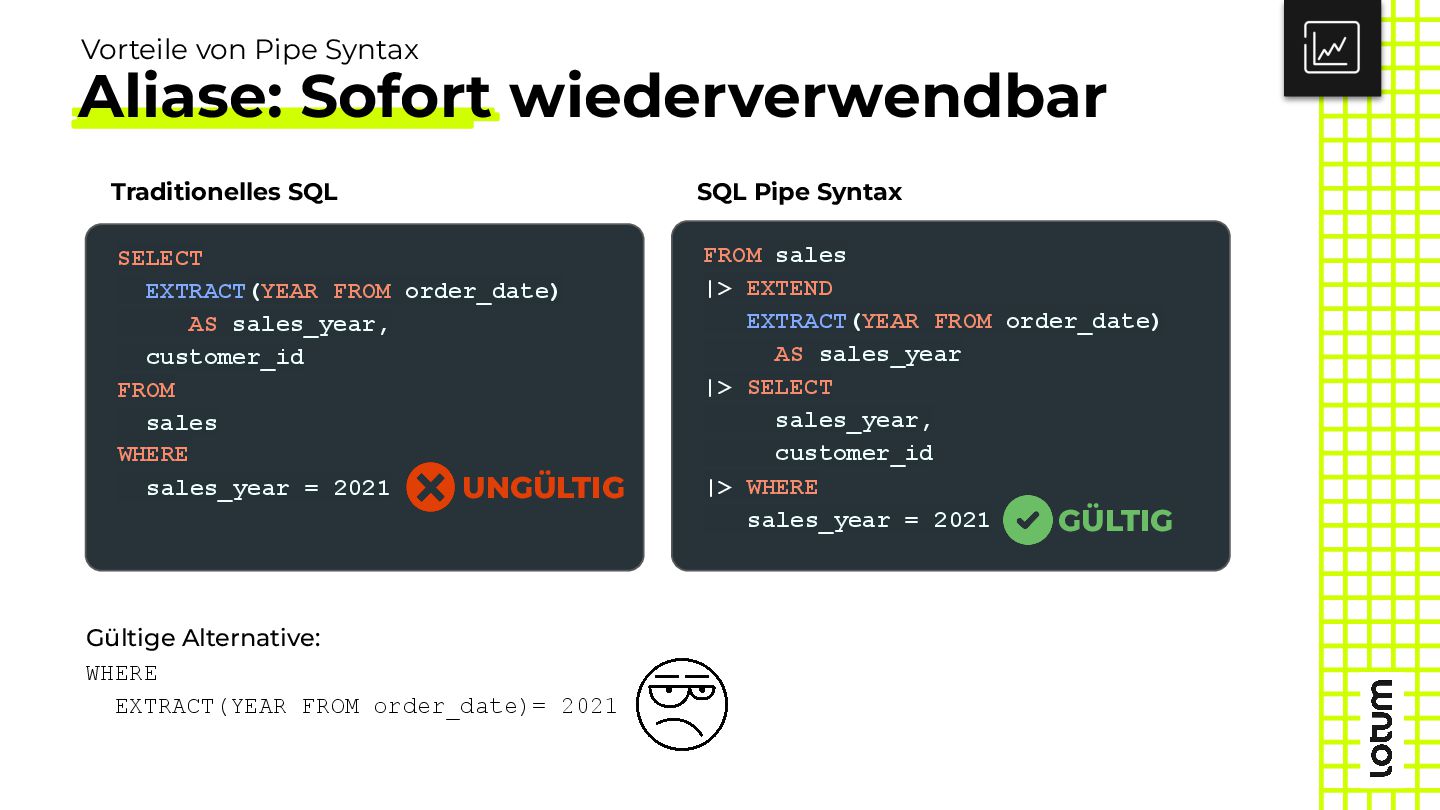
2021 SQL Pipe Syntax FROM sales |> EXTEND EXTRACT(YEAR FROM order_date) AS sales_year |> SELECT sales_year, customer_id SELECT EXTRACT(YEAR FROM order_date) AS sales_year, customer_id FROM sales Traditionelles SQL UNGÜLTIG WHERE sales_year = 2021 |> WHERE sales_year = 2021 GÜLTIG Vorteile von Pipe Syntax
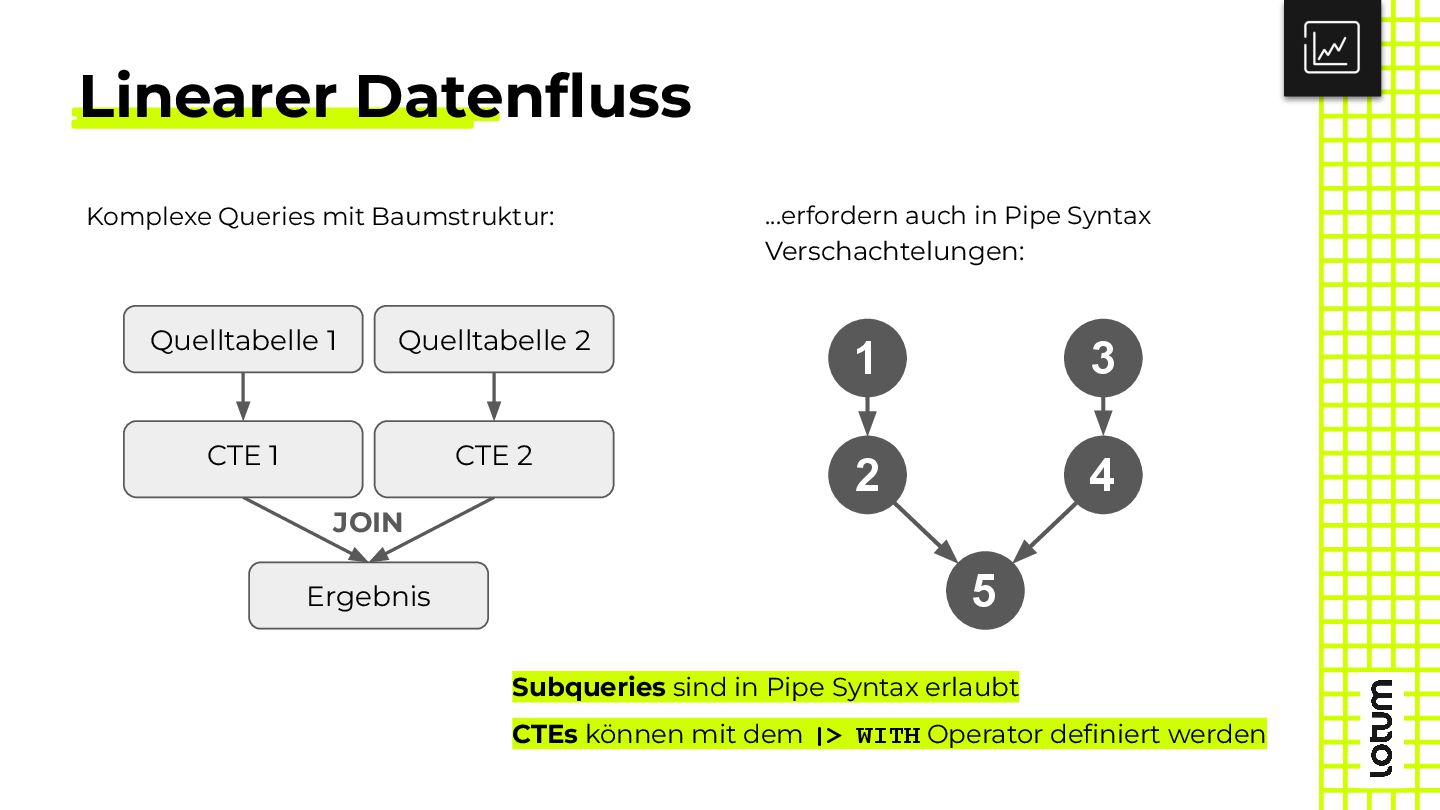
können mit dem |> WITH Operator definiert werden Komplexe Queries mit Baumstruktur: Ergebnis JOIN CTE 1 CTE 2 Quelltabelle 2 Quelltabelle 1 …erfordern auch in Pipe Syntax Verschachtelungen: 1 2 4 5 3
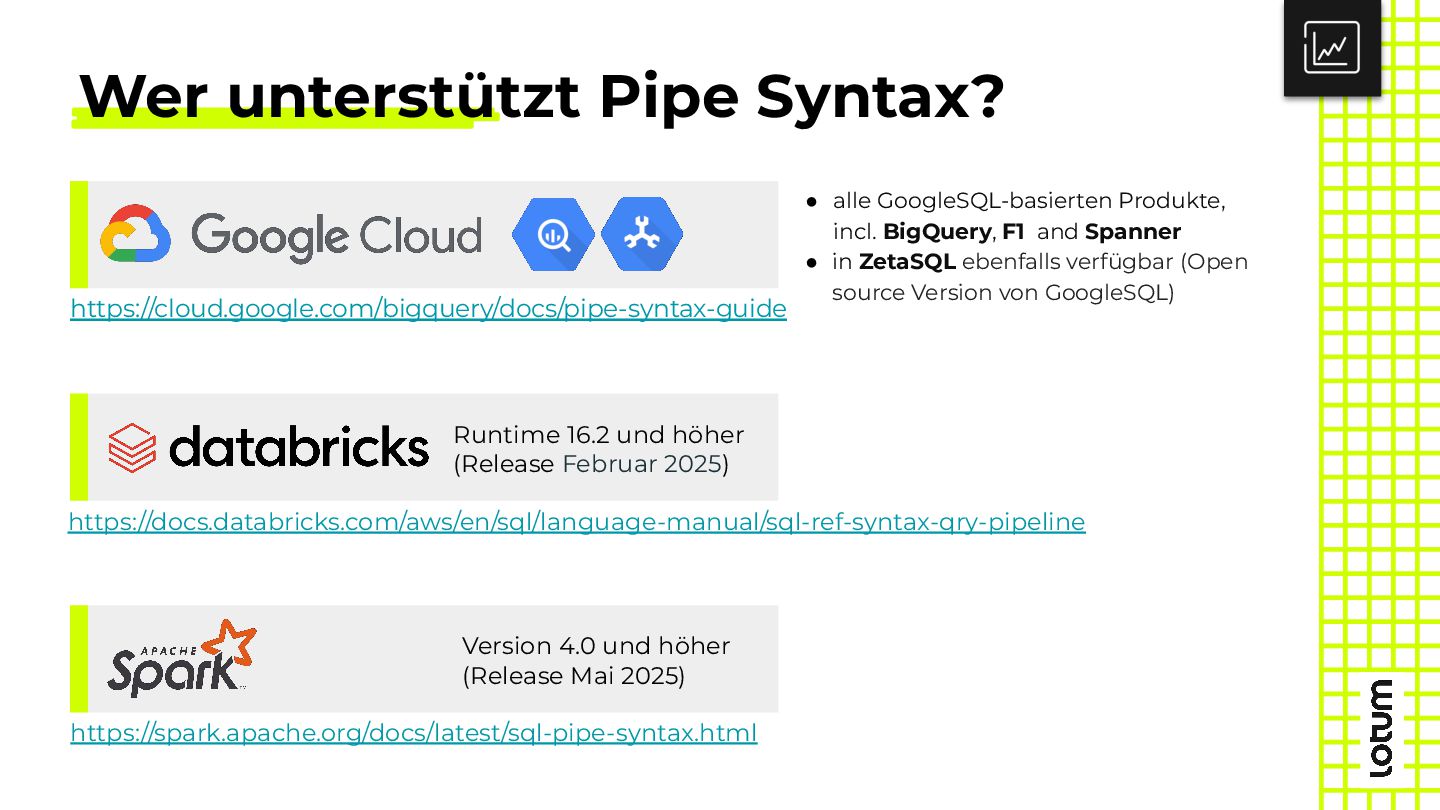
Mai 2025) https://spark.apache.org/docs/latest/sql-pipe-syntax.html Runtime 16.2 und höher (Release Februar 2025) https://docs.databricks.com/aws/en/sql/language-manual/sql-ref-syntax-qry-pipeline https://cloud.google.com/bigquery/docs/pipe-syntax-guide • alle GoogleSQL-basierten Produkte, incl. BigQuery, F1 and Spanner • in ZetaSQL ebenfalls verfügbar (Open source Version von GoogleSQL)
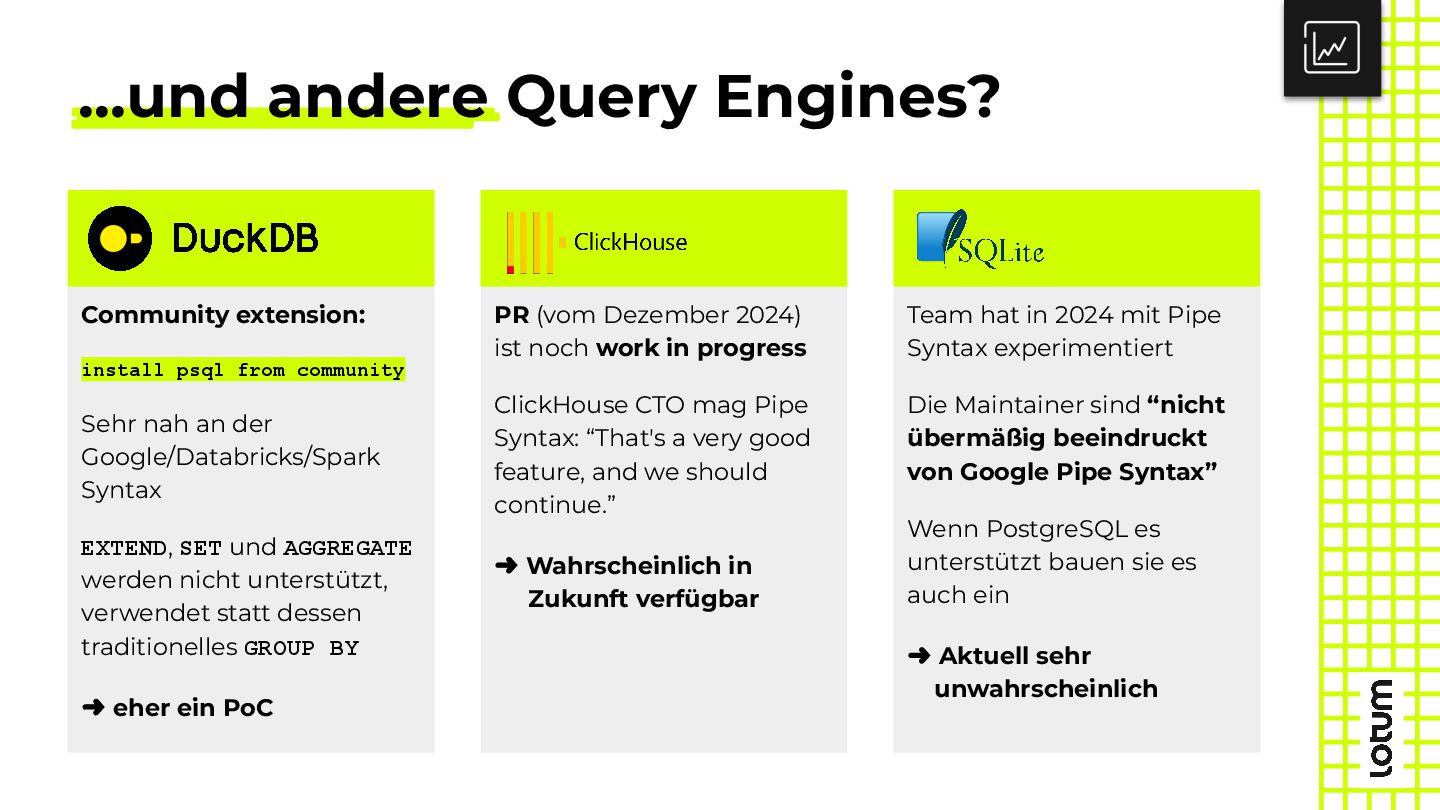
community Sehr nah an der Google/Databricks/Spark Syntax EXTEND, SET und AGGREGATE werden nicht unterstützt, verwendet statt dessen traditionelles GROUP BY ➜ eher ein PoC Team hat in 2024 mit Pipe Syntax experimentiert Die Maintainer sind “nicht übermäßig beeindruckt von Google Pipe Syntax” Wenn PostgreSQL es unterstützt bauen sie es auch ein ➜ Aktuell sehr unwahrscheinlich PR (vom Dezember 2024) ist noch work in progress ClickHouse CTO mag Pipe Syntax: “That's a very good feature, and we should continue.” ➜ Wahrscheinlich in Zukunft verfügbar
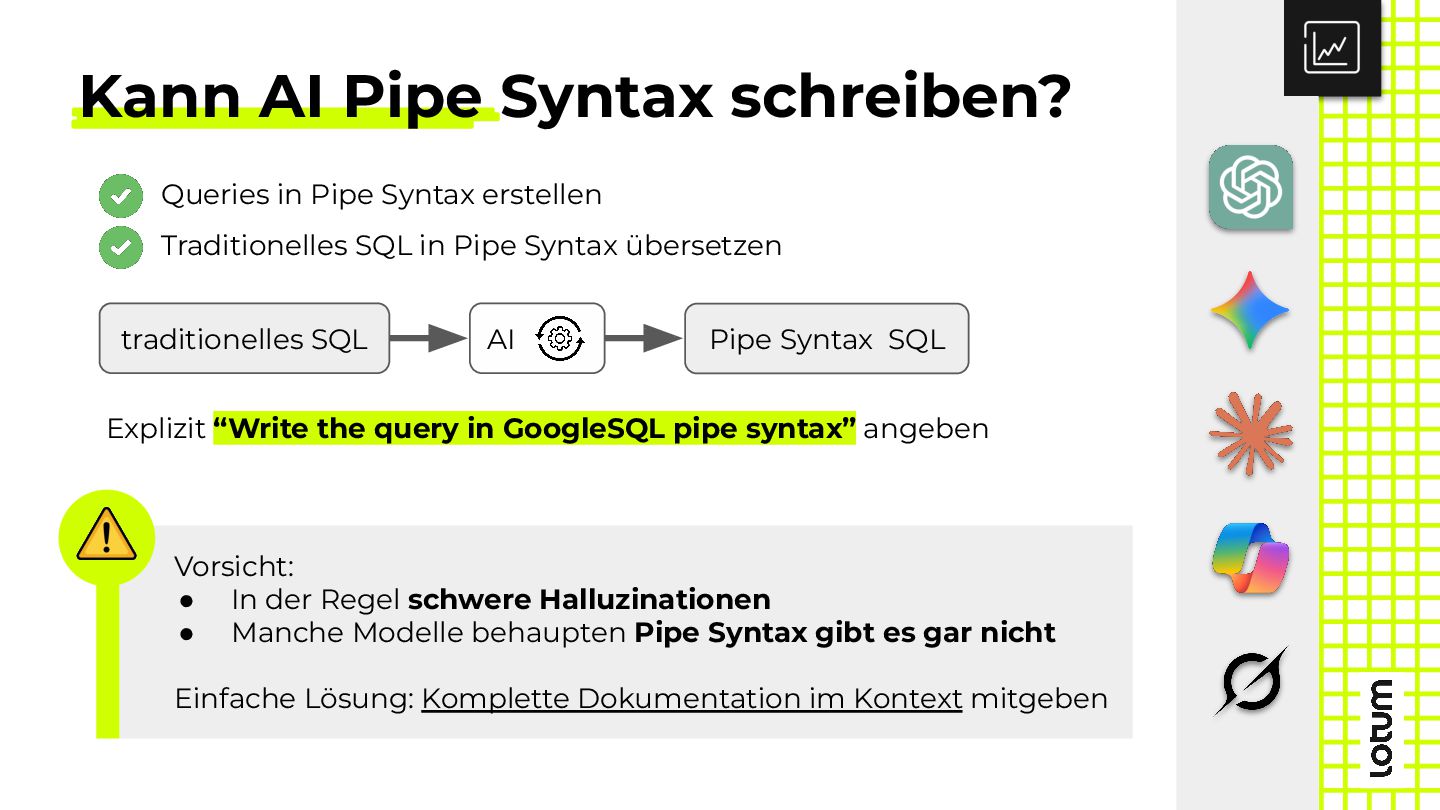
in GoogleSQL pipe syntax” angeben traditionelles SQL Pipe Syntax SQL AI Vorsicht: • In der Regel schwere Halluzinationen • Manche Modelle behaupten Pipe Syntax gibt es gar nicht Einfache Lösung: Komplette Dokumentation im Kontext mitgeben Queries in Pipe Syntax erstellen Traditionelles SQL in Pipe Syntax übersetzen
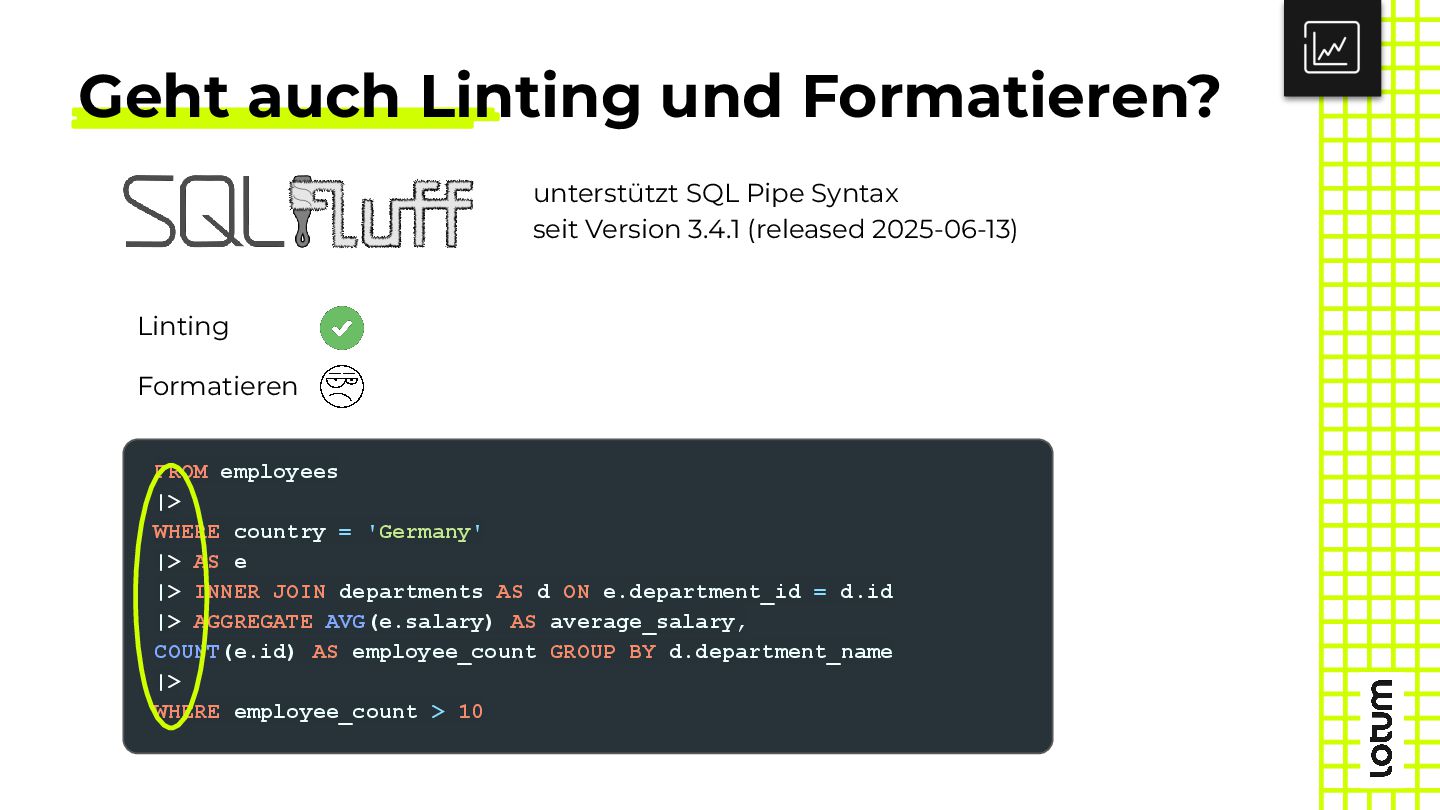
seit Version 3.4.1 (released 2025-06-13) FROM employees |> WHERE country = 'Germany' |> AS e |> INNER JOIN departments AS d ON e.department_id = d.id |> AGGREGATE AVG(e.salary) AS average_salary, COUNT(e.id) AS employee_count GROUP BY d.department_name |> WHERE employee_count > 10 Linting Formatieren
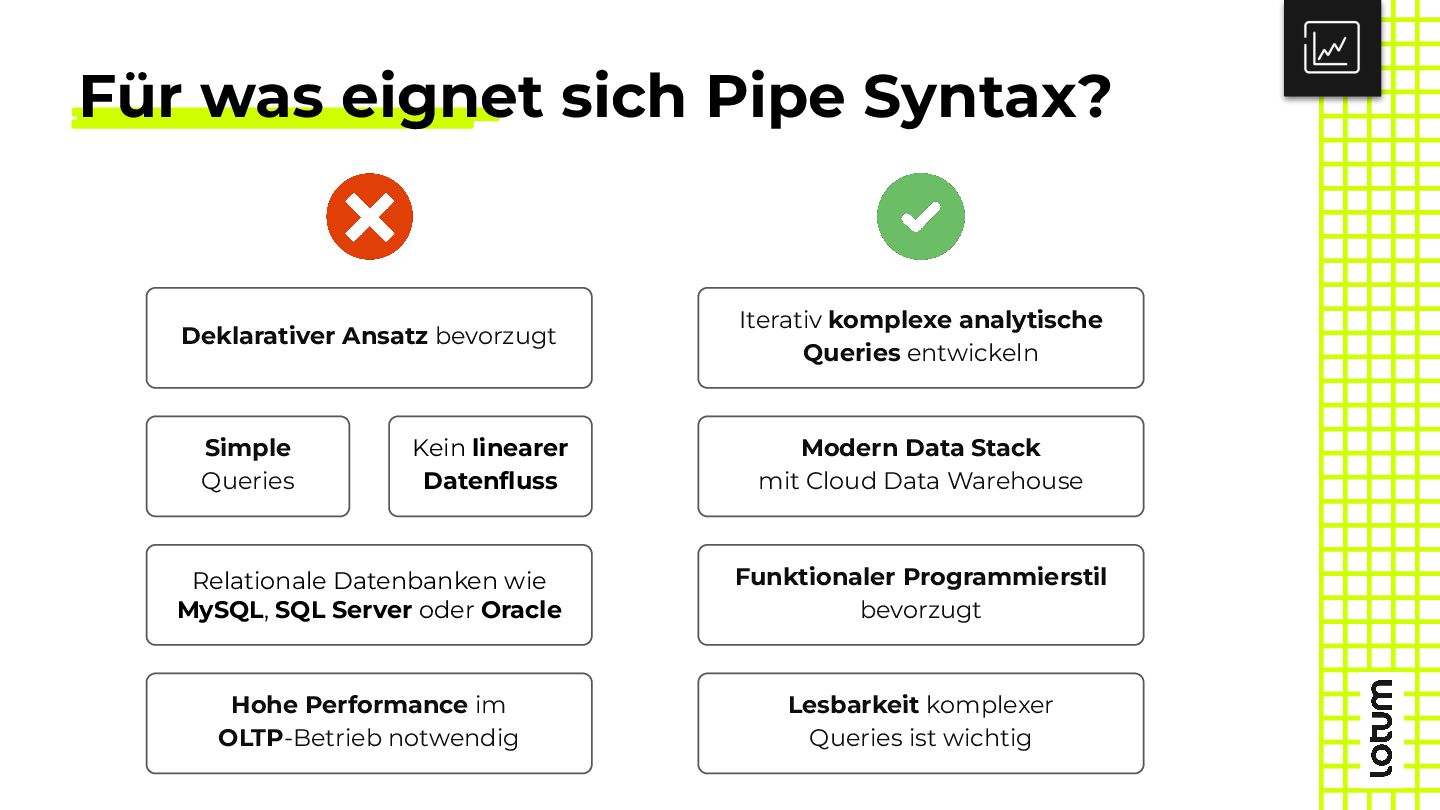
Queries entwickeln Modern Data Stack mit Cloud Data Warehouse Lesbarkeit komplexer Queries ist wichtig Funktionaler Programmierstil bevorzugt Relationale Datenbanken wie MySQL, SQL Server oder Oracle Hohe Performance im OLTP-Betrieb notwendig Deklarativer Ansatz bevorzugt Simple Queries Kein linearer Datenfluss


 tobiaslampertlotum
 mkilby
 addyosmani
 soudai
 michielstock
 csswizardry
 lara
 rmw
 smashingmag
 jonoalderson
 cassininazir
 thirion