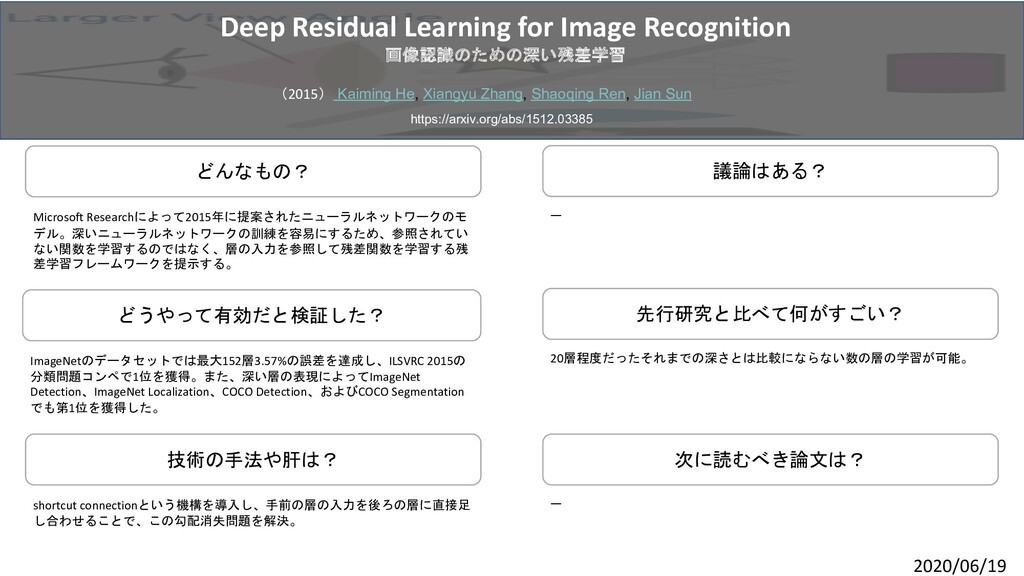
Scale Visual Recognition Challenge(ILSVRC) 2012で87.5%のトッ プ1精度、CIFAR-10で99.4%、Visual Task Adaptation Benchmark (VTAB)の19タス クで76.3%を達成。 大きいデータセットでモデルを事前学習し、BiTハイパーパラメータを調整す ることで高いスコアを獲得。ハイパーパラメータは入力画像の大きさ、 MixUPの使用有無、学習率スケジュールの3つのみ。 一般的な画像認識モデルで使用されているバッチノームやドロップアウト、 Weight Decayなどを使用せずに高スコアを獲得している。 2019年12月24日にGoogle Brainから発表されたモデル。大規模データによる事 前学習とターゲットタスクでのモデルの微調整によるパラダイムを再検討し、 Big Transfer (BiT)と呼ぶシンプルなレシピを提案する。 Big Transfer (BiT): General Visual Representation Learning BiT : 一般的な視覚表現学習 (2019) Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Joan Puigcerver, Jessica Yung, Sylvain Gelly, Neil Houlsby https://arxiv.org/abs/1912.11370 2020/06/19


 reverentgeek
 addyosmani
 yeseniaperezcruz
 uxyall
 axbom
 kevinliebholz
 lauravandoore
 lara
 tomoyanonymous
 eileencodes
 mayunak
 akosma