Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
LayoutLLM: Layout Instruction Tuning with Large...
Search
Yuta Kamikawa
July 07, 2024
2.3k
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
LayoutLLM: Layout Instruction Tuning with Large Language Models for Document Understanding
Yuta Kamikawa
July 07, 2024
Featured
See All Featured
What does AI have to do with Human Rights?
axbom
PRO
1
2.4k
Amusing Abliteration
ianozsvald
1
320
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
620
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
42k
Utilizing Notion as your number one productivity tool
mfonobong
4
610
Writing Fast Ruby
sferik
630
63k
Java REST API Framework Comparison - PWX 2021
mraible
34
9.7k
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
350
Understanding Cognitive Biases in Performance Measurement
bluesmoon
32
3k
Visualization
eitanlees
153
17k
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
960
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Transcript
© LayerX Inc. 【論文紹介】 LayoutLLM: Layout Instruction Tuning with Large
Language Models for Document Understanding Chuwei Luo, Yufan Shen, Zhaoqing Zhu, Qi Zheng, Zhi Yu, Cong Yao 2024/07/07 第61回 コンピュータビジョン勉強会@関東(前編) Yuta Kamikawa(株式会社LayerX)
© LayerX Inc. 2 • 経歴 ◦ 京都大学情報学研究科 知能情報学専攻 ◦
2019/04 ~ 2024/03 Preferred Networks ▪ サッカーや医療などの分野で機械学習を用いたシステムの開発 ◦ 2024/04 ~ LayerX 機械学習エンジニア ▪ 請求書や領収書をはじめとする書類から支払金額や日付などの項目を OCRで読み取る機能の開発を行っています • 初勉強会ですが、これから積極的に参加していきたいと思っています! • 懇親会も参加予定です!よろしくお願いします!! 自己紹介 上川 優太(Yuta Kamikawa)
特に注釈がなければ 資料ないの画像等は論文内のものを使用しています
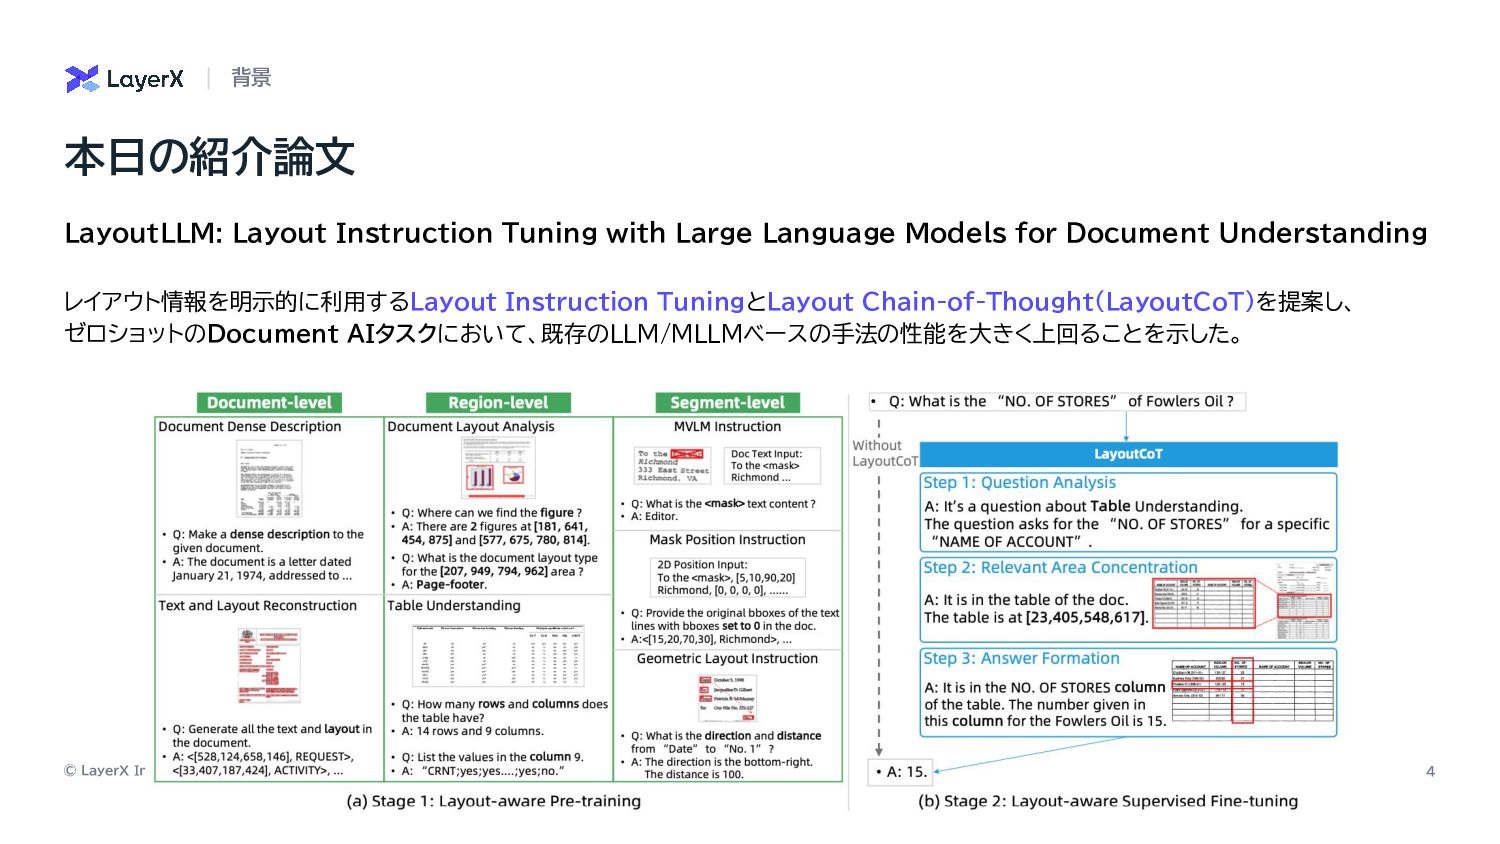
© LayerX Inc. 4 本日の紹介論文 背景 LayoutLLM: Layout Instruction Tuning
with Large Language Models for Document Understanding レイアウト情報を明示的に利用するLayout Instruction TuningとLayout Chain-of-Thought(LayoutCoT)を提案し、 ゼロショットのDocument AIタスクにおいて、既存のLLM/MLLMベースの手法の性能を大きく上回ることを示した。
目次 Agenda • 背景 • 提案手法 • まとめ
背景
© LayerX Inc. 7 Document AIとは 背景 ドキュメントを読み取り、分析し、理解するといったタスクを解くAI技術 OCR[1] Layout
Analysis[2] DocVQA[3]
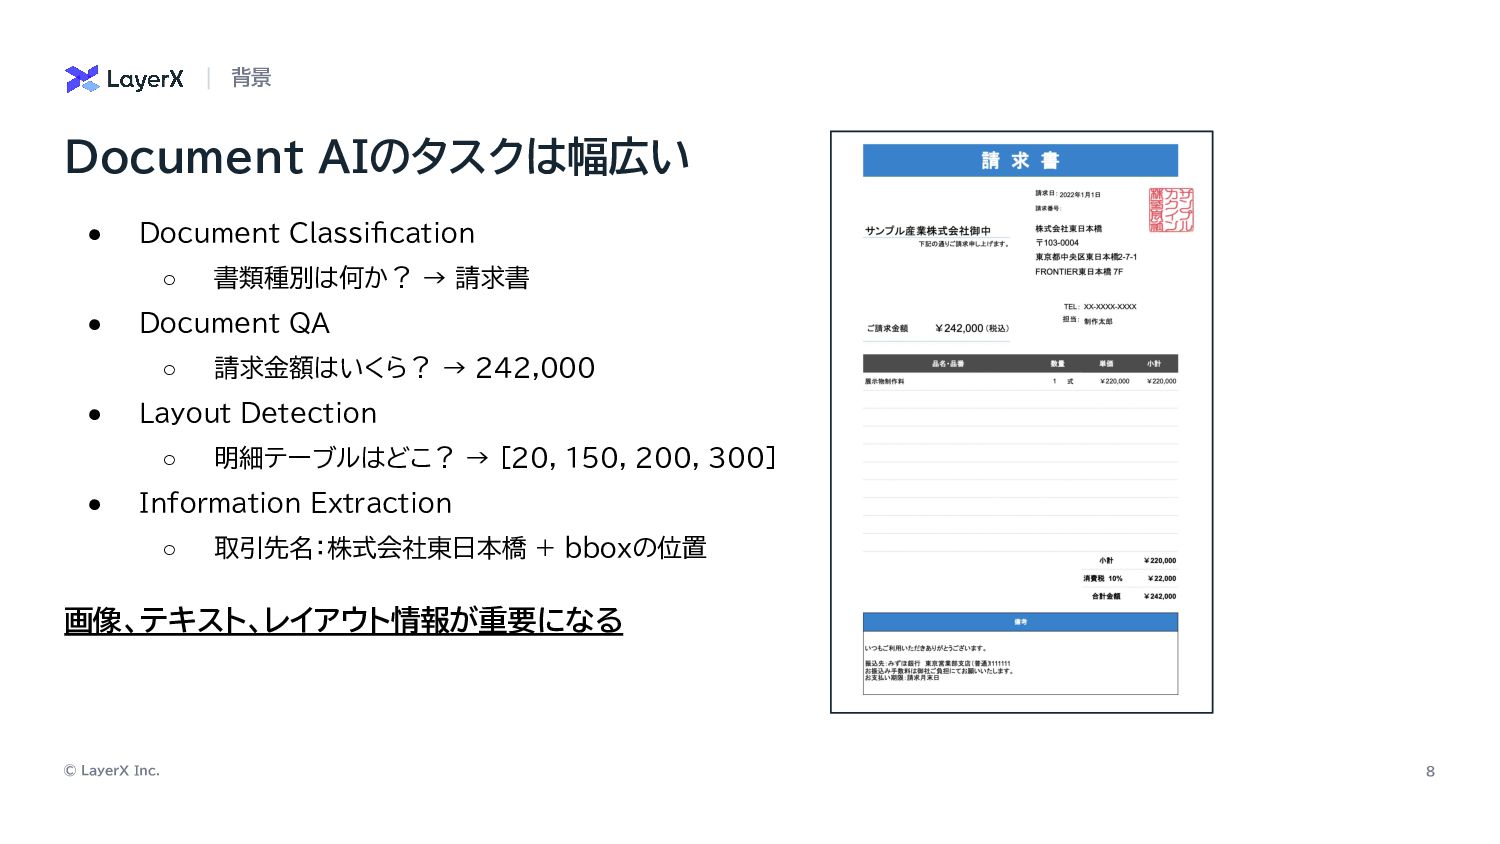
© LayerX Inc. 8 Document AIのタスクは幅広い 背景 • Document Classification
◦ 書類種別は何か? → 請求書 • Document QA ◦ 請求金額はいくら? → 242,000 • Layout Detection ◦ 明細テーブルはどこ? → [20, 150, 200, 300] • Information Extraction ◦ 取引先名:株式会社東日本橋 + bboxの位置 画像、テキスト、レイアウト情報が重要になる
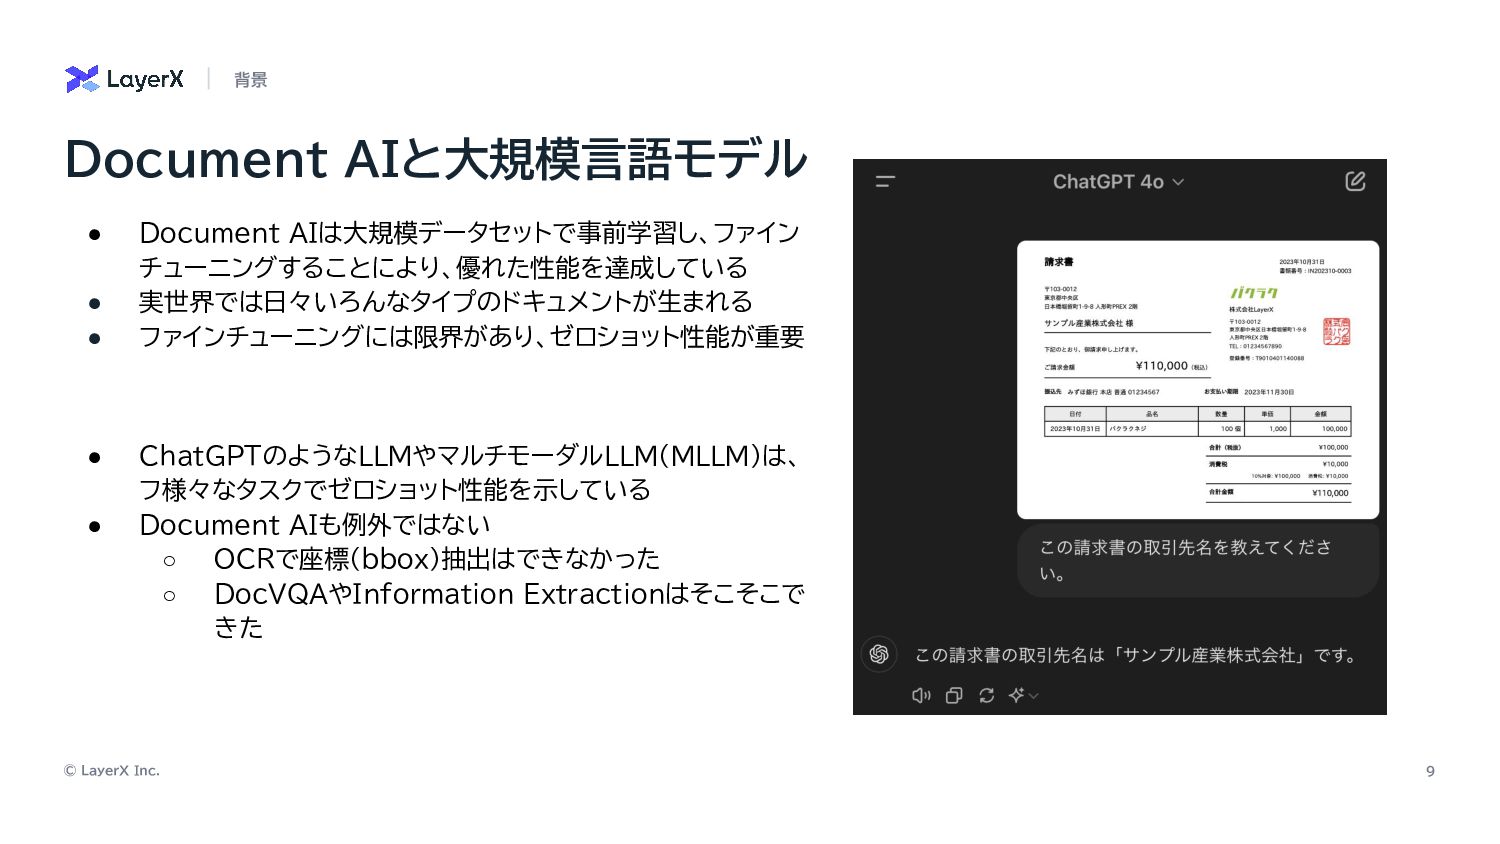
© LayerX Inc. 9 Document AIと大規模言語モデル 背景 • Document AIは大規模データセットで事前学習し、ファイン
チューニングすることにより、優れた性能を達成している • 実世界では日々いろんなタイプのドキュメントが生まれる • ファインチューニングには限界があり、ゼロショット性能が重要 • ChatGPTのようなLLMやマルチモーダルLLM(MLLM)は、 フ様々なタスクでゼロショット性能を示している • Document AIも例外ではない ◦ OCRで座標(bbox)抽出はできなかった ◦ DocVQAやInformation Extractionはそこそこで きた
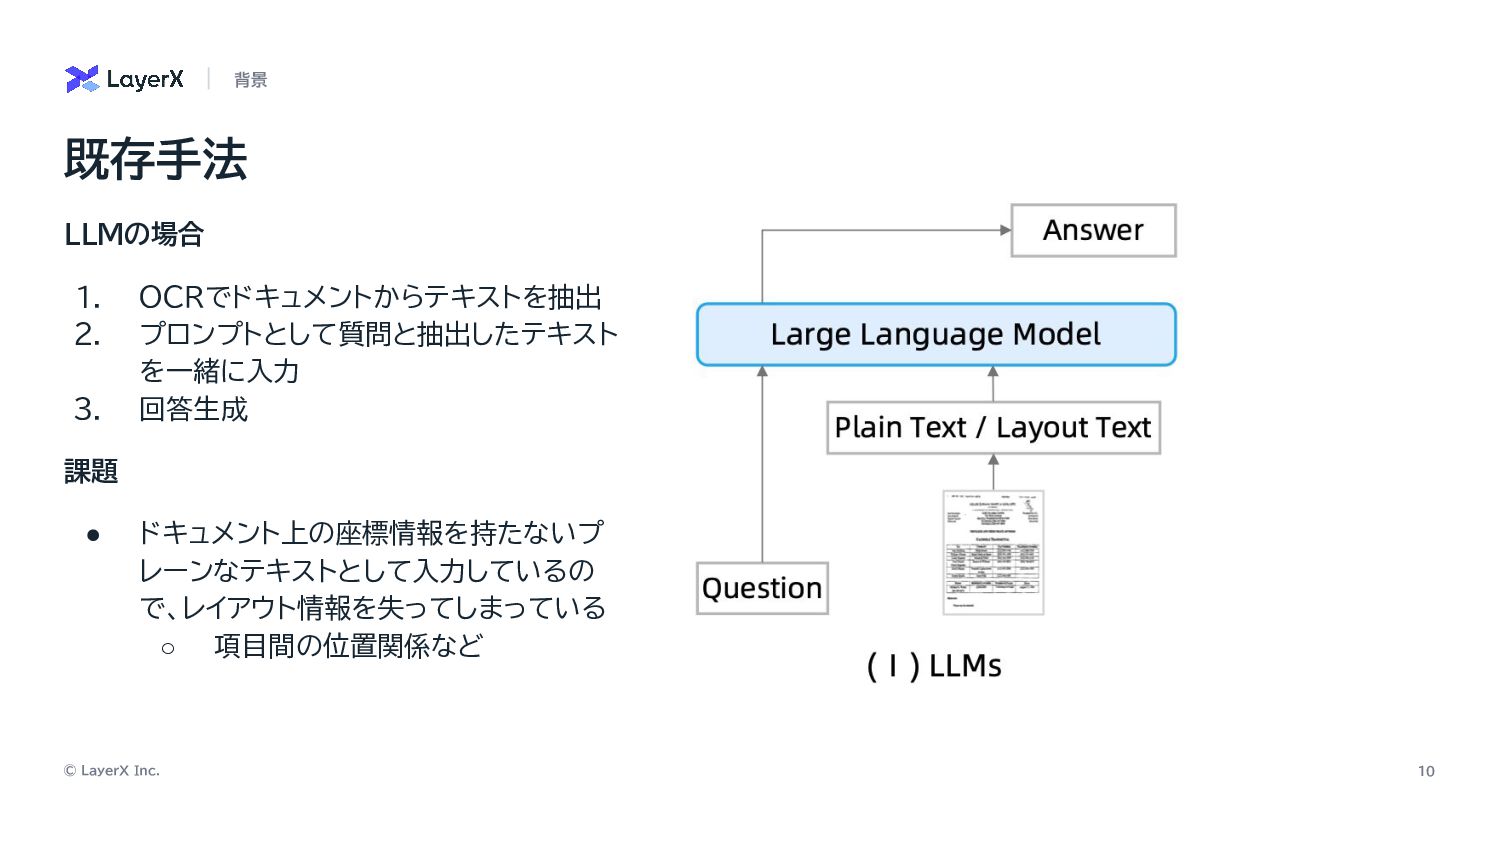
© LayerX Inc. 10 LLMの場合 1. OCRでドキュメントからテキストを抽出 2. プロンプトとして質問と抽出したテキスト を一緒に入力
3. 回答生成 課題 • ドキュメント上の座標情報を持たないプ レーンなテキストとして入力しているの で、レイアウト情報を失ってしまっている ◦ 項目間の位置関係など 既存手法 背景
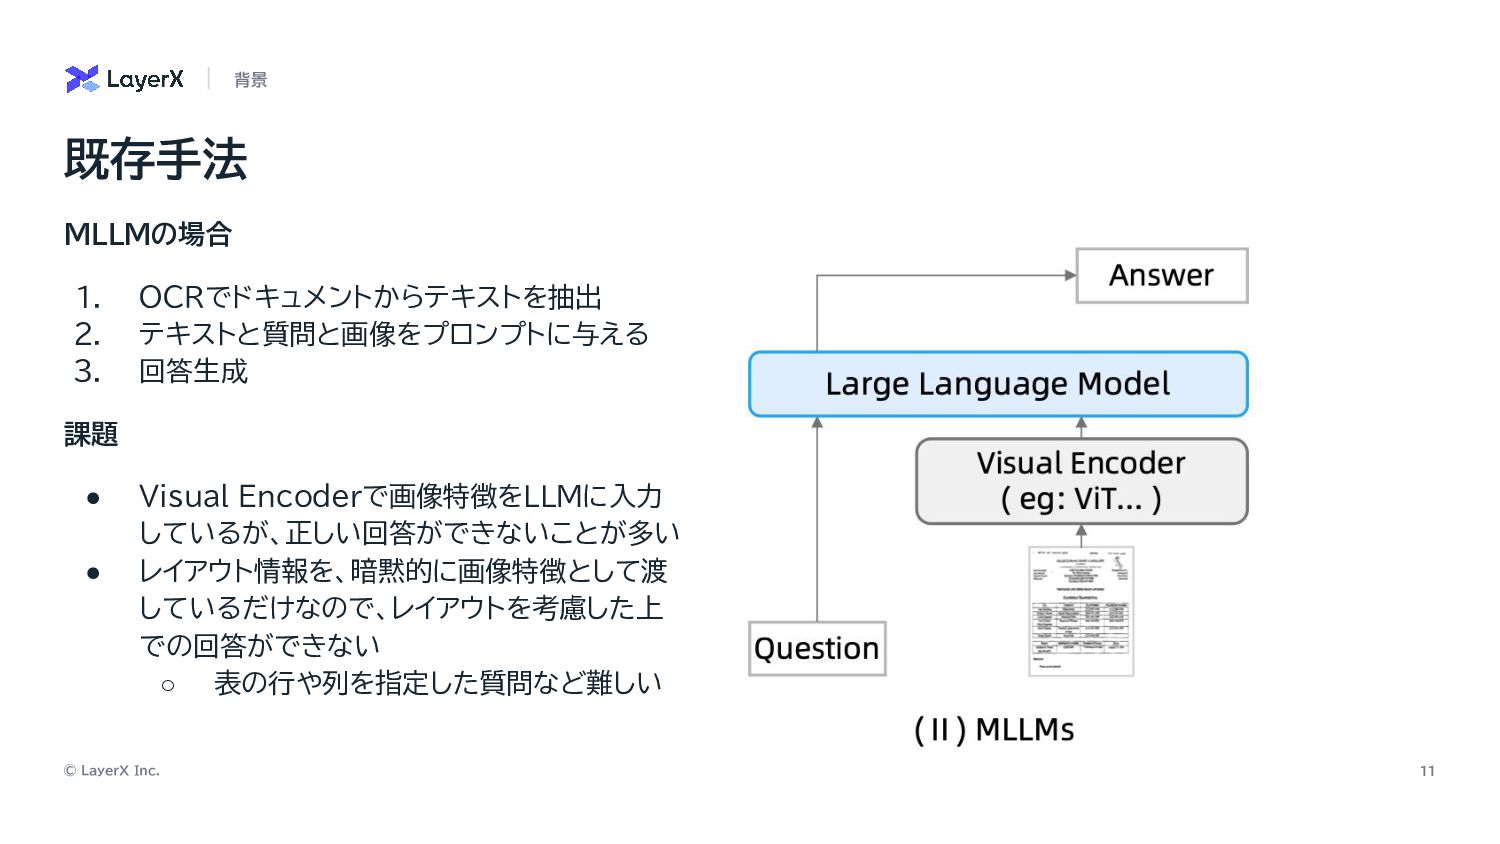
© LayerX Inc. 11 MLLMの場合 1. OCRでドキュメントからテキストを抽出 2. テキストと質問と画像をプロンプトに与える 3.
回答生成 課題 • Visual Encoderで画像特徴をLLMに入力 しているが、正しい回答ができないことが多い • レイアウト情報を、暗黙的に画像特徴として渡 しているだけなので、レイアウトを考慮した上 での回答ができない ◦ 表の行や列を指定した質問など難しい 既存手法 背景
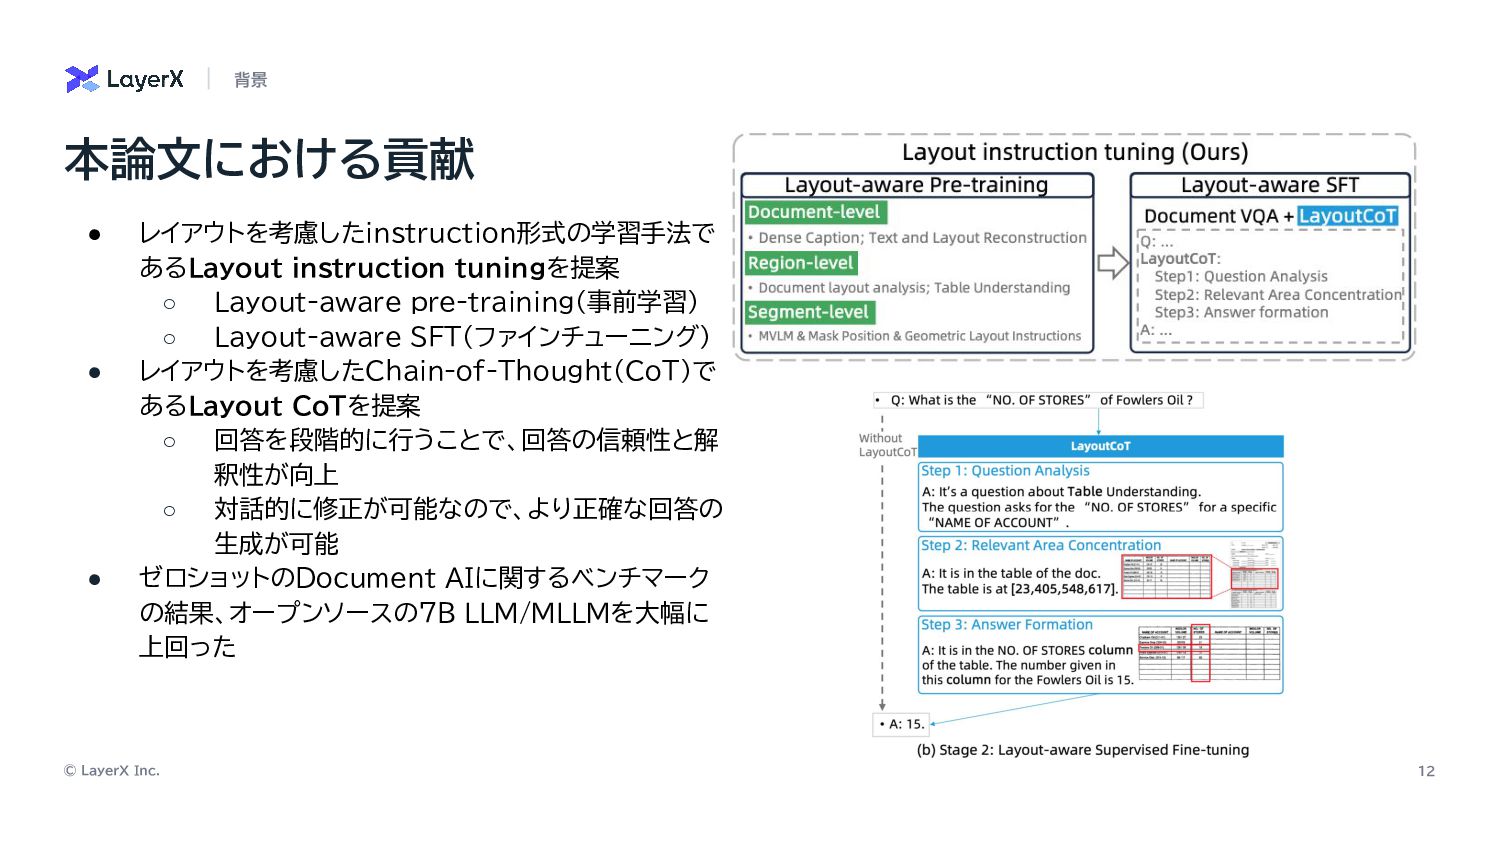
© LayerX Inc. 12 本論文における貢献 背景 • レイアウトを考慮したinstruction形式の学習手法で あるLayout instruction
tuningを提案 ◦ Layout-aware pre-training(事前学習) ◦ Layout-aware SFT(ファインチューニング) • レイアウトを考慮したChain-of-Thought(CoT)で あるLayout CoTを提案 ◦ 回答を段階的に行うことで、回答の信頼性と解 釈性が向上 ◦ 対話的に修正が可能なので、より正確な回答の 生成が可能 • ゼロショットのDocument AIに関するベンチマーク の結果、オープンソースの7B LLM/MLLMを大幅に 上回った
提案手法
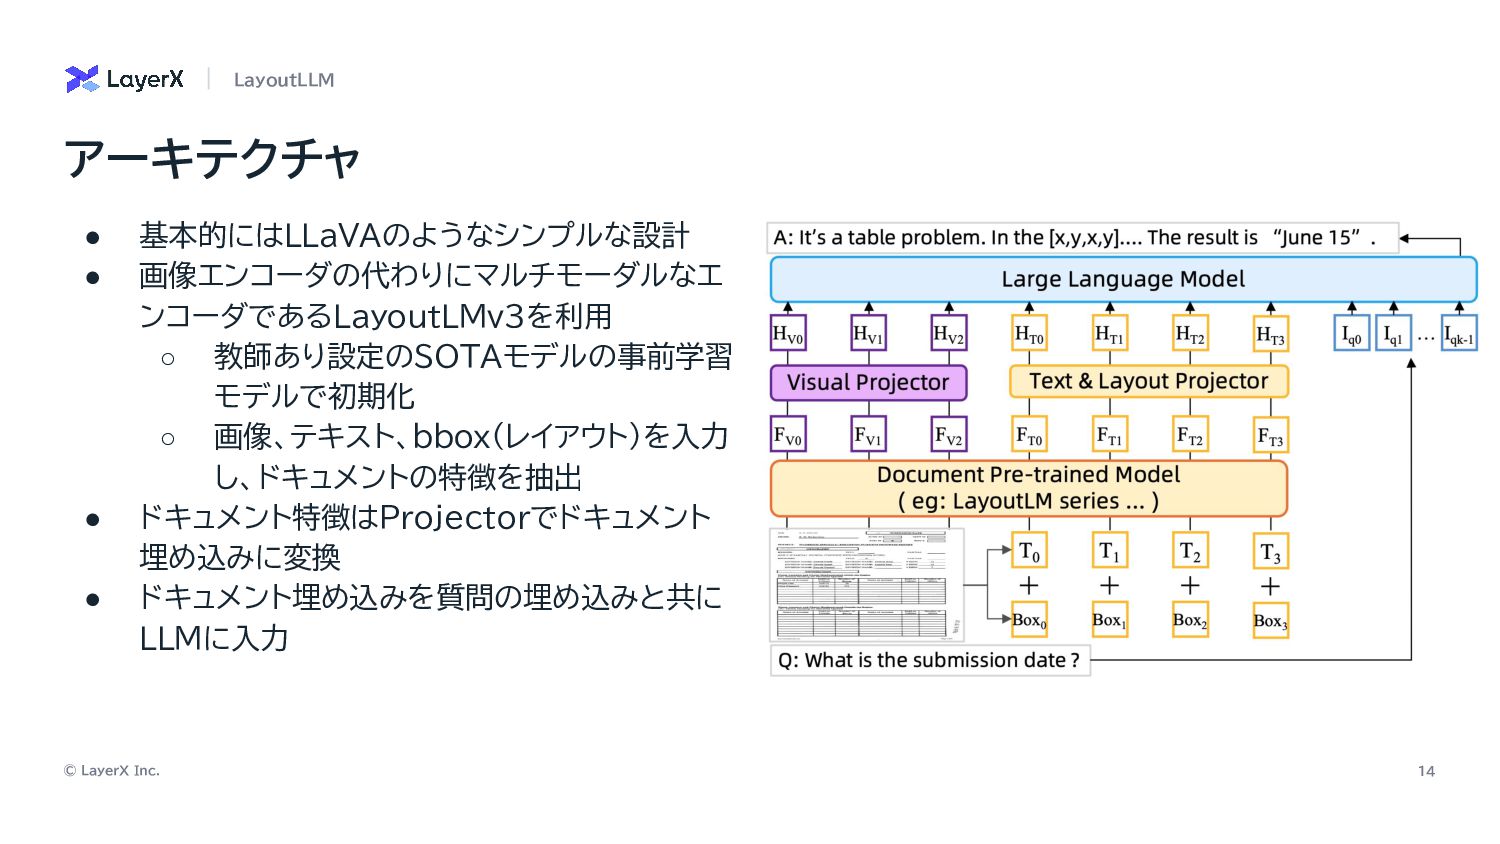
© LayerX Inc. 14 • 基本的にはLLaVAのようなシンプルな設計 • 画像エンコーダの代わりにマルチモーダルなエ ンコーダであるLayoutLMv3を利用 ◦
教師あり設定のSOTAモデルの事前学習 モデルで初期化 ◦ 画像、テキスト、bbox(レイアウト)を入力 し、ドキュメントの特徴を抽出 • ドキュメント特徴はProjectorでドキュメント 埋め込みに変換 • ドキュメント埋め込みを質問の埋め込みと共に LLMに入力 アーキテクチャ LayoutLLM
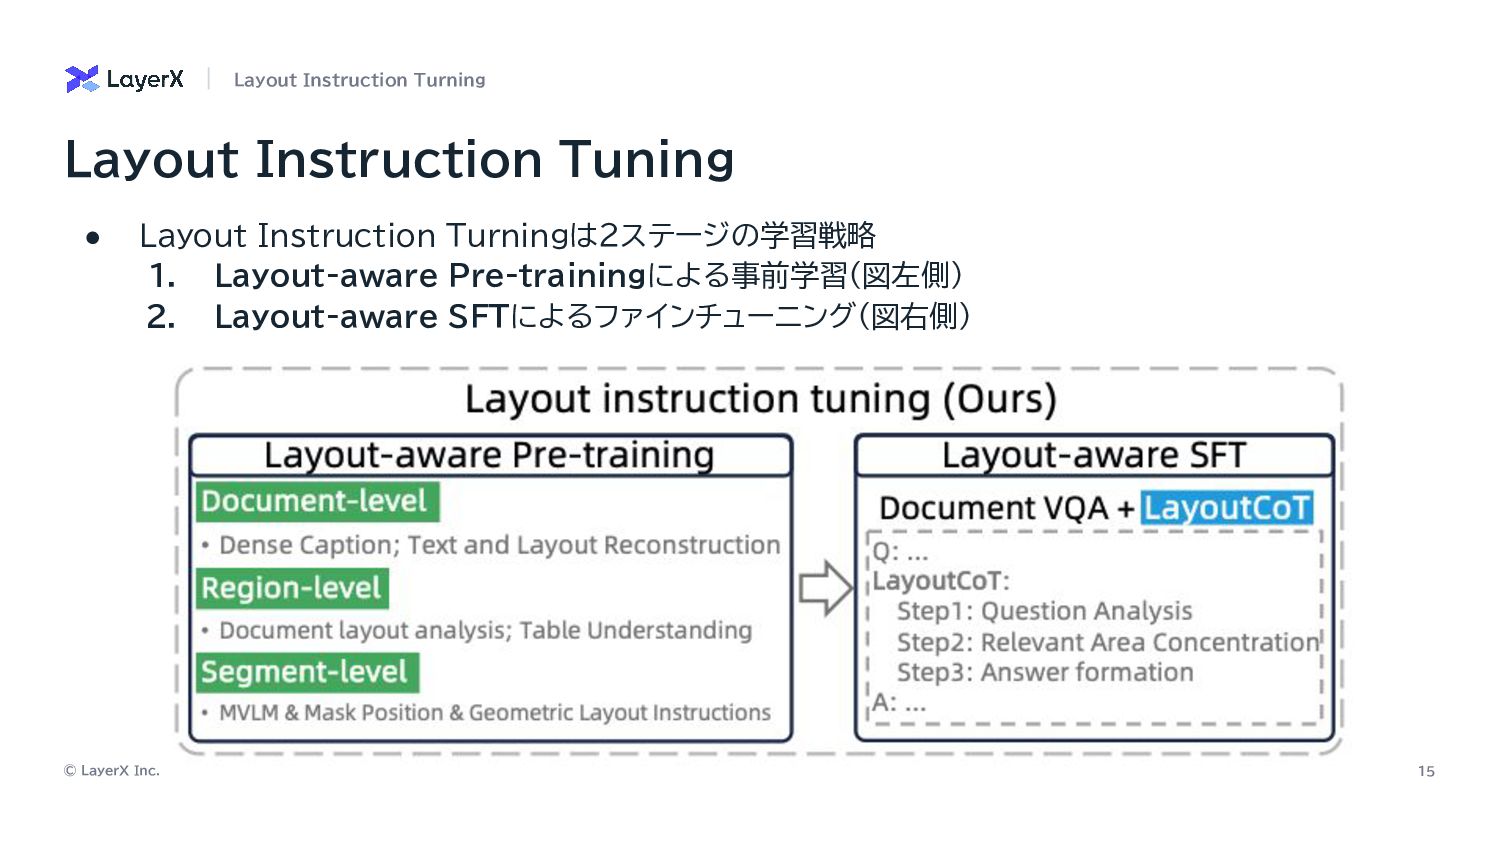
© LayerX Inc. 15 • Layout Instruction Turningは2ステージの学習戦略 1. Layout-aware
Pre-trainingによる事前学習(図左側) 2. Layout-aware SFTによるファインチューニング(図右側) Layout Instruction Tuning Layout Instruction Turning
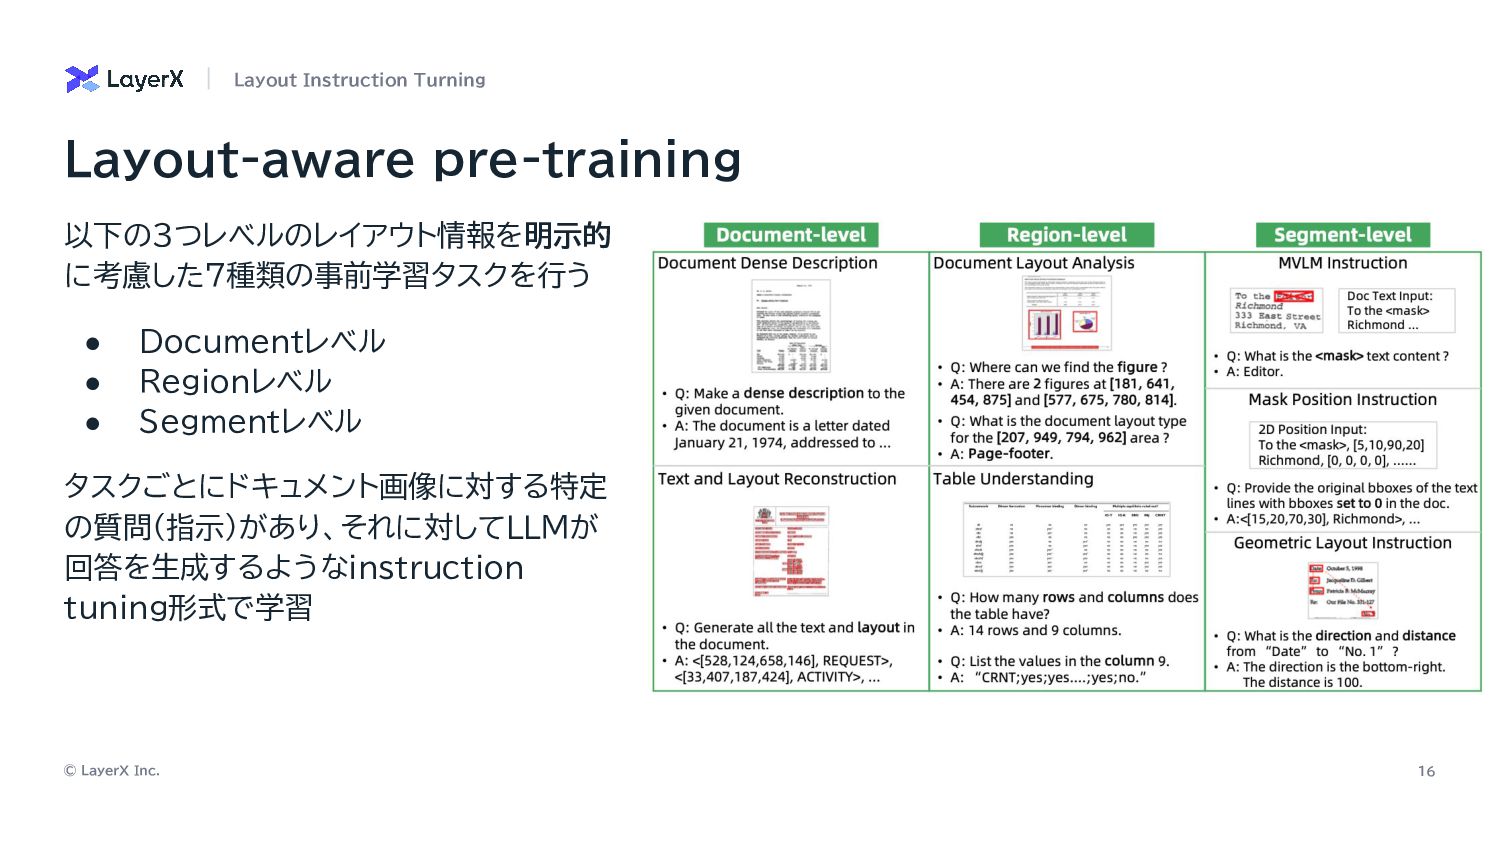
© LayerX Inc. 16 Layout-aware pre-training Layout Instruction Turning 以下の3つレベルのレイアウト情報を明示的
に考慮した7種類の事前学習タスクを行う • Documentレベル • Regionレベル • Segmentレベル タスクごとにドキュメント画像に対する特定 の質問(指示)があり、それに対してLLMが 回答を生成するようなinstruction tuning形式で学習
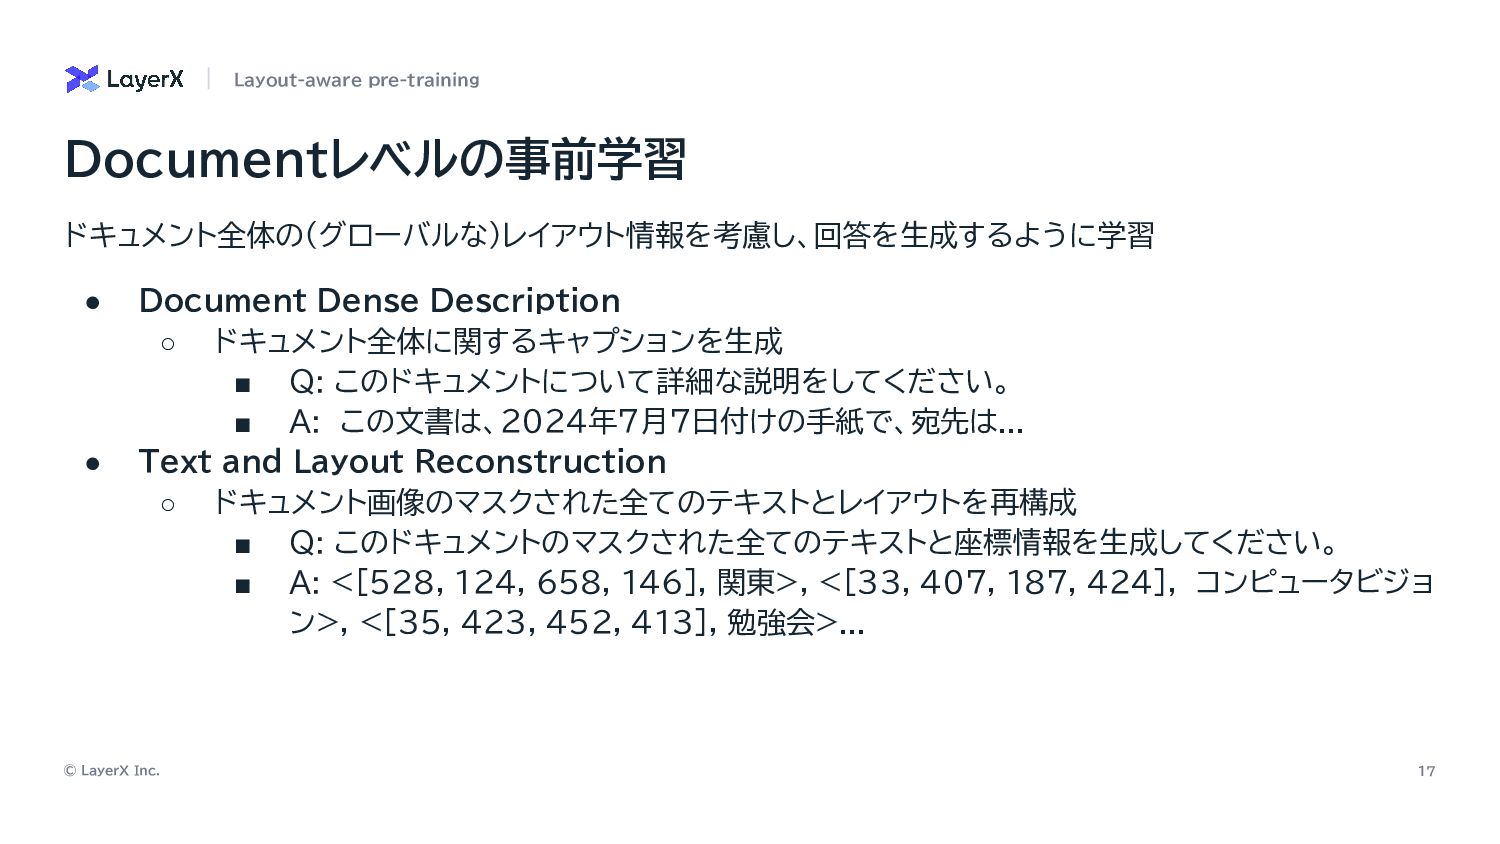
© LayerX Inc. 17 ドキュメント全体の(グローバルな)レイアウト情報を考慮し、回答を生成するように学習 • Document Dense Description ◦
ドキュメント全体に関するキャプションを生成 ▪ Q: このドキュメントについて詳細な説明をしてください。 ▪ A: この文書は、2024年7月7日付けの手紙で、宛先は... • Text and Layout Reconstruction ◦ ドキュメント画像のマスクされた全てのテキストとレイアウトを再構成 ▪ Q: このドキュメントのマスクされた全てのテキストと座標情報を生成してください。 ▪ A: <[528, 124, 658, 146], 関東>, <[33, 407, 187, 424], コンピュータビジョ ン>, <[35, 423, 452, 413], 勉強会>... Documentレベルの事前学習 Layout-aware pre-training
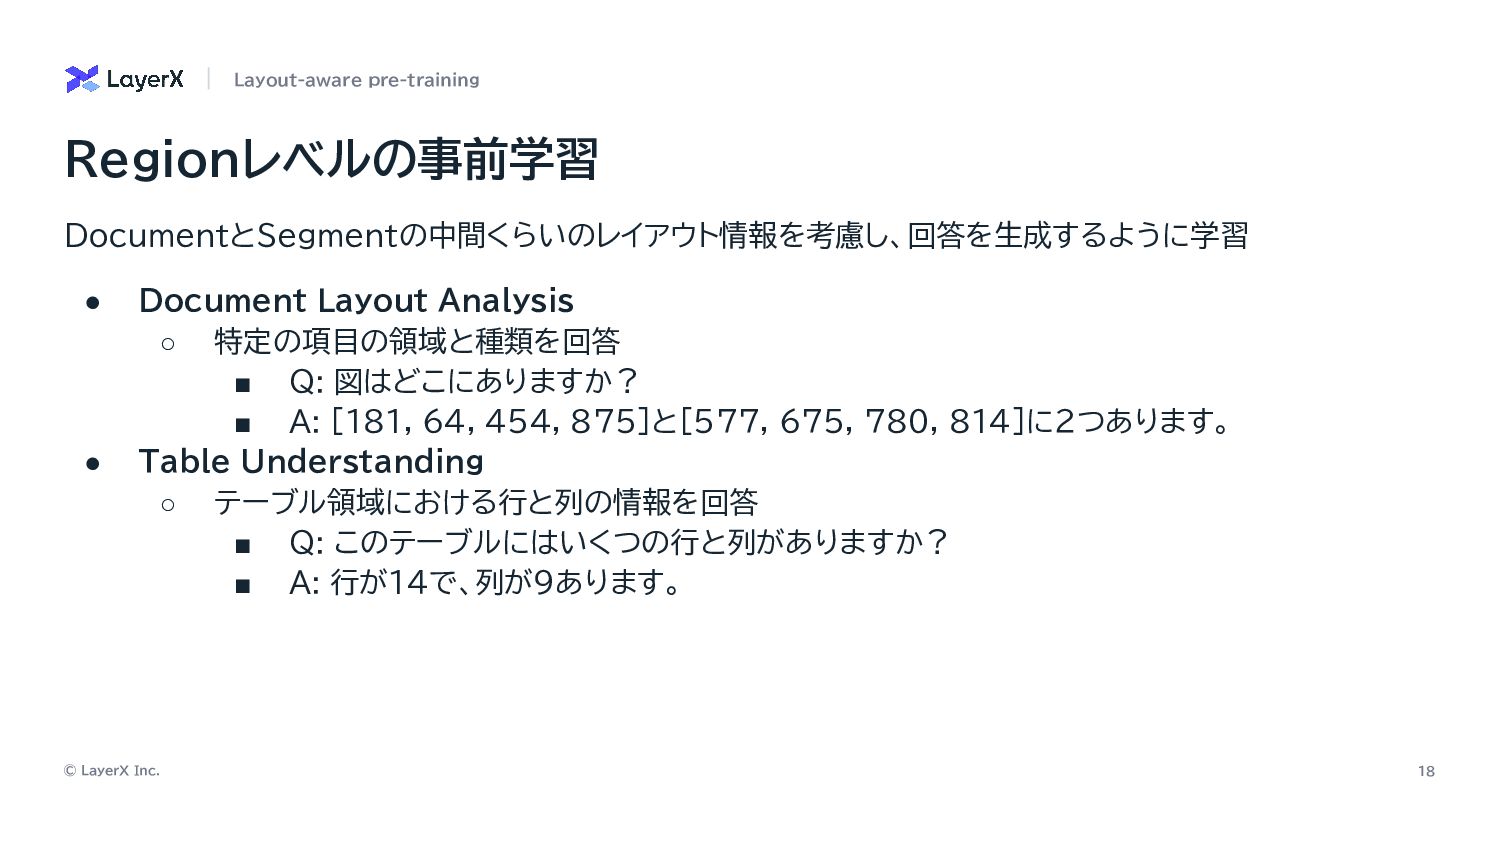
© LayerX Inc. 18 DocumentとSegmentの中間くらいのレイアウト情報を考慮し、回答を生成するように学習 • Document Layout Analysis ◦
特定の項目の領域と種類を回答 ▪ Q: 図はどこにありますか? ▪ A: [181, 64, 454, 875]と[577, 675, 780, 814]に2つあります。 • Table Understanding ◦ テーブル領域における行と列の情報を回答 ▪ Q: このテーブルにはいくつの行と列がありますか? ▪ A: 行が14で、列が9あります。 Regionレベルの事前学習 Layout-aware pre-training
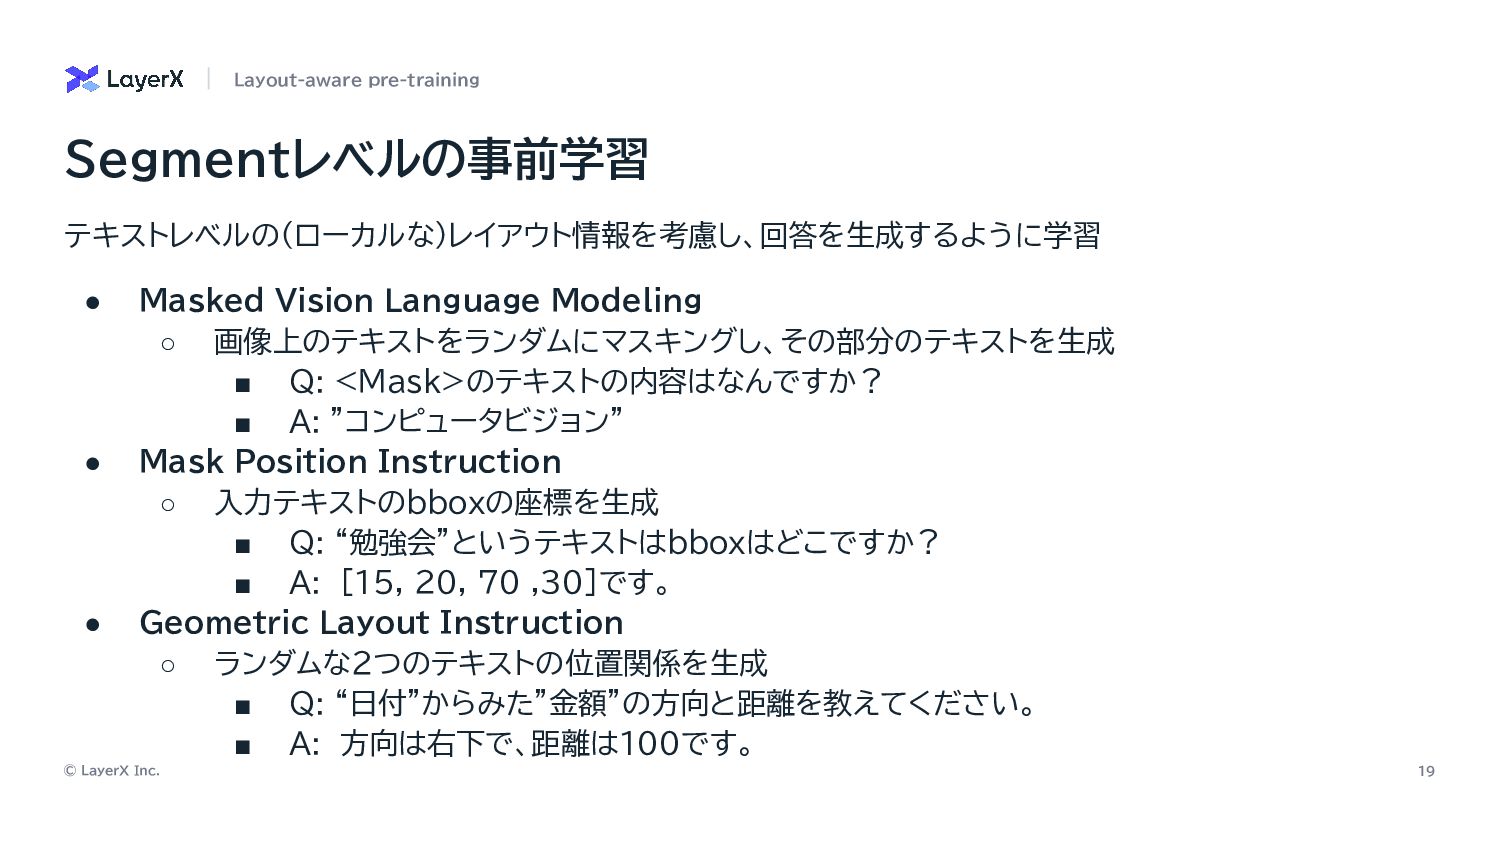
© LayerX Inc. 19 テキストレベルの(ローカルな)レイアウト情報を考慮し、回答を生成するように学習 • Masked Vision Language Modeling
◦ 画像上のテキストをランダムにマスキングし、その部分のテキストを生成 ▪ Q: <Mask>のテキストの内容はなんですか? ▪ A: ”コンピュータビジョン” • Mask Position Instruction ◦ 入力テキストのbboxの座標を生成 ▪ Q: “勉強会”というテキストはbboxはどこですか? ▪ A: [15, 20, 70 ,30]です。 • Geometric Layout Instruction ◦ ランダムな2つのテキストの位置関係を生成 ▪ Q: “日付”からみた”金額”の方向と距離を教えてください。 ▪ A: 方向は右下で、距離は100です。 Segmentレベルの事前学習 Layout-aware pre-training
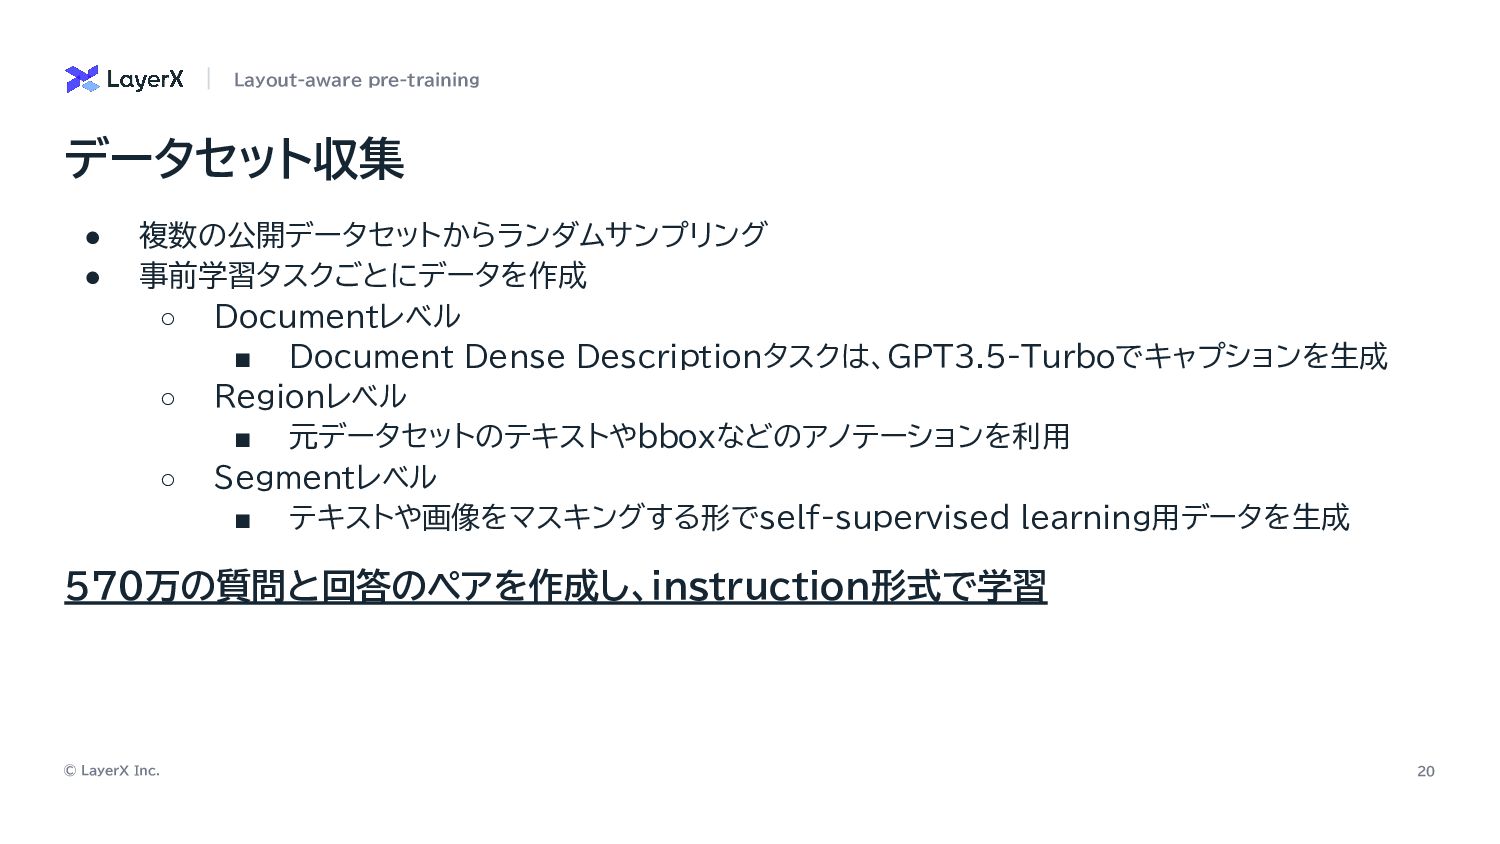
© LayerX Inc. 20 • 複数の公開データセットからランダムサンプリング • 事前学習タスクごとにデータを作成 ◦ Documentレベル
▪ Document Dense Descriptionタスクは、GPT3.5-Turboでキャプションを生成 ◦ Regionレベル ▪ 元データセットのテキストやbboxなどのアノテーションを利用 ◦ Segmentレベル ▪ テキストや画像をマスキングする形でself-supervised learning用データを生成 570万の質問と回答のペアを作成し、instruction形式で学習 データセット収集 Layout-aware pre-training
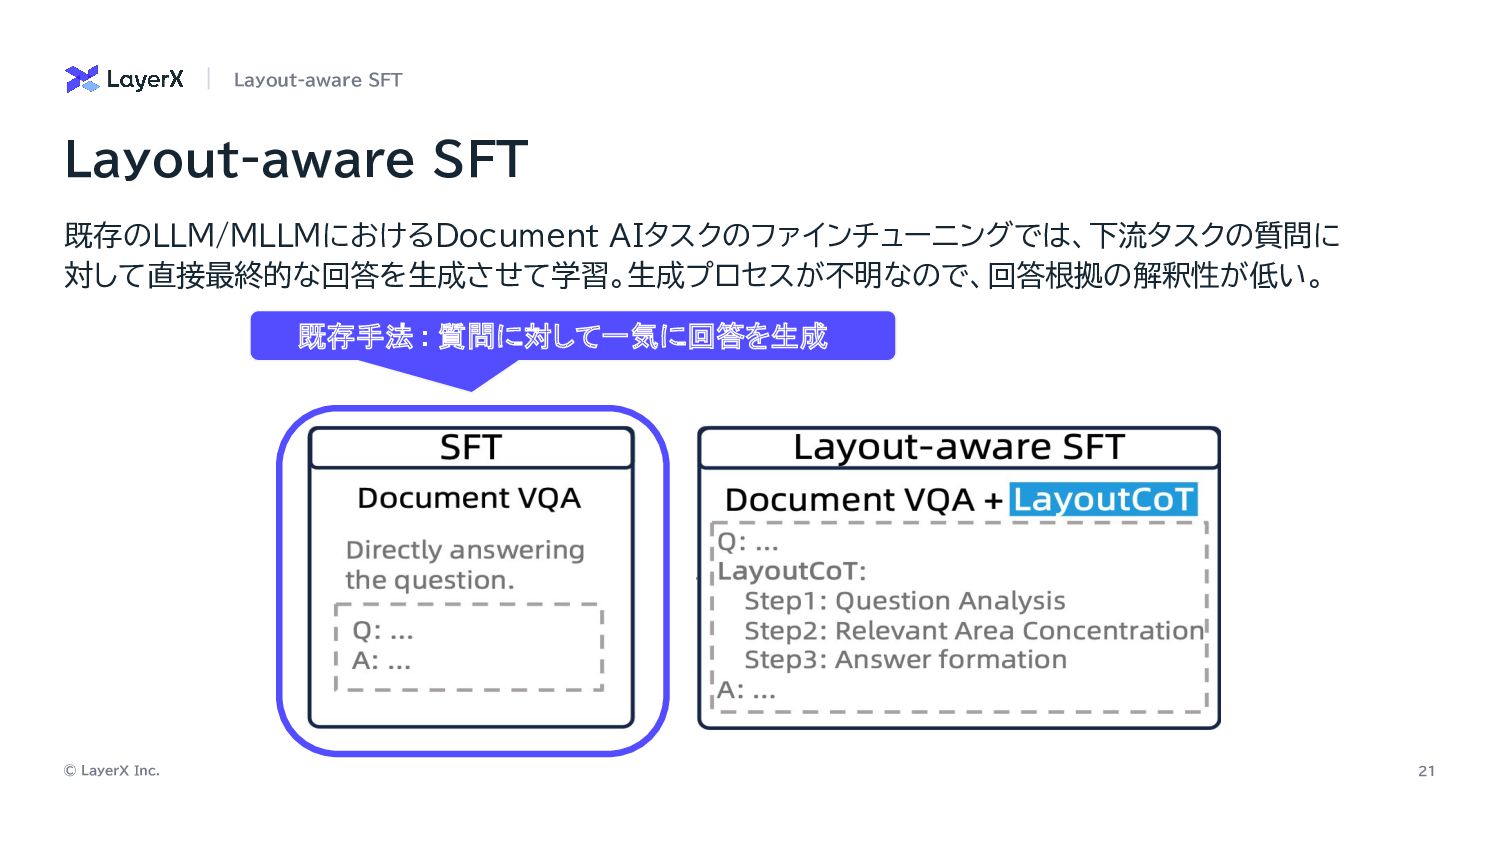
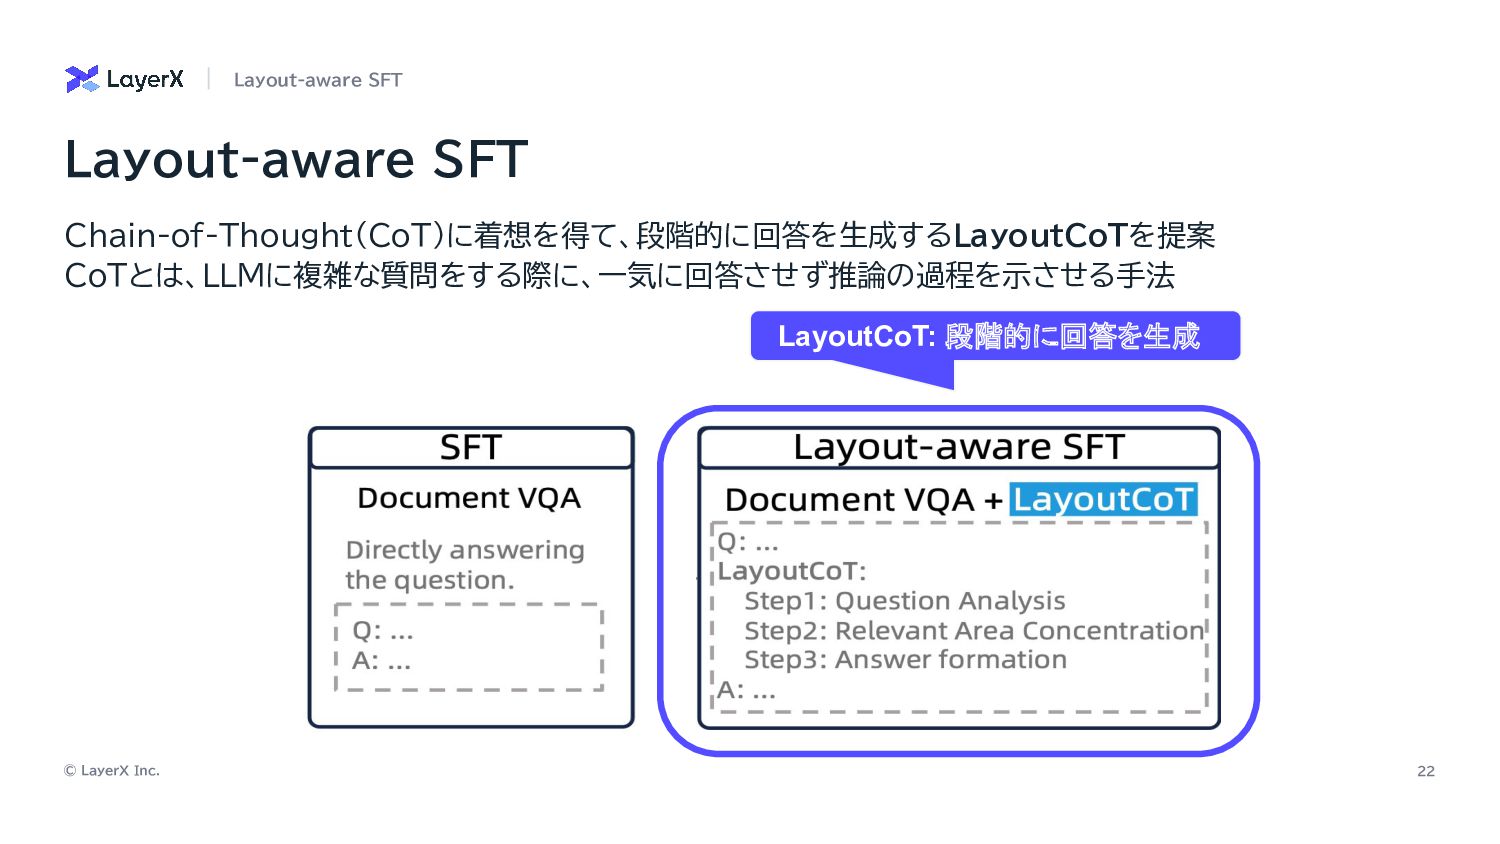
© LayerX Inc. 21 既存のLLM/MLLMにおけるDocument AIタスクのファインチューニングでは、下流タスクの質問に 対して直接最終的な回答を生成させて学習。生成プロセスが不明なので、回答根拠の解釈性が低い。 Layout-aware SFT Layout-aware
SFT 既存手法 : 質問に対して一気に回答を生成
© LayerX Inc. 22 Chain-of-Thought(CoT)に着想を得て、段階的に回答を生成するLayoutCoTを提案 CoTとは、LLMに複雑な質問をする際に、一気に回答させず推論の過程を示させる手法 Layout-aware SFT Layout-aware SFT
LayoutCoT: 段階的に回答を生成
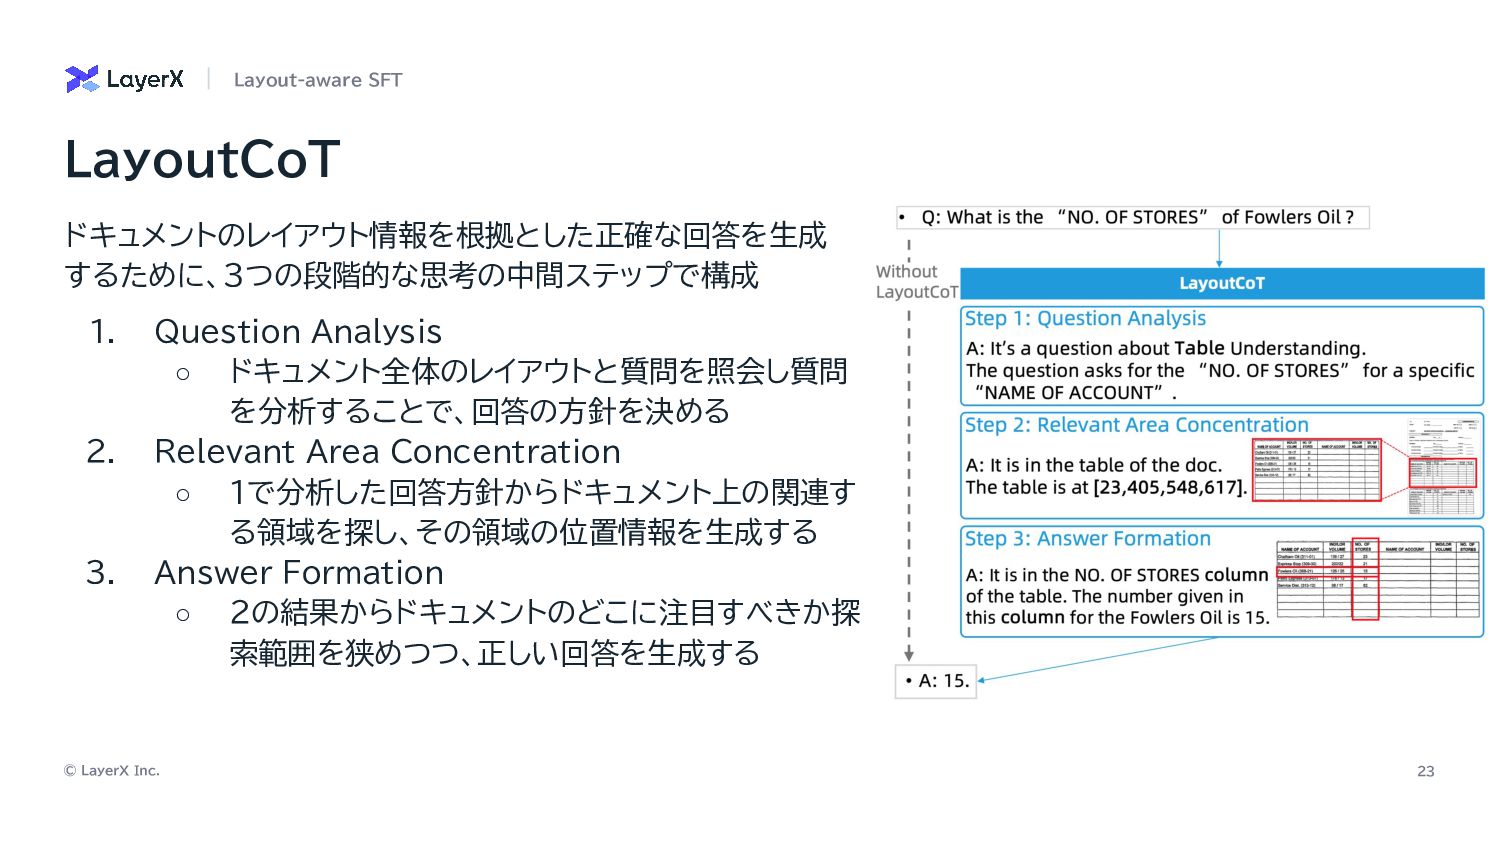
© LayerX Inc. 23 ドキュメントのレイアウト情報を根拠とした正確な回答を生成 するために、3つの段階的な思考の中間ステップで構成 LayoutCoT Layout-aware SFT 1.
Question Analysis ◦ ドキュメント全体のレイアウトと質問を照会し質問 を分析することで、回答の方針を決める 2. Relevant Area Concentration ◦ 1で分析した回答方針からドキュメント上の関連す る領域を探し、その領域の位置情報を生成する 3. Answer Formation ◦ 2の結果からドキュメントのどこに注目すべきか探 索範囲を狭めつつ、正しい回答を生成する
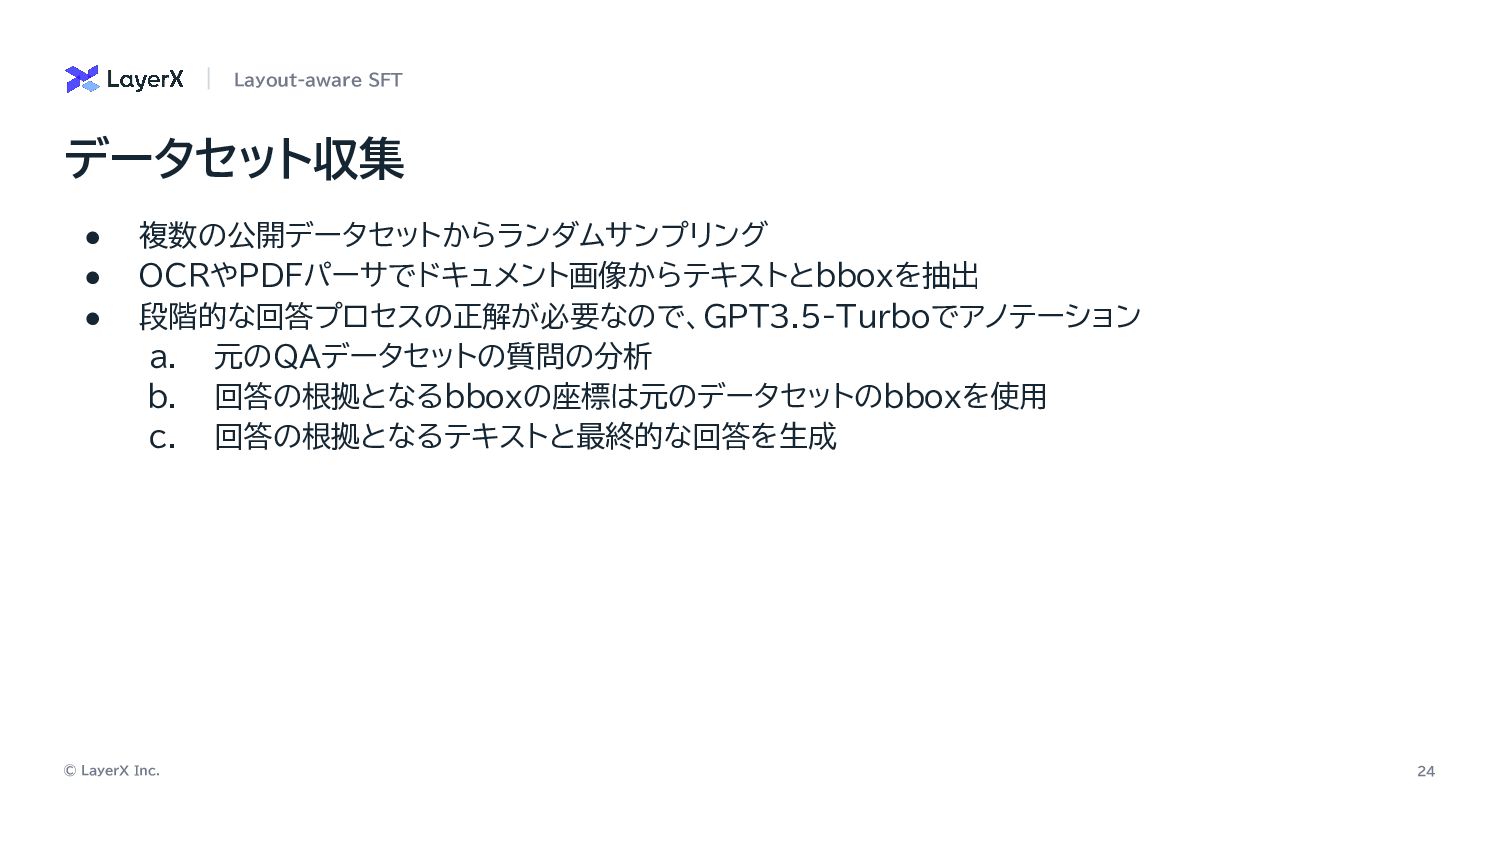
© LayerX Inc. 24 • 複数の公開データセットからランダムサンプリング • OCRやPDFパーサでドキュメント画像からテキストとbboxを抽出 • 段階的な回答プロセスの正解が必要なので、GPT3.5-Turboでアノテーション
a. 元のQAデータセットの質問の分析 b. 回答の根拠となるbboxの座標は元のデータセットのbboxを使用 c. 回答の根拠となるテキストと最終的な回答を生成 データセット収集 Layout-aware SFT
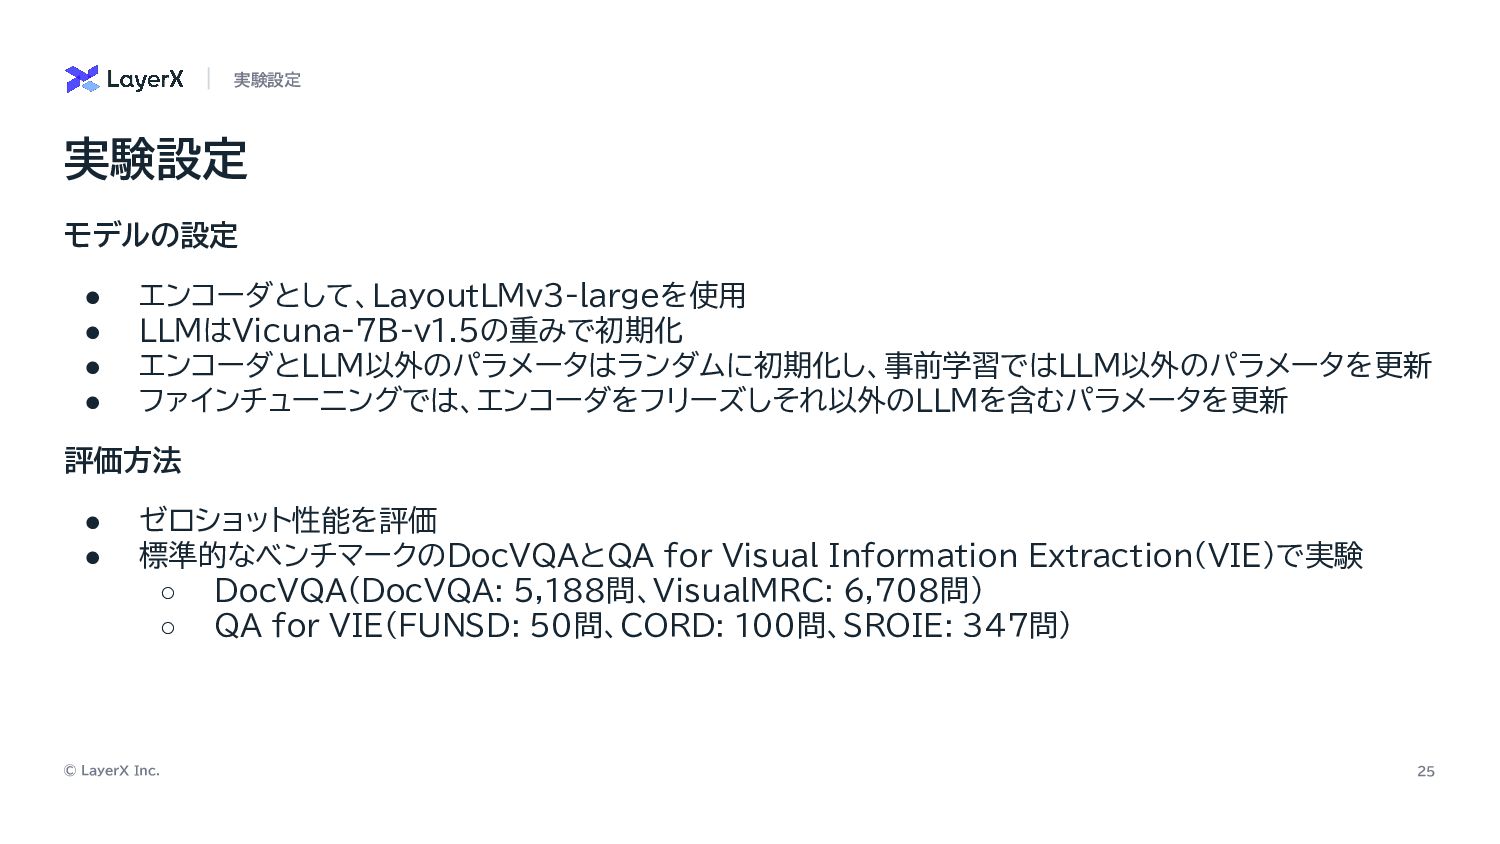
© LayerX Inc. 25 モデルの設定 • エンコーダとして、LayoutLMv3-largeを使用 • LLMはVicuna-7B-v1.5の重みで初期化 •
エンコーダとLLM以外のパラメータはランダムに初期化し、事前学習ではLLM以外のパラメータを更新 • ファインチューニングでは、エンコーダをフリーズしそれ以外のLLMを含むパラメータを更新 評価方法 • ゼロショット性能を評価 • 標準的なベンチマークのDocVQAとQA for Visual Information Extraction(VIE)で実験 ◦ DocVQA(DocVQA: 5,188問、VisualMRC: 6,708問) ◦ QA for VIE(FUNSD: 50問、CORD: 100問、SROIE: 347問) 実験設定 実験設定
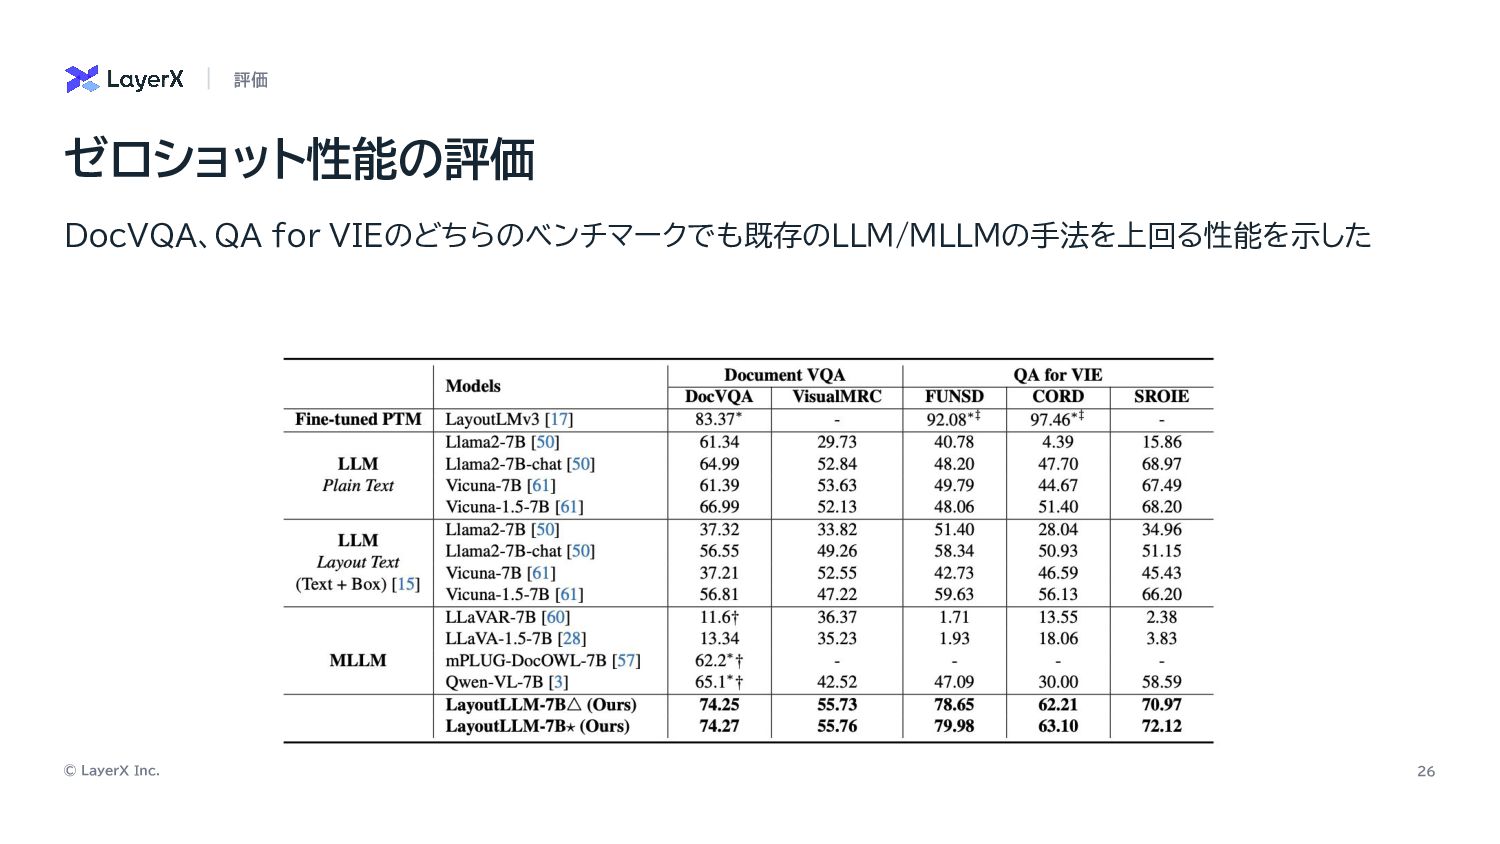
© LayerX Inc. 26 DocVQA、QA for VIEのどちらのベンチマークでも既存のLLM/MLLMの手法を上回る性能を示した ゼロショット性能の評価 評価
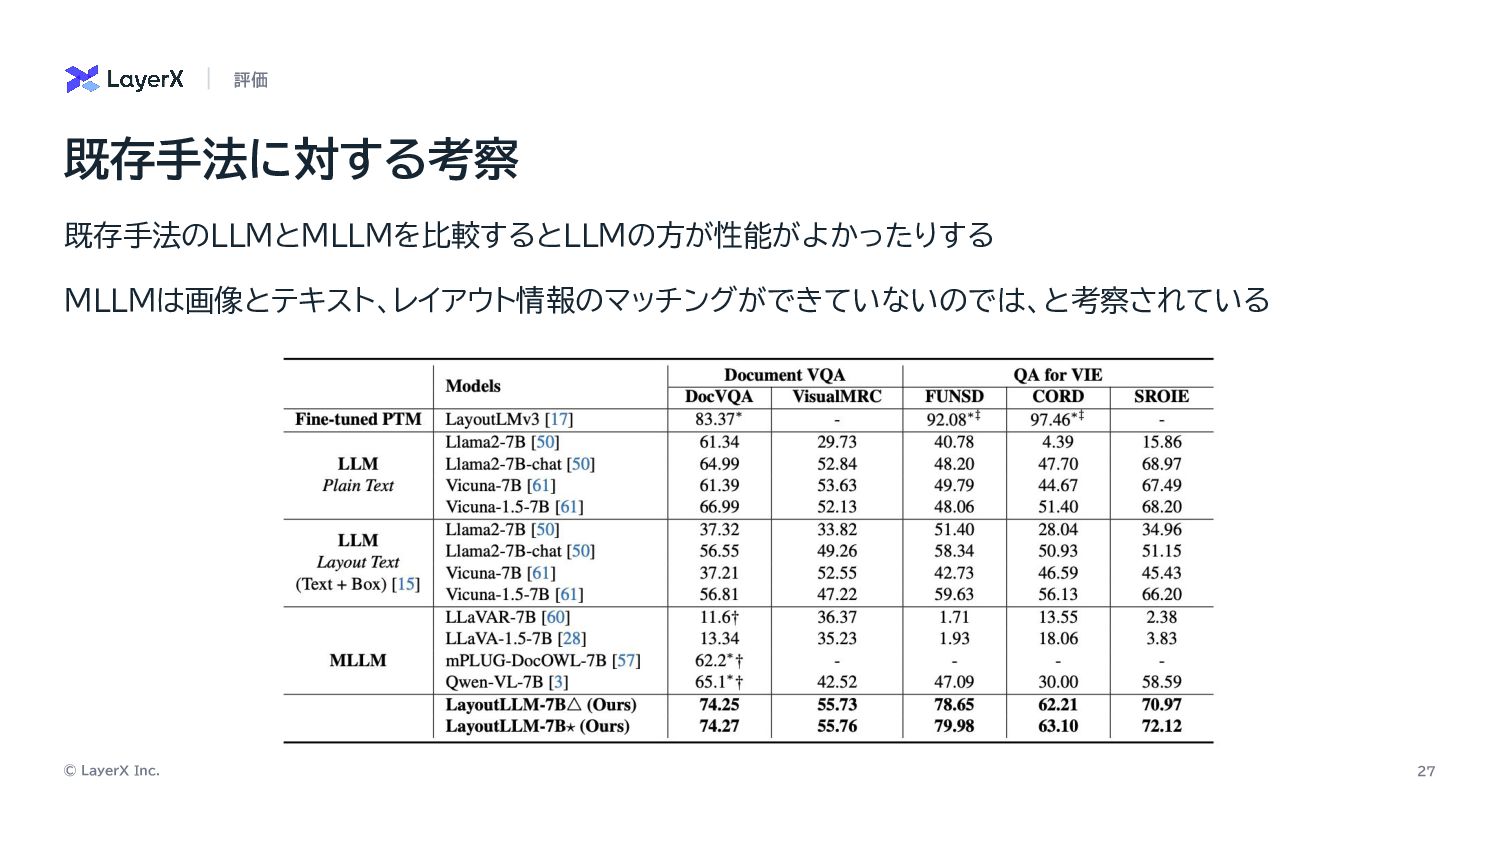
© LayerX Inc. 27 既存手法のLLMとMLLMを比較するとLLMの方が性能がよかったりする MLLMは画像とテキスト、レイアウト情報のマッチングができていないのでは、と考察されている 既存手法に対する考察 評価
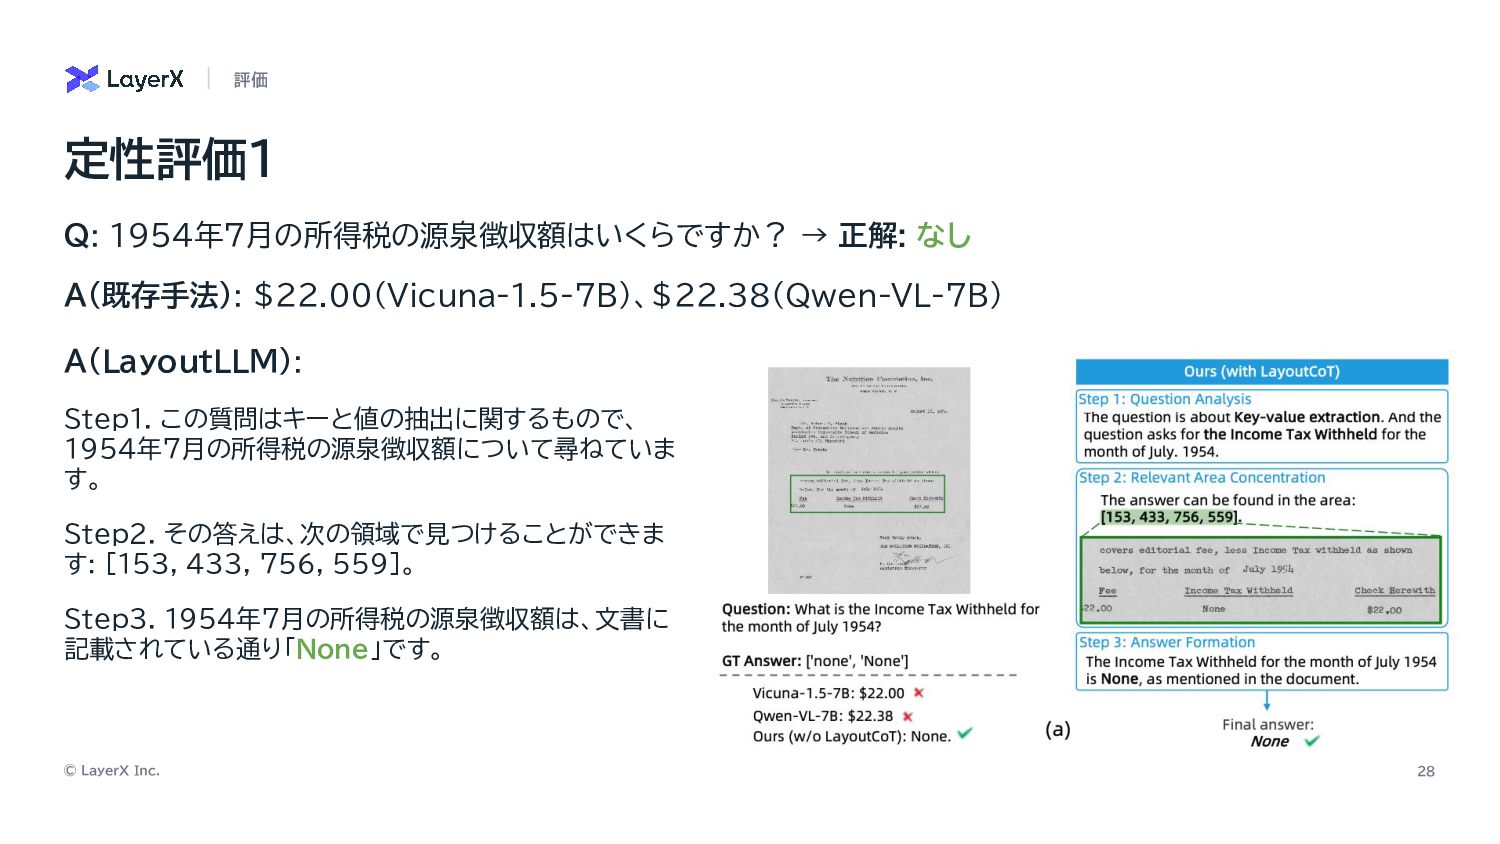
© LayerX Inc. 28 Q: 1954年7月の所得税の源泉徴収額はいくらですか? → 正解: なし A(既存手法):
$22.00(Vicuna-1.5-7B)、$22.38(Qwen-VL-7B) 定性評価1 評価 A(LayoutLLM): Step1. この質問はキーと値の抽出に関するもので、 1954年7月の所得税の源泉徴収額について尋ねていま す。 Step2. その答えは、次の領域で見つけることができま す: [153, 433, 756, 559]。 Step3. 1954年7月の所得税の源泉徴収額は、文書に 記載されている通り「None」です。
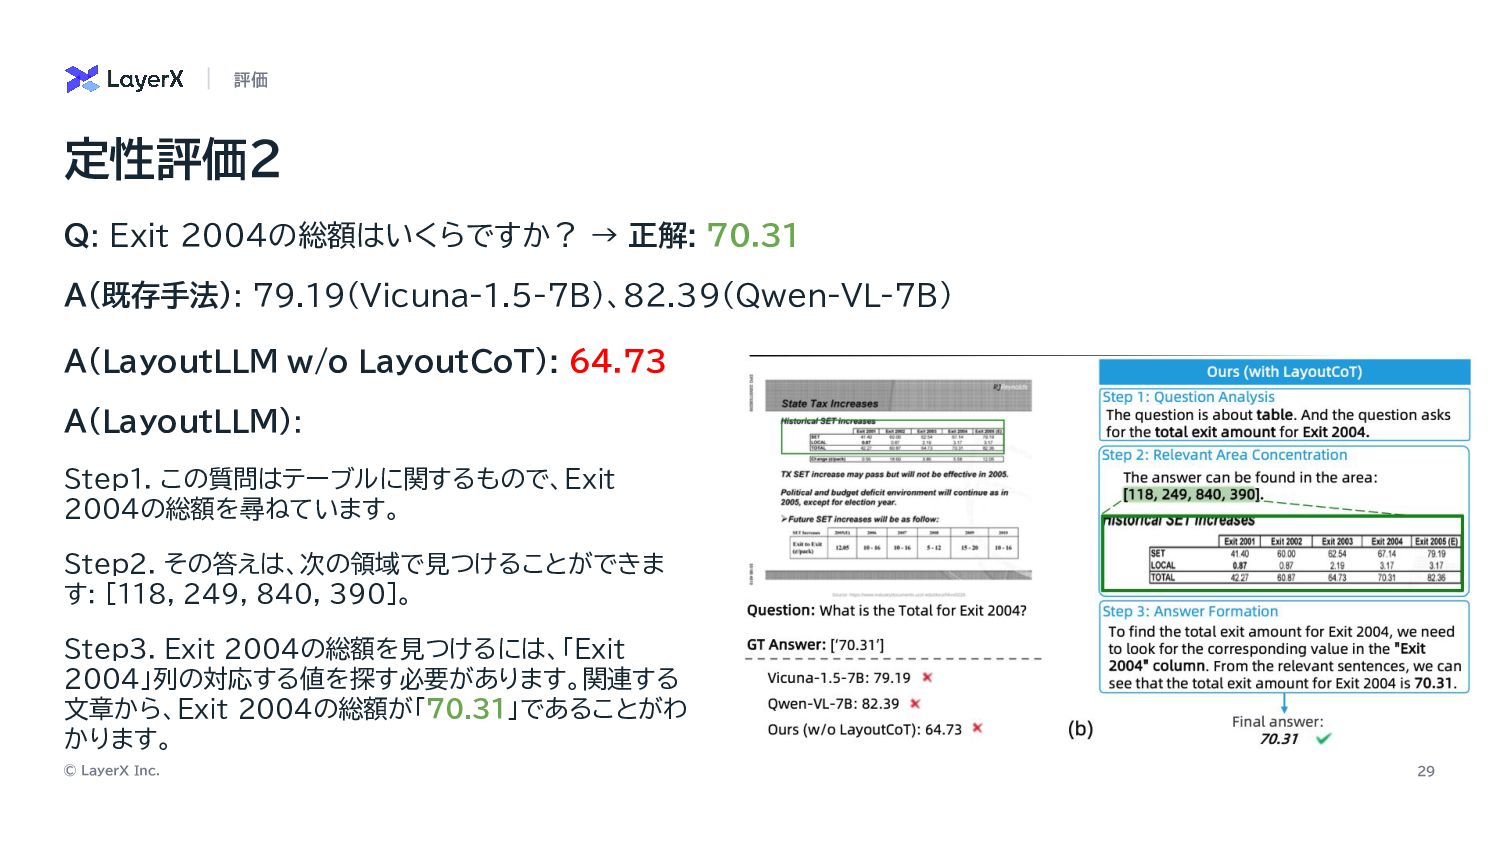
© LayerX Inc. 29 Q: Exit 2004の総額はいくらですか? → 正解: 70.31
A(既存手法): 79.19(Vicuna-1.5-7B)、82.39(Qwen-VL-7B) 定性評価2 評価 A(LayoutLLM w/o LayoutCoT): 64.73 A(LayoutLLM): Step1. この質問はテーブルに関するもので、Exit 2004の総額を尋ねています。 Step2. その答えは、次の領域で見つけることができま す: [118, 249, 840, 390]。 Step3. Exit 2004の総額を見つけるには、「Exit 2004」列の対応する値を探す必要があります。関連する 文章から、Exit 2004の総額が「70.31」であることがわ かります。
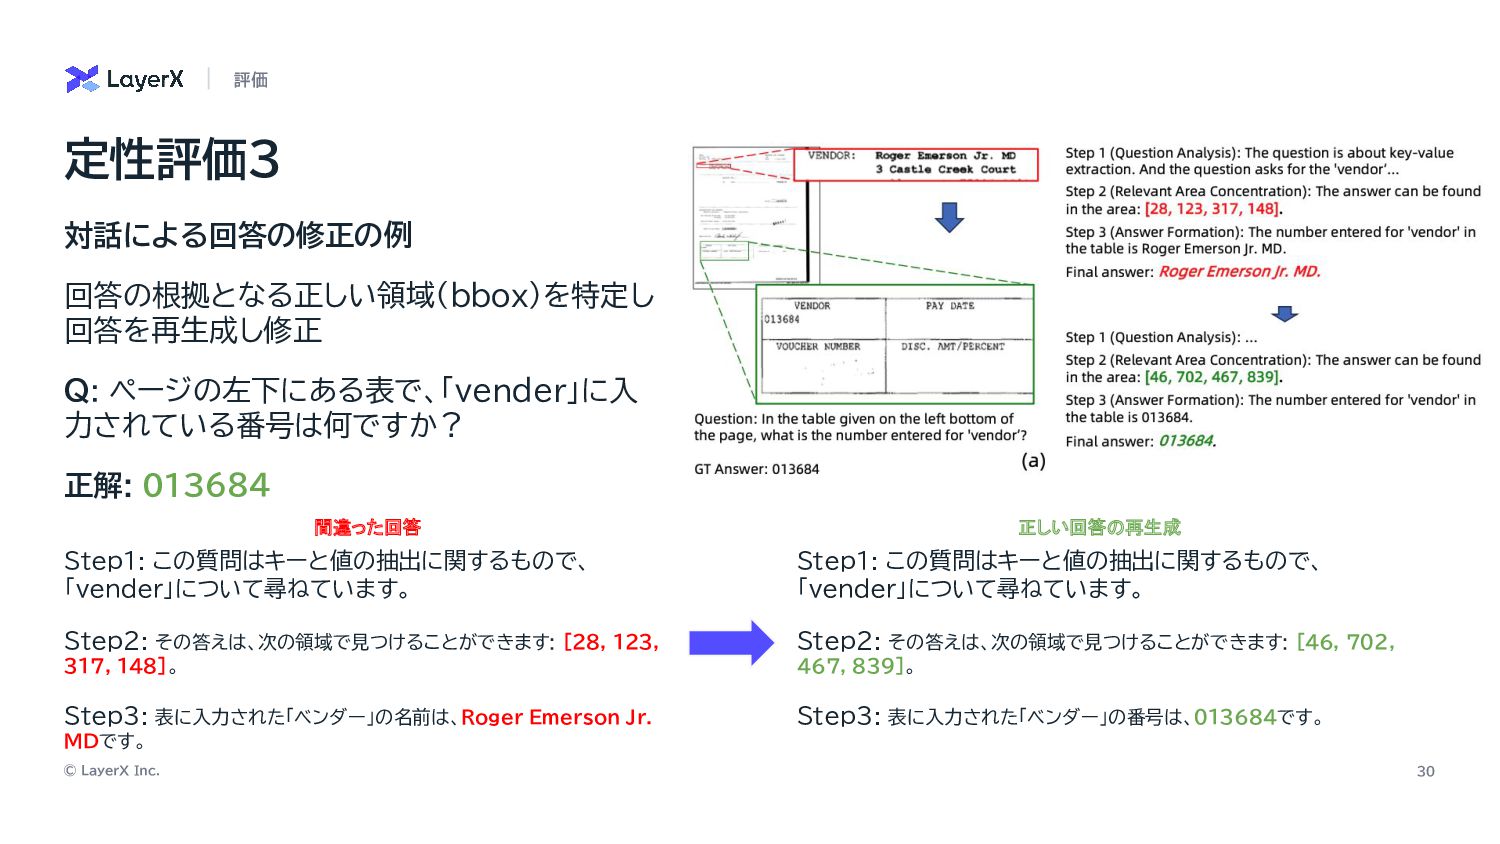
© LayerX Inc. 30 Step1: この質問はキーと値の抽出に関するもので、 「vender」について尋ねています。 Step2: その答えは、次の領域で見つけることができます: [28,
123, 317, 148]。 Step3: 表に入力された「ベンダー」の名前は、Roger Emerson Jr. MDです。 定性評価3 評価 Step1: この質問はキーと値の抽出に関するもので、 「vender」について尋ねています。 Step2: その答えは、次の領域で見つけることができます: [46, 702, 467, 839]。 Step3: 表に入力された「ベンダー」の番号は、013684です。 対話による回答の修正の例 回答の根拠となる正しい領域(bbox)を特定し 回答を再生成し修正 Q: ページの左下にある表で、「vender」に入 力されている番号は何ですか? 正解: 013684 間違った回答 正しい回答の再生成
まとめ
© LayerX Inc. 32 まとめ まとめ • Document AIのための大規模言語モデルであるLayoutLLMの紹介 •
レイアウトを明示的に考慮したLayout instruction tuningを提案 • LayoutCoTで段階的に回答を生成することによって、回答の精度および信頼性と解釈性が向上 ◦ 対話的に修正し正しい回答を生成することも可能 • 結果として、ゼロショットの性能評価において、標準的なベンチマークで既存手法を大きく上回った
ご清聴ありがとうございました
© LayerX Inc. 34 参考文献 [1] https://github.com/JaidedAI/EasyOCR [2] PubLayNet: largest
dataset ever for document layout analysis, https://arxiv.org/abs/1908.07836 [3] Document AI: Benchmarks, Models and Applications, https://arxiv.org/abs/2111.08609


 axbom
 ianozsvald
 reverentgeek
 akihiro_kokubo
 mfonobong
 sferik
 mraible
 greggifford
 bluesmoon
 eitanlees
 frankvandijk
 tammyeverts