Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Ubie における評価駆動開発の取り組み (Evaluation-Driven Develop...

Avatar for Akira Tameoka Akira Tameoka
September 20, 2026
55

Ubie における評価駆動開発の取り組み (Evaluation-Driven Development at Ubie) , September 18, 2026

Slides from "Evaluation-Driven Development at Ubie," presented at the Women in ML Japan Autumn Lightning Talks on AI Agents, September 18, 2026.
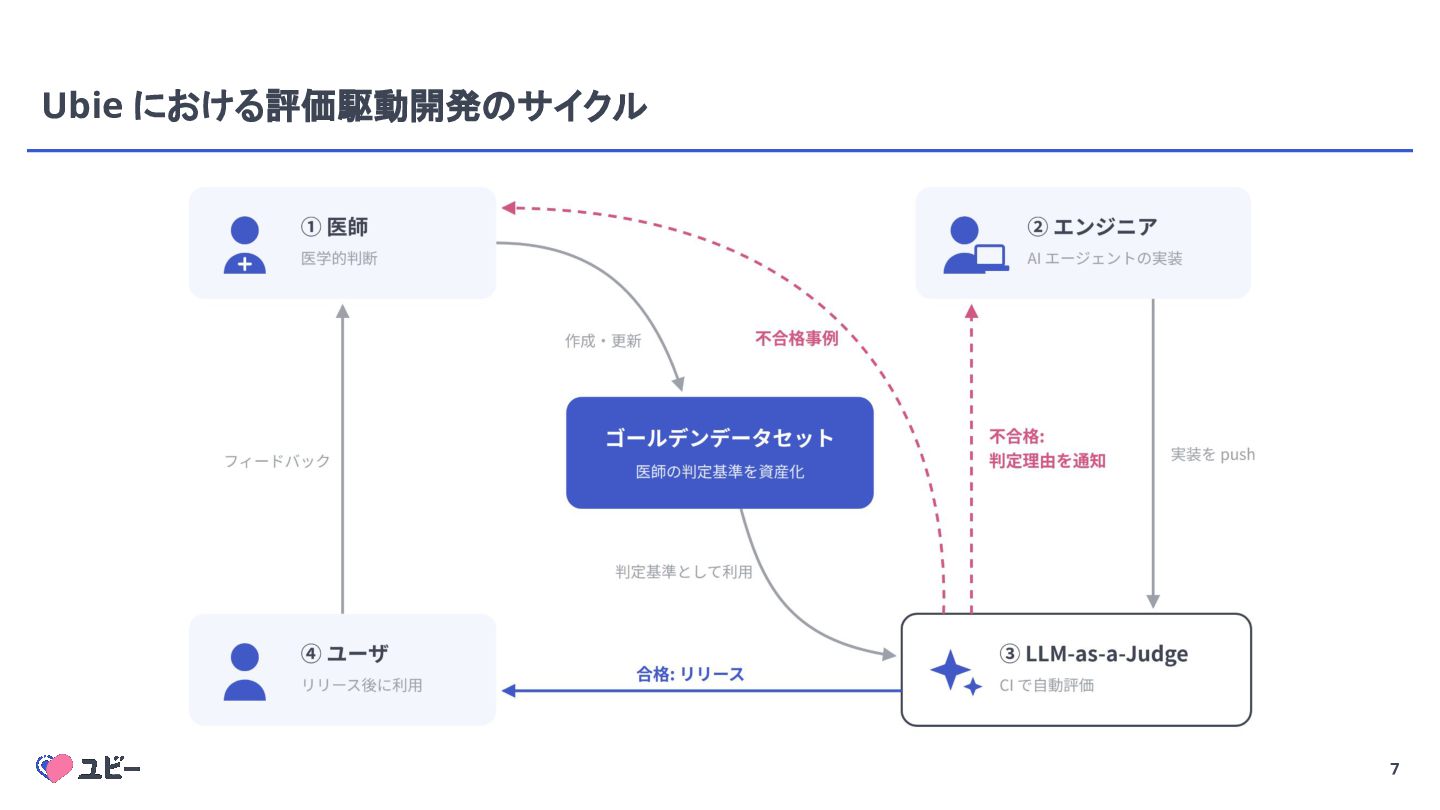
This talk introduces how Ubie guides healthcare AI development using expert-defined golden datasets and automated LLM-as-a-Judge evaluations, continually refining the criteria through feedback.
A clinical search case study shows how an AI coding agent used evaluations as guardrails to improve response speed. Tuning the thinking budget and parallelizing search API requests reduced both p50 and p95 time to first token (TTFT) to roughly one-third of their previous values while maintaining quality scores.

2026 年 9 月 18 日に開催された ML女子部「AIエージェント 秋のLT大会」での登壇資料です。
専門家の判断を反映したゴールデンデータセットと LLM-as-a-Judge による自動評価を軸に、Ubie の評価駆動開発を紹介します。評価結果で変更の採否を判断し、フィードバックを通じて評価基準も改善します。
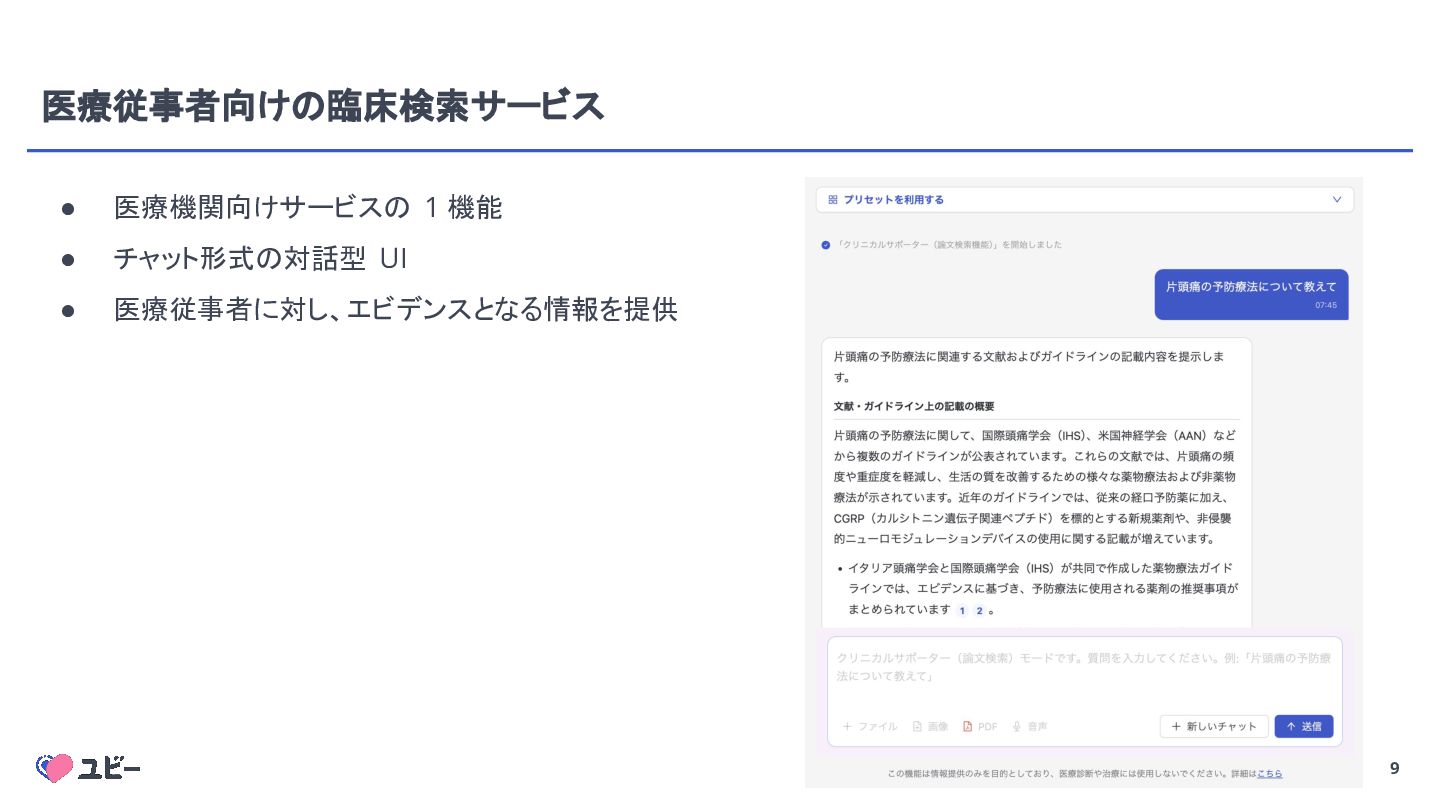
医療従事者向けの臨床検索サービスでは、評価をガードレールとして開発用 AI が速度改善を実施。thinking budget の調整と検索 API の並列化により、品質スコアを維持しながら、回答開始までの時間(TTFT)を p50・p95 ともに約 1/3 に短縮しました。

Avatar for Akira Tameoka

Akira Tameoka

September 20, 2026

Transcript

  1. 自己紹介 • 爲岡 啓 (ためおか あきら) • Software Engineer @

    Ubie • ヘルスケアエージェントの機能開発と評価を担当 2
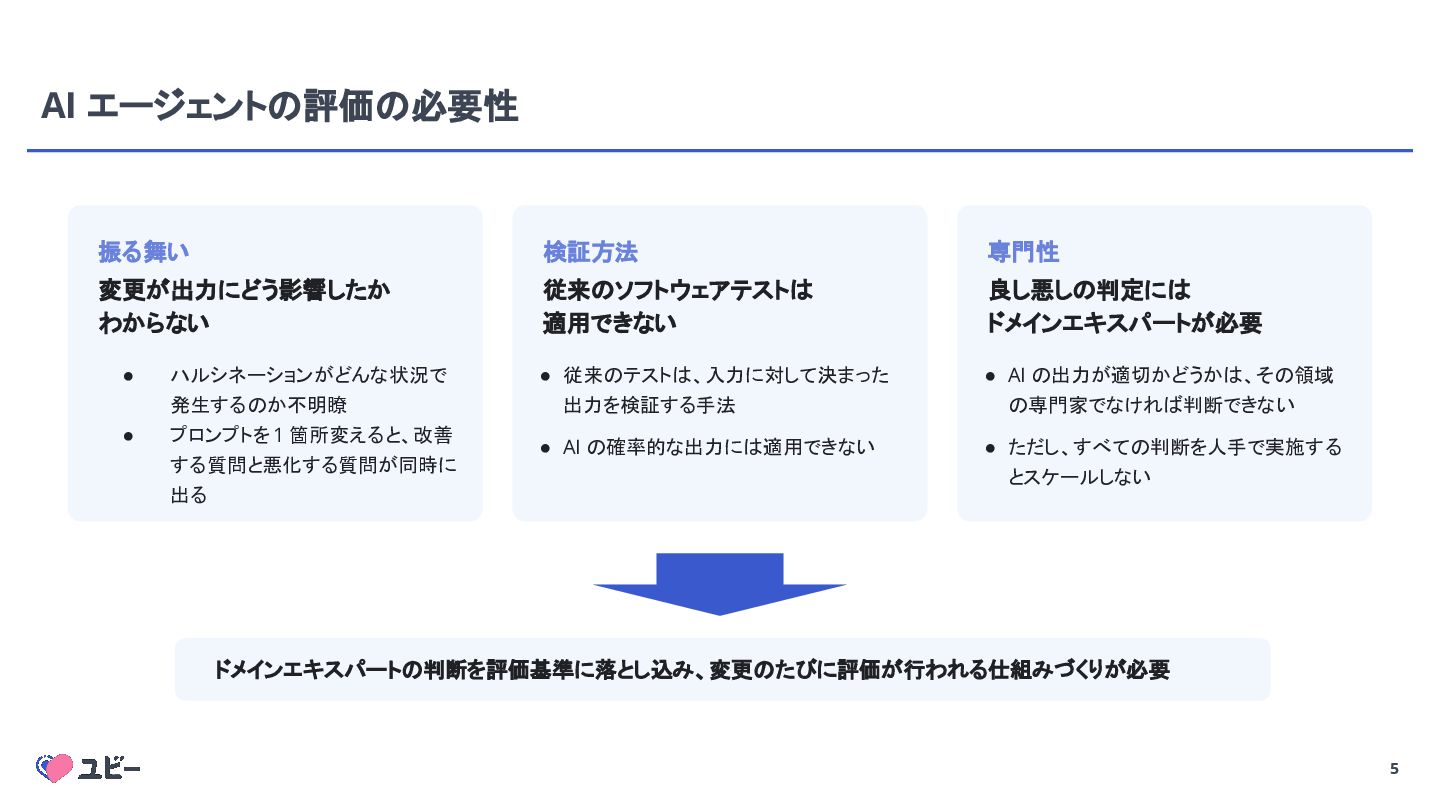
  2. AI エージェントの評価の必要性 振る舞い 検証方法 専門性 変更が出力にどう影響したか わからない 従来のソフトウェアテストは 適用できない 良し悪しの判定には

    ドメインエキスパートが必要 • 従来のテストは、入力に対して決まった 出力を検証する手法 • AI の出力が適切かどうかは、その領域 の専門家でなければ判断できない • AI の確率的な出力には適用できない • ただし、すべての判断を人手で実施する • • ハルシネーションがどんな状況で 発生するのか不明瞭 プロンプトを 1 箇所変えると、改善 する質問と悪化する質問が同時に 出る とスケールしない ドメインエキスパートの判断を評価基準に落とし込み、変更のたびに評価が行われる仕組みづくりが必要 5
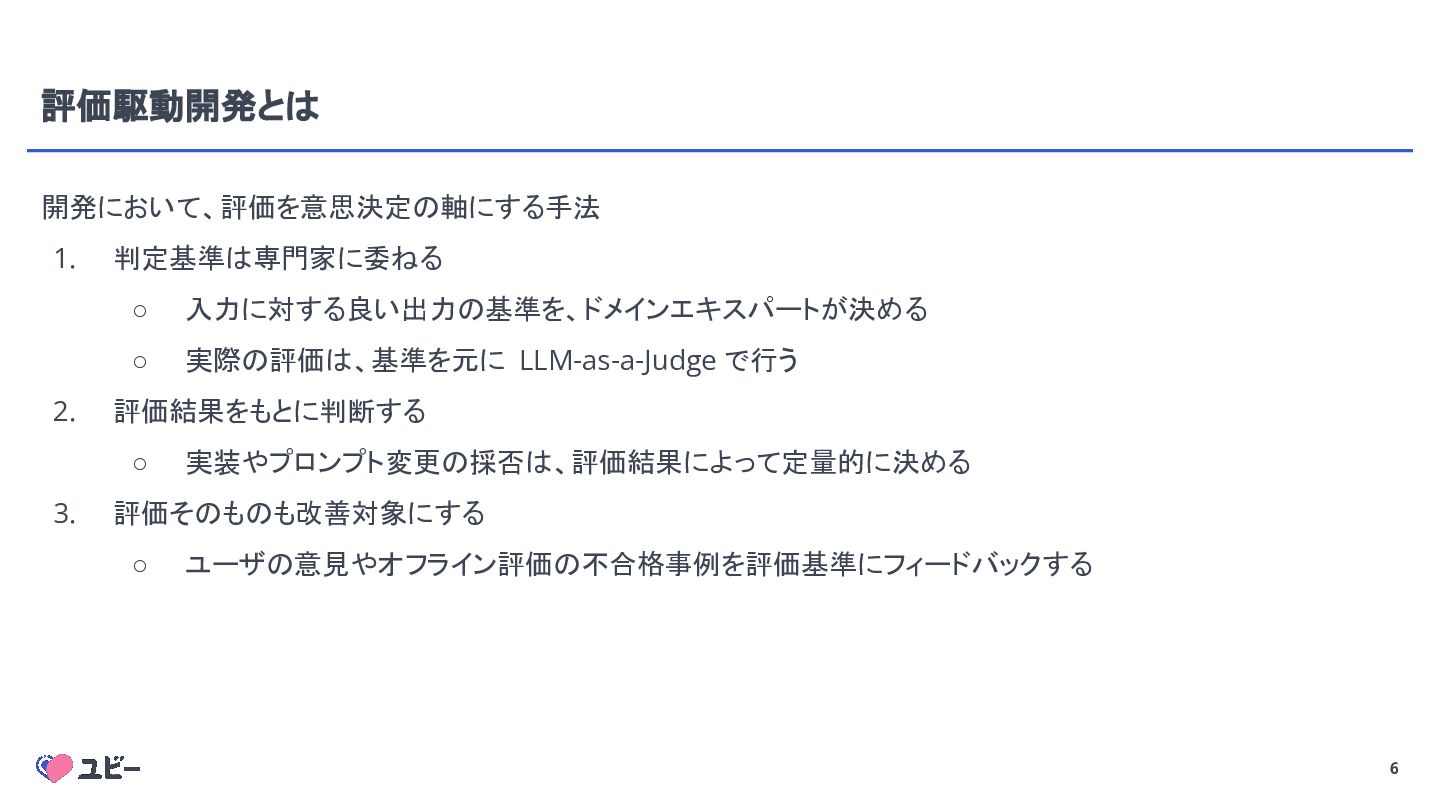
  3. 評価駆動開発とは 開発において、評価を意思決定の軸にする手法 1. 2. 判定基準は専門家に委ねる ◦ 入力に対する良い出力の基準を、ドメインエキスパートが決める ◦ 実際の評価は、基準を元に LLM-as-a-Judge

    で行う 評価結果をもとに判断する ◦ 3. 実装やプロンプト変更の採否は、評価結果によって定量的に決める 評価そのものも改善対象にする ◦ ユーザの意見やオフライン評価の不合格事例を評価基準にフィードバックする 6
  4. 評価を利用したユーザ体験の改善 • ゴールデンデータセットや、開発用 AI のための評価ハーネスに関しては用意できていた • メッセージを送信してから回答が始まるまでに時間がかかるのが課題だった • 評価をガードレールとして、品質を維持しつつ速度改善ができないか検証 ◦

    回答速度が改善しそうなテーマを、開発用 AI と壁打ちしつつ洗い出し ◦ ゴール設定し loop を回す ▪ 「各テーマをそれぞれ実装・評価して、品質を担保する評価性能を維持したうえで、回答速度が 改善しているか確認して。品質が悪化していれば棄却して」 10
  5. 改善の成果 • 結果 ◦ • 開発用 AI がボトルネックを特定し、速度改善につながった ▪ thinking

    budget のスイートスポットの発見 ▪ 外部の論文検索 API へのリクエスト並列化 成果 ◦ TTFT (p50)、TTFT (p95) いずれも約 1/3 に🚀 ◦ 速度改善しつつ品質スコアも維持 🔥 11
  6. まとめ • • 評価駆動開発 ◦ 開発において、評価を意思決定の軸にする手法 ◦ AI エージェントを安定的かつ効率的に開発できる 学び

    ◦ 開発用 AI 向けのプロンプトは、壁打ちしながら AI 自身に書いてもらうとよい ◦ 改修対象のコードベースやドキュメントを読み込ませる ◦ 「A という背景で B をしたい。C と考えているが、抜けている観点を指摘して。不明点は質問して」 ◦ 「ここまでの会話をふまえて、ゴールを設定して loop を回すためのプロンプトを書いて」 12