Upgrade to Pro — share decks privately, control downloads, hide ads and more …

RAGシステムの開発・研究の経験則

 RAGシステムの開発・研究の経験則

Avatar for Yuta Ojima

Yuta Ojima

March 23, 2025

Other Decks in Research

Transcript

  1. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo Contents 1.RAGの研究と現実 2.ナレッジグラフの構築 3.パイプラインの検討 4.評価手法 5.修士の研究を通じての反省 2
  2. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo スライドの目標・こちらから提供できること 目標 n RAG開発における処理の選択肢の提示 n RAGでやりたいことの明確化 こちらから提供できること n 修士の研究 (大体10ヶ月ほど) を通して実際に実装・実践した経験, 論 文調査などで得られた知見 n RAGの研究は非常に幅広いため, 私が全てを網羅できているわけでは ないことをご了承ください n 自分が実践, 研究した範囲はごく一部 3
  3. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 修士の研究内容をざっくりと GraphRAG (情報技術) × トラックの故障解析 (製造業) n 既存のナレッジグラフを用いたGraphRAGで, 専門性の高いトラックの 故障解析ができるか, 解析のために必要な処理は何かを研究 n トラックメーカーとの共同研究→独自の故障文書に書かれた情報の知識継承 n 新たなGraphRAGパイプライン, EdgeGraphRAGを提案 n 一定の有効性と現時点での課題を示した n 詳細は[1]を参照 4
  4. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

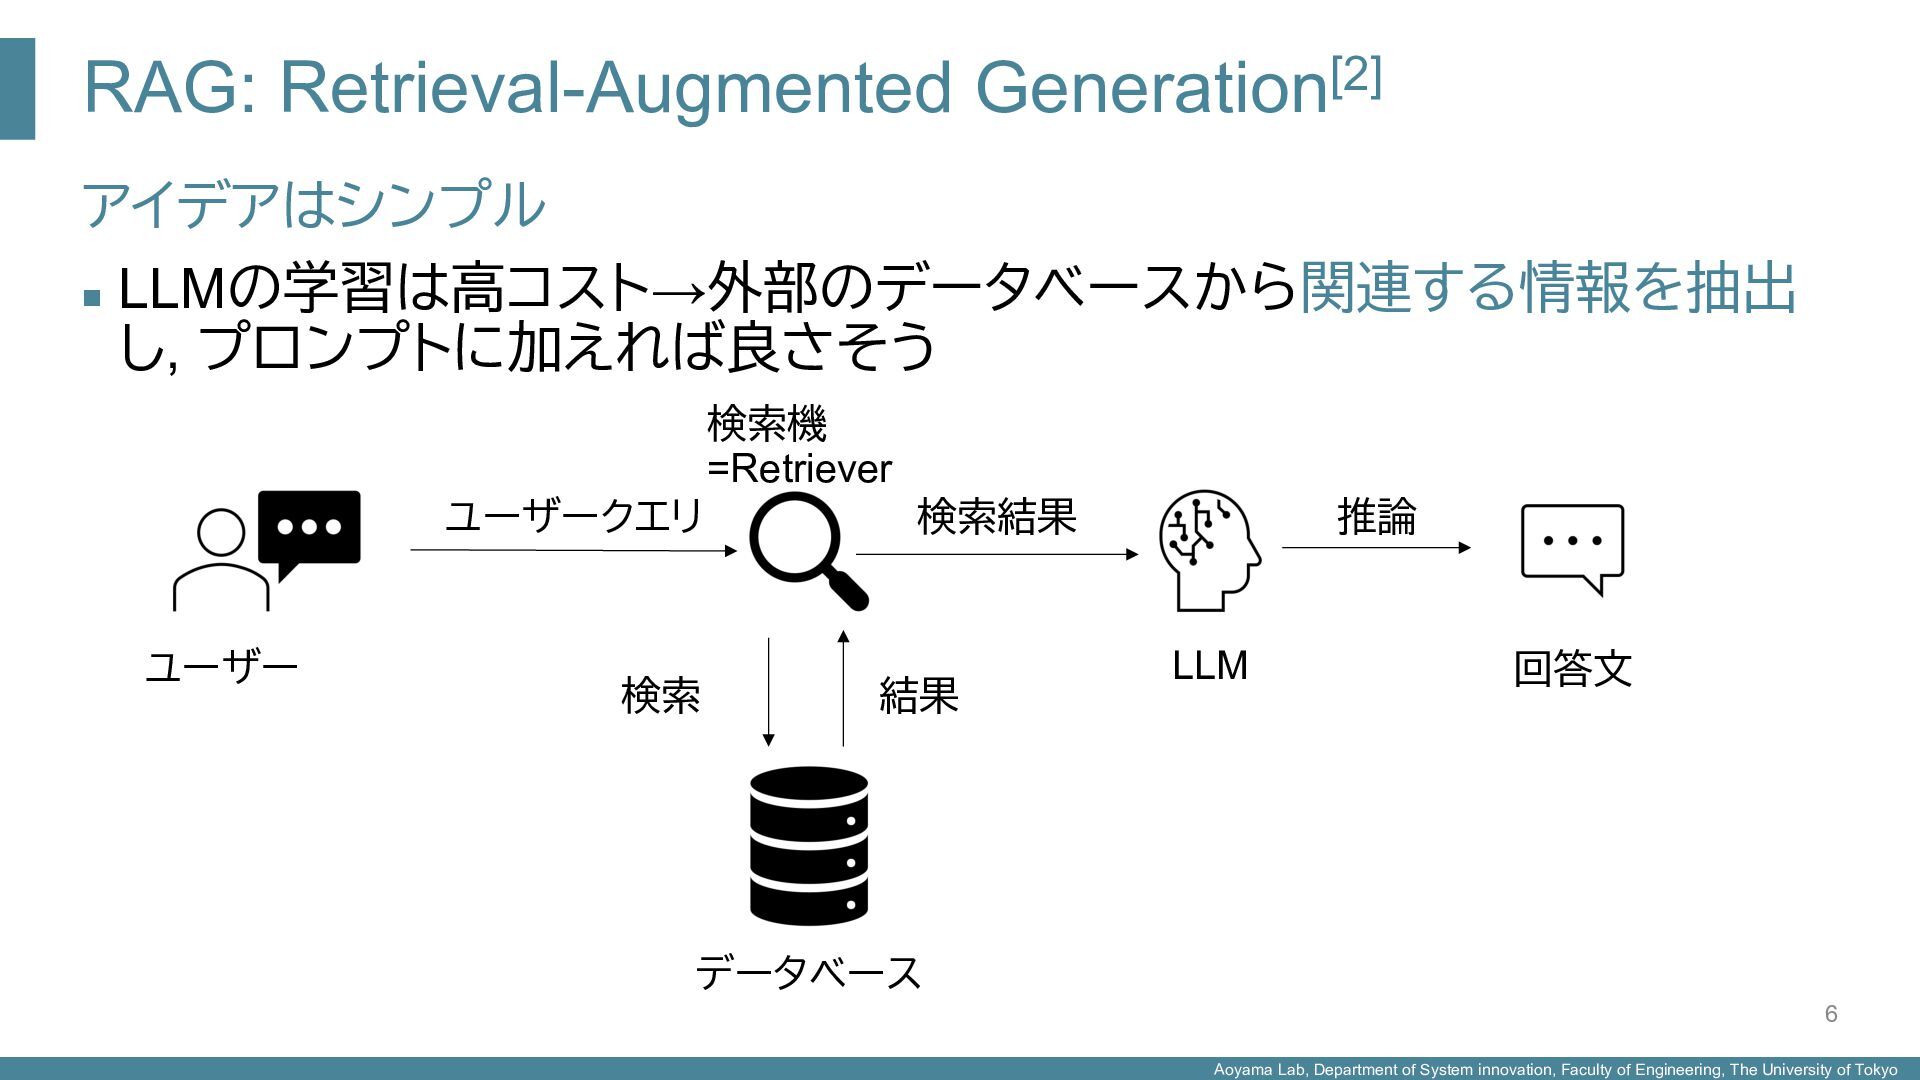
    University of Tokyo RAG: Retrieval-Augmented Generation[2] アイデアはシンプル n LLMの学習は高コスト→外部のデータベースから関連する情報を抽出 し, プロンプトに加えれば良さそう 6 ユーザー 検索機 =Retriever データベース LLM ユーザークエリ 検索 結果 検索結果 推論 回答文
  5. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

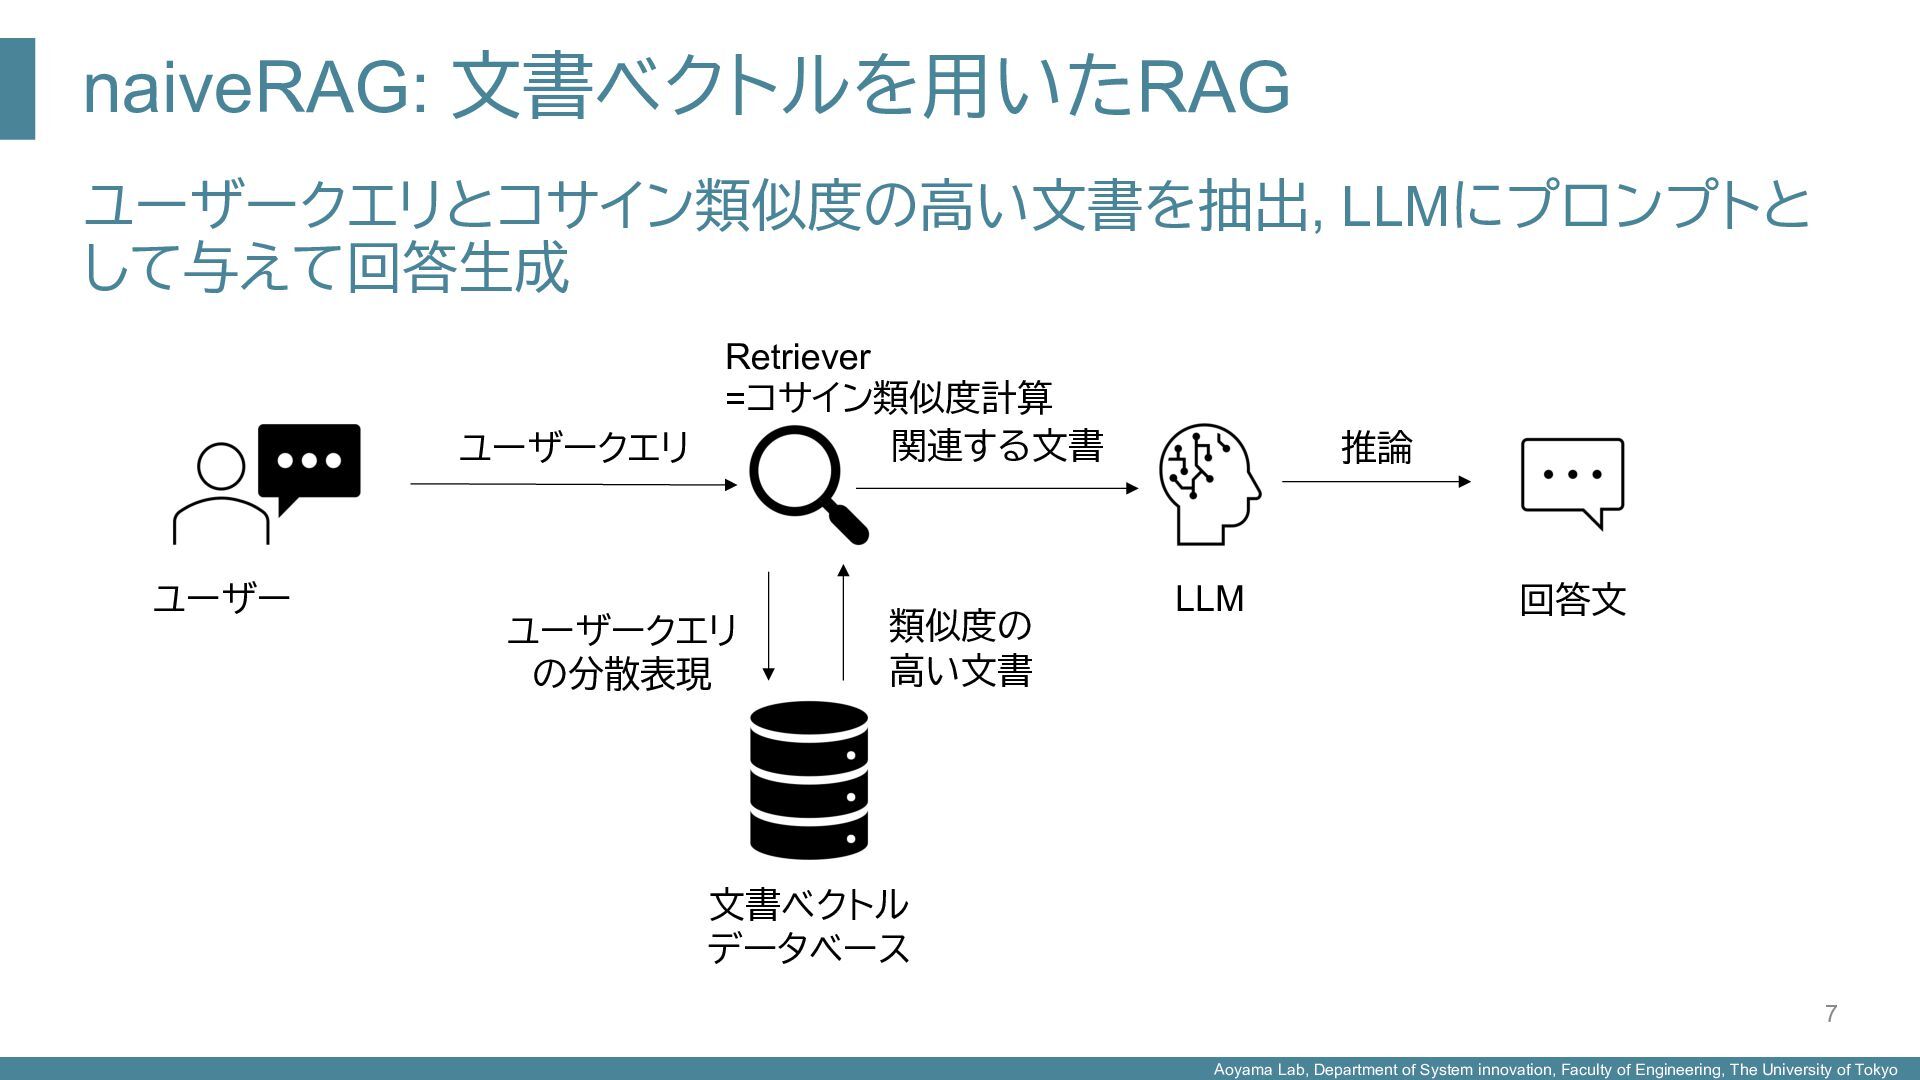
    University of Tokyo naiveRAG: 文書ベクトルを用いたRAG ユーザークエリとコサイン類似度の高い文書を抽出, LLMにプロンプトと して与えて回答生成 7 ユーザー Retriever =コサイン類似度計算 文書ベクトル データベース LLM ユーザークエリ ユーザークエリ の分散表現 類似度の 高い文書 関連する文書 推論 回答文
  6. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

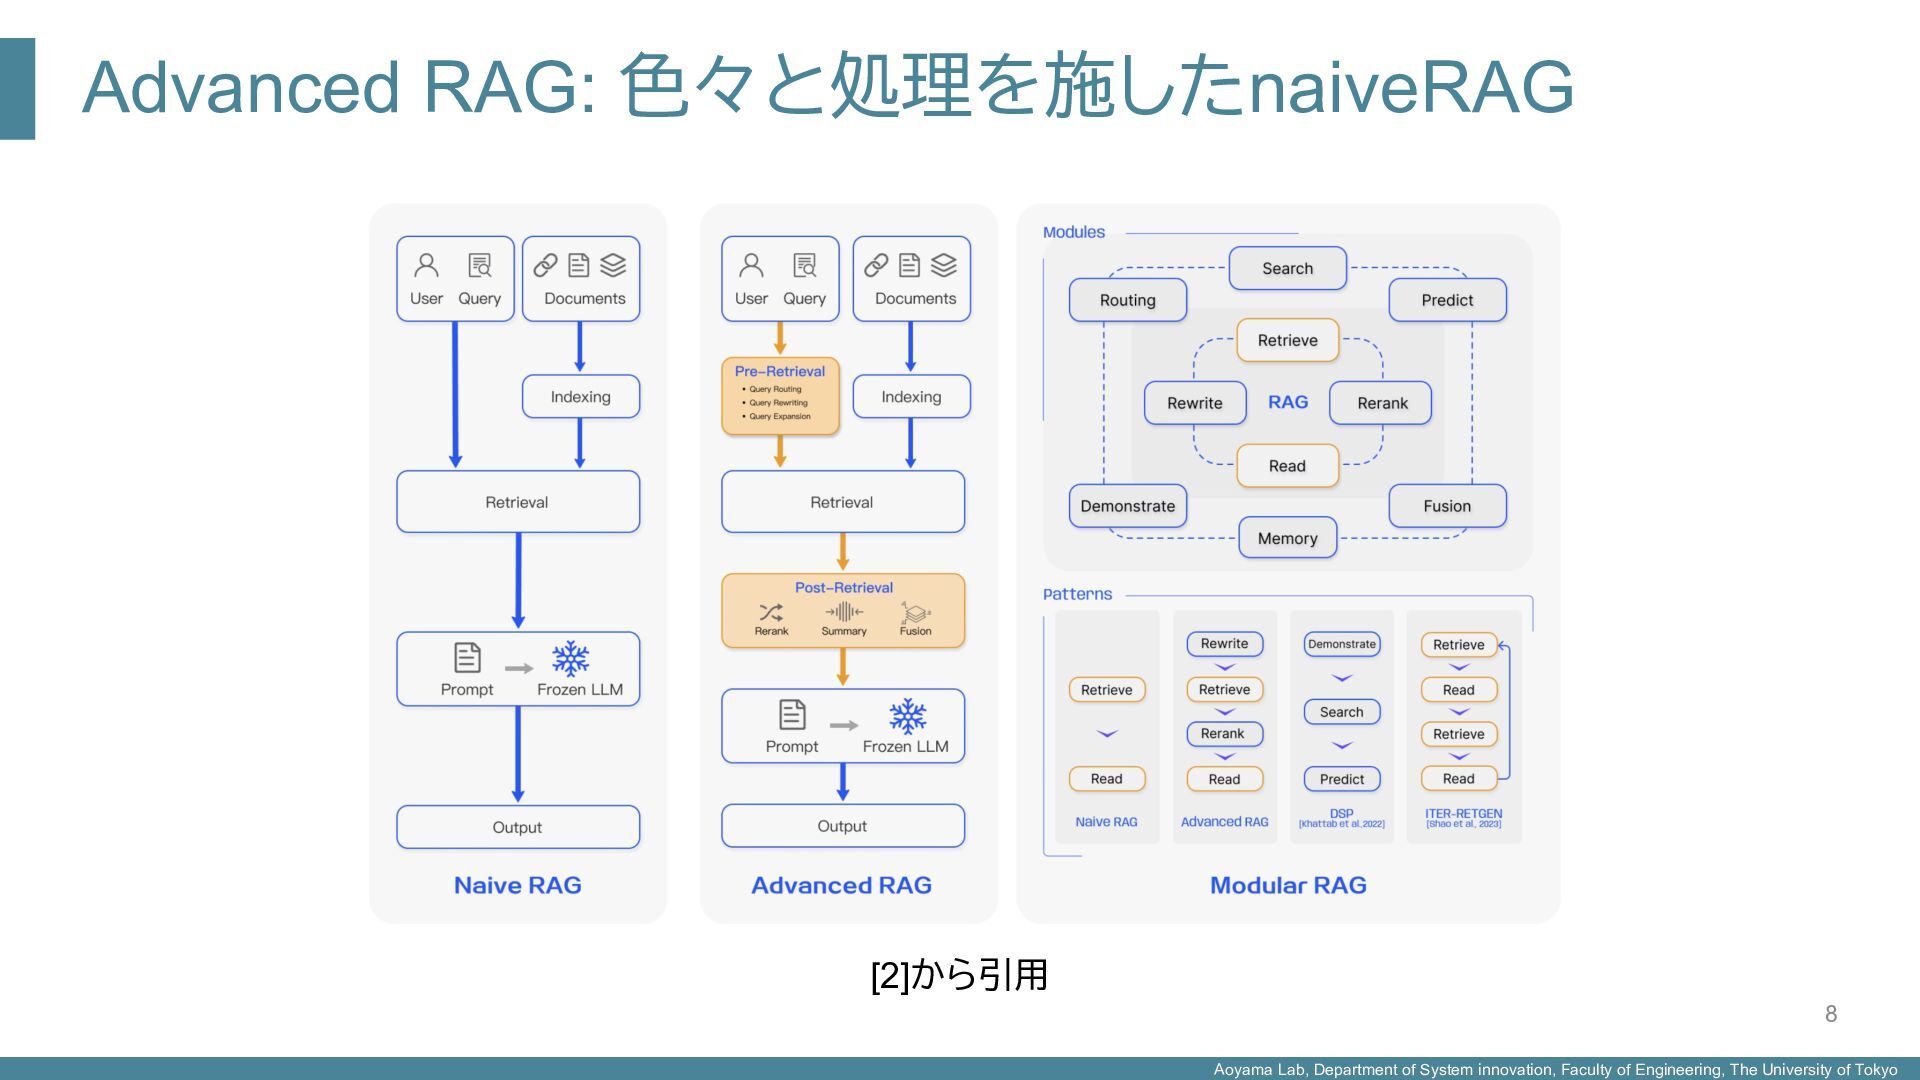
    University of Tokyo Advanced RAG: 色々と処理を施したnaiveRAG 8 [2]から引用
  7. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

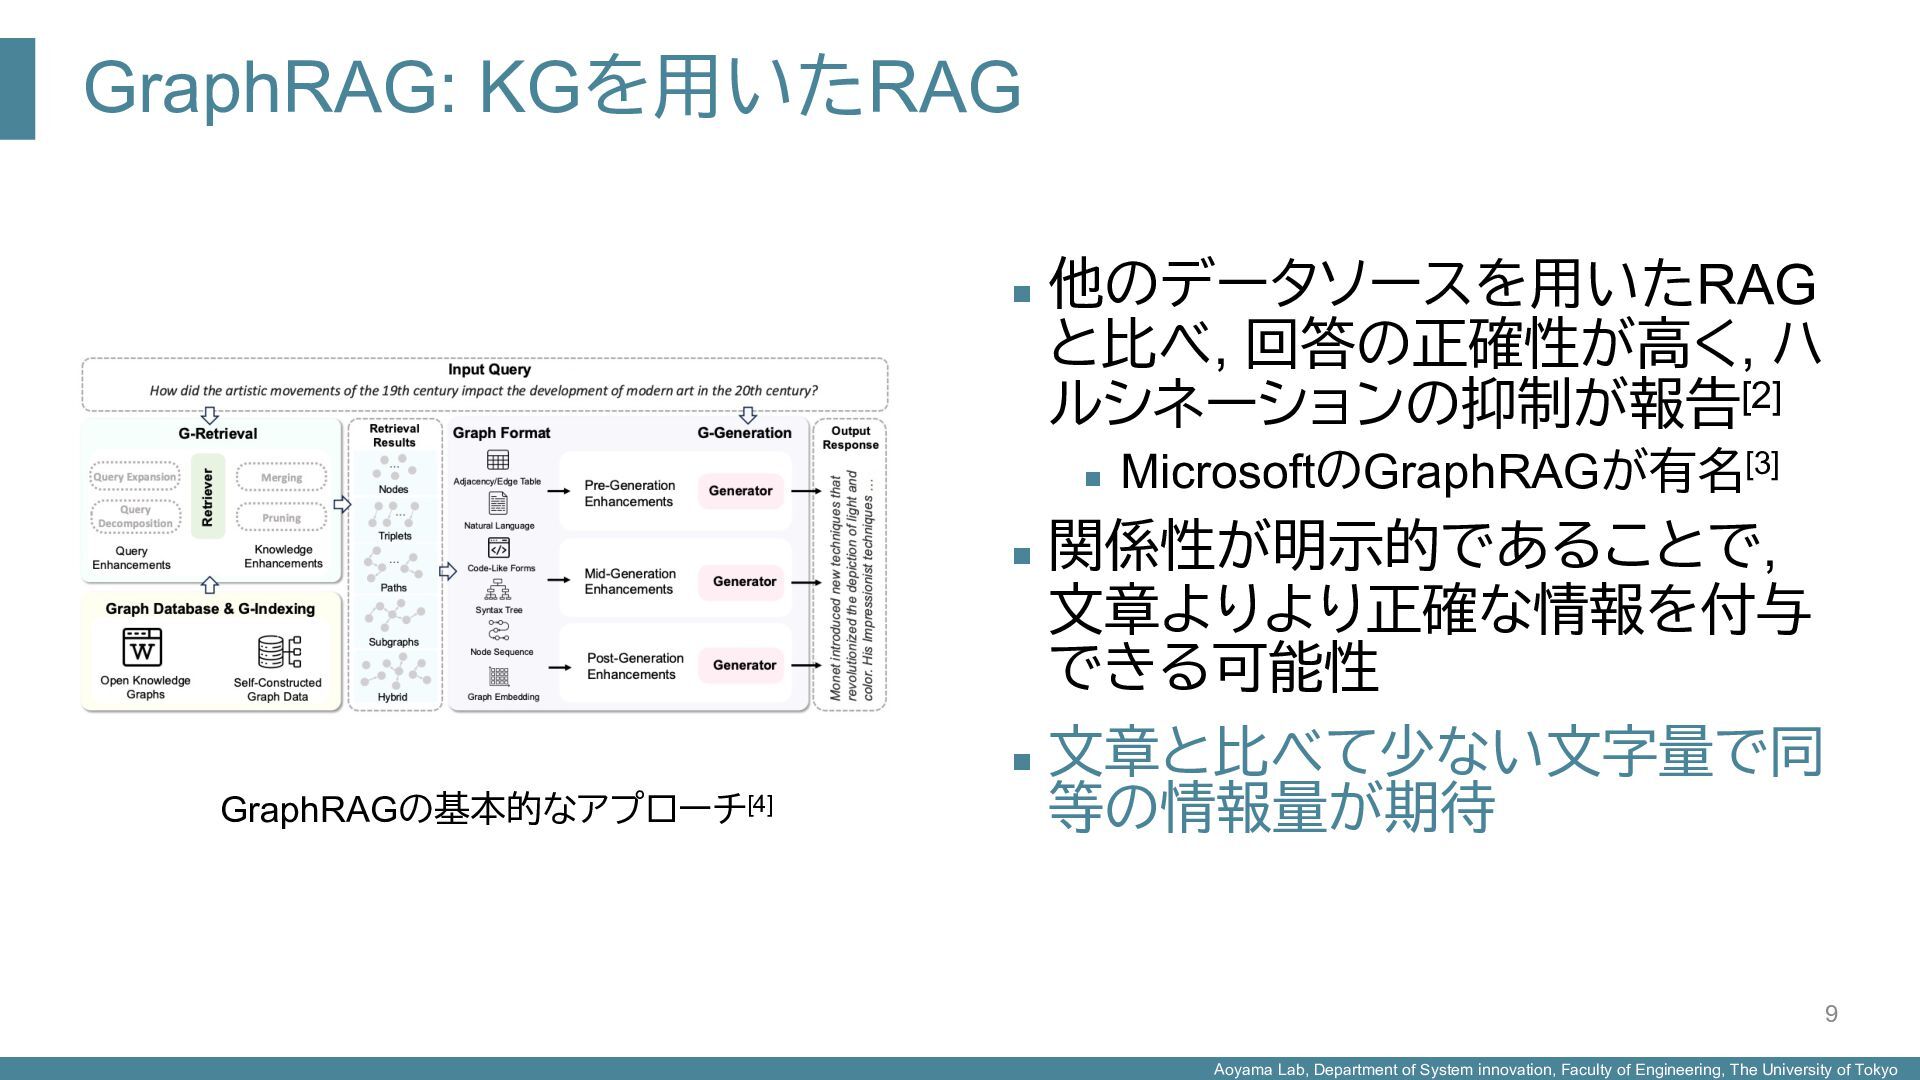
    University of Tokyo GraphRAG: KGを用いたRAG n 他のデータソースを用いたRAG と比べ, 回答の正確性が高く, ハ ルシネーションの抑制が報告[2] n MicrosoftのGraphRAGが有名[3] n 関係性が明示的であることで, 文章よりより正確な情報を付与 できる可能性 n 文章と比べて少ない文字量で同 等の情報量が期待 9 GraphRAGの基本的なアプローチ[4]
  8. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

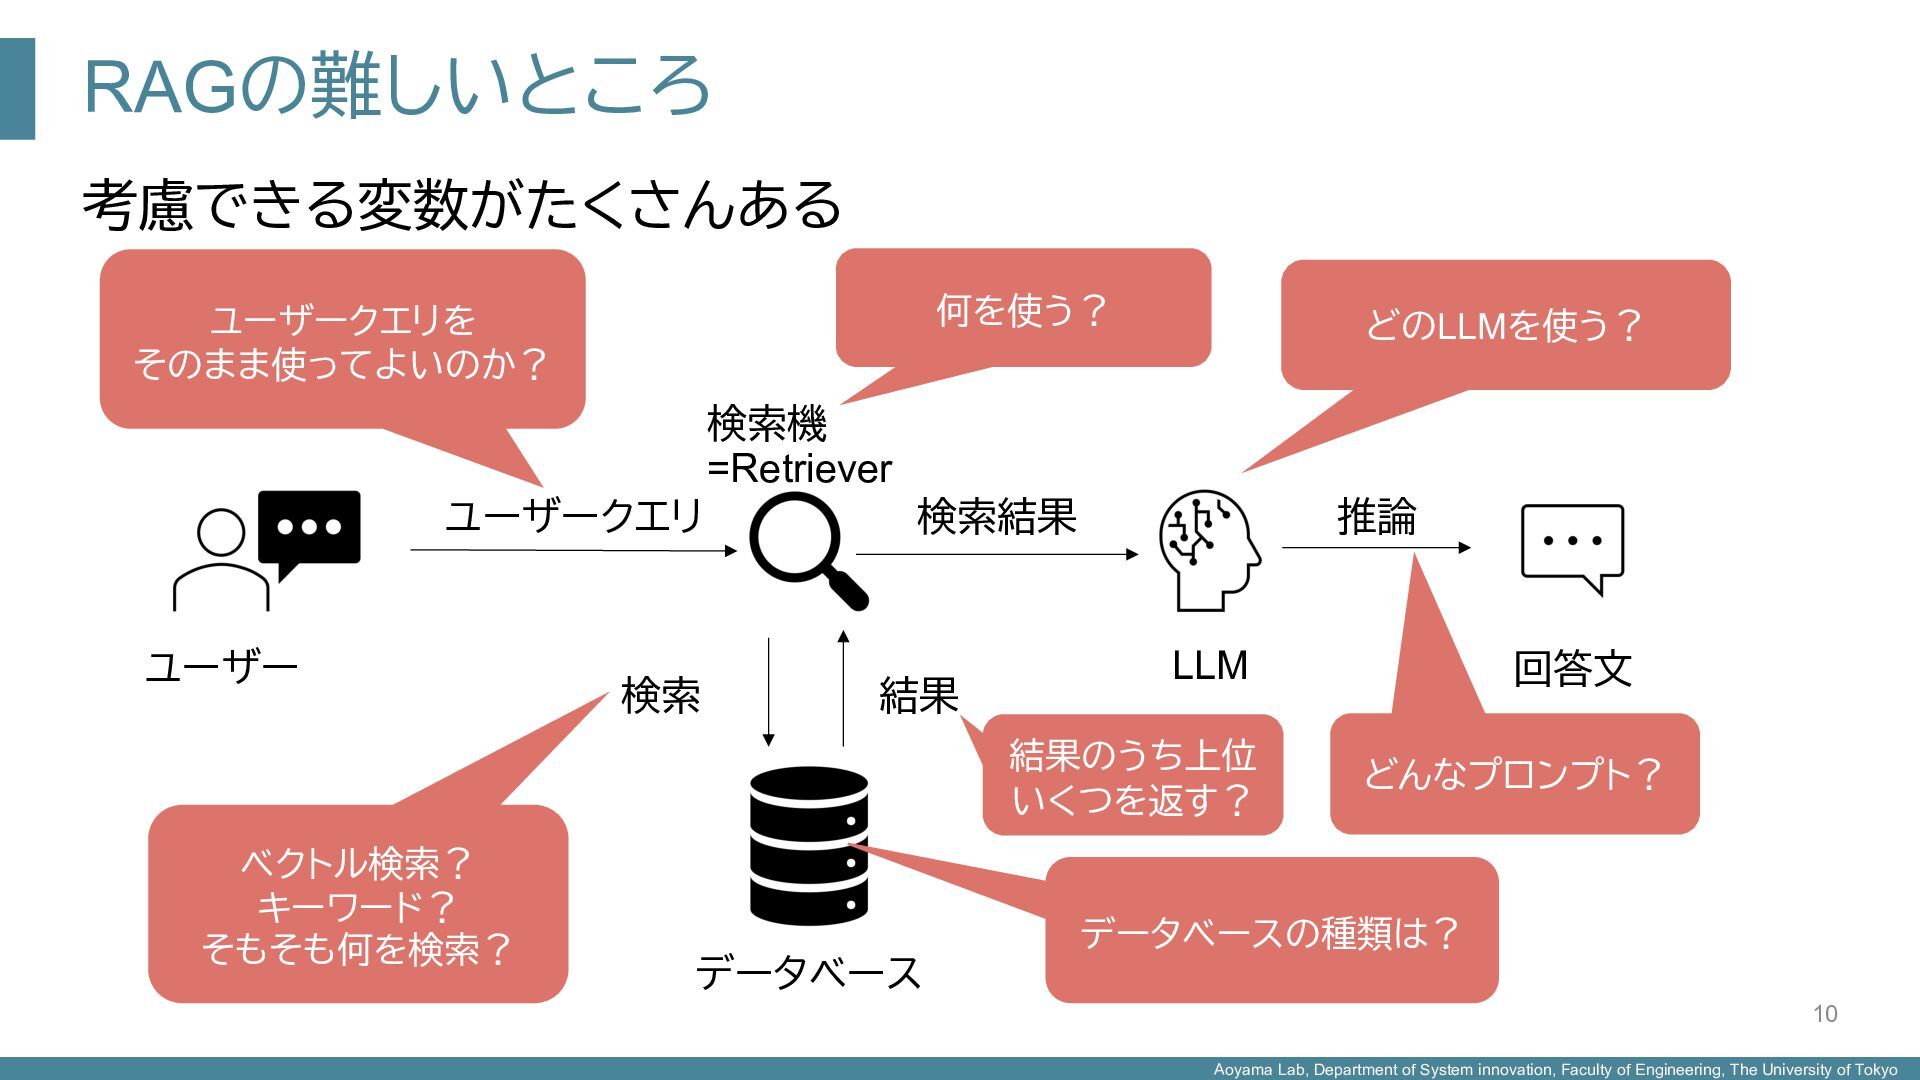
    University of Tokyo RAGの難しいところ 考慮できる変数がたくさんある 10 ユーザー 検索機 =Retriever データベース LLM ユーザークエリ 検索 結果 検索結果 推論 回答文 ユーザークエリを そのまま使ってよいのか? データベースの種類は? 何を使う? どんなプロンプト? ベクトル検索? キーワード? そもそも何を検索? 結果のうち上位 いくつを返す? どのLLMを使う?
  9. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo RAGの難しいところ n 変数が多いので, 精度向上のための検証対象も増える n 加えて, 何をもって精度が向上したかを見るべきかも難しい 残念ながら万能解がない項目→全てケースバイケースの話 n どういう処理をすれば最も効果的か? n データソースには何を用いるのが適切か? n RAGシステムによる生成文をどのように評価すればよいか? 11
  10. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

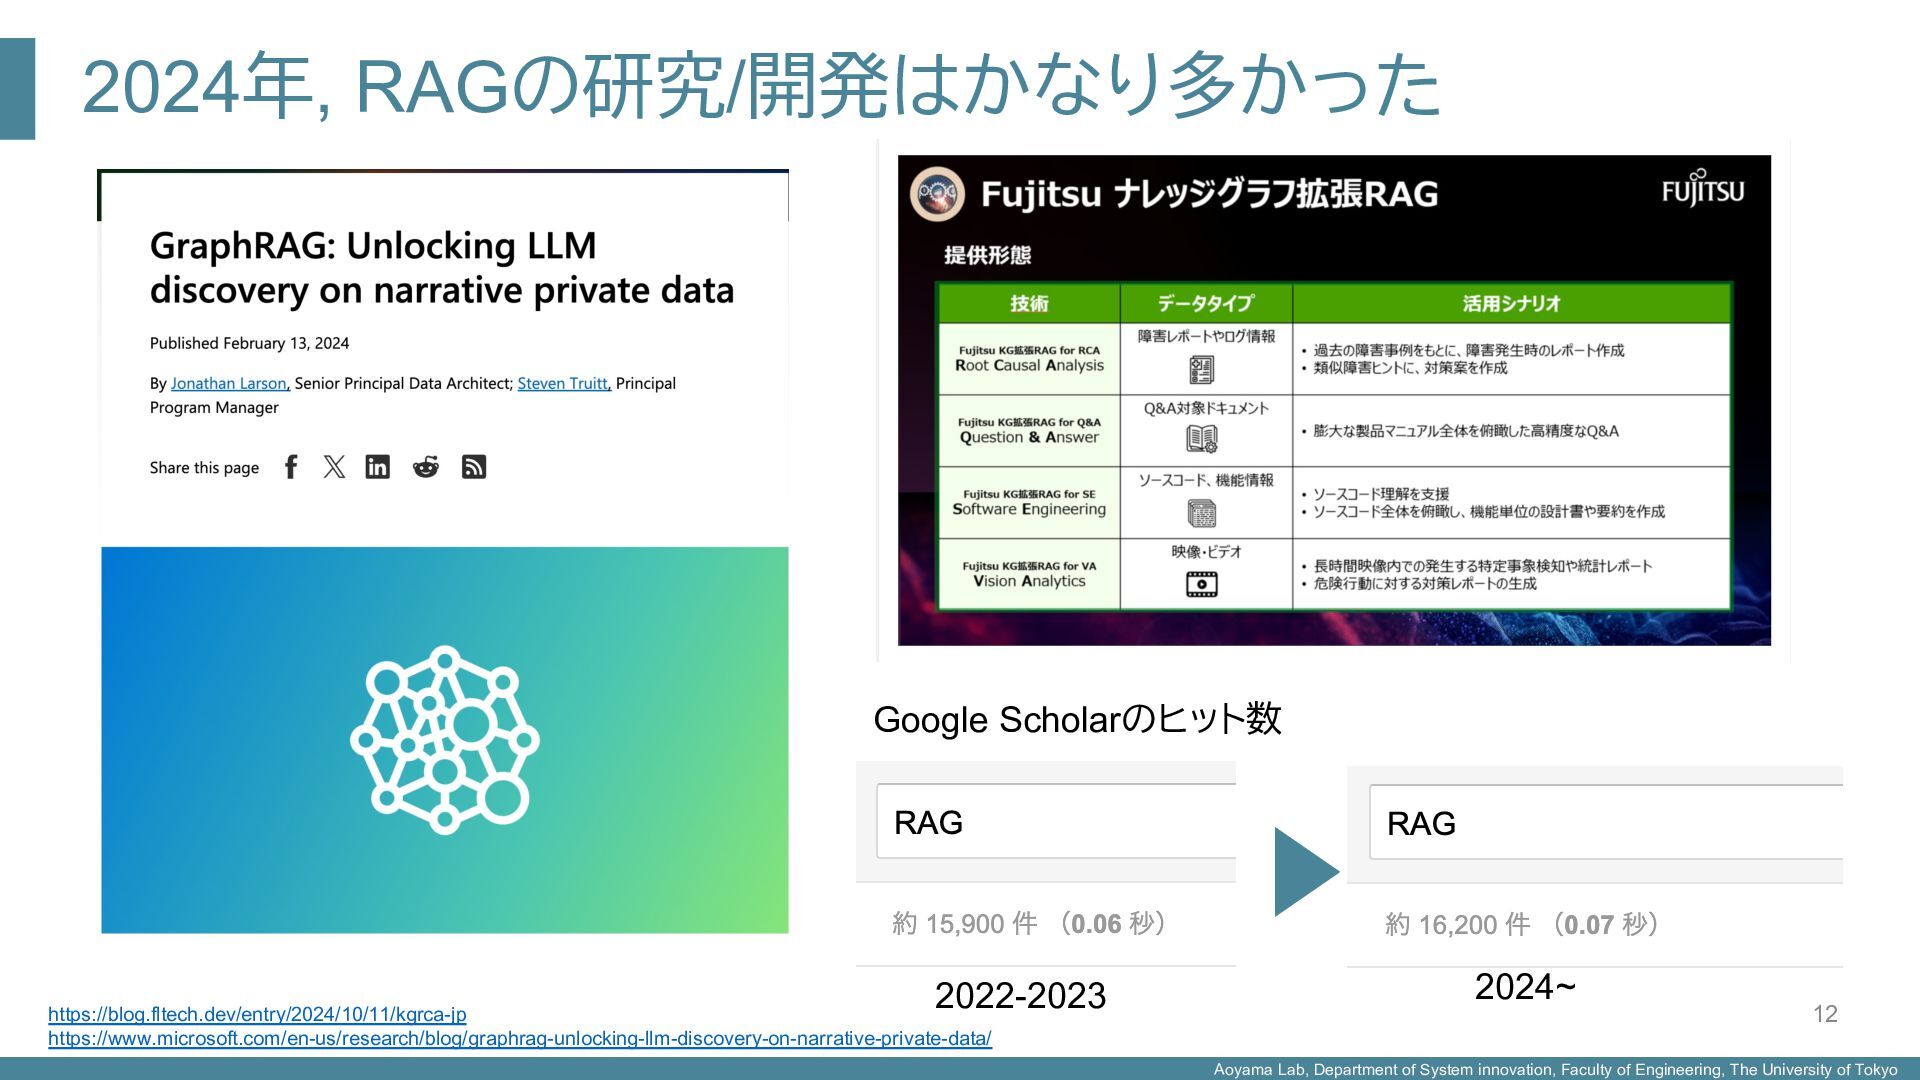
    University of Tokyo 2024年, RAGの研究/開発はかなり多かった 12 2022-2023 2024~ Google Scholarのヒット数 https://blog.fltech.dev/entry/2024/10/11/kgrca-jp https://www.microsoft.com/en-us/research/blog/graphrag-unlocking-llm-discovery-on-narrative-private-data/
  11. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

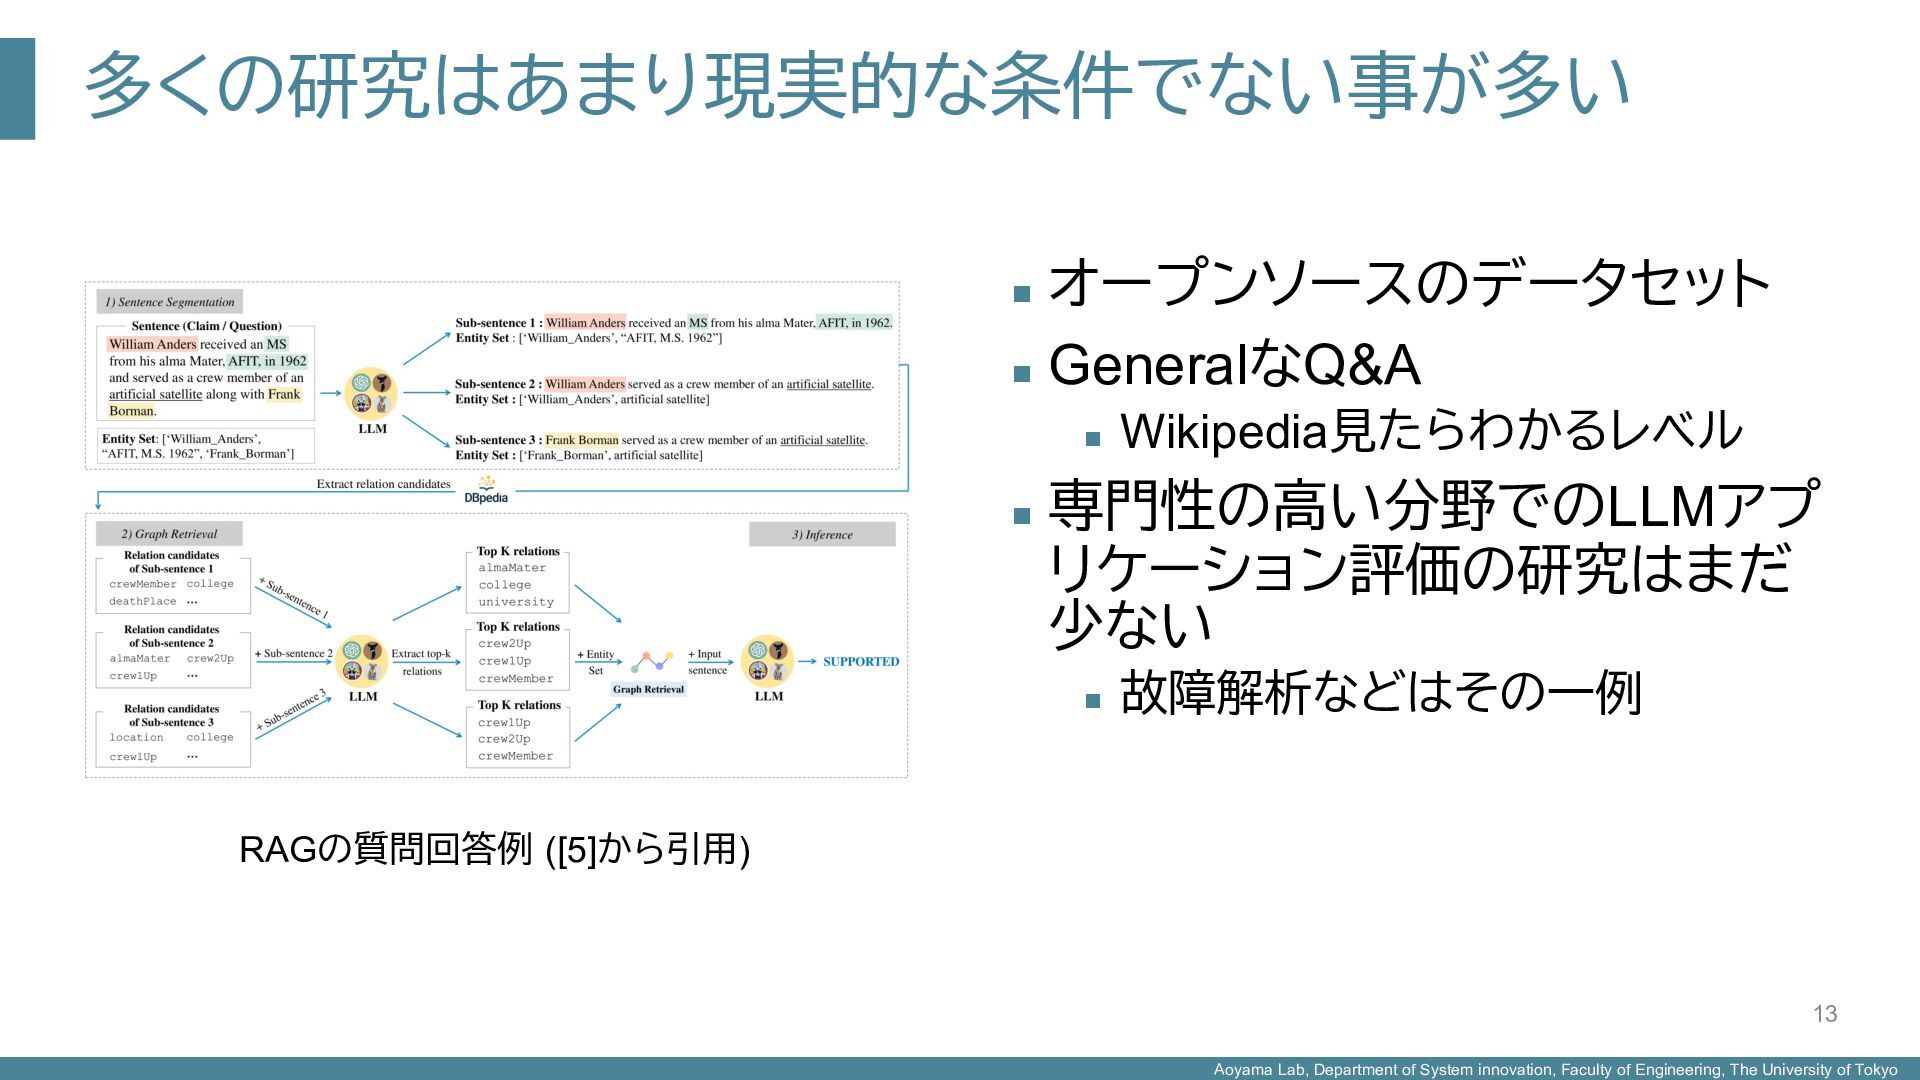
    University of Tokyo 多くの研究はあまり現実的な条件でない事が多い n オープンソースのデータセット n GeneralなQ&A n Wikipedia見たらわかるレベル n 専門性の高い分野でのLLMアプ リケーション評価の研究はまだ 少ない n 故障解析などはその一例 13 RAGの質問回答例 ([5]から引用)
  12. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 現実的でない≠使えない RAGのパイプラインに組み込む選択肢は豊富にある n 状況に応じてどんな処理が精度向上に寄与しそうかを選別し, 組み込 むのが大事 余談) 専門的, 企業独自の領域の話でRAGを研究するのは, 論文として は書きにくい n 元のデータがオープンデータではないので, 再現性が難しい 14
  13. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 用語の整理 n LLM: 大規模言語モデル, Large Language Model, 生成AI n DB: データベース n KG: ナレッジグラフ, Knowledge Graph n ユーザークエリ: ユーザーから送信されたプロンプト n パイプライン: RAGシステム一連の処理の流れ n NLP: 自然言語処理, Natural Language Processing 15
  14. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

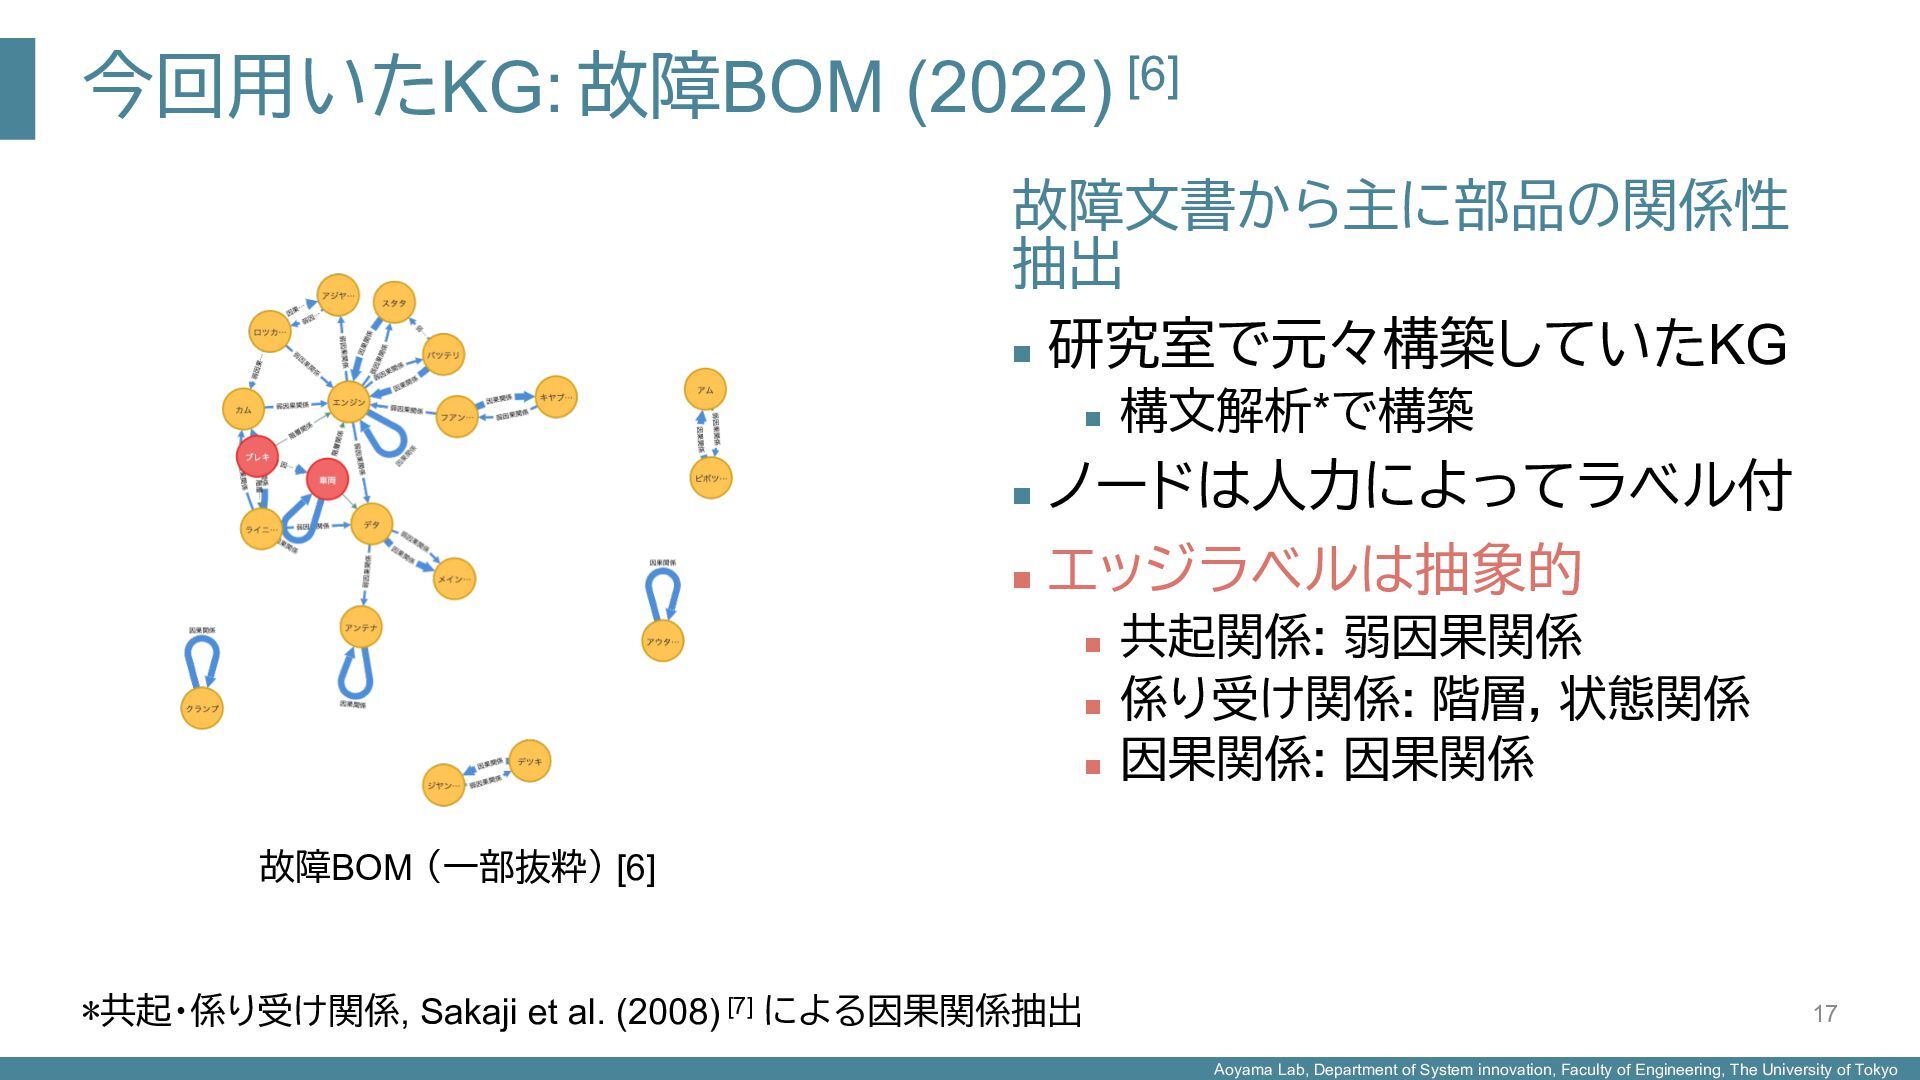
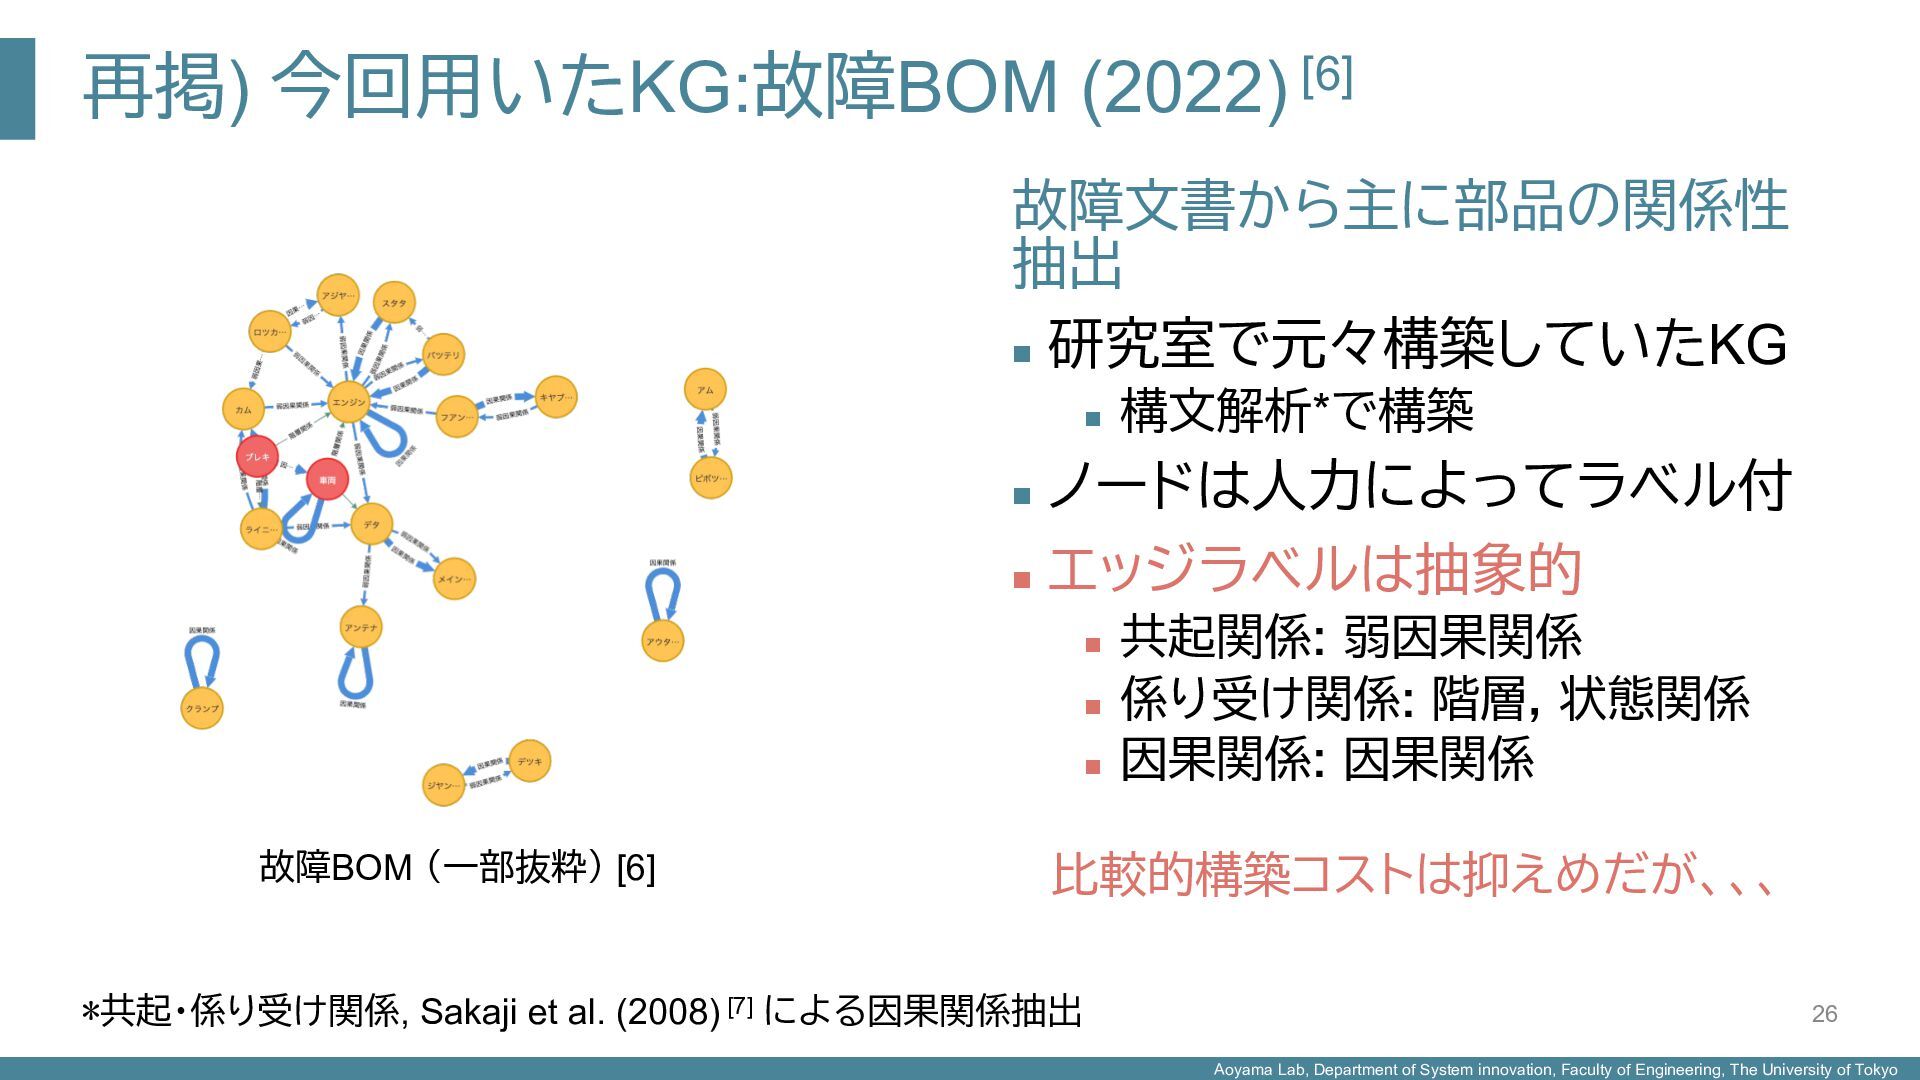
    University of Tokyo 今回用いたKG: 故障BOM (2022) [6] 故障文書から主に部品の関係性 抽出 n 研究室で元々構築していたKG n 構文解析*で構築 n ノードは人力によってラベル付 n エッジラベルは抽象的 n 共起関係: 弱因果関係 n 係り受け関係: 階層, 状態関係 n 因果関係: 因果関係 17 故障BOM (一部抜粋) [6] *共起・係り受け関係, Sakaji et al. (2008) [7] による因果関係抽出
  15. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

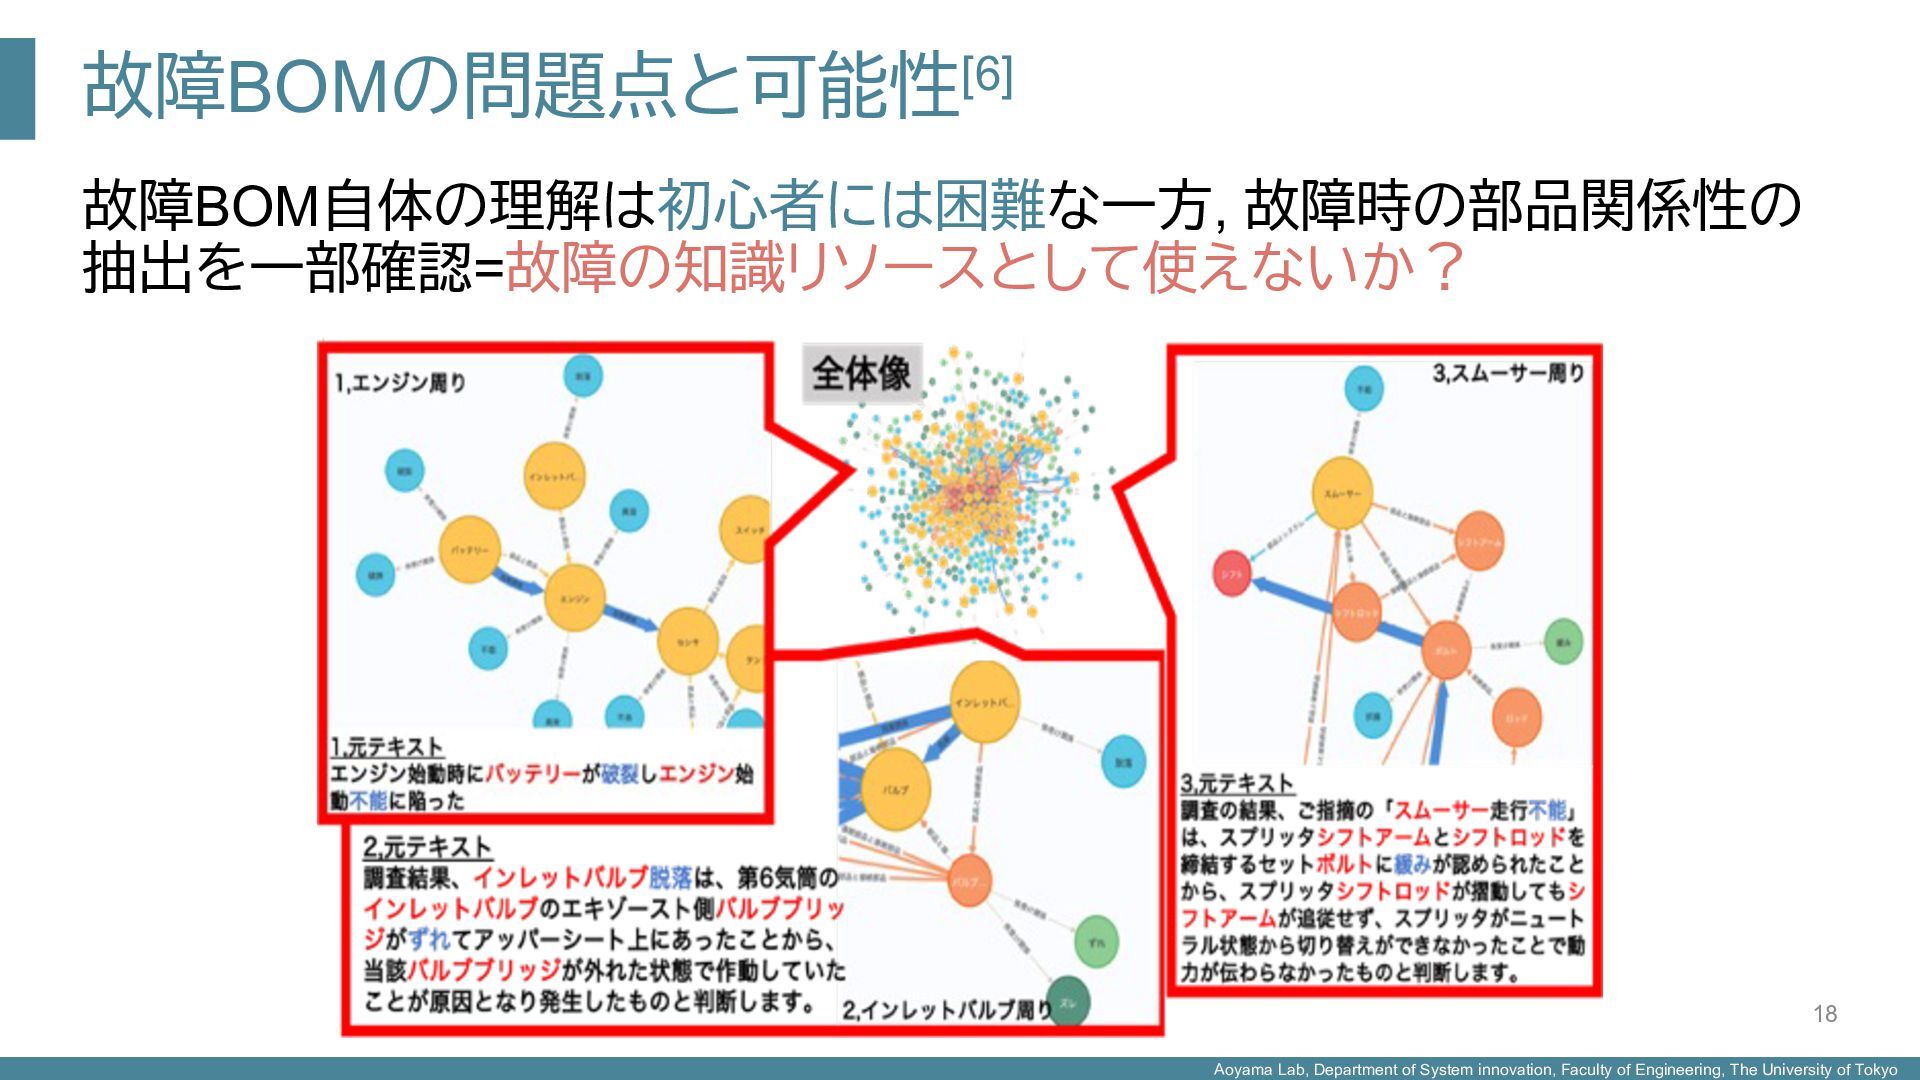
    University of Tokyo 故障BOMの問題点と可能性[6] 故障BOM自体の理解は初心者には困難な一方, 故障時の部品関係性の 抽出を一部確認=故障の知識リソースとして使えないか? 18
  16. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo やったこと エッジの具体性を増すことはひとまず必要 n 関係こそが知識である! n とはいえ, KGにおいて考えられるエッジはかなり多いはず n オントロジー関連の研究でよく詰まる原因は考えられるエッジの多さ →LLMで出力できないか? n 加えて, サブグラフのフィルタリングにベクトルを用いたい →トリプル単位で分散表現の埋め込み 19
  17. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

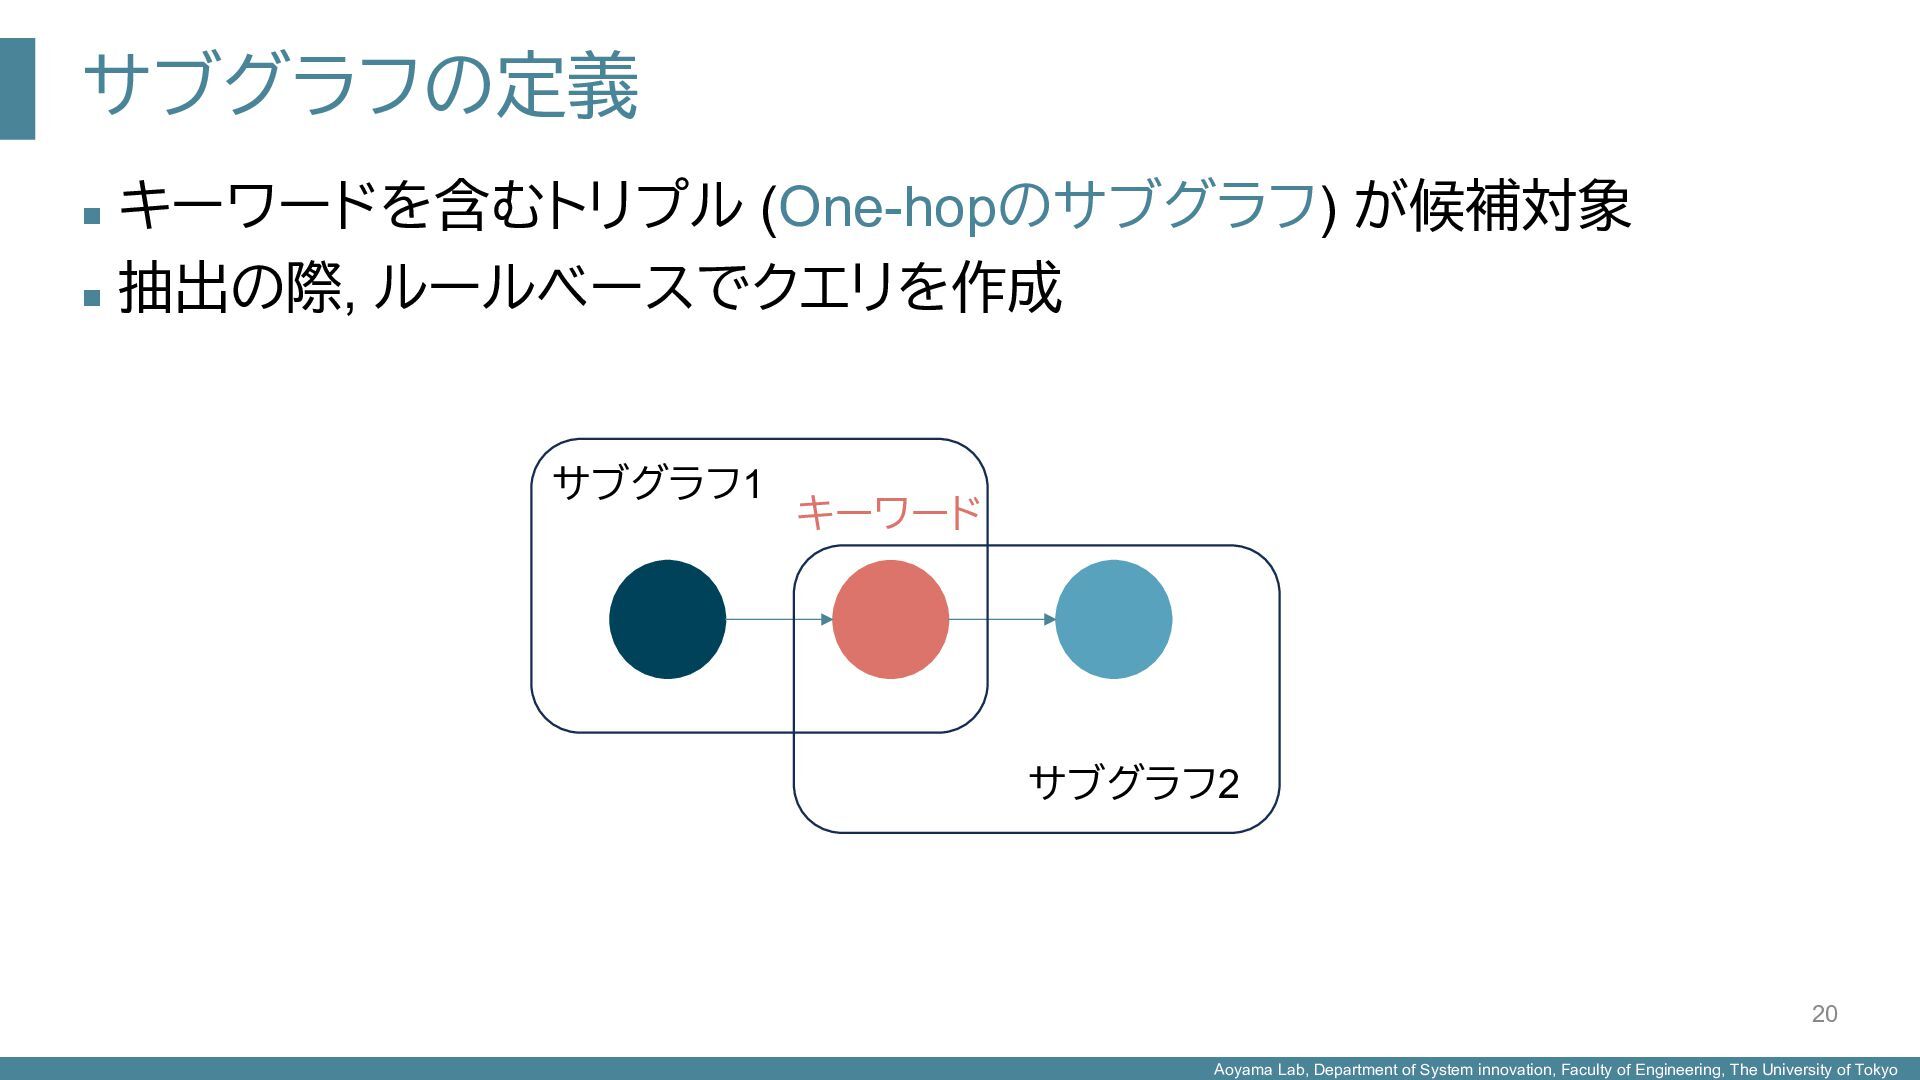
    University of Tokyo サブグラフの定義 n キーワードを含むトリプル (One-hopのサブグラフ) が候補対象 n 抽出の際, ルールベースでクエリを作成 20 キーワード サブグラフ1 サブグラフ2
  18. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

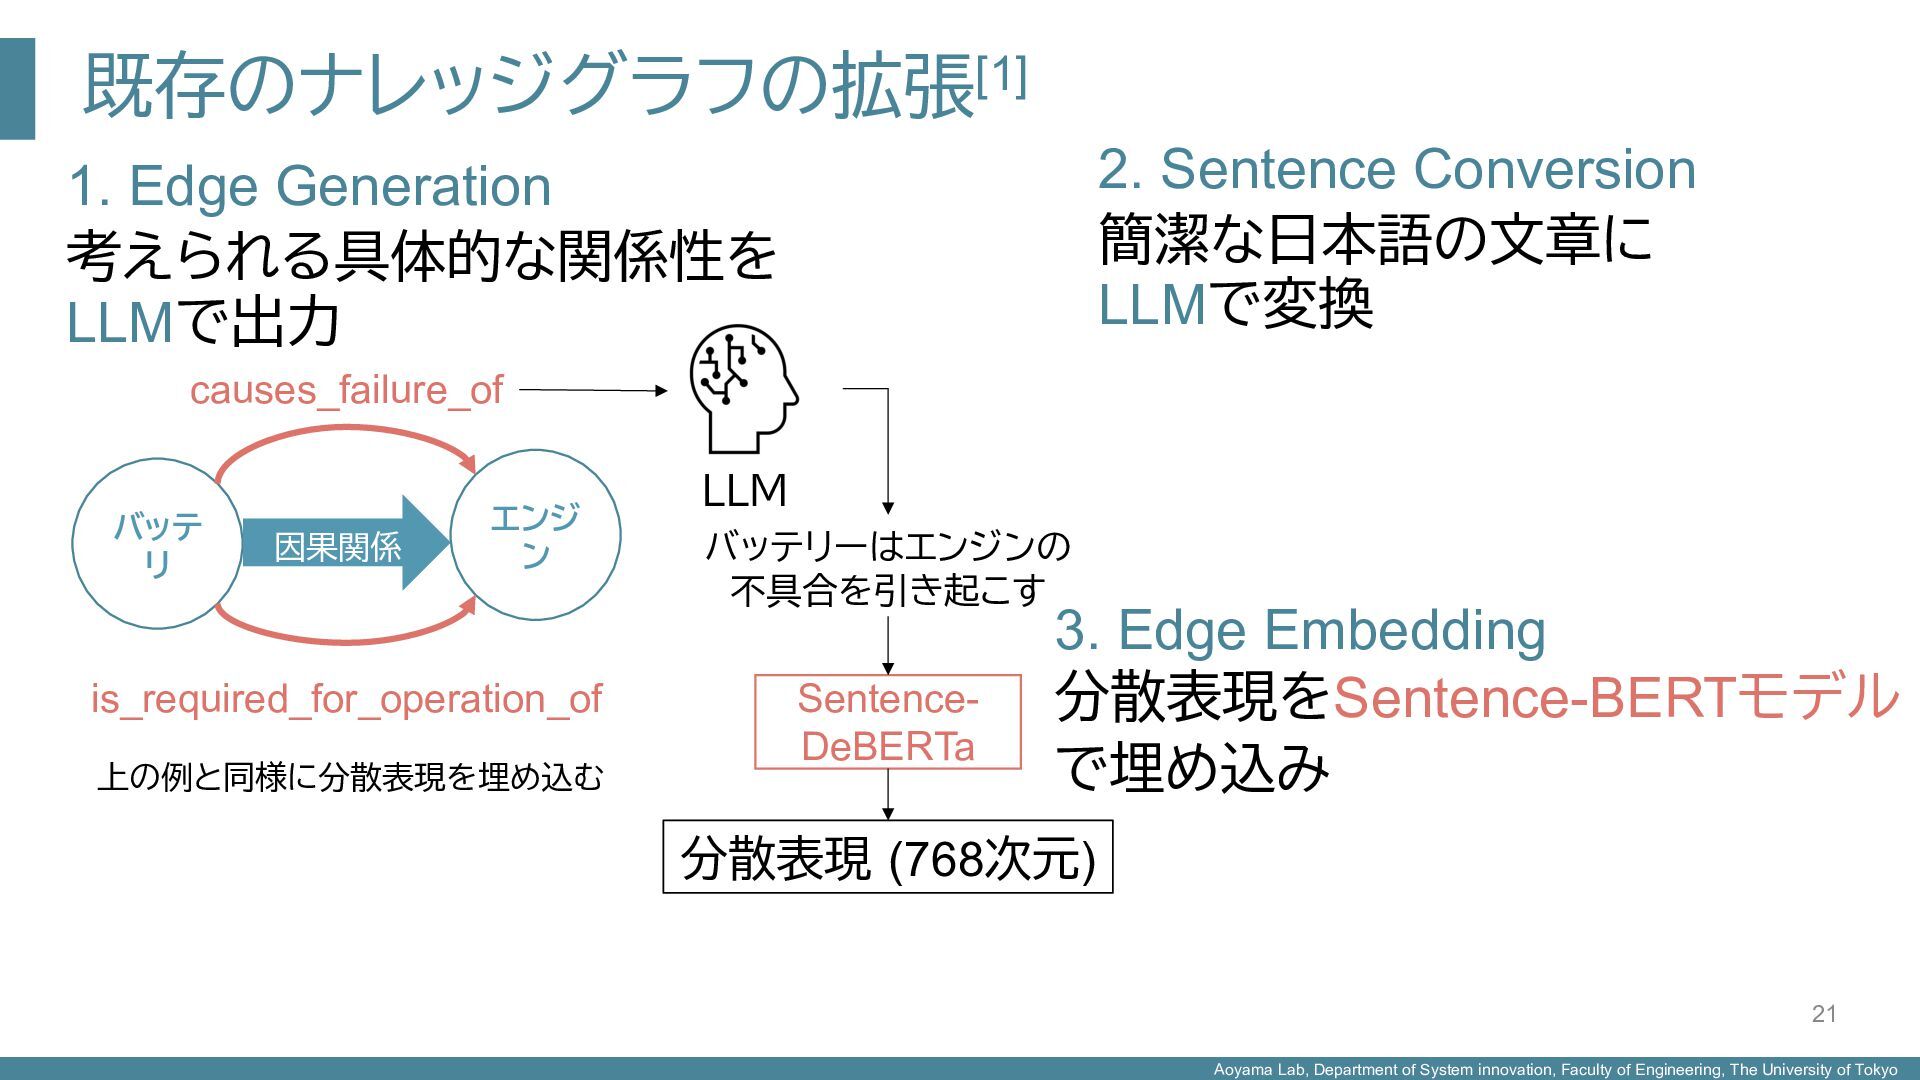
    University of Tokyo 既存のナレッジグラフの拡張[1] 21 バッテ リ エンジ ン 因果関係 causes_failure_of is_required_for_operation_of バッテリーはエンジンの 不具合を引き起こす LLM 2. Sentence Conversion 簡潔な日本語の文章に LLMで変換 1. Edge Generation 考えられる具体的な関係性を LLMで出力 Sentence- DeBERTa 分散表現 (768次元) 上の例と同様に分散表現を埋め込む 3. Edge Embedding 分散表現をSentence-BERTモデル で埋め込み
  19. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

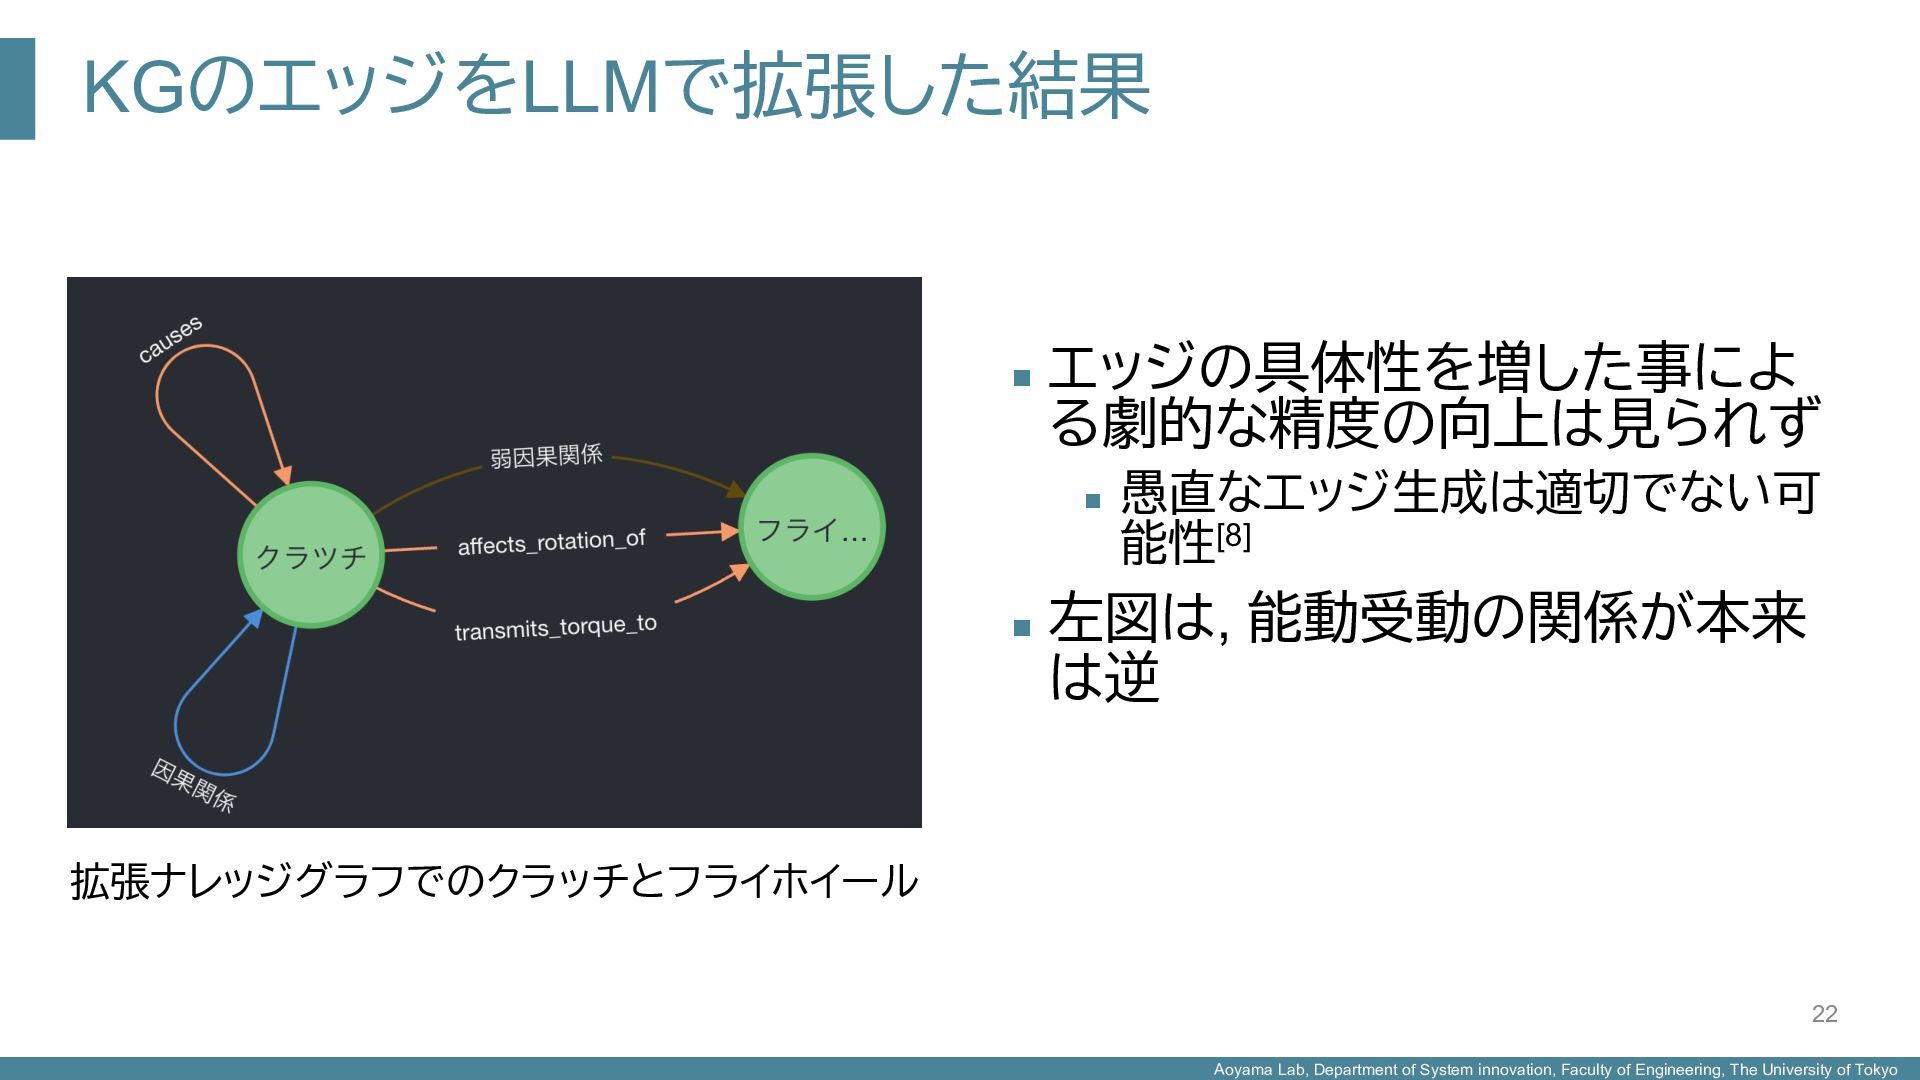
    University of Tokyo KGのエッジをLLMで拡張した結果 n エッジの具体性を増した事によ る劇的な精度の向上は見られず n 愚直なエッジ生成は適切でない可 能性[8] n 左図は, 能動受動の関係が本来 は逆 22 拡張ナレッジグラフでのクラッチとフライホイール
  20. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 過去のQA 質問 n エッジを具体的にする際, 元の故障文書は参照しなかったのか? 回答 n 参照しなかった n 具体的な関係性生成の際, プロンプトに含めるのは一つの手 n 一方で, それでやるとただ文章をグラフデータに変換しただけのように なることが多く, 知識と言うには厳しい場合を予備実験で観測 n ナレッジグラフという観点からは, あまり得策とは言えない 23
  21. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 過去のQA 質問 n キーワード検索とベクトル検索で社内の技術文章の検索と要約する RAGのPOCを行っているが、検索および要約の精度が悪いという課題 がある。ナレッジグラフを併用すると、RAG精度が向上する可能性はあ るか? 回答 n KGと文書の組み合わせで精度が向上する研究は存在[9] n 精度向上は十分に見込める, ただしKGの構築は高難易度 24
  22. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

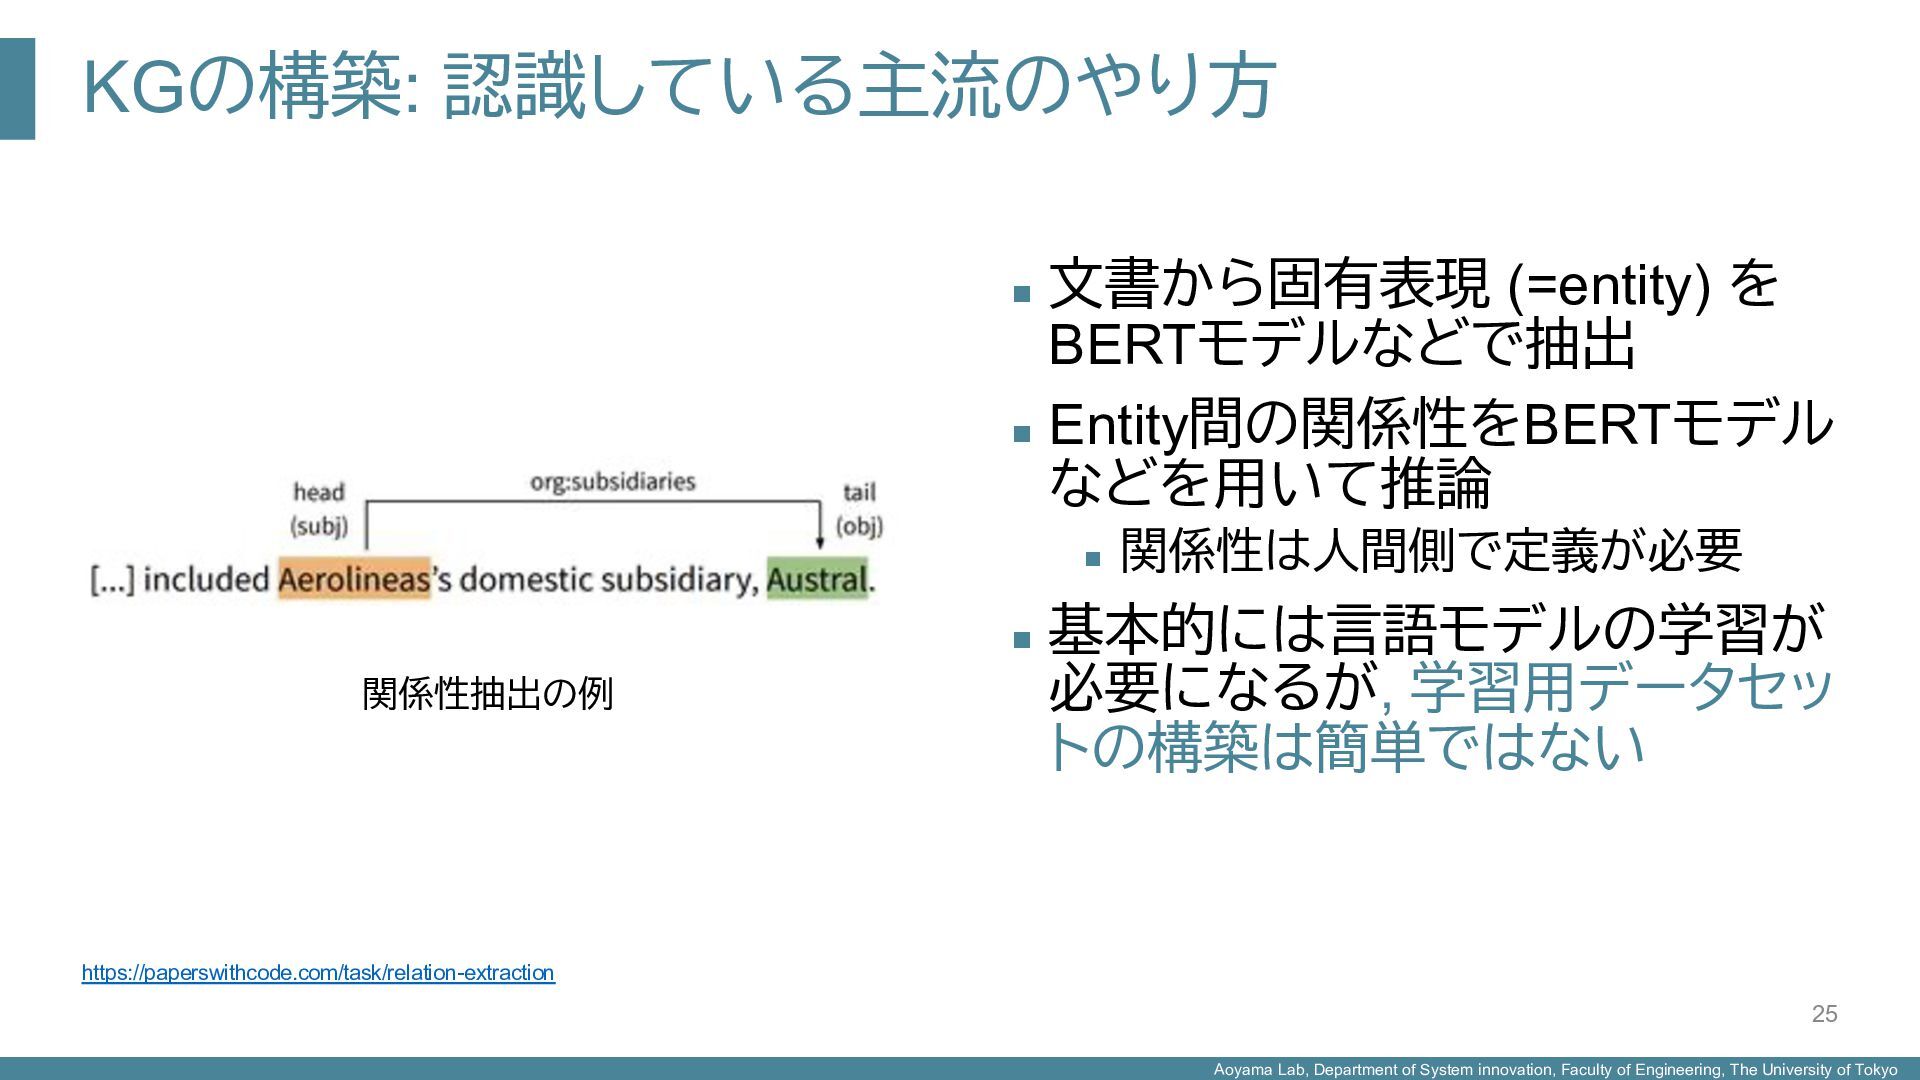
    University of Tokyo KGの構築: 認識している主流のやり方 n 文書から固有表現 (=entity) を BERTモデルなどで抽出 n Entity間の関係性をBERTモデル などを用いて推論 n 関係性は人間側で定義が必要 n 基本的には言語モデルの学習が 必要になるが, 学習用データセッ トの構築は簡単ではない 25 関係性抽出の例 https://paperswithcode.com/task/relation-extraction
  23. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 再掲) 今回用いたKG:故障BOM (2022) [6] 故障文書から主に部品の関係性 抽出 n 研究室で元々構築していたKG n 構文解析*で構築 n ノードは人力によってラベル付 n エッジラベルは抽象的 n 共起関係: 弱因果関係 n 係り受け関係: 階層, 状態関係 n 因果関係: 因果関係 26 故障BOM (一部抜粋) [6] *共起・係り受け関係, Sakaji et al. (2008) [7] による因果関係抽出 比較的構築コストは抑えめだが、、、
  24. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

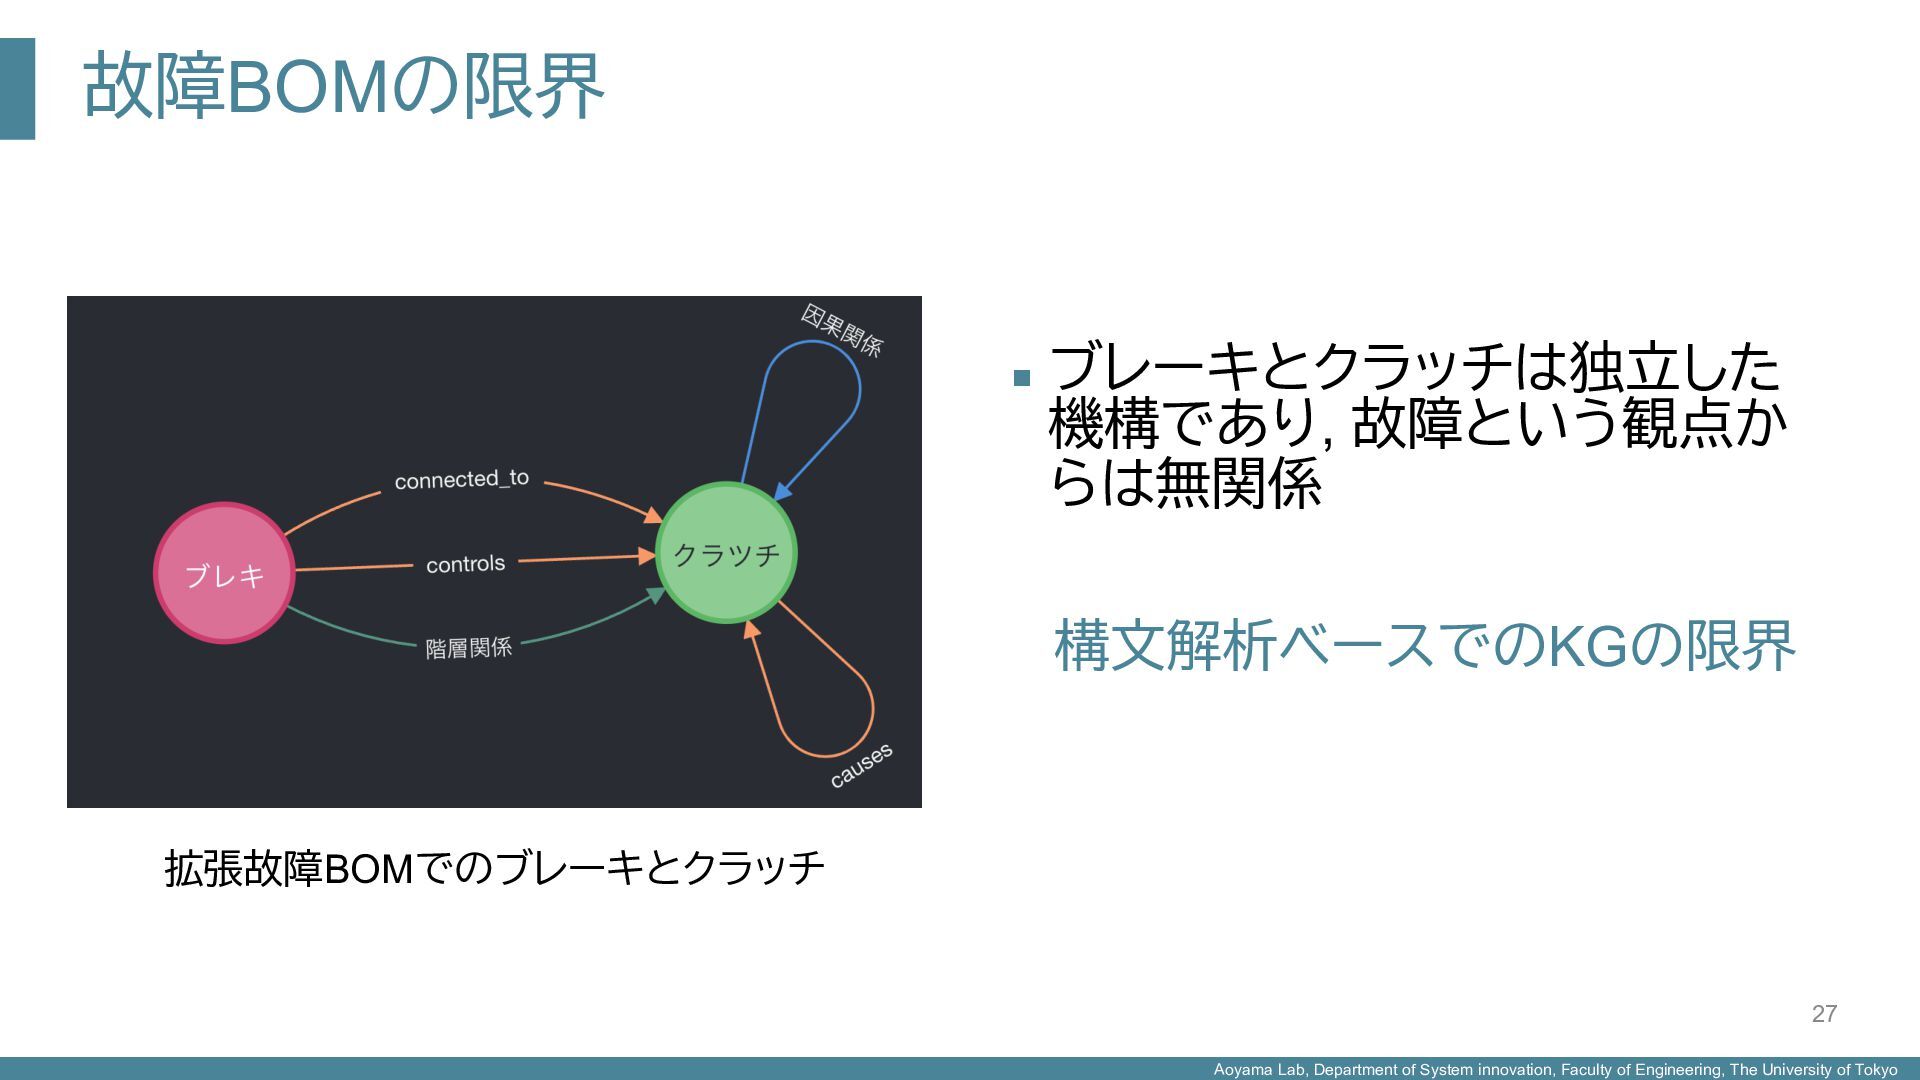
    University of Tokyo 故障BOMの限界 n ブレーキとクラッチは独立した 機構であり, 故障という観点か らは無関係 構文解析ベースでのKGの限界 27 拡張故障BOMでのブレーキとクラッチ
  25. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

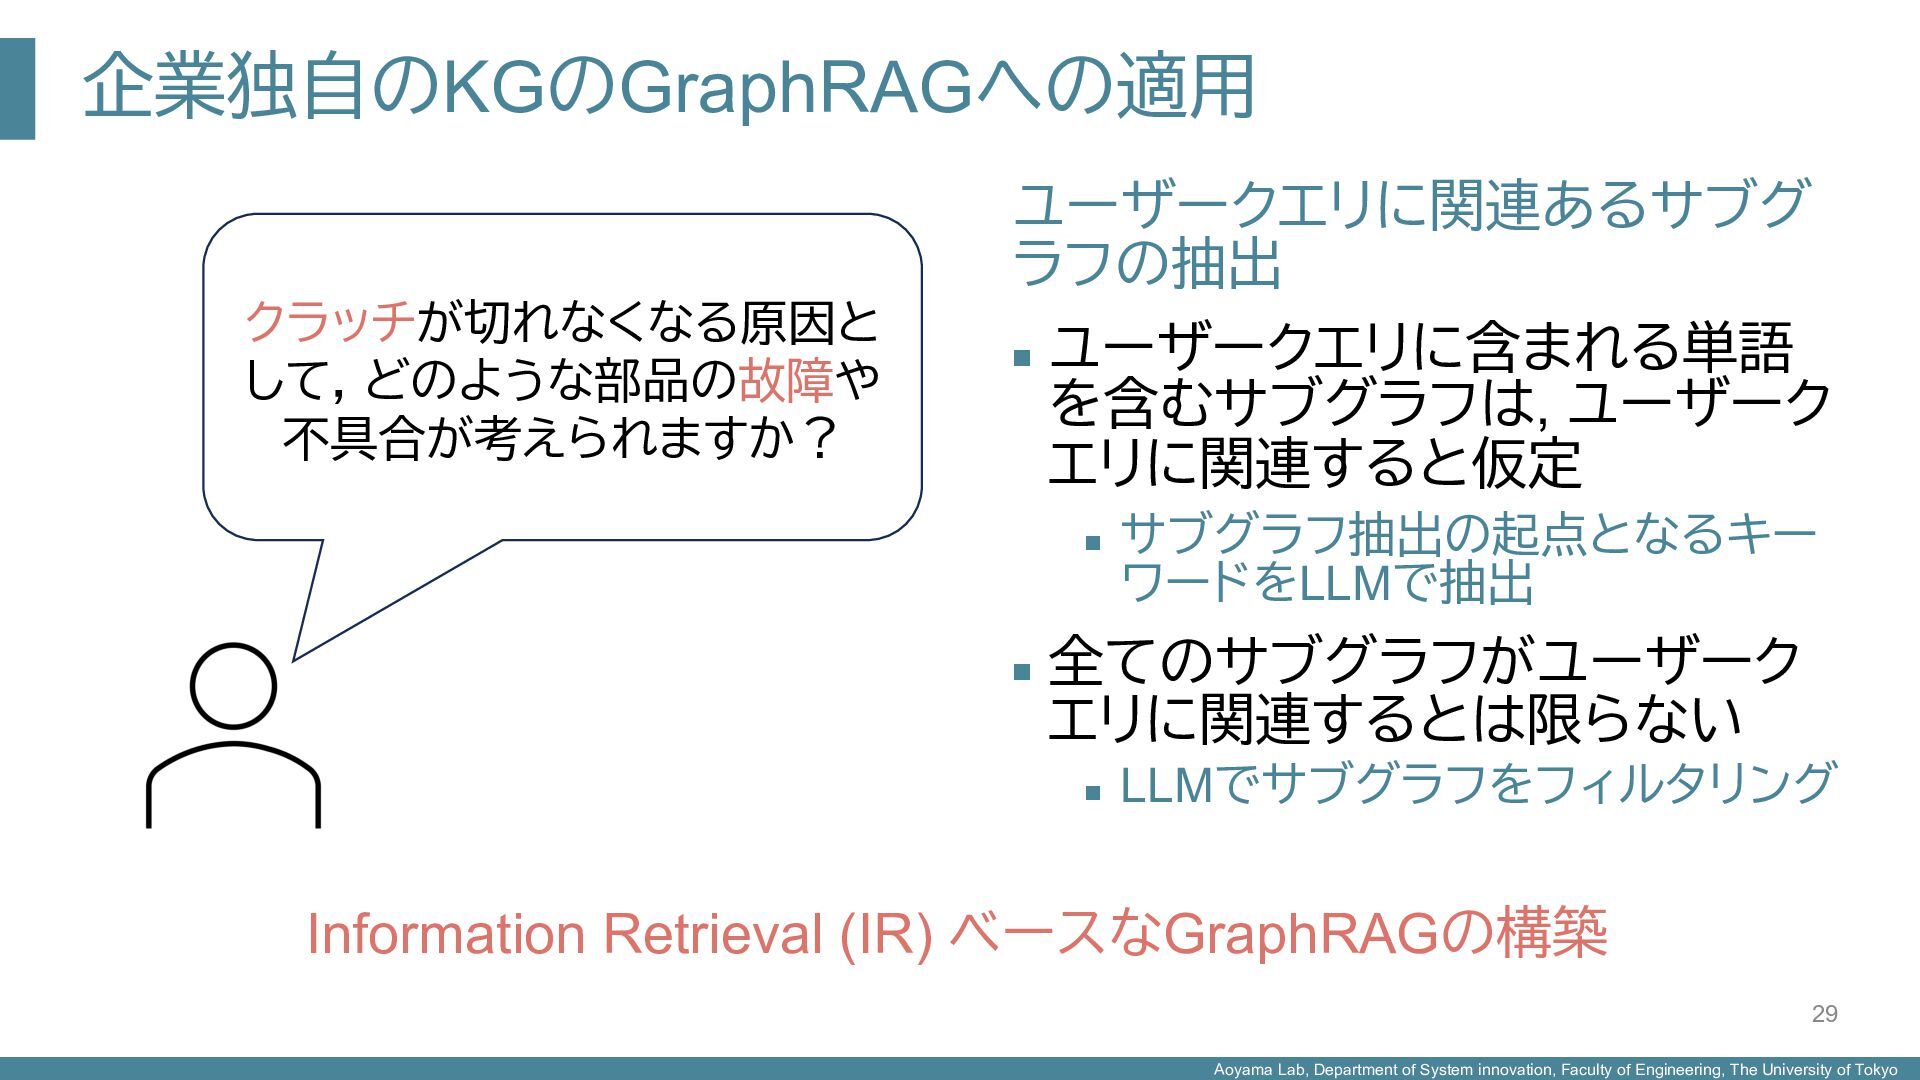
    University of Tokyo 企業独自のKGのGraphRAGへの適用 ユーザークエリに関連あるサブグ ラフの抽出 n ユーザークエリに含まれる単語 を含むサブグラフは, ユーザーク エリに関連すると仮定 n サブグラフ抽出の起点となるキー ワードをLLMで抽出 n 全てのサブグラフがユーザーク エリに関連するとは限らない n LLMでサブグラフをフィルタリング 29 クラッチが切れなくなる原因と して, どのような部品の故障や 不具合が考えられますか? Information Retrieval (IR) ベースなGraphRAGの構築
  26. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

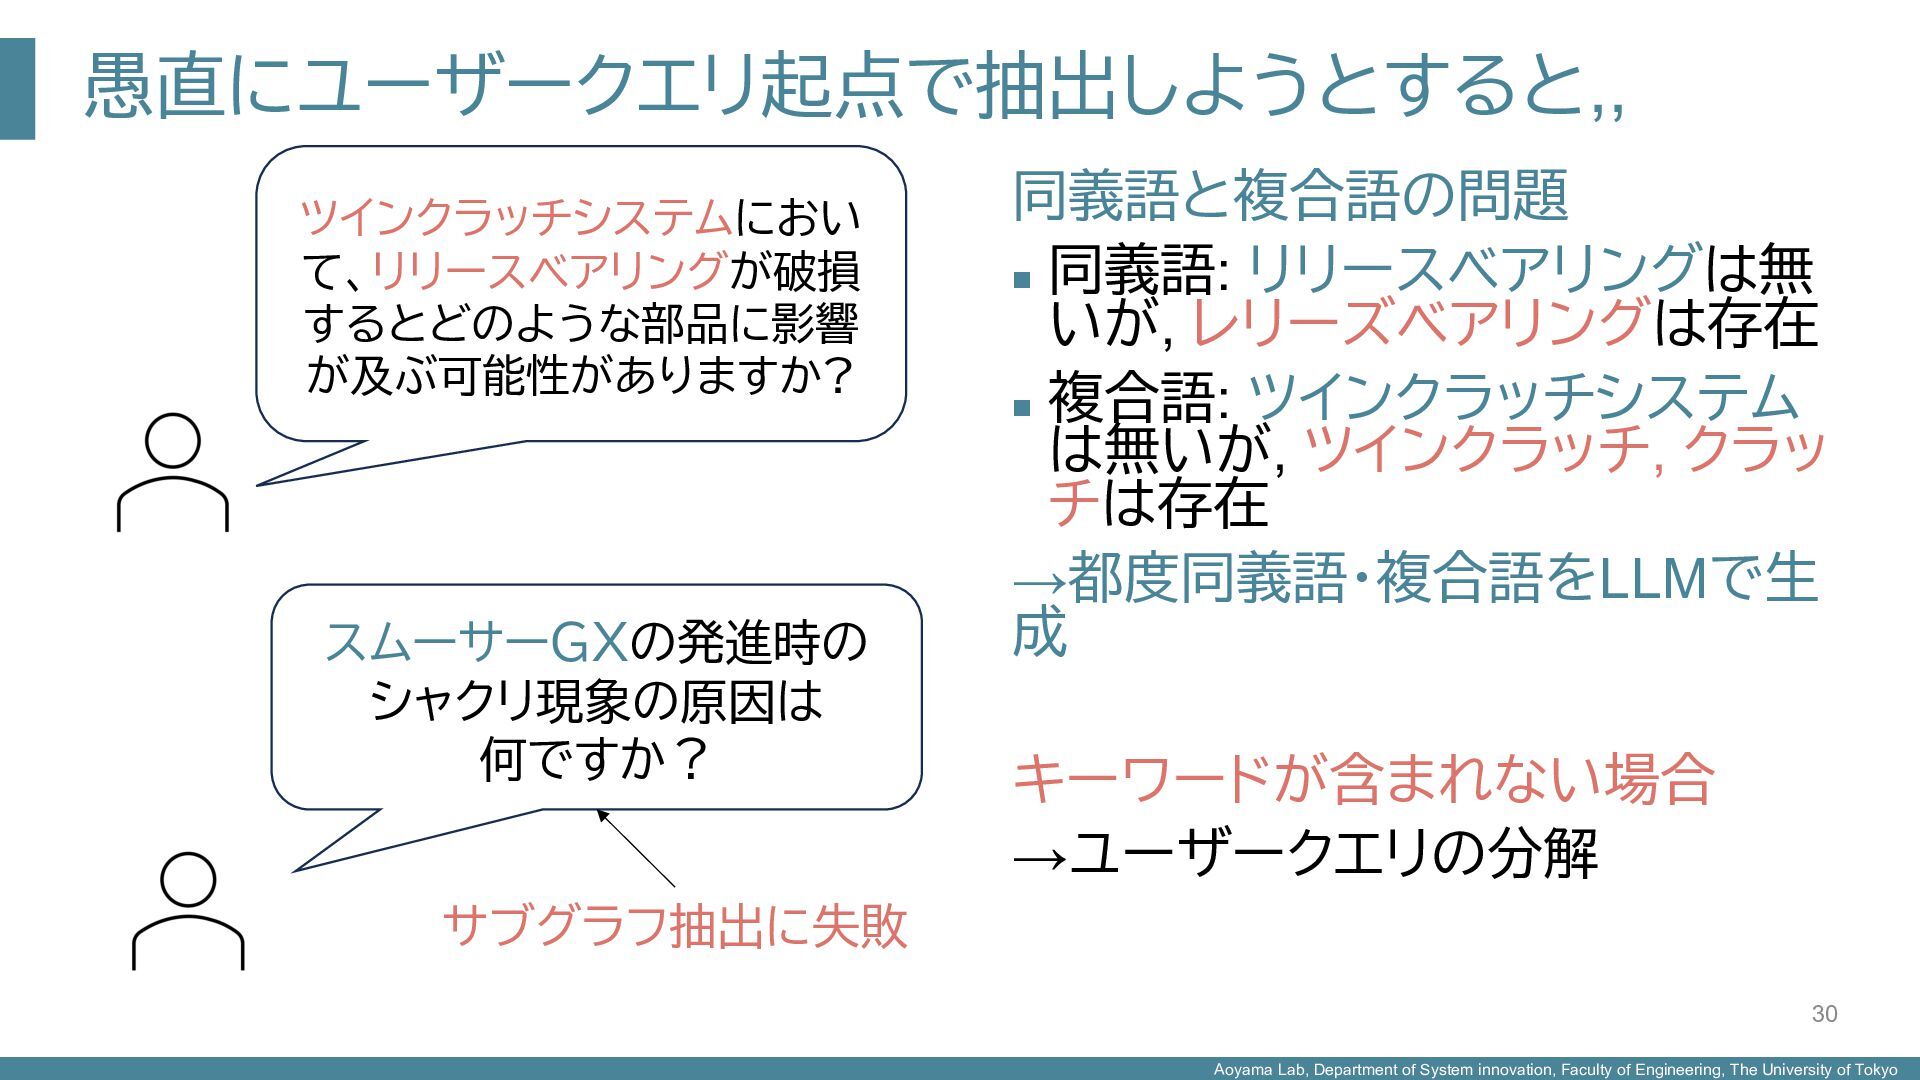
    University of Tokyo 愚直にユーザークエリ起点で抽出しようとすると,, 同義語と複合語の問題 n 同義語: リリースベアリングは無 いが, レリーズベアリングは存在 n 複合語: ツインクラッチシステム は無いが, ツインクラッチ, クラッ チは存在 →都度同義語・複合語をLLMで生 成 キーワードが含まれない場合 →ユーザークエリの分解 30 ツインクラッチシステムにおい て、リリースベアリングが破損 するとどのような部品に影響 が及ぶ可能性がありますか? スムーサーGXの発進時の シャクリ現象の原因は 何ですか? サブグラフ抽出に失敗
  27. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

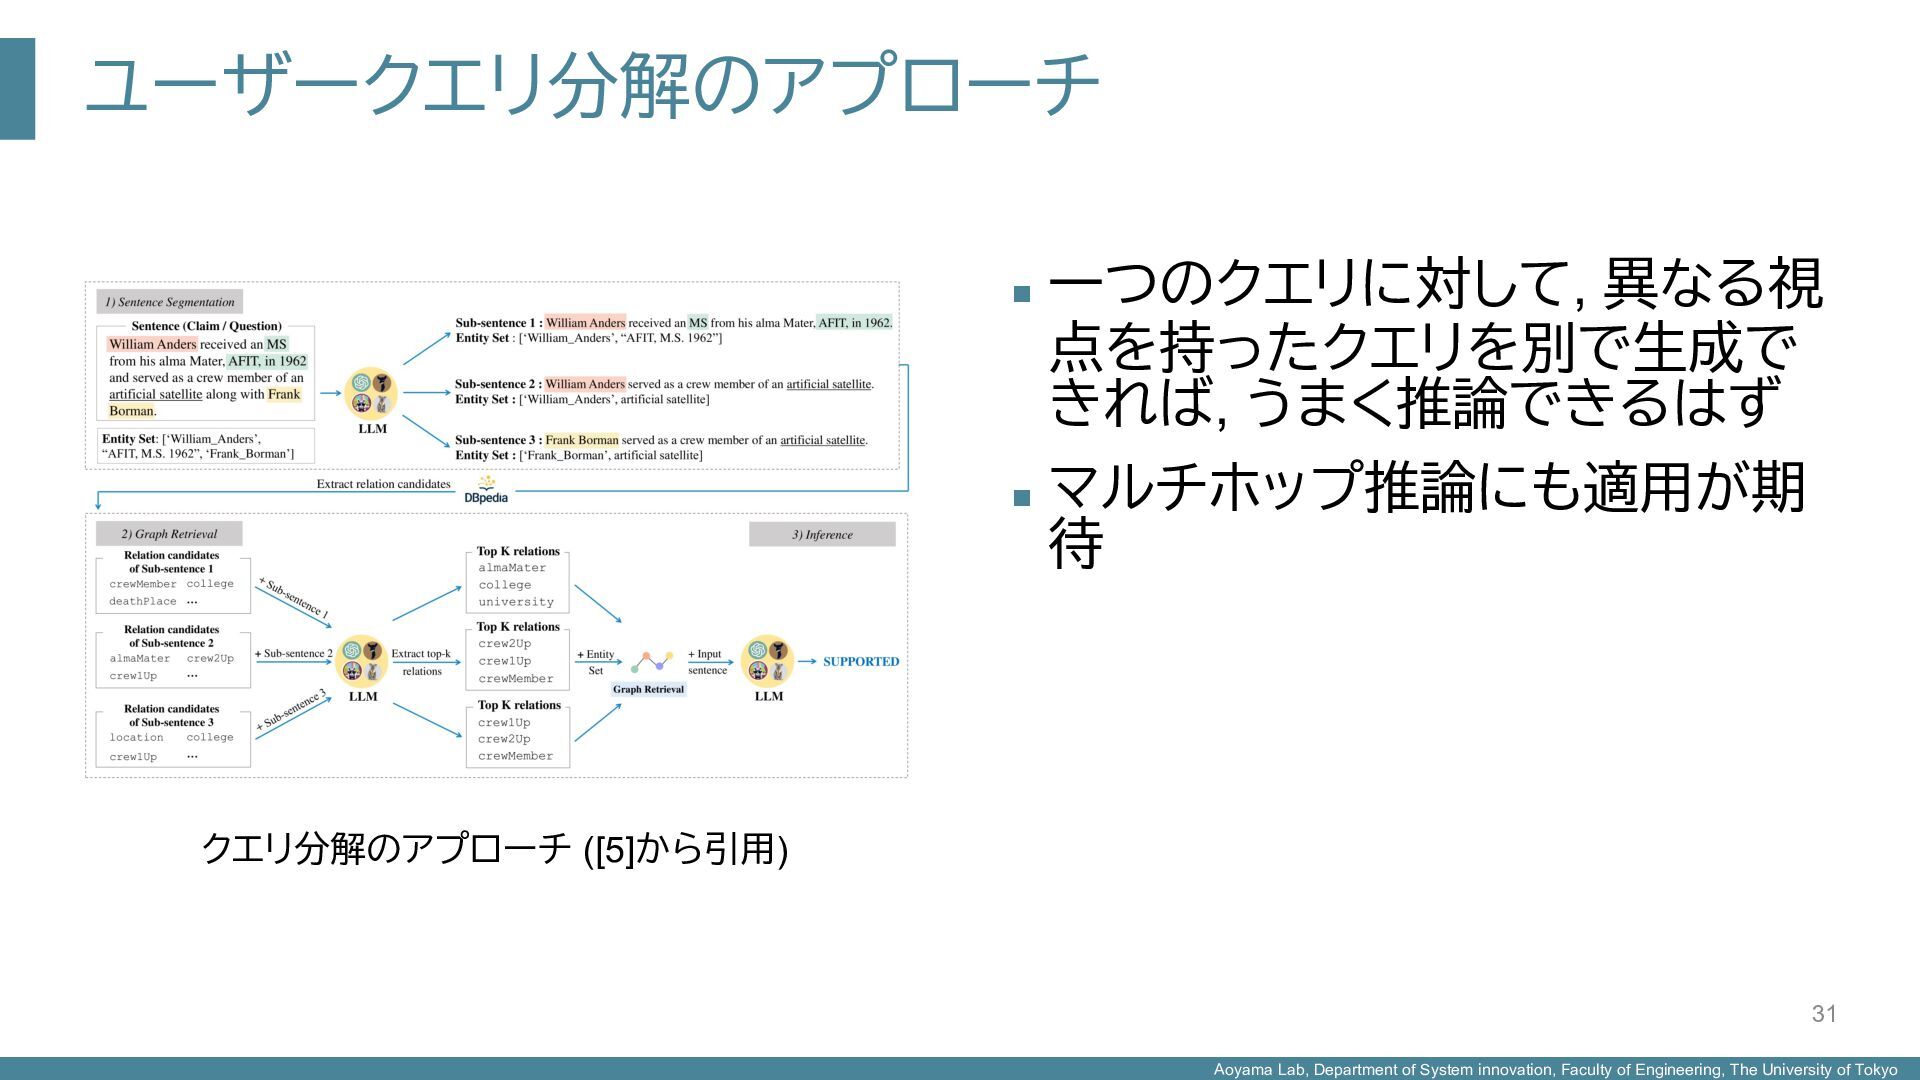
    University of Tokyo ユーザークエリ分解のアプローチ n 一つのクエリに対して, 異なる視 点を持ったクエリを別で生成で きれば, うまく推論できるはず n マルチホップ推論にも適用が期 待 31 クエリ分解のアプローチ ([5]から引用)
  28. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

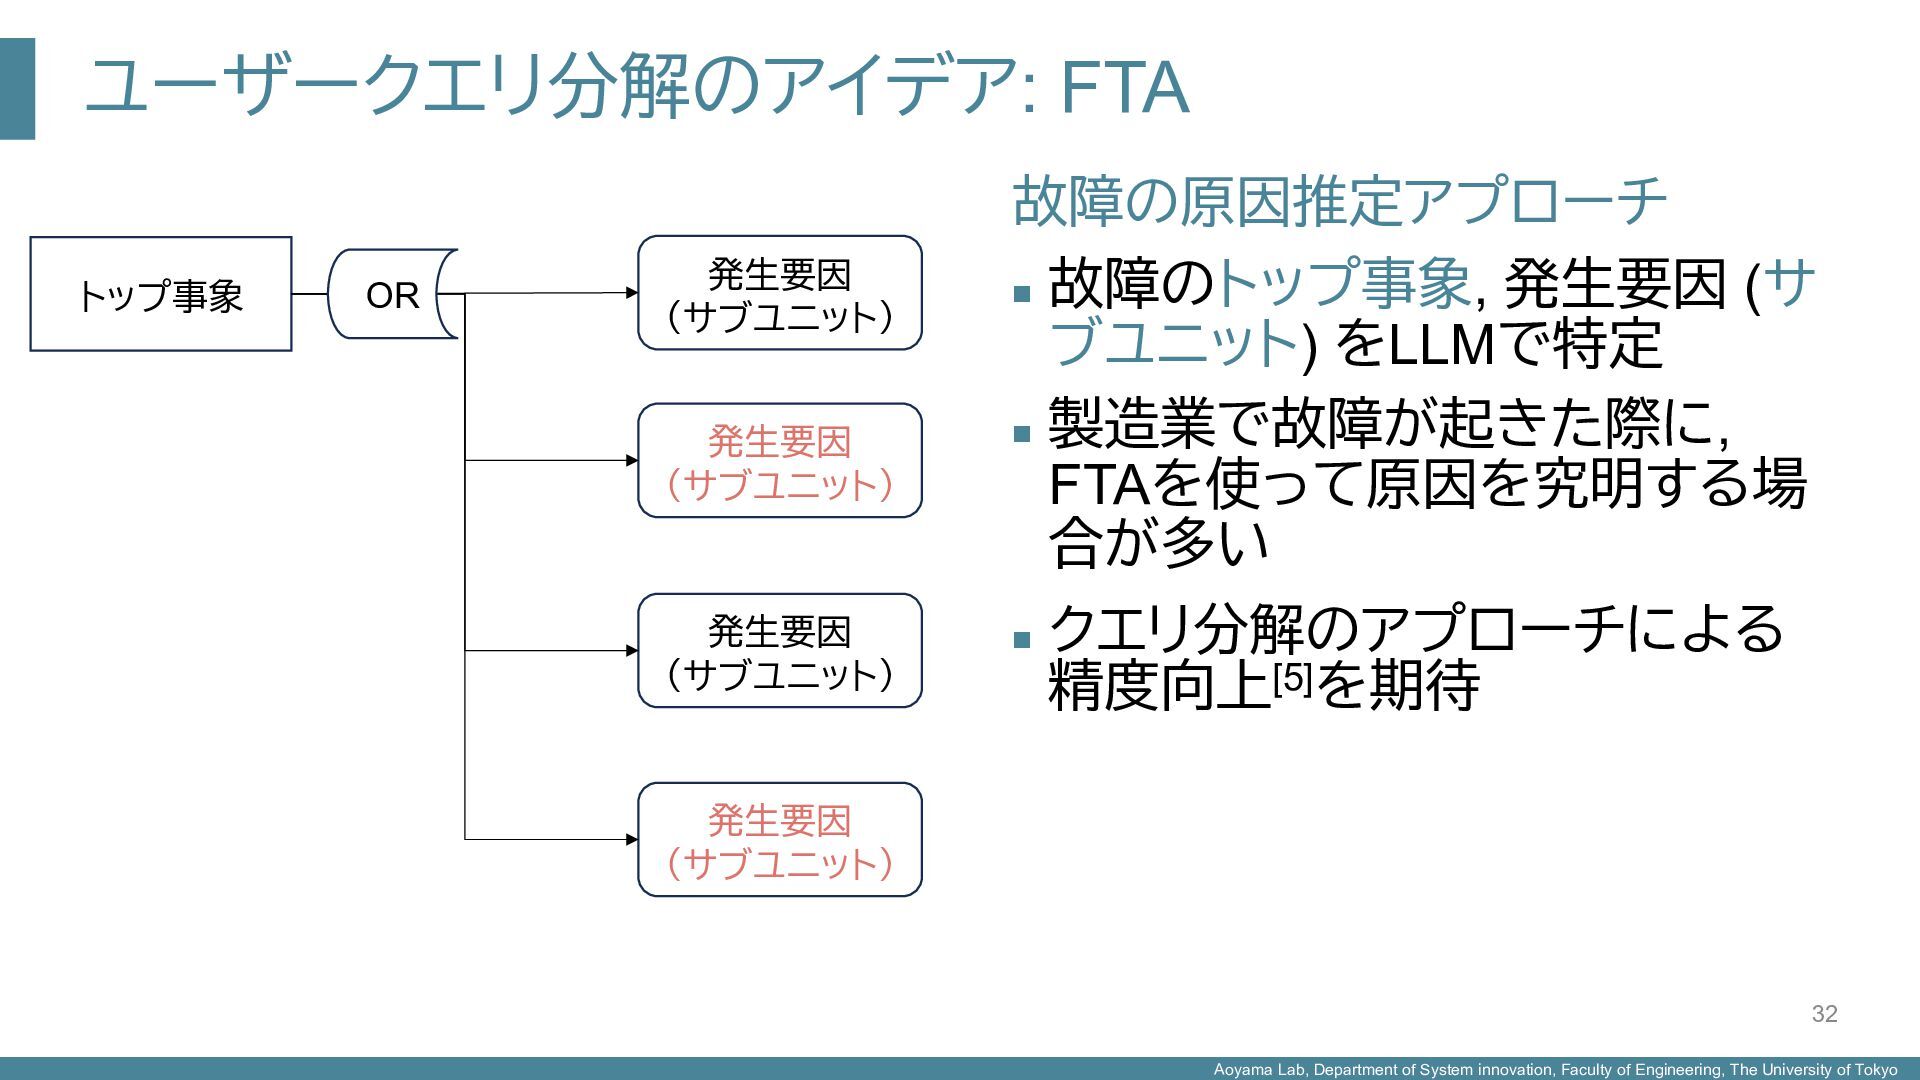
    University of Tokyo ユーザークエリ分解のアイデア: FTA 故障の原因推定アプローチ n 故障のトップ事象, 発生要因 (サ ブユニット) をLLMで特定 n 製造業で故障が起きた際に, FTAを使って原因を究明する場 合が多い n クエリ分解のアプローチによる 精度向上[5]を期待 32 トップ事象 発生要因 (サブユニット) 発生要因 (サブユニット) 発生要因 (サブユニット) 発生要因 (サブユニット) OR
  29. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

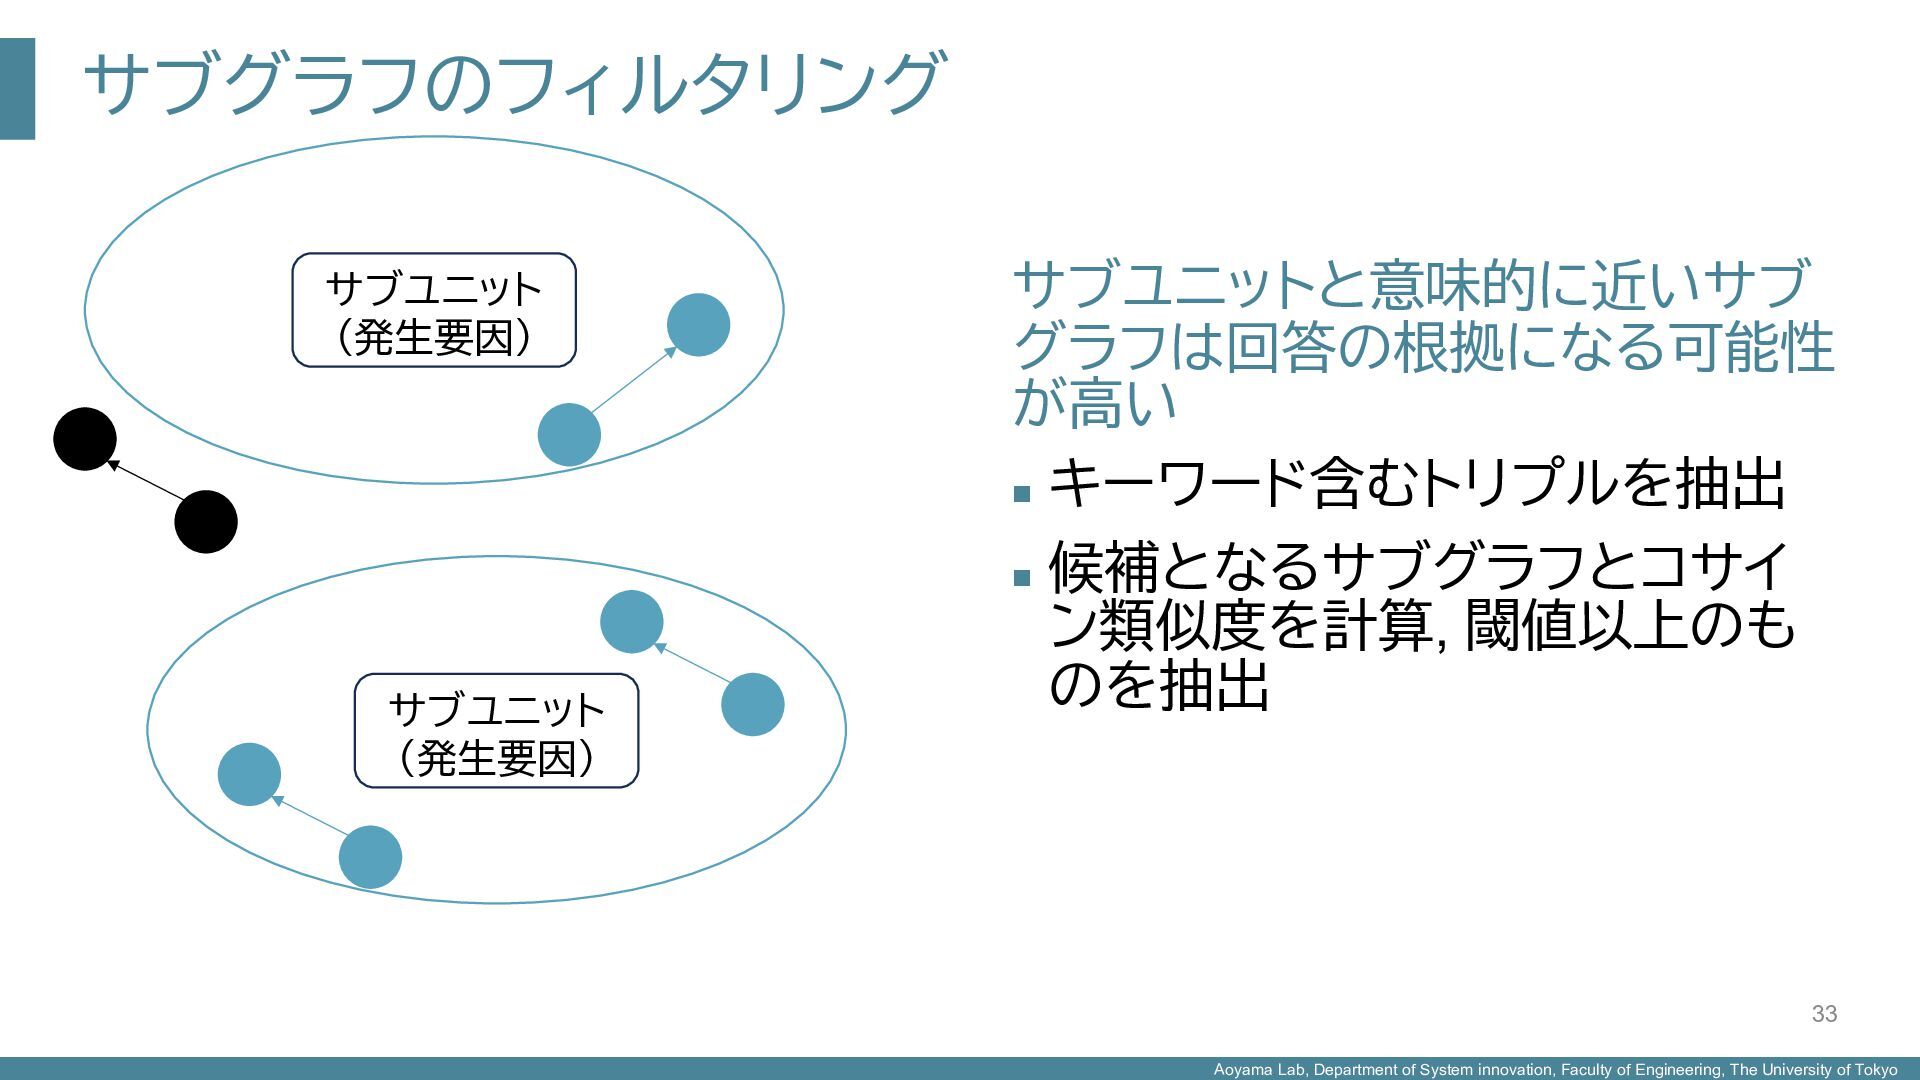
    University of Tokyo サブグラフのフィルタリング サブユニットと意味的に近いサブ グラフは回答の根拠になる可能性 が高い n キーワード含むトリプルを抽出 n 候補となるサブグラフとコサイ ン類似度を計算, 閾値以上のも のを抽出 33 サブユニット (発生要因) サブユニット (発生要因)
  30. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

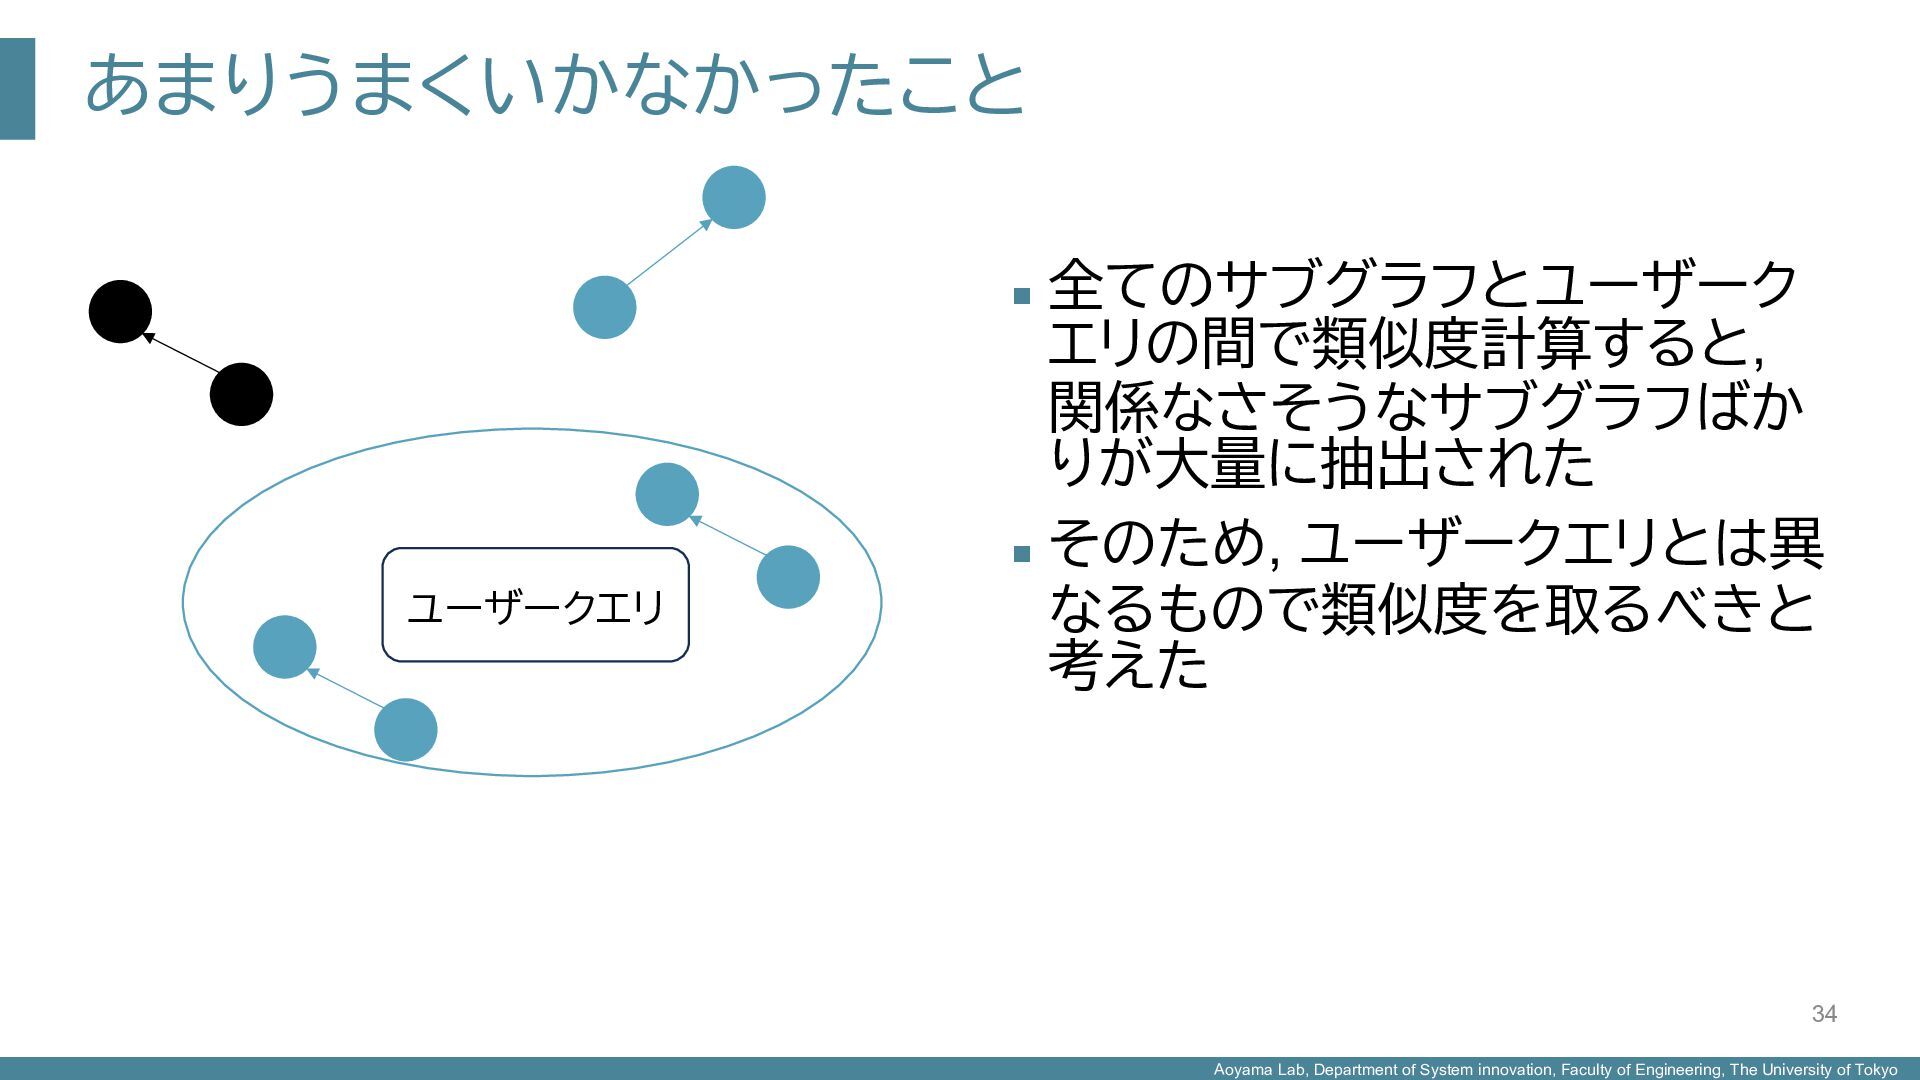
    University of Tokyo あまりうまくいかなかったこと n 全てのサブグラフとユーザーク エリの間で類似度計算すると, 関係なさそうなサブグラフばか りが大量に抽出された n そのため, ユーザークエリとは異 なるもので類似度を取るべきと 考えた 34 ユーザークエリ
  31. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

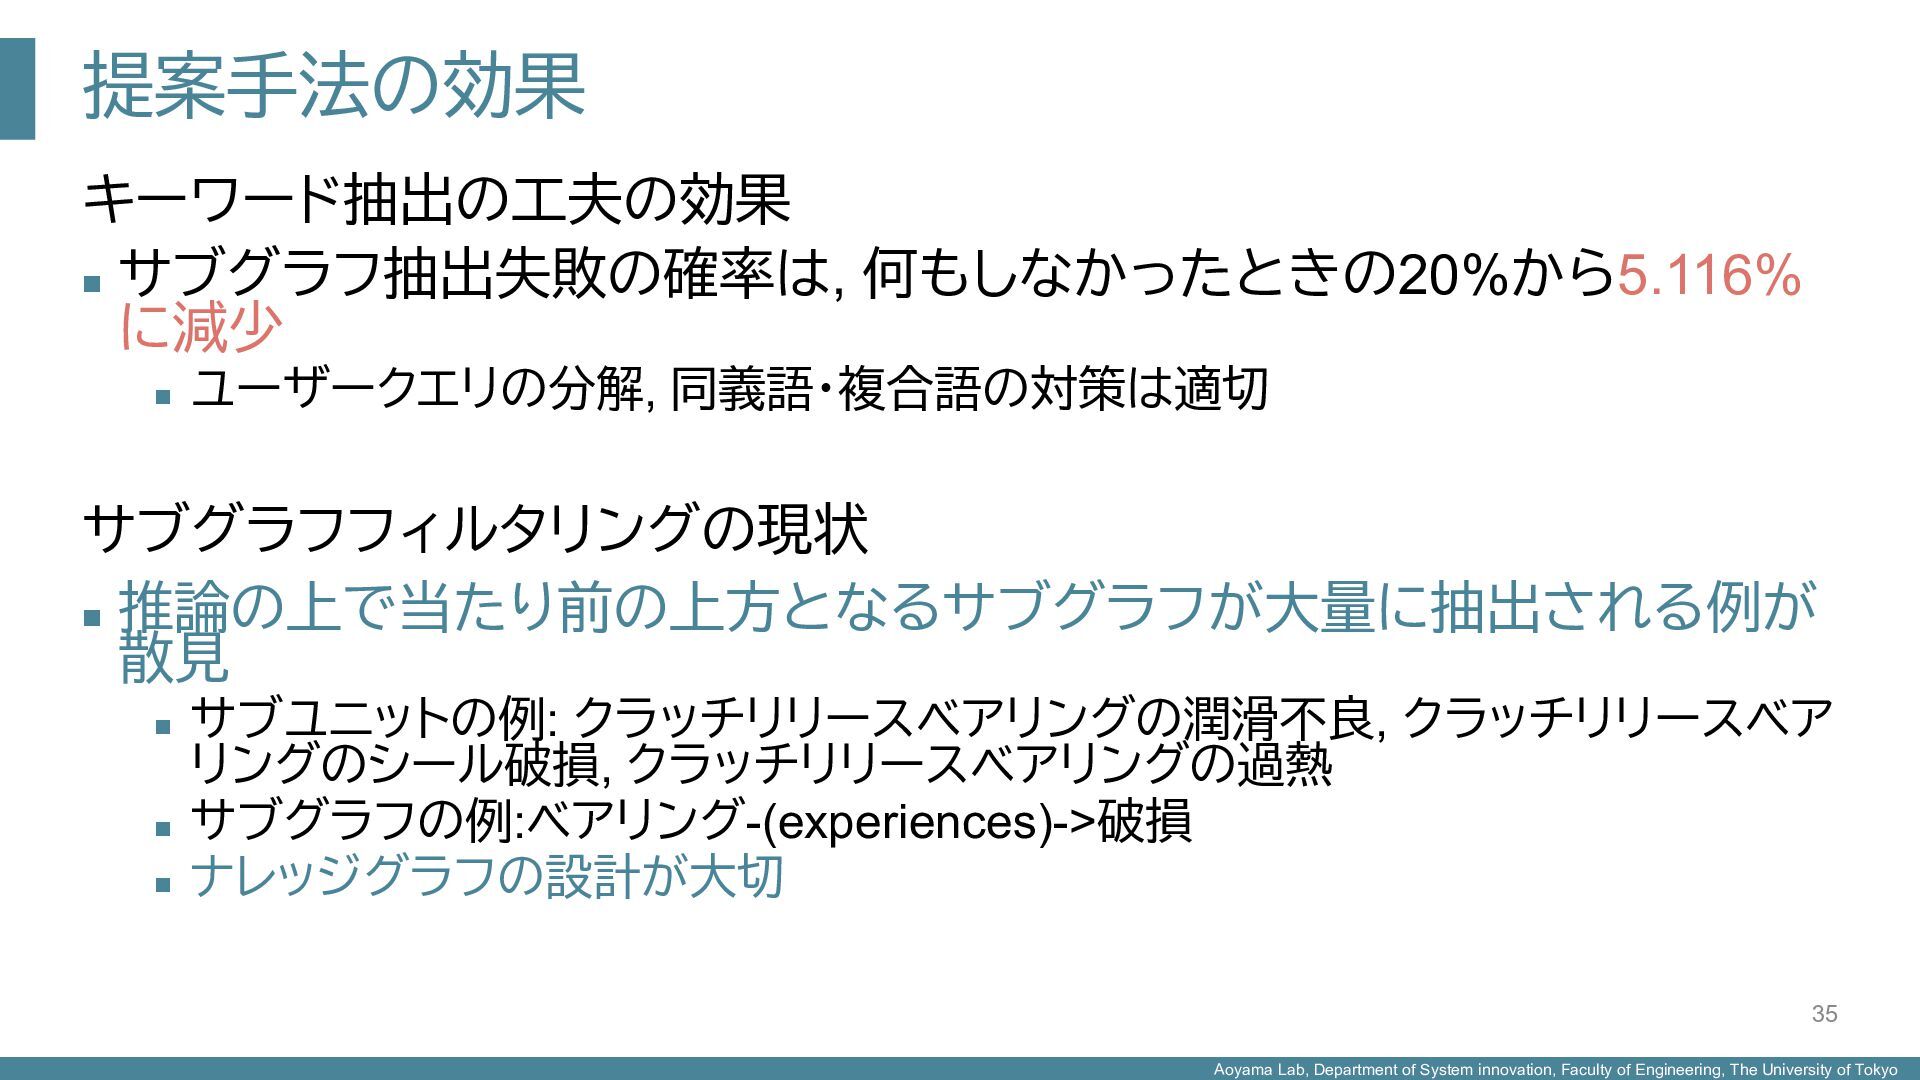
    University of Tokyo 提案手法の効果 キーワード抽出の工夫の効果 n サブグラフ抽出失敗の確率は, 何もしなかったときの20%から5.116% に減少 n ユーザークエリの分解, 同義語・複合語の対策は適切 サブグラフフィルタリングの現状 n 推論の上で当たり前の上方となるサブグラフが大量に抽出される例が 散見 n サブユニットの例: クラッチリリースベアリングの潤滑不良, クラッチリリースベア リングのシール破損, クラッチリリースベアリングの過熱 n サブグラフの例:ベアリング-(experiences)->破損 n ナレッジグラフの設計が大切 35
  32. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

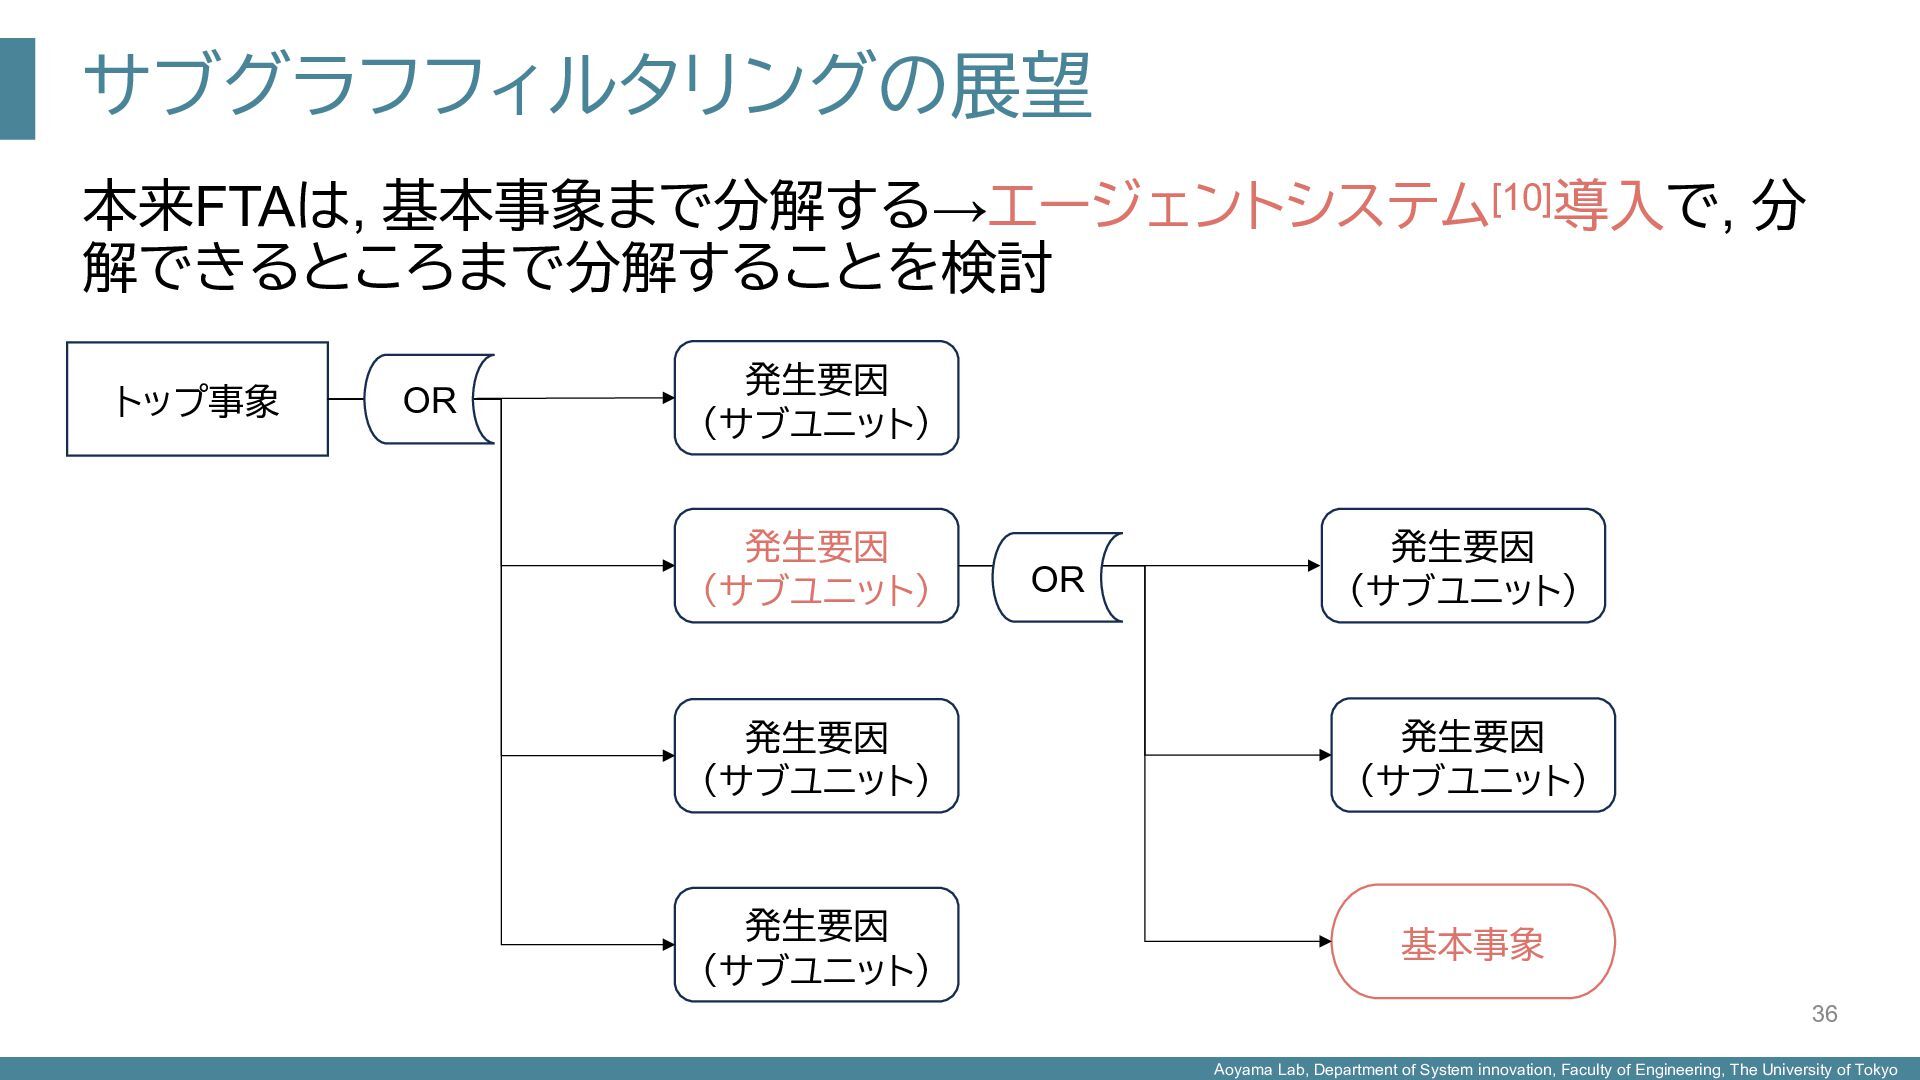
    University of Tokyo サブグラフフィルタリングの展望 本来FTAは, 基本事象まで分解する→エージェントシステム[10]導入で, 分 解できるところまで分解することを検討 36 トップ事象 発生要因 (サブユニット) 発生要因 (サブユニット) 発生要因 (サブユニット) 発生要因 (サブユニット) OR 発生要因 (サブユニット) 基本事象 発生要因 (サブユニット) OR
  33. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

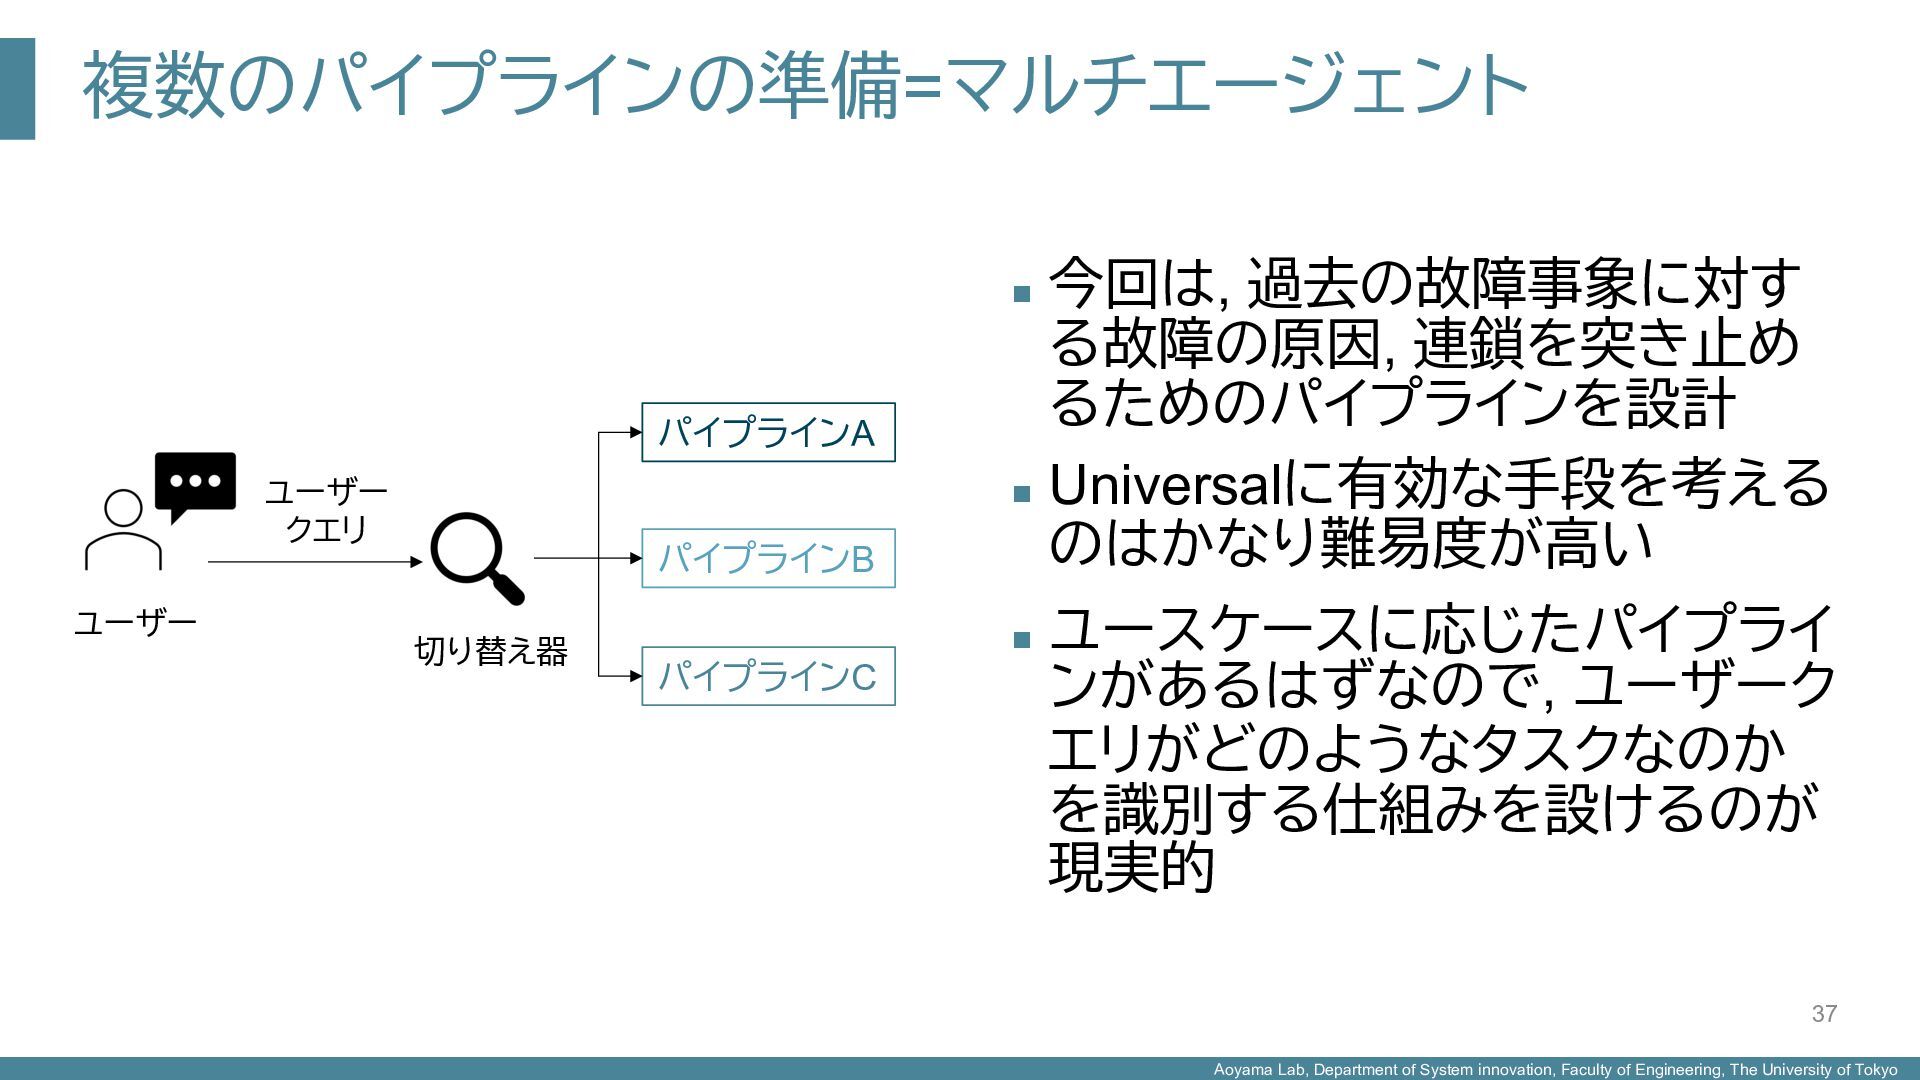
    University of Tokyo 複数のパイプラインの準備=マルチエージェント n 今回は, 過去の故障事象に対す る故障の原因, 連鎖を突き止め るためのパイプラインを設計 n Universalに有効な手段を考える のはかなり難易度が高い n ユースケースに応じたパイプライ ンがあるはずなので, ユーザーク エリがどのようなタスクなのか を識別する仕組みを設けるのが 現実的 37 ユーザー ユーザー クエリ パイプラインA パイプラインB パイプラインC 切り替え器
  34. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

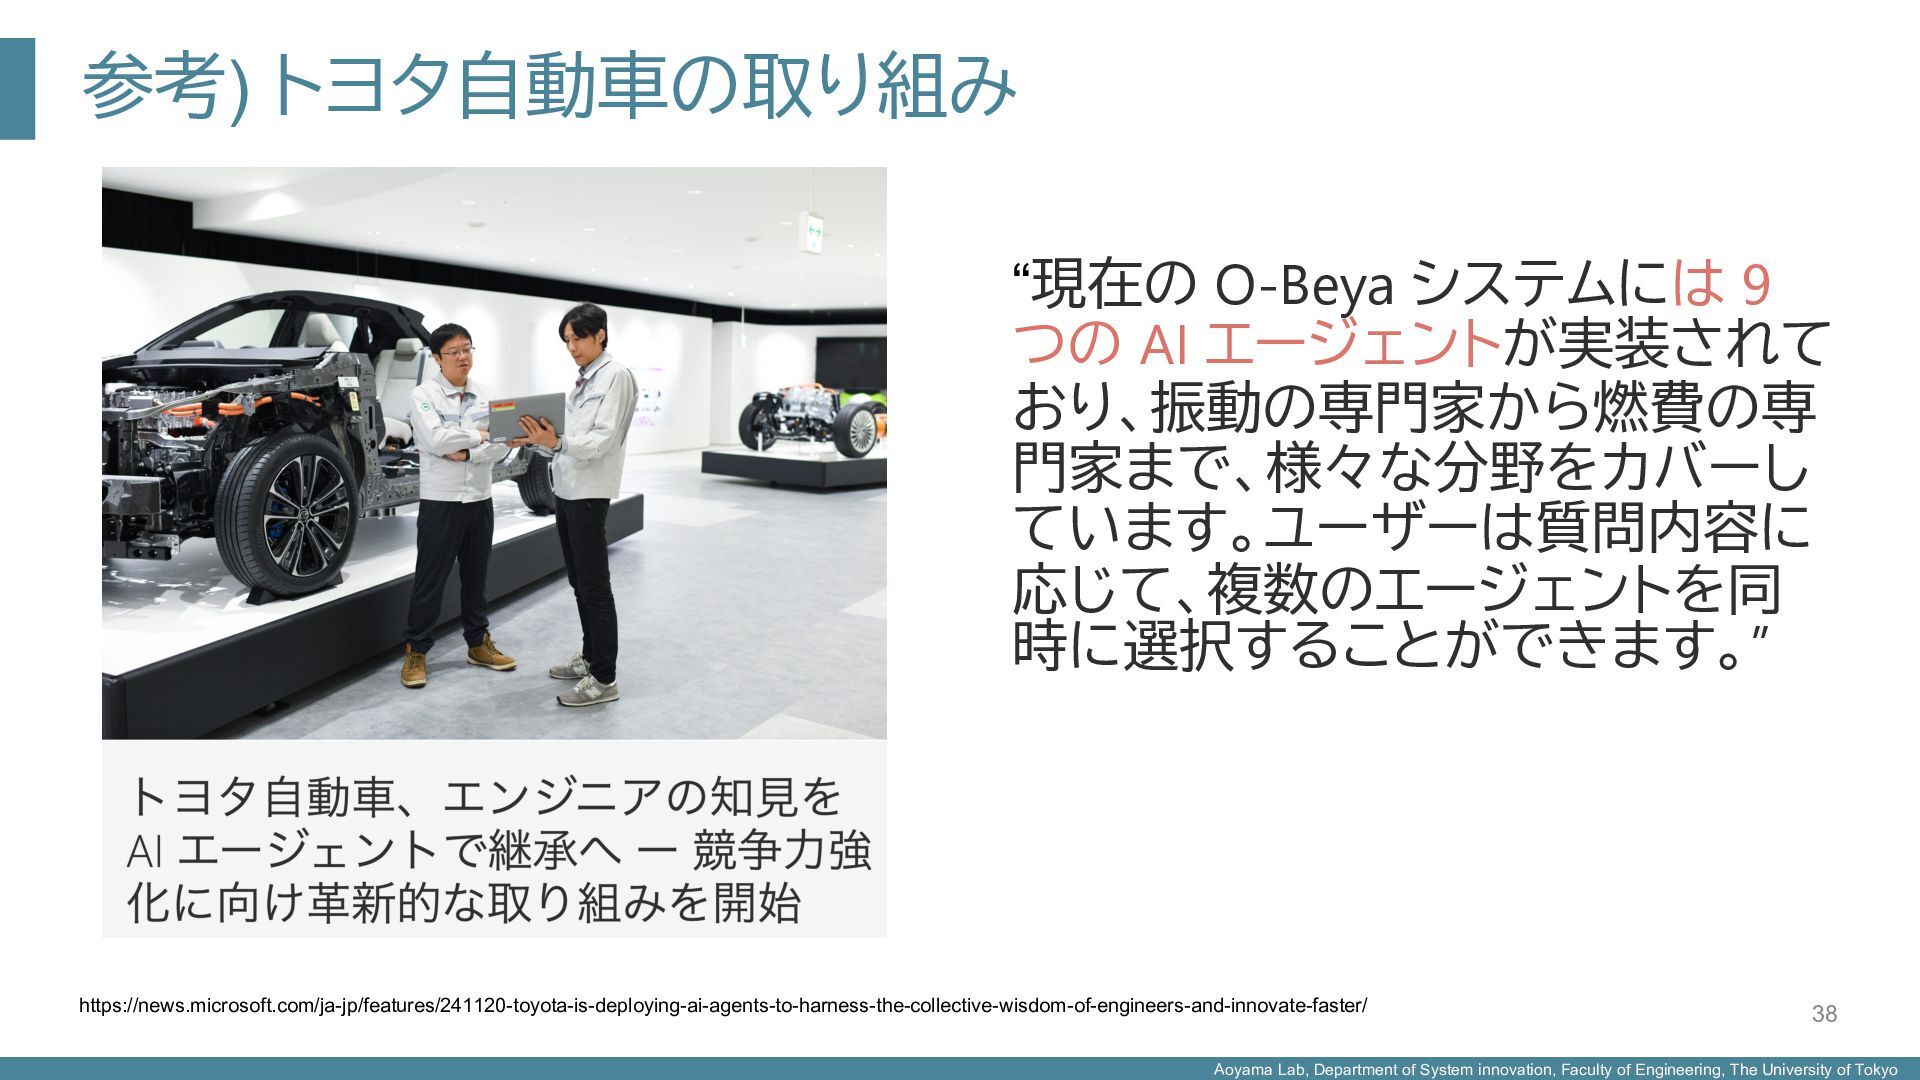
    University of Tokyo 参考) トヨタ自動車の取り組み “現在の O-Beya システムには 9 つの AI エージェントが実装されて おり、振動の専門家から燃費の専 門家まで、様々な分野をカバーし ています。ユーザーは質問内容に 応じて、複数のエージェントを同 時に選択することができます。” 38 https://news.microsoft.com/ja-jp/features/241120-toyota-is-deploying-ai-agents-to-harness-the-collective-wisdom-of-engineers-and-innovate-faster/
  35. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

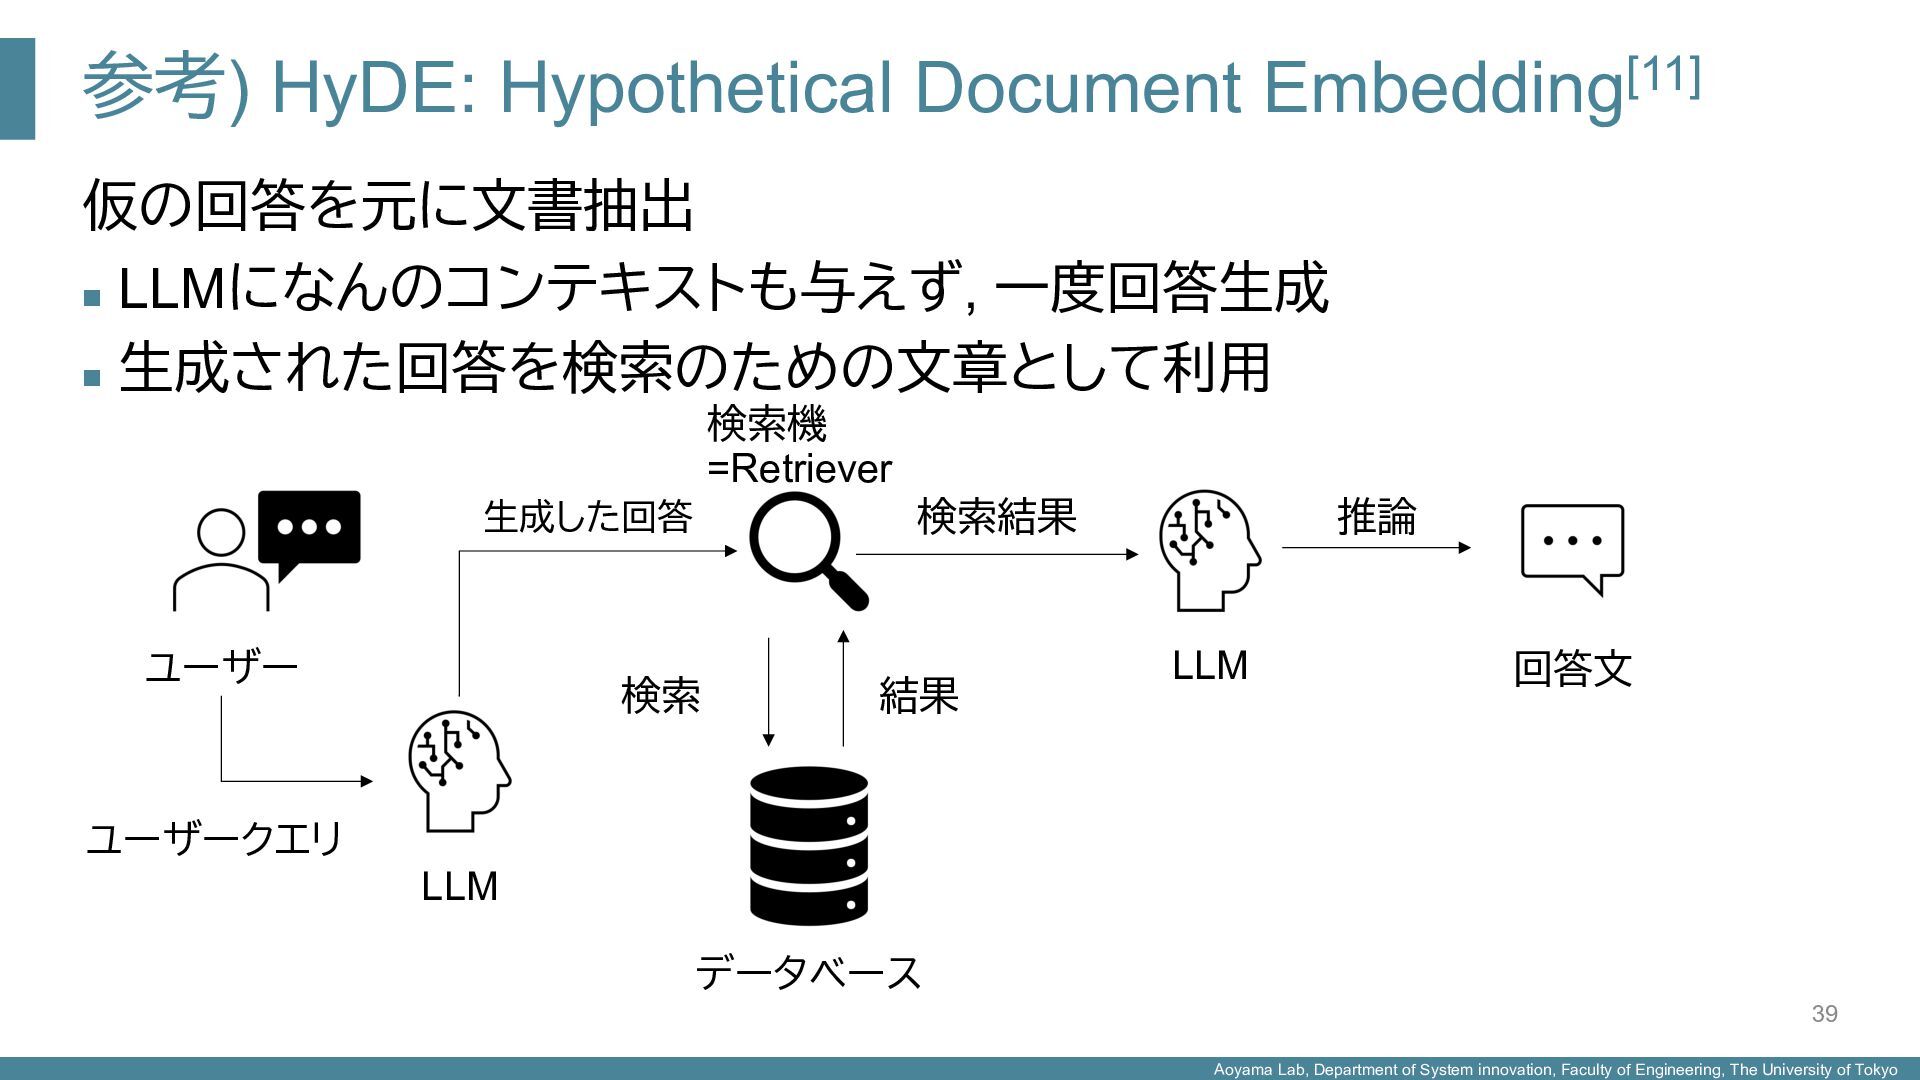
    University of Tokyo 参考) HyDE: Hypothetical Document Embedding[11] 仮の回答を元に文書抽出 n LLMになんのコンテキストも与えず, 一度回答生成 n 生成された回答を検索のための文章として利用 39 ユーザー 検索機 =Retriever データベース LLM ユーザークエリ 検索 結果 検索結果 推論 回答文 LLM 生成した回答
  36. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

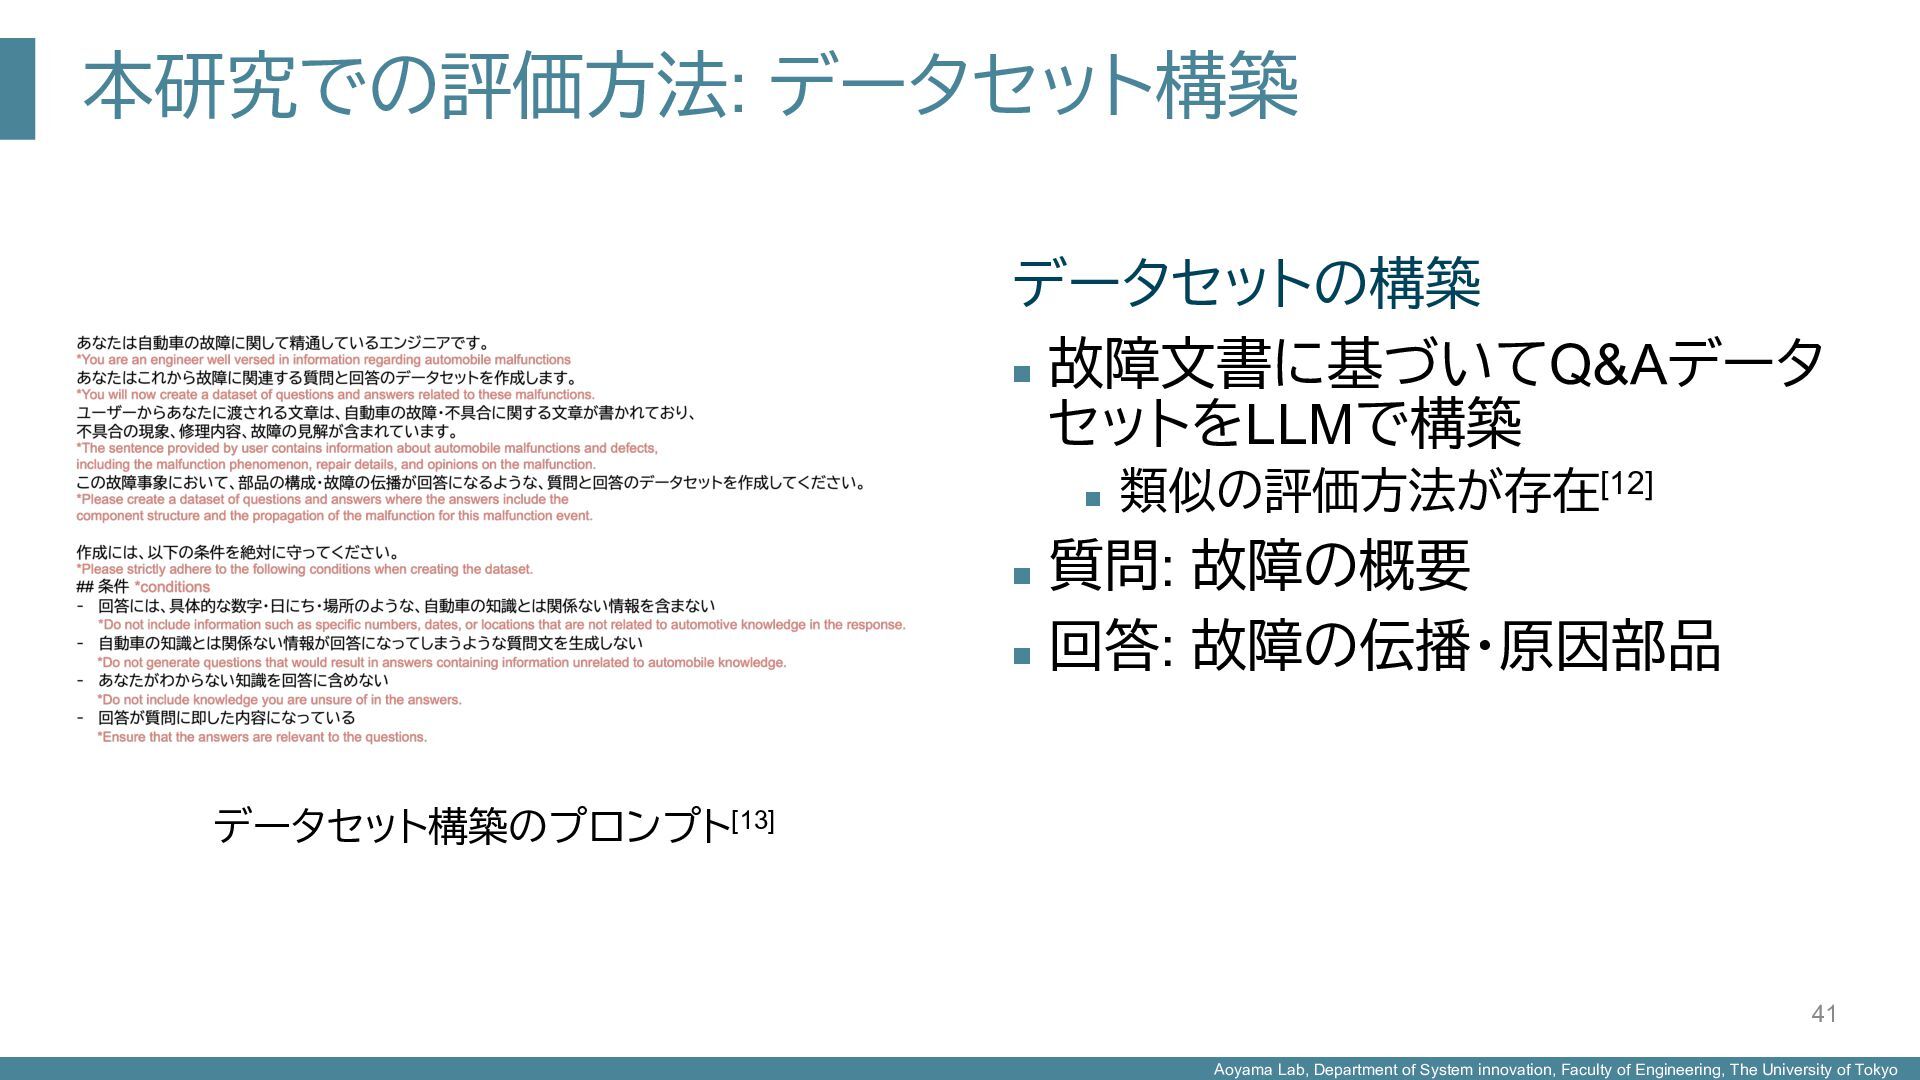
    University of Tokyo 本研究での評価方法: データセット構築 データセットの構築 n 故障文書に基づいてQ&Aデータ セットをLLMで構築 n 類似の評価方法が存在[12] n 質問: 故障の概要 n 回答: 故障の伝播・原因部品 41 データセット構築のプロンプト[13]
  37. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

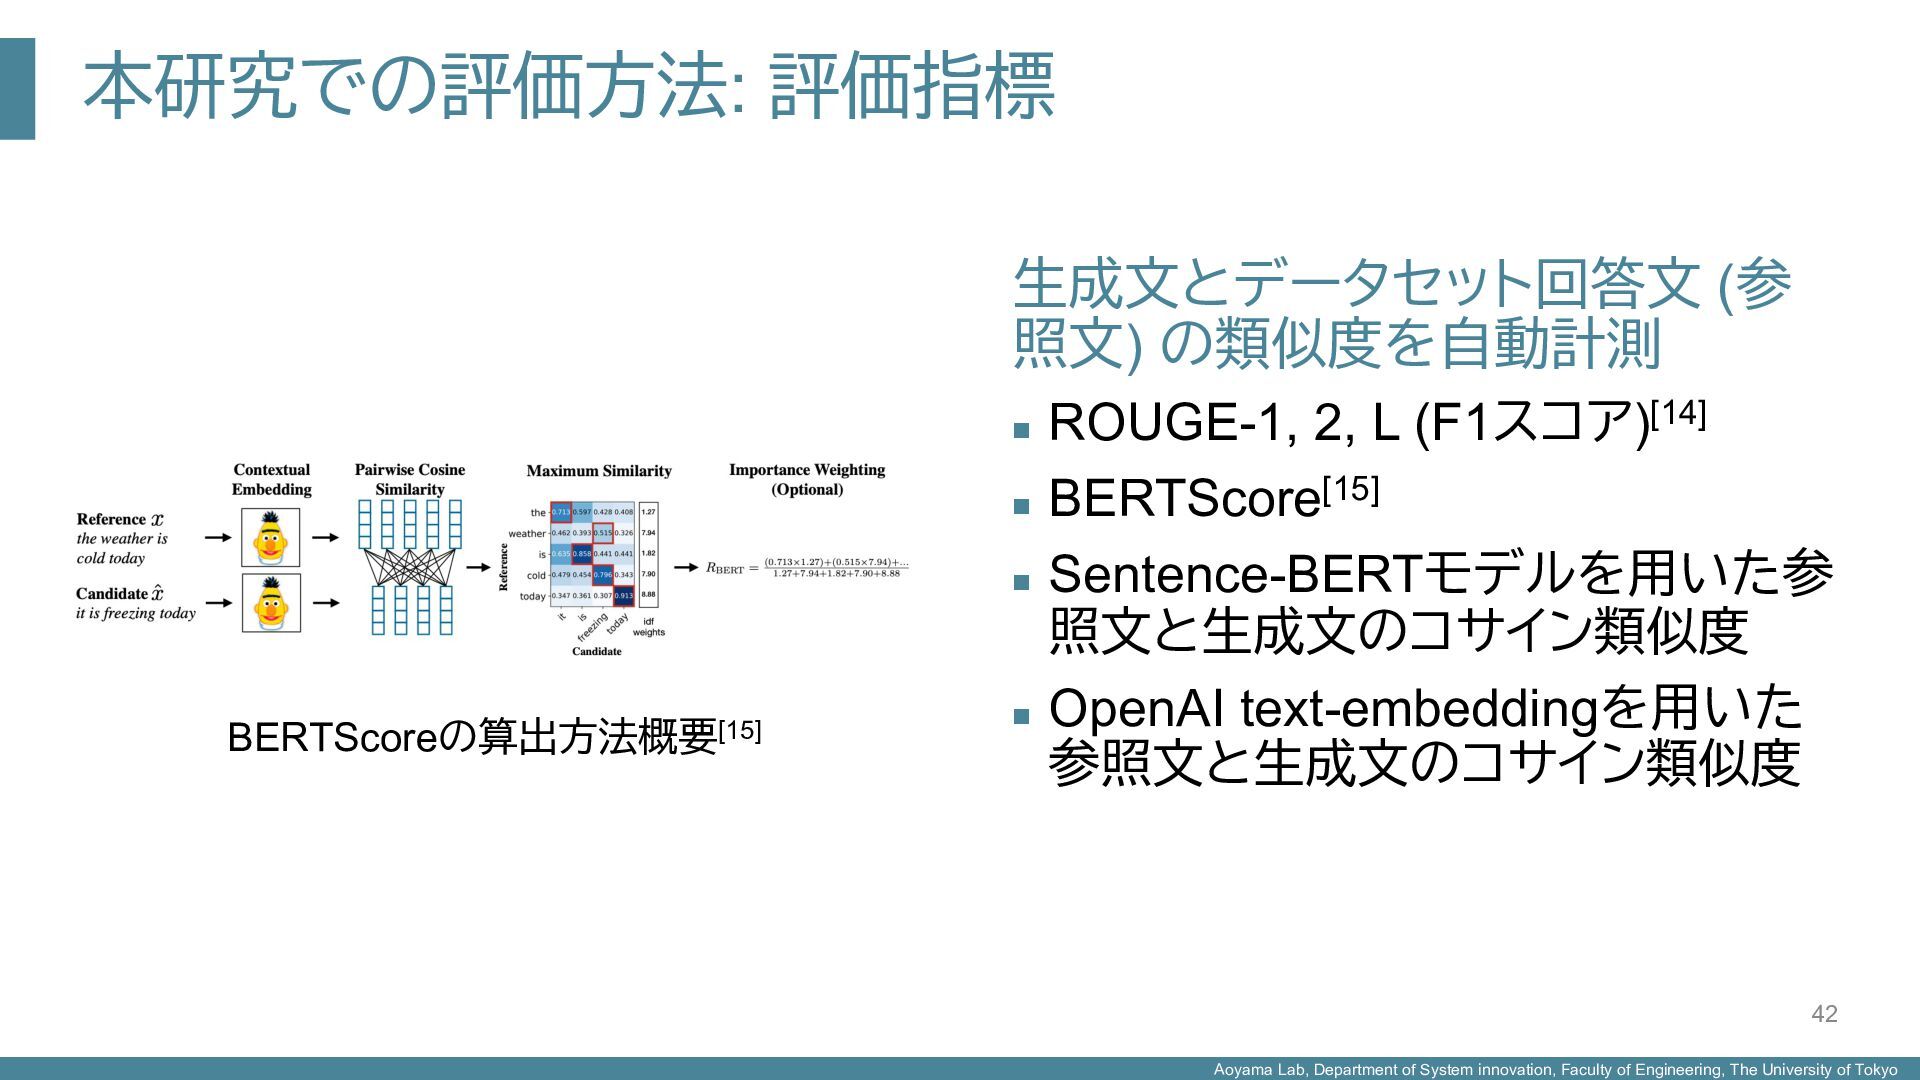
    University of Tokyo 本研究での評価方法: 評価指標 生成文とデータセット回答文 (参 照文) の類似度を自動計測 n ROUGE-1, 2, L (F1スコア)[14] n BERTScore[15] n Sentence-BERTモデルを用いた参 照文と生成文のコサイン類似度 n OpenAI text-embeddingを用いた 参照文と生成文のコサイン類似度 42 BERTScoreの算出方法概要[15]
  38. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 自動評価指標の問題点 n 単語の言い換えにとても弱い (特にROUGE) n “意味”というよりは, “如何に同じ単語が用いられているか”, という部分 での評価にどうしてもなってしまう 43
  39. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo よくあるQA 質問 n RAG評価用のQ&A作成に人手がかかりすぎるという課題がある。LLM を用いてQ&Aを作成することも検討しているが、このような手法は一 般的か? 回答 n 論文ではあまり見かけないが, プロダクト単位では技術記事で多く見か けるので, 一般的と言える n 理想: Q&AのデータセットをLLMで構築→人手評価で質問・回答に問題 がないかを確認 44
  40. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

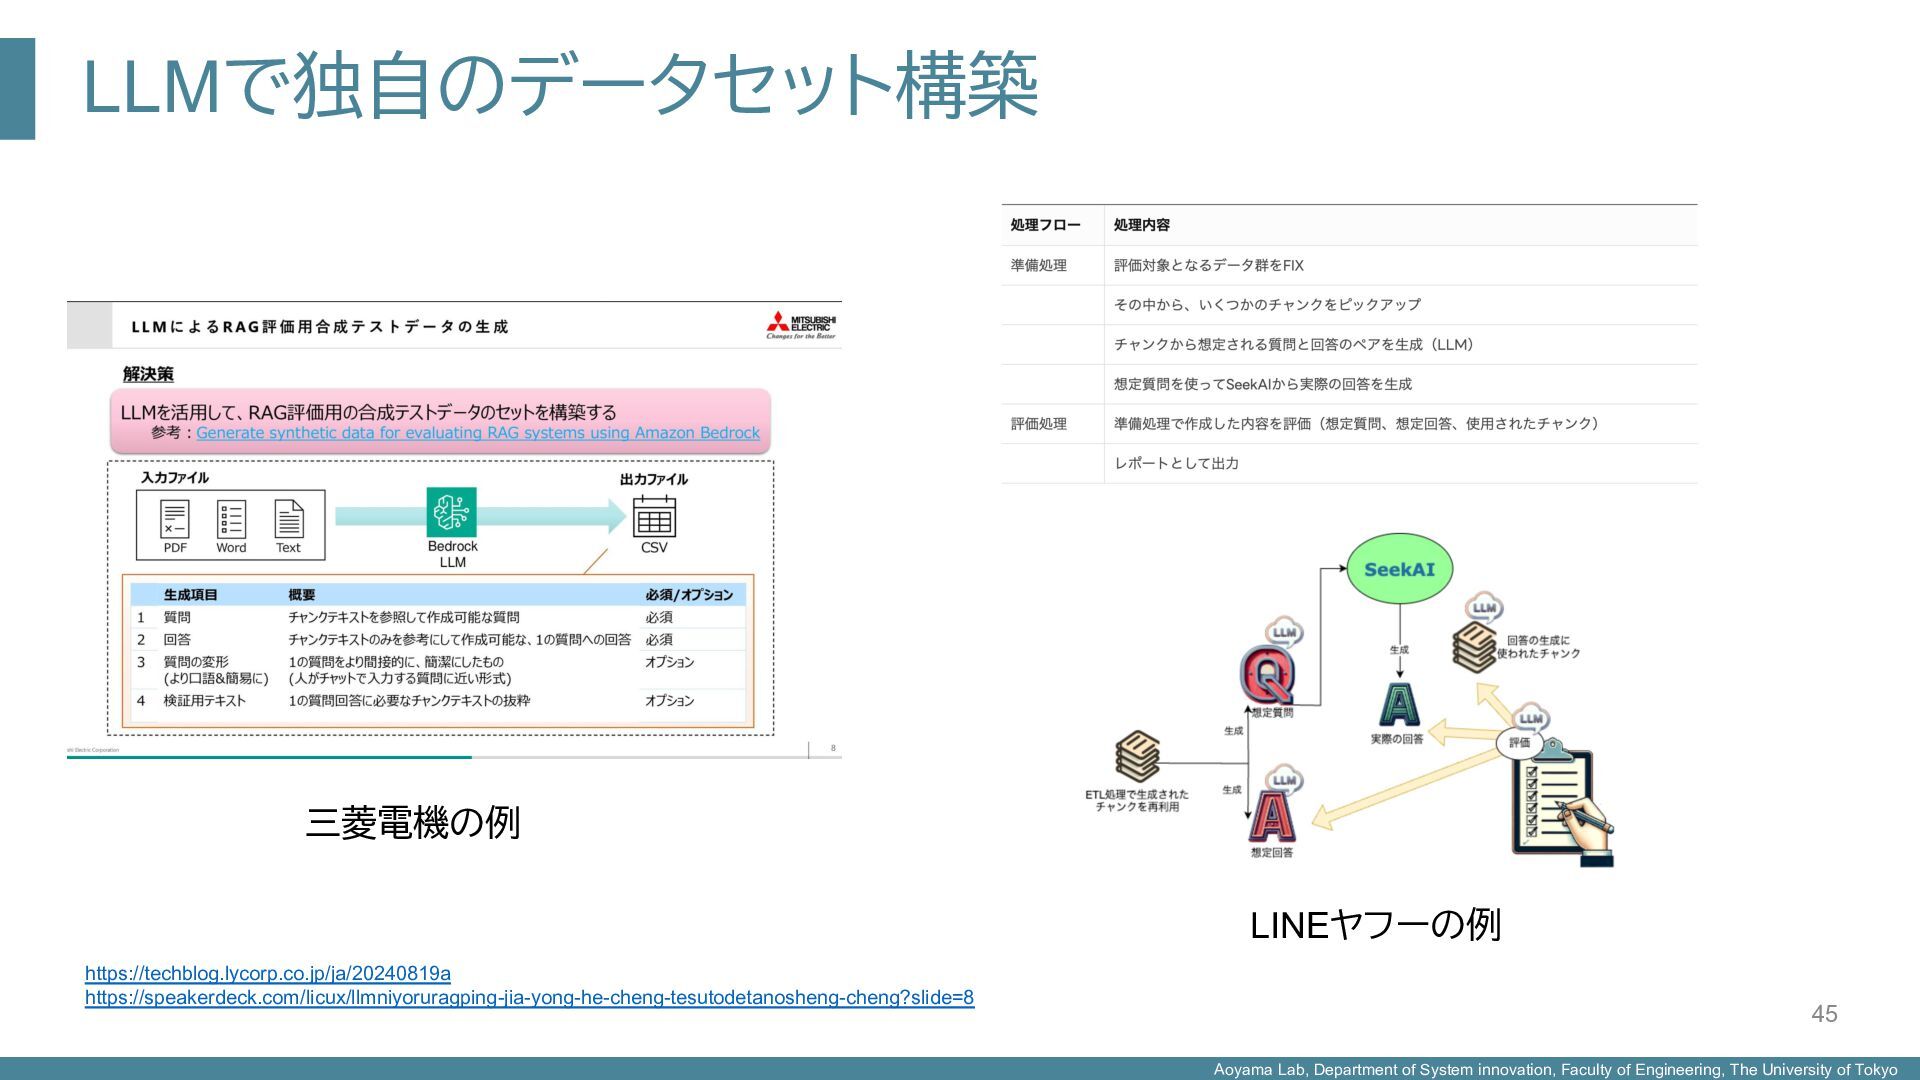
    University of Tokyo LLMで独自のデータセット構築 45 三菱電機の例 LINEヤフーの例 https://techblog.lycorp.co.jp/ja/20240819a https://speakerdeck.com/licux/llmniyoruragping-jia-yong-he-cheng-tesutodetanosheng-cheng?slide=8
  41. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

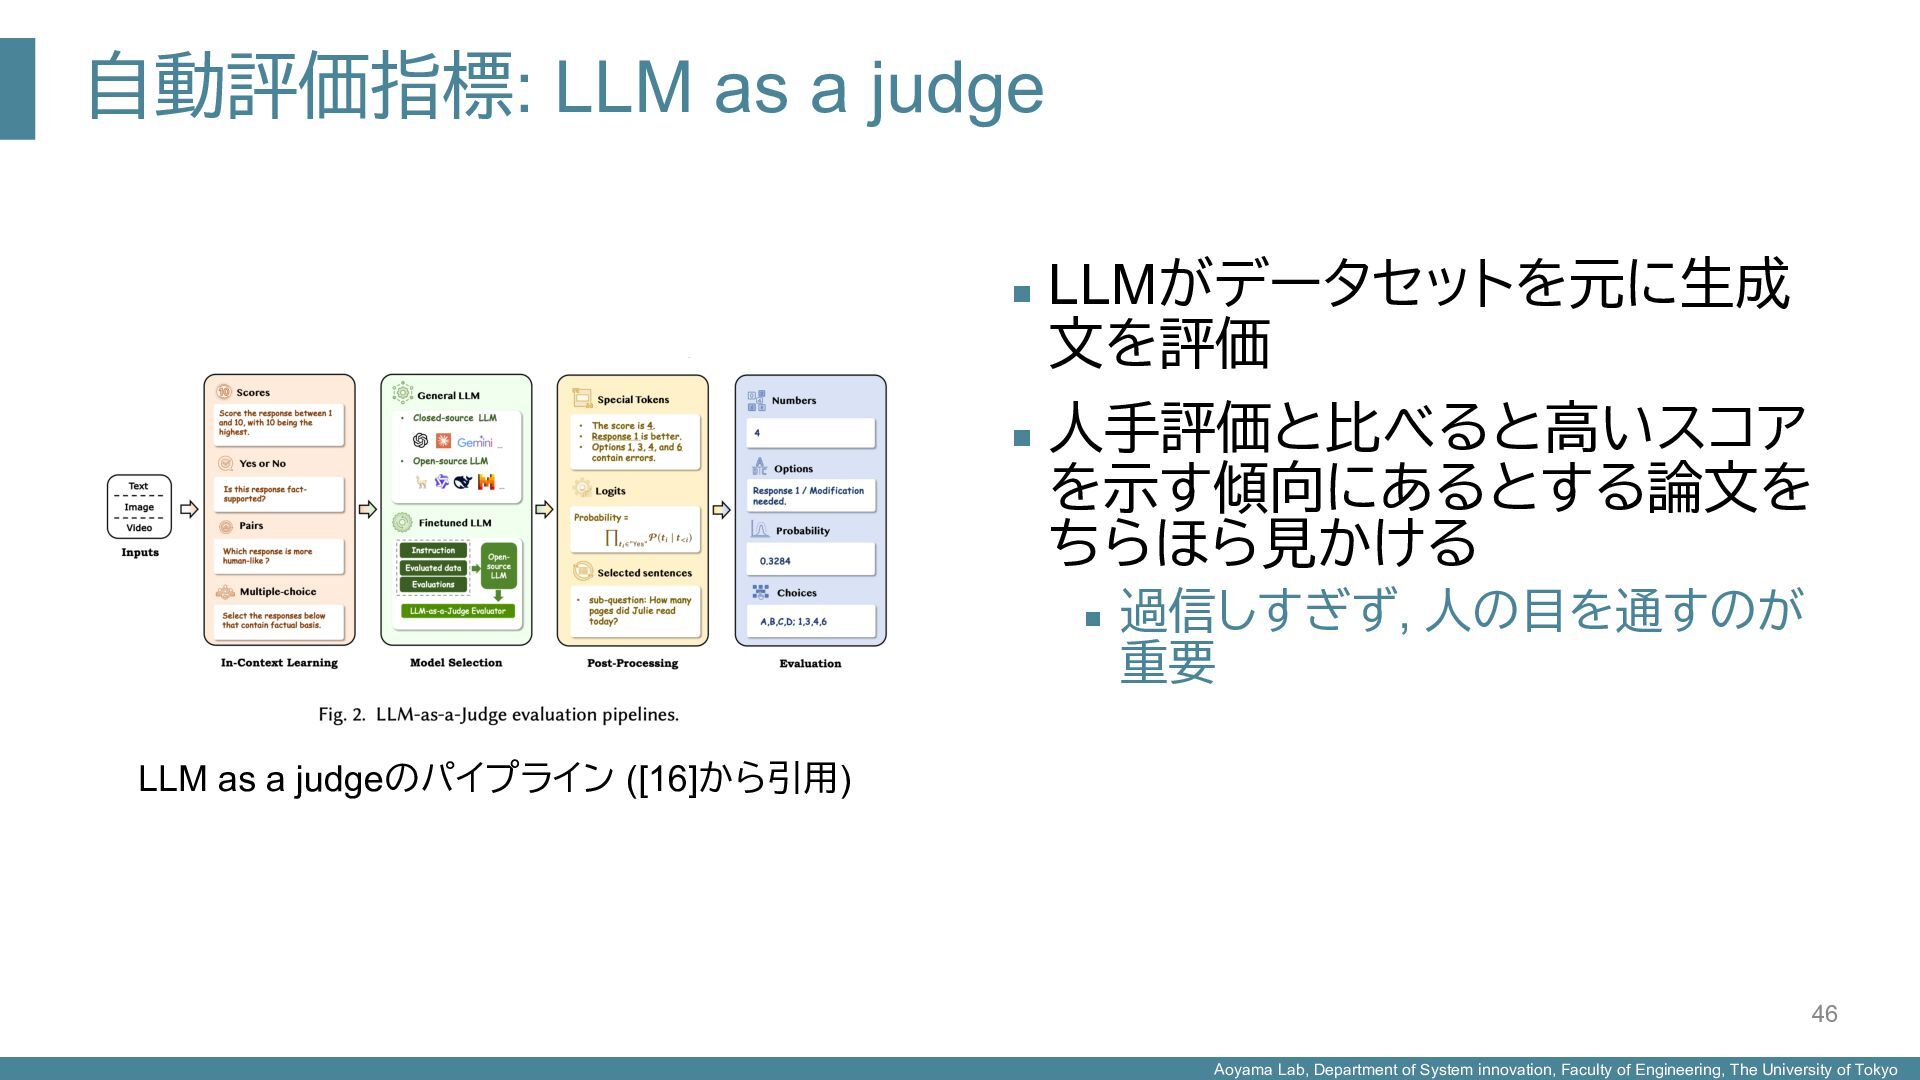
    University of Tokyo 自動評価指標: LLM as a judge n LLMがデータセットを元に生成 文を評価 n 人手評価と比べると高いスコア を示す傾向にあるとする論文を ちらほら見かける n 過信しすぎず, 人の目を通すのが 重要 46 LLM as a judgeのパイプライン ([16]から引用)
  42. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

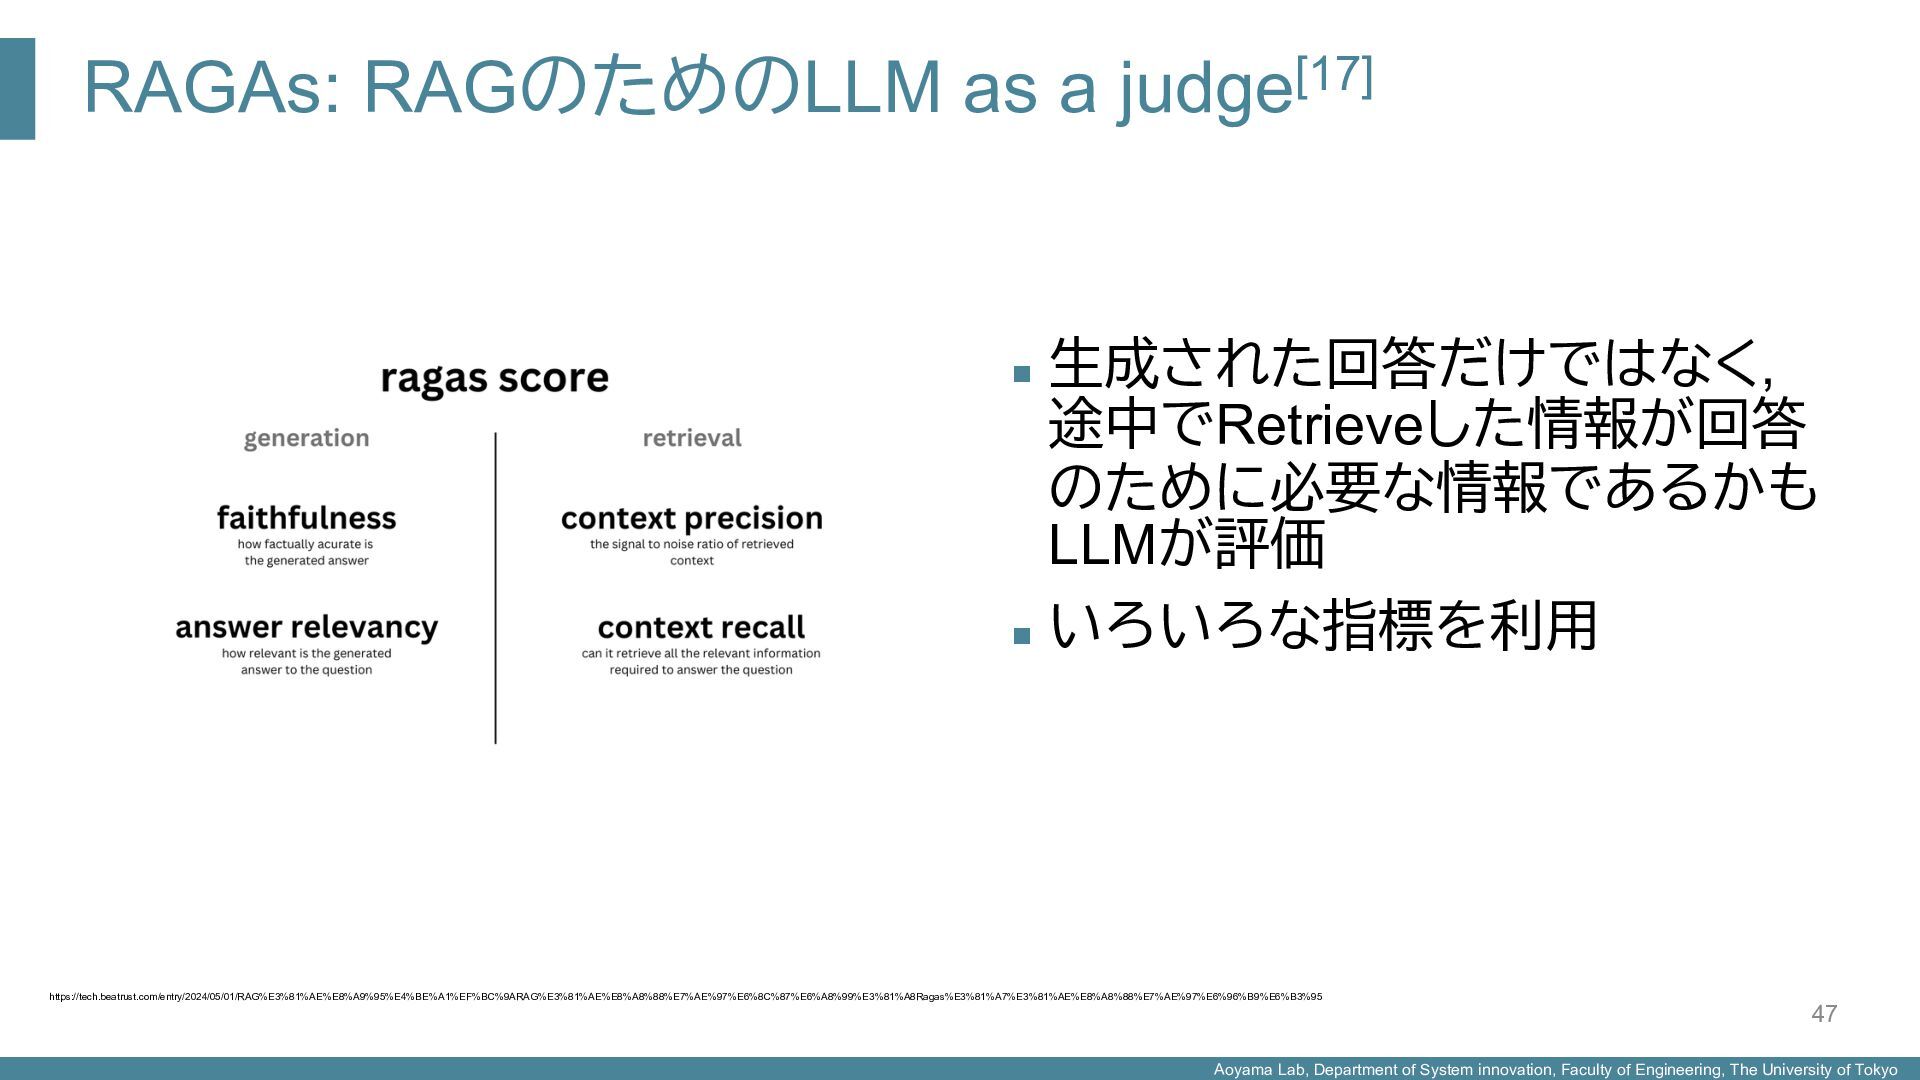
    University of Tokyo RAGAs: RAGのためのLLM as a judge[17] n 生成された回答だけではなく, 途中でRetrieveした情報が回答 のために必要な情報であるかも LLMが評価 n いろいろな指標を利用 47 https://tech.beatrust.com/entry/2024/05/01/RAG%E3%81%AE%E8%A9%95%E4%BE%A1%EF%BC%9ARAG%E3%81%AE%E8%A8%88%E7%AE%97%E6%8C%87%E6%A8%99%E3%81%A8Ragas%E3%81%A7%E3%81%AE%E8%A8%88%E7%AE%97%E6%96%B9%E6%B3%95
  43. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 製造業特有の問題 産業に共通するデータセットが存在しない n 金融, 医療業界ではQ&Aデータセットが多く存在する n 金融ならFinQA[18], 医療ならMedQuAD[19] n 製造業におけるAIのデータセットは画像解析系がほとんど n 企業における固有表現の多さ, 画像の多さがネックであると予想 n 企業がデータを公開したがらないなど 48
  44. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

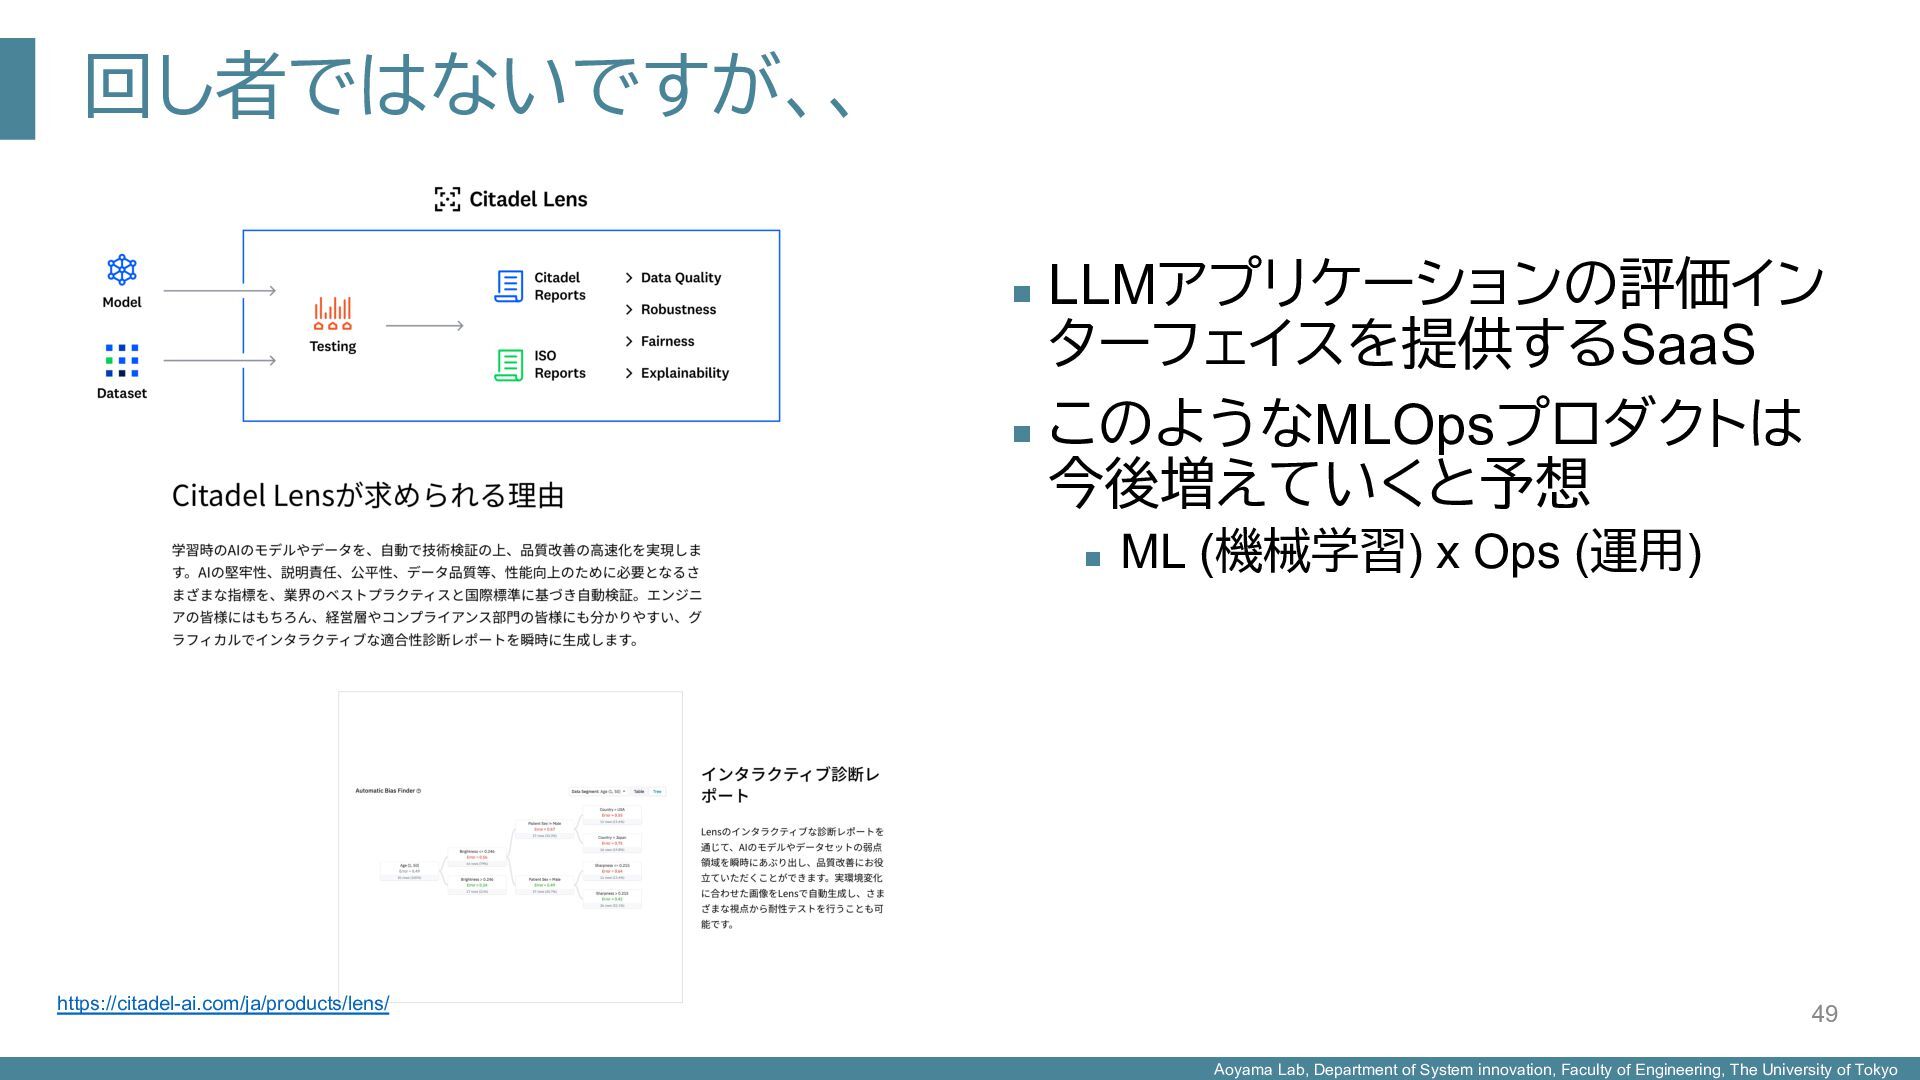
    University of Tokyo 回し者ではないですが、、 n LLMアプリケーションの評価イン ターフェイスを提供するSaaS n このようなMLOpsプロダクトは 今後増えていくと予想 n ML (機械学習) x Ops (運用) 49 https://citadel-ai.com/ja/products/lens/
  45. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 考慮すべきだったこと: パイプライン・評価方法 パイプライン n 故障の原因推定と一言で言っても, それが例えば部品が特定できれば よいのか, 実際に行った操作が特定できればよいのかによってだいぶ 変わってくる n プロンプトに応じてどのタスクを実行するべきかを判定 n タスクに応じたRAGのアプローチを実行=マルチエージェント化 n RAGのパイプラインだけでなく, 利用するデータソースも切り替えるほうが良い 評価方法 n より大局的な内容を含むデータセット n 故障BOMに使われていない文書を用いたデータセットの構築 51
  46. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo 反省事項 n スモールステップで小さい仮説を多く立てて, 実証するサイクルを早く 回す n システム開発全般に言えることですが,, n 変数が多いので, できるだけチームワークで実行する n 自動評価指標だけにこだわらず, 生成文に愚直に向き合う 52
  47. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo References [1]小島 湧太, 坂地 泰紀, 鈴木 雅弘, 中村 格士, 坂田 大晃, 関 和也, 勅使河原 優, 山下 雅己, 青山 和浩.故障解析における事前学習済みSentence- DeBERTaによる拡張ナレッジグラフとクエリ分解を用いたGraphRAG. 言語処理学会第31回年次大会. 2025. [2] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Meng Wang, and Haofen Wang. Retrieval- Augmented Generation for Large Language Models: A Survey, 2024. arXiv preprint. arXiv:2312.10997. [3] Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, and Jonathan Larson. From Local to Global: A Graph RAG Approach to Query-Focused Summarization, 2024. arXiv preprint. arXiv:2404.16130. [4] Boci Peng, Yun Zhu, Yongchao Liu, Xiaohe Bo, Haizhou Shi, Chuntao Hong, Yan Zhang, and Siliang Tang. Graph Retrieval-Augmented Generation: A Survey, 2024. arXiv preprint. arXiv:2408.08921. [5] Jiho Kim, Yeonsu Kwon, Yohan Jo, and Edward Choi. KG-GPT: A General Framework for Reasoning on Knowledge Graphs Using Large Language Models. In Houda Bouamor, Juan Pino, and Kalika Bali, editors, Findings of the Association for Computational Linguistics: EMNLP 2023, pp. 9410–9421, Singapore, December 2023. Association for Computational Linguistics. [6]原祥太, 小澤秀明, 山下雅己, 山田周歩, 坂地泰紀, 青山和浩. 製品情報のテキストマイニングに よる設計開発・保守のナレッジマネジメント. 設計 工学・システム部門講演会講演論文集, Vol. 2022.32, p. 1201, 2022. [7] Hiroki Sakaji, Satoshi Sekine, and Shigeru Masuyama. Extracting Causal Knowledge Using Clue Phrases and Syntactic Patterns. In Practical Aspects of Knowledge Management, pp. 111–122, Berlin, Heidelberg, 2008. Springer Berlin Heidelberg. [8] Linyi Ding, Sizhe Zhou, Jinfeng Xiao, and Jiawei Han. Automated Construction of Theme-specific Knowledge Graphs, 2024. arXiv preprint. arXiv:2404.19146. [9] Bhaskarjit Sarmah, Dhagash Mehta, Benika Hall, Rohan Rao, Sunil Patel, and Stefano Pasquali. Hybridrag: Integrating knowledge graphs and vector retrieval augmented generation for efficient information extraction. In Proceedings of the 5th ACM International Conference on AI in Finance, ICAIF ’24, p. 608âA ¸S616, New York, NY, USA, 2024. Association for ComputingMachinery. 53
  48. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo References [10] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, Wayne Xin Zhao, Zhewei Wei, and Jirong Wen. A survey on large language model based autonomous agents. Frontiers of Computer Science, Vol. 18, No. 6, p. 186345, Mar 2024. [11] Luyu Gao, Xueguang Ma, Jimmy Lin, and Jamie Callan. Precise Zero-Shot Dense Retrieval without Relevance Labels. In Anna Rogers, Jordan Boyd-Graber, and Naoaki Okazaki, editors, Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pp. 1762–1777, Toronto, Canada, July 2023. Association for Computational Linguistics. [12] AngelsBalaguer,VinamraBenara,RenatoLuizdeFreitasCunha,RobertodeM.EstevÃcˇoFilho, Todd Hendry, Daniel Holstein, Jennifer Marsman, Nick Mecklenburg, Sara Malvar, Leonardo O. Nunes, Rafael Padilha, Morris Sharp, Bruno Silva, Swati Sharma, Vijay Aski, and Ranveer Chandra. RAG vs Fine-tuning: Pipelines, Tradeoffs, and a Case Study on Agriculture, 2024. arXiv preprint. arXiv:2401.08406. [13] Yuta Ojima, Hiroki Sakaji, Tadashi Nakamura, Hiroaki Sakata, Kazuya Seki, Yuu Teshigawara, Masami Yamashita, and Kazuhiro Aoyama. Knowledge Management for Automobile Failure Analysis Using Graph RAG. In 2024 IEEE International Conference on Big Data (IEEE BigData 2024), 2024. [14] Chin-Yew Lin. ROUGE: A Package for Automatic Evaluation of Summaries. In Text Summarization Branches Out, pp. 74–81, Barcelona, Spain, July 2004. Association for Computational Linguistics. [15] Tianyi Zhang, Varsha Kishore, Felix Wu, Kilian Q. Weinberger, and Yoav Artzi. BERTScore: Evaluating Text Generation with BERT. In 8th International Conference on Learning Representations, ICLR 2020, Addis Ababa, Ethiopia, April 26-30, 2020, 2020. [16] Jiawei Gu, Xuhui Jiang, Zhichao Shi, Hexiang Tan, Xuehao Zhai, Chengjin Xu, Wei Li, Yinghan Shen, Shengjie Ma, Honghao Liu, Saizhuo Wang, Kun Zhang, Yuanzhuo Wang, Wen Gao, Lionel Ni and Jian Guo. A Survey on LLM-as-a-Judge, 2024. arXiv preprint. arXiv:2411.15594 [17] Shahul Es, Jithin James, Luis Espinosa Anke, and Steven Schockaert. RAGAs: Automated Evaluation of Retrieval Augmented Generation. In Nikolaos Aletras and Orphee De Clercq, editors, Proceedings of the 18th Conference of the European Chapter of the Association for Computational Linguistics: System Demonstrations, pp. 150–158, St. Julians, Malta, March 2024. Association for Computational Linguistics. 54
  49. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo References [18] Zhiyu Chen, Wenhu Chen, Charese Smiley, Sameena Shah, Iana Borova, Dylan Langdon, Reema Moussa, Matt Beane, Ting-Hao Huang, Bryan Routledge, and William Yang Wang. FinQA: A Dataset of Numerical Reasoning over Financial Data. In Marie-Francine Moens, Xuanjing Huang, Lucia Specia, and Scott Wen-tau Yih, editors, Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, pp. 3697–3711, Online and Punta Cana, Dominican Republic, November 2021. Association for Computational Linguistics. [19] Asma Ben Abacha and Dina Demner-Fushman. A question-entailment approach to question answering. BMC Bioinformatics, Vol. 20, No. 1, p. 511, Oct 2019. 55
  50. Aoyama Lab, Department of System innovation, Faculty of Engineering, The

    University of Tokyo References: others n 斎藤彰. AI の進化は故障解析に何をもたらすのか ~その期待とリスク~. 日本信頼性学会 誌 信頼性, Vol. 40, No. 2, pp. 64–71, 2018. n Long Ouyang, Jeff Wu, Xu Jiang, Diogo Almeida, Carroll L. Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul Christiano, Jan Leike, and Ryan Lowe. Training language models to follow instructions with human feed- back. In Proceedings of the 36th International Conference on Neural Information Processing Systems, NIPS ’22, Red Hook, NY, USA, 2024. Curran Associates Inc. n Linyao Yang, Hongyang Chen, Zhao Li, Xiao Ding, and Xindong Wu. Give us the Facts: Enhancing Large Language Models With Knowledge Graphs for Fact-Aware Language Modeling. IEEE Transactions on Knowledge and Data Engineering, Vol. PP, pp. 1– 20, 07 2024. n Pengcheng He, Xiaodong Liu, Jianfeng Gao, and Weizhu Chen. DeBERTa: Decoding-enhanced BERT with Disentangled Attention. In International Conference on Learning Representations, 2021. n Nils Reimers and Iryna Gurevych. Sentence-BERT: Sentence Embeddings using Siamese BERT- Networks. In Kentaro Inui, Jing Jiang, Vincent Ng, and Xiaojun Wan, editors, Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th Inter- national Joint Conference on Natural Language Processing (EMNLP- IJCNLP), pp. 3982–3992, Hong Kong, China, November 2019. Association for Computational Linguistics. n Hiroki Sakaji, Masahiro Suzuki, Kiyoshi Izumi, and Hiroyuki Mitsugi. Gradual Further Pre-training Architecture for Economics/Finance Domain Adaptation of Language Model. In 2022 IEEE international Conference on Big Data (Big Data), pp.2352–2355, 2022. 56