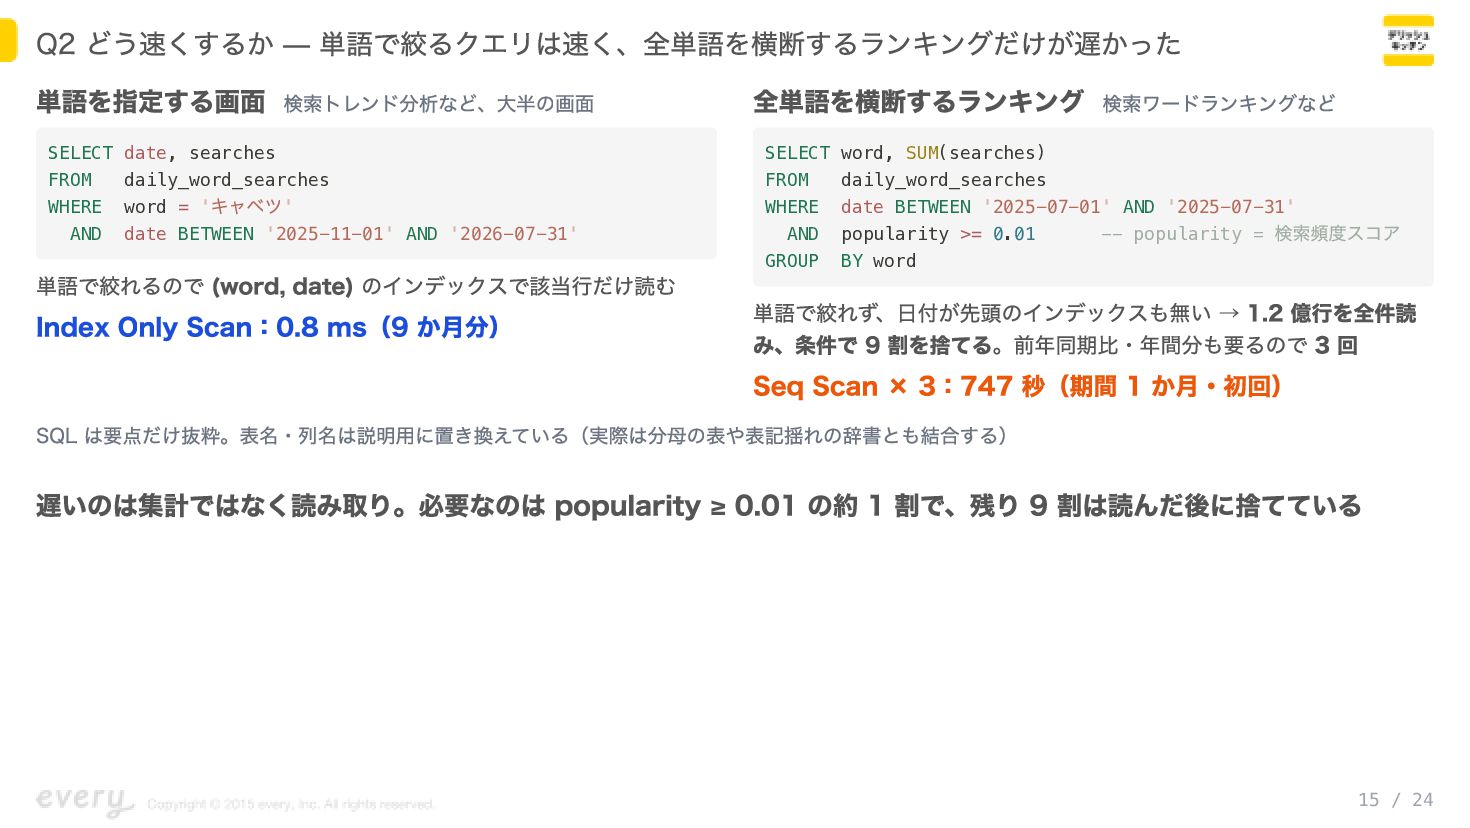
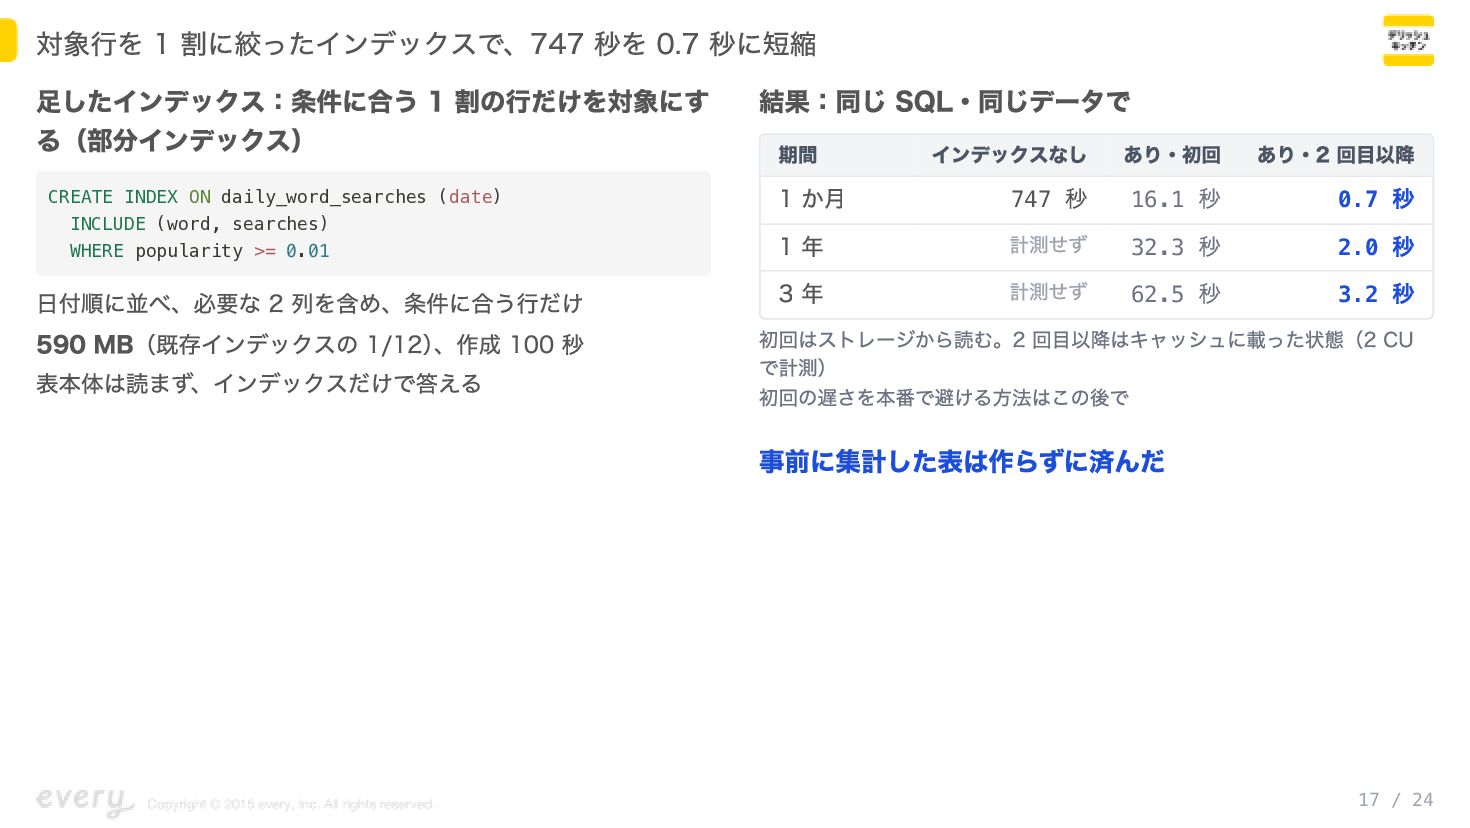
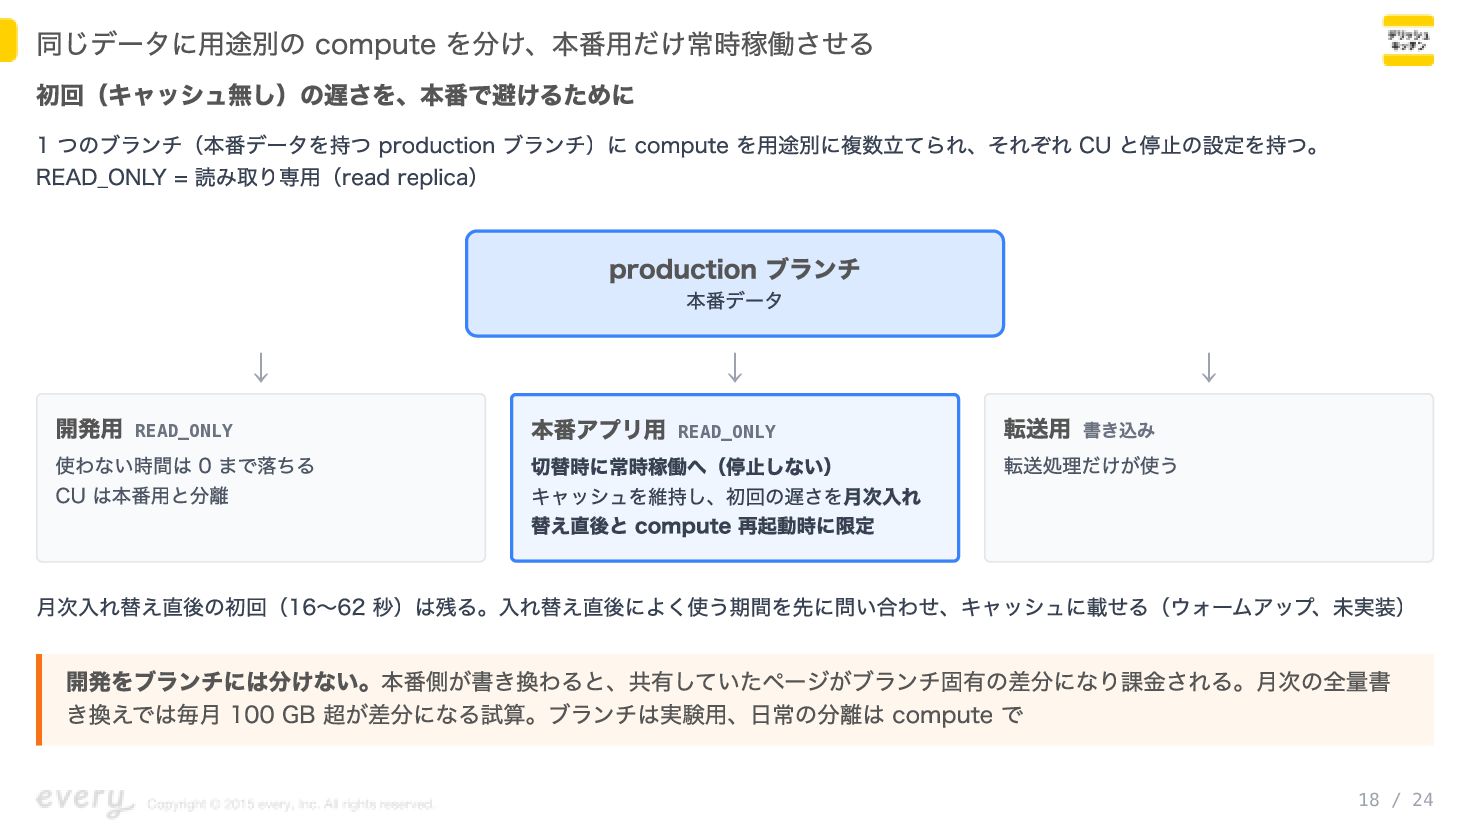
searches FROM daily_word_searches WHERE word = ' ' AND date BETWEEN '2025-11-01' AND '2026-07-31' SELECT word, SUM(searches) FROM daily_word_searches WHERE date BETWEEN '2025-07-01' AND '2025-07-31' AND popularity >= 0.01 -- popularity = GROUP BY word キャベツ 単語で絞れるので (word, date) のインデックスで該当行だけ読む Index Only Scan:0.8 ms(9 か月分) 検索頻度スコア 単語で絞れず、日付が先頭のインデックスも無い → 1.2 億行を全件読 み、条件で 9 割を捨てる。前年同期比・年間分も要るので 3 回 Seq Scan × 3:747 秒(期間 1 か月・初回) SQL は要点だけ抜粋。表名・列名は説明用に置き換えている(実際は分母の表や表記揺れの辞書とも結合する) 遅いのは集計ではなく読み取り。必要なのは popularity ≥ 0.01 の約 1 割で、残り 9 割は読んだ後に捨てている 15 / 24


 everypr
 katarinadahlin
 davetheseo
 jacobtomlinson
 stephaniewalter
 holman
 cassininazir
 szymonslowik
 keathley
 chriscoyier
 soudai
 bluesmoon
 62gerente