Upgrade to Pro — share decks privately, control downloads, hide ads and more …

「全部送る」をやめる New Relic データ設計

Avatar for Fukuda-K Fukuda-K
June 17, 2026
39

「全部送る」をやめる New Relic データ設計

2026年5月26日に開催された「New Relic Advance NEXT」におけるLT資料です。
https://newrelic.com/jp/event/new-relic-advance-next

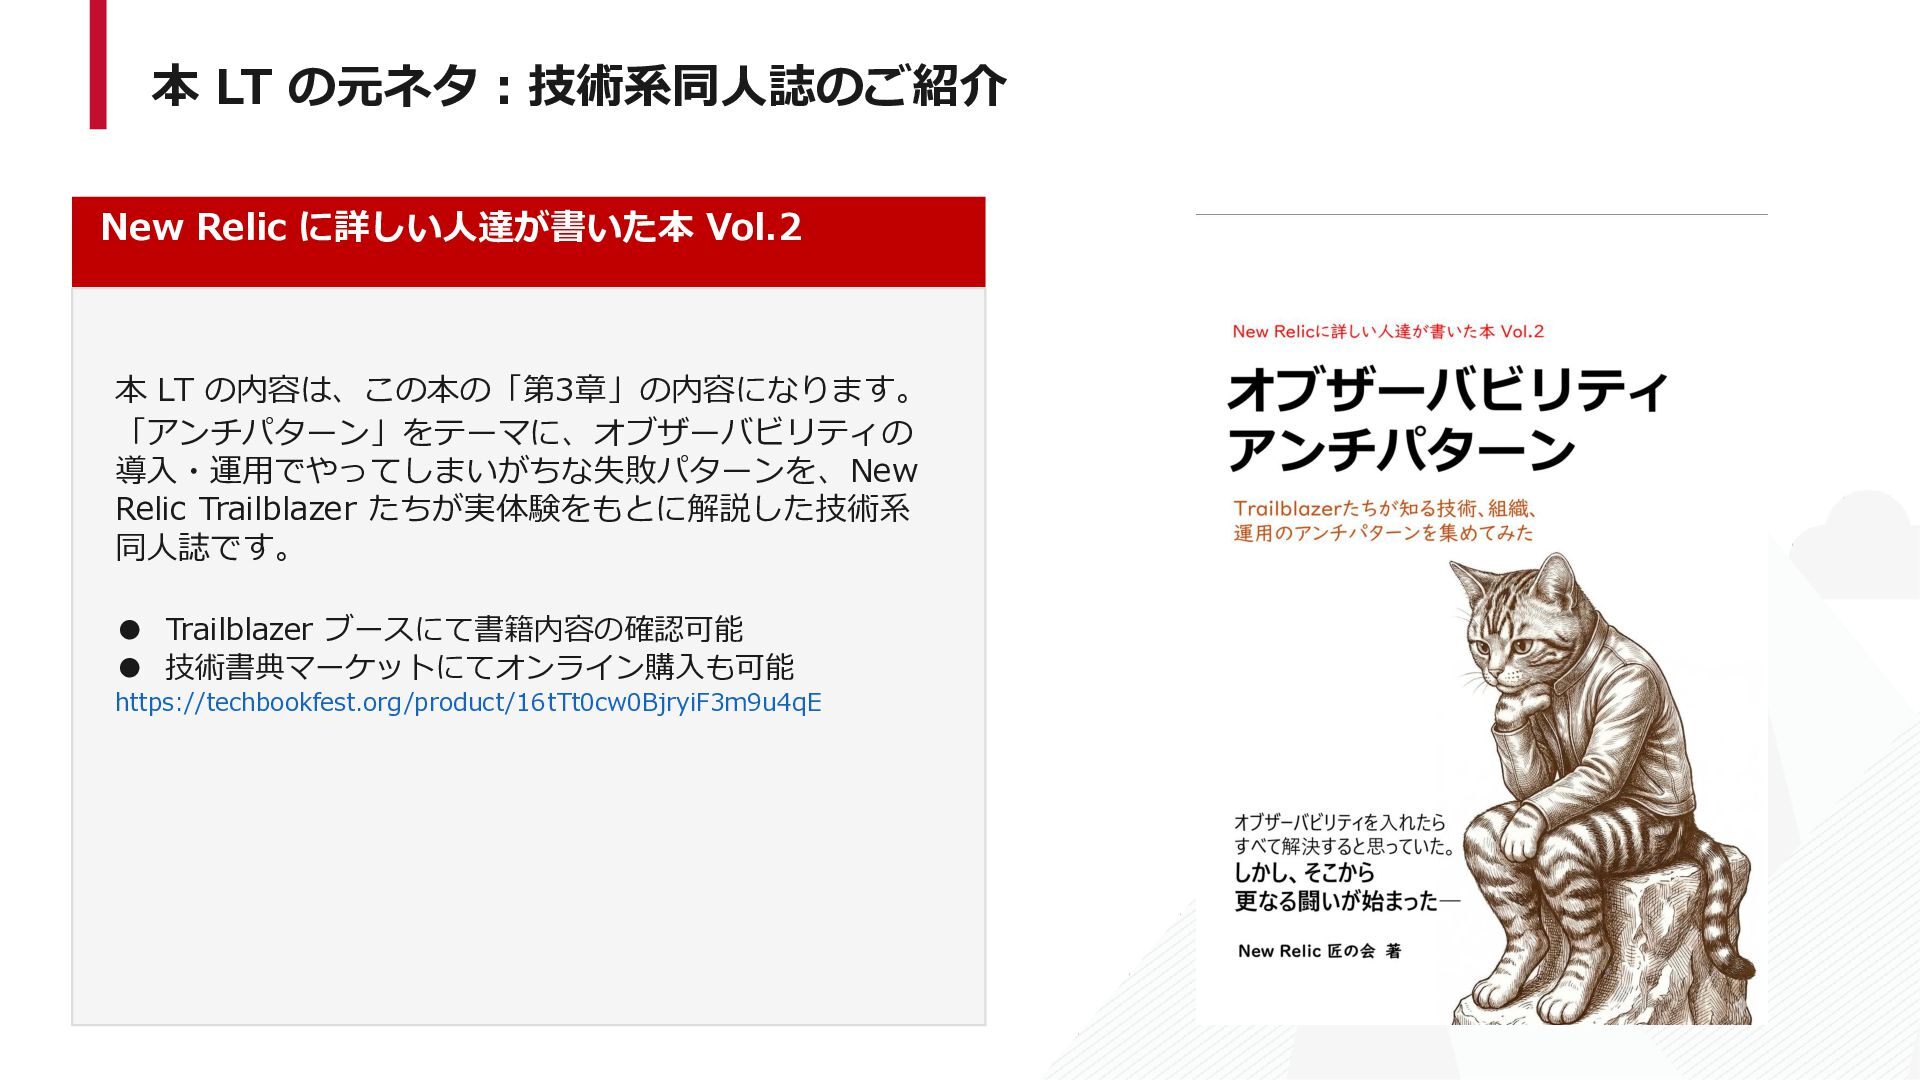
技術書典20にて頒布いたしましたNew Relic Trailblazerの有志が、 オブザーバビリティにまつわる 「アンチパターン」を持ち寄った技術同人誌『オブザーバビリティアンチパターン』にて私が担当した第3章の内容に関するLT資料になります。

Avatar for Fukuda-K

Fukuda-K

June 17, 2026

Transcript

  1. 2 自己紹介 氏名 • 福田 圭 (ふくだ けい) 所属 •

    株式会社サーバーワークス • 主にお客様へNew Relicの導入支援をしております • New Relic Trailblazer New Relic Trailblazerとは • 各New Relicパートナー企業から、オブザーバビリティの普及をリードする現役エンジニアが 選出されたグループ • 登壇・執筆・同人誌制作など、コミュニティ活動も一緒にやっています
  2. 本 LT の元ネタ:技術系同人誌のご紹介 New Relic に詳しい人達が書いた本 Vol.2 本 LT の内容は、この本の「第3章」の内容になります。

    「アンチパターン」をテーマに、オブザーバビリティの 導入・運用でやってしまいがちな失敗パターンを、New Relic Trailblazer たちが実体験をもとに解説した技術系 同人誌です。 • Trailblazer ブースにて書籍内容の確認可能 • 技術書典マーケットにてオンライン購入も可能 https://techbookfest.org/product/16tTt0cw0BjryiF3m9u4qE
  3. 01 オブザーバビリティとは何か、なぜ New Relic が必要か 02 「全部送る」が招く 3 つの問題とその構造 03

    解決策:目的から逆算するデータ設計とダッシュボード運用 04 実践:障害対応フロー設計と段階的なデータ拡張 本日のアジェンダ
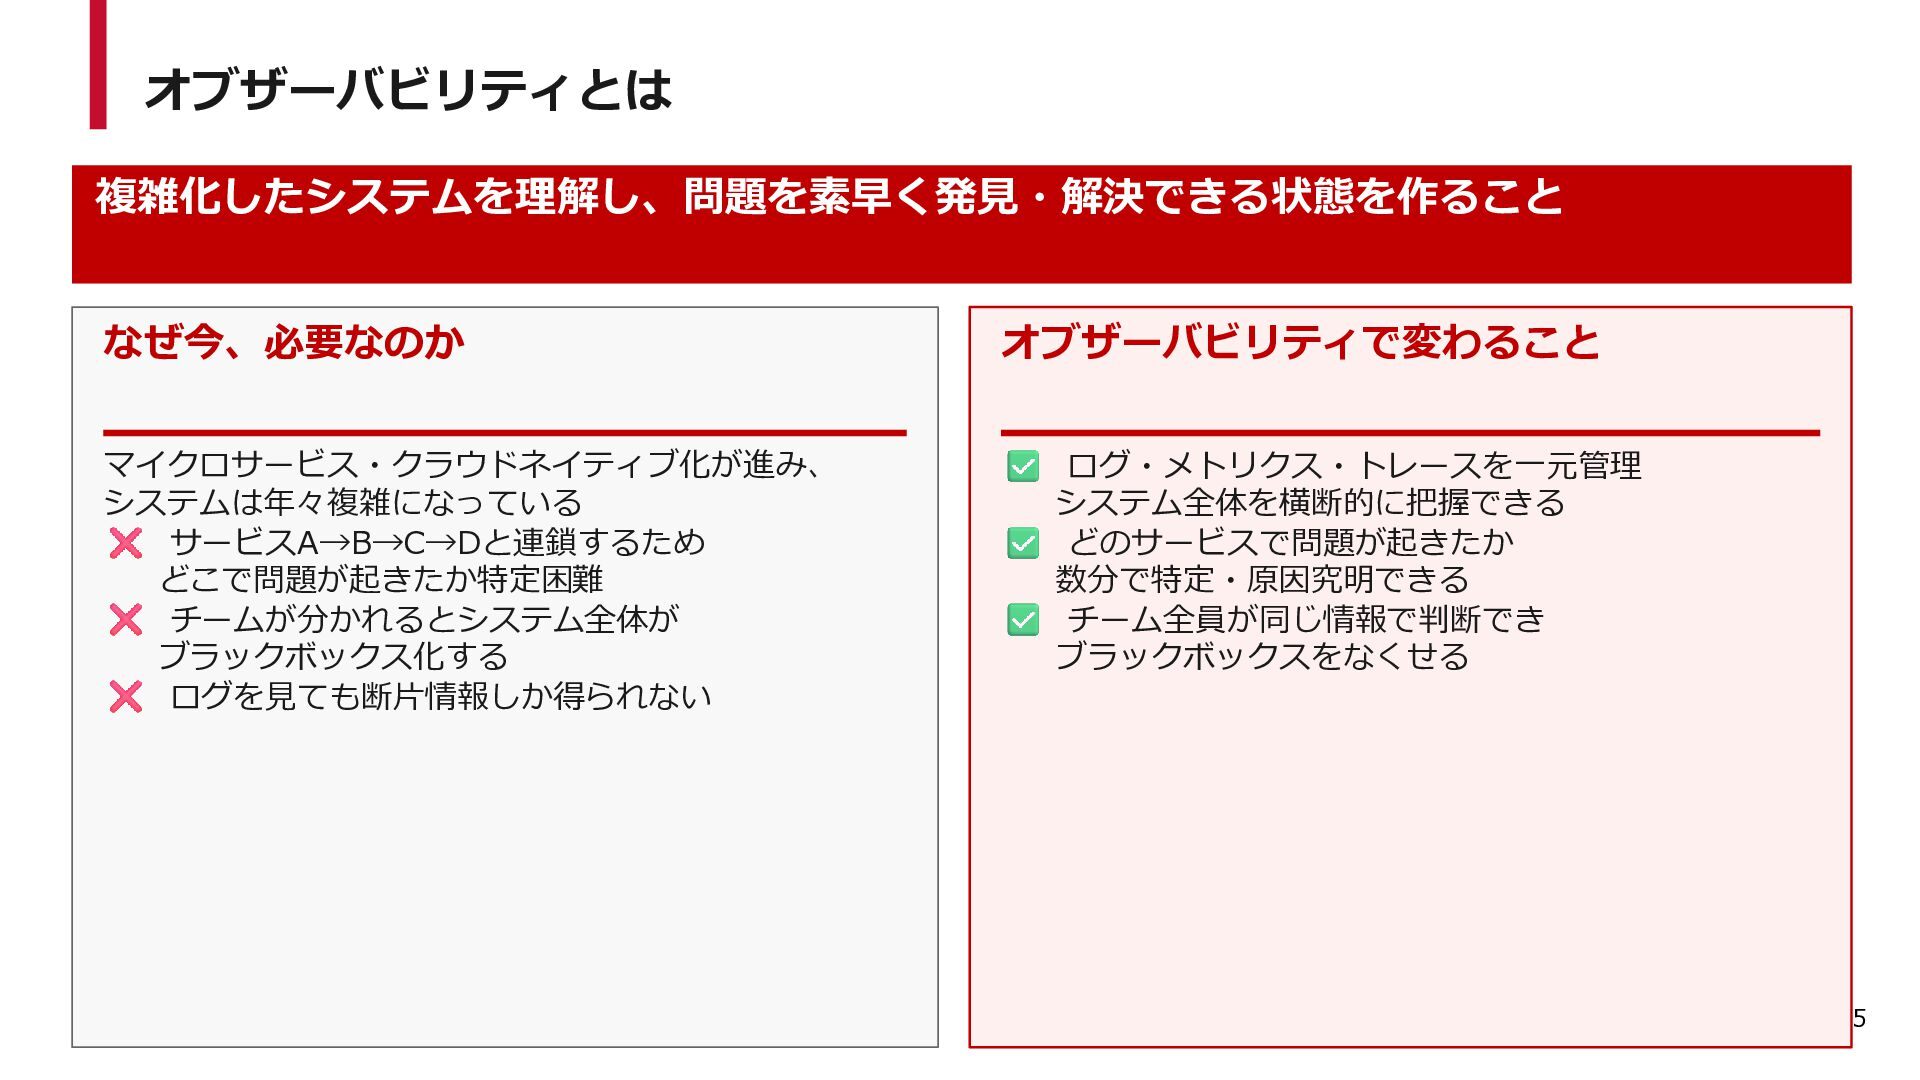
  4. 5 オブザーバビリティとは 複雑化したシステムの「内側」を理解し、問題を素早く発見・解決できる状態を作ること 複雑化したシステムを理解し、問題を素早く発見・解決できる状態を作ること なぜ今、必要なのか マイクロサービス・クラウドネイティブ化が進み、 システムは年々複雑になっている サービスA→B→C→Dと連鎖するため どこで問題が起きたか特定困難 チームが分かれるとシステム全体が

    ブラックボックス化する ログを見ても断片情報しか得られない オブザーバビリティで変わること ログ・メトリクス・トレースを一元管理 システム全体を横断的に把握できる どのサービスで問題が起きたか 数分で特定・原因究明できる チーム全員が同じ情報で判断でき ブラックボックスをなくせる
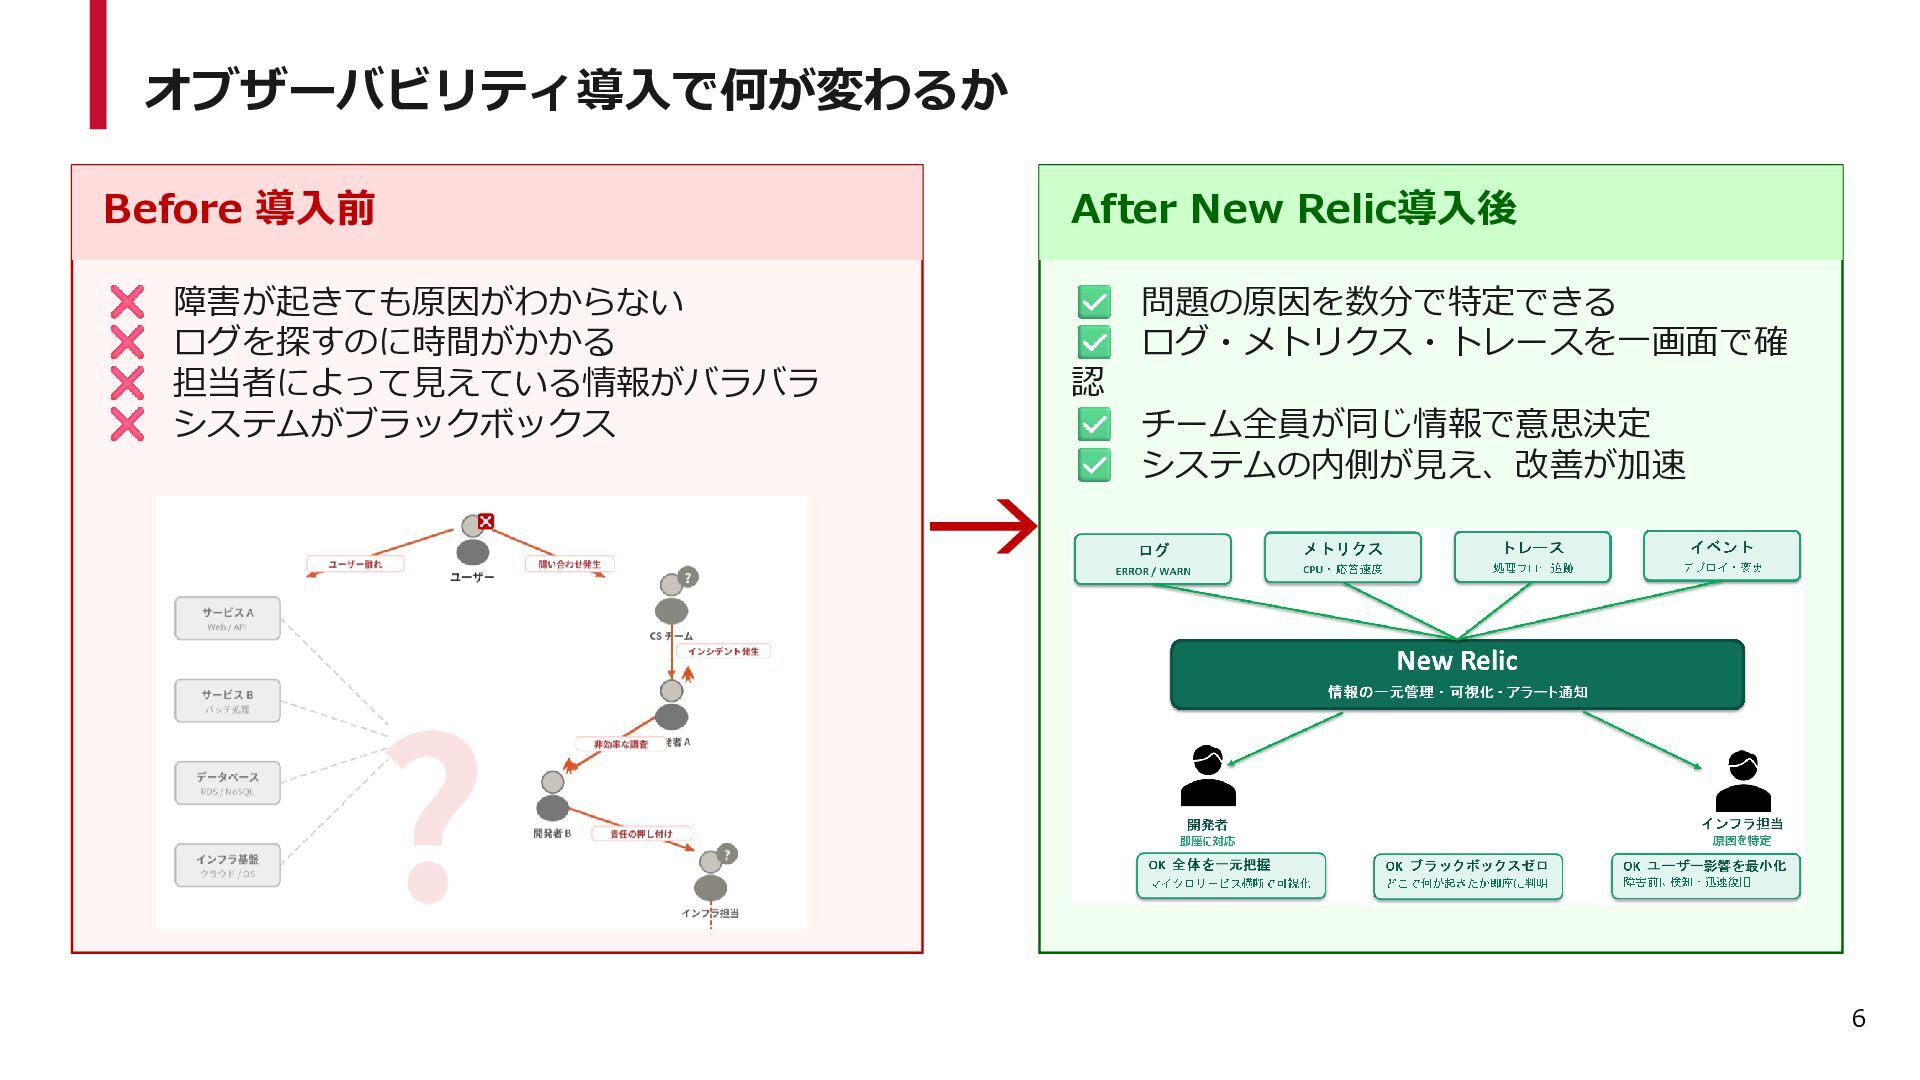
  5. 6 Before 導入前 障害が起きても原因がわからない ログを探すのに時間がかかる 担当者によって見えている情報がバラバラ システムがブラックボックス → After New

    Relic導入後 問題の原因を数分で特定できる ログ・メトリクス・トレースを一画面で確 認 チーム全員が同じ情報で意思決定 システムの内側が見え、改善が加速 オブザーバビリティ導入で何が変わるか
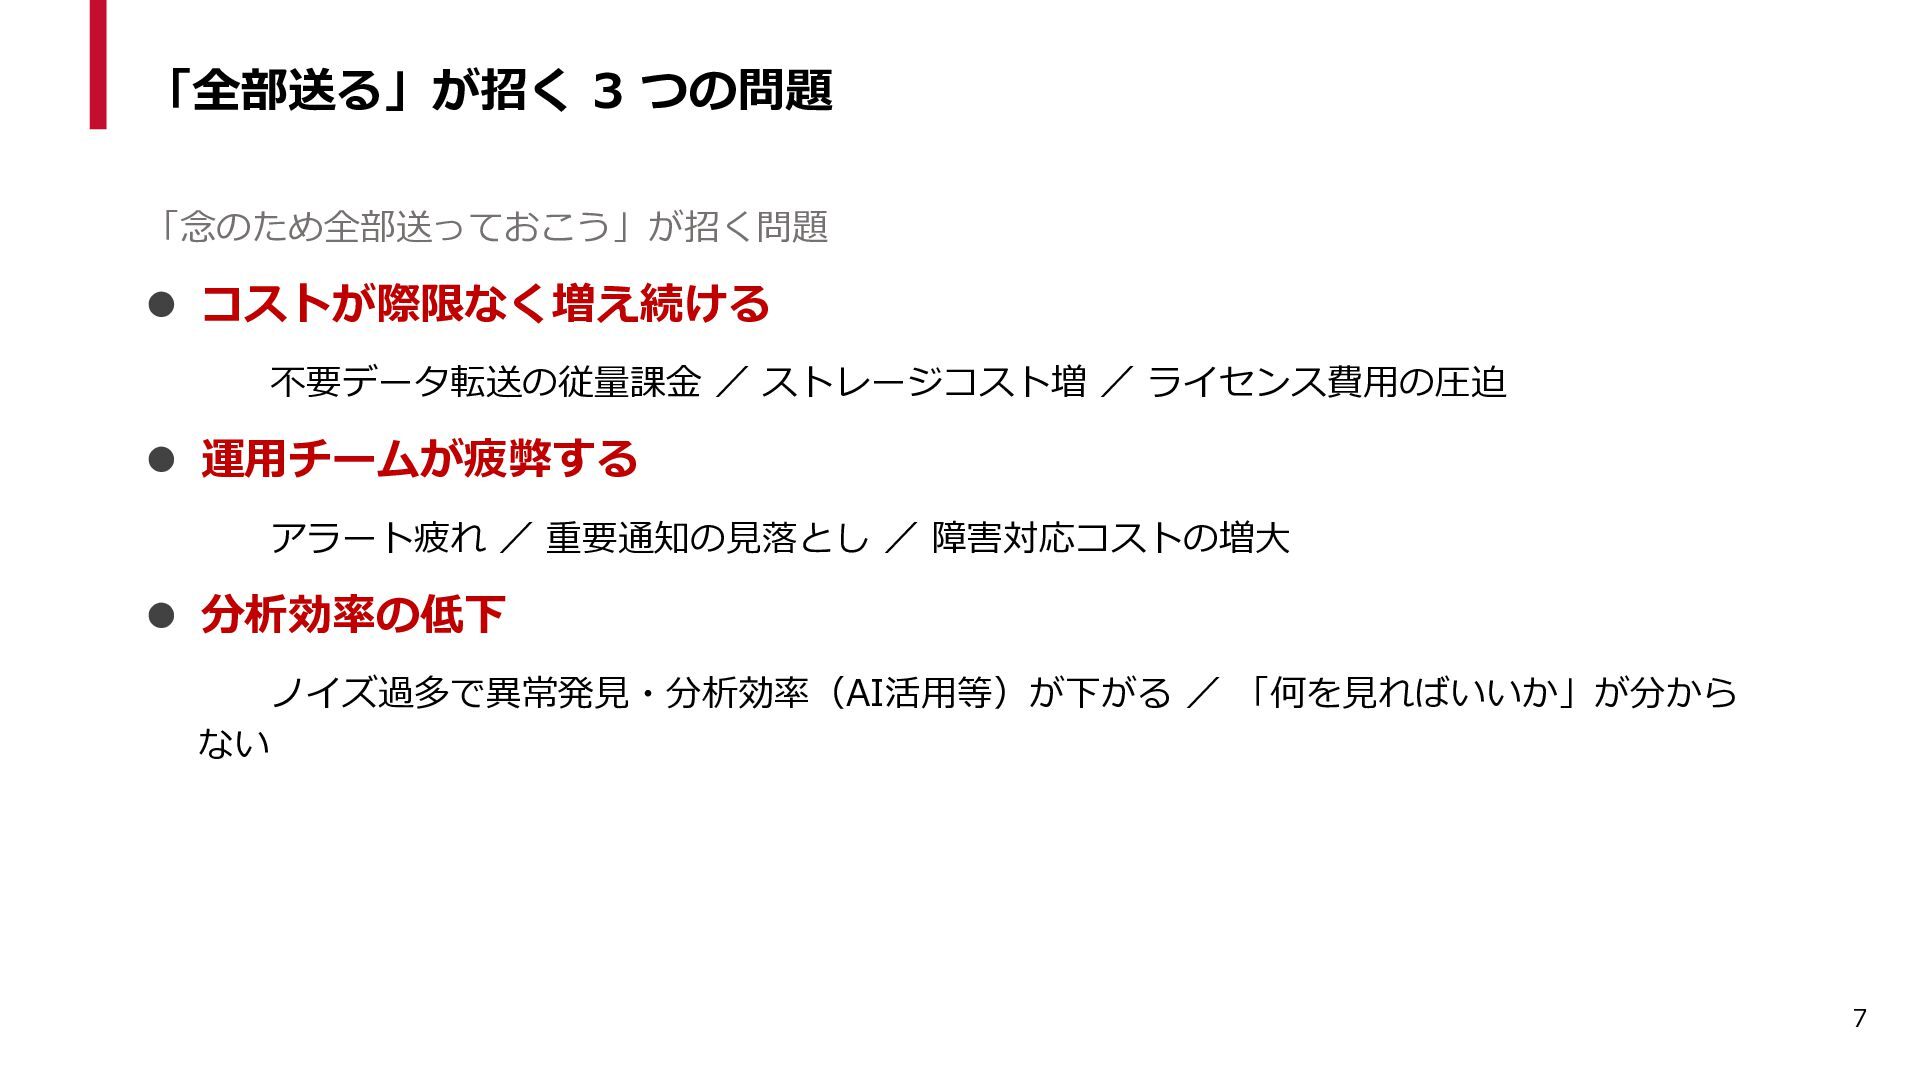
  6. 7 「全部送る」が招く 3 つの問題 「念のため全部送っておこう」が招く問題 ⚫ コストが際限なく増え続ける 不要データ転送の従量課金 / ストレージコスト増

    / ライセンス費用の圧迫 ⚫ 運用チームが疲弊する アラート疲れ / 重要通知の見落とし / 障害対応コストの増大 ⚫ 分析効率の低下 ノイズ過多で異常発見・分析効率(AI活用等)が下がる / 「何を見ればいいか」が分から ない
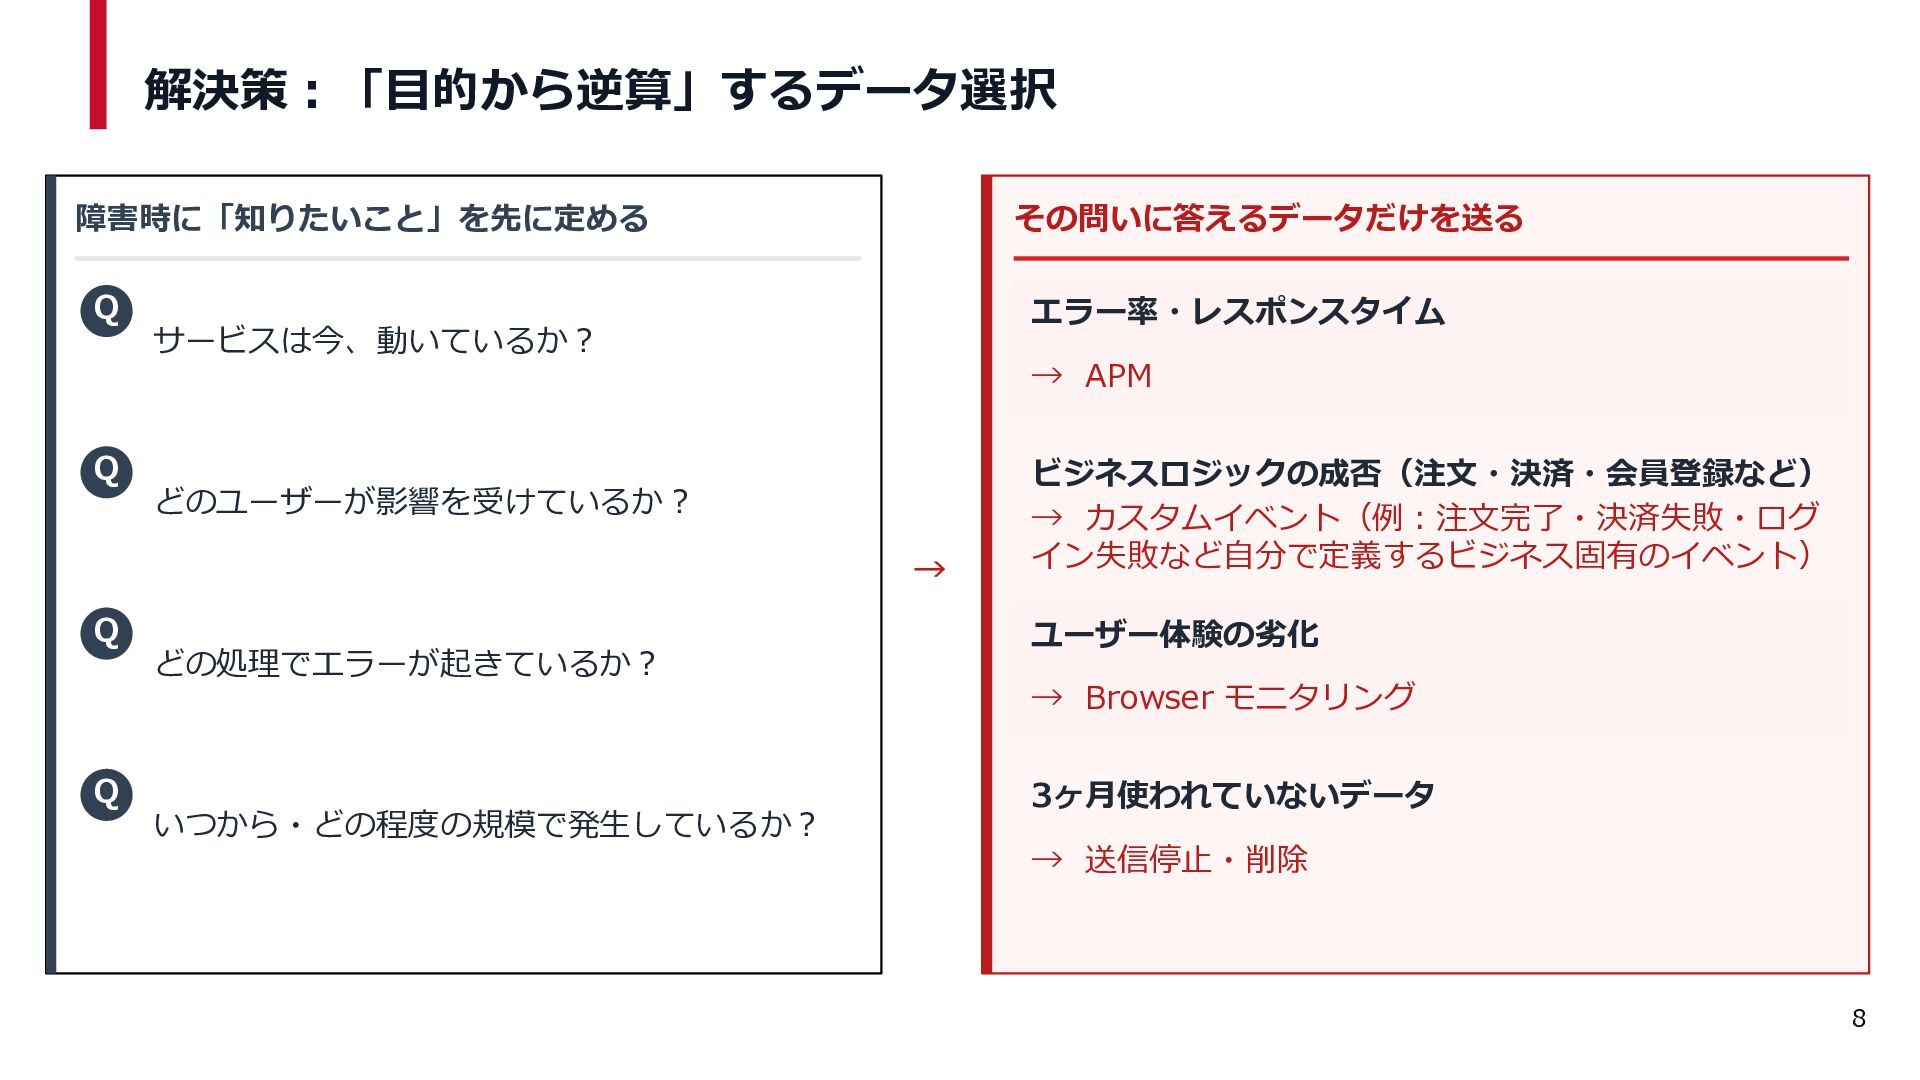
  7. 8 障害時に「知りたいこと」を先に定める Q サービスは今、動いているか? Q どのユーザーが影響を受けているか? Q どの処理でエラーが起きているか? Q いつから・どの程度の規模で発生しているか?

    → その問いに答えるデータだけを送る エラー率・レスポンスタイム → APM ビジネスロジックの成否(注文・決済・会員登録など) → カスタムイベント(例:注文完了・決済失敗・ログ イン失敗など自分で定義するビジネス固有のイベント) ユーザー体験の劣化 → Browser モニタリング 3ヶ月使われていないデータ → 送信停止・削除 解決策:「目的から逆算」するデータ選択
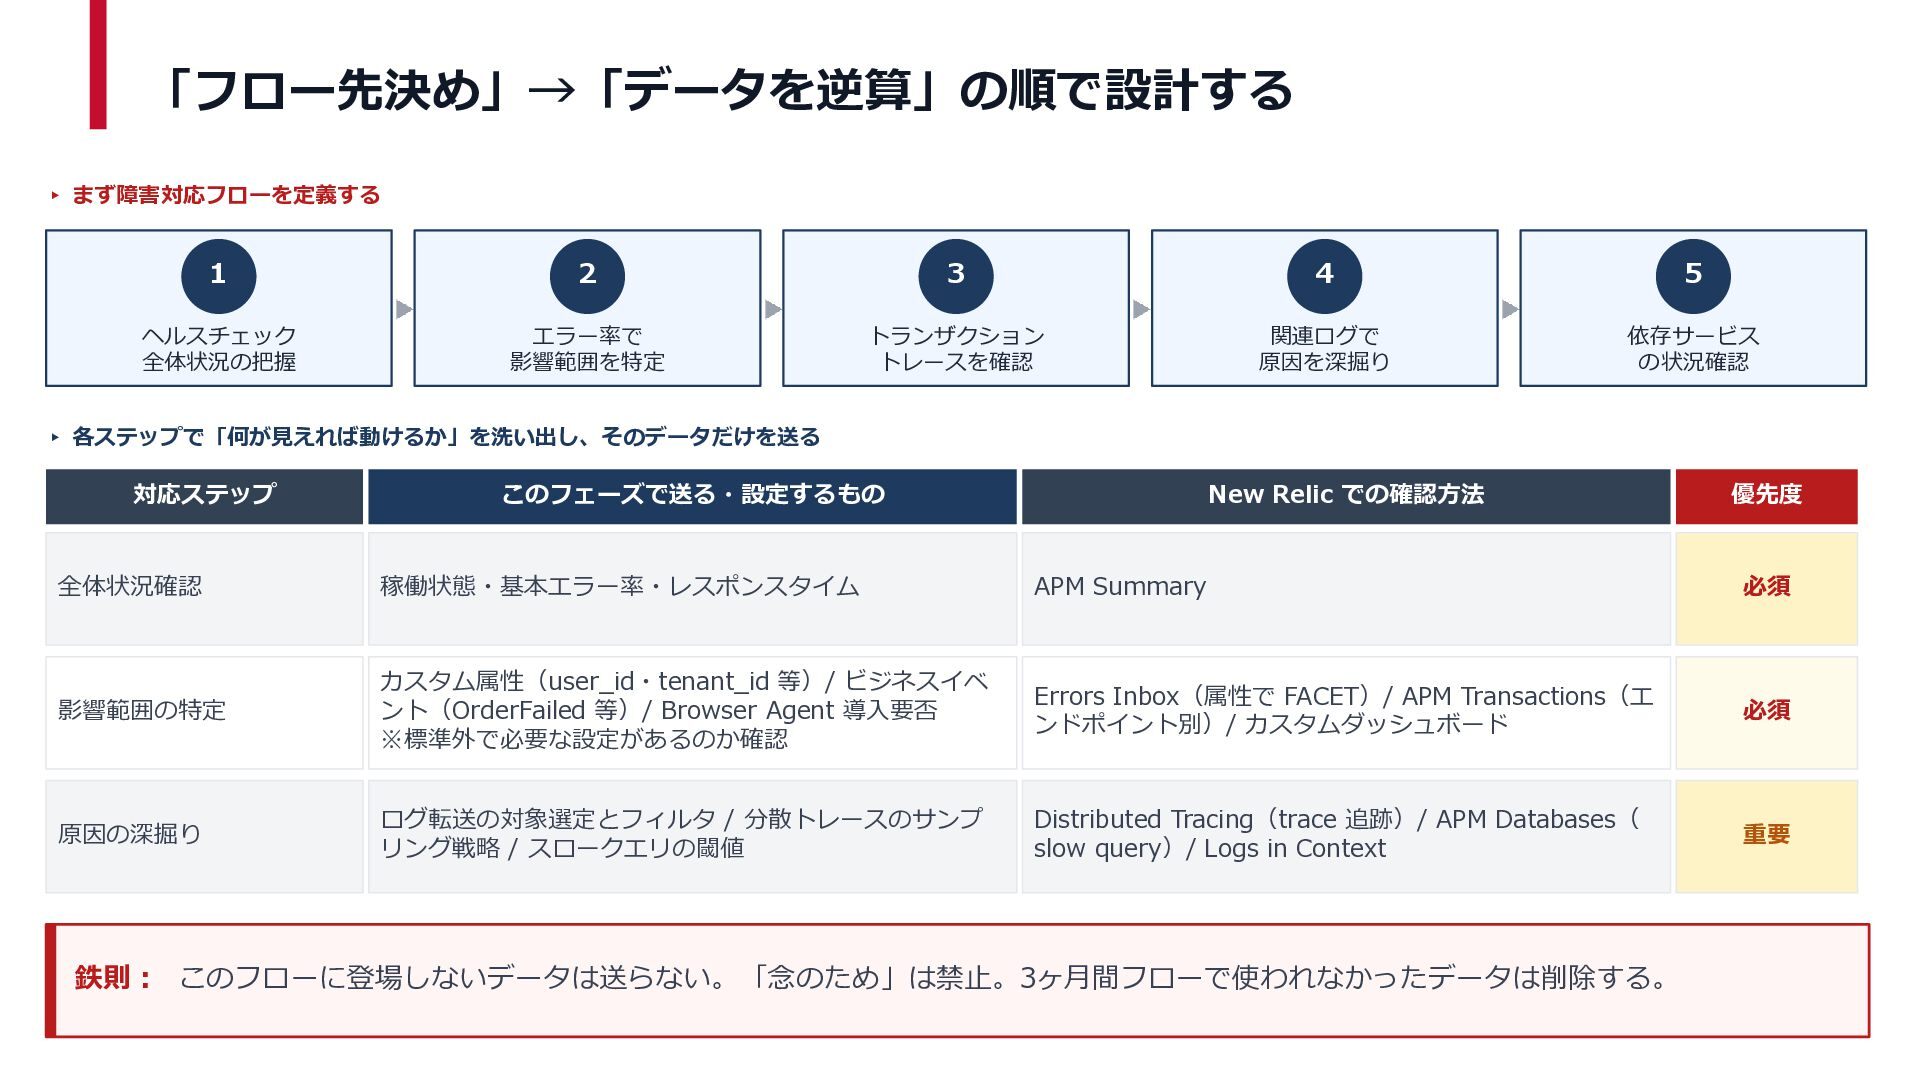
  8. 9 ▸ まず障害対応フローを定義する 1 ヘルスチェック 全体状況の把握 2 エラー率で 影響範囲を特定 3

    トランザクション トレースを確認 4 関連ログで 原因を深掘り 5 依存サービス の状況確認 ▸ 各ステップで「何が見えれば動けるか」を洗い出し、そのデータだけを送る 対応ステップ このフェーズで送る・設定するもの New Relic での確認方法 優先度 全体状況確認 稼働状態・基本エラー率・レスポンスタイム APM Summary 必須 影響範囲の特定 カスタム属性(user_id・tenant_id 等)/ ビジネスイベ ント(OrderFailed 等)/ Browser Agent 導入要否 ※標準外で必要な設定があるのか確認 Errors Inbox(属性で FACET)/ APM Transactions(エ ンドポイント別)/ カスタムダッシュボード 必須 原因の深掘り ログ転送の対象選定とフィルタ / 分散トレースのサンプ リング戦略 / スロークエリの閾値 Distributed Tracing(trace 追跡)/ APM Databases( slow query)/ Logs in Context 重要 鉄則: このフローに登場しないデータは送らない。「念のため」は禁止。3ヶ月間フローで使われなかったデータは削除する。 「フロー先決め」→「データを逆算」の順で設計する
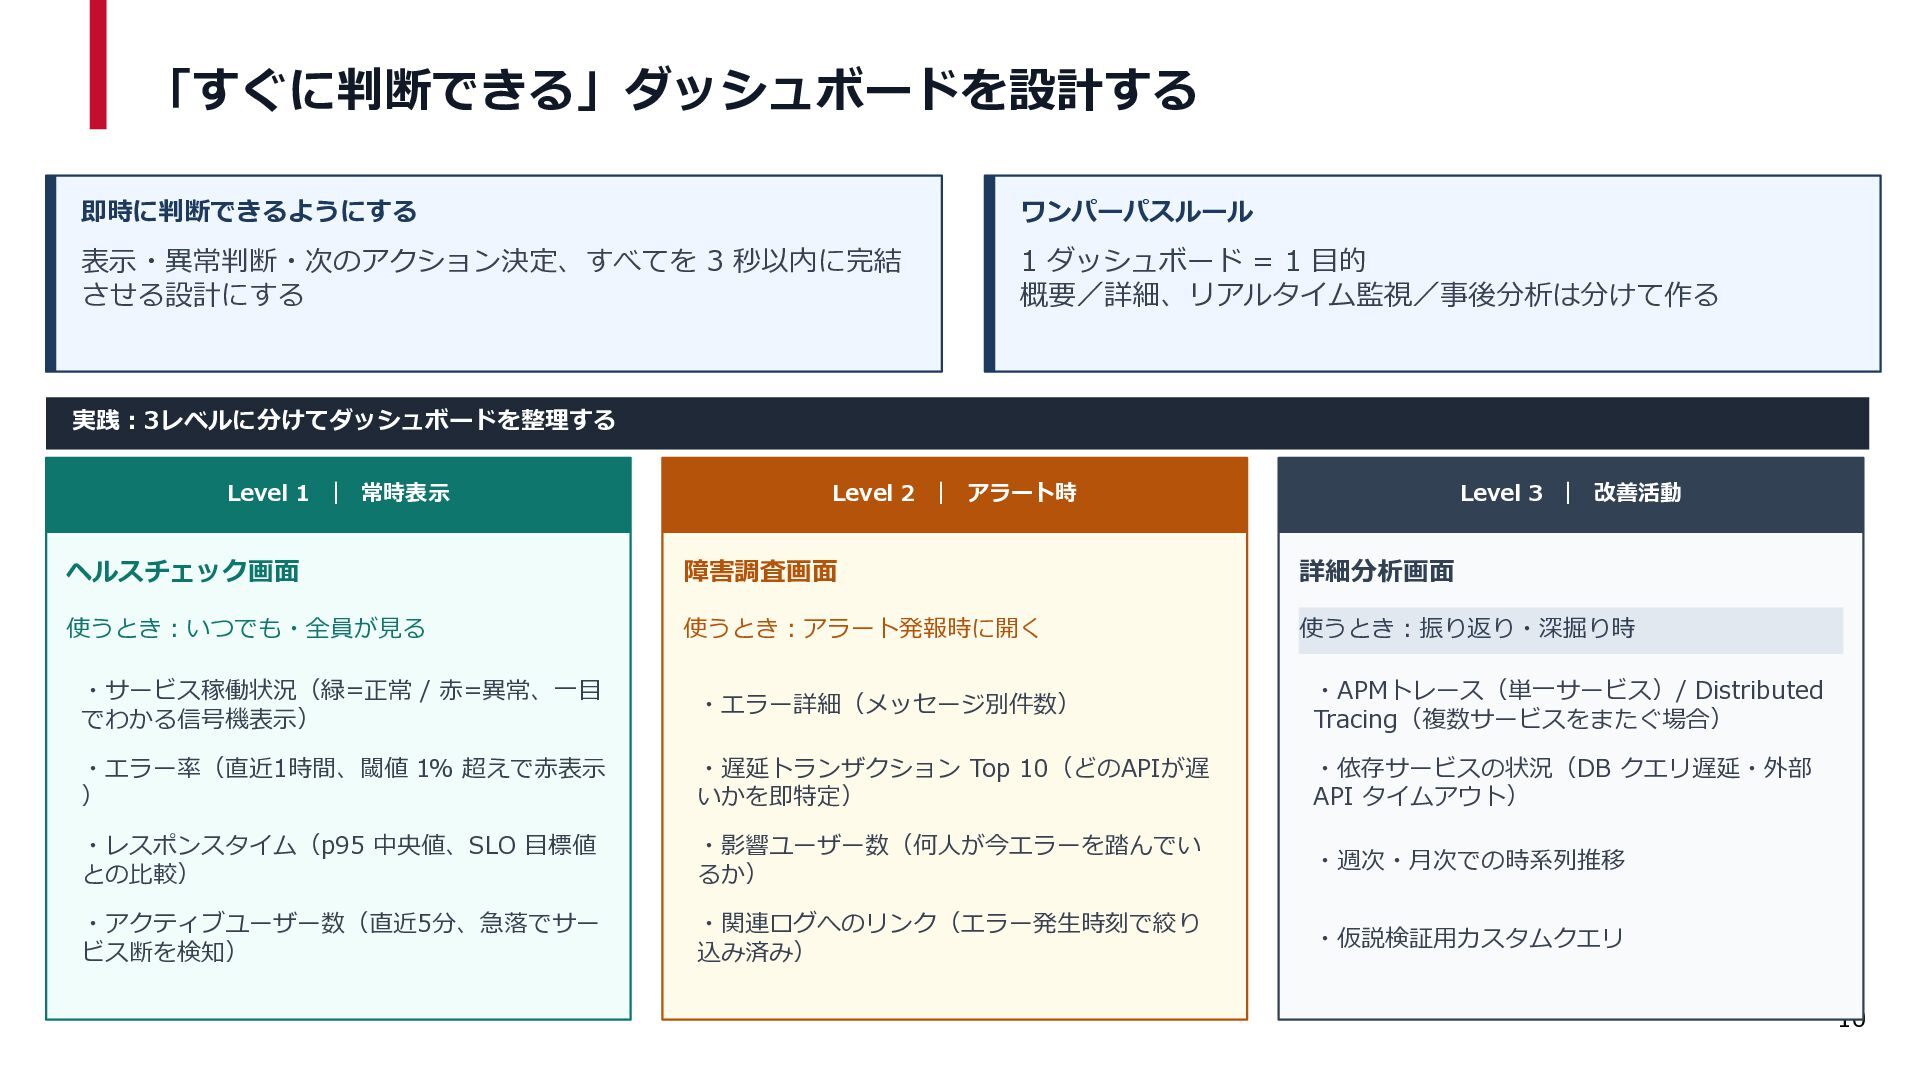
  9. 10 即時に判断できるようにする 表示・異常判断・次のアクション決定、すべてを 3 秒以内に完結 させる設計にする ワンパーパスルール 1 ダッシュボード =

    1 目的 概要/詳細、リアルタイム監視/事後分析は分けて作る 実践:3レベルに分けてダッシュボードを整理する Level 1 | 常時表示 ヘルスチェック画面 使うとき:いつでも・全員が見る ・サービス稼働状況(緑=正常 / 赤=異常、一目 でわかる信号機表示) ・エラー率(直近1時間、閾値 1% 超えで赤表示 ) ・レスポンスタイム(p95 中央値、SLO 目標値 との比較) ・アクティブユーザー数(直近5分、急落でサー ビス断を検知) Level 2 | アラート時 障害調査画面 使うとき:アラート発報時に開く ・エラー詳細(メッセージ別件数) ・遅延トランザクション Top 10(どのAPIが遅 いかを即特定) ・影響ユーザー数(何人が今エラーを踏んでい るか) ・関連ログへのリンク(エラー発生時刻で絞り 込み済み) Level 3 | 改善活動 詳細分析画面 使うとき:振り返り・深掘り時 ・APMトレース(単一サービス)/ Distributed Tracing(複数サービスをまたぐ場合) ・依存サービスの状況(DB クエリ遅延・外部 API タイムアウト) ・週次・月次での時系列推移 ・仮説検証用カスタムクエリ 「すぐに判断できる」ダッシュボードを設計する
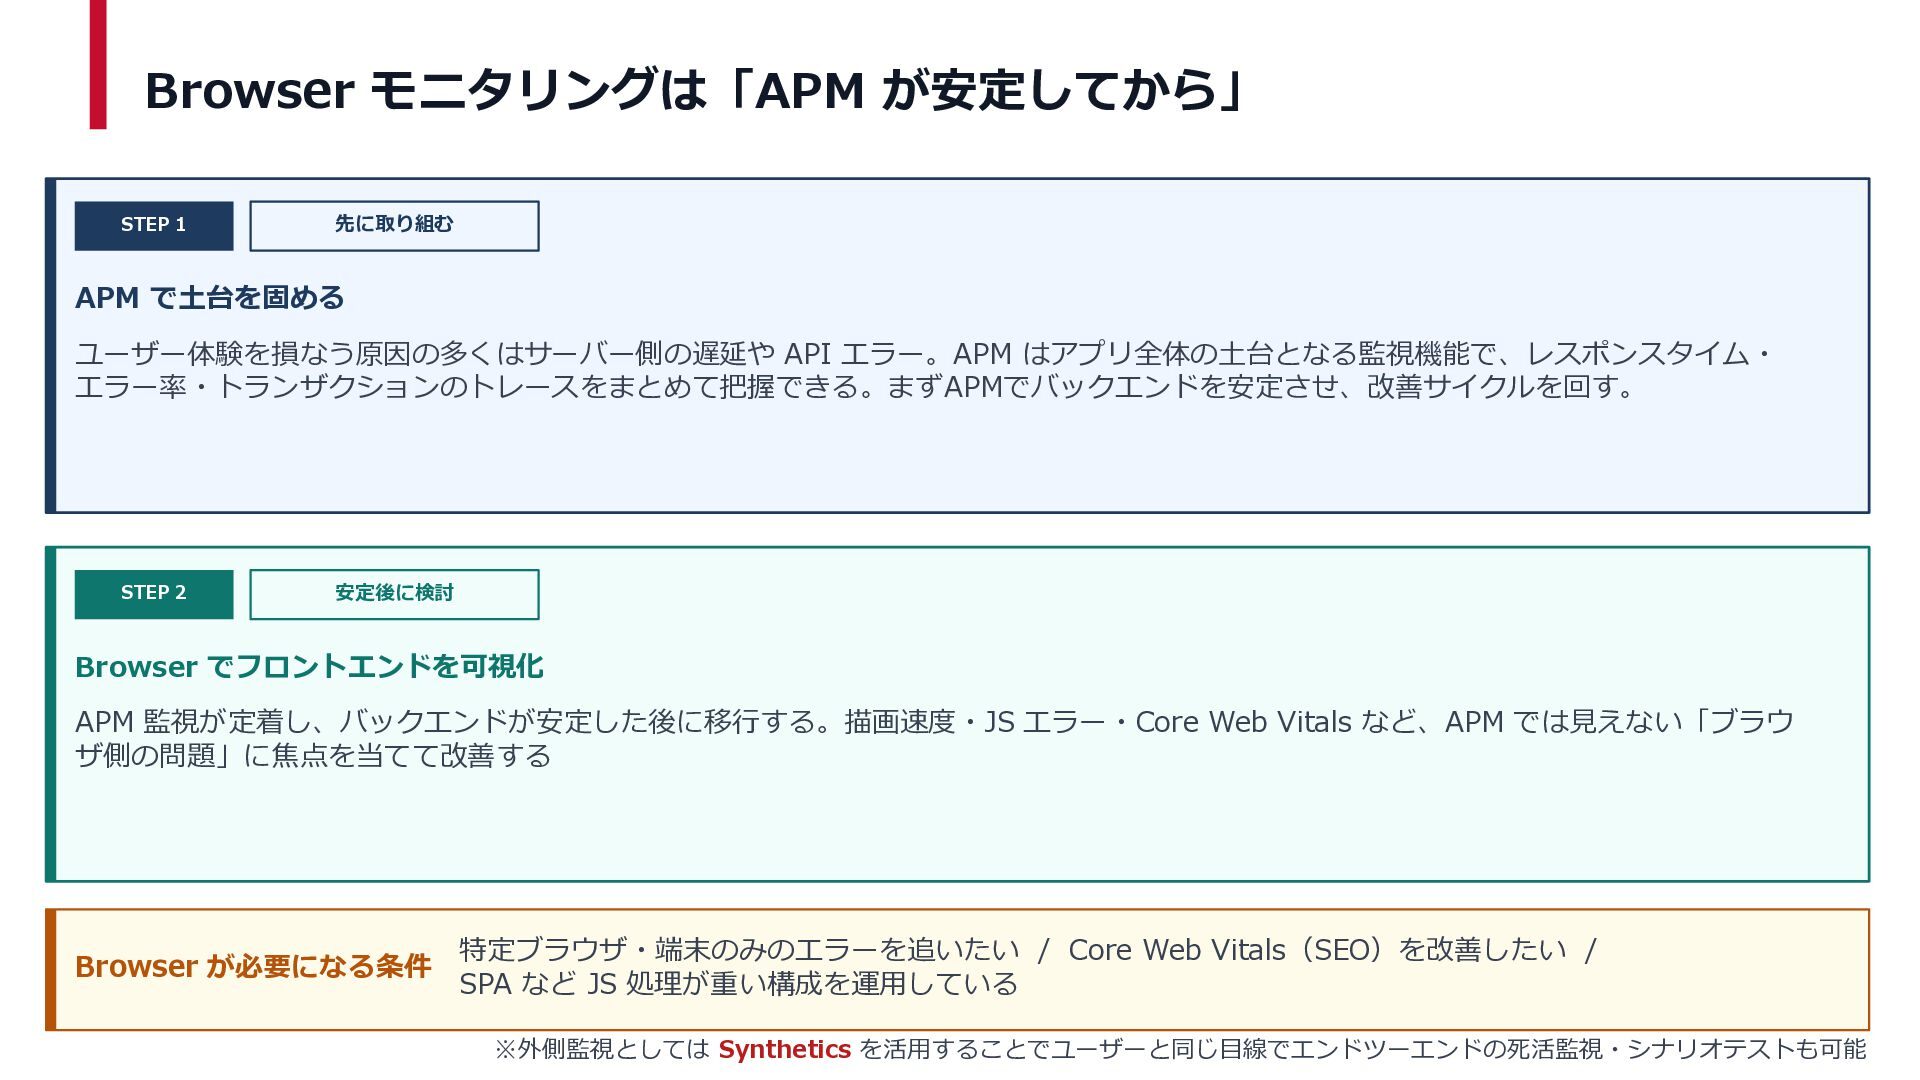
  10. 11 STEP 1 先に取り組む APM で土台を固める ユーザー体験を損なう原因の多くはサーバー側の遅延や API エラー。APM はアプリ全体の土台となる監視機能で、レスポンスタイム・

    エラー率・トランザクションのトレースをまとめて把握できる。まずAPMでバックエンドを安定させ、改善サイクルを回す。 STEP 2 安定後に検討 Browser でフロントエンドを可視化 APM 監視が定着し、バックエンドが安定した後に移行する。描画速度・JS エラー・Core Web Vitals など、APM では見えない「ブラウ ザ側の問題」に焦点を当てて改善する Browser が必要になる条件 特定ブラウザ・端末のみのエラーを追いたい / Core Web Vitals(SEO)を改善したい / SPA など JS 処理が重い構成を運用している Browser モニタリングは「APM が安定してから」 ※外側監視としては Synthetics を活用することでユーザーと同じ目線でエンドツーエンドの死活監視・シナリオテストも可能
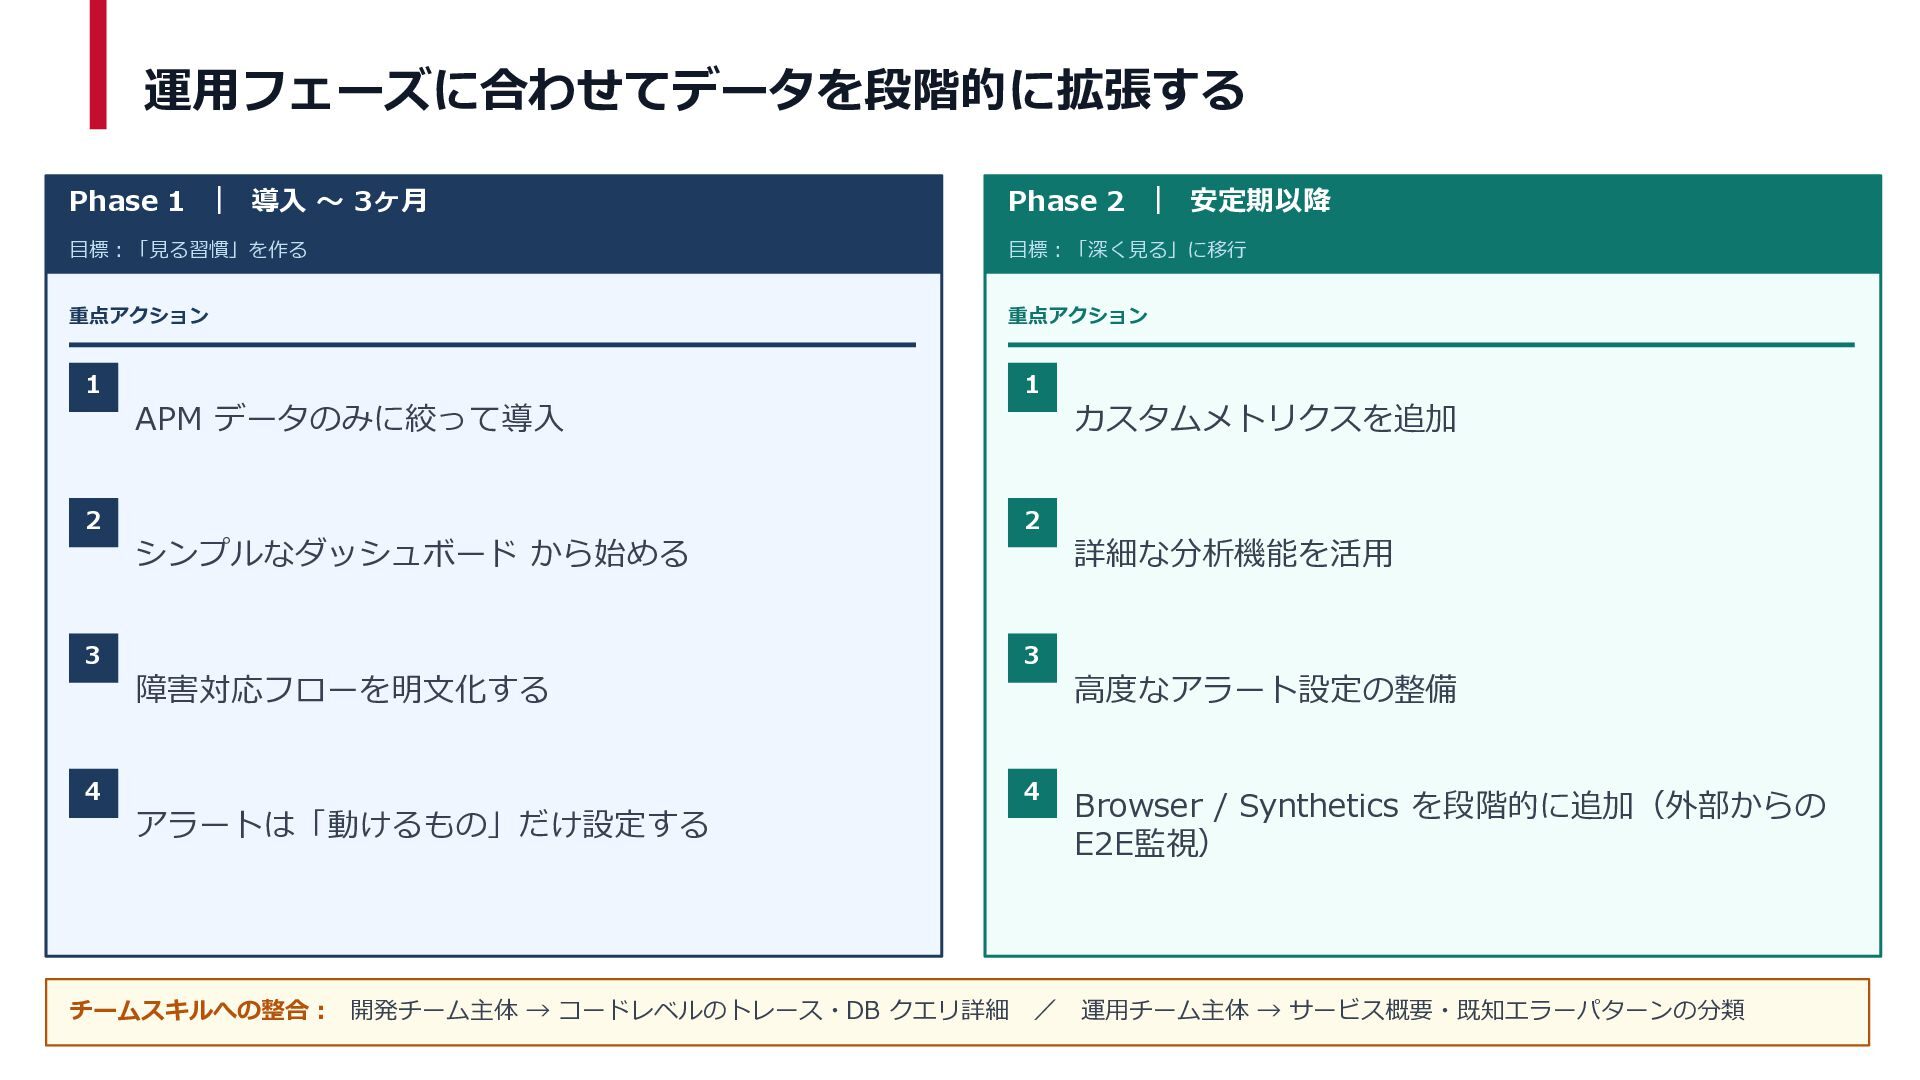
  11. 12 Phase 1 | 導入 ~ 3ヶ月 目標:「見る習慣」を作る 重点アクション 1

    APM データのみに絞って導入 2 シンプルなダッシュボード から始める 3 障害対応フローを明文化する 4 アラートは「動けるもの」だけ設定する Phase 2 | 安定期以降 目標:「深く見る」に移行 重点アクション 1 カスタムメトリクスを追加 2 詳細な分析機能を活用 3 高度なアラート設定の整備 4 Browser / Synthetics を段階的に追加(外部からの E2E監視) チームスキルへの整合: 開発チーム主体 → コードレベルのトレース・DB クエリ詳細 / 運用チーム主体 → サービス概要・既知エラーパターンの分類 運用フェーズに合わせてデータを段階的に拡張する
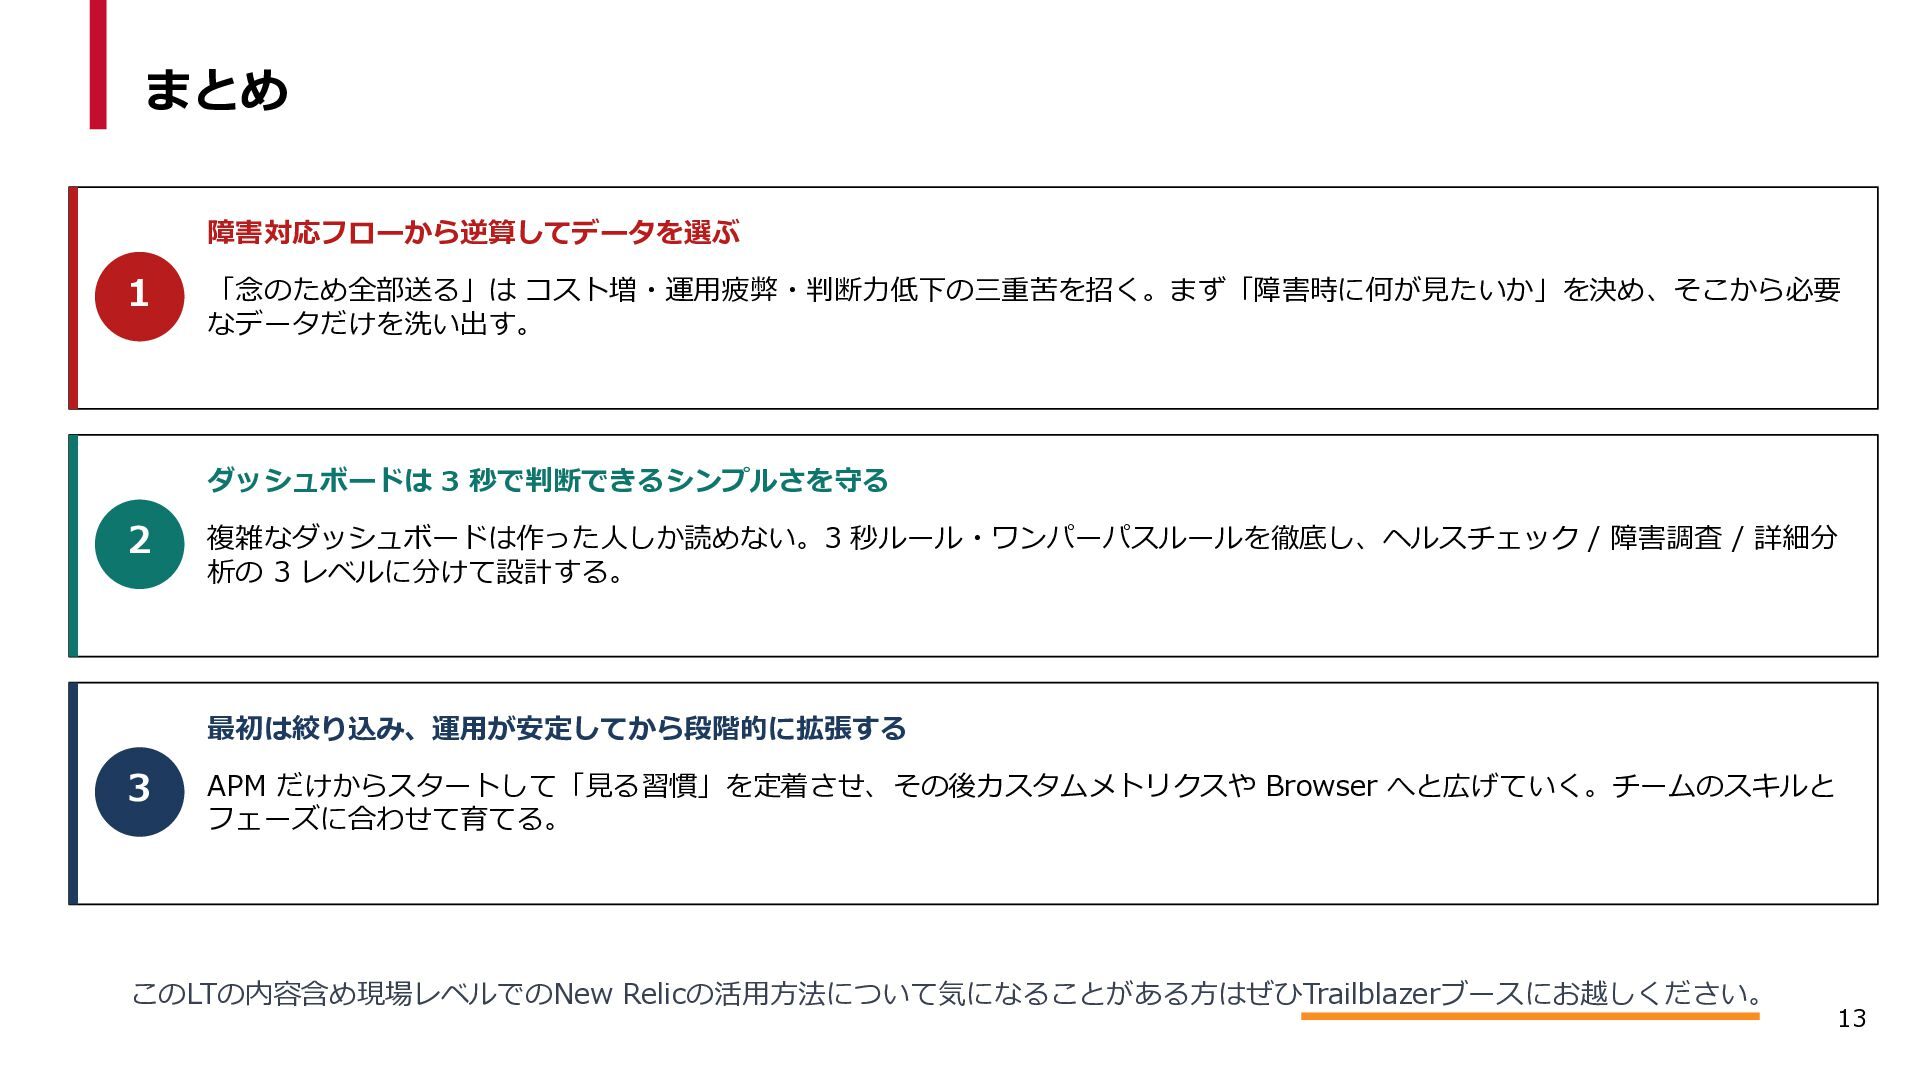
  12. 13 1 障害対応フローから逆算してデータを選ぶ 「念のため全部送る」は コスト増・運用疲弊・判断力低下の三重苦を招く。まず「障害時に何が見たいか」を決め、そこから必要 なデータだけを洗い出す。 2 ダッシュボードは 3 秒で判断できるシンプルさを守る

    複雑なダッシュボードは作った人しか読めない。3 秒ルール・ワンパーパスルールを徹底し、ヘルスチェック / 障害調査 / 詳細分 析の 3 レベルに分けて設計する。 3 最初は絞り込み、運用が安定してから段階的に拡張する APM だけからスタートして「見る習慣」を定着させ、その後カスタムメトリクスや Browser へと広げていく。チームのスキルと フェーズに合わせて育てる。 まとめ このLTの内容含め現場レベルでのNew Relicの活用方法について気になることがある方はぜひTrailblazerブースにお越しください。