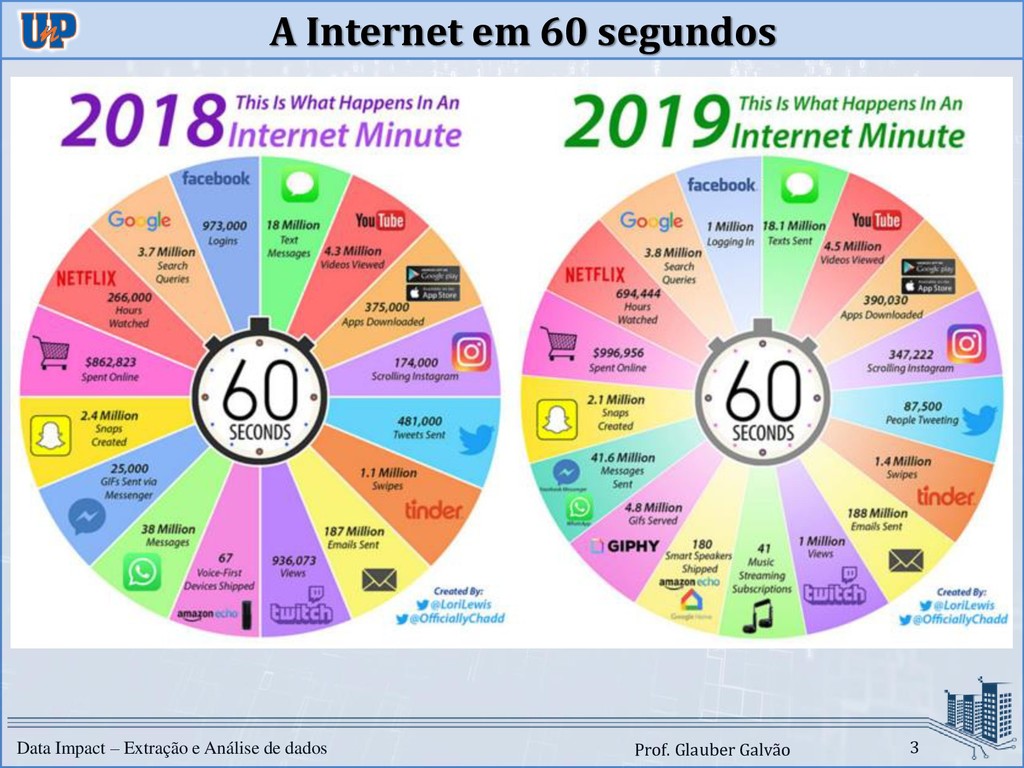
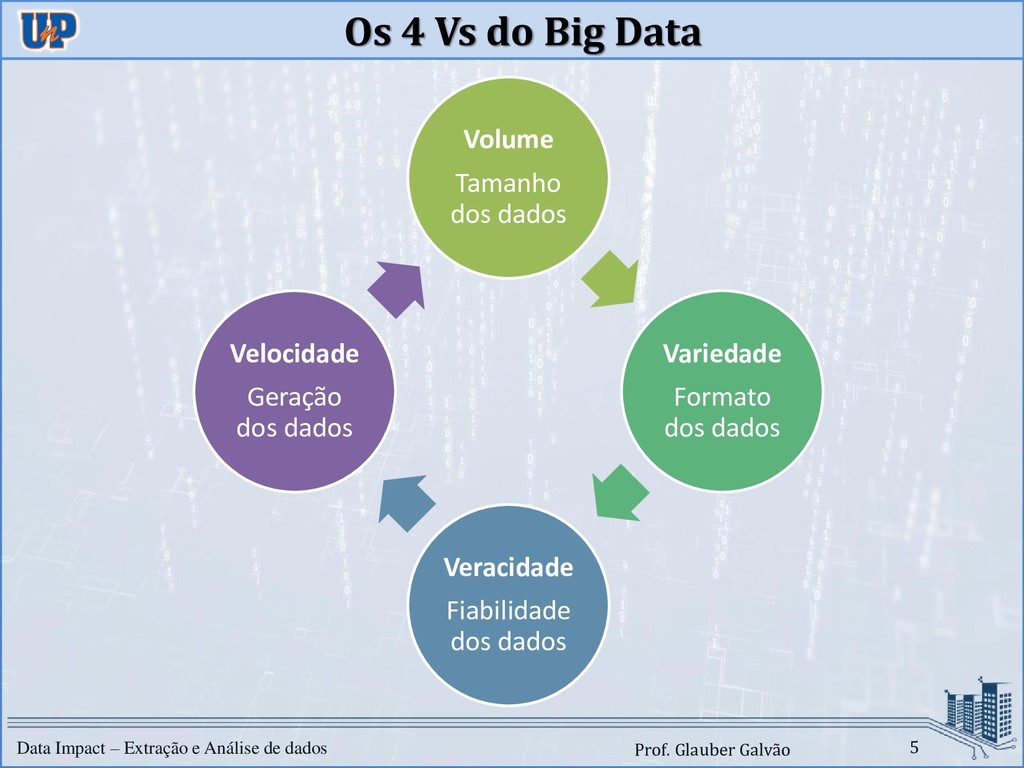
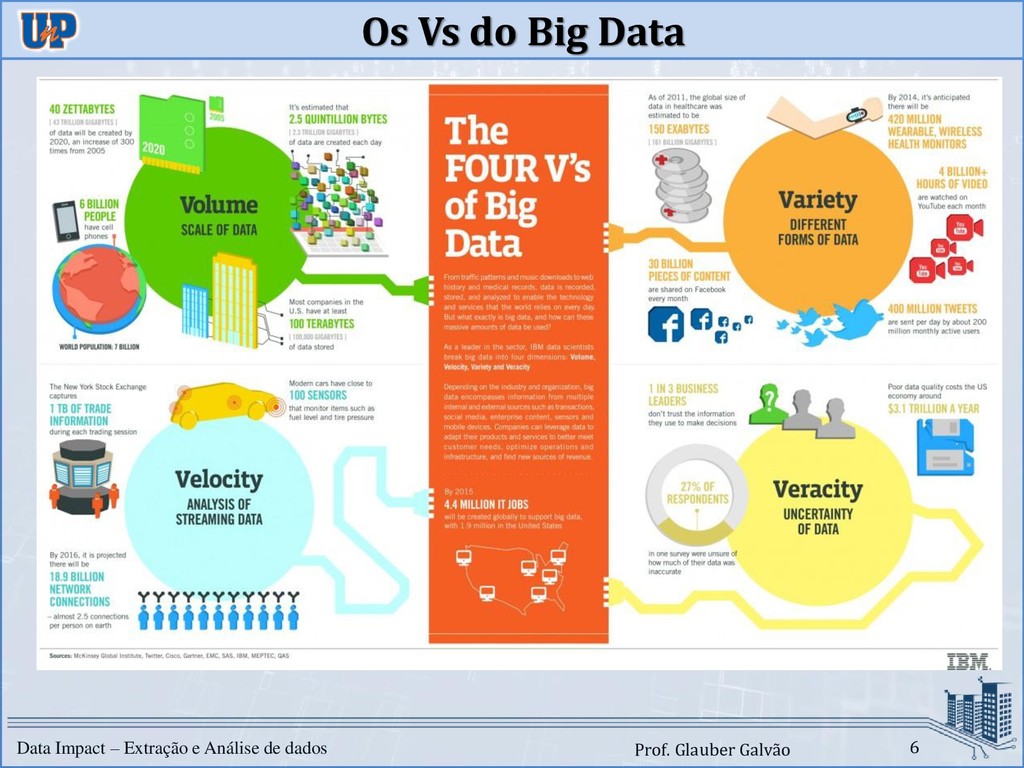
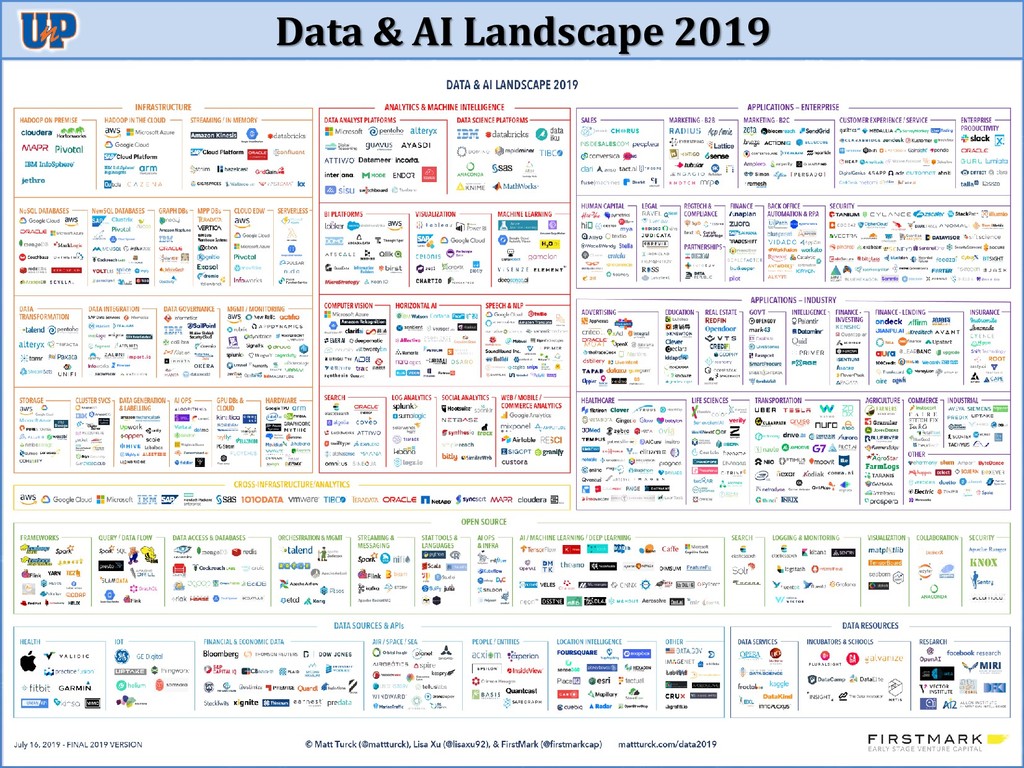
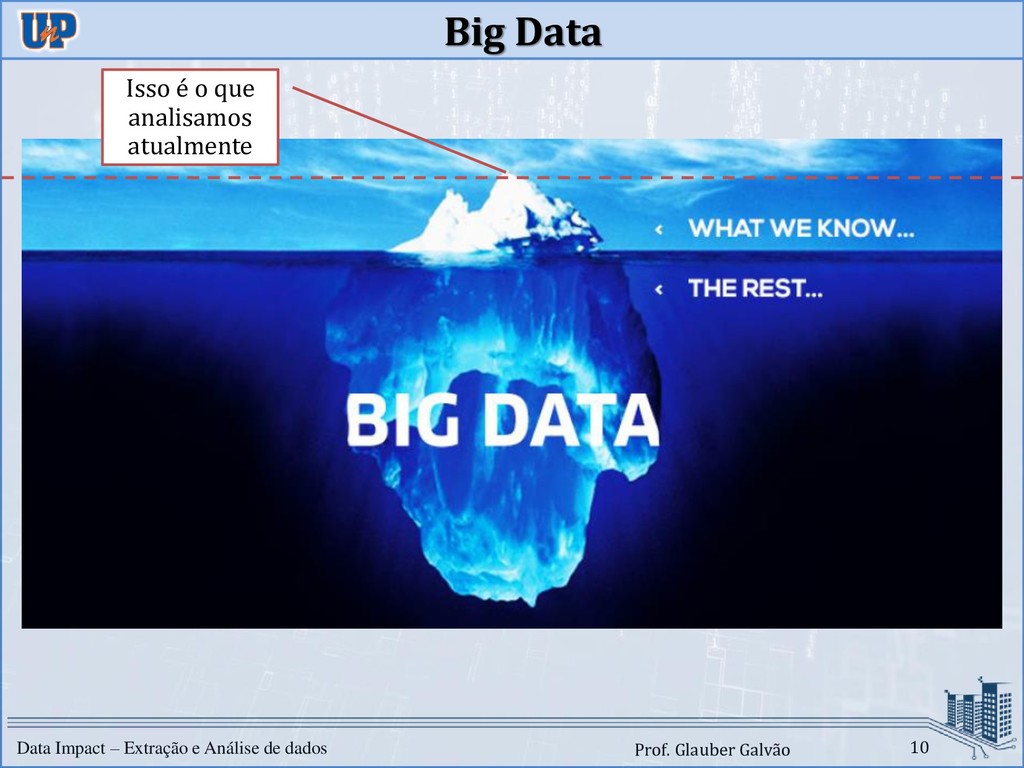
Glauber Galvão Big Data É o termo que descreve o imenso volume de dados – estruturados e não estruturados – que impactam os negócios no dia a dia. Mas o importante não é a quantidade de dados, e sim o que as empresas fazem com os dados que realmente importam. (SAS)
Glauber Galvão Hadoop É uma coleção de subprojetos relacionados para computação distribuída, sendo todos eles hospedados pela Apache Software Foundation.
Glauber Galvão Hadoop • Sistema em processamento de dados distribuído. • Para processar grandes volumes de dados em batch. • Dois elementos principais: Map Reduce e HDFS. o Map Reduce: Processamento o HDFS (Hadoop Distributed File System): Sistemas de arquivos distribuídos
Glauber Galvão Hive • Criado pelo Facebook • Baseado na arquitetura Map Reduce / HDFS • Porém estruturados de forma semelhante a um banco de dados relacional. • Utiliza linguagem de programação SQL: popular e fácil.
Glauber Galvão Hive • Armazém de dados distribuído sobre o Map Reduce / HDFS. • Características de banco de dados relacionais: banco de dados / tabelas / views / funções / SQL • Não implementa funções não analíticas (ex: PK, FK) • Open Source • Mantido pela Fundação Apache • Analítica, não transacional
Glauber Galvão Apache Impala • Alternativa da Cloudera para “SQL em Hadoop” • Objetivo é ser mais rápido que o Hive padrão (com engine MR) • Impala não é baseado em MapReduce • Tem menor latência e melhor desempenho em consultas médias • SQL Baseado no Hive
Glauber Galvão Apache Spark • Engine rápido e de uso geral para processamento de dados em larga escala. • É mais veloz que o Hadoop MapReduce, significativamente (100x mais rápido). • Utiliza o Hadoop HDFS como base, mas pode ser usado com Cassandra, Hbase e MongoDB. • Suporta linguagens como Python, R, Scala e Java.
Glauber Galvão Referências Apache Hadoop https://hadoop.apache.org Apache Spark https://spark.apache.org/ What is Apache Spark? https://databricks.com/spark/about Apache Spark e Data Science http://www.cienciaedados.com/apache-spark-e-data-science/ Apache Spark for Microsoft Azure HDInsight https://azure.microsoft.com/en-ca/services/hdinsight/apache-spark/


 gogutan
 kentarofujii
 masakiokuda
 ishikawa_satoru
 recruitengineers
 hiracky16
 daidaidai
 sansantech
 techtekt
 makocchi
 kentapapa
 glaforge
 retrage
 nikkihalliwell
 dugsong
 katarinadahlin
 bkeepers
 matthewcrist
 malarkey
 jacobian
 trallard
 jeffersonlam
 bermonpainter
 tammyeverts