Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
クラウドネイティブDBはいかにして制約を克服したか?_ver_tbts2026
Search
hacomono Inc.
PRO
November 06, 2026
130
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
クラウドネイティブDBはいかにして制約を克服したか?_ver_tbts2026
hacomono Inc.
PRO
November 06, 2026
More Decks by hacomono Inc.
See All by hacomono Inc.
マルチプロダクトを支えるSelf-service基盤構築の軌跡
hacomono
PRO
0
120
師匠と弟子が「現場」で戦う —フルリモート時代のプロダクトエンジニアJEDI育成プログラムの全貌
hacomono
PRO
0
760
10人は喜んでも、10万人は喜ばない。 10万人の”来たい”を、構造で作る。
hacomono
PRO
0
120
正しく凹む技術:運動で感情を GC(ガベージコレクション )しよう
hacomono
PRO
1
310
開発者の認知負荷軽減を目指して選んだCrossplane - Self-serviceの理想と現実
hacomono
PRO
0
440
クラウドネイティブ DB はいかにして制約を 克服したか? 〜進化歴史から紐解く、スケーラブルアーキテクチャ設計指針〜
hacomono
PRO
8
2.1k
AI ネイティブな開発プロセスを目指して ~田中のローカルmac編~
hacomono
PRO
1
120
新規事業×QAの挑戦:不確実性を乗りこなす!フェーズごとに求められるQAの役割変革
hacomono
PRO
0
730
テストプロセスにおけるAI活用 :人間とAIの共存
hacomono
PRO
0
670
Featured
See All Featured
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
70
68k
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
760
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.6k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2.1k
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
600
Making the Leap to Tech Lead
cromwellryan
135
10k
Scaling GitHub
holman
464
140k
Visualization
eitanlees
153
17k
GitHub's CSS Performance
jonrohan
1033
470k
Transcript
クラウドネイティブDBは いかにして制約を 克服したか? 〜進化の歴史から紐解く、スケーラブルアーキテクチャの設計指針〜 @bootjp db tech showcase 2026
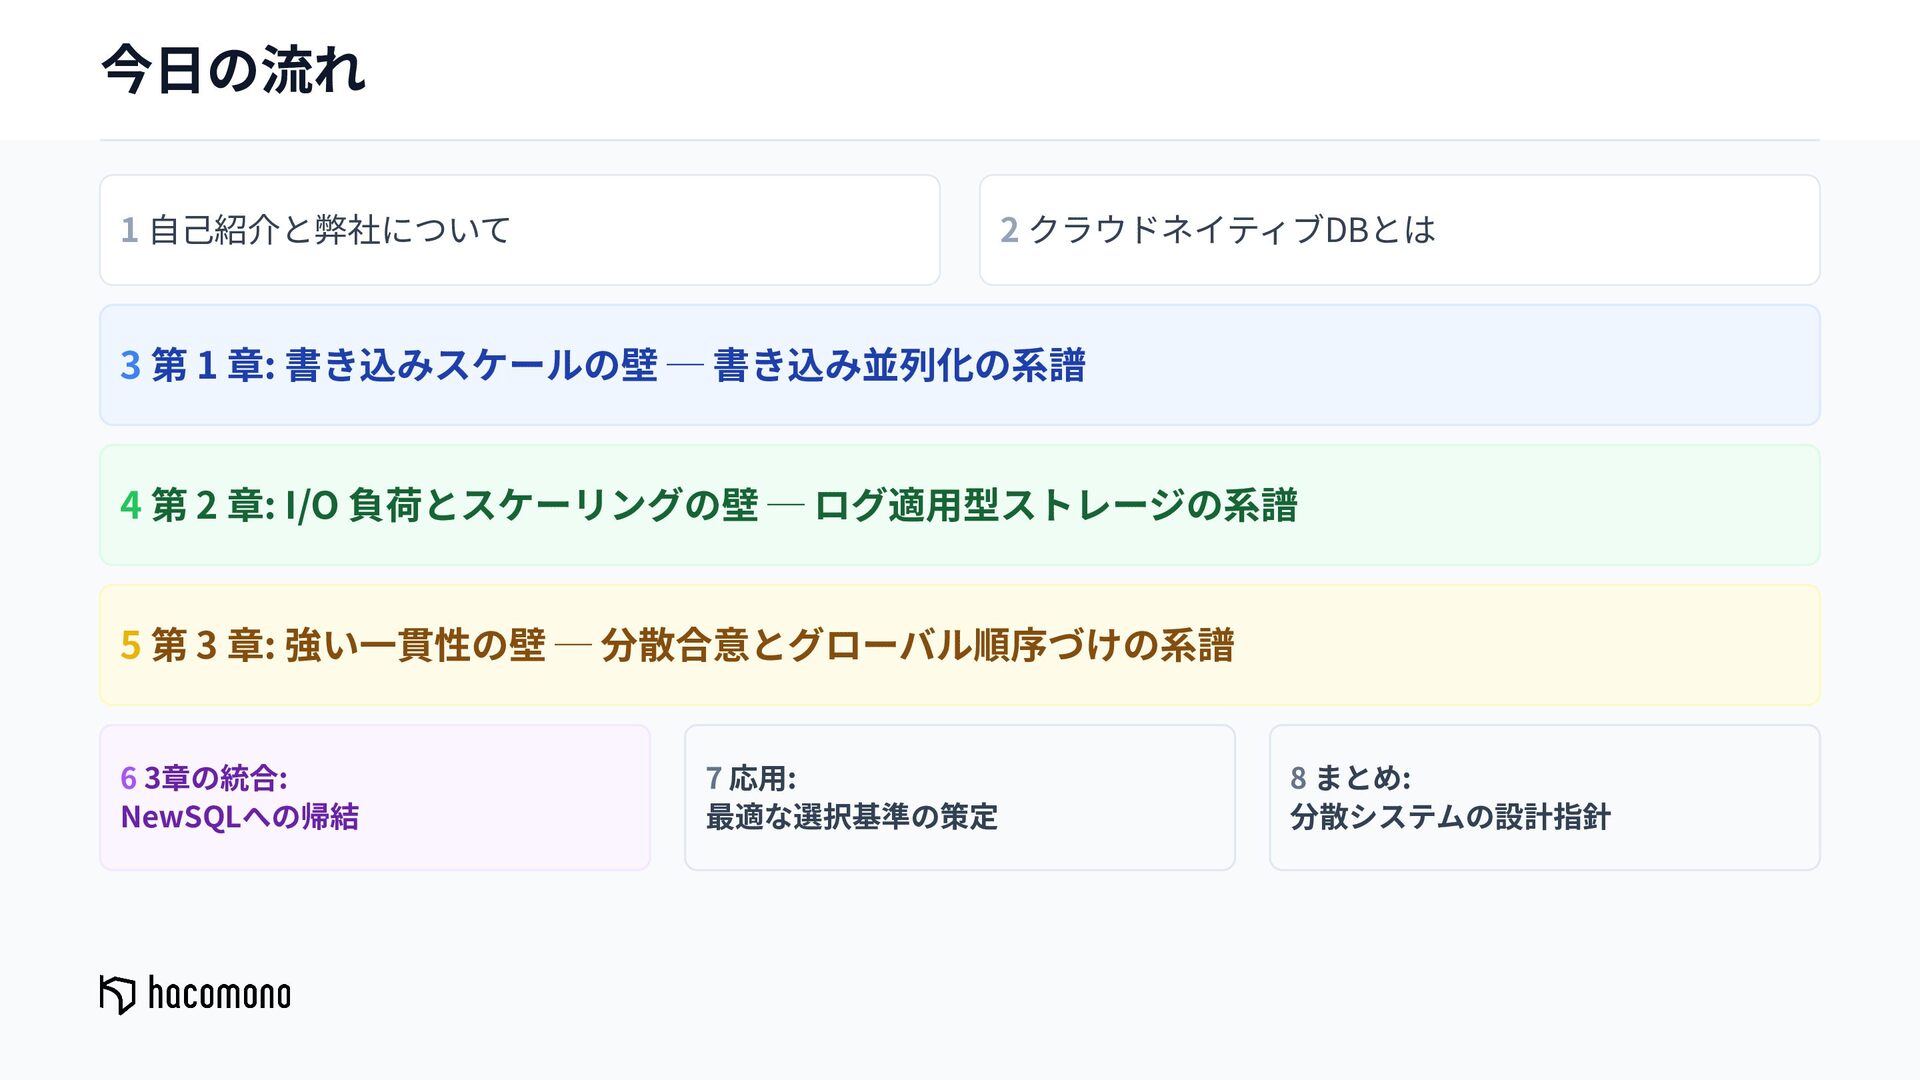
今⽇の流れ 1 ⾃⼰紹介と弊社について 2 クラウドネイティブDBとは 3 第 1 章: 書き込みスケールの壁
─ 書き込み並列化の系譜 4 第 2 章: I/O 負荷とスケーリングの壁 ─ ログ適⽤型ストレージの系譜 5 第 3 章: 強い⼀貫性の壁 ─ 分散合意とグローバル順序づけの系譜 6 3章の統合: NewSQLへの帰結 7 応⽤: 最適な選択基準の策定 8 まとめ: 分散システムの設計指針
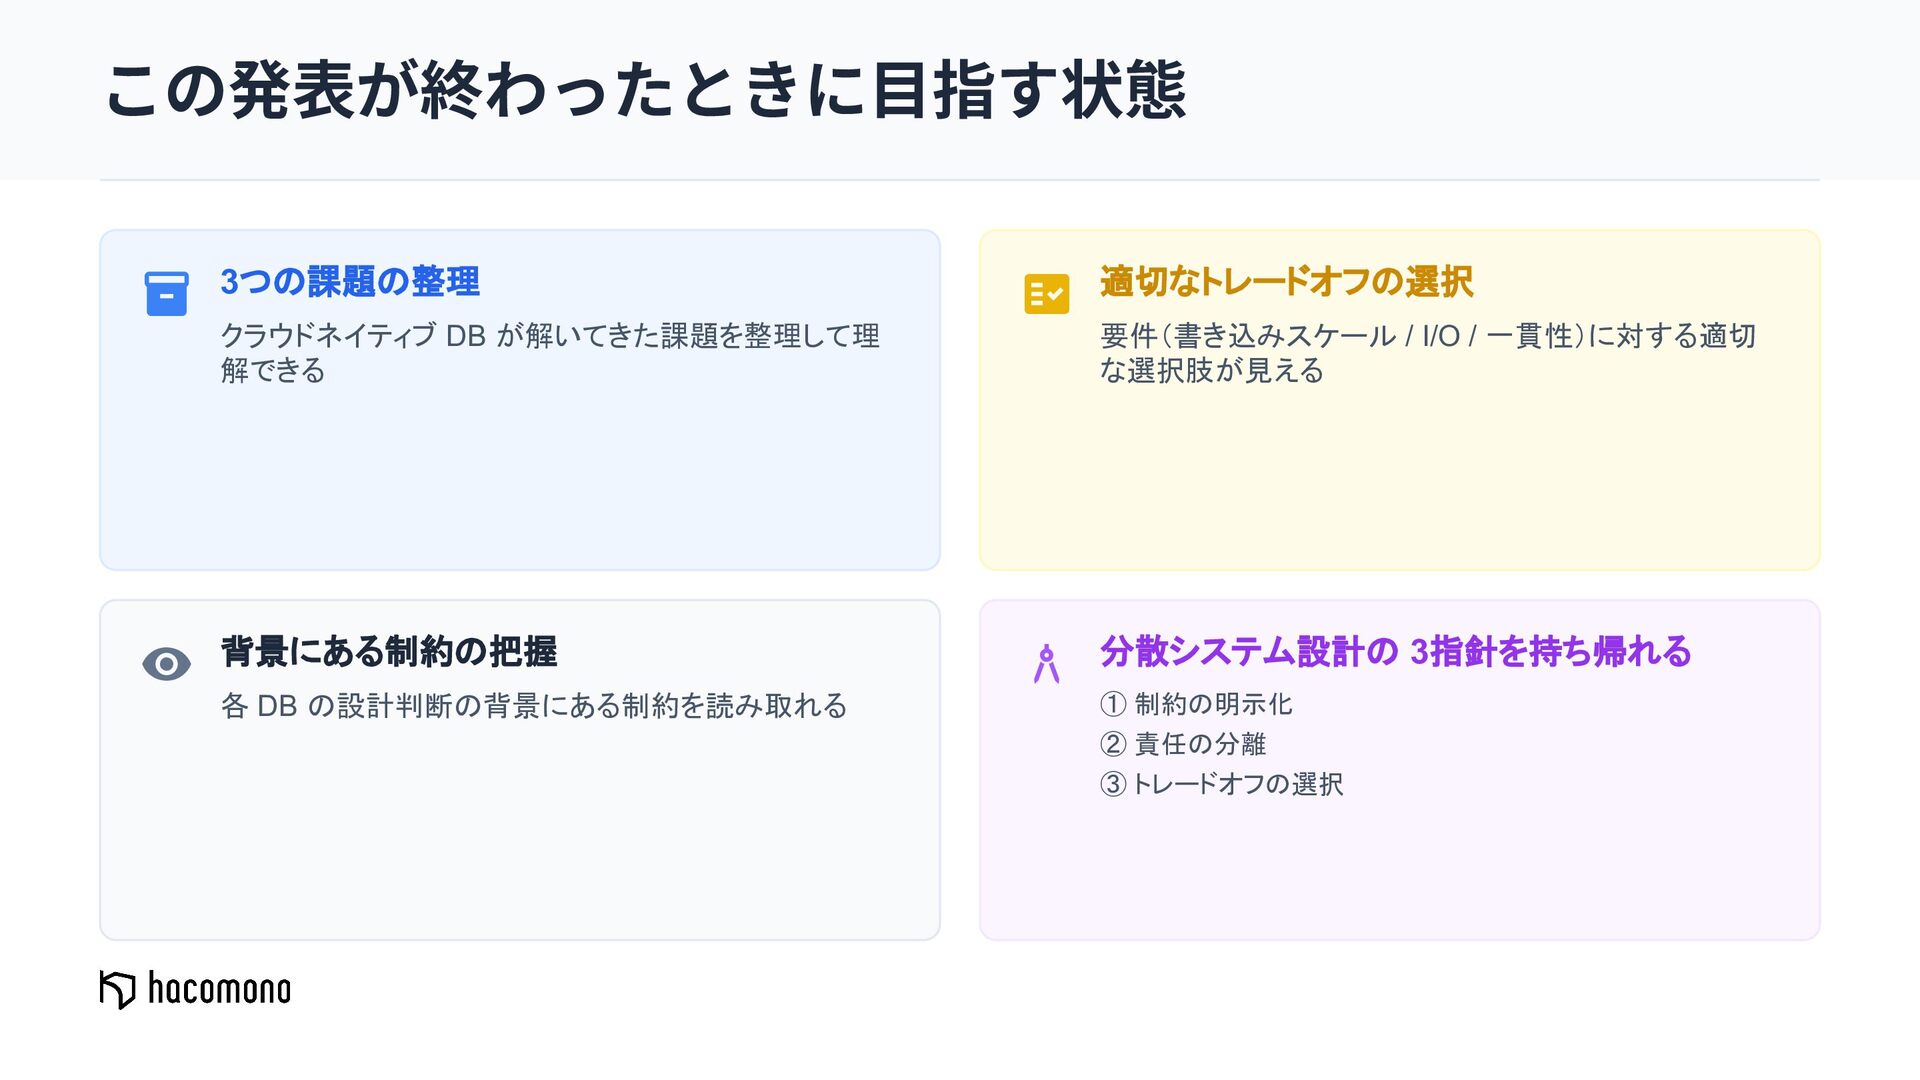
この発表が終わったときに⽬指す状態 クラウドネイティブ DB が解いてきた課題を整理して理 3つの課題の整理 適切なトレードオフの選択 要件(書き込みスケール /
I/O / 一貫性)に対する適切 解できる な選択肢が見える 背景にある制約の把握 分散システム設計の 3指針を持ち帰れる 各 DB の設計判断の背景にある制約を読み取れる ① 制約の明示化 ② 責任の分離 ③ トレードオフの選択
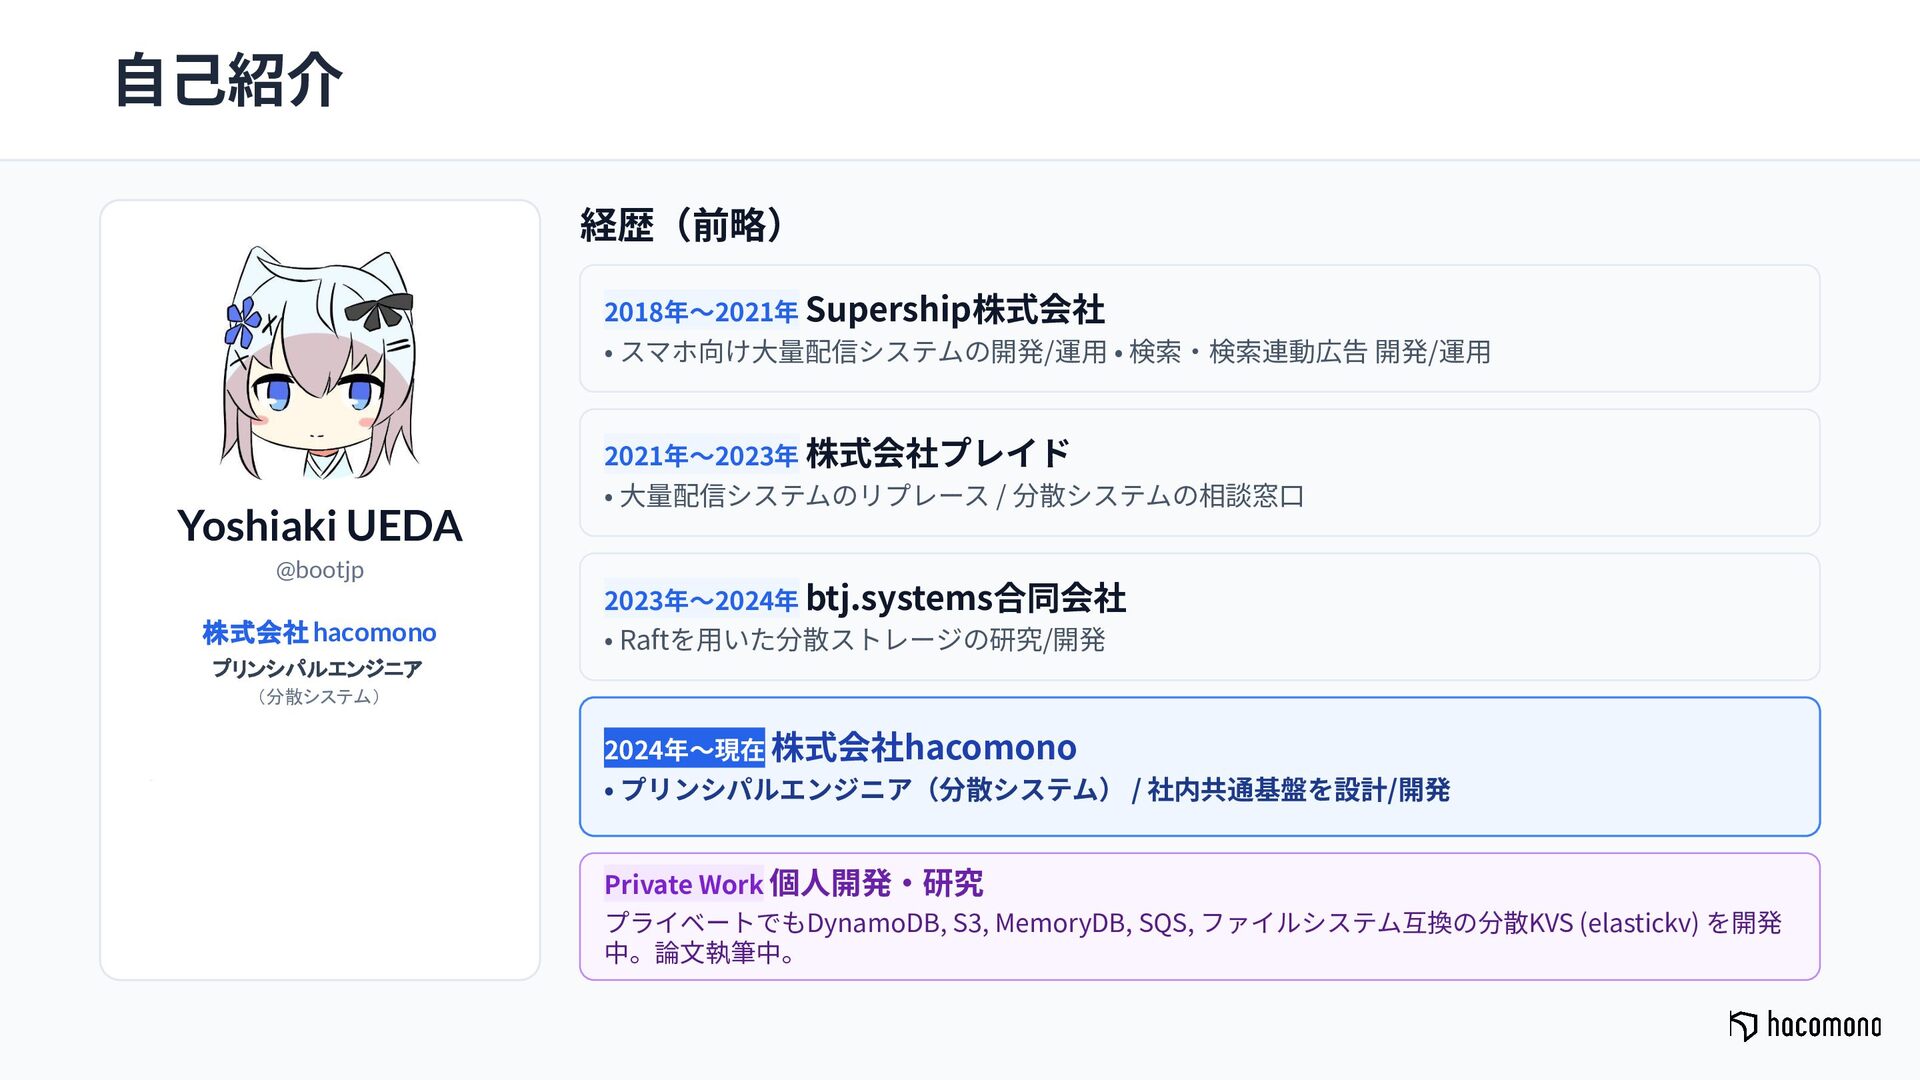
⾃⼰紹介 経歴(前略) 2018年〜2021年 Supership株式会社 • スマホ向け⼤量配信システムの開発/運⽤ • 検索‧検索連動広告 開発/運⽤ 2021年〜2023年
株式会社プレイド Yoshiaki UEDA @bootjp 株式会社 hacomono • ⼤量配信システムのリプレース / 分散システムの相談窓⼝ 2023年〜2024年 btj.systems合同会社 • Raftを⽤いた分散ストレージの研究/開発 プリンシパルエンジニア (分散システム) 2024年〜現在 株式会社hacomono • プリンシパルエンジニア(分散システム) / 社内共通基盤を設計/開発 Private Work 個⼈開発‧研究 プライベートでもDynamoDB, S3, MemoryDB, SQS, ファイルシステム互換の分散KVS (elastickv) を開発 中。論⽂執筆中。
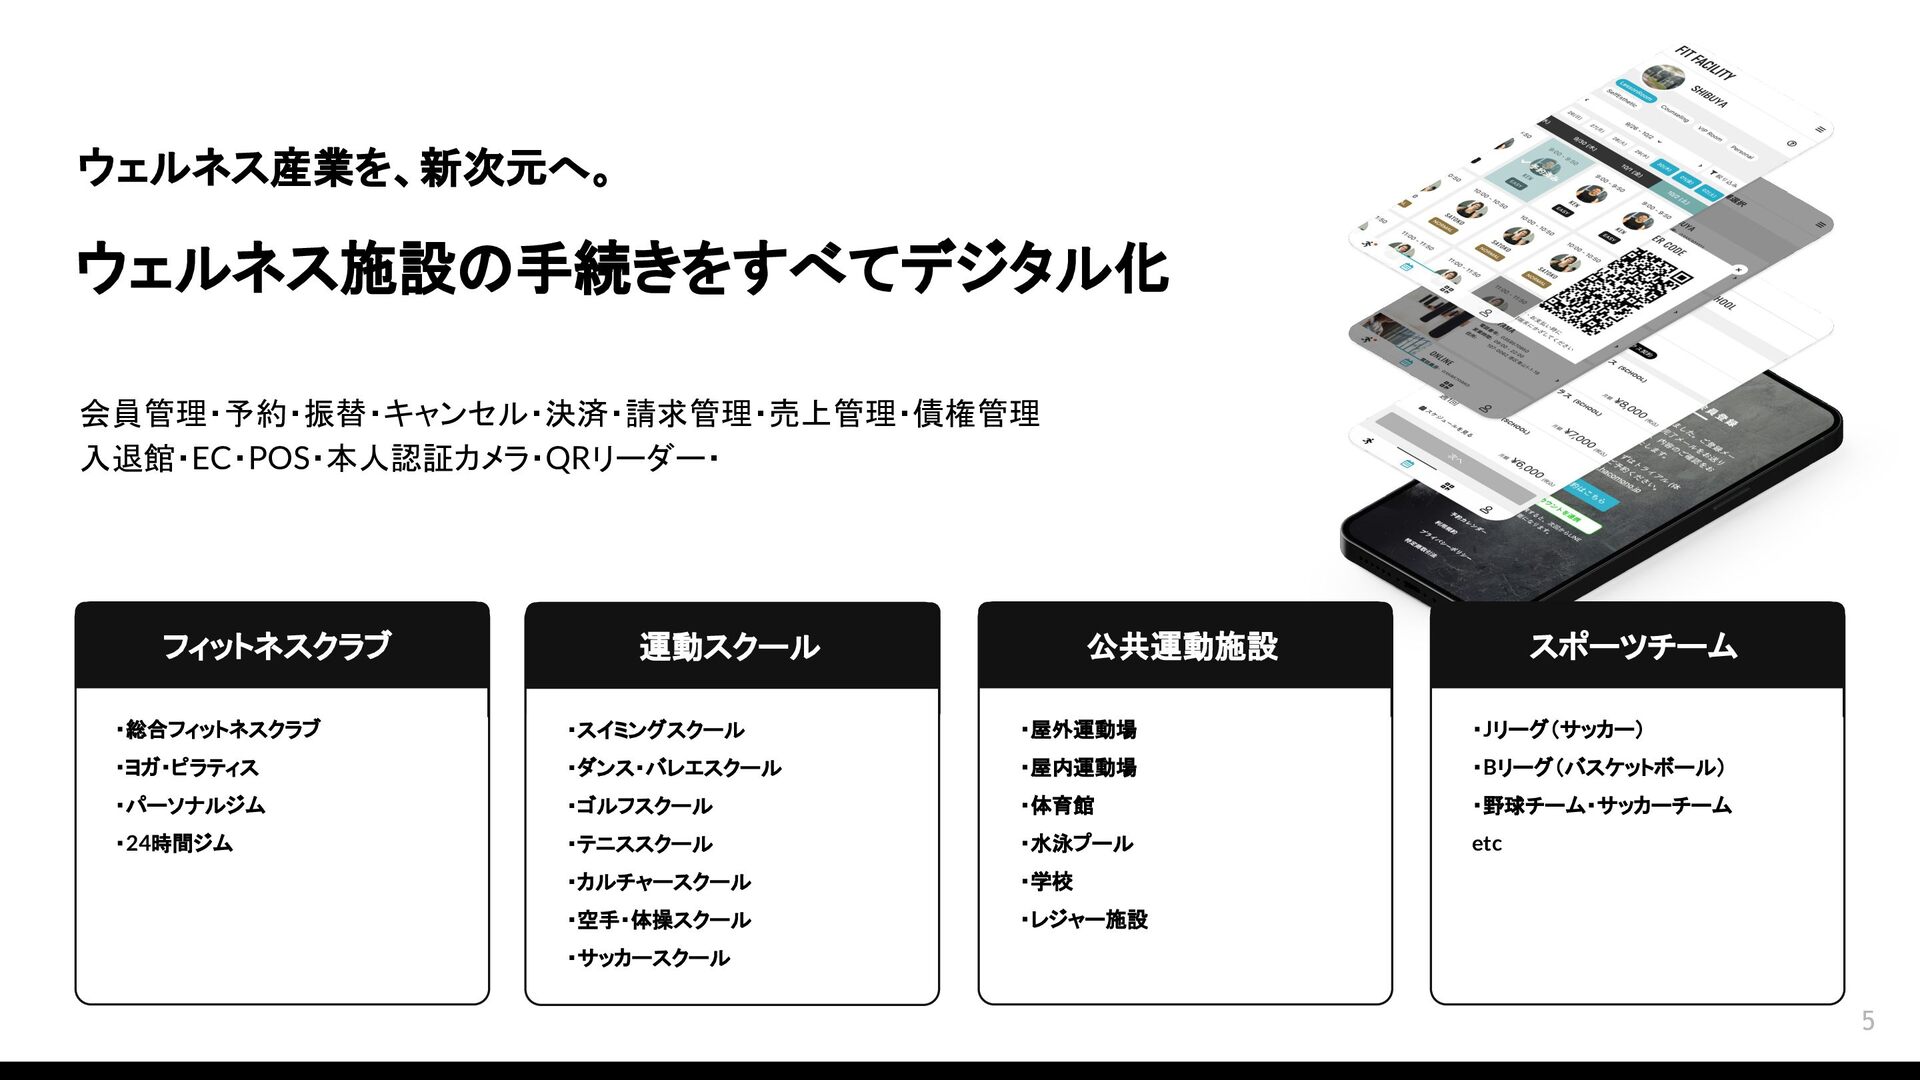
ウェルネス産業を、新次元へ。 ウェルネス施設の手続きをすべてデジタル化 会員管理・予約・振替・キャンセル・決済・請求管理・売上管理・債権管理 入退館・EC・POS・本人認証カメラ・QRリーダー・ フィットネスクラブ 公共運動施設 運動スクール スポーツチーム ・総合フィットネスクラブ ・スイミングスクール
・屋外運動場 ・Jリーグ(サッカー) ・ヨガ・ピラティス ・ダンス・バレエスクール ・屋内運動場 ・Bリーグ(バスケットボール) ・パーソナルジム ・ゴルフスクール ・体育館 ・野球チーム・サッカーチーム ・24時間ジム ・テニススクール ・水泳プール etc ・カルチャースクール ・学校 ・空手・体操スクール ・レジャー施設 ・サッカースクール 5
13,000店舗・施設での導入実績 総合スポーツクラブ ゴルフ ヨガ・ピラティス 運動スクール パーソナルジム プロスポーツ(サッカー・バスケ) 24時間ジム 公共運動・学校施設 サウナ・エステ
コワーキング
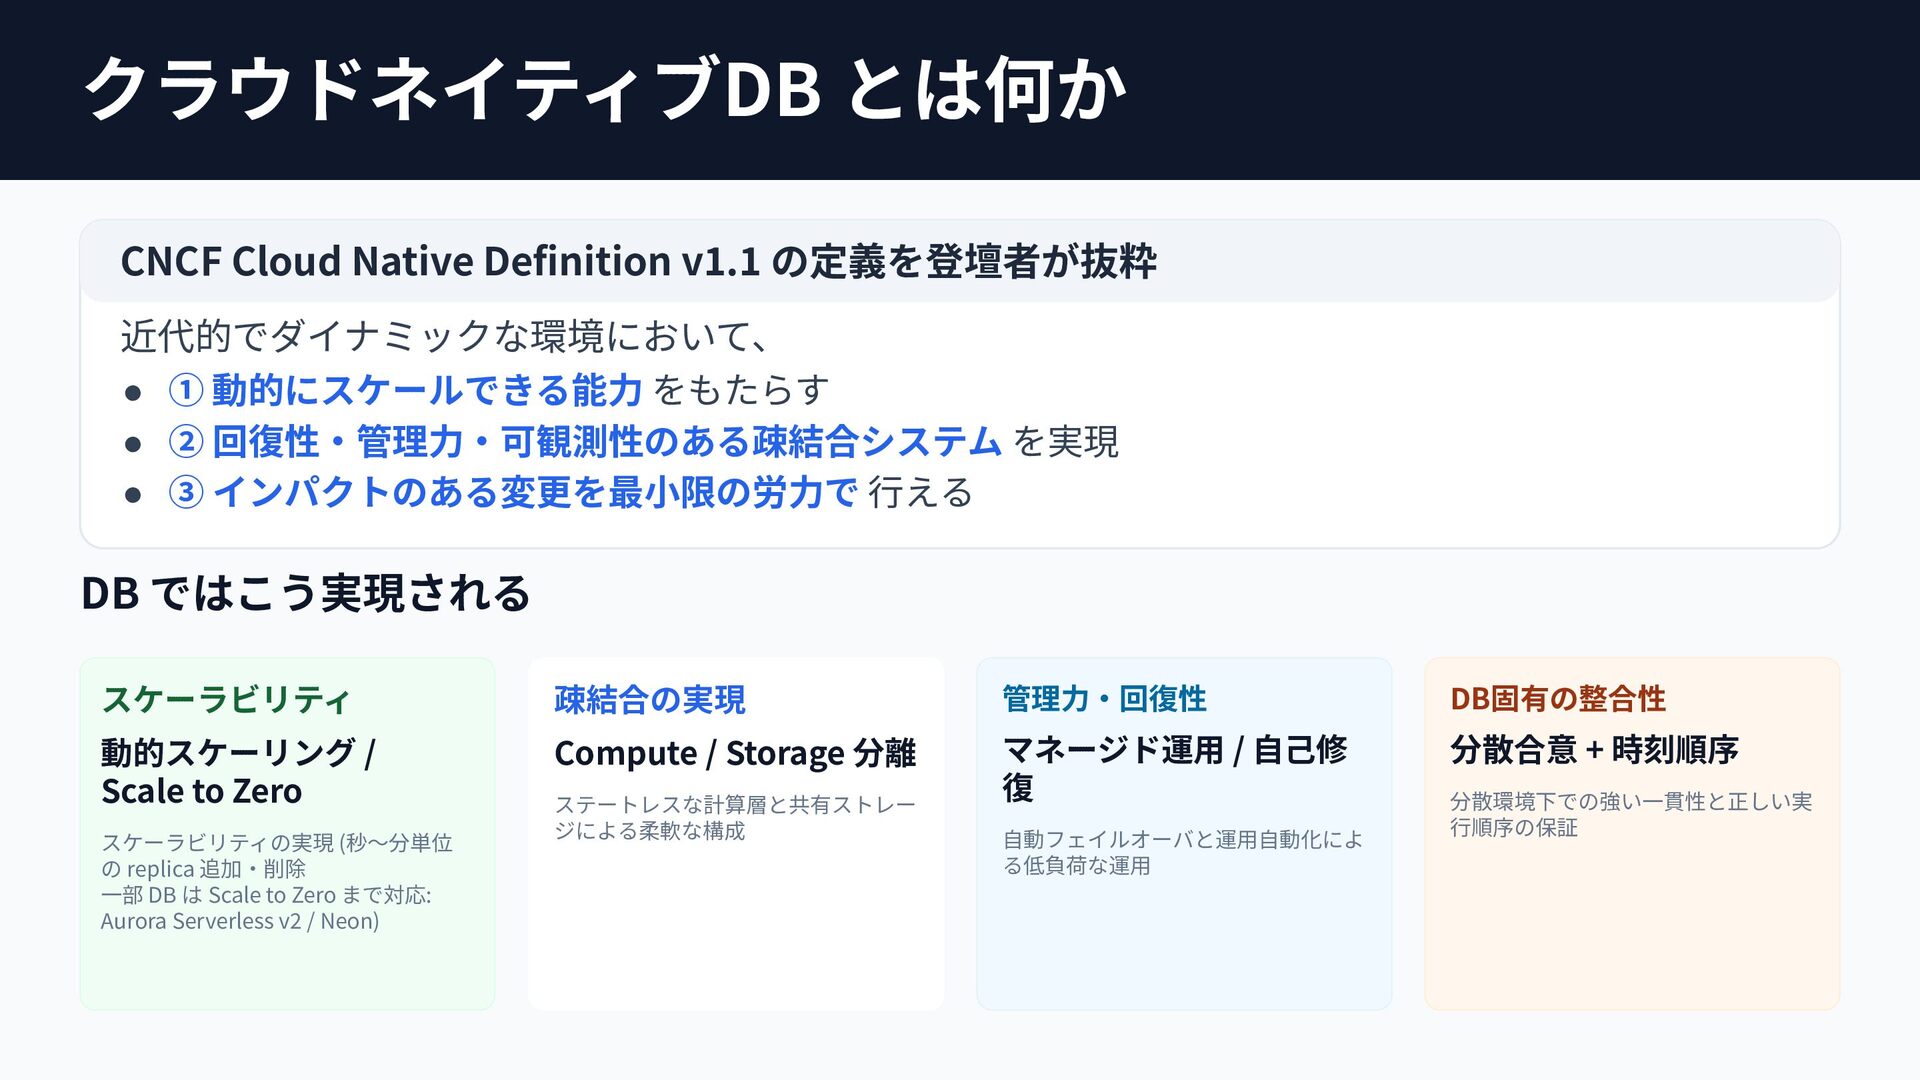
クラウドネイティブDB とは何か CNCF Cloud Native Definition v1.1 の定義を登壇者が抜粋 近代的でダイナミックな環境において、 •
① 動的にスケールできる能⼒ をもたらす • ② 回復性‧管理⼒‧可観測性のある疎結合システム を実現 • ③ インパクトのある変更を最⼩限の労⼒で ⾏える DB ではこう実現される スケーラビリティ 疎結合の実現 管理⼒‧回復性 DB固有の整合性 動的スケーリング / Scale to Zero Compute / Storage 分離 マネージド運⽤ / ⾃⼰修 復 分散合意 + 時刻順序 スケーラビリティの実現 (秒〜分単位 の replica 追加‧削除 ⼀部 DB は Scale to Zero まで対応: Aurora Serverless v2 / Neon) ステートレスな計算層と共有ストレー ジによる柔軟な構成 ⾃動フェイルオーバと運⽤⾃動化によ る低負荷な運⽤ 分散環境下での強い⼀貫性と正しい実 ⾏順序の保証
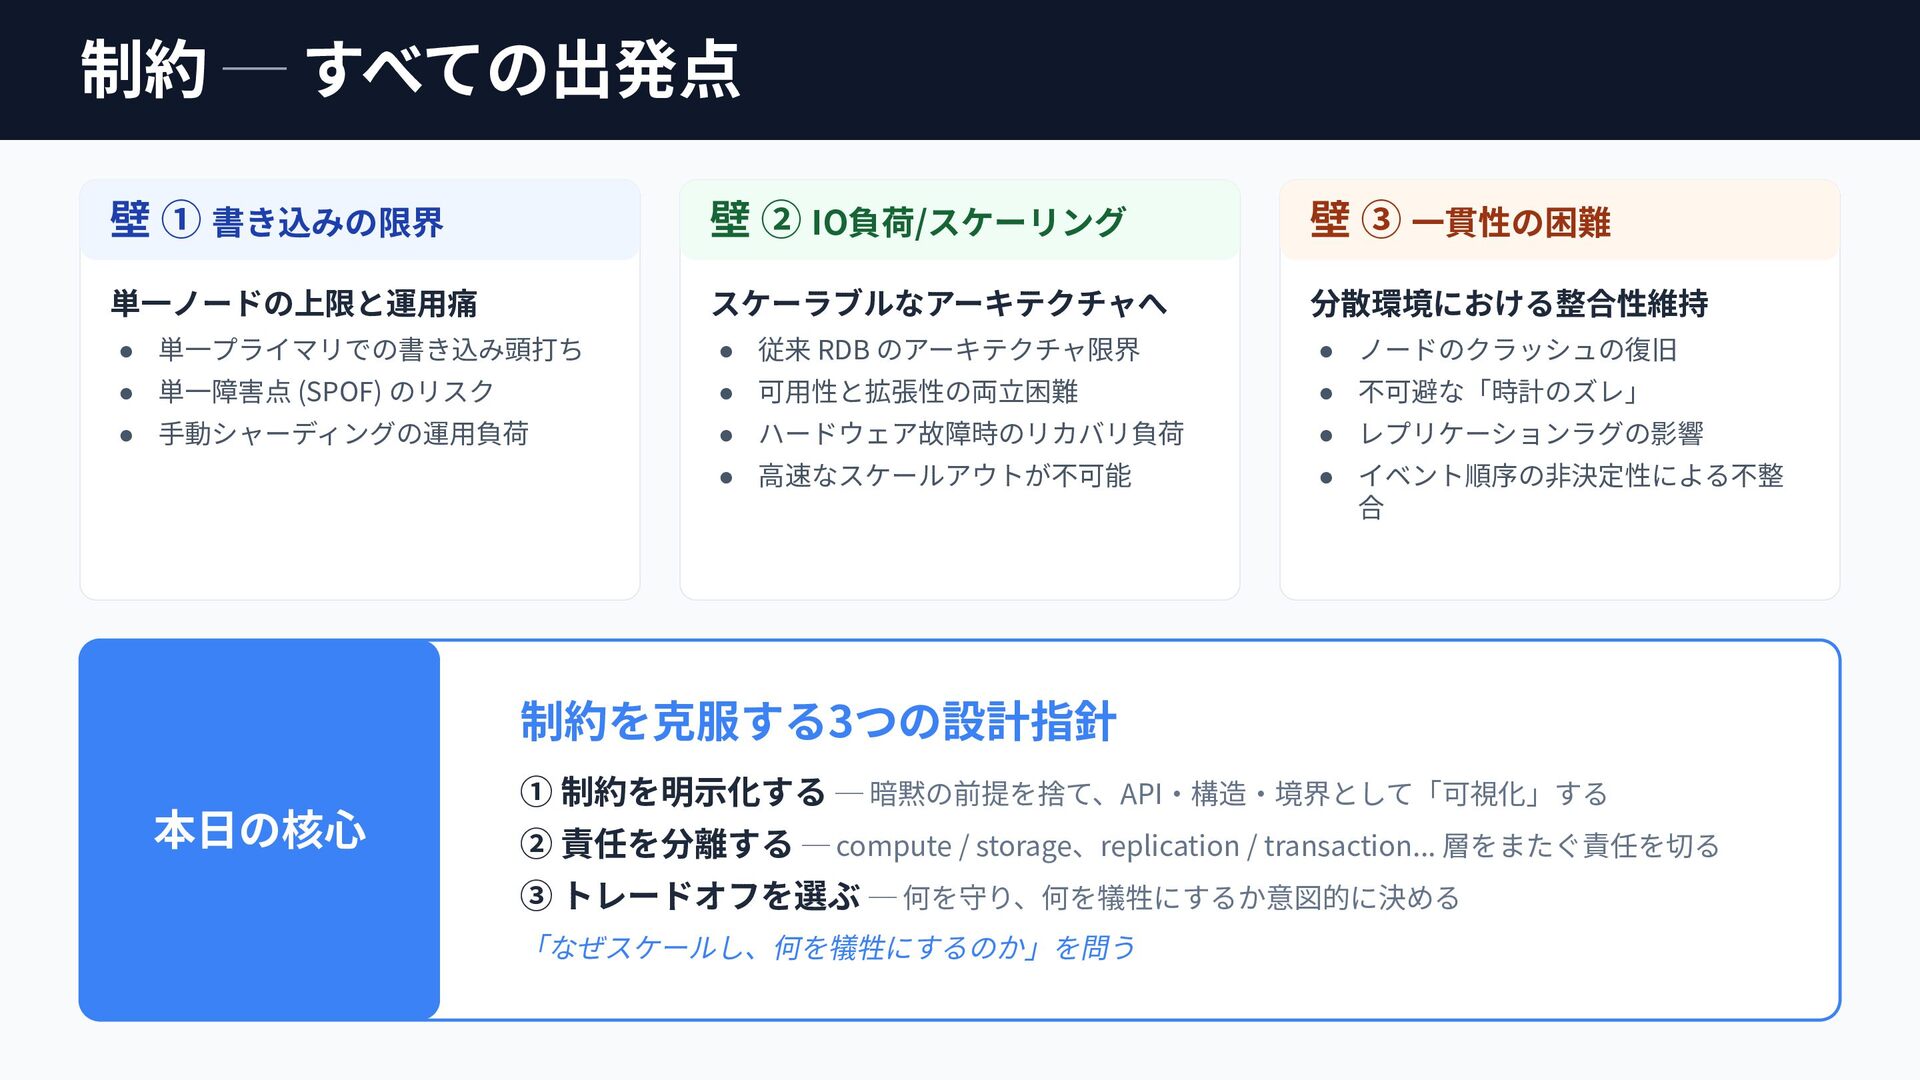
制約 ─ すべての出発点 壁 ① 書き込みの限界 壁 ② IO負荷/スケーリング 壁
③ ⼀貫性の困難 単⼀ノードの上限と運⽤痛 スケーラブルなアーキテクチャへ 分散環境における整合性維持 • 単⼀プライマリでの書き込み頭打ち • 従来 RDB のアーキテクチャ限界 • ノードのクラッシュの復旧 • 単⼀障害点 (SPOF) のリスク • 可⽤性と拡張性の両⽴困難 • 不可避な「時計のズレ」 • ⼿動シャーディングの運⽤負荷 • ハードウェア故障時のリカバリ負荷 • レプリケーションラグの影響 • ⾼速なスケールアウトが不可能 • イベント順序の⾮決定性による不整 合 制約を克服する3つの設計指針 本⽇の核⼼ ① 制約を明⽰化する ─ 暗黙の前提を捨て、API‧構造‧境界として「可視化」する ② 責任を分離する ─ compute / storage、replication / transaction... 層をまたぐ責任を切る ③ トレードオフを選ぶ ─ 何を守り、何を犠牲にするか意図的に決める 「なぜスケールし、何を犠牲にするのか」を問う
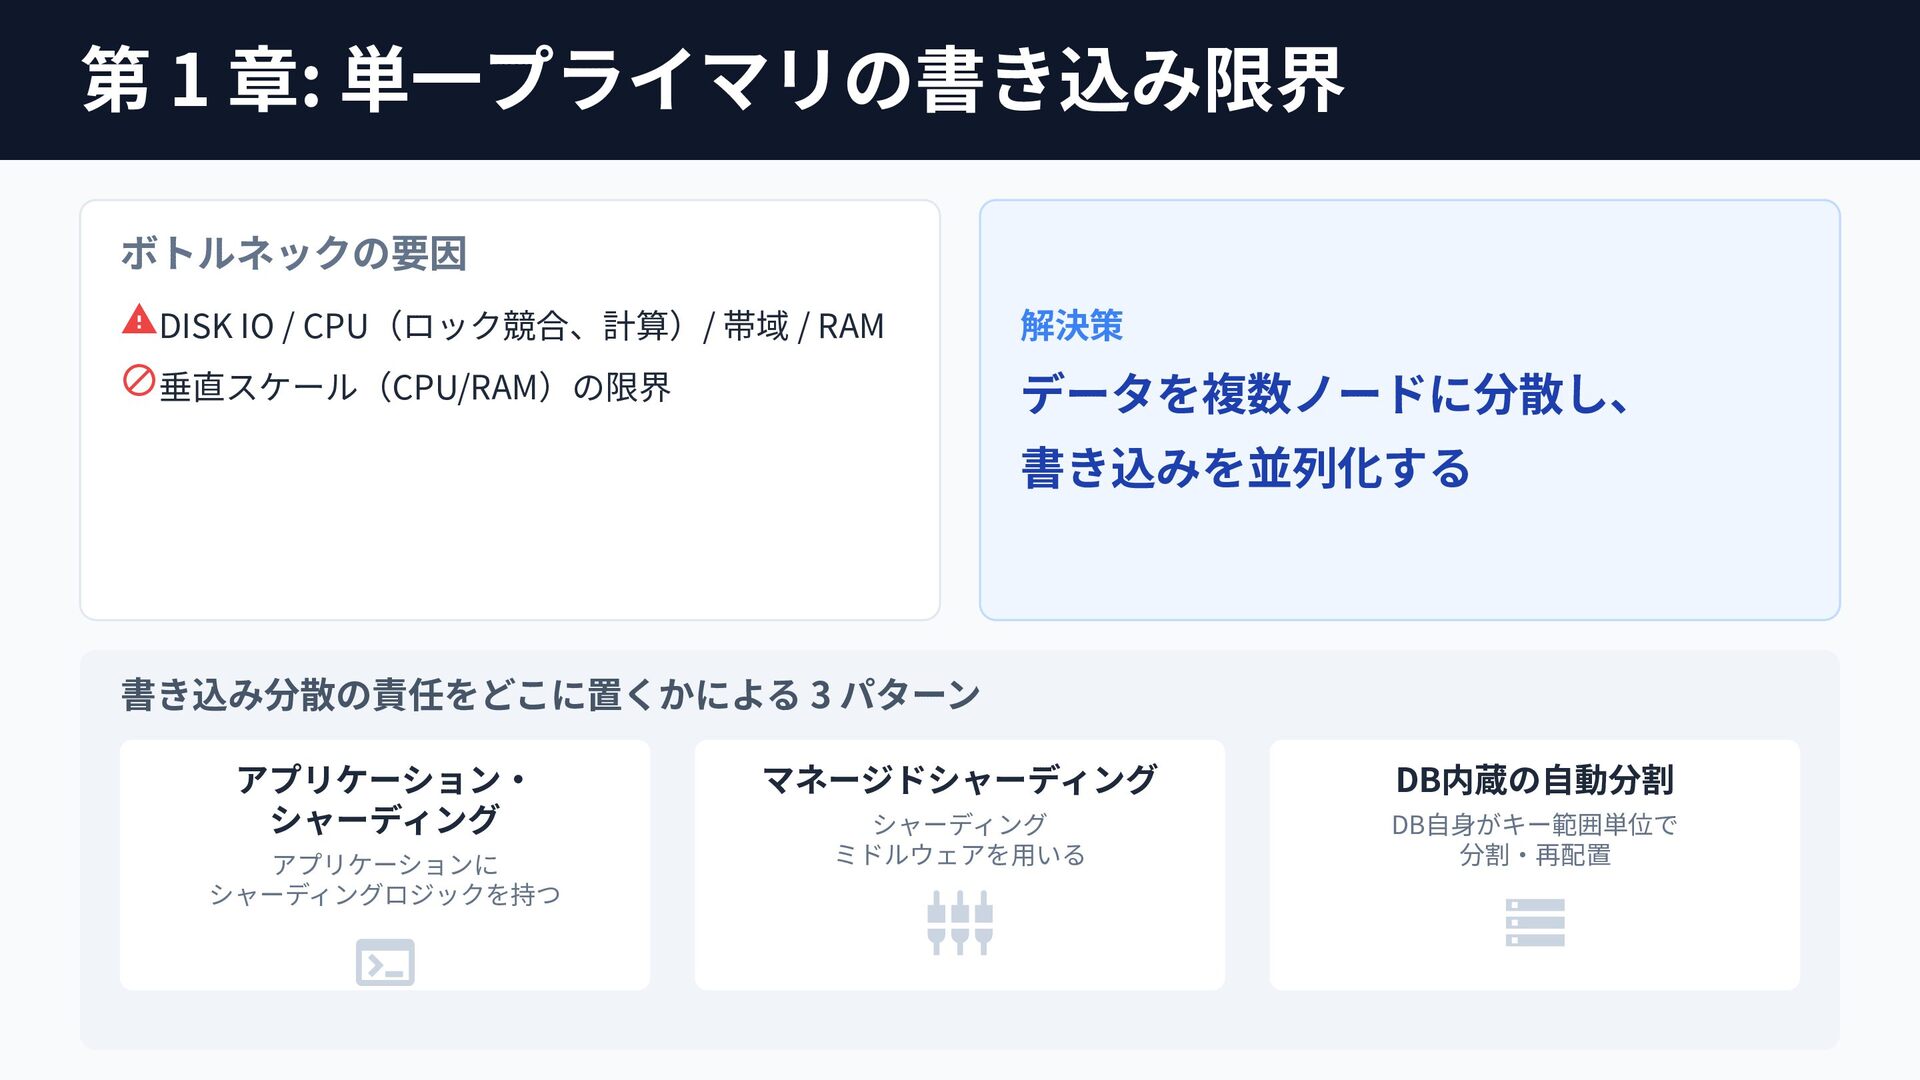
第 1 章: 単⼀プライマリの書き込み限界 ボトルネックの要因 DISK IO / CPU(ロック競合、計算)/ 帯域
/ RAM 解決策 垂直スケール(CPU/RAM)の限界 データを複数ノードに分散し、 書き込みを並列化する 書き込み分散の責任をどこに置くかによる 3 パターン アプリケーション‧ シャーディング アプリケーションに シャーディングロジックを持つ マネージドシャーディング DB内蔵の⾃動分割 シャーディング ミドルウェアを⽤いる DB⾃⾝がキー範囲単位で 分割‧再配置
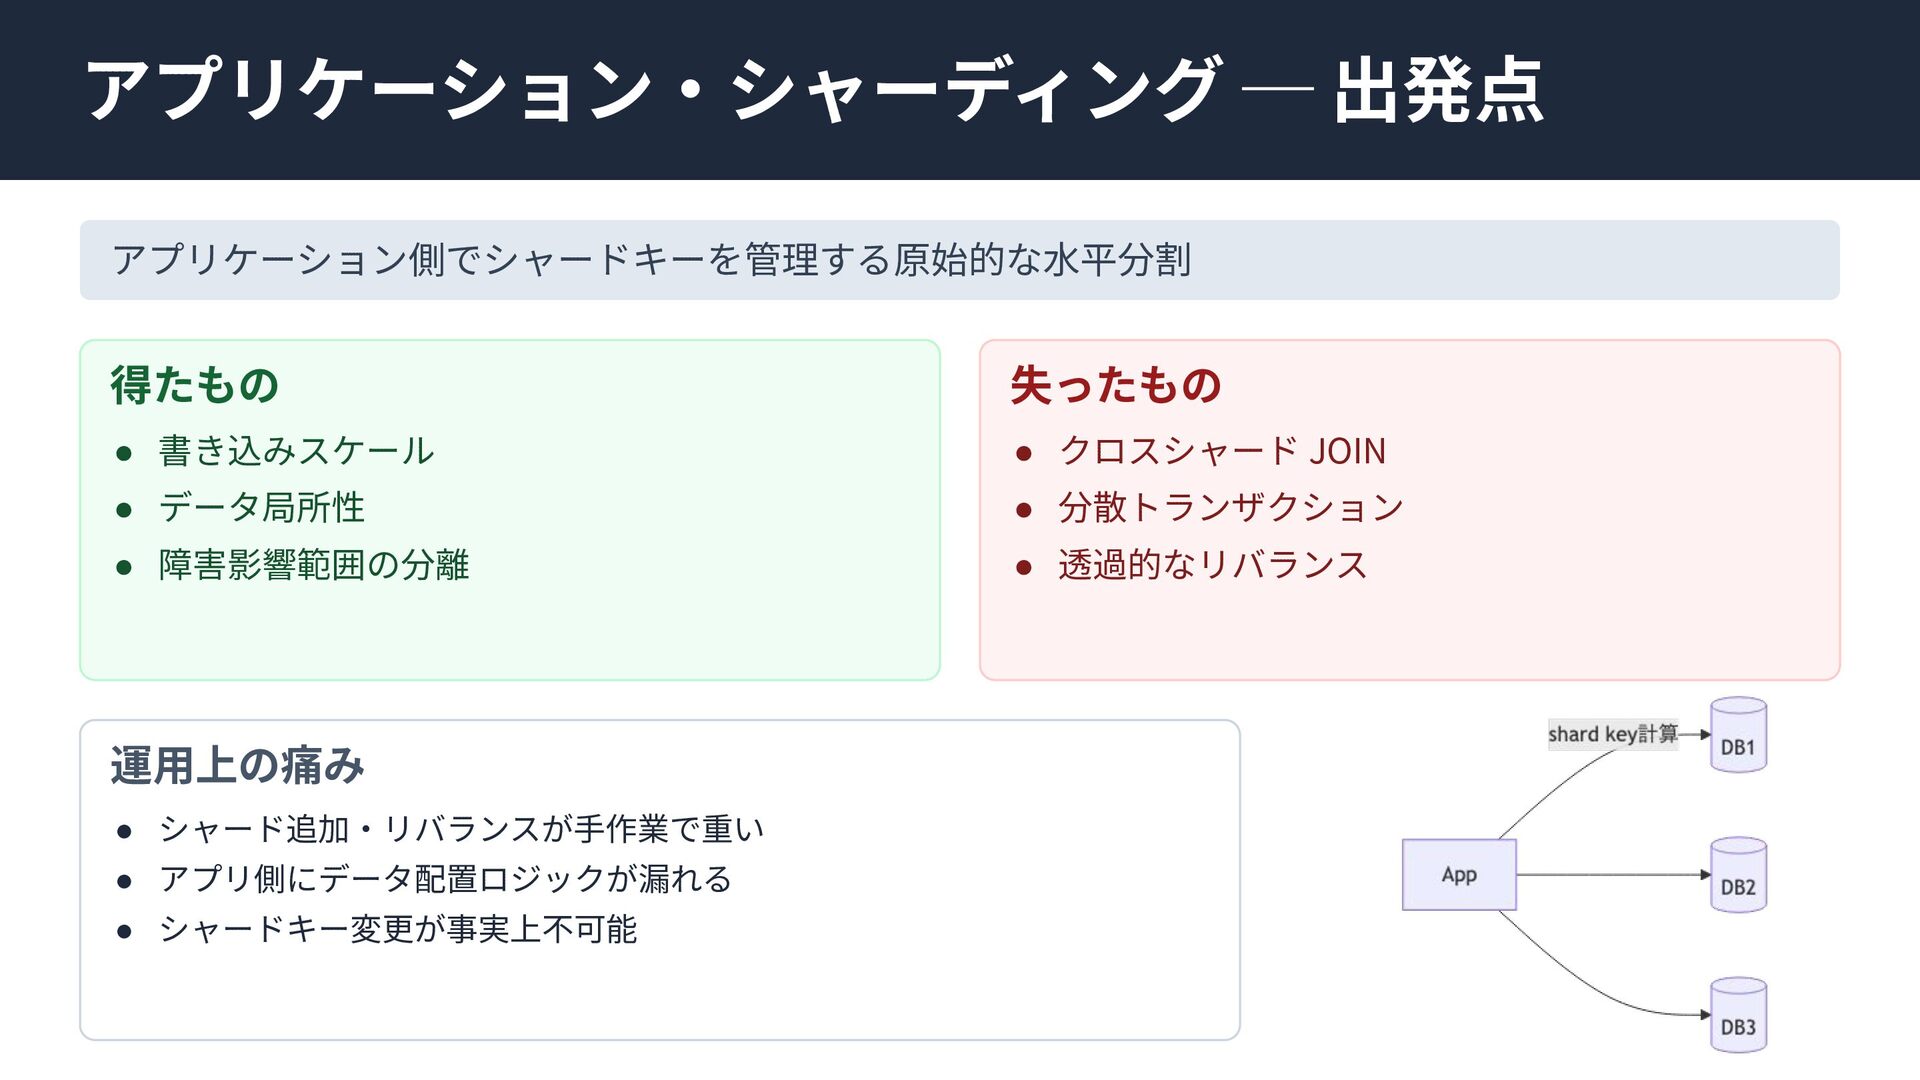
アプリケーション‧シャーディング ─ 出発点 アプリケーション側でシャードキーを管理する原始的な⽔平分割 得たもの 失ったもの • 書き込みスケール • クロスシャード
JOIN • データ局所性 • 分散トランザクション • 障害影響範囲の分離 • 透過的なリバランス 運⽤上の痛み • シャード追加‧リバランスが⼿作業で重い • アプリ側にデータ配置ロジックが漏れる • シャードキー変更が事実上不可能
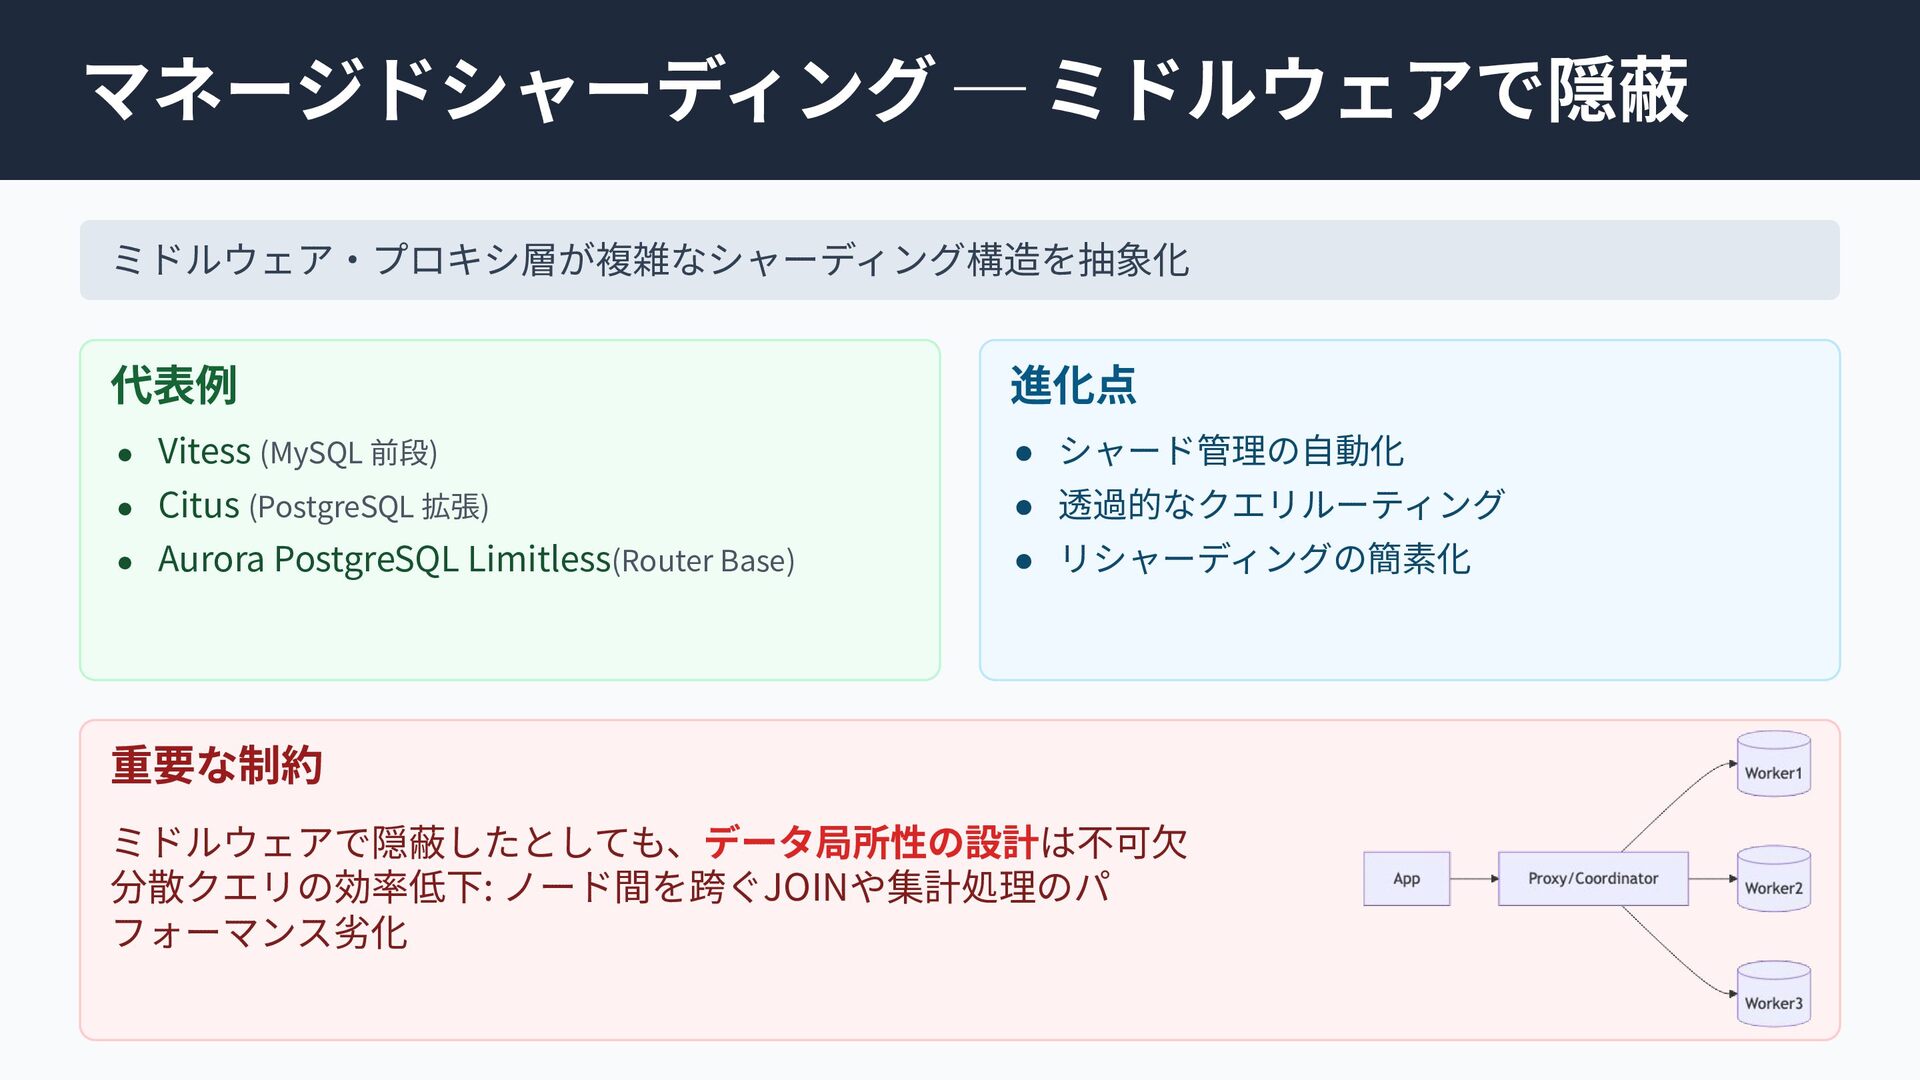
マネージドシャーディング ─ ミドルウェアで隠蔽 ミドルウェア‧プロキシ層が複雑なシャーディング構造を抽象化 代表例 進化点 • Vitess (MySQL 前段)
• シャード管理の⾃動化 • Citus (PostgreSQL 拡張) • 透過的なクエリルーティング • Aurora PostgreSQL Limitless(Router Base) • リシャーディングの簡素化 重要な制約 ミドルウェアで隠蔽したとしても、データ局所性の設計は不可⽋ 分散クエリの効率低下: ノード間を跨ぐJOINや集計処理のパ フォーマンス劣化
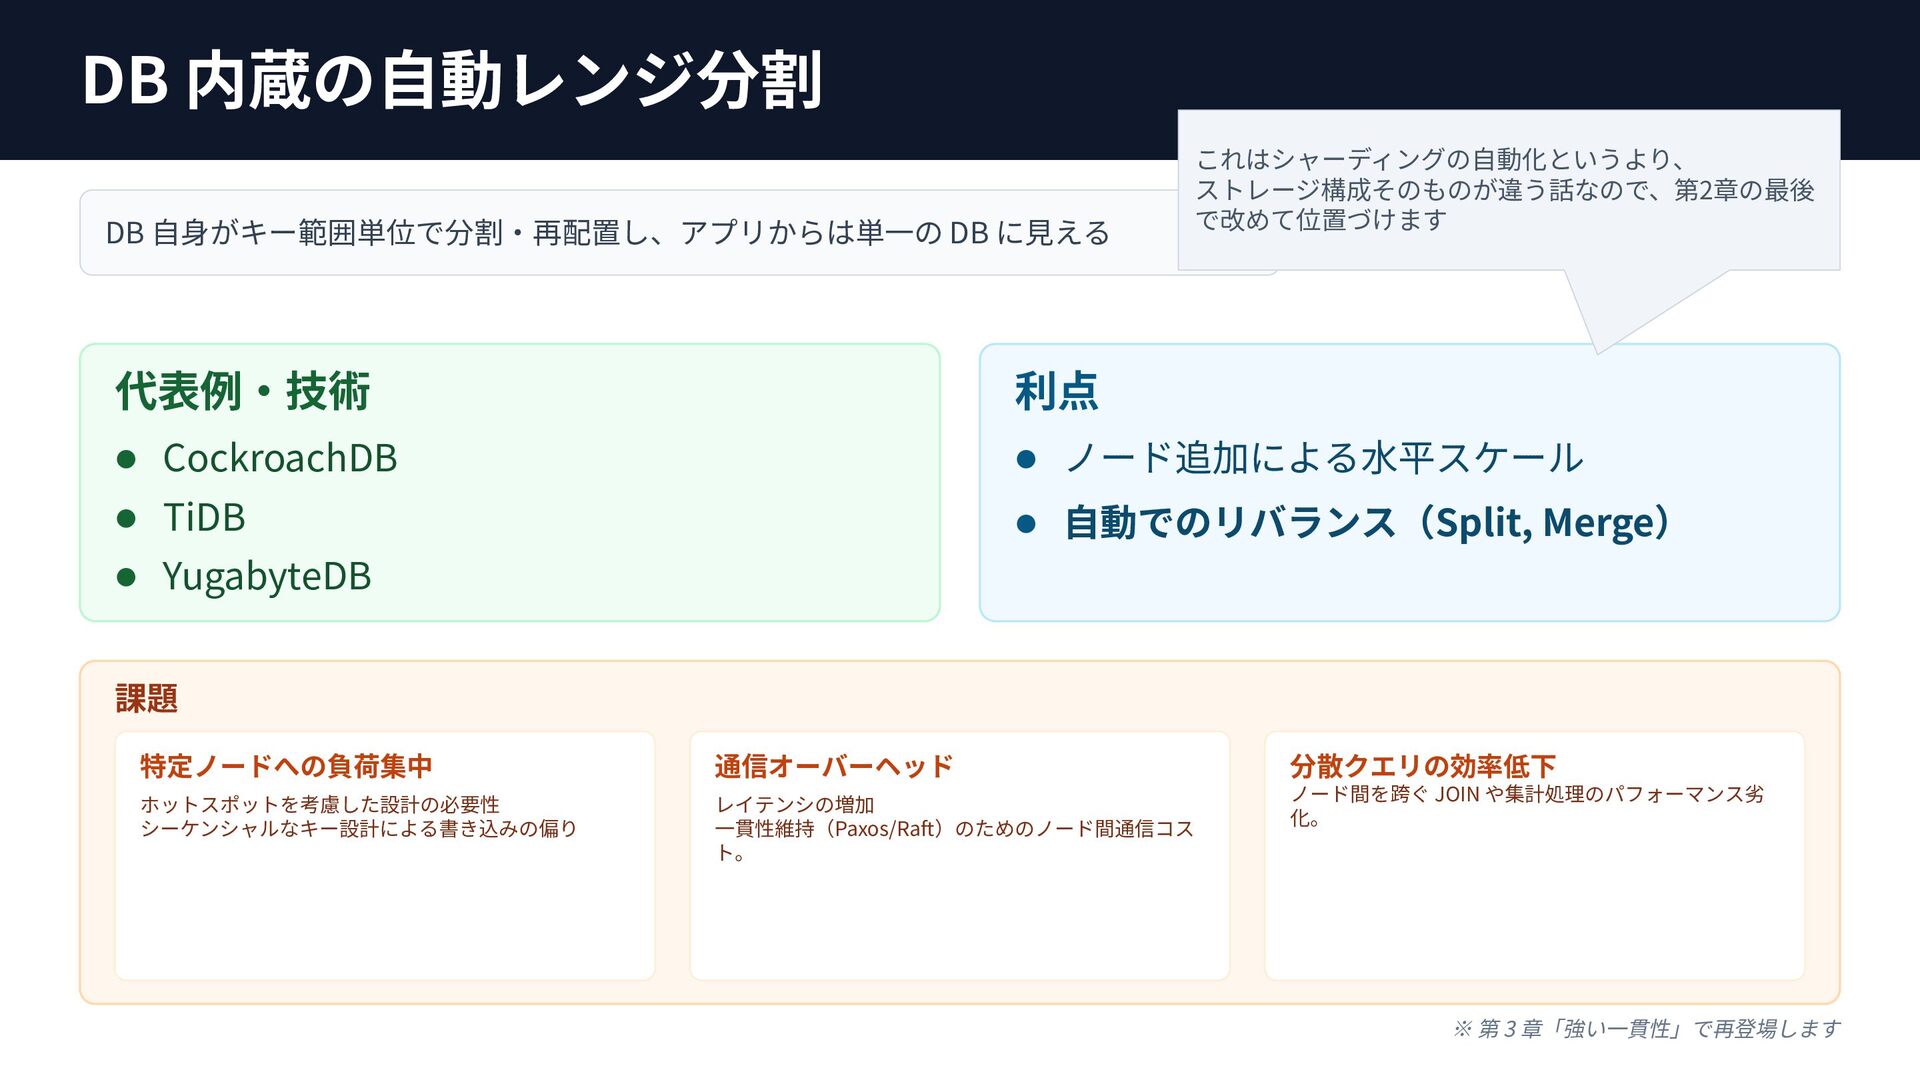
DB 内蔵の⾃動レンジ分割 DB ⾃⾝がキー範囲単位で分割‧再配置し、アプリからは単⼀の DB に⾒える これはシャーディングの⾃動化というより、 ストレージ構成そのものが違う話なので、第2章の最後 で改めて位置づけます 代表例‧技術
利点 • CockroachDB • TiDB • YugabyteDB • ノード追加による⽔平スケール • ⾃動でのリバランス(Split, Merge) 課題 特定ノードへの負荷集中 通信オーバーヘッド ホットスポットを考慮した設計の必要性 シーケンシャルなキー設計による書き込みの偏り レイテンシの増加 ⼀貫性維持(Paxos/Raft)のためのノード間通信コス ト。 分散クエリの効率低下 ノード間を跨ぐ JOIN や集計処理のパフォーマンス劣 化。 ※ 第 3 章「強い⼀貫性」で再登場します
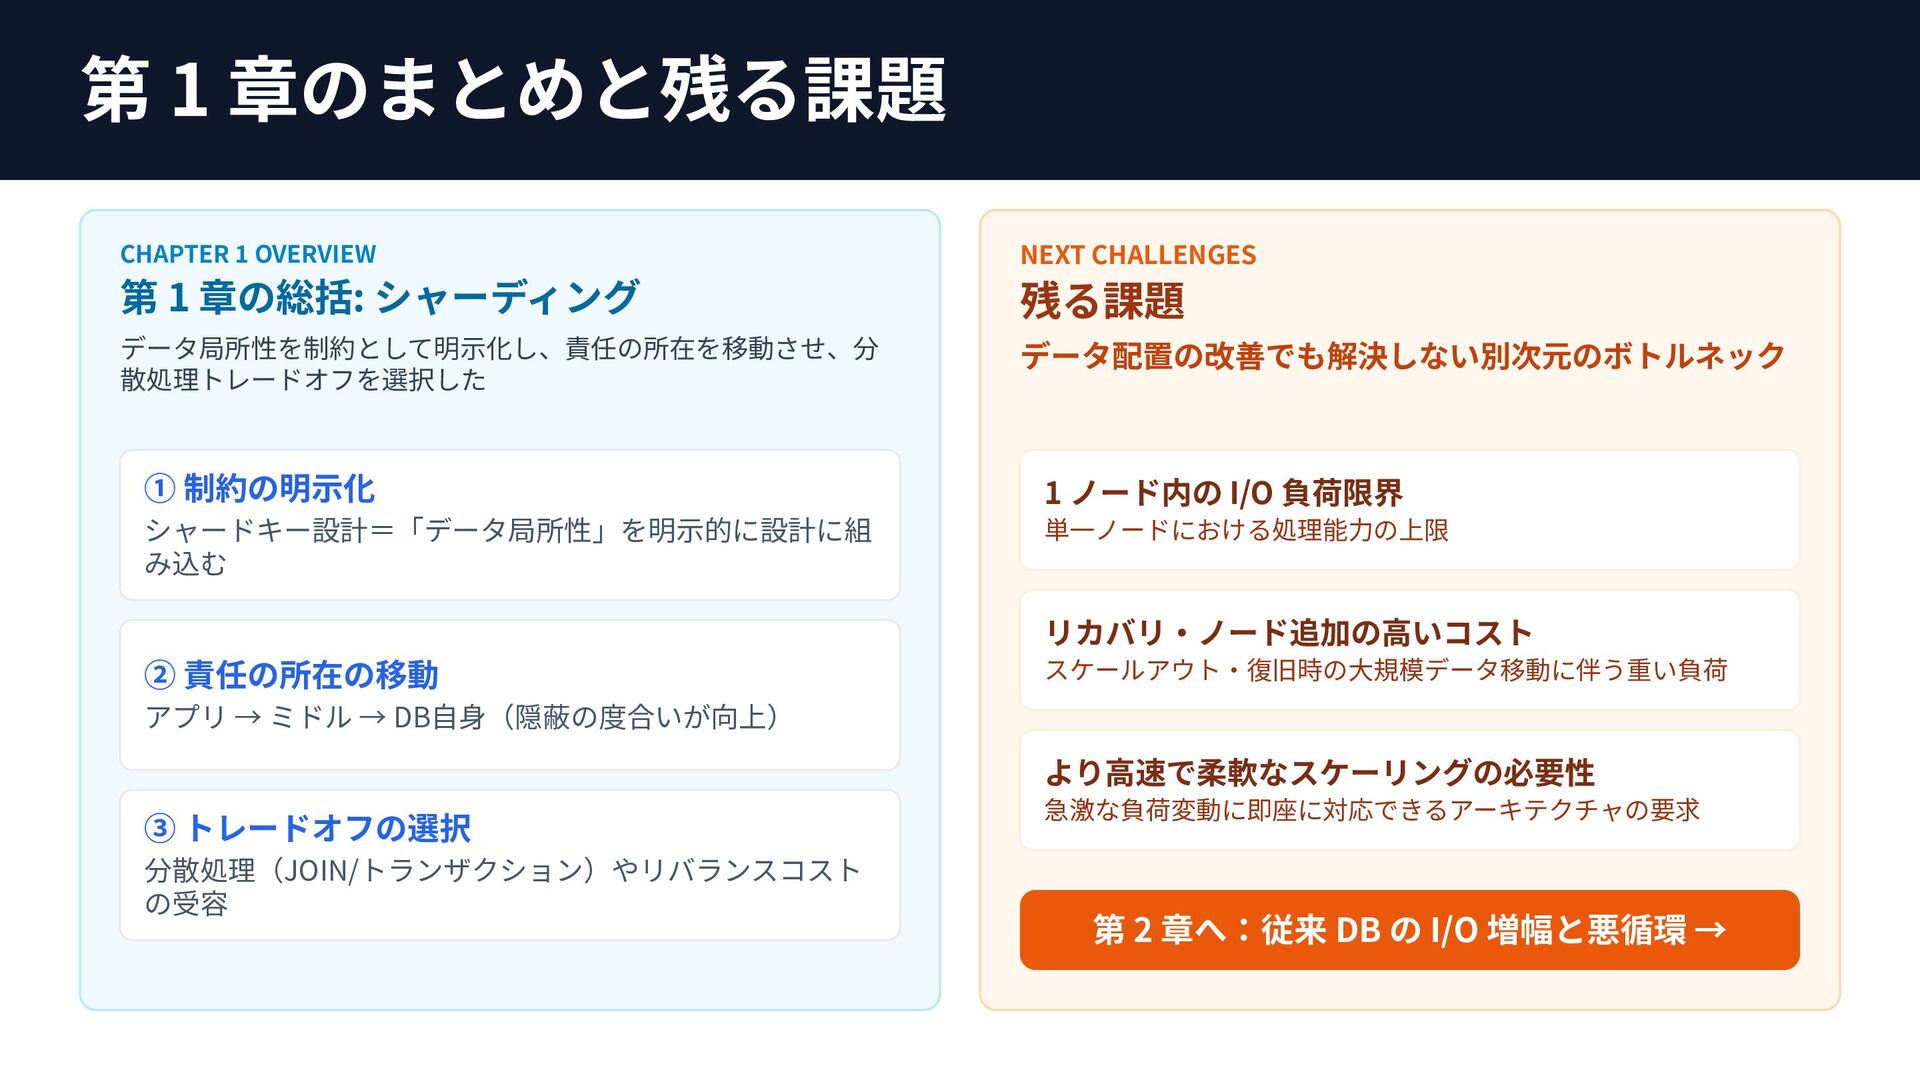
第 1 章のまとめと残る課題 CHAPTER 1 OVERVIEW NEXT CHALLENGES 第 1
章の総括: シャーディング 残る課題 データ局所性を制約として明⽰化し、責任の所在を移動させ、分 散処理トレードオフを選択した データ配置の改善でも解決しない別次元のボトルネック ① 制約の明⽰化 1 ノード内の I/O 負荷限界 シャードキー設計=「データ局所性」を明⽰的に設計に組 み込む 単⼀ノードにおける処理能⼒の上限 リカバリ‧ノード追加の⾼いコスト ② 責任の所在の移動 スケールアウト‧復旧時の⼤規模データ移動に伴う重い負荷 アプリ → ミドル → DB⾃⾝(隠蔽の度合いが向上) より⾼速で柔軟なスケーリングの必要性 ③ トレードオフの選択 分散処理(JOIN/トランザクション)やリバランスコスト の受容 急激な負荷変動に即座に対応できるアーキテクチャの要求 第 2 章へ:従来 DB の I/O 増幅と悪循環 →
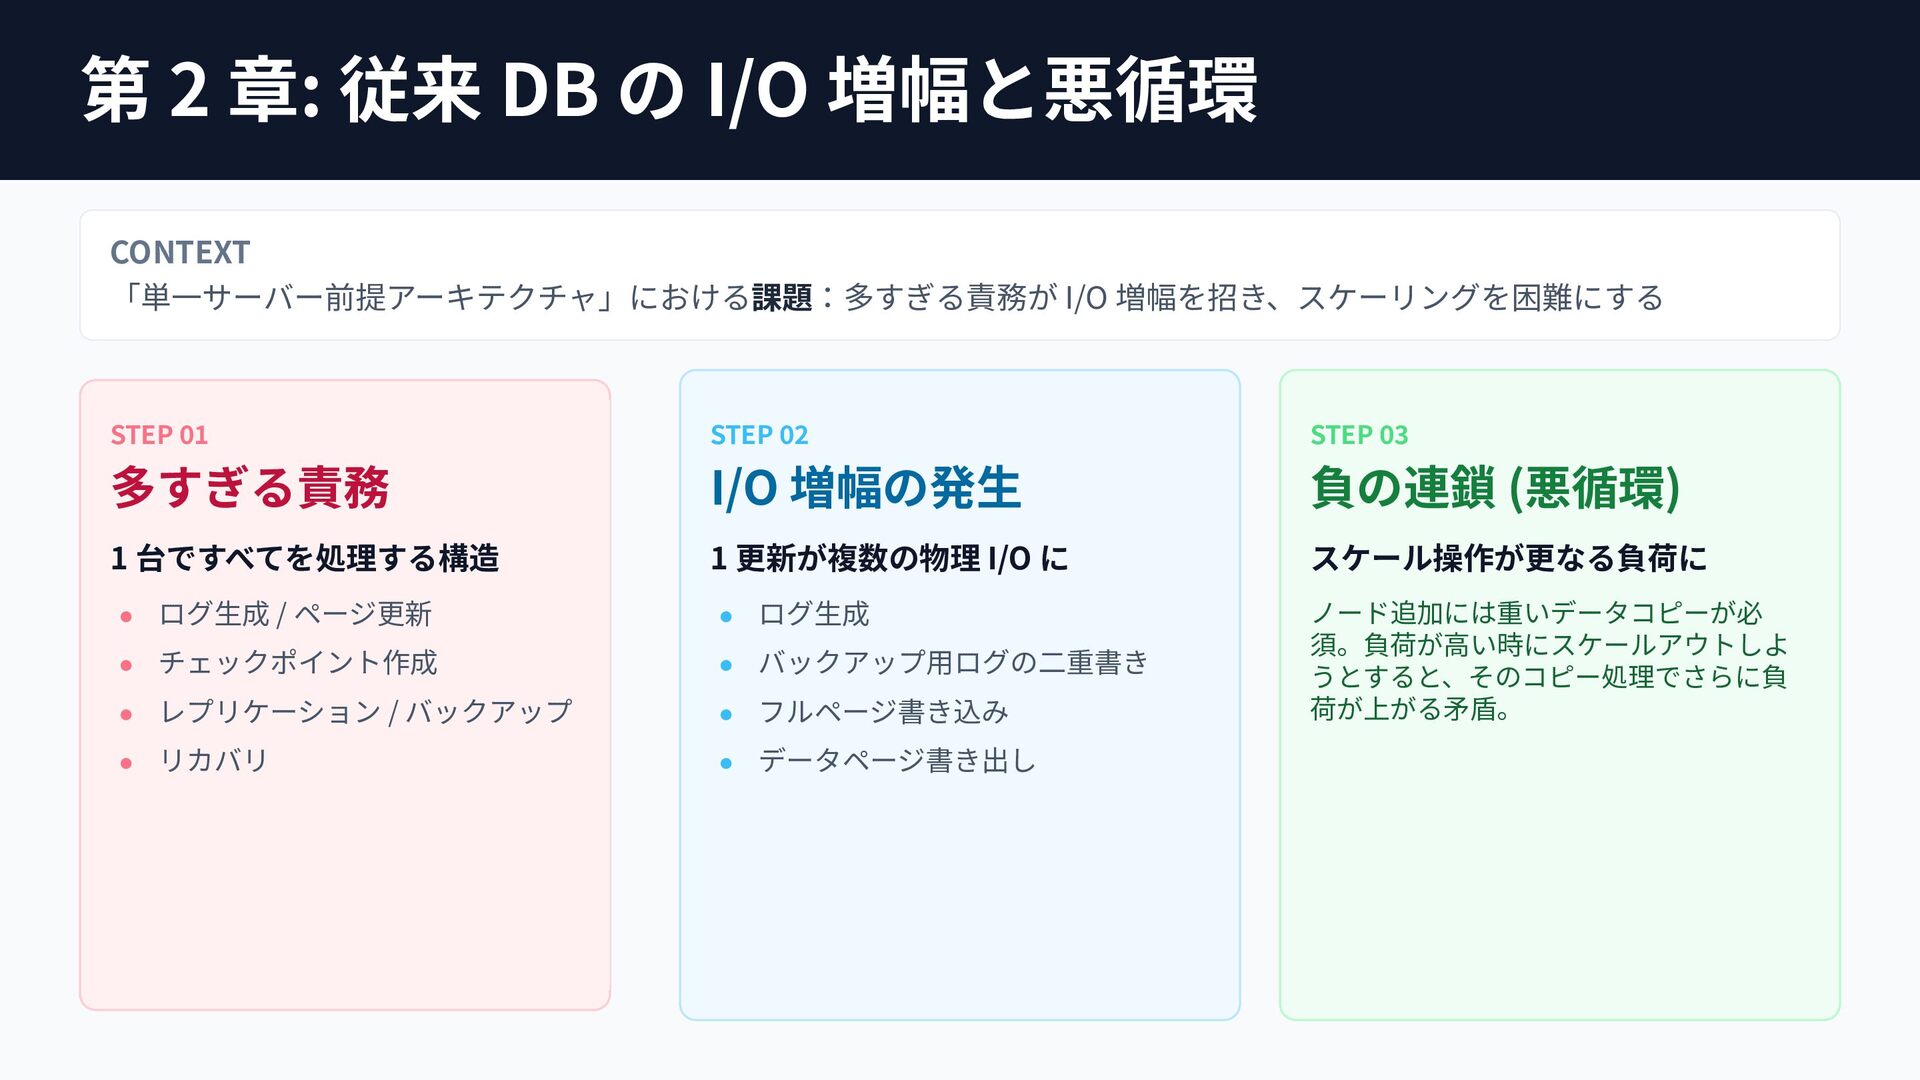
第 2 章: 従来 DB の I/O 増幅と悪循環 CONTEXT 「単⼀サーバー前提アーキテクチャ」における課題:多すぎる責務が
I/O 増幅を招き、スケーリングを困難にする STEP 01 STEP 02 STEP 03 多すぎる責務 I/O 増幅の発⽣ 負の連鎖 (悪循環) 1 台ですべてを処理する構造 1 更新が複数の物理 I/O に スケール操作が更なる負荷に • ログ⽣成 / ページ更新 • ログ⽣成 • チェックポイント作成 • バックアップ⽤ログの⼆重書き • レプリケーション / バックアップ • フルページ書き込み ノード追加には重いデータコピーが必 須。負荷が⾼い時にスケールアウトしよ うとすると、そのコピー処理でさらに負 荷が上がる⽭盾。 • リカバリ • データページ書き出し
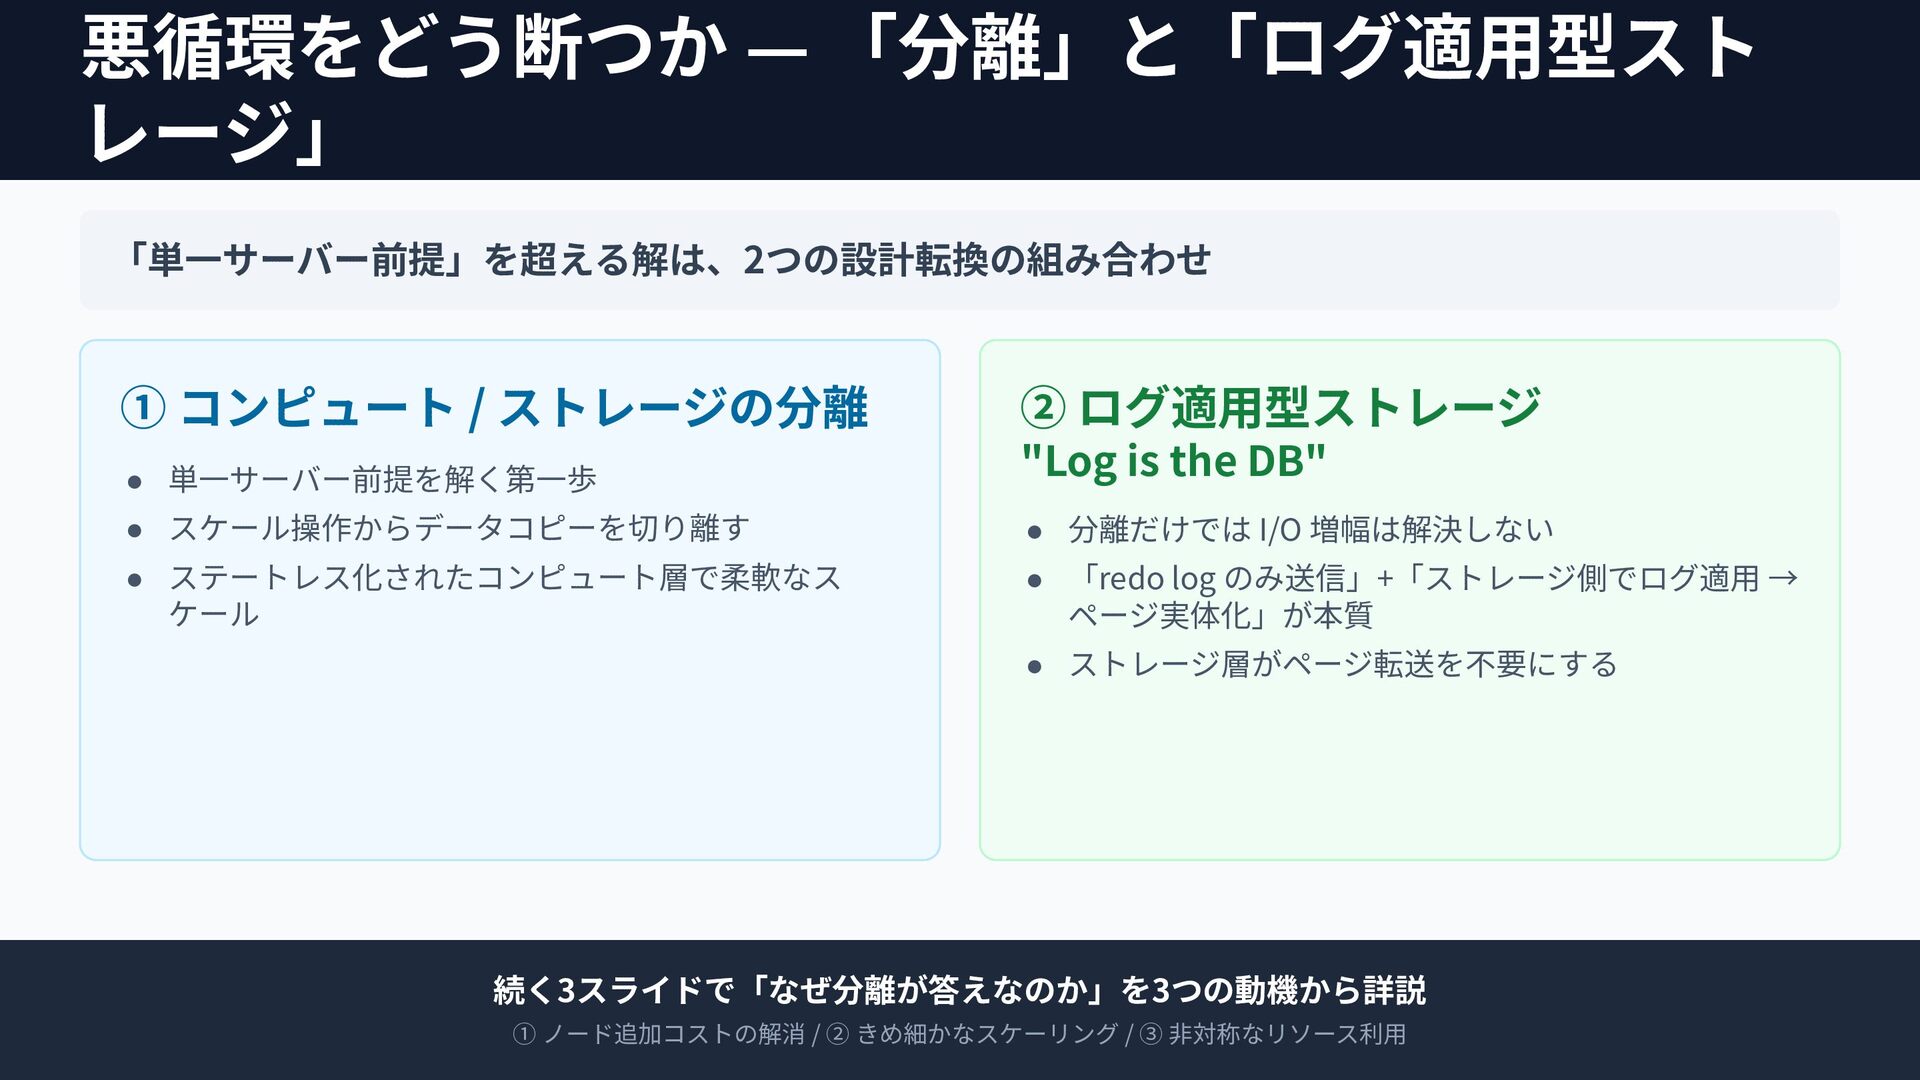
悪循環をどう断つか — 「分離」と「ログ適⽤型スト レージ」 「単⼀サーバー前提」を超える解は、2つの設計転換の組み合わせ ① コンピュート / ストレージの分離 •
単⼀サーバー前提を解く第⼀歩 ② ログ適⽤型ストレージ "Log is the DB" • スケール操作からデータコピーを切り離す • 分離だけでは I/O 増幅は解決しない • ステートレス化されたコンピュート層で柔軟なス ケール • 「redo log のみ送信」+「ストレージ側でログ適⽤ → ページ実体化」が本質 • ストレージ層がページ転送を不要にする 続く3スライドで「なぜ分離が答えなのか」を3つの動機から詳説 ① ノード追加コストの解消 / ② きめ細かなスケーリング / ③ ⾮対称なリソース利⽤
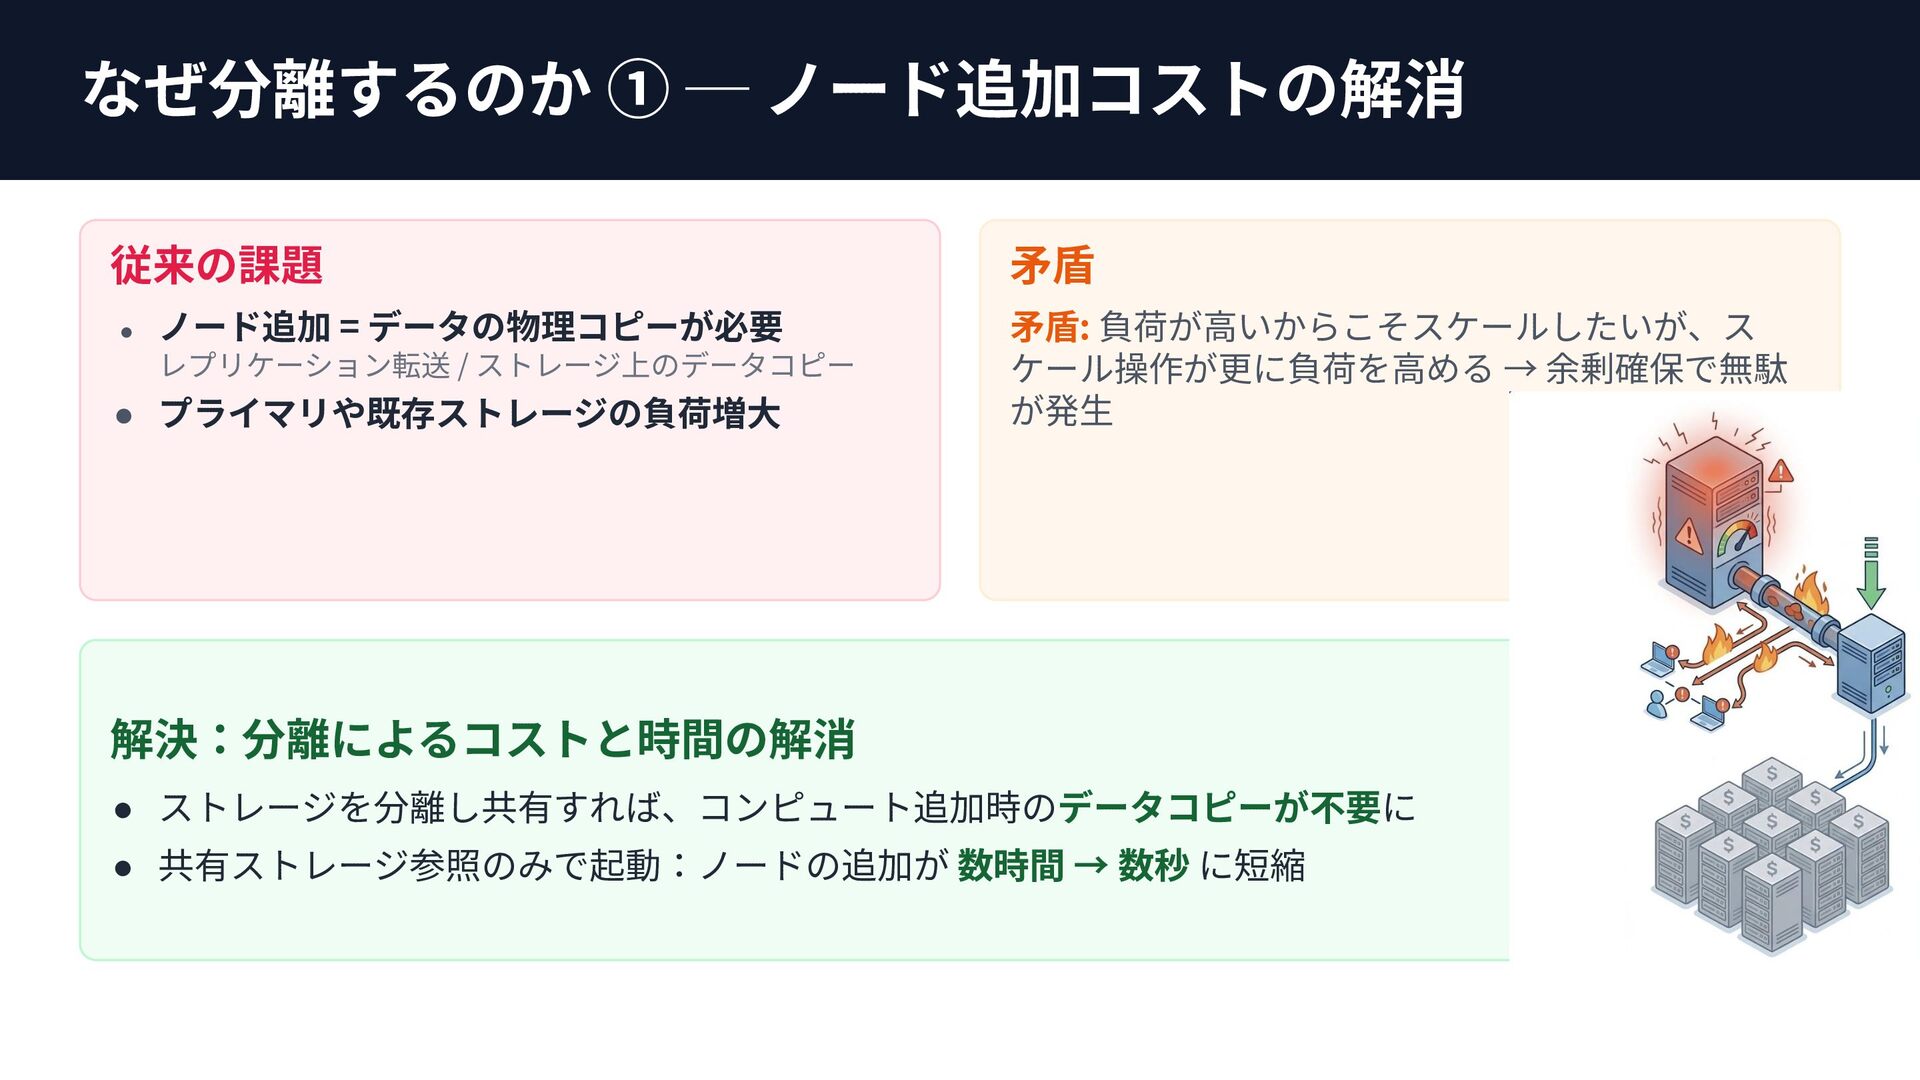
なぜ分離するのか ① ─ ノード追加コストの解消 従来の課題 • ノード追加 = データの物理コピーが必要 レプリケーション転送
/ ストレージ上のデータコピー • プライマリや既存ストレージの負荷増⼤ ⽭盾 ⽭盾: 負荷が⾼いからこそスケールしたいが、ス ケール操作が更に負荷を⾼める → 余剰確保で無駄 が発⽣ 解決:分離によるコストと時間の解消 • ストレージを分離し共有すれば、コンピュート追加時のデータコピーが不要に • 共有ストレージ参照のみで起動:ノードの追加が 数時間 → 数秒 に短縮
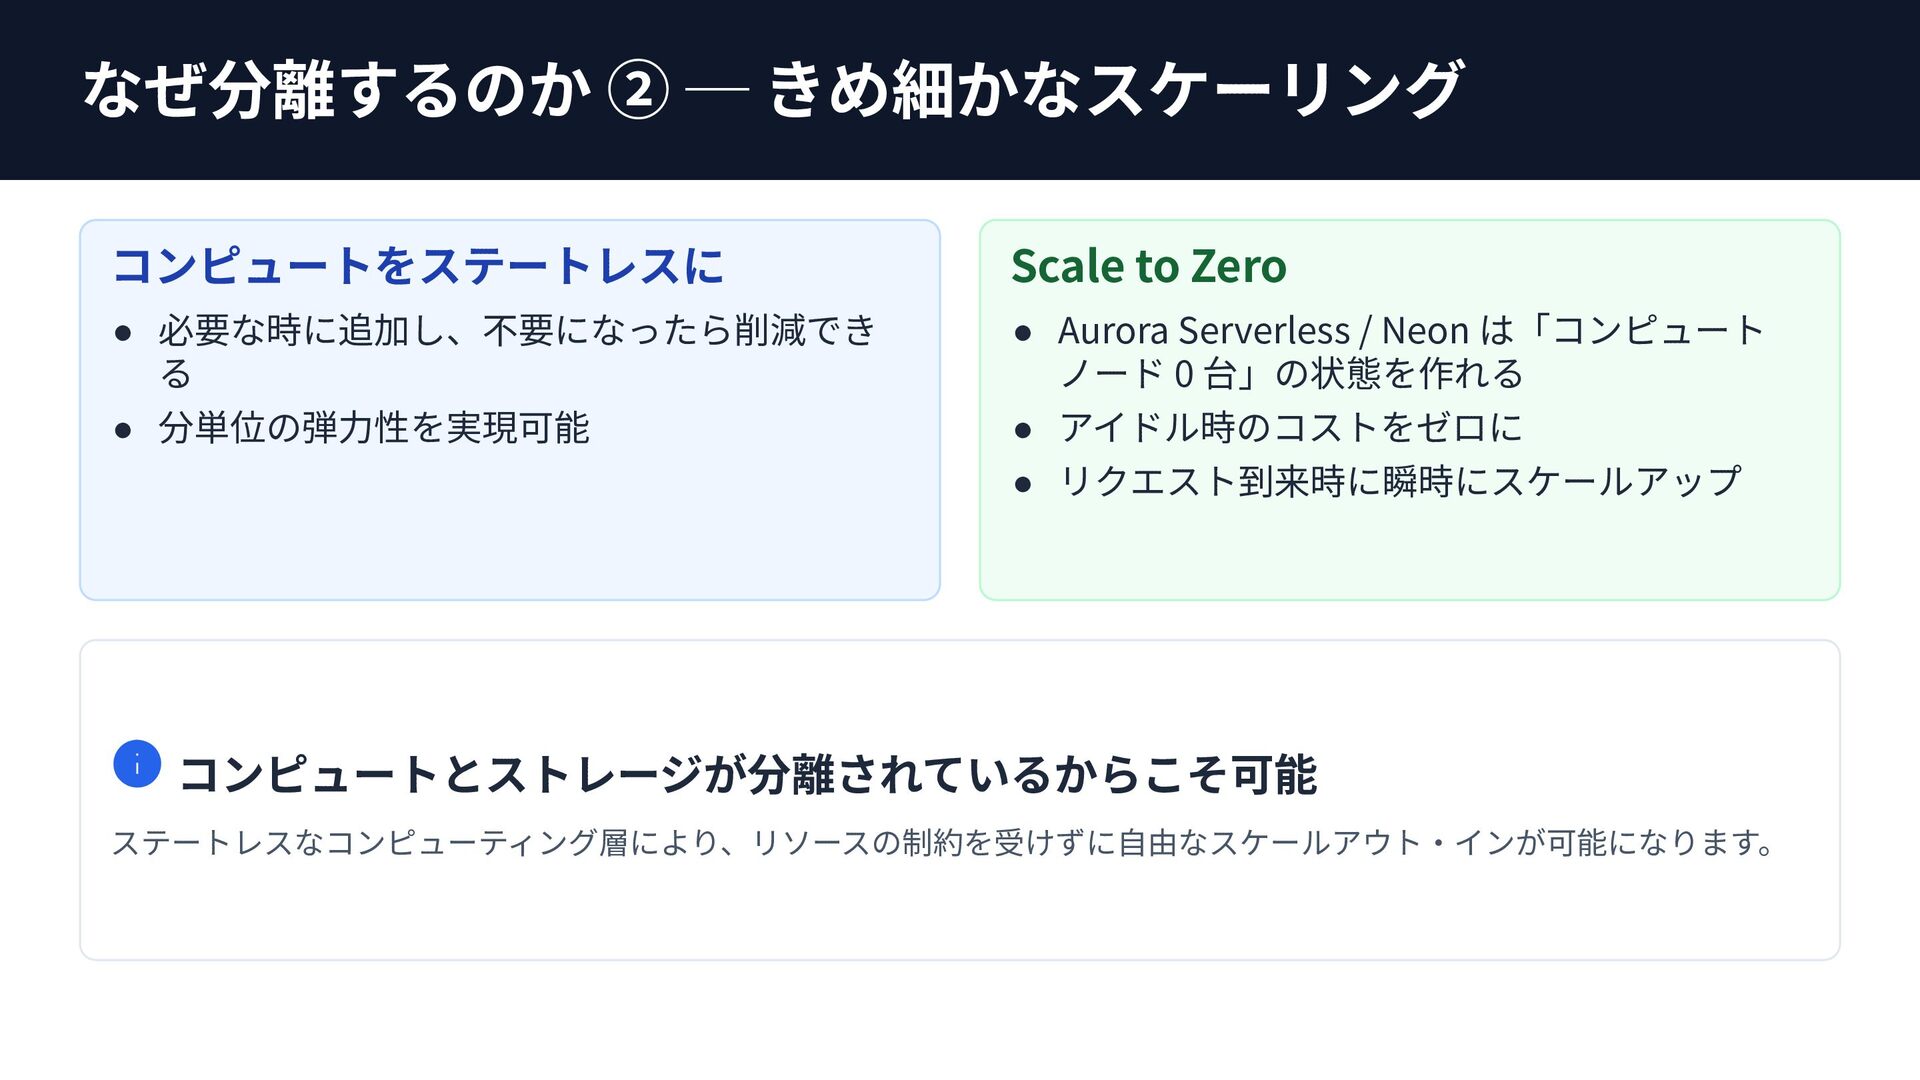
なぜ分離するのか ② ─ きめ細かなスケーリング コンピュートをステートレスに Scale to Zero • 必要な時に追加し、不要になったら削減でき
る • 分単位の弾⼒性を実現可能 • Aurora Serverless / Neon は「コンピュート ノード 0 台」の状態を作れる • アイドル時のコストをゼロに • リクエスト到来時に瞬時にスケールアップ コンピュートとストレージが分離されているからこそ可能 ステートレスなコンピューティング層により、リソースの制約を受けずに⾃由なスケールアウト‧インが可能になります。
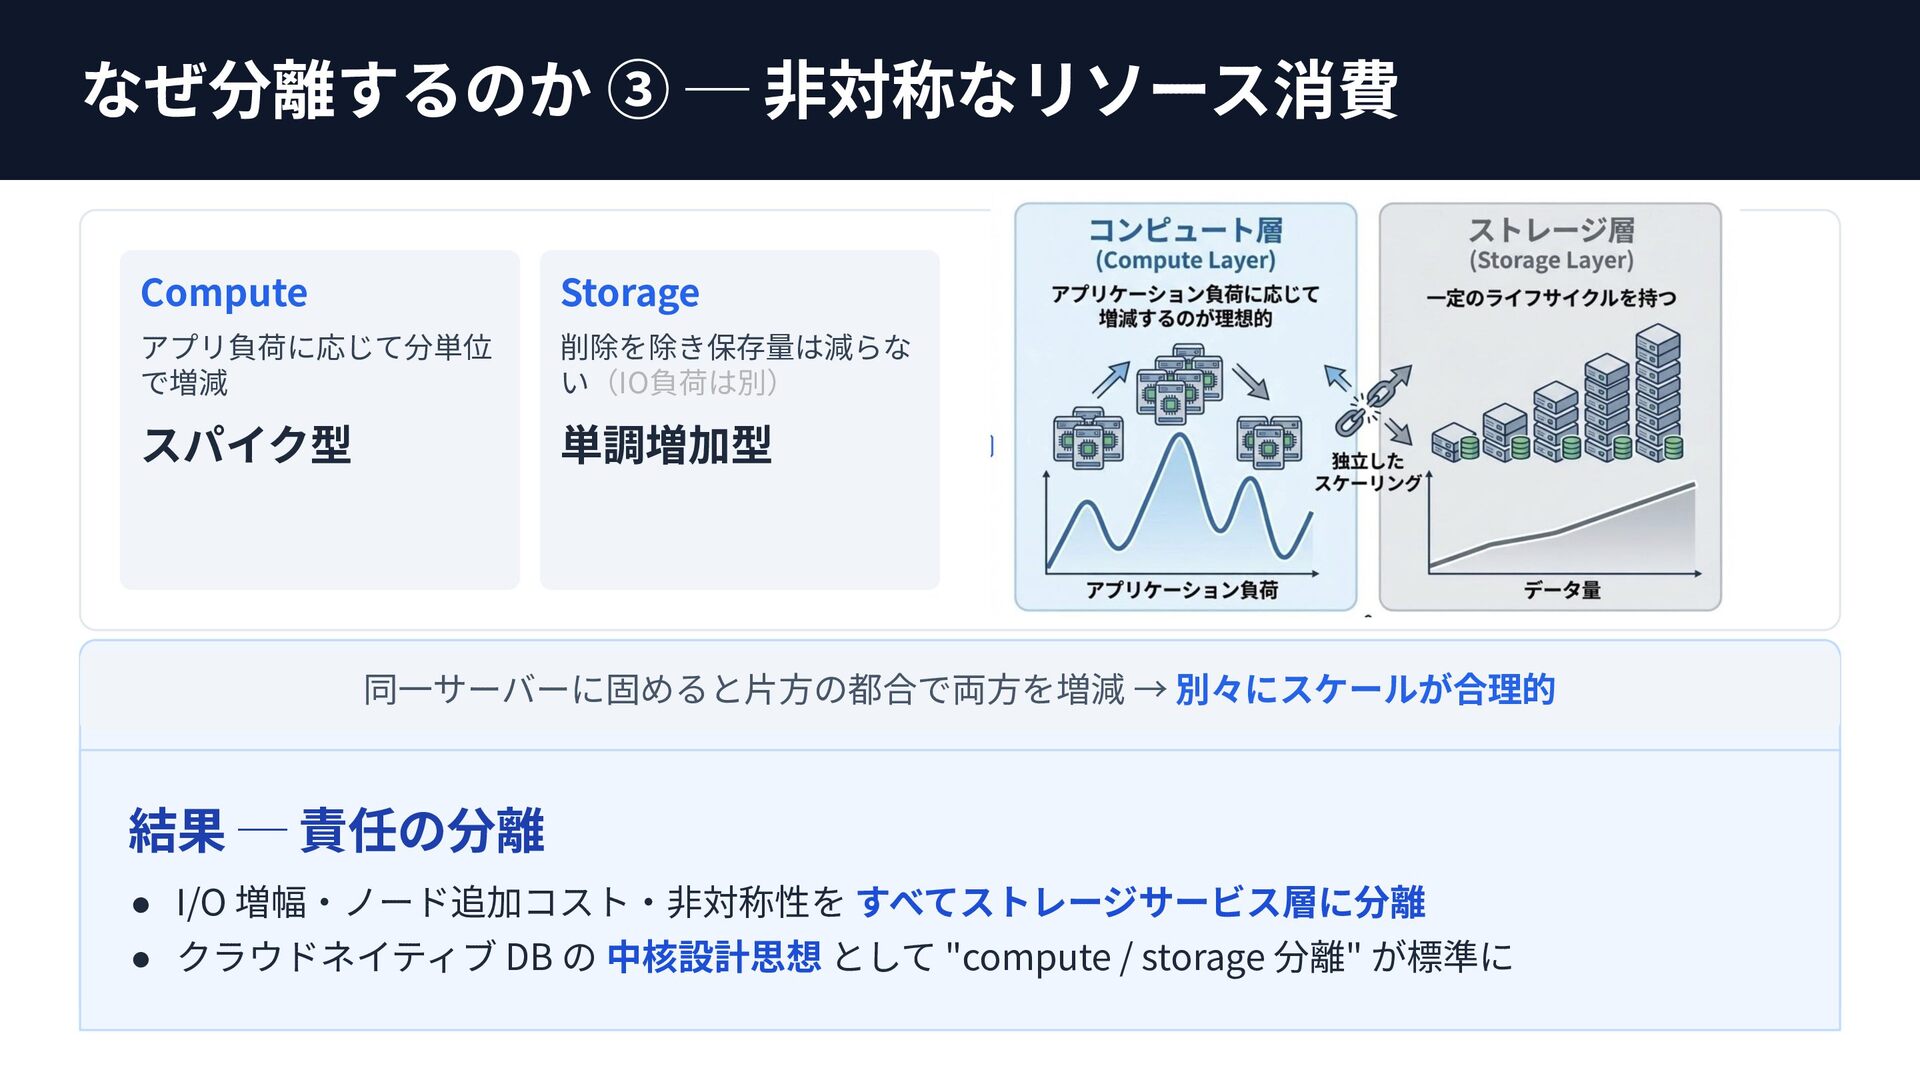
なぜ分離するのか ③ ─ ⾮対称なリソース消費 Compute Storage アプリ負荷に応じて分単位 で増減 削除を除き保存量は減らな い(IO負荷は別)
スパイク型 単調増加型 同⼀サーバーに固めると⽚⽅の都合で両⽅を増減 → 別々にスケールが合理的 結果 ─ 責任の分離 • I/O 増幅‧ノード追加コスト‧⾮対称性を すべてストレージサービス層に分離 • クラウドネイティブ DB の 中核設計思想 として "compute / storage 分離" が標準に
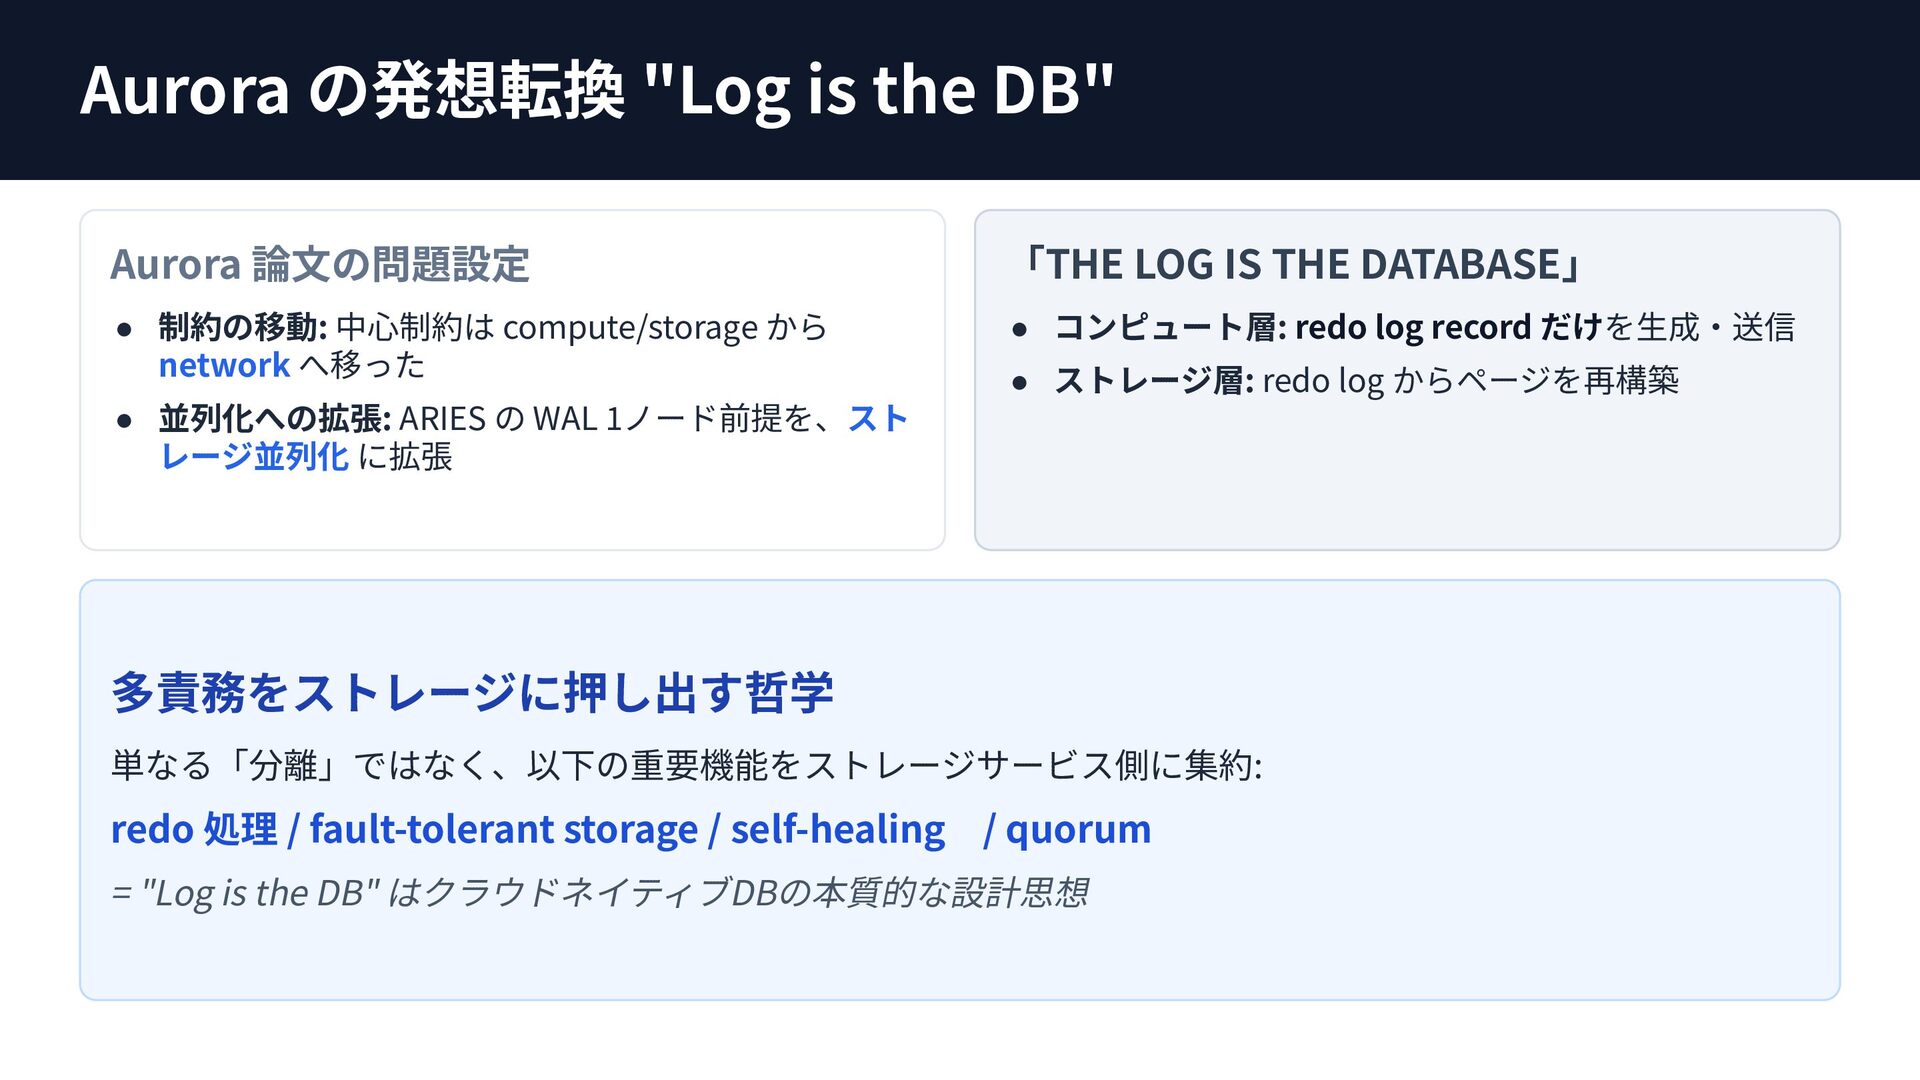
Aurora の発想転換 "Log is the DB" Aurora 論⽂の問題設定 「THE LOG
IS THE DATABASE」 • 制約の移動: 中⼼制約は compute/storage から network へ移った • コンピュート層: redo log record だけを⽣成‧送信 • ストレージ層: redo log からページを再構築 • 並列化への拡張: ARIES の WAL 1ノード前提を、スト レージ並列化 に拡張 多責務をストレージに押し出す哲学 単なる「分離」ではなく、以下の重要機能をストレージサービス側に集約: redo 処理 / fault-tolerant storage / self-healing / quorum = "Log is the DB" はクラウドネイティブDBの本質的な設計思想
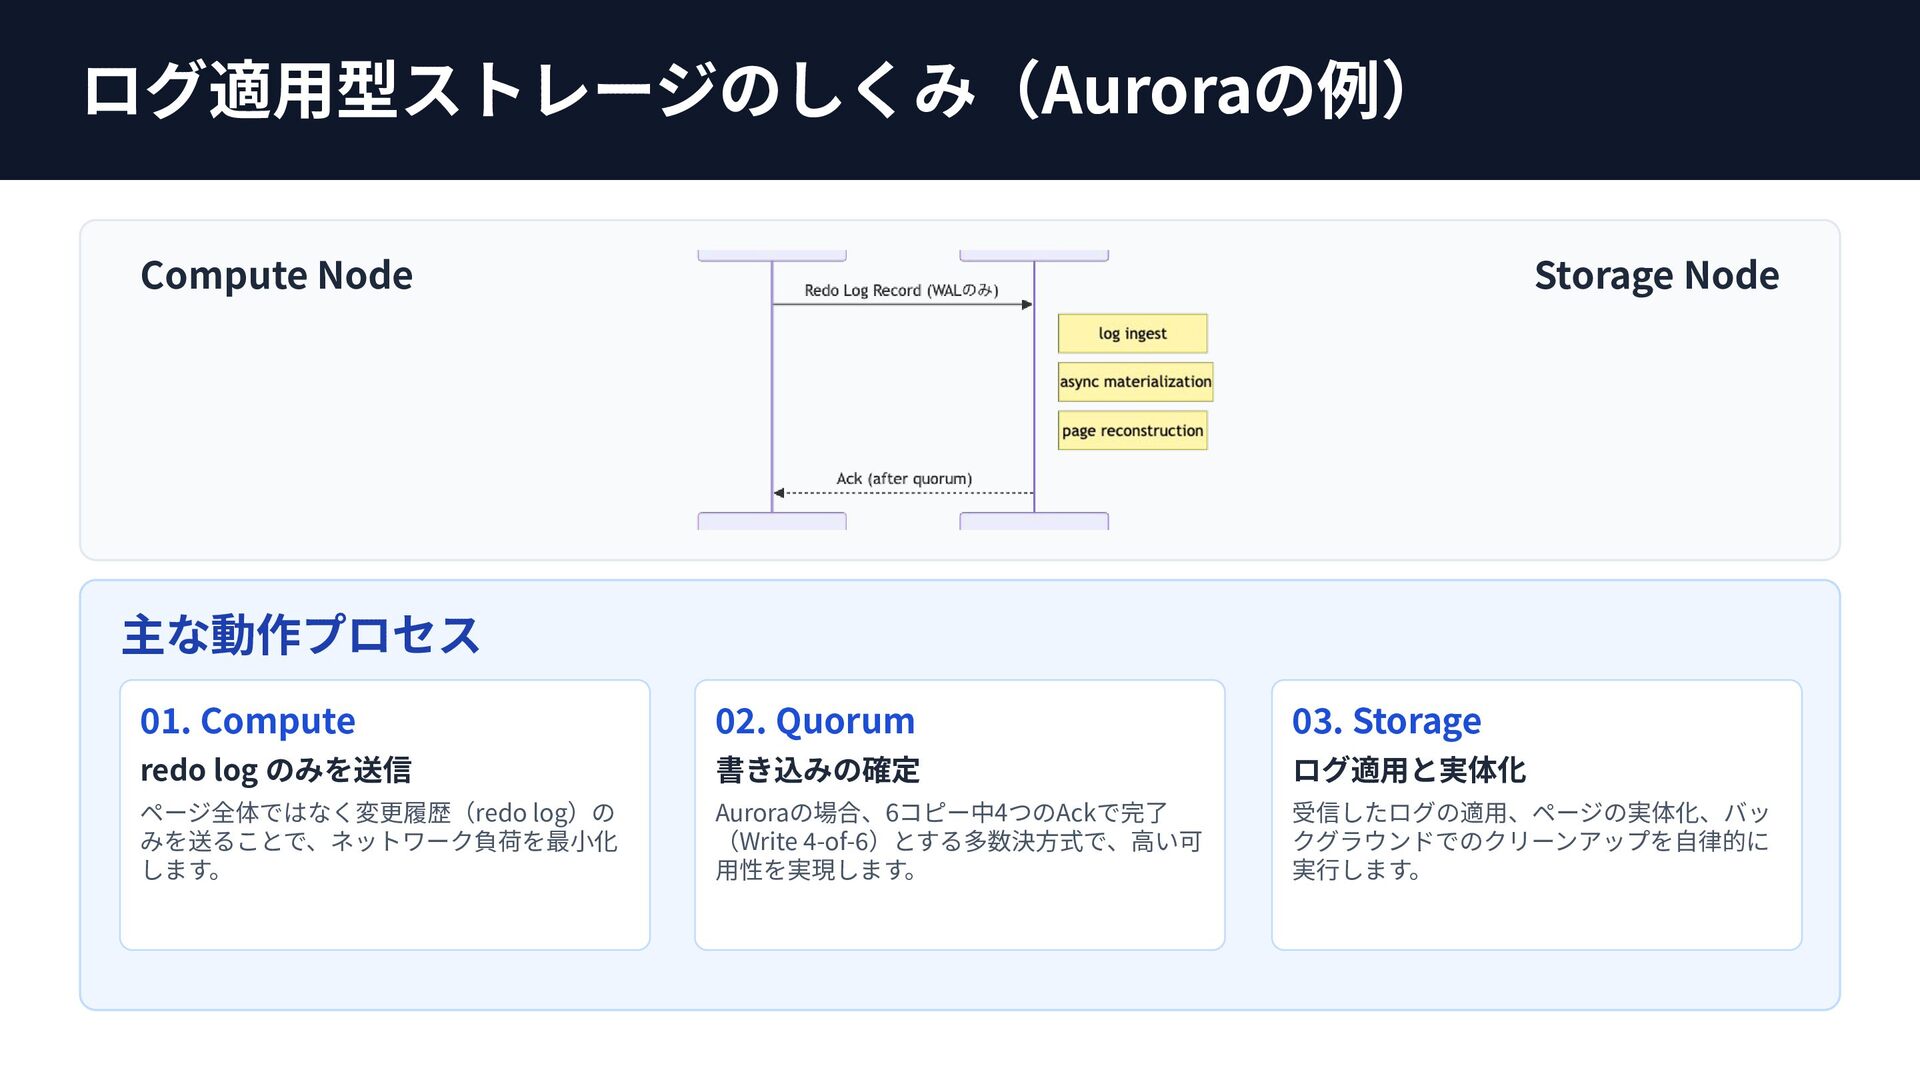
ログ適⽤型ストレージのしくみ(Auroraの例) Compute Node Storage Node 主な動作プロセス 01. Compute 02. Quorum
03. Storage redo log のみを送信 書き込みの確定 ログ適⽤と実体化 ページ全体ではなく変更履歴(redo log)の みを送ることで、ネットワーク負荷を最⼩化 します。 Auroraの場合、6コピー中4つのAckで完了 (Write 4-of-6)とする多数決⽅式で、⾼い可 ⽤性を実現します。 受信したログの適⽤、ページの実体化、バッ クグラウンドでのクリーンアップを⾃律的に 実⾏します。
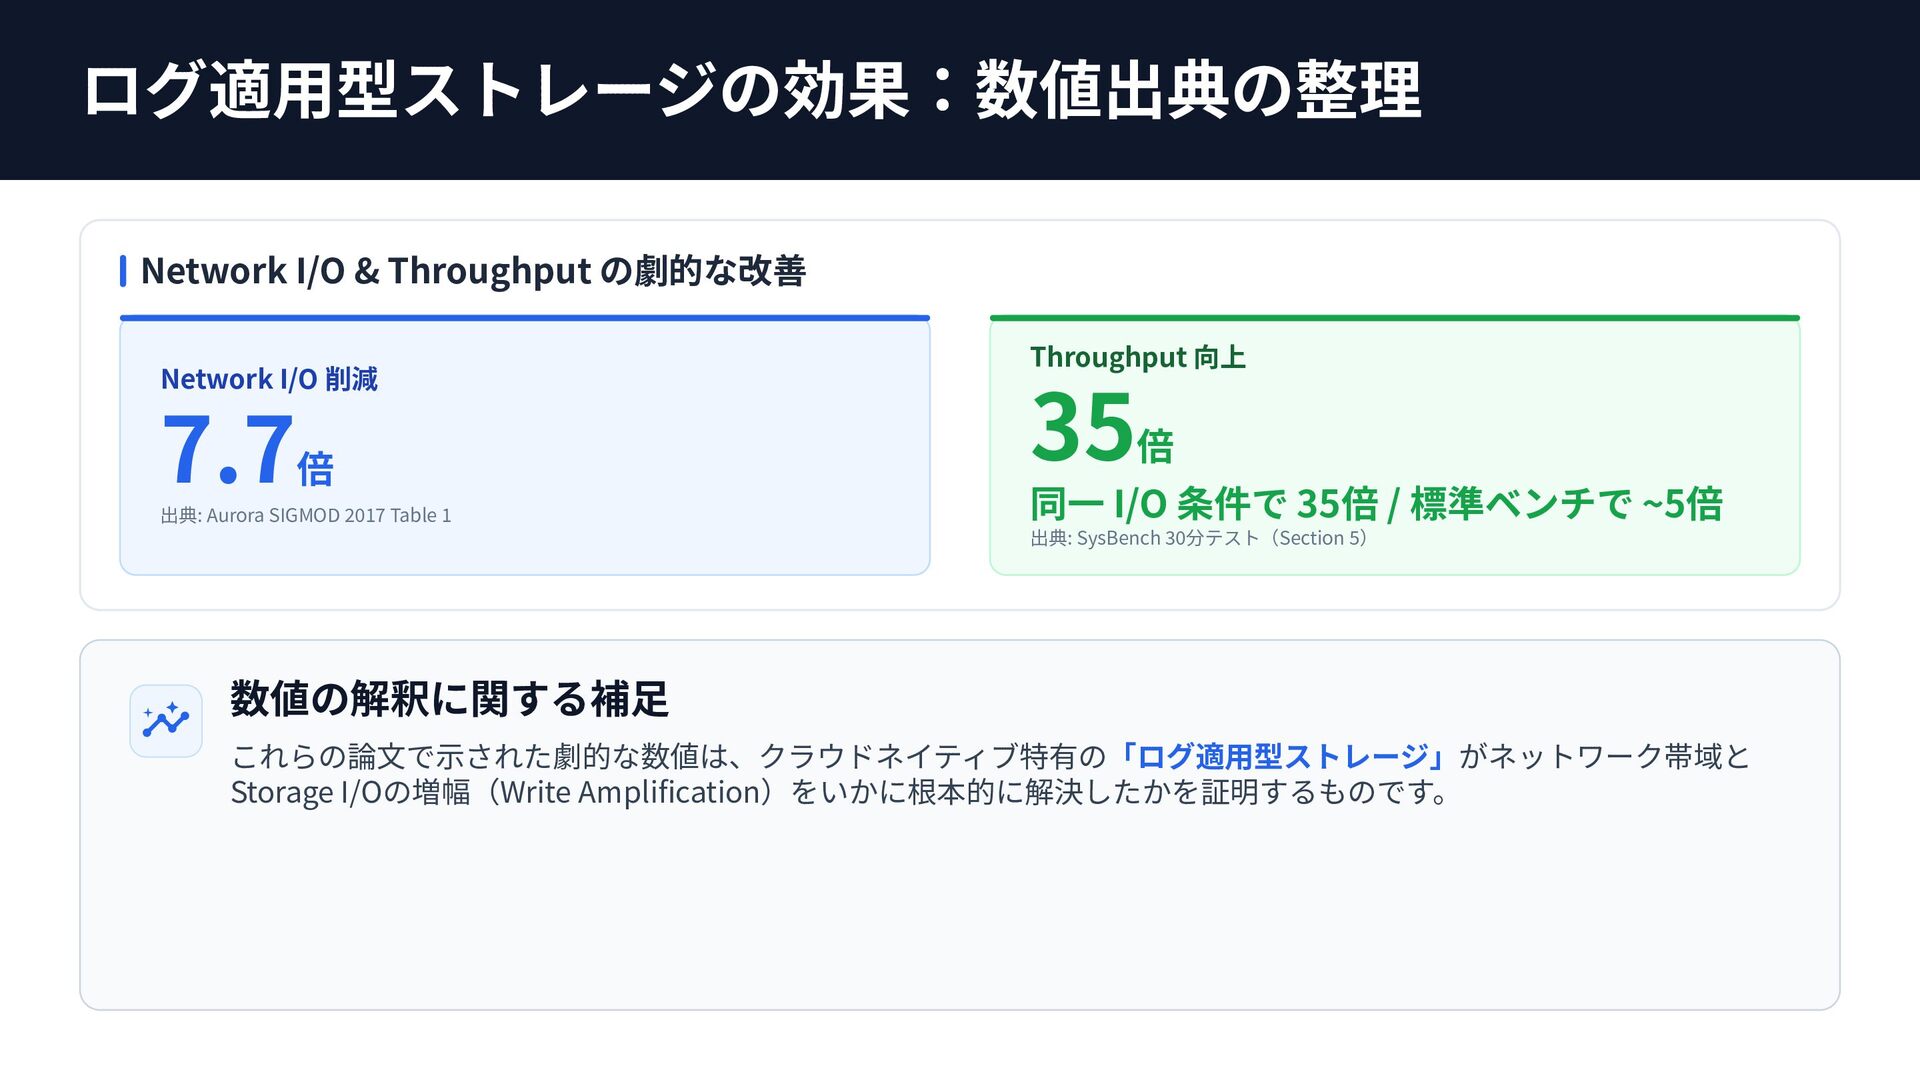
ログ適⽤型ストレージの効果:数値出典の整理 Network I/O & Throughput の劇的な改善 Network I/O 削減 7.7倍
出典: Aurora SIGMOD 2017 Table 1 Throughput 向上 35倍 同⼀ I/O 条件で 35倍 / 標準ベンチで ~5倍 出典: SysBench 30分テスト(Section 5) 数値の解釈に関する補⾜ これらの論⽂で⽰された劇的な数値は、クラウドネイティブ特有の「ログ適⽤型ストレージ」がネットワーク帯域と Storage I/Oの増幅(Write Amplification)をいかに根本的に解決したかを証明するものです。
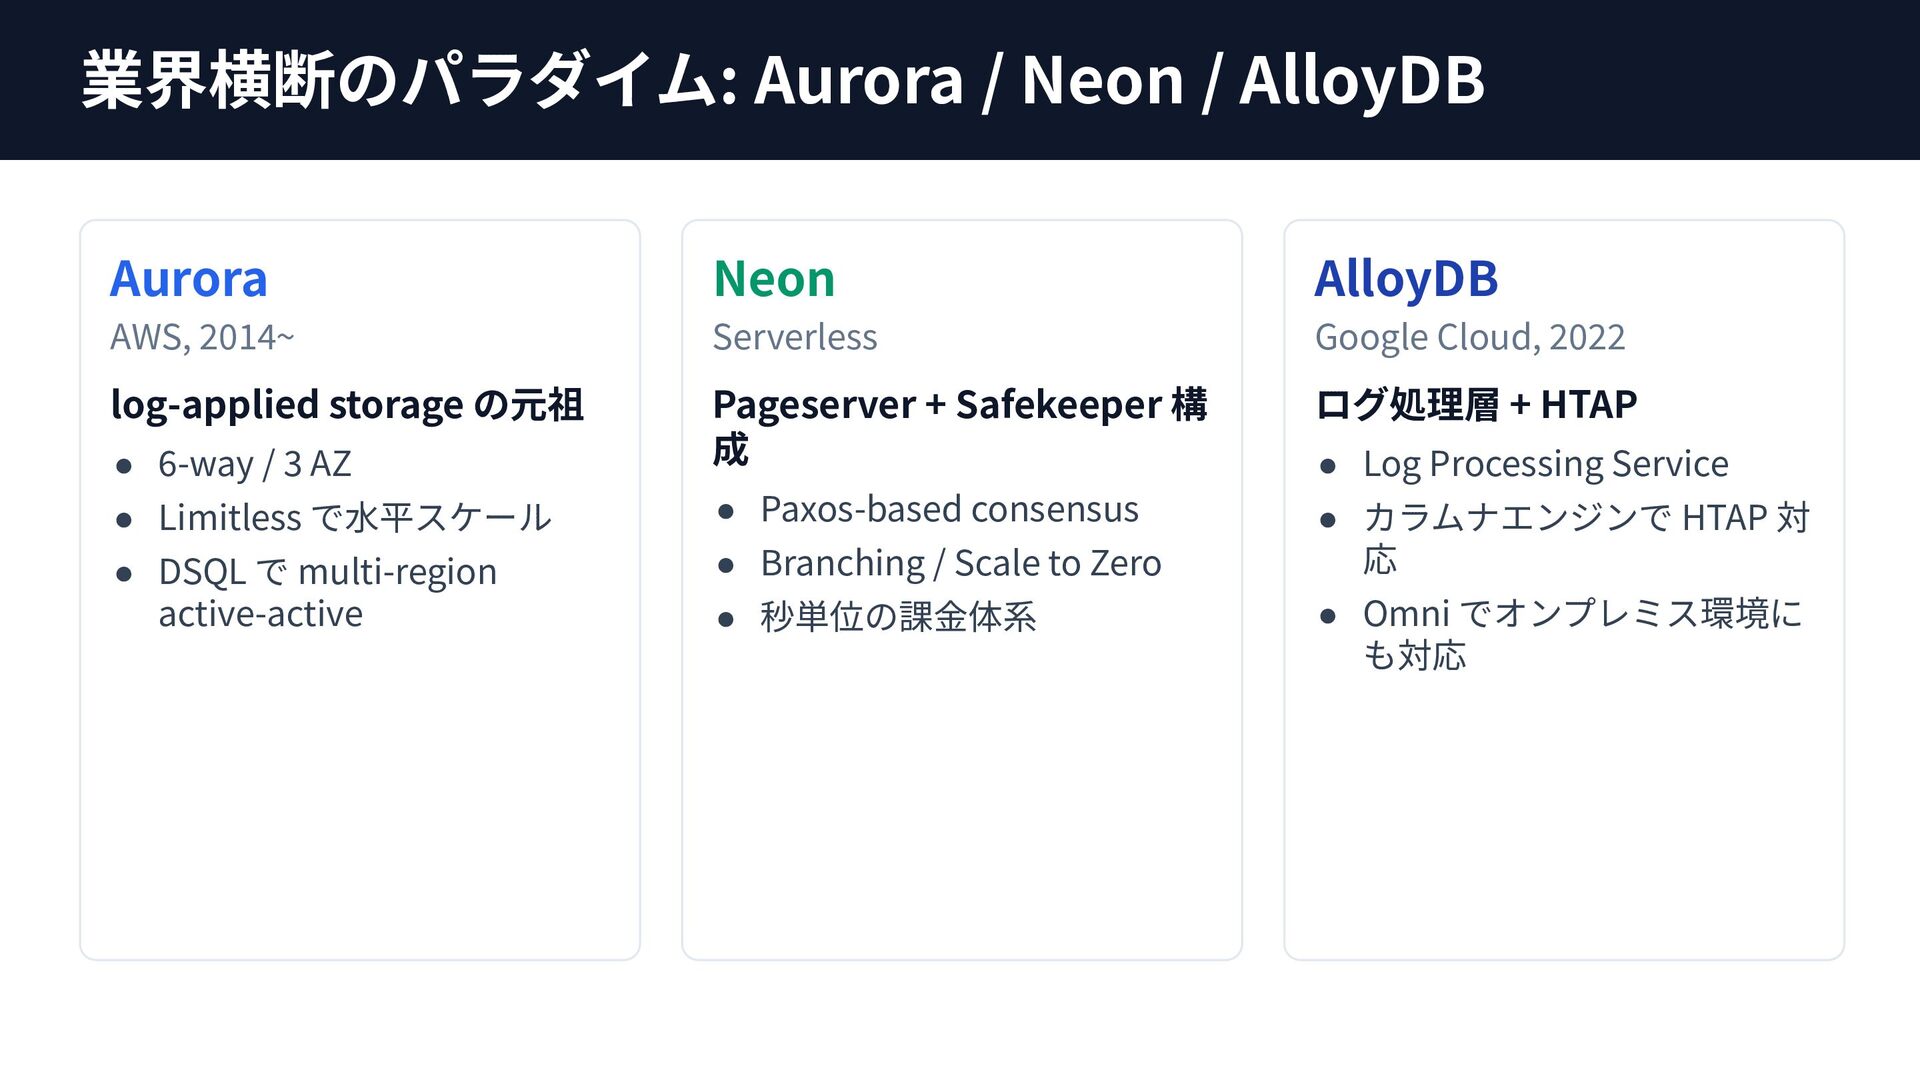
業界横断のパラダイム: Aurora / Neon / AlloyDB Aurora Neon AlloyDB AWS,
2014~ Serverless Google Cloud, 2022 log-applied storage の元祖 ログ処理層 + HTAP • 6-way / 3 AZ Pageserver + Safekeeper 構 成 • Limitless で⽔平スケール • Paxos-based consensus • DSQL で multi-region active-active • Branching / Scale to Zero • カラムナエンジンで HTAP 対 応 • 秒単位の課⾦体系 • Log Processing Service • Omni でオンプレミス環境に も対応
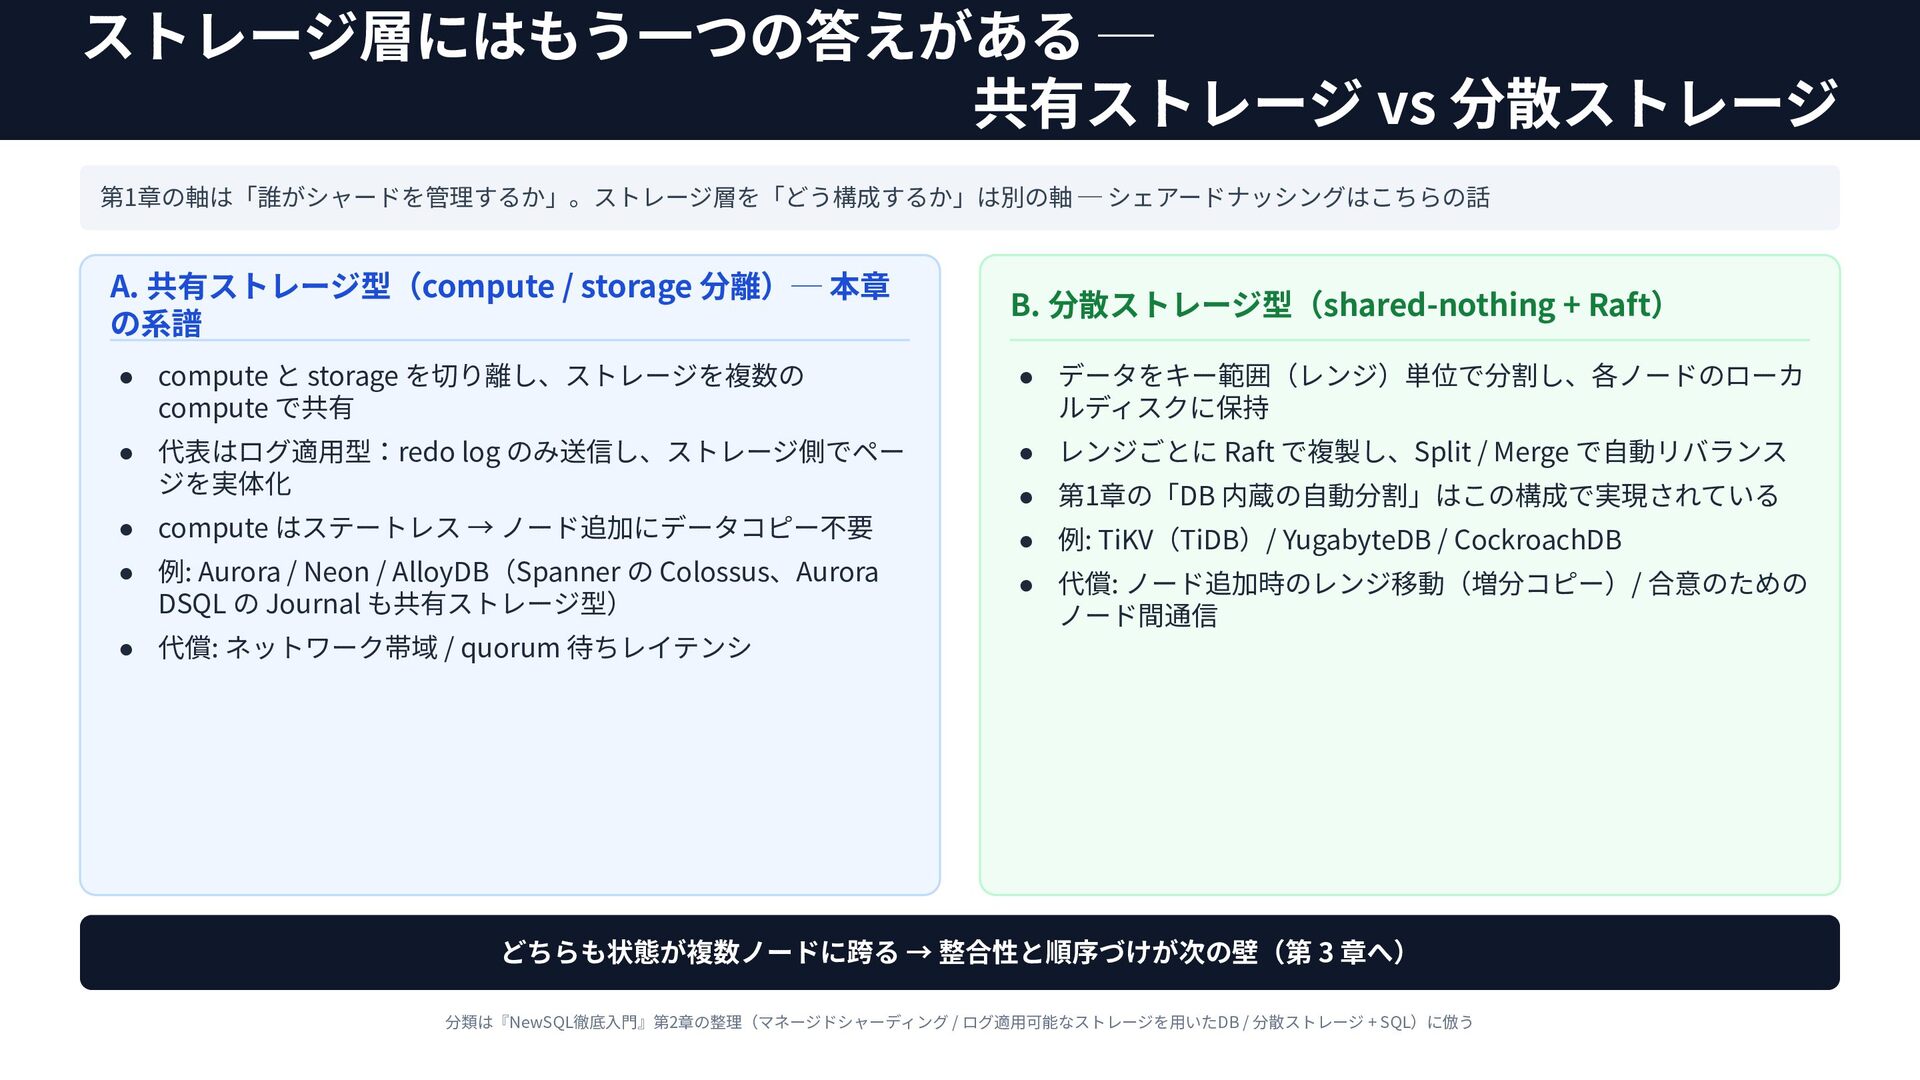
ストレージ層にはもう⼀つの答えがある ─ 共有ストレージ vs 分散ストレージ 第1章の軸は「誰がシャードを管理するか」。ストレージ層を「どう構成するか」は別の軸 ─ シェアードナッシングはこちらの話 A. 共有ストレージ型(compute
/ storage 分離)─ 本章 の系譜 B. 分散ストレージ型(shared-nothing + Raft) • compute と storage を切り離し、ストレージを複数の compute で共有 • データをキー範囲(レンジ)単位で分割し、各ノードのローカ ルディスクに保持 • 代表はログ適⽤型:redo log のみ送信し、ストレージ側でペー ジを実体化 • レンジごとに Raft で複製し、Split / Merge で⾃動リバランス • compute はステートレス → ノード追加にデータコピー不要 • 例: TiKV(TiDB)/ YugabyteDB / CockroachDB • 例: Aurora / Neon / AlloyDB(Spanner の Colossus、Aurora DSQL の Journal も共有ストレージ型) • 代償: ノード追加時のレンジ移動(増分コピー)/ 合意のための ノード間通信 • 第1章の「DB 内蔵の⾃動分割」はこの構成で実現されている • 代償: ネットワーク帯域 / quorum 待ちレイテンシ どちらも状態が複数ノードに跨る → 整合性と順序づけが次の壁(第 3 章へ) 分類は『NewSQL徹底⼊⾨』第2章の整理(マネージドシャーディング / ログ適⽤可能なストレージを⽤いたDB / 分散ストレージ + SQL)に倣う
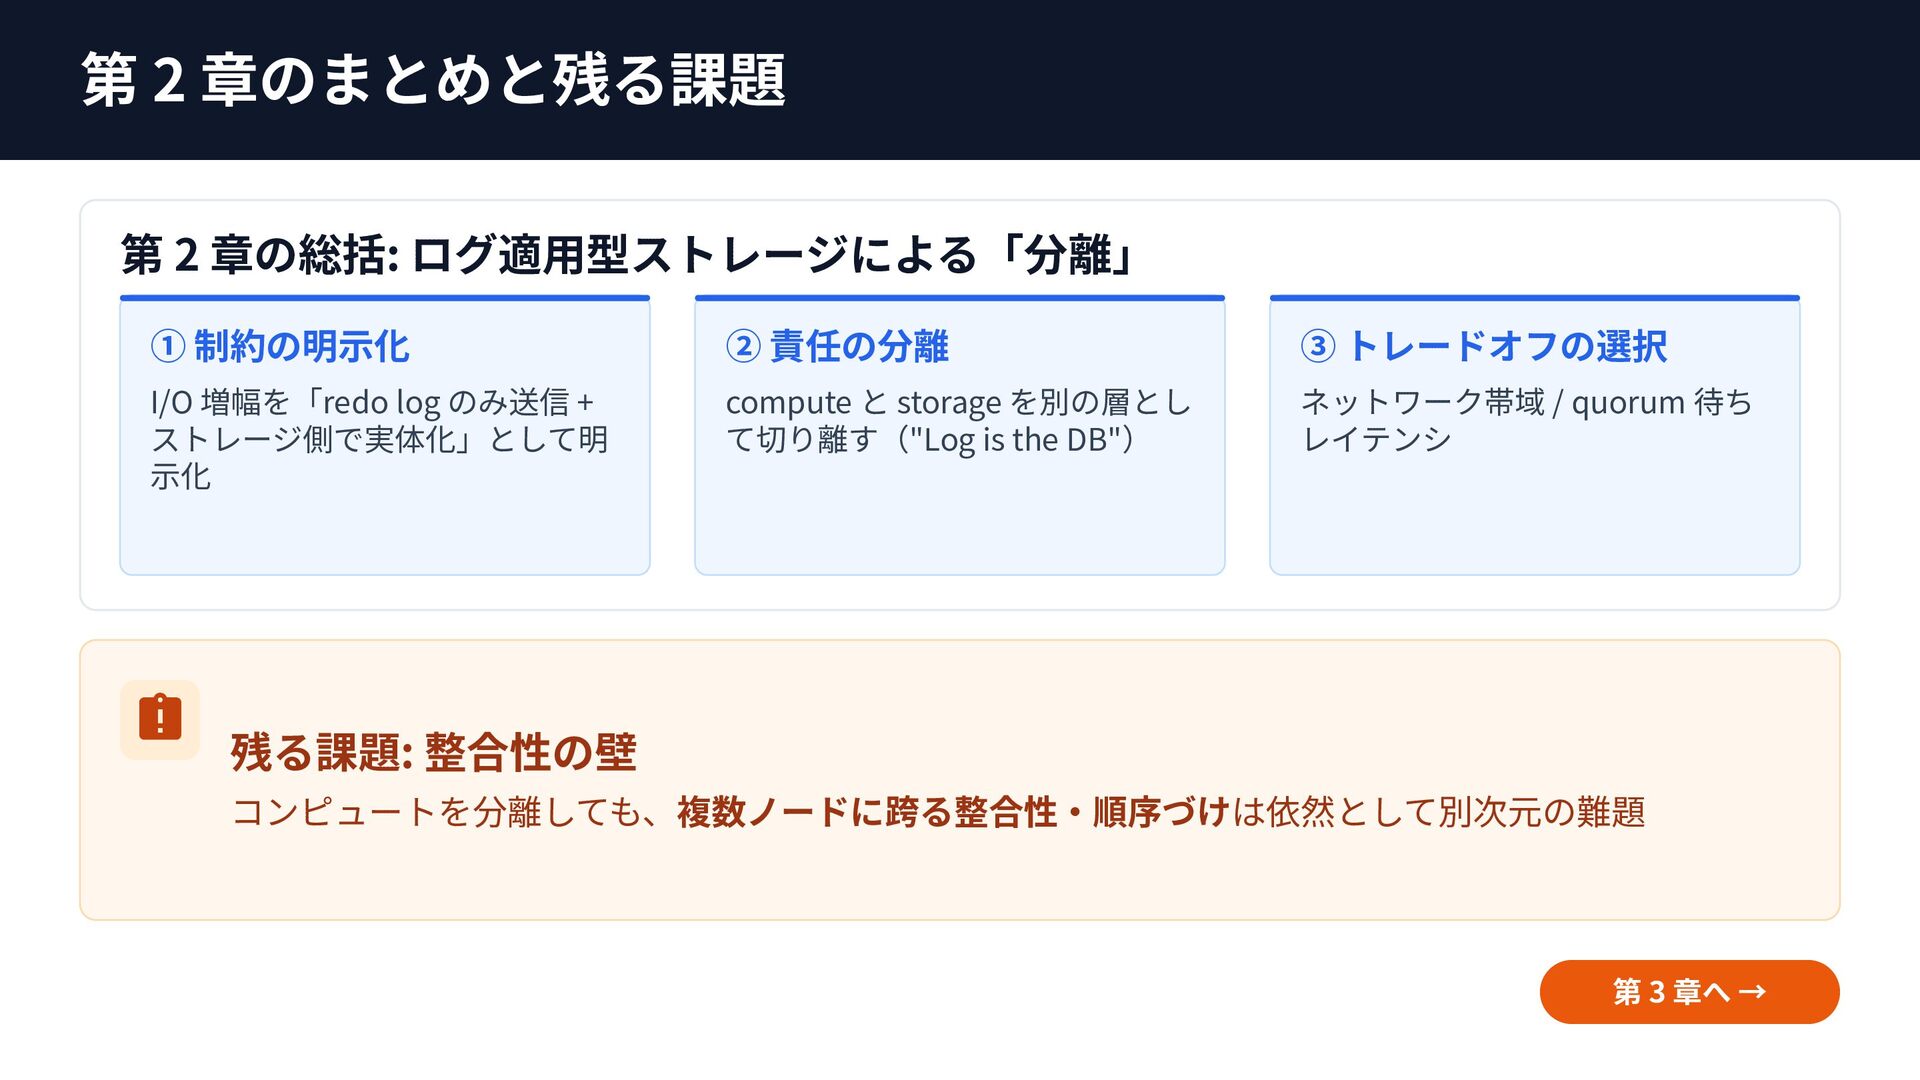
第 2 章のまとめと残る課題 第 2 章の総括: ログ適⽤型ストレージによる「分離」 ① 制約の明⽰化 ②
責任の分離 ③ トレードオフの選択 I/O 増幅を「redo log のみ送信 + ストレージ側で実体化」として明 ⽰化 compute と storage を別の層とし て切り離す("Log is the DB") ネットワーク帯域 / quorum 待ち レイテンシ 残る課題: 整合性の壁 コンピュートを分離しても、複数ノードに跨る整合性‧順序づけは依然として別次元の難題 第 3 章へ →
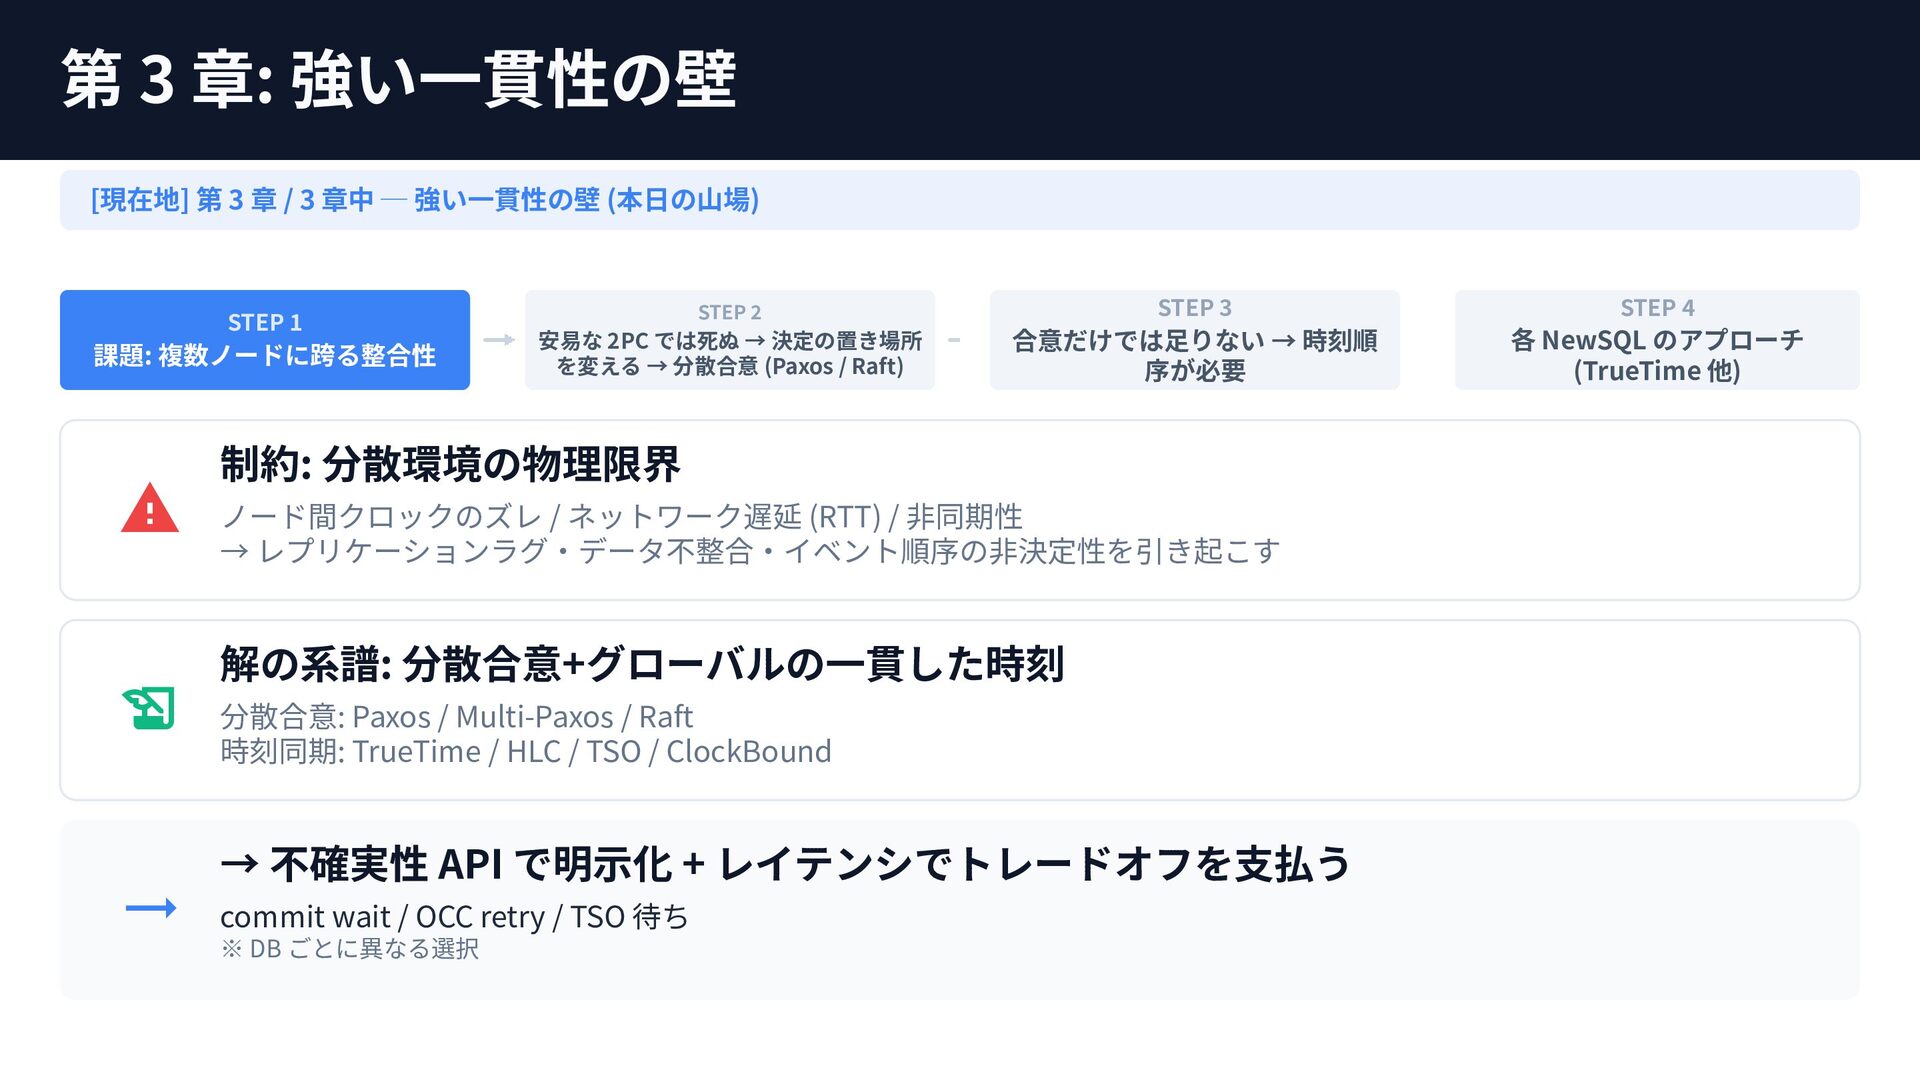
第 3 章: 強い⼀貫性の壁 [現在地] 第 3 章 / 3
章中 ─ 強い⼀貫性の壁 (本⽇の⼭場) STEP 1 課題: 複数ノードに跨る整合性 STEP 2 STEP 3 STEP 4 安易な 2PC では死ぬ → 決定の置き場所 を変える → 分散合意 (Paxos / Raft) 合意だけでは⾜りない → 時刻順 序が必要 各 NewSQL のアプローチ (TrueTime 他) 制約: 分散環境の物理限界 / ネットワーク遅延 (RTT) / ⾮同期性 ノード間クロックのズレ → レプリケーションラグ‧データ不整合‧イベント順序の⾮決定性を引き起こす 解の系譜: 分散合意+グローバルの⼀貫した時刻 Paxos / Multi-Paxos / Raft 分散合意: 時刻同期: TrueTime / HLC / TSO / ClockBound → 不確実性 API で明⽰化 + レイテンシでトレードオフを⽀払う commit wait / OCC retry / TSO 待ち ※ DB ごとに異なる選択
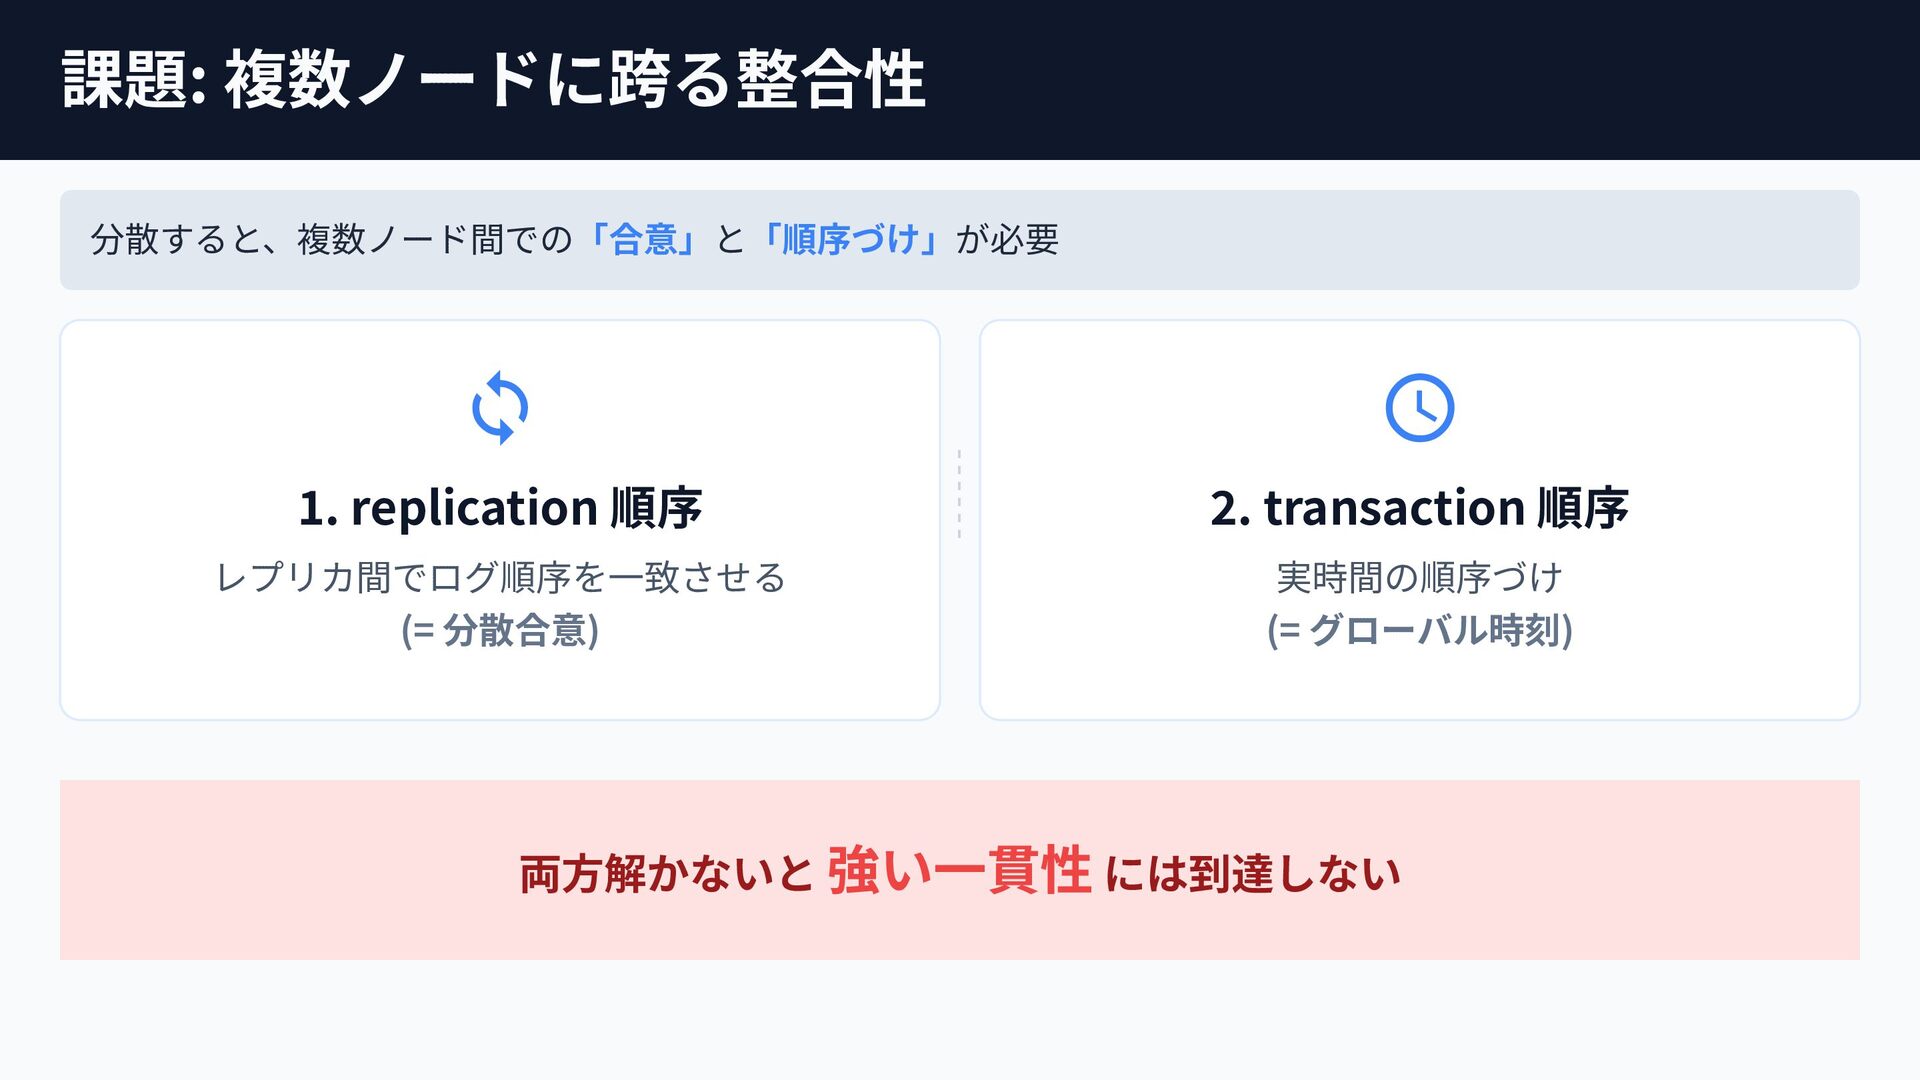
課題: 複数ノードに跨る整合性 分散すると、複数ノード間での「合意」と「順序づけ」が必要 1. replication 順序 2. transaction
順序 レプリカ間でログ順序を⼀致させる (= 分散合意) 実時間の順序づけ (= グローバル時刻) 両⽅解かないと 強い⼀貫性 には到達しない
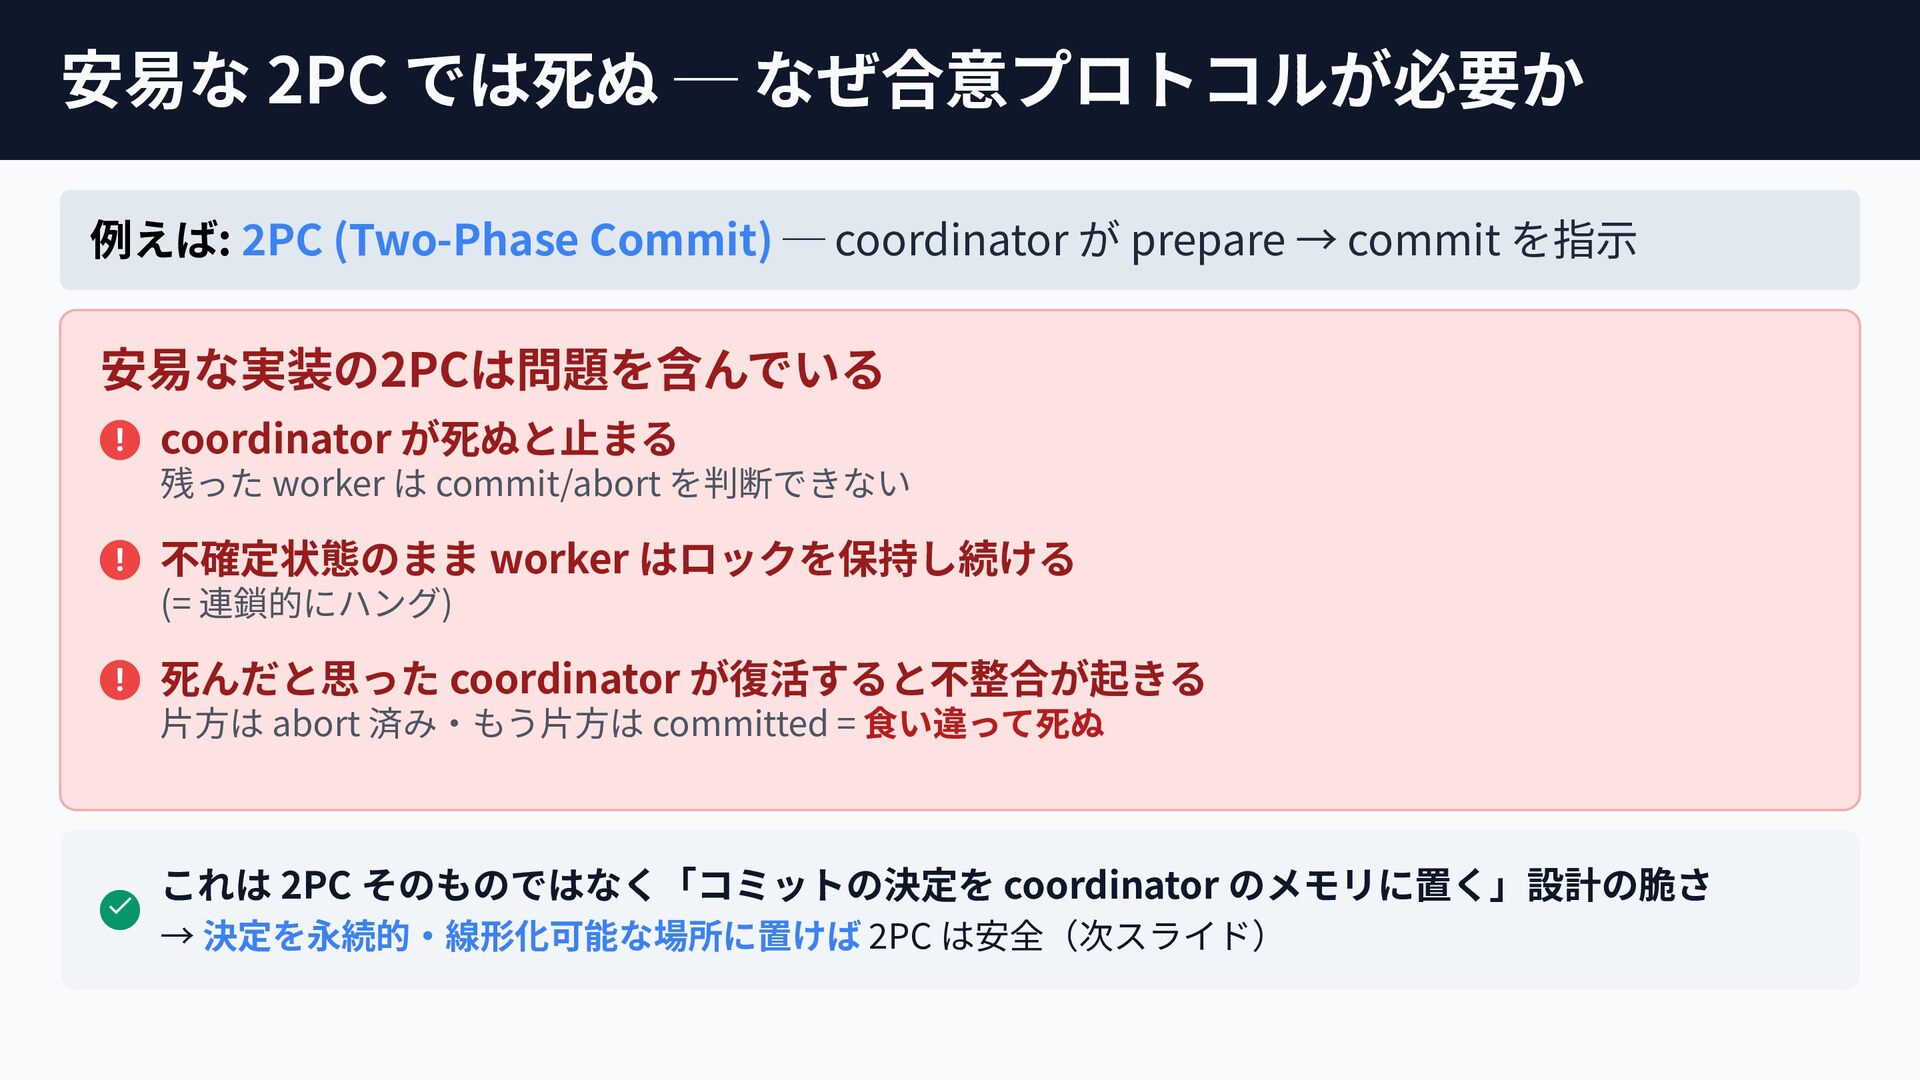
安易な 2PC では死ぬ ─ なぜ合意プロトコルが必要か 例えば: 2PC (Two-Phase Commit) ─
coordinator が prepare → commit を指⽰ 安易な実装の2PCは問題を含んでいる ! coordinator が死ぬと⽌まる 残った worker は commit/abort を判断できない ! 不確定状態のまま worker はロックを保持し続ける (= 連鎖的にハング) ! 死んだと思った coordinator が復活すると不整合が起きる ⽚⽅は abort 済み‧もう⽚⽅は committed = ⾷い違って死ぬ これは 2PC そのものではなく「コミットの決定を coordinator のメモリに置く」設計の脆さ → 決定を永続的‧線形化可能な場所に置けば 2PC は安全(次スライド)
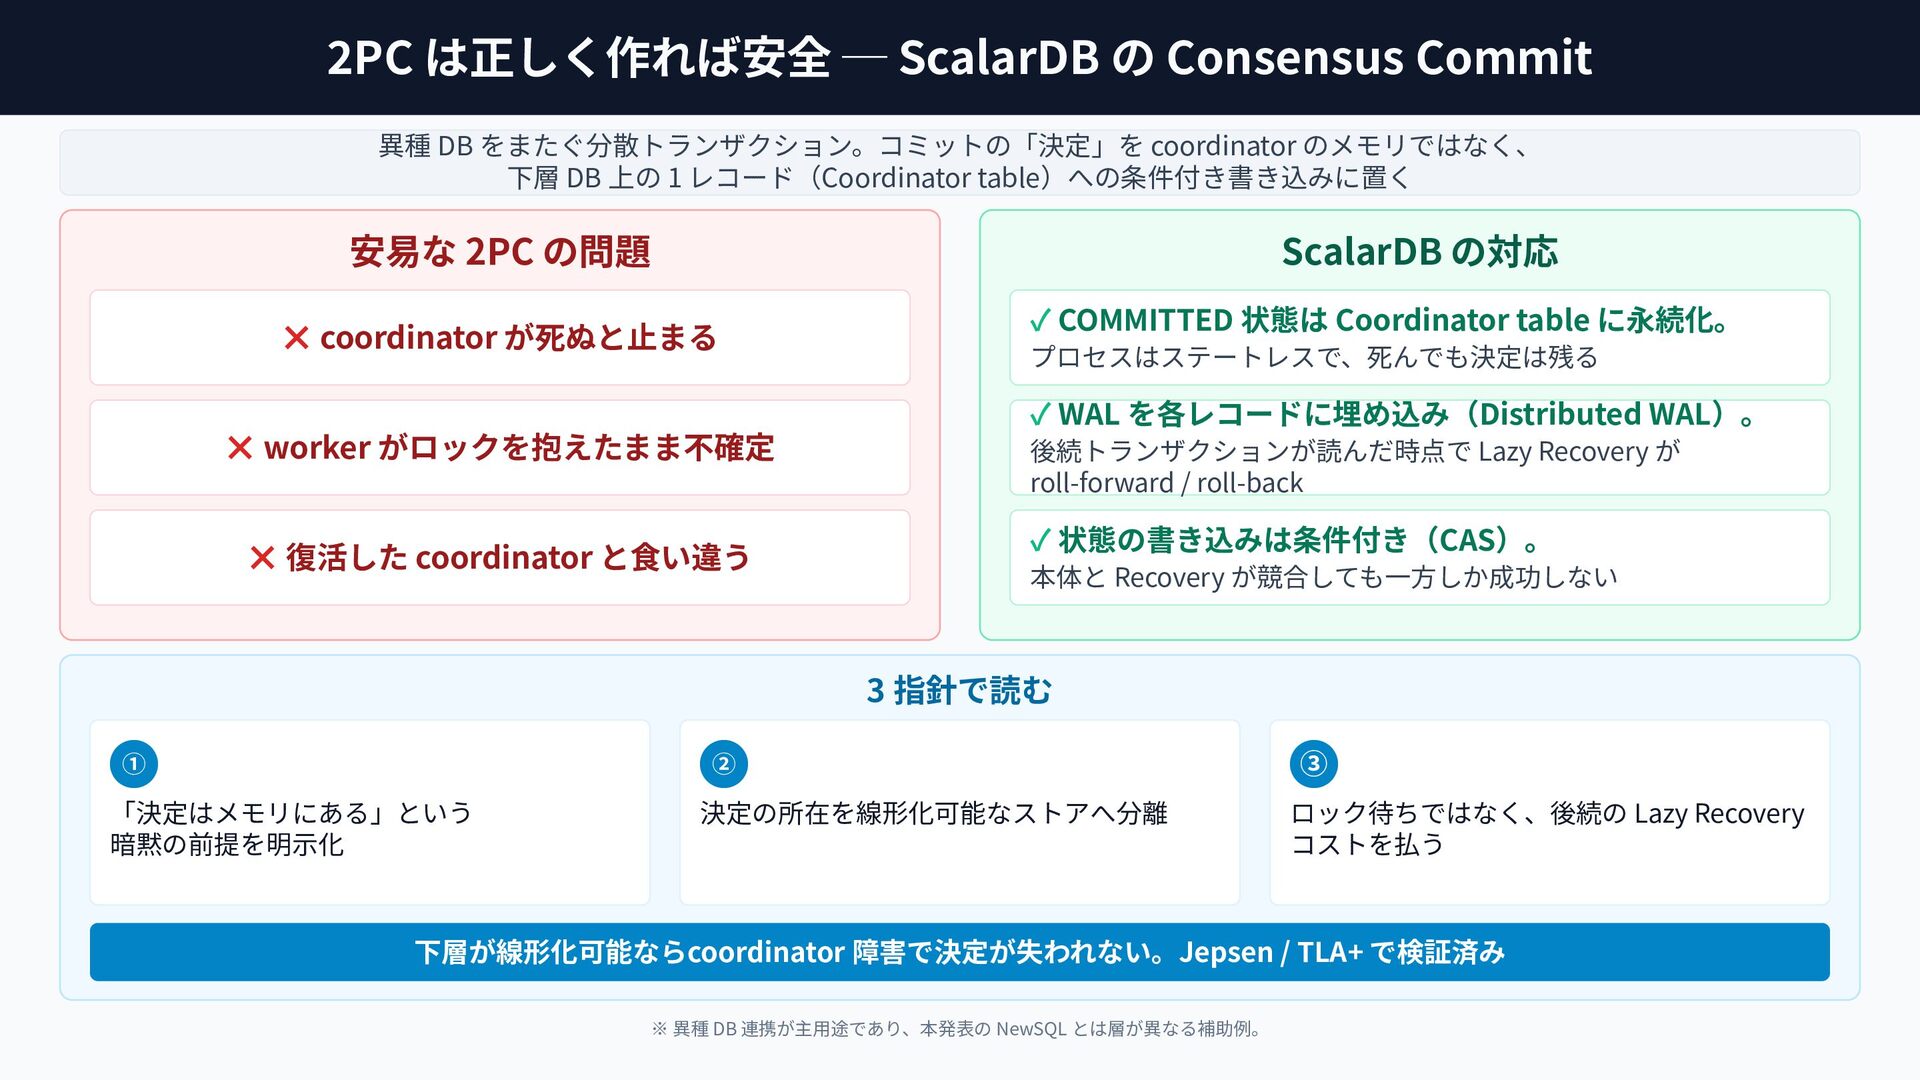
2PC は正しく作れば安全 ─ ScalarDB の Consensus Commit 異種 DB をまたぐ分散トランザクション。コミットの「決定」を
coordinator のメモリではなく、 下層 DB 上の 1 レコード(Coordinator table)への条件付き書き込みに置く 安易な 2PC の問題 ScalarDB の対応 ✕ coordinator が死ぬと⽌まる ✓ COMMITTED 状態は Coordinator table に永続化。 プロセスはステートレスで、死んでも決定は残る ✓ WAL を各レコードに埋め込み(Distributed WAL)。 ✕ worker がロックを抱えたまま不確定 ✕ 復活した coordinator と⾷い違う 後続トランザクションが読んだ時点で Lazy Recovery が roll-forward / roll-back ✓ 状態の書き込みは条件付き(CAS)。 本体と Recovery が競合しても⼀⽅しか成功しない 3 指針で読む ① ② ③ 「決定はメモリにある」という 暗黙の前提を明⽰化 決定の所在を線形化可能なストアへ分離 ロック待ちではなく、後続の Lazy Recovery コストを払う 下層が線形化可能ならcoordinator 障害で決定が失われない。Jepsen / TLA+ で検証済み ※ 異種 DB 連携が主⽤途であり、本発表の NewSQL とは層が異なる補助例。
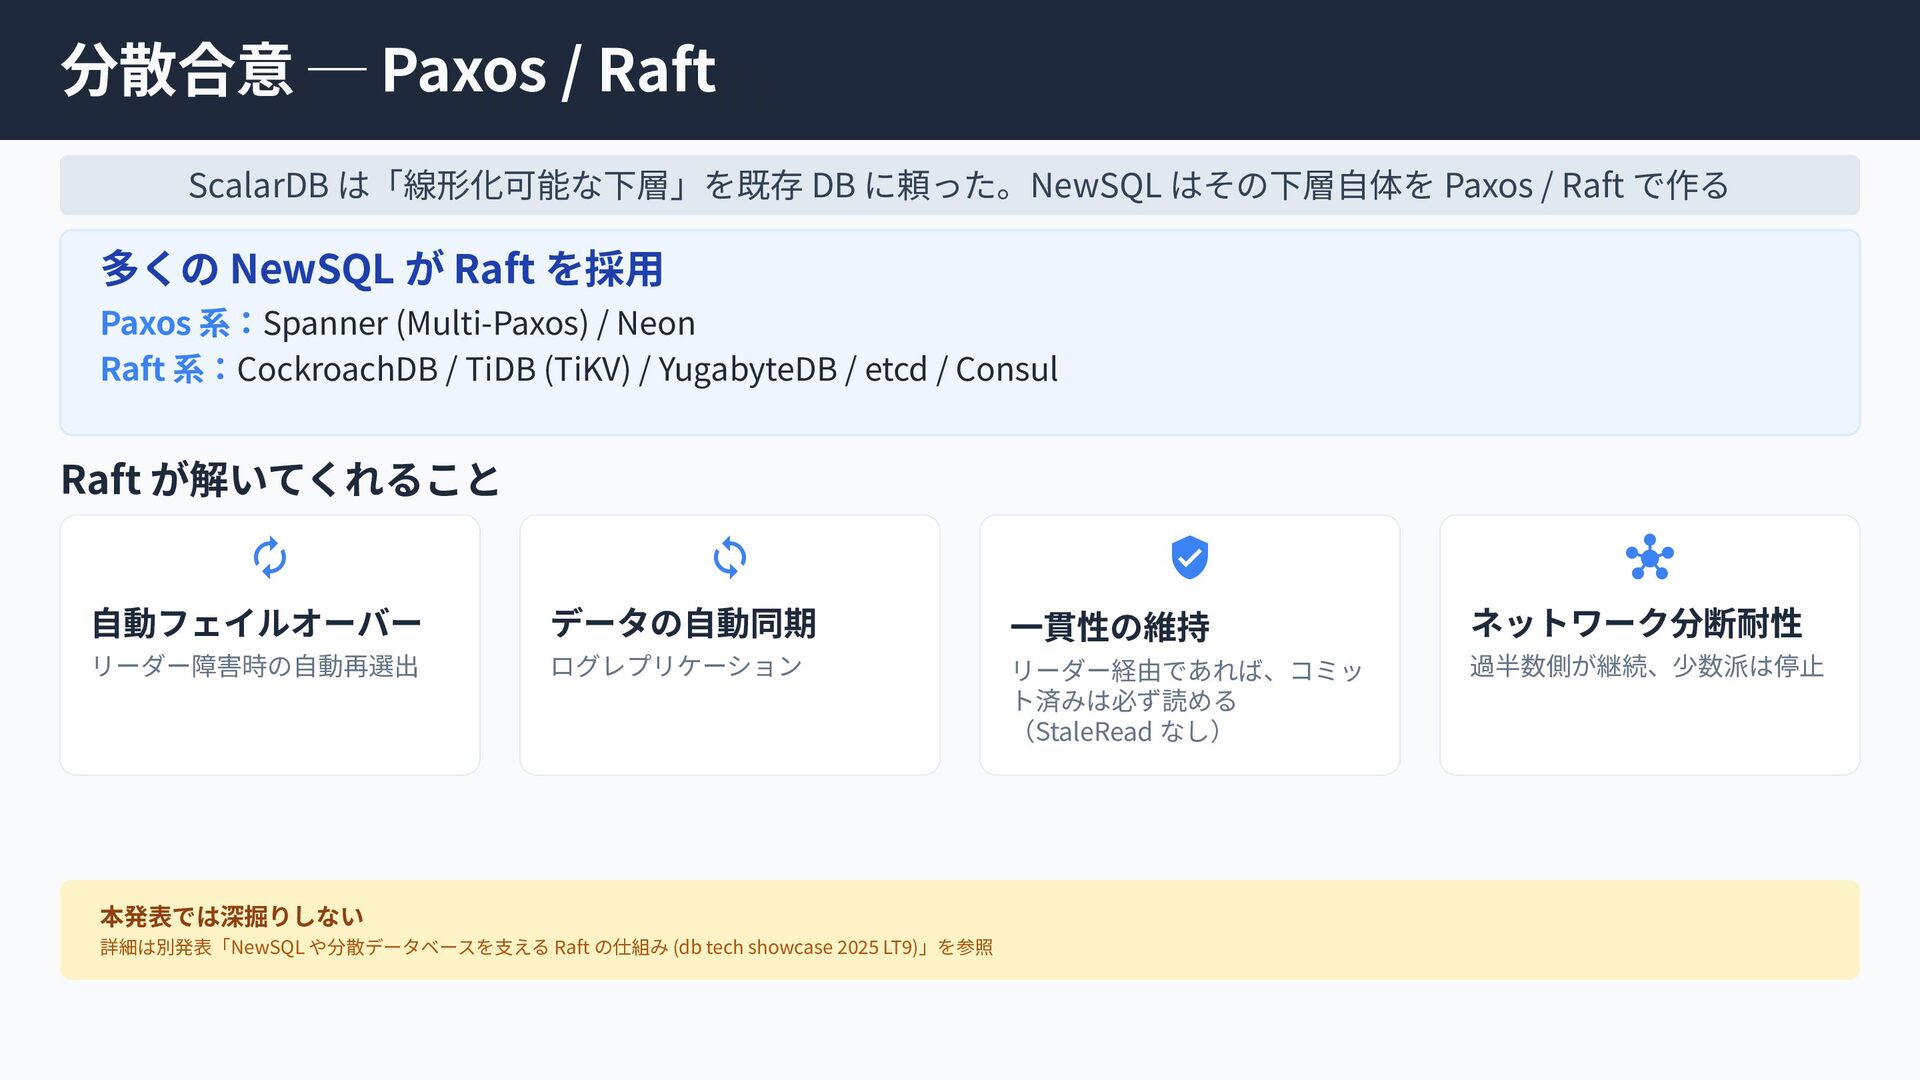
分散合意 ─ Paxos / Raft 分散合意 ─ Paxos / Raft
ScalarDB は「線形化可能な下層」を既存 DB に頼った。NewSQL はその下層⾃体を Paxos / Raft で作る 多くの NewSQL が Raft を採⽤ Paxos 系:Spanner (Multi-Paxos) / Neon Raft 系:CockroachDB / TiDB (TiKV) / YugabyteDB / etcd / Consul Raft が解いてくれること ⾃動フェイルオーバー データの⾃動同期 ⼀貫性の維持 ネットワーク分断耐性 リーダー障害時の⾃動再選出 ログレプリケーション リーダー経由であれば、コミッ ト済みは必ず読める (StaleRead なし) 過半数側が継続、少数派は停⽌ 本発表では深掘りしない 詳細は別発表「NewSQL や分散データベースを⽀える Raft の仕組み (db tech showcase 2025 LT9)」を参照
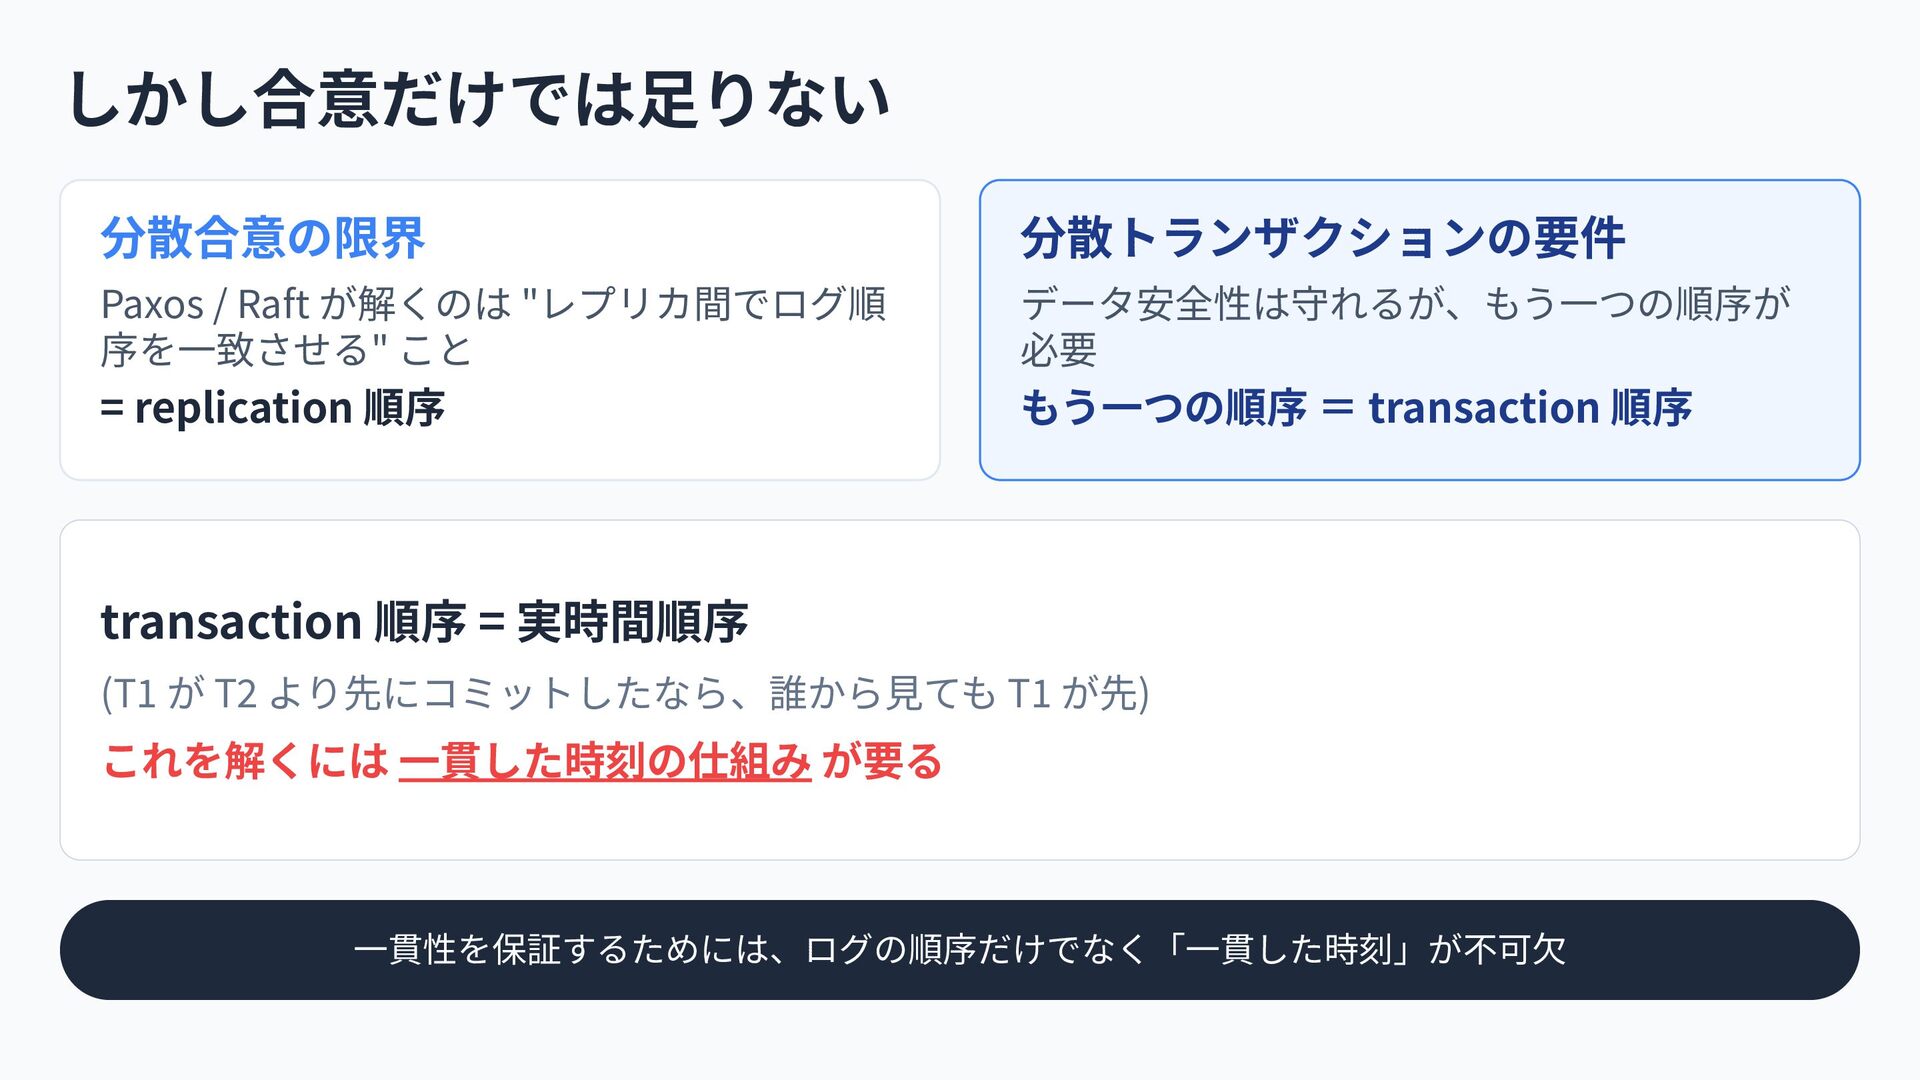
しかし合意だけでは⾜りない 分散合意の限界 分散トランザクションの要件 Paxos / Raft が解くのは "レプリカ間でログ順 序を⼀致させる" こと
データ安全性は守れるが、もう⼀つの順序が 必要 = replication 順序 もう⼀つの順序 = transaction 順序 transaction 順序 = 実時間順序 (T1 が T2 より先にコミットしたなら、誰から⾒ても T1 が先) これを解くには ⼀貫した時刻の仕組み が要る ⼀貫性を保証するためには、ログの順序だけでなく「⼀貫した時刻」が不可⽋
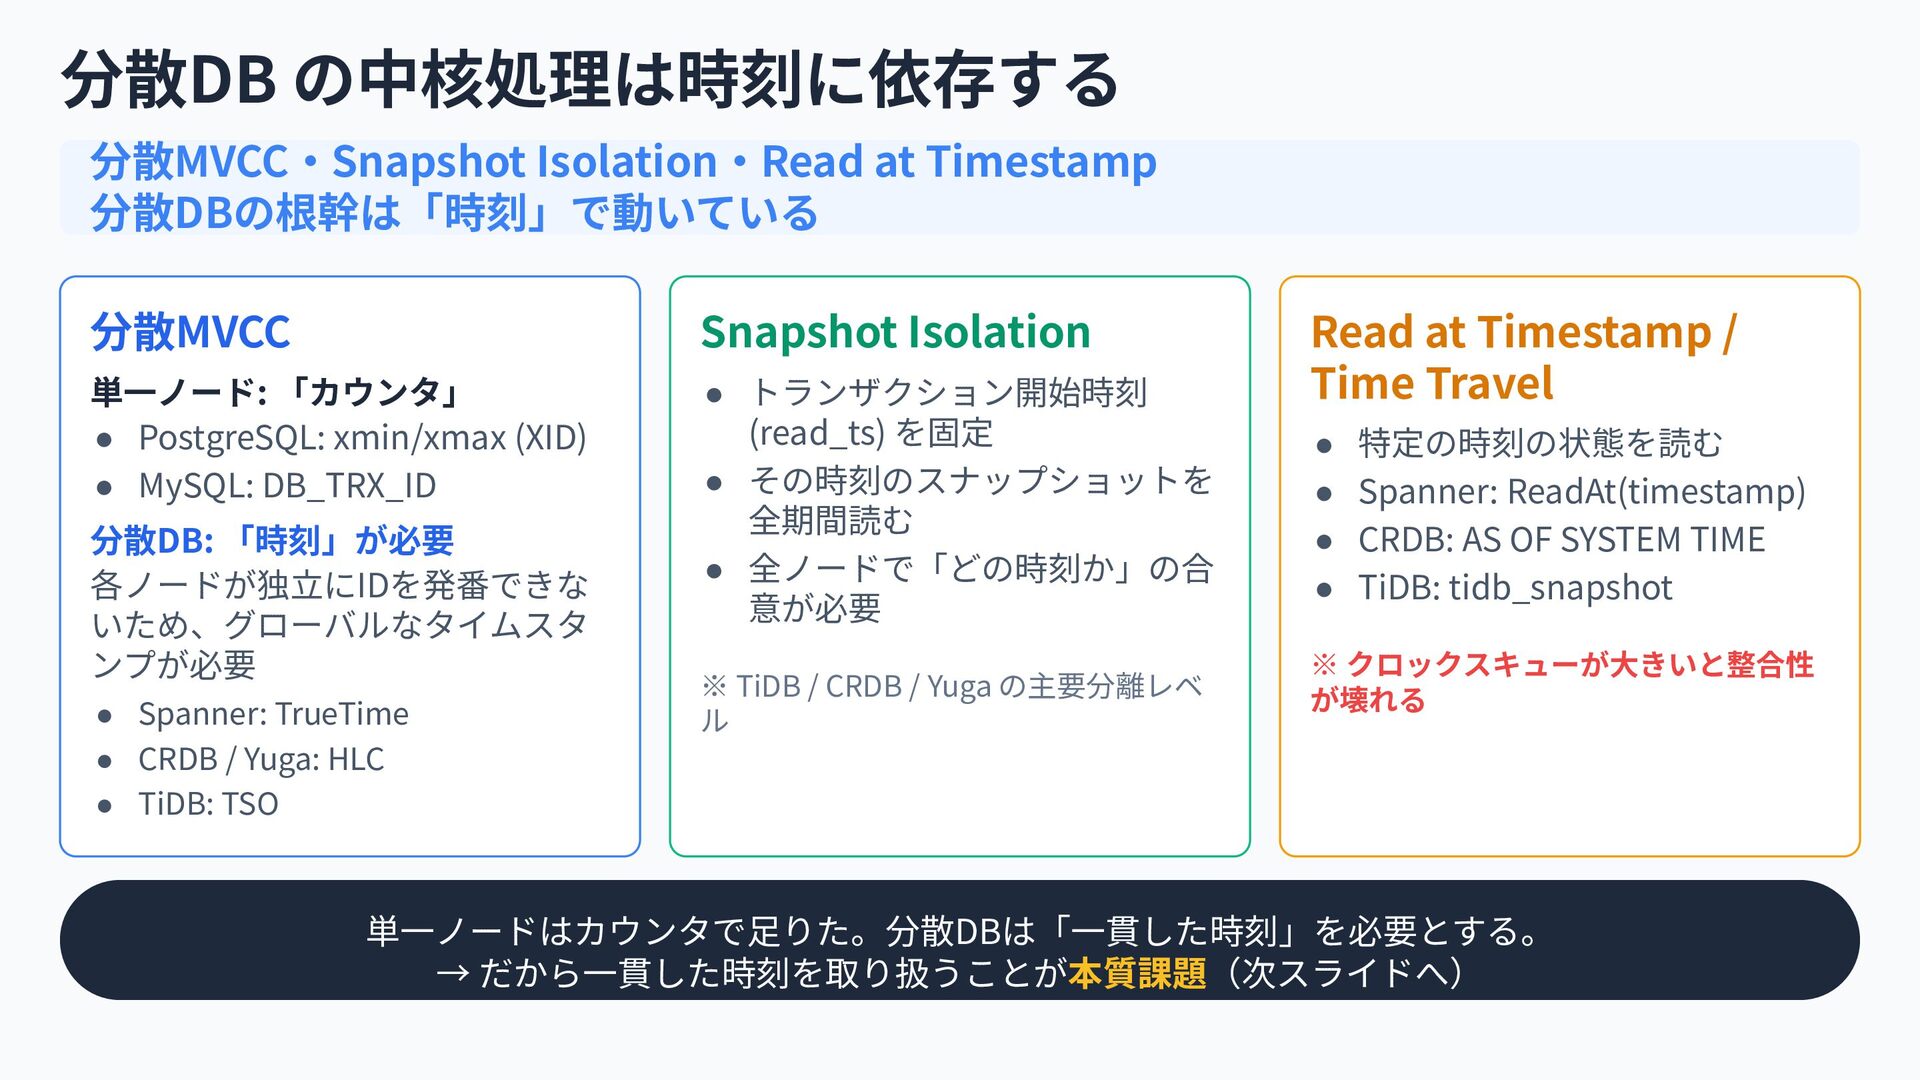
分散DB の中核処理は時刻に依存する 分散MVCC‧Snapshot Isolation‧Read at Timestamp 分散DBの根幹は「時刻」で動いている 分散MVCC Snapshot Isolation
単⼀ノード: 「カウンタ」 • PostgreSQL: xmin/xmax (XID) • MySQL: DB_TRX_ID • トランザクション開始時刻 (read_ts) を固定 • その時刻のスナップショットを 全期間読む • 全ノードで「どの時刻か」の合 意が必要 分散DB: 「時刻」が必要 各ノードが独⽴にIDを発番できな いため、グローバルなタイムスタ ンプが必要 • Spanner: TrueTime • CRDB / Yuga: HLC • TiDB: TSO ※ TiDB / CRDB / Yuga の主要分離レベ ル Read at Timestamp / Time Travel • • • • 特定の時刻の状態を読む Spanner: ReadAt(timestamp) CRDB: AS OF SYSTEM TIME TiDB: tidb_snapshot ※ クロックスキューが⼤きいと整合性 が壊れる 単⼀ノードはカウンタで⾜りた。分散DBは「⼀貫した時刻」を必要とする。 → だから⼀貫した時刻を取り扱うことが本質課題(次スライドへ)
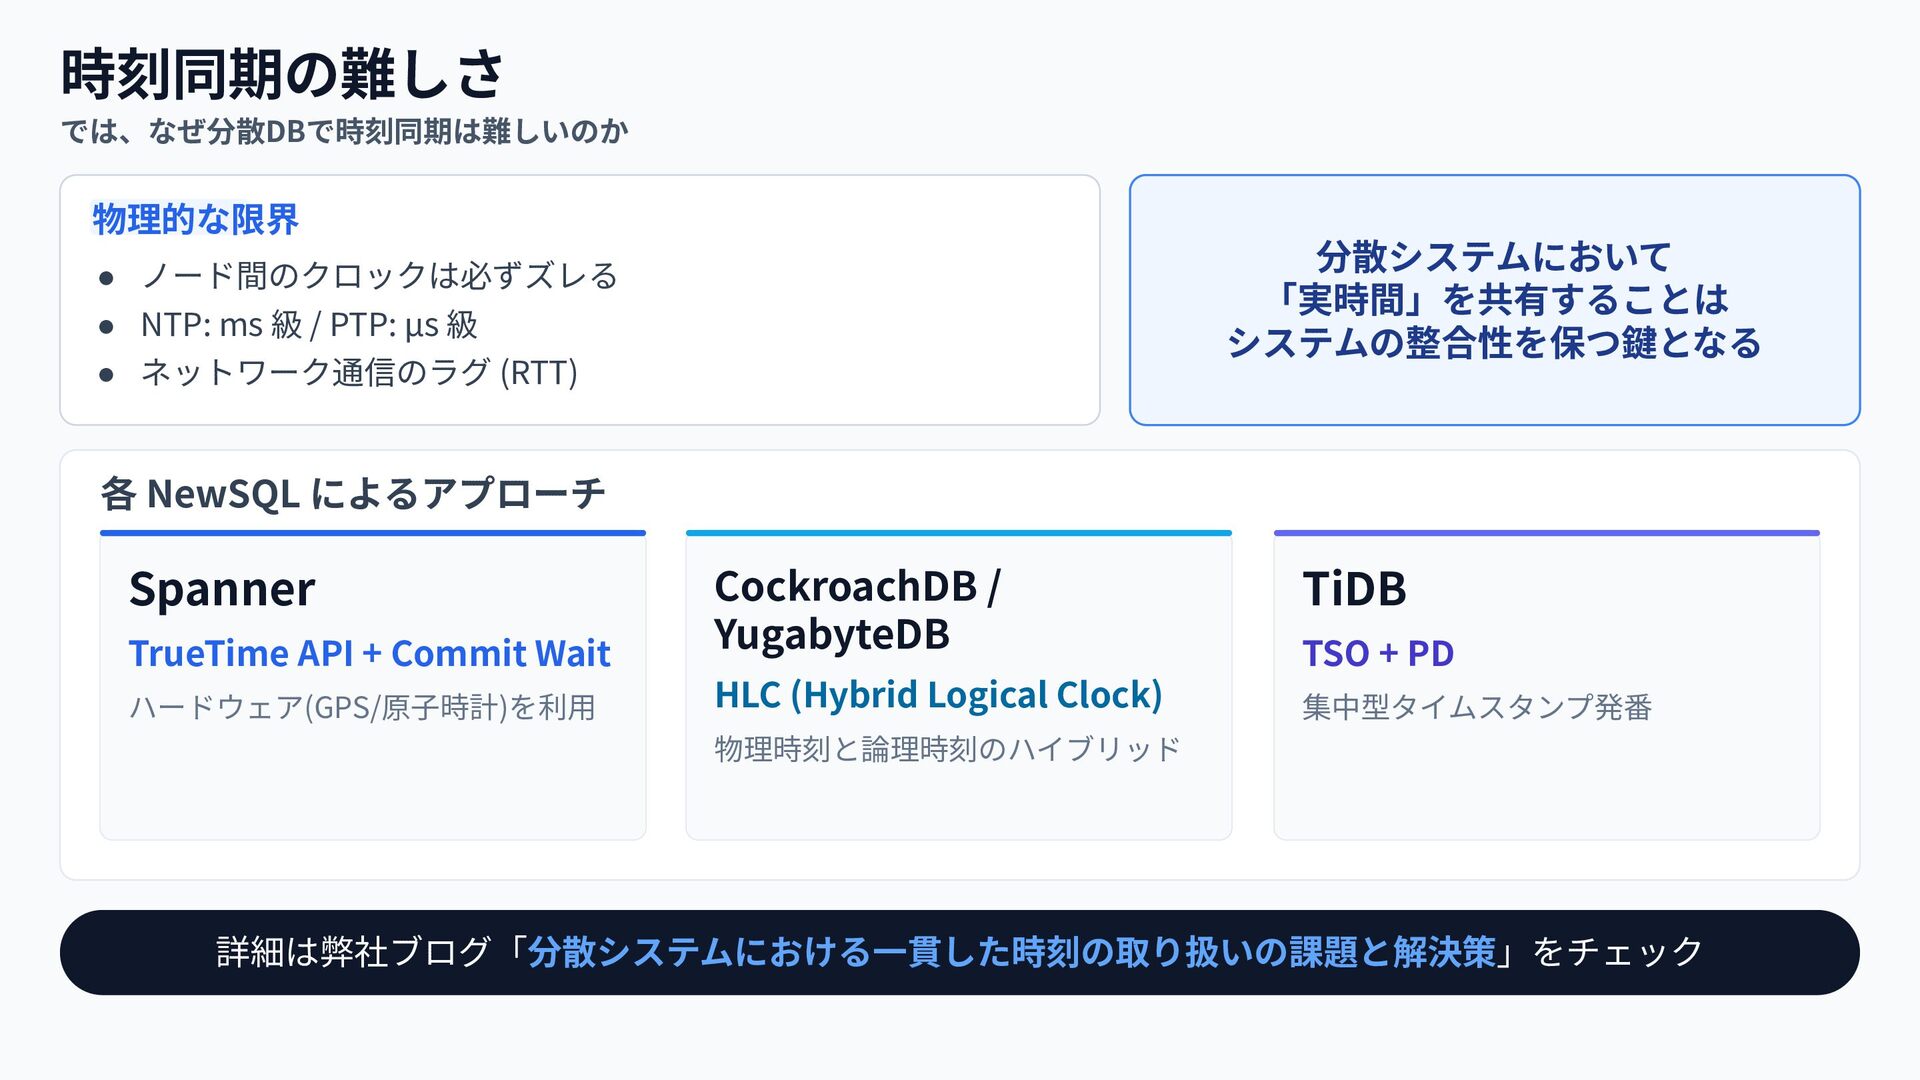
時刻同期の難しさ では、なぜ分散DBで時刻同期は難しいのか 物理的な限界 分散システムにおいて 「実時間」を共有することは システムの整合性を保つ鍵となる • ノード間のクロックは必ずズレる • NTP:
ms 級 / PTP: μs 級 • ネットワーク通信のラグ (RTT) 各 NewSQL によるアプローチ Spanner TrueTime API + Commit Wait ハードウェア(GPS/原⼦時計)を利⽤ CockroachDB / YugabyteDB HLC (Hybrid Logical Clock) TiDB TSO + PD 集中型タイムスタンプ発番 物理時刻と論理時刻のハイブリッド 詳細は弊社ブログ「分散システムにおける⼀貫した時刻の取り扱いの課題と解決策」をチェック
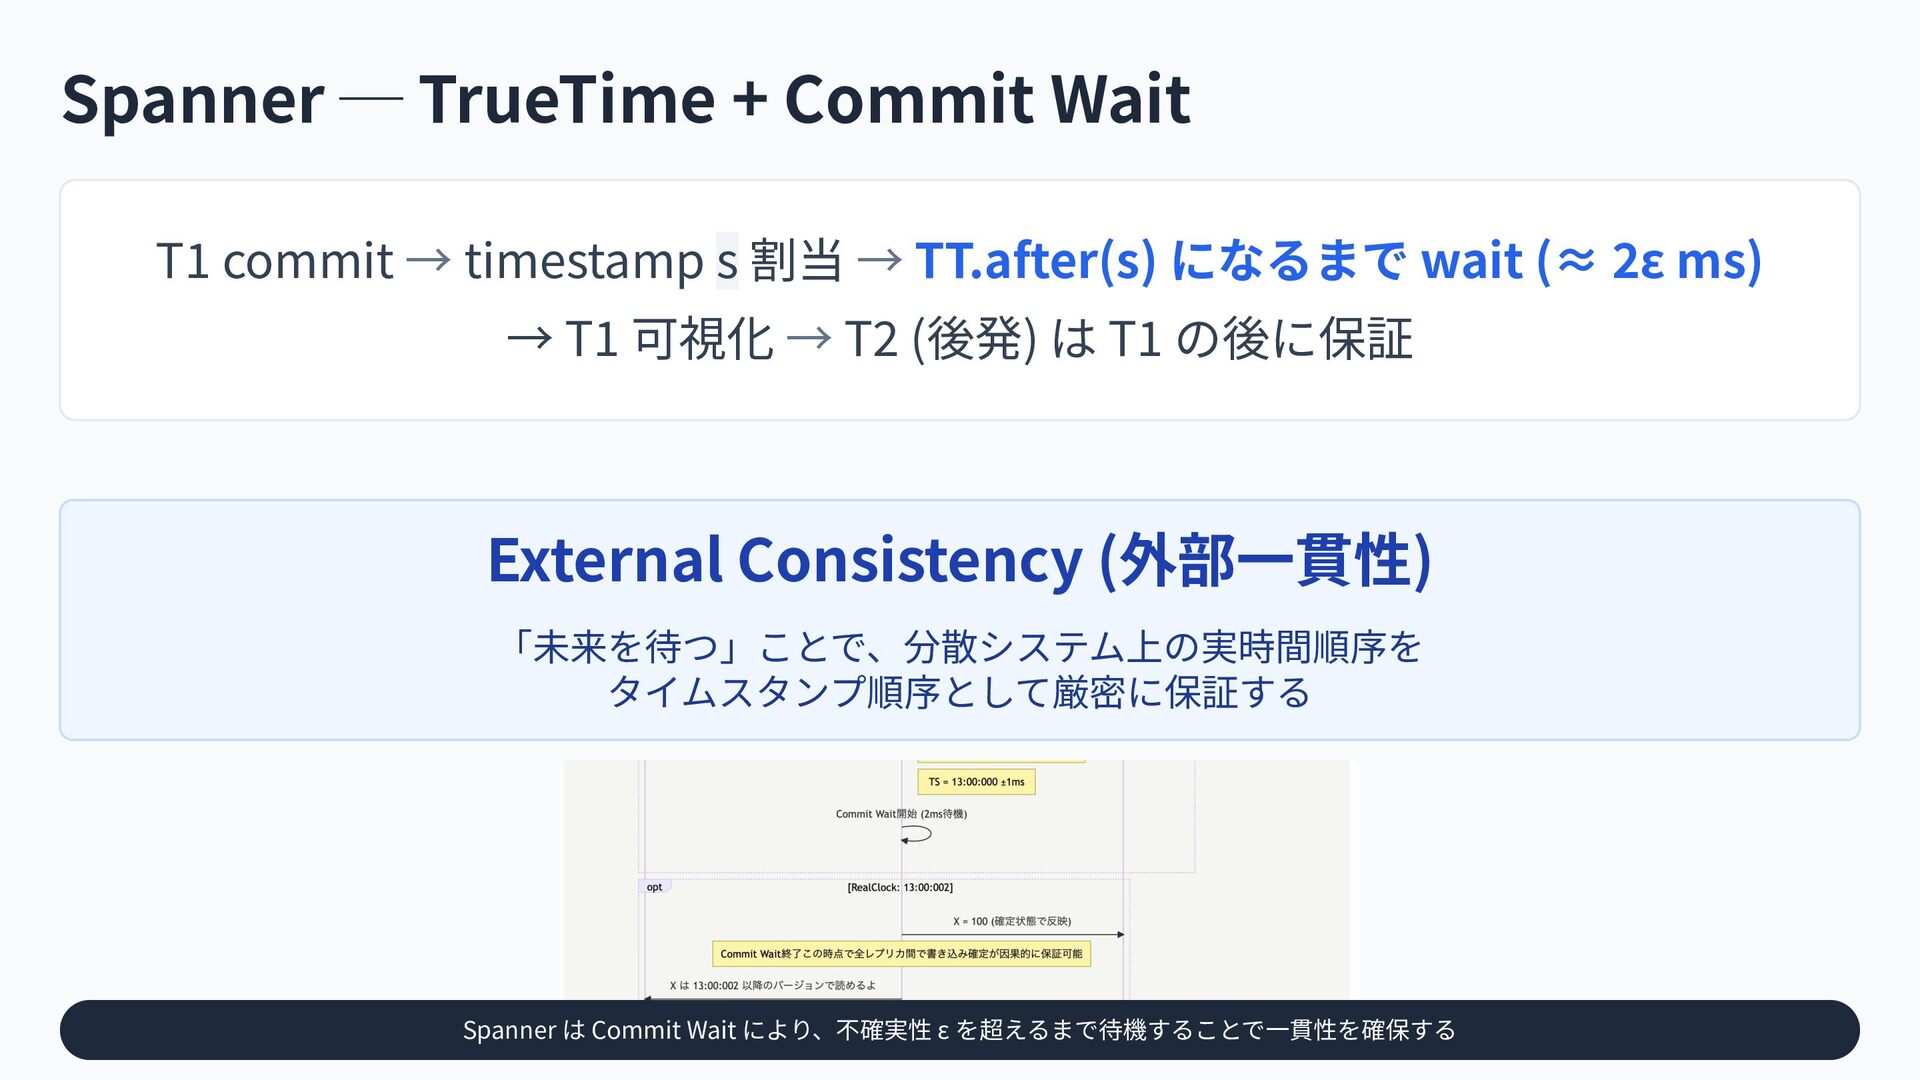
Spanner ─ TrueTime + Commit Wait T1 commit → timestamp
s 割当 → TT.after(s) になるまで wait (≈ 2ε ms) → T1 可視化 → T2 (後発) は T1 の後に保証 External Consistency (外部⼀貫性) 「未来を待つ」ことで、分散システム上の実時間順序を タイムスタンプ順序として厳密に保証する Spanner は Commit Wait により、不確実性 ε を超えるまで待機することで⼀貫性を確保する
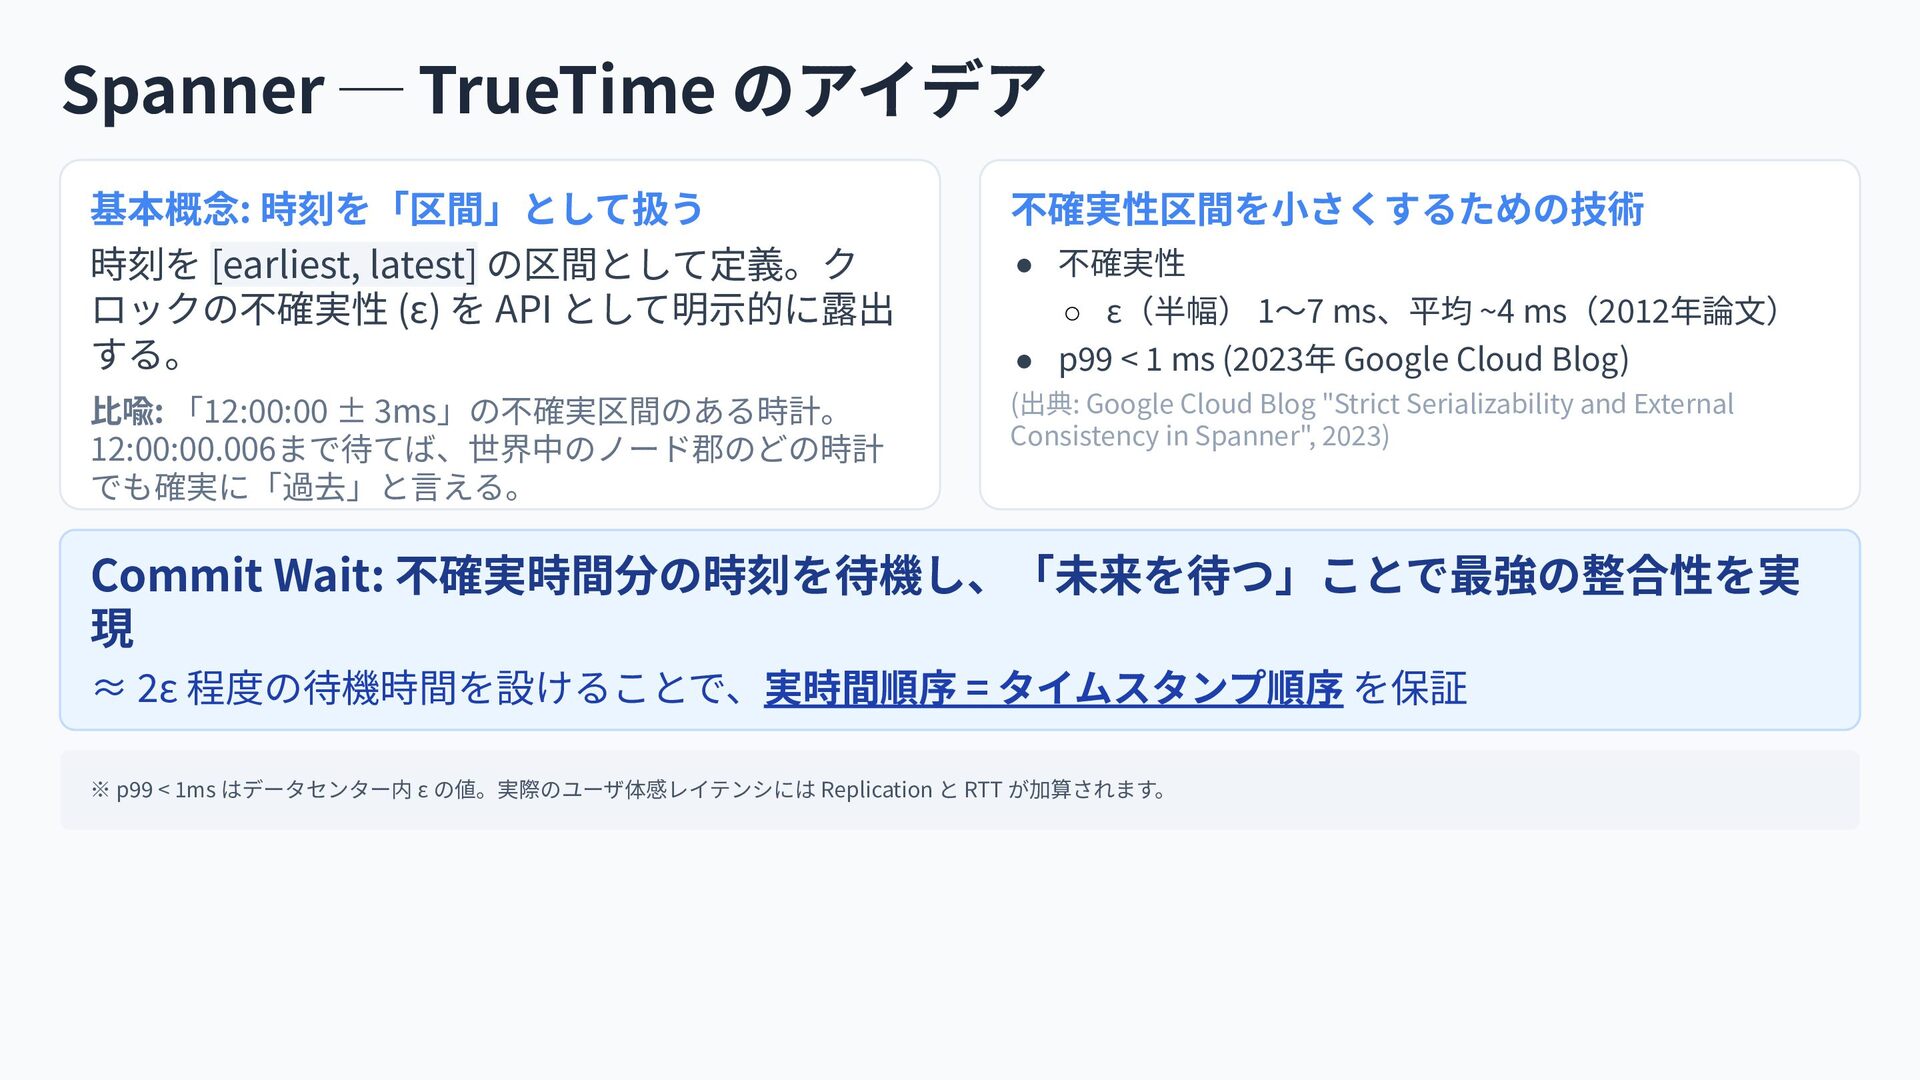
Spanner ─ TrueTime のアイデア 基本概念: 時刻を「区間」として扱う 時刻を [earliest, latest] の区間として定義。ク
ロックの不確実性 (ε) を API として明⽰的に露出 する。 不確実性区間を⼩さくするための技術 ⽐喩: 「12:00:00 ± 3ms」の不確実区間のある時計。 12:00:00.006まで待てば、世界中のノード郡のどの時計 でも確実に「過去」と⾔える。 (出典: Google Cloud Blog "Strict Serializability and External Consistency in Spanner", 2023) • 不確実性 ◦ ε(半幅) 1〜7 ms、平均 ~4 ms(2012年論⽂) • p99 < 1 ms (2023年 Google Cloud Blog) Commit Wait: 不確実時間分の時刻を待機し、「未来を待つ」ことで最強の整合性を実 現 ≈ 2ε 程度の待機時間を設けることで、実時間順序 = タイムスタンプ順序 を保証 ※ p99 < 1ms はデータセンター内 ε の値。実際のユーザ体感レイテンシには Replication と RTT が加算されます。
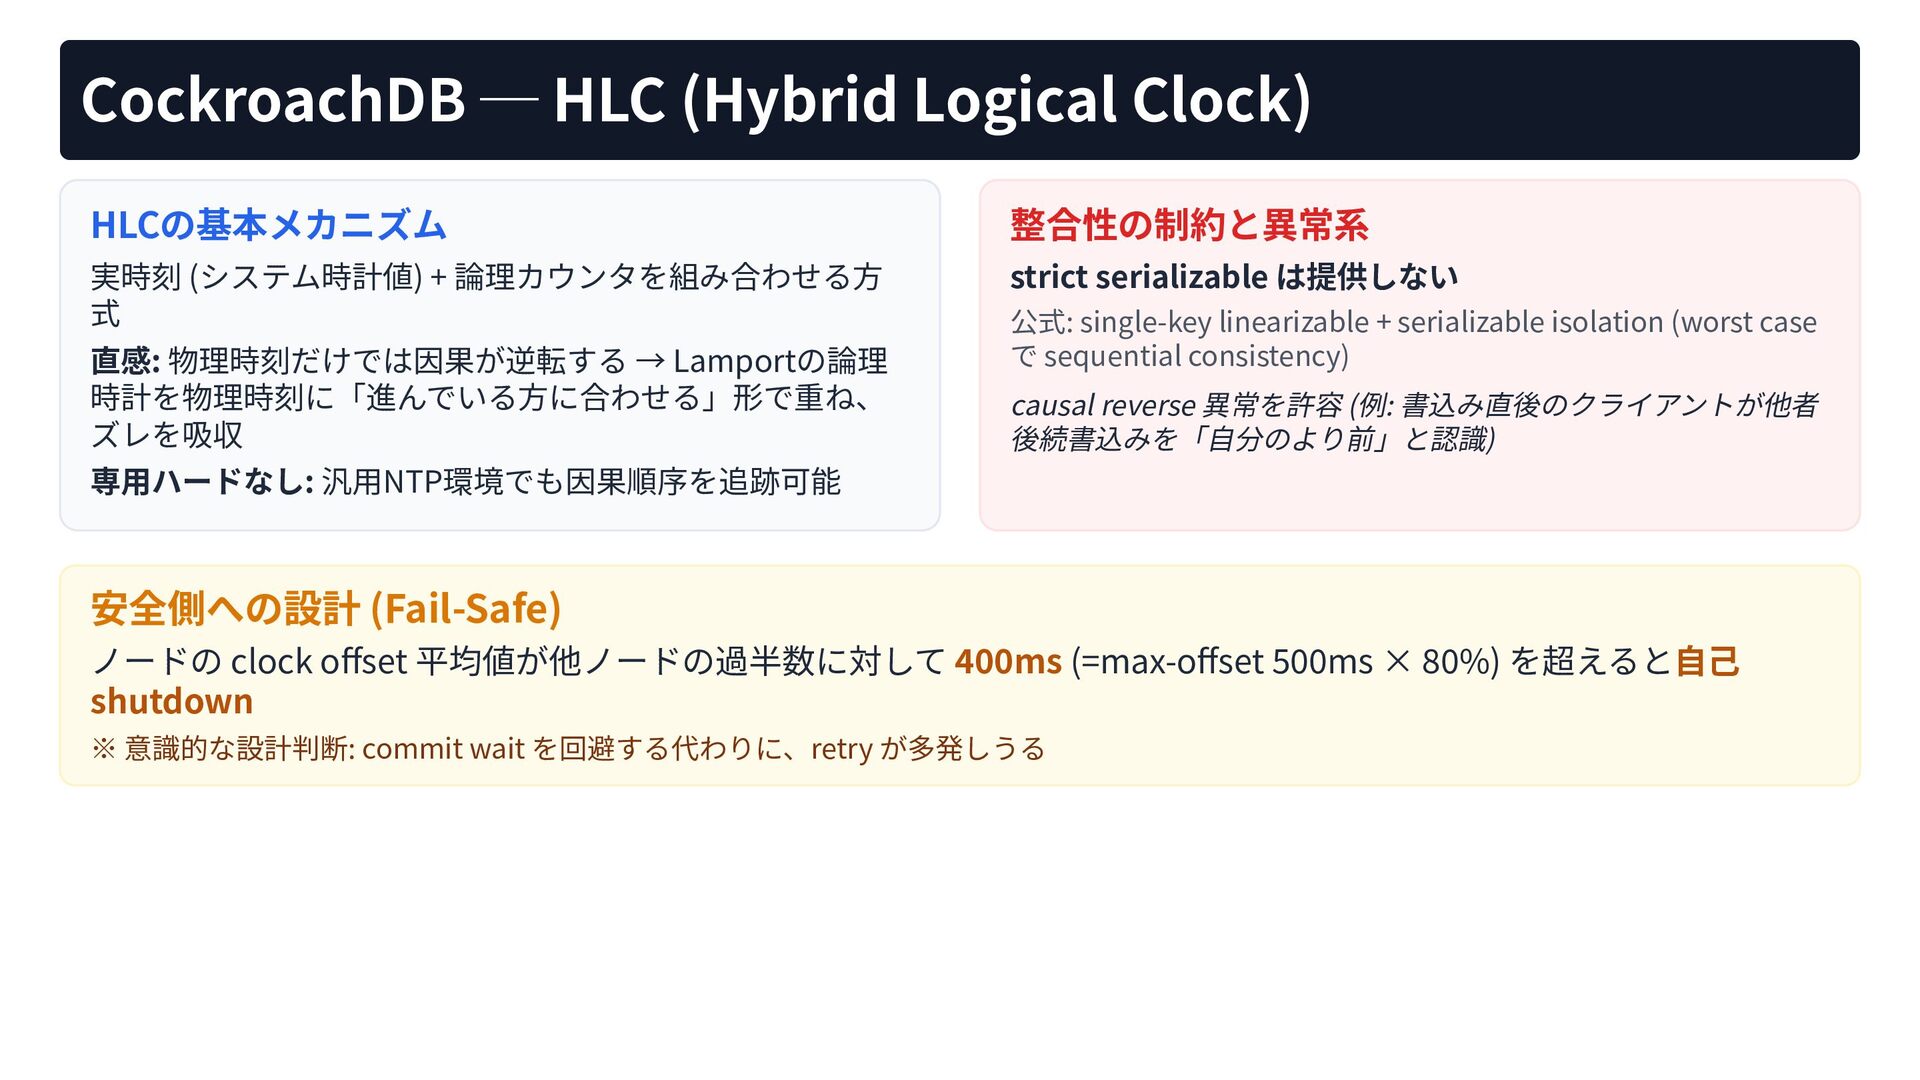
CockroachDB ─ HLC (Hybrid Logical Clock) HLCの基本メカニズム 整合性の制約と異常系 実時刻 (システム時計値)
+ 論理カウンタを組み合わせる⽅ 式 strict serializable は提供しない 直感: 物理時刻だけでは因果が逆転する → Lamportの論理 時計を物理時刻に「進んでいる⽅に合わせる」形で重ね、 ズレを吸収 公式: single-key linearizable + serializable isolation (worst case で sequential consistency) causal reverse 異常を許容 (例: 書込み直後のクライアントが他者 後続書込みを「⾃分のより前」と認識) 専⽤ハードなし: 汎⽤NTP環境でも因果順序を追跡可能 安全側への設計 (Fail-Safe) ノードの clock offset 平均値が他ノードの過半数に対して 400ms (=max-offset 500ms × 80%) を超えると⾃⼰ shutdown ※ 意識的な設計判断: commit wait を回避する代わりに、retry が多発しうる
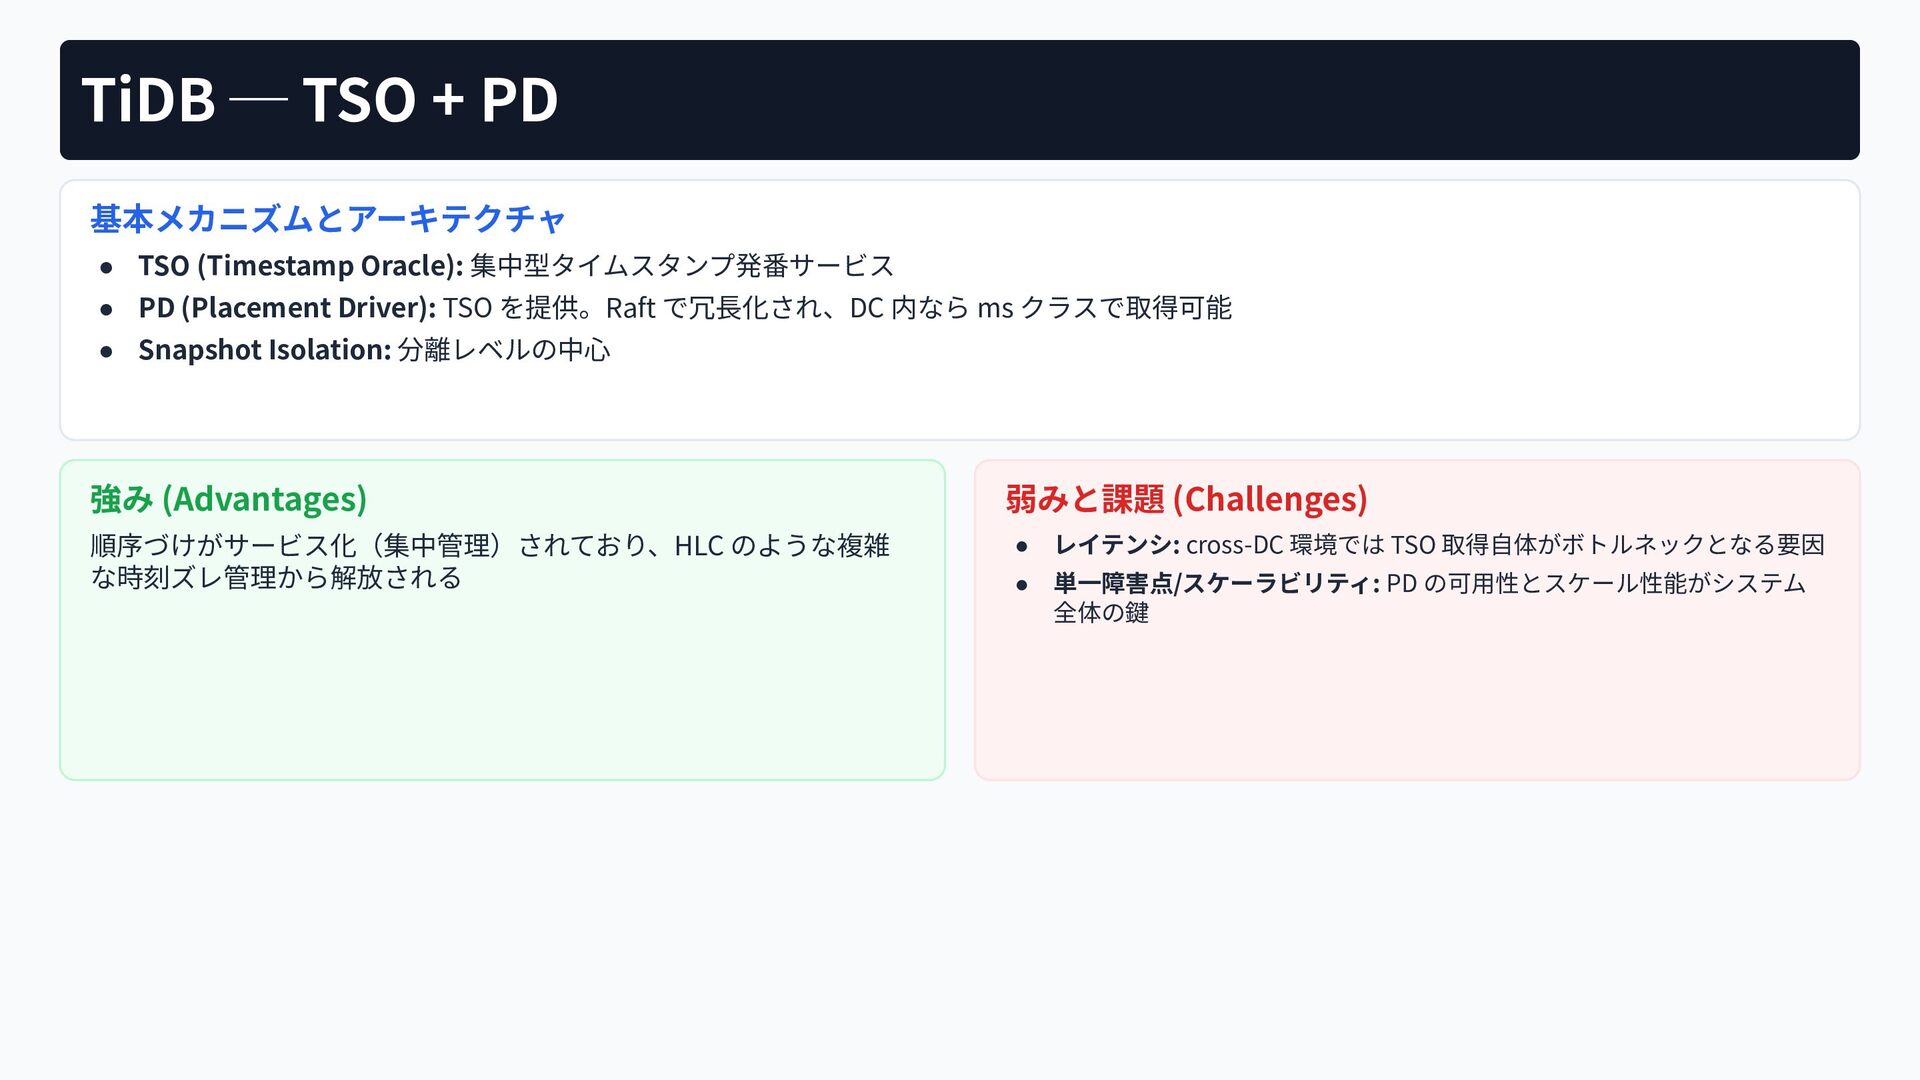
TiDB ─ TSO + PD 基本メカニズムとアーキテクチャ • TSO (Timestamp Oracle):
集中型タイムスタンプ発番サービス • PD (Placement Driver): TSO を提供。Raft で冗⻑化され、DC 内なら ms クラスで取得可能 • Snapshot Isolation: 分離レベルの中⼼ 強み (Advantages) 弱みと課題 (Challenges) 順序づけがサービス化(集中管理)されており、HLC のような複雑 な時刻ズレ管理から解放される • レイテンシ: cross-DC 環境では TSO 取得⾃体がボトルネックとなる要因 • 単⼀障害点/スケーラビリティ: PD の可⽤性とスケール性能がシステム 全体の鍵
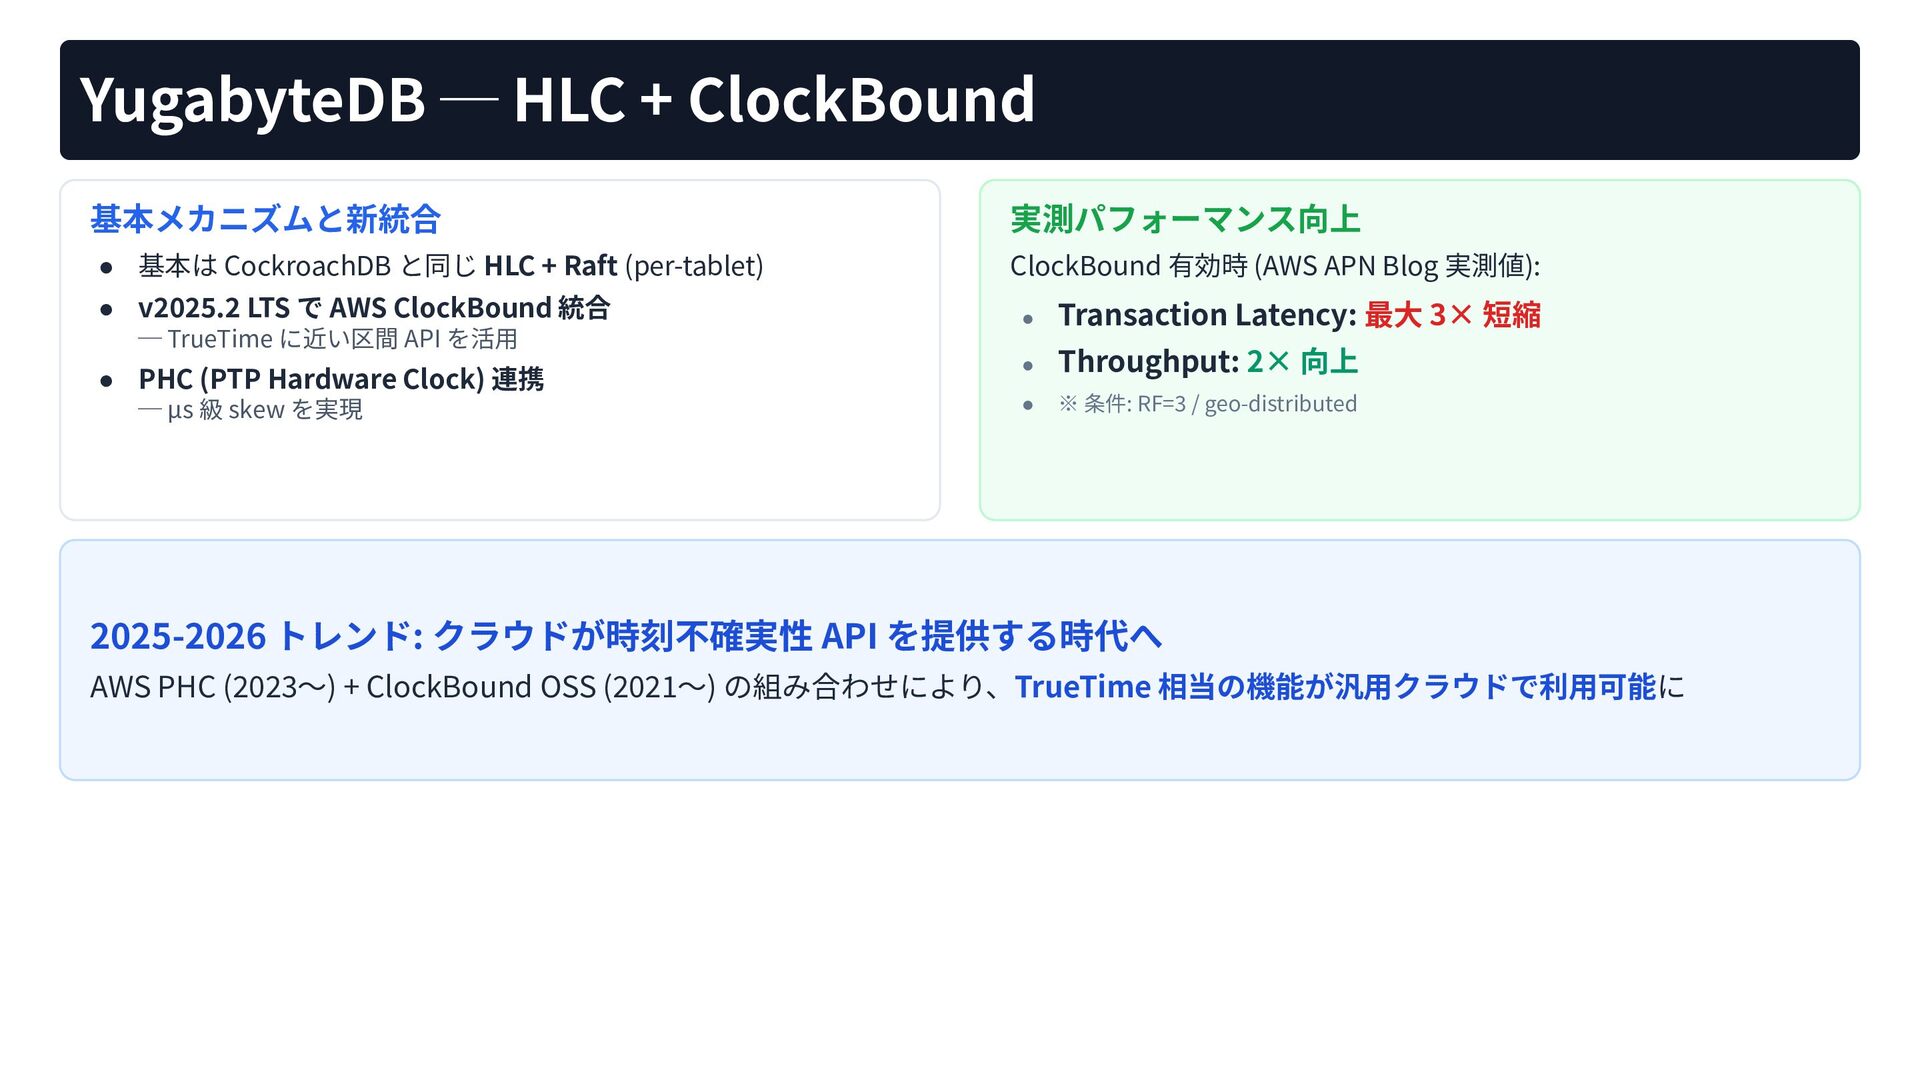
YugabyteDB ─ HLC + ClockBound 基本メカニズムと新統合 実測パフォーマンス向上 • 基本は CockroachDB
と同じ HLC + Raft (per-tablet) ClockBound 有効時 (AWS APN Blog 実測値): • v2025.2 LTS で AWS ClockBound 統合 • Transaction Latency: 最⼤ 3× 短縮 • Throughput: 2× 向上 • ※ 条件: RF=3 / geo-distributed ─ TrueTime に近い区間 API を活⽤ • PHC (PTP Hardware Clock) 連携 ─ μs 級 skew を実現 2025-2026 トレンド: クラウドが時刻不確実性 API を提供する時代へ AWS PHC (2023〜) + ClockBound OSS (2021〜) の組み合わせにより、TrueTime 相当の機能が汎⽤クラウドで利⽤可能に
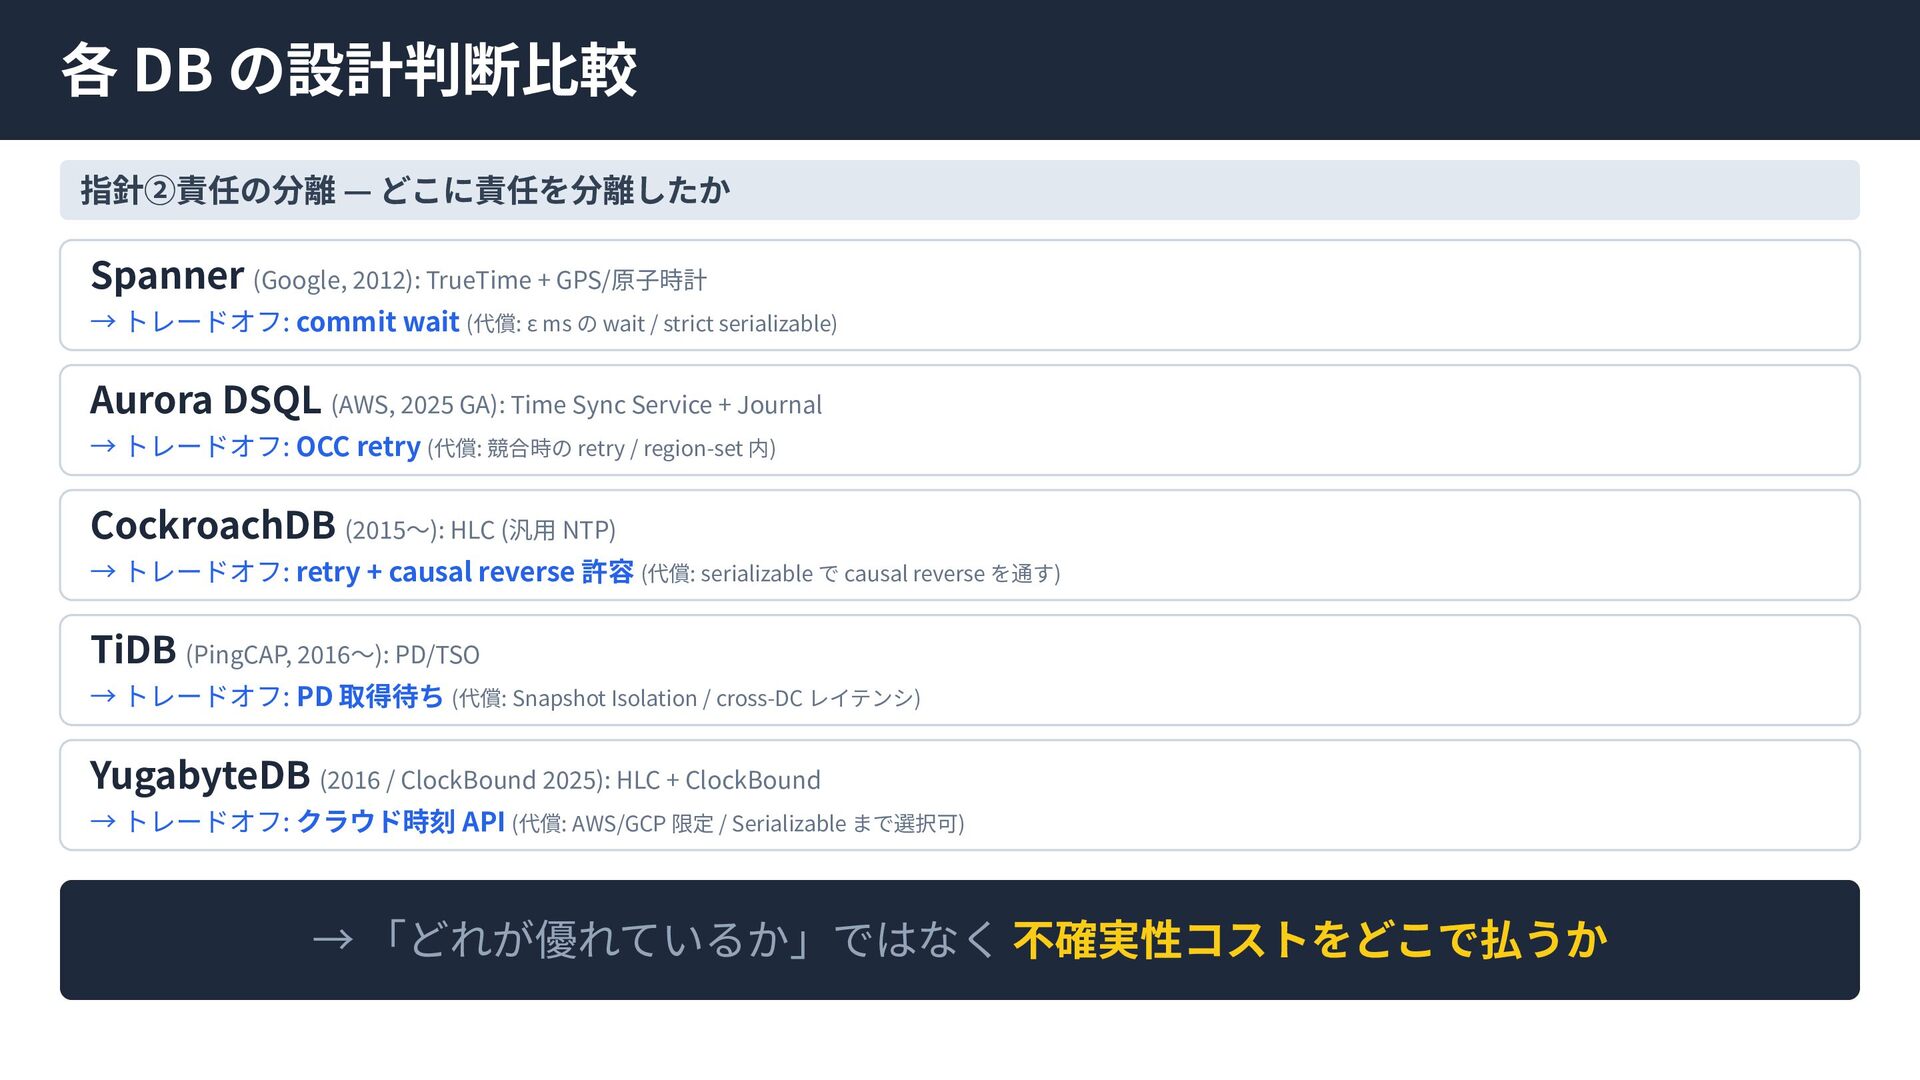
各 DB の設計判断⽐較 指針②責任の分離 — どこに責任を分離したか Spanner (Google, 2012): TrueTime
+ GPS/原⼦時計 → トレードオフ: commit wait (代償: ε ms の wait / strict serializable) Aurora DSQL (AWS, 2025 GA): Time Sync Service + Journal → トレードオフ: OCC retry (代償: 競合時の retry / region-set 内) CockroachDB (2015〜): HLC (汎⽤ NTP) → トレードオフ: retry + causal reverse 許容 (代償: serializable で causal reverse を通す) TiDB (PingCAP, 2016〜): PD/TSO → トレードオフ: PD 取得待ち (代償: Snapshot Isolation / cross-DC レイテンシ) YugabyteDB (2016 / ClockBound 2025): HLC + ClockBound → トレードオフ: クラウド時刻 API (代償: AWS/GCP 限定 / Serializable まで選択可) → 「どれが優れているか」ではなく 不確実性コストをどこで払うか
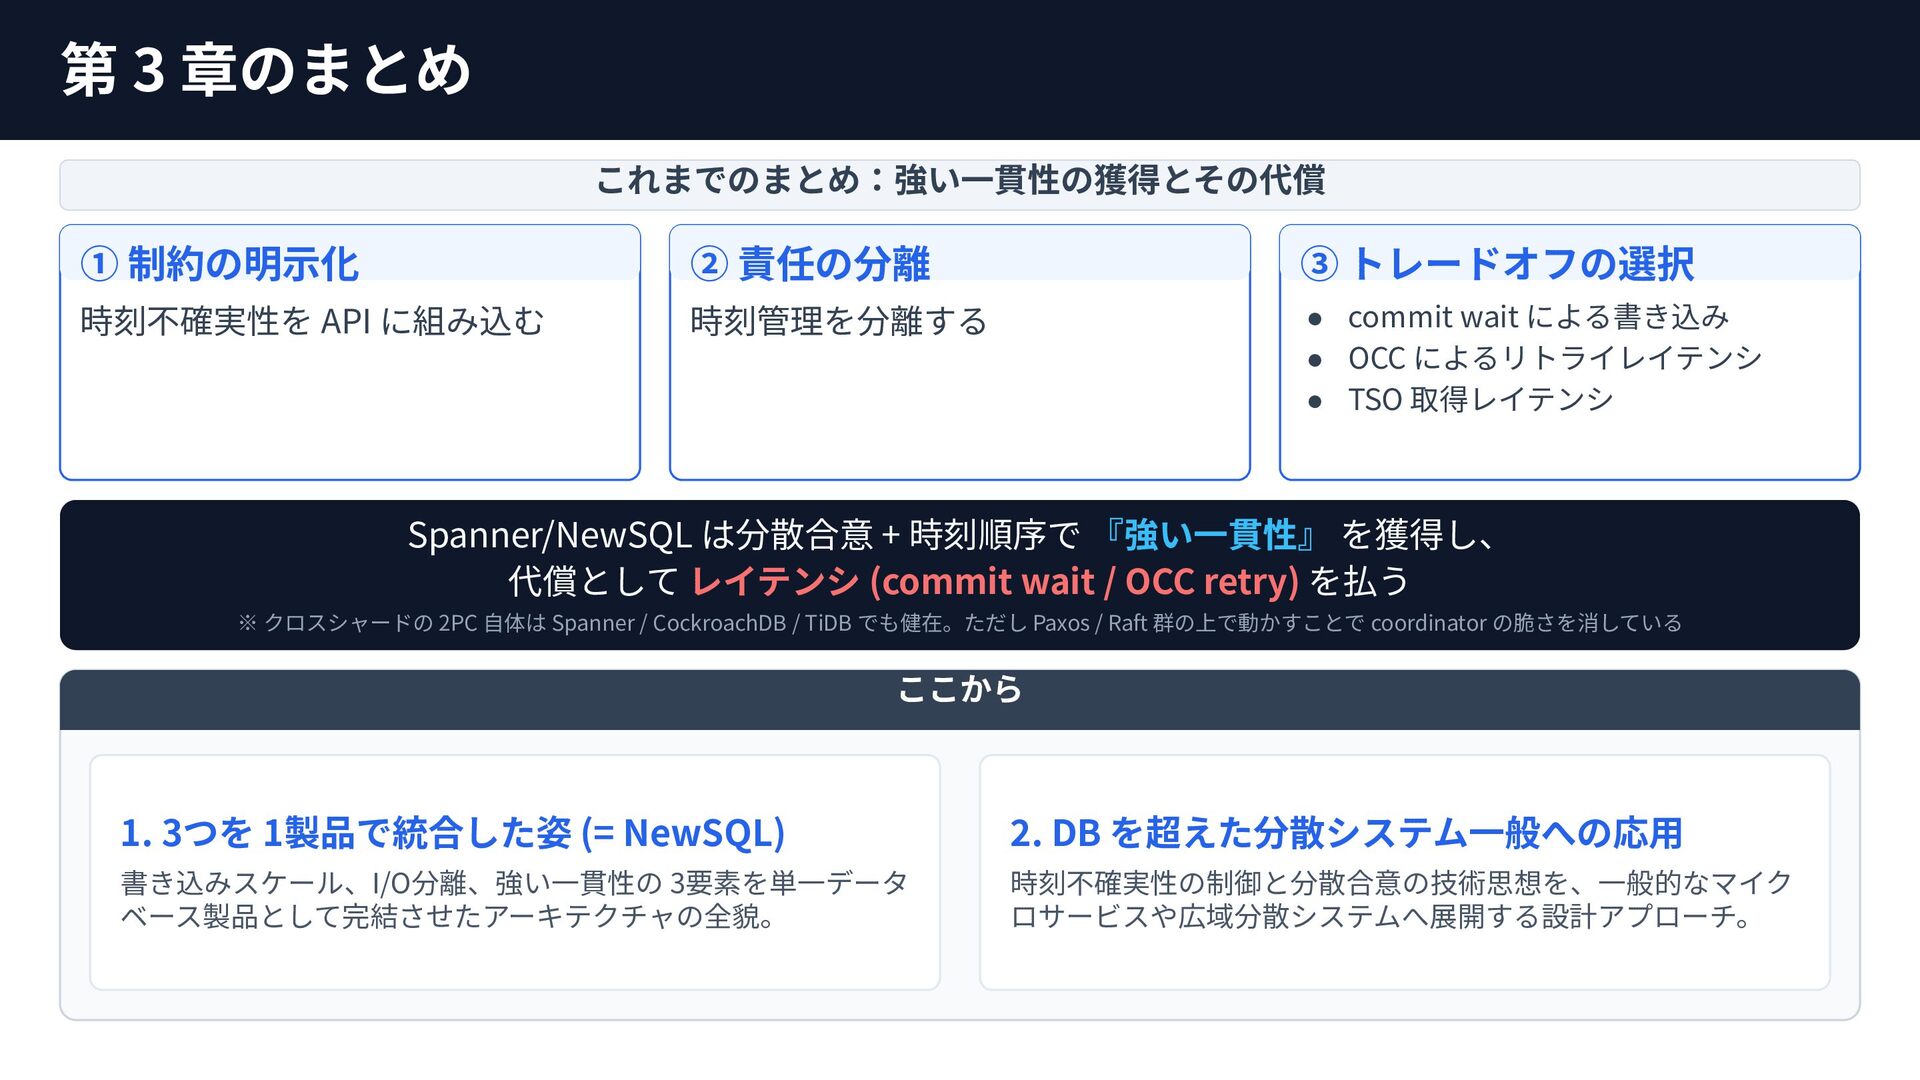
第 3 章のまとめ これまでのまとめ:強い⼀貫性の獲得とその代償 ① 制約の明⽰化 ② 責任の分離 ③ トレードオフの選択
時刻不確実性を API に組み込む 時刻管理を分離する • commit wait による書き込み • OCC によるリトライレイテンシ • TSO 取得レイテンシ Spanner/NewSQL は分散合意 + 時刻順序で 『強い⼀貫性』 を獲得し、 代償として レイテンシ (commit wait / OCC retry) を払う ※ クロスシャードの 2PC ⾃体は Spanner / CockroachDB / TiDB でも健在。ただし Paxos / Raft 群の上で動かすことで coordinator の脆さを消している ここから 1. 3つを 1製品で統合した姿 (= NewSQL) 2. DB を超えた分散システム⼀般への応⽤ 書き込みスケール、I/O分離、強い⼀貫性の 3要素を単⼀データ ベース製品として完結させたアーキテクチャの全貌。 時刻不確実性の制御と分散合意の技術思想を、⼀般的なマイク ロサービスや広域分散システムへ展開する設計アプローチ。
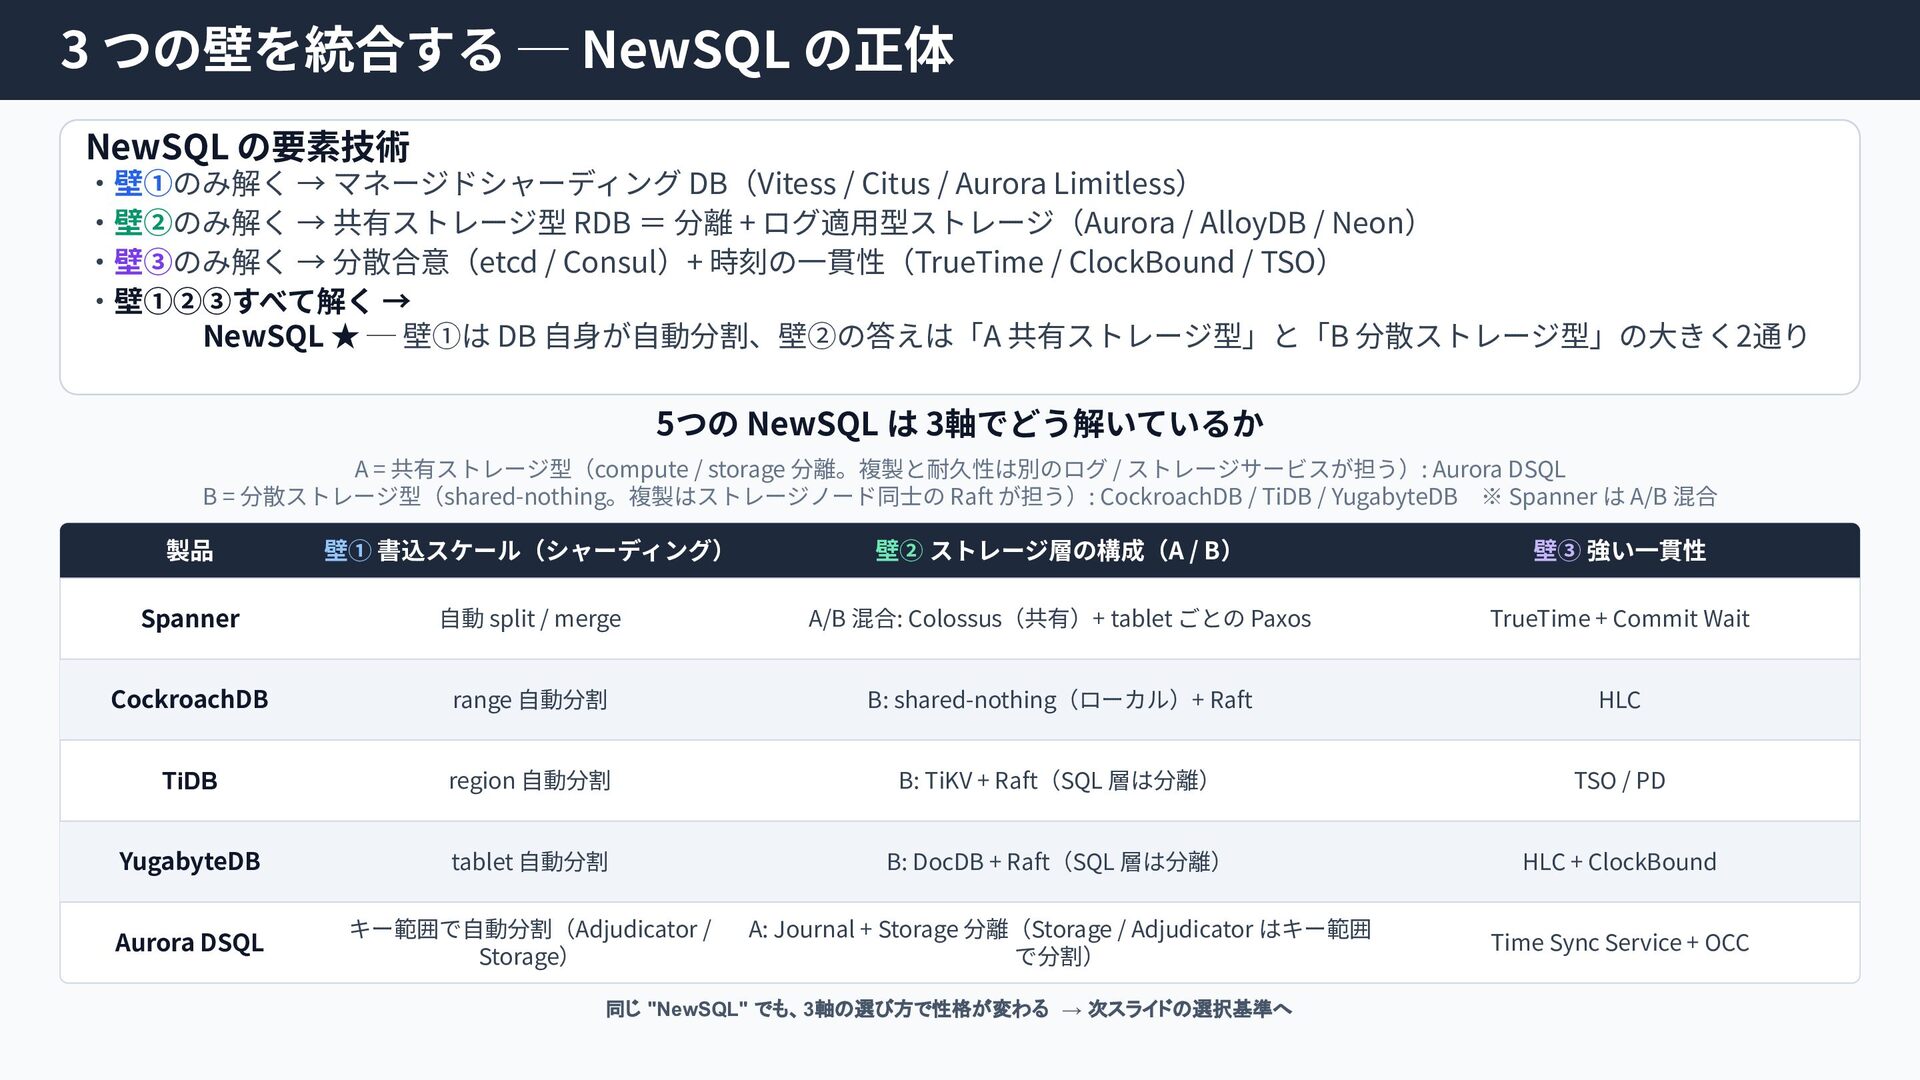
3 つの壁を統合する ─ NewSQL の正体 NewSQL の要素技術 ‧壁①のみ解く → マネージドシャーディング
DB(Vitess / Citus / Aurora Limitless) ‧壁②のみ解く → 共有ストレージ型 RDB = 分離 + ログ適⽤型ストレージ(Aurora / AlloyDB / Neon) ‧壁③のみ解く → 分散合意(etcd / Consul)+ 時刻の⼀貫性(TrueTime / ClockBound / TSO) ‧壁①②③すべて解く → NewSQL ★ ─ 壁①は DB ⾃⾝が⾃動分割、壁②の答えは「A 共有ストレージ型」と「B 分散ストレージ型」の⼤きく2通り 5つの NewSQL は 3軸でどう解いているか A = 共有ストレージ型(compute / storage 分離。複製と耐久性は別のログ / ストレージサービスが担う): Aurora DSQL B = 分散ストレージ型(shared-nothing。複製はストレージノード同⼠の Raft が担う): CockroachDB / TiDB / YugabyteDB ※ Spanner は A/B 混合 製品 壁① 書込スケール(シャーディング) 壁② ストレージ層の構成(A / B) 壁③ 強い⼀貫性 Spanner ⾃動 split / merge A/B 混合: Colossus(共有)+ tablet ごとの Paxos TrueTime + Commit Wait CockroachDB range ⾃動分割 B: shared-nothing(ローカル)+ Raft HLC TiDB region ⾃動分割 B: TiKV + Raft(SQL 層は分離) TSO / PD YugabyteDB tablet ⾃動分割 B: DocDB + Raft(SQL 層は分離) HLC + ClockBound Aurora DSQL キー範囲で⾃動分割(Adjudicator / Storage) A: Journal + Storage 分離(Storage / Adjudicator はキー範囲 で分割) Time Sync Service + OCC 同じ "NewSQL" でも、3軸の選び方で性格が変わる → 次スライドの選択基準へ
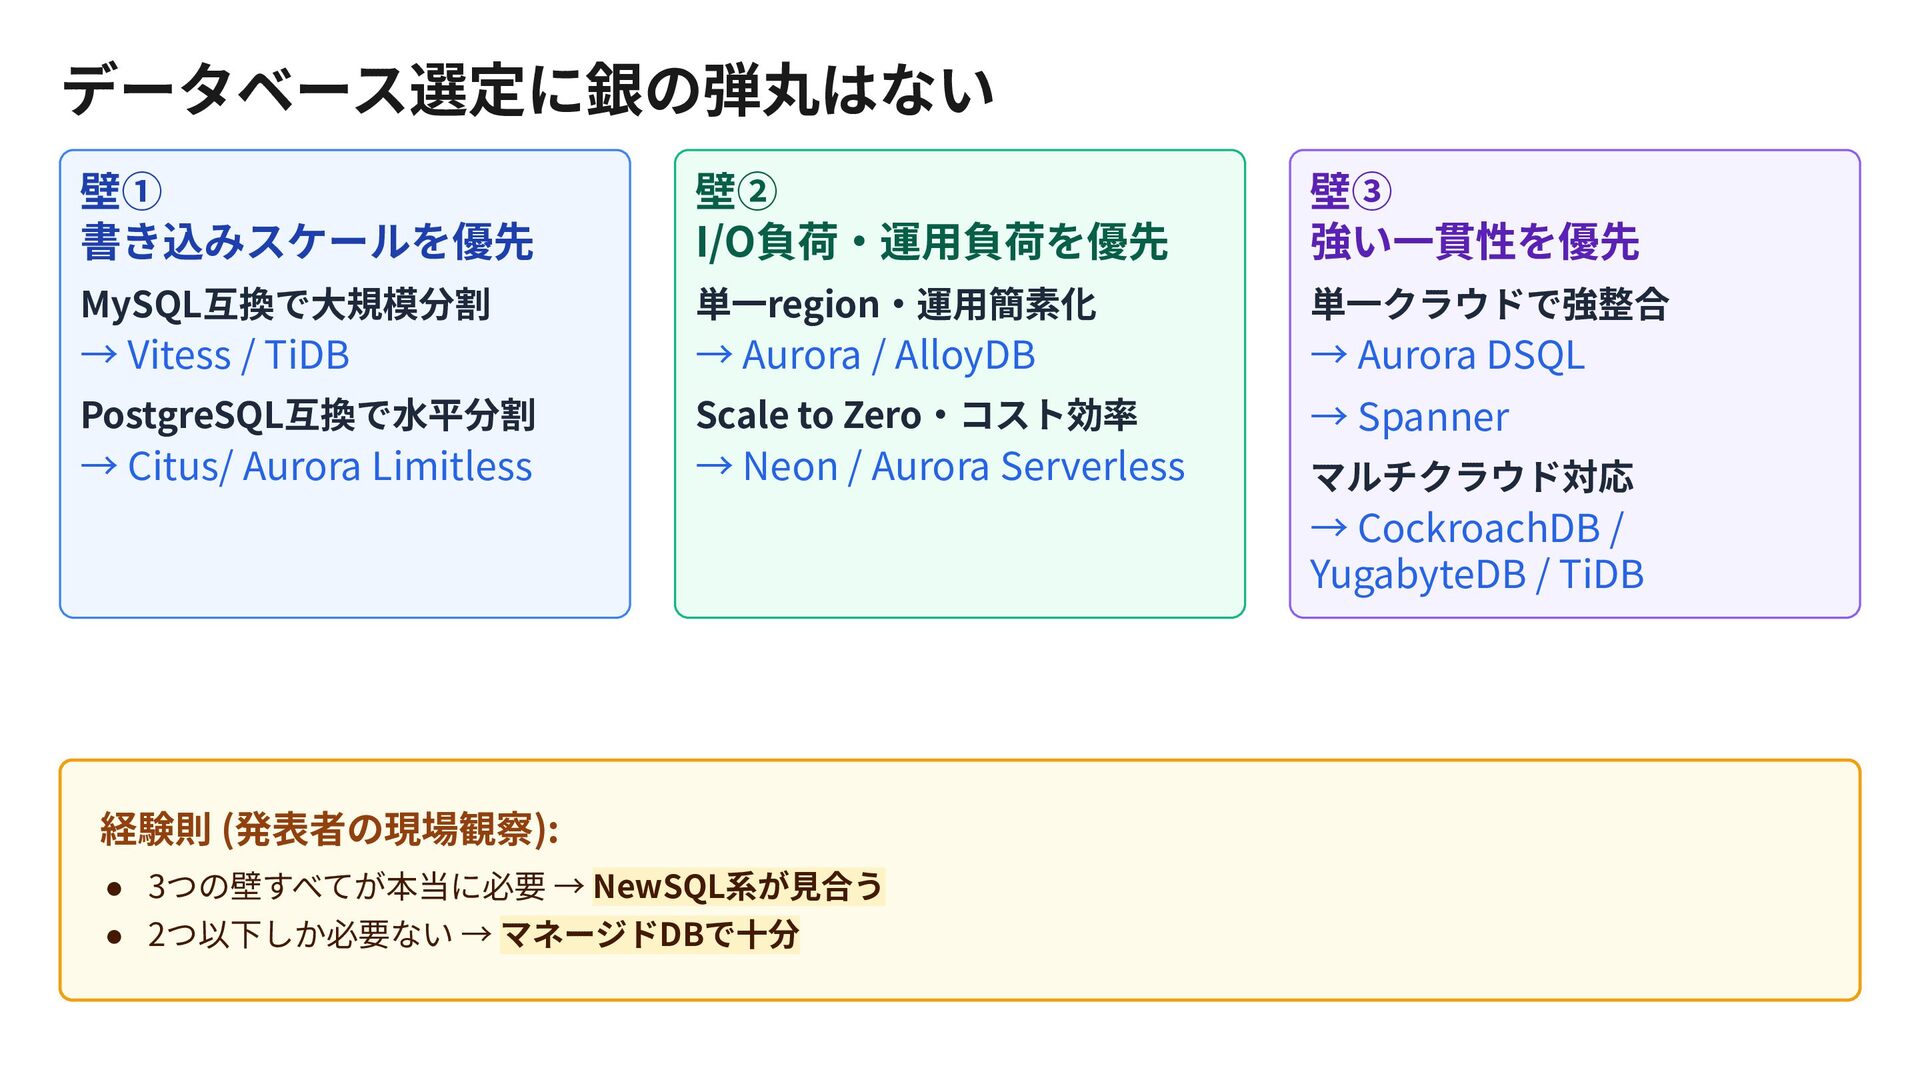
データベース選定に銀の弾丸はない 壁① 書き込みスケールを優先 壁② I/O負荷‧運⽤負荷を優先 壁③ 強い⼀貫性を優先 MySQL互換で⼤規模分割 単⼀region‧運⽤簡素化 単⼀クラウドで強整合
→ Vitess / TiDB → Aurora / AlloyDB → Aurora DSQL PostgreSQL互換で⽔平分割 Scale to Zero‧コスト効率 → Spanner → Citus/ Aurora Limitless → Neon / Aurora Serverless マルチクラウド対応 → CockroachDB / YugabyteDB / TiDB 経験則 (発表者の現場観察): • 3つの壁すべてが本当に必要 → NewSQL系が⾒合う • 2つ以下しか必要ない → マネージドDBで⼗分
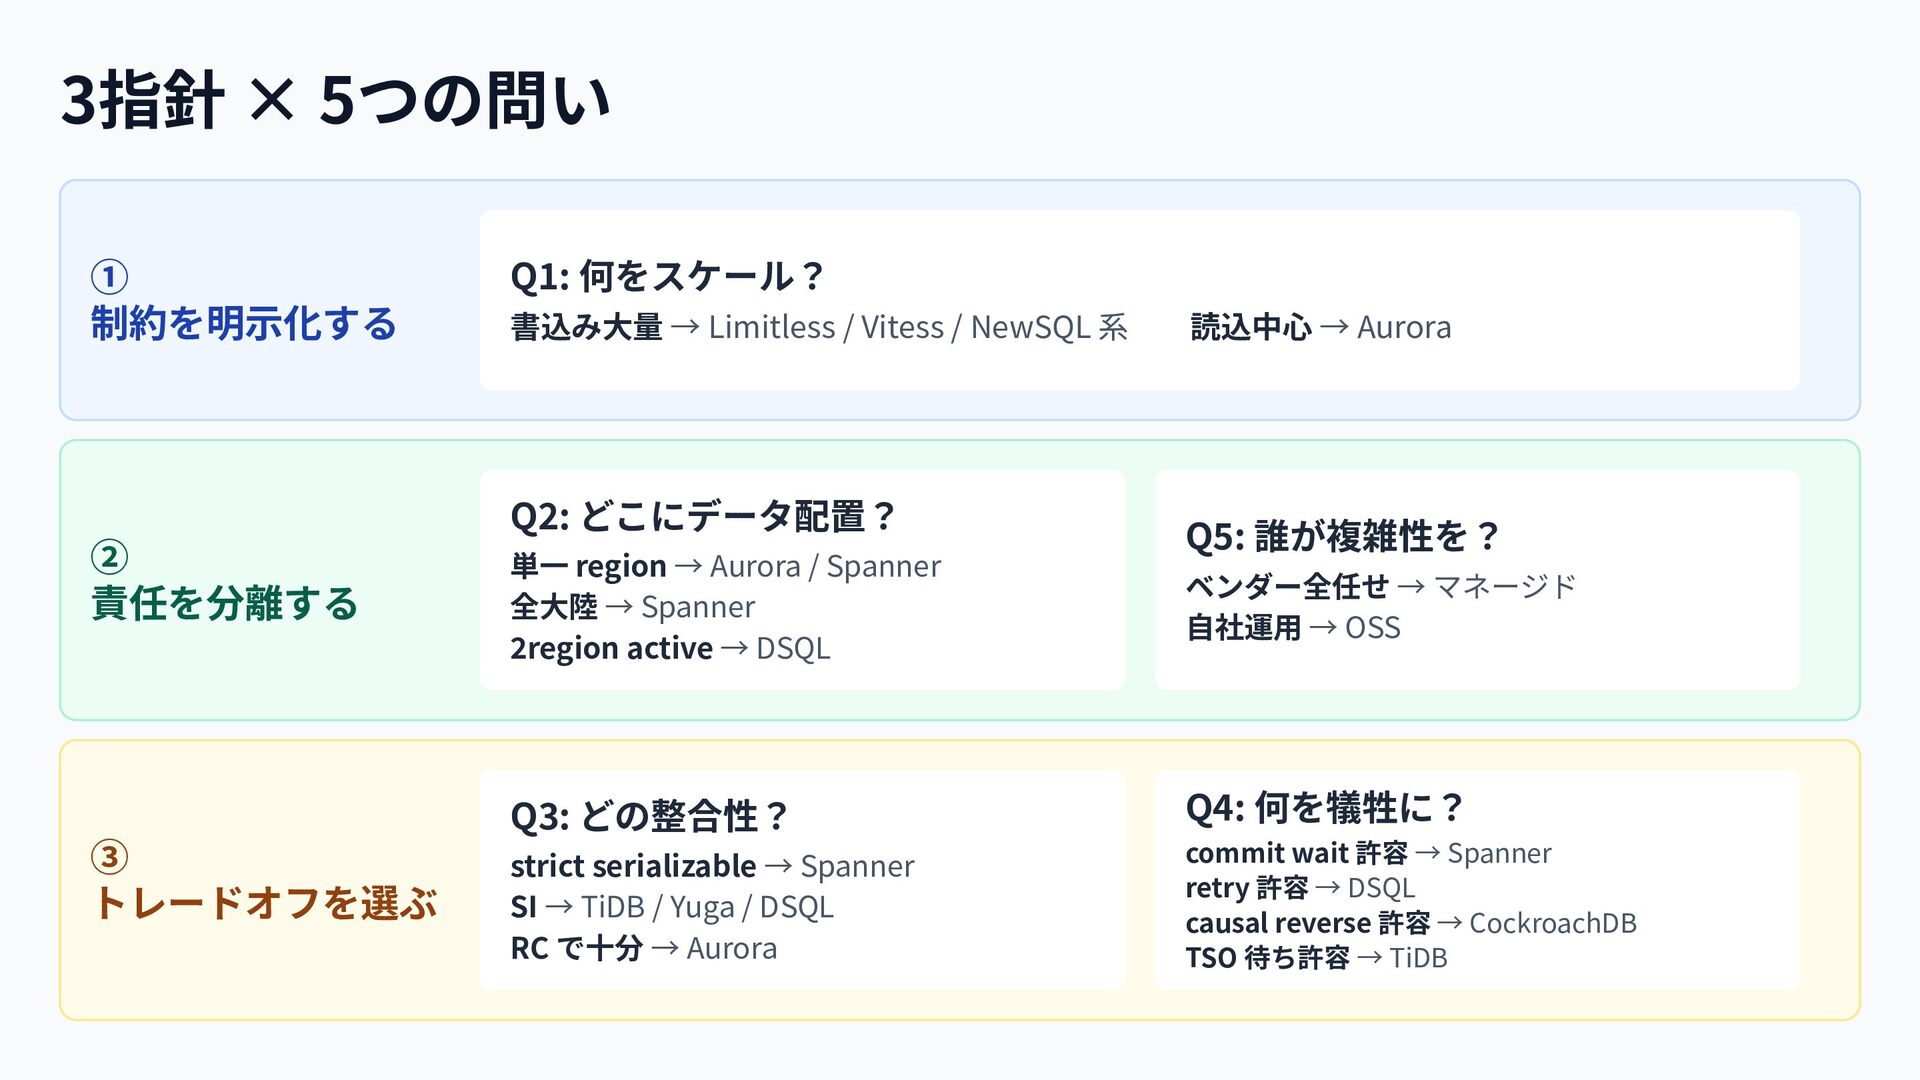
3指針 × 5つの問い ① 制約を明⽰化する Q1: 何をスケール? 書込み⼤量 → Limitless
/ Vitess / NewSQL 系 Q2: どこにデータ配置? ② 責任を分離する ③ トレードオフを選ぶ 単⼀ region → Aurora / Spanner 全⼤陸 → Spanner 2region active → DSQL 読込中⼼ → Aurora Q5: 誰が複雑性を? ベンダー全任せ → マネージド ⾃社運⽤ → OSS Q3: どの整合性? Q4: 何を犠牲に? strict serializable → Spanner SI → TiDB / Yuga / DSQL RC で⼗分 → Aurora commit wait 許容 → Spanner retry 許容 → DSQL causal reverse 許容 → CockroachDB TSO 待ち許容 → TiDB
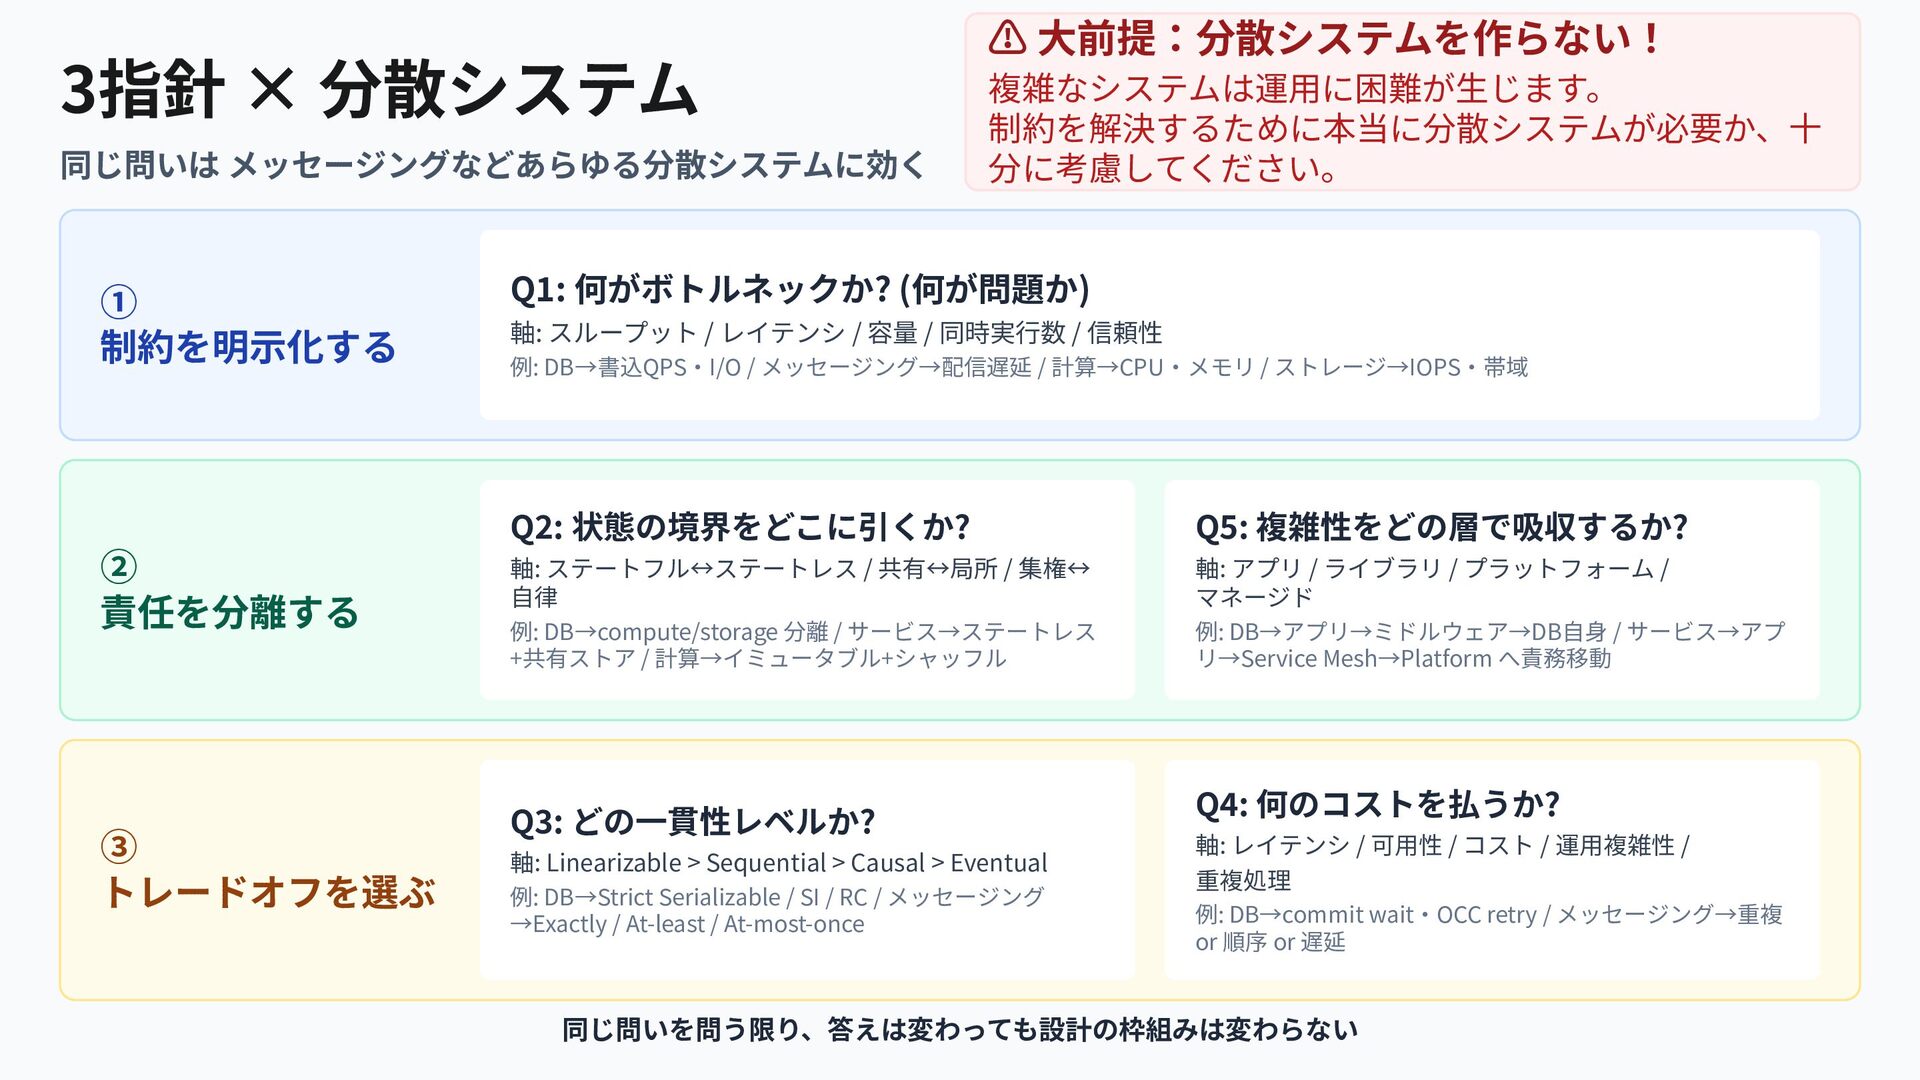
3指針 × 分散システム 同じ問いは メッセージングなどあらゆる分散システムに効く ① 制約を明⽰化する ② 責任を分離する ③
トレードオフを選ぶ ⚠ ⼤前提:分散システムを作らない! 複雑なシステムは運⽤に困難が⽣じます。 制約を解決するために本当に分散システムが必要か、⼗ 分に考慮してください。 Q1: 何がボトルネックか? (何が問題か) 軸: スループット / レイテンシ / 容量 / 同時実⾏数 / 信頼性 例: DB→書込QPS‧I/O / メッセージング→配信遅延 / 計算→CPU‧メモリ / ストレージ→IOPS‧帯域 Q2: 状態の境界をどこに引くか? Q5: 複雑性をどの層で吸収するか? 軸: ステートフル↔ステートレス / 共有↔局所 / 集権↔ ⾃律 軸: アプリ / ライブラリ / プラットフォーム / マネージド 例: DB→compute/storage 分離 / サービス→ステートレス +共有ストア / 計算→イミュータブル+シャッフル 例: DB→アプリ→ミドルウェア→DB⾃⾝ / サービス→アプ リ→Service Mesh→Platform へ責務移動 Q3: どの⼀貫性レベルか? 軸: Linearizable > Sequential > Causal > Eventual 例: DB→Strict Serializable / SI / RC / メッセージング →Exactly / At-least / At-most-once Q4: 何のコストを払うか? 軸: レイテンシ / 可⽤性 / コスト / 運⽤複雑性 / 重複処理 例: DB→commit wait‧OCC retry / メッセージング→重複 or 順序 or 遅延 同じ問いを問う限り、答えは変わっても設計の枠組みは変わらない
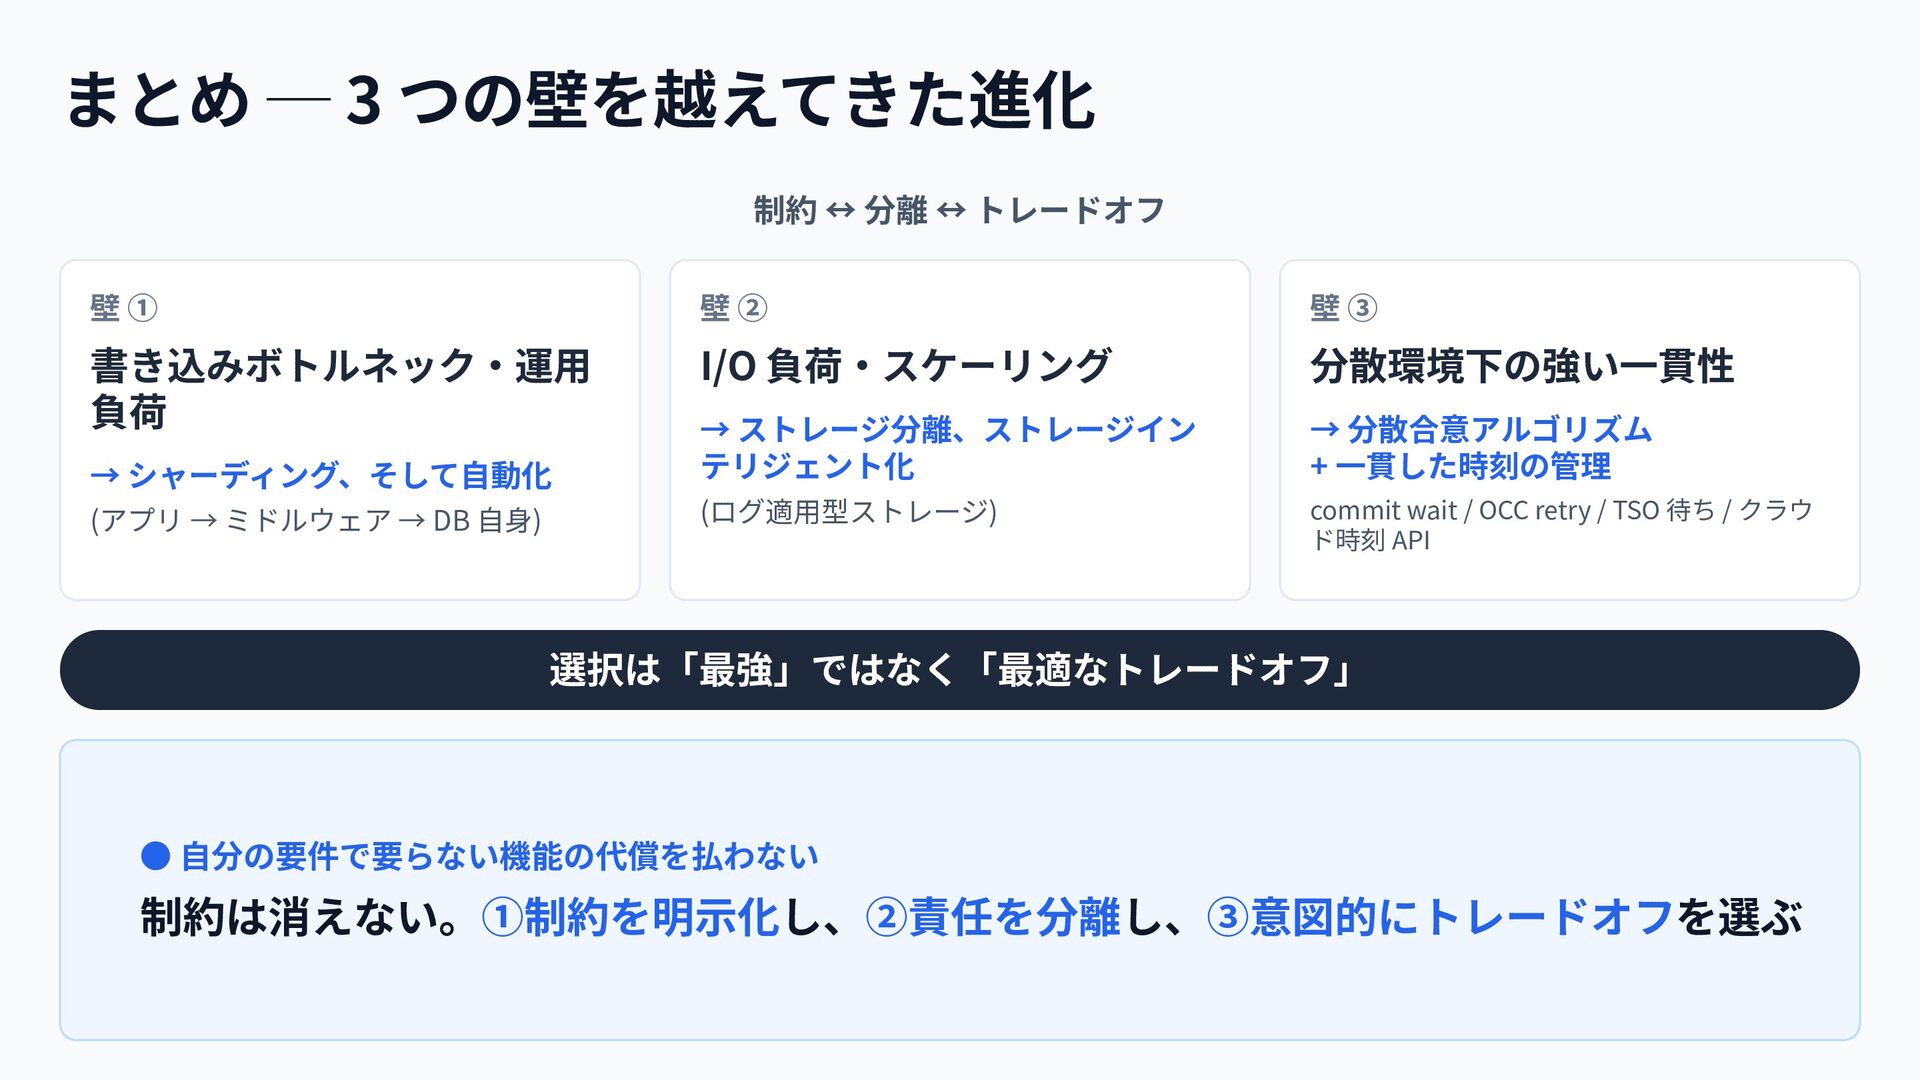
まとめ ─ 3 つの壁を越えてきた進化 制約 ↔ 分離 ↔ トレードオフ 壁①
壁② 壁③ 書き込みボトルネック‧運⽤ 負荷 I/O 負荷‧スケーリング 分散環境下の強い⼀貫性 → シャーディング、そして⾃動化 → ストレージ分離、ストレージイン テリジェント化 → 分散合意アルゴリズム + ⼀貫した時刻の管理 (アプリ → ミドルウェア → DB ⾃⾝) (ログ適⽤型ストレージ) commit wait / OCC retry / TSO 待ち / クラウ ド時刻 API 選択は「最強」ではなく「最適なトレードオフ」 • ⾃分の要件で要らない機能の代償を払わない 制約は消えない。①制約を明⽰化し、②責任を分離し、③意図的にトレードオフを選ぶ
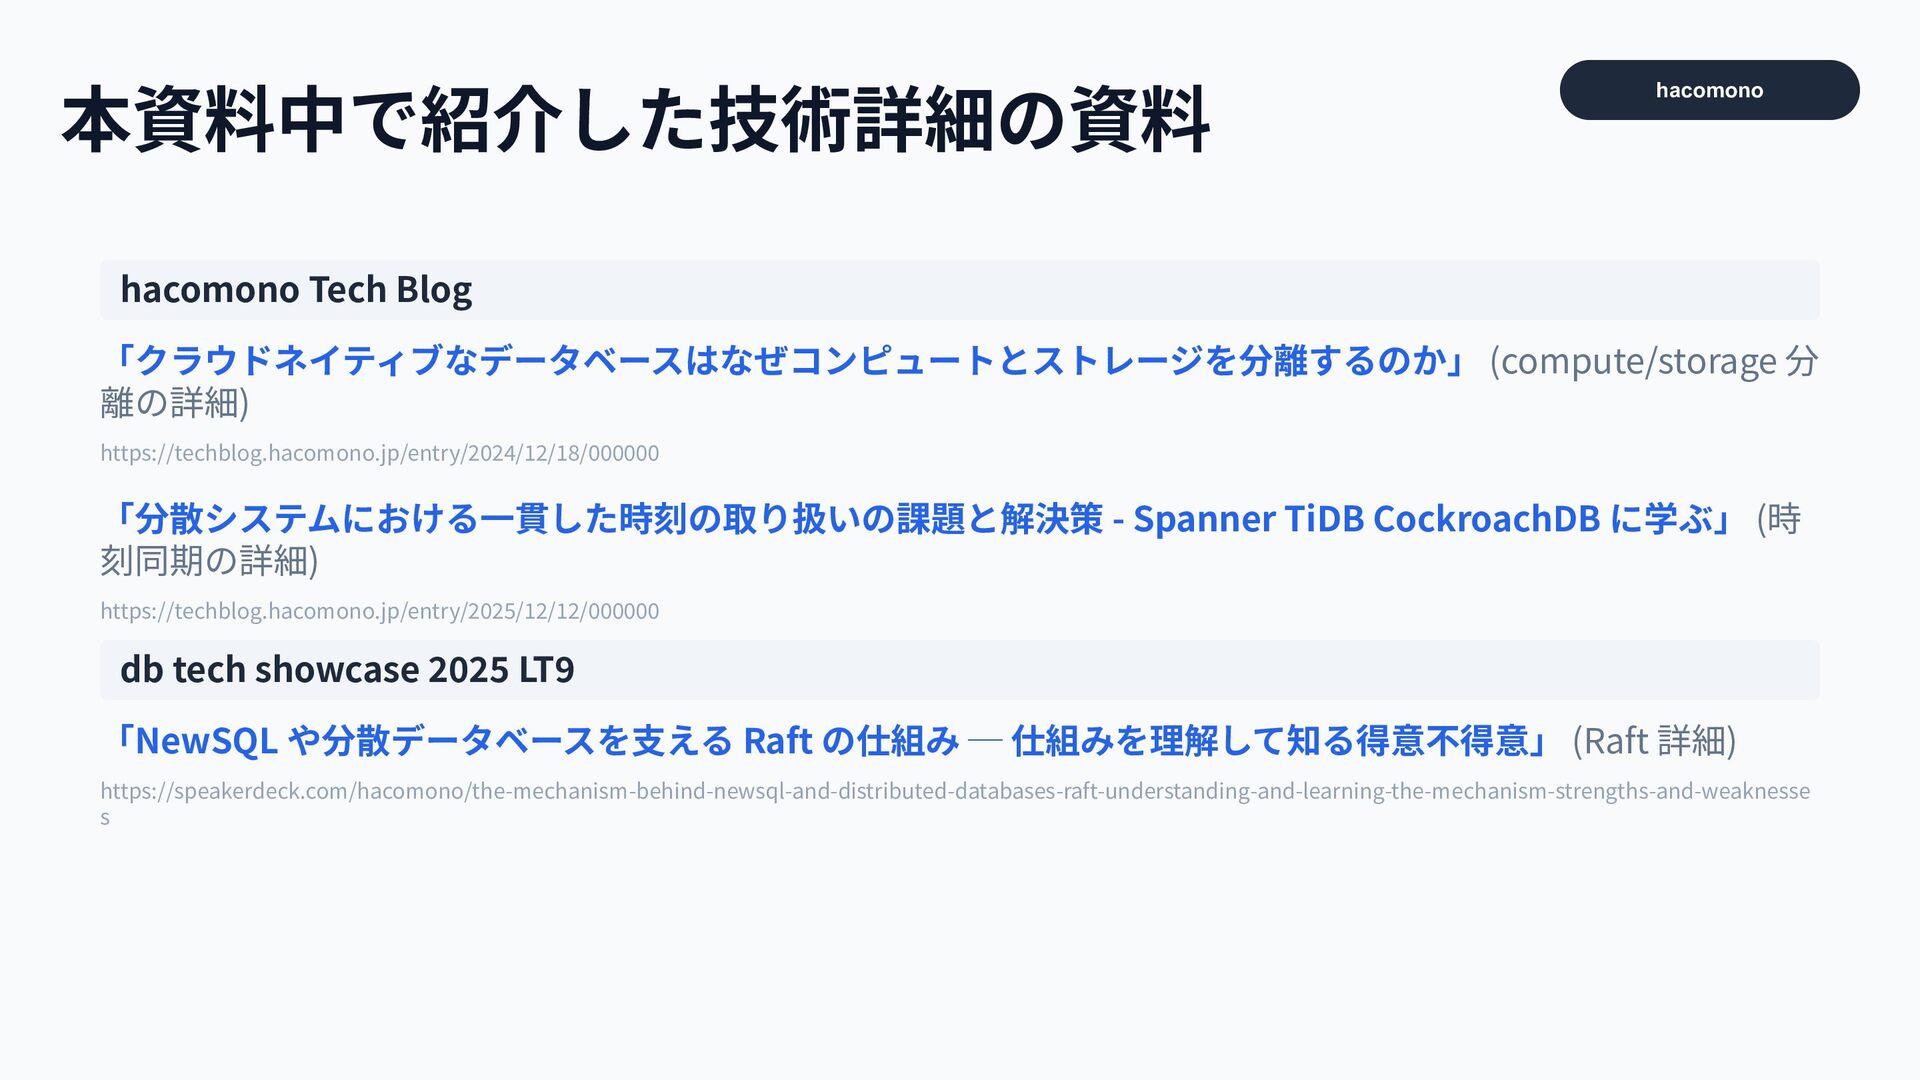
本資料中で紹介した技術詳細の資料 hacomono hacomono Tech Blog 「クラウドネイティブなデータベースはなぜコンピュートとストレージを分離するのか」 (compute/storage 分 離の詳細) https://techblog.hacomono.jp/entry/2024/12/18/000000
「分散システムにおける⼀貫した時刻の取り扱いの課題と解決策 - Spanner TiDB CockroachDB に学ぶ」 (時 刻同期の詳細) https://techblog.hacomono.jp/entry/2025/12/12/000000 db tech showcase 2025 LT9 「NewSQL や分散データベースを⽀える Raft の仕組み ─ 仕組みを理解して知る得意不得意」 (Raft 詳細) https://speakerdeck.com/hacomono/the-mechanism-behind-newsql-and-distributed-databases-raft-understanding-and-learning-the-mechanism-strengths-and-weaknesse s
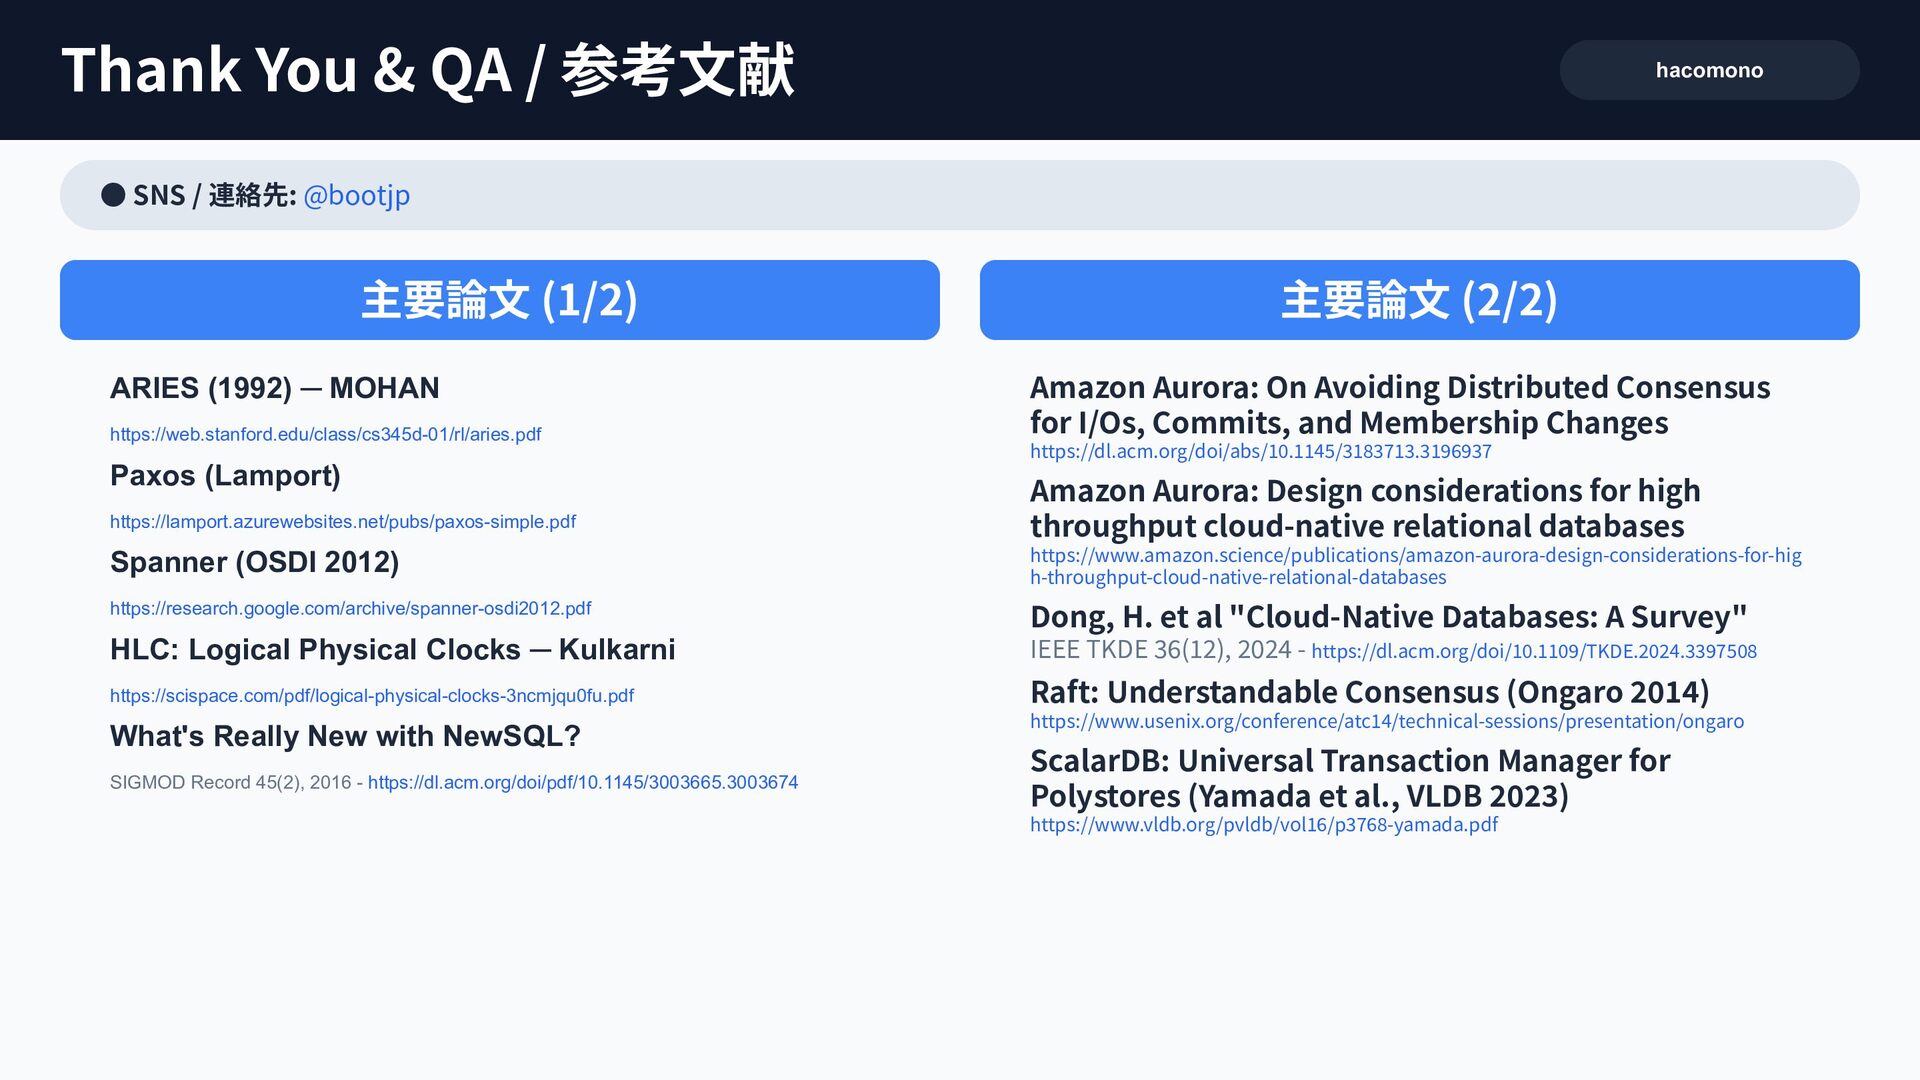
Thank You & QA / 参考⽂献 hacomono • SNS /
連絡先: @bootjp 主要論⽂ (1/2) ARIES (1992) ─ MOHAN https://web.stanford.edu/class/cs345d-01/rl/aries.pdf Paxos (Lamport) 主要論⽂ (2/2) Amazon Aurora: On Avoiding Distributed Consensus for I/Os, Commits, and Membership Changes https://dl.acm.org/doi/abs/10.1145/3183713.3196937 https://lamport.azurewebsites.net/pubs/paxos-simple.pdf Amazon Aurora: Design considerations for high throughput cloud-native relational databases Spanner (OSDI 2012) https://www.amazon.science/publications/amazon-aurora-design-considerations-for-hig h-throughput-cloud-native-relational-databases https://research.google.com/archive/spanner-osdi2012.pdf Dong, H. et al "Cloud-Native Databases: A Survey" HLC: Logical Physical Clocks ─ Kulkarni IEEE TKDE 36(12), 2024 - https://dl.acm.org/doi/10.1109/TKDE.2024.3397508 https://scispace.com/pdf/logical-physical-clocks-3ncmjqu0fu.pdf Raft: Understandable Consensus (Ongaro 2014) What's Really New with NewSQL? SIGMOD Record 45(2), 2016 - https://dl.acm.org/doi/pdf/10.1145/3003665.3003674 https://www.usenix.org/conference/atc14/technical-sessions/presentation/ongaro ScalarDB: Universal Transaction Manager for Polystores (Yamada et al., VLDB 2023) https://www.vldb.org/pvldb/vol16/p3768-yamada.pdf
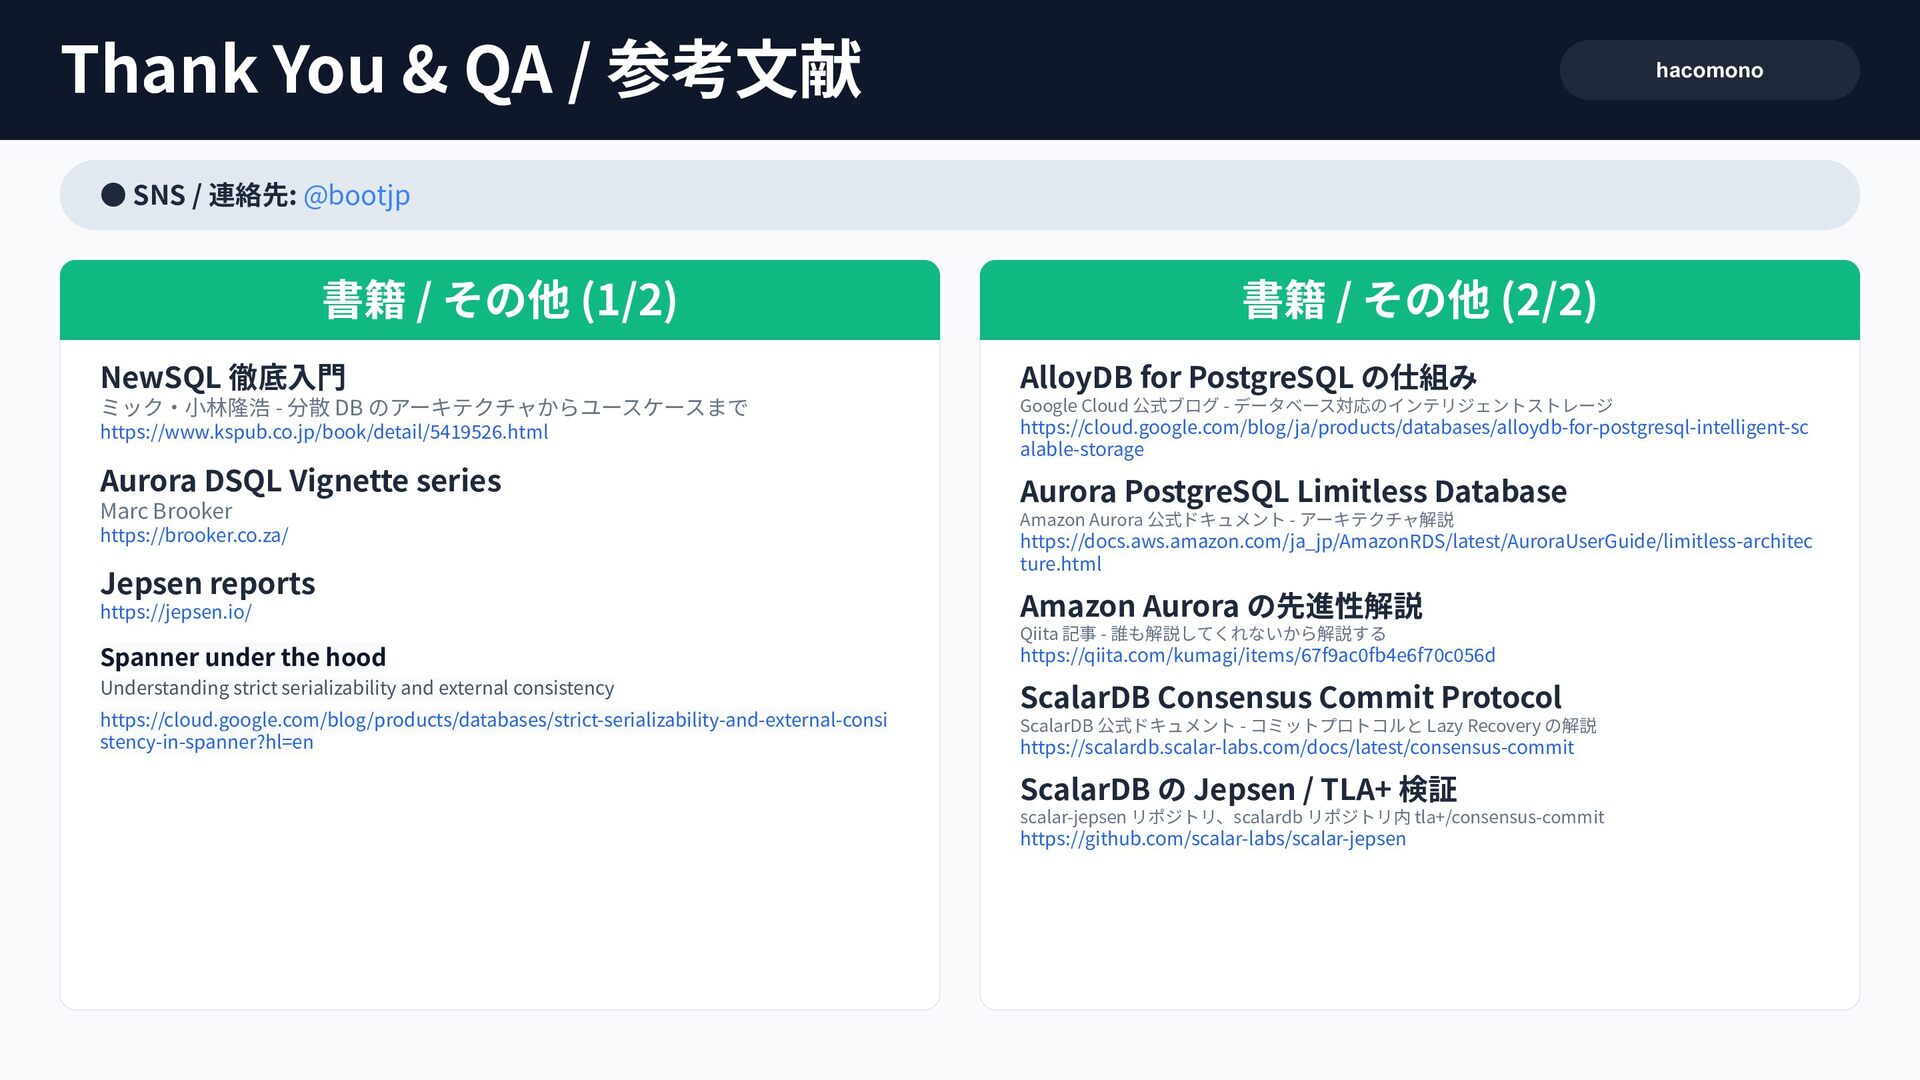
Thank You & QA / 参考⽂献 hacomono • SNS /
連絡先: @bootjp 書籍 / その他 (1/2) 書籍 / その他 (2/2) NewSQL 徹底⼊⾨ AlloyDB for PostgreSQL の仕組み ミック‧⼩林隆浩 - 分散 DB のアーキテクチャからユースケースまで Google Cloud 公式ブログ - データベース対応のインテリジェントストレージ https://www.kspub.co.jp/book/detail/5419526.html Aurora DSQL Vignette series Marc Brooker https://brooker.co.za/ Jepsen reports https://jepsen.io/ https://cloud.google.com/blog/ja/products/databases/alloydb-for-postgresql-intelligent-sc alable-storage Aurora PostgreSQL Limitless Database Amazon Aurora 公式ドキュメント - アーキテクチャ解説 https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/limitless-architec ture.html Amazon Aurora の先進性解説 Qiita 記事 - 誰も解説してくれないから解説する Spanner under the hood https://qiita.com/kumagi/items/67f9ac0fb4e6f70c056d Understanding strict serializability and external consistency ScalarDB Consensus Commit Protocol https://cloud.google.com/blog/products/databases/strict-serializability-and-external-consi stency-in-spanner?hl=en ScalarDB 公式ドキュメント - コミットプロトコルと Lazy Recovery の解説 https://scalardb.scalar-labs.com/docs/latest/consensus-commit ScalarDB の Jepsen / TLA+ 検証 scalar-jepsen リポジトリ、scalardb リポジトリ内 tla+/consensus-commit https://github.com/scalar-labs/scalar-jepsen
Thank You & QA • SNS / 連絡先: @bootjp ご静聴いただきありがとうございました。
質問/お問い合わせはSNSでもお気軽に どうぞ! @bootjp


 hacomono
 madoxten
 eileencodes
 baasie
 inesmontani
 joshbly
 axbom
 maggiecrowley
 skoyamalab
 cromwellryan
 holman
 eitanlees
 jonrohan