Upgrade to Pro — share decks privately, control downloads, hide ads and more …

品質を落とさずにCostを抑えるMulti-Agent設計

Avatar for Inoue Shuichi Inoue Shuichi
September 01, 2026

 品質を落とさずにCostを抑えるMulti-Agent設計

`「AI利用料」を抑えるトークン最適化術 -アクセンチュア・タイミー・LINEヤフー3社のゲストが登壇 `で発表した内容になります。
https://levtechlab.connpass.com/event/400571/

Avatar for Inoue Shuichi

Inoue Shuichi

September 01, 2026

Other Decks in Programming

Transcript

  1. 自己紹介 井上 秀一 / Hideichi 年4月 LINEヤフー株式会社に新卒入社(3年目) 社内向け Kubernetes as

    a Service 基盤 FKE の運用 開発 社内で 生成AI推進、エバンジェリスト を担当 趣味: ドライブ・映画・美味しいものを食べる 2024 2
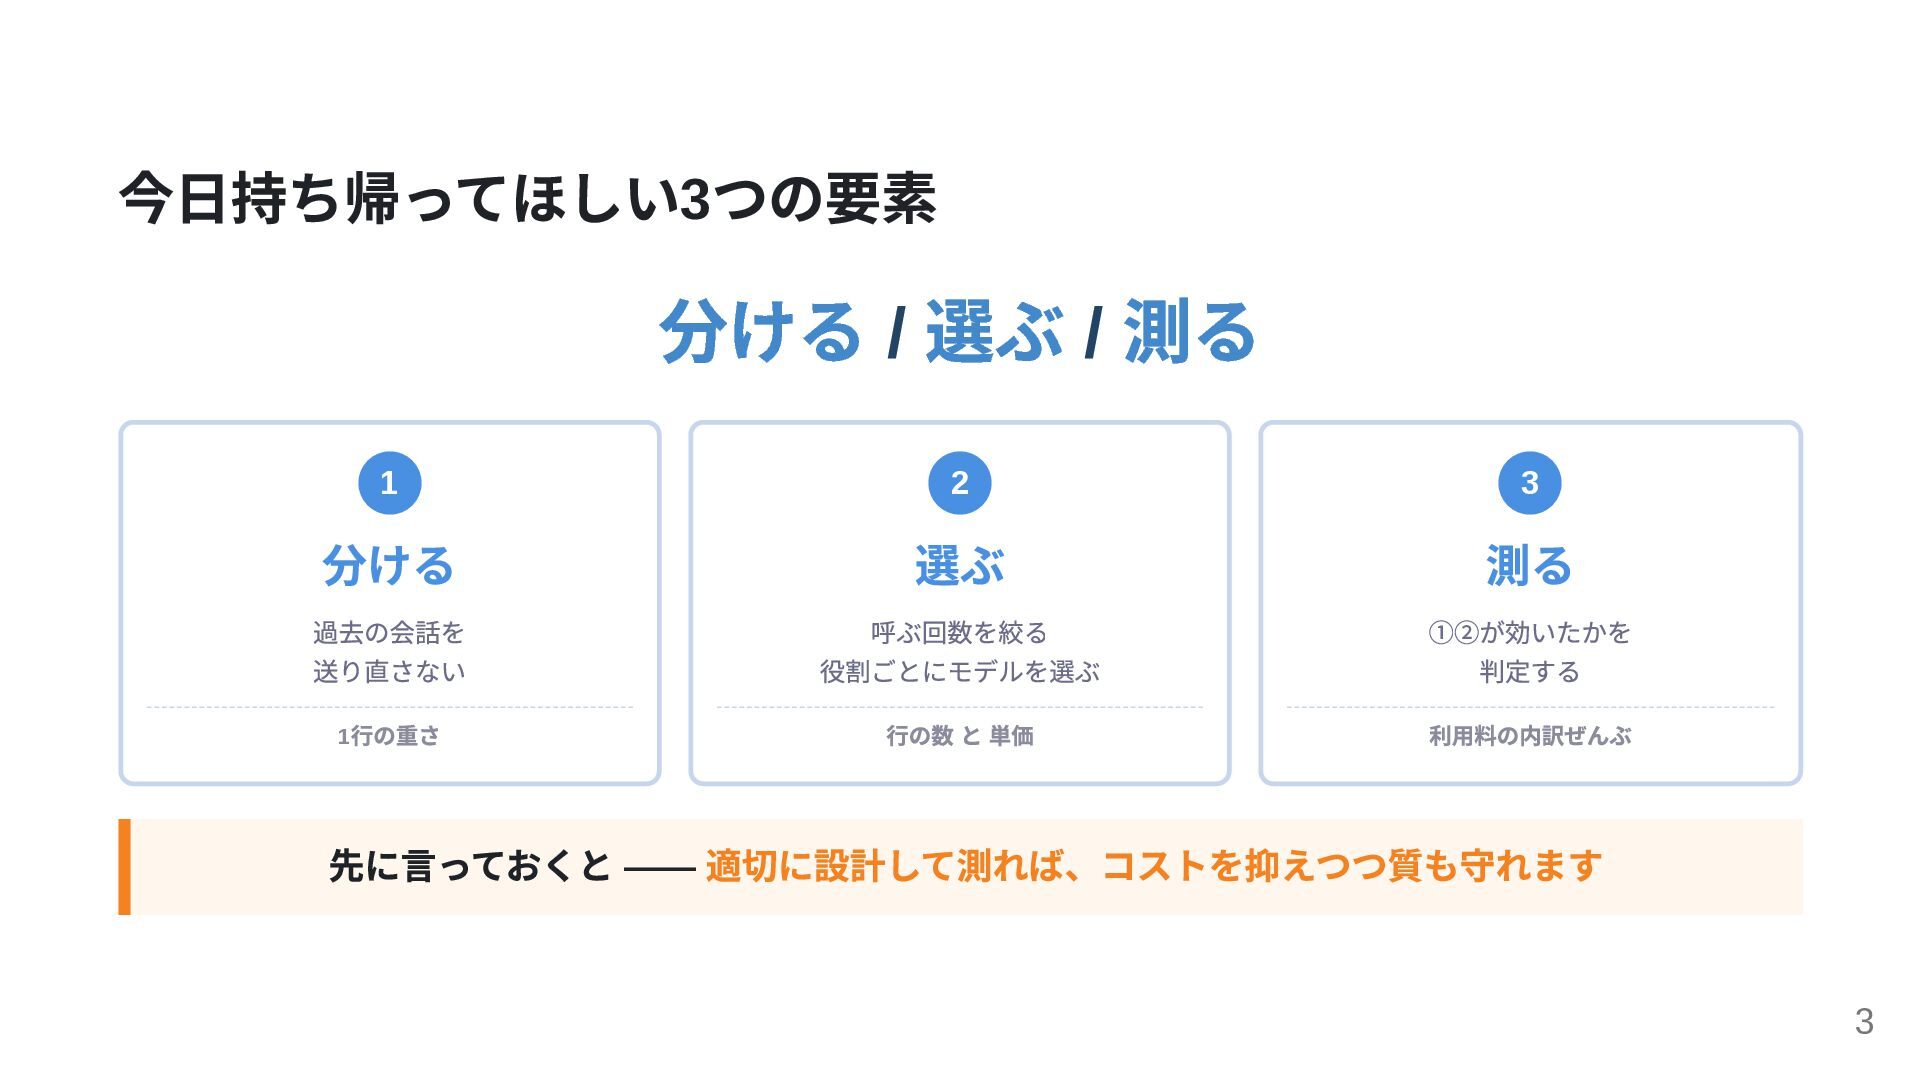
  2. 今日持ち帰ってほしい3つの要素 分ける / 選ぶ / 測る 1 分ける 2 選ぶ

    3 測る 過去の会話を 送り直さない 呼ぶ回数を絞る 役割ごとにモデルを選ぶ ①②が効いたかを 判定する 行の重さ 行の数 と 単価 利用料の内訳ぜんぶ 1 先に言っておくと ―― 適切に設計して測れば、コストを抑えつつ質も守れます 3
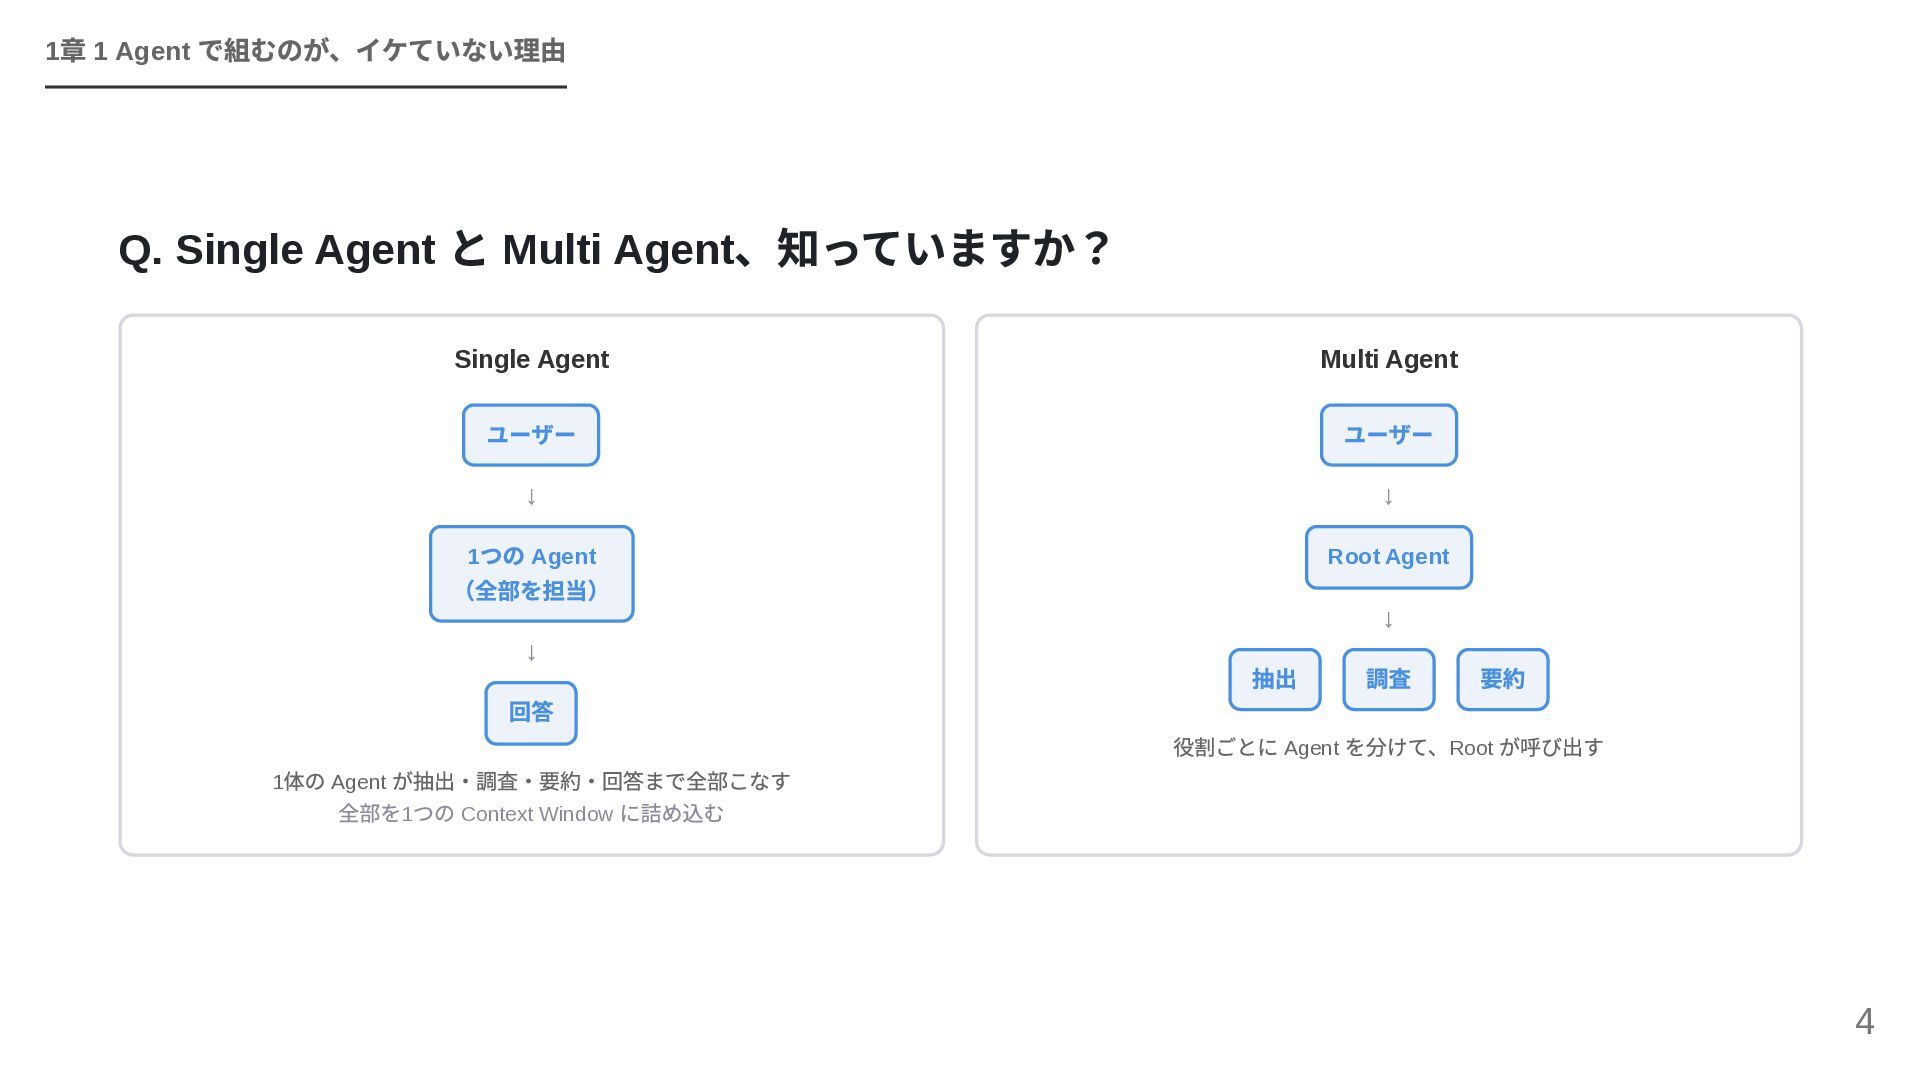
  3. 章 1 Agent で組むのが、イケていない理由 1 Q. Single Agent と Multi

    Agent、知っていますか? Single Agent Multi Agent ユーザー ユーザー ↓ ↓ つの Agent (全部を担当) 1 ↓ 回答 1 体の Agent が抽出・調査・要約・回答まで全部こなす 全部を1つの Context Window に詰め込む Root Agent ↓ 抽出 調査 要約 役割ごとに Agent を分けて、Root が呼び出す 4
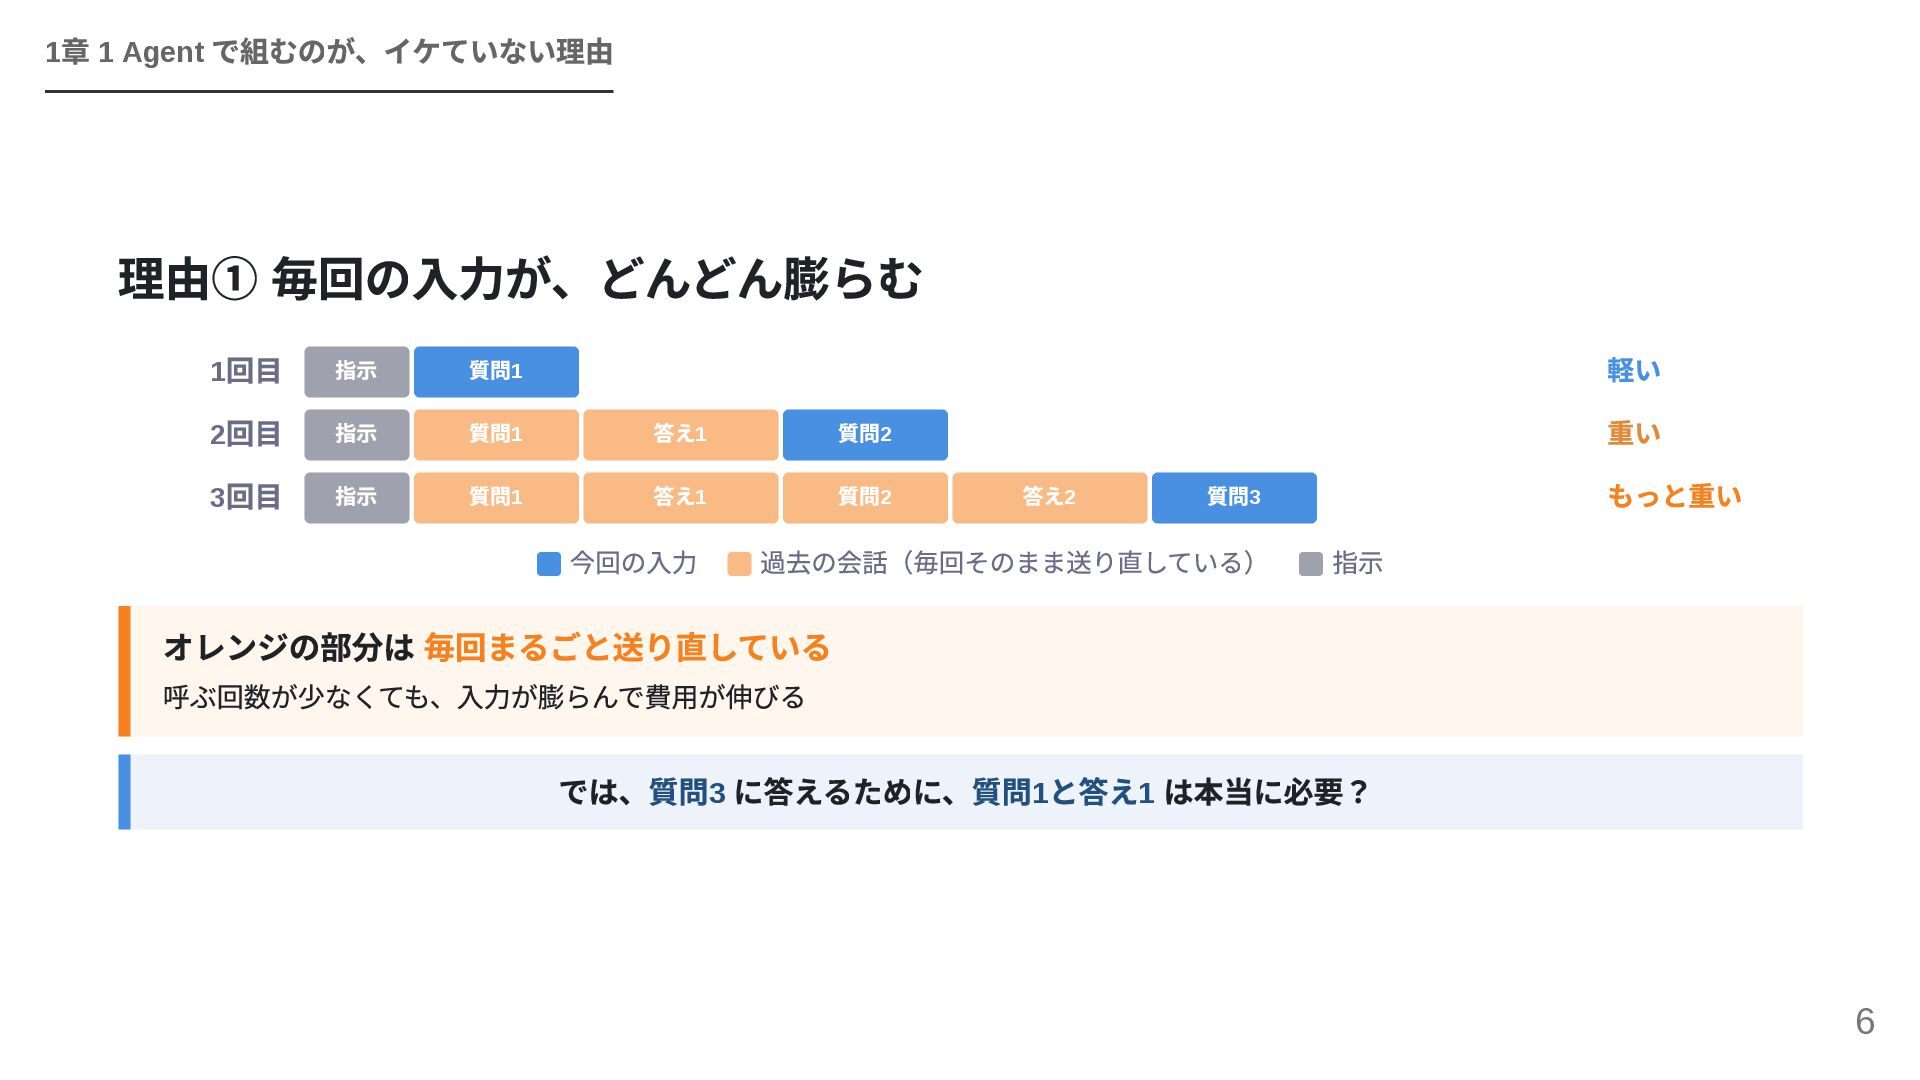
  4. 章 1 Agent で組むのが、イケていない理由 1 理由① 毎回の入力が、どんどん膨らむ 回目 2回目 3回目

    1 指示 指示 指示 質問1 質問1 質問1 答え1 答え1 今回の入力 質問2 質問2 答え2 質問3 過去の会話(毎回そのまま送り直している) 指示 軽い 重い もっと重い オレンジの部分は 毎回まるごと送り直している 呼ぶ回数が少なくても、入力が膨らんで費用が伸びる では、質問3 に答えるために、質問1と答え1 は本当に必要? 6
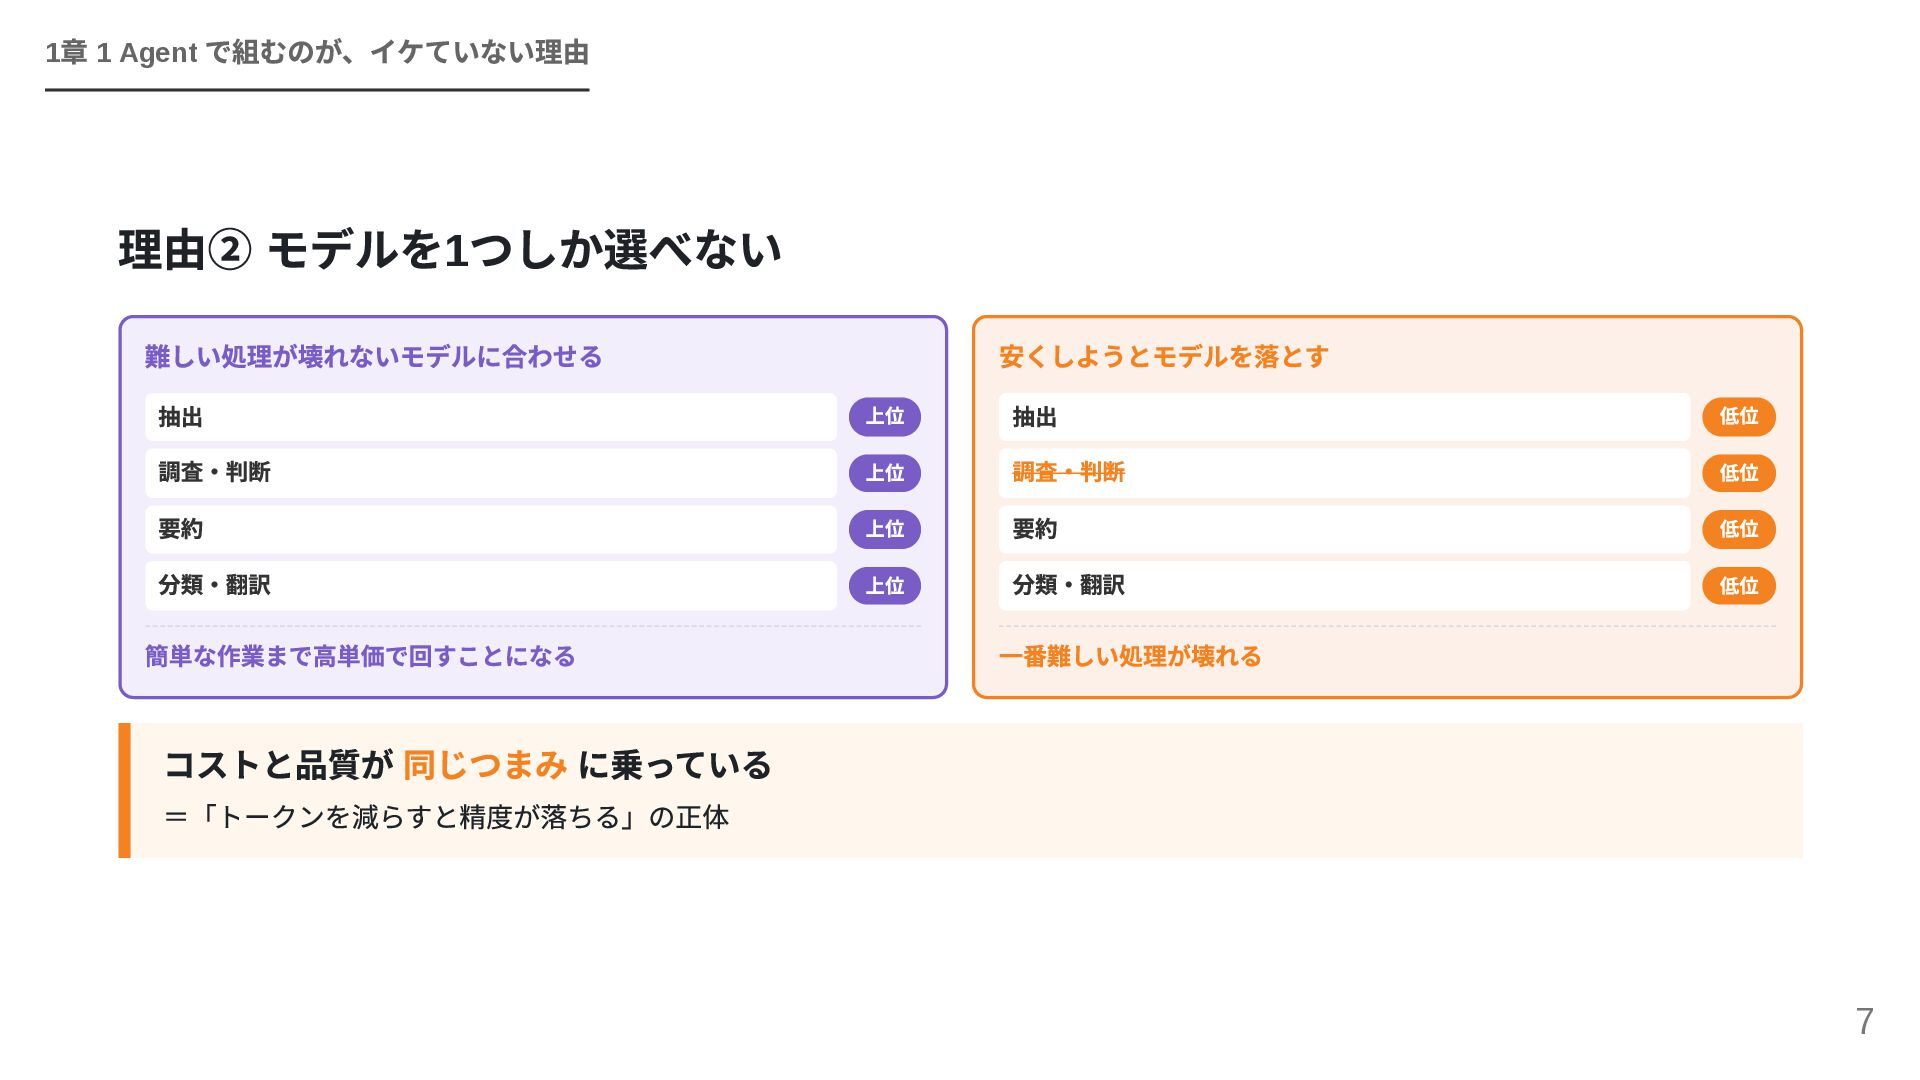
  5. 章 1 Agent で組むのが、イケていない理由 1 理由② モデルを1つしか選べない 難しい処理が壊れないモデルに合わせる 抽出 調査・判断

    要約 分類・翻訳 簡単な作業まで高単価で回すことになる 安くしようとモデルを落とす 上位 上位 上位 上位 抽出 調査・判断 要約 分類・翻訳 低位 低位 低位 低位 一番難しい処理が壊れる コストと品質が 同じつまみ に乗っている =「トークンを減らすと精度が落ちる」の正体 7
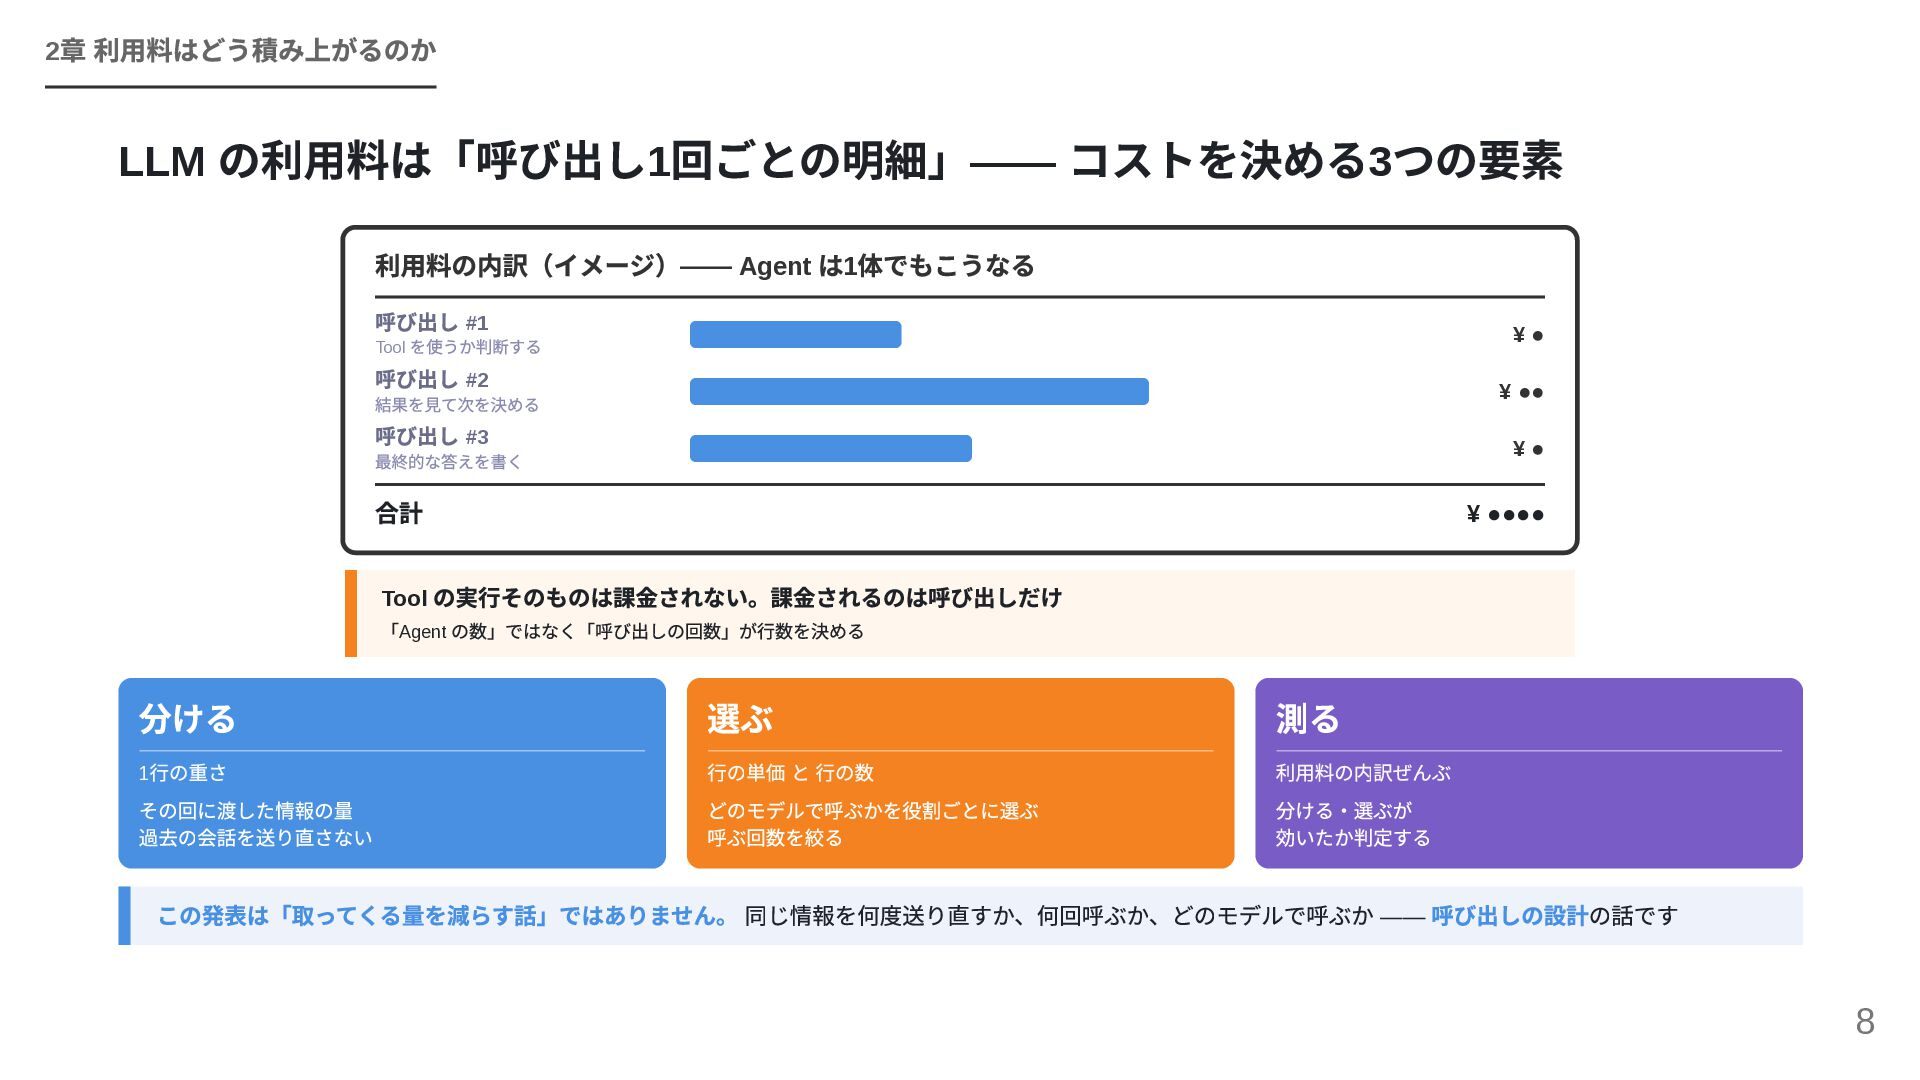
  6. 章 利用料はどう積み上がるのか 2 LLM の利用料は「呼び出し1回ごとの明細」―― コストを決める3つの要素 利用料の内訳(イメージ)―― Agent は1体でもこうなる 呼び出し

    #1 を使うか判断する 呼び出し #2 結果を見て次を決める 呼び出し #3 ¥• Tool ¥ •• ¥• 最終的な答えを書く 合計 Tool ¥ •••• の実行そのものは課金されない。課金されるのは呼び出しだけ 「Agent の数」ではなく「呼び出しの回数」が行数を決める 分ける 行の重さ その回に渡した情報の量 過去の会話を送り直さない 1 選ぶ 行の単価 と 行の数 どのモデルで呼ぶかを役割ごとに選ぶ 呼ぶ回数を絞る 測る 利用料の内訳ぜんぶ 分ける・選ぶが 効いたか判定する この発表は「取ってくる量を減らす話」ではありません。 同じ情報を何度送り直すか、何回呼ぶか、どのモデルで呼ぶか ―― 呼び出しの設計の話です 8
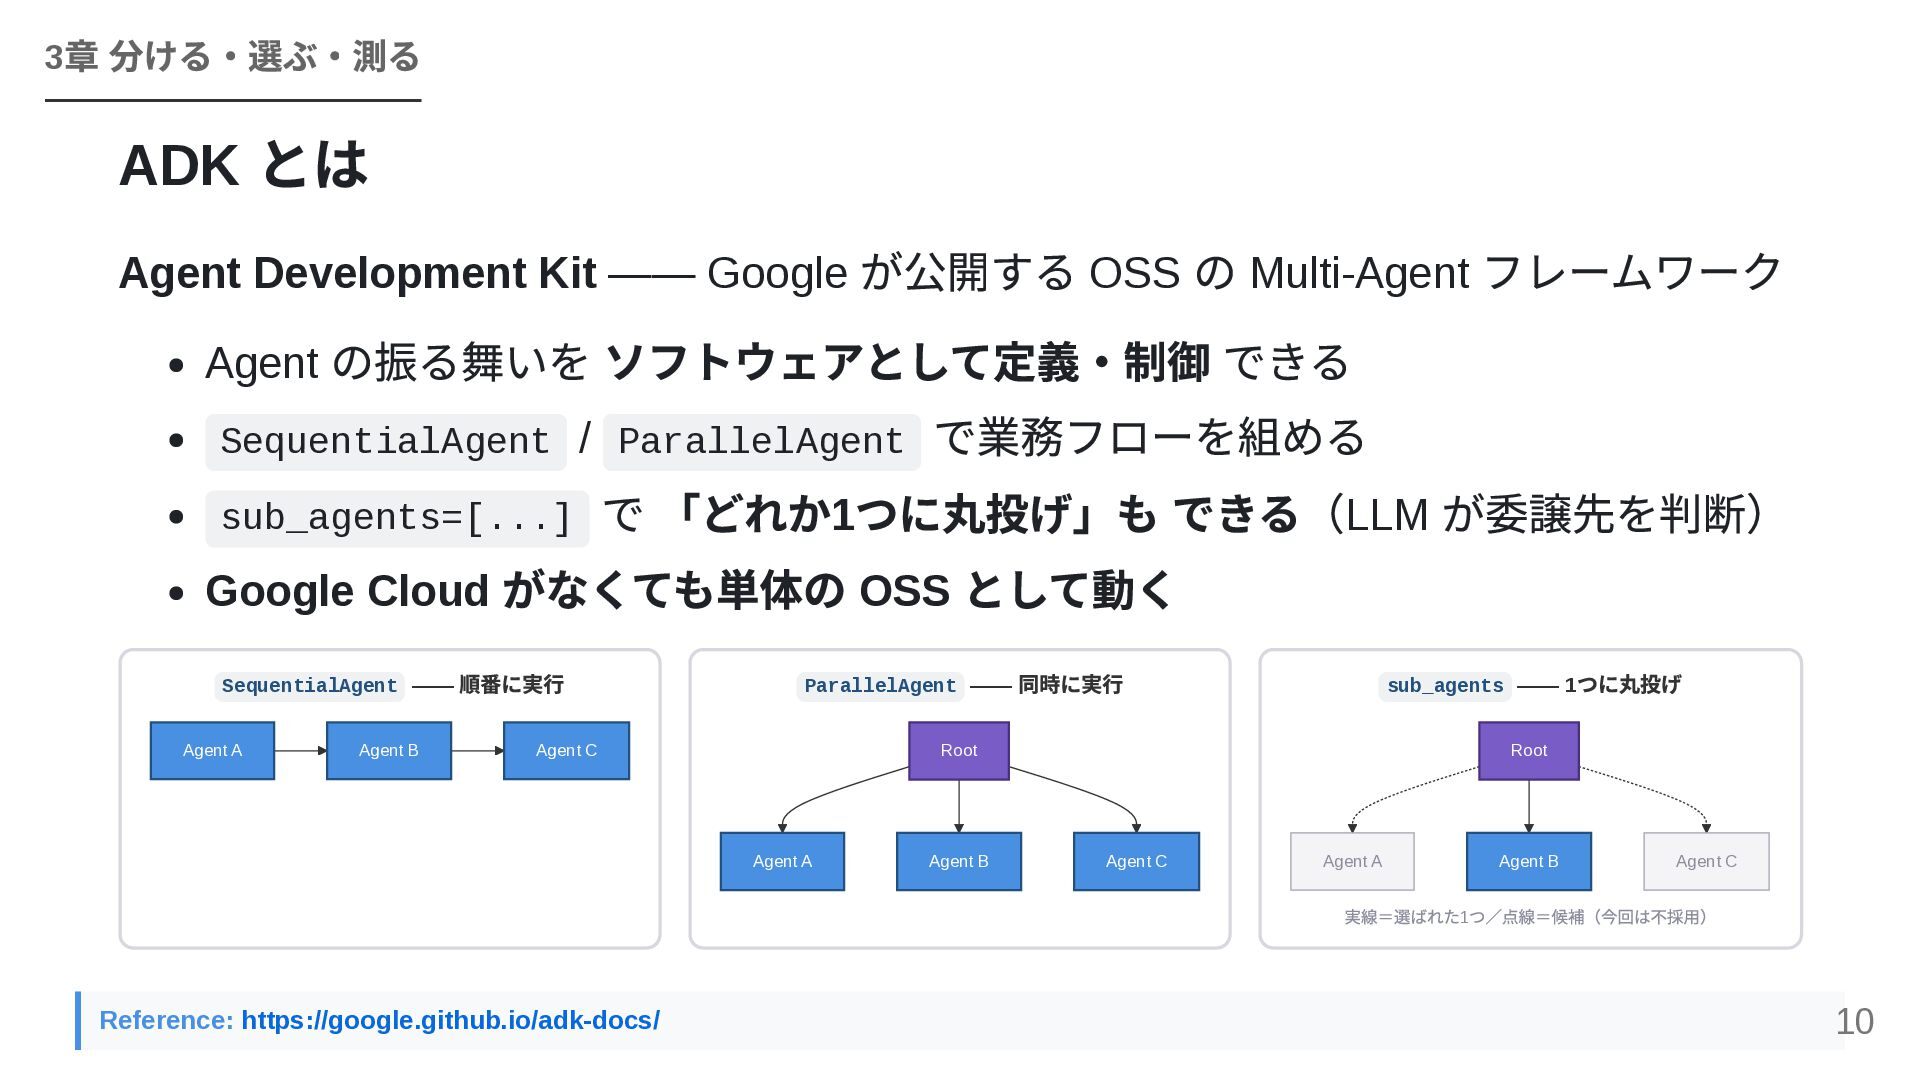
  7. 章 分ける・選ぶ・測る 3 ADK とは が公開する OSS の Multi-Agent フレームワーク

    Agent の振る舞いを ソフトウェアとして定義・制御 できる SequentialAgent / ParallelAgent で業務フローを組める sub_agents=[...] で 「どれか1つに丸投げ」も できる(LLM が委譲先を判断) Google Cloud がなくても単体の OSS として動く Agent Development Kit ―― Google SequentialAgent ―― Agent A Agent B 順番に実行 ParallelAgent ―― Agent C 同時に実行 sub_agents ―― 1 Root Agent A Agent B つに丸投げ Root Agent C Agent A Agent B Agent C 実線=選ばれた1つ/点線=候補(今回は不採用) Reference: https://google.github.io/adk-docs/ 10
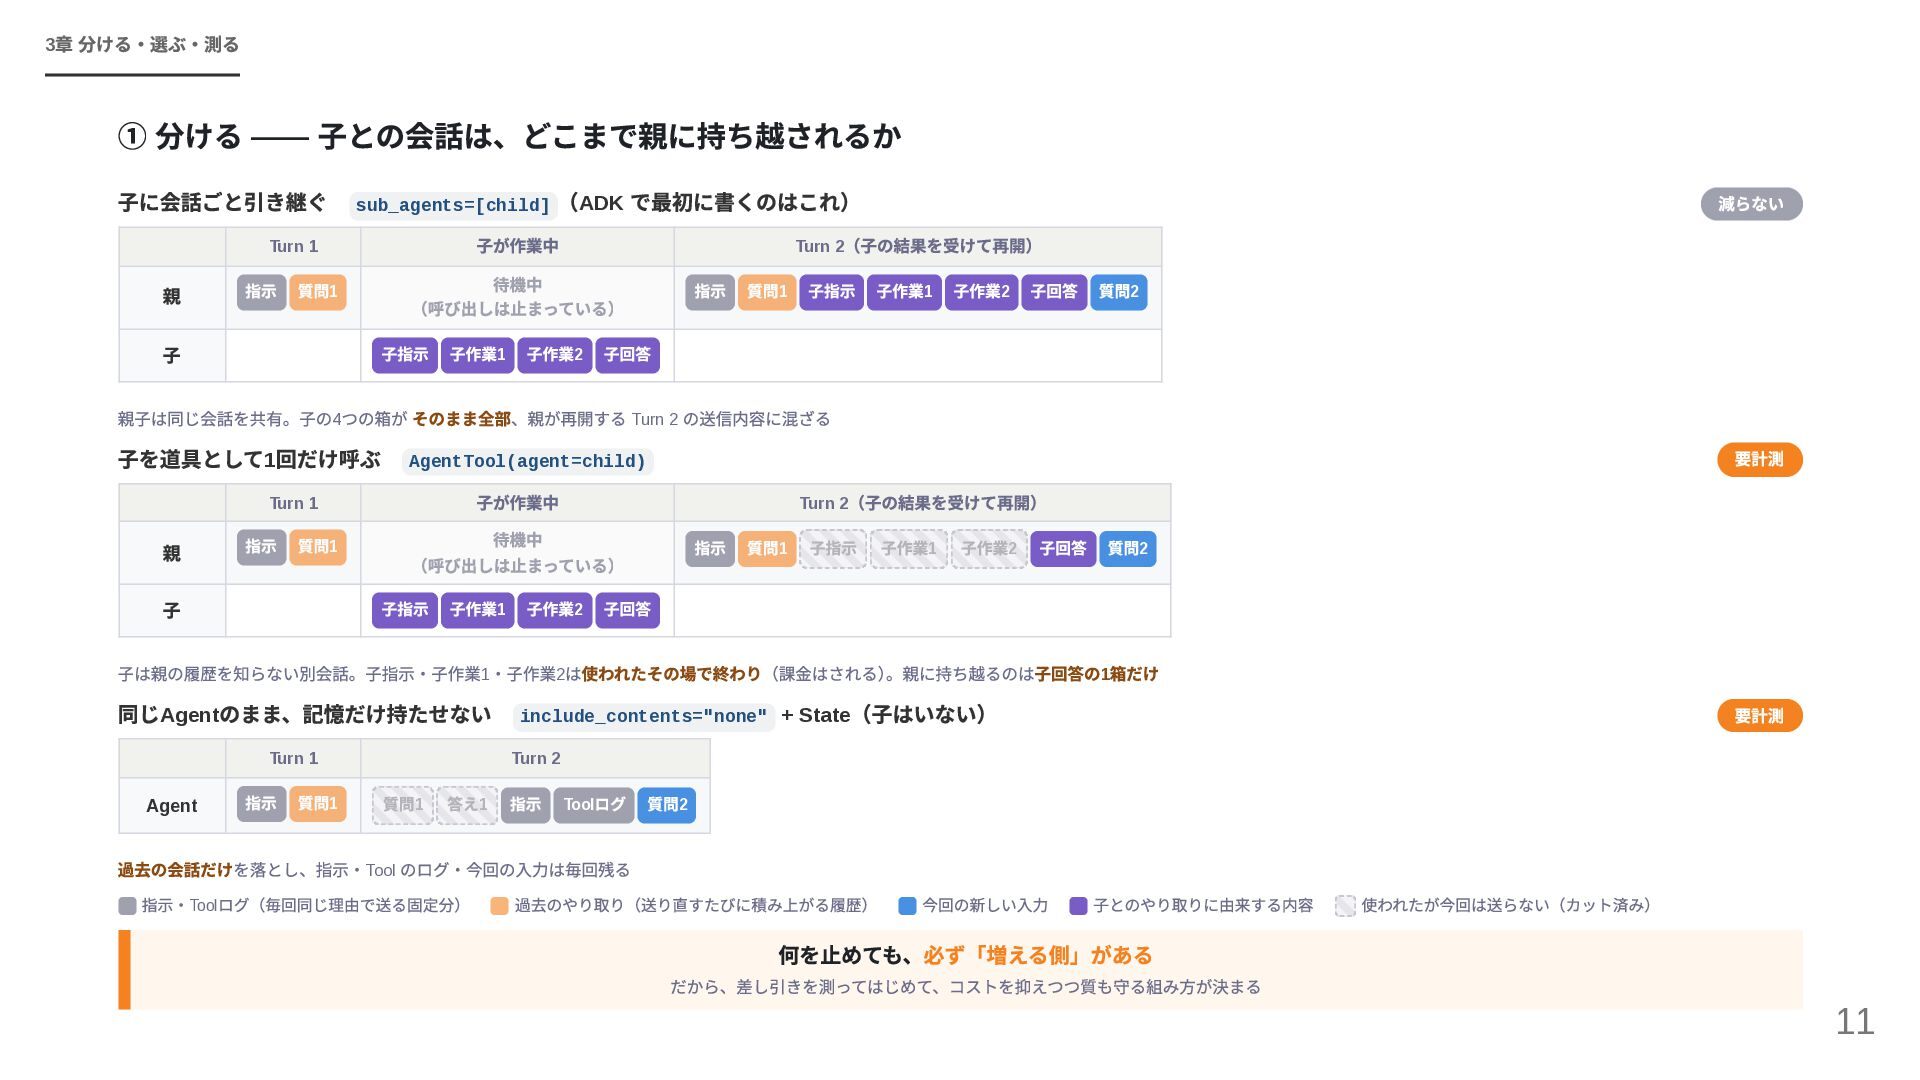
  8. 3 章 分ける・選ぶ・測る ① 分ける ―― 子との会話は、どこまで親に持ち越されるか 子に会話ごと引き継ぐ sub_agents=[child] (ADK

    で最初に書くのはこれ) Turn 1 親 指示 質問1 子 子が作業中 待機中 (呼び出しは止まっている) 子指示 子作業1 子作業2 子回答 減らない (子の結果を受けて再開) 指示 質問1 子指示 子作業1 子作業2 子回答 質問2 Turn 2 親子は同じ会話を共有。子の4つの箱が そのまま全部、親が再開する Turn 2 の送信内容に混ざる 子を道具として1回だけ呼ぶ AgentTool(agent=child) Turn 1 親 指示 質問1 子 子が作業中 待機中 (呼び出しは止まっている) 子指示 子作業1 子作業2 子回答 要計測 (子の結果を受けて再開) 指示 質問1 子指示 子作業1 子作業2 子回答 質問2 Turn 2 子は親の履歴を知らない別会話。子指示・子作業1・子作業2は使われたその場で終わり(課金はされる)。親に持ち越るのは子回答の1箱だけ 同じAgentのまま、記憶だけ持たせない include_contents="none" + State(子はいない) Agent Turn 1 Turn 2 指示 質問1 質問1 答え1 指示 Toolログ 質問2 過去の会話だけを落とし、指示・Tool のログ・今回の入力は毎回残る 指示・Toolログ(毎回同じ理由で送る固定分) 過去のやり取り(送り直すたびに積み上がる履歴) 今回の新しい入力 子とのやり取りに由来する内容 要計測 使われたが今回は送らない(カット済み) 何を止めても、必ず「増える側」がある だから、差し引きを測ってはじめて、コストを抑えつつ質も守る組み方が決まる 11
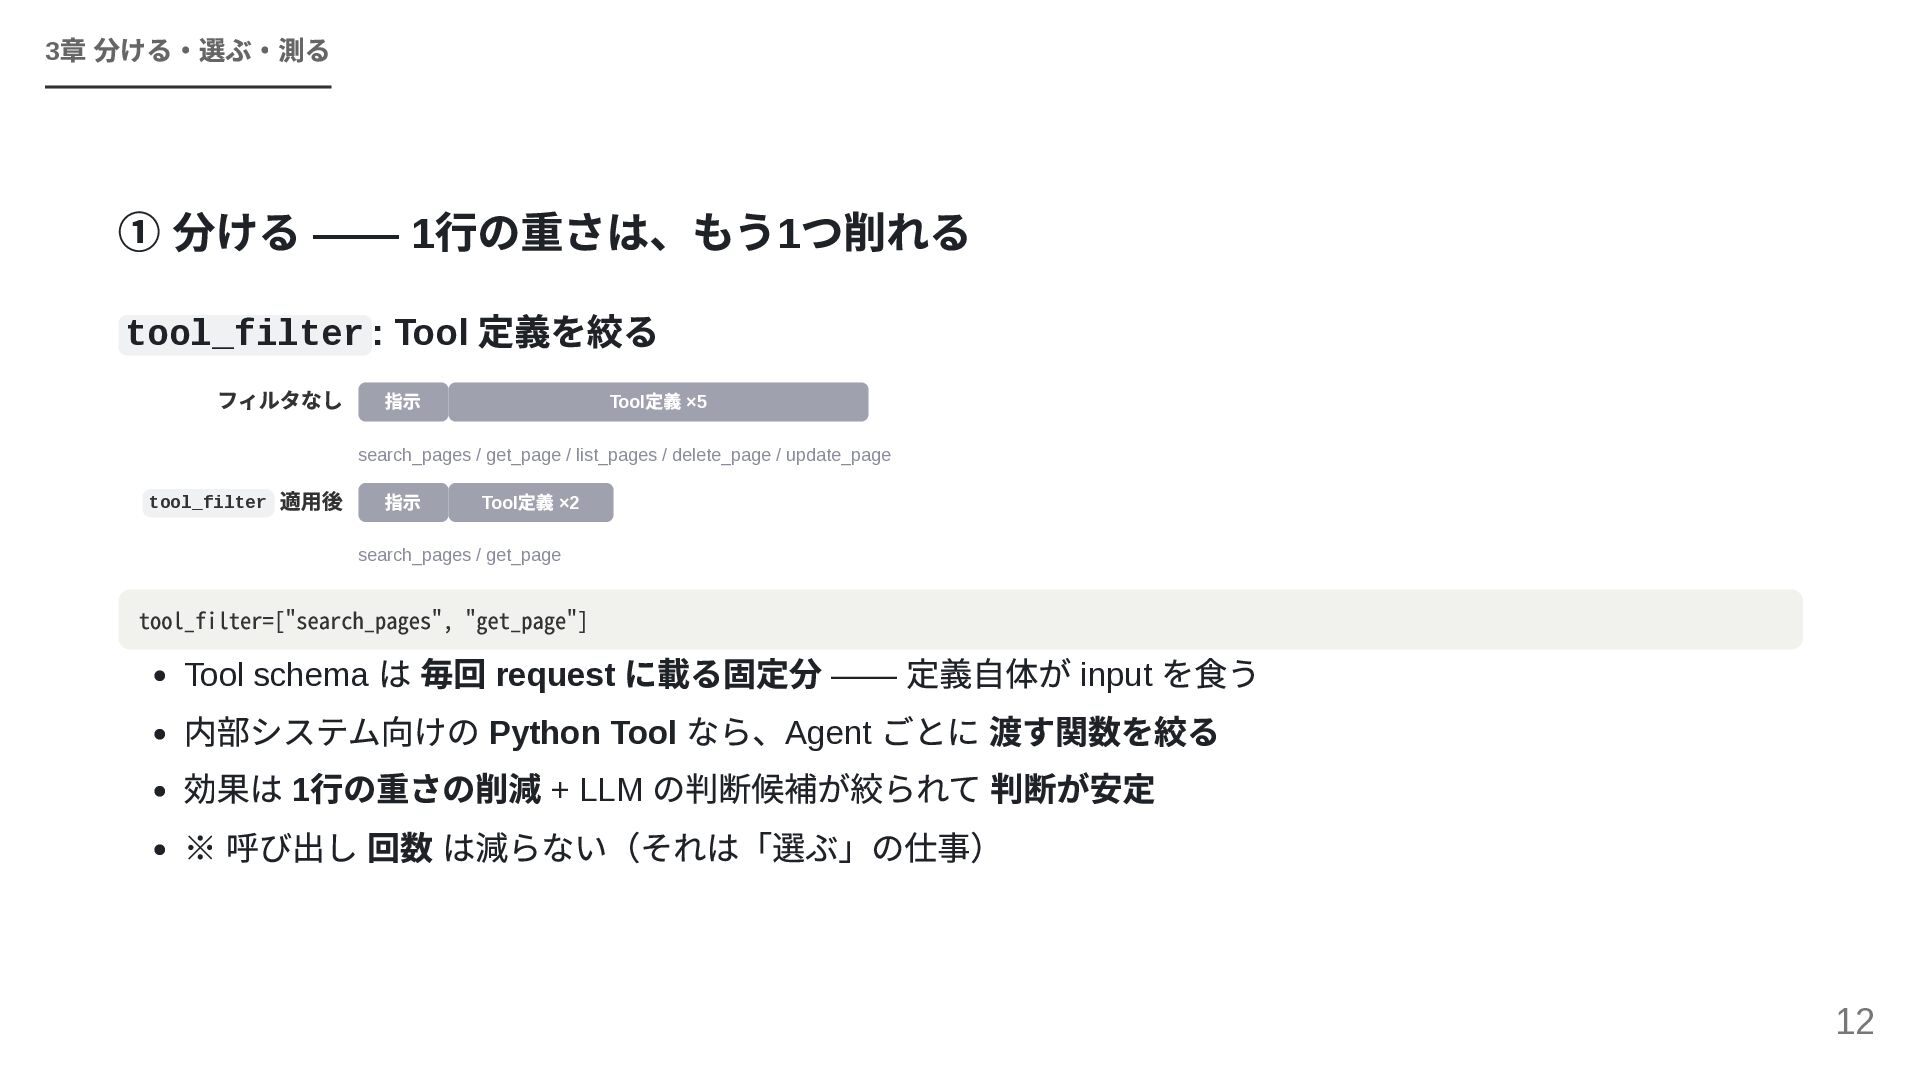
  9. 章 分ける・選ぶ・測る 3 ① 分ける ―― 1行の重さは、もう1つ削れる tool_filter : Tool

    フィルタなし 指示 定義を絞る Tool 定義 ×5 search_pages / get_page / list_pages / delete_page / update_page tool_filter 適用後 指示 Tool 定義 ×2 search_pages / get_page tool_filter=["search_pages", "get_page"] は 毎回 request に載る固定分 ―― 定義自体が input を食う 内部システム向けの Python Tool なら、Agent ごとに 渡す関数を絞る 効果は 1行の重さの削減 + LLM の判断候補が絞られて 判断が安定 ※ 呼び出し 回数 は減らない(それは「選ぶ」の仕事) Tool schema 12
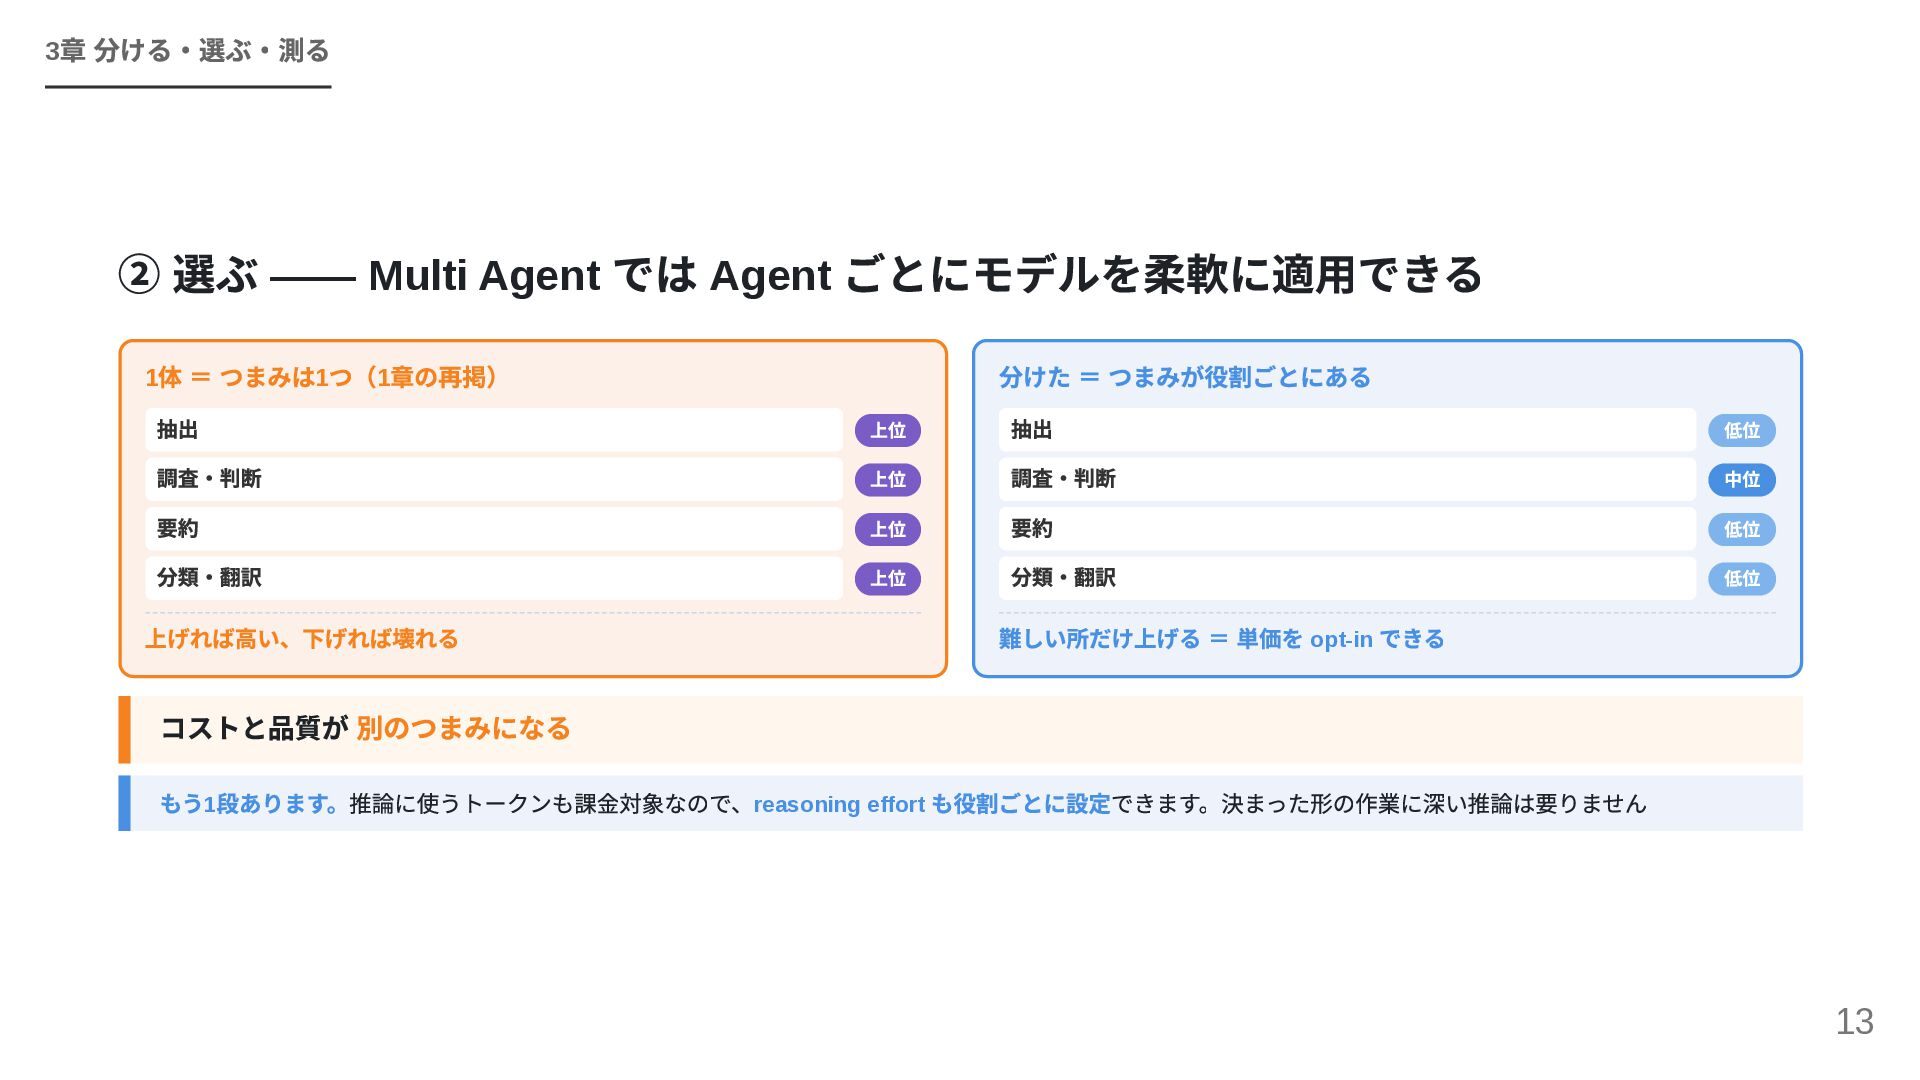
  10. 章 分ける・選ぶ・測る 3 ② 選ぶ ―― Multi Agent では Agent

    ごとにモデルを柔軟に適用できる 1 体 = つまみは1つ(1章の再掲) 抽出 調査・判断 要約 分類・翻訳 上げれば高い、下げれば壊れる 上位 上位 上位 上位 分けた = つまみが役割ごとにある 抽出 調査・判断 要約 分類・翻訳 低位 中位 低位 低位 難しい所だけ上げる = 単価を opt-in できる コストと品質が 別のつまみになる もう1段あります。推論に使うトークンも課金対象なので、reasoning effort も役割ごとに設定できます。決まった形の作業に深い推論は要りません 13
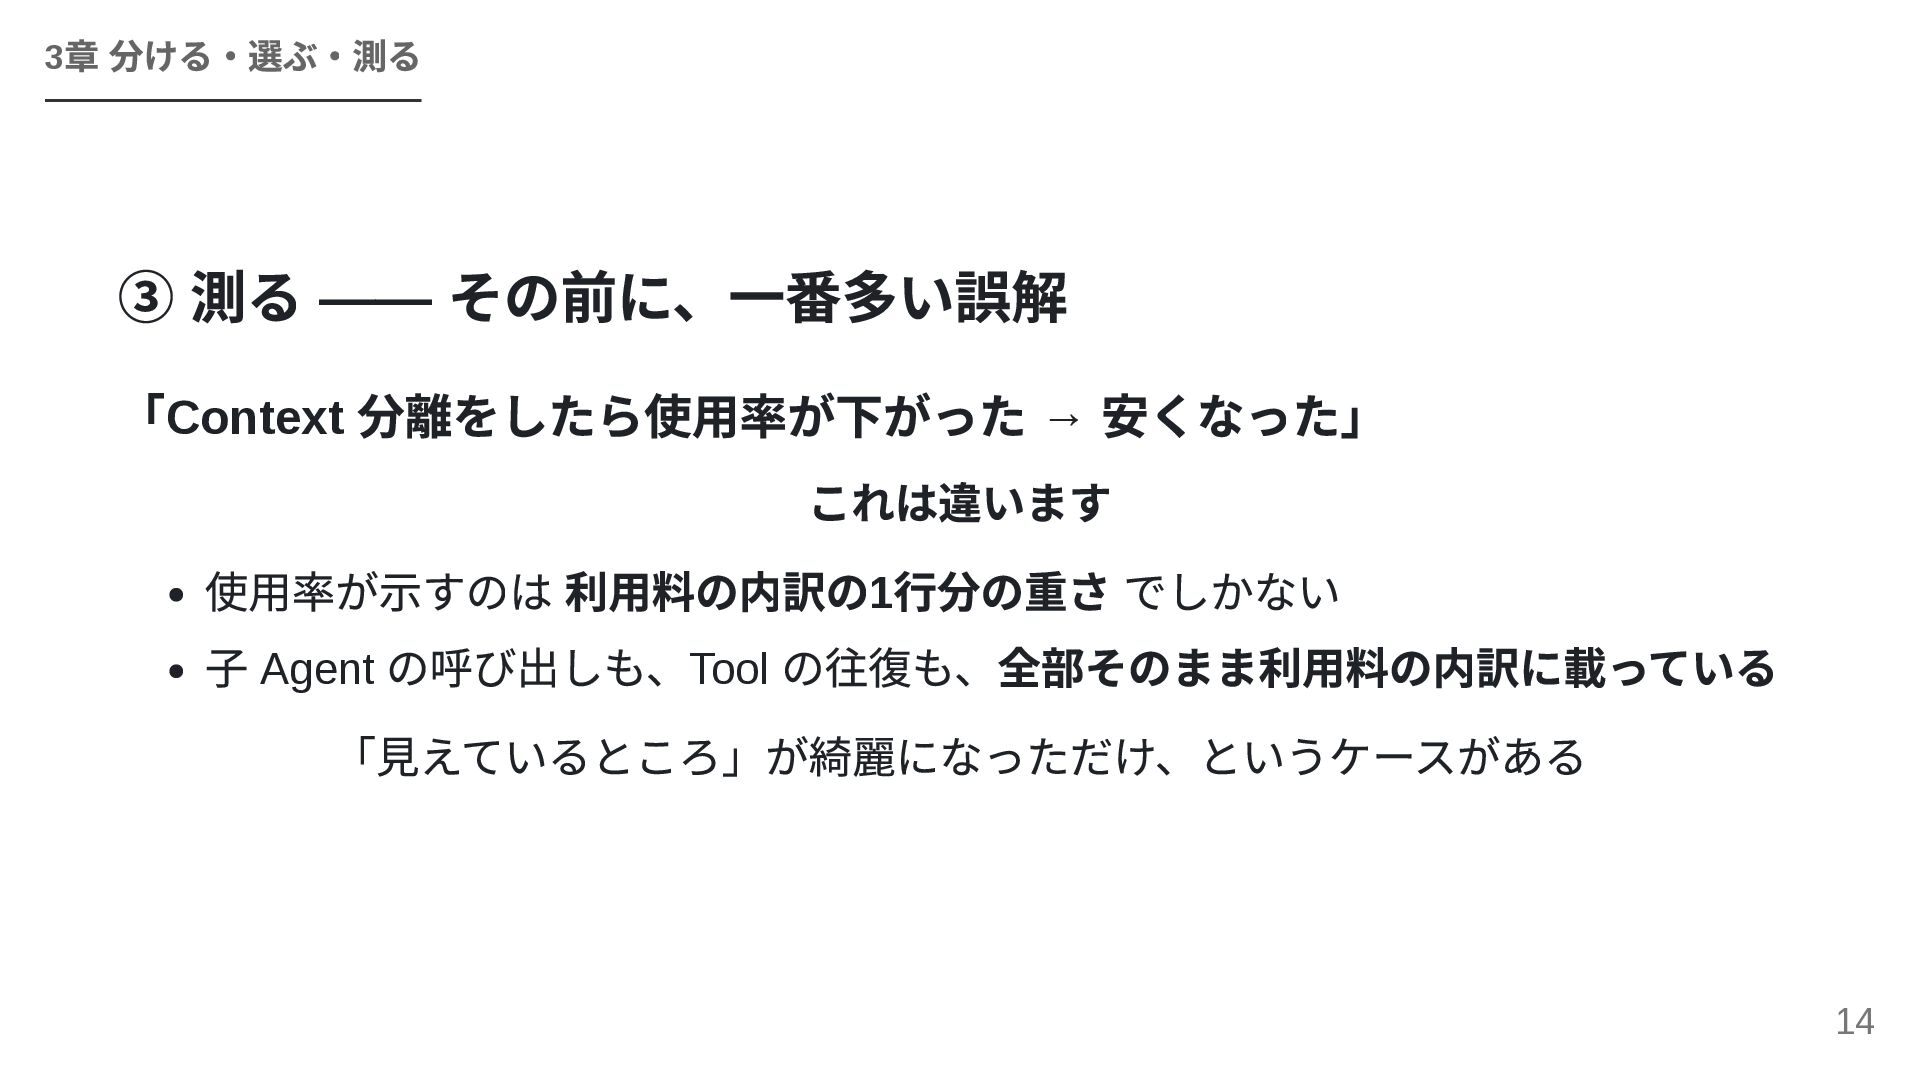
  11. 章 分ける・選ぶ・測る 3 ③ 測る ―― その前に、一番多い誤解 「Context 分離をしたら使用率が下がった →

    安くなった」 これは違います 使用率が示すのは 利用料の内訳の1行分の重さ でしかない 子 Agent の呼び出しも、Tool の往復も、全部そのまま利用料の内訳に載っている 「見えているところ」が綺麗になっただけ、というケースがある 14
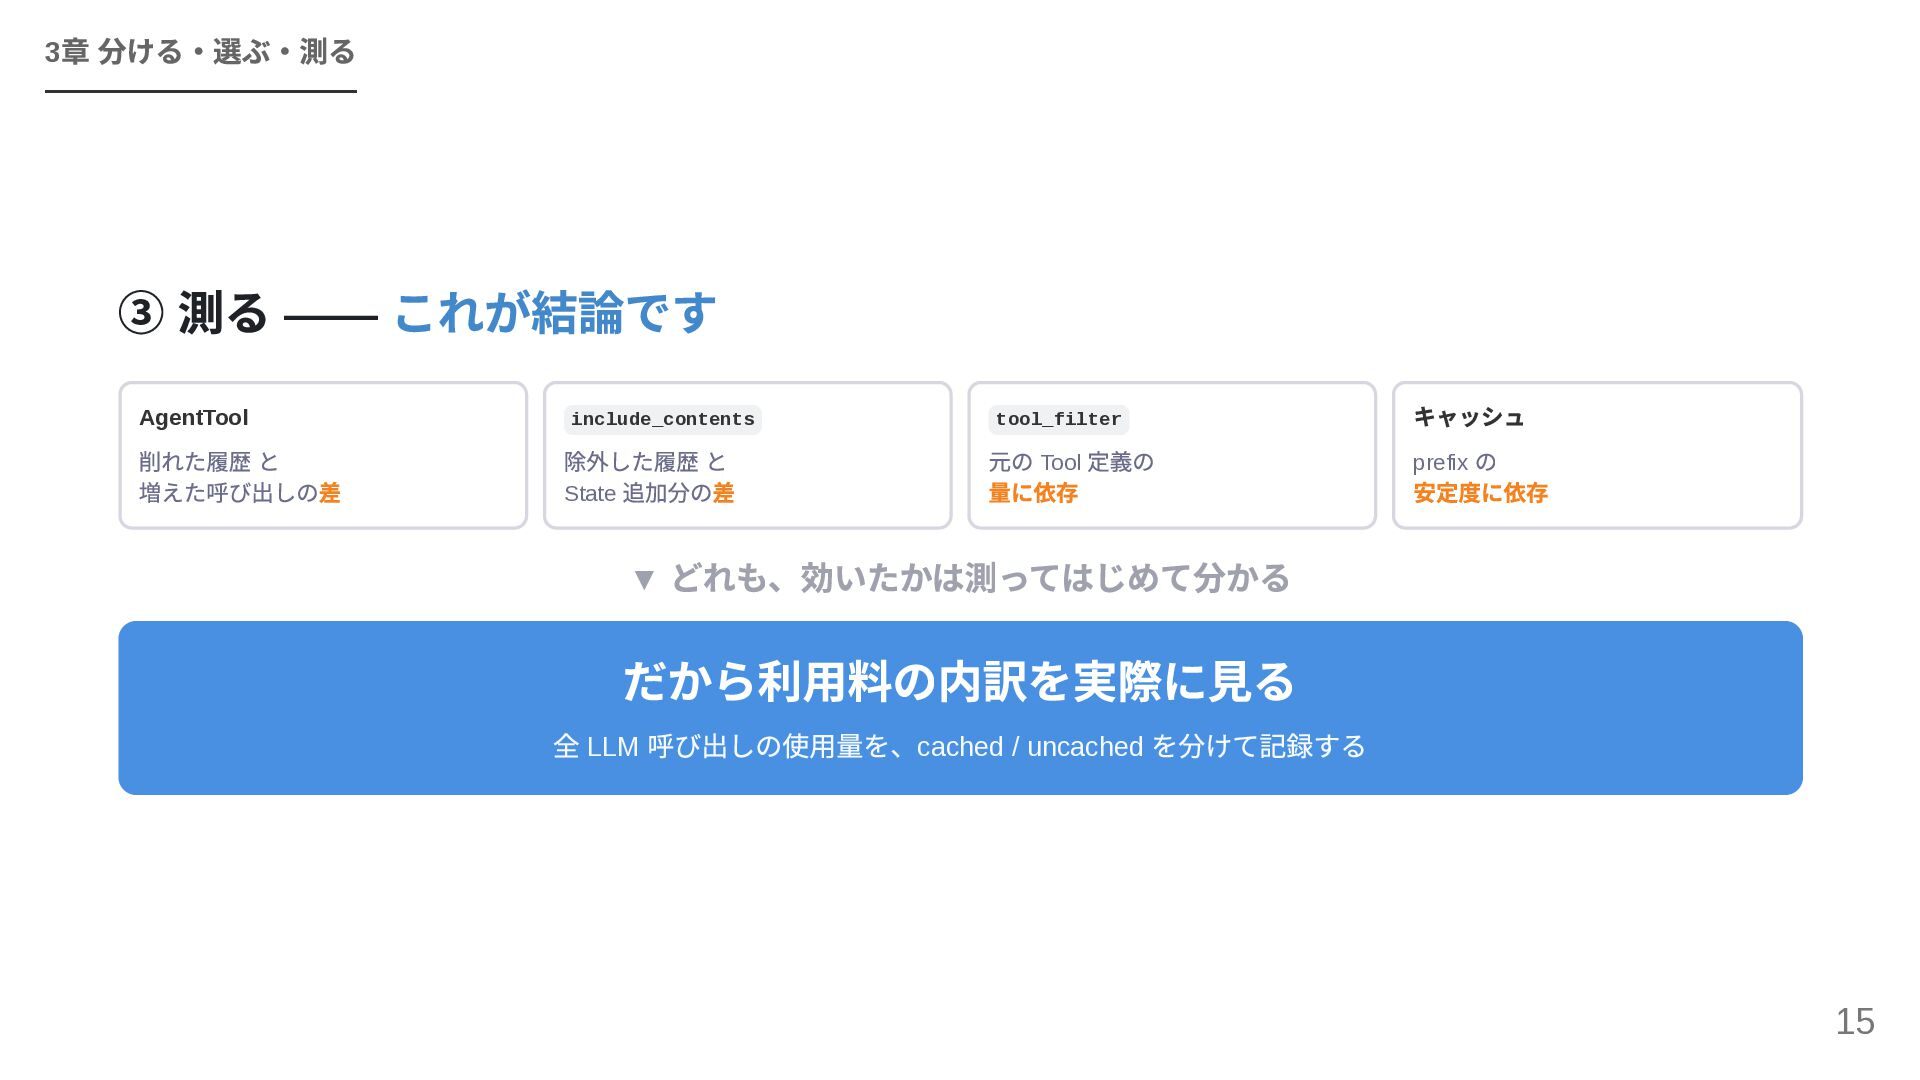
  12. 章 分ける・選ぶ・測る 3 ③ 測る ―― これが結論です AgentTool 削れた履歴 と

    増えた呼び出しの差 include_contents 除外した履歴 と State 追加分の差 ▼ tool_filter 元の Tool 定義の 量に依存 キャッシュ prefix の 安定度に依存 どれも、効いたかは測ってはじめて分かる だから利用料の内訳を実際に見る 全 LLM 呼び出しの使用量を、cached / uncached を分けて記録する 15
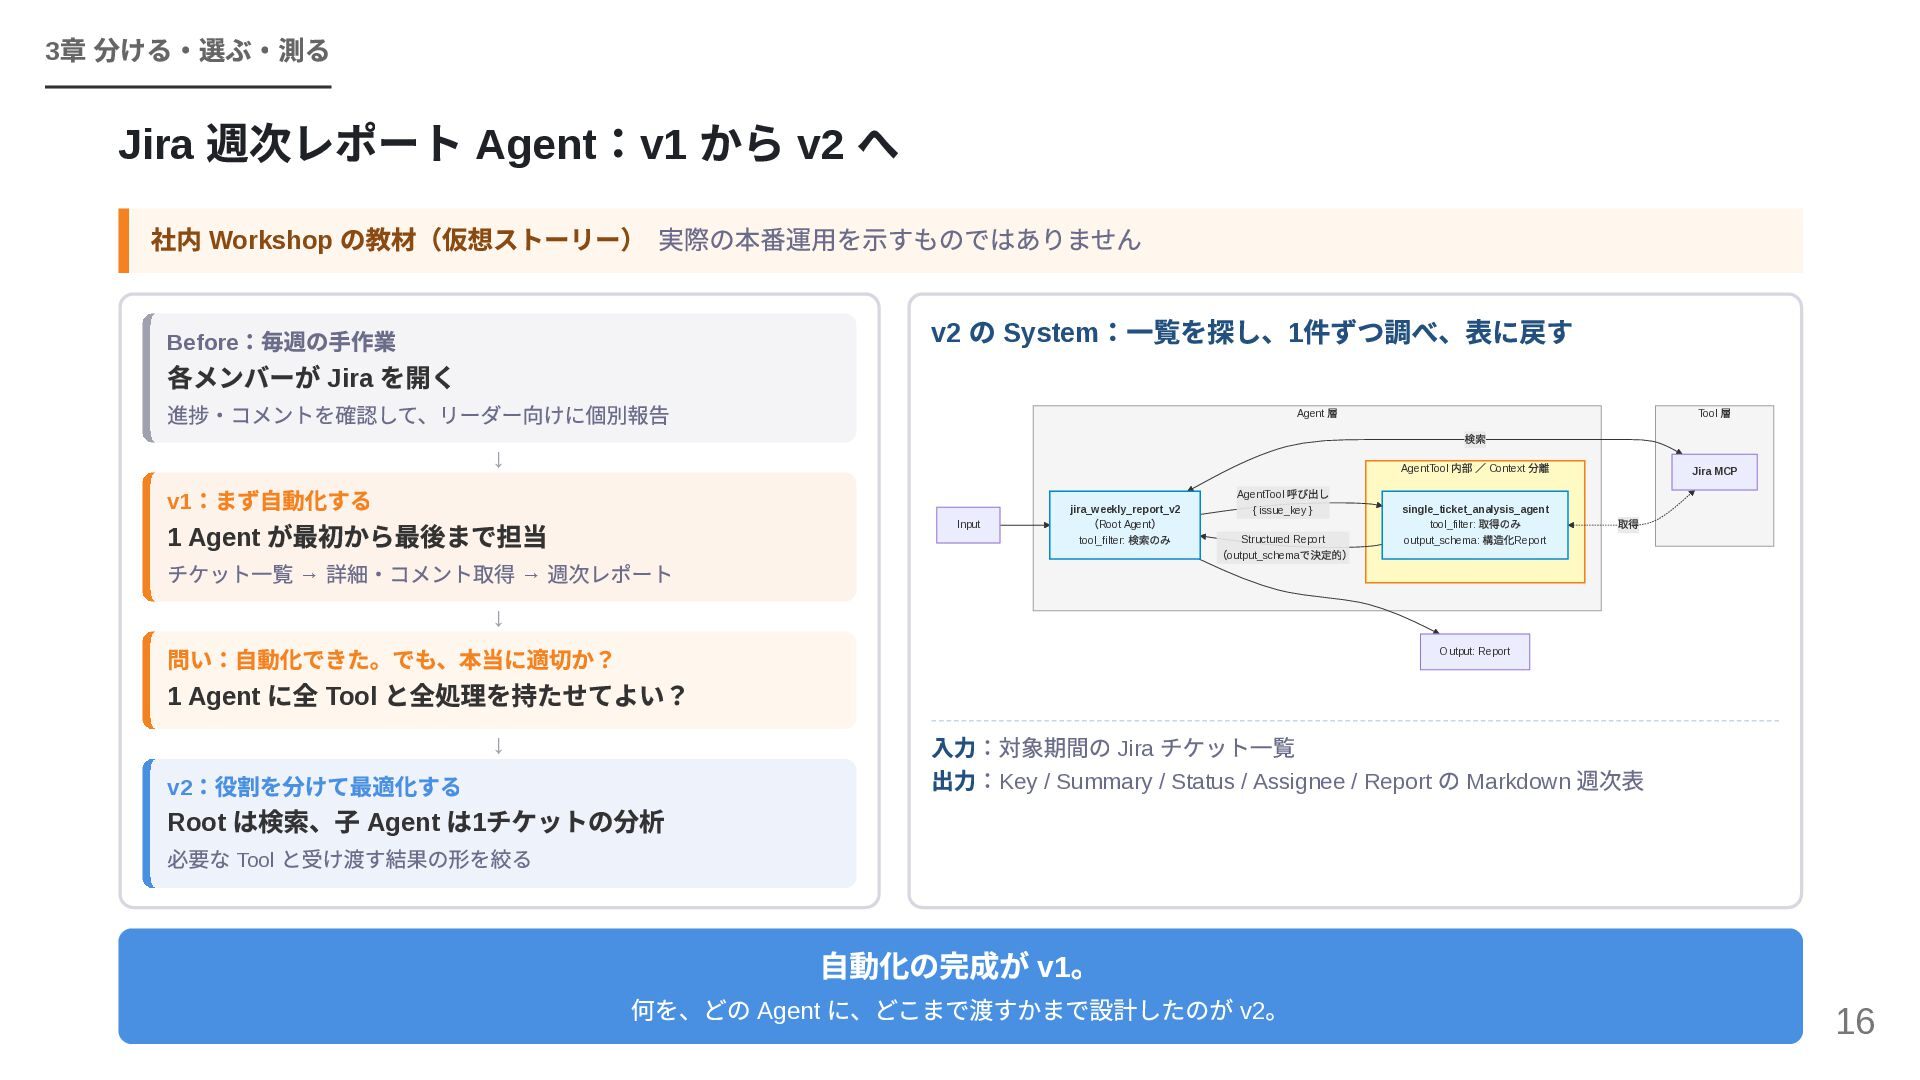
  13. 章 分ける・選ぶ・測る 3 Jira 週次レポート Agent:v1 から v2 へ 社内

    Workshop の教材(仮想ストーリー) 実際の本番運用を示すものではありません Before :毎週の手作業 v2 各メンバーが Jira を開く の System:一覧を探し、1件ずつ調べ、表に戻す 進捗・コメントを確認して、リーダー向けに個別報告 v1 :まず自動化する 1 Agent Agent 層 ↓ が最初から最後まで担当 Input チケット一覧 → 詳細・コメント取得 → 週次レポート jira_weekly_report_v2 Root Agent tool_filter: ( ) 検索のみ 呼び出し AgentTool { issue_key } ( Structured Report output_schema で決定的) Tool 検索 AgentTool 内部 ∕ Context 分離 single_ticket_analysis_agent tool_filter: output_schema: Report 取得のみ 構造化 層 Jira MCP 取得 ↓ 問い:自動化できた。でも、本当に適切か? 1 Agent v2 に全 Tool と全処理を持たせてよい? :役割を分けて最適化する Root ↓ は検索、子 Agent は1チケットの分析 Output: Report 入力:対象期間の Jira チケット一覧 出力:Key / Summary / Status / Assignee / Report の Markdown 週次表 必要な Tool と受け渡す結果の形を絞る 自動化の完成が v1。 何を、どの Agent に、どこまで渡すかまで設計したのが v2。 16
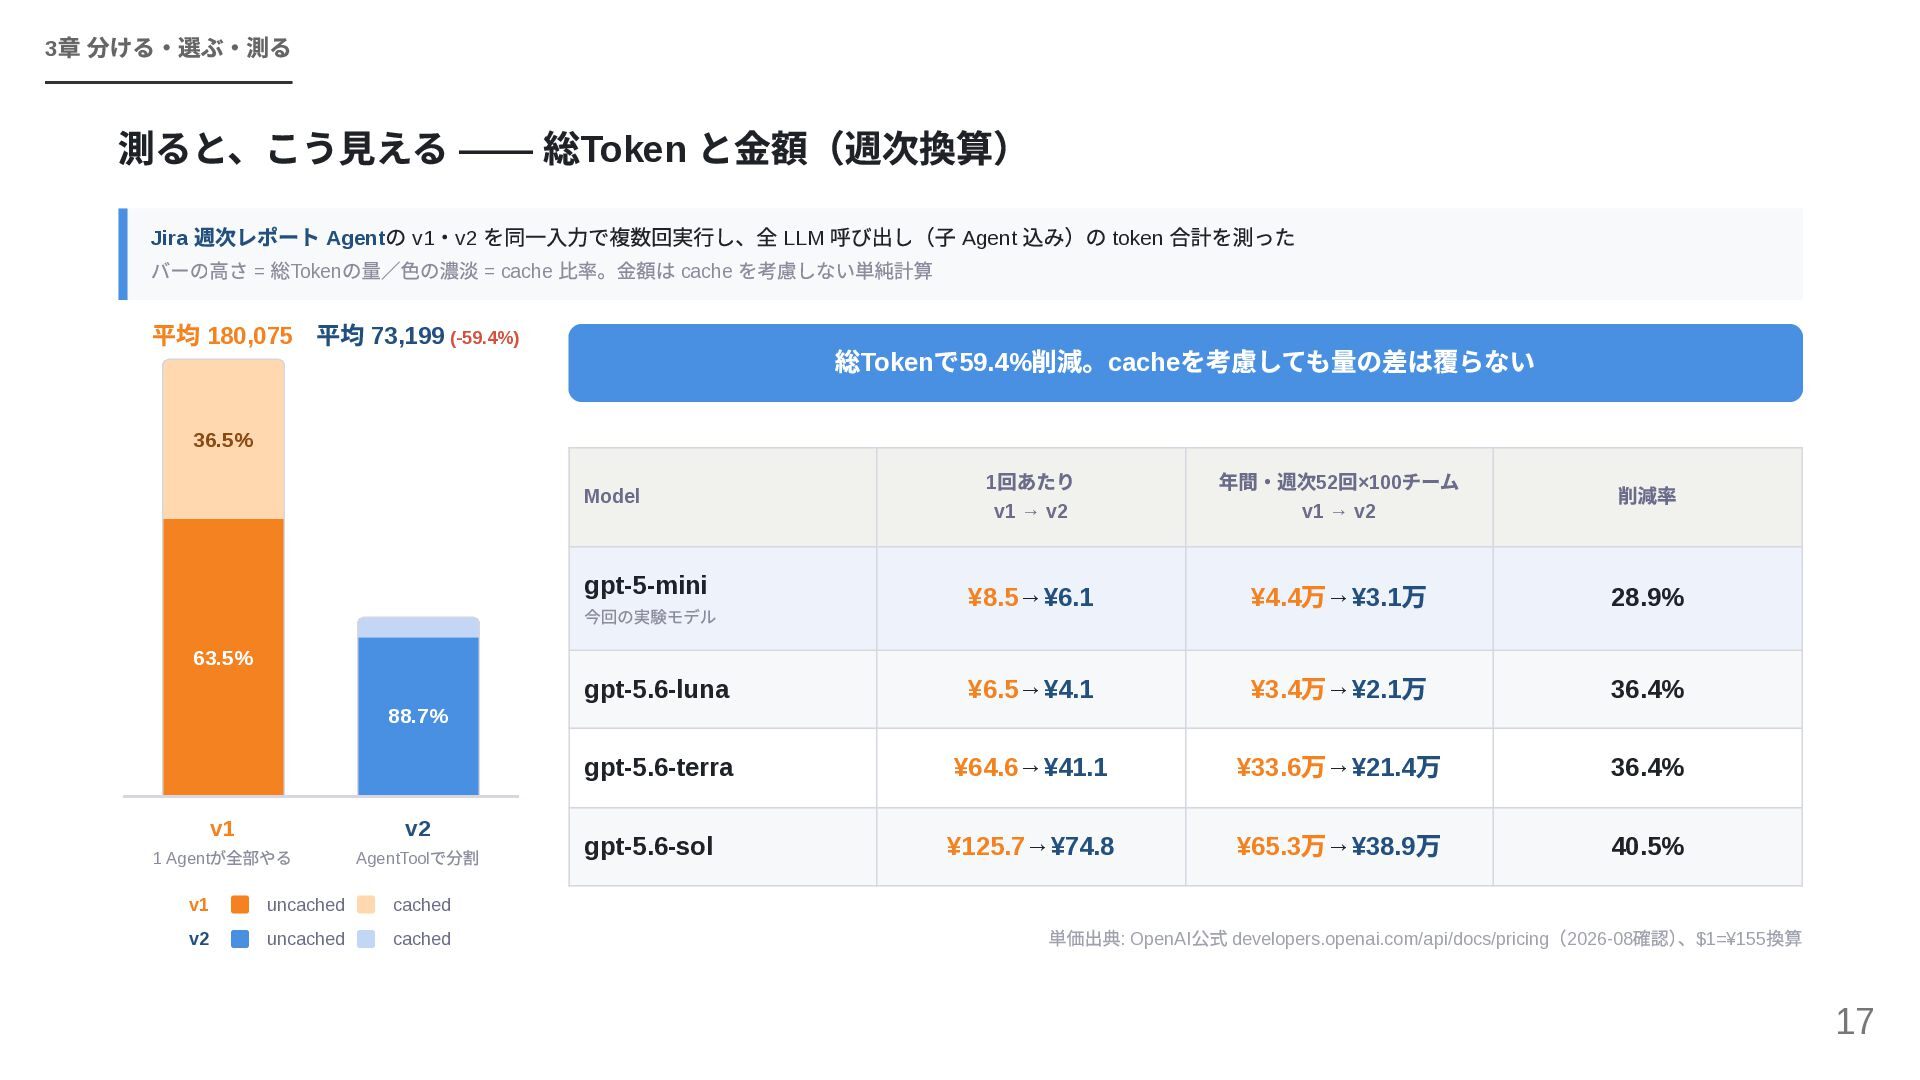
  14. 章 分ける・選ぶ・測る 3 測ると、こう見える ―― 総Token と金額(週次換算) Jira 週次レポート Agentの

    v1・v2 を同一入力で複数回実行し、全 LLM 呼び出し(子 Agent 込み)の token 合計を測った バーの高さ = 総Tokenの量/色の濃淡 = cache 比率。金額は cache を考慮しない単純計算 平均 180,075 平均 73,199 総Tokenで59.4%削減。cacheを考慮しても量の差は覆らない (-59.4%) 36.5% Model 回あたり 1 v1 → v2 年間・週次52回×100チーム v1 → v2 gpt-5-mini 今回の実験モデル ¥8.5→¥6.1 ¥4.4 万→¥3.1万 28.9% gpt-5.6-luna ¥6.5→¥4.1 ¥3.4 万→¥2.1万 36.4% gpt-5.6-terra ¥64.6→¥41.1 ¥33.6 万→¥21.4万 36.4% gpt-5.6-sol ¥125.7→¥74.8 ¥65.3 万→¥38.9万 40.5% 63.5% 88.7% v1 が全部やる 1 Agent v2 で分割 AgentTool v1 uncached cached v2 uncached cached 削減率 単価出典: OpenAI公式 developers.openai.com/api/docs/pricing(2026-08確認)、$1=¥155換算 17
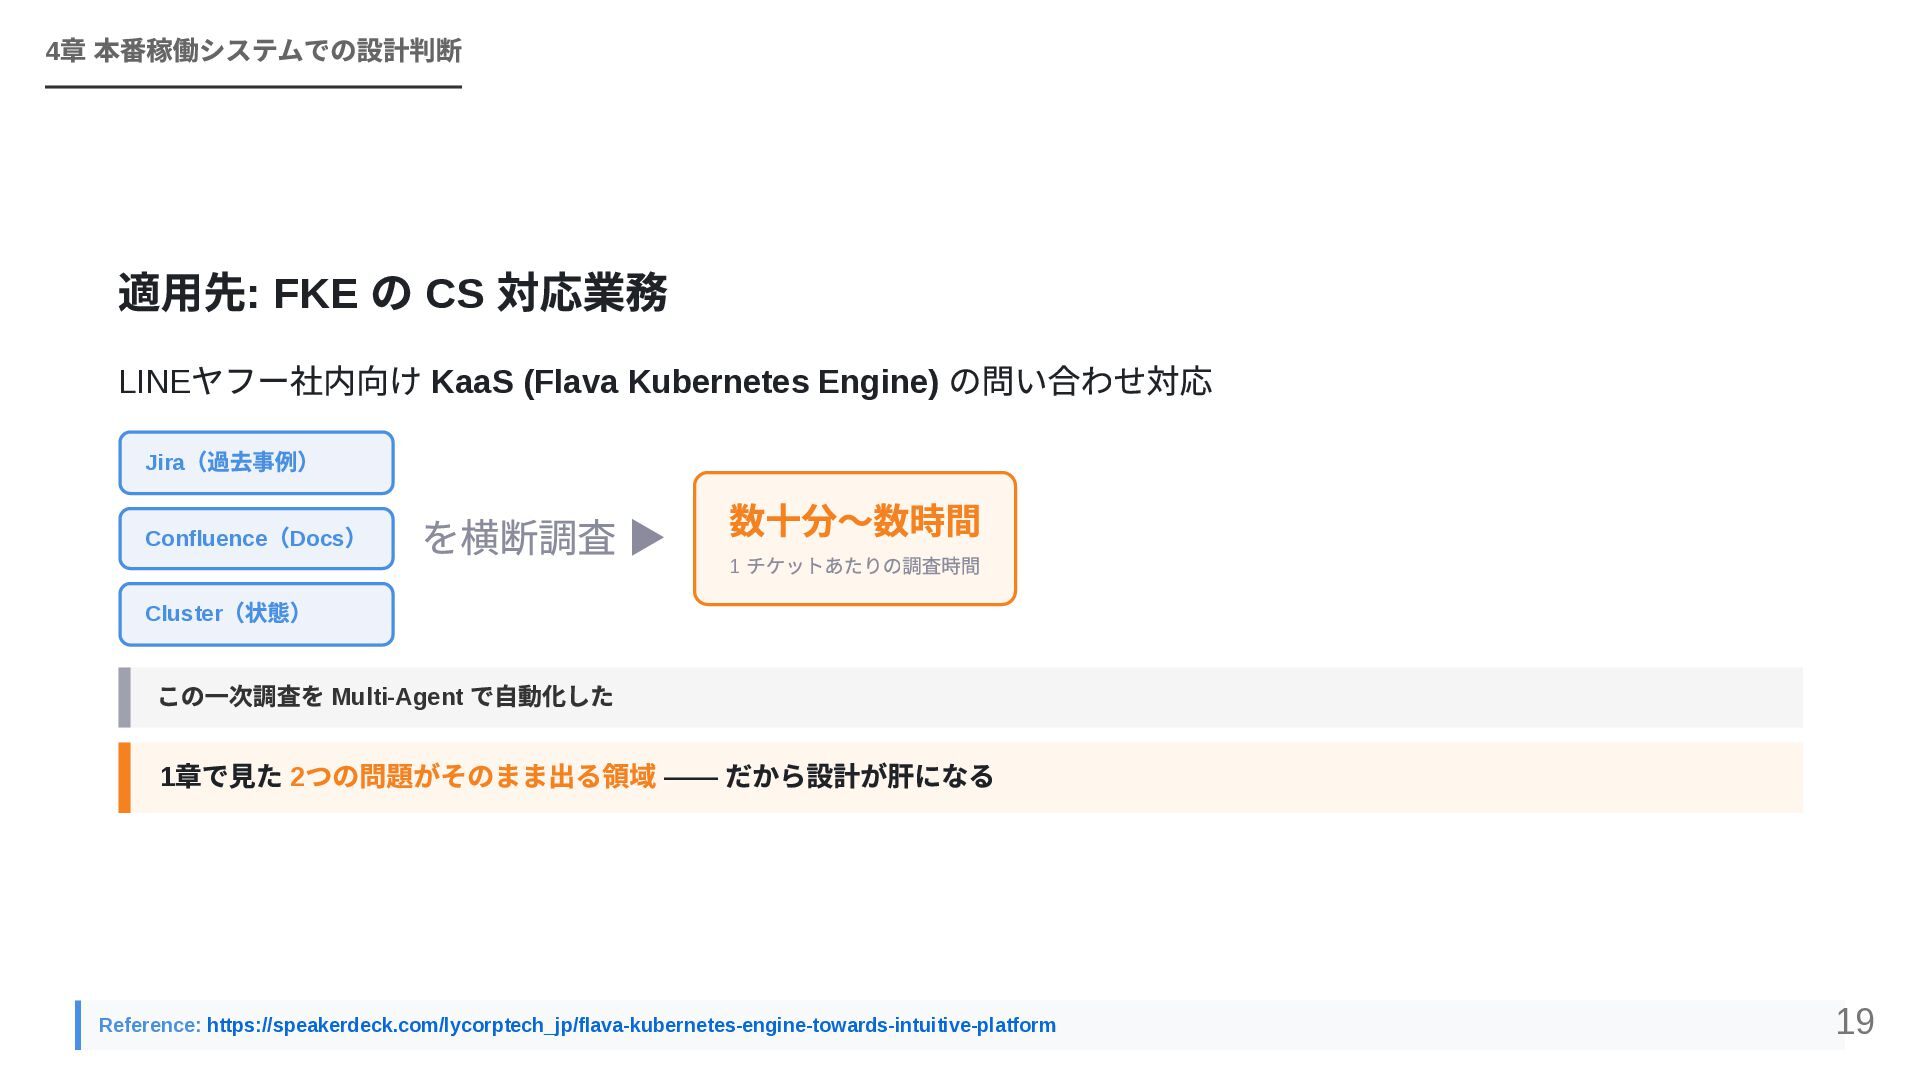
  15. 章 本番稼働システムでの設計判断 4 適用先: FKE の CS 対応業務 LINE ヤフー社内向け

    KaaS (Flava Kubernetes Engine) の問い合わせ対応 (過去事例) Jira Confluence Cluster (Docs) (状態) を横断調査 ▶ 数十分〜数時間 チケットあたりの調査時間 1 この一次調査を Multi-Agent で自動化した 1 章で見た 2つの問題がそのまま出る領域 ―― だから設計が肝になる Reference: https://speakerdeck.com/lycorptech_jp/flava-kubernetes-engine-towards-intuitive-platform 19
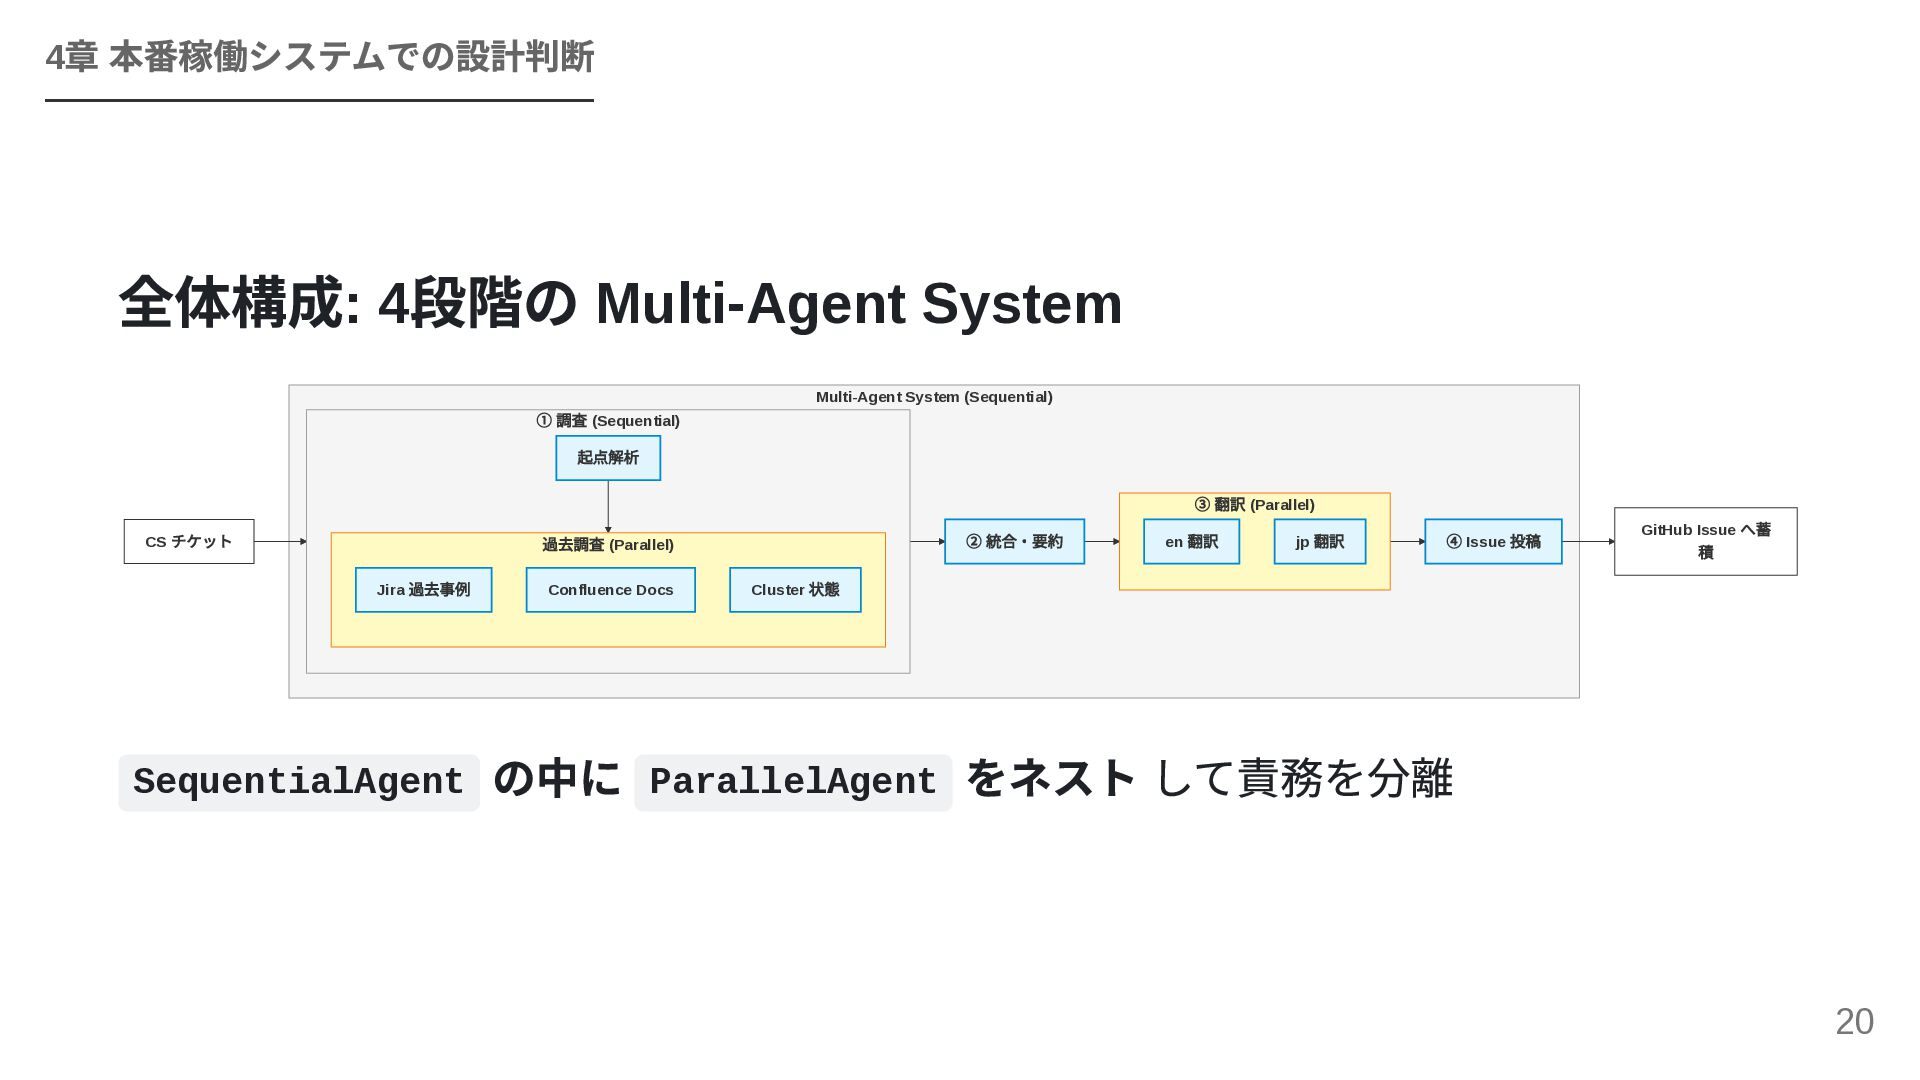
  16. 章 本番稼働システムでの設計判断 4 全体構成: 4段階の Multi-Agent System Multi-Agent System (Sequential)

    ① 調査 (Sequential) 起点解析 CS チケット ② 統合‧要約 過去調査 (Parallel) Jira 過去事例 SequentialAgent Confluence Docs Cluster ③ 翻訳 (Parallel) en 翻訳 jp 翻訳 ④ Issue 投稿 状態 GitHub Issue 積 へ蓄 の中に ParallelAgent をネスト して責務を分離 20
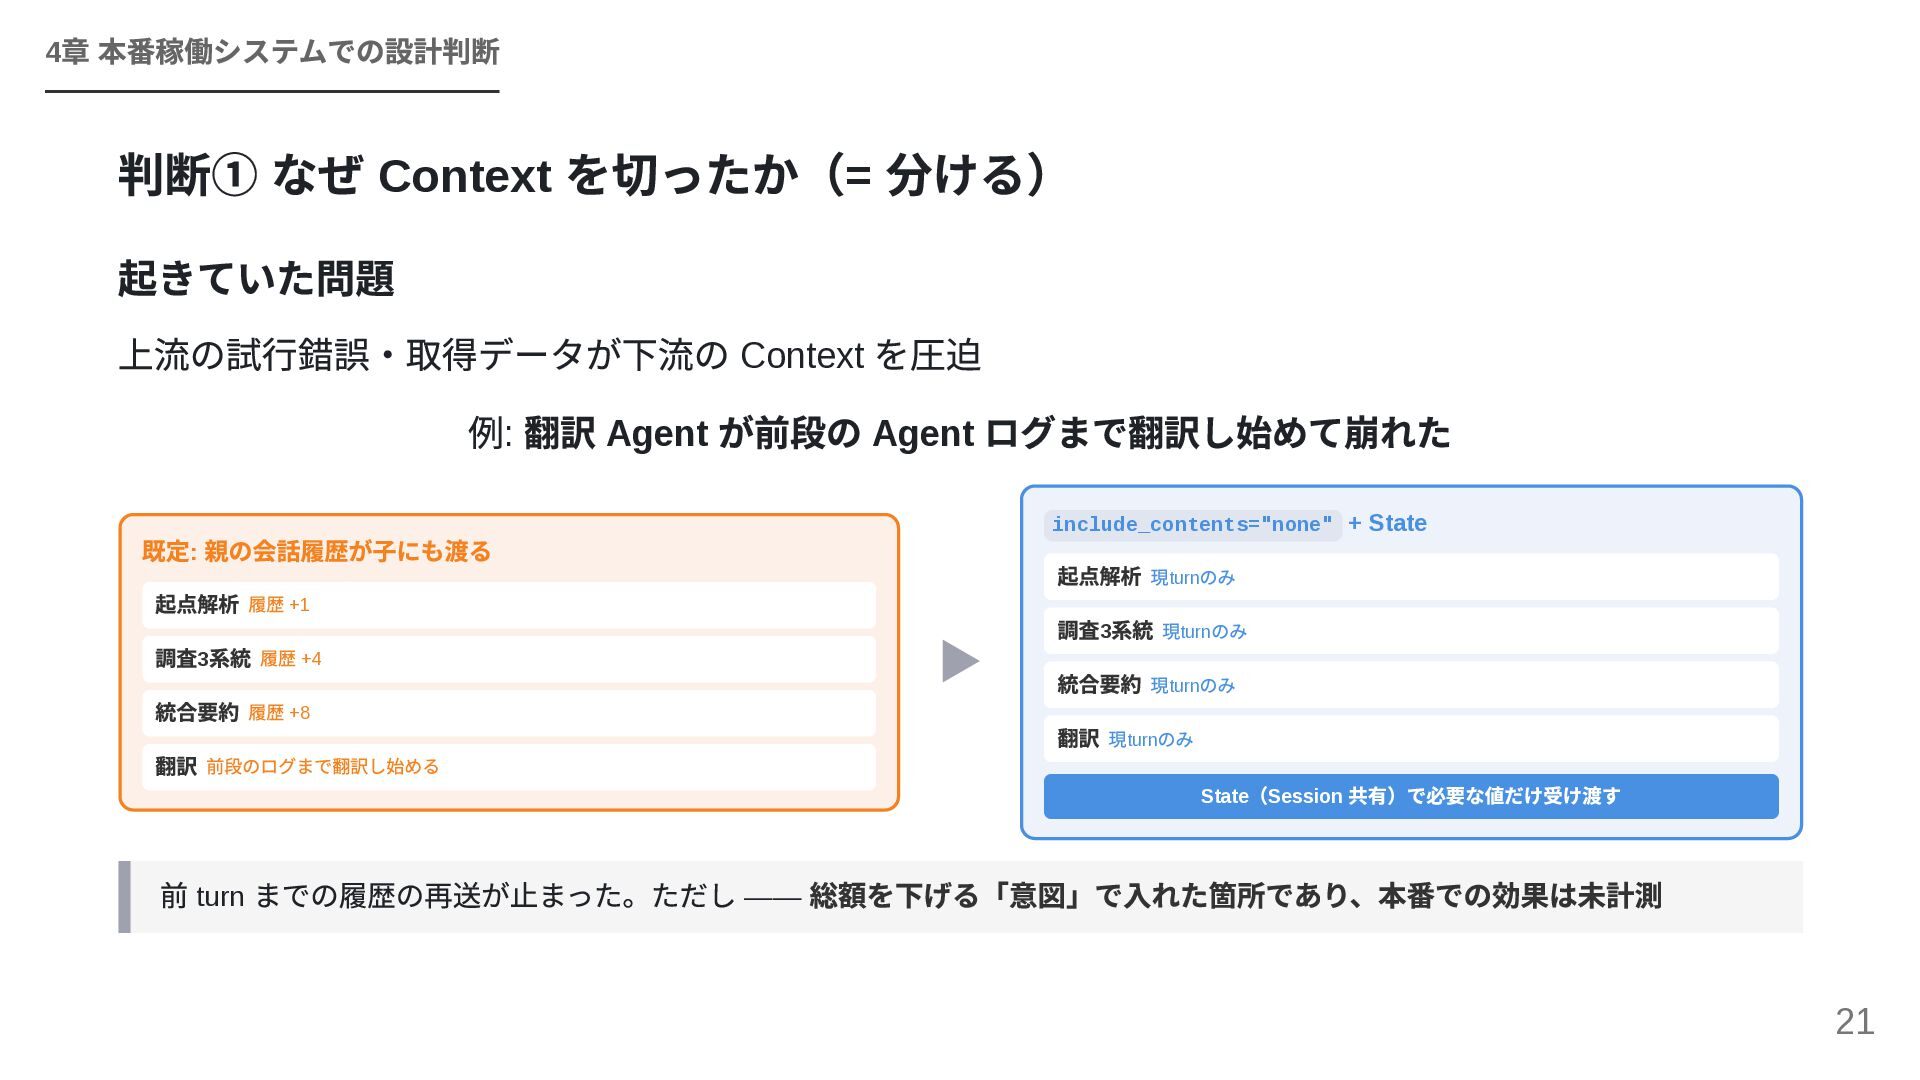
  17. 章 本番稼働システムでの設計判断 4 判断① なぜ Context を切ったか(= 分ける) 起きていた問題 上流の試行錯誤・取得データが下流の

    Context を圧迫 例: 翻訳 Agent が前段の Agent ログまで翻訳し始めて崩れた include_contents="none" + State 既定: 親の会話履歴が子にも渡る 起点解析 履歴 +1 調査3系統 履歴 +4 統合要約 履歴 +8 翻訳 前段のログまで翻訳し始める ▶ 起点解析 現turnのみ 調査3系統 現turnのみ 統合要約 現turnのみ 翻訳 現turnのみ State (Session 共有)で必要な値だけ受け渡す 前 turn までの履歴の再送が止まった。ただし ―― 総額を下げる「意図」で入れた箇所であり、本番での効果は未計測 21
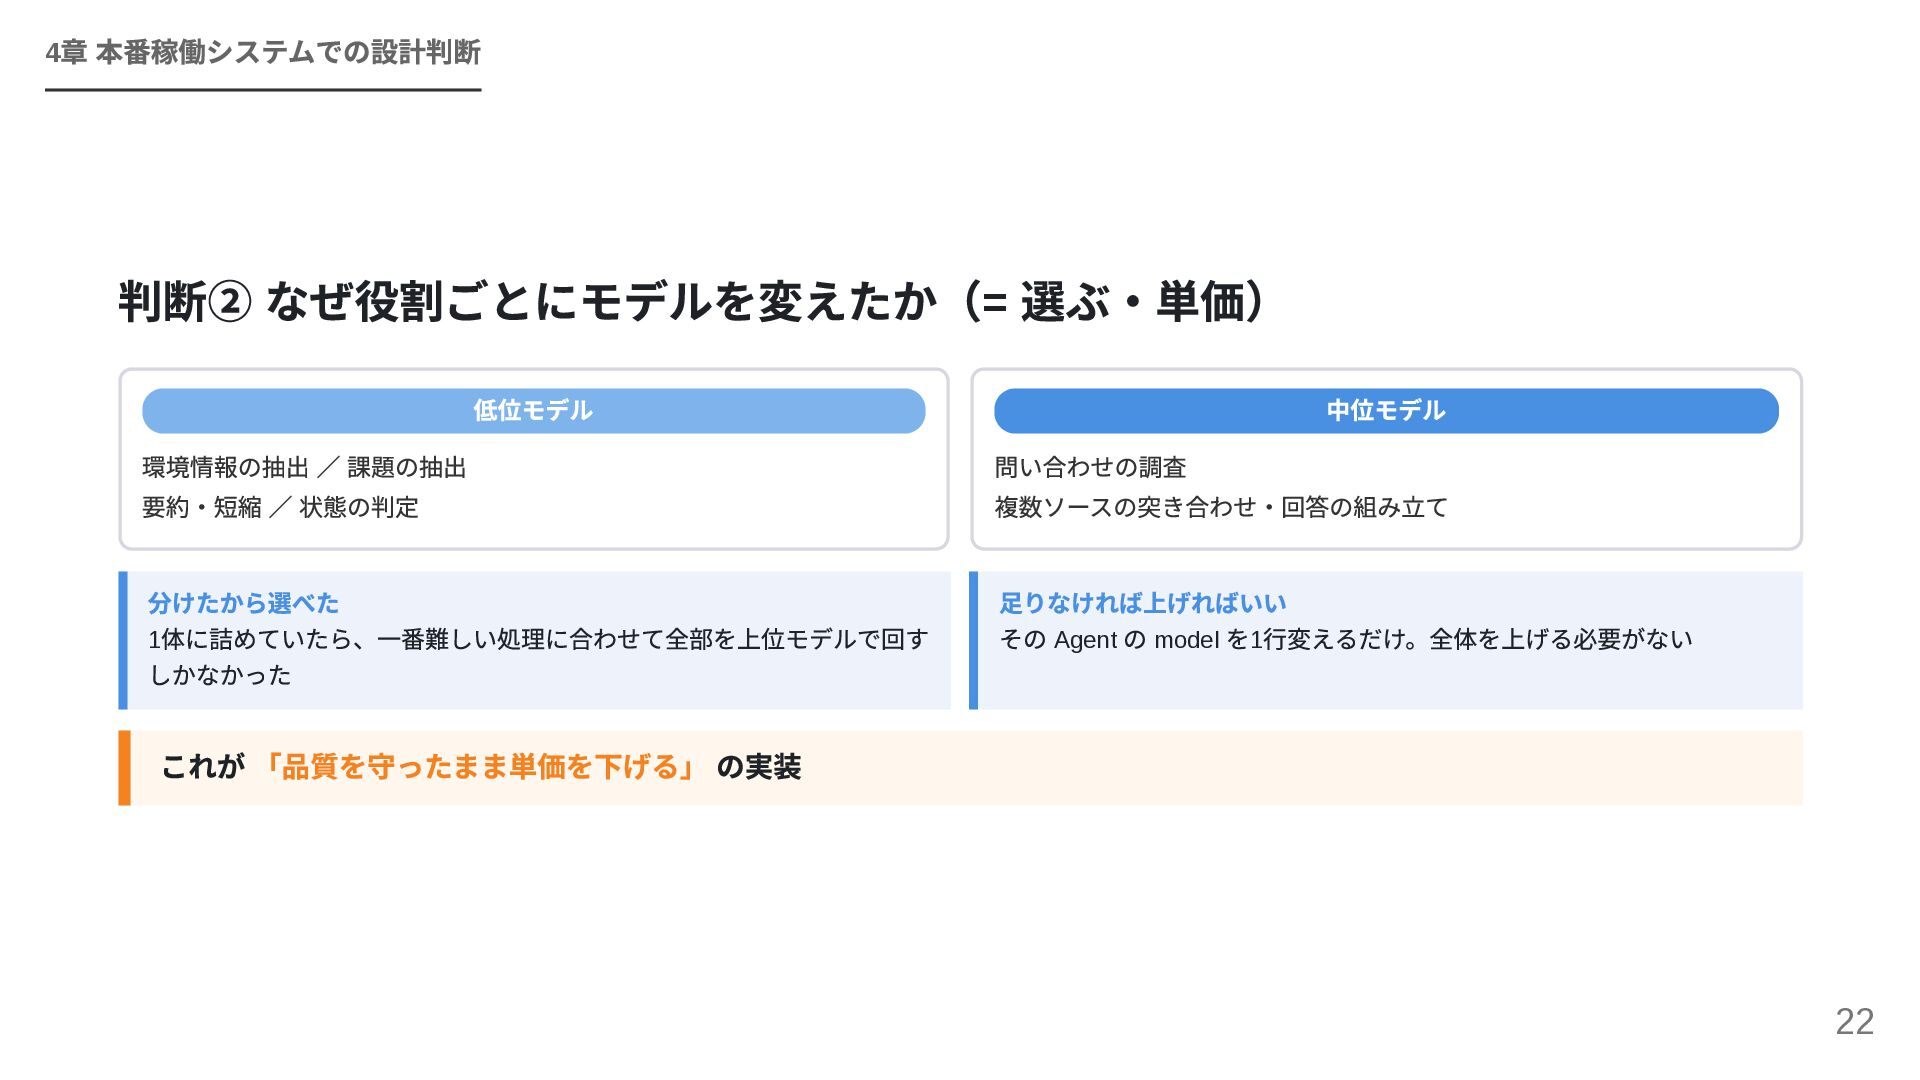
  18. 章 本番稼働システムでの設計判断 4 判断② なぜ役割ごとにモデルを変えたか(= 選ぶ・単価) 環境情報の抽出 / 課題の抽出 要約・短縮

    / 状態の判定 低位モデル 分けたから選べた 1体に詰めていたら、一番難しい処理に合わせて全部を上位モデルで回す しかなかった 中位モデル 問い合わせの調査 複数ソースの突き合わせ・回答の組み立て 足りなければ上げればいい その Agent の model を1行変えるだけ。全体を上げる必要がない これが 「品質を守ったまま単価を下げる」 の実装 22
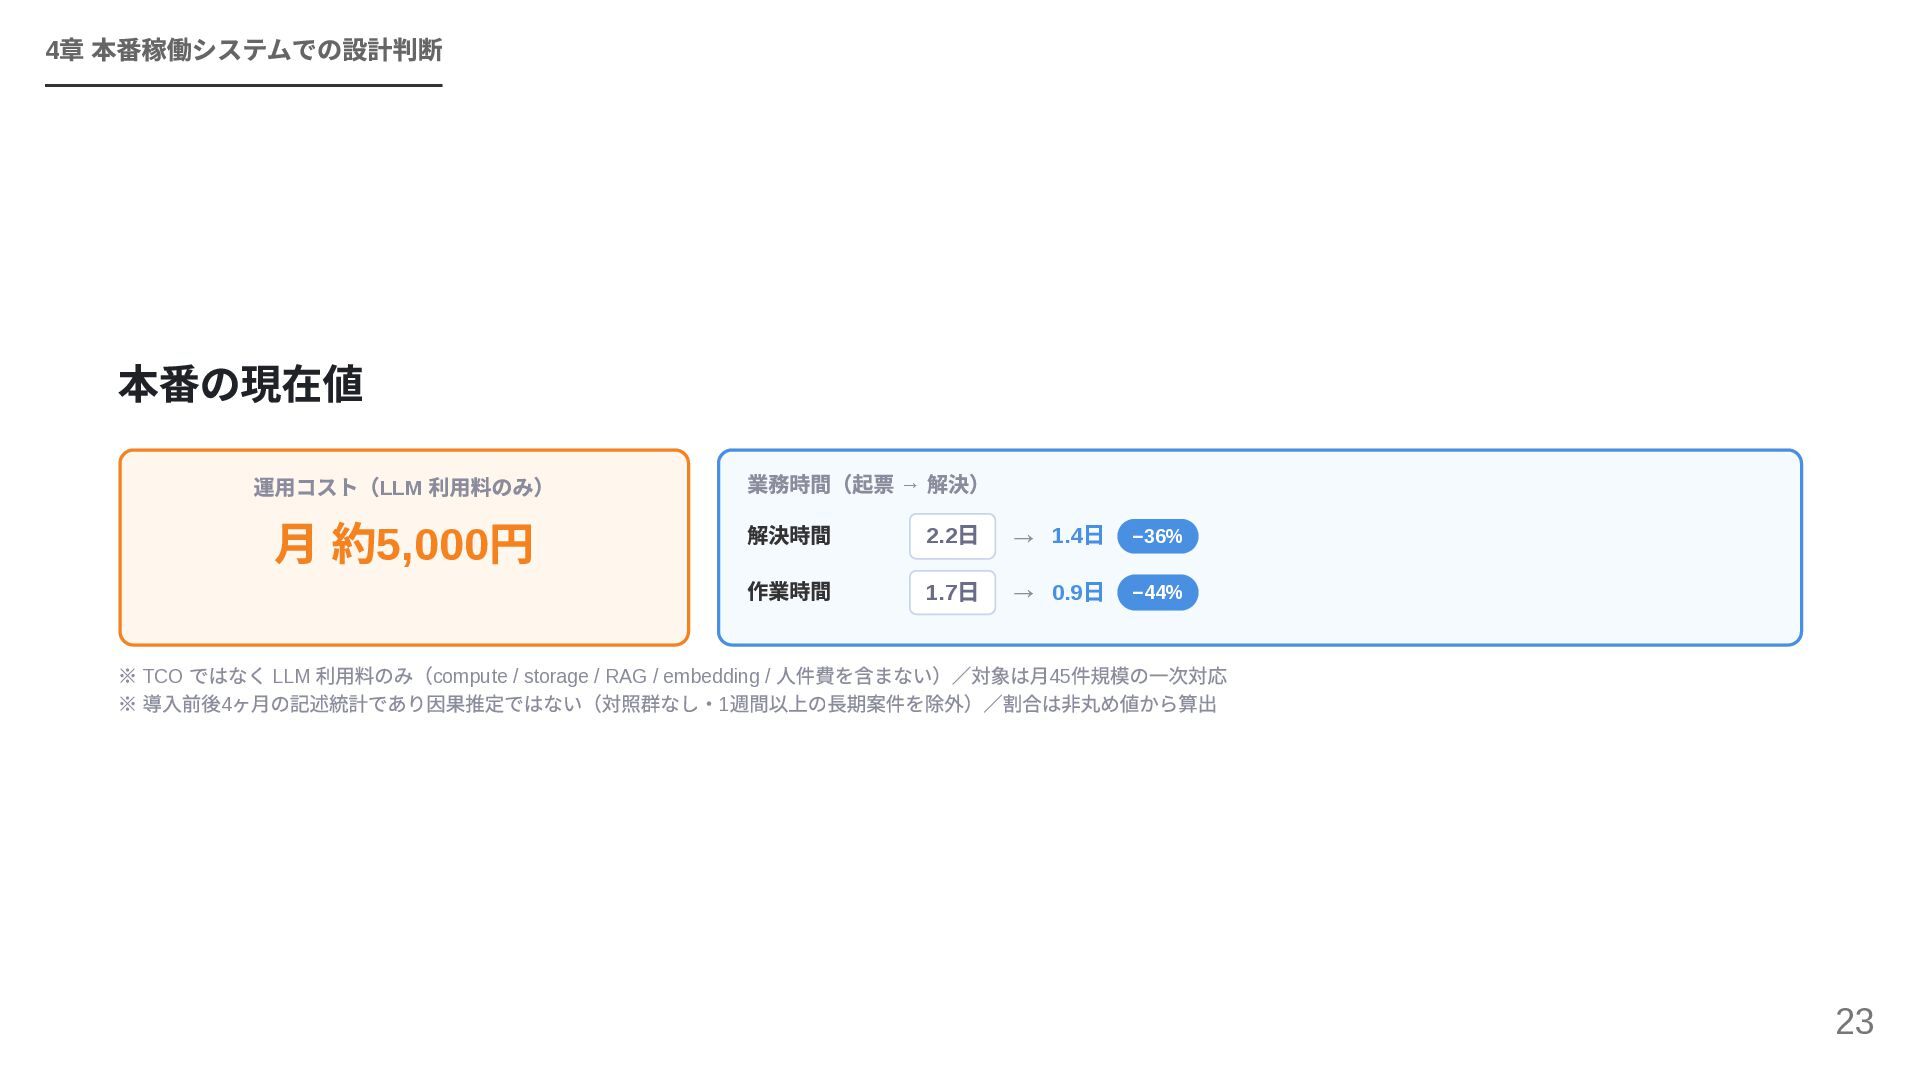
  19. 章 本番稼働システムでの設計判断 4 本番の現在値 運用コスト(LLM 利用料のみ) 月 約5,000円 業務時間(起票 →

    解決) 解決時間 2.2日 → 1.4日 −36% 作業時間 1.7日 → 0.9日 −44% ※ TCO ではなく LLM 利用料のみ(compute / storage / RAG / embedding / 人件費を含まない)/対象は月45件規模の一次対応 ※ 導入前後4ヶ月の記述統計であり因果推定ではない(対照群なし・1週間以上の長期案件を除外)/割合は非丸め値から算出 23
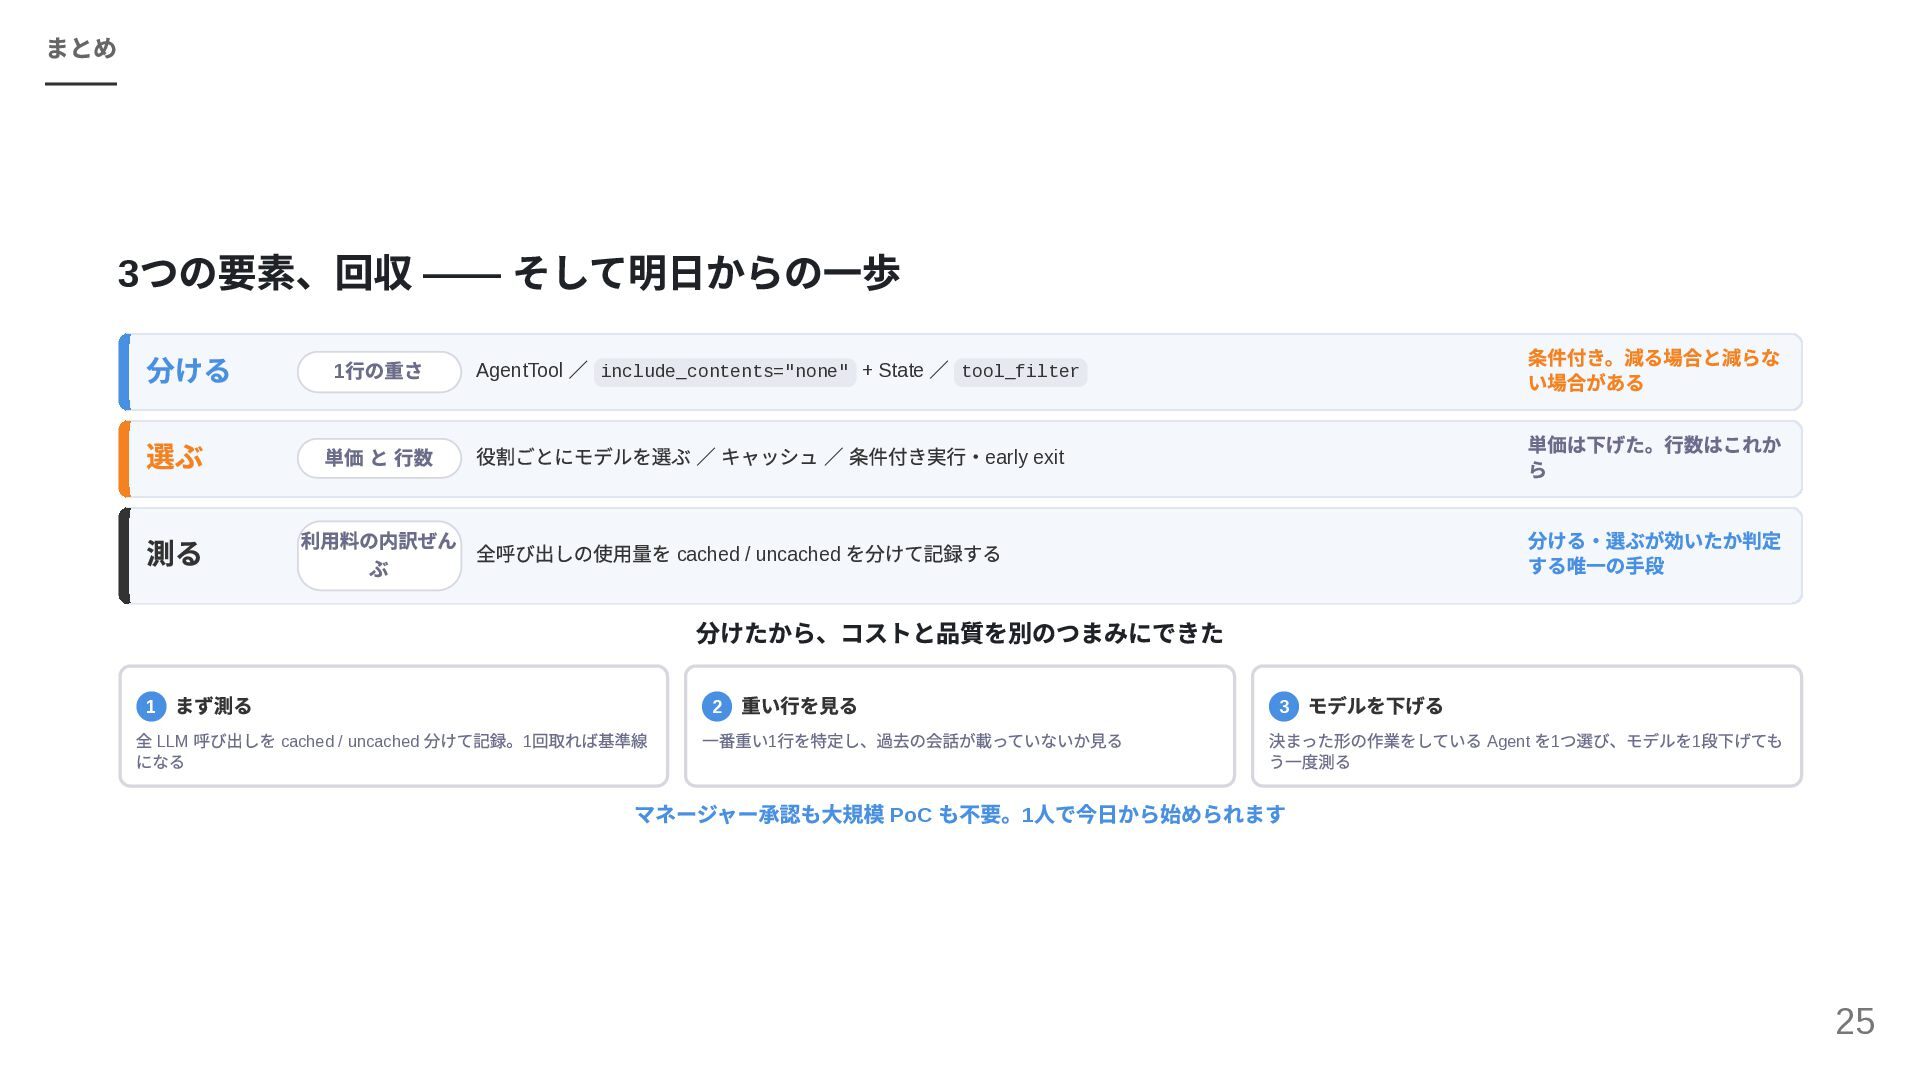
  20. まとめ 3 つの要素、回収 ―― そして明日からの一歩 分ける 選ぶ 単価 と 行数

    測る 利用料の内訳ぜん 全呼び出しの使用量を cached / uncached を分けて記録する ぶ 1 行の重さ / include_contents="none" + State / tool_filter 条件付き。減る場合と減らな い場合がある 役割ごとにモデルを選ぶ / キャッシュ / 条件付き実行・early exit 単価は下げた。行数はこれか ら AgentTool 分ける・選ぶが効いたか判定 する唯一の手段 分けたから、コストと品質を別のつまみにできた 1 まず測る 全 LLM 呼び出しを cached / uncached 分けて記録。1回取れば基準線 になる 2 重い行を見る 一番重い1行を特定し、過去の会話が載っていないか見る 3 モデルを下げる 決まった形の作業をしている Agent を1つ選び、モデルを1段下げても う一度測る マネージャー承認も大規模 PoC も不要。1人で今日から始められます 25