Share
Embed
最先端NLP勉強会2025: Disentangling Memory and Reasoning Ability in Large Language Models
Ryuki Ida
August 19, 2025
Transcript
16 slides
-
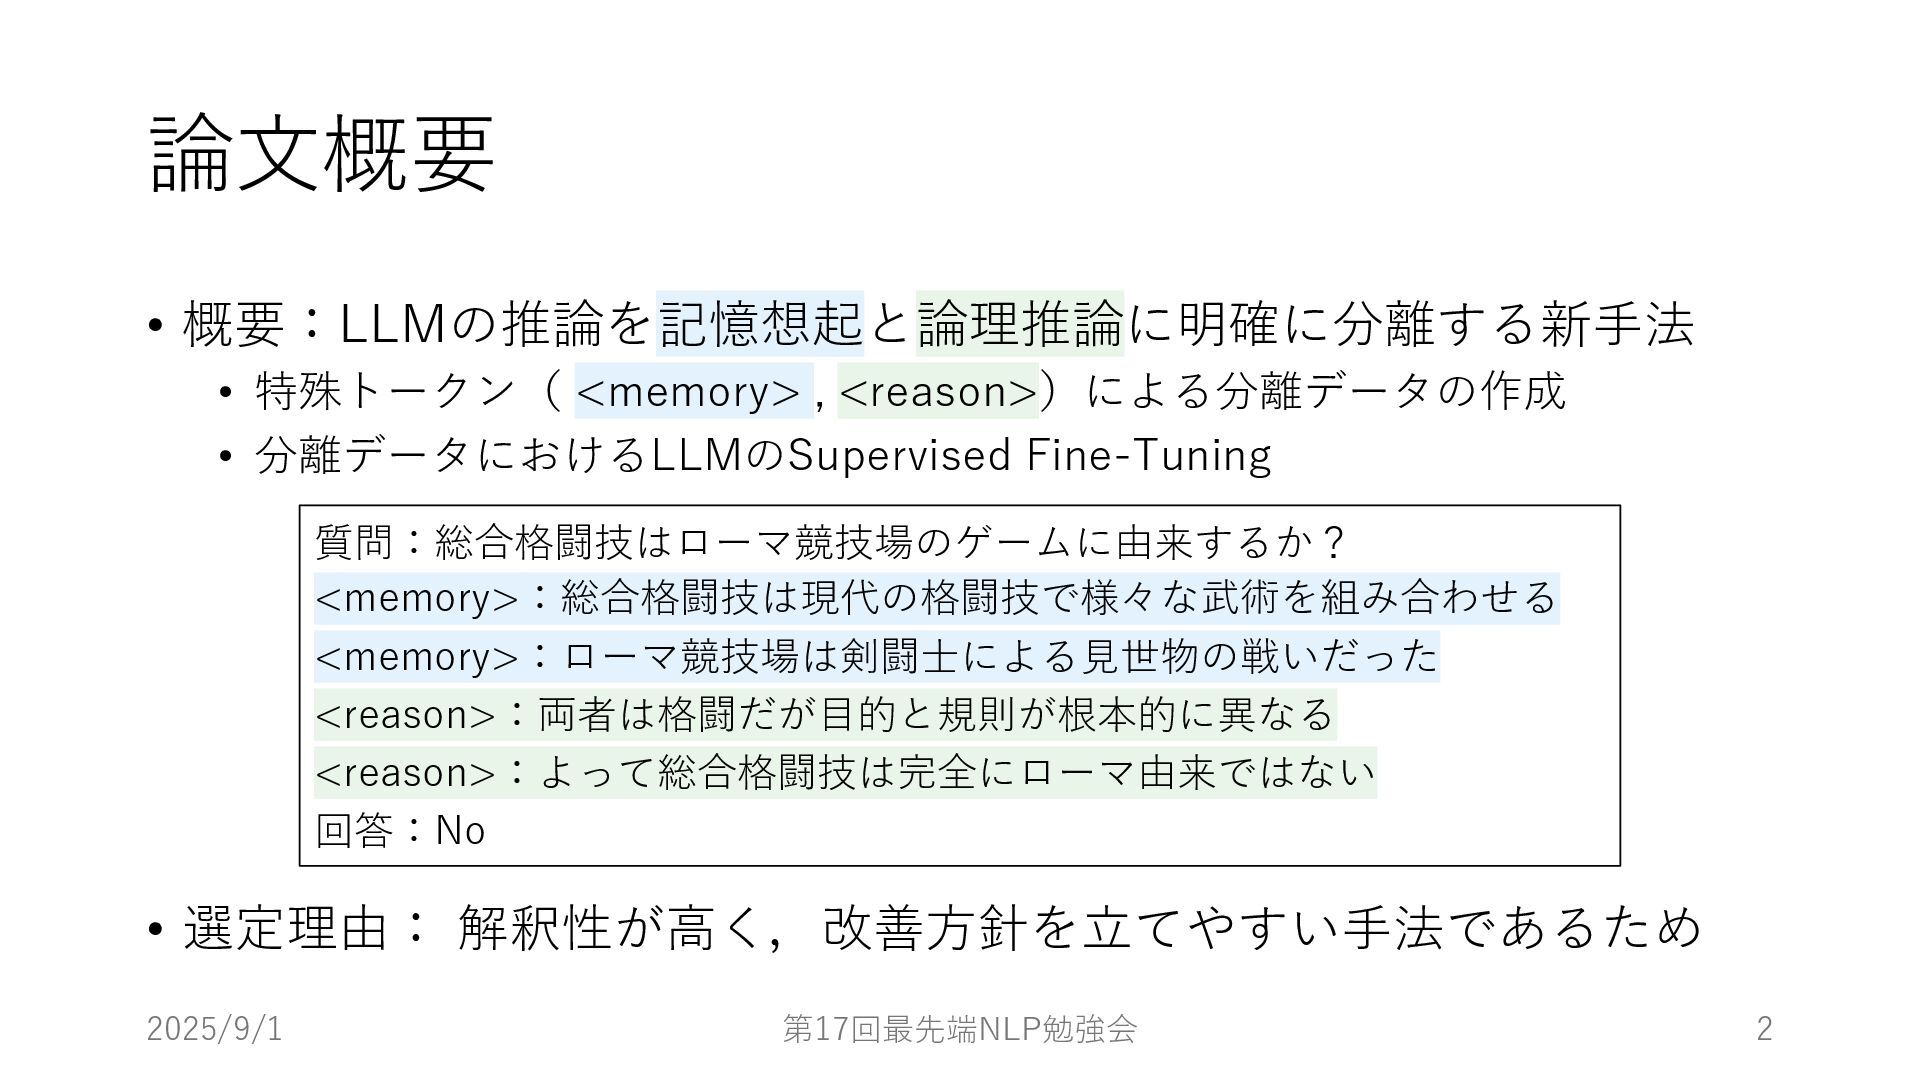
論⽂概要 • 概要:LLMの推論を記憶想起と論理推論に明確に分離する新⼿法 • 特殊トークン( <memory> , <reason>)による分離データの作成 • 分離データにおけるLLMのSupervised
Fine-Tuning • 選定理由: 解釈性が⾼く,改善⽅針を⽴てやすい⼿法であるため 2025/9/1 第17回最先端NLP勉強会 2 質問:総合格闘技はローマ競技場のゲームに由来するか? <memory>:総合格闘技は現代の格闘技で様々な武術を組み合わせる <memory>:ローマ競技場は剣闘⼠による⾒世物の戦いだった <reason>:両者は格闘だが⽬的と規則が根本的に異なる <reason>:よって総合格闘技は完全にローマ由来ではない 回答:No -
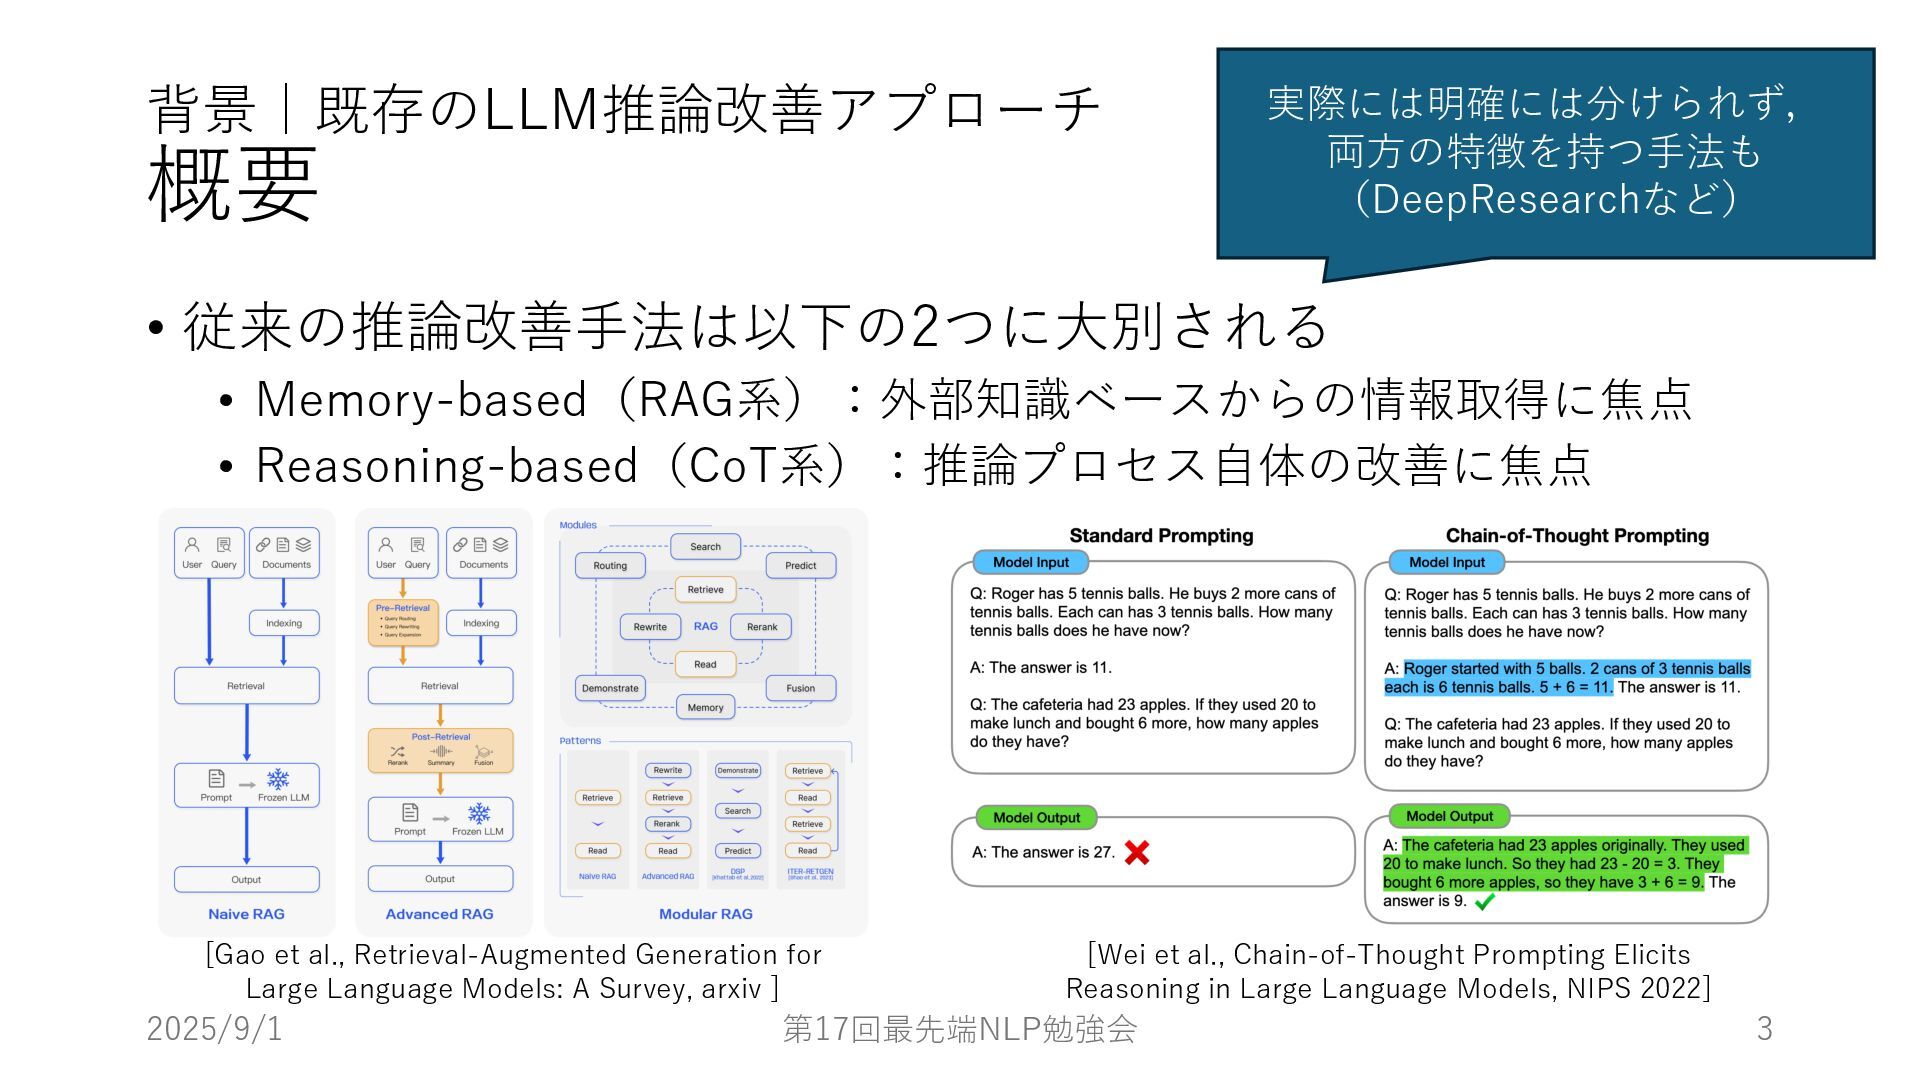
背景|既存のLLM推論改善アプローチ 概要 • 従来の推論改善⼿法は以下の2つに⼤別される • Memory-based(RAG系):外部知識ベースからの情報取得に焦点 • Reasoning-based(CoT系):推論プロセス⾃体の改善に焦点 2025/9/1 第17回最先端NLP勉強会
3 [Gao et al., Retrieval-Augmented Generation for Large Language Models: A Survey, arxiv ] [Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, NIPS 2022] 実際には明確には分けられず, 両⽅の特徴を持つ⼿法も (DeepResearchなど) -
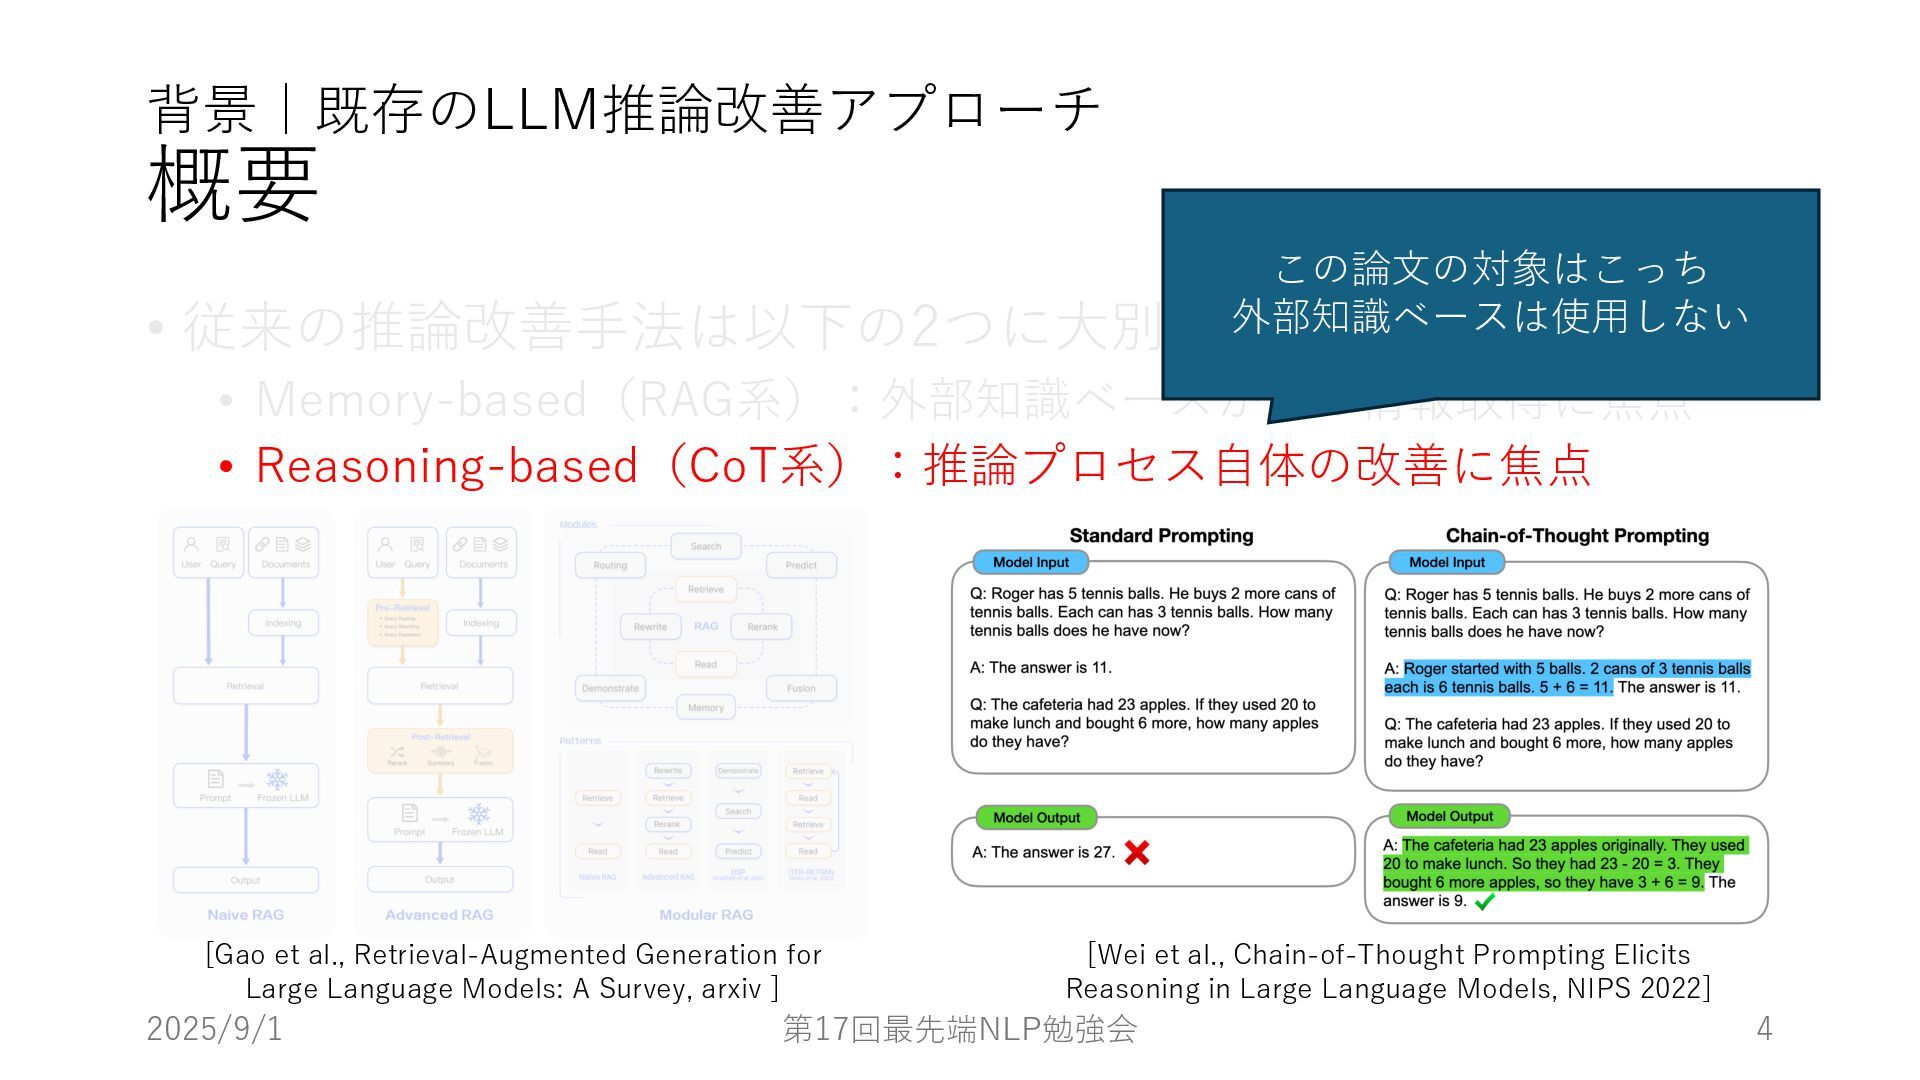
背景|既存のLLM推論改善アプローチ 概要 • 従来の推論改善⼿法は以下の2つに⼤別される • Memory-based(RAG系):外部知識ベースからの情報取得に焦点 • Reasoning-based(CoT系):推論プロセス⾃体の改善に焦点 2025/9/1 第17回最先端NLP勉強会
4 [Gao et al., Retrieval-Augmented Generation for Large Language Models: A Survey, arxiv ] [Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, NIPS 2022] この論⽂の対象はこっち 外部知識ベースは使⽤しない -
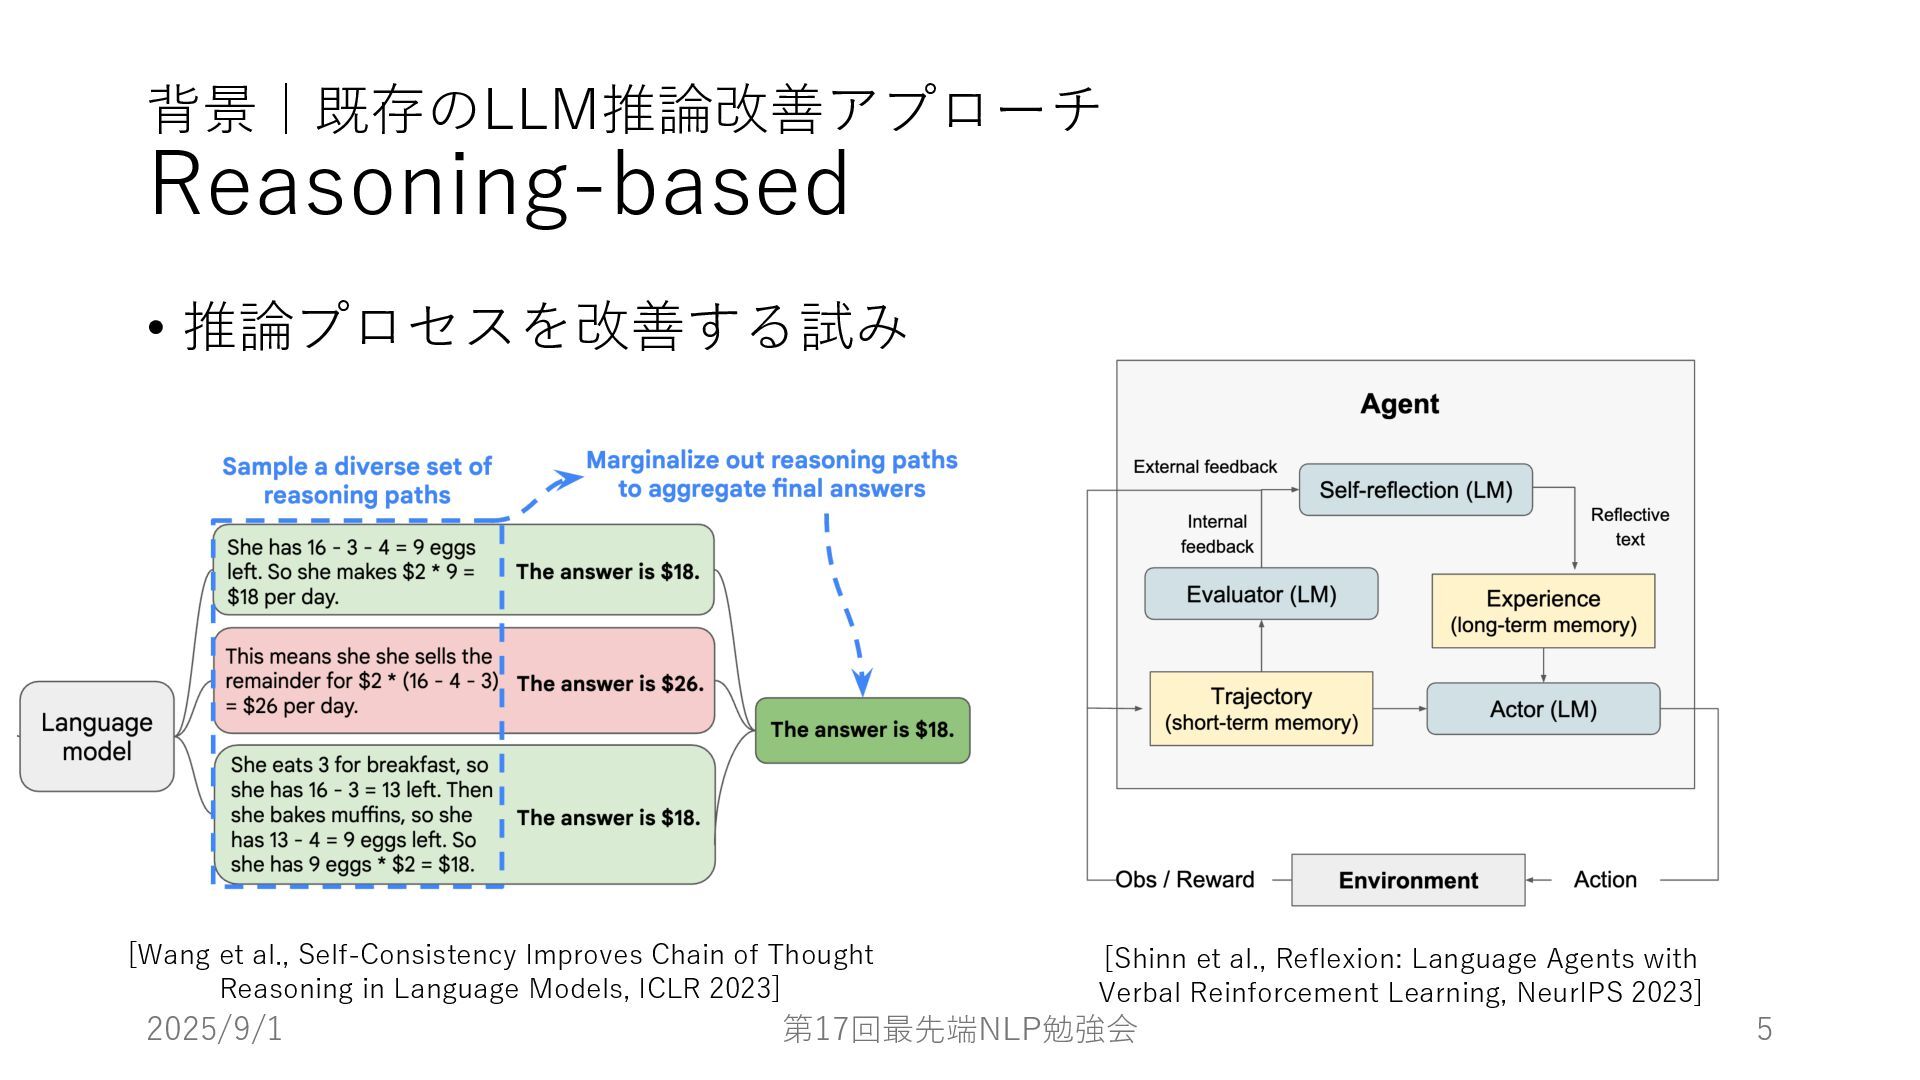
背景|既存のLLM推論改善アプローチ Reasoning-based • 推論プロセスを改善する試み 2025/9/1 第17回最先端NLP勉強会 5 [Wang et al.,
Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023] [Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning, NeurIPS 2023] -
背景|既存のLLM推論改善アプローチ Planning-token [Wang et al., COLM2024] • ⽬的:構造的な推論ステップの⽣成によるCoTの改善 • ⼿法:各ステップの先頭に計画トークンを配置して学習・推論
• 計画トークンによりそのステップの意図を指⽰ 2025/9/1 第17回最先端NLP勉強会 6 -
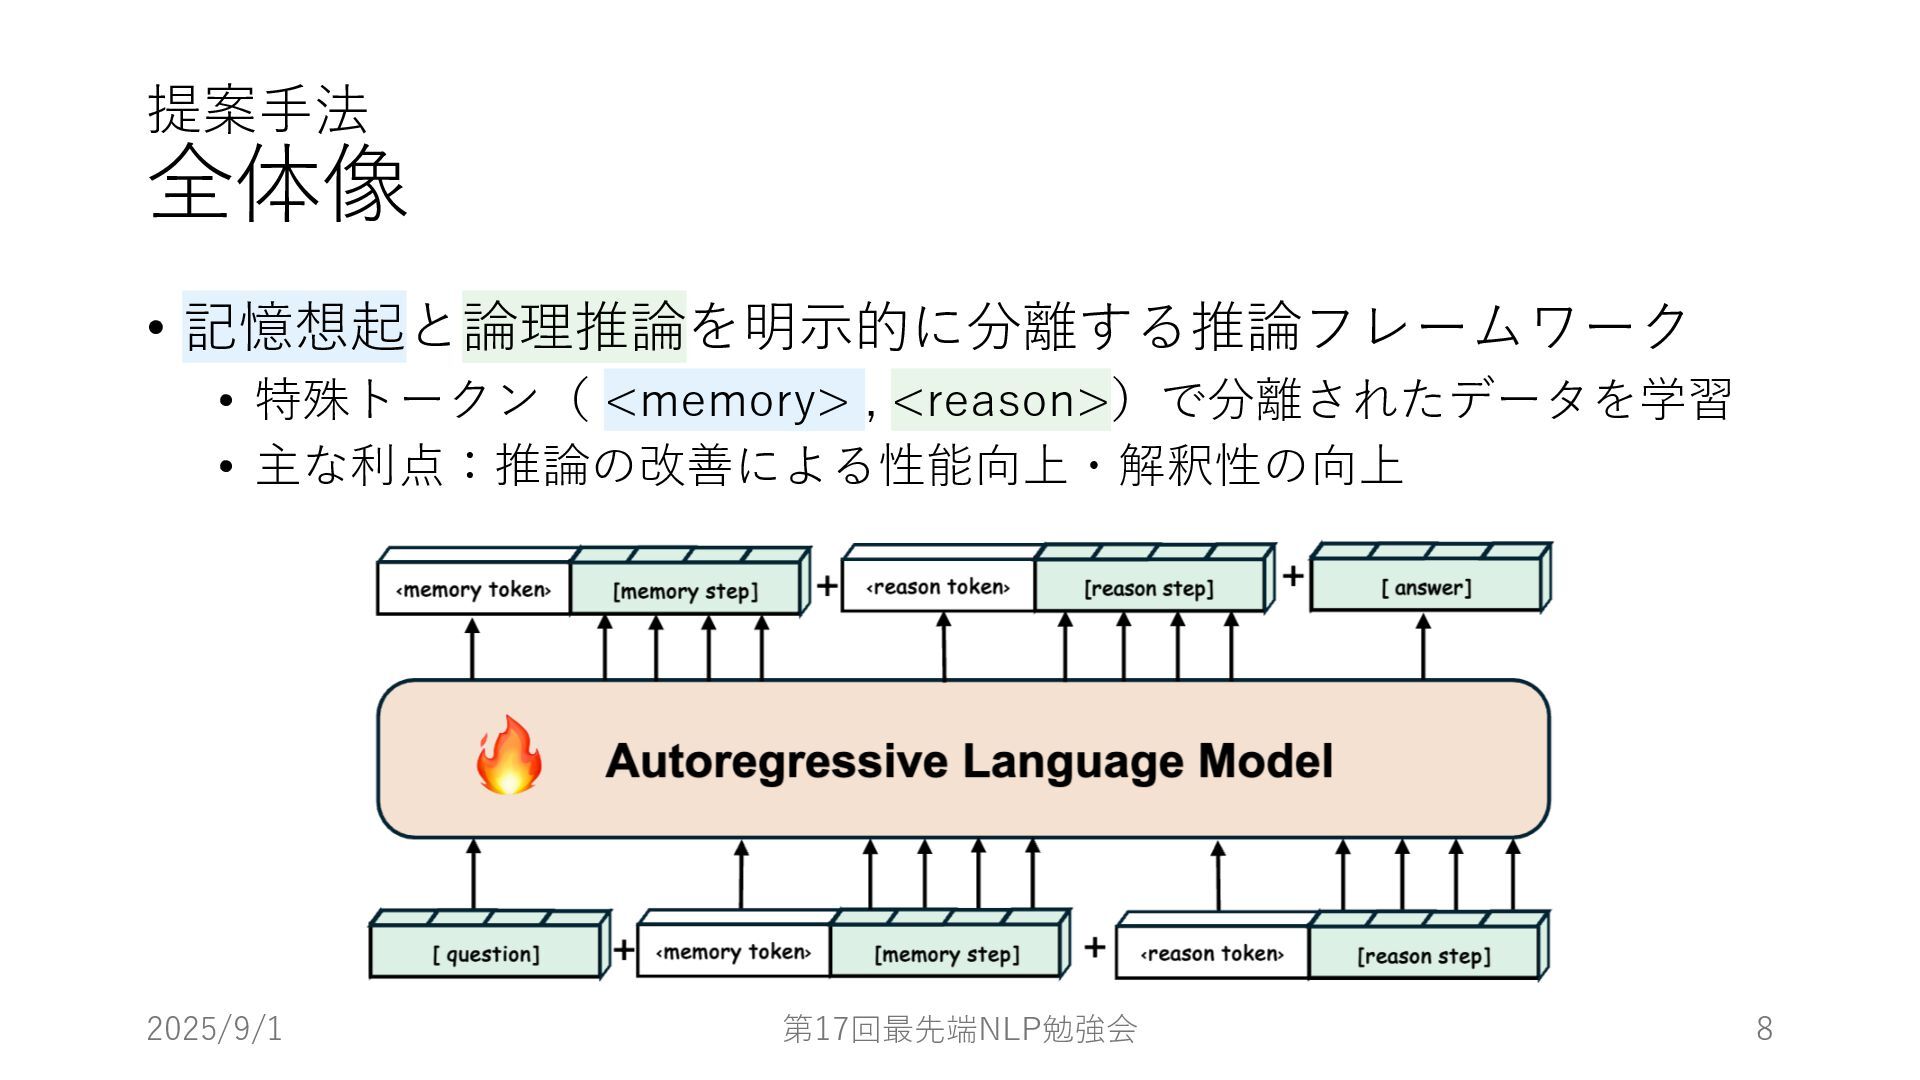
提案⼿法 全体像 • 記憶想起と論理推論を明⽰的に分離する推論フレームワーク • 特殊トークン( <memory> , <reason>)で分離されたデータを学習 •
主な利点:推論の改善による性能向上・解釈性の向上 2025/9/1 第17回最先端NLP勉強会 8 -
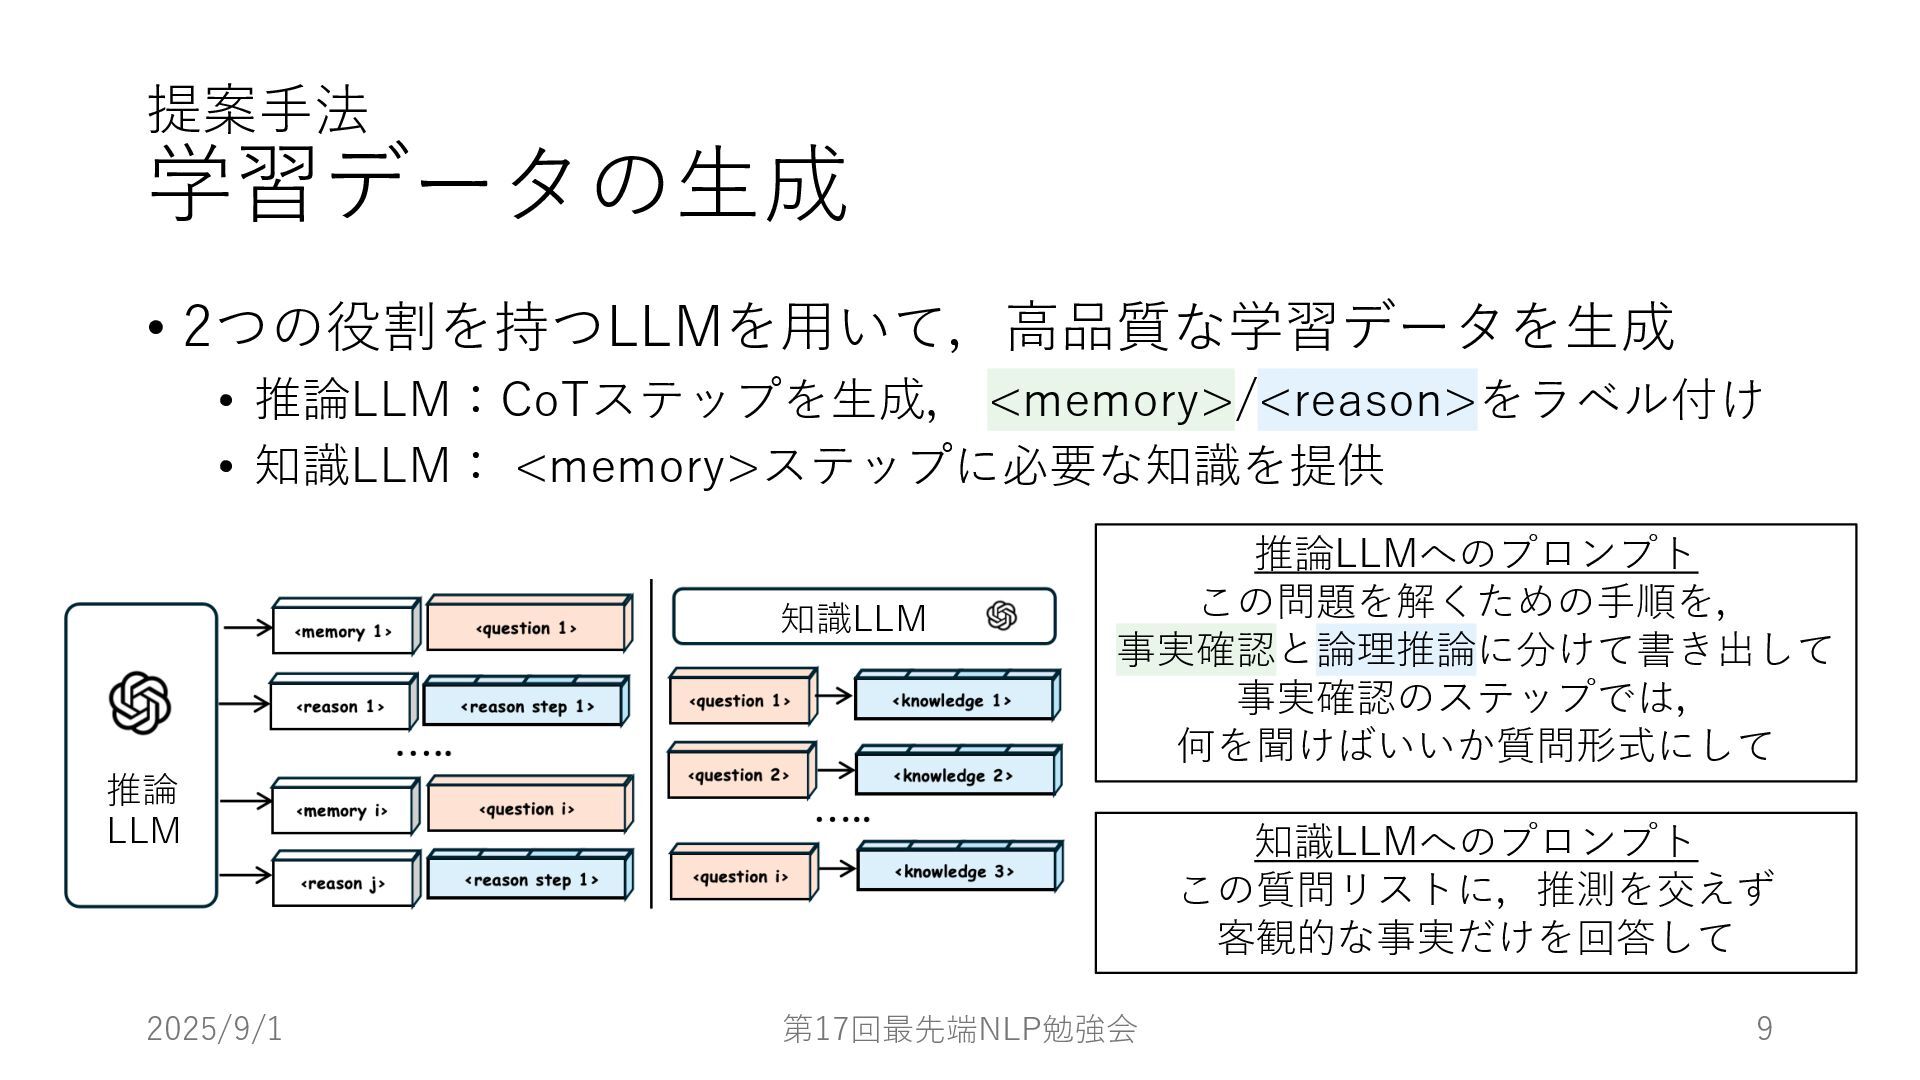
提案⼿法 学習データの⽣成 • 2つの役割を持つLLMを⽤いて,⾼品質な学習データを⽣成 • 推論LLM:CoTステップを⽣成, <memory>/<reason>をラベル付け • 知識LLM: <memory>ステップに必要な知識を提供
2025/9/1 第17回最先端NLP勉強会 9 推論 LLM 知識LLM 推論LLMへのプロンプト この問題を解くための⼿順を, 事実確認と論理推論に分けて書き出して 事実確認のステップでは, 何を聞けばいいか質問形式にして 知識LLMへのプロンプト この質問リストに,推測を交えず 客観的な事実だけを回答して -
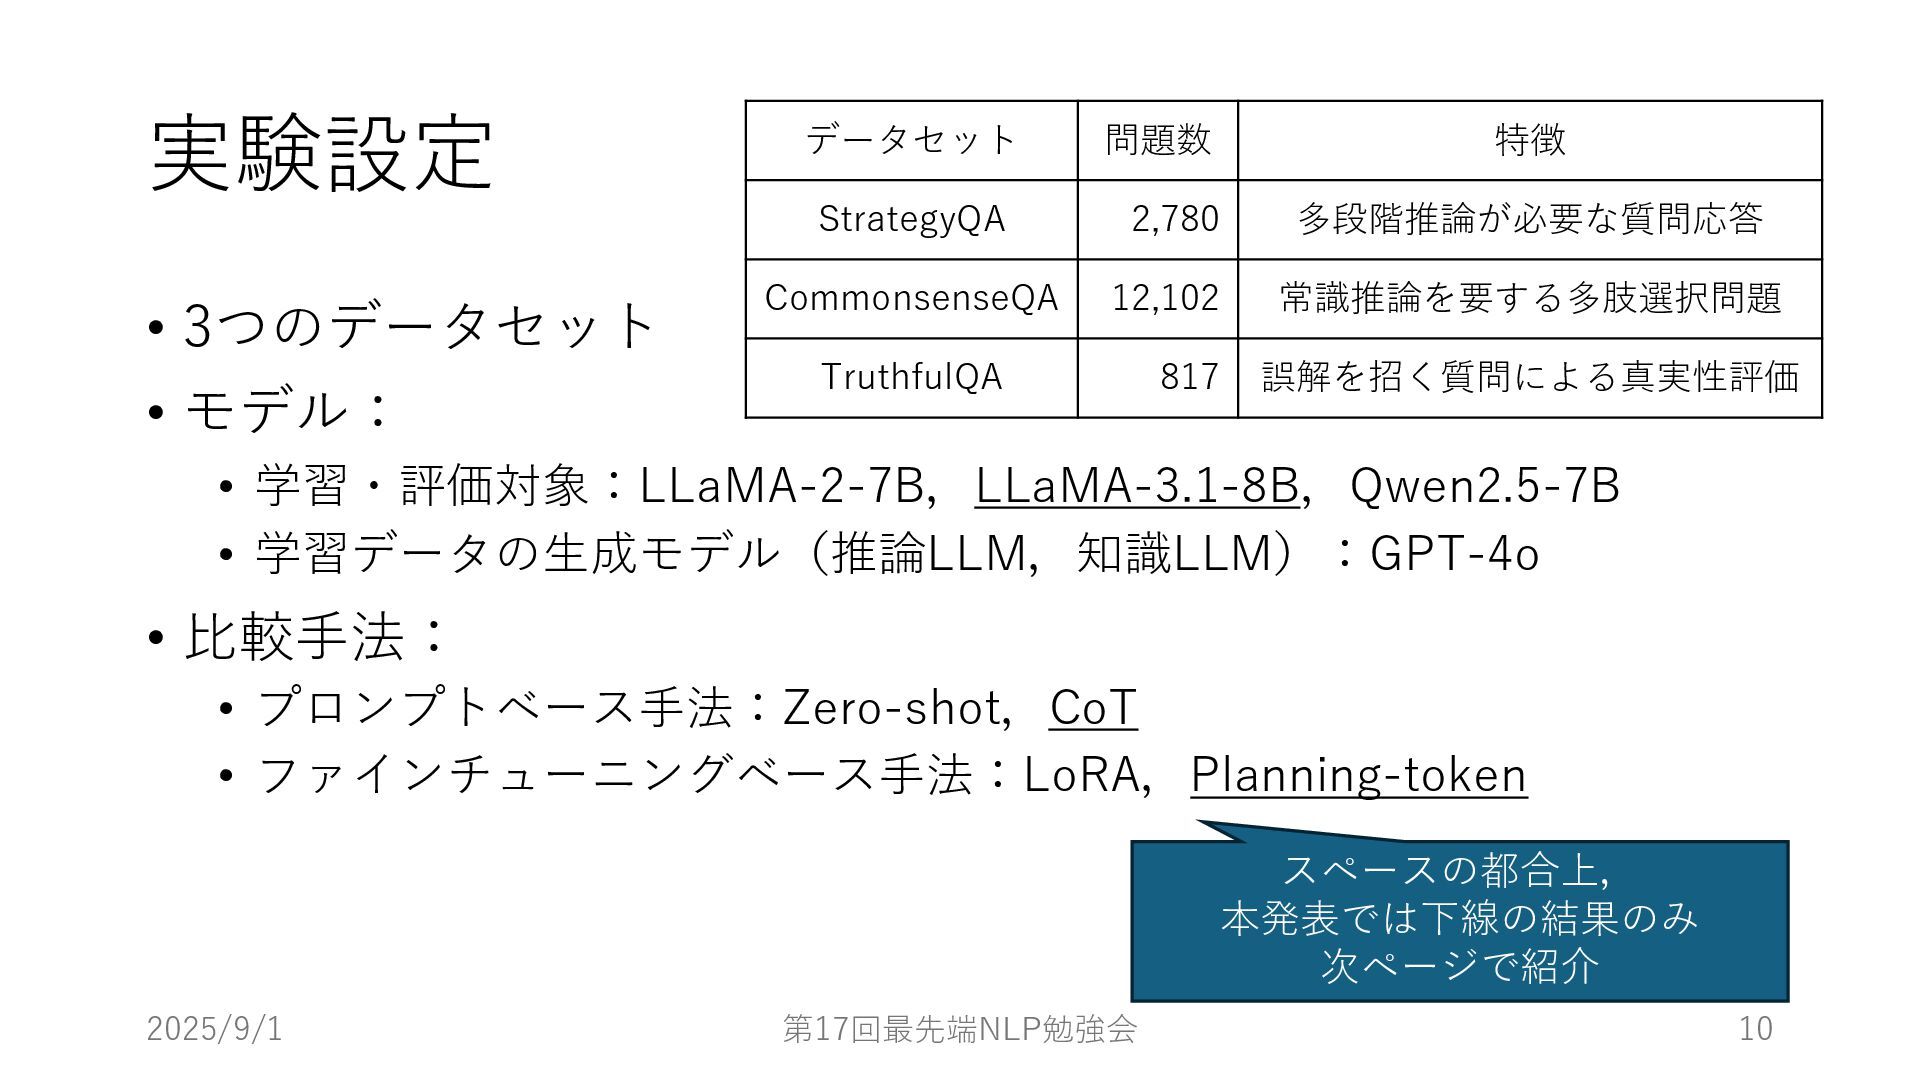
実験設定 • 3つのデータセット • モデル: • 学習・評価対象:LLaMA-2-7B,LLaMA-3.1-8B,Qwen2.5-7B • 学習データの⽣成モデル(推論LLM,知識LLM):GPT-4o •
⽐較⼿法: • プロンプトベース⼿法:Zero-shot,CoT • ファインチューニングベース⼿法:LoRA,Planning-token 2025/9/1 第17回最先端NLP勉強会 10 データセット 問題数 特徴 StrategyQA 2,780 多段階推論が必要な質問応答 CommonsenseQA 12,102 常識推論を要する多肢選択問題 TruthfulQA 817 誤解を招く質問による真実性評価 スペースの都合上, 本発表では下線の結果のみ 次ページで紹介 -
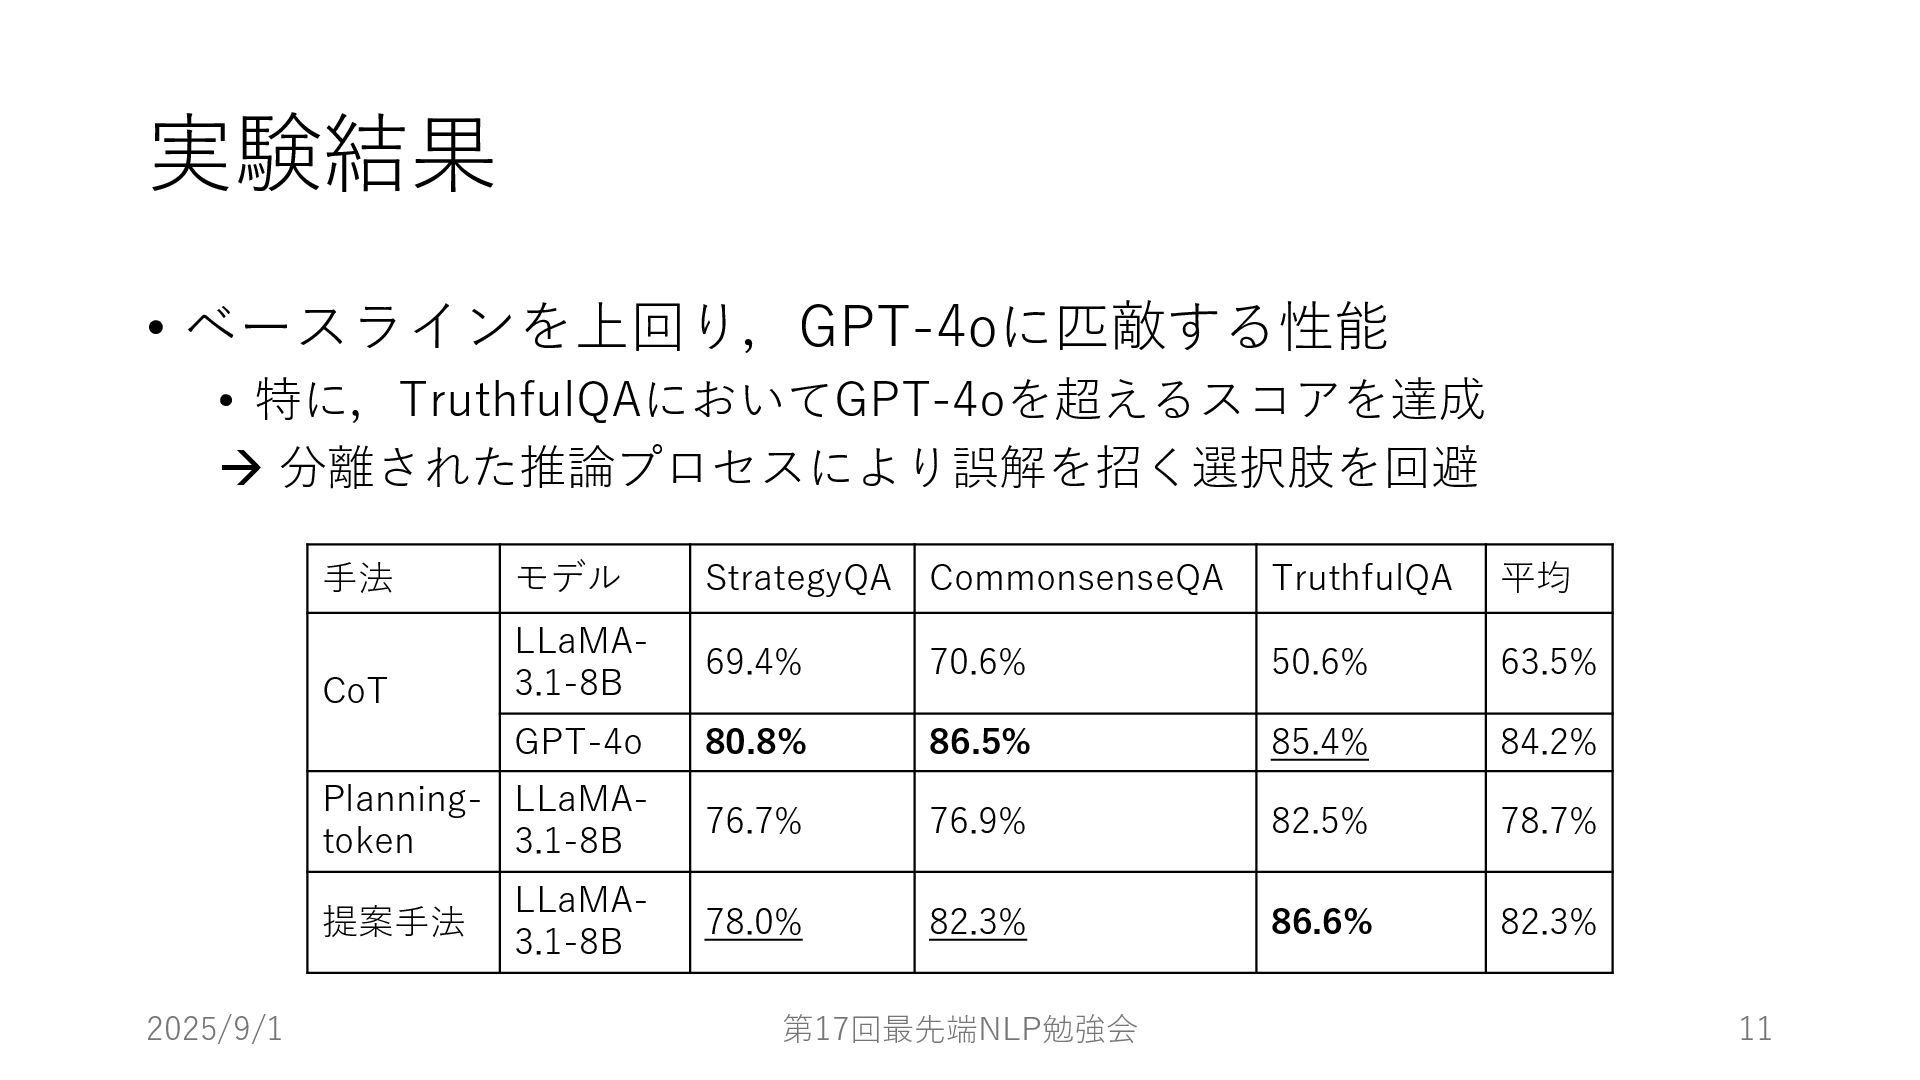
実験結果 • ベースラインを上回り,GPT-4oに匹敵する性能 • 特に,TruthfulQAにおいてGPT-4oを超えるスコアを達成 à 分離された推論プロセスにより誤解を招く選択肢を回避 2025/9/1 第17回最先端NLP勉強会 11
⼿法 モデル StrategyQA CommonsenseQA TruthfulQA 平均 CoT LLaMA- 3.1-8B 69.4% 70.6% 50.6% 63.5% GPT-4o 80.8% 86.5% 85.4% 84.2% Planning- token LLaMA- 3.1-8B 76.7% 76.9% 82.5% 78.7% 提案⼿法 LLaMA- 3.1-8B 78.0% 82.3% 86.6% 82.3% -
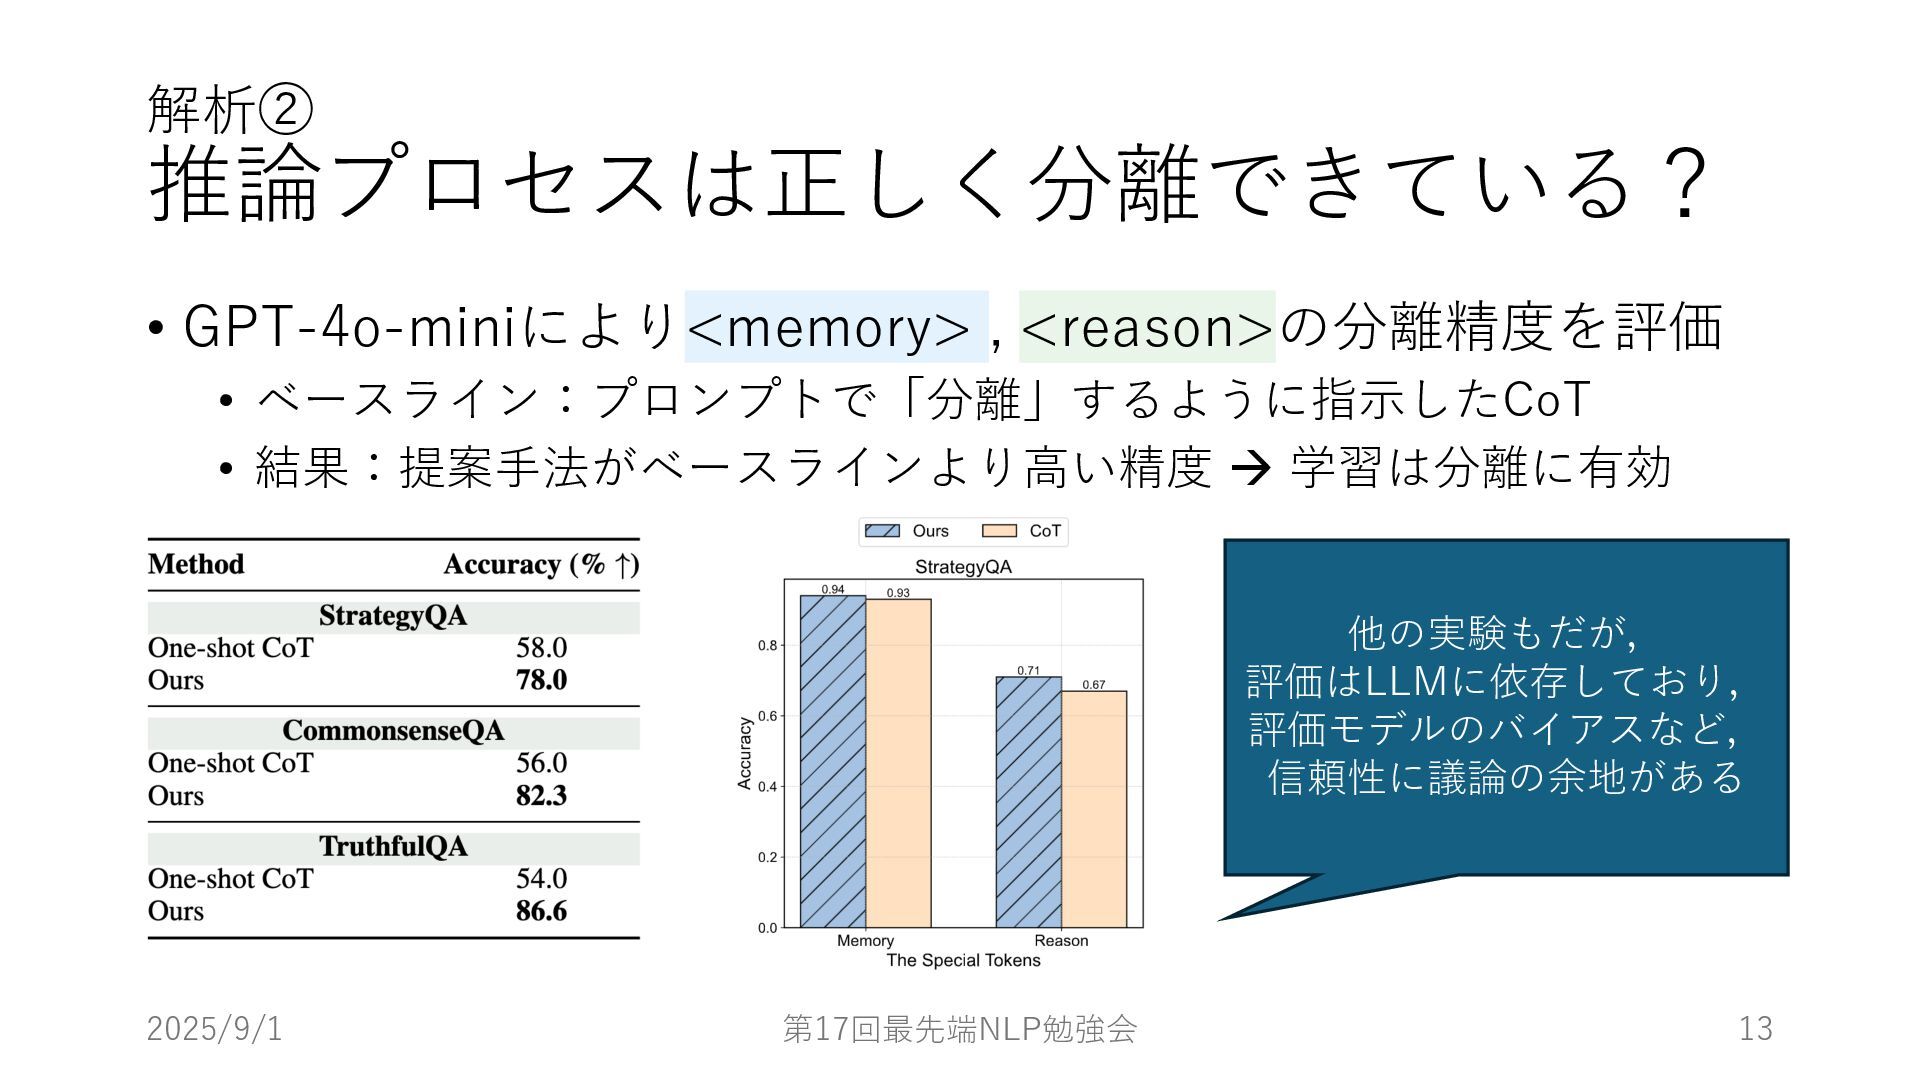
解析② 推論プロセスは正しく分離できている? • GPT-4o-miniにより<memory> , <reason>の分離精度を評価 • ベースライン:プロンプトで「分離」するように指⽰したCoT • 結果:提案⼿法がベースラインより⾼い精度
à 学習は分離に有効 2025/9/1 第17回最先端NLP勉強会 13 他の実験もだが, 評価はLLMに依存しており, 評価モデルのバイアスなど, 信頼性に議論の余地がある -
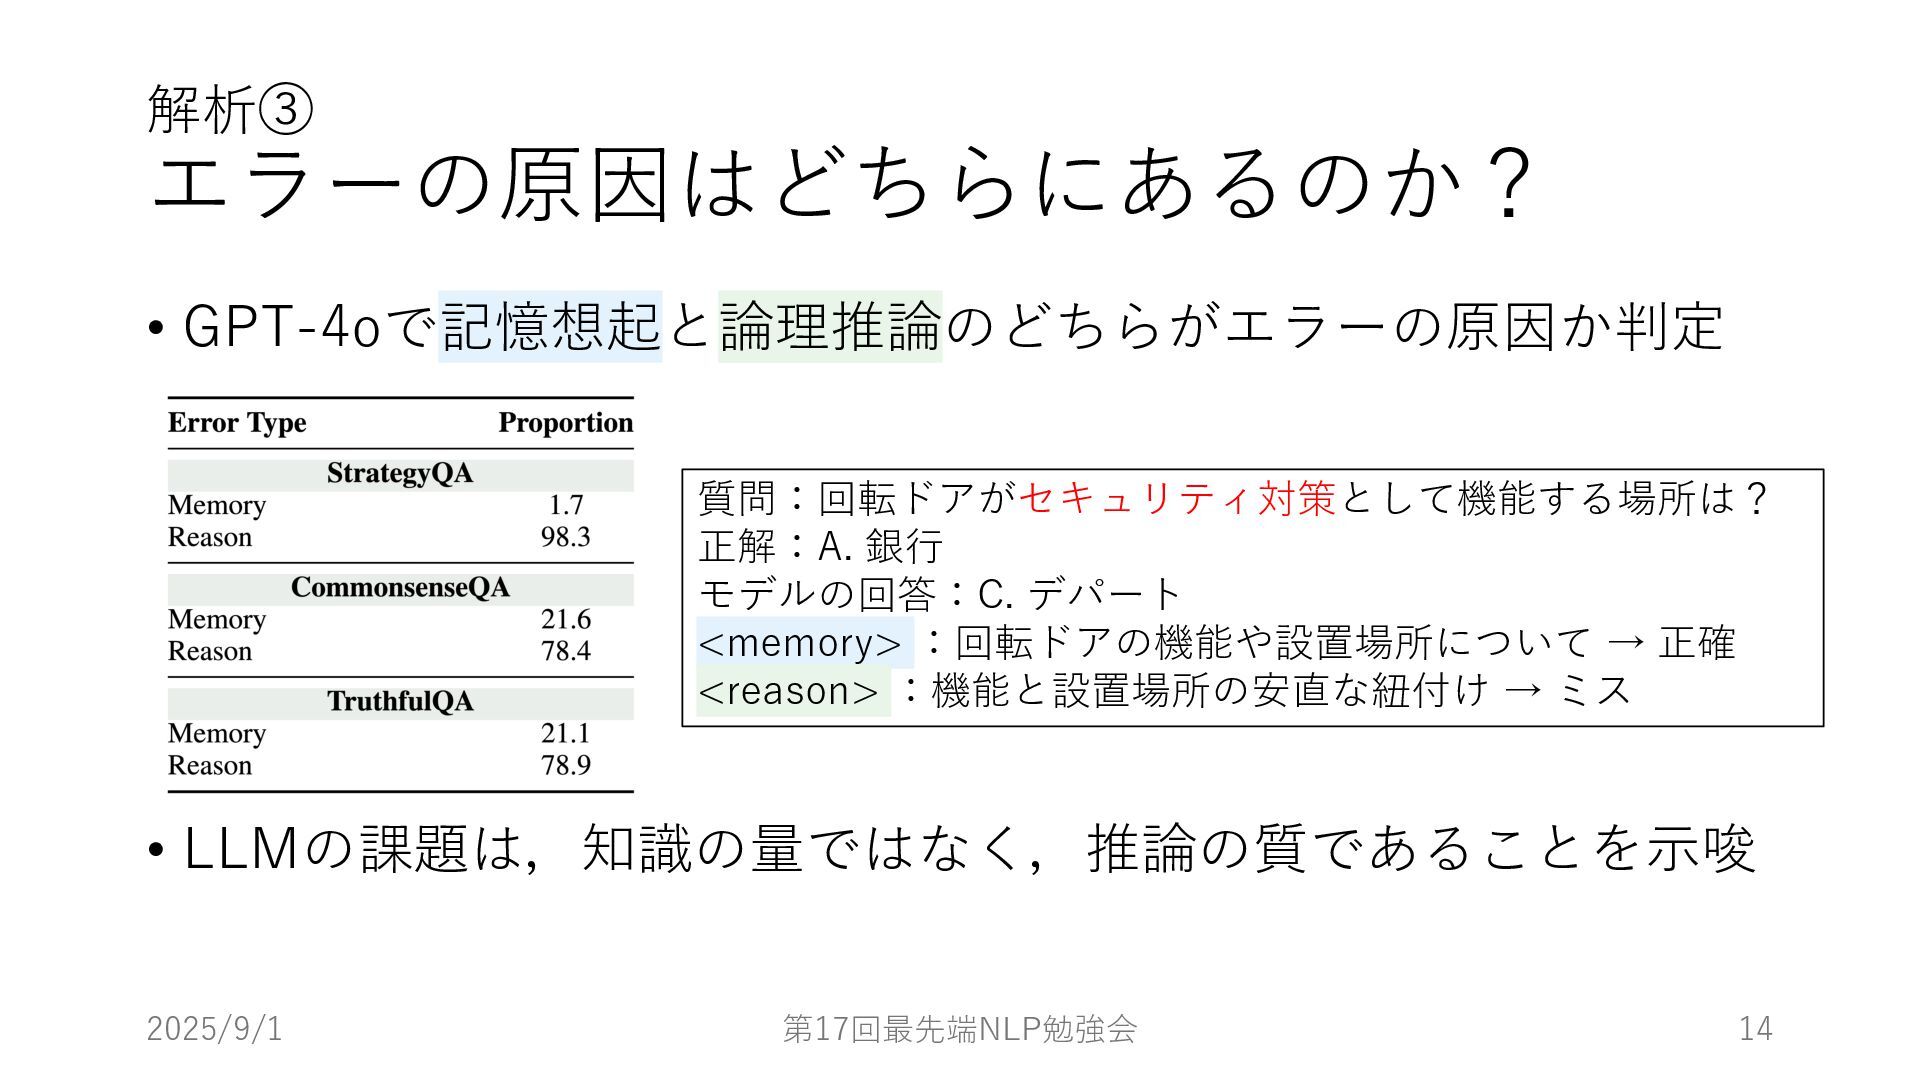
解析③ エラーの原因はどちらにあるのか? • GPT-4oで記憶想起と論理推論のどちらがエラーの原因か判定 • LLMの課題は,知識の量ではなく,推論の質であることを⽰唆 2025/9/1 第17回最先端NLP勉強会 14 質問:回転ドアがセキュリティ対策として機能する場所は?
正解:A. 銀⾏ モデルの回答:C. デパート <memory> :回転ドアの機能や設置場所について → 正確 <reason> :機能と設置場所の安直な紐付け → ミス -
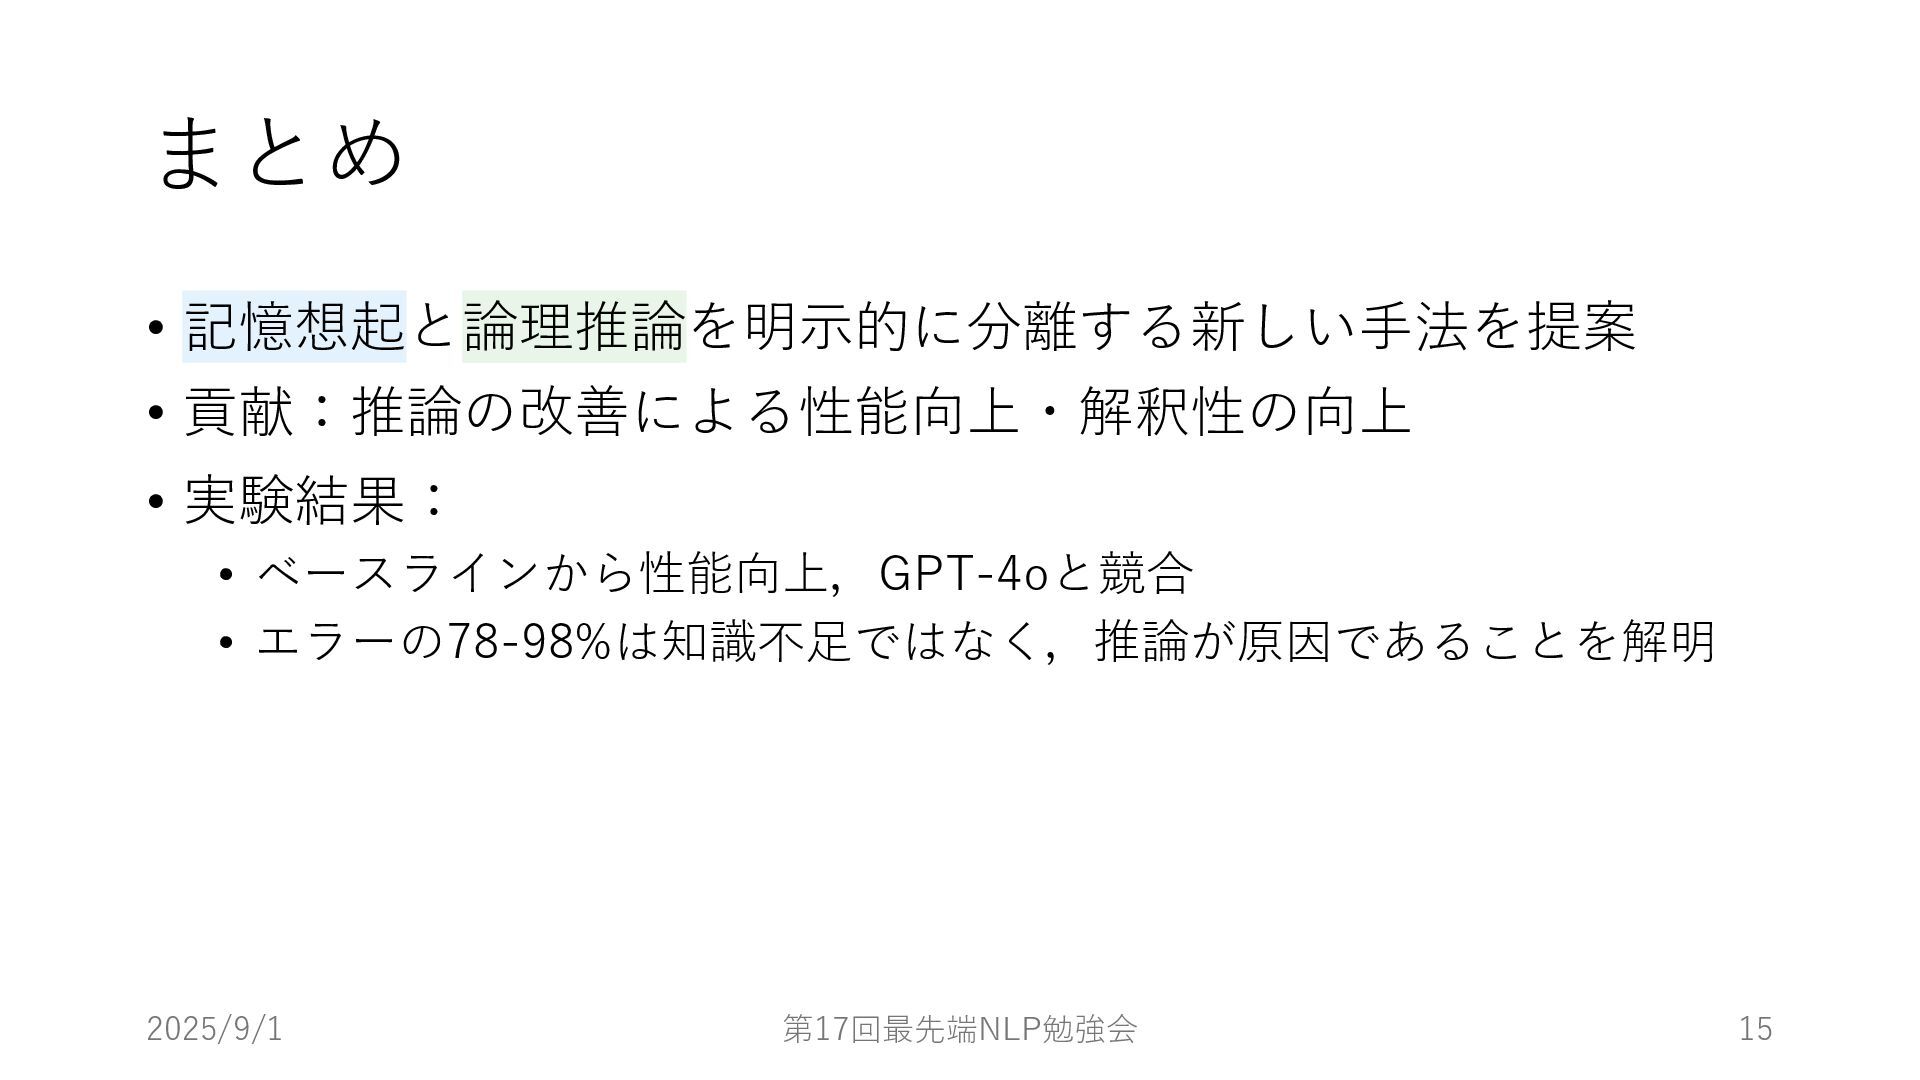
まとめ • 記憶想起と論理推論を明⽰的に分離する新しい⼿法を提案 • 貢献:推論の改善による性能向上・解釈性の向上 • 実験結果: • ベースラインから性能向上,GPT-4oと競合 •
エラーの78-98%は知識不⾜ではなく,推論が原因であることを解明 2025/9/1 第17回最先端NLP勉強会 15 -
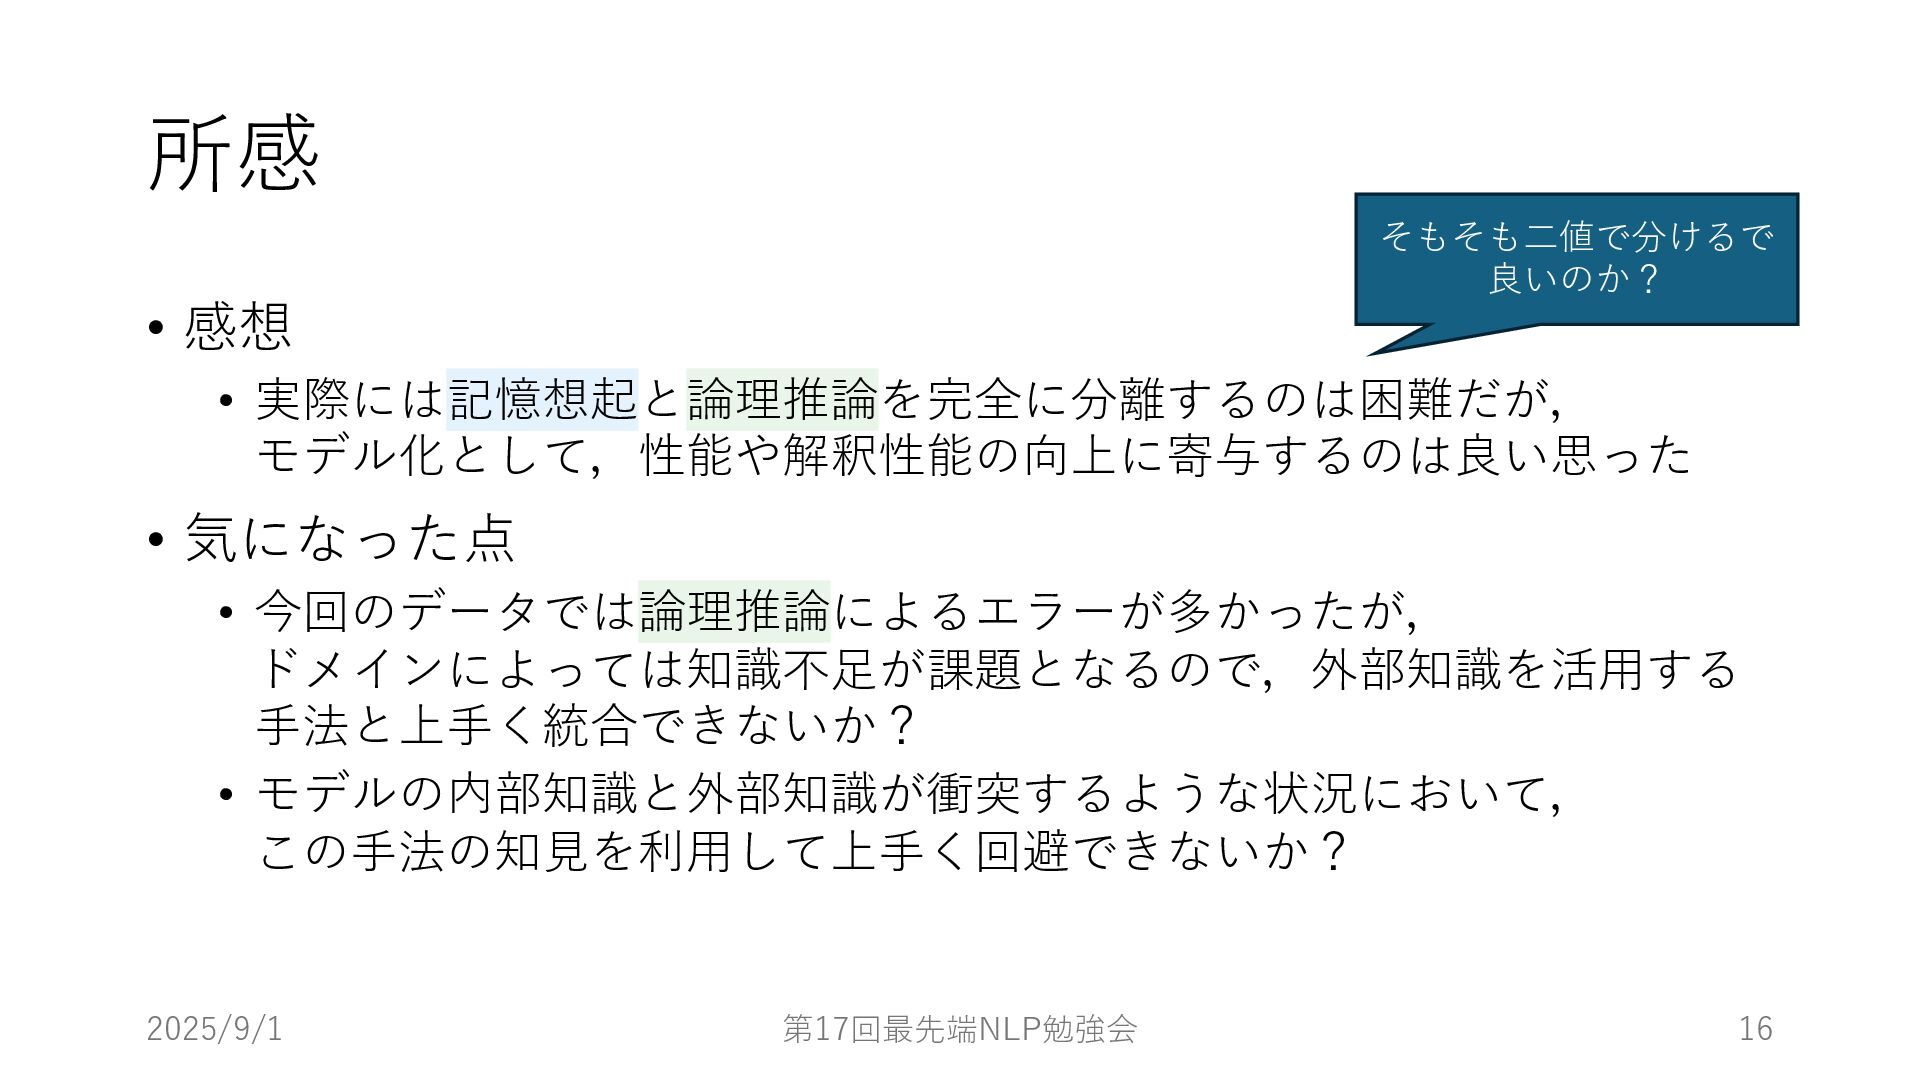
所感 • 感想 • 実際には記憶想起と論理推論を完全に分離するのは困難だが, モデル化として,性能や解釈性能の向上に寄与するのは良い思った • 気になった点 • 今回のデータでは論理推論によるエラーが多かったが,
ドメインによっては知識不⾜が課題となるので,外部知識を活⽤する ⼿法と上⼿く統合できないか? • モデルの内部知識と外部知識が衝突するような状況において, この⼿法の知⾒を利⽤して上⼿く回避できないか? 2025/9/1 第17回最先端NLP勉強会 16 そもそも⼆値で分けるで 良いのか?