Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ito_b4_01_temp
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
kaito1210
February 20, 2014
35
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ito_b4_01_temp
kaito1210
February 20, 2014
More Decks by kaito1210
See All by kaito1210
ito_b4_01
kaito1210
0
130
ito_b3_04
kaito1210
0
160
ito_b3_03
kaito1210
0
210
ito_b3_02
kaito1210
0
40
ito_b3_01
kaito1210
0
39
Featured
See All Featured
The AI Revolution Will Not Be Monopolized: How open-source beats economies of scale, even for LLMs
inesmontani
PRO
3
3.8k
Bash Introduction
62gerente
615
220k
Making Projects Easy
brettharned
120
6.8k
Claude Code のすすめ
schroneko
67
230k
My Coaching Mixtape
mlcsv
0
360
Stop Working from a Prison Cell
hatefulcrawdad
274
21k
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
330
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
400
Ecommerce SEO: The Keys for Success Now & Beyond - #SERPConf2024
aleyda
1
2.2k
The Cost Of JavaScript in 2023
addyosmani
55
10k
Transcript
2014/02/20 伊藤
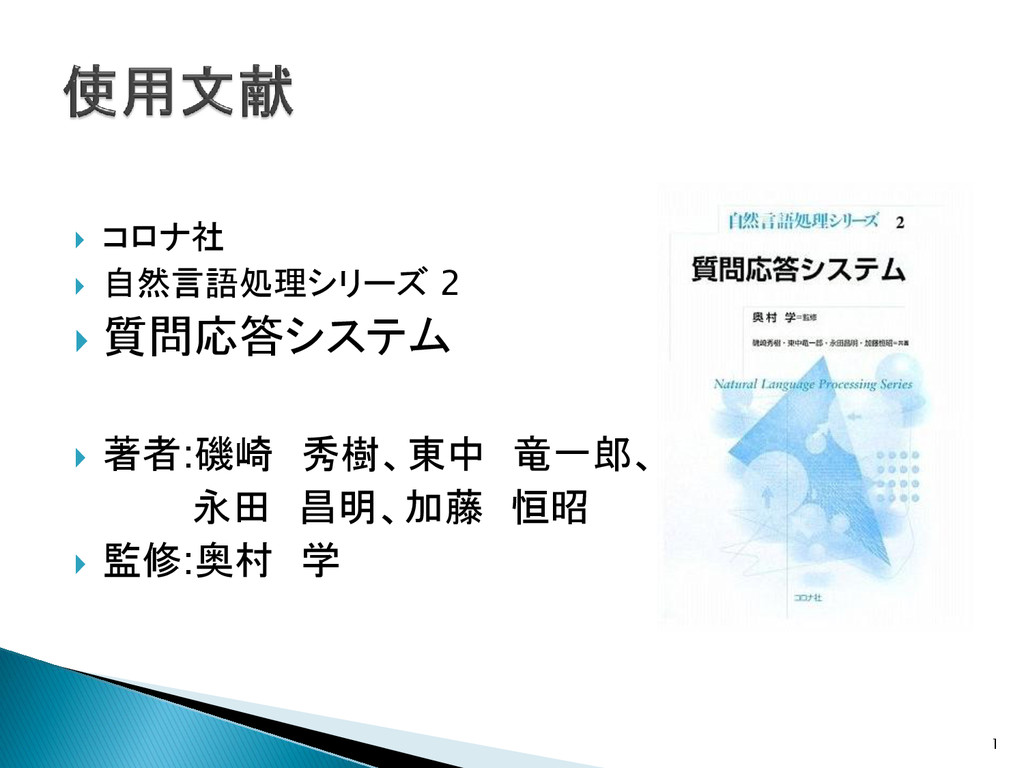
コロナ社 自然言語処理シリーズ 2 質問応答システム 著者:磯崎 秀樹、東中
竜一郎、 永田 昌明、加藤 恒昭 監修:奥村 学 1
単純な事実や出来事に対して質問応答を行う 2
回答が限定される ・人名 ・地名 ・組織名 ・値段 ・日時 ・距離 etc… 短い言葉で簡潔に表すことのできるものに限られる 3
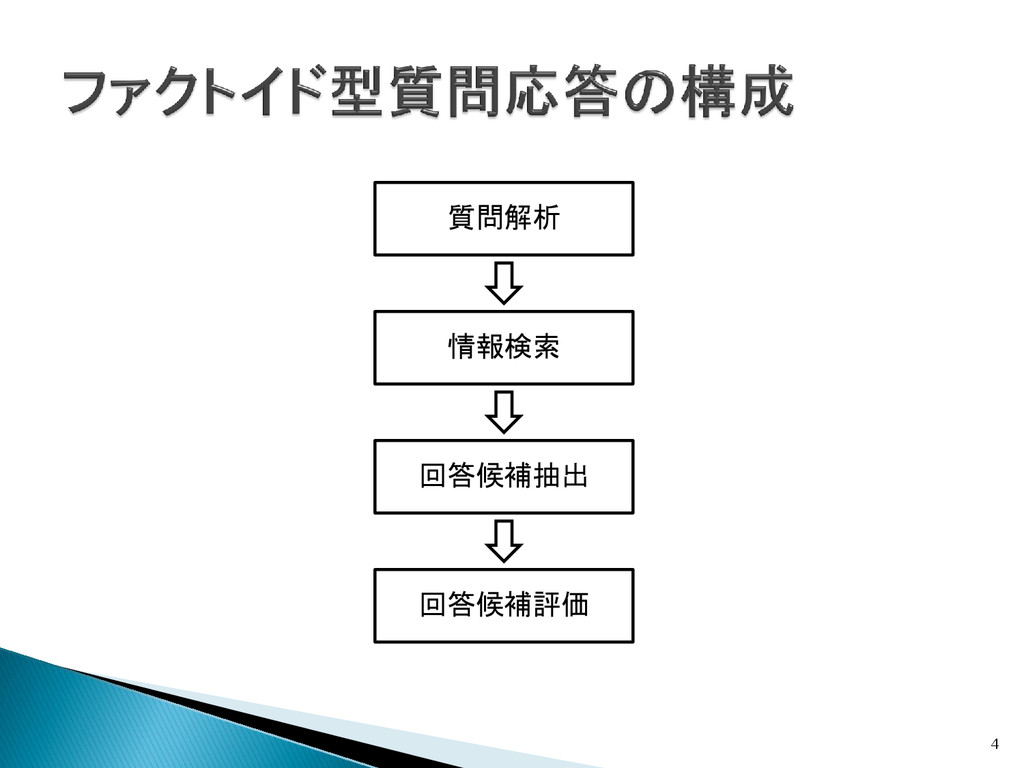
質問解析 情報検索 回答候補抽出 回答候補評価 4
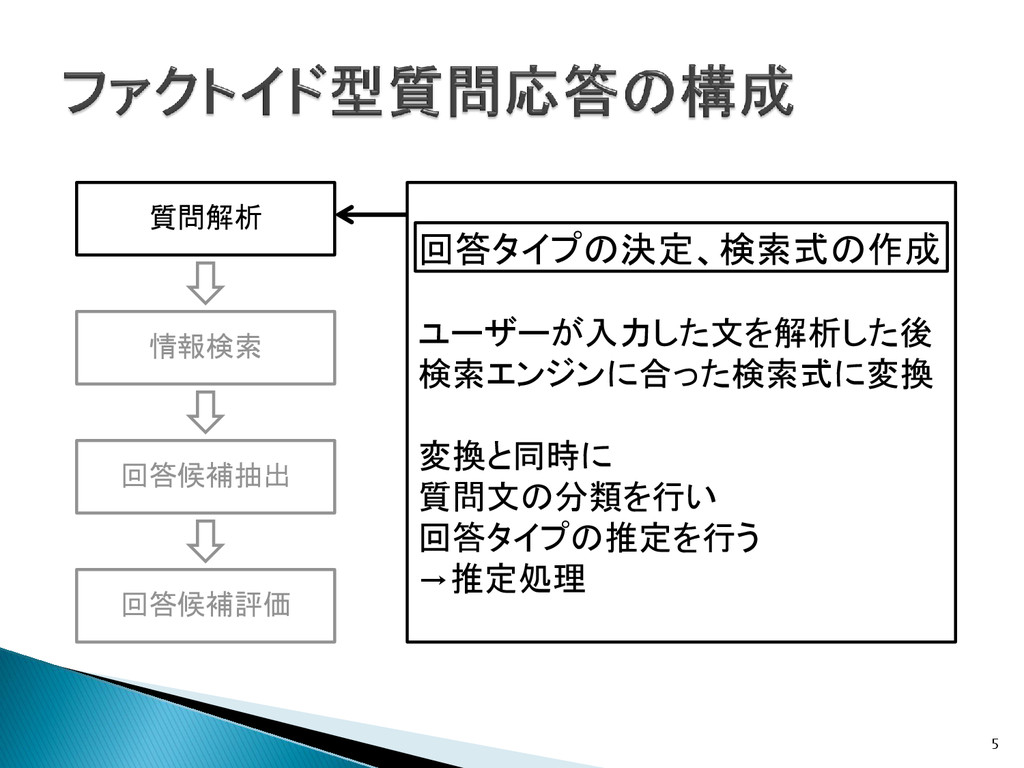
質問解析 情報検索 回答候補抽出 回答候補評価 回答タイプの決定、検索式の作成 ユーザーが入力した文を解析した後 検索エンジンに合った検索式に変換 変換と同時に 質問文の分類を行い 回答タイプの推定を行う
→推定処理 5
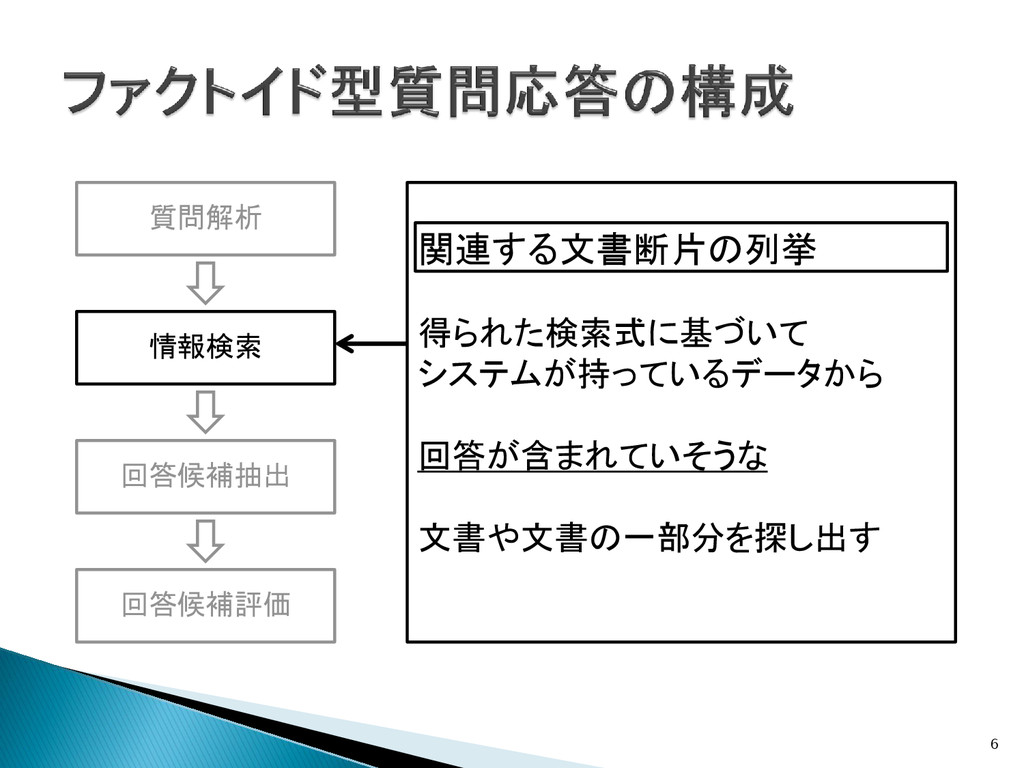
質問解析 情報検索 回答候補抽出 回答候補評価 関連する文書断片の列挙 得られた検索式に基づいて システムが持っているデータから 回答が含まれていそうな 文書や文書の一部分を探し出す 6
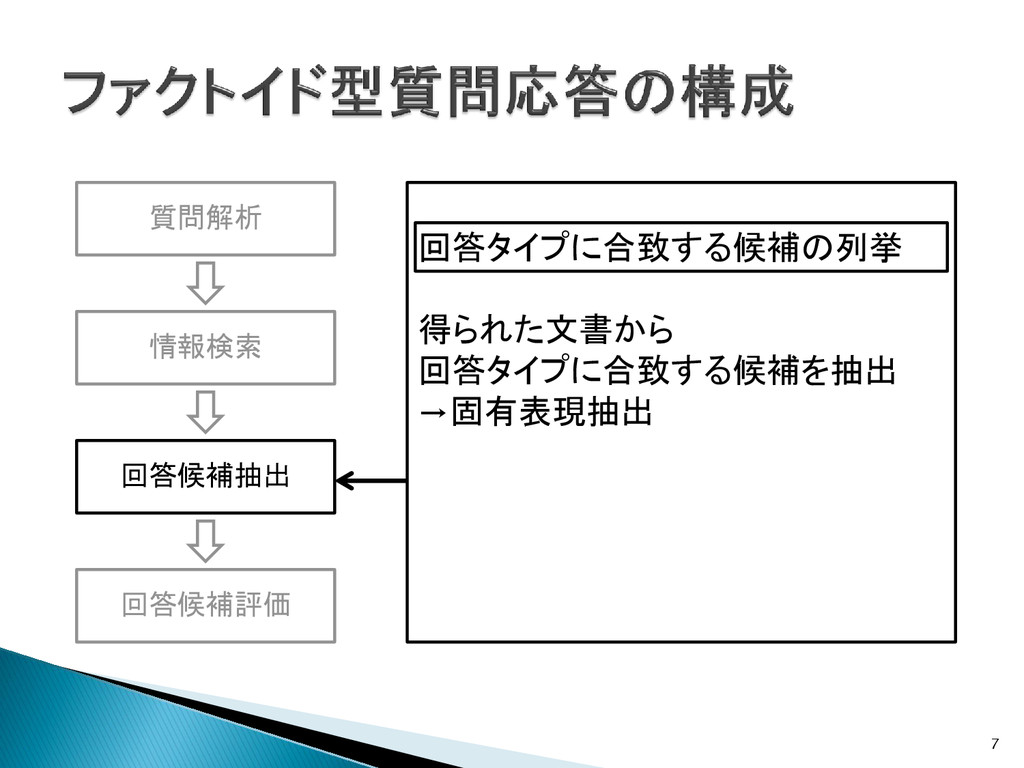
質問解析 情報検索 回答候補抽出 回答候補評価 回答タイプに合致する候補の列挙 得られた文書から 回答タイプに合致する候補を抽出 →固有表現抽出 7
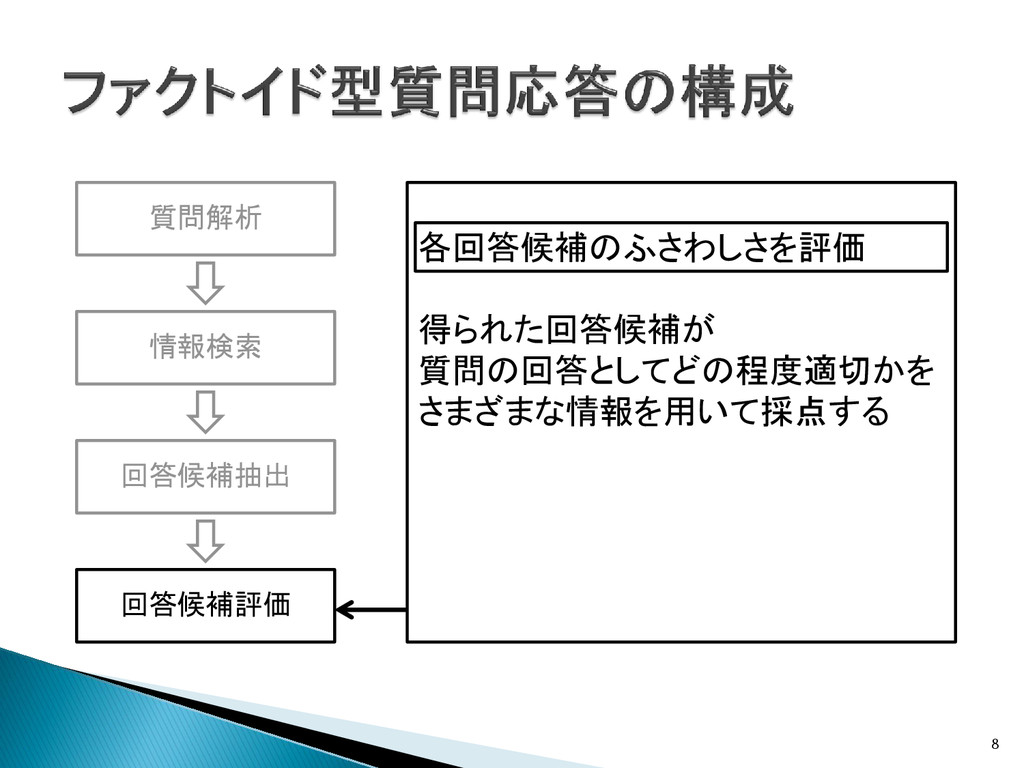
質問解析 情報検索 回答候補抽出 回答候補評価 各回答候補のふさわしさを評価 得られた回答候補が 質問の回答としてどの程度適切かを さまざまな情報を用いて採点する 8
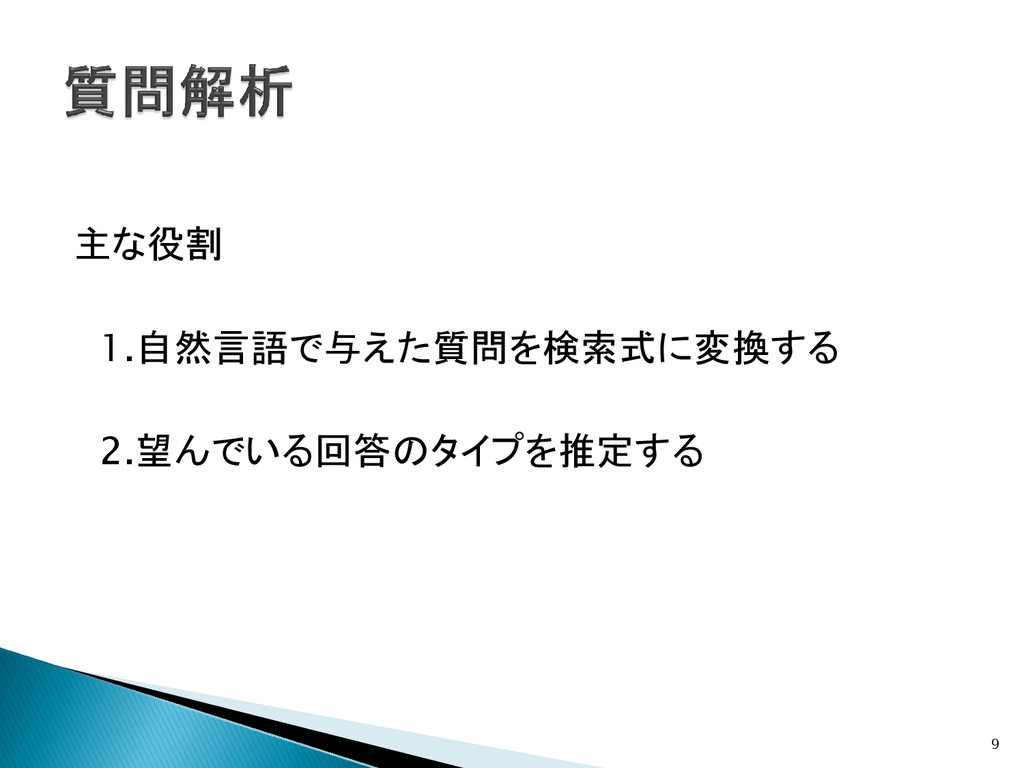
主な役割 1.自然言語で与えた質問を検索式に変換する 2.望んでいる回答のタイプを推定する 9
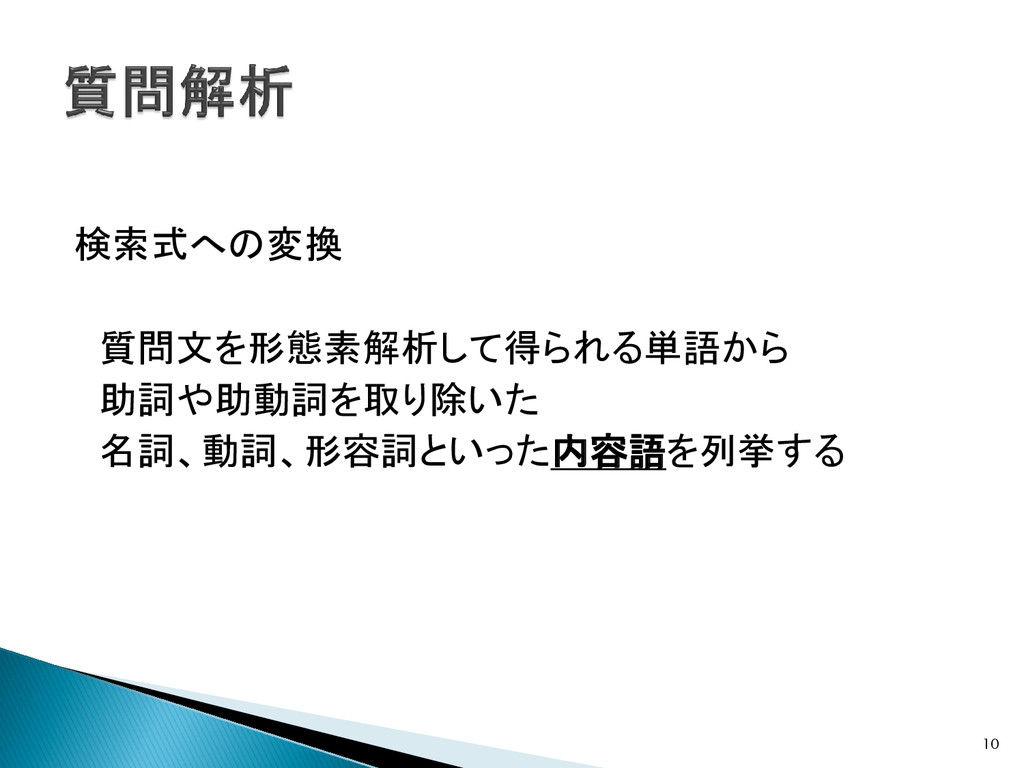
検索式への変換 質問文を形態素解析して得られる単語から 助詞や助動詞を取り除いた 名詞、動詞、形容詞といった内容語を列挙する 10
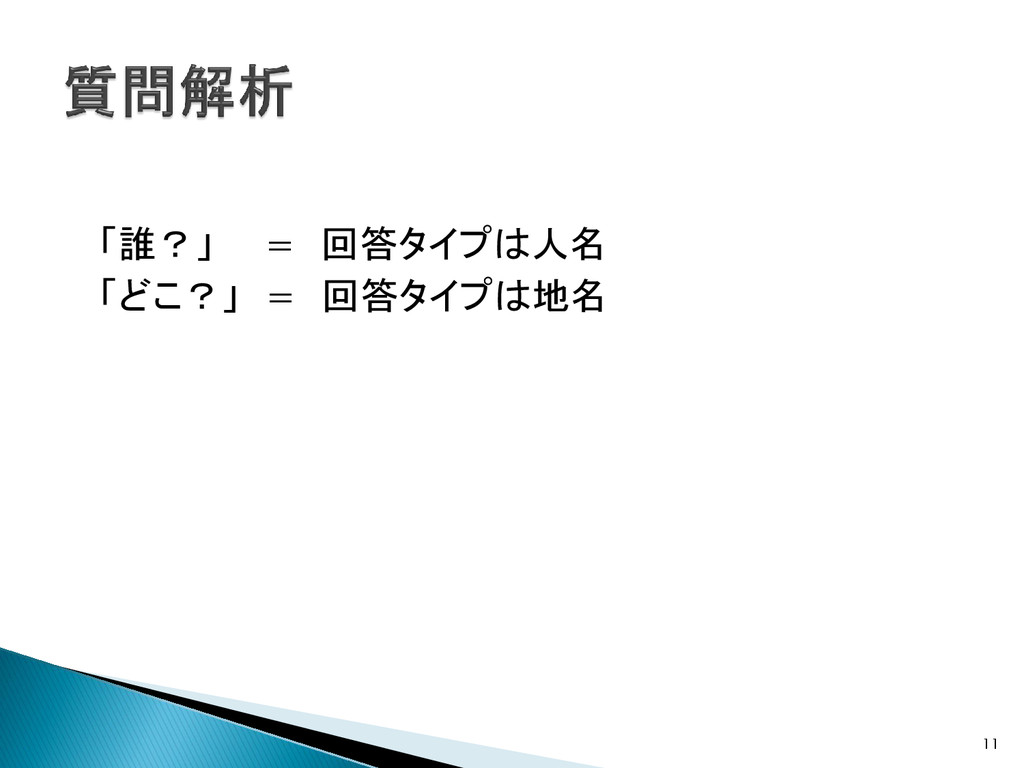
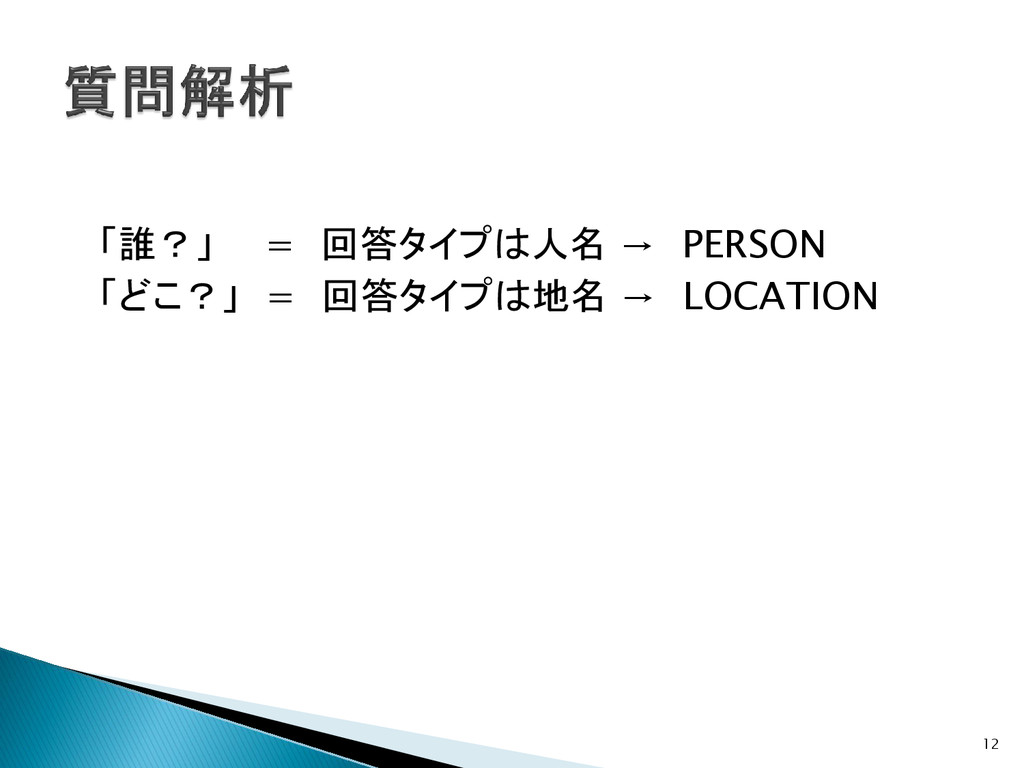
「誰?」 = 回答タイプは人名 「どこ?」 = 回答タイプは地名 11
「誰?」 = 回答タイプは人名 → PERSON 「どこ?」 = 回答タイプは地名 → LOCATION
12
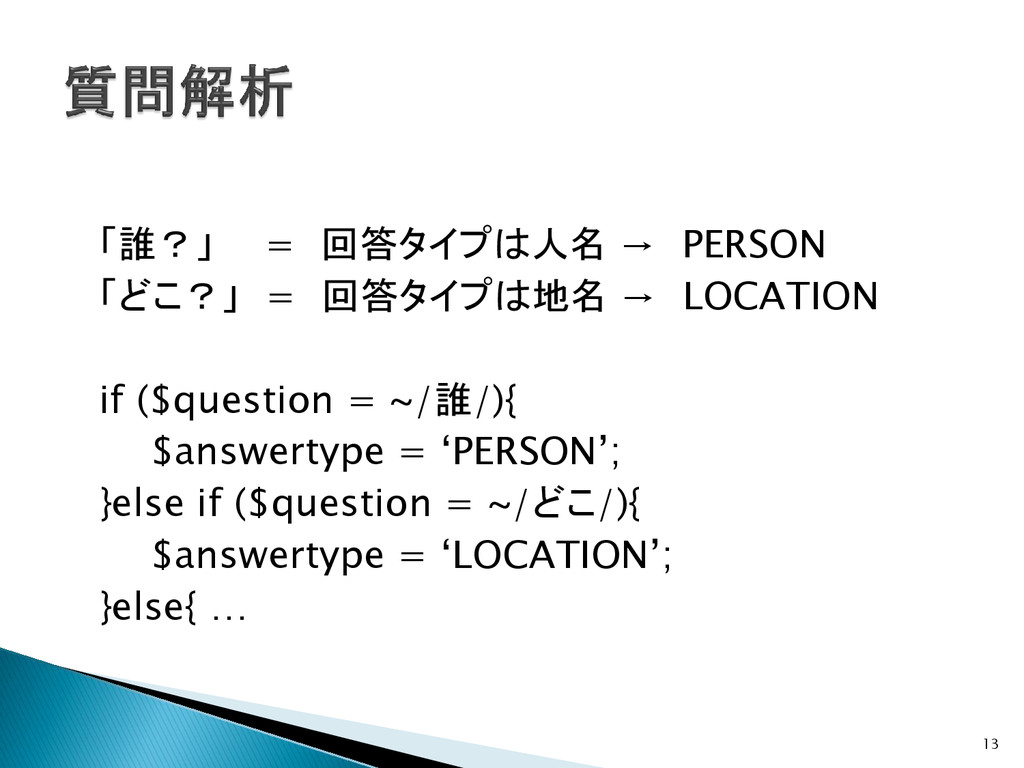
「誰?」 = 回答タイプは人名 → PERSON 「どこ?」 = 回答タイプは地名 → LOCATION
if ($question = ~/誰/){ $answertype = ‘PERSON’; }else if ($question = ~/どこ/){ $answertype = ‘LOCATION’; }else{ … 13
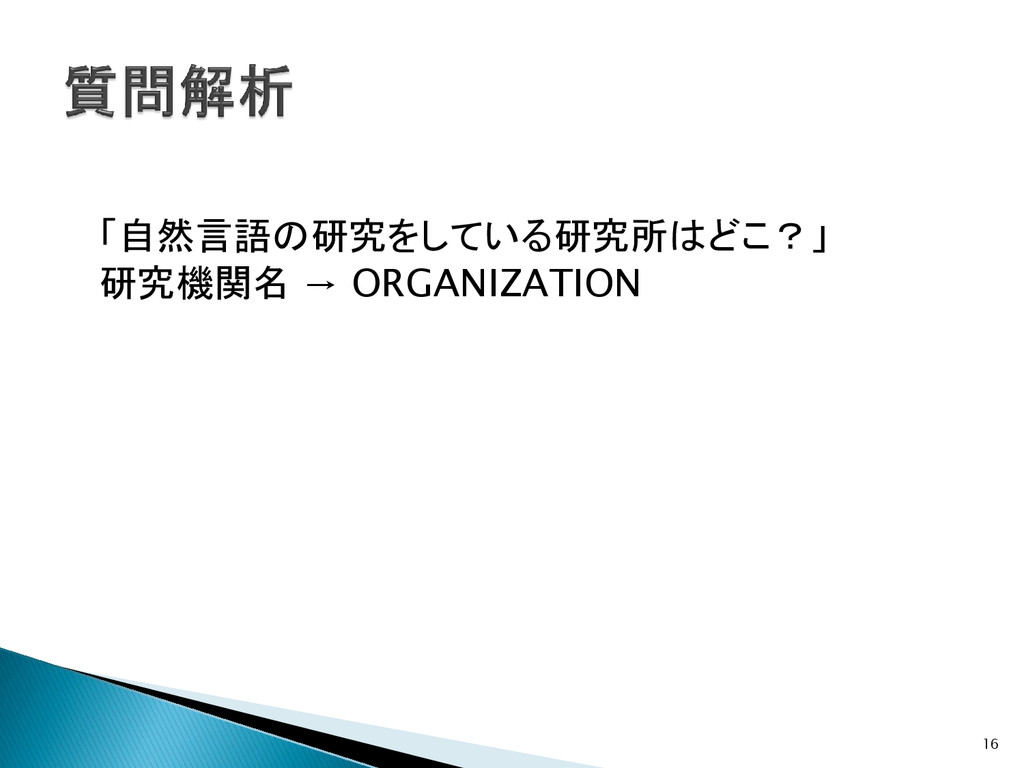
「自然言語の研究をしている研究所はどこ?」 14
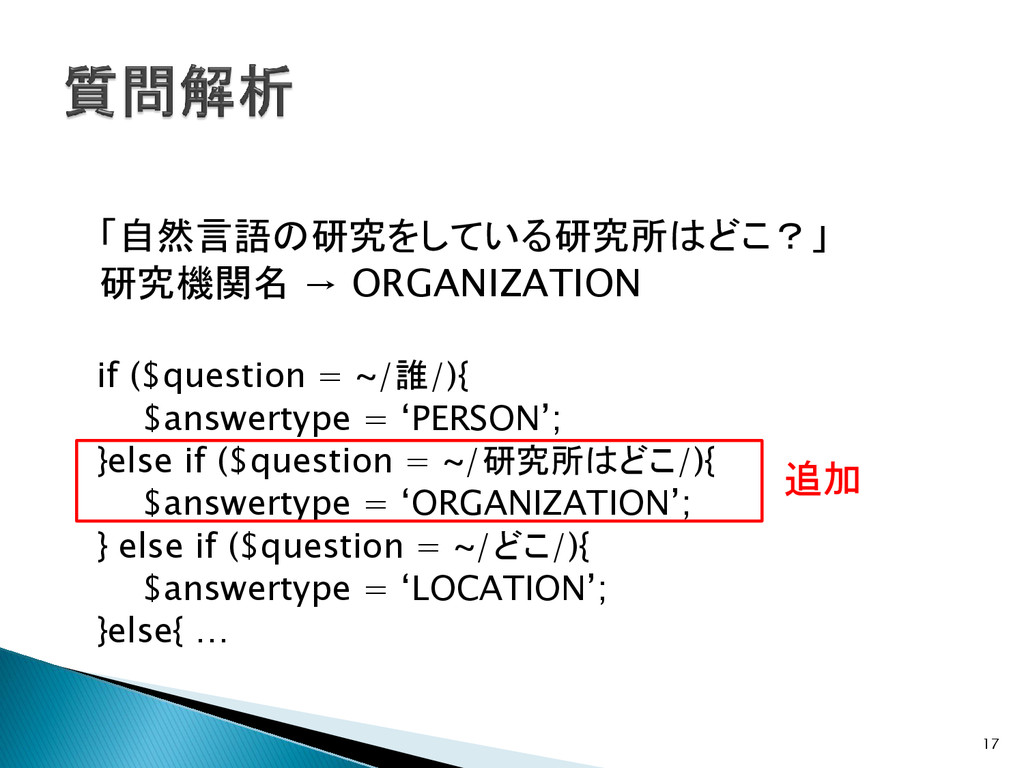
「自然言語の研究をしている研究所はどこ?」 →質問が「どこ?」ではあるが 回答タイプは場所ではなく研究機関名 15
「自然言語の研究をしている研究所はどこ?」 研究機関名 → ORGANIZATION if ($question = ~/誰/){ $answertype =
‘PERSON’; }else if ($question = ~/研究所はどこ/){ $answertype = ‘ORGANIZATION’; } else if ($question = ~/どこ/){ $answertype = ‘LOCATION’; }else (…){ 16
「自然言語の研究をしている研究所はどこ?」 研究機関名 → ORGANIZATION if ($question = ~/誰/){ $answertype =
‘PERSON’; }else if ($question = ~/研究所はどこ/){ $answertype = ‘ORGANIZATION’; } else if ($question = ~/どこ/){ $answertype = ‘LOCATION’; }else{ … 追加 17
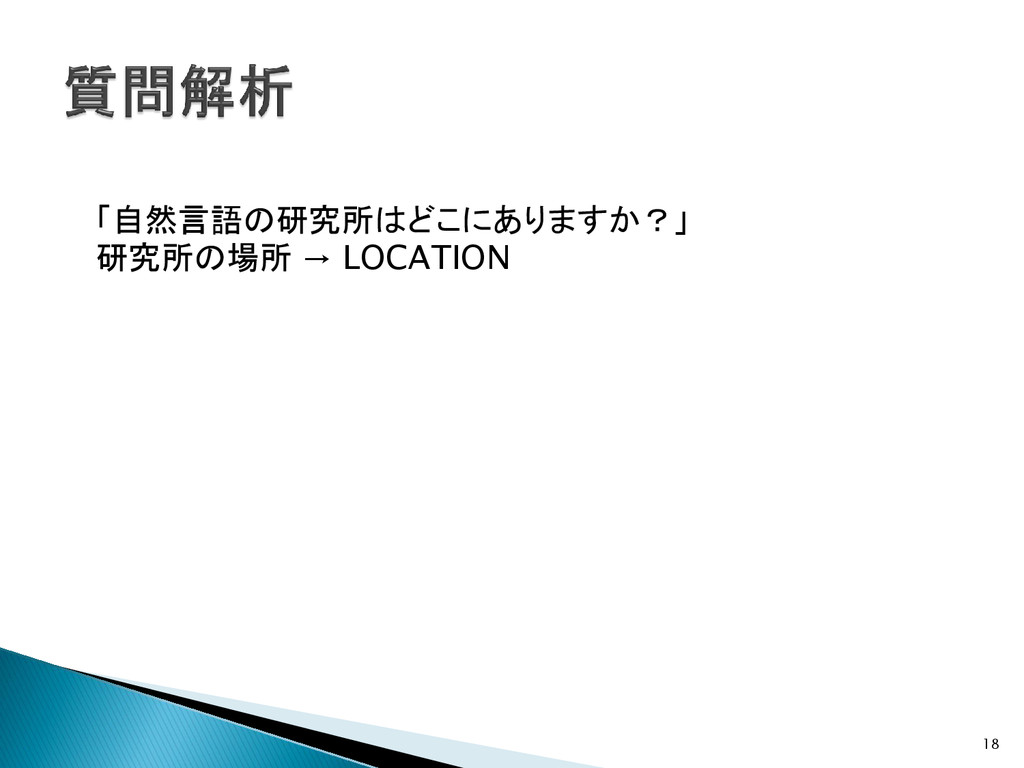
「自然言語の研究所はどこにありますか?」 研究所の場所 → LOCATION if ($question = ~/誰/){ $answertype =
‘PERSON’; } else if ($question = ~/どこにあ(る|り|った)/){ $answertype = ‘ORGANIZATION’; } else if ($question = ~/研究所はどこ/){ $answertype = ‘ORGANIZATION’; } else if ($question = ~/どこ/){ $answertype = ‘LOCATION’; }else (…){ 18
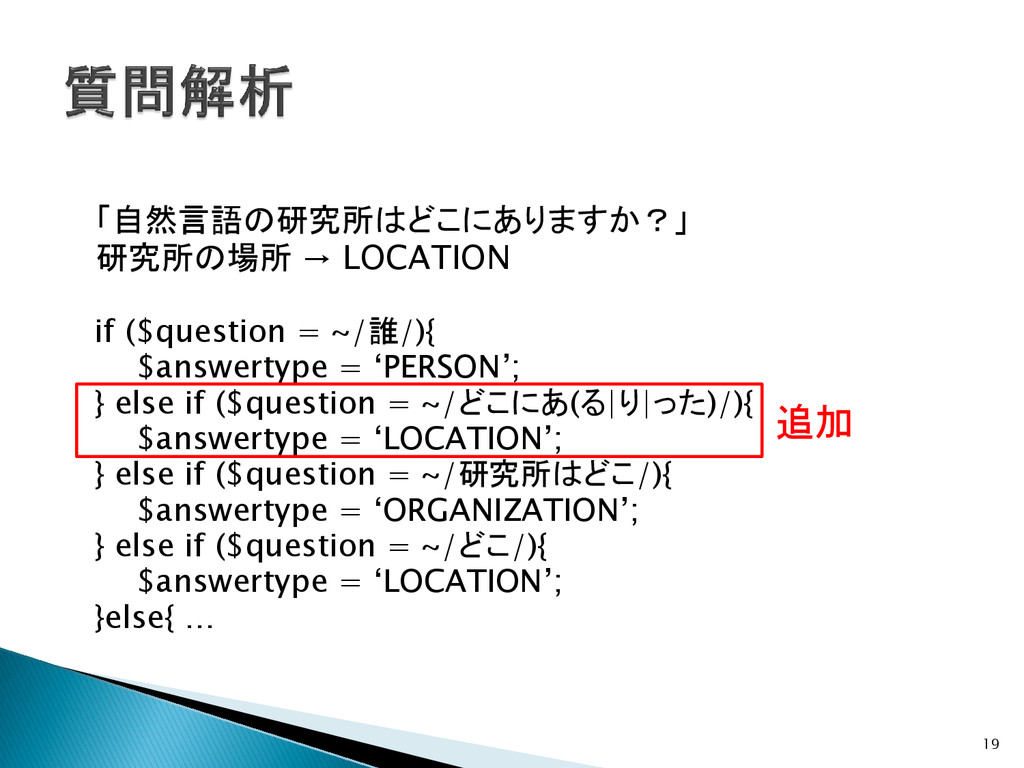
「自然言語の研究所はどこにありますか?」 研究所の場所 → LOCATION if ($question = ~/誰/){ $answertype =
‘PERSON’; } else if ($question = ~/どこにあ(る|り|った)/){ $answertype = ‘LOCATION’; } else if ($question = ~/研究所はどこ/){ $answertype = ‘ORGANIZATION’; } else if ($question = ~/どこ/){ $answertype = ‘LOCATION’; }else{ … 追加 19
というように 質問毎に回答タイプを追加していくのは 手間がかかる プログラムは汚くなるし分かりにくくなる 20
現在の多くのシステムは「ルール記述言語」を作成 “誰” -> type = PERSON “の” {品詞=名詞,語義=役職} “は” ->
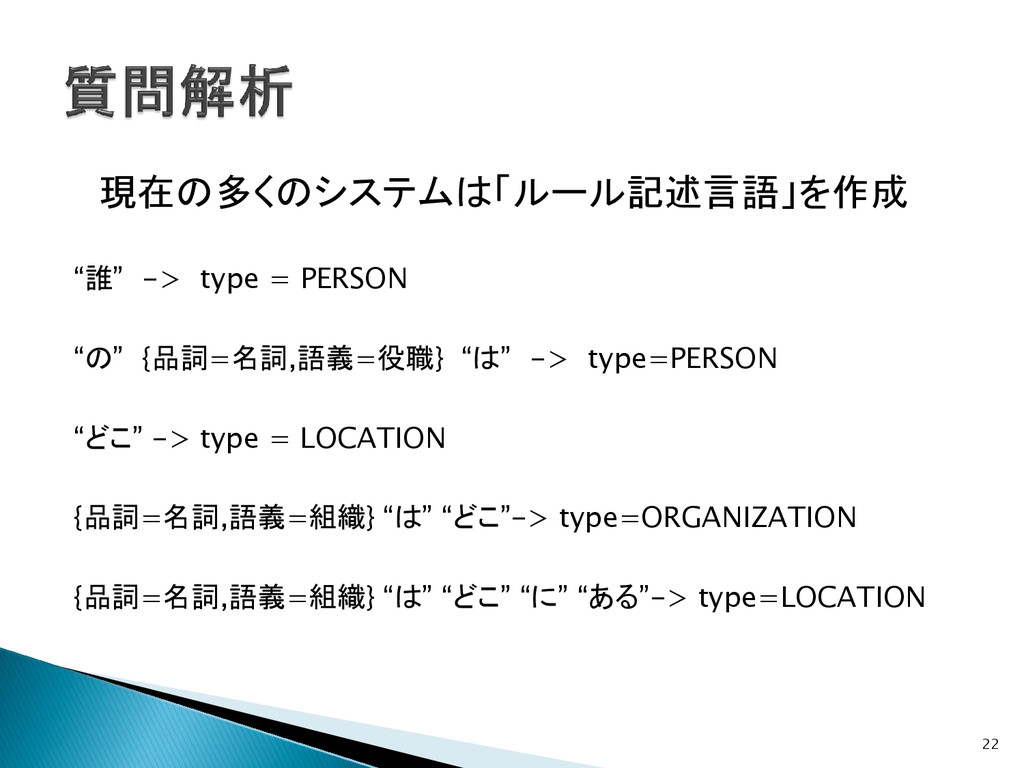
type=PERSON “どこ” -> type = LOCATION {品詞=名詞,語義=組織} “は” “どこ”-> type=ORGANIZATION {品詞=名詞,語義=組織} “は” “どこ” “に” “ある”-> type=LOCATION 21
現在の多くのシステムは「ルール記述言語」を作成 “誰” -> type = PERSON “の” {品詞=名詞,語義=役職} “は” ->
type=PERSON “どこ” -> type = LOCATION {品詞=名詞,語義=組織} “は” “どこ”-> type=ORGANIZATION {品詞=名詞,語義=組織} “は” “どこ” “に” “ある”-> type=LOCATION 22
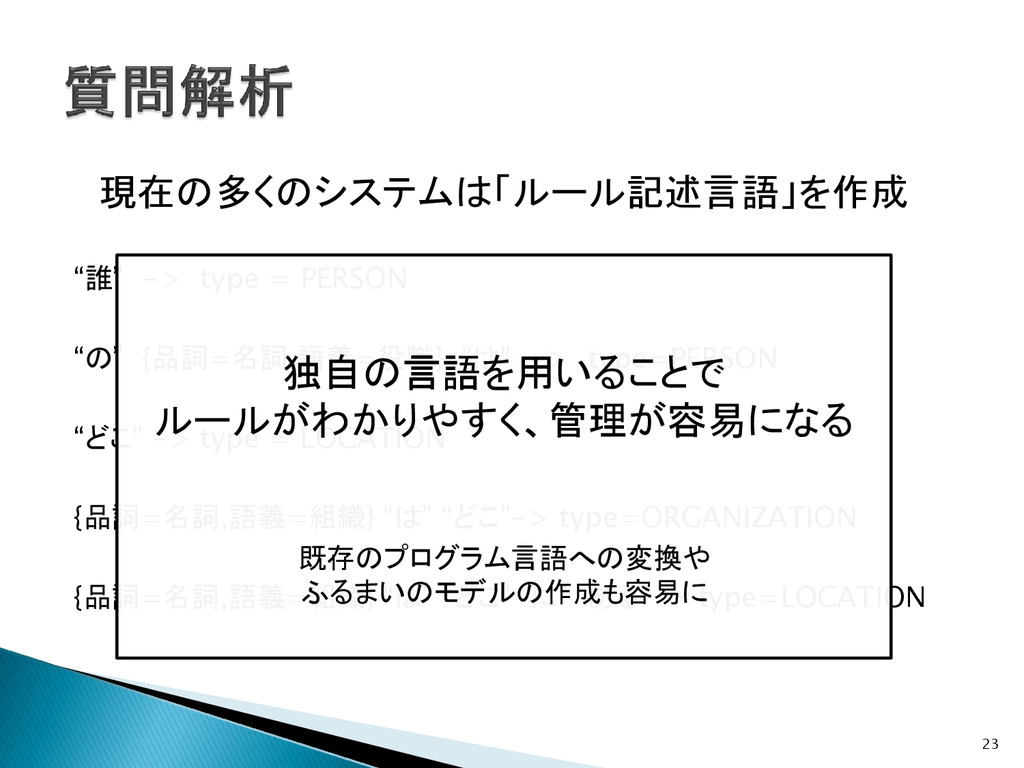
現在の多くのシステムは「ルール記述言語」を作成 “誰” -> type = PERSON “の” {品詞=名詞,語義=役職} “は” ->
type=PERSON “どこ” -> type = LOCATION {品詞=名詞,語義=組織} “は” “どこ”-> type=ORGANIZATION {品詞=名詞,語義=組織} “は” “どこ” “に” “ある”-> type=LOCATION 独自の言語を用いることで ルールがわかりやすく、管理が容易になる 既存のプログラム言語への変換や ふるまいのモデルの作成も容易に 23
ルール記述言語を用いることで簡潔になるものの 質問毎に回答タイプを追加していくため 手間がかかることは変わらない プログラムは見やすくなる 24
特にルールが増加していくと 人の手では管理や処理ができなくなる可能性がある →機械に自動でルール管理や処理を 「機械学習」 を用いて行わせる 25
「機械学習」 ・トレーニングデータを用意し、教師あり学習を行う ・ルールの作成が機械学習のツールによって行われる ためルールの干渉についての問題は解消される 機械学習について細かい説明は割愛 26
質問解析によって得られた ・形態素解析によって得られた検索式 ・ルール記述言語や機械学習により推定された回答タイプ この2つのデータに対して情報検索を行う 27
多用な質問に答えるため検索式から全文検索を行う 28
全文検索に用いられるインデックス構成法 1.転置インデックス 2.文字n-gram 3.接尾辞配列 29
1.転置インデックス 事前に文書全体を処理し 単語や文字列がどのあたりにあるかを調べ インデックスとして保存しておく インデックスを検索することで 文書の一部分から抽出が可能 30
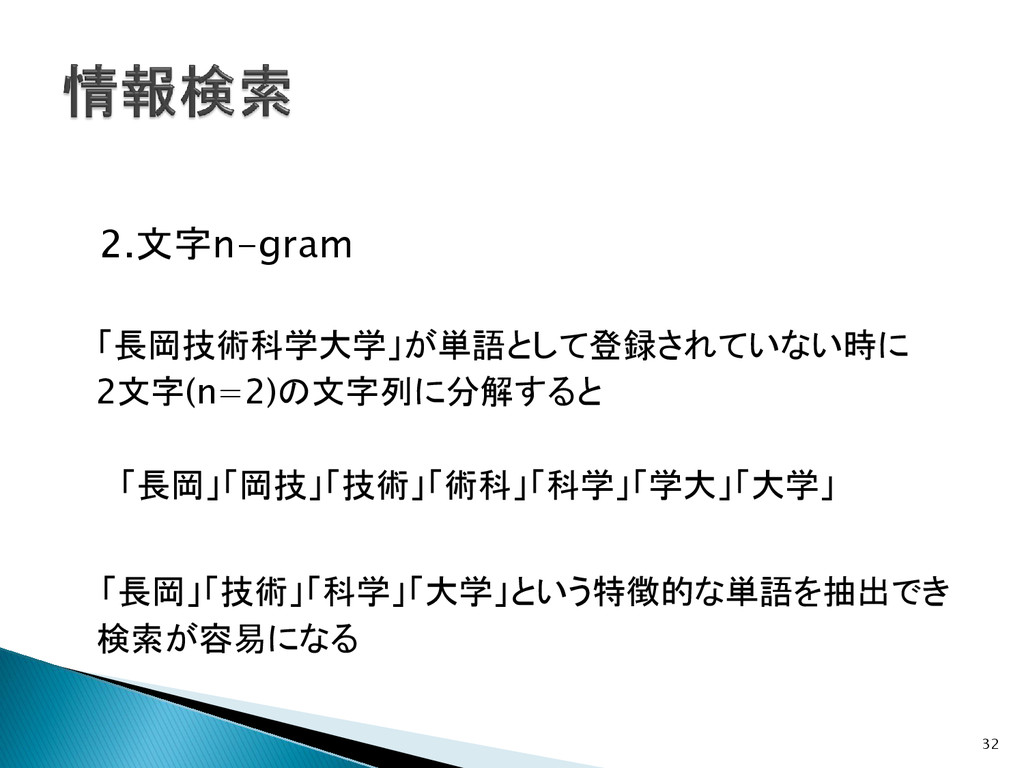
2.文字n-gram 単語をn文字の文字列に分解する 分解された文字列は前後の文脈に依存しないため 質問と回答候補のどちらにも含まれるはず 31
2.文字n-gram 「長岡技術科学大学」が単語として登録されていない時に 2文字(n=2)の文字列に分解すると 「長岡」「岡技」「技術」「術科」「科学」「学大」「大学」 「長岡」「技術」「科学」「大学」という特徴的な単語を抽出でき 検索が容易になる 32
3.接尾辞配列 テキスト中の接尾辞を辞書順に並べ それに対するポインタを配列に格納したもの 33
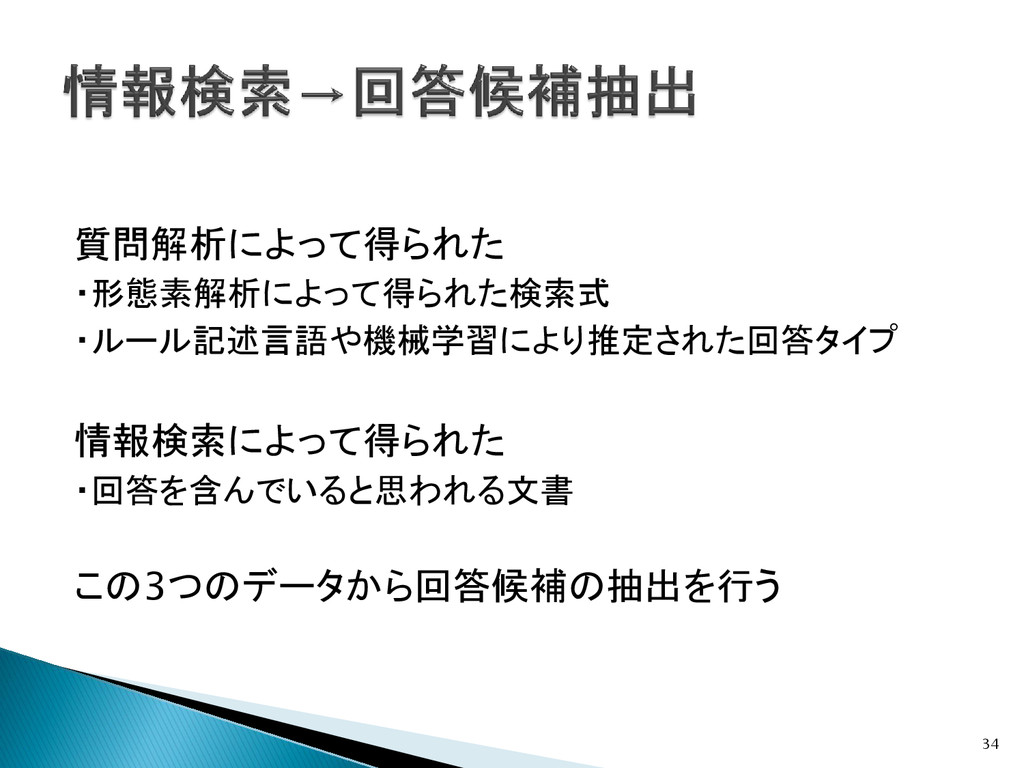
質問解析によって得られた ・形態素解析によって得られた検索式 ・ルール記述言語や機械学習により推定された回答タイプ 情報検索によって得られた ・回答を含んでいると思われる文書 この3つのデータから回答候補の抽出を行う 34
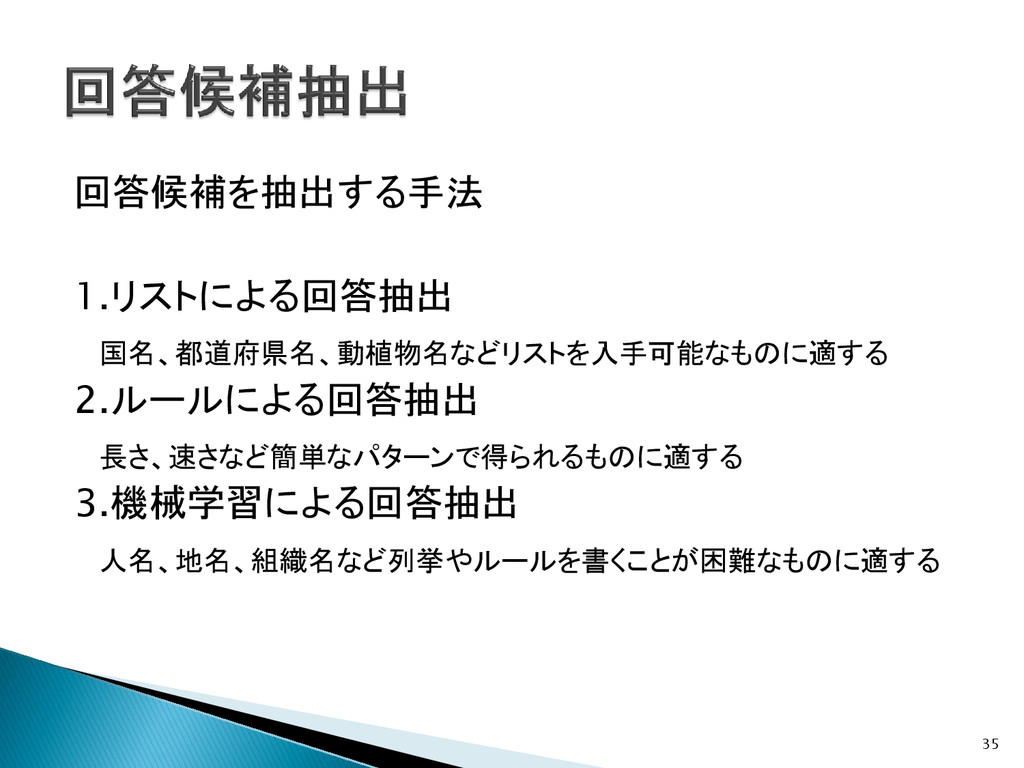
回答候補を抽出する手法 1.リストによる回答抽出 国名、都道府県名、動植物名などリストを入手可能なものに適する 2.ルールによる回答抽出 長さ、速さなど簡単なパターンで得られるものに適する 3.機械学習による回答抽出 人名、地名、組織名など列挙やルールを書くことが困難なものに適する 35
回答候補抽出に特に重要となるのが 「固有表現抽出」 36
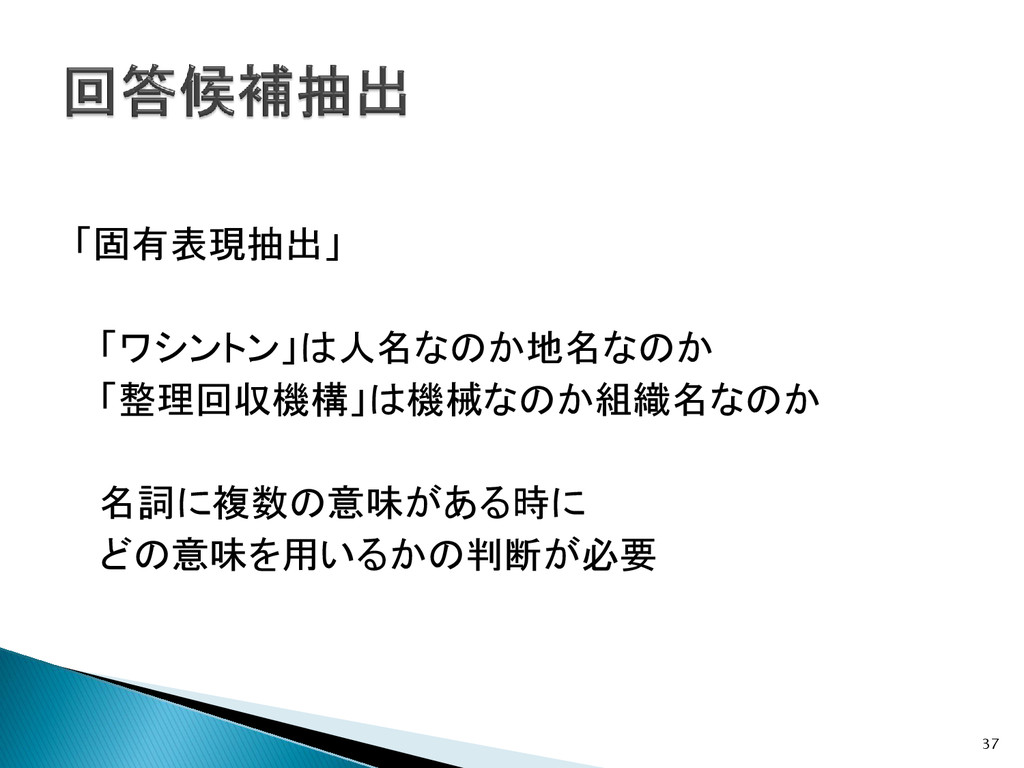
「固有表現抽出」 「ワシントン」は人名なのか地名なのか 「整理回収機構」は機械なのか組織名なのか 名詞に複数の意味がある時に どの意味を用いるかの判断が必要 37
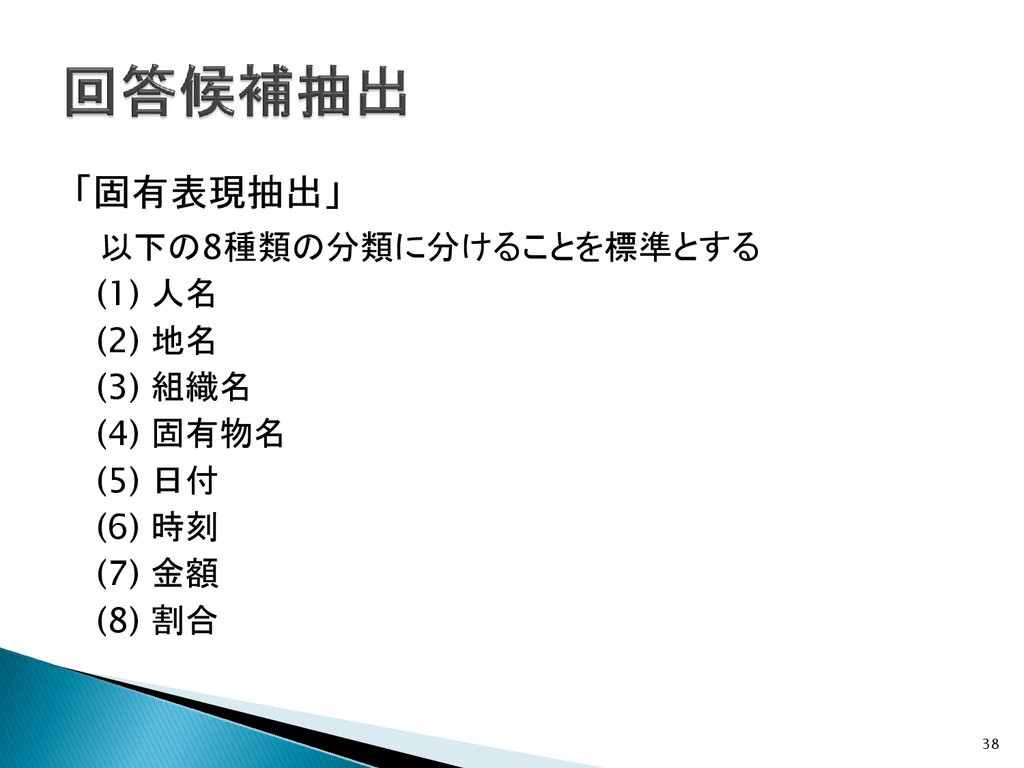
「固有表現抽出」 以下の8種類の分類に分けることを標準とする (1) 人名 (2) 地名 (3) 組織名 (4) 固有物名
(5) 日付 (6) 時刻 (7) 金額 (8) 割合 38
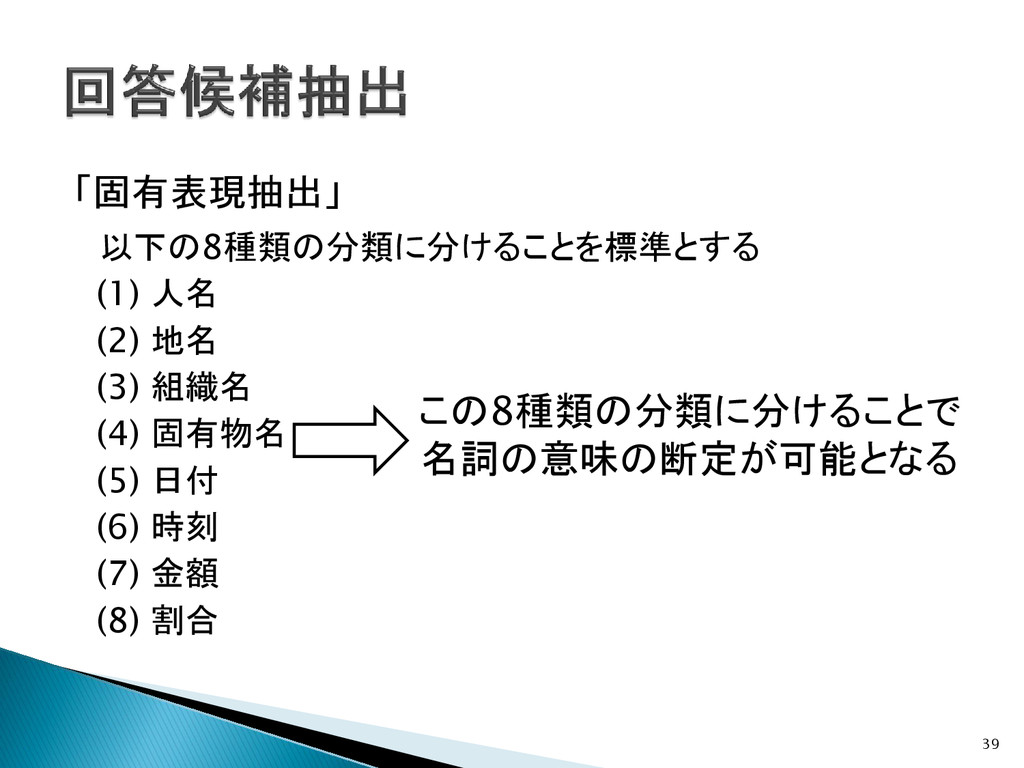
「固有表現抽出」 以下の8種類の分類に分けることを標準とする (1) 人名 (2) 地名 (3) 組織名 (4) 固有物名
(5) 日付 (6) 時刻 (7) 金額 (8) 割合 39 この8種類の分類に分けることで 名詞の意味の断定が可能となる
回答候補抽出によって得られた 回答を評価し質問応答の回答として提示する 40
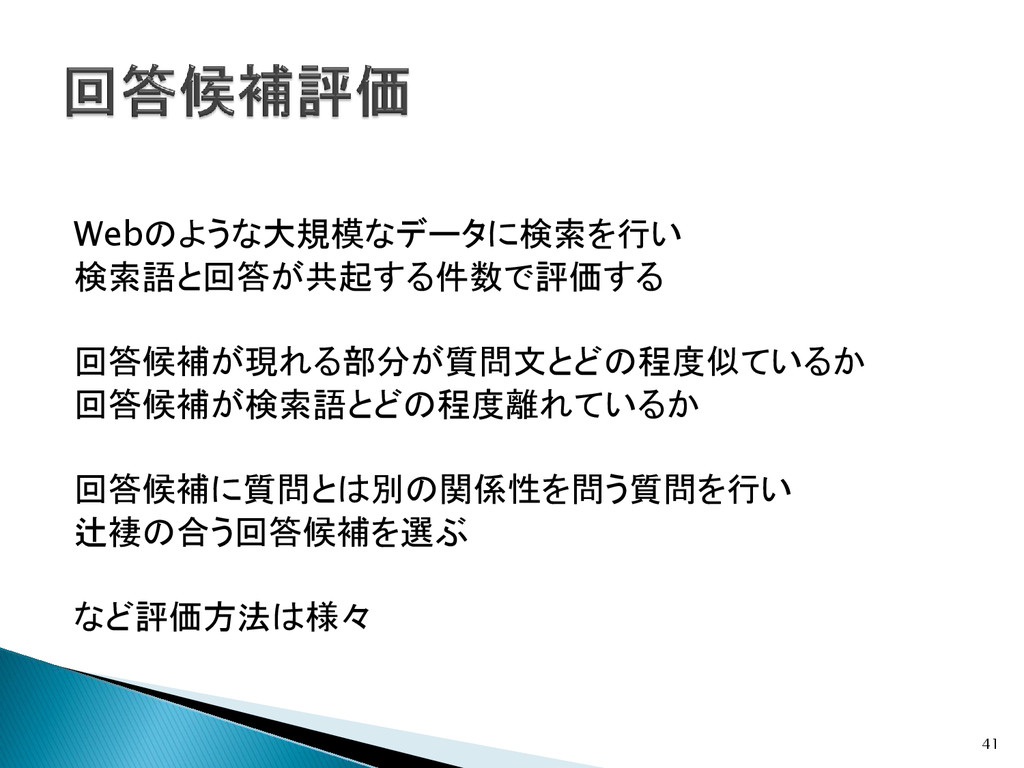
Webのような大規模なデータに検索を行い 検索語と回答が共起する件数で評価する 回答候補が現れる部分が質問文とどの程度似ているか 回答候補が検索語とどの程度離れているか 回答候補に質問とは別の関係性を問う質問を行い 辻褄の合う回答候補を選ぶ など評価方法は様々 41
ノンファクトイド型質問応答 について発表致します 42
43
機械学習について http://www.jnlp.org/takeno/b3zemi/3rdweek 接尾辞配列について スライド 17-18 http://www.jnlp.org/takahashi/b3seminar/no5
44


 kaito1210
 inesmontani
 62gerente
 brettharned
 schroneko
 mlcsv
 hatefulcrawdad
 katarinadahlin
 denniskardys
 sugarenia
 reverentgeek
 aleyda
 addyosmani