Share
Embed
はじめての生成AIローカルLLM、llama.cppとllamafile。練習演習あり初心者向け講座
OSC名古屋2024の発表資料です。初心者向け生成AI資料です。
kapper1224
May 25, 2024
Transcript
47 slides
-
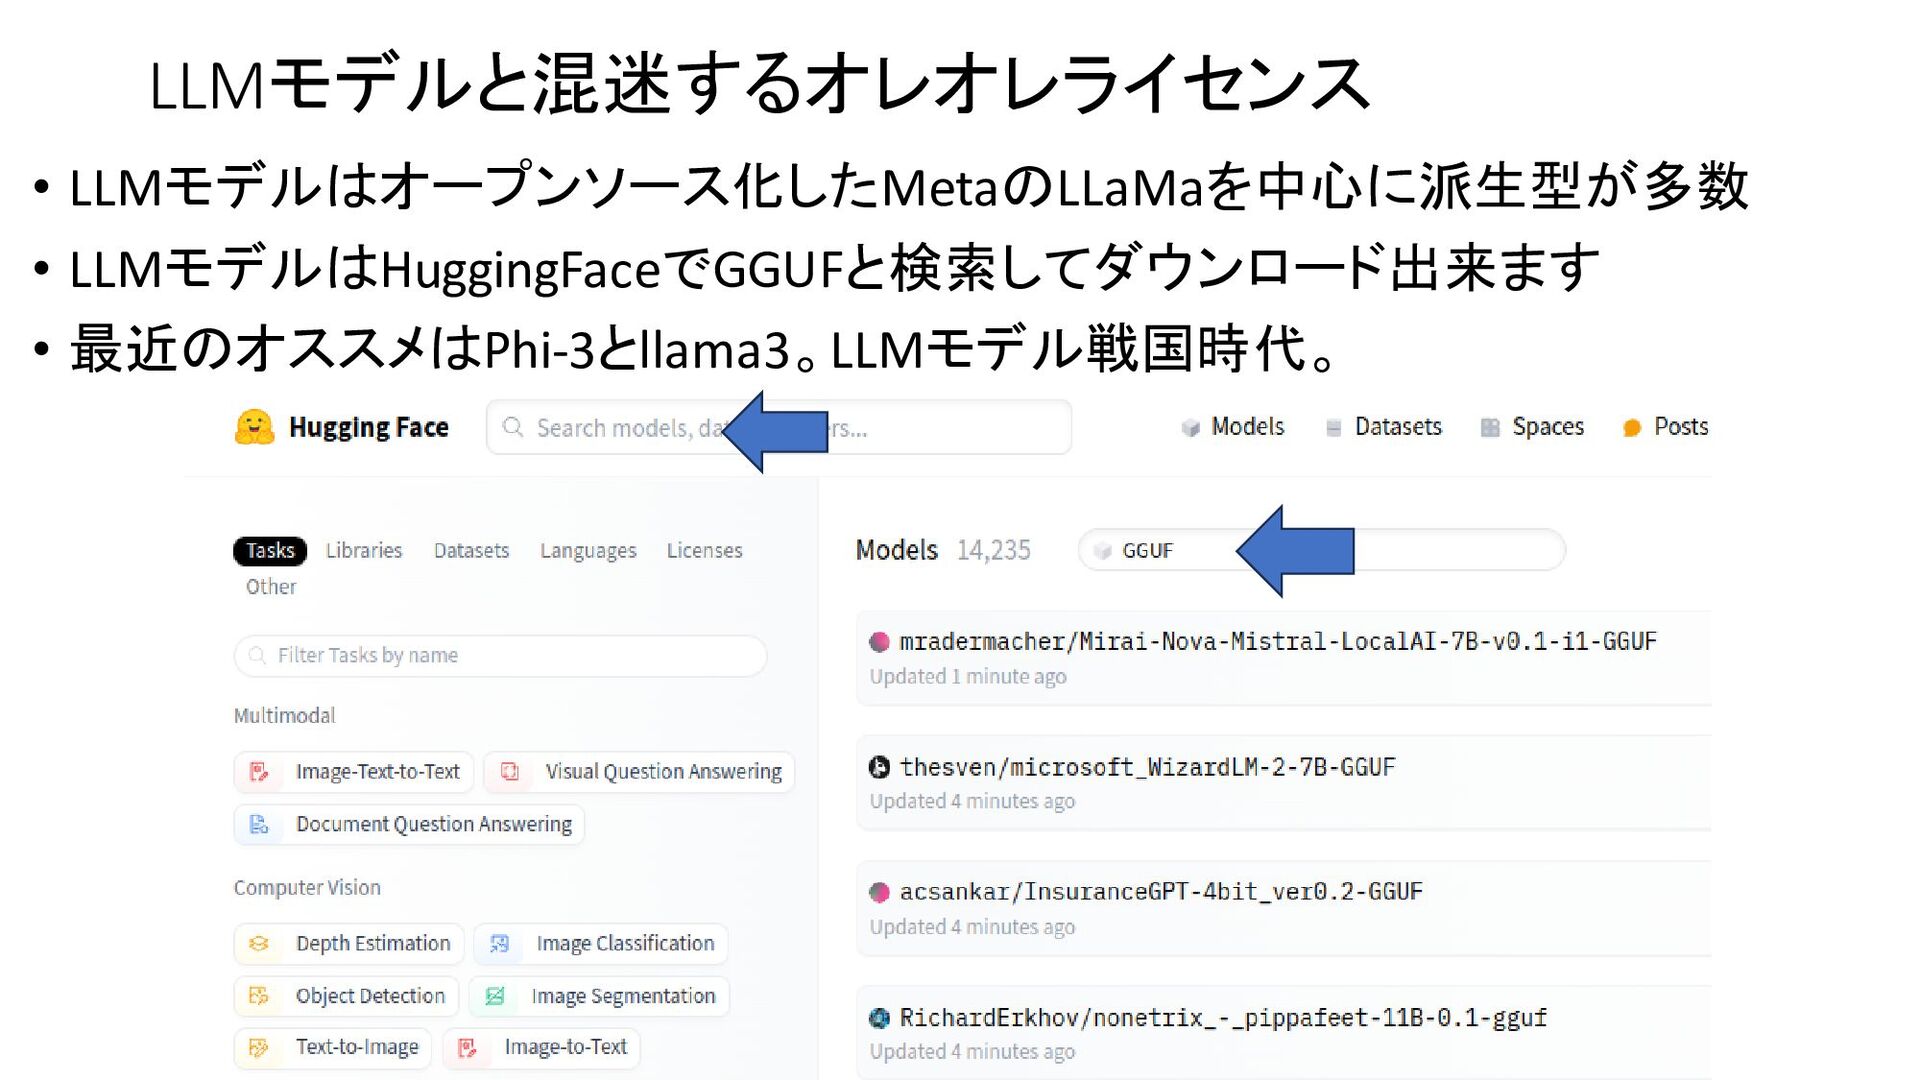
はじめての生成AIローカルLLM、llama.cppとllamafile。練 習演習あり初心者向け講座 発表者:Kapper ガジェットハッキング ユーザーグループ This Presentation: Slideshare & PDF
files publication of my HP http://kapper1224.sakura.ne.jp Gadget Hacking User Group Speaker:Kapper 1.準備 2.ローカルLLMと生成AI 3. llamafile演習 4.llama.cpp,Ollama他 5.その他 OSC名古屋2024 2024年5月25日 Place: 中小企業振興会館 15:00〜15:45 メインテーマ「ガジェット&生成AI」 -
自己紹介 Self Introduction • My name: Kapper • Twitter account:@kapper1224
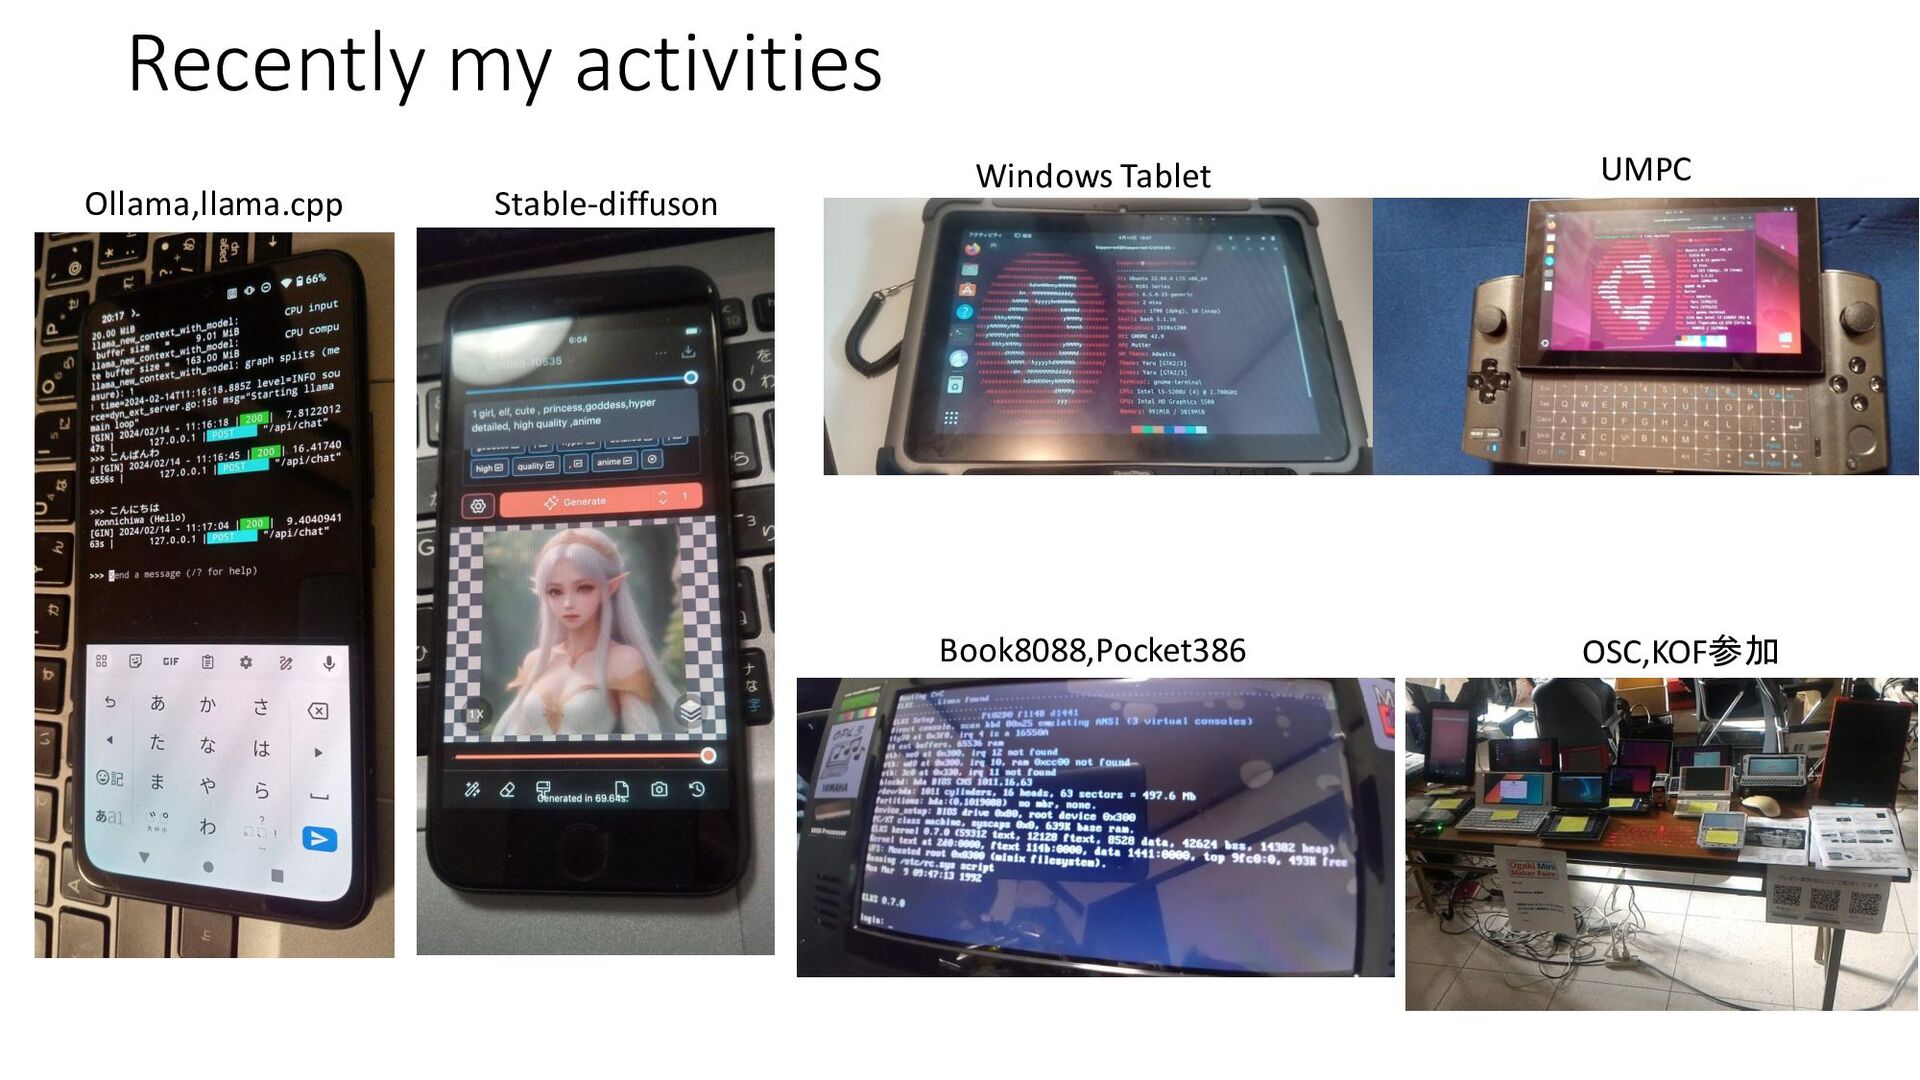
• HP:http://kapper1224.sakura.ne.jp • Slideshare: http://www.slideshare.net/kapper1224 • Mastodon:https://pawoo.net/@kapper1224/ • Facebook:https://www.facebook.com/kapper1224/ • My nobels:https://ncode.syosetu.com/n7491fi/ • My Togetter:https://togetter.com/id/kapper1224 • My Youtube:http://kapper1224.sakura.ne.jp/Youtube.html • My Hobby:Linux、*BSD、and Mobile Devices • My favorite words:The records are the more important than the experiment. • Test Model:Netwalker、Nokia N900、DynabookAZ、RaspberryPi、Nexus7、Nexus5、Chromebook、GPD-WIN、GPD- Pocket、Macbook、NANOTE、Windows Tablet、SailfishOS、UBPorts、postmarketOS、NetBSD and The others... • Recent my Activity: • Hacking Generative AI (Images and LLM) in a lot of devices. • Hacking Linux on Windows10 Tablet (Intel Atom) and Android Smartphone. • Hacking NetBSD and OpenBSD on UEFI and Windows Tablet. • I have over 200 Windows Tablet and 120 ARM Android, and test it now. • 後、最近小説家になろうで異世界で製造業と産業革命の小説書いていますなう。 -
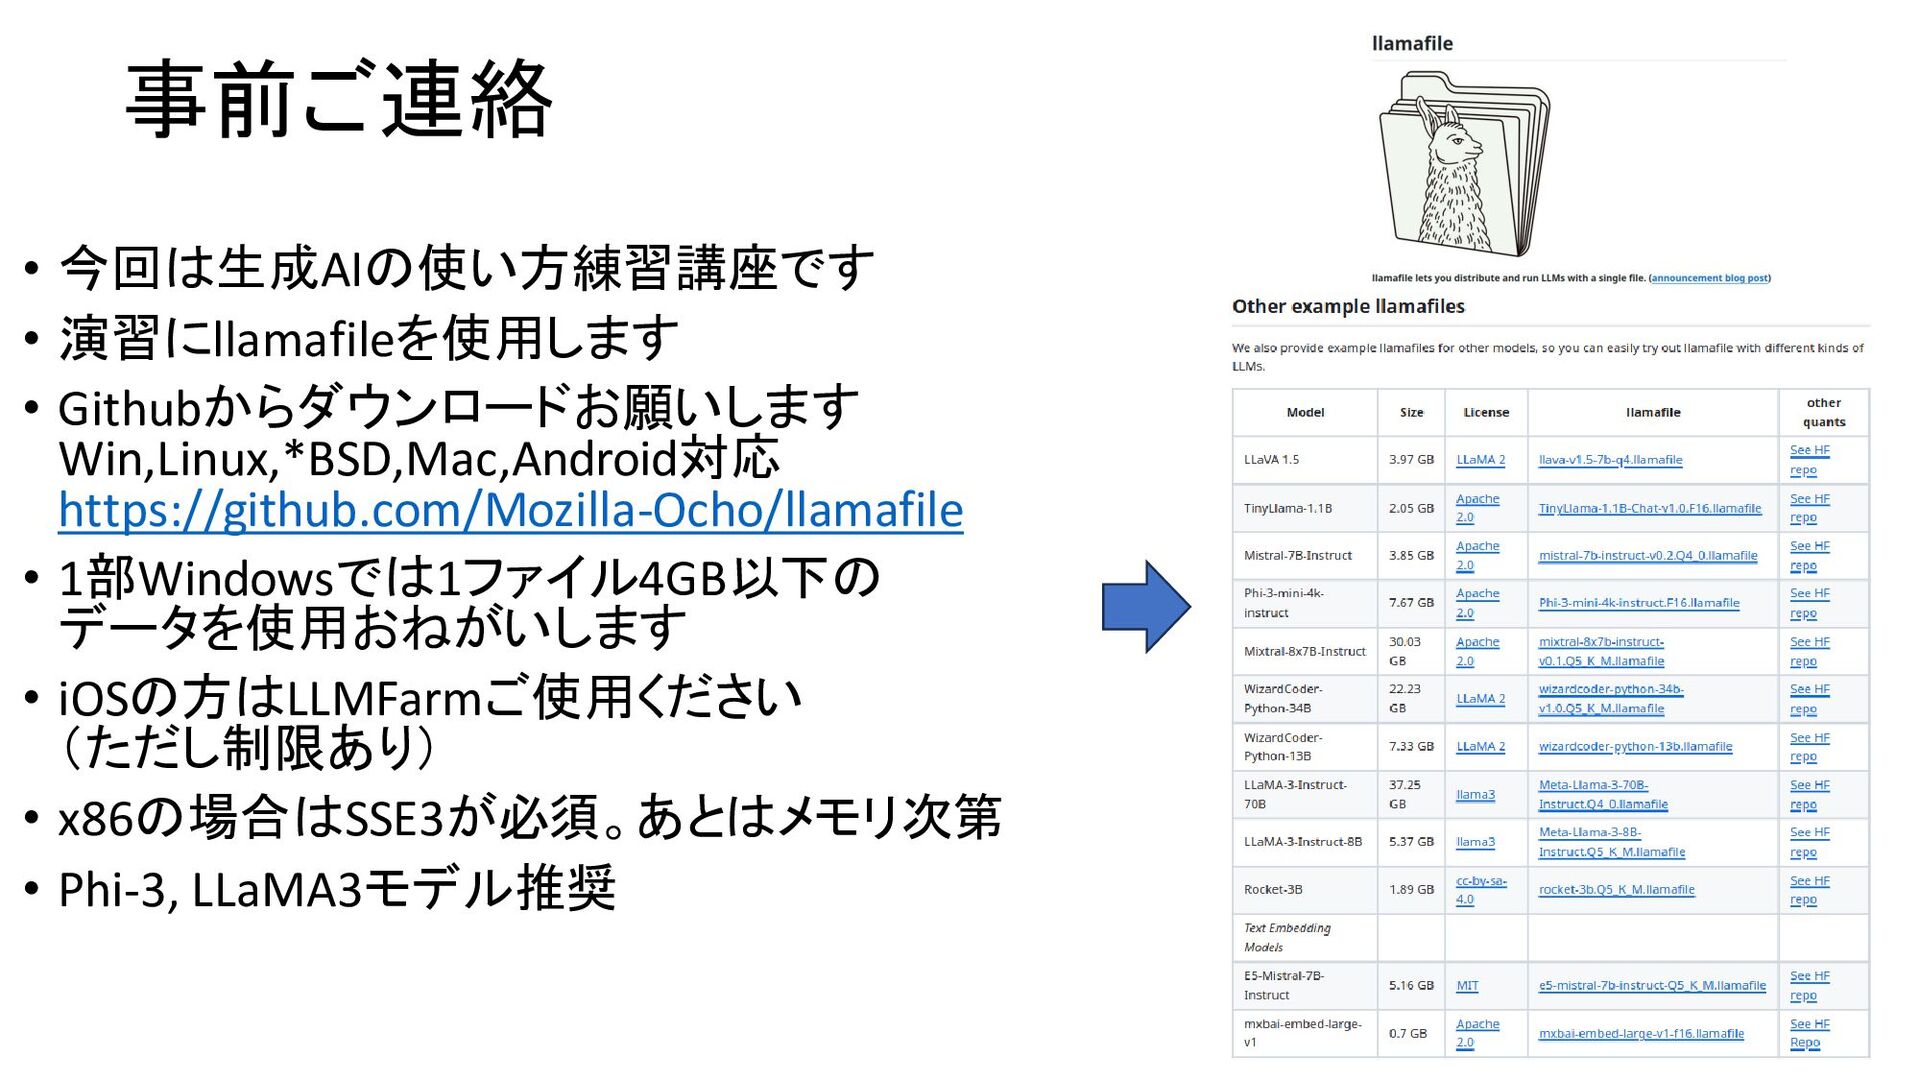
事前ご連絡 • 今回は生成AIの使い方練習講座です • 演習にllamafileを使用します • Githubからダウンロードお願いします Win,Linux,*BSD,Mac,Android対応 https://github.com/Mozilla-Ocho/llamafile •
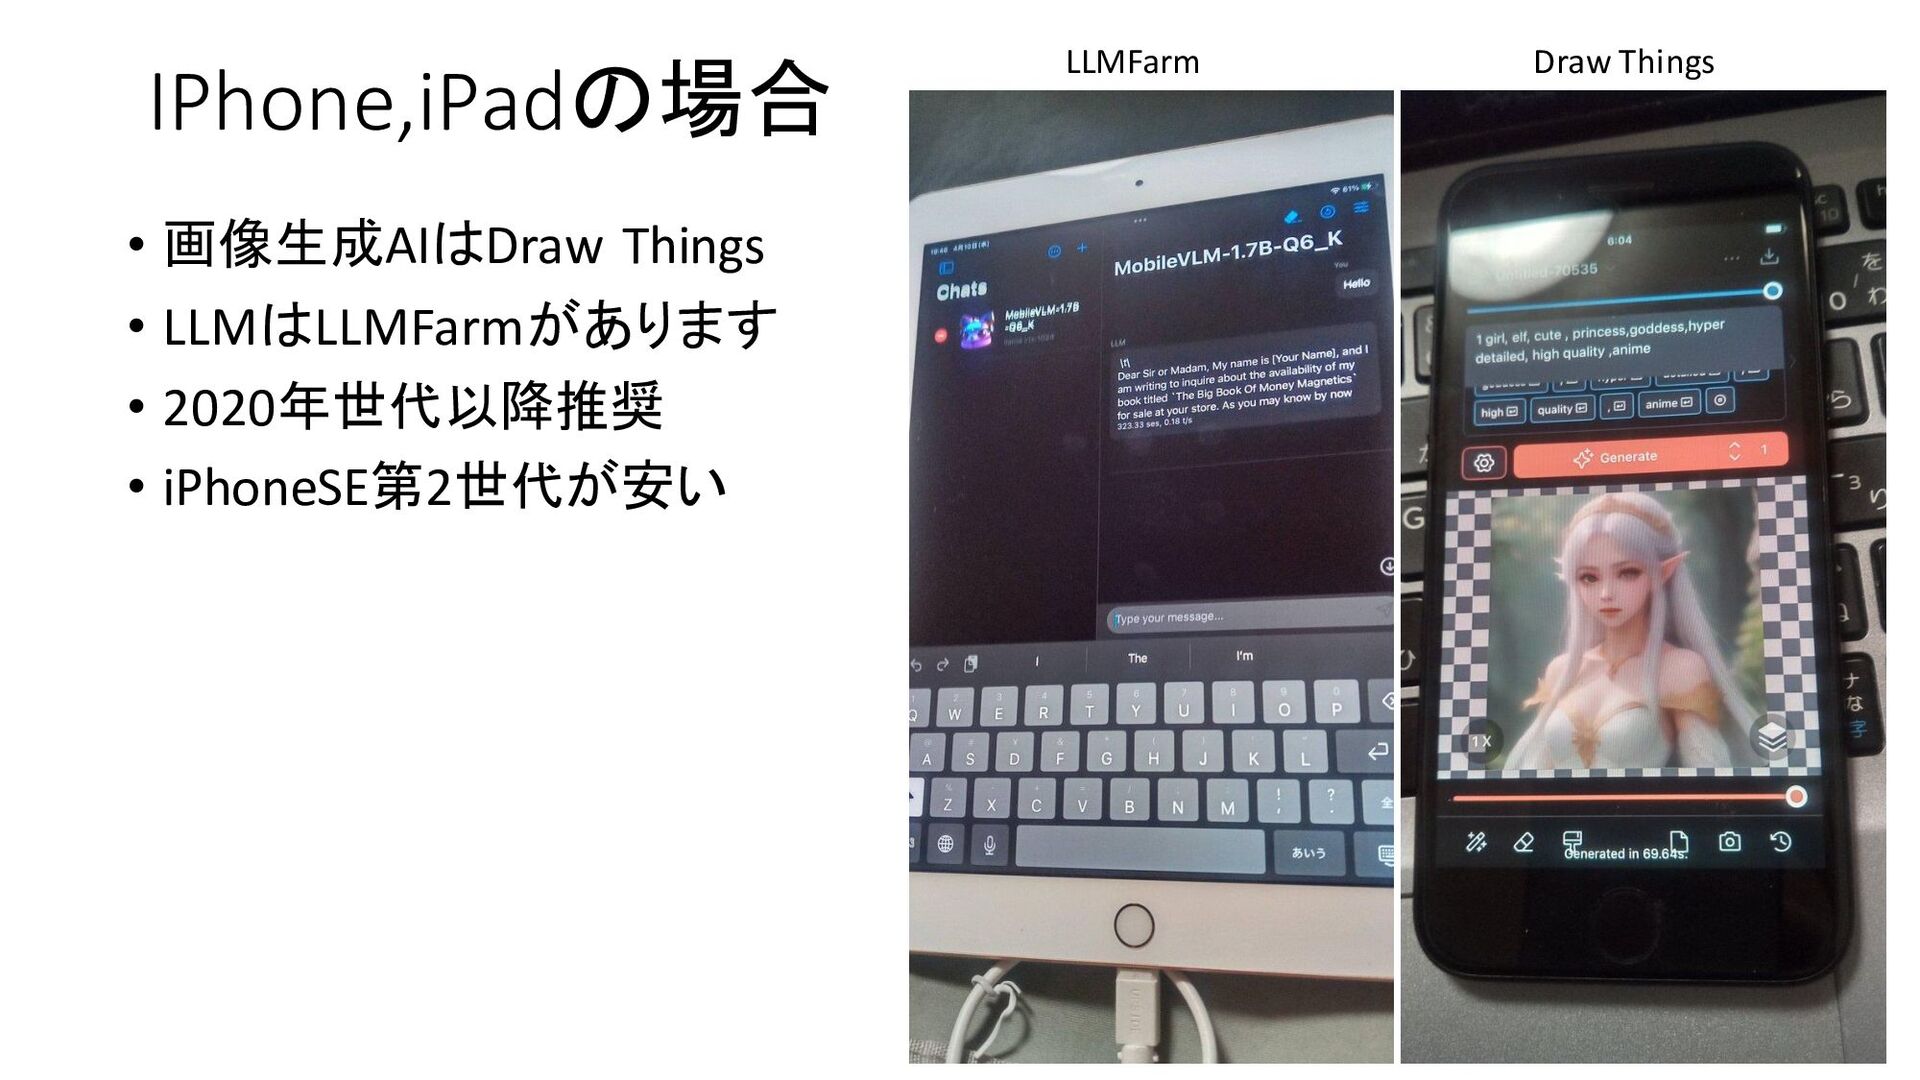
1部Windowsでは1ファイル4GB以下の データを使用おねがいします • iOSの方はLLMFarmご使用ください (ただし制限あり) • x86の場合はSSE3が必須。あとはメモリ次第 • Phi-3, LLaMA3モデル推奨 -
llamafileの使い方 • Windowsの場合。名前を変更し.exeを付けて実行 • Unix系の場合。chmod +x ファイル名で実行形式にして • ./llama〜 で実行。ブラウザで
チャットモード • モデルを指定する時は -m モデル名 でサーバ版起動 • コマンド実行 ./llamafile -m モデル名 -p "### (質問) ### Response." 後でもう一度ご説明致しますが、気が向いたら練習をお願いします -
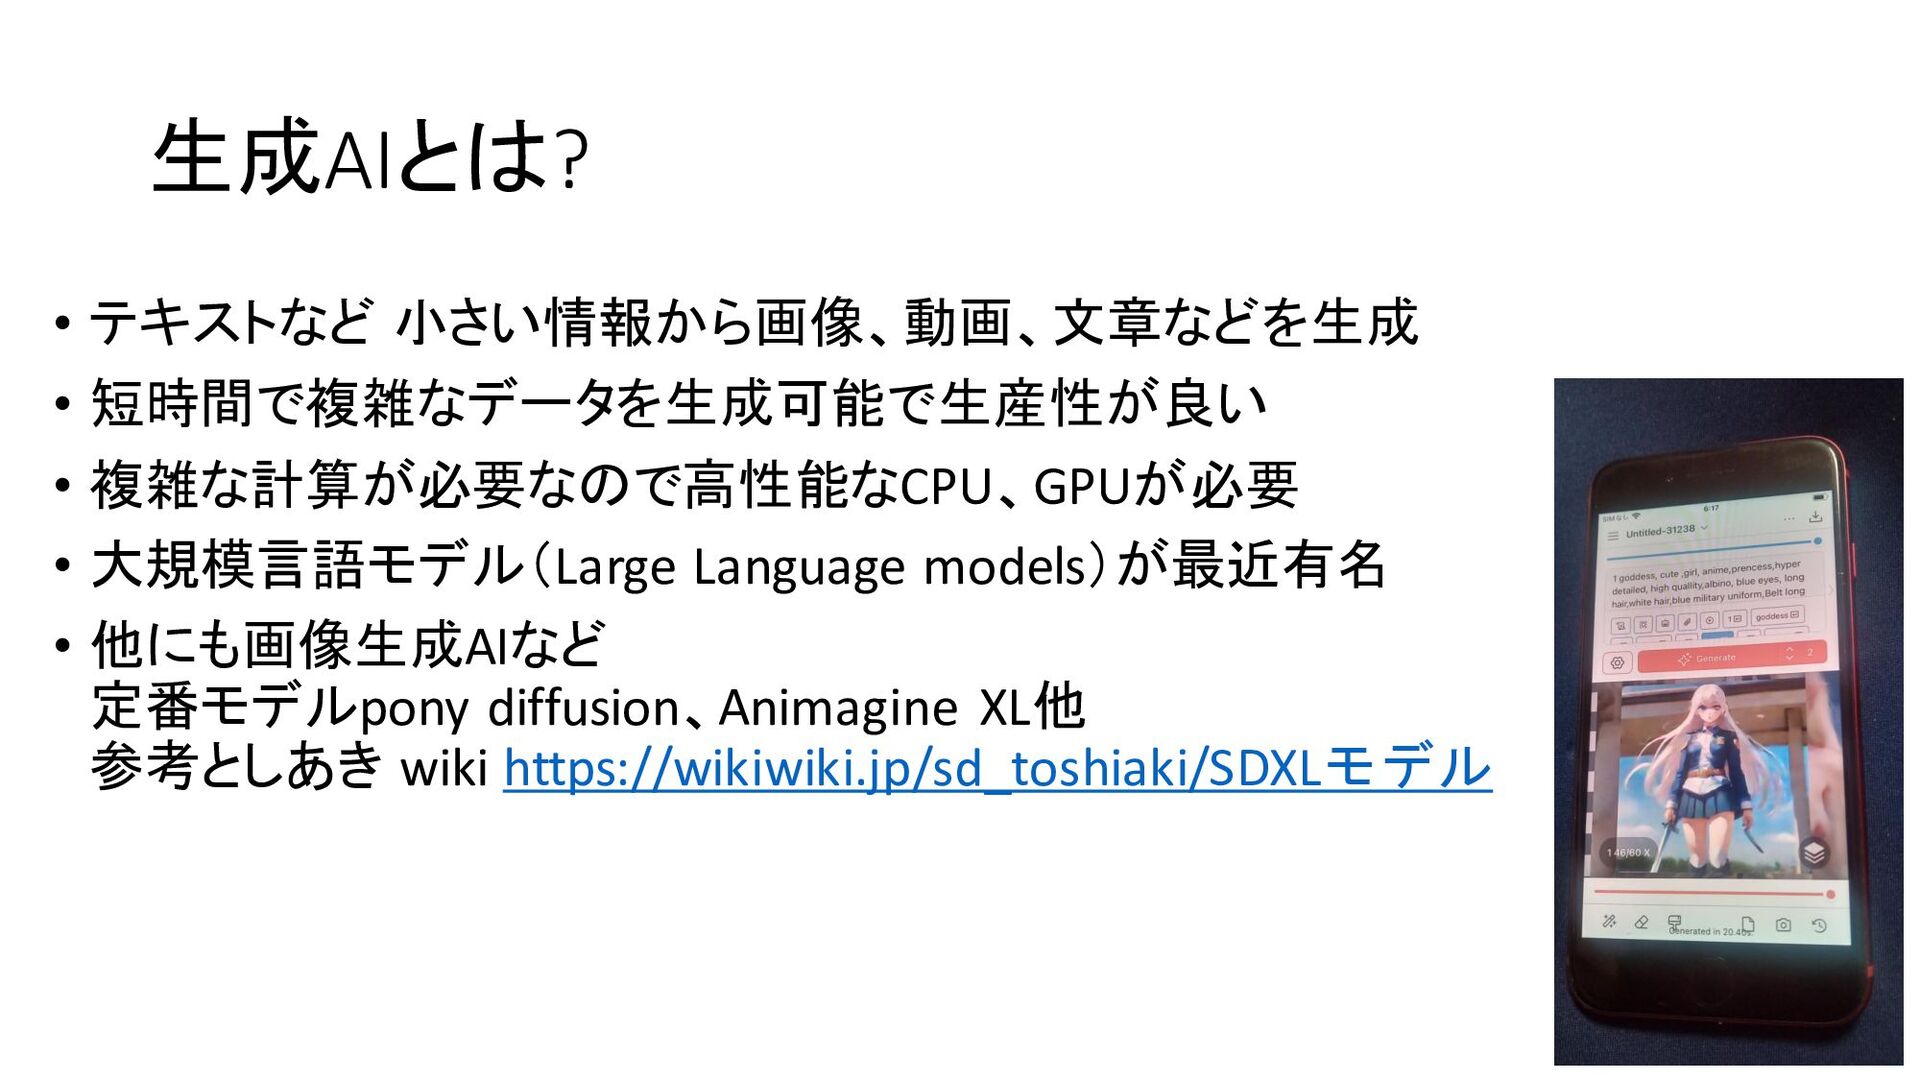
生成AIとは? • テキストなど 小さい情報から画像、動画、文章などを生成 • 短時間で複雑なデータを生成可能で生産性が良い • 複雑な計算が必要なので高性能なCPU、GPUが必要 • 大規模言語モデル(Large
Language models)が最近有名 • 他にも画像生成AIなど 定番モデルpony diffusion、Animagine XL他 参考としあき wiki https://wikiwiki.jp/sd_toshiaki/SDXLモデル -
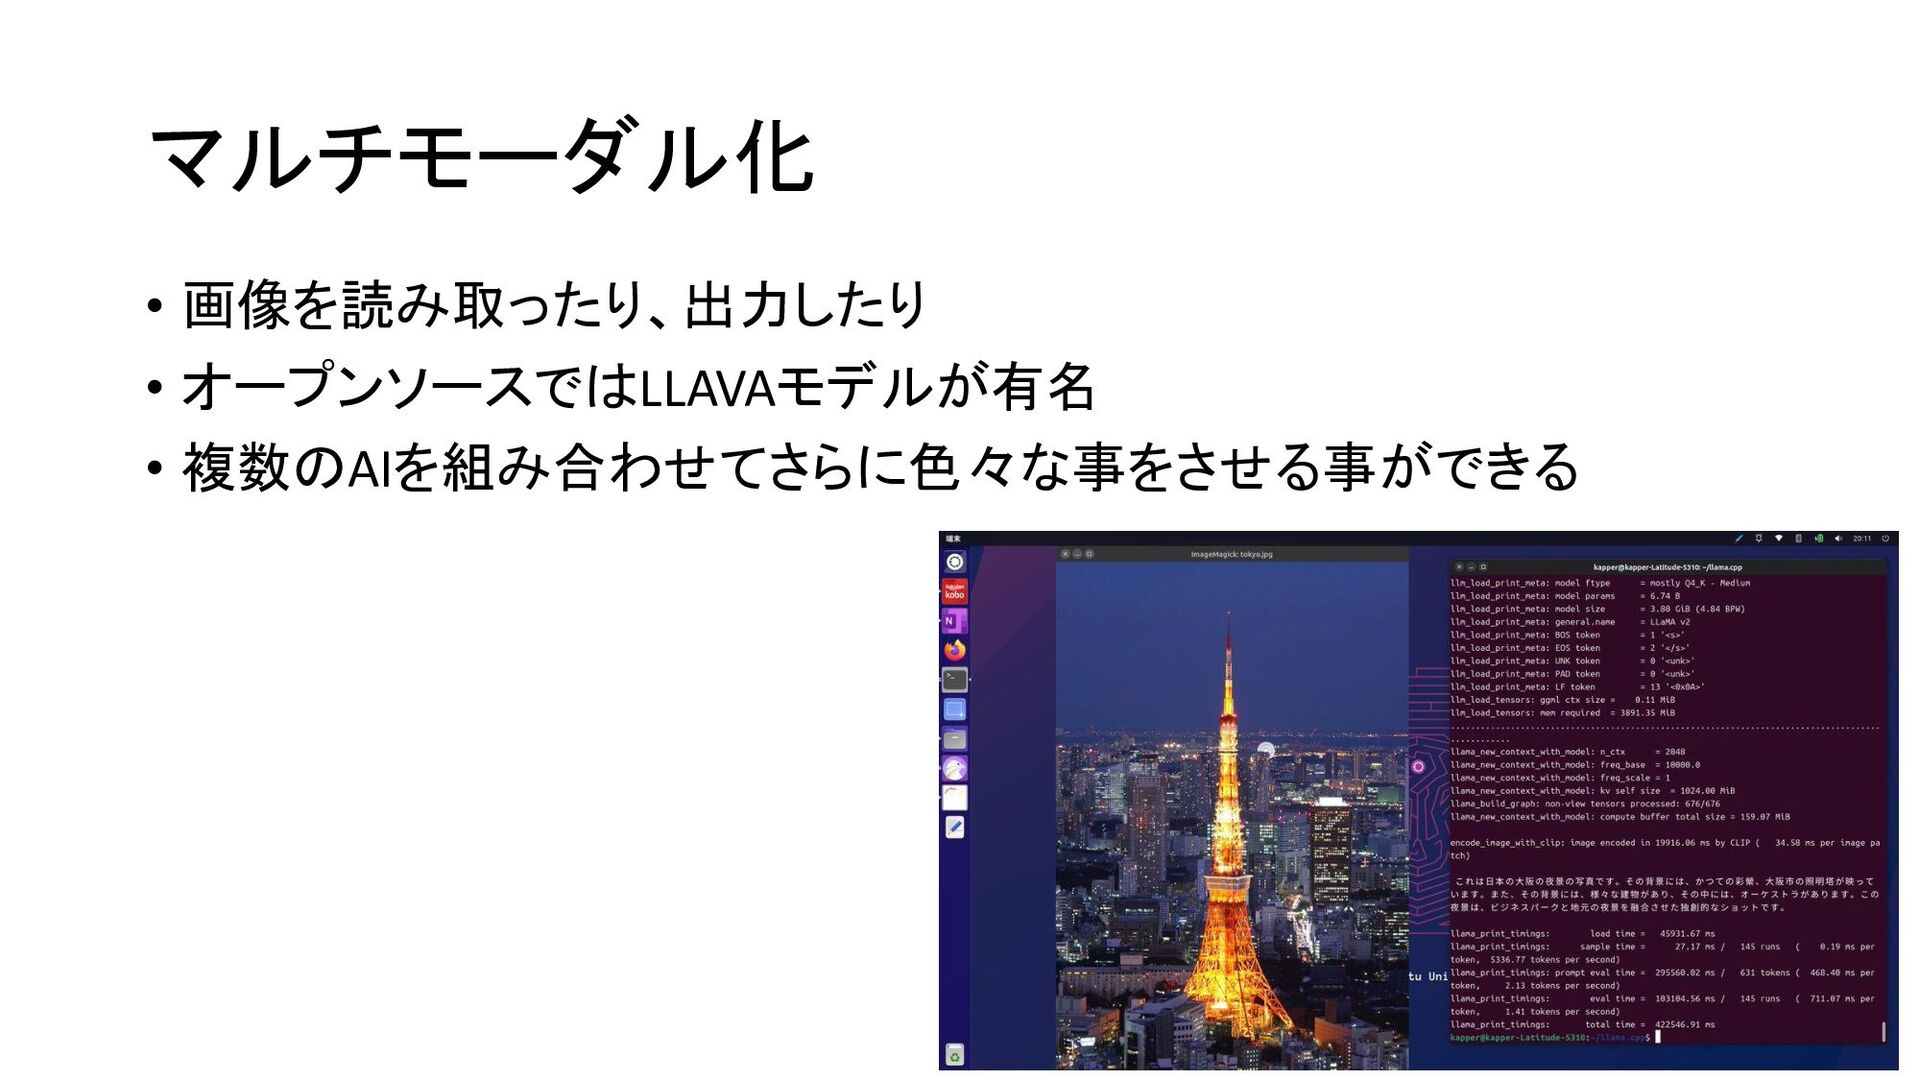
最近のLLMとは?(Large Language Models大規模言語モデル) • LLMとはChatGPT類似品の総称でText to Textの生成AI • ChatGPTが最大手。1万個のNVIDIA A100
GPUを使いAI学習。 • 出力される情報を他のAIと組み合わせ活用範囲が拡大 • 計算するGPUコストかかりすぎるので、低コストのコンパクトLLM必要 • 英語圏中心で日本語はイマイチ。特に専門用語に弱い • 本質的に何でも出来るAIの必要は無い。高コスト • 自由に改変出来て、自由に使えるライセンスのLLMに注目 • CPUで動かすならWebサーバ、ブラウザも重し。Xさえ不要 -
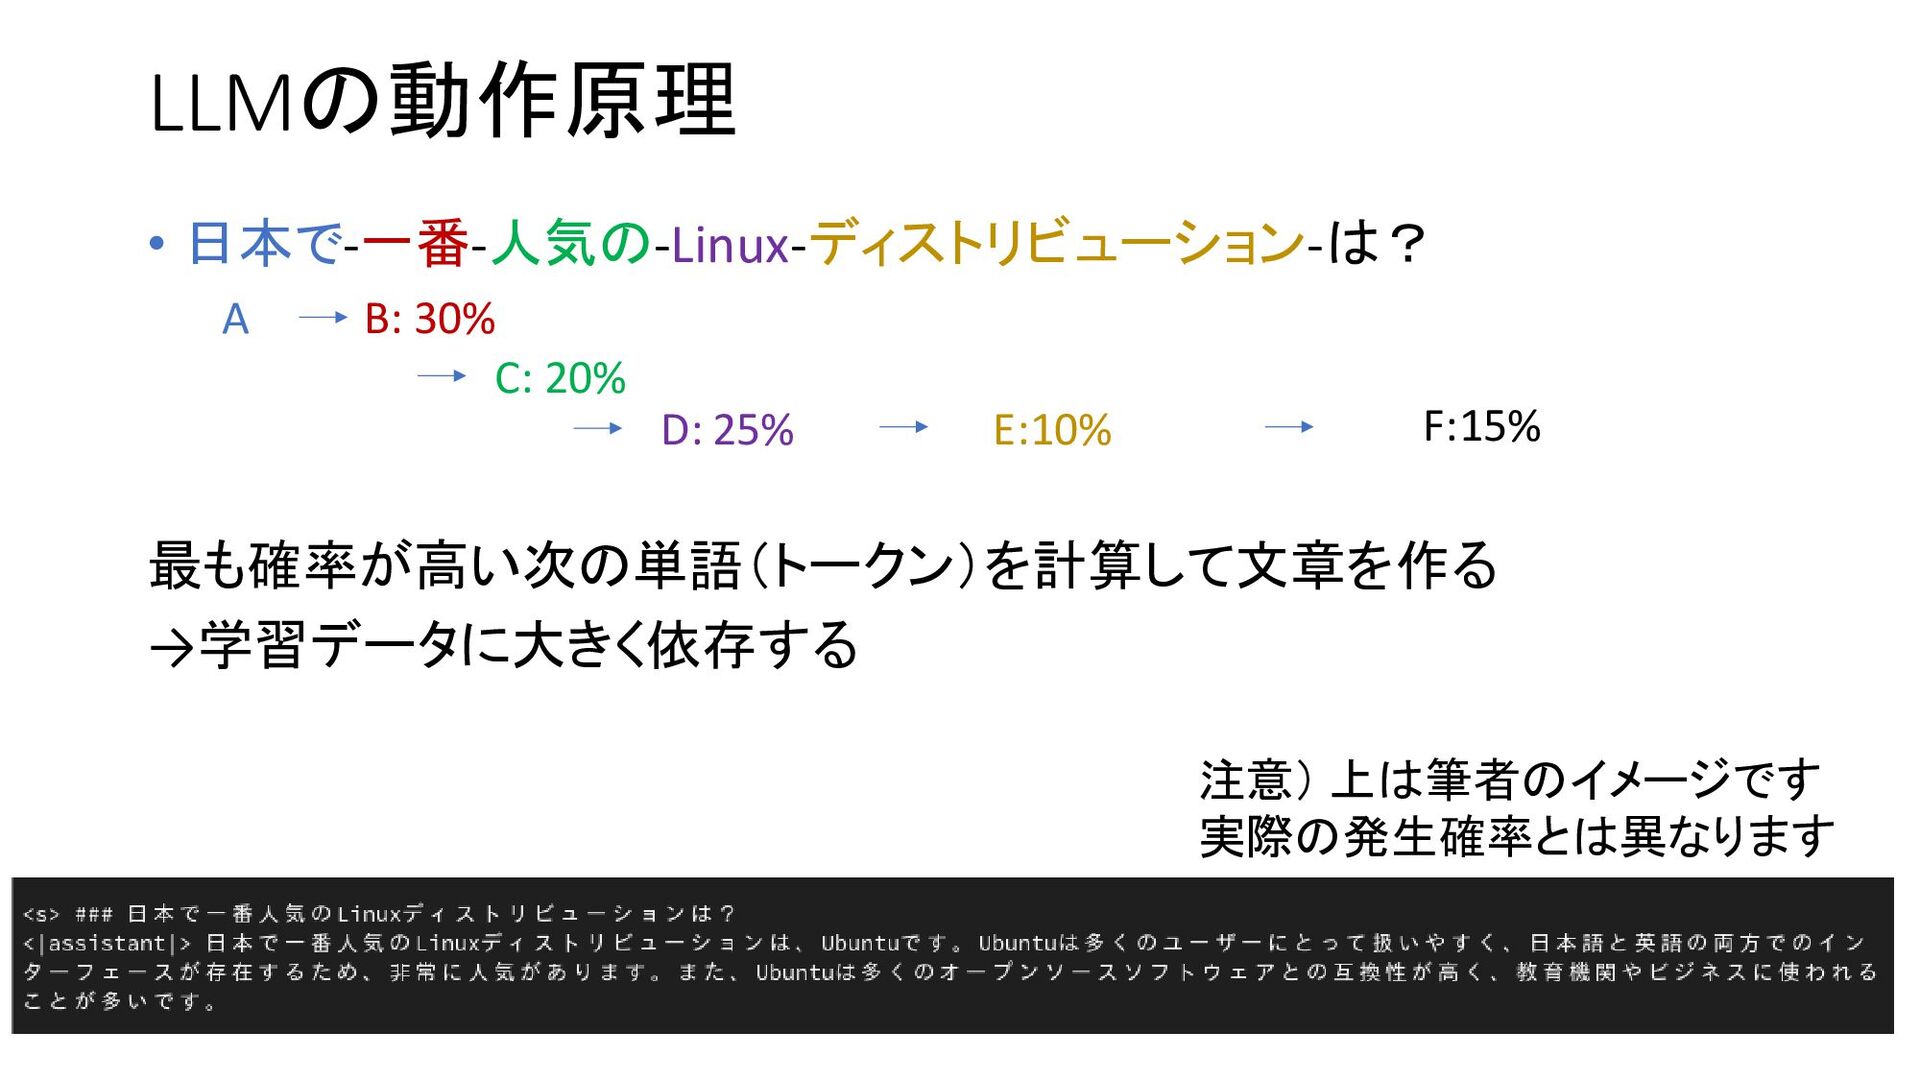
LLMの動作原理 • 日本で-一番-人気の-Linux-ディストリビューション-は? 最も確率が高い次の単語(トークン)を計算して文章を作る →学習データに大きく依存する B: 30% C: 20% D:
25% E:10% F:15% A 注意) 上は筆者のイメージです 実際の発生確率とは異なります -
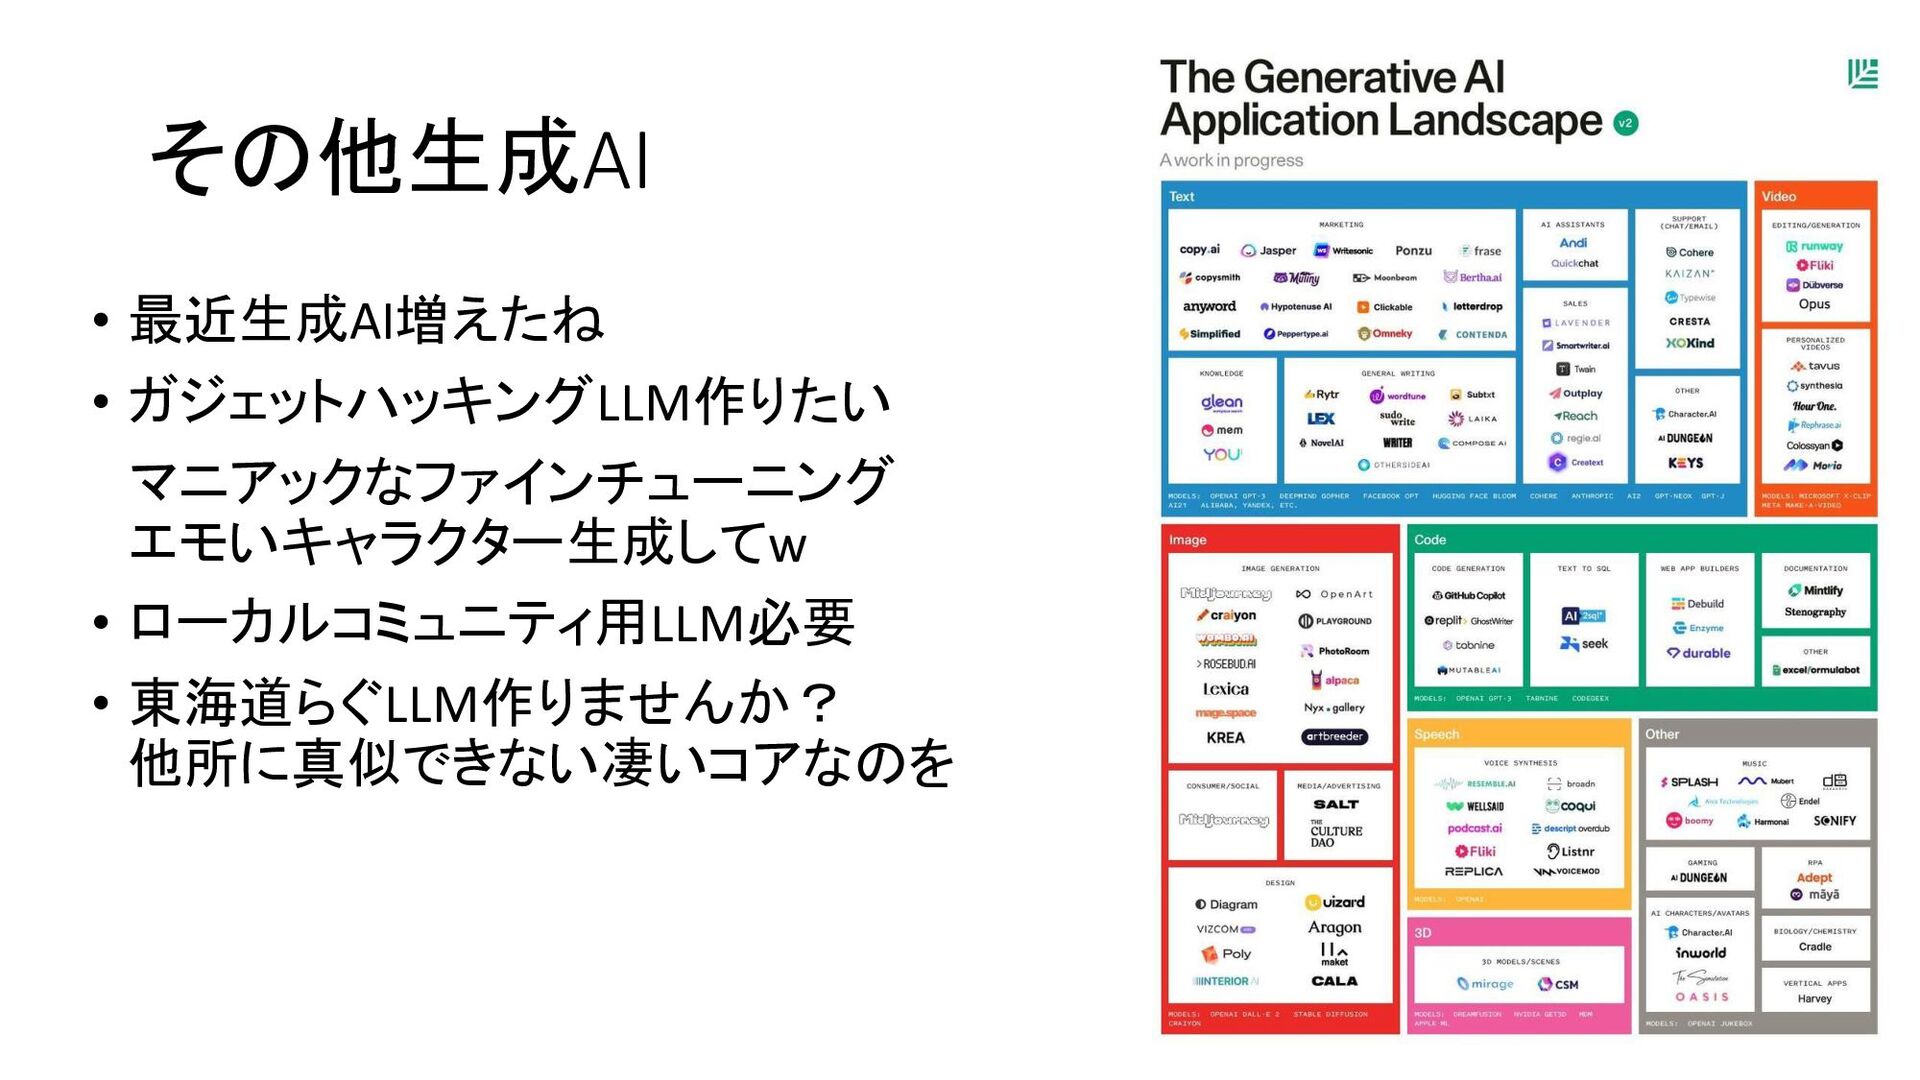
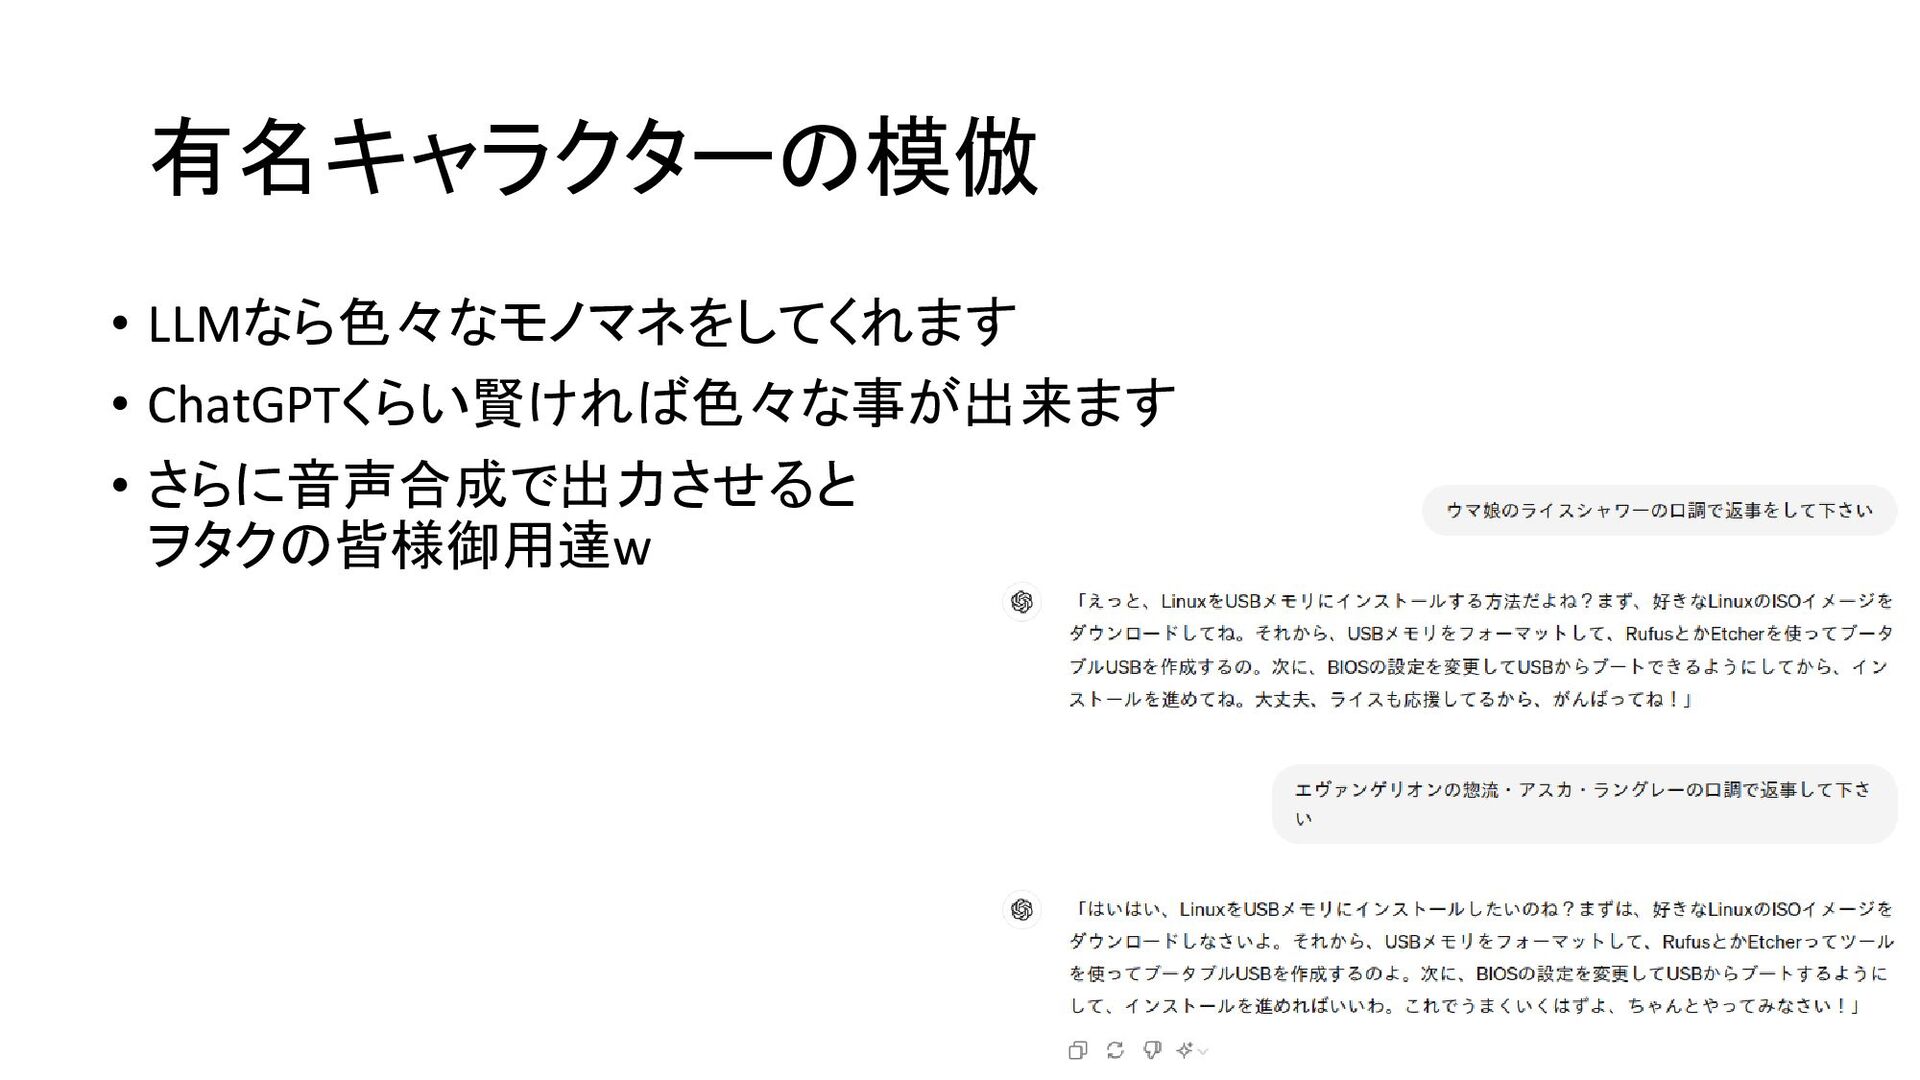
その他生成AI • 最近生成AI増えたね • ガジェットハッキングLLM作りたい マニアックなファインチューニング エモいキャラクター生成してw • ローカルコミュニティ用LLM必要 •
東海道らぐLLM作りませんか? 他所に真似できない凄いコアなのを -
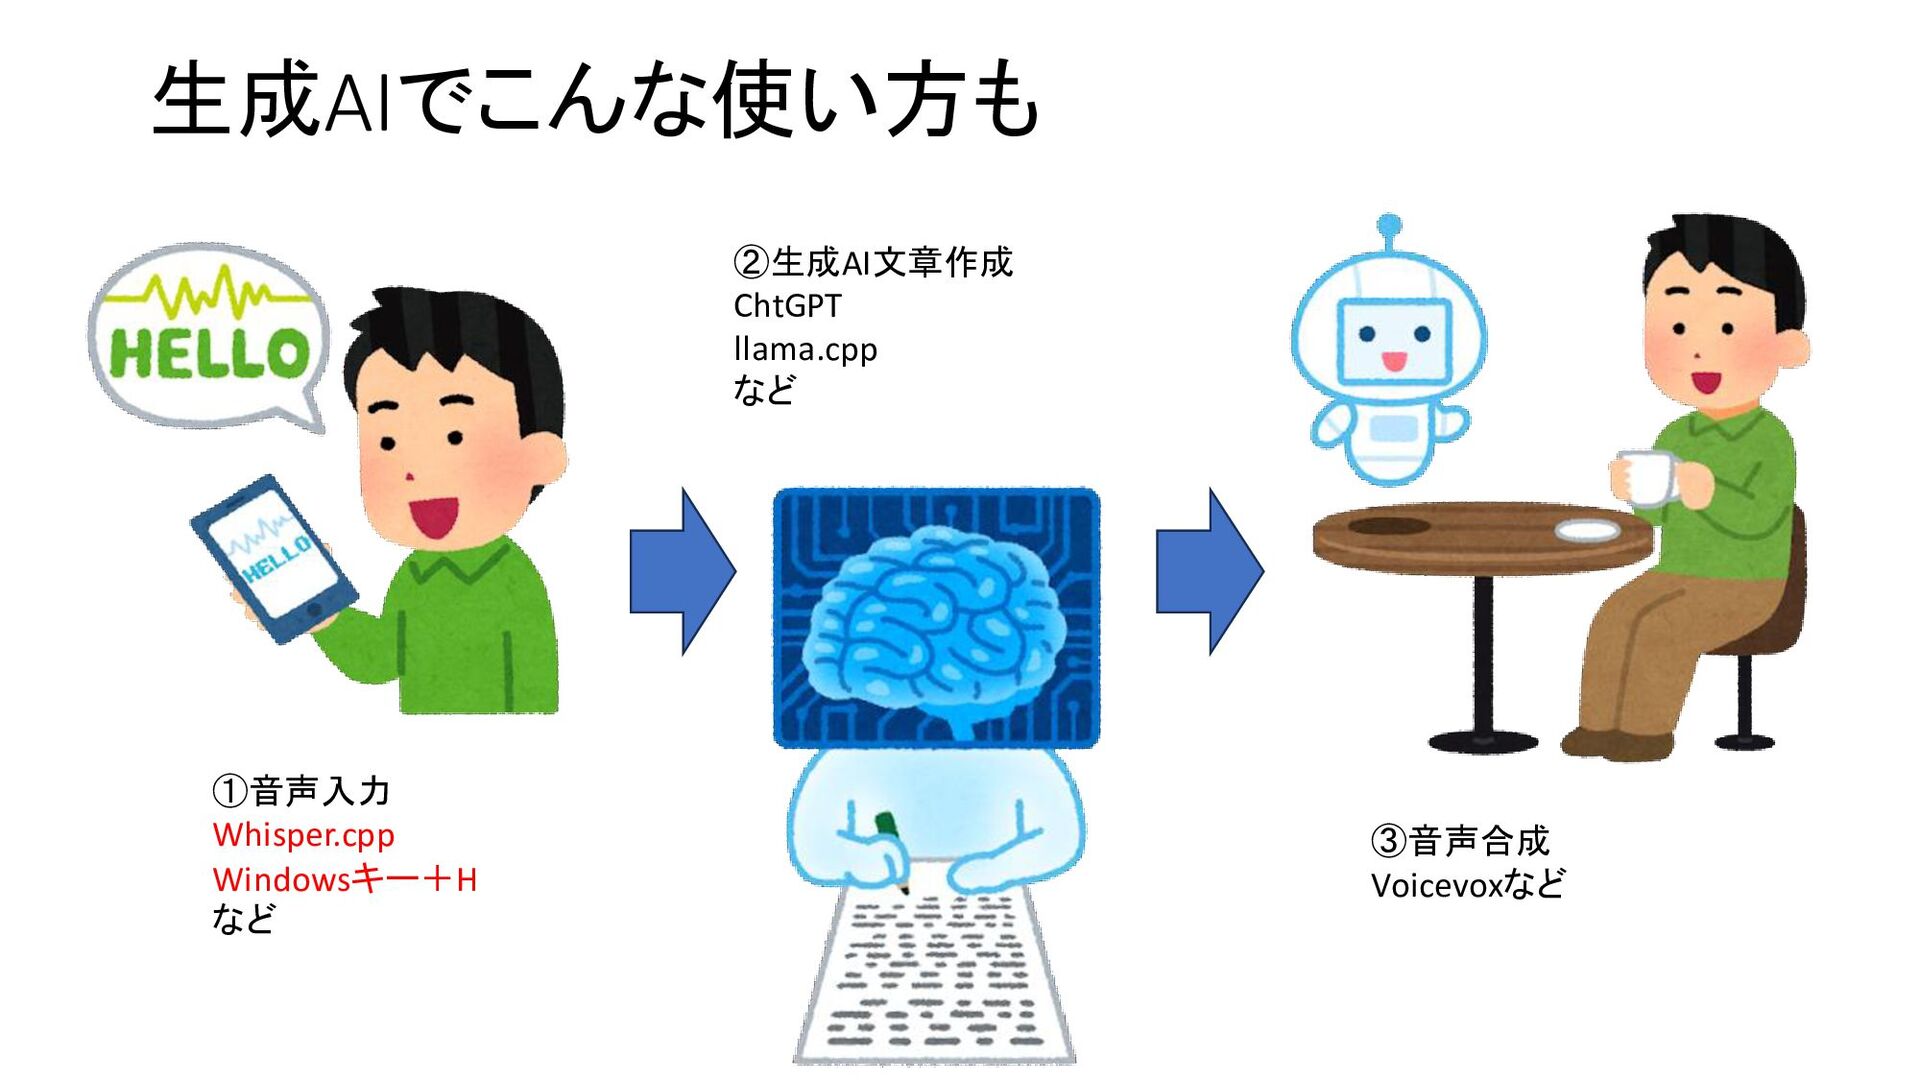
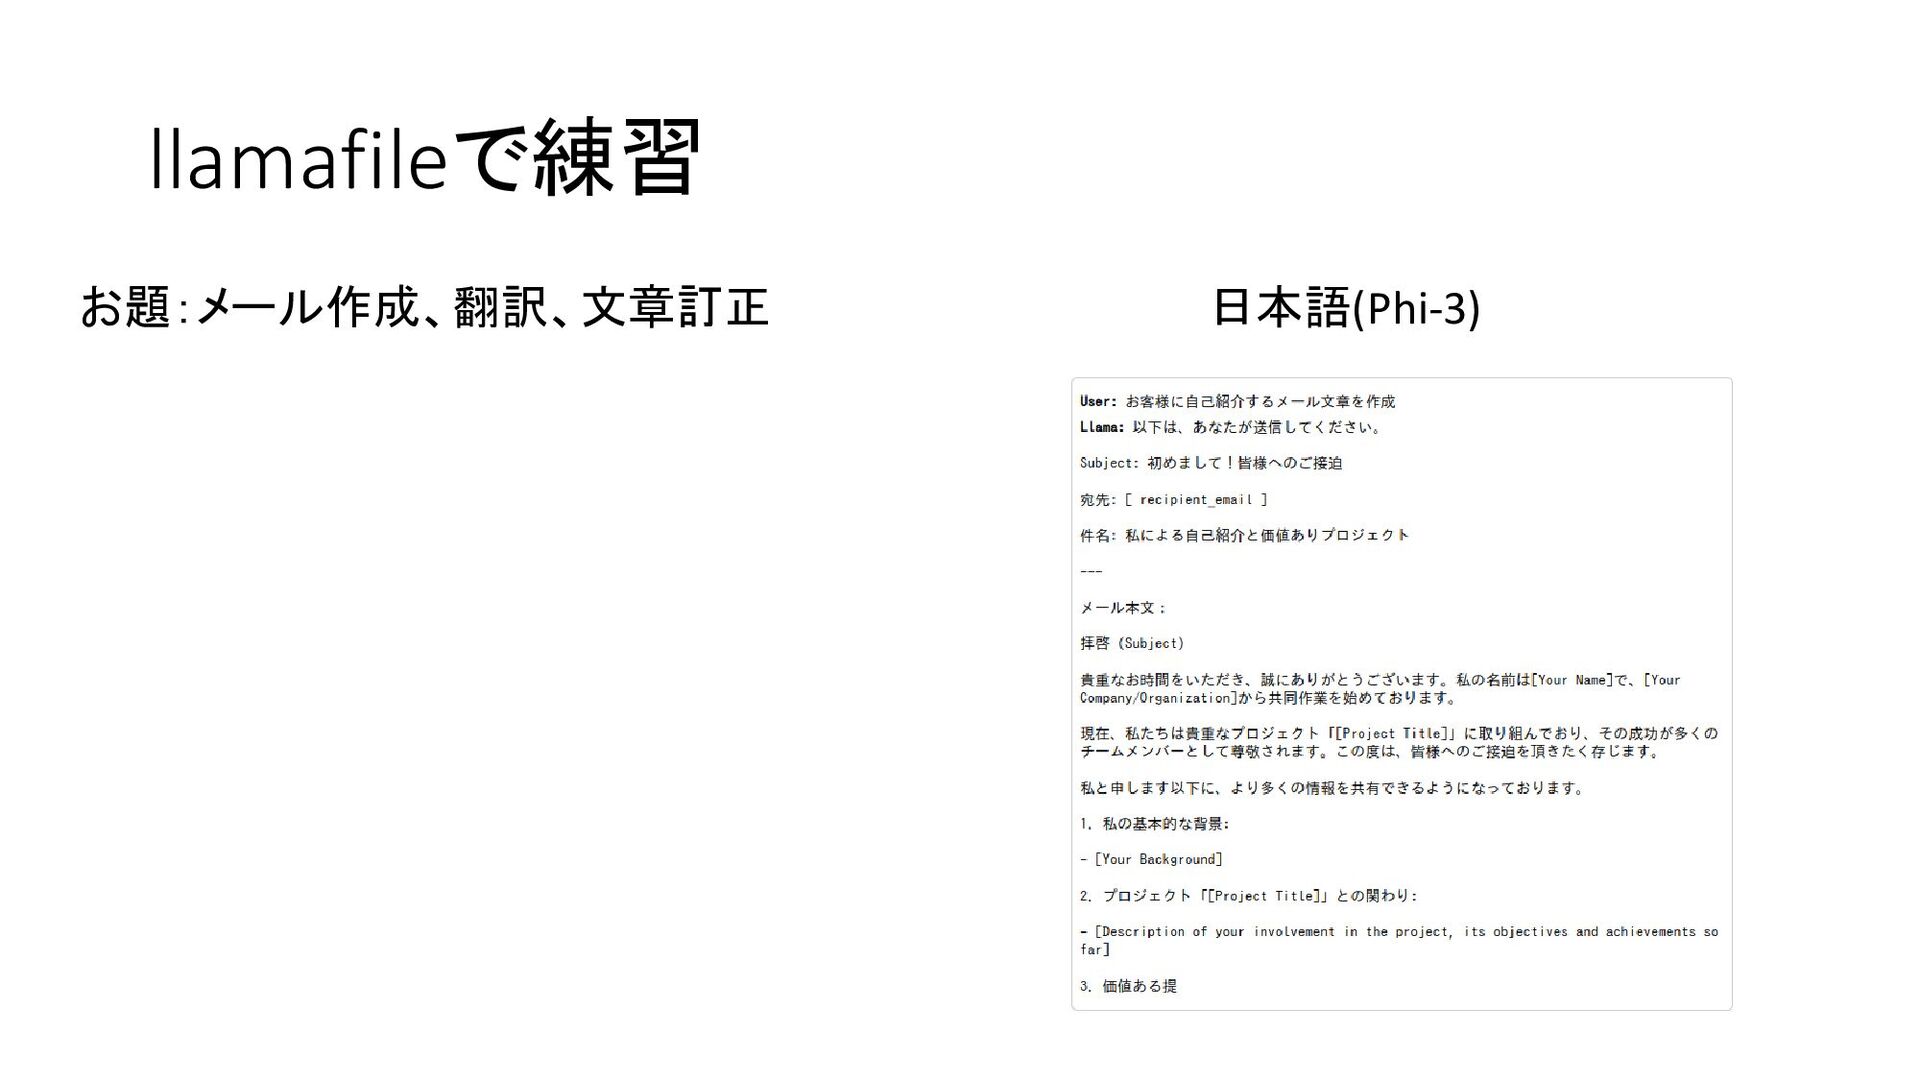
お仕事で生成AI • プログラムレスで色々 • 翻訳、メール作成 • 対話型業務をAIチャットで • 画像、資料を作成 •
いつのまにかRPAはどこにいった? 今後のビジネスの中心 • 賢さ ≠ 語彙力、情報量 -
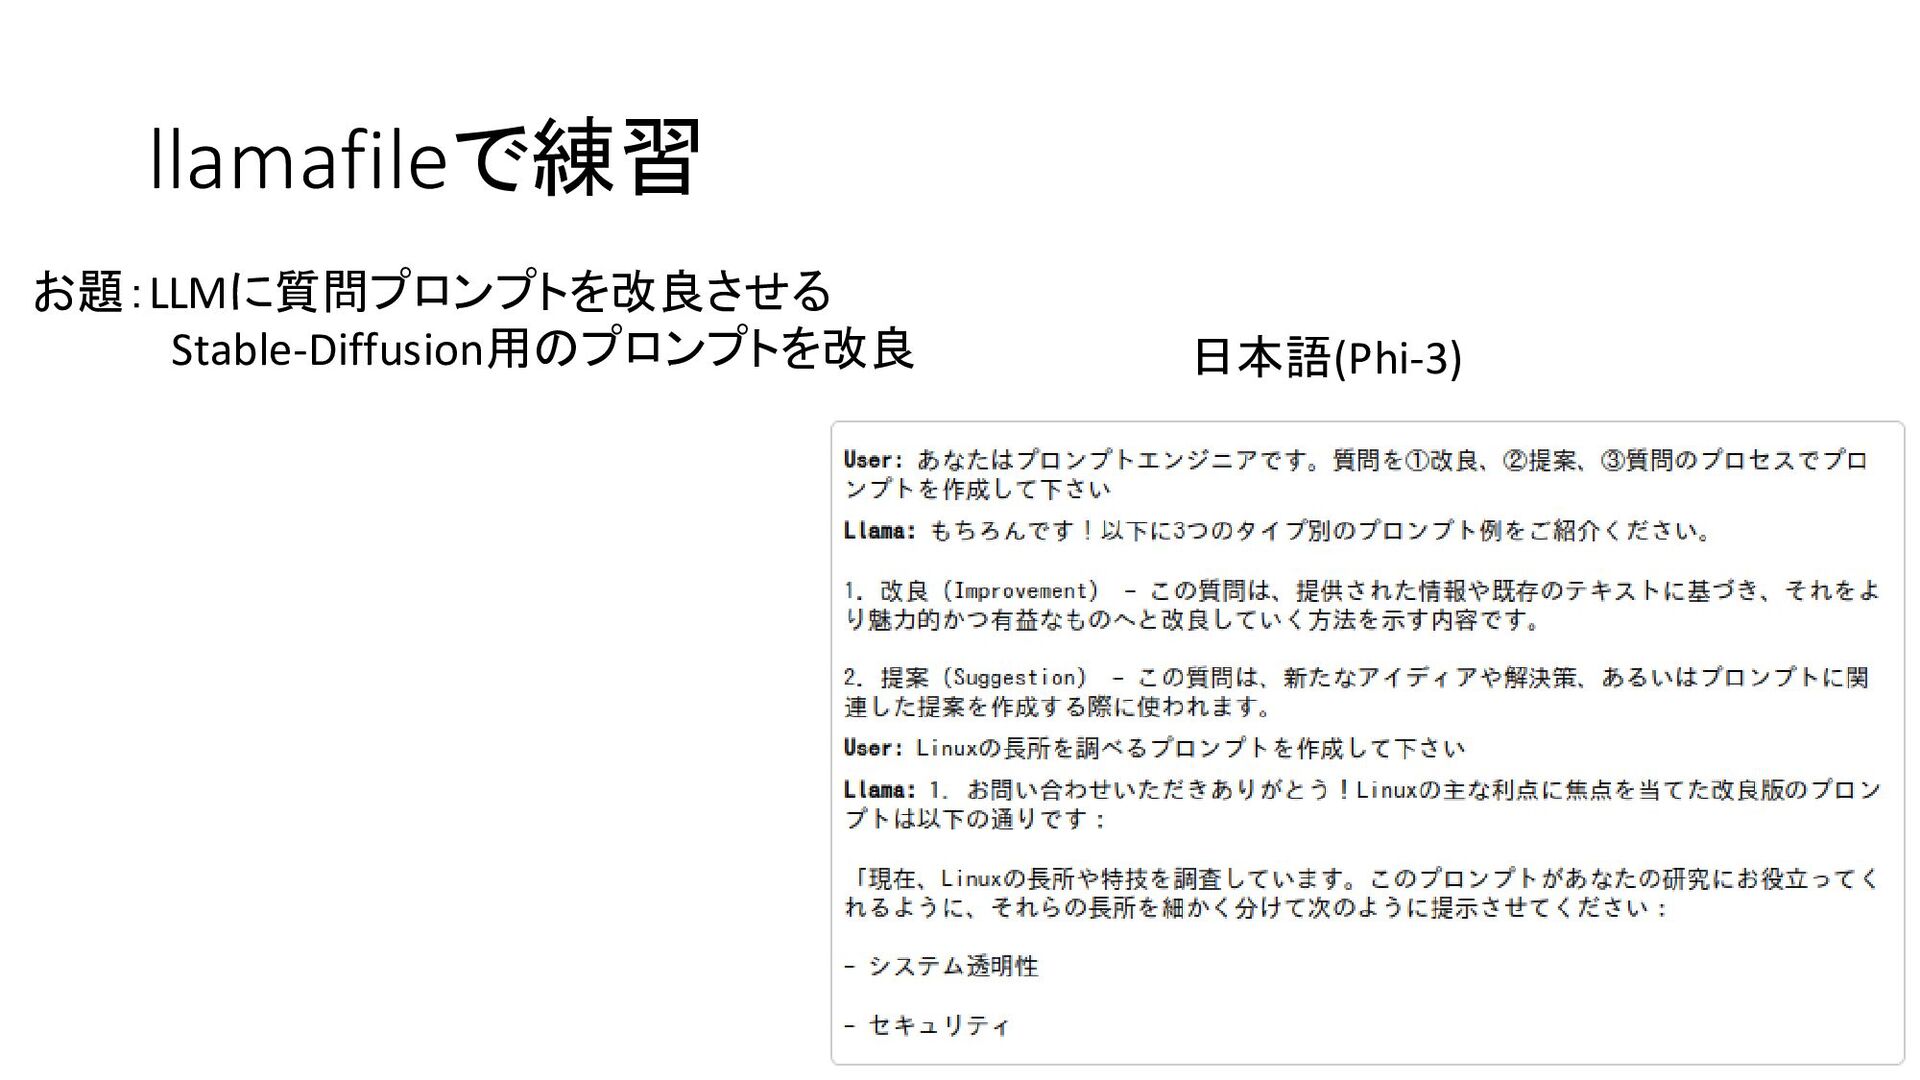
プロンプトエンジニアリング • そもそも プロンプトとは?システム操作などに使う文字列 • LLMに回答を引き出すための良い文字列の並べ方 • Zero-Shot:事前情報入力なし。一般的な回答 • Few-Shot:具体例追加。より細かい精度UP
• CoT:手順を箇条書きで追加。段階的に考え、間違い視覚化 • ToT:回答を自己評価させる • ReAct:Thought、Action、Observationから考えさせる • 深津式:あなたは〜です。#条件〜 -
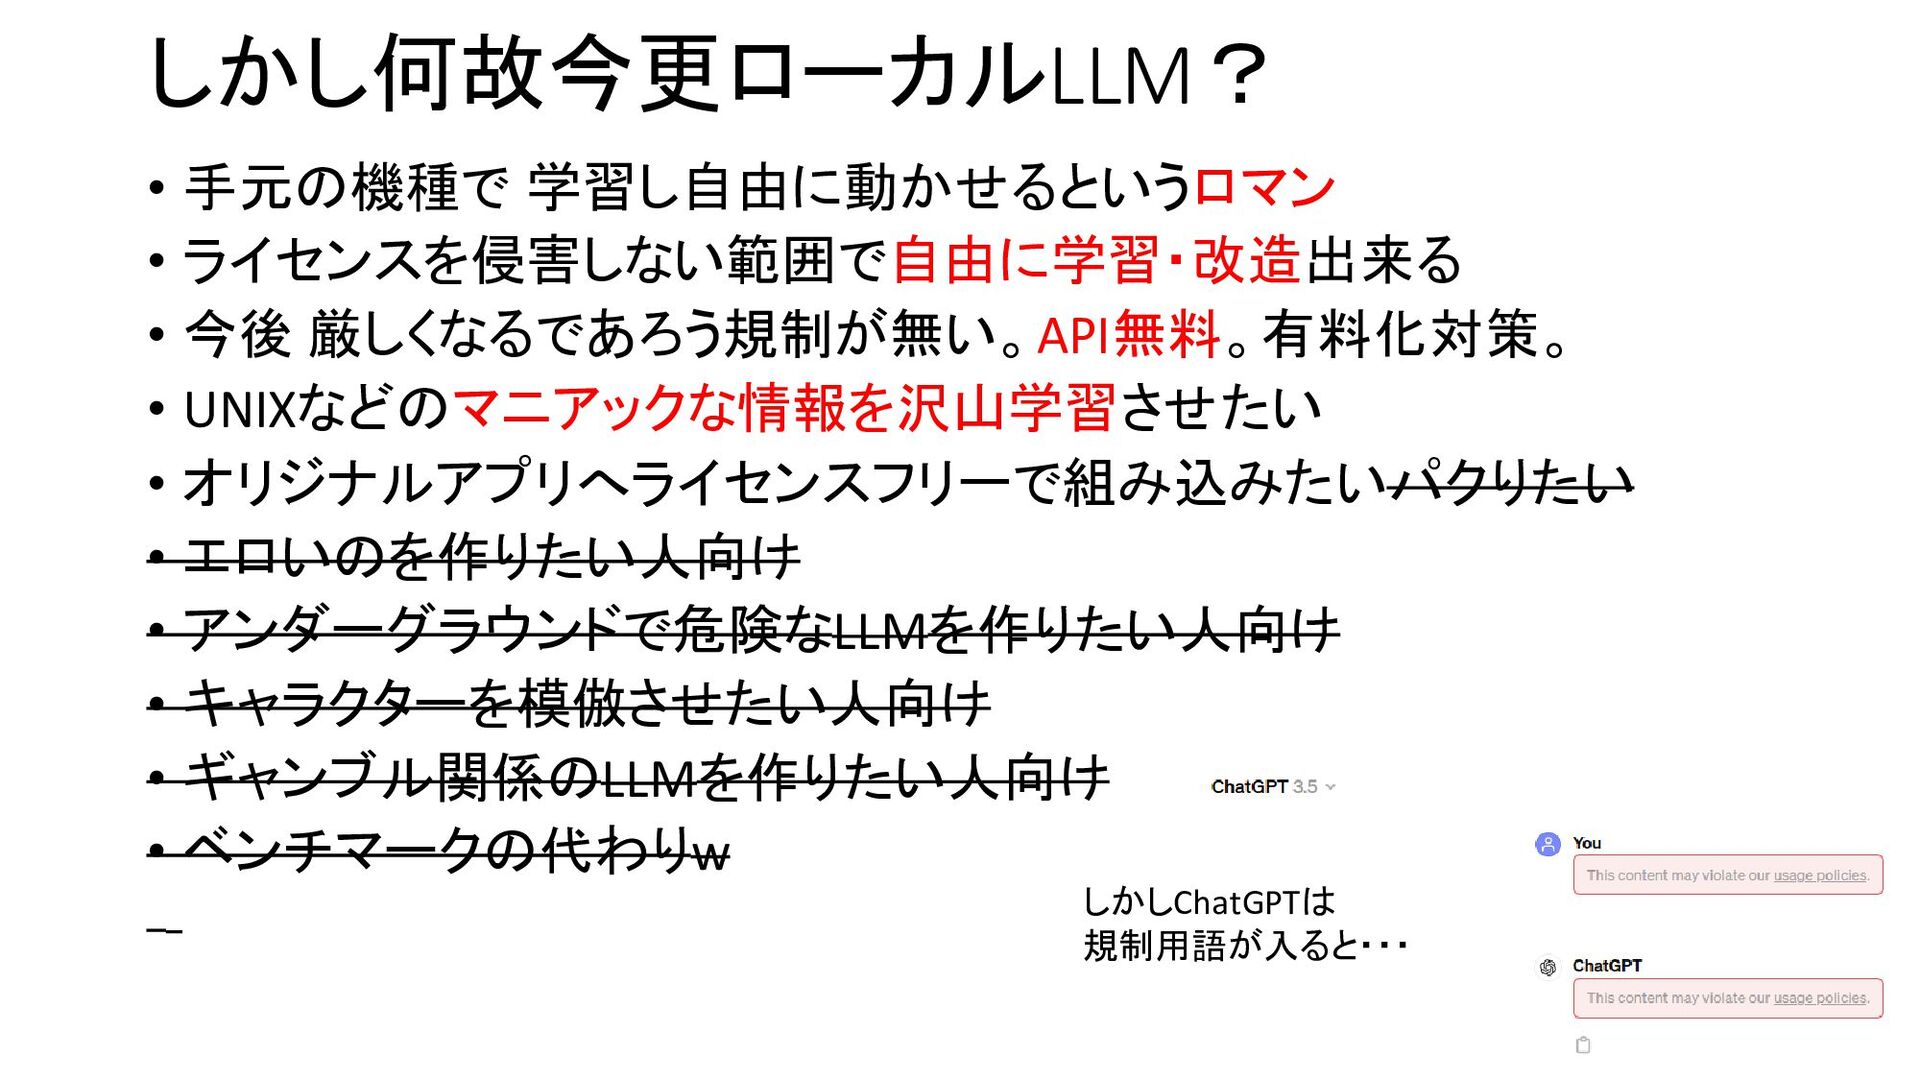
しかし何故今更ローカルLLM? • 手元の機種で 学習し自由に動かせるというロマン • ライセンスを侵害しない範囲で自由に学習・改造出来る • 今後 厳しくなるであろう規制が無い。API無料。有料化対策。 •
UNIXなどのマニアックな情報を沢山学習させたい • オリジナルアプリへライセンスフリーで組み込みたいパクりたい • エロいのを作りたい人向け • アンダーグラウンドで危険なLLMを作りたい人向け • キャラクターを模倣させたい人向け • ギャンブル関係のLLMを作りたい人向け • ベンチマークの代わりw しかしChatGPTは 規制用語が入ると・・・ -
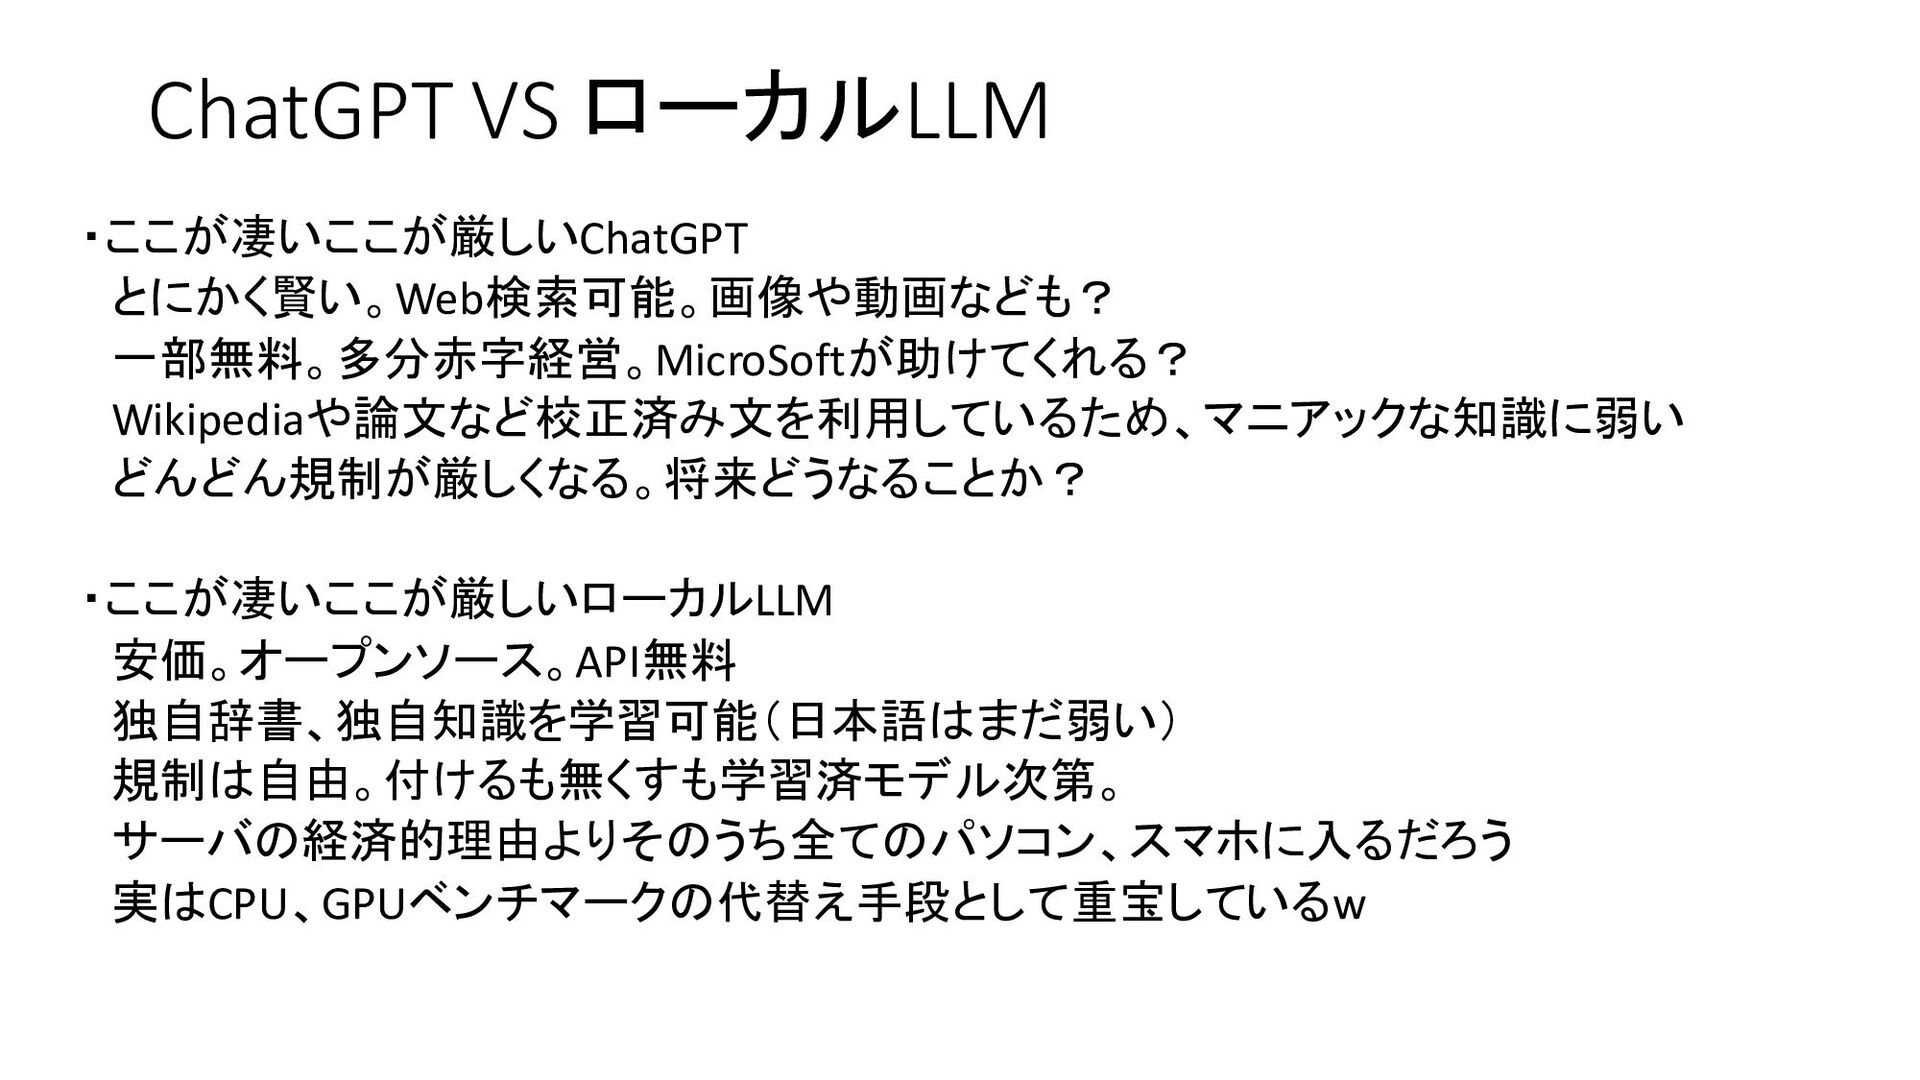
ChatGPT VS ローカルLLM ・ここが凄いここが厳しいChatGPT とにかく賢い。Web検索可能。画像や動画なども? 一部無料。多分赤字経営。MicroSoftが助けてくれる? Wikipediaや論文など校正済み文を利用しているため、マニアックな知識に弱い どんどん規制が厳しくなる。将来どうなることか? ・ここが凄いここが厳しいローカルLLM 安価。オープンソース。API無料
独自辞書、独自知識を学習可能(日本語はまだ弱い) 規制は自由。付けるも無くすも学習済モデル次第。 サーバの経済的理由よりそのうち全てのパソコン、スマホに入るだろう 実はCPU、GPUベンチマークの代替え手段として重宝しているw -
llamafileの使い方 • Windowsの場合。名前を変更し.exeを付けて実行 • Unix系の場合。chmod +x ファイル名で実行形式にして chmod +x llama
• ./llama〜 で実行。ブラウザで チャットモード • モデルを指定する時は -m モデル名 でサーバ版起動 • コマンド実行 ./llamafile -m モデル名 -p "### (質問) ### Response." -
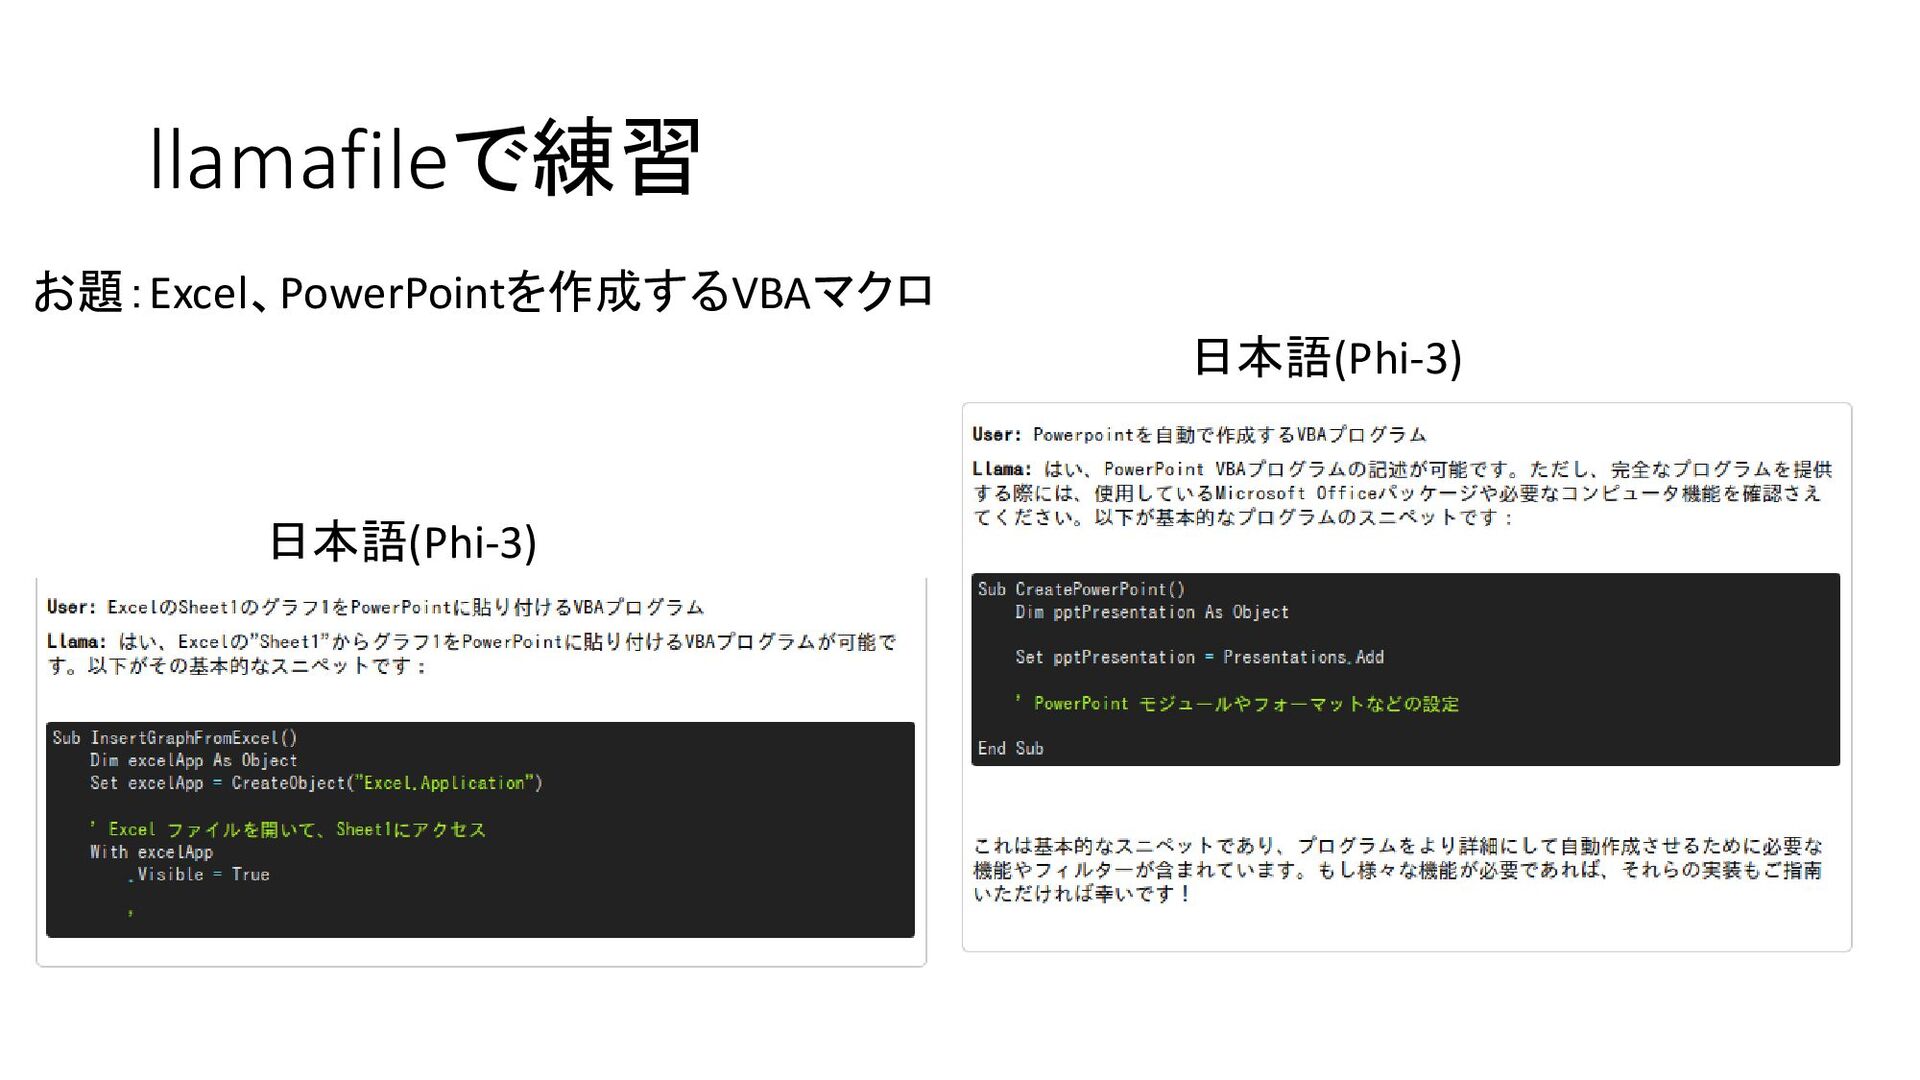
llamafileで練習してみましょう ①ダウンロード後は実行形式に変換 Windowsでは右クリックでファイル名を変更、.exe を 付ける UNIXではchmod +x llama〜 ②ダウンロードしたら普通に実行 ./llama〜
GPUを使う時は ./llama〜 -ngl 999 実行したらWebブラウザで http://127.0.0.1:8080 を開く -
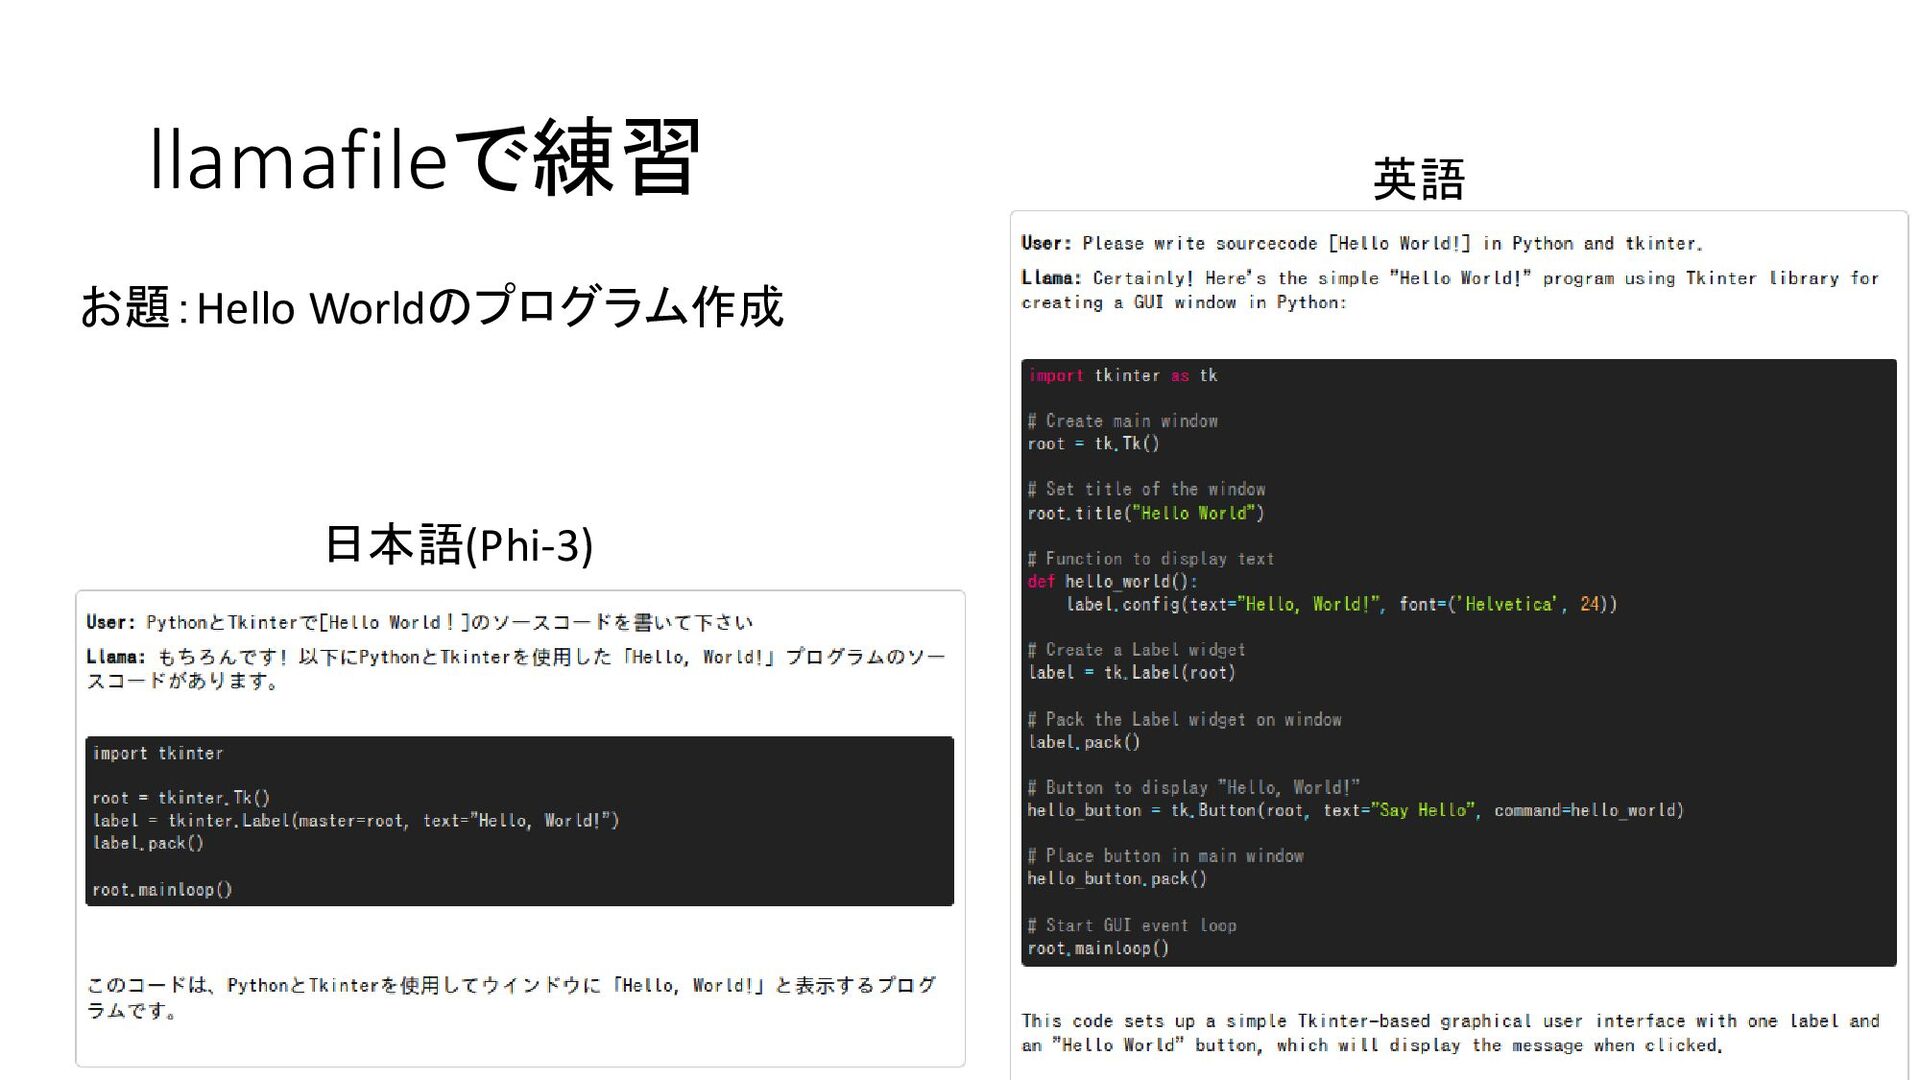
llamafileで練習 ③こんな画面が出てくるので一番下の 入力欄に英語で質問 例) Please write sourcecode [Hello World!] in
Python and TKinter. 注)Phi-3,LLaMA3なら日本語もOK PythonとTKinterで[Hello World!]の ソースコードを書いて下さい -
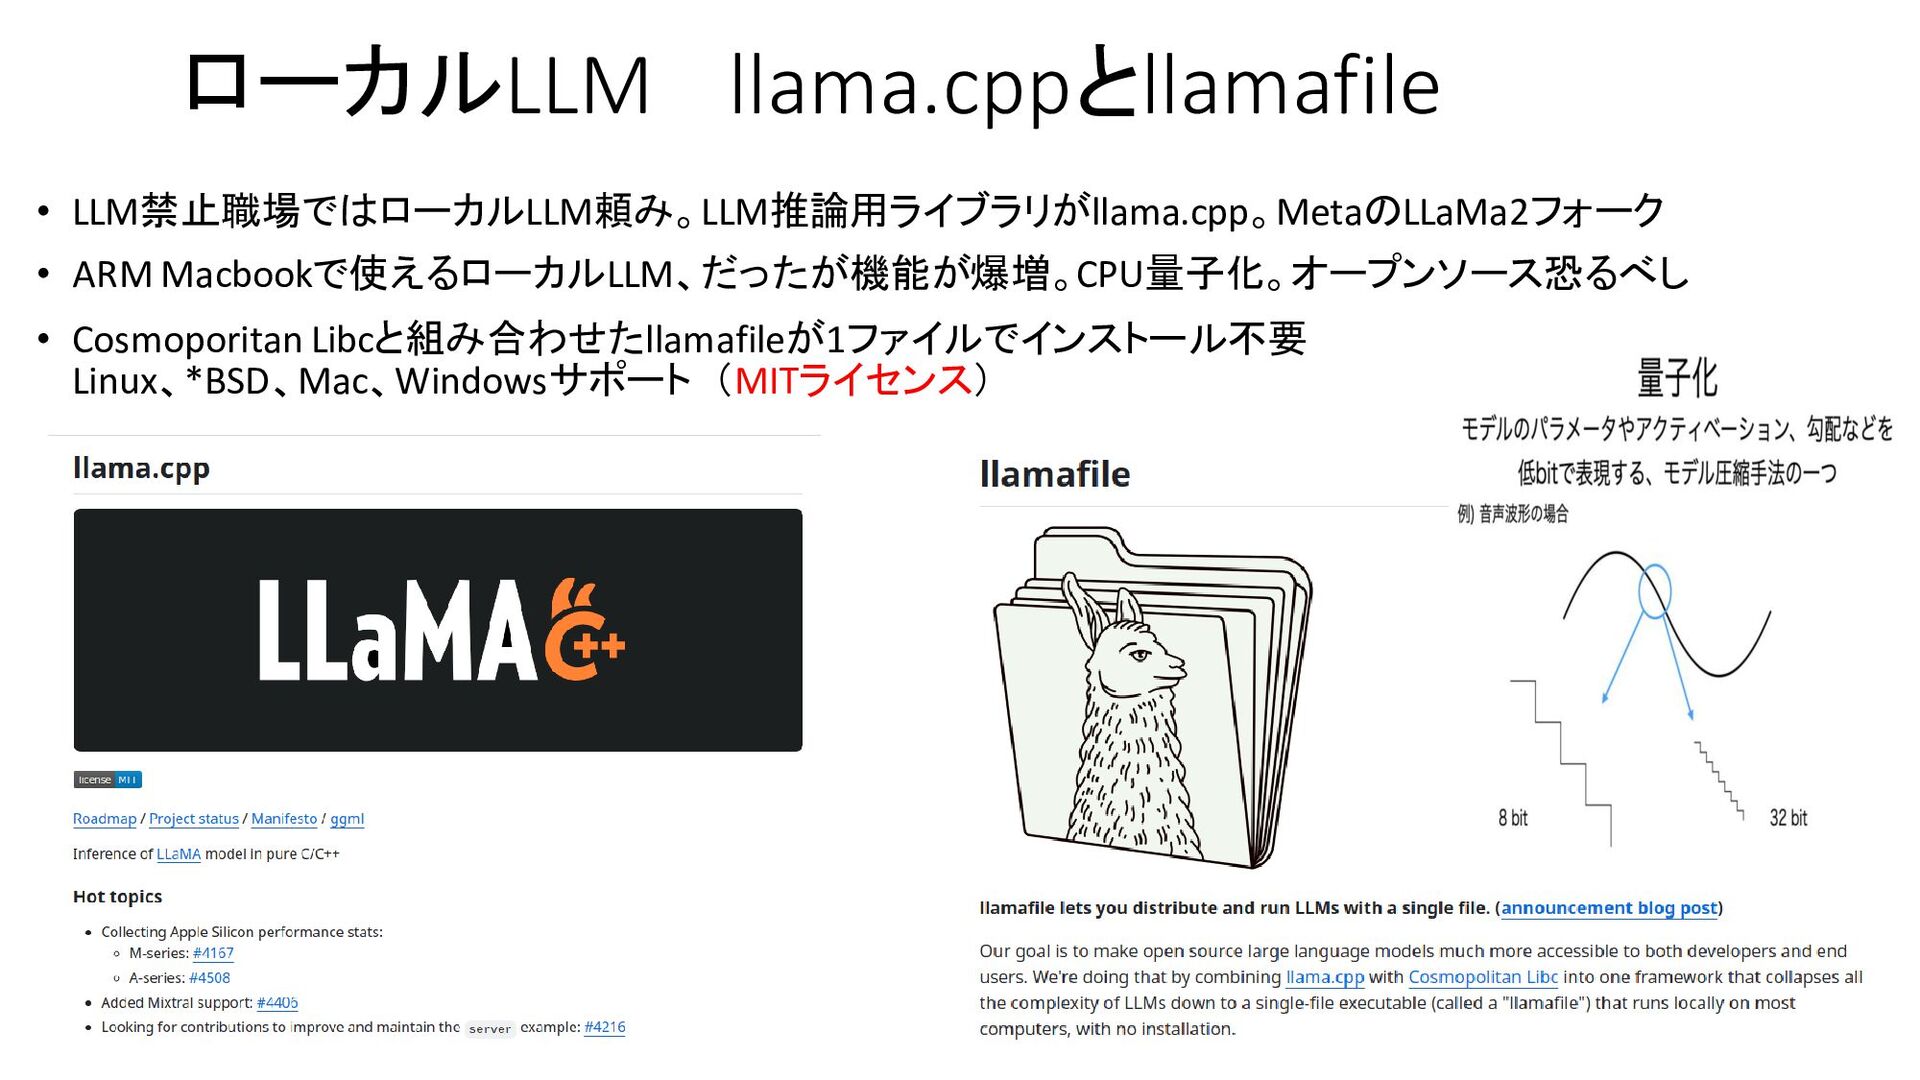
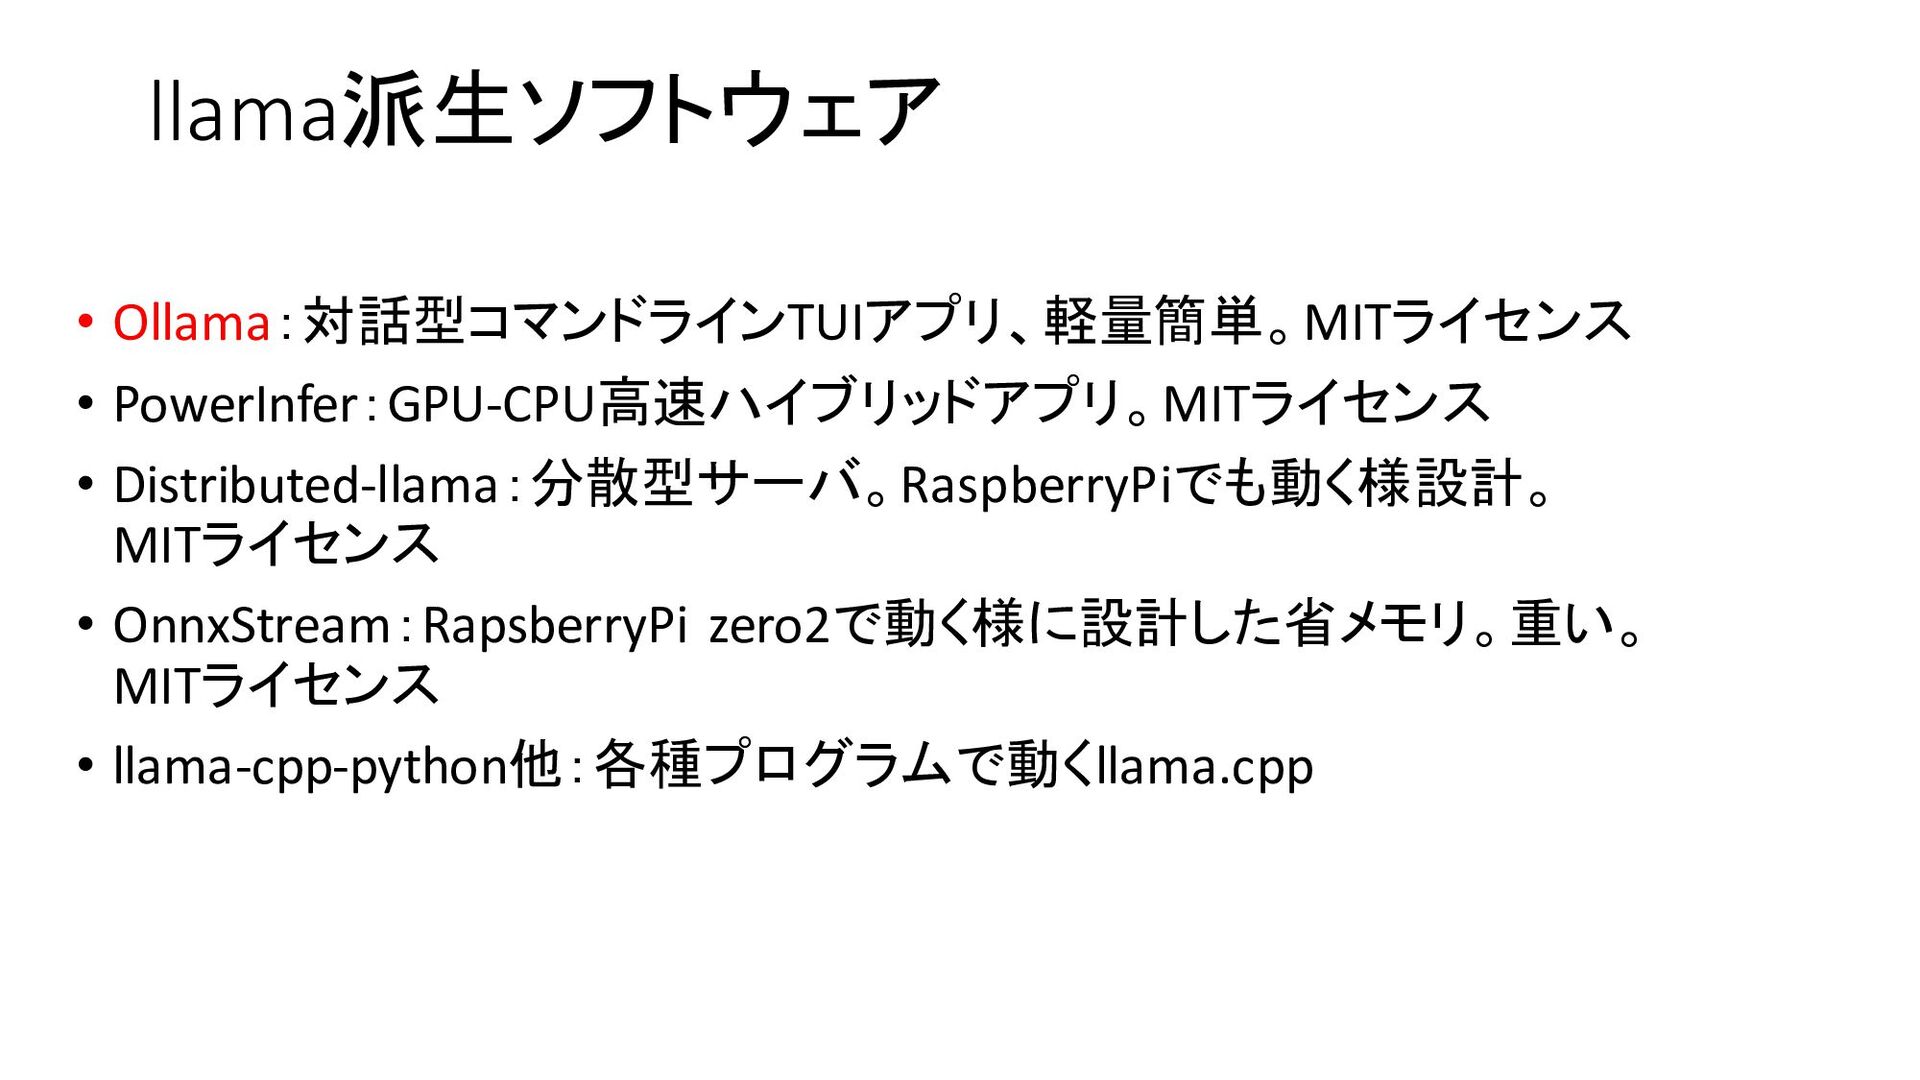
llama派生ソフトウェア • Ollama:対話型コマンドラインTUIアプリ、軽量簡単。MITライセンス • PowerInfer:GPU-CPU高速ハイブリッドアプリ。MITライセンス • Distributed-llama:分散型サーバ。RaspberryPiでも動く様設計。 MITライセンス • OnnxStream:RapsberryPi
zero2で動く様に設計した省メモリ。重い。 MITライセンス • llama-cpp-python他:各種プログラムで動くllama.cpp -
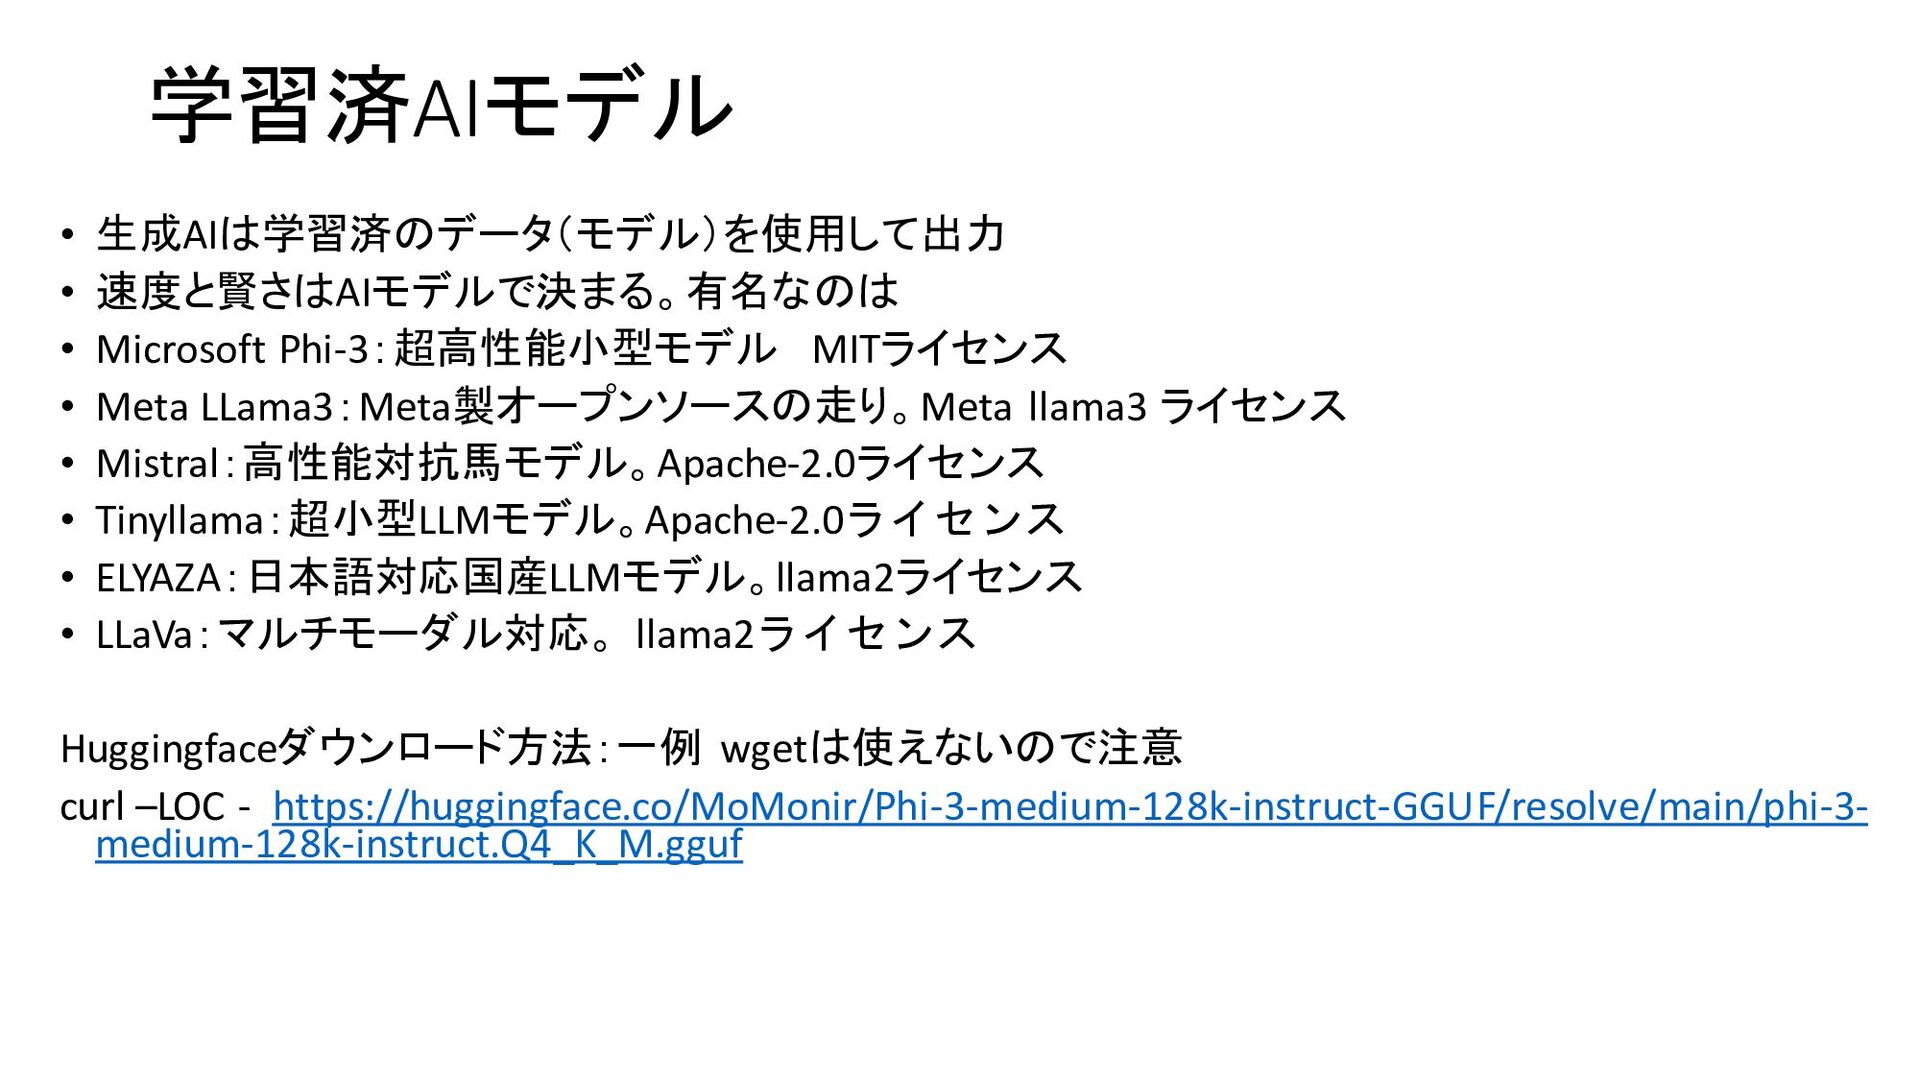
学習済AIモデル • 生成AIは学習済のデータ(モデル)を使用して出力 • 速度と賢さはAIモデルで決まる。有名なのは • Microsoft Phi-3:超高性能小型モデル MITライセンス •
Meta LLama3:Meta製オープンソースの走り。Meta llama3 ライセンス • Mistral:高性能対抗馬モデル。Apache-2.0ライセンス • Tinyllama:超小型LLMモデル。Apache-2.0ライセンス • ELYAZA:日本語対応国産LLMモデル。llama2ライセンス • LLaVa:マルチモーダル対応。llama2ライセンス Huggingfaceダウンロード方法:一例 wgetは使えないので注意 curl –LOC - https://huggingface.co/MoMonir/Phi-3-medium-128k-instruct-GGUF/resolve/main/phi-3- medium-128k-instruct.Q4_K_M.gguf -
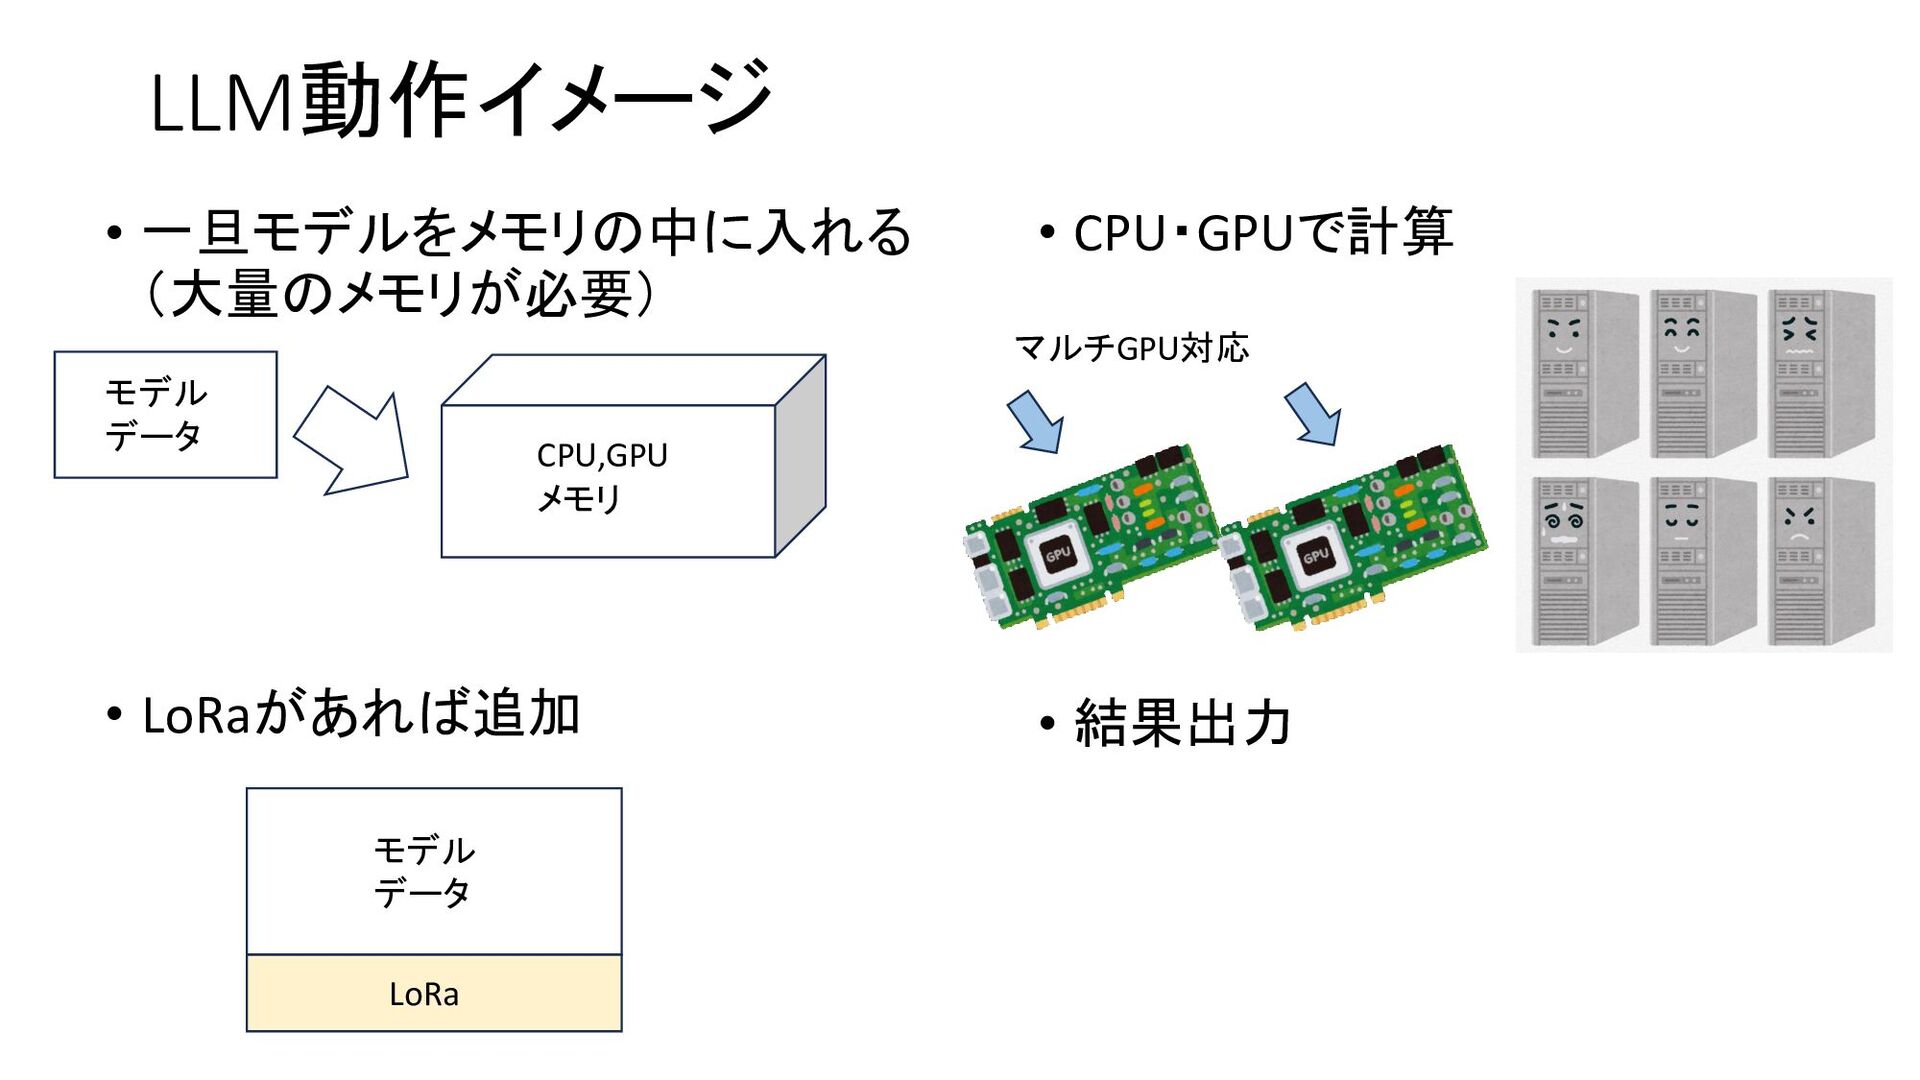
LLM動作イメージ • 一旦モデルをメモリの中に入れる (大量のメモリが必要) oメモリ CPU,GPU メモリ • 結果出力 モデル
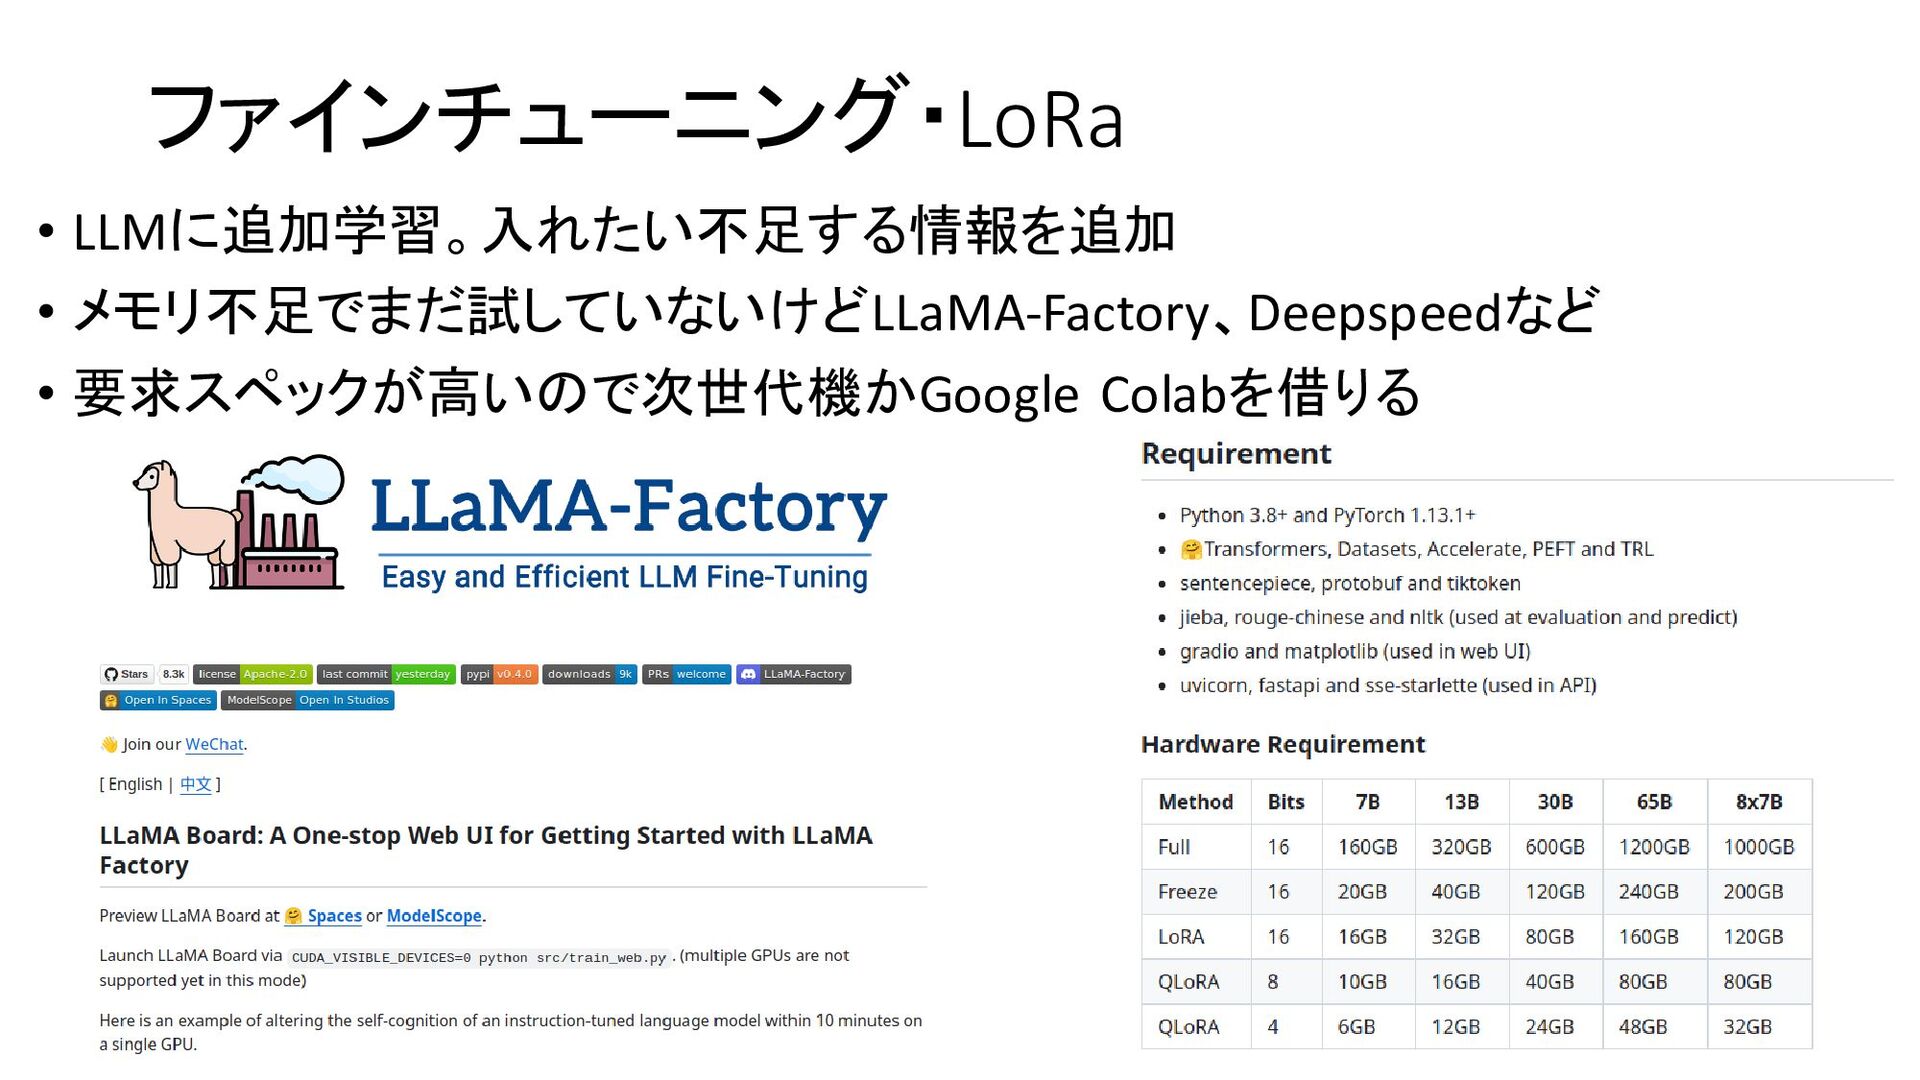
データ • CPU・GPUで計算 モデル データ LoRa マルチGPU対応 • LoRaがあれば追加 -
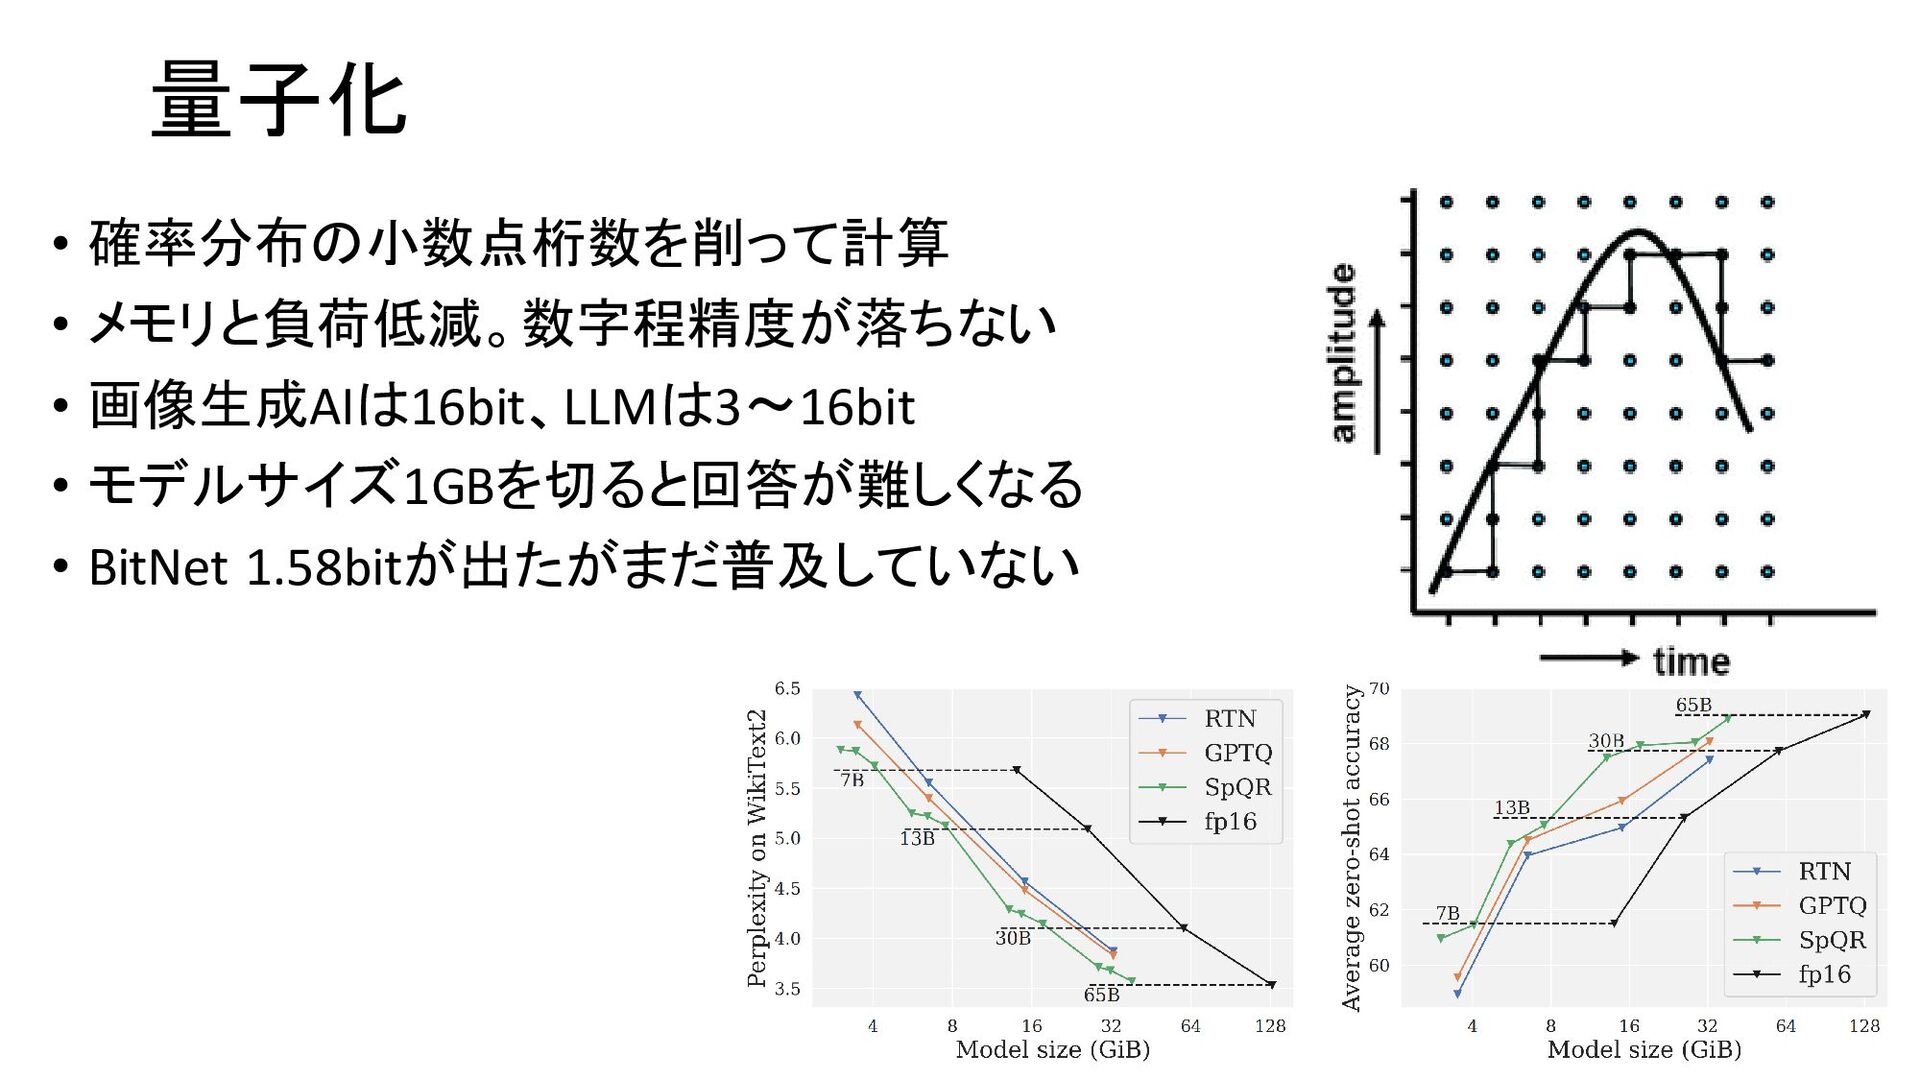
量子化 • 確率分布の小数点桁数を削って計算 • メモリと負荷低減。数字程精度が落ちない • 画像生成AIは16bit、LLMは3〜16bit • モデルサイズ1GBを切ると回答が難しくなる •
BitNet 1.58bitが出たがまだ普及していない -
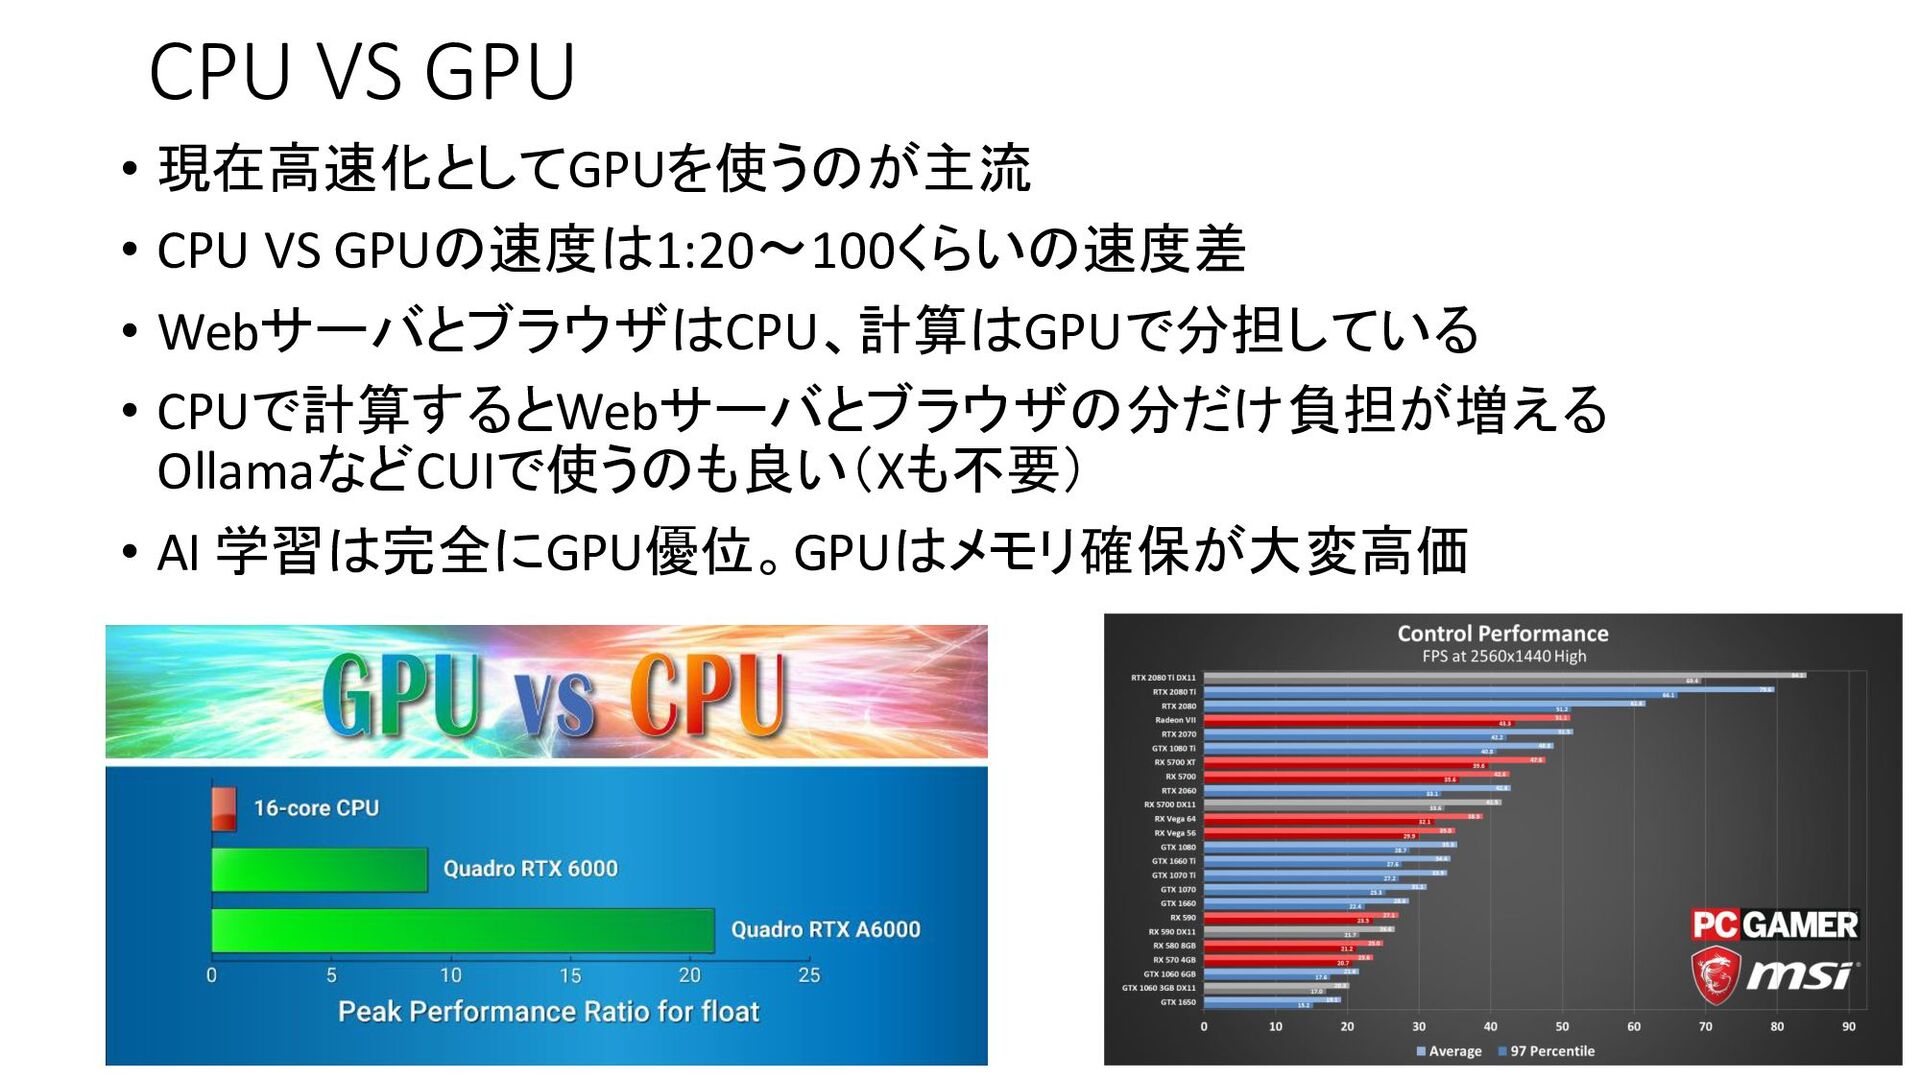
CPU VS GPU • 現在高速化としてGPUを使うのが主流 • CPU VS GPUの速度は1:20〜100くらいの速度差 •
WebサーバとブラウザはCPU、計算はGPUで分担している • CPUで計算するとWebサーバとブラウザの分だけ負担が増える OllamaなどCUIで使うのも良い(Xも不要) • AI 学習は完全にGPU優位。GPUはメモリ確保が大変高価 -
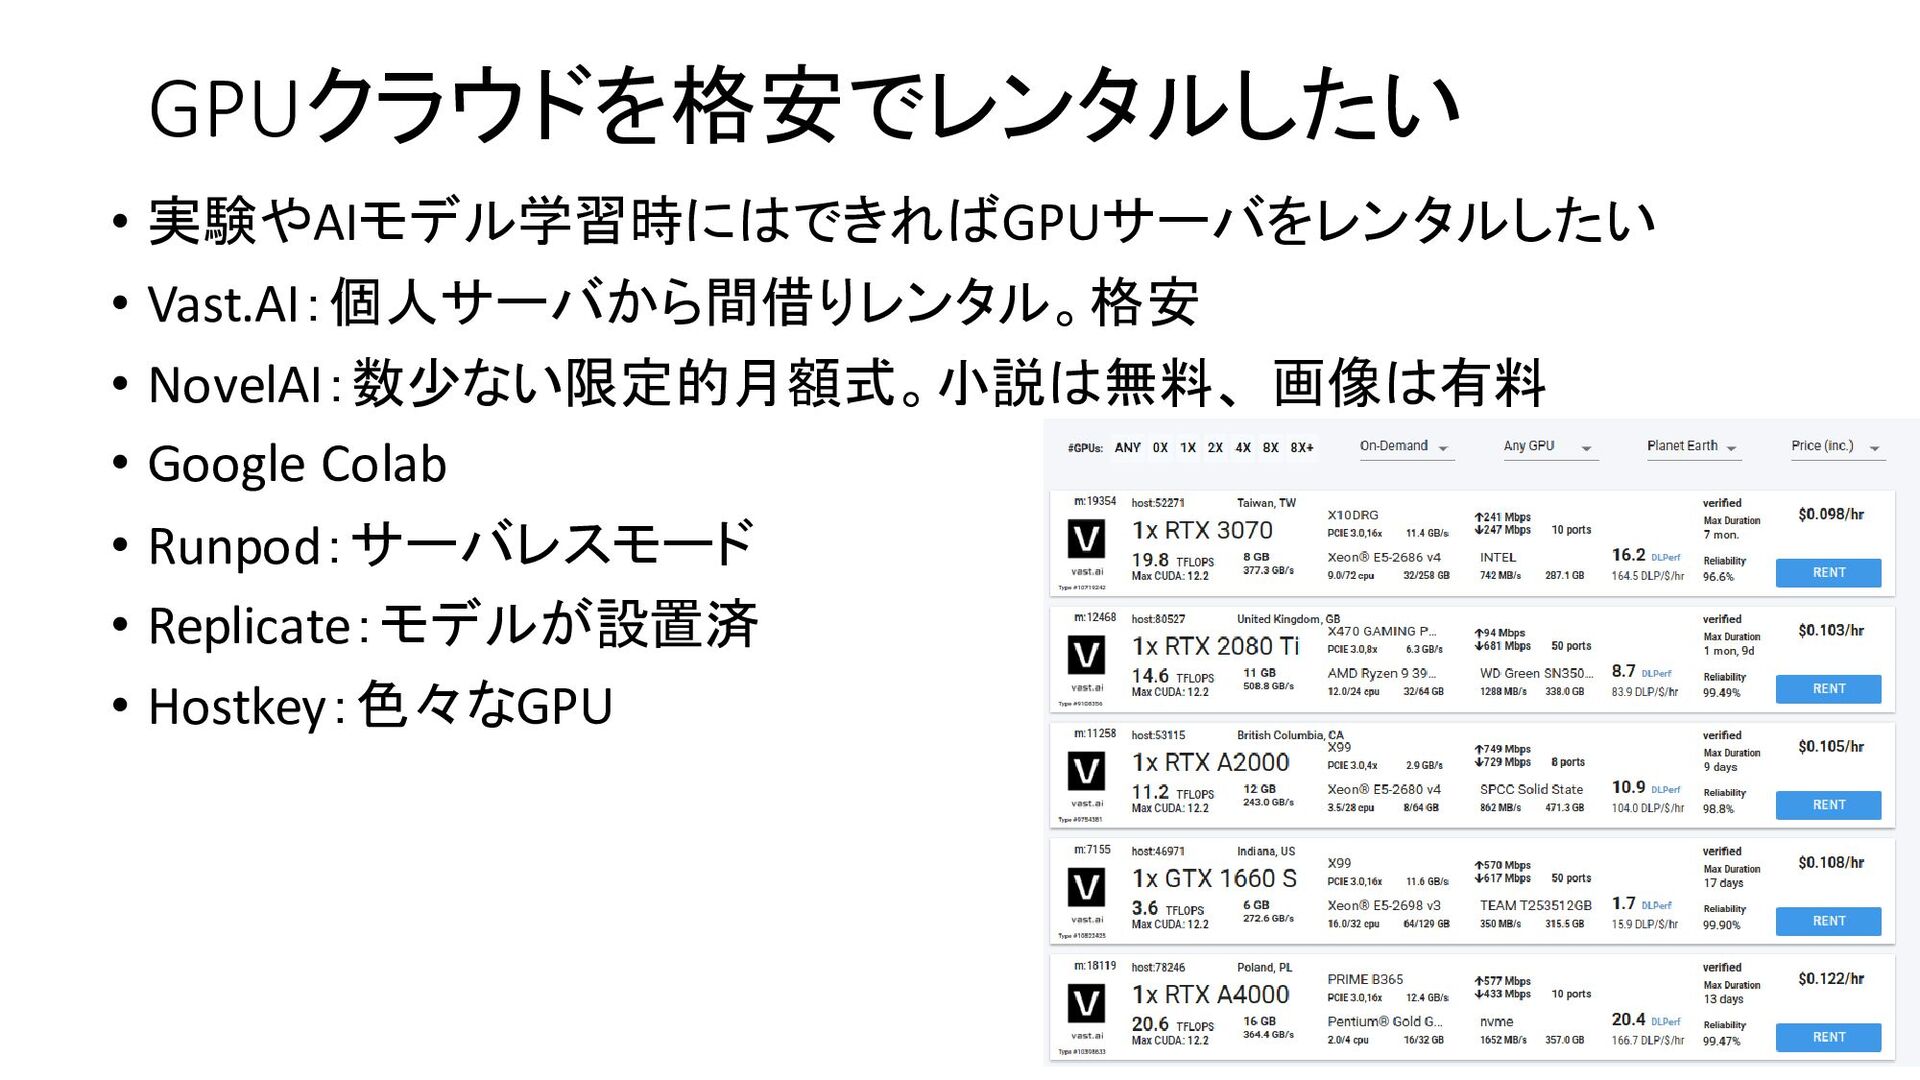
GPUクラウドを格安でレンタルしたい • 実験やAIモデル学習時にはできればGPUサーバをレンタルしたい • Vast.AI:個人サーバから間借りレンタル。格安 • NovelAI:数少ない限定的月額式。小説は無料、 画像は有料 • Google
Colab • Runpod:サーバレスモード • Replicate:モデルが設置済 • Hostkey:色々なGPU -
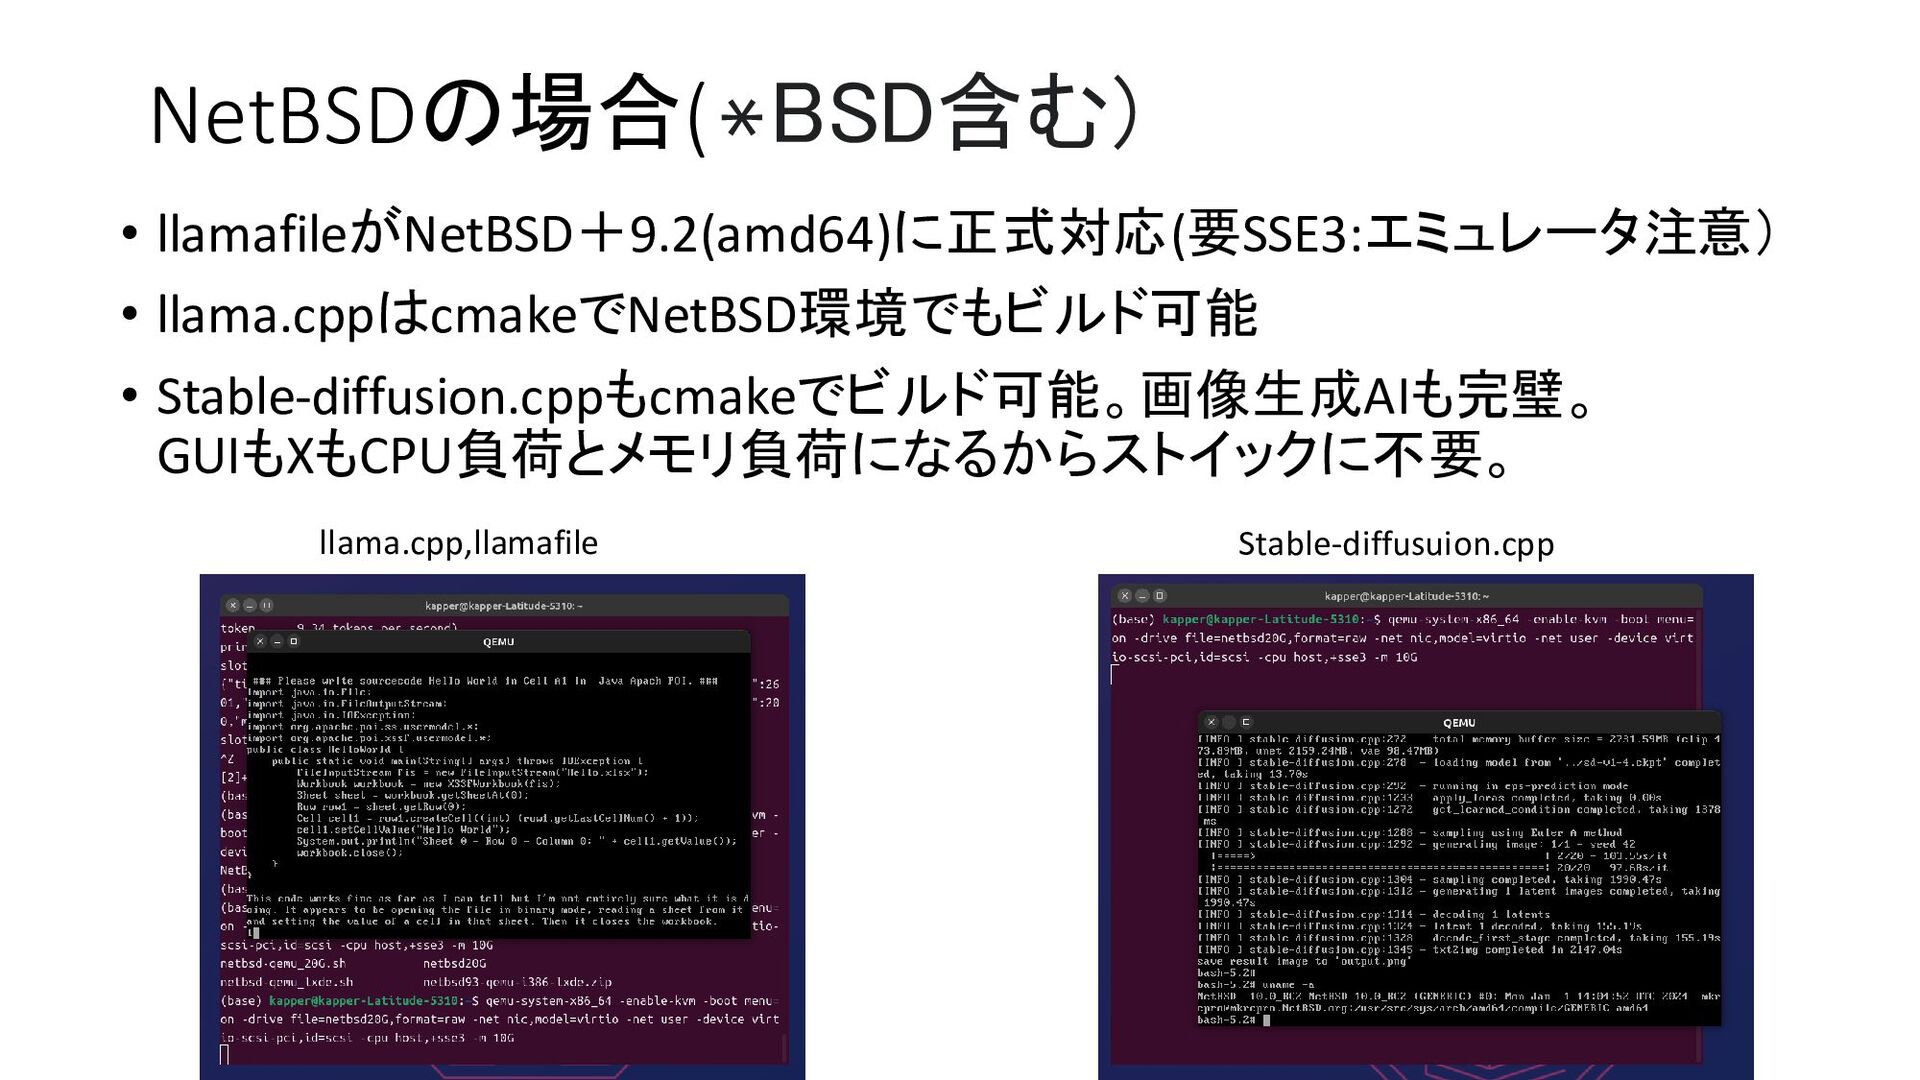
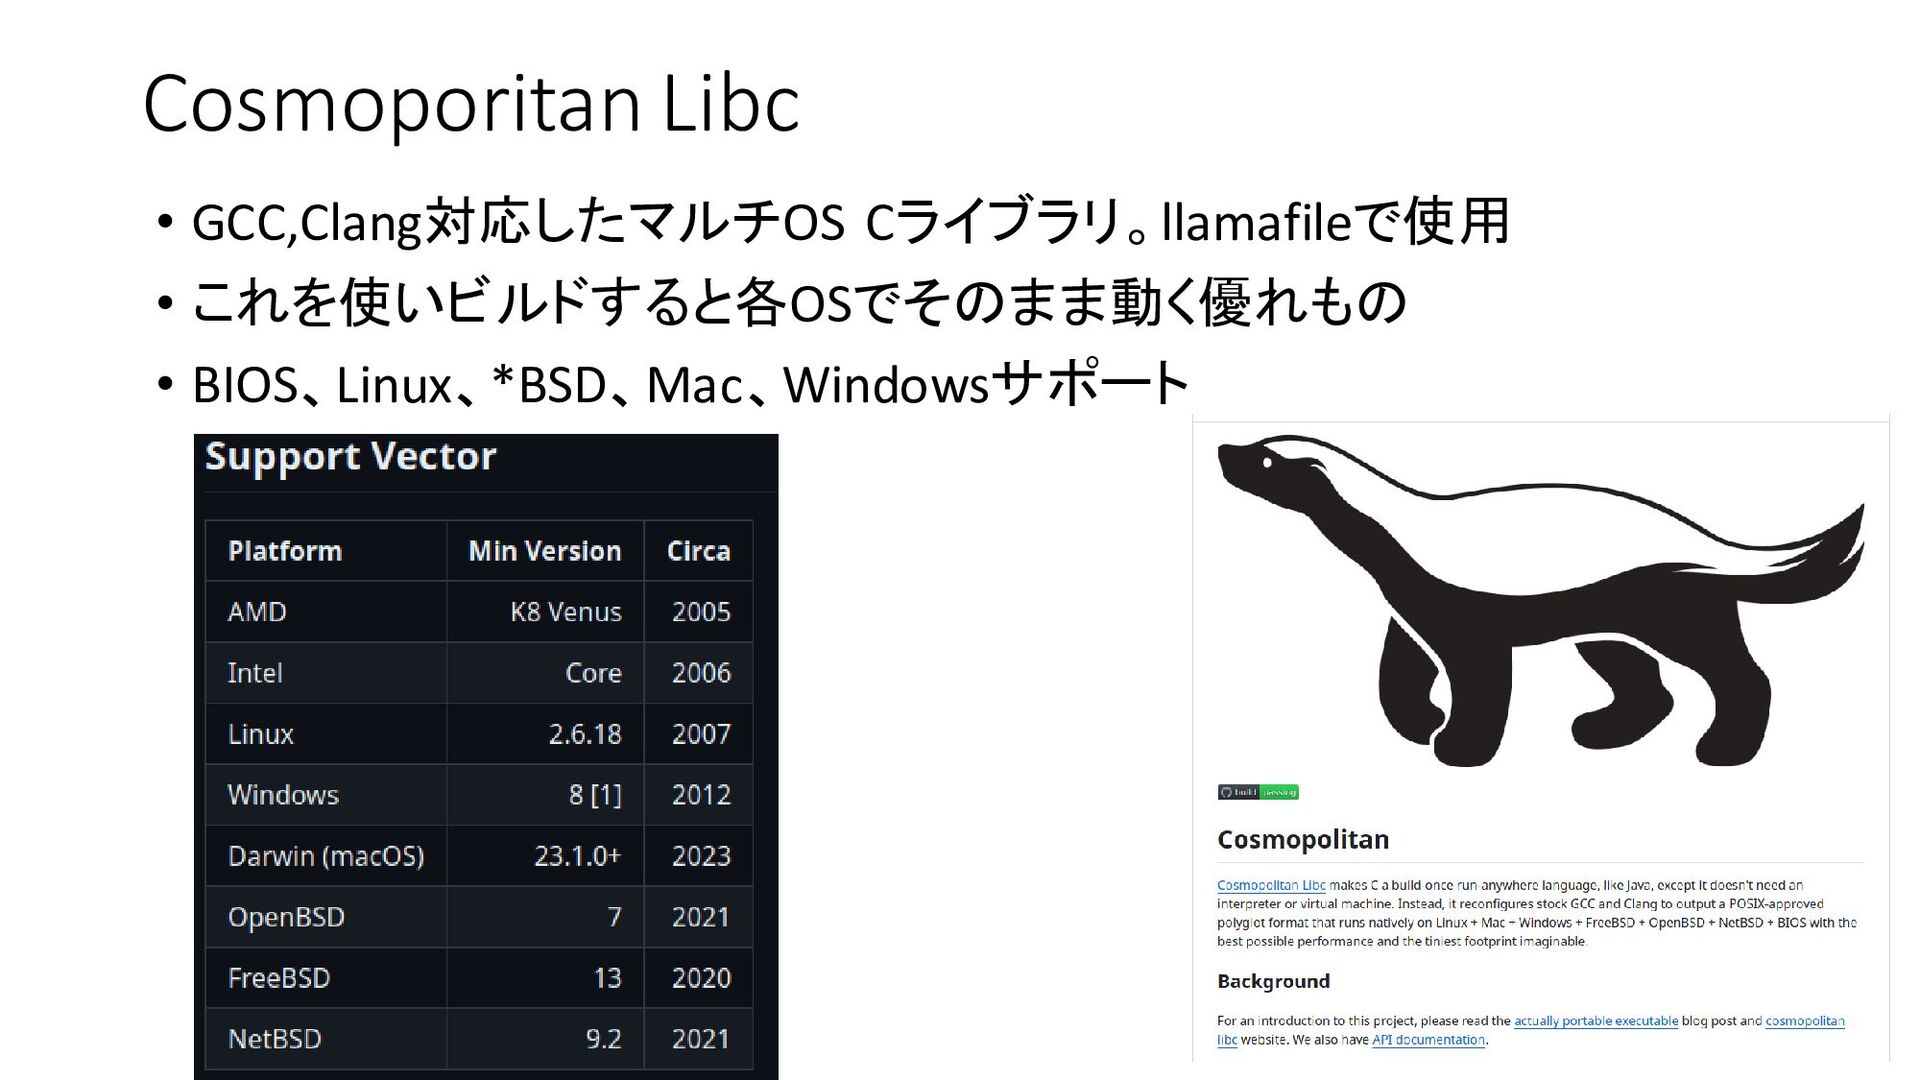
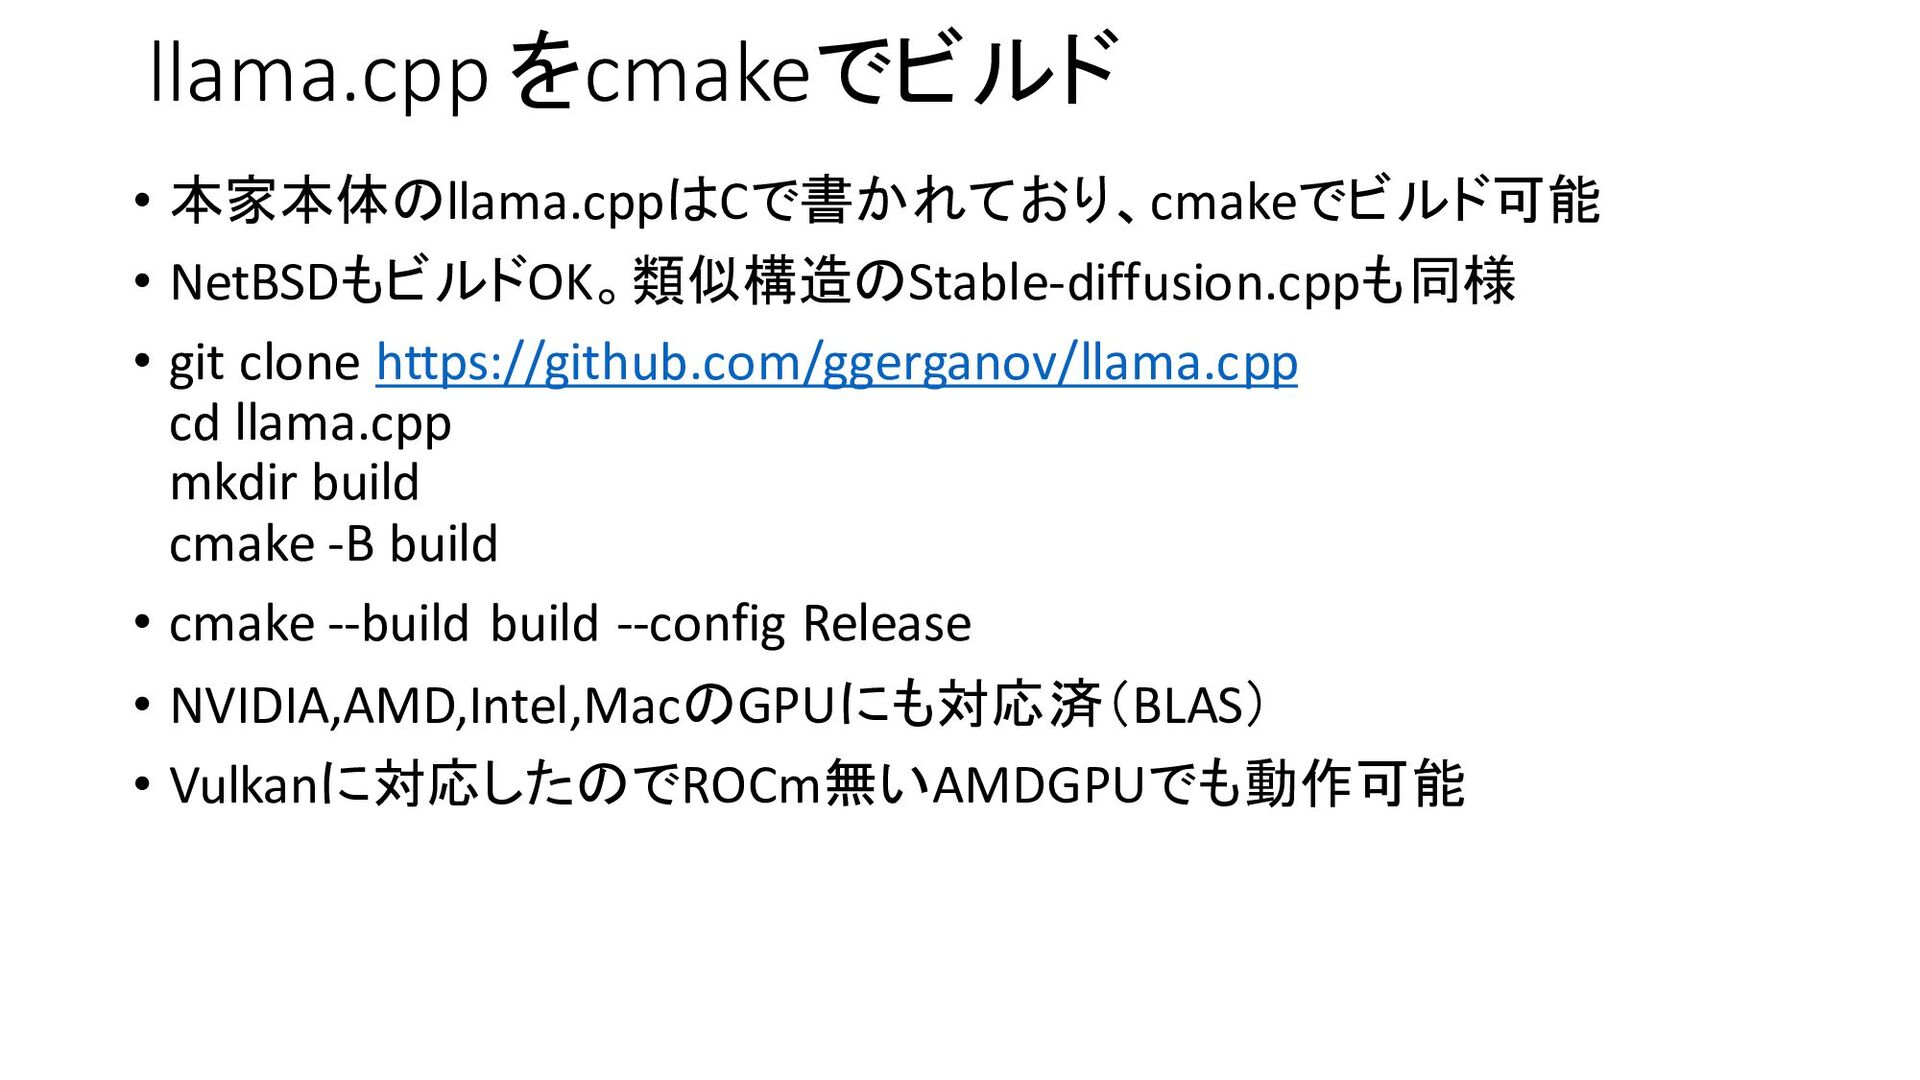
llama.cpp をcmakeでビルド • 本家本体のllama.cppはCで書かれており、cmakeでビルド可能 • NetBSDもビルドOK。類似構造のStable-diffusion.cppも同様 • git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp mkdir build cmake -B build • cmake --build build --config Release • NVIDIA,AMD,Intel,MacのGPUにも対応済(BLAS) • Vulkanに対応したのでROCm無いAMDGPUでも動作可能 -
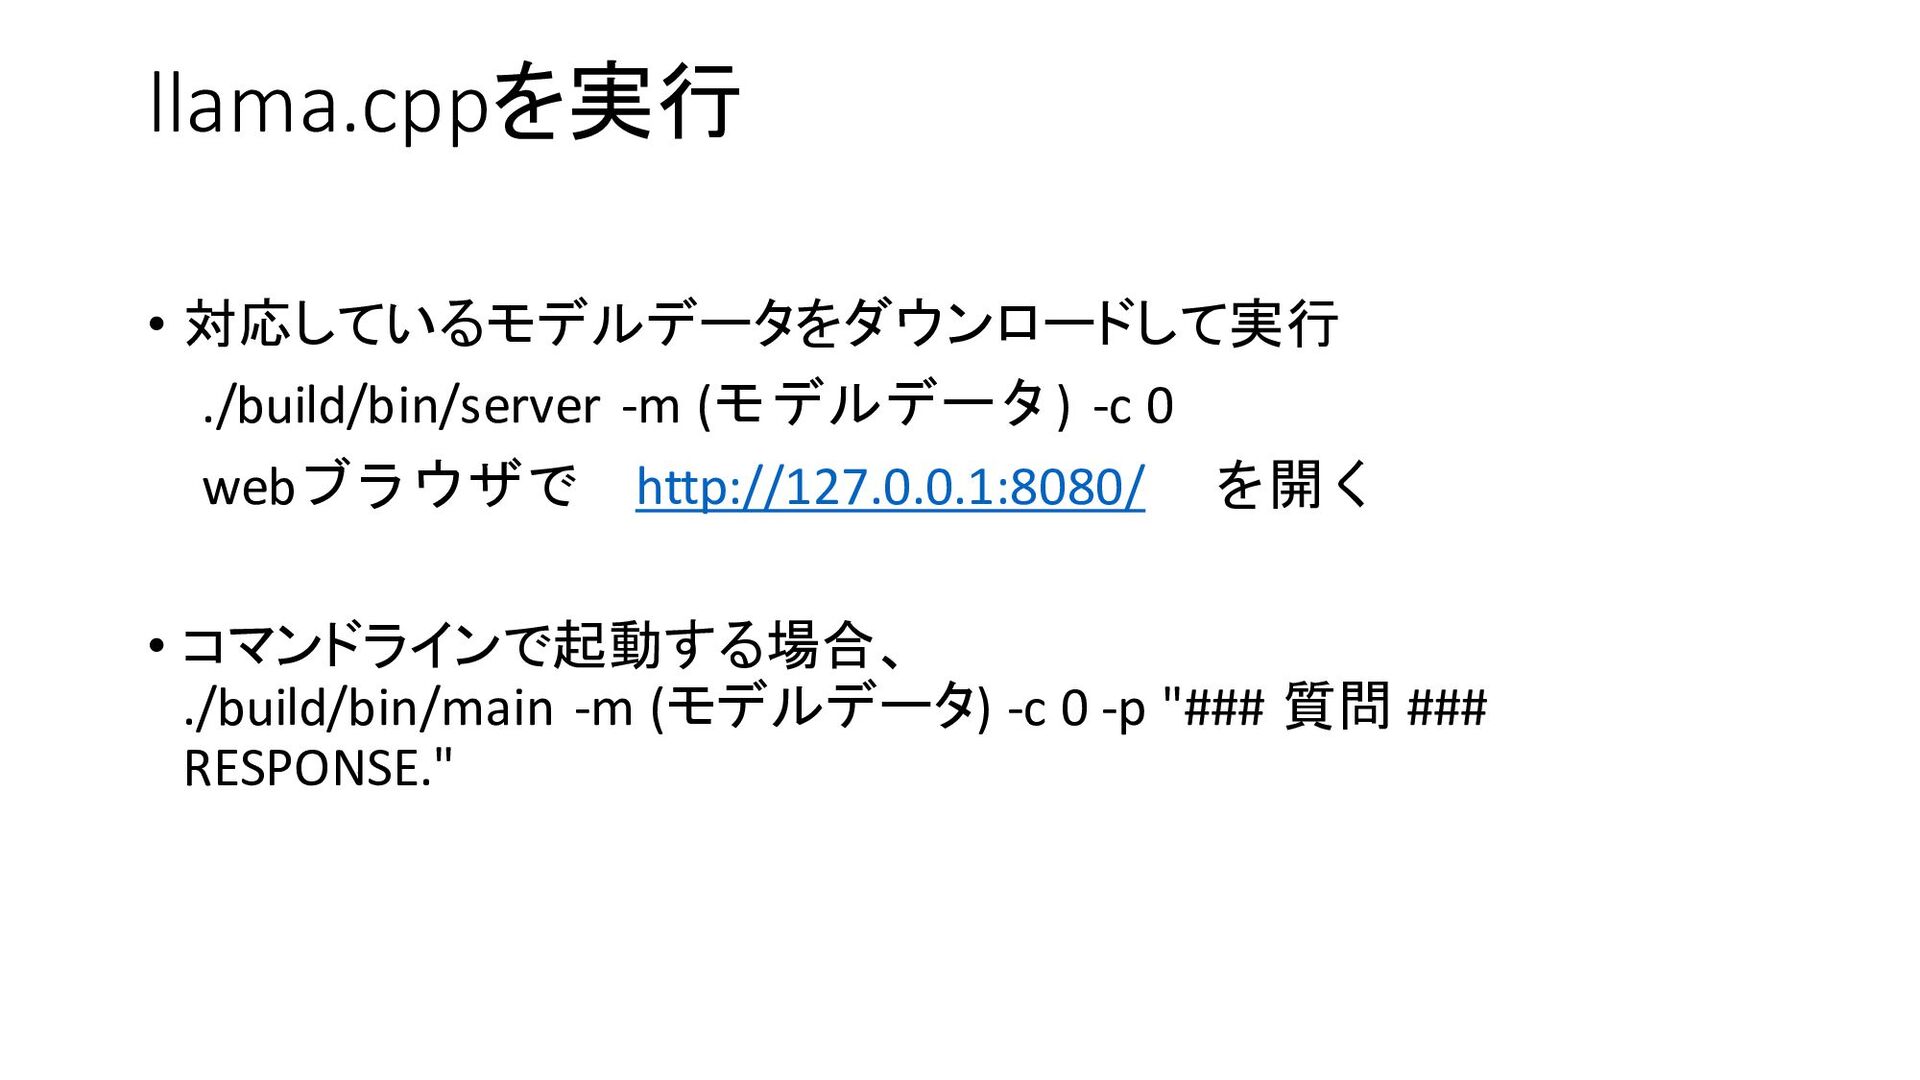
llama.cppを実行 • 対応しているモデルデータをダウンロードして実行 ./build/bin/server -m (モデルデータ) -c 0 webブラウザで http://127.0.0.1:8080/
を開く • コマンドラインで起動する場合、 ./build/bin/main -m (モデルデータ) -c 0 -p "### 質問 ### RESPONSE." -
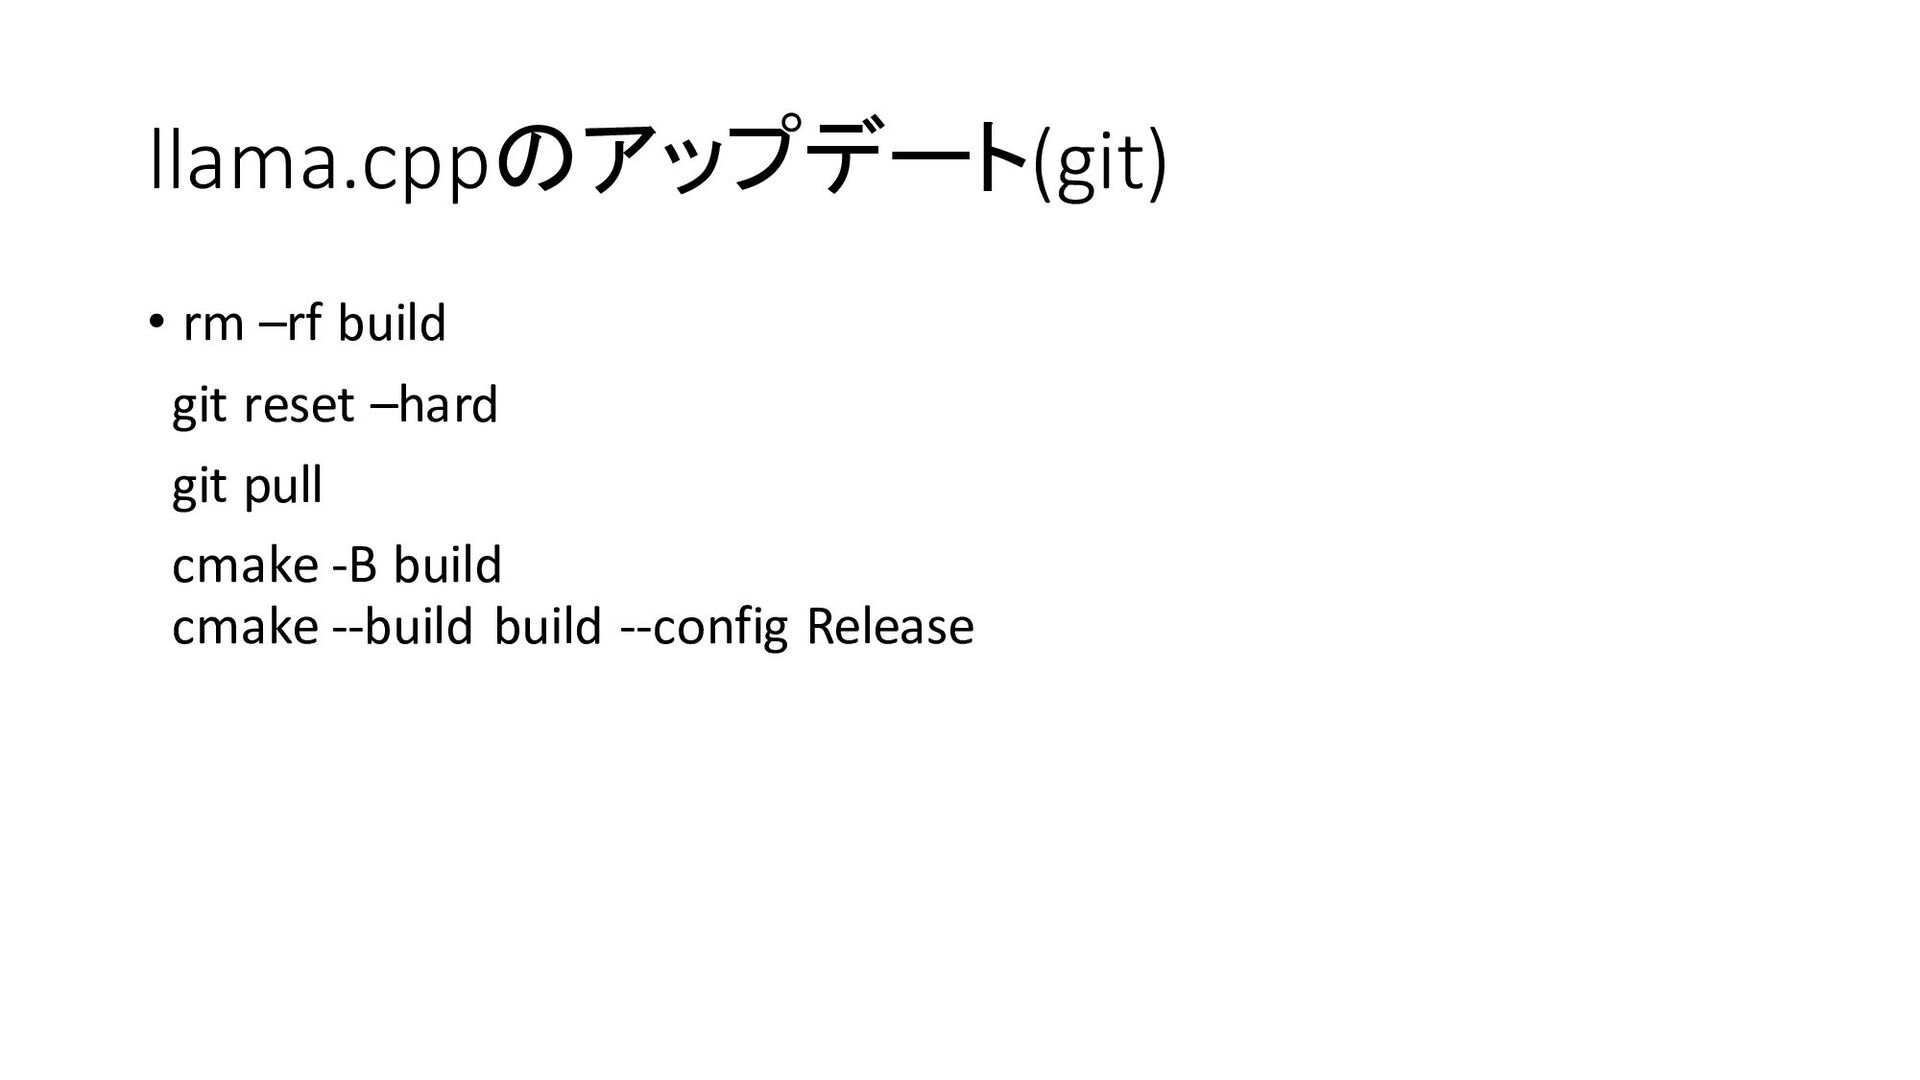
llama.cppのアップデート(git) • rm –rf build git reset –hard git pull
cmake -B build cmake --build build --config Release -
Ollamaのインストール(注:Linuxのみ) • Linux版インストール curl -fsSL https://ollama.com/install.sh | sh ollama run
llama3 • Mac版、Windows版は公式GitHubからインストラーダウンロー ド -
よくある質問・疑問点 • CPUではだめなんですか? --- 遅いだけです。CPUメモリは安い。 • 日本語が賢くないのですが --- 今はPhi-3,llama3が良いです •
NVIDIA以外のGPUは動くのですか? --- vulkan,Metalでも動きます • ノートパソコンの内蔵GPUは使えますか? ---メモリ500MBなのできつい • GPUは借りた方が安いですか? --- 学習させるなら時間に応じて • 思ったような回答が出てきません --- プロンプトを工夫 • そもそもローカルでLLMを使う意味は? ---ロマン、商売用、独自規格