Upgrade to Pro — share decks privately, control downloads, hide ads and more …

BedrockとLambdaで作る リアルタイム進行型推理ゲーム

Avatar for kawai kawai
September 30, 2026

BedrockとLambdaで作る リアルタイム進行型推理ゲーム

Avatar for kawai

kawai

September 30, 2026

Other Decks in Technology

Transcript

  1. 🐰 🐺 🦉<題して、 もりのたんていじけんぼ 🐶 🌳🪓 ワン - - を、紹介します。

    利用費を超爆裂低コストに抑えた(後述)地球🌍に優しい、 リアルタイム推理アドベンチャーゲーム(を、目指しました) 4匹の動物たちのなかに、村の危険を脅かす因子を特定します 証言をもとに、誰が犯人かを推理します
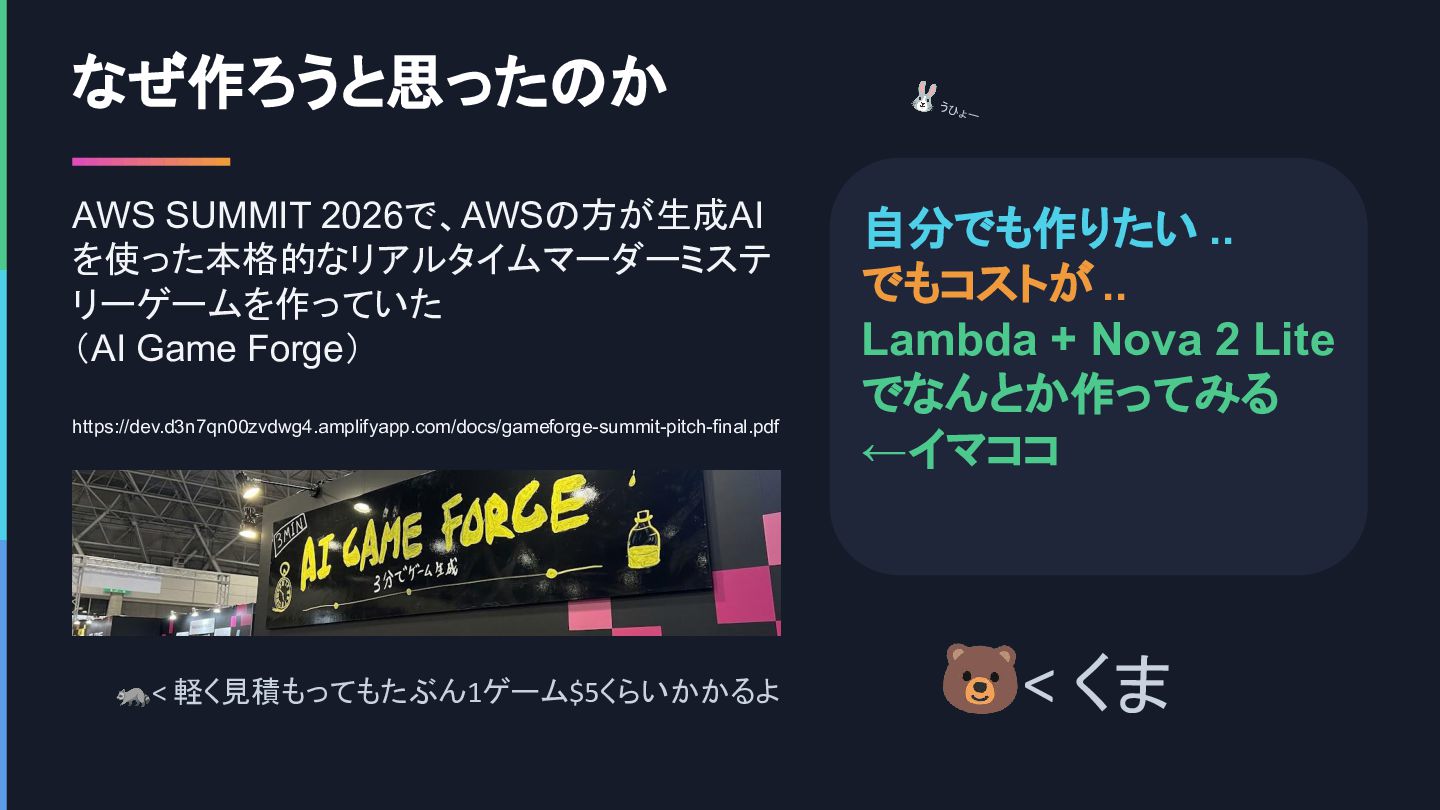
  2. なぜ作ろうと思ったのか AWS SUMMIT 2026で、AWSの方が生成AI を使った本格的なリアルタイムマーダーミステ リーゲームを作っていた (AI Game Forge) https://dev.d3n7qn00zvdwg4.amplifyapp.com/docs/gameforge-summit-pitch-final.pdf

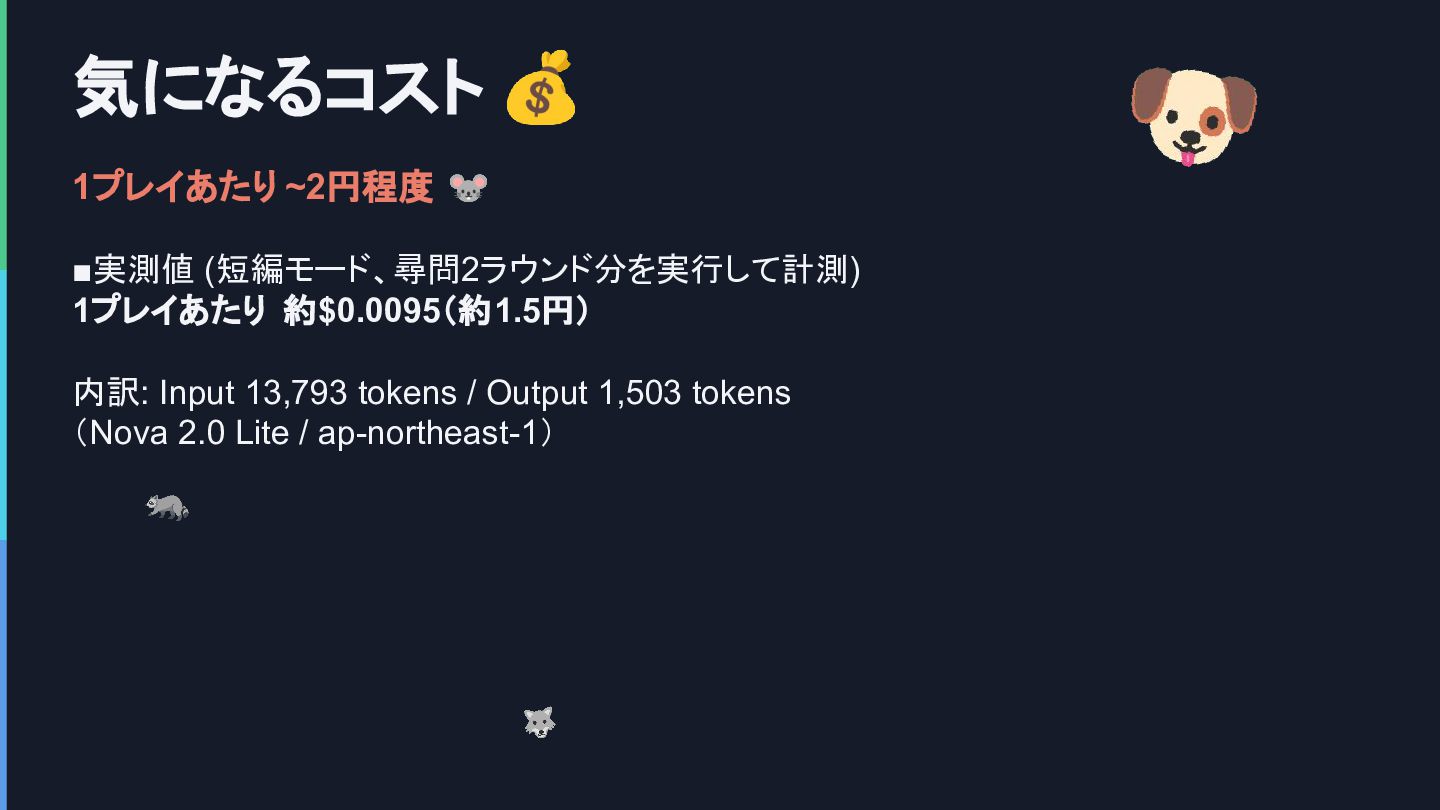
    🦝< 軽く見積もってもたぶん1ゲーム$5くらいかかるよ 🐰うひ ょー 自分でも作りたい .. でもコストが .. Lambda + Nova 2 Lite でなんとか作ってみる ←イマココ 🐻< くま
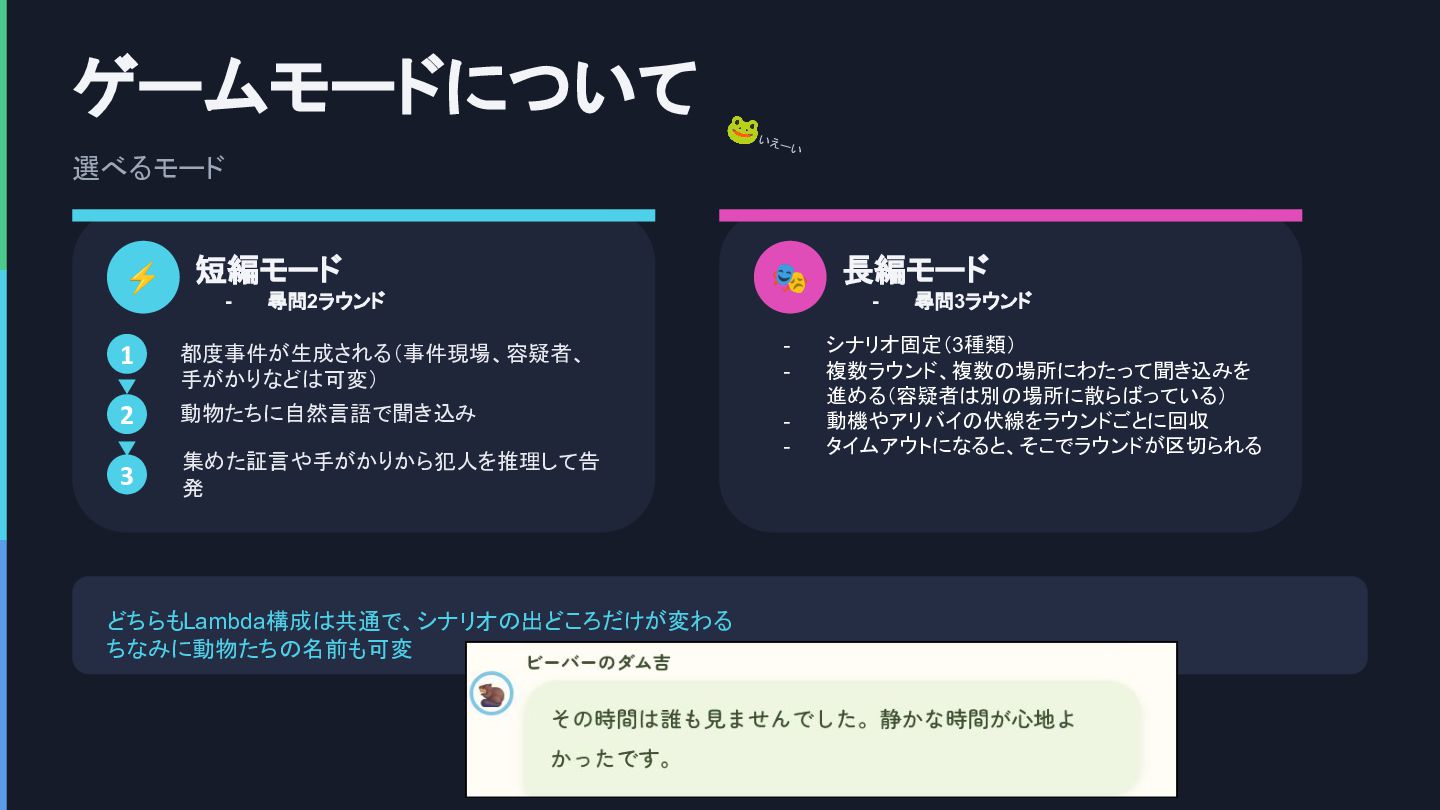
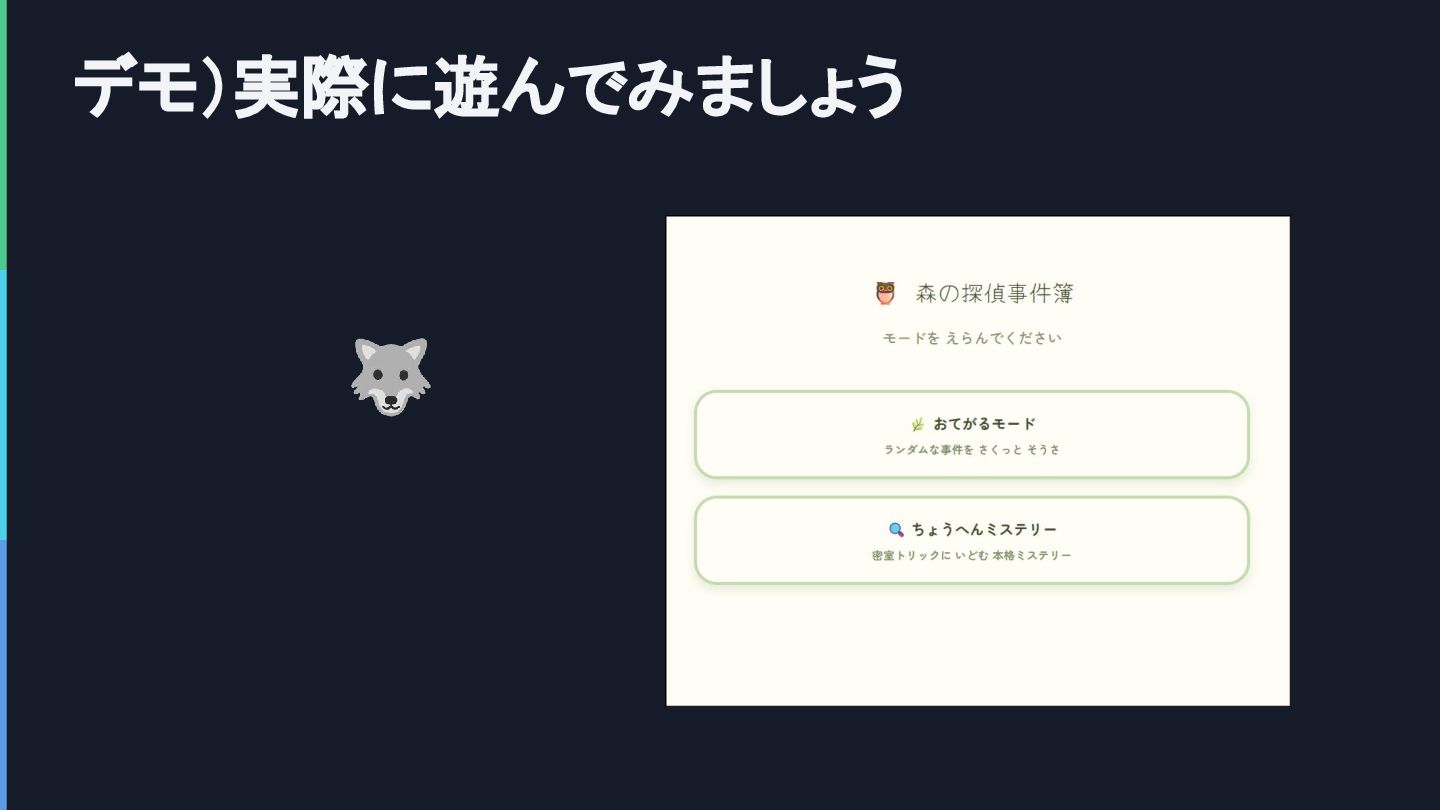
  3. ゲームモードについて 🐸 いえー い 選べるモード ⚡ 短編モード 1 都度事件が生成される(事件現場、容疑者、 手がかりなどは可変)

    2 動物たちに自然言語で聞き込み 3 集めた証言や手がかりから犯人を推理して告 発 - 尋問2ラウンド どちらもLambda構成は共通で、シナリオの出どころだけが変わる ちなみに動物たちの名前も可変 🎭 - 長編モード - 尋問3ラウンド シナリオ固定(3種類) 複数ラウンド、複数の場所にわたって聞き込みを 進める(容疑者は別の場所に散らばっている) 動機やアリバイの伏線をラウンドごとに回収 タイムアウトになると、そこでラウンドが区切られる
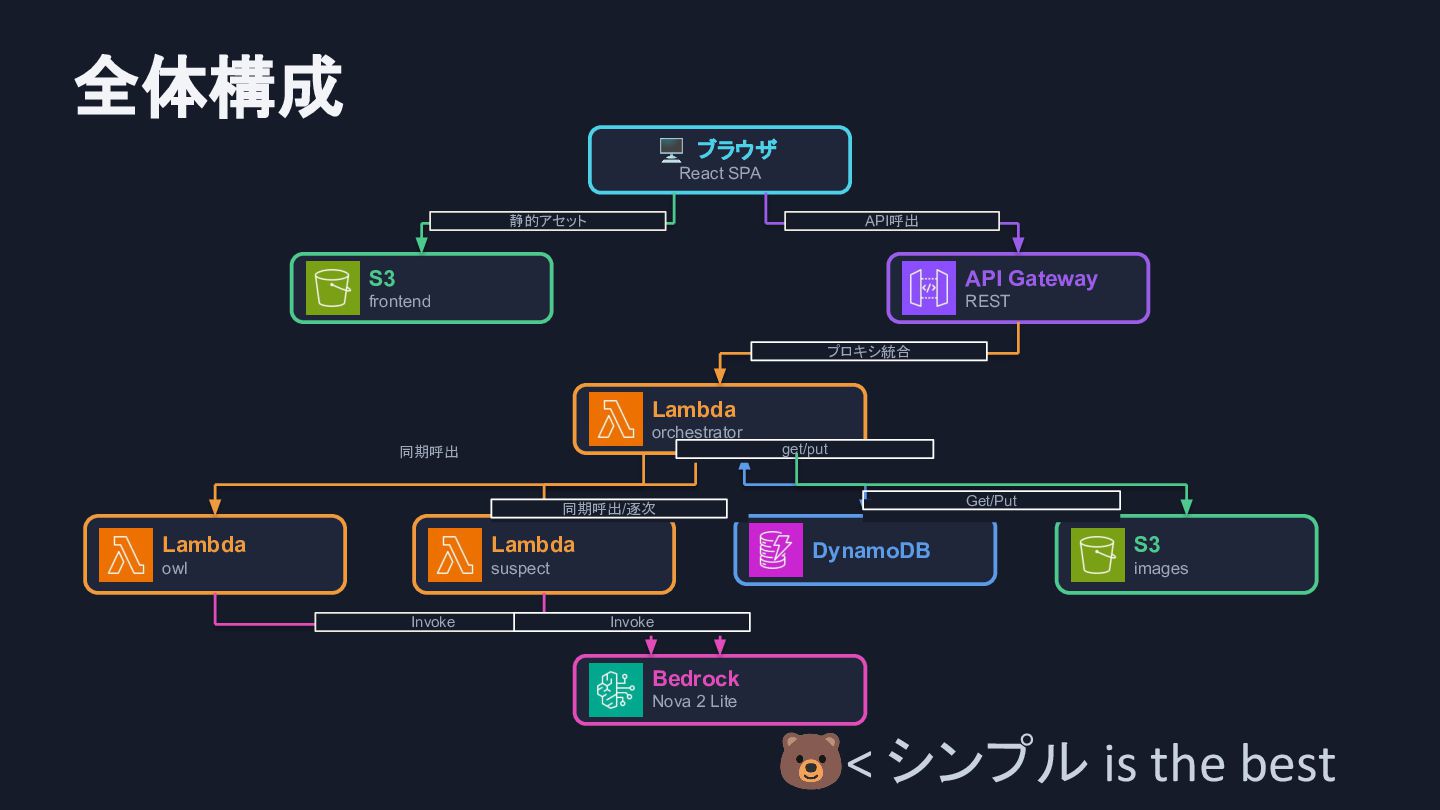
  4. 全体構成 🖥 ブラウザ React SPA 静的アセット API呼出 S3 API Gateway

    frontend REST プロキシ統合 Lambda orchestrator get/put 同期呼出 Get/Put 同期呼出/逐次 Lambda Lambda owl suspect Invoke DynamoDB S3 images Invoke Bedrock Nova 2 Lite 🐻< シンプル is the best
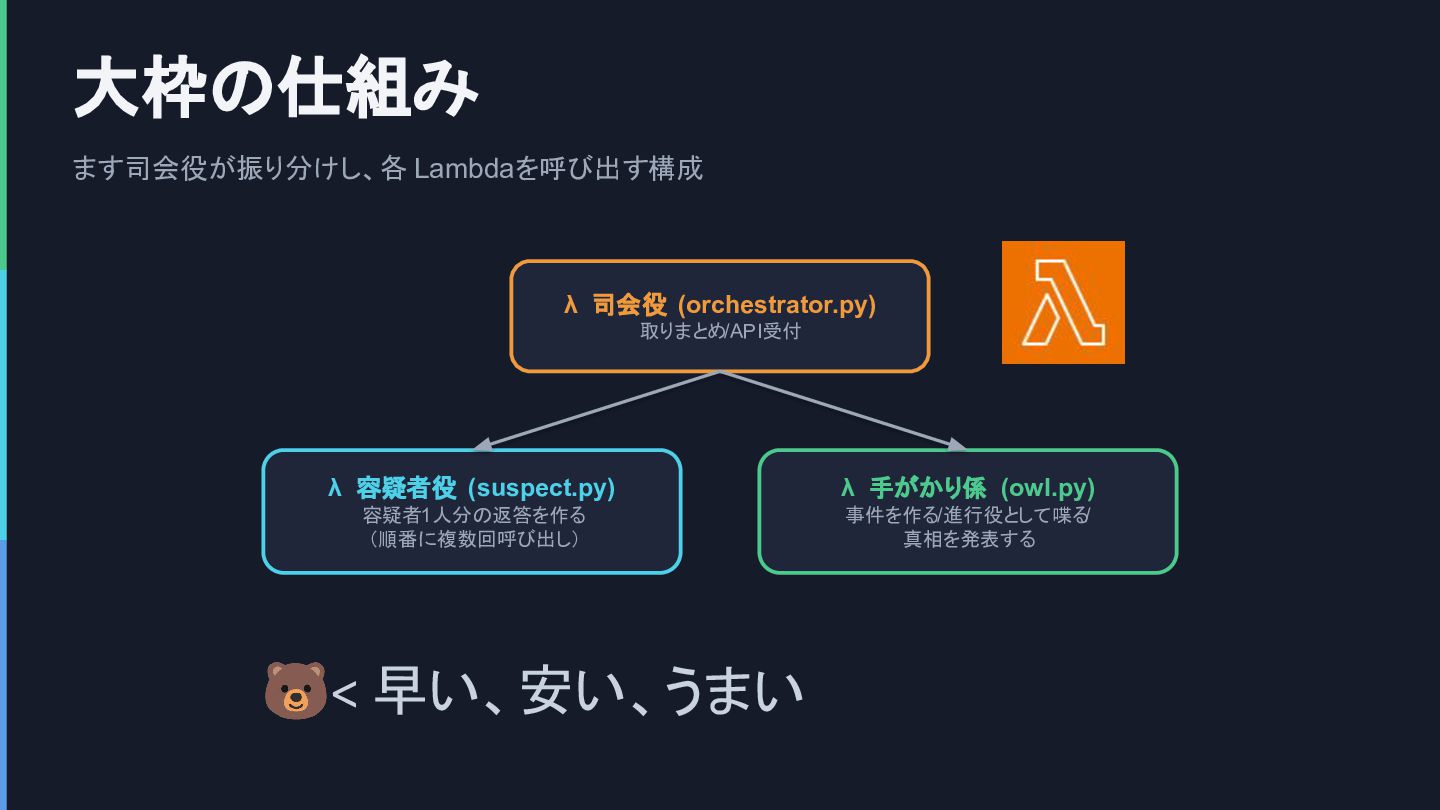
  5. 大枠の仕組み ます司会役が振り分けし、各 Lambdaを呼び出す構成 λ 司会役 (orchestrator.py) 取りまとめ/API受付 λ 容疑者役 (suspect.py)

    λ 手がかり係 (owl.py) 容疑者1人分の返答を作る (順番に複数回呼び出し) 事件を作る/進行役として喋る/ 真相を発表する 🐻< 早い、安い、うまい
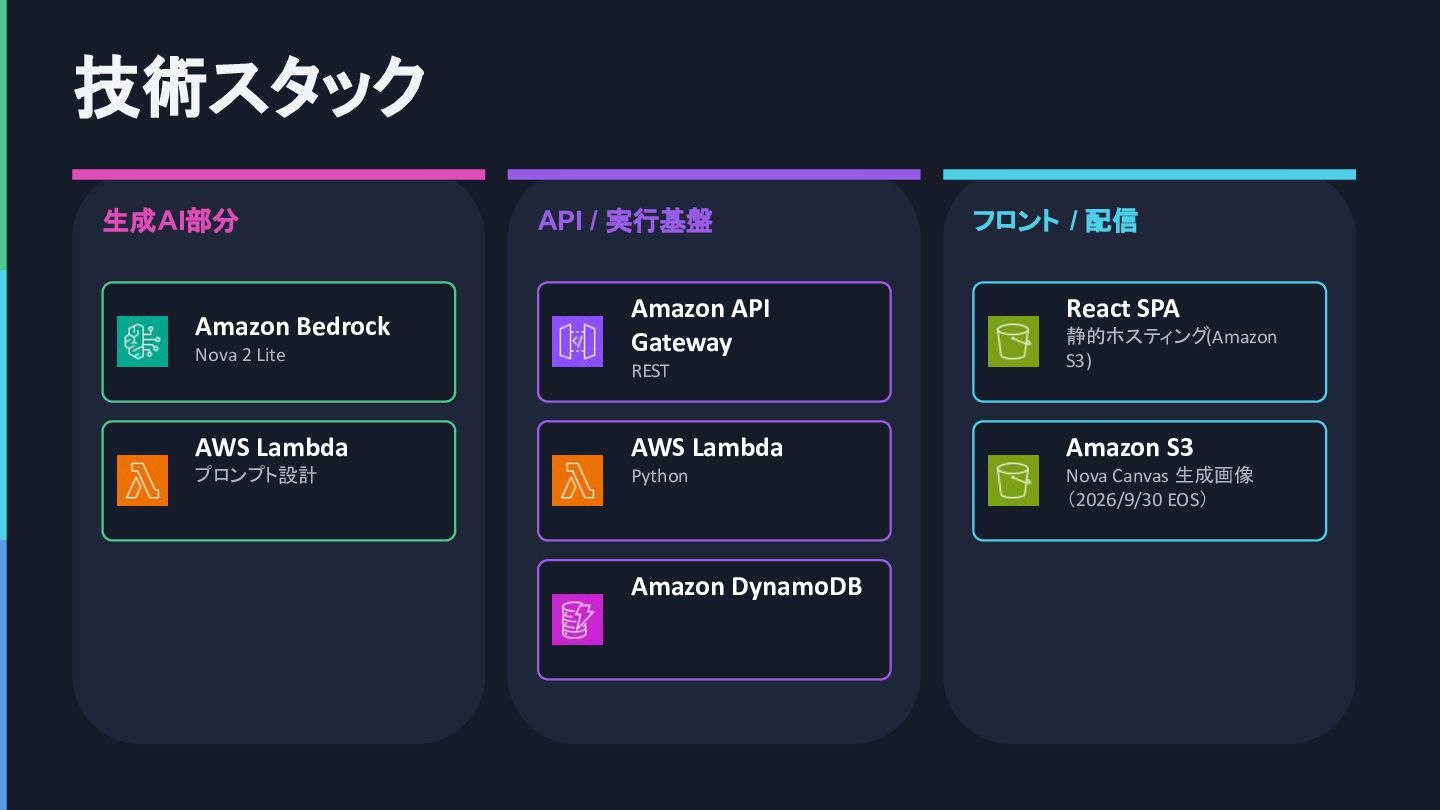
  6. 技術スタック 生成AI部分 API / 実行基盤 フロント / 配信 React SPA

    Nova 2 Lite Amazon API Gateway REST 静的ホスティング(Amazon S3) AWS Lambda AWS Lambda Amazon S3 プロンプト設計 Python Nova Canvas 生成画像 (2026/9/30 EOS) Amazon Bedrock Amazon DynamoDB
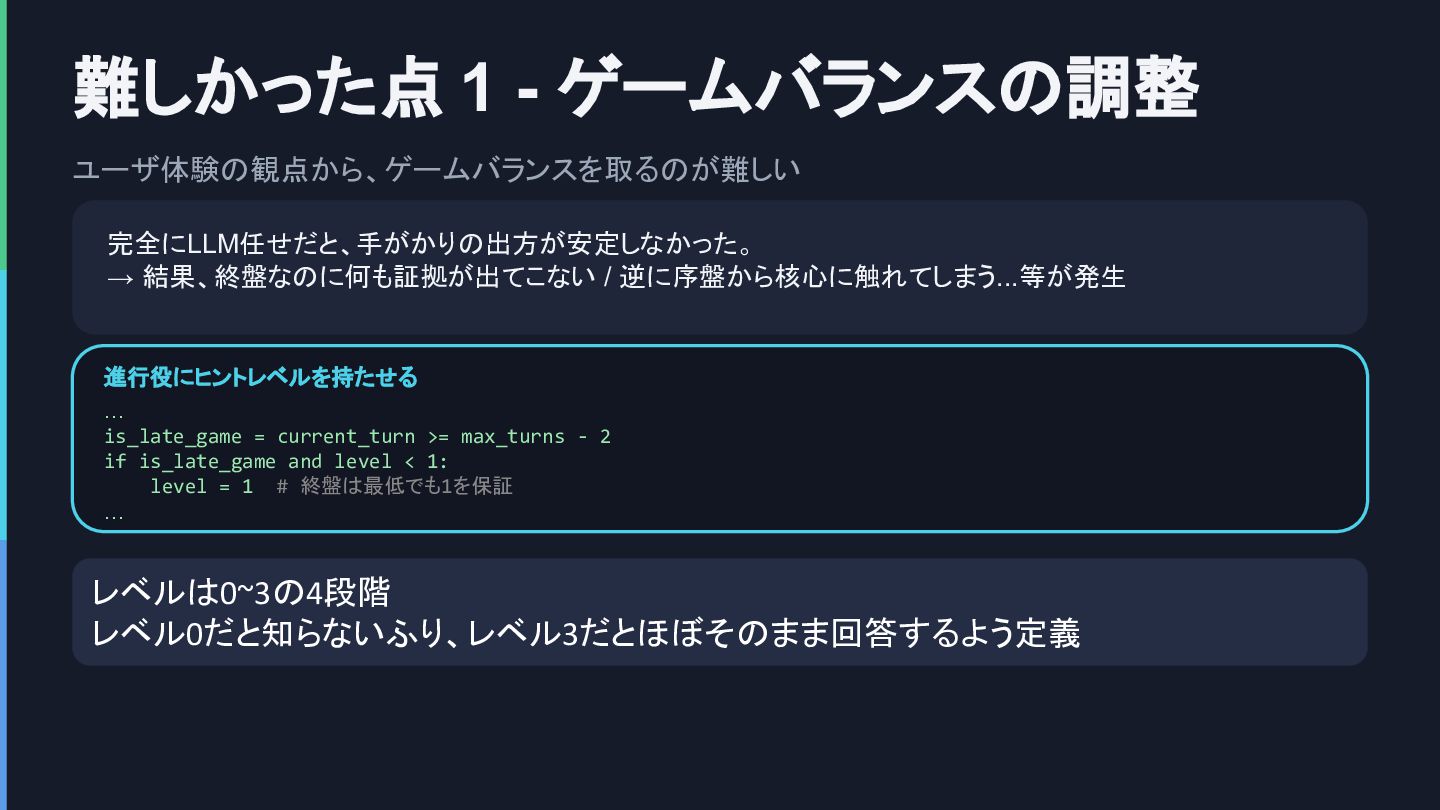
  7. 難しかった点 1 - ゲームバランスの調整 �� ユーザ体験の観点から、ゲームバランスを取るのが難しい 完全にLLM任せだと、手がかりの出方が安定しなかった。 → 結果、終盤なのに何も証拠が出てこない /

    逆に序盤から核心に触れてしまう...等が発生 進行役にヒントレベルを持たせる … is_late_game = current_turn >= max_turns - 2 if is_late_game and level < 1: level = 1 # 終盤は最低でも1を保証 … レベルは0~3の4段階 レベル0だと知らないふり、レベル3だとほぼそのまま回答するよう定義
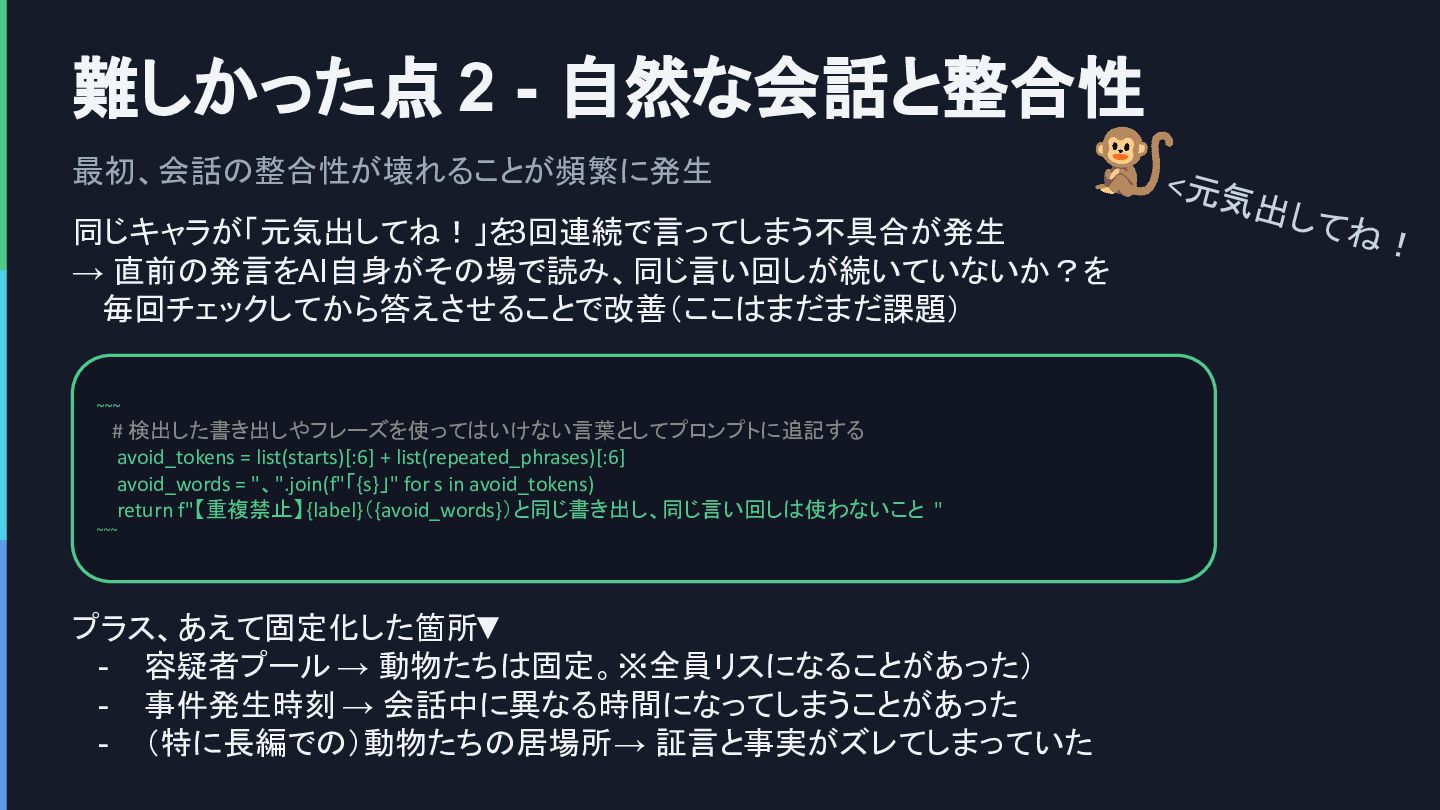
  8. 難しかった点 2 - 自然な会話と整合性 🐒<元 最初、会話の整合性が壊れることが頻繁に発生 同じキャラが「元気出してね!」を3回連続で言ってしまう不具合が発生 → 直前の発言をAI自身がその場で読み、同じ言い回しが続いていないか?を 毎回チェックしてから答えさせることで改善(ここはまだまだ課題)

    ~~~ # 検出した書き出しやフレーズを使ってはいけない言葉としてプロンプトに追記する avoid_tokens = list(starts)[:6] + list(repeated_phrases)[:6] avoid_words = "、".join(f"「{s}」" for s in avoid_tokens) return f"【重複禁止】 {label}({avoid_words})と同じ書き出し、同じ言い回しは使わないこと " ~~~ プラス、あえて固定化した箇所▼ - 容疑者プール → 動物たちは固定。※全員リスになることがあった) - 事件発生時刻 → 会話中に異なる時間になってしまうことがあった - (特に長編での)動物たちの居場所 → 証言と事実がズレてしまっていた 気出 してね !
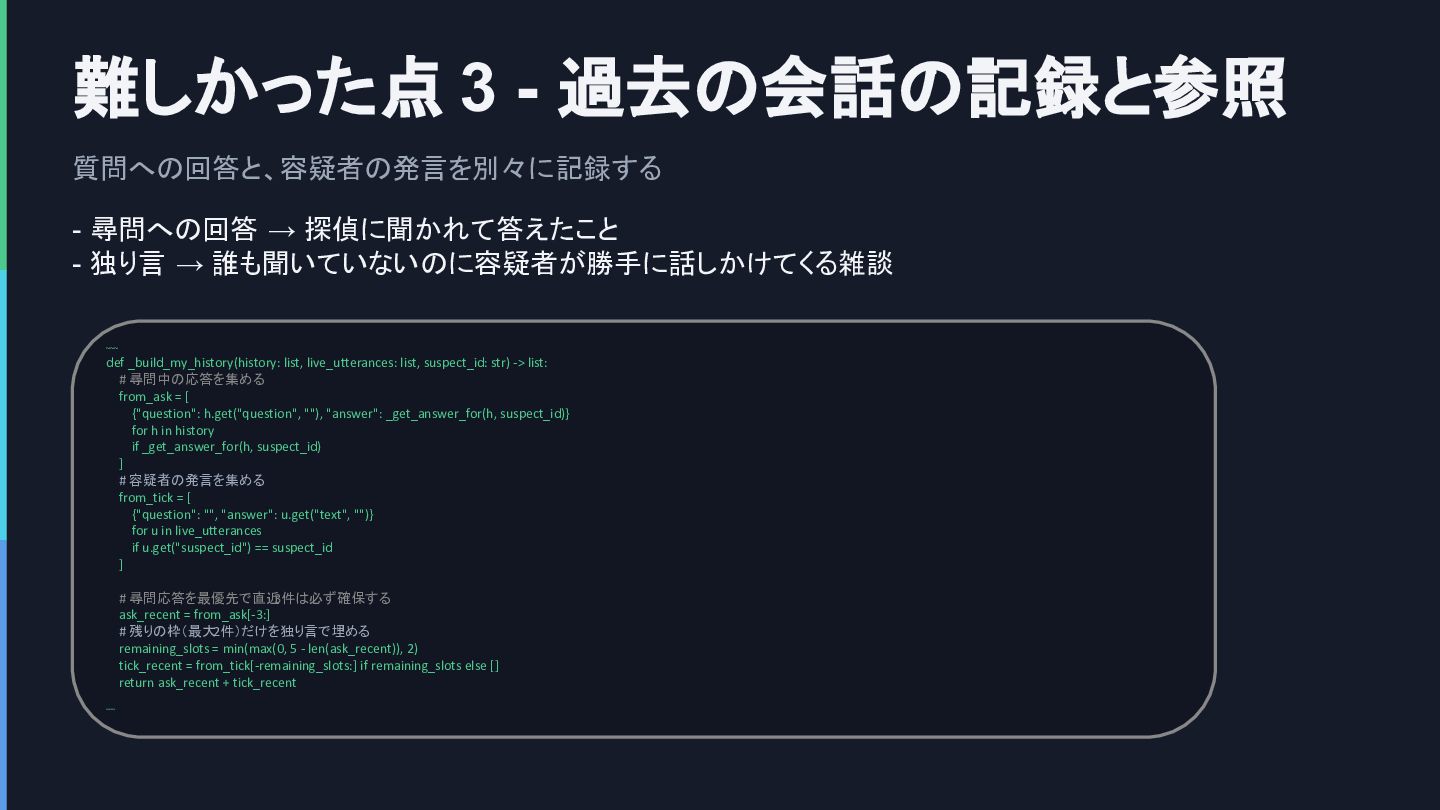
  9. 難しかった点 3 - 過去の会話の記録と参照 質問への回答と、容疑者の発言を別々に記録する - 尋問への回答 → 探偵に聞かれて答えたこと -

    独り言 → 誰も聞いていないのに容疑者が勝手に話しかけてくる雑談 ~~~ def _build_my_history(history: list, live_utterances: list, suspect_id: str) -> list: # 尋問中の応答を集める from_ask = [ {"question": h.get("question", ""), "answer": _get_answer_for(h, suspect_id)} for h in history if _get_answer_for(h, suspect_id) ] # 容疑者の発言を集める from_tick = [ {"question": "", "answer": u.get("text", "")} for u in live_utterances if u.get("suspect_id") == suspect_id ] # 尋問応答を最優先で直近3件は必ず確保する ask_recent = from_ask[-3:] # 残りの枠(最大2件)だけを独り言で埋める remaining_slots = min(max(0, 5 - len(ask_recent)), 2) tick_recent = from_tick[-remaining_slots:] if remaining_slots else [] return ask_recent + tick_recent ~~~ ��
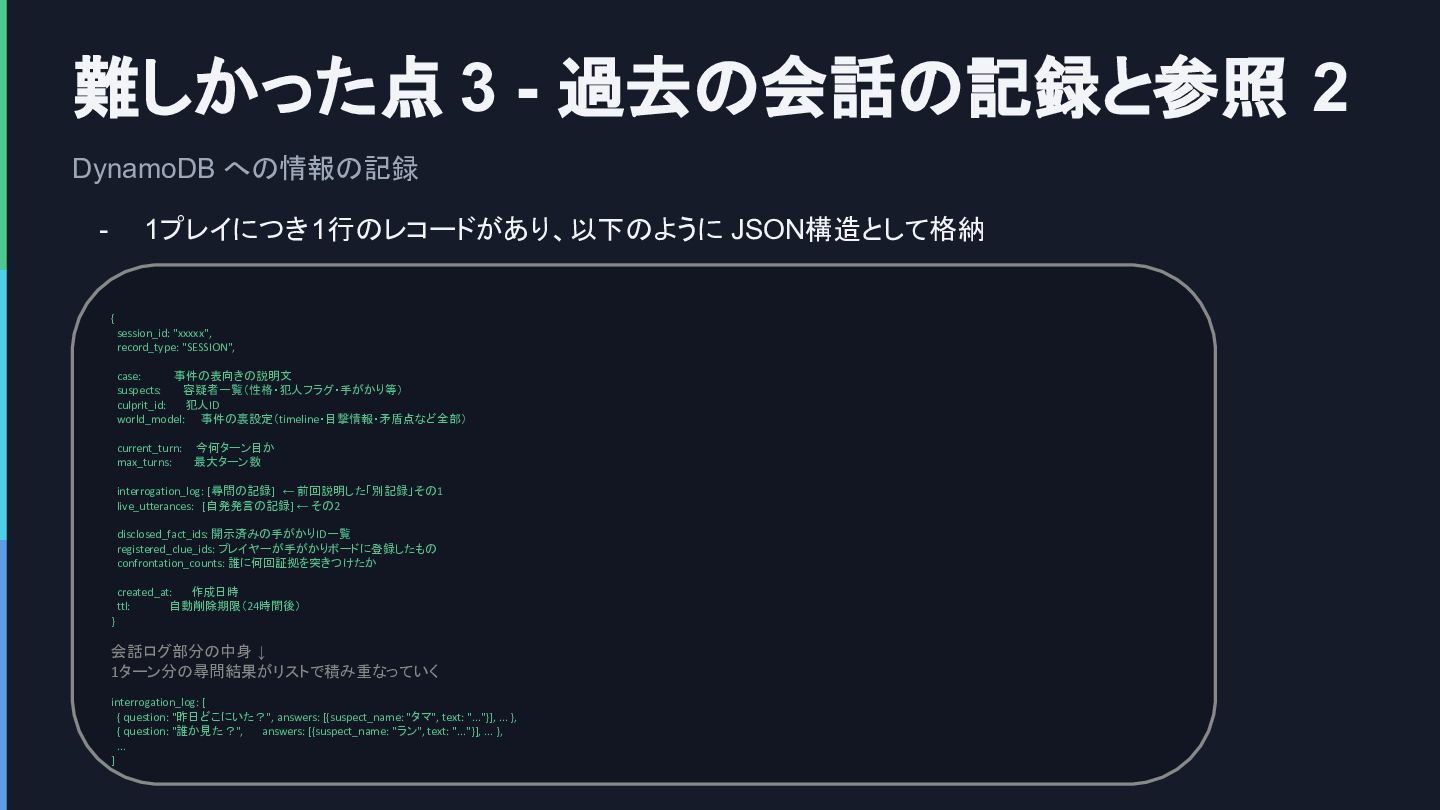
  10. 難しかった点 3 - 過去の会話の記録と参照 2 - 1プレイにつき1行のレコードがあり、以下のように JSON構造として格納 { session_id:

    "xxxxx", record_type: "SESSION", case: 事件の表向きの説明文 suspects: 容疑者一覧(性格・犯人フラグ・手がかり等) culprit_id: 犯人ID world_model: 事件の裏設定(timeline・目撃情報・矛盾点など全部) current_turn: 今何ターン目か max_turns: 最大ターン数 interrogation_log: [尋問の記録] ← 前回説明した「別記録」その1 live_utterances: [自発発言の記録] ← その2 disclosed_fact_ids: 開示済みの手がかりID一覧 registered_clue_ids: プレイヤーが手がかりボードに登録したもの confrontation_counts: 誰に何回証拠を突きつけたか created_at: 作成日時 ttl: 自動削除期限(24時間後) } 会話ログ部分の中身 ↓ 1ターン分の尋問結果がリストで積み重なっていく interrogation_log: [ { question: "昨日どこにいた?", answers: [{suspect_name: "タマ", text: "..."}], ... }, { question: "誰か見た?", answers: [{suspect_name: "ラン", text: "..."}], ... }, ... ] �� DynamoDB への情報の記録