Share
Embed
我が社のデータエンジニアリング現場#Chatwork編_2024/05/22
K.Mitsuhashi
May 23, 2024
Transcript
93 slides
-
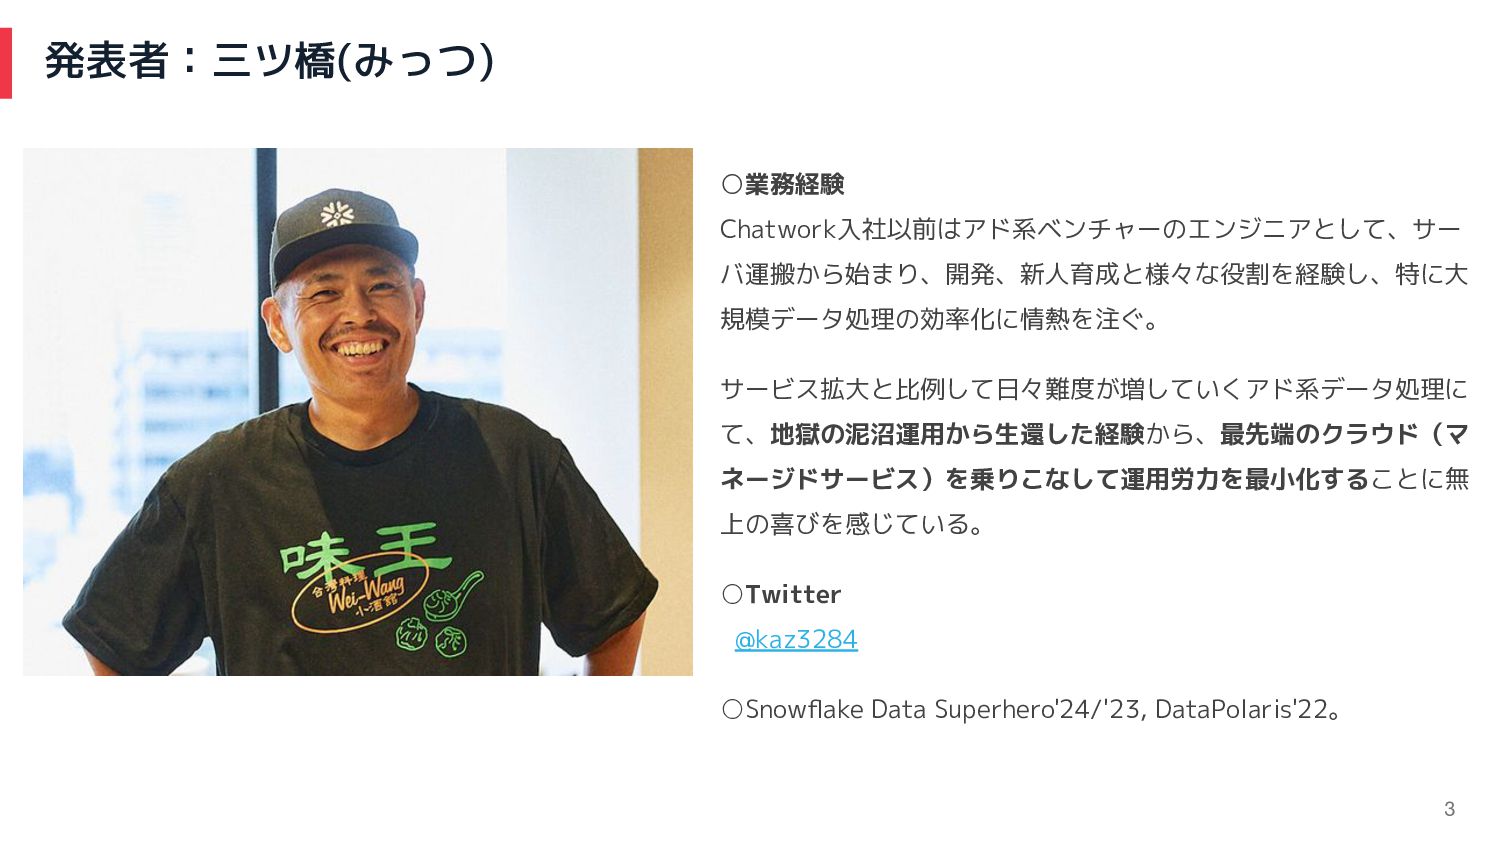
発表者:三ツ橋(みっつ) 3 ◦業務経験 Chatwork入社以前はアド系ベンチャーのエンジニアとして、サー バ運搬から始まり、開発、新人育成と様々な役割を経験し、特に大 規模データ処理の効率化に情熱を注ぐ。 サービス拡大と比例して日々難度が増していくアド系データ処理に て、地獄の泥沼運用から生還した経験から、最先端のクラウド(マ ネージドサービス)を乗りこなして運用労力を最小化することに無 上の喜びを感じている。
◦Twitter @kaz3284 ◦Snowflake Data Superhero'24/'23, DataPolaris'22。 -
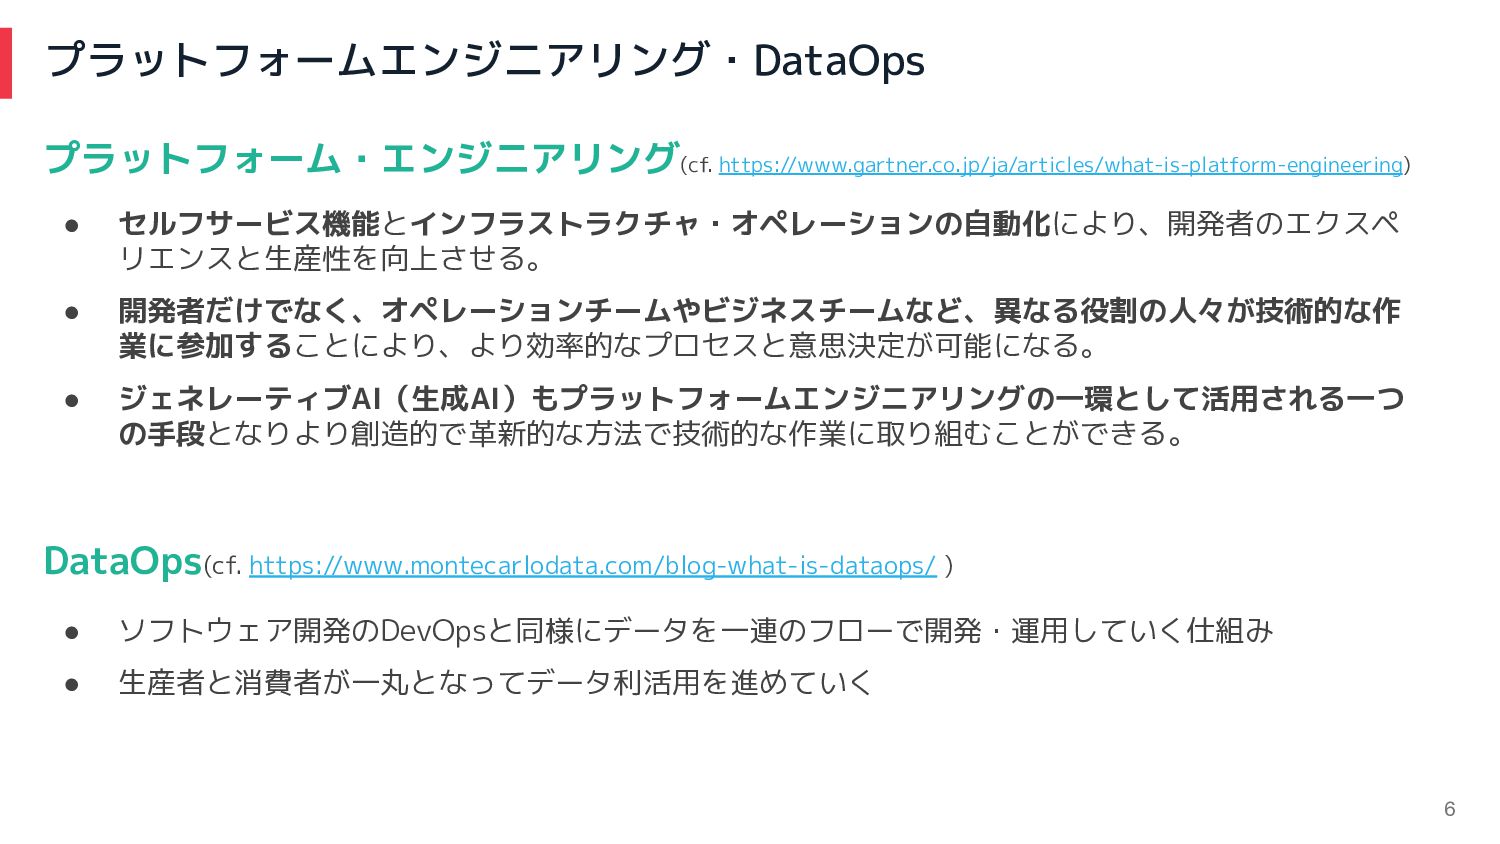
プラットフォームエンジニアリング・DataOps 6 プラットフォーム・エンジニアリング(cf. https://www.gartner.co.jp/ja/articles/what-is-platform-engineering) • セルフサービス機能とインフラストラクチャ・オペレーションの自動化により、開発者のエクスペ リエンスと生産性を向上させる。 • 開発者だけでなく、オペレーションチームやビジネスチームなど、異なる役割の人々が技術的な作 業に参加することにより、より効率的なプロセスと意思決定が可能になる。
• ジェネレーティブAI(生成AI)もプラットフォームエンジニアリングの一環として活用される一つ の手段となりより創造的で革新的な方法で技術的な作業に取り組むことができる。 DataOps(cf. https://www.montecarlodata.com/blog-what-is-dataops/ ) • ソフトウェア開発のDevOpsと同様にデータを一連のフローで開発・運用していく仕組み • 生産者と消費者が一丸となってデータ利活用を進めていく -
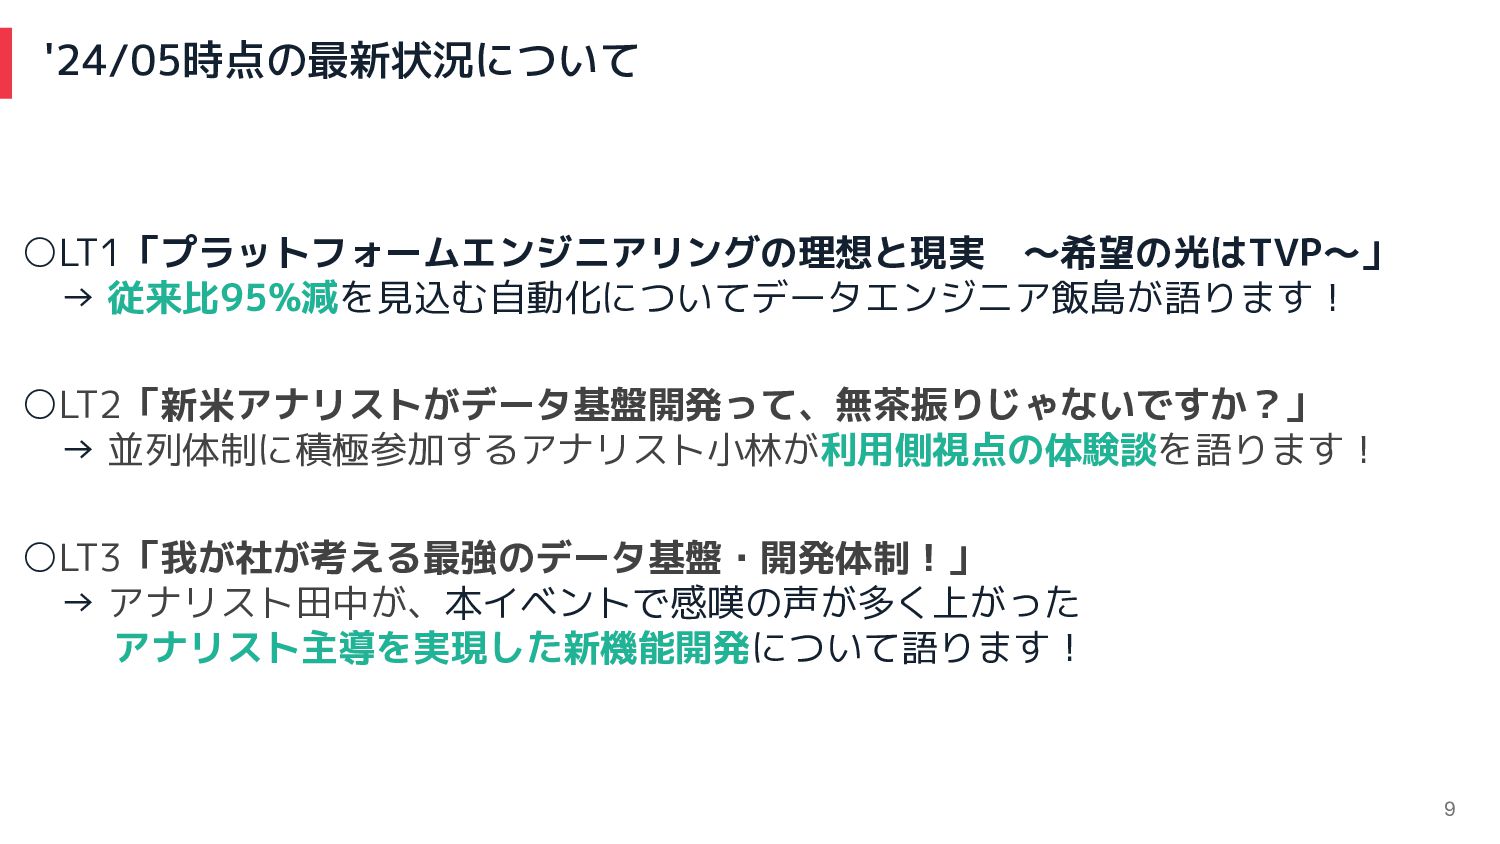
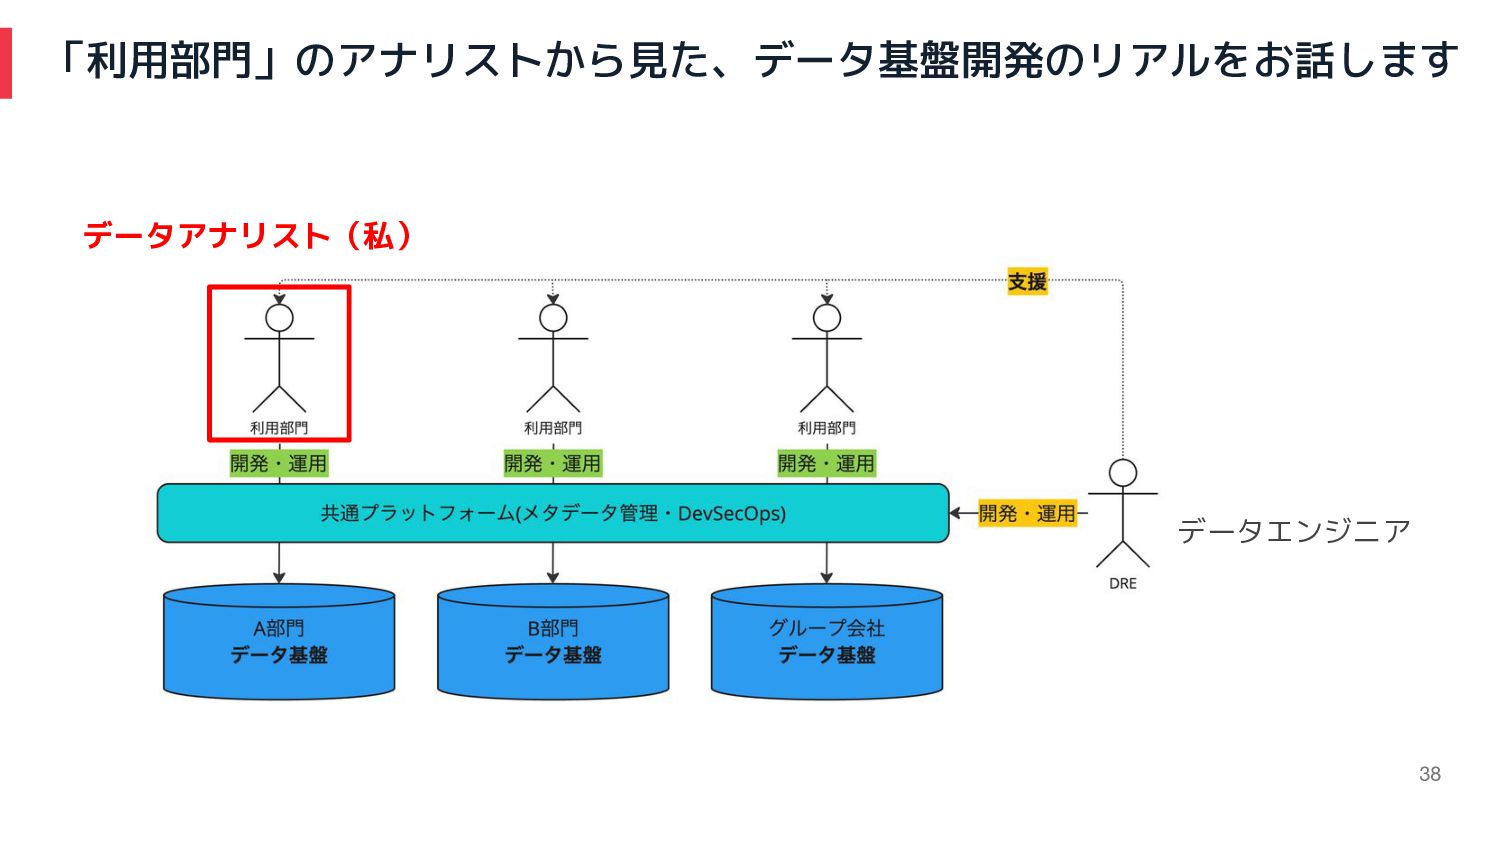
'24/05時点の最新状況について 9 ◦LT1「プラットフォームエンジニアリングの理想と現実 〜希望の光はTVP〜」 → 従来比95%減を見込む自動化についてデータエンジニア飯島が語ります! ◦LT2「新米アナリストがデータ基盤開発って、無茶振りじゃないですか?」 → 並列体制に積極参加するアナリスト小林が利用側視点の体験談を語ります! ◦LT3「我が社が考える最強のデータ基盤・開発体制!」 →
アナリスト田中が、本イベントで感嘆の声が多く上がった アナリスト主導を実現した新機能開発について語ります! -
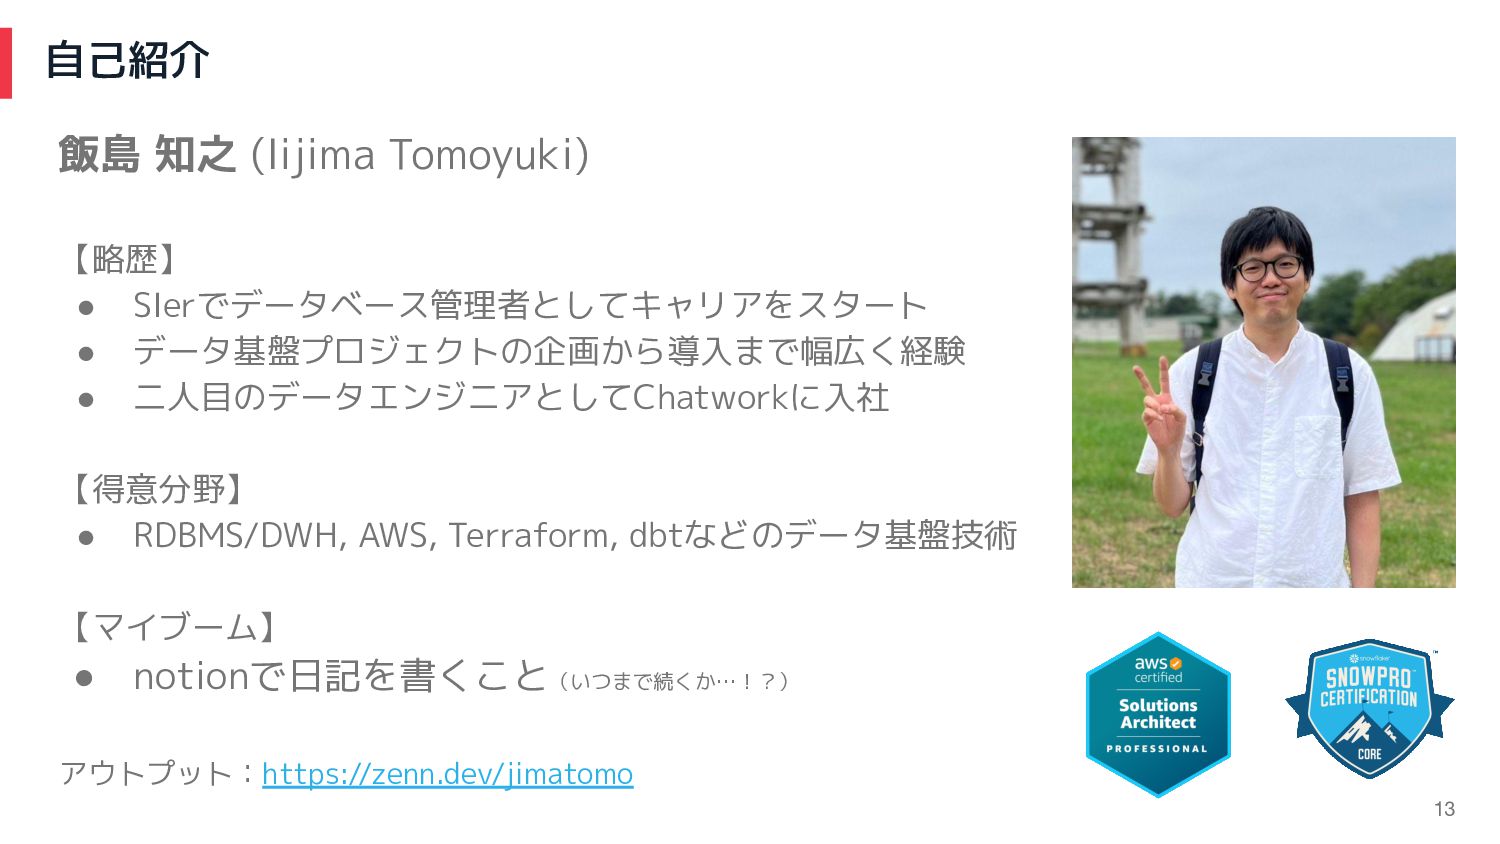
自己紹介 飯島 知之 (Iijima Tomoyuki) 【略歴】 • SIerでデータベース管理者としてキャリアをスタート • データ基盤プロジェクトの企画から導入まで幅広く経験
• 二人目のデータエンジニアとしてChatworkに入社 【得意分野】 • RDBMS/DWH, AWS, Terraform, dbtなどのデータ基盤技術 【マイブーム】 • notionで日記を書くこと(いつまで続くか…!?) アウトプット:https://zenn.dev/jimatomo 13 -
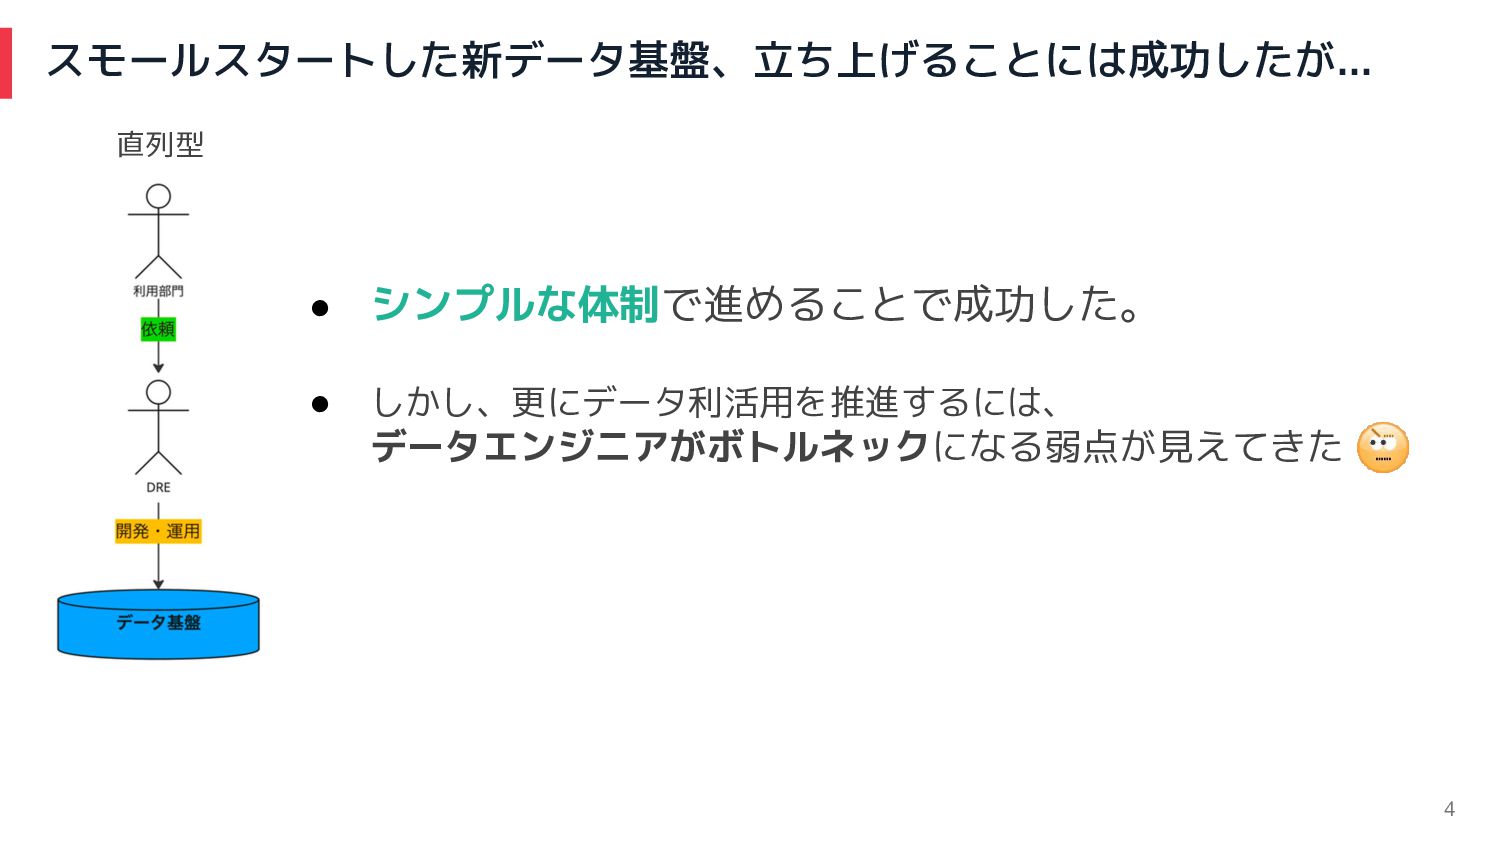
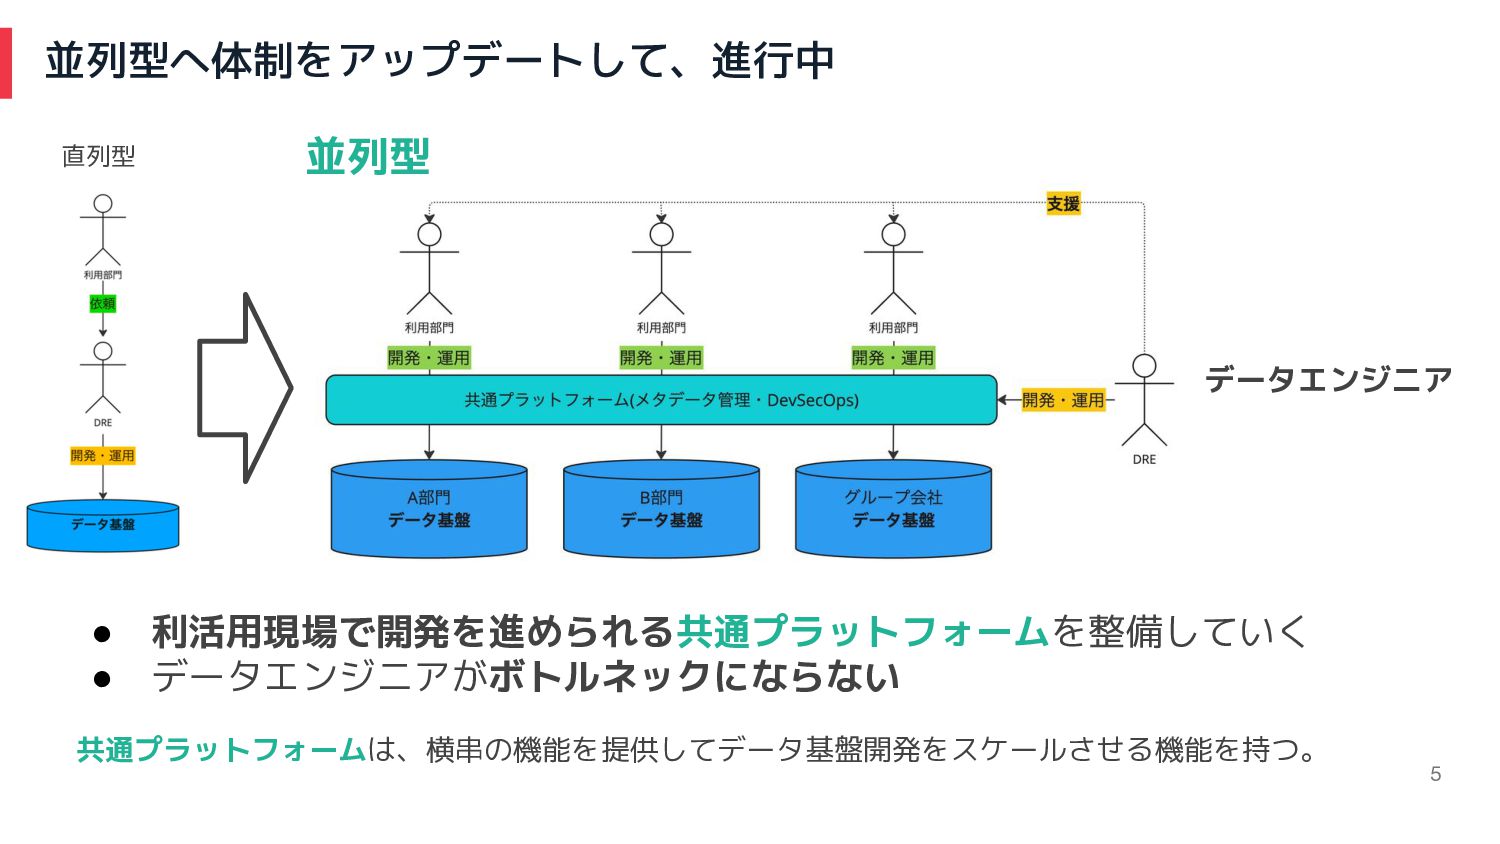
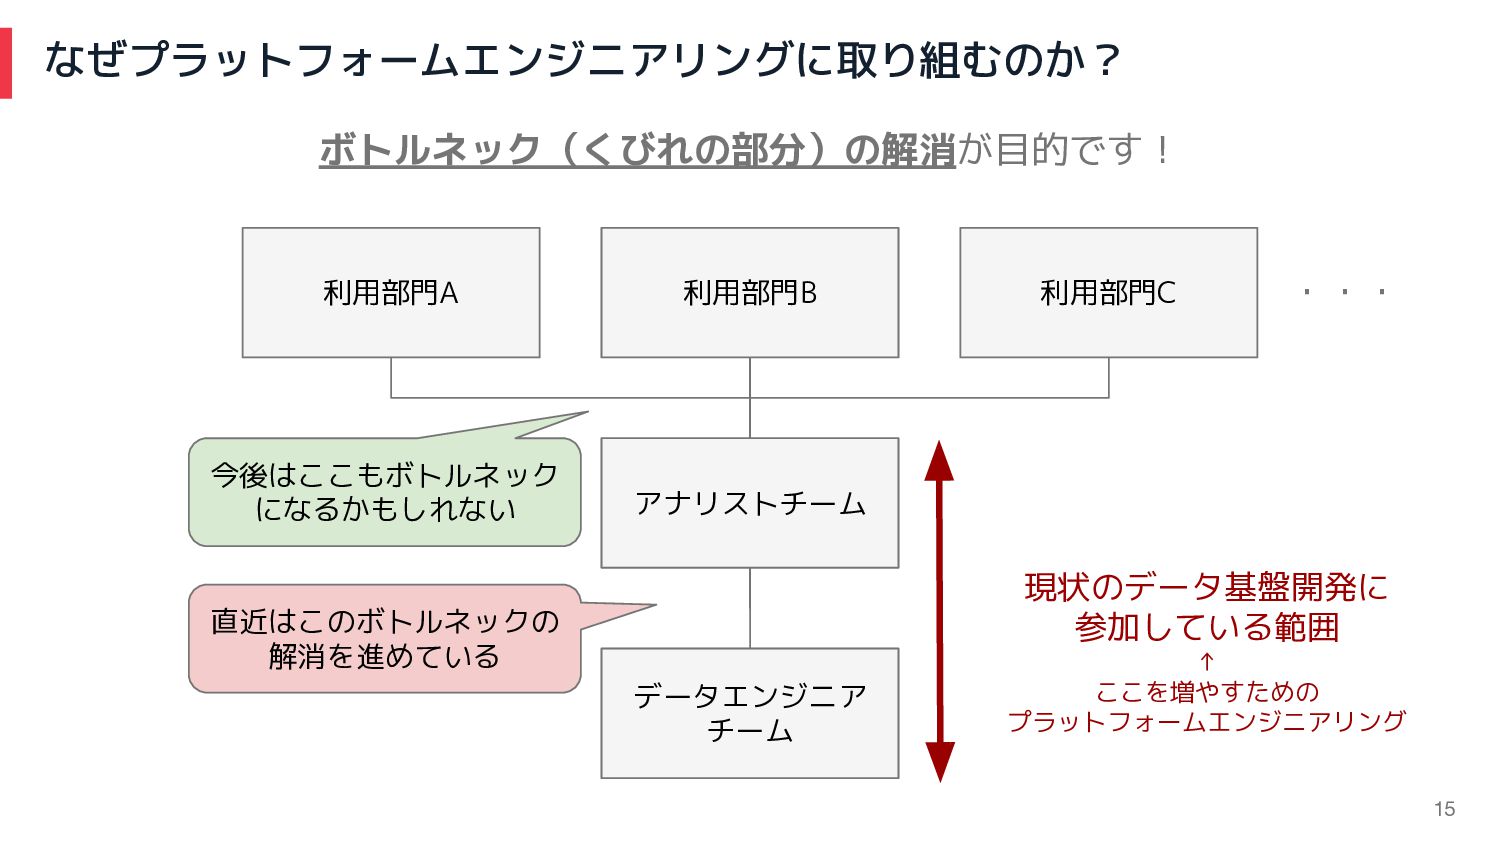
なぜプラットフォームエンジニアリングに取り組むのか? ボトルネック(くびれの部分)の解消が目的です! 利用部門B アナリストチーム データエンジニア チーム 利用部門C 利用部門A ・・・ 今後はここもボトルネック
になるかもしれない 直近はこのボトルネックの 解消を進めている 現状のデータ基盤開発に 参加している範囲 ↑ ここを増やすための プラットフォームエンジニアリング 15 -
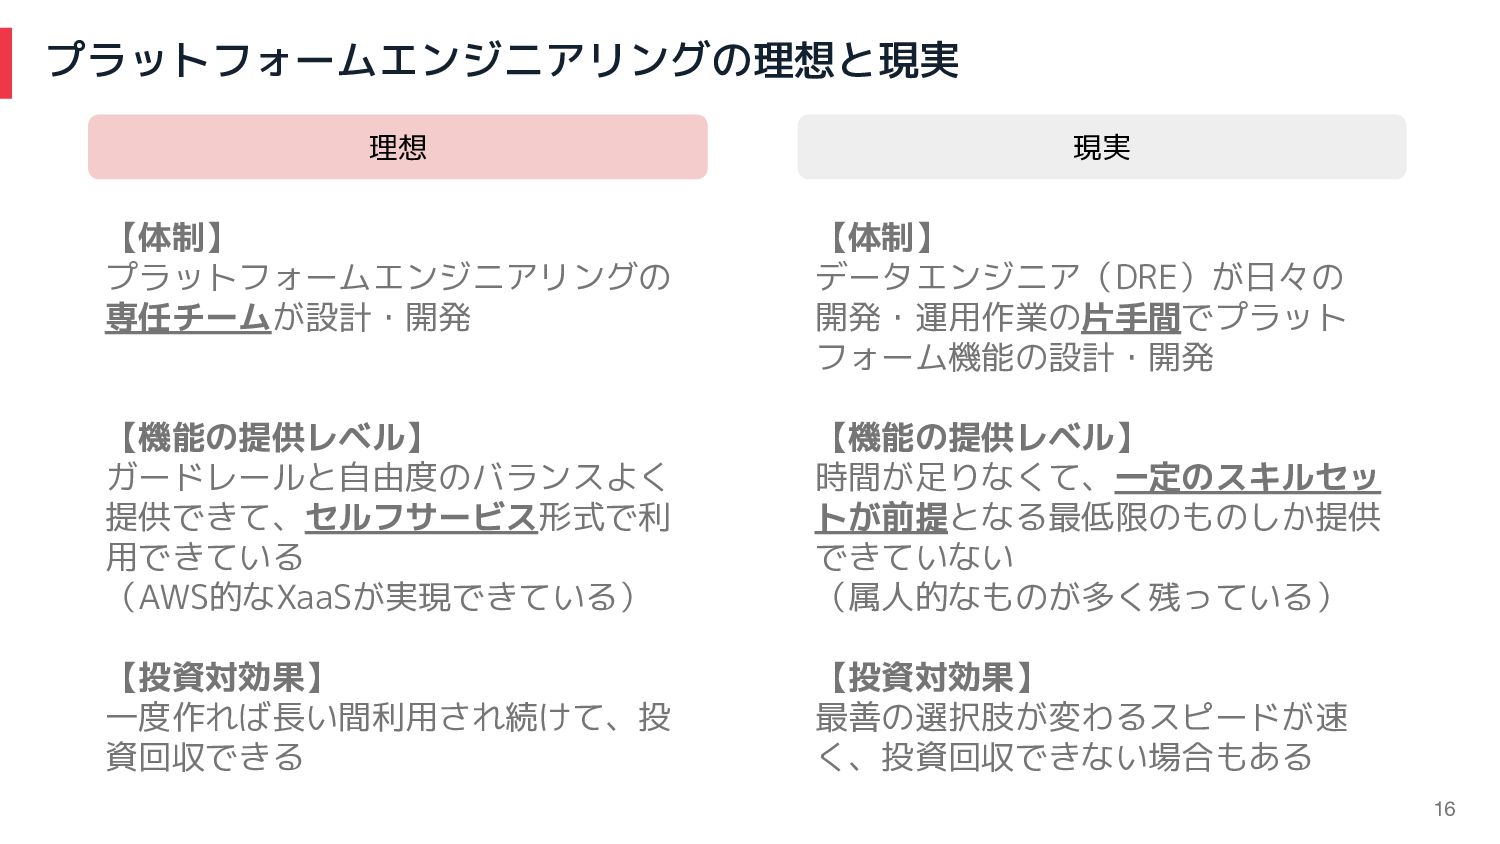
プラットフォームエンジニアリングの理想と現実 理想 現実 【体制】 プラットフォームエンジニアリングの 専任チームが設計・開発 【機能の提供レベル】 ガードレールと自由度のバランスよく 提供できて、セルフサービス形式で利 用できている
(AWS的なXaaSが実現できている) 【投資対効果】 一度作れば長い間利用され続けて、投 資回収できる 【体制】 データエンジニア(DRE)が日々の 開発・運用作業の片手間でプラット フォーム機能の設計・開発 【機能の提供レベル】 時間が足りなくて、一定のスキルセッ トが前提となる最低限のものしか提供 できていない (属人的なものが多く残っている) 【投資対効果】 最善の選択肢が変わるスピードが速 く、投資回収できない場合もある 16 -
希望の光はTVP (Thinnest Viable Platform) TVP (Thinnest Viable Platform) とは、(かなりざっくり解釈すると) 「最低限のプラットフォーム」のこと
最低限とは具体的に? → ドキュメント(開発者向けのWikiなど)でOK (ハードルが超低い…!) 参考:https://teamtopologies.com/key-concepts (本質的なところを見誤らなければ) こんな簡単なことでもいいんだ!と、 一歩踏み出す勇気をくれる考え方 18 -
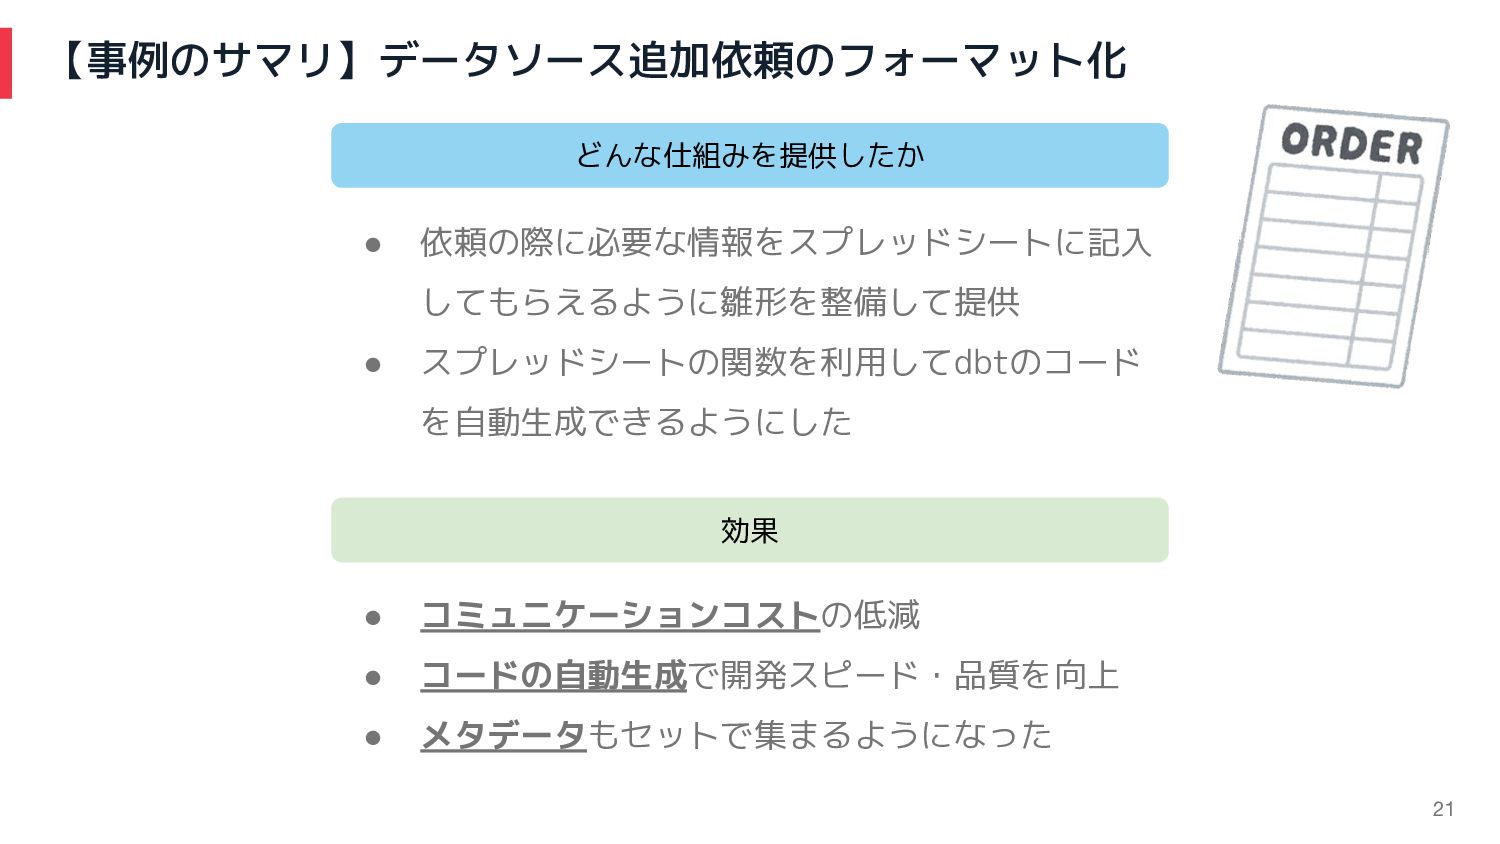
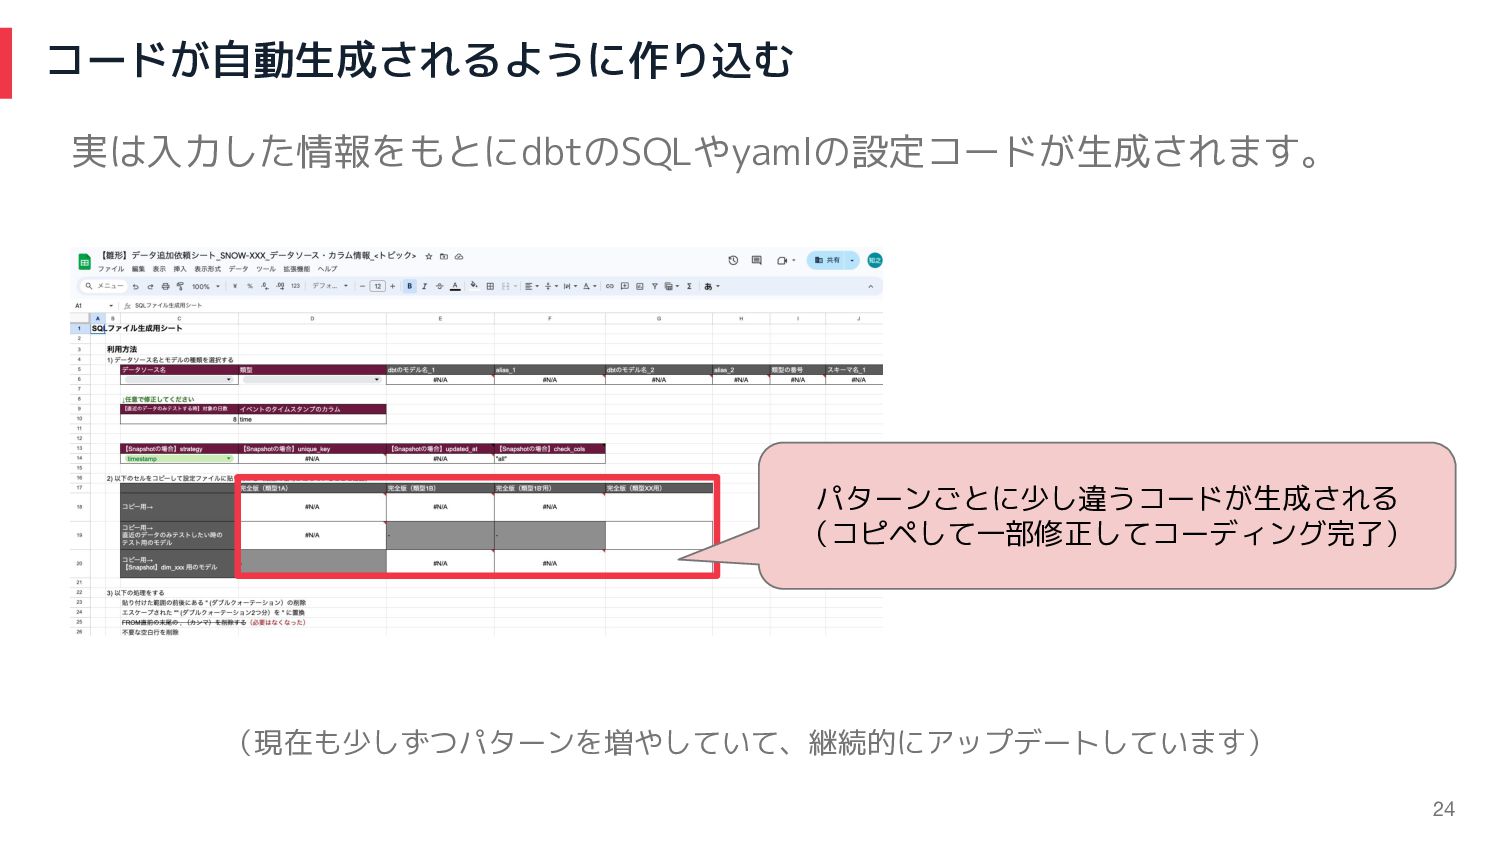
【事例のサマリ】データソース追加依頼のフォーマット化 効果 • コミュニケーションコストの低減 • コードの自動生成で開発スピード・品質を向上 • メタデータもセットで集まるようになった どんな仕組みを提供したか •
依頼の際に必要な情報をスプレッドシートに記入 してもらえるように雛形を整備して提供 • スプレッドシートの関数を利用してdbtのコード を自動生成できるようにした 21 -
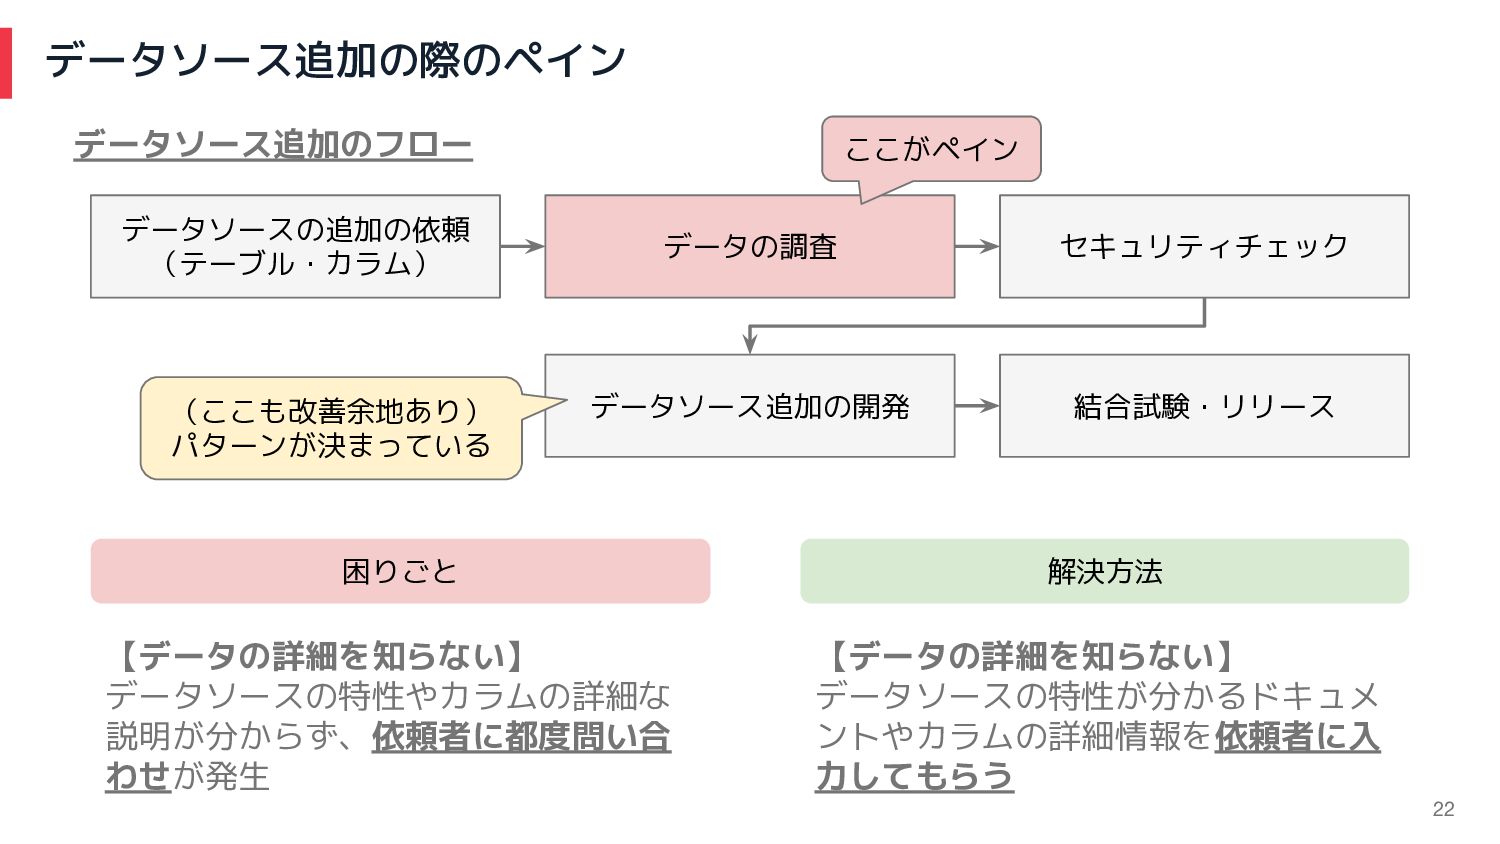
データソース追加の際のペイン 困りごと 解決方法 【データの詳細を知らない】 データソースの特性やカラムの詳細な 説明が分からず、依頼者に都度問い合 わせが発生 【データの詳細を知らない】 データソースの特性が分かるドキュメ ントやカラムの詳細情報を依頼者に入
力してもらう データソースの追加の依頼 (テーブル・カラム) データの調査 セキュリティチェック データソース追加の開発 結合試験・リリース データソース追加のフロー ここがペイン (ここも改善余地あり) パターンが決まっている 22 -
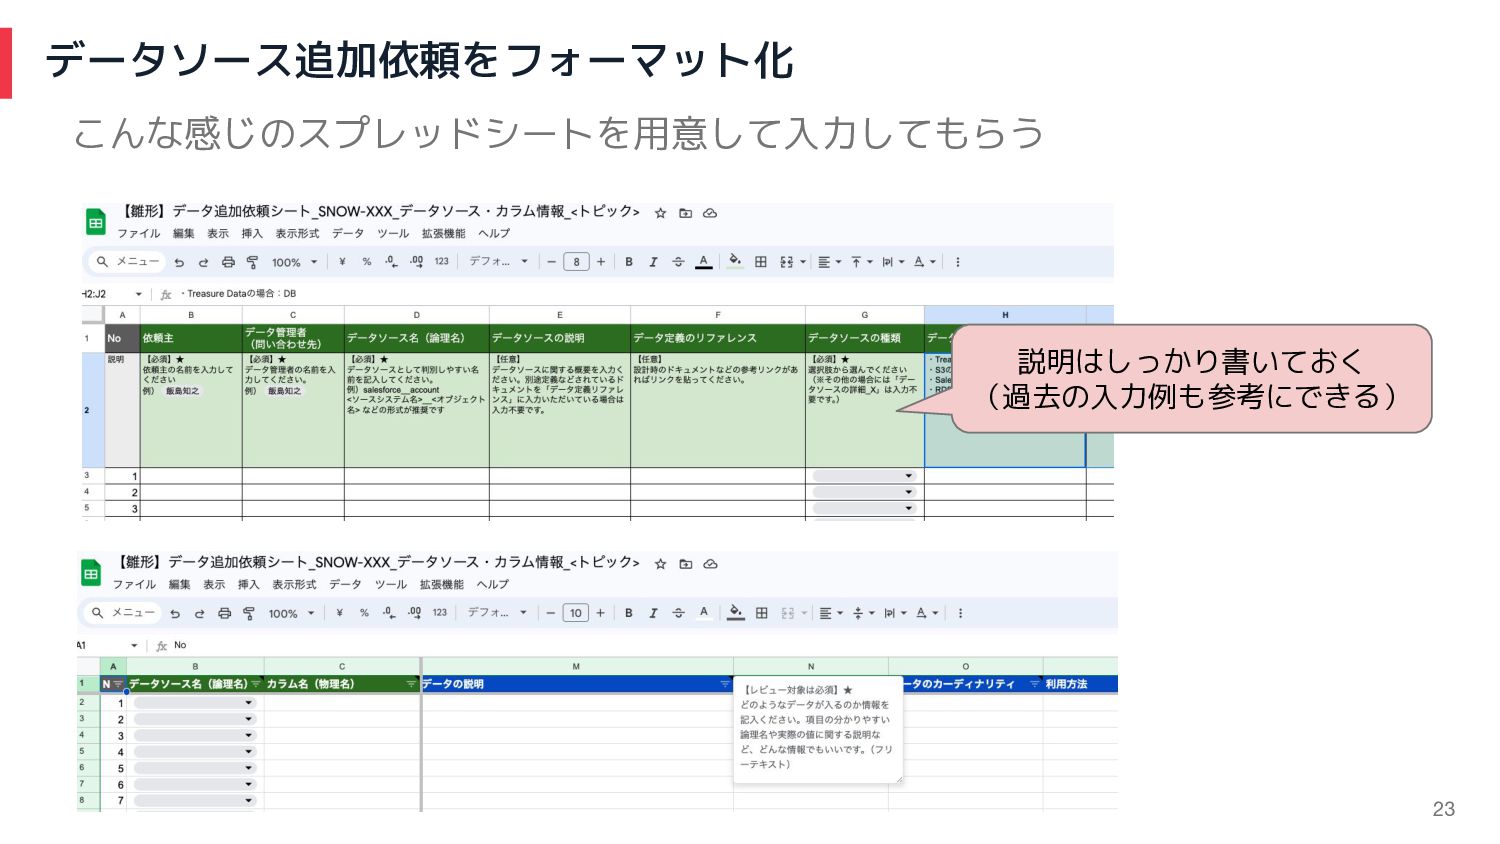
【事例のサマリ】データソース追加依頼のフォーマット化 効果 • コミュニケーションコストの低減 • コードの自動生成で開発スピード・品質を向上 • メタデータもセットで集まるようになった どんな仕組みを提供したか •
依頼の際に必要な情報をスプレッドシートに記入 してもらえるように雛形を整備して提供 • スプレッドシートの関数を利用してdbtのコード を自動生成できるようにした 25 -
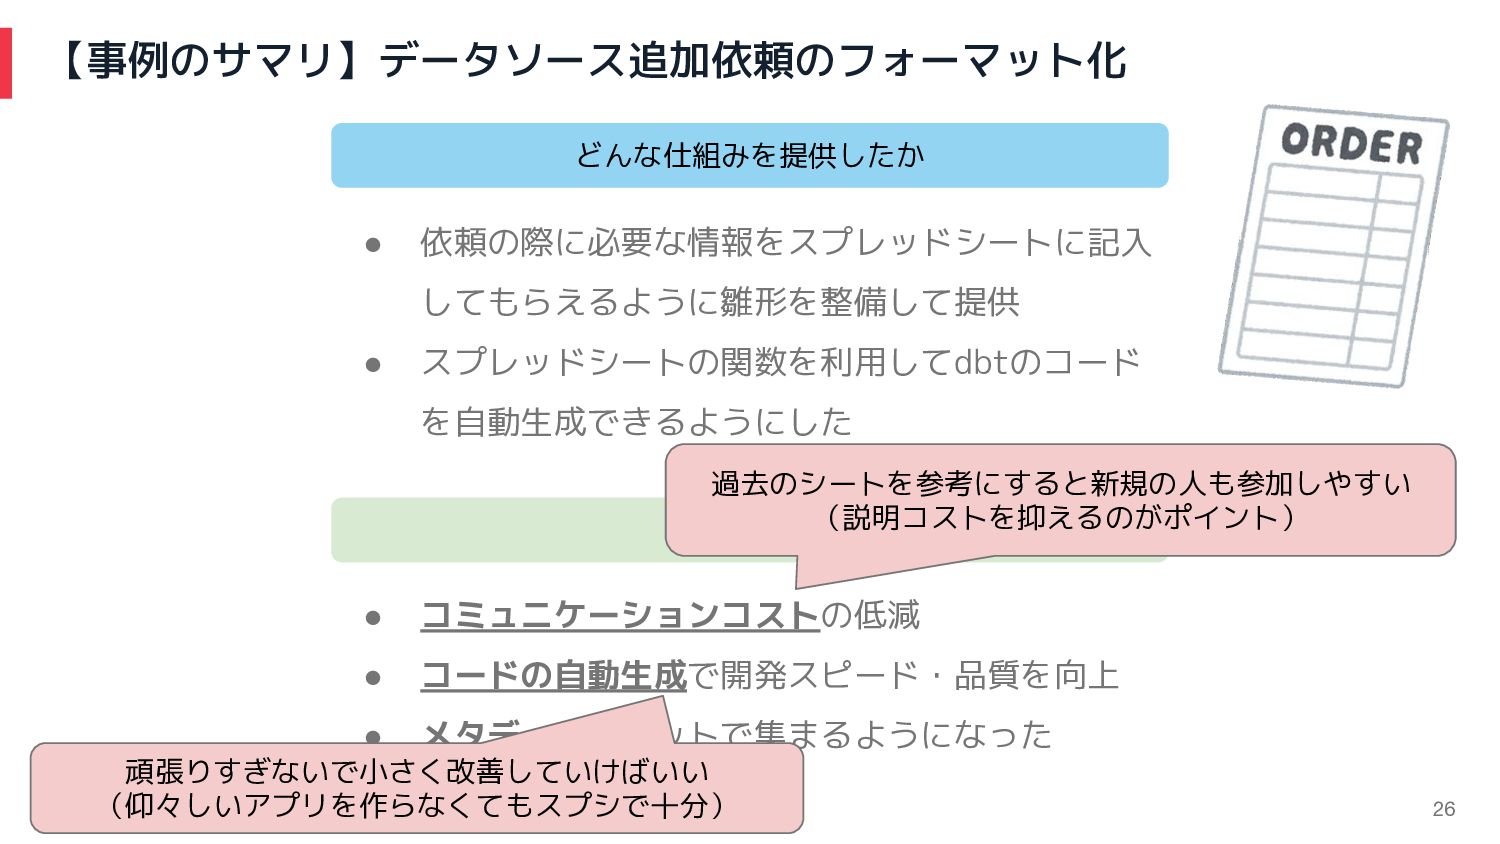
【事例のサマリ】データソース追加依頼のフォーマット化 効果 • コミュニケーションコストの低減 • コードの自動生成で開発スピード・品質を向上 • メタデータもセットで集まるようになった どんな仕組みを提供したか •
依頼の際に必要な情報をスプレッドシートに記入 してもらえるように雛形を整備して提供 • スプレッドシートの関数を利用してdbtのコード を自動生成できるようにした 過去のシートを参考にすると新規の人も参加しやすい (説明コストを抑えるのがポイント) 頑張りすぎないで小さく改善していけばいい (仰々しいアプリを作らなくてもスプシで十分) 26 -
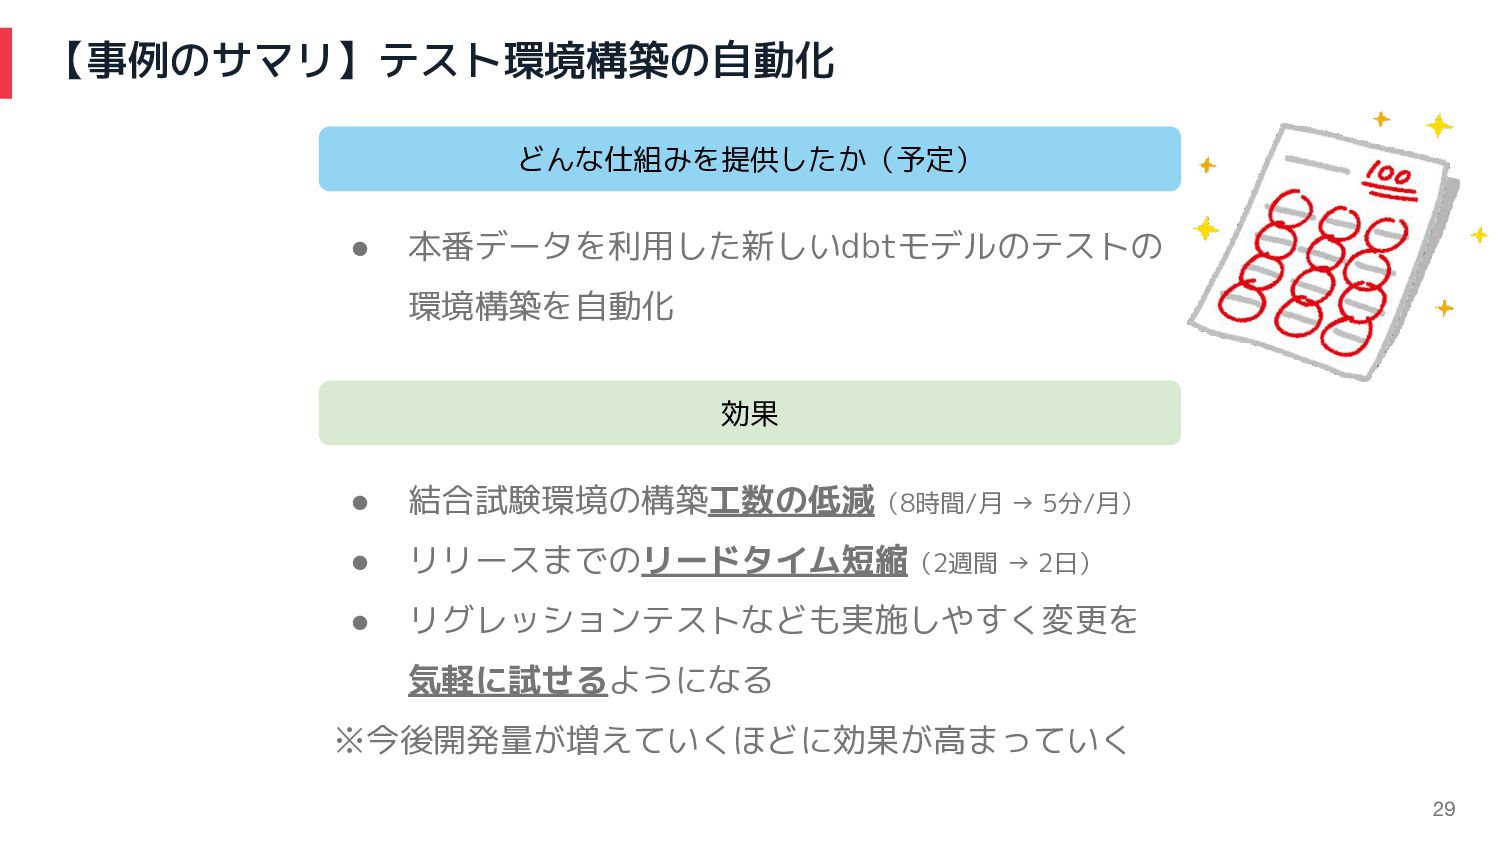
【事例のサマリ】テスト環境構築の自動化 効果 • 結合試験環境の構築工数の低減(8時間/月 → 5分/月) • リリースまでのリードタイム短縮(2週間 → 2日)
• リグレッションテストなども実施しやすく変更を 気軽に試せるようになる ※今後開発量が増えていくほどに効果が高まっていく どんな仕組みを提供したか(予定) • 本番データを利用した新しいdbtモデルのテストの 環境構築を自動化 29 -
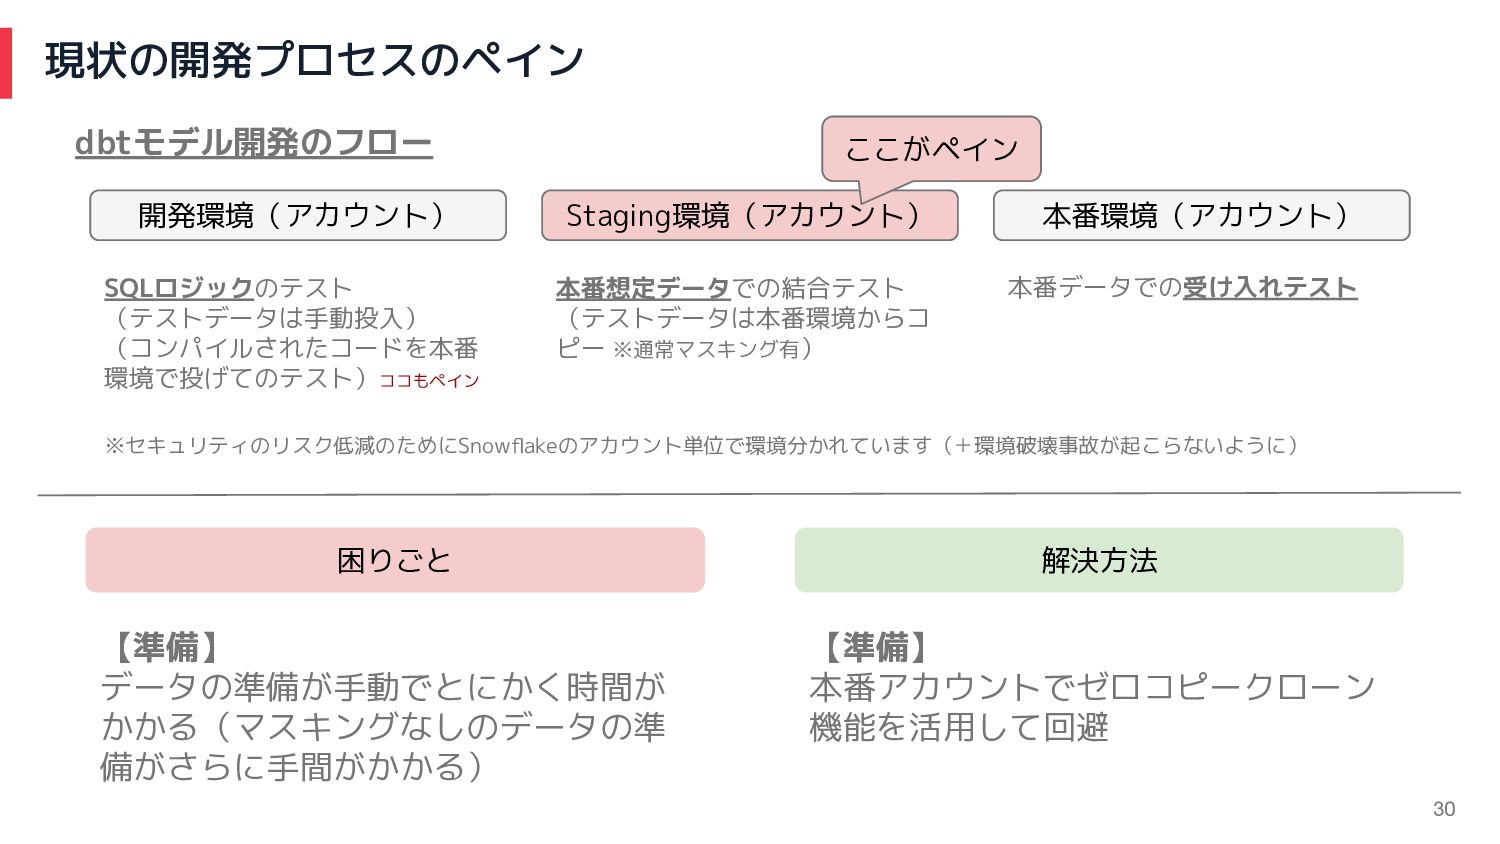
現状の開発プロセスのペイン 困りごと 解決方法 【準備】 データの準備が手動でとにかく時間が かかる(マスキングなしのデータの準 備がさらに手間がかかる) 開発環境(アカウント) Staging環境(アカウント) 本番環境(アカウント)
※セキュリティのリスク低減のためにSnowflakeのアカウント単位で環境分かれています(+環境破壊事故が起こらないように) dbtモデル開発のフロー SQLロジックのテスト (テストデータは手動投入) (コンパイルされたコードを本番 環境で投げてのテスト)ココもペイン 本番想定データでの結合テスト (テストデータは本番環境からコ ピー ※通常マスキング有) 本番データでの受け入れテスト 【準備】 本番アカウントでゼロコピークローン 機能を活用して回避 ここがペイン 30 -
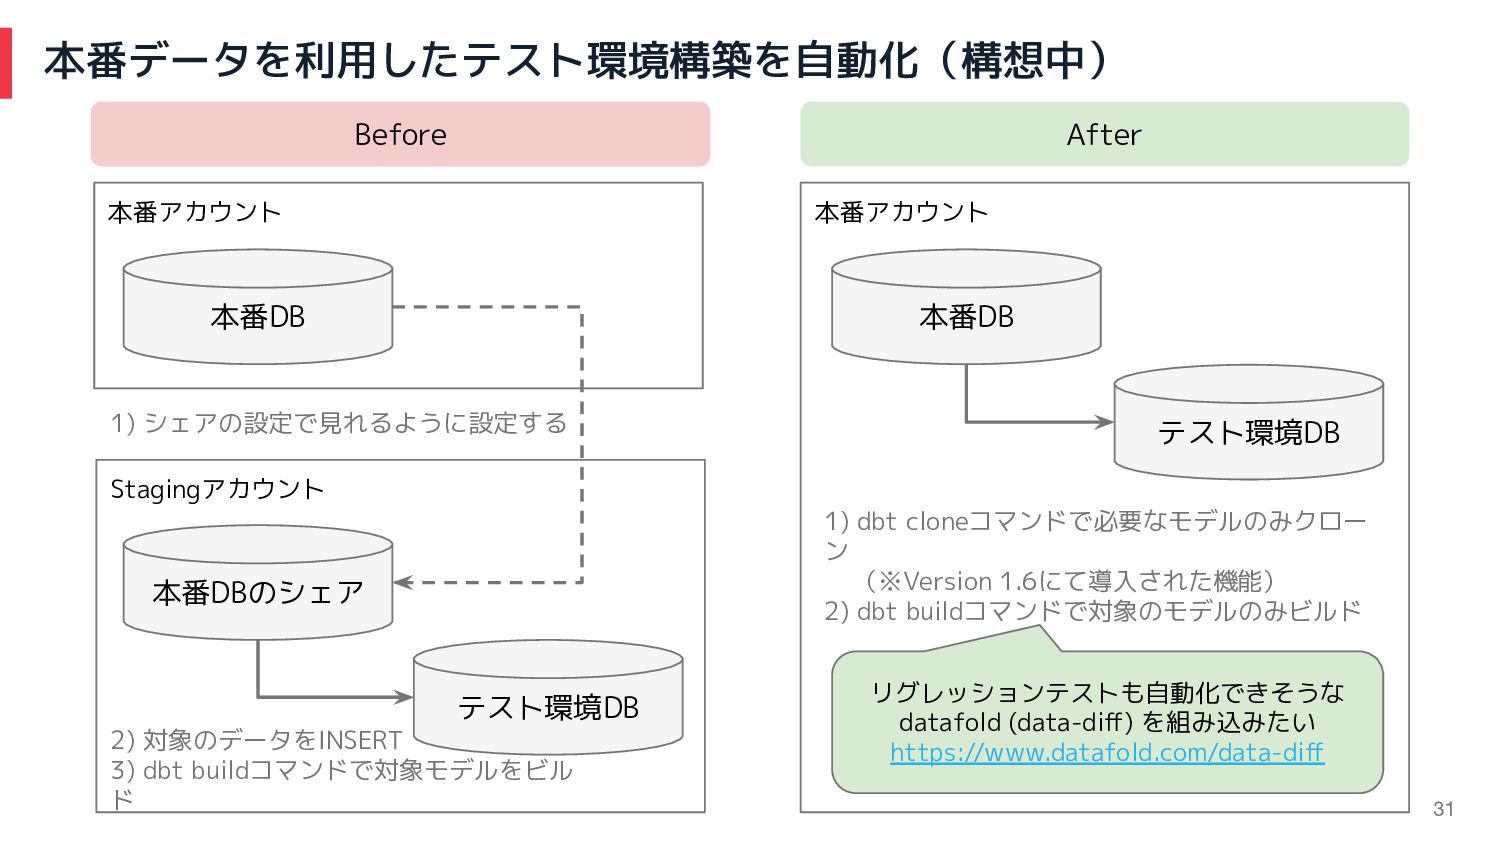
本番アカウント 本番データを利用したテスト環境構築を自動化(構想中) 本番DB テスト環境DB 1) dbt cloneコマンドで必要なモデルのみクロー ン (※Version 1.6にて導入された機能)
2) dbt buildコマンドで対象のモデルのみビルド リグレッションテストも自動化できそうな datafold (data-diff) を組み込みたい https://www.datafold.com/data-diff Before After 本番アカウント Stagingアカウント 本番DB 本番DBのシェア テスト環境DB 1) シェアの設定で見れるように設定する 2) 対象のデータをINSERT 3) dbt buildコマンドで対象モデルをビル ド 31 -
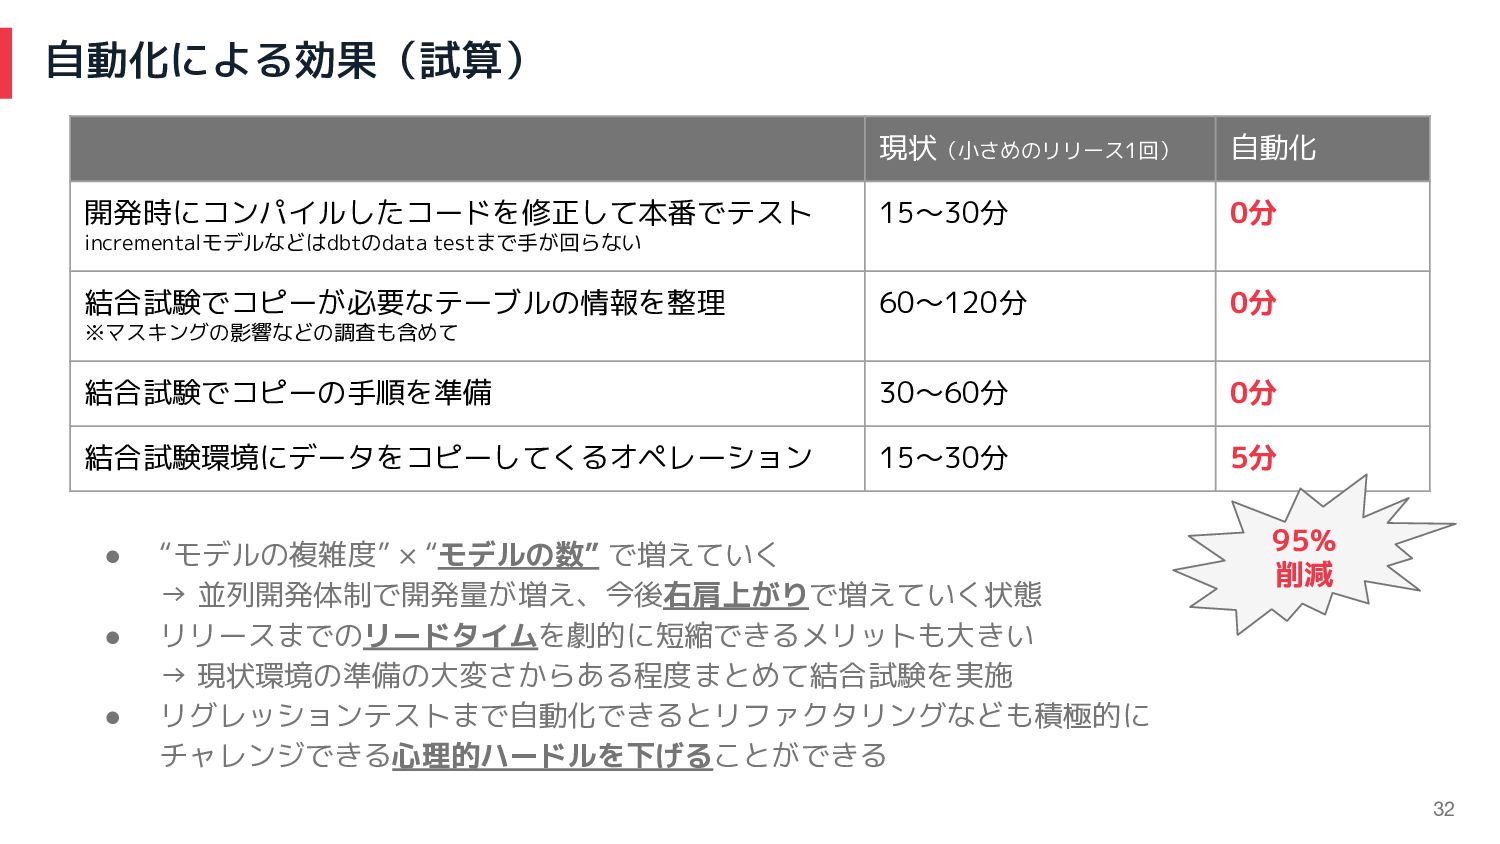
自動化による効果(試算) 現状(小さめのリリース1回) 自動化 開発時にコンパイルしたコードを修正して本番でテスト incrementalモデルなどはdbtのdata testまで手が回らない 15〜30分 0分 結合試験でコピーが必要なテーブルの情報を整理 ※マスキングの影響などの調査も含めて
60〜120分 0分 結合試験でコピーの手順を準備 30〜60分 0分 結合試験環境にデータをコピーしてくるオペレーション 15〜30分 5分 • “モデルの複雑度” × “モデルの数” で増えていく → 並列開発体制で開発量が増え、今後右肩上がりで増えていく状態 • リリースまでのリードタイムを劇的に短縮できるメリットも大きい → 現状環境の準備の大変さからある程度まとめて結合試験を実施 • リグレッションテストまで自動化できるとリファクタリングなども積極的に チャレンジできる心理的ハードルを下げることができる 95% 削減 32 -
本質はいつもシンプル 今回取り上げた事例に共通しているポイントは以下の3つ • 利用者の声を拾う ◦ 効果が高いものはユーザが一番知っている(自分もユーザの一人) • ペインが継続していくものを対象にする ◦ 繰り返し使えるものでないと投資対効果が出ない
• 最初から頑張り過ぎない ◦ これが一番大事(TVPという考え方が一歩踏みだす勇気をくれる) Thinnest Viable Platform で一歩先のデータ基盤へ進化させています! (今回取り上げられなかった他にもやりたいことが山積みです) 35 頑張ろうという気持ちは大事 頑張り過ぎないバランスも大事 -
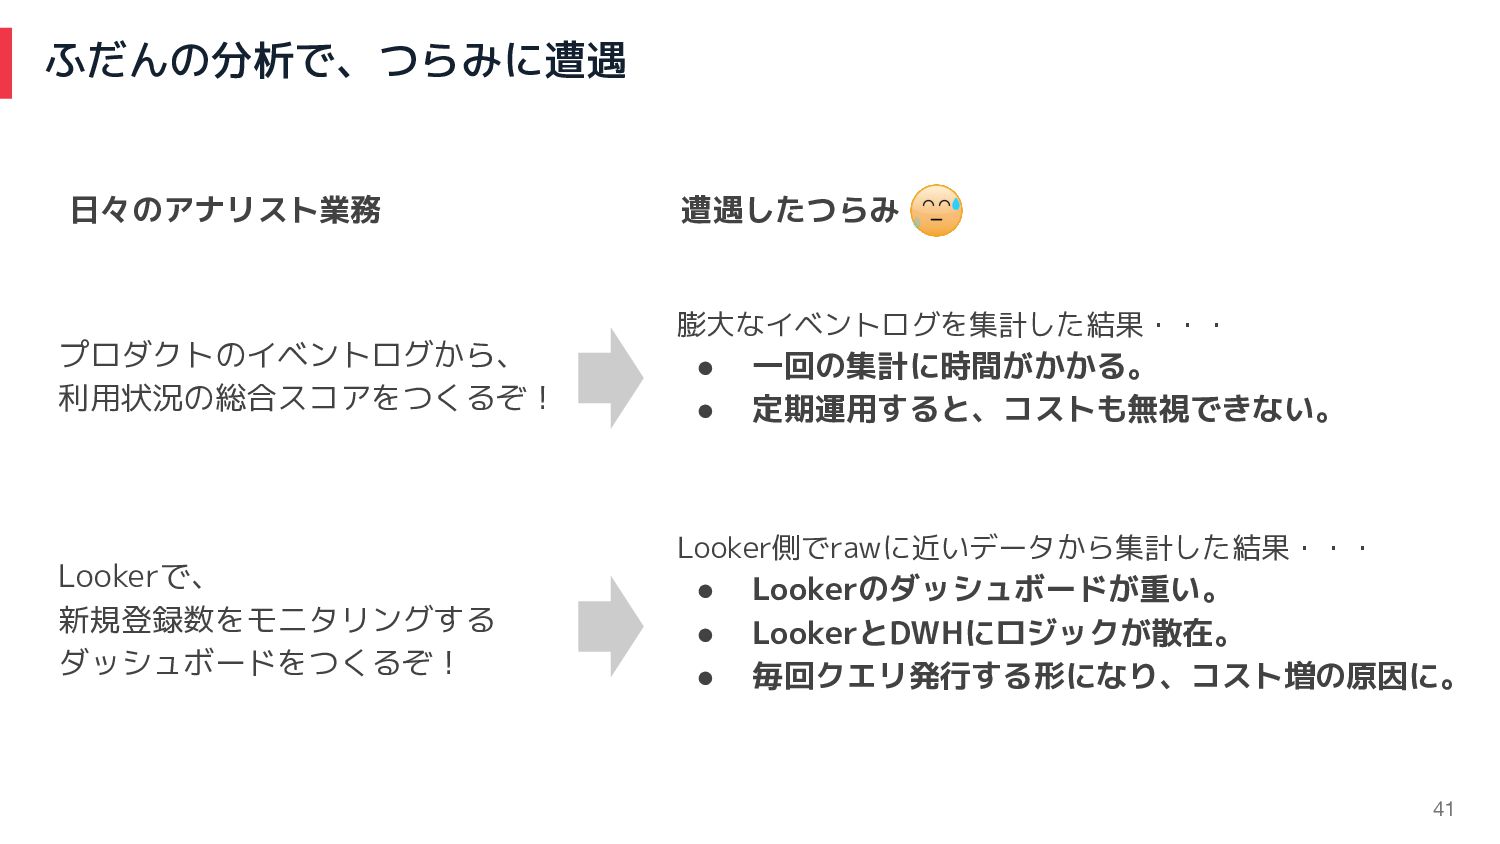
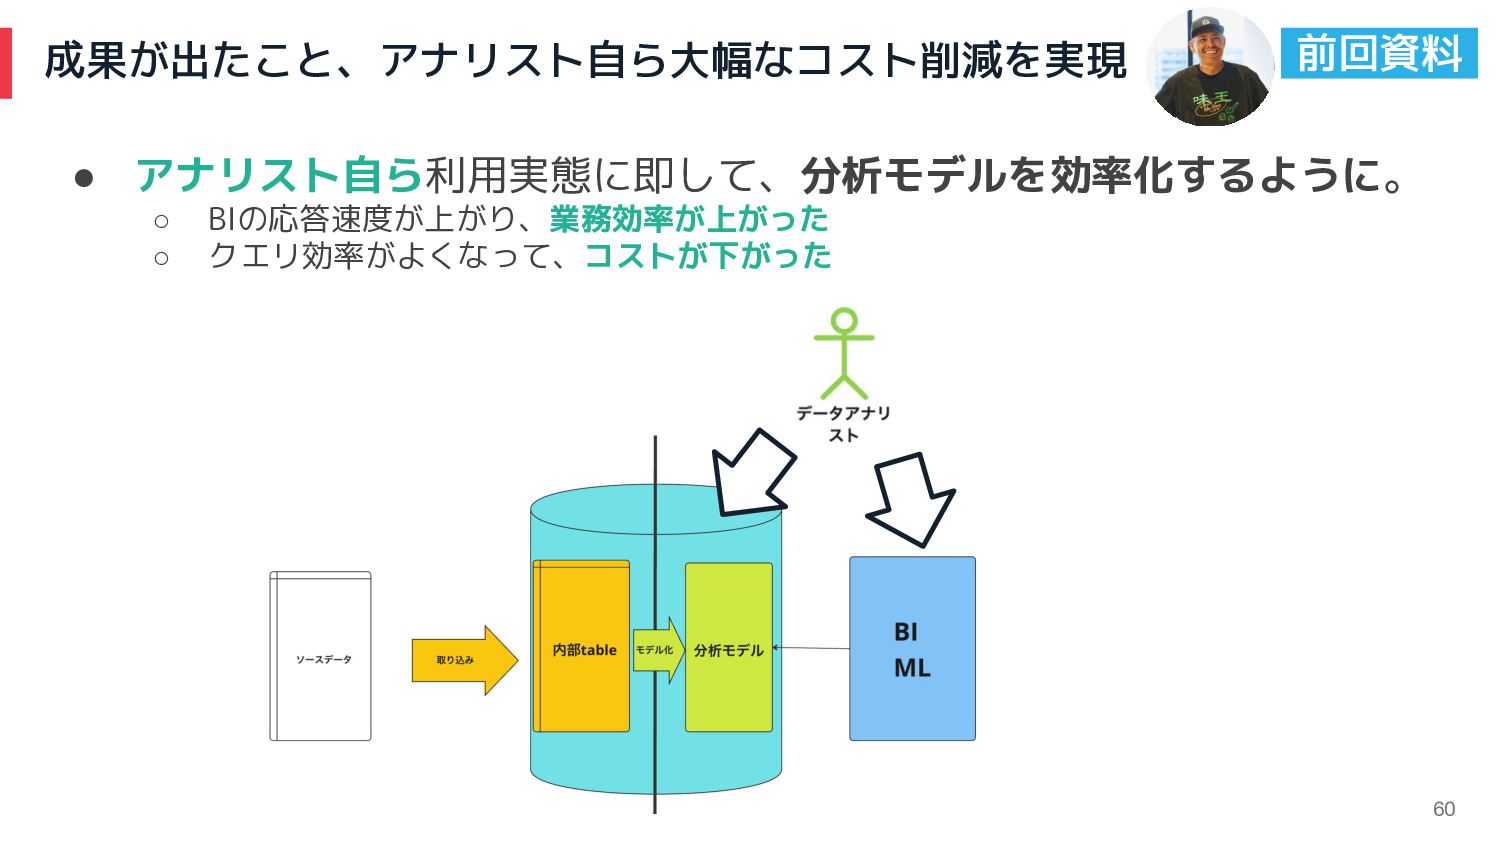
ふだんの分析で、つらみに遭遇 41 Looker側でrawに近いデータから集計した結果・・・ • Lookerのダッシュボードが重い。 • LookerとDWHにロジックが散在。 • 毎回クエリ発行する形になり、コスト増の原因に。 膨大なイベントログを集計した結果・・・
• 一回の集計に時間がかかる。 • 定期運用すると、コストも無視できない。 遭遇したつらみ 日々のアナリスト業務 Lookerで、 新規登録数をモニタリングする ダッシュボードをつくるぞ! プロダクトのイベントログから、 利用状況の総合スコアをつくるぞ! -
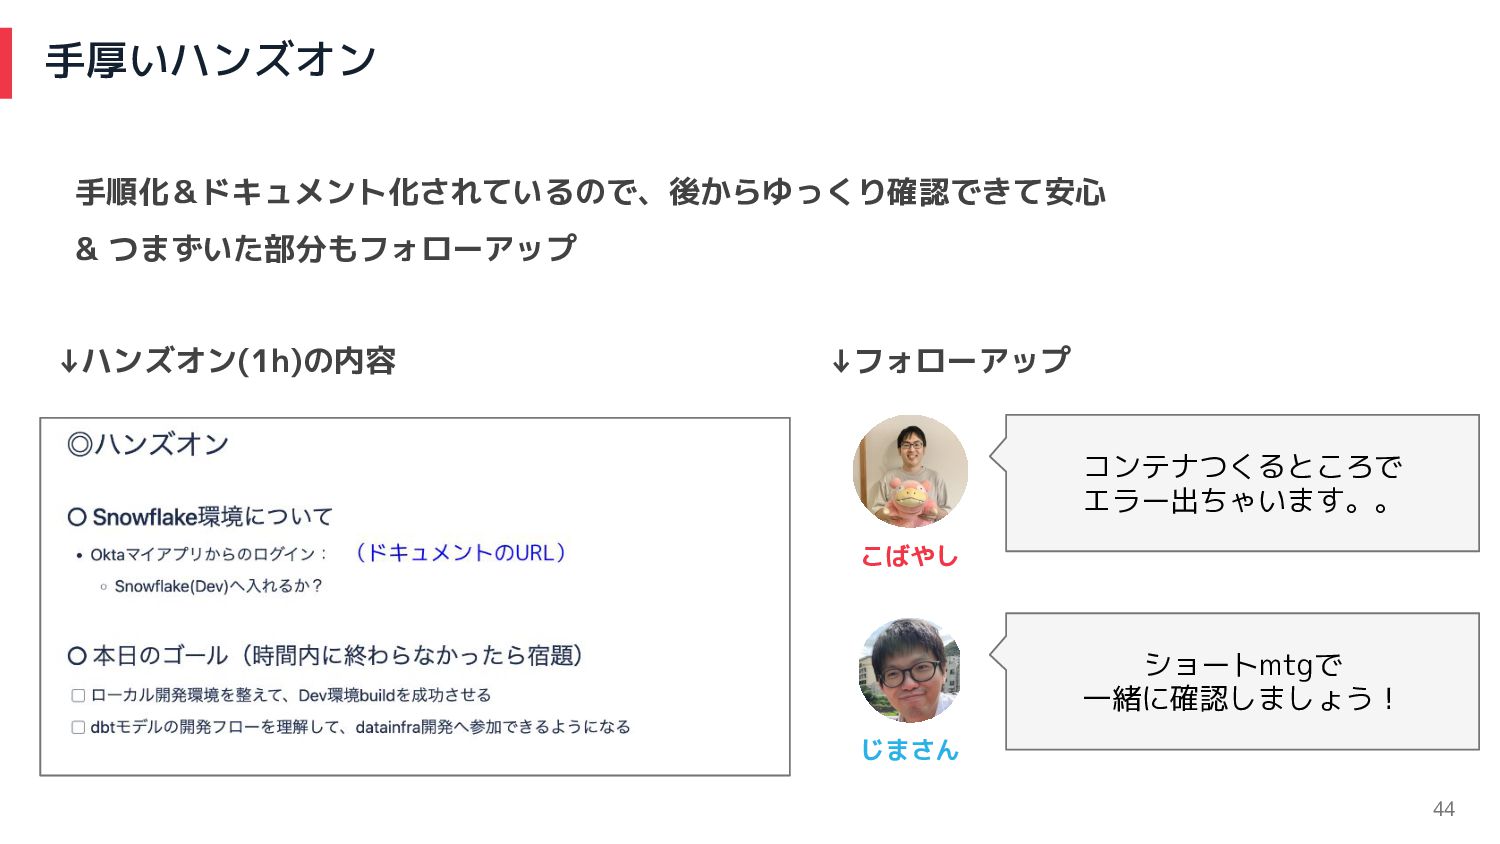
手厚いハンズオン 44 手順化&ドキュメント化されているので、後からゆっくり確認できて安心 & つまずいた部分もフォローアップ ↓ハンズオン(1h)の内容 ↓フォローアップ こばやし じまさん コンテナつくるところで
エラー出ちゃいます。。 ショートmtgで 一緒に確認しましょう! -
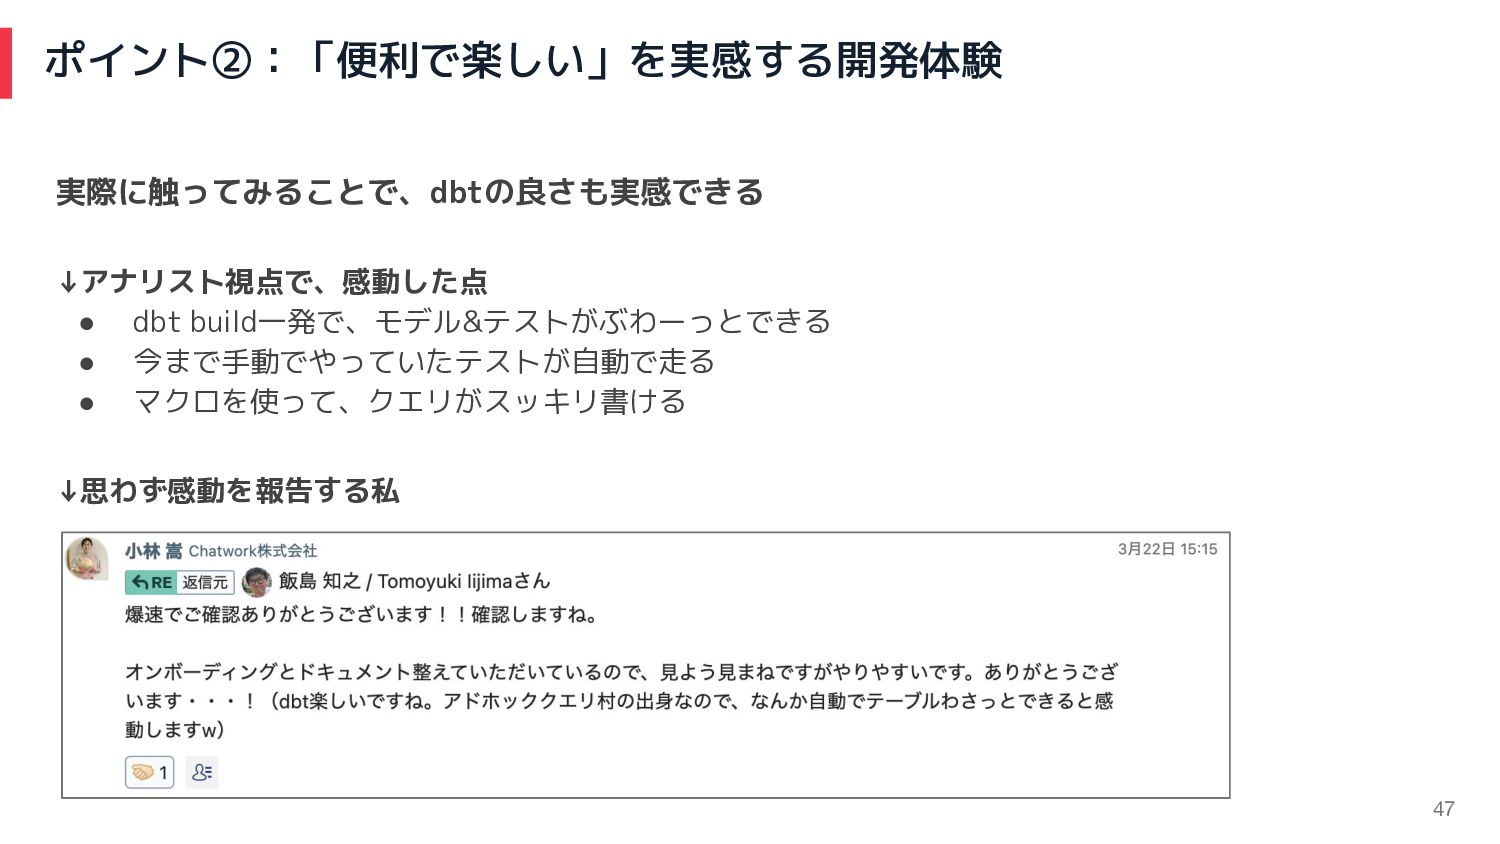
ポイント②:「便利で楽しい」を実感する開発体験 47 実際に触ってみることで、dbtの良さも実感できる ↓アナリスト視点で、感動した点 • dbt build一発で、モデル&テストがぶわーっとできる • 今まで手動でやっていたテストが自動で走る •
マクロを使って、クエリがスッキリ書ける ↓思わず感動を報告する私 -
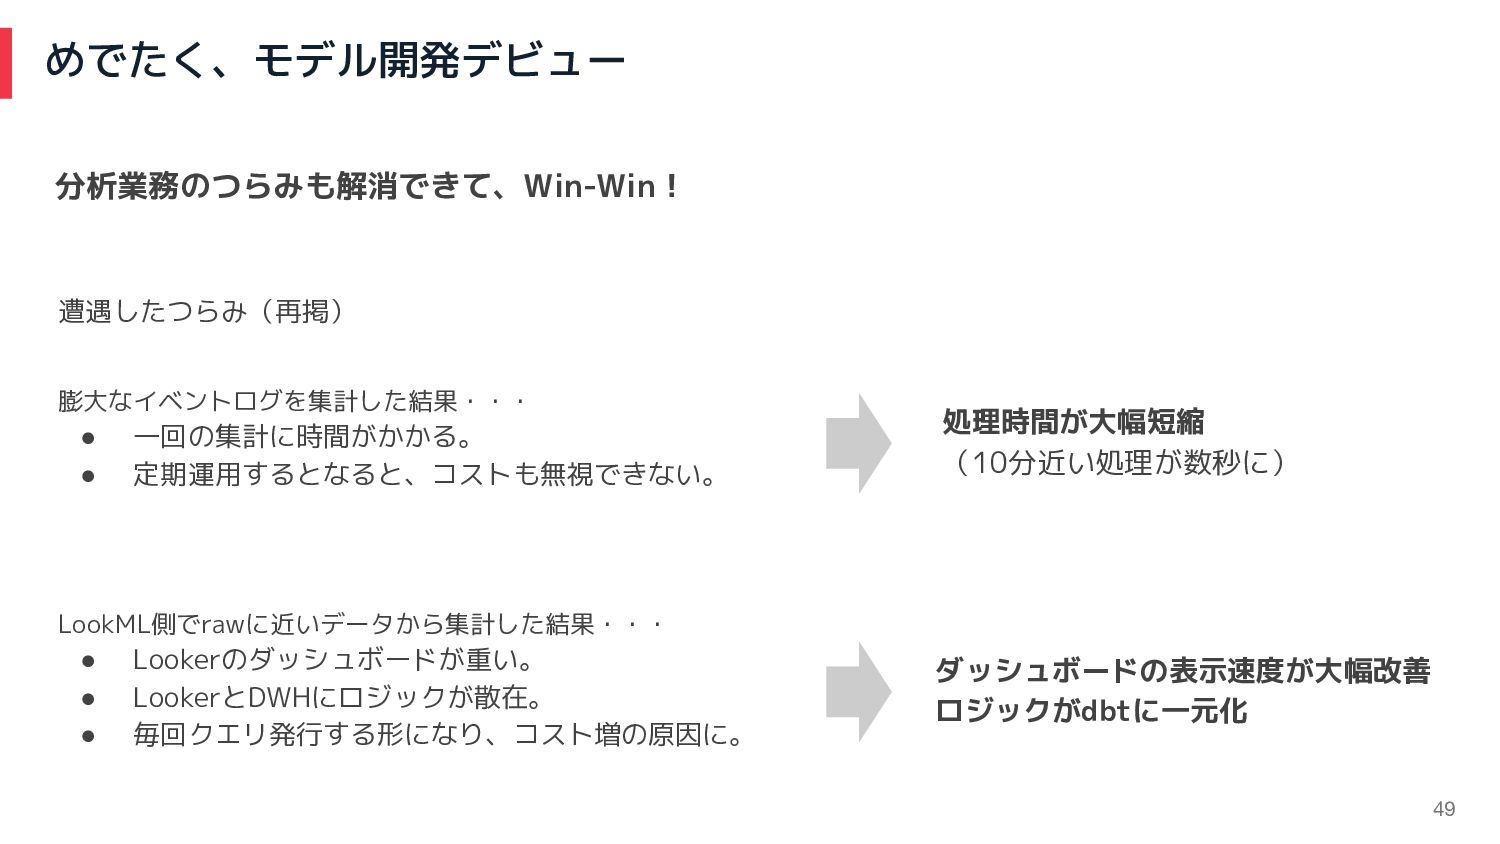
めでたく、モデル開発デビュー 49 LookML側でrawに近いデータから集計した結果・・・ • Lookerのダッシュボードが重い。 • LookerとDWHにロジックが散在。 • 毎回クエリ発行する形になり、コスト増の原因に。 膨大なイベントログを集計した結果・・・
• 一回の集計に時間がかかる。 • 定期運用するとなると、コストも無視できない。 遭遇したつらみ(再掲) ダッシュボードの表示速度が大幅改善 ロジックがdbtに一元化 処理時間が大幅短縮 (10分近い処理が数秒に) 分析業務のつらみも解消できて、Win-Win! -
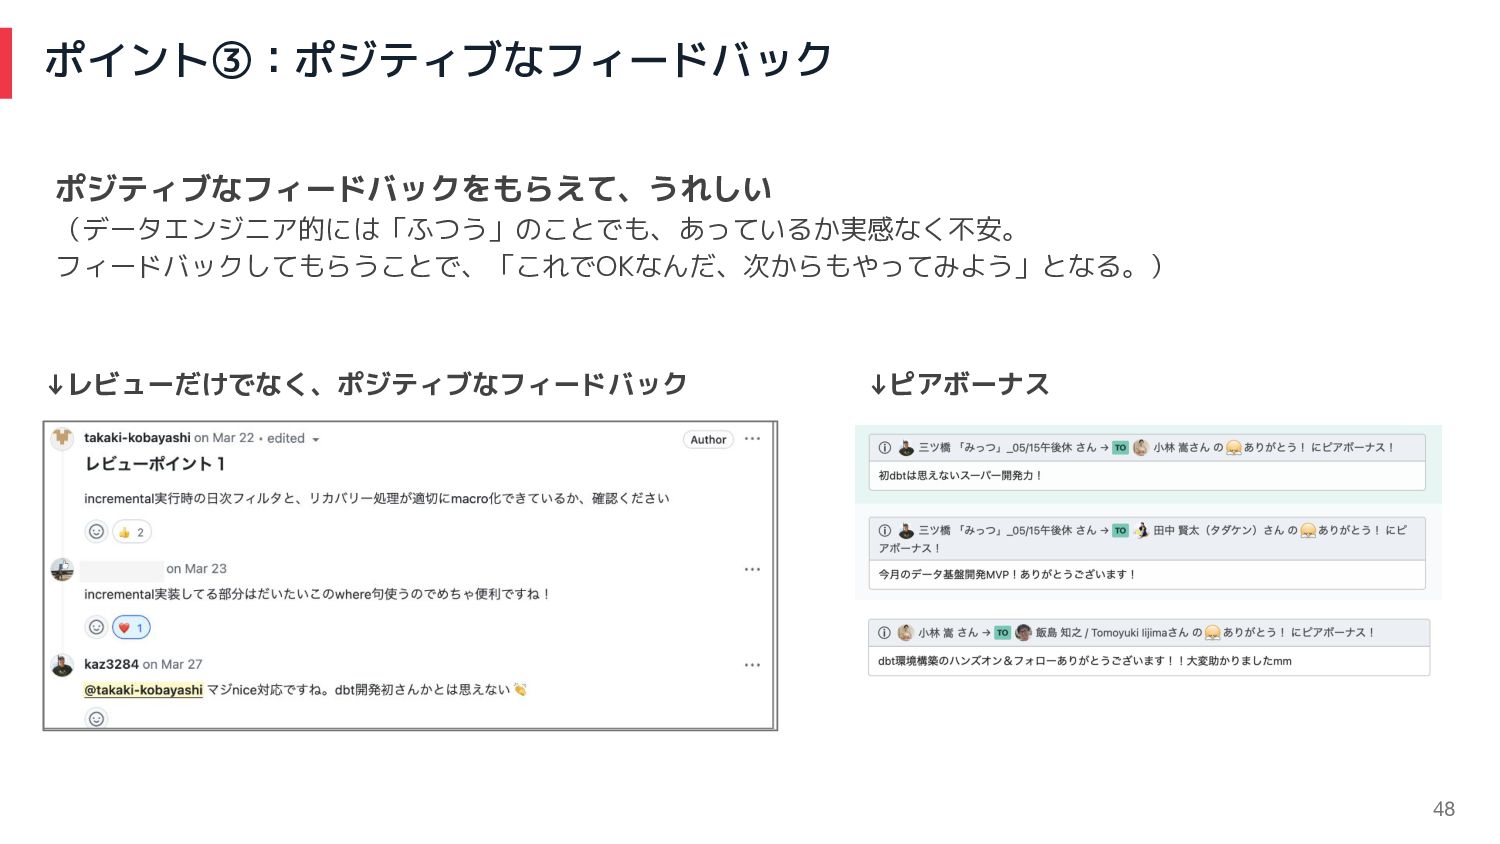
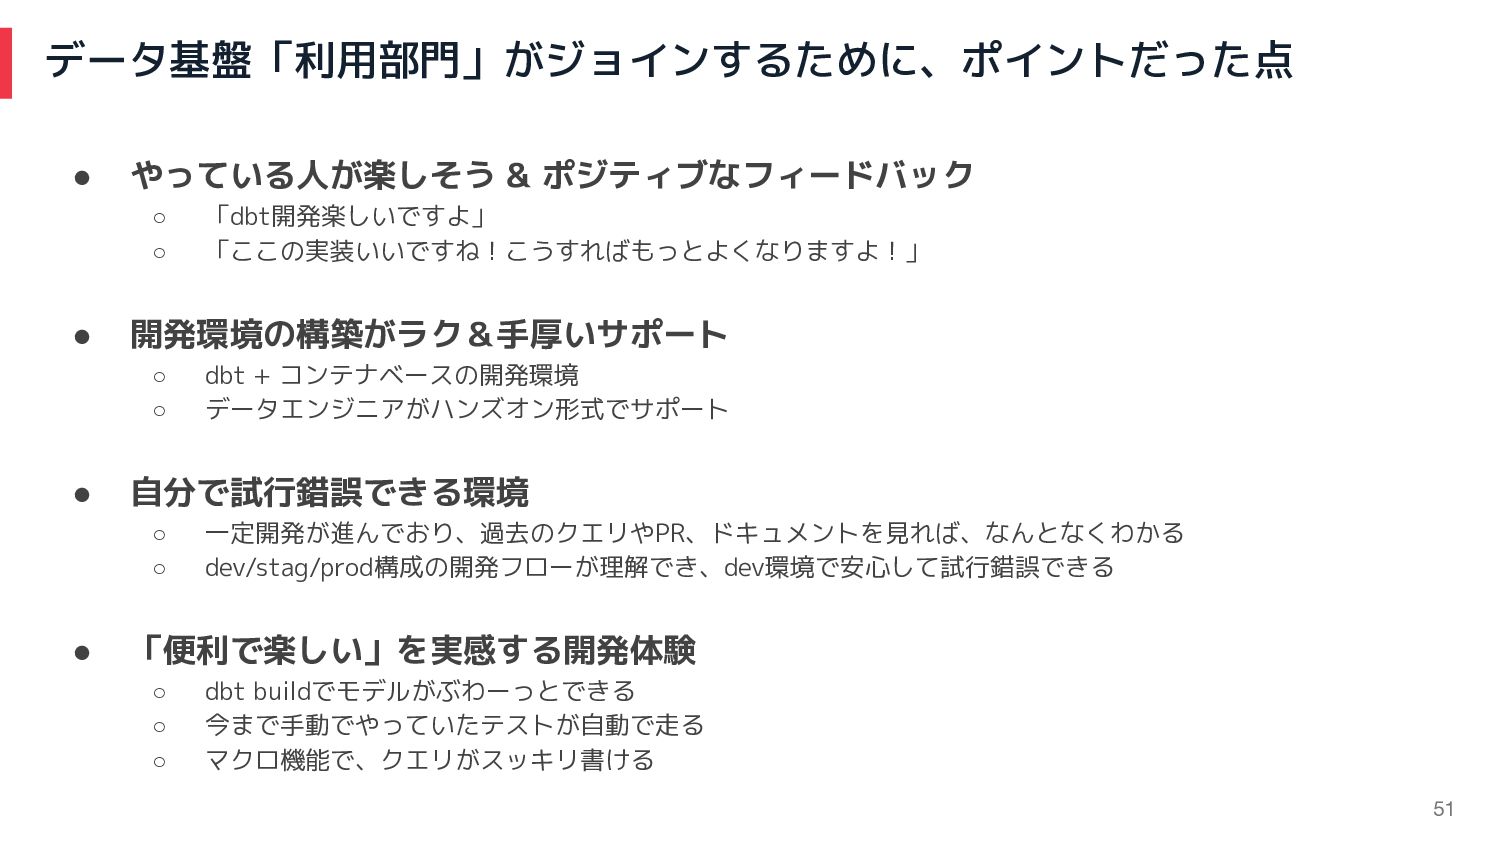
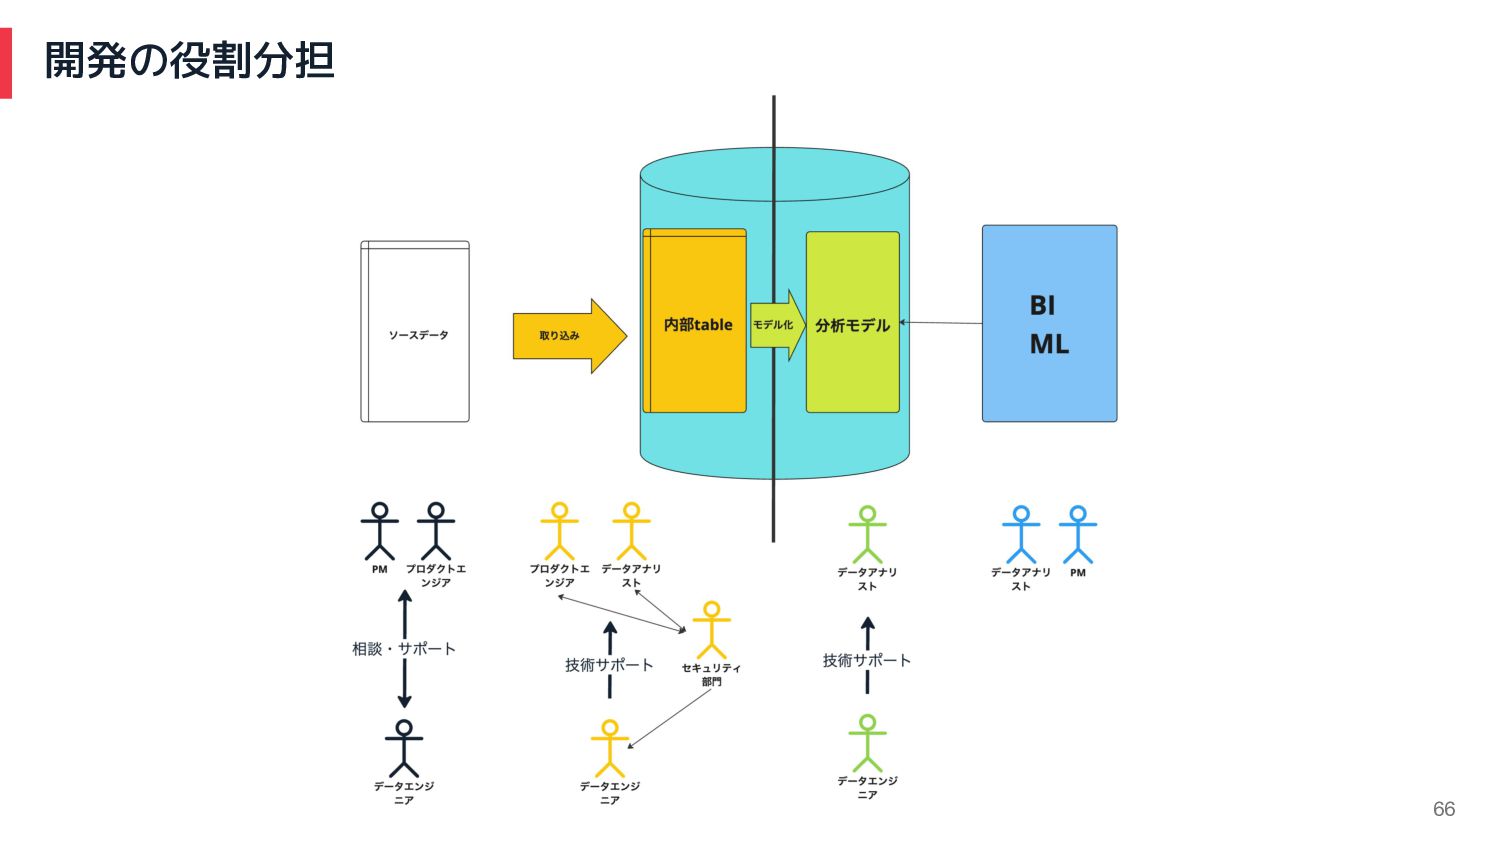
データ基盤「利用部門」がジョインするために、ポイントだった点 51 • やっている人が楽しそう & ポジティブなフィードバック ◦ 「dbt開発楽しいですよ」 ◦ 「ここの実装いいですね!こうすればもっとよくなりますよ!」
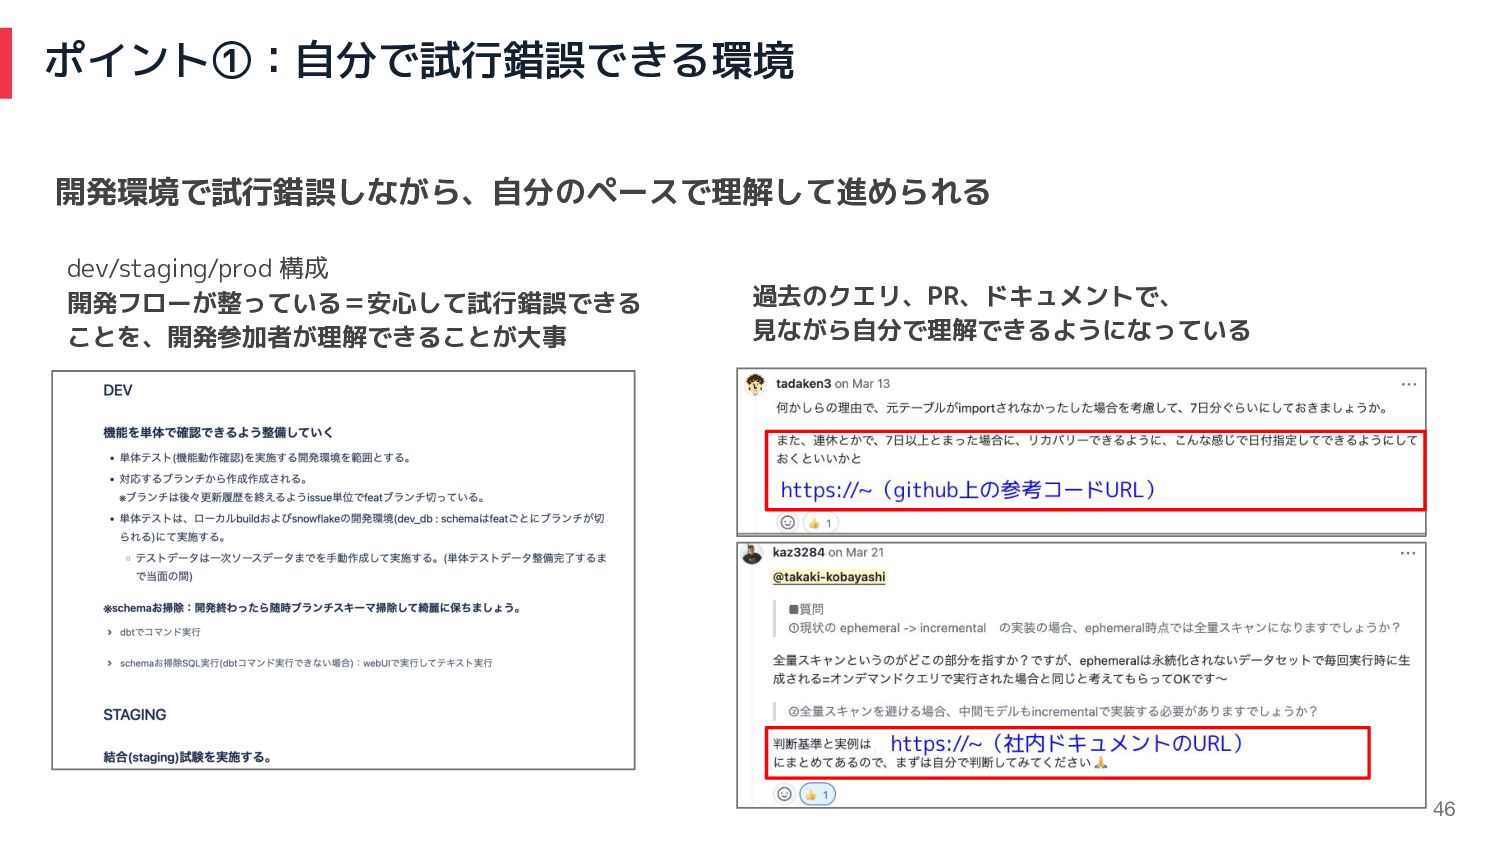
• 開発環境の構築がラク&手厚いサポート ◦ dbt + コンテナベースの開発環境 ◦ データエンジニアがハンズオン形式でサポート • 自分で試行錯誤できる環境 ◦ 一定開発が進んでおり、過去のクエリやPR、ドキュメントを見れば、なんとなくわかる ◦ dev/stag/prod構成の開発フローが理解でき、dev環境で安心して試行錯誤できる • 「便利で楽しい」を実感する開発体験 ◦ dbt buildでモデルがぶわーっとできる ◦ 今まで手動でやっていたテストが自動で走る ◦ マクロ機能で、クエリがスッキリ書ける -
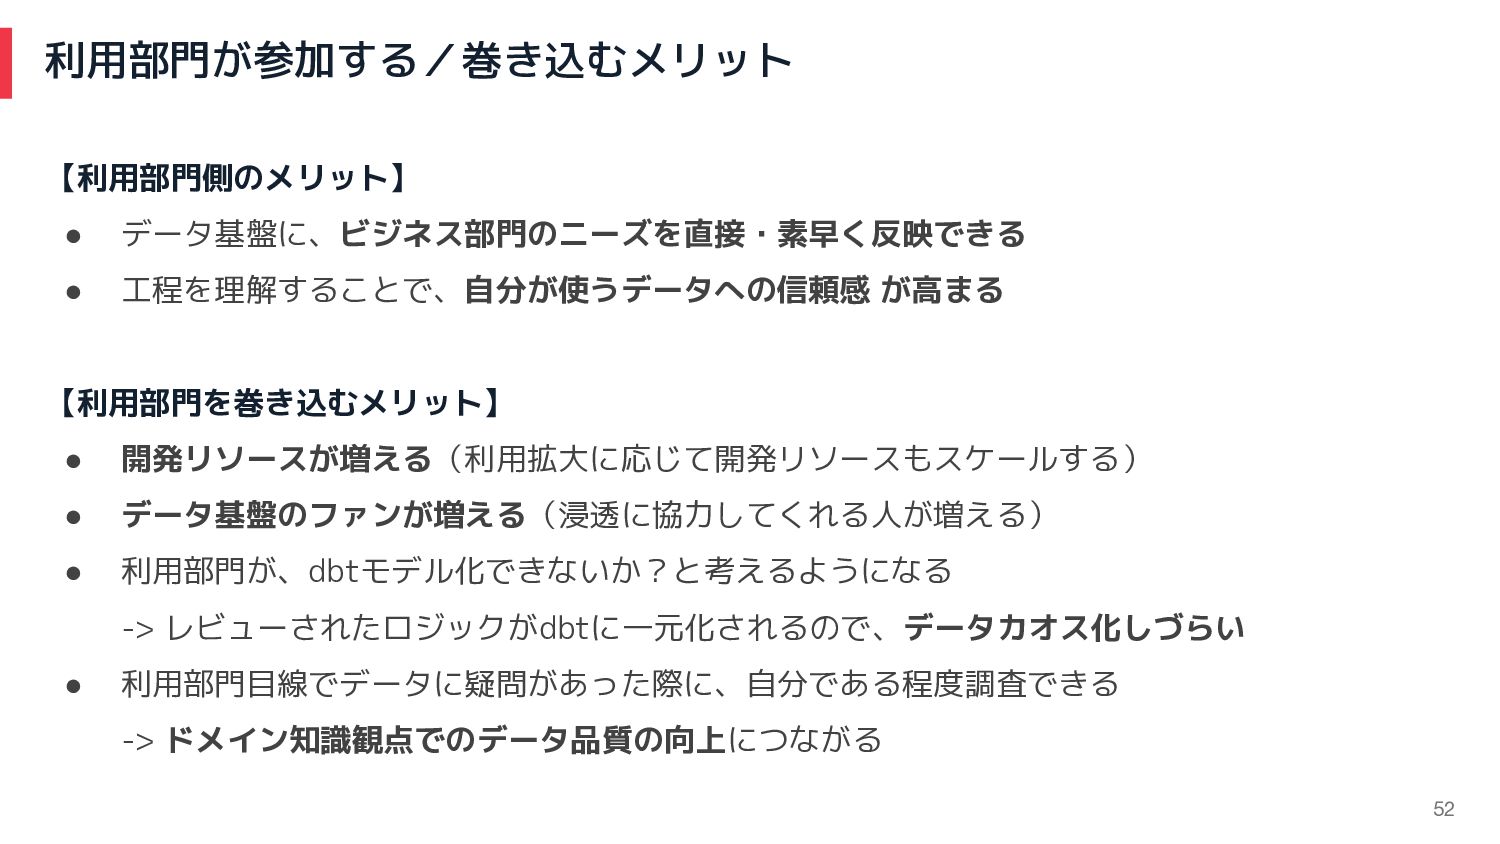
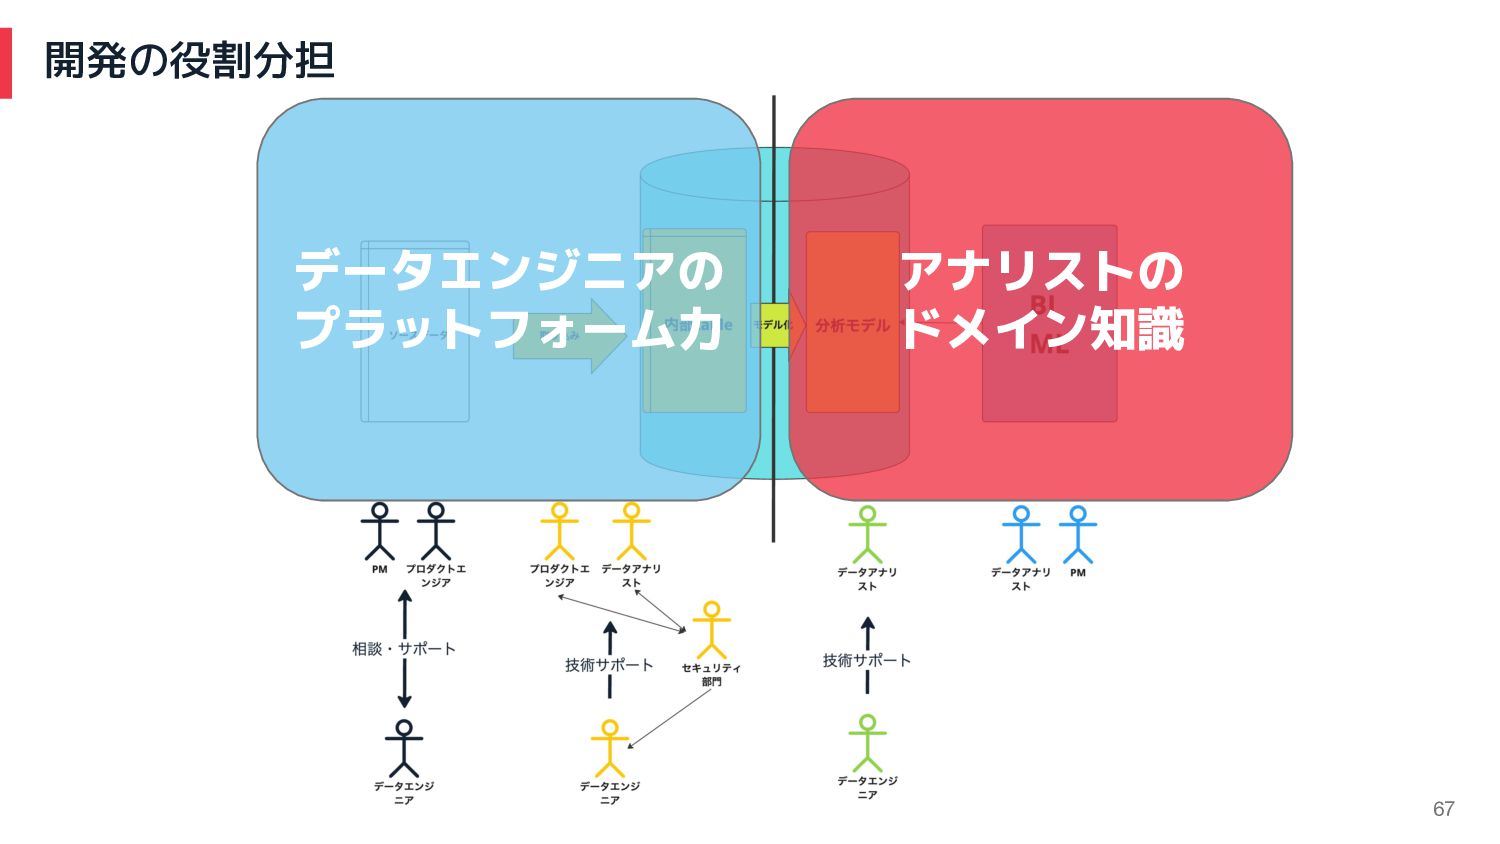
利用部門が参加する/巻き込むメリット 52 【利用部門側のメリット】 • データ基盤に、ビジネス部門のニーズを直接・素早く反映できる • 工程を理解することで、自分が使うデータへの信頼感 が高まる 【利用部門を巻き込むメリット】 •
開発リソースが増える(利用拡大に応じて開発リソースもスケールする) • データ基盤のファンが増える(浸透に協力してくれる人が増える) • 利用部門が、dbtモデル化できないか?と考えるようになる -> レビューされたロジックがdbtに一元化されるので、データカオス化しづらい • 利用部門目線でデータに疑問があった際に、自分である程度調査できる -> ドメイン知識観点でのデータ品質の向上につながる -
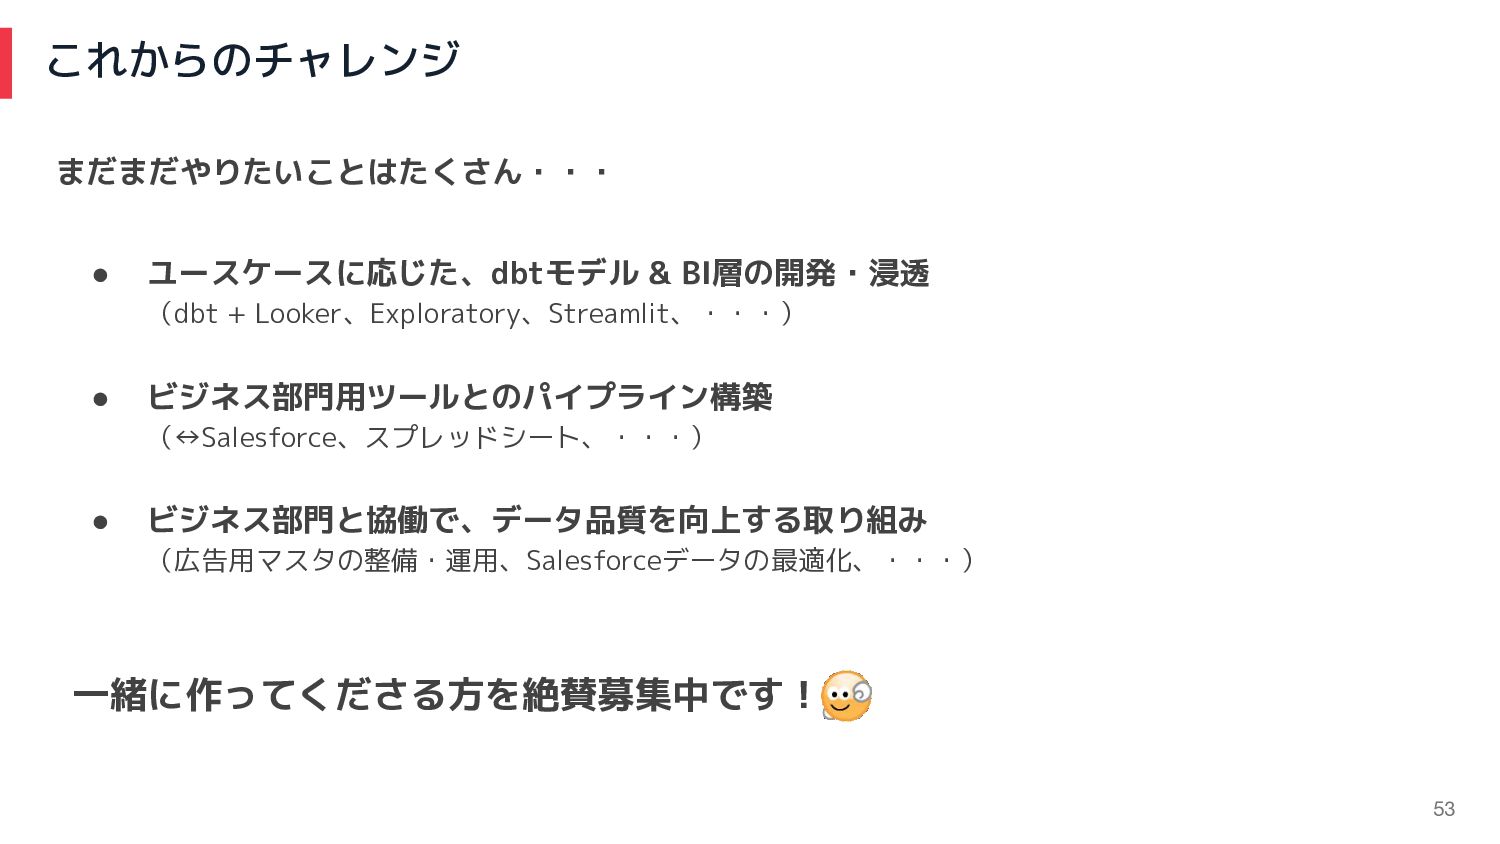
これからのチャレンジ 53 • ユースケースに応じた、dbtモデル & BI層の開発・浸透 (dbt + Looker、Exploratory、Streamlit、・・・) •
ビジネス部門用ツールとのパイプライン構築 (↔Salesforce、スプレッドシート、・・・) • ビジネス部門と協働で、データ品質を向上する取り組み (広告用マスタの整備・運用、Salesforceデータの最適化、・・・) 一緒に作ってくださる方を絶賛募集中です! まだまだやりたいことはたくさん・・・ -
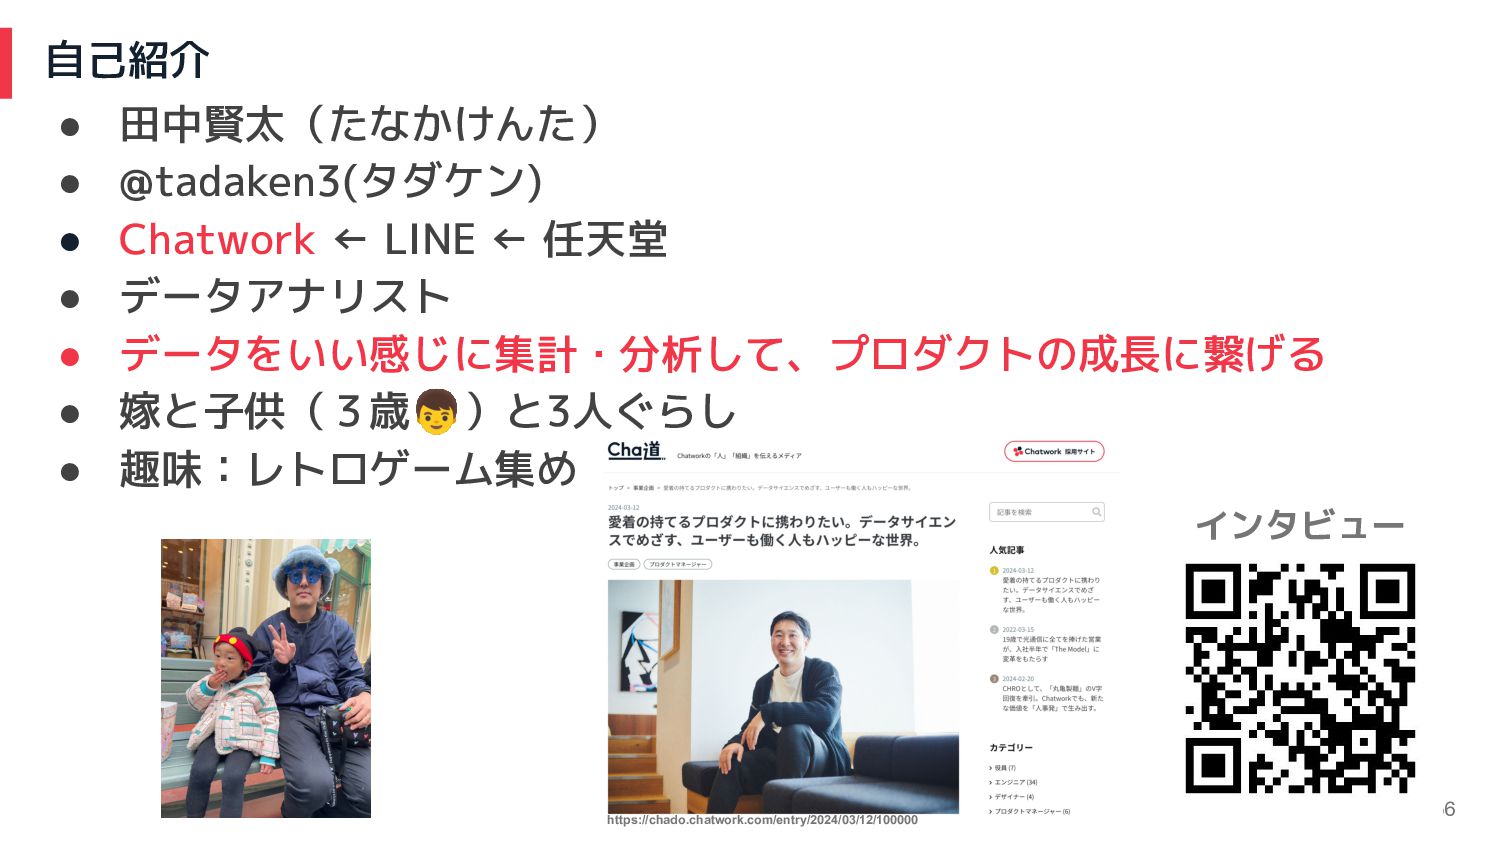
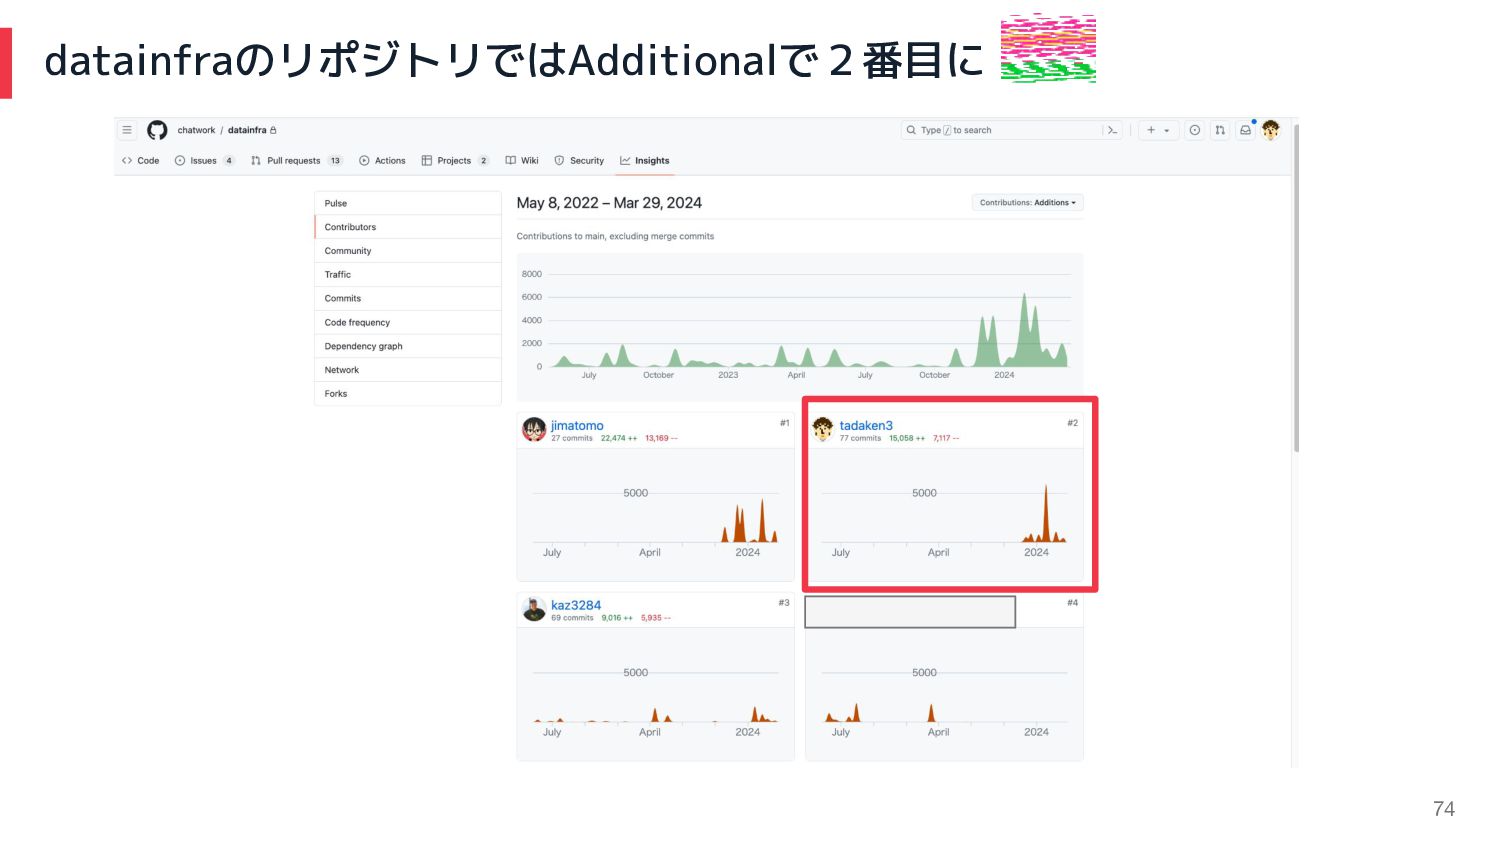
自己紹介 56 • 田中賢太(たなかけんた) • @tadaken3(タダケン) • Chatwork ← LINE
← 任天堂 • データアナリスト • データをいい感じに集計・分析して、プロダクトの成長に繋げる • 嫁と子供(3歳👦)と3人ぐらし • 趣味:レトロゲーム集め https://chado.chatwork.com/entry/2024/03/12/100000 インタビュー -
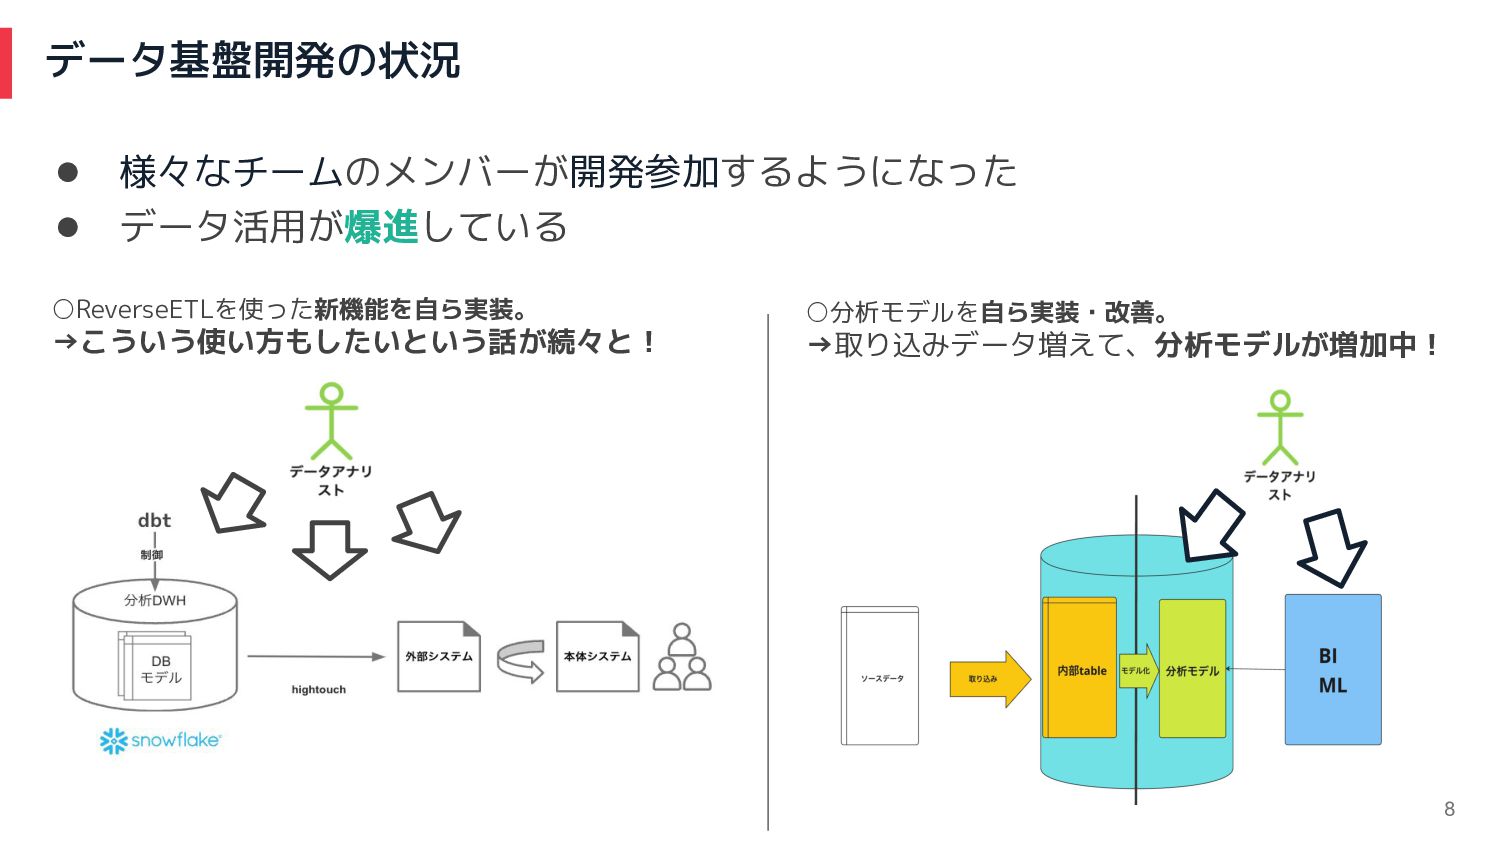
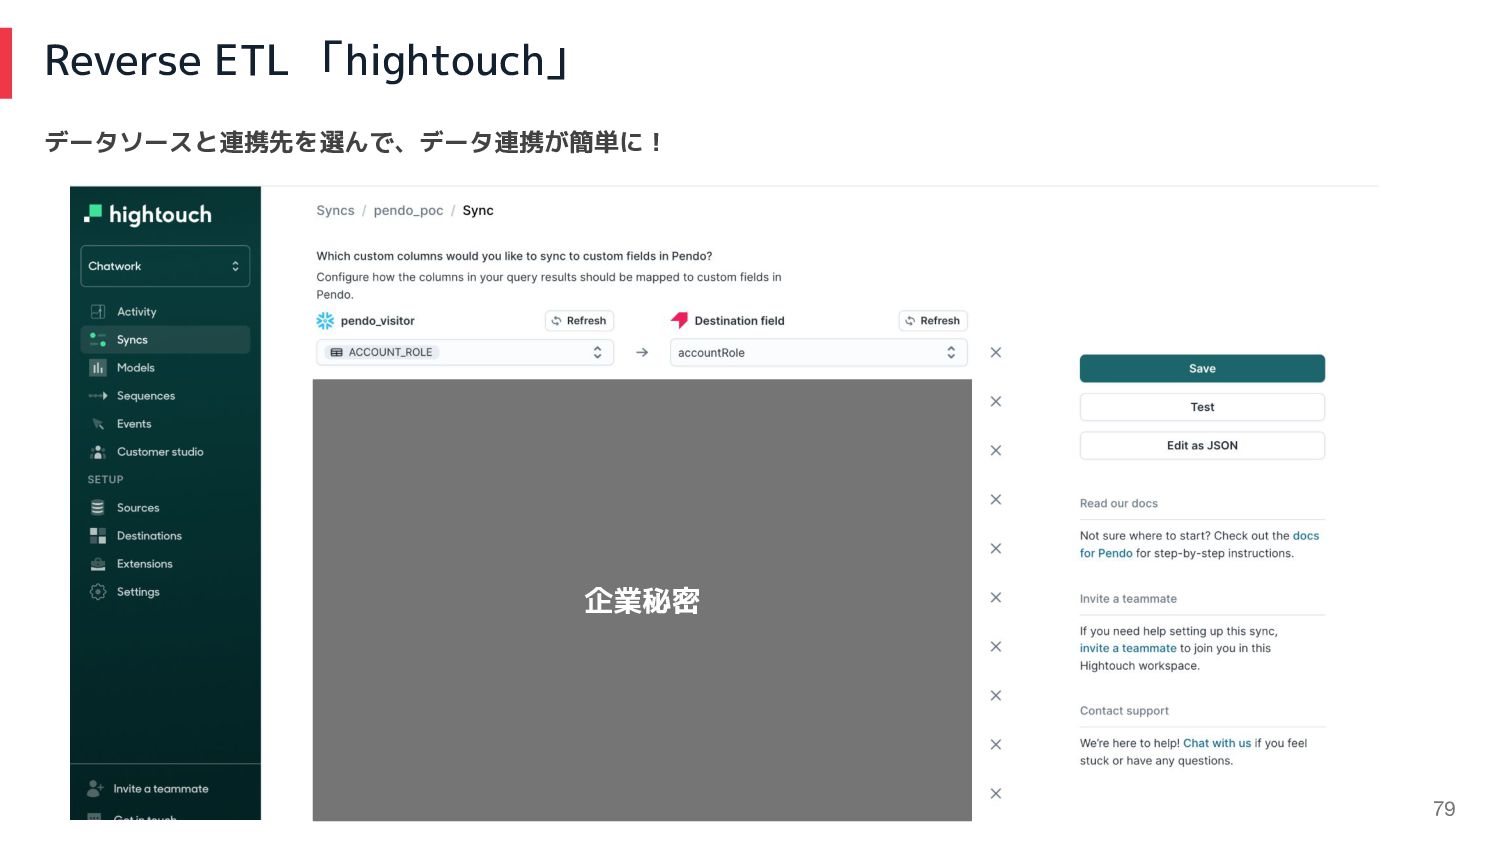
• 利用部門が自分たちで開発するとか、アナリストの人が開発なしで 新機能実現とかすごい。いい話すぎる • アナリストだけでリバースETL構築。素晴らしい • 「アナリストが自ら分析機能を実現した」のは大きいな、データ民主 化はもはや当たり前で「データ分析」の民主化が必要 • データの利用者たちが横串でデータを利用できるようになることって
素敵。DataOpsだなあ 「我が社が考える最強のデータ基盤'24最新版」の反響 61 実際のX(旧Twitter)のコメントはこちら https://twitter.com/hashtag/ChatworkTechTalk?src=hashtag_click&f=live -
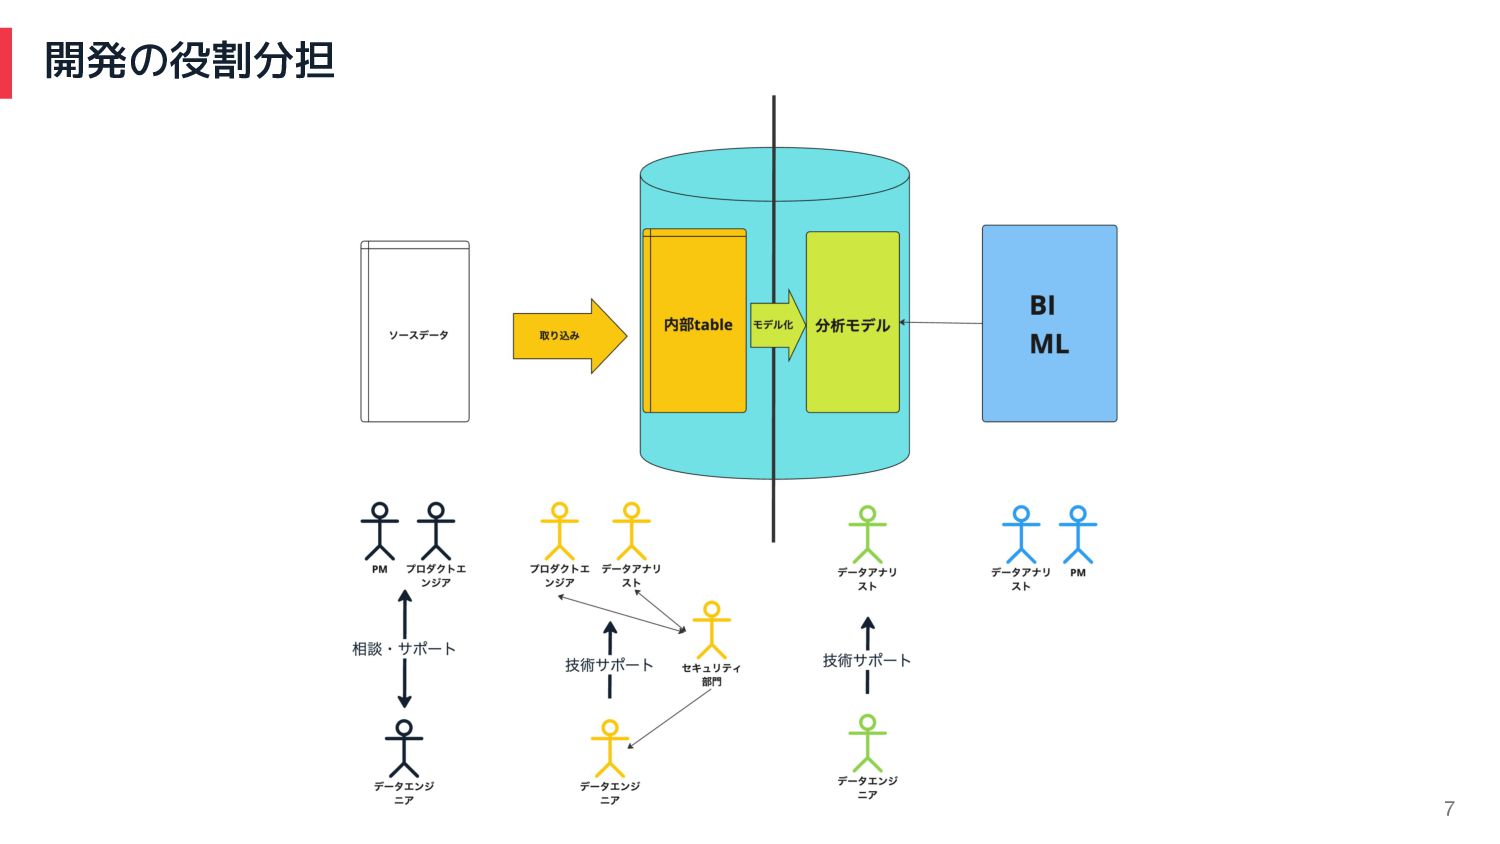
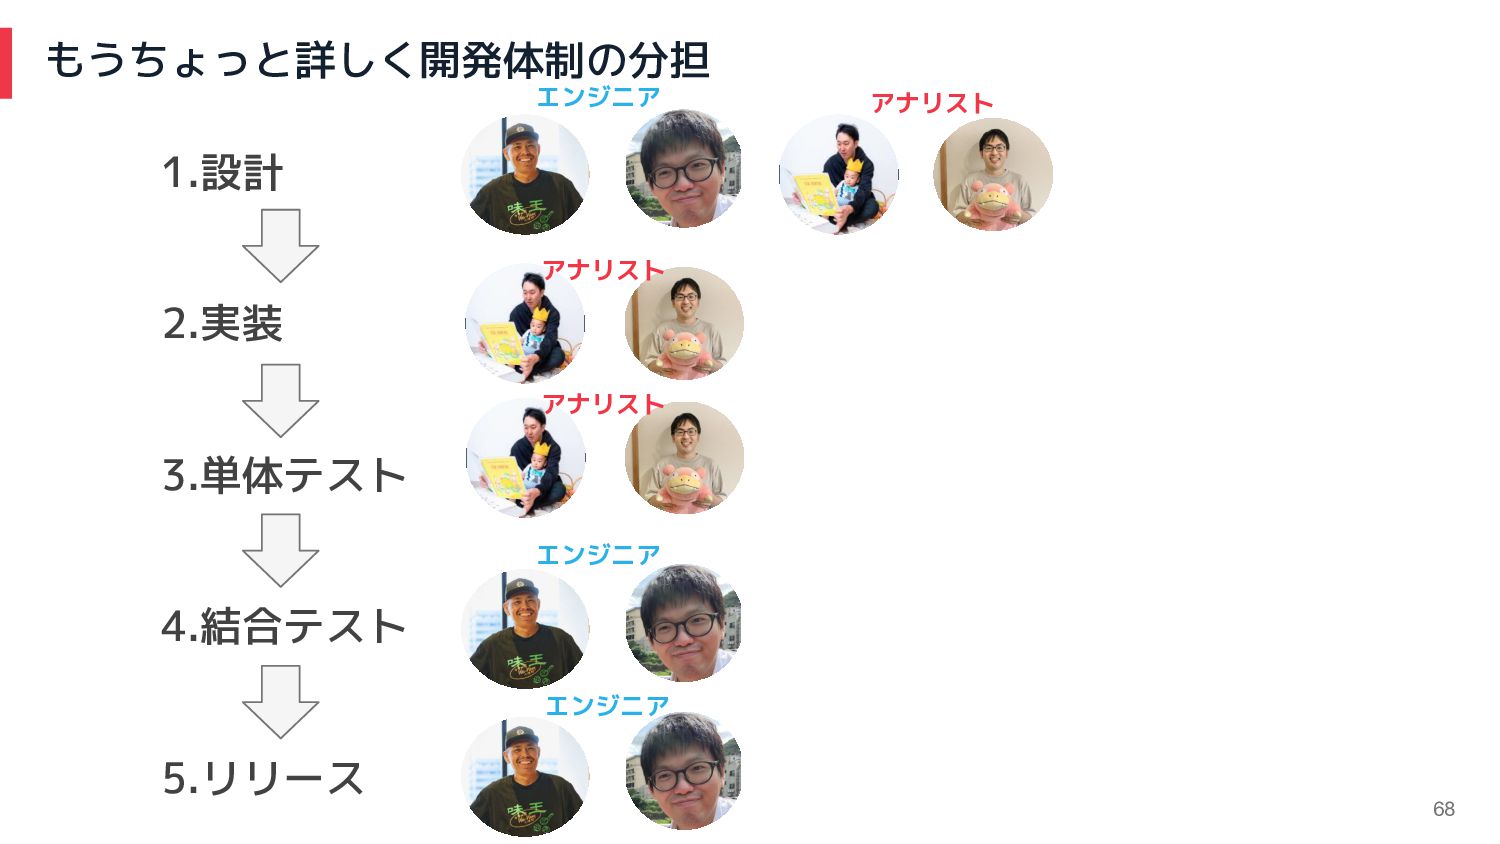
68 もうちょっと詳しく開発体制の分担 1.設計 2.実装 3.単体テスト 4.結合テスト 5.リリース エンジニア アナリスト エンジニア
エンジニア アナリスト アナリスト -
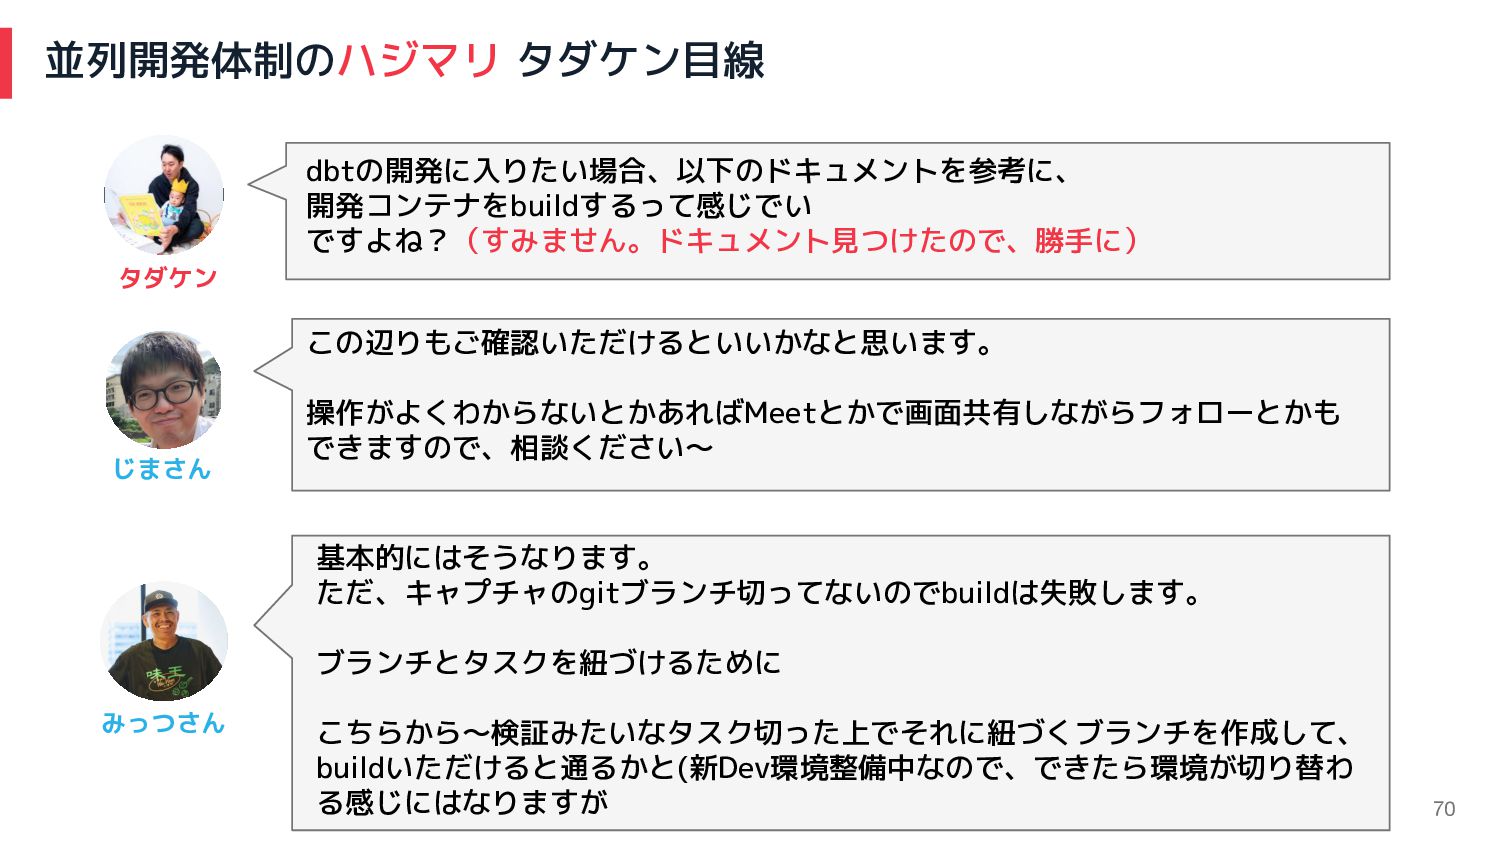
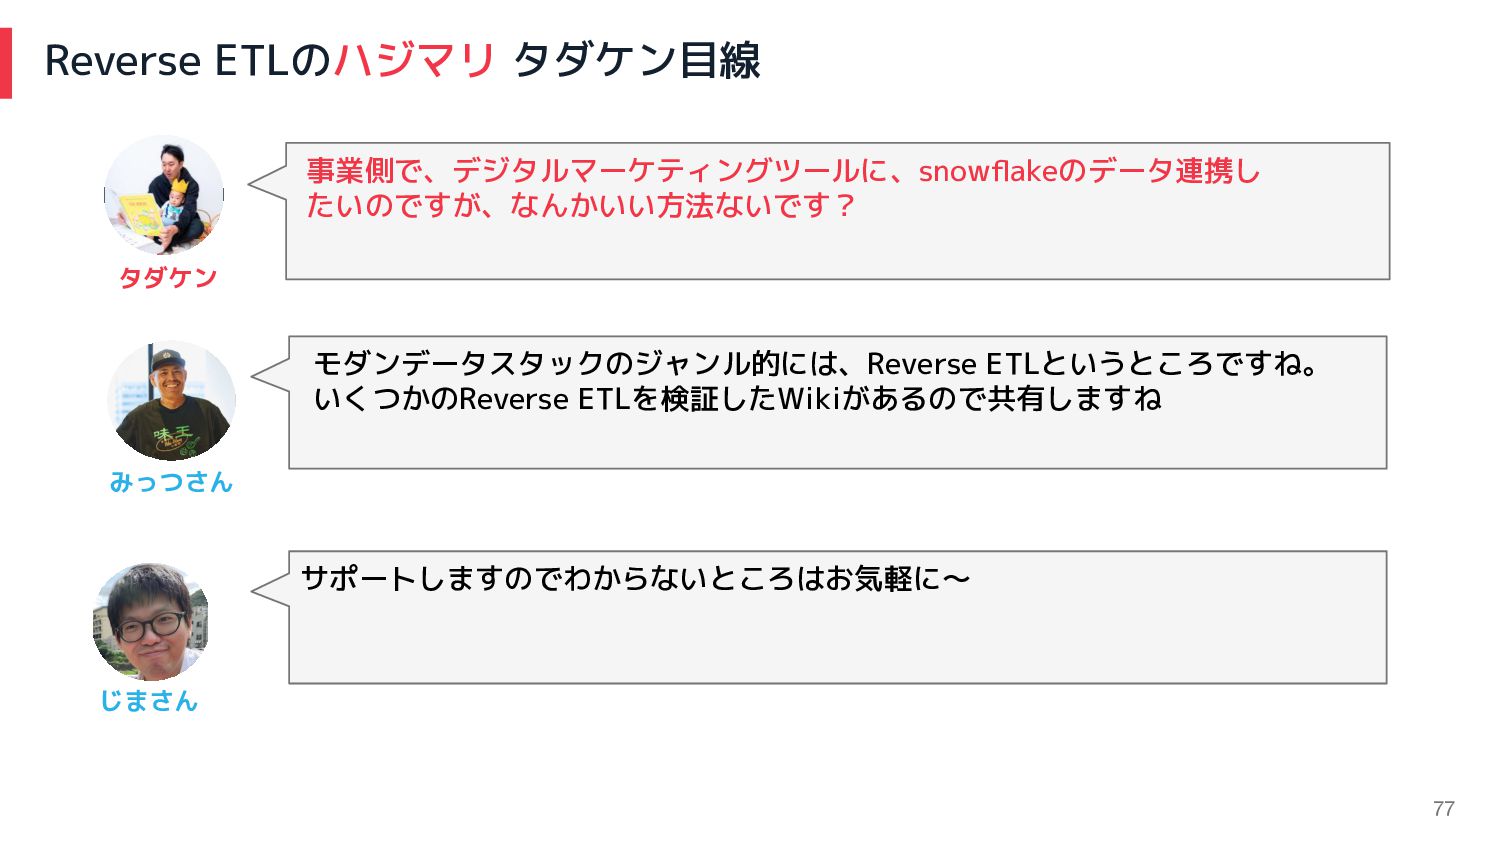
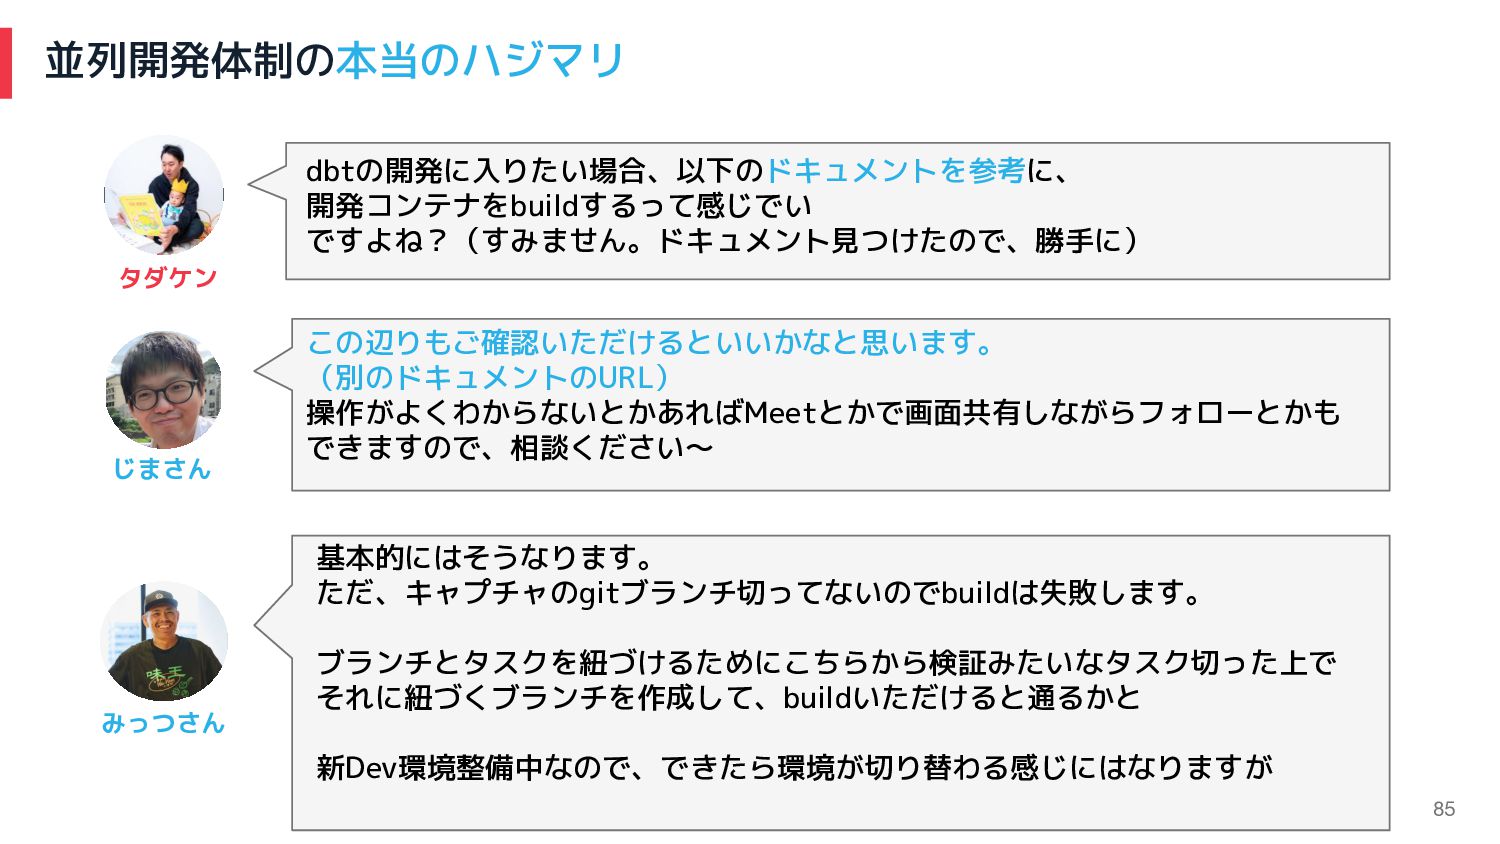
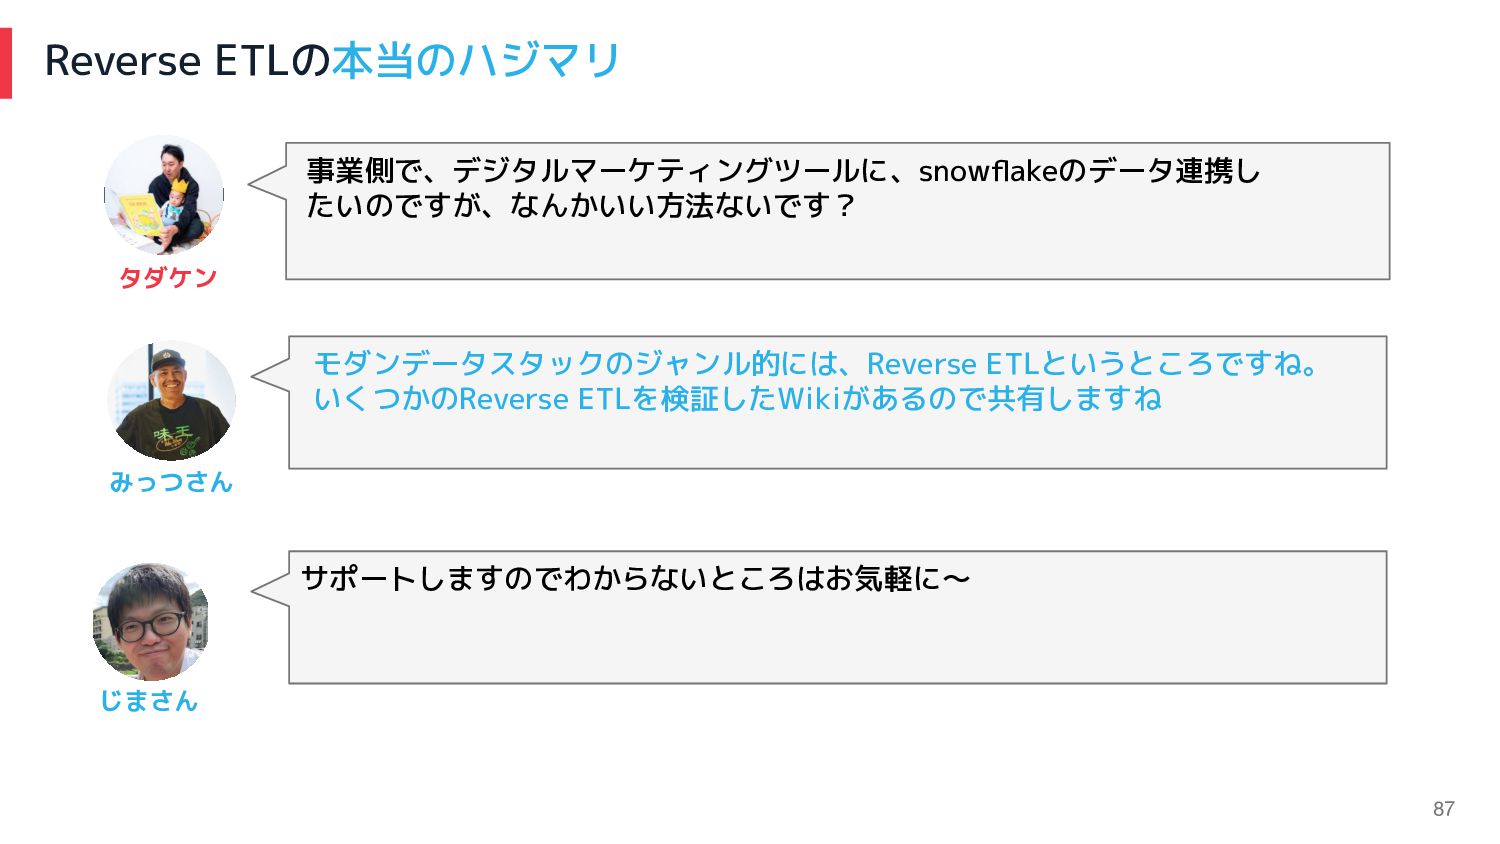
70 並列開発体制のハジマリ タダケン目線 dbtの開発に入りたい場合、以下のドキュメントを参考に、 開発コンテナをbuildするって感じでい ですよね?(すみません。ドキュメント見つけたので、勝手に) この辺りもご確認いただけるといいかなと思います。 操作がよくわからないとかあればMeetとかで画面共有しながらフォローとかも できますので、相談ください〜 基本的にはそうなります。
ただ、キャプチャのgitブランチ切ってないのでbuildは失敗します。 ブランチとタスクを紐づけるために こちらから〜検証みたいなタスク切った上でそれに紐づくブランチを作成して、 buildいただけると通るかと(新Dev環境整備中なので、できたら環境が切り替わ る感じにはなりますが じまさん みっつさん タダケン -
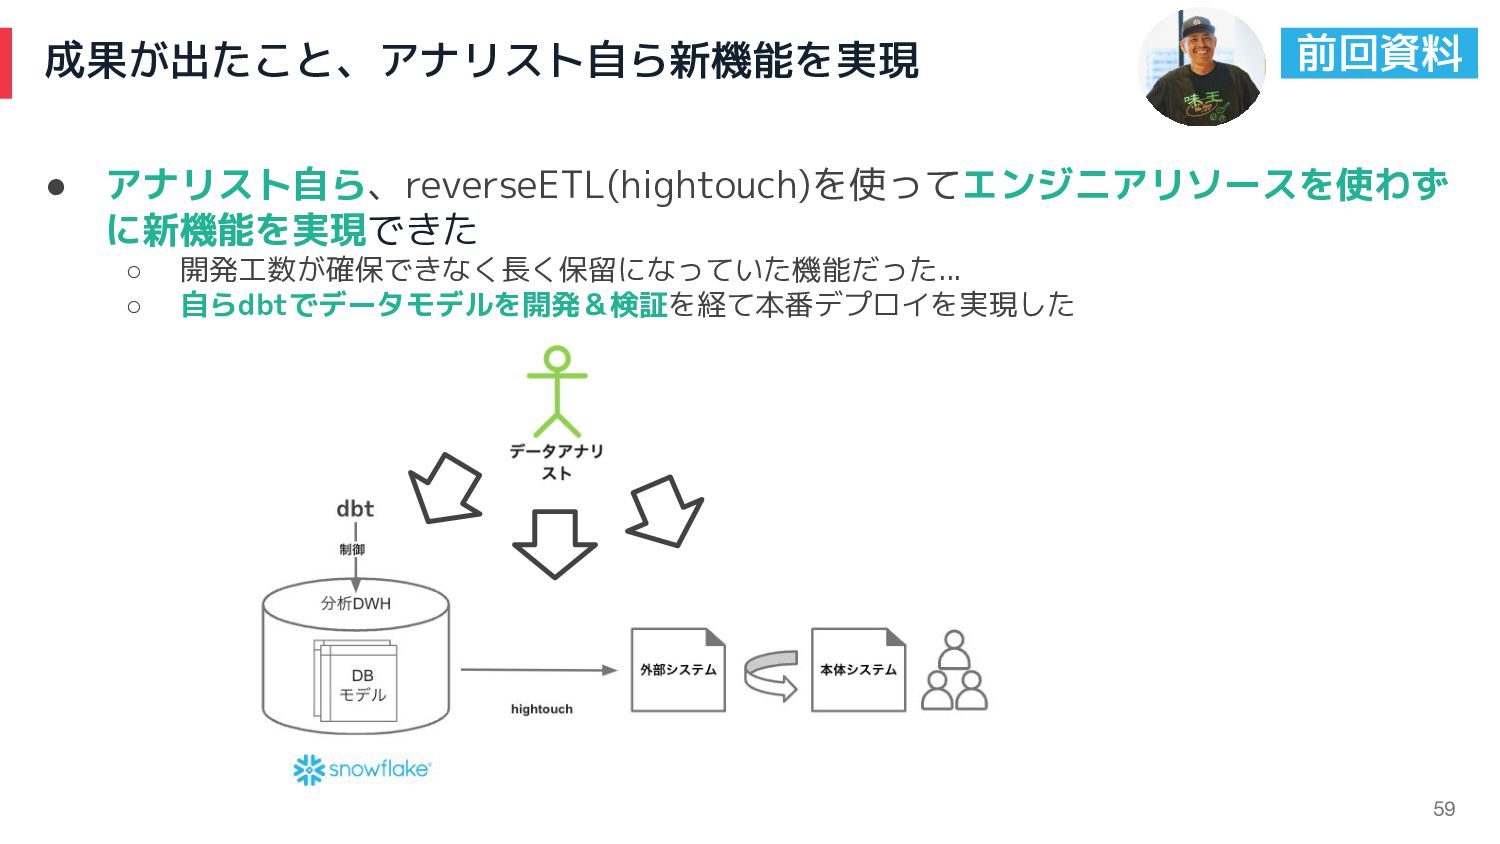
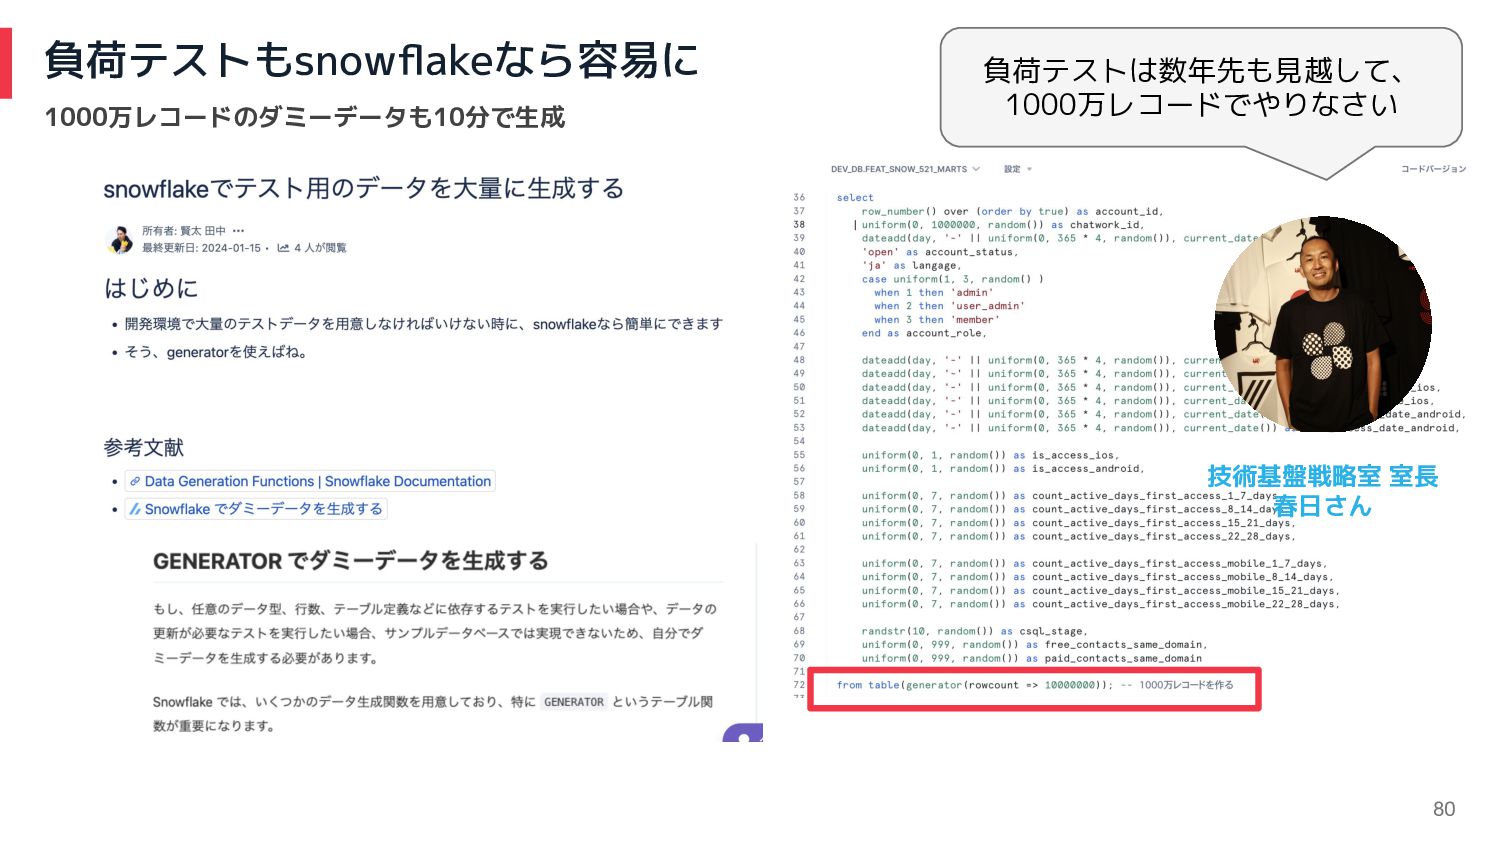
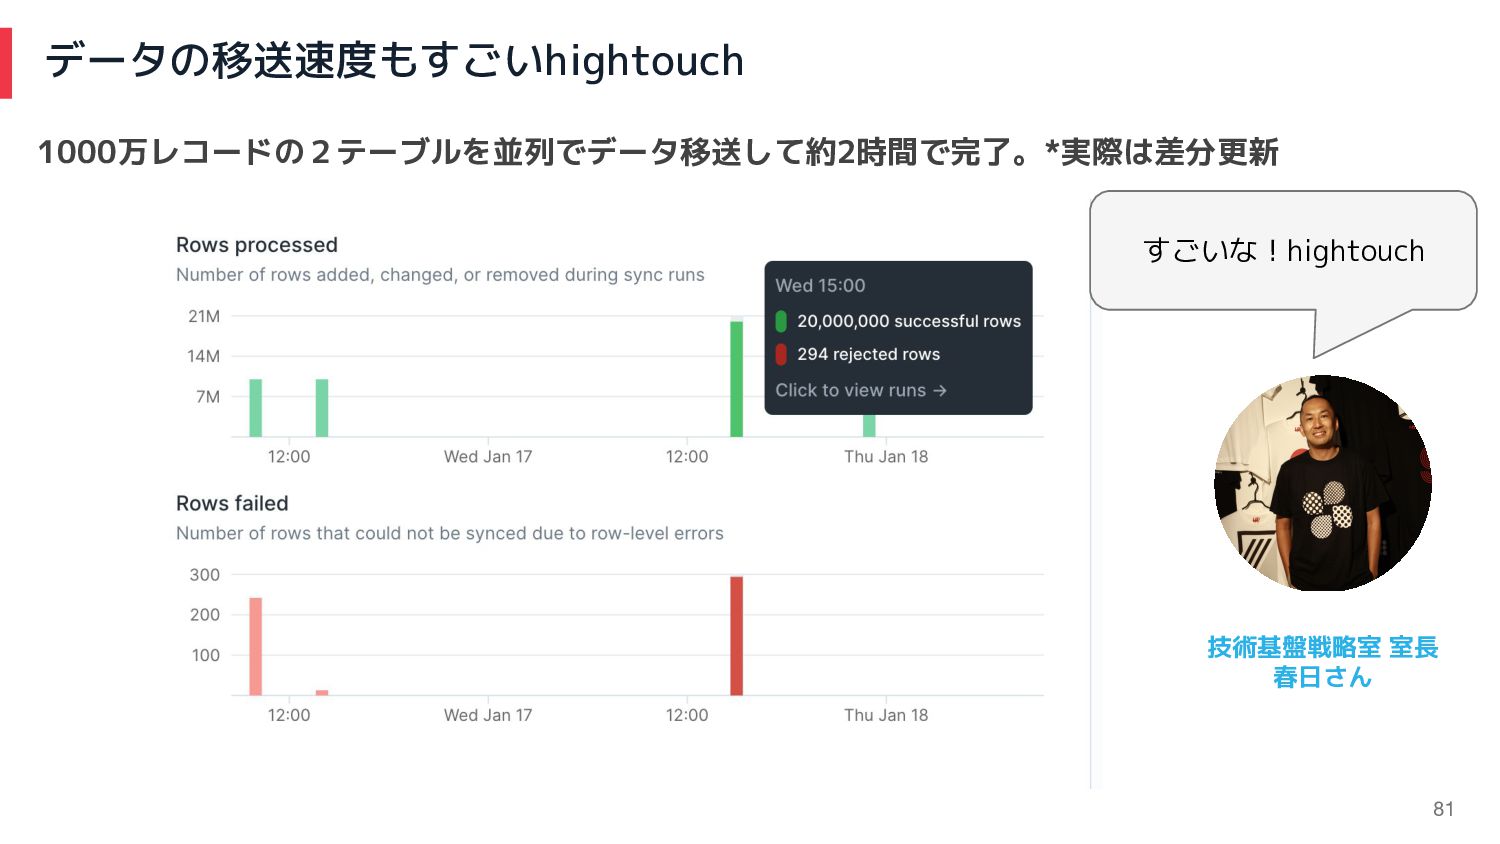
78 並列型の開発体制:Reverse ETLの実装 やったこと 1. 要求・要件整理 2. 検証(要件を満たせるか) 3. 負荷試験
4. データ連携用dbt modelの開発 5. Reverse ETLの実装 -
85 dbtの開発に入りたい場合、以下のドキュメントを参考に、 開発コンテナをbuildするって感じでい ですよね?(すみません。ドキュメント見つけたので、勝手に) この辺りもご確認いただけるといいかなと思います。 (別のドキュメントのURL) 操作がよくわからないとかあればMeetとかで画面共有しながらフォローとかも できますので、相談ください〜 基本的にはそうなります。 ただ、キャプチャのgitブランチ切ってないのでbuildは失敗します。
ブランチとタスクを紐づけるためにこちらから検証みたいなタスク切った上で それに紐づくブランチを作成して、buildいただけると通るかと 新Dev環境整備中なので、できたら環境が切り替わる感じにはなりますが じまさん みっつさん タダケン 並列開発体制の本当のハジマリ -
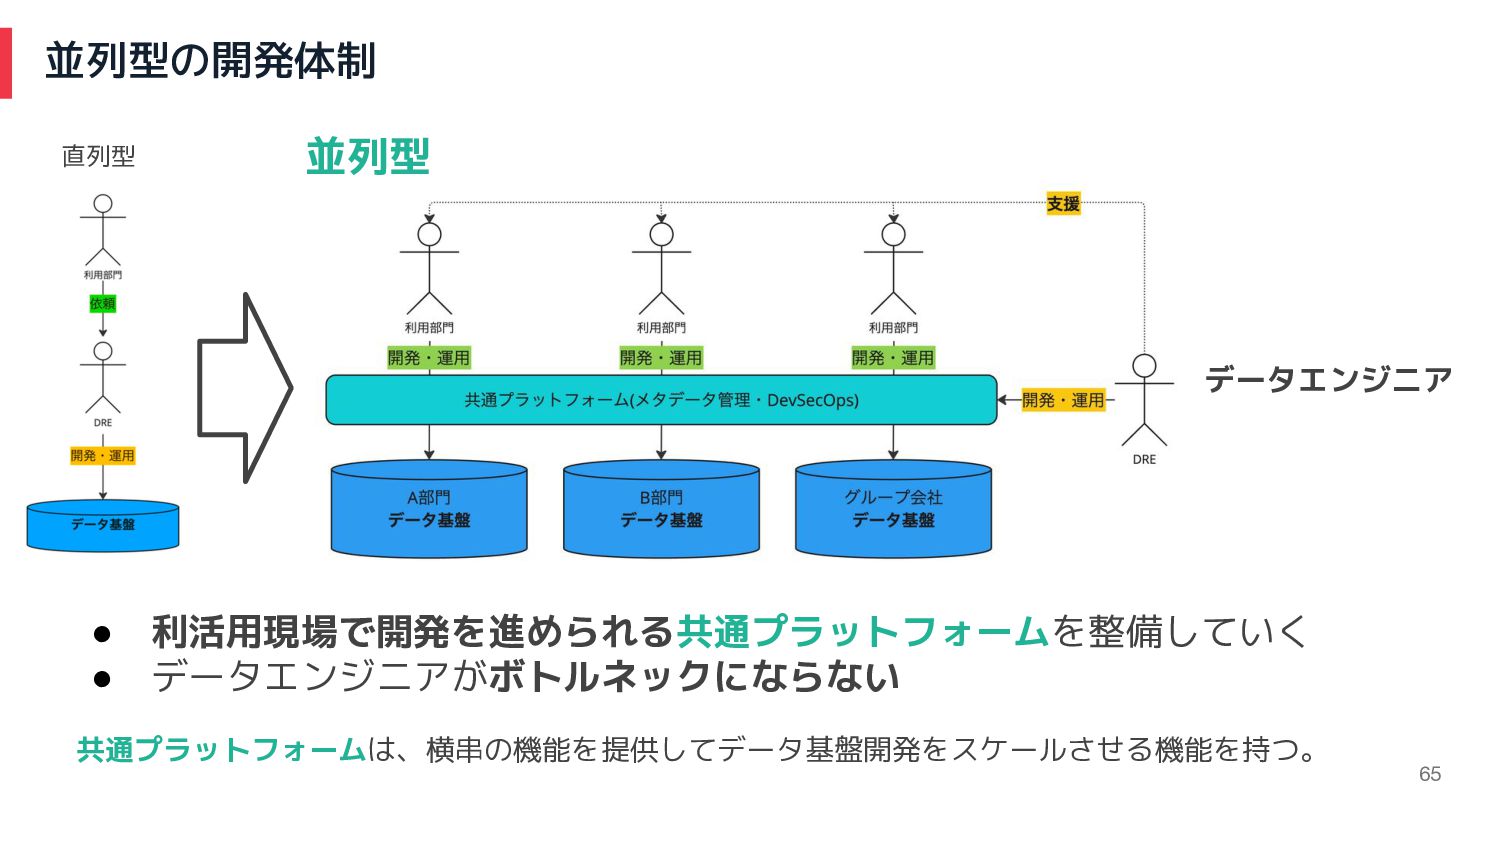
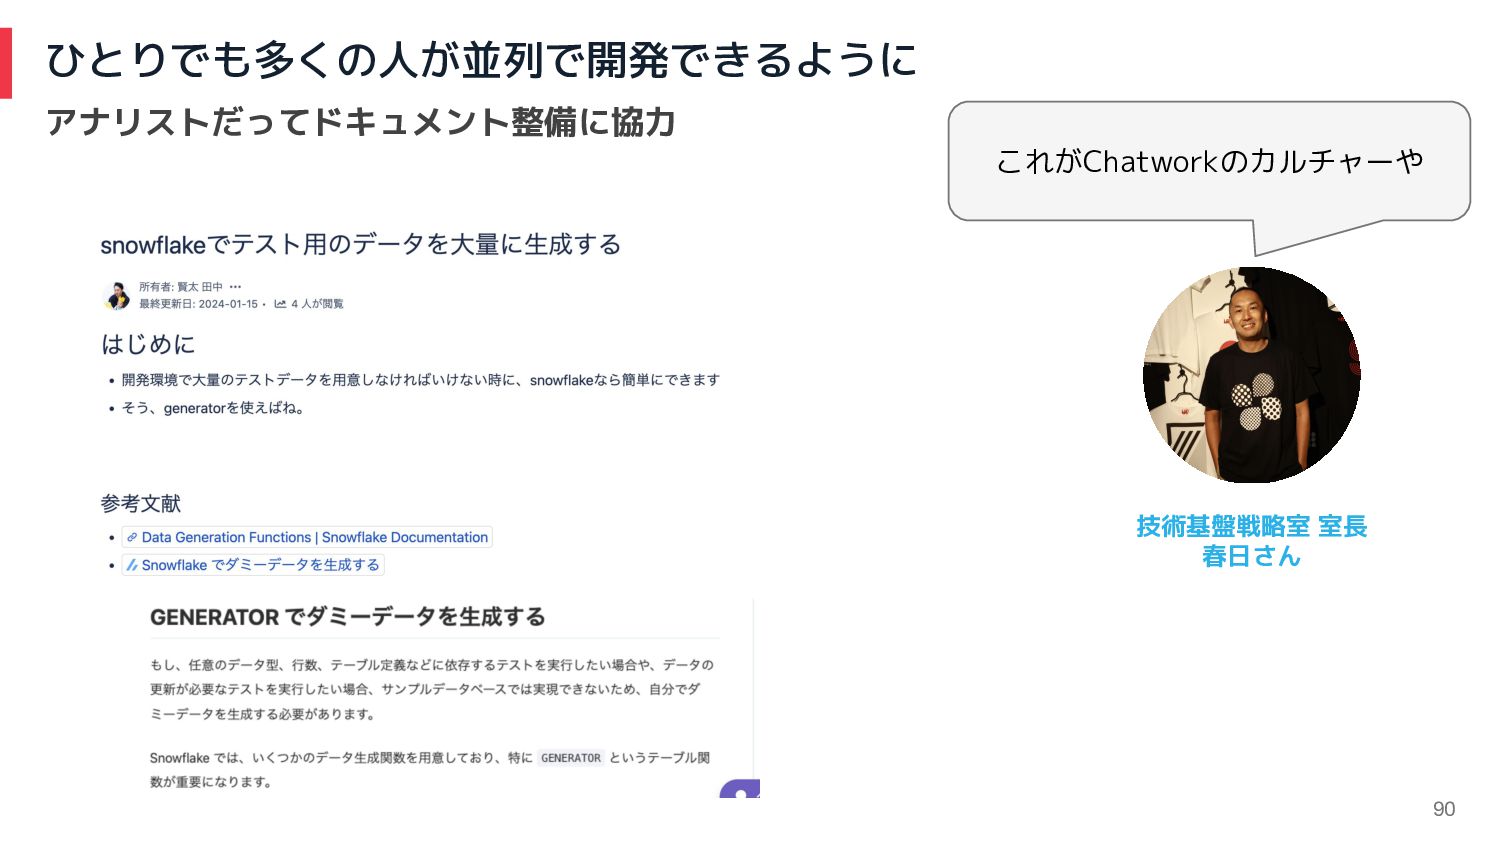
• セルフサービスと自動化を通じて、開発業務の生産性を向上させること • アナリストチーム(not エンジニア)が開発に参加でき、より迅速に価値を提供できる • エンジニアは、プラットフォームをより拡充させる業務に取り組むことが可能 • 将来的には、生成AIを活用し、オペレーションチームやビジネスチームも 開発に参加できるかも
プラットフォームエンジニアリングとは? 89 *ガードナーが2022に提唱した概念 cf. https://www.gartner.co.jp/ja/articles/what-is-platform-engineering -
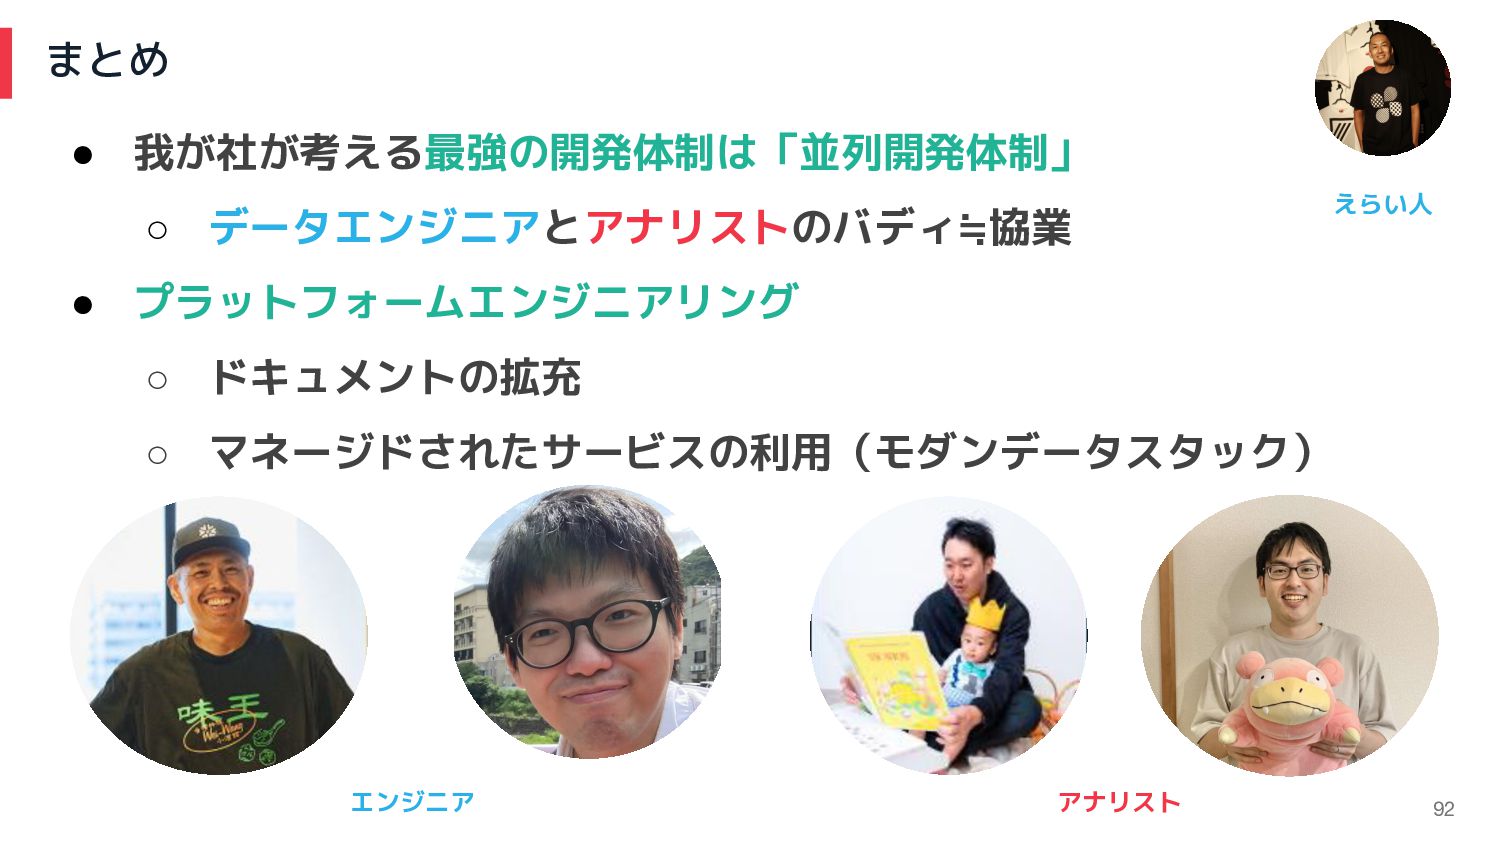
まとめ 92 • 我が社が考える最強の開発体制は「並列開発体制」 ◦ データエンジニアとアナリストのバディ≒協業 • プラットフォームエンジニアリング ◦ ドキュメントの拡充
◦ マネージドされたサービスの利用(モダンデータスタック) エンジニア アナリスト えらい人