Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
実測データからサービスの成長余力を測る。負荷シナリオ・テストデータ・限界値の設計
Search
zosokh
November 17, 2026
Technology
42
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
実測データからサービスの成長余力を測る。負荷シナリオ・テストデータ・限界値の設計
Cloud Native Days Winter 2026
2026/11/18
zosokh
November 17, 2026
Transcript
54 slides
実測データから サービスの成長余力を測る 負荷シナリオ・テストデータ・限界値の設計 CNDW2026 2026.11.18 ヒエイカザト
自己紹介 ヒエイカザト 株式会社Kyash SRE [写真] @zosokh #野球観戦 #東京ヤクルトスワローズ #三児の父 2
サービスの拡張を計画していく中で、出てきた問い 事業の成長を 今のシステムは受け止められるのか? 3
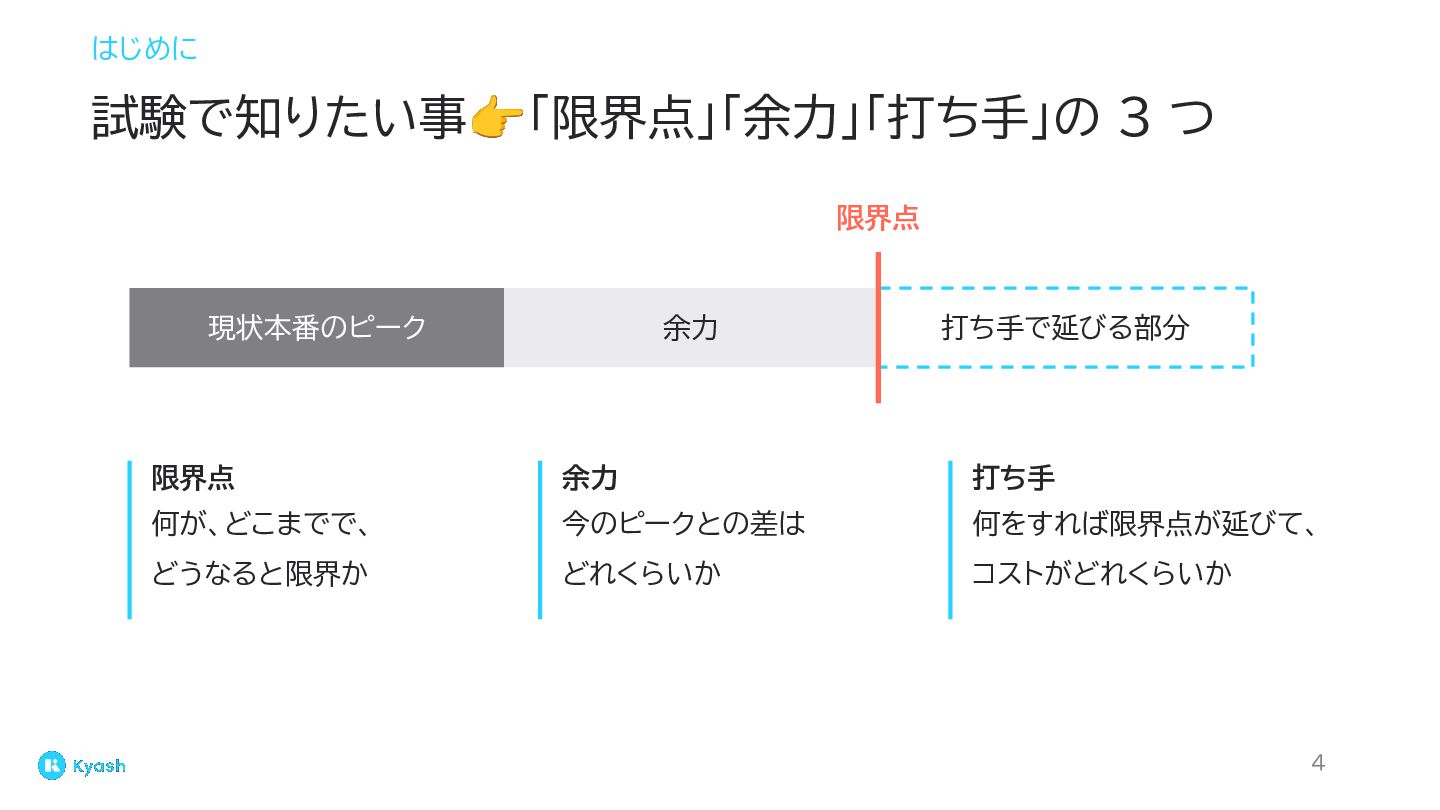
はじめに 試験で知りたい事👉「限界点」「余力」「打ち手」の 3 つ 限界点 現状本番のピーク 余力 打ち手で延びる部分 限界点 余力
打ち手 何が、どこまでで、 今のピークとの差は 何をすれば限界点が延びて、 どうなると限界か どれくらいか コストがどれくらいか 4
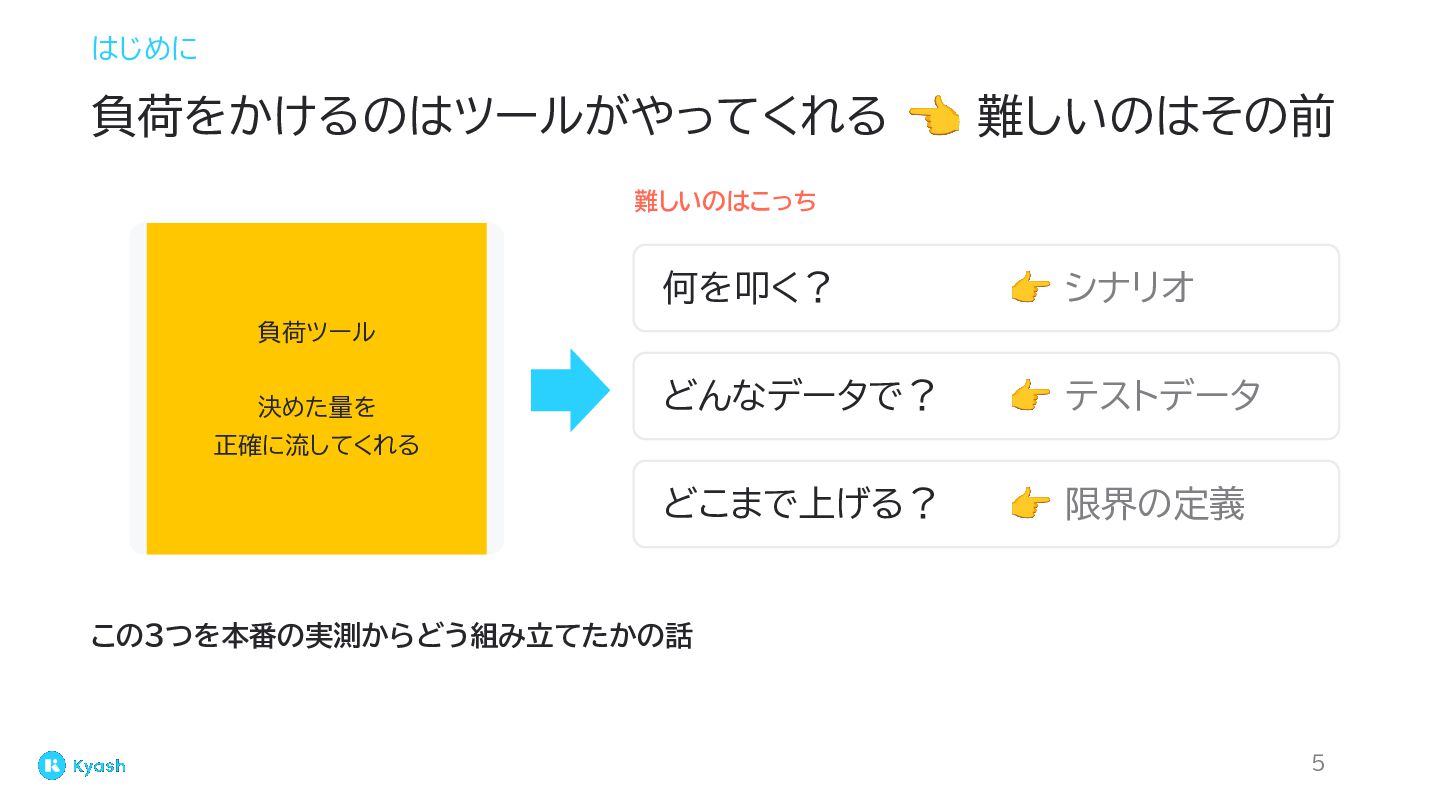
はじめに 負荷をかけるのはツールがやってくれる 👈 難しいのはその前 難しいのはこっち 何を叩く? 👉 シナリオ どんなデータで? 👉
テストデータ どこまで上げる? 👉 限界の定義 負荷ツール 決めた量を 正確に流してくれる この3つを本番の実測からどう組み立てたかの話 5
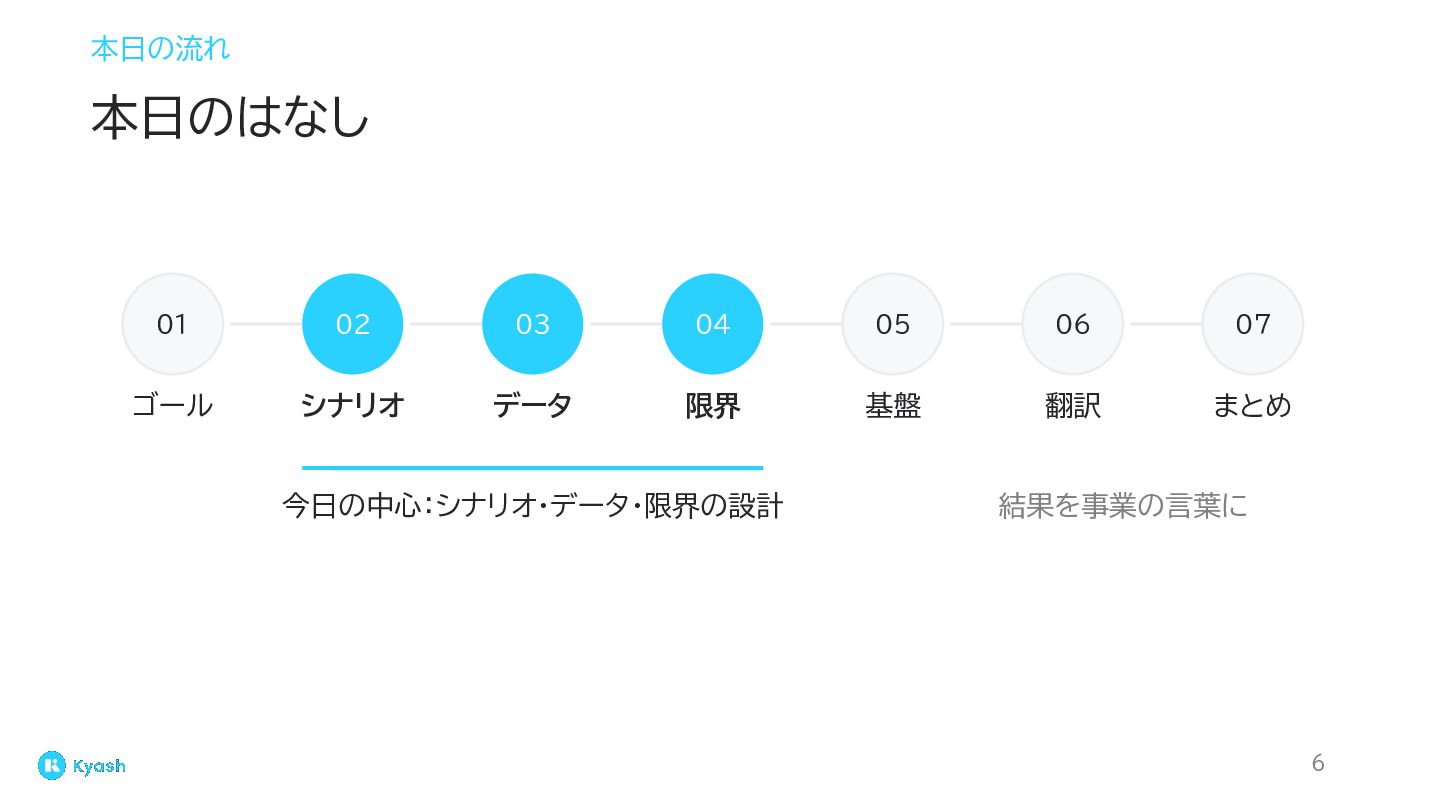
本日の流れ 本日のはなし 01 02 03 04 05 06 07 ゴール
シナリオ データ 限界 基盤 翻訳 まとめ 今日の中心:シナリオ・データ・限界の設計 結果を事業の言葉に 6
01|ゴールを先に決める • 01 ゴール ©Kyash Inc. ◦ 02 シナリオ ◦
03 データ ◦ 04 限界 ◦ 05 基盤 ◦ 06 翻訳 ◦ 07 まとめ 7
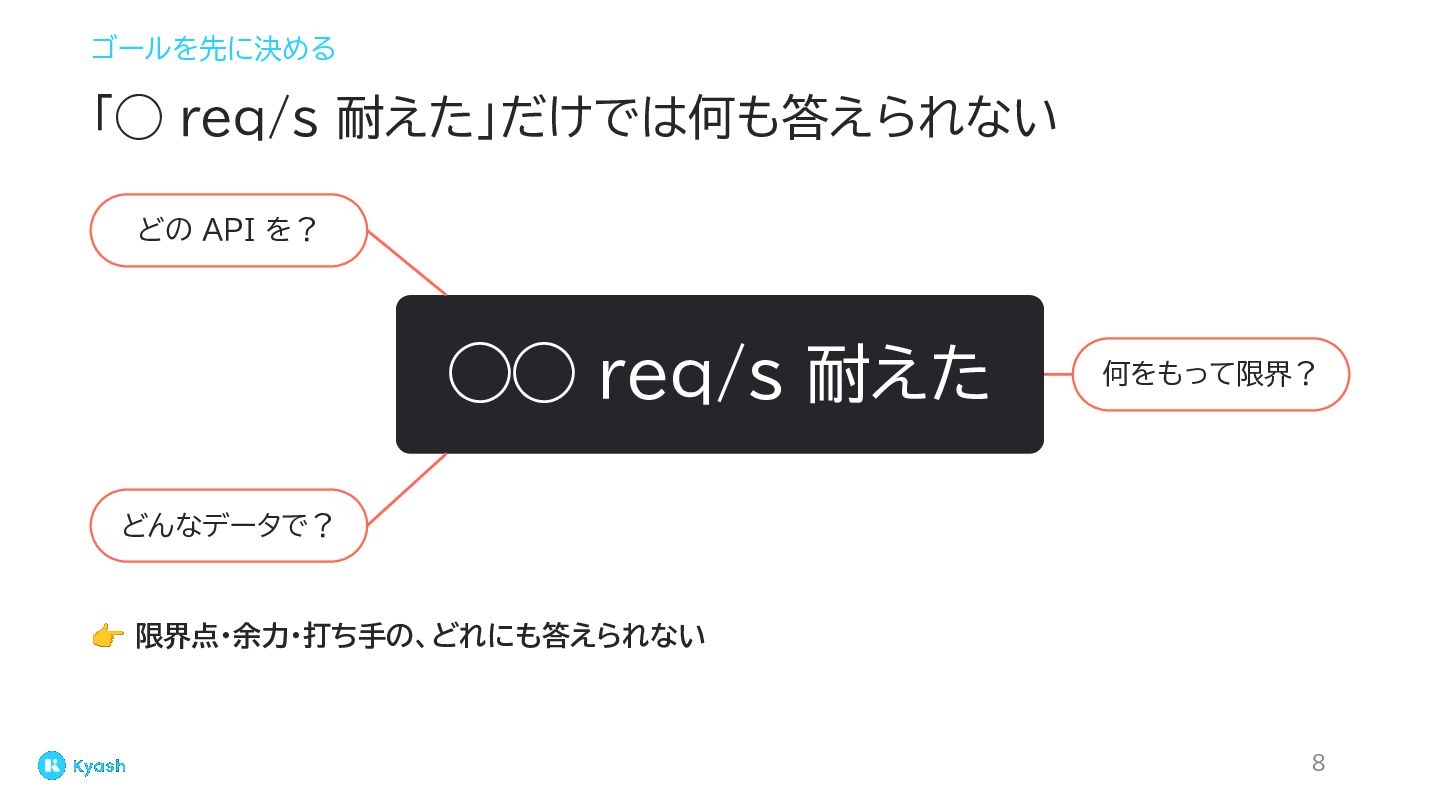
ゴールを先に決める 「◯ req/s 耐えた」だけでは何も答えられない どの API を? ◯◯ req/s 耐えた
何をもって限界? どんなデータで? 👉 限界点・余力・打ち手の、どれにも答えられない 8
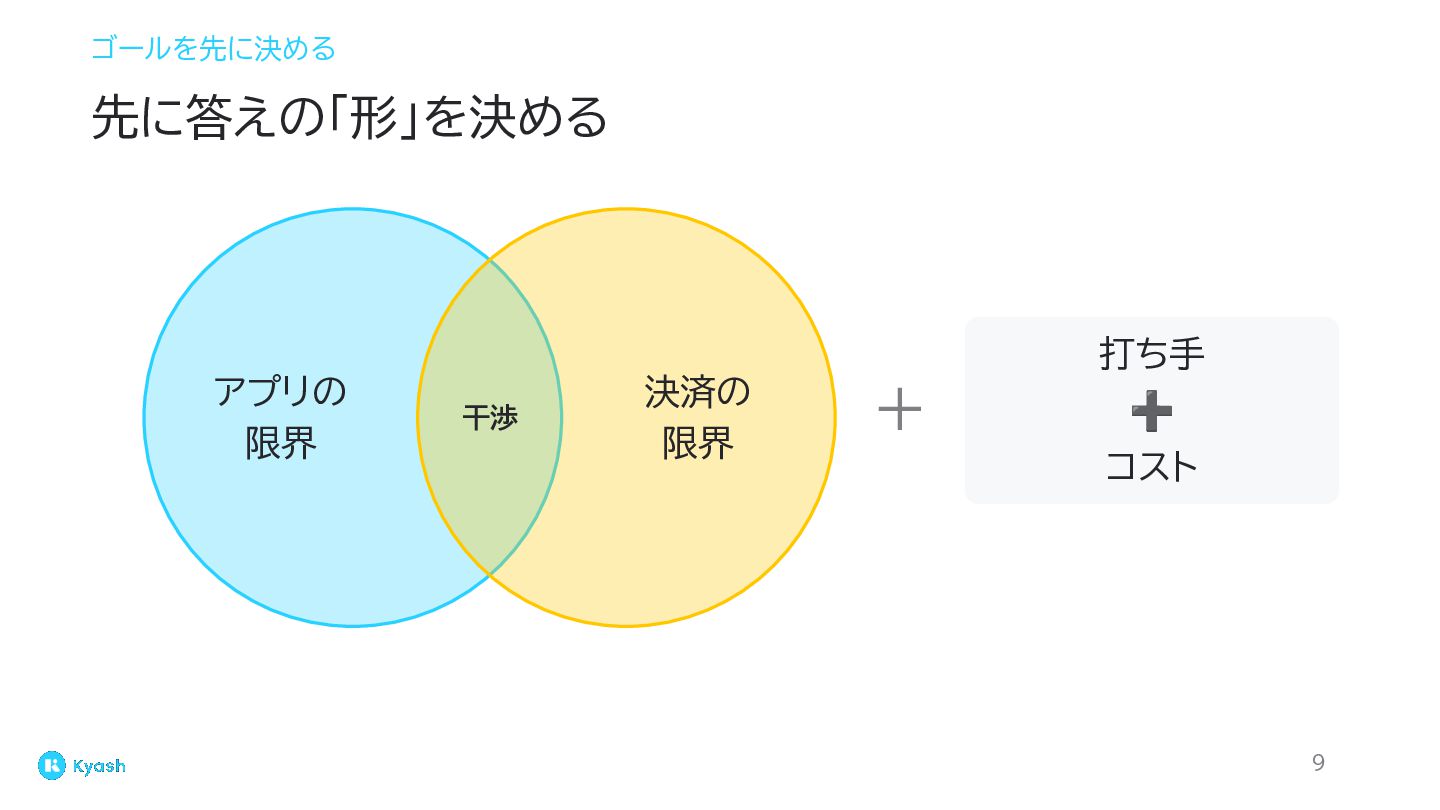
ゴールを先に決める 先に答えの「形」を決める 打ち手 アプリの 限界 干渉 決済の 限界 + ➕
コスト 9
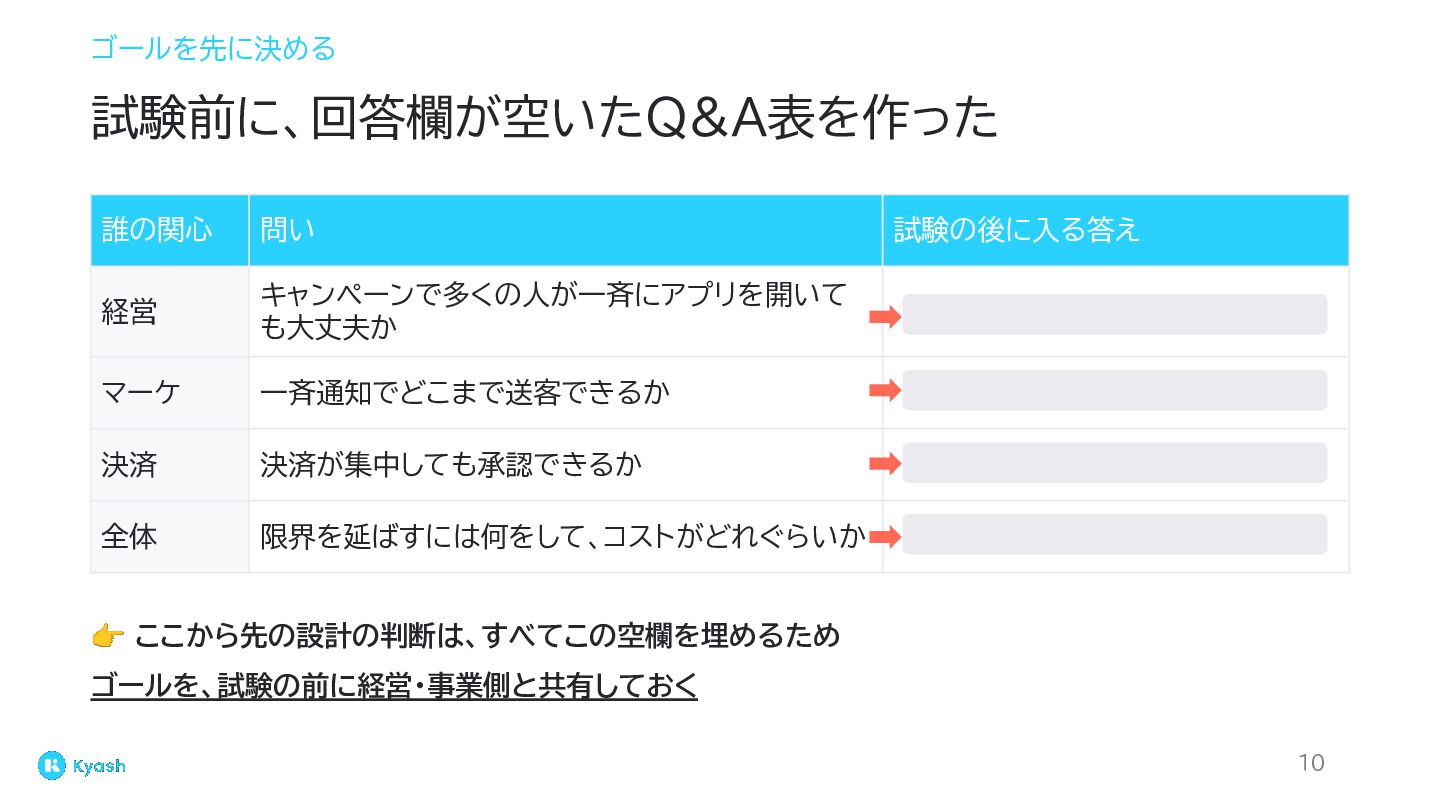
ゴールを先に決める 試験前に、回答欄が空いたQ&A表を作った 誰の関心 問い 経営 キャンペーンで多くの人が一斉にアプリを開いて も大丈夫か マーケ 一斉通知でどこまで送客できるか 決済
決済が集中しても承認できるか 全体 限界を延ばすには何をして、コストがどれぐらいか 試験の後に入る答え 👉 ここから先の設計の判断は、すべてこの空欄を埋めるため ゴールを、試験の前に経営・事業側と共有しておく 10
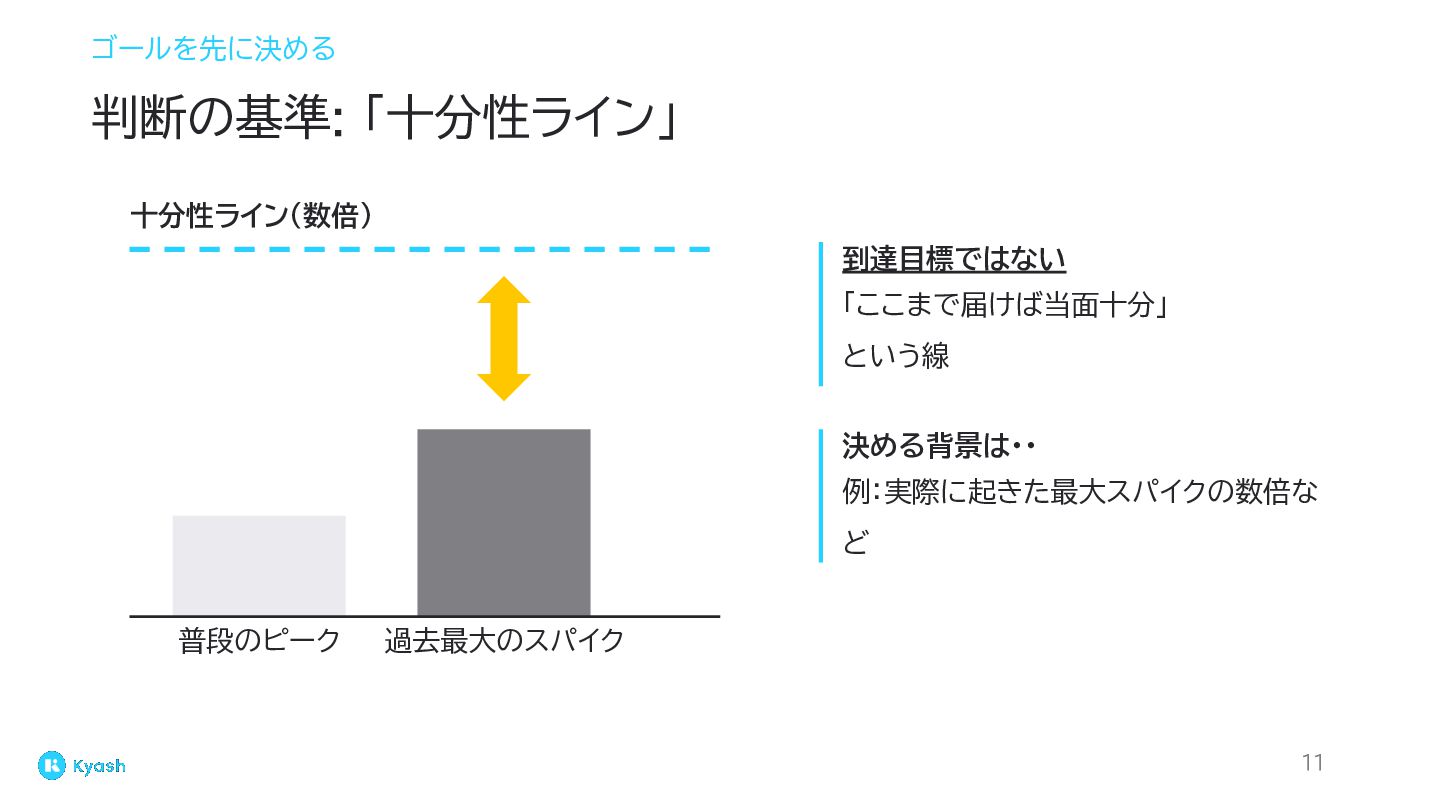
ゴールを先に決める 判断の基準: 「十分性ライン」 十分性ライン(数倍) 到達目標ではない 「ここまで届けば当面十分」 という線 決める背景は・・ 例:実際に起きた最大スパイクの数倍な ど
普段のピーク 過去最大のスパイク 11
02|シナリオ(何を叩くか) ◦ 01 ゴール ©Kyash Inc. • 02 シナリオ ◦
03 データ ◦ 04 限界 ◦ 05 基盤 ◦ 06 翻訳 ◦ 07 まとめ 12
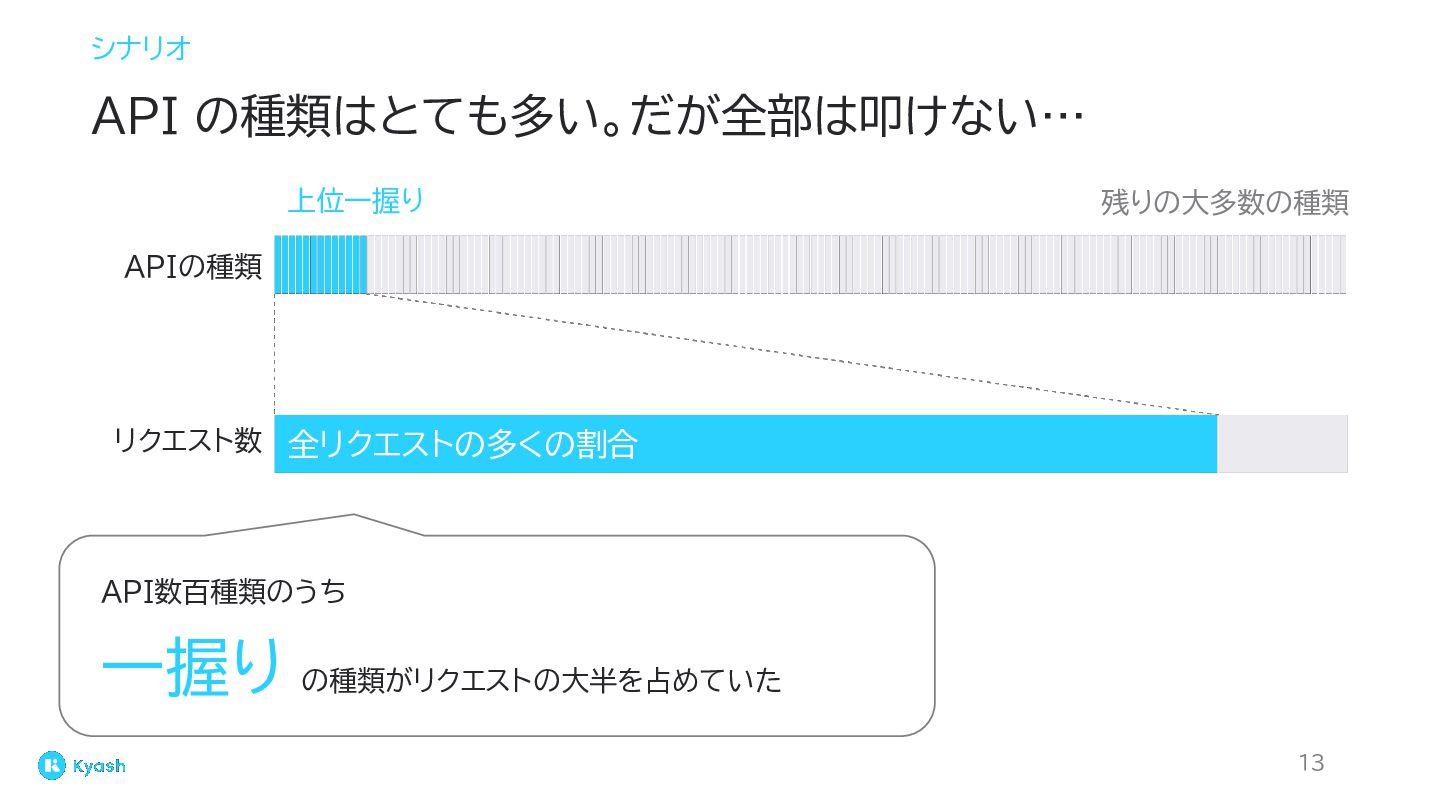
シナリオ API の種類はとても多い。だが全部は叩けない… 上位一握り 残りの大多数の種類 APIの種類 リクエスト数 全リクエストの多くの割合 API数百種類のうち 一握り
の種類がリクエストの大半を占めていた 13
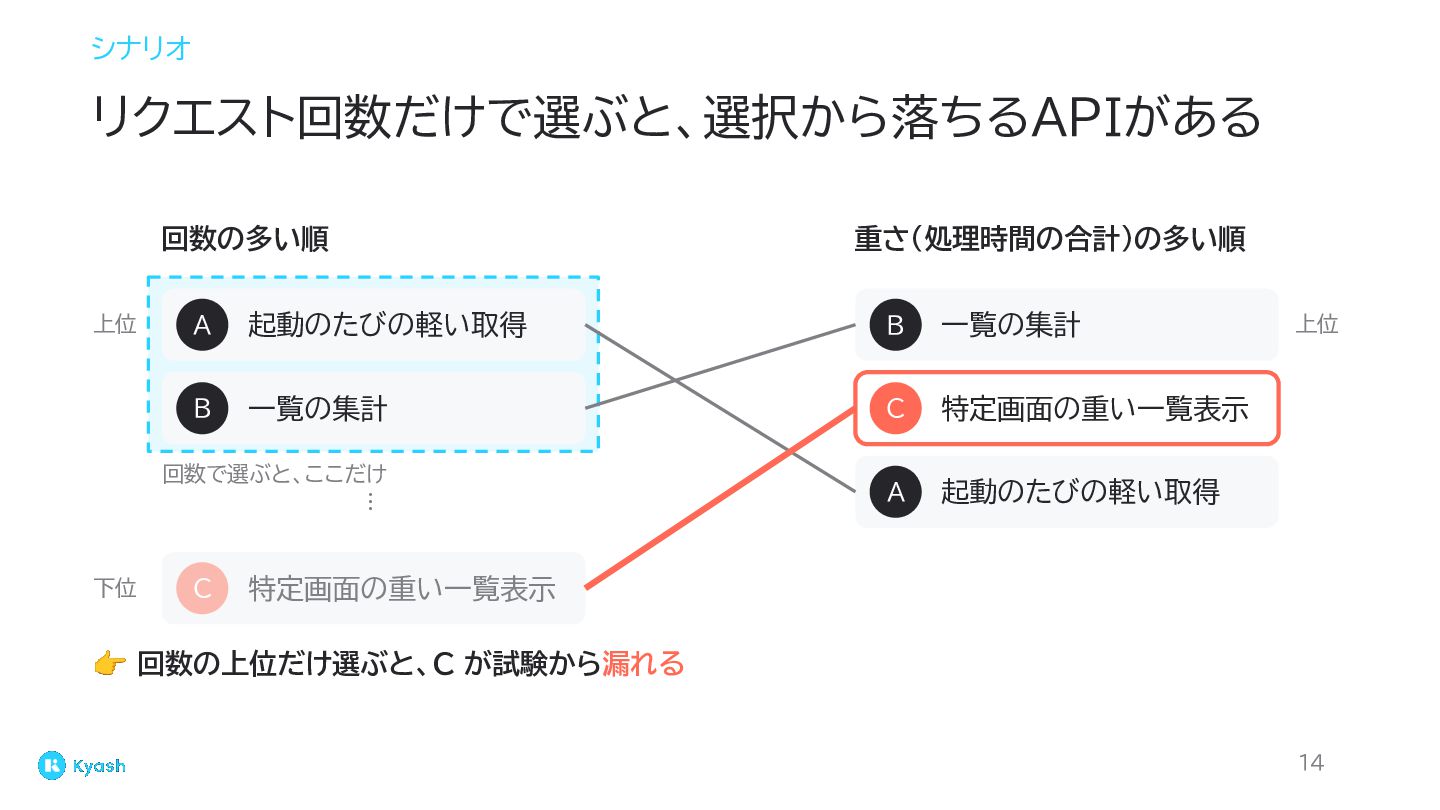
シナリオ リクエスト回数だけで選ぶと、選択から落ちるAPIがある 回数の多い順 上位 重さ(処理時間の合計)の多い順 A 起動のたびの軽い取得 B 一覧の集計 B
一覧の集計 C 特定画面の重い一覧表示 A 起動のたびの軽い取得 回数で選ぶと、ここだけ ⋮ 下位 C 上位 特定画面の重い一覧表示 👉 回数の上位だけ選ぶと、C が試験から漏れる 14
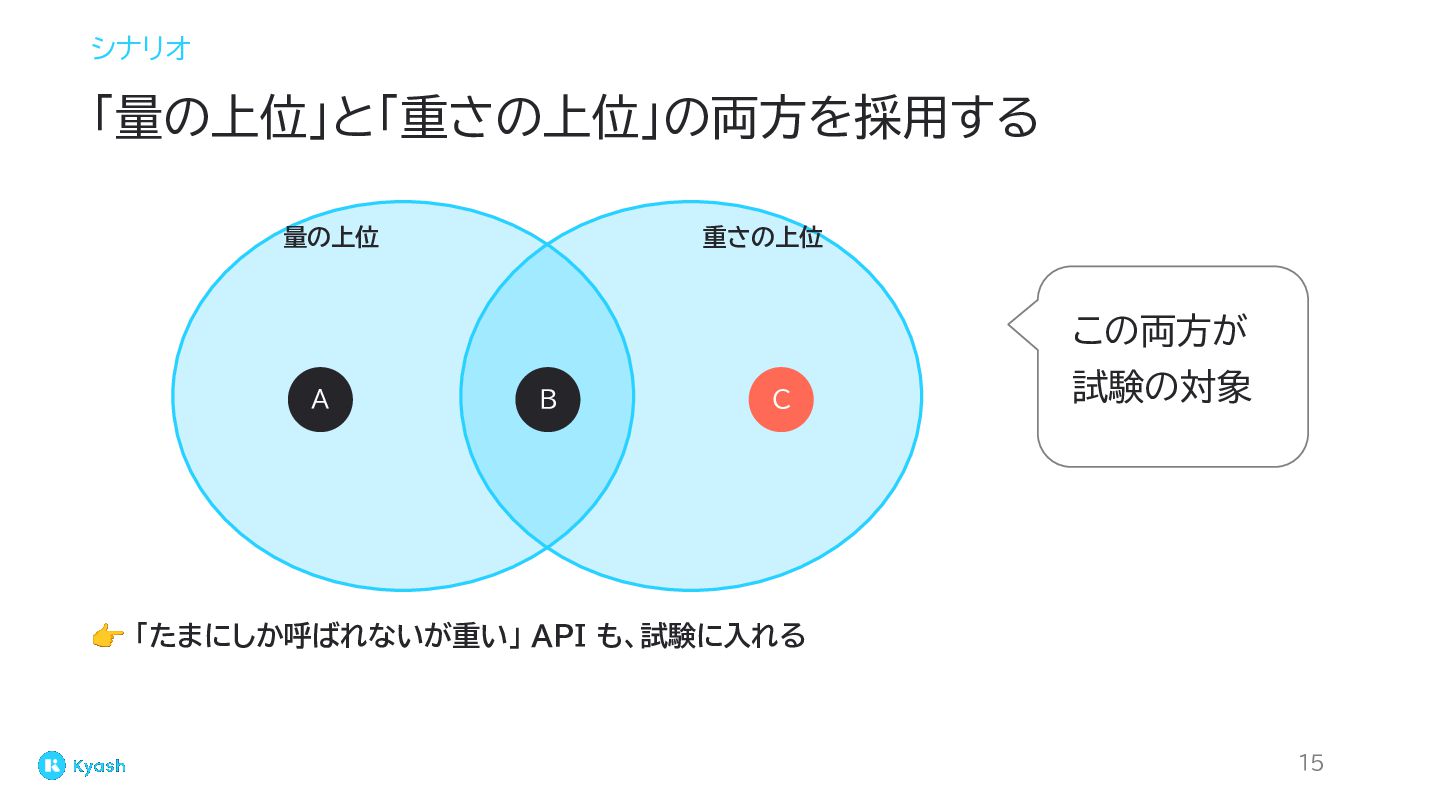
シナリオ 「量の上位」と「重さの上位」の両方を採用する 量の上位 重さの上位 この両方が A B C 試験の対象 👉
「たまにしか呼ばれないが重い」 API も、試験に入れる 15
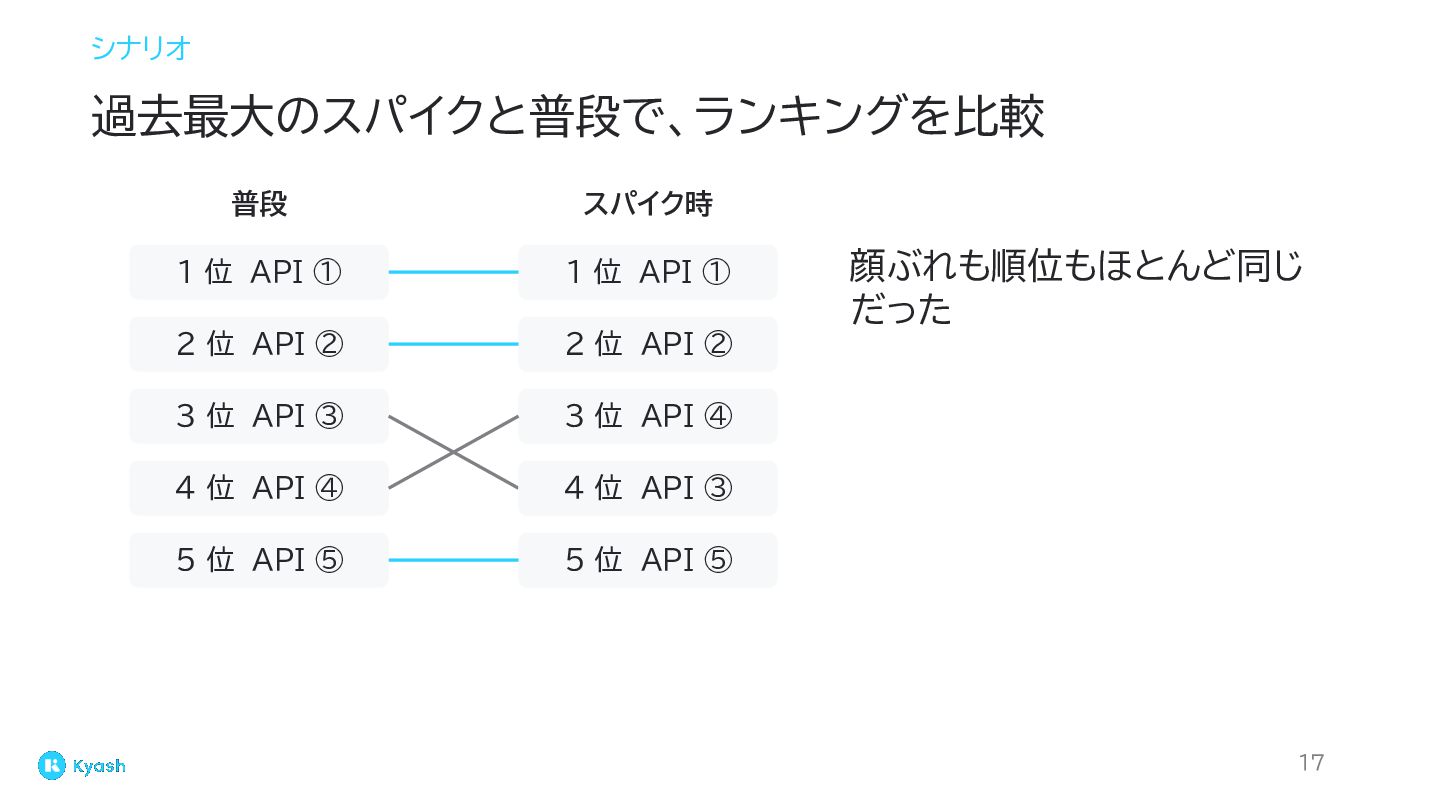
ここで疑問 一斉にアプリが開かれたとき(スパイク)は、 普段と違うAPI が呼ばれているかも? 16
シナリオ 過去最大のスパイクと普段で、ランキングを比較 普段 スパイク時 1 位 API ① 1 位
API ① 2 位 API ② 2 位 API ② 3 位 API ③ 3 位 API ④ 4 位 API ④ 4 位 API ③ 5 位 API ⑤ 5 位 API ⑤ 顔ぶれも順位もほとんど同じ だった 17
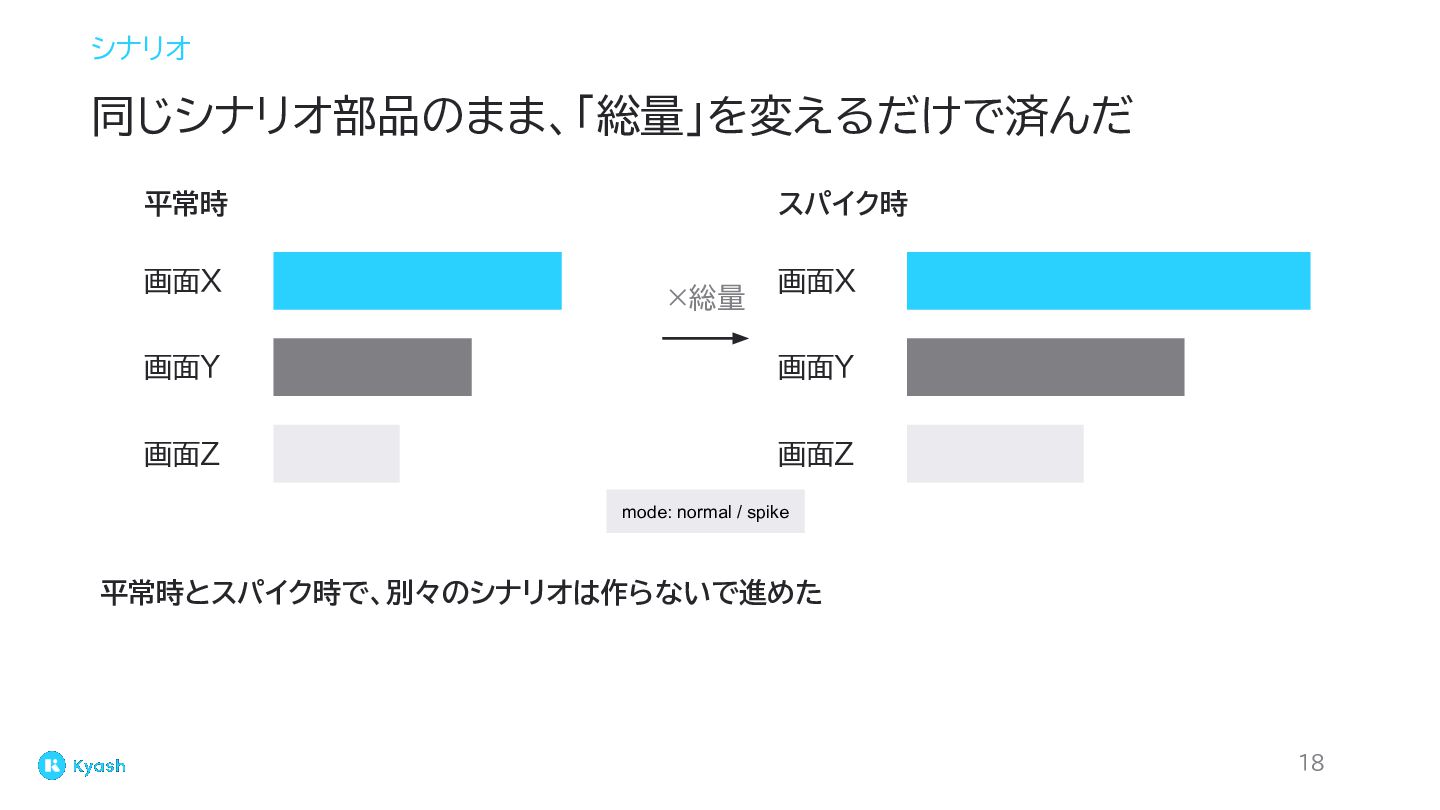
シナリオ 同じシナリオ部品のまま、「総量」を変えるだけで済んだ 平常時 画面X スパイク時 ×総量 画面X 画面Y 画面Y 画面Z
画面Z mode: normal / spike 平常時とスパイク時で、別々のシナリオは作らないで進めた 18
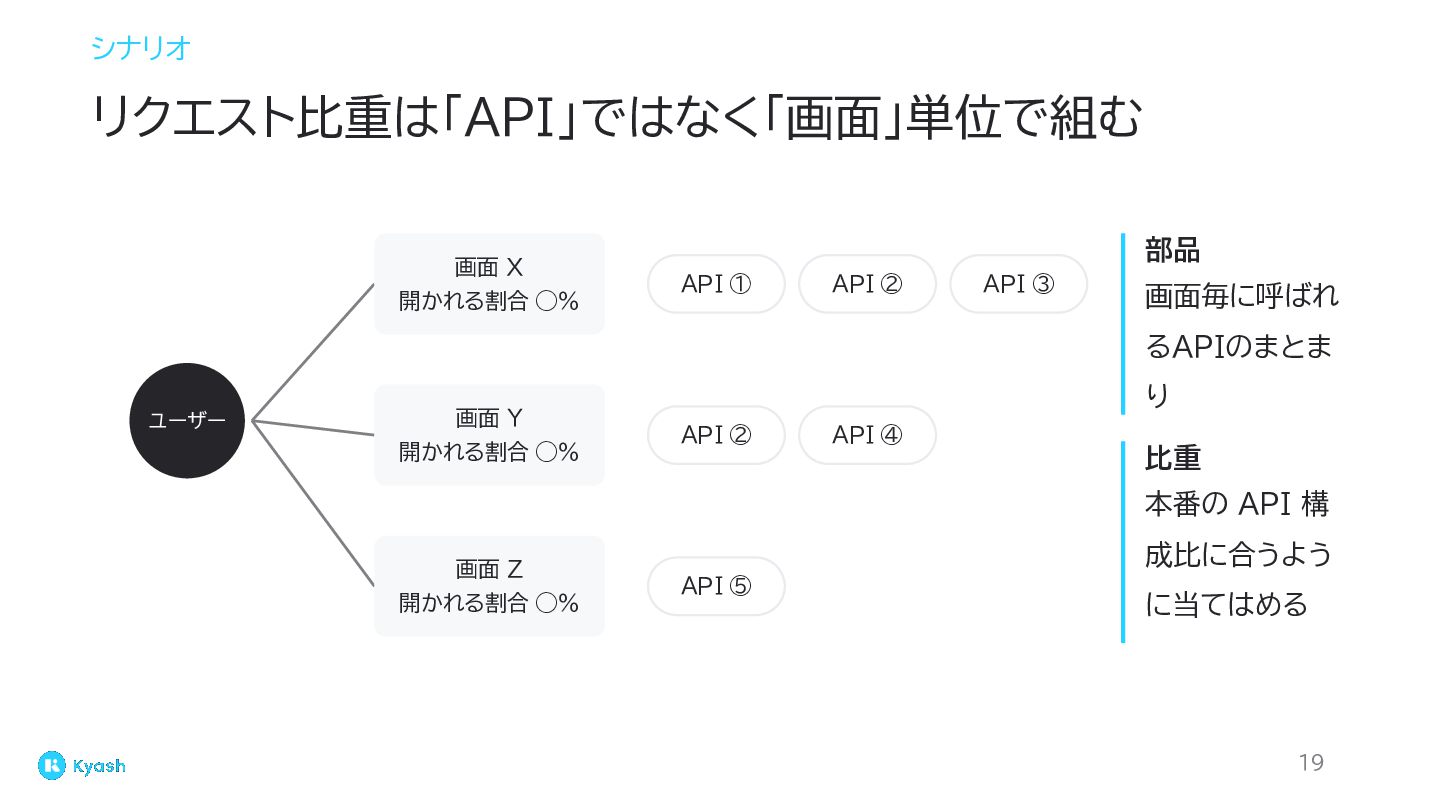
シナリオ リクエスト比重は「API」ではなく「画面」単位で組む 画面 X 開かれる割合 ◯% 部品 API ① API
② API ③ 画面毎に呼ばれ るAPIのまとま ユーザー 画面 Y 開かれる割合 ◯% り API ② API ④ 比重 本番の API 構 画面 Z 開かれる割合 ◯% 成比に合うよう API ⑤ に当てはめる 19
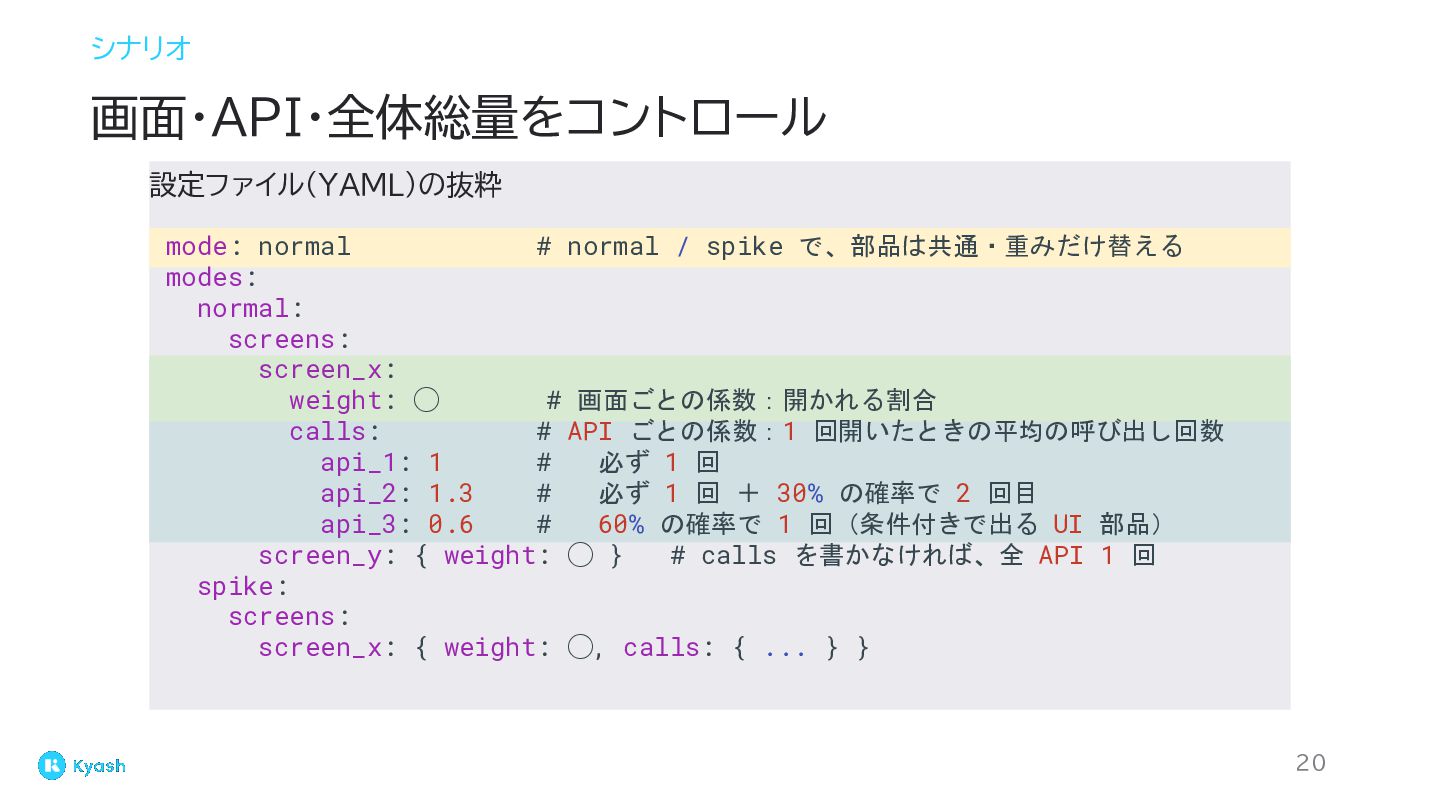
シナリオ 画面・API・全体総量をコントロール 設定ファイル(YAML)の抜粋 mode: normal # normal / spike で、部品は共通・重みだけ替える
modes: normal: screens: screen_x: weight: ◯ # 画面ごとの係数:開かれる割合 calls: # API ごとの係数:1 回開いたときの平均の呼び出し回数 api_1: 1 # 必ず 1 回 api_2: 1.3 # 必ず 1 回 + 30% の確率で 2 回目 api_3: 0.6 # 60% の確率で 1 回(条件付きで出る UI 部品) screen_y: { weight: ◯ } # calls を書かなければ、全 API 1 回 spike: screens: screen_x: { weight: ◯, calls: { ... } } 20
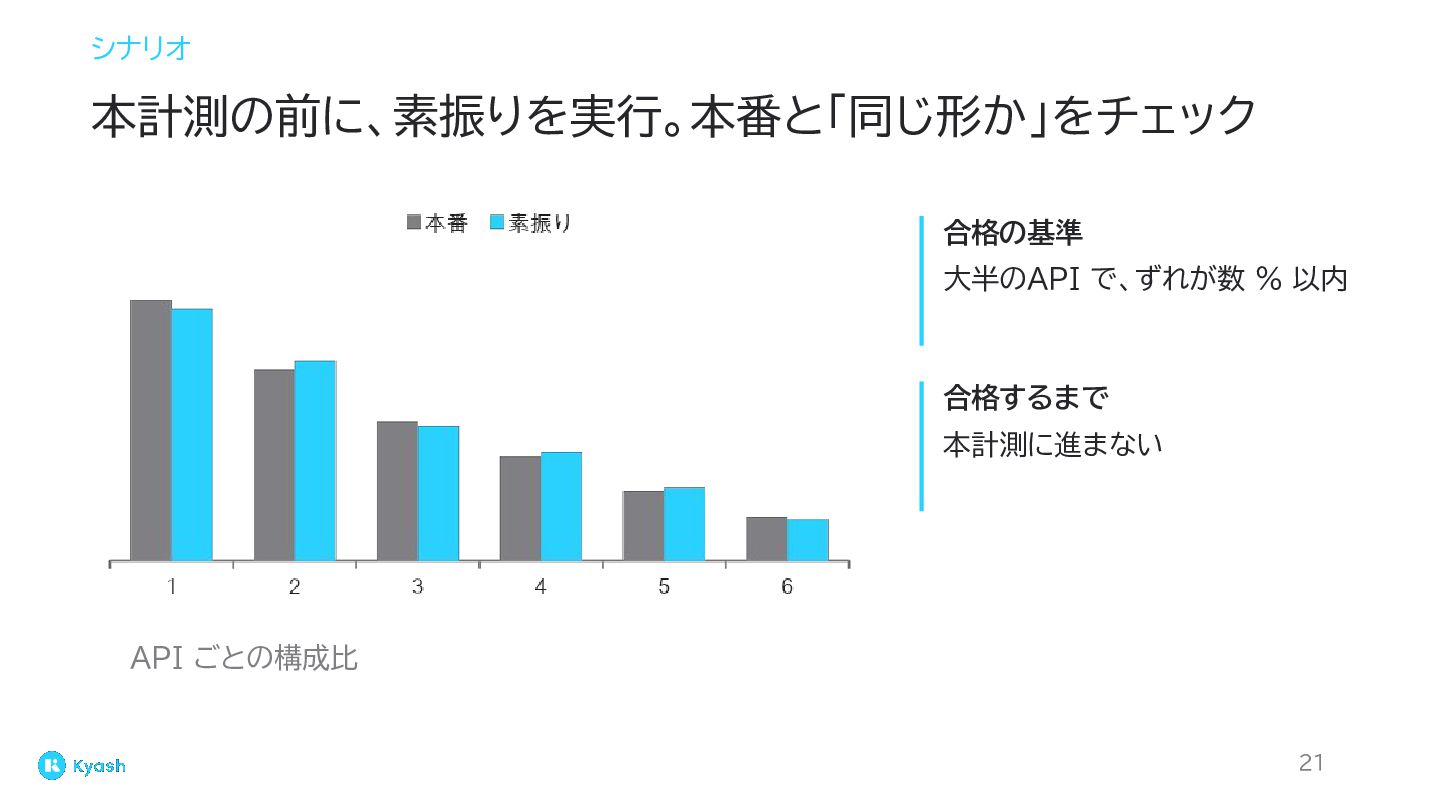
シナリオ 本計測の前に、素振りを実行。本番と「同じ形か」をチェック 合格の基準 大半のAPI で、ずれが数 % 以内 合格するまで 本計測に進まない API
ごとの構成比 21
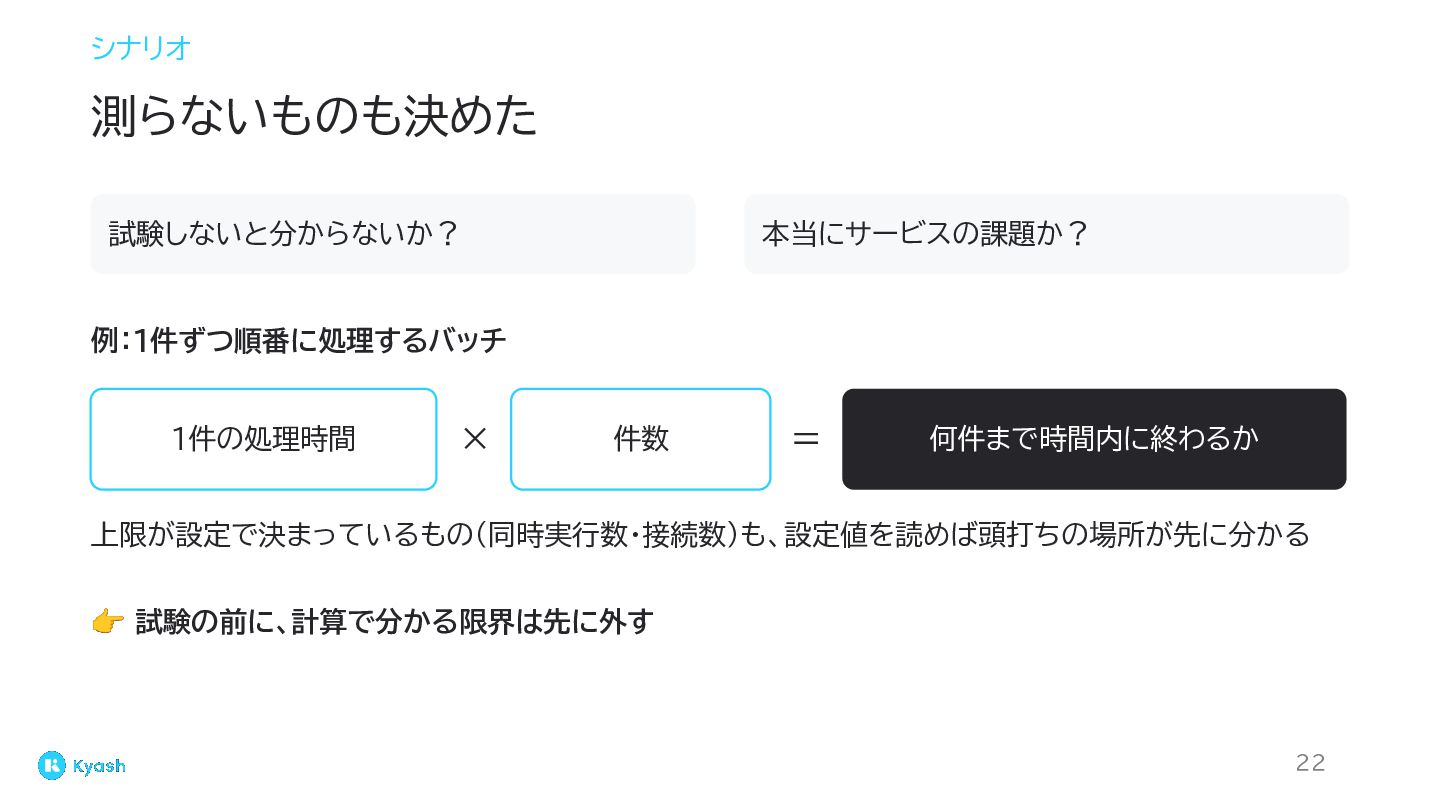
シナリオ 測らないものも決めた 試験しないと分からないか? 本当にサービスの課題か? 例:1件ずつ順番に処理するバッチ 1件の処理時間 × 件数 = 何件まで時間内に終わるか
上限が設定で決まっているもの(同時実行数・接続数)も、設定値を読めば頭打ちの場所が先に分かる 👉 試験の前に、計算で分かる限界は先に外す 22
03|テストデータ(何で叩くか) ◦ 01 ゴール ©Kyash Inc. ◦ 02 シナリオ •
03 データ ◦ 04 限界 ◦ 05 基盤 ◦ 06 翻訳 ◦ 07 まとめ 23
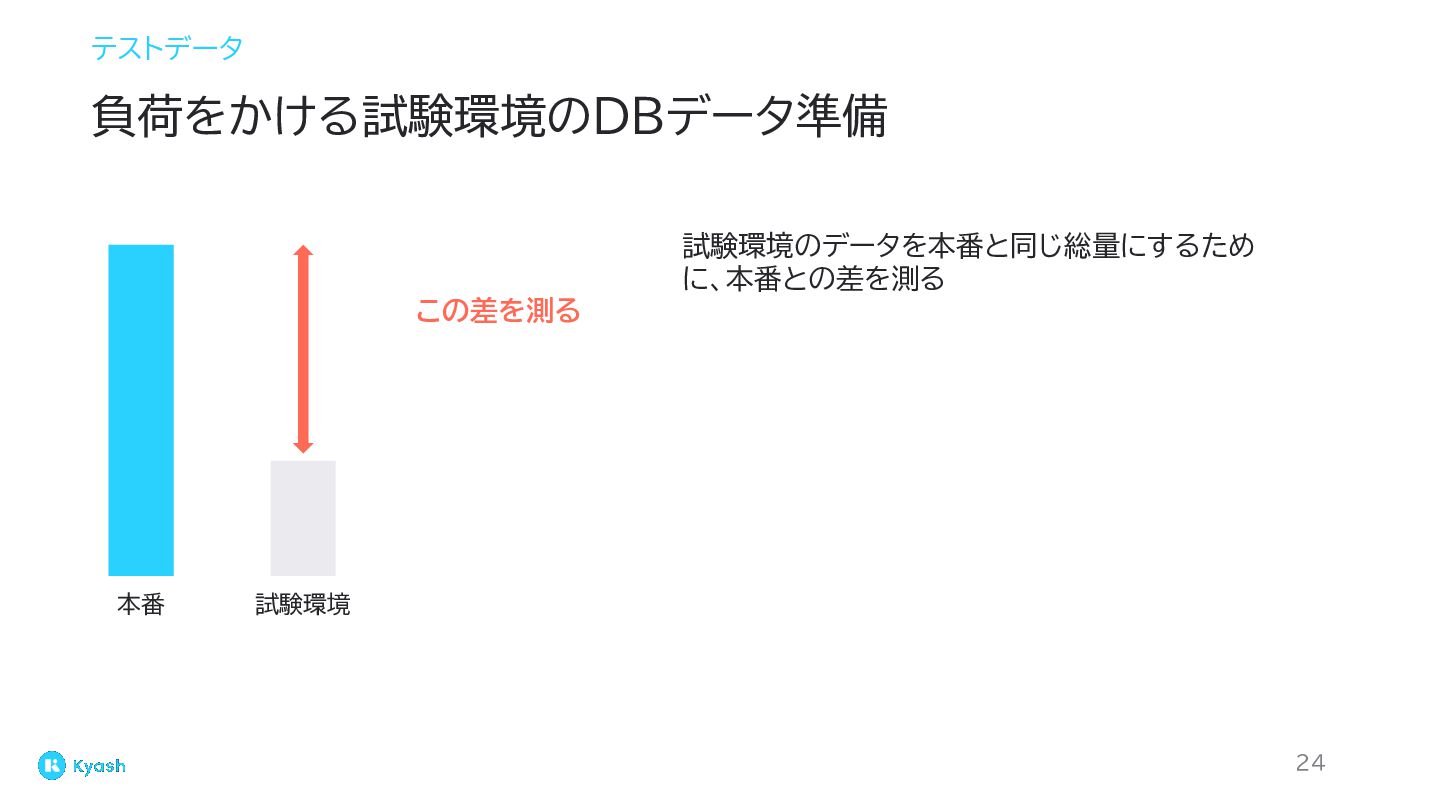
テストデータ 負荷をかける試験環境のDBデータ準備 試験環境のデータを本番と同じ総量にするため に、本番との差を測る この差を測る 本番 試験環境 24
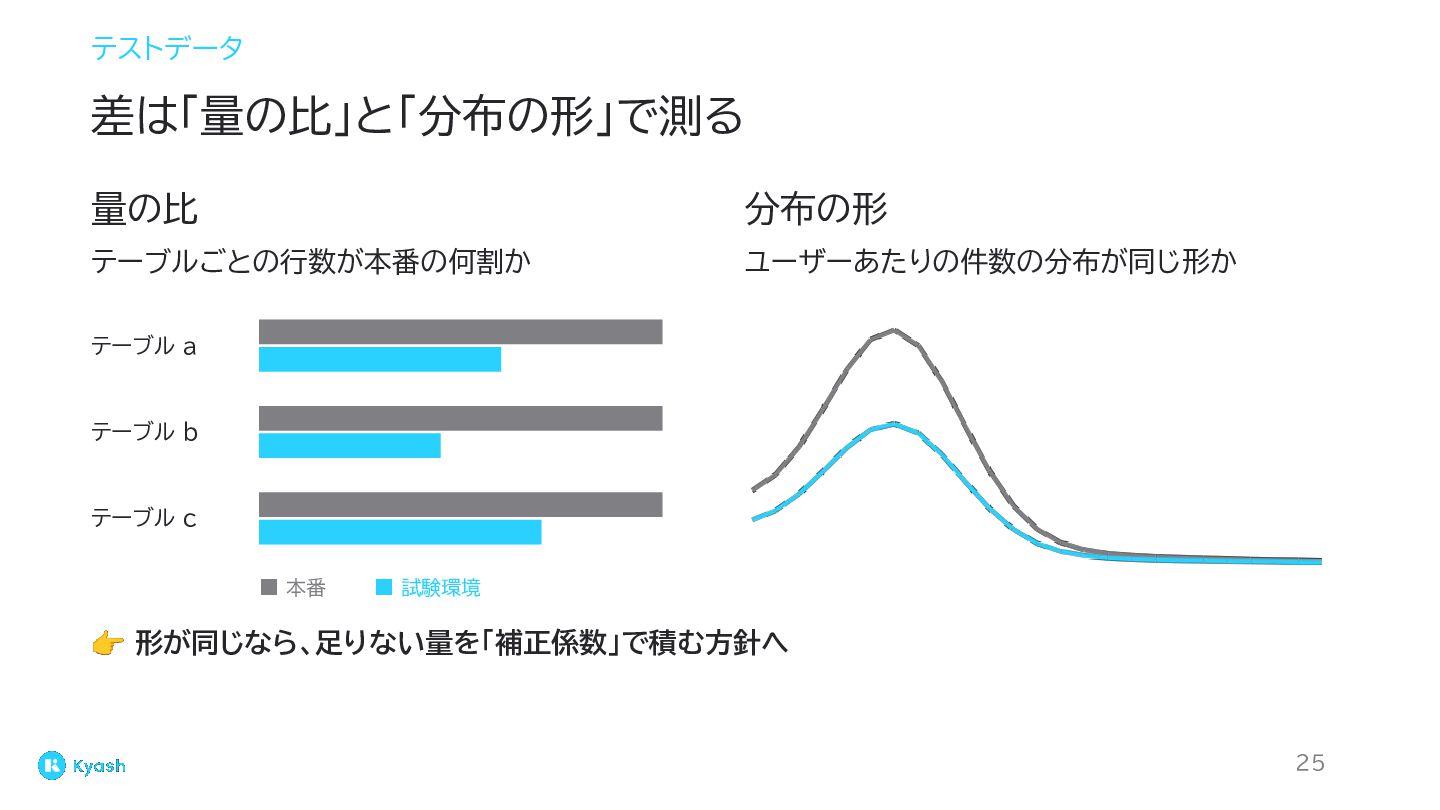
テストデータ 差は「量の比」と「分布の形」で測る 量の比 分布の形 テーブルごとの行数が本番の何割か ユーザーあたりの件数の分布が同じ形か テーブル a テーブル b
テーブル c ▪ 本番 ▪ 試験環境 👉 形が同じなら、足りない量を「補正係数」で積む方針へ 25
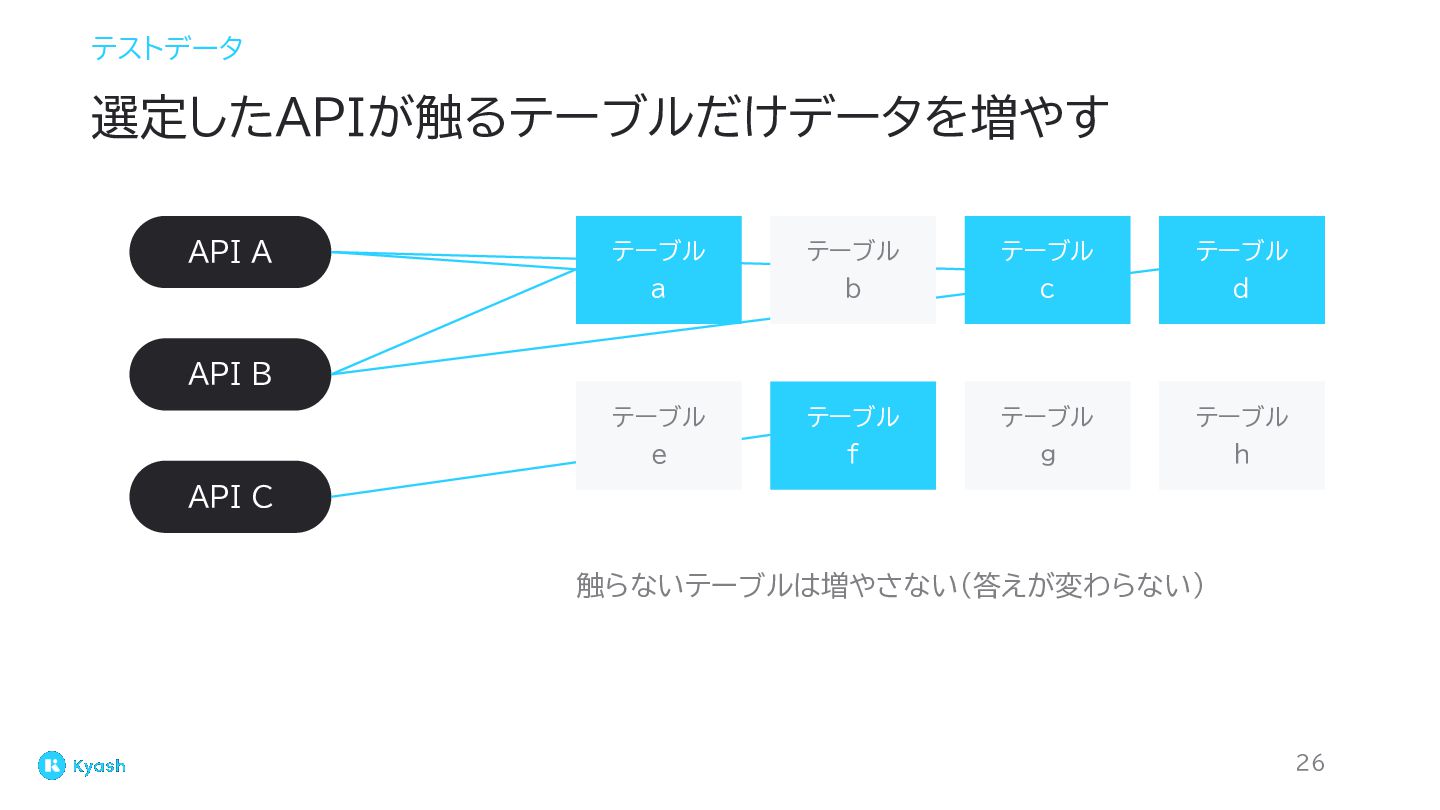
テストデータ 選定したAPIが触るテーブルだけデータを増やす API A テーブル テーブル テーブル テーブル a b
c d テーブル テーブル テーブル テーブル e f g h API B API C 触らないテーブルは増やさない(答えが変わらない) 26
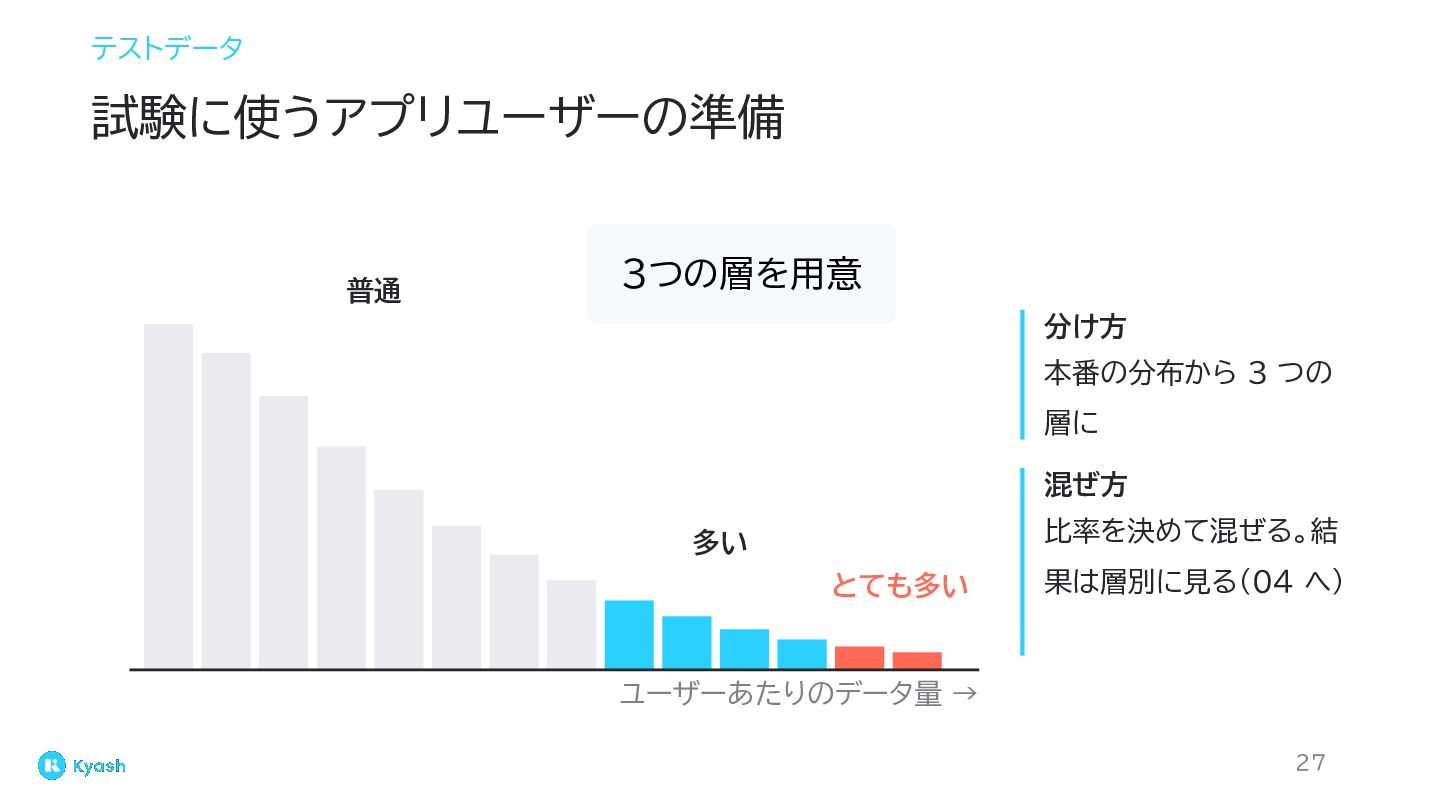
テストデータ 試験に使うアプリユーザーの準備 普通 3つの層を用意 分け方 本番の分布から 3 つの 層に 混ぜ方
比率を決めて混ぜる。結 多い とても多い 果は層別に見る(04 へ) ユーザーあたりのデータ量 → 27
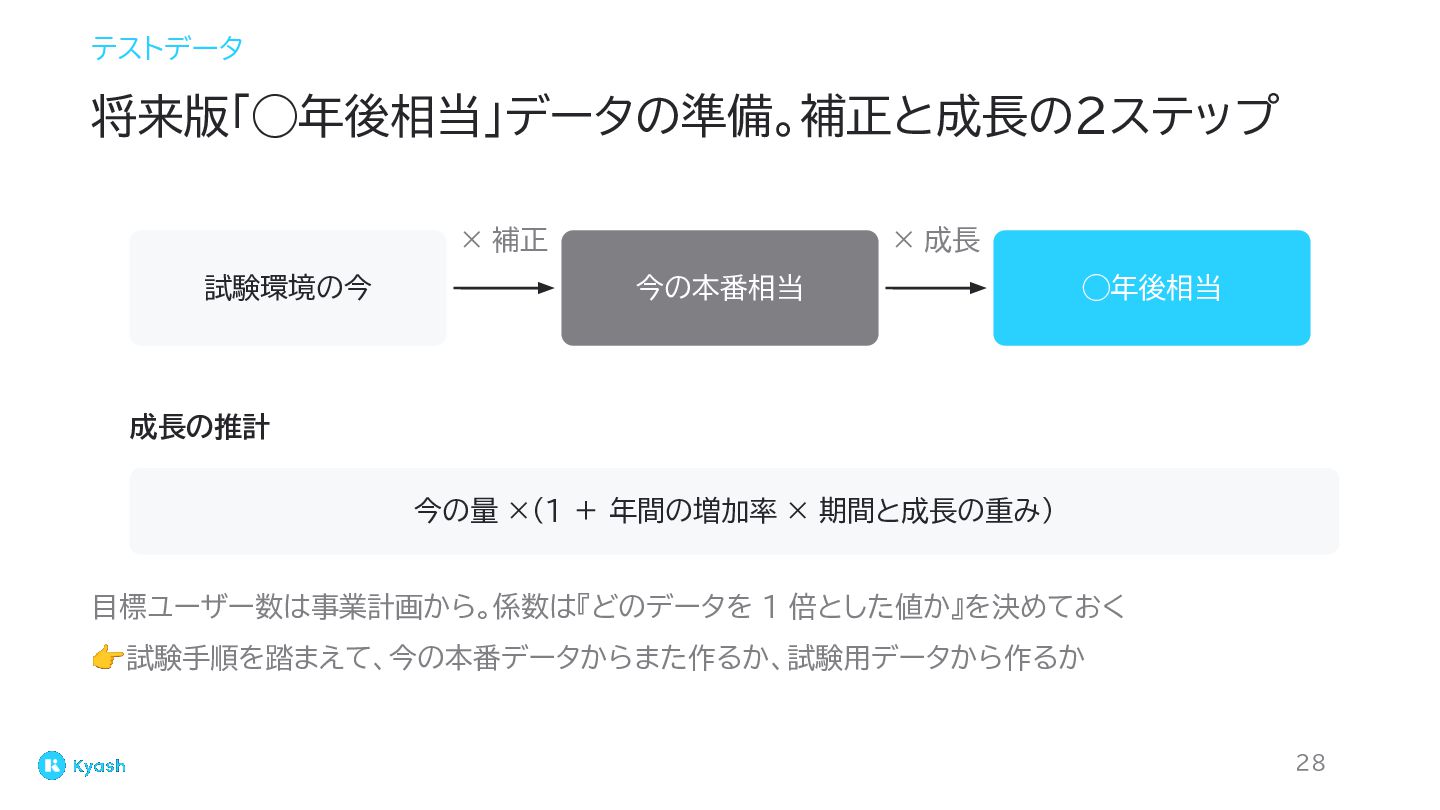
テストデータ 将来版「◯年後相当」データの準備。補正と成長の2ステップ × 補正 試験環境の今 × 成長 今の本番相当 ◯年後相当 成長の推計
今の量 ×(1 + 年間の増加率 × 期間と成長の重み) 目標ユーザー数は事業計画から。係数は『どのデータを 1 倍とした値か』を決めておく 👉試験手順を踏まえて、今の本番データからまた作るか、試験用データから作るか 28
04|限界(どこで止めるか) ◦ 01 ゴール ©Kyash Inc. ◦ 02 シナリオ ◦
03 データ • 04 限界 ◦ 05 基盤 ◦ 06 翻訳 ◦ 07 まとめ 29
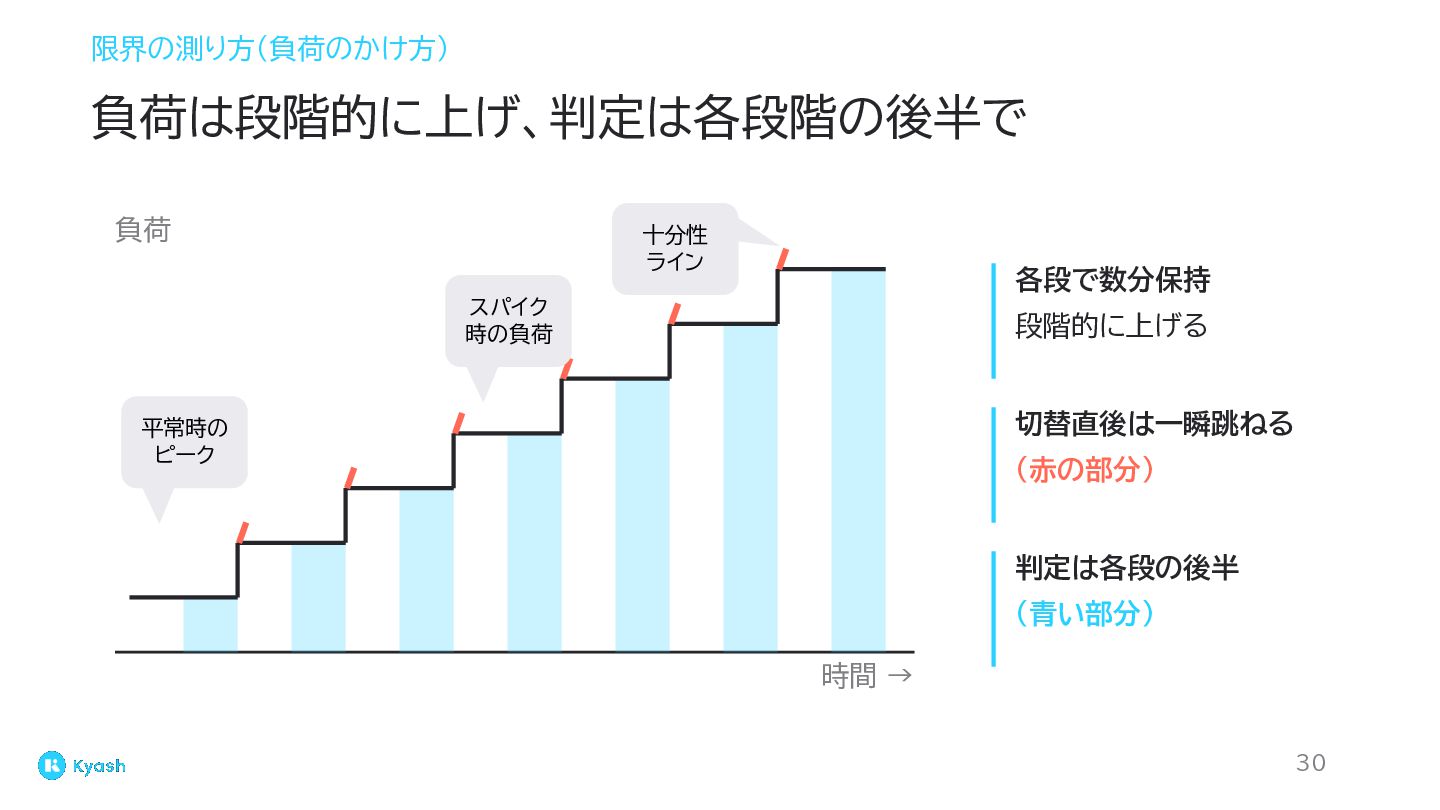
限界の測り方(負荷のかけ方) 負荷は段階的に上げ、判定は各段階の後半で 負荷 十分性 ライン 各段で数分保持 スパイク 時の負荷 段階的に上げる 切替直後は一瞬跳ねる
平常時の ピーク (赤の部分) 判定は各段の後半 (青い部分) 時間 → 30
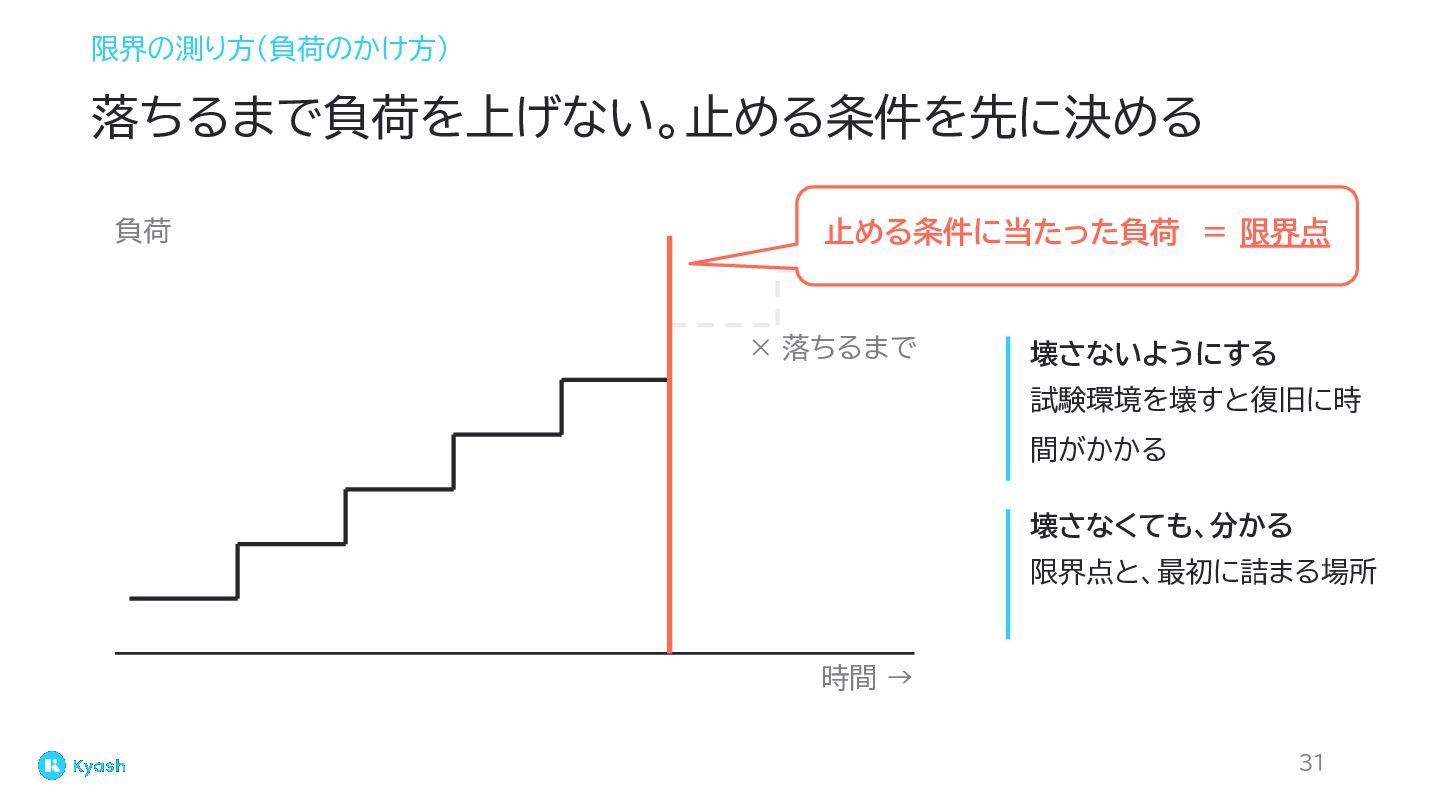
限界の測り方(負荷のかけ方) 落ちるまで負荷を上げない。止める条件を先に決める 負荷 止める条件に当たった負荷 = 限界点 × 落ちるまで 壊さないようにする 試験環境を壊すと復旧に時
間がかかる 壊さなくても、分かる 限界点と、最初に詰まる場所 時間 → 31
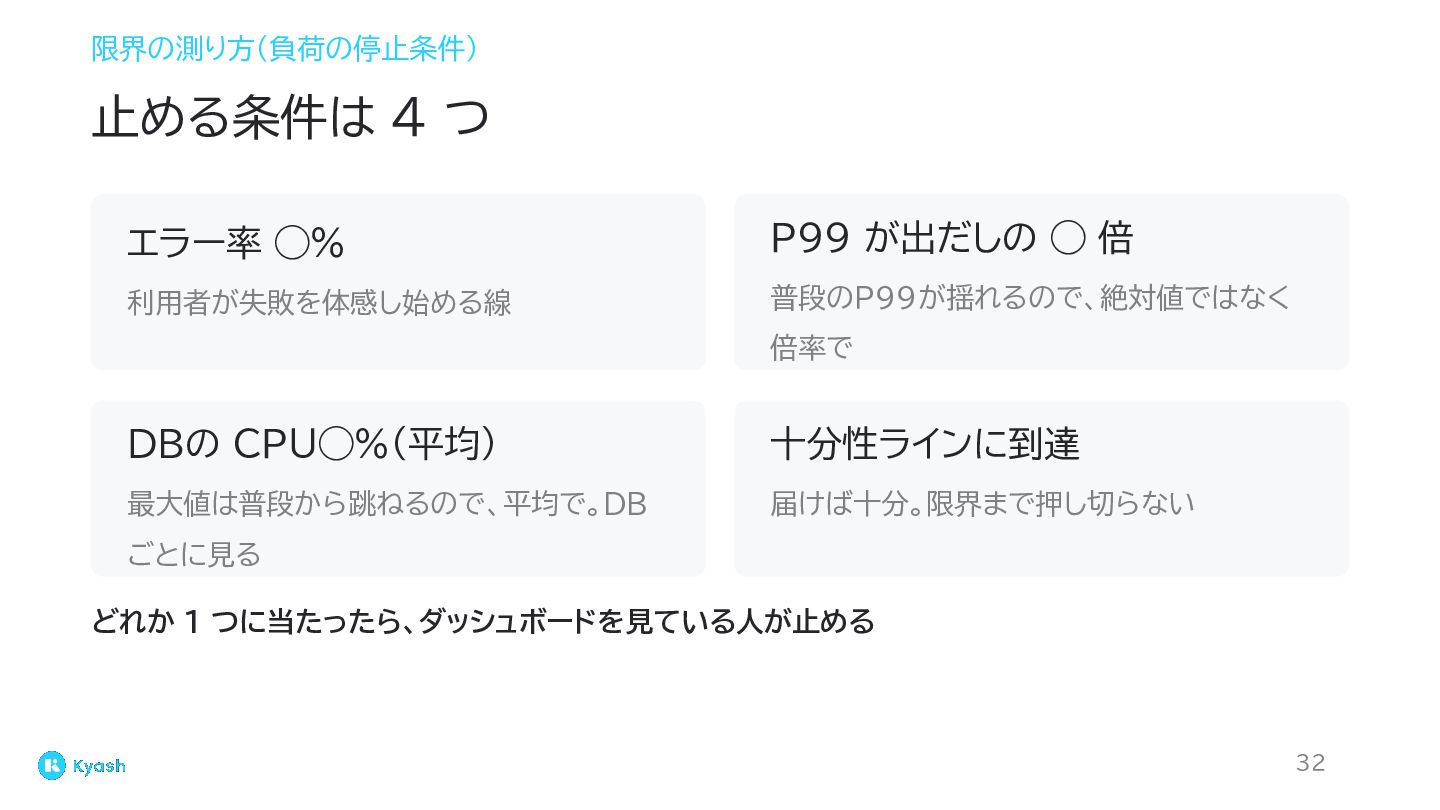
限界の測り方(負荷の停止条件) 止める条件は 4 つ エラー率 ◯% P99 が出だしの ◯ 倍
利用者が失敗を体感し始める線 普段のP99が揺れるので、絶対値ではなく 倍率で DBの CPU◯%(平均) 十分性ラインに到達 最大値は普段から跳ねるので、平均で。DB 届けば十分。限界まで押し切らない ごとに見る どれか 1 つに当たったら、ダッシュボードを見ている人が止める 32
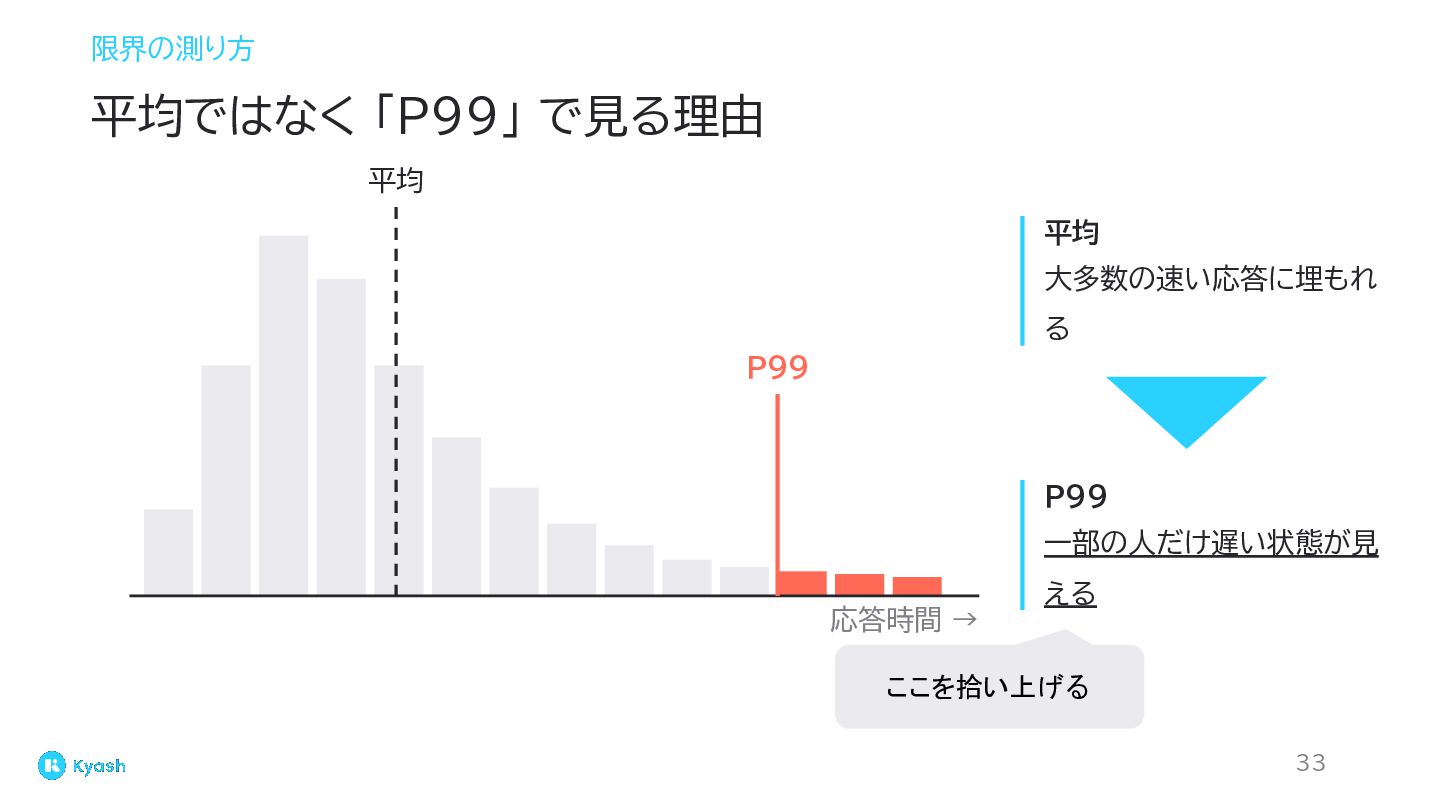
限界の測り方 平均ではなく 「P99」 で見る理由 平均 平均 大多数の速い応答に埋もれ る P99 P99
一部の人だけ遅い状態が見 応答時間 → える ここを拾い上げる 33
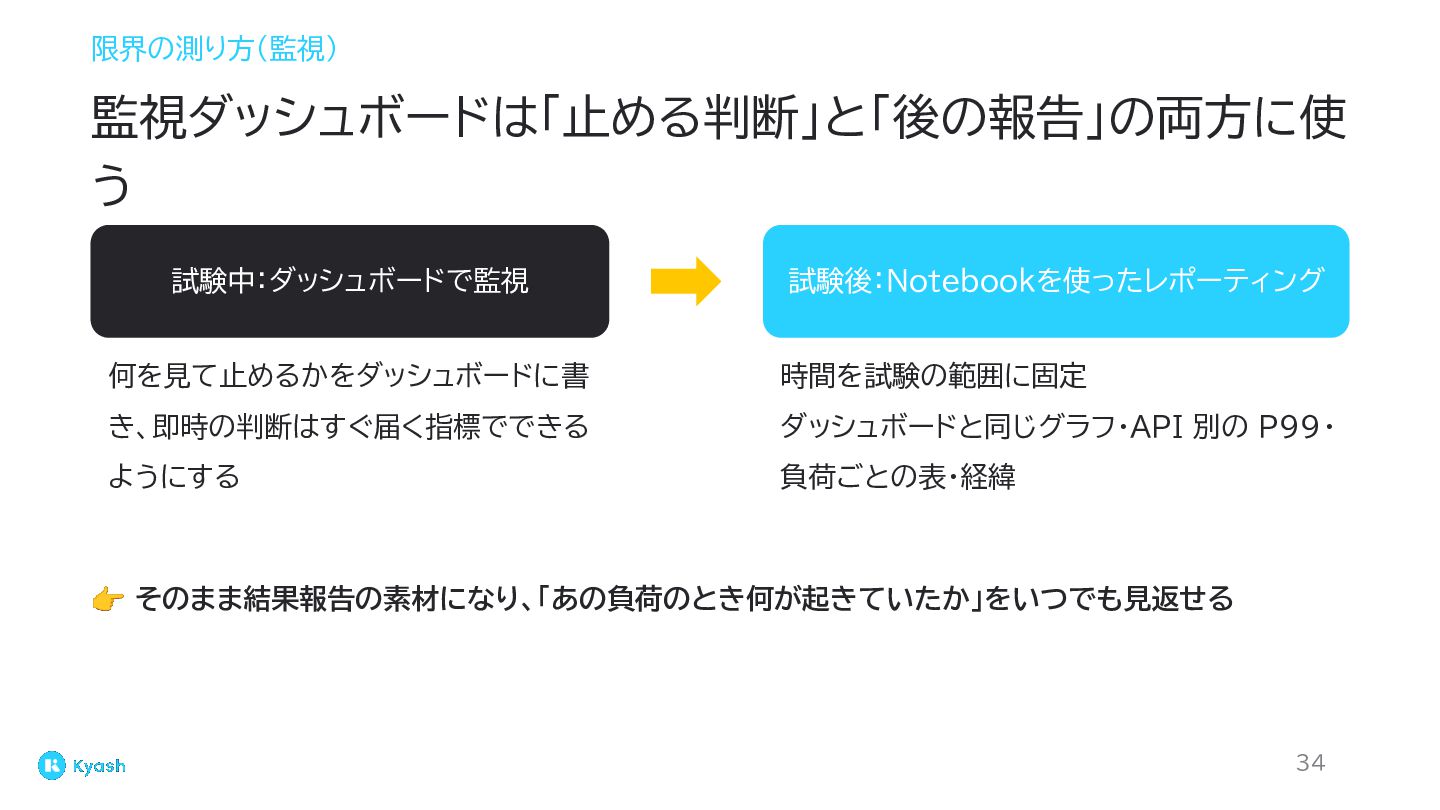
限界の測り方(監視) 監視ダッシュボードは「止める判断」と「後の報告」の両方に使 う 試験中:ダッシュボードで監視 試験後:Notebookを使ったレポーティング 何を見て止めるかをダッシュボードに書 時間を試験の範囲に固定 き、即時の判断はすぐ届く指標でできる ダッシュボードと同じグラフ・API 別の
P99・ ようにする 負荷ごとの表・経緯 👉 そのまま結果報告の素材になり、「あの負荷のとき何が起きていたか」をいつでも見返せる 34
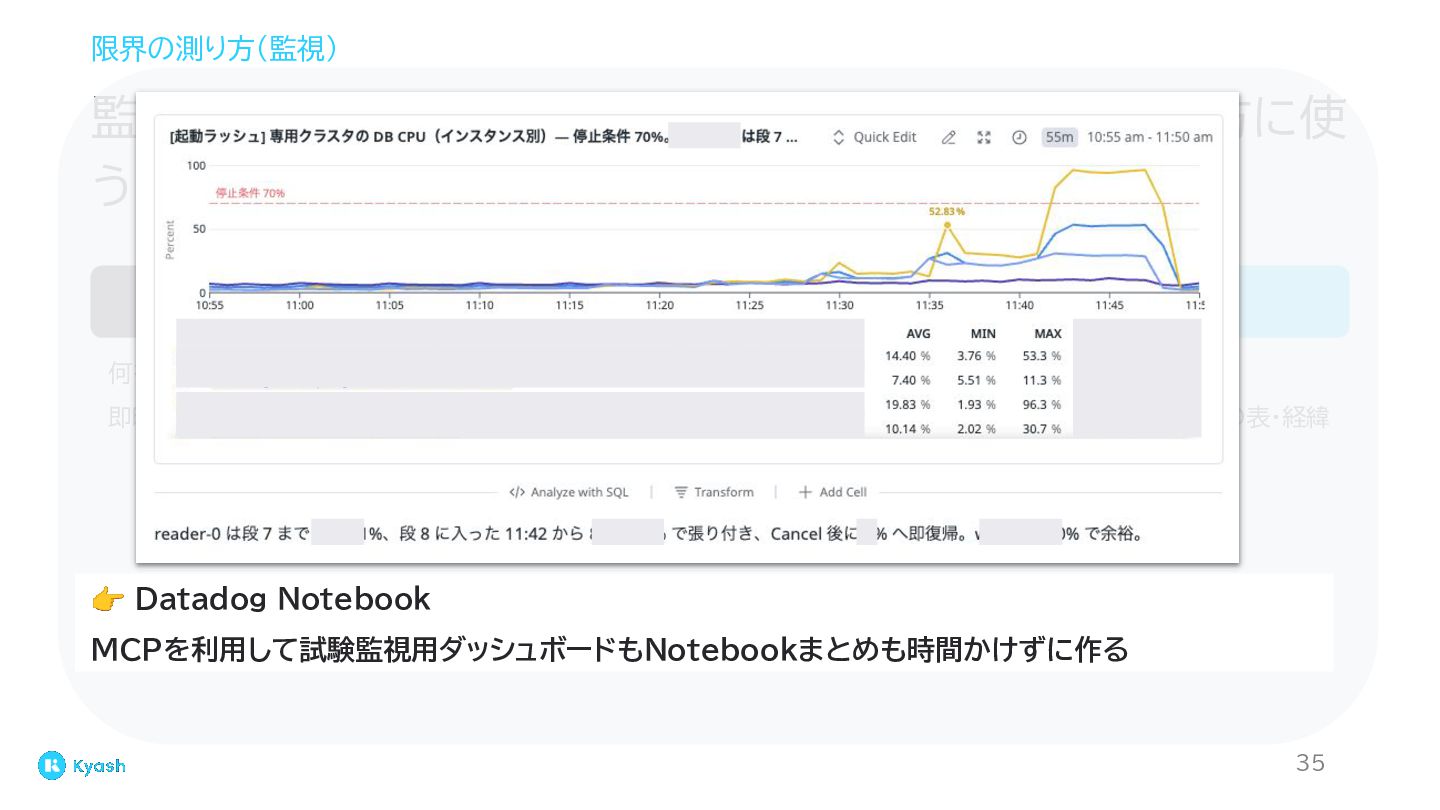
限界の測り方(監視) 監視ダッシュボードは「止める判断」と「後の報告」の両方に使 う 試験中:ダッシュボード 試験後:Notebook 何を見て止めるかを、盤面に書いておく 時間を試験の範囲に固定 即時の判断は、すぐ届く指標で 盤面と同じグラフ・API 別の
P99・段ごとの表・経緯 👉 Datadog そのまま結果報告の素材になり、「あの段で何が起きていたか」をいつでも見返せる Notebook MCPを利用して試験監視用ダッシュボードもNotebookまとめも時間かけずに作る 35
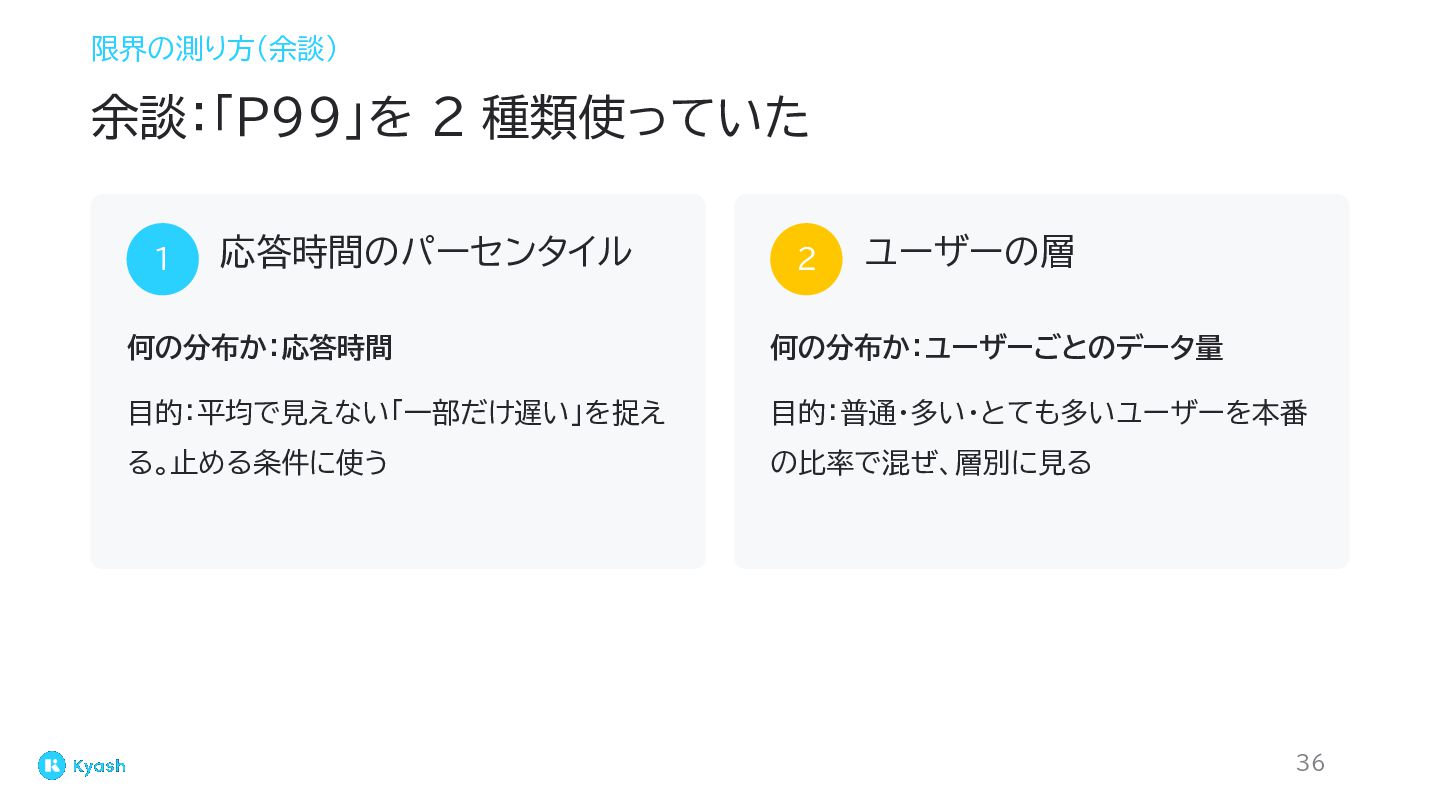
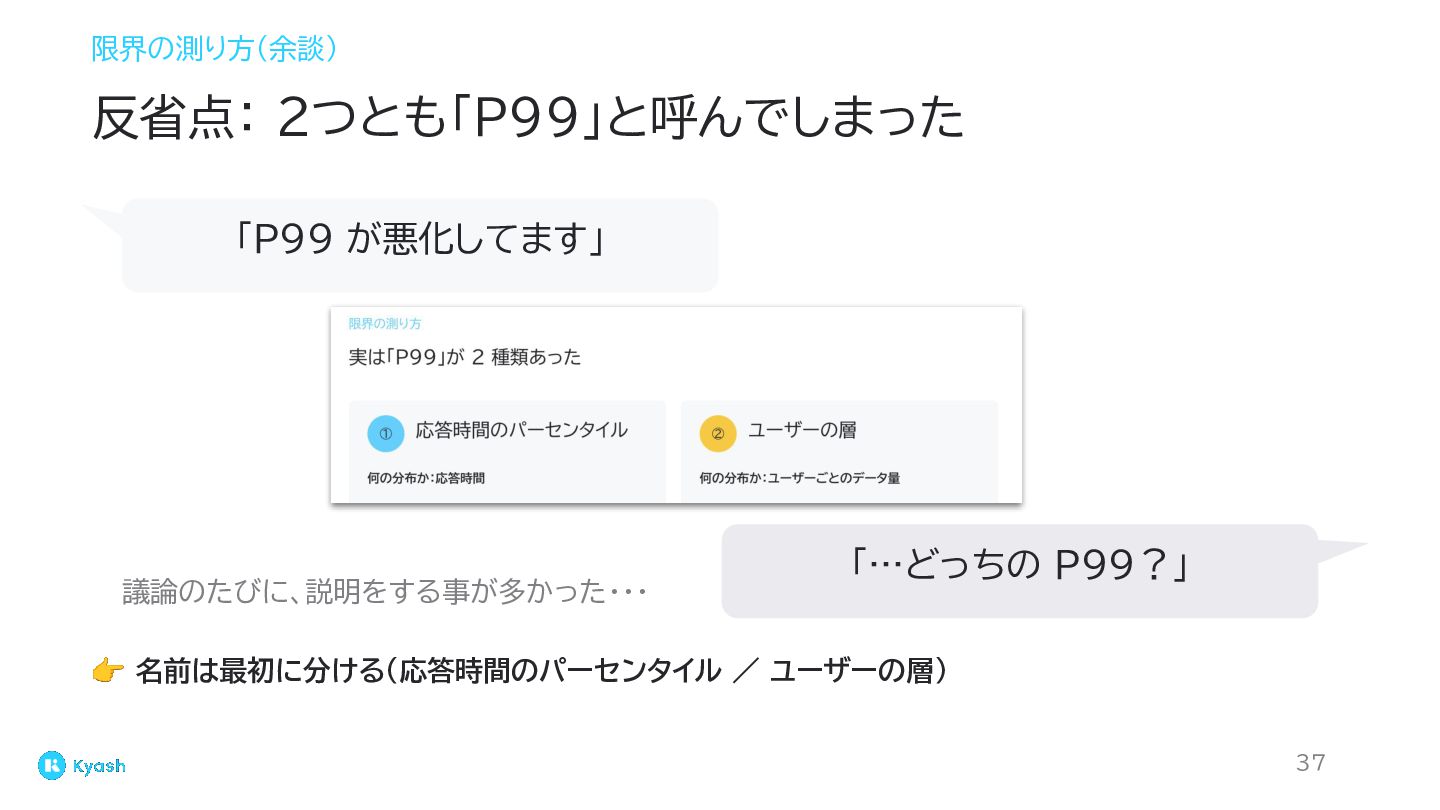
限界の測り方(余談) 余談:「P99」を 2 種類使っていた 1 応答時間のパーセンタイル 2 ユーザーの層 何の分布か:応答時間 何の分布か:ユーザーごとのデータ量
目的:平均で見えない「一部だけ遅い」を捉え 目的:普通・多い・とても多いユーザーを本番 る。止める条件に使う の比率で混ぜ、層別に見る 36
限界の測り方(余談) 反省点: 2つとも「P99」と呼んでしまった 「P99 が悪化してます」 議論のたびに、説明をする事が多かった・・・ 「…どっちの P99?」 👉 名前は最初に分ける(応答時間のパーセンタイル
/ ユーザーの層) 37
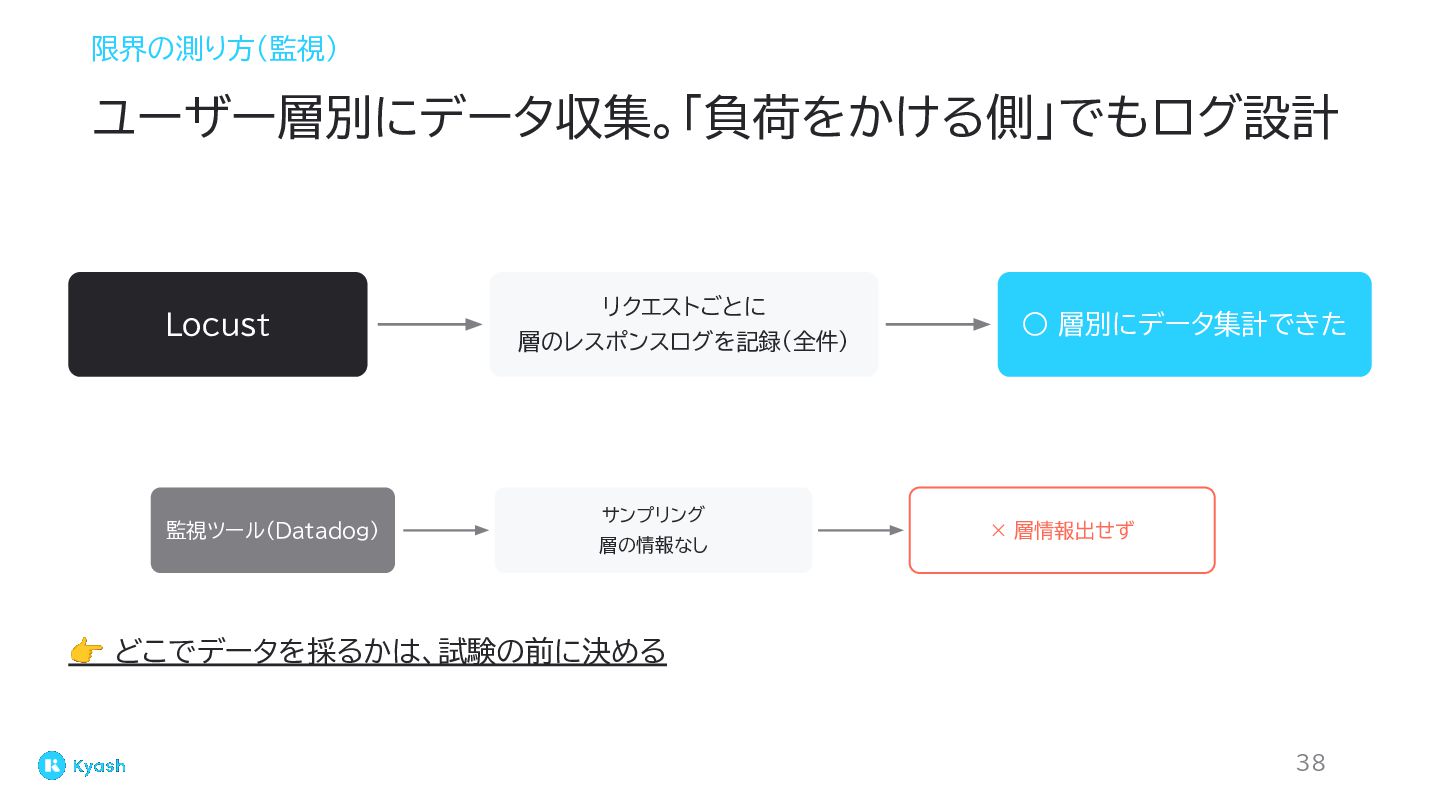
限界の測り方(監視) ユーザー層別にデータ収集。「負荷をかける側」でもログ設計 Locust 監視ツール(Datadog) リクエストごとに 層のレスポンスログを記録(全件) サンプリング 層の情報なし ◦ 層別にデータ集計できた
× 層情報出せず 👉 どこでデータを採るかは、試験の前に決める 38
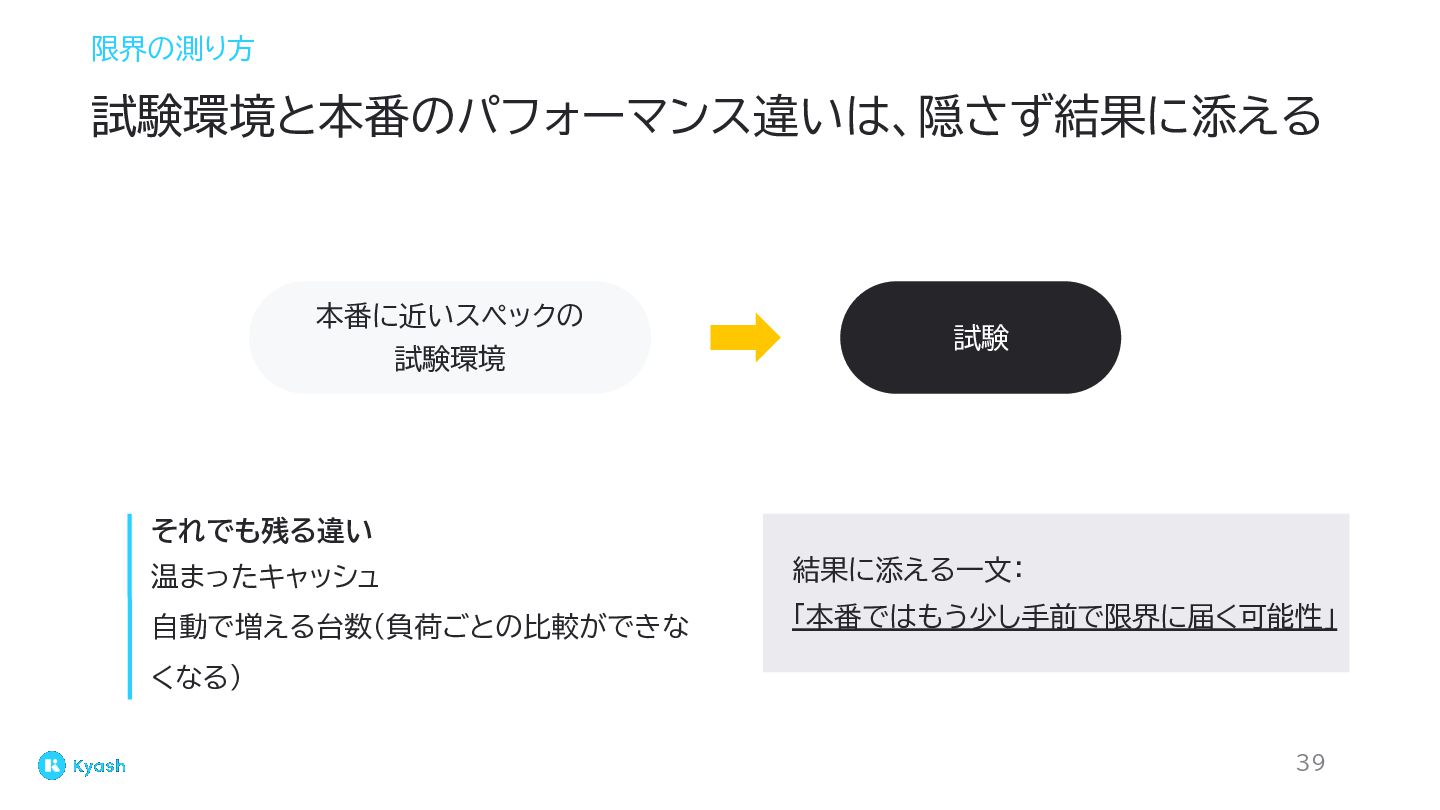
限界の測り方 試験環境と本番のパフォーマンス違いは、隠さず結果に添える 本番に近いスペックの 試験環境 試験 それでも残る違い 温まったキャッシュ 結果に添える一文: 自動で増える台数(負荷ごとの比較ができな 「本番ではもう少し手前で限界に届く可能性」
くなる) 39
05|実行の基盤と安全 ◦ 01 ゴール ©Kyash Inc. ◦ 02 シナリオ ◦
03 データ ◦ 04 限界 • 05 基盤 ◦ 06 翻訳 ◦ 07 まとめ 40
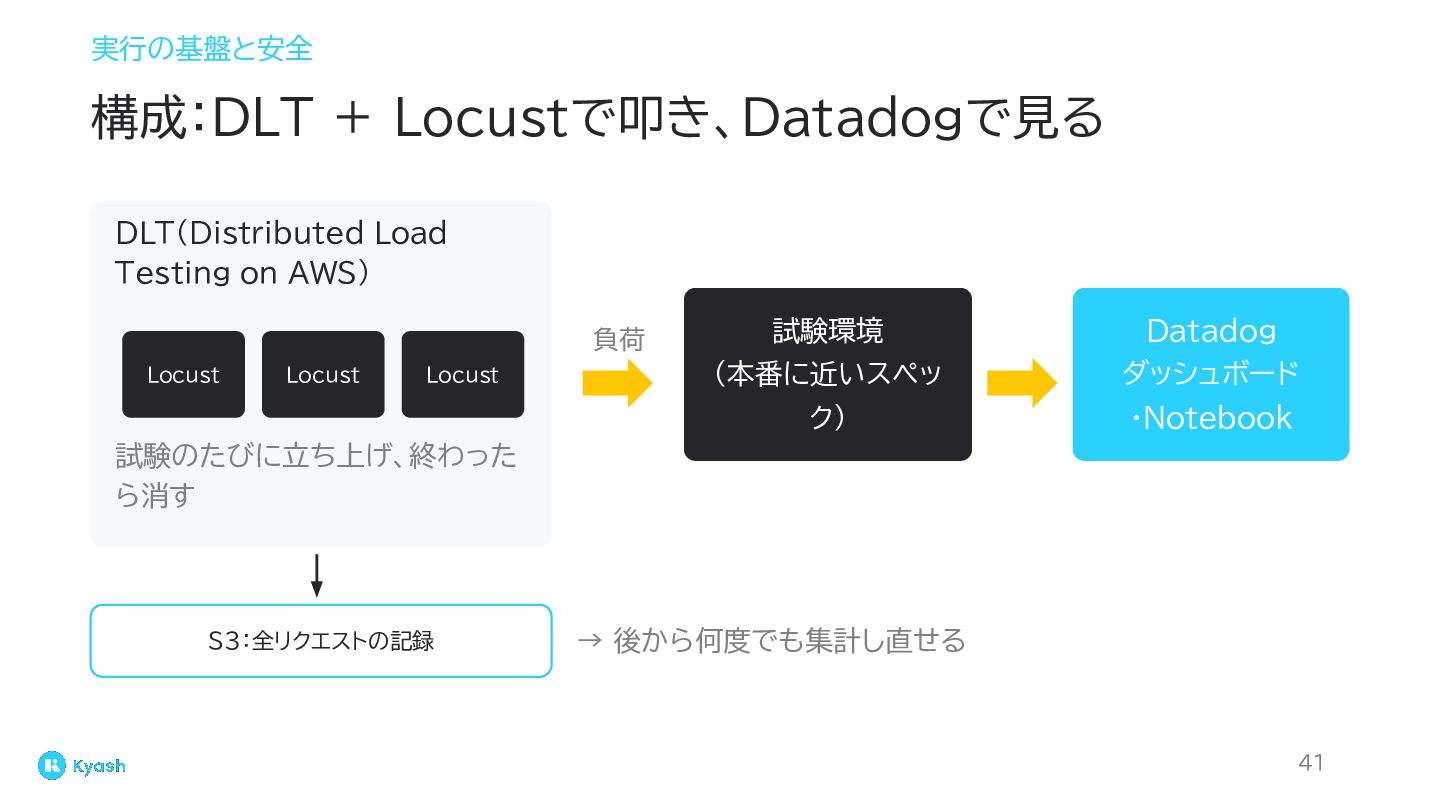
実行の基盤と安全 構成:DLT + Locustで叩き、Datadogで見る DLT(Distributed Load Testing on AWS) 負荷
Locust Locust Locust 試験環境 Datadog (本番に近いスペッ ダッシュボード ク) ・Notebook 試験のたびに立ち上げ、終わった ら消す S3:全リクエストの記録 → 後から何度でも集計し直せる 41
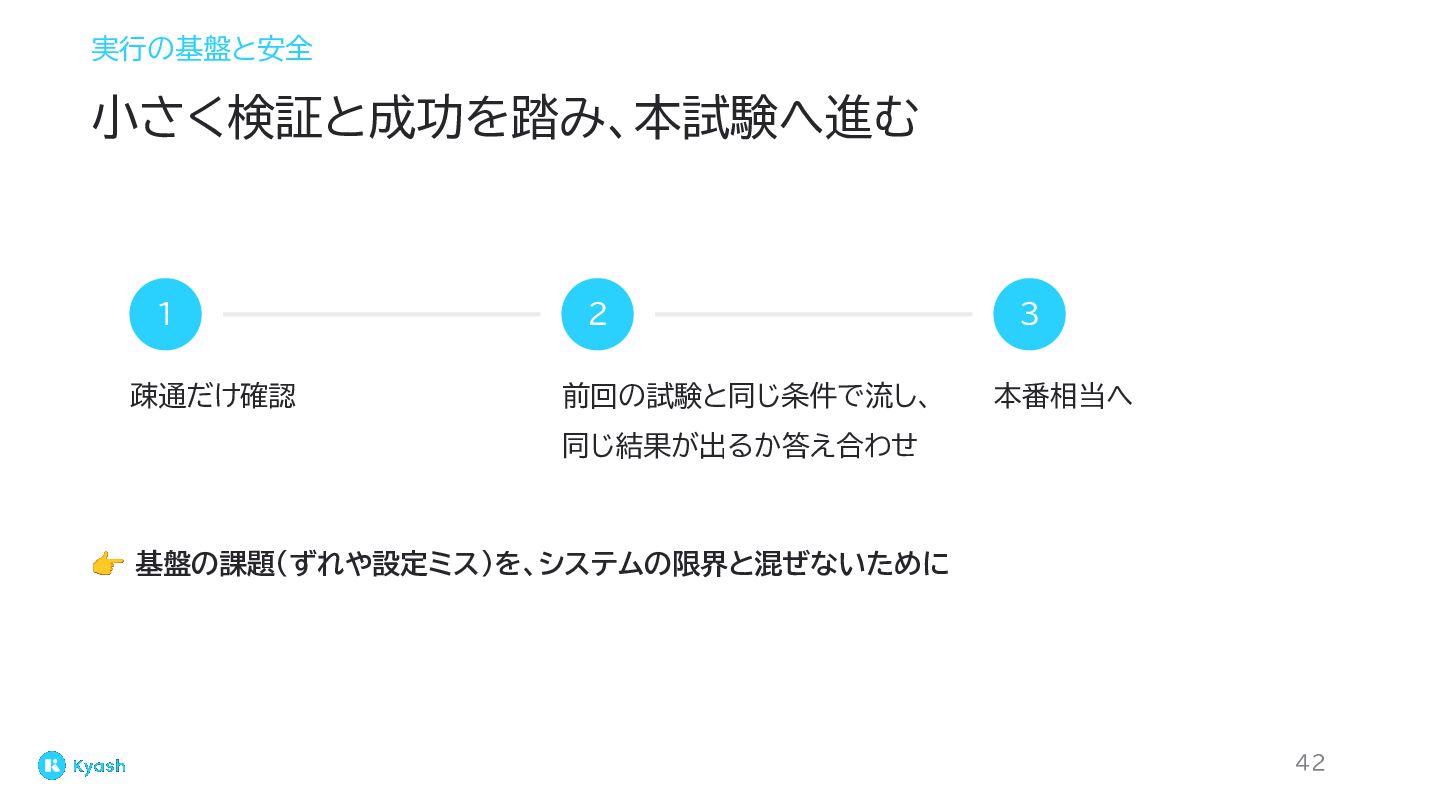
実行の基盤と安全 小さく検証と成功を踏み、本試験へ進む 1 疎通だけ確認 2 前回の試験と同じ条件で流し、 3 本番相当へ 同じ結果が出るか答え合わせ 👉
基盤の課題(ずれや設定ミス)を、システムの限界と混ぜないために 42
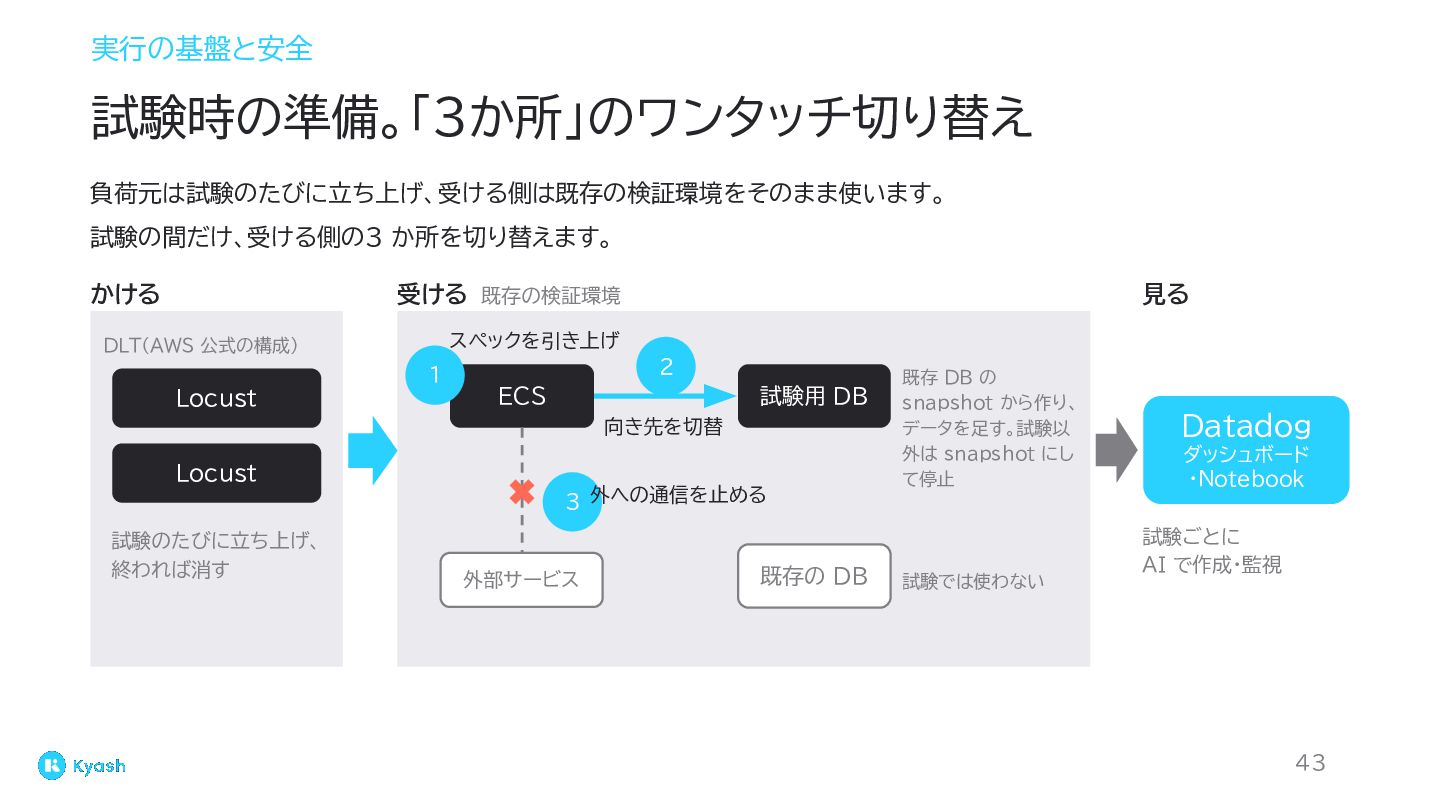
実行の基盤と安全 試験時の準備。「3か所」のワンタッチ切り替え 負荷元は試験のたびに立ち上げ、受ける側は既存の検証環境をそのまま使います。 試験の間だけ、受ける側の3 か所を切り替えます。 かける 受ける 既存の検証環境 スペックを引き上げ DLT(AWS
公式の構成) 1 Locust 見る 2 ECS 試験用 DB 向き先を切替 Locust 3 外への通信を止める 試験のたびに立ち上げ、 終われば消す 外部サービス 既存の DB 既存 DB の snapshot から作り、 データを足す。試験以 外は snapshot にし て停止 試験では使わない Datadog ダッシュボード ・Notebook 試験ごとに AI で作成・監視 43
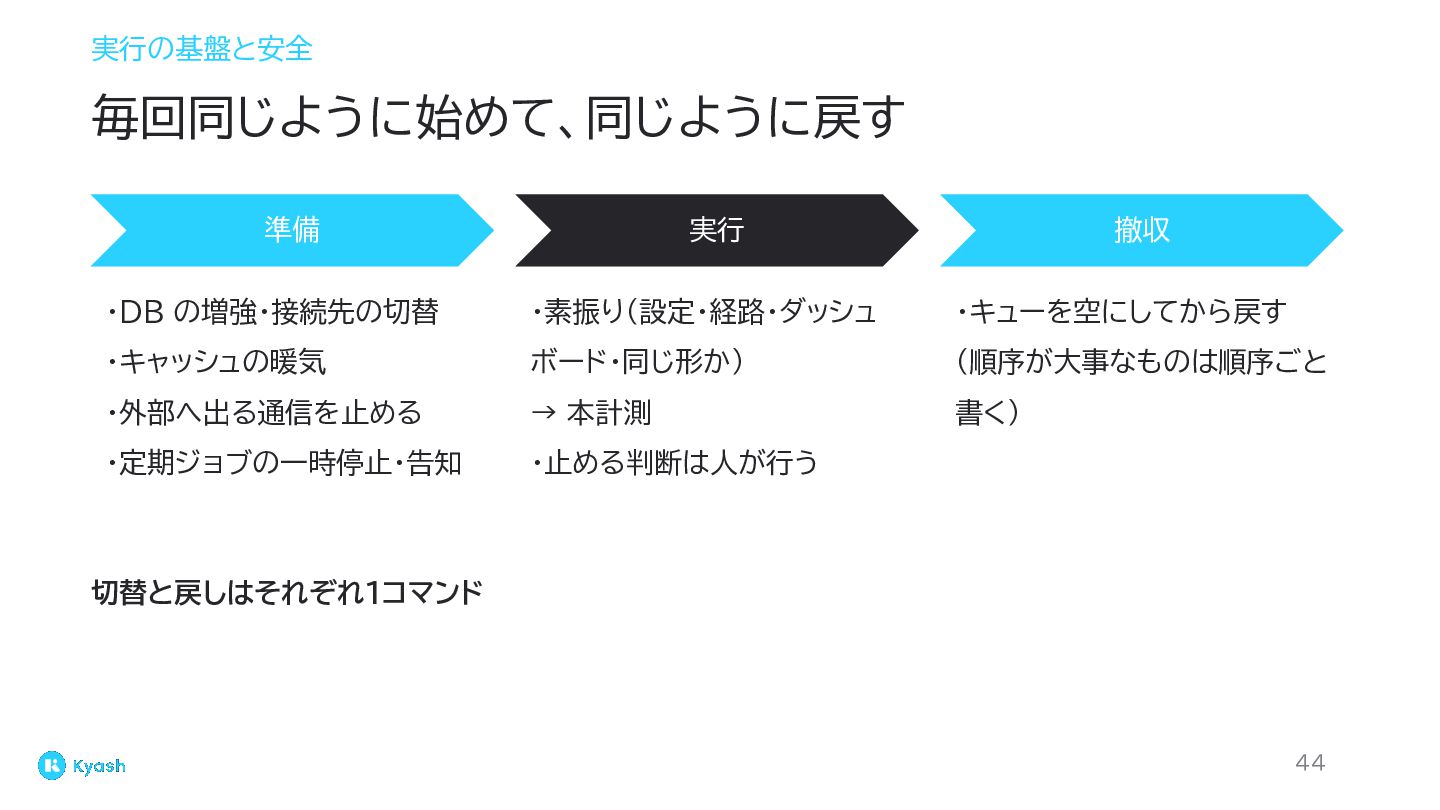
実行の基盤と安全 毎回同じように始めて、同じように戻す 準備 実行 撤収 ・DB の増強・接続先の切替 ・素振り(設定・経路・ダッシュ ・キューを空にしてから戻す ・キャッシュの暖気
ボード・同じ形か) (順序が大事なものは順序ごと ・外部へ出る通信を止める → 本計測 書く) ・定期ジョブの一時停止・告知 ・止める判断は人が行う 切替と戻しはそれぞれ1コマンド 44
06|事業への翻訳 ◦ 01 ゴール ©Kyash Inc. ◦ 02 シナリオ ◦
03 データ ◦ 04 限界 ◦ 05 基盤 • 06 翻訳 ◦ 07 まとめ 45
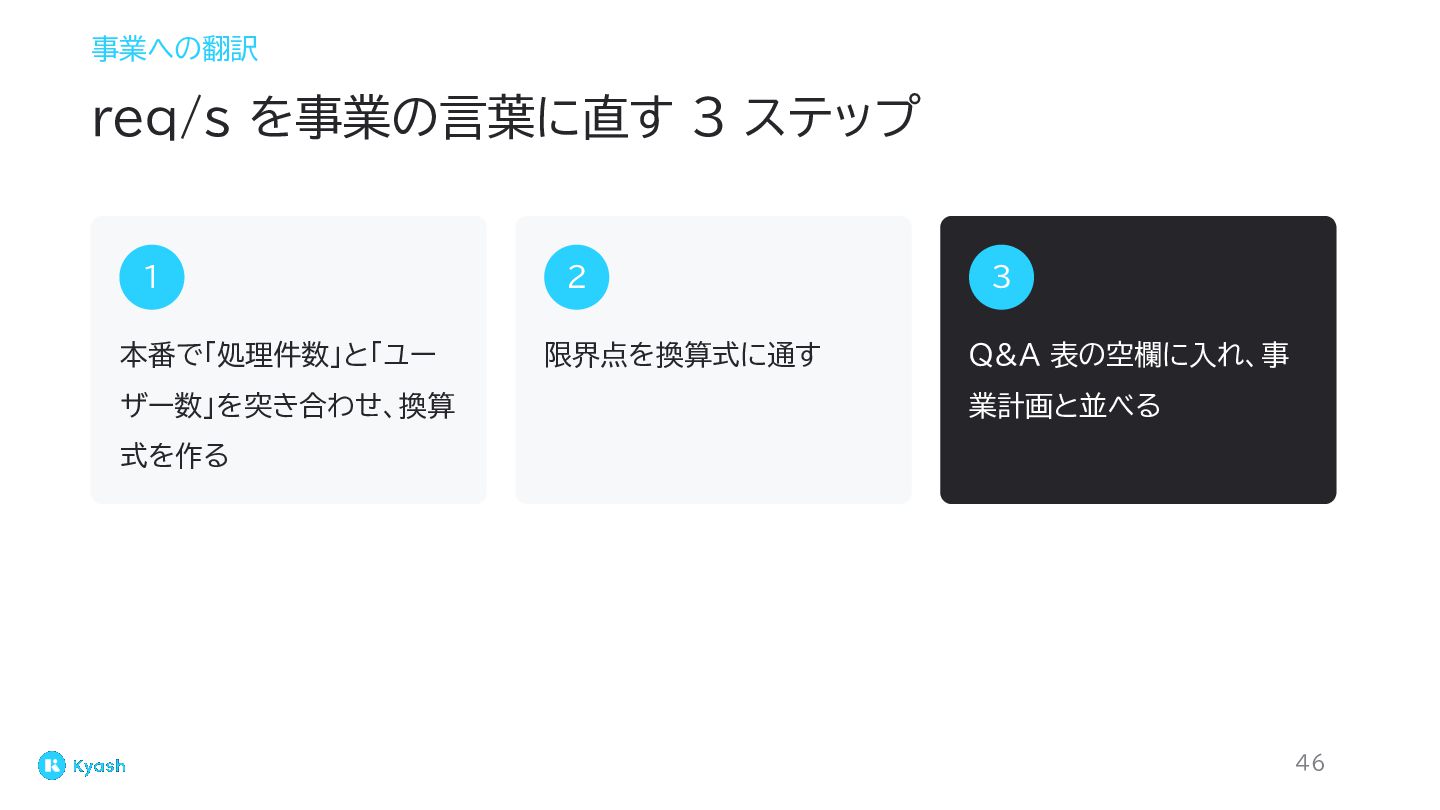
事業への翻訳 req/s を事業の言葉に直す 3 ステップ 1 本番で「処理件数」と「ユー ザー数」を突き合わせ、換算 2 限界点を換算式に通す
3 Q&A 表の空欄に入れ、事 業計画と並べる 式を作る 46
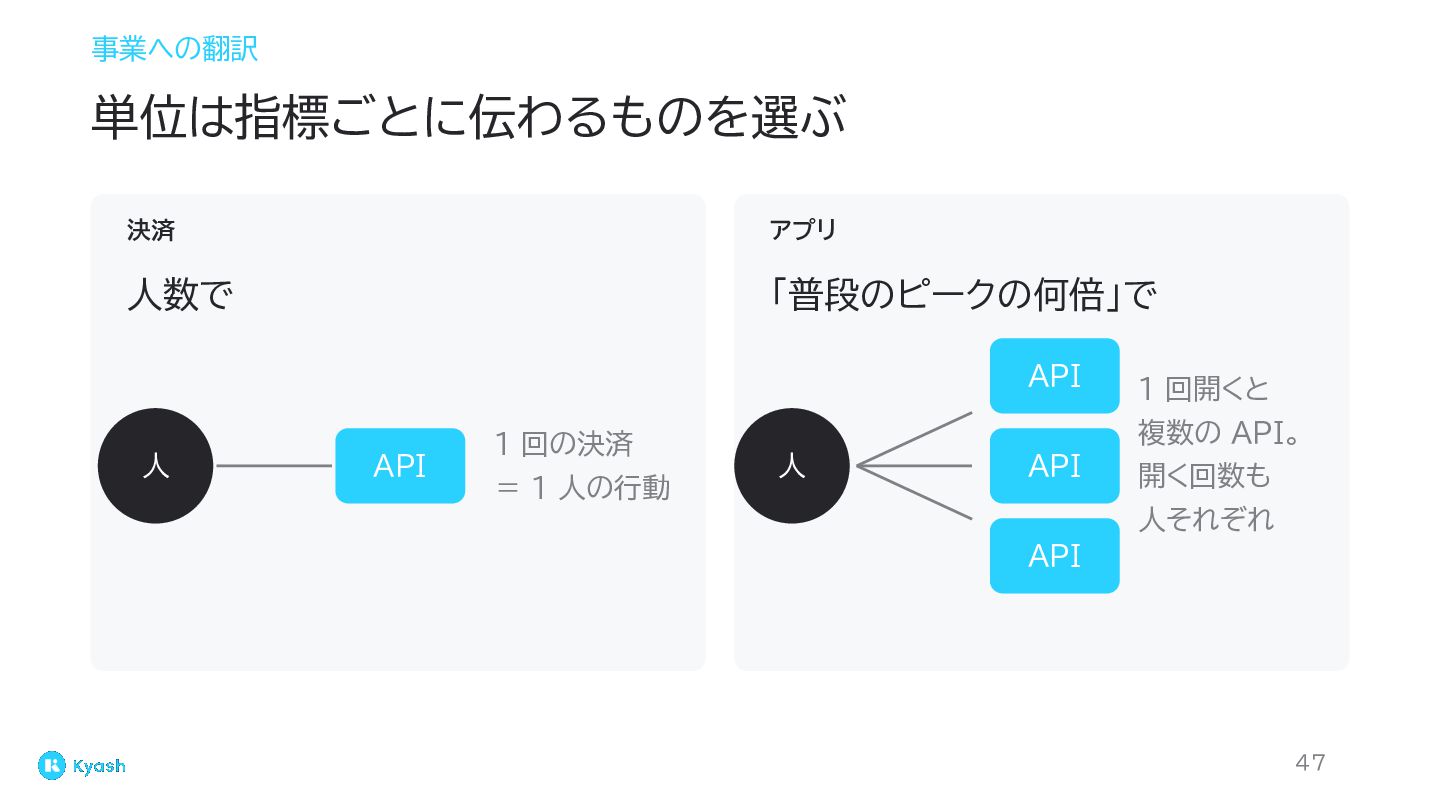
事業への翻訳 単位は指標ごとに伝わるものを選ぶ 決済 アプリ 人数で 「普段のピークの何倍」で API 人 API 1
回の決済 = 1 人の行動 1 回開くと 複数の API。 人 API 開く回数も 人それぞれ API 47
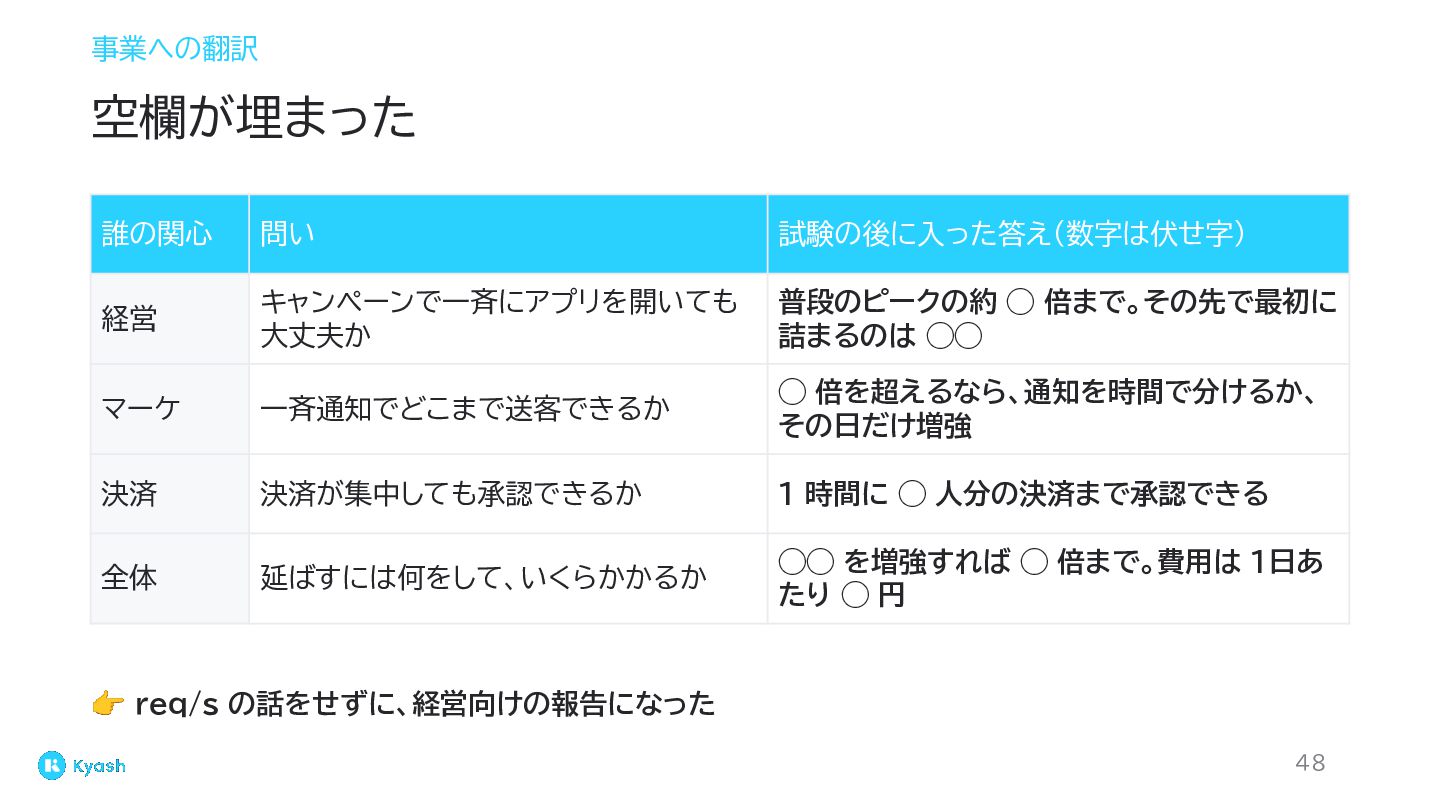
事業への翻訳 空欄が埋まった 誰の関心 問い 試験の後に入った答え(数字は伏せ字) 経営 キャンペーンで一斉にアプリを開いても 大丈夫か 普段のピークの約 ◯
倍まで。その先で最初に 詰まるのは ◯◯ マーケ 一斉通知でどこまで送客できるか ◯ 倍を超えるなら、通知を時間で分けるか、 その日だけ増強 決済 決済が集中しても承認できるか 1 時間に ◯ 人分の決済まで承認できる 全体 延ばすには何をして、いくらかかるか ◯◯ を増強すれば ◯ 倍まで。費用は 1日あ たり ◯ 円 👉 req/s の話をせずに、経営向けの報告になった 48
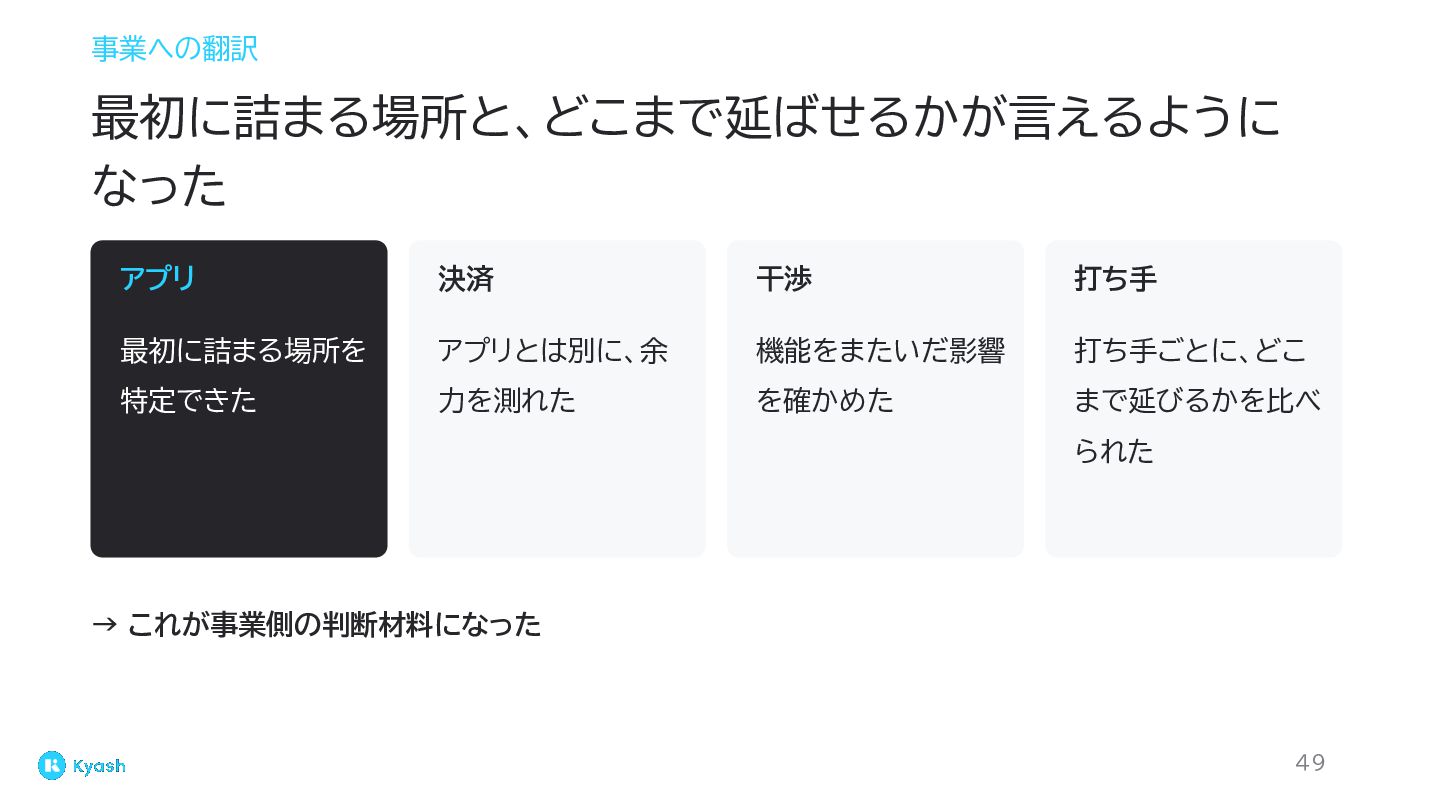
事業への翻訳 最初に詰まる場所と、どこまで延ばせるかが言えるように なった アプリ 決済 干渉 打ち手 最初に詰まる場所を アプリとは別に、余 機能をまたいだ影響
打ち手ごとに、どこ 特定できた 力を測れた を確かめた まで延びるかを比べ られた → これが事業側の判断材料になった 49
07|AI の使いどころ・今後・まとめ ◦ 01 ゴール ©Kyash Inc. ◦ 02 シナリオ
◦ 03 データ ◦ 04 限界 ◦ 05 基盤 ◦ 06 翻訳 • 07 まとめ 50
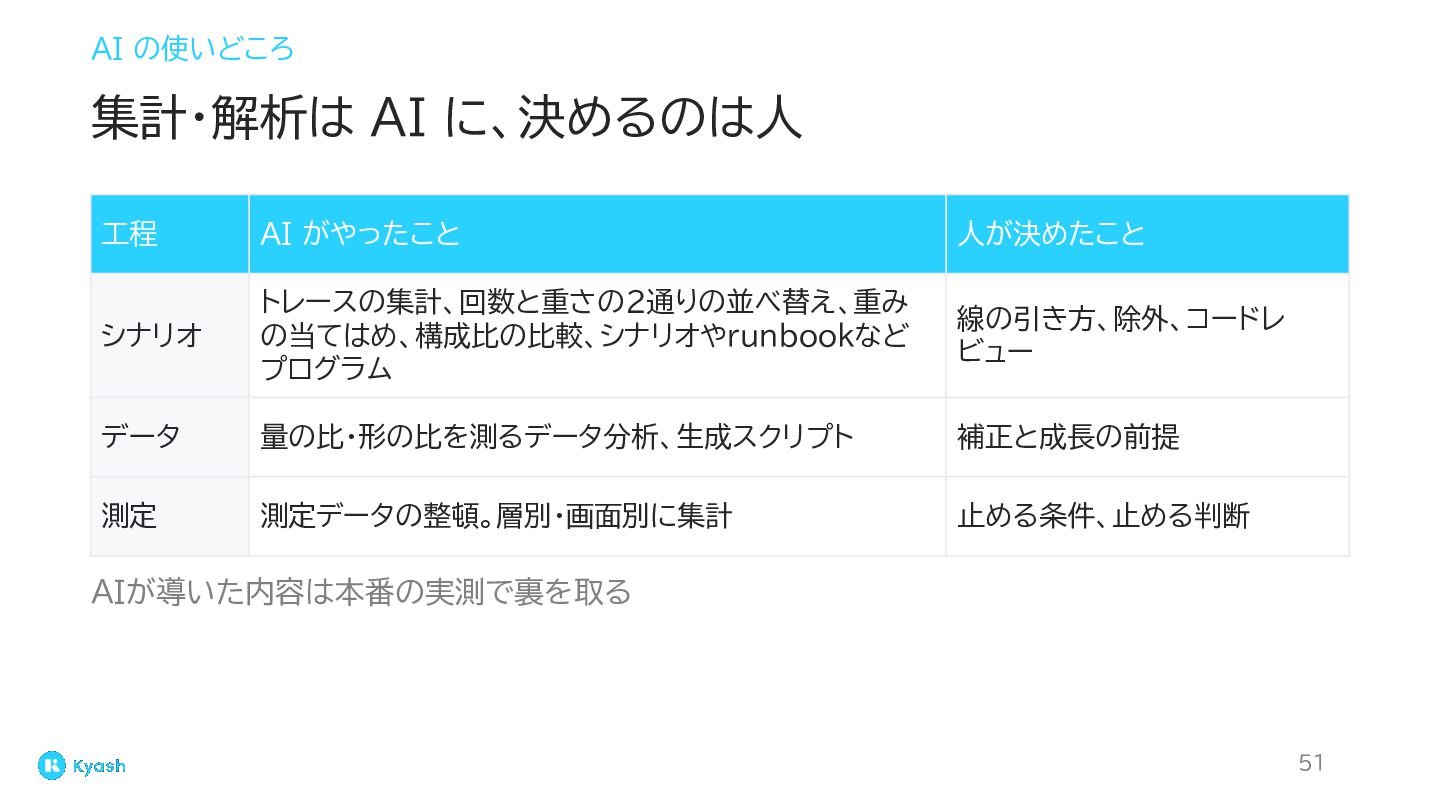
AI の使いどころ 集計・解析は AI に、決めるのは人 工程 AI がやったこと 人が決めたこと シナリオ
トレースの集計、回数と重さの2通りの並べ替え、重み の当てはめ、構成比の比較、シナリオやrunbookなど プログラム 線の引き方、除外、コードレ ビュー データ 量の比・形の比を測るデータ分析、生成スクリプト 補正と成長の前提 測定 測定データの整頓。層別・画面別に集計 止める条件、止める判断 AIが導いた内容は本番の実測で裏を取る 51
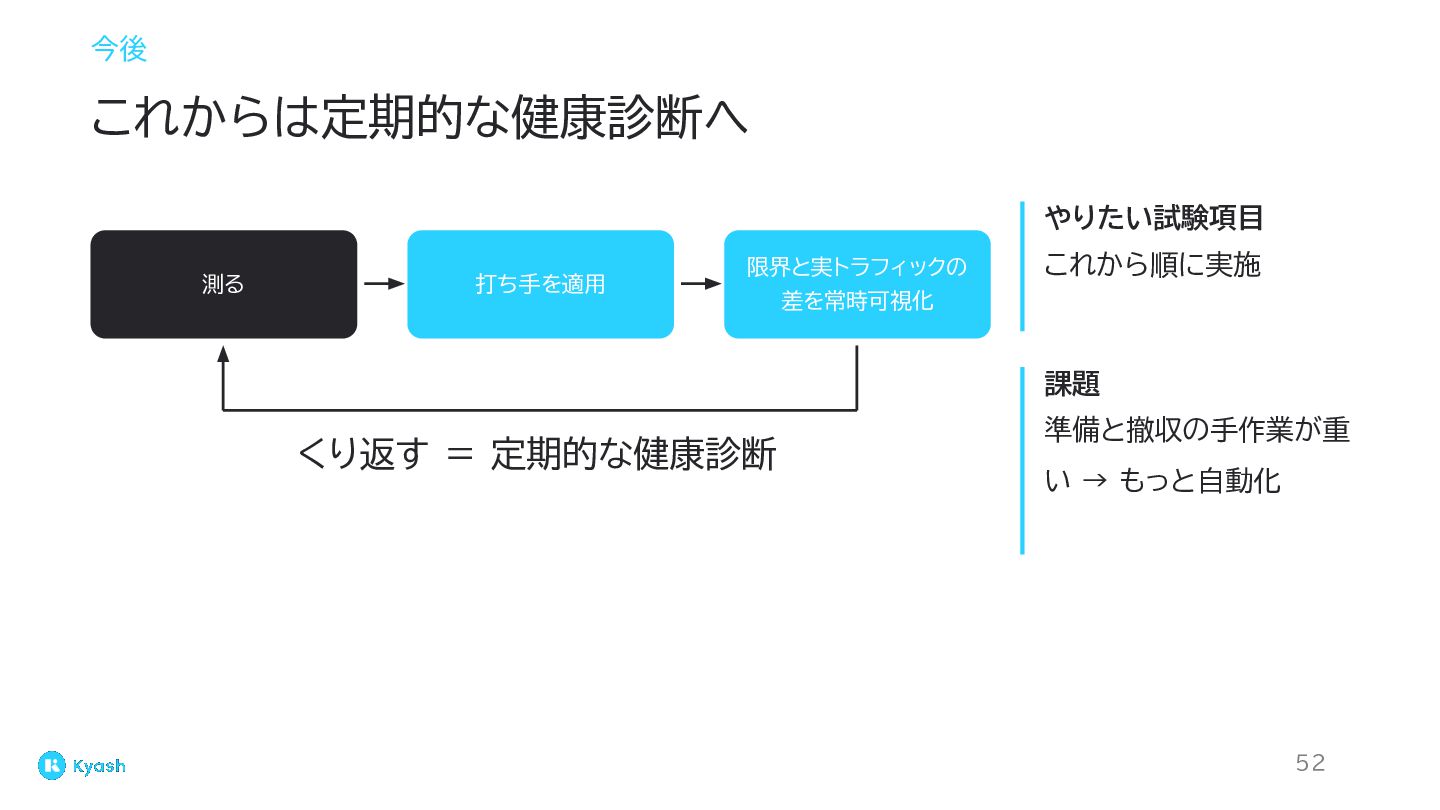
今後 これからは定期的な健康診断へ やりたい試験項目 測る 打ち手を適用 限界と実トラフィックの これから順に実施 差を常時可視化 課題 くり返す
= 定期的な健康診断 準備と撤収の手作業が重 い → もっと自動化 52
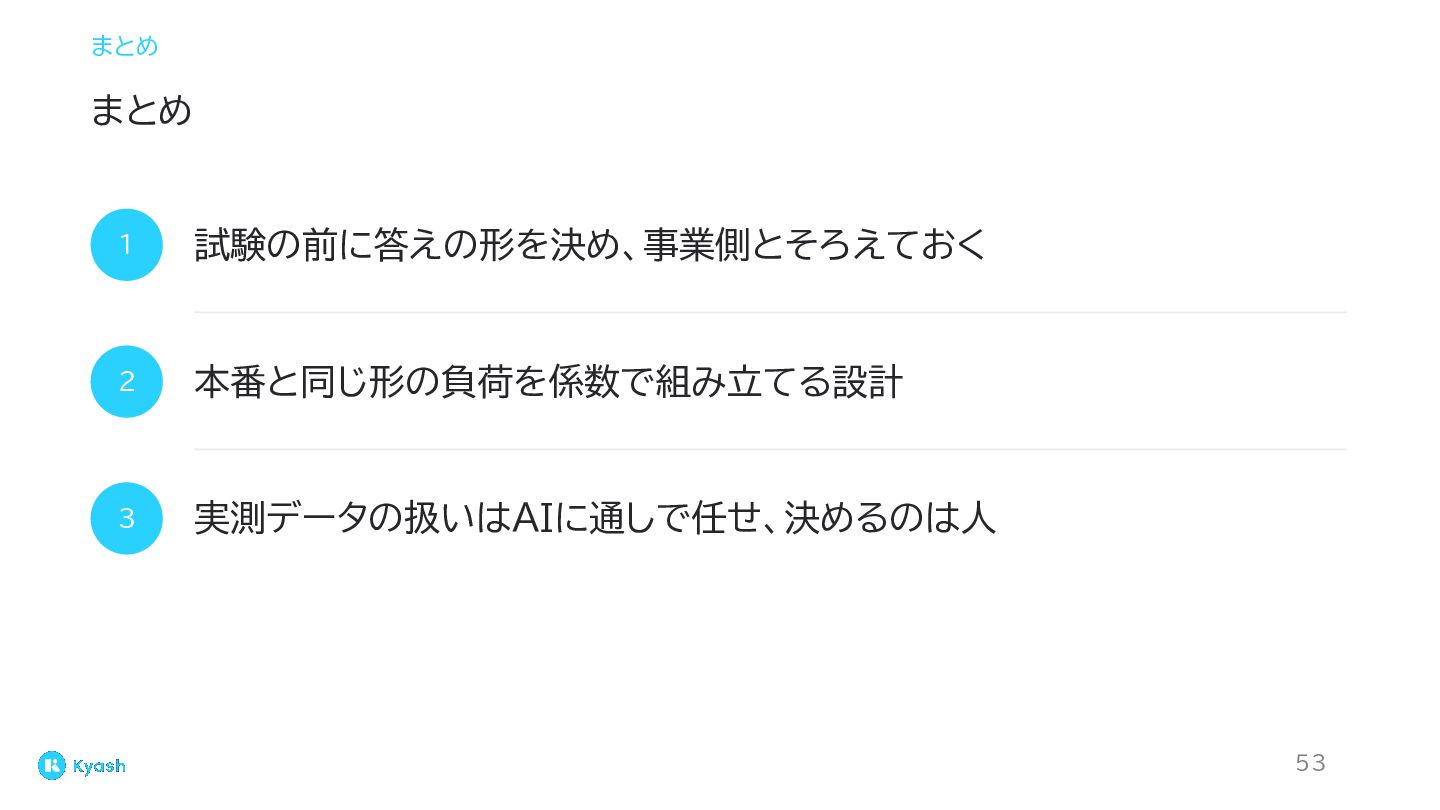
まとめ まとめ 1 試験の前に答えの形を決め、事業側とそろえておく 2 本番と同じ形の負荷を係数で組み立てる設計 3 実測データの扱いはAIに通しで任せ、決めるのは人 53
ご清聴ありがとうございました
More Decks by zosokh
See All by zosokh
Team operations that are not burdened by SRE
kazatohiei
1
950
テストコード文化を0から作り、変化し続けた組織
kazatohiei
2
2.6k
開発生産性を取り入れたばかりの組織が、スキルと生産性向上を紐づける
kazatohiei
1
410
アプリケーションをリプレイスしたら チームとサービス運用に向き合えた
kazatohiei
1
1.1k
PhinxによるDBマイグレーションとサービス運用
kazatohiei
0
1.9k
エラー監視とテスト体制への改善作戦 / PHPerKaigi2022
kazatohiei
7
5.5k
サービス運用エンジニアによるPHP8バージョンアップ奮闘記 / PHPカンファレンス2021
kazatohiei
0
1.3k
Other Decks in Technology
See All in Technology
お風呂場をサーバルームにしよう
yusuke427
0
360
これからのデータエンジニアの役割について考える / Rethinking the Role of Data Engineers in the AI Era
okiyuki99
1
540
契約書SaaSにAIエージェントを組み込む
sansantech
PRO
0
190
Kansai WordPress Meetup@大阪『ブロックテーマを作る上で知っておくべきこと
torounit
0
250
エンタープライズ事業未経験のデータ屋、 AI時代にN回撃沈する.pdf
ryoskdara_
0
150
こんなに変わった! AWSネットワークの常識
shotashiratori
16
11k
OpenTelemetryで変わった 新時代のCloudWatchメトリクス監視
tsukuboshi
0
450
20261113_JAWS_Osaka
takuyay0ne
1
580
未来を描き変化の中で学び直す ヴァンガードから考える、AI時代のチーム開発
lamb_moko
0
100
ノードが消える前提で設計する!Karpenterで金融システムを止めないためのノウハウ大全
daitak
1
110
Del vibe coding a un Desarrollo (agéntico) fiable
jcabot
0
170
SREのためのFinOps入門
muziyoshiz
3
1.6k
Featured
See All Featured
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
400
The Art of Programming - Codeland 2020
erikaheidi
57
15k
Mobile First: as difficult as doing things right
swwweet
225
10k
[SF Ruby Conf 2025] Rails X
palkan
3
1.5k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
570
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
The Language of Interfaces
destraynor
162
27k
Between Models and Reality
mayunak
4
590
Crafting Experiences
bethany
1
450
Facilitating Awesome Meetings
lara
57
7.2k
Design of three-dimensional binary manipulators for pick-and-place task avoiding obstacles (IECON2024)
konakalab
0
670
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
350


 kazatohiei
 yusuke427
 okiyuki99
 sansantech
 torounit
 ryoskdara_
 shotashiratori
 tsukuboshi
 takuyay0ne
 lamb_moko
 daitak
 jcabot
 muziyoshiz
 jdejongh
 erikaheidi
 swwweet
 palkan
 jct
 marcduiker
 destraynor
 mayunak
 bethany
 lara
 konakalab
 katarinadahlin