Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【pret-a-porter】LOCAL AI HACKATHON #000 発表資料
Search
けん玉
April 01, 2024
40
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【pret-a-porter】LOCAL AI HACKATHON #000 発表資料
けん玉
April 01, 2024
Featured
See All Featured
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
エンジニアに許された特別な時間の終わり
watany
109
250k
Mind Mapping
helmedeiros
1
400
Between Models and Reality
mayunak
4
500
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.8k
The Mindset for Success: Future Career Progression
greggifford
PRO
0
540
The Art of Programming - Codeland 2020
erikaheidi
57
14k
My Coaching Mixtape
mlcsv
0
360
The Anti-SEO Checklist Checklist. Pubcon Cyber Week
ryanjones
0
270
Imperfection Machines: The Place of Print at Facebook
scottboms
270
14k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1.1k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
Transcript
日本語INSTRUCTION-TUNING/RLHFデータセット生成を目的とした 指示生成モデルと応答生成モデルの作成 pret-a-porter けん玉、すでぃー、ぴゅう太 2024年4月1日 Local AI Hackathon #000
アジェンダ • 目的 • メンバー紹介 • 成果物 • ハッカソンでの取り組み ▪
指示生成モデルと応答生成モデル ▪ pret-a-porter-instructionについて ▪ oasst2-chatの評価 ▪ Chat-with-cosmopediaについて ▪ その他の取り組み • 今後の活動 • まとめ
一般に、LLMの対話タスクにおける精度は • 事前学習データ • Fine-tuningに使われるinstructionデータ 2つのクオリティに大きく左右されます。 しかし、日本語のinstructionデータセットは英語に比べると数が少なく、その中でも オープンソースで高品質なものに限定すると、学習を行うのに十分な数が揃わない のが現状です。 そこで、指示生成と応答生成に特化したモデルをそれぞれ作成することで、
データそのものに留まらず、「高品質なデータ生成の民主化」を目指します。 目的
メンバー紹介 けん玉 ぴゅう太 すでぃー @kendama_ai Kendamarron @sudy_super sudy-super @AiXsatoshi aixsatoshi
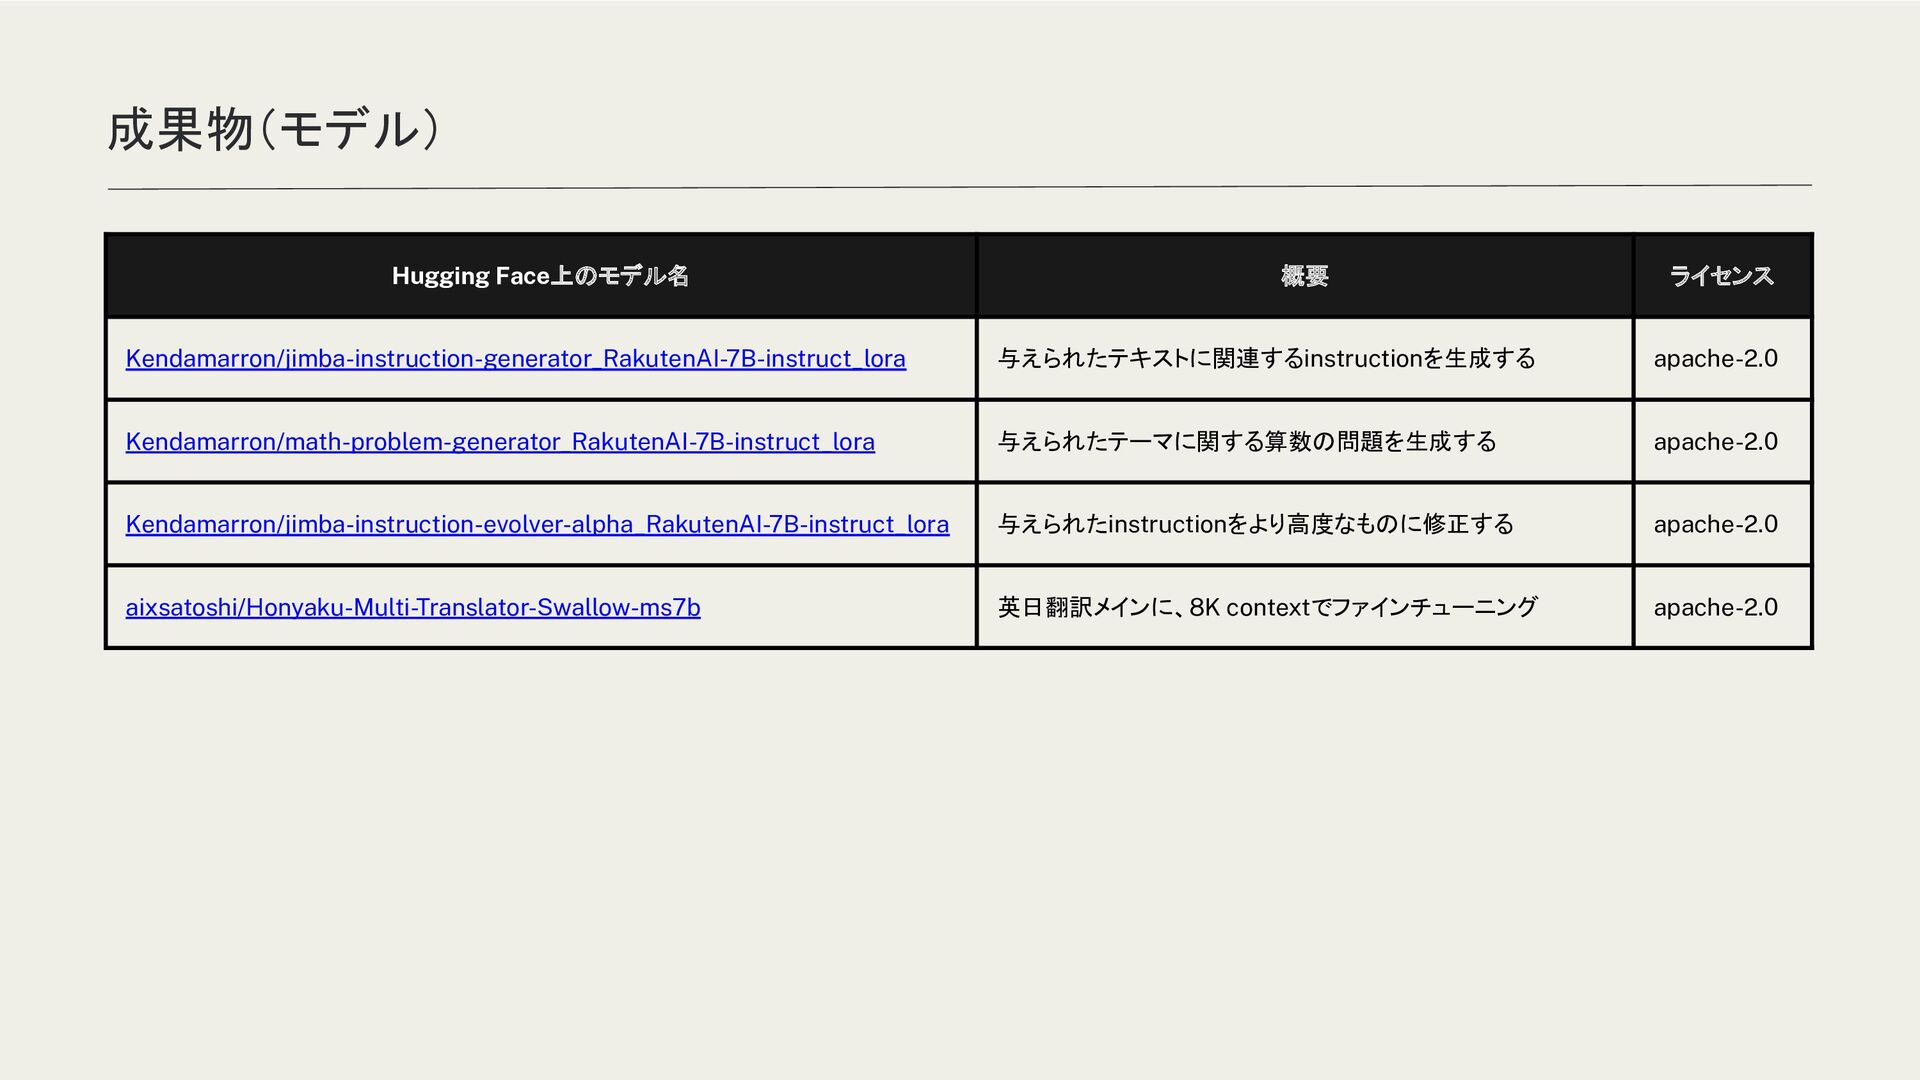
Hugging Face上のモデル名 概要 ライセンス Kendamarron/jimba-instruction-generator_RakutenAI-7B-instruct_lora 与えられたテキストに関連するinstructionを生成する apache-2.0 Kendamarron/math-problem-generator_RakutenAI-7B-instruct_lora 与えられたテーマに関する算数の問題を生成する apache-2.0
Kendamarron/jimba-instruction-evolver-alpha_RakutenAI-7B-instruct_lora 与えられたinstructionをより高度なものに修正する apache-2.0 aixsatoshi/Honyaku-Multi-Translator-Swallow-ms7b 英日翻訳メインに、8K contextでファインチューニング apache-2.0 成果物(モデル)
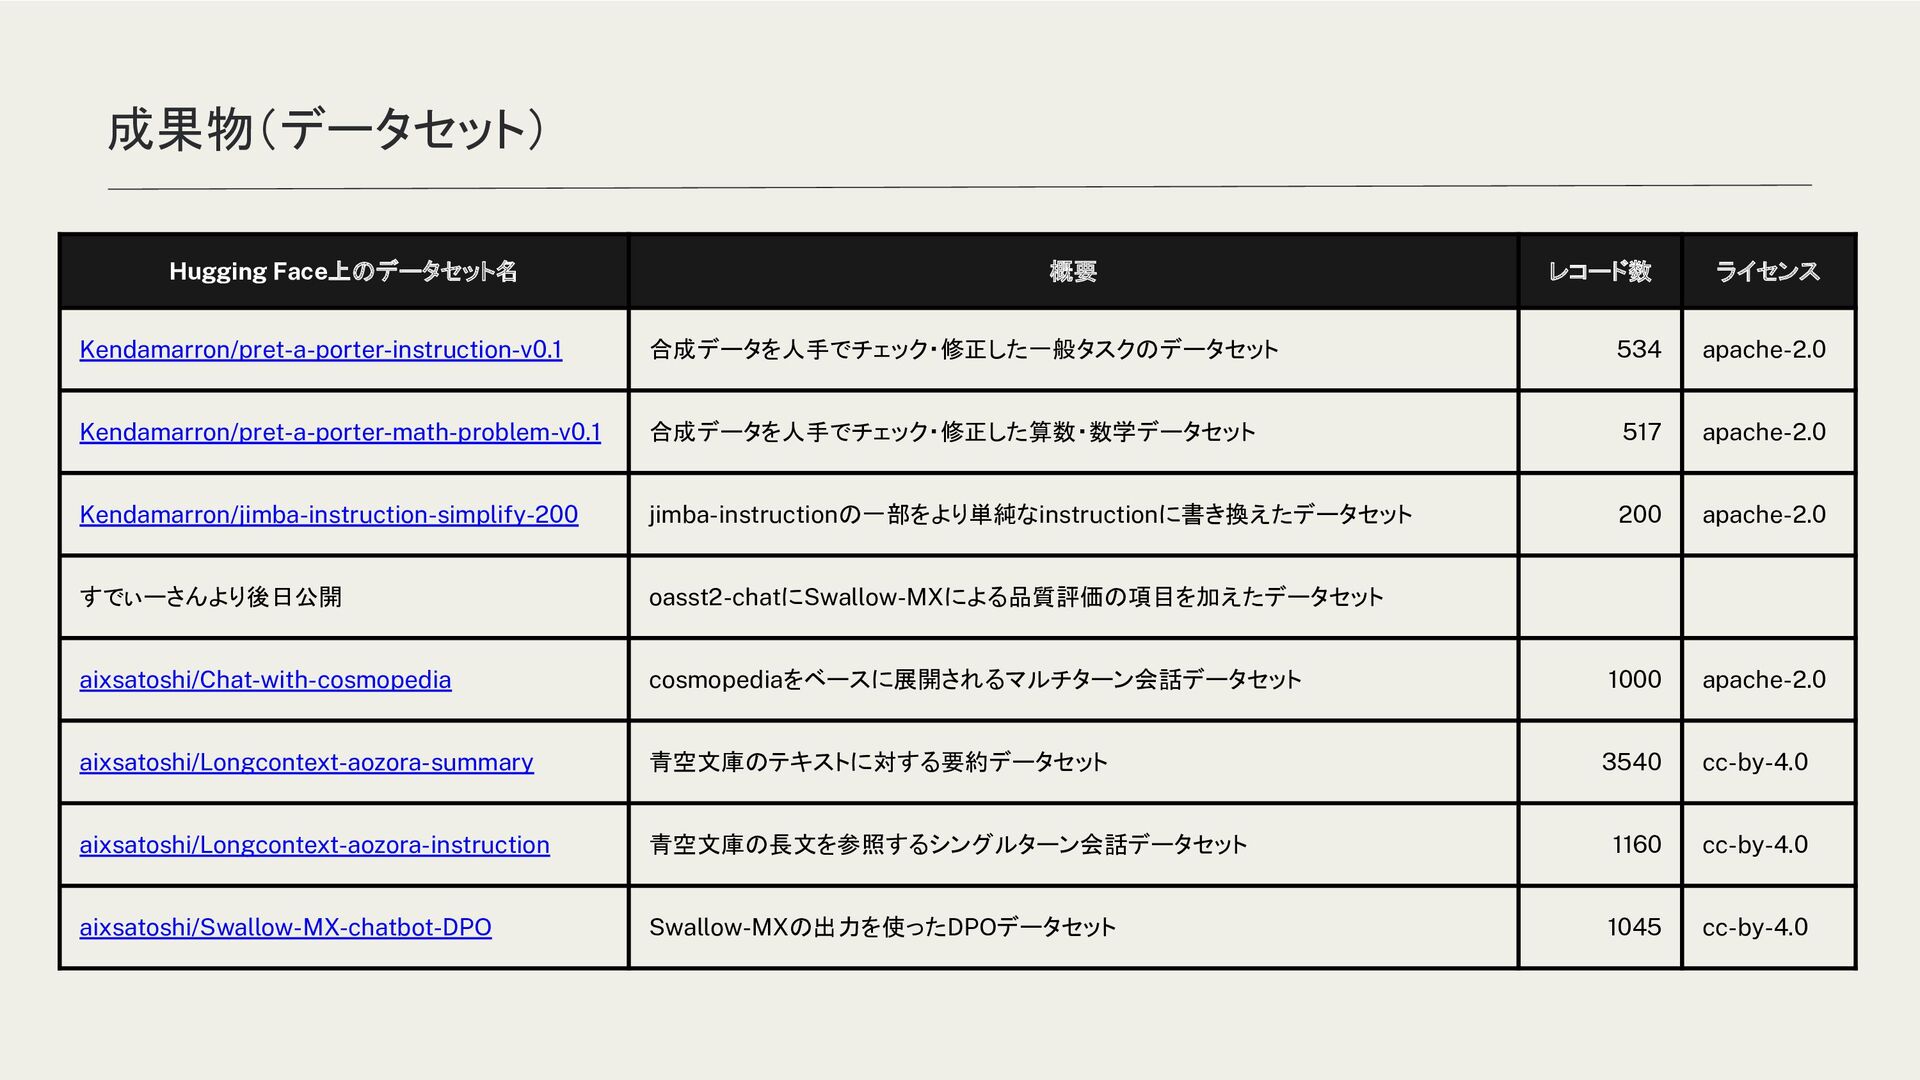
Hugging Face上のデータセット名 概要 レコード数 ライセンス Kendamarron/pret-a-porter-instruction-v0.1 合成データを人手でチェック・修正した一般タスクのデータセット 534 apache-2.0 Kendamarron/pret-a-porter-math-problem-v0.1
合成データを人手でチェック・修正した算数・数学データセット 517 apache-2.0 Kendamarron/jimba-instruction-simplify-200 jimba-instructionの一部をより単純なinstructionに書き換えたデータセット 200 apache-2.0 すでぃーさんより後日公開 oasst2-chatにSwallow-MXによる品質評価の項目を加えたデータセット aixsatoshi/Chat-with-cosmopedia cosmopediaをベースに展開されるマルチターン会話データセット 1000 apache-2.0 aixsatoshi/Longcontext-aozora-summary 青空文庫のテキストに対する要約データセット 3540 cc-by-4.0 aixsatoshi/Longcontext-aozora-instruction 青空文庫の長文を参照するシングルターン会話データセット 1160 cc-by-4.0 aixsatoshi/Swallow-MX-chatbot-DPO Swallow-MXの出力を使ったDPOデータセット 1045 cc-by-4.0 成果物(データセット)
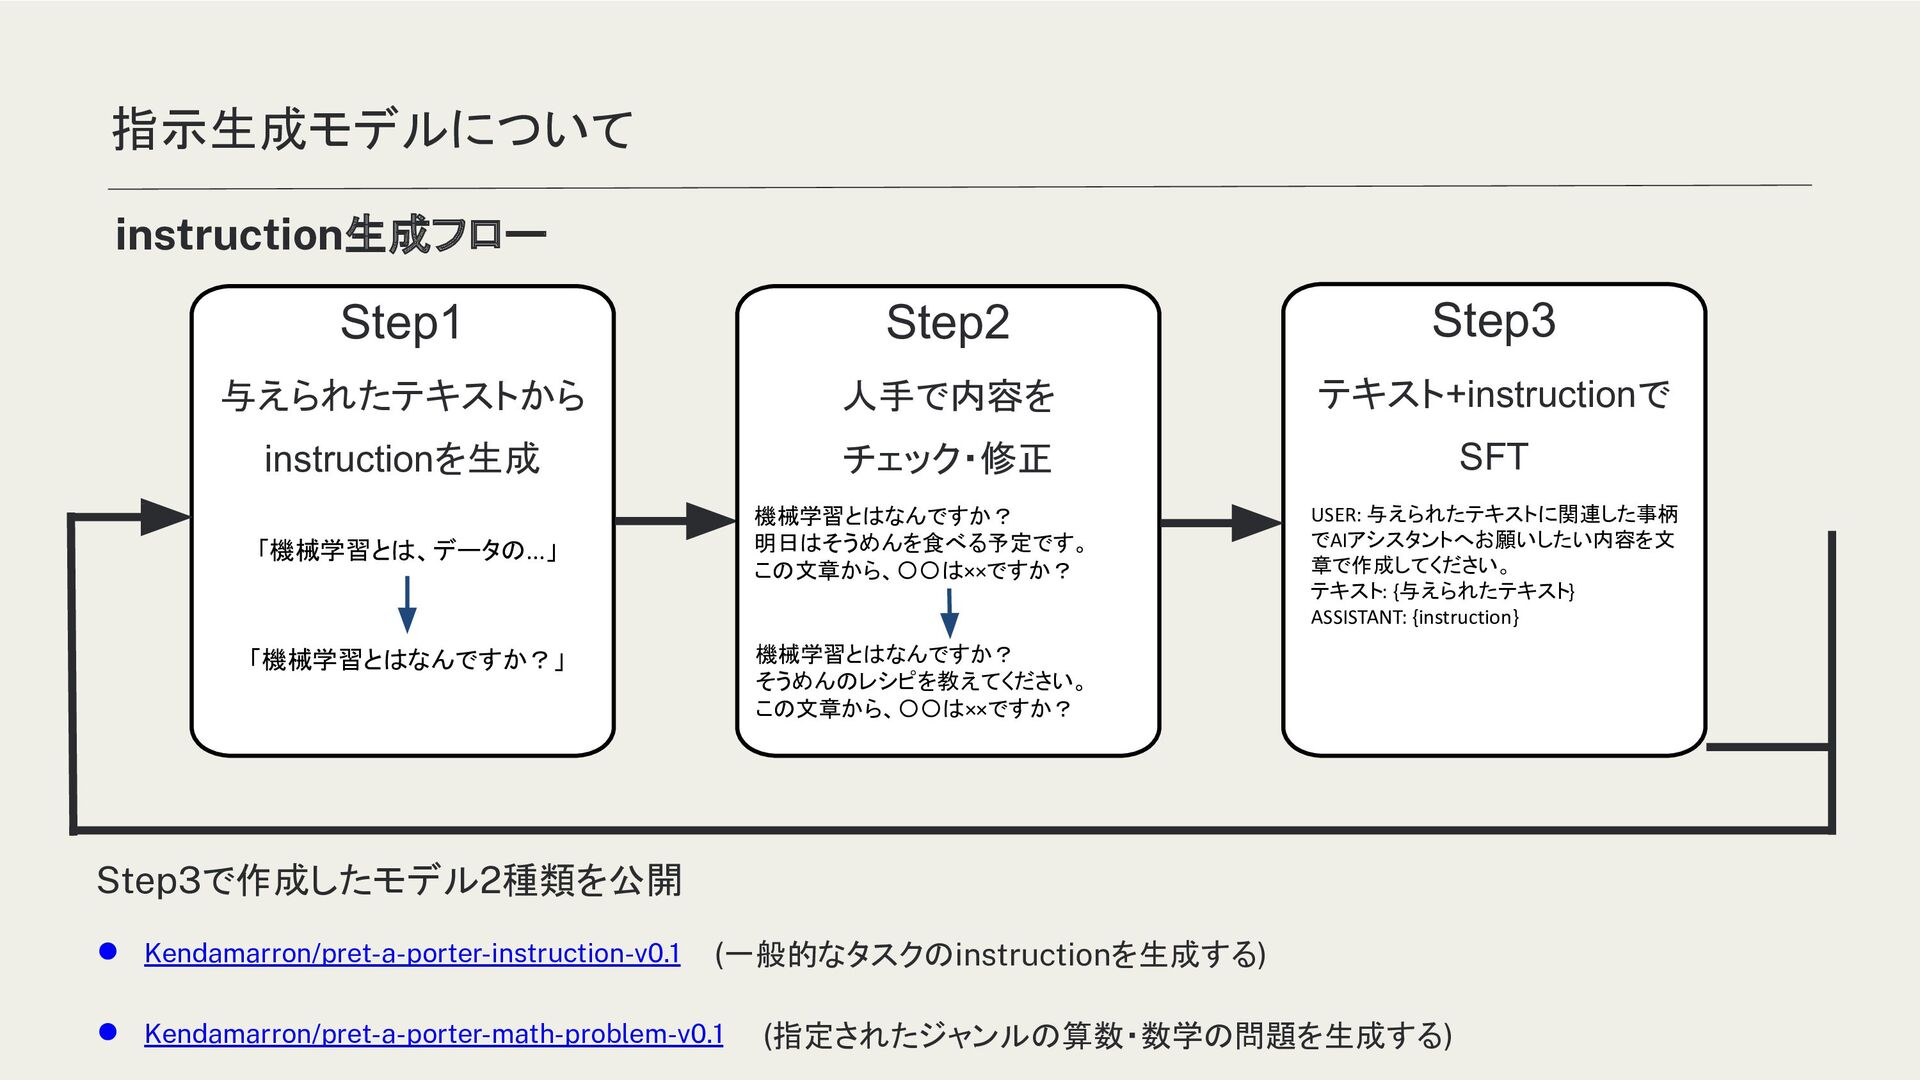
指示生成モデルについて Step1 与えられたテキストから instructionを生成 Step2 人手で内容を チェック・修正 Step3 テキスト+instructionで SFT
「機械学習とは、データの...」 「機械学習とはなんですか?」 機械学習とはなんですか? 明日はそうめんを食べる予定です。 この文章から、〇〇は××ですか? 機械学習とはなんですか? そうめんのレシピを教えてください。 この文章から、〇〇は××ですか? USER: 与えられたテキストに関連した事柄 でAIアシスタントへお願いしたい内容を文 章で作成してください。 テキスト: {与えられたテキスト} ASSISTANT: {instruction} instruction生成フロー Step3で作成したモデル2種類を公開 • Kendamarron/pret-a-porter-instruction-v0.1 • Kendamarron/pret-a-porter-math-problem-v0.1 (一般的なタスクのinstructionを生成する) (指定されたジャンルの算数・数学の問題を生成する)
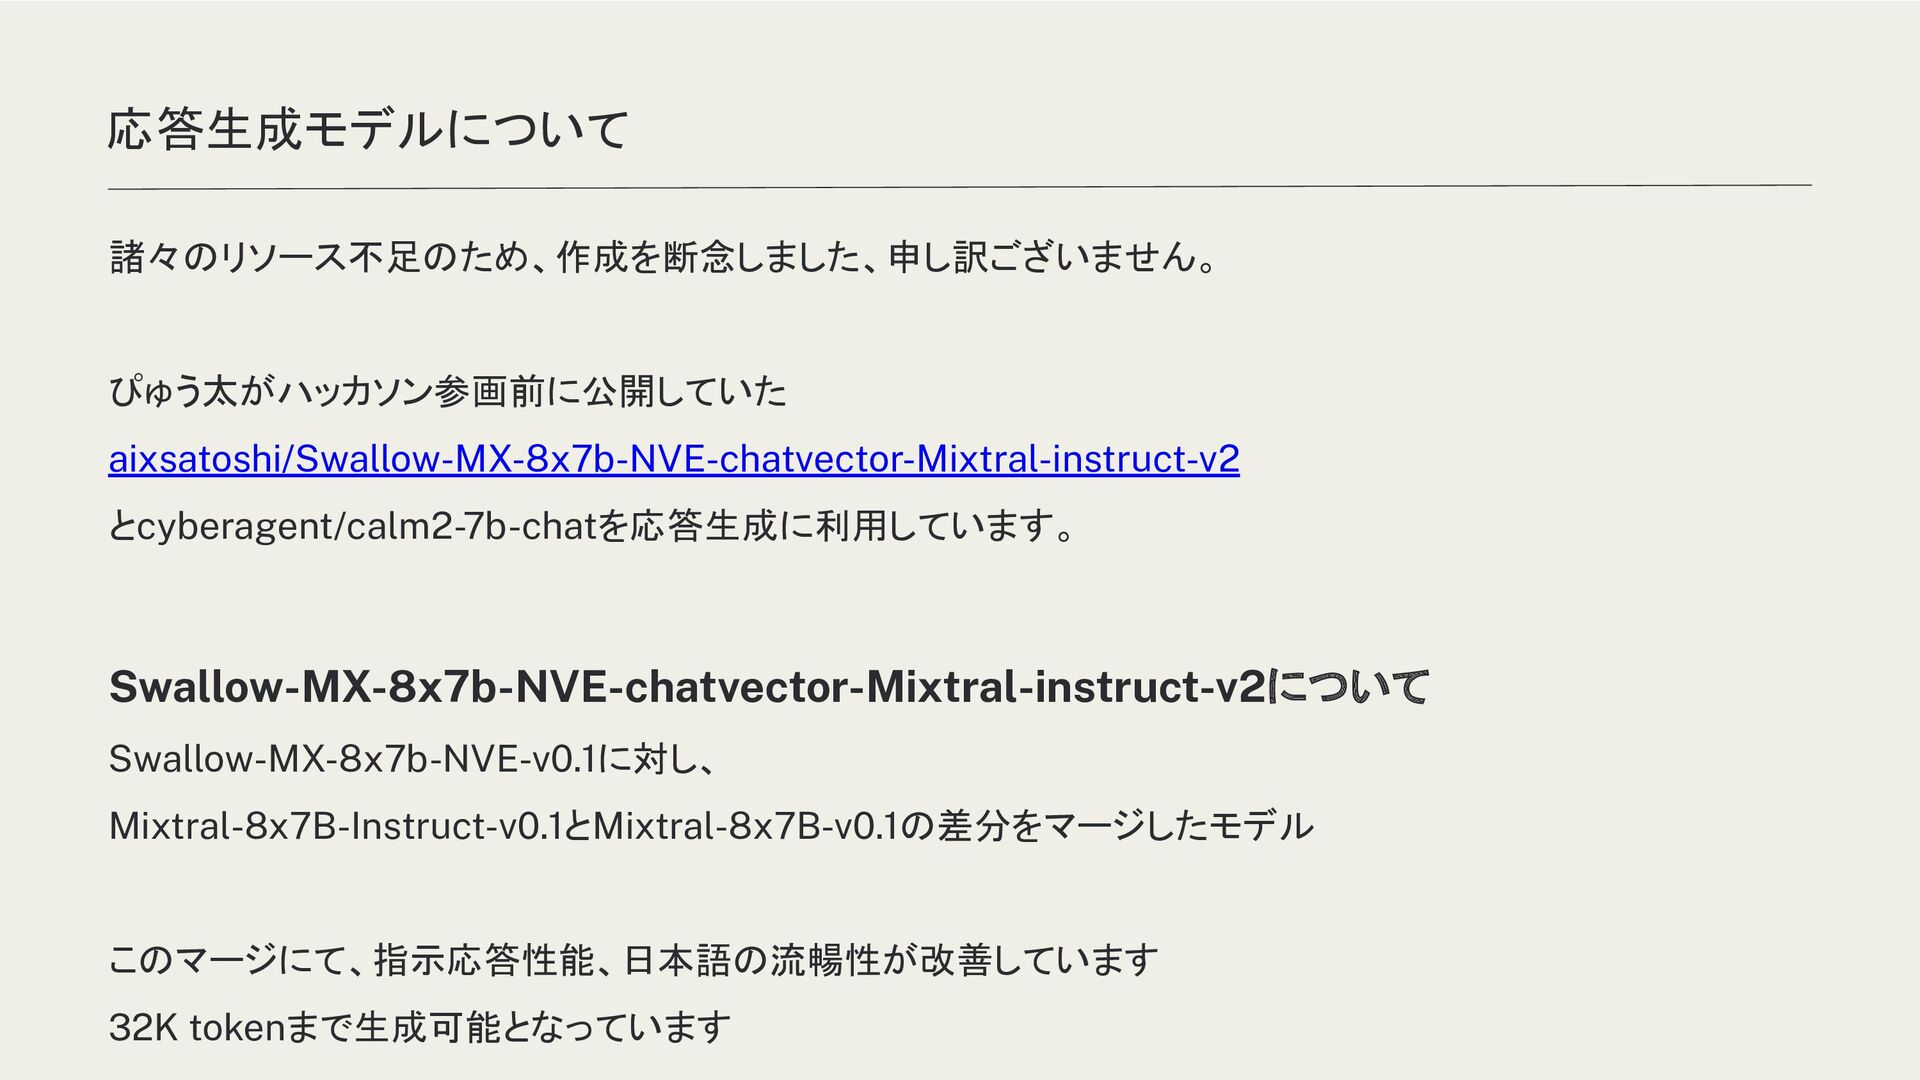
応答生成モデルについて 諸々のリソース不足のため、作成を断念しました、申し訳ございません。 ぴゅう太がハッカソン参画前に公開していた aixsatoshi/Swallow-MX-8x7b-NVE-chatvector-Mixtral-instruct-v2 とcyberagent/calm2-7b-chatを応答生成に利用しています。 Swallow-MX-8x7b-NVE-chatvector-Mixtral-instruct-v2について Swallow-MX-8x7b-NVE-v0.1に対し、 Mixtral-8x7B-Instruct-v0.1とMixtral-8x7B-v0.1の差分をマージしたモデル このマージにて、指示応答性能、日本語の流暢性が改善しています 32K
tokenまで生成可能となっています
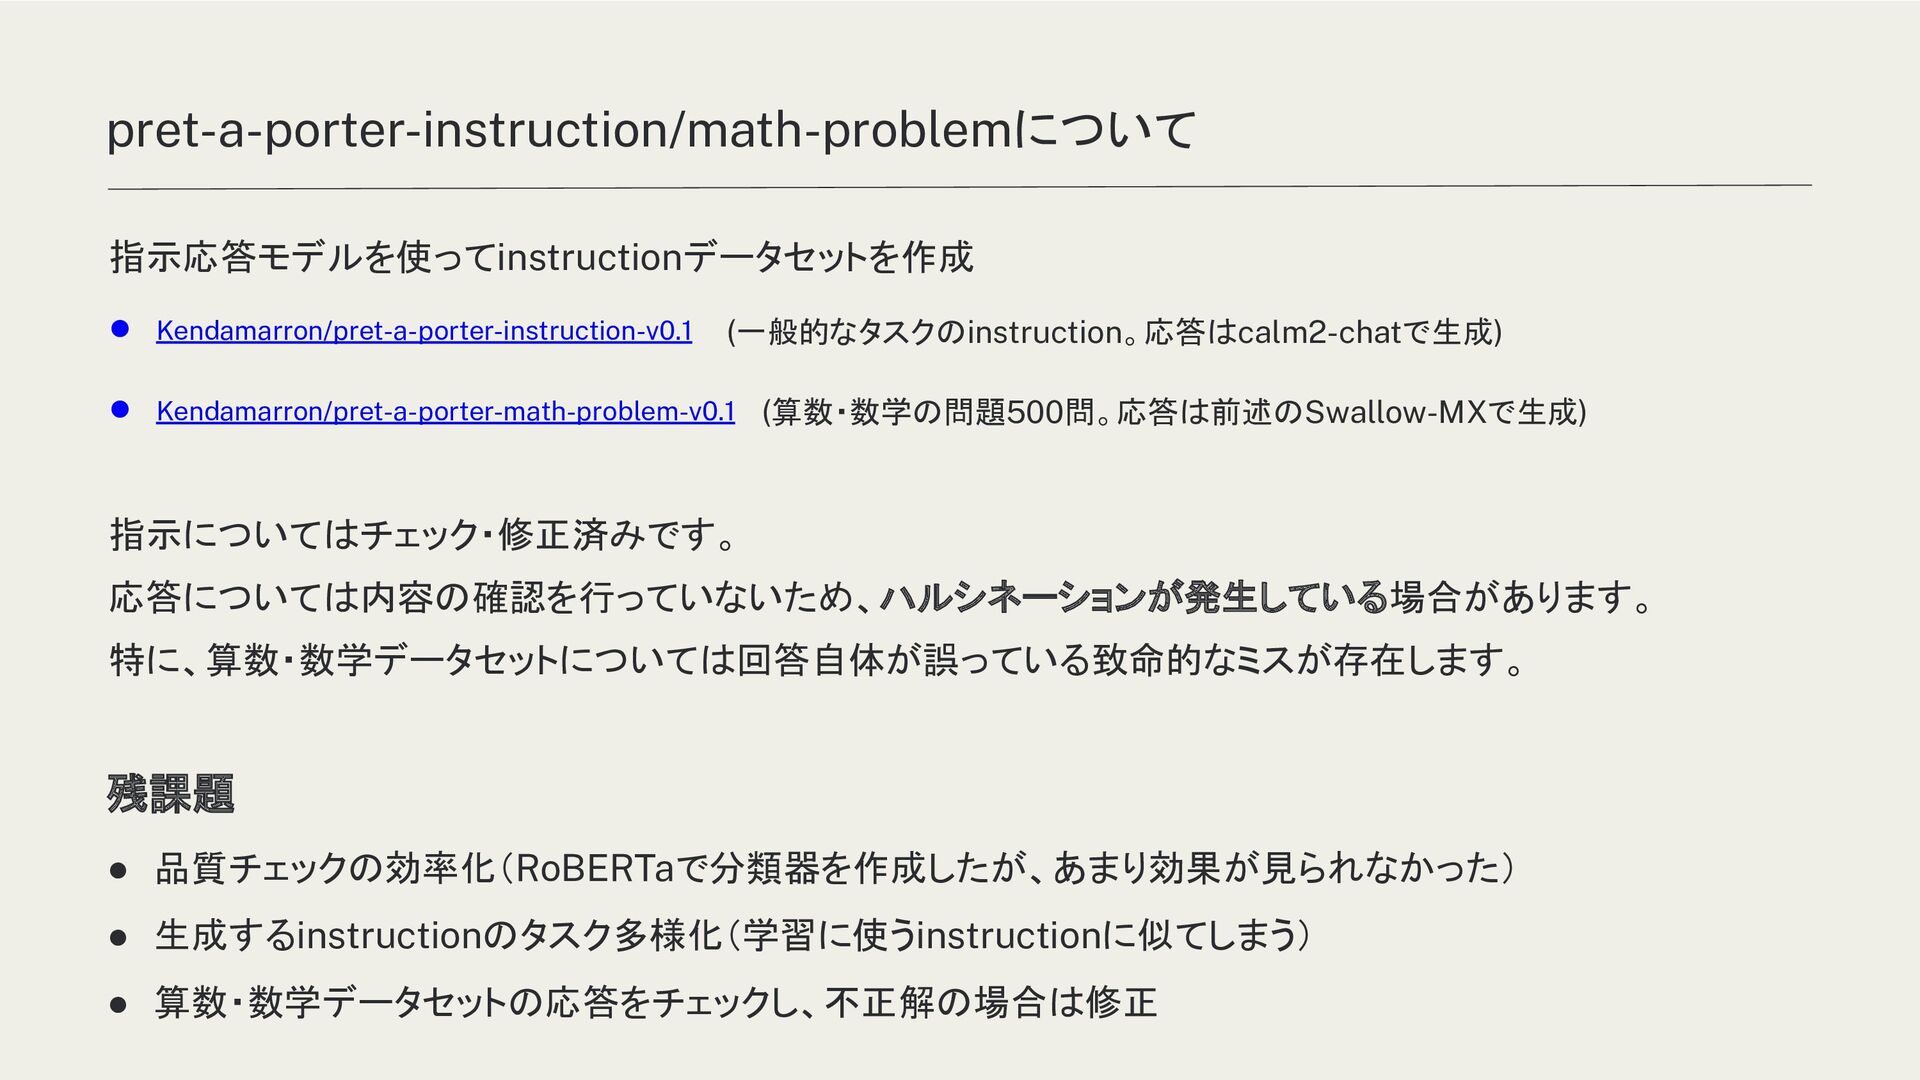
pret-a-porter-instruction/math-problemについて 指示応答モデルを使ってinstructionデータセットを作成 • Kendamarron/pret-a-porter-instruction-v0.1 • Kendamarron/pret-a-porter-math-problem-v0.1 指示についてはチェック・修正済みです。 応答については内容の確認を行っていないため、ハルシネーションが発生している場合があります。 特に、算数・数学データセットについては回答自体が誤っている致命的なミスが存在します。 残課題
• 品質チェックの効率化(RoBERTaで分類器を作成したが、あまり効果が見られなかった) • 生成するinstructionのタスク多様化(学習に使うinstructionに似てしまう) • 算数・数学データセットの応答をチェックし、不正解の場合は修正 (一般的なタスクのinstruction。応答はcalm2-chatで生成) (算数・数学の問題500問。応答は前述のSwallow-MXで生成)
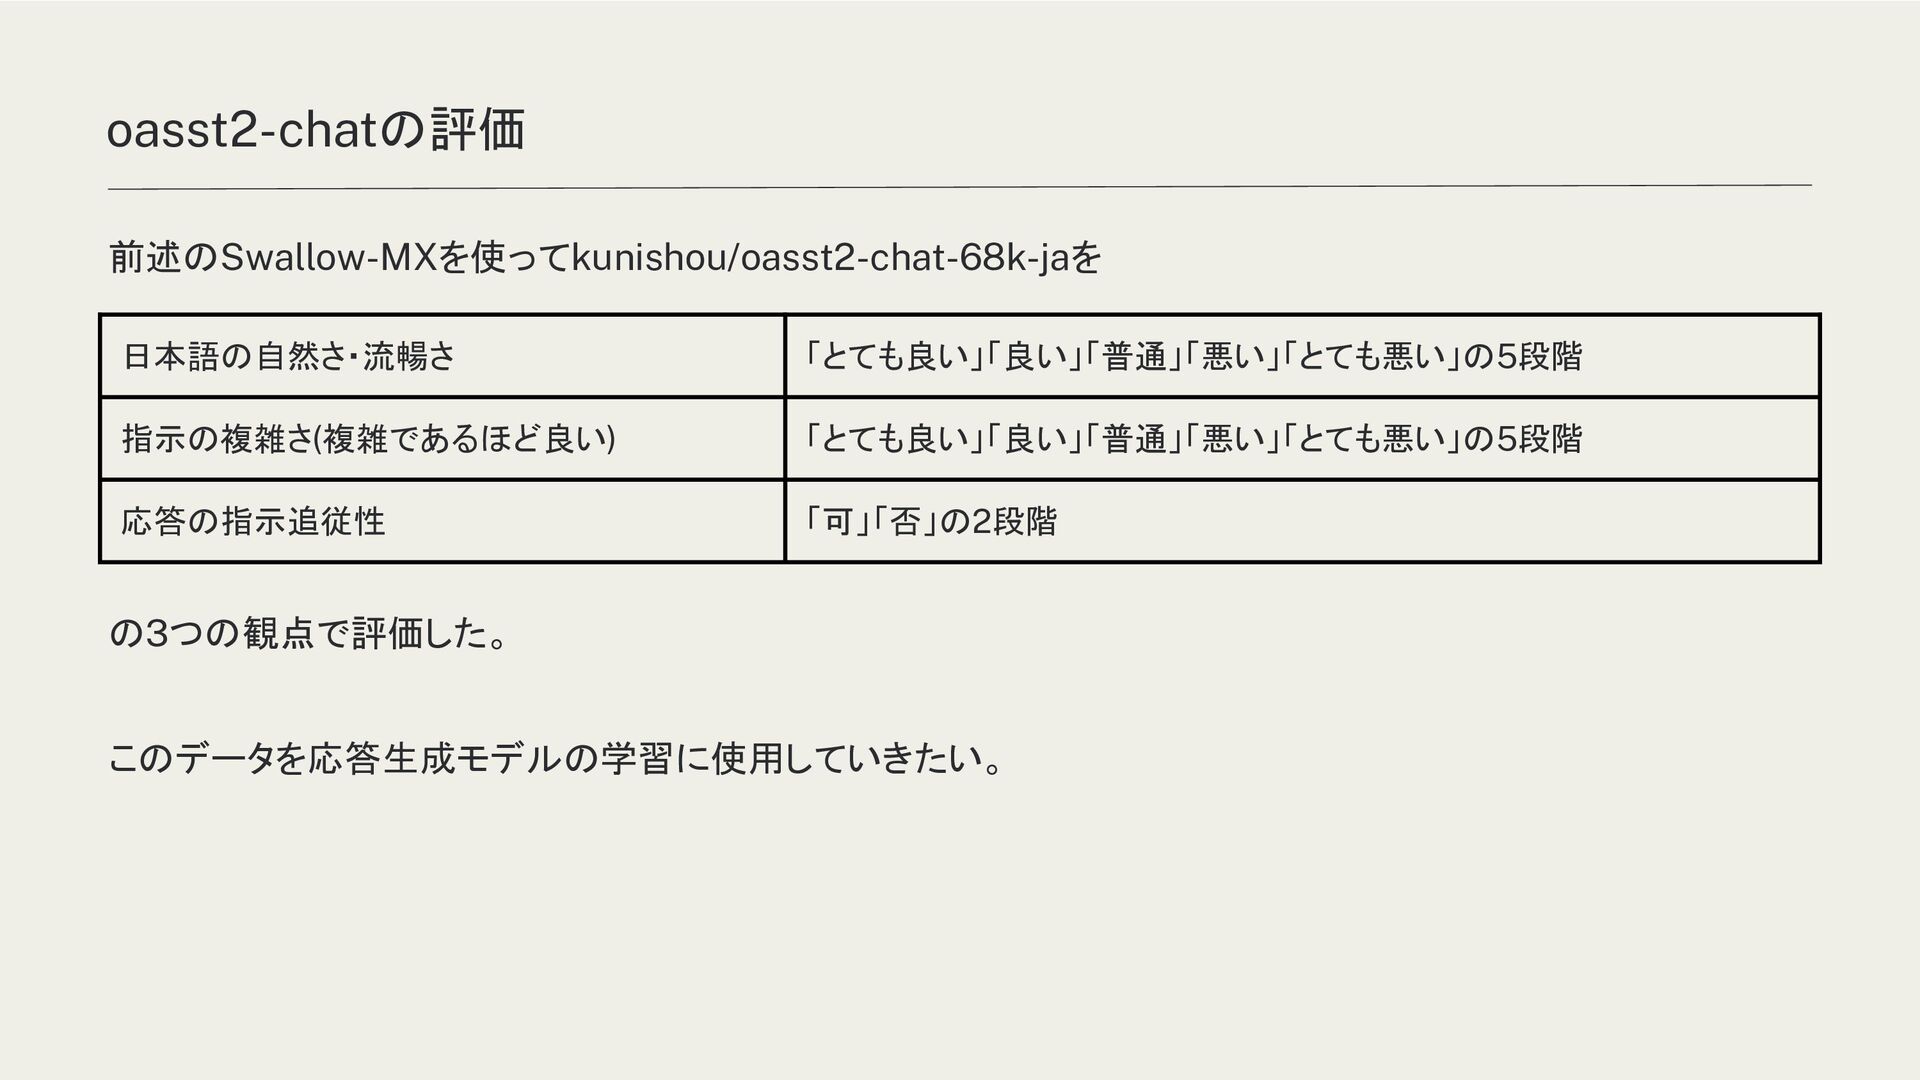
oasst2-chatの評価 前述のSwallow-MXを使ってkunishou/oasst2-chat-68k-jaを の3つの観点で評価した。 このデータを応答生成モデルの学習に使用していきたい。 日本語の自然さ・流暢さ 「とても良い」「良い」「普通」「悪い」「とても悪い」の5段階 指示の複雑さ(複雑であるほど良い) 「とても良い」「良い」「普通」「悪い」「とても悪い」の5段階 応答の指示追従性 「可」「否」の2段階
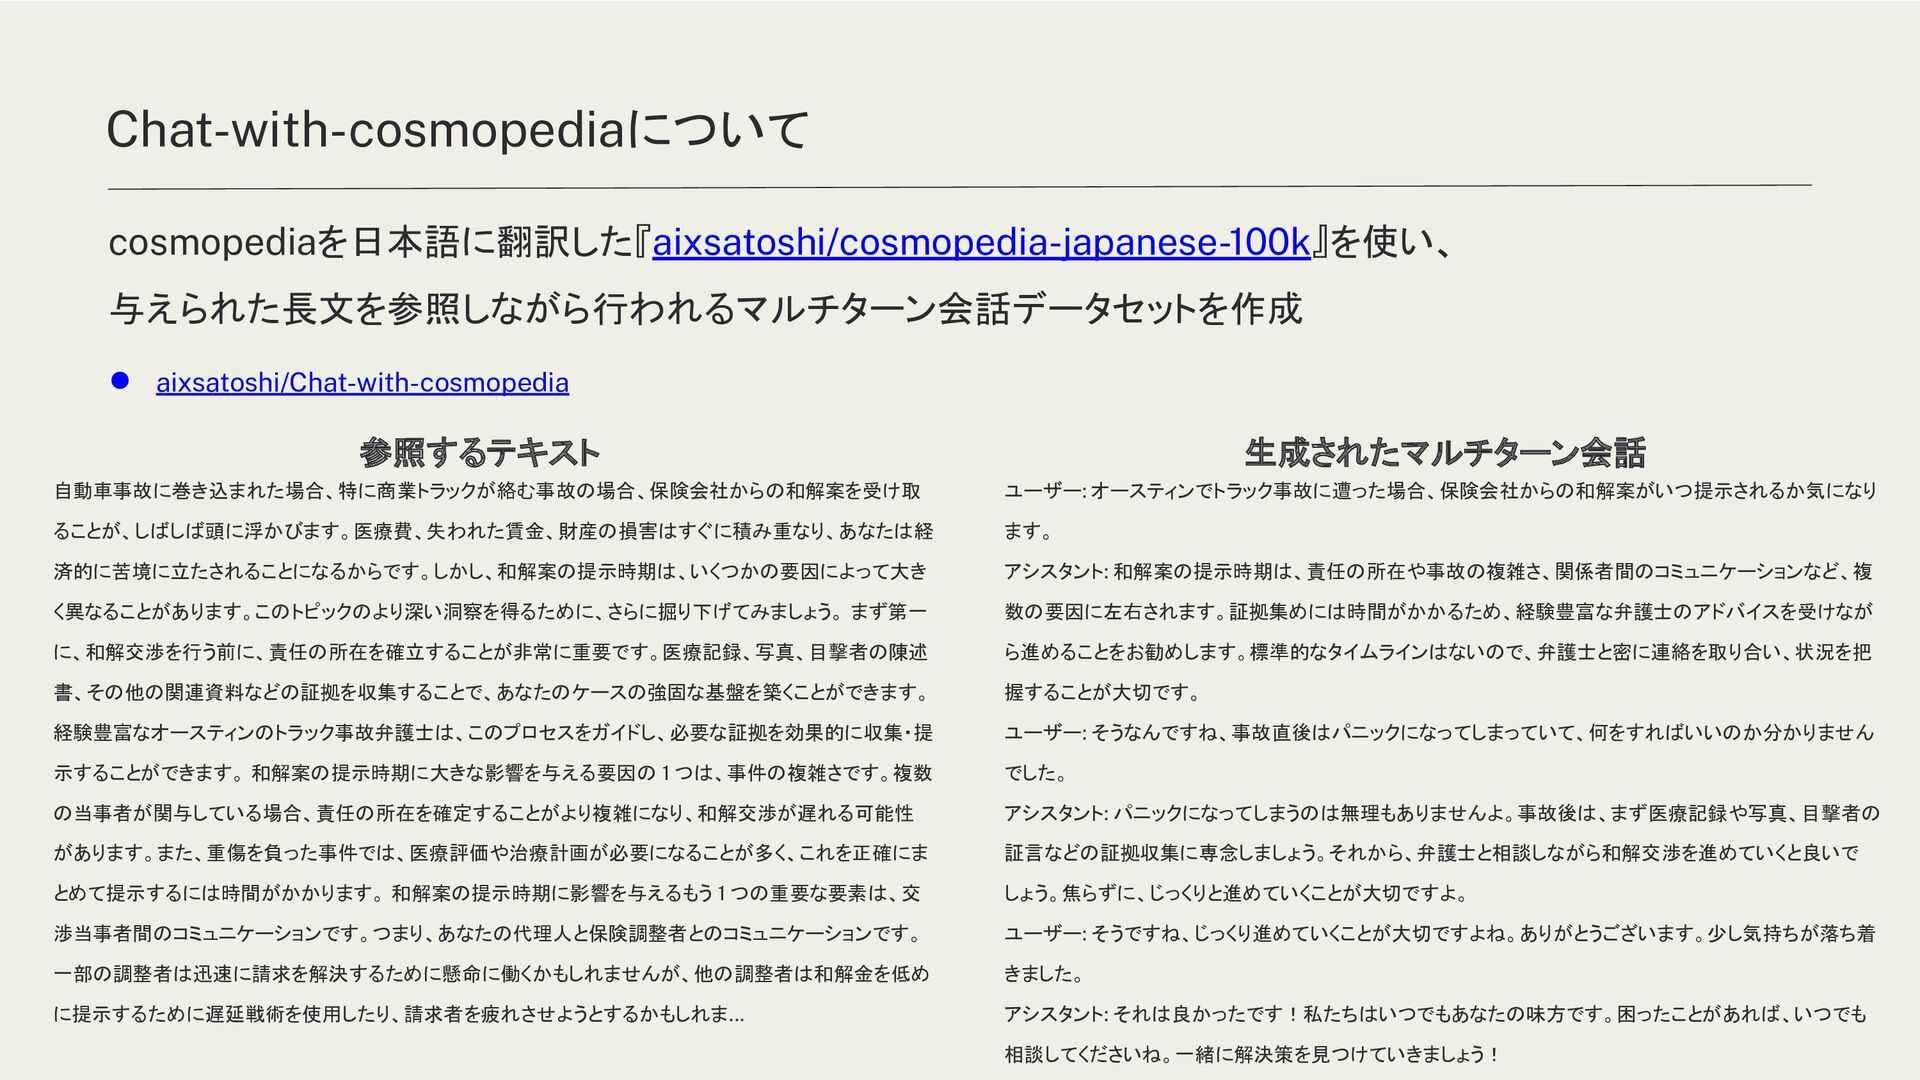
Chat-with-cosmopediaについて cosmopediaを日本語に翻訳した『aixsatoshi/cosmopedia-japanese-100k』を使い、 与えられた長文を参照しながら行われるマルチターン会話データセットを作成 • aixsatoshi/Chat-with-cosmopedia ユーザー: オースティンでトラック事故に遭った場合、保険会社からの和解案がいつ提示されるか気になり ます。 アシスタント: 和解案の提示時期は、責任の所在や事故の複雑さ、関係者間のコミュニケーションなど、複
数の要因に左右されます。証拠集めには時間がかかるため、経験豊富な弁護士のアドバイスを受けなが ら進めることをお勧めします。標準的なタイムラインはないので、弁護士と密に連絡を取り合い、状況を把 握することが大切です。 ユーザー: そうなんですね、事故直後はパニックになってしまっていて、何をすればいいのか分かりません でした。 アシスタント: パニックになってしまうのは無理もありませんよ。事故後は、まず医療記録や写真、目撃者の 証言などの証拠収集に専念しましょう。それから、弁護士と相談しながら和解交渉を進めていくと良いで しょう。焦らずに、じっくりと進めていくことが大切ですよ。 ユーザー: そうですね、じっくり進めていくことが大切ですよね。ありがとうございます。少し気持ちが落ち着 きました。 アシスタント: それは良かったです!私たちはいつでもあなたの味方です。困ったことがあれば、いつでも 相談してくださいね。一緒に解決策を見つけていきましょう! 自動車事故に巻き込まれた場合、特に商業トラックが絡む事故の場合、保険会社からの和解案を受け取 ることが、しばしば頭に浮かびます。医療費、失われた賃金、財産の損害はすぐに積み重なり、あなたは経 済的に苦境に立たされることになるからです。しかし、和解案の提示時期は、いくつかの要因によって大き く異なることがあります。このトピックのより深い洞察を得るために、さらに掘り下げてみましょう。 まず第一 に、和解交渉を行う前に、責任の所在を確立することが非常に重要です。医療記録、写真、目撃者の陳述 書、その他の関連資料などの証拠を収集することで、あなたのケースの強固な基盤を築くことができます。 経験豊富なオースティンのトラック事故弁護士は、このプロセスをガイドし、必要な証拠を効果的に収集・提 示することができます。 和解案の提示時期に大きな影響を与える要因の 1 つは、事件の複雑さです。複数 の当事者が関与している場合、責任の所在を確定することがより複雑になり、和解交渉が遅れる可能性 があります。また、重傷を負った事件では、医療評価や治療計画が必要になることが多く、これを正確にま とめて提示するには時間がかかります。 和解案の提示時期に影響を与えるもう 1 つの重要な要素は、交 渉当事者間のコミュニケーションです。つまり、あなたの代理人と保険調整者とのコミュニケーションです。 一部の調整者は迅速に請求を解決するために懸命に働くかもしれませんが、他の調整者は和解金を低め に提示するために遅延戦術を使用したり、請求者を疲れさせようとするかもしれま... 参照するテキスト 生成されたマルチターン会話
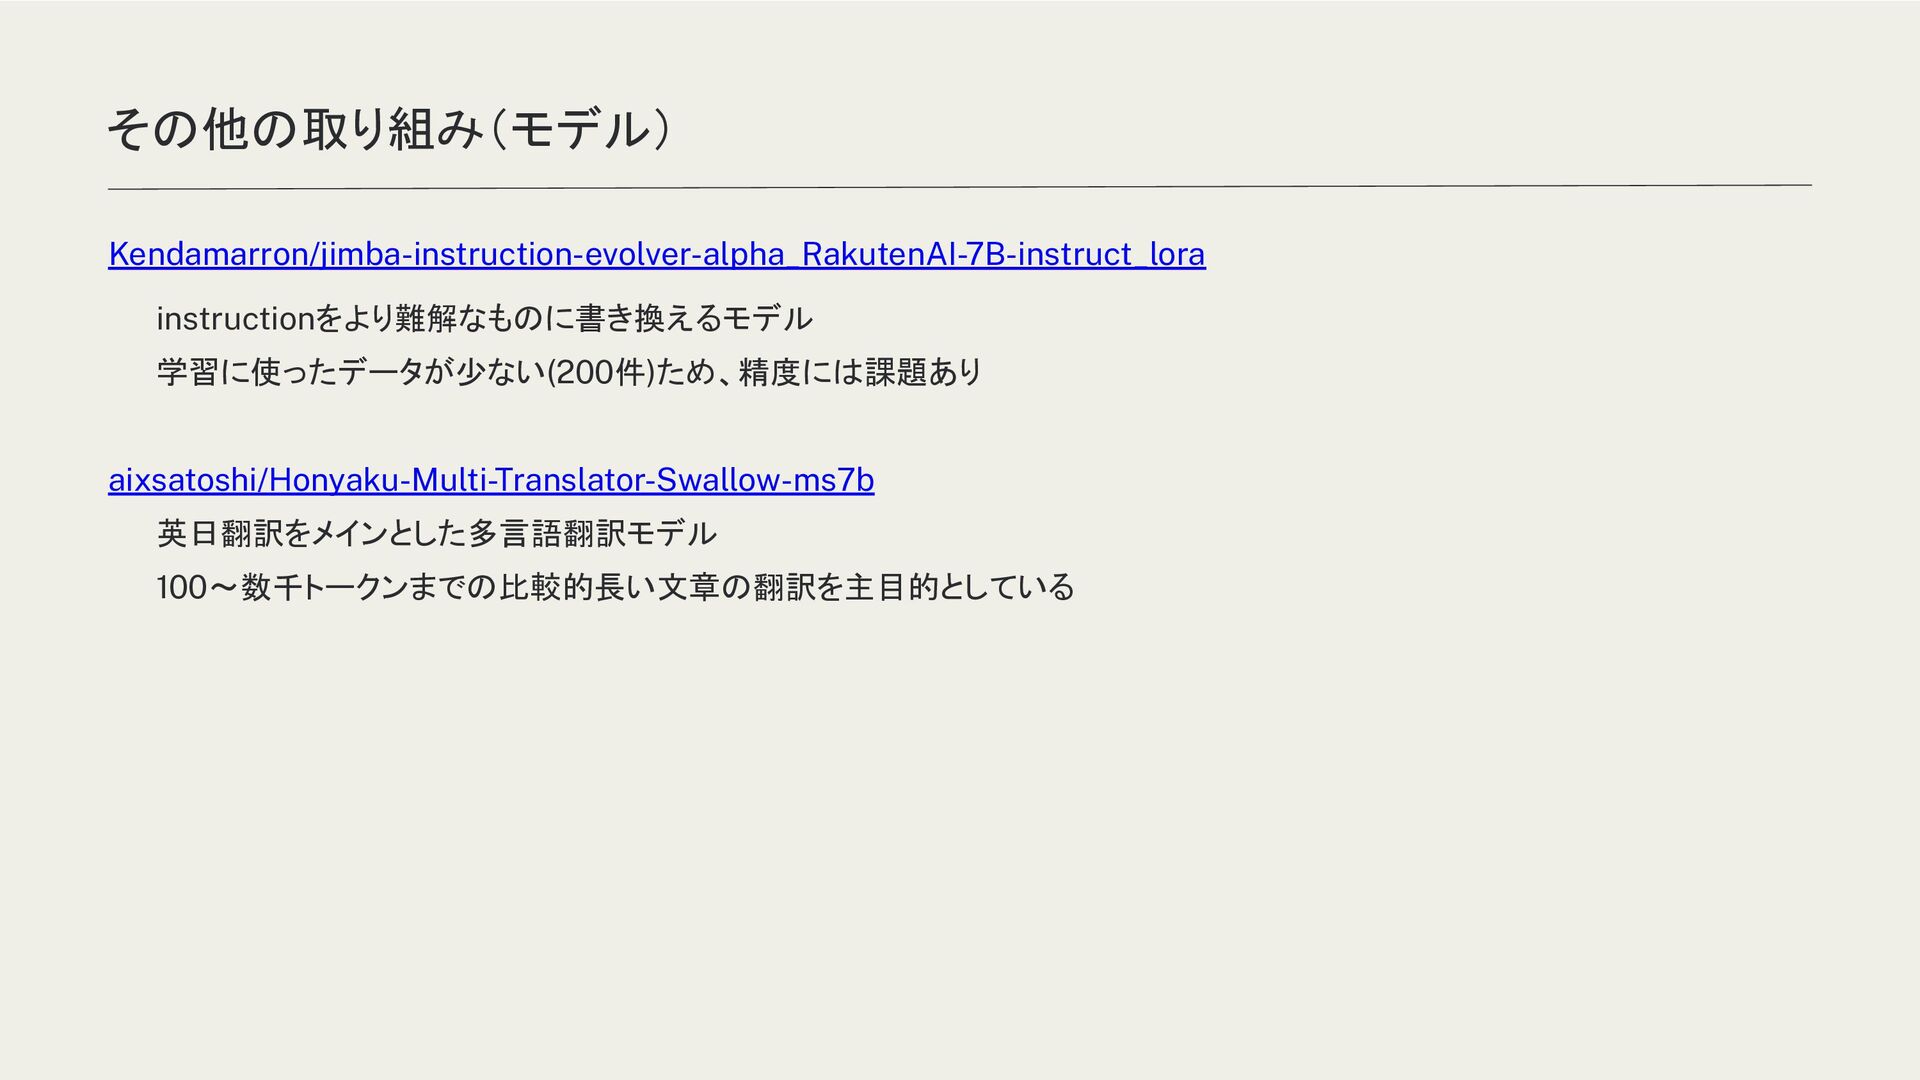
その他の取り組み(モデル) Kendamarron/jimba-instruction-evolver-alpha_RakutenAI-7B-instruct_lora instructionをより難解なものに書き換えるモデル 学習に使ったデータが少ない(200件)ため、精度には課題あり aixsatoshi/Honyaku-Multi-Translator-Swallow-ms7b 英日翻訳をメインとした多言語翻訳モデル 100~数千トークンまでの比較的長い文章の翻訳を主目的としている
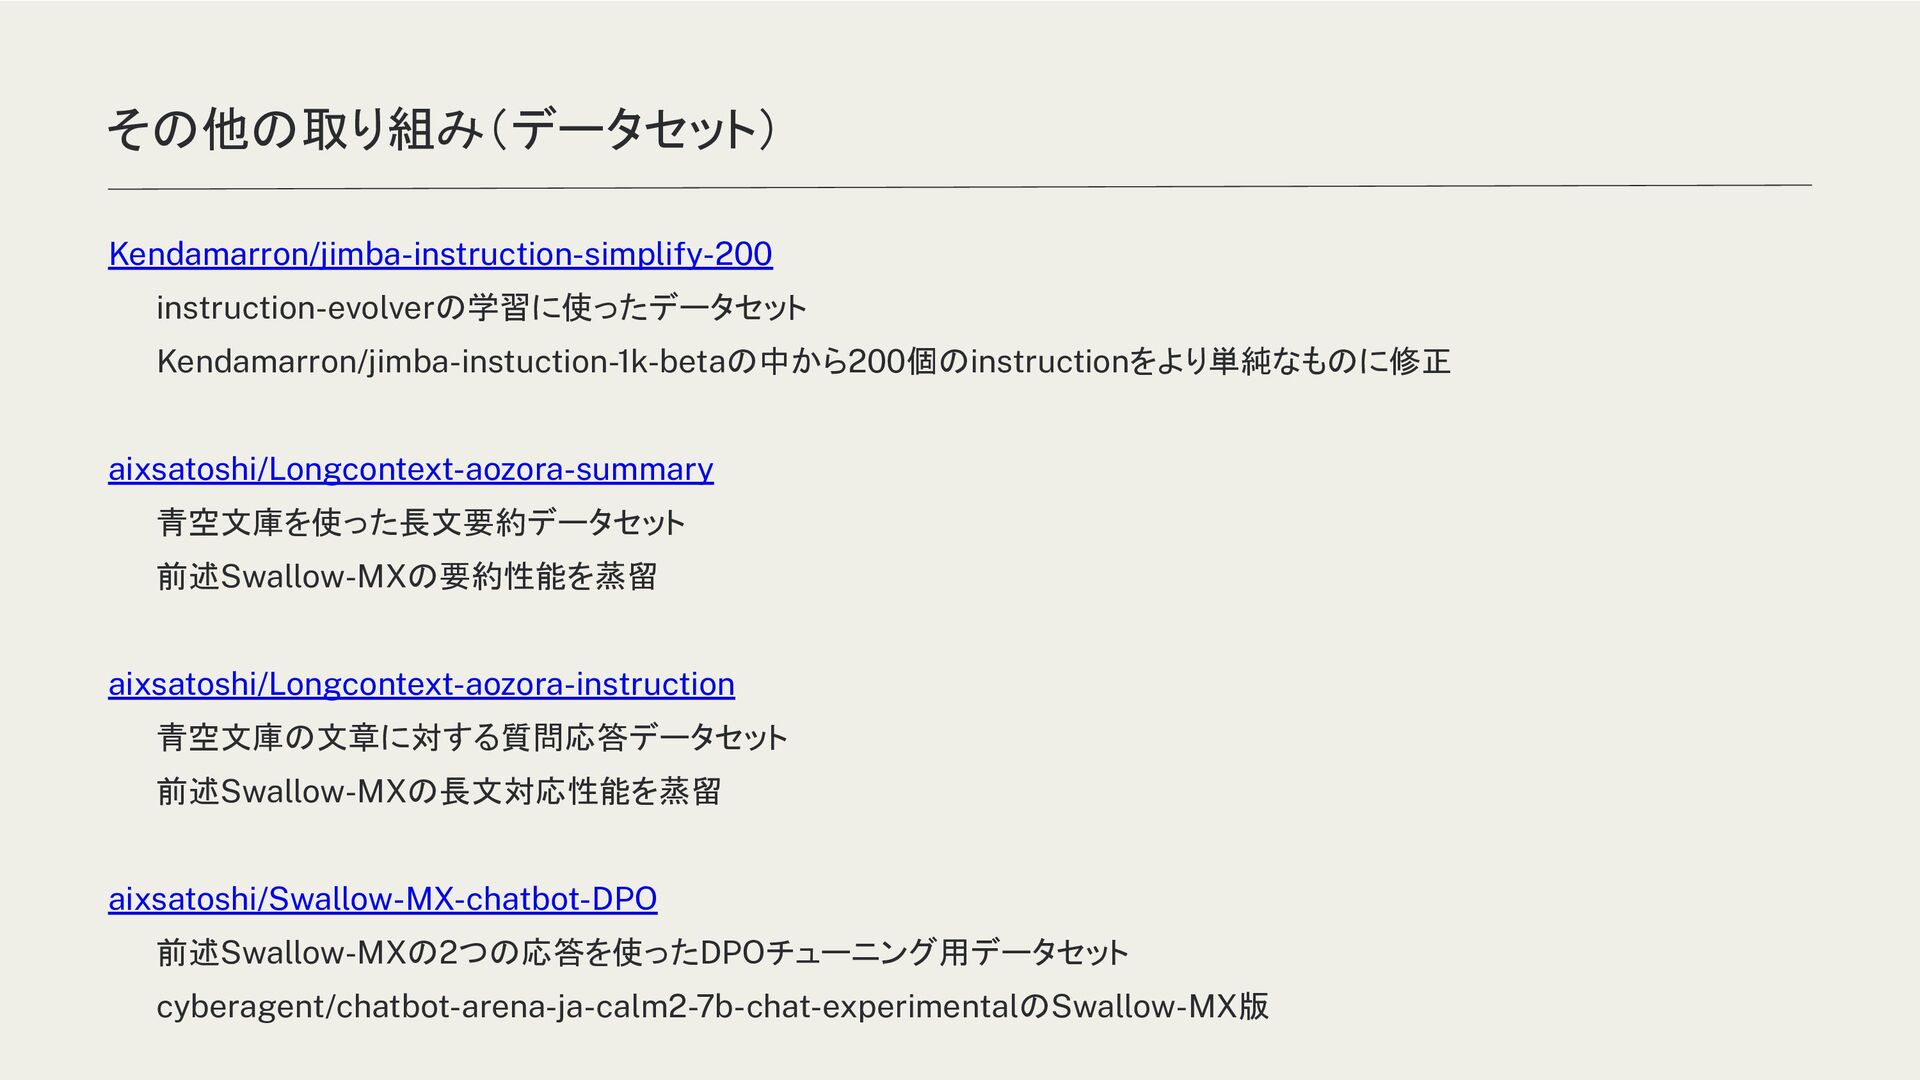
その他の取り組み(データセット) Kendamarron/jimba-instruction-simplify-200 instruction-evolverの学習に使ったデータセット Kendamarron/jimba-instuction-1k-betaの中から200個のinstructionをより単純なものに修正 aixsatoshi/Longcontext-aozora-summary 青空文庫を使った長文要約データセット 前述Swallow-MXの要約性能を蒸留 aixsatoshi/Longcontext-aozora-instruction 青空文庫の文章に対する質問応答データセット 前述Swallow-MXの長文対応性能を蒸留
aixsatoshi/Swallow-MX-chatbot-DPO 前述Swallow-MXの2つの応答を使ったDPOチューニング用データセット cyberagent/chatbot-arena-ja-calm2-7b-chat-experimentalのSwallow-MX版
今後の取り組み • ハルシネーションが発生している応答の修正 • Swallow-MXのファインチューニングによる生成する応答の品質向上 • 指示・応答生成モデルによるデータセットの拡充 • Long-contextの海外データセット翻訳 •
生成したデータセットでファインチューニングしたモデルで各種ベンチマークを実施
まとめ • オープンソースのLLMを使って合成instructionデータセットを作成した • Swallow-MXの登場で合成データを作りやすくなった • 生成物の品質・ファクトチェックを自動化するのには限界がある
ご清聴ありがとうございました ぜひ投票をお願いします!
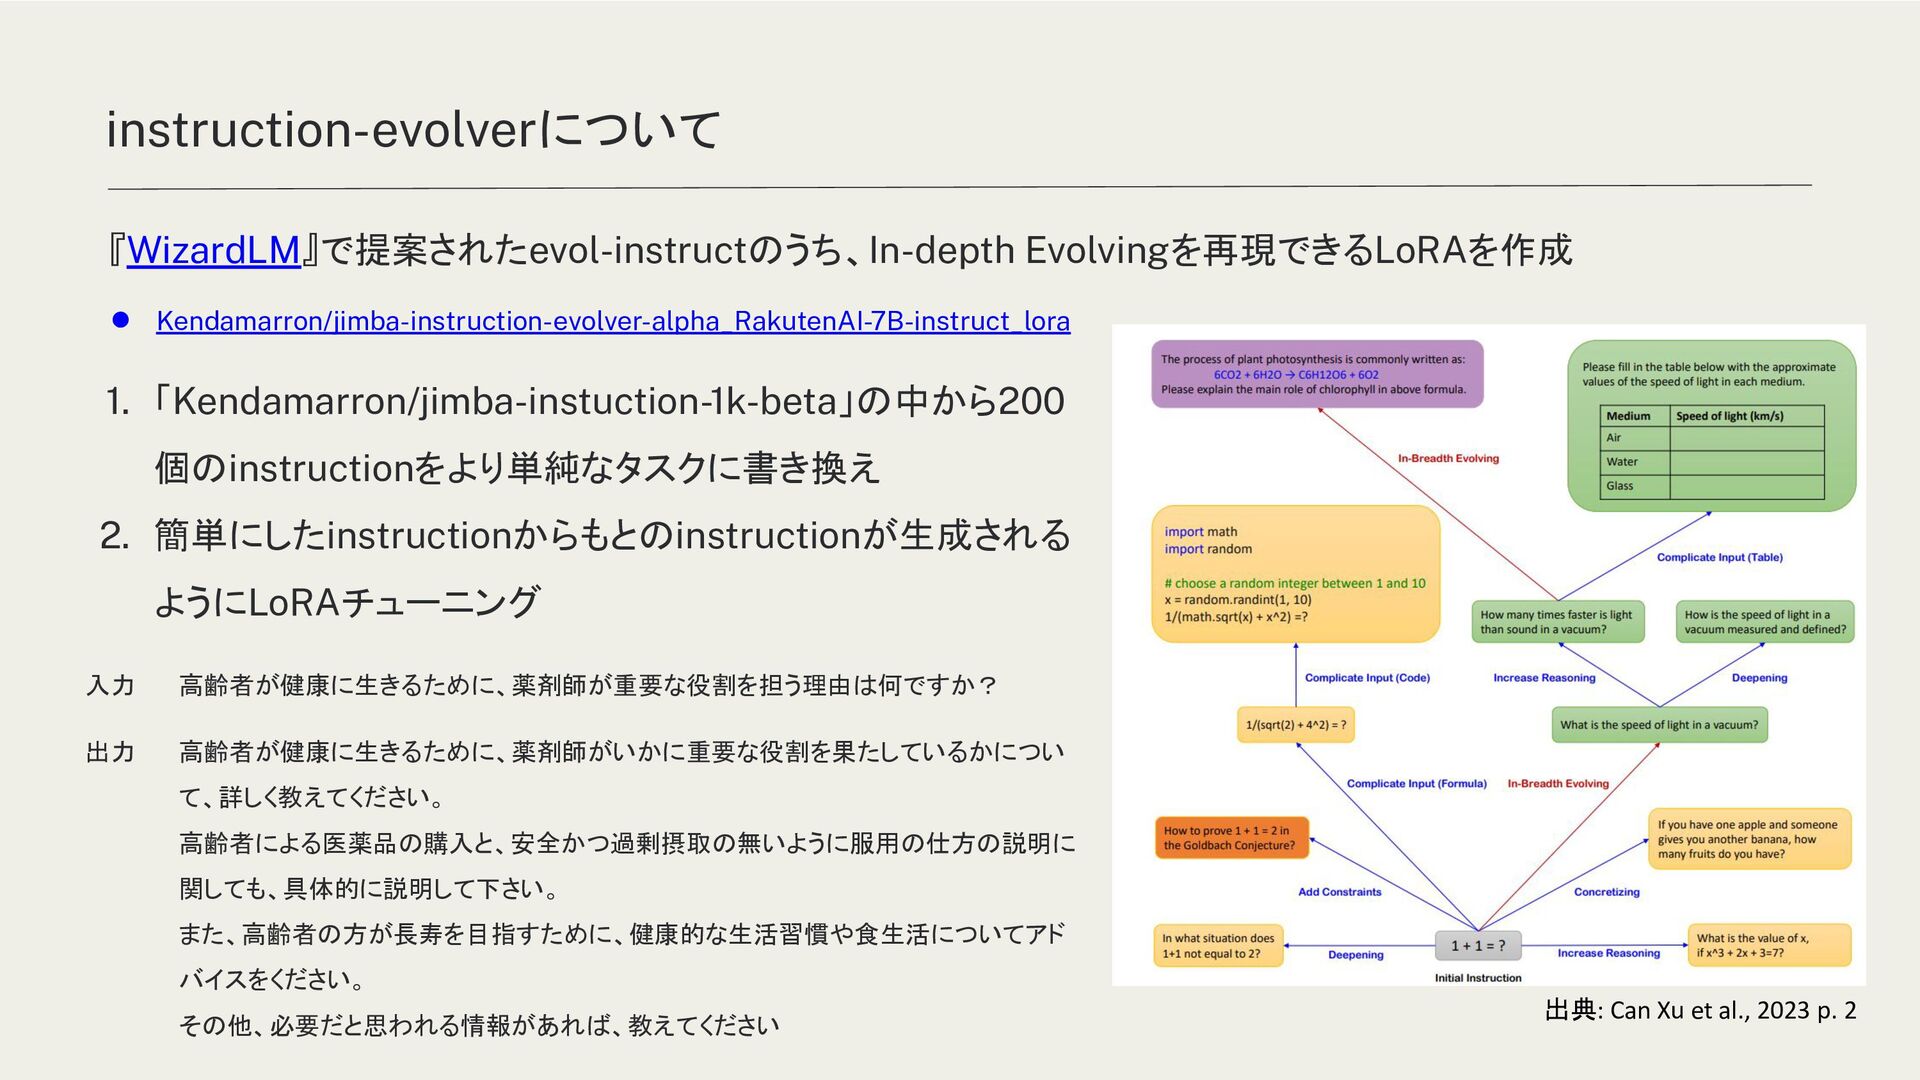
instruction-evolverについて 『WizardLM』で提案されたevol-instructのうち、In-depth Evolvingを再現できるLoRAを作成 • Kendamarron/jimba-instruction-evolver-alpha_RakutenAI-7B-instruct_lora 出典: Can Xu et al.,
2023 p. 2 1. 「Kendamarron/jimba-instuction-1k-beta」の中から200 個のinstructionをより単純なタスクに書き換え 2. 簡単にしたinstructionからもとのinstructionが生成される ようにLoRAチューニング 高齢者が健康に生きるために、薬剤師が重要な役割を担う理由は何ですか? 高齢者が健康に生きるために、薬剤師がいかに重要な役割を果たしているかについ て、詳しく教えてください。 高齢者による医薬品の購入と、安全かつ過剰摂取の無いように服用の仕方の説明に 関しても、具体的に説明して下さい。 また、高齢者の方が長寿を目指すために、健康的な生活習慣や食生活についてアド バイスをください。 その他、必要だと思われる情報があれば、教えてください 入力 出力


 kastner
 watany
 helmedeiros
 mayunak
 rmw
 greggifford
 erikaheidi
 mlcsv
 ryanjones
 scottboms
 tammyeverts
 bcantrill