Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
企業の信用リスク分析 ~信用格付モデルの構築~
Search
Kensei
March 08, 2020
610
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
企業の信用リスク分析 ~信用格付モデルの構築~
Kensei
March 08, 2020
Featured
See All Featured
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
270
How to train your dragon (web standard)
notwaldorf
96
6.9k
エンジニアに許された特別な時間の終わり
watany
109
250k
10 Git Anti Patterns You Should be Aware of
lemiorhan
PRO
659
62k
Typedesign – Prime Four
hannesfritz
42
3.2k
Navigating Weather and Climate Data
rabernat
0
560
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
530
More Than Pixels: Becoming A User Experience Designer
marktimemedia
3
570
GraphQLとの向き合い方2022年版
quramy
50
15k
Optimizing for Happiness
mojombo
378
71k
Making Projects Easy
brettharned
120
6.8k
Optimising Largest Contentful Paint
csswizardry
37
4k
Transcript
小森 健世 D F Data Finance 企業の信用リスク分析 ~信用格付モデルの構築~
Copyright 2020 Kensei Komori 1 0.目次 1.分析目的の設定 2.仮説を立てる 3.データの準備 4.データの確認
5.モデルの決定 6.モデルの構築・評価 8.今後に向けて 7.ビジネス活用の例
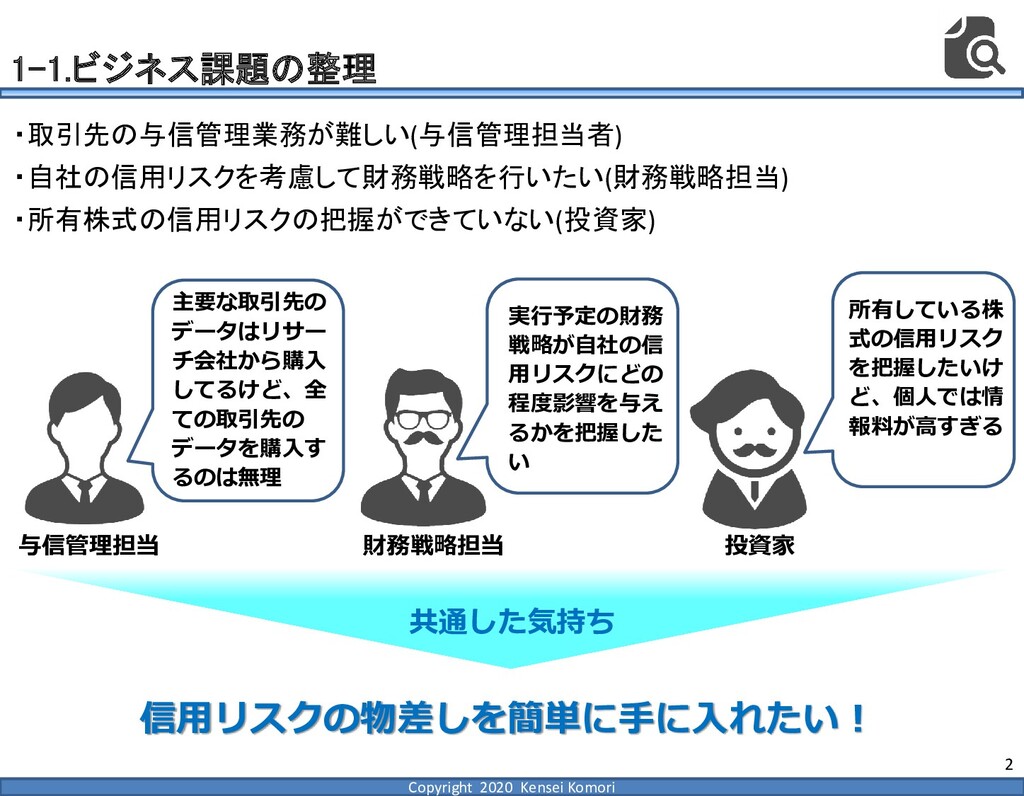
Copyright 2020 Kensei Komori 2 1-1.ビジネス課題の整理 与信管理担当 財務戦略担当 投資家 主要な取引先の
データはリサー チ会社から購入 してるけど、全 ての取引先の データを購入す るのは無理 ・取引先の与信管理業務が難しい(与信管理担当者) ・自社の信用リスクを考慮して財務戦略を行いたい(財務戦略担当) ・所有株式の信用リスクの把握ができていない(投資家) 実行予定の財務 戦略が自社の信 用リスクにどの 程度影響を与え るかを把握した い 所有している株 式の信用リスク を把握したいけ ど、個人では情 報料が高すぎる 信用リスクの物差しを簡単に手に入れたい! 共通した気持ち
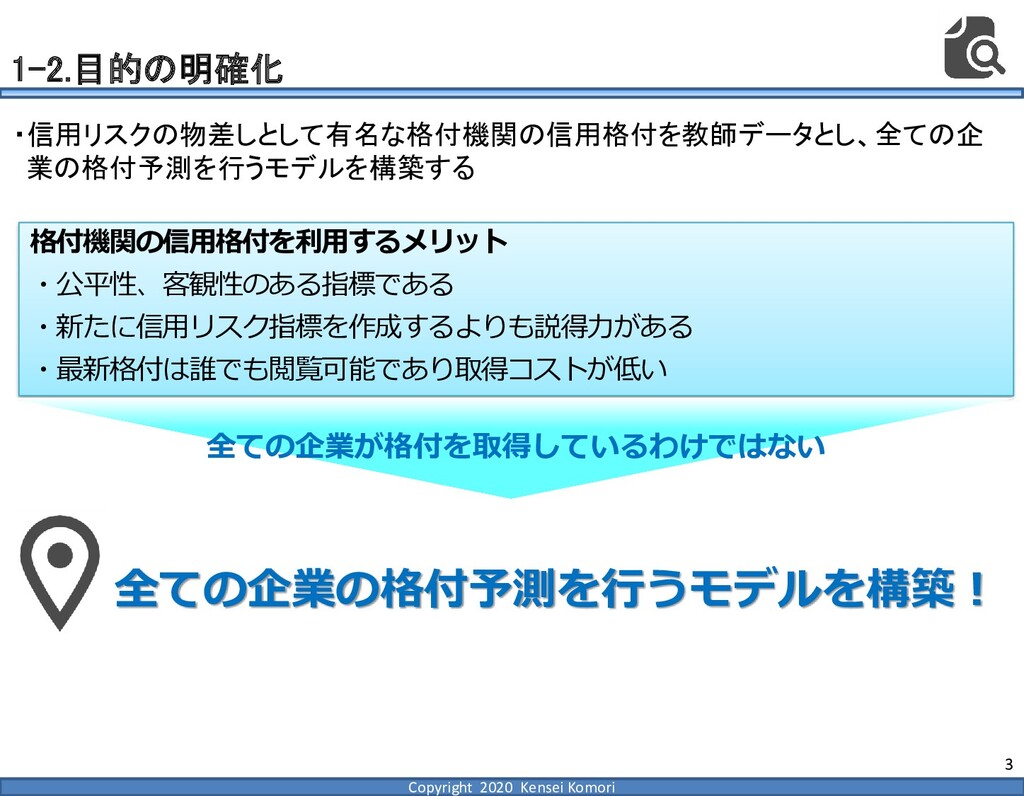
Copyright 2020 Kensei Komori 3 1-2.目的の明確化 ・信用リスクの物差しとして有名な格付機関の信用格付を教師データとし、全ての企 業の格付予測を行うモデルを構築する 格付機関の信用格付を利用するメリット ・公平性、客観性のある指標である
・新たに信用リスク指標を作成するよりも説得力がある ・最新格付は誰でも閲覧可能であり取得コストが低い 全ての企業が格付を取得しているわけではない 全ての企業の格付予測を行うモデルを構築!
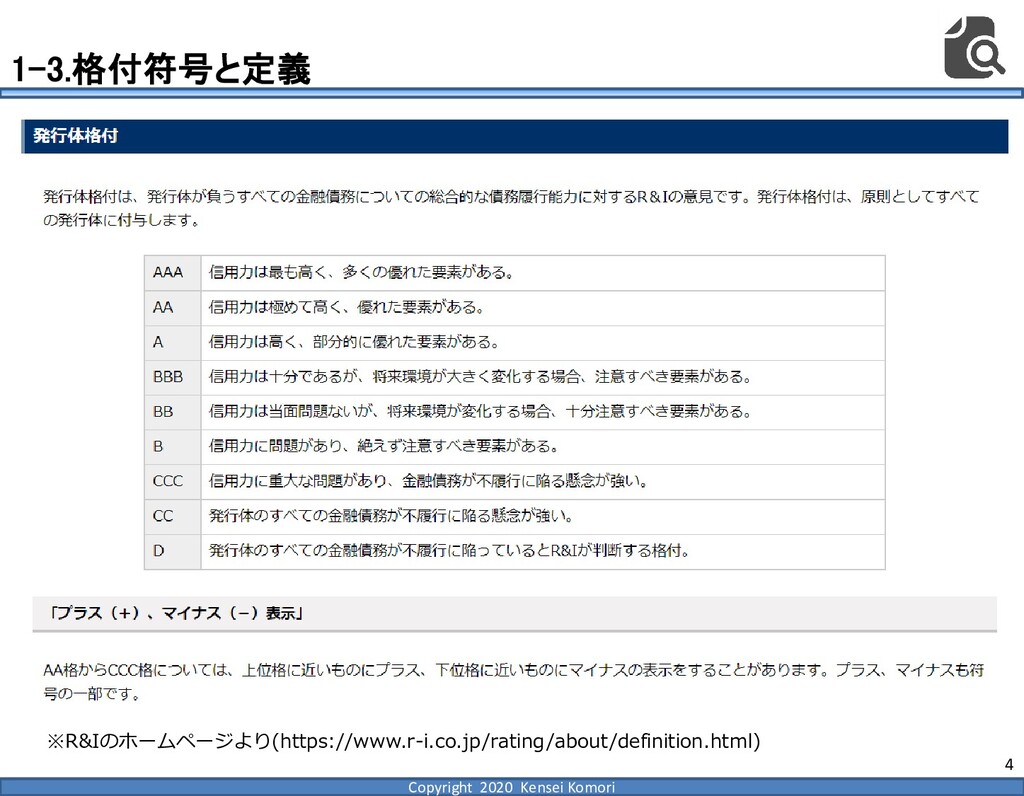
Copyright 2020 Kensei Komori 4 1-3.格付符号と定義 ※R&Iのホームページより(https://www.r-i.co.jp/rating/about/definition.html)
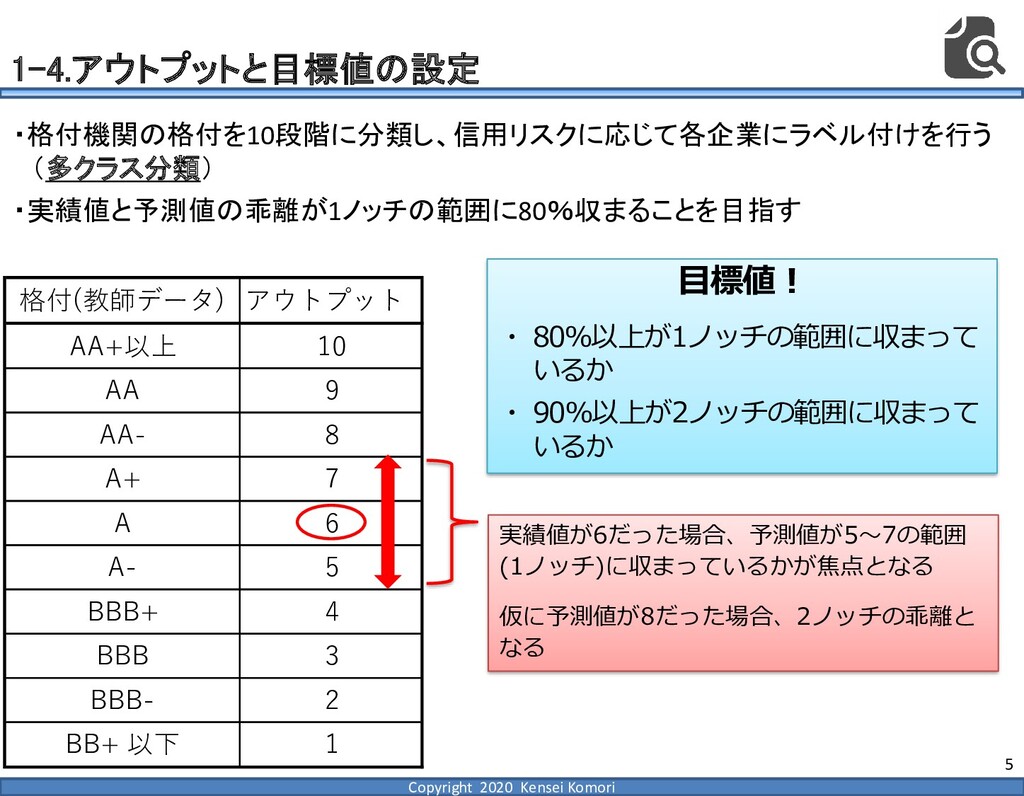
Copyright 2020 Kensei Komori 5 1-4.アウトプットと目標値の設定 ・格付機関の格付を10段階に分類し、信用リスクに応じて各企業にラベル付けを行う (多クラス分類) ・実績値と予測値の乖離が1ノッチの範囲に80%収まることを目指す 実績値が6だった場合、予測値が5~7の範囲
(1ノッチ)に収まっているかが焦点となる 仮に予測値が8だった場合、2ノッチの乖離と なる 格付(教師データ) アウトプット AA+以上 10 AA 9 AA- 8 A+ 7 A 6 A- 5 BBB+ 4 BBB 3 BBB- 2 BB+ 以下 1 目標値! ・ 80%以上が1ノッチの範囲に収まって いるか ・ 90%以上が2ノッチの範囲に収まって いるか
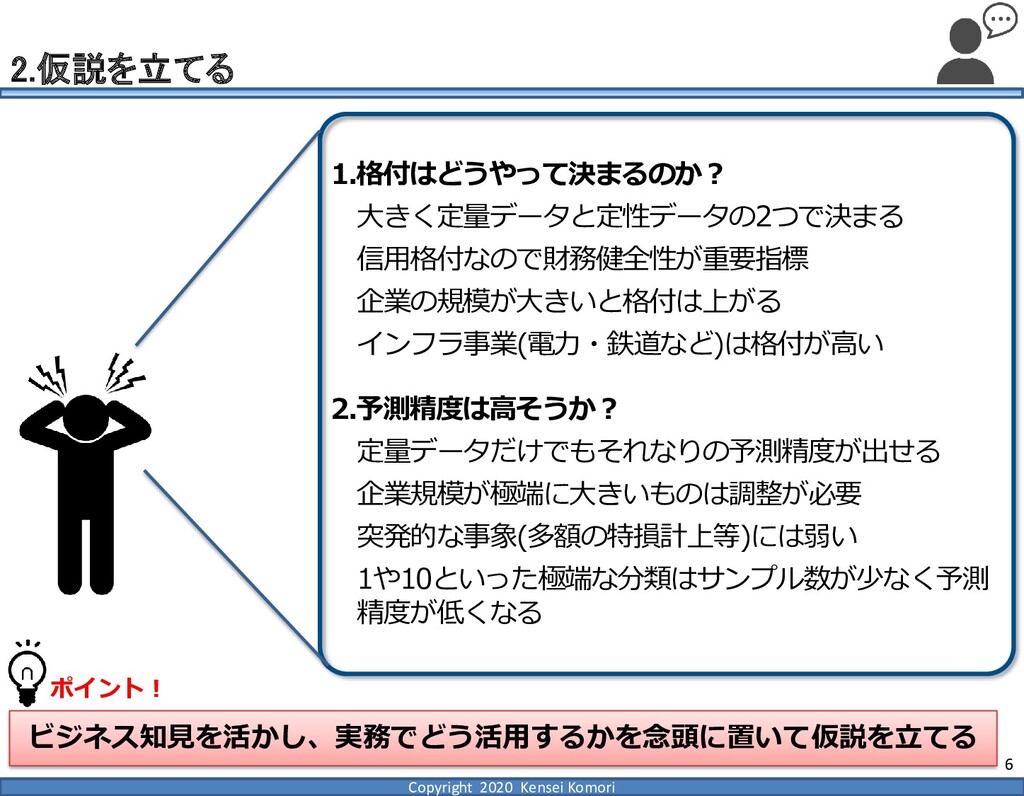
Copyright 2020 Kensei Komori 6 2.仮説を立てる 1.格付はどうやって決まるのか? 大きく定量データと定性データの2つで決まる 信用格付なので財務健全性が重要指標 企業の規模が大きいと格付は上がる
インフラ事業(電力・鉄道など)は格付が高い 2.予測精度は高そうか? 定量データだけでもそれなりの予測精度が出せる 企業規模が極端に大きいものは調整が必要 突発的な事象(多額の特損計上等)には弱い 1や10といった極端な分類はサンプル数が少なく予測 精度が低くなる ビジネス知見を活かし、実務でどう活用するかを念頭に置いて仮説を立てる ポイント!
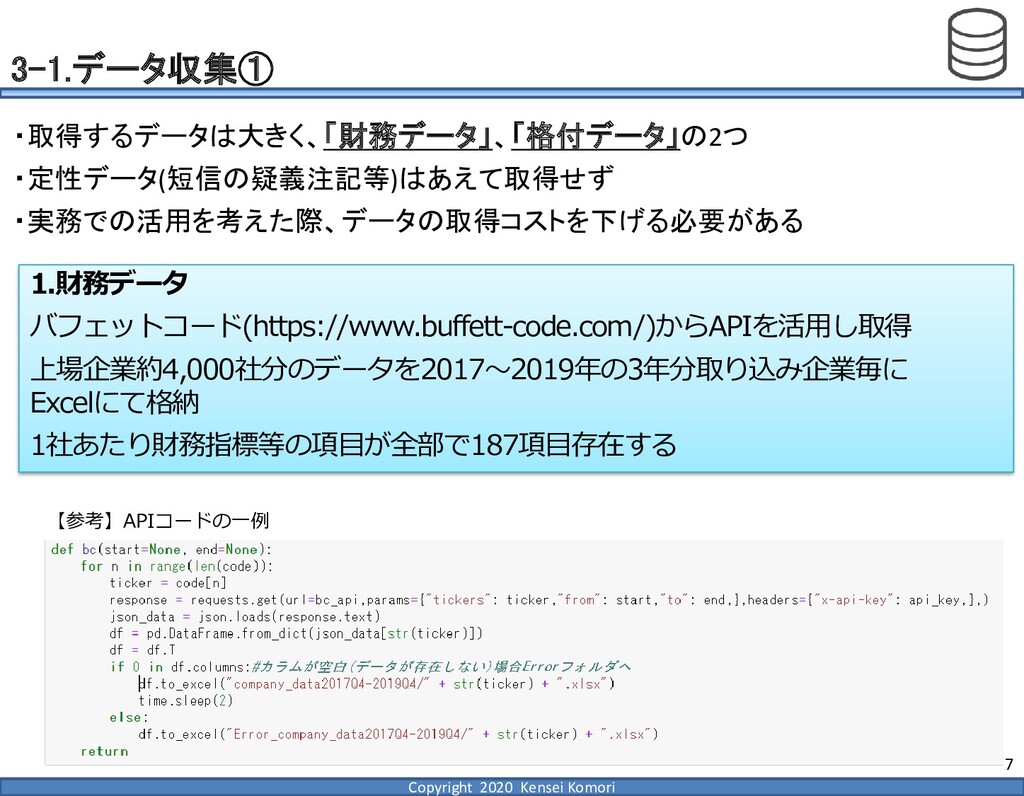
Copyright 2020 Kensei Komori 7 3-1.データ収集① ・取得するデータは大きく、「財務データ」、「格付データ」の2つ ・定性データ(短信の疑義注記等)はあえて取得せず ・実務での活用を考えた際、データの取得コストを下げる必要がある 1.財務データ
バフェットコード(https://www.buffett-code.com/)からAPIを活用し取得 上場企業約4,000社分のデータを2017~2019年の3年分取り込み企業毎に Excelにて格納 1社あたり財務指標等の項目が全部で187項目存在する 【参考】APIコードの一例
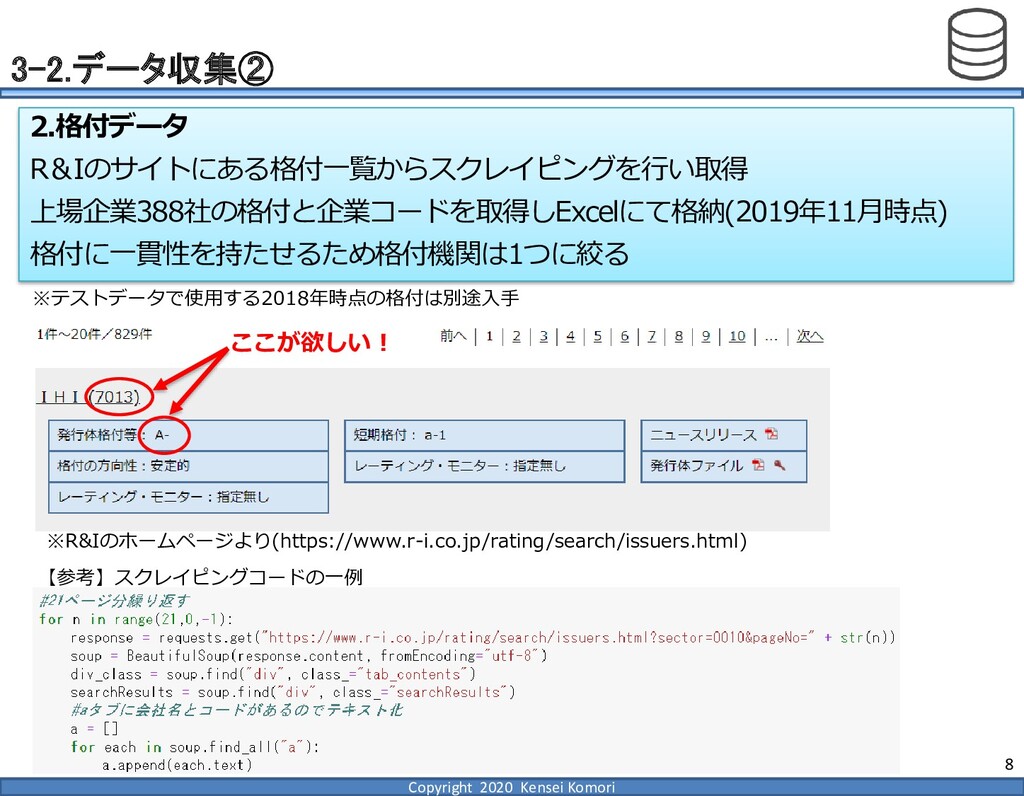
Copyright 2020 Kensei Komori 8 3-2.データ収集② 2.格付データ R&Iのサイトにある格付一覧からスクレイピングを行い取得 上場企業388社の格付と企業コードを取得しExcelにて格納(2019年11月時点) 格付に一貫性を持たせるため格付機関は1つに絞る
※R&Iのホームページより(https://www.r-i.co.jp/rating/search/issuers.html) 【参考】スクレイピングコードの一例 ここが欲しい! ※テストデータで使用する2018年時点の格付は別途入手
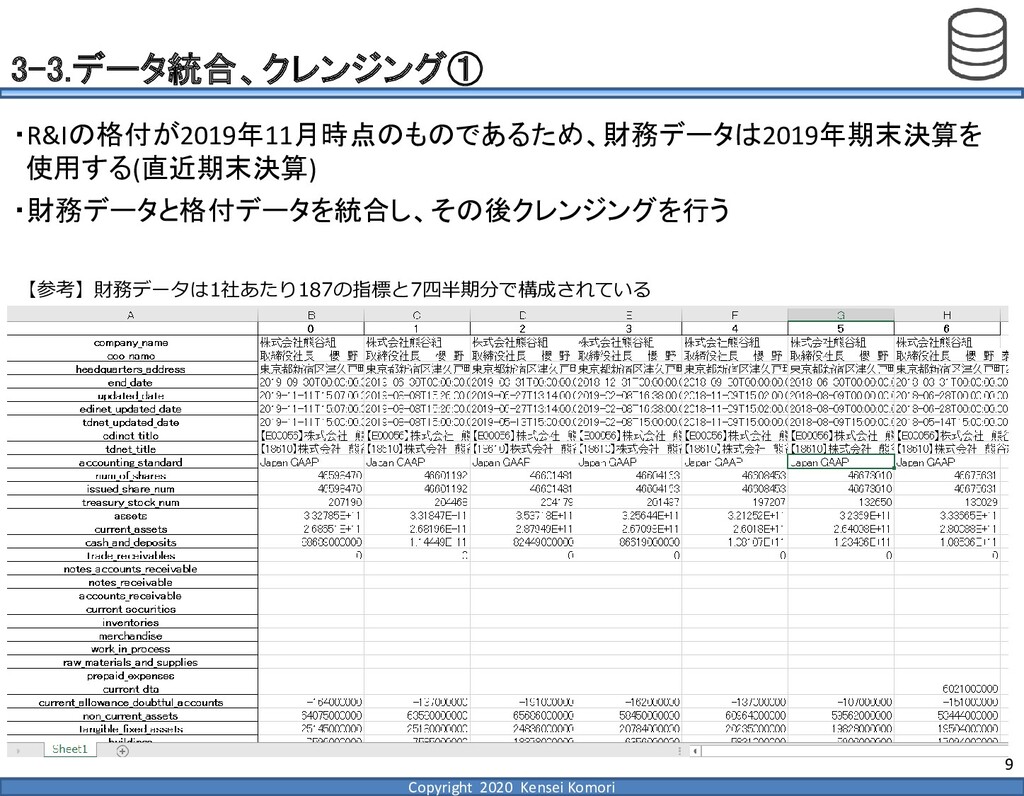
Copyright 2020 Kensei Komori 9 3-3.データ統合、クレンジング① ・R&Iの格付が2019年11月時点のものであるため、財務データは2019年期末決算を 使用する(直近期末決算) ・財務データと格付データを統合し、その後クレンジングを行う 【参考】財務データは1社あたり187の指標と7四半期分で構成されている
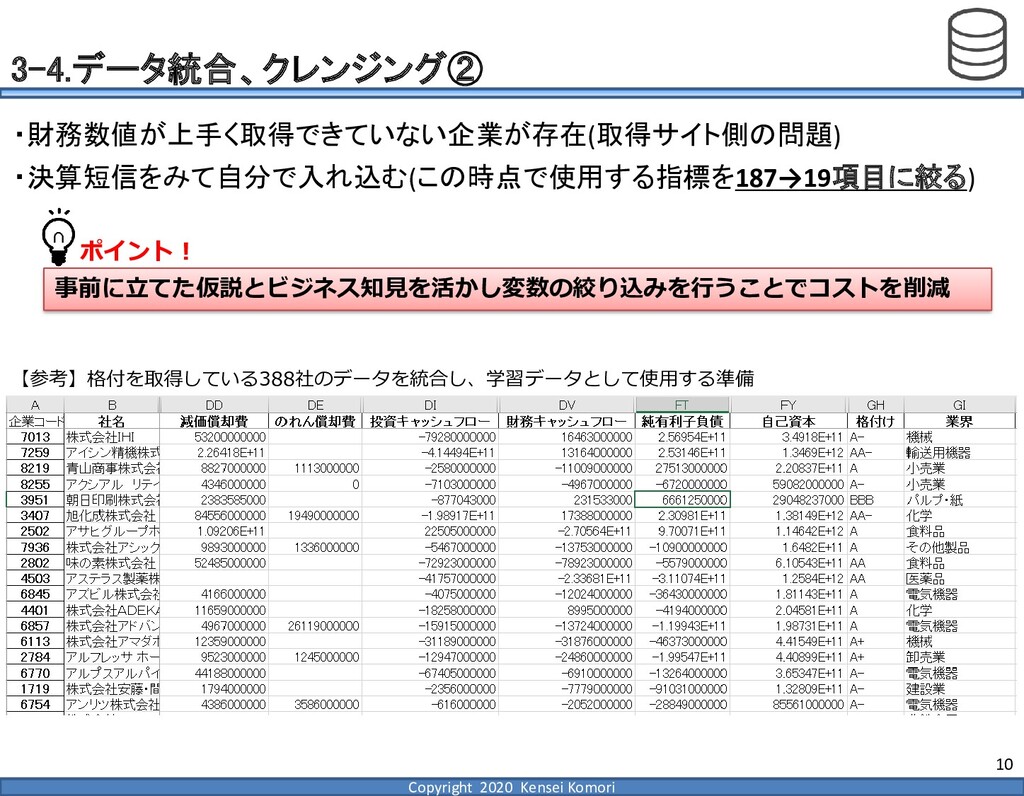
Copyright 2020 Kensei Komori 10 3-4.データ統合、クレンジング② 【参考】格付を取得している388社のデータを統合し、学習データとして使用する準備 ・財務数値が上手く取得できていない企業が存在(取得サイト側の問題) ・決算短信をみて自分で入れ込む(この時点で使用する指標を187→19項目に絞る) 事前に立てた仮説とビジネス知見を活かし変数の絞り込みを行うことでコストを削減
ポイント!
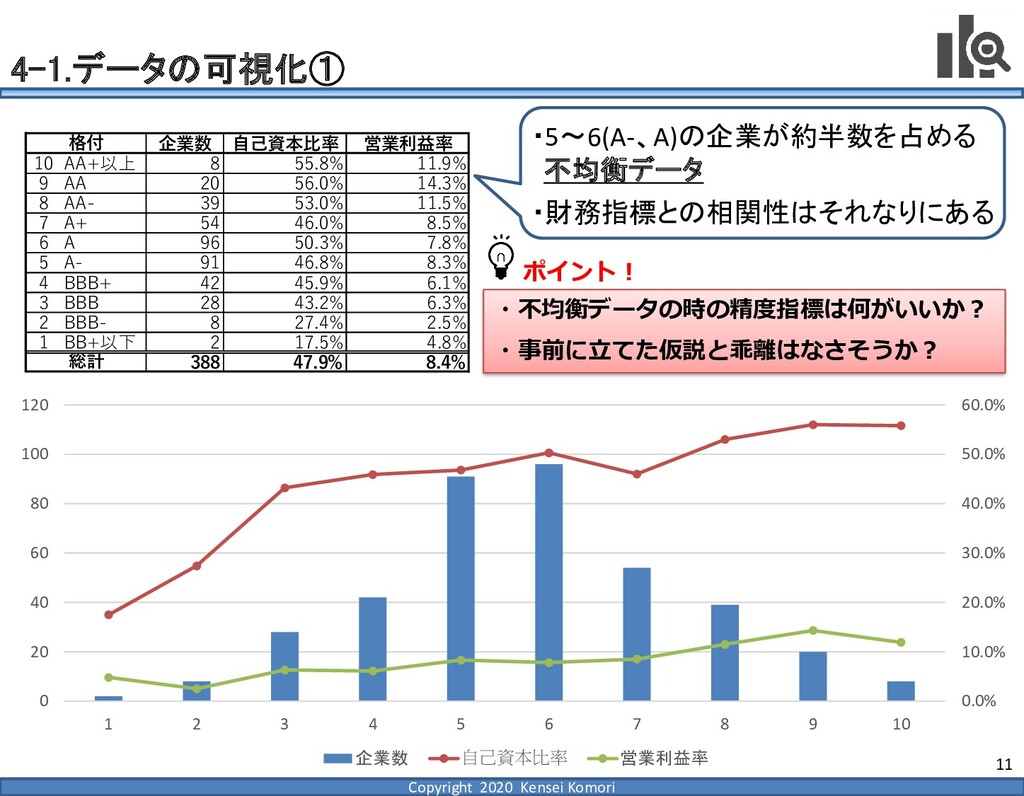
Copyright 2020 Kensei Komori 11 0.0% 10.0% 20.0% 30.0% 40.0%
50.0% 60.0% 0 20 40 60 80 100 120 1 2 3 4 5 6 7 8 9 10 企業数 自己資本比率 営業利益率 4-1.データの可視化① 企業数 自己資本比率 営業利益率 10 AA+以上 8 55.8% 11.9% 9 AA 20 56.0% 14.3% 8 AA- 39 53.0% 11.5% 7 A+ 54 46.0% 8.5% 6 A 96 50.3% 7.8% 5 A- 91 46.8% 8.3% 4 BBB+ 42 45.9% 6.1% 3 BBB 28 43.2% 6.3% 2 BBB- 8 27.4% 2.5% 1 BB+以下 2 17.5% 4.8% 388 47.9% 8.4% 格付 総計 ・5~6(A-、A)の企業が約半数を占める 不均衡データ ・財務指標との相関性はそれなりにある ・不均衡データの時の精度指標は何がいいか? ・事前に立てた仮説と乖離はなさそうか? ポイント!
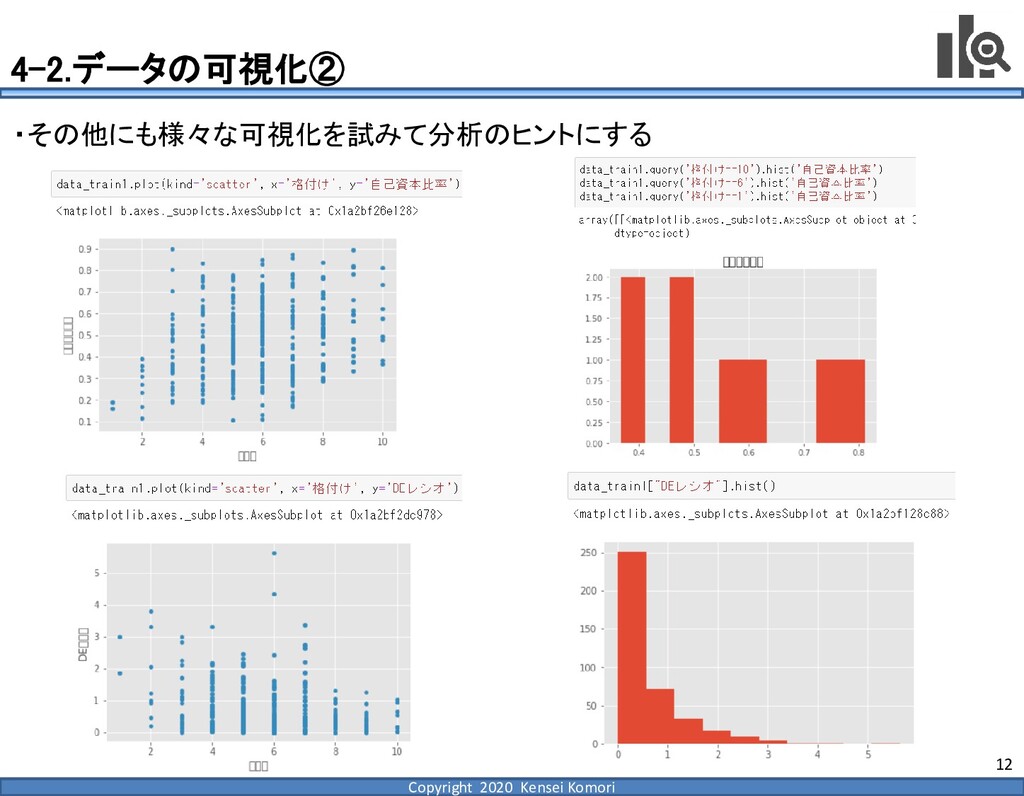
Copyright 2020 Kensei Komori 12 4-2.データの可視化② ・その他にも様々な可視化を試みて分析のヒントにする
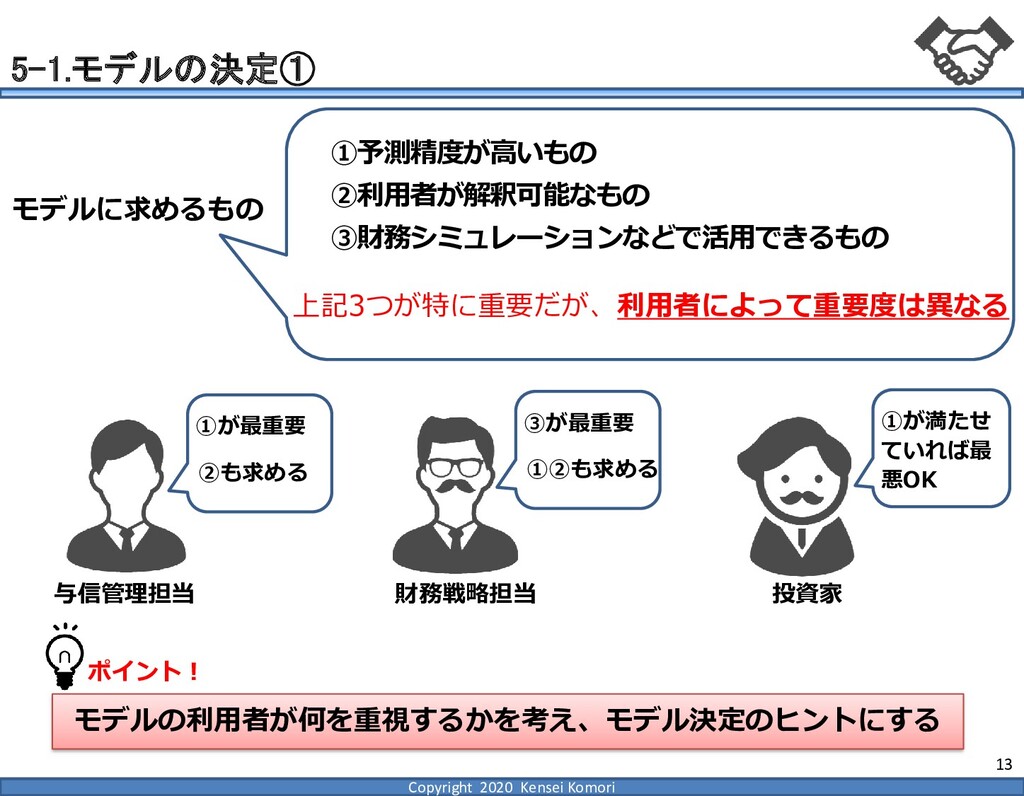
Copyright 2020 Kensei Komori 13 5-1.モデルの決定① ①予測精度が高いもの ②利用者が解釈可能なもの ③財務シミュレーションなどで活用できるもの モデルに求めるもの
上記3つが特に重要だが、利用者によって重要度は異なる 与信管理担当 財務戦略担当 投資家 ①が最重要 ②も求める ③が最重要 ①②も求める ①が満たせ ていれば最 悪OK モデルの利用者が何を重視するかを考え、モデル決定のヒントにする ポイント!
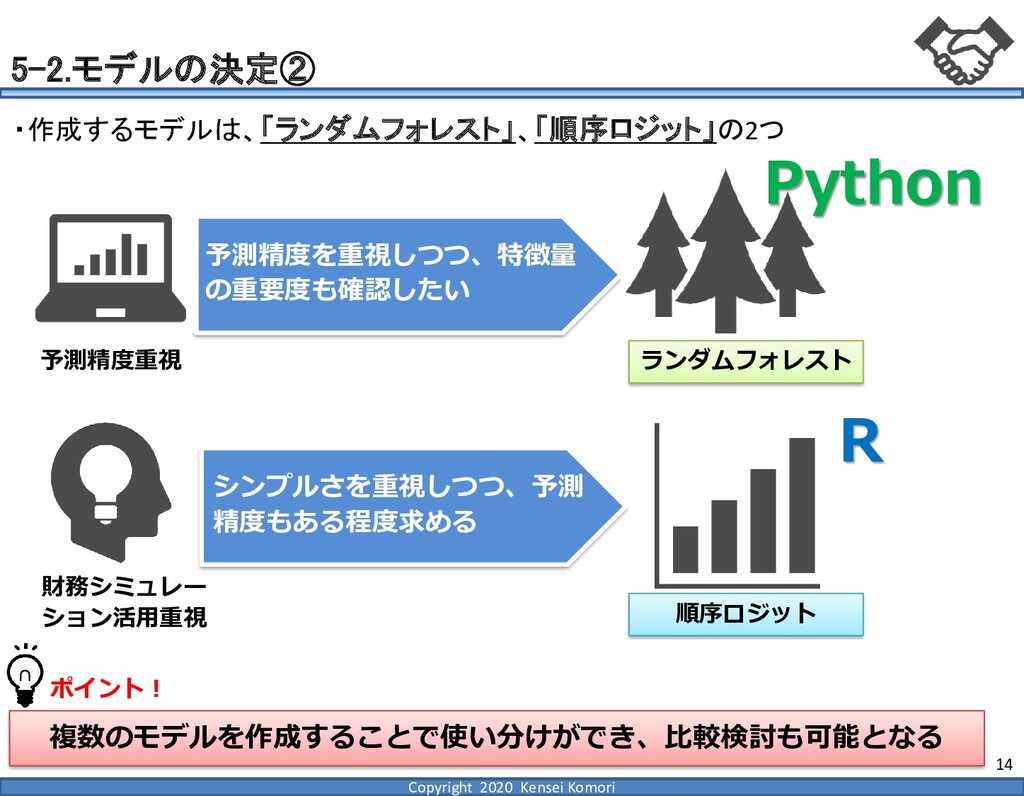
Copyright 2020 Kensei Komori 14 5-2.モデルの決定② 予測精度重視 予測精度を重視しつつ、特徴量 の重要度も確認したい 財務シミュレー
ション活用重視 シンプルさを重視しつつ、予測 精度もある程度求める ランダムフォレスト 順序ロジット Python R 複数のモデルを作成することで使い分けができ、比較検討も可能となる ポイント! ・作成するモデルは、「ランダムフォレスト」、「順序ロジット」の2つ
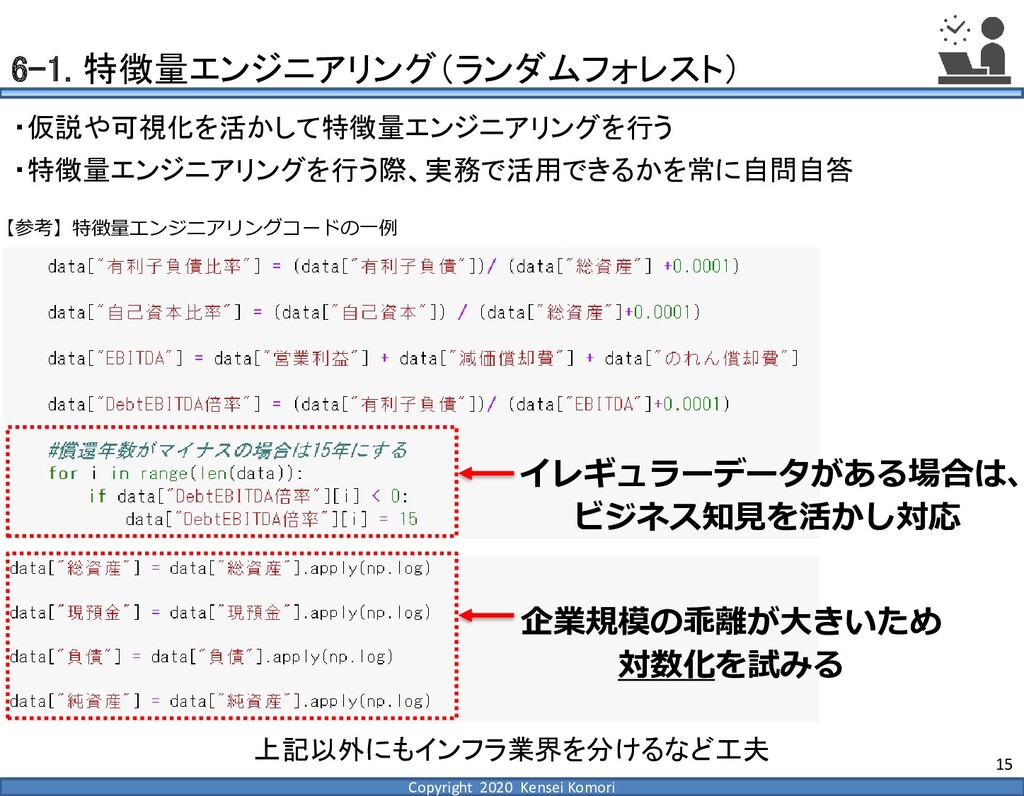
Copyright 2020 Kensei Komori 15 6-1. 特徴量エンジニアリング(ランダムフォレスト) ・仮説や可視化を活かして特徴量エンジニアリングを行う ・特徴量エンジニアリングを行う際、実務で活用できるかを常に自問自答 【参考】特徴量エンジニアリングコードの一例
企業規模の乖離が大きいため 対数化を試みる イレギュラーデータがある場合は、 ビジネス知見を活かし対応 上記以外にもインフラ業界を分けるなど工夫
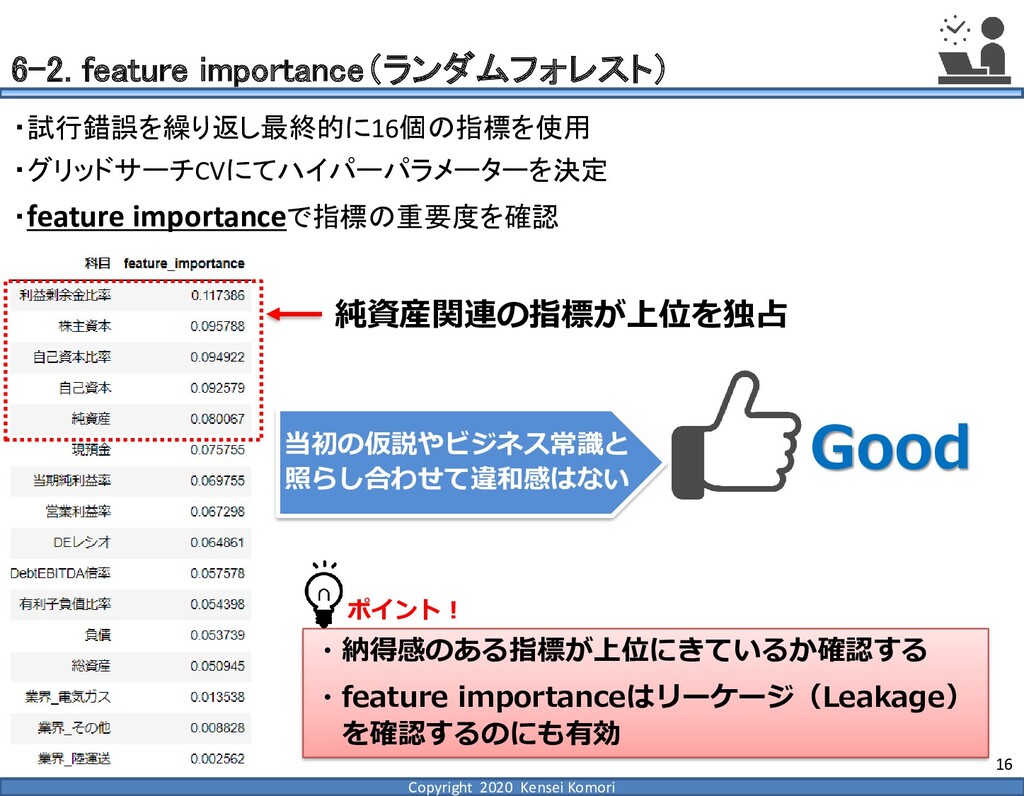
Copyright 2020 Kensei Komori 16 6-2. feature importance(ランダムフォレスト) ・試行錯誤を繰り返し最終的に16個の指標を使用 ・グリッドサーチCVにてハイパーパラメーターを決定
・feature importanceで指標の重要度を確認 純資産関連の指標が上位を独占 ・納得感のある指標が上位にきているか確認する ・feature importanceはリーケージ(Leakage) を確認するのにも有効 ポイント! 予測精度を重視しつつ、特徴量 の重要度も確認したい Good 当初の仮説やビジネス常識と 照らし合わせて違和感はない
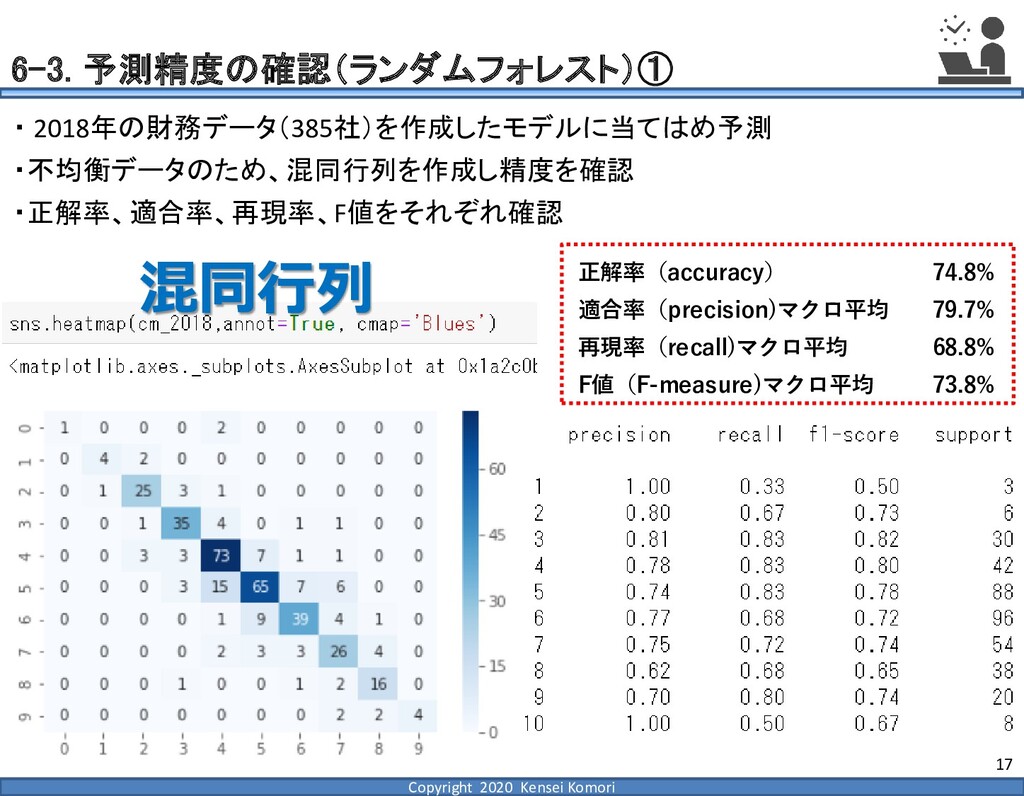
Copyright 2020 Kensei Komori 17 6-3. 予測精度の確認(ランダムフォレスト)① ・ 2018年の財務データ(385社)を作成したモデルに当てはめ予測 ・不均衡データのため、混同行列を作成し精度を確認
・正解率、適合率、再現率、F値をそれぞれ確認 正解率(accuracy) 74.8% 適合率(precision)マクロ平均 79.7% 再現率(recall)マクロ平均 68.8% F値(F-measure)マクロ平均 73.8% 混同行列
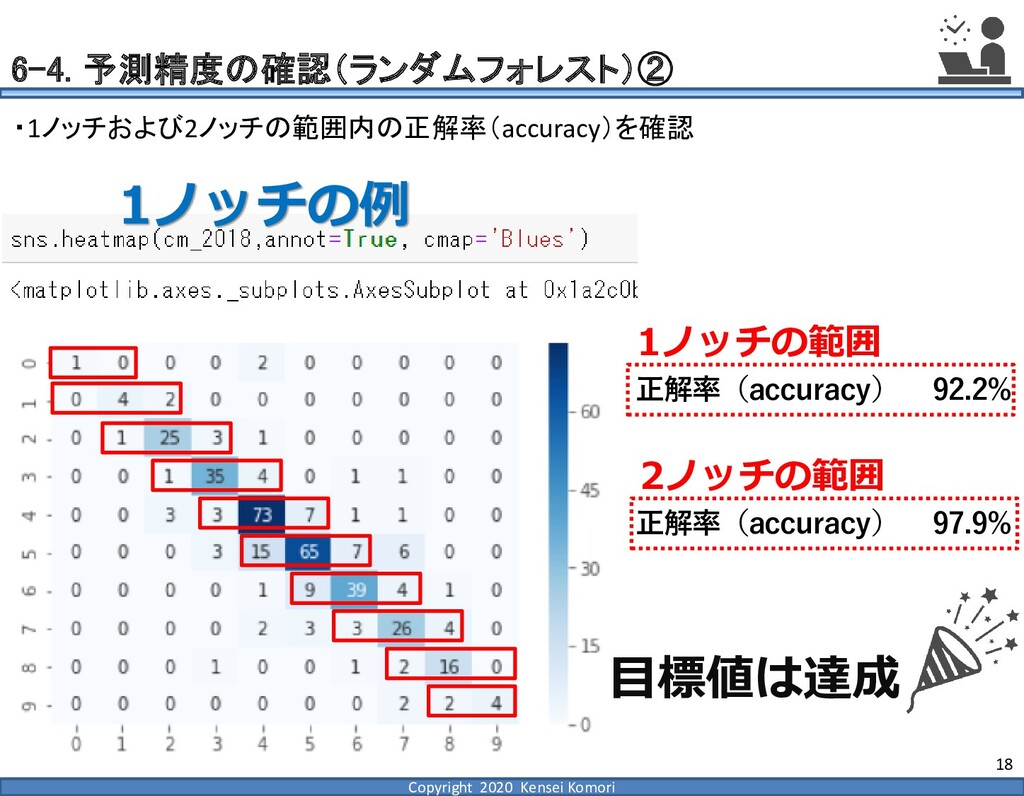
Copyright 2020 Kensei Komori 18 6-4. 予測精度の確認(ランダムフォレスト)② ・1ノッチおよび2ノッチの範囲内の正解率(accuracy)を確認 1ノッチの例 正解率(accuracy)
92.2% 1ノッチの範囲 正解率(accuracy) 97.9% 2ノッチの範囲 目標値は達成
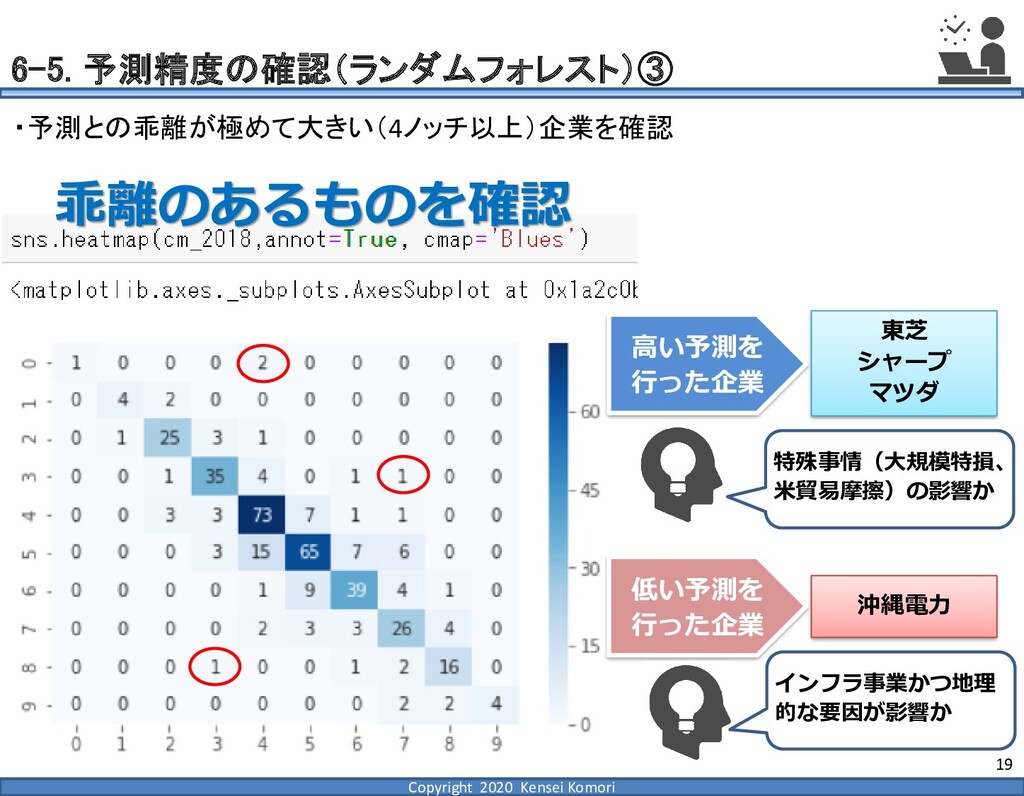
Copyright 2020 Kensei Komori 19 6-5. 予測精度の確認(ランダムフォレスト)③ ・予測との乖離が極めて大きい(4ノッチ以上)企業を確認 乖離のあるものを確認 高い予測を
行った企業 低い予測を 行った企業 東芝 シャープ マツダ 沖縄電力 特殊事情(大規模特損、 米貿易摩擦)の影響か インフラ事業かつ地理 的な要因が影響か
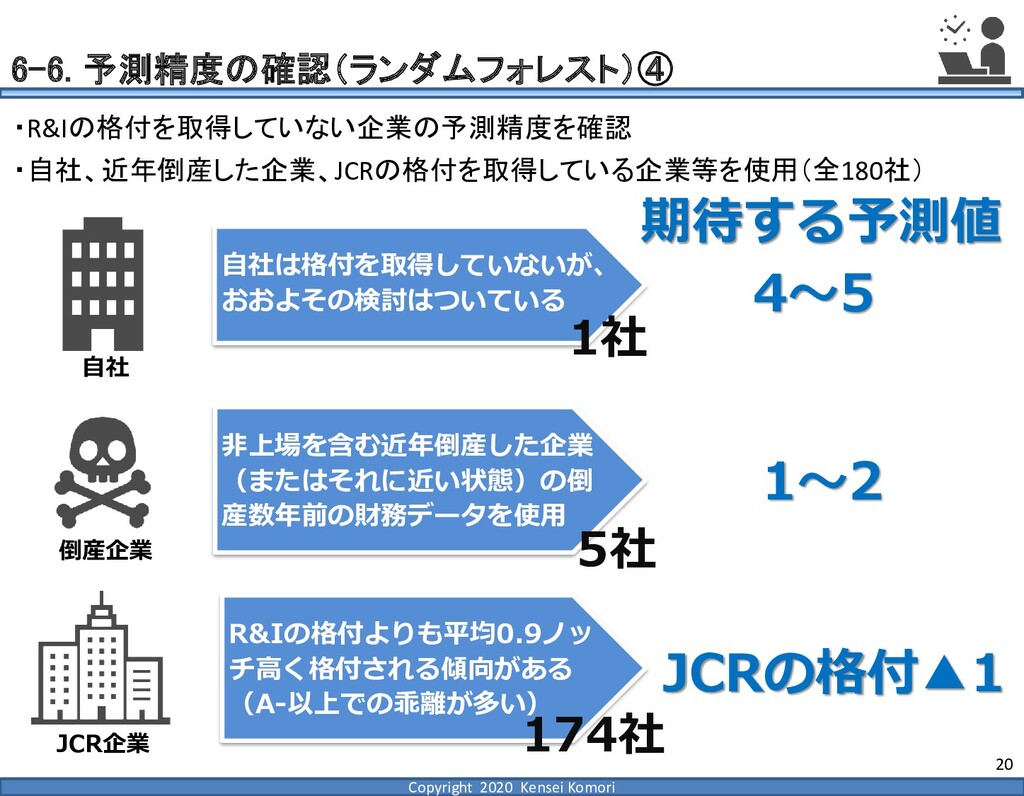
Copyright 2020 Kensei Komori 20 6-6. 予測精度の確認(ランダムフォレスト)④ ・R&Iの格付を取得していない企業の予測精度を確認 ・自社、近年倒産した企業、JCRの格付を取得している企業等を使用(全180社) 自社
自社は格付を取得していないが、 おおよその検討はついている 倒産企業 JCR企業 非上場を含む近年倒産した企業 (またはそれに近い状態)の倒 産数年前の財務データを使用 R&Iの格付よりも平均0.9ノッ チ高く格付される傾向がある (A-以上での乖離が多い) 4~5 1社 5社 174社 1~2 JCRの格付▲1 期待する予測値
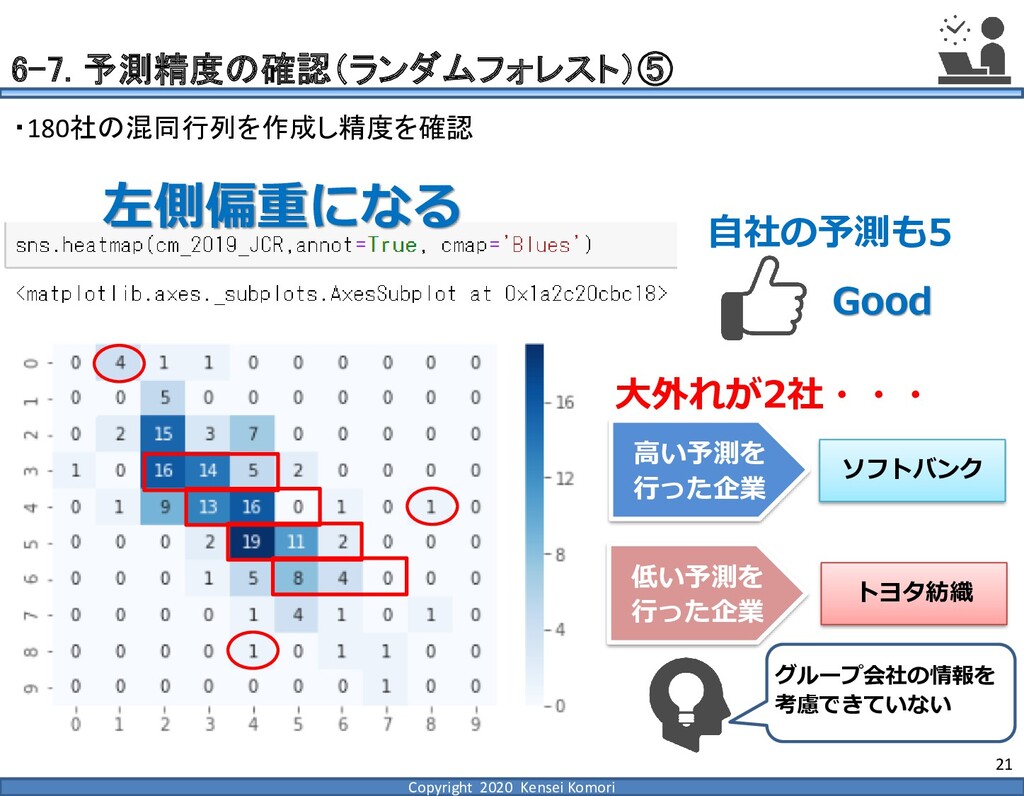
Copyright 2020 Kensei Komori 21 6-7. 予測精度の確認(ランダムフォレスト)⑤ ・180社の混同行列を作成し精度を確認 左側偏重になる Good
自社の予測も5 高い予測を 行った企業 ソフトバンク 大外れが2社・・・ 低い予測を 行った企業 トヨタ紡織 グループ会社の情報を 考慮できていない
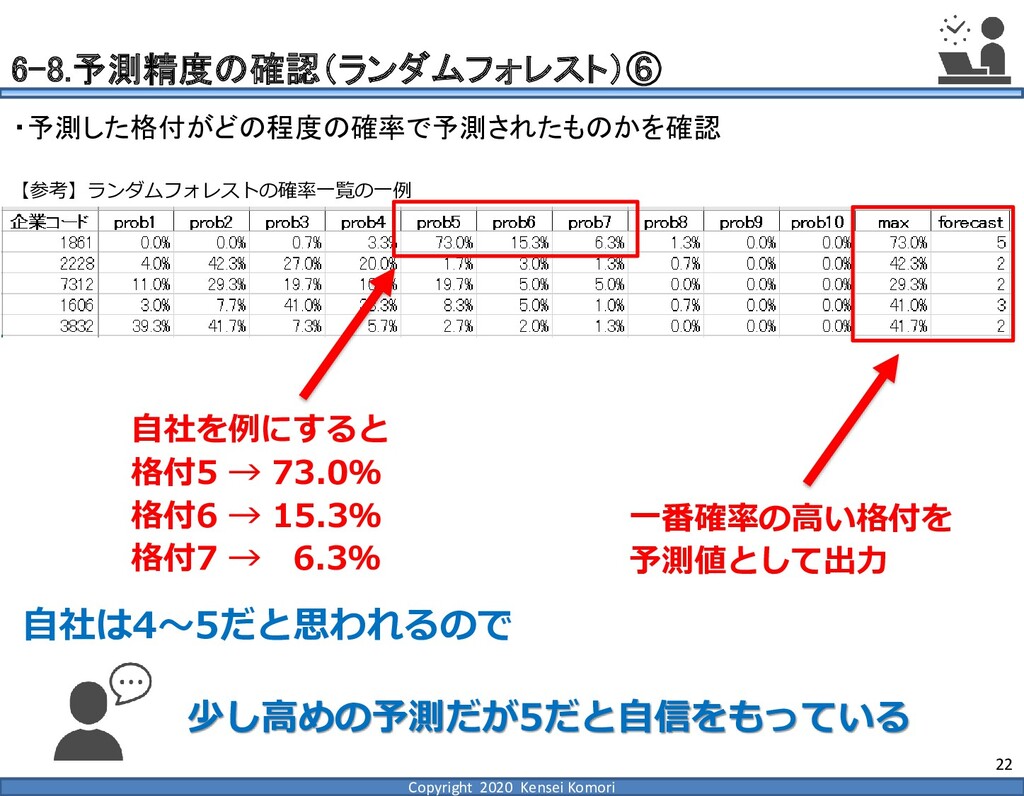
Copyright 2020 Kensei Komori 22 6-8.予測精度の確認(ランダムフォレスト)⑥ ・予測した格付がどの程度の確率で予測されたものかを確認 【参考】ランダムフォレストの確率一覧の一例 自社を例にすると 格付5
→ 73.0% 格付6 → 15.3% 格付7 → 6.3% 少し高めの予測だが5だと自信をもっている 自社は4~5だと思われるので 一番確率の高い格付を 予測値として出力
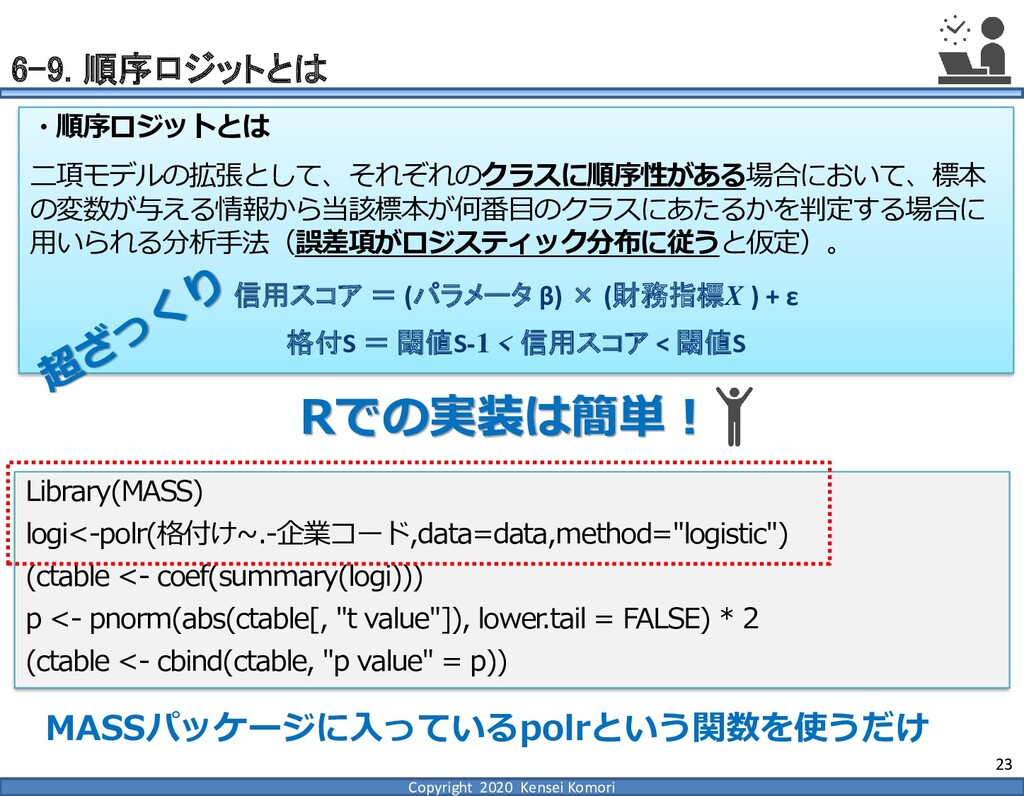
Copyright 2020 Kensei Komori 23 6-9. 順序ロジットとは ・順序ロジットとは 二項モデルの拡張として、それぞれのクラスに順序性がある場合において、標本 の変数が与える情報から当該標本が何番目のクラスにあたるかを判定する場合に
用いられる分析手法(誤差項がロジスティック分布に従うと仮定)。 信用スコア = (パラメータ β) × (財務指標X ) + ε 格付S = 閾値S-1 < 信用スコア < 閾値S Rでの実装は簡単! Library(MASS) logi<-polr(格付け~.-企業コード,data=data,method="logistic") (ctable <- coef(summary(logi))) p <- pnorm(abs(ctable[, "t value"]), lower.tail = FALSE) * 2 (ctable <- cbind(ctable, "p value" = p)) MASSパッケージに入っているpolrという関数を使うだけ
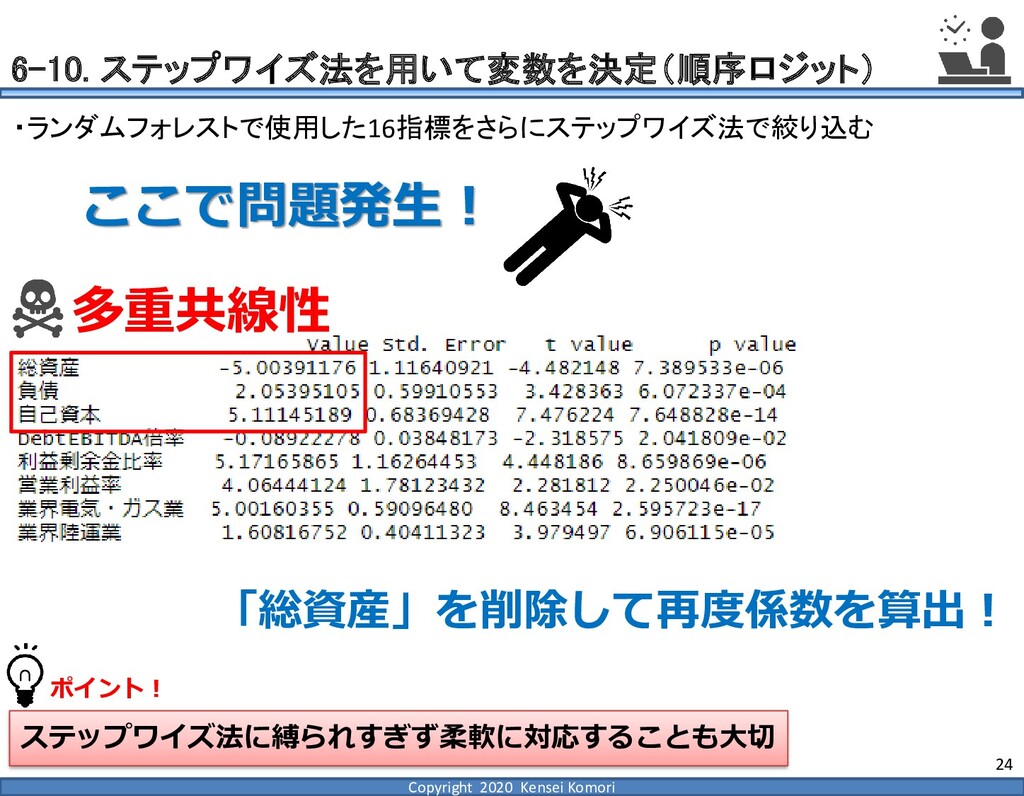
Copyright 2020 Kensei Komori 24 6-10. ステップワイズ法を用いて変数を決定(順序ロジット) ・ランダムフォレストで使用した16指標をさらにステップワイズ法で絞り込む ここで問題発生! 多重共線性
ステップワイズ法に縛られすぎず柔軟に対応することも大切 ポイント! 「総資産」を削除して再度係数を算出!
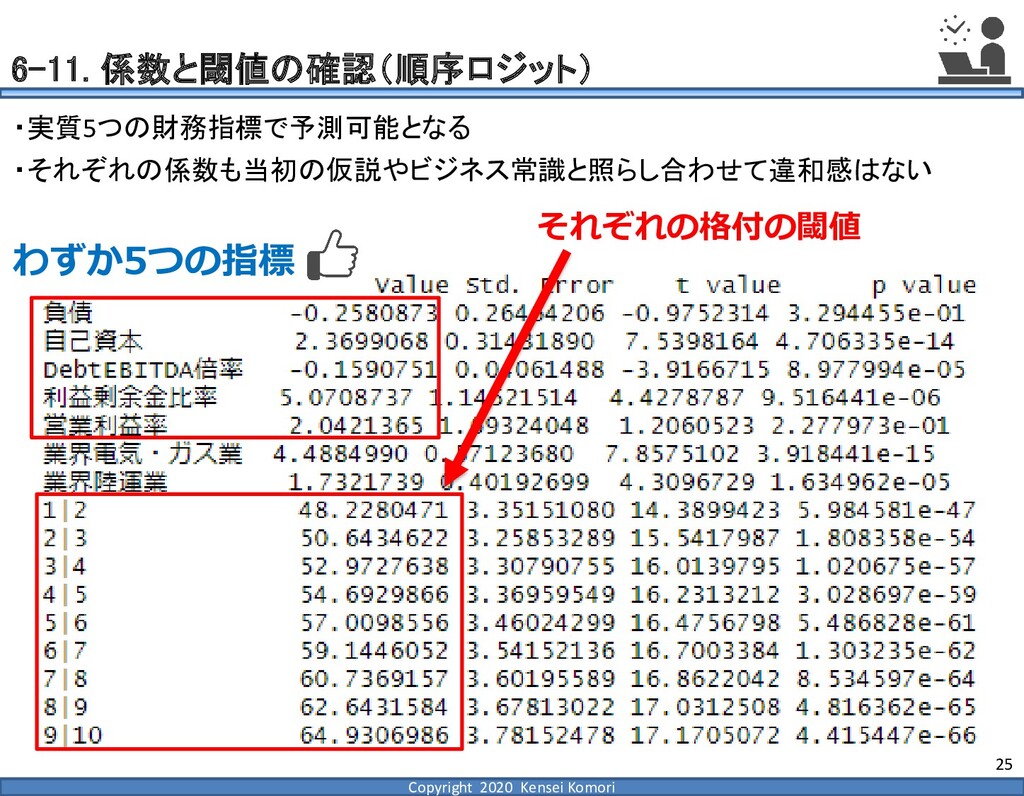
Copyright 2020 Kensei Komori 25 6-11. 係数と閾値の確認(順序ロジット) ・実質5つの財務指標で予測可能となる ・それぞれの係数も当初の仮説やビジネス常識と照らし合わせて違和感はない わずか5つの指標
それぞれの格付の閾値
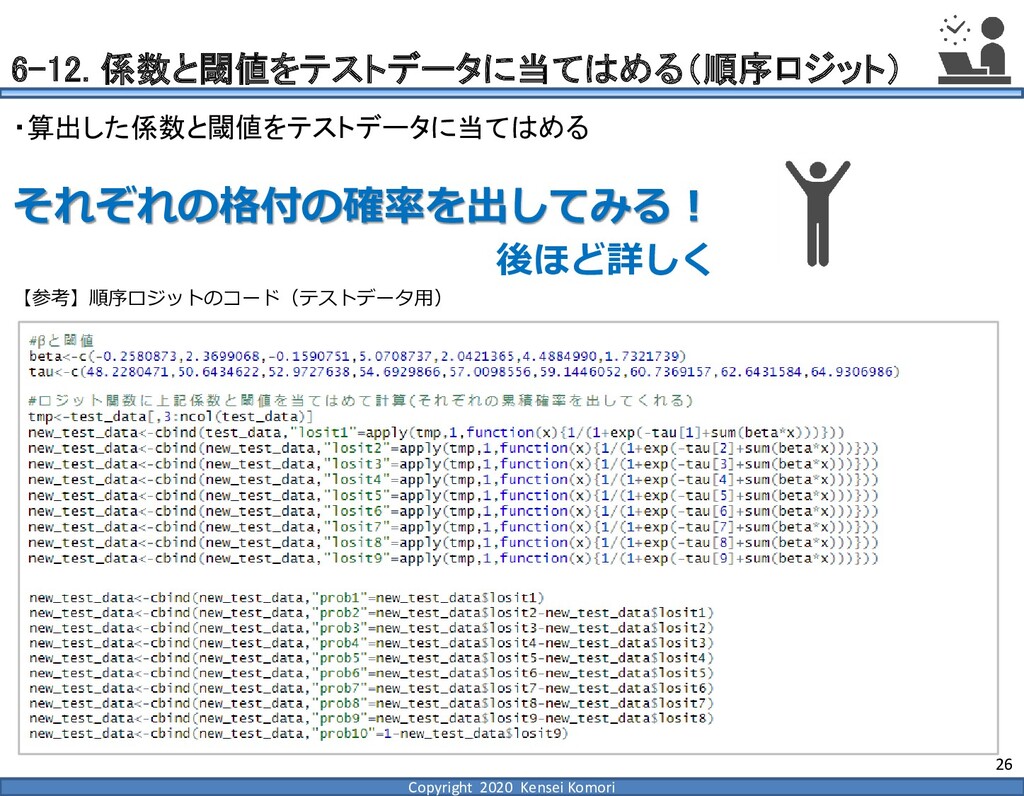
Copyright 2020 Kensei Komori 26 6-12. 係数と閾値をテストデータに当てはめる(順序ロジット) ・算出した係数と閾値をテストデータに当てはめる 【参考】順序ロジットのコード(テストデータ用) それぞれの格付の確率を出してみる!
後ほど詳しく
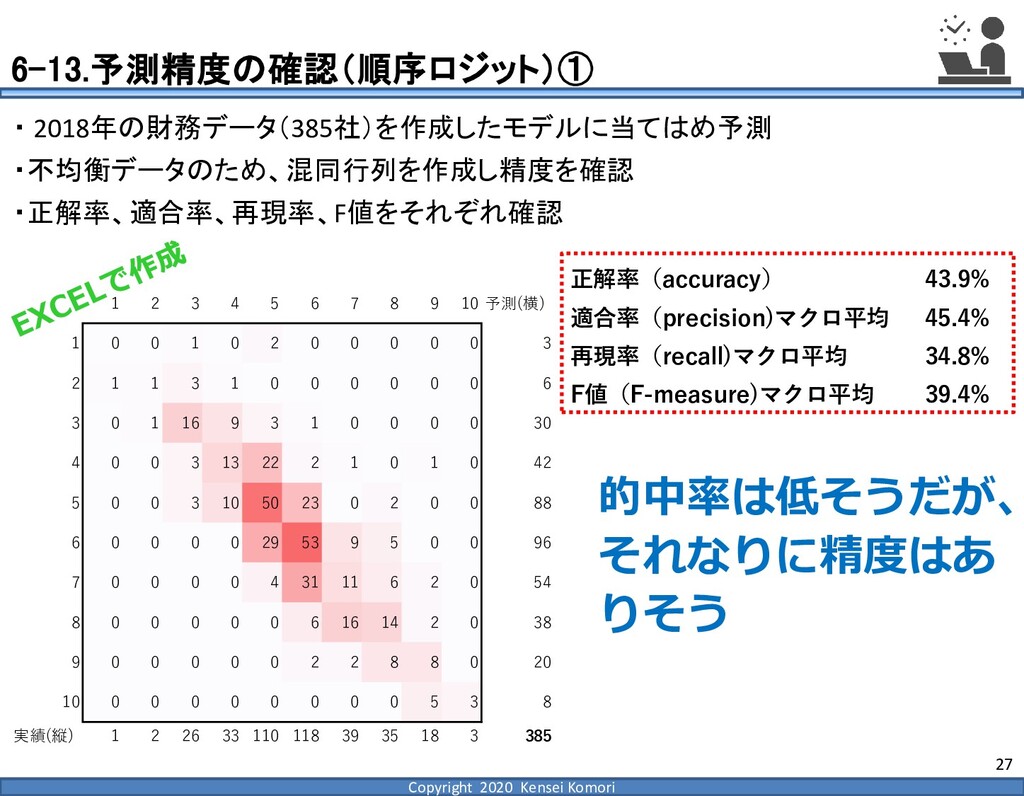
Copyright 2020 Kensei Komori 27 6-13.予測精度の確認(順序ロジット)① ・ 2018年の財務データ(385社)を作成したモデルに当てはめ予測 ・不均衡データのため、混同行列を作成し精度を確認 ・正解率、適合率、再現率、F値をそれぞれ確認
1 2 3 4 5 6 7 8 9 10 予測(横) 1 0 0 1 0 2 0 0 0 0 0 3 2 1 1 3 1 0 0 0 0 0 0 6 3 0 1 16 9 3 1 0 0 0 0 30 4 0 0 3 13 22 2 1 0 1 0 42 5 0 0 3 10 50 23 0 2 0 0 88 6 0 0 0 0 29 53 9 5 0 0 96 7 0 0 0 0 4 31 11 6 2 0 54 8 0 0 0 0 0 6 16 14 2 0 38 9 0 0 0 0 0 2 2 8 8 0 20 10 0 0 0 0 0 0 0 0 5 3 8 実績(縦) 1 2 26 33 110 118 39 35 18 3 385 正解率(accuracy) 43.9% 適合率(precision)マクロ平均 45.4% 再現率(recall)マクロ平均 34.8% F値(F-measure)マクロ平均 39.4% 的中率は低そうだが、 それなりに精度はあ りそう
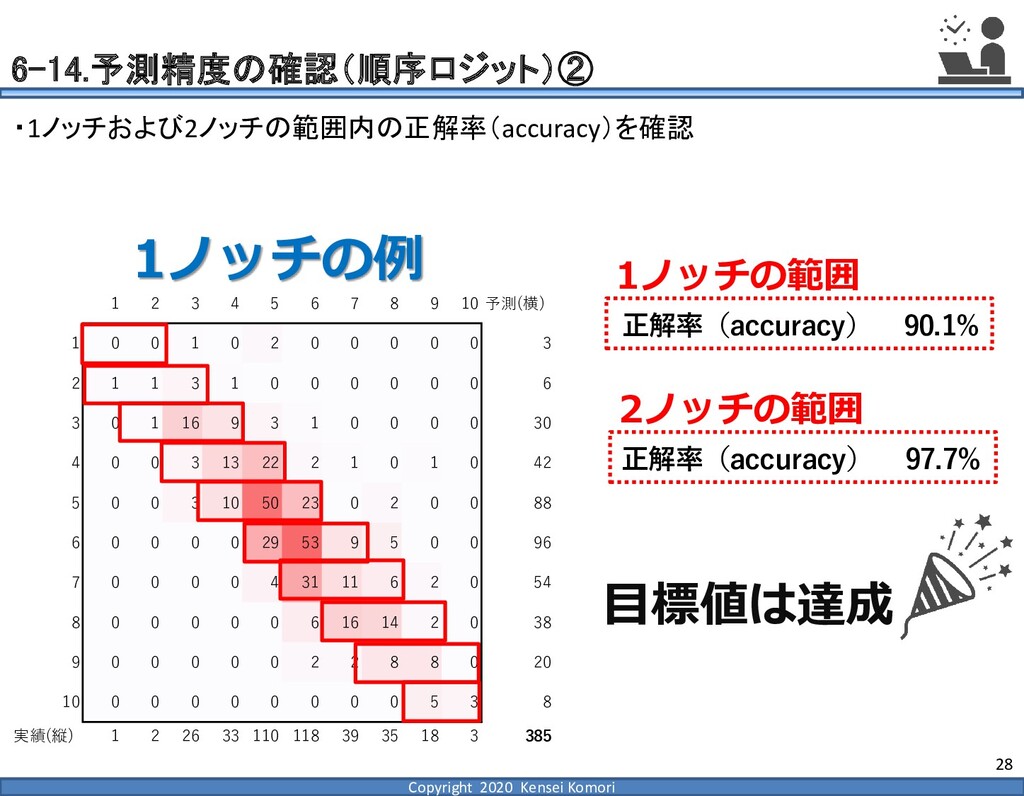
Copyright 2020 Kensei Komori 28 6-14.予測精度の確認(順序ロジット)② 1 2 3 4
5 6 7 8 9 10 予測(横) 1 0 0 1 0 2 0 0 0 0 0 3 2 1 1 3 1 0 0 0 0 0 0 6 3 0 1 16 9 3 1 0 0 0 0 30 4 0 0 3 13 22 2 1 0 1 0 42 5 0 0 3 10 50 23 0 2 0 0 88 6 0 0 0 0 29 53 9 5 0 0 96 7 0 0 0 0 4 31 11 6 2 0 54 8 0 0 0 0 0 6 16 14 2 0 38 9 0 0 0 0 0 2 2 8 8 0 20 10 0 0 0 0 0 0 0 0 5 3 8 実績(縦) 1 2 26 33 110 118 39 35 18 3 385 ・1ノッチおよび2ノッチの範囲内の正解率(accuracy)を確認 1ノッチの範囲 2ノッチの範囲 1ノッチの例 正解率(accuracy) 90.1% 正解率(accuracy) 97.7% 目標値は達成
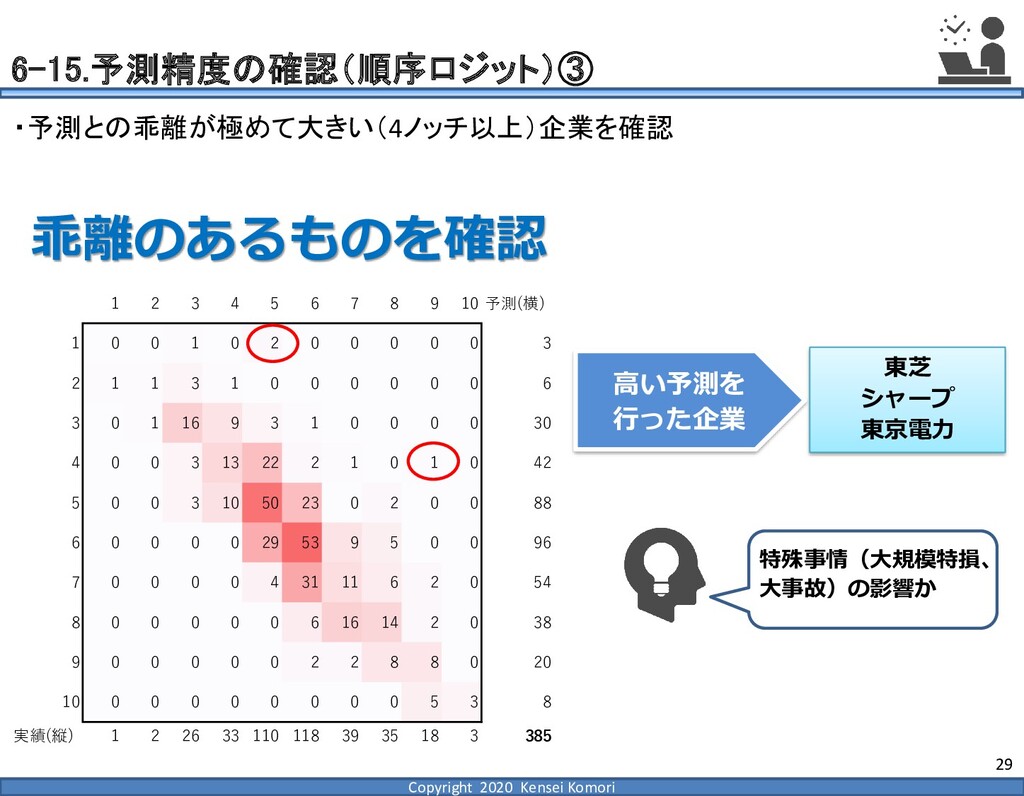
Copyright 2020 Kensei Komori 29 6-15.予測精度の確認(順序ロジット)③ 1 2 3 4
5 6 7 8 9 10 予測(横) 1 0 0 1 0 2 0 0 0 0 0 3 2 1 1 3 1 0 0 0 0 0 0 6 3 0 1 16 9 3 1 0 0 0 0 30 4 0 0 3 13 22 2 1 0 1 0 42 5 0 0 3 10 50 23 0 2 0 0 88 6 0 0 0 0 29 53 9 5 0 0 96 7 0 0 0 0 4 31 11 6 2 0 54 8 0 0 0 0 0 6 16 14 2 0 38 9 0 0 0 0 0 2 2 8 8 0 20 10 0 0 0 0 0 0 0 0 5 3 8 実績(縦) 1 2 26 33 110 118 39 35 18 3 385 ・予測との乖離が極めて大きい(4ノッチ以上)企業を確認 乖離のあるものを確認 高い予測を 行った企業 東芝 シャープ 東京電力 特殊事情(大規模特損、 大事故)の影響か
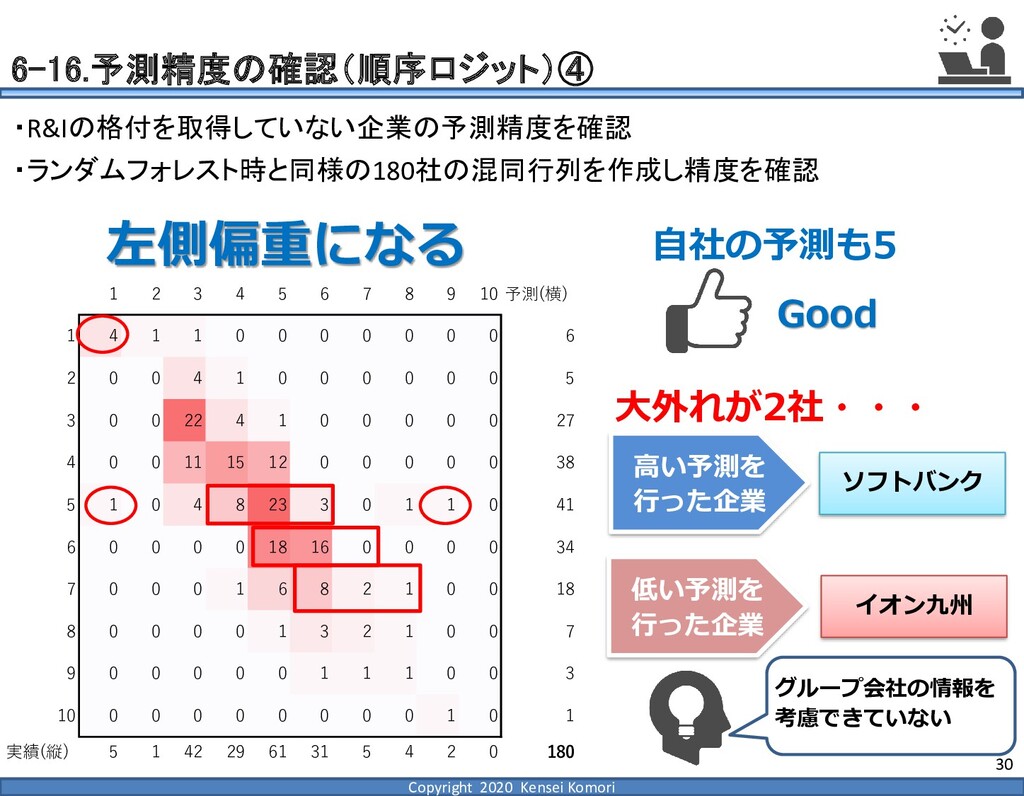
Copyright 2020 Kensei Komori 30 6-16.予測精度の確認(順序ロジット)④ ・R&Iの格付を取得していない企業の予測精度を確認 ・ランダムフォレスト時と同様の180社の混同行列を作成し精度を確認 1 2
3 4 5 6 7 8 9 10 予測(横) 1 4 1 1 0 0 0 0 0 0 0 6 2 0 0 4 1 0 0 0 0 0 0 5 3 0 0 22 4 1 0 0 0 0 0 27 4 0 0 11 15 12 0 0 0 0 0 38 5 1 0 4 8 23 3 0 1 1 0 41 6 0 0 0 0 18 16 0 0 0 0 34 7 0 0 0 1 6 8 2 1 0 0 18 8 0 0 0 0 1 3 2 1 0 0 7 9 0 0 0 0 0 1 1 1 0 0 3 10 0 0 0 0 0 0 0 0 1 0 1 実績(縦) 5 1 42 29 61 31 5 4 2 0 180 左側偏重になる Good 自社の予測も5 高い予測を 行った企業 ソフトバンク 大外れが2社・・・ 低い予測を 行った企業 イオン九州 グループ会社の情報を 考慮できていない
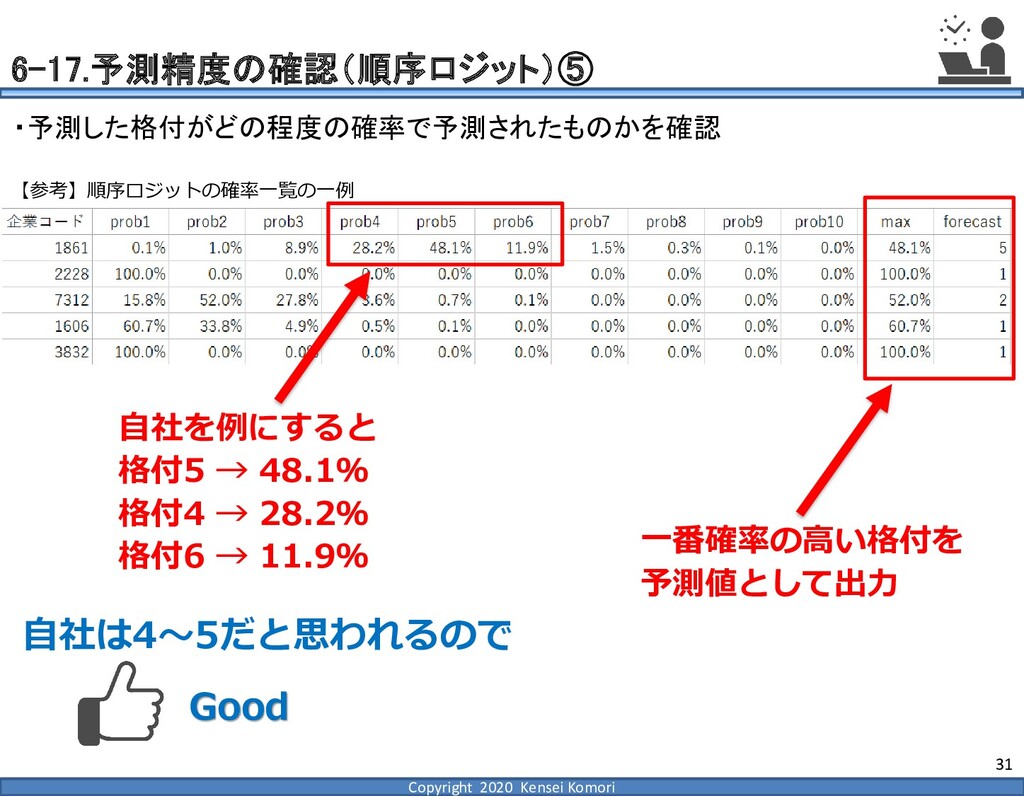
Copyright 2020 Kensei Komori 31 6-17.予測精度の確認(順序ロジット)⑤ ・予測した格付がどの程度の確率で予測されたものかを確認 【参考】順序ロジットの確率一覧の一例 自社を例にすると 格付5
→ 48.1% 格付4 → 28.2% 格付6 → 11.9% Good 自社は4~5だと思われるので 一番確率の高い格付を 予測値として出力
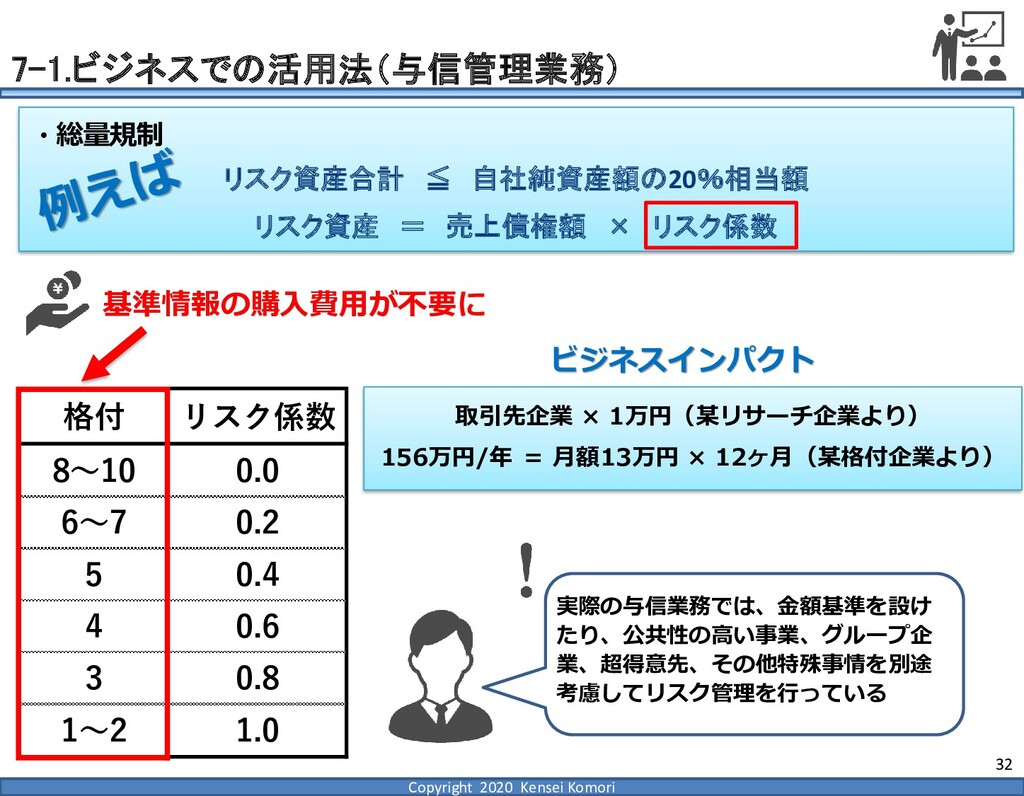
Copyright 2020 Kensei Komori 32 7-1.ビジネスでの活用法(与信管理業務) ・総量規制 リスク資産合計 ≦ 自社純資産額の20%相当額
リスク資産 = 売上債権額 × リスク係数 格付 リスク係数 8~10 0.0 6~7 0.2 5 0.4 4 0.6 3 0.8 1~2 1.0 取引先企業 × 1万円(某リサーチ企業より) 156万円/年 = 月額13万円 × 12ヶ月(某格付企業より) 基準情報の購入費用が不要に ビジネスインパクト 実際の与信業務では、金額基準を設け たり、公共性の高い事業、グループ企 業、超得意先、その他特殊事情を別途 考慮してリスク管理を行っている
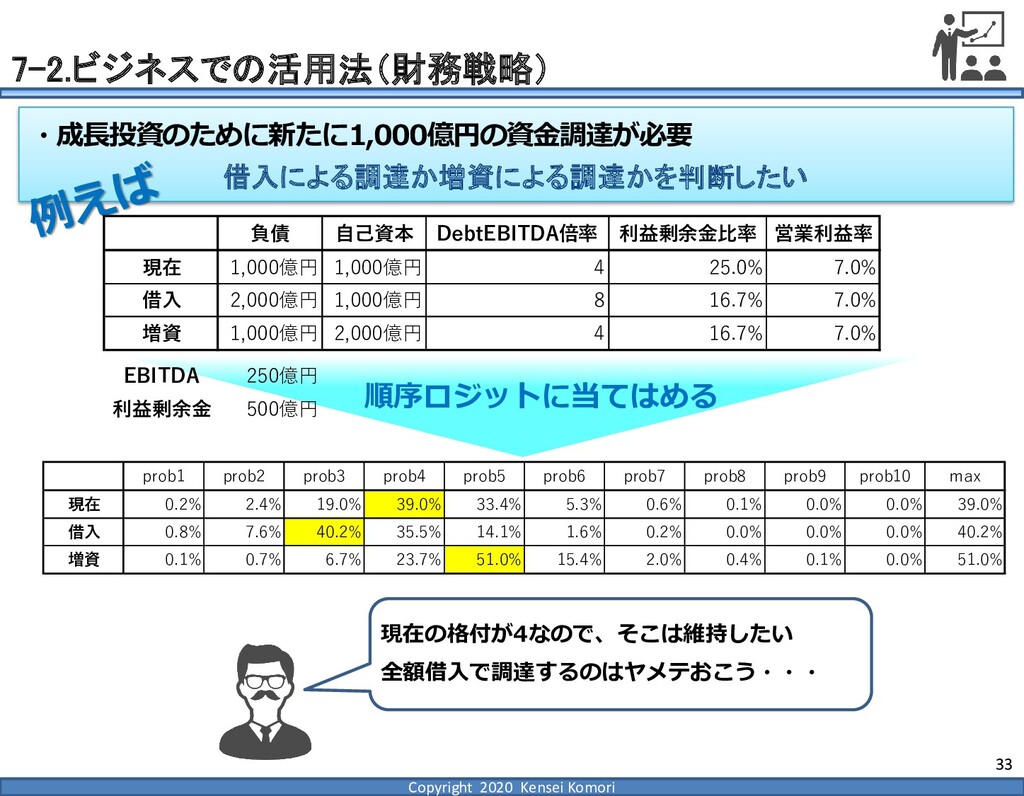
Copyright 2020 Kensei Komori 33 7-2.ビジネスでの活用法(財務戦略) ・成長投資のために新たに1,000億円の資金調達が必要 借入による調達か増資による調達かを判断したい 負債 自己資本
DebtEBITDA倍率 利益剰余金比率 営業利益率 現在 1,000億円 1,000億円 4 25.0% 7.0% 借入 2,000億円 1,000億円 8 16.7% 7.0% 増資 1,000億円 2,000億円 4 16.7% 7.0% EBITDA 250億円 利益剰余金 500億円 順序ロジットに当てはめる prob1 prob2 prob3 prob4 prob5 prob6 prob7 prob8 prob9 prob10 max 現在 0.2% 2.4% 19.0% 39.0% 33.4% 5.3% 0.6% 0.1% 0.0% 0.0% 39.0% 借入 0.8% 7.6% 40.2% 35.5% 14.1% 1.6% 0.2% 0.0% 0.0% 0.0% 40.2% 増資 0.1% 0.7% 6.7% 23.7% 51.0% 15.4% 2.0% 0.4% 0.1% 0.0% 51.0% 現在の格付が4なので、そこは維持したい 全額借入で調達するのはヤメテおこう・・・
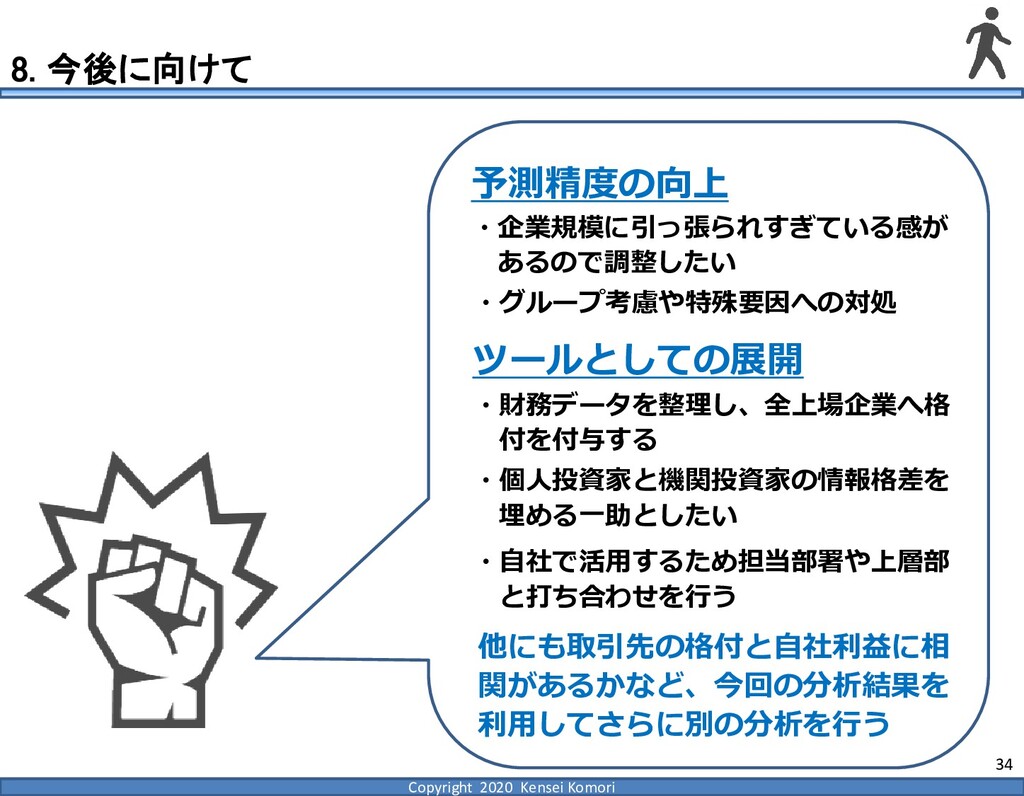
Copyright 2020 Kensei Komori 34 8. 今後に向けて 予測精度の向上 ・企業規模に引っ張られすぎている感が あるので調整したい
・グループ考慮や特殊要因への対処 ツールとしての展開 ・財務データを整理し、全上場企業へ格 付を付与する ・個人投資家と機関投資家の情報格差を 埋める一助としたい ・自社で活用するため担当部署や上層部 と打ち合わせを行う 他にも取引先の格付と自社利益に相 関があるかなど、今回の分析結果を 利用してさらに別の分析を行う


 stuffmc
 notwaldorf
 watany
 lemiorhan
 hannesfritz
 rabernat
 tammyeverts
 marktimemedia
 quramy
 mojombo
 brettharned
 csswizardry