Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ACL読み会2026@名大:LLM-Powered Benchmark Factory: Re...

Avatar for RYO KOJIMA RYO KOJIMA
September 23, 2026
73

ACL読み会2026@名大:LLM-Powered Benchmark Factory: Reliable, Generic, and Efficient

Avatar for RYO KOJIMA

RYO KOJIMA

September 23, 2026

Transcript

  1. 背景|ベンチマーク⾃動⽣成の必要性 • LLMの公開数が⼤幅に増加 & LLMの応⽤先も増加 • 応⽤先のタスクに応じて適切なLLMを選択したい • ⽤途に応じたベンチマークを適宜作成する必要 →LLMを⽤いたベンチマークの⾃動⽣成

    • ⼈⼿と⽐較して時間的・⾦銭的に低コスト • ベンチマーク⽣成の起点は⼤きく2つ • 既存ベンチマークを起点に拡張(例:問題の難易度を上げる) • ⼈⼿作成の評価要件を起点に新規作成(例:新たなタスクのデータセットを作る) 3
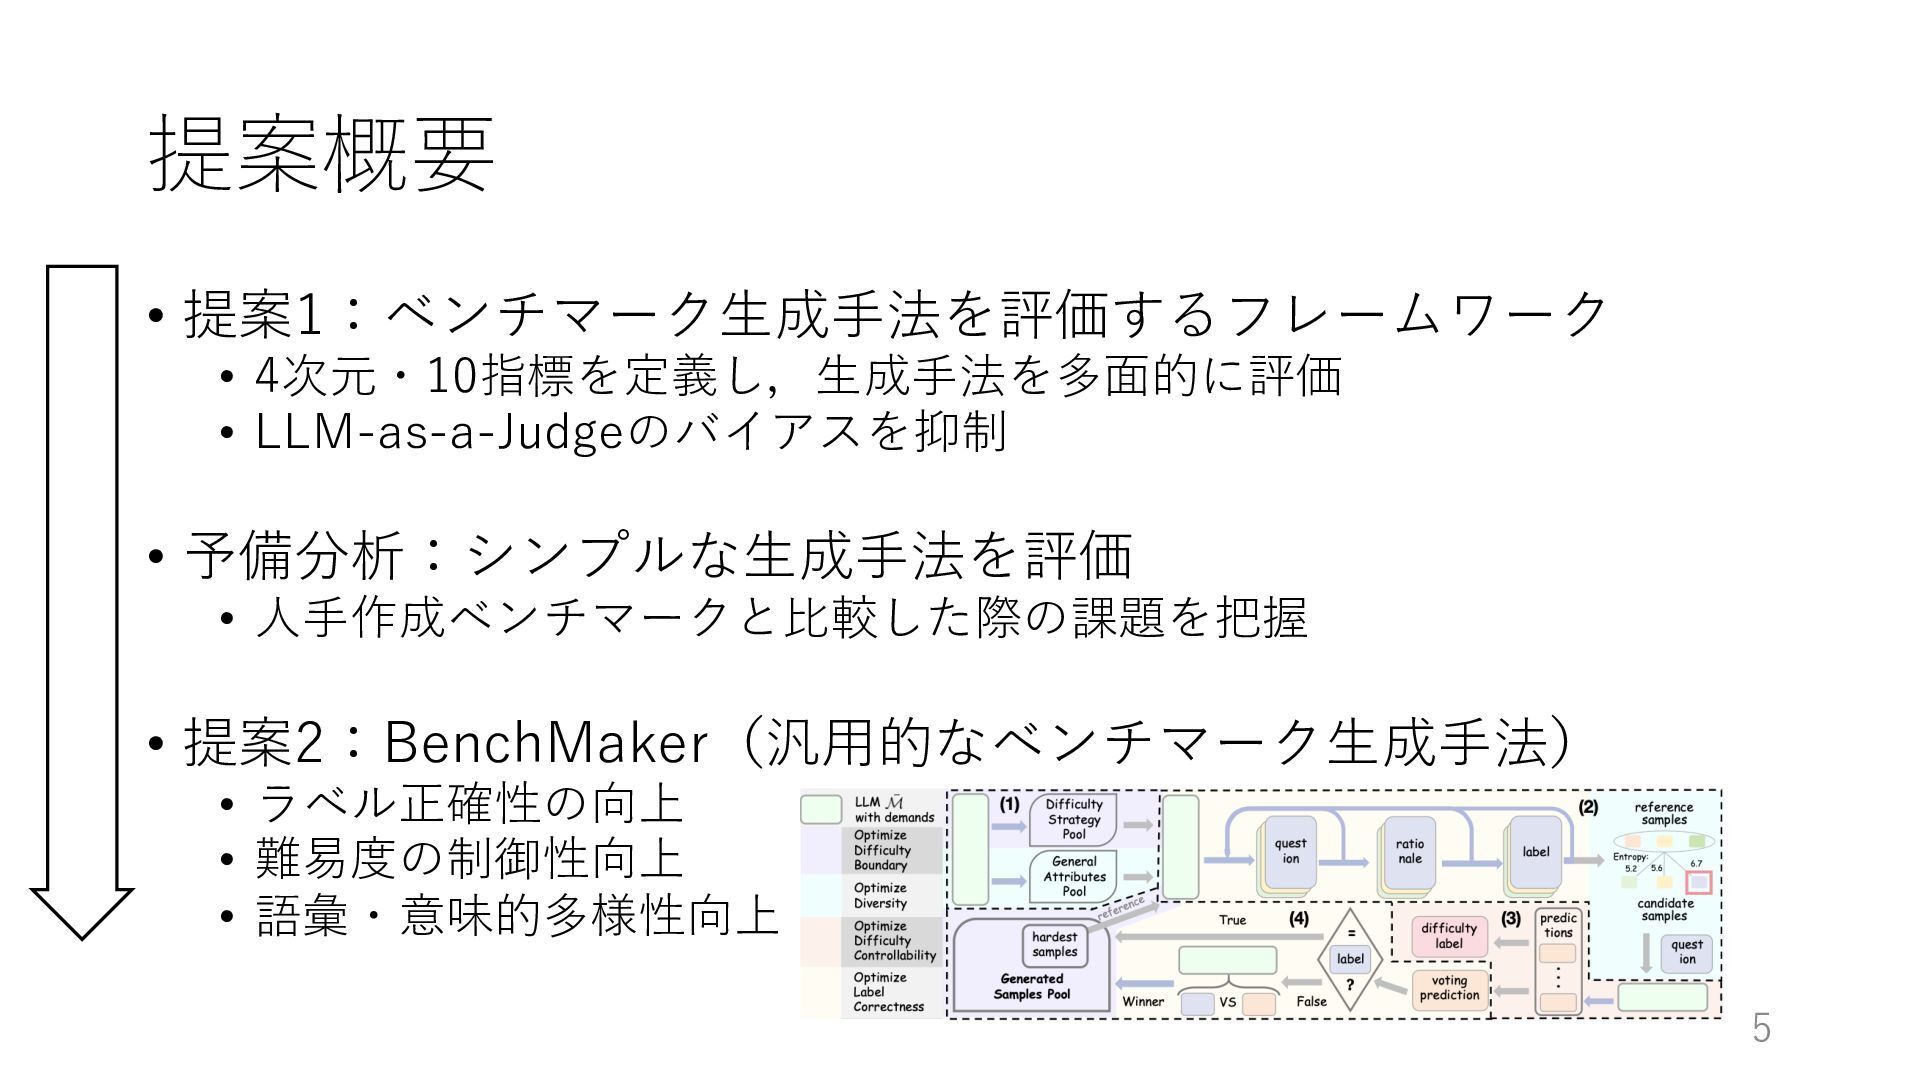
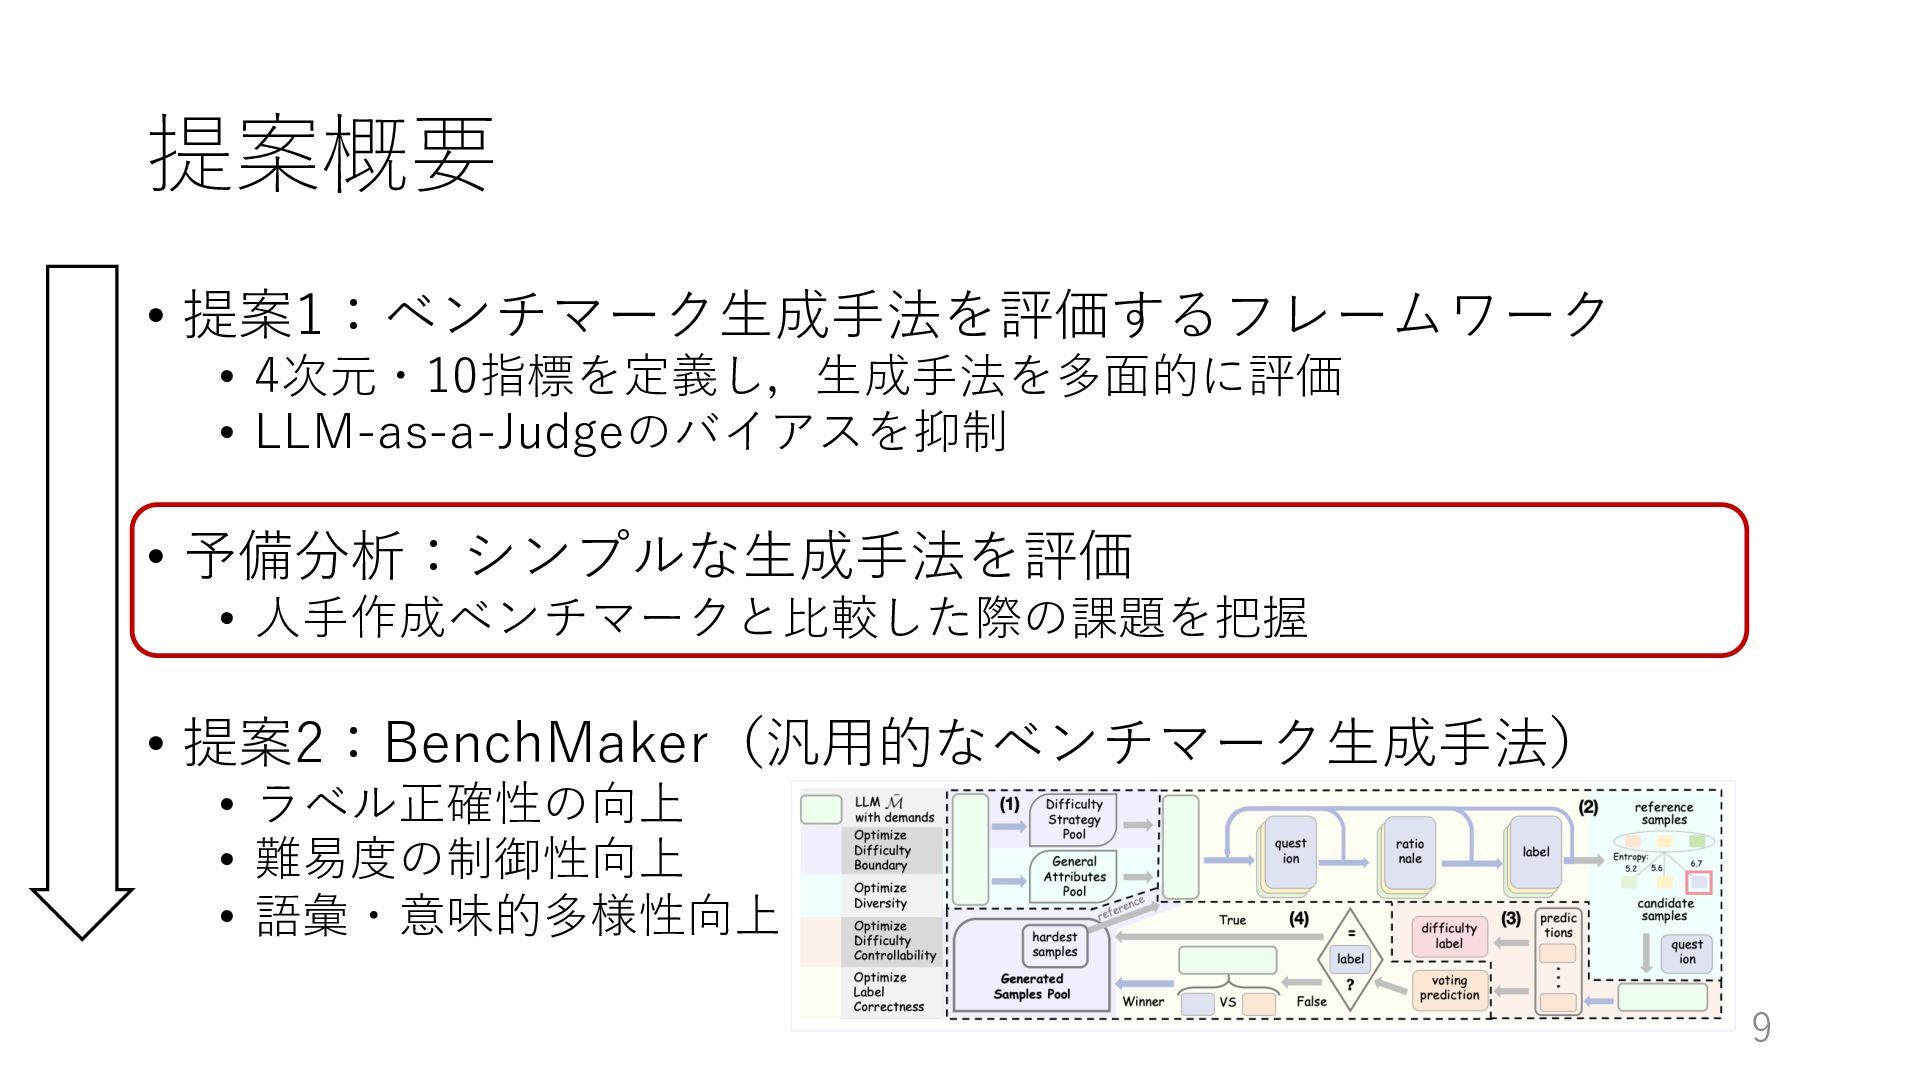
  2. 提案概要 • 提案1:ベンチマーク⽣成⼿法を評価するフレームワーク • 4次元・10指標を定義し,⽣成⼿法を多⾯的に評価 • LLM-as-a-Judgeのバイアスを抑制 • 予備分析:シンプルな⽣成⼿法を評価 •

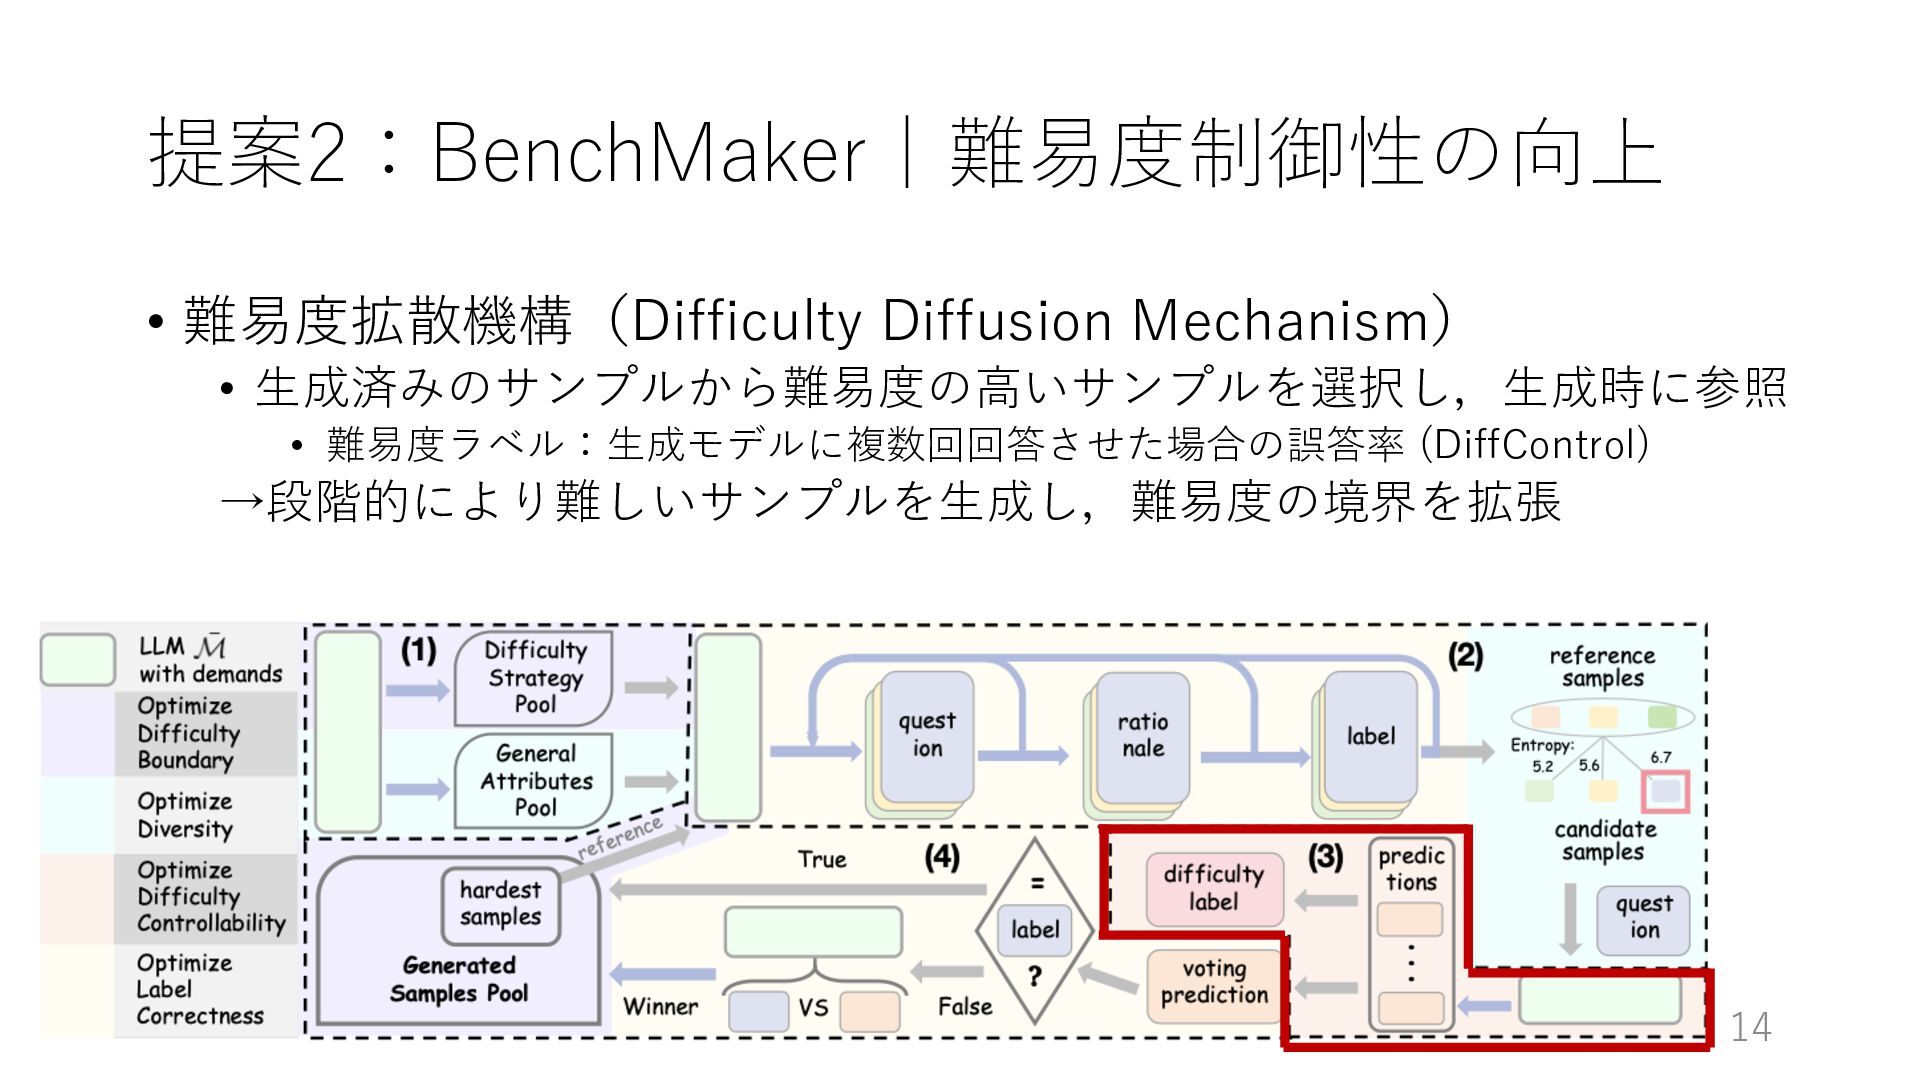
    ⼈⼿作成ベンチマークと⽐較した際の課題を把握 • 提案2:BenchMaker(汎⽤的なベンチマーク⽣成⼿法) • ラベル正確性の向上 • 難易度の制御性向上 • 語彙・意味的多様性向上 5
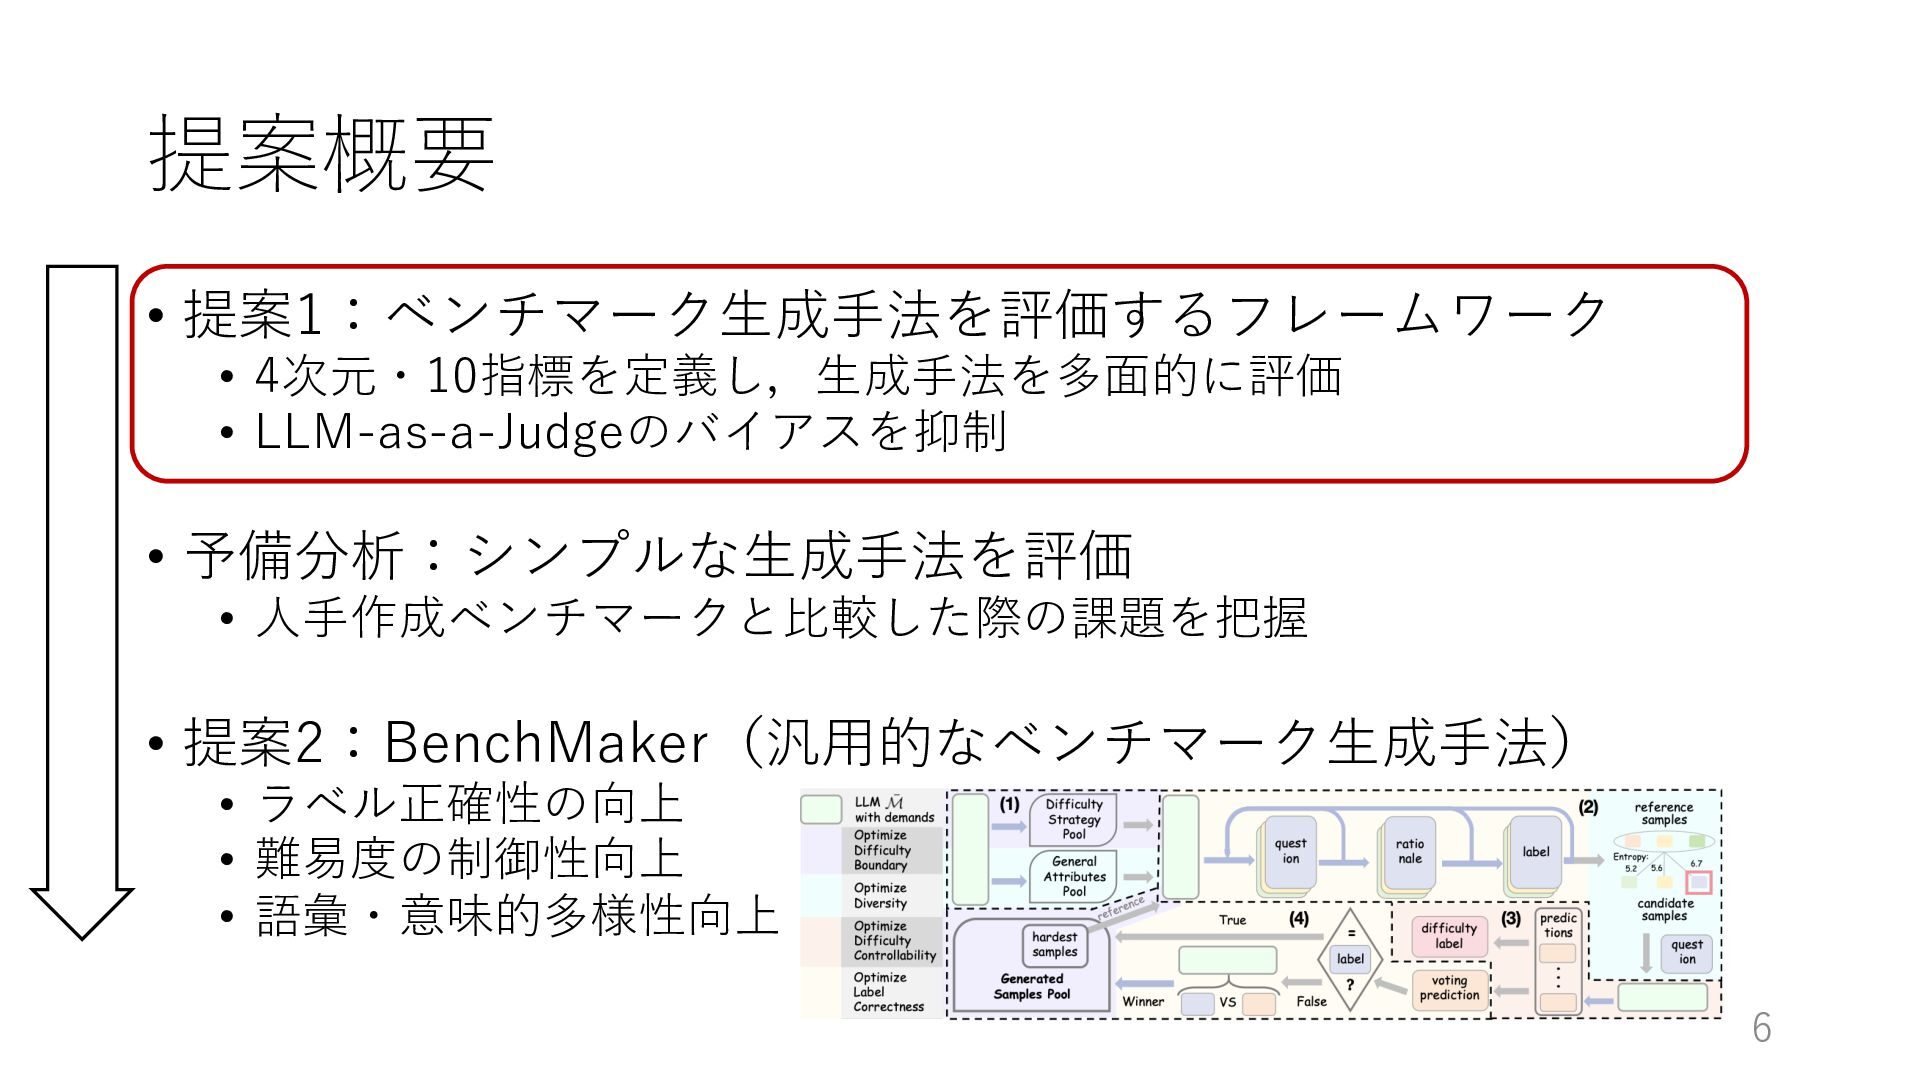
  3. 提案概要 • 提案1:ベンチマーク⽣成⼿法を評価するフレームワーク • 4次元・10指標を定義し,⽣成⼿法を多⾯的に評価 • LLM-as-a-Judgeのバイアスを抑制 • 予備分析:シンプルな⽣成⼿法を評価 •

    ⼈⼿作成ベンチマークと⽐較した際の課題を把握 • 提案2:BenchMaker(汎⽤的なベンチマーク⽣成⼿法) • ラベル正確性の向上 • 難易度の制御性向上 • 語彙・意味的多様性向上 6
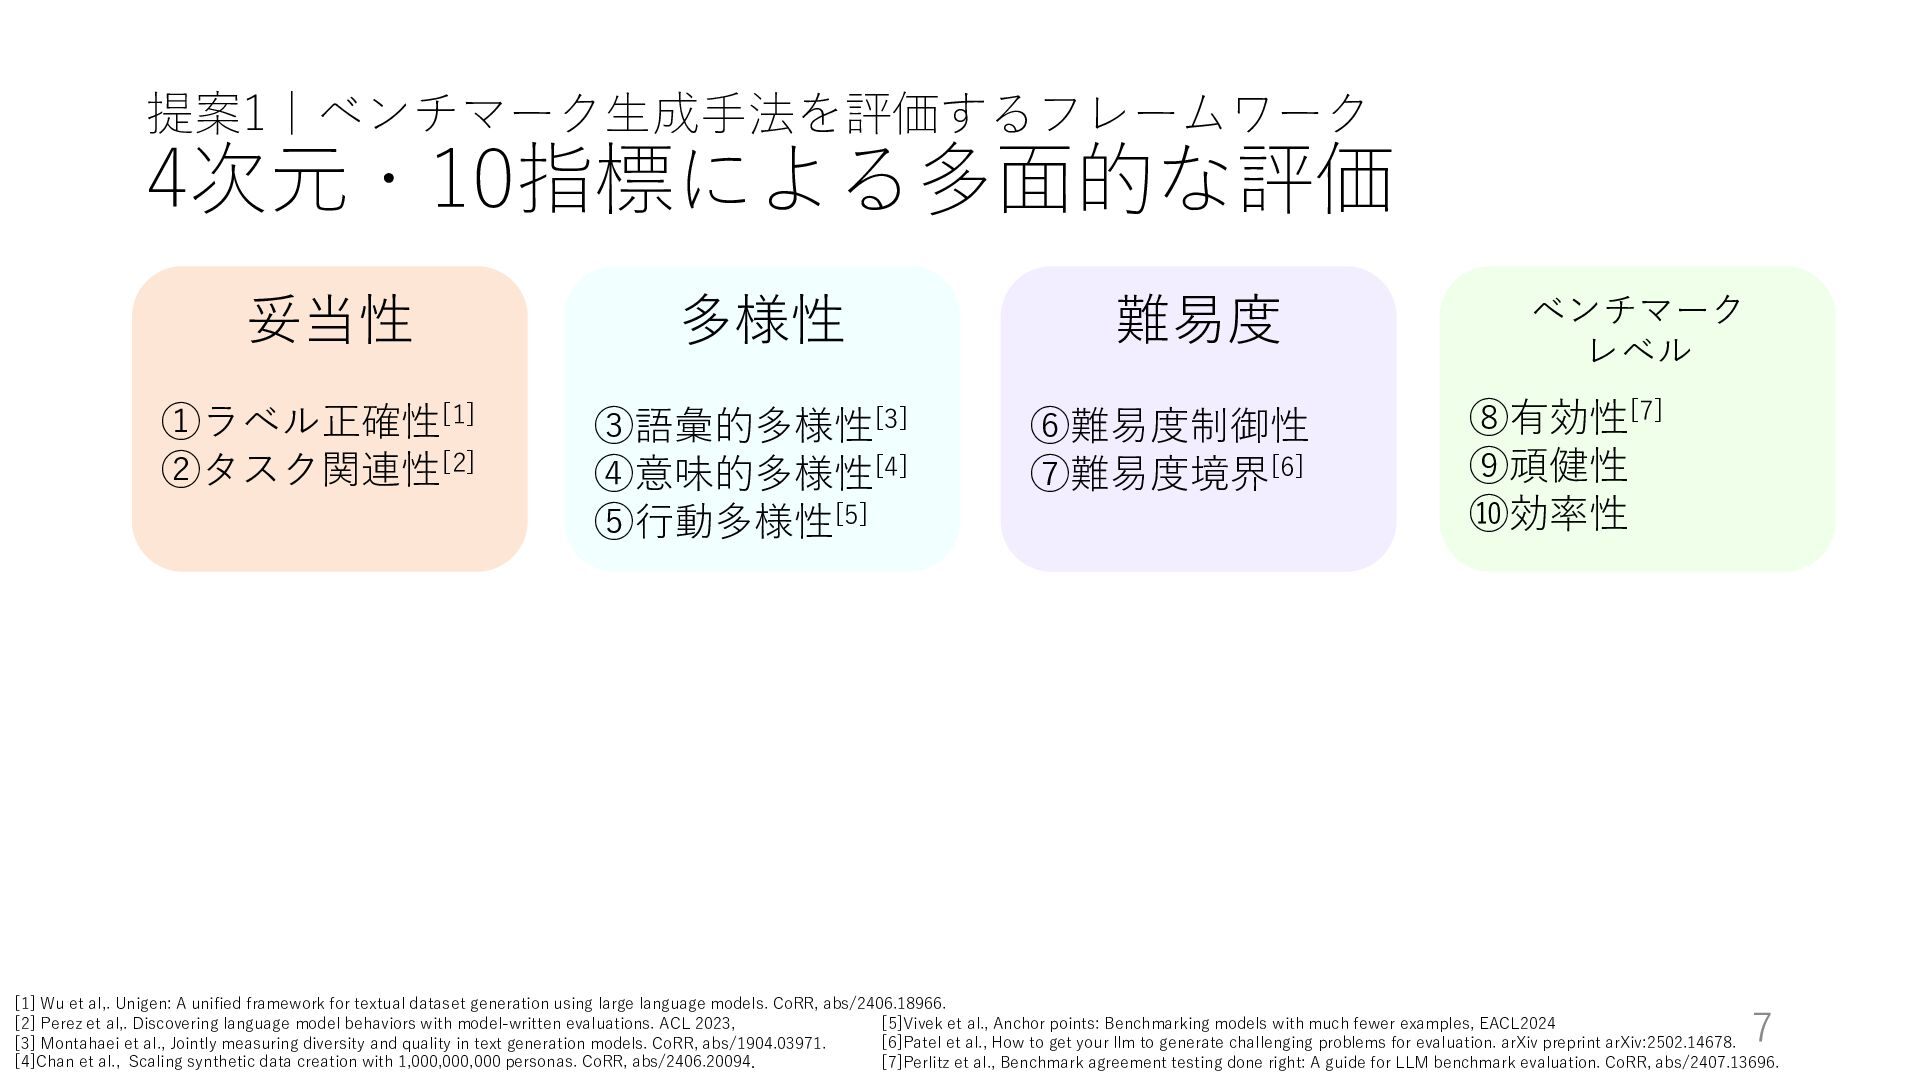
  4. 提案1|ベンチマーク⽣成⼿法を評価するフレームワーク 4次元・10指標による多⾯的な評価 妥当性 多様性 ①ラベル正確性[1] ②タスク関連性[2] ③語彙的多様性[3] ④意味的多様性[4] ⑤⾏動多様性[5] 難易度

    ⑥難易度制御性 ⑦難易度境界[6] ベンチマーク レベル ⑧有効性[7] ⑨頑健性 ⑩効率性 [1] Wu et al,. Unigen: A unified framework for textual dataset generation using large language models. CoRR, abs/2406.18966. [5]Vivek et al., Anchor points: Benchmarking models with much fewer examples, EACL2024 [2] Perez et al,. Discovering language model behaviors with model-written evaluations. ACL 2023, [6]Patel et al., How to get your llm to generate challenging problems for evaluation. arXiv preprint arXiv:2502.14678. [3] Montahaei et al., Jointly measuring diversity and quality in text generation models. CoRR, abs/1904.03971. [4]Chan et al., Scaling synthetic data creation with 1,000,000,000 personas. CoRR, abs/2406.20094. [7]Perlitz et al., Benchmark agreement testing done right: A guide for LLM benchmark evaluation. CoRR, abs/2407.13696. 7
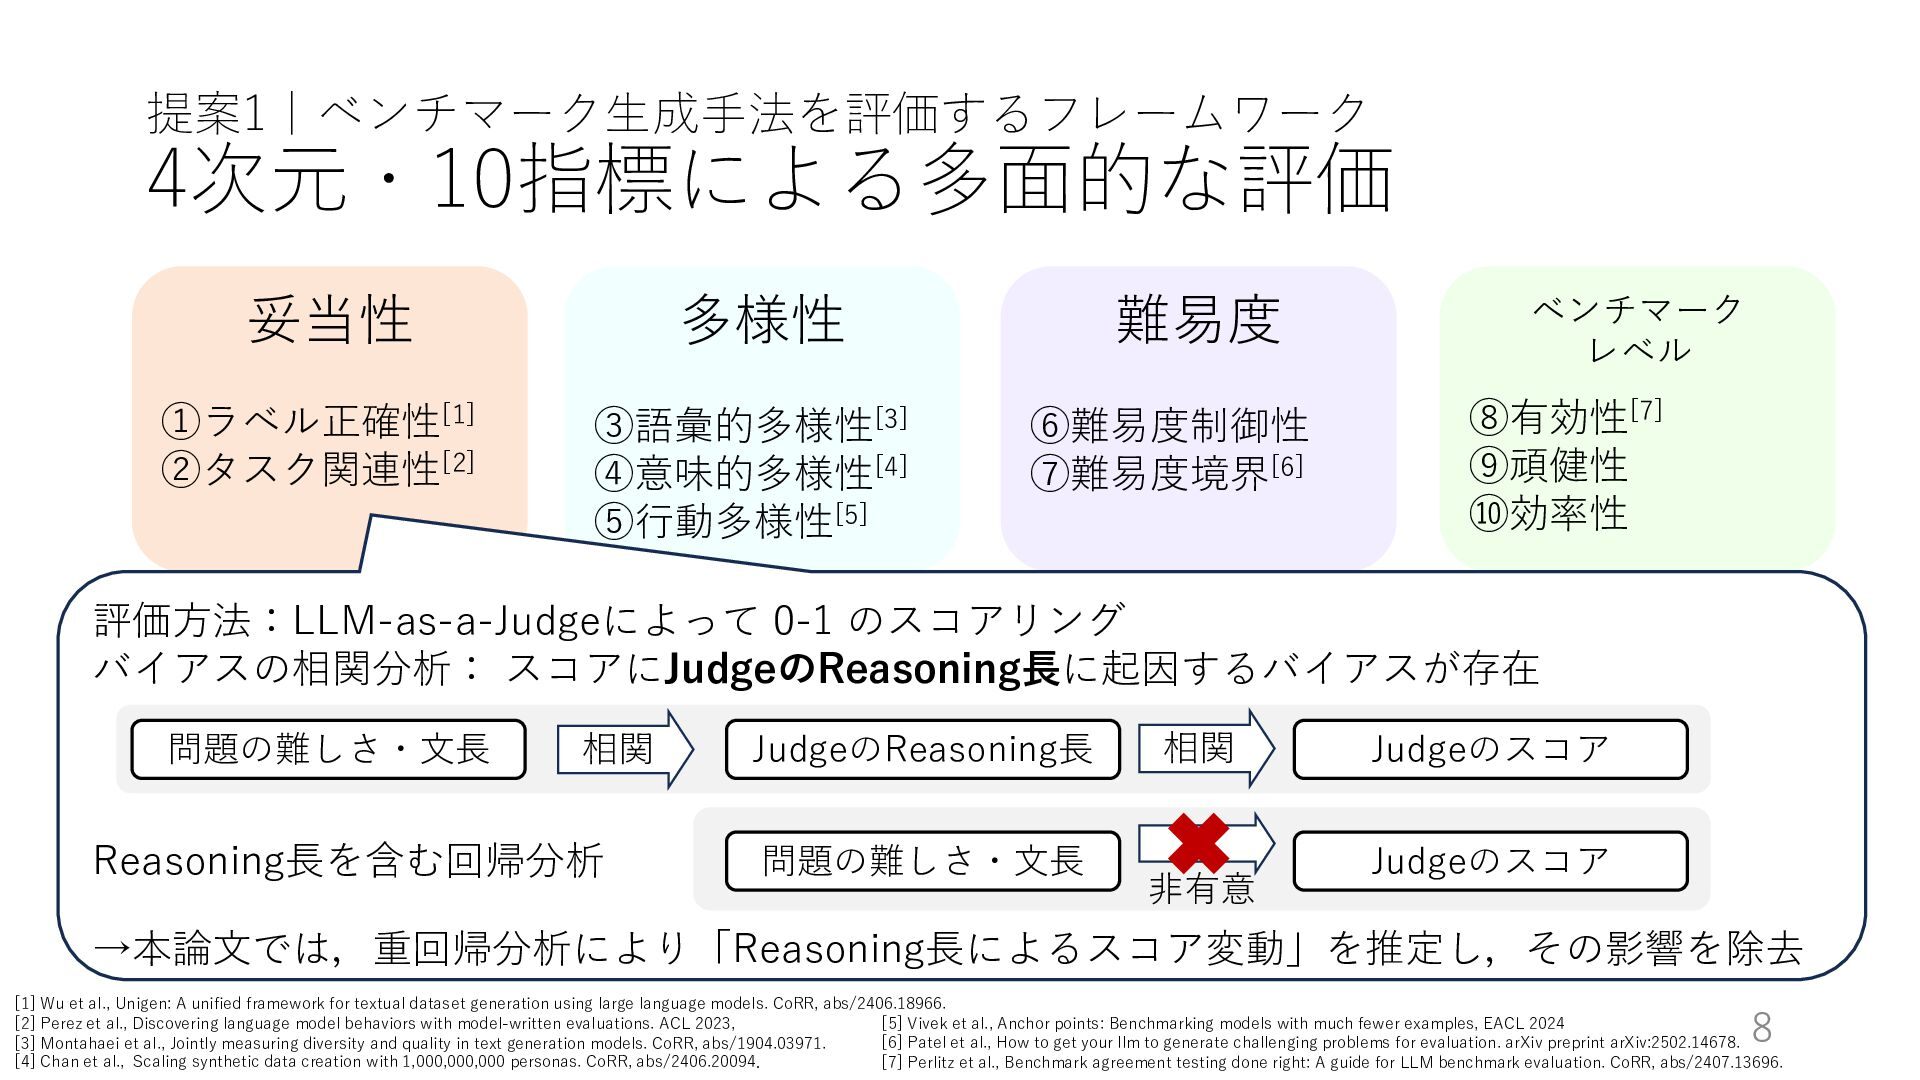
  5. 提案1|ベンチマーク⽣成⼿法を評価するフレームワーク 4次元・10指標による多⾯的な評価 妥当性 多様性 ①ラベル正確性[1] ②タスク関連性[2] ③語彙的多様性[3] ④意味的多様性[4] ⑤⾏動多様性[5] 難易度

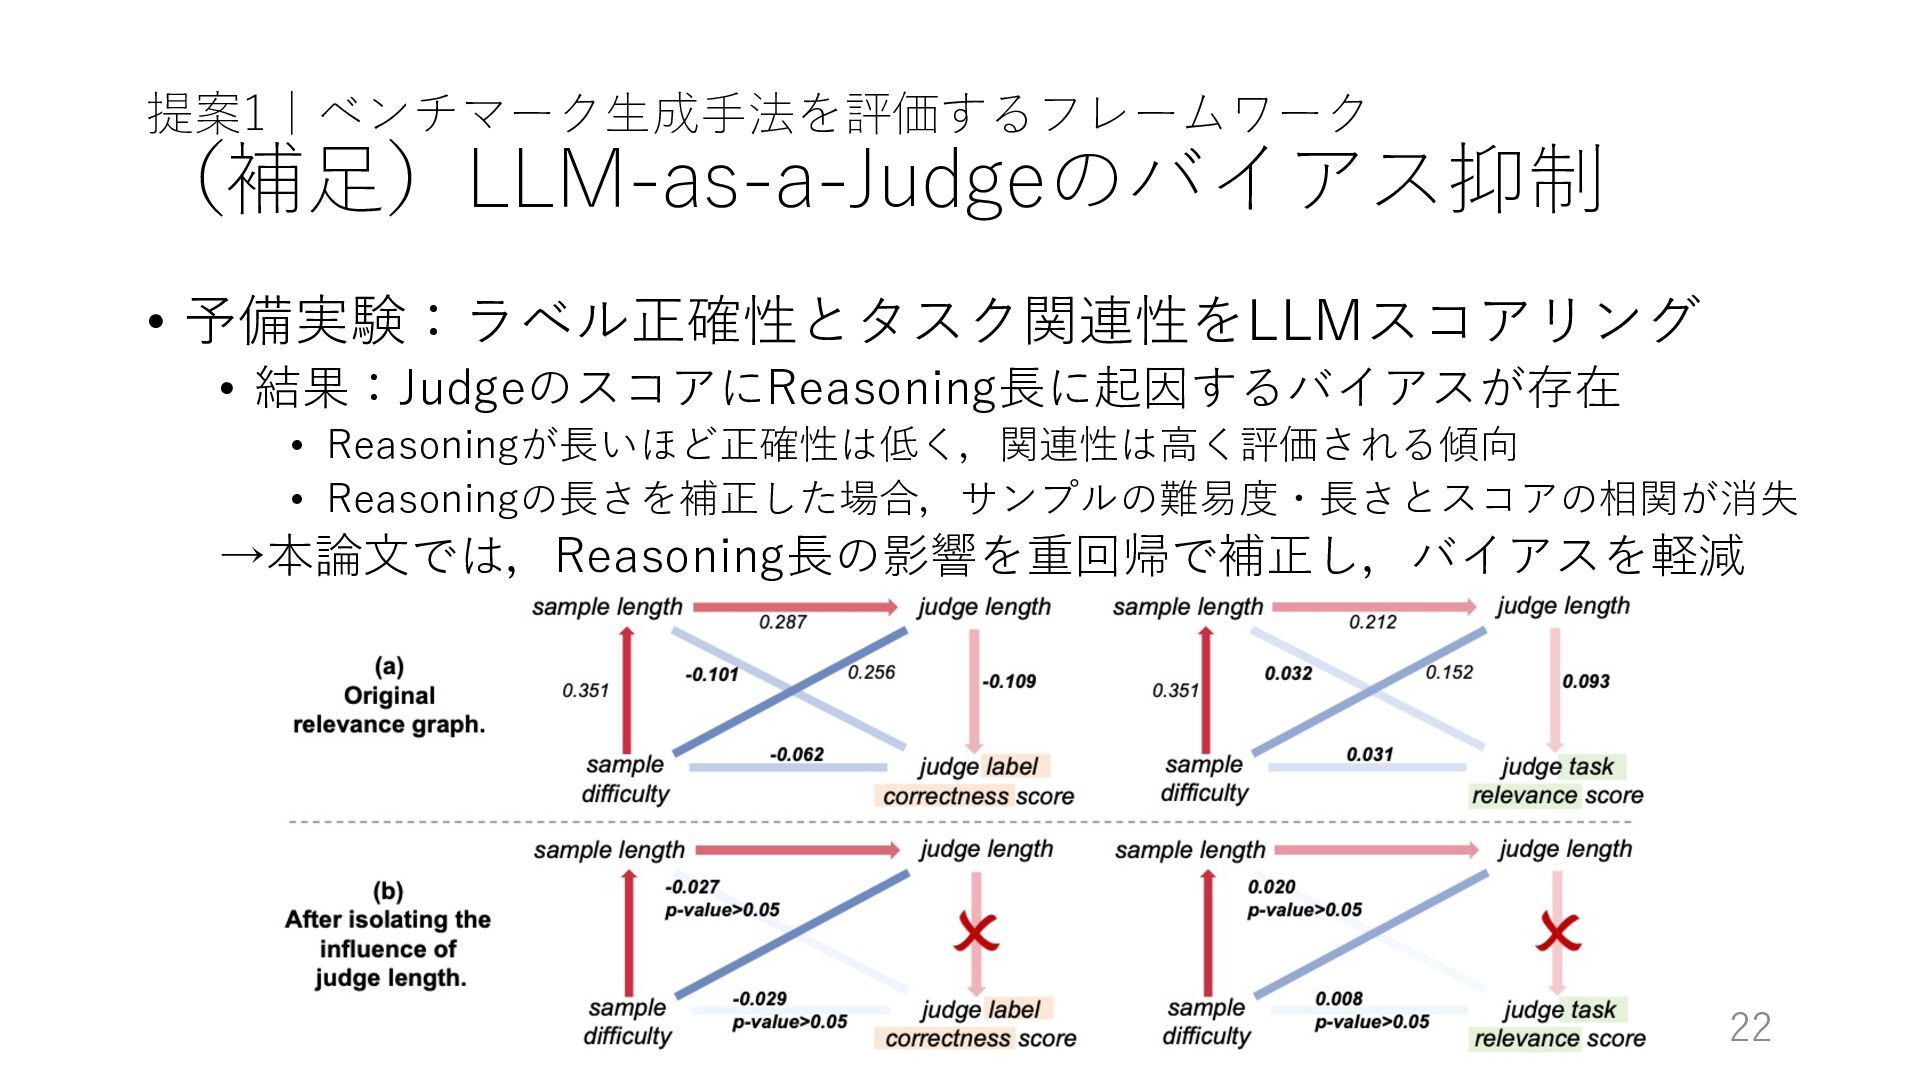
    ⑥難易度制御性 ⑦難易度境界[6] ベンチマーク レベル ⑧有効性[7] ⑨頑健性 ⑩効率性 評価⽅法:LLM-as-a-Judgeによって 0-1 のスコアリング バイアスの相関分析: スコアにJudgeのReasoning⻑に起因するバイアスが存在 問題の難しさ・⽂⻑ 相関 Reasoning⻑を含む回帰分析 JudgeのReasoning⻑ 問題の難しさ・⽂⻑ 相関 ⾮有意 Judgeのスコア Judgeのスコア →本論⽂では,重回帰分析により「Reasoning⻑によるスコア変動」を推定し,その影響を除去 [1] Wu et al., Unigen: A unified framework for textual dataset generation using large language models. CoRR, abs/2406.18966. [5] Vivek et al., Anchor points: Benchmarking models with much fewer examples, EACL 2024 [2] Perez et al., Discovering language model behaviors with model-written evaluations. ACL 2023, [6] Patel et al., How to get your llm to generate challenging problems for evaluation. arXiv preprint arXiv:2502.14678. [3] Montahaei et al., Jointly measuring diversity and quality in text generation models. CoRR, abs/1904.03971. [4] Chan et al., Scaling synthetic data creation with 1,000,000,000 personas. CoRR, abs/2406.20094. [7] Perlitz et al., Benchmark agreement testing done right: A guide for LLM benchmark evaluation. CoRR, abs/2407.13696. 8
  6. 提案概要 • 提案1:ベンチマーク⽣成⼿法を評価するフレームワーク • 4次元・10指標を定義し,⽣成⼿法を多⾯的に評価 • LLM-as-a-Judgeのバイアスを抑制 • 予備分析:シンプルな⽣成⼿法を評価 •

    ⼈⼿作成ベンチマークと⽐較した際の課題を把握 • 提案2:BenchMaker(汎⽤的なベンチマーク⽣成⼿法) • ラベル正確性の向上 • 難易度の制御性向上 • 語彙・意味的多様性向上 9
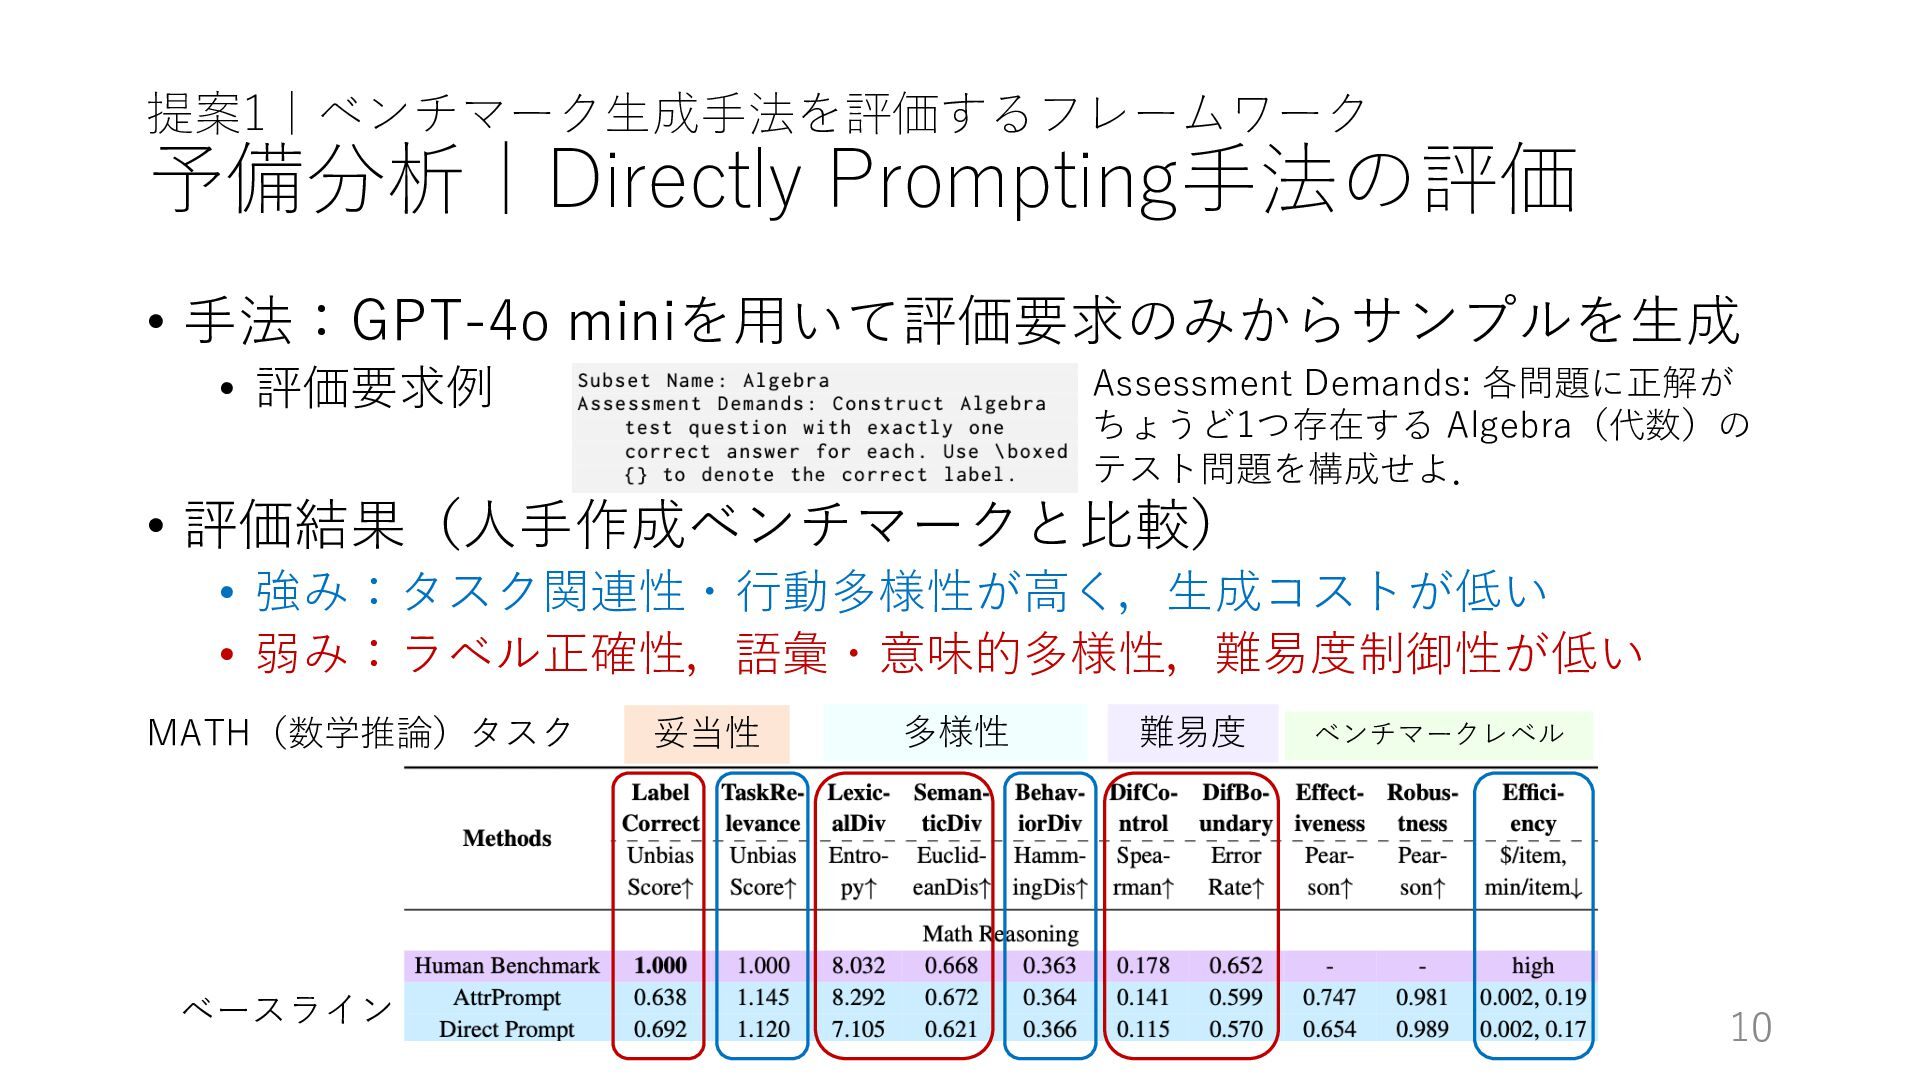
  7. 提案1|ベンチマーク⽣成⼿法を評価するフレームワーク 予備分析|Directly Prompting⼿法の評価 • ⼿法:GPT-4o miniを⽤いて評価要求のみからサンプルを⽣成 • 評価要求例 Assessment Demands:

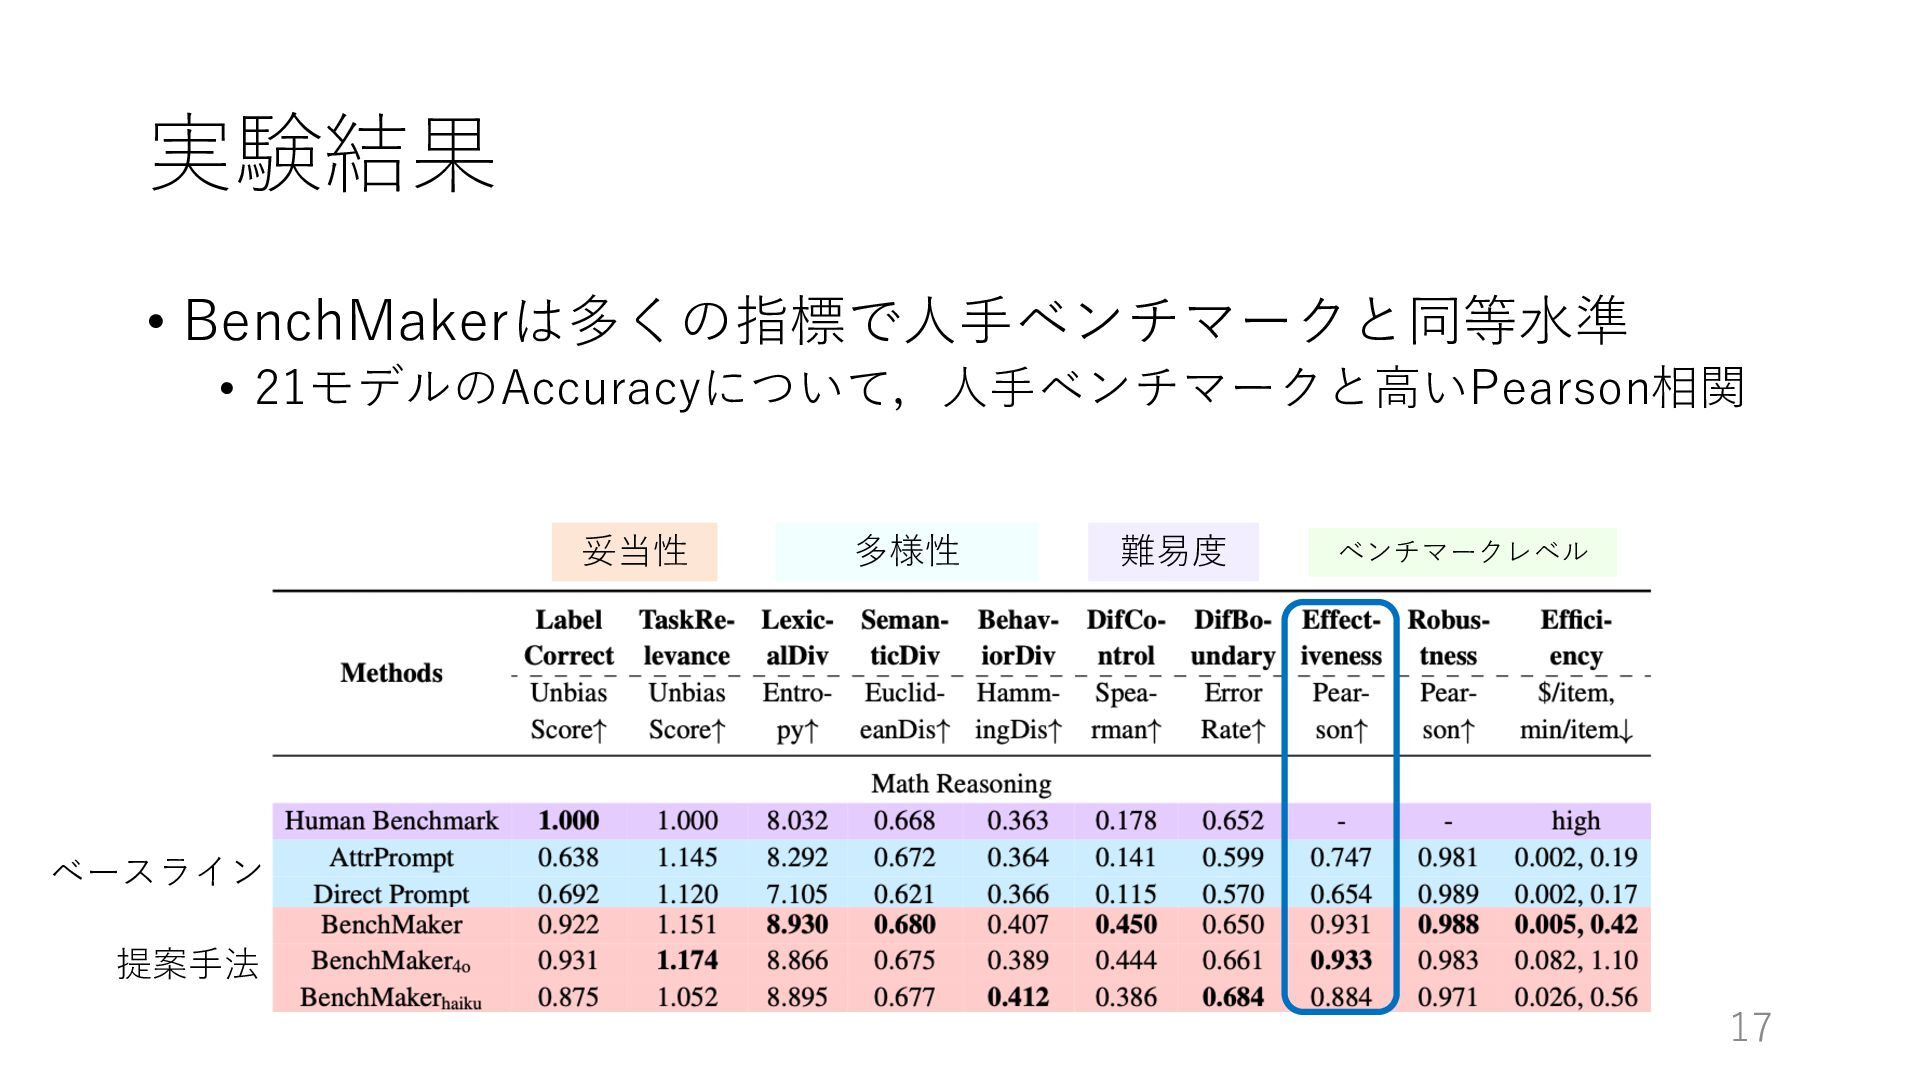
    各問題に正解が ちょうど1つ存在する Algebra(代数)の テスト問題を構成せよ. • 評価結果(⼈⼿作成ベンチマークと⽐較) • 強み:タスク関連性・⾏動多様性が⾼く,⽣成コストが低い • 弱み:ラベル正確性,語彙・意味的多様性,難易度制御性が低い MATH(数学推論)タスク ベースライン 妥当性 多様性 難易度 ベンチマークレベル 10
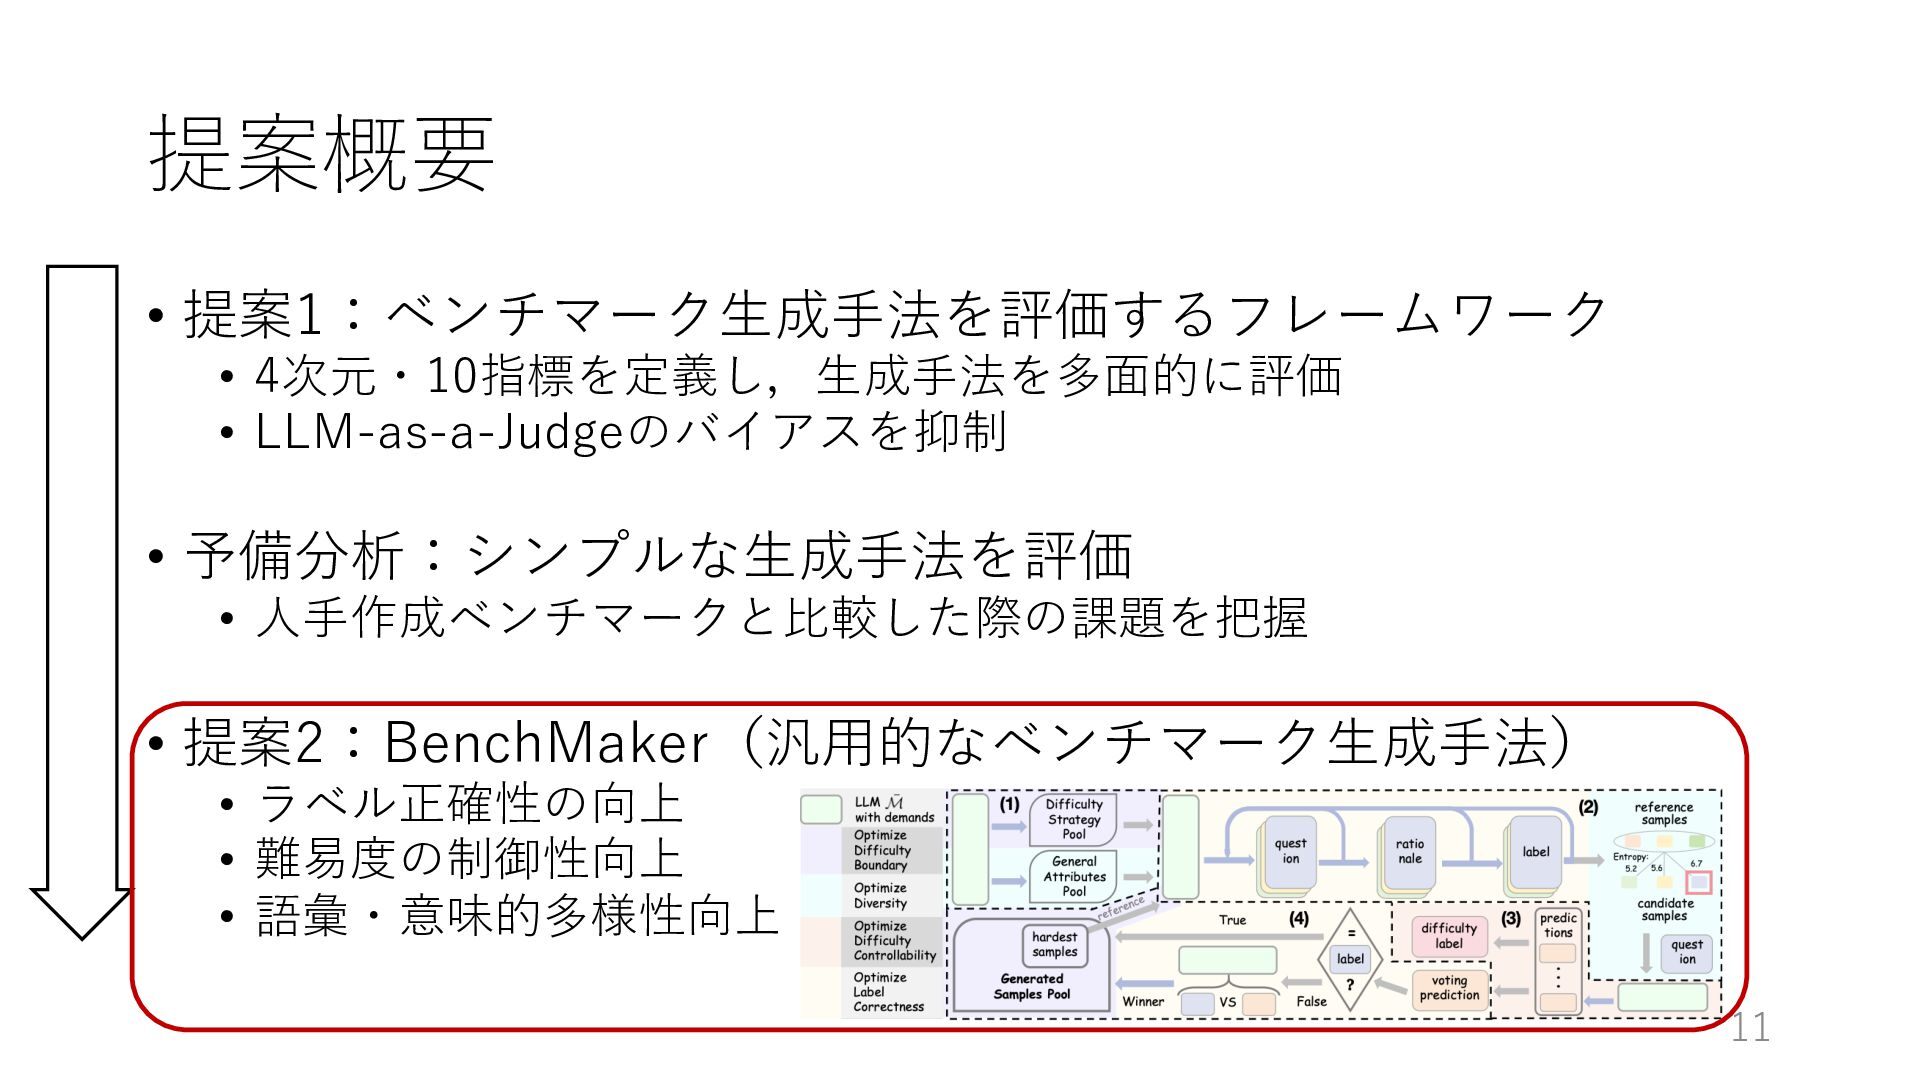
  8. 提案概要 • 提案1:ベンチマーク⽣成⼿法を評価するフレームワーク • 4次元・10指標を定義し,⽣成⼿法を多⾯的に評価 • LLM-as-a-Judgeのバイアスを抑制 • 予備分析:シンプルな⽣成⼿法を評価 •

    ⼈⼿作成ベンチマークと⽐較した際の課題を把握 • 提案2:BenchMaker(汎⽤的なベンチマーク⽣成⼿法) • ラベル正確性の向上 • 難易度の制御性向上 • 語彙・意味的多様性向上 11
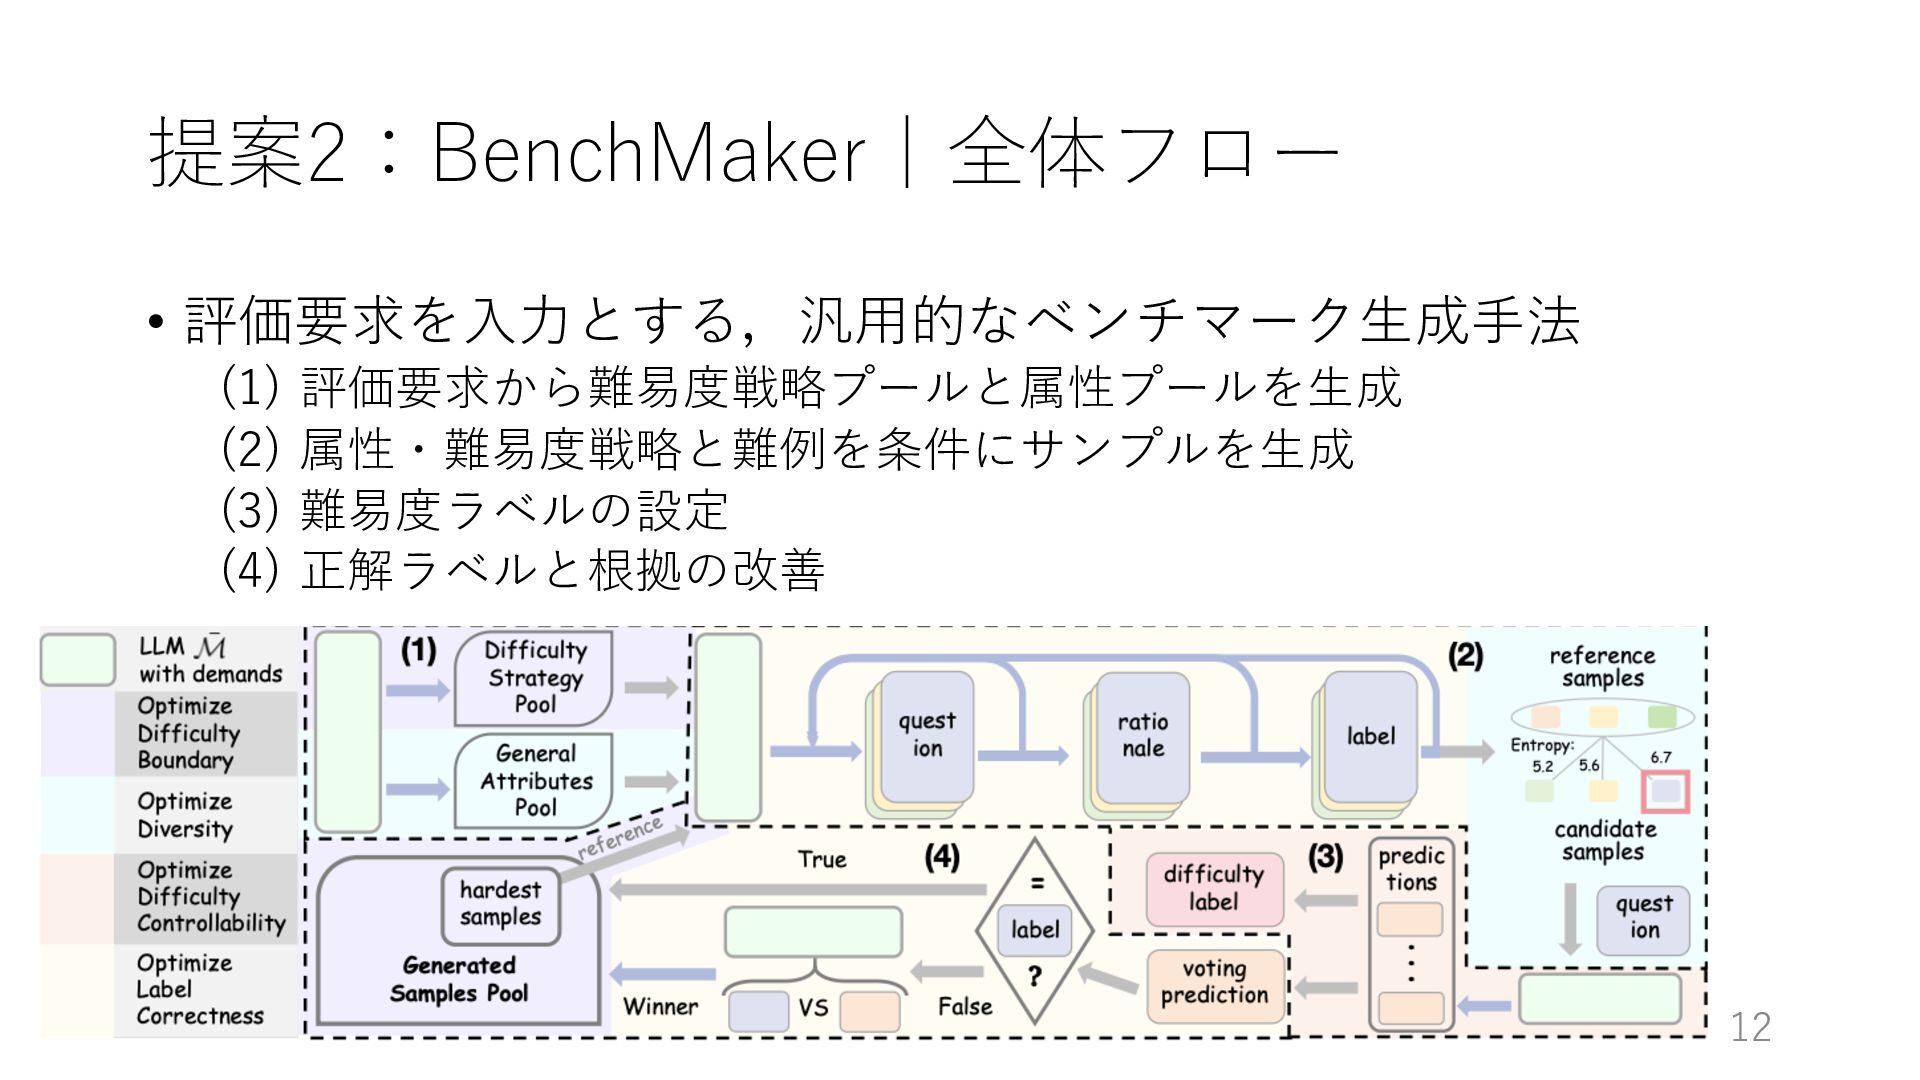
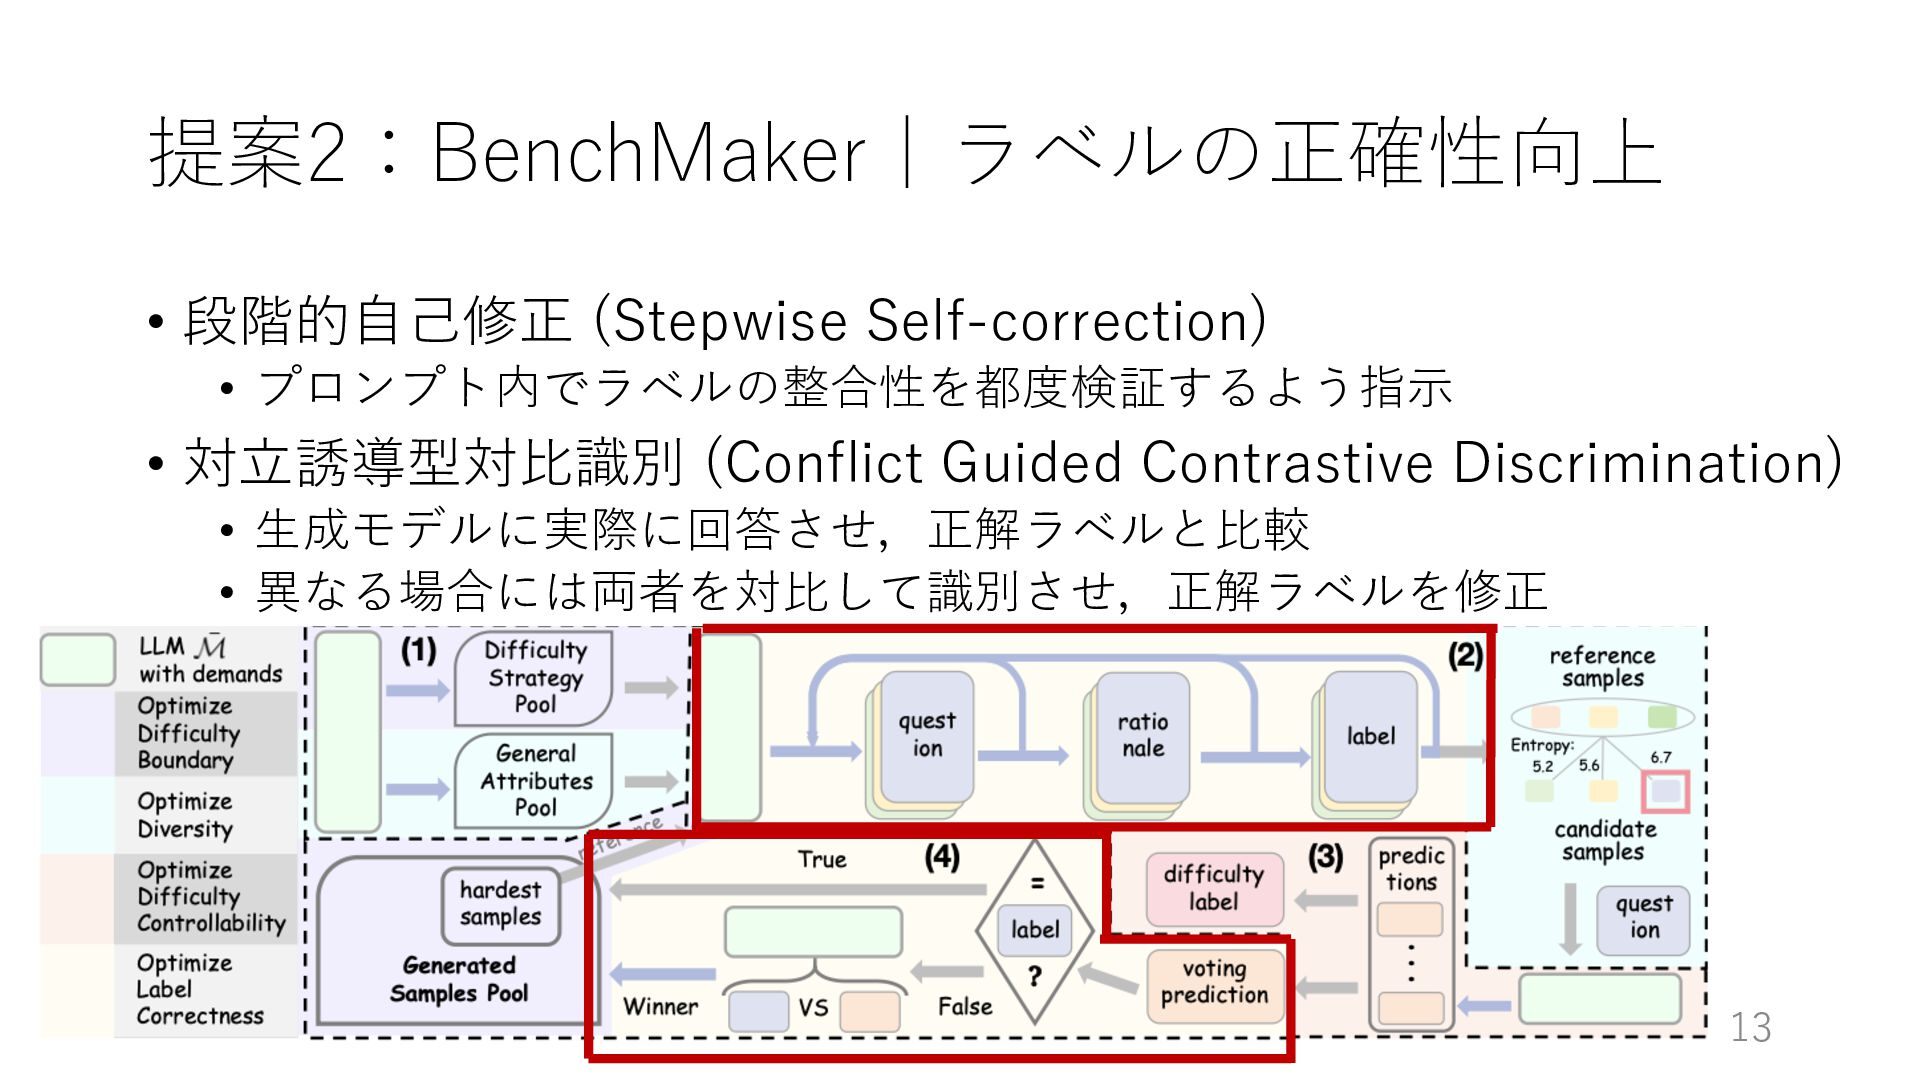
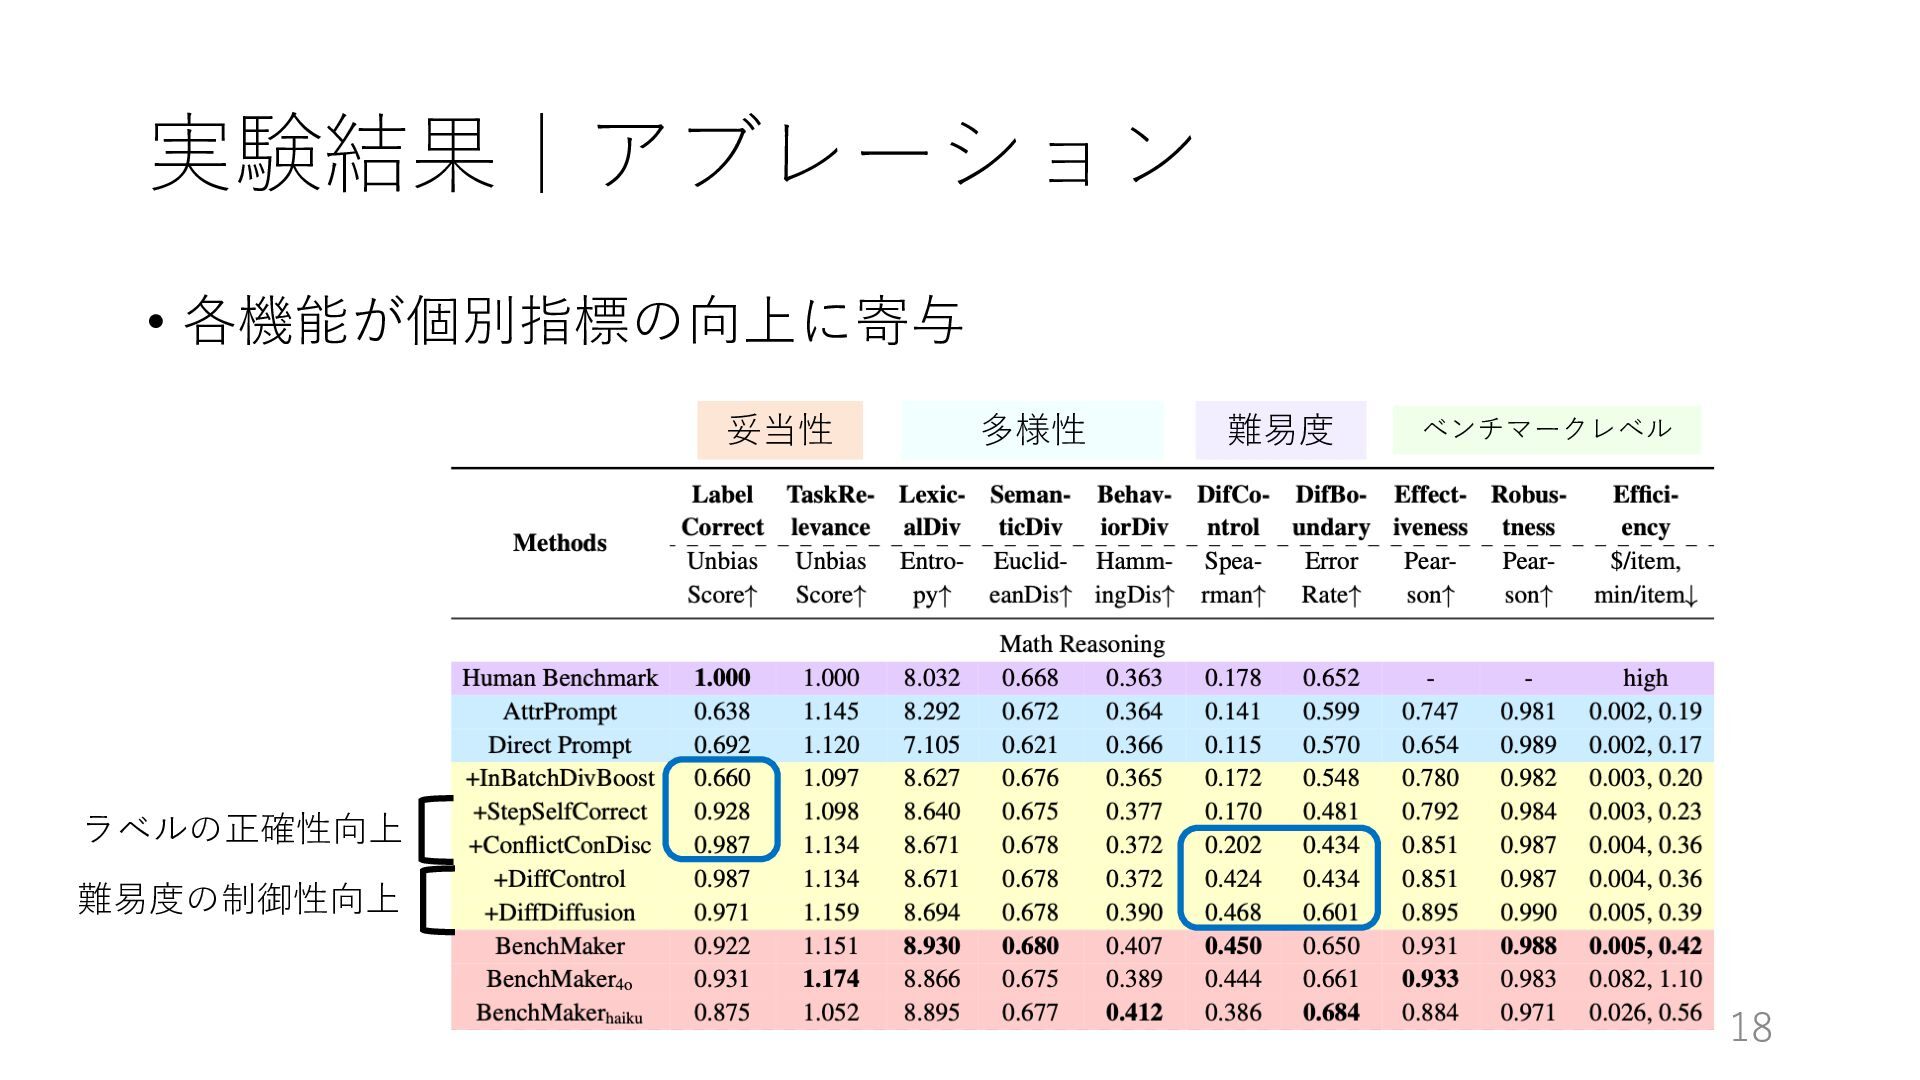
  9. 提案2:BenchMaker|ラベルの正確性向上 • 段階的⾃⼰修正 (Stepwise Self-correction) • プロンプト内でラベルの整合性を都度検証するよう指⽰ • 対⽴誘導型対⽐識別 (Conflict

    Guided Contrastive Discrimination) • ⽣成モデルに実際に回答させ,正解ラベルと⽐較 • 異なる場合には両者を対⽐して識別させ,正解ラベルを修正 13
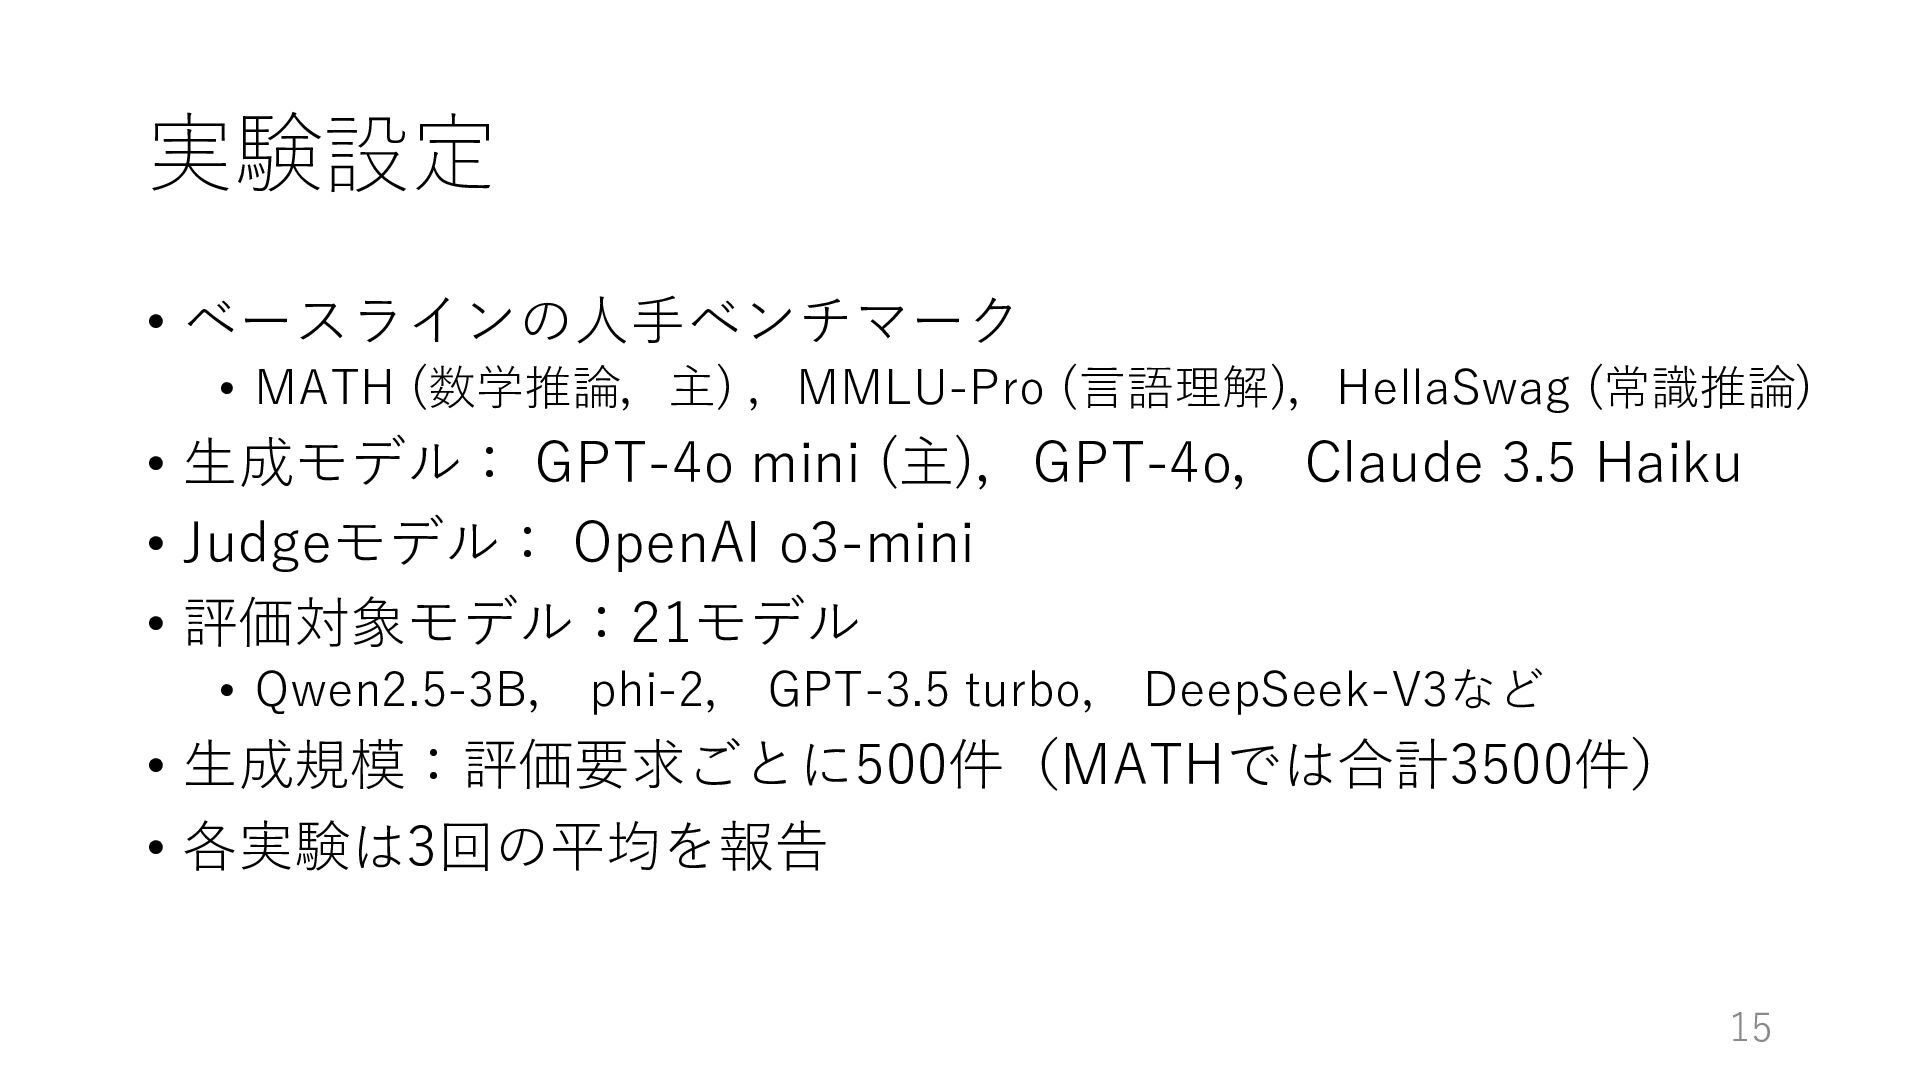
  10. 実験設定 • ベースラインの⼈⼿ベンチマーク • MATH (数学推論,主) ,MMLU-Pro (⾔語理解),HellaSwag (常識推論) •

    ⽣成モデル: GPT-4o mini (主),GPT-4o, Claude 3.5 Haiku • Judgeモデル: OpenAI o3-mini • 評価対象モデル:21モデル • Qwen2.5-3B, phi-2, GPT-3.5 turbo, DeepSeek-V3など • ⽣成規模:評価要求ごとに500件(MATHでは合計3500件) • 各実験は3回の平均を報告 15
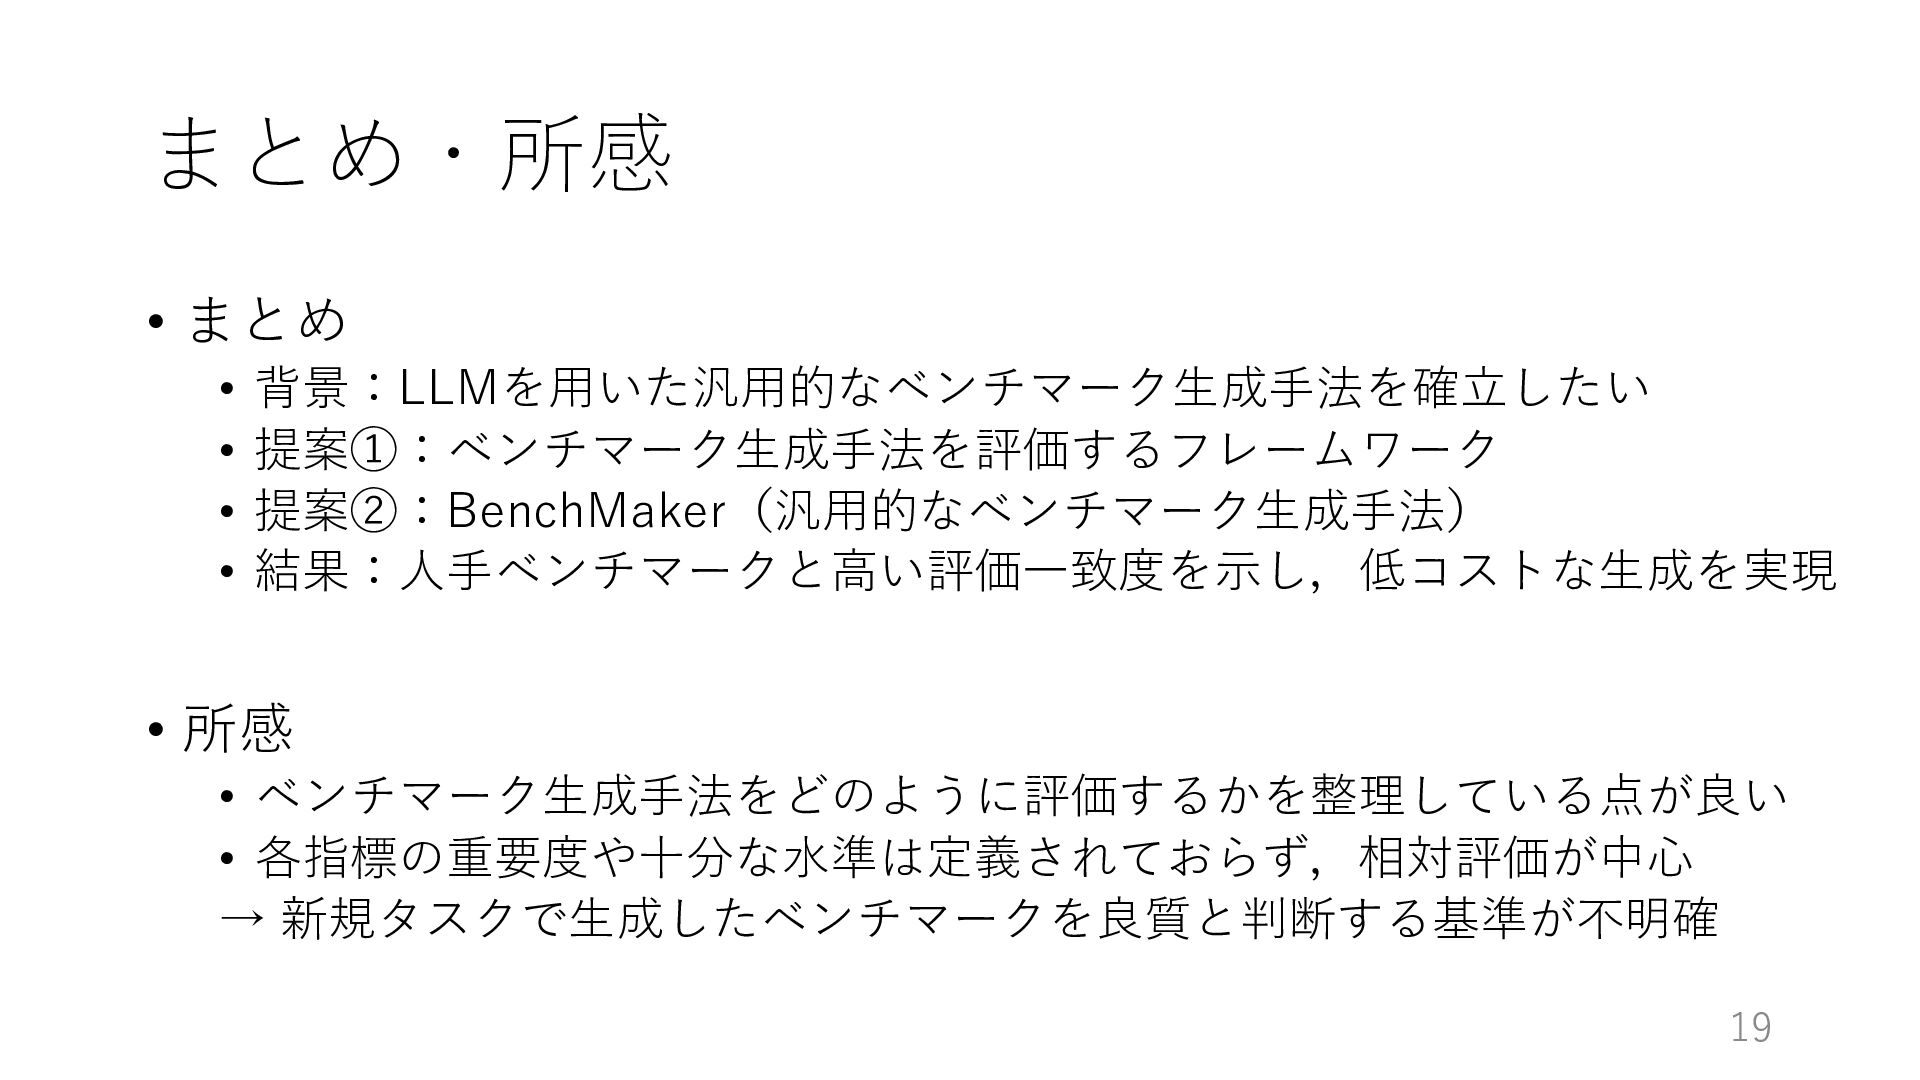
  11. まとめ・所感 • まとめ • 背景:LLMを⽤いた汎⽤的なベンチマーク⽣成⼿法を確⽴したい • 提案①:ベンチマーク⽣成⼿法を評価するフレームワーク • 提案②:BenchMaker(汎⽤的なベンチマーク⽣成⼿法) •

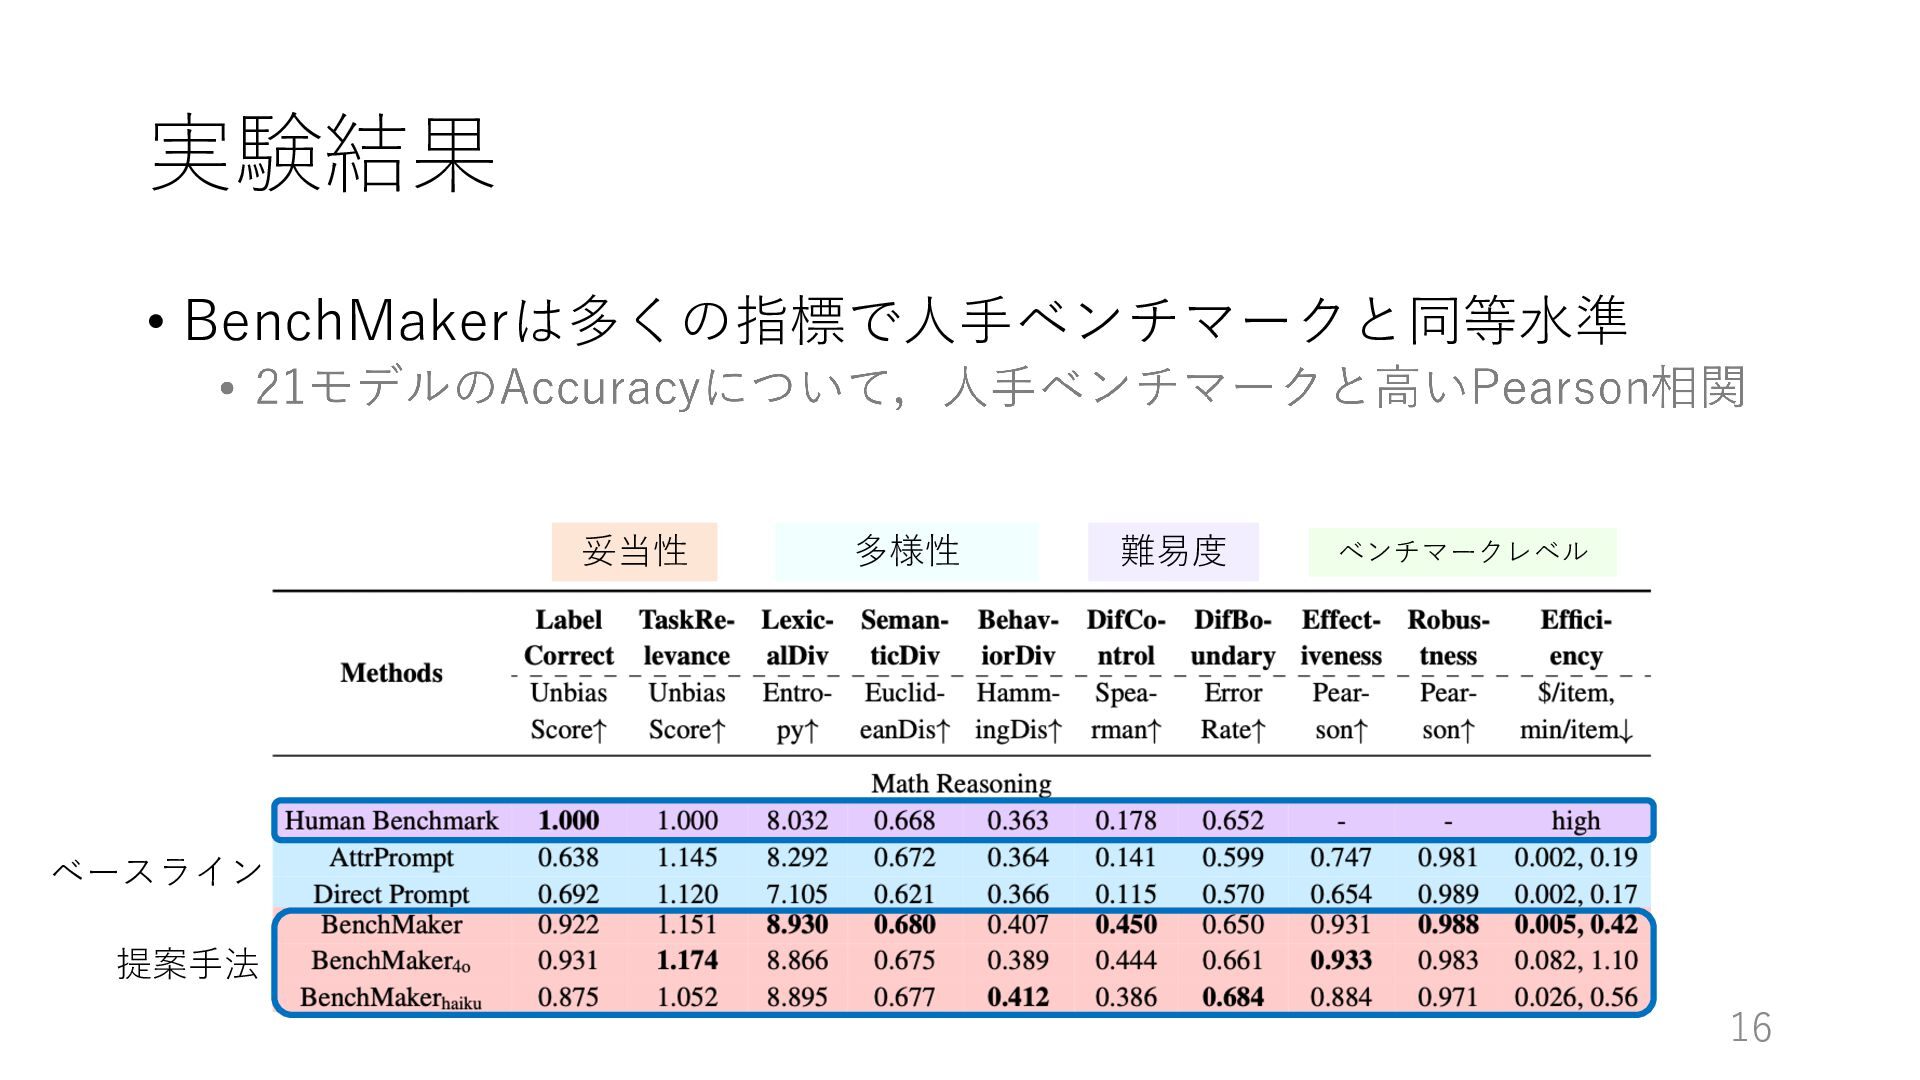
    結果:⼈⼿ベンチマークと⾼い評価⼀致度を⽰し,低コストな⽣成を実現 • 所感 • ベンチマーク⽣成⼿法をどのように評価するかを整理している点が良い • 各指標の重要度や⼗分な⽔準は定義されておらず,相対評価が中⼼ → 新規タスクで⽣成したベンチマークを良質と判断する基準が不明確 19
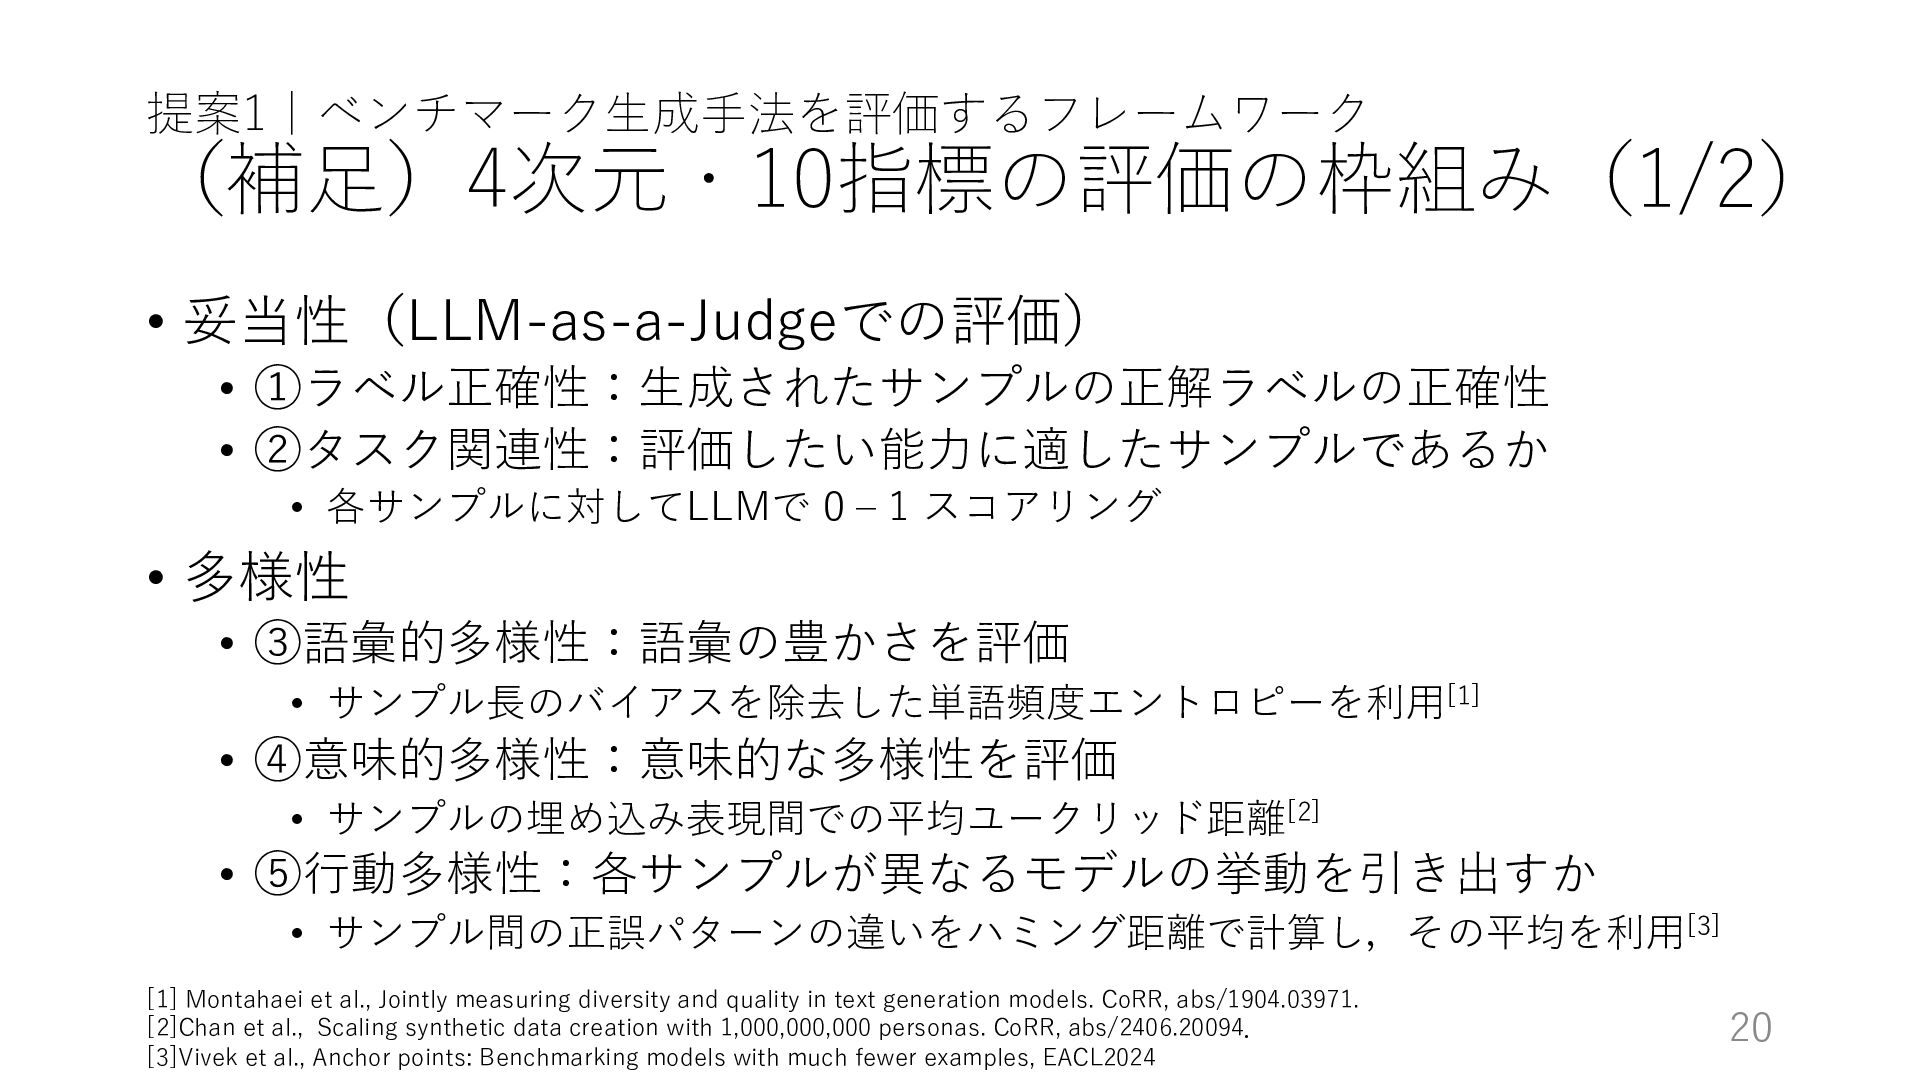
  12. 提案1|ベンチマーク⽣成⼿法を評価するフレームワーク (補⾜)4次元・10指標の評価の枠組み(1/2) • 妥当性(LLM-as-a-Judgeでの評価) • ①ラベル正確性:⽣成されたサンプルの正解ラベルの正確性 • ②タスク関連性:評価したい能⼒に適したサンプルであるか • 各サンプルに対してLLMで

    0 ‒ 1 スコアリング • 多様性 • ③語彙的多様性:語彙の豊かさを評価 • サンプル⻑のバイアスを除去した単語頻度エントロピーを利⽤[1] • ④意味的多様性:意味的な多様性を評価 • サンプルの埋め込み表現間での平均ユークリッド距離[2] • ⑤⾏動多様性:各サンプルが異なるモデルの挙動を引き出すか • サンプル間の正誤パターンの違いをハミング距離で計算し,その平均を利⽤[3] [1] Montahaei et al., Jointly measuring diversity and quality in text generation models. CoRR, abs/1904.03971. [2]Chan et al., Scaling synthetic data creation with 1,000,000,000 personas. CoRR, abs/2406.20094. [3]Vivek et al., Anchor points: Benchmarking models with much fewer examples, EACL2024 20
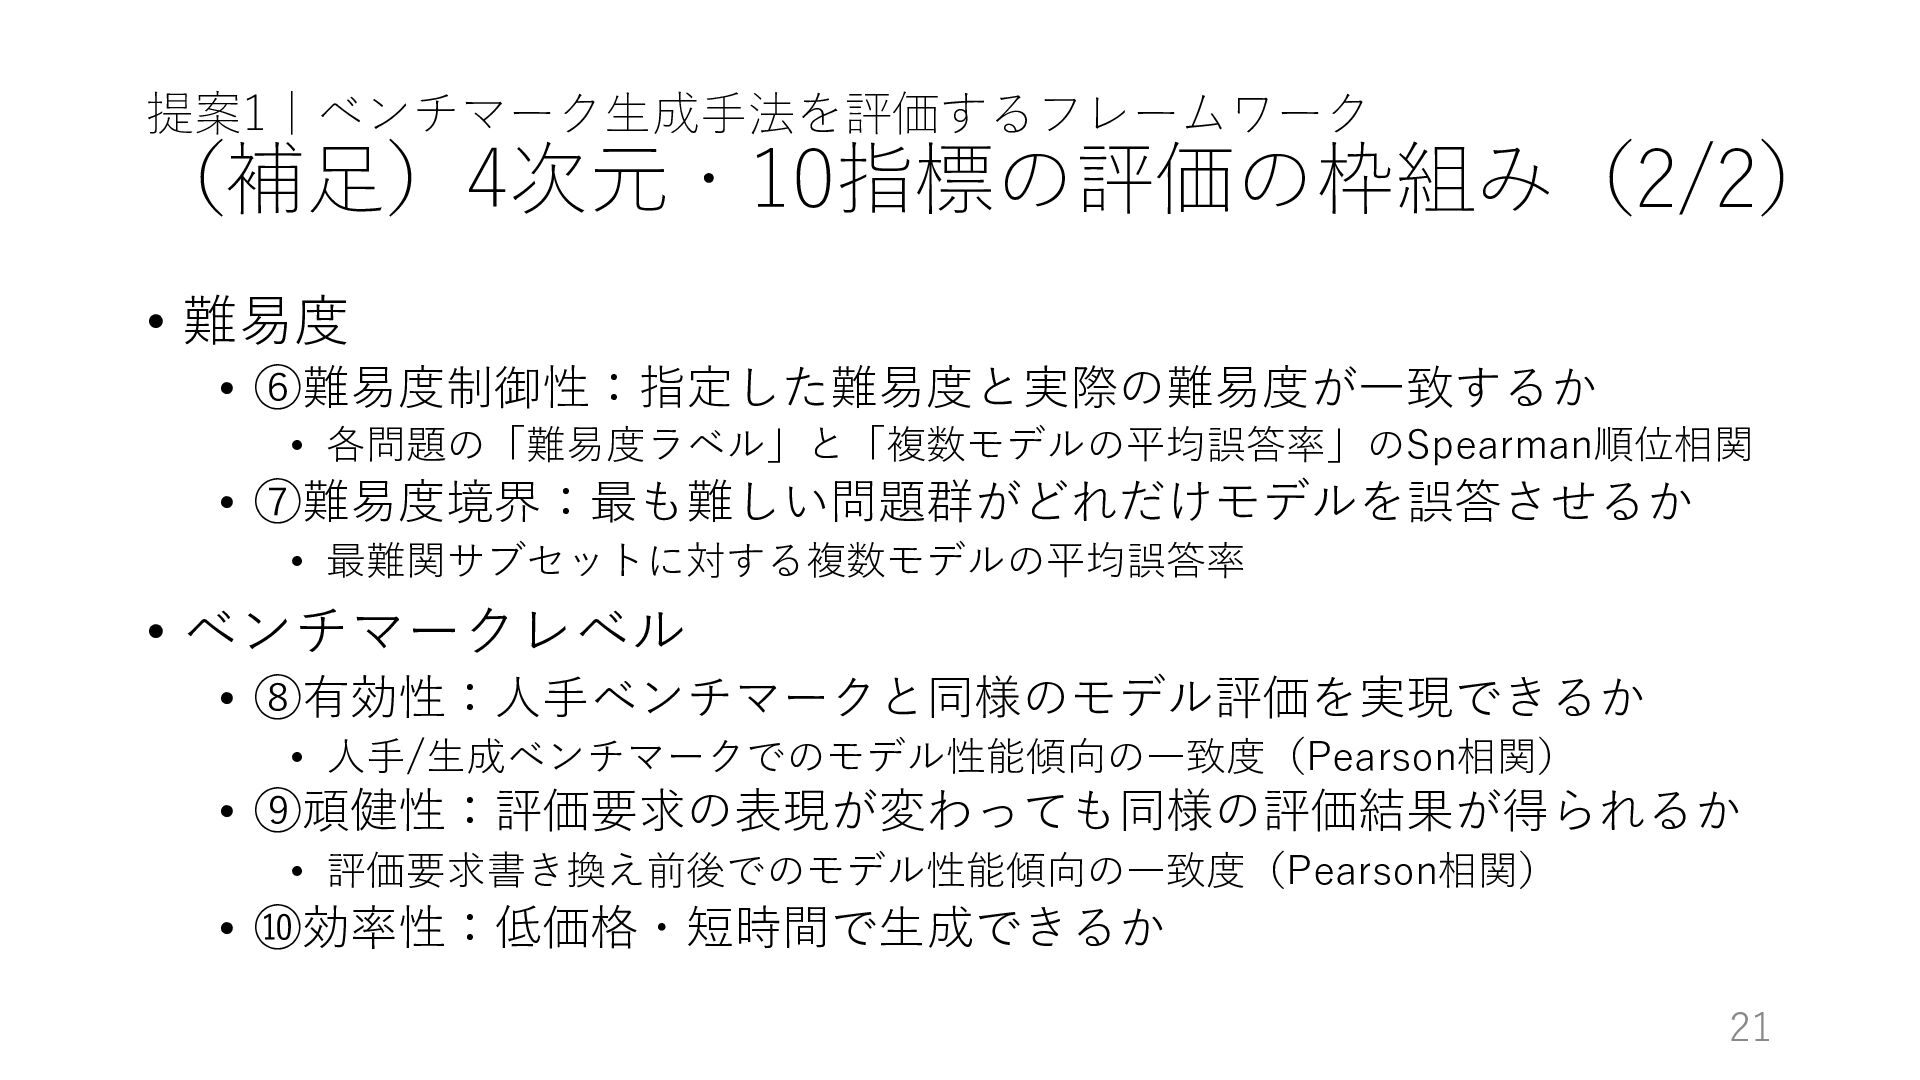
  13. 提案1|ベンチマーク⽣成⼿法を評価するフレームワーク (補⾜)4次元・10指標の評価の枠組み(2/2) • 難易度 • ⑥難易度制御性:指定した難易度と実際の難易度が⼀致するか • 各問題の「難易度ラベル」と「複数モデルの平均誤答率」のSpearman順位相関 • ⑦難易度境界:最も難しい問題群がどれだけモデルを誤答させるか

    • 最難関サブセットに対する複数モデルの平均誤答率 • ベンチマークレベル • ⑧有効性:⼈⼿ベンチマークと同様のモデル評価を実現できるか • ⼈⼿/⽣成ベンチマークでのモデル性能傾向の⼀致度(Pearson相関) • ⑨頑健性:評価要求の表現が変わっても同様の評価結果が得られるか • 評価要求書き換え前後でのモデル性能傾向の⼀致度(Pearson相関) • ⑩効率性:低価格・短時間で⽣成できるか 21