Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
RISC-V 64 Assembly Essentials
Search
Latte72
September 24, 2026
17
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
RISC-V 64 Assembly Essentials
Latte72
September 24, 2026
More Decks by Latte72
See All by Latte72
Building an Out-of-Order CPU
latte72
1
790
Be Mindful of Fonts
latte72
0
140
Introduction to Git & GitHub
latte72
1
560
x86-64 Assembly Essentials
latte72
10
6.7k
Featured
See All Featured
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.8k
Building an army of robots
kneath
307
46k
Heart Work Chapter 1 - Part 1
lfama
PRO
10
36k
A better future with KSS
kneath
240
18k
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.5k
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
280
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Designing for humans not robots
tammielis
254
26k
SEO for Brand Visibility & Recognition
aleyda
0
4.7k
Tell your own story through comics
letsgokoyo
1
1.1k
Bash Introduction
62gerente
615
220k
HDC tutorial
michielstock
2
880
Transcript
RV64IMAC アセンブリ入門 Latte72 (@Latte72R)
00 はじめに 自己紹介 名前: Latte72 興味分野 所属: 慶應義塾大学理工学部 低レイヤー全般 X
/ GitHub: @Latte72R 自作 OS HP: https://latte72.net/ 自作コンパイラ 自作 CPU 2
01 はじめに
01 はじめに このスライドの内容 書いてあること RISC-V とは何か RV64IMAC アセンブリの基礎文法 レジスタ・関数・分岐の書き方 書いていないこと
C 言語の文法そのもの 発展的な最適化・特権命令 RISC-V 以外のアーキテクチャについて 4
01 はじめに 対象読者 対象の読者 RV64IMAC アセンブリの基礎文法を学びたい方 C 言語の簡単な処理をアセンブリに書き換えたい方 対象でない読者 発展的な最適化や特権命令を学びたい方
C 言語の文法を学びたい方 x86-64 や Arm64 などのアーキテクチャについて学びたい方 5
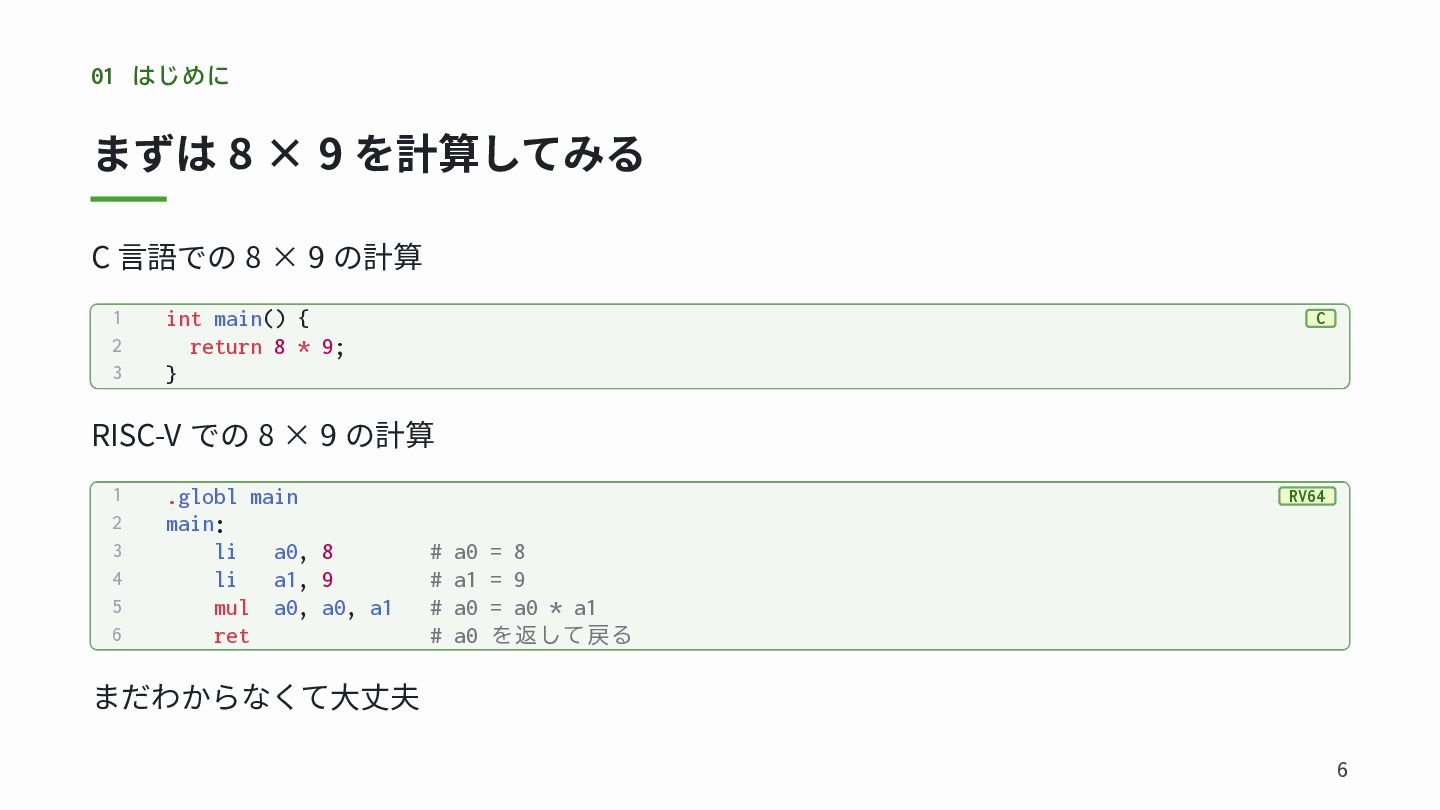
01 はじめに まずは 8 × 9 を計算してみる C 言語での 8
× 9 の計算 1 2 3 int main() { return 8 * 9; } C RISC-V での 8 × 9 の計算 1 2 3 4 5 6 .globl main main: li a0, 8 li a1, 9 mul a0, a0, a1 ret RV64 # a0 = 8 # a1 = 9 # a0 = a0 * a1 # a0 を返して戻る まだわからなくて大丈夫 6
01 はじめに GAS 記法について GNU アセンブラ (GAS) の記法を使う このスライドでは RV64IMAC
の命令を GAS の記法で解説する コメントは # で書く main を外部から参照できるように .globl main と書く レジスタは ABI 名 (a0, ra, sp …) で書く 7
02 RISC-V とは
02 RISC-V とは アセンブリ言語とは C や Python より ハードウェアに近い 言語
CPU には様々な種類がある x86-64, Arm64, RISC-V, MIPS … 同じ C の処理でも,CPU によって使う命令は異なる アセンブリは,その CPU の命令を人が読める名前で書いたもの 9
02 RISC-V とは RV64IMAC って何? RV64: 整数レジスタと基本的な演算の幅が 64bit I: 整数の基本命令
(土台) M: かけ算・わり算 (mul / div / rem) A: アトミック操作 (マルチコアの同期用) C: 16bit の短い命令 (コードを小さくできる) RV64I を土台に M・A・C の拡張を加えた構成 10
02 RISC-V とは RISC-V の誕生 2010 年に UC Berkeley で開発が始まった
Krste Asanović と大学院生が開発を開始 David Patterson は当時の研究プロジェクト責任者 オープンで無償で利用できる ISA 名前の V は Berkeley の RISC 研究の第 5 世代を表す 11
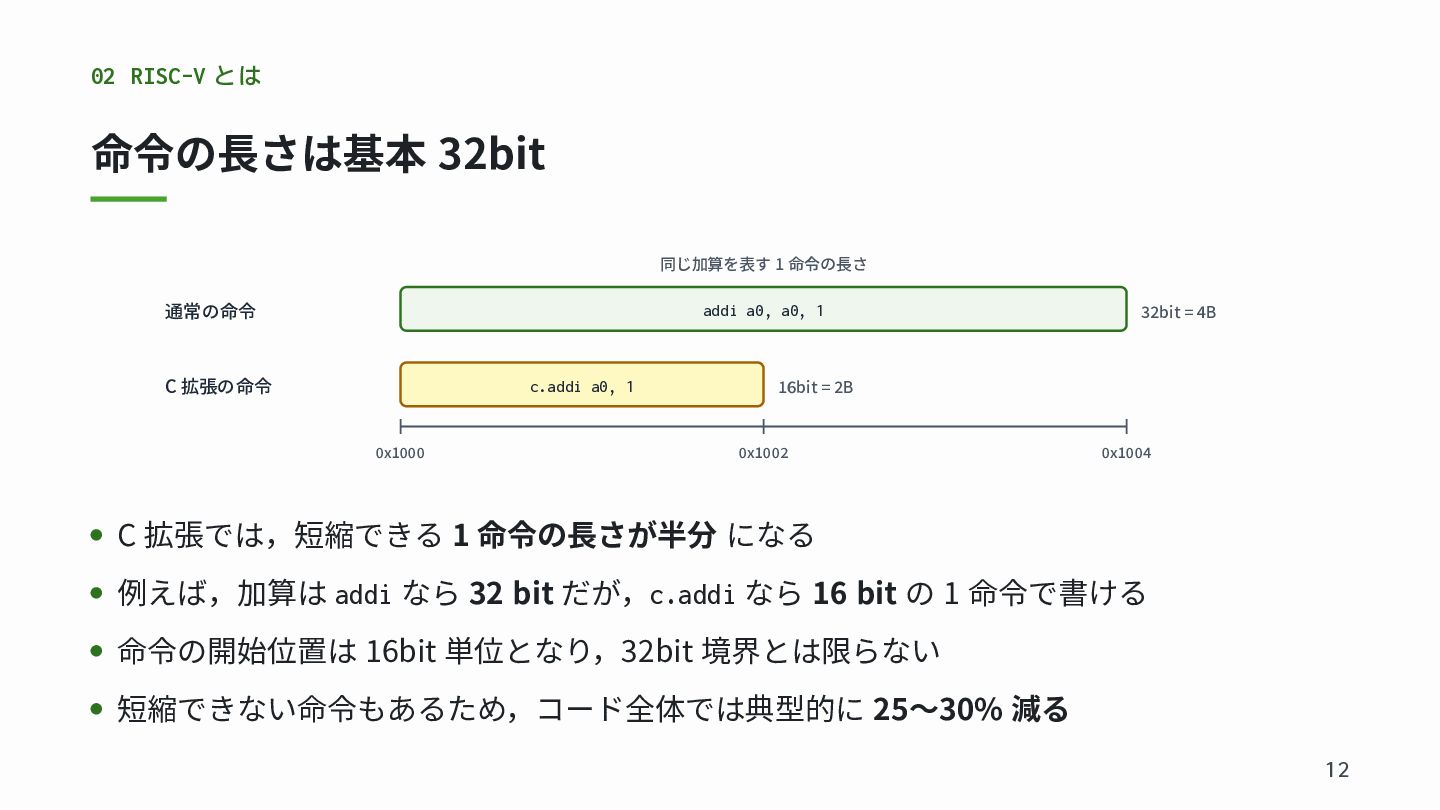
02 RISC-V とは 命令の長さは基本 32bit 同じ加算を表す 1 命令の長さ 通常の命令 addi
a0, a0, 1 C 拡張の命令 c.addi a0, 1 0x1000 32bit = 4B 16bit = 2B 0x1002 0x1004 C 拡張では,短縮できる 1 命令の長さが半分 になる 例えば,加算は addi なら 32 bit だが,c.addi なら 16 bit の 1 命令で書ける 命令の開始位置は 16bit 単位となり,32bit 境界とは限らない 短縮できない命令もあるため,コード全体では典型的に 25〜30% 減る 12
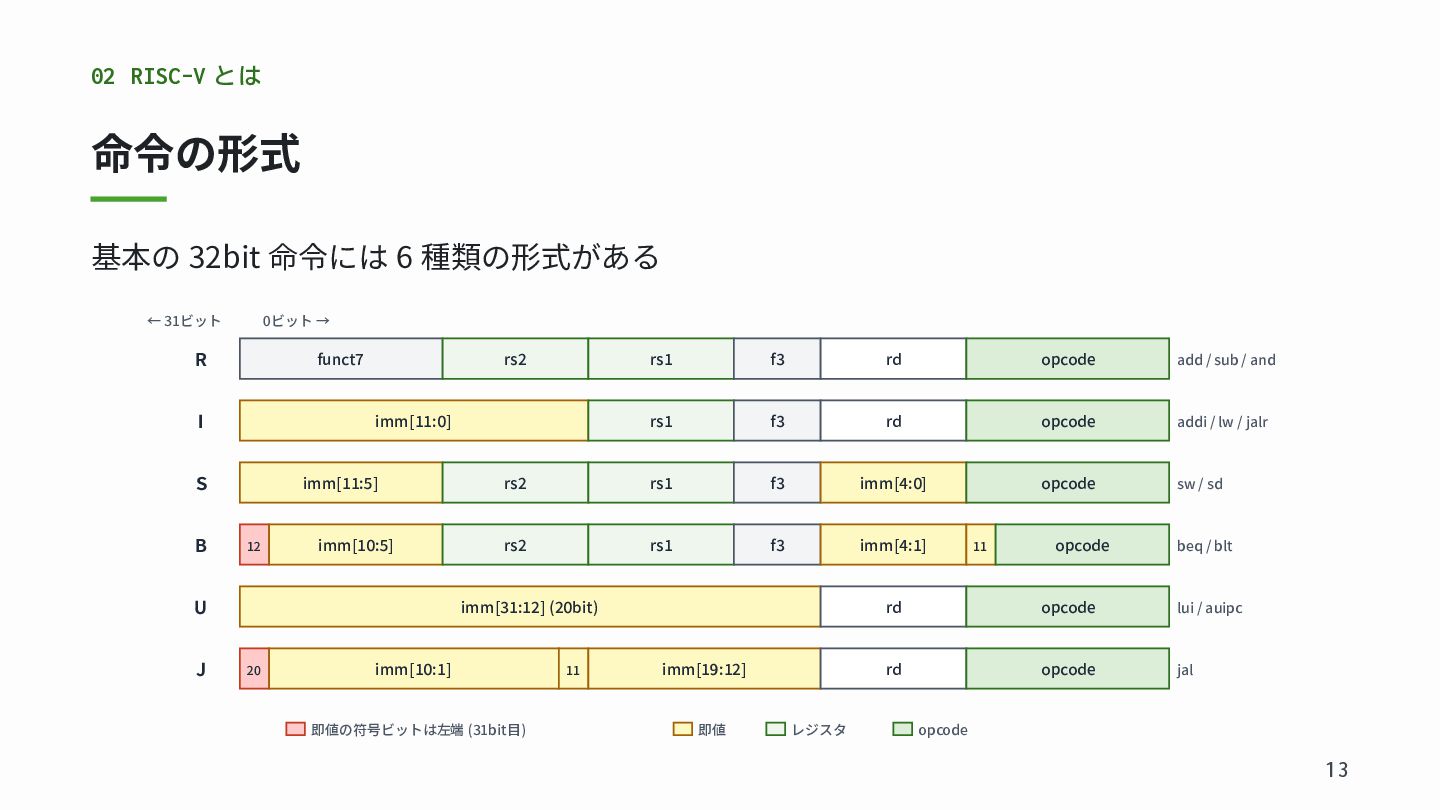
02 RISC-V とは 命令の形式 基本の 32bit 命令には 6 種類の形式がある ←
31ビット 0ビット → R funct7 I imm[11:5] 12 imm[10:5] U J rs1 f3 rd opcode add / sub / and rs1 f3 rd opcode addi / lw / jalr rs2 rs1 f3 imm[4:0] opcode sw / sd rs2 rs1 f3 imm[4:1] imm[11:0] S B rs2 imm[31:12] (20bit) 20 imm[10:1] 即値の符号ビットは左端 (31bit目) 11 imm[19:12] 即値 レジスタ 11 opcode beq / blt rd opcode lui / auipc rd opcode jal opcode 13
03 命令とレジスタ
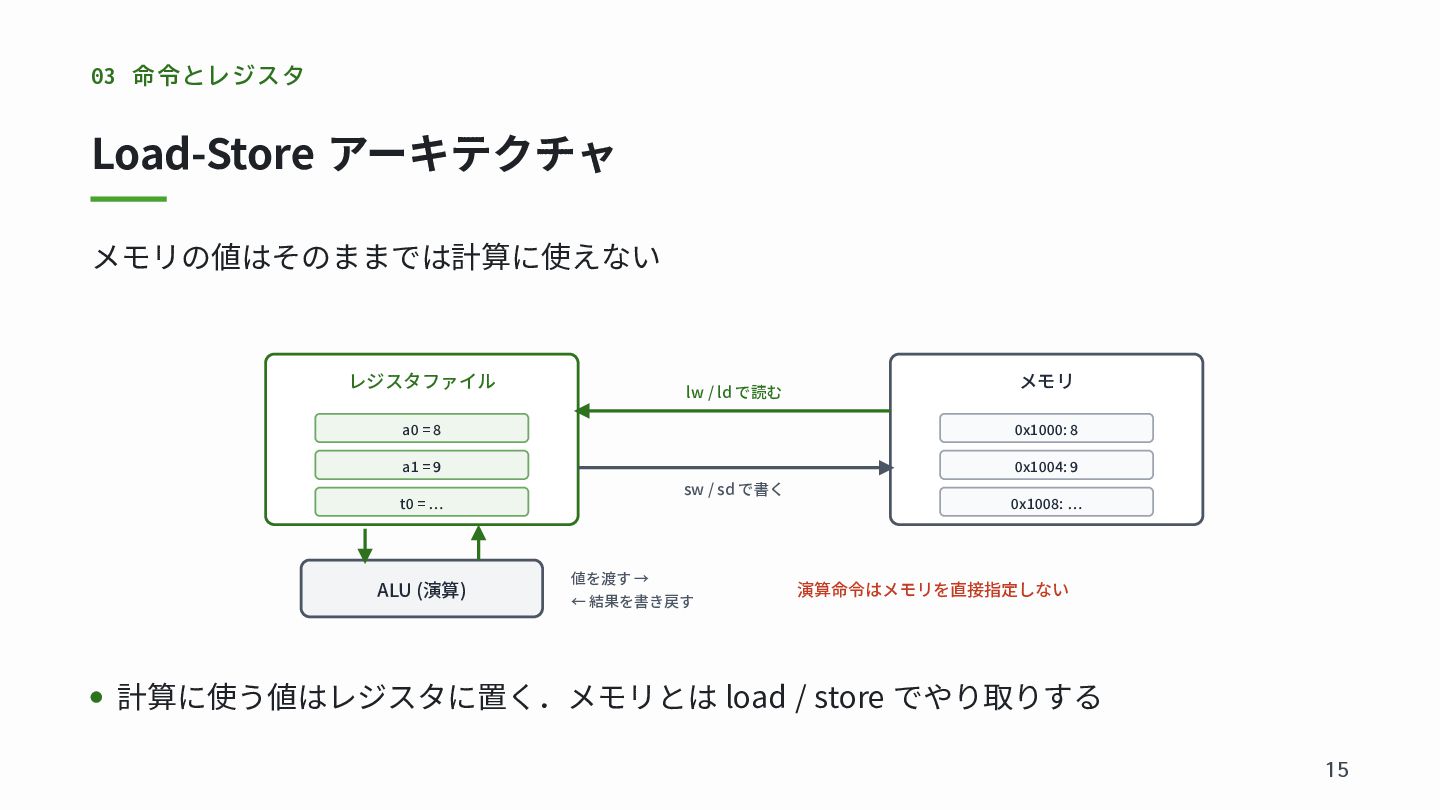
03 命令とレジスタ Load-Store アーキテクチャ メモリの値はそのままでは計算に使えない レジスタファイル lw / ld で読む
a0 = 8 0x1000: 8 a1 = 9 0x1004: 9 sw / sd で書く t0 = … ALU (演算) メモリ 値を渡す → ← 結果を書き戻す 0x1008: … 演算命令はメモリを直接指定しない 計算に使う値はレジスタに置く.メモリとは load / store でやり取りする 15
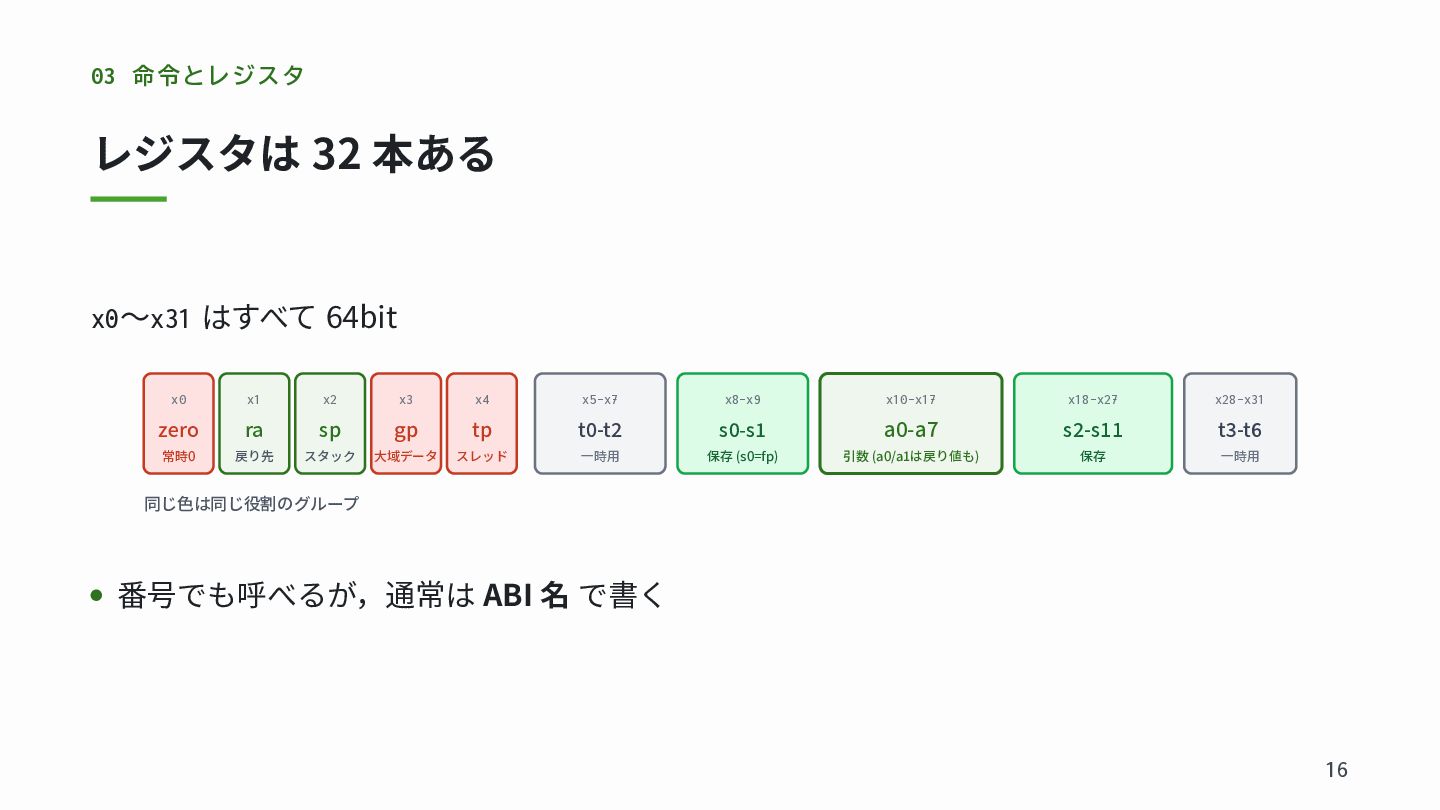
03 命令とレジスタ レジスタは 32 本ある x0〜x31 はすべて 64bit x0 x1
x2 x3 x4 x5-x7 x8-x9 x10-x17 x18-x27 x28-x31 zero ra sp gp tp t0-t2 s0-s1 a0-a7 s2-s11 t3-t6 常時0 戻り先 スタック 大域データ スレッド 一時用 保存 (s0=fp) 引数 (a0/a1は戻り値も) 保存 一時用 同じ色は同じ役割のグループ 番号でも呼べるが,通常は ABI 名 で書く 16
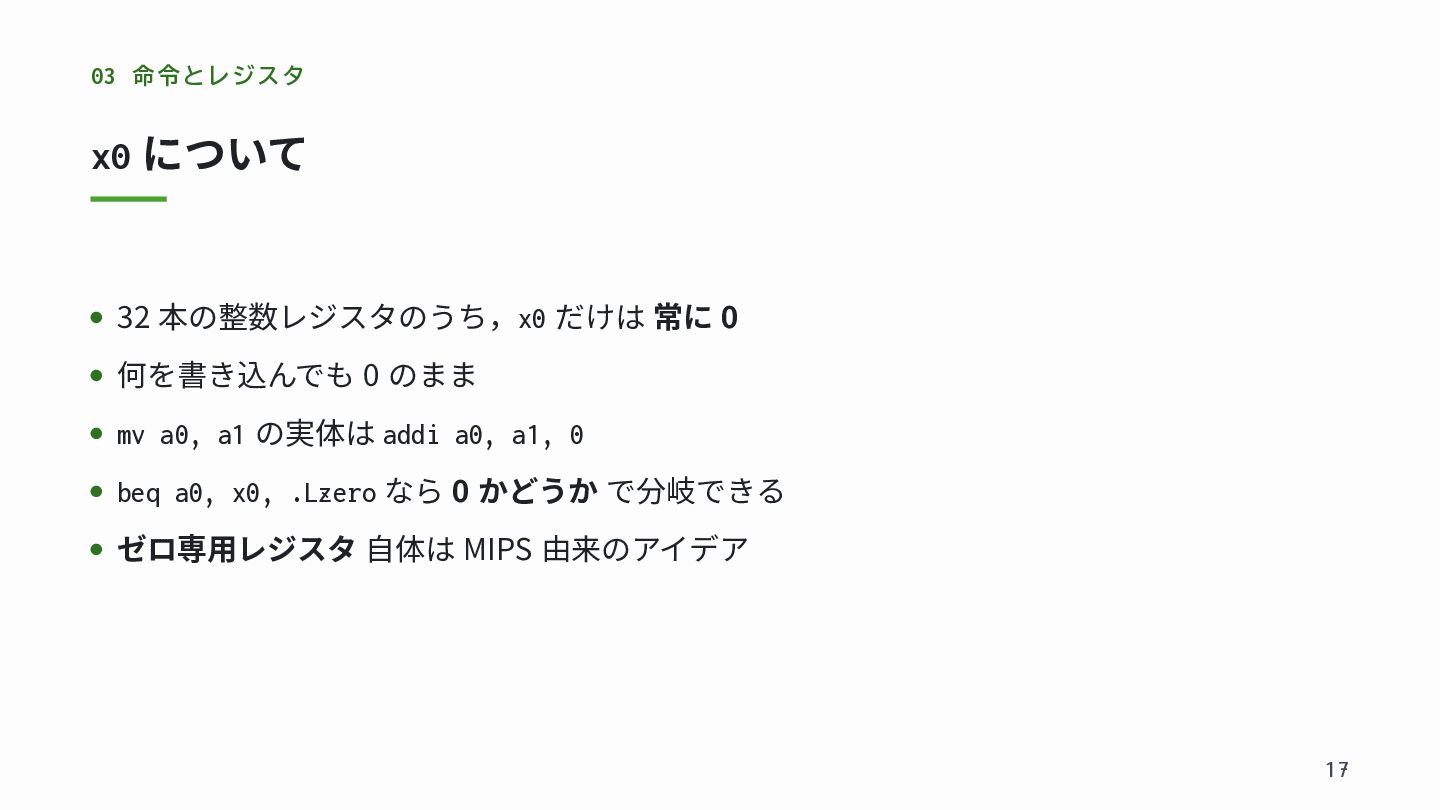
03 命令とレジスタ x0 について 32 本の整数レジスタのうち,x0 だけは 常に 0 何を書き込んでも
0 のまま mv a0, a1 の実体は addi a0, a1, 0 beq a0, x0, .Lzero なら 0 かどうか で分岐できる ゼロ専用レジスタ 自体は MIPS 由来のアイデア 17
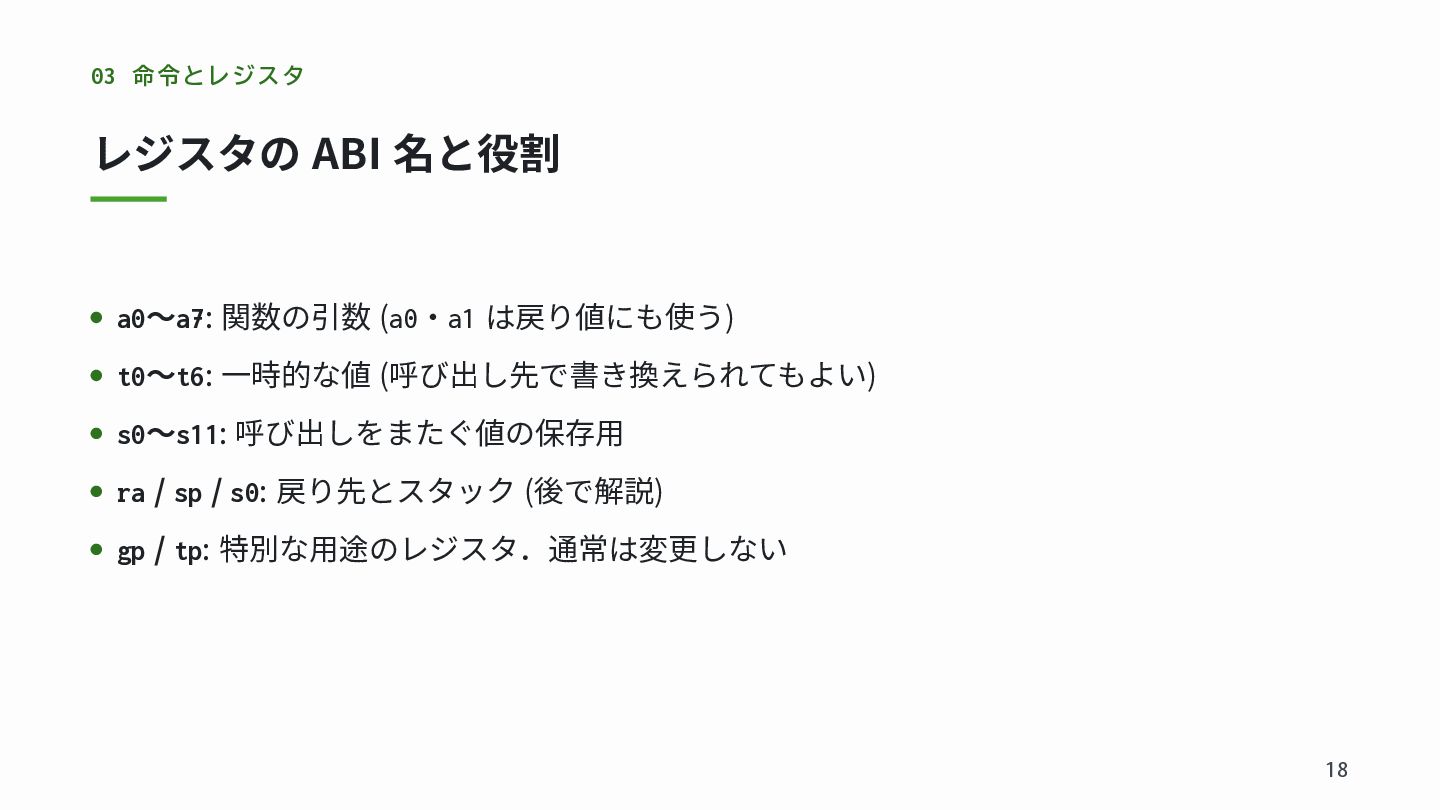
03 命令とレジスタ レジスタの ABI 名と役割 a0〜a7: 関数の引数 (a0・a1 は戻り値にも使う) t0〜t6:
一時的な値 (呼び出し先で書き換えられてもよい) s0〜s11: 呼び出しをまたぐ値の保存用 ra / sp / s0: 戻り先とスタック (後で解説) gp / tp: 特別な用途のレジスタ.通常は変更しない 18
04 スタック
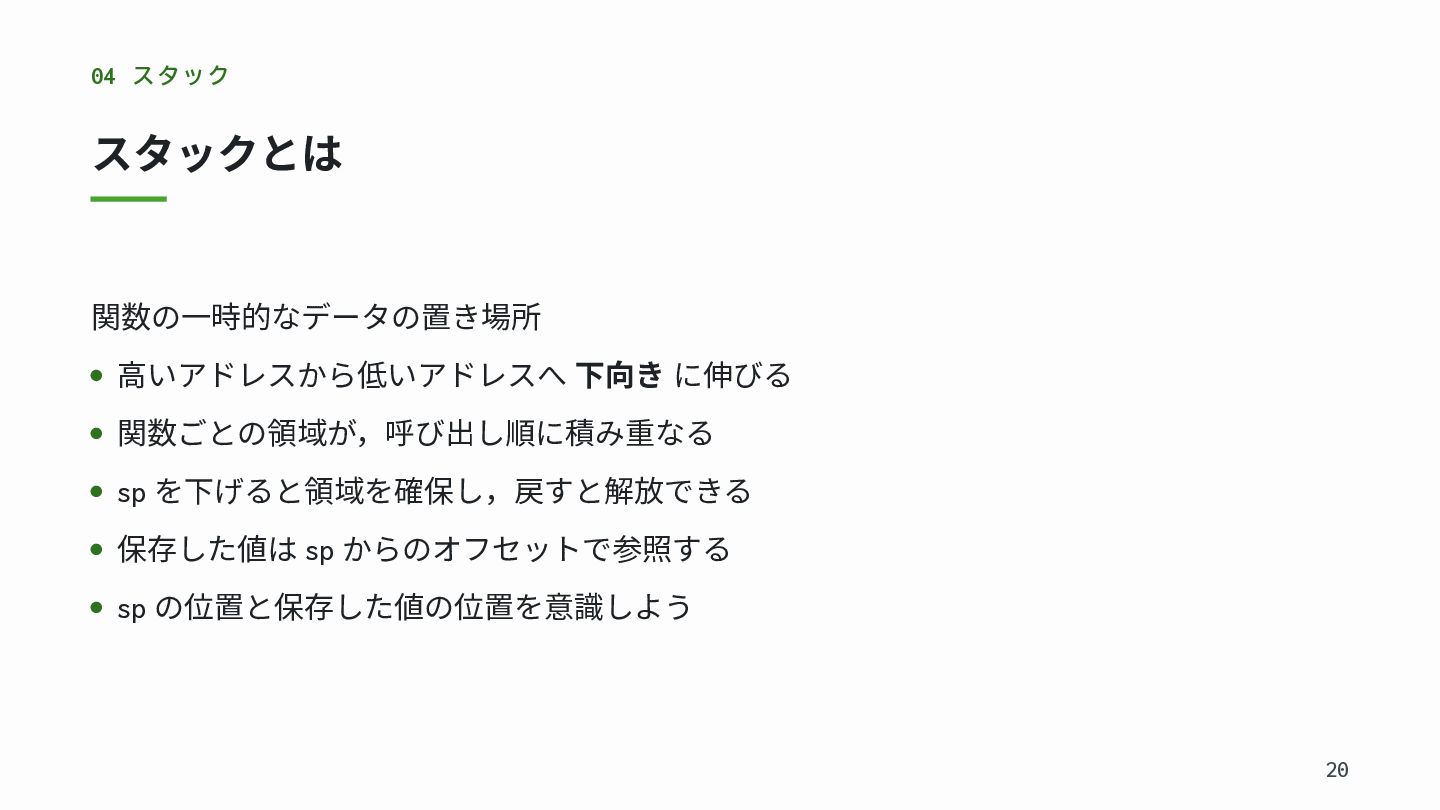
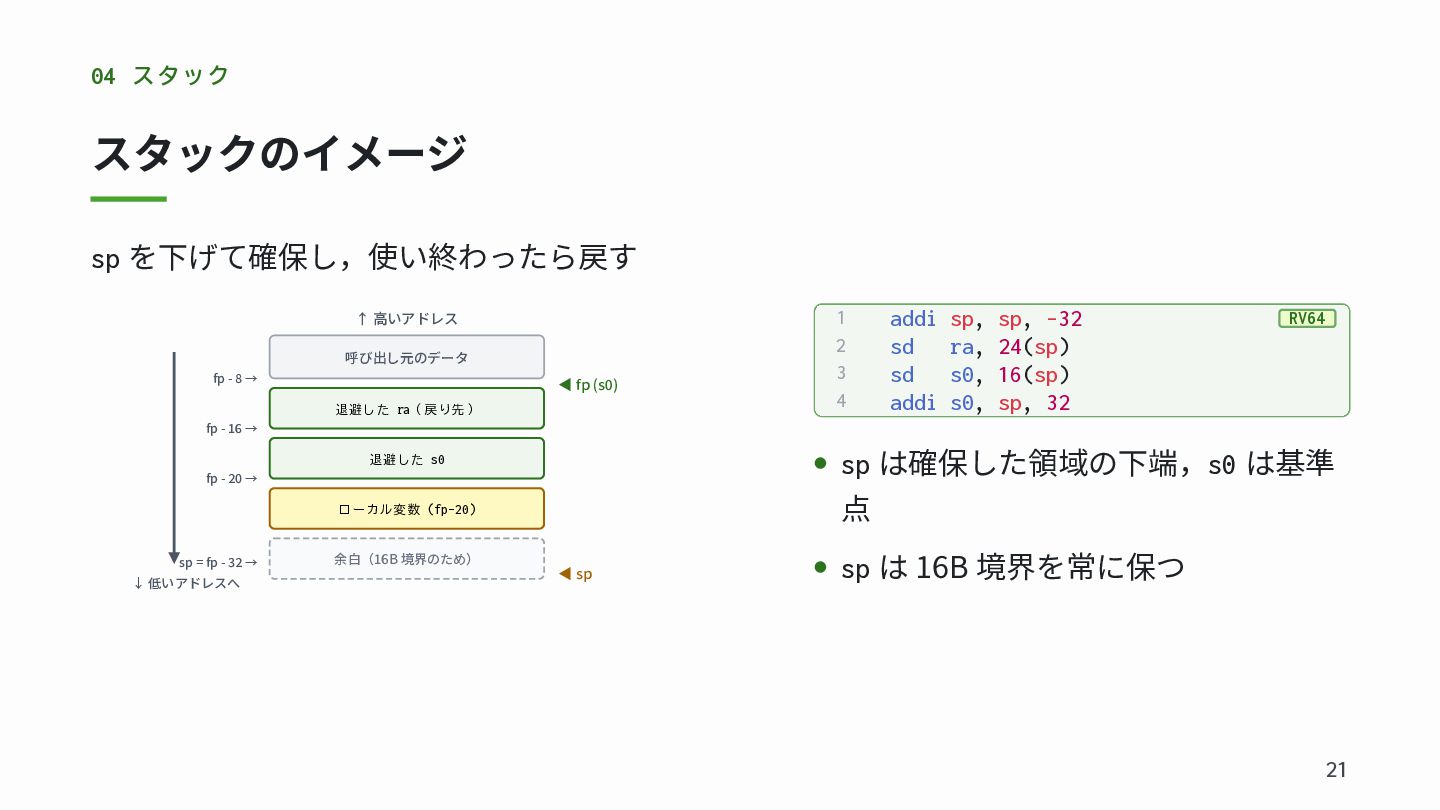
04 スタック スタックとは 関数の一時的なデータの置き場所 高いアドレスから低いアドレスへ 下向き に伸びる 関数ごとの領域が,呼び出し順に積み重なる sp を下げると領域を確保し,戻すと解放できる
保存した値は sp からのオフセットで参照する sp の位置と保存した値の位置を意識しよう 20
04 スタック スタックのイメージ sp を下げて確保し,使い終わったら戻す ↑ 高いアドレス 呼び出し元のデータ fp -
8 → ◀ fp (s0) 退避した ra(戻り先) 1 2 3 4 addi sp, sp, -32 sd ra, 24(sp) sd s0, 16(sp) addi s0, sp, 32 RV64 fp - 16 → sp は確保した領域の下端,s0 は基準 退避した s0 fp - 20 → 点 ローカル変数 (fp-20) sp = fp - 32 → ↓ 低いアドレスへ 余白(16B 境界のため) ◀ sp sp は 16B 境界を常に保つ 21
04 スタック 3 つの大事なレジスタ sp (x2): スタックの先頭 (Stack Pointer) s0
(x8): 保存用レジスタ (Frame Pointer にも使う) ra (x1): 戻り先のアドレス (Return Address) pc: 実行中の命令のアドレス(x86 の rip に相当) pc は 32 本の整数レジスタには含まれない 22
04 スタック push / pop はない! 自分で sp を動かして sd
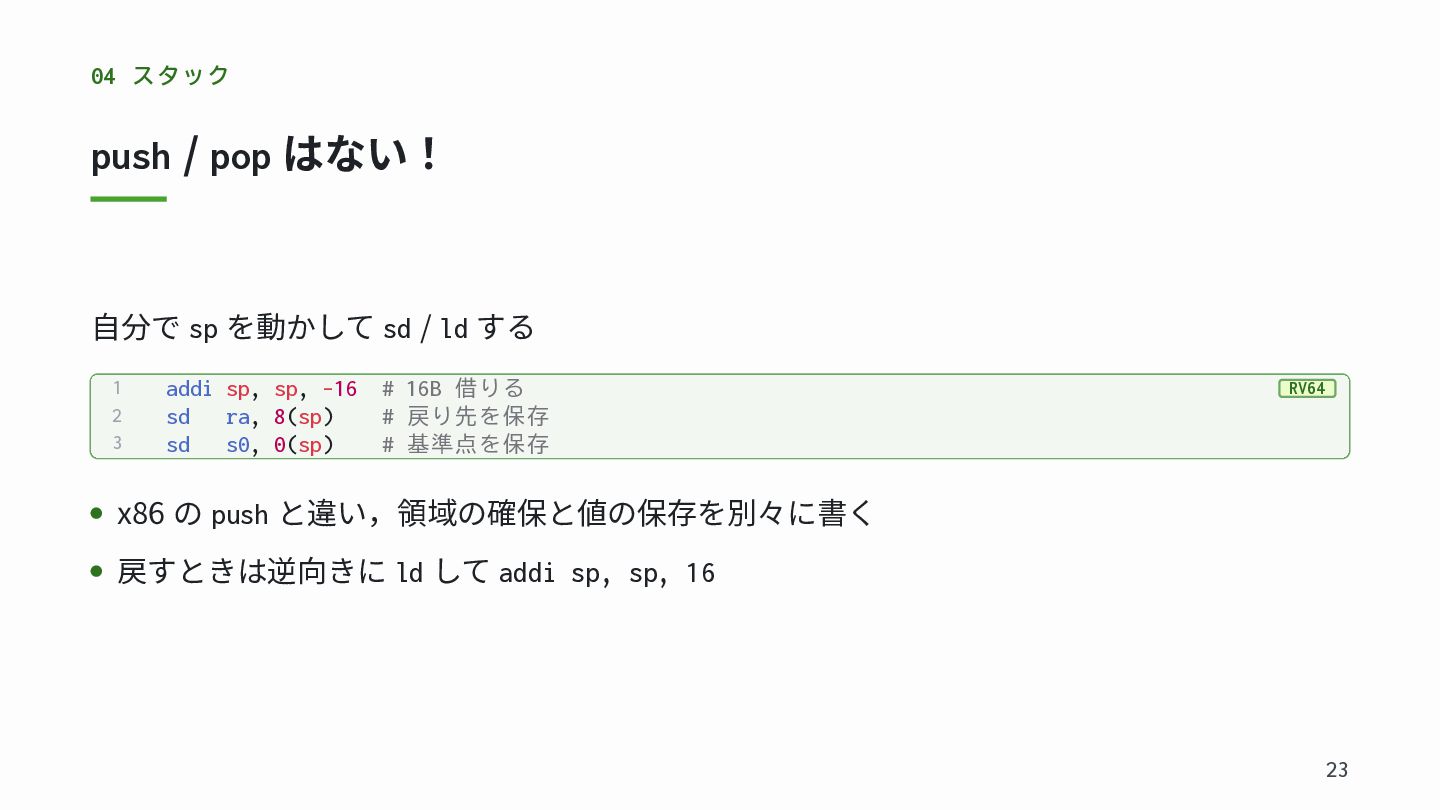
/ ld する 1 2 3 addi sp, sp, -16 sd ra, 8(sp) sd s0, 0(sp) # 16B 借りる # 戻り先を保存 # 基準点を保存 RV64 x86 の push と違い,領域の確保と値の保存を別々に書く 戻すときは逆向きに ld して addi sp, sp, 16 23
05 データ転送と計算
05 データ転送と計算 計算命令は 3 オペランド x86 の 2 オペランド命令との違い 1
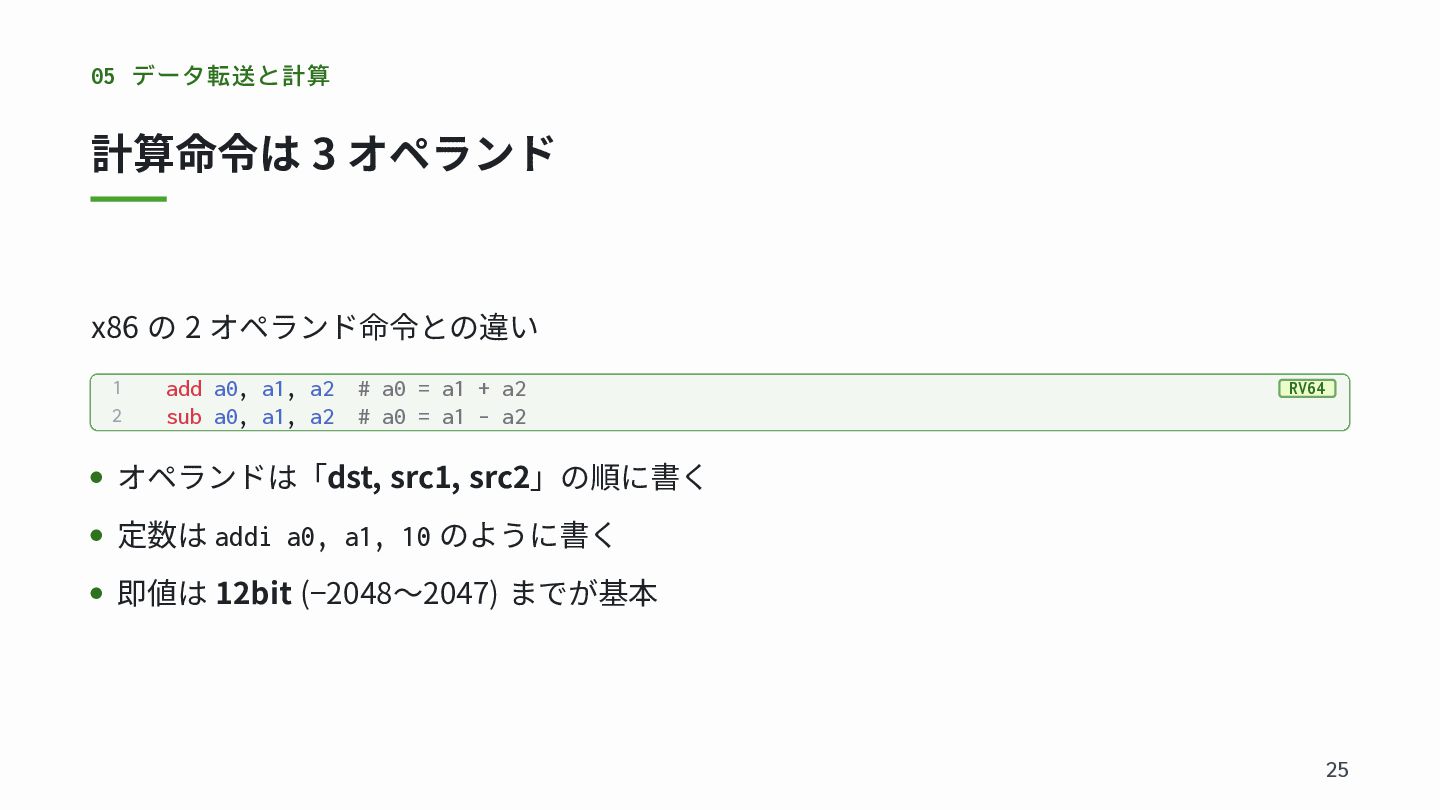
2 add a0, a1, a2 sub a0, a1, a2 # a0 = a1 + a2 # a0 = a1 - a2 RV64 オペランドは「dst, src1, src2」の順に書く 定数は addi a0, a1, 10 のように書く 即値は 12bit (−2048〜2047) までが基本 25
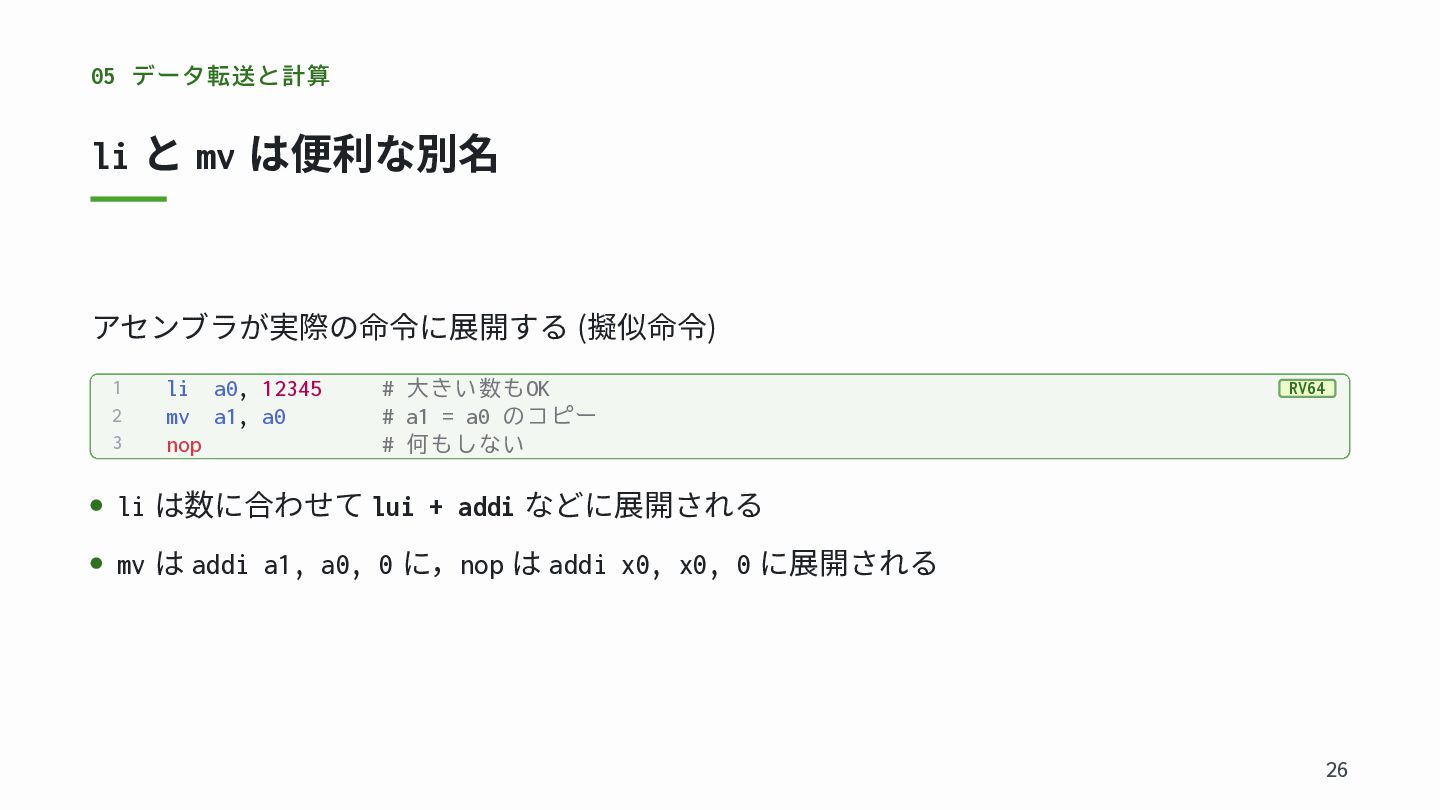
05 データ転送と計算 li と mv は便利な別名 アセンブラが実際の命令に展開する (擬似命令) 1 2
3 li a0, 12345 mv a1, a0 nop # 大きい数もOK # a1 = a0 のコピー # 何もしない RV64 li は数に合わせて lui + addi などに展開される mv は addi a1, a0, 0 に,nop は addi x0, x0, 0 に展開される 26
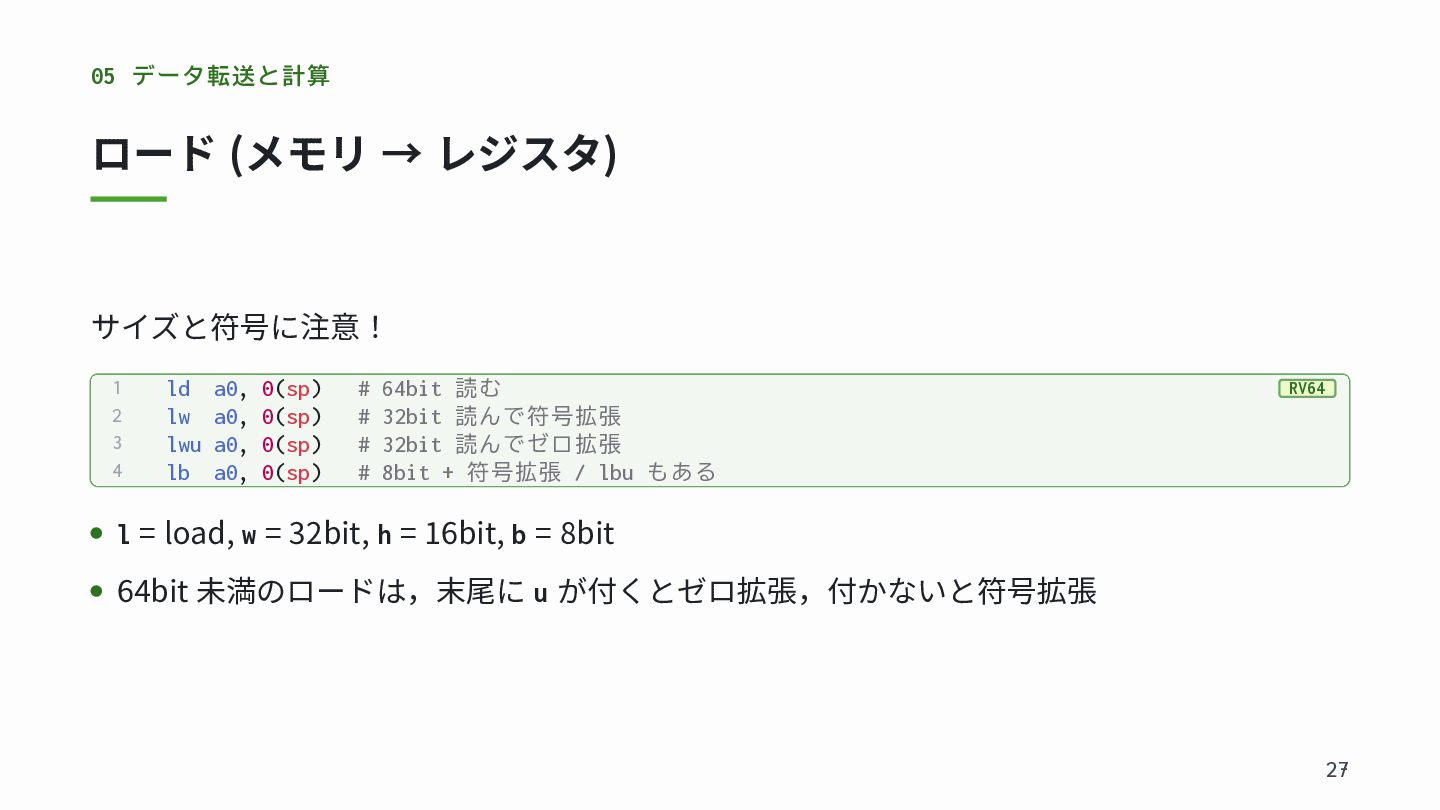
05 データ転送と計算 ロード (メモリ → レジスタ) サイズと符号に注意! 1 2 3
4 ld a0, 0(sp) lw a0, 0(sp) lwu a0, 0(sp) lb a0, 0(sp) # 64bit 読む # 32bit 読んで符号拡張 # 32bit 読んでゼロ拡張 # 8bit + 符号拡張 / lbu もある RV64 l = load, w = 32bit, h = 16bit, b = 8bit 64bit 未満のロードは,末尾に u が付くとゼロ拡張,付かないと符号拡張 27
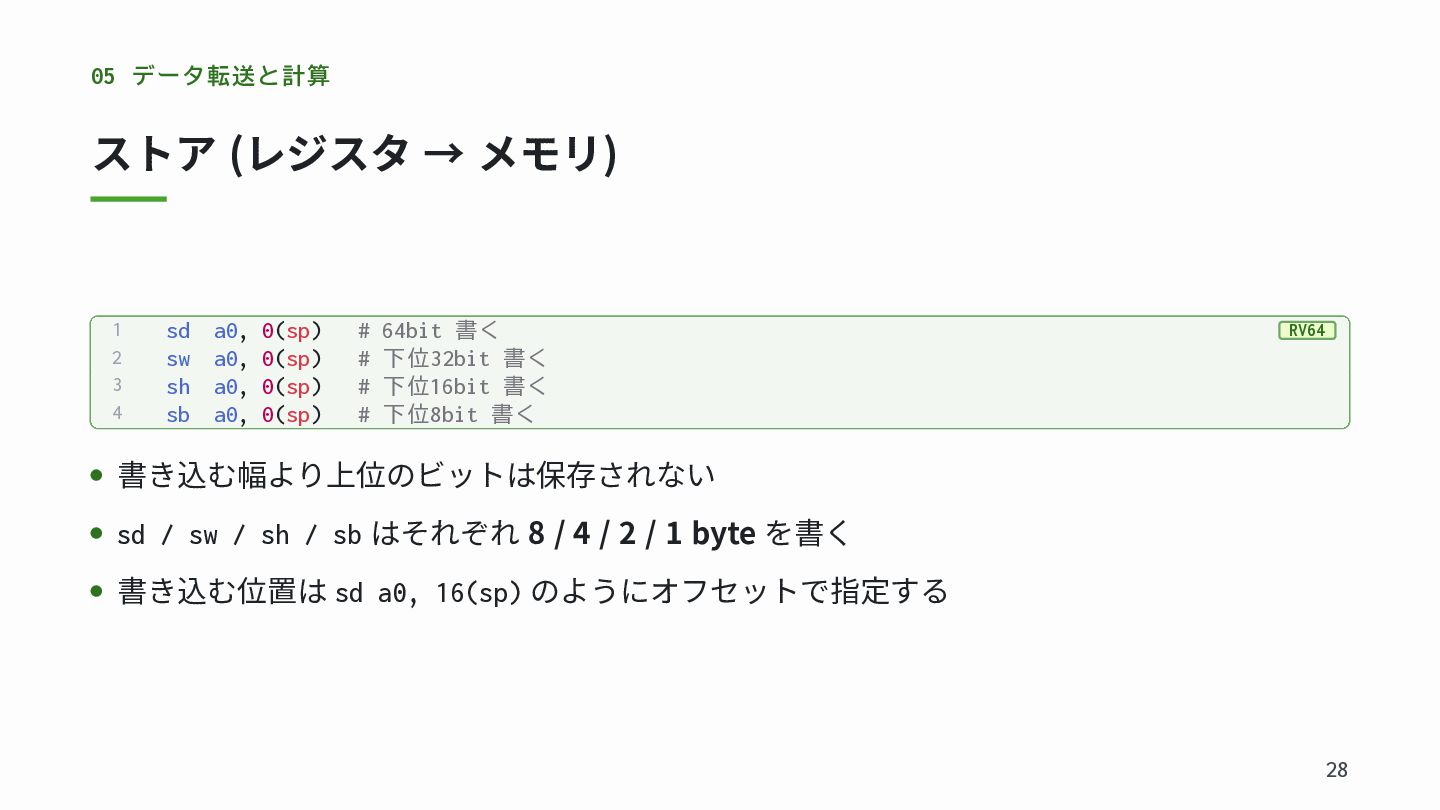
05 データ転送と計算 ストア (レジスタ → メモリ) 1 2 3 4
sd sw sh sb a0, 0(sp) a0, 0(sp) a0, 0(sp) a0, 0(sp) # 64bit 書く # 下位32bit 書く # 下位16bit 書く # 下位8bit 書く RV64 書き込む幅より上位のビットは保存されない sd / sw / sh / sb はそれぞれ 8 / 4 / 2 / 1 byte を書く 書き込む位置は sd a0, 16(sp) のようにオフセットで指定する 28
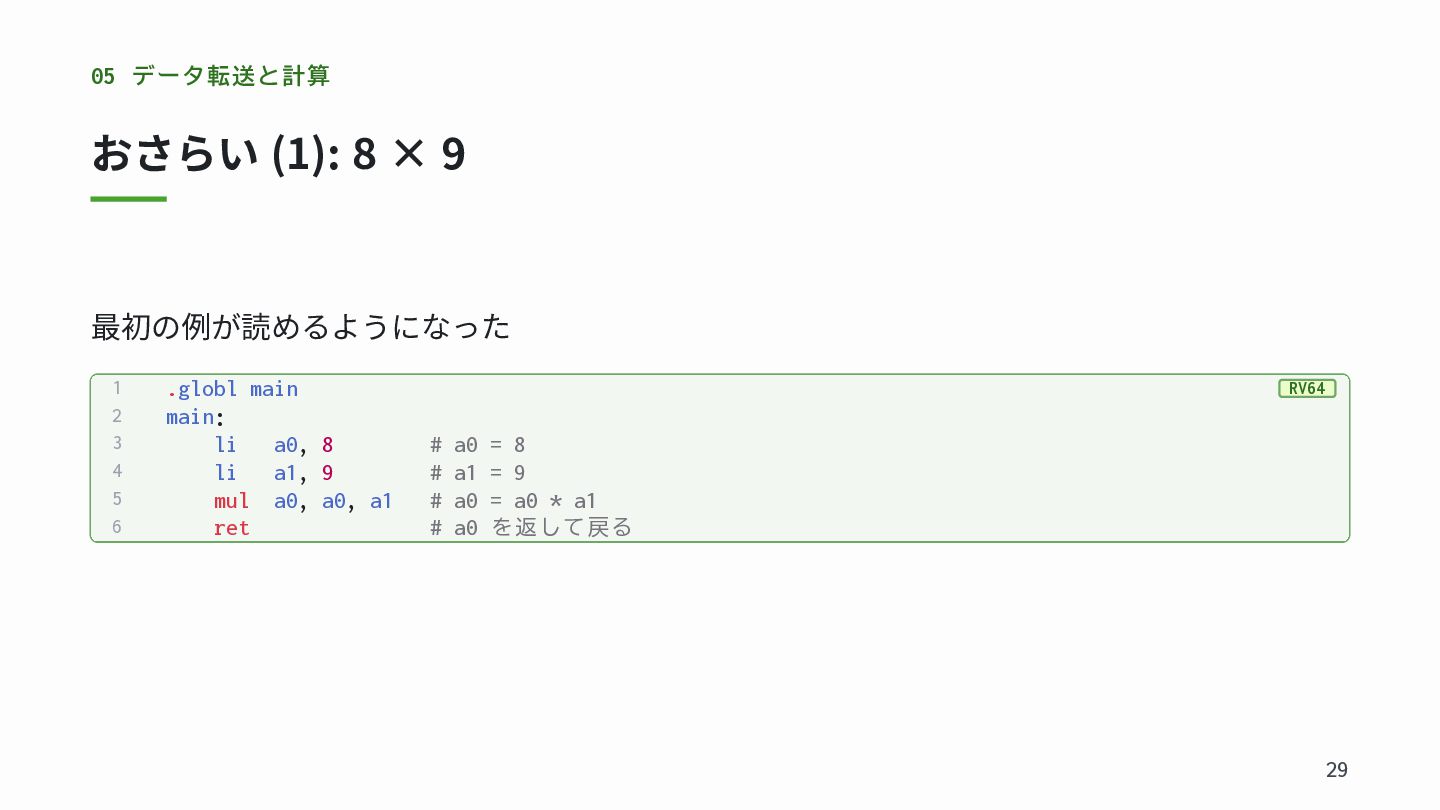
05 データ転送と計算 おさらい (1): 8 × 9 最初の例が読めるようになった 1 2
3 4 5 6 .globl main main: li a0, 8 li a1, 9 mul a0, a0, a1 ret RV64 # a0 = 8 # a1 = 9 # a0 = a0 * a1 # a0 を返して戻る 29
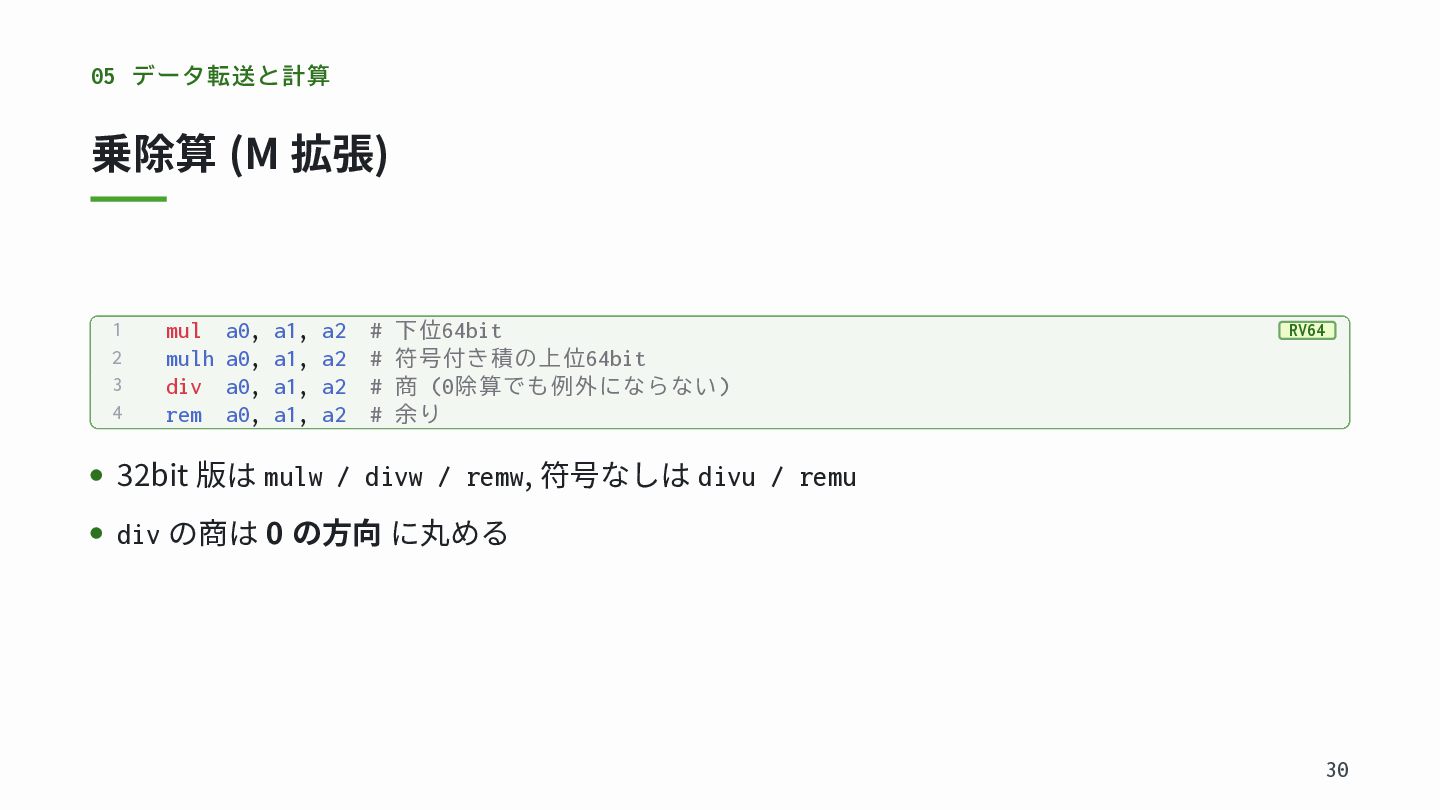
05 データ転送と計算 乗除算 (M 拡張) 1 2 3 4 mul
a0, a1, a2 mulh a0, a1, a2 div a0, a1, a2 rem a0, a1, a2 # 下位64bit # 符号付き積の上位64bit # 商 (0除算でも例外にならない) # 余り RV64 32bit 版は mulw / divw / remw, 符号なしは divu / remu div の商は 0 の方向 に丸める 30
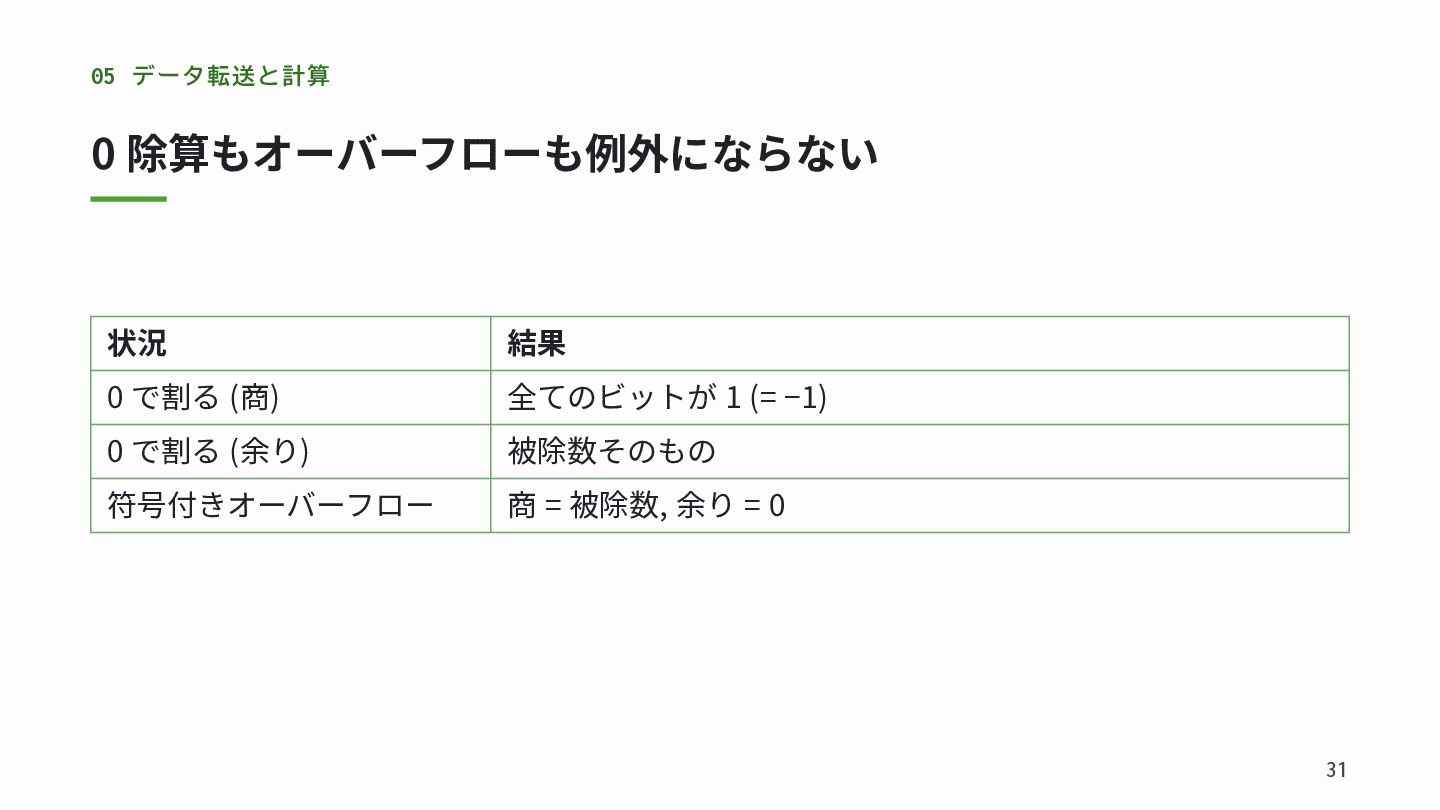
05 データ転送と計算 0 除算もオーバーフローも例外にならない 状況 結果 0 で割る (商) 全てのビットが
1 (= −1) 0 で割る (余り) 被除数そのもの 符号付きオーバーフロー 商 = 被除数, 余り = 0 31
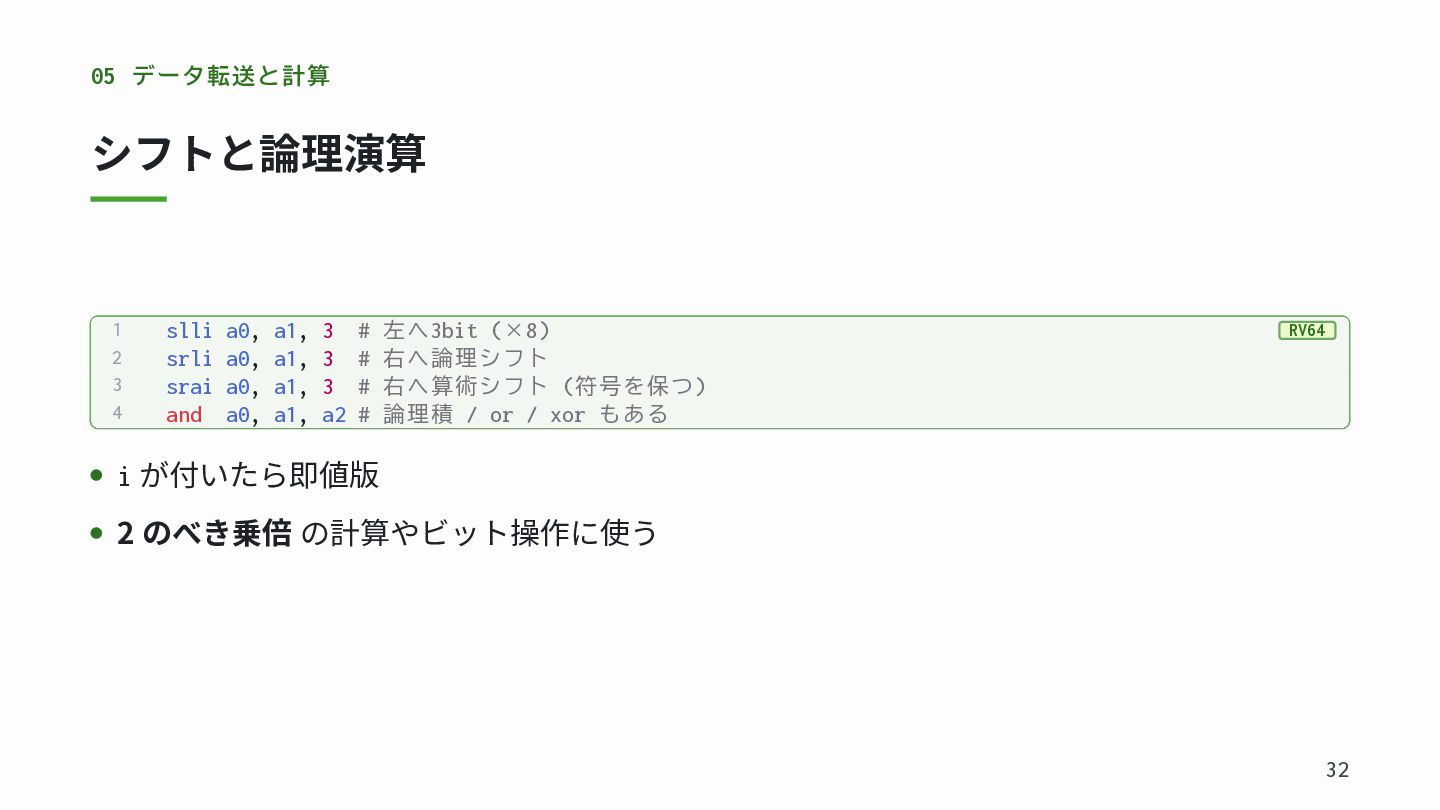
05 データ転送と計算 シフトと論理演算 1 2 3 4 slli a0, a1,
3 # 左へ3bit (×8) srli a0, a1, 3 # 右へ論理シフト srai a0, a1, 3 # 右へ算術シフト (符号を保つ) and a0, a1, a2 # 論理積 / or / xor もある RV64 i が付いたら即値版 2 のべき乗倍 の計算やビット操作に使う 32
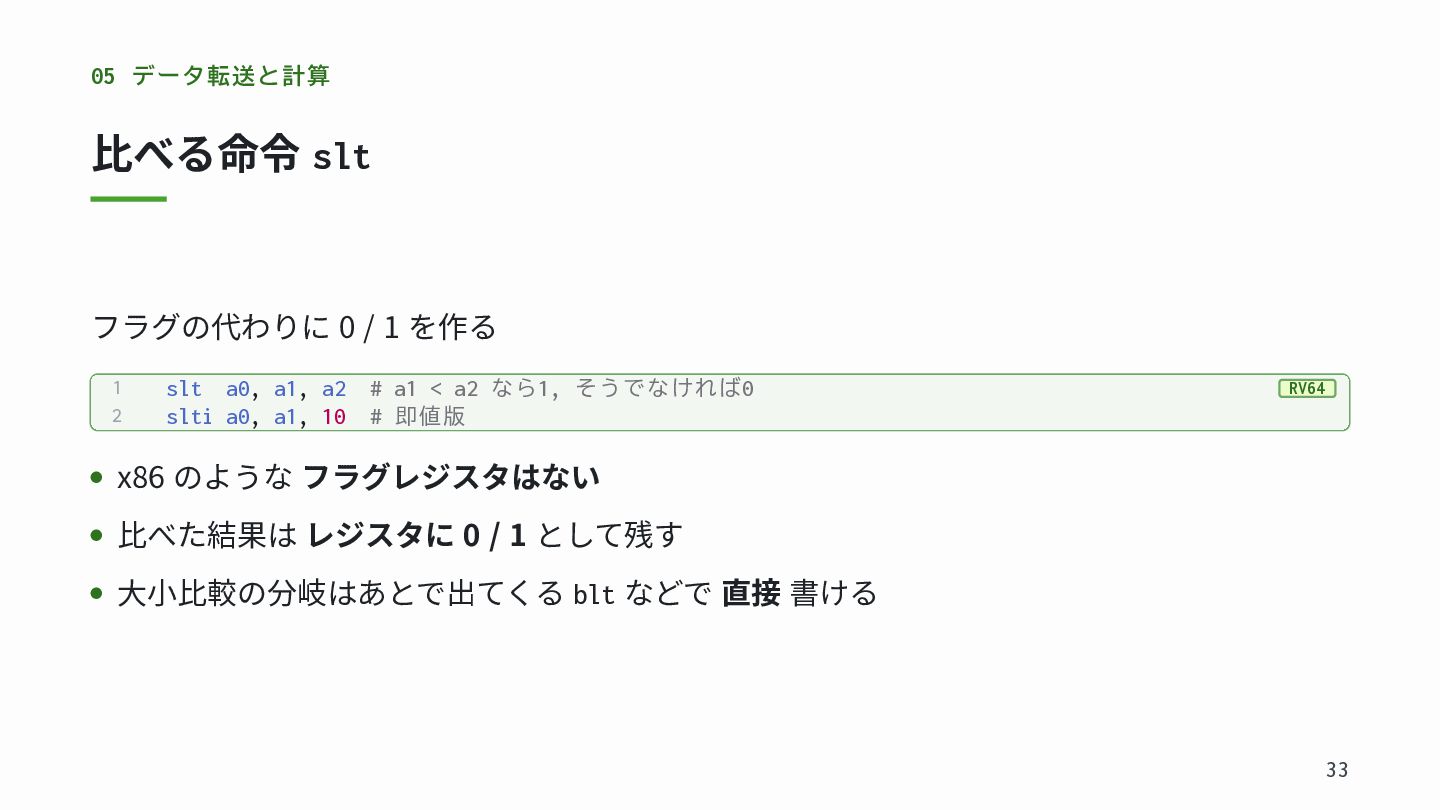
05 データ転送と計算 比べる命令 slt フラグの代わりに 0 / 1 を作る 1
2 slt a0, a1, a2 slti a0, a1, 10 # a1 < a2 なら1, そうでなければ0 # 即値版 RV64 x86 のような フラグレジスタはない 比べた結果は レジスタに 0 / 1 として残す 大小比較の分岐はあとで出てくる blt などで 直接 書ける 33
06 関数
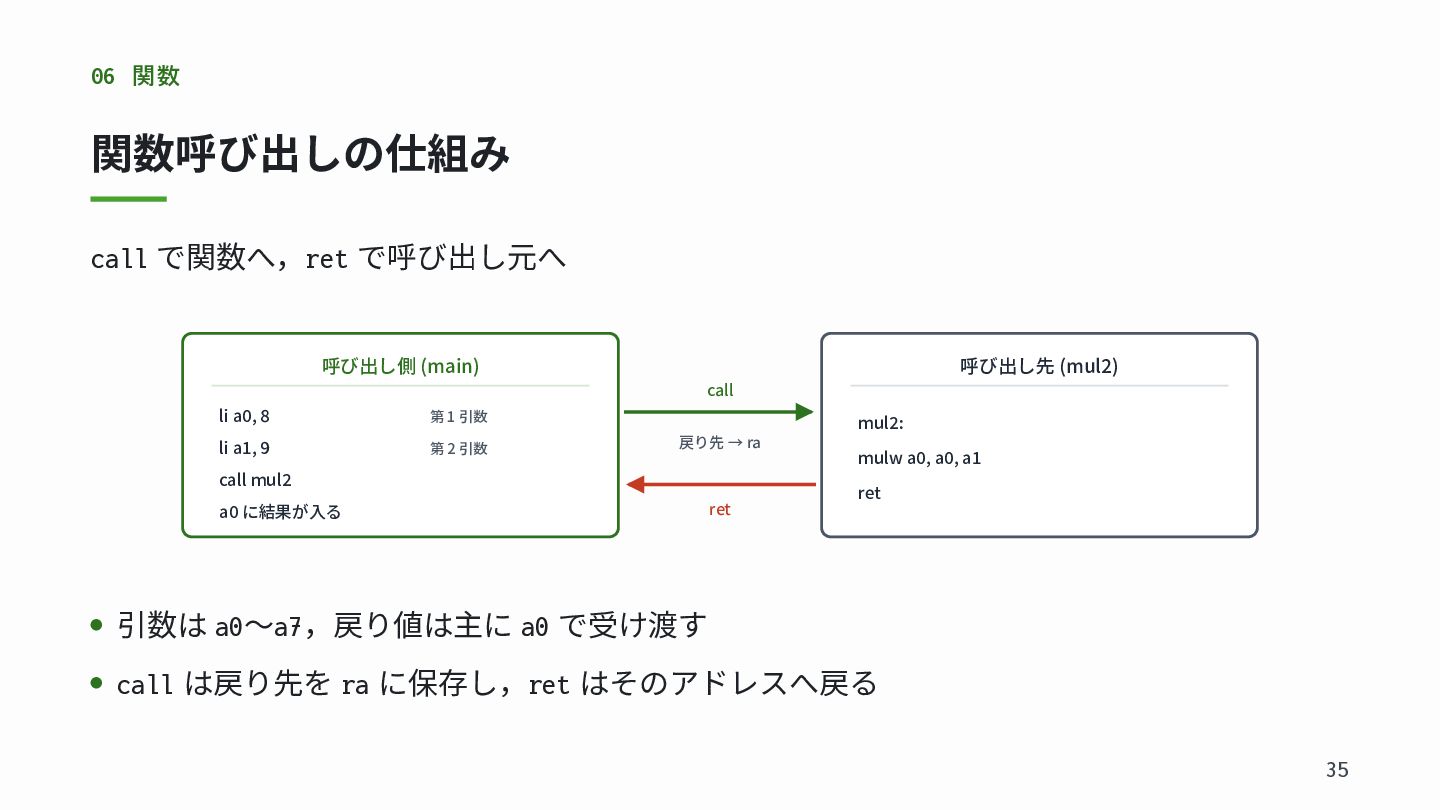
06 関数 関数呼び出しの仕組み call で関数へ,ret で呼び出し元へ 呼び出し側 (main) 呼び出し先 (mul2)
call li a0, 8 第 1 引数 li a1, 9 第 2 引数 mul2: 戻り先 → ra call mul2 a0 に結果が入る ret mulw a0, a0, a1 ret 引数は a0〜a7,戻り値は主に a0 で受け渡す call は戻り先を ra に保存し,ret はそのアドレスへ戻る 35
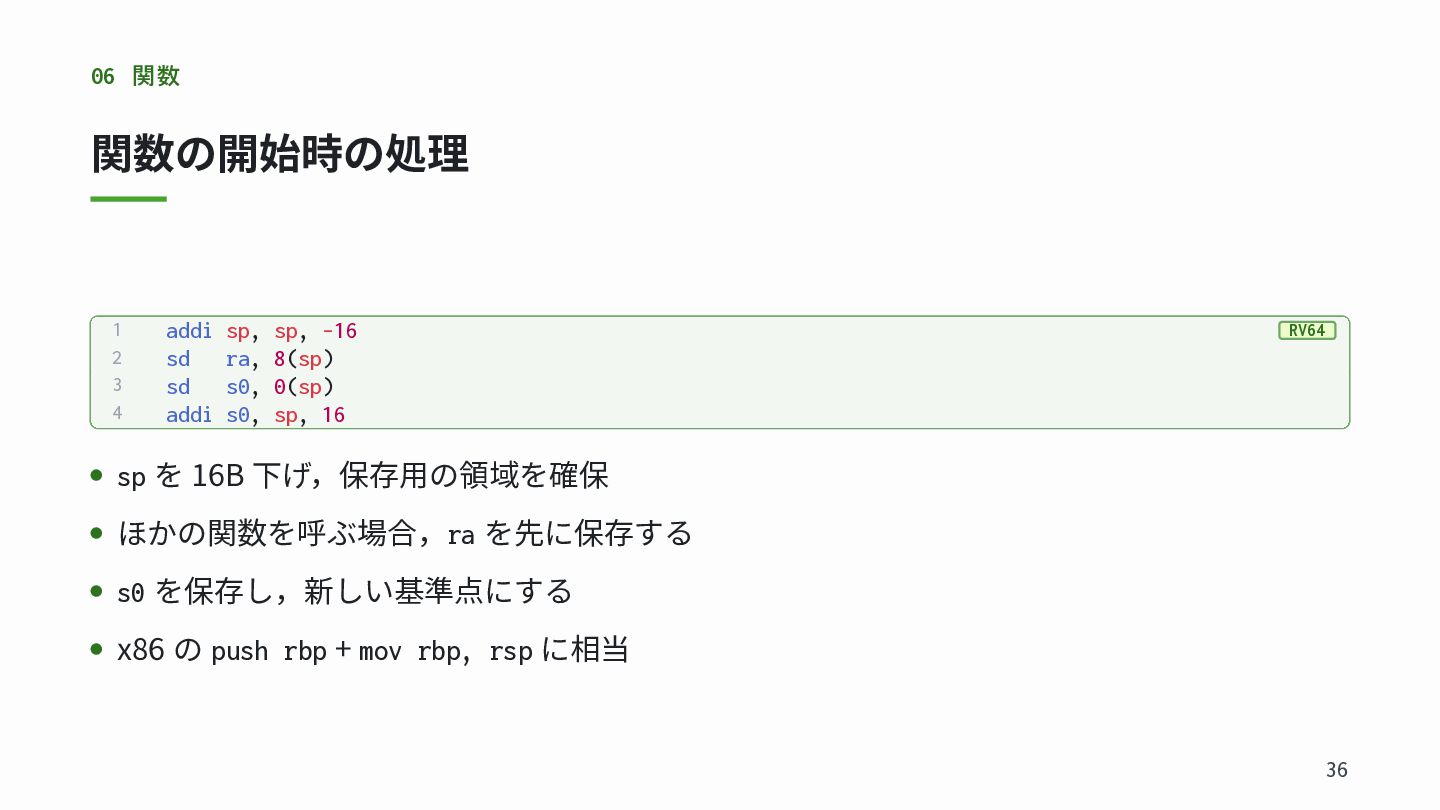
06 関数 関数の開始時の処理 1 2 3 4 addi sp, sp,
-16 sd ra, 8(sp) sd s0, 0(sp) addi s0, sp, 16 RV64 sp を 16B 下げ,保存用の領域を確保 ほかの関数を呼ぶ場合,ra を先に保存する s0 を保存し,新しい基準点にする x86 の push rbp + mov rbp, rsp に相当 36
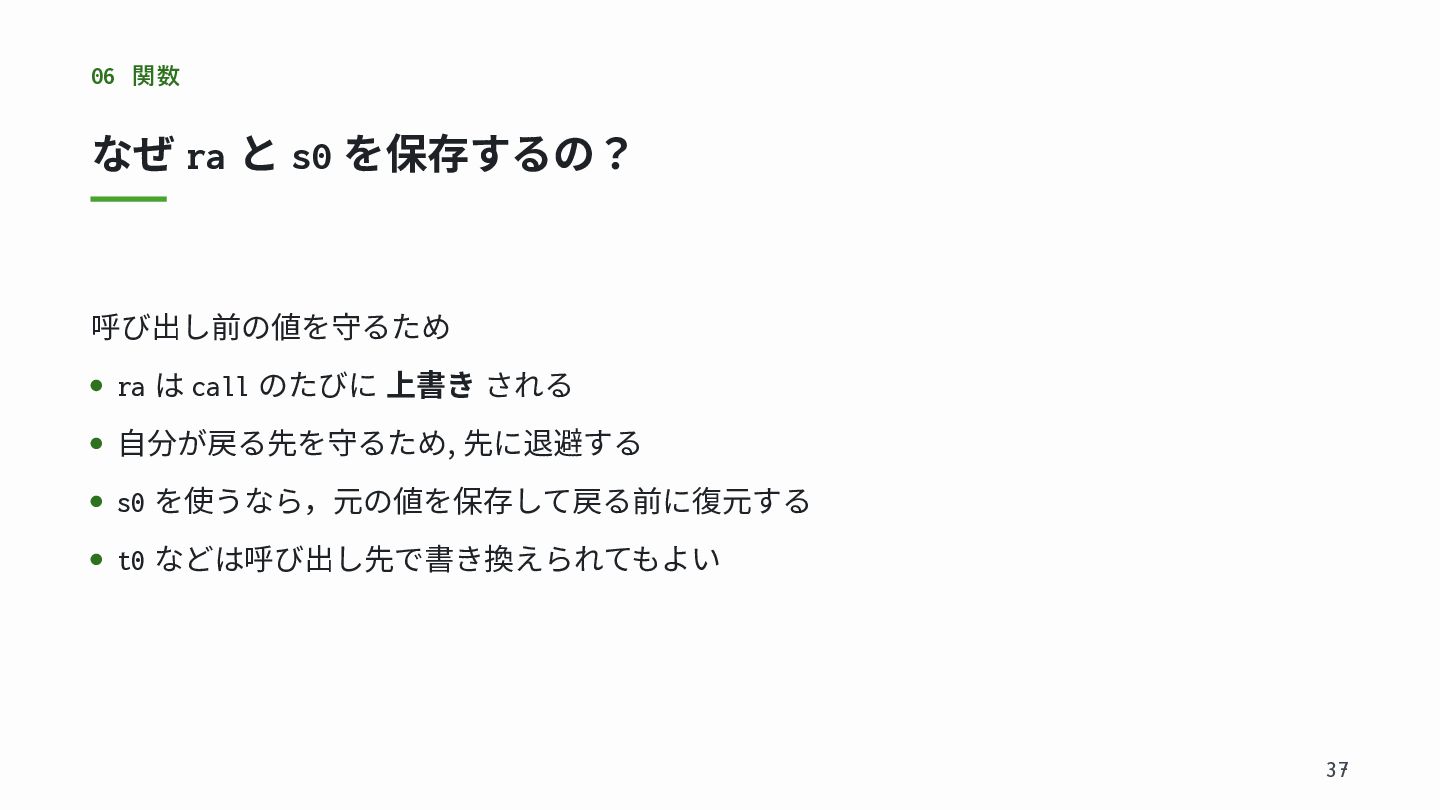
06 関数 なぜ ra と s0 を保存するの? 呼び出し前の値を守るため ra は
call のたびに 上書き される 自分が戻る先を守るため, 先に退避する s0 を使うなら,元の値を保存して戻る前に復元する t0 などは呼び出し先で書き換えられてもよい 37
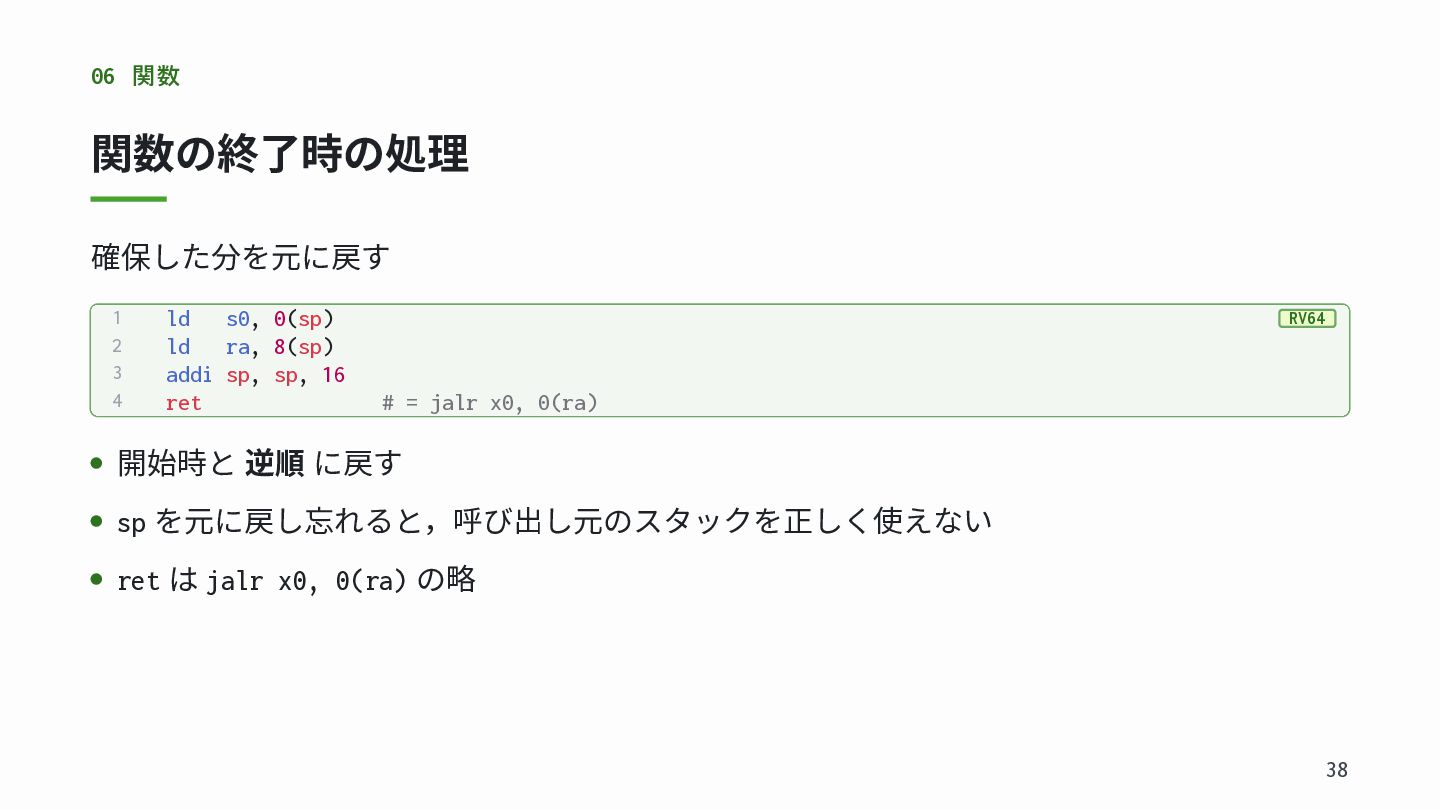
06 関数 関数の終了時の処理 確保した分を元に戻す 1 2 3 4 ld s0,
0(sp) ld ra, 8(sp) addi sp, sp, 16 ret RV64 # = jalr x0, 0(ra) 開始時と 逆順 に戻す sp を元に戻し忘れると,呼び出し元のスタックを正しく使えない ret は jalr x0, 0(ra) の略 38
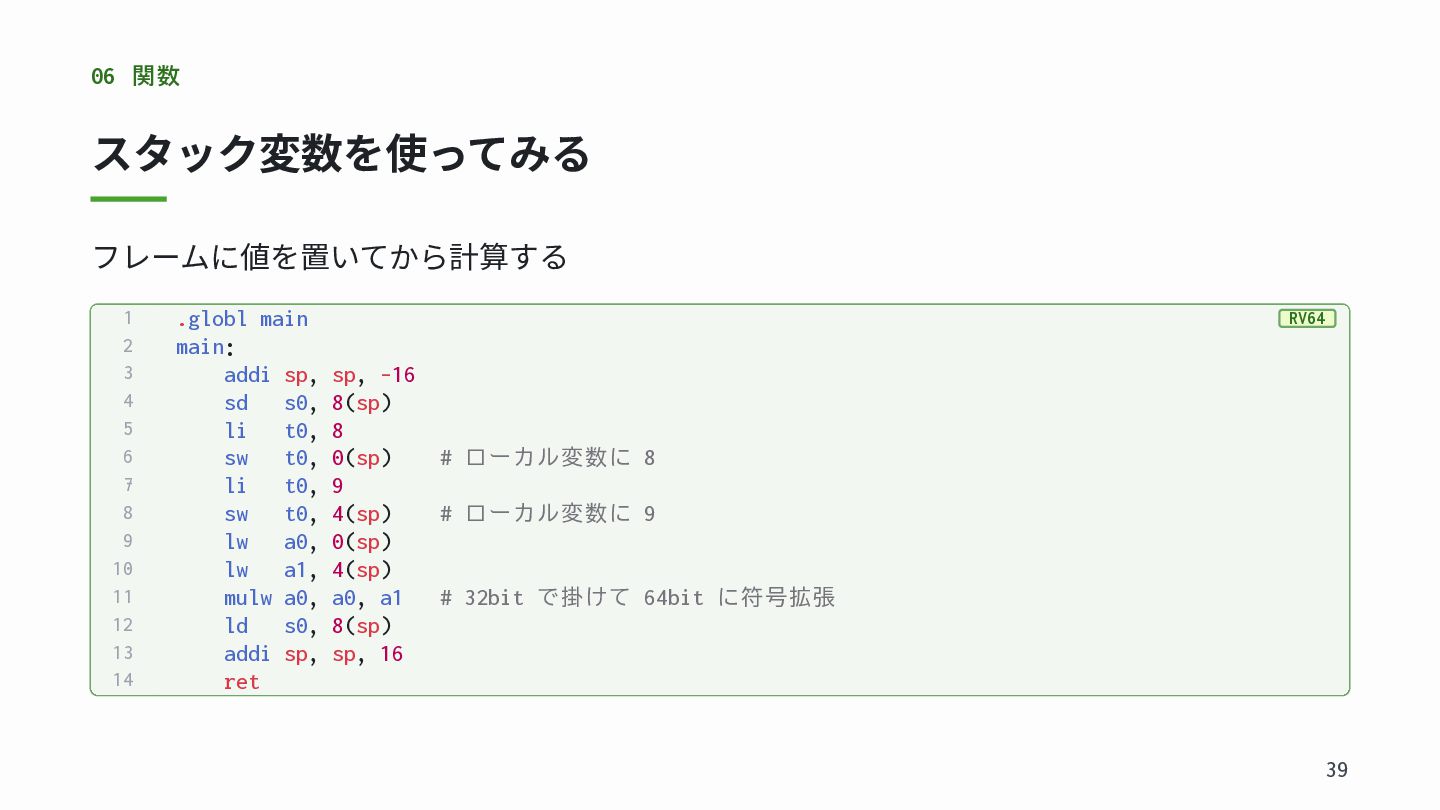
06 関数 スタック変数を使ってみる フレームに値を置いてから計算する 1 2 3 4 5 6
7 8 9 10 11 12 13 14 .globl main main: addi sp, sp, -16 sd s0, 8(sp) li t0, 8 sw t0, 0(sp) li t0, 9 sw t0, 4(sp) lw a0, 0(sp) lw a1, 4(sp) mulw a0, a0, a1 ld s0, 8(sp) addi sp, sp, 16 ret RV64 # ローカル変数に 8 # ローカル変数に 9 # 32bit で掛けて 64bit に符号拡張 39
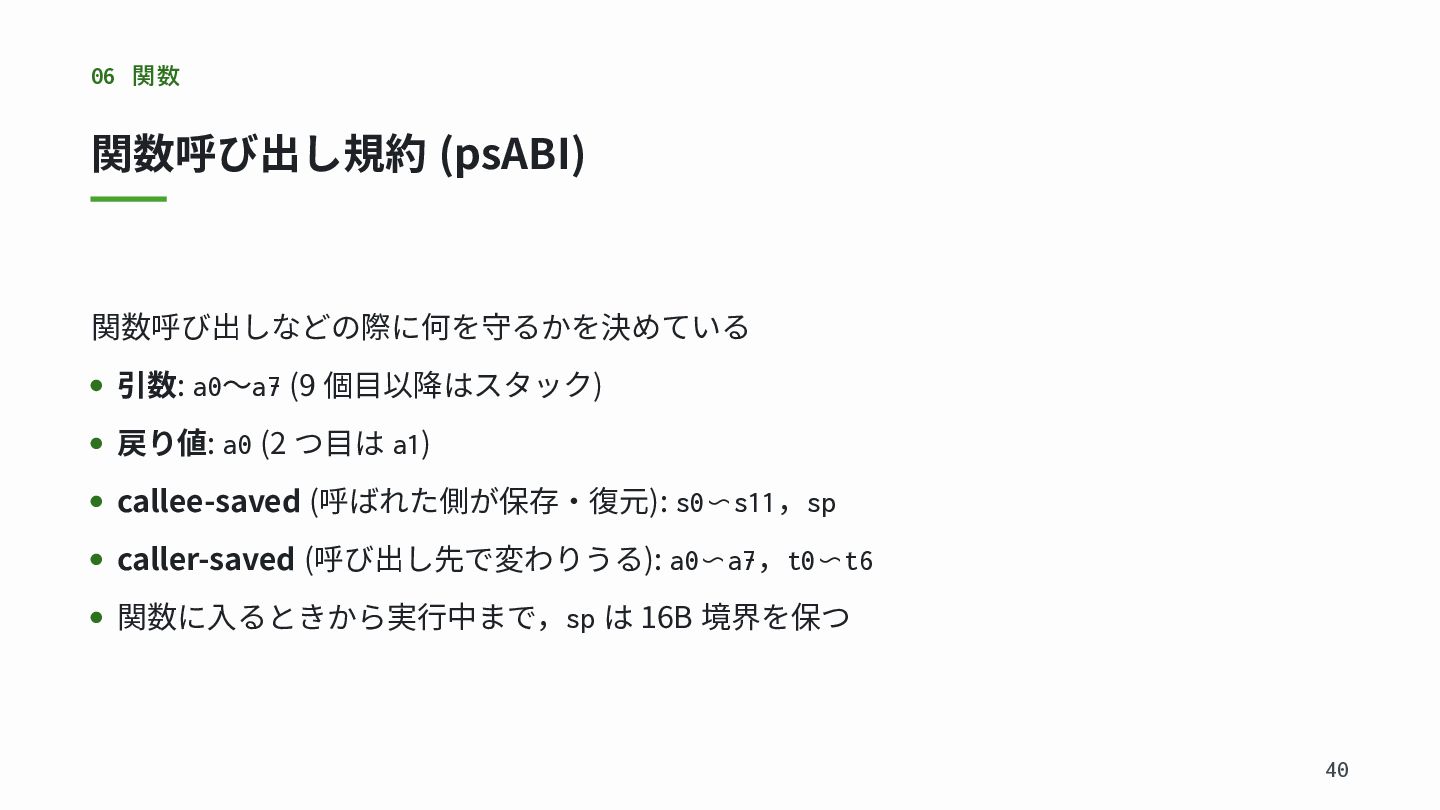
06 関数 関数呼び出し規約 (psABI) 関数呼び出しなどの際に何を守るかを決めている 引数: a0〜a7 (9 個目以降はスタック) 戻り値:
a0 (2 つ目は a1) callee-saved (呼ばれた側が保存・復元): s0〜s11,sp caller-saved (呼び出し先で変わりうる): a0〜a7,t0〜t6 関数に入るときから実行中まで,sp は 16B 境界を保つ 40
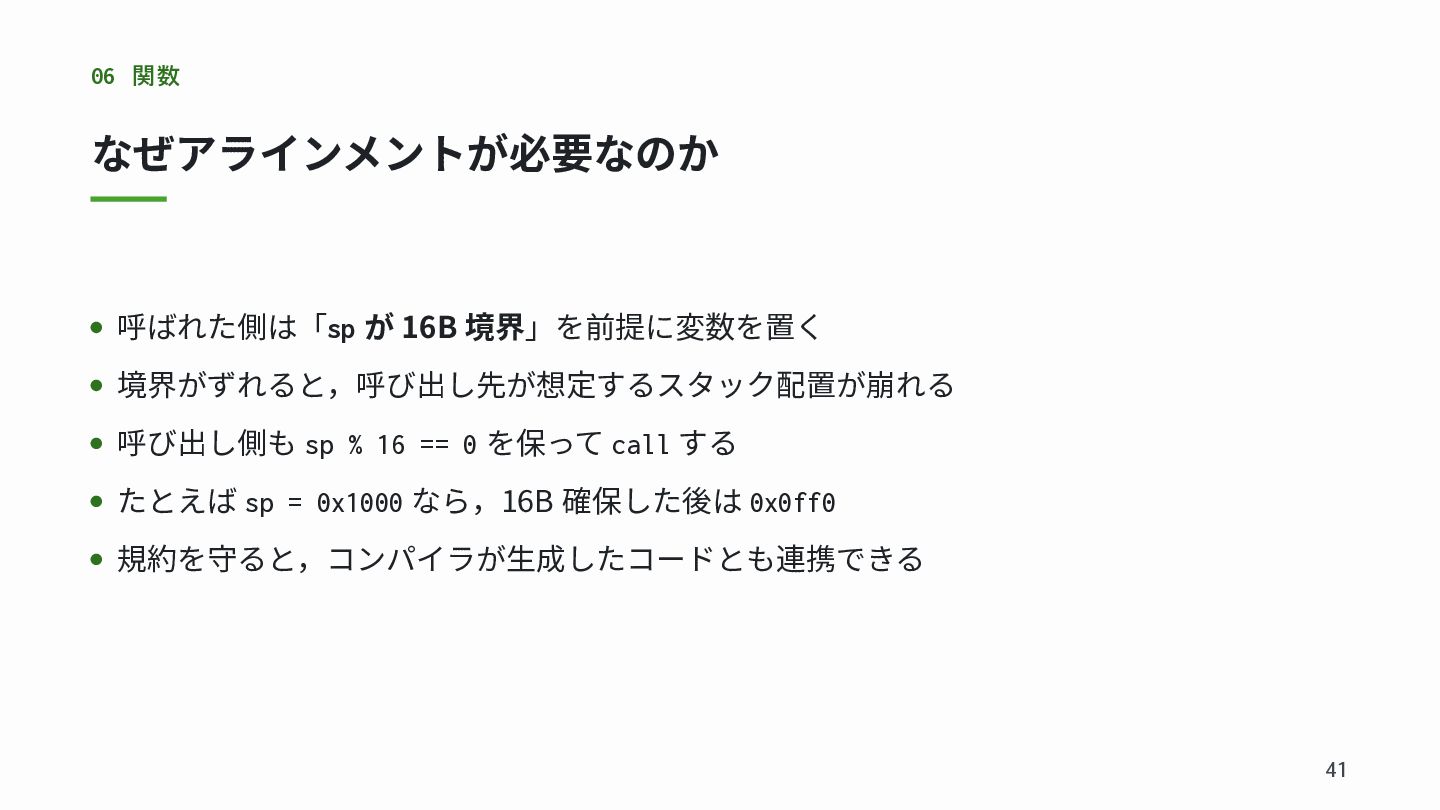
06 関数 なぜアラインメントが必要なのか 呼ばれた側は「sp が 16B 境界」を前提に変数を置く 境界がずれると,呼び出し先が想定するスタック配置が崩れる 呼び出し側も sp
% 16 == 0 を保って call する たとえば sp = 0x1000 なら,16B 確保した後は 0x0ff0 規約を守ると,コンパイラが生成したコードとも連携できる 41
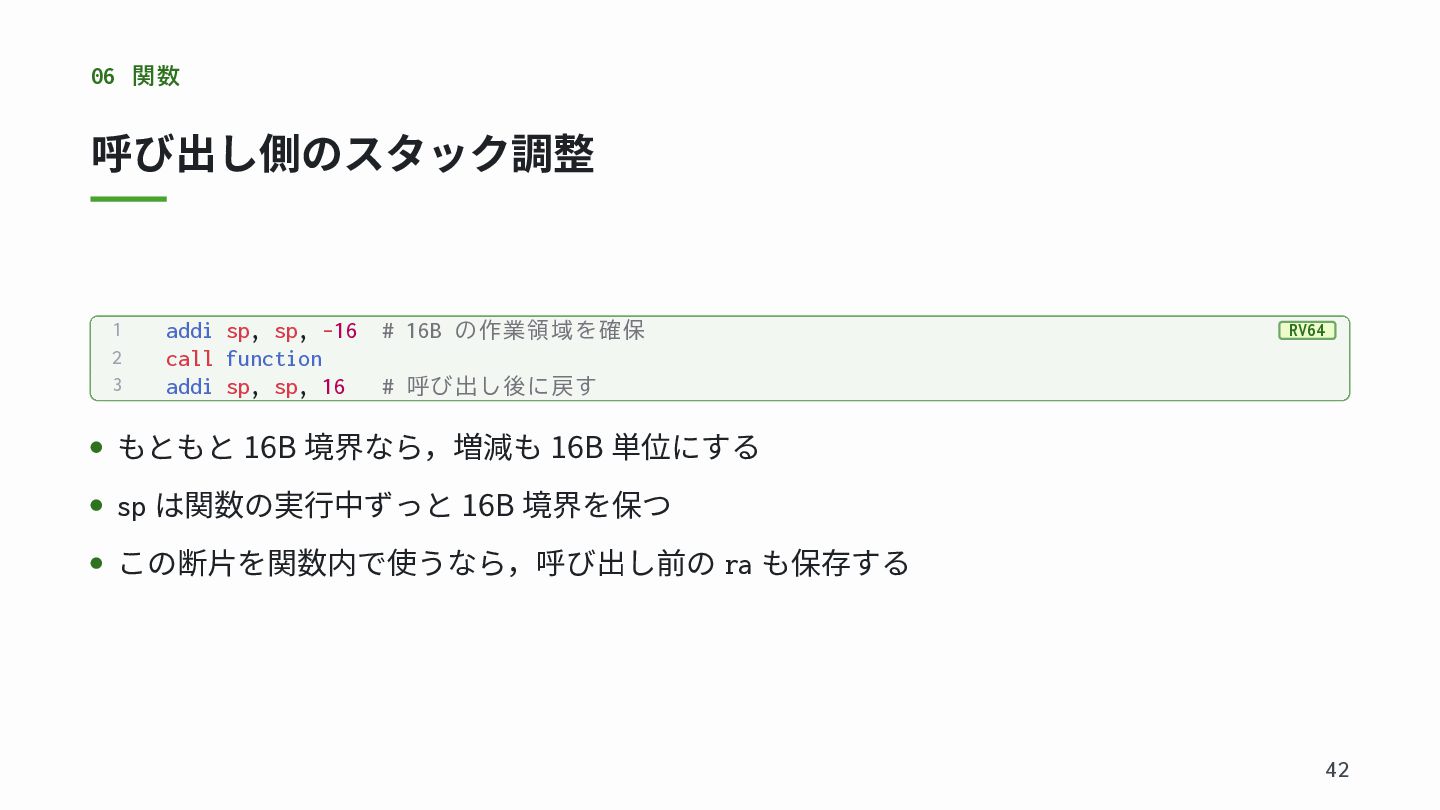
06 関数 呼び出し側のスタック調整 1 2 3 addi sp, sp, -16
call function addi sp, sp, 16 # 16B の作業領域を確保 RV64 # 呼び出し後に戻す もともと 16B 境界なら,増減も 16B 単位にする sp は関数の実行中ずっと 16B 境界を保つ この断片を関数内で使うなら,呼び出し前の ra も保存する 42
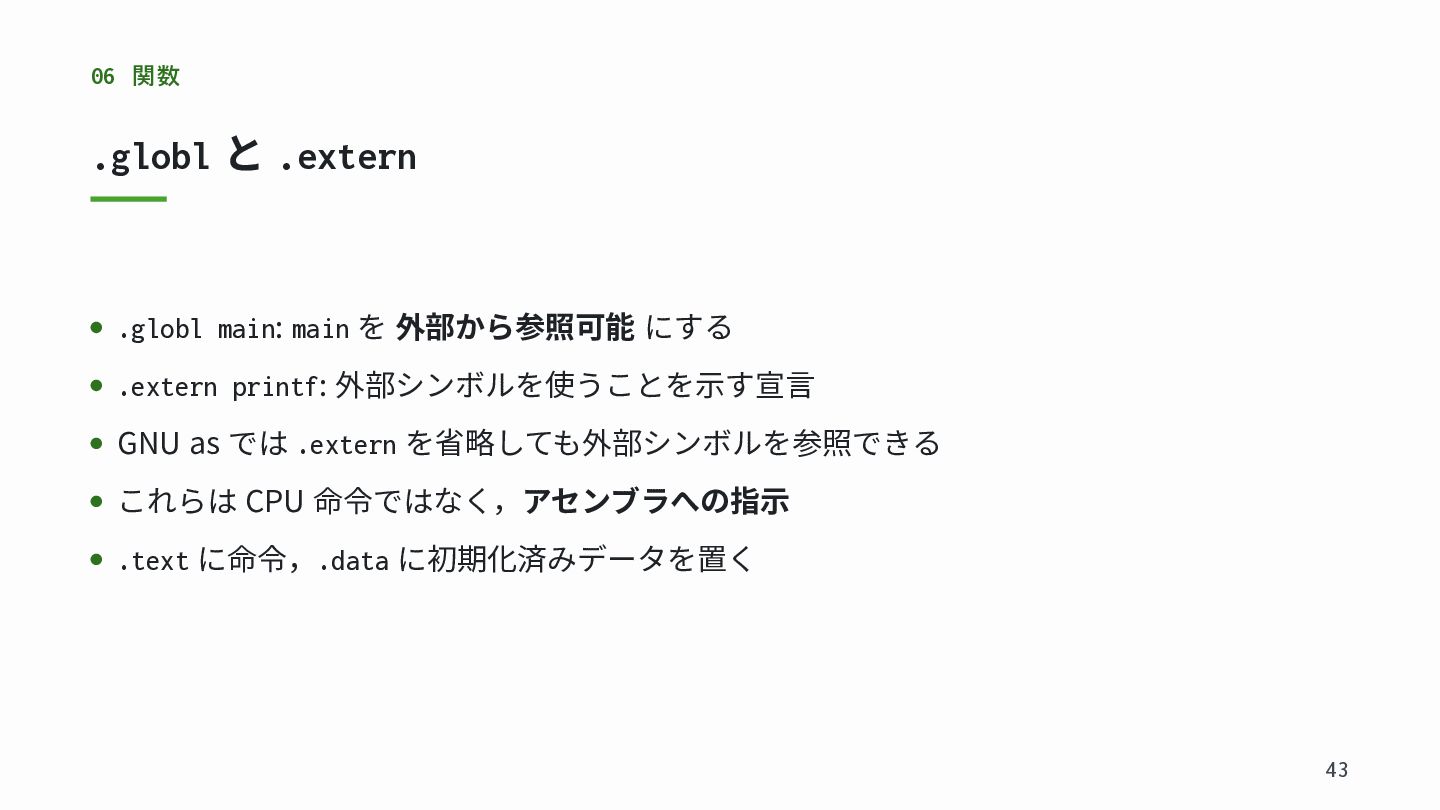
06 関数 .globl と .extern .globl main: main を 外部から参照可能
にする .extern printf: 外部シンボルを使うことを示す宣言 GNU as では .extern を省略しても外部シンボルを参照できる これらは CPU 命令ではなく,アセンブラへの指示 .text に命令,.data に初期化済みデータを置く 43
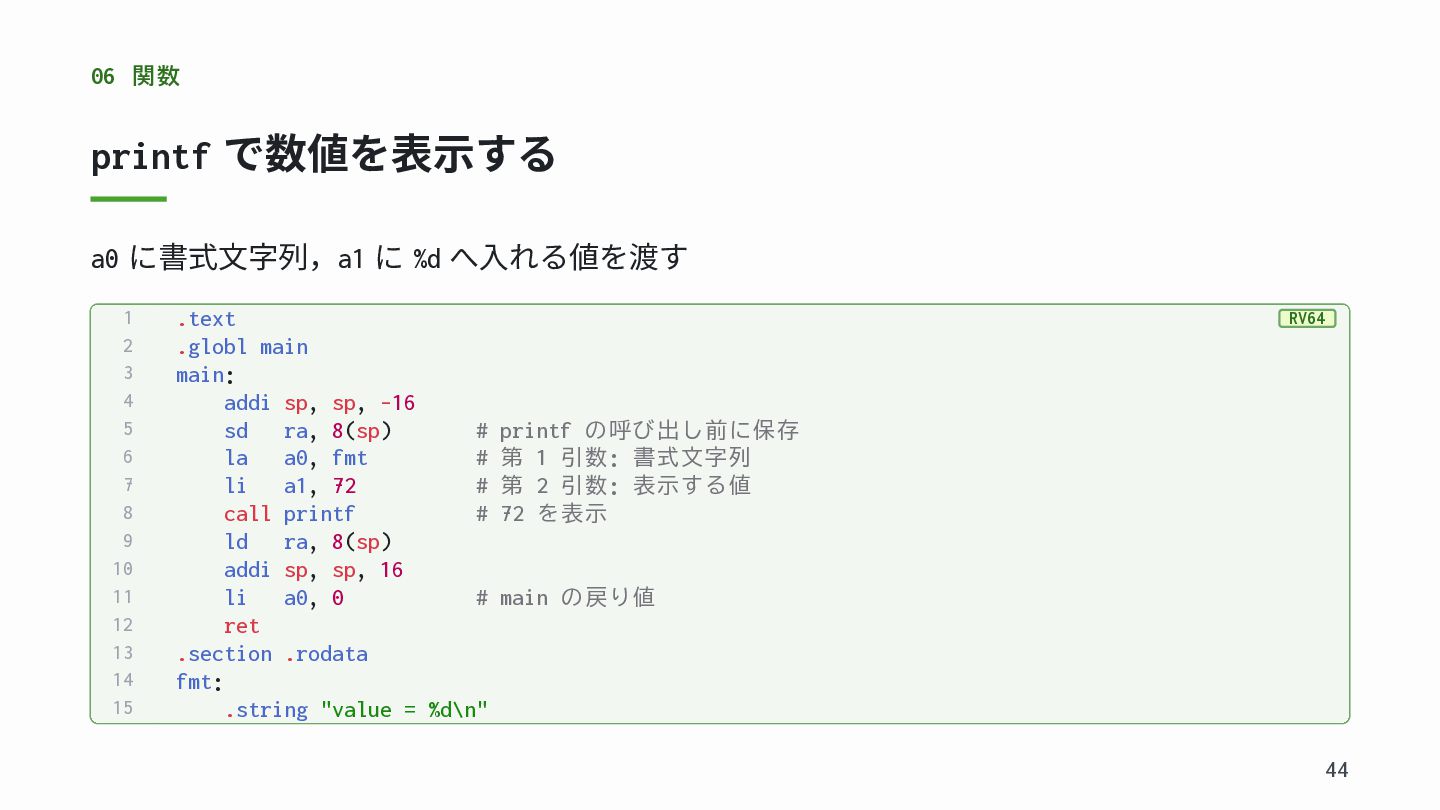
06 関数 printf で数値を表示する a0 に書式文字列,a1 に %d へ入れる値を渡す 1
2 3 4 5 6 7 8 9 10 11 12 13 14 15 .text .globl main main: addi sp, sp, -16 sd ra, 8(sp) # printf の呼び出し前に保存 la a0, fmt # 第 1 引数: 書式文字列 li a1, 72 # 第 2 引数: 表示する値 call printf # 72 を表示 ld ra, 8(sp) addi sp, sp, 16 li a0, 0 # main の戻り値 ret .section .rodata fmt: .string "value = %d\n" RV64 44
07 分岐とループ
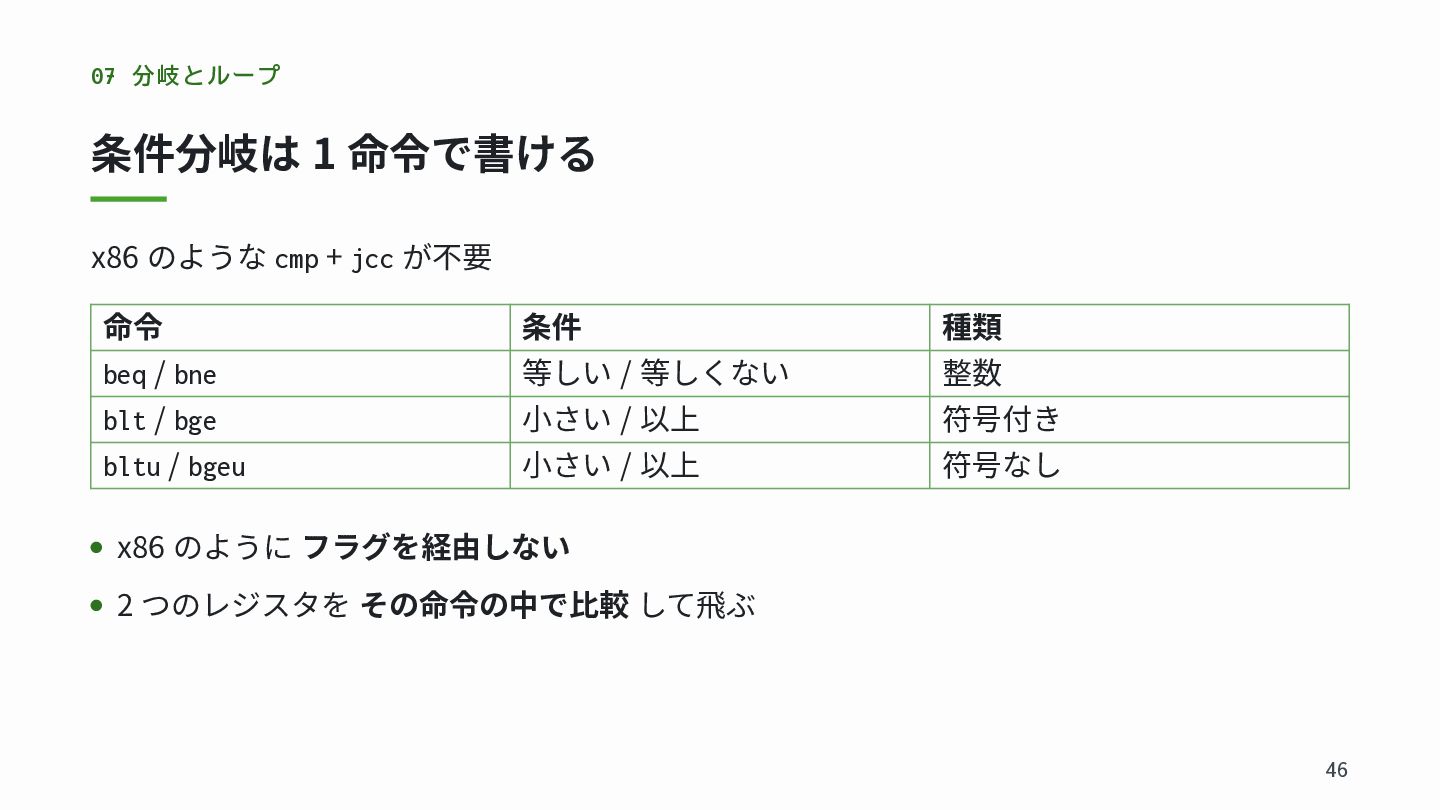
07 分岐とループ 条件分岐は 1 命令で書ける x86 のような cmp + jcc
が不要 命令 条件 種類 beq / bne 等しい / 等しくない 整数 blt / bge 小さい / 以上 符号付き bltu / bgeu 小さい / 以上 符号なし x86 のように フラグを経由しない 2 つのレジスタを その命令の中で比較 して飛ぶ 46
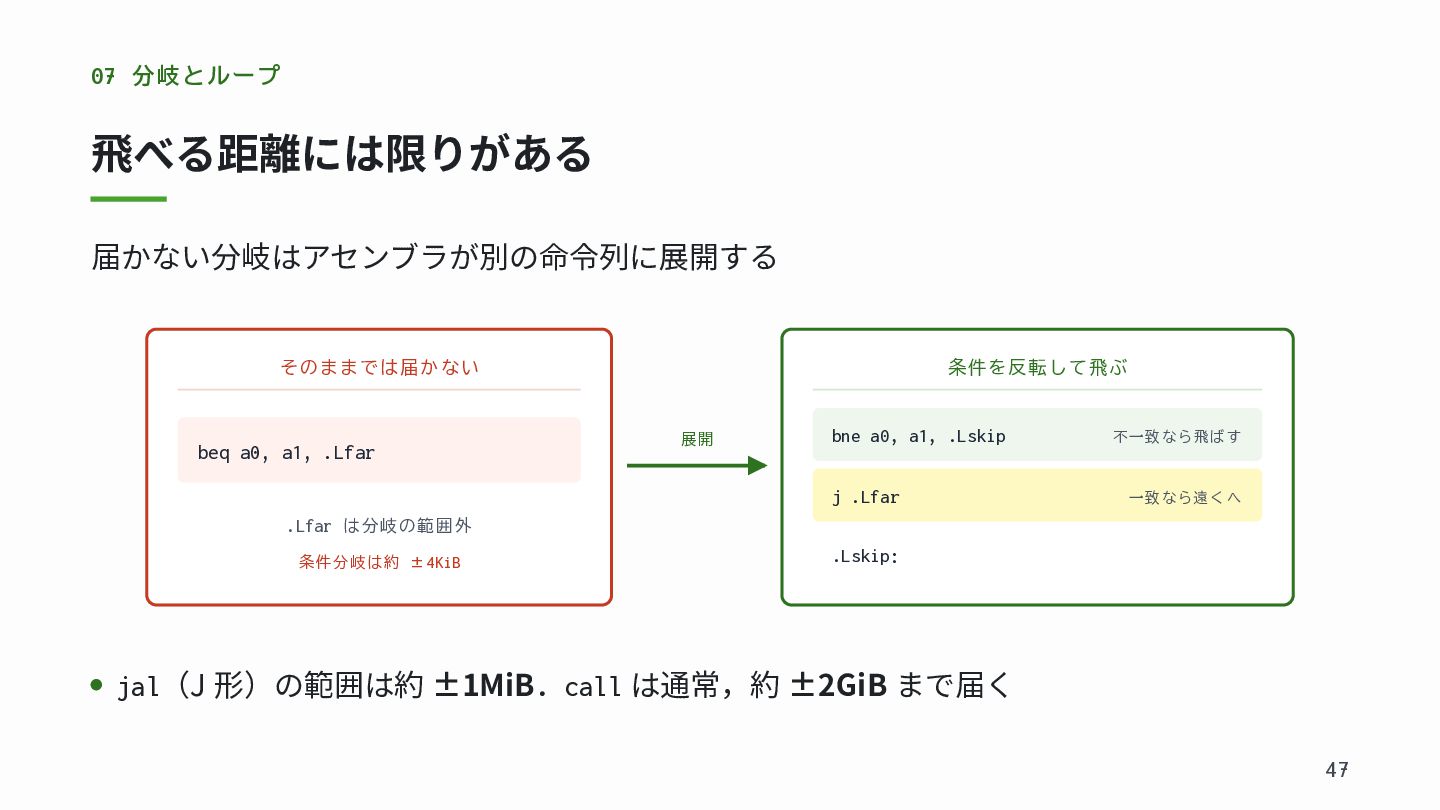
07 分岐とループ 飛べる距離には限りがある 届かない分岐はアセンブラが別の命令列に展開する そのままでは届かない beq a0, a1, .Lfar 条件を反転して飛ぶ
展開 bne a0, a1, .Lskip j .Lfar 不一致なら飛ばす 一致なら遠くへ .Lfar は分岐の範囲外 条件分岐は約 ±4KiB .Lskip: jal(J 形)の範囲は約 ±1MiB.call は通常,約 ±2GiB まで届く 47
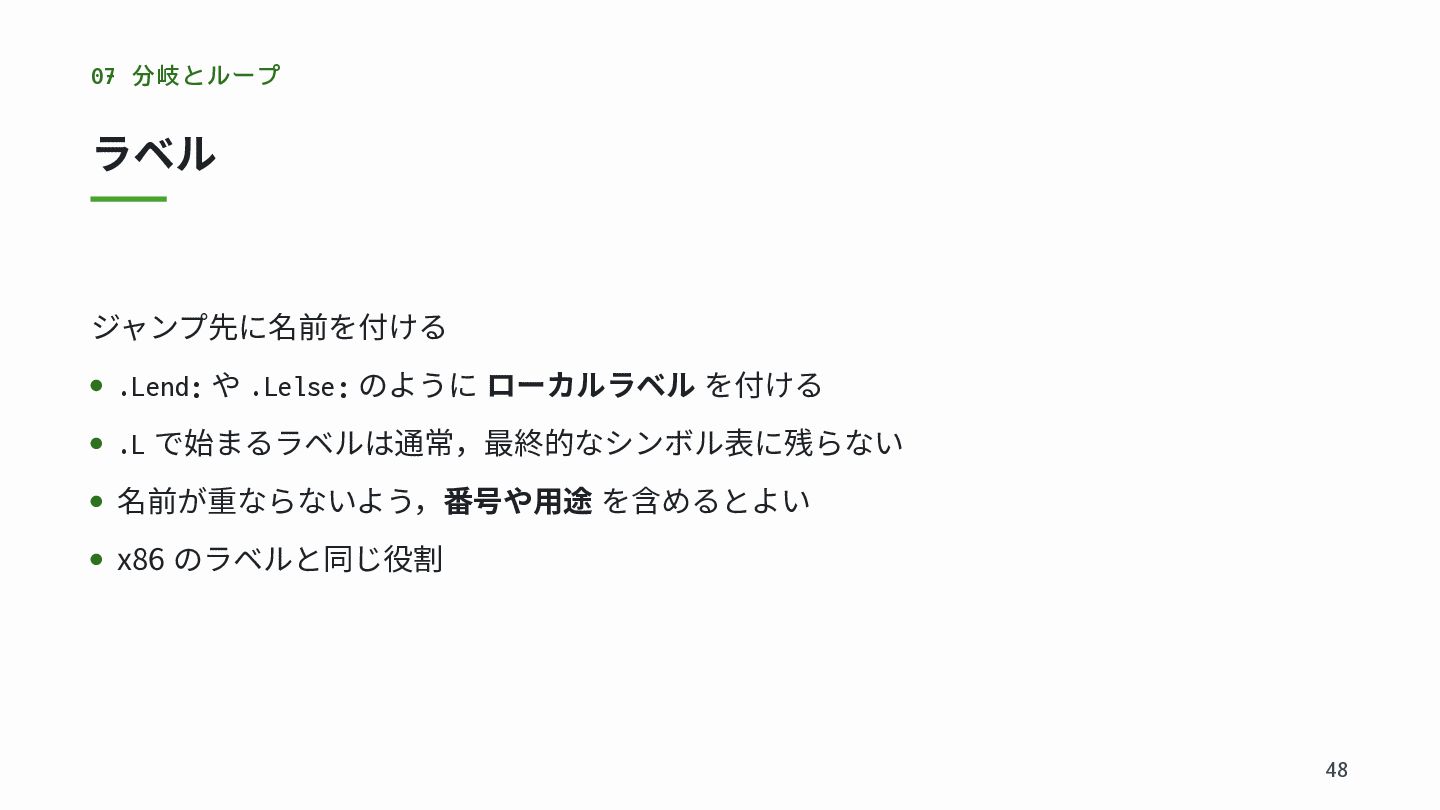
07 分岐とループ ラベル ジャンプ先に名前を付ける .Lend: や .Lelse: のように ローカルラベル を付ける
.L で始まるラベルは通常,最終的なシンボル表に残らない 名前が重ならないよう,番号や用途 を含めるとよい x86 のラベルと同じ役割 48
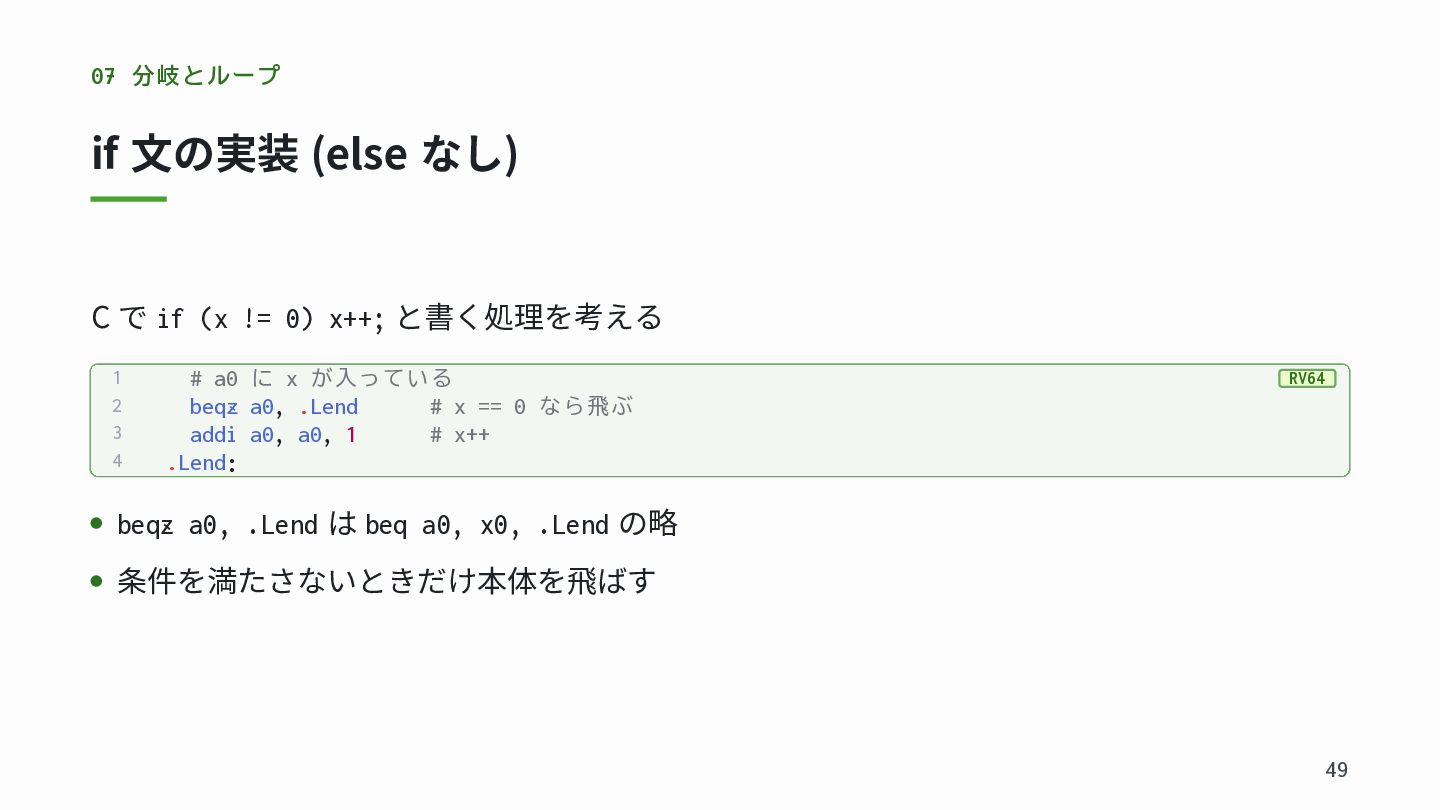
07 分岐とループ if 文の実装 (else なし) C で if (x
!= 0) x++; と書く処理を考える 1 2 3 4 # a0 に x が入っている beqz a0, .Lend # x == 0 なら飛ぶ addi a0, a0, 1 # x++ .Lend: RV64 beqz a0, .Lend は beq a0, x0, .Lend の略 条件を満たさないときだけ本体を飛ばす 49
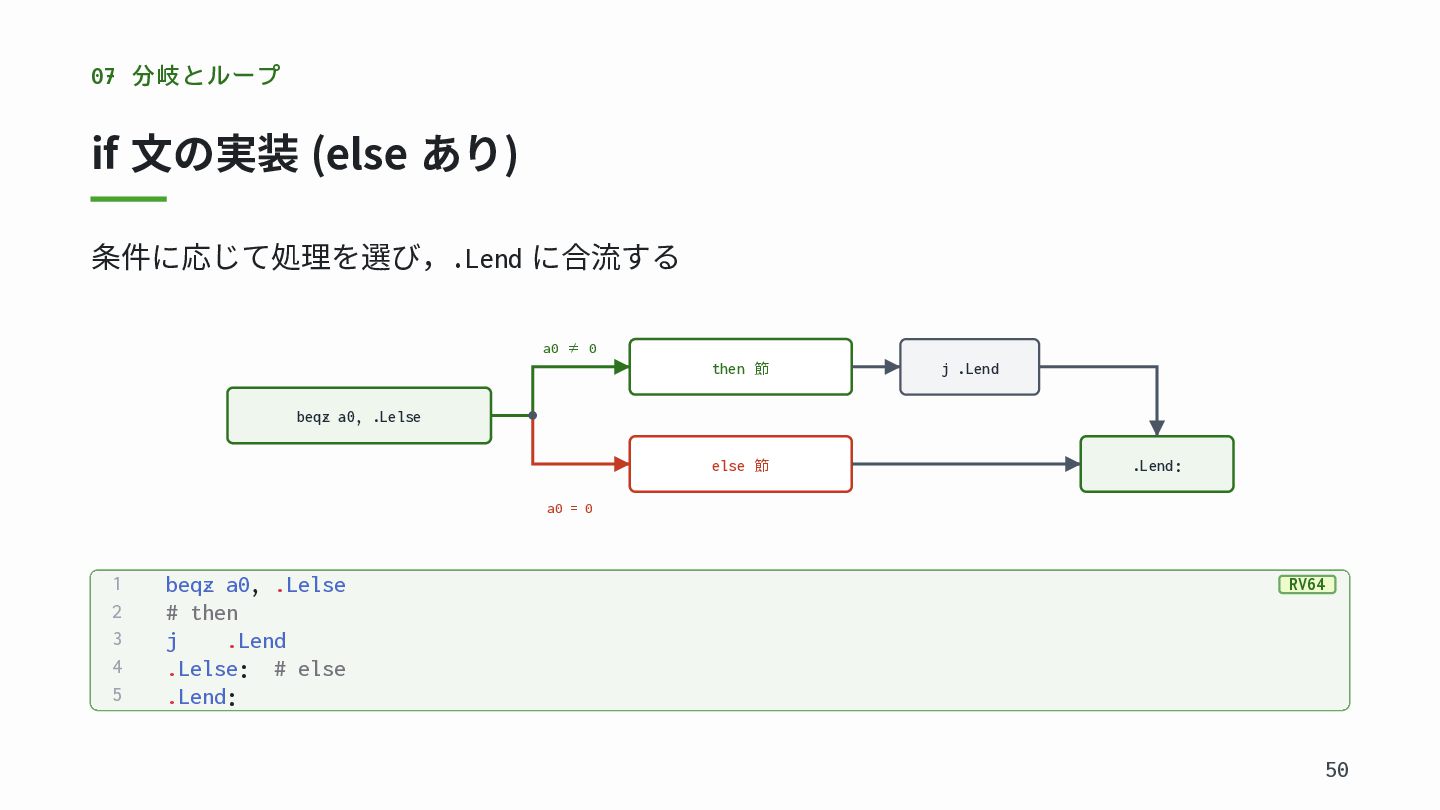
07 分岐とループ if 文の実装 (else あり) 条件に応じて処理を選び,.Lend に合流する a0 ≠
0 then 節 j .Lend beqz a0, .Lelse else 節 .Lend: a0 = 0 1 2 3 4 5 beqz a0, .Lelse # then j .Lend .Lelse: # else .Lend: RV64 50
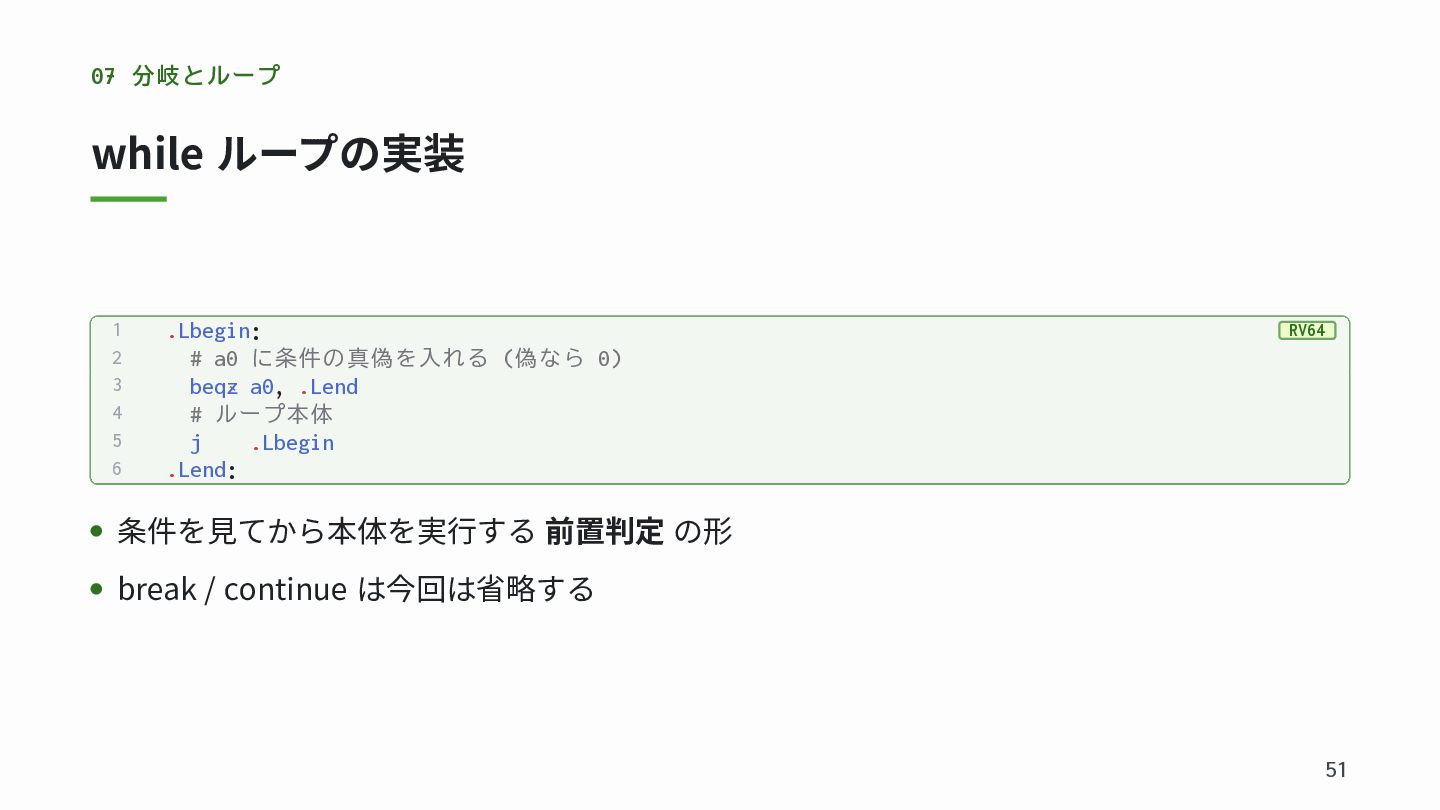
07 分岐とループ while ループの実装 1 2 3 4 5 6
.Lbegin: # a0 に条件の真偽を入れる (偽なら 0) beqz a0, .Lend # ループ本体 j .Lbegin .Lend: RV64 条件を見てから本体を実行する 前置判定 の形 break / continue は今回は省略する 51
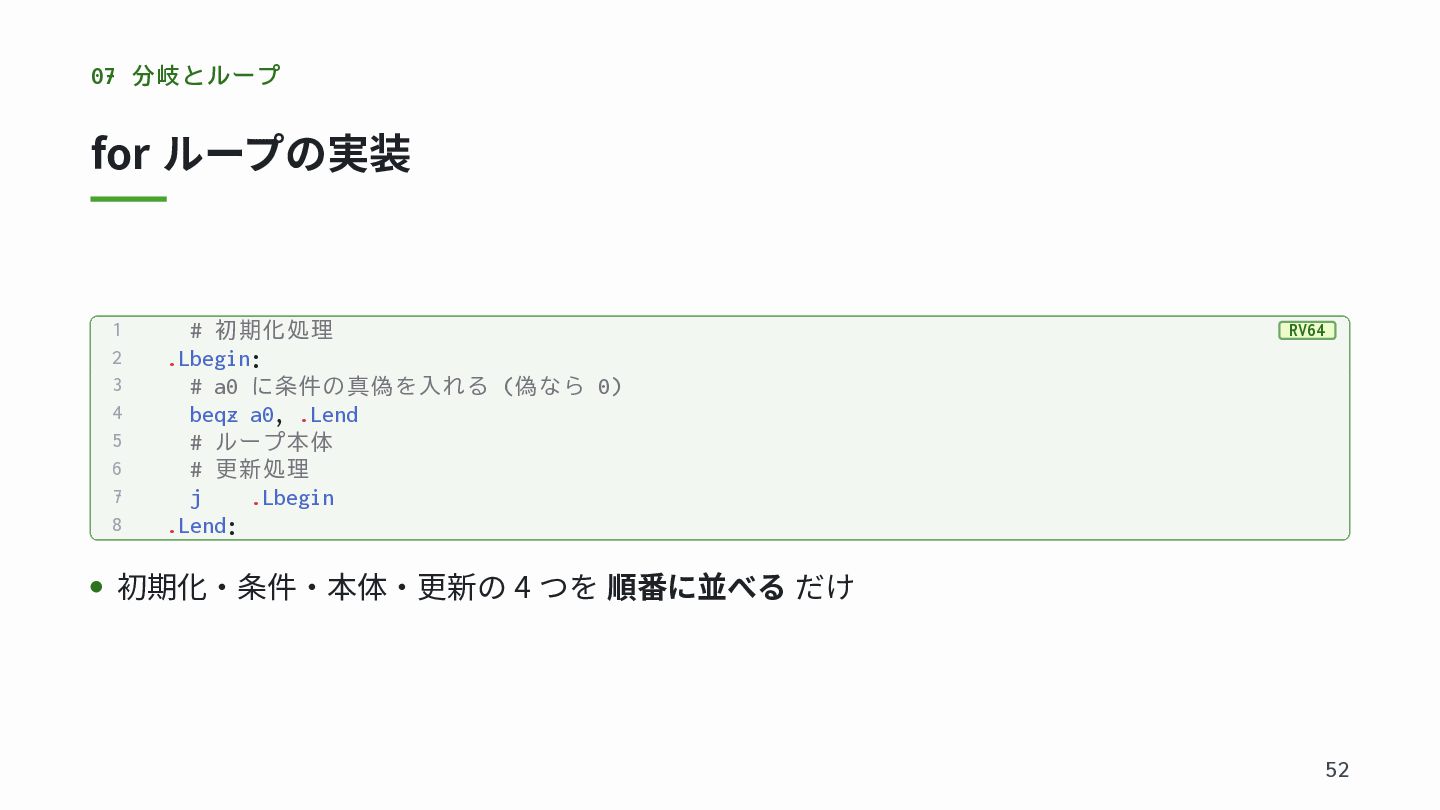
07 分岐とループ for ループの実装 1 2 3 4 5 6
7 8 # 初期化処理 .Lbegin: # a0 に条件の真偽を入れる (偽なら 0) beqz a0, .Lend # ループ本体 # 更新処理 j .Lbegin .Lend: RV64 初期化・条件・本体・更新の 4 つを 順番に並べる だけ 52
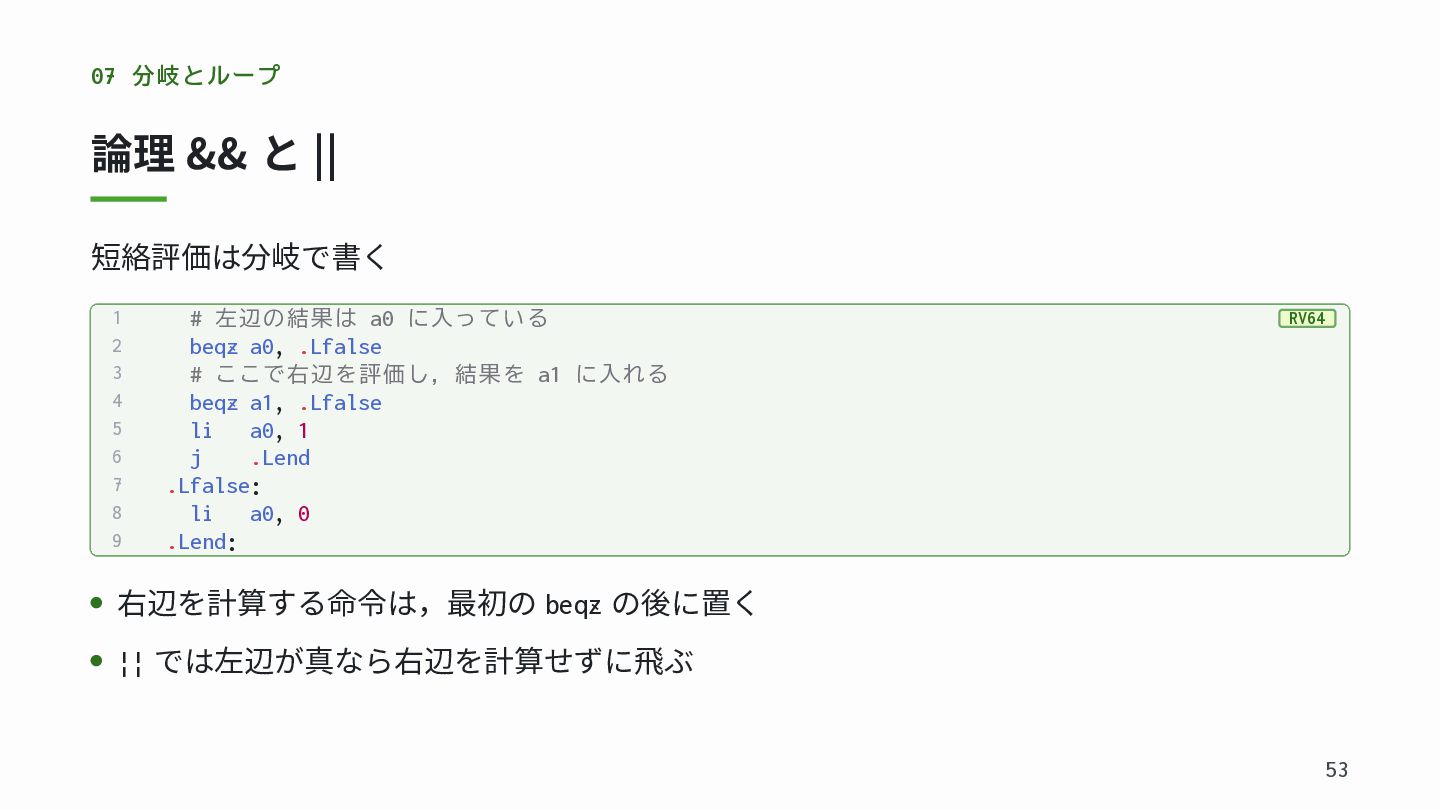
07 分岐とループ 論理 && と || 短絡評価は分岐で書く 1 2 3
4 5 6 7 8 9 # 左辺の結果は a0 に入っている beqz a0, .Lfalse # ここで右辺を評価し,結果を a1 に入れる beqz a1, .Lfalse li a0, 1 j .Lend .Lfalse: li a0, 0 .Lend: RV64 右辺を計算する命令は,最初の beqz の後に置く || では左辺が真なら右辺を計算せずに飛ぶ 53
08 データとアドレス
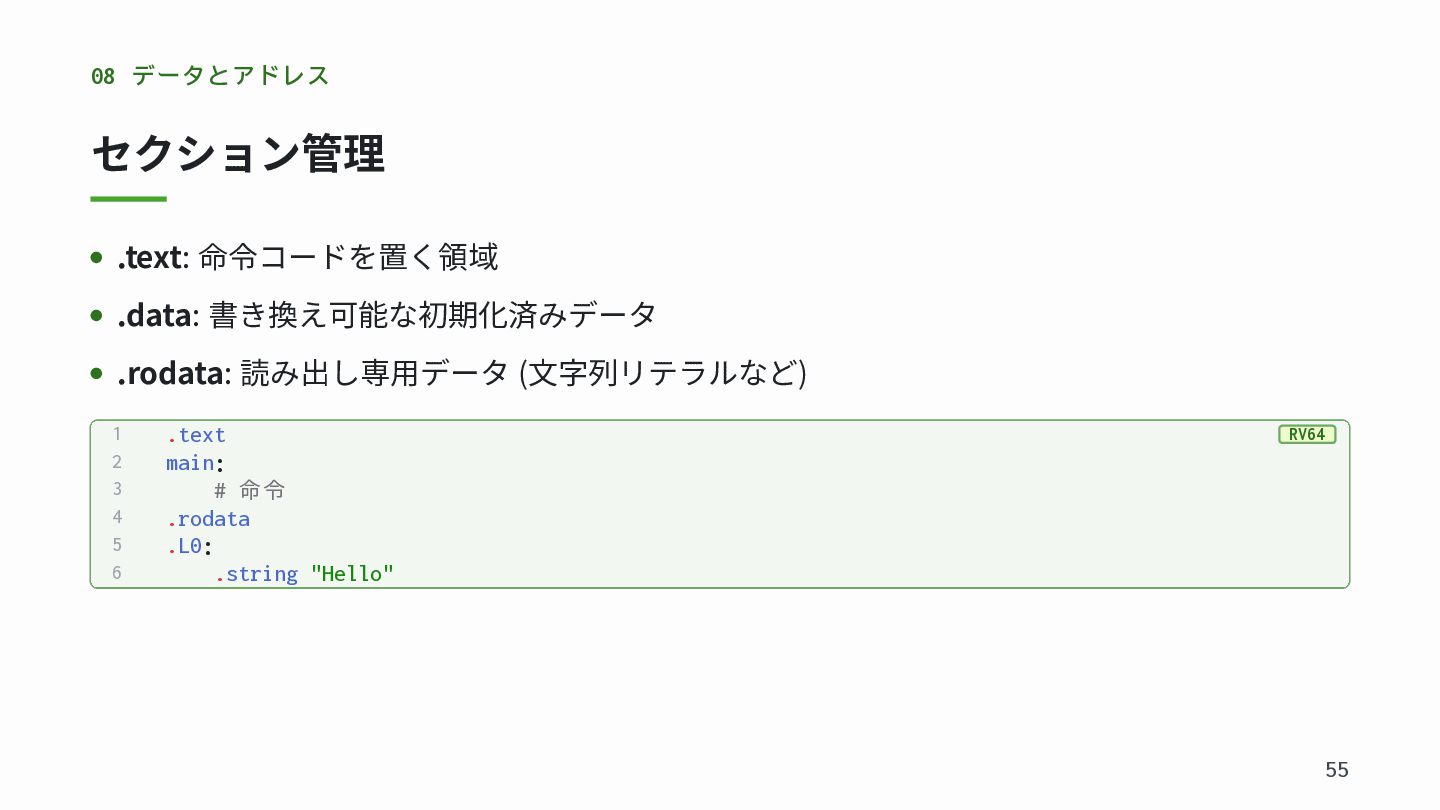
08 データとアドレス セクション管理 .text: 命令コードを置く領域 .data: 書き換え可能な初期化済みデータ .rodata: 読み出し専用データ (文字列リテラルなど)
1 2 3 4 5 6 .text main: # 命令 .rodata .L0: .string "Hello" RV64 55
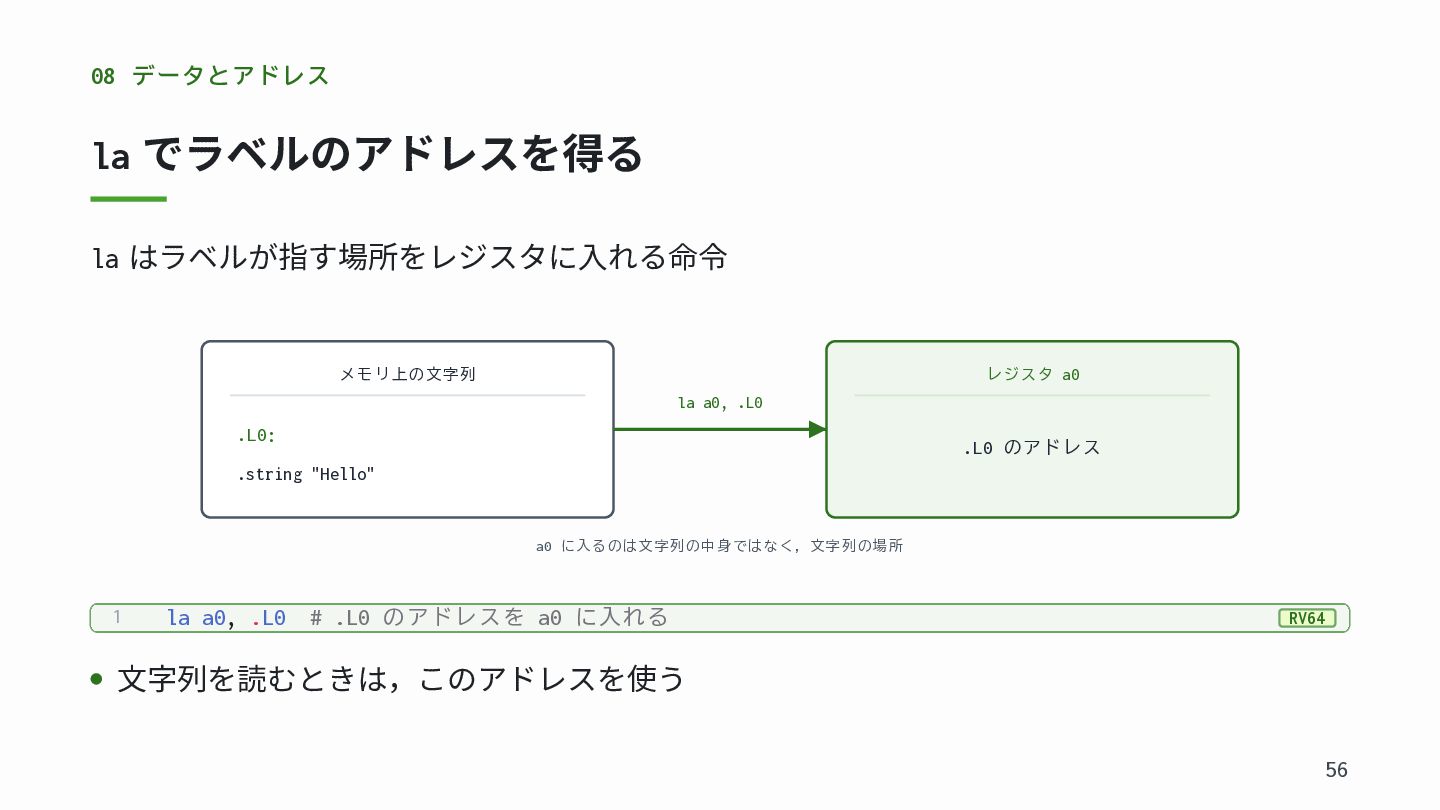
08 データとアドレス la でラベルのアドレスを得る la はラベルが指す場所をレジスタに入れる命令 メモリ上の文字列 レジスタ a0 la
a0, .L0 .L0: .L0 のアドレス .string "Hello" a0 に入るのは文字列の中身ではなく,文字列の場所 1 la a0, .L0 # .L0 のアドレスを a0 に入れる RV64 文字列を読むときは,このアドレスを使う 56
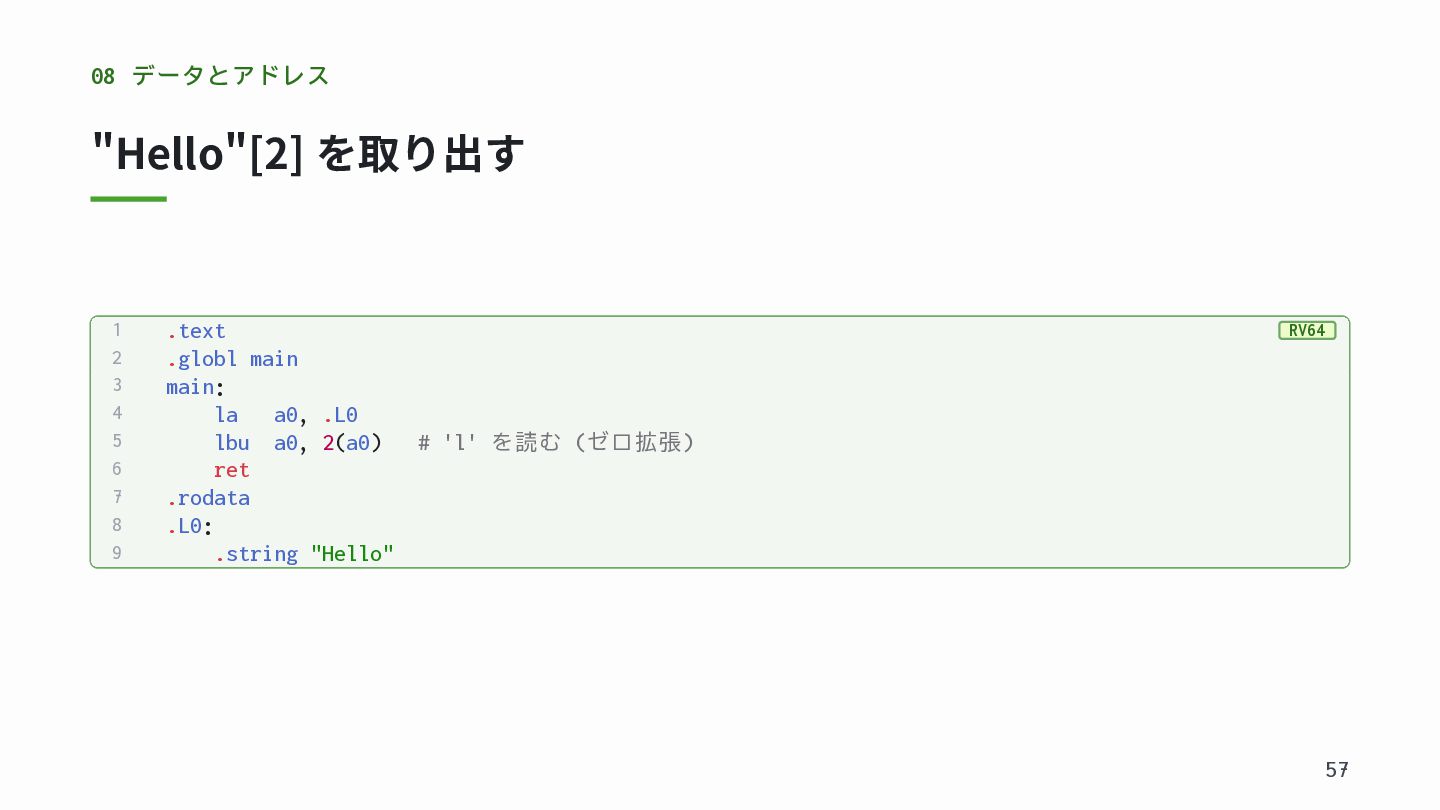
08 データとアドレス "Hello"[2] を取り出す 1 2 3 4 5 6
7 8 9 .text .globl main main: la a0, .L0 lbu a0, 2(a0) ret .rodata .L0: .string "Hello" RV64 # 'l' を読む (ゼロ拡張) 57
09 まとめ 参考資料① RISC-V 非特権命令セット仕様 https://docs.riscv.org/reference/isa/ RISC-V psABI (呼び出し規約) https://riscv-non-isa.github.io/riscv-elf-psabi-doc/
GNU as RISC-V 依存機能 https://sourceware.org/binutils/docs/as/RISC-V-Dependent.html RISC-V の歴史と名前 https://riscv.org/about/faq/ 58
09 まとめ 参考資料② 『低レイヤを知りたい人のための C コンパイラ作成入門』 https://www.sigbus.info/compilerbook HCCC_Tutorial (x86-64 版チュートリアル)
https://github.com/Alignof/HCCC_Tutorial HCCC 競技サイト https://hccc.contest.seccon.jp/ 59


 latte72
 tammyeverts
 kneath
 lfama
 inesmontani
 stephenakadiri
 aleyda
 tammielis
 letsgokoyo
 62gerente
 michielstock