Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
(n=1の)テーブルデータコンペの取り組み方
Search
Sponsored
·
SiteGround - Reliable hosting with speed, security, and support you can count on.
→
Makoto Hyodo
September 20, 2023
Technology
5.2k
7
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
(n=1の)テーブルデータコンペの取り組み方
2023/9/23の関東Kaggler会でお話する予定の資料です!
Makoto Hyodo
September 20, 2023
Other Decks in Technology
See All in Technology
その Lambda、8分で 管理者権限まで奪われます
k1nakayama
7
3.5k
絵ではじめるKubernetesセキュリティ
aoi1
4
690
時うどん〜Socket.getifaddrsで学ぶネットワーク編 / Tokiudon: The Socket.getifaddrs Edition
coe401_
4
210
The Knowledge Spine: A Machine-Executable Ontology for Governed Marketing Activation
vananth22
0
120
現場で役立つ技術負債の効果的な返済方法
masuda220
PRO
10
5k
登壇の自信を奪う3匹のオバケ / 3 Ghosts That Rob You of Your Confidence in Public Speaking
pauli
9
1.1k
AIエージェントを最高のパートナーに育てる方法|評価と判断軸を育てる5つのステップ
koichiaoki
1
160
アクセスキーこわい やめかたと漏らさない工夫
sassssan68
1
600
【技術的負債conf】事業成長に伴う技術的負債の説明責任とAIによるモニタリング、認知的負債について
i35_267
3
2k
なぜ「決定性」が 決定的に重要なのか? Durable Execution 基盤の数理的理解 #serverlessjp / ServerlessDays Tokyo 2026
ytaka23
3
1.1k
beyond jj: config & tools ecosystem
indirect
0
5.8k
AIエージェントの自己改善をどう設計するか / How to Design Self-Improvement for AI Agents
22mi
25
17k
Featured
See All Featured
[RailsConf 2023 Opening Keynote] The Magic of Rails
eileencodes
31
10k
New Earth Scene 8
popppiees
4
2.6k
A Modern Web Designer's Workflow
chriscoyier
699
190k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.3k
Building AI with AI
inesmontani
PRO
1
1.2k
GitHub's CSS Performance
jonrohan
1033
470k
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
520
Fireside Chat
paigeccino
43
4k
Taking LLMs out of the black box: A practical guide to human-in-the-loop distillation
inesmontani
PRO
3
2.4k
Measuring Dark Social's Impact On Conversion and Attribution
stephenakadiri
2
280
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
530
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
Transcript
(n=1の)テーブルデータコンペの 取り組み方 2023/09/23 関東Kaggler会
自己紹介 兵藤 誠(Makotu) ※kaggleのアイコンはその時々の推しのアニメやVtuberのキャラにしており 安定してなかったんですが今は上のアイコン(有馬かな)に落ち着いています。 • 普段は受託分析会社でクライアントワーク • 仕事では基本的にテーブルデータを触ることが多い •
データ分析よりクライアントコミュニケーション 関連の方がたぶん得意 1~2年前くらいに使ってたやつ
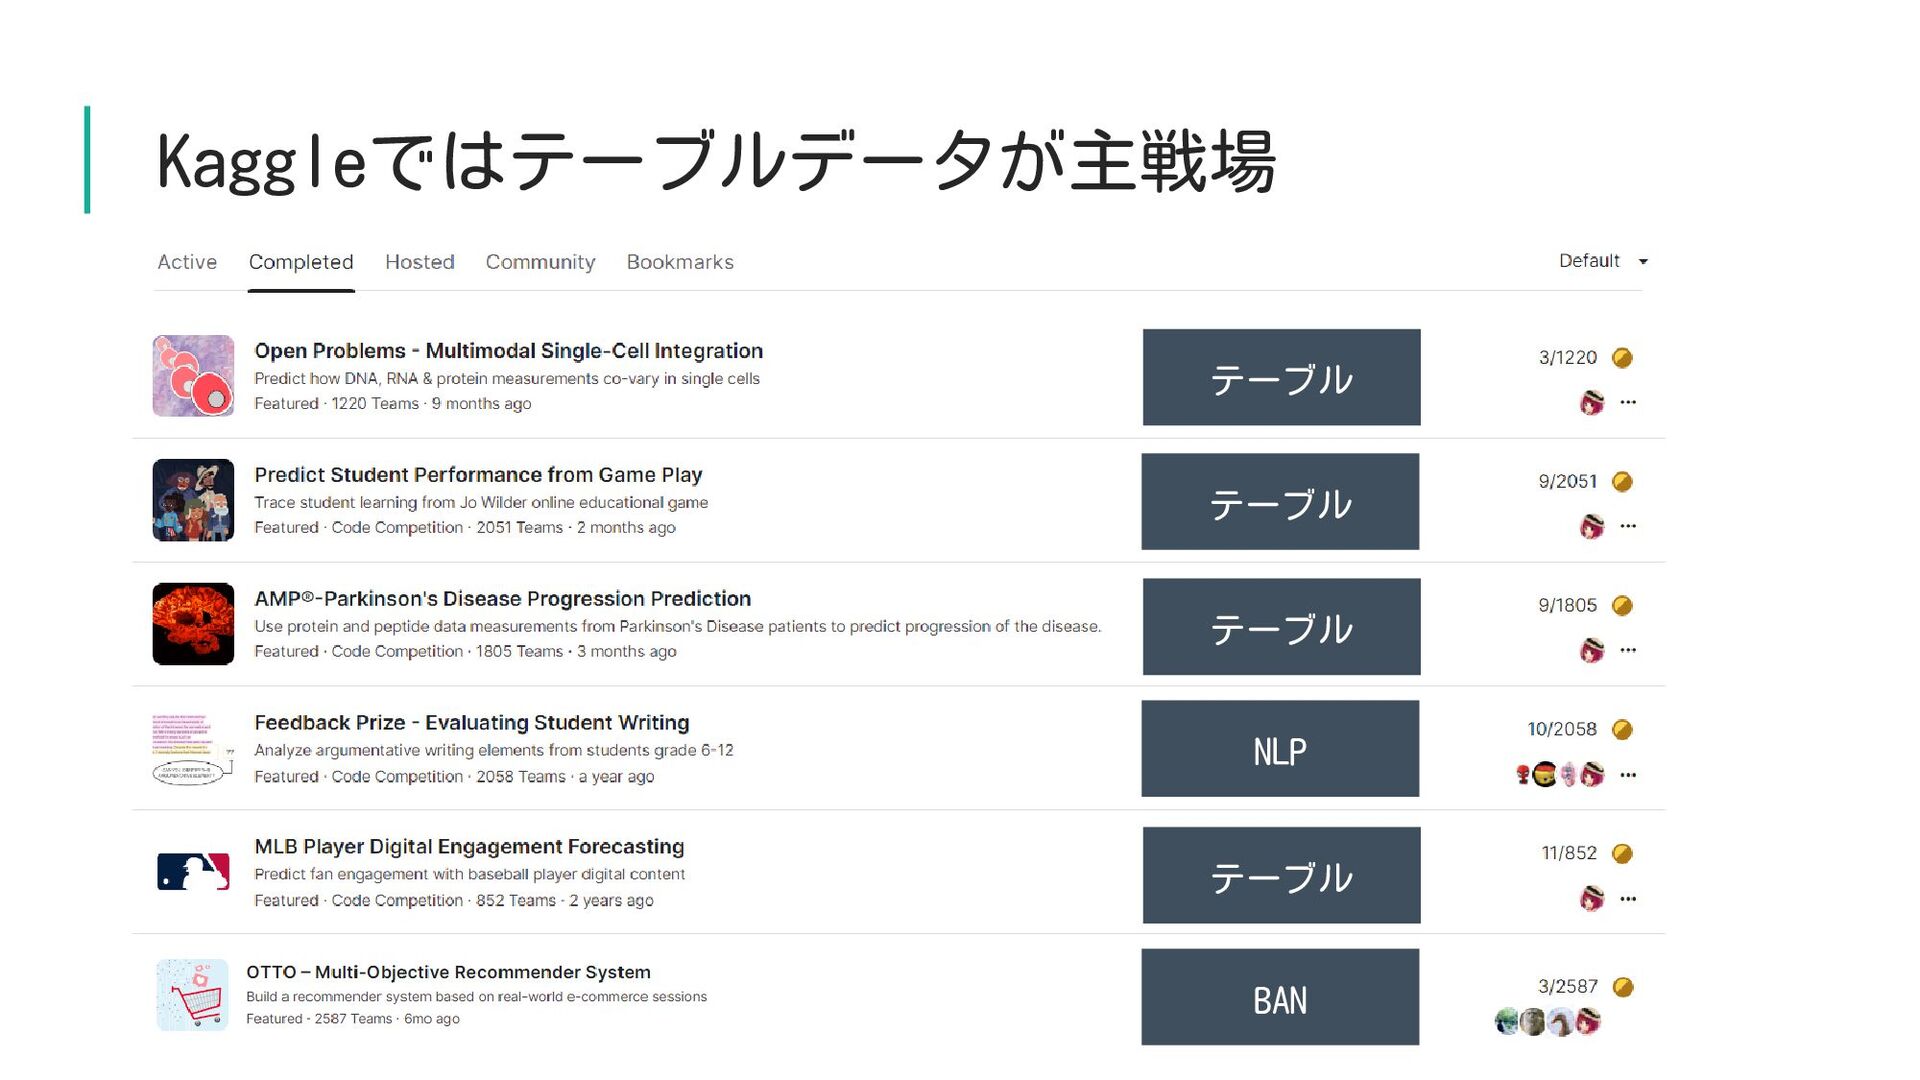
Kaggleではテーブルデータが主戦場 テーブル テーブル テーブル テーブル NLP BAN
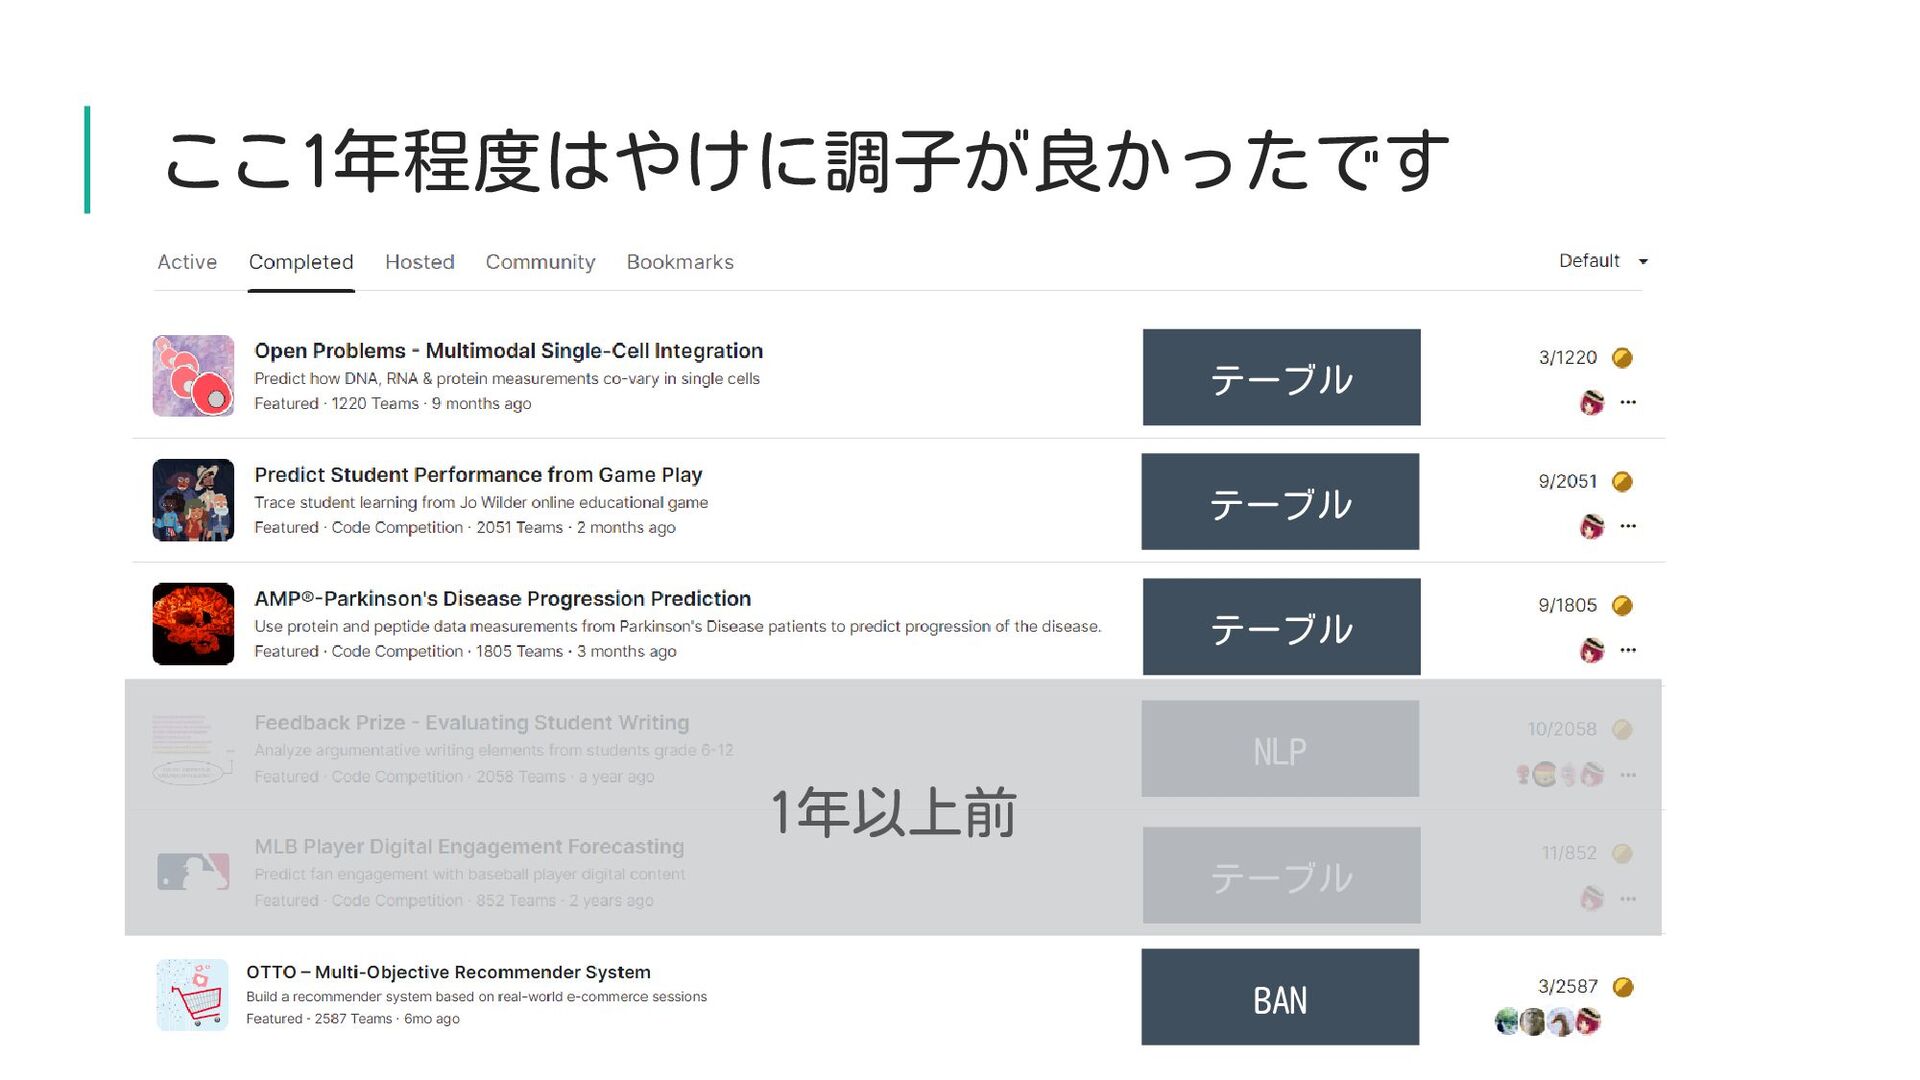
ここ1年程度はやけに調子が良かったです テーブル テーブル テーブル テーブル NLP BAN 1年以上前
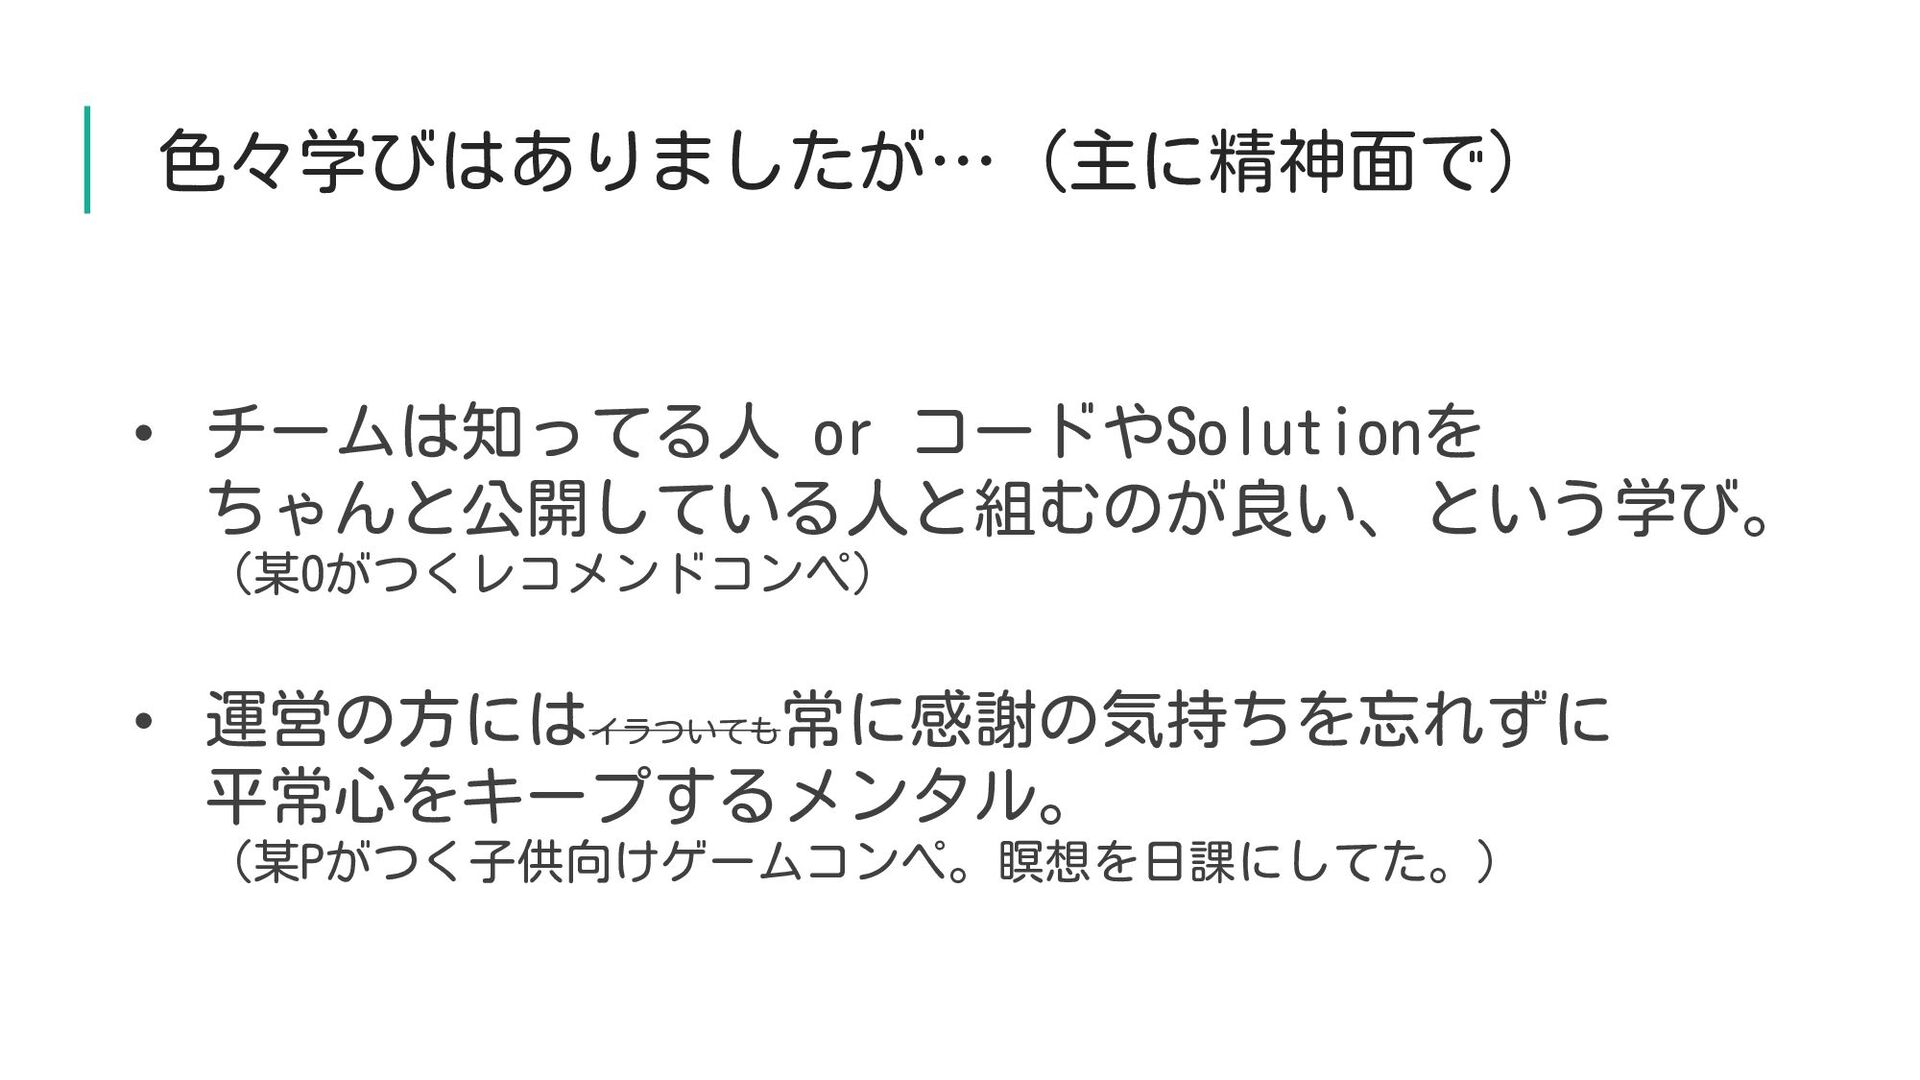
色々学びはありましたが…(主に精神面で) • チームは知ってる人 or コードやSolutionを ちゃんと公開している人と組むのが良い、という学び。 (某Oがつくレコメンドコンペ) • 運営の方にはイラついても 常に感謝の気持ちを忘れずに
平常心をキープするメンタル。 (某Pがつく子供向けゲームコンペ。瞑想を日課にしてた。)
今日は自分の取り組み姿勢について話します テーブルデータコンペの取り組み方全般 • 各コンペのSolutionはDiscussionを見れば良いので割愛 • 「銀・銅メダルは毎回取れるんだけど」くらいの方のご参考になれば
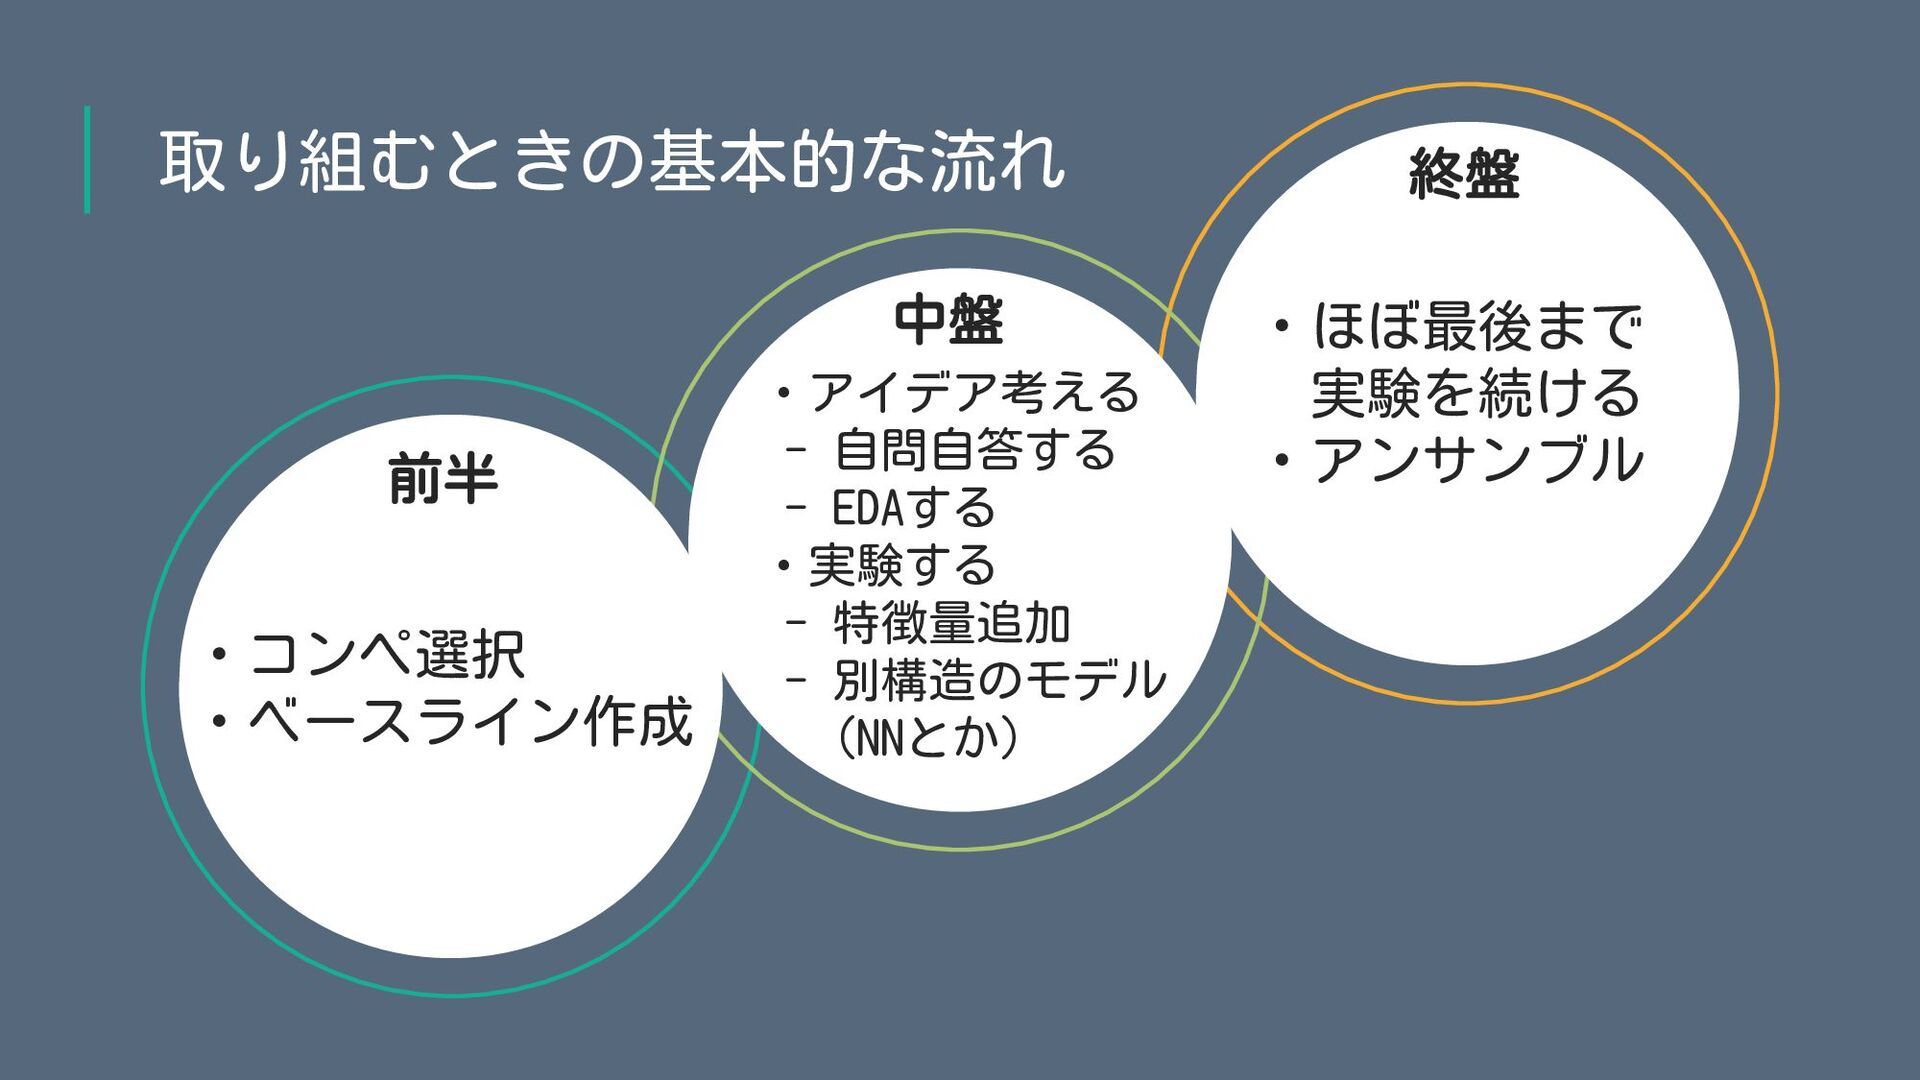
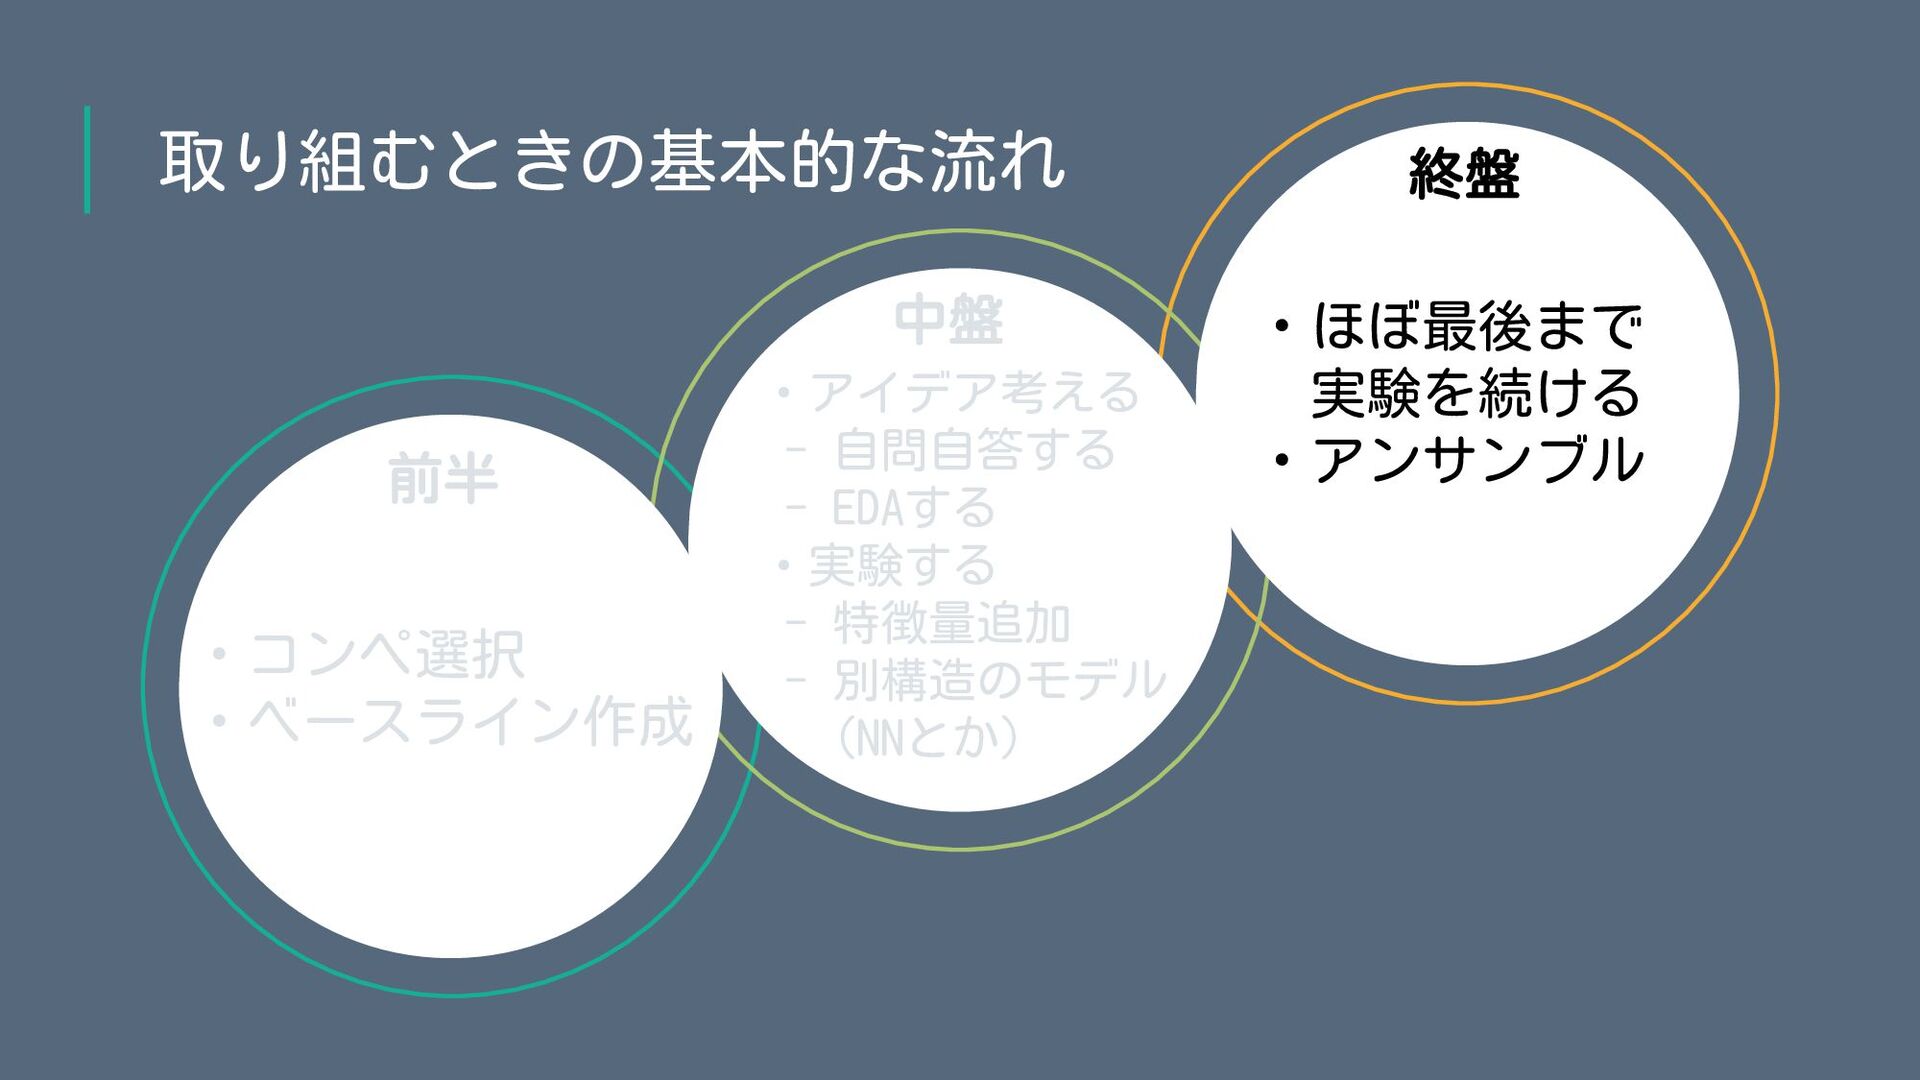
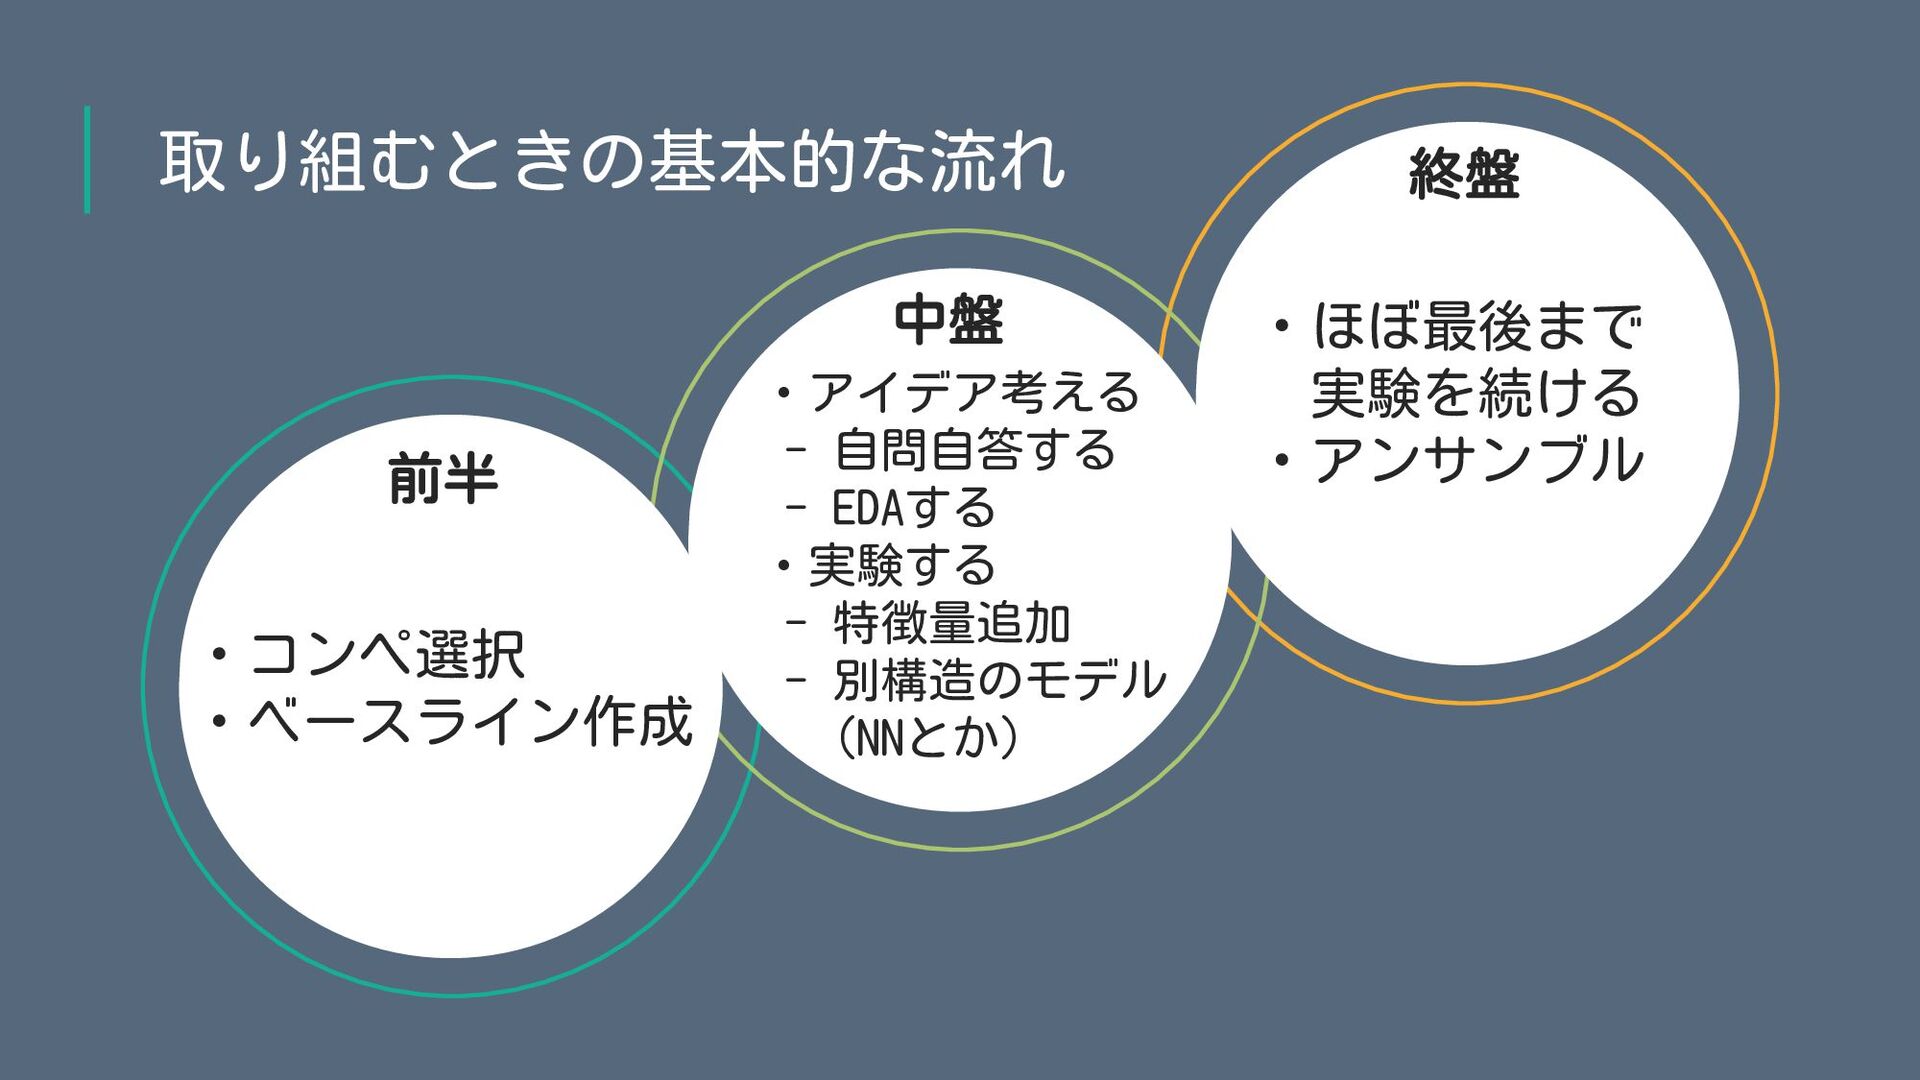
取り組むときの基本的な流れ ・コンペ選択 ・ベースライン作成 ・アイデア考える - 自問自答する - EDAする ・実験する -
特徴量追加 - 別構造のモデル (NNとか) ・ほぼ最後まで 実験を続ける ・アンサンブル 前半 中盤 終盤
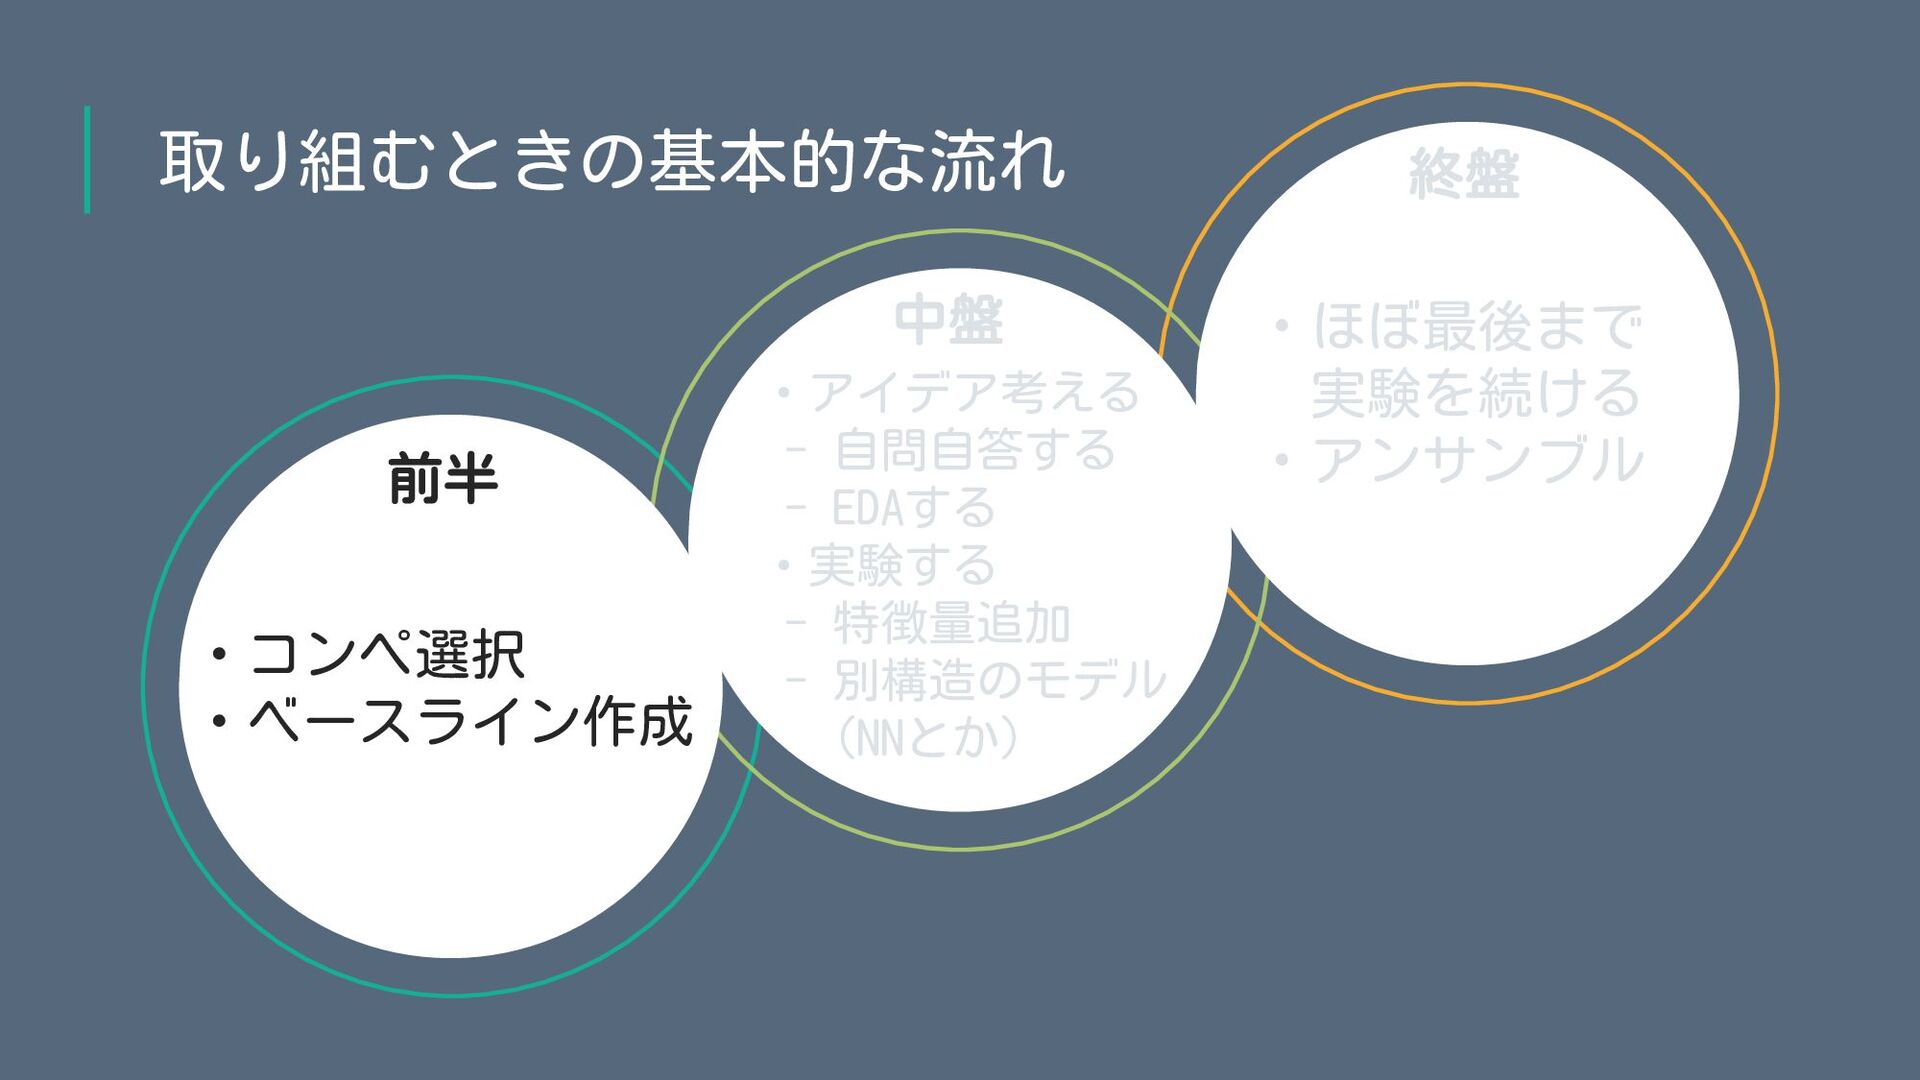
取り組むときの基本的な流れ ・コンペ選択 ・ベースライン作成 ・アイデア考える - 自問自答する - EDAする ・実験する -
特徴量追加 - 別構造のモデル (NNとか) ・ほぼ最後まで 実験を続ける ・アンサンブル 前半 中盤 終盤
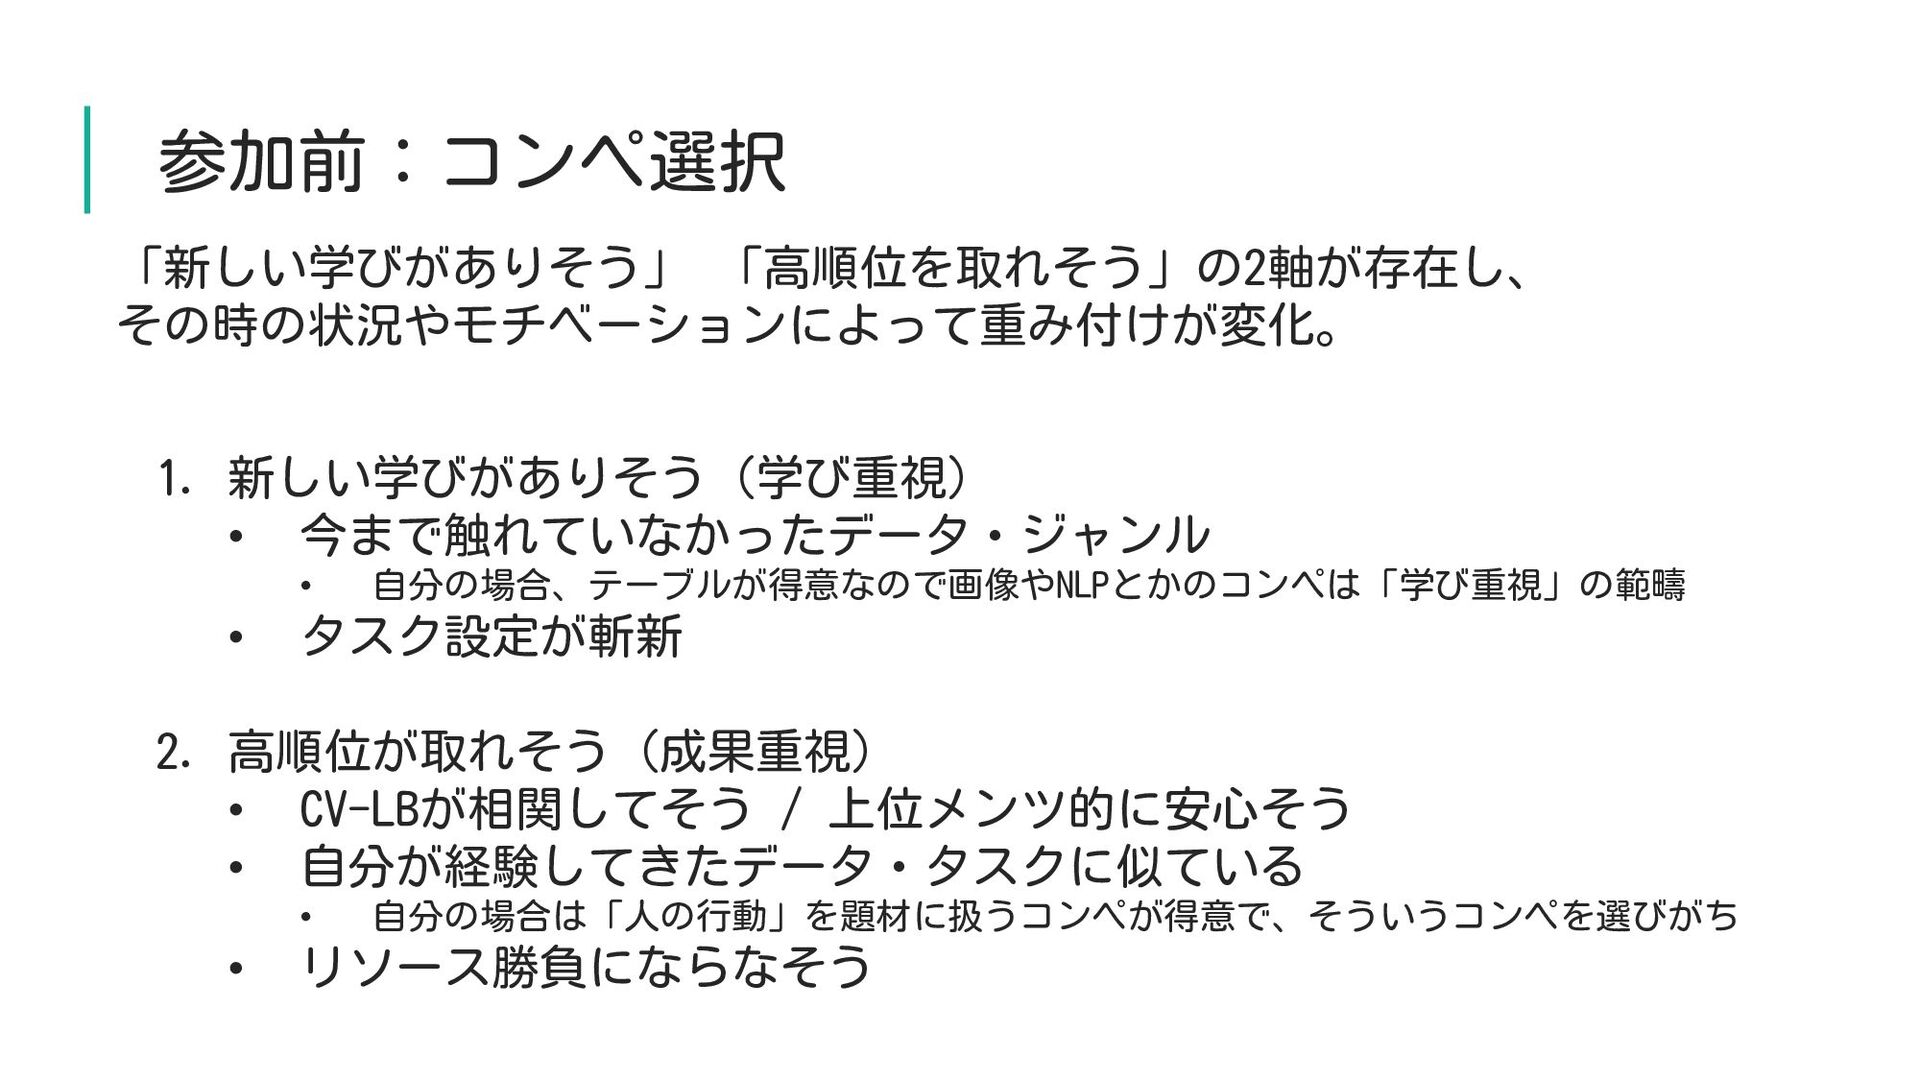
参加前:コンペ選択 1. 新しい学びがありそう(学び重視) • 今まで触れていなかったデータ・ジャンル • 自分の場合、テーブルが得意なので画像やNLPとかのコンペは「学び重視」の範疇 • タスク設定が斬新 2.
高順位が取れそう(成果重視) • CV-LBが相関してそう / 上位メンツ的に安心そう • 自分が経験してきたデータ・タスクに似ている • 自分の場合は「人の行動」を題材に扱うコンペが得意で、そういうコンペを選びがち • リソース勝負にならなそう 「新しい学びがありそう」 「高順位を取れそう」の2軸が存在し、 その時の状況やモチベーションによって重み付けが変化。
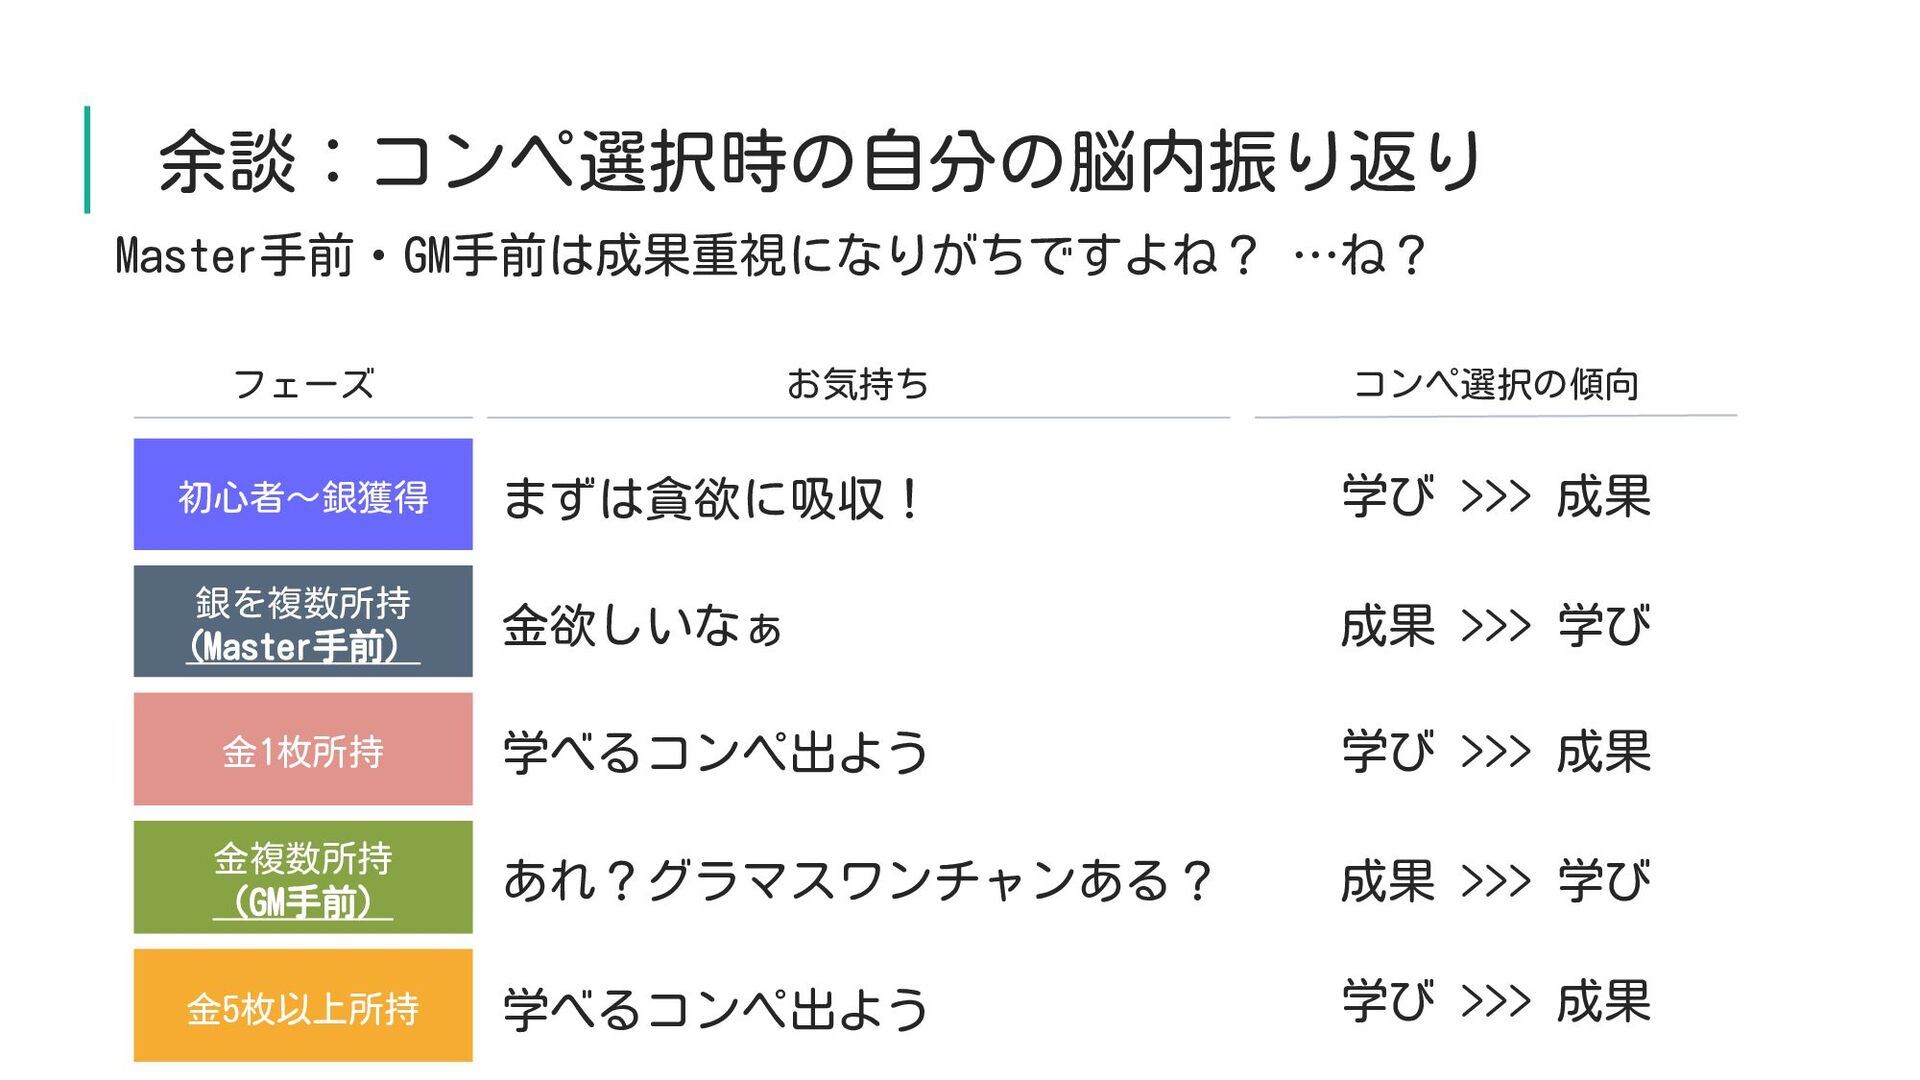
余談:コンペ選択時の自分の脳内振り返り Master手前・GM手前は成果重視になりがちですよね? …ね? 初心者~銀獲得 まずは貪欲に吸収! 金欲しいなぁ 学べるコンペ出よう 銀を複数所持 (Master手前) 金1枚所持
金複数所持 (GM手前) あれ?グラマスワンチャンある? 学べるコンペ出よう 金5枚以上所持 フェーズ お気持ち コンペ選択の傾向 学び >>> 成果 学び >>> 成果 成果 >>> 学び 学び >>> 成果 成果 >>> 学び
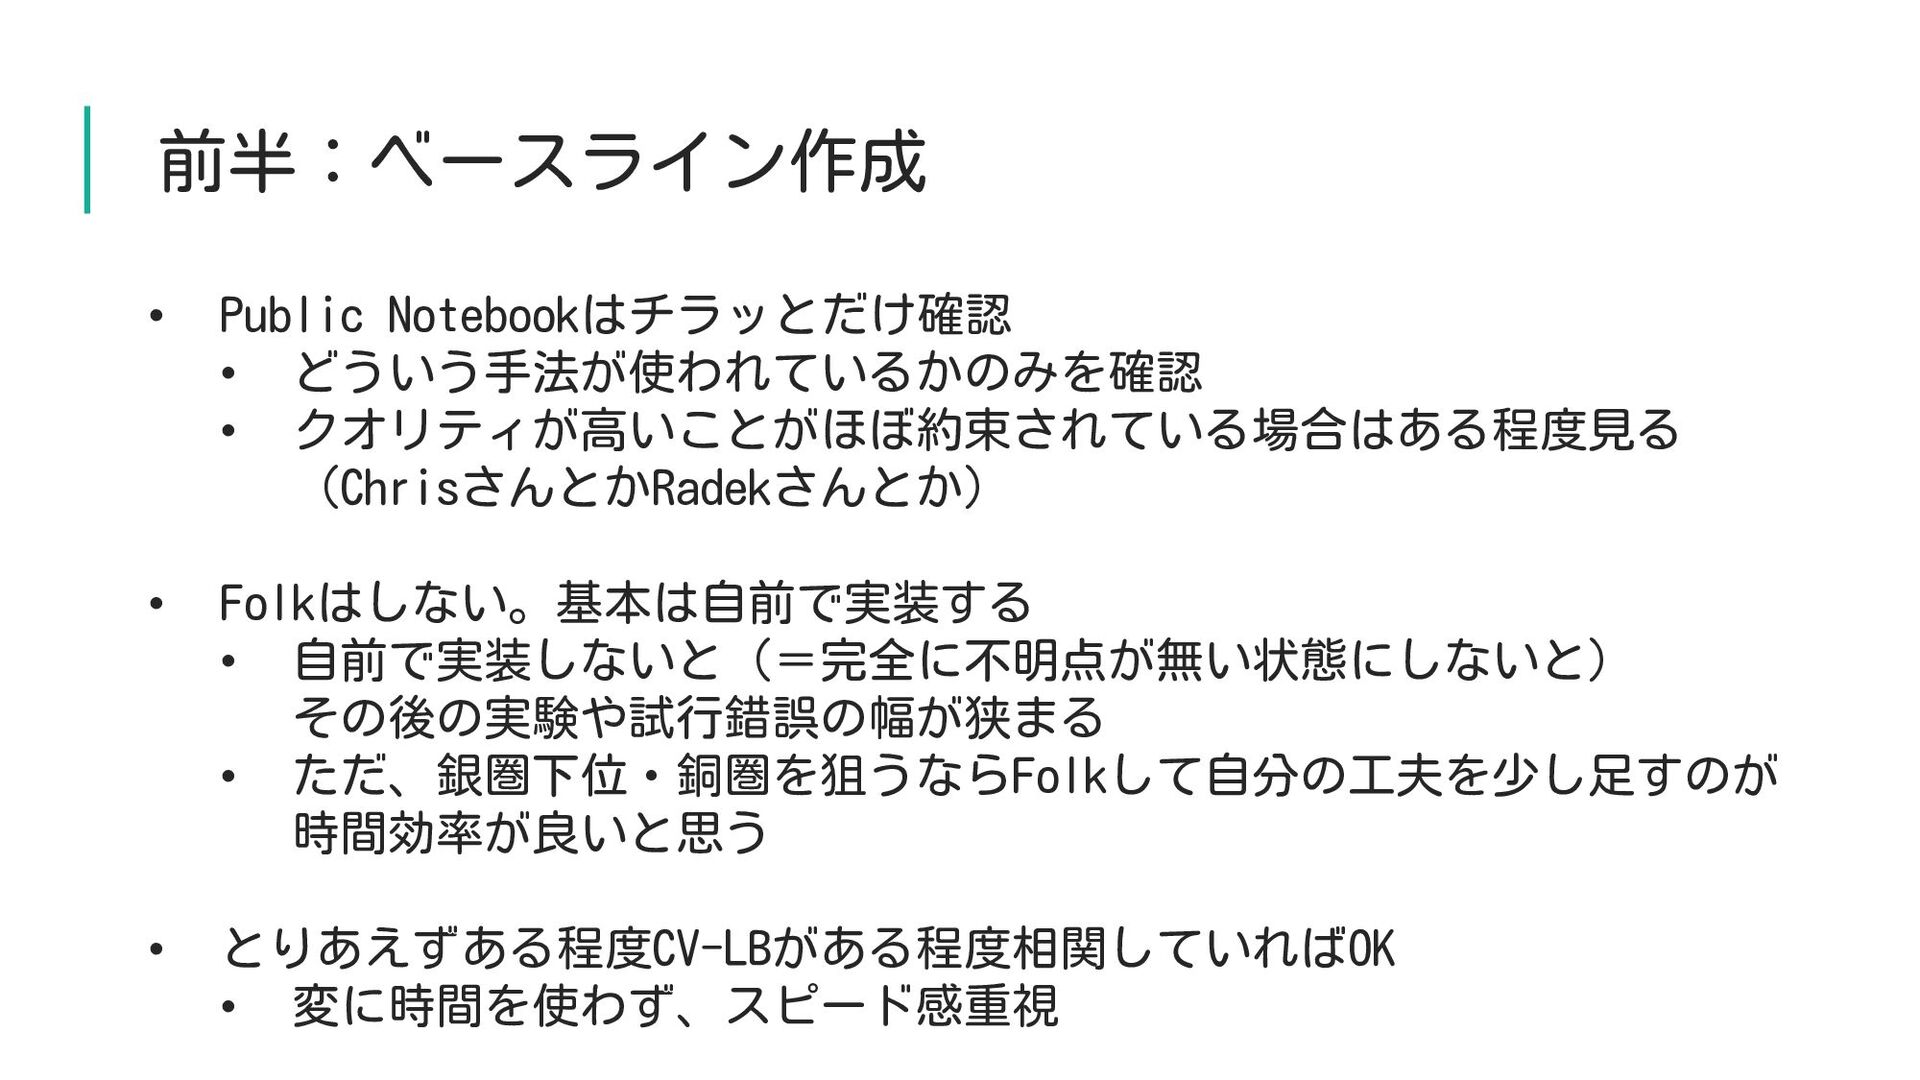
前半:ベースライン作成 • Public Notebookはチラッとだけ確認 • どういう手法が使われているかのみを確認 • クオリティが高いことがほぼ約束されている場合はある程度見る (ChrisさんとかRadekさんとか) •
Folkはしない。基本は自前で実装する • 自前で実装しないと(=完全に不明点が無い状態にしないと) その後の実験や試行錯誤の幅が狭まる • ただ、銀圏下位・銅圏を狙うならFolkして自分の工夫を少し足すのが 時間効率が良いと思う • とりあえずある程度CV-LBがある程度相関していればOK • 変に時間を使わず、スピード感重視
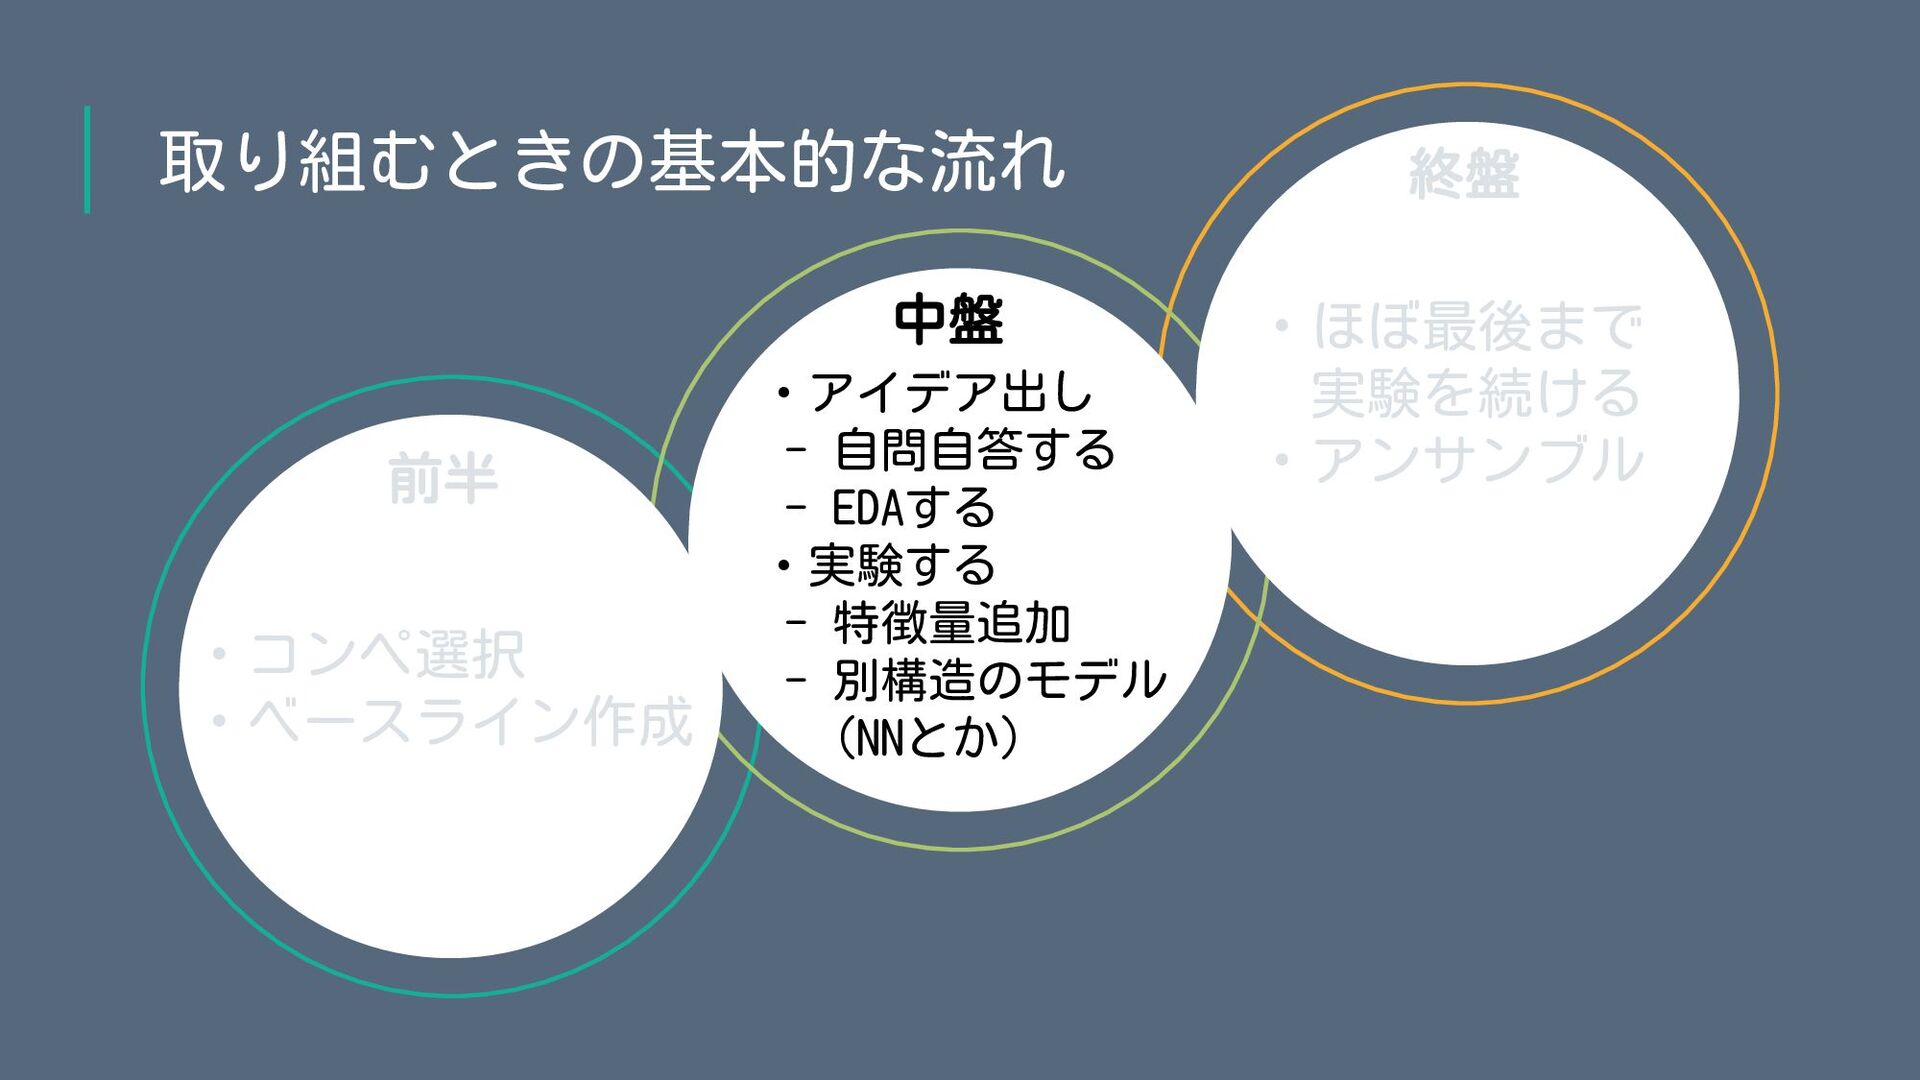
取り組むときの基本的な流れ ・コンペ選択 ・ベースライン作成 ・アイデア出し - 自問自答する - EDAする ・実験する -
特徴量追加 - 別構造のモデル (NNとか) ・ほぼ最後まで 実験を続ける ・アンサンブル 前半 中盤 終盤
中盤:アイデア出し(自問自答する) • データの背景や、ユーザーの行動や気持ちを想像して もっと良い特徴量や見落としている要素が無いかを自問自答する。 • 試行錯誤がうまくいかなった際、なんでうまくいかなかったのか?を 自分に問いかける。 散歩したりお風呂入ったりなど自分がリラックスできる時間帯に行い、 思いついたらslackの自分の個人チャンネルに投下する。
• このコンペってどんなコンペだっけ?登場人物誰だっけ? 登場人物の行動の特徴は? • 任意のUser_idの人になったと仮定して、どういう行動を取りそう? たまーにやりそうな行動は?明らか変な行動は? • 今の知識のままコンペ初期にタイムスリップしたとして、 どういうアプローチや何に気をつける? •
今までの実験で「あれ?」って思ったことは何?それはなぜ? • 今の実験、なんでうまくいかなかったと思う、ねえなんで? • いきなり強い人から「そのアプローチ全然間違ってるよ」と 言われたと仮定して、何が間違っていそう? 自分に問いかける質問例
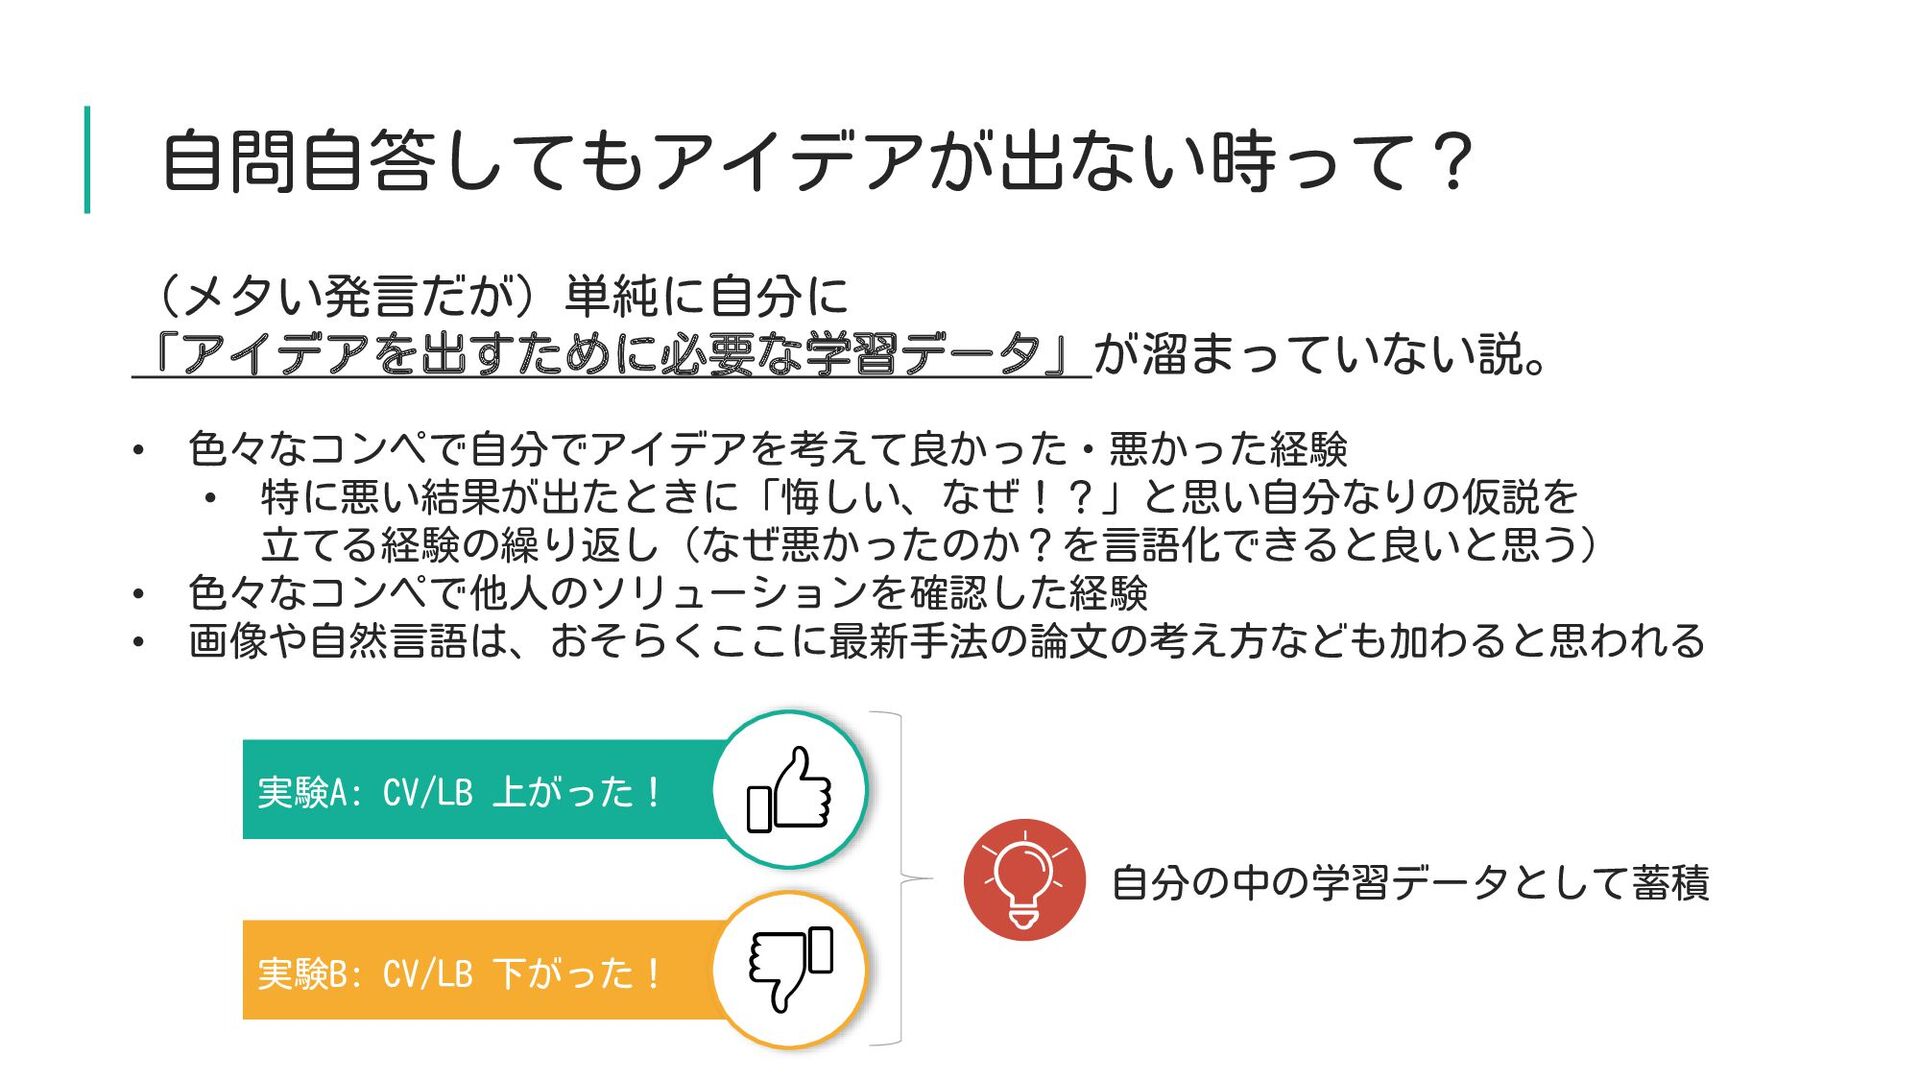
実験B: CV/LB 下がった! 自問自答してもアイデアが出ない時って? (メタい発言だが)単純に自分に 「アイデアを出すために必要な学習データ」が溜まっていない説。 • 色々なコンペで自分でアイデアを考えて良かった・悪かった経験 • 特に悪い結果が出たときに「悔しい、なぜ!?」と思い自分なりの仮説を
立てる経験の繰り返し(なぜ悪かったのか?を言語化できると良いと思う) • 色々なコンペで他人のソリューションを確認した経験 • 画像や自然言語は、おそらくここに最新手法の論文の考え方なども加わると思われる 実験A: CV/LB 上がった! 自分の中の学習データとして蓄積
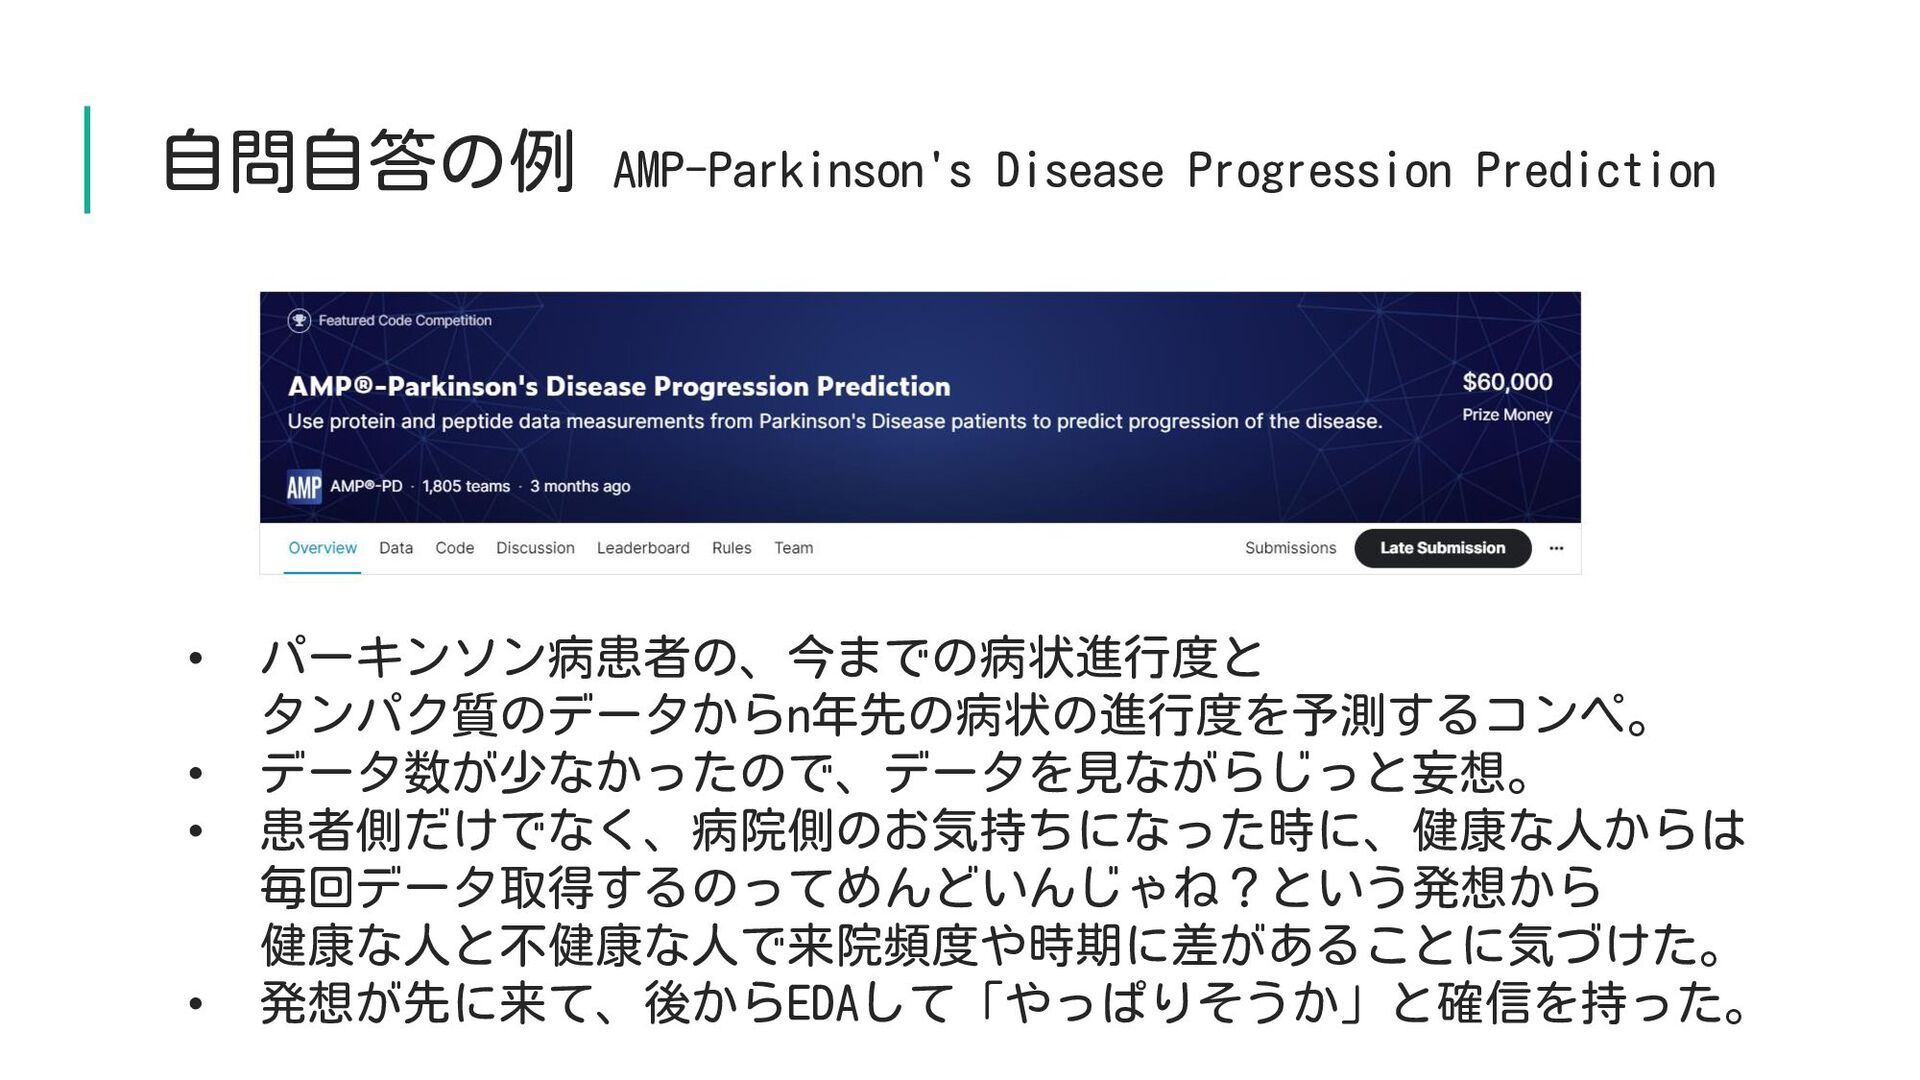
• パーキンソン病患者の、今までの病状進行度と タンパク質のデータからn年先の病状の進行度を予測するコンペ。 • データ数が少なかったので、データを見ながらじっと妄想。 • 患者側だけでなく、病院側のお気持ちになった時に、健康な人からは 毎回データ取得するのってめんどいんじゃね?という発想から 健康な人と不健康な人で来院頻度や時期に差があることに気づけた。 •
発想が先に来て、後からEDAして「やっぱりそうか」と確信を持った。 自問自答の例 AMP-Parkinson's Disease Progression Prediction
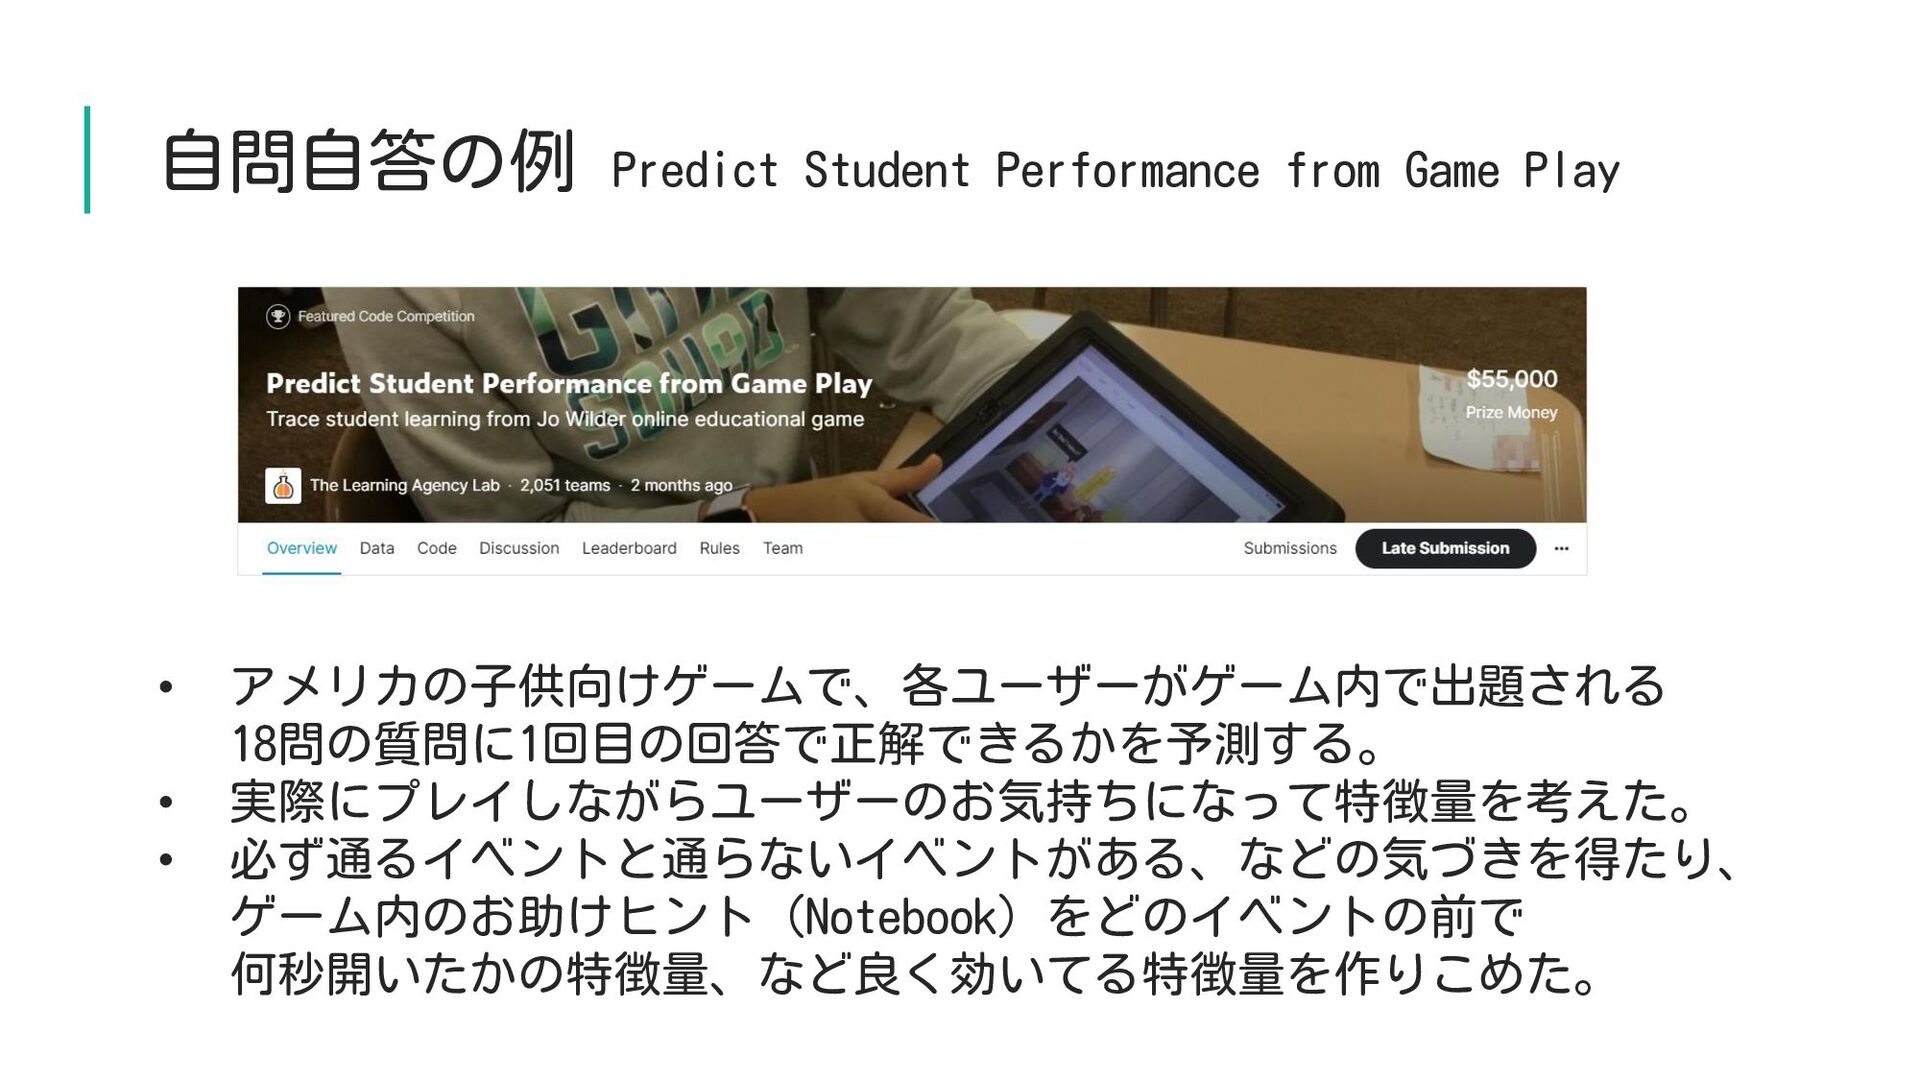
• アメリカの子供向けゲームで、各ユーザーがゲーム内で出題される 18問の質問に1回目の回答で正解できるかを予測する。 • 実際にプレイしながらユーザーのお気持ちになって特徴量を考えた。 • 必ず通るイベントと通らないイベントがある、などの気づきを得たり、 ゲーム内のお助けヒント(Notebook)をどのイベントの前で 何秒開いたかの特徴量、など良く効いてる特徴量を作りこめた。 自問自答の例
Predict Student Performance from Game Play
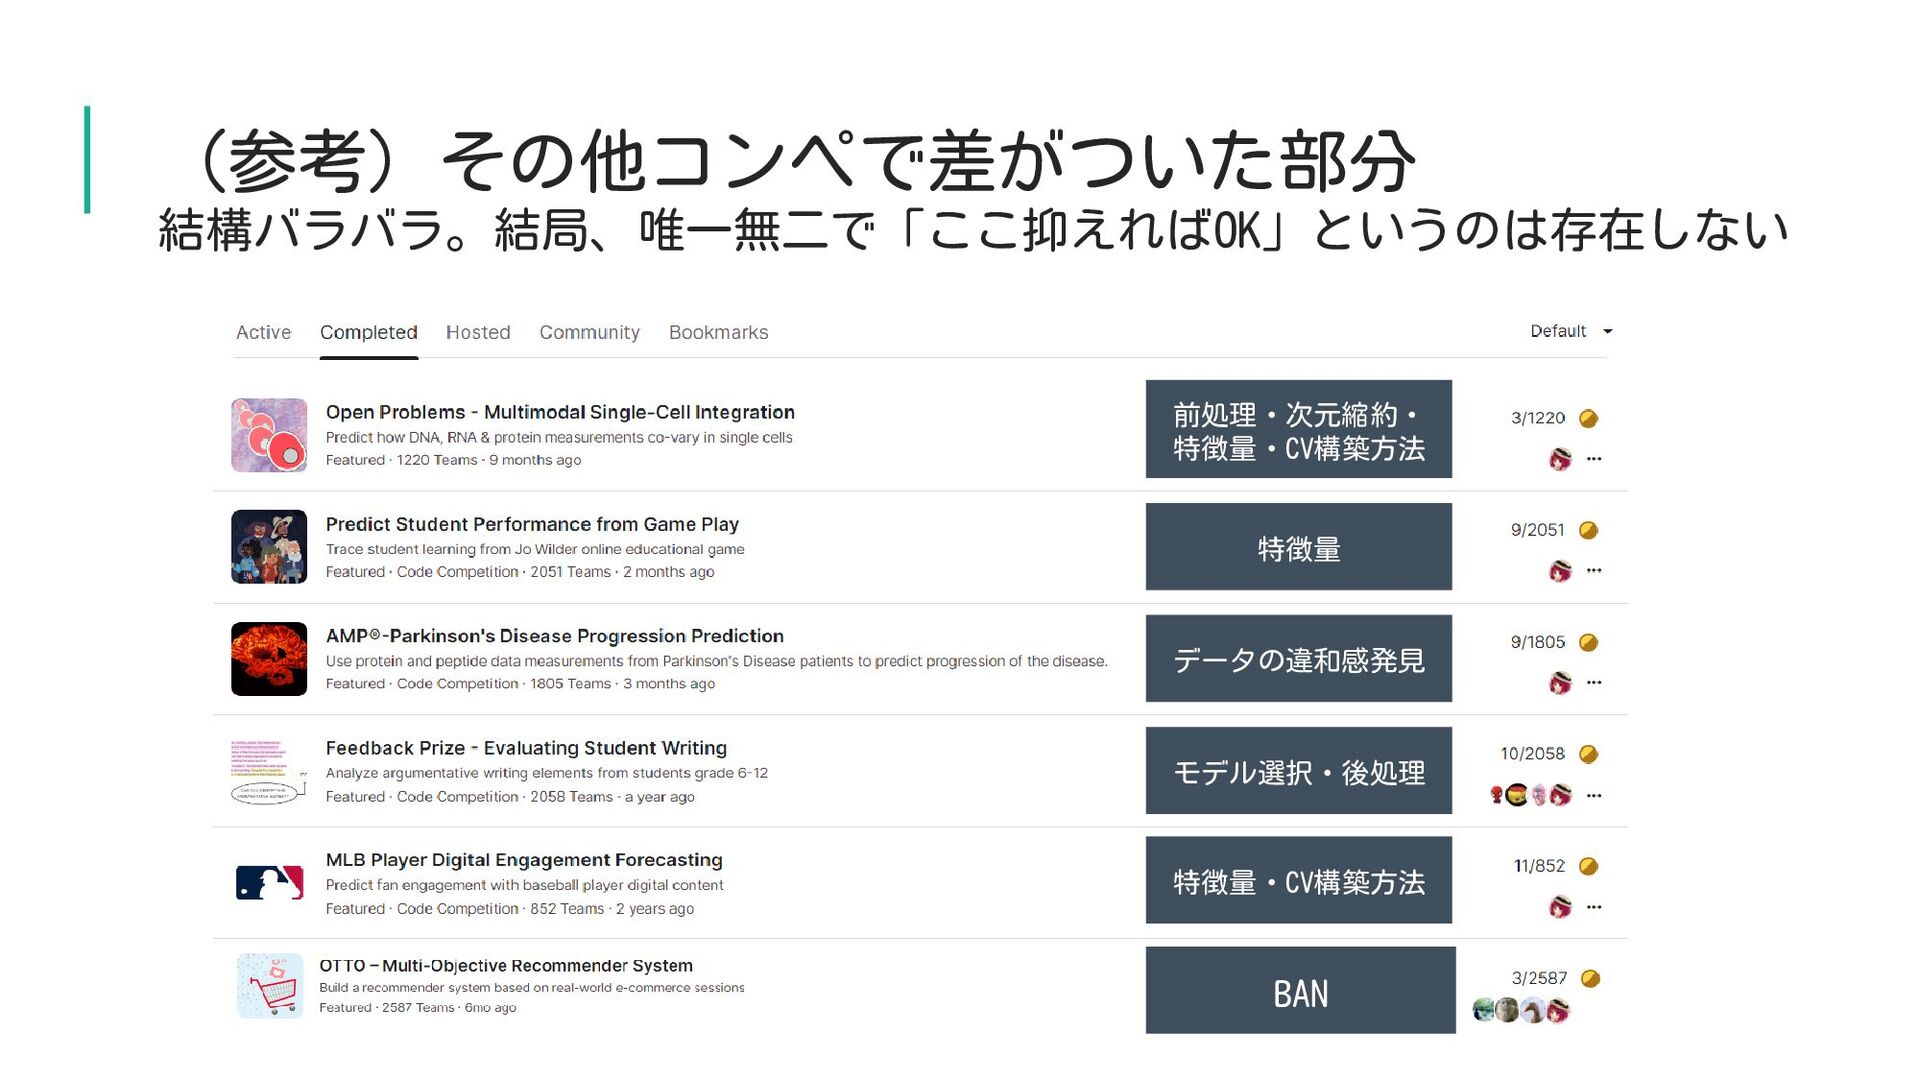
(参考)その他コンペで差がついた部分 結構バラバラ。結局、唯一無二で「ここ抑えればOK」というのは存在しない 前処理・次元縮約・ 特徴量・CV構築方法 特徴量 モデル選択・後処理 特徴量・CV構築方法 データの違和感発見 BAN
中盤:EDA • EDAは中盤以降に実施。(publicのEDAだけは初期にサラッと見る) 試行錯誤がうまくいかない理由を確認したり、考えたアイデアや 仮説がうまくいきそうかを確認するときに初めてEDAして確認する。 「探索的」データ分析は探索する明確な目的が無いと時間の無駄。 • 上記のように主に目的を持って探索することが多いが、あまりに 行き詰ったら、目的無くデータ見たりグラフ作ったりして じーっと違和感を探すことも。
画像コンペで、画像を見て人の目で違和感を見つけるのに似ているかも。
中盤:実験 1実験 1Notebook派閥 • ファイル名を「exp_xxx_(実験内容)_(cv)」ってする。 基本一人で見返す(自分がわかれば良い)ので管理は適当。 • パラメータセンシティブではないテーブルデータコンペは正直これで十分。
取り組むときの基本的な流れ ・コンペ選択 ・ベースライン作成 ・アイデア考える - 自問自答する - EDAする ・実験する -
特徴量追加 - 別構造のモデル (NNとか) ・ほぼ最後まで 実験を続ける ・アンサンブル 前半 中盤 終盤
終盤:アンサンブル • アンサンブルにはそこまで時間かけない派 • CV見ながらアンサンブルして、後は最後まで 実験に時間を費やすことが多い (アイデア出ない時にアンサンブルに時間かけるイメージ)
その他(1) • (少なくとも勾配ブースティング系がメインのコンペについては) パラメータチューニングにほぼ時間をかけない (同じ時間で別のアイデアを試す方が投資対効果が大きい印象) • テーブルデータであっても、勾配ブースティングだけでは金圏に 辿り着ける可能性は低くなっている(特に時系列が絡むケース)。 NN系(MLP・LSTM・Transformer)はある程度自由に組めると良さげ。
その他(2) • シンプルな法則として、試行錯誤の量・質と最終成績は (変なコンペじゃない限り)ある程度は関連してるはず。 • 試行錯誤の量も質も、投資する時間と関連してるはず。 • 「色々なコンペに出て、色々な解法を考えて試して、 ある程度の時間をちゃんと投資する」ことを繰り返せば 結果はついてくるのでは。
取り組むときの基本的な流れ ・コンペ選択 ・ベースライン作成 ・アイデア考える - 自問自答する - EDAする ・実験する -
特徴量追加 - 別構造のモデル (NNとか) ・ほぼ最後まで 実験を続ける ・アンサンブル 前半 中盤 終盤
今後の目標 ・テーブル以外でソロ金取って、 ソロ金5枚のGMになることをゆるく目指してみる。 (参加コンペは「学び重視」に重きを置く)
ご清聴ありがとうございました!

 SiteGround - Reliable hosting with speed, security, and support you can count on.


 k1nakayama
 aoi1
 coe401_
 vananth22
 masuda220
 pauli
 koichiaoki
 sassssan68
 i35_267
 ytaka23
 indirect
 22mi
 eileencodes
 popppiees
 chriscoyier
 szymonslowik
 inesmontani
 jonrohan
 reverentgeek
 paigeccino
 stephenakadiri
 mfonobong
 bcantrill