Upgrade to Pro — share decks privately, control downloads, hide ads and more …

推論基盤と Scale-Up Interconnect の現状と制約から俯瞰する技術動向

推論基盤と Scale-Up Interconnect の現状と制約から俯瞰する技術動向

Gisium Open Sessions #1

Avatar for Masayuki Kobayashi

Masayuki Kobayashi

October 29, 2026

More Decks by Masayuki Kobayashi

Other Decks in Technology

Transcript

  1. Dynamic-Solution-Group 推論基盤と Scale-Up Interconnect の 現状と制約から俯瞰する技術動向 Gisium Open Sessions #1

    AIインフラの現在地 ― 最新技術トレンドを俯瞰する 2026 年 10 月 29 日 小林 正幸 / Gisium株式会社 © 2026 Gisium Inc. All rights reserved
  2. はじめに 免責事項 1 本セッションの内容は話者個人の見解であり、所属する組織や Gisium の公式見解ではありません。 2 引用した事実・数値はすべて公開情報(Hot Chips 38、Hot

    Interconnects 33、MUG'26、OCP China Day 2026、TEF 2025、Marvell Investor Day 2026、各社の公式ブログ・論文)に基づきます。出典は末尾の付録にまとめています。口頭発言の引用は趣旨の要約を含みま す。Hot Chips 38 など、本セッション時点でスライド・録画が一般公開前の講演(公開は 2026 年 12 月頃の見込み)は、話者の聴講メモ に基づきます。会場写真は話者が OCP Global Summit 2026(San Jose)と COMPUTEX 2026(台北)で撮影したものです。 3 性能・価格などの数値の多くは各社の自社測定や予測であり、第三者による再現検証を経ていません。「話者試算」と記した箇所は公開仕 様に基づく概算です。 4 特定の製品・企業・投資を推奨するものではありません。記載の製品名・サービス名は各社の商標または登録商標です。 5 本資料の作成には生成 AI を活用しています。内容は話者が確認し、記述の責任は話者にあります。 © 2026 Gisium Inc. All rights reserved 2
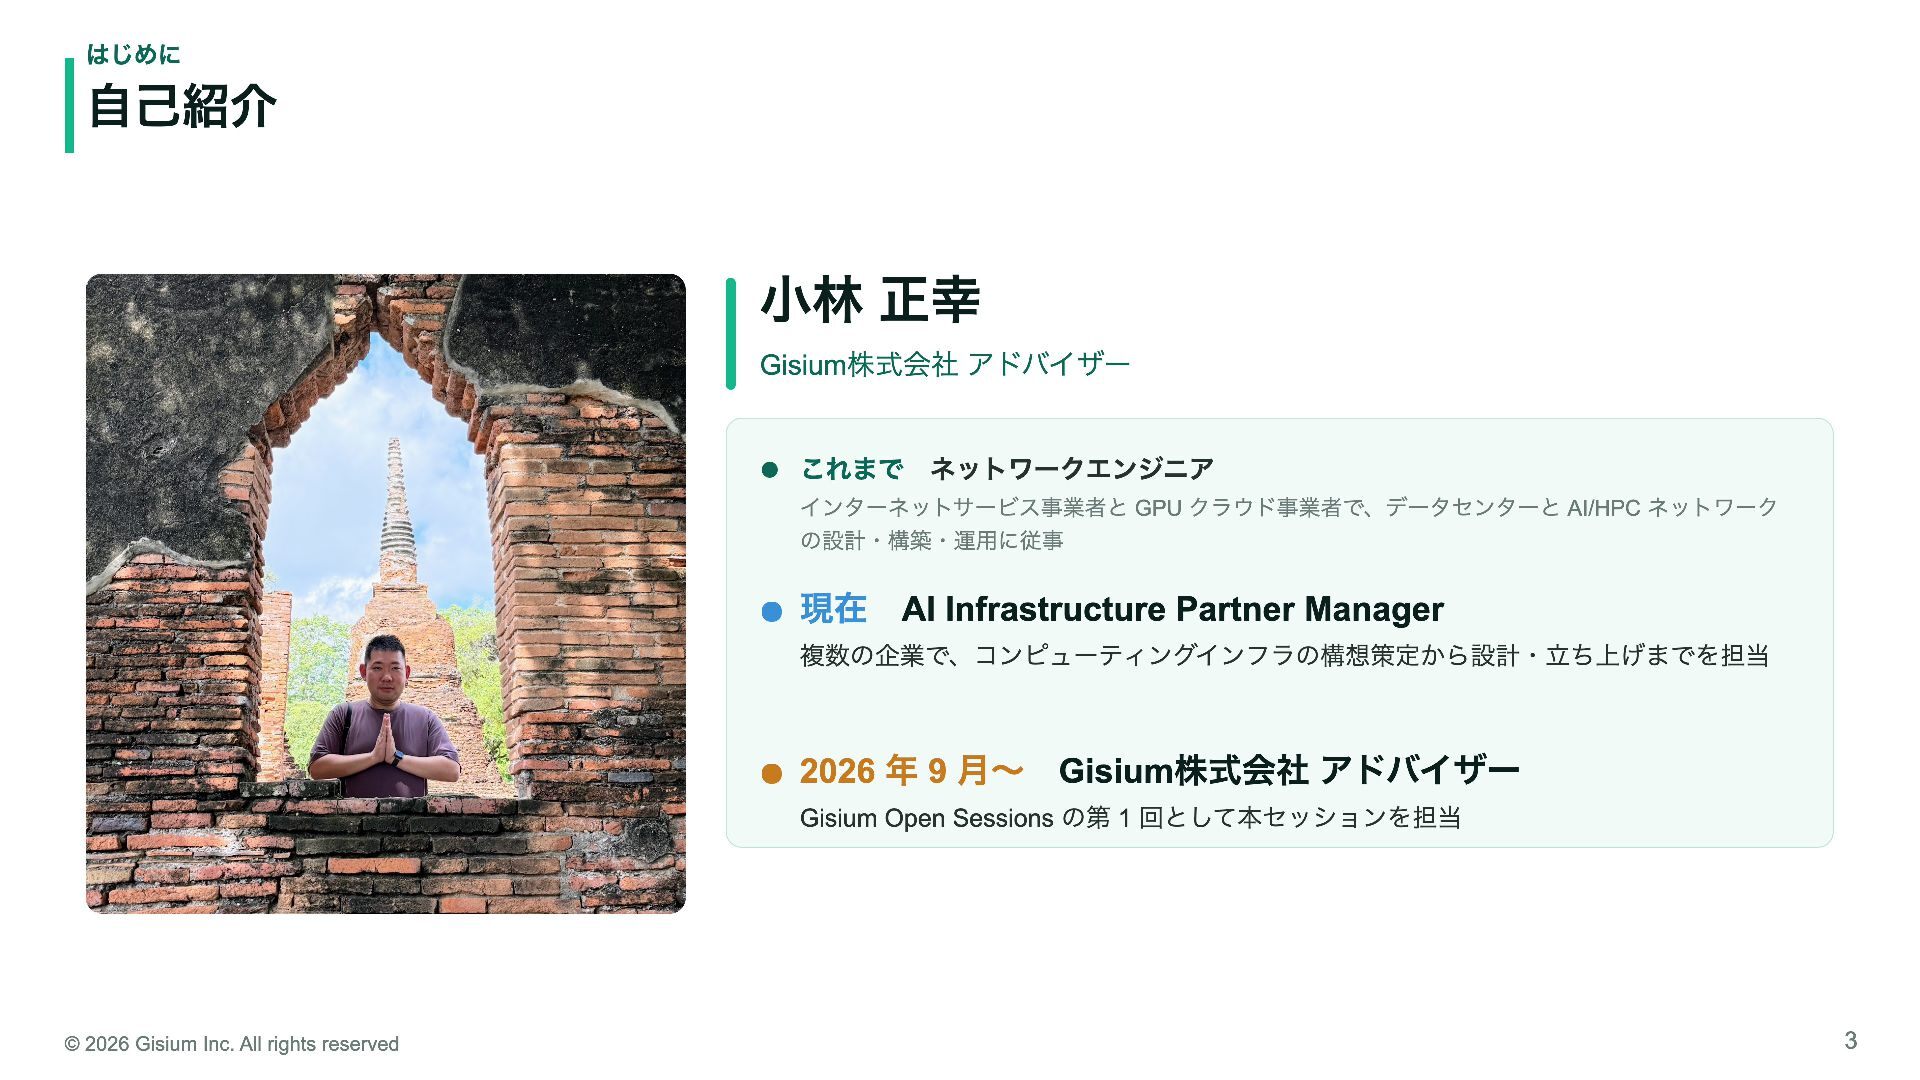
  3. はじめに 自己紹介 小林 正幸 Gisium株式会社 アドバイザー これまで ネットワークエンジニア インターネットサービス事業者と GPU

    クラウド事業者で、データセンターと AI/HPC ネットワーク の設計・構築・運用に従事 現在 AI Infrastructure Partner Manager 複数の企業で、コンピューティングインフラの構想策定から設計・立ち上げまでを担当 2026 年 9 月〜 Gisium株式会社 アドバイザー Gisium Open Sessions の第 1 回として本セッションを担当 © 2026 Gisium Inc. All rights reserved 3
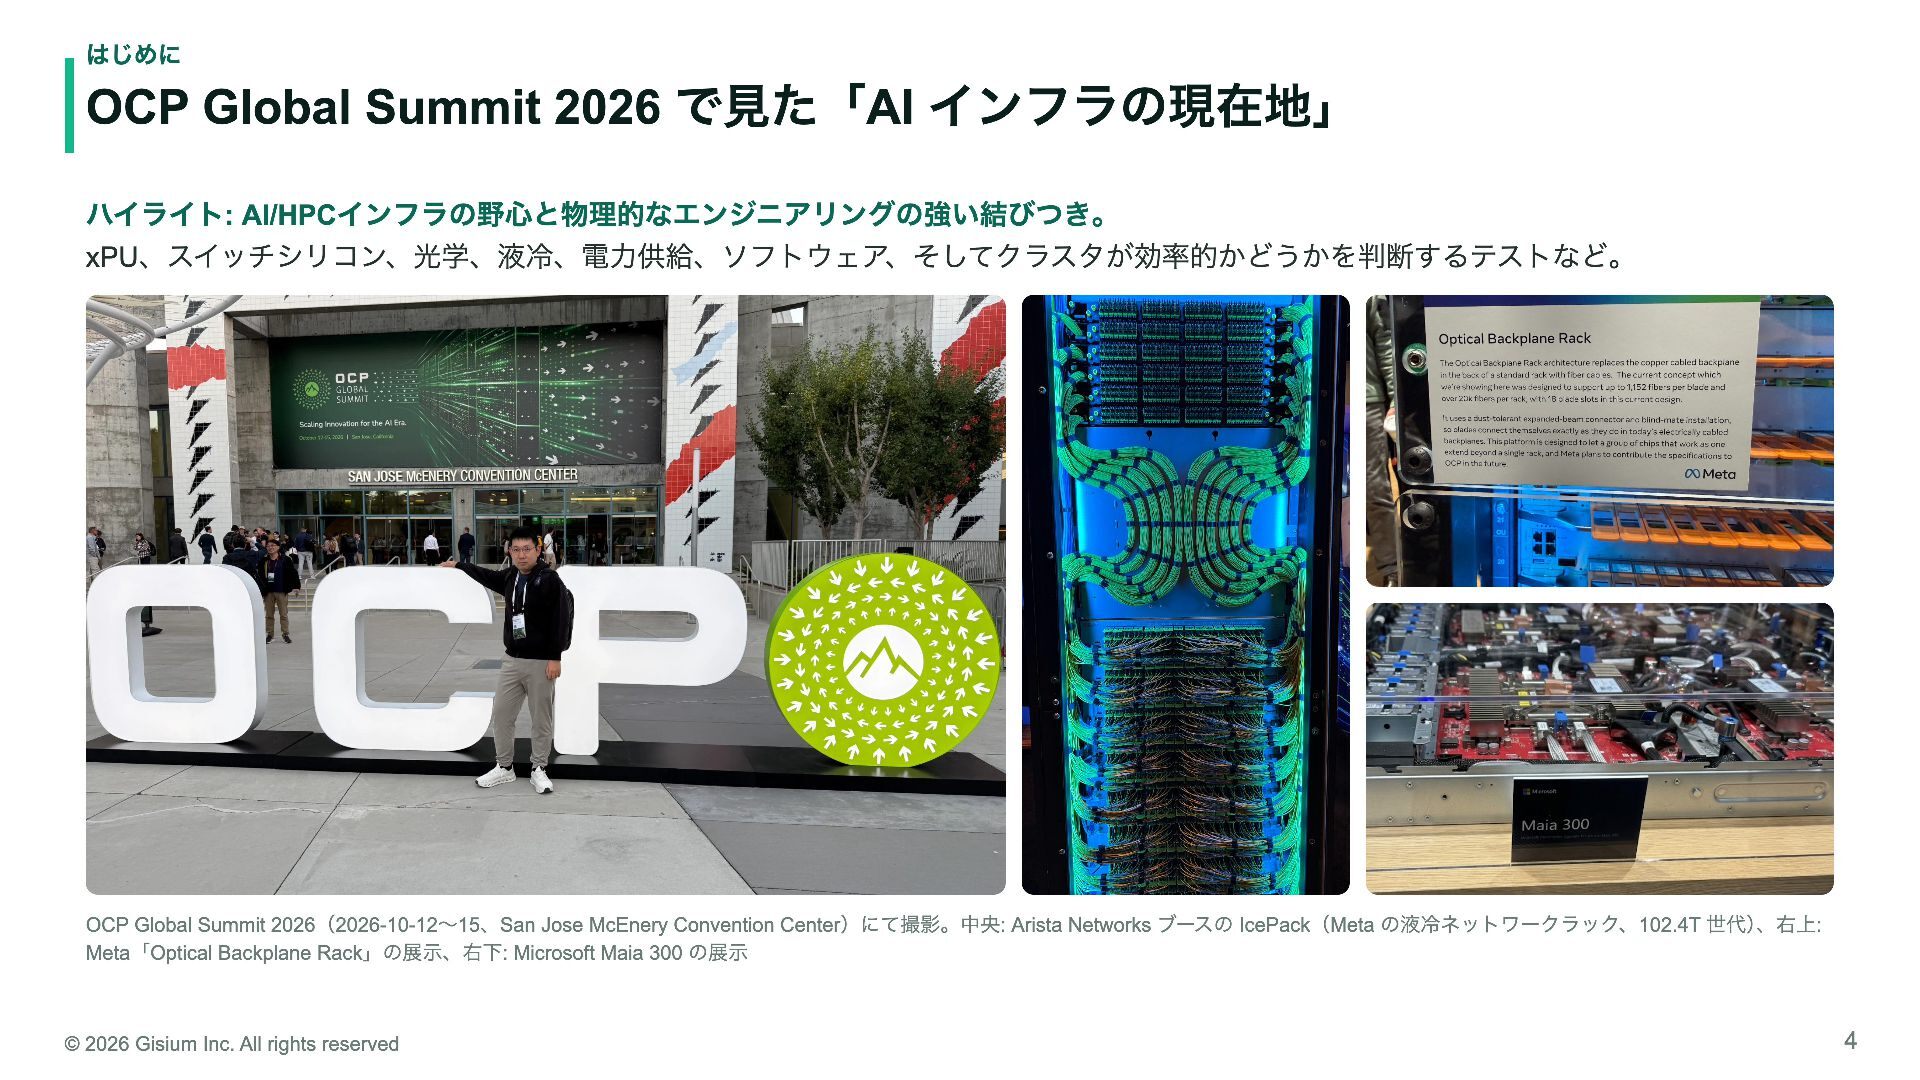
  4. はじめに OCP Global Summit 2026 で見た「AI インフラの現在地」 ハイライト: AI/HPCインフラの野心と物理的なエンジニアリングの強い結びつき。 xPU、スイッチシリコン、光学、液冷、電力供給、ソフトウェア、そしてクラスタが効率的かどうかを判断するテストなど。

    OCP Global Summit 2026(2026-10-12〜15、San Jose McEnery Convention Center)にて撮影。中央: Arista Networks ブースの IcePack(Meta の液冷ネットワークラック、102.4T 世代)、右上: Meta「Optical Backplane Rack」の展示、右下: Microsoft Maia 300 の展示 © 2026 Gisium Inc. All rights reserved 4
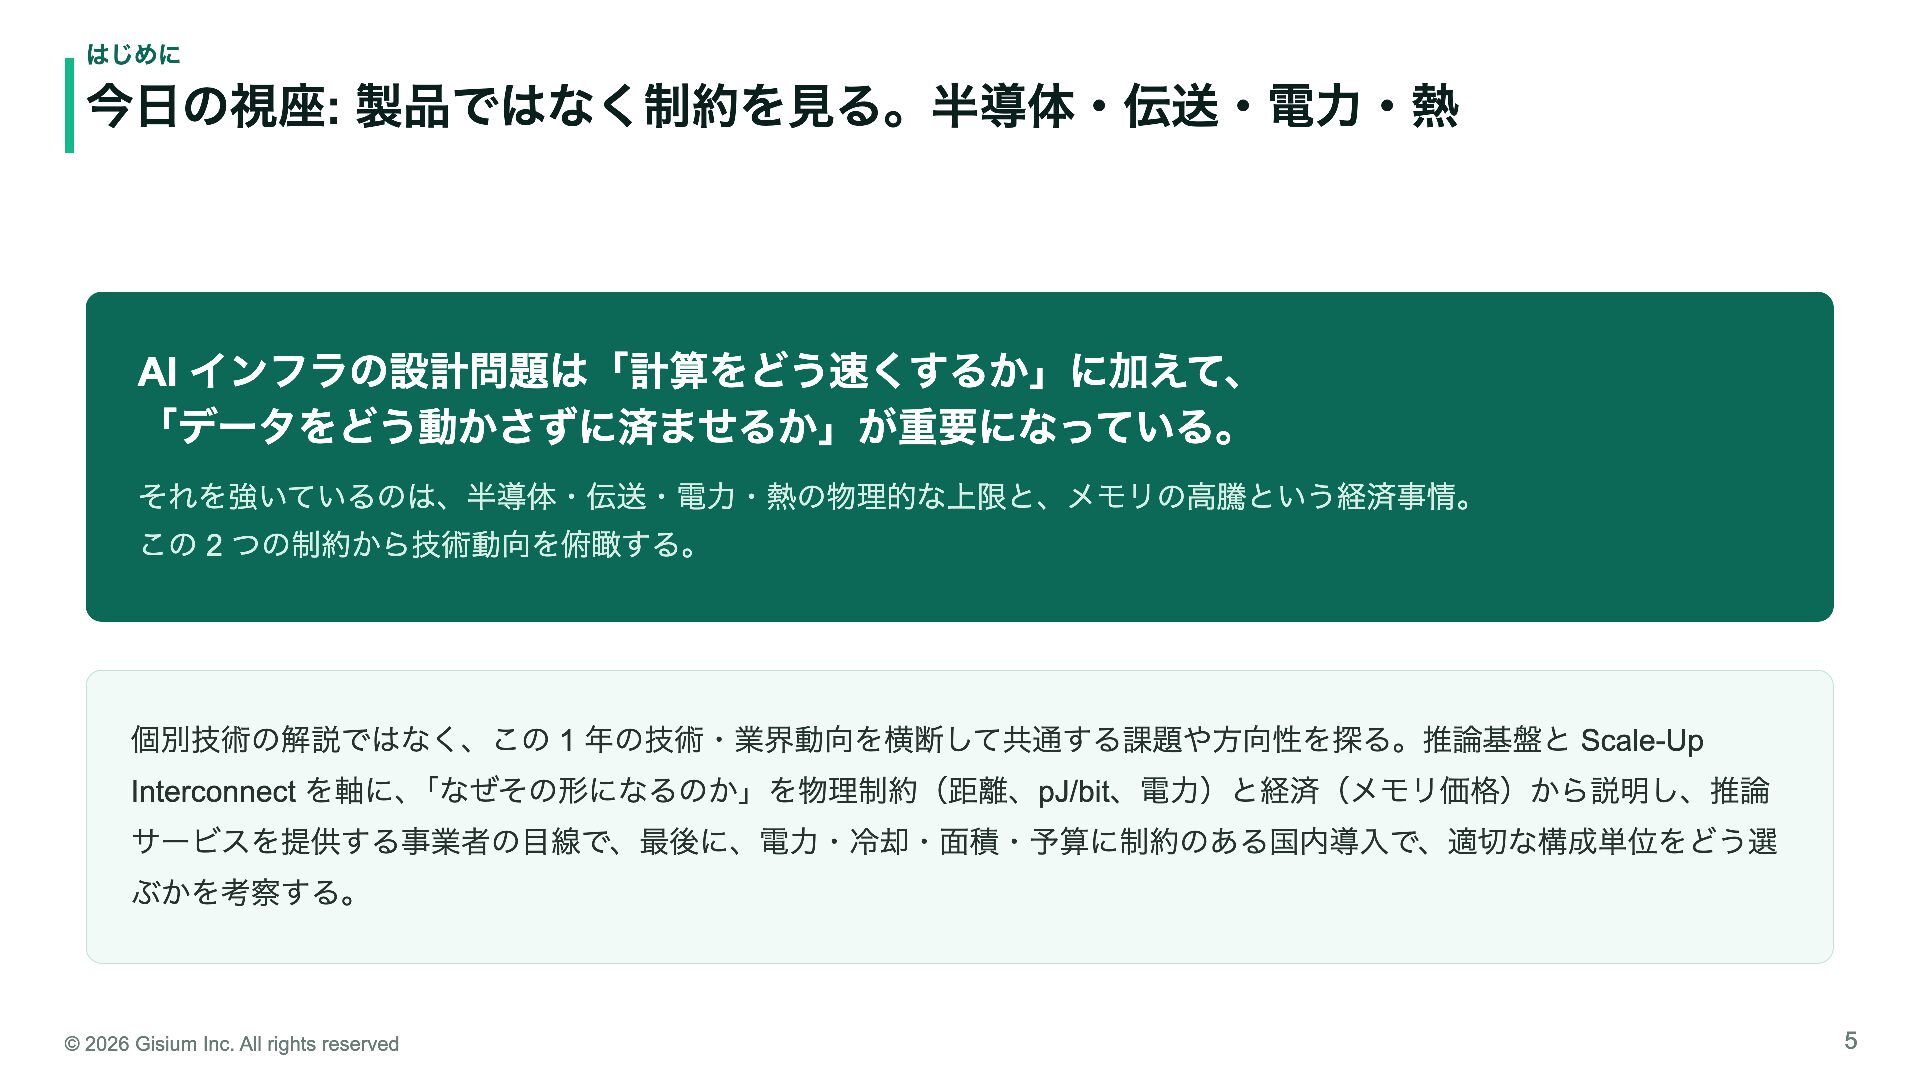
  5. はじめに 今日の視座: 製品ではなく制約を見る。半導体・伝送・電力・熱 AI インフラの設計問題は「計算をどう速くするか」に加えて、 「データをどう動かさずに済ませるか」が重要になっている。 それを強いているのは、半導体・伝送・電力・熱の物理的な上限と、メモリの高騰という経済事情。 この 2 つの制約から技術動向を俯瞰する。

    個別技術の解説ではなく、この 1 年の技術・業界動向を横断して共通する課題や方向性を探る。推論基盤と Scale-Up Interconnect を軸に、「なぜその形になるのか」を物理制約(距離、pJ/bit、電力)と経済(メモリ価格)から説明し、推論 サービスを提供する事業者の目線で、最後に、電力・冷却・面積・予算に制約のある国内導入で、適切な構成単位をどう選 ぶかを考察する。 © 2026 Gisium Inc. All rights reserved 5
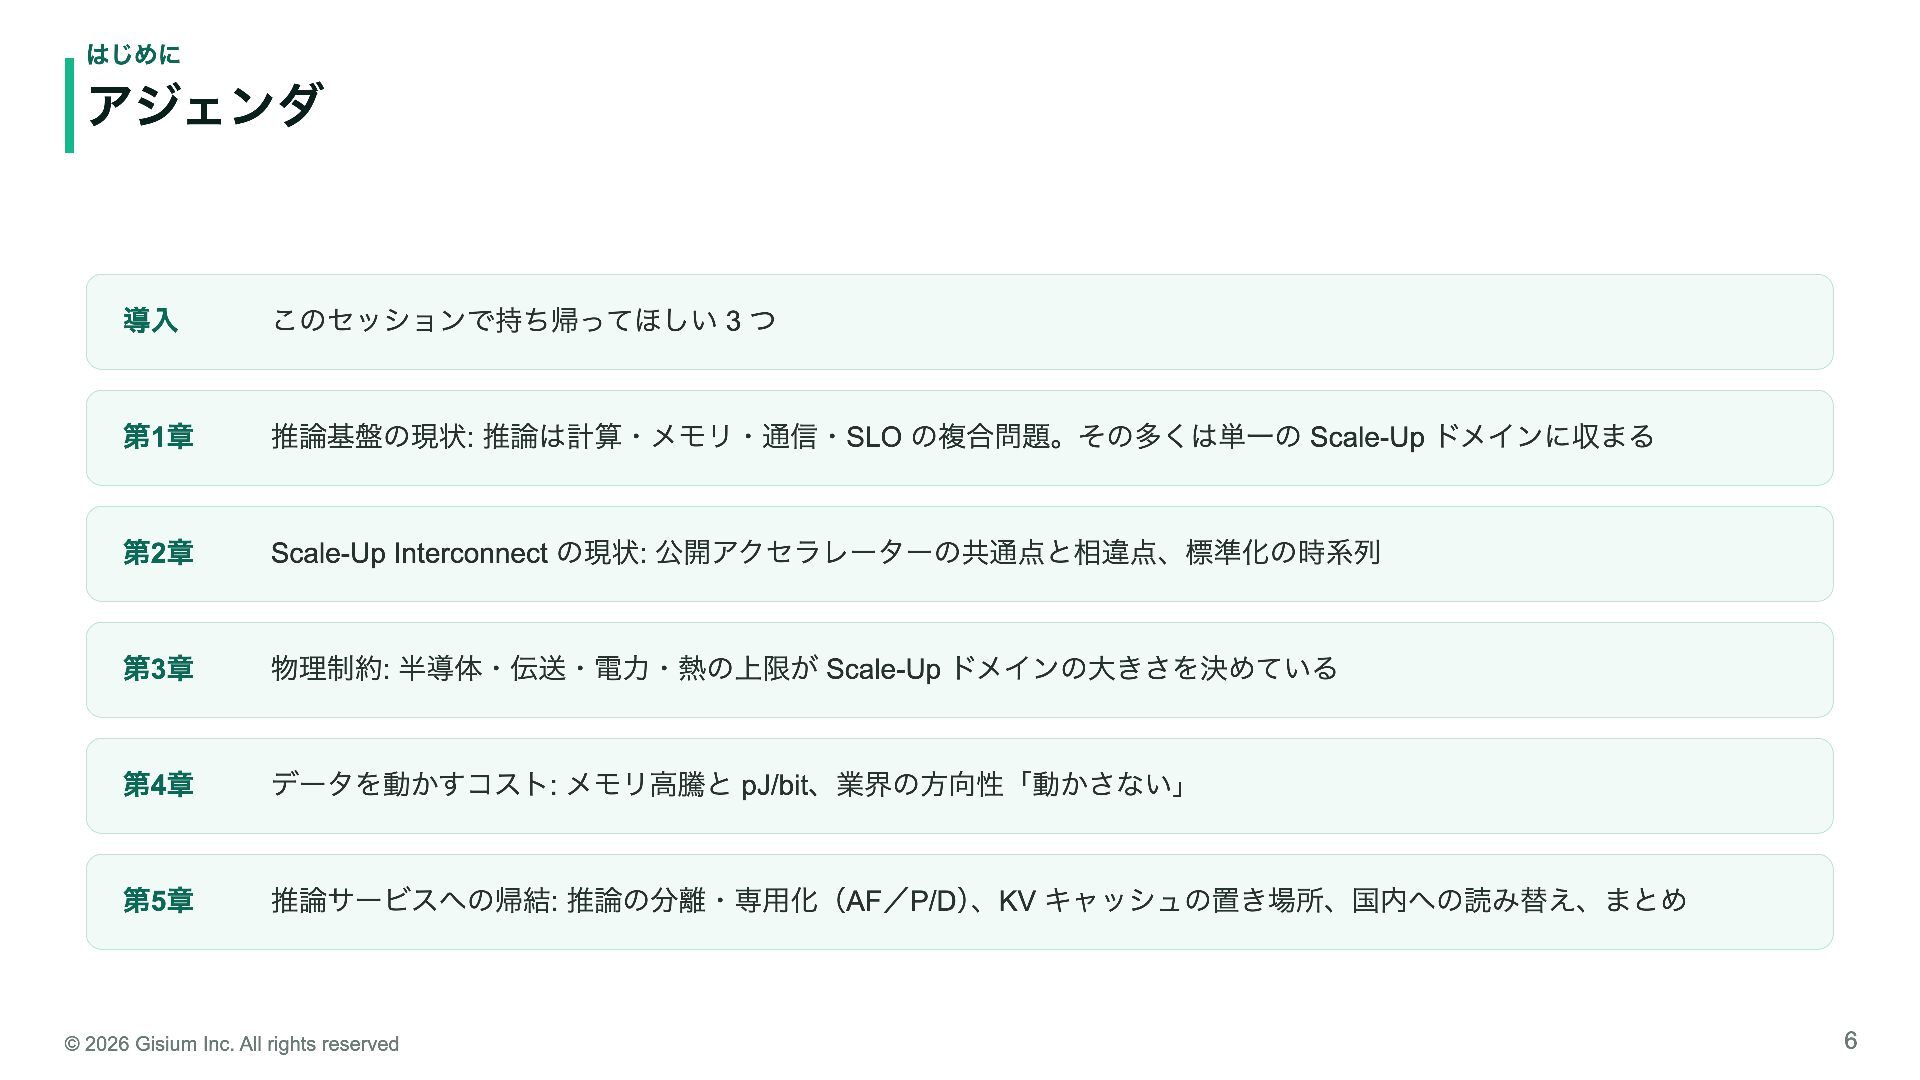
  6. はじめに アジェンダ 導入 このセッションで持ち帰ってほしい 3 つ 第1章 推論基盤の現状: 推論は計算・メモリ・通信・SLO の複合問題。その多くは単一の

    Scale-Up ドメインに収まる 第2章 Scale-Up Interconnect の現状: 公開アクセラレーターの共通点と相違点、標準化の時系列 第3章 物理制約: 半導体・伝送・電力・熱の上限が Scale-Up ドメインの大きさを決めている 第4章 データを動かすコスト: メモリ高騰と pJ/bit、業界の方向性「動かさない」 第5章 推論サービスへの帰結: 推論の分離・専用化(AF/P/D)、KV キャッシュの置き場所、国内への読み替え、まとめ © 2026 Gisium Inc. All rights reserved 6
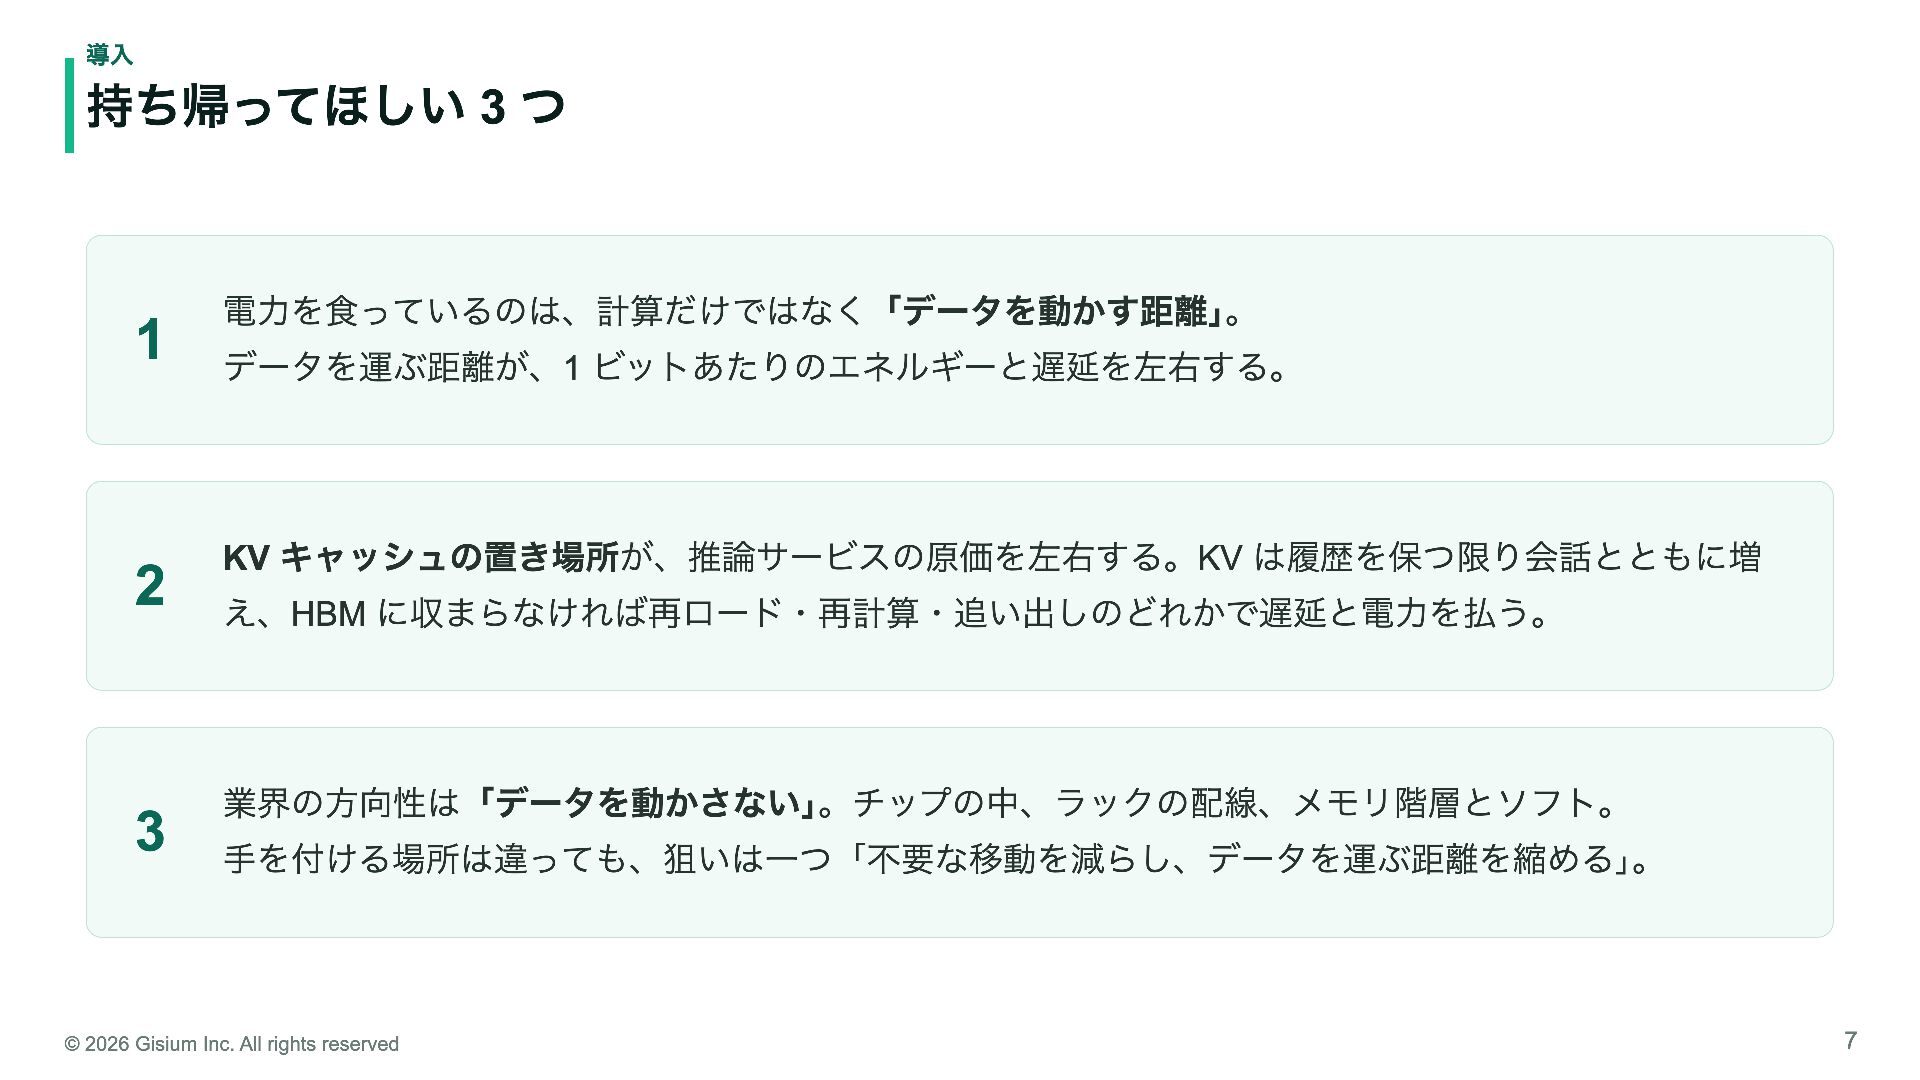
  7. 導入 持ち帰ってほしい 3 つ 1 2 3 電力を食っているのは、計算だけではなく「データを動かす距離」。 データを運ぶ距離が、1 ビットあたりのエネルギーと遅延を左右する。

    KV キャッシュの置き場所が、推論サービスの原価を左右する。KV は履歴を保つ限り会話とともに増 え、HBM に収まらなければ再ロード・再計算・追い出しのどれかで遅延と電力を払う。 業界の方向性は「データを動かさない」。チップの中、ラックの配線、メモリ階層とソフト。 手を付ける場所は違っても、狙いは一つ「不要な移動を減らし、データを運ぶ距離を縮める」。 © 2026 Gisium Inc. All rights reserved 7
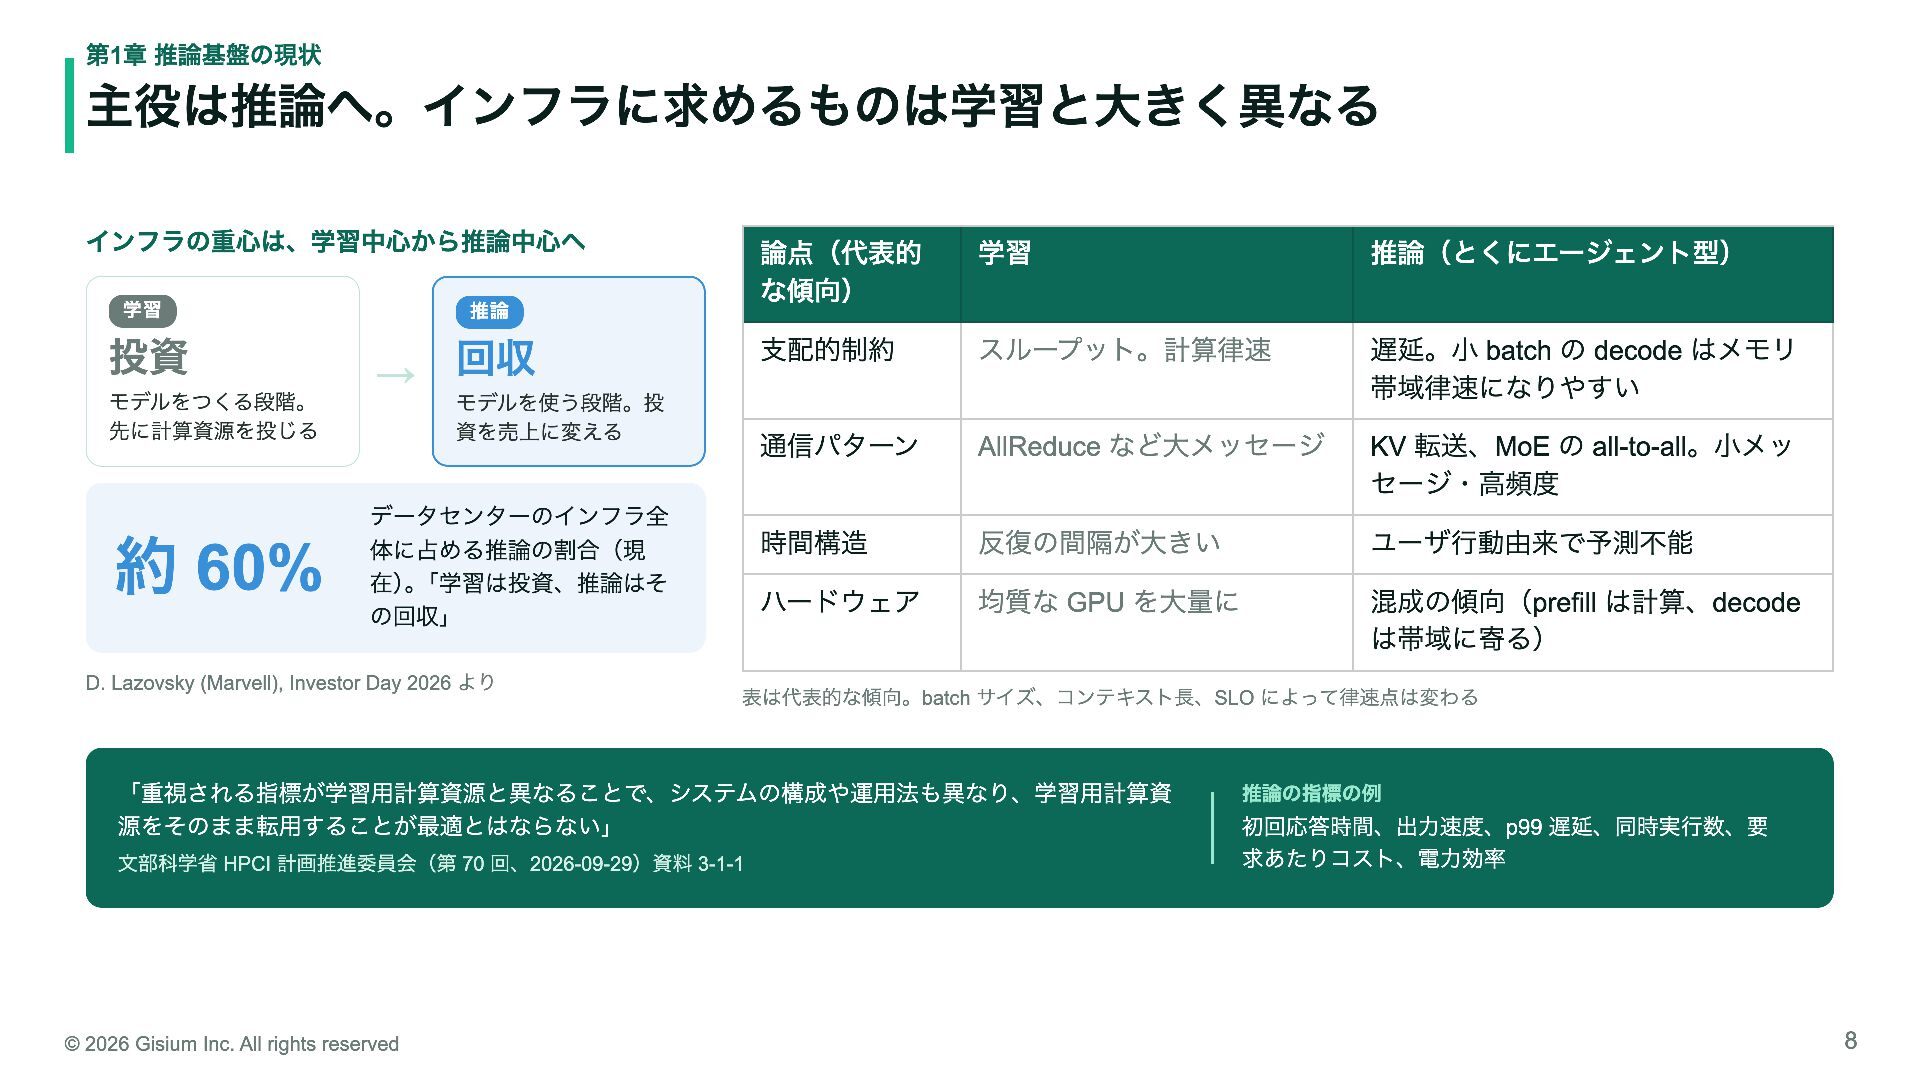
  8. 第1章 推論基盤の現状 主役は推論へ。インフラに求めるものは学習と大きく異なる インフラの重心は、学習中心から推論中心へ 学習 投資 推論 → 回収 モデルをつくる段階。

    先に計算資源を投じる モデルを使う段階。投 資を売上に変える 約 60% データセンターのインフラ全 体に占める推論の割合(現 在)。「学習は投資、推論はそ の回収」 D. Lazovsky (Marvell), Investor Day 2026 より 論点(代表的 な傾向) 学習 推論(とくにエージェント型) 支配的制約 スループット。計算律速 遅延。小 batch の decode はメモリ 帯域律速になりやすい 通信パターン AllReduce など大メッセージ KV 転送、MoE の all-to-all。小メッ セージ・高頻度 時間構造 反復の間隔が大きい ユーザ行動由来で予測不能 ハードウェア 均質な GPU を大量に 混成の傾向(prefill は計算、decode は帯域に寄る) 表は代表的な傾向。batch サイズ、コンテキスト長、SLO によって律速点は変わる 「重視される指標が学習用計算資源と異なることで、システムの構成や運用法も異なり、学習用計算資 源をそのまま転用することが最適とはならない」 文部科学省 HPCI 計画推進委員会(第 70 回、2026-09-29)資料 3-1-1 © 2026 Gisium Inc. All rights reserved 推論の指標の例 初回応答時間、出力速度、p99 遅延、同時実行数、要 求あたりコスト、電力効率 8
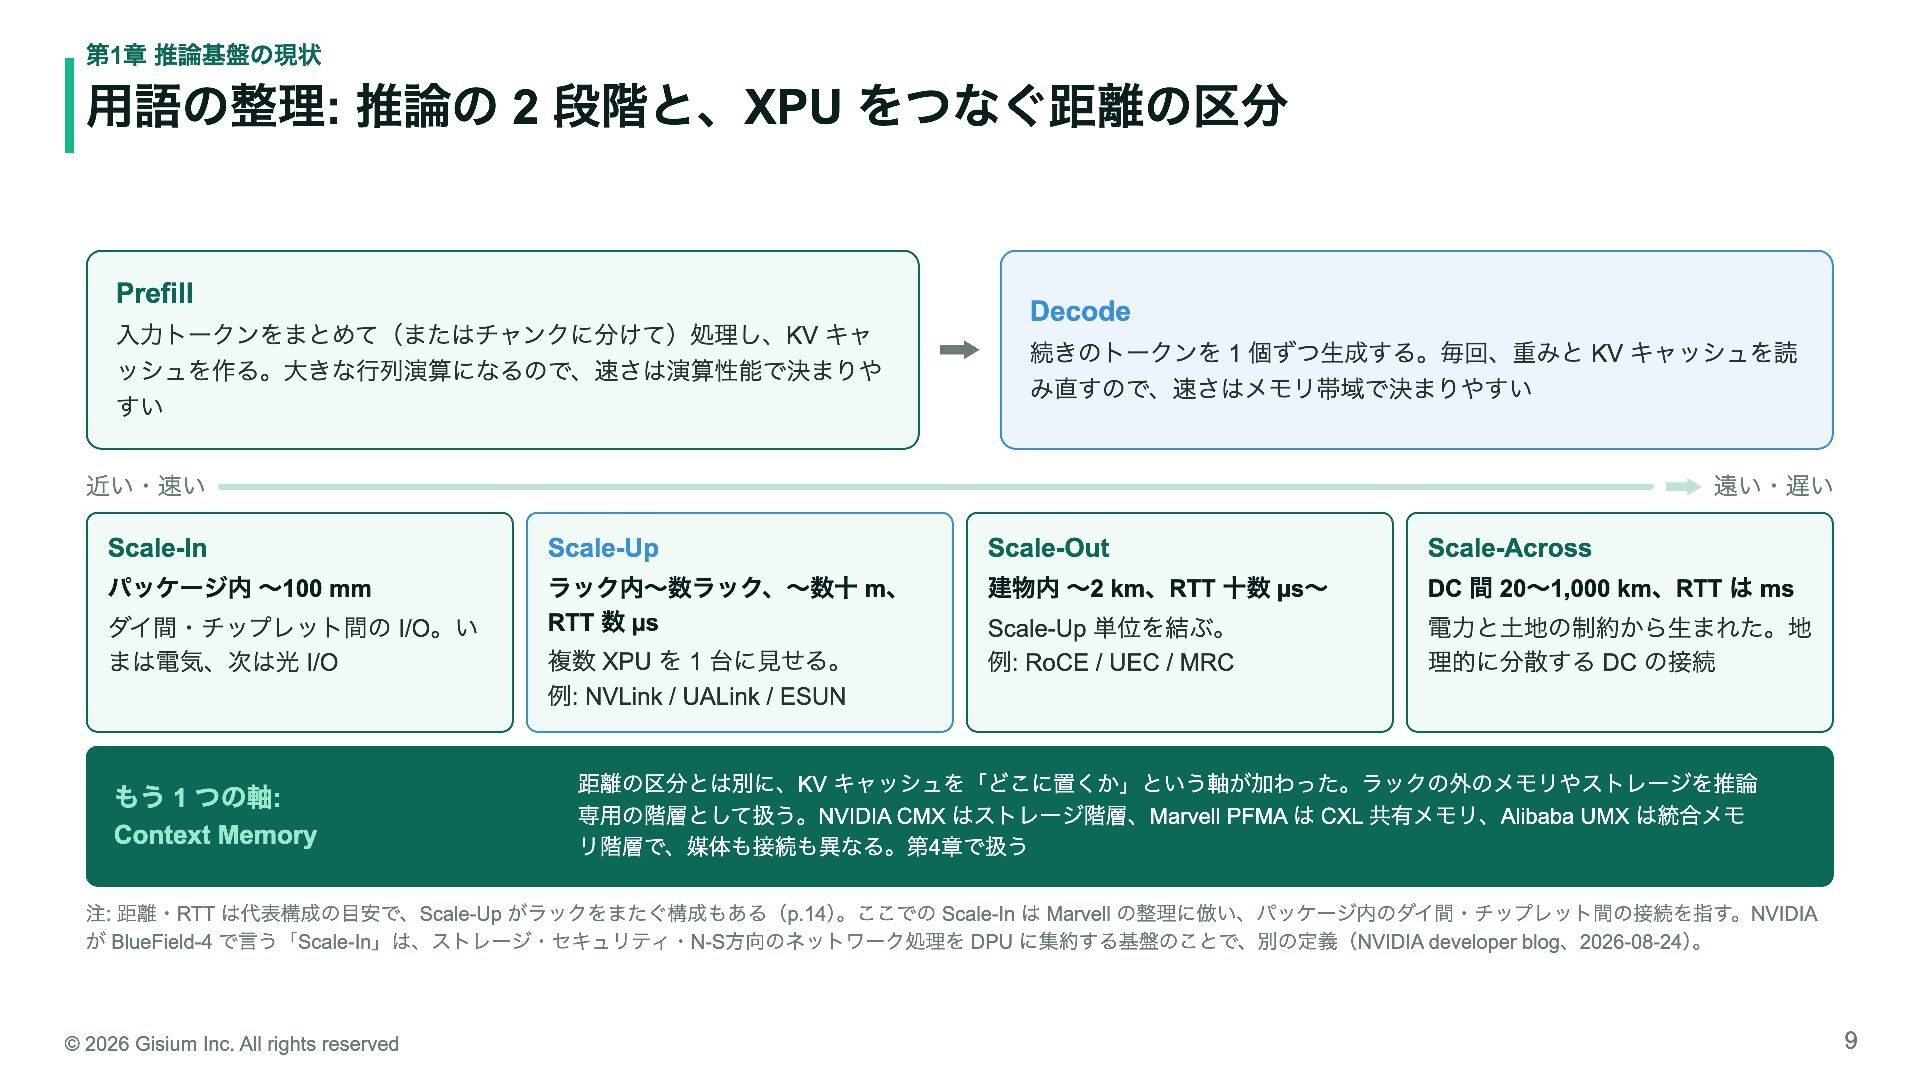
  9. 第1章 推論基盤の現状 用語の整理: 推論の 2 段階と、XPU をつなぐ距離の区分 Prefill 入力トークンをまとめて(またはチャンクに分けて)処理し、KV キャ

    ッシュを作る。大きな行列演算になるので、速さは演算性能で決まりや すい Decode 続きのトークンを 1 個ずつ生成する。毎回、重みと KV キャッシュを読 み直すので、速さはメモリ帯域で決まりやすい 近い・速い 遠い・遅い Scale-In Scale-Up Scale-Out Scale-Across パッケージ内 〜100 mm ラック内〜数ラック、〜数十 m、 RTT 数 µs 建物内 〜2 km、RTT 十数 µs〜 DC 間 20〜1,000 km、RTT は ms Scale-Up 単位を結ぶ。 例: RoCE / UEC / MRC 電力と土地の制約から生まれた。地 理的に分散する DC の接続 ダイ間・チップレット間の I/O。い まは電気、次は光 I/O もう 1 つの軸: Context Memory 複数 XPU を 1 台に見せる。 例: NVLink / UALink / ESUN 距離の区分とは別に、KV キャッシュを「どこに置くか」という軸が加わった。ラックの外のメモリやストレージを推論 専用の階層として扱う。NVIDIA CMX はストレージ階層、Marvell PFMA は CXL 共有メモリ、Alibaba UMX は統合メモ リ階層で、媒体も接続も異なる。第4章で扱う 注: 距離・RTT は代表構成の目安で、Scale-Up がラックをまたぐ構成もある(p.14)。ここでの Scale-In は Marvell の整理に倣い、パッケージ内のダイ間・チップレット間の接続を指す。NVIDIA が BlueField-4 で言う「Scale-In」は、ストレージ・セキュリティ・N-S方向のネットワーク処理を DPU に集約する基盤のことで、別の定義(NVIDIA developer blog、2026-08-24)。 © 2026 Gisium Inc. All rights reserved 9
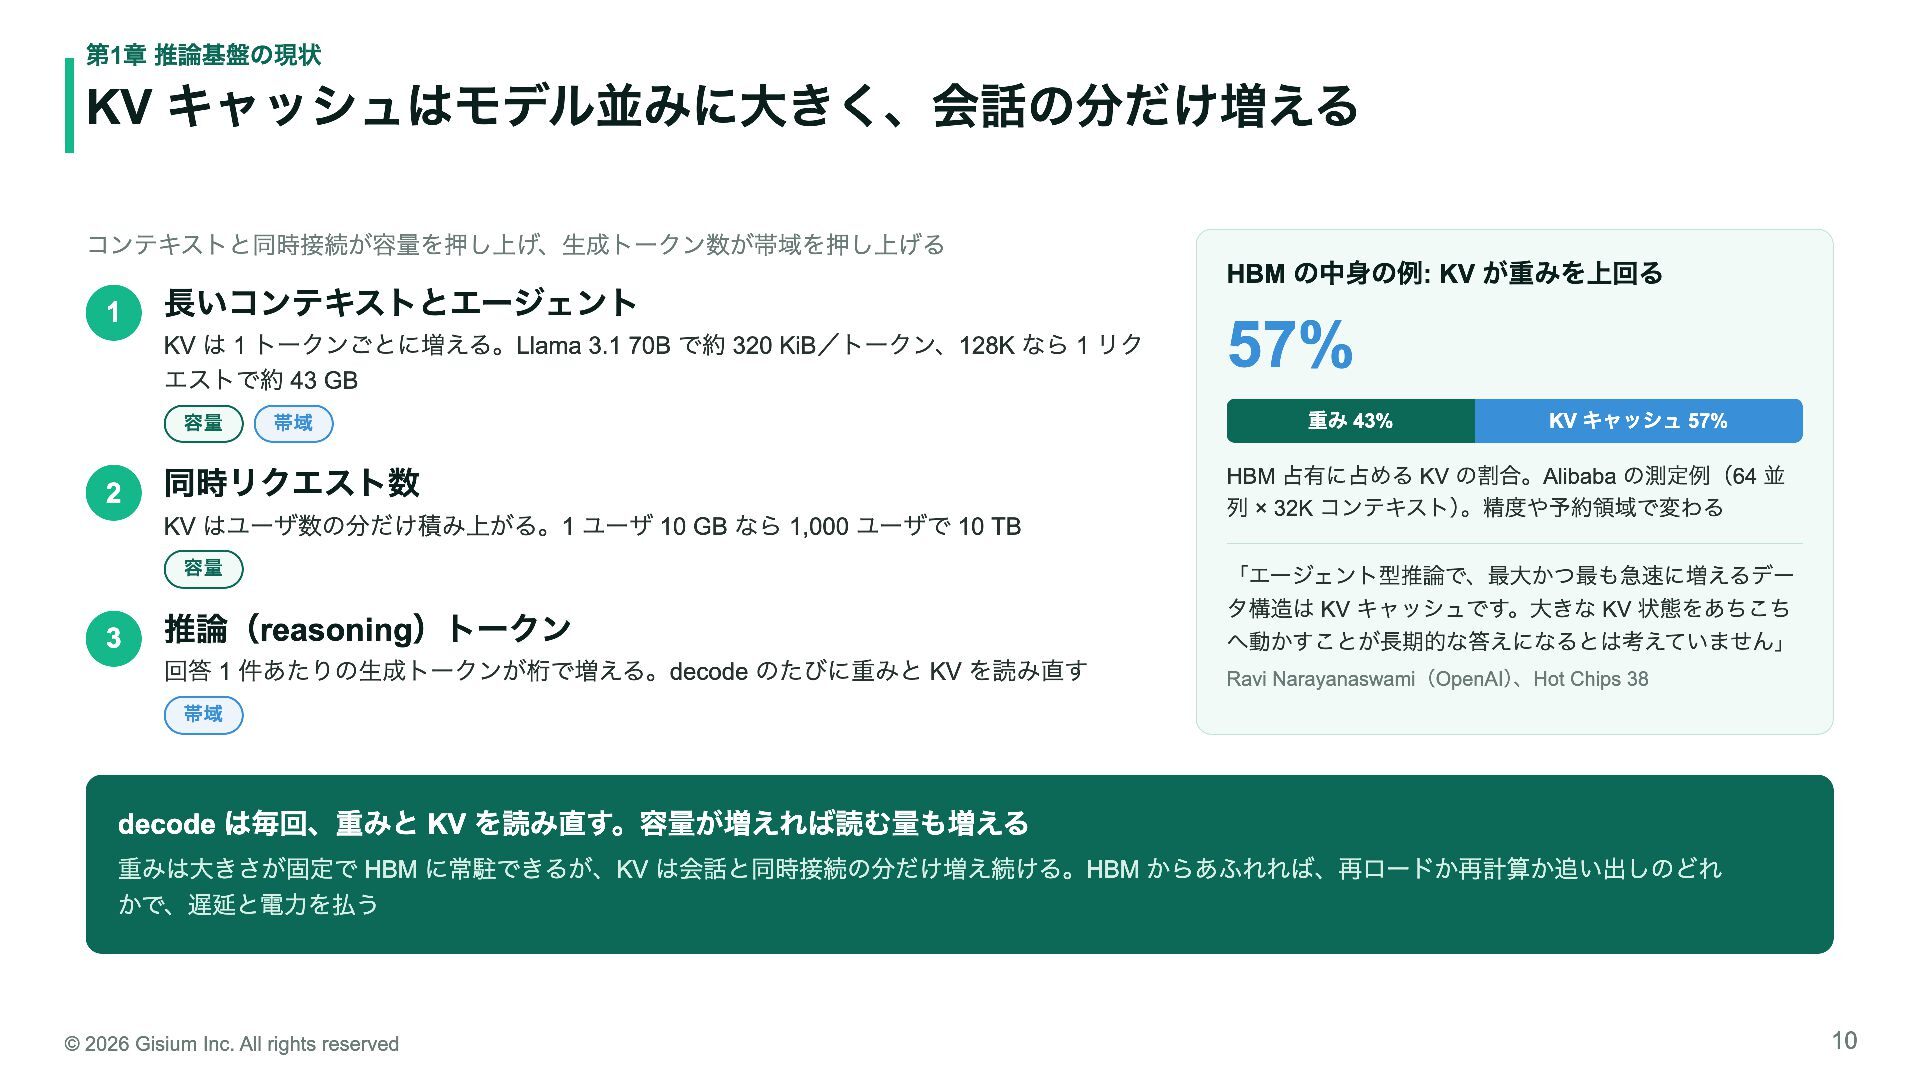
  10. 第1章 推論基盤の現状 KV キャッシュはモデル並みに大きく、会話の分だけ増える コンテキストと同時接続が容量を押し上げ、生成トークン数が帯域を押し上げる HBM の中身の例: KV が重みを上回る 1

    長いコンテキストとエージェント KV は 1 トークンごとに増える。Llama 3.1 70B で約 320 KiB/トークン、128K なら 1 リク エストで約 43 GB 容量 2 帯域 同時リクエスト数 KV はユーザ数の分だけ積み上がる。1 ユーザ 10 GB なら 1,000 ユーザで 10 TB 容量 3 57% 重み 43% KV キャッシュ 57% HBM 占有に占める KV の割合。Alibaba の測定例(64 並 列 × 32K コンテキスト)。精度や予約領域で変わる 推論(reasoning)トークン 「エージェント型推論で、最大かつ最も急速に増えるデー タ構造は KV キャッシュです。大きな KV 状態をあちこち へ動かすことが長期的な答えになるとは考えていません」 回答 1 件あたりの生成トークンが桁で増える。decode のたびに重みと KV を読み直す Ravi Narayanaswami(OpenAI)、Hot Chips 38 帯域 decode は毎回、重みと KV を読み直す。容量が増えれば読む量も増える 重みは大きさが固定で HBM に常駐できるが、KV は会話と同時接続の分だけ増え続ける。HBM からあふれれば、再ロードか再計算か追い出しのどれ かで、遅延と電力を払う © 2026 Gisium Inc. All rights reserved 10
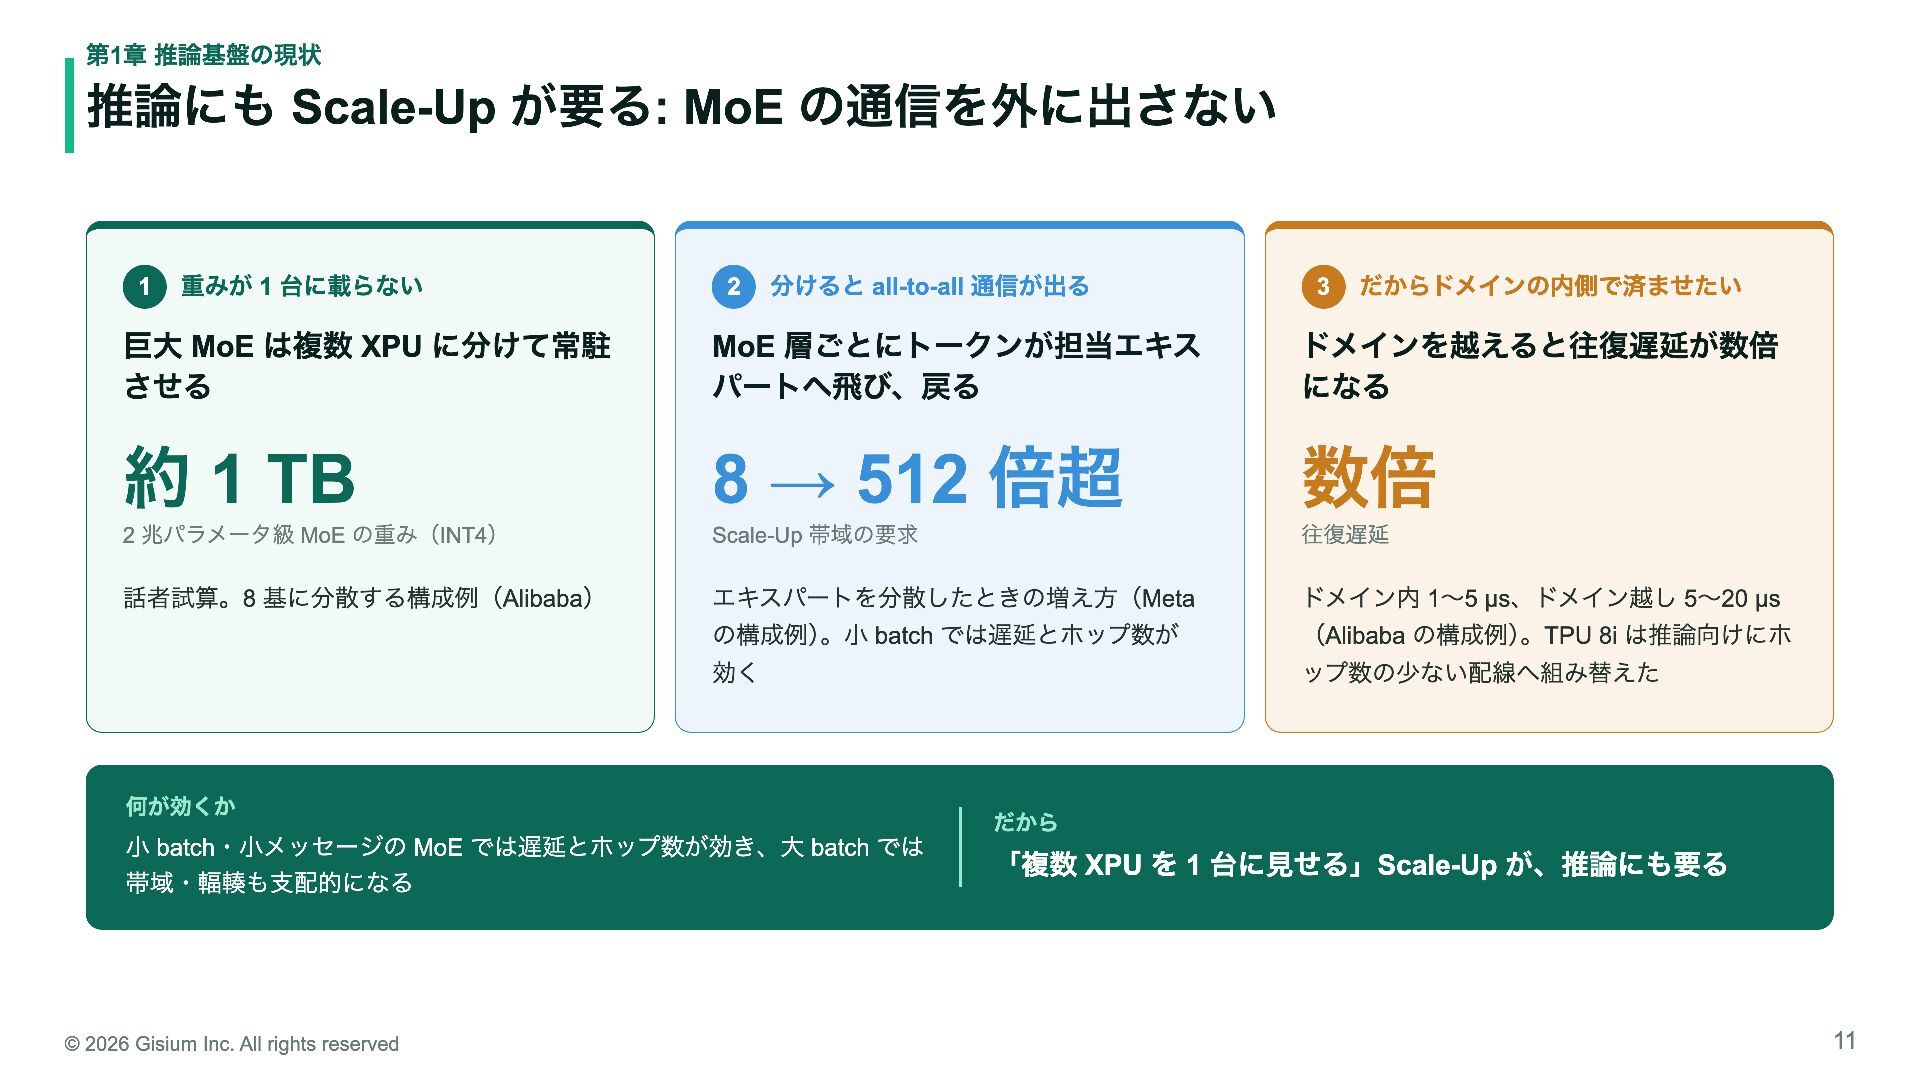
  11. 第1章 推論基盤の現状 推論にも Scale-Up が要る: MoE の通信を外に出さない 1 重みが 1

    台に載らない 2 分けると all-to-all 通信が出る 3 だからドメインの内側で済ませたい 巨大 MoE は複数 XPU に分けて常駐 させる MoE 層ごとにトークンが担当エキス パートへ飛び、戻る ドメインを越えると往復遅延が数倍 になる 約 1 TB 8 → 512 倍超 数倍 2 兆パラメータ級 MoE の重み(INT4) Scale-Up 帯域の要求 往復遅延 話者試算。8 基に分散する構成例(Alibaba) エキスパートを分散したときの増え方(Meta ドメイン内 1〜5 µs、ドメイン越し 5〜20 µs の構成例)。小 batch では遅延とホップ数が (Alibaba の構成例)。TPU 8i は推論向けにホ 効く ップ数の少ない配線へ組み替えた 何が効くか 小 batch・小メッセージの MoE では遅延とホップ数が効き、大 batch では 帯域・輻輳も支配的になる © 2026 Gisium Inc. All rights reserved だから 「複数 XPU を 1 台に見せる」Scale-Up が、推論にも要る 11
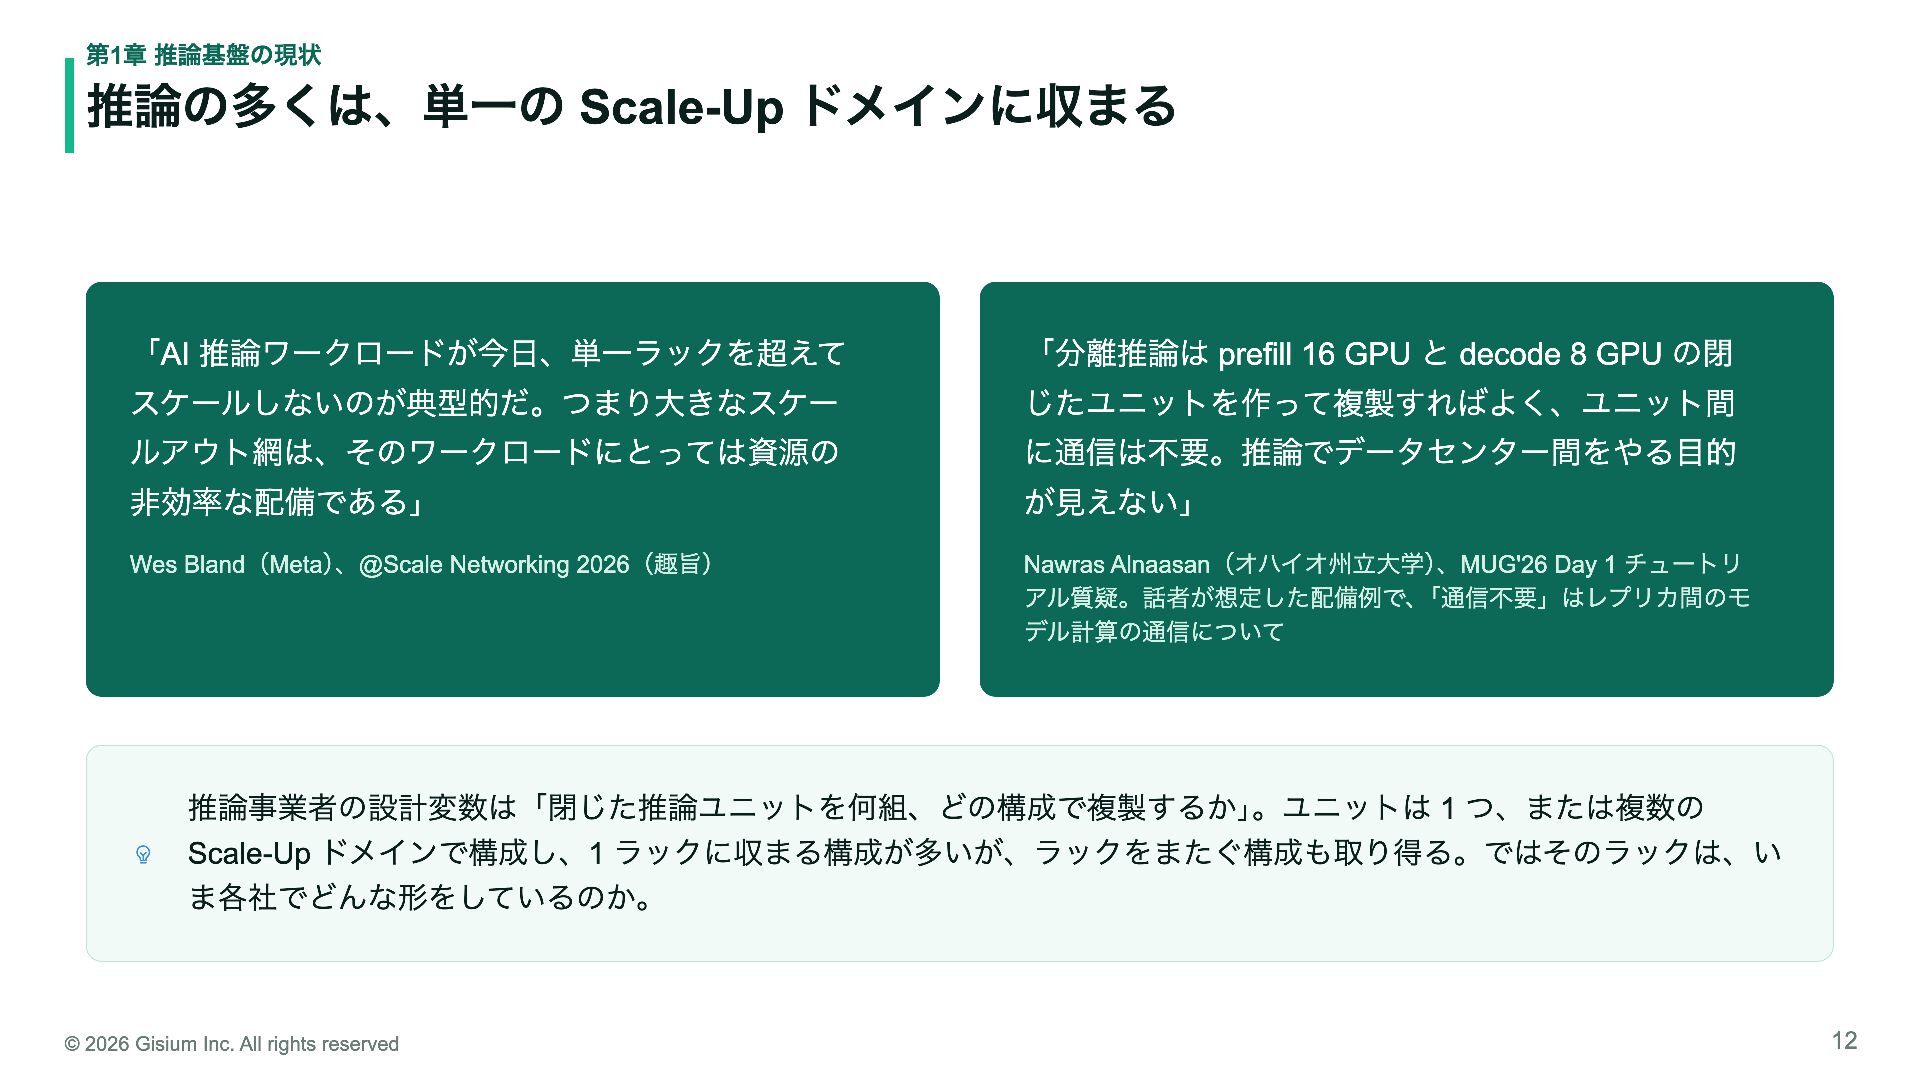
  12. 第1章 推論基盤の現状 推論の多くは、単一の Scale-Up ドメインに収まる 「AI 推論ワークロードが今日、単一ラックを超えて 「分離推論は prefill 16

    GPU と decode 8 GPU の閉 スケールしないのが典型的だ。つまり大きなスケー じたユニットを作って複製すればよく、ユニット間 ルアウト網は、そのワークロードにとっては資源の に通信は不要。推論でデータセンター間をやる目的 非効率な配備である」 が見えない」 Wes Bland(Meta)、@Scale Networking 2026(趣旨) Nawras Alnaasan(オハイオ州立大学)、MUG'26 Day 1 チュートリ アル質疑。話者が想定した配備例で、「通信不要」はレプリカ間のモ デル計算の通信について  推論事業者の設計変数は「閉じた推論ユニットを何組、どの構成で複製するか」。ユニットは 1 つ、または複数の Scale-Up ドメインで構成し、1 ラックに収まる構成が多いが、ラックをまたぐ構成も取り得る。ではそのラックは、い ま各社でどんな形をしているのか。 © 2026 Gisium Inc. All rights reserved 12
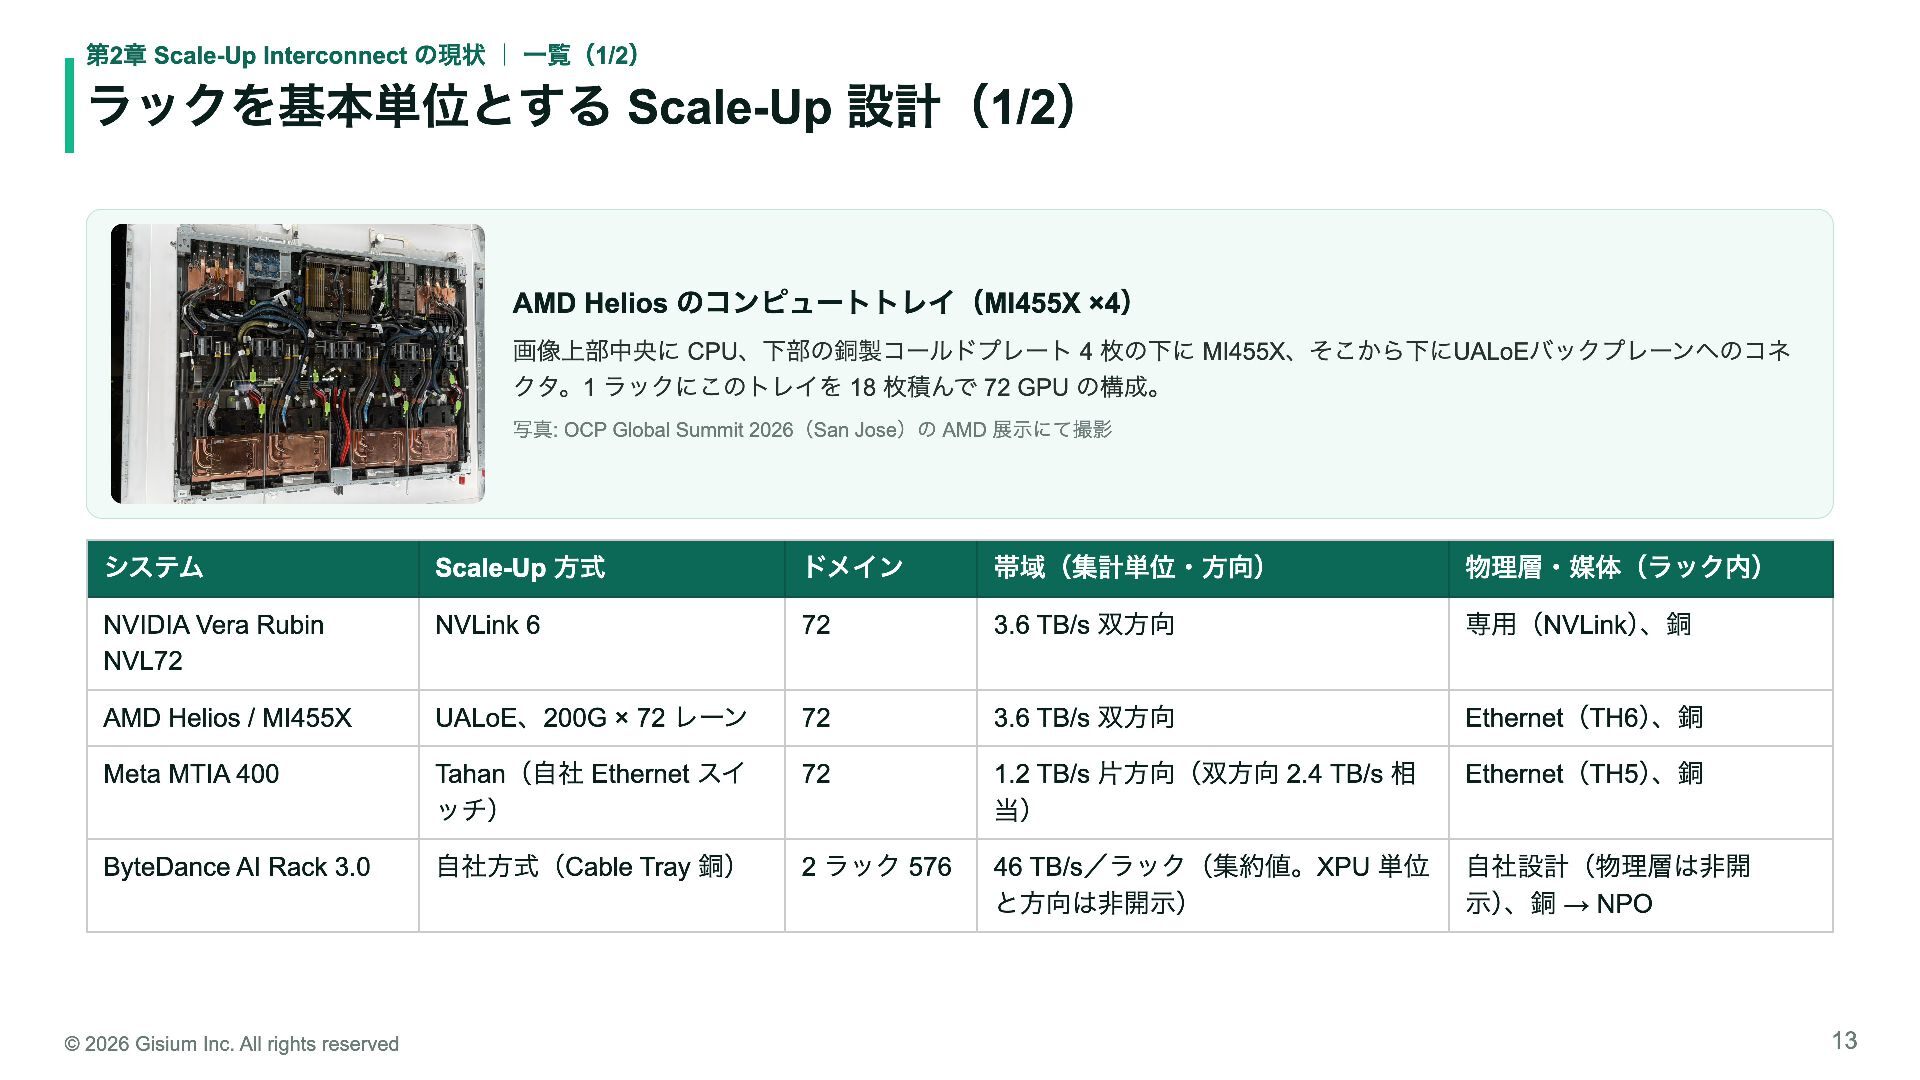
  13. 第2章 Scale-Up Interconnect の現状 | 一覧(1/2) ラックを基本単位とする Scale-Up 設計(1/2) AMD

    Helios のコンピュートトレイ(MI455X ×4) 画像上部中央に CPU、下部の銅製コールドプレート 4 枚の下に MI455X、そこから下にUALoEバックプレーンへのコネ クタ。1 ラックにこのトレイを 18 枚積んで 72 GPU の構成。 写真: OCP Global Summit 2026(San Jose)の AMD 展示にて撮影 システム Scale-Up 方式 ドメイン 帯域(集計単位・方向) 物理層・媒体(ラック内) NVIDIA Vera Rubin NVL72 NVLink 6 72 3.6 TB/s 双方向 専用(NVLink)、銅 AMD Helios / MI455X UALoE、200G × 72 レーン 72 3.6 TB/s 双方向 Ethernet(TH6)、銅 Meta MTIA 400 Tahan(自社 Ethernet スイ ッチ) 72 1.2 TB/s 片方向(双方向 2.4 TB/s 相 当) Ethernet(TH5)、銅 ByteDance AI Rack 3.0 自社方式(Cable Tray 銅) 2 ラック 576 46 TB/s/ラック(集約値。XPU 単位 と方向は非開示) 自社設計(物理層は非開示)、 銅 → NPO © 2026 Gisium Inc. All rights reserved 13
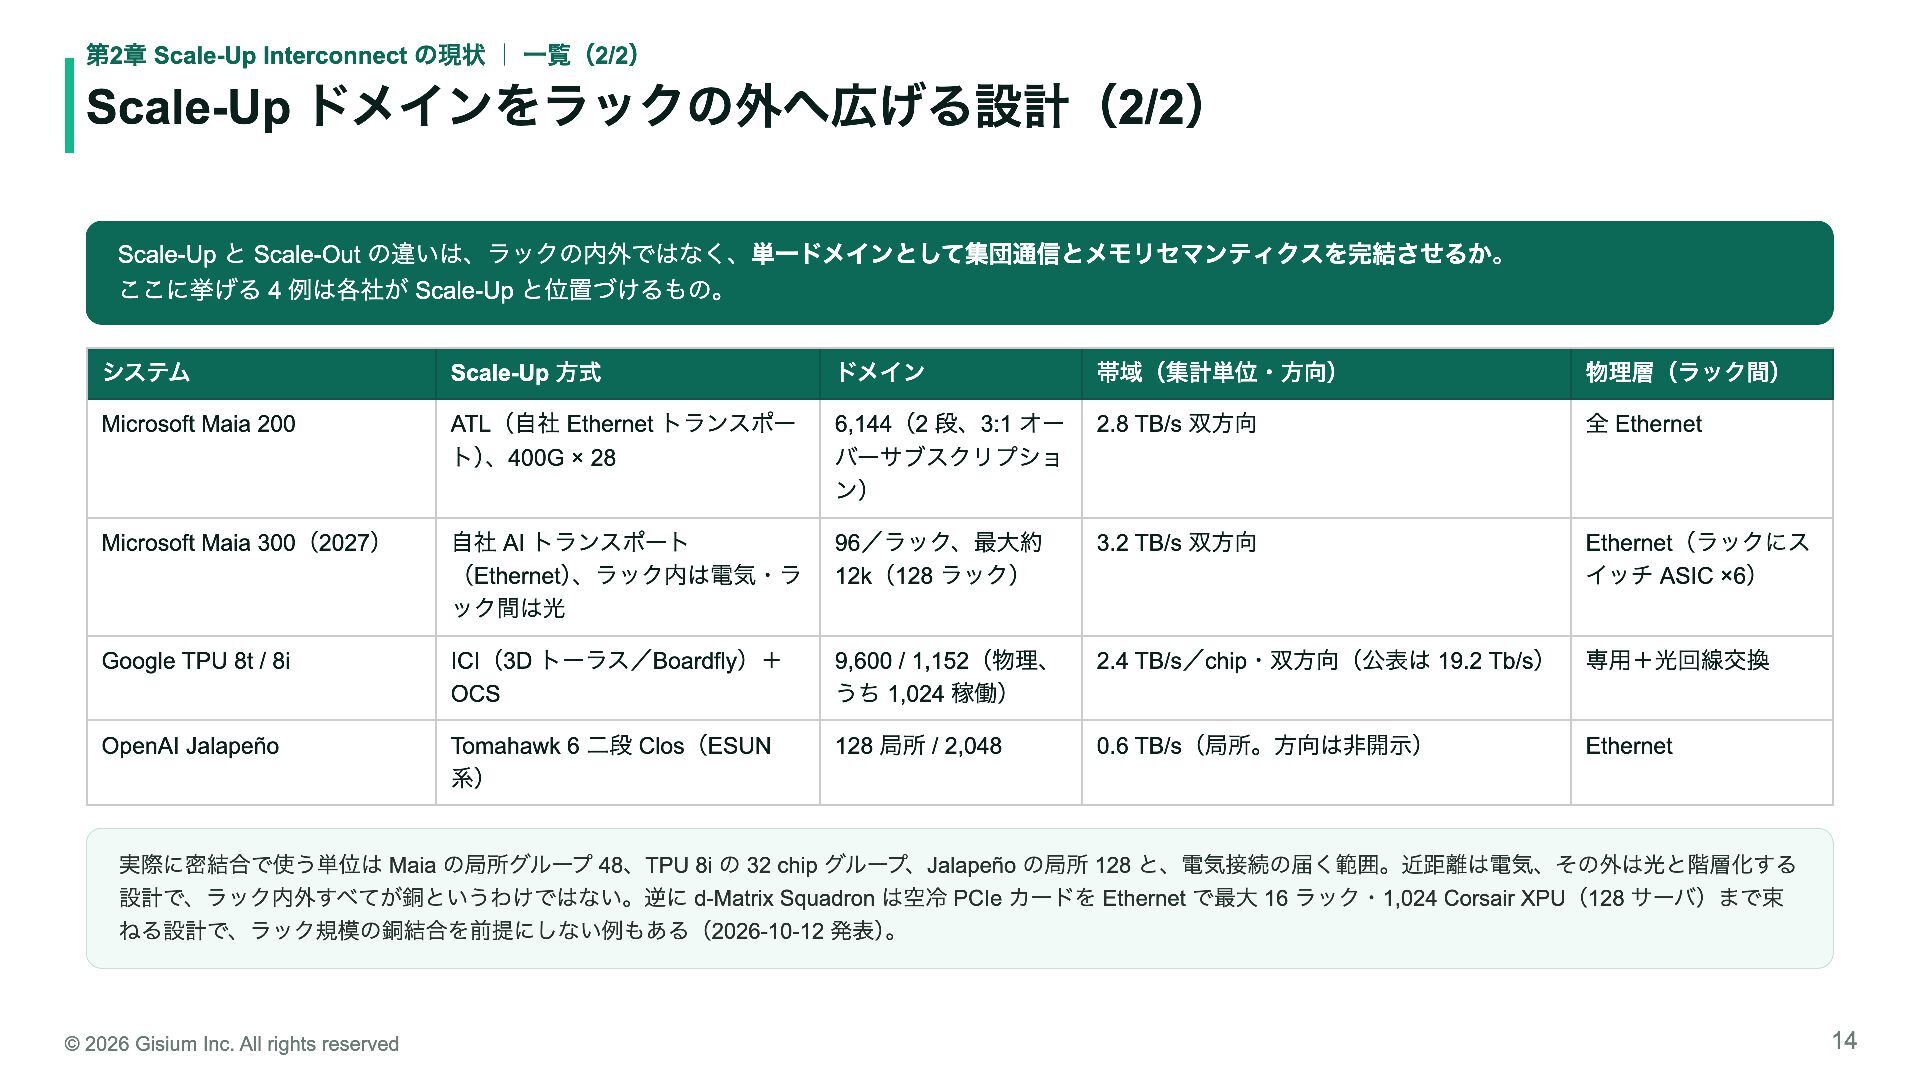
  14. 第2章 Scale-Up Interconnect の現状 | 一覧(2/2) Scale-Up ドメインをラックの外へ広げる設計(2/2) Scale-Up と

    Scale-Out の違いは、ラックの内外ではなく、単一ドメインとして集団通信とメモリセマンティクスを完結させるか。 ここに挙げる 4 例は各社が Scale-Up と位置づけるもの。 システム Scale-Up 方式 ドメイン 帯域(集計単位・方向) 物理層(ラック間) Microsoft Maia 200 ATL(自社 Ethernet トランスポー ト)、400G × 28 6,144(2 段、3:1 オー バーサブスクリプショ ン) 2.8 TB/s 双方向 全 Ethernet Microsoft Maia 300(2027) 自社 AI トランスポート (Ethernet)、ラック内は電気・ラ ック間は光 96/ラック、最大約 12k(128 ラック) 3.2 TB/s 双方向 Ethernet(ラックにス イッチ ASIC ×6) Google TPU 8t / 8i ICI(3D トーラス/Boardfly)+ OCS 9,600 / 1,152(物理、 うち 1,024 稼働) 2.4 TB/s/chip・双方向(公表は 19.2 Tb/s) 専用+光回線交換 OpenAI Jalapeño Tomahawk 6 二段 Clos(ESUN 系) 128 局所 / 2,048 0.6 TB/s(局所。方向は非開示) Ethernet 実際に密結合で使う単位は Maia の局所グループ 48、TPU 8i の 32 chip グループ、Jalapeño の局所 128 と、電気接続の届く範囲。近距離は電気、その外は光と階層化する 設計で、ラック内外すべてが銅というわけではない。逆に d-Matrix Squadron は空冷 PCIe カードを Ethernet で最大 16 ラック・1,024 Corsair XPU(128 サーバ)まで束 ねる設計で、ラック規模の銅結合を前提にしない例もある(2026-10-12 発表)。 © 2026 Gisium Inc. All rights reserved 14
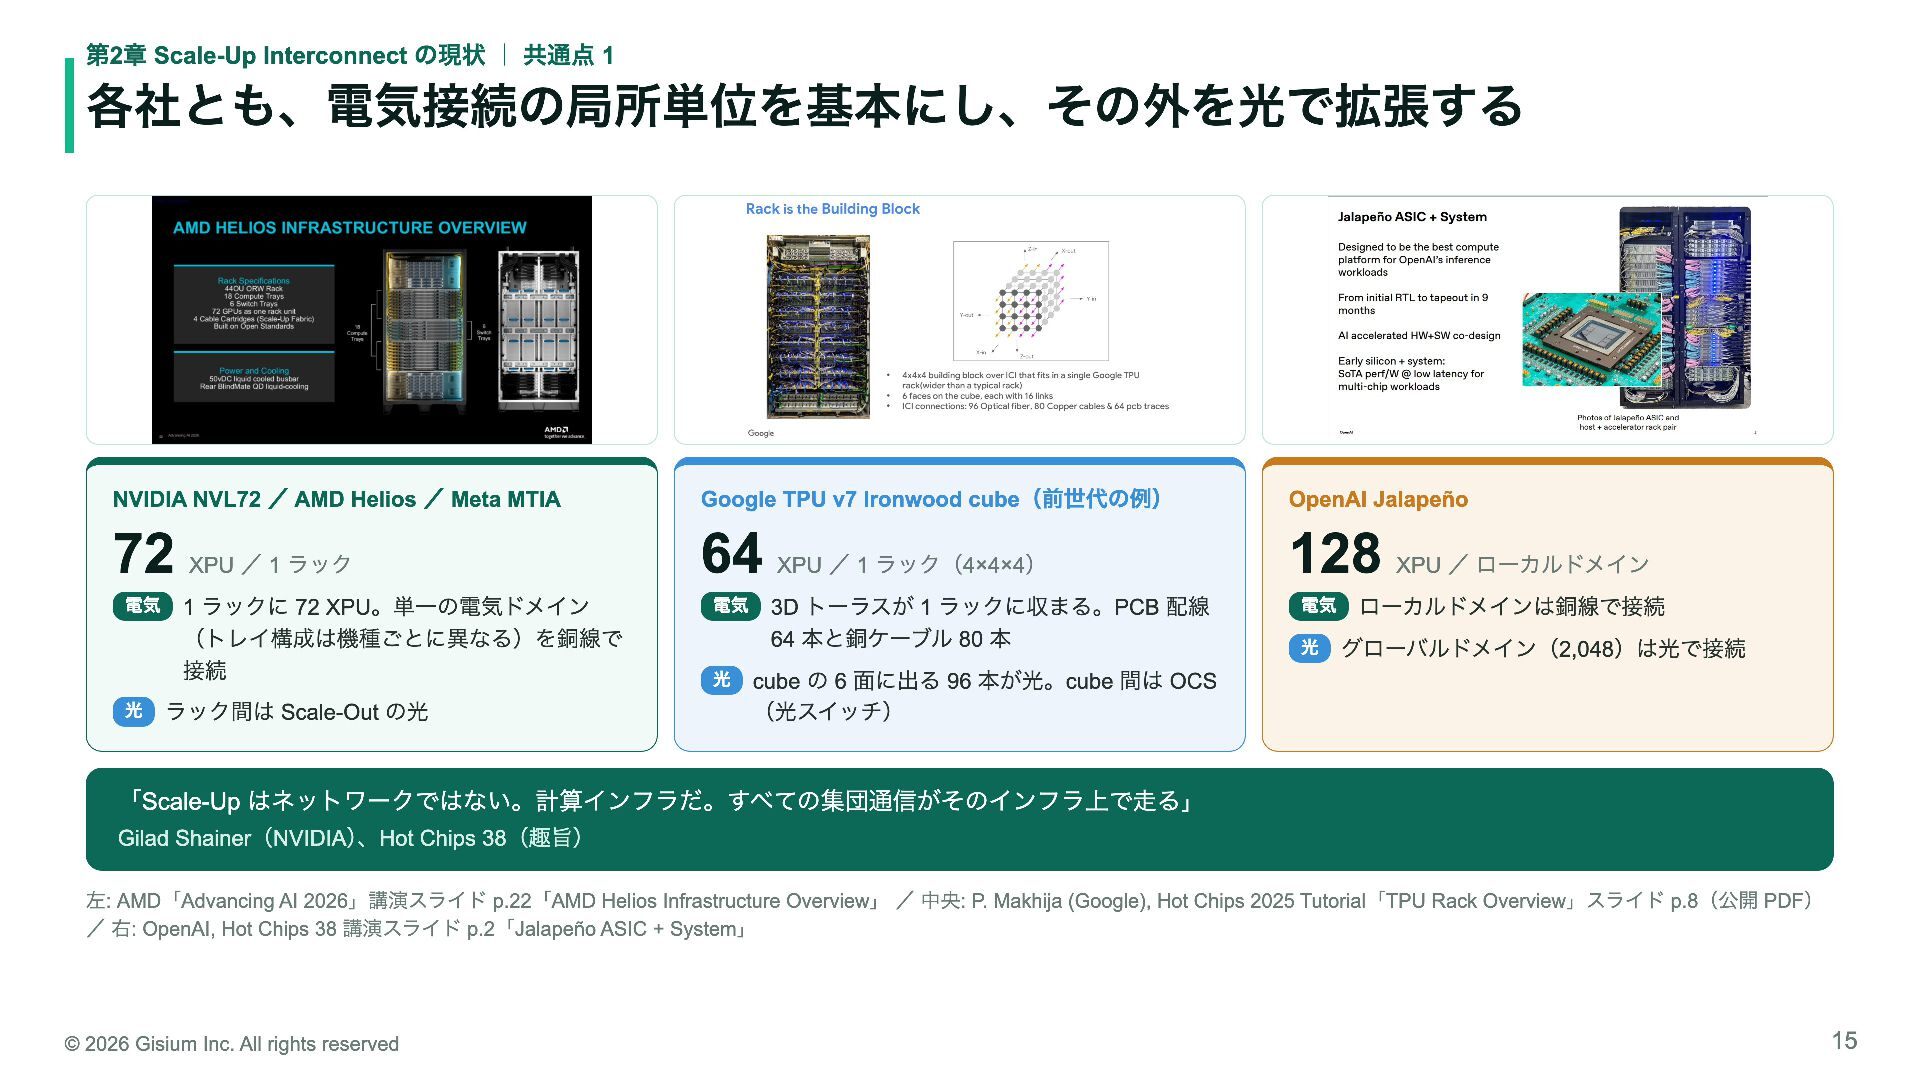
  15. 第2章 Scale-Up Interconnect の現状 | 共通点 1 各社とも、電気接続の局所単位を基本にし、その外を光で拡張する NVIDIA NVL72

    / AMD Helios / Meta MTIA Google TPU v7 Ironwood cube(前世代の例) OpenAI Jalapeño 72 64 128 電気 光 XPU / 1 ラック 1 ラックに 72 XPU。単一の電気ドメイン (トレイ構成は機種ごとに異なる)を銅線で 接続 ラック間は Scale-Out の光 電気 光 XPU / 1 ラック(4×4×4) 3D トーラスが 1 ラックに収まる。PCB 配線 64 本と銅ケーブル 80 本 電気 光 XPU / ローカルドメイン ローカルドメインは銅線で接続 グローバルドメイン(2,048)は光で接続 cube の 6 面に出る 96 本が光。cube 間は OCS (光スイッチ) 「Scale-Up はネットワークではない。計算インフラだ。すべての集団通信がそのインフラ上で走る」 Gilad Shainer(NVIDIA)、Hot Chips 38(趣旨) 左: AMD「Advancing AI 2026」講演スライド p.22「AMD Helios Infrastructure Overview」 / 中央: P. Makhija (Google), Hot Chips 2025 Tutorial「TPU Rack Overview」スライド p.8(公開 PDF) / 右: OpenAI, Hot Chips 38 講演スライド p.2「Jalapeño ASIC + System」 © 2026 Gisium Inc. All rights reserved 15
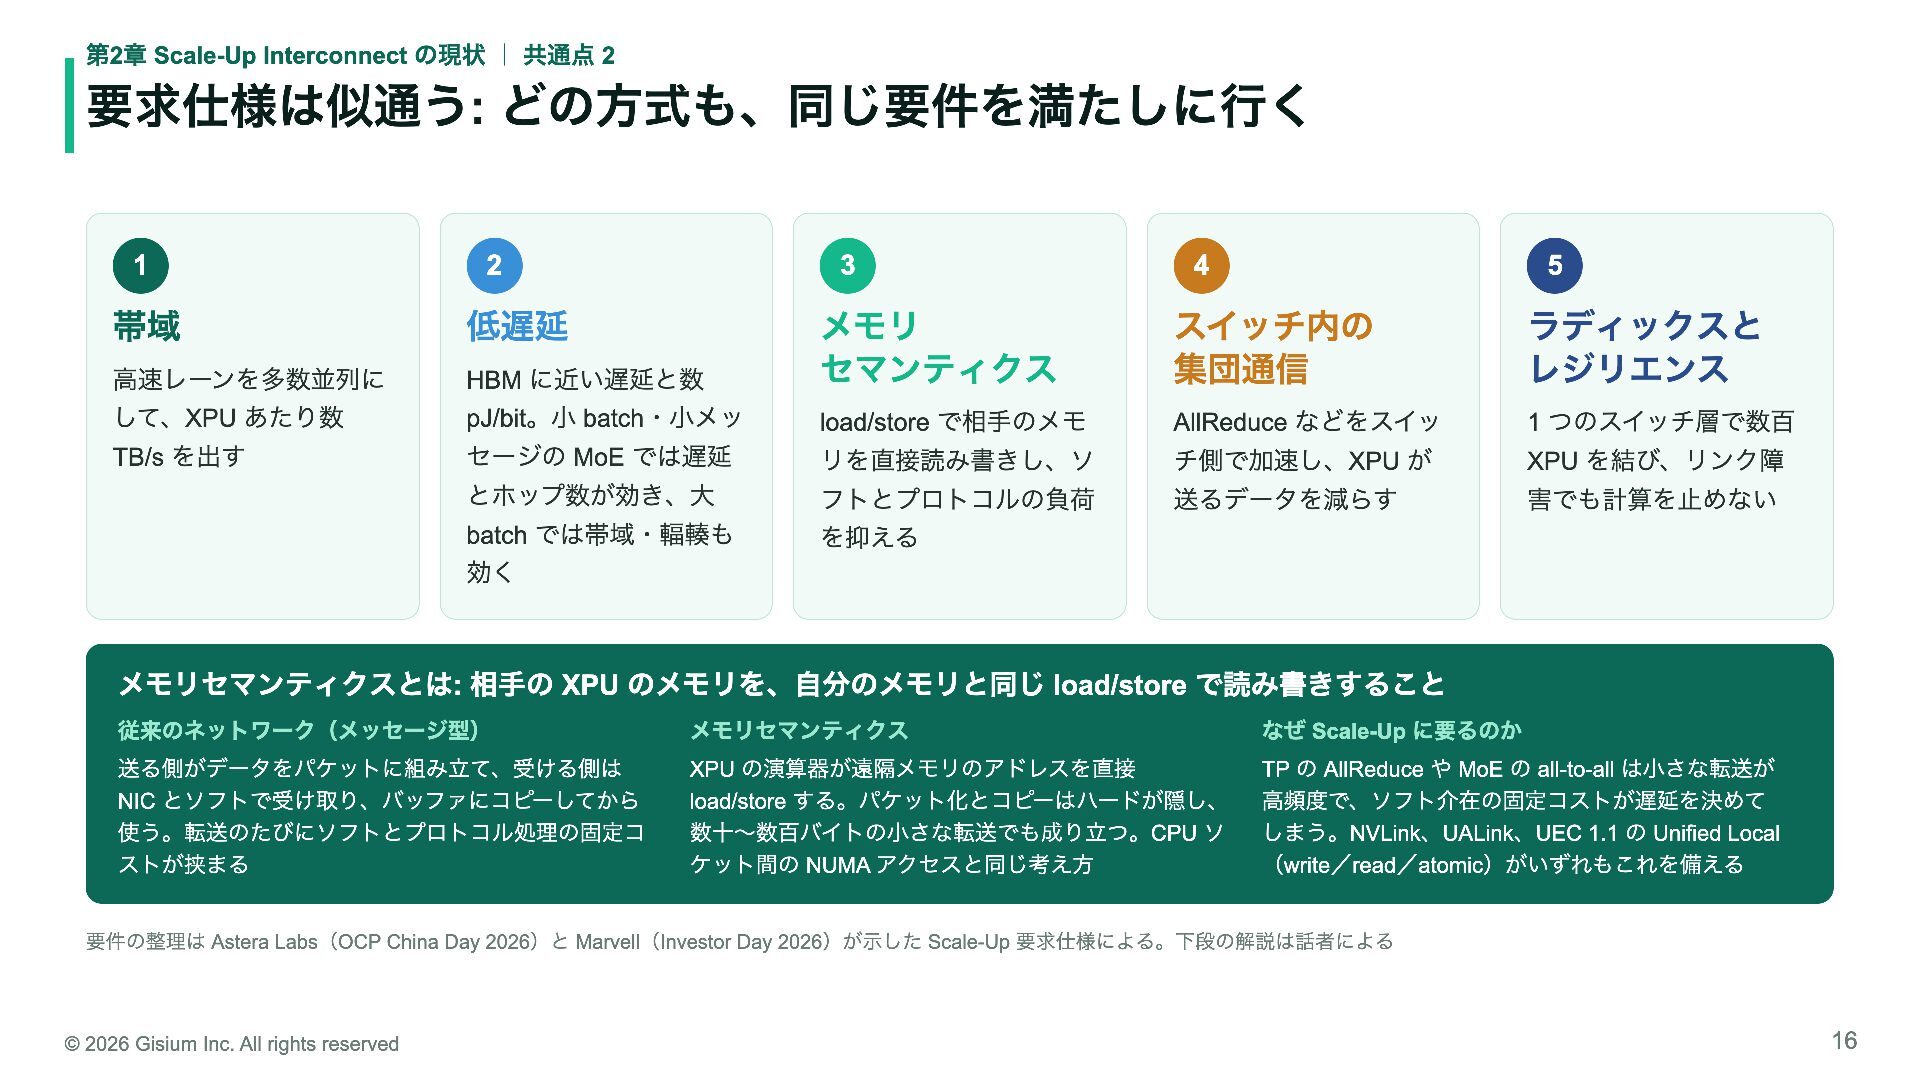
  16. 第2章 Scale-Up Interconnect の現状 | 共通点 2 要求仕様は似通う: どの方式も、同じ要件を満たしに行く 1

    2 帯域 低遅延 高速レーンを多数並列に 3 4 5 HBM に近い遅延と数 メモリ セマンティクス スイッチ内の 集団通信 ラディックスと レジリエンス して、XPU あたり数 pJ/bit。小 batch・小メッ load/store で相手のメモ AllReduce などをスイッ 1 つのスイッチ層で数百 TB/s を出す セージの MoE では遅延 リを直接読み書きし、ソ チ側で加速し、XPU が XPU を結び、リンク障 とホップ数が効き、大 フトとプロトコルの負荷 送るデータを減らす 害でも計算を止めない batch では帯域・輻輳も を抑える 効く メモリセマンティクスとは: 相手の XPU のメモリを、自分のメモリと同じ load/store で読み書きすること 従来のネットワーク(メッセージ型) メモリセマンティクス なぜ Scale-Up に要るのか 送る側がデータをパケットに組み立て、受ける側は NIC とソフトで受け取り、バッファにコピーしてから 使う。転送のたびにソフトとプロトコル処理の固定コ ストが挟まる XPU の演算器が遠隔メモリのアドレスを直接 load/store する。パケット化とコピーはハードが隠し、 数十〜数百バイトの小さな転送でも成り立つ。CPU ソ ケット間の NUMA アクセスと同じ考え方 TP の AllReduce や MoE の all-to-all は小さな転送が 高頻度で、ソフト介在の固定コストが遅延を決めて しまう。NVLink、UALink、UEC 1.1 の Unified Local (write/read/atomic)がいずれもこれを備える 要件の整理は Astera Labs(OCP China Day 2026)と Marvell(Investor Day 2026)が示した Scale-Up 要求仕様による。下段の解説は話者による © 2026 Gisium Inc. All rights reserved 16
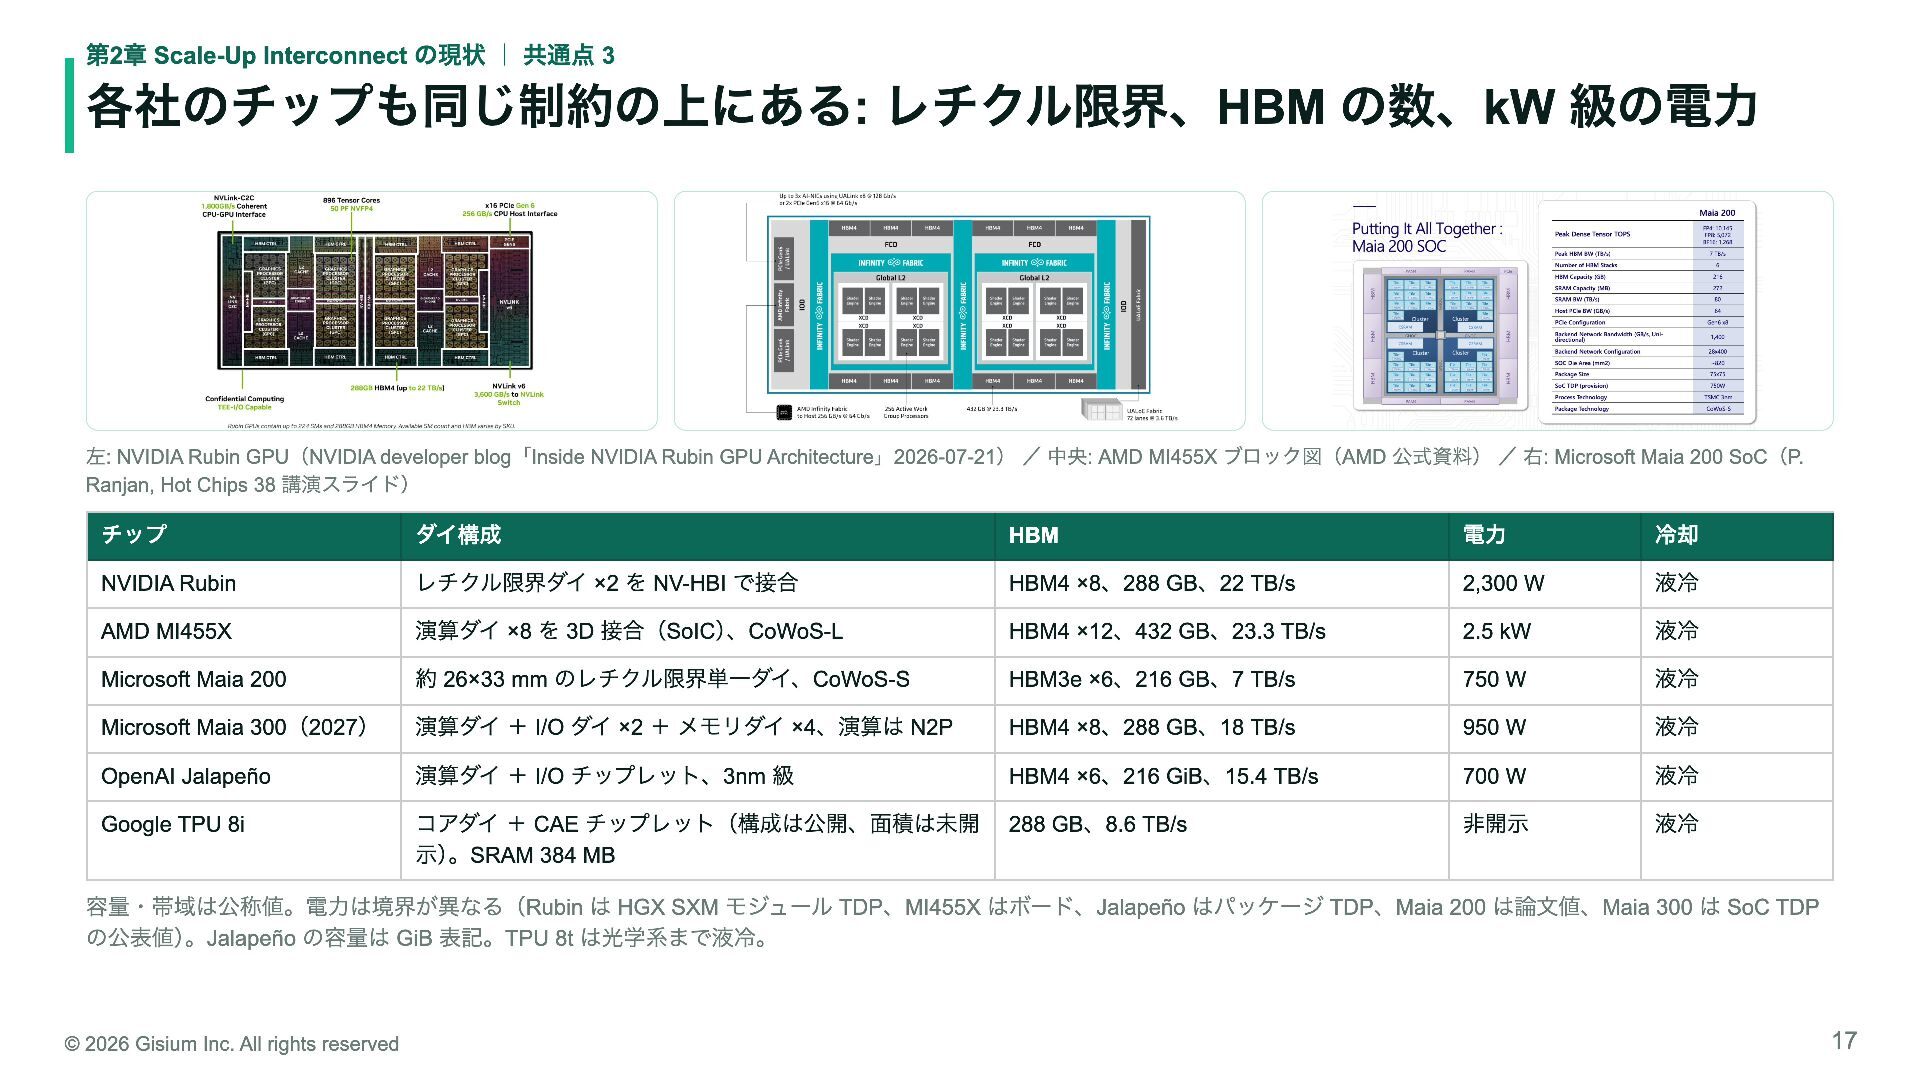
  17. 第2章 Scale-Up Interconnect の現状 | 共通点 3 各社のチップも同じ制約の上にある: レチクル限界、HBM の数、kW

    級の電力 左: NVIDIA Rubin GPU(NVIDIA developer blog「Inside NVIDIA Rubin GPU Architecture」2026-07-21) / 中央: AMD MI455X ブロック図(AMD 公式資料) / 右: Microsoft Maia 200 SoC(P. Ranjan, Hot Chips 38 講演スライド) チップ ダイ構成 HBM 電力 冷却 NVIDIA Rubin レチクル限界ダイ ×2 を NV-HBI で接合 HBM4 ×8、288 GB、22 TB/s 2,300 W 液冷 AMD MI455X 演算ダイ ×8 を 3D 接合(SoIC)、CoWoS-L HBM4 ×12、432 GB、23.3 TB/s 2.5 kW 液冷 Microsoft Maia 200 約 26×33 mm のレチクル限界単一ダイ、CoWoS-S HBM3e ×6、216 GB、7 TB/s 750 W 液冷 Microsoft Maia 300(2027) 演算ダイ + I/O ダイ ×2 + メモリダイ ×4、演算は N2P HBM4 ×8、288 GB、18 TB/s 950 W 液冷 OpenAI Jalapeño 演算ダイ + I/O チップレット、3nm 級 HBM4 ×6、216 GiB、15.4 TB/s 700 W 液冷 Google TPU 8i コアダイ + CAE チップレット(構成は公開、面積は未開 示)。SRAM 384 MB 288 GB、8.6 TB/s 非開示 液冷 容量・帯域は公称値。電力は境界が異なる(Rubin は HGX SXM モジュール TDP、MI455X はボード、Jalapeño はパッケージ TDP、Maia 200 は論文値、Maia 300 は SoC TDP の公表値)。Jalapeño の容量は GiB 表記。TPU 8t は光学系まで液冷。 © 2026 Gisium Inc. All rights reserved 17
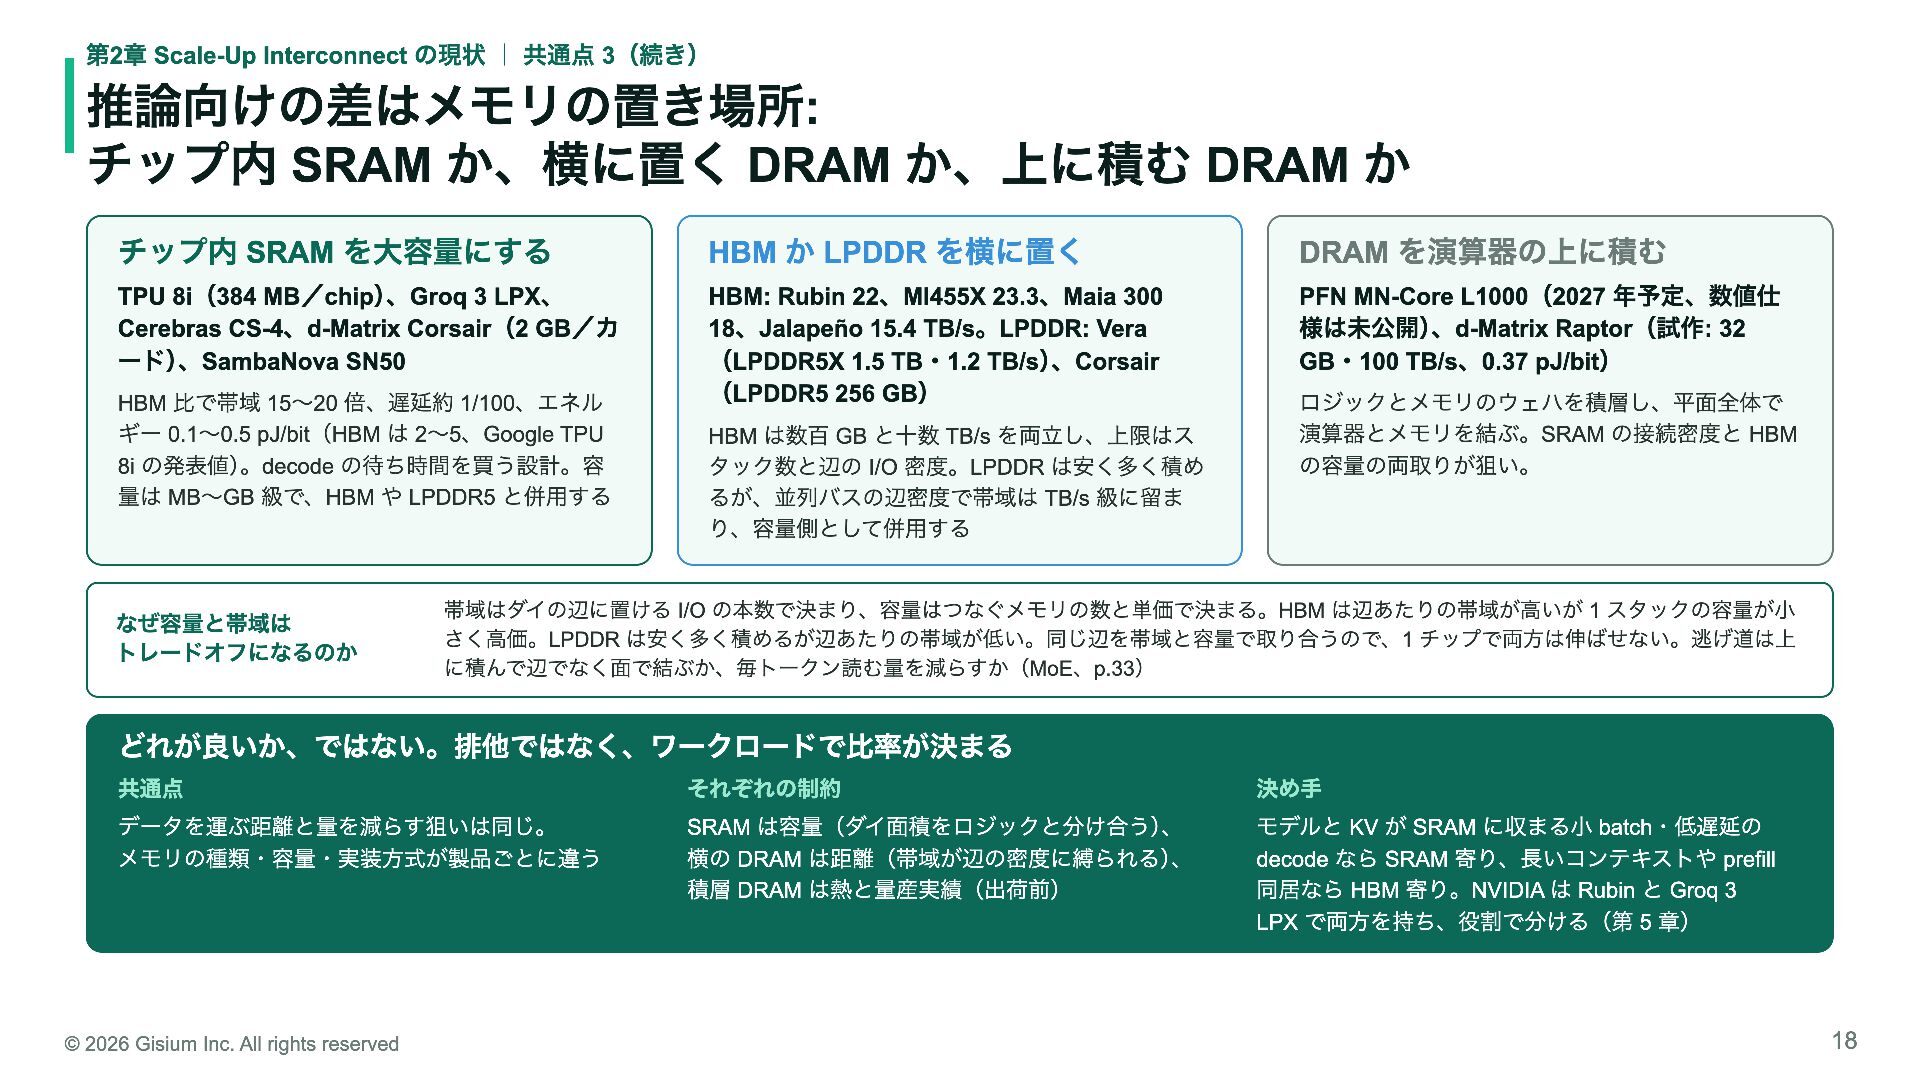
  18. 第2章 Scale-Up Interconnect の現状 | 共通点 3(続き) 推論向けの差はメモリの置き場所: チップ内 SRAM

    か、横に置く DRAM か、上に積む DRAM か チップ内 SRAM を大容量にする HBM か LPDDR を横に置く DRAM を演算器の上に積む TPU 8i(384 MB/chip)、Groq 3 LPX、 Cerebras CS-4、d-Matrix Corsair(2 GB/カ ード)、SambaNova SN50 HBM: Rubin 22、MI455X 23.3、Maia 300 18、Jalapeño 15.4 TB/s。LPDDR: Vera (LPDDR5X 1.5 TB・1.2 TB/s)、Corsair (LPDDR5 256 GB) PFN MN-Core L1000(2027 年予定、数値仕 様は未公開)、d-Matrix Raptor(試作: 32 GB・100 TB/s、0.37 pJ/bit) HBM 比で帯域 15〜20 倍、遅延約 1/100、エネル ギー 0.1〜0.5 pJ/bit(HBM は 2〜5、Google TPU 8i の発表値)。decode の待ち時間を買う設計。容 量は MB〜GB 級で、HBM や LPDDR5 と併用する なぜ容量と帯域は トレードオフになるのか HBM は数百 GB と十数 TB/s を両立し、上限はス タック数と辺の I/O 密度。LPDDR は安く多く積め るが、並列バスの辺密度で帯域は TB/s 級に留ま り、容量側として併用する ロジックとメモリのウェハを積層し、平面全体で 演算器とメモリを結ぶ。SRAM の接続密度と HBM の容量の両取りが狙い。 帯域はダイの辺に置ける I/O の本数で決まり、容量はつなぐメモリの数と単価で決まる。HBM は辺あたりの帯域が高いが 1 スタックの容量が小 さく高価。LPDDR は安く多く積めるが辺あたりの帯域が低い。同じ辺を帯域と容量で取り合うので、1 チップで両方は伸ばせない。逃げ道は上 に積んで辺でなく面で結ぶか、毎トークン読む量を減らすか(MoE、p.33) どれが良いか、ではない。排他ではなく、ワークロードで比率が決まる 共通点 それぞれの制約 決め手 データを運ぶ距離と量を減らす狙いは同じ。 メモリの種類・容量・実装方式が製品ごとに違う SRAM は容量(ダイ面積をロジックと分け合う)、 横の DRAM は距離(帯域が辺の密度に縛られる)、 積層 DRAM は熱と量産実績(出荷前) モデルと KV が SRAM に収まる小 batch・低遅延の decode なら SRAM 寄り、長いコンテキストや prefill 同居なら HBM 寄り。NVIDIA は Rubin と Groq 3 LPX で両方を持ち、役割で分ける(第 5 章) © 2026 Gisium Inc. All rights reserved 18
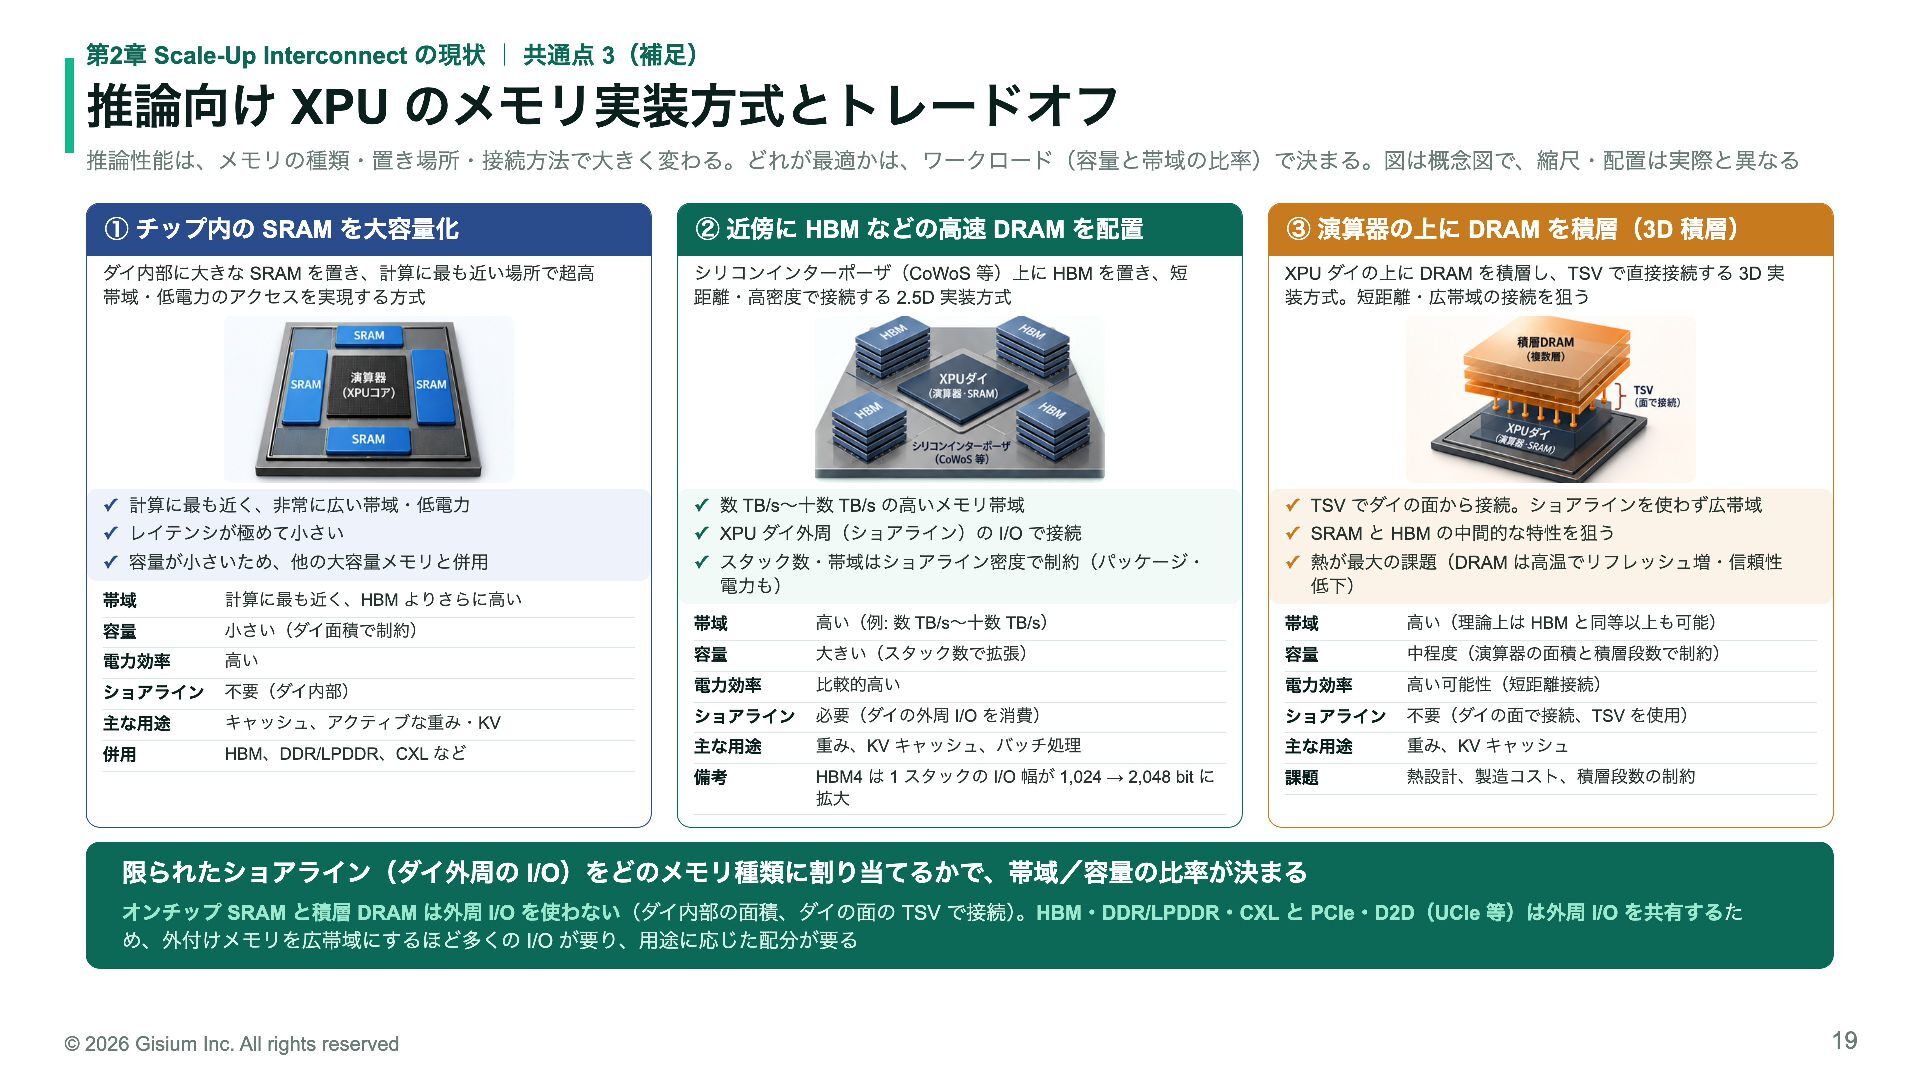
  19. 第2章 Scale-Up Interconnect の現状 | 共通点 3(補足) 推論向け XPU のメモリ実装方式とトレードオフ

    推論性能は、メモリの種類・置き場所・接続方法で大きく変わる。どれが最適かは、ワークロード(容量と帯域の比率)で決まる。図は概念図で、縮尺・配置は実際と異なる ① チップ内の SRAM を大容量化 ② 近傍に HBM などの高速 DRAM を配置 ③ 演算器の上に DRAM を積層(3D 積層) ダイ内部に大きな SRAM を置き、計算に最も近い場所で超高 帯域・低電力のアクセスを実現する方式 シリコンインターポーザ(CoWoS 等)上に HBM を置き、短 距離・高密度で接続する 2.5D 実装方式 XPU ダイの上に DRAM を積層し、TSV で直接接続する 3D 実 装方式。短距離・広帯域の接続を狙う ✓ 計算に最も近く、非常に広い帯域・低電力 ✓ 数 TB/s〜十数 TB/s の高いメモリ帯域 ✓ TSV でダイの面から接続。ショアラインを使わず広帯域 ✓ レイテンシが極めて小さい ✓ XPU ダイ外周(ショアライン)の I/O で接続 ✓ SRAM と HBM の中間的な特性を狙う ✓ 容量が小さいため、他の大容量メモリと併用 ✓ スタック数・帯域はショアライン密度で制約(パッケージ・ 電力も) ✓ 熱が最大の課題(DRAM は高温でリフレッシュ増・信頼性 低下) 帯域 計算に最も近く、HBM よりさらに高い 容量 小さい(ダイ面積で制約) 帯域 高い(例: 数 TB/s〜十数 TB/s) 帯域 高い(理論上は HBM と同等以上も可能) 電力効率 高い 容量 大きい(スタック数で拡張) 容量 中程度(演算器の面積と積層段数で制約) ショアライン 不要(ダイ内部) 電力効率 比較的高い 電力効率 高い可能性(短距離接続) 主な用途 キャッシュ、アクティブな重み・KV ショアライン 必要(ダイの外周 I/O を消費) ショアライン 不要(ダイの面で接続、TSV を使用) 併用 HBM、DDR/LPDDR、CXL など 主な用途 重み、KV キャッシュ、バッチ処理 主な用途 重み、KV キャッシュ 備考 HBM4 は 1 スタックの I/O 幅が 1,024 → 2,048 bit に 拡大 課題 熱設計、製造コスト、積層段数の制約 限られたショアライン(ダイ外周の I/O)をどのメモリ種類に割り当てるかで、帯域/容量の比率が決まる オンチップ SRAM と積層 DRAM は外周 I/O を使わない(ダイ内部の面積、ダイの面の TSV で接続)。HBM・DDR/LPDDR・CXL と PCIe・D2D(UCIe 等)は外周 I/O を共有するた め、外付けメモリを広帯域にするほど多くの I/O が要り、用途に応じた配分が要る © 2026 Gisium Inc. All rights reserved 19
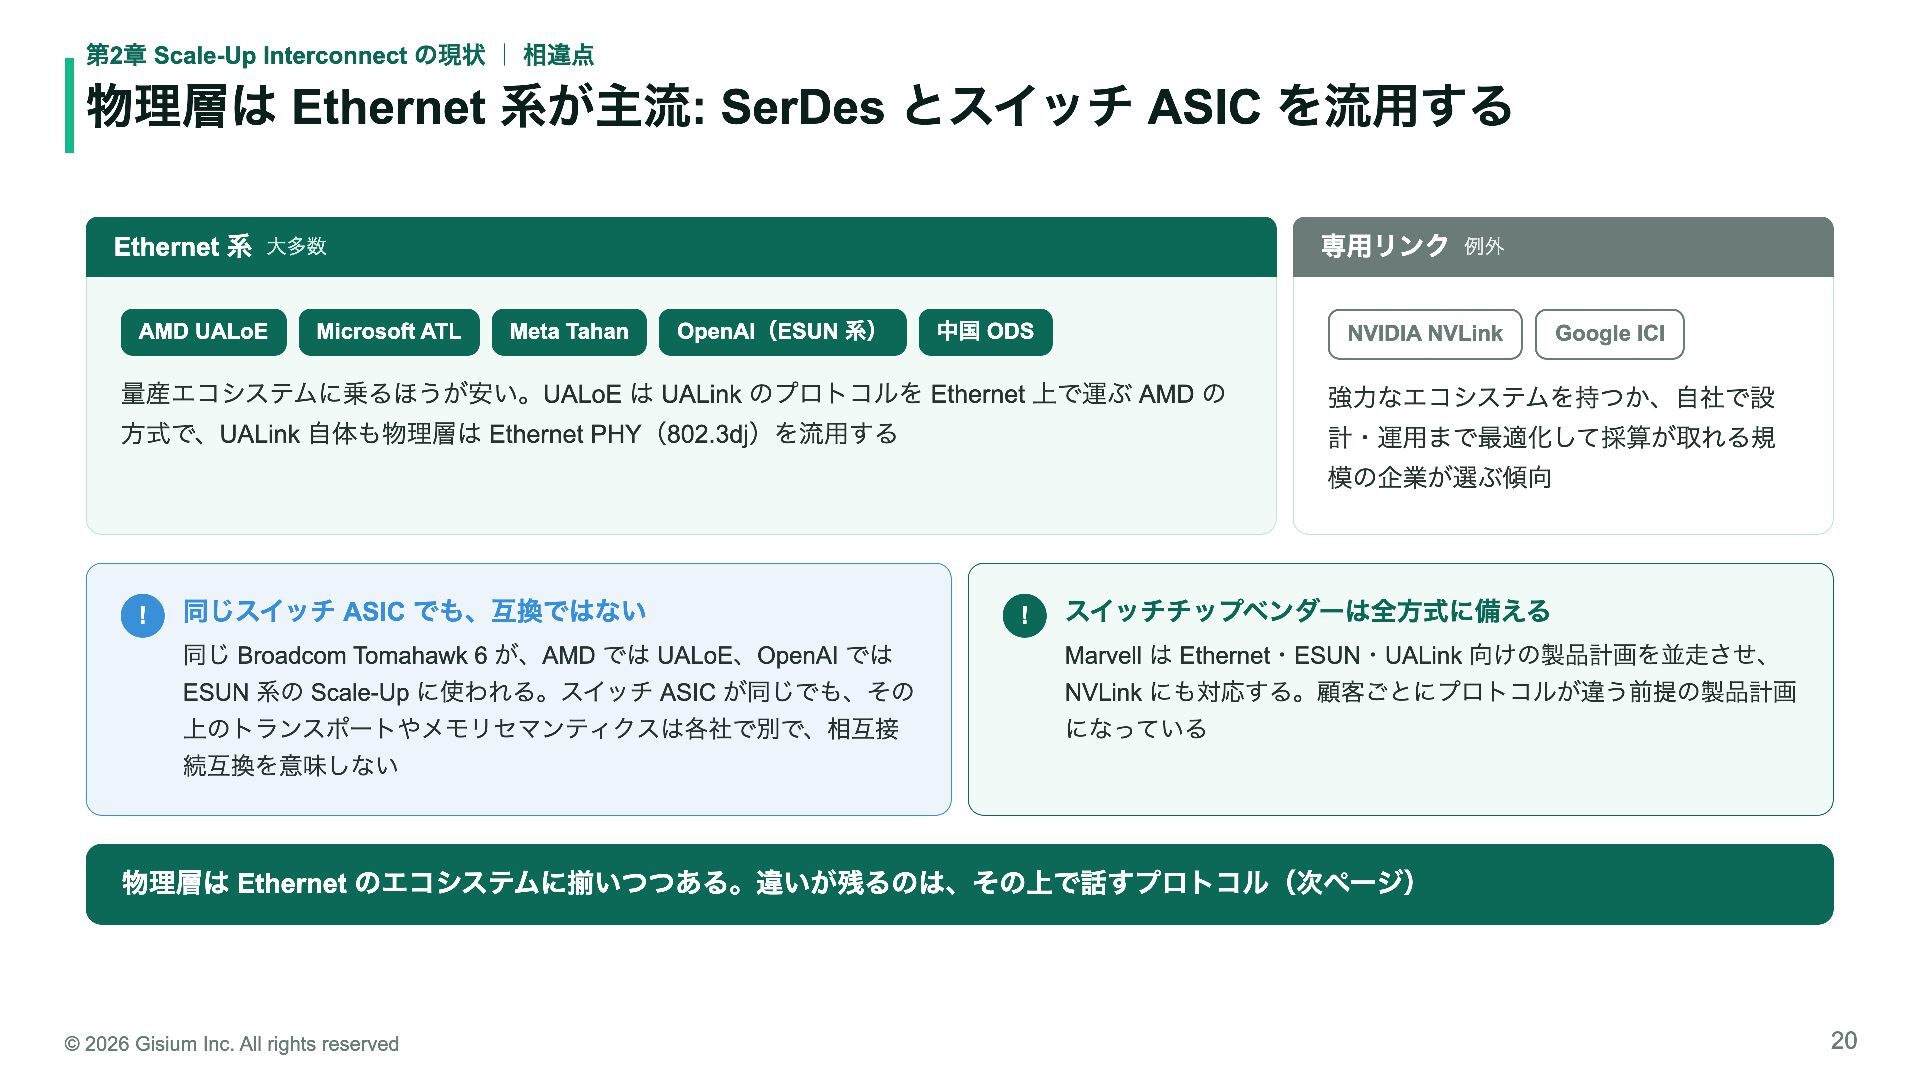
  20. 第2章 Scale-Up Interconnect の現状 | 相違点 物理層は Ethernet 系が主流: SerDes

    とスイッチ ASIC を流用する Ethernet 系 大多数 AMD UALoE Microsoft ATL 専用リンク 例外 Meta Tahan OpenAI(ESUN 系) 中国 ODS NVIDIA NVLink Google ICI 量産エコシステムに乗るほうが安い。UALoE は UALink のプロトコルを Ethernet 上で運ぶ AMD の 強力なエコシステムを持つか、自社で設 方式で、UALink 自体も物理層は Ethernet PHY(802.3dj)を流用する 計・運用まで最適化して採算が取れる規 模の企業が選ぶ傾向 ! 同じスイッチ ASIC でも、互換ではない ! スイッチチップベンダーは全方式に備える 同じ Broadcom Tomahawk 6 が、AMD では UALoE、OpenAI では Marvell は Ethernet・ESUN・UALink 向けの製品計画を並走させ、 ESUN 系の Scale-Up に使われる。スイッチ ASIC が同じでも、その NVLink にも対応する。顧客ごとにプロトコルが違う前提の製品計画 上のトランスポートやメモリセマンティクスは各社で別で、相互接 になっている 続互換を意味しない 物理層は Ethernet のエコシステムに揃いつつある。違いが残るのは、その上で話すプロトコル(次ページ) © 2026 Gisium Inc. All rights reserved 20
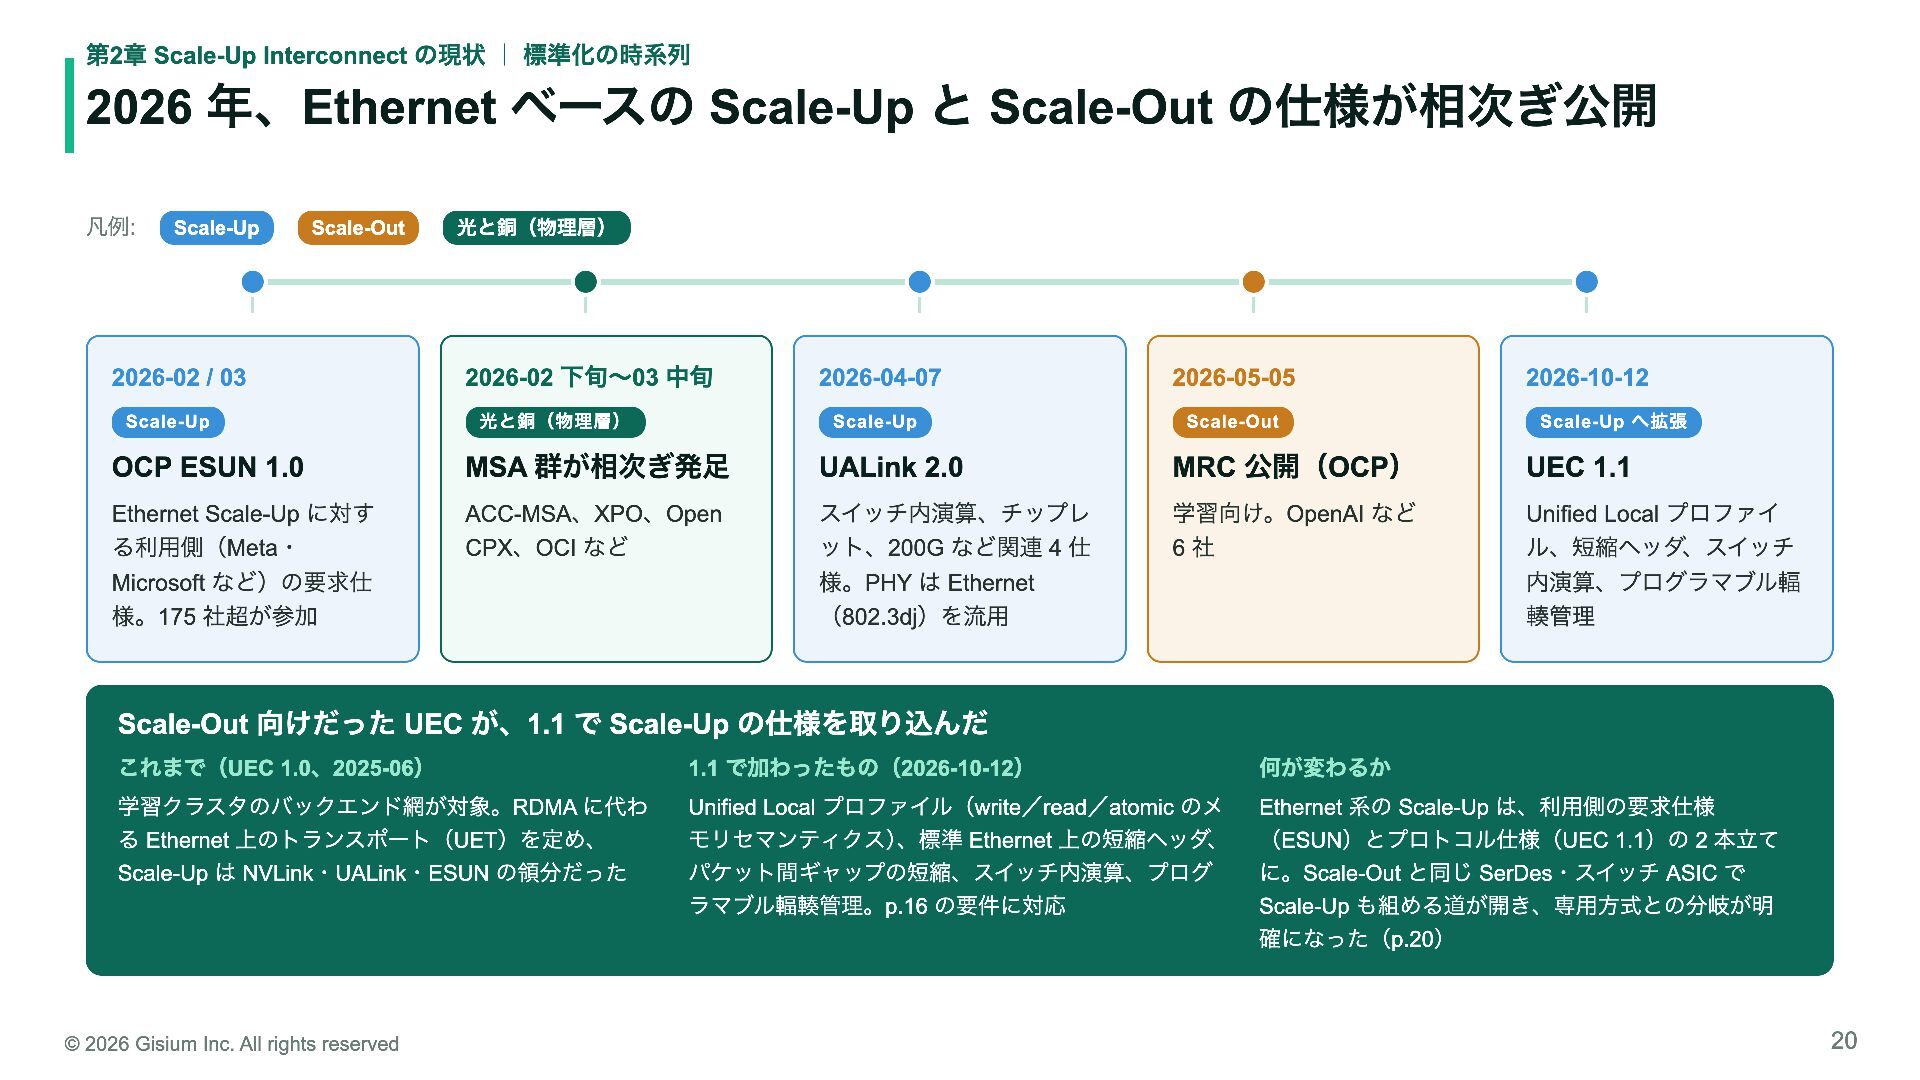
  21. 第2章 Scale-Up Interconnect の現状 | 標準化の時系列 2026 年、Ethernet ベースの Scale-Up

    と Scale-Out の仕様が相次ぎ公開 凡例: Scale-Up Scale-Out 2026-02 / 03 Scale-Up 光と銅(物理層) 2026-02 下旬〜03 中旬 光と銅(物理層) 2026-04-07 2026-05-05 Scale-Up Scale-Out 2026-10-12 Scale-Up へ拡張 OCP ESUN 1.0 MSA 群が相次ぎ発足 UALink 2.0 MRC 公開(OCP) UEC 1.1 Ethernet Scale-Up に対す る利用側(Meta・ Microsoft など)の要求仕 様。175 社超が参加 ACC-MSA、XPO、Open CPX、OCI など スイッチ内演算、チップレ ット、200G など関連 4 仕 様。PHY は Ethernet (802.3dj)を流用 学習向け。OpenAI など 6社 Unified Local プロファイ ル、短縮ヘッダ、スイッチ 内演算、プログラマブル輻 輳管理 Scale-Out 向けだった UEC が、1.1 で Scale-Up の仕様を取り込んだ これまで(UEC 1.0、2025-06) 1.1 で加わったもの(2026-10-12) 何が変わるか 学習クラスタのバックエンド網が対象。RDMA に代わ る Ethernet 上のトランスポート(UET)を定め、 Scale-Up は NVLink・UALink・ESUN の領分だった Unified Local プロファイル(write/read/atomic のメ モリセマンティクス)、標準 Ethernet 上の短縮ヘッダ、 パケット間ギャップの短縮、スイッチ内演算、プログ ラマブル輻輳管理。p.16 の要件に対応 Ethernet 系の Scale-Up は、利用側の要求仕様 (ESUN)とプロトコル仕様(UEC 1.1)の 2 本立て に。Scale-Out と同じ SerDes・スイッチ ASIC で Scale-Up も組める道が開き、専用方式との分岐が明 確になった(p.20) © 2026 Gisium Inc. All rights reserved 20
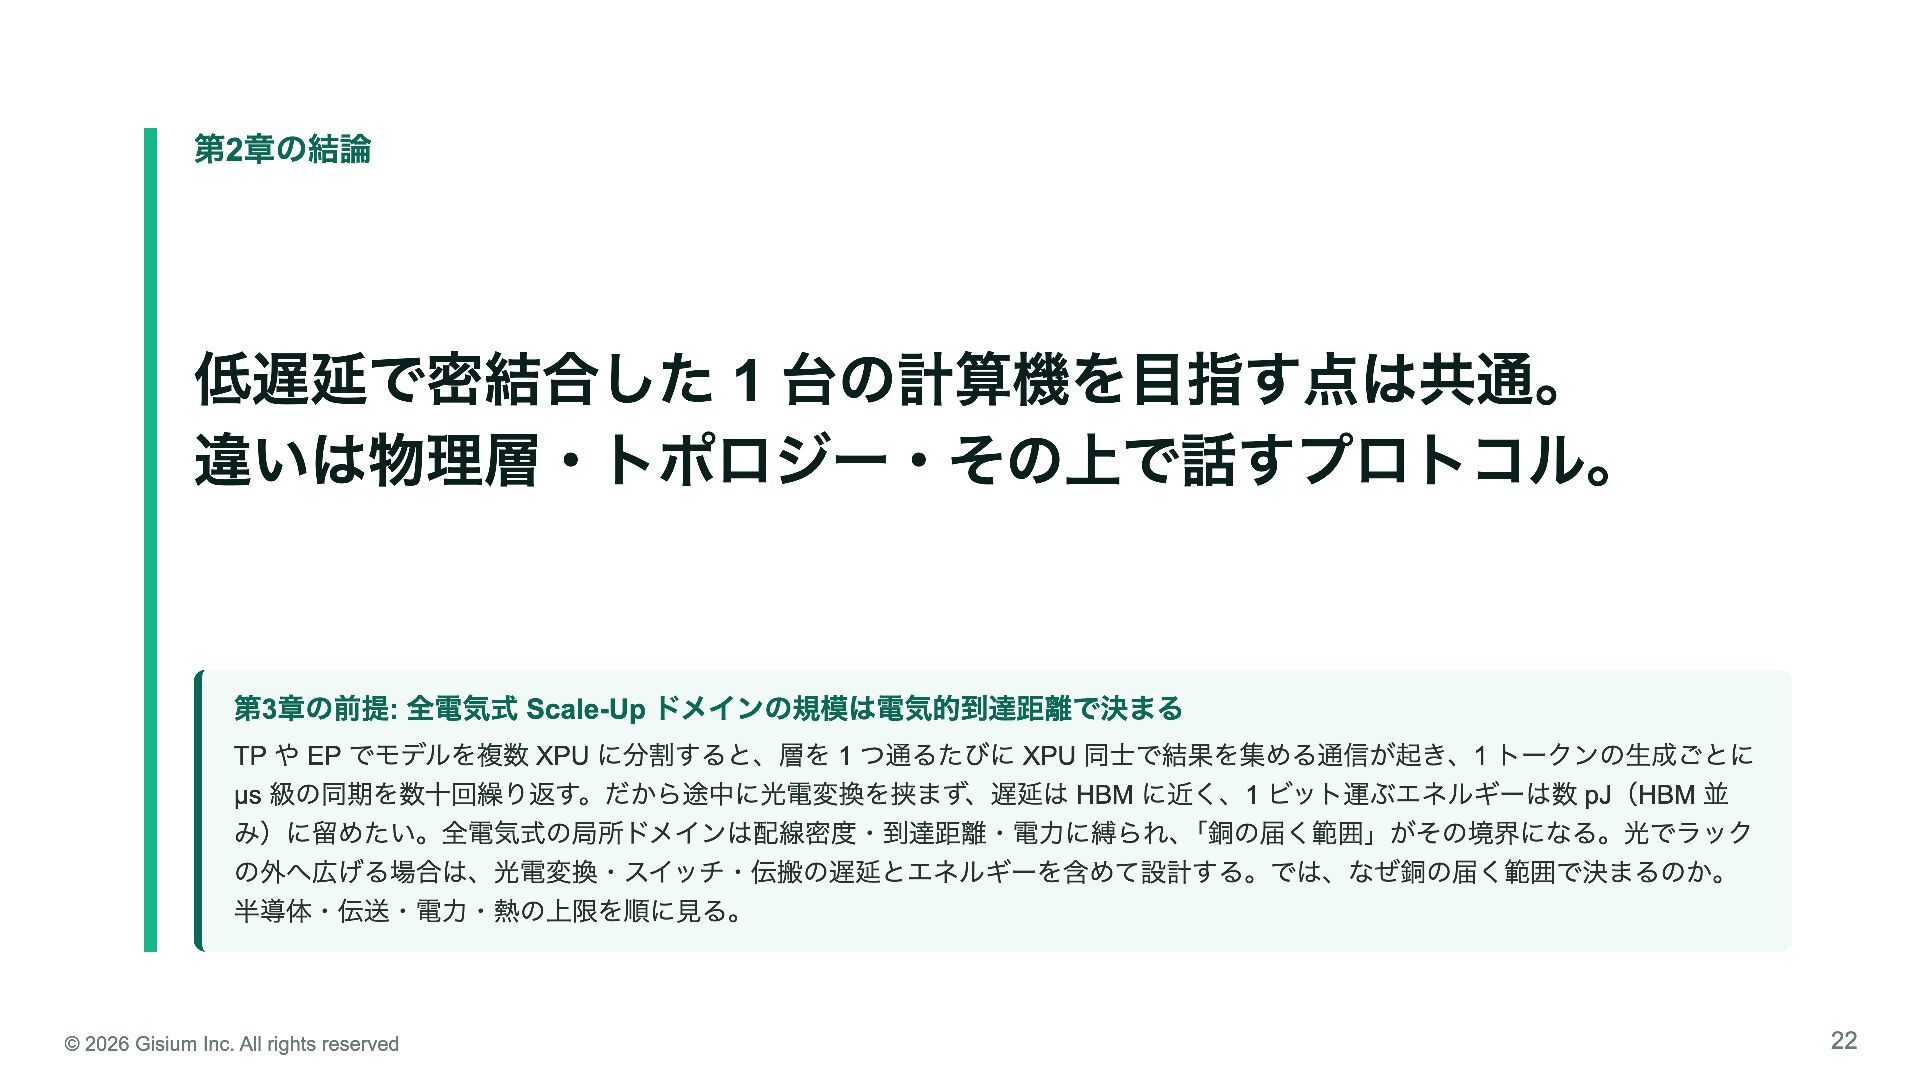
  22. 第2章の結論 低遅延で密結合した 1 台の計算機を目指す点は共通。 違いは物理層・トポロジー・その上で話すプロトコル。 第3章の前提: 全電気式 Scale-Up ドメインの規模は電気的到達距離で決まる TP

    や EP でモデルを複数 XPU に分割すると、層を 1 つ通るたびに XPU 同士で結果を集める通信が起き、1 トークンの生成ごとに µs 級の同期を数十回繰り返す。だから途中に光電変換を挟まず、遅延は HBM に近く、1 ビット運ぶエネルギーは数 pJ(HBM 並 み)に留めたい。全電気式の局所ドメインは配線密度・到達距離・電力に縛られ、「銅の届く範囲」がその境界になる。光でラック の外へ広げる場合は、光電変換・スイッチ・伝搬の遅延とエネルギーを含めて設計する。では、なぜ銅の届く範囲で決まるのか。 半導体・伝送・電力・熱の上限を順に見る。 © 2026 Gisium Inc. All rights reserved 22
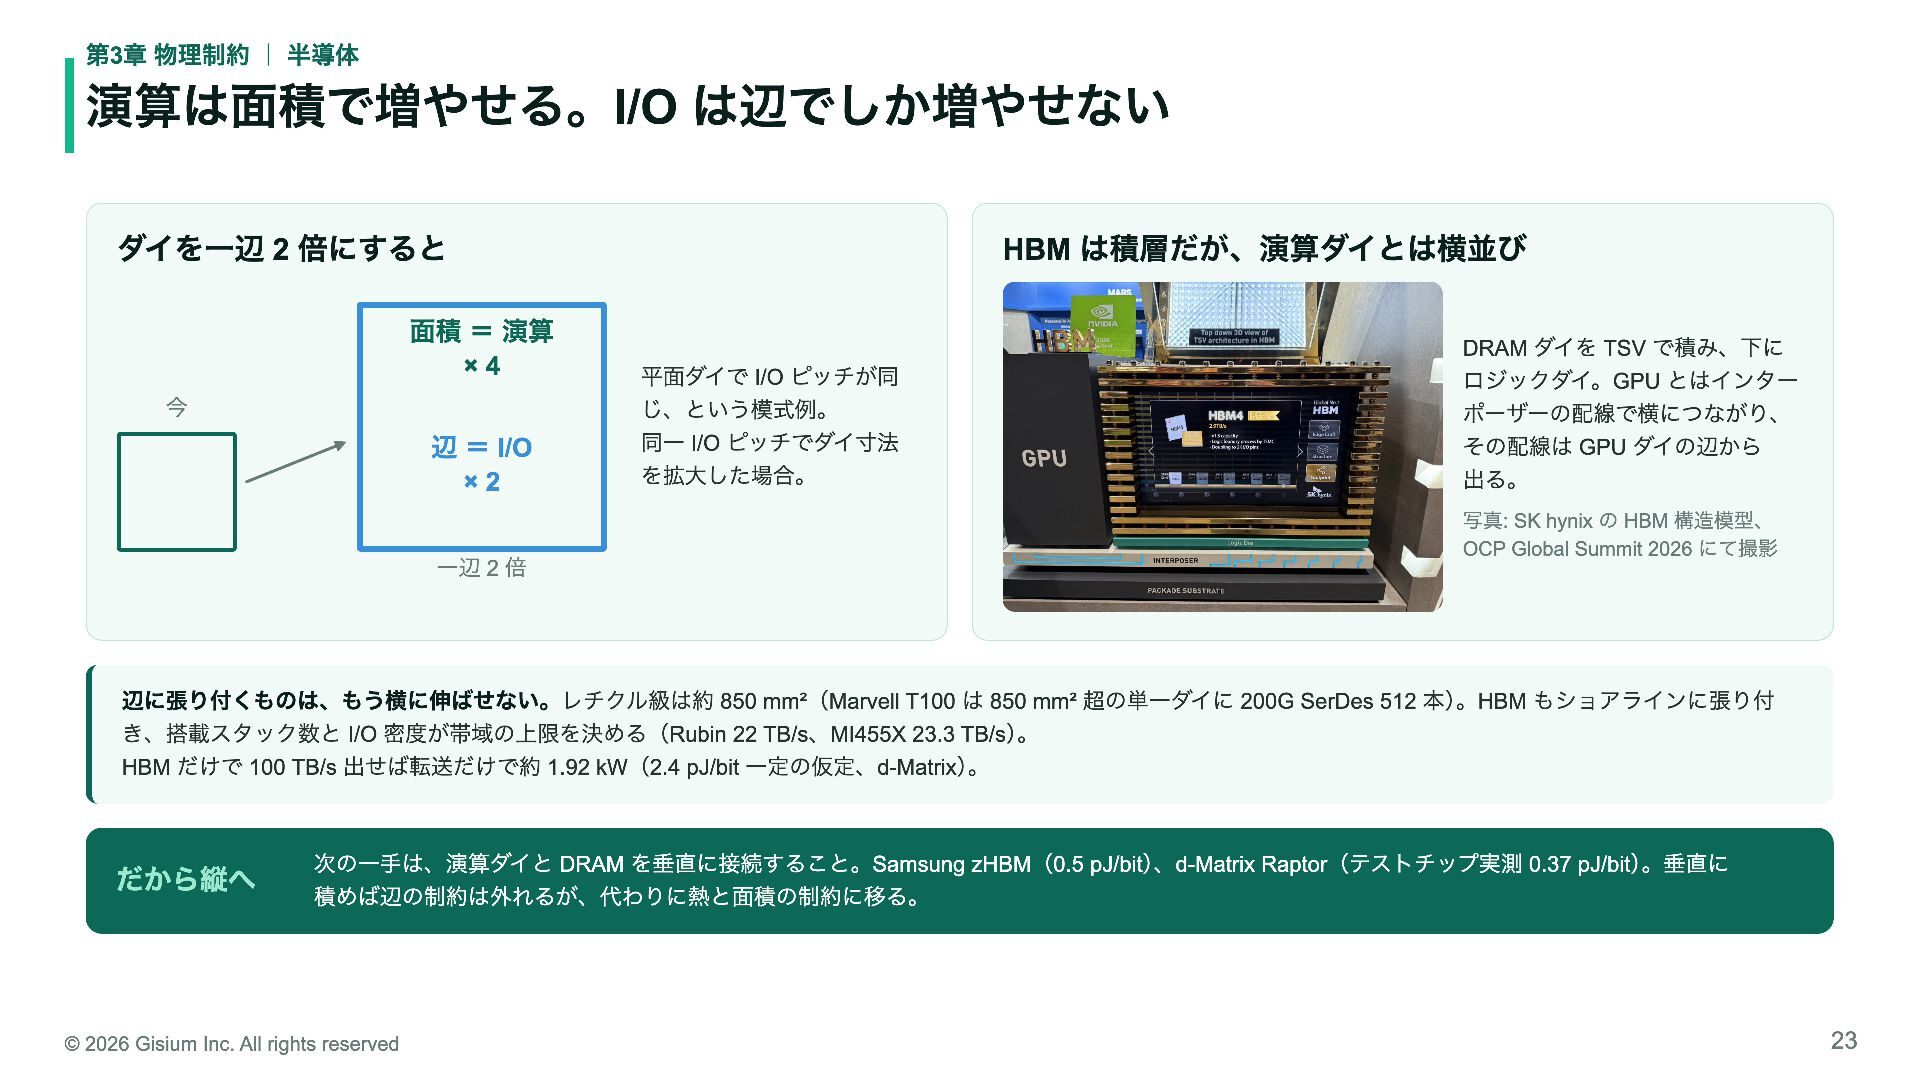
  23. 第3章 物理制約 | 半導体 演算は面積で増やせる。I/O は辺でしか増やせない ダイを一辺 2 倍にすると 面積

    = 演算 ×4 今 辺 = I/O ×2 HBM は積層だが、演算ダイとは横並び 平面ダイで I/O ピッチが同 じ、という模式例。 同一 I/O ピッチでダイ寸法 を拡大した場合。 DRAM ダイを TSV で積み、下に ロジックダイ。GPU とはインター ポーザーの配線で横につながり、 その配線は GPU ダイの辺から 出る。 写真: SK hynix の HBM 構造模型、 OCP Global Summit 2026 にて撮影 一辺 2 倍 辺に張り付くものは、もう横に伸ばせない。レチクル級は約 850 mm²(Marvell T100 は 850 mm² 超の単一ダイに 200G SerDes 512 本)。HBM もショアラインに張り付 き、搭載スタック数と I/O 密度が帯域の上限を決める(Rubin 22 TB/s、MI455X 23.3 TB/s)。 HBM だけで 100 TB/s 出せば転送だけで約 1.92 kW(2.4 pJ/bit 一定の仮定、d-Matrix)。 だから縦へ 次の一手は、演算ダイと DRAM を垂直に接続すること。Samsung zHBM(0.5 pJ/bit)、d-Matrix Raptor(テストチップ実測 0.37 pJ/bit)。垂直に 積めば辺の制約は外れるが、代わりに熱と面積の制約に移る。 © 2026 Gisium Inc. All rights reserved 23
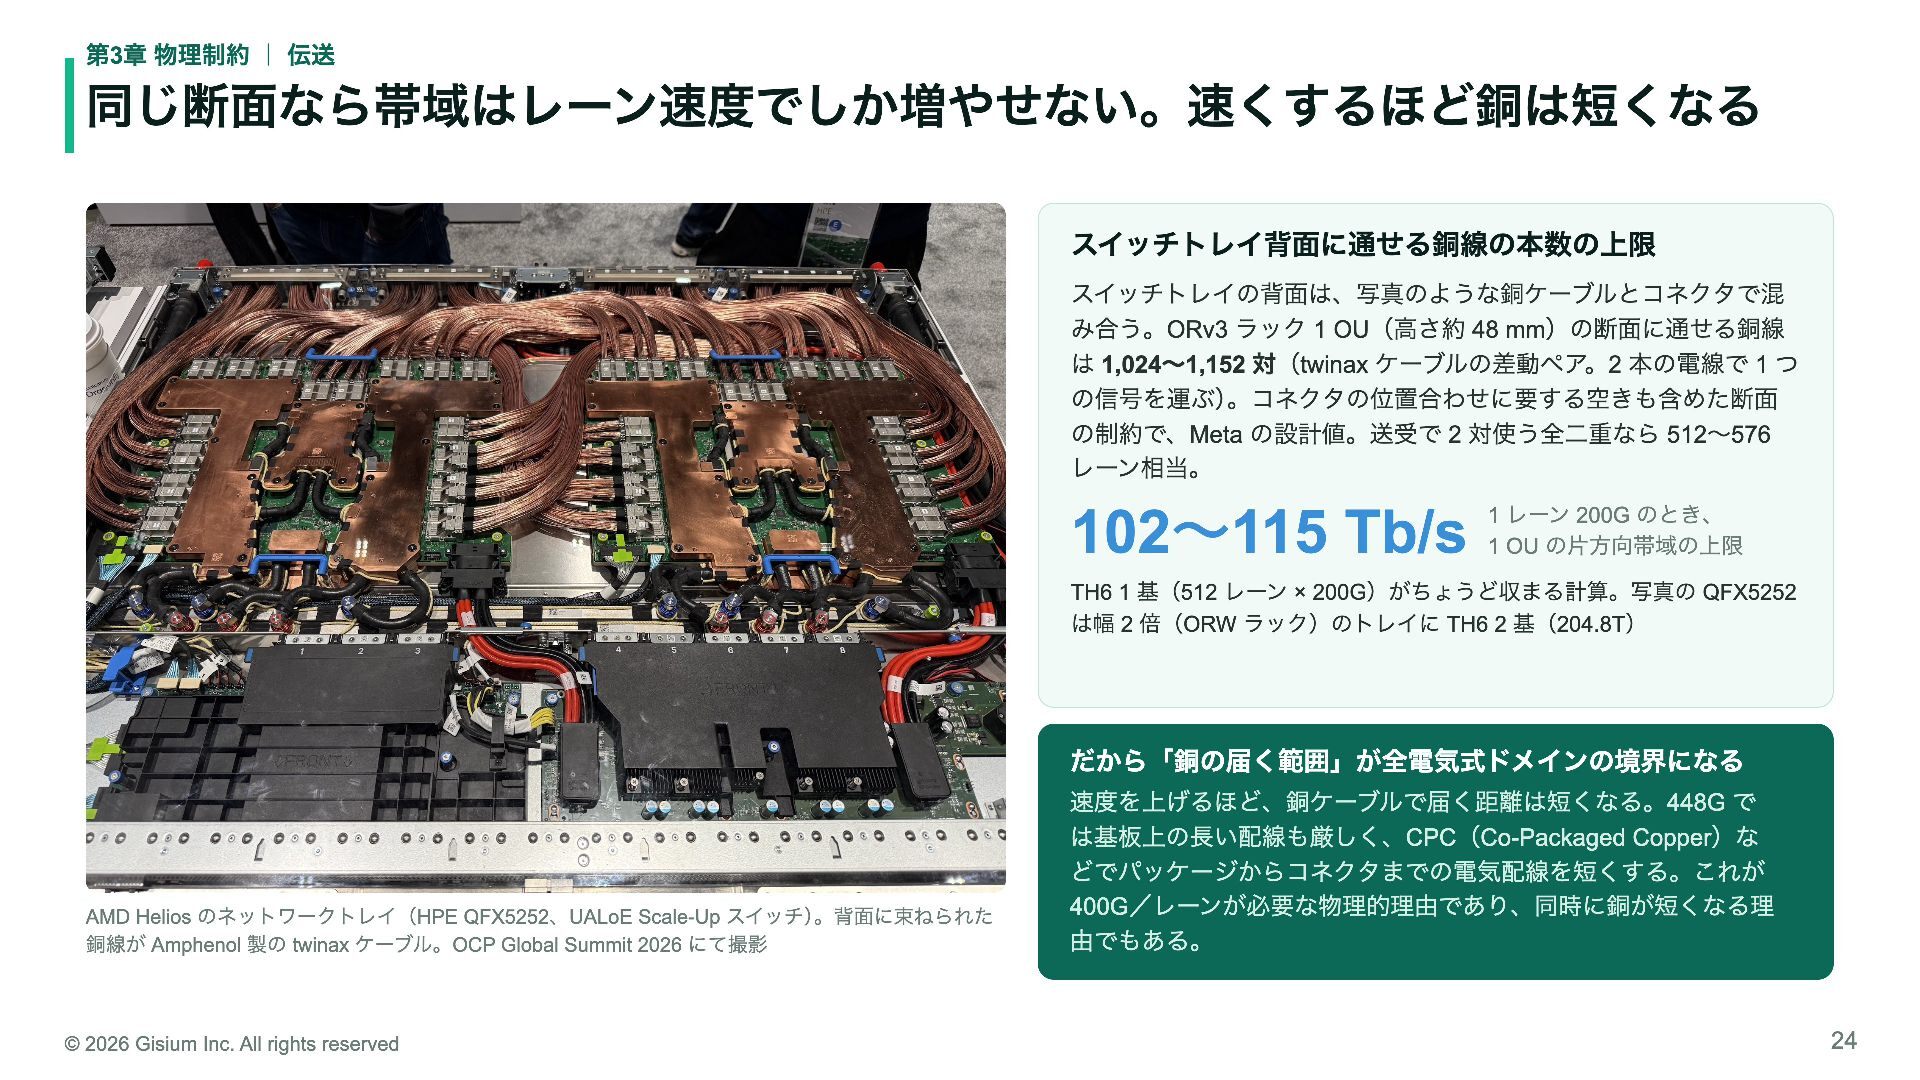
  24. 第3章 物理制約 | 伝送 同じ断面なら帯域はレーン速度でしか増やせない。速くするほど銅は短くなる スイッチトレイ背面に通せる銅線の本数の上限 スイッチトレイの背面は、写真のような銅ケーブルとコネクタで混 み合う。ORv3 ラック 1

    OU(高さ約 48 mm)の断面に通せる銅線 は 1,024〜1,152 対(twinax ケーブルの差動ペア。2 本の電線で 1 つ の信号を運ぶ)。コネクタの位置合わせに要する空きも含めた断面 の制約で、Meta の設計値。送受で 2 対使う全二重なら 512〜576 レーン相当。 102〜115 Tb/s 1 レーン 200G のとき、 1 OU の片方向帯域の上限 TH6 1 基(512 レーン × 200G)がちょうど収まる計算。写真の QFX5252 は幅 2 倍(ORW ラック)のトレイに TH6 2 基(204.8T) だから「銅の届く範囲」が全電気式ドメインの境界になる AMD Helios のネットワークトレイ(HPE QFX5252、UALoE Scale-Up スイッチ)。背面に束ねられた 銅線が Amphenol 製の twinax ケーブル。OCP Global Summit 2026 にて撮影 © 2026 Gisium Inc. All rights reserved 速度を上げるほど、銅ケーブルで届く距離は短くなる。448G で は基板上の長い配線も厳しく、CPC(Co-Packaged Copper)な どでパッケージからコネクタまでの電気配線を短くする。これが 400G/レーンが必要な物理的理由であり、同時に銅が短くなる理 由でもある。 24
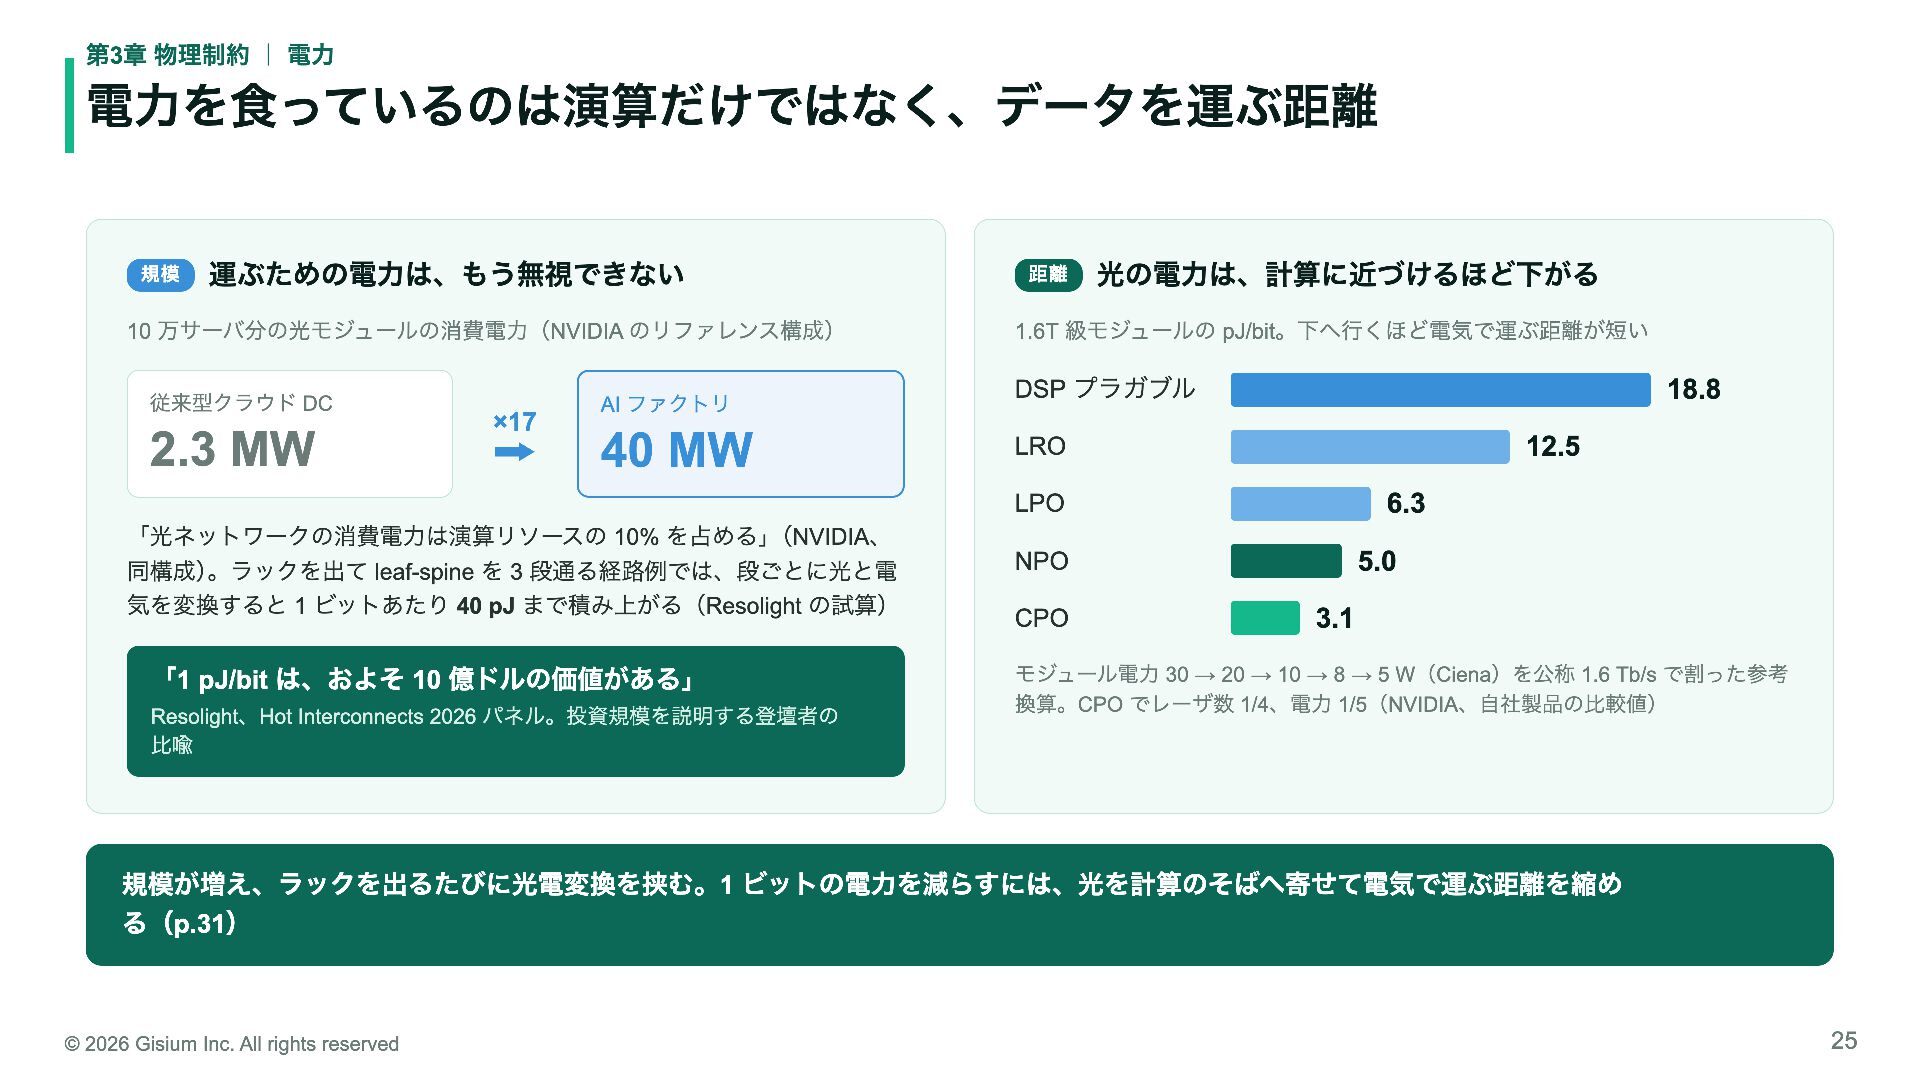
  25. 第3章 物理制約 | 電力 電力を食っているのは演算だけではなく、データを運ぶ距離 規模 運ぶための電力は、もう無視できない 10 万サーバ分の光モジュールの消費電力(NVIDIA のリファレンス構成)

    従来型クラウド DC 2.3 MW ×17 AI ファクトリ 40 MW 距離 光の電力は、計算に近づけるほど下がる 1.6T 級モジュールの pJ/bit。下へ行くほど電気で運ぶ距離が短い 18.8 DSP プラガブル 12.5 LRO 6.3 LPO 「光ネットワークの消費電力は演算リソースの 10% を占める」(NVIDIA、 同構成)。ラックを出て leaf-spine を 3 段通る経路例では、段ごとに光と電 気を変換すると 1 ビットあたり 40 pJ まで積み上がる(Resolight の試算) 「1 pJ/bit は、およそ 10 億ドルの価値がある」 Resolight、Hot Interconnects 2026 パネル。投資規模を説明する登壇者の 比喩 5.0 NPO CPO 3.1 モジュール電力 30 → 20 → 10 → 8 → 5 W(Ciena)を公称 1.6 Tb/s で割った参考 換算。CPO でレーザ数 1/4、電力 1/5(NVIDIA、自社製品の比較値) 規模が増え、ラックを出るたびに光電変換を挟む。1 ビットの電力を減らすには、光を計算のそばへ寄せて電気で運ぶ距離を縮め る(p.31) © 2026 Gisium Inc. All rights reserved 25
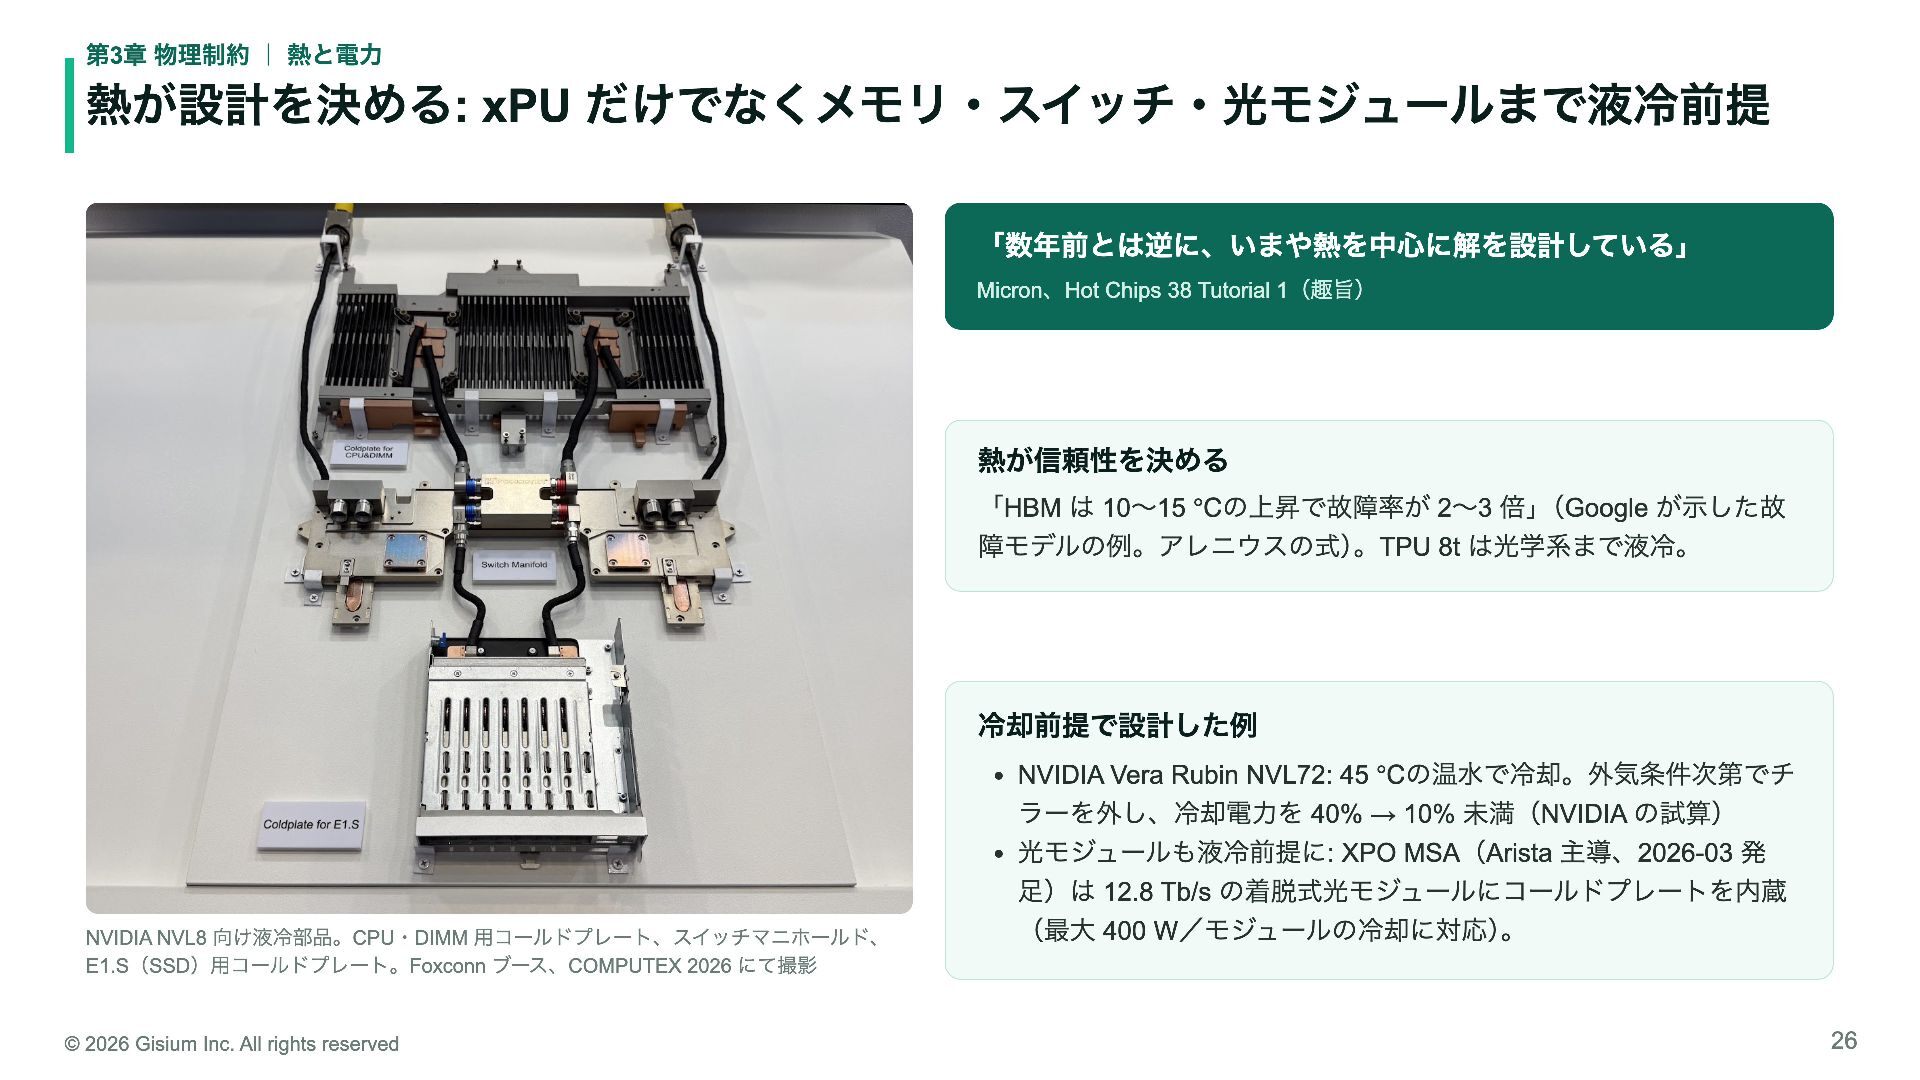
  26. 第3章 物理制約 | 熱と電力 熱が設計を決める: xPU だけでなくメモリ・スイッチ・光モジュールまで液冷前提 「数年前とは逆に、いまや熱を中心に解を設計している」 Micron、Hot Chips

    38 Tutorial 1(趣旨) 熱が信頼性を決める 「HBM は 10〜15 ℃の上昇で故障率が 2〜3 倍」(Google が示した故 障モデルの例。アレニウスの式)。TPU 8t は光学系まで液冷。 冷却前提で設計した例 NVIDIA NVL8 向け液冷部品。CPU・DIMM 用コールドプレート、スイッチマニホールド、 E1.S(SSD)用コールドプレート。Foxconn ブース、COMPUTEX 2026 にて撮影 © 2026 Gisium Inc. All rights reserved NVIDIA Vera Rubin NVL72: 45 ℃の温水で冷却。外気条件次第でチ ラーを外し、冷却電力を 40% → 10% 未満(NVIDIA の試算) 光モジュールも液冷前提に: XPO MSA(Arista 主導、2026-03 発 足)は 12.8 Tb/s の着脱式光モジュールにコールドプレートを内蔵 (最大 400 W/モジュールの冷却に対応)。 26
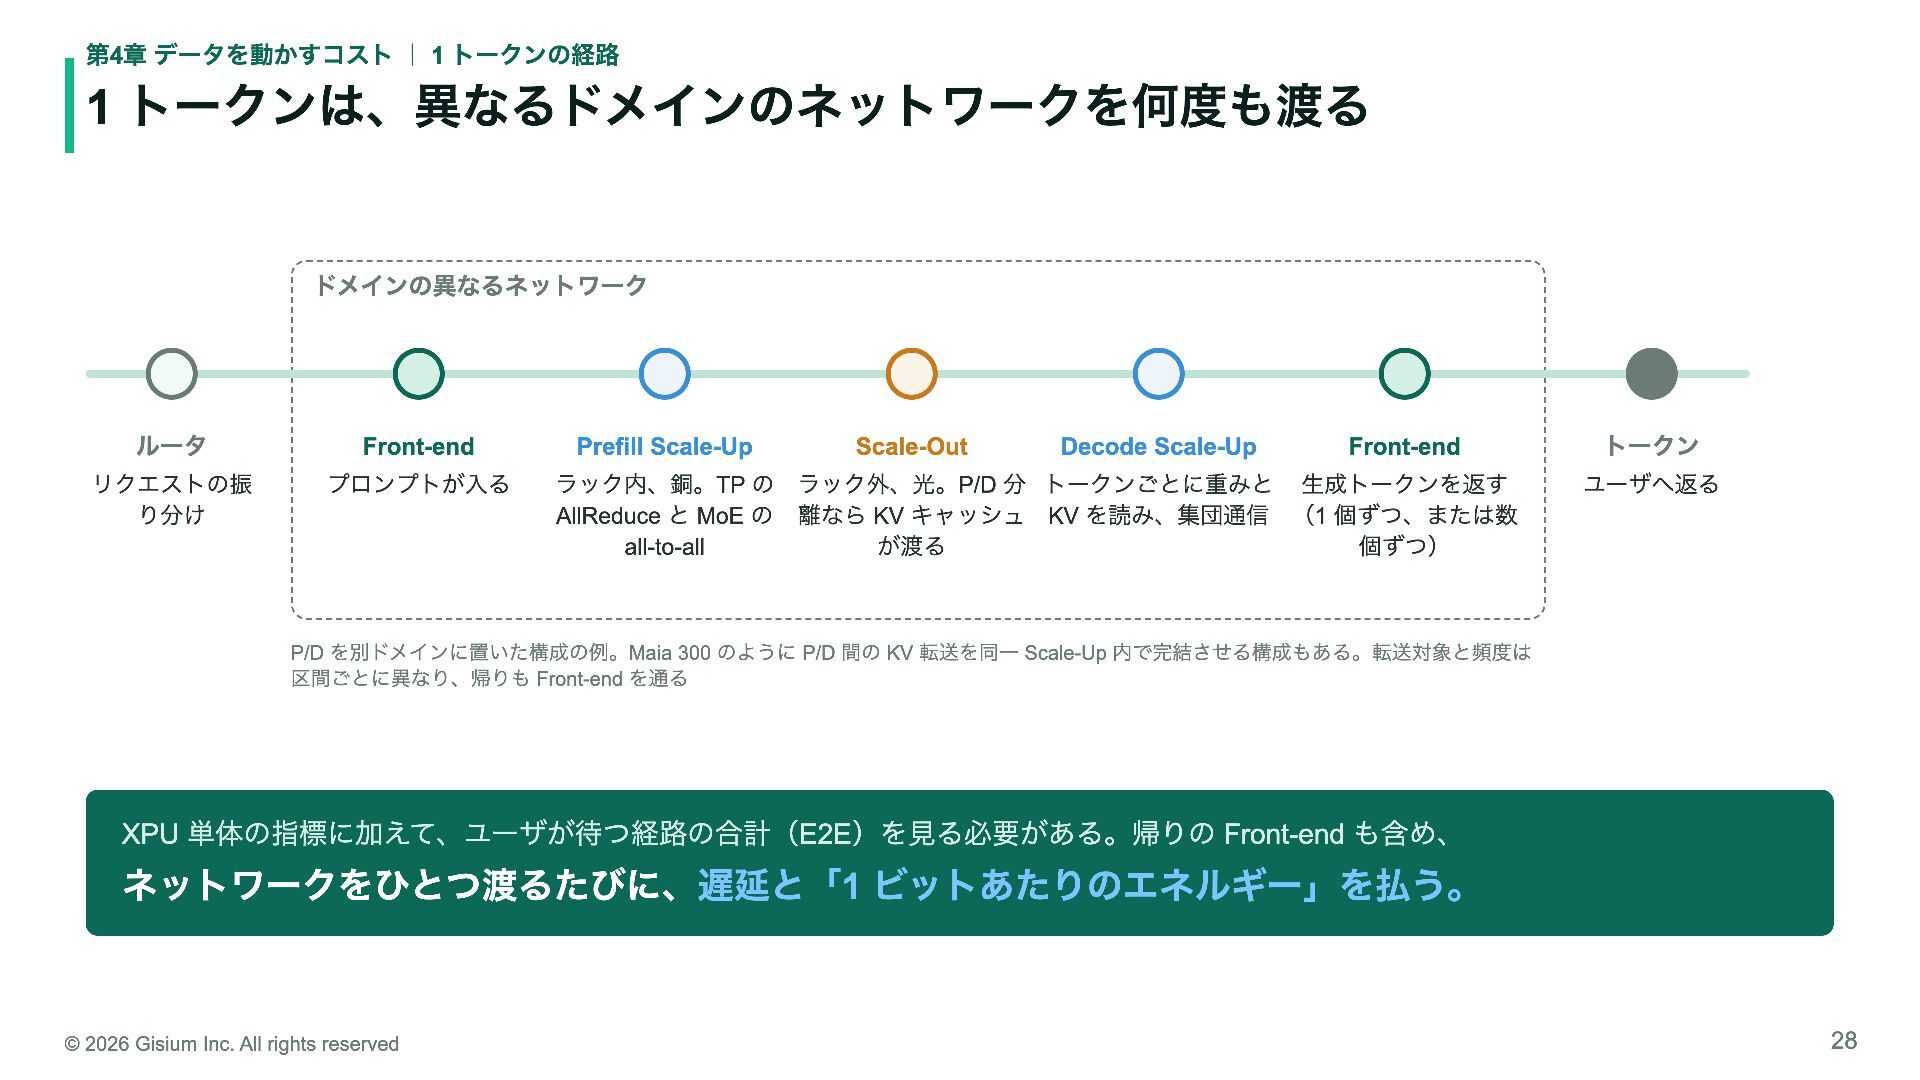
  27. 第4章 データを動かすコスト | 1 トークンの経路 1 トークンは、異なるドメインのネットワークを何度も渡る ドメインの異なるネットワーク ルータ Front-end

    リクエストの振 り分け プロンプトが入る Prefill Scale-Up Scale-Out Decode Scale-Up Front-end ラック内、銅。TP の ラック外、光。P/D 分 トークンごとに重みと 生成トークンを返す AllReduce と MoE の 離なら KV キャッシュ KV を読み、集団通信 (1 個ずつ、または数 all-to-all が渡る 個ずつ) トークン ユーザへ返る P/D を別ドメインに置いた構成の例。Maia 300 のように P/D 間の KV 転送を同一 Scale-Up 内で完結させる構成もある。転送対象と頻度は 区間ごとに異なり、帰りも Front-end を通る XPU 単体の指標に加えて、ユーザが待つ経路の合計(E2E)を見る必要がある。帰りの Front-end も含め、 ネットワークをひとつ渡るたびに、遅延と「1 ビットあたりのエネルギー」を払う。 © 2026 Gisium Inc. All rights reserved 28
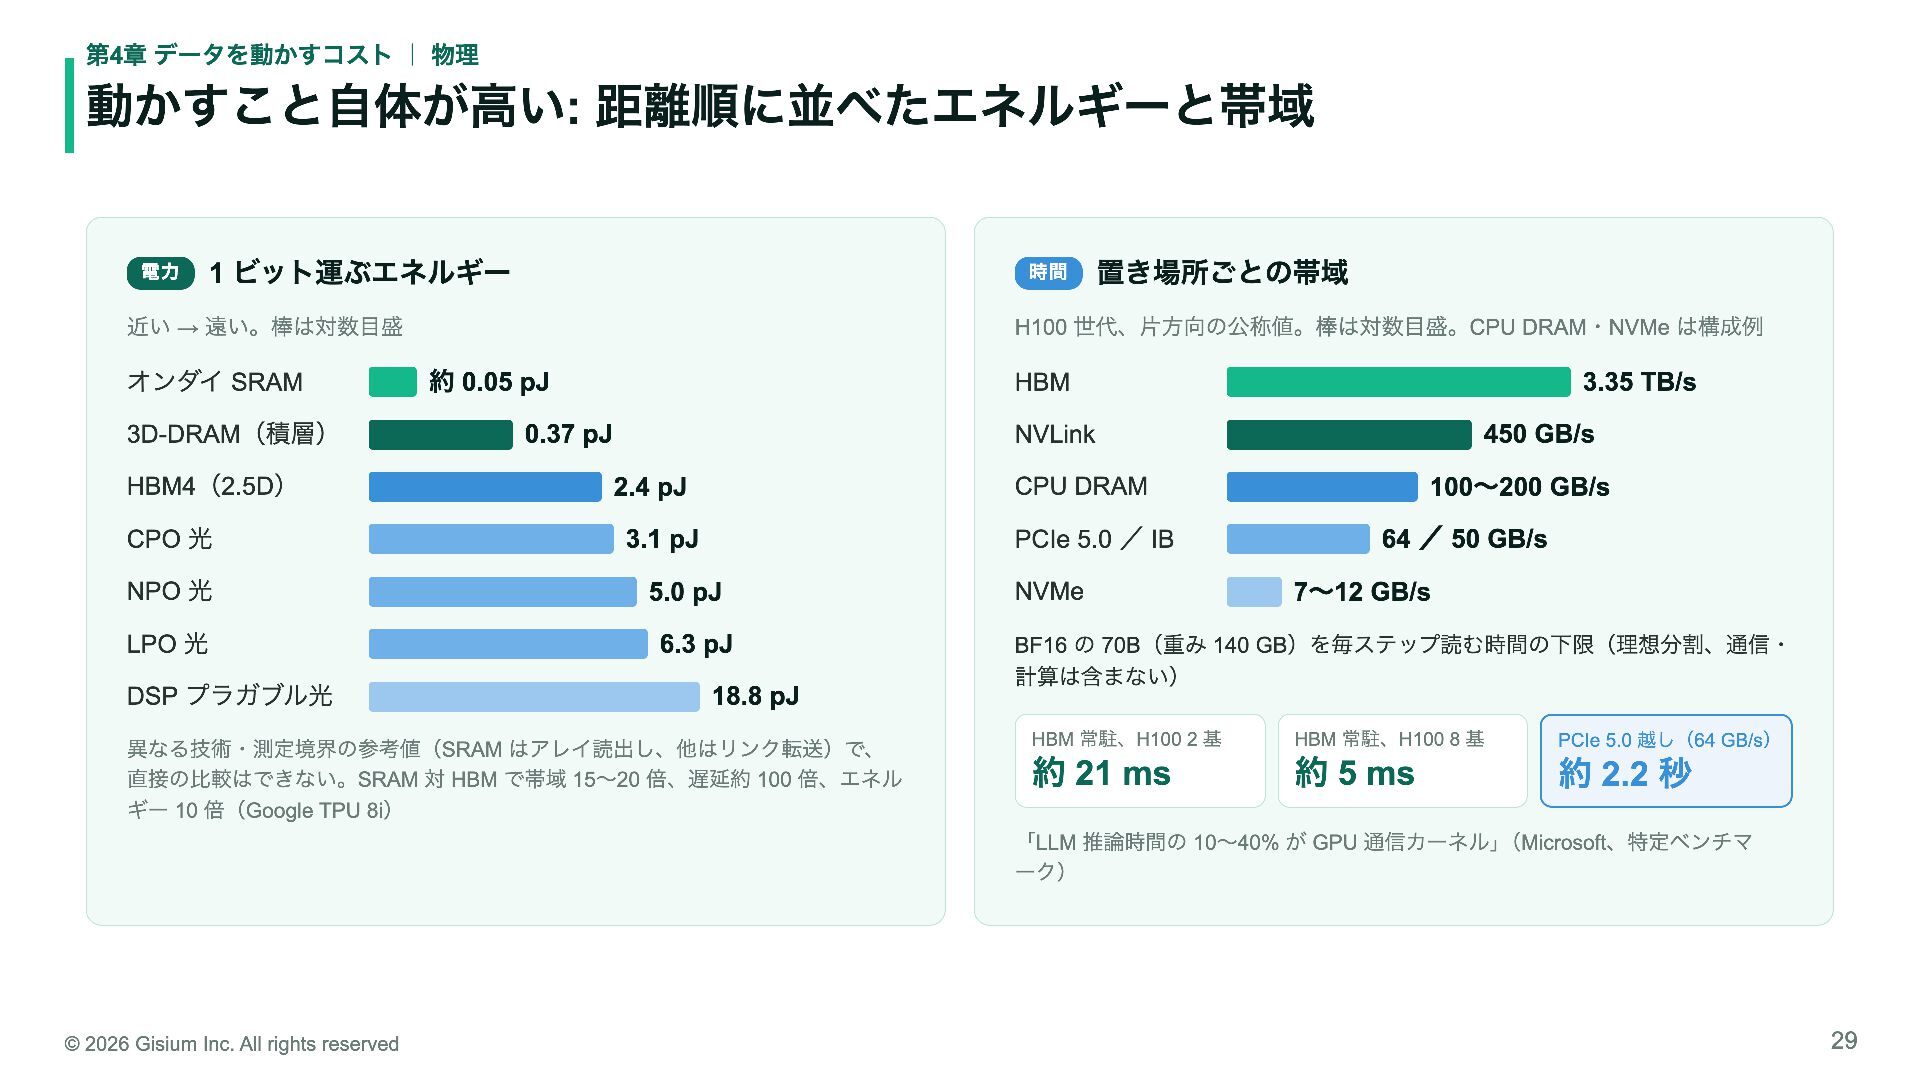
  28. 第4章 データを動かすコスト | 物理 動かすこと自体が高い: 距離順に並べたエネルギーと帯域 電力 1 ビット運ぶエネルギー 時間

    近い → 遠い。棒は対数目盛 オンダイ SRAM 3D-DRAM(積層) 置き場所ごとの帯域 H100 世代、片方向の公称値。棒は対数目盛。CPU DRAM・NVMe は構成例 約 0.05 pJ 3.35 TB/s HBM 0.37 pJ 450 GB/s NVLink HBM4(2.5D) 2.4 pJ CPU DRAM CPO 光 3.1 pJ PCIe 5.0 / IB 100〜200 GB/s 64 / 50 GB/s NPO 光 5.0 pJ NVMe LPO 光 6.3 pJ BF16 の 70B(重み 140 GB)を毎ステップ読む時間の下限(理想分割、通信・ 計算は含まない) DSP プラガブル光 18.8 pJ 異なる技術・測定境界の参考値(SRAM はアレイ読出し、他はリンク転送)で、 直接の比較はできない。SRAM 対 HBM で帯域 15〜20 倍、遅延約 100 倍、エネル ギー 10 倍(Google TPU 8i) 7〜12 GB/s HBM 常駐、H100 2 基 HBM 常駐、H100 8 基 PCIe 5.0 越し(64 GB/s) 約 21 ms 約 5 ms 約 2.2 秒 「LLM 推論時間の 10〜40% が GPU 通信カーネル」(Microsoft、特定ベンチマ ーク) © 2026 Gisium Inc. All rights reserved 29
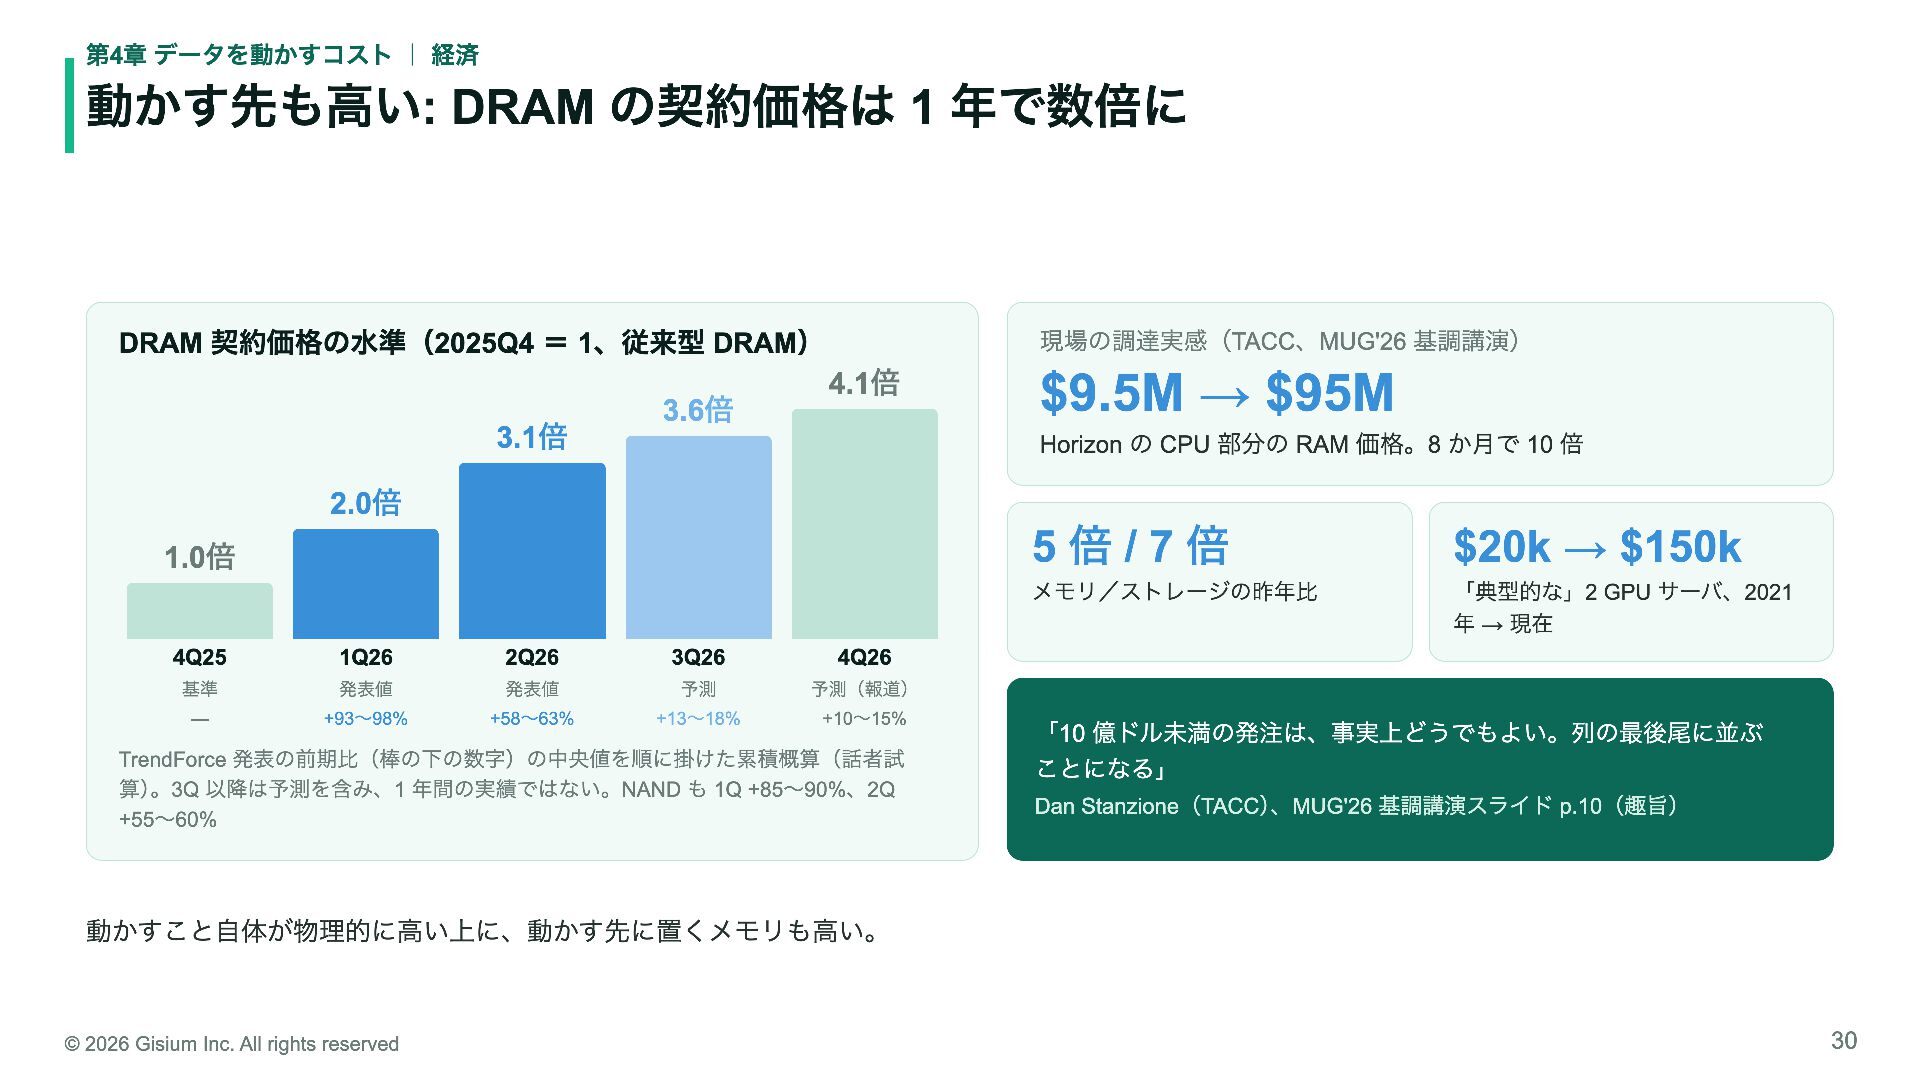
  29. 第4章 データを動かすコスト | 経済 動かす先も高い: DRAM の契約価格は 1 年で数倍に 現場の調達実感(TACC、MUG'26

    基調講演) DRAM 契約価格の水準(2025Q4 = 1、従来型 DRAM) 3.1倍 3.6倍 4.1倍 $9.5M → $95M Horizon の CPU 部分の RAM 価格。8 か月で 10 倍 2.0倍 1.0倍 4Q25 1Q26 2Q26 3Q26 4Q26 基準 発表値 発表値 予測 予測(報道) — +93〜98% +58〜63% +13〜18% +10〜15% TrendForce 発表の前期比(棒の下の数字)の中央値を順に掛けた累積概算(話者試 算)。3Q 以降は予測を含み、1 年間の実績ではない。NAND も 1Q +85〜90%、2Q +55〜60% 5倍/7倍 $20k → $150k メモリ/ストレージの昨年比 「典型的な」2 GPU サーバ、2021 年 → 現在 「10 億ドル未満の発注は、事実上どうでもよい。列の最後尾に並ぶ ことになる」 Dan Stanzione(TACC)、MUG'26 基調講演スライド p.10(趣旨) 動かすこと自体が物理的に高い上に、動かす先に置くメモリも高い。 © 2026 Gisium Inc. All rights reserved 30
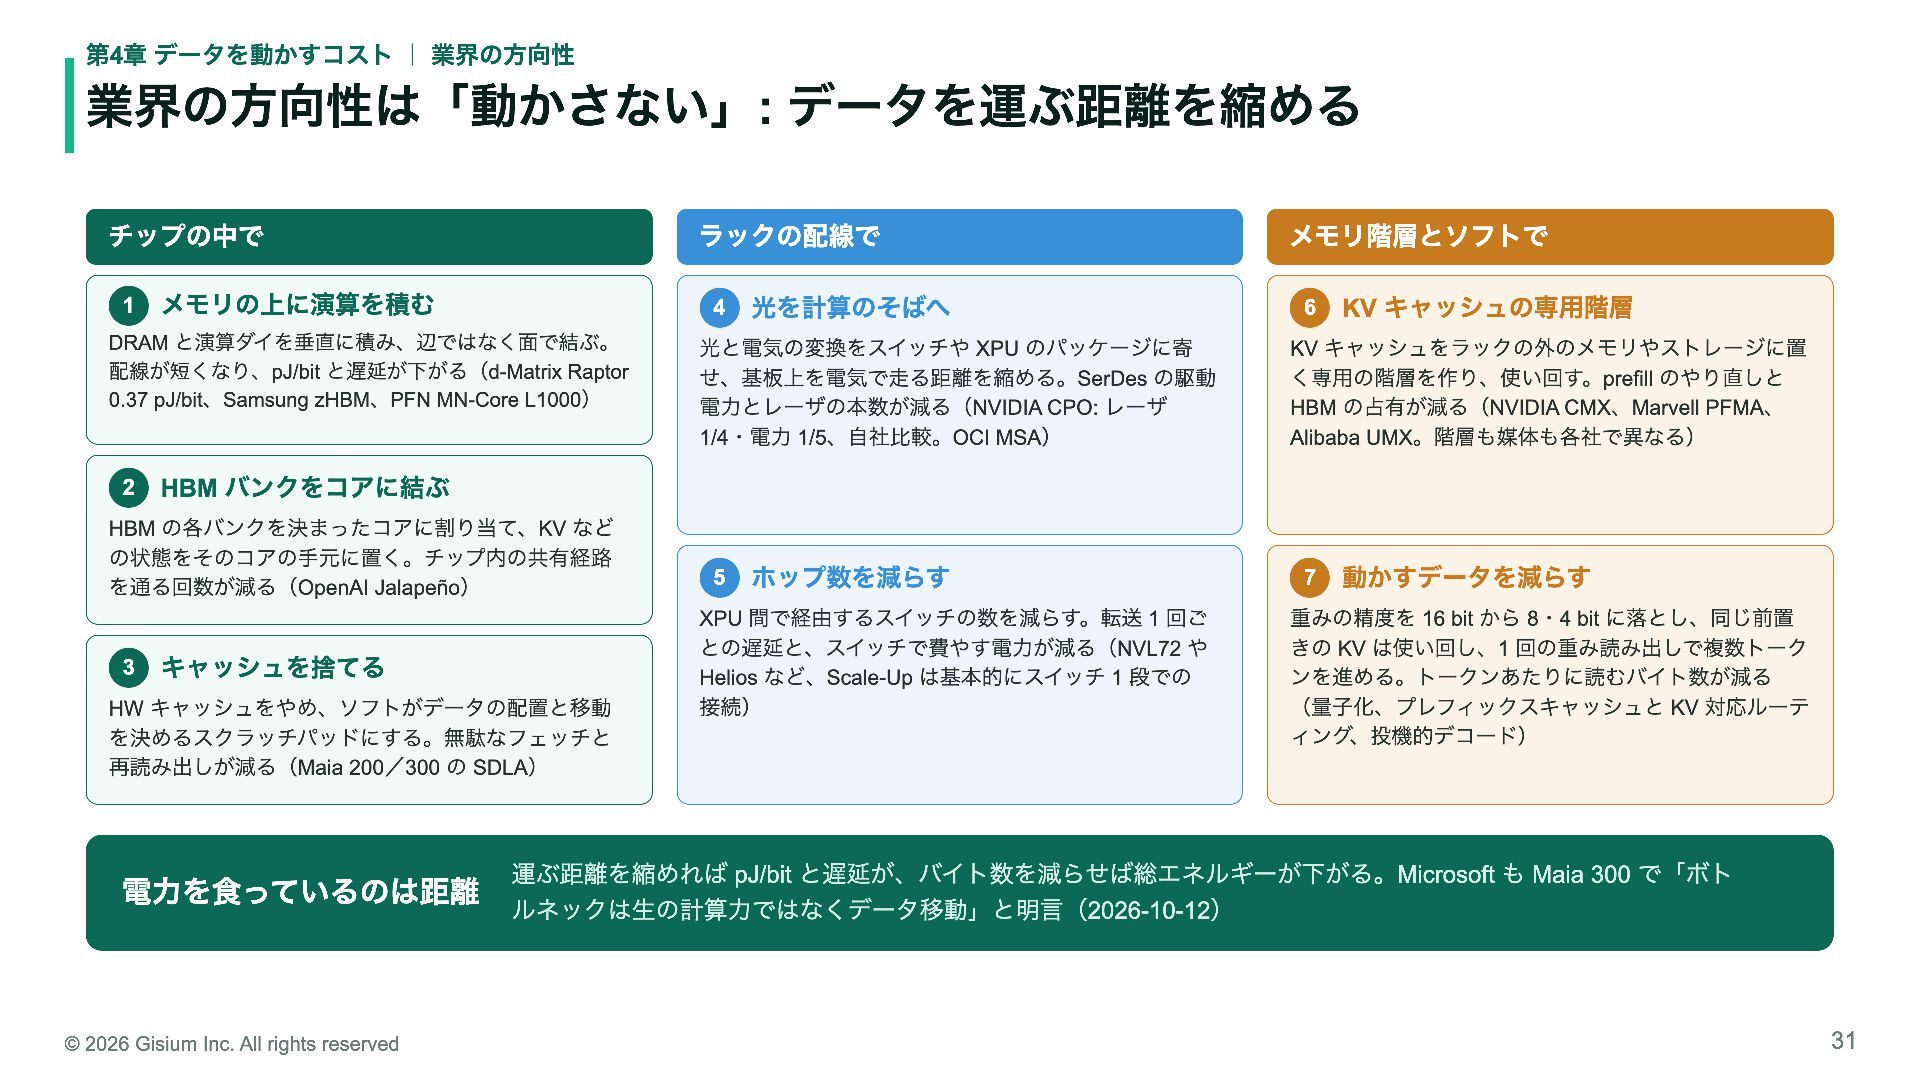
  30. 第4章 データを動かすコスト | 業界の方向性 業界の方向性は「動かさない」: データを運ぶ距離を縮める チップの中で 1 ラックの配線で メモリの上に演算を積む

    4 DRAM と演算ダイを垂直に積み、辺ではなく面で結ぶ。 配線が短くなり、pJ/bit と遅延が下がる(d-Matrix Raptor 0.37 pJ/bit、Samsung zHBM、PFN MN-Core L1000) 2 光と電気の変換をスイッチや XPU のパッケージに寄 せ、基板上を電気で走る距離を縮める。SerDes の駆動 電力とレーザの本数が減る(NVIDIA CPO: レーザ 1/4・電力 1/5、自社比較。OCI MSA) 6 KV キャッシュの専用階層 KV キャッシュをラックの外のメモリやストレージに置 く専用の階層を作り、使い回す。prefill のやり直しと HBM の占有が減る(NVIDIA CMX、Marvell PFMA、 Alibaba UMX。階層も媒体も各社で異なる) HBM バンクをコアに結ぶ HBM の各バンクを決まったコアに割り当て、KV など の状態をそのコアの手元に置く。チップ内の共有経路 を通る回数が減る(OpenAI Jalapeño) 3 光を計算のそばへ メモリ階層とソフトで キャッシュを捨てる HW キャッシュをやめ、ソフトがデータの配置と移動 を決めるスクラッチパッドにする。無駄なフェッチと 再読み出しが減る(Maia 200/300 の SDLA) 電力を食っているのは距離 © 2026 Gisium Inc. All rights reserved 5 ホップ数を減らす XPU 間で経由するスイッチの数を減らす。転送 1 回ご との遅延と、スイッチで費やす電力が減る(NVL72 や Helios など、Scale-Up は基本的にスイッチ 1 段での 接続) 7 動かすデータを減らす 重みの精度を 16 bit から 8・4 bit に落とし、同じ前置 きの KV は使い回し、1 回の重み読み出しで複数トーク ンを進める。トークンあたりに読むバイト数が減る (量子化、プレフィックスキャッシュと KV 対応ルーテ ィング、投機的デコード) 運ぶ距離を縮めれば pJ/bit と遅延が、バイト数を減らせば総エネルギーが下がる。Microsoft も Maia 300 で「ボト ルネックは生の計算力ではなくデータ移動」と明言(2026-10-12) 31
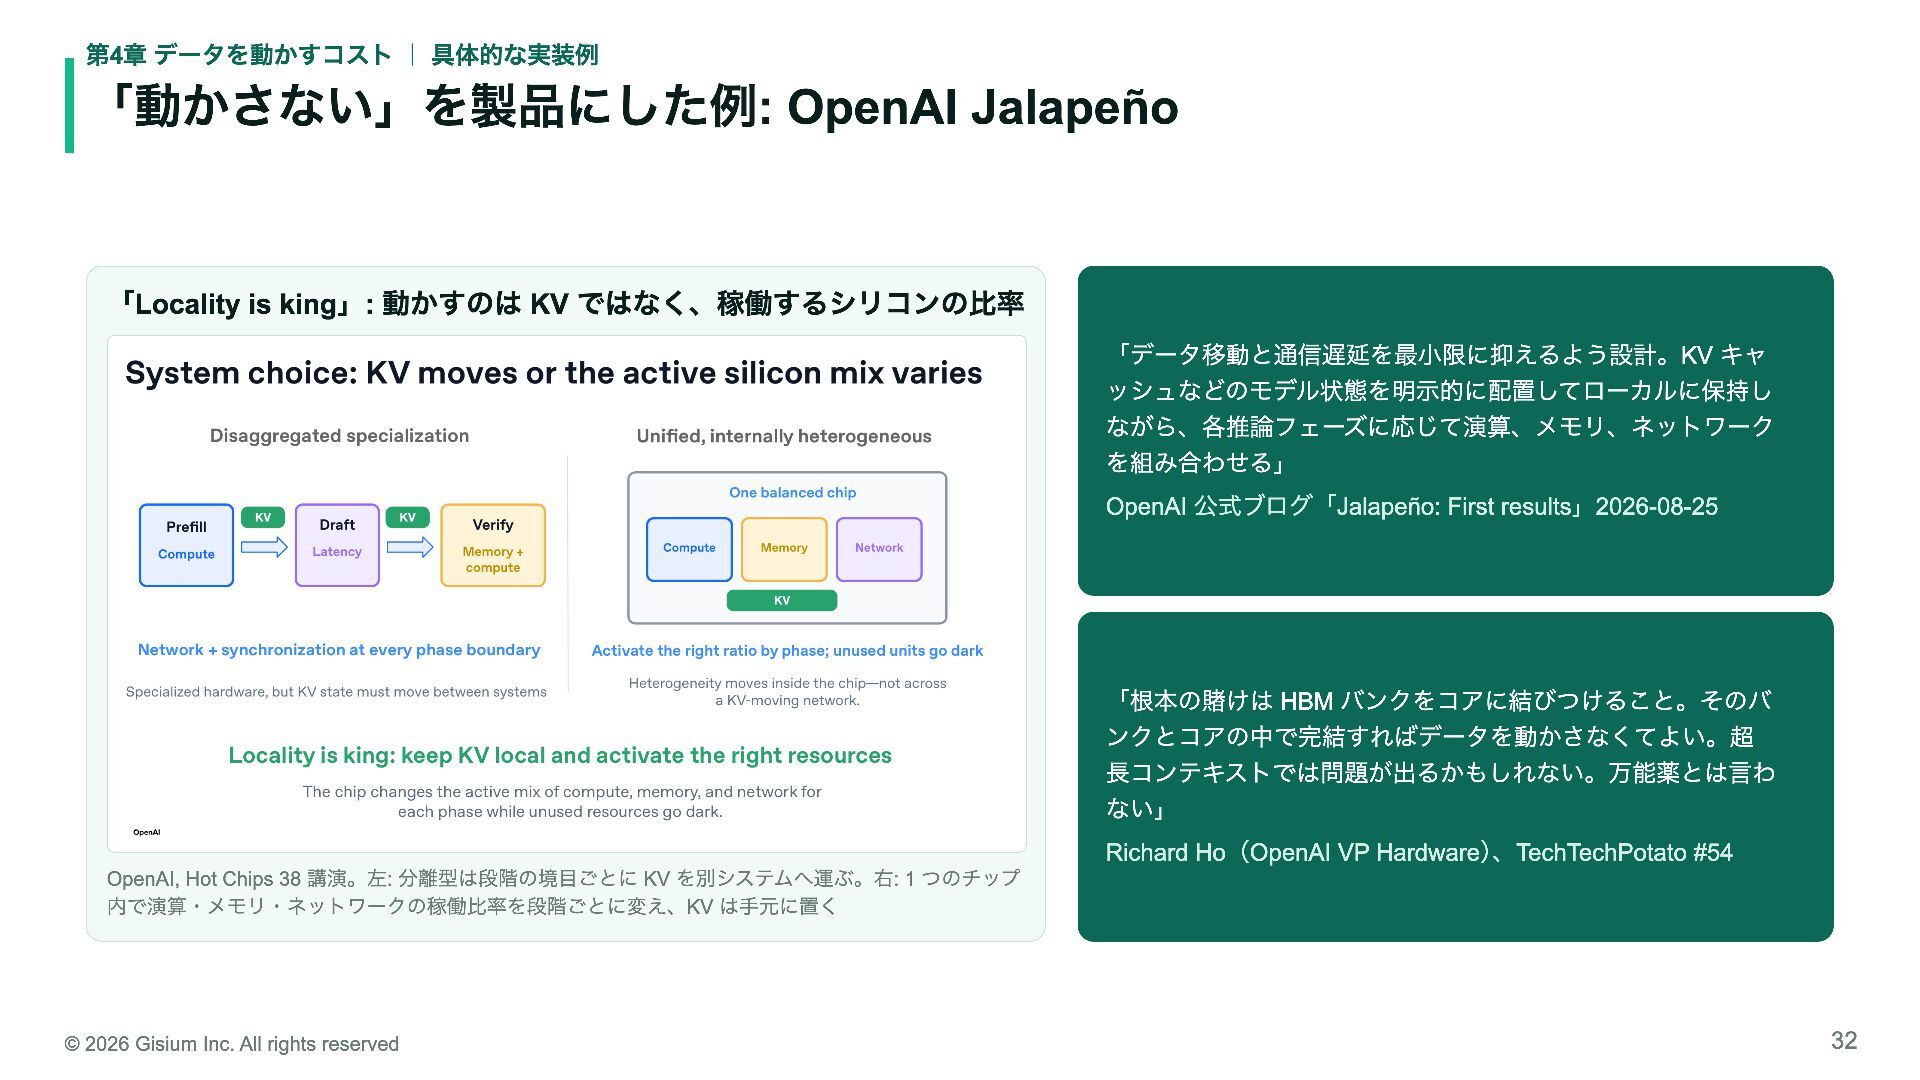
  31. 第4章 データを動かすコスト | 具体的な実装例 「動かさない」を製品にした例: OpenAI Jalapeño 「Locality is king」:

    動かすのは KV ではなく、稼働するシリコンの比率 「データ移動と通信遅延を最小限に抑えるよう設計。KV キャ ッシュなどのモデル状態を明示的に配置してローカルに保持し ながら、各推論フェーズに応じて演算、メモリ、ネットワーク を組み合わせる」 OpenAI 公式ブログ「Jalapeño: First results」2026-08-25 「根本の賭けは HBM バンクをコアに結びつけること。そのバ ンクとコアの中で完結すればデータを動かさなくてよい。超 長コンテキストでは問題が出るかもしれない。万能薬とは言わ ない」 Richard Ho(OpenAI VP Hardware)、TechTechPotato #54 OpenAI, Hot Chips 38 講演。左: 分離型は段階の境目ごとに KV を別システムへ運ぶ。右: 1 つのチップ 内で演算・メモリ・ネットワークの稼働比率を段階ごとに変え、KV は手元に置く © 2026 Gisium Inc. All rights reserved 32
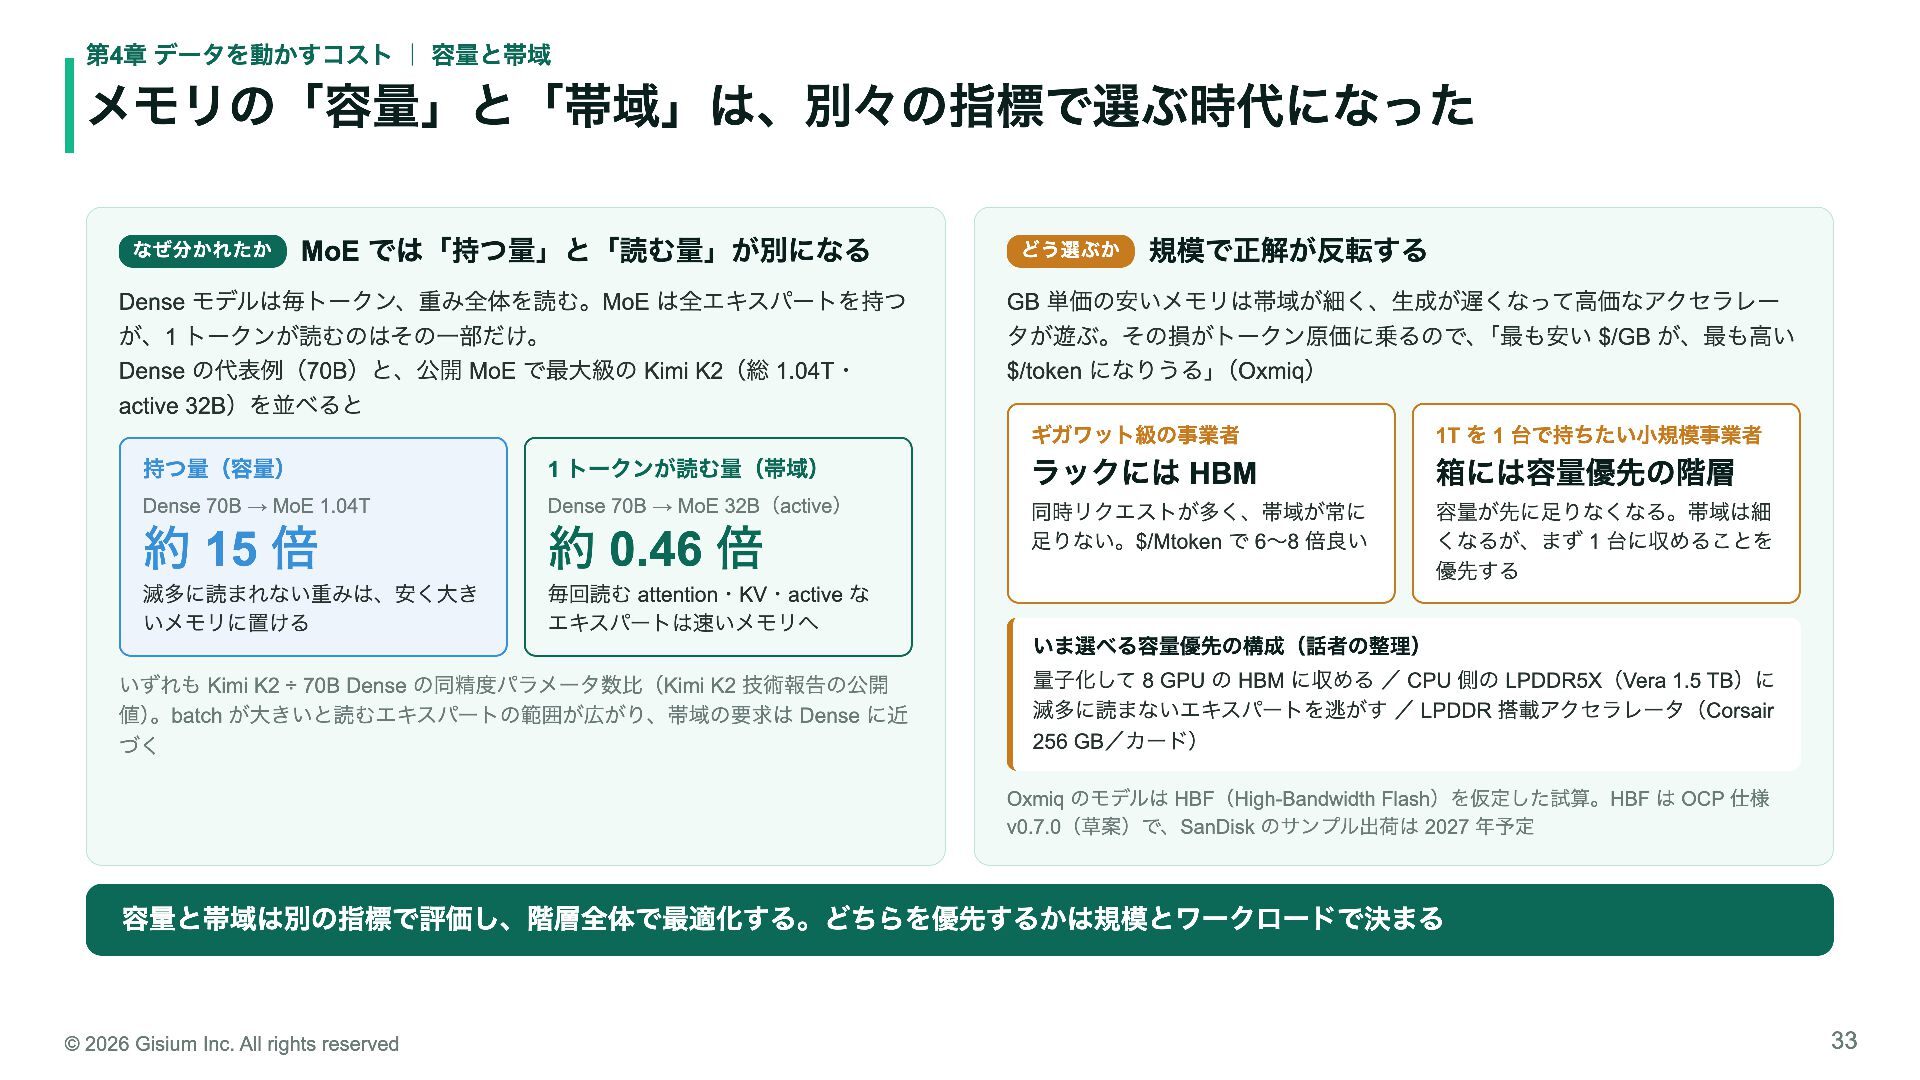
  32. 第4章 データを動かすコスト | 容量と帯域 メモリの「容量」と「帯域」は、別々の指標で選ぶ時代になった なぜ分かれたか MoE では「持つ量」と「読む量」が別になる Dense モデルは毎トークン、重み全体を読む。MoE

    は全エキスパートを持つ が、1 トークンが読むのはその一部だけ。 Dense の代表例(70B)と、公開 MoE で最大級の Kimi K2(総 1.04T・ active 32B)を並べると どう選ぶか 規模で正解が反転する GB 単価の安いメモリは帯域が細く、生成が遅くなって高価なアクセラレー タが遊ぶ。その損がトークン原価に乗るので、「最も安い $/GB が、最も高い $/token になりうる」(Oxmiq) ギガワット級の事業者 1T を 1 台で持ちたい小規模事業者 持つ量(容量) 1 トークンが読む量(帯域) ラックには HBM 箱には容量優先の階層 Dense 70B → MoE 1.04T Dense 70B → MoE 32B(active) 約 15 倍 約 0.46 倍 同時リクエストが多く、帯域が常に 足りない。$/Mtoken で 6〜8 倍良い 容量が先に足りなくなる。帯域は細 くなるが、まず 1 台に収めることを 優先する 滅多に読まれない重みは、安く大き いメモリに置ける 毎回読む attention・KV・active な エキスパートは速いメモリへ いま選べる容量優先の構成(話者の整理) いずれも Kimi K2 ÷ 70B Dense の同精度パラメータ数比(Kimi K2 技術報告の公開 値)。batch が大きいと読むエキスパートの範囲が広がり、帯域の要求は Dense に近 づく 量子化して 8 GPU の HBM に収める / CPU 側の LPDDR5X(Vera 1.5 TB)に 滅多に読まないエキスパートを逃がす / LPDDR 搭載アクセラレータ(Corsair 256 GB/カード) Oxmiq のモデルは HBF(High-Bandwidth Flash)を仮定した試算。HBF は OCP 仕様 v0.7.0(草案)で、SanDisk のサンプル出荷は 2027 年予定 容量と帯域は別の指標で評価し、階層全体で最適化する。どちらを優先するかは規模とワークロードで決まる © 2026 Gisium Inc. All rights reserved 33
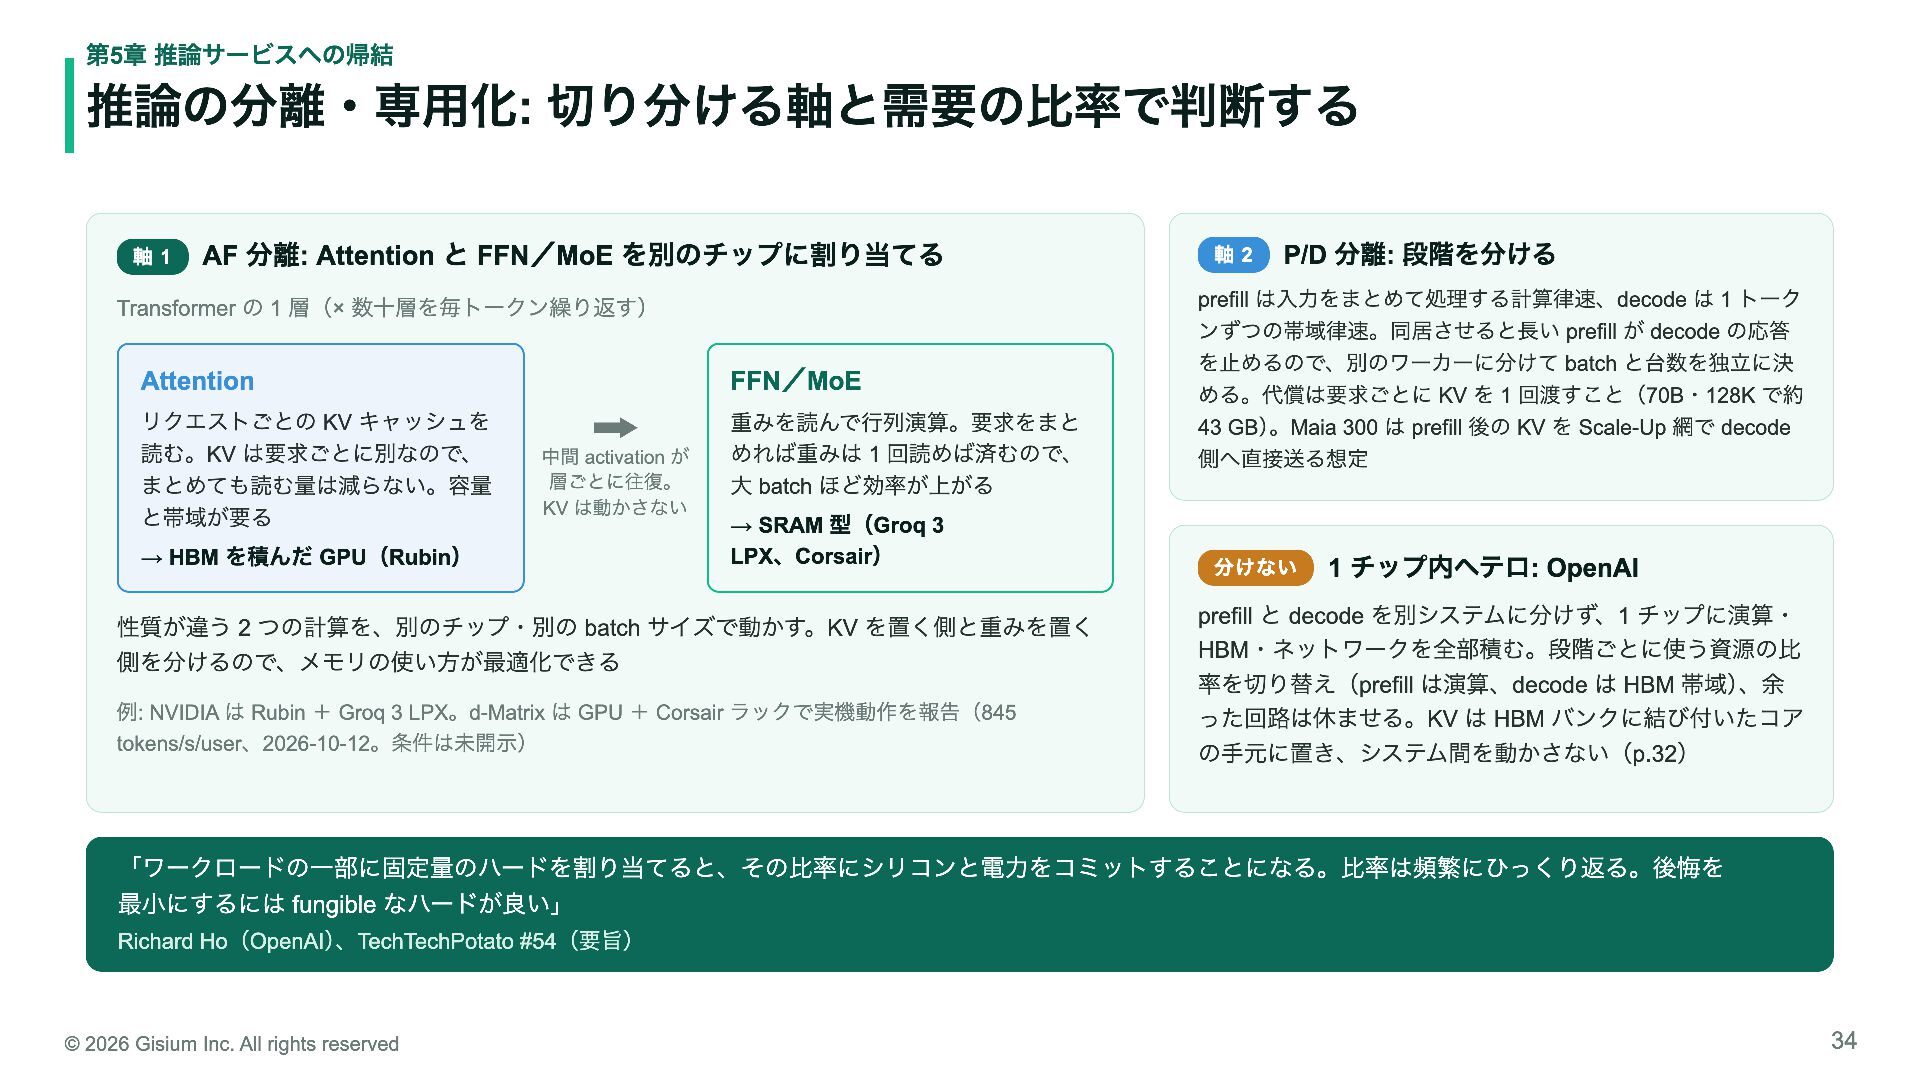
  33. 第5章 推論サービスへの帰結 推論の分離・専用化: 切り分ける軸と需要の比率で判断する 軸1 AF 分離: Attention と FFN/MoE

    を別のチップに割り当てる 軸2 P/D 分離: 段階を分ける prefill は入力をまとめて処理する計算律速、decode は 1 トーク Transformer の 1 層(× 数十層を毎トークン繰り返す) ンずつの帯域律速。同居させると長い prefill が decode の応答 Attention FFN/MoE リクエストごとの KV キャッシュを 読む。KV は要求ごとに別なので、 まとめても読む量は減らない。容量 と帯域が要る 重みを読んで行列演算。要求をまと めれば重みは 1 回読めば済むので、 大 batch ほど効率が上がる 中間 activation が 層ごとに往復。 KV は動かさない → HBM を積んだ GPU(Rubin) → SRAM 型(Groq 3 LPX、Corsair) 性質が違う 2 つの計算を、別のチップ・別の batch サイズで動かす。KV を置く側と重みを置く 側を分けるので、メモリの使い方が最適化できる 例: NVIDIA は Rubin + Groq 3 LPX。d-Matrix は GPU + Corsair ラックで実機動作を報告(845 tokens/s/user、2026-10-12。条件は未開示) を止めるので、別のワーカーに分けて batch と台数を独立に決 める。代償は要求ごとに KV を 1 回渡すこと(70B・128K で約 43 GB)。Maia 300 は prefill 後の KV を Scale-Up 網で decode 側へ直接送る想定 分けない 1 チップ内ヘテロ: OpenAI prefill と decode を別システムに分けず、1 チップに演算・ HBM・ネットワークを全部積む。段階ごとに使う資源の比 率を切り替え(prefill は演算、decode は HBM 帯域)、余 った回路は休ませる。KV は HBM バンクに結び付いたコア の手元に置き、システム間を動かさない(p.32) 「ワークロードの一部に固定量のハードを割り当てると、その比率にシリコンと電力をコミットすることになる。比率は頻繁にひっくり返る。後悔を 最小にするには fungible なハードが良い」 Richard Ho(OpenAI)、TechTechPotato #54(要旨) © 2026 Gisium Inc. All rights reserved 34
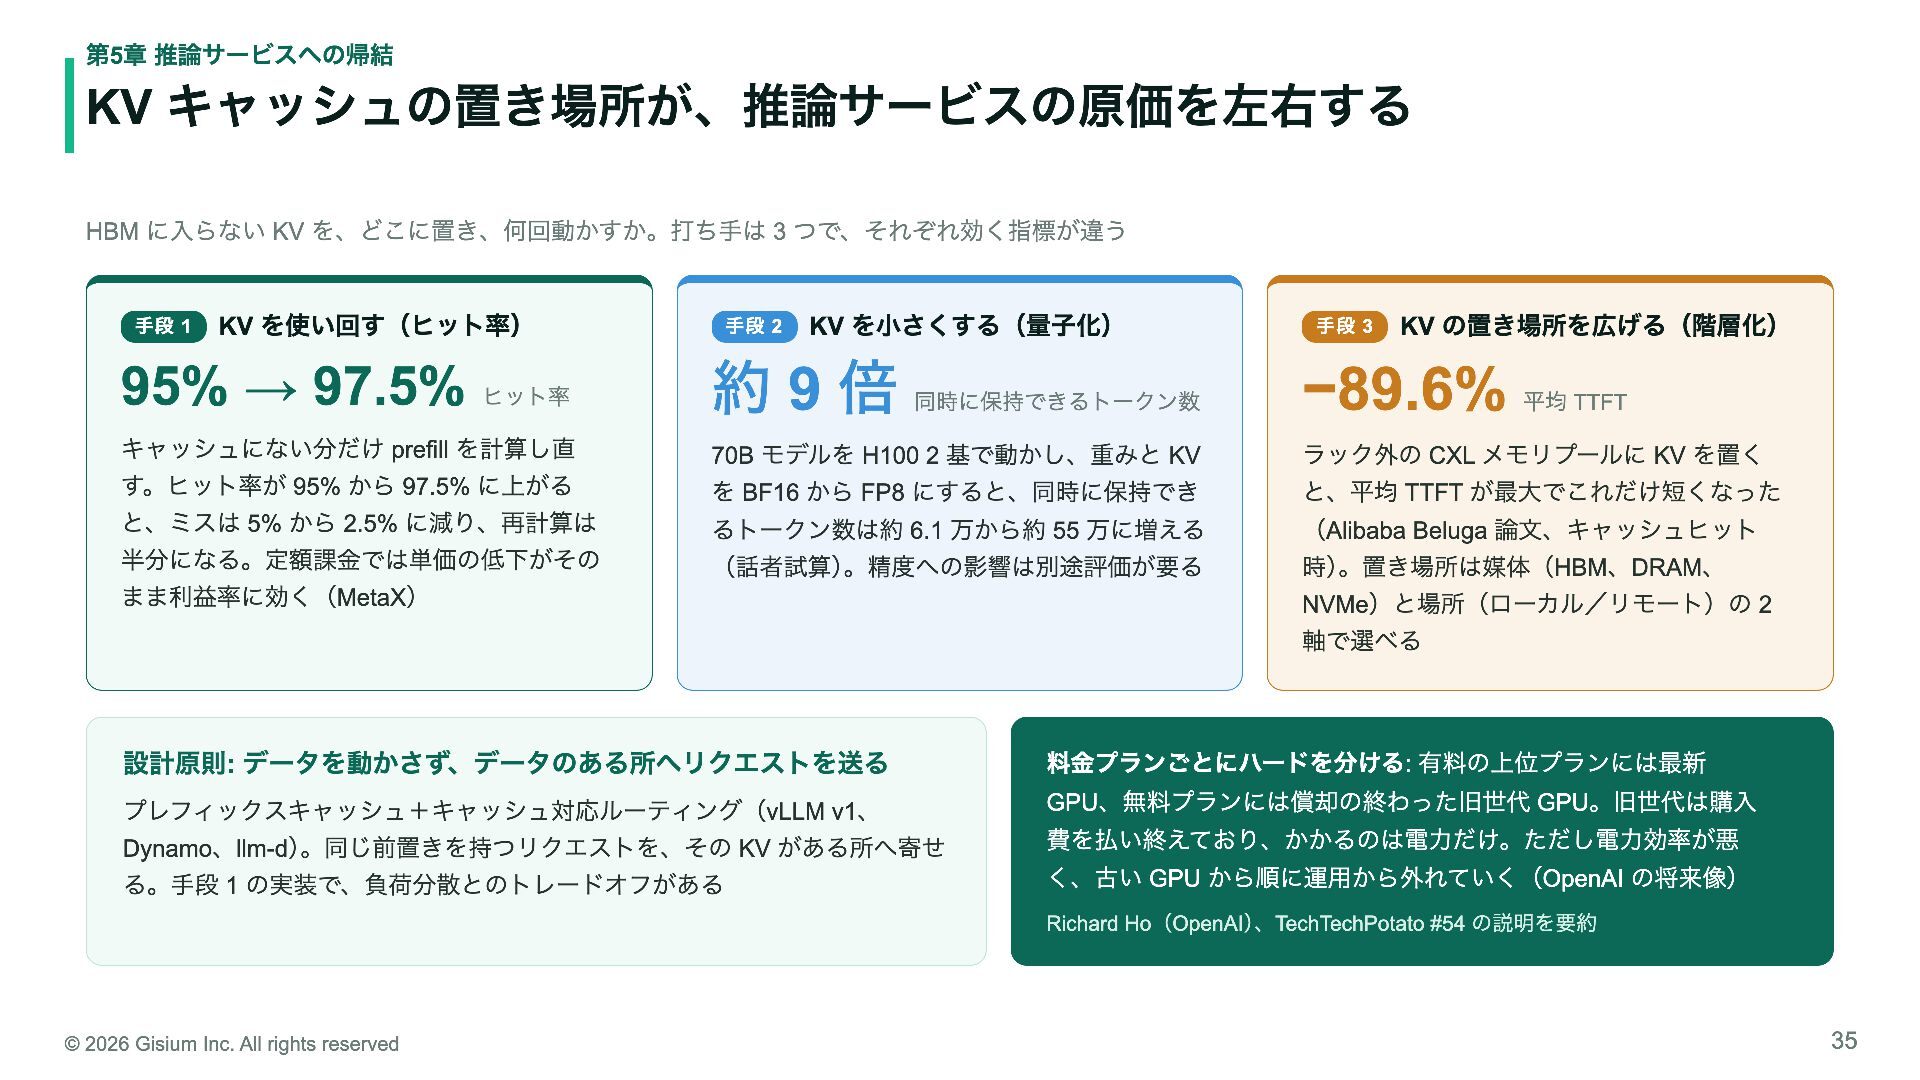
  34. 第5章 推論サービスへの帰結 KV キャッシュの置き場所が、推論サービスの原価を左右する HBM に入らない KV を、どこに置き、何回動かすか。打ち手は 3 つで、それぞれ効く指標が違う

    手段 1 KV を使い回す(ヒット率) 手段 2 KV を小さくする(量子化) 手段 3 KV の置き場所を広げる(階層化) 95% → 97.5% ヒット率 約9倍 キャッシュにない分だけ prefill を計算し直 70B モデルを H100 2 基で動かし、重みと KV ラック外の CXL メモリプールに KV を置く す。ヒット率が 95% から 97.5% に上がる を BF16 から FP8 にすると、同時に保持でき と、平均 TTFT が最大でこれだけ短くなった と、ミスは 5% から 2.5% に減り、再計算は るトークン数は約 6.1 万から約 55 万に増える (Alibaba Beluga 論文、キャッシュヒット 半分になる。定額課金では単価の低下がその (話者試算)。精度への影響は別途評価が要る 時)。置き場所は媒体(HBM、DRAM、 同時に保持できるトークン数 まま利益率に効く(MetaX) −89.6% 平均 TTFT NVMe)と場所(ローカル/リモート)の 2 軸で選べる 設計原則: データを動かさず、データのある所へリクエストを送る 料金プランごとにハードを分ける: 有料の上位プランには最新 プレフィックスキャッシュ+キャッシュ対応ルーティング(vLLM v1、 GPU、無料プランには償却の終わった旧世代 GPU。旧世代は購入 Dynamo、llm-d)。同じ前置きを持つリクエストを、その KV がある所へ寄せ 費を払い終えており、かかるのは電力だけ。ただし電力効率が悪 る。手段 1 の実装で、負荷分散とのトレードオフがある く、古い GPU から順に運用から外れていく(OpenAI の将来像) Richard Ho(OpenAI)、TechTechPotato #54 の説明を要約 © 2026 Gisium Inc. All rights reserved 35
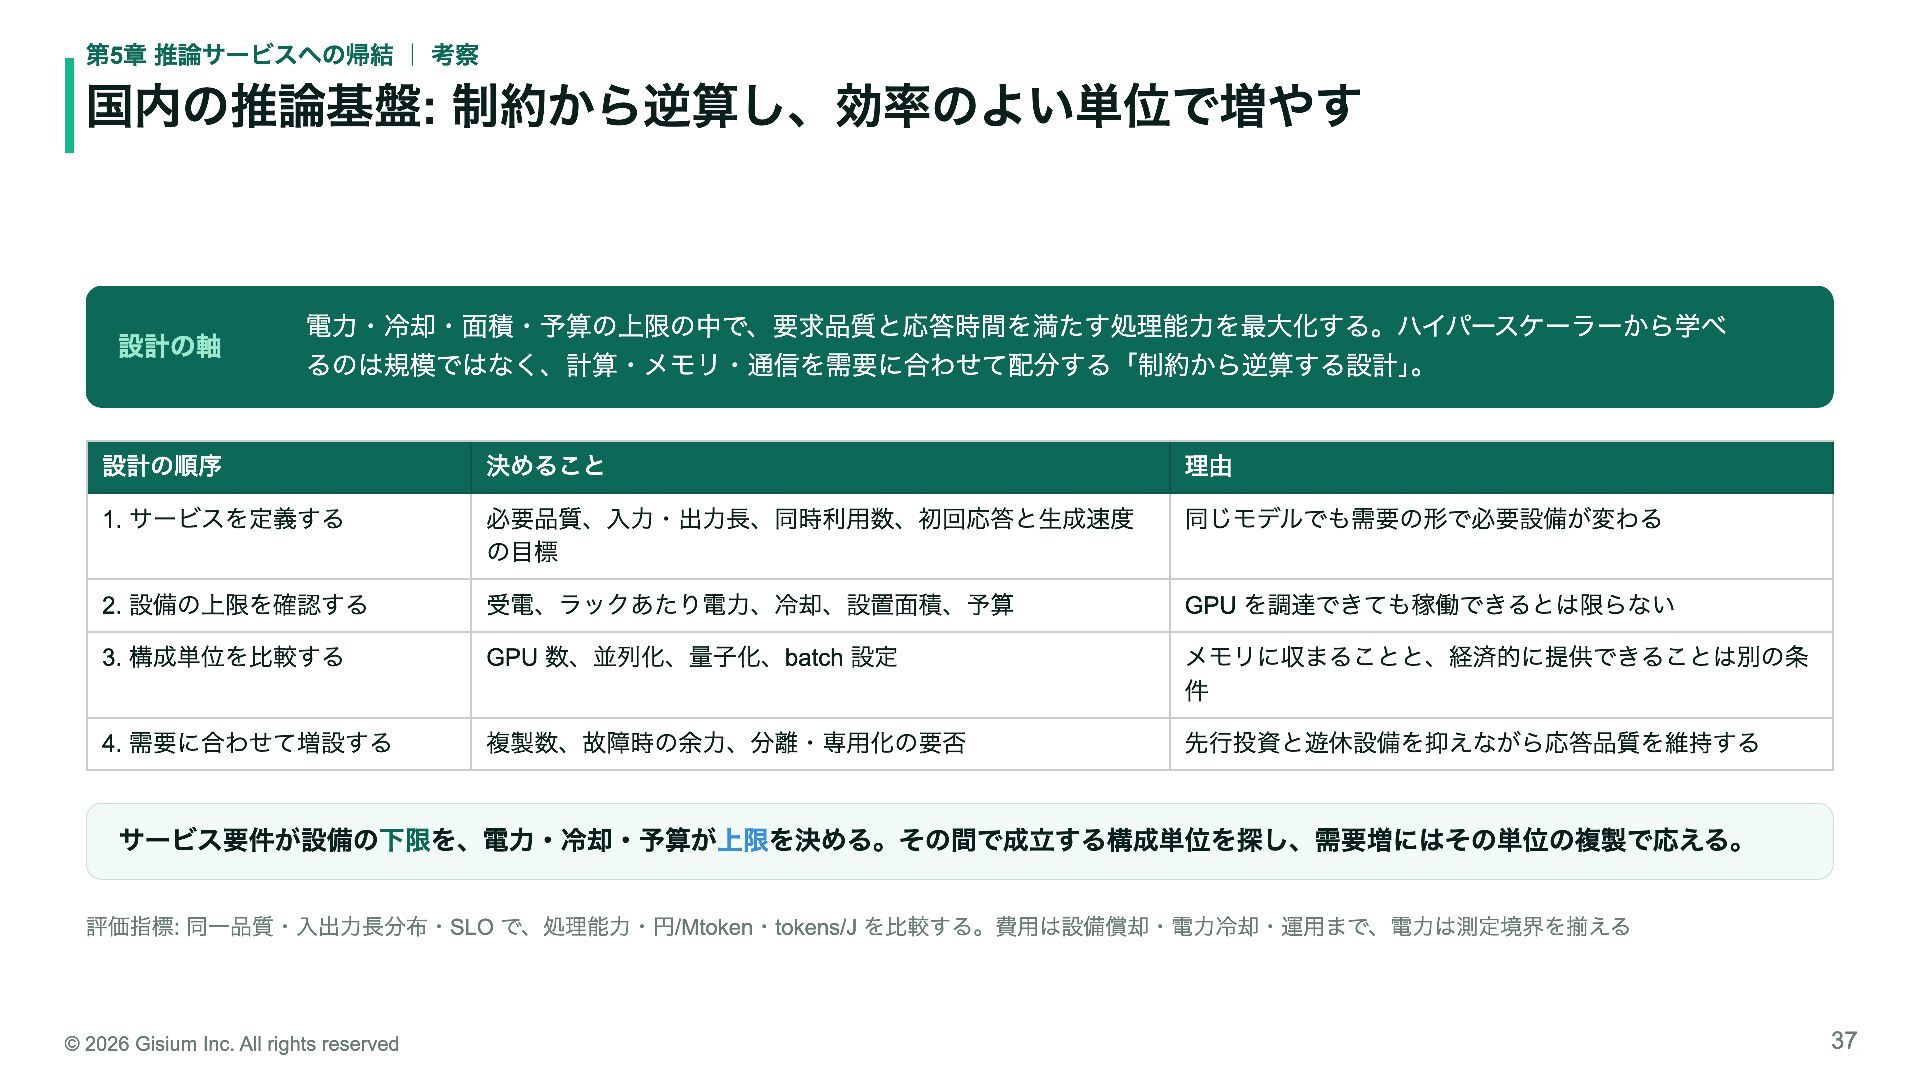
  35. 第5章 推論サービスへの帰結 | 考察 国内の推論基盤: 制約から逆算し、効率のよい単位で増やす 設計の軸 電力・冷却・面積・予算の上限の中で、要求品質と応答時間を満たす処理能力を最大化する。ハイパースケーラーから学べ るのは規模ではなく、計算・メモリ・通信を需要に合わせて配分する「制約から逆算する設計」。 設計の順序

    決めること 理由 1. サービスを定義する 必要品質、入力・出力長、同時利用数、初回応答と生成速度 の目標 同じモデルでも需要の形で必要設備が変わる 2. 設備の上限を確認する 受電、ラックあたり電力、冷却、設置面積、予算 GPU を調達できても稼働できるとは限らない 3. 構成単位を比較する GPU 数、並列化、量子化、batch 設定 メモリに収まることと、経済的に提供できることは別の条 件 4. 需要に合わせて増設する 複製数、故障時の余力、分離・専用化の要否 先行投資と遊休設備を抑えながら応答品質を維持する サービス要件が設備の下限を、電力・冷却・予算が上限を決める。その間で成立する構成単位を探し、需要増にはその単位の複製で応える。 評価指標: 同一品質・入出力長分布・SLO で、処理能力・円/Mtoken・tokens/J を比較する。費用は設備償却・電力冷却・運用まで、電力は測定境界を揃える © 2026 Gisium Inc. All rights reserved 37
  36. まとめ 持ち帰ってほしい 3 つ(再掲) 1 2 3 電力を食っているのは、計算だけではなく「データを動かす距離」。 データを運ぶ距離が、1 ビットあたりのエネルギーと遅延を左右する。

    KV キャッシュの置き場所が、推論サービスの原価を左右する。KV は履歴を保つ限り会話とともに増 え、HBM に収まらなければ再ロード・再計算・追い出しのどれかで遅延と電力を払う。 業界の方向性は「データを動かさない」。チップの中、ラックの配線、メモリ階層とソフト。 手を付ける場所は違っても、狙いは一つ「不要な移動を減らし、データを運ぶ距離を縮める」。 © 2026 Gisium Inc. All rights reserved 38
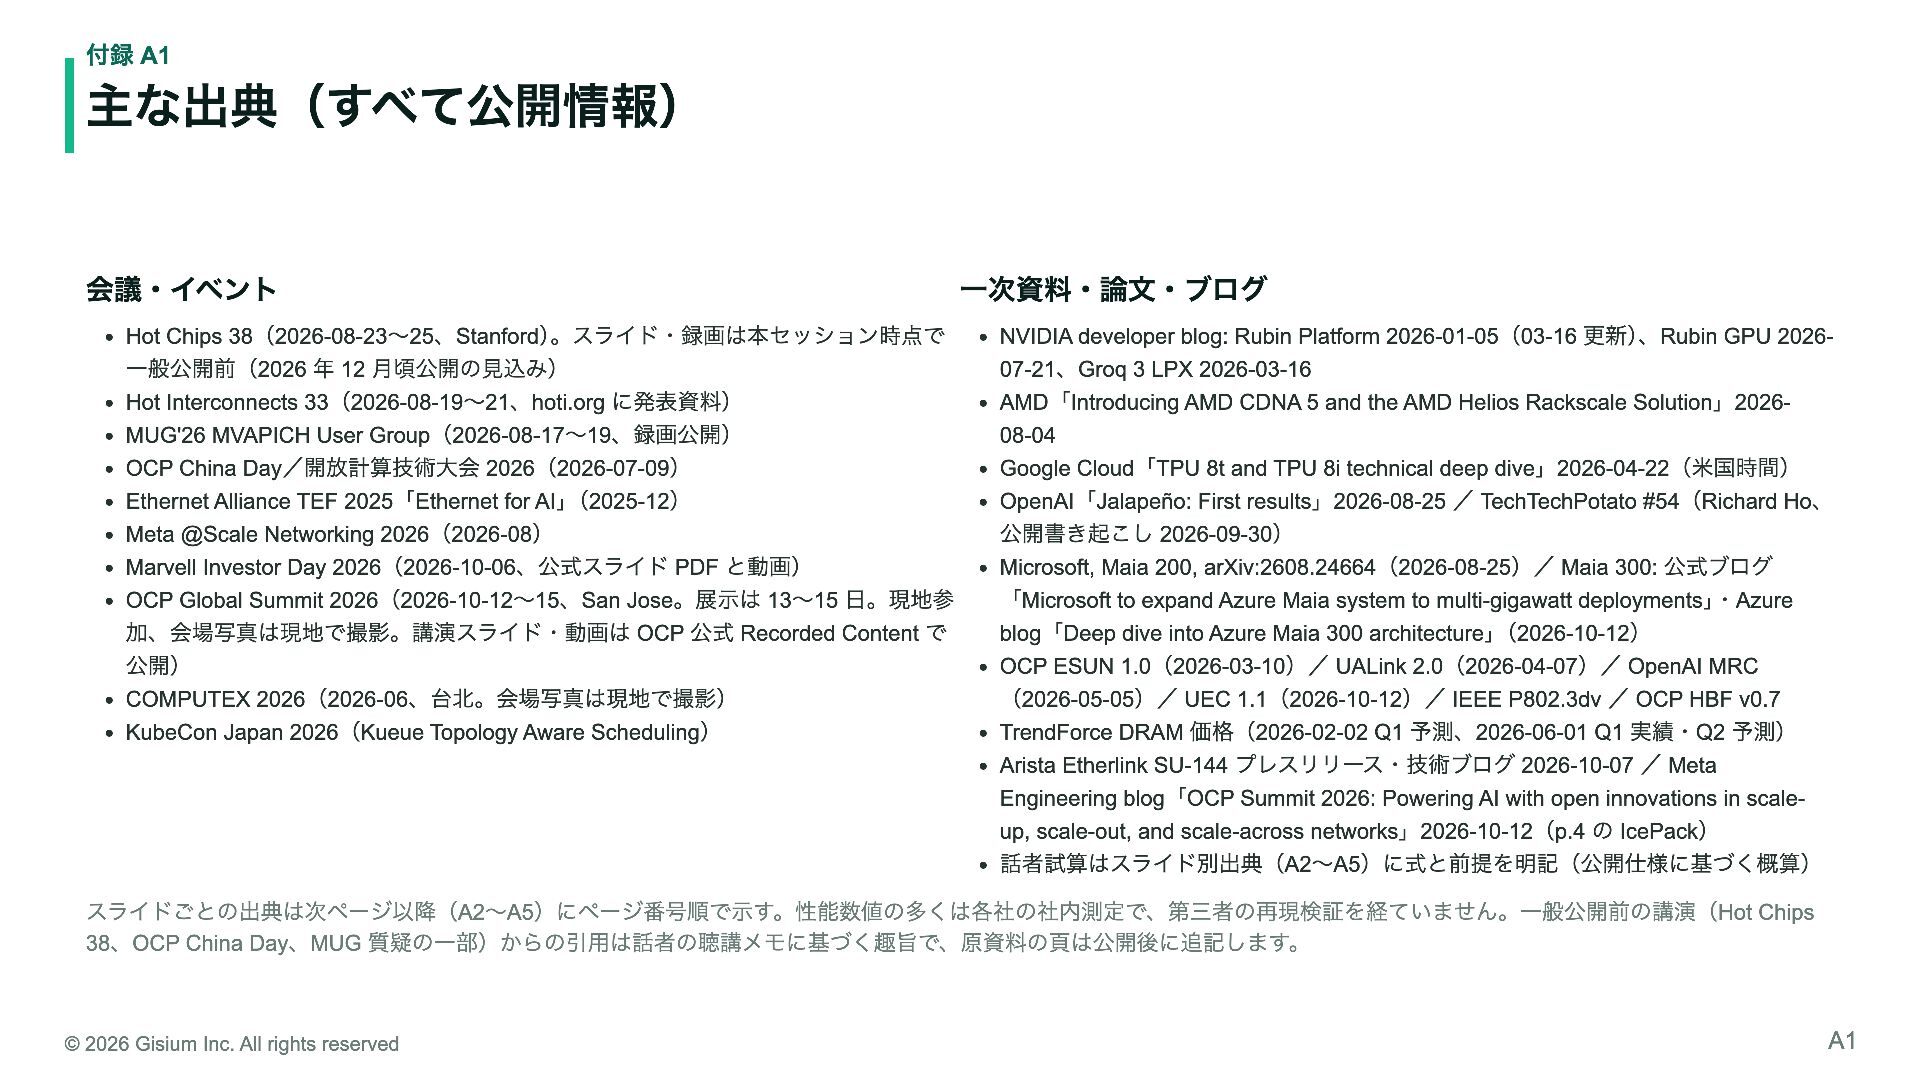
  37. 付録 A1 主な出典(すべて公開情報) 会議・イベント Hot Chips 38(2026-08-23〜25、Stanford)。スライド・録画は本セッション時点で 一般公開前(2026 年 12

    月頃公開の見込み) Hot Interconnects 33(2026-08-19〜21、hoti.org に発表資料) MUG'26 MVAPICH User Group(2026-08-17〜19、録画公開) OCP China Day/開放計算技術大会 2026(2026-07-09) Ethernet Alliance TEF 2025「Ethernet for AI」(2025-12) Meta @Scale Networking 2026(2026-08) Marvell Investor Day 2026(2026-10-06、公式スライド PDF と動画) OCP Global Summit 2026(2026-10-12〜15、San Jose。展示は 13〜15 日。現地参 加、会場写真は現地で撮影。講演スライド・動画は OCP 公式 Recorded Content で 公開) COMPUTEX 2026(2026-06、台北。会場写真は現地で撮影) KubeCon Japan 2026(Kueue Topology Aware Scheduling) 一次資料・論文・ブログ NVIDIA developer blog: Rubin Platform 2026-01-05(03-16 更新)、Rubin GPU 202607-21、Groq 3 LPX 2026-03-16 AMD「Introducing AMD CDNA 5 and the AMD Helios Rackscale Solution」202608-04 Google Cloud「TPU 8t and TPU 8i technical deep dive」2026-04-22(米国時間) OpenAI「Jalapeño: First results」2026-08-25 / TechTechPotato #54(Richard Ho、 公開書き起こし 2026-09-30) Microsoft, Maia 200, arXiv:2608.24664(2026-08-25)/ Maia 300: 公式ブログ 「Microsoft to expand Azure Maia system to multi-gigawatt deployments」・Azure blog「Deep dive into Azure Maia 300 architecture」(2026-10-12) OCP ESUN 1.0(2026-03-10)/ UALink 2.0(2026-04-07)/ OpenAI MRC (2026-05-05)/ UEC 1.1(2026-10-12)/ IEEE P802.3dv / OCP HBF v0.7 TrendForce DRAM 価格(2026-02-02 Q1 予測、2026-06-01 Q1 実績・Q2 予測) Arista Etherlink SU-144 プレスリリース・技術ブログ 2026-10-07 / Meta Engineering blog「OCP Summit 2026: Powering AI with open innovations in scaleup, scale-out, and scale-across networks」2026-10-12(p.4 の IcePack) 話者試算はスライド別出典(A2〜A5)に式と前提を明記(公開仕様に基づく概算) スライドごとの出典は次ページ以降(A2〜A5)にページ番号順で示す。性能数値の多くは各社の社内測定で、第三者の再現検証を経ていません。一般公開前の講演(Hot Chips 38、OCP China Day、MUG 質疑の一部)からの引用は話者の聴講メモに基づく趣旨で、原資料の頁は公開後に追記します。 © 2026 Gisium Inc. All rights reserved A1
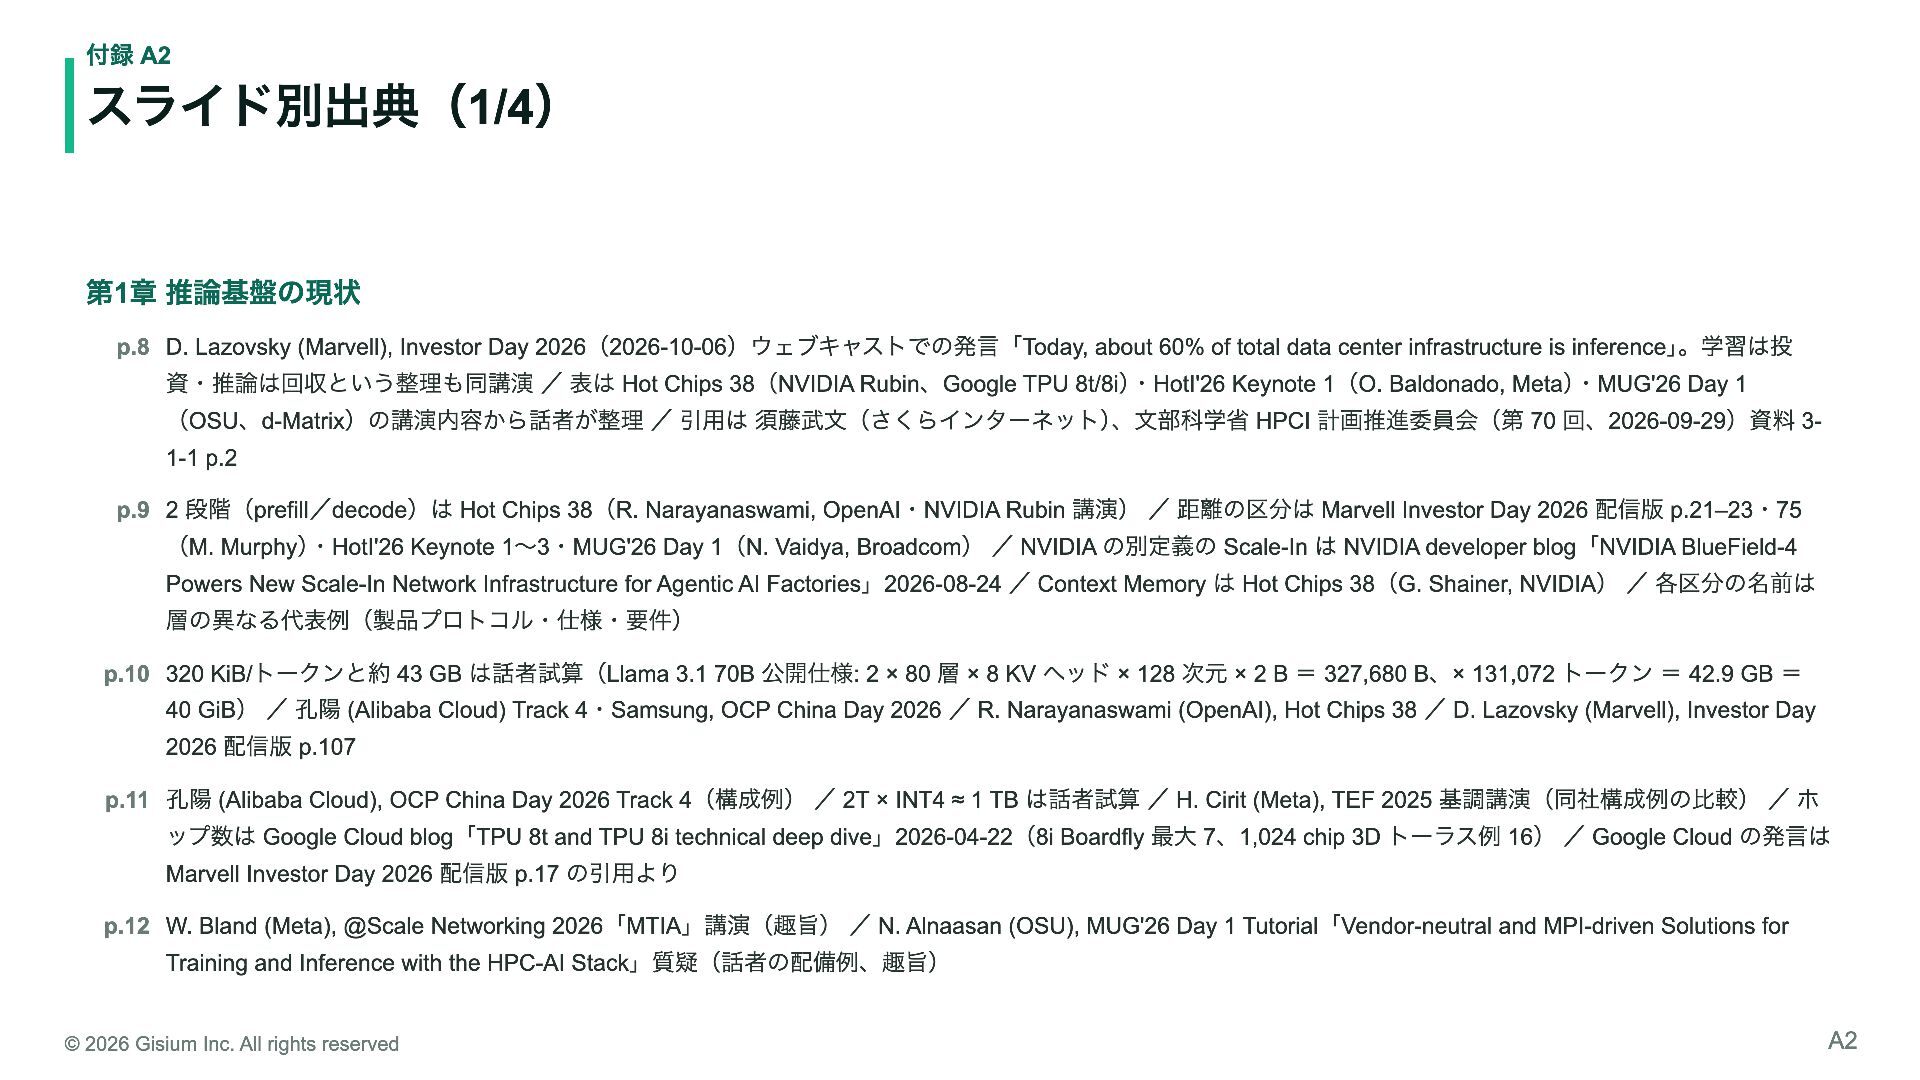
  38. 付録 A2 スライド別出典(1/4) 第1章 推論基盤の現状 p.8 D. Lazovsky (Marvell), Investor

    Day 2026(2026-10-06)ウェブキャストでの発言「Today, about 60% of total data center infrastructure is inference」。学習は投 資・推論は回収という整理も同講演 / 表は Hot Chips 38(NVIDIA Rubin、Google TPU 8t/8i)・HotI'26 Keynote 1(O. Baldonado, Meta)・MUG'26 Day 1 (OSU、d-Matrix)の講演内容から話者が整理 / 引用は 須藤武文(さくらインターネット)、文部科学省 HPCI 計画推進委員会(第 70 回、2026-09-29)資料 31-1 p.2 p.9 2 段階(prefill/decode)は Hot Chips 38(R. Narayanaswami, OpenAI・NVIDIA Rubin 講演) / 距離の区分は Marvell Investor Day 2026 配信版 p.21–23・75 (M. Murphy)・HotI'26 Keynote 1〜3・MUG'26 Day 1(N. Vaidya, Broadcom) / NVIDIA の別定義の Scale-In は NVIDIA developer blog「NVIDIA BlueField-4 Powers New Scale-In Network Infrastructure for Agentic AI Factories」2026-08-24 / Context Memory は Hot Chips 38(G. Shainer, NVIDIA) / 各区分の名前は 層の異なる代表例(製品プロトコル・仕様・要件) p.10 320 KiB/トークンと約 43 GB は話者試算(Llama 3.1 70B 公開仕様: 2 × 80 層 × 8 KV ヘッド × 128 次元 × 2 B = 327,680 B、× 131,072 トークン = 42.9 GB = 40 GiB) / 孔陽 (Alibaba Cloud) Track 4・Samsung, OCP China Day 2026 / R. Narayanaswami (OpenAI), Hot Chips 38 / D. Lazovsky (Marvell), Investor Day 2026 配信版 p.107 p.11 孔陽 (Alibaba Cloud), OCP China Day 2026 Track 4(構成例) / 2T × INT4 ≈ 1 TB は話者試算 / H. Cirit (Meta), TEF 2025 基調講演(同社構成例の比較) / ホ ップ数は Google Cloud blog「TPU 8t and TPU 8i technical deep dive」2026-04-22(8i Boardfly 最大 7、1,024 chip 3D トーラス例 16) / Google Cloud の発言は Marvell Investor Day 2026 配信版 p.17 の引用より p.12 W. Bland (Meta), @Scale Networking 2026「MTIA」講演(趣旨) / N. Alnaasan (OSU), MUG'26 Day 1 Tutorial「Vendor-neutral and MPI-driven Solutions for Training and Inference with the HPC-AI Stack」質疑(話者の配備例、趣旨) © 2026 Gisium Inc. All rights reserved A2
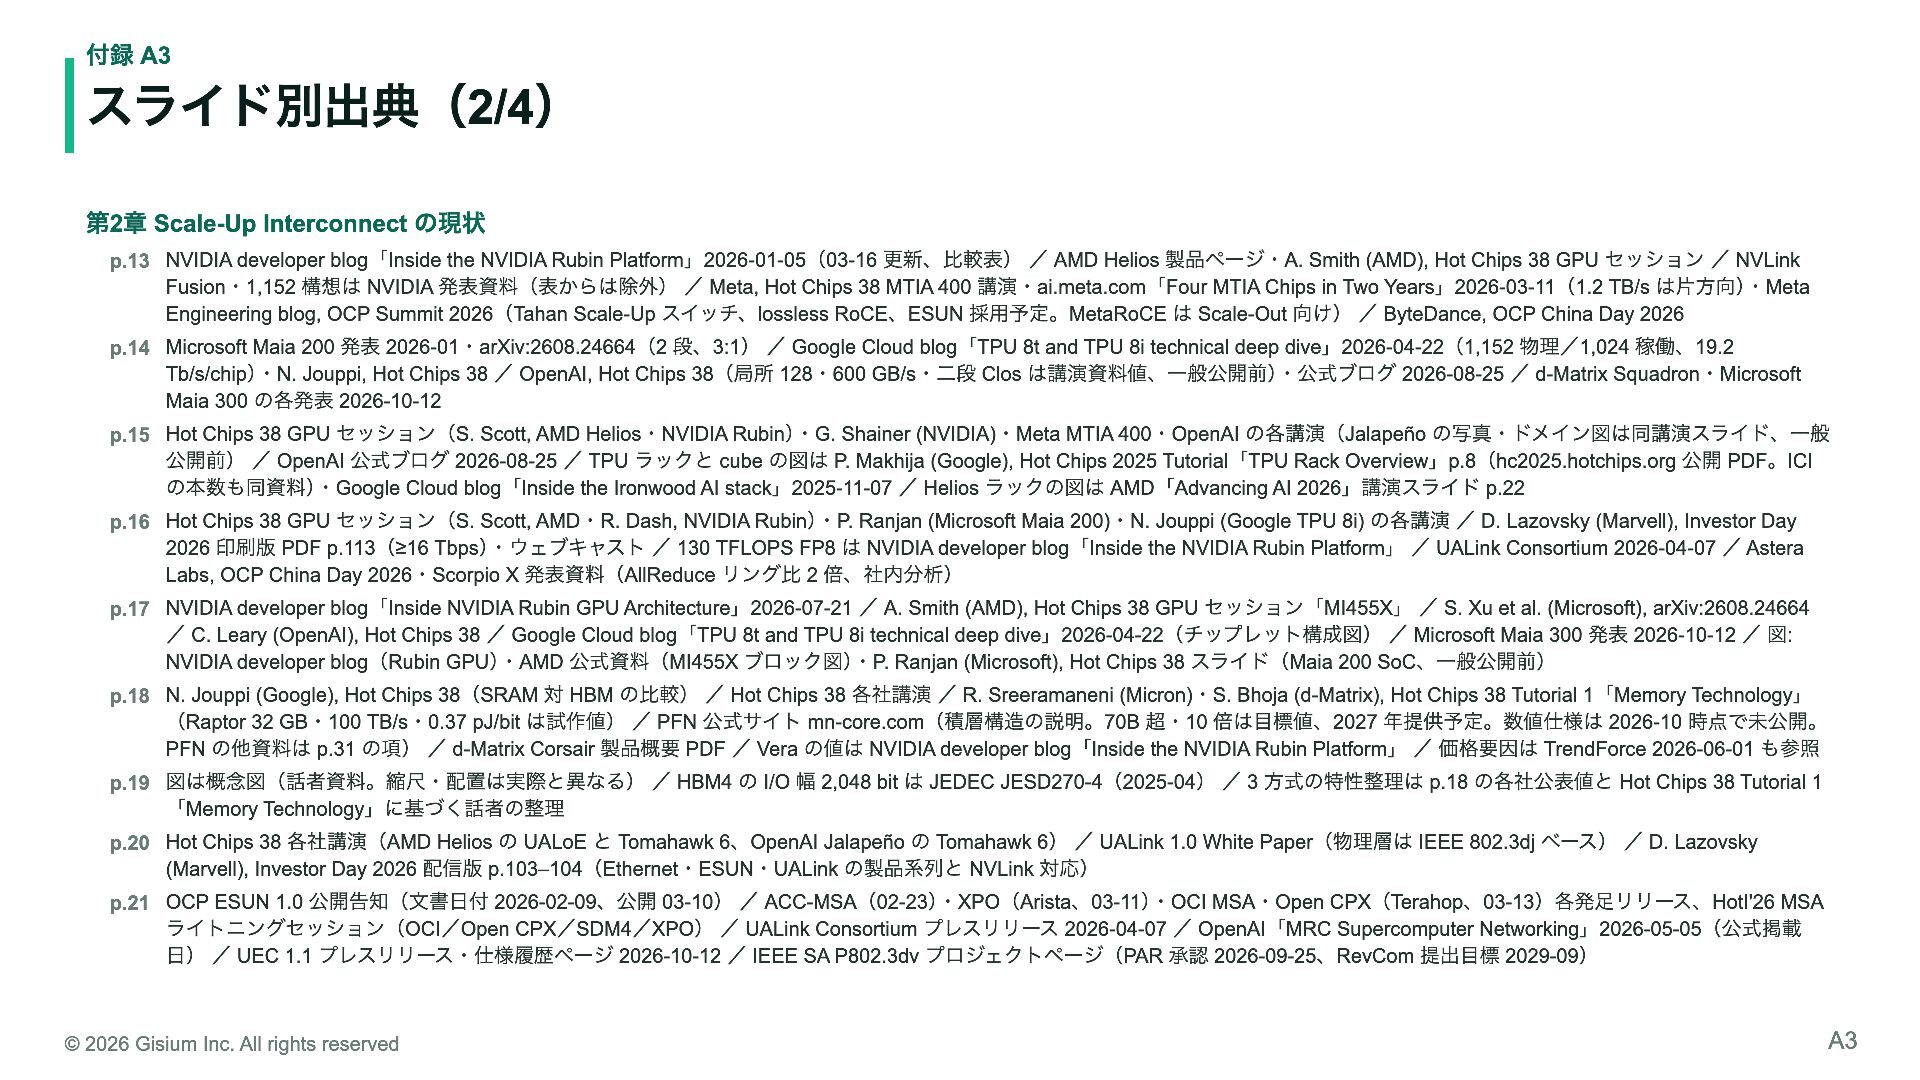
  39. 付録 A3 スライド別出典(2/4) 第2章 Scale-Up Interconnect の現状 p.13 NVIDIA developer

    blog「Inside the NVIDIA Rubin Platform」2026-01-05(03-16 更新、比較表) / AMD Helios 製品ページ・A. Smith (AMD), Hot Chips 38 GPU セッション / NVLink Fusion・1,152 構想は NVIDIA 発表資料(表からは除外) / Meta, Hot Chips 38 MTIA 400 講演・ai.meta.com「Four MTIA Chips in Two Years」2026-03-11(1.2 TB/s は片方向)・Meta Engineering blog, OCP Summit 2026(Tahan Scale-Up スイッチ、lossless RoCE、ESUN 採用予定。MetaRoCE は Scale-Out 向け) / ByteDance, OCP China Day 2026 p.14 Microsoft Maia 200 発表 2026-01・arXiv:2608.24664(2 段、3:1) / Google Cloud blog「TPU 8t and TPU 8i technical deep dive」2026-04-22(1,152 物理/1,024 稼働、19.2 Tb/s/chip)・N. Jouppi, Hot Chips 38 / OpenAI, Hot Chips 38(局所 128・600 GB/s・二段 Clos は講演資料値、一般公開前)・公式ブログ 2026-08-25 / d-Matrix Squadron・Microsoft Maia 300 の各発表 2026-10-12 p.15 Hot Chips 38 GPU セッション(S. Scott, AMD Helios・NVIDIA Rubin)・G. Shainer (NVIDIA)・Meta MTIA 400・OpenAI の各講演(Jalapeño の写真・ドメイン図は同講演スライド、一般 公開前) / OpenAI 公式ブログ 2026-08-25 / TPU ラックと cube の図は P. Makhija (Google), Hot Chips 2025 Tutorial「TPU Rack Overview」p.8(hc2025.hotchips.org 公開 PDF。ICI の本数も同資料)・Google Cloud blog「Inside the Ironwood AI stack」2025-11-07 / Helios ラックの図は AMD「Advancing AI 2026」講演スライド p.22 p.16 Hot Chips 38 GPU セッション(S. Scott, AMD・R. Dash, NVIDIA Rubin)・P. Ranjan (Microsoft Maia 200)・N. Jouppi (Google TPU 8i) の各講演 / D. Lazovsky (Marvell), Investor Day 2026 印刷版 PDF p.113(≥16 Tbps)・ウェブキャスト / 130 TFLOPS FP8 は NVIDIA developer blog「Inside the NVIDIA Rubin Platform」 / UALink Consortium 2026-04-07 / Astera Labs, OCP China Day 2026・Scorpio X 発表資料(AllReduce リング比 2 倍、社内分析) p.17 NVIDIA developer blog「Inside NVIDIA Rubin GPU Architecture」2026-07-21 / A. Smith (AMD), Hot Chips 38 GPU セッション「MI455X」 / S. Xu et al. (Microsoft), arXiv:2608.24664 / C. Leary (OpenAI), Hot Chips 38 / Google Cloud blog「TPU 8t and TPU 8i technical deep dive」2026-04-22(チップレット構成図) / Microsoft Maia 300 発表 2026-10-12 / 図: NVIDIA developer blog(Rubin GPU)・AMD 公式資料(MI455X ブロック図)・P. Ranjan (Microsoft), Hot Chips 38 スライド(Maia 200 SoC、一般公開前) p.18 N. Jouppi (Google), Hot Chips 38(SRAM 対 HBM の比較) / Hot Chips 38 各社講演 / R. Sreeramaneni (Micron)・S. Bhoja (d-Matrix), Hot Chips 38 Tutorial 1「Memory Technology」 (Raptor 32 GB・100 TB/s・0.37 pJ/bit は試作値) / PFN 公式サイト mn-core.com(積層構造の説明。70B 超・10 倍は目標値、2027 年提供予定。数値仕様は 2026-10 時点で未公開。 PFN の他資料は p.31 の項) / d-Matrix Corsair 製品概要 PDF / Vera の値は NVIDIA developer blog「Inside the NVIDIA Rubin Platform」 / 価格要因は TrendForce 2026-06-01 も参照 p.19 図は概念図(話者資料。縮尺・配置は実際と異なる) / HBM4 の I/O 幅 2,048 bit は JEDEC JESD270-4(2025-04) / 3 方式の特性整理は p.18 の各社公表値と Hot Chips 38 Tutorial 1 「Memory Technology」に基づく話者の整理 p.20 Hot Chips 38 各社講演(AMD Helios の UALoE と Tomahawk 6、OpenAI Jalapeño の Tomahawk 6) / UALink 1.0 White Paper(物理層は IEEE 802.3dj ベース) / D. Lazovsky (Marvell), Investor Day 2026 配信版 p.103–104(Ethernet・ESUN・UALink の製品系列と NVLink 対応) p.21 OCP ESUN 1.0 公開告知(文書日付 2026-02-09、公開 03-10) / ACC-MSA(02-23)・XPO(Arista、03-11)・OCI MSA・Open CPX(Terahop、03-13)各発足リリース、HotI'26 MSA ライトニングセッション(OCI/Open CPX/SDM4/XPO) / UALink Consortium プレスリリース 2026-04-07 / OpenAI「MRC Supercomputer Networking」2026-05-05(公式掲載 日) / UEC 1.1 プレスリリース・仕様履歴ページ 2026-10-12 / IEEE SA P802.3dv プロジェクトページ(PAR 承認 2026-09-25、RevCom 提出目標 2029-09) © 2026 Gisium Inc. All rights reserved A3
  40. 付録 A4 スライド別出典(3/4) 第2章の結論 p.22 S. Scott (AMD), Hot Chips

    38 GPU セッション(口頭、趣旨) / 前提の帯は話者の整理。根拠は p.16 の Scale-Up 要求仕様(HBM に近い遅延、数 pJ/bit)と p.24 の光の電力 第3章 物理制約 p.23 H. Cirit (Meta), TEF 2025 基調講演(スライド見出し「Beachfront Bottleneck of Scale-in Systems」) / N. Vaidya (Broadcom), MUG'26 Day 1 / S. Bharathi (Marvell), Investor Day 2026 ウェブキャスト / S. Bhoja (d-Matrix)・Samsung, Hot Chips 38 Tutorial 1「Memory Technology」(1.92 kW は 2.4 pJ/bit 一定の仮定、0.37/0.5 pJ/bit はテストチップ値) / HBM 帯域は NVIDIA・AMD の公表仕様 / Marvell T100 の 850 mm² 超・512 SerDes は Investor Day 2026 資料 p.24 写真: AMD Helios ネットワークトレイ(HPE Juniper QFX5252、Amphenol 製 twinax ケーブル)、OCP Global Summit 2026 HPE ブースにて撮影。TH6 2 基・1 OU ダブルワイドは ServeTheHome「This is the AMD Helios HPE Juniper QFX5252 Switch Tray at OCP 2026」 / H. Cirit (Meta), TEF 2025 基調講演スライド PDF p.18(ethernetalliance.org 公開。1,024〜 1,152 はケーブルバックプレーンの断面に収容できる差動ペア数の設計値。102.4〜115.2 Tb/s 片方向は 512〜576 レーン × 200G の話者換算) / 448G と CPC は IEEE P802.3dv PAR (目的)・TE Connectivity, TEF 2025 Panel 5 / 到達距離の傾向は B. Riaz (Ciena), HotI'26 Keynote 3・D. Lazovsky (Marvell), Investor Day 2026 ウェブキャスト p.25 G. Shainer (NVIDIA), TEF 2025 Panel 4 / B. Riaz (Ciena) HotI'26 Keynote 3(W 値。pJ/bit は公称 1.6 Tb/s で割った話者換算)・Resolight (Shapiro) HotI'26 Day 1 パネル(40 pJ/bit は経 路例の試算) / G. Shainer (NVIDIA), Hot Chips 38「Spectrum-X」講演 p.26 写真: Foxconn ブースの NVIDIA NVL8 向け液冷部品、COMPUTEX 2026 にて撮影 / Hot Chips 38 Tutorial 1(R. Sreeramaneni, Micron)・S. Lakshmanamurthy (Google)・GPU セッショ ン(NVIDIA Rubin NVL72・S. Scott, AMD Helios) / Arista プレスリリース「XPO High Density Liquid Cooled Pluggable Optics」2026-03-12(12.8 Tb/s・400 W・Bechtolsheim の発 言) / 口頭補足: Helios は AMD 公式資料、Maia 300 は Microsoft 公式ブログ 2026-10-12、電力密度想定は 高暁軍 (ByteDance), OCP China Day 2026 p.27 話者のまとめ(出典なし) 第4章 データを動かすコスト p.28 経路図は話者の整理(P/D 分離時の代表経路。Router/front-end/prefill scale-up/scale-out/decode scale-up/token の区分は講演スライドの表記に倣う) p.29 Hot Chips 38 Tutorial 1「Memory Technology」(S. Bhoja d-Matrix、Samsung、Micron) / N. Jouppi (Google), Hot Chips 38 / B. Riaz (Ciena), HotI'26 Keynote 3 / 帯域は NVIDIA H100 公式仕様(片方向に統一: NVLink 450 GB/s、PCIe 5.0 x16 約 64 GB/s、IB 400G 50 GB/s 線速度) / 約 21 ms・約 5 ms・約 2.2 秒は話者試算(140 GB ÷ (n × 3.35 TB/s)、140 GB ÷ 64 GB/s、通信等を除く下限) / Microsoft (MSCCL++), MUG'26 Day 2(特定ベンチマークの値) / CPU DRAM・NVMe の帯域は構成例 p.30 TrendForce プレスリリース 2026-03-31(1Q26E・2Q26F 表)・2026-06-01(1Q26 実績 +93〜98%)・2026-07-03(2Q26・3Q26E 表)。4Q26 の +10〜15% は TrendForce プレスリリー ス 2026-09-30 / 約 3.6 倍(Q3 まで)・約 4.1 倍(Q4 予測まで)は中央値の積(話者試算) / D. Stanzione (TACC), MUG'26 Day 2 基調講演「NSF/TACC Horizon: A MUG Shot」スラ イド PDF p.8–10(mug.mvapich.cse.ohio-state.edu で公開。同氏の調達経験) / R. Ho (OpenAI), TechTechPotato #54(公開書き起こし 2026-09-30、要旨) © 2026 Gisium Inc. All rights reserved A4
  41. 付録 A5 スライド別出典(4/4) 第4章 データを動かすコスト(続き) p.31 Hot Chips 38 Tutorial

    1(d-Matrix、Samsung)・NVIDIA BlueField-4/Spectrum-X・OpenAI・Google の各講演 / HotI'26 Keynote 2(G. Shainer, NVIDIA)・R. Mahatme (Marvell) スポン サー講演 / Alibaba Cloud, OCP China Day 2026 / S. Xu et al. (Microsoft), arXiv:2608.24664・Microsoft 公式ブログ 2026-10-12(Maia 300、帯の引用の要旨) / PFN プレスリリース 2024-11-15(2026 年目標)・PFN Corporate Factbook 2026 年更新版・公式サイト mn-core.com(2027 年提供予定、積層構造の説明)・「MN-Core シリーズの展望」2024-12-19(JFocus 掲載 PDF) / 量子化・投機的デコード・KV キャッシュ対応ルーティングは S. Omura・Y. Zhan (LY Corporation), KubeCon + CloudNativeCon Japan 2026 と llm-d/SGLang の公 開ドキュメント p.32 OpenAI 公式ブログ「Jalapeño: First results」2026-08-25 / R. Ho (OpenAI), TechTechPotato #54(2026-09) / 図は R. Ho・R. Narayanaswami・C. Leary (OpenAI), Hot Chips 38 講演 スライド p.21(一般公開前) p.33 Kimi K2 技術報告(Moonshot AI。総 1.04T・active 32B。約 15 倍・約 0.46 倍は 70B Dense との同精度パラメータ数比、話者試算) / Intel Crescent Island, Hot Chips 38 GPU セッショ ン(7.5 倍・1/4.4 は精度前提込みの分析値、口頭補足) / Oxmiq, Hot Chips 38 Tutorial 1(Kimi K3 内訳と HBF 経済モデルは同社試算) / SambaNova, Hot Chips 38 / OCP HBF 仕様 v0.7.0(草案、2026-08) / SanDisk Investor Day 2026-08-13(サンプル 2027 年) / 容量優先の選択肢は話者の整理(Vera は NVIDIA 発表値、Corsair は d-Matrix 製品概要) 第5章 推論サービスへの帰結 p.34 Hot Chips 38(NVIDIA Rubin・Groq 3 LPX・R. Narayanaswami, OpenAI の各講演)・NVIDIA developer blog「Inside NVIDIA Groq 3 LPX」2026-03-16(attention/FFN 分離の構成図) / d-Matrix Squadron プレスリリース(PR Newswire 2026-10-12。845 tokens/s/user と 64 ユーザ合計 20,415 tokens/s は別々に報告された同社デモ値で同一条件ではない。モデル・ GPU は未開示) / S. Xu et al. (Microsoft), arXiv:2608.24664・Azure blog「Deep dive into Azure Maia 300 architecture」2026-10-12(KV を decode 側へ直接送る記述) / R. Ho (OpenAI), TechTechPotato #54(要旨) p.35 MetaX, OCP China Day 2026 / Alibaba Cloud, Beluga 論文(キャッシュヒット評価の平均 TTFT 最大 89.6% 短縮) / 同時保持トークン数は話者試算: (160 GB − 重み) ÷ KV/トークン。 重み 140 GB(BF16)/70 GB(FP8)、KV 320 KiB/160 KiB、ランタイム予約なし → 約 61,000/約 549,000 / ヒット率の半減はミス分の再計算について / R. Ho (OpenAI), TechTechPotato #54 p.36 話者による問いかけ(日本編への橋渡し。出典なし) p.37 話者の考察(国内導入への適用方針。日本向けの最適構成を実証したものではない) / 設計の軸は Microsoft Research「Splitwise: Efficient Generative LLM Inference Using Phase Splitting」(ISCA 2024)の考え方を参照 p.38 p.7 の 3 点の再掲。出典は各章のページを参照 締め p.39 R. Narayanaswami (OpenAI), Hot Chips 38(2026-08-25、口頭、趣旨) / 2 文は話者のまとめ(2 文目は C. Leary (OpenAI), Hot Chips 38 の発言の言い換え) © 2026 Gisium Inc. All rights reserved A5
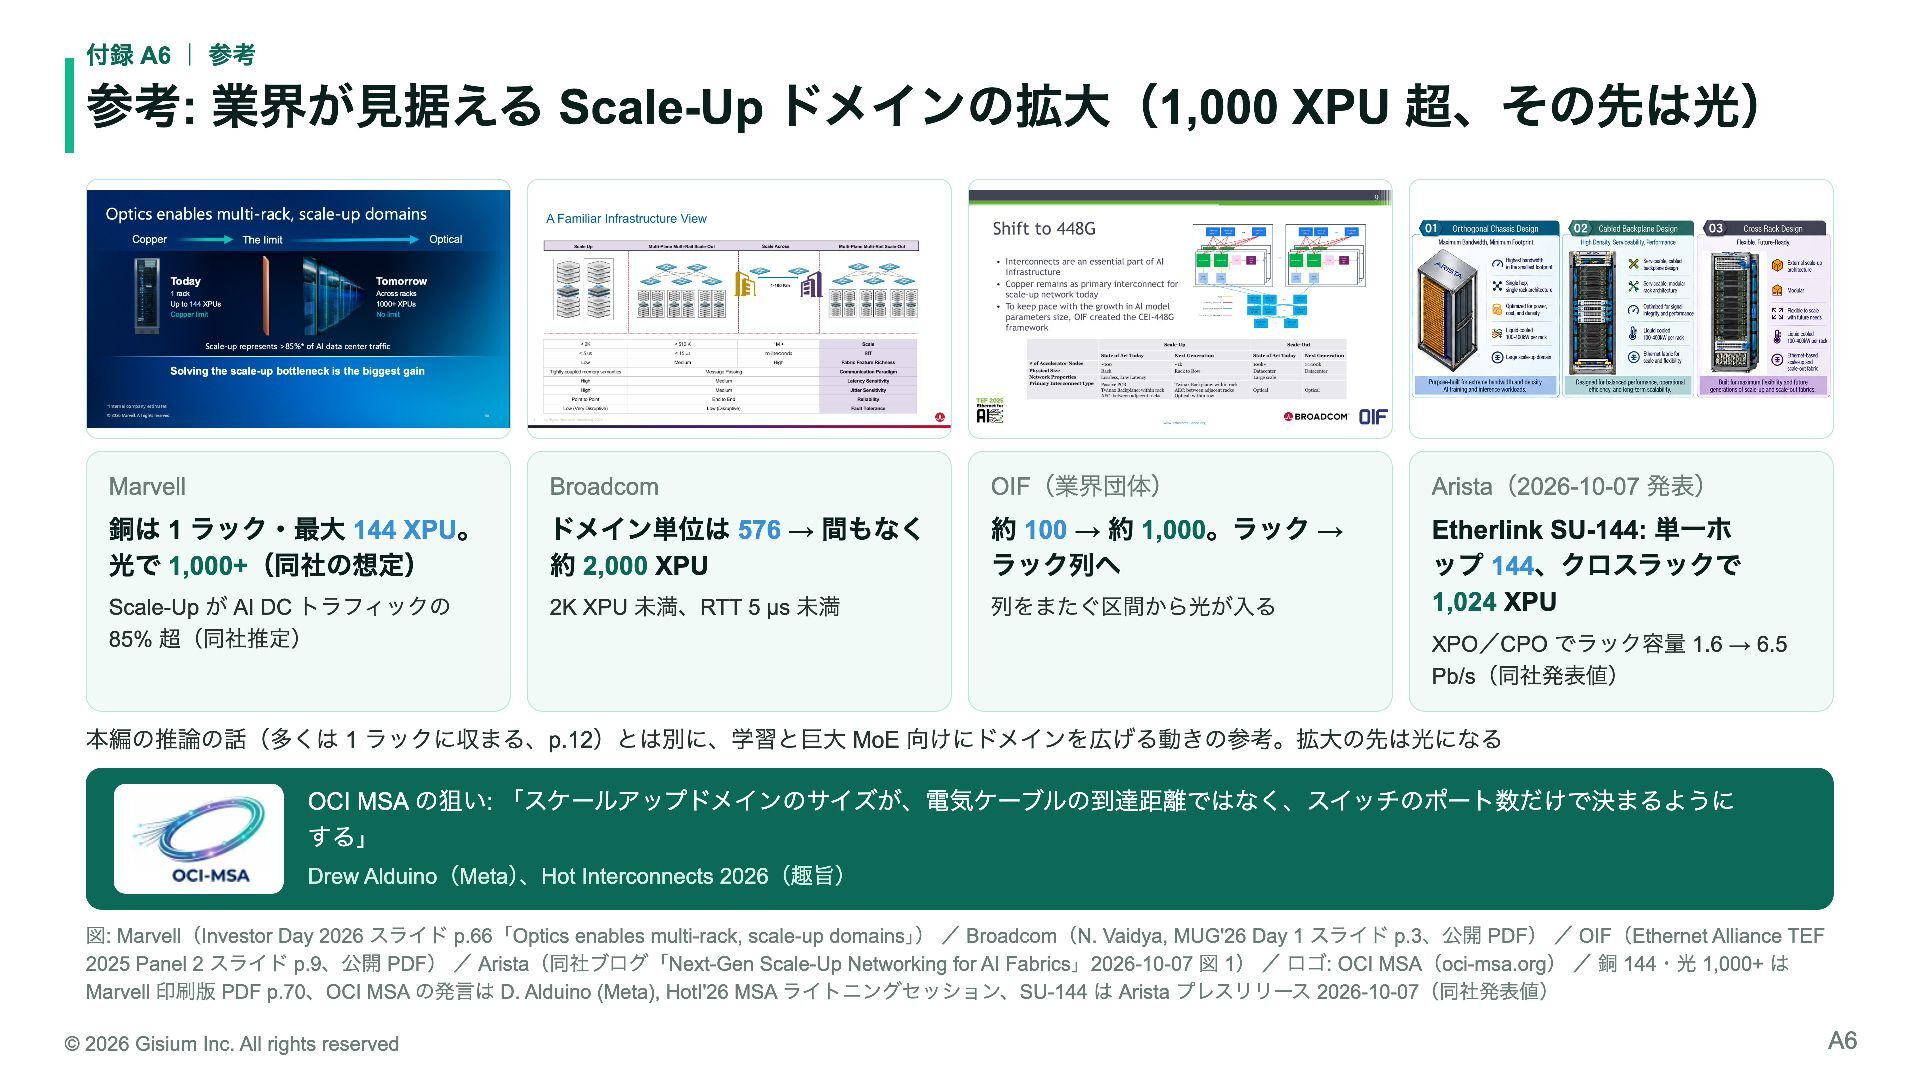
  42. 付録 A6 | 参考 参考: 業界が見据える Scale-Up ドメインの拡大(1,000 XPU 超、その先は光)

    Marvell Broadcom OIF(業界団体) Arista(2026-10-07 発表) 銅は 1 ラック・最大 144 XPU。 光で 1,000+(同社の想定) ドメイン単位は 576 → 間もなく 約 2,000 XPU 約 100 → 約 1,000。ラック → ラック列へ Scale-Up が AI DC トラフィックの 85% 超(同社推定) 2K XPU 未満、RTT 5 µs 未満 列をまたぐ区間から光が入る Etherlink SU-144: 単一ホ ップ 144、クロスラックで 1,024 XPU XPO/CPO でラック容量 1.6 → 6.5 Pb/s(同社発表値) 本編の推論の話(多くは 1 ラックに収まる、p.12)とは別に、学習と巨大 MoE 向けにドメインを広げる動きの参考。拡大の先は光になる OCI MSA の狙い: 「スケールアップドメインのサイズが、電気ケーブルの到達距離ではなく、スイッチのポート数だけで決まるように する」 Drew Alduino(Meta)、Hot Interconnects 2026(趣旨) 図: Marvell(Investor Day 2026 スライド p.66「Optics enables multi-rack, scale-up domains」) / Broadcom(N. Vaidya, MUG'26 Day 1 スライド p.3、公開 PDF) / OIF(Ethernet Alliance TEF 2025 Panel 2 スライド p.9、公開 PDF) / Arista(同社ブログ「Next-Gen Scale-Up Networking for AI Fabrics」2026-10-07 図 1) / ロゴ: OCI MSA(oci-msa.org) / 銅 144・光 1,000+ は Marvell 印刷版 PDF p.70、OCI MSA の発言は D. Alduino (Meta), HotI'26 MSA ライトニングセッション、SU-144 は Arista プレスリリース 2026-10-07(同社発表値) © 2026 Gisium Inc. All rights reserved A6