Pelanggan • Data Cleansing-Standarisasi kolom Nama Lengkap • Data Cleansing-Standarisasi kolom Tanggal Lahir • Data Cleansing-Deduplikasi Data • Data Enrichment
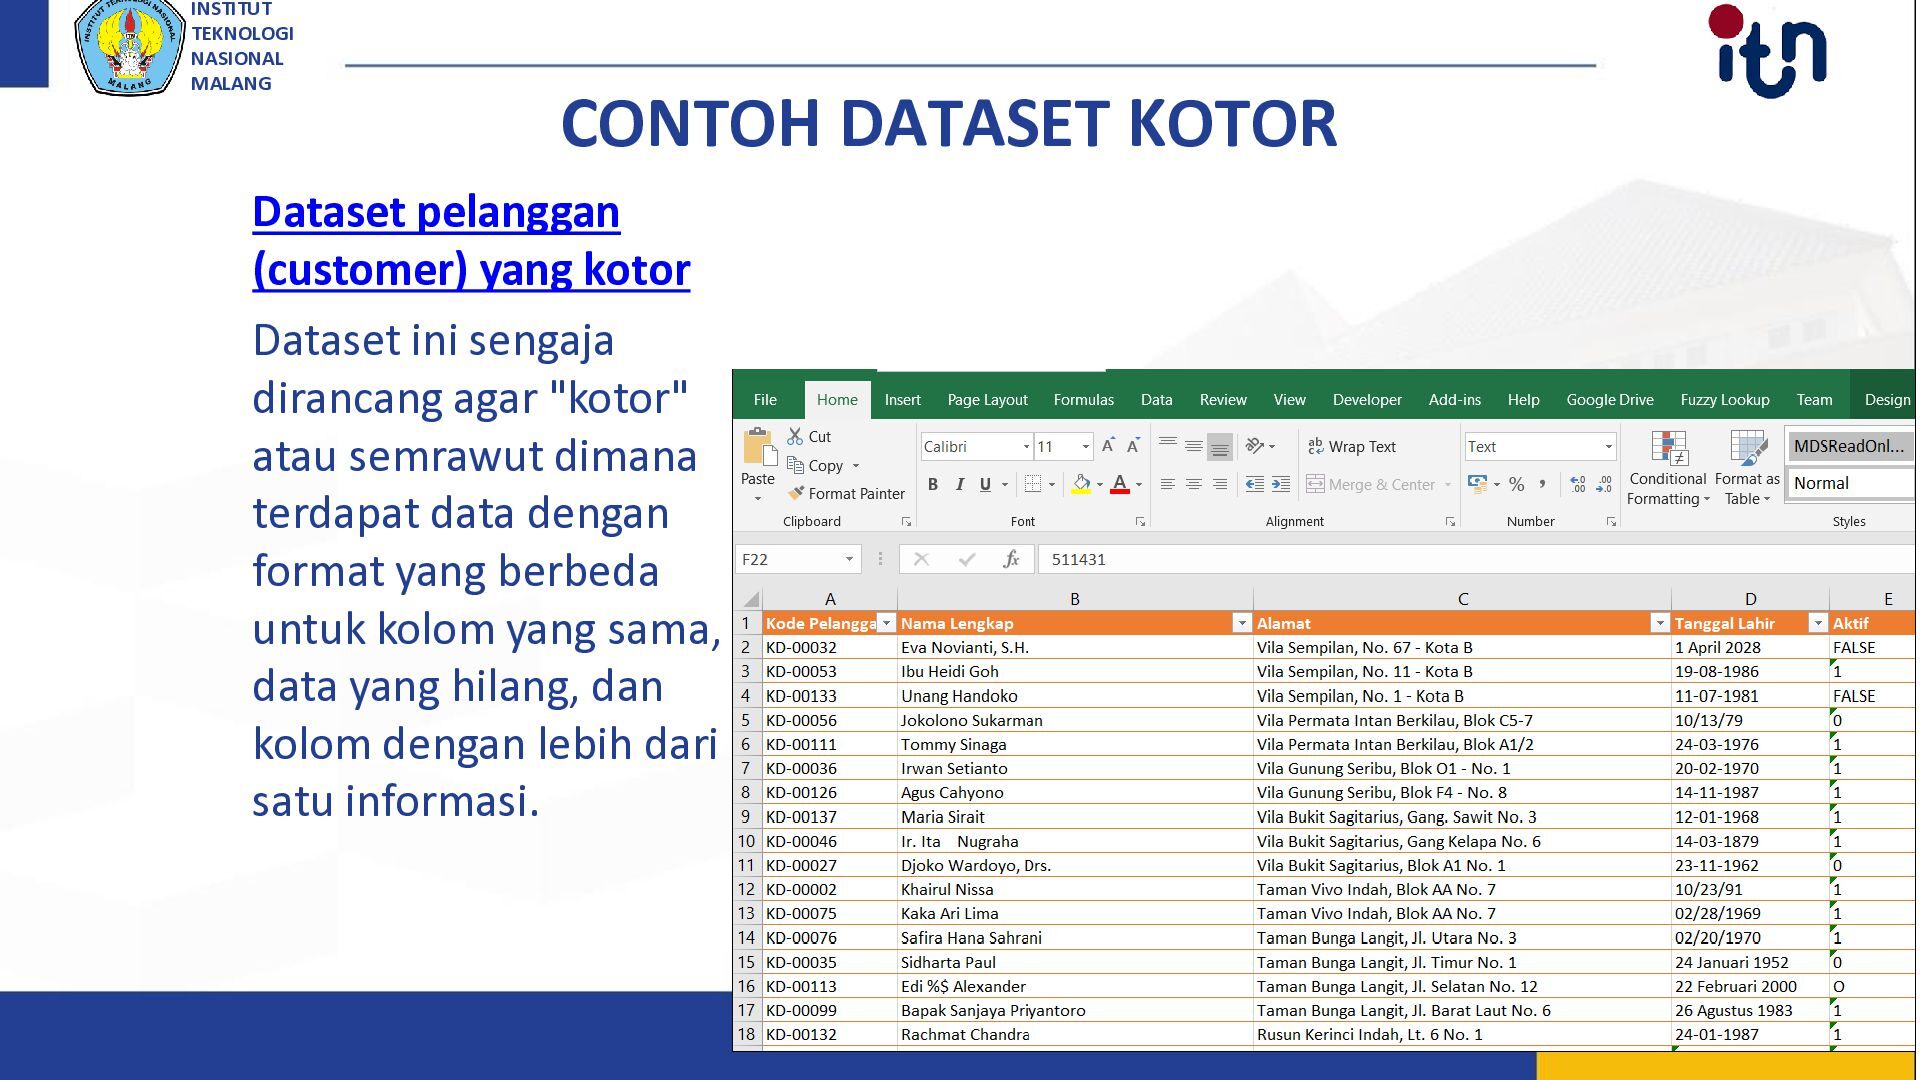
yang kotor Dataset ini sengaja dirancang agar "kotor" atau semrawut dimana terdapat data dengan format yang berbeda untuk kolom yang sama, data yang hilang, dan kolom dengan lebih dari satu informasi.
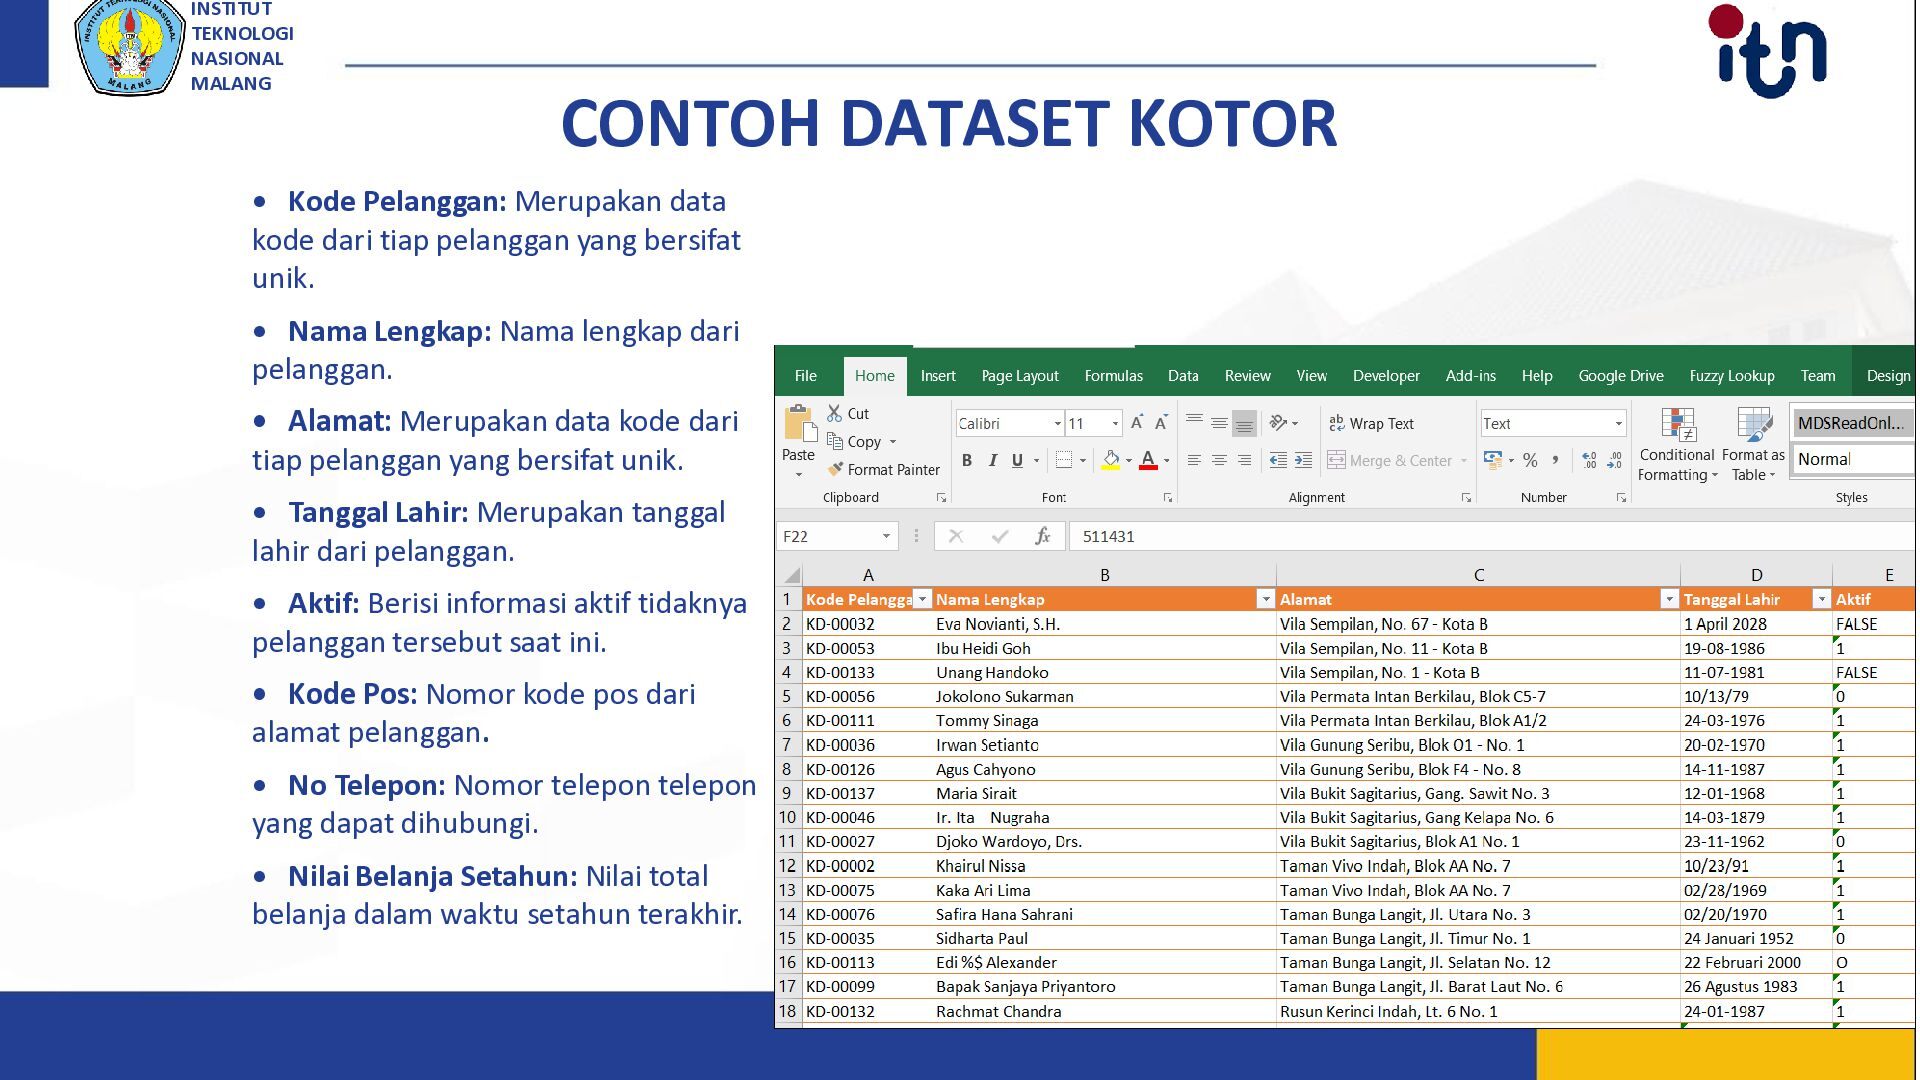
Merupakan data kode dari tiap pelanggan yang bersifat unik. • Nama Lengkap: Nama lengkap dari pelanggan. • Alamat: Merupakan data kode dari tiap pelanggan yang bersifat unik. • Tanggal Lahir: Merupakan tanggal lahir dari pelanggan. • Aktif: Berisi informasi aktif tidaknya pelanggan tersebut saat ini. • Kode Pos: Nomor kode pos dari alamat pelanggan. • No Telepon: Nomor telepon telepon yang dapat dihubungi. • Nilai Belanja Setahun: Nilai total belanja dalam waktu setahun terakhir.
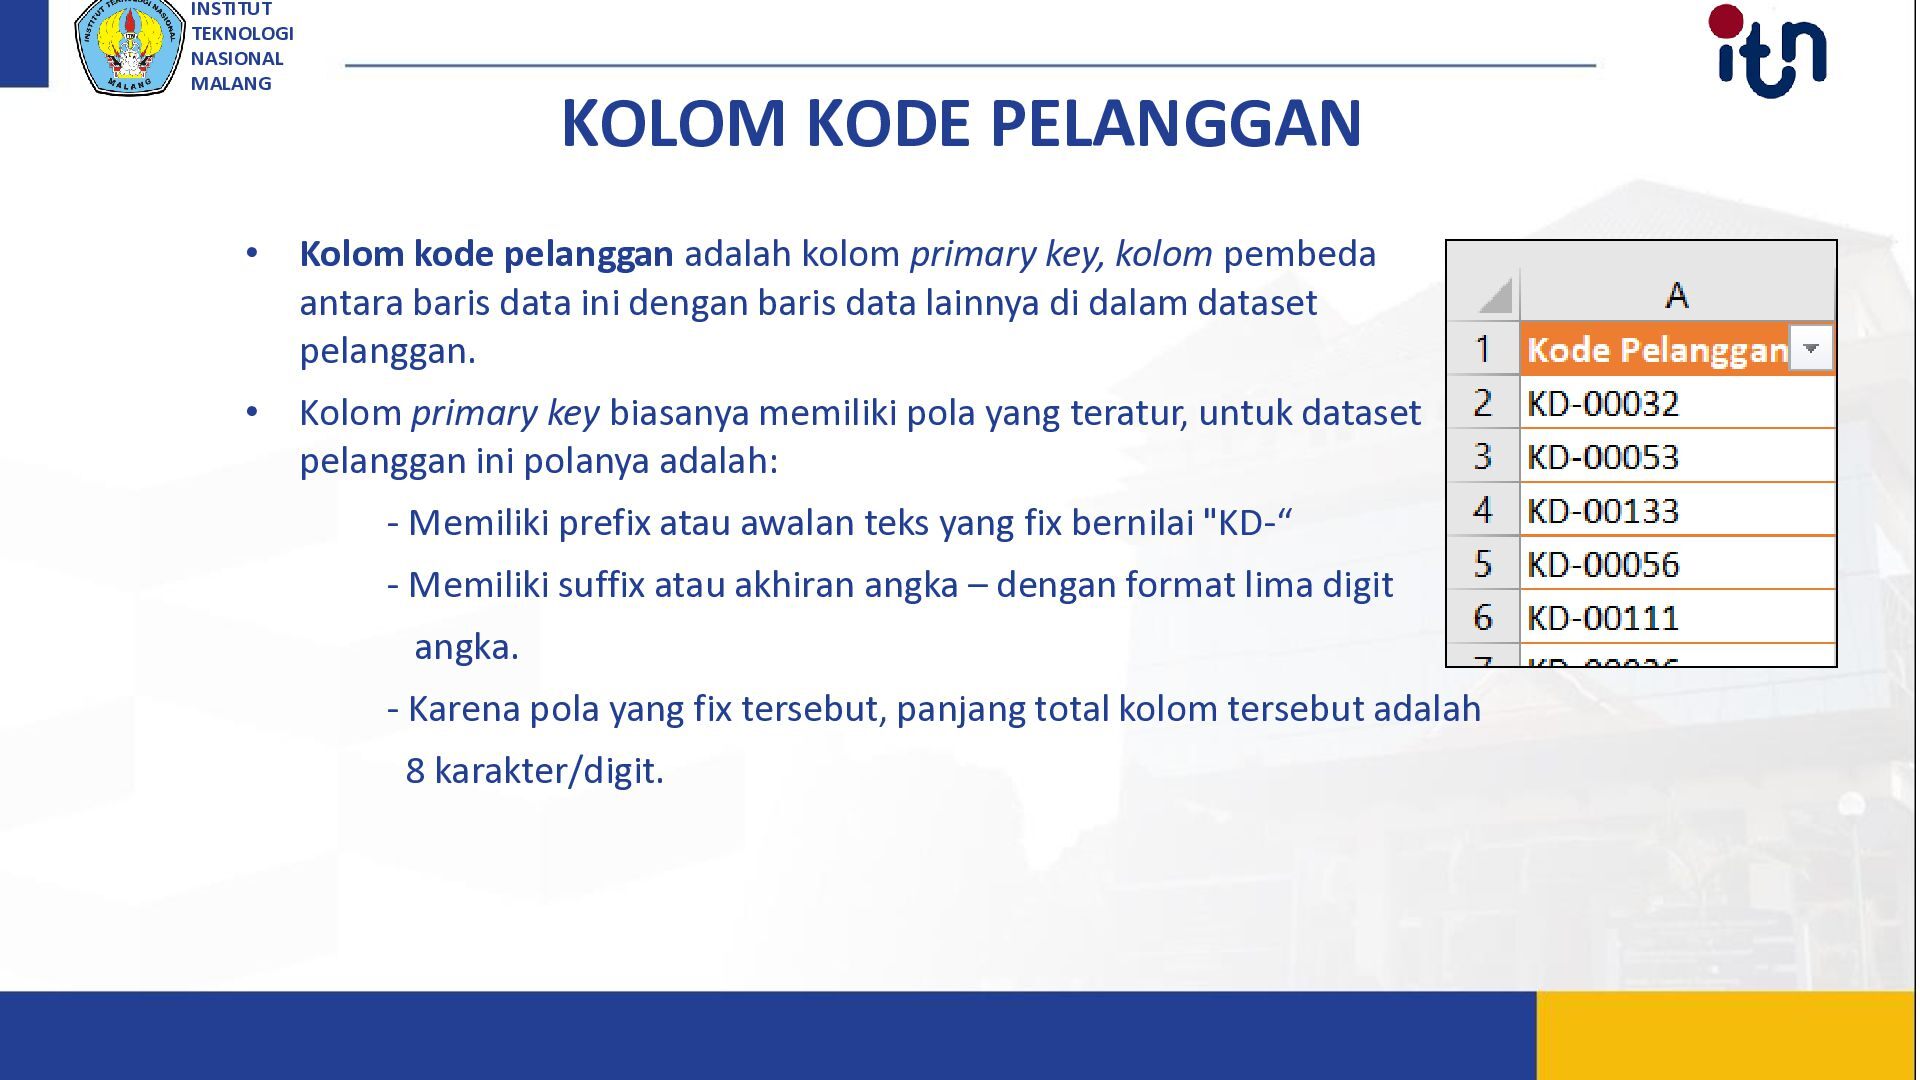
pelanggan adalah kolom primary key, kolom pembeda antara baris data ini dengan baris data lainnya di dalam dataset pelanggan. • Kolom primary key biasanya memiliki pola yang teratur, untuk dataset pelanggan ini polanya adalah: - Memiliki prefix atau awalan teks yang fix bernilai "KD-“ - Memiliki suffix atau akhiran angka – dengan format lima digit angka. - Karena pola yang fix tersebut, panjang total kolom tersebut adalah 8 karakter/digit.
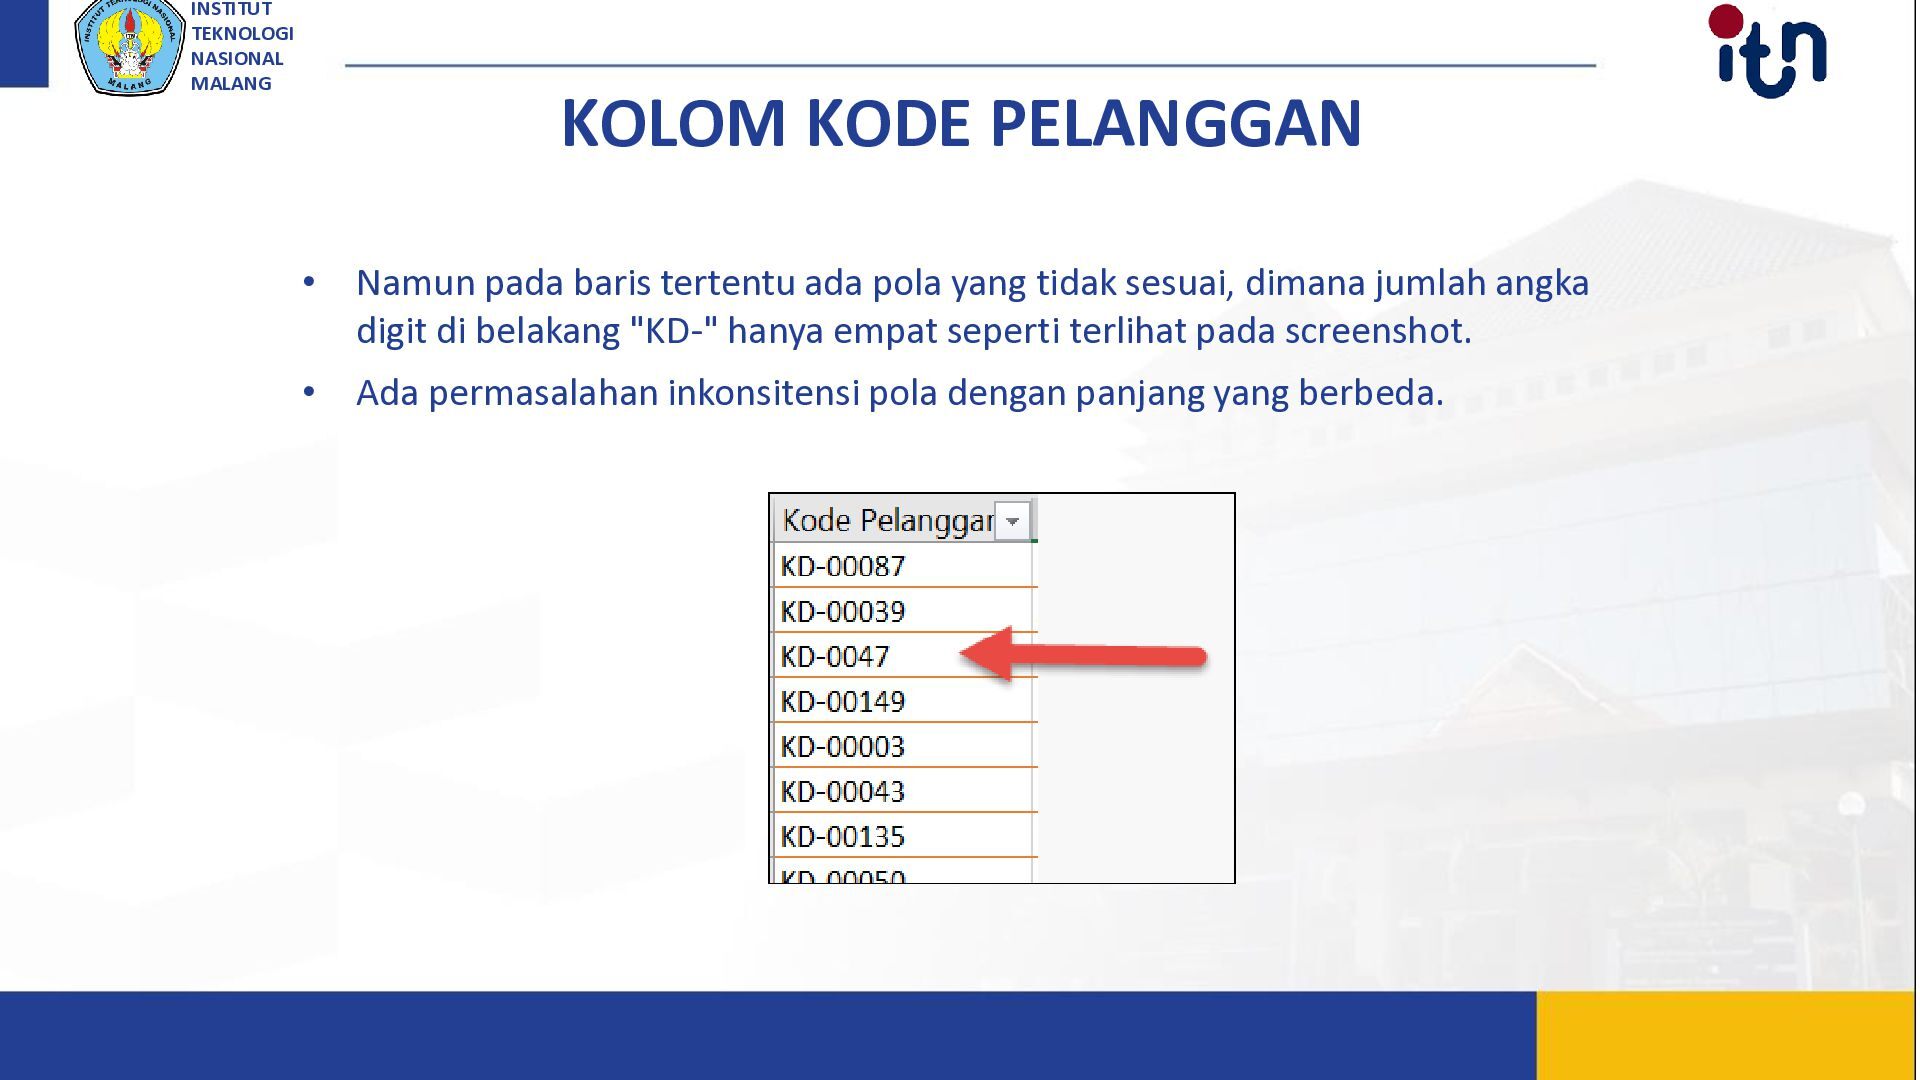
baris tertentu ada pola yang tidak sesuai, dimana jumlah angka digit di belakang "KD-" hanya empat seperti terlihat pada screenshot. • Ada permasalahan inkonsitensi pola dengan panjang yang berbeda.
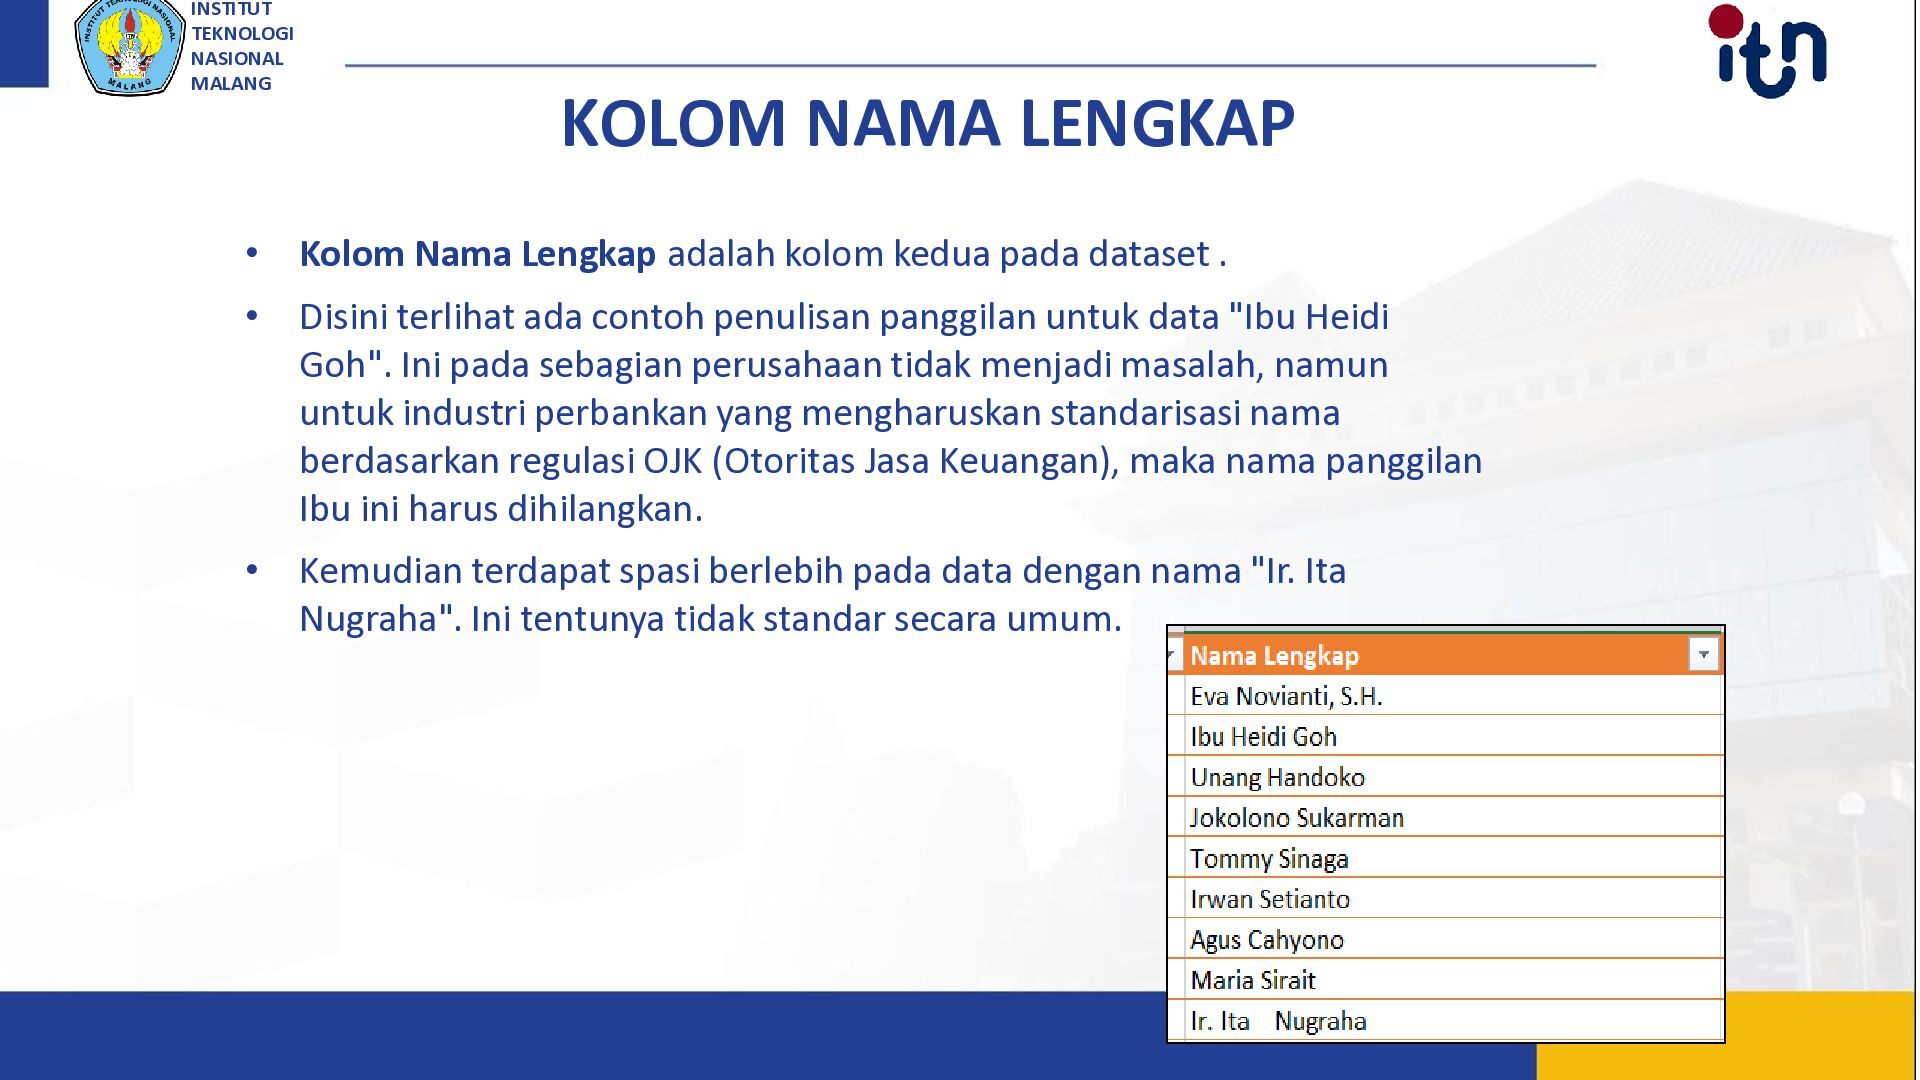
Lengkap adalah kolom kedua pada dataset . • Disini terlihat ada contoh penulisan panggilan untuk data "Ibu Heidi Goh". Ini pada sebagian perusahaan tidak menjadi masalah, namun untuk industri perbankan yang mengharuskan standarisasi nama berdasarkan regulasi OJK (Otoritas Jasa Keuangan), maka nama panggilan Ibu ini harus dihilangkan. • Kemudian terdapat spasi berlebih pada data dengan nama "Ir. Ita Nugraha". Ini tentunya tidak standar secara umum.
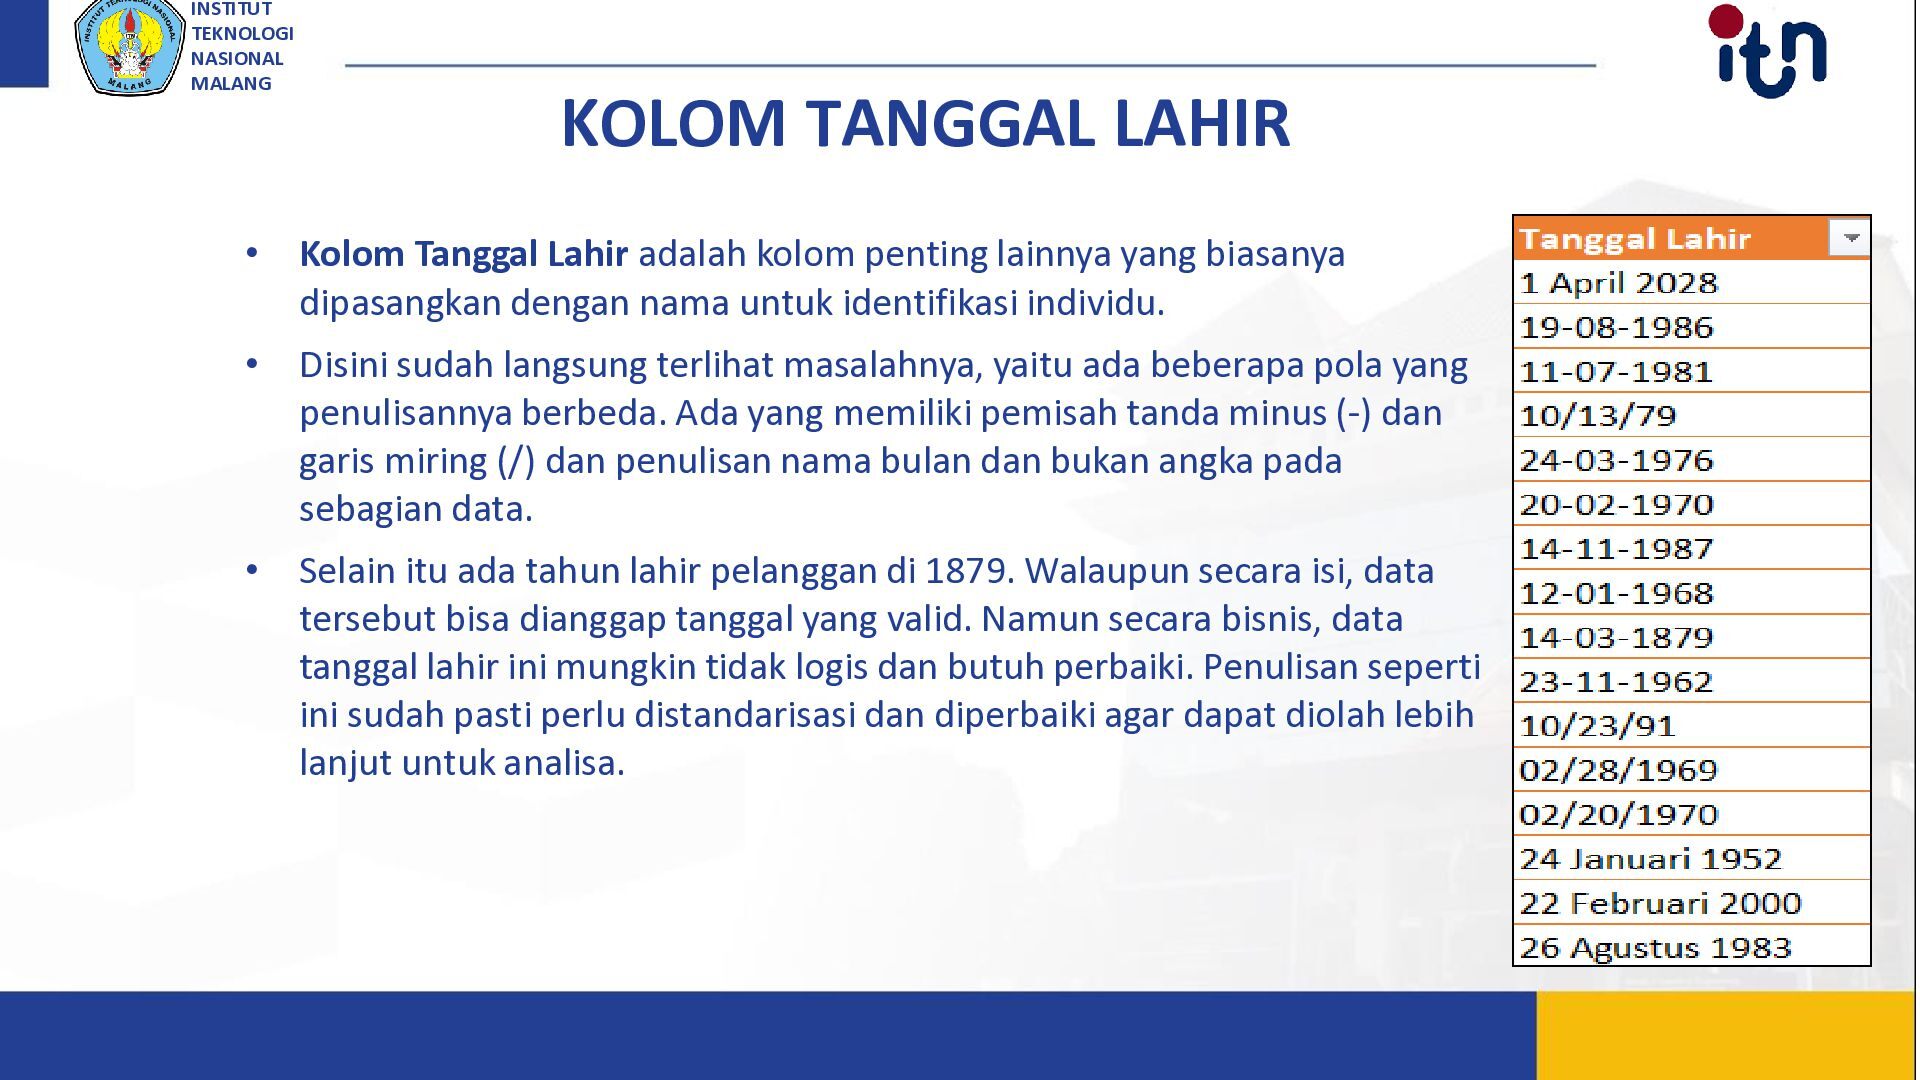
Lahir adalah kolom penting lainnya yang biasanya dipasangkan dengan nama untuk identifikasi individu. • Disini sudah langsung terlihat masalahnya, yaitu ada beberapa pola yang penulisannya berbeda. Ada yang memiliki pemisah tanda minus (-) dan garis miring (/) dan penulisan nama bulan dan bukan angka pada sebagian data. • Selain itu ada tahun lahir pelanggan di 1879. Walaupun secara isi, data tersebut bisa dianggap tanggal yang valid. Namun secara bisnis, data tanggal lahir ini mungkin tidak logis dan butuh perbaiki. Penulisan seperti ini sudah pasti perlu distandarisasi dan diperbaiki agar dapat diolah lebih lanjut untuk analisa.
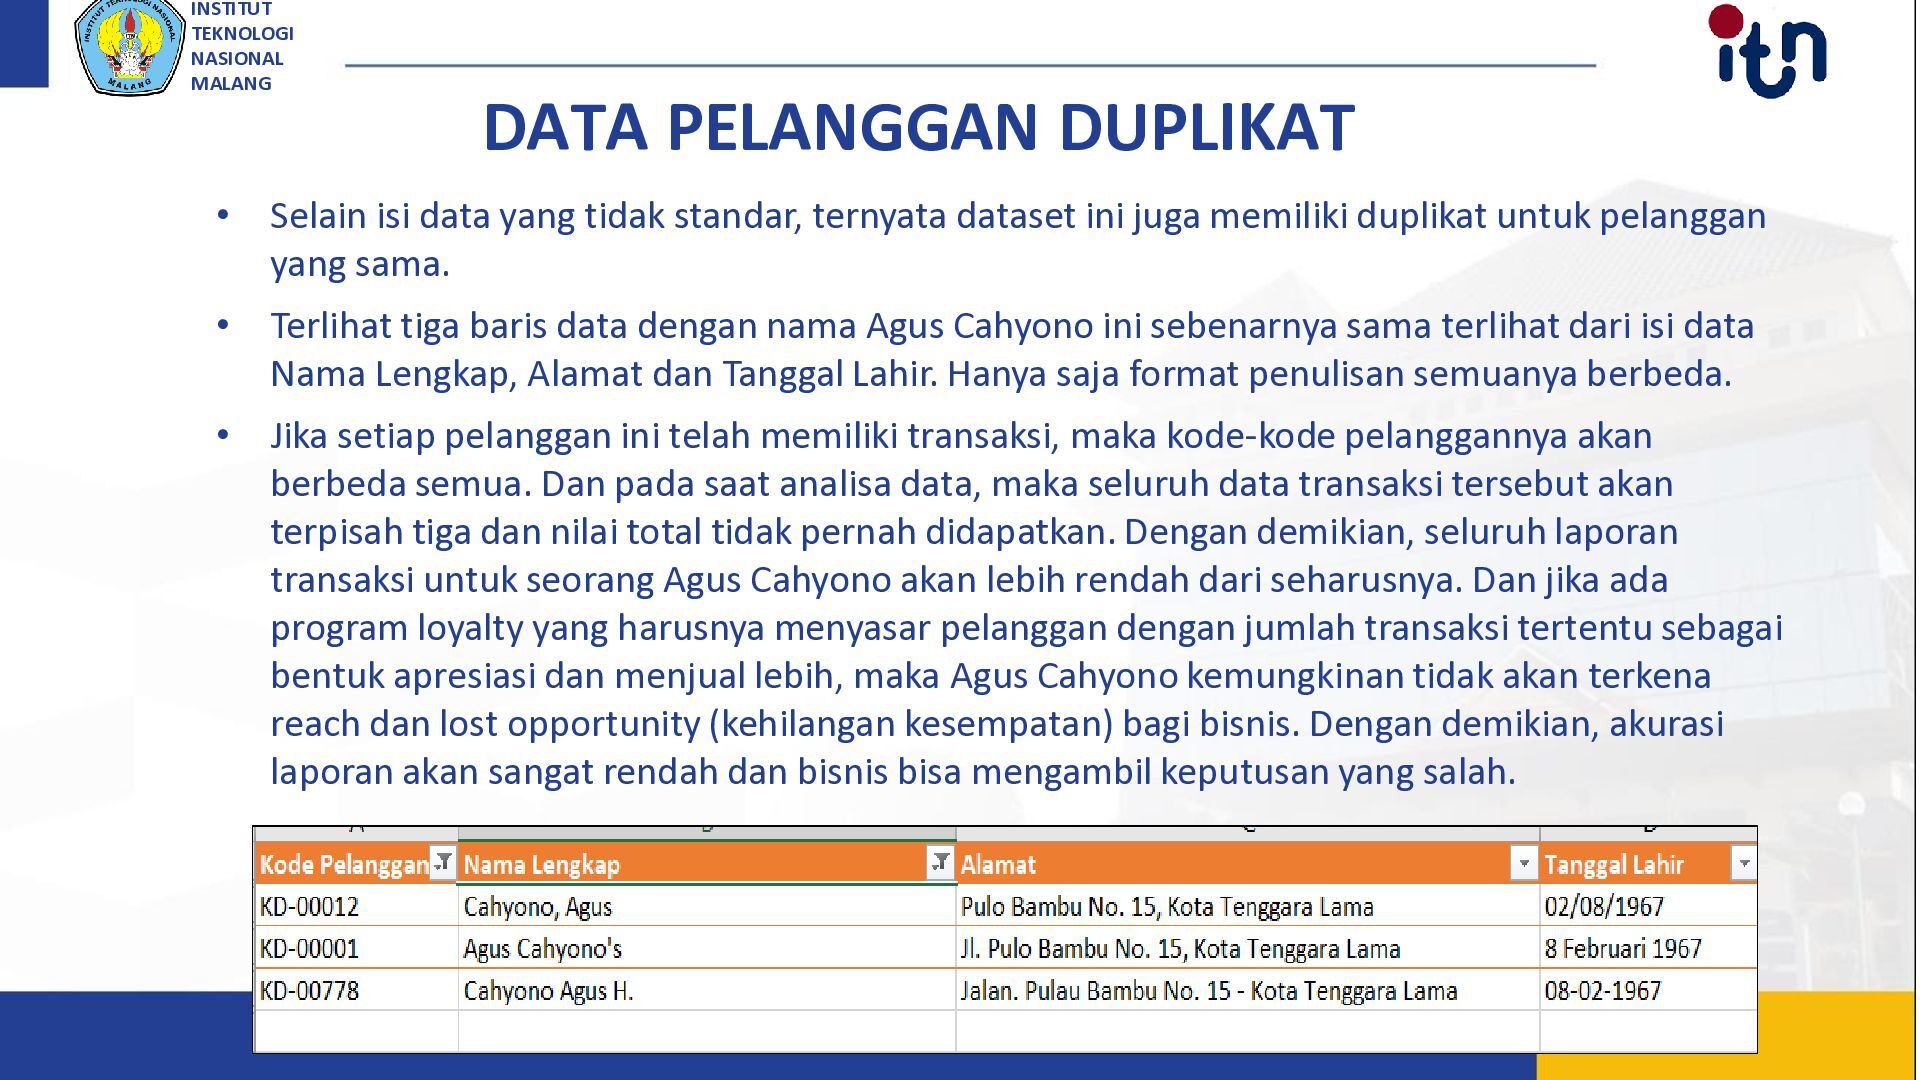
data yang tidak standar, ternyata dataset ini juga memiliki duplikat untuk pelanggan yang sama. • Terlihat tiga baris data dengan nama Agus Cahyono ini sebenarnya sama terlihat dari isi data Nama Lengkap, Alamat dan Tanggal Lahir. Hanya saja format penulisan semuanya berbeda. • Jika setiap pelanggan ini telah memiliki transaksi, maka kode-kode pelanggannya akan berbeda semua. Dan pada saat analisa data, maka seluruh data transaksi tersebut akan terpisah tiga dan nilai total tidak pernah didapatkan. Dengan demikian, seluruh laporan transaksi untuk seorang Agus Cahyono akan lebih rendah dari seharusnya. Dan jika ada program loyalty yang harusnya menyasar pelanggan dengan jumlah transaksi tertentu sebagai bentuk apresiasi dan menjual lebih, maka Agus Cahyono kemungkinan tidak akan terkena reach dan lost opportunity (kehilangan kesempatan) bagi bisnis. Dengan demikian, akurasi laporan akan sangat rendah dan bisnis bisa mengambil keputusan yang salah.
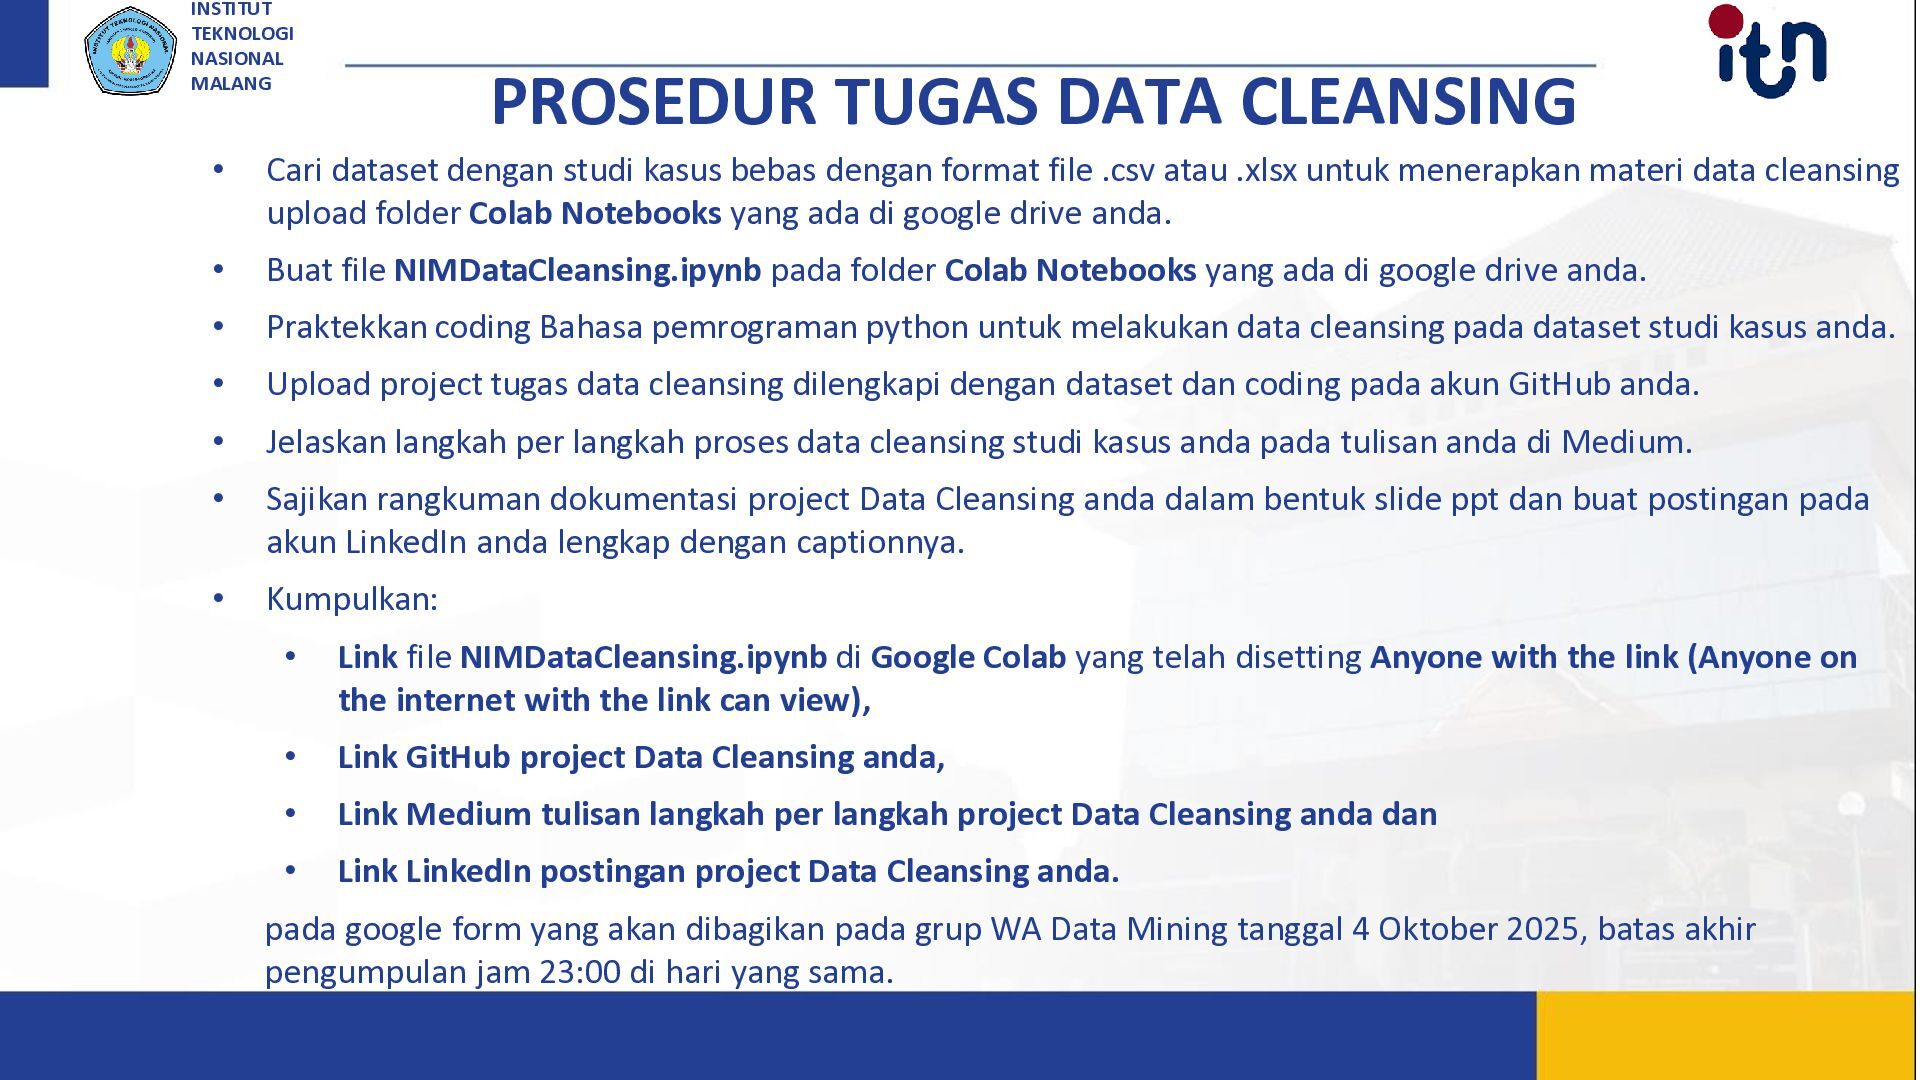
dataset dengan studi kasus bebas dengan format file .csv atau .xlsx untuk menerapkan materi data cleansing upload folder Colab Notebooks yang ada di google drive anda. • Buat file NIMDataCleansing.ipynb pada folder Colab Notebooks yang ada di google drive anda. • Praktekkan coding Bahasa pemrograman python untuk melakukan data cleansing pada dataset studi kasus anda. • Upload project tugas data cleansing dilengkapi dengan dataset dan coding pada akun GitHub anda. • Jelaskan langkah per langkah proses data cleansing studi kasus anda pada tulisan anda di Medium. • Sajikan rangkuman dokumentasi project Data Cleansing anda dalam bentuk slide ppt dan buat postingan pada akun LinkedIn anda lengkap dengan captionnya. • Kumpulkan: • Link file NIMDataCleansing.ipynb di Google Colab yang telah disetting Anyone with the link (Anyone on the internet with the link can view), • Link GitHub project Data Cleansing anda, • Link Medium tulisan langkah per langkah project Data Cleansing anda dan • Link LinkedIn postingan project Data Cleansing anda. pada google form yang akan dibagikan pada grup WA Data Mining tanggal 4 Oktober 2025, batas akhir pengumpulan jam 23:00 di hari yang sama.


 kneath
 auna
 akosma
 62gerente
 techseoconnect
 ryanjones
 stuffmc
 akashhashmi
 takai
 kristinabergwall1
 geshan
 skipperchong