ypeSafe Jevは、文章生成を行わず**「構造化された意思決定(型付きの値)」の出力に完全特化した新カテゴリのAIモデル(System One Model)**です1more_horiz。
1. TypeSafe Jevの概要開発背景と基本コンセプト
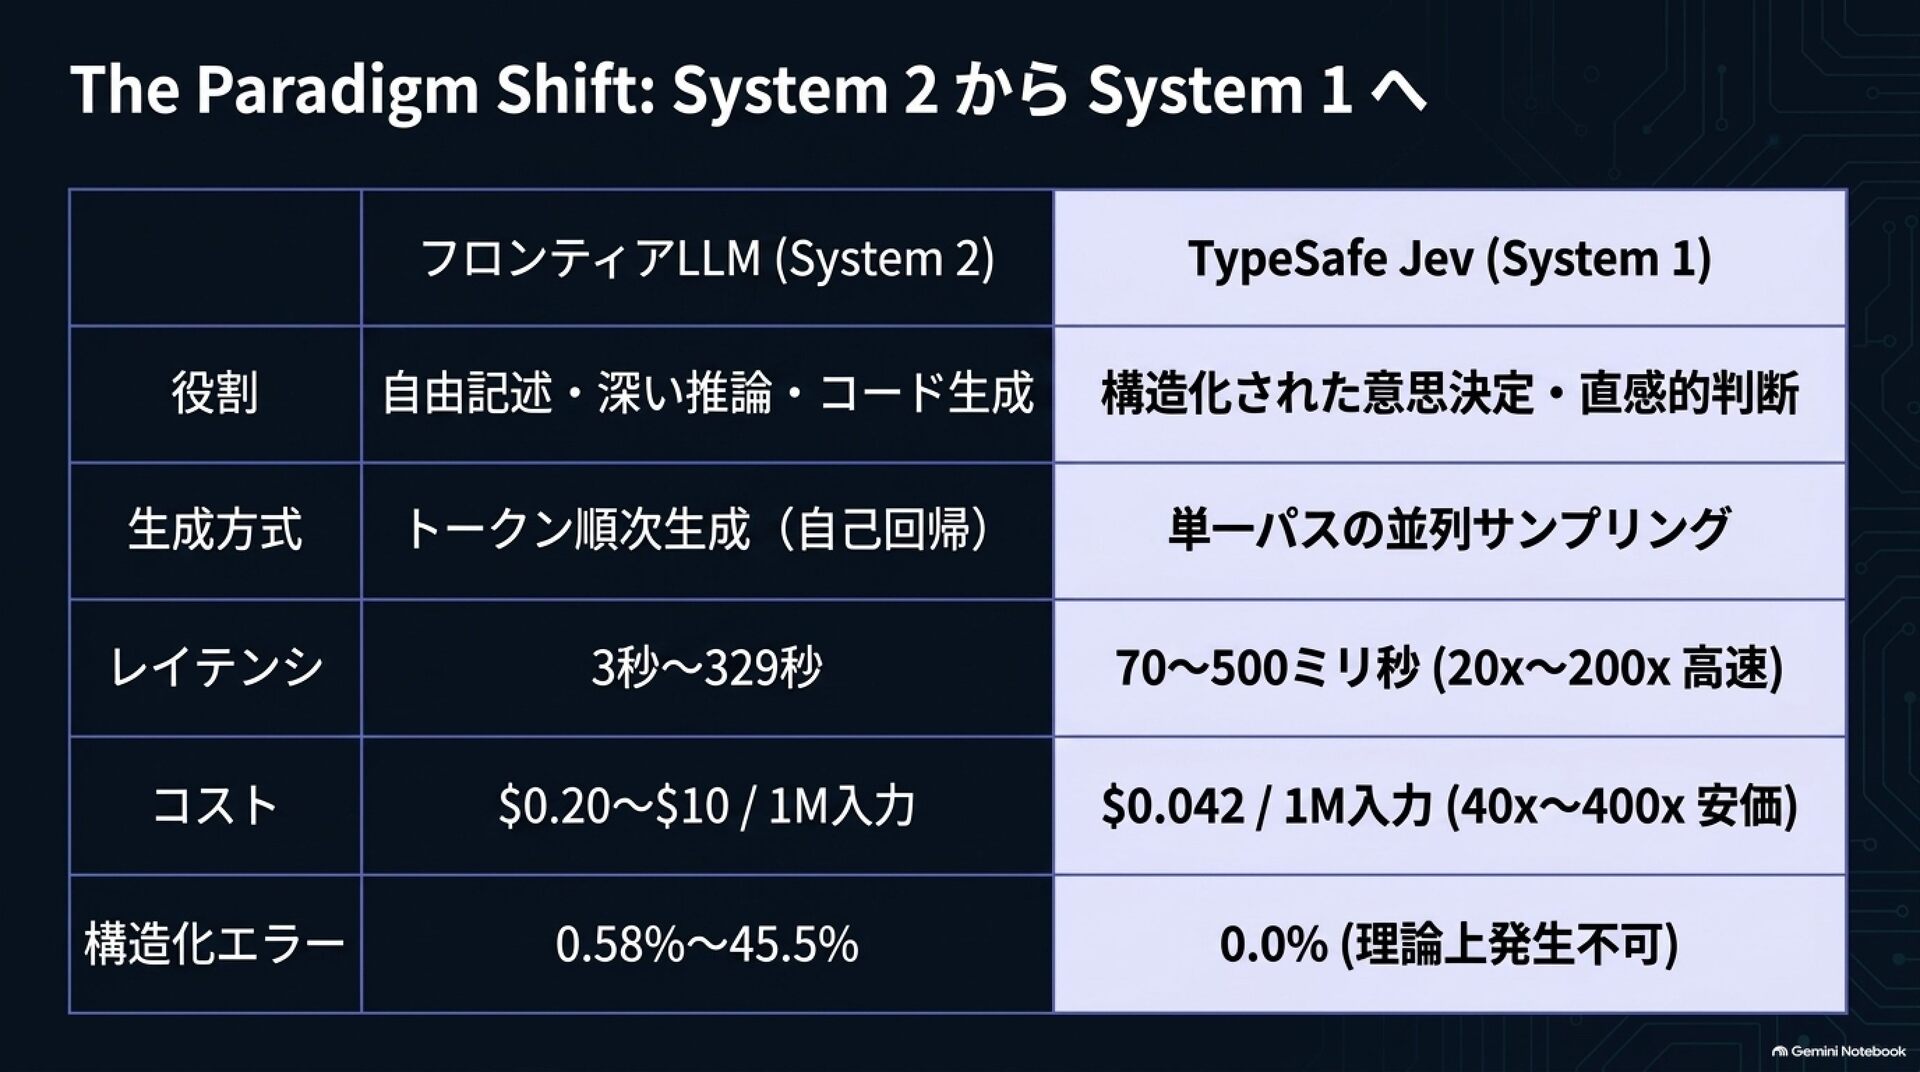
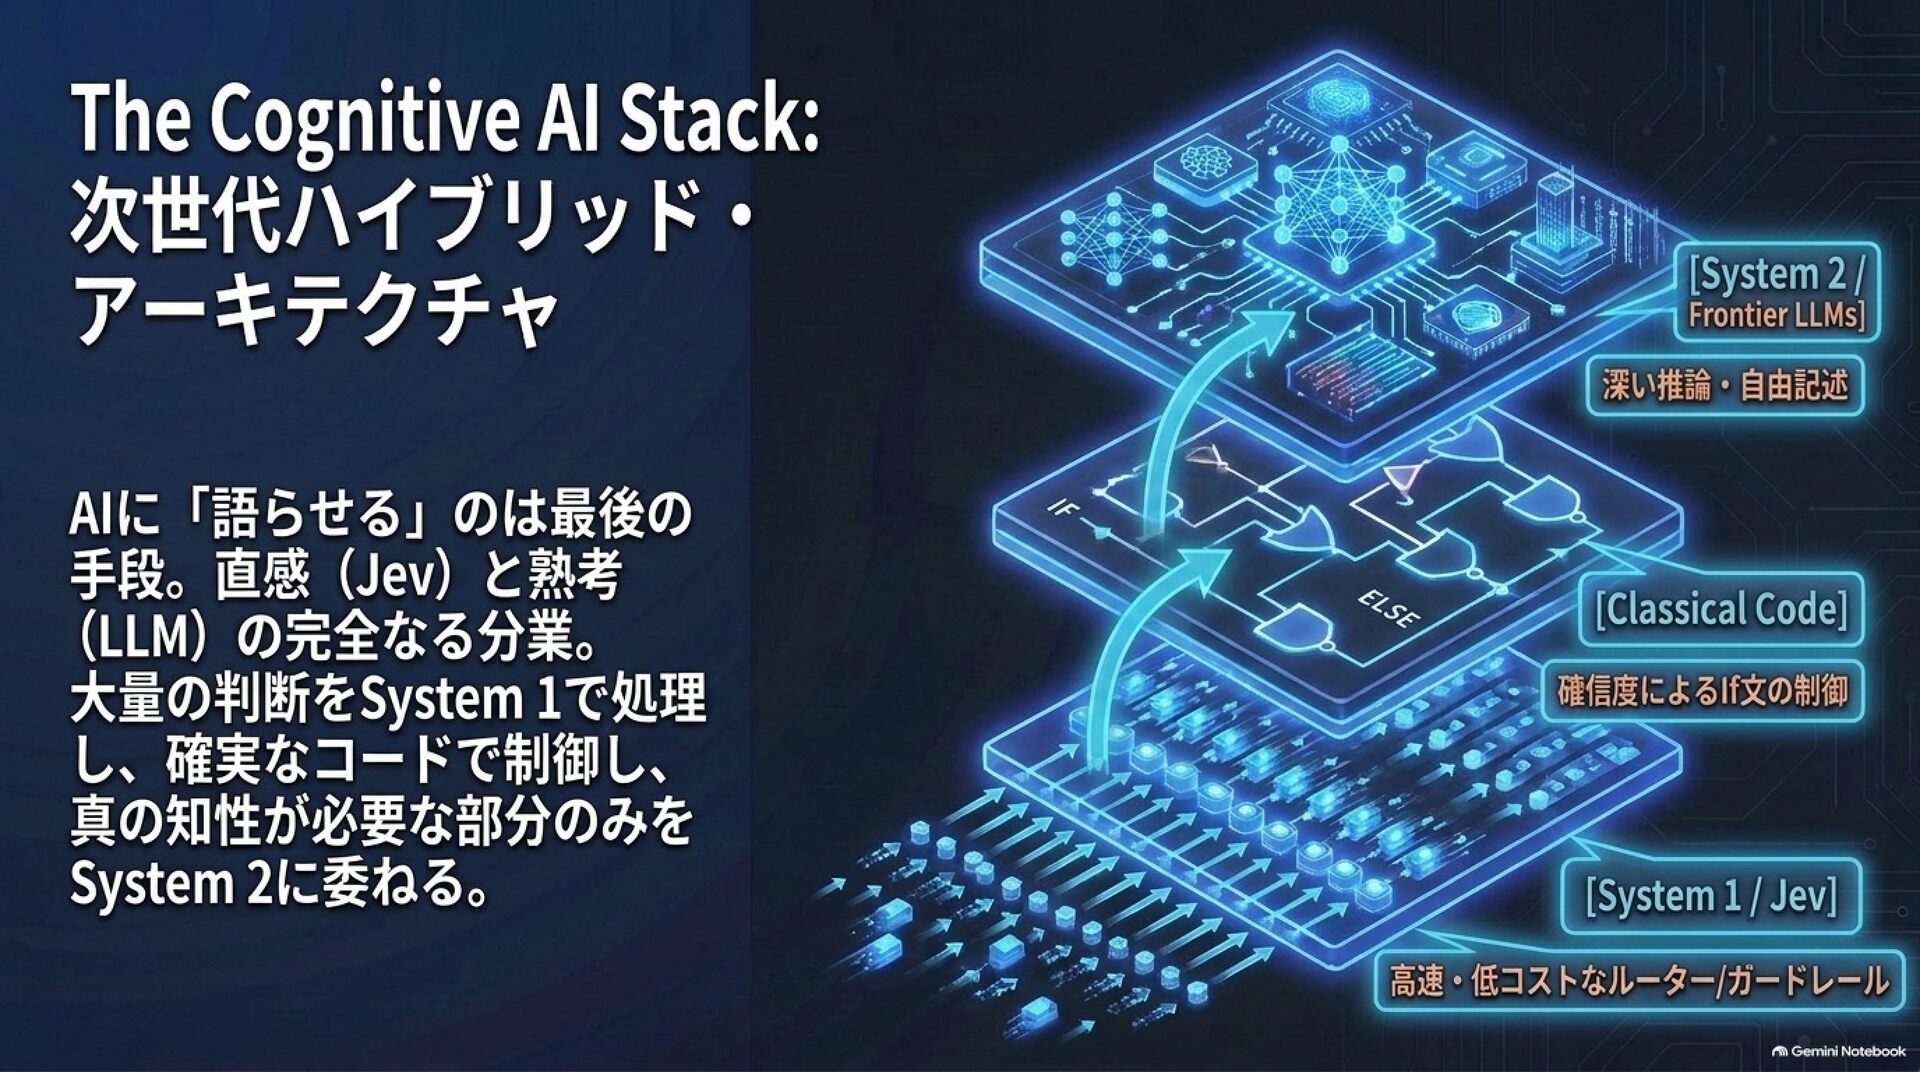
OpenAIにてRLHF(Human Feedbackからの強化学習)やInstructGPTの共同発明者であったDiogo Almeida氏らが設立したTypeSafe AI社により、2026年9月15日に公開されました。認知心理学者ダニエル・カーネマンの二重過程理論における「System 1(直感的・高速な判断)」を模倣して構築されています。
「喋らないAI」のパラダイム
従来のLLM(大規模言語モデル)のようにテキストやコードをトークン単位で生成する機能(System 2)をあえて完全に排除し、不完全・非構造化テキストなどの「状態(State)」を受け取って固定的な型付きデータ(Choice, Score, Noul)のみを返却します。
圧倒的な低遅延と低コスト
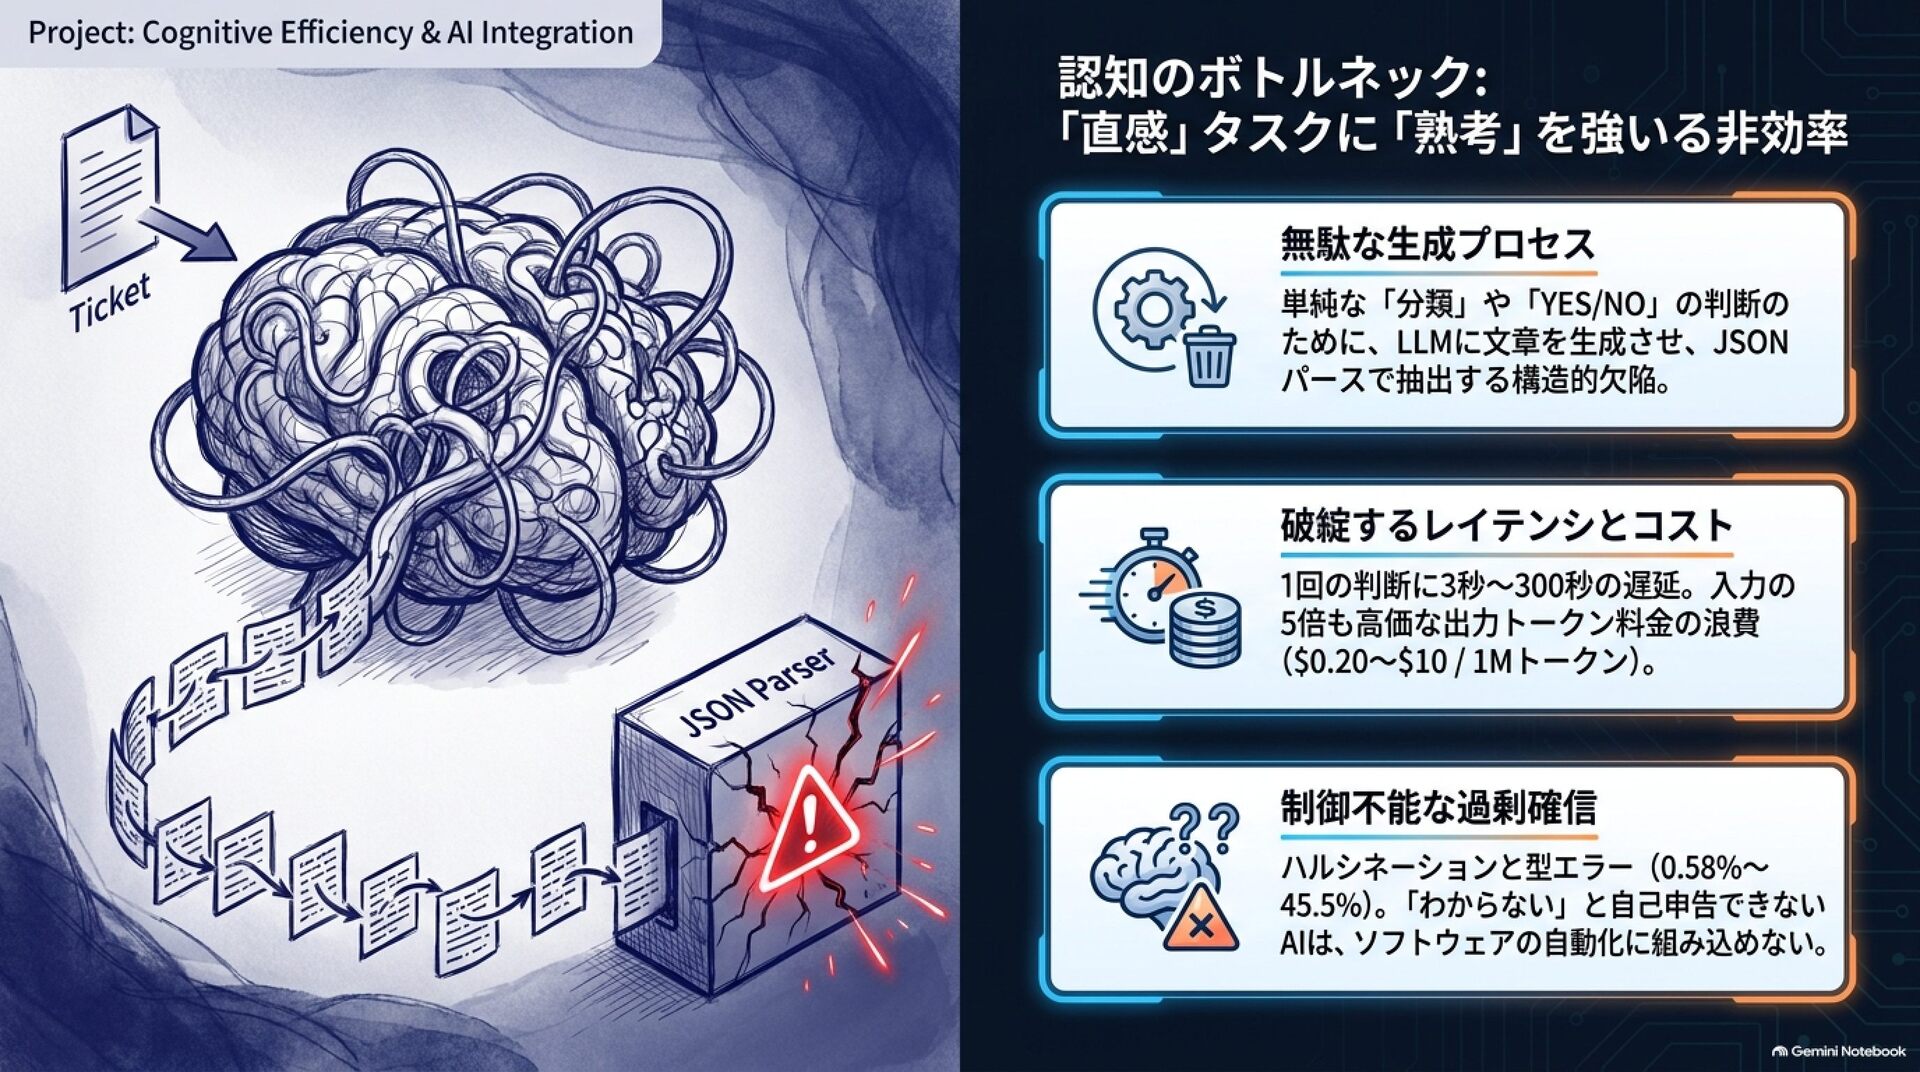
応答遅延は70ミリ秒〜500ミリ秒(平均100ms前後)であり、従来LLMの数秒〜数十秒に比べて圧倒的に高速です。価格は入力100万トークンあたり$0.042で、出力トークン費用は**無料(無償提供)**とされています。
2. Jevの技術的構造・アーキテクチャ
① 並列サンプリング・アーキテクチャ(Parallel Sampling Architecture)
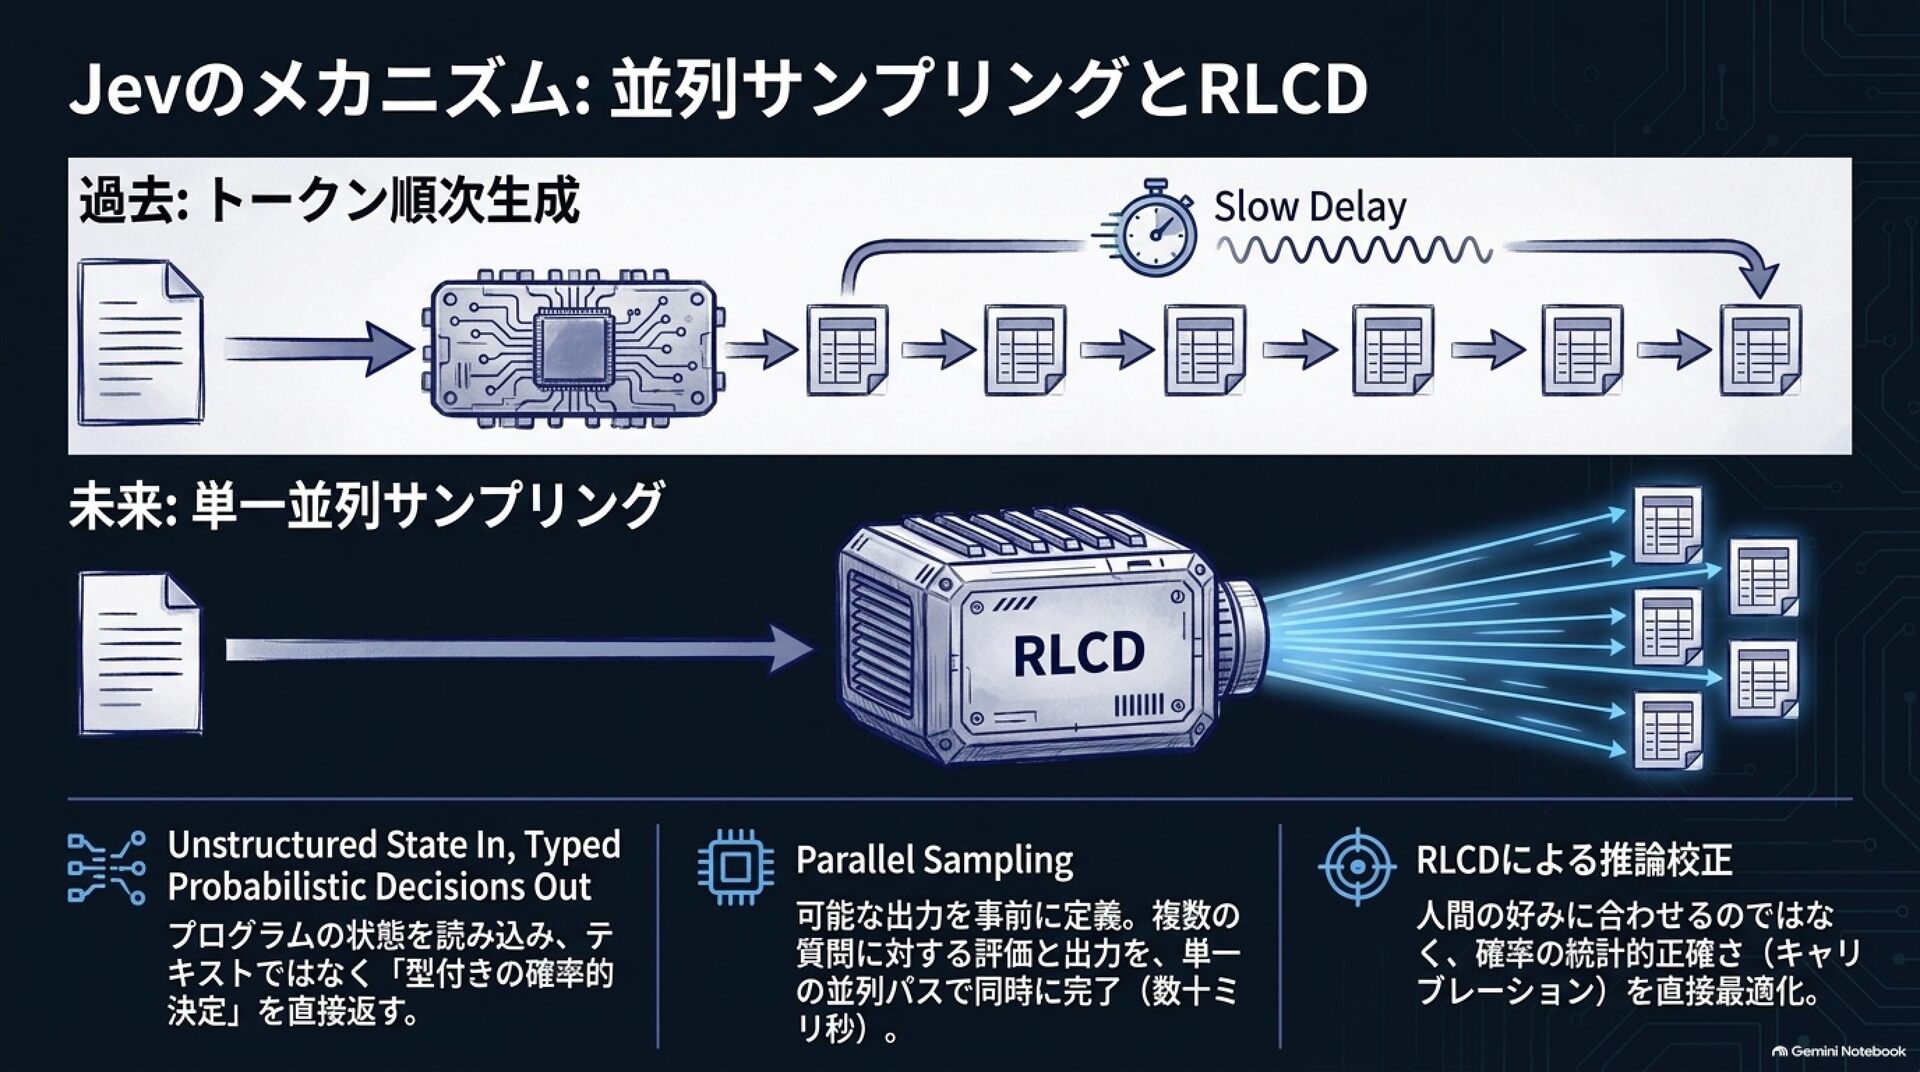
従来のLLMは1トークンずつ順番に生成する自己回帰的(Autoregressive)サンプリングを行うため、構文解析やパースの遅延が発生し、出力崩れのリスクがありました。Jevは可能出力空間をあらかじめスキーマで拘束し、**単一の並列パス(Parallel Pass)**で全ての評価項目や設問を同時にサンプリングして回答を算出します。
② RLCD(Reinforcement Learning for Calibrated Decisions)
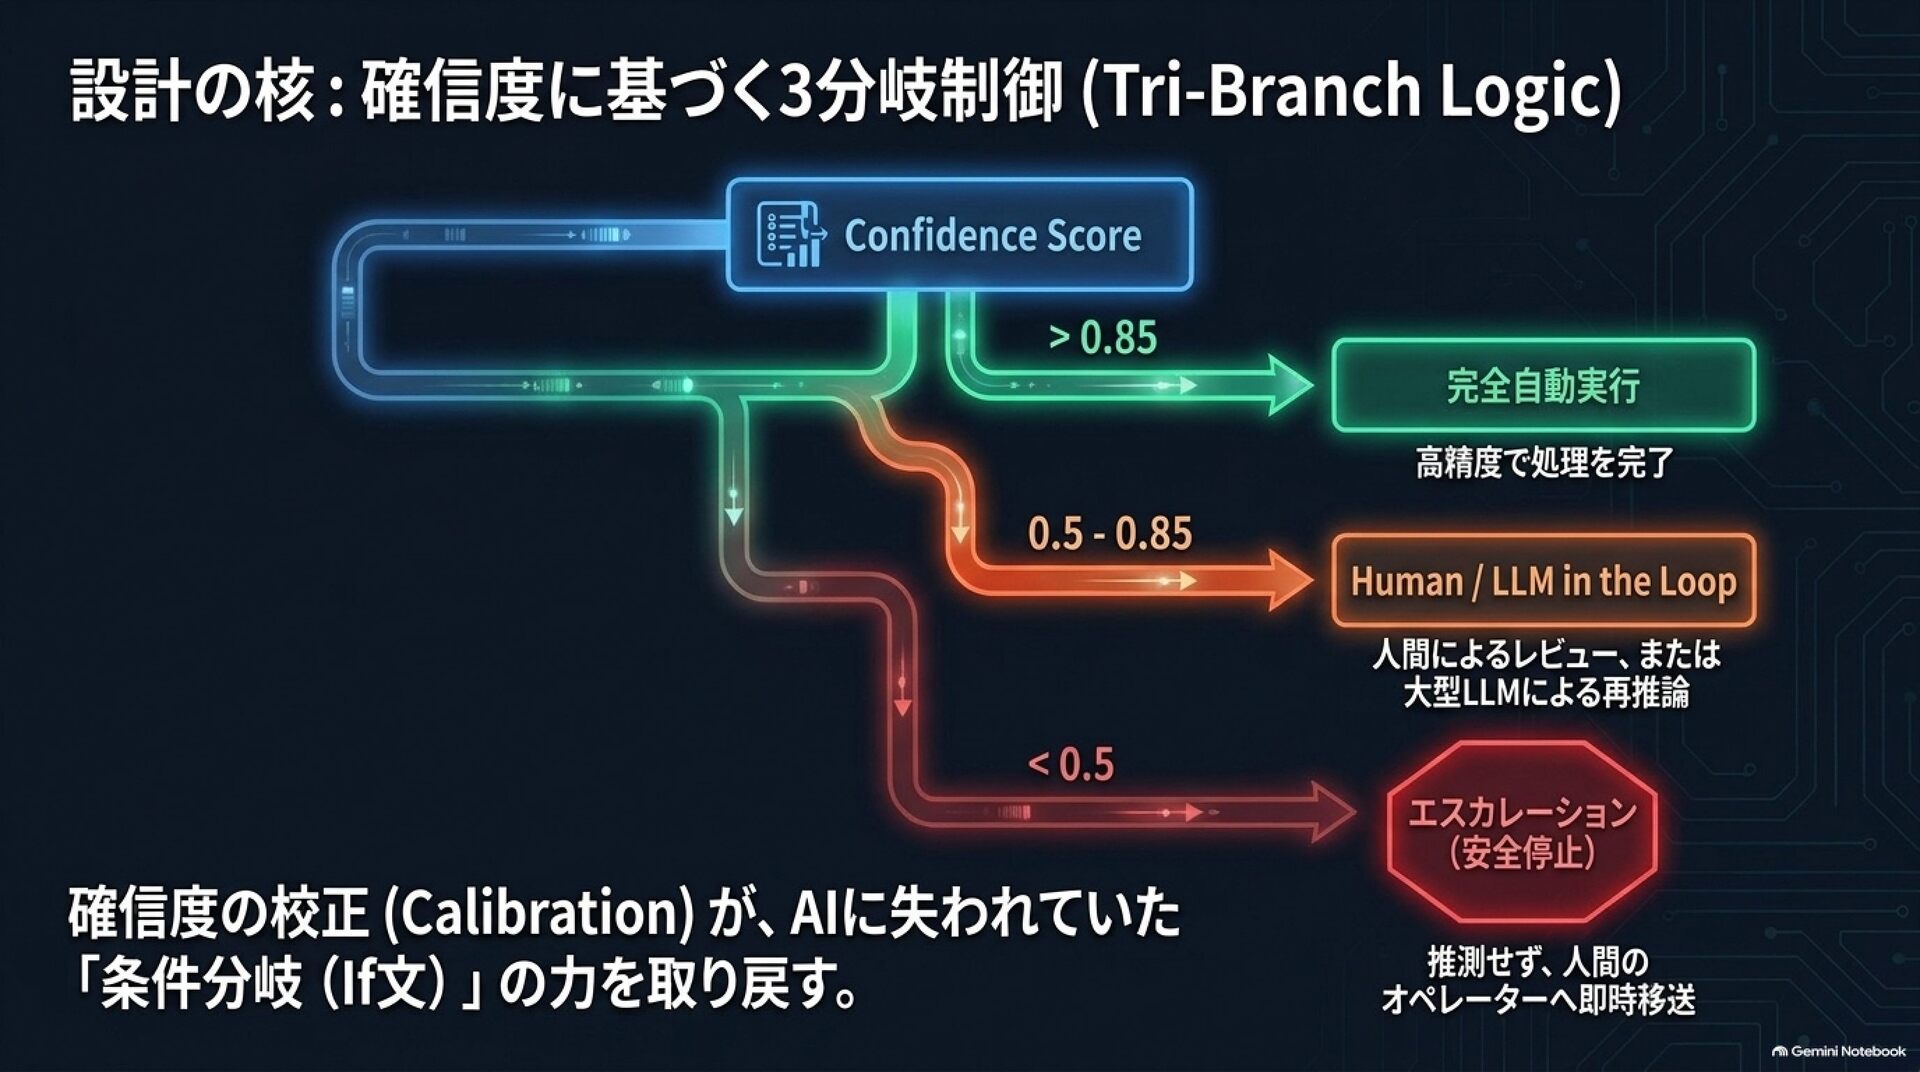
対話の心地よさを最適化するRLHFや検証可能報酬を最適化するRLVRではなく、**確信度(統計的校正)の正確性を直接最適化する「RLCD」**という学習手法を採用しています。モデルが「確信度90%」と返した試行群を集計すると実際に約90%の確率で正解するよう校正(Calibration)されているため、開発者は確信度スコアをそのままプログラムの条件分岐閾値(例: 0.85以上なら自動実行、未満なら人間へ回す)として利用できます。
③ 3つの核心的意思決定プリミティブ
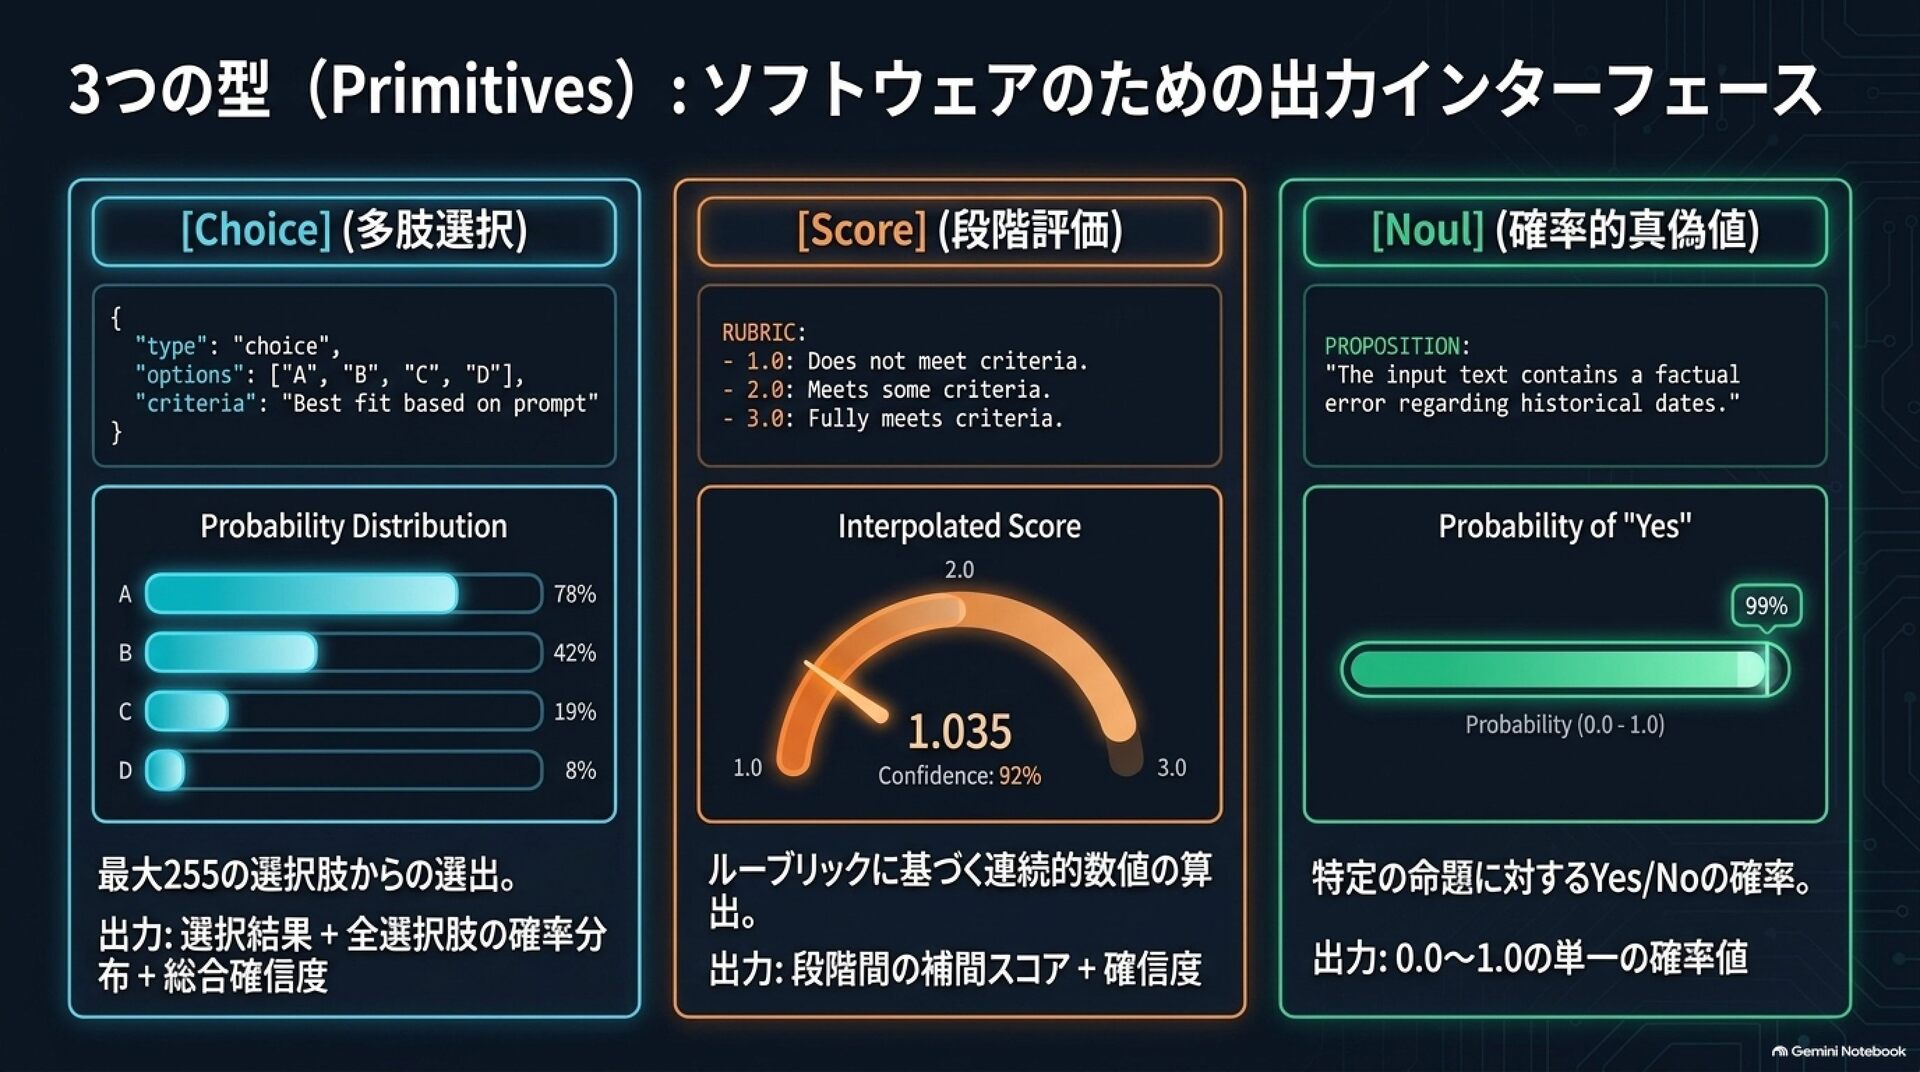
Jevの出力インターフェースは、ソフトウェアの基本データ型に対応する3つのネイティブ・プリミティブのみで構成されています。
Choice(多肢選択)
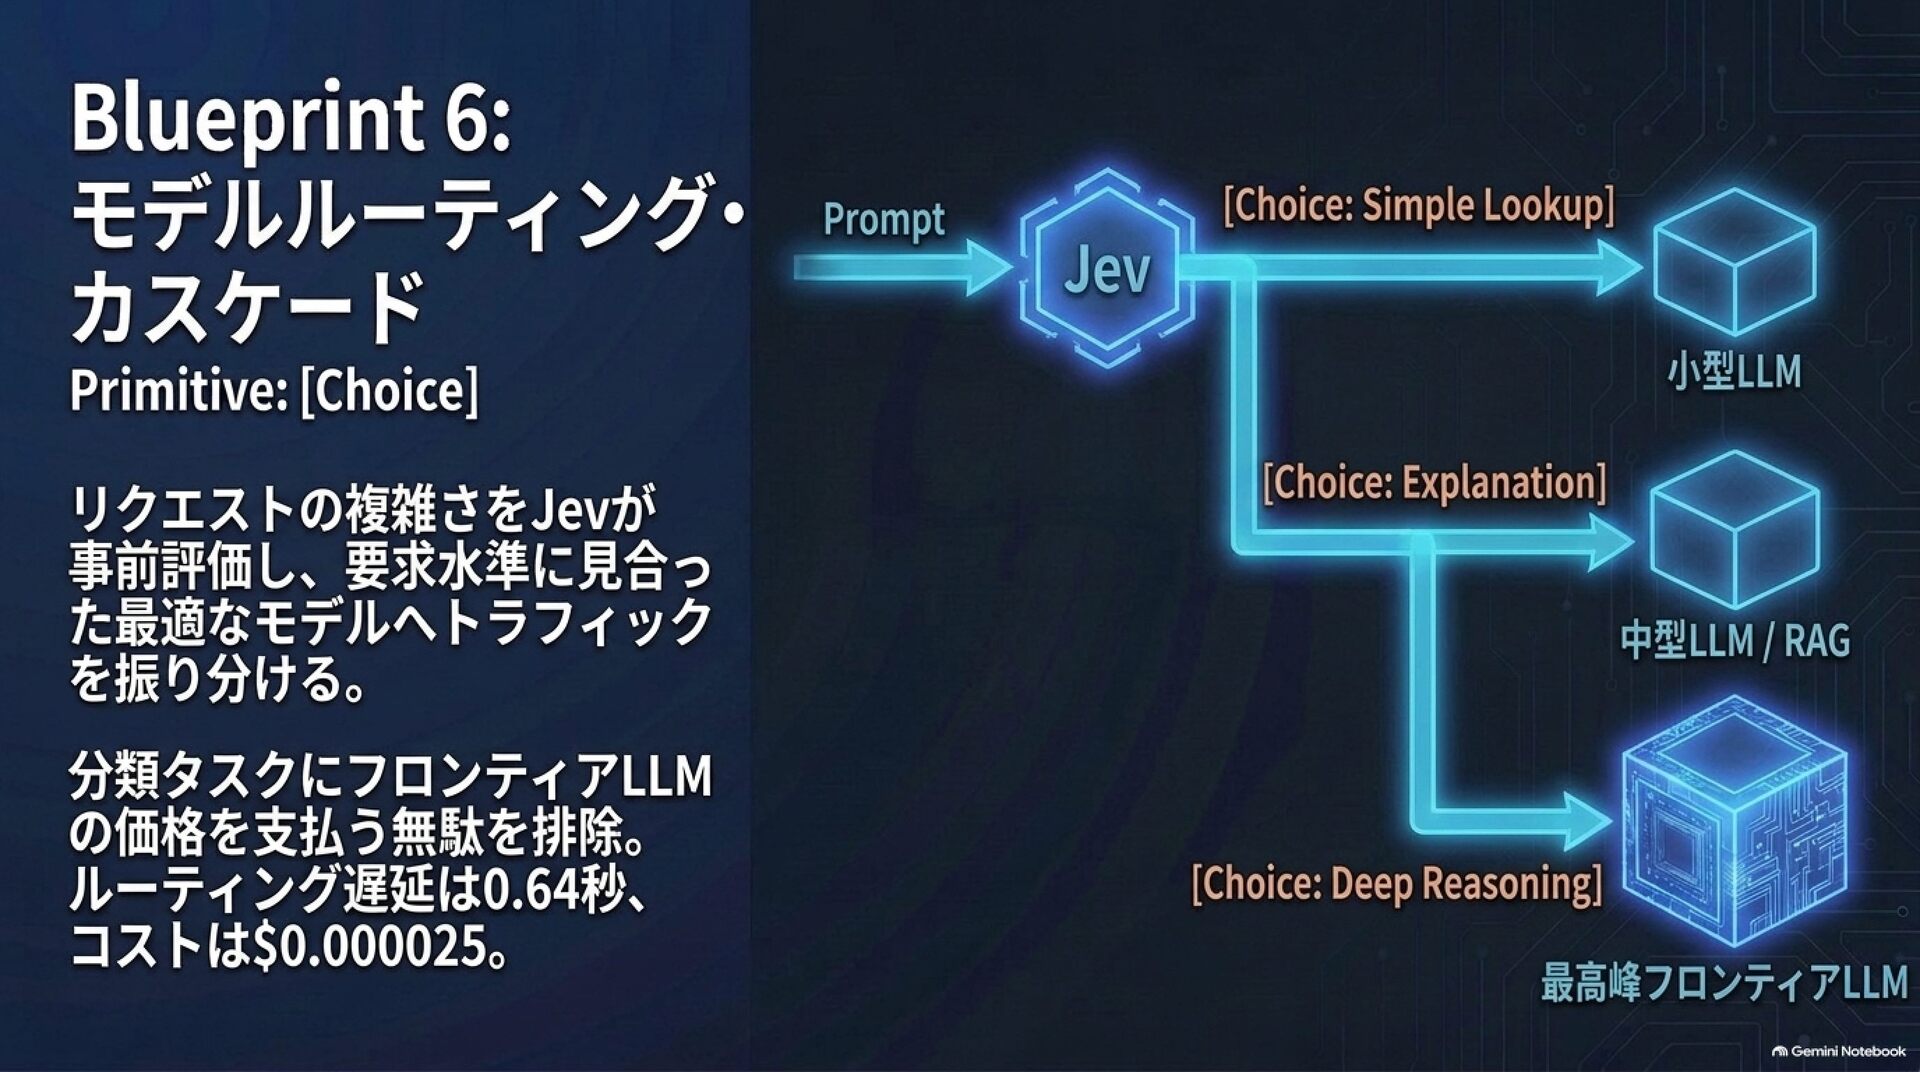
最大255個の選択肢の中から最適な1つを特定します19more_horiz。選定された選択肢に加え、全選択肢の確率分布と総合確信度(Confidence Score)を返します。
Score(段階・連続評価)
記述されたルーブリック(評価基準)に基づき、連続値(例: 1.035のような補間スコア)や段階数値を算出します。
Noul(二値判定)
条件の成否をブーリアン(True/False)で判別します。True判定の確率P(True)自体が不確実性のシグナルとして機能します。
④ 技術的境界と保証
出力エラー率0%の保証:
定義されたスキーマ外の不正値や型エラーを出力することは原理的に発生しません。
自由記述の不可:
文章の要約、翻訳、コード記述などの生成タスクは一切不可能です。
入力バジェットの制約:
コンテキストウィンドウの上限は約32,000トークン程度であり、長大な文脈をそのまま投入する場合は前処理が必要です。
3. 主な使用例(ユースケース)
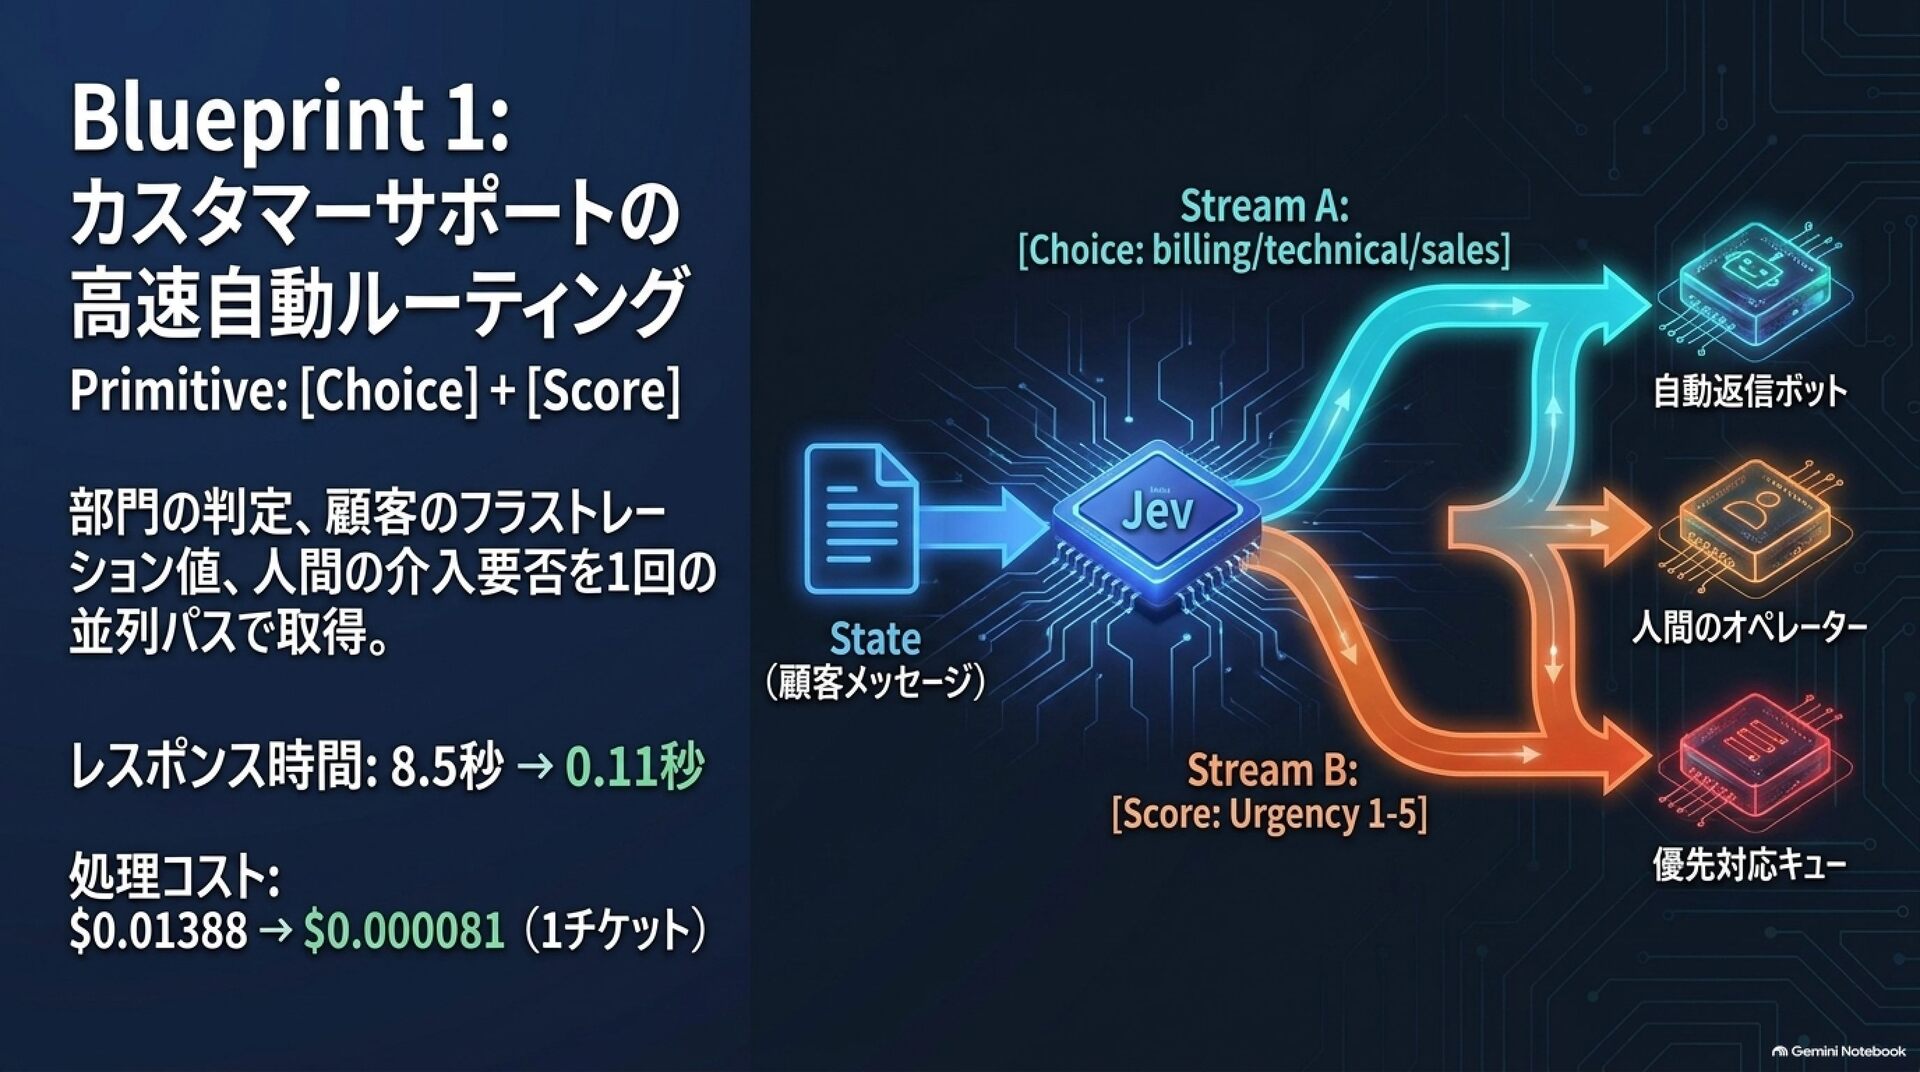
カスタマーサポートの自動ルーティング
問い合わせ本文から担当部署(Choice)、緊急度(Score)、人間対応の必要性(Noul)を100ms未満で一括判定し、自動割り振りを行います。
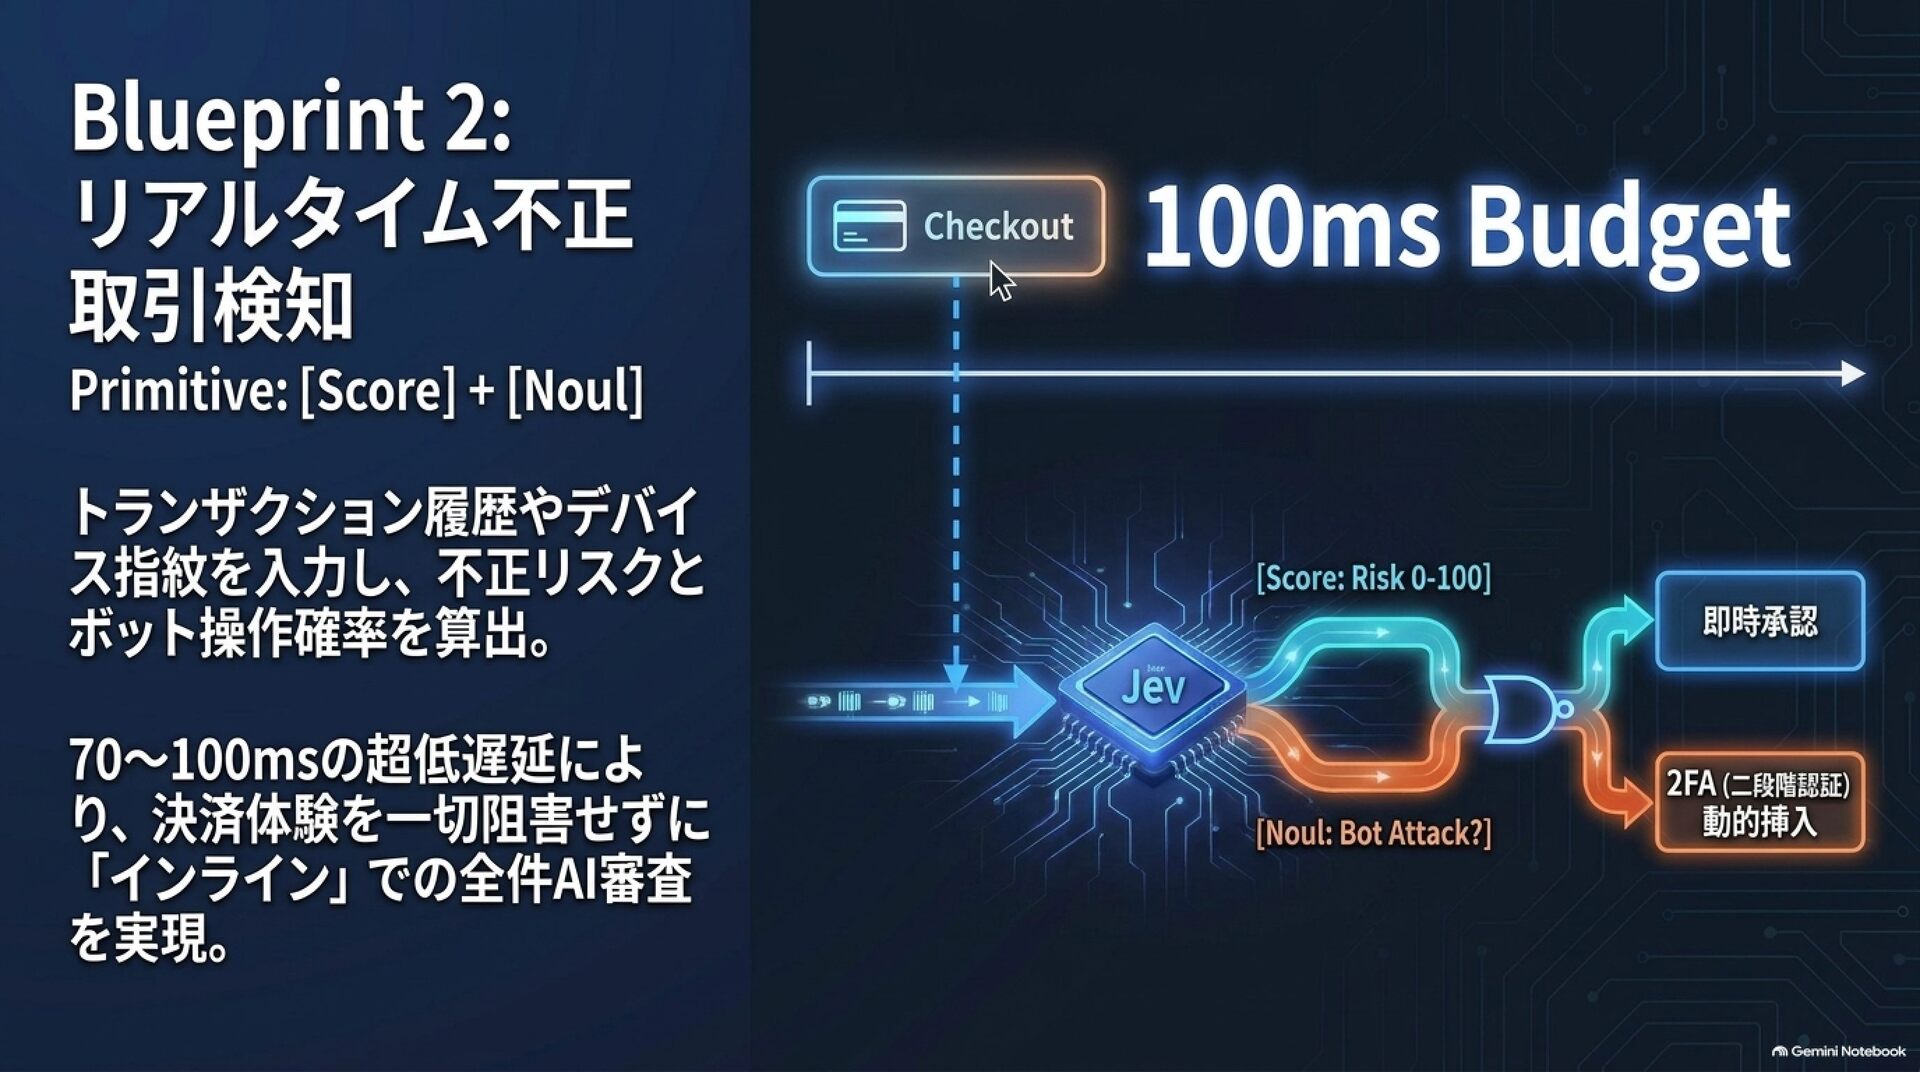
リアルタイム不正取引スコアリング
決済承認枠(数ミリ秒以内)の制約下で、取引履歴やデバイス情報からリスク度をリアルタイム数値化して2FA要求や自動拒否を制御します。
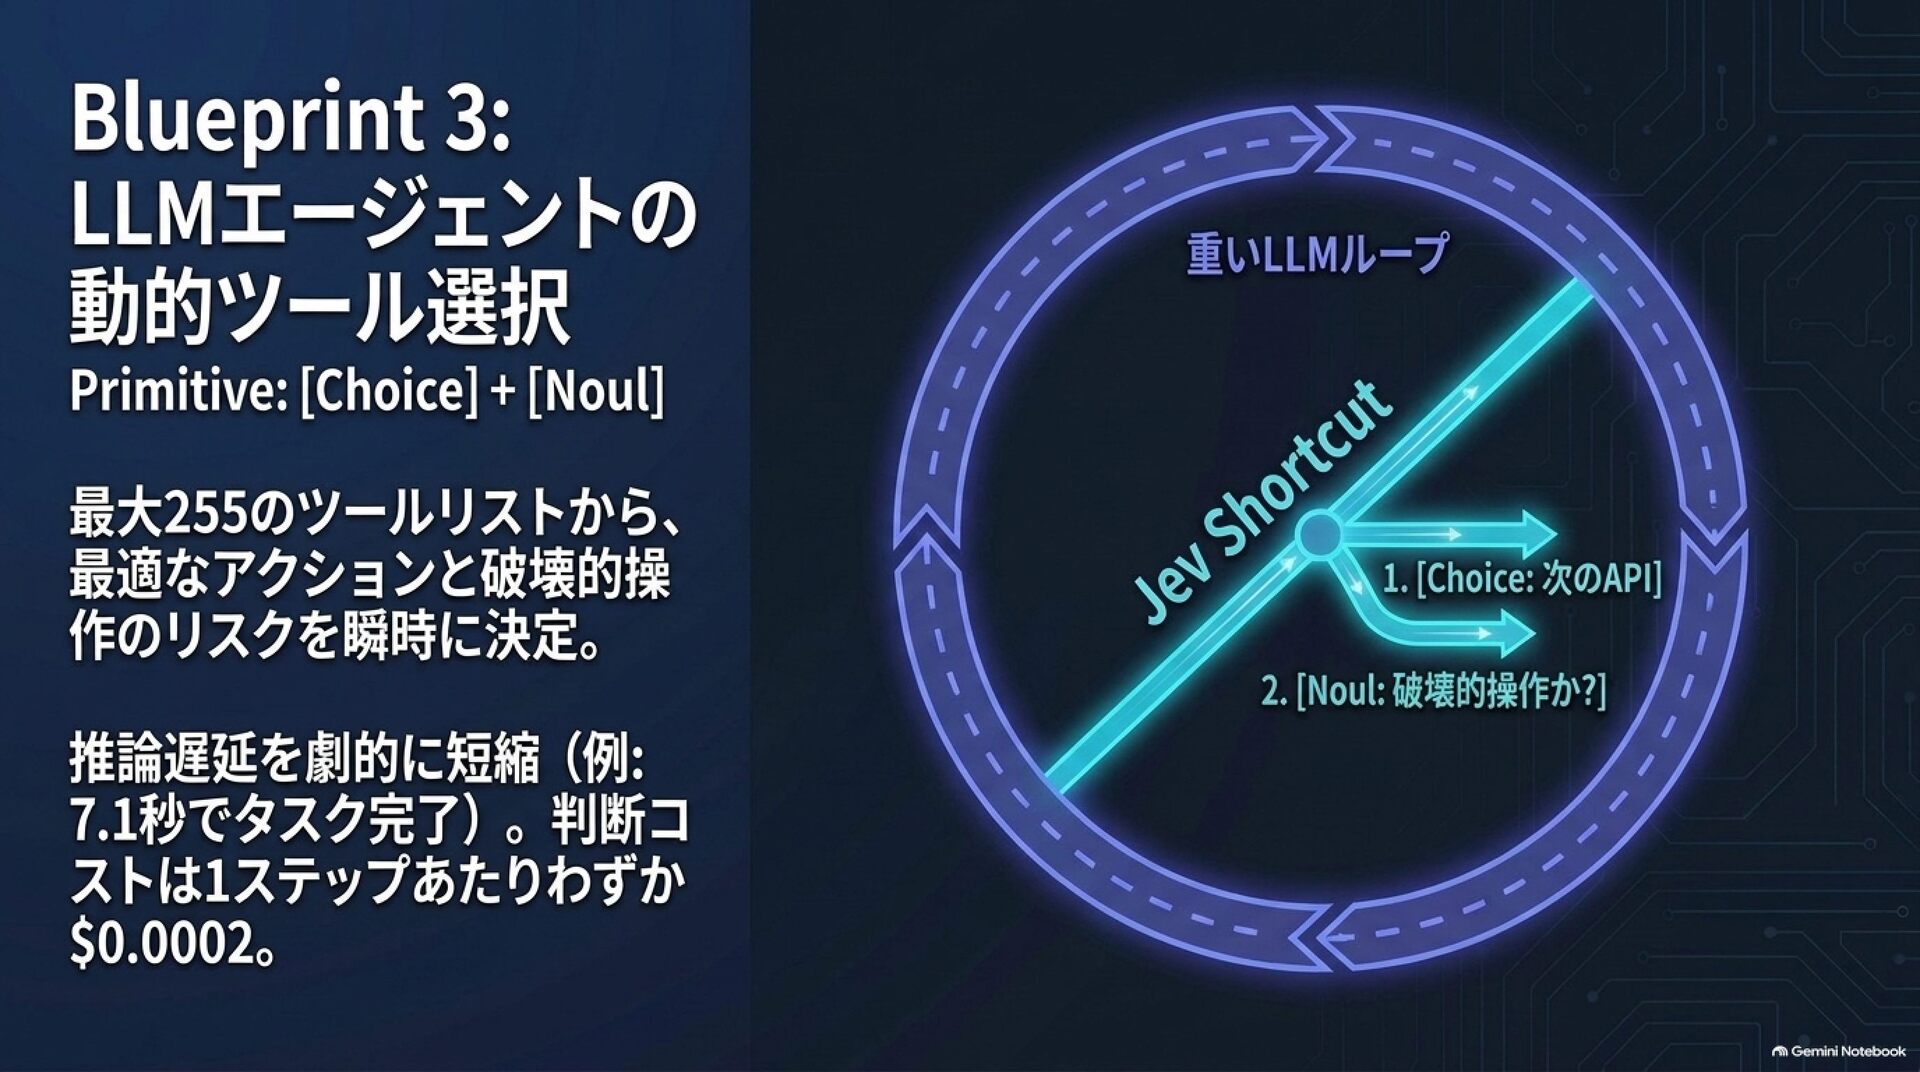
LLMエージェントの動的ツール選択・制御
Agentic Workflowにおける「次に呼び出すAPIツールの決定」や「危険な操作の有無」をJevに移管し、思考ループの遅延とトークンコストを劇的に削減します。
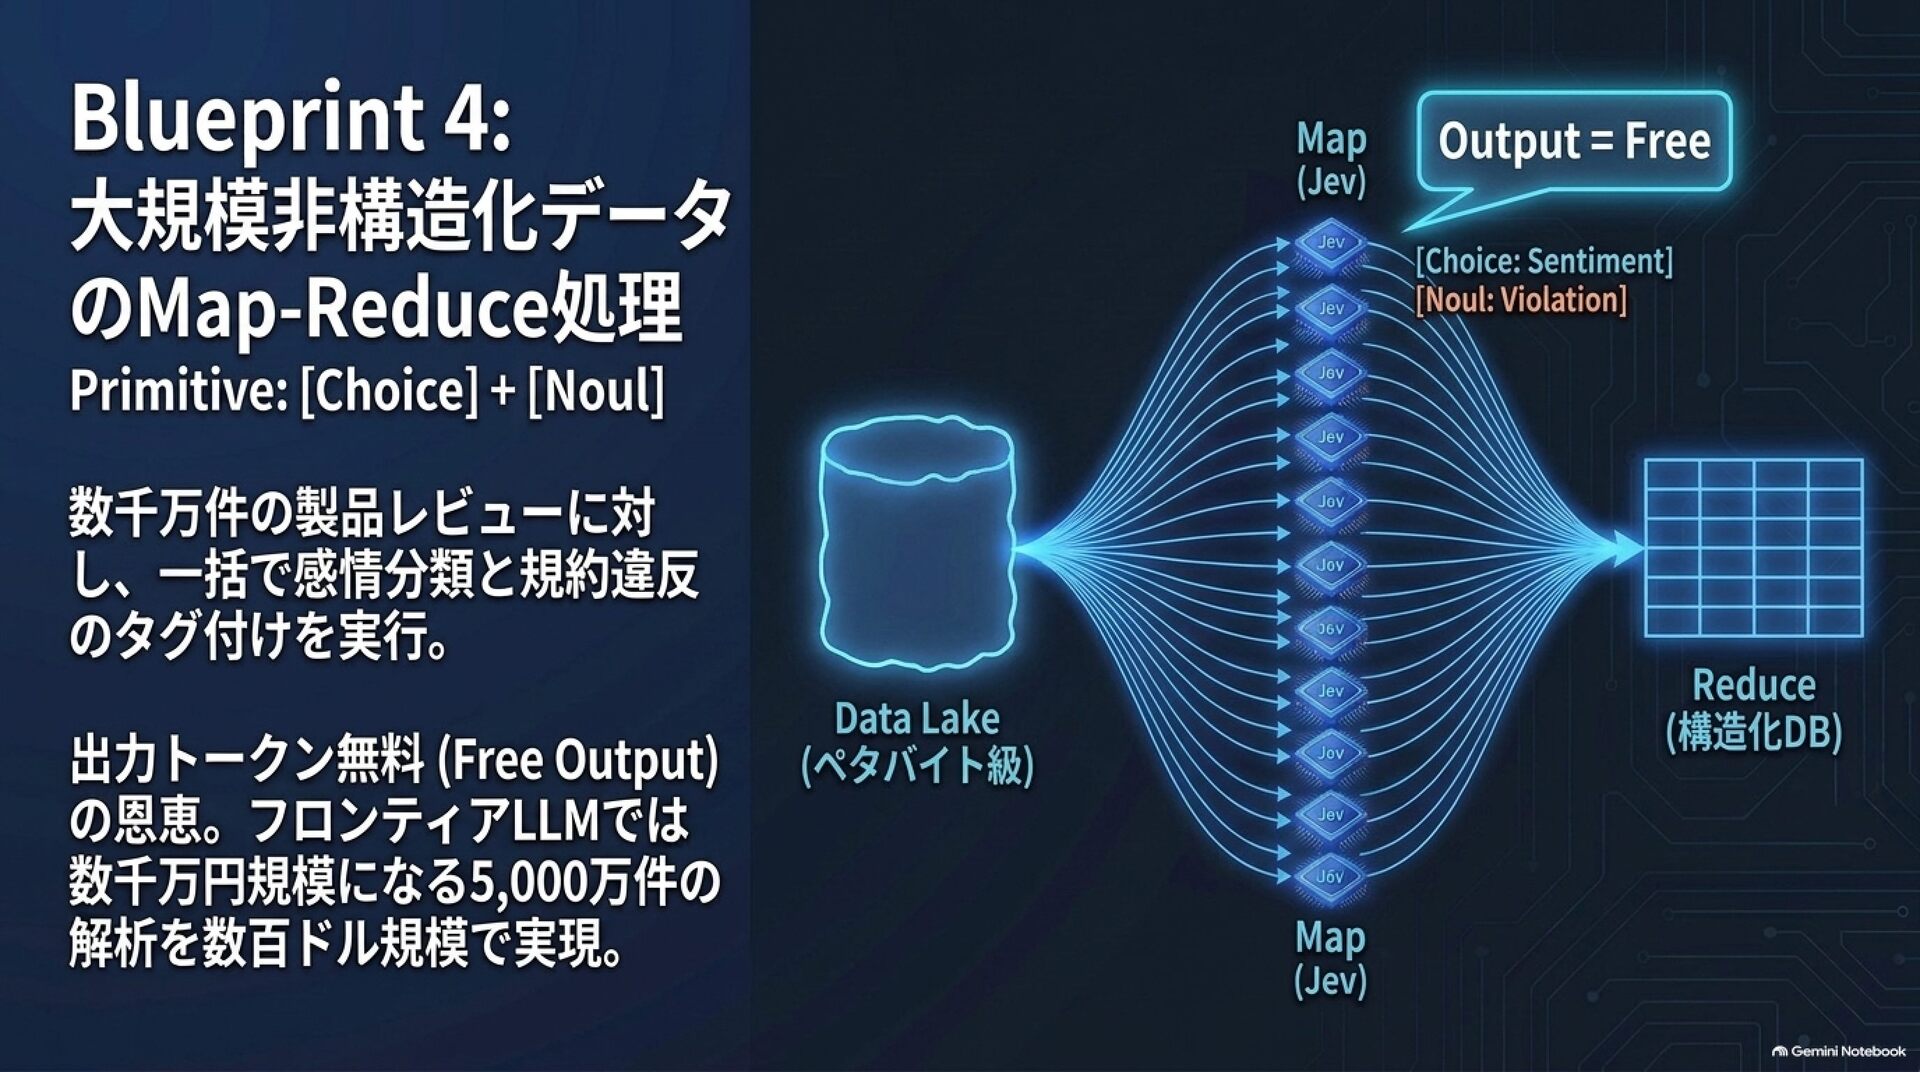
大規模データのMap-Reduce解析
数百万〜数億件のレビュー文やログデータに対して、カテゴリ分類や感情分析を一括分散処理します。出力トークンが無料のため極めて安価に実施できます。
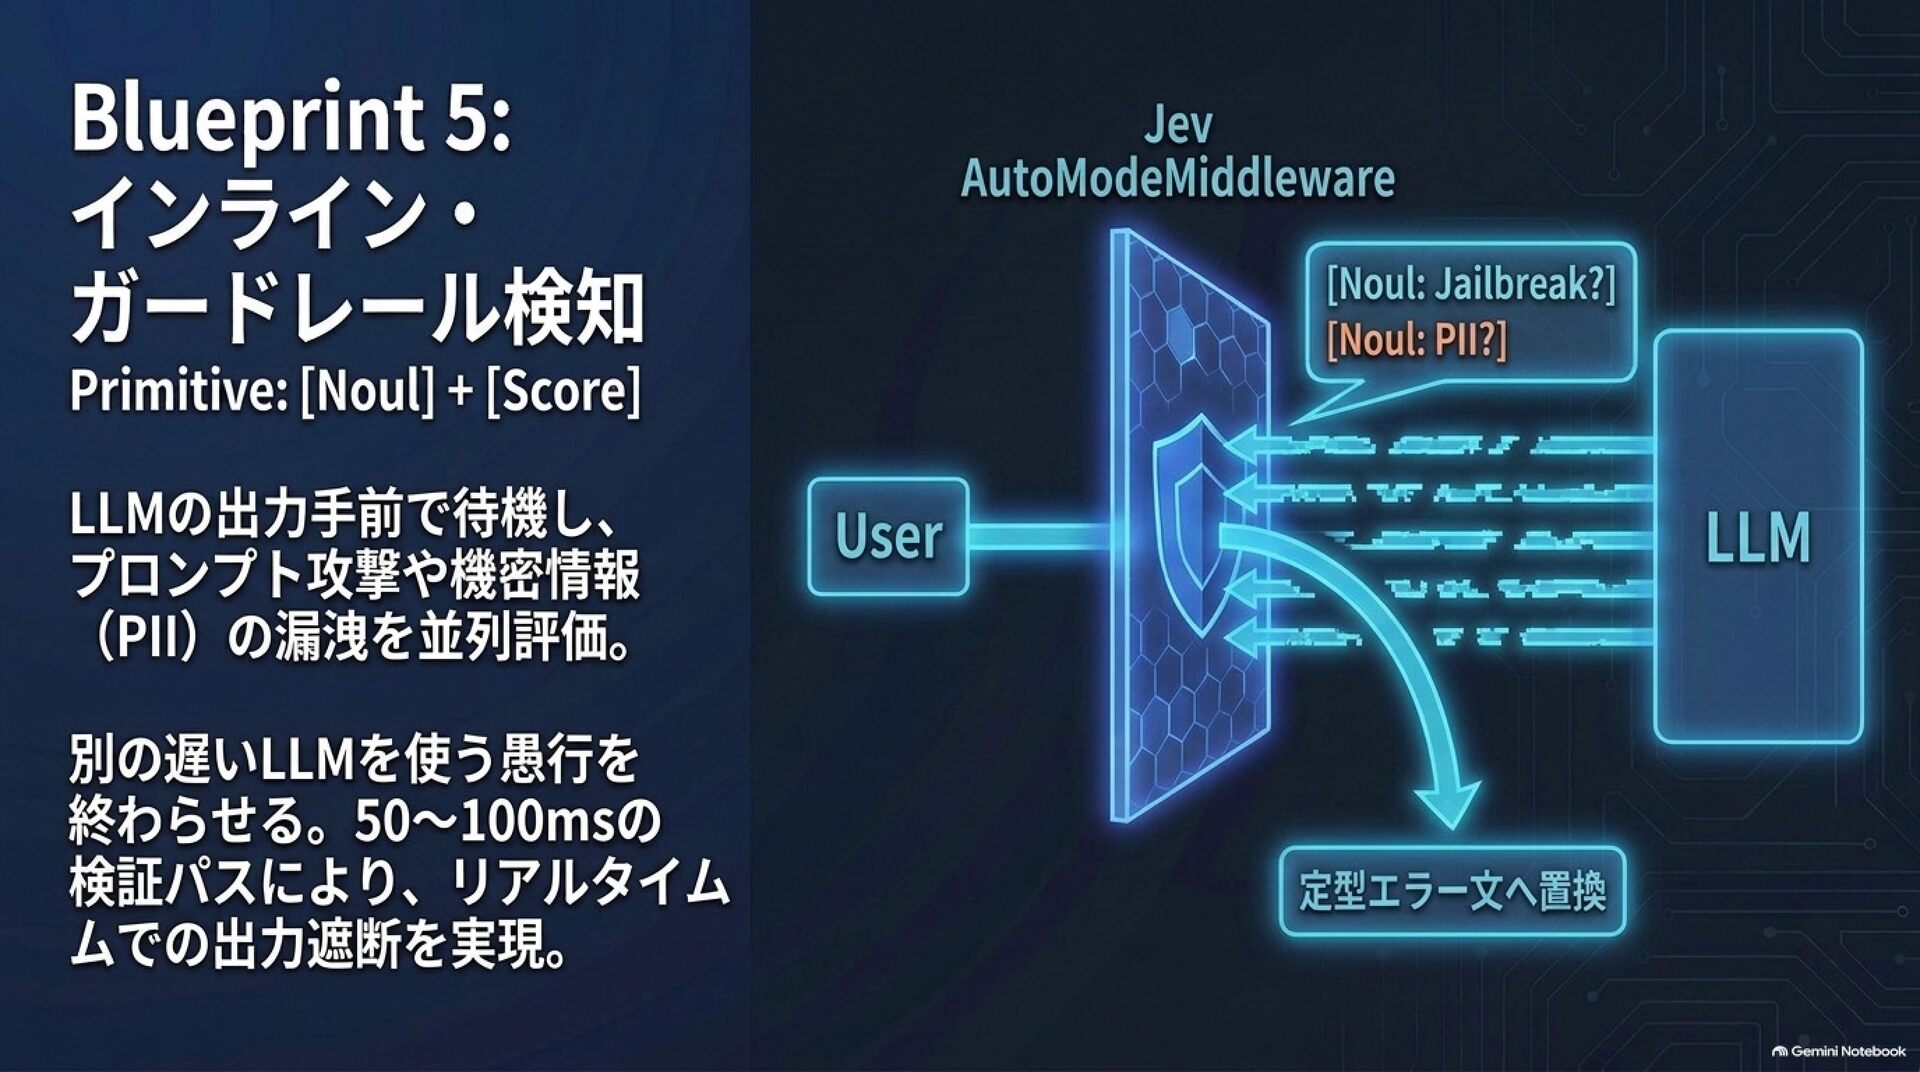
インライン・ガードレール&セキュリティ検知
LLMへの入力(プロンプトインジェクション検知)や出力(個人情報・有害表現の検知)をミリ秒単位で判定・遮断します。
LLMモデルルーティング(カスケード)
リクエストの難易度を事前判定し、簡易な質問は軽量モデルや定型文へ、複雑な推論のみ高価なLLMへ振り分けることでインフラ費用を最適化します。


 nagatsu
 waiwai2111
 civitaspo
 teru0x1
 nanaism
 nao_randd
 uhyo
 nek0128
 ota1022
 minorun365
 7nohe
 kameitomohiro
 bata_24
 jcasabona
 eileencodes
 tammyeverts
 jnunemaker
 palkan
 maggiecrowley
 productmarketing
 greggifford
 szymonslowik
 jakevdp
 sergeychernyshev