Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
名古屋NLP ACL読み会2026 西出
Search
Ryusei Nishide
September 23, 2026
64
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
名古屋NLP ACL読み会2026 西出
Ryusei Nishide
September 23, 2026
Featured
See All Featured
How GitHub (no longer) Works
holman
316
150k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
270
Automating Front-end Workflow
addyosmani
1369
210k
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
520
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
440
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
750
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
640
Google's AI Overviews - The New Search
badams
0
1.6k
Designing Experiences People Love
moore
143
24k
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
300
A Modern Web Designer's Workflow
chriscoyier
699
190k
Transcript
読み手:西出 隆盛(豊田工業大学 知識データ工学研究室 M2) ACL読み会2026@名大 ※ 図表は論文より引用
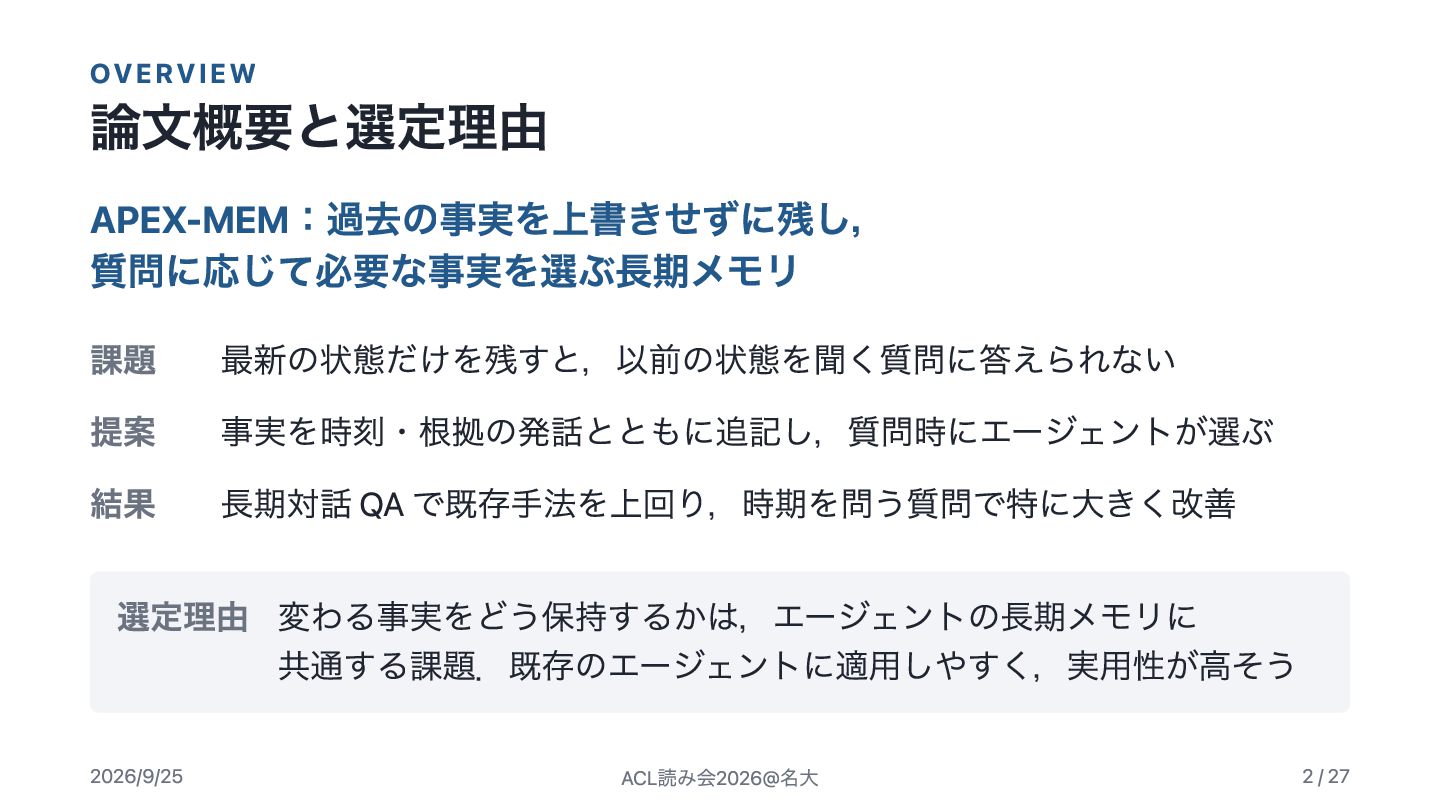
OVERVIEW 論文概要と選定理由 APEX-MEM:過去の事実を上書きせずに残し, 質問に応じて必要な事実を選ぶ長期メモリ 課題 最新の状態だけを残すと,以前の状態を聞く質問に答えられない 提案 事実を時刻・根拠の発話とともに追記し,質問時にエージェントが選ぶ 結果 長期対話
QA で既存手法を上回り,時期を問う質問で特に大きく改善 選定理由 変わる事実をどう保持するかは,エージェントの長期メモリに 共通する課題.既存のエージェントに適用しやすく,実用性が高そう 2026/9/25 ACL読み会2026@名大 2 / 27
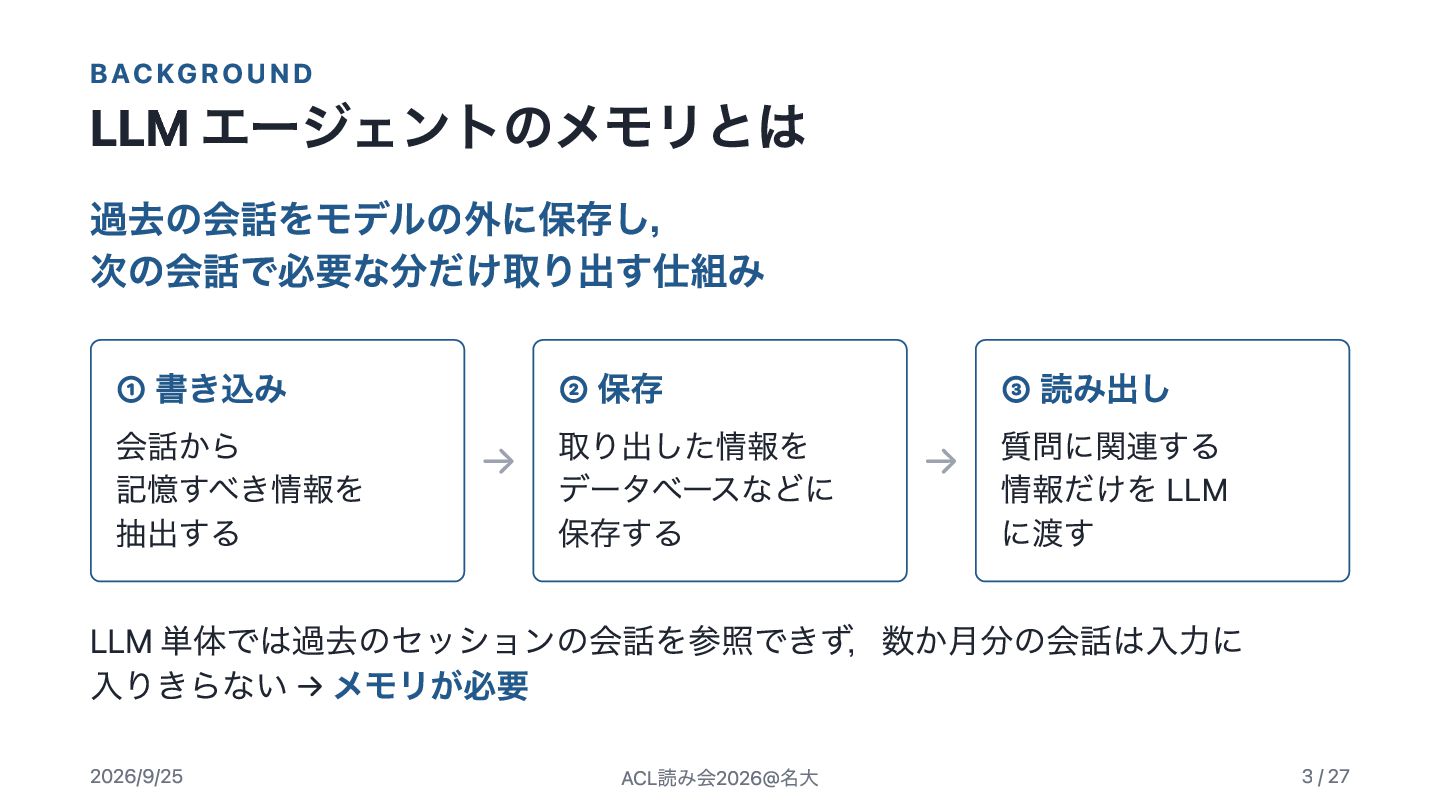
BACKGROUND LLM エージェントのメモリとは 過去の会話をモデルの外に保存し, 次の会話で必要な分だけ取り出す仕組み ① 書き込み 会話から 記憶すべき情報を 抽出する
② 保存 → 取り出した情報を データベースなどに 保存する ③ 読み出し → 質問に関連する 情報だけを LLM に渡す LLM 単体では過去のセッションの会話を参照できず,数か月分の会話は入力に 入りきらない → メモリが必要 2026/9/25 ACL読み会2026@名大 3 / 27
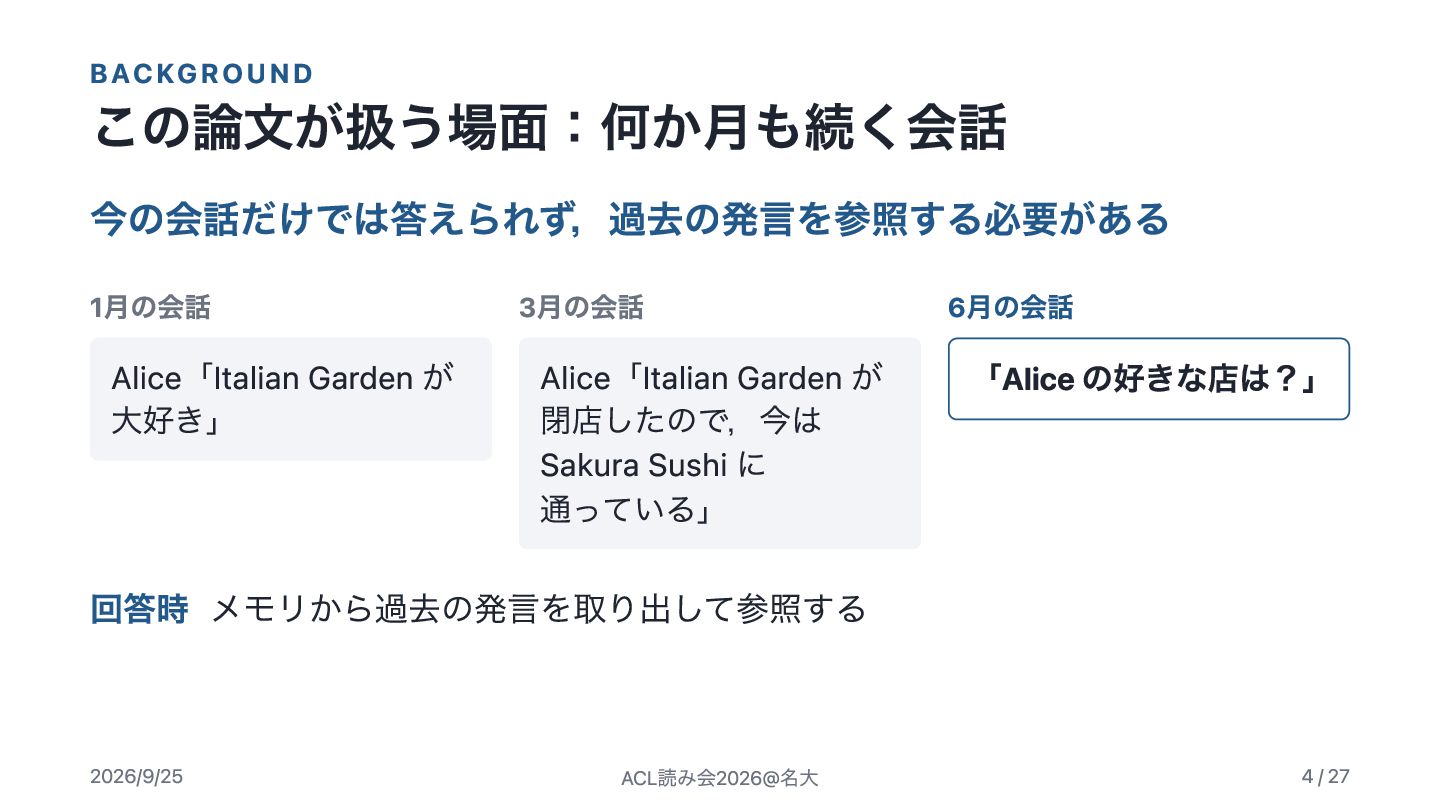
BACKGROUND この論文が扱う場面:何か月も続く会話 今の会話だけでは答えられず,過去の発言を参照する必要がある 1月の会話 Alice「Italian Garden が 大好き」 3月の会話 Alice「Italian
Garden が 閉店したので,今は Sakura Sushi に 通っている」 6月の会話 「Alice の好きな店は?」 回答時 メモリから過去の発言を取り出して参照する 2026/9/25 ACL読み会2026@名大 4 / 27
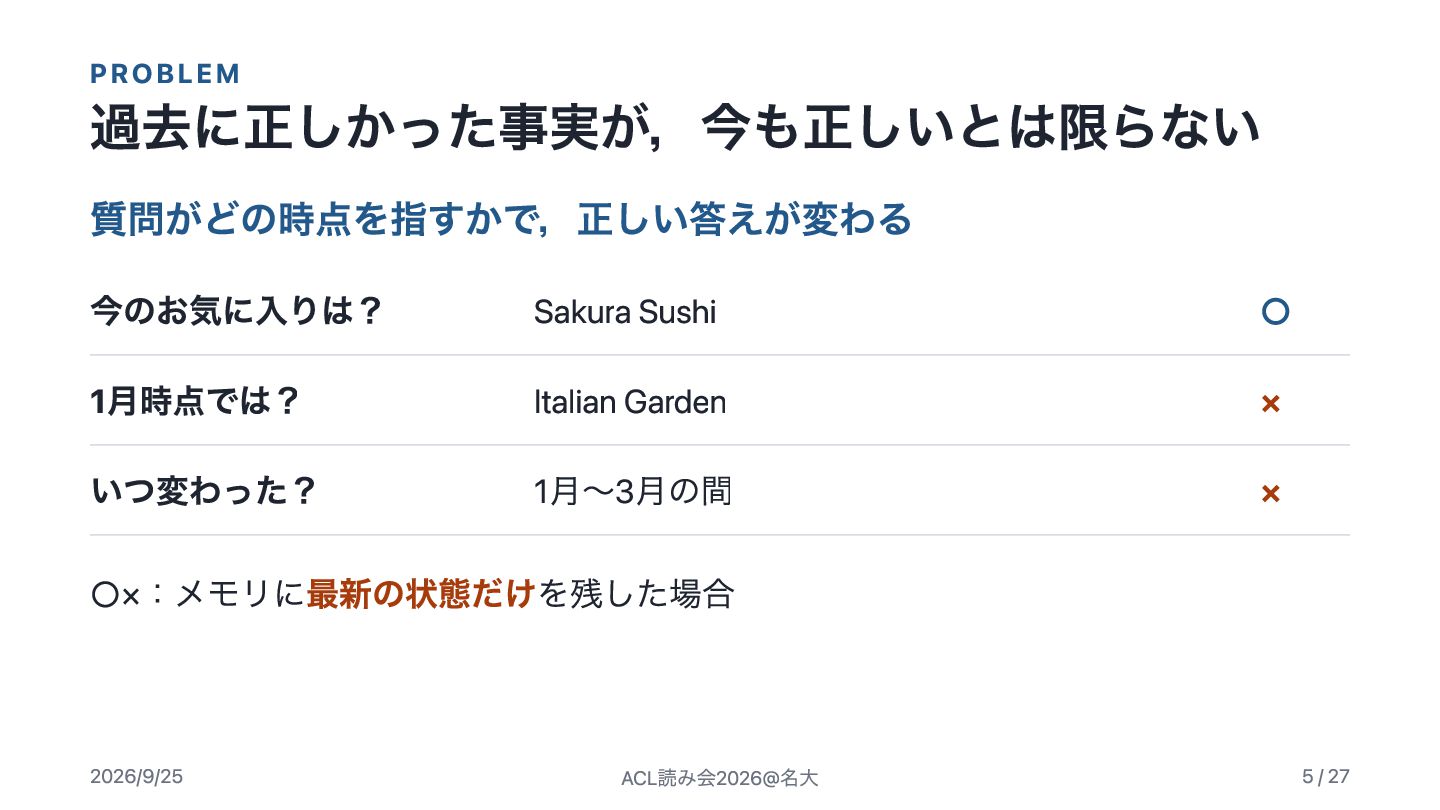
PROBLEM 過去に正しかった事実が,今も正しいとは限らない 質問がどの時点を指すかで,正しい答えが変わる 今のお気に入りは? 1月時点では? いつ変わった? Sakura Sushi Italian Garden
1月〜3月の間 ◦ × × ◦×:メモリに最新の状態だけを残した場合 2026/9/25 ACL読み会2026@名大 5 / 27
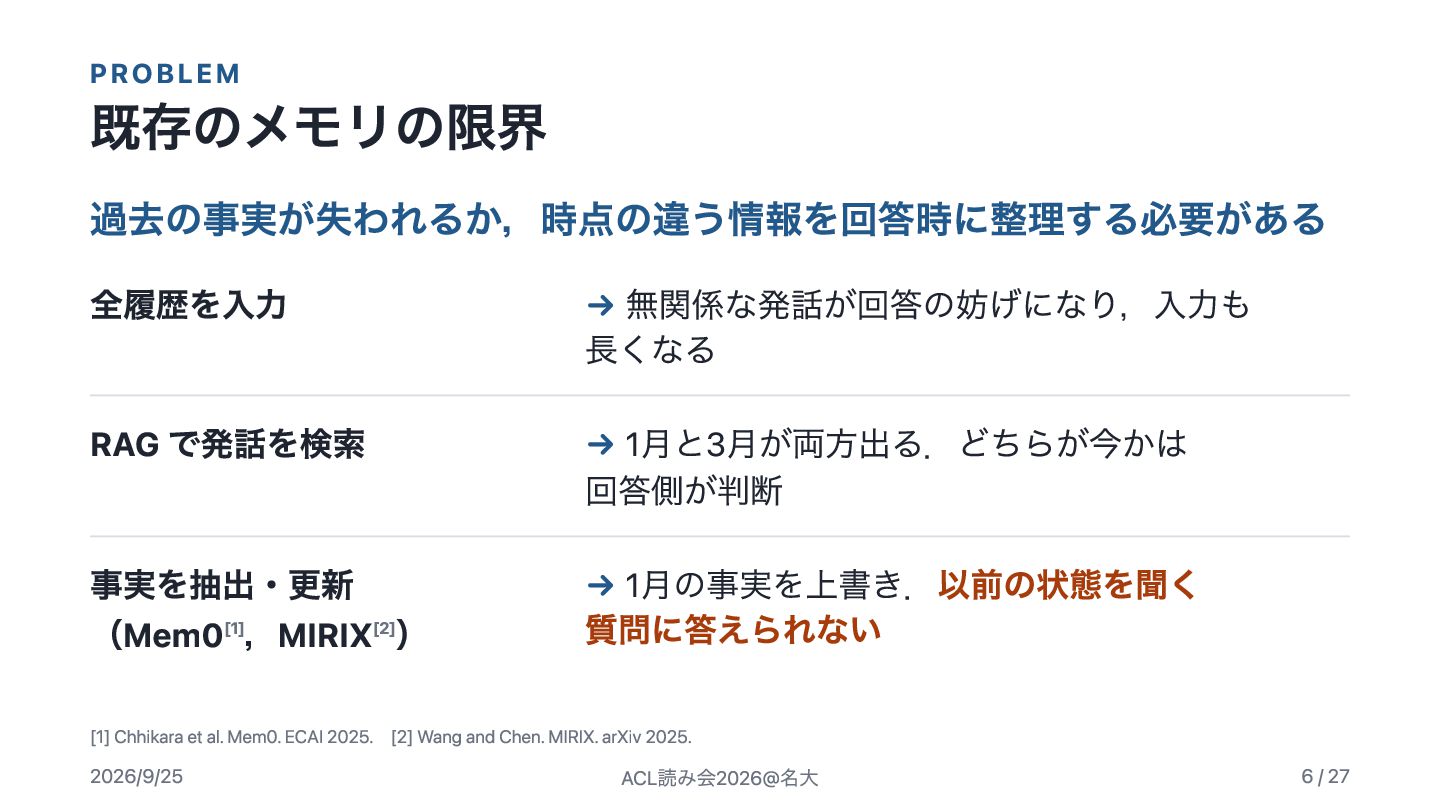
PROBLEM 既存のメモリの限界 過去の事実が失われるか,時点の違う情報を回答時に整理する必要がある 全履歴を入力 RAG で発話を検索 事実を抽出・更新 (Mem0[1],MIRIX[2]) → 無関係な発話が回答の妨げになり,入力も
長くなる → 1月と3月が両方出る.どちらが今かは 回答側が判断 → 1月の事実を上書き.以前の状態を聞く 質問に答えられない [1] Chhikara et al. Mem0. ECAI 2025. [2] Wang and Chen. MIRIX. arXiv 2025. 2026/9/25 ACL読み会2026@名大 6 / 27
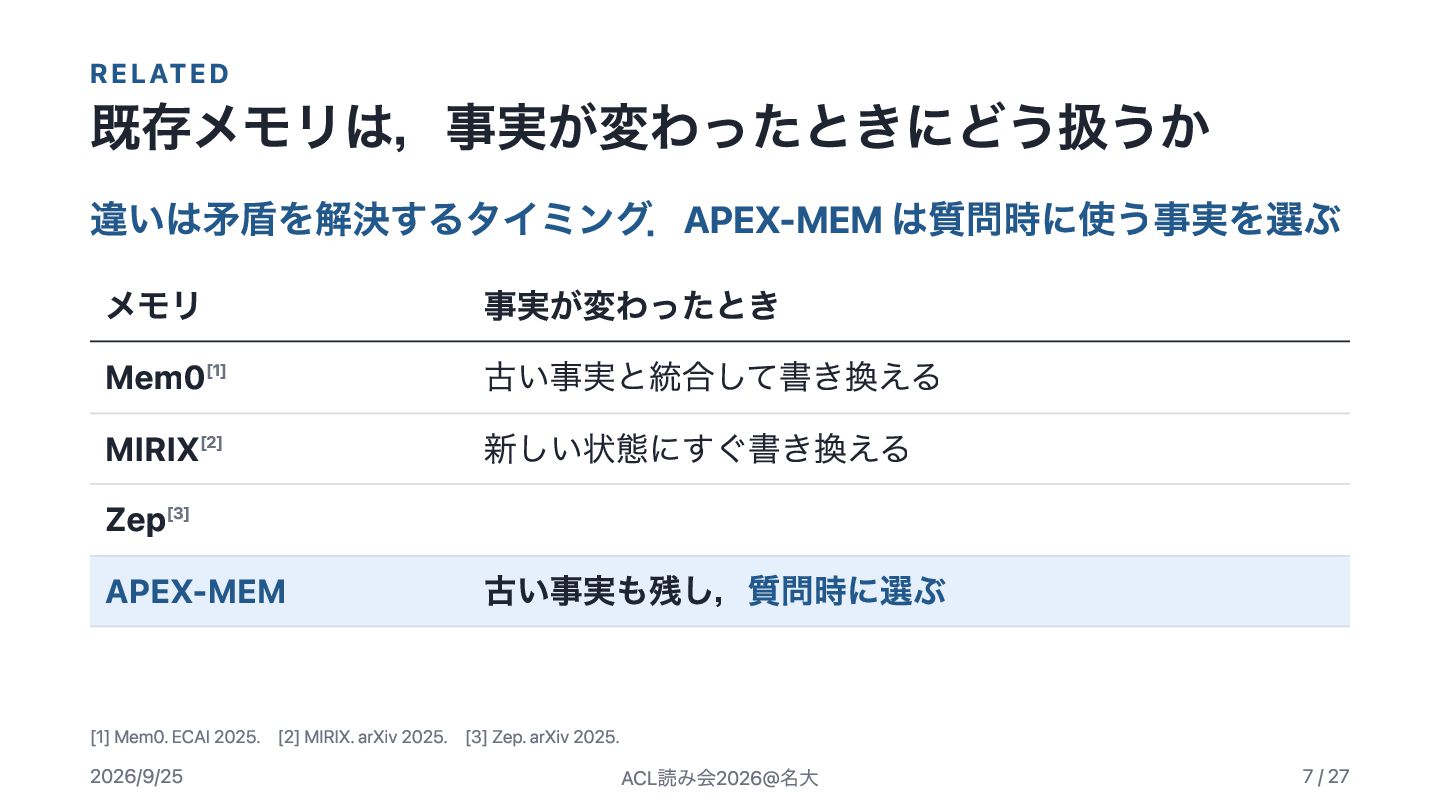
RELATED 既存メモリは,事実が変わったときにどう扱うか 違いは矛盾を解決するタイミング.APEX-MEM は質問時に使う事実を選ぶ メモリ Mem0[1] MIRIX[2] Zep[3] APEX-MEM 事実が変わったとき
古い事実と統合して書き換える 新しい状態にすぐ書き換える 古い事実も残し,質問時に選ぶ [1] Mem0. ECAI 2025. [2] MIRIX. arXiv 2025. [3] Zep. arXiv 2025. 2026/9/25 ACL読み会2026@名大 7 / 27
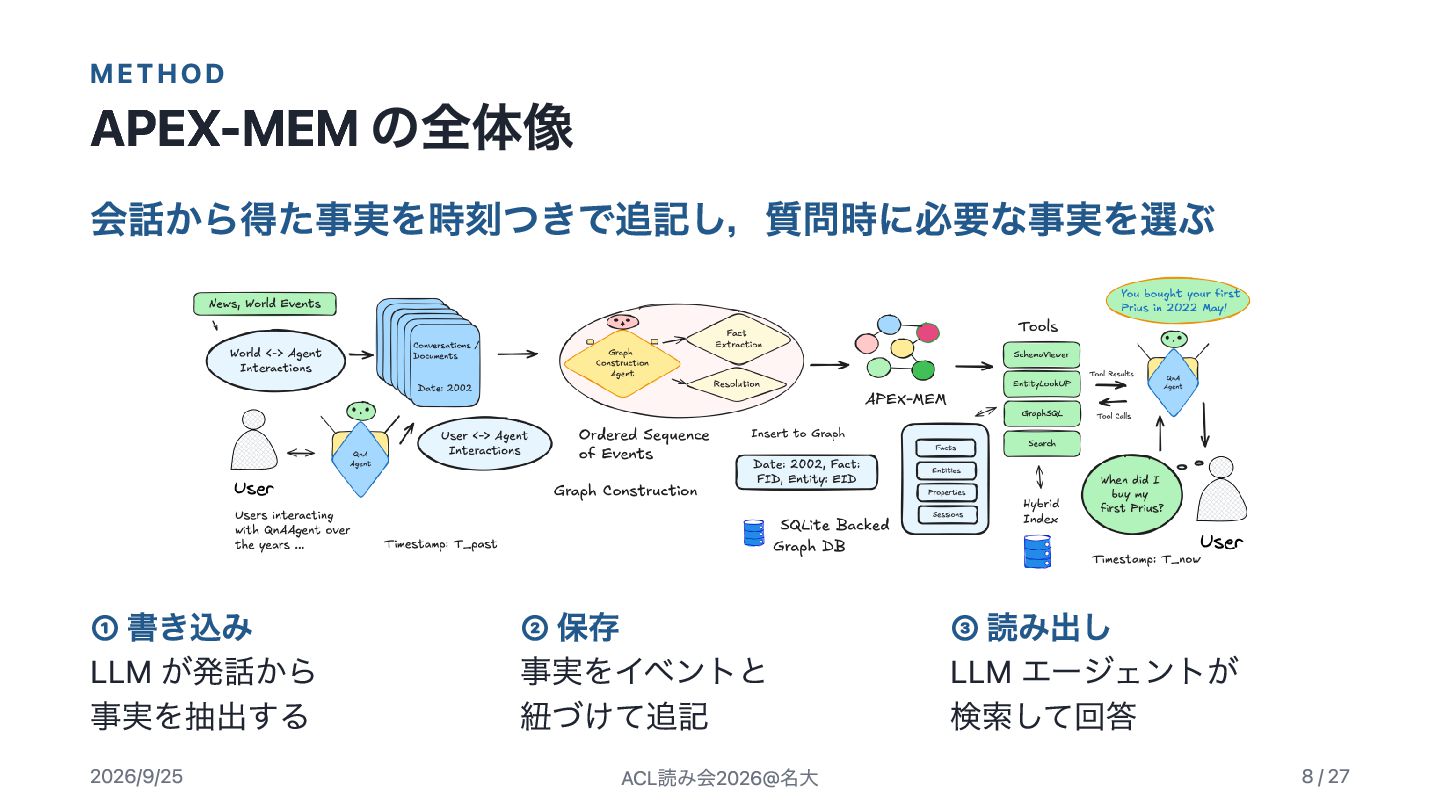
METHOD APEX-MEM の全体像 会話から得た事実を時刻つきで追記し,質問時に必要な事実を選ぶ ① 書き込み LLM が発話から 事実を抽出する 2026/9/25
② 保存 事実をイベントと 紐づけて追記 ACL読み会2026@名大 ③ 読み出し LLM エージェントが 検索して回答 8 / 27
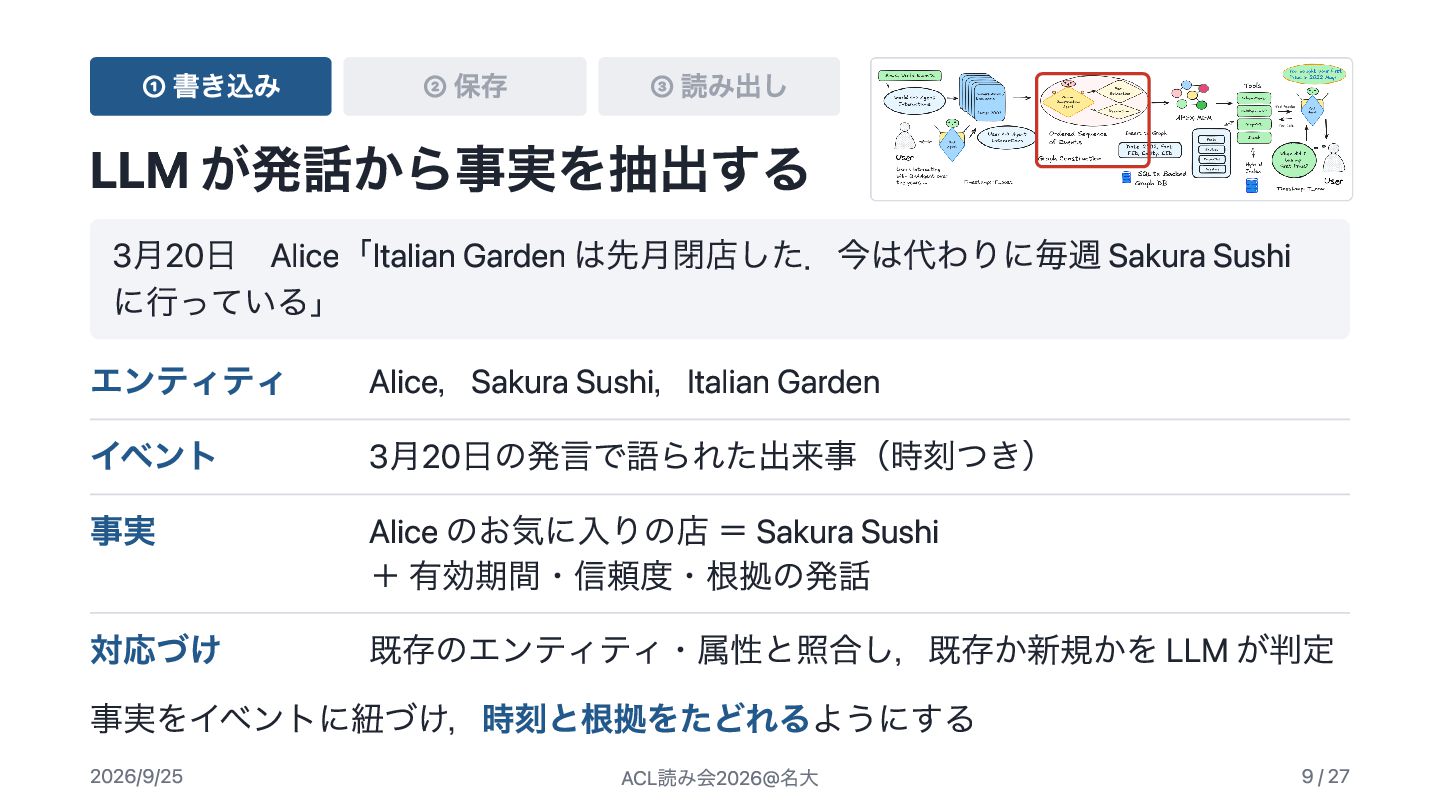
① 書き込み ② 保存 ③ 読み出し LLM が発話から事実を抽出する 3月20日 Alice「Italian
Garden は先月閉店した.今は代わりに毎週 Sakura Sushi に行っている」 エンティティ Alice,Sakura Sushi,Italian Garden イベント 3月20日の発言で語られた出来事(時刻つき) 事実 Alice のお気に入りの店 = Sakura Sushi + 有効期間・信頼度・根拠の発話 対応づけ 既存のエンティティ・属性と照合し,既存か新規かを LLM が判定 事実をイベントに紐づけ,時刻と根拠をたどれるようにする 2026/9/25 ACL読み会2026@名大 9 / 27
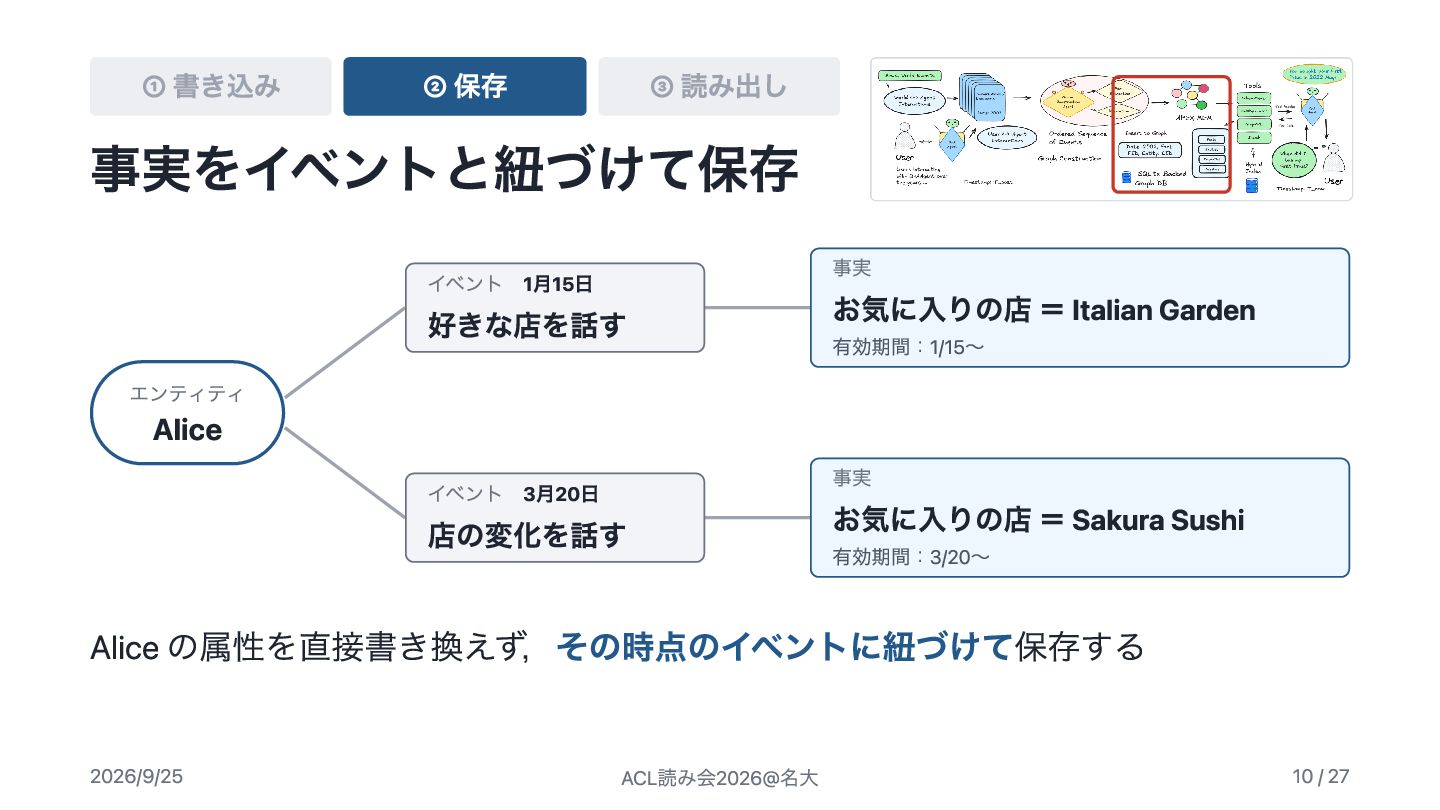
① 書き込み ② 保存 ③ 読み出し 事実をイベントと紐づけて保存 イベント 1月15日 好きな店を話す
エンティティ Alice イベント 3月20日 店の変化を話す 事実 お気に入りの店 = Italian Garden 有効期間:1/15〜 事実 お気に入りの店 = Sakura Sushi 有効期間:3/20〜 Alice の属性を直接書き換えず,その時点のイベントに紐づけて保存する 2026/9/25 ACL読み会2026@名大 10 / 27
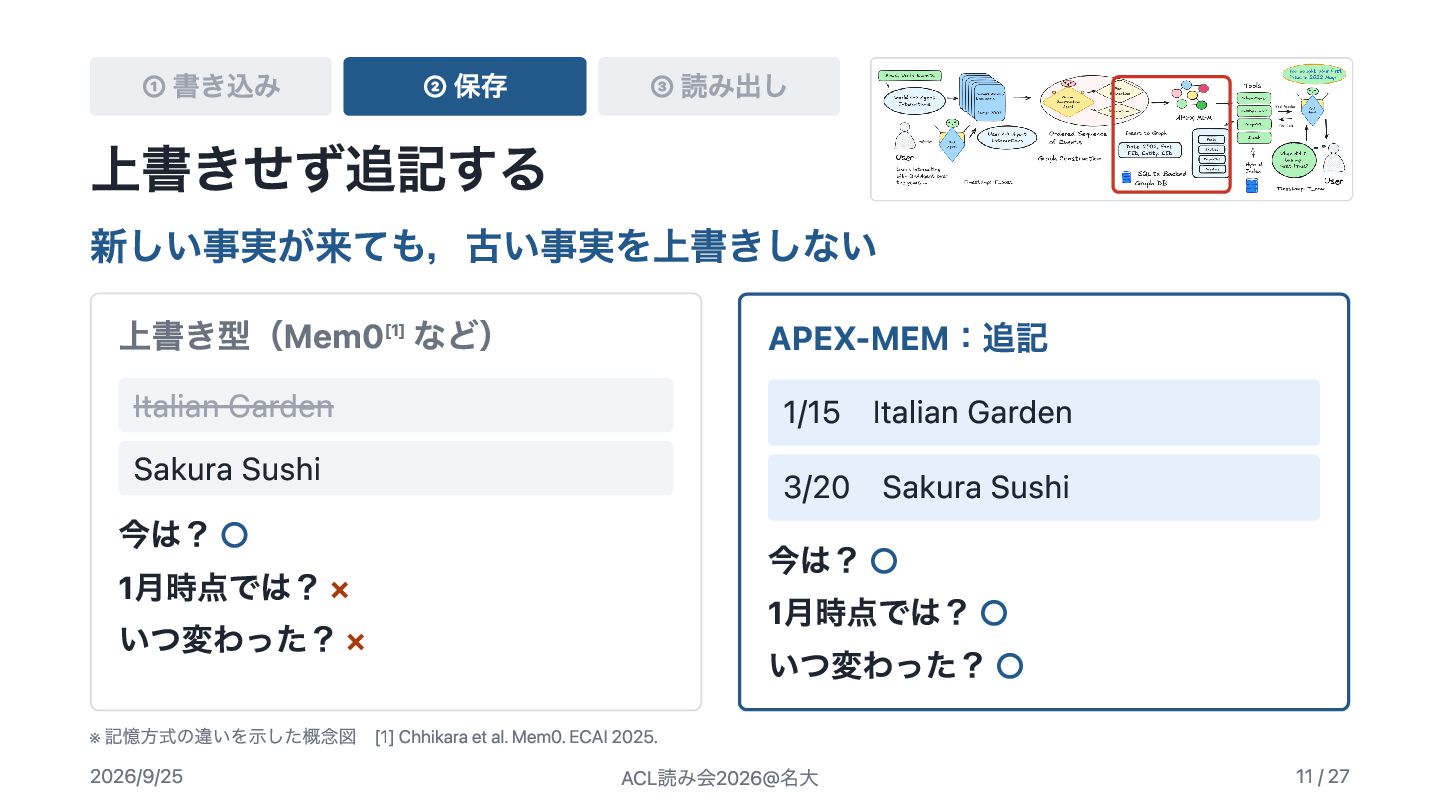
① 書き込み ② 保存 上書きせず追記する ③ 読み出し 新しい事実が来ても,古い事実を上書きしない 上書き型(Mem0[1] など)
Italian Garden Sakura Sushi 今は? ◦ 1月時点では? × いつ変わった? × ※ APEX-MEM:追記 1/15 Italian Garden 3/20 Sakura Sushi 今は? ◦ 1月時点では? ◦ いつ変わった? ◦ 記憶方式の違いを示した概念図 [1] Chhikara et al. Mem0. ECAI 2025. 2026/9/25 ACL読み会2026@名大 11 / 27
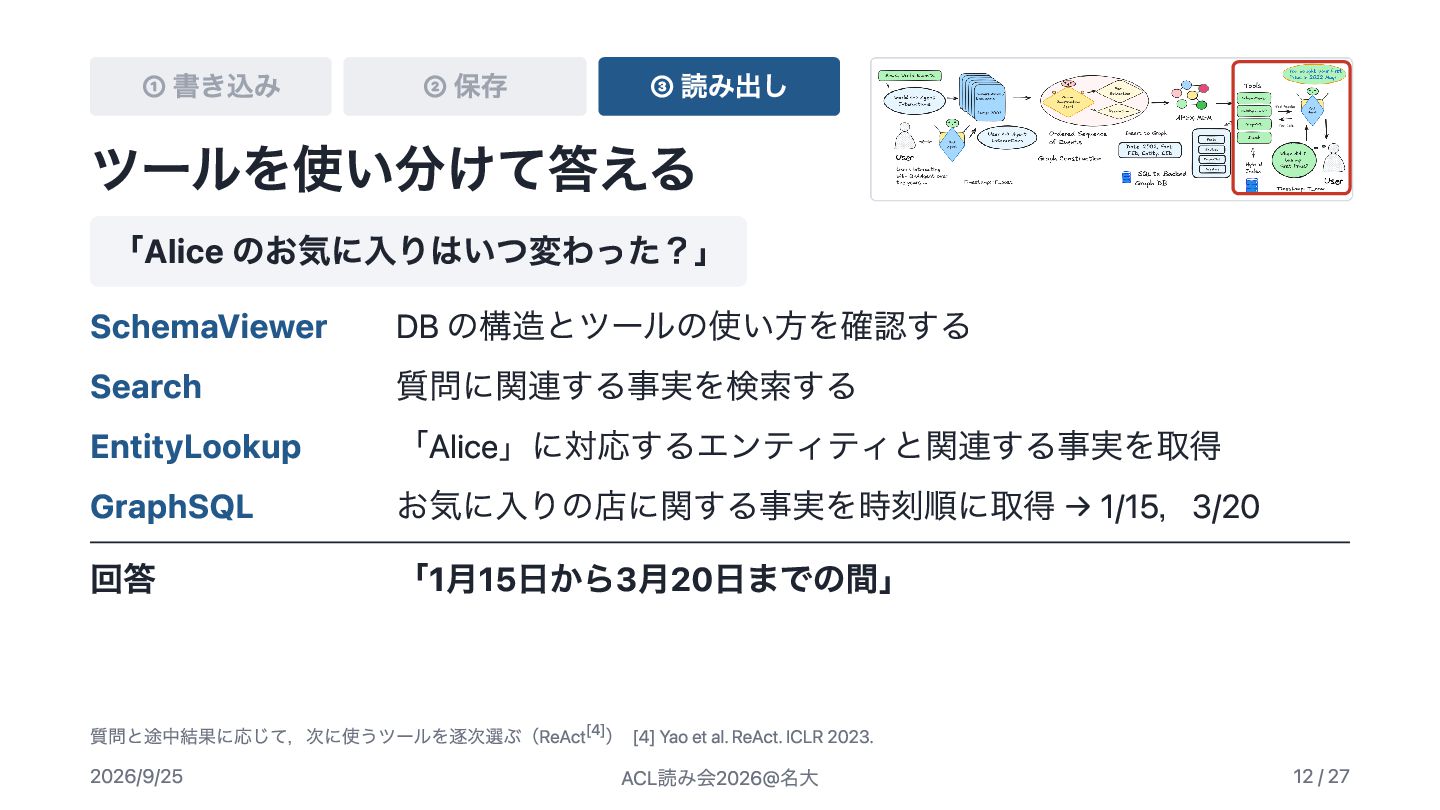
① 書き込み ② 保存 ③ 読み出し ツールを使い分けて答える 「Alice のお気に入りはいつ変わった?」 SchemaViewer
DB の構造とツールの使い方を確認する Search 質問に関連する事実を検索する EntityLookup 「Alice」に対応するエンティティと関連する事実を取得 GraphSQL お気に入りの店に関する事実を時刻順に取得 → 1/15,3/20 回答 「1月15日から3月20日までの間」 質問と途中結果に応じて,次に使うツールを逐次選ぶ(ReAct[4]) [4] Yao et al. ReAct. ICLR 2023. 2026/9/25 ACL読み会2026@名大 12 / 27
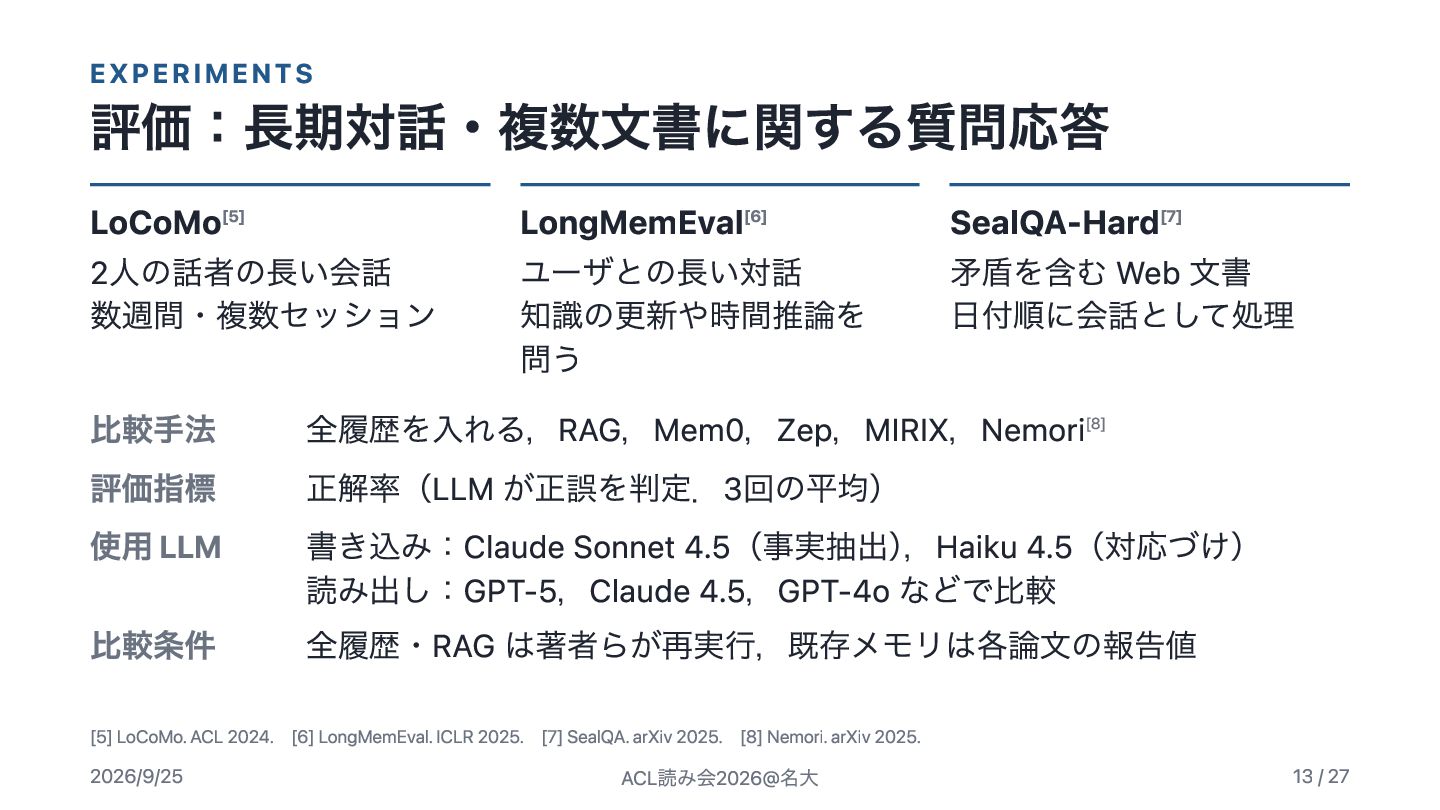
EXPERIMENTS 評価:長期対話・複数文書に関する質問応答 LoCoMo[5] 2人の話者の長い会話 数週間・複数セッション 比較手法 評価指標 使用 LLM 比較条件
LongMemEval[6] SealQA-Hard[7] ユーザとの長い対話 矛盾を含む Web 文書 知識の更新や時間推論を 日付順に会話として処理 問う 全履歴を入れる,RAG,Mem0,Zep,MIRIX,Nemori[8] 正解率(LLM が正誤を判定.3回の平均) 書き込み:Claude Sonnet 4.5(事実抽出),Haiku 4.5(対応づけ) 読み出し:GPT-5,Claude 4.5,GPT-4o などで比較 全履歴・RAG は著者らが再実行,既存メモリは各論文の報告値 [5] LoCoMo. ACL 2024. [6] LongMemEval. ICLR 2025. [7] SealQA. arXiv 2025. [8] Nemori. arXiv 2025. 2026/9/25 ACL読み会2026@名大 13 / 27
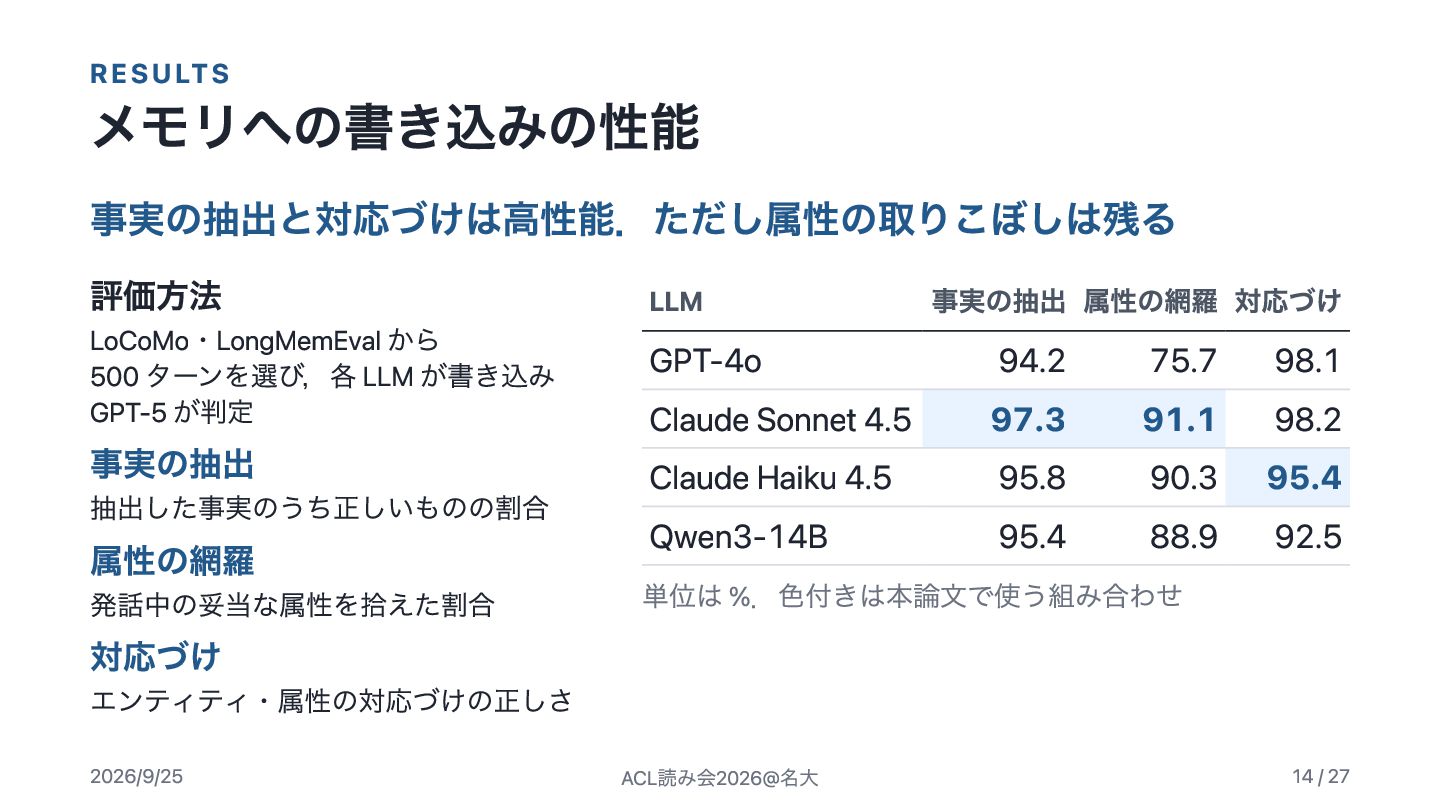
RESULTS メモリへの書き込みの性能 事実の抽出と対応づけは高性能.ただし属性の取りこぼしは残る 評価方法 LoCoMo・LongMemEval から 500 ターンを選び,各 LLM が書き込み
GPT-5 が判定 事実の抽出 抽出した事実のうち正しいものの割合 属性の網羅 発話中の妥当な属性を拾えた割合 対応づけ LLM GPT-4o Claude Sonnet 4.5 Claude Haiku 4.5 Qwen3-14B 事実の抽出 属性の網羅 対応づけ 94.2 97.3 95.8 95.4 75.7 91.1 90.3 88.9 単位は %.色付きは本論文で使う組み合わせ 98.1 98.2 95.4 92.5 エンティティ・属性の対応づけの正しさ 2026/9/25 ACL読み会2026@名大 14 / 27
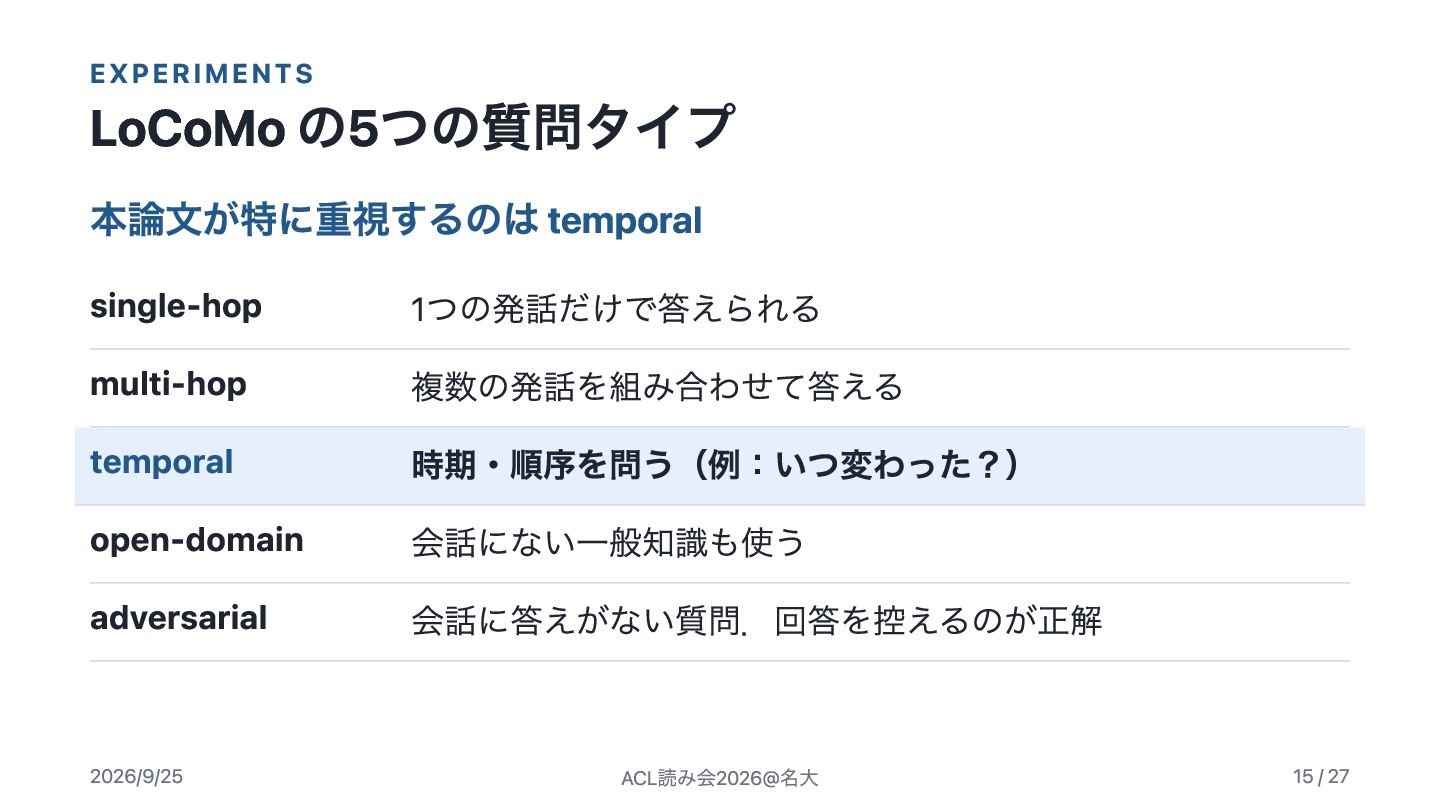
EXPERIMENTS LoCoMo の5つの質問タイプ 本論文が特に重視するのは temporal single-hop multi-hop temporal open-domain adversarial
2026/9/25 1つの発話だけで答えられる 複数の発話を組み合わせて答える 時期・順序を問う(例:いつ変わった?) 会話にない一般知識も使う 会話に答えがない質問.回答を控えるのが正解 ACL読み会2026@名大 15 / 27
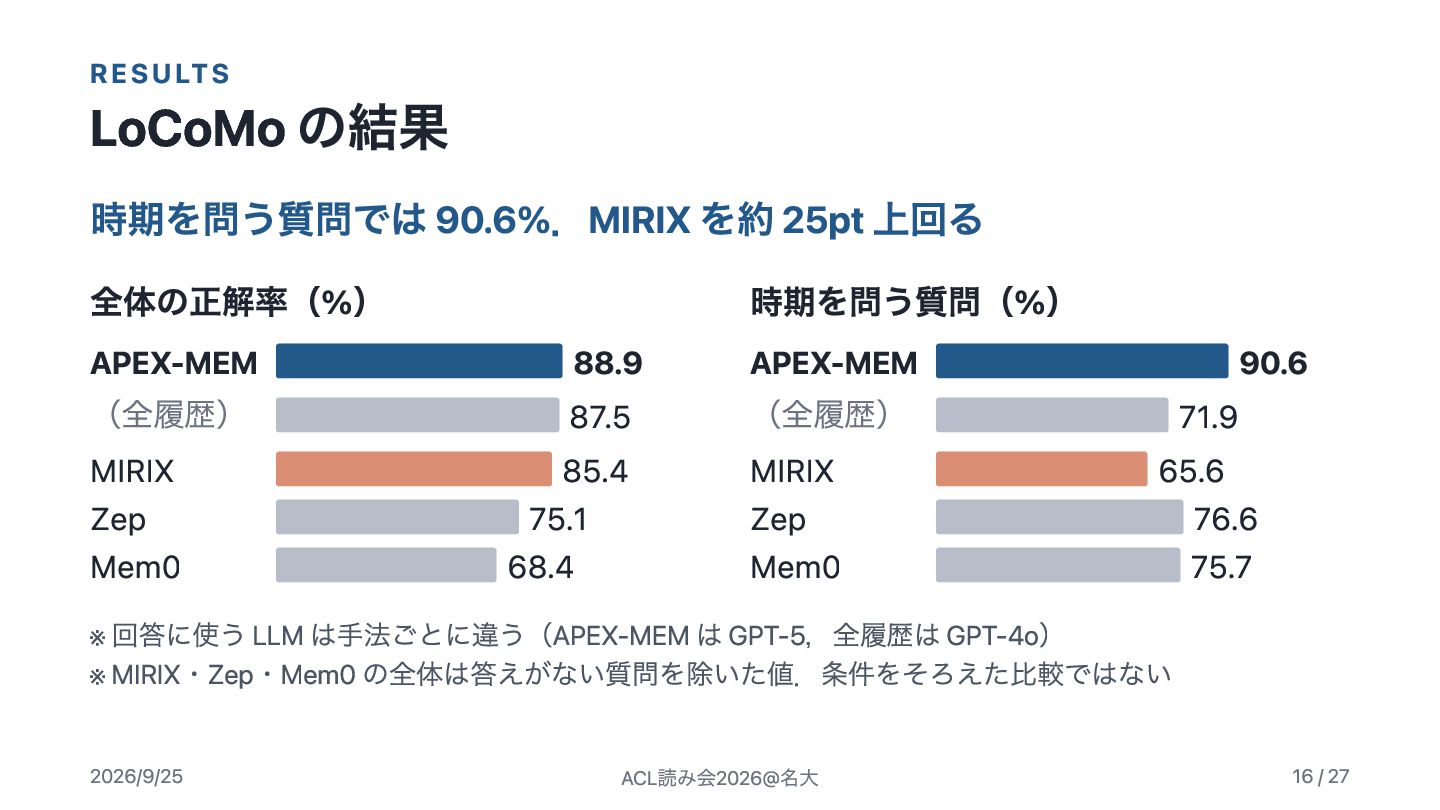
RESULTS LoCoMo の結果 時期を問う質問では 90.6%.MIRIX を約 25pt 上回る 全体の正解率(%) APEX-MEM
(全履歴) MIRIX Zep Mem0 ※ ※ 88.9 87.5 85.4 75.1 68.4 時期を問う質問(%) APEX-MEM (全履歴) MIRIX Zep Mem0 90.6 71.9 65.6 76.6 75.7 回答に使う LLM は手法ごとに違う(APEX-MEM は GPT-5,全履歴は GPT-4o) MIRIX・Zep・Mem0 の全体は答えがない質問を除いた値.条件をそろえた比較ではない 2026/9/25 ACL読み会2026@名大 16 / 27
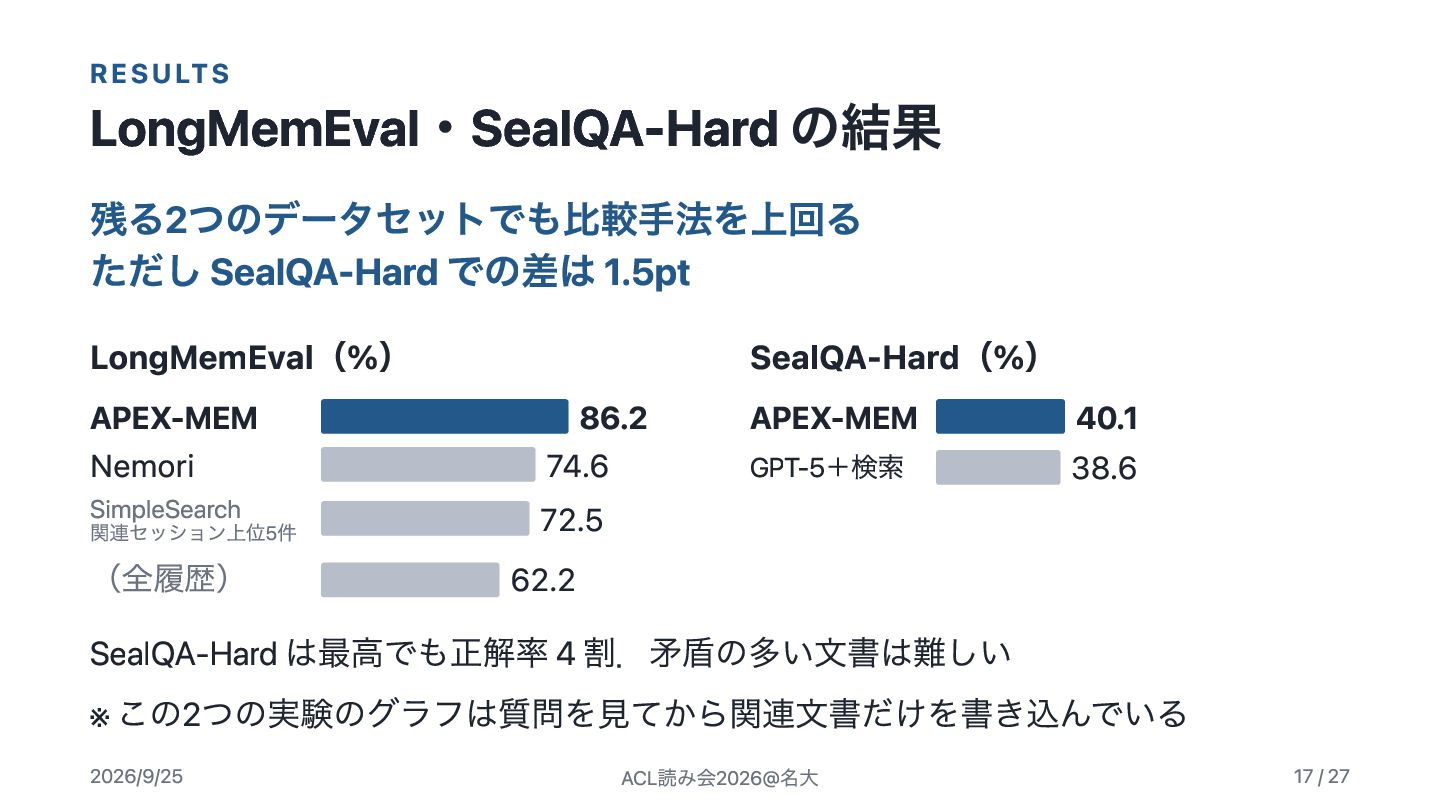
RESULTS LongMemEval・SealQA-Hard の結果 残る2つのデータセットでも比較手法を上回る ただし SealQA-Hard での差は 1.5pt LongMemEval(%) APEX-MEM
Nemori SealQA-Hard(%) APEX-MEM 40.1 GPT-5+検索 38.6 86.2 74.6 SimpleSearch 72.5 関連セッション上位5件 (全履歴) 62.2 SealQA-Hard は最高でも正解率 4 割.矛盾の多い文書は難しい ※ この2つの実験のグラフは質問を見てから関連文書だけを書き込んでいる 2026/9/25 ACL読み会2026@名大 17 / 27
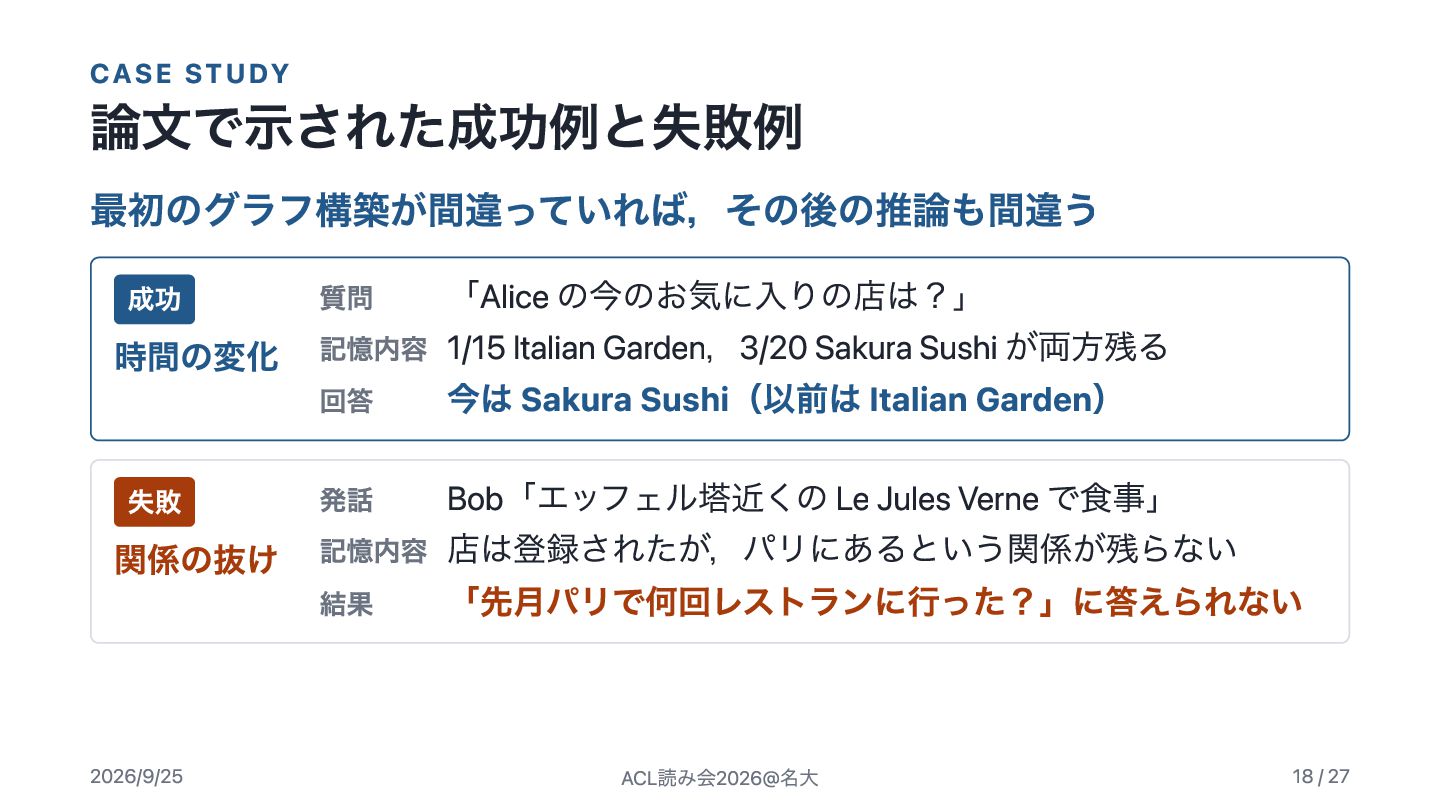
CASE STUDY 論文で示された成功例と失敗例 最初のグラフ構築が間違っていれば,その後の推論も間違う 成功 質問 「Alice の今のお気に入りの店は?」 記憶内容 1/15
Italian Garden,3/20 Sakura Sushi が両方残る 回答 今は Sakura Sushi(以前は Italian Garden) 失敗 発話 Bob「エッフェル塔近くの Le Jules Verne で食事」 記憶内容 店は登録されたが,パリにあるという関係が残らない 結果 「先月パリで何回レストランに行った?」に答えられない 時間の変化 関係の抜け 2026/9/25 ACL読み会2026@名大 18 / 27
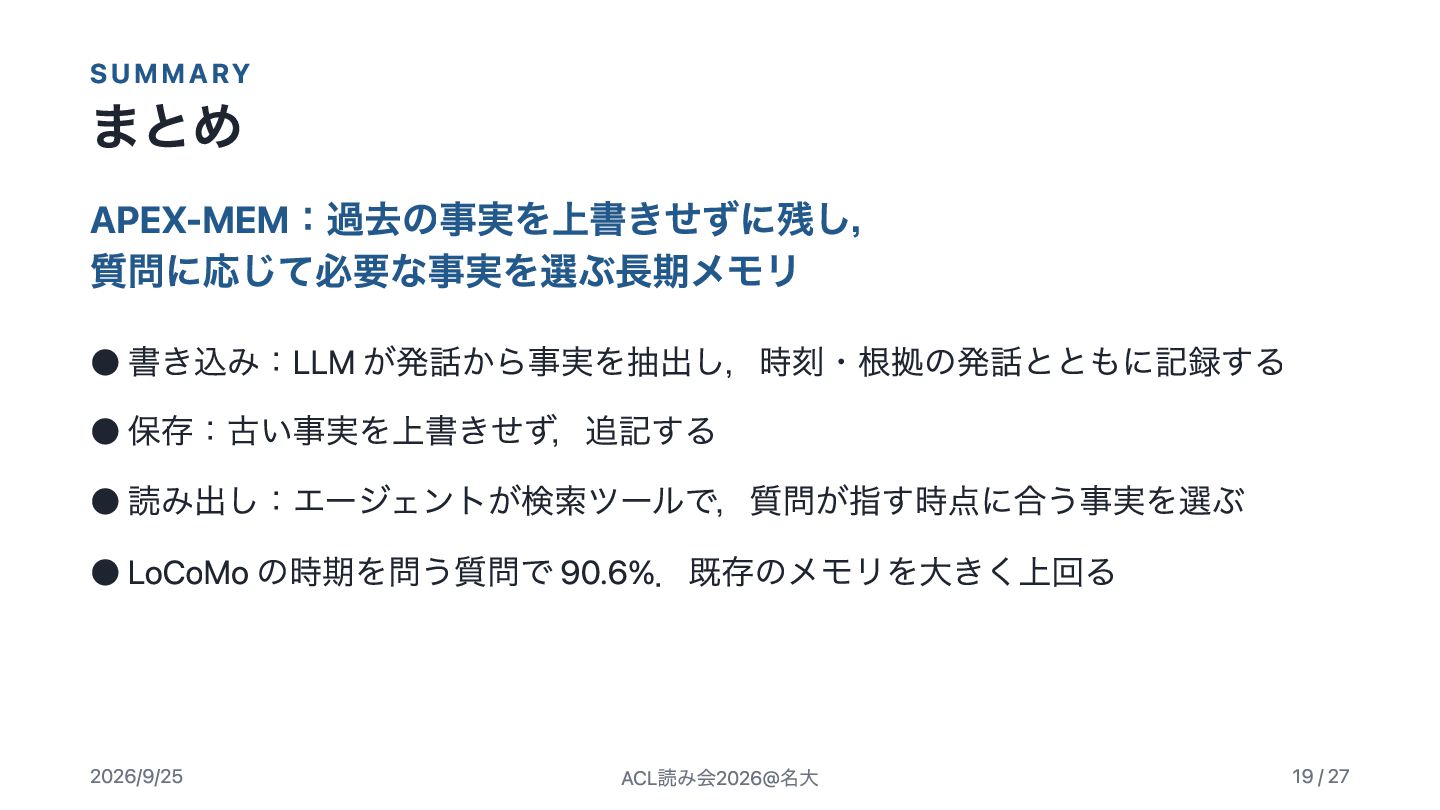
SUMMARY まとめ APEX-MEM:過去の事実を上書きせずに残し, 質問に応じて必要な事実を選ぶ長期メモリ • 書き込み:LLM が発話から事実を抽出し,時刻・根拠の発話とともに記録する • 保存:古い事実を上書きせず,追記する •
読み出し:エージェントが検索ツールで,質問が指す時点に合う事実を選ぶ • LoCoMo の時期を問う質問で 90.6%.既存のメモリを大きく上回る 2026/9/25 ACL読み会2026@名大 19 / 27
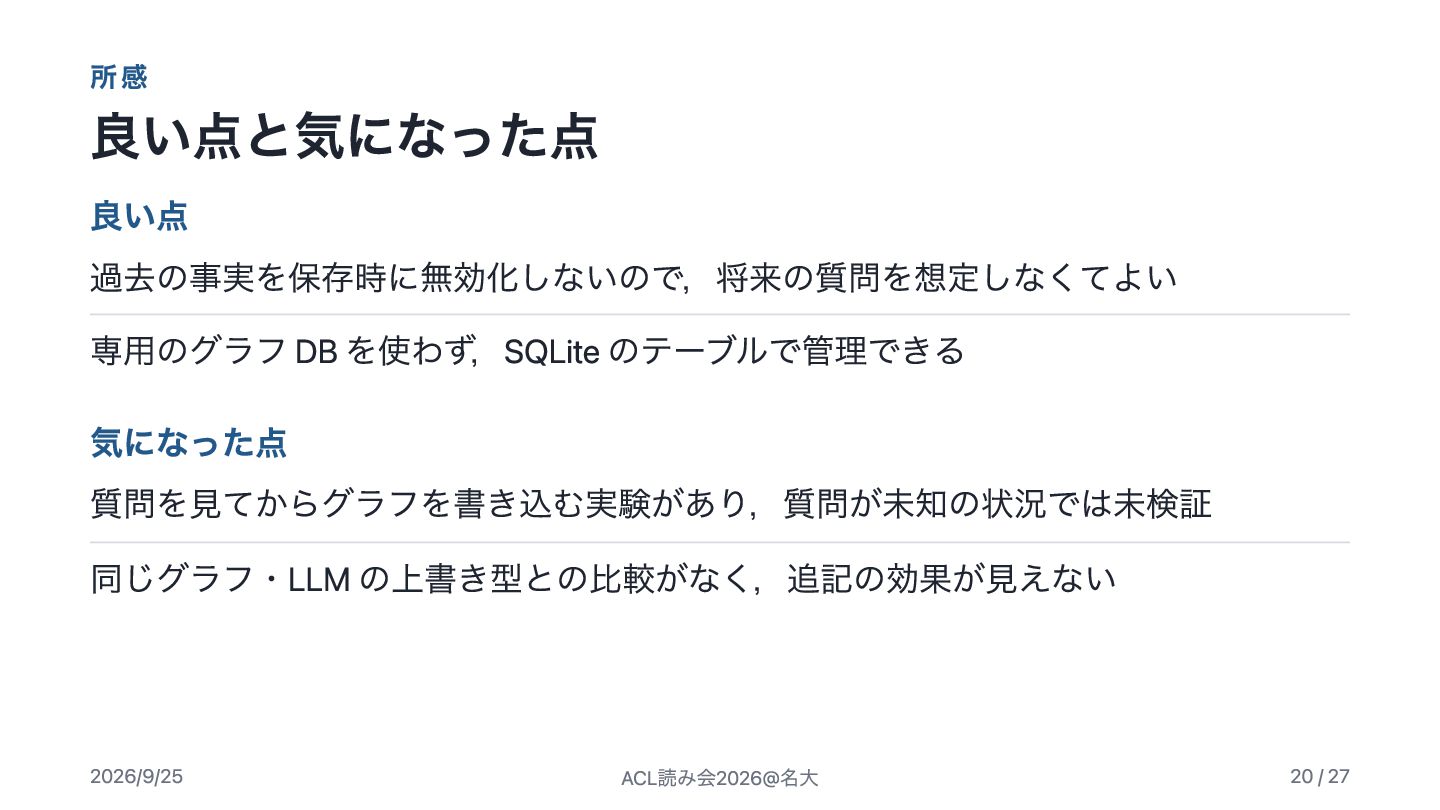
所感 良い点と気になった点 良い点 過去の事実を保存時に無効化しないので,将来の質問を想定しなくてよい 専用のグラフ DB を使わず,SQLite のテーブルで管理できる 気になった点 質問を見てからグラフを書き込む実験があり,質問が未知の状況では未検証
同じグラフ・LLM の上書き型との比較がなく,追記の効果が見えない 2026/9/25 ACL読み会2026@名大 20 / 27
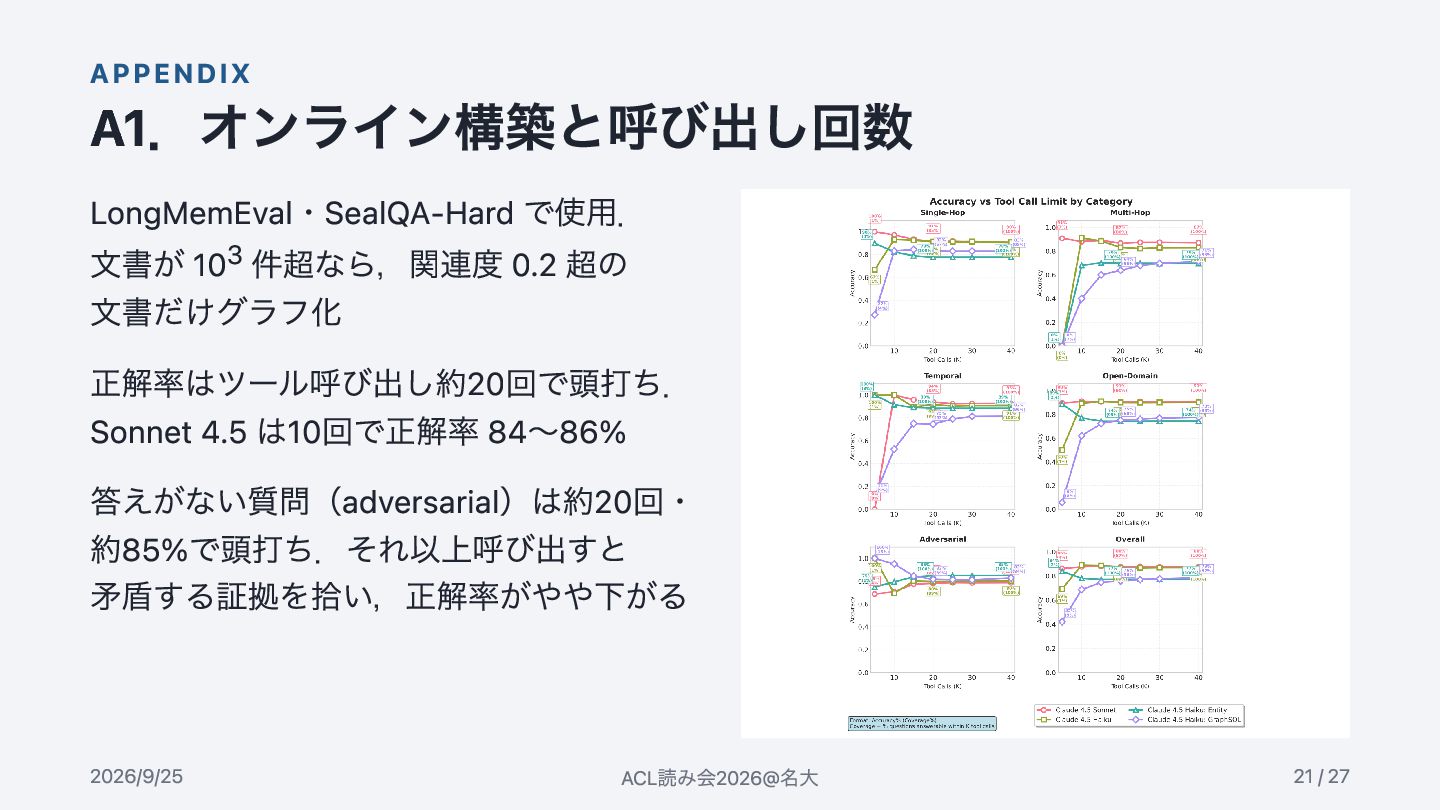
APPENDIX A1.オンライン構築と呼び出し回数 LongMemEval・SealQA-Hard で使用. 文書が 103 件超なら,関連度 0.2 超の 文書だけグラフ化
正解率はツール呼び出し約20回で頭打ち. Sonnet 4.5 は10回で正解率 84〜86% 答えがない質問(adversarial)は約20回・ 約85%で頭打ち.それ以上呼び出すと 矛盾する証拠を拾い,正解率がやや下がる 2026/9/25 ACL読み会2026@名大 21 / 27
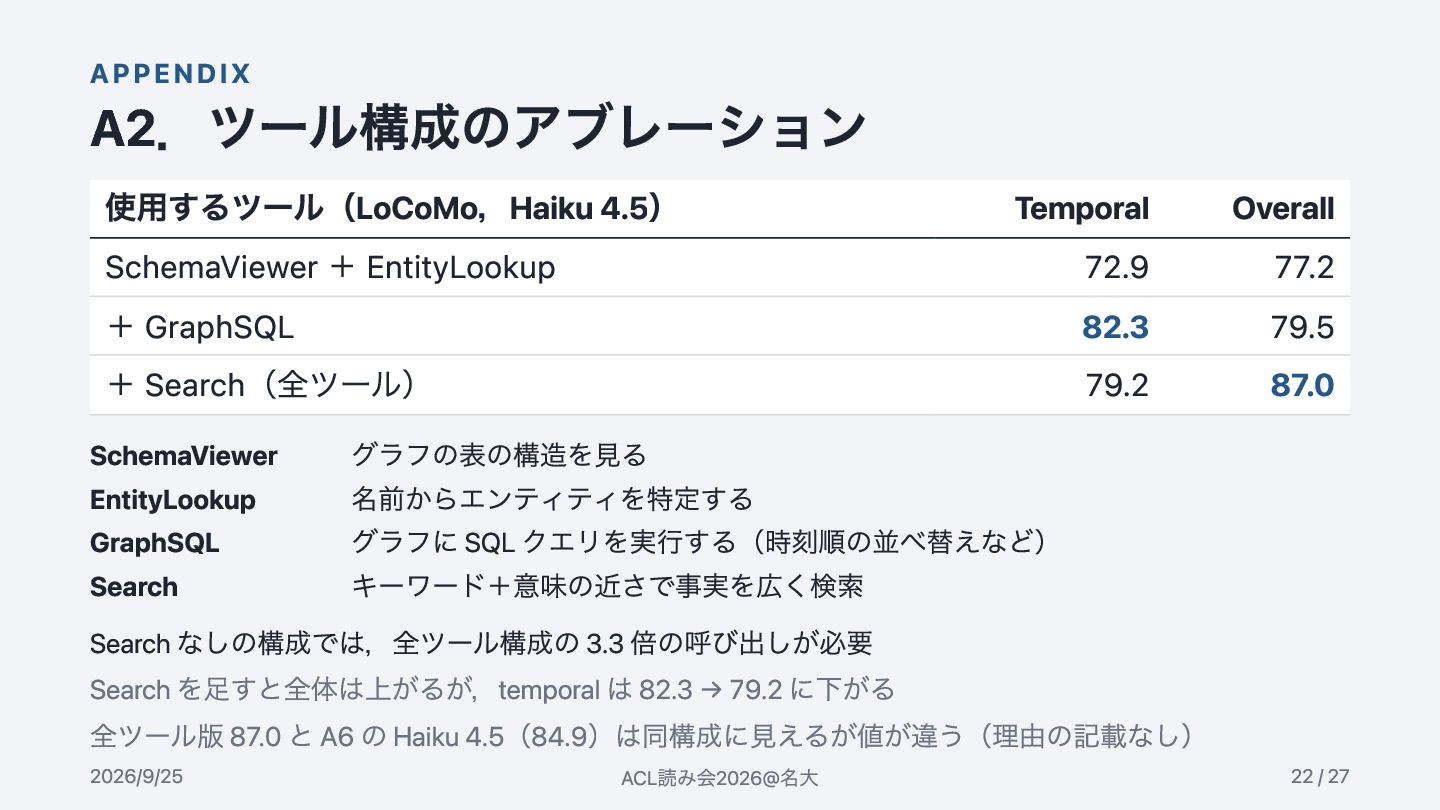
APPENDIX A2.ツール構成のアブレーション 使用するツール(LoCoMo,Haiku 4.5) SchemaViewer + EntityLookup + GraphSQL +
Search(全ツール) Temporal 72.9 82.3 79.2 SchemaViewer グラフの表の構造を見る EntityLookup 名前からエンティティを特定する GraphSQL グラフに SQL クエリを実行する(時刻順の並べ替えなど) Search キーワード+意味の近さで事実を広く検索 Search なしの構成では,全ツール構成の 3.3 倍の呼び出しが必要 Search を足すと全体は上がるが,temporal は 82.3 → 79.2 に下がる 全ツール版 87.0 と A6 の Haiku 4.5(84.9)は同構成に見えるが値が違う(理由の記載なし) 2026/9/25 ACL読み会2026@名大 Overall 77.2 79.5 87.0 22 / 27
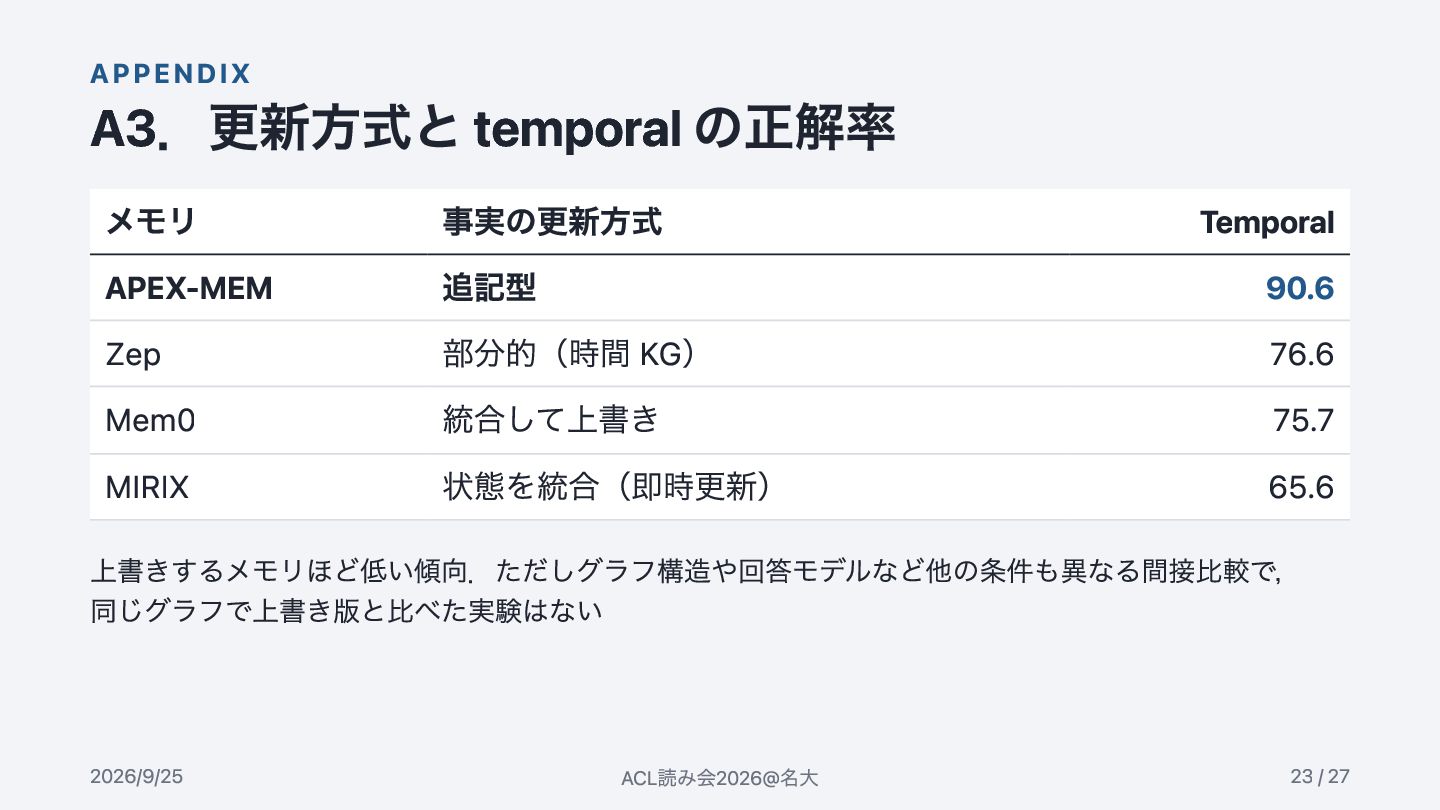
APPENDIX A3.更新方式と temporal の正解率 メモリ APEX-MEM Zep Mem0 MIRIX 事実の更新方式
追記型 部分的(時間 KG) 統合して上書き 状態を統合(即時更新) Temporal 90.6 76.6 75.7 65.6 上書きするメモリほど低い傾向.ただしグラフ構造や回答モデルなど他の条件も異なる間接比較で, 同じグラフで上書き版と比べた実験はない 2026/9/25 ACL読み会2026@名大 23 / 27
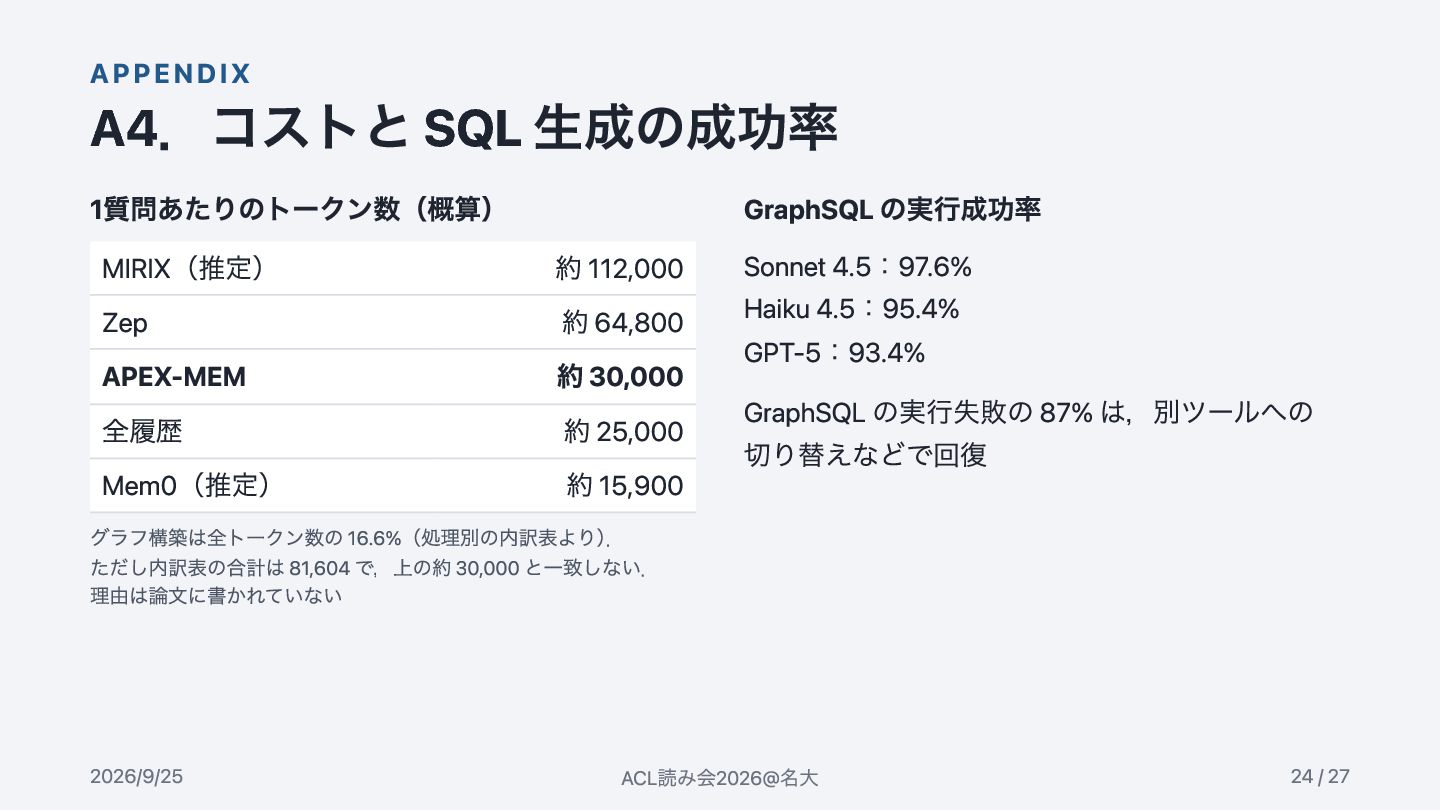
APPENDIX A4.コストと SQL 生成の成功率 1質問あたりのトークン数(概算) MIRIX(推定) 約 112,000 Zep 約
64,800 APEX-MEM 約 30,000 全履歴 約 25,000 Mem0(推定) 約 15,900 GraphSQL の実行成功率 Sonnet 4.5:97.6% Haiku 4.5:95.4% GPT-5:93.4% GraphSQL の実行失敗の 87% は,別ツールへの 切り替えなどで回復 グラフ構築は全トークン数の 16.6%(処理別の内訳表より). ただし内訳表の合計は 81,604 で,上の約 30,000 と一致しない. 理由は論文に書かれていない 2026/9/25 ACL読み会2026@名大 24 / 27
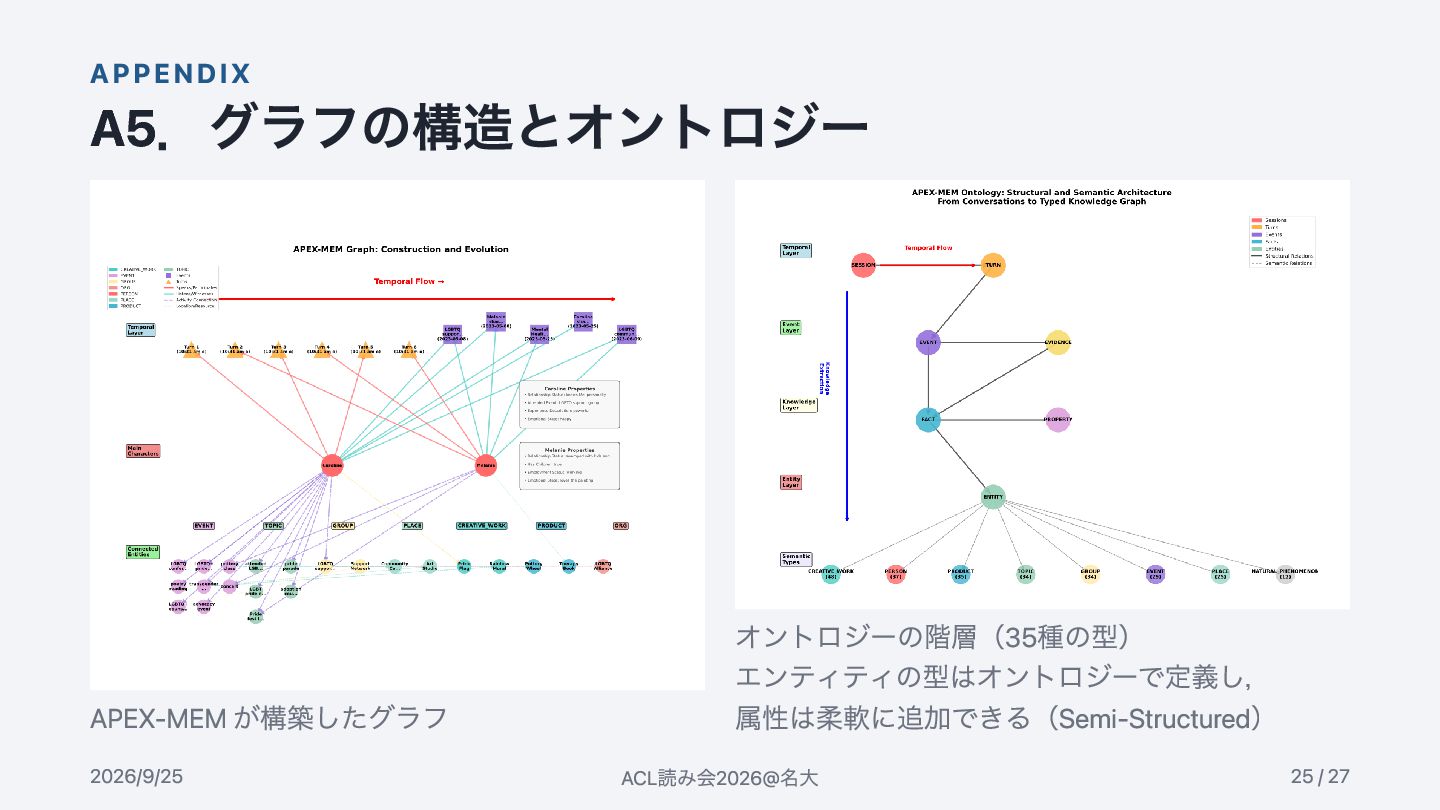
APPENDIX A5.グラフの構造とオントロジー APEX-MEM が構築したグラフ 2026/9/25 オントロジーの階層(35種の型) エンティティの型はオントロジーで定義し, 属性は柔軟に追加できる(Semi-Structured) ACL読み会2026@名大 25
/ 27
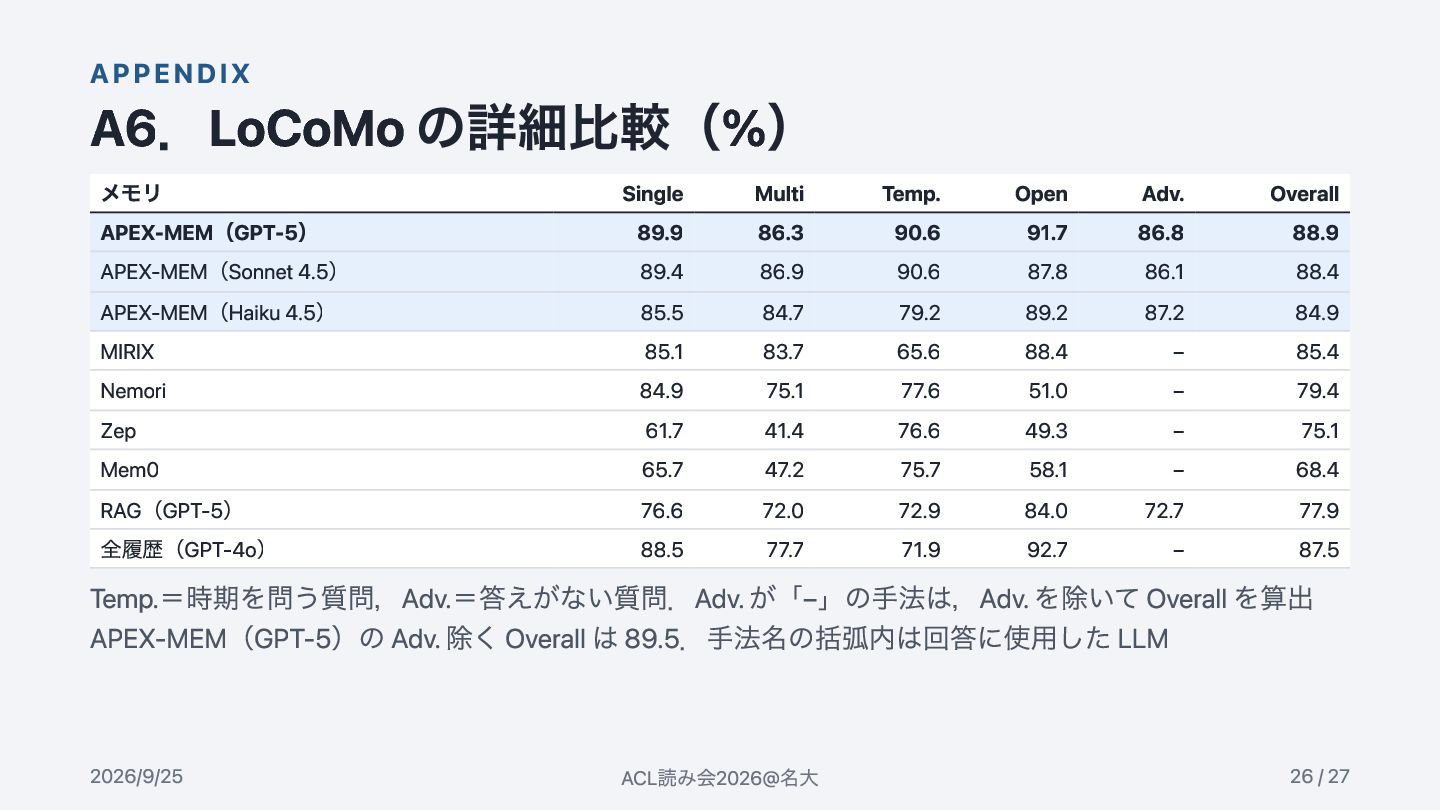
APPENDIX A6.LoCoMo の詳細比較(%) メモリ APEX-MEM(GPT-5) APEX-MEM(Sonnet 4.5) APEX-MEM(Haiku 4.5) MIRIX
Nemori Zep Mem0 RAG(GPT-5) 全履歴(GPT-4o) Single 89.9 89.4 85.5 85.1 84.9 61.7 65.7 76.6 88.5 2026/9/25 ACL読み会2026@名大 Multi 86.3 86.9 84.7 83.7 75.1 41.4 47.2 72.0 77.7 Temp. 90.6 90.6 79.2 65.6 77.6 76.6 75.7 72.9 71.9 Open 91.7 87.8 89.2 88.4 51.0 49.3 58.1 84.0 92.7 Adv. 86.8 86.1 87.2 – – – – 72.7 – Overall 88.9 88.4 84.9 85.4 79.4 75.1 68.4 77.9 87.5 Temp.=時期を問う質問,Adv.=答えがない質問.Adv. が「–」の手法は,Adv. を除いて Overall を算出 APEX-MEM(GPT-5)の Adv. 除く Overall は 89.5.手法名の括弧内は回答に使用した LLM 26 / 27
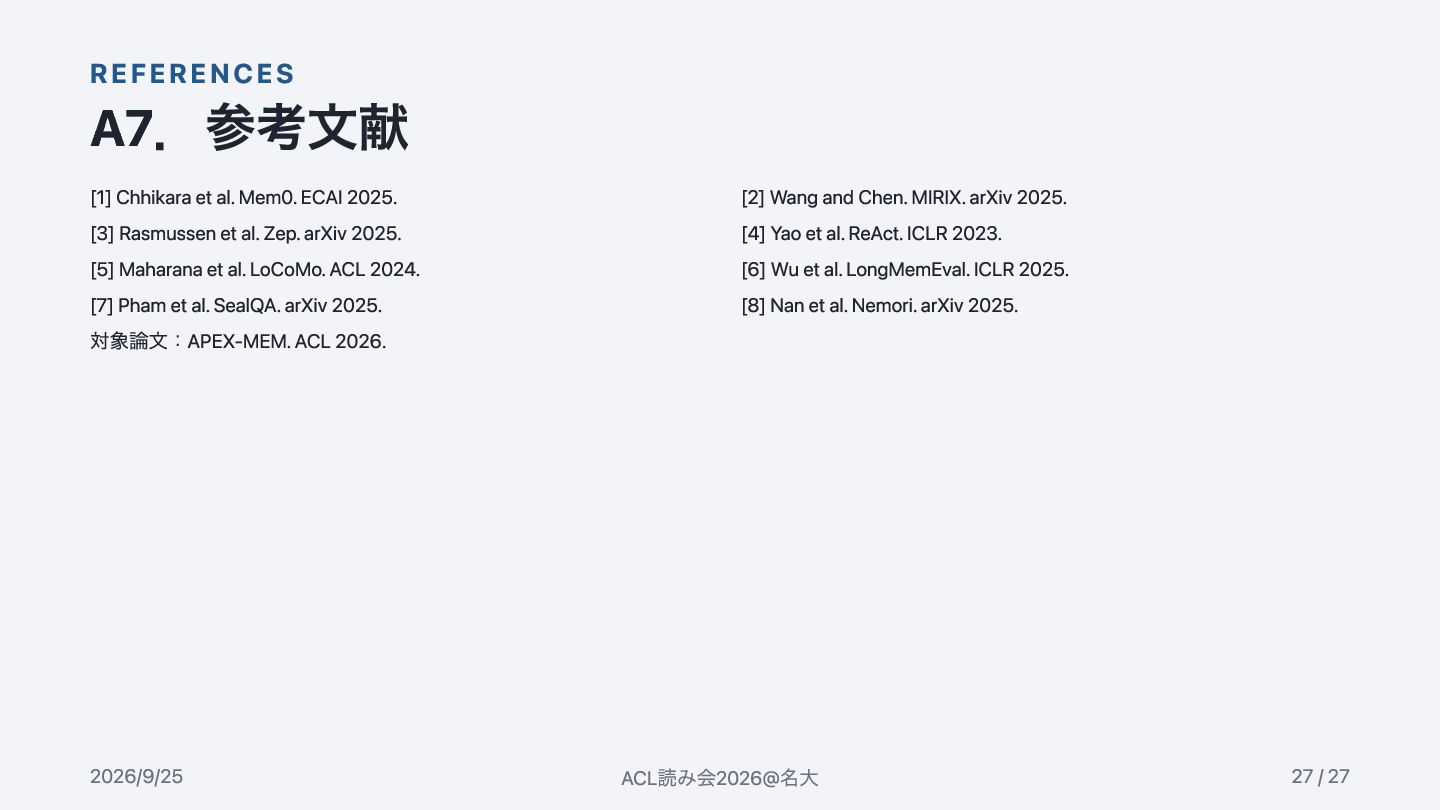
REFERENCES A7.参考文献 [1] Chhikara et al. Mem0. ECAI 2025. [3]
Rasmussen et al. Zep. arXiv 2025. [5] Maharana et al. LoCoMo. ACL 2024. [7] Pham et al. SealQA. arXiv 2025. 対象論文:APEX-MEM. ACL 2026. 2026/9/25 [2] Wang and Chen. MIRIX. arXiv 2025. [4] Yao et al. ReAct. ICLR 2023. [6] Wu et al. LongMemEval. ICLR 2025. [8] Nan et al. Nemori. arXiv 2025. ACL読み会2026@名大 27 / 27


 holman
 stuffmc
 addyosmani
 ks91
 minecr
 inesmontani
 reverentgeek
 badams
 moore
 aleyda
 sarafernandez
 chriscoyier