Share
Embed
AIエージェントアーキテクト生成メタエージェント
Taka
August 12, 2026
Transcript
21 slides
-
【 AI】 AILT会 - vol.2 ② AIエージェントアーキテクト生成メタエージェント 複数のMCPサーバーを束ねて「AIシステムアーキテクト」を作った話 2026 年8月12
日(水) 登壇者:野崎 高弘 AILT会 - vol.2② 1 -
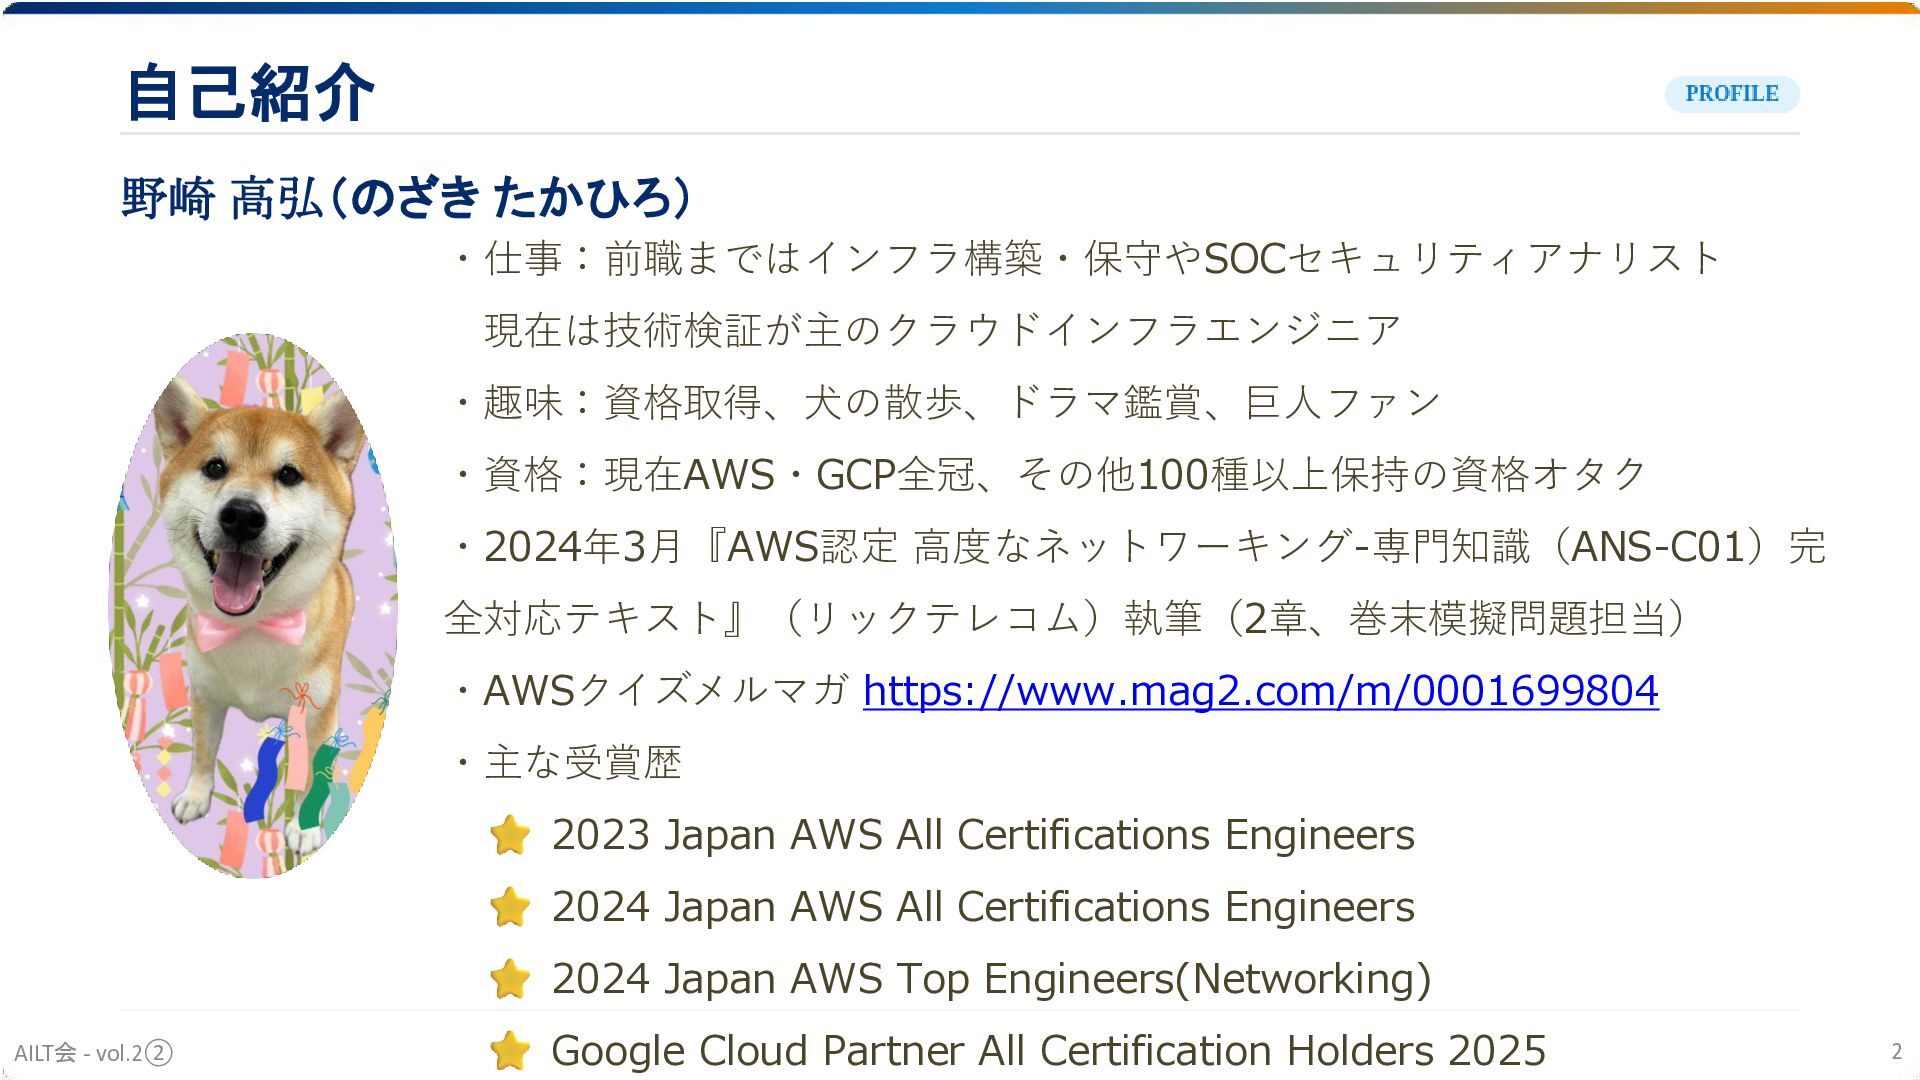
自己紹介 野崎 高弘(のざき たかひろ) ・仕事:前職まではインフラ構築・保守やSOCセキュリティアナリスト 現在は技術検証が主のクラウドインフラエンジニア ・趣味:資格取得、犬の散歩、ドラマ鑑賞、巨人ファン ・資格:現在AWS・GCP全冠、その他100種以上保持の資格オタク ・2024年3月『AWS認定 高度なネットワーキング-専門知識(ANS-C01)完
全対応テキスト』(リックテレコム)執筆(2章、巻末模擬問題担当) ・AWSクイズメルマガ https://www.mag2.com/m/0001699804 ・主な受賞歴 2023 Japan AWS All Certifications Engineers 2024 Japan AWS All Certifications Engineers 2024 Japan AWS Top Engineers(Networking) AILT会 - vol.2② Google Cloud Partner All Certification Holders 2025 2 -
背景・目的・やりたいこと 「こういうことができるAIエージェントを作りたいんだけど、ど んなツールを使ってどんな構成にすればいいんだろう?」—— このシステム設計の初手を、自動化できないかと考えました。 作ったのは、Strands Agents と複数の MCPサーバーを組み合わ せて、要件を投げると「最新トレンド」と「AWSの最新情報」を 横断的に収集し、最適なシステム構成を提案してくれるエージェ
ント、AIシステムアーキテクトエージェント です。 本LTではその設計と実装を、つまずいた点も含めて紹介します。 AILT会 - vol.2② 3 -
何を解決したかったか 新しいAIエージェントやツールを設計するとき、以下を毎回手作業でやって いました。 • X(Twitter)やWeb、GitHub Trendingで「今何が話題か」を調べる • Zenn・Qiitaで実装事例を探す • AWS
Bedrock AgentCore のような、更新の速いマネージドサービスの最 新機能を確認する • それらを踏まえて、要件に合ったツール・サービスを選定し、アーキテク チャに落とし込む この一連の情報収集と統合をMCPサーバー群とLLMに任せることにしました。 AILT会 - vol.2② 4 -
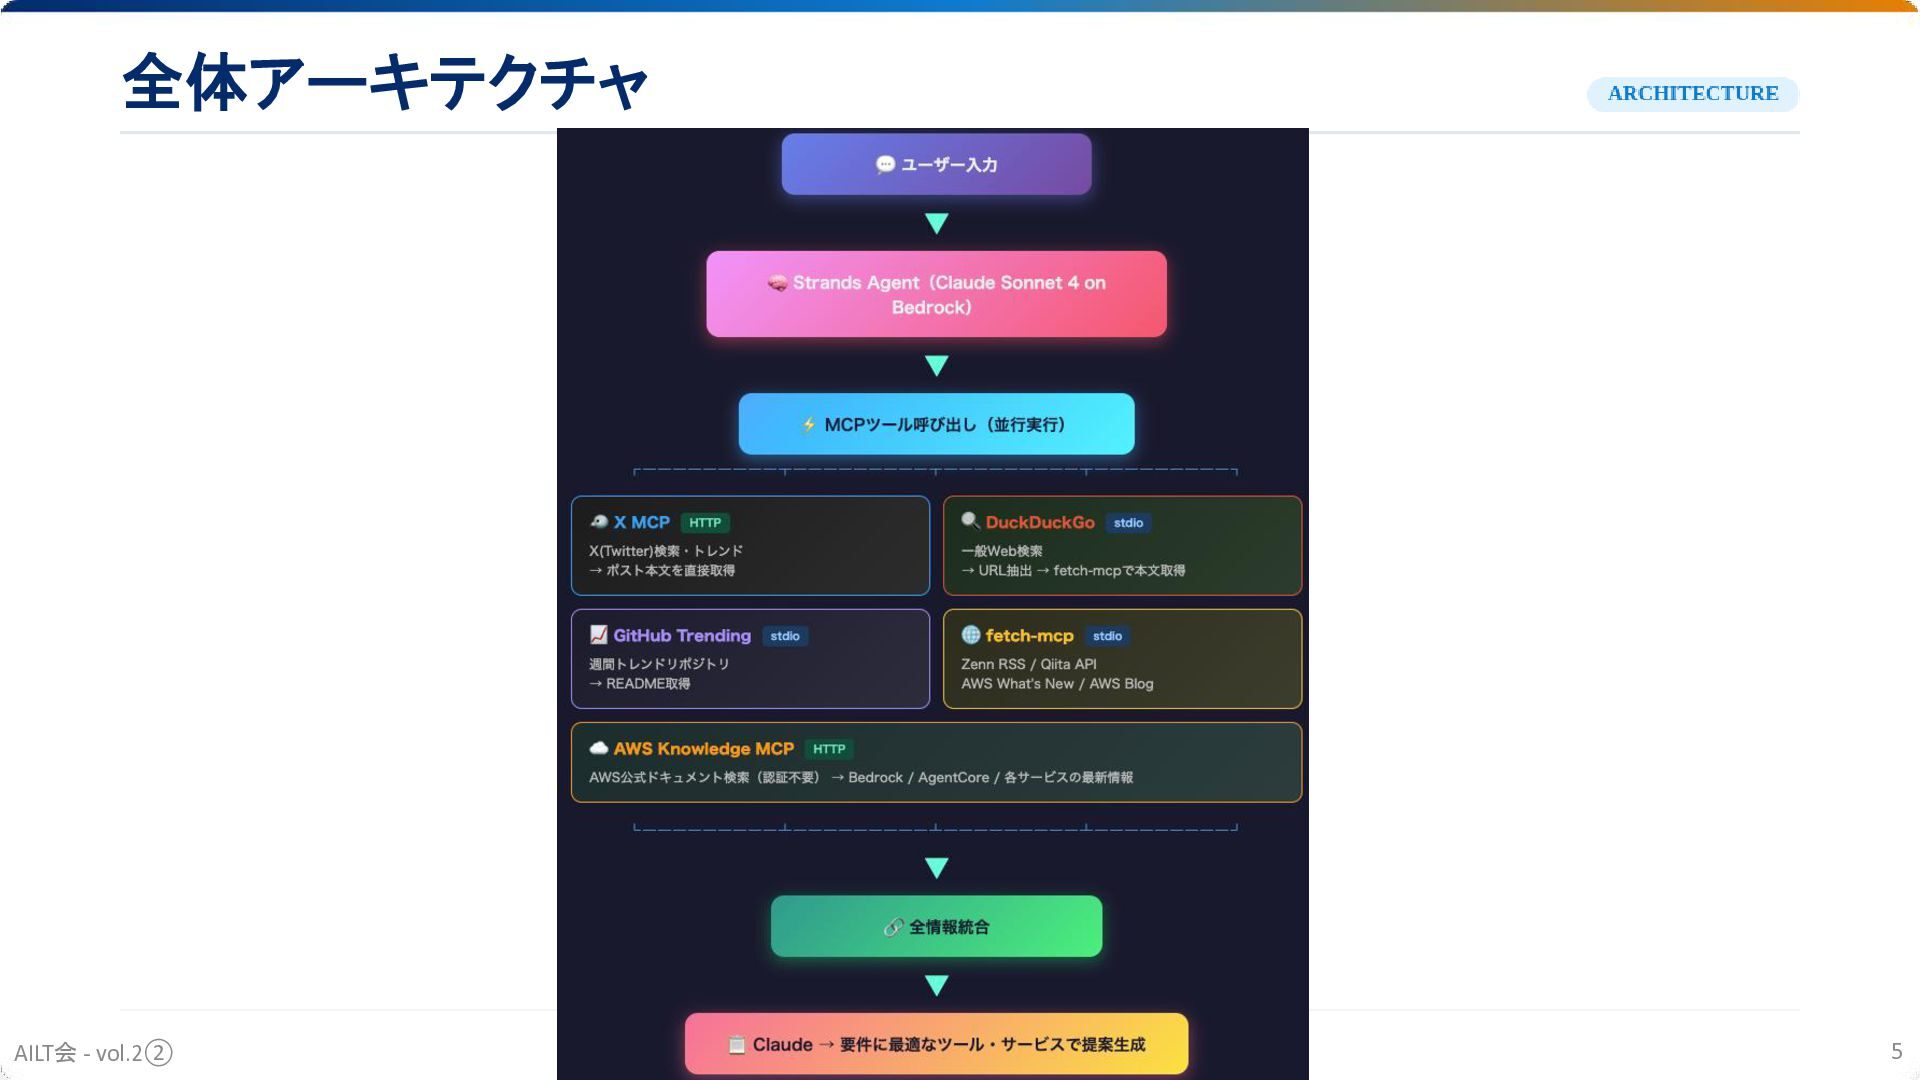
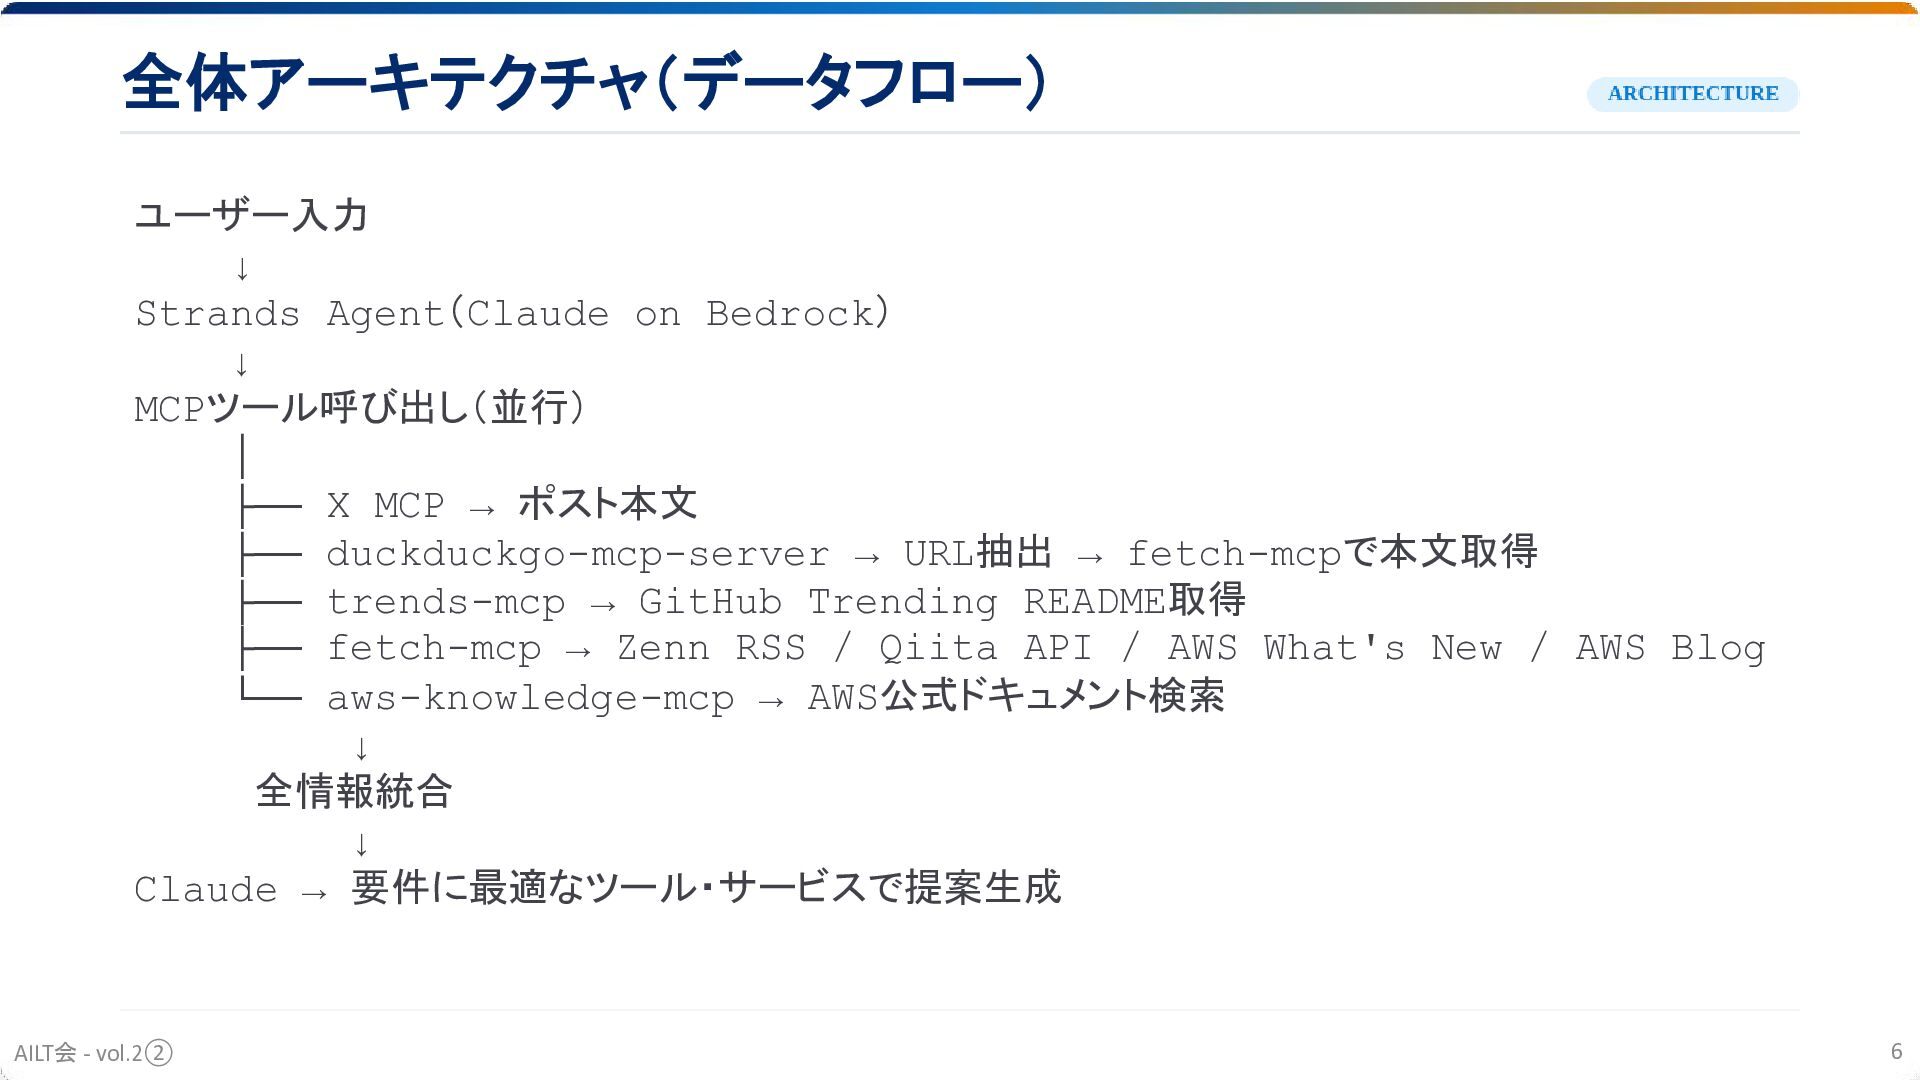
全体アーキテクチャ(データフロー) ユーザー入力 ↓ Strands Agent(Claude on Bedrock) ↓ MCPツール呼び出し(並行) │
├── X MCP → ポスト本文 ├── duckduckgo-mcp-server → URL抽出 → fetch-mcpで本文取得 ├── trends-mcp → GitHub Trending README取得 ├── fetch-mcp → Zenn RSS / Qiita API / AWS What's New / AWS Blog └── aws-knowledge-mcp → AWS公式ドキュメント検索 ↓ 全情報統合 ↓ Claude → 要件に最適なツール・サービスで提案生成 AILT会 - vol.2② 6 -
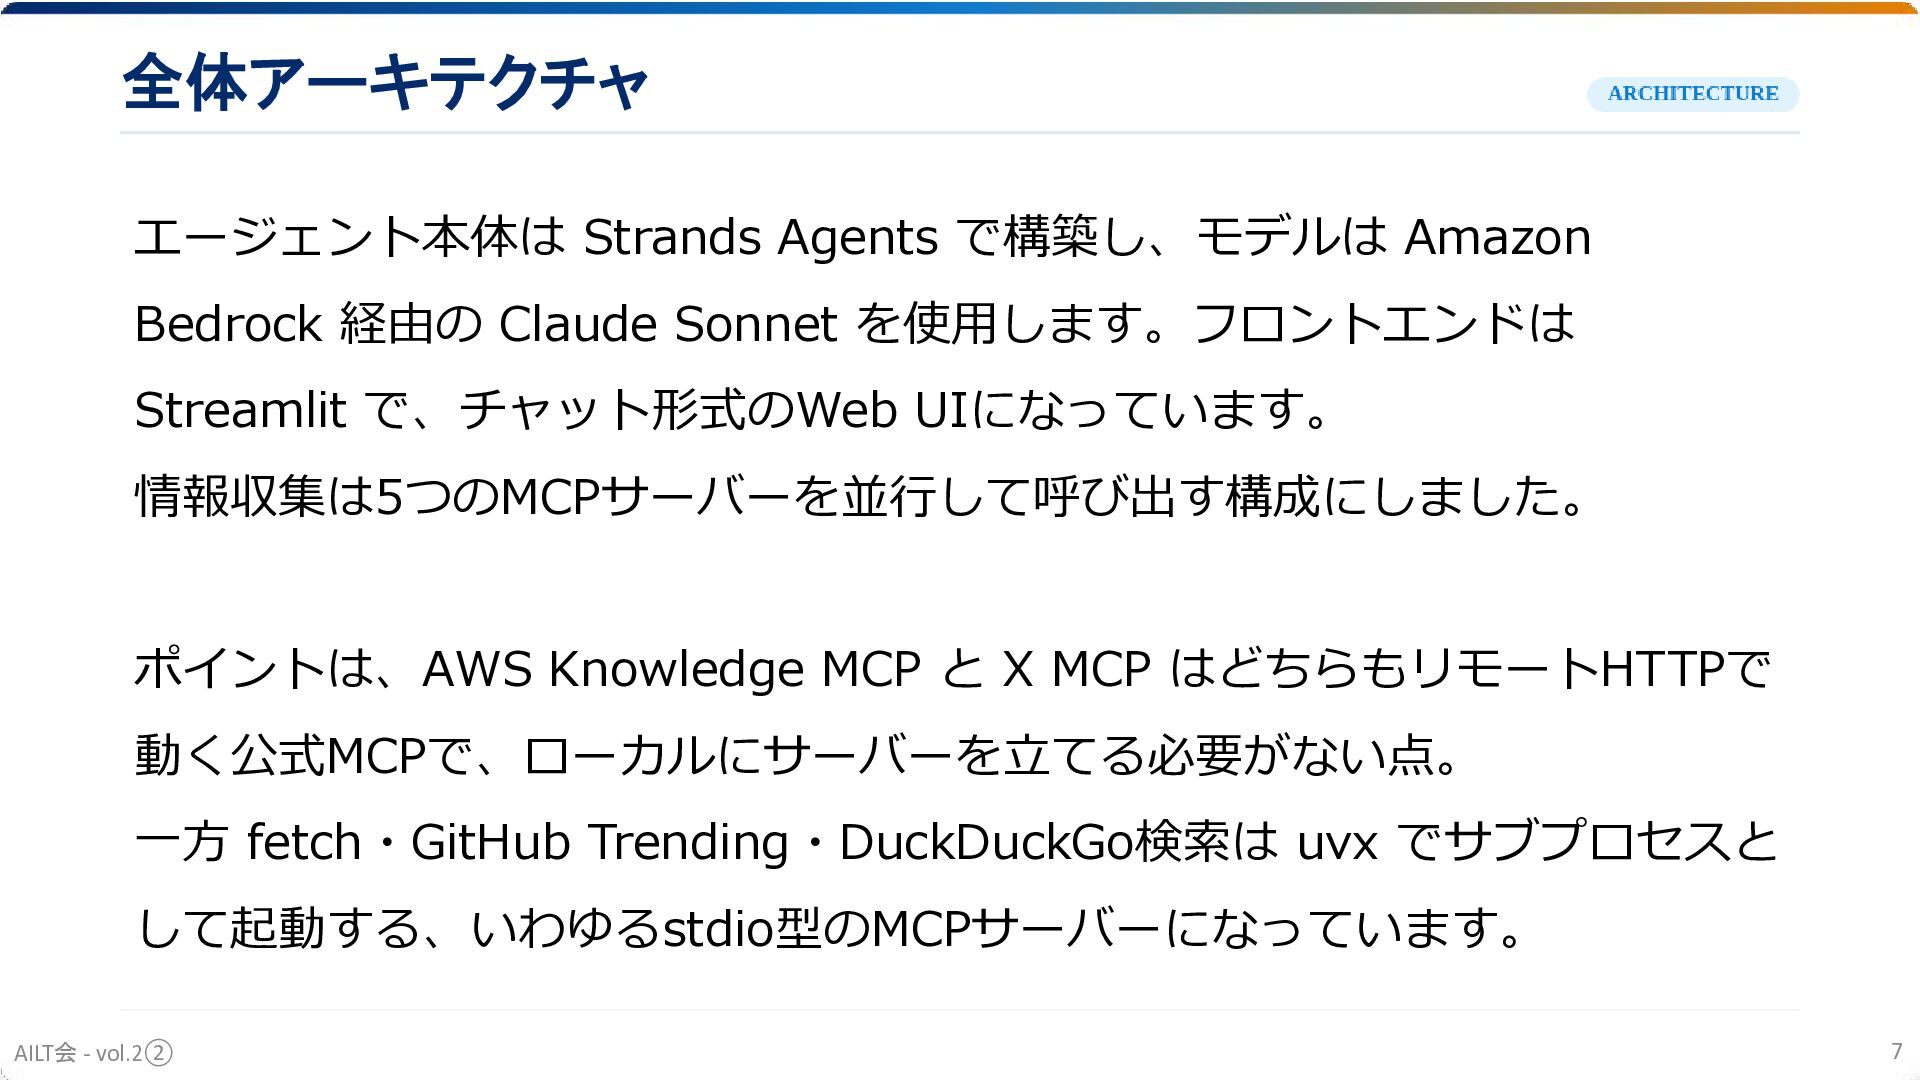
全体アーキテクチャ エージェント本体は Strands Agents で構築し、モデルは Amazon Bedrock 経由の Claude Sonnet
を使用します。フロントエンドは Streamlit で、チャット形式のWeb UIになっています。 情報収集は5つのMCPサーバーを並行して呼び出す構成にしました。 ポイントは、AWS Knowledge MCP と X MCP はどちらもリモートHTTPで 動く公式MCPで、ローカルにサーバーを立てる必要がない点。 一方 fetch・GitHub Trending・DuckDuckGo検索は uvx でサブプロセスと して起動する、いわゆるstdio型のMCPサーバーになっています。 AILT会 - vol.2② 7 -
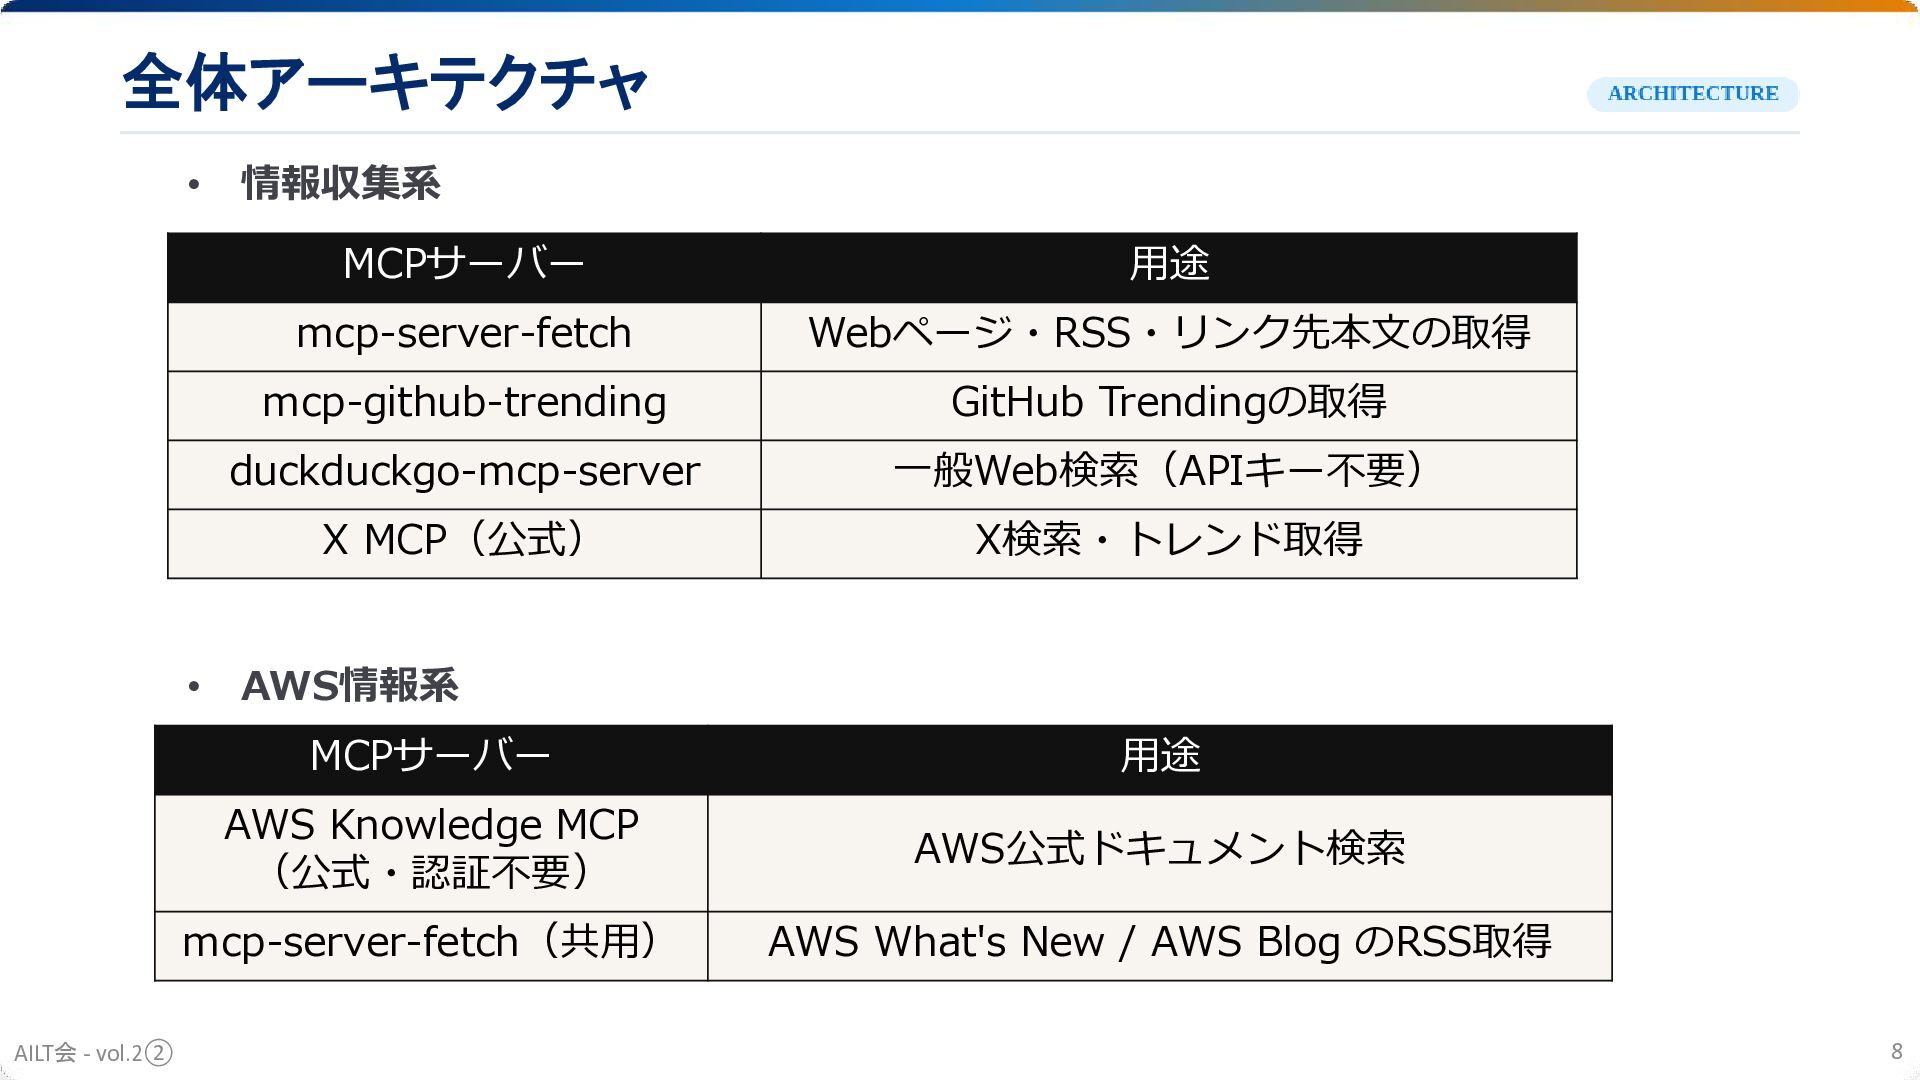
全体アーキテクチャ • 情報収集系 MCPサーバー 用途 mcp-server-fetch Webページ・RSS・リンク先本文の取得 mcp-github-trending GitHub Trendingの取得
duckduckgo-mcp-server 一般Web検索(APIキー不要) X MCP(公式) X検索・トレンド取得 • AWS情報系 AILT会 - vol.2② MCPサーバー 用途 AWS Knowledge MCP (公式・認証不要) AWS公式ドキュメント検索 mcp-server-fetch(共用) AWS What's New / AWS Blog のRSS取得 8 -
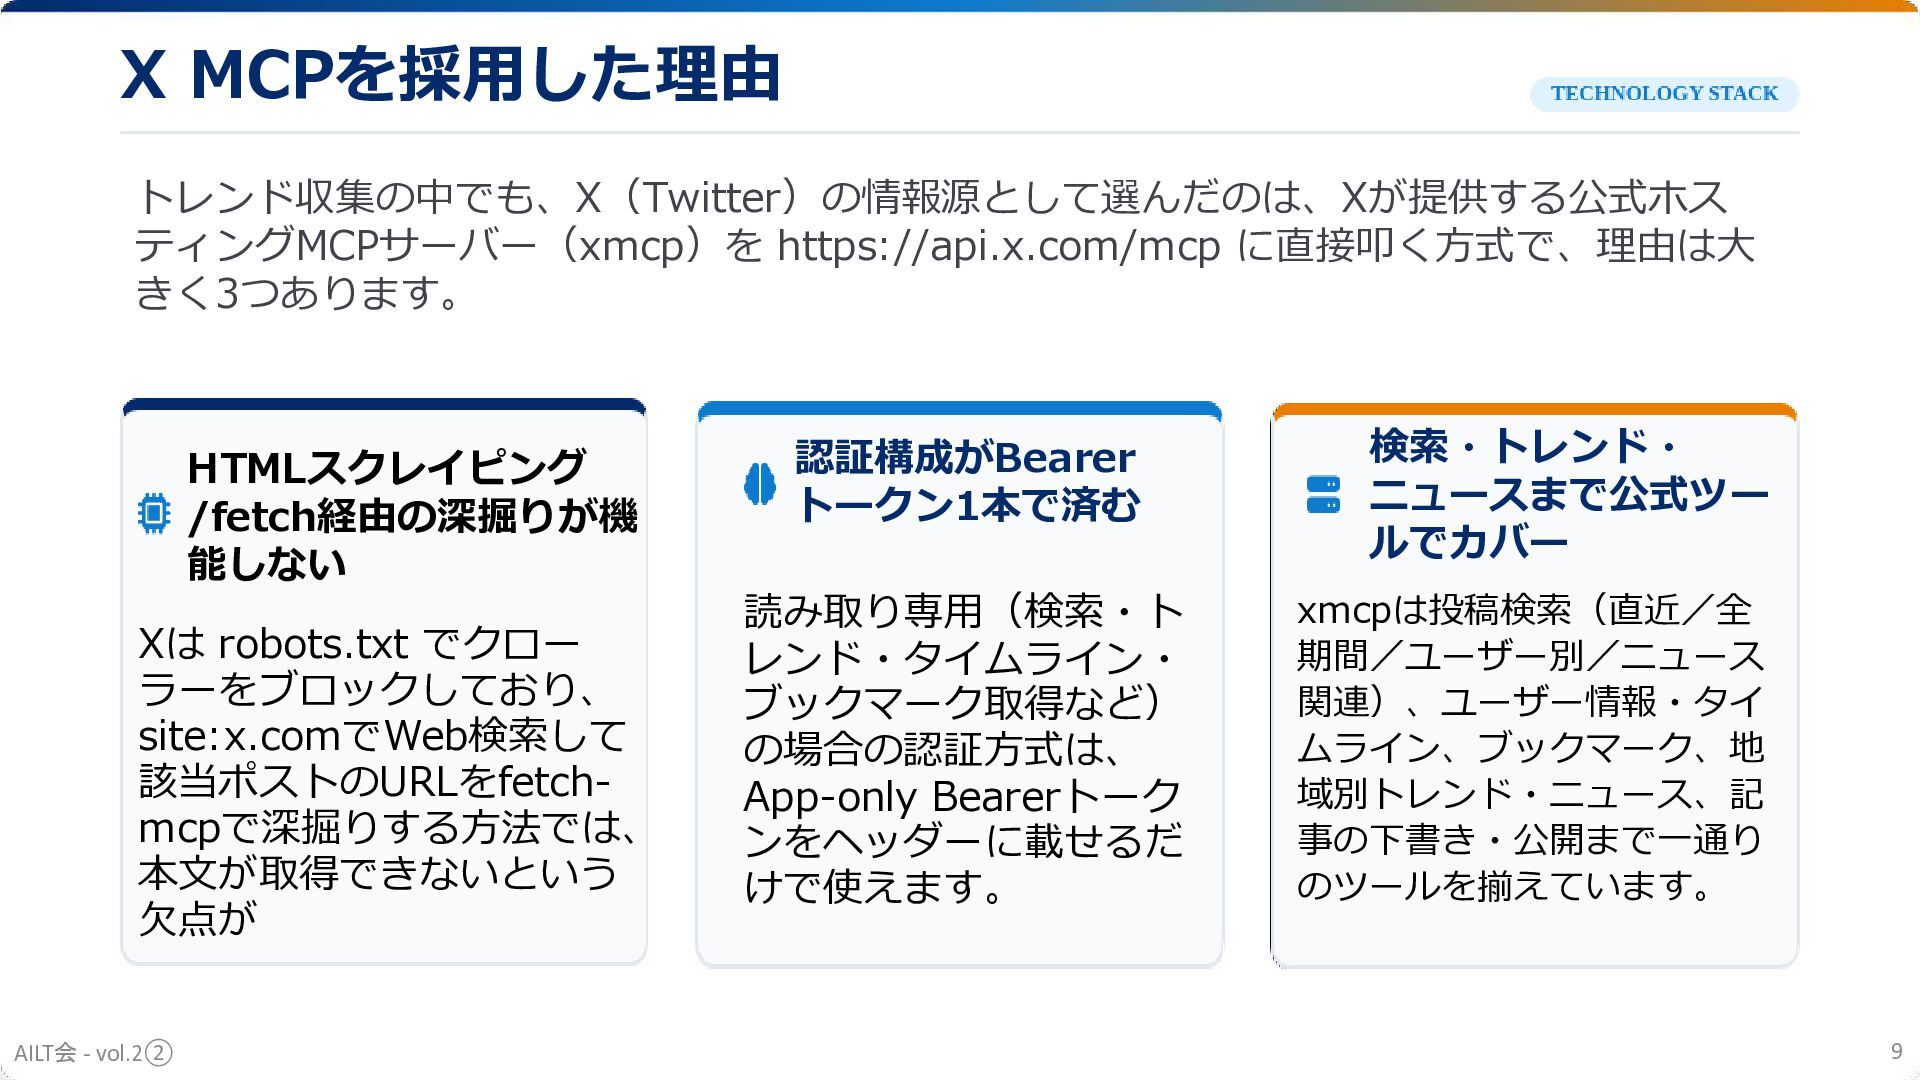
X MCPを採用した理由 トレンド収集の中でも、X(Twitter)の情報源として選んだのは、Xが提供する公式ホス ティングMCPサーバー(xmcp)を https://api.x.com/mcp に直接叩く方式で、理由は大 きく3つあります。 HTMLスクレイピング /fetch経由の深掘りが機 能しない
Xは robots.txt でクロー ラーをブロックしており、 site:x.comでWeb検索して 該当ポストのURLをfetchmcpで深掘りする方法では、 本文が取得できないという 欠点が AILT会 - vol.2② 認証構成がBearer トークン1本で済む 読み取り専用(検索・ト レンド・タイムライン・ ブックマーク取得など) の場合の認証方式は、 App-only Bearerトーク ンをヘッダーに載せるだ けで使えます。 検索・トレンド・ ニュースまで公式ツー ルでカバー xmcpは投稿検索(直近/全 期間/ユーザー別/ニュース 関連)、ユーザー情報・タイ ムライン、ブックマーク、地 域別トレンド・ニュース、記 事の下書き・公開まで一通り のツールを揃えています。 9 -
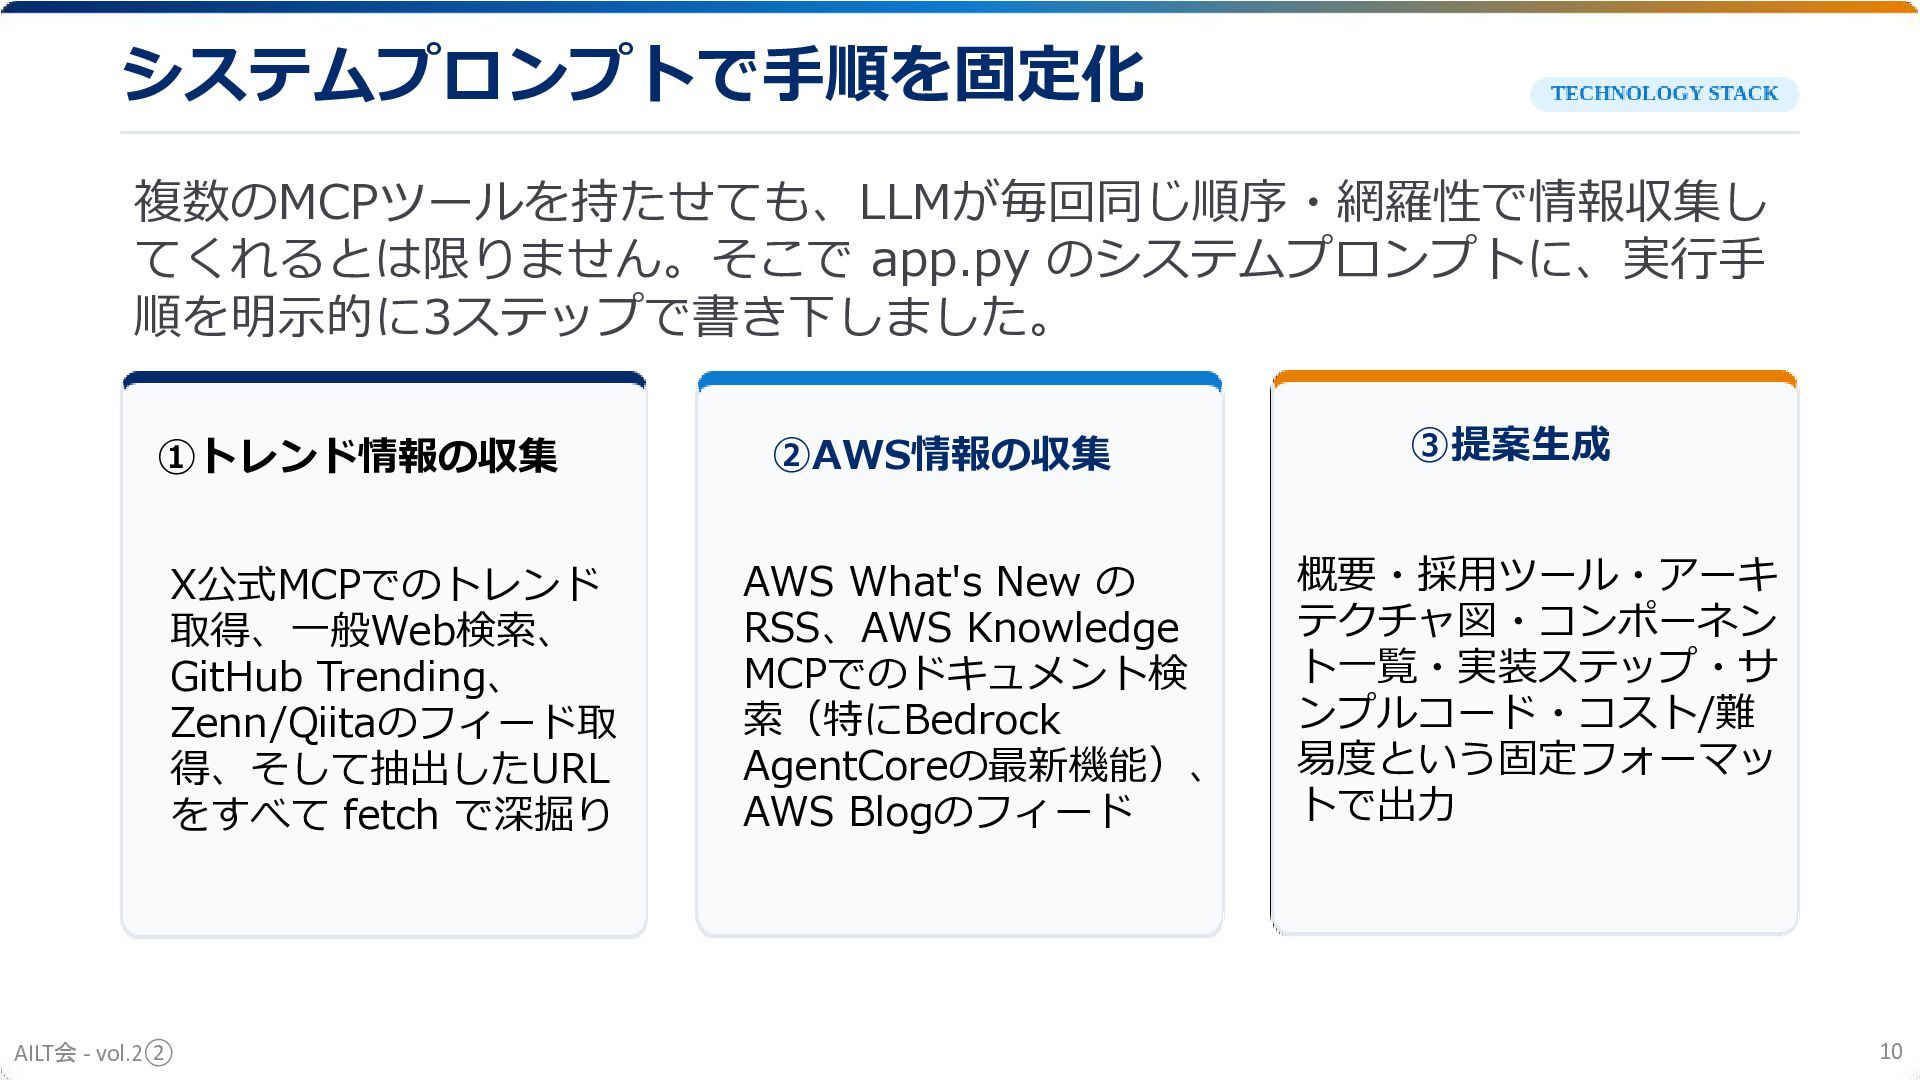
システムプロンプトで手順を固定化 複数のMCPツールを持たせても、LLMが毎回同じ順序・網羅性で情報収集し てくれるとは限りません。そこで app.py のシステムプロンプトに、実行手 順を明示的に3ステップで書き下しました。 ①トレンド情報の収集 X公式MCPでのトレンド 取得、一般Web検索、 GitHub
Trending、 Zenn/Qiitaのフィード取 得、そして抽出したURL をすべて fetch で深掘り AILT会 - vol.2② ②AWS情報の収集 AWS What's New の RSS、AWS Knowledge MCPでのドキュメント検 索(特にBedrock AgentCoreの最新機能)、 AWS Blogのフィード ③提案生成 概要・採用ツール・アーキ テクチャ図・コンポーネン ト一覧・実装ステップ・サ ンプルコード・コスト/難 易度という固定フォーマッ トで出力 10 -
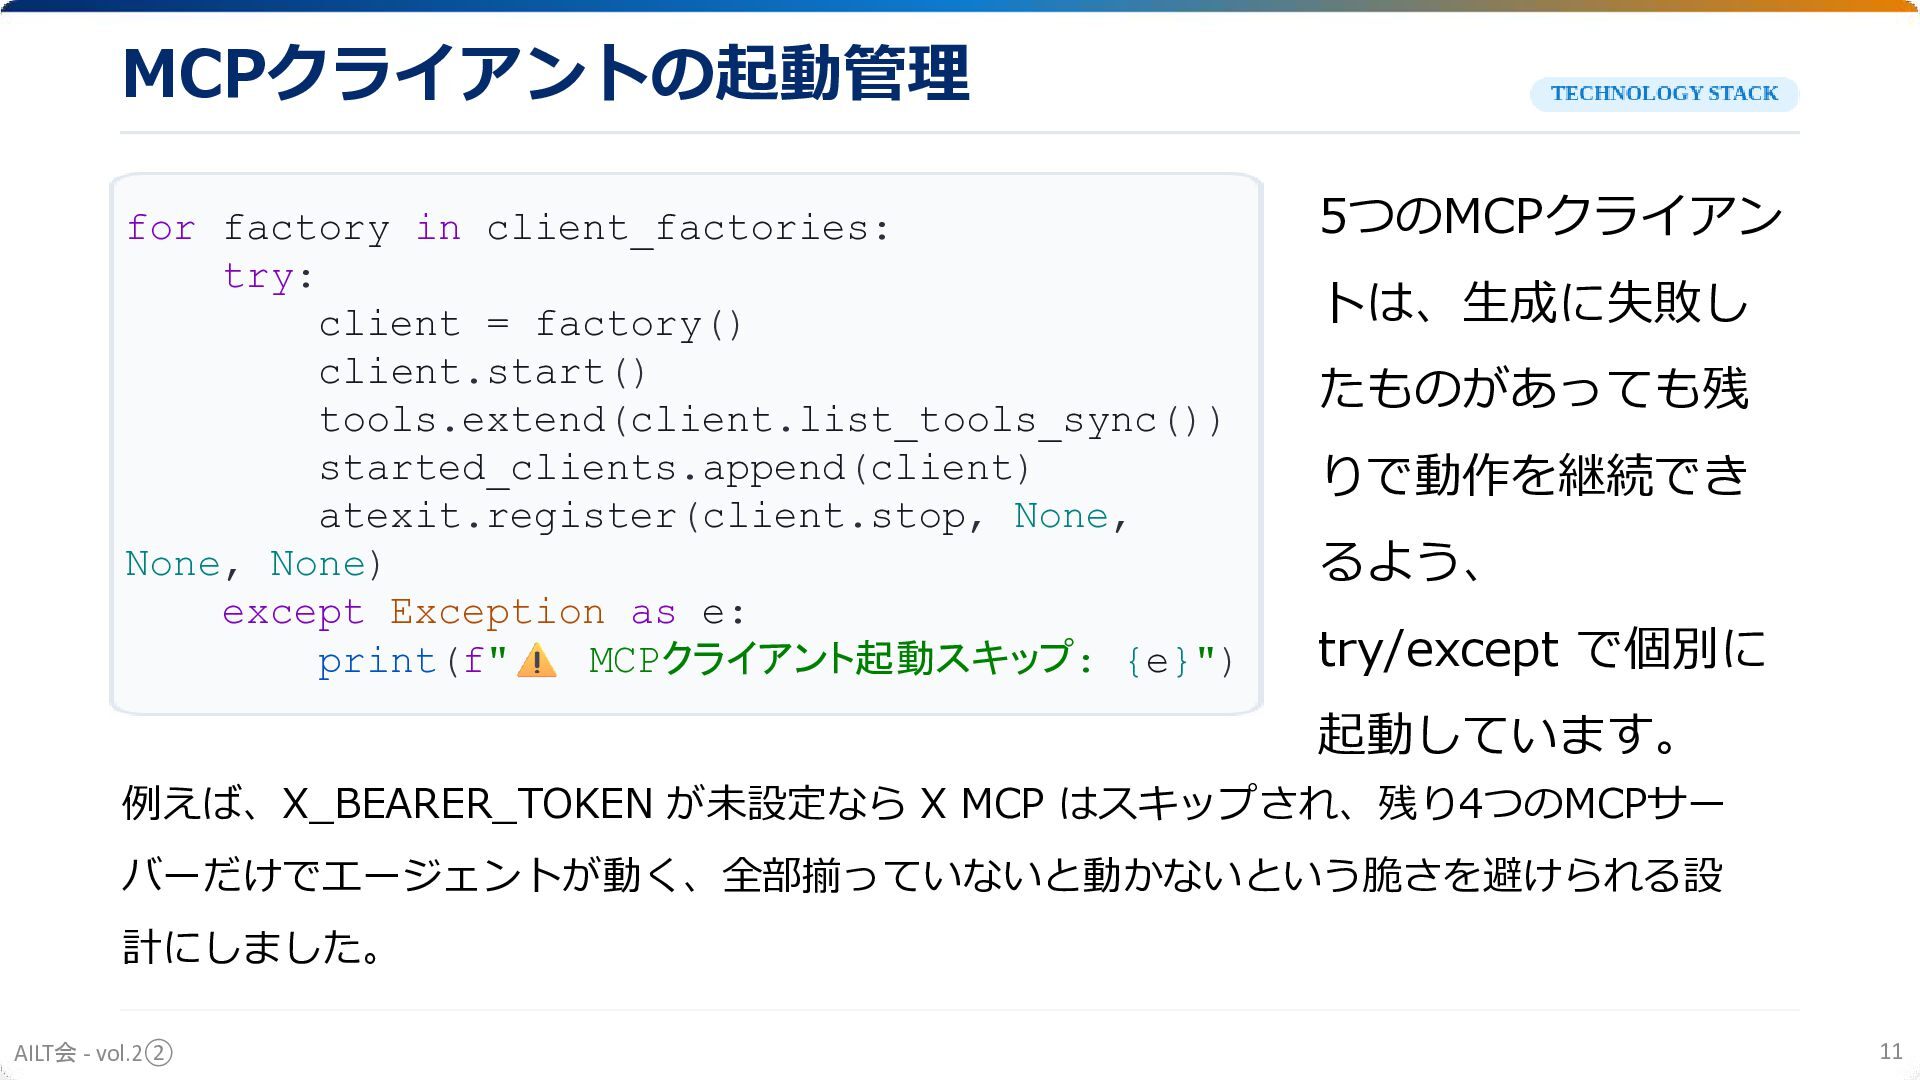
MCPクライアントの起動管理 for factory in client_factories: try: client = factory() client.start()
tools.extend(client.list_tools_sync()) started_clients.append(client) atexit.register(client.stop, None, None, None) except Exception as e: print(f" MCPクライアント起動スキップ: {e}") 5つのMCPクライアン トは、生成に失敗し たものがあっても残 りで動作を継続でき るよう、 try/except で個別に 起動しています。 例えば、X_BEARER_TOKEN が未設定なら X MCP はスキップされ、残り4つのMCPサー バーだけでエージェントが動く、全部揃っていないと動かないという脆さを避けられる設 計にしました。 AILT会 - vol.2② 11 -
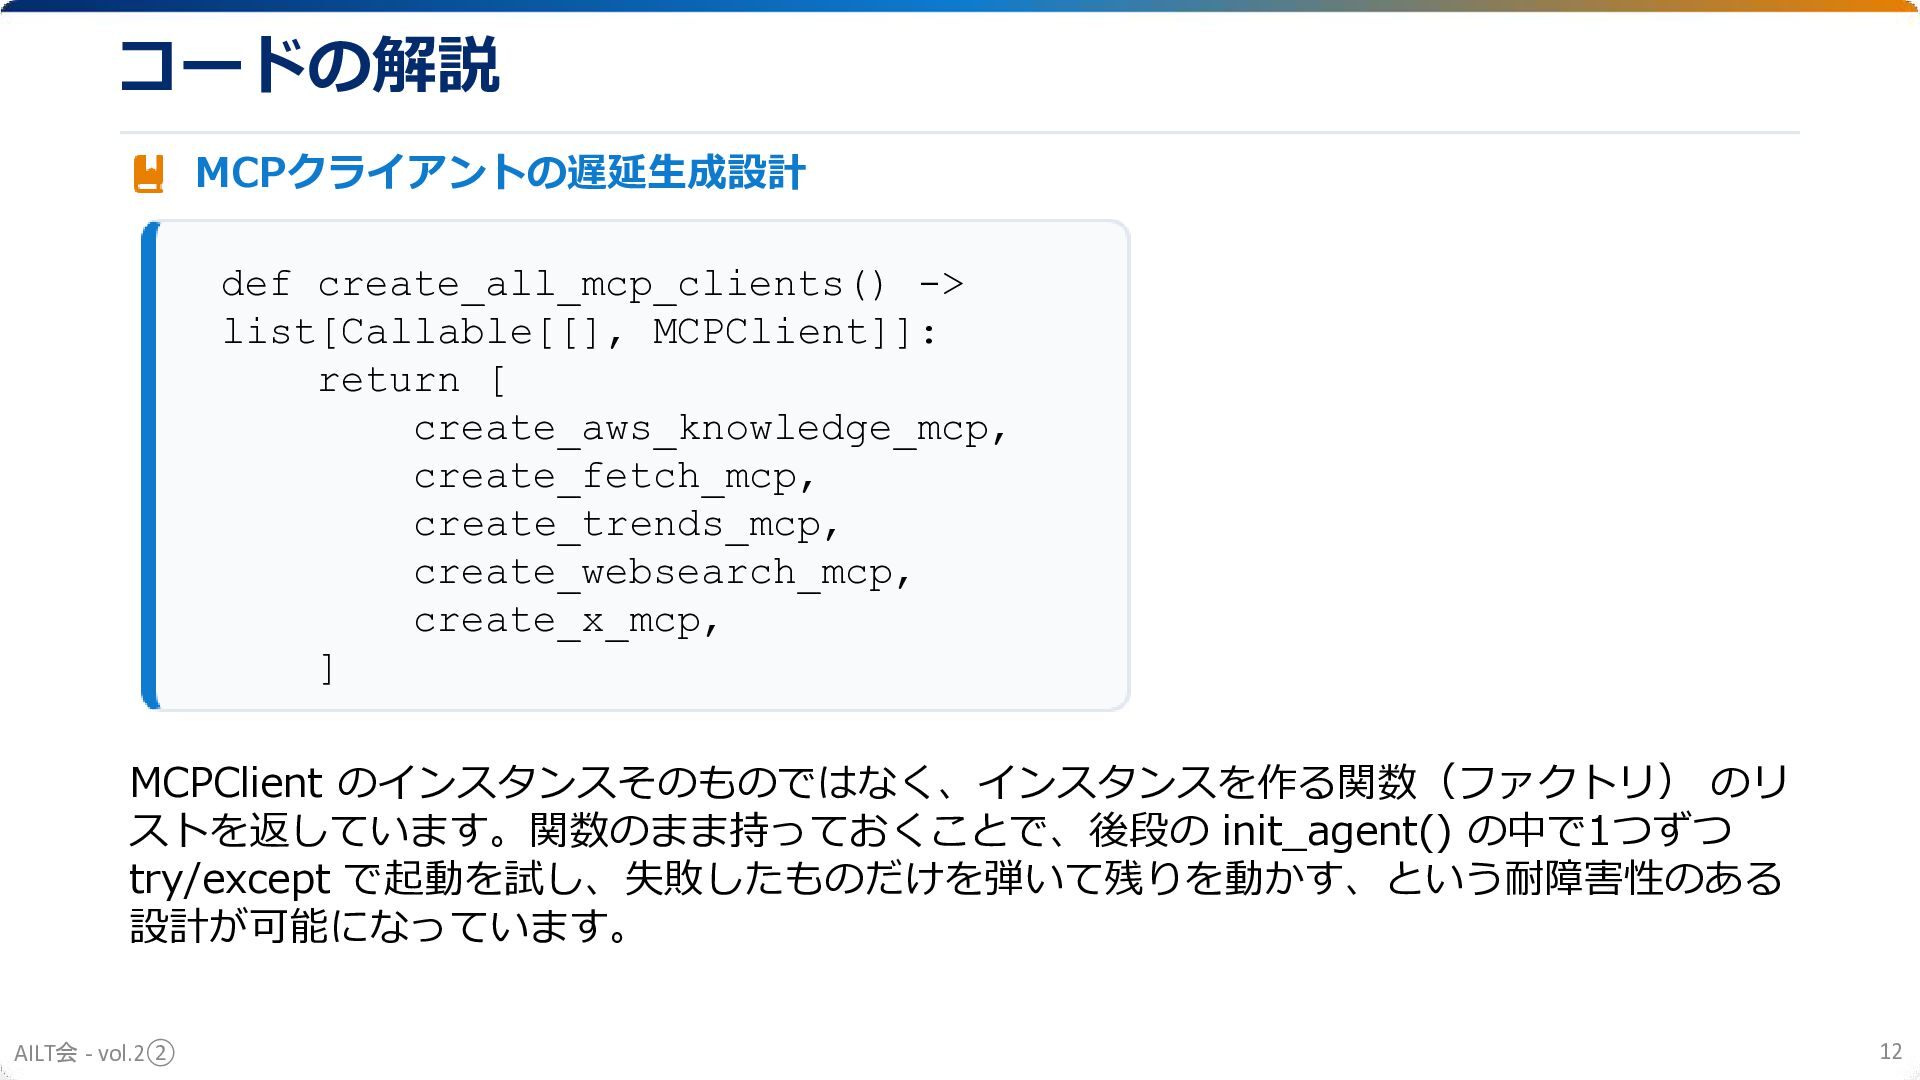
コードの解説 MCPクライアントの遅延生成設計 def create_all_mcp_clients() -> list[Callable[[], MCPClient]]: return [ create_aws_knowledge_mcp,
create_fetch_mcp, create_trends_mcp, create_websearch_mcp, create_x_mcp, ] MCPClient のインスタンスそのものではなく、インスタンスを作る関数(ファクトリ) のリ ストを返しています。関数のまま持っておくことで、後段の init_agent() の中で1つずつ try/except で起動を試し、失敗したものだけを弾いて残りを動かす、という耐障害性のある 設計が可能になっています。 AILT会 - vol.2② 12 -
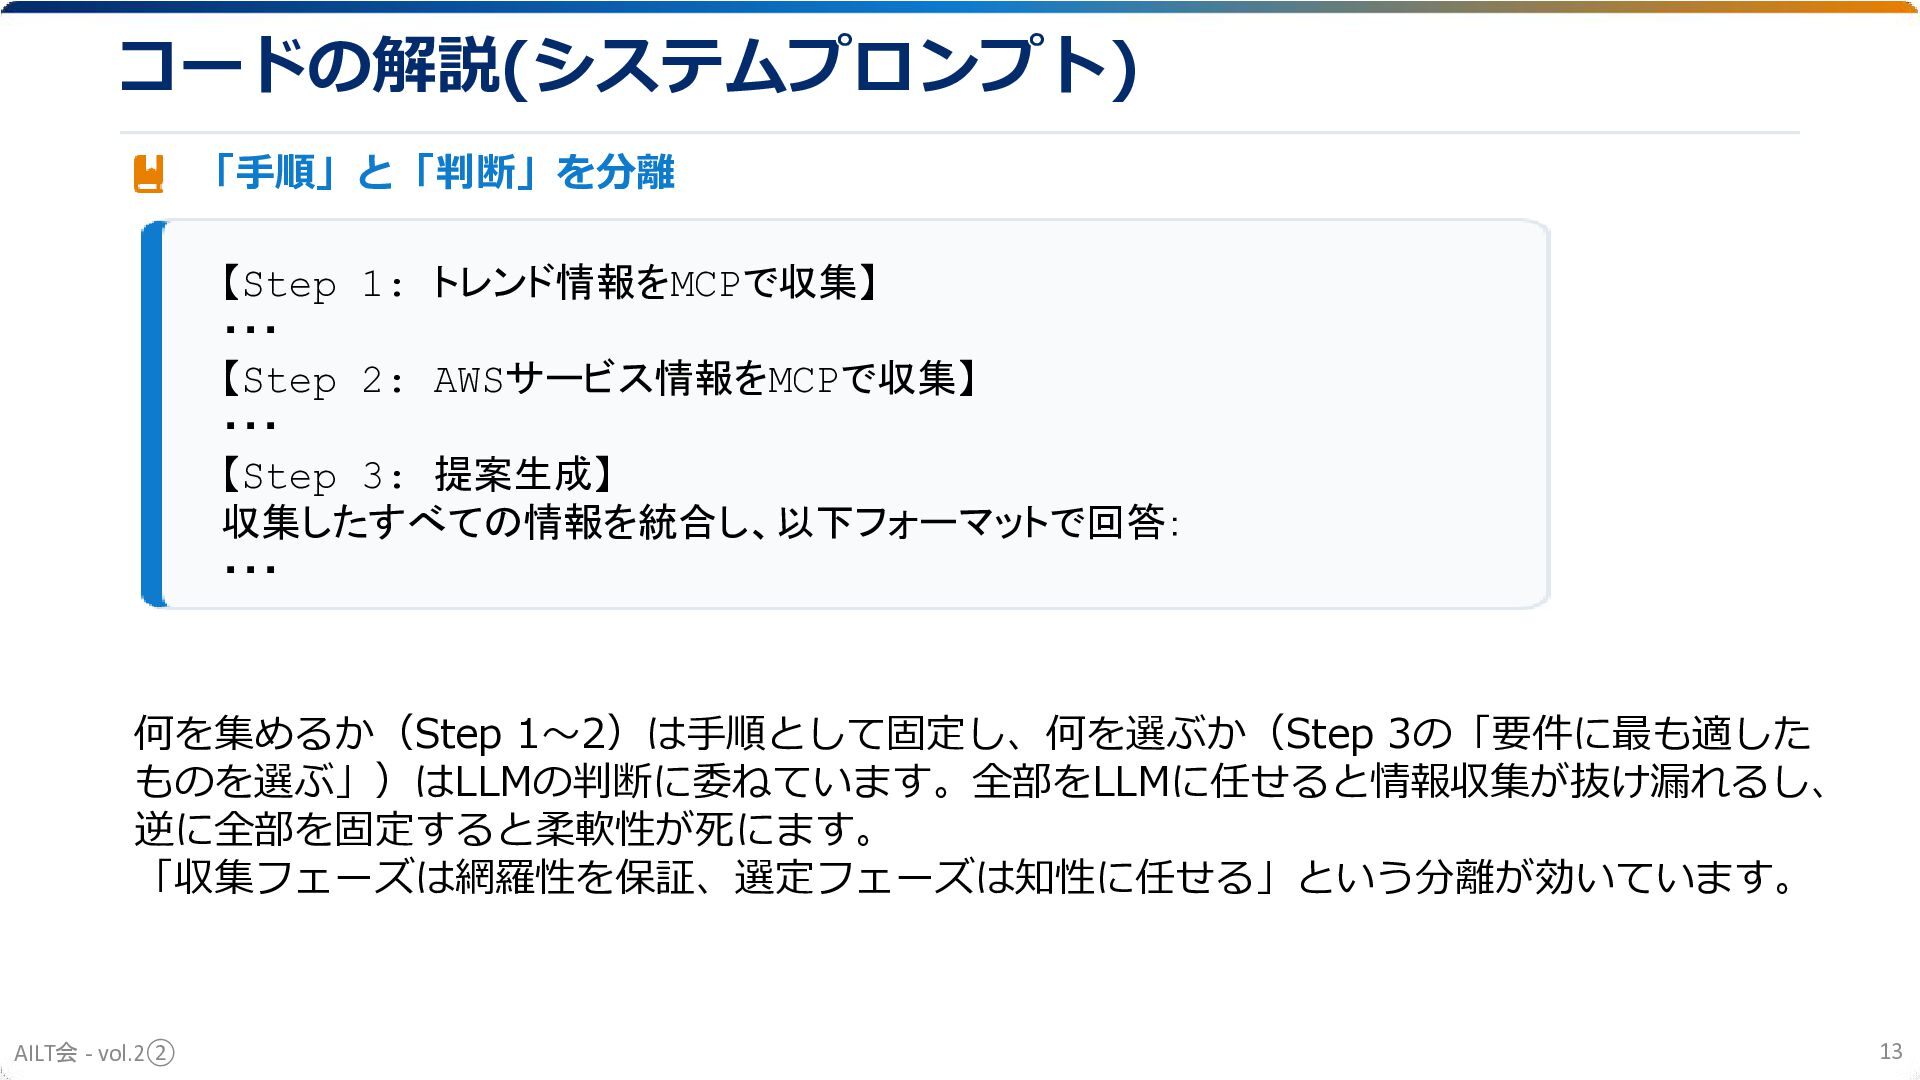
コードの解説(システムプロンプト) 「手順」と「判断」を分離 【Step 1: トレンド情報をMCPで収集】 ・・・ 【Step 2: AWSサービス情報をMCPで収集】 ・・・
【Step 3: 提案生成】 収集したすべての情報を統合し、以下フォーマットで回答: ・・・ 何を集めるか(Step 1〜2)は手順として固定し、何を選ぶか(Step 3の「要件に最も適した ものを選ぶ」)はLLMの判断に委ねています。全部をLLMに任せると情報収集が抜け漏れるし、 逆に全部を固定すると柔軟性が死にます。 「収集フェーズは網羅性を保証、選定フェーズは知性に任せる」という分離が効いています。 AILT会 - vol.2② 13 -
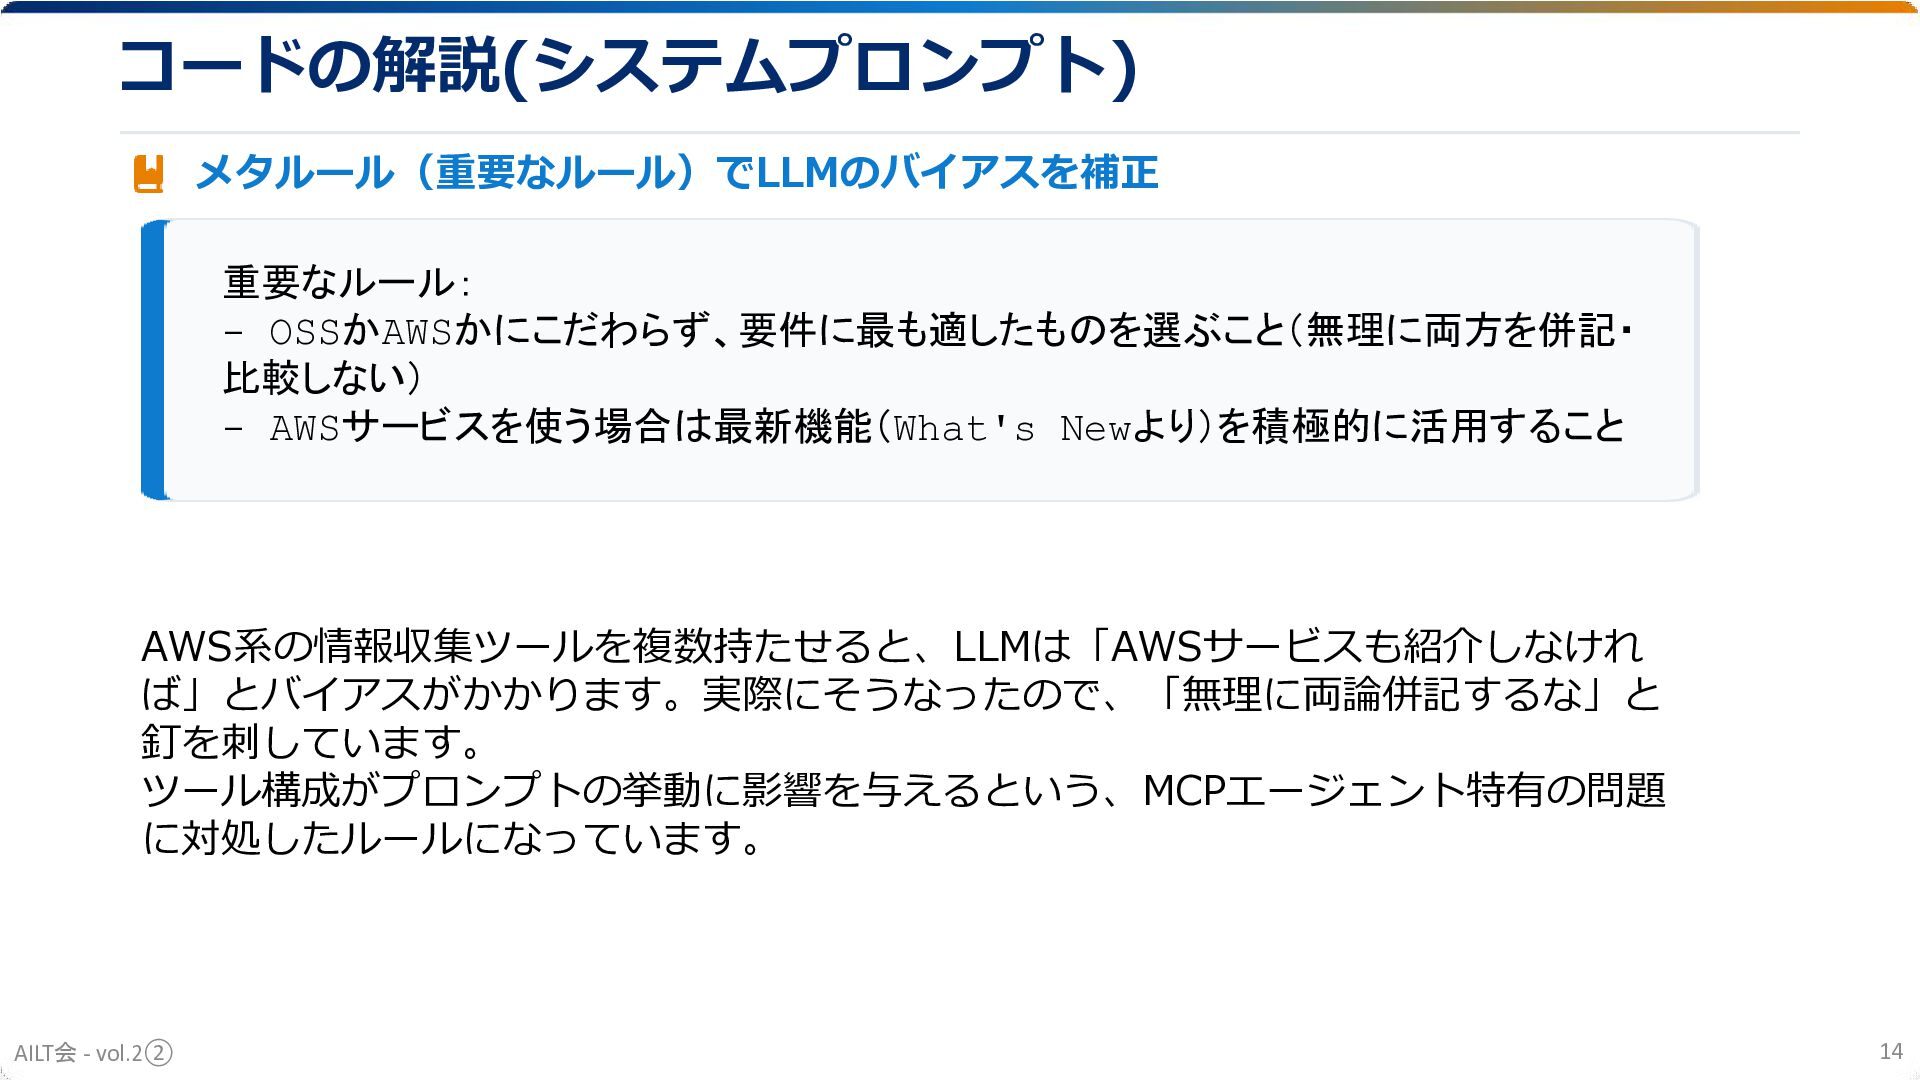
コードの解説(システムプロンプト) メタルール(重要なルール)でLLMのバイアスを補正 重要なルール: - OSSかAWSかにこだわらず、要件に最も適したものを選ぶこと(無理に両方を併記・ 比較しない) - AWSサービスを使う場合は最新機能(What's Newより)を積極的に活用すること AWS系の情報収集ツールを複数持たせると、LLMは「AWSサービスも紹介しなけれ
ば」とバイアスがかかります。実際にそうなったので、「無理に両論併記するな」と 釘を刺しています。 ツール構成がプロンプトの挙動に影響を与えるという、MCPエージェント特有の問題 に対処したルールになっています。 AILT会 - vol.2② 14 -
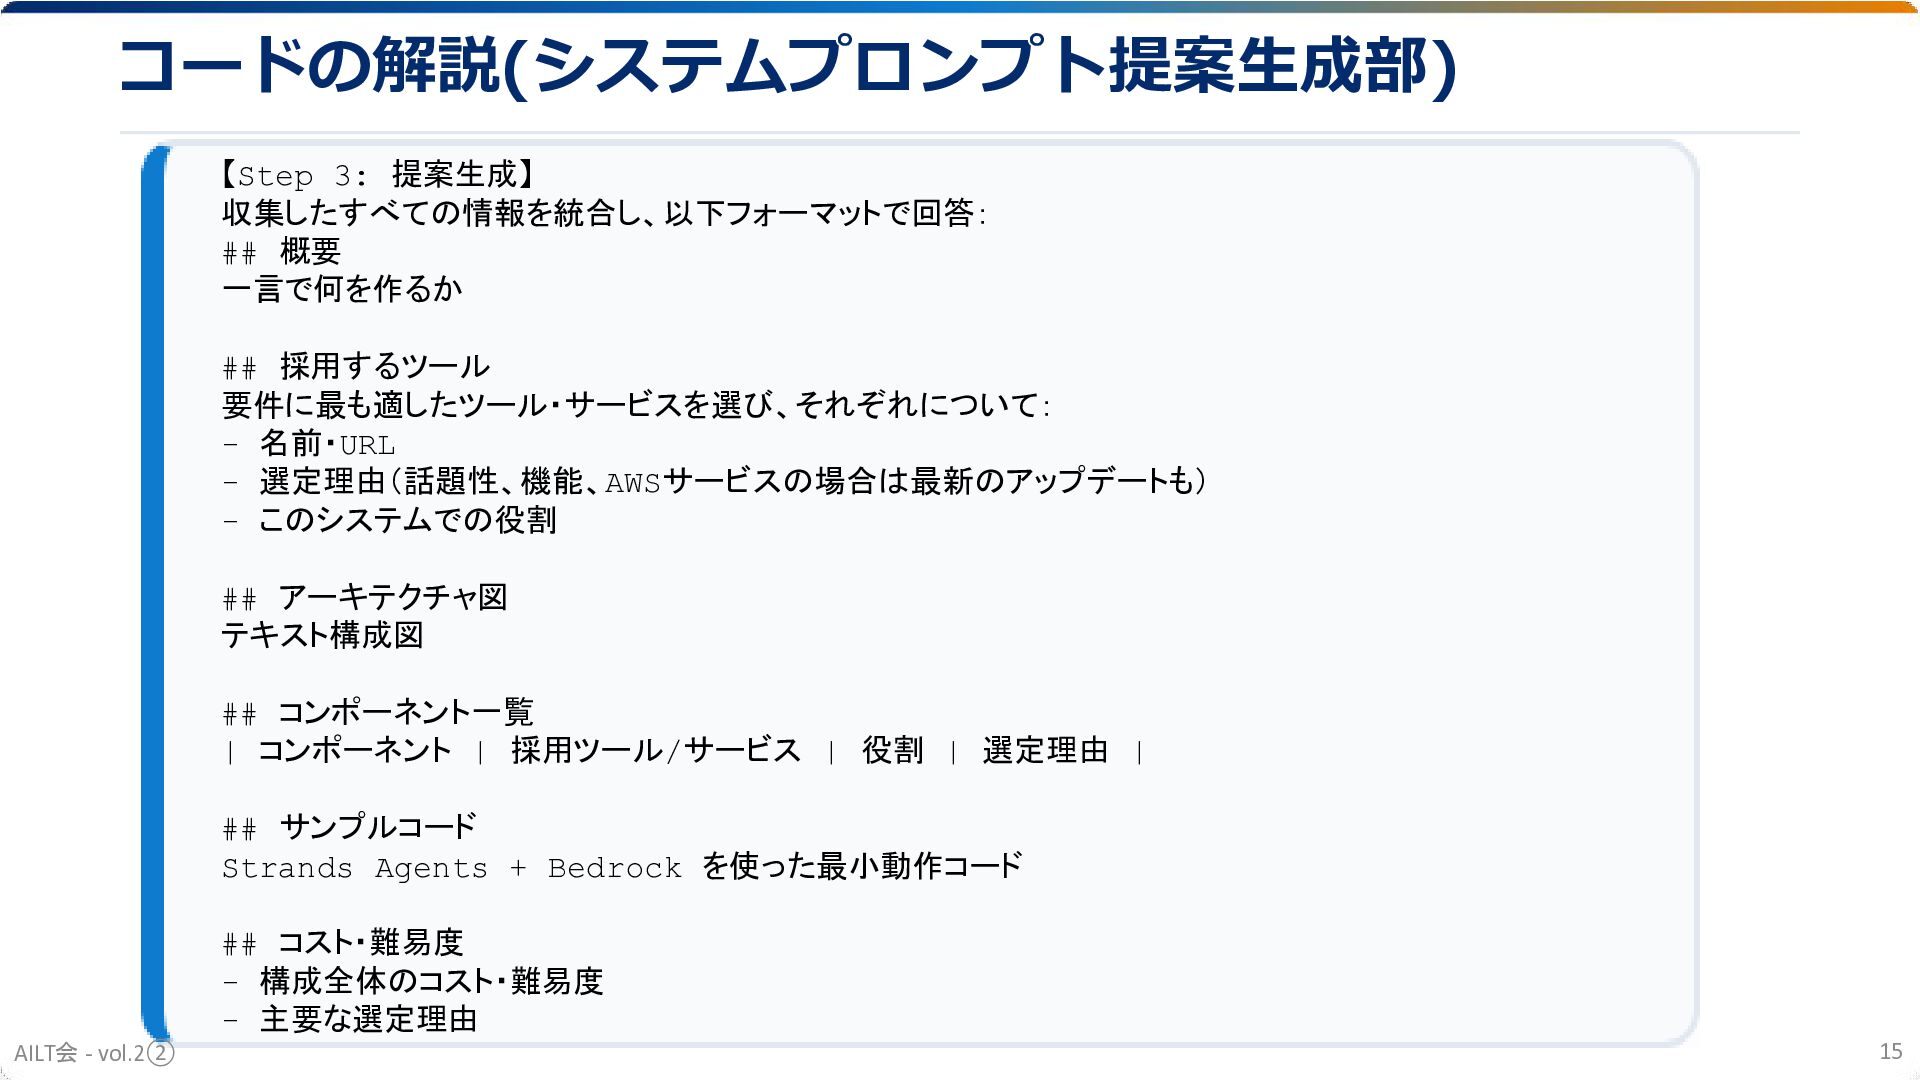
コードの解説(システムプロンプト提案生成部) 【Step 3: 提案生成】 収集したすべての情報を統合し、以下フォーマットで回答: ## 概要 一言で何を作るか ## 採用するツール
要件に最も適したツール・サービスを選び、それぞれについて: - 名前・URL - 選定理由(話題性、機能、AWSサービスの場合は最新のアップデートも) - このシステムでの役割 ## アーキテクチャ図 テキスト構成図 ## コンポーネント一覧 | コンポーネント | 採用ツール/サービス | 役割 | 選定理由 | ## サンプルコード Strands Agents + Bedrock を使った最小動作コード ## コスト・難易度 - 構成全体のコスト・難易度 - 主要な選定理由 AILT会 - vol.2② 15 -
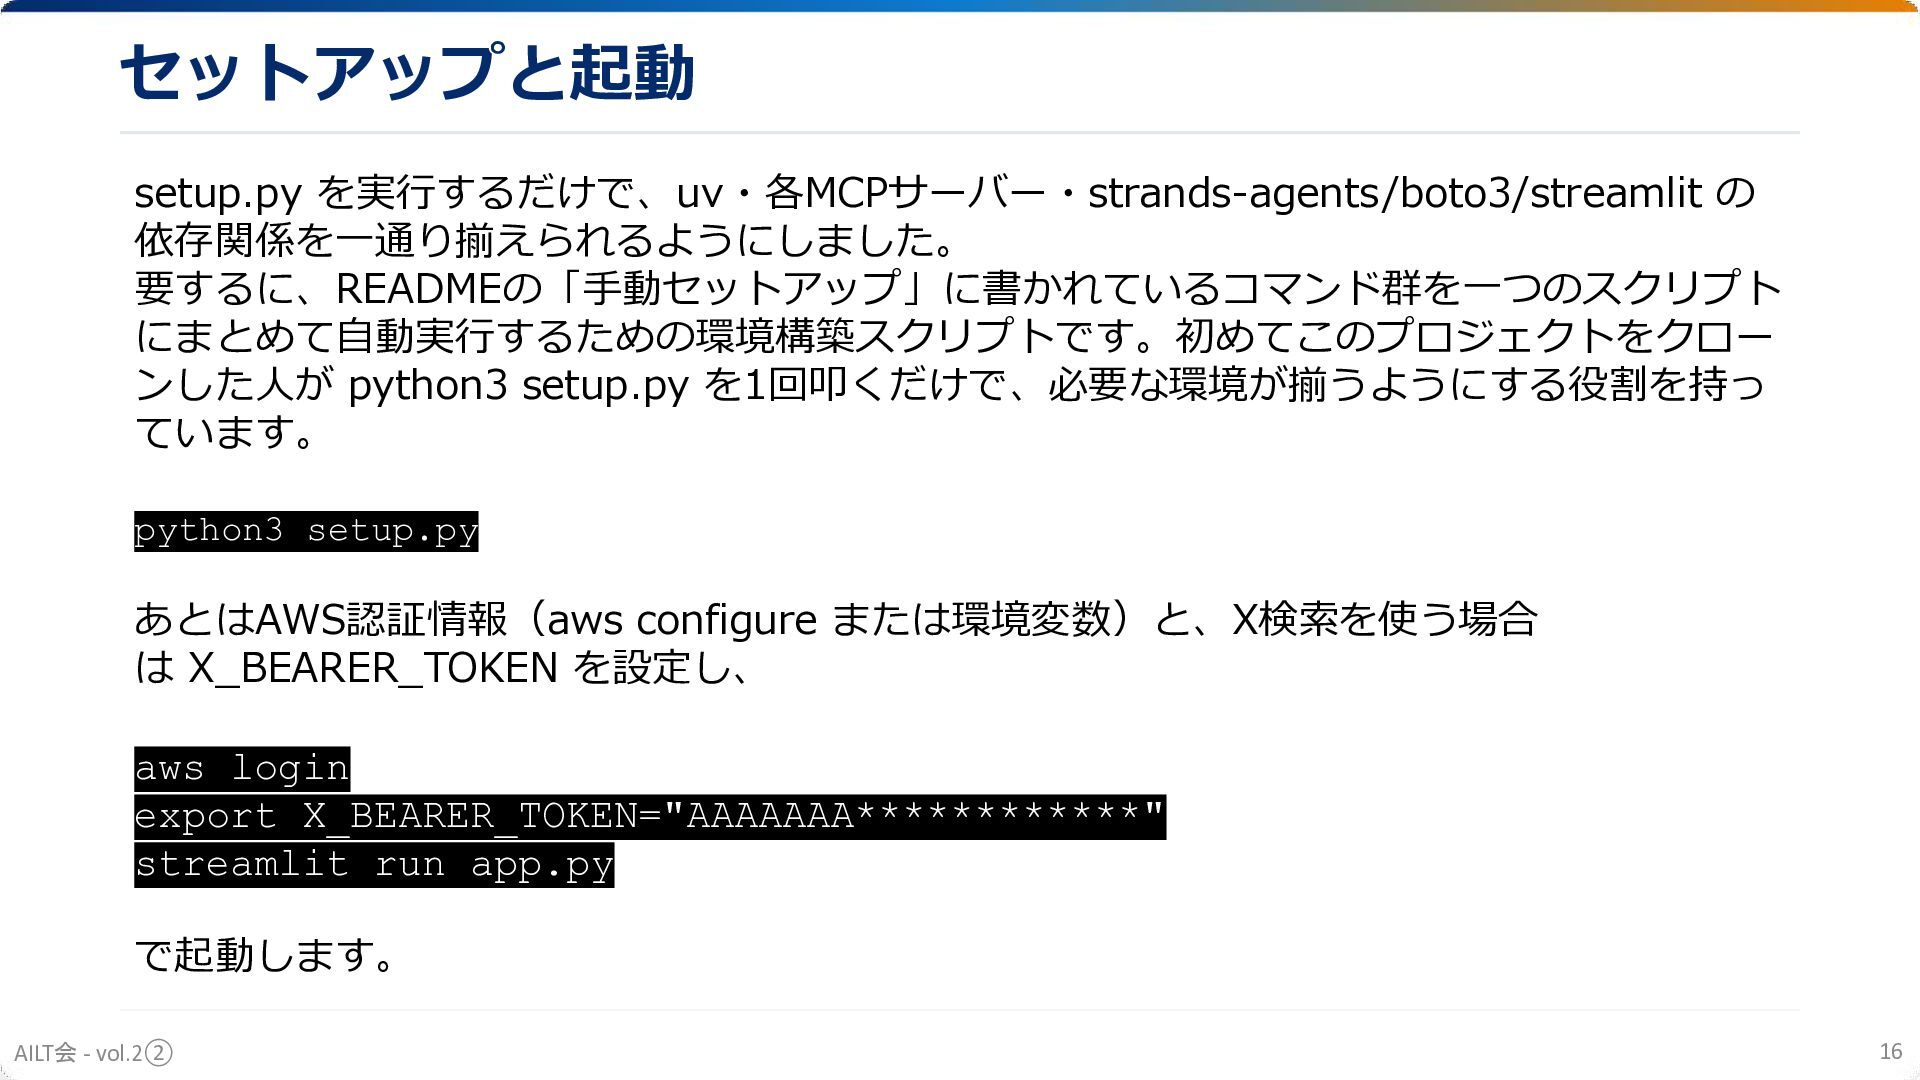
セットアップと起動 setup.py を実行するだけで、uv・各MCPサーバー・strands-agents/boto3/streamlit の 依存関係を一通り揃えられるようにしました。 要するに、READMEの「手動セットアップ」に書かれているコマンド群を一つのスクリプト にまとめて自動実行するための環境構築スクリプトです。初めてこのプロジェクトをクロー ンした人が python3 setup.py
を1回叩くだけで、必要な環境が揃うようにする役割を持っ ています。 python3 setup.py あとはAWS認証情報(aws configure または環境変数)と、X検索を使う場合 は X_BEARER_TOKEN を設定し、 aws login export X_BEARER_TOKEN="AAAAAAA************" streamlit run app.py で起動します。 AILT会 - vol.2② 16 -
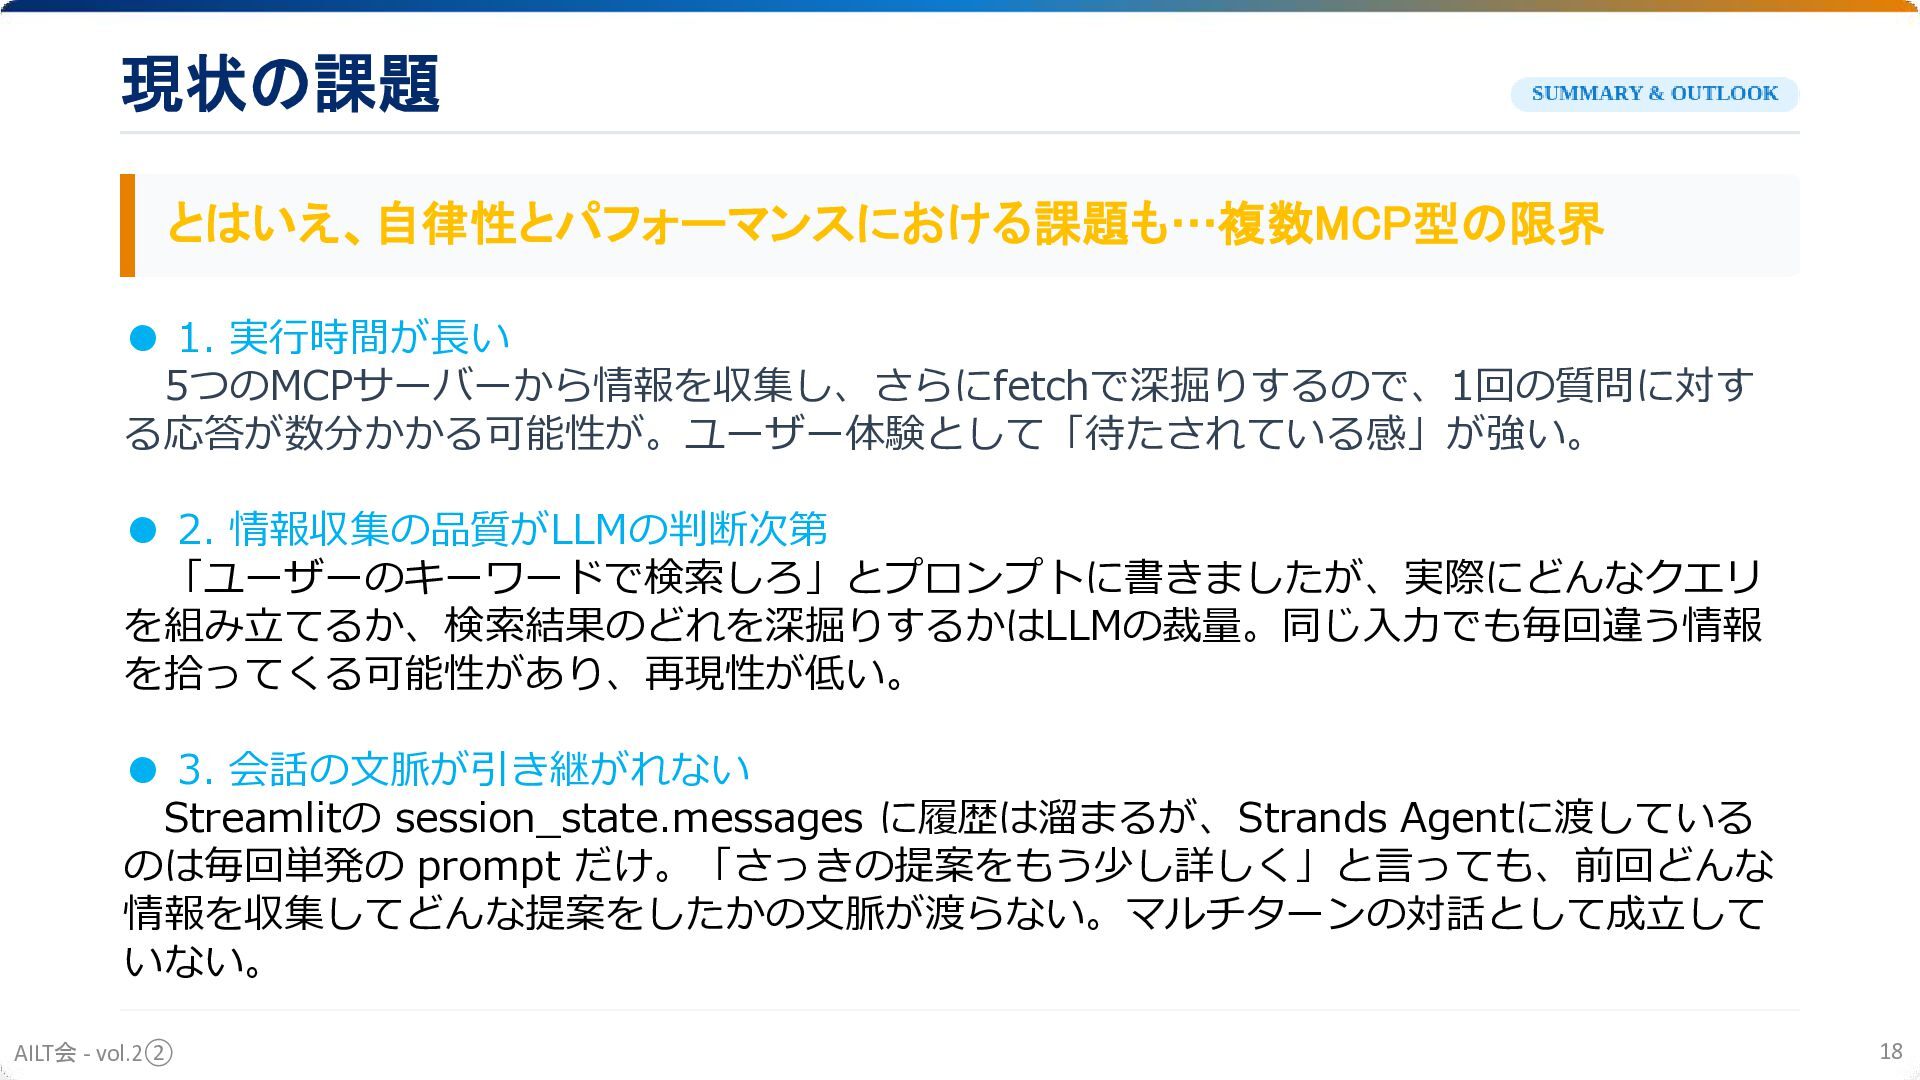
現状の課題 とはいえ、自律性とパフォーマンスにおける課題も…複数MCP型の限界 • 1. 実行時間が長い 5つのMCPサーバーから情報を収集し、さらにfetchで深掘りするので、1回の質問に対す る応答が数分かかる可能性が。ユーザー体験として「待たされている感」が強い。 • 2. 情報収集の品質がLLMの判断次第
「ユーザーのキーワードで検索しろ」とプロンプトに書きましたが、実際にどんなクエリ を組み立てるか、検索結果のどれを深掘りするかはLLMの裁量。同じ入力でも毎回違う情報 を拾ってくる可能性があり、再現性が低い。 • 3. 会話の文脈が引き継がれない Streamlitの session_state.messages に履歴は溜まるが、Strands Agentに渡している のは毎回単発の prompt だけ。「さっきの提案をもう少し詳しく」と言っても、前回どんな 情報を収集してどんな提案をしたかの文脈が渡らない。マルチターンの対話として成立して いない。 AILT会 - vol.2② 18 -
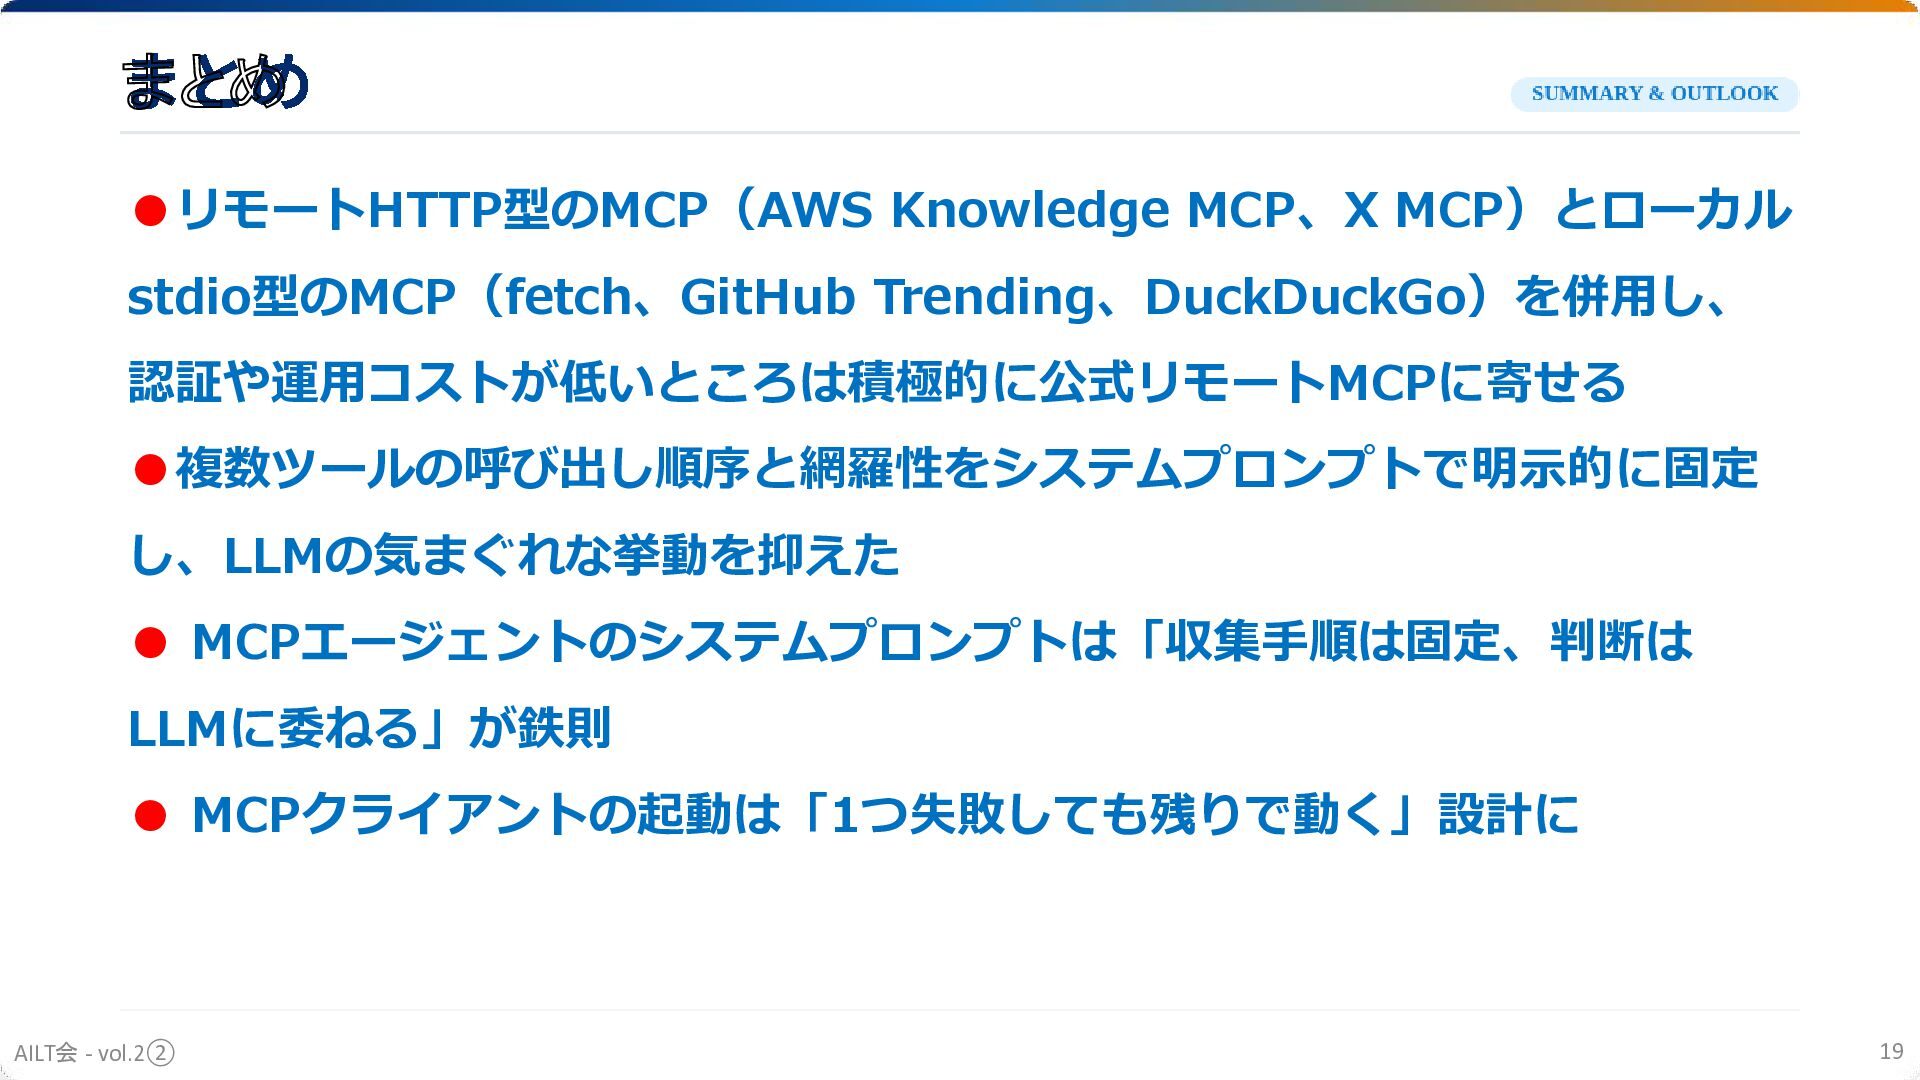
まとめ •リモートHTTP型のMCP(AWS Knowledge MCP、X MCP)とローカル stdio型のMCP(fetch、GitHub Trending、DuckDuckGo)を併用し、 認証や運用コストが低いところは積極的に公式リモートMCPに寄せる •複数ツールの呼び出し順序と網羅性をシステムプロンプトで明示的に固定 し、LLMの気まぐれな挙動を抑えた
• MCPエージェントのシステムプロンプトは「収集手順は固定、判断は LLMに委ねる」が鉄則 • MCPクライアントの起動は「1つ失敗しても残りで動く」設計に AILT会 - vol.2② 19 -
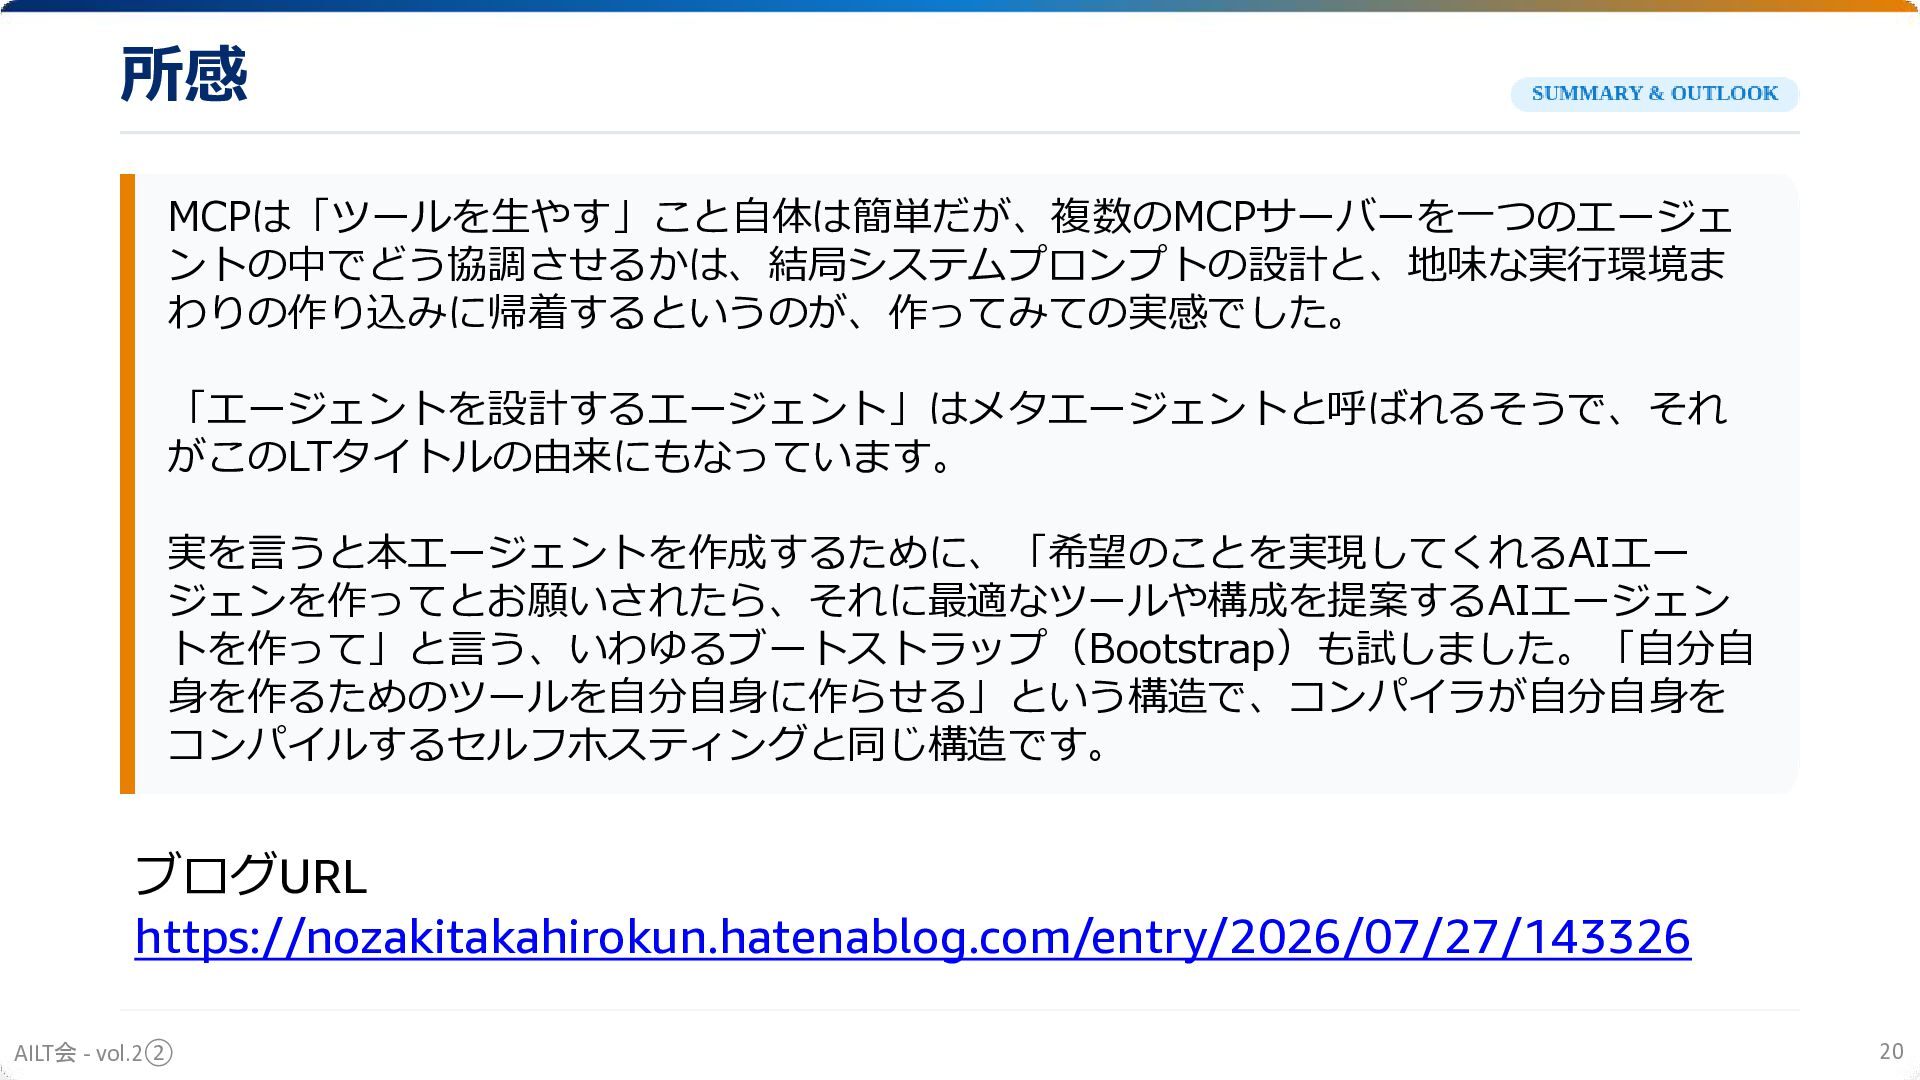
所感 MCPは「ツールを生やす」こと自体は簡単だが、複数のMCPサーバーを一つのエージェ ントの中でどう協調させるかは、結局システムプロンプトの設計と、地味な実行環境ま わりの作り込みに帰着するというのが、作ってみての実感でした。 「エージェントを設計するエージェント」はメタエージェントと呼ばれるそうで、それ がこのLTタイトルの由来にもなっています。 実を言うと本エージェントを作成するために、「希望のことを実現してくれるAIエー ジェンを作ってとお願いされたら、それに最適なツールや構成を提案するAIエージェン トを作って」と言う、いわゆるブートストラップ(Bootstrap)も試しました。「自分自 身を作るためのツールを自分自身に作らせる」という構造で、コンパイラが自分自身を
コンパイルするセルフホスティングと同じ構造です。 ブログURL https://nozakitakahirokun.hatenablog.com/entry/2026/07/27/143326 AILT会 - vol.2② 20 -
ご清聴ありがとうございました ★ご 質問・ 感想などございましたらお 気軽にお 寄せください !★ AI LT会 –
vol. 2 AILT会 - vol.2② 21