Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[Spatial AI 勉強会] Cov2Pose: Leveraging Spatial C...
Search
o.token
July 19, 2026
Technology
0
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[Spatial AI 勉強会] Cov2Pose: Leveraging Spatial Covariance for Direct Manifold-aware 6-DoF Object Pose Estimation
o.token
July 19, 2026
Other Decks in Technology
See All in Technology
Gemini Intelligence 入門 ― AppFunctions と Gemini Nano
takuroabe
0
290
しろおびから始める!ログ活用の第一歩
shumei_ito
0
950
Optunaの最新リリースv5.0について
pfn
PRO
0
120
TinyGoでオブザーバビリティ?OpenTelemetryはTinyGoで使えるのか / Is OpenTelemetry available in TinyGo environment?
ymotongpoo
2
140
実践! SRE × AI - ABEMA における AIOps -
tetsuya28
8
3.1k
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
180
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
140
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
1.7k
React改造してみた
tsukina_7mochi
0
110
エンタメ企業のM&Aを支えるデータ基盤 ― 統合から店舗のリアルタイム分析まで / Data Engineering Summit 2026
genda
0
190
コンテナ運用におけるネットワーク・コンテナコストの削減方法/How to Reduce Network and Container Costs in Container Operations
masakiokuda
1
280
V8のArray.prototype.flatを最大約20倍速くするまでと、巨大OSSへの大規模コミットの道のり
riyaamemiya
0
300
Featured
See All Featured
Visual Storytelling: How to be a Superhuman Communicator
reverentgeek
2
710
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
The untapped power of vector embeddings
frankvandijk
2
1.9k
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.8k
Navigating Team Friction
lara
192
16k
Evolving SEO for Evolving Search Engines
ryanjones
0
330
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.6k
Practical Orchestrator
shlominoach
192
12k
A designer walks into a library…
pauljervisheath
211
25k
Claude Code のすすめ
schroneko
67
230k
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
600
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
Transcript
Cov2Pose Leveraging Spatial Covariance for Direct Manifold-aware 6-DoF Object Pose
Estimation Nassim Ali Ousalah, Peyman Rostami, Vincent Gaudillière, Emmanuel Koumandakis, Anis Kacem, Enjie Ghorbel, Djamila Aouada arXiv:2603.19961v2, 26 March 2026
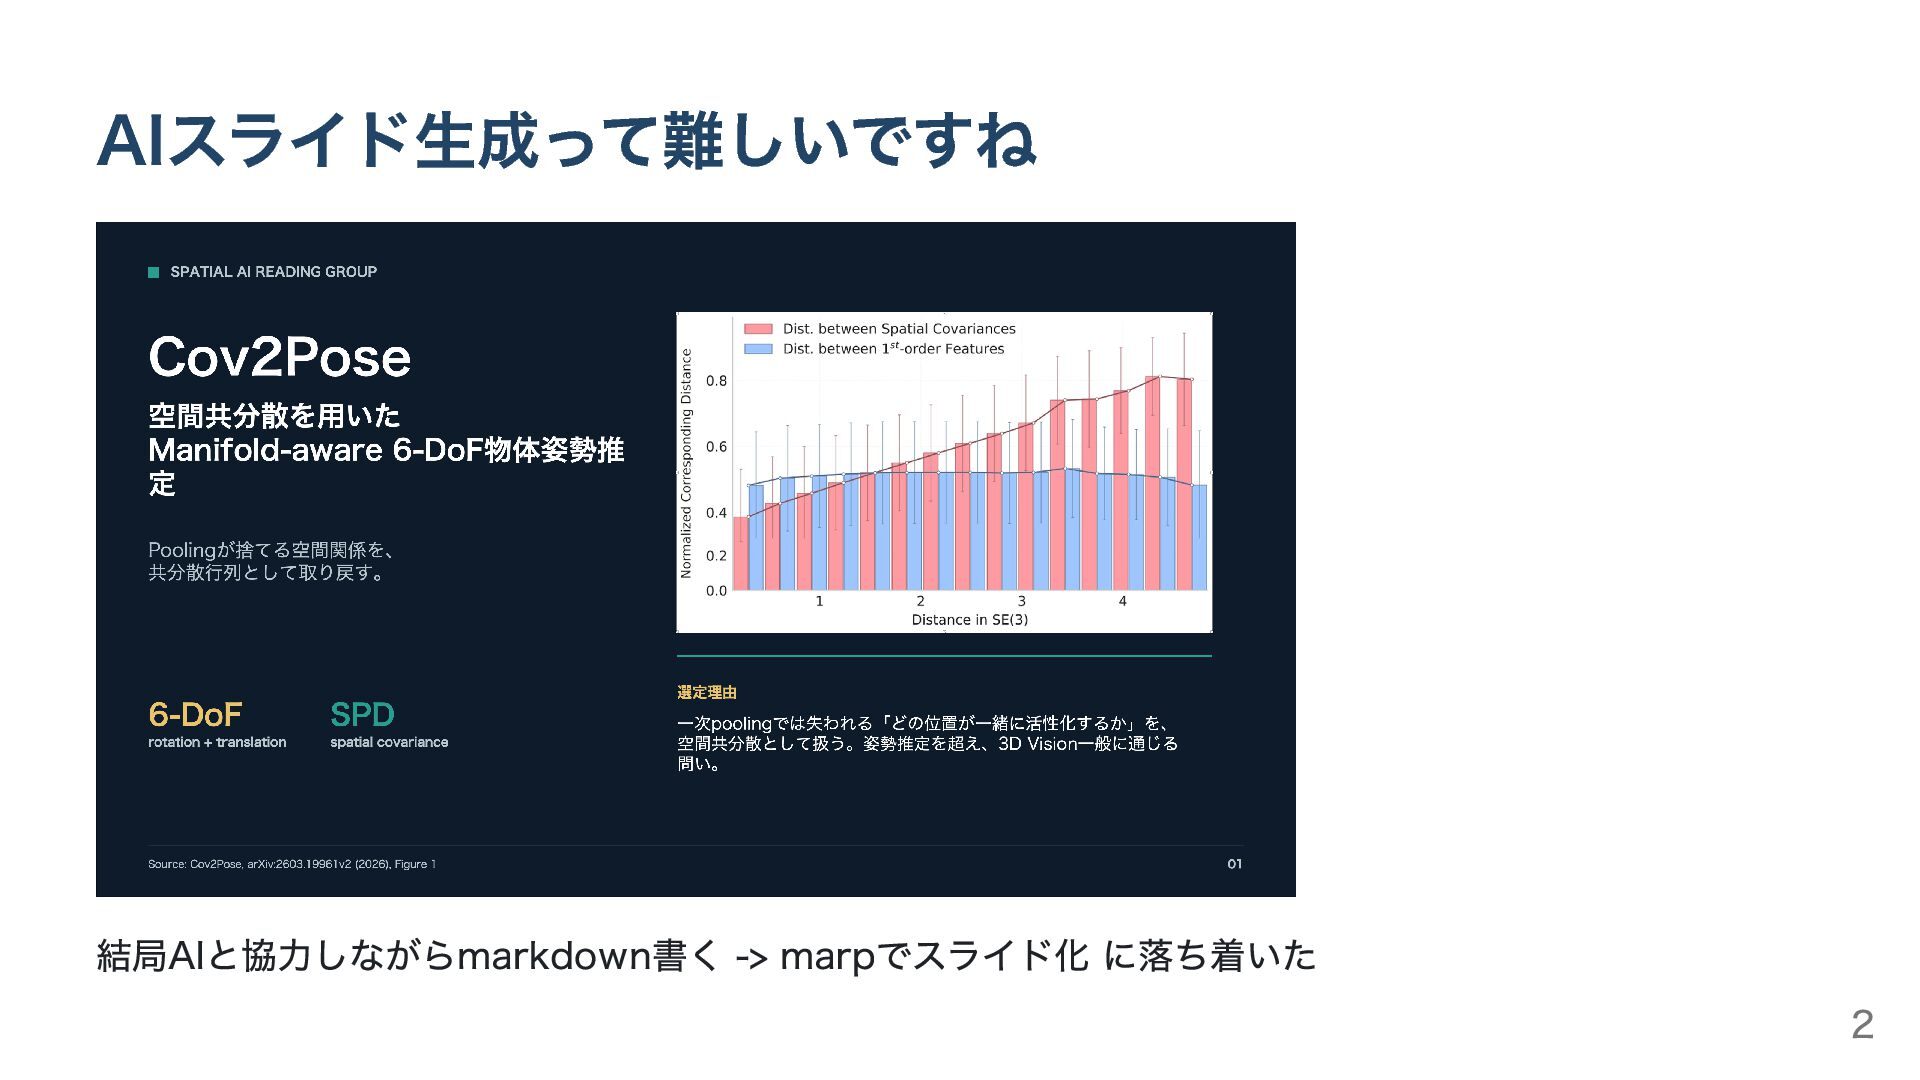
AIスライド生成って難しいですね 結局AIと協力しながらmarkdown書く -> marpでスライド化 に落ち着いた 2
Table of Content 1. 背景 2. 問題設定と仮説 3. 提案手法 4.
実験と結果 5. アブレーション、限界、まとめ 3
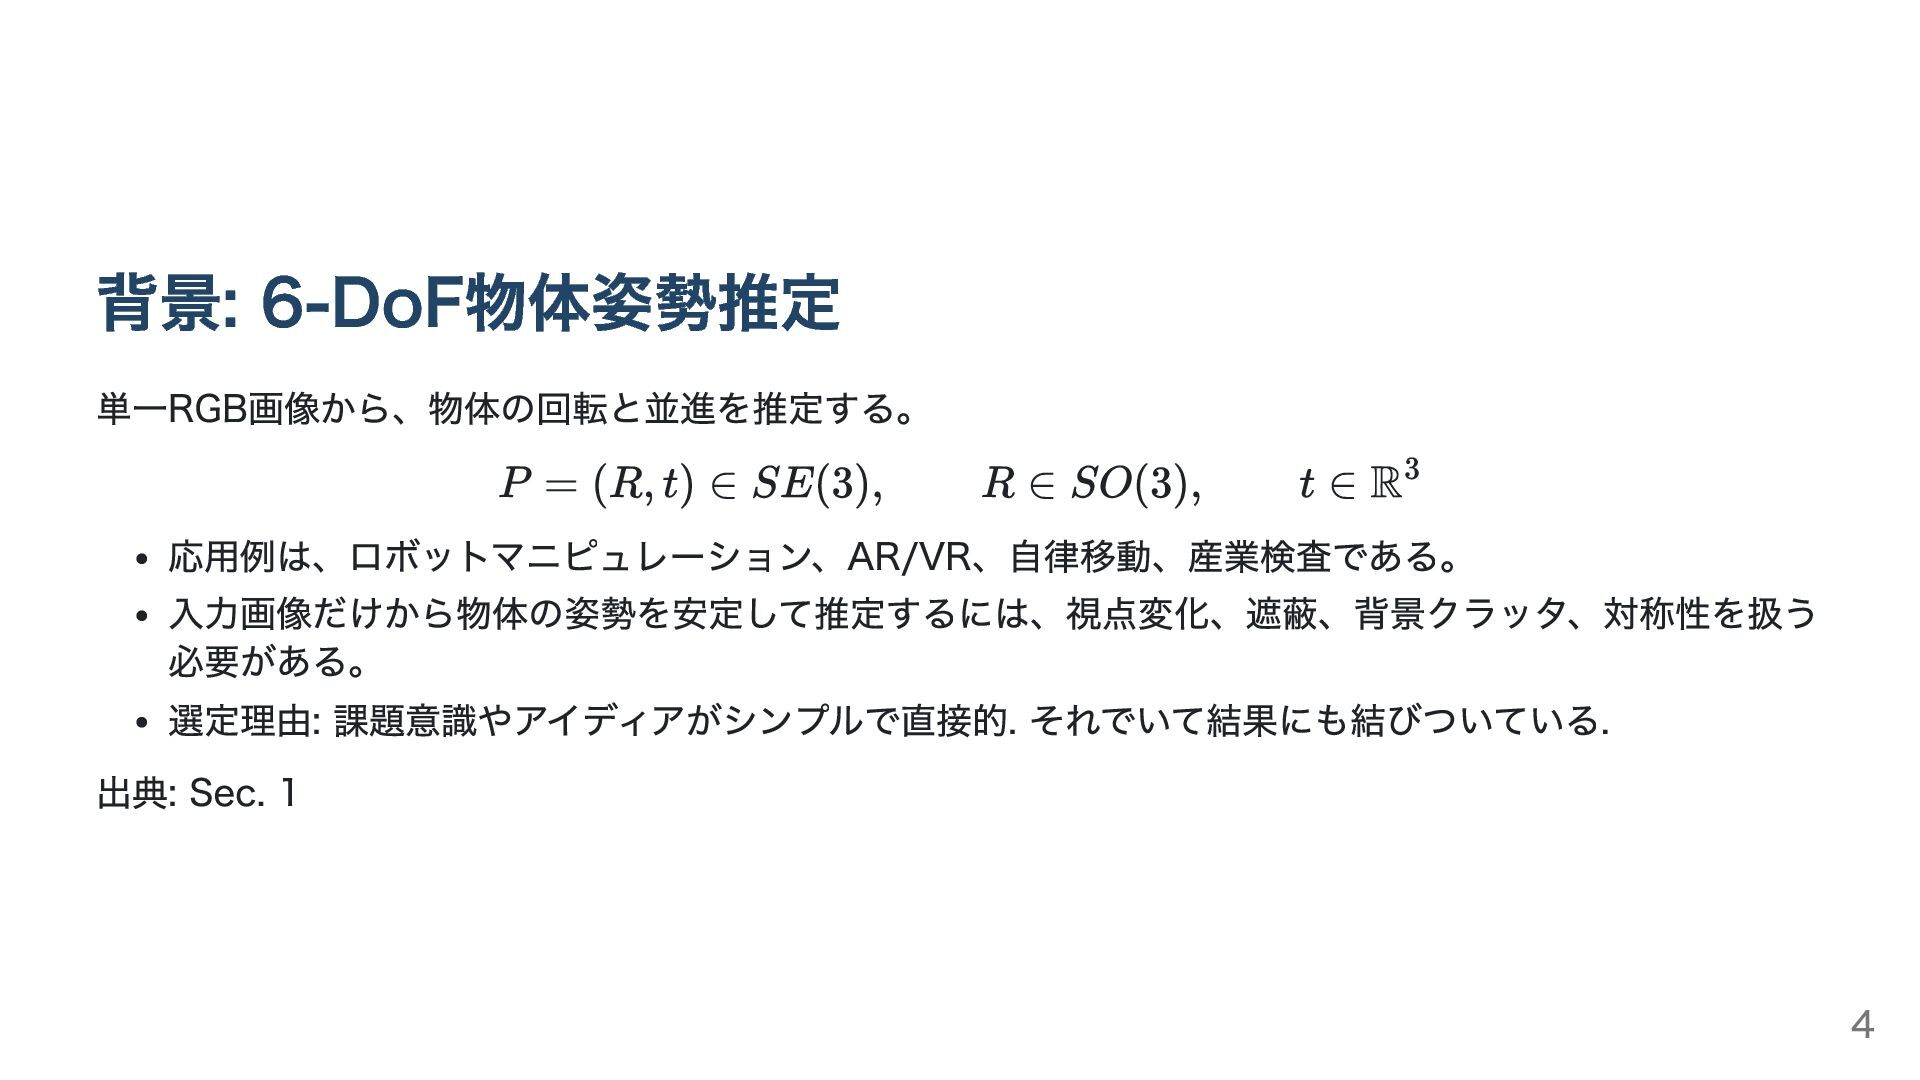
背景: 6-DoF物体姿勢推定 単一RGB画像から、物体の回転と並進を推定する。 応用例は、ロボットマニピュレーション、AR/VR、自律移動、産業検査である。 入力画像だけから物体の姿勢を安定して推定するには、視点変化、遮蔽、背景クラッタ、対称性を扱う 必要がある。 選定理由: 課題意識やアイディアがシンプルで直接的. それでいて結果にも結びついている. 出典:
Sec. 1 4
背景: 既存手法と本論文の位置づけ RGBベースの6-DoF姿勢推定は、主に次の3系統に整理できる。 PnP / 対応点ベース: 2D–3D対応点や物体座標を推定してPnPを解く。精度は高いが、対応推定と幾 何ソルバを必要とする。 Render-and-compare: 仮説姿勢で物体をレンダリングし、入力との整合を反復的に最適化する。
3Dモデルと反復処理を要する。 直接回帰: RGB画像から姿勢を単一forward passで回帰する。高速だが、一般に精度で不利である。 直接回帰は計算負荷で他に優る一方、精度で劣る Cov2Poseは直接回帰に属する。CADモデル・PnP・反復レンダリングを使わず、空間共分散とSPD多様 体上の処理で直接回帰を強化する。 出典: Sec. 1, 2 5
課題意識 本論文が直接回帰に対して指摘する課題は2つである。 1. 特徴表現 AverageやMax poolingは、特徴マップの空間的な二次統計を捨てる。 空間位置どうしの共変動は、視点変化と姿勢に関連する可能性がある。 2. 姿勢表現 Euler角や四元数には、回転空間上で不連続な表現が含まれる。
直接回帰では、連続な回転表現とそれに整合した学習が望ましい。 出典: Sec. 1, 3 6
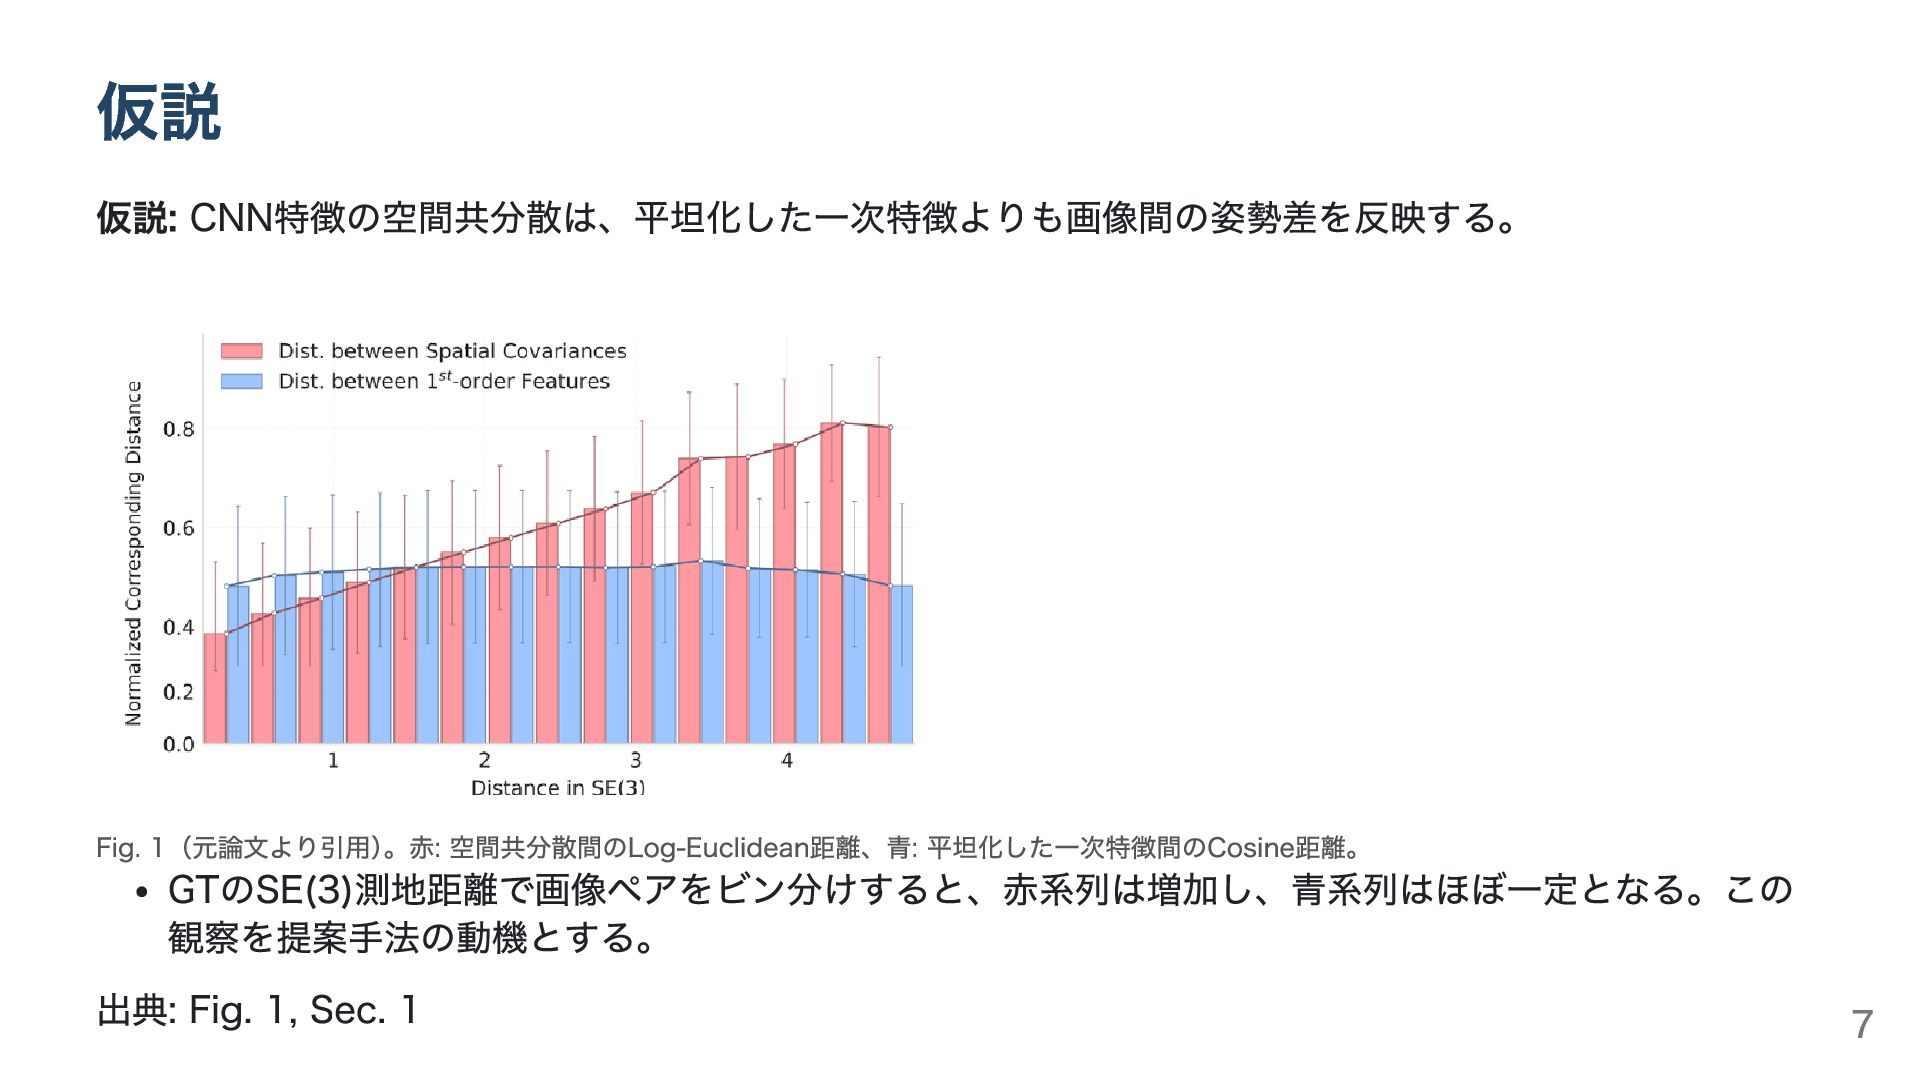
仮説 仮説: CNN特徴の空間共分散は、平坦化した一次特徴よりも画像間の姿勢差を反映する。 Fig. 1(元論文より引用) 。赤: 空間共分散間のLog-Euclidean距離、青: 平坦化した一次特徴間のCosine距離。 GTのSE(3)測地距離で画像ペアをビン分けすると、赤系列は増加し、青系列はほぼ一定となる。この 観察を提案手法の動機とする。
出典: Fig. 1, Sec. 1 7
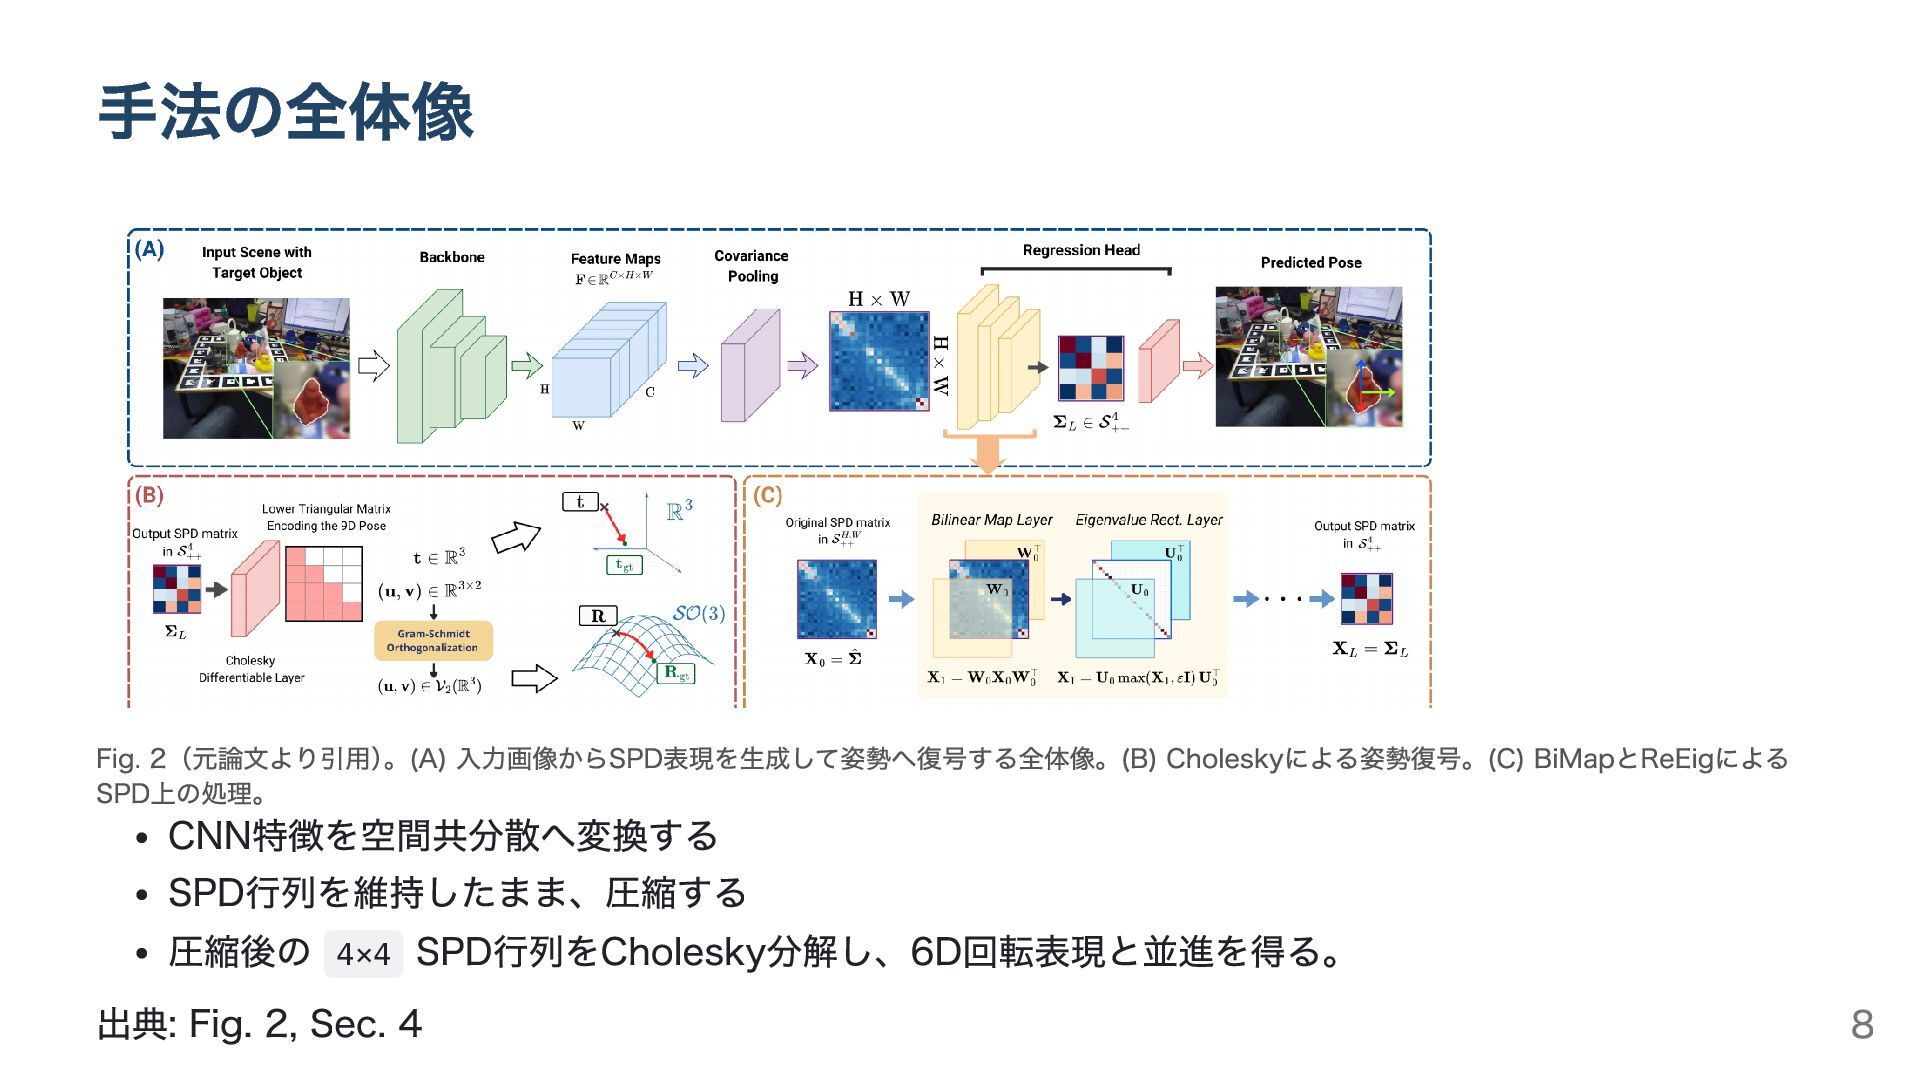
手法の全体像 Fig. 2(元論文より引用) 。(A) 入力画像からSPD表現を生成して姿勢へ復号する全体像。(B) Choleskyによる姿勢復号。(C) BiMapとReEigによる SPD上の処理。 CNN特徴を空間共分散へ変換する SPD行列を維持したまま、圧縮する
圧縮後の 4×4 SPD行列をCholesky分解し、6D回転表現と並進を得る。 出典: Fig. 2, Sec. 4 8
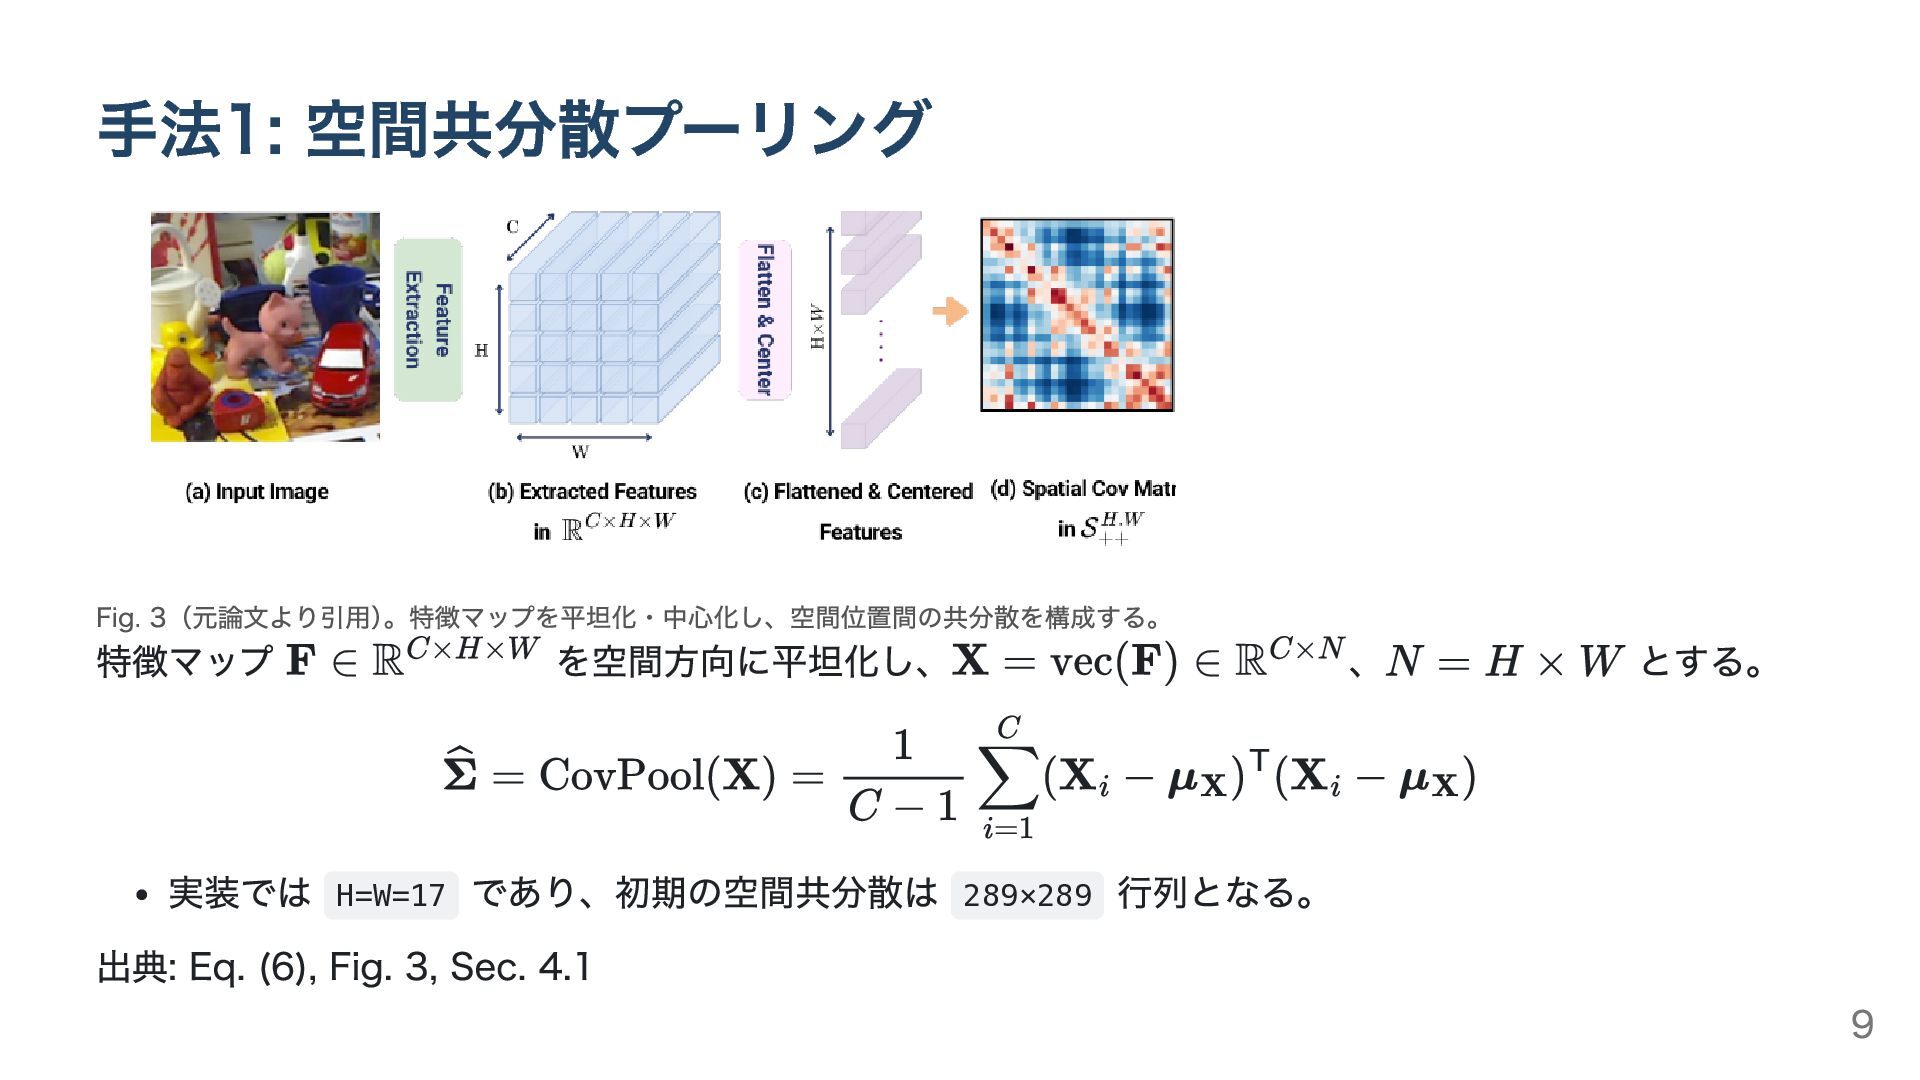
手法1: 空間共分散プーリング Fig. 3(元論文より引用) 。特徴マップを平坦化・中心化し、空間位置間の共分散を構成する。 特徴マップ を空間方向に平坦化し、 、 とする。 実装では
H=W=17 であり、初期の空間共分散は 289×289 行列となる。 出典: Eq. (6), Fig. 3, Sec. 4.1 9
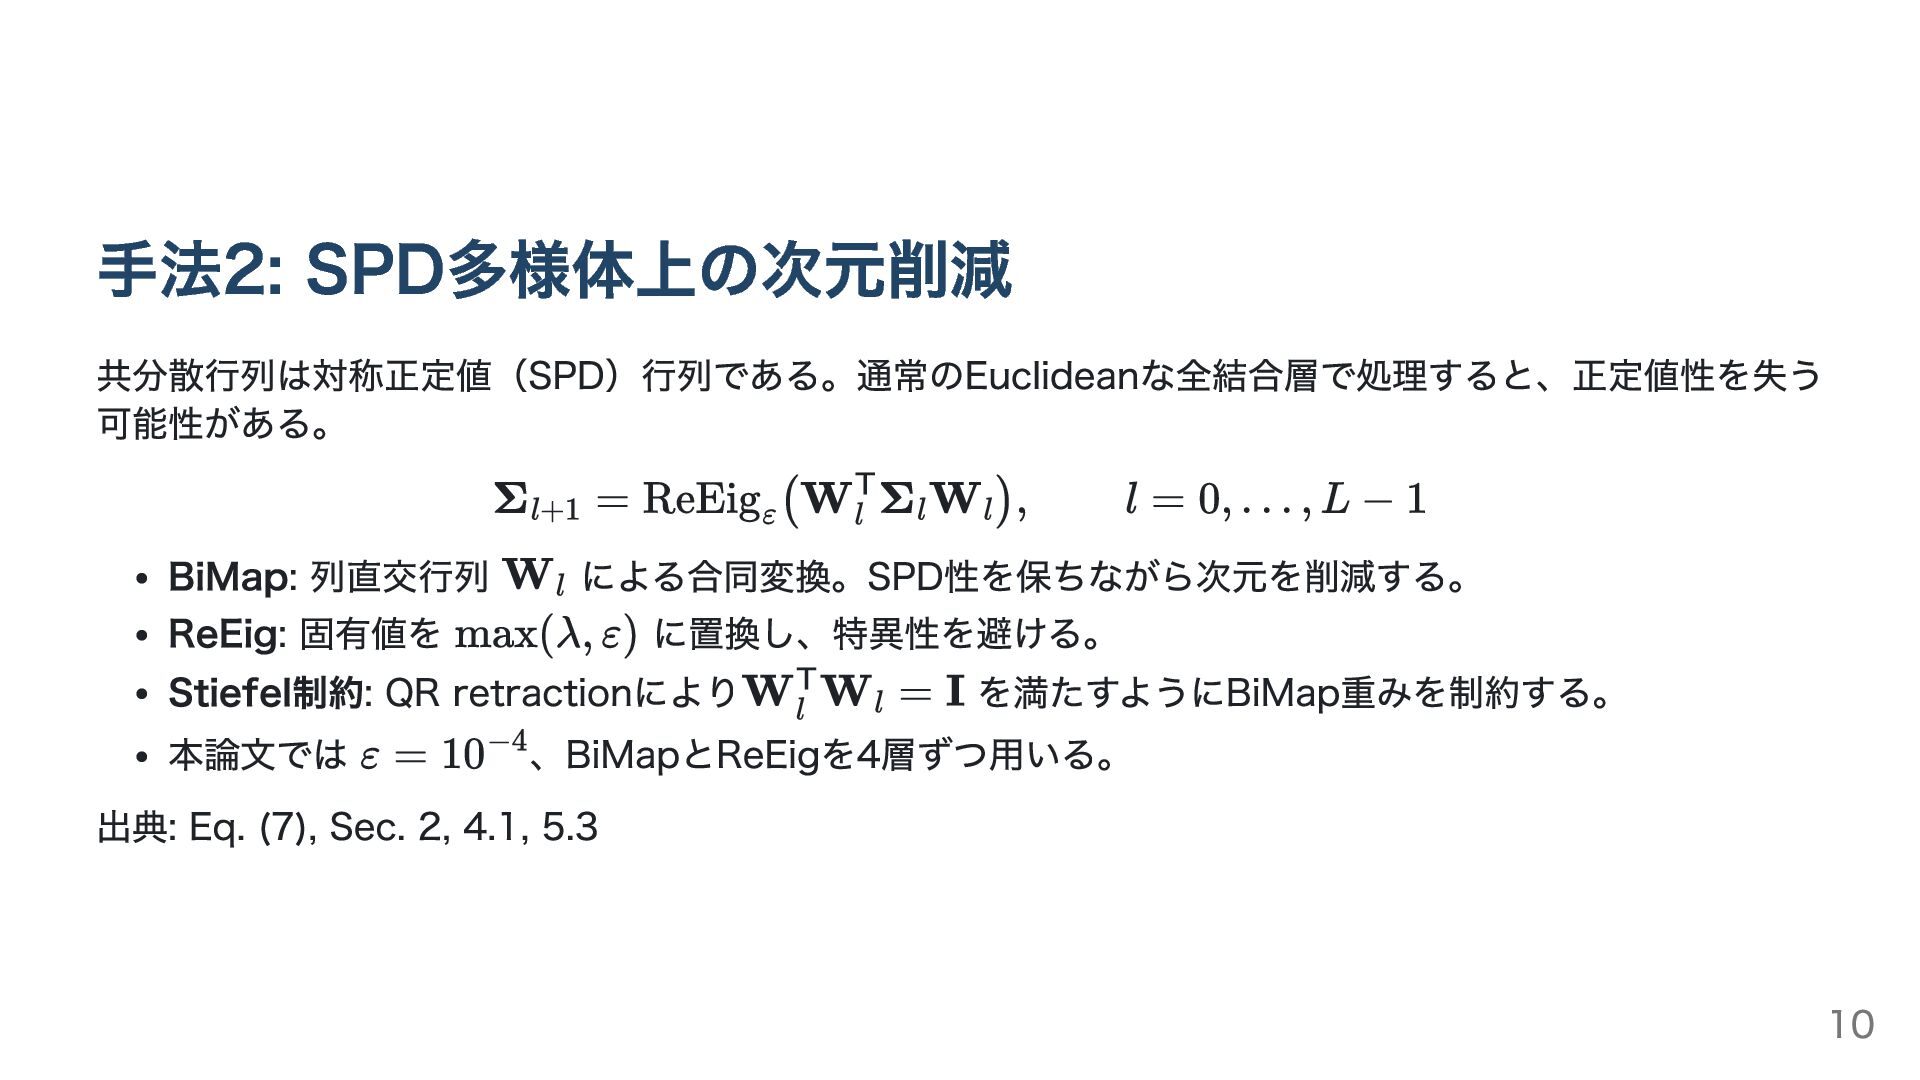
手法2: SPD多様体上の次元削減 共分散行列は対称正定値(SPD)行列である。通常のEuclideanな全結合層で処理すると、正定値性を失う 可能性がある。 BiMap: 列直交行列 による合同変換。SPD性を保ちながら次元を削減する。 ReEig: 固有値を に置換し、特異性を避ける。
Stiefel制約: QR retractionにより を満たすようにBiMap重みを制約する。 本論文では 、BiMapとReEigを4層ずつ用いる。 出典: Eq. (7), Sec. 2, 4.1, 5.3 10
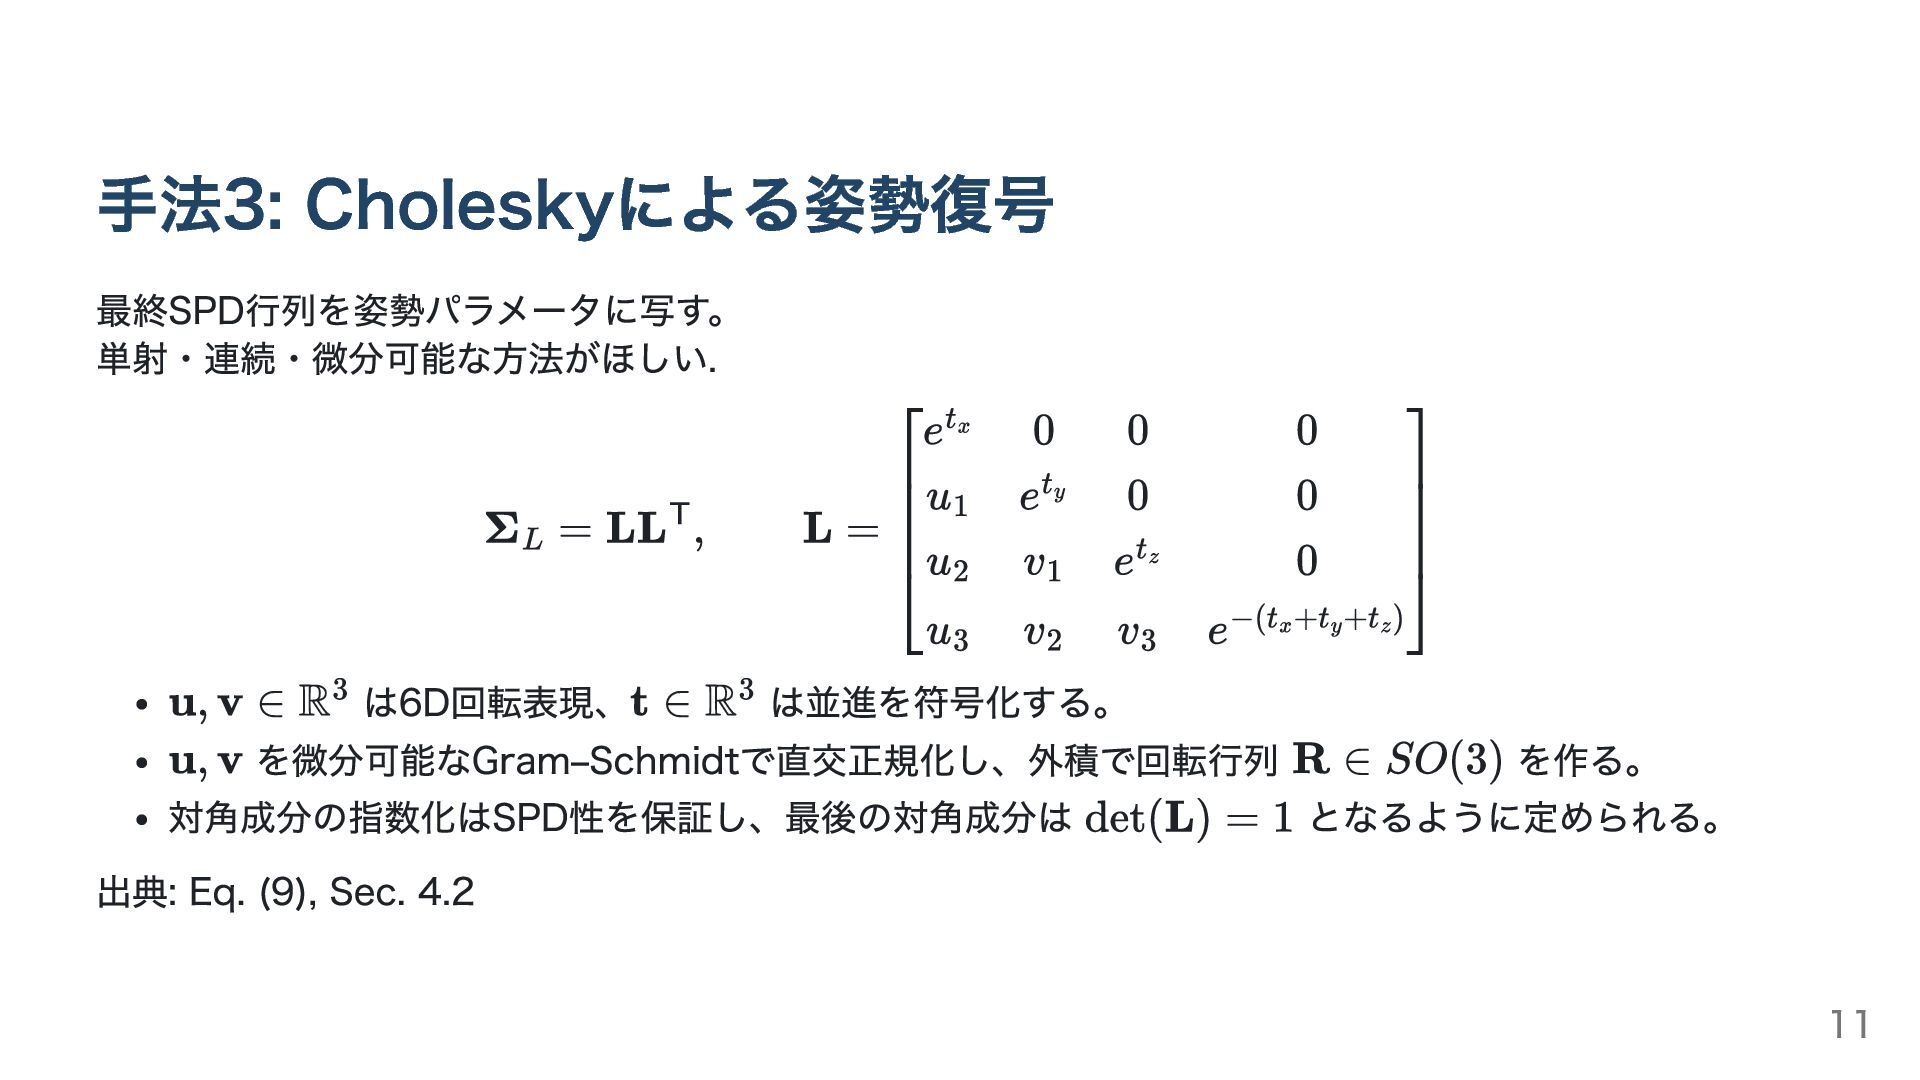
手法3: Choleskyによる姿勢復号 最終SPD行列を姿勢パラメータに写す。 単射・連続・微分可能な方法がほしい. は6D回転表現、 は並進を符号化する。 を微分可能なGram–Schmidtで直交正規化し、外積で回転行列 を作る。 対角成分の指数化はSPD性を保証し、最後の対角成分は となるように定められる。
出典: Eq. (9), Sec. 4.2 11
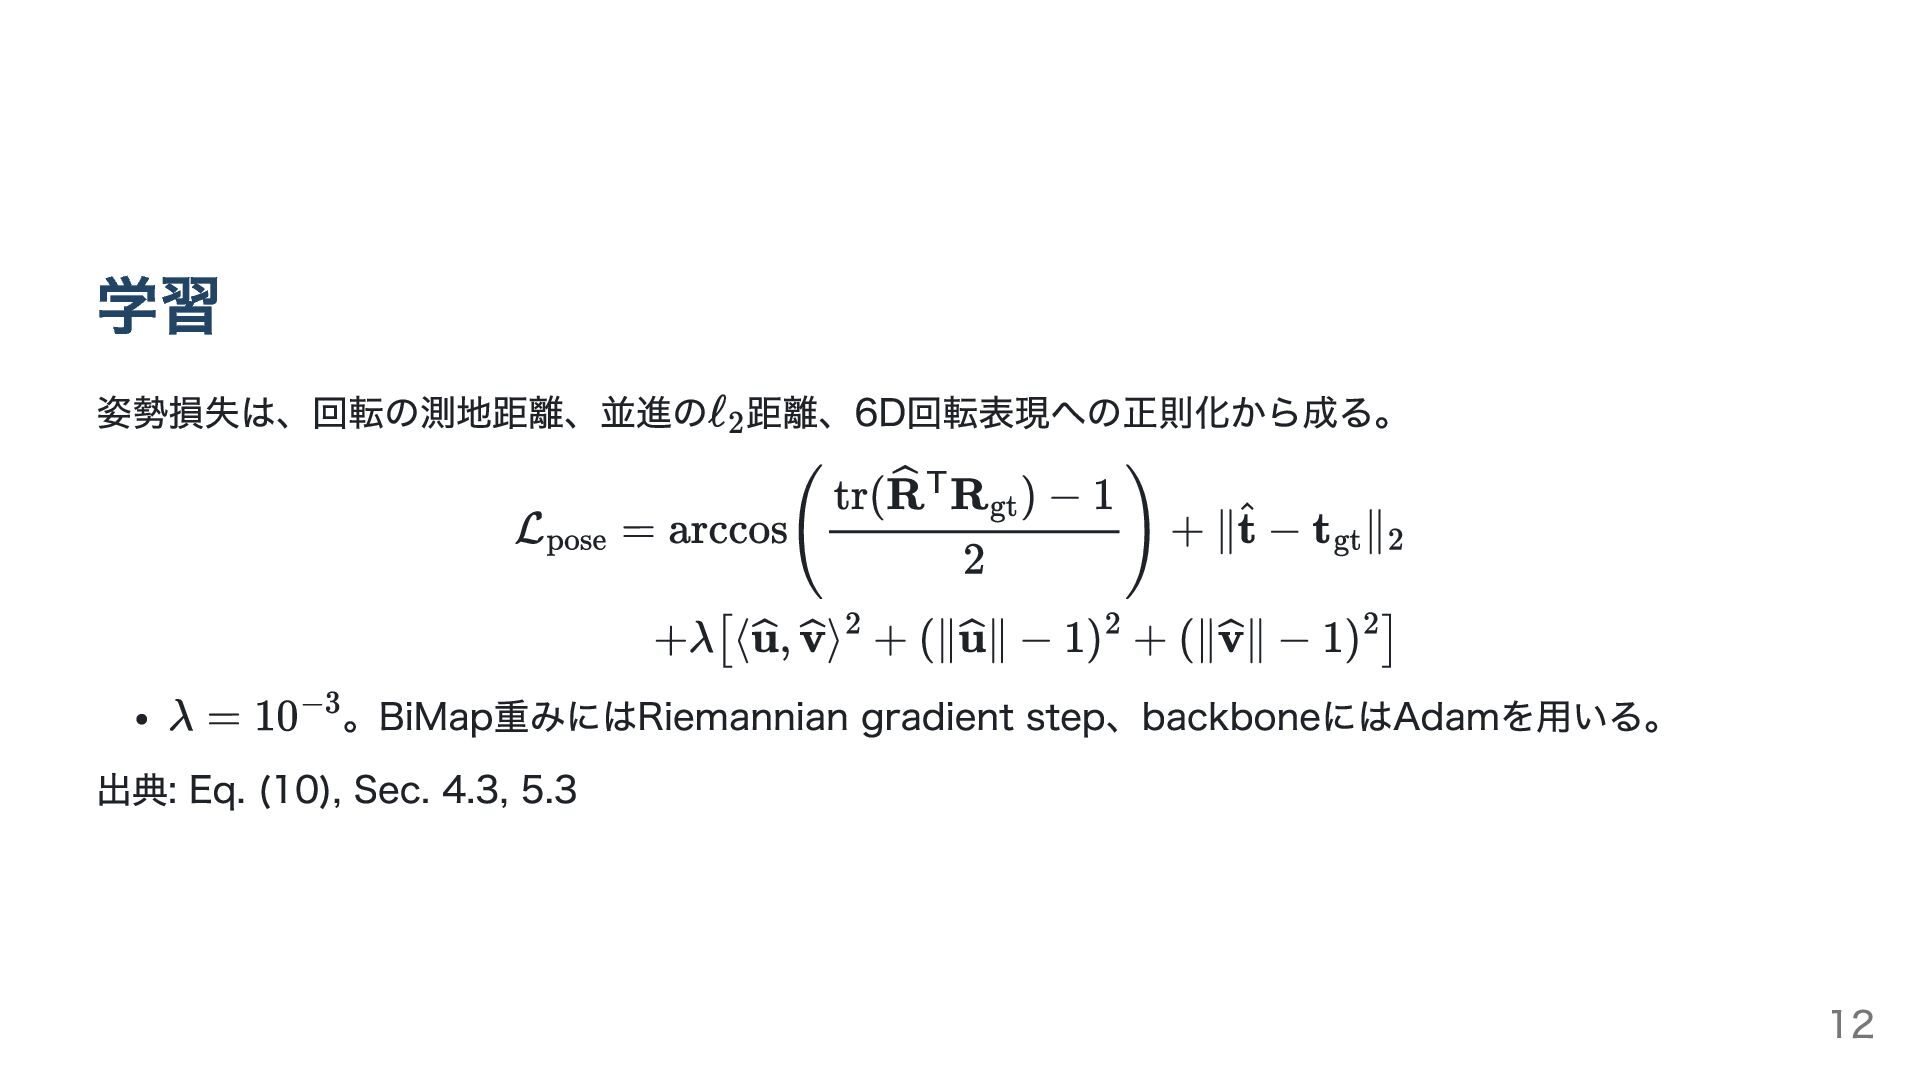
学習 姿勢損失は、回転の測地距離、並進の 距離、6D回転表現への正則化から成る。 。BiMap重みにはRiemannian gradient step、backboneにはAdamを用いる。 出典: Eq. (10), Sec.
4.3, 5.3 12
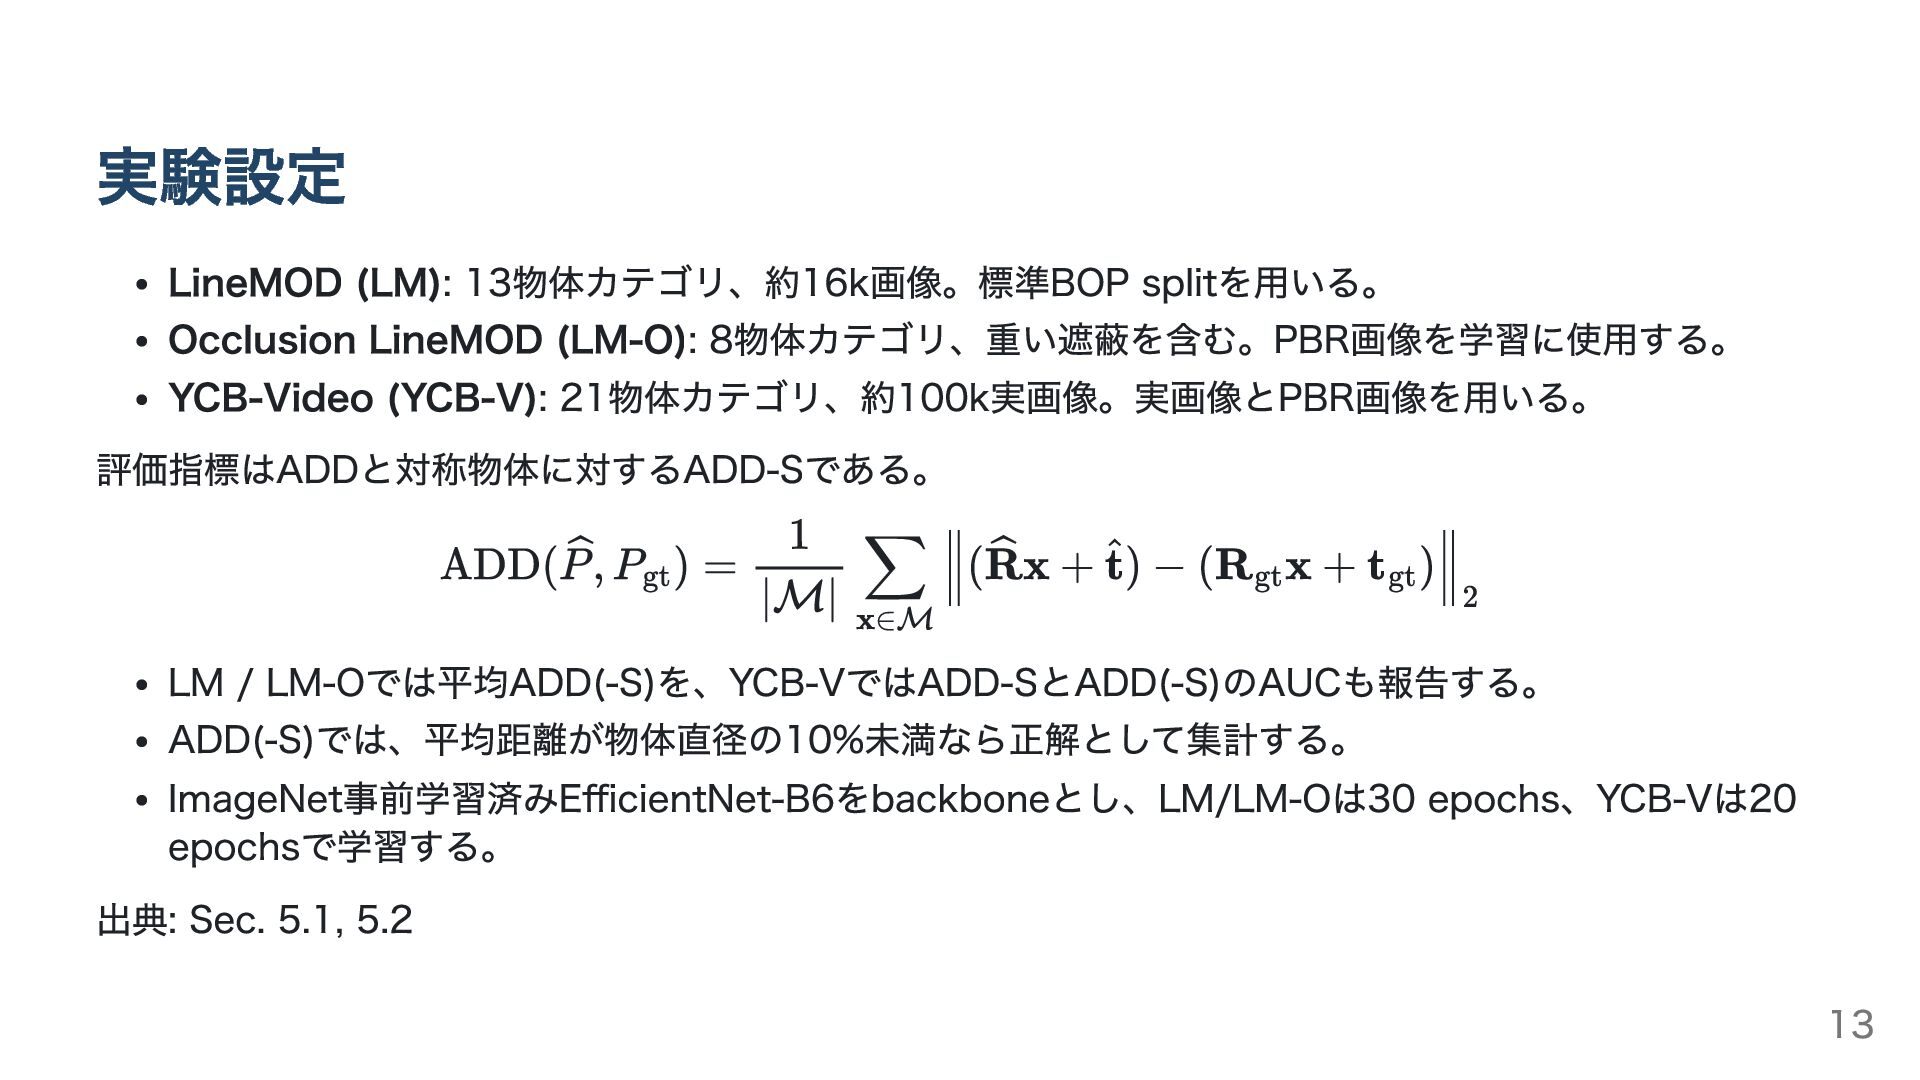
実験設定 LineMOD (LM): 13物体カテゴリ、約16k画像。標準BOP splitを用いる。 Occlusion LineMOD (LM-O): 8物体カテゴリ、重い遮蔽を含む。PBR画像を学習に使用する。 YCB-Video
(YCB-V): 21物体カテゴリ、約100k実画像。実画像とPBR画像を用いる。 評価指標はADDと対称物体に対するADD-Sである。 LM / LM-Oでは平均ADD(-S)を、YCB-VではADD-SとADD(-S)のAUCも報告する。 ADD(-S)では、平均距離が物体直径の10%未満なら正解として集計する。 ImageNet事前学習済みEfficientNet-B6をbackboneとし、LM/LM-Oは30 epochs、YCB-Vは20 epochsで学習する。 出典: Sec. 5.1, 5.2 13
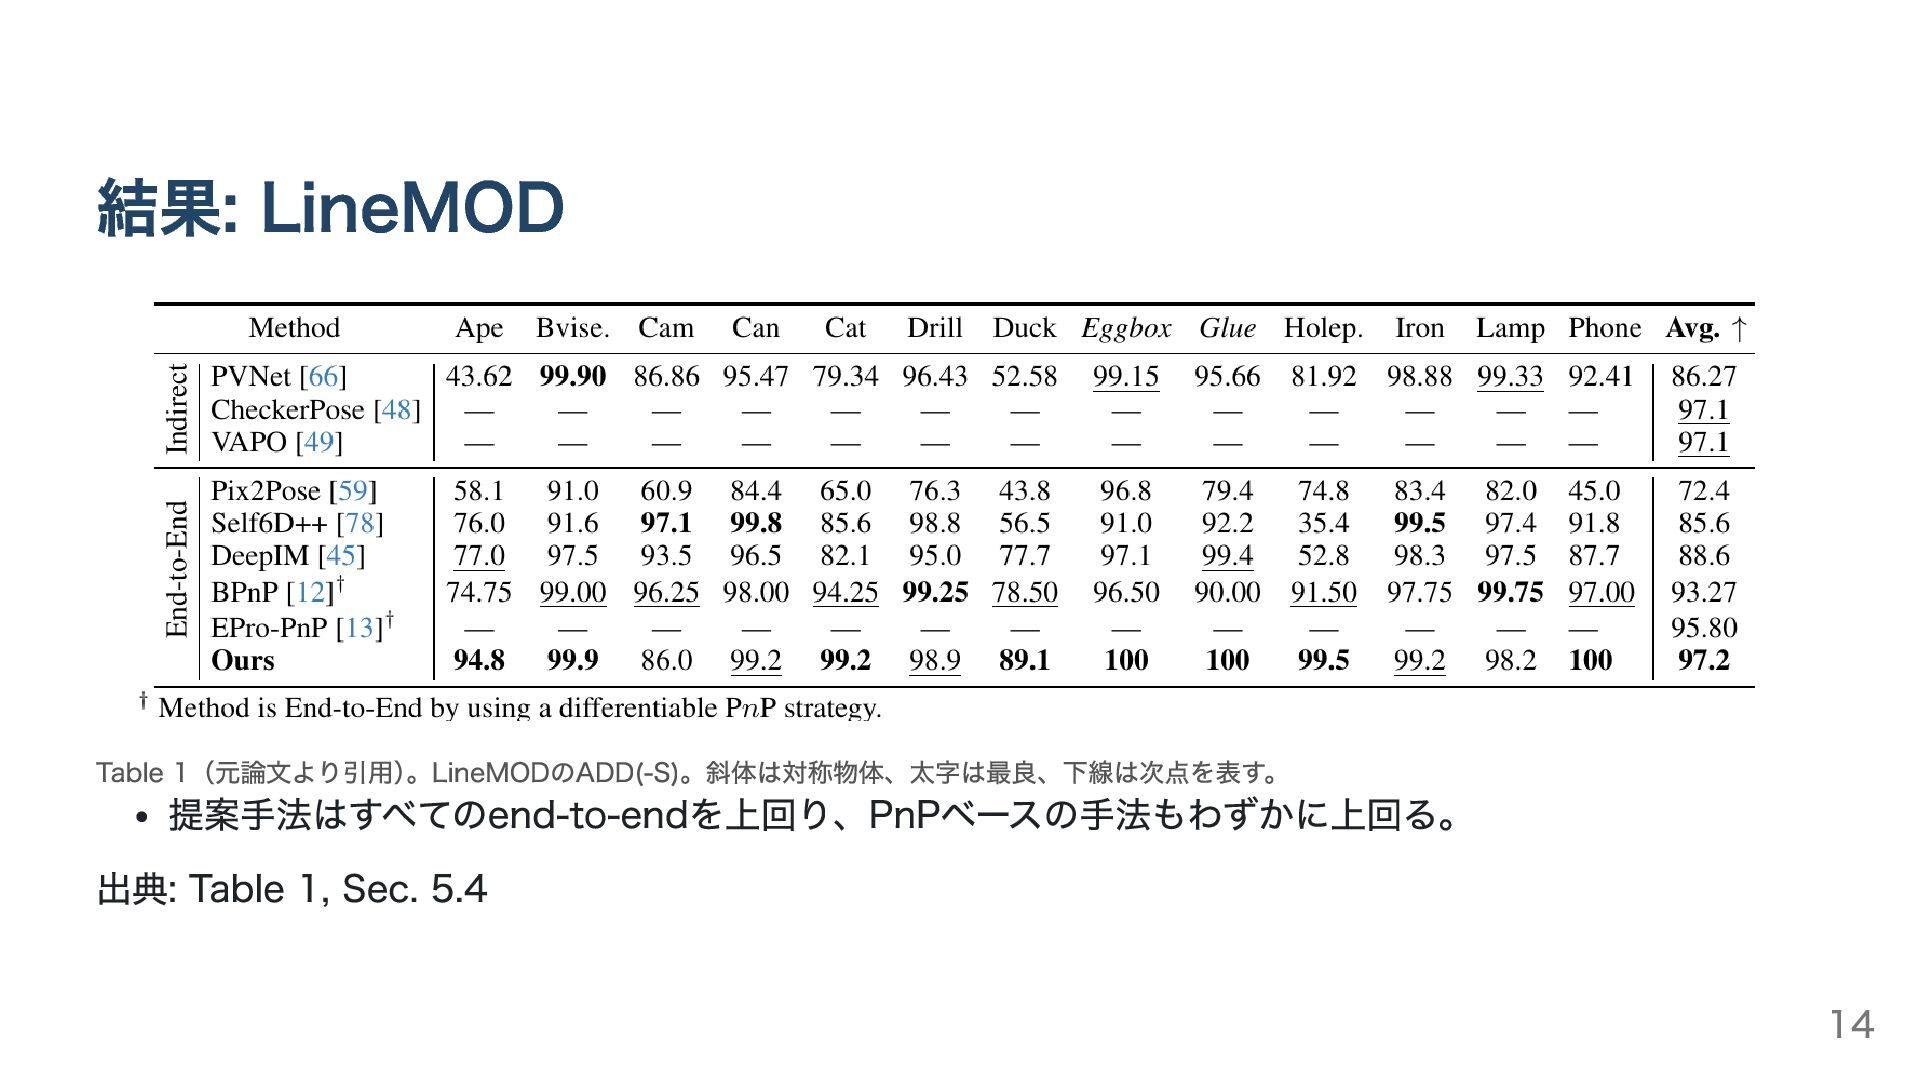
結果: LineMOD Table 1(元論文より引用) 。LineMODのADD(-S)。斜体は対称物体、太字は最良、下線は次点を表す。 提案手法はすべてのend-to-endを上回り、PnPベースの手法もわずかに上回る。 出典: Table 1, Sec.
5.4 14
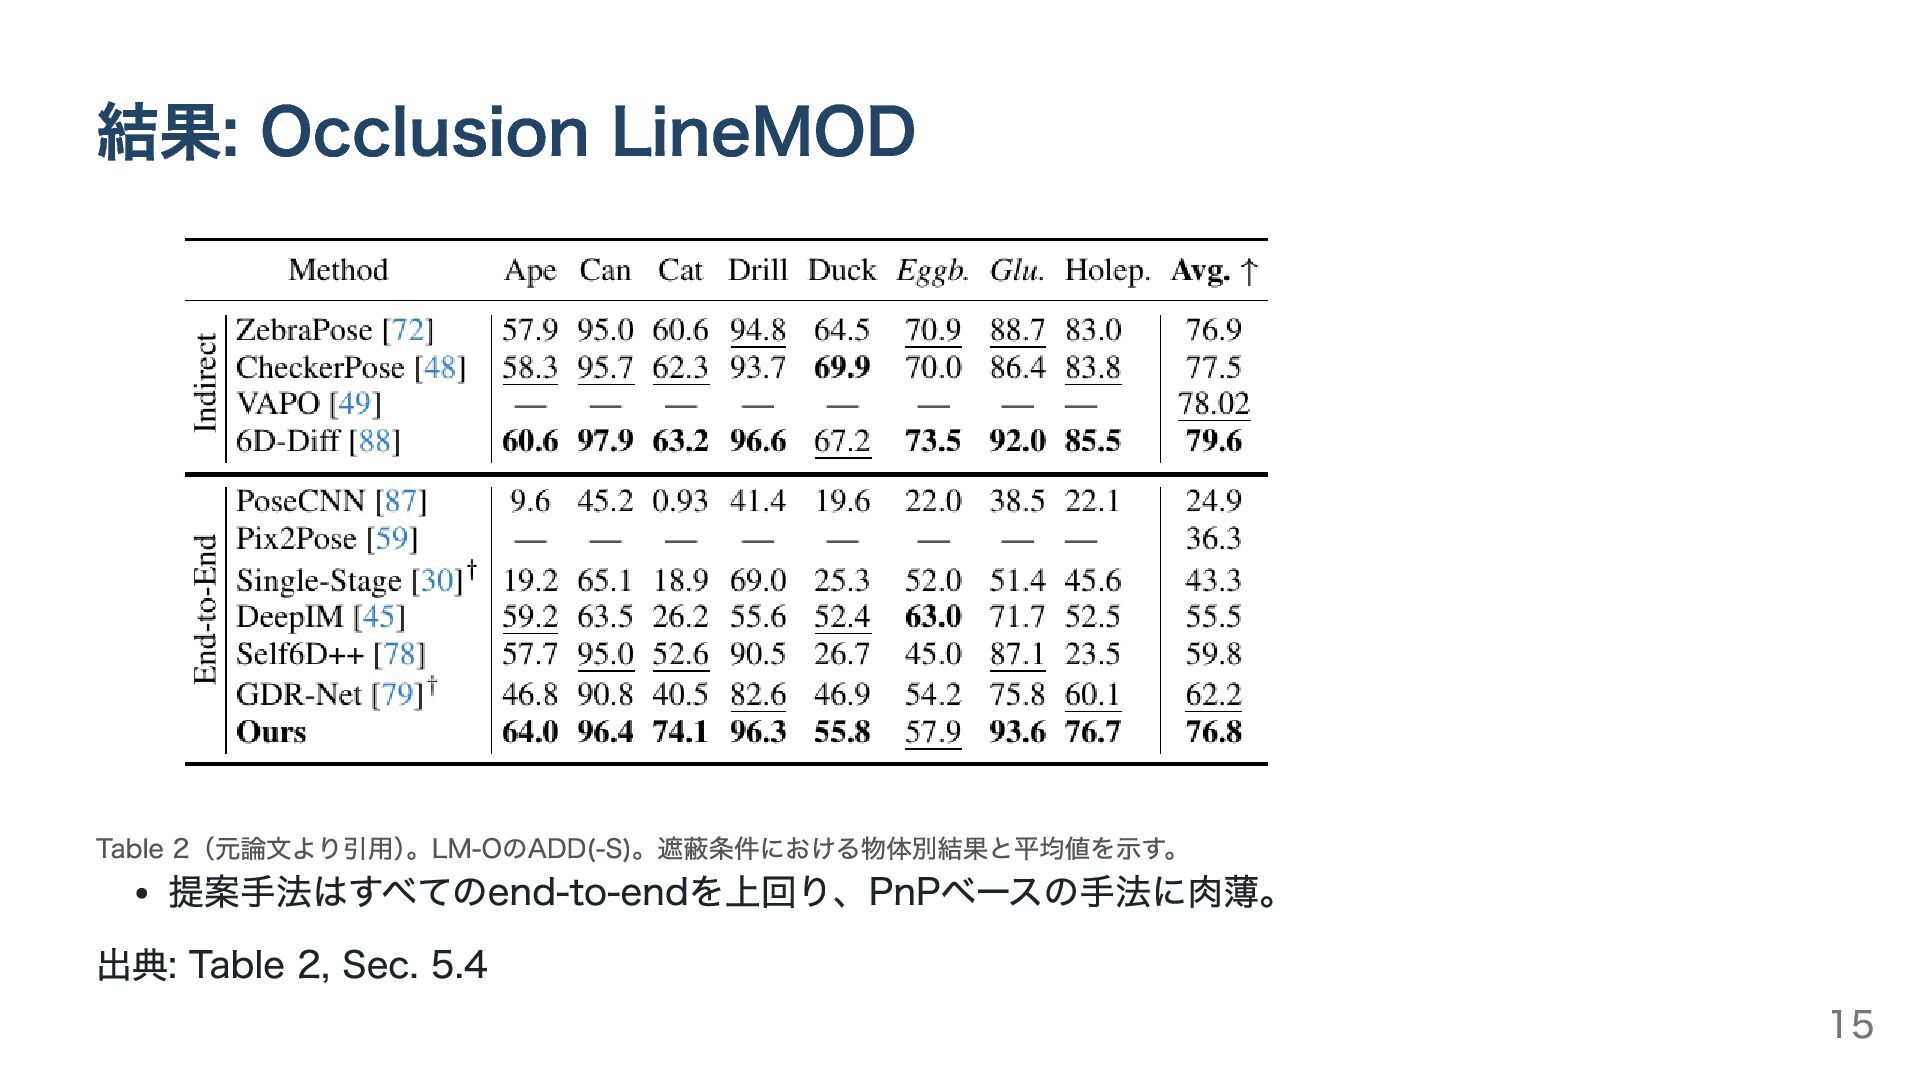
結果: Occlusion LineMOD Table 2(元論文より引用) 。LM-OのADD(-S)。遮蔽条件における物体別結果と平均値を示す。 提案手法はすべてのend-to-endを上回り、PnPベースの手法に肉薄。 出典: Table 2,
Sec. 5.4 15
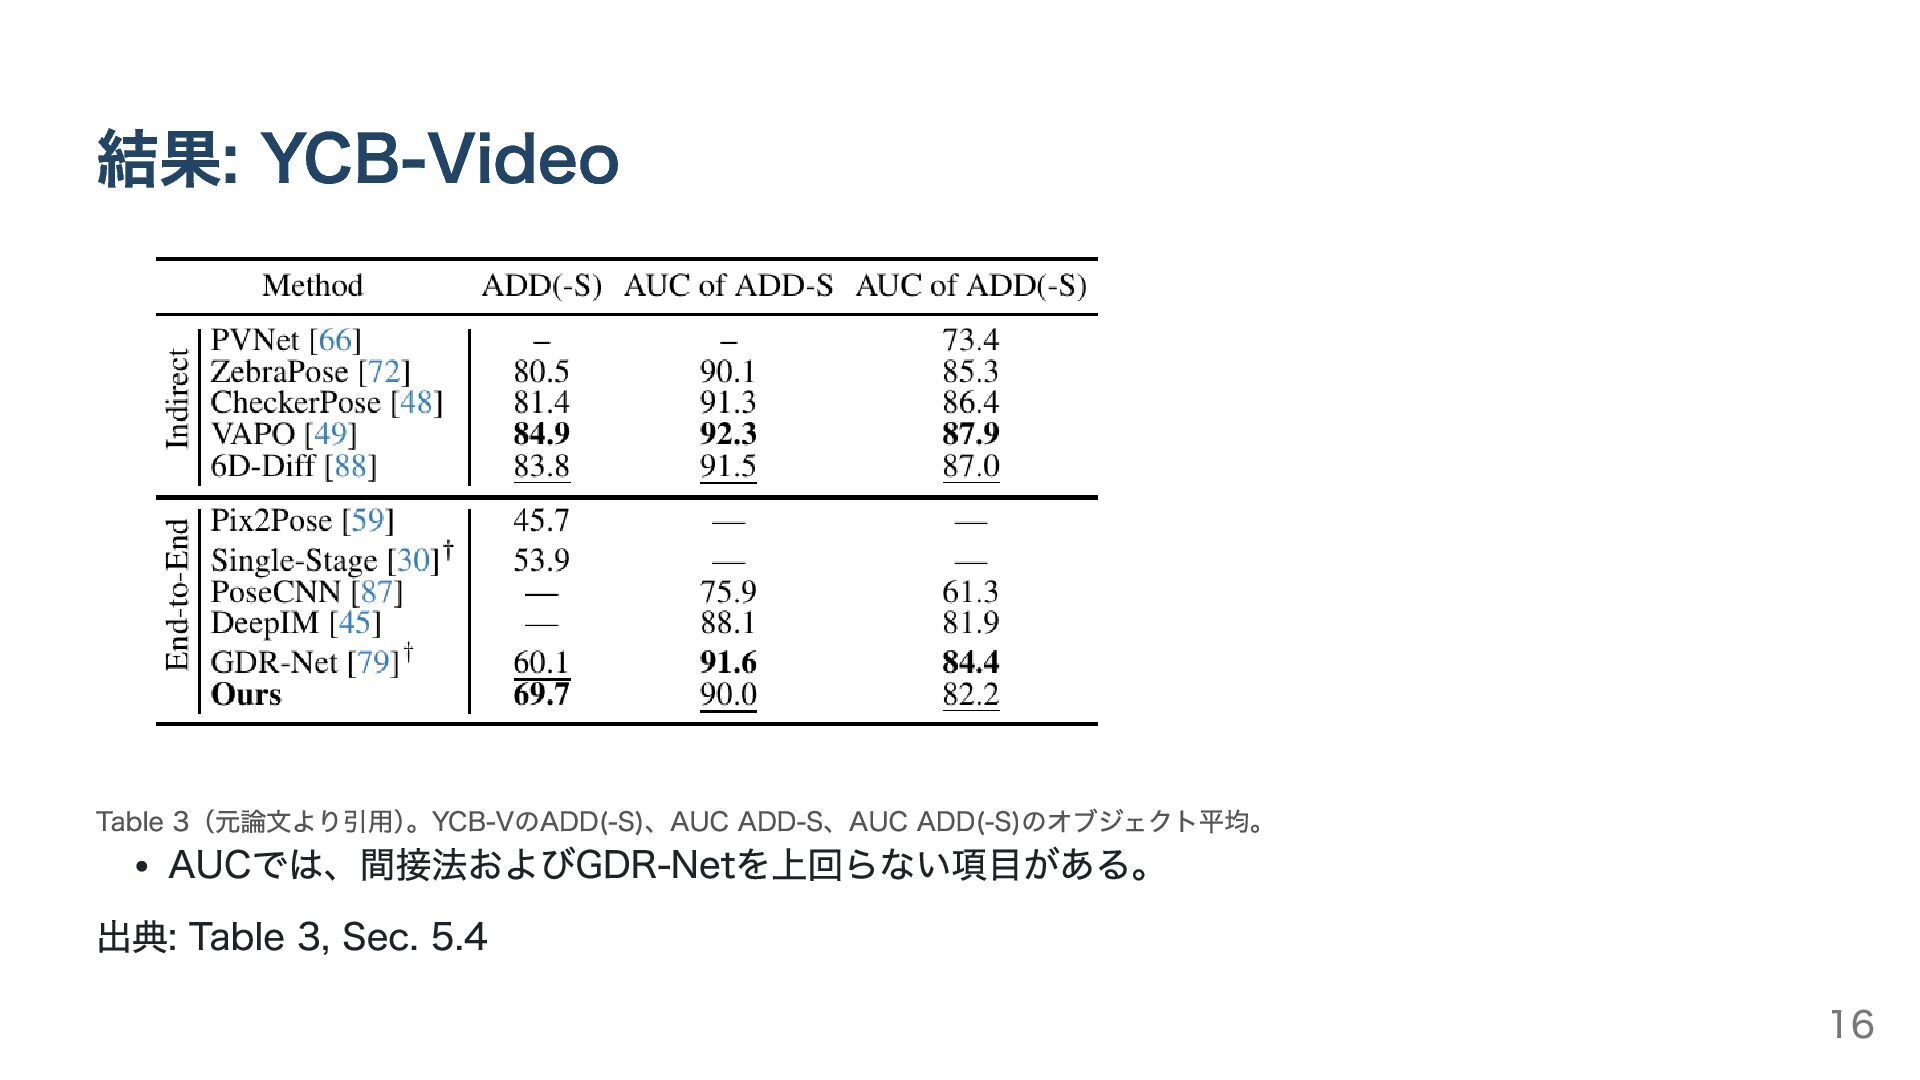
結果: YCB-Video Table 3(元論文より引用) 。YCB-VのADD(-S)、AUC ADD-S、AUC ADD(-S)のオブジェクト平均。 AUCでは、間接法およびGDR-Netを上回らない項目がある。 出典: Table
3, Sec. 5.4 16
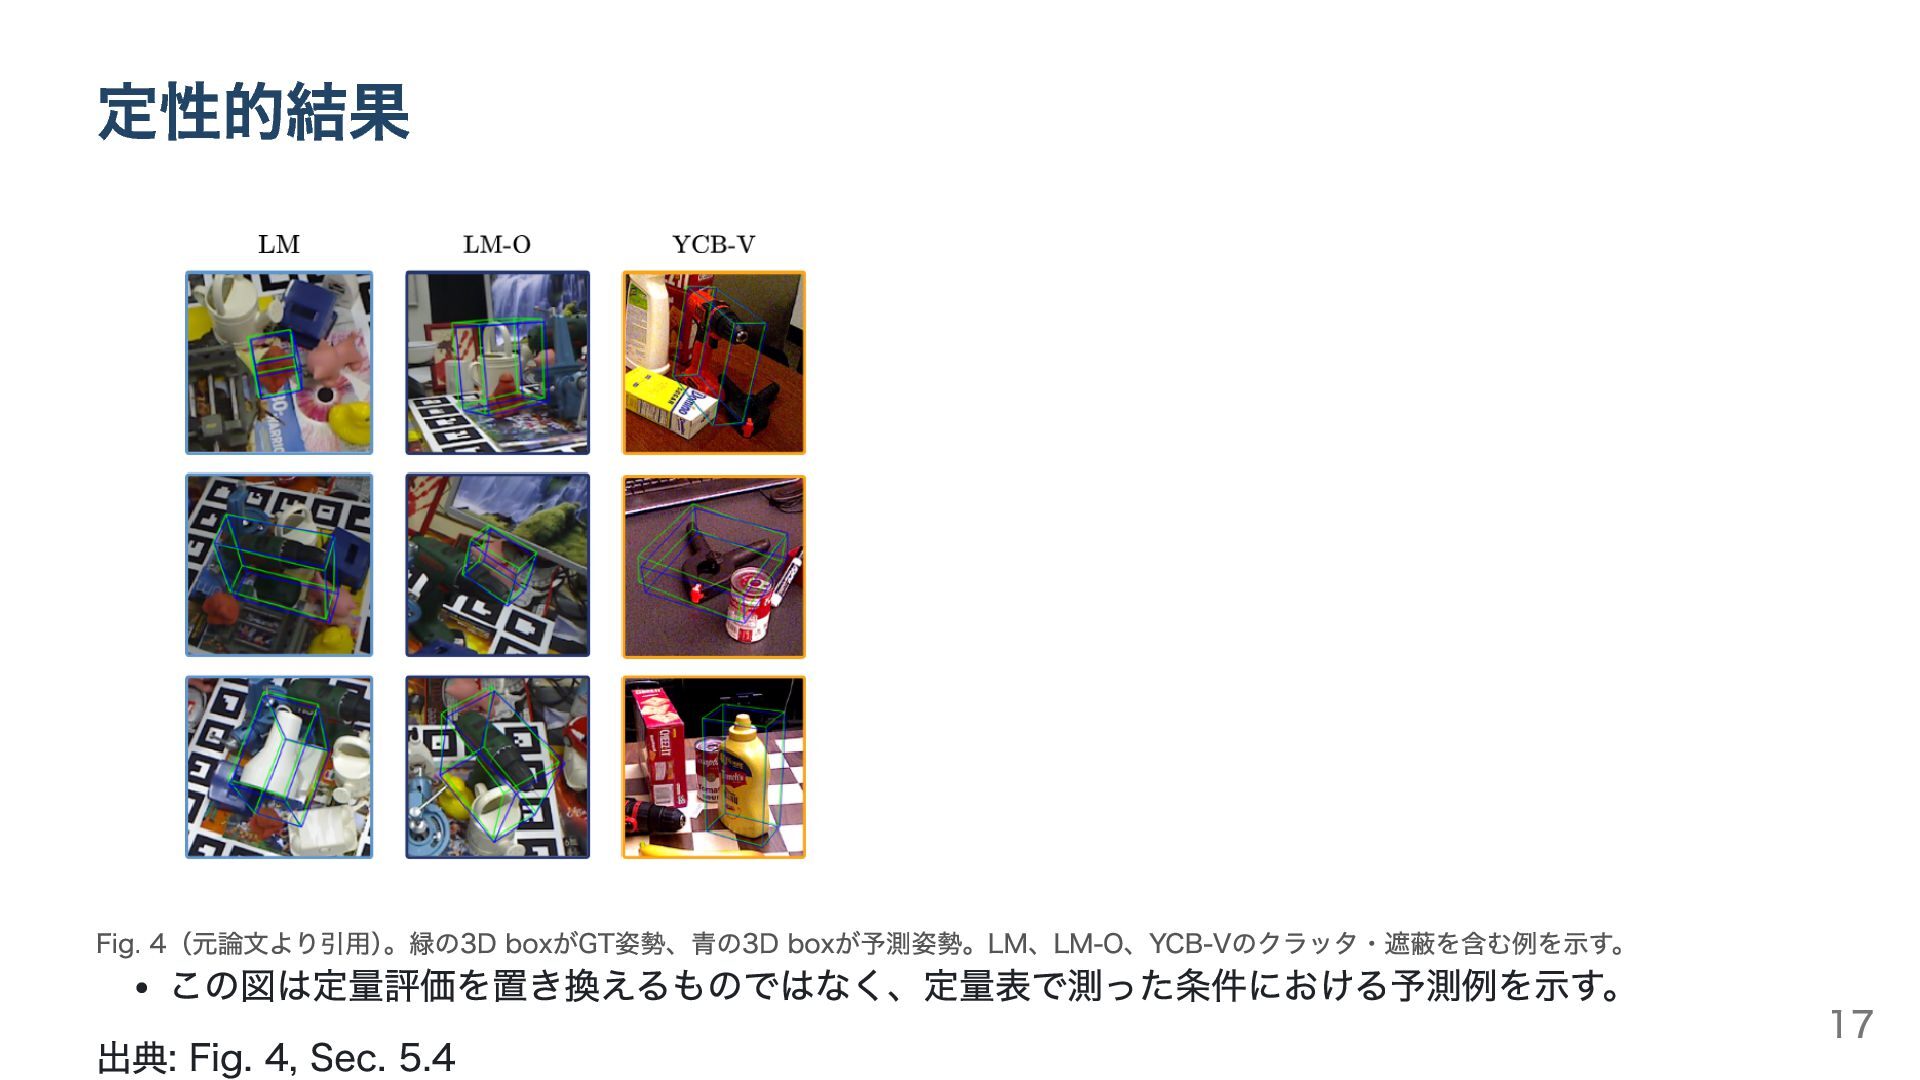
定性的結果 Fig. 4(元論文より引用) 。緑の3D boxがGT姿勢、青の3D boxが予測姿勢。LM、LM-O、YCB-Vのクラッタ・遮蔽を含む例を示す。 この図は定量評価を置き換えるものではなく、定量表で測った条件における予測例を示す。 出典: Fig. 4,
Sec. 5.4 17
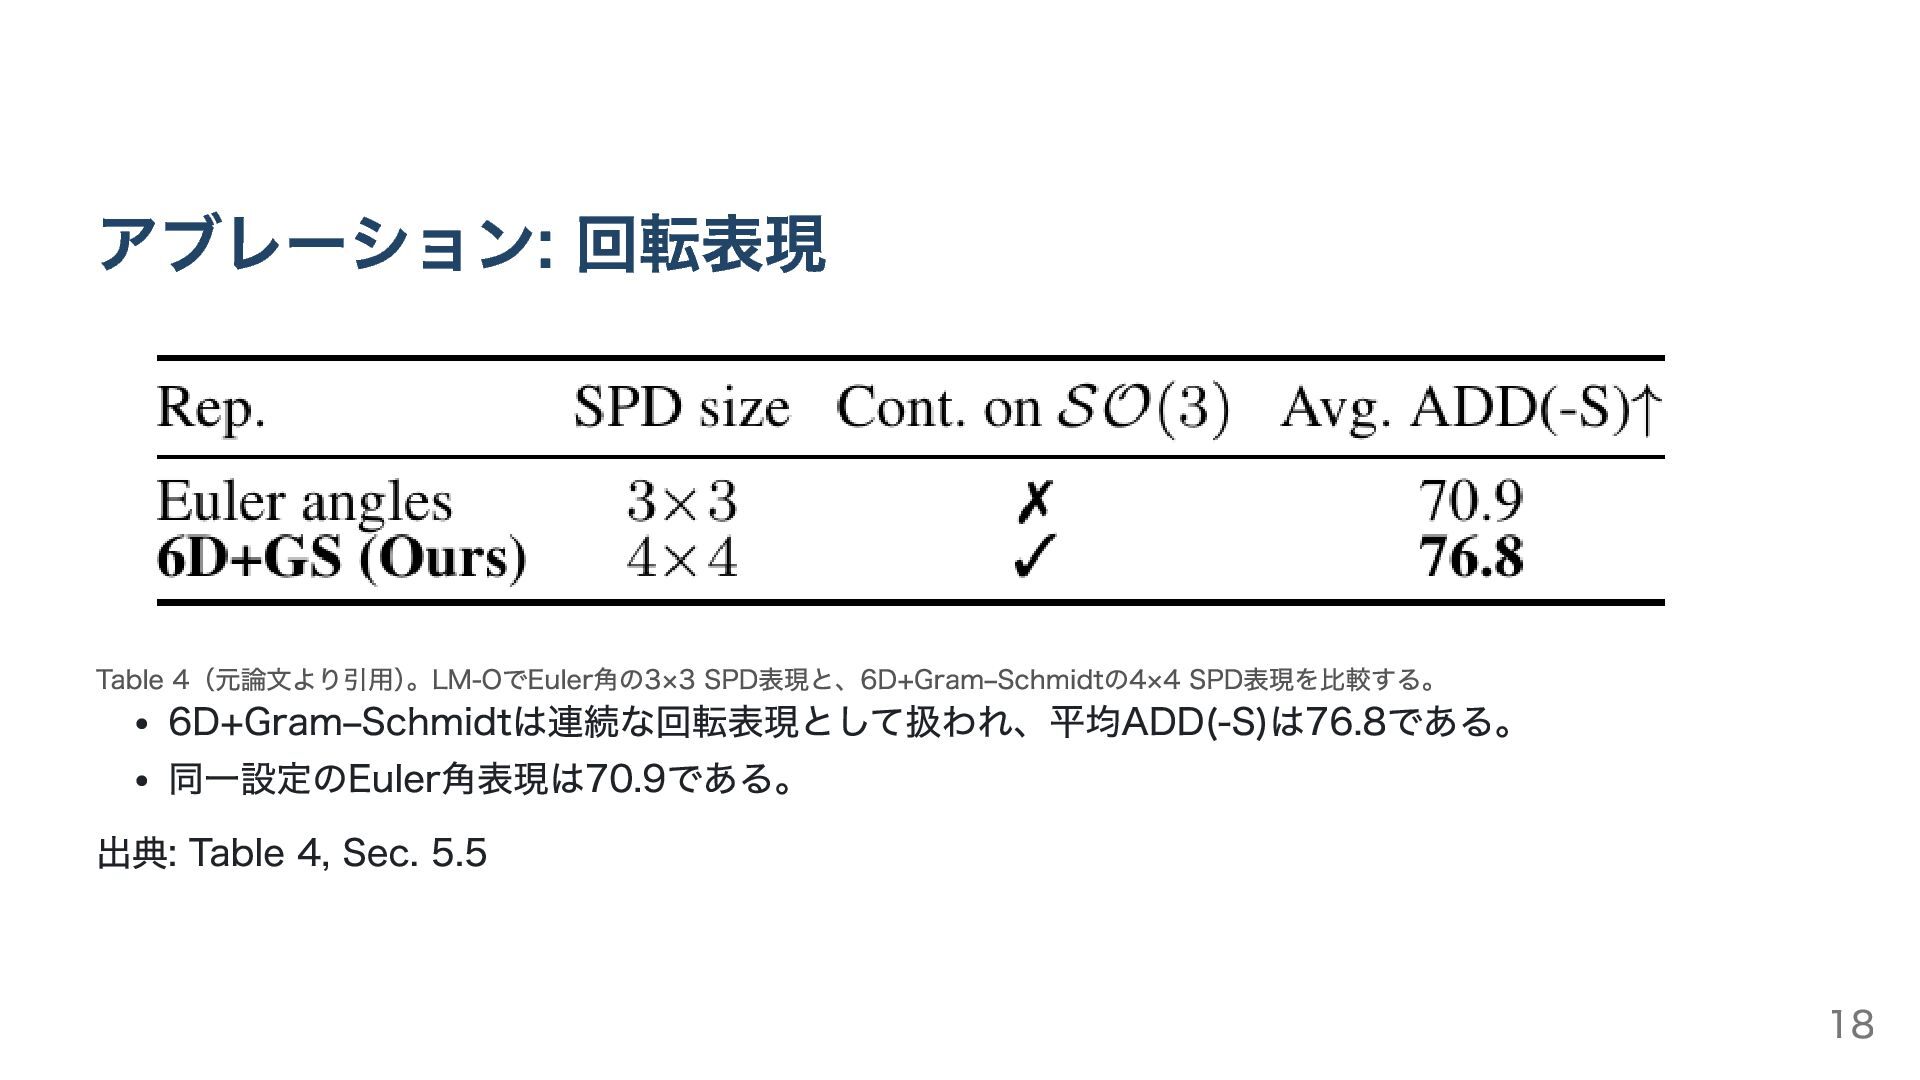
アブレーション: 回転表現 Table 4(元論文より引用) 。LM-OでEuler角の3×3 SPD表現と、6D+Gram–Schmidtの4×4 SPD表現を比較する。 6D+Gram–Schmidtは連続な回転表現として扱われ、平均ADD(-S)は76.8である。 同一設定のEuler角表現は70.9である。 出典:
Table 4, Sec. 5.5 18
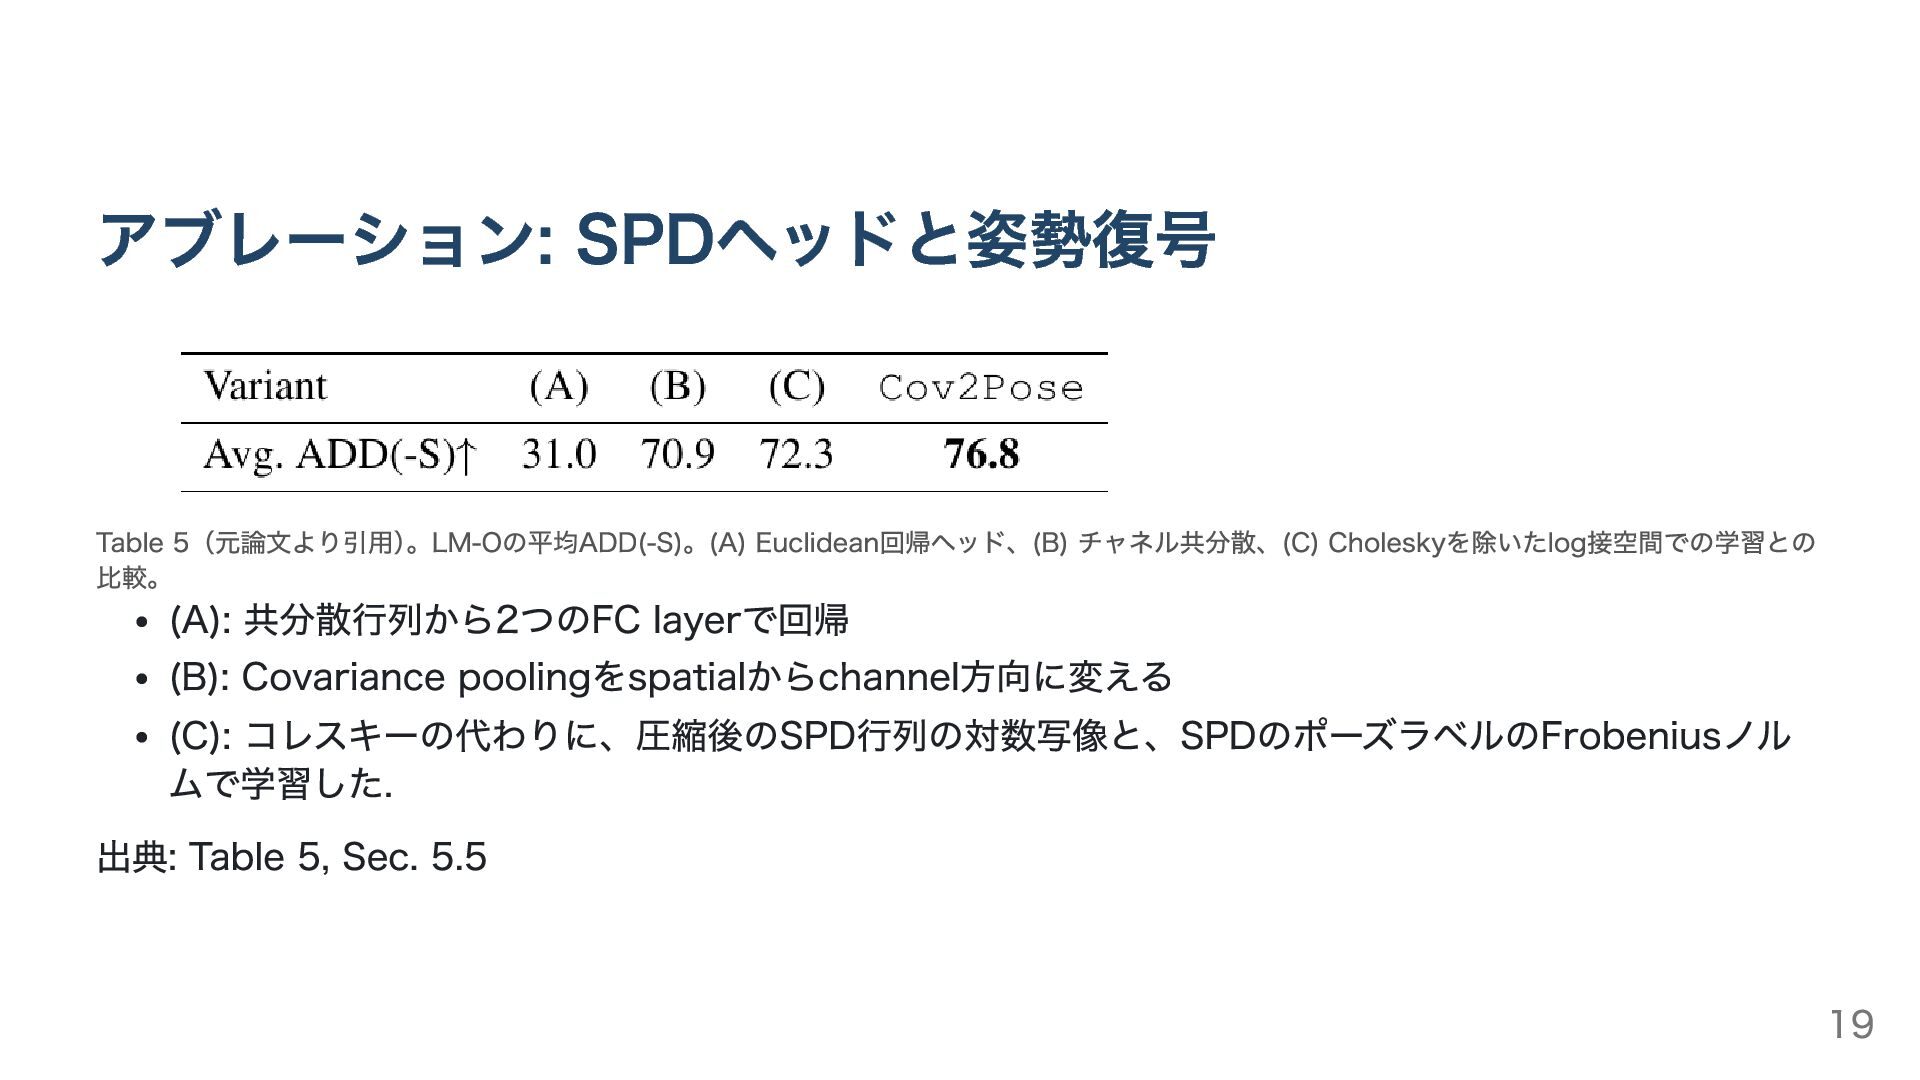
アブレーション: SPDヘッドと姿勢復号 Table 5(元論文より引用) 。LM-Oの平均ADD(-S)。(A) Euclidean回帰ヘッド、(B) チャネル共分散、(C) Choleskyを除いたlog接空間での学習との 比較。 (A):
共分散行列から2つのFC layerで回帰 (B): Covariance poolingをspatialからchannel方向に変える (C): コレスキーの代わりに、圧縮後のSPD行列の対数写像と、SPDのポーズラベルのFrobeniusノル ムで学習した. 出典: Table 5, Sec. 5.5 19
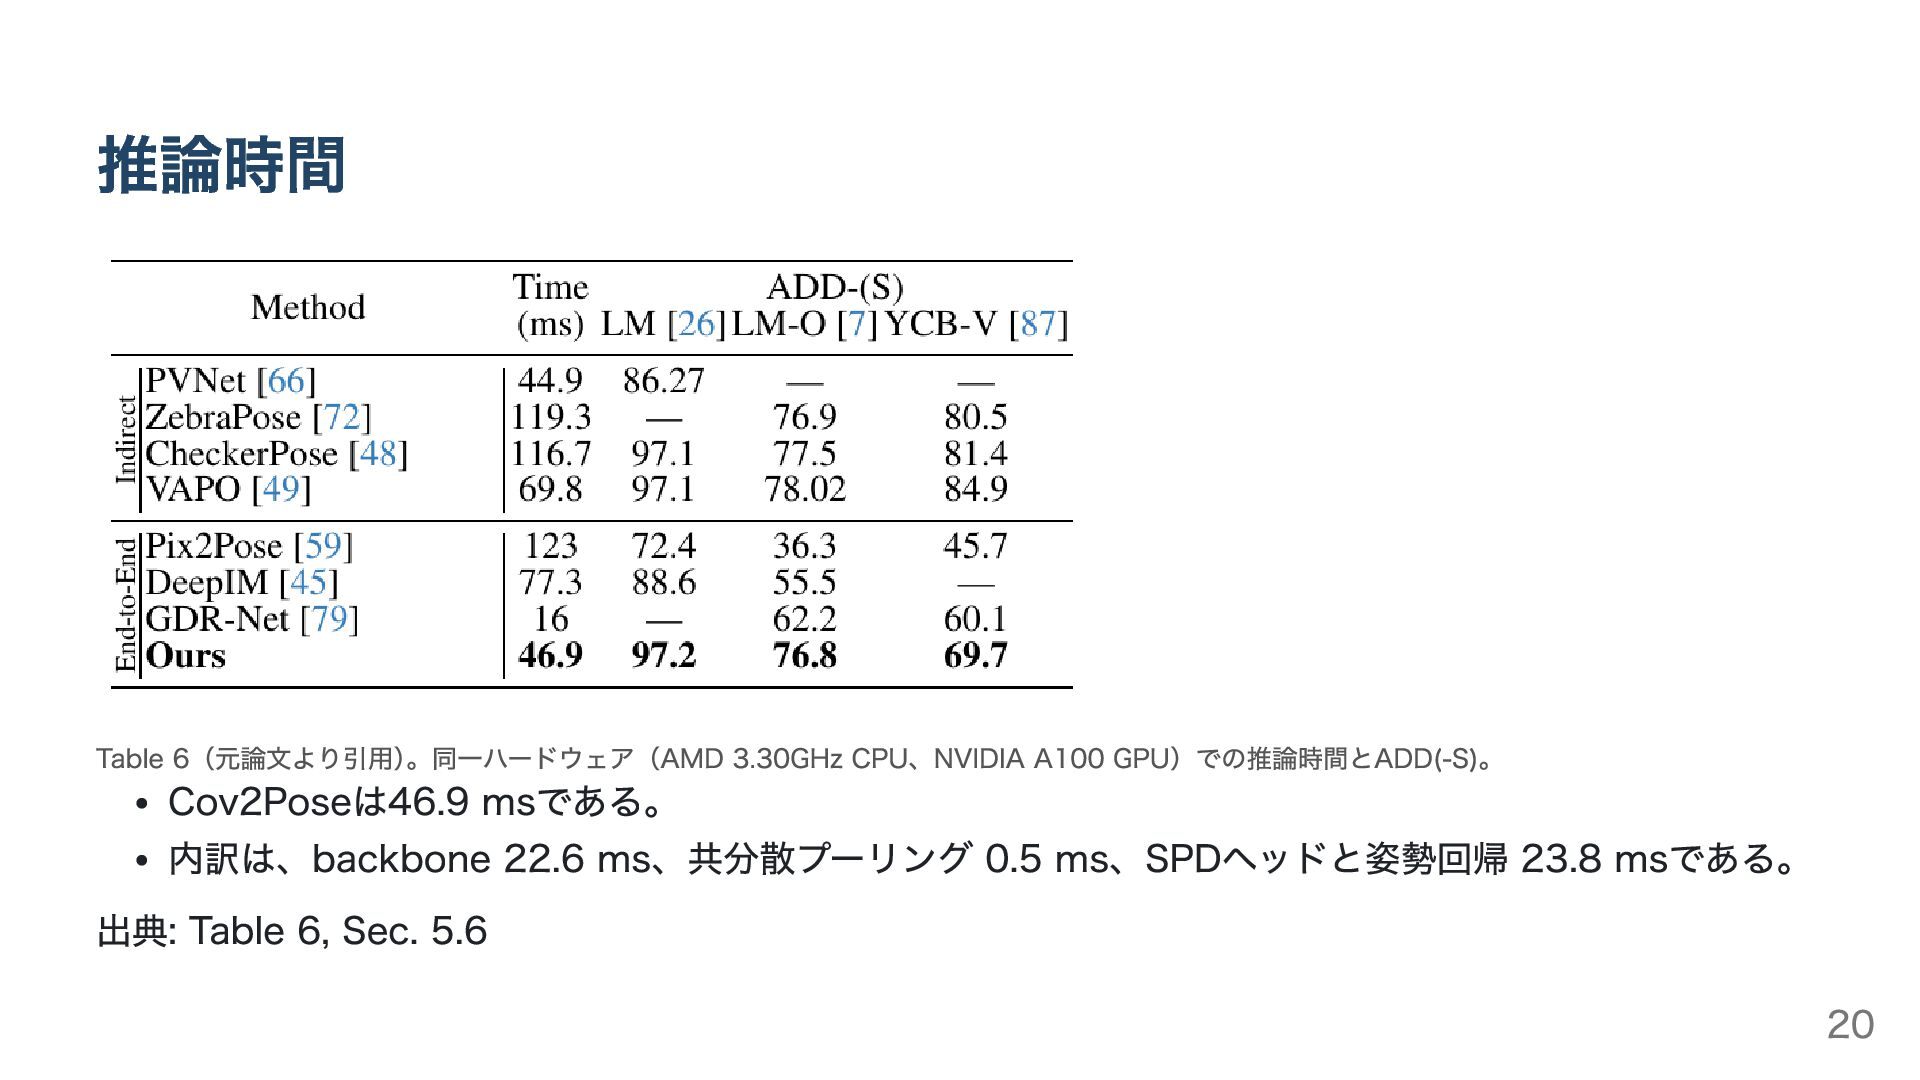
推論時間 Table 6(元論文より引用) 。同一ハードウェア(AMD 3.30GHz CPU、NVIDIA A100 GPU)での推論時間とADD(-S)。 Cov2Poseは46.9 msである。
内訳は、backbone 22.6 ms、共分散プーリング 0.5 ms、SPDヘッドと姿勢回帰 23.8 msである。 出典: Table 6, Sec. 5.6 20
まとめ Global Poolingで捨ててしまっている空間情報を活かす Cov2Poseは、空間共分散をSPD表現として扱い、幾何を保ったまま圧縮して連続な姿勢表現へ復号 する直接回帰手法である。 LM、LM-O、YCB-Vで評価され、既存の直説法に優り、間接法との差を縮めた. 一方で、比較対象の間接法や微分可能PnPが高い値を示す指標・データセットがある。 著者らは、物体対称性を明示的に扱っていないことを限界として挙げ、対称性認識型の学習と推論を今 後の課題としている。 所感:
比較的シンプルな構成で、しっかり精度改善しているのが素晴らしい 所感: 提案手法の下流が強引な印象. もっと良い方法はないのかな 6次の回転表現を選んだから6+3で9自由度必要 -> 下三角行列だと3次で6, 4次で10要素 -> 4次にする. あまる一要素はdet = 1になるようにしとく 出典: Sec. 5.4–5.6, Sec. 6 21


 takuroabe
 shumei_ito
 pfn
 ymotongpoo
 tetsuya28
 jtakeda
 ishikawa_satoru
 tsukina_7mochi
 genda
 masakiokuda
 riyaamemiya
 reverentgeek
 katarinadahlin
 frankvandijk
 aleyda
 lara
 ryanjones
 irinanazarova
 shlominoach
 pauljervisheath
 schroneko
 marktimemedia
 axbom